

O programa JumpStart da Supermicro se consolidou como uma das ferramentas mais úteis no conjunto de ferramentas de avaliação pré-compra para infraestrutura de IA. Em vez de uma demonstração roteirizada em um ambiente compartilhado, o JumpStart oferece aos usuários qualificados acesso gratuito e por tempo limitado a servidores de produção reais via SSH, IPMI e VNC, permitindo que executem cargas de trabalho em hardware real. Em novembro passado, analisamos o programa detalhadamente usando um sistema X14 com uma placa NVIDIA HGX B200 e obtivemos uma visão clara do que uma semana de acesso dedicado pode e não pode revelar. Desta vez, a Supermicro forneceu acesso a um sistema H14 8U com uma configuração de acelerador bem diferente.
Testamos o sistema AS-8126GS-TNMR , uma plataforma 8U refrigerada a ar, construída em torno de dois processadores AMD EPYC 9575F e oito GPUs AMD Instinct MI350X. A MI350X é a principal aceleradora de data center da AMD atualmente, construída com a arquitetura CDNA de 4ª geração no processo de 3nm da TSMC e apresentando 288 GB de HBM3e por GPU. Com oito GPUs interconectadas via AMD Infinity Fabric, o servidor oferece 2.3 TB de memória total de GPU em um único nó, com uma largura de banda agregada de 1,024 GB/s. O sistema completo utiliza seis fontes de alimentação de 5,250 W com certificação Titanium em uma configuração redundante 3+3, e a Supermicro disponibilizou rede dedicada de 400 Gbps por GPU para implantações de escalabilidade horizontal.
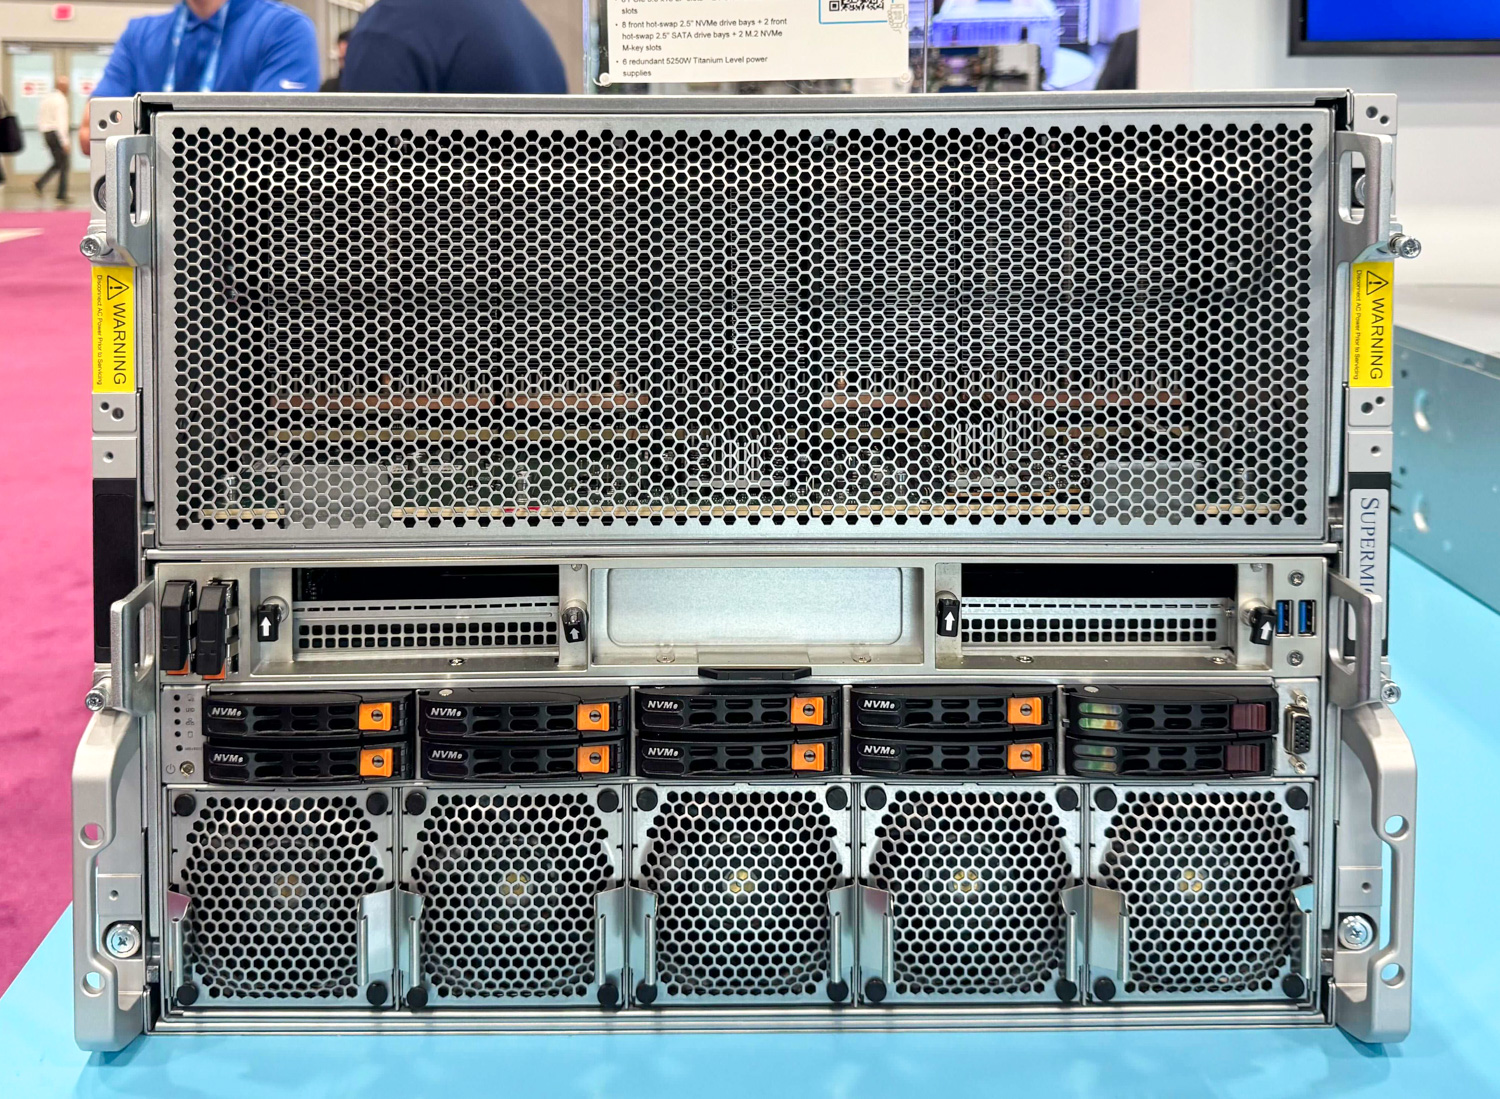
A posição da AMD no mercado de GPUs para data centers mudou significativamente nos últimos dois anos, e a geração MI350X representa um desafio competitivo mais sério para a NVIDIA do que qualquer produto Instinct anterior. O ROCm 7, lançado em setembro de 2025 e agora na versão 7.2, trouxe suporte nativo para MI350X, além de um desempenho de inferência drasticamente aprimorado, atualizações da API HIP que eliminam a lacuna de compatibilidade com CUDA e suporte ampliado a frameworks, incluindo PyTorch, JAX, TensorFlow, ONNX Runtime, vLLM e SGLang.
O projeto vLLM adicionou um pipeline de CI dedicado para AMD ROCm no final de dezembro de 2025, tornando o hardware da AMD uma plataforma de primeira classe nessa pilha de inferência, em vez de uma mera adaptação. A adoção do ecossistema também é difícil de ignorar: a AMD e a Meta anunciaram um acordo plurianual e multigeração para a implementação de GPUs de 6 gigawatts em fevereiro de 2026, com base nas implementações de produção existentes da Meta com hardware das séries MI300 e MI350. Esse nível de comprometimento de uma das maiores operadoras de infraestrutura de IA do mundo não é mera nota de marketing.
Para organizações que estão avaliando infraestrutura de aceleradores de IA, o prazo de entrega do hardware da NVIDIA continua sendo uma preocupação. A questão é se a AMD é uma alternativa viável, em vez de apenas uma opção de último recurso. Com base em uma semana de testes com o ROCm 7.2.0 e o vLLM atual, a resposta é significativamente diferente da que tínhamos há 18 meses.
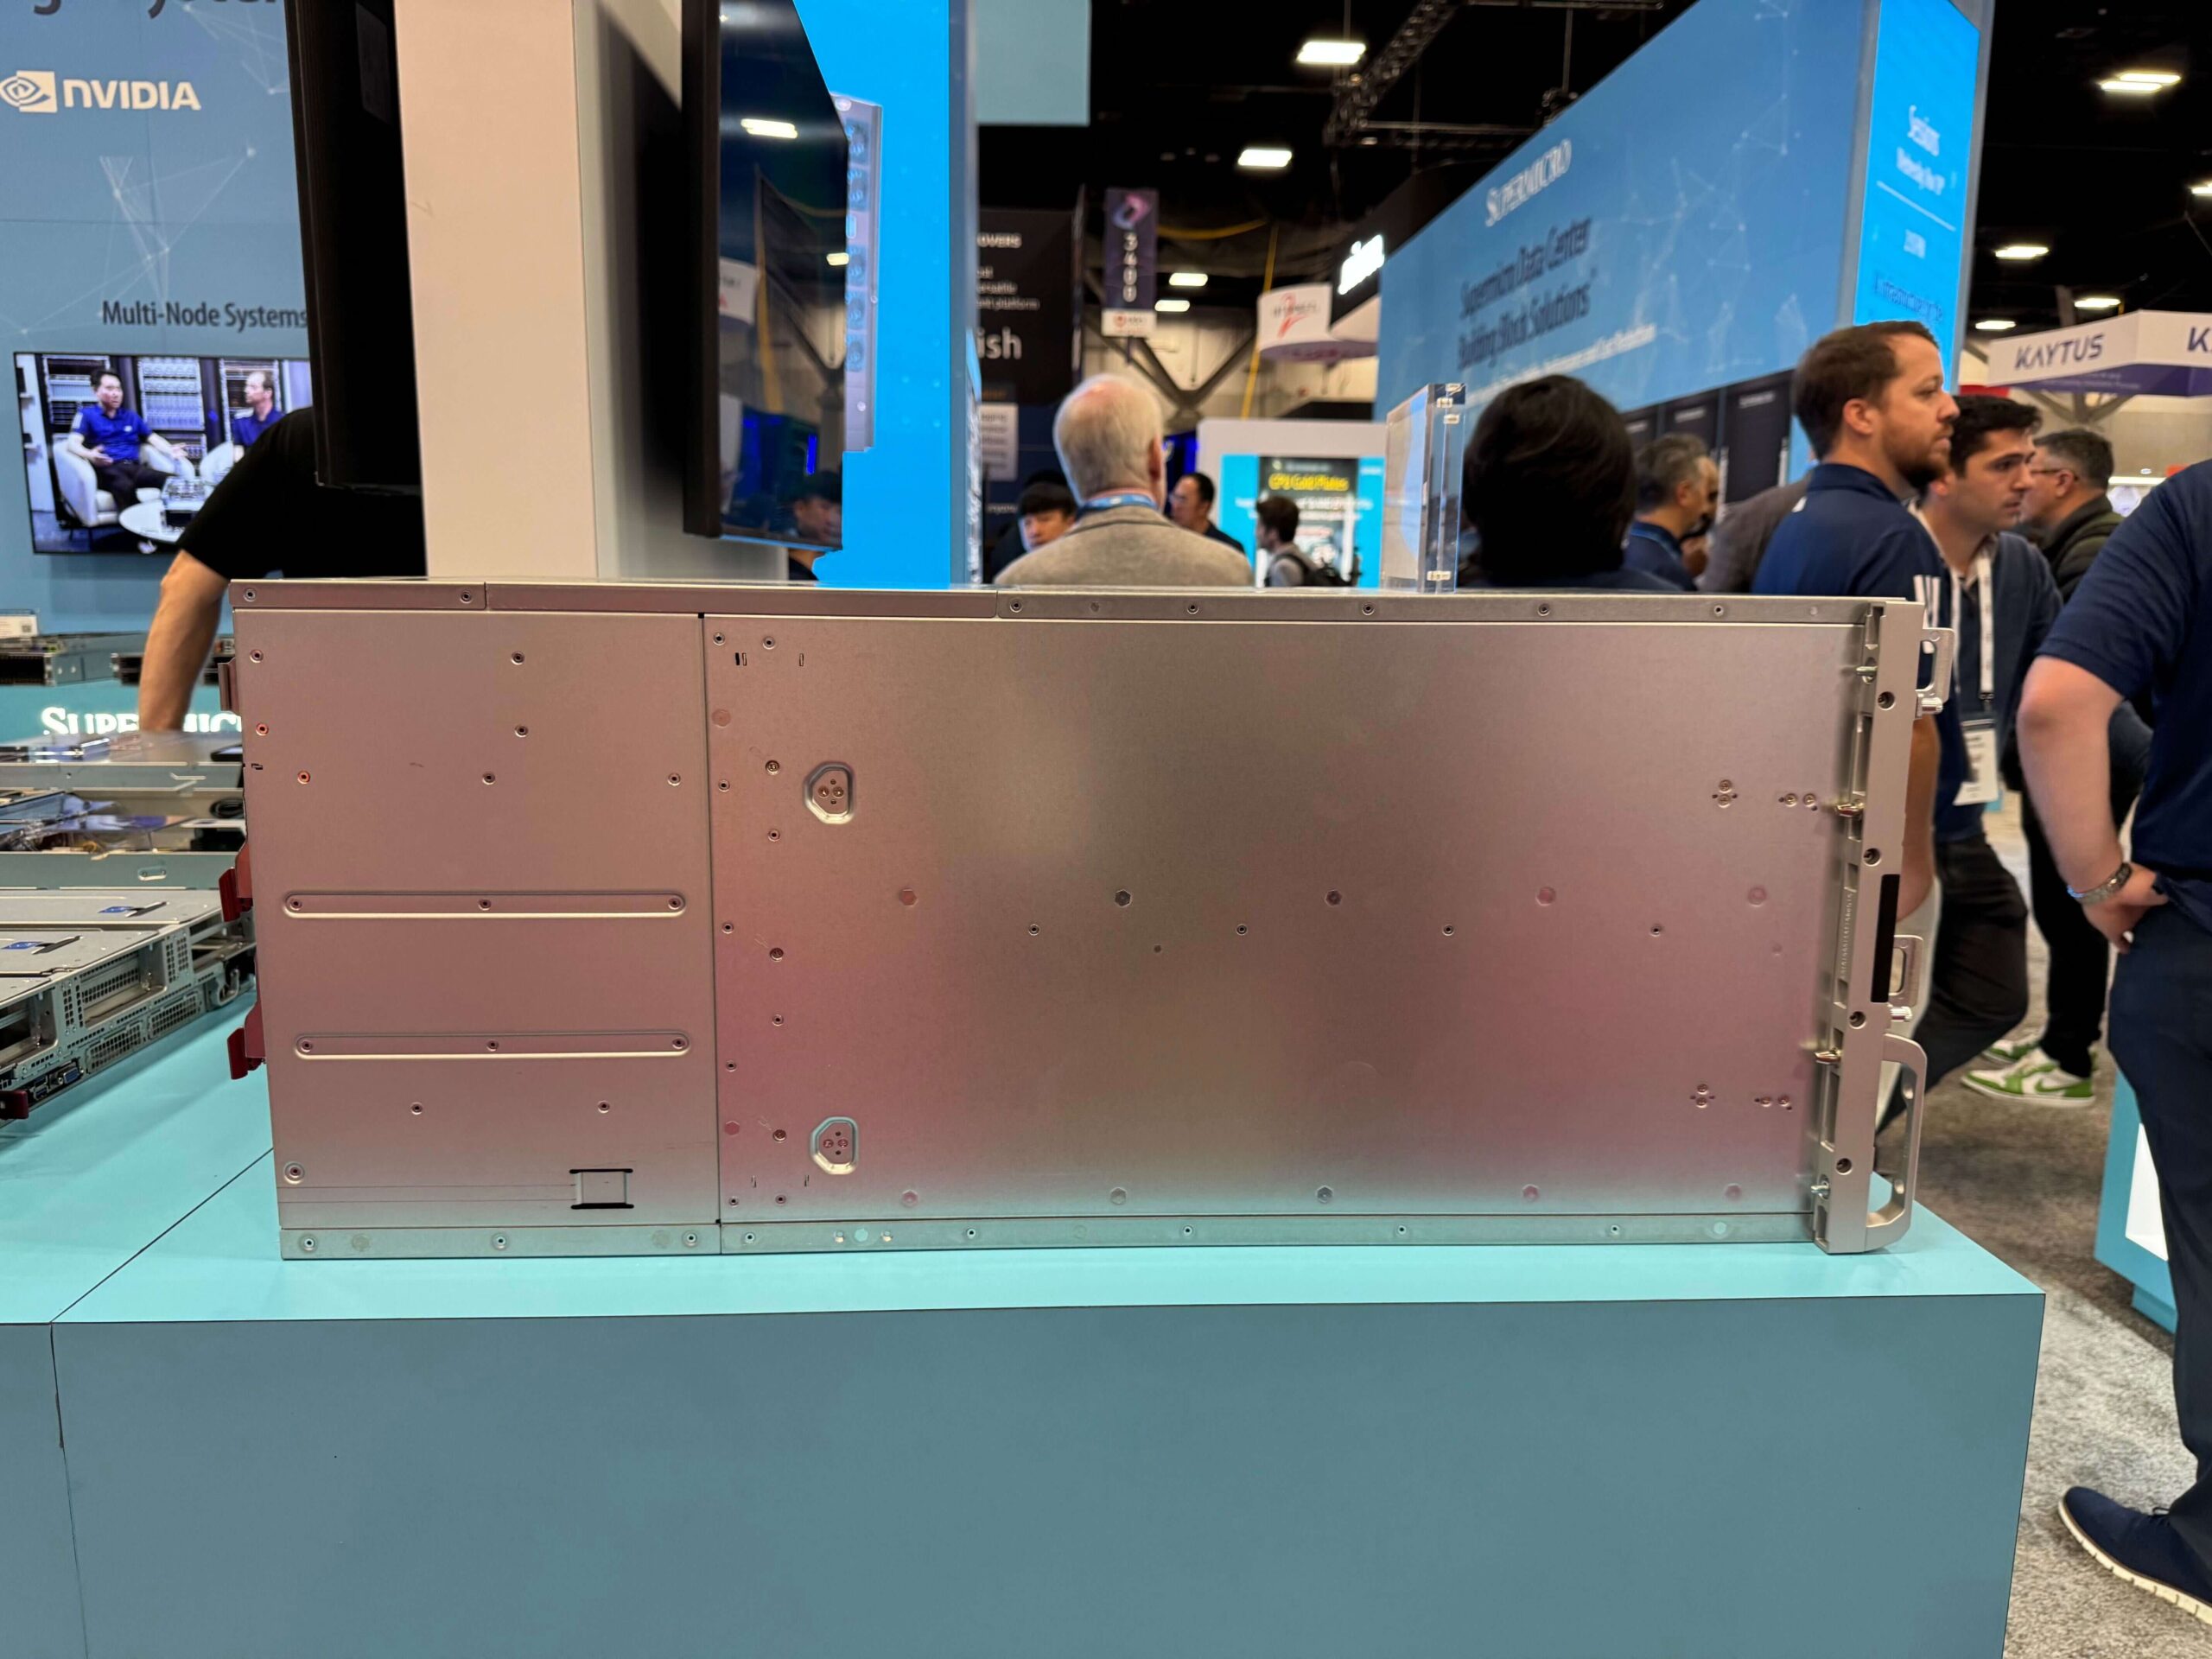
Nossos testes abrangeram uma seleção de modelos populares; os 2.3 TB de HBM3e em um único nó permitiram a inferência em um único servidor para modelos com muitos parâmetros, incluindo o Kimi K2.5 e o MiniMax M2.5 da Moonshot.
AMD Instinct MI350X: Arquitetura e melhorias geracionais
O MI350X representa o salto geracional mais ambicioso da AMD em termos de arquitetura na linha de produtos Instinct até o momento. Compreender as decisões de engenharia por trás dele fornece um contexto importante para interpretar os resultados de desempenho subsequentes.
Arquitetura do CDNA 4 e Transição do Nó de Processo
A principal mudança da série MI300 para a série MI350 centra-se na adoção do processo de fabricação N3P da TSMC para os Chiplets de Computação Aceleradora (XCDs), em substituição à fabricação de 5 nm utilizada na geração anterior. O número total de transistores atinge aproximadamente 185 bilhões, um aumento de cerca de 21% em relação à geração MI300, alcançado sem um aumento correspondente no consumo de energia.
A MI350X mantém a estratégia comprovada de encapsulamento multichiplet da AMD. Em sua essência, o pacote da GPU apresenta oito Chiplets de Computação Aceleradora (XCDs) como os principais mecanismos de computação. Cada XCD abriga quatro mecanismos de shader, cada um com oito unidades de computação CDNA 4 ativas, resultando em 32 CUs por XCD e um total de 256 CUs para o acelerador completo.
A camada de E/S do chip também foi consolidada de quatro para dois blocos no design do pacote CDNA 4. Essa reorganização permitiu à AMD dobrar a largura do barramento Infinity Fabric, melhorando a largura de banda bisseccional e, ao mesmo tempo, reduzindo a frequência do barramento e a tensão de operação para diminuir o consumo de energia.
Unidades de computação redesenhadas e suporte de precisão expandido.
Com os recursos de matemática matricial da unidade de computação CDNA 4, há um aumento substancial: as CUs MI350 oferecem um aumento de 2x na taxa de transferência por CU para operações de 16 bits (BF16, FP16) e 8 bits (FP8, INT8) em comparação com suas contrapartes MI300.
Além dos ganhos brutos de produtividade, o CDNA 4 introduz suporte de hardware para tipos de dados de menor precisão ausentes na série MI300, especificamente FP6 e FP4, juntamente com o suporte existente para FP8 herdado da geração anterior.
Além desses formatos padrão, o MI350X adiciona suporte nativo de hardware para as variantes de microescalonamento OCP: MXFP4, MXFP6 e MXFP8. Os formatos de microescalonamento são projetados para oferecer as vantagens de desempenho da computação de menor precisão, mantendo a qualidade de saída mais próxima dos níveis de referência de maior precisão do que a quantização padrão normalmente permite. Este não é um desenvolvimento específico da AMD. O formato NVFP4 da NVIDIA opera com os mesmos princípios de microescalonamento e tem sido amplamente adotado em implementações de modelos de ponta, com a família GPT-OSS da OpenAI como um dos exemplos mais proeminentes construídos em torno desses formatos. O suporte nativo do MI350X ao MXFP4 permite que ele atenda a essas e outras famílias de modelos quantizados semelhantes sem recorrer à emulação de software ou à promoção de precisão.
O MI350X oferece 9.2 PFLOPs em MXFP4 e MXFP6, em comparação com 4.6 PFLOPs em OCP-FP8, com 2.3 PFLOPs em FP16 e um clock de pico do processador de 2,200 MHz. Para implementações otimizadas para inferência, onde a quantização em microescala é viável, a capacidade computacional efetivamente dobra em relação às cargas de trabalho FP8. Uma nova ALU vetorial também foi adicionada à unidade de computação CDNA 4, suportando operações de 2 bits e capaz de acumular resultados BF16 em FP32, proporcionando flexibilidade adicional para cargas de trabalho vetoriais de baixa precisão fora do caminho de computação matricial principal.
Subsistema de memória: HBM3e, Infinity Cache e eficiência de largura de banda.
A série MI350 apresenta um subsistema de memória substancialmente aprimorado com oito módulos de memória HBM3e, fornecendo uma capacidade total de 288 GB por GPU. Cada módulo de 36 GB, composto por 12 dispositivos de 24 Gbit de altura, opera na velocidade máxima de 8 Gbps por pino da HBM3e. A arquitetura mantém o Infinity Cache da AMD, um cache do lado da memória posicionado entre a HBM e os caches Infinity Fabric/L2. Ele compreende 128 canais, cada um com 2 MB de cache, totalizando 256 MB por GPU. A AMD ampliou os barramentos de rede integrados nos IODs e os opera com uma tensão reduzida, possibilitando uma largura de banda de memória por watt aproximadamente 1.3 vezes maior em comparação com a série MI300.
O aumento na capacidade de memória de 192 GB para 288 GB no MI300X amplia a vantagem da AMD em espaço de memória por GPU, com implicações diretas para inferência de modelos grandes. Cada GPU MI350X pode hospedar independentemente modelos com mais de 500 bilhões de parâmetros. Em um servidor com oito GPUs, o total de 2.3 TB de HBM3e elimina os requisitos de distribuição em vários nós que complicam as implementações com trilhões de parâmetros, como demonstram os resultados do Kimi K2.5 e do MiniMax M2.5 nesta análise.
Arquitetura flexível de particionamento e implantação
A série MI350 suporta particionamento flexível de GPU por soquete, com a memória dividida em dois clusters separados. Essa flexibilidade também se aplica aos XCDs, onde o cluster XCD quádruplo pode ser dividido em blocos duplos ou simples, permitindo que o chip suporte configurações como 8 instâncias de modelos de 70 bits em CPX+NPS2. Para organizações que executam cargas de trabalho de inferência heterogêneas em infraestrutura compartilhada, esse recurso de particionamento reduz a necessidade de hardware dedicado por camada de modelo e melhora a economia de utilização em ambientes de implantação mistos.
A série MI350 também mantém compatibilidade direta com a infraestrutura UBB (Universal Base Board) usada nos sistemas da série MI300. Os chassis de servidor, a alimentação e a infraestrutura de refrigeração existentes são mantidos sem modificações, reduzindo as dificuldades de atualização para organizações com implantações ativas do MI300.
MI355X: O irmão com refrigeração líquida
A série MI350 é comercializada em duas variantes, construídas com o mesmo silício subjacente e otimizadas para diferentes faixas de operação térmica. O MI350X testado aqui é a variante com refrigeração a ar, enquanto o MI355X é sua contraparte com refrigeração líquida, projetada para implantações de maior densidade onde a infraestrutura de refrigeração líquida direta está disponível.
Embora ambas as variantes sejam construídas com o mesmo hardware fundamental, o maior consumo de energia operacional do MI355X permite frequências de clock sustentadas mais altas, resultando em uma vantagem de desempenho de aproximadamente 20% em cargas de trabalho reais de ponta a ponta, em comparação com o MI350X. O MI355X possui um limite de TBP de 1,400 W, contra 1,000 W do MI350X, com velocidade de clock máxima de 2.4 GHz, em comparação com 2.2 GHz na variante refrigerada a ar.
Em termos geracionais, a plataforma MI355X oferece um aumento de desempenho teórico máximo de até 4 vezes em relação ao MI300X, com ganhos reais de inferência de aproximadamente 4.2 vezes em cargas de trabalho de agentes e chatbots e cerca de 3 vezes em cenários de geração de conteúdo. Para organizações que avaliam implantações do MI350X, a diferença de desempenho de 20% entre as duas variantes representa um limite máximo claro. Instalações com infraestrutura de refrigeração a ar devem avaliar o MI355X para determinar se o investimento em refrigeração proporciona um aumento de desempenho suficiente para seu perfil de carga de trabalho específico antes de optar por configurações com refrigeração a ar em larga escala.
Acessando a placa-mãe AMD Instinct MI350X através do programa Supermicro JumpStart
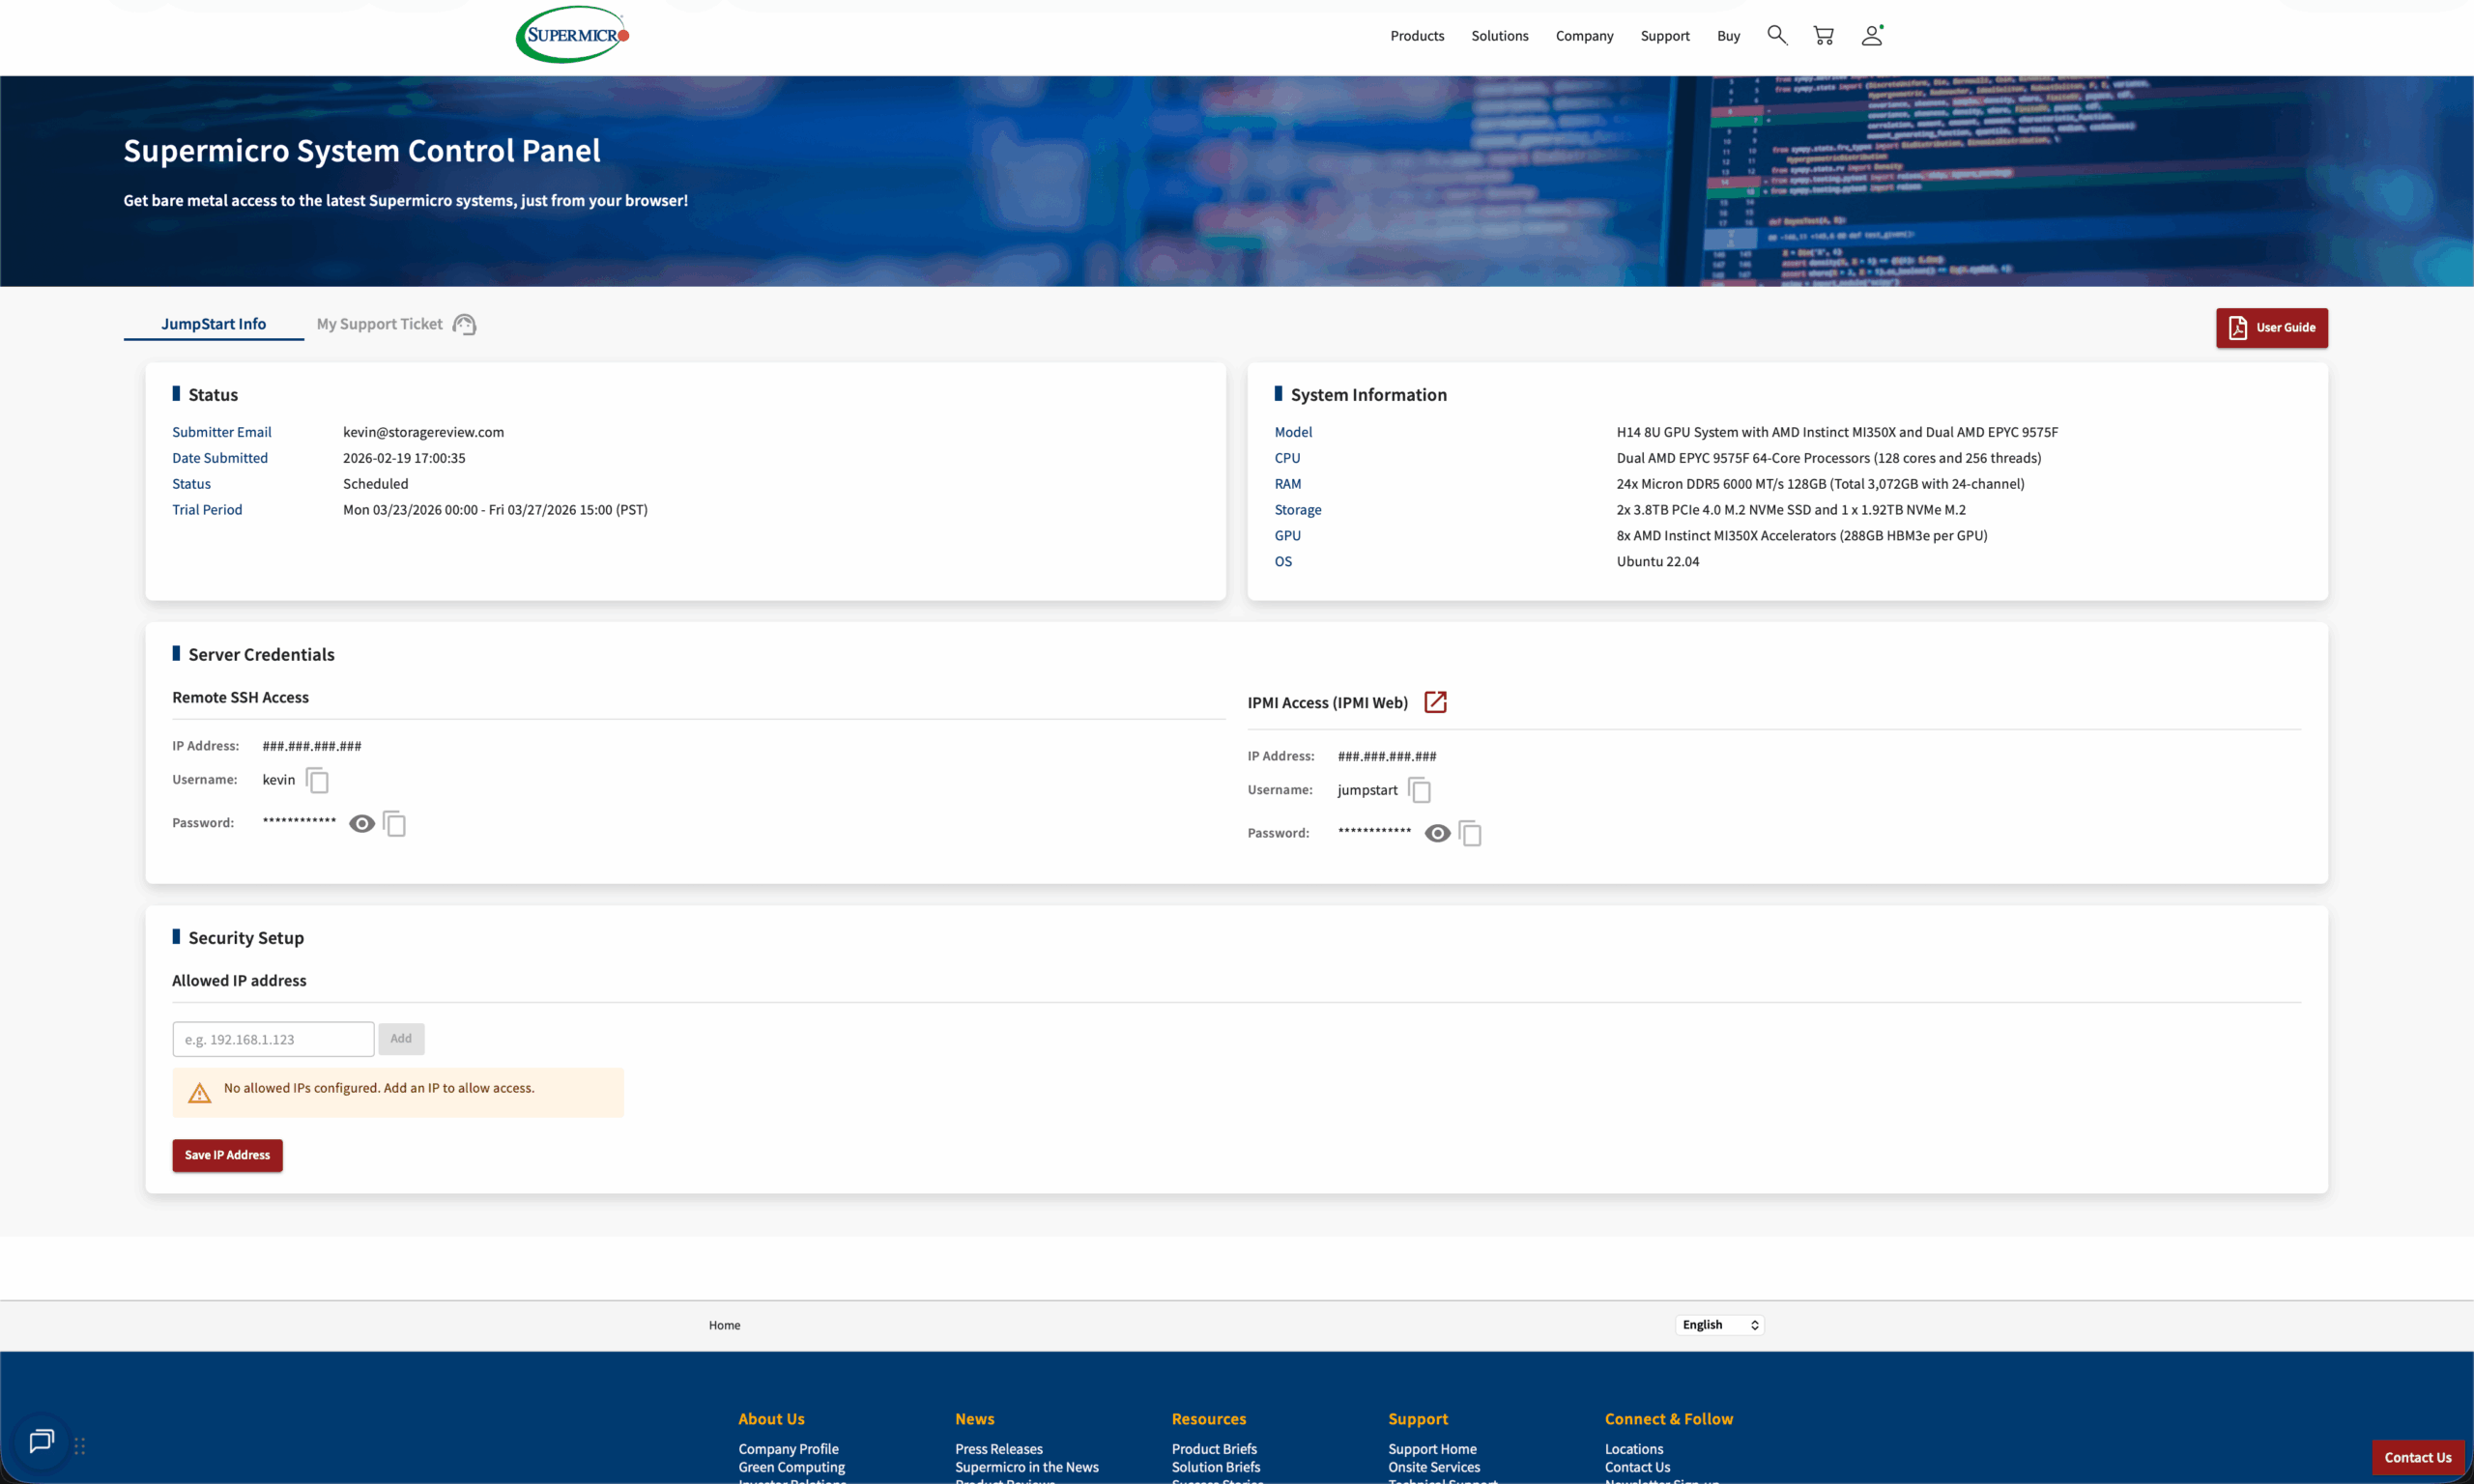
Para começar a usar o JumpStart, é necessário se cadastrar no portal da Supermicro, onde usuários qualificados podem navegar pelos sistemas disponíveis e agendar um período de reserva. Após a aprovação, o portal fornece credenciais SSH, acesso IPMI e um console remoto baseado na web durante o período da reserva. O sistema chega com o Ubuntu pré-instalado e pronto para uso. Não há atraso no provisionamento e nenhuma interação com o suporte é necessária para começar. Nossa reserva foi de 23 a 27 de março de 2026, o que nos deu uma semana inteira na plataforma, assim como em nossa experiência anterior com o JumpStart no HGX B200.
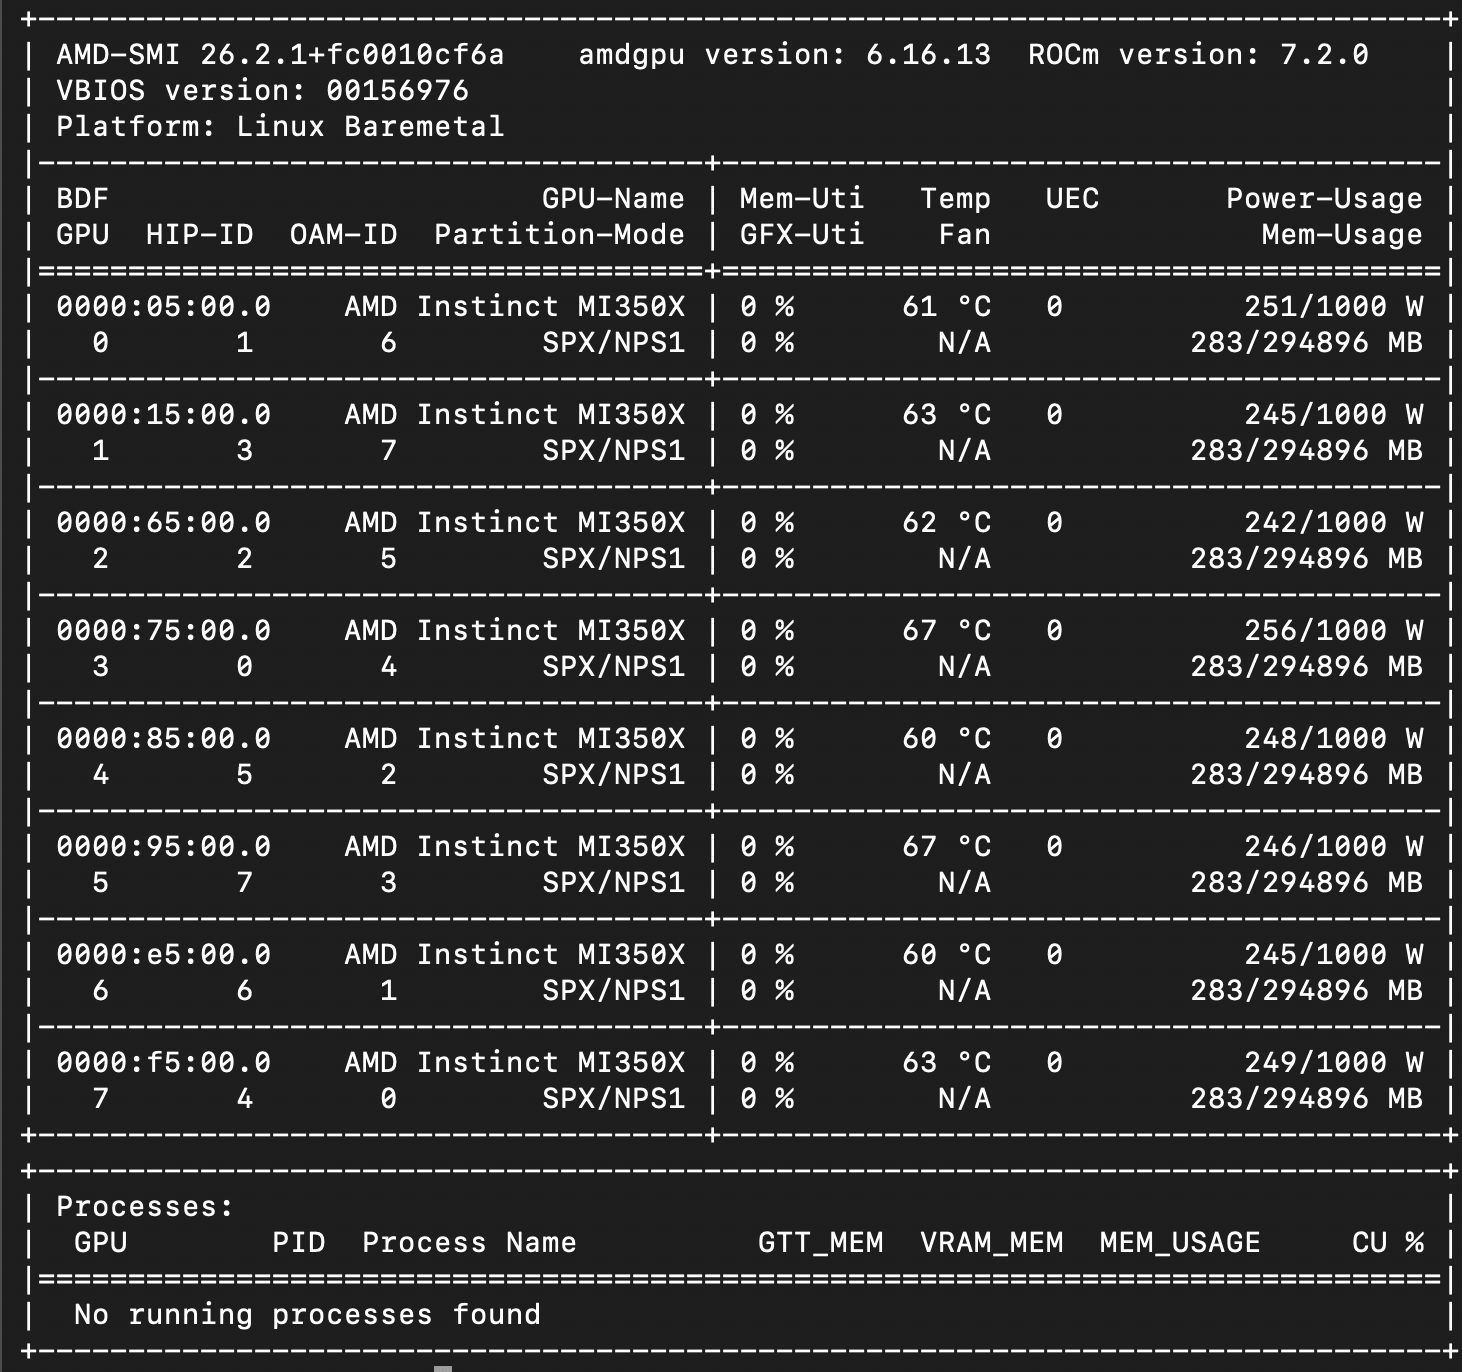
A captura de tela abaixo mostra a saída do terminal do jumpstart para o sistema H14, com a ferramenta AMD-SMI exibindo as oito GPUs AMD Instinct MI350X e suas versões de software em execução.
Resultados dos testes de desempenho do AMD Instinct MI350X
Configuração do sistema
- Chassi: Supermicro H14
- CPU: Dual AMD EPYC 9575F
- Memória: 3TB DDR5
- GPU: oito AMD Instinct MI350X
- Armazenamento: 2 SSDs NVMe M.2 PCIe 4.0 de 3.8 TB e 1 SSD NVMe M.2 de 1.92 TB.
Resumo dos Resultados
| Modelo | Precisão | Igual (256/256) | Pré-enchimento pesado (8k/1k) | Decodificação pesada (1k/8k) |
|---|---|---|---|---|
| GPT-OSS 20B | NVFP4 | 62,247 | 123,714 | 32,468 |
| GPT-OSS 120B | NVFP4 | 33,538 | 84,018 | 20,602 |
| Lhama 3.1 8B Instruir | BF16 | 51,467 | 77,658 * | 19,326 |
| Mistral Pequeno 3.1 24B | FP8 | 40,742 | 56,093 | 14,557 |
| Mistral Pequeno 3.1 24B | BF16 | 30,530 | 53,740 | 13,559 |
| Qwen3 Coder 30B A3B | BF16 | 34,980 | 51,550 | 11,782 |
| Qwen3 Coder 30B A3B | FP8 | 25,928 | 47,179 | 11,014 |
| MiniMax M2.5 | FP8 em escala de bloco | 14,391 | 23,689 | 6,068 |
| Kimi K2.5 | INT4 QAT + BF16 | 6,527 | 11,256 | 2,513 |
| Todos os valores em tok/s, com pico de produção em BS=256. *O pré-enchimento pesado de Llama 3.1 8B atingiu o pico em BS=128 (77,658 tok/s); em BS=256, o valor foi de 76,893 tok/s. | ||||
Claude Code Serving – MiniMax M2.5
Além dos benchmarks tradicionais de inferência LLM bruta, queríamos avaliar o desempenho desse hardware em um fluxo de trabalho de codificação com agentes, especificamente atendendo a múltiplas sessões simultâneas do Claude Code com um modelo hospedado localmente. Esse caso de uso se relaciona diretamente à produtividade da equipe de desenvolvimento: quantos engenheiros podem usar simultaneamente um assistente de codificação com IA, hospedado em um único nó, antes que a experiência seja prejudicada?
Para testar isso, criamos um ambiente de benchmark que gera um conjunto de dados com problemas de programação de dificuldade moderada (tarefas como implementar um cache LRU, construir um aplicativo de lista de tarefas de linha de comando, escrever um conversor de Markdown e construir uma API REST) e executa cada sessão do Claude Code em seu próprio contêiner Docker contra o servidor vLLM local. Um proxy transparente fica entre as sessões e o endpoint de inferência, capturando métricas por requisição para cada instância do Claude Code. O modelo usado foi o MiniMax M2.5, servido via vLLM nas oito GPUs MI350X. Embora não seja o modelo de programação mais bem classificado em rankings públicos, o M2.5 é um modelo competente que muitos usuários executam localmente, incluindo muitos de nossos amigos desenvolvedores.
Como ponto de referência inicial, utilizamos a taxa de transferência média de saída do Claude Opus 4.6 da Anthropic via OpenRouter.ai, um dos serviços de roteamento mais populares para acesso a APIs em produção. Essa linha de base resulta em aproximadamente 37 tokens por segundo por requisição de API.
Medimos duas métricas principais: a média de tokens de saída por segundo por sessão do Claude Code (o que cada desenvolvedor experimenta) e o total de tokens de saída por segundo em todas as sessões (o trabalho total que o servidor está produzindo).
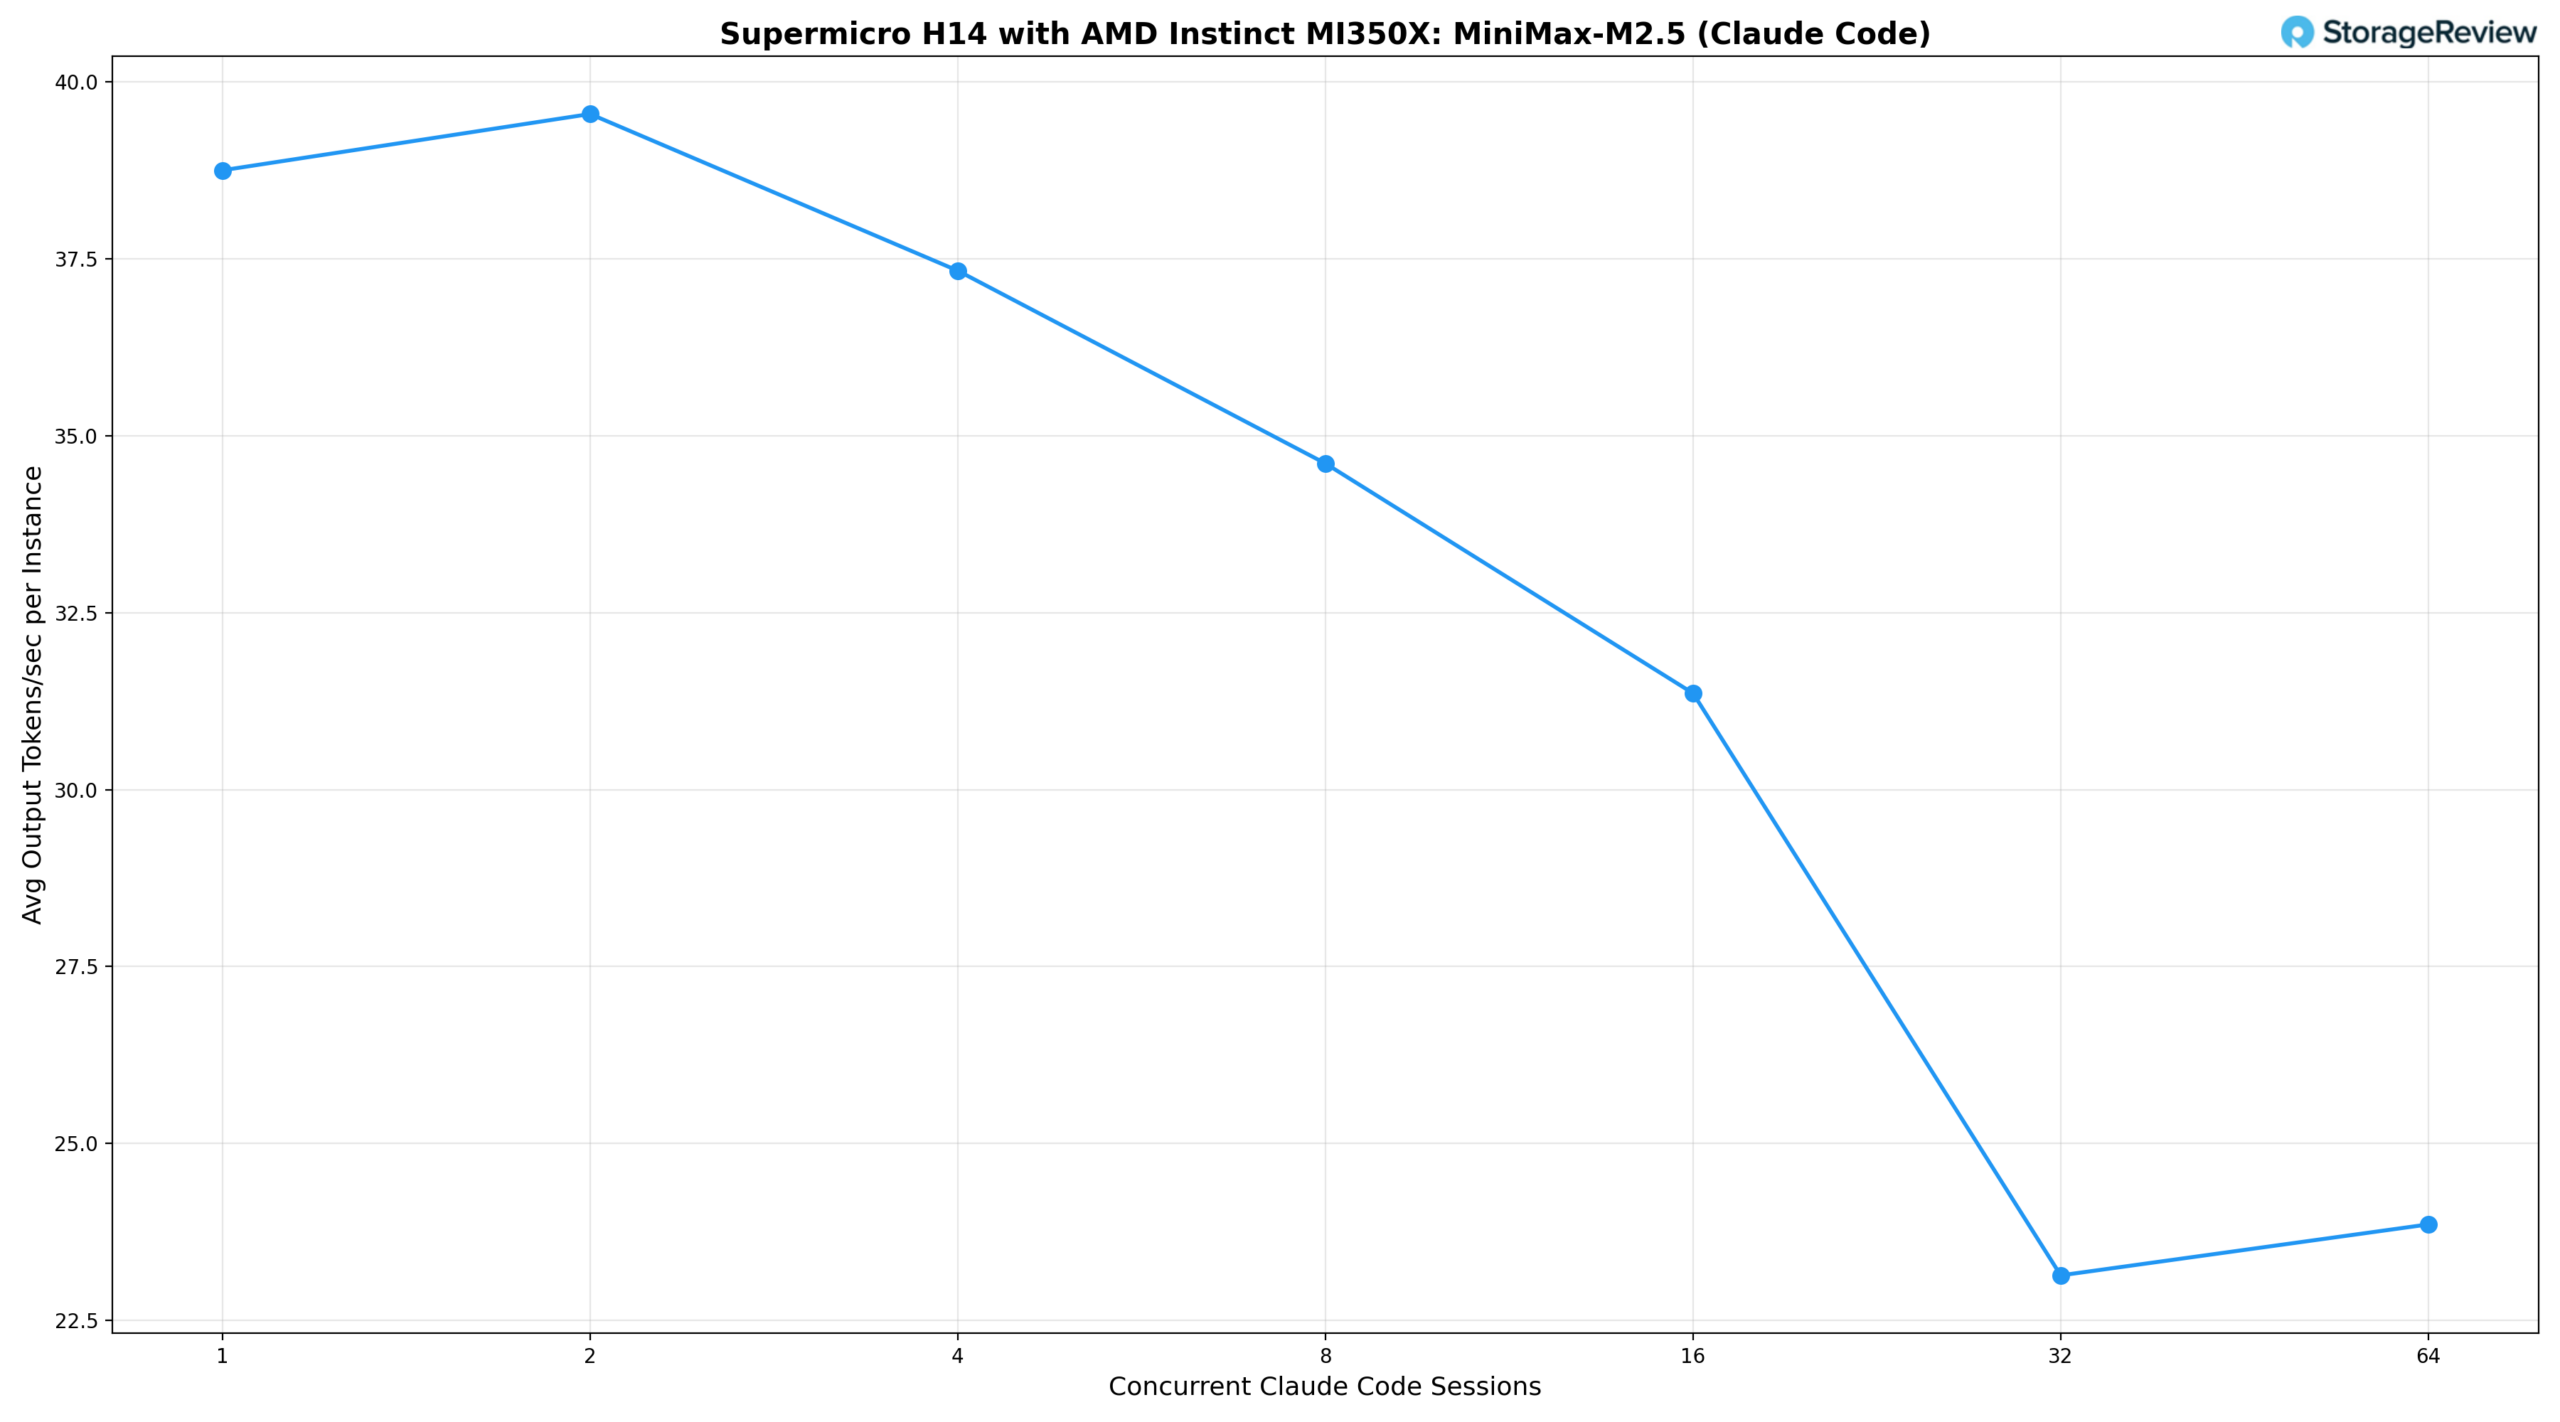
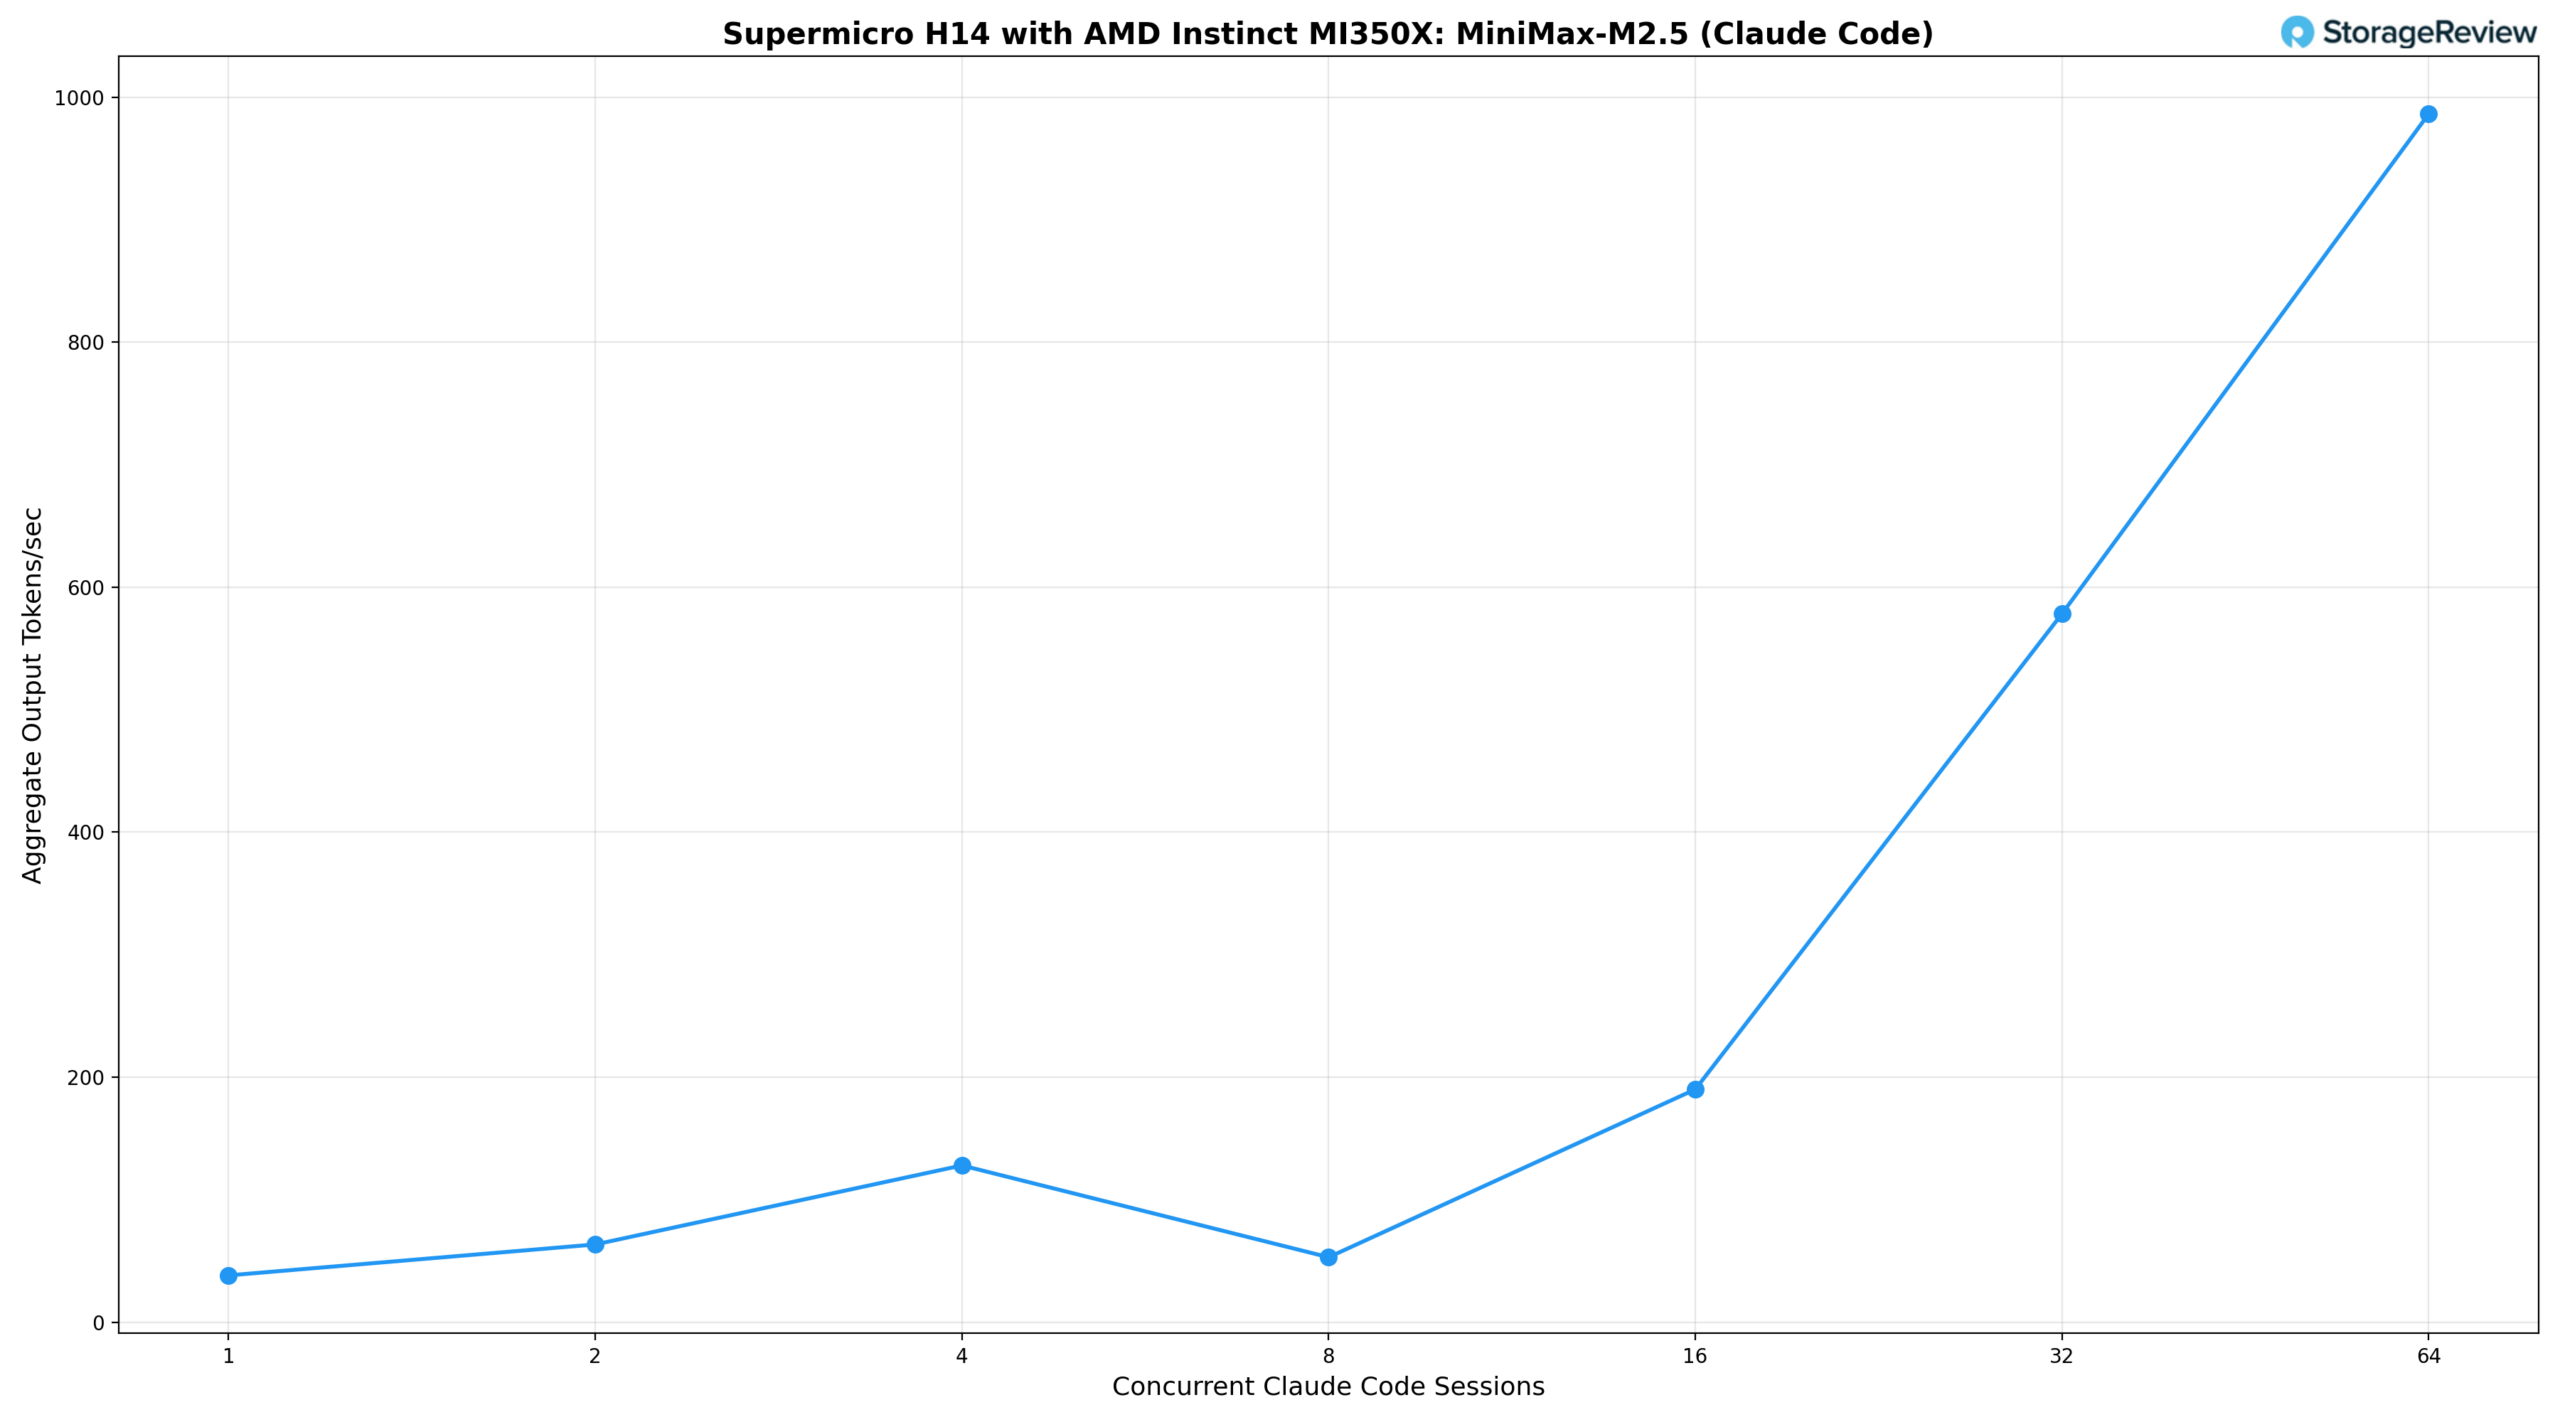
Analisando os resultados, uma única sessão simultânea oferece 38.8 tok/s por usuário e 38 tok/s no total, ligeiramente acima da linha de base da nuvem OpenRouter. Com duas sessões, o sistema atinge 39.5 tok/s por usuário, à medida que o processamento em lote do vLLM começa a amortizar a sobrecarga, com a taxa de transferência agregada subindo para 63 tok/s. Quatro sessões simultâneas atingem 37.3 tok/s por usuário, igualando a linha de base da nuvem enquanto atendem quatro desenvolvedores simultaneamente, com a taxa de transferência agregada chegando a 128 tok/s. A partir de oito sessões, a taxa de transferência por instância começa a diminuir: 34.6 tok/s por usuário com oito sessões, 31.4 tok/s com dezesseis, com um total de 190 tok/s, e se estabiliza em torno de 23 tok/s por usuário com 32 e 64 sessões, enquanto a taxa de transferência agregada sobe para 578 tok/s e 986 tok/s, respectivamente. Este é o clássico dilema entre processamento em lote e interatividade: o sistema pode atingir uma taxa de transferência total significativamente maior processando mais solicitações em lote, mas cada usuário experimenta tempos de resposta mais lentos. Mesmo com 64 usuários simultâneos, cada desenvolvedor ainda tem uma experiência interativa utilizável, embora visivelmente mais lenta do que a configuração básica da nuvem.
Para organizações que avaliam o custo de dezenas de assinaturas simultâneas de APIs comerciais em comparação com a infraestrutura própria, a vantagem é clara: um único nó MI350X pode atender a uma equipe de desenvolvimento de 16 a 32 engenheiros, mantendo velocidades de resposta por usuário entre 60% e 85% da linha de base da nuvem, enquanto fornece uma produção agregada de 600 a 1,000 tok/s, com os benefícios adicionais de localidade de dados, sem cobranças de API por token e controle total sobre a seleção do modelo.
Serviço online vLLM – Desempenho de inferência LLM
O vLLM é um dos mecanismos de inferência e serviço de alto desempenho mais populares para LLMs. O benchmark de serviço online do vLLM avalia o desempenho real desse mecanismo de inferência sob solicitações simultâneas. Ele simula cargas de trabalho de produção enviando solicitações para um servidor vLLM em execução, com parâmetros configuráveis como taxa de solicitações, comprimentos de entrada/saída e número de clientes simultâneos. O benchmark mede métricas importantes, incluindo taxa de transferência (tokens por segundo), tempo até o primeiro token e tempo por token de saída (TPOT), ajudando os usuários a entender como o vLLM se comporta sob diferentes condições de carga.
Testamos o desempenho de inferência em um conjunto abrangente de modelos que abrangem várias arquiteturas, escalas de parâmetros e estratégias de quantização para avaliar a taxa de transferência sob diferentes perfis de concorrência.
GPT-OSS 120B e 20B
A família de modelos GPT-OSS foi testada nas configurações 120B e 20B no Supermicro H14.
GPT-OSS 120B
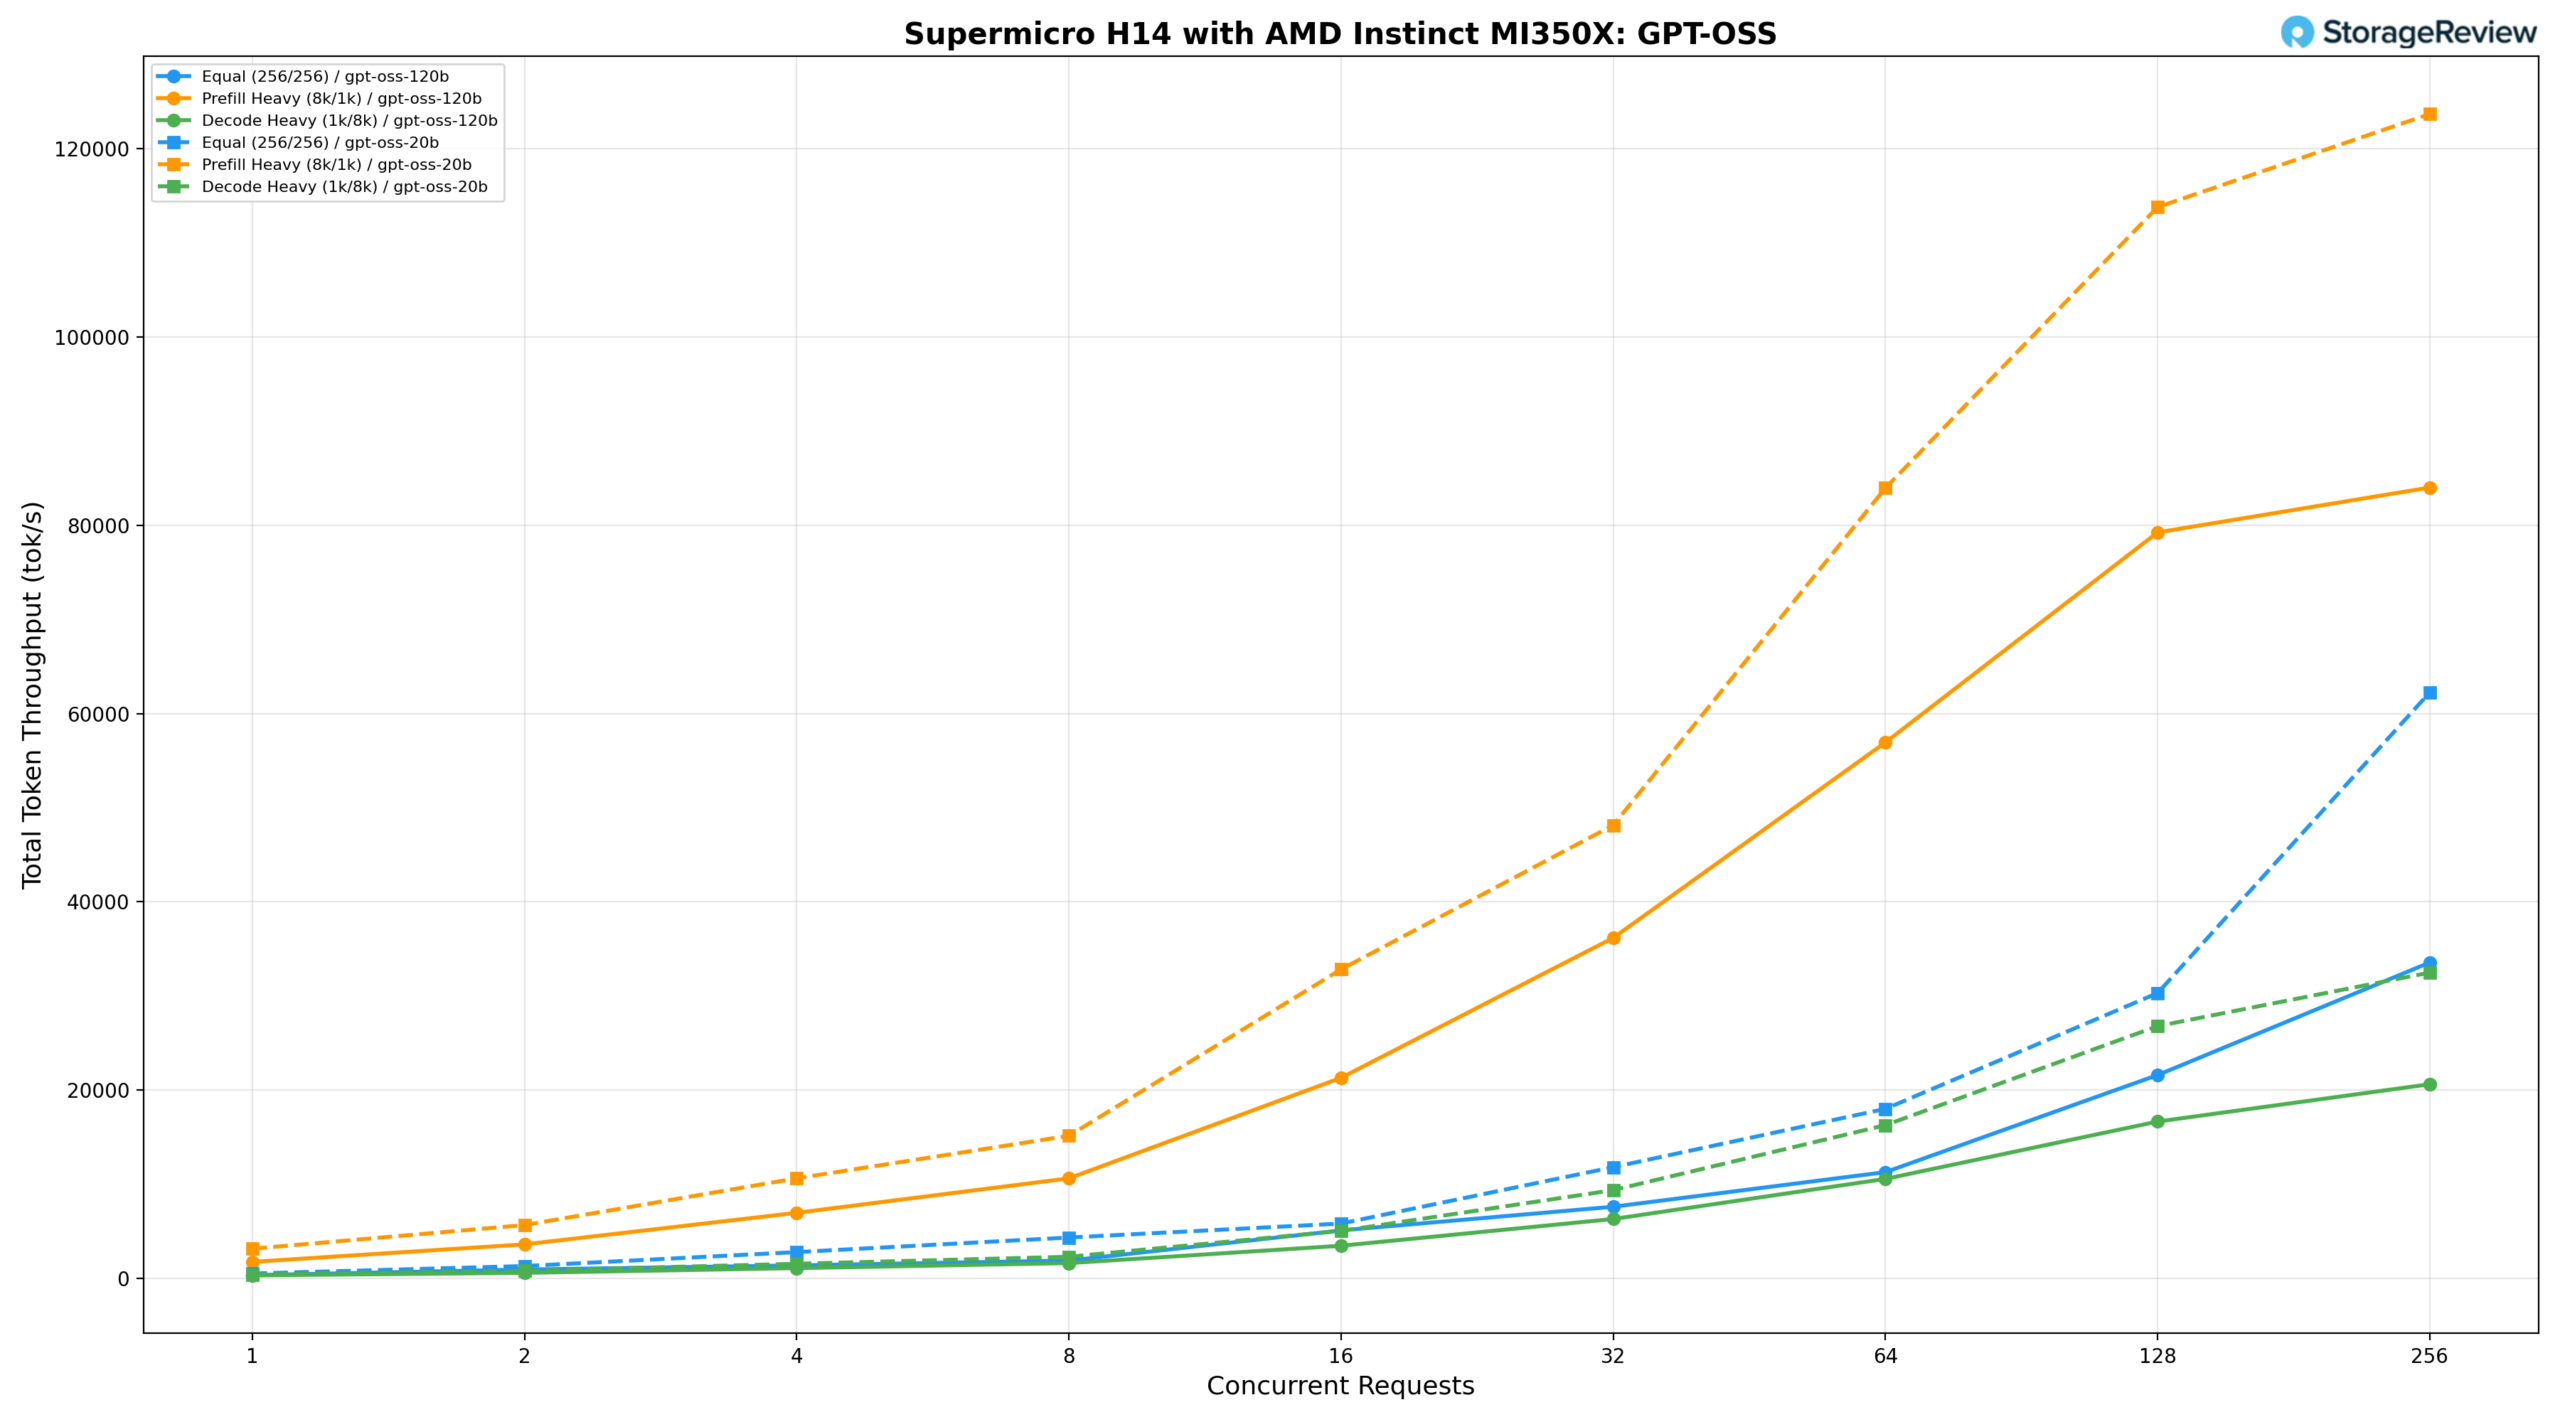
O modelo 120B sob carga de trabalho igual (256/256) fornece 313.42 tok/s em BS=1, atinge 11,261.72 tok/s em BS=64 e alcança um pico de 33,538.23 tok/s em BS=256. Com pré-carregamento pesado (8k/1k), inicia em 1,724.84 tok/s, sobe para 36,156.80 tok/s em BS=32 e 79,247.76 tok/s em BS=128, atingindo um pico de 84,018.79 tok/s em BS=256. A decodificação intensiva (1k/8k) aumenta de 288.90 tok/s em BS=1 para 20,602.52 tok/s em BS=256, com a latência permanecendo bem controlada em níveis de concorrência mais baixos.
GPT-OSS 20B
O modelo 20B oferece 485.17 tok/s em BS=1 sob carga de trabalho equivalente, atingindo 17,986.36 tok/s em BS=64 e alcançando um pico de 62,247.52 tok/s em BS=256. O pré-enchimento intenso começa em 3,120.72 tok/s, sobe para 48,132.52 tok/s em BS=32 e 83,968.71 tok/s em BS=64, atingindo um pico de 123,714.50 tok/s em BS=256 — a maior taxa de transferência de pré-enchimento absoluta registrada em ambos os tamanhos de modelo. A taxa de transferência com decodificação intensiva aumenta de 378.20 tok/s em BS=1 para 32,468.67 tok/s em BS=256, oferecendo aproximadamente 1.6 vezes a taxa de transferência de decodificação do 120B no pico de concorrência, mantendo características de latência mais baixas em todo o processo.
Qwen3 Coder 30B A3B Instruct e FP8 Instruct
O módulo Qwen3-Coder-30B-A3B-Instruct no Supermicro H14 foi testado nas precisões padrão (BF16) e FP8.
Qwen3-Coder-30B-A3B-Instrução (BF16)
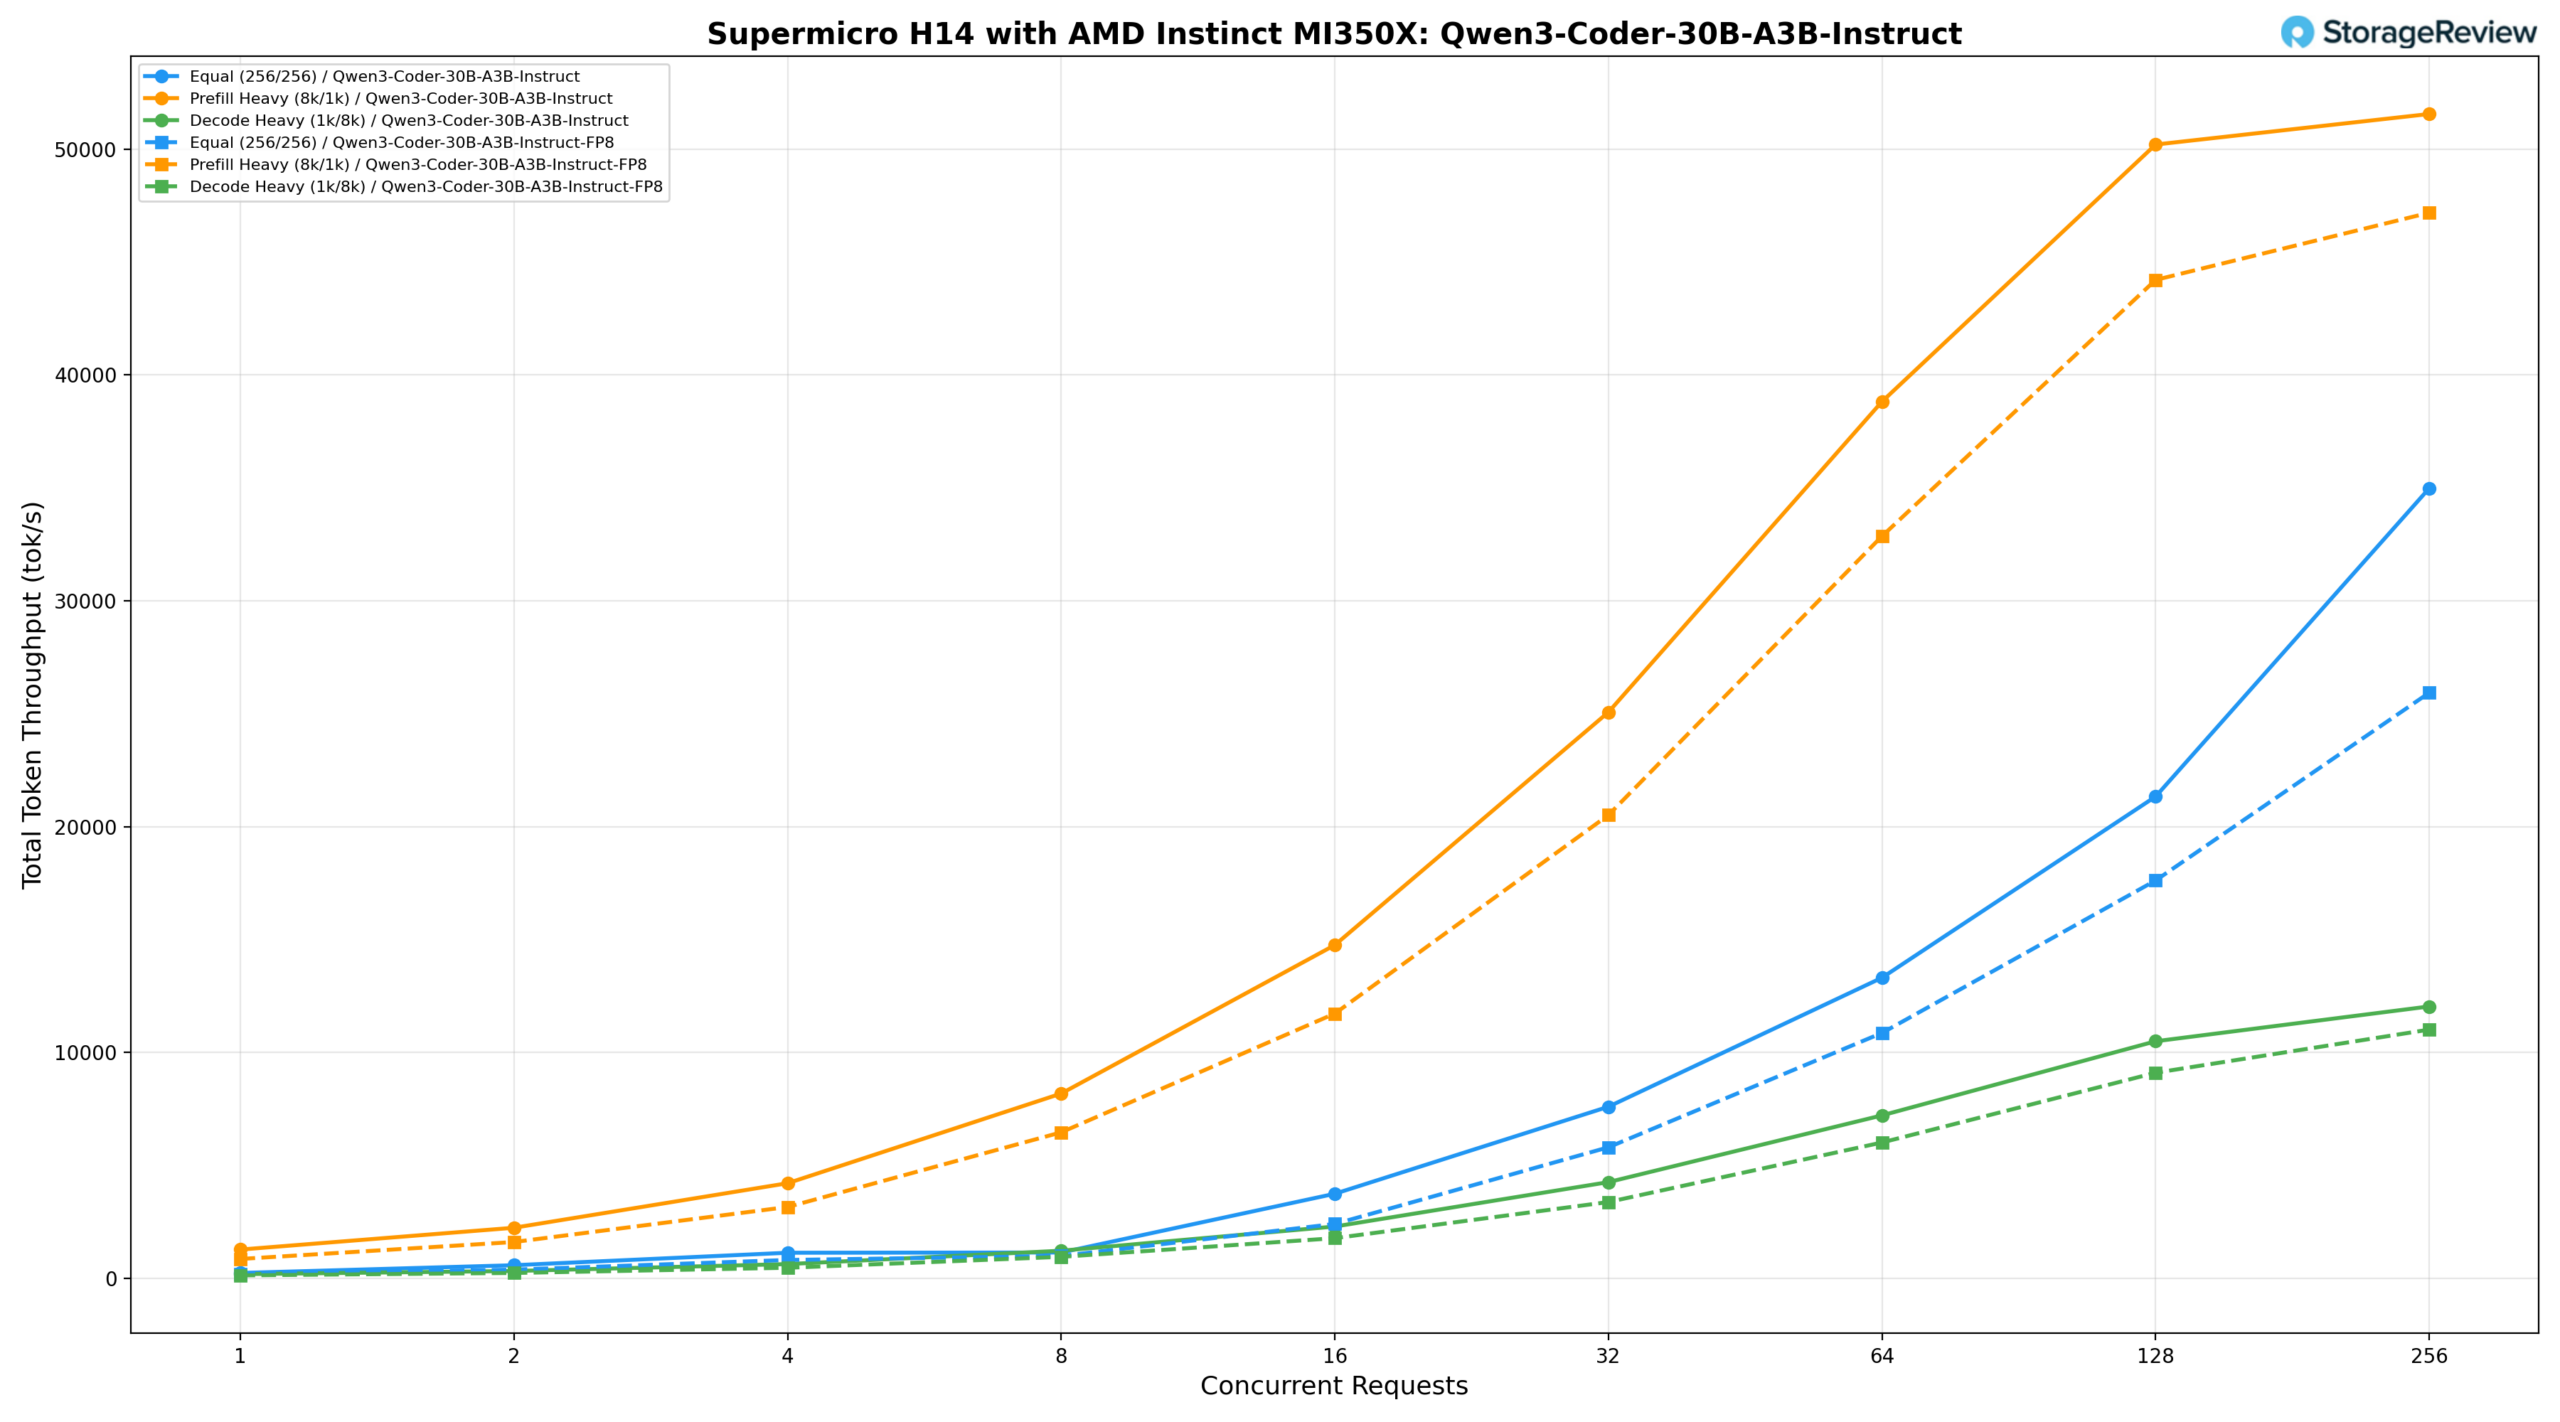
Na BF16, a carga de trabalho igual (256/256) fornece 240.53 tok/s em BS=1, atingindo 13,312.70 tok/s em BS=64 e 21,333.79 tok/s em BS=128, com um pico de taxa de transferência de 34,980.97 tok/s em BS=256. A carga de trabalho com pré-enchimento intenso (8k/1k) começa em 1,276.76 tok/s, sobe para 25,069.32 tok/s em BS=32 e 50,198.94 tok/s em BS=128, atingindo um pico de 51,550.66 tok/s em BS=256. A taxa de transferência com decodificação intensa (1k/8k) aumenta de forma constante, de aproximadamente 188 tok/s em BS=1 para 11,782 tok/s em BS=256, mantendo o perfil de latência mais preciso dos três cenários.
Qwen3-Coder-30B-A3B-Instruct (FP8)
A variante FP8 oferece 188.92 tok/s em BS=1 sob carga de trabalho equivalente, atingindo 10,866.27 tok/s em BS=64 e 17,617.60 tok/s em BS=128, com pico de 25,928.77 tok/s em BS=256 — ficando ligeiramente abaixo dos resultados do BF16 em toda a faixa. A taxa de transferência com pré-carregamento pesado começa em 860.07 tok/s, sobe para 20,513.77 tok/s em BS=32 e 44,205.46 tok/s em BS=128, com pico de 47,179.15 tok/s em BS=256. A taxa de transferência com decodificação intensa aumenta de 133.79 tok/s em BS=1 para 11,014.95 tok/s em BS=256, escalando de forma consistente e permanecendo próxima ao BF16 durante todo o período.
Mistral Pequeno 3.1 24B Instruções 2503
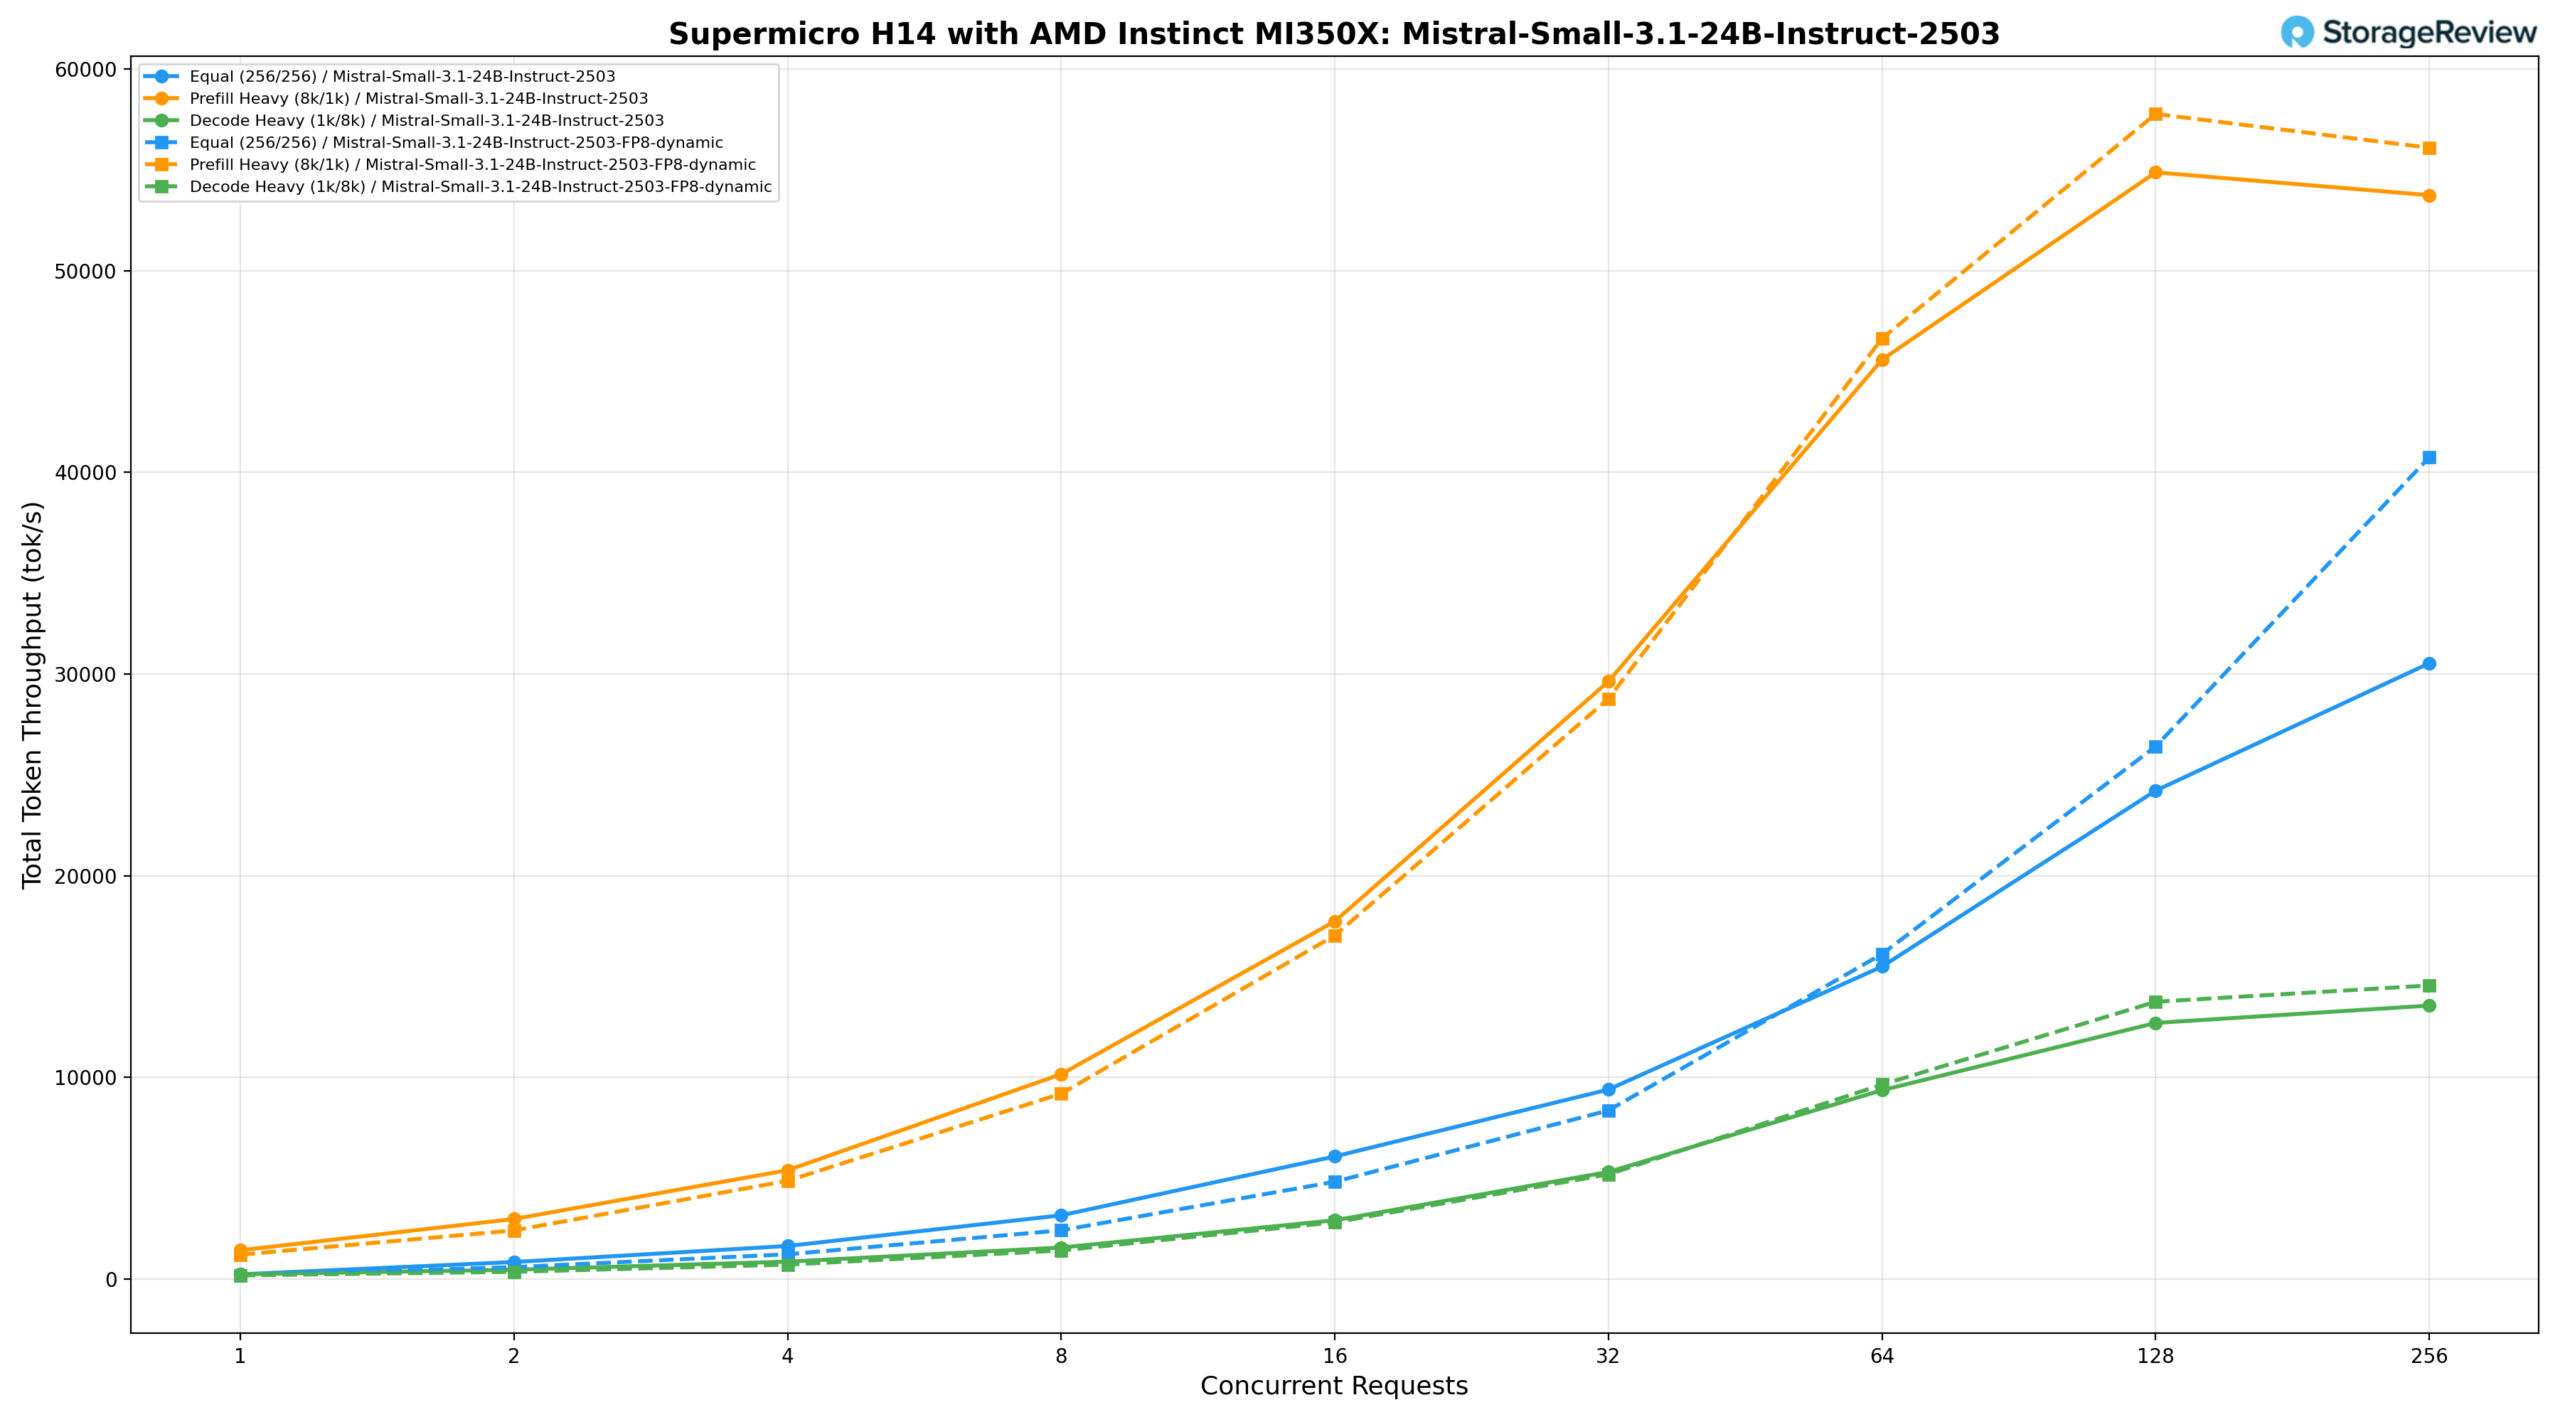
A instrução Mistral-Small-3.1-24B-Instruct-2503 no H14 foi testada com precisão padrão e FP8-dinâmica, mostrando escalabilidade consistente em todos os três perfis de carga de trabalho.
Mistral-Pequeno-3.1-24B-Instruções-2503 (BF16)
Com precisão BF16, a carga de trabalho igual (256/256) fornece 236.15 tok/s em BS=1, atingindo 15,494.56 tok/s em BS=64, 24,216.52 tok/s em BS=128 e alcançando um pico de 30,530.54 tok/s em BS=256. A carga de trabalho com pré-preenchimento pesado (8k/1k) começa em 1,429.41 tok/s, sobe para 29,631.68 tok/s em BS=32 e 54,871.74 tok/s em BS=128, atingindo um pico de 53,740.04 tok/s em BS=256. A decodificação pesada (1k/8k) aumenta de 242.66 tok/s em BS=1 para 13,559.19 tok/s em BS=256, escalando de forma constante em toda a faixa.
Mistral-Small-3.1-24B-Instruct-2503 (FP8-dinâmico)
A variante FP8-dinâmica atinge 184.25 tok/s com BS=1 sob a mesma carga de trabalho, alcançando 16,113.95 tok/s com BS=64 e 26,409.01 tok/s com BS=128, com um pico de 40,742.04 tok/s com BS=256. A variante com pré-preenchimento pesado inicia em 1,210.06 tok/s, sobe para 28,773.52 tok/s com BS=32 e 57,765.02 tok/s com BS=128, com um pico de 56,093.09 tok/s com BS=256, liderando o resultado de precisão padrão a partir de BS=64. A taxa de transferência com alta decodificação aumenta de 183.94 tok/s em BS=1 para 14,557.94 tok/s em BS=256, mantendo-se próxima na faixa intermediária antes de ultrapassar ligeiramente em BS=128 e BS=256.
Lhama 3.1 8B Instruir
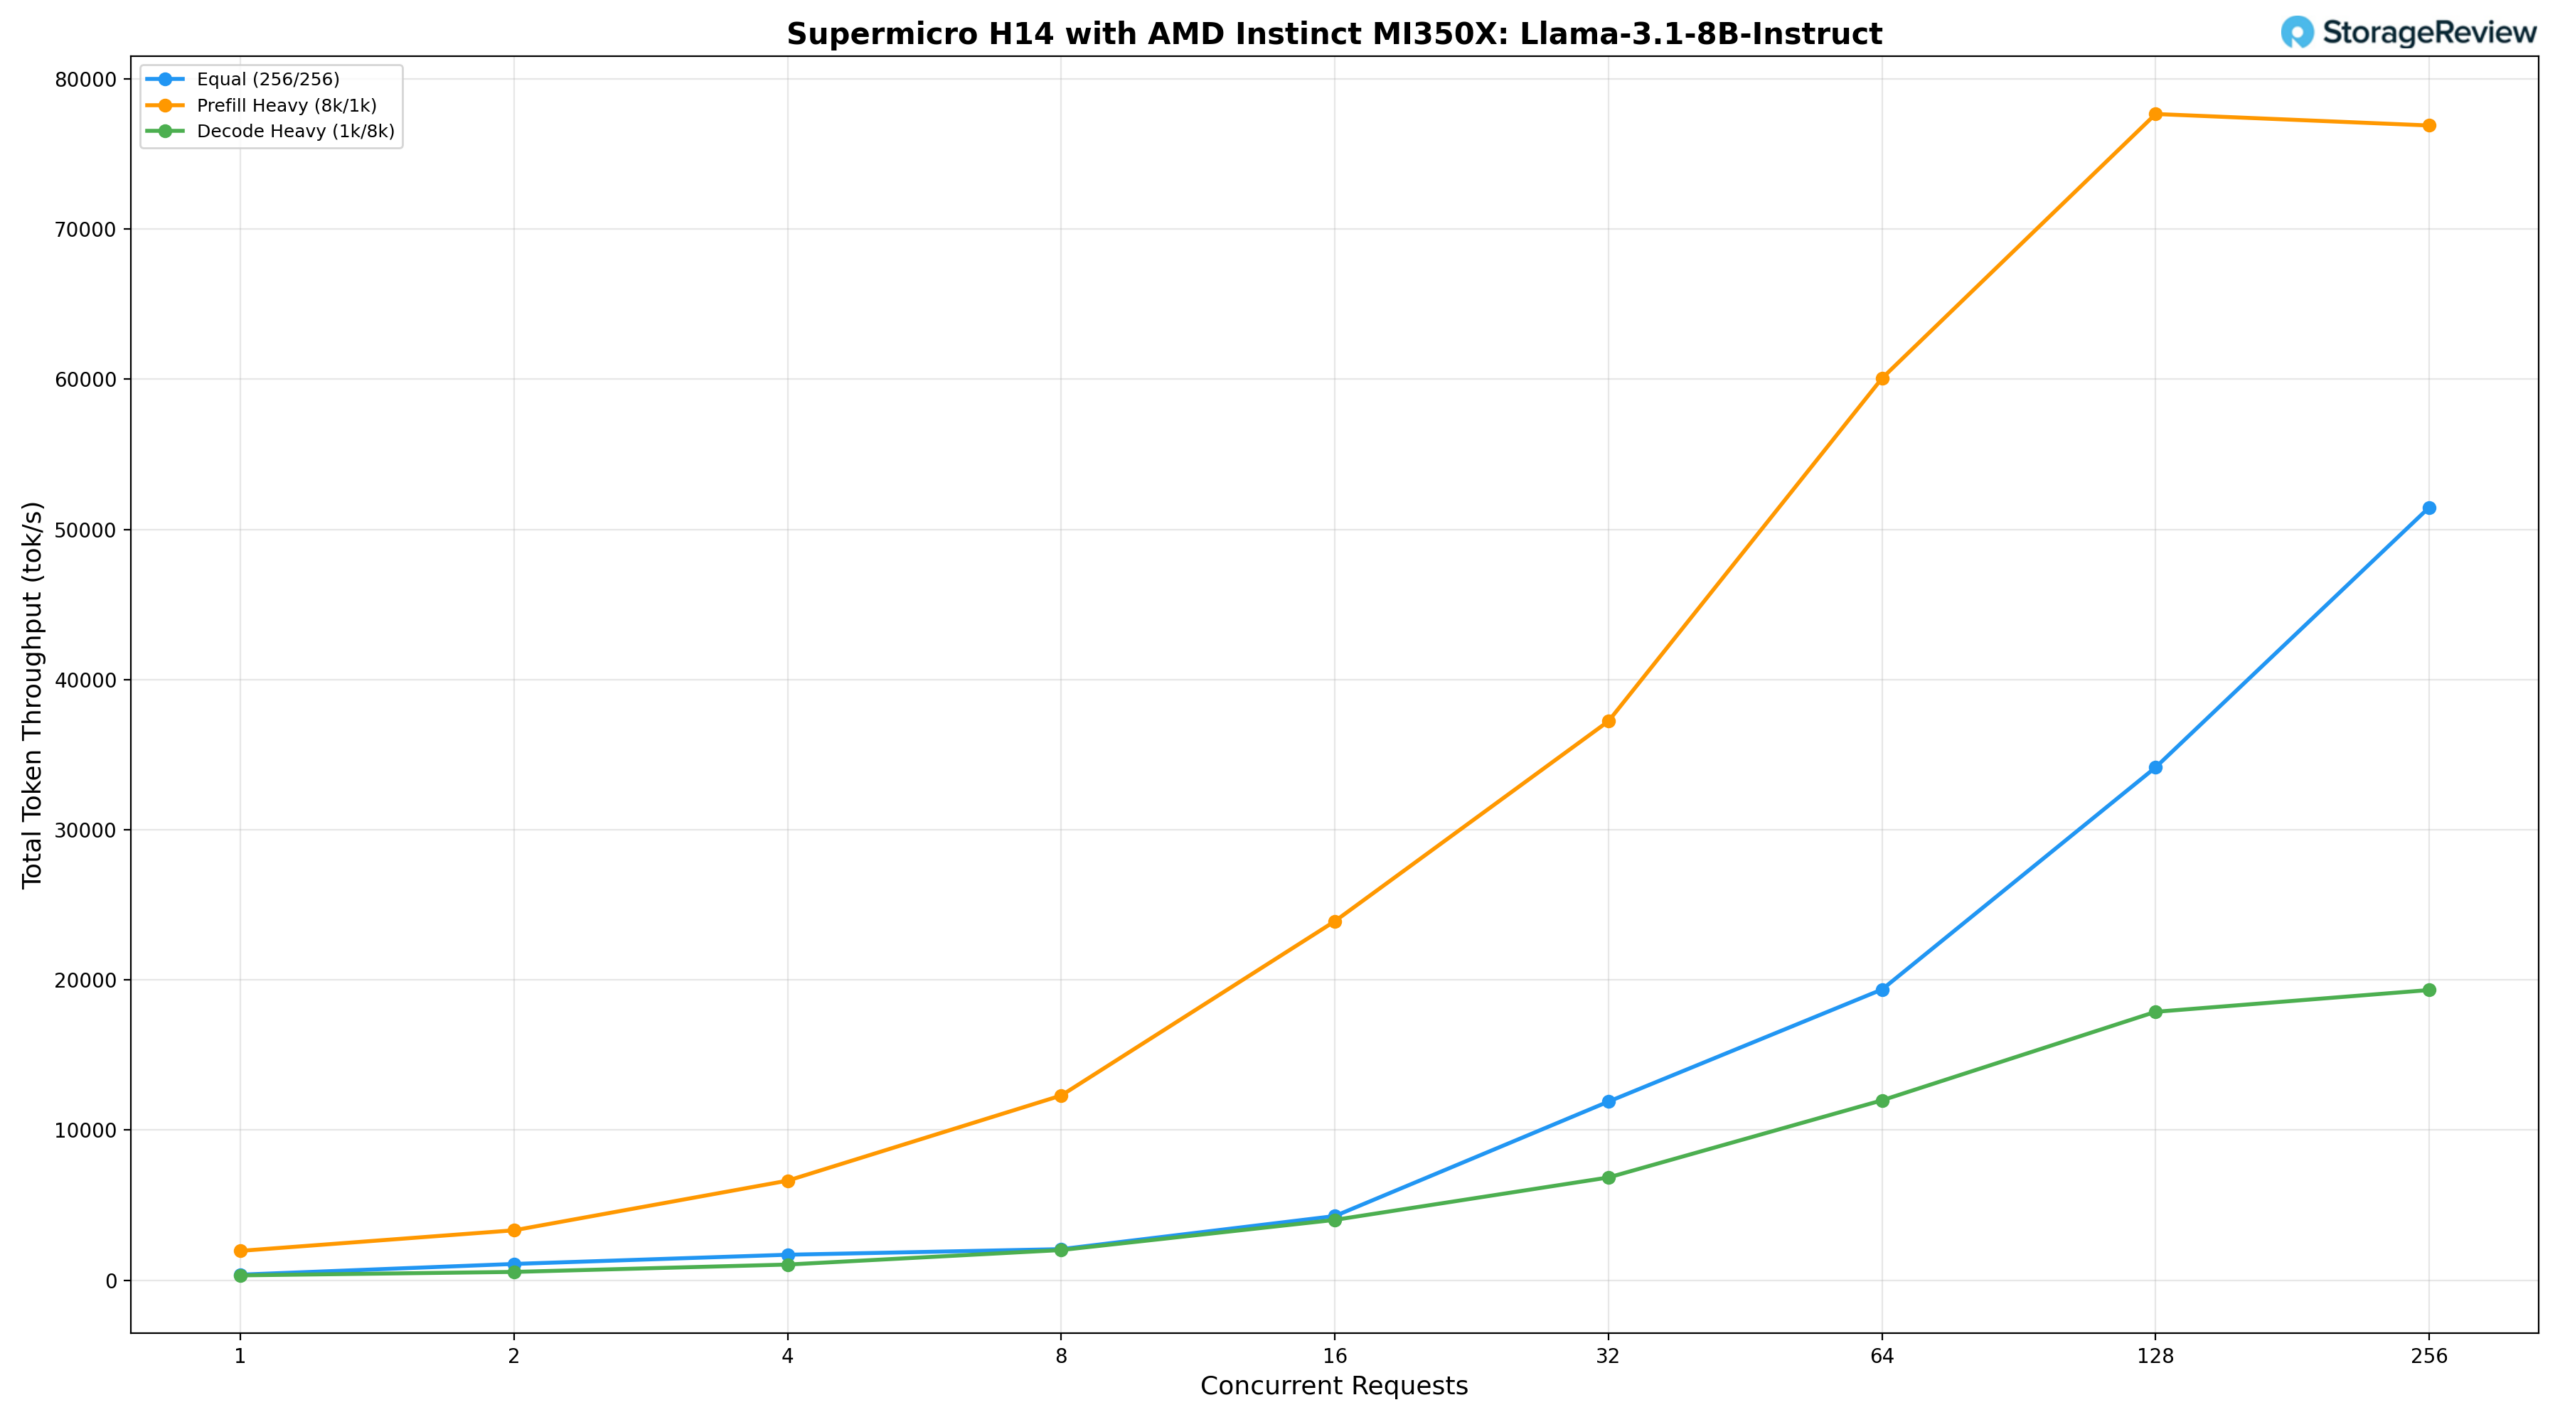
Para o Llama-3.1-8B-Instruct, observamos que a carga de trabalho igual (256/256) fornece 373.26 tok/s em BS=1, atingindo 19,363.33 tok/s em BS=64, 34,155.70 tok/s em BS=128 e alcançando um pico de 51,467.30 tok/s em BS=256. A carga de trabalho com pré-carregamento pesado (8k/1k) começa em 1,959.04 tok/s, sobe para 37,227.63 tok/s em BS=32 e 60,062.40 tok/s em BS=64, atingindo um pico de 77,658.50 tok/s em BS=128 antes de diminuir ligeiramente para 76,893.77 tok/s em BS=256. O modelo com alta demanda de decodificação (1k/8k) inicia em 326.48 tok/s, atingindo 17,877.52 tok/s em BS=128 e 19,326.35 tok/s em BS=256, mantendo uma latência por token menor em níveis de concorrência mais altos do que qualquer um dos modelos maiores testados.
MiniMax M2.5
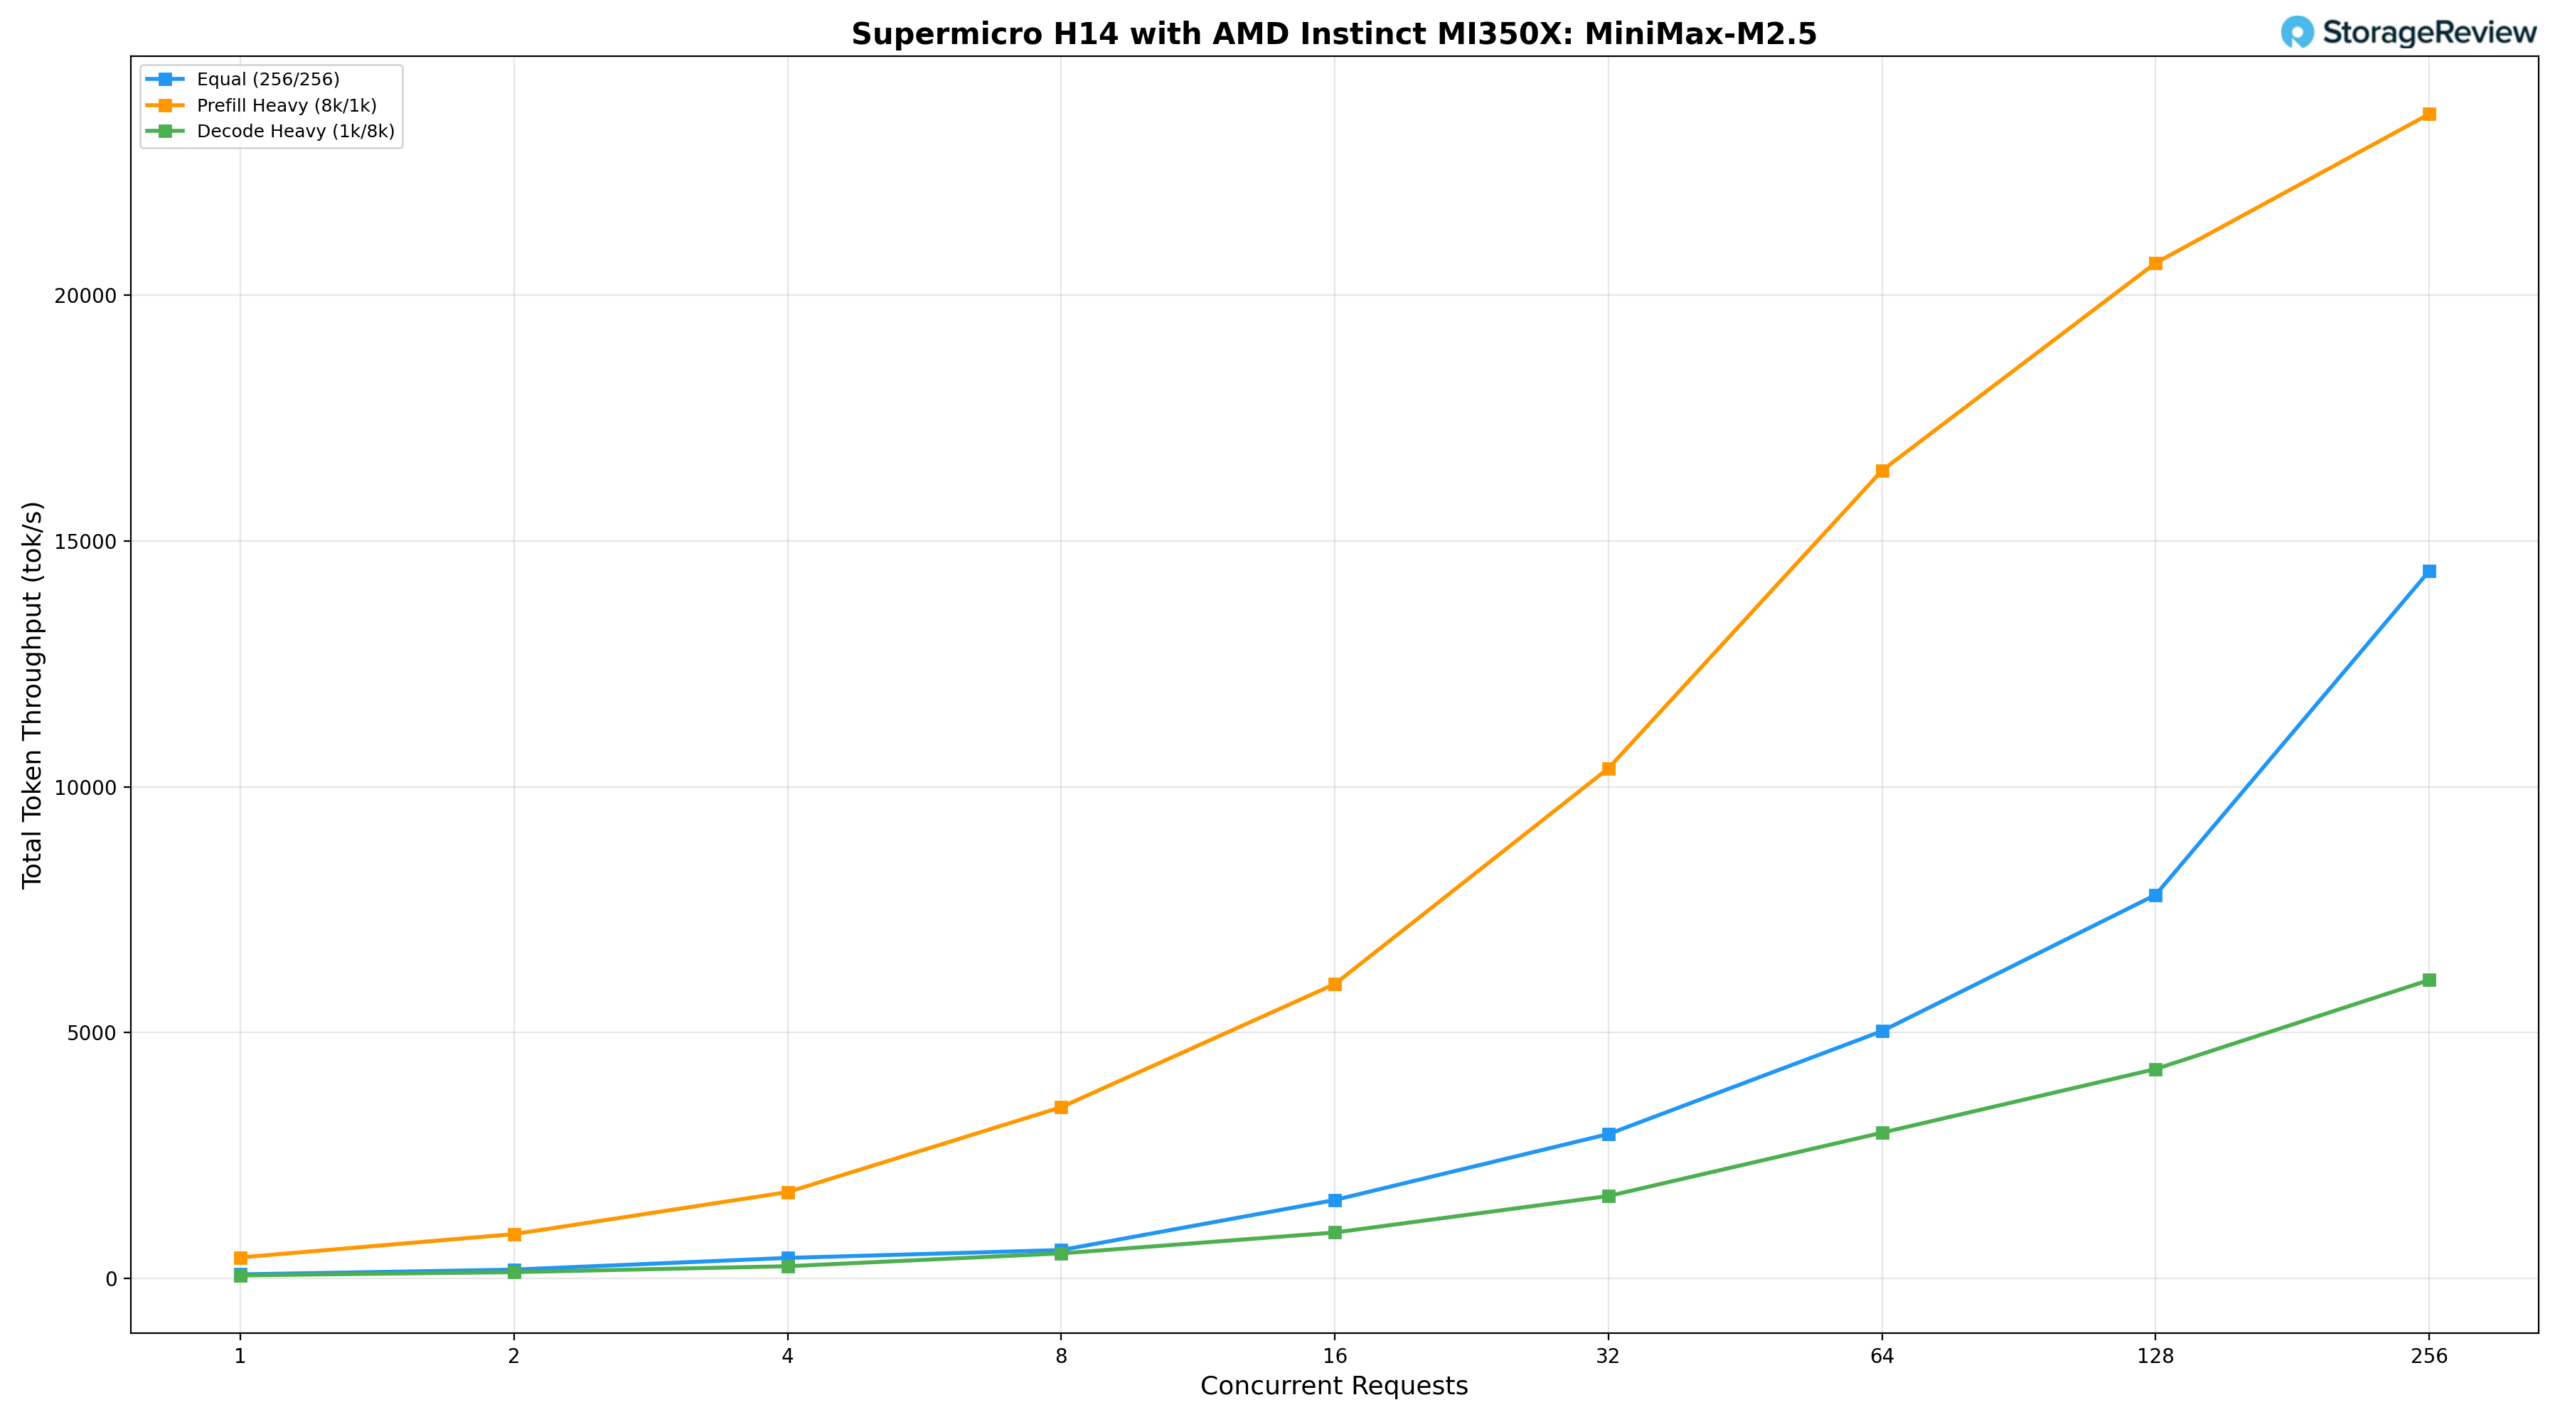
O MiniMax-M2.5 no H14 completa a linha de modelos, posicionando-se entre o Kimi K2.5 e os modelos de tamanho médio em termos de perfil de desempenho, com características que refletem sua arquitetura de processamento misto. A carga de trabalho igual (256/256) oferece 79.31 tok/s com BS=1, atingindo 5,029.76 tok/s com BS=64, 7,801.10 tok/s com BS=128 e 14,391.98 tok/s com BS=256. O cenário com uso intensivo de pré-preenchimento (8k/1k) apresenta a escalabilidade mais forte entre os três, começando em 424.41 tok/s e subindo para 10,376.75 tok/s com BS=32 e 20,658.57 tok/s com BS=128, atingindo um pico de 23,689.18 tok/s com BS=256. O cenário com uso intensivo de decodificação (1k/8k) escala de forma constante para 4,257.68 tok/s com BS=128 e 6,068.70 tok/s com BS=256, oferecendo o crescimento de latência mais consistente em toda a faixa de concorrência.
Kimi K2.5
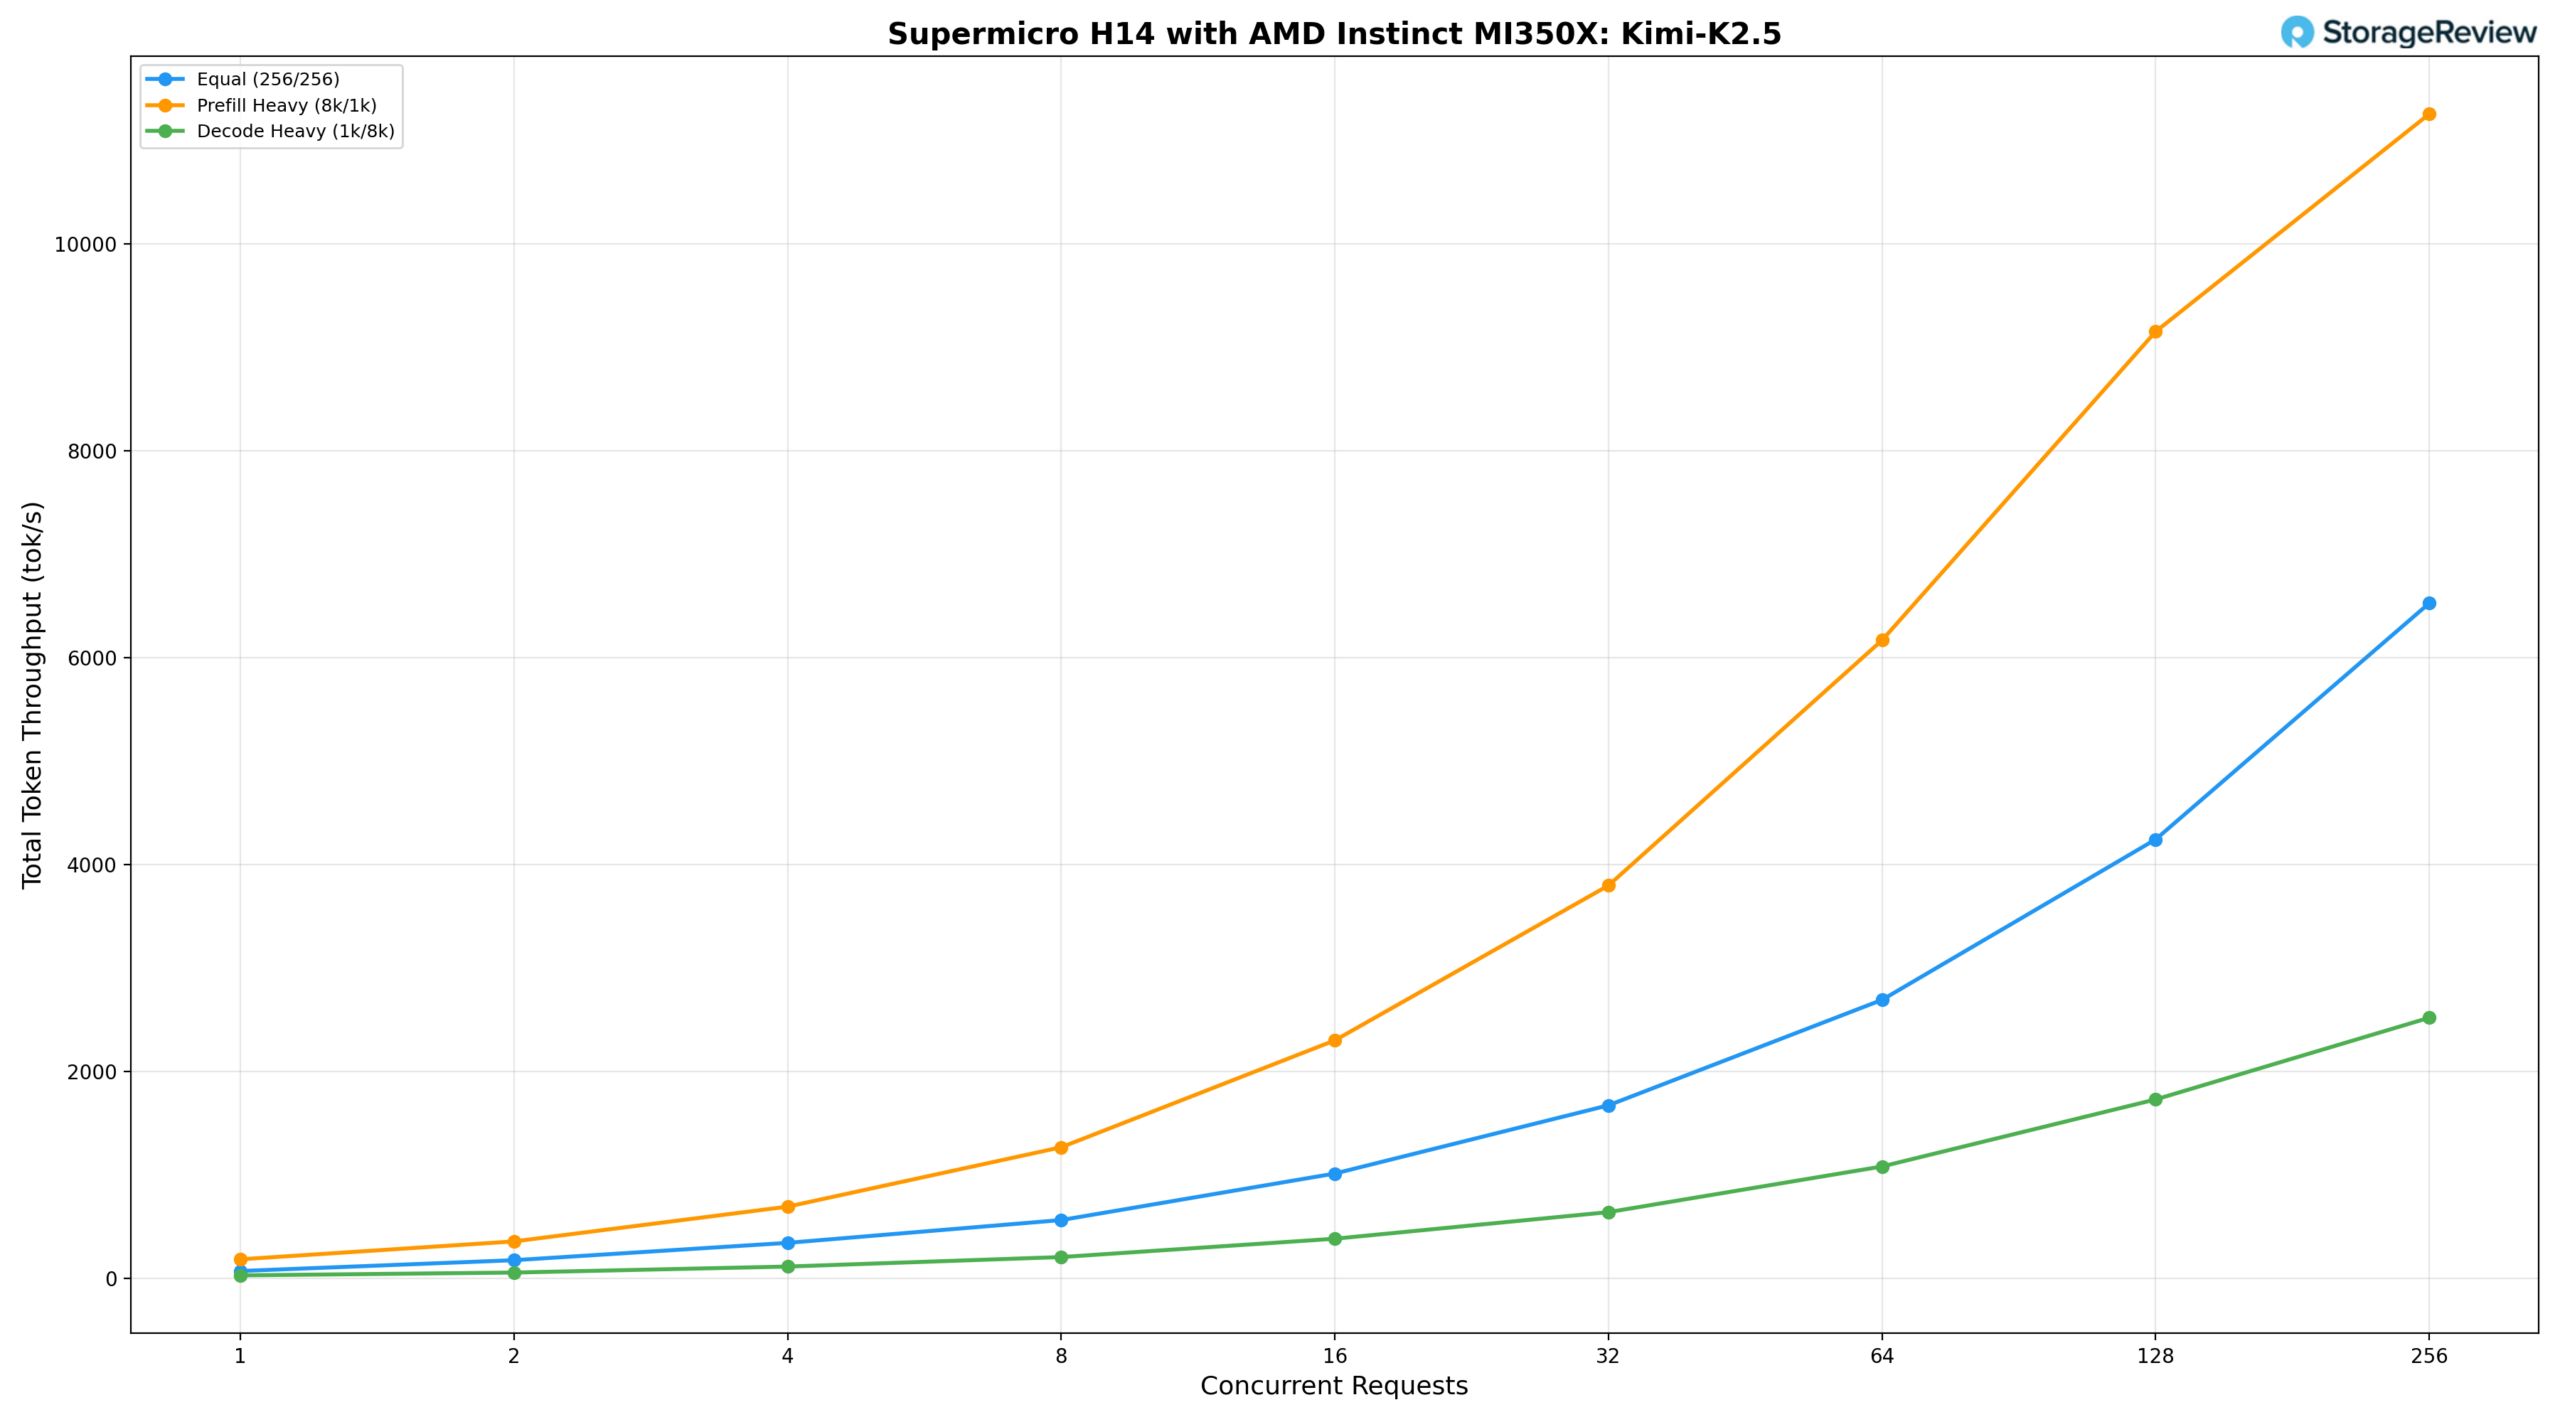
O modelo Kimi K2.5 de 1 trilhão de parâmetros no H14 é o maior e mais inteligente modelo testado nesta análise, e seu desempenho reflete essa complexidade.
A carga de trabalho igual (256/256) oferece 72.06 tok/s em BS=1, atingindo 2,693.07 tok/s em BS=64, 4,244.27 tok/s em BS=128 e um pico de 6,527.62 tok/s em BS=256. A carga de trabalho com pré-preenchimento intenso (8k/1k) escala de forma mais agressiva, começando em 185.29 tok/s e atingindo 3,798.85 tok/s em BS=32 e 9,153.12 tok/s em BS=128, com um pico de taxa de transferência de 11,256.69 tok/s em BS=256. O aumento abrupto de BS=128 para BS=256 acarreta um custo de latência significativo, indicando que o sistema está se aproximando de seus limites de memória e computação com a profundidade total do lote para esse tamanho de modelo. A decodificação intensiva (1k/8k) aumenta de 29.88 tok/s em BS=1 para 2,513.85 tok/s em BS=256, apresentando a curva de escalabilidade mais acentuada dos três cenários, ao mesmo tempo que demonstra ganhos de taxa de transferência consistentes em toda a gama.
Conclusão
O AMD Instinct MI350X oferece desempenho de inferência muito competitivo em todos os perfis de carga de trabalho testados aqui, e o Supermicro AS-8126GS-TNMR fornece uma plataforma bem projetada para tirar proveito disso. Com 288 GB de HBM3e por acelerador e oito GPUs interconectadas por meio do Infinity Fabric, os 2.3 TB de memória de GPU agregada disponíveis em um único nó são suficientes para atender modelos com trilhões de parâmetros, como Kimi K2.5 e MiniMax M2.5, sem a necessidade de distribuição em vários nós ou soluções alternativas de particionamento de modelos. Essa capacidade simplifica consideravelmente a arquitetura de implantação para inferência em larga escala.
Os modelos menores também apresentaram resultados expressivos. O Llama 3.1 8B ultrapassou 77,000 tok/s sob cargas de trabalho com grande volume de pré-preenchimento, e arquiteturas de médio porte, como o Mistral Small 3.1 24B e o Qwen3 Coder 30B, mantiveram alta taxa de transferência com latência bem controlada em toda a faixa de concorrência. De modo geral, os resultados indicam uma plataforma de hardware que escala de forma previsível sob carga, em vez de apresentar quedas bruscas em profundidades de lote maiores.
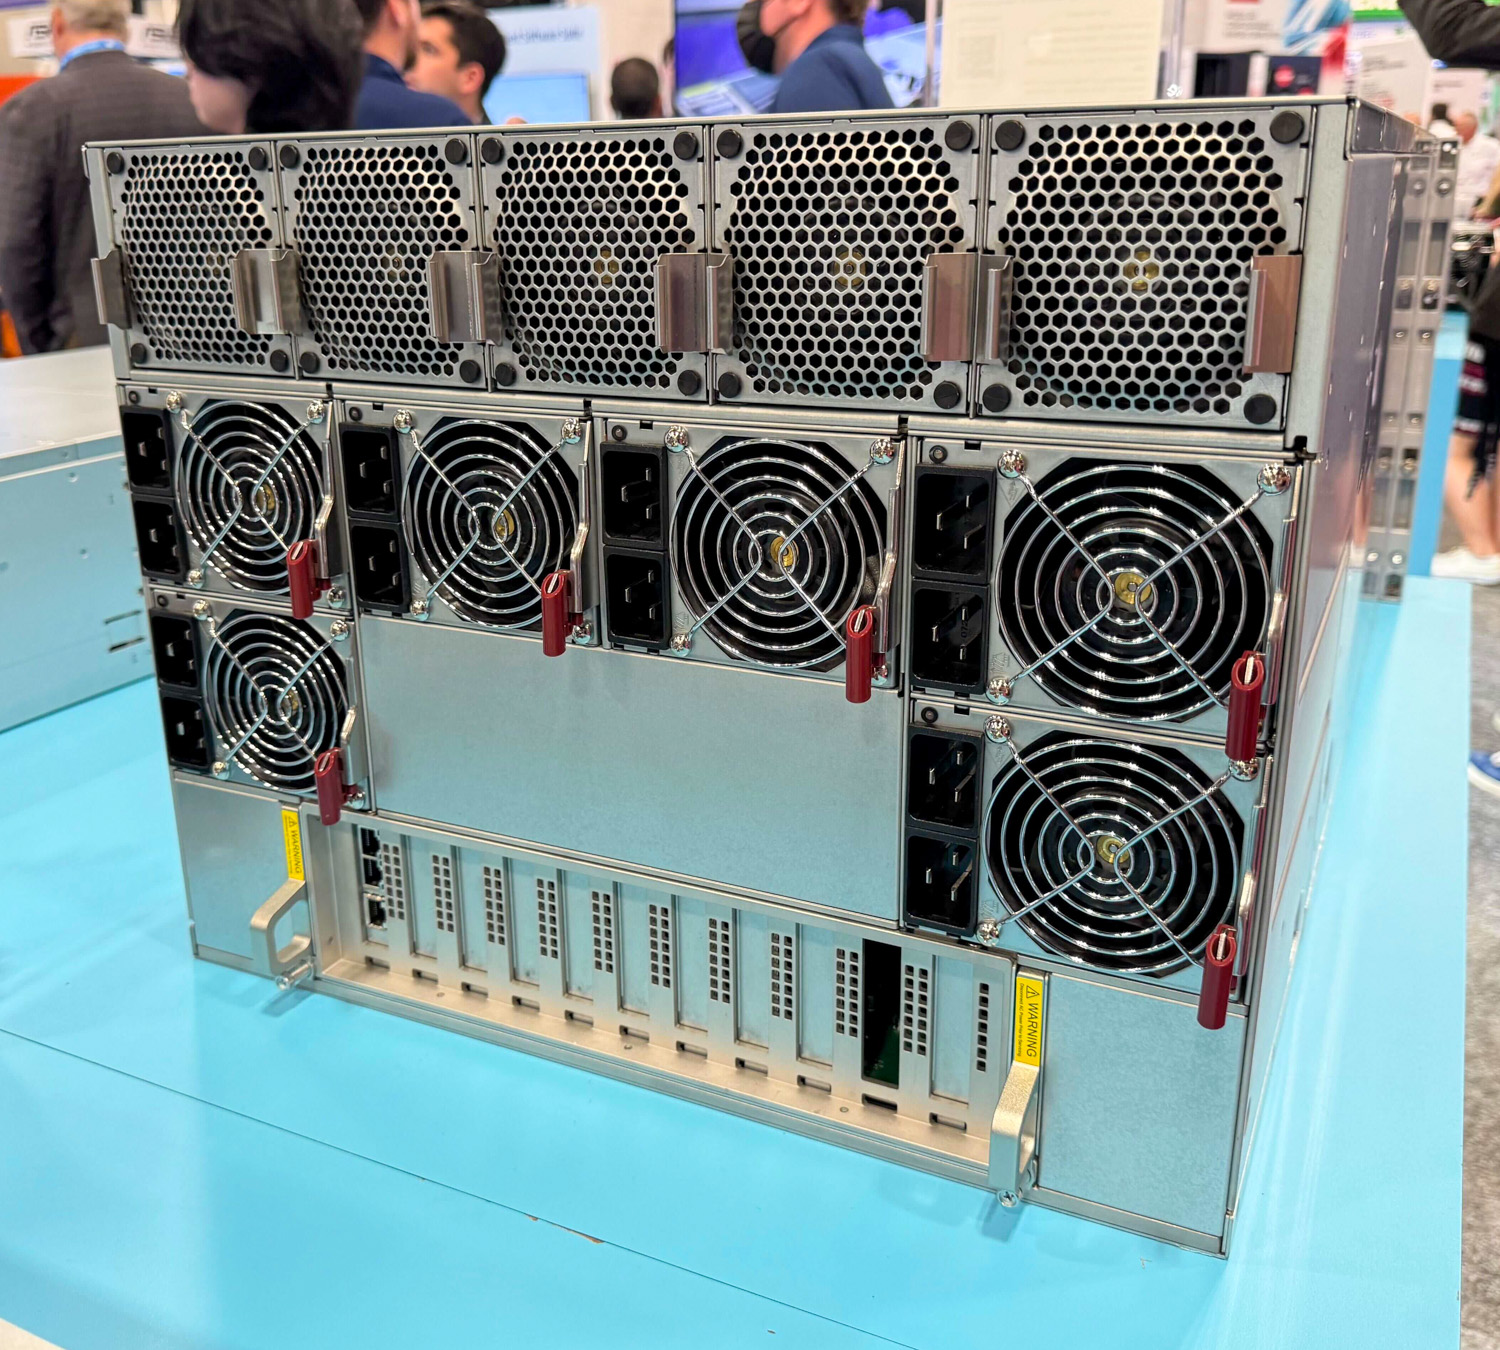
O ROCm 7.2 traz melhorias significativas para a pilha de software de inferência da AMD, principalmente quando combinado com o vLLM 0.18. Essa combinação proporciona uma experiência de serviço notavelmente mais estável e com melhor desempenho do que as gerações anteriores do ROCm, com suporte mais amplo a frameworks e menos problemas que caracterizavam as implementações anteriores do Instinct. Vale destacar também o impulso do ecossistema em torno do hardware da AMD: o vLLM agora mantém um pipeline de CI dedicado para o AMD ROCm, e o compromisso da Meta com a implementação em múltiplas gerações na escala de 6 gigawatts reforça que a validação em produção vai muito além de ambientes de benchmark controlados.
A avaliação do servidor Claude Code adiciona uma perspectiva prática aos números brutos de throughput. Um único nó MI350X manteve velocidades de resposta próximas às da nuvem para até 16 sessões de codificação simultâneas e permaneceu interativo com até 64 usuários simultâneos, produzindo quase 1,000 tok/s de saída agregada. Para organizações que avaliam o custo de assinaturas de APIs comerciais em comparação com infraestrutura própria, a relação custo-benefício se torna evidente nessa densidade, com vantagens adicionais em termos de localidade de dados, eliminação de custos por token e seleção irrestrita de modelos.
O programa JumpStart da Supermicro continua a consolidar sua posição no processo de avaliação de infraestrutura. O acesso direto ao hardware de produção, sem custos adicionais de provisionamento, permitiu-nos executar cargas de trabalho reais em condições reais durante todo o período de testes. Para equipes que realizam avaliações de aquisição de aceleradores, esse nível de acesso prático continua sendo muito mais informativo do que comparações de especificações técnicas ou demonstrações selecionadas de fornecedores.



 Amazon