

Familia de procesoare pentru servere EPYC de a 6-a generație de la AMD, cu nume de cod Venice, aduce nucleele Zen 6 și Zen 6c într-o gamă concepută pentru a acoperi fiecare aspect al pieței serverelor. AMD crește numărul de nuclee și vitezele de ceas și oferă acestor nuclee considerabil mai multă lățime de bandă pentru a lucra, printr-un subsistem de memorie mai mare și prin trecerea la PCIe Gen6. Amploarea familiei oferă AMD spațiu pentru a atinge densitatea maximă de calcul, construind în același timp componente în funcție de cerințele serverelor enterprise și ale gazdelor AI.
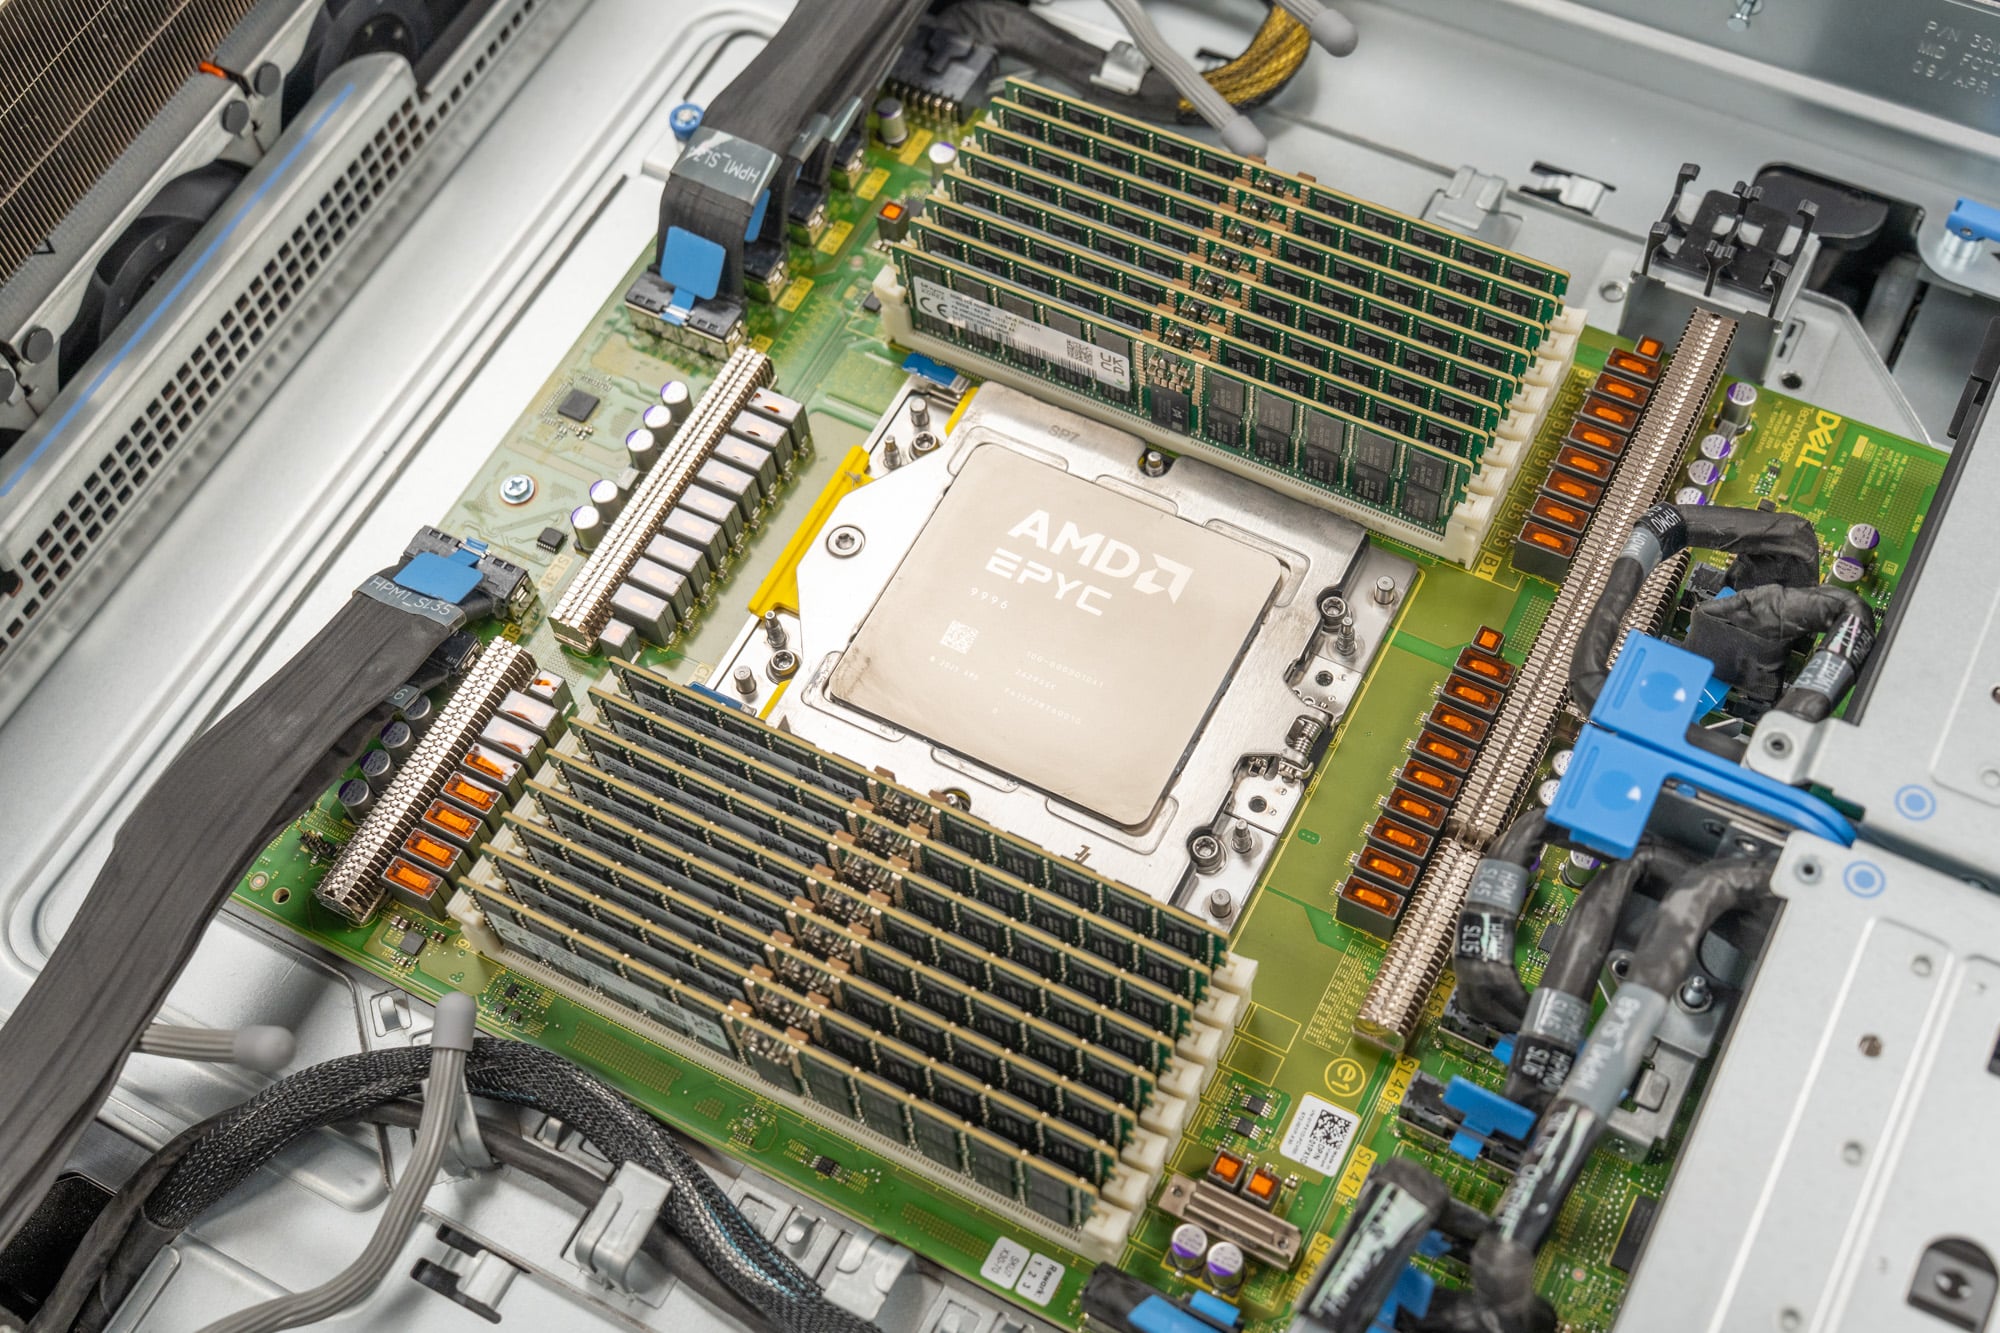
Această recenzie se concentrează pe Venice SP7, socketul mai mare pentru centre de date de la AMD, care suportă șaisprezece canale de memorie și procesoare de până la 600W. Platforma Venice SP8, axată pe întreprinderi, și Verano bazat pe LPDDR, răspunsul AMD la NVIDIA Vera , sunt programate să sosească anul viitor, în 2027. Datele noastre de testare provin de la EPYC 9996 cu 256 de nuclee din PowerEdge R9825 de la Dell și de la platforma de referință AMD Nigeria, care ne-a oferit și o privire asupra EPYC 9686F cu 96 de nuclee și 5.3 GHz și asupra a ceea ce adaugă memoria MRDIMM-12800 la același siliciu.
Intrebari cu cheie
- Cel mai rapid procesor de server pe care l-am testat. Două procesoare EPYC 9996 cu 256 de nuclee din serverul Dell PowerEdge R9825 au rulat GROMACS benchPEP de 1.8 ori mai rapid decât serverul EPYC 9965 cu 384 de nuclee, au rezolvat problema rețelei OpenFOAM de dimensiuni mari de 2.6 ori mai rapid și au criptat AES-256-GCM de 1.7 ori mai rapid, la 6.8 TB/s. Un socket a deservit 76.5 milioane de cereri Valkey GET pe secundă.
- Veneția îi învinge pe Vera și Xeon la majoritatea sarcinilor de calcul. Împotriva lui Vera, R9825 a rulat benchPEP de 4.7 ori mai rapid, a criptat de 5.4 ori mai rapid, a comprimat de 2.1 ori mai rapid în 7-Zip, a rezolvat rețeaua OpenFOAM de dimensiuni mari de 1.8 ori mai rapid și a servit de 3.4 ori mai multe cereri Valkey de la un singur socket, reducând în același timp latența HammerDB cu 30% până la 51% la sarcină adaptată. Împotriva lui Xeon 6978P, a fost mai bun cu 2.6x pe benchPEP și 2.7x pe AES.
- Viteza per nucleu este din nou la nivelul x86. Pe un număr de 16 nuclee pereche, Zen 6c a rulat GROMACS benchMEM cu 67% mai rapid decât Zen 5c și de 2.5 ori mai rapid decât Olympus. Un singur fir de execuție Zen 6c cu pin a fost comprimat cu 16% mai rapid decât Olympus în 7-Zip și criptat de 2.9 ori mai rapid, iar EPYC 9686F de 5.3 GHz a depășit Vera în toate cele trei teste Python cu timpi de rulare cu 10% până la 38% mai scurți.
- Memoria contează la fel de mult ca numărul de nuclee. Mutarea acelorași două procesoare 9996 de la DDR5-8000 la MRDIMM-12800 a crescut lățimea de bandă STREAM Triad cu 58% și a redus rezoluția OpenFOAM cu 21%. 9686F cu 96 de nuclee pe MRDIMM-uri a atins aproape 2 TB/s și a finalizat această rețea la o distanță de 13% față de R9825 cu 512 nuclee pe DDR5-8000.
- Vera menține avantajul în ceea ce privește lățimea de bandă brută și interconectarea. Pe STREAM Triad brut, Venice este cu 42% în urma vitezei de 2,073 GB/s a Verei pe DDR5-8000 și cu 8% pe MRDIMM-uri, deși configurația MRDIMM mută mai multe date decât Vera odată ce citirile pe care STREAM nu le ia în calcul sunt adăugate. NVLink-C2C al Verei oferă o lățime de bandă la socket-ul remote de 4.6 ori mai mare decât xGMI-ul AMD, iar aceeași legătură oferă Verei o conexiune CPU-GPU a cărei lățime de bandă nu se potrivește cu nicio platformă x86.
- Bazele de date sunt împărțite între cele două. În runda HammerDB din noiembrie, un socket EPYC 9996 cu 256 de nuclee a depășit socketul cu 88 de nuclee al Vera cu 14% pe MySQL și a egalat situația pe VillageSQL, în timp ce Vera a condus MariaDB și PostgreSQL cu 11% până la 12%. Venice a redus latența PAYMENT p99 cu 30% până la 51% la încărcare egală, iar un socket 9686F cu 96 de nuclee a înregistrat cel mai mare rezultat PostgreSQL din rundă, de 3.03 milioane NOPM.
Gama SP7
Gama SP7 stabilește cadrul pentru discuția despre arhitectură care urmează. Modelul emblematic al gamei Venice este EPYC 9996 cu 256 de nuclee, o creștere de 33.3% față de EPYC 9965 cu 192 de nuclee de la Turin . AMD face un salt și mai mare cu componentele sale de înaltă frecvență, trecând de la un maxim de 64 de nuclee cu 9575F de la Turin la 96 de nuclee cu 9686F, o creștere de 50% a numărului de nuclee, iar 9686F atinge, de asemenea, o creștere maximă de 5.3 GHz. AMD a publicat lista completă EPYC 9006, formată din 31 de părți , în octombrie; componentele SP7 la care facem referire în această recenzie sunt mai jos.
| procesor | miezuri/filete | Boost de bază / maxim | cache-L3 | Putere implicită a procesorului |
|---|---|---|---|---|
| EPYC 9996 | 256 / 512 | 2.55 / 4.1 GHz | 1,024MB | 600W |
| EPYC 9966 | 192 / 384 | 2.9 / 4.0 GHz | 768MB | 600W |
| EPYC 9846 | 168 / 336 | 2.85 / 3.7 GHz | 768MB | 500W |
| EPYC 9756 | 128 / 256 | 3.15 / 4.0 GHz | 512MB | 500W |
| EPYC 9686F | 96 / 192 | 4.05 / 5.3 GHz | 384MB | 600W |
| EPYC 9G76 | 96 / 192 | 3.4 / 4.8 GHz | 384MB | 500W |
| EPYC 9656 | 96 / 192 | 3.05 / 3.7 GHz | 512MB | 400W |
| EPYC 9586F | 64 / 128 | 3.75 / 5.0 GHz | 384MB | 500W |
| EPYC 9556 | 64 / 128 | 2.75 / 4.3 GHz | 384MB | 300W |
AMD a declarat că componentele SP7 sunt disponibile în general pe 10 noiembrie, urmând ca sistemele OEM să fie livrate și instanțele Azure și OCI să urmeze, iar afirmațiile sale privind lansarea au stabilit standardul față de care testele noastre se confruntă. Comparativ cu EPYC de a 5-a generație, AMD plasează Venice la 2.0x pe SPECint 2026, 2.4x pe SPECfp 2026, 2.7x pe STREAM, 1.4x pe HPL și 1.3x pe DGEMM.
Acestea sunt cifrele AMD din testele AMD, iar noi acoperim afirmațiile sale IPC cu designul de bază de mai jos; rezultatul nostru STREAM Triad, prezentat mai jos, se situează la 1.9x față de placa emblematică din Torino pe DDR5-8000 și 3.0x pe MRDIMM-12800.
Împotriva NVIDIA Vera, AMD declară o valoare de 1.2x per nucleu pe întregul SPECrate 2026 pentru partea sa de frecvență cu 96 de nuclee și de 2.2x per platformă pentru 9996, iar la lansare a adăugat 3.7x pe SPECrate 2017 pentru un 9996 cu două socketuri, un rezultat publicat de 5,470 față de o estimare AMD de 1,459 pentru Vera. Cifra per nucleu se potrivește cu rezultatul nostru fixat 7-Zip, unde 9686F a comprimat cu 16% mai rapid decât un nucleu Olympus, iar cifrele platformei se încadrează în suita noastră, unde marja 9996 față de Vera variază de la paritate pe OLTP până la 5.4x pe cod cripto. Același scor publicat este de 1.68x față de 3,260 al unui EPYC 9965 cu două socketuri.
AMD descrie, de asemenea, trei puncte de funcționare pentru gamă. O componentă cu 256 de nuclee la 400W este prezentată pentru găzduire în masă, unde utilizarea este de 50% până la 100%, iar puterea este de 1.2W până la 2.0W per nucleu; aceleași 256 de nuclee la 600W vizează cloud și centre de date mainstream cu un debit de 1.7W până la 3.5W per nucleu; iar componentele cu 96 de nuclee la 500W și 600W deservesc noduri head HPC și sensibile la latență funcționează la 5W până la 10W per nucleu, cu o marjă de funcționare pentru a atinge 5.3GHz. 9996 și 9686F pe care le-am testat se află în al doilea și al treilea dintre aceste puncte.
Venice aduce, de asemenea, trei controale de alimentare la nivel de platformă, începând cu Unified Power Provisioning, care stabilește un buget pentru SoC și modulele sale DIMM, astfel încât un rack să poată recupera capacitatea blocată; AMD spune că de obicei 15% până la 25% din capacitatea rack-ului rămâne neutilizată. Modelul de lansare AMD plasează 16 servere 9996 cu două socketuri într-un rack de 35 kW la bugetul implicit de 830 W pentru fiecare SoC și modulele sale DIMM și aproape 19 cu acest buget setat cu 15% mai mic, la 706 W, pentru un cost mediu de performanță de 1%.
Scalarea puterii bazată pe utilizare permite ca puterea socketului să urmărească numărul de nuclee active, menținând puterea completă în rezervă pentru rafale, iar tehnologia Frequency Adaptive Spectrum setează o frecvență minimă per grup de nuclee, astfel încât o componentă fizică să poată fi vândută în mai multe niveluri de performanță. Niciuna dintre cele trei nu a afectat testele noastre la puterea implicită și vom analiza modul în care producătorii de echipamente originale le expun pe măsură ce firmware-ul se maturizează.
În interiorul nucleului: Zen 6 și Zen 6c
Gama Venice este alimentată de chipleturile AMD Zen 6 și Zen 6c, ambele construite pe procesul N2 de la TSMC. Comparativ cu modelele Zen 5 și Zen 5c de la Torino, aceste noi matrițe cu nuclee complexe, sau CCD-uri, oferă un număr mai mare de nuclee și cache-uri mai mari.
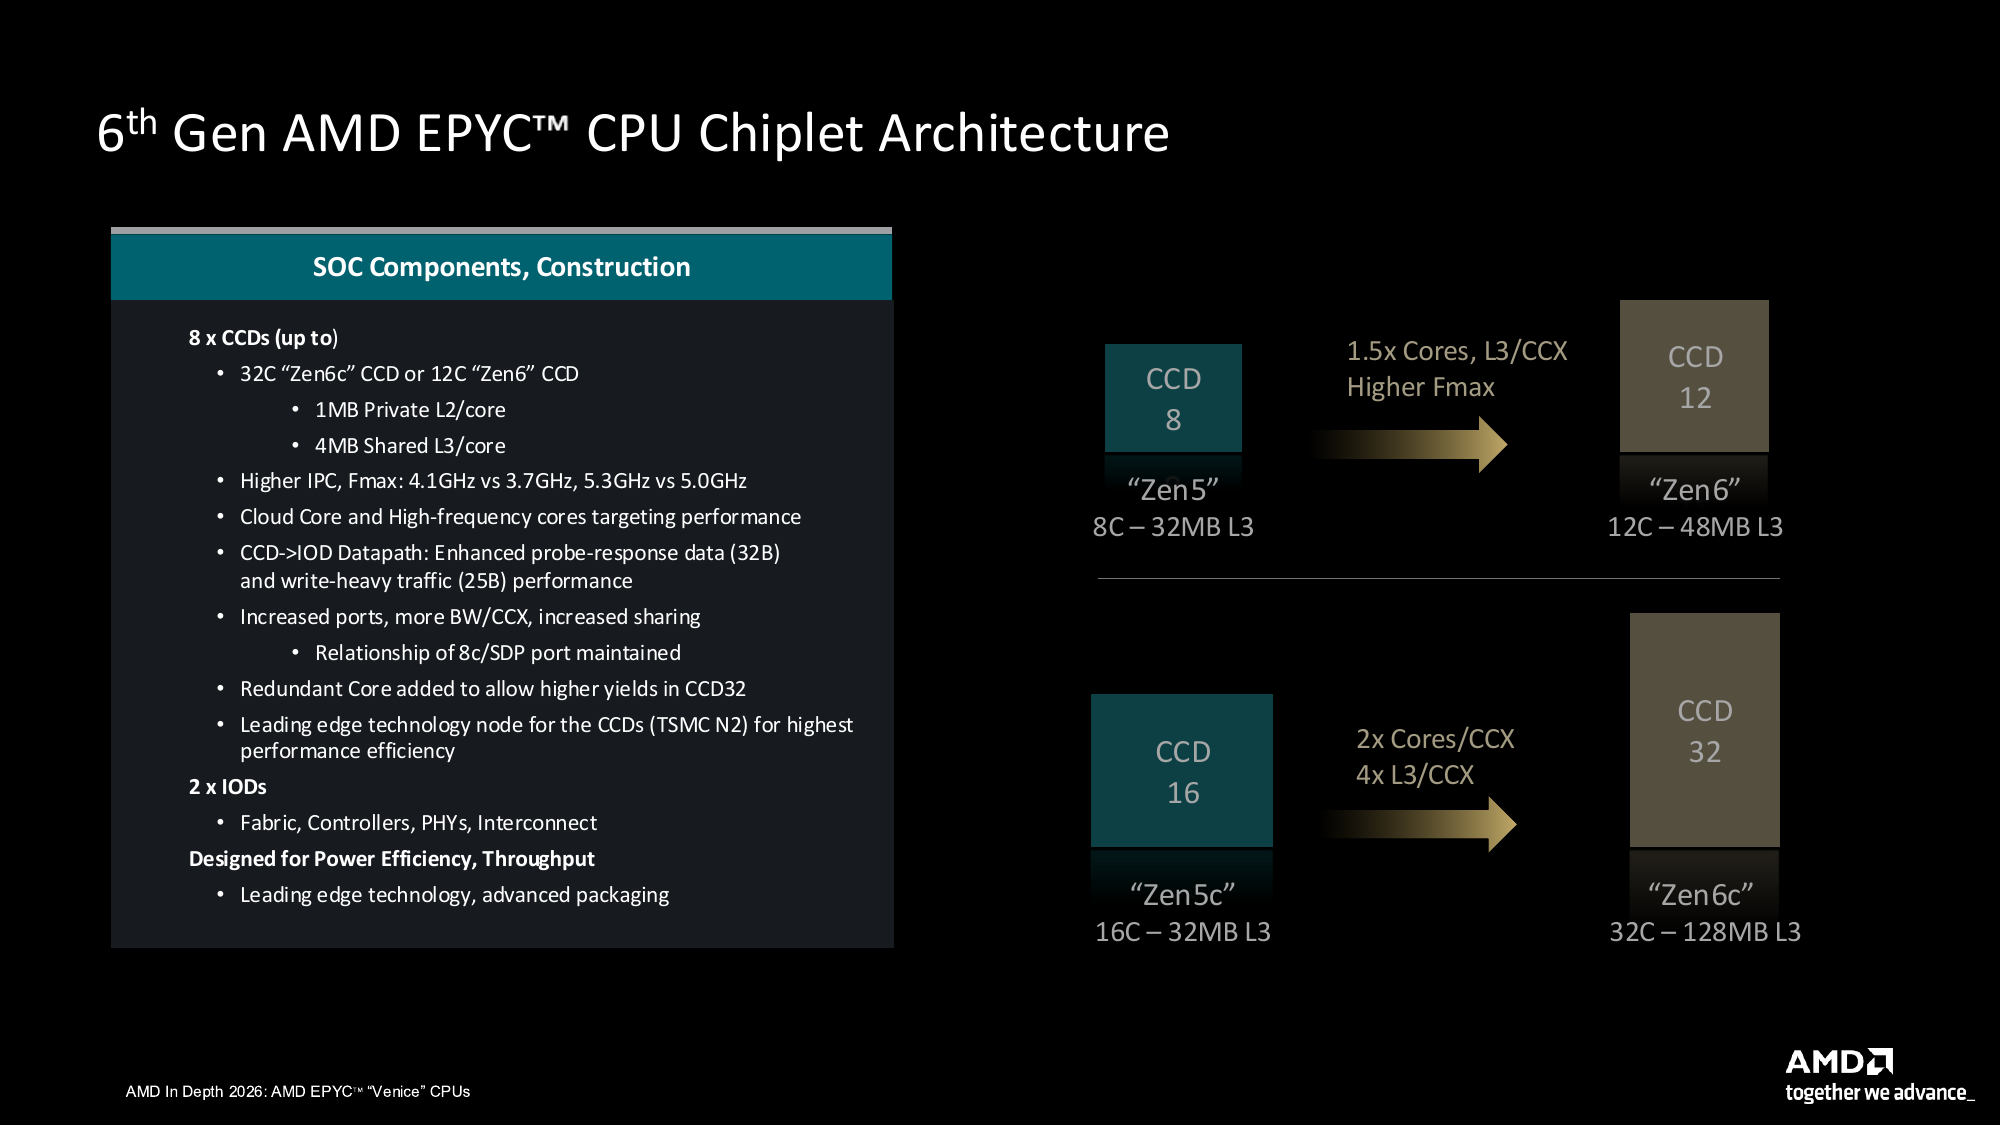
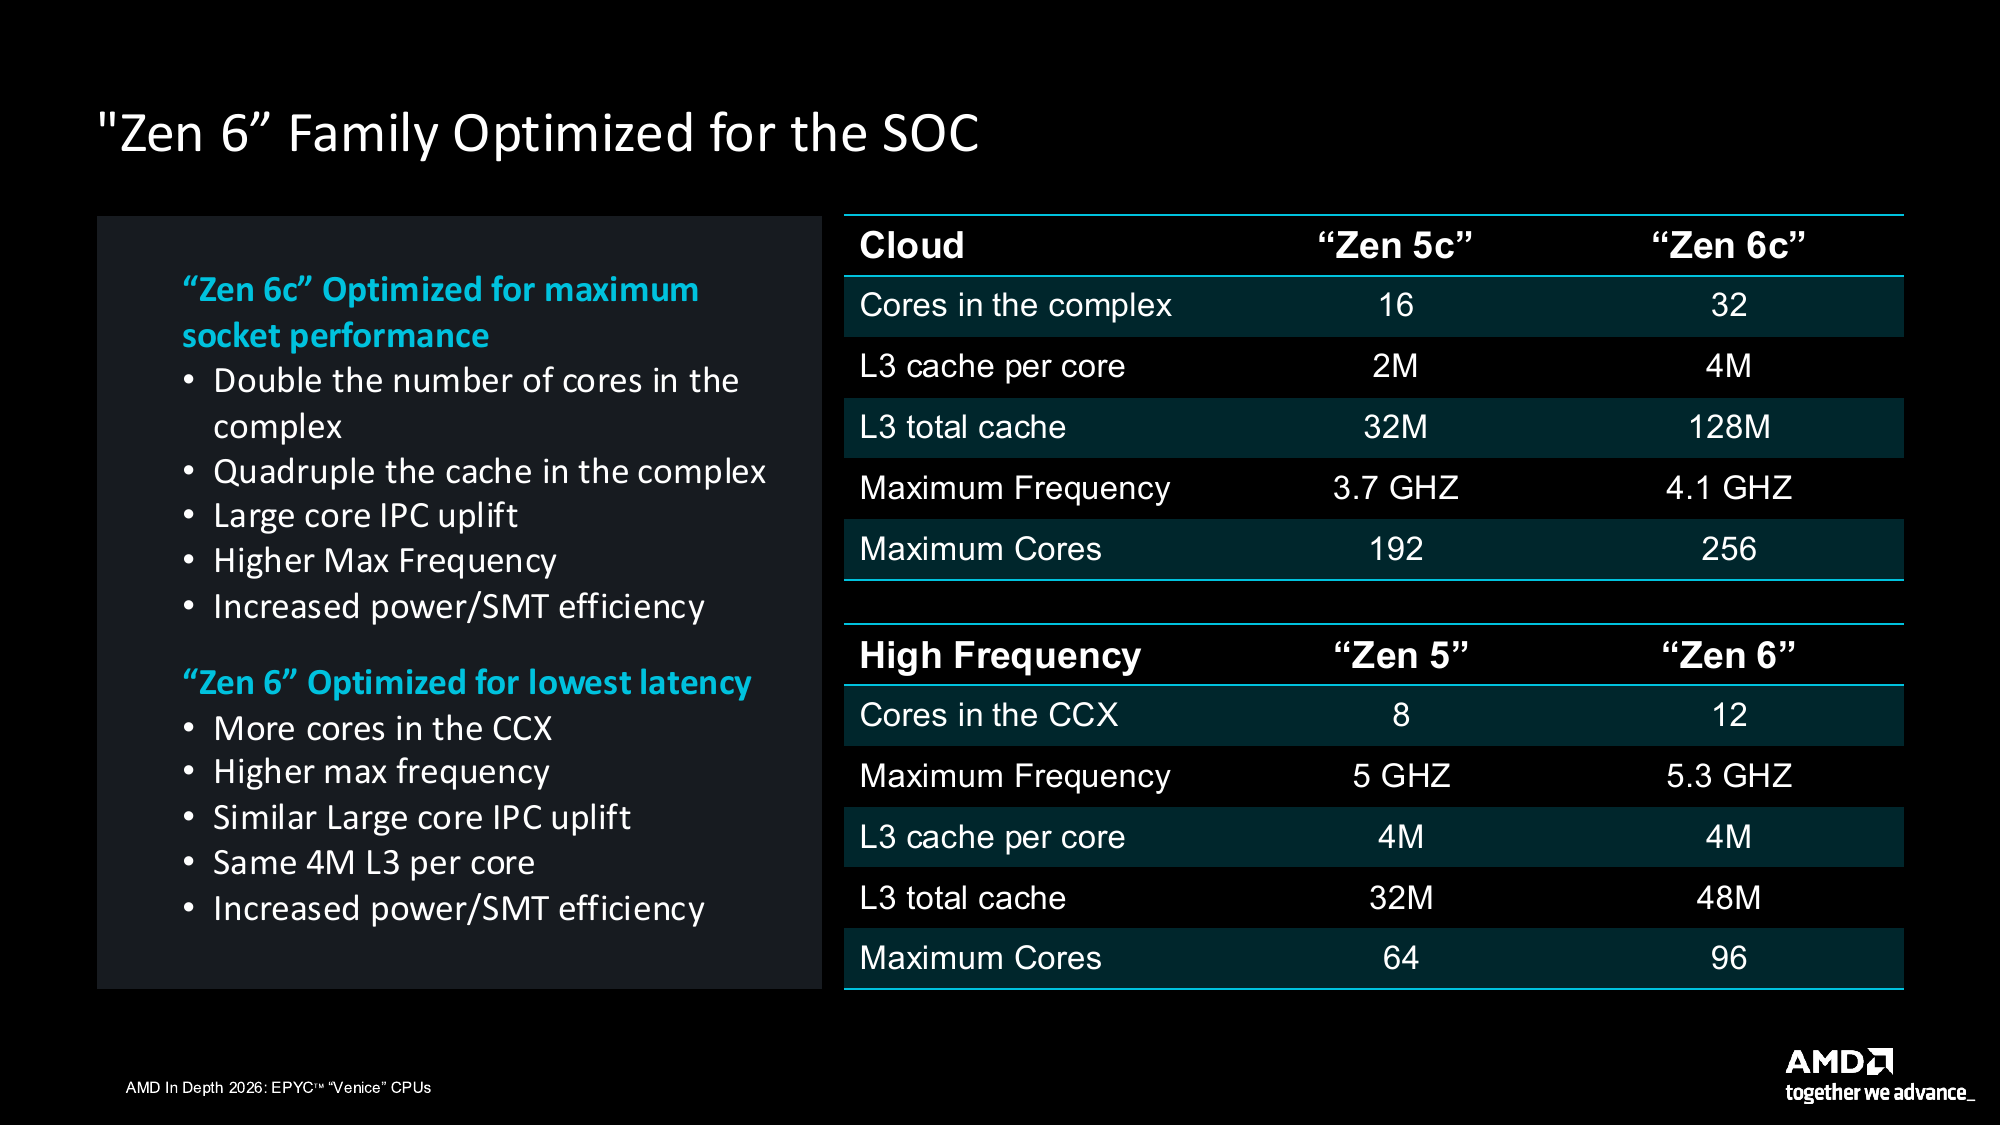
Este util să știm de la bun început că Zen 6 și Zen 6c nu sunt două modele diferite, așa cum sunt nucleele P și E de la Intel. AMD construiește ambele pe aceeași microarhitectură, fiecare caracteristică și fiecare cale de date fiind partajată între cele două. Zen 6c este o implementare compactată fizic care schimbă viteza de ceas cu suprafața și puterea, astfel încât poate încadra mult mai multe nuclee pe un singur die. AMD listează o frecvență maximă de 5.3 GHz pentru Zen 6, față de 5.0 GHz pe Zen 5, și 4.1 GHz pentru Zen 6c, față de 3.7 GHz pe Zen 5c.
CCD-ul standard Zen 6 crește de la opt nuclee Zen 5 ale modelului Turin la doisprezece. Fiecare nucleu păstrează 1 MB de L2 privat, oferind CCD-ului 12 MB de L2 agregat, în timp ce L3-ul partajat, din care se utilizează toate cele douăsprezece nuclee, crește de la 32 MB la 48 MB. Aceasta menține raportul la 4 MB de L3 per nucleu, la fel ca la Zen 5, astfel încât matrița mai mare adaugă capacitate fără a dilua memoria cache disponibilă fiecărui nucleu.
Zen 6c face saltul mai mare, dublând cele șaisprezece nuclee din CCD-ul Zen 5c de la Turin la 32 și cvadruplând L3-ul partajat de la 32MB la 128MB, ceea ce dublează și L3-ul per nucleu de la 2MB la 4MB. Fiecare nucleu își păstrează 1MB L2, aducând capacitatea totală L2 a CCD-ului la 32MB. Opt dintre aceste CCD-uri oferă procesorului 9996 cele 256 de nuclee și 512 fire de execuție, împreună cu 256MB de L2 total și 1,024MB de L3.
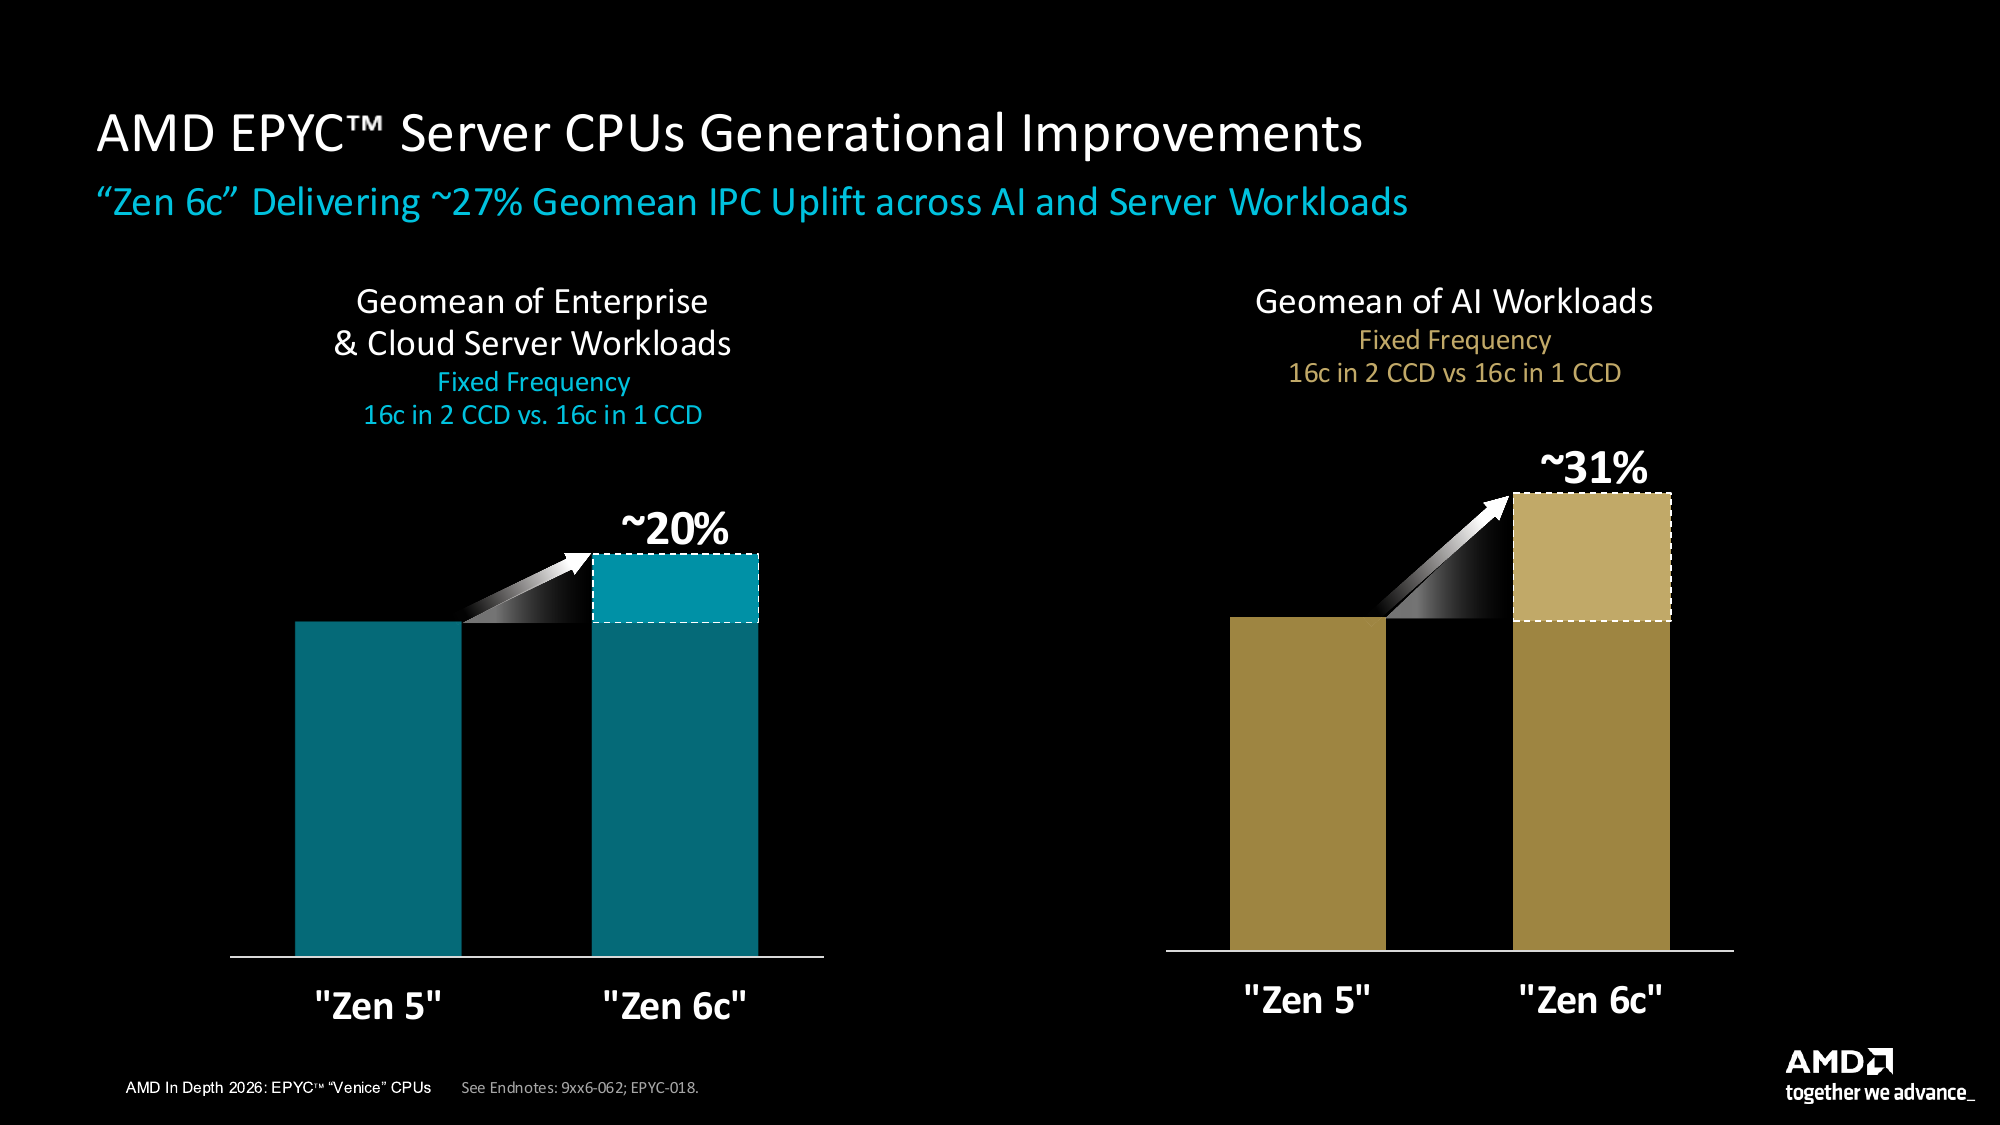
Această structură este importantă pentru modul în care AMD își formulează afirmațiile privind performanța. Cifra principală a AMD este o creștere a mediei geomezie a IPC de aproximativ 27% pentru Zen 6c față de Zen 5, atât pentru sarcinile de lucru bazate pe inteligență artificială, cât și pentru cele de server. IPC, sau instrucțiuni pe ciclu, descrie cât de multă muncă execută un nucleu în fiecare ciclu de ceas, independent de frecvență. AMD împarte acest rezultat în două medii geomezie: aproximativ 20% pentru sarcinile de lucru ale serverelor enterprise și cloud și aproximativ 31% pentru sarcinile de lucru bazate pe inteligență artificială. AMD subliniază că acestea au fost măsurate la o frecvență fixă, comparând 16 nuclee Zen 5 distribuite pe două CCD-uri cu 16 nuclee Zen 6c într-un singur CCD.
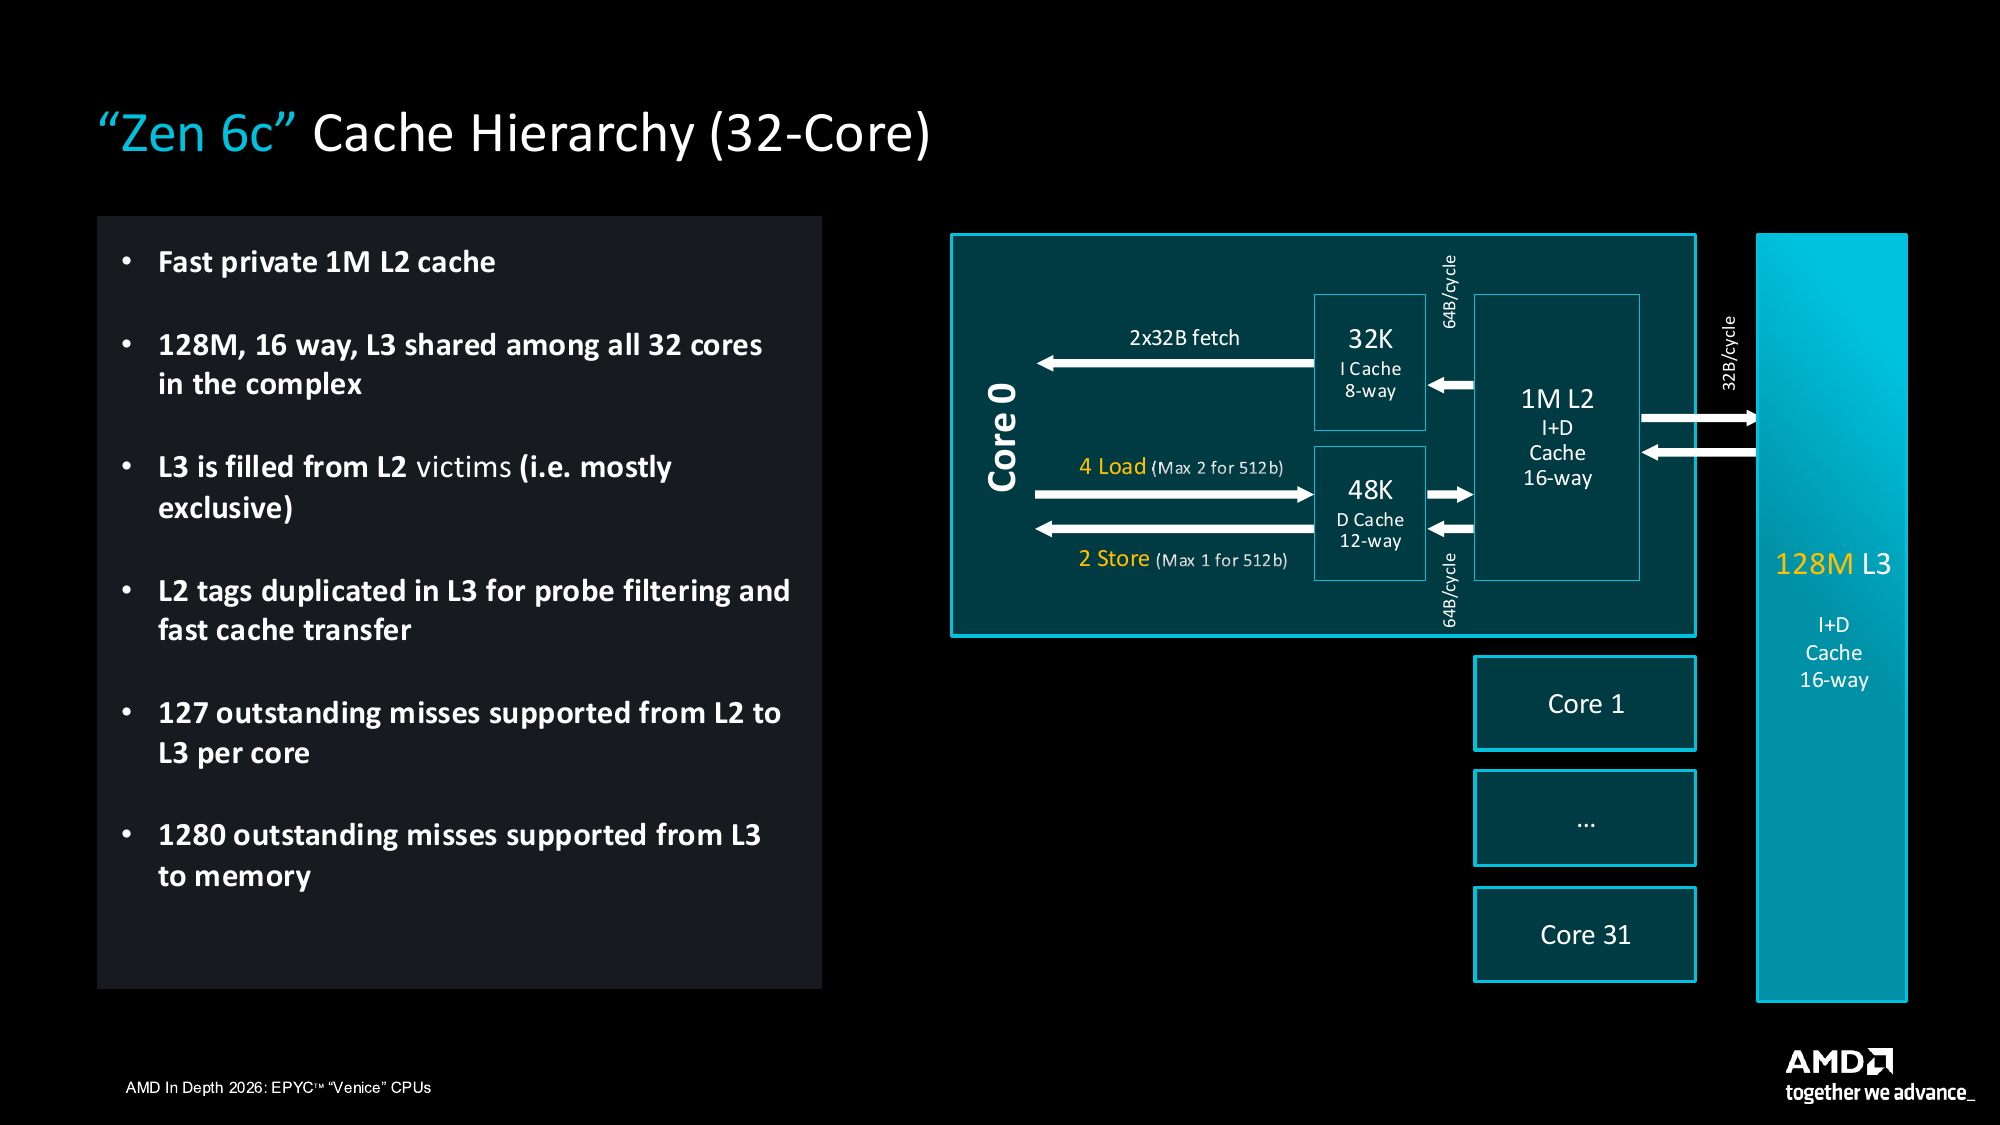
Revenind mai aproape de unitățile de execuție, fiecare nucleu Zen 6c are o memorie cache de instrucțiuni L1 pe 8 căi, de 32KB, și o memorie cache de date L1 pe 12 căi, de 48KB. Asociativitatea descrie câte locații din memoria cache este permisă să ocupe o anumită adresă de memorie; o asociativitate mai mare reduce șansa ca două fragmente de date utilizate frecvent să se evicteze reciproc. Singurul competitor din generația actuală, Vera de la NVIDIA cu nucleul său Olympus, are 64KB de memorie cache de instrucțiuni, 96KB de memorie cache de date și 2MB de memorie L2 privată per nucleu.
| Resursă de bază | AMD Zen 6c | NVIDIA Olympus |
|---|---|---|
| Predicție de ramificație preluată | Până la două pe ciclu; până la trei ferestre de predicție pe ciclu | Până la două pe ciclu |
| Stiva de adrese de returnare | 64 de intrări | Nedezvăluit |
| Preluare instrucțiuni L1 | Două fluxuri de 32 de octeți (64 de octeți pe ciclu) | 128 de octeți pe ciclu |
| Lățimea decodării | Două decodoare cu patru lățimi | Zece late |
| Cache-ul operațiunilor decodificate | 6.75 mii de operațiuni; până la 18 operațiuni pe ciclu în coadă | Nu este descrisă nicio cale echivalentă de cache a operațiunilor în stil x86 |
| Dispecerat / pensionare | Opt lățime / opt lățime | Alocare / angajare pe zece niveluri |
| Reordonare buffer | 640 de intrări | Capacitate nedivulgată |
| Planificatoare întregi | Împărțit: 96 intrări ALU/AGU partajate plus 48 intrări ALU dedicate | Nedezvăluit |
| Registre fizice întregi | 352 | Nedezvăluit |
| Execuție de numere întregi | Șase ALU-uri, doi multiplicatori | Opt ALU-uri simple, două ALU-uri complexe, două unități CRC |
| Unități de execuție a ramurilor | Trei | Patru |
| Execuție vectorială | Cale de date pe 512 biți; două conducte de multiplicare/FMA și două de adunare; patru conducte VNNI INT8 | Șase conducte SVE2 pe 128 de biți, două cu criptomonede |
| Încărcați / depozitați conducte | Patru conducte de încărcare/depozitare; până la patru încărcări și două depozite pe ciclu | Patru încărcături, două depozite |
| Încărcați / stocați cozi | 80 / 128 intrări | Nedezvăluit |
| TLB de date (L1 / L2) | 96 de intrări / 4K intrări | Nedezvăluit |
| Cache-ul de instrucțiuni L1 | 32KB, 8-căi | 64KB, 4-căi |
| Cache de date L1 | Latență de încărcare de 48KB, 12-căi, patru cicluri | 96KB, 6-căi |
| Privat L2 | 1 MB, 16-căi | 2 MB, 8-căi |
| Cache de ultimul nivel partajat | 128 MB, 16 căi, per CCD cu 32 de nuclee | 164 MB memorie cache la nivel de sistem pe 88 de nuclee |
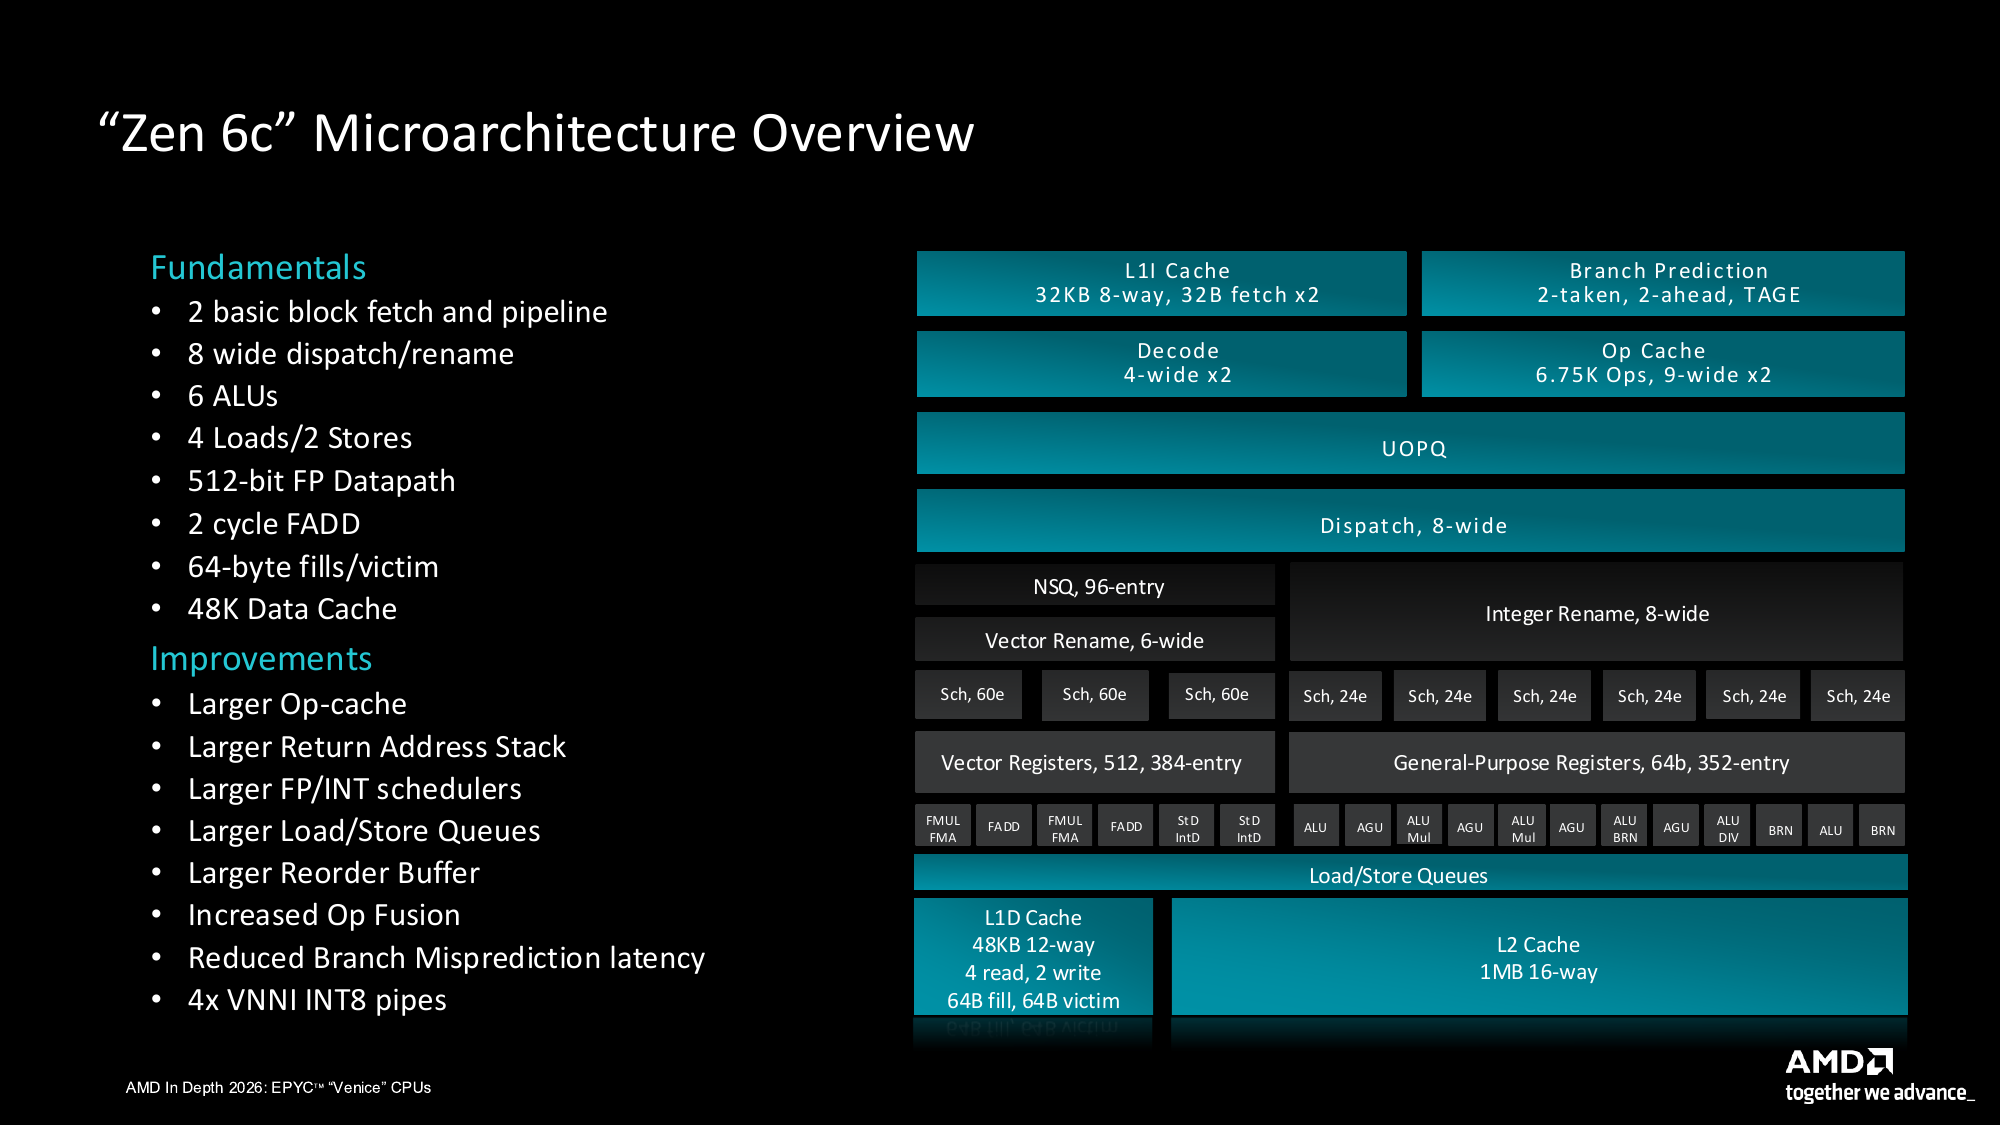
Front End-ul: Predicție, Recuperare și Decodare
Partea frontală este partea nucleului responsabilă de furnizarea de instrucțiuni motorului de execuție. Aceasta prezice unde va merge programul în continuare, preia octeții instrucțiunilor din acea locație și îi decodează în operațiuni interne pe care nucleul le poate programa. Interpretoarele, motoarele de baze de date și aplicațiile server mari fac ca această muncă să fie solicitantă, deoarece blocurile lor scurte de cod se termină frecvent în ramificații care modifică următoarea adresă de preluare. O ramificație preluată trimite execuția către ținta sa, în timp ce o ramificație neluată continuă prin instrucțiunile secvențiale care o urmează. De fiecare dată când partea frontală ghicește greșit, lucrarea preluată pe calea greșită trebuie aruncată.
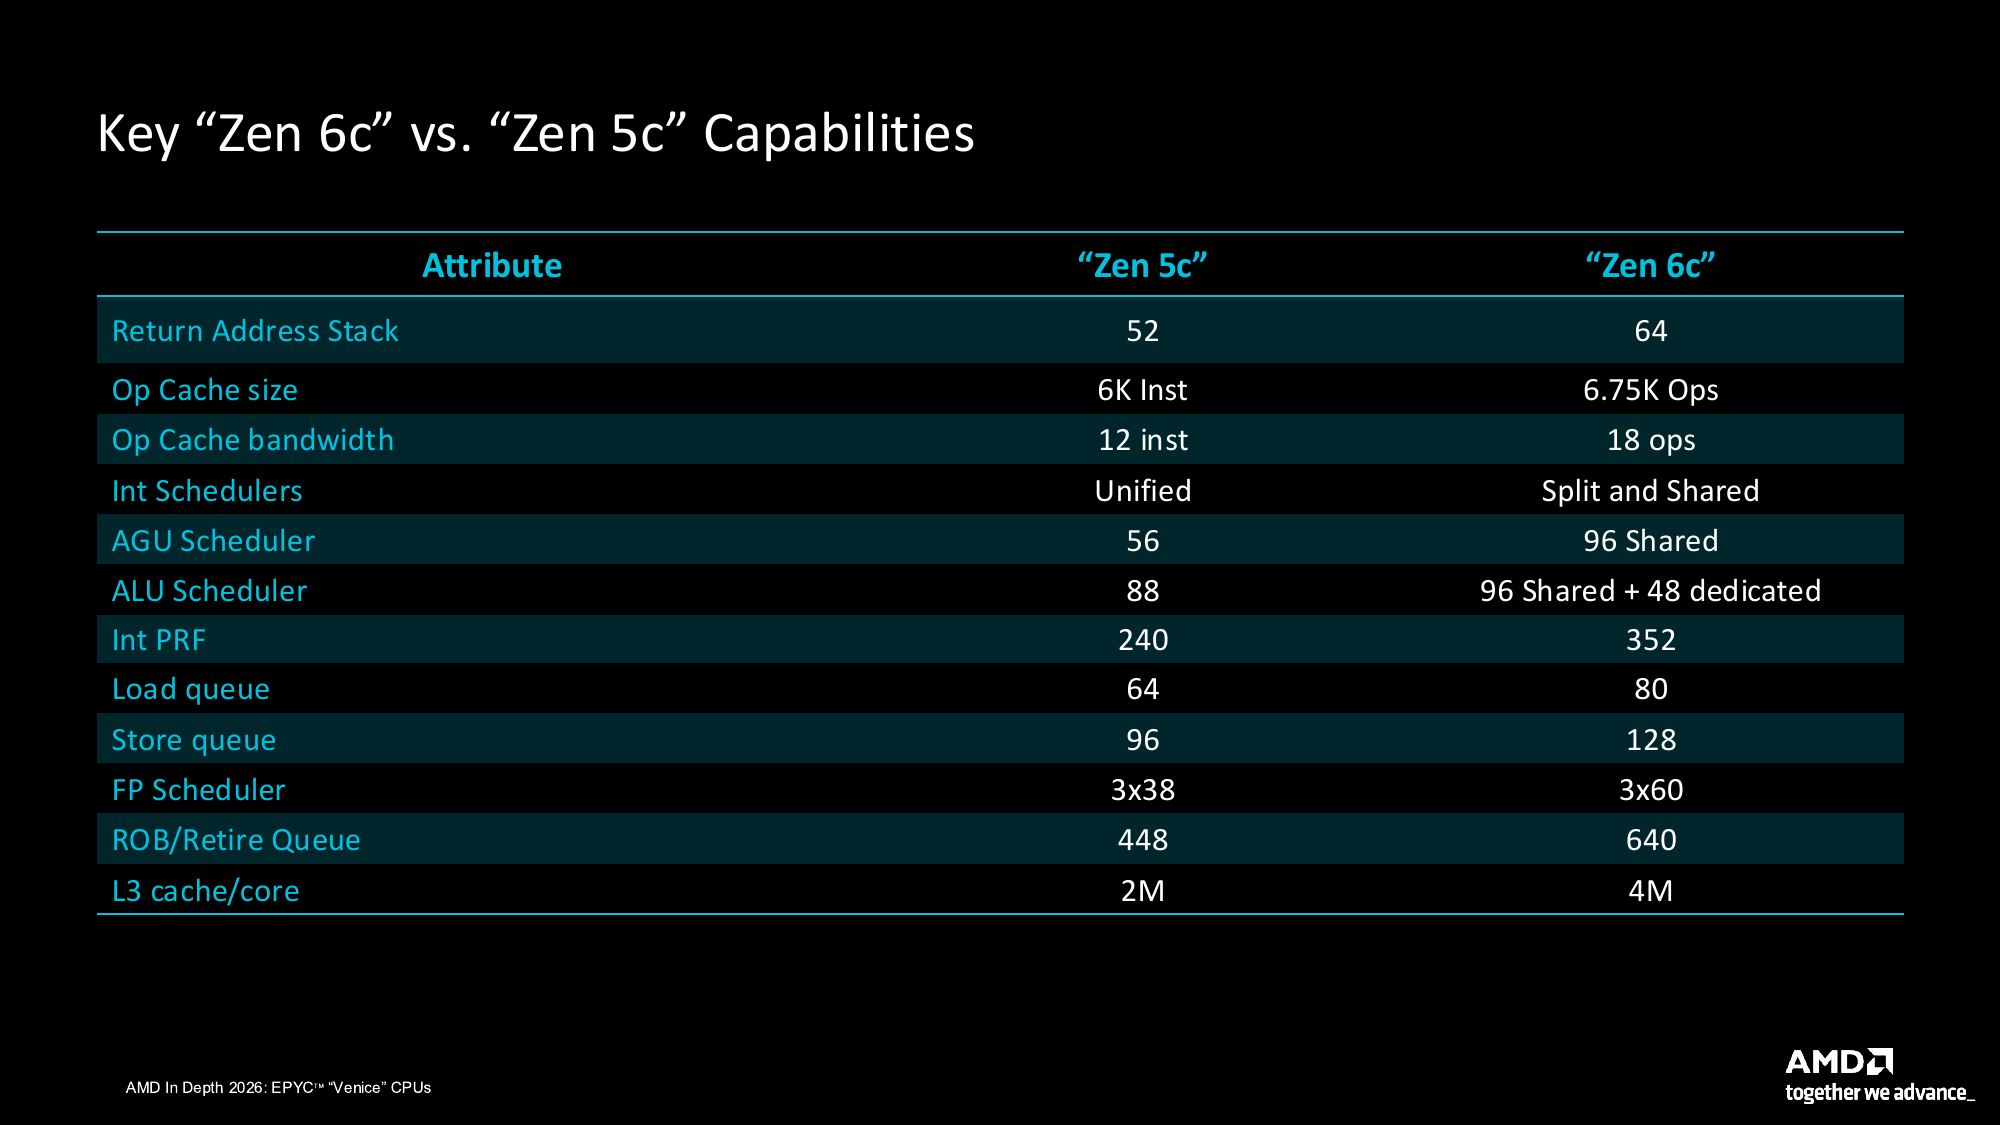
Pentru a ghici bine, Zen 6c folosește un predictor TAGE, iar AMD spune că tabelele sale de predicție au fost reglate pentru Zen 6, iar cozile de predicție a ramurilor au fost mărite. Predictorul poate produce două predicții pe ciclu și până la trei ferestre de predicție pe ciclu. O stivă de adrese de retur cu 64 de intrări, față de 52 pe Zen 5c, urmărește unde ar trebui să se întoarcă apelurile de funcții.
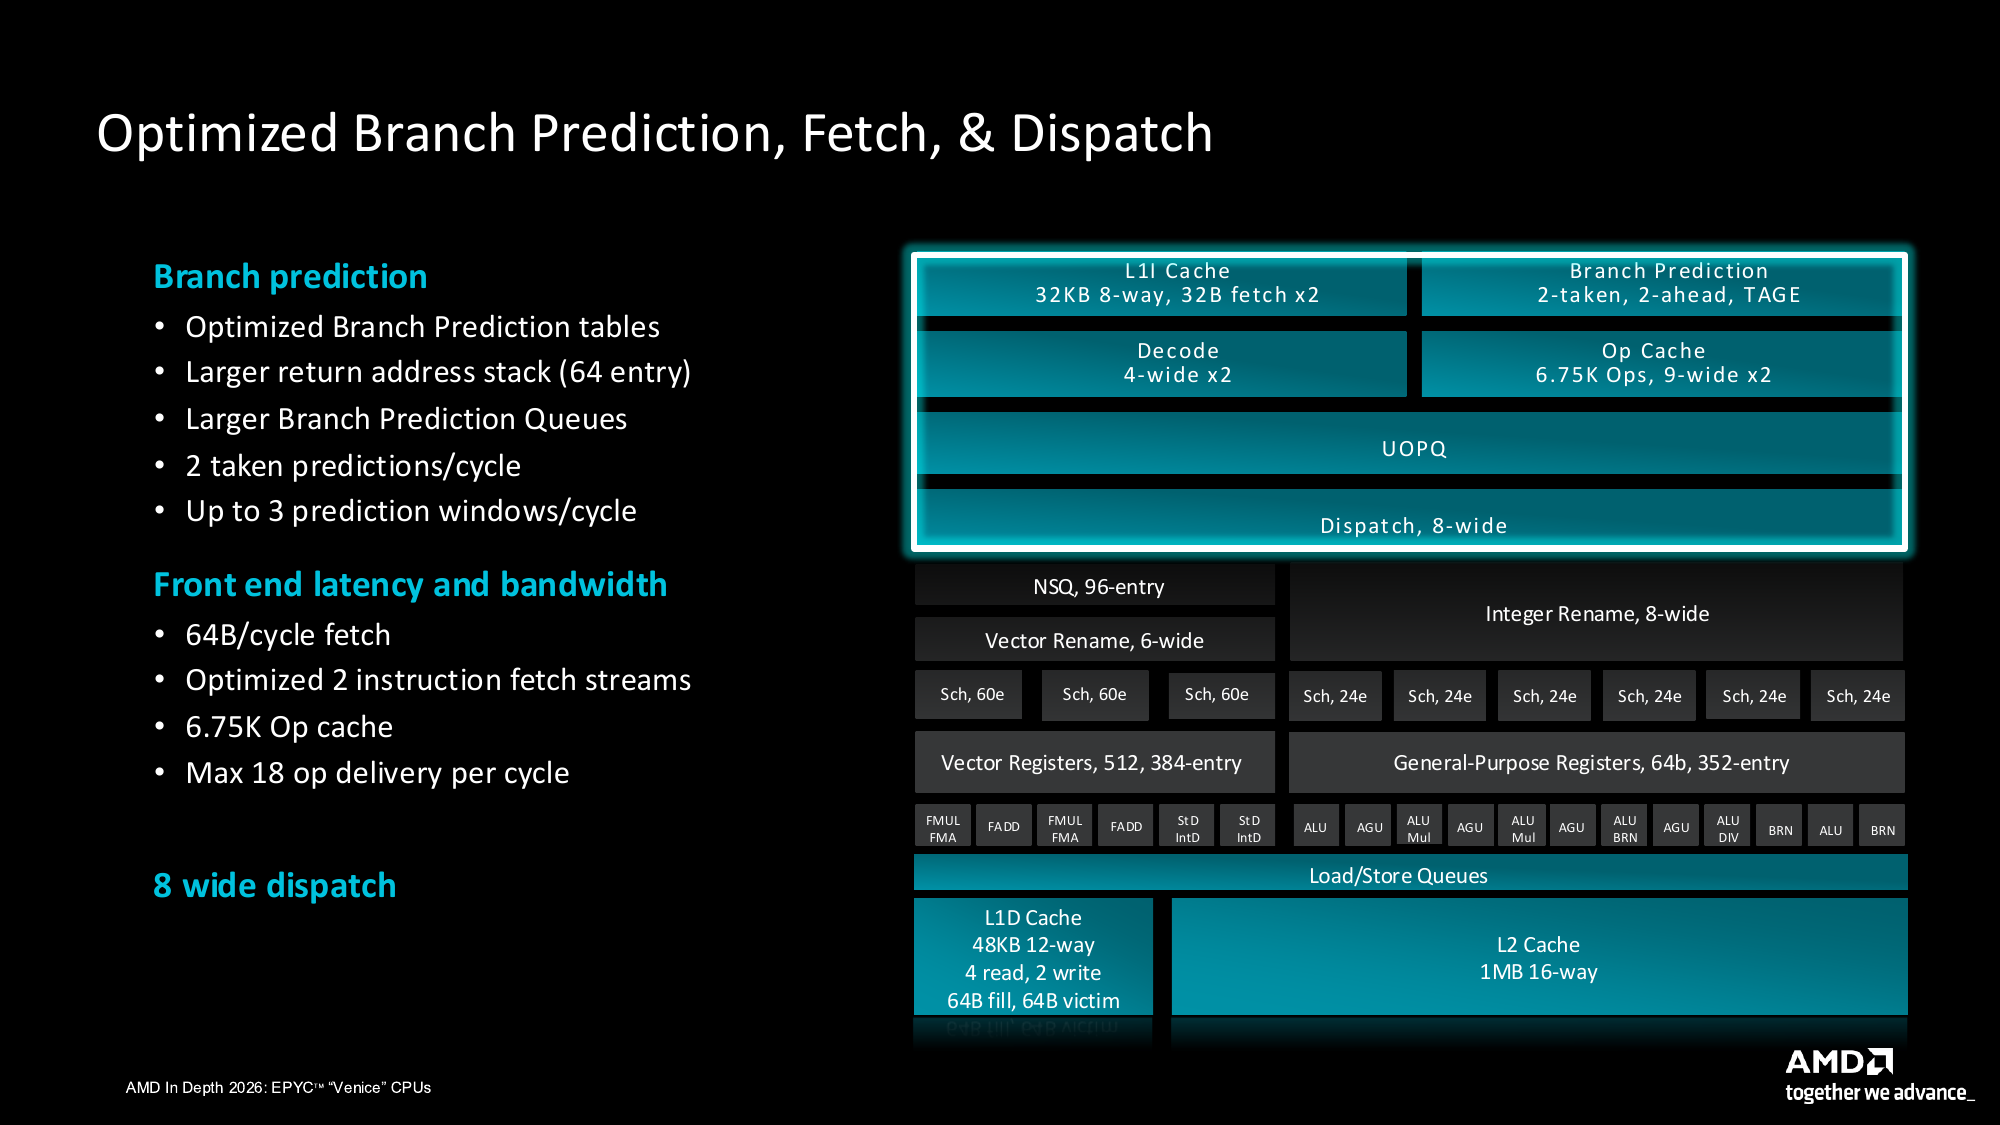
Nucleul urmează ruta prezisă și se recuperează atunci când o predicție se dovedește greșită, iar AMD spune că Zen 6 scurtează această recuperare prin reducerea latenței predicțiilor greșite ale ramificării. Vera potrivește plafonul de două ramificări pe ciclu cu un predictor neural și mecanisme de predicție specializate. Prin urmare, ambele modele pot anticipa mai mult de o redirecționare prezisă pe ciclu, ceea ce ajută livrarea instrucțiunilor să țină pasul cu codul care își schimbă frecvent direcția.
Odată ce calea este prezisă, octeții instrucțiunii trebuie să sosească. Zen 6c alimentează două fluxuri de fetch de 32 de octeți, 64 de octeți pe ciclu în total, din memoria cache de instrucțiuni L1 de 32KB către decodoare pereche cu patru lățimi. Olympus preia 128 de octeți pe ciclu și utilizează un decodor cu zece lățimi, oferind Vera calea de fetch și decodare mai largă. Cele două seturi de instrucțiuni funcționează diferit pentru codare: instrucțiunile x86 variază în lungime și pot transporta mai multă muncă per instrucțiune, în timp ce instrucțiunile Arm au lungime fixă. Prin urmare, aceste lățimi descriu furnizarea de instrucțiuni și nu fixează o relație între debitul aplicației pe cele două nuclee.
AMD oferă, de asemenea, Zen 6c o memorie cache de 6.75K operațiuni, față de 6K pe Zen 5c, care conține lucrări decodificate anterior. Decodificarea x86 este una dintre cele mai mari sarcini consumatoare de energie din nucleu, așa că omiterea ei este valoroasă. O accesare a memoriei cache de operațiuni alimentează direct coada de operațiuni, eliminând decodările repetate din cale.
Cache-ul poate livra până la 18 operațiuni pe ciclu către acea coadă, față de 12, confortabil înainte de etapa de dispecerizare cu lățimea de opt. Buclele fierbinți pot reutiliza în mod constant aceste operațiuni, ceea ce eliberează decodoarele de la reconstruirea aceleiași lucrări la fiecare trecere. AMD a îmbunătățit, de asemenea, fuziunea operațiunilor în Zen 6, combinând anumite perechi de operațiuni într-una singură, astfel încât acestea să consume mai puțin spațiu în cozile din aval.
Planificarea și execuția numerelor întregi
După front-end, nucleul are un flux de operații în ordinea programului, dar nu există nicio regulă care să impună executarea lor în această ordine. Execuția în afara ordinii permite nucleului să execute orice operație ale cărei intrări sunt gata, chiar dacă instrucțiuni mai vechi sunt încă în așteptare. Pentru a face acest lucru sigur, nucleul efectuează mai întâi redenumirea registrelor. Programele reutilizează un set mic de nume de registre arhitecturale în mod repetat; redenumirea mapează fiecare valoare nouă pe unul dintr-un pool mult mai mare de registre fizice, astfel încât instrucțiunile independente care se întâmplă să reutilizeze același nume nu trebuie să se aștepte unele pe altele.
Etapa de redenumire și dispecerizare cu lățime de opt a Zen 6c alimentează 352 de registre fizice întregi, față de 240 pe Zen 5c. Un buffer de reordonare cu 640 de intrări, față de 448, urmărește fiecare operațiune în desfășurare. Bufferul de reordonare este structura de evidență contabilă care permite operațiunilor să se termine în afara ordinii, în timp ce nucleul încă completează rezultatele în ordinea originală a programului. Dimensiunea sa stabilește cât de mult înainte de o instrucțiune blocată poate nucleul să caute muncă independentă.
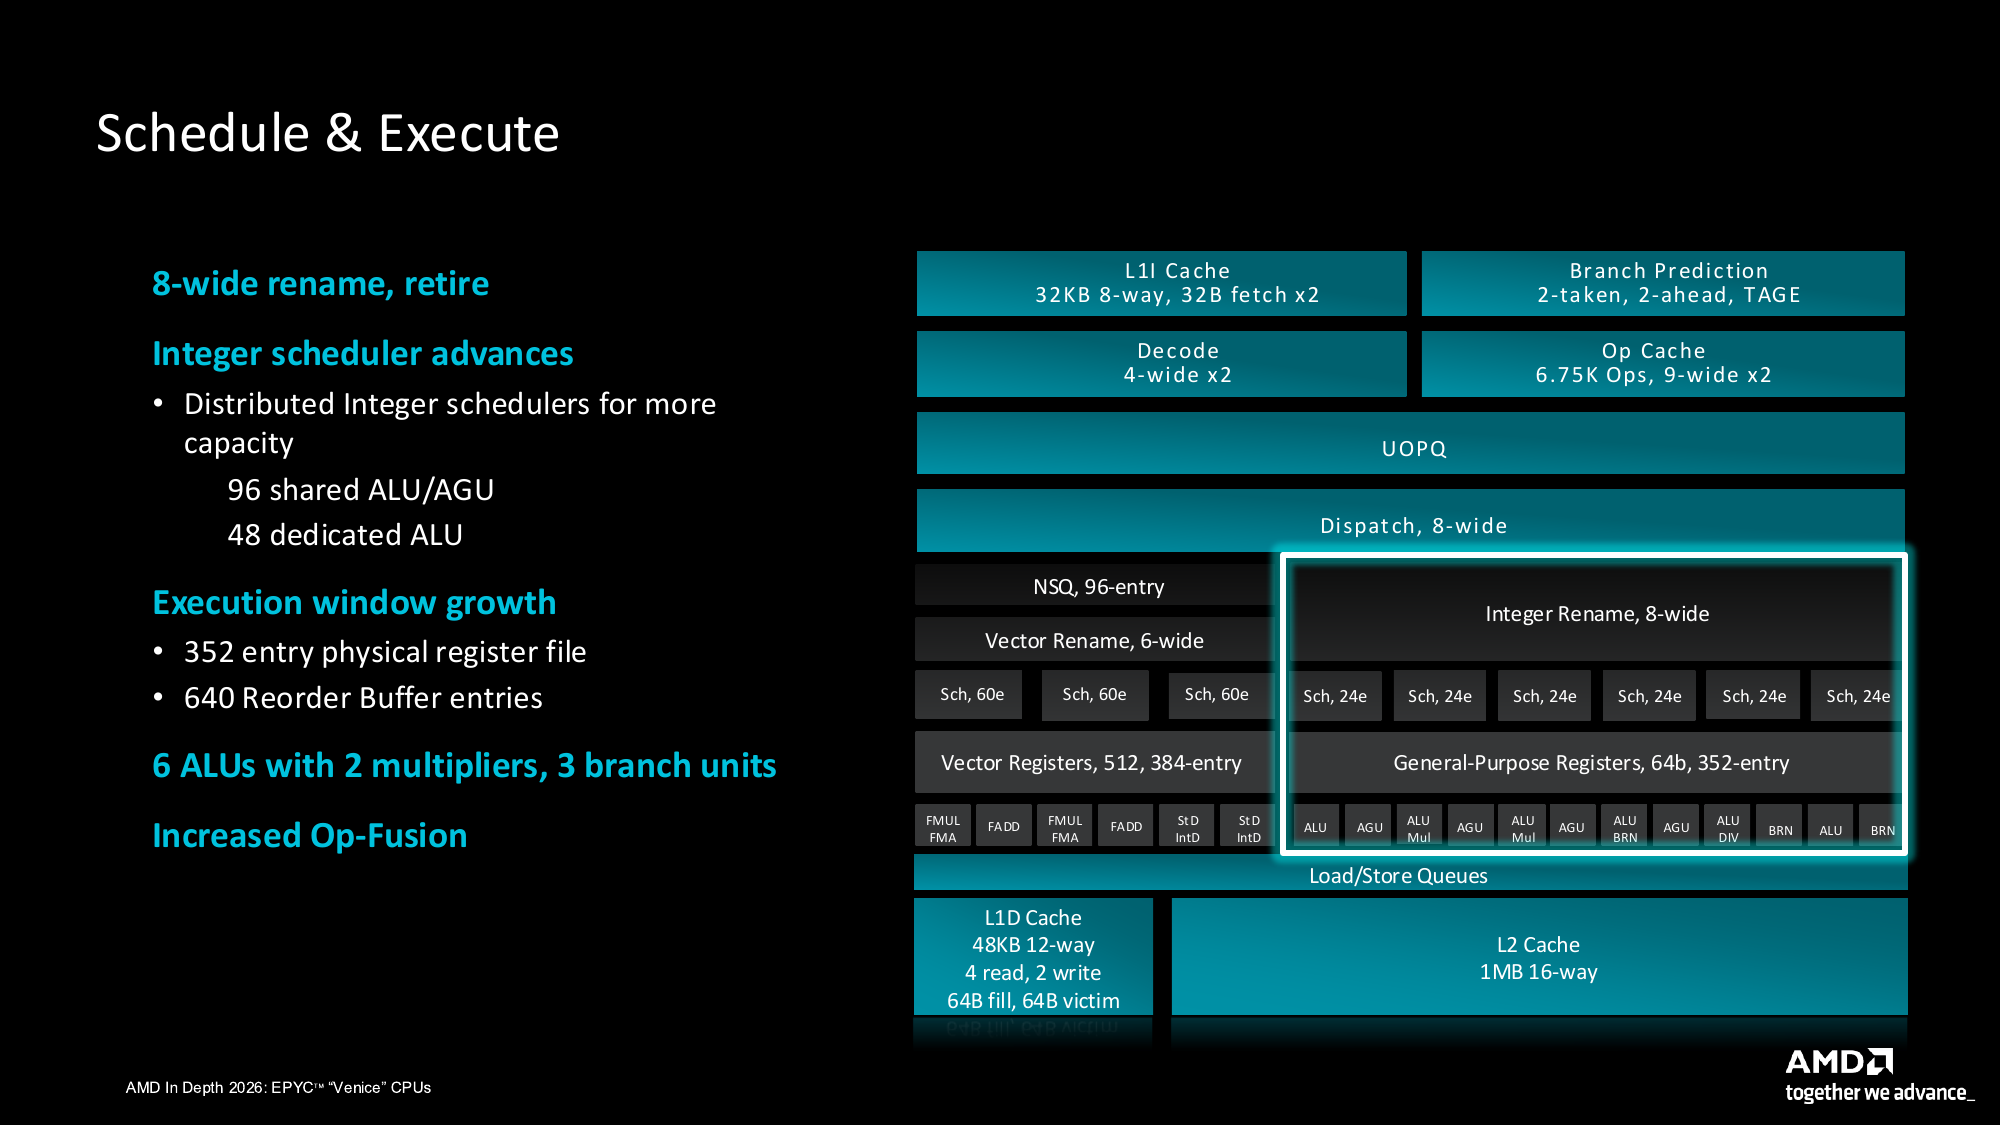
Între unitățile de dispecerat și cele de execuție se află planificatoarele, care rețin operațiunile până când intrările lor sunt gata. Aici, AMD a făcut o modificare structurală: Zen 5 folosea un planificator unificat de numere întregi, iar Zen 6 îl împarte, cu 96 de intrări partajate între munca aritmetică (ALU) și cea de generare a adreselor (AGU), plus 48 de intrări dedicate operațiilor ALU. Zen 5c avea 88 de intrări ALU și 56 de intrări AGU. AMD a extins, de asemenea, planificatoarele în virgulă mobilă, iar rezultatul este o capacitate totală de planificare mai mare, astfel încât mai multe operații pot aștepta intrările lor fără a bloca dispecerat.
Această fereastră de programare permite unui lucrător al bazei de date să suprapună căutări independente, de exemplu, sau să continue calculele aritmetice în timp ce o încărcare anterioară așteaptă date. Olympus folosește o alocare pe zece niveluri pentru a-și furniza mecanismul de execuție și adaugă predicția valorii și redenumirea memoriei pentru a ajuta la avansarea prin dependențe.
Motorul de numere întregi al Zen 6c include șase ALU-uri, doi multiplicatori de numere întregi și trei unități de execuție a ramificării. Aceste unități de ramificare rezolvă rezultatul real al fiecărei ramificări după ce front-end-ul a prezis deja calea. Olympus are patru unități de execuție a ramificării, alături de mecanismul său mai larg de alocare și validare. Resursele abordează diferite părți ale procesării instrucțiunilor, deoarece prezicerea unei ramificări din timp și rezolvarea acesteia în timpul execuției sunt sarcini separate.
Execuție vectorială
Instrucțiunile vectoriale sau SIMD aplică o singură operație mai multor elemente de date simultan, ceea ce le face esențiale pentru lucrul numeric, compresie, media și, din ce în ce mai mult, inferență AI. Motorul vectorial nativ pe 512 biți de la AMD revine atât în Zen 6, cât și în Zen 6c, ceea ce înseamnă că o singură instrucțiune AVX-512 operează pe întregul registru de 512 biți într-o singură trecere, fără a fi împărțită în două jumătăți. Hardware-ul de execuție include două conducte de multiplicare/FMA, două conducte de adunare și patru conducte VNNI INT8, dublu față de cele două de pe Zen 5.
Cea mai mare schimbare este aritmetica completă AVX-512 FP16: Zen 5 putea converti doar valori cu precizie de jumătate, iar Zen 6 calcula direct pe baza lor. Pentru software-ul care poate utiliza aritmetica cu precizie de jumătate, un vector de 512 biți conține 32 de valori FP16 față de șaisprezece valori FP32.
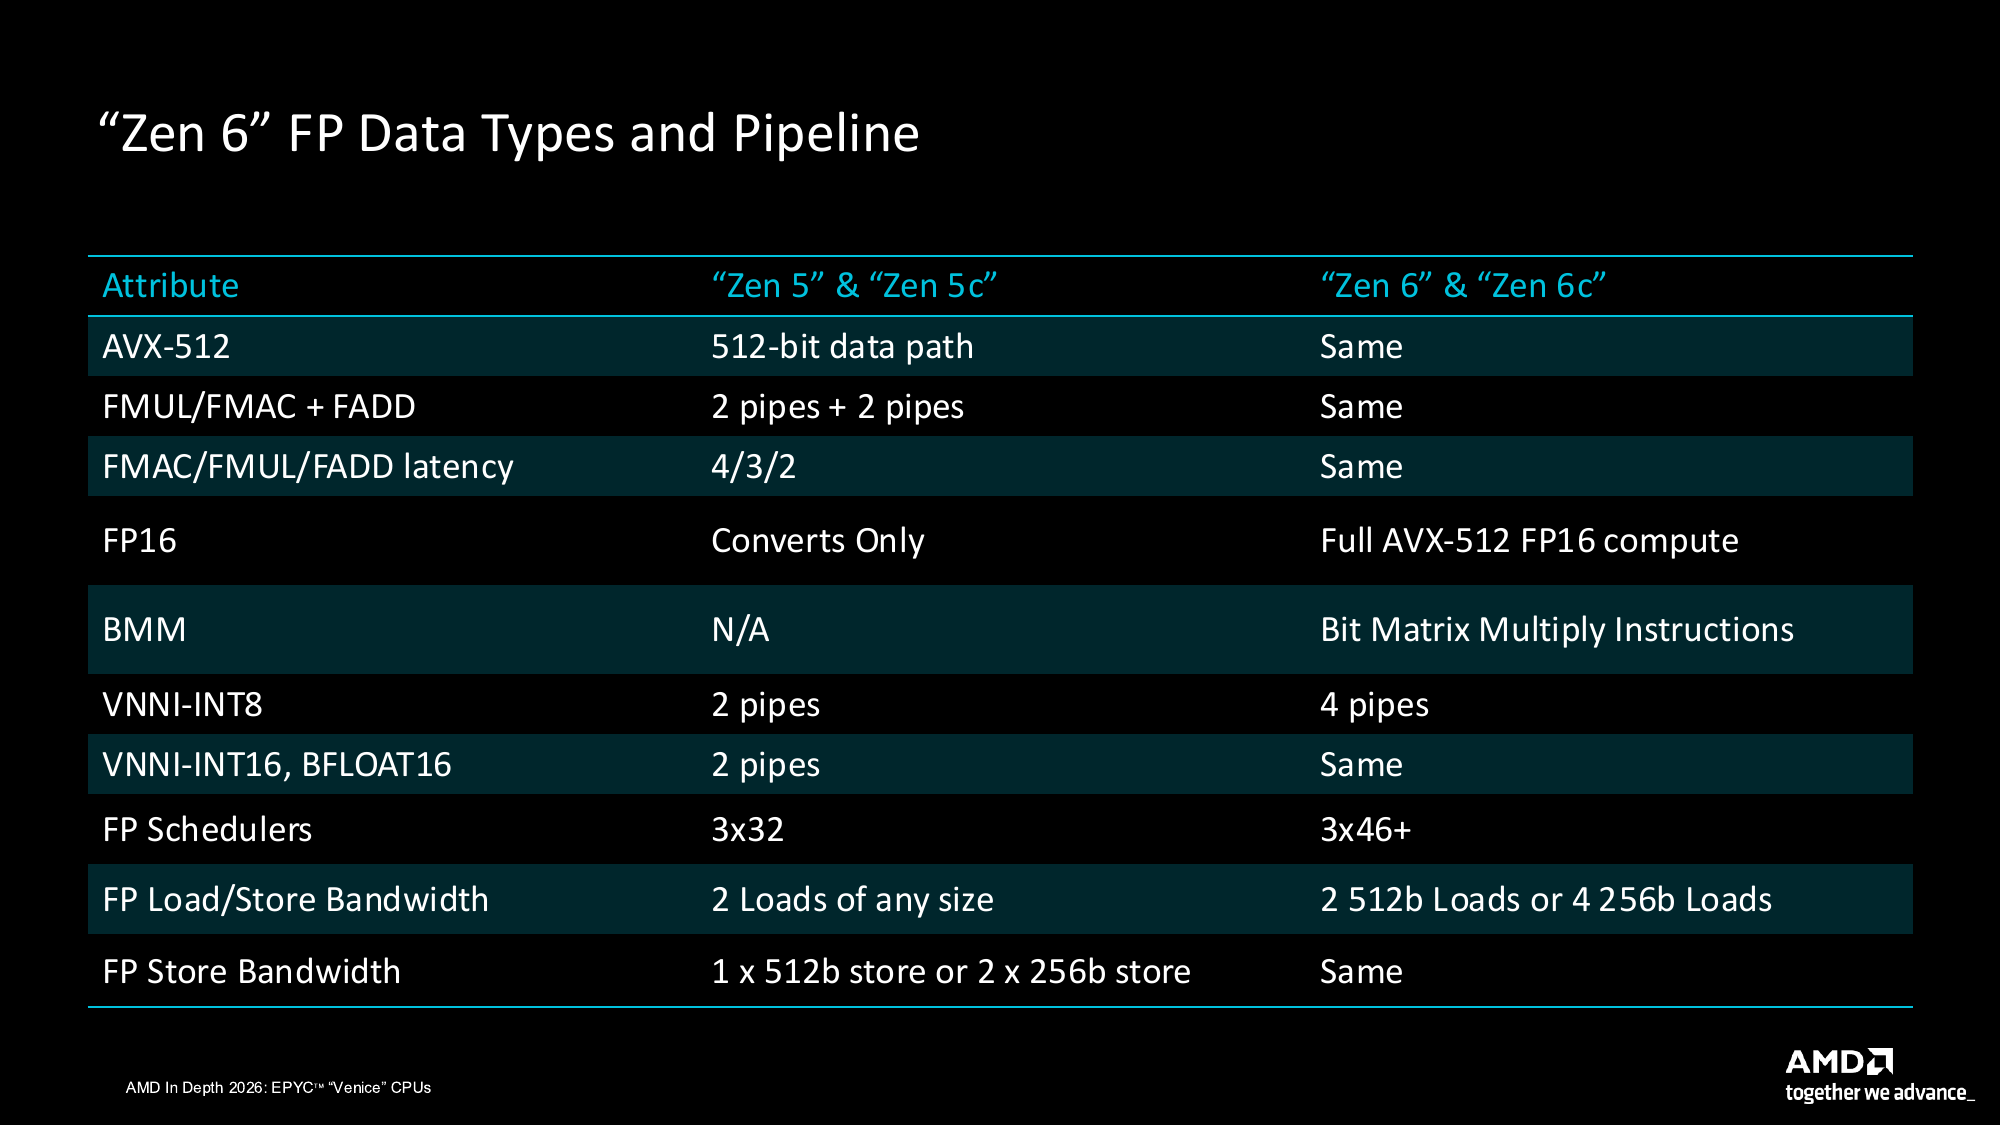
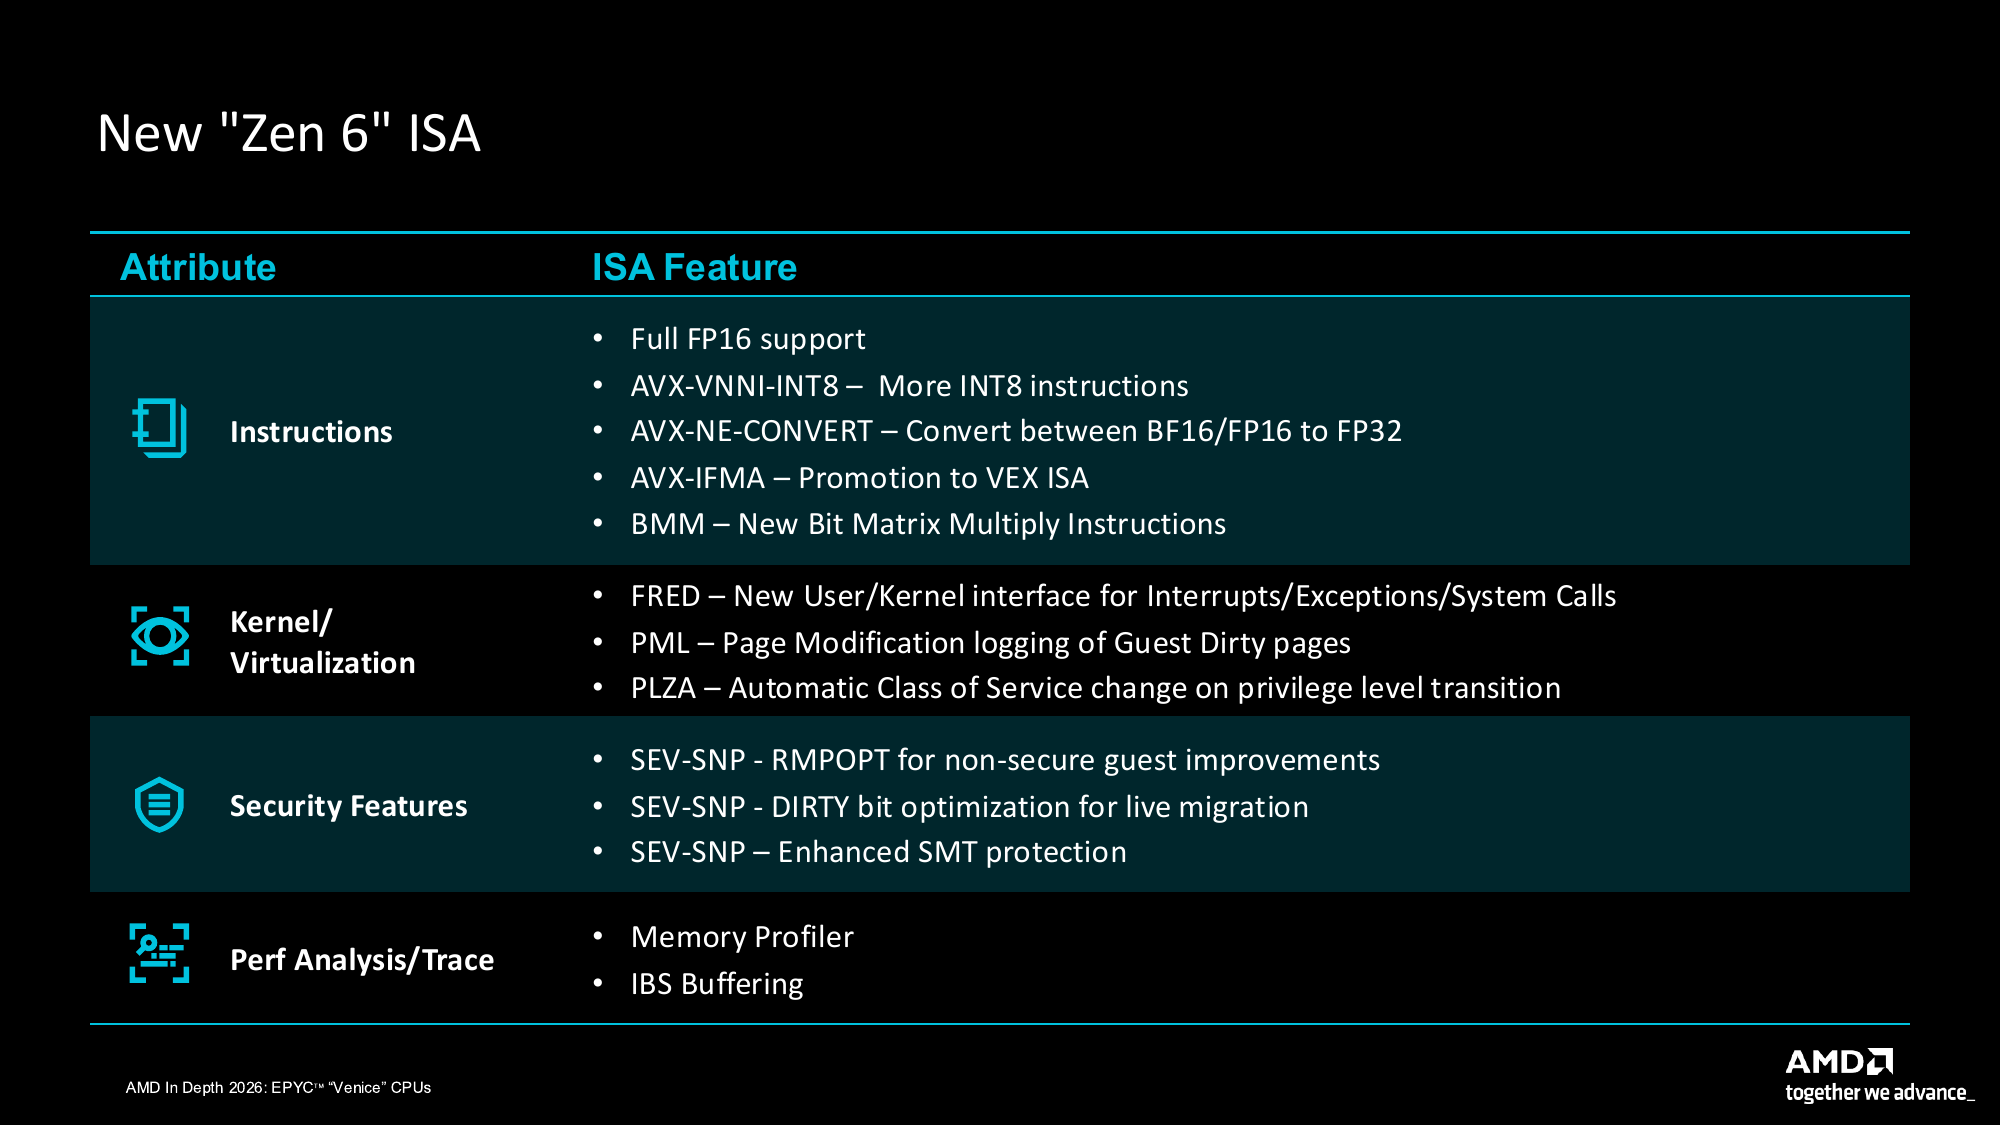
Zen 6 adaugă alte câteva extensii de set de instrucțiuni destinate acelorași sarcini de lucru: AVX-512 BMM, un nou set de instrucțiuni de înmulțire a matricei de biți; AVX-VNNI-INT8, mai multe instrucțiuni de produs scalar INT8 în codificarea VEX; AVX-NE-CONVERT, pentru convertirea valorilor BF16 și FP16 în FP32; și AVX-IFMA, adunare-înmulțire fuzionată cu numere întregi promovată la codificarea VEX. Suportul existent pentru AVX-512, inclusiv BF16 și VNNI-INT16, este preluat de la Zen 5. Software-ul necesită suport pentru compilator și bibliotecă pentru a utiliza aceste extensii.
Vera adoptă o abordare diferită, cu șase unități de execuție SVE2 pe 128 de biți și suport FP8. Venice are vectori nativi mai largi, în timp ce Vera are șase unități mai restrânse disponibile pentru procesarea instrucțiunilor SIMD. Comparația utilă depinde de aritmetica necesară unei sarcini de lucru: calculele FP16, produsele scalare INT8 și operațiile FP8 utilizează instrucțiuni diferite și impun cerințe diferite asupra hardware-ului de execuție.
Ambele modele specifică o latență de două cicluri pentru adunarea în virgulă mobilă. Acest lucru este important atunci când fiecare adunare are nevoie de rezultatul adunării anterioare, deoarece un motor vectorial larg trebuie să aștepte în continuare aceste dependențe. Căutarea vectorială și sarcinile de lucru numerice pot beneficia de lățimea programului Venice atunci când codul lor expune suficientă muncă paralelă și utilizează tipuri de date care se potrivesc cu conductele disponibile, iar rezultatele noastre GROMACS de mai jos arată cum arată acest lucru în practică.
Încărcarea, stocarea și menținerea datelor în mișcare
Un motor vectorial pe 512 biți este la fel de rapid ca datele care îl alimentează, iar această sarcină revine unității de încărcare/stocare. Zen 6c are patru conducte de încărcare/stocare care pot gestiona un mix de până la patru încărcări și două stocări pe ciclu. Pentru codul vectorial, aceasta echivalează cu două încărcări pe 512 biți sau patru încărcări pe 256 biți pe ciclu, în timp ce Zen 5 gestiona două încărcări de orice dimensiune, împreună cu o stocare pe 512 biți sau două stocări pe 256 biți, în funcție de mixul de instrucțiuni.
O coadă de încărcare cu 80 de intrări și o coadă de stocare cu 128 de intrări, în creștere față de 64 și 96 pe Zen 5c, mențin cererile în zbor, alături de o coadă scalabilă de ordonare a încărcării. O încărcare care ajunge în memoria cache de date L1 are o latență specificată de patru cicluri, iar L1 schimbă date cu L2 printr-o cale de umplere și victimă de 64 de octeți pe ciclu.
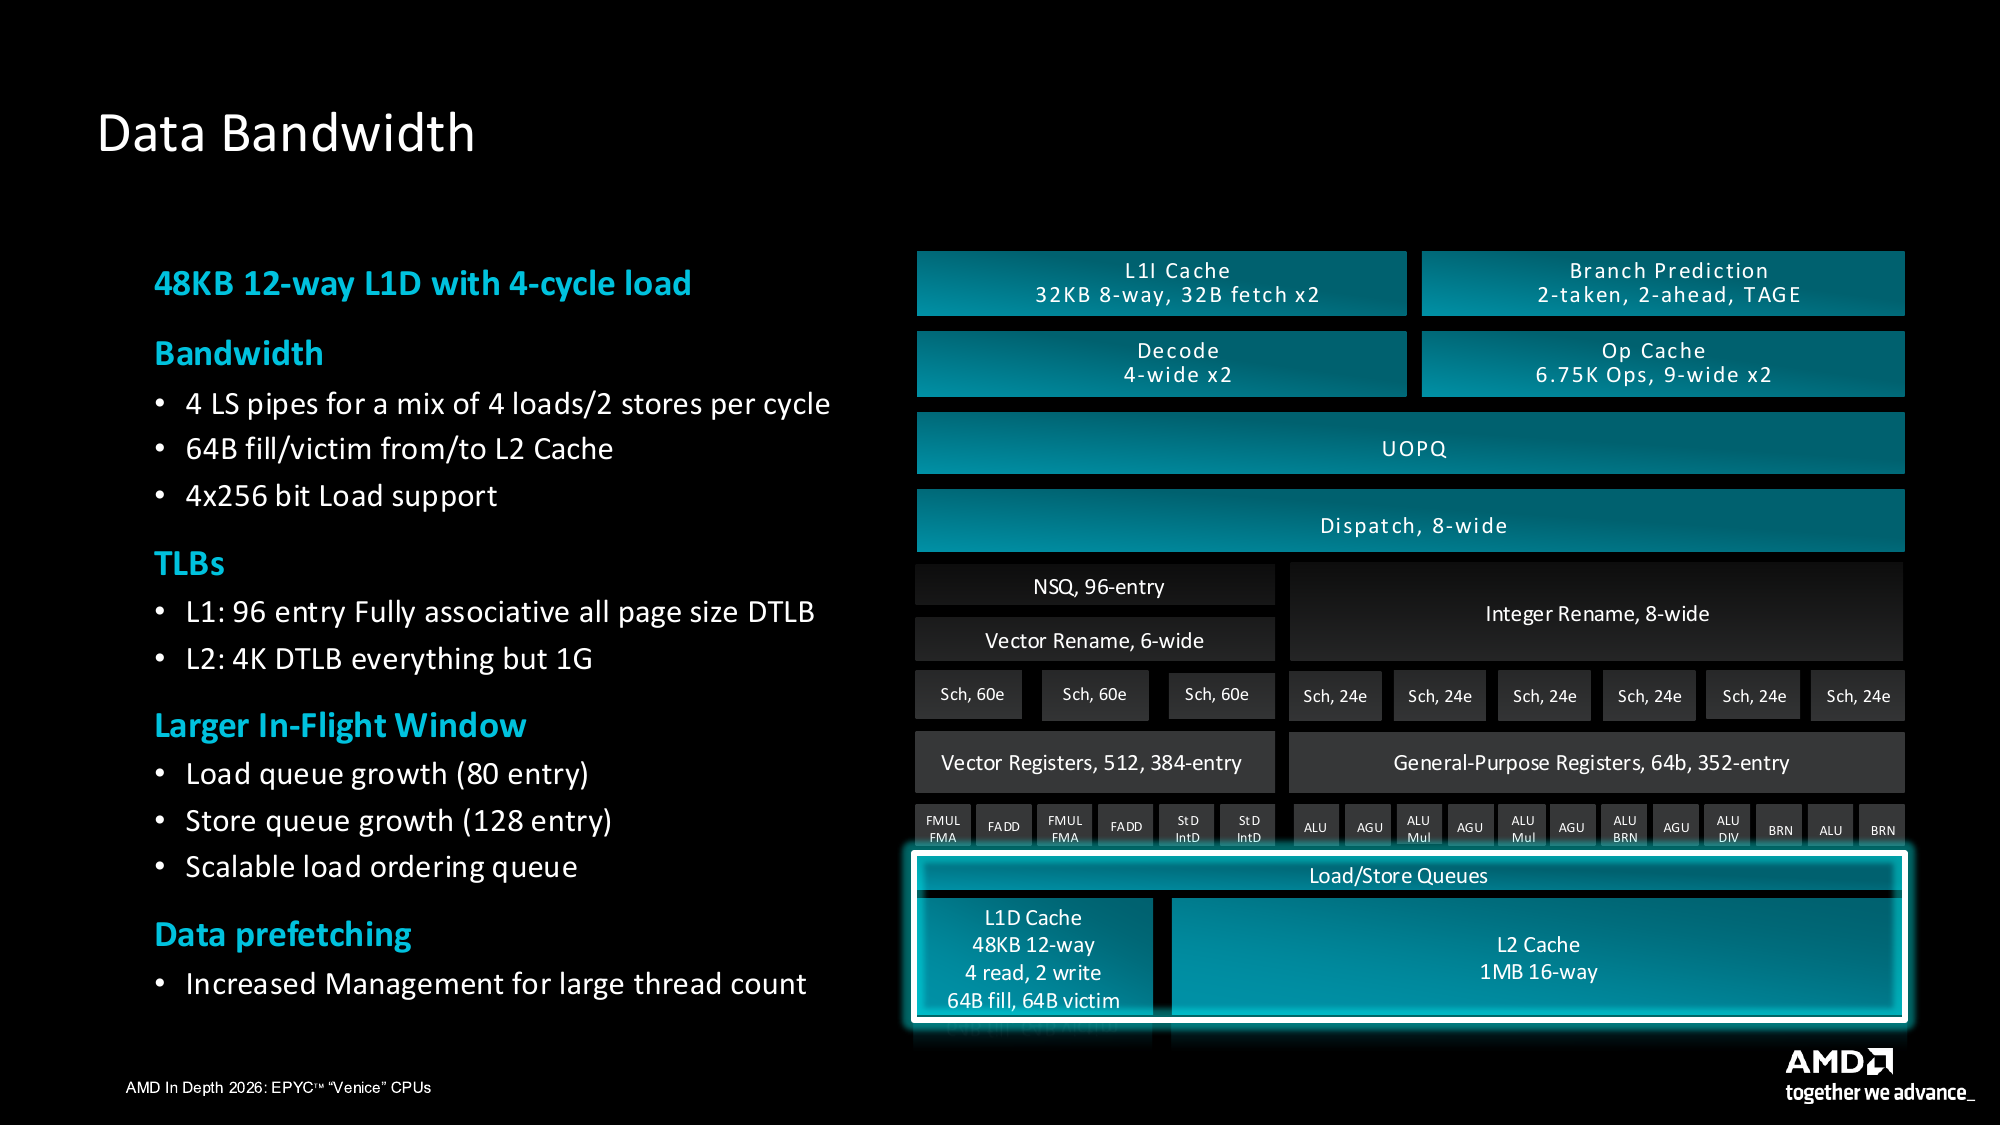
Fiecare încărcare necesită, de asemenea, o adresă virtuală tradusă într-una fizică, iar bufferele de tip „translation lookaside” (TLB-uri) stochează în cache aceste traduceri, astfel încât nucleul să nu fie nevoit să parcurgă tabelele de pagini la fiecare accesare. Zen 6 are un TLB de date L1 cu 96 de intrări, susținut de un TLB de date L2 cu 4K de intrări, care acoperă orice dimensiune de pagină, cu excepția paginilor de 1 GB. Bazele de date mari în memorie și motoarele de analiză cu modele de acces dispersate se bazează puternic pe acoperirea TLB.
Aceste cozi oferă nucleului spațiu pentru a se suprapune accese independente la memorie. Urmărirea unui lanț de pointeri este mai dificilă, deoarece o singură încărcare trebuie să returneze adresa înainte ca următoarea adresă să fie cunoscută. Nucleul Olympus al Verei abordează o parte din această muncă cu un prefetcher de grafuri care recunoaște modele precum A[B[i]], unde un index preluat dintr-o matrice identifică elementul necesar din alta, oferind hardware-ului șansa de a prelua acea a doua valoare înainte de cerere.
O eroare în L1 trimite cererea mai departe prin ierarhia cache-ului. L2 privat cu 16 căi al nucleului și L3 partajat al CCD-ului său oferă următoarele oportunități de a găsi datele, cererile trecând prin matrița I/O atunci când trebuie să ajungă la memorie. Aici începe să afecteze aspectul chiplet-ului Venice cât timp așteaptă un nucleu operanzii săi. Între timp, nucleul continuă să execute operații independente în afara ordinii pentru a-și menține unitățile ocupate. Instrucțiunile finalizate se retrag apoi în ordinea programului, astfel încât software-ul să vadă secvența așteptată de rezultate; Zen 6c are o retragere pe opt lățimi față de etapa de validare pe zece lățimi a Olympus.
Două module I/O și șaisprezece canale de memorie
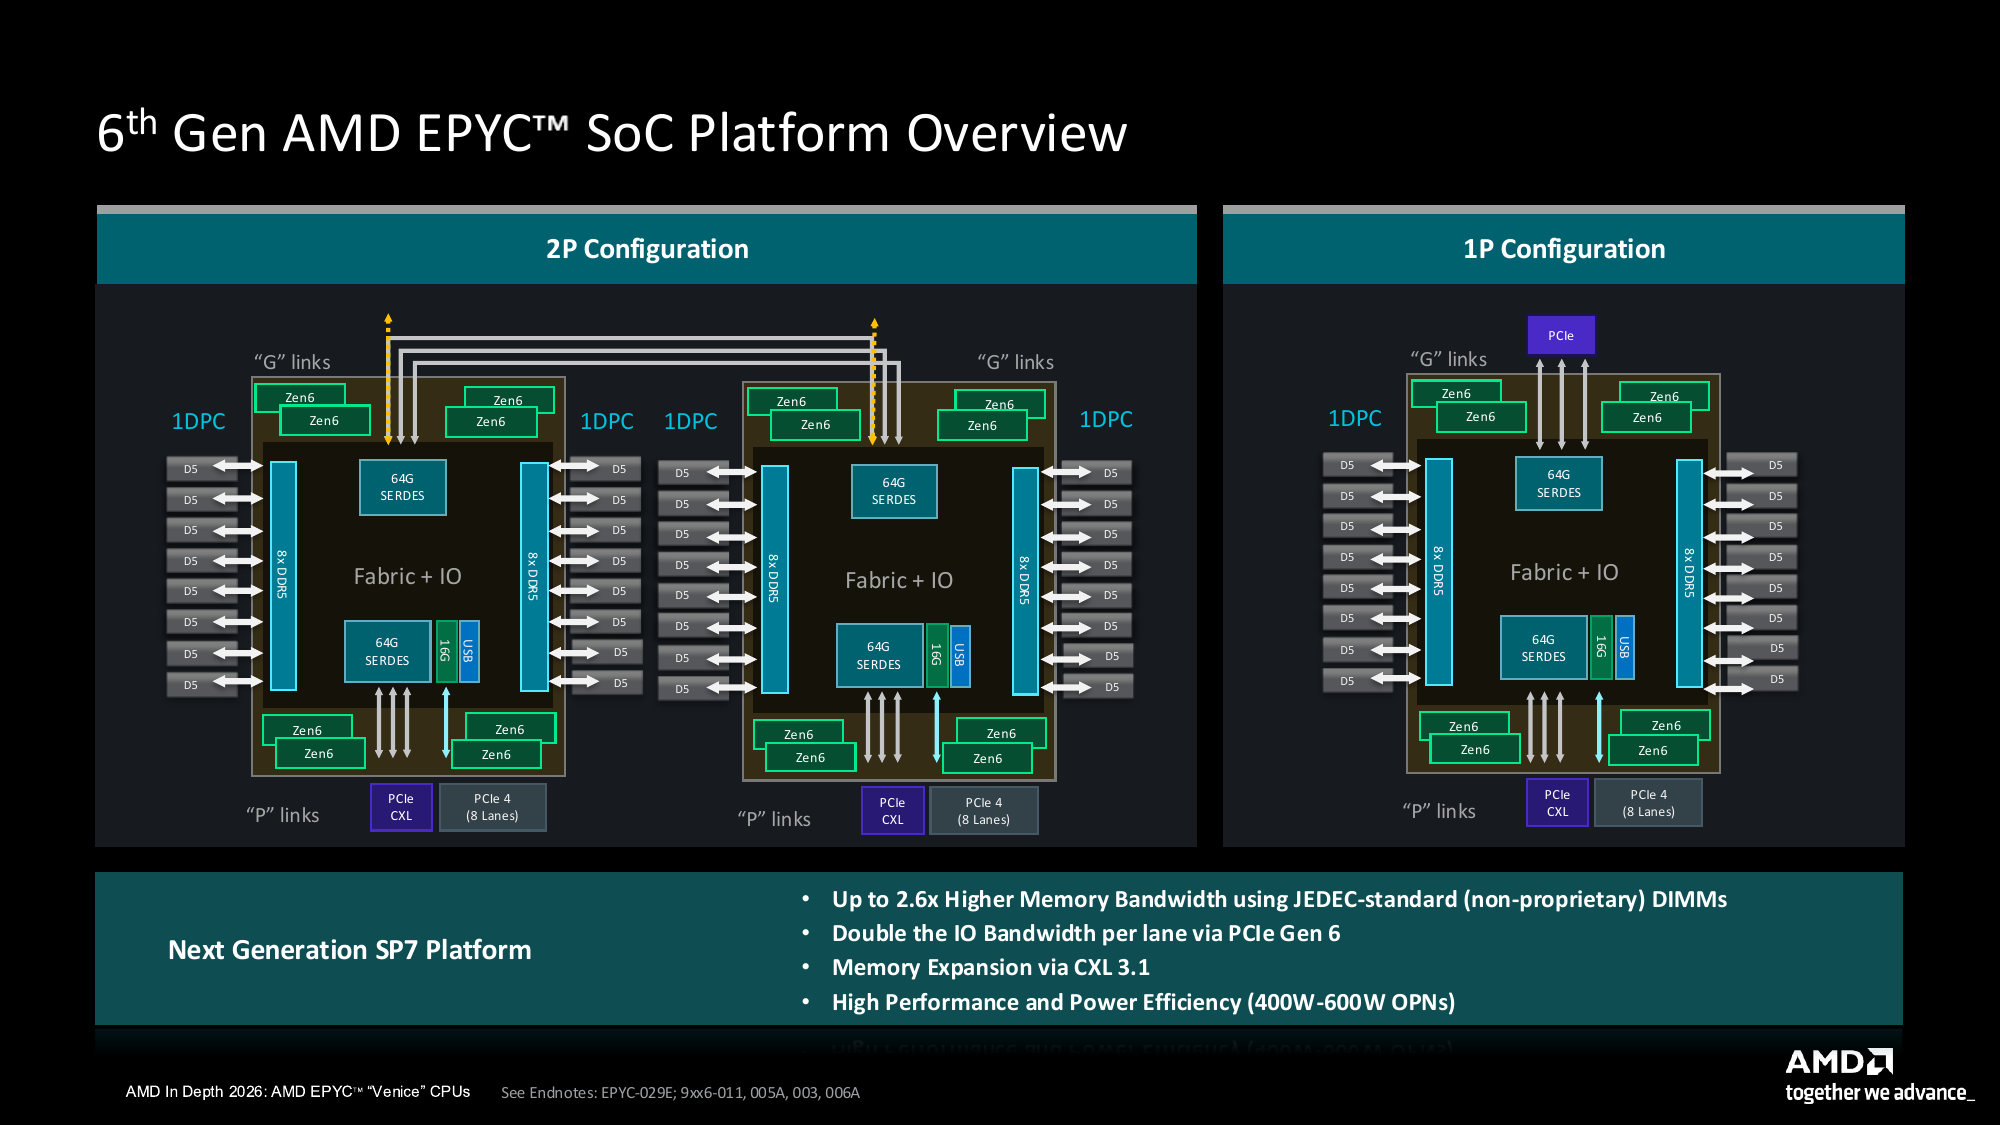
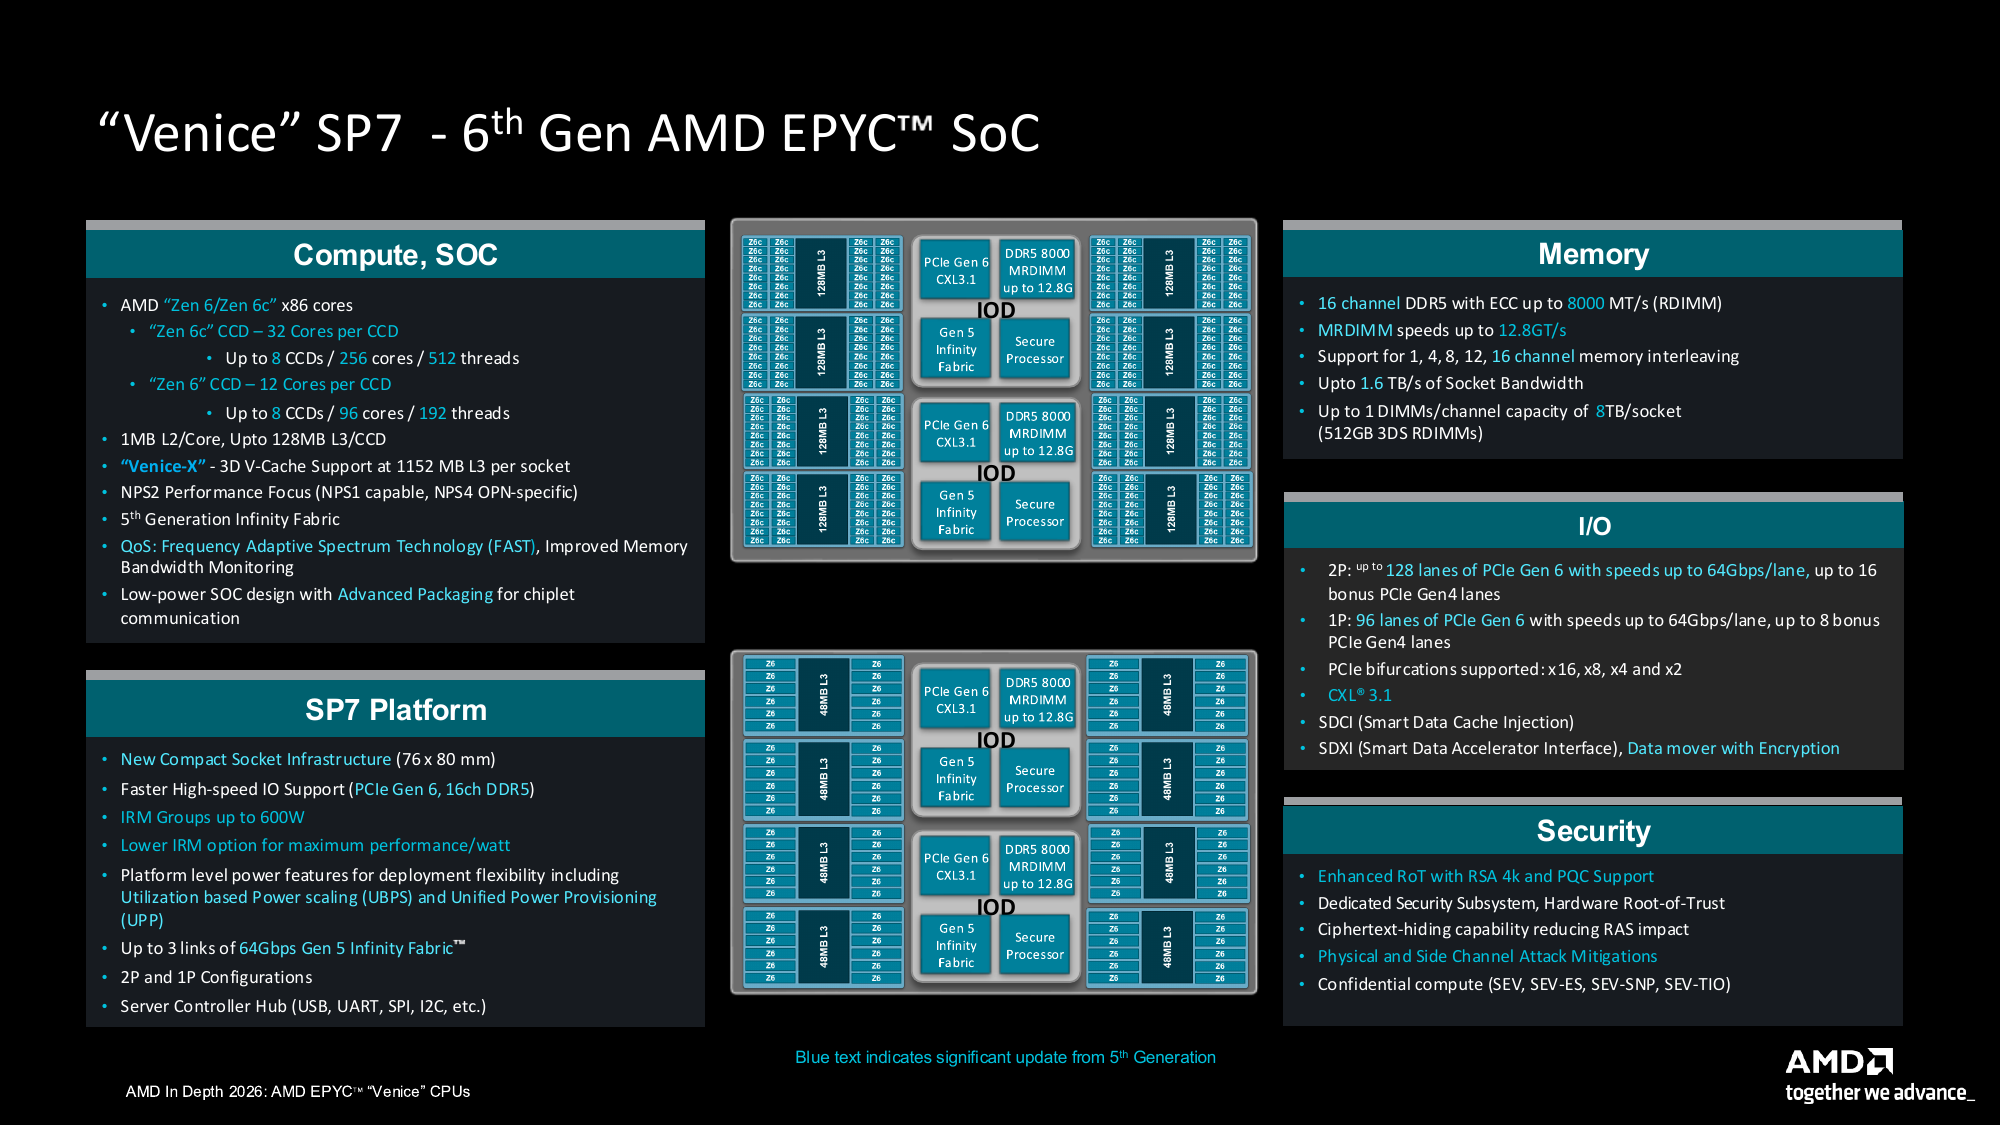
Dincolo de CCD-uri, nucleele au nevoie de o modalitate de a ajunge la memorie, dispozitive și între ele. În fiecare EPYC de la Roma încoace, această sarcină a aparținut unui die I/O separat, sau IOD, iar Venice îl împarte în două. Fiecare IOD transportă opt canale de memorie DDR5, 48 de benzi de SerDes de 64Gb/s și opt benzi de SerDes mai lente de 16Gb/s pentru I/O auxiliar. Un SerDes, prescurtare de la serializer/deserializer, este transceiverul de mare viteză care transportă trafic PCIe, CXL și socket-to-socket.
În pachetul complet cu opt CCD-uri, patru CCD-uri se atașează la fiecare IOD, iar cele două IOD-uri sunt matrițe identice rotite la 180 de grade unul față de celălalt. Acestea se bazează pe un proces de 6 nm, în timp ce CCD-urile au trecut la 2 nm, deoarece circuitele analogice I/O beneficiază puțin de la cele mai noi noduri.
Modul în care chipleturile comunică între ele s-a schimbat și el. AMD folosește Elevated Fanout Bridges, sau EFB, pentru comunicarea dintre die-uri, cu scopul de a reduce energia și latența acestor transferuri. Generațiile anterioare de EPYC rulau legături die-to-die prin conexiuni seriale pe substratul organic al capsulatei. EFB plasează o punte mică și densă sub marginile die-ului, permițând mult mai multe conexiuni scurte și late. AMD spune că acest lucru reduce energia pe bit și eliberează energie pentru nuclee. Legăturile rulează Infinity Fabric de a cincea generație de la AMD, care adaugă și schimbări mai rapide ale stării de alimentare a fabric-ului, astfel încât interconectarea poate scădea la o putere mai mică atunci când traficul este redus.
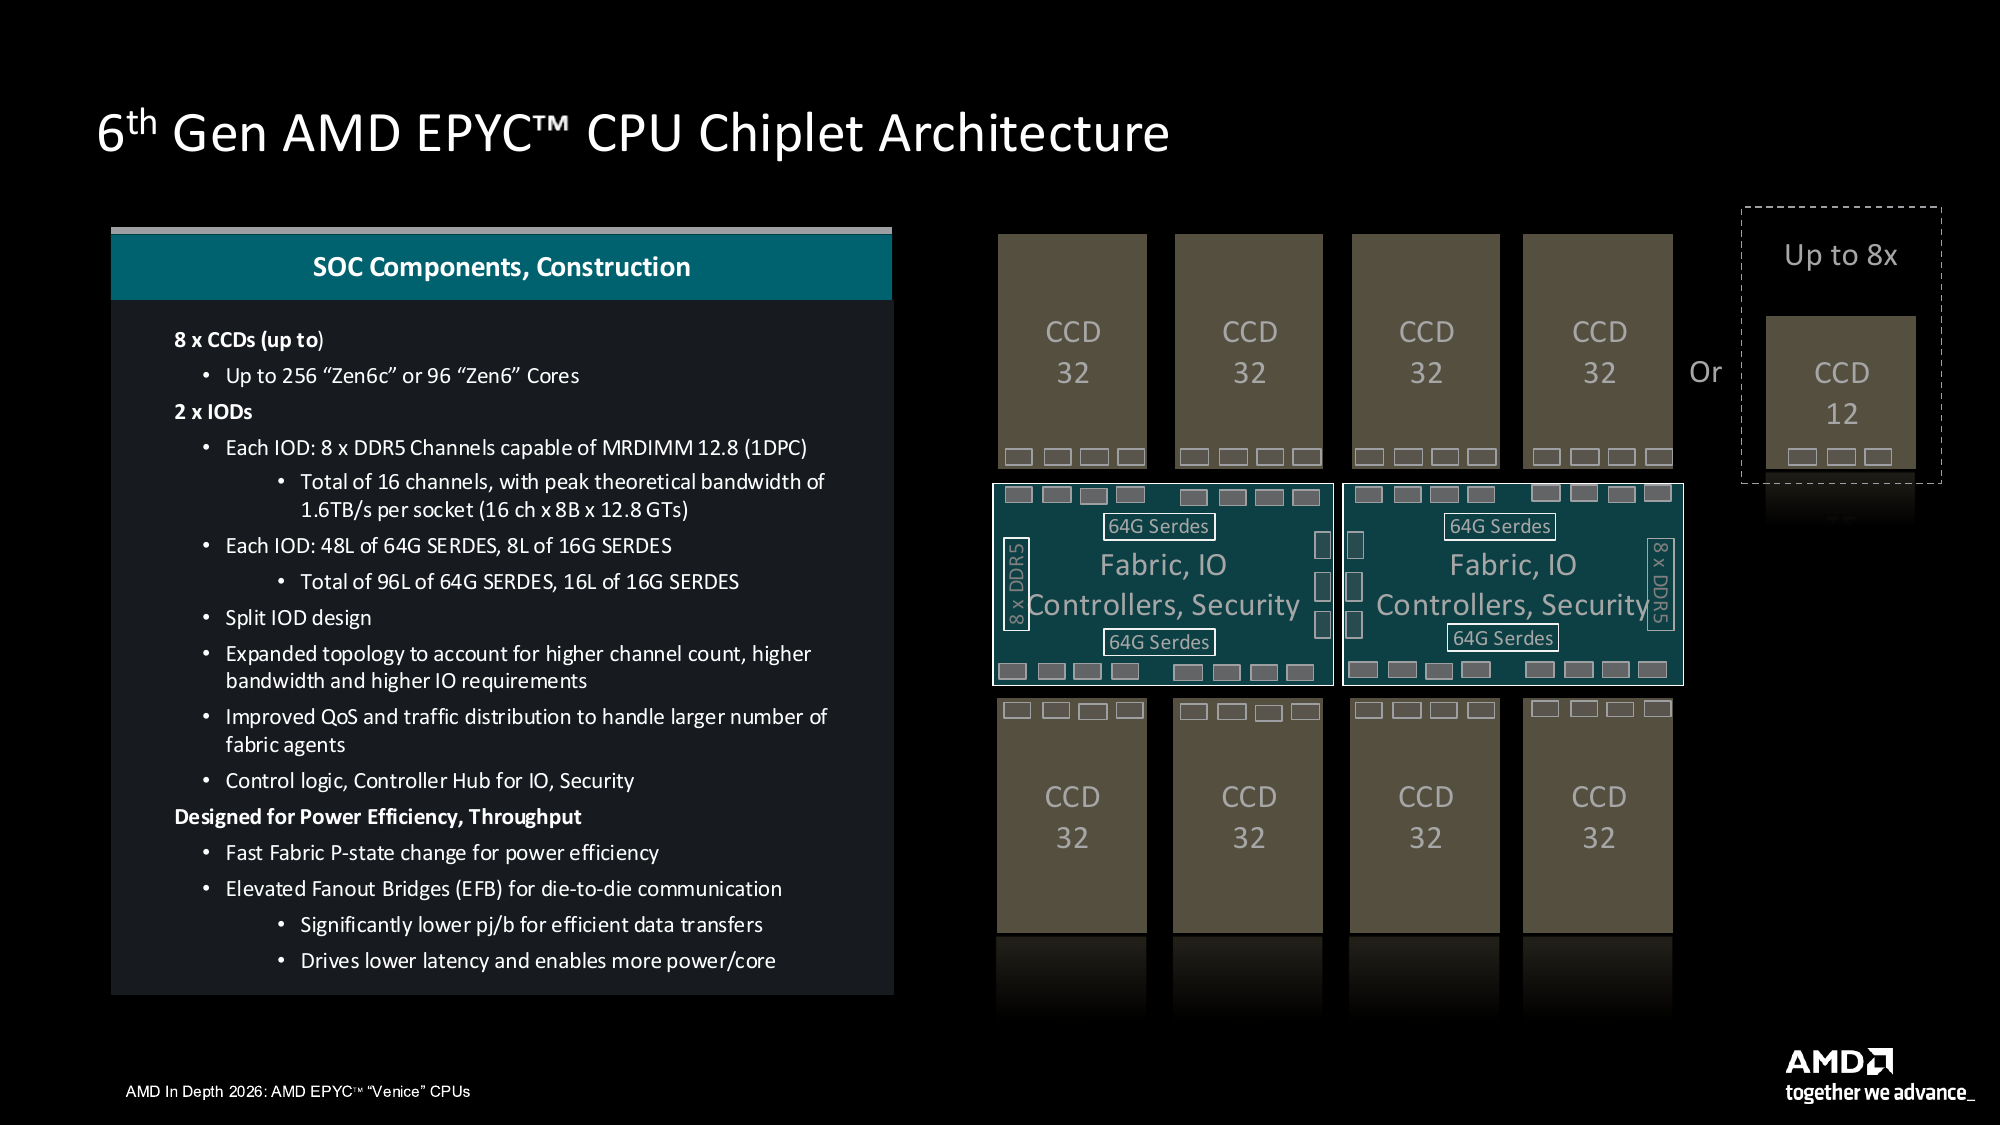
Aceasta oferă fiecărei jumătăți a procesorului controlere de memorie dedicate, resurse I/O, securitate și fabric. Un CCD ajunge la controlerele sale locale de memorie prin IOD-ul la care se conectează, iar accesarea controlerelor de pe celălalt IOD adaugă încă un salt peste Infinity Fabric și latența care vine odată cu aceasta. Setările NPS permit software-ului să utilizeze această diviziune atunci când plasează thread-uri și memoria lor.
Împreună, cele două IOD-uri oferă SP7 șaisprezece canale de memorie la câte un DIMM per canal. Memorii RDIMM DDR5 funcționează la viteze de până la 8,000 MT/s, producând o lățime de bandă teoretică de 1.024 TB/s. Memorii MRDIMM duc interfața la 12,800 MT/s și ridică acest plafon la 1.6384 TB/s, baza pentru cifra principală de 1.6 TB/s a AMD.
Un MRDIMM, sau DIMM cu rang multiplexat, își obține viteza de la bufferele de pe modul care combină traficul de la ranguri multiple pe interfața gazdă mai rapidă, crescând cantitatea de date pe care canalele o pot transporta. Latența accesului aleatoriu depinde în continuare de temporizările memoriei și de ruta parcursă pentru a o accesa. SP7 are, de asemenea, loc pentru până la 8 TB de memorie folosind șaisprezece RDIMM-uri 3DS de 512 GB.
Împotriva concurenței, modulele LPDDR5X SOCAMM2 înlocuibile de la Vera suportă până la 1.5 TB de memorie și până la 1.2 TB/s de lățime de bandă, plasându-le între plafoanele de lățime de bandă RDIMM și MRDIMM ale Venice. Cât de departe ajunge această lățime de bandă depinde și de numărul de nuclee. Împărțirea cifrelor principale dă aproximativ 6.4 GB/s pe nucleu pentru un Venice cu 256 de nuclee cu MRDIMM-uri, 17.1 GB/s pentru un Venice cu 96 de nuclee la aceeași rată de memorie și 13.6 GB/s pentru Vera cu 88 de nuclee. Canalele de memorie sunt partajate, astfel încât nucleele individuale nu primesc o alocare fixă, dar calculul ajută la explicarea motivului pentru care 9996 și 9686F pot avea cerințe foarte diferite asupra aceluiași subsistem de memorie SP7.
Când șaisprezece canale de DRAM nu sunt suficiente, capacitatea poate crește peste CXL. SP7 oferă, de asemenea, CXL 3.1 pe până la 96 dintre benzile PCIe Gen6 per socket, iar AMD evaluează fiecare legătură x16 la aproximativ 128 GB/s de lățime de bandă brută la un hop NUMA de latență, aceasta fiind calea către memorie dincolo de cele șaisprezece canale atunci când capacitatea contează mai mult decât viteza.
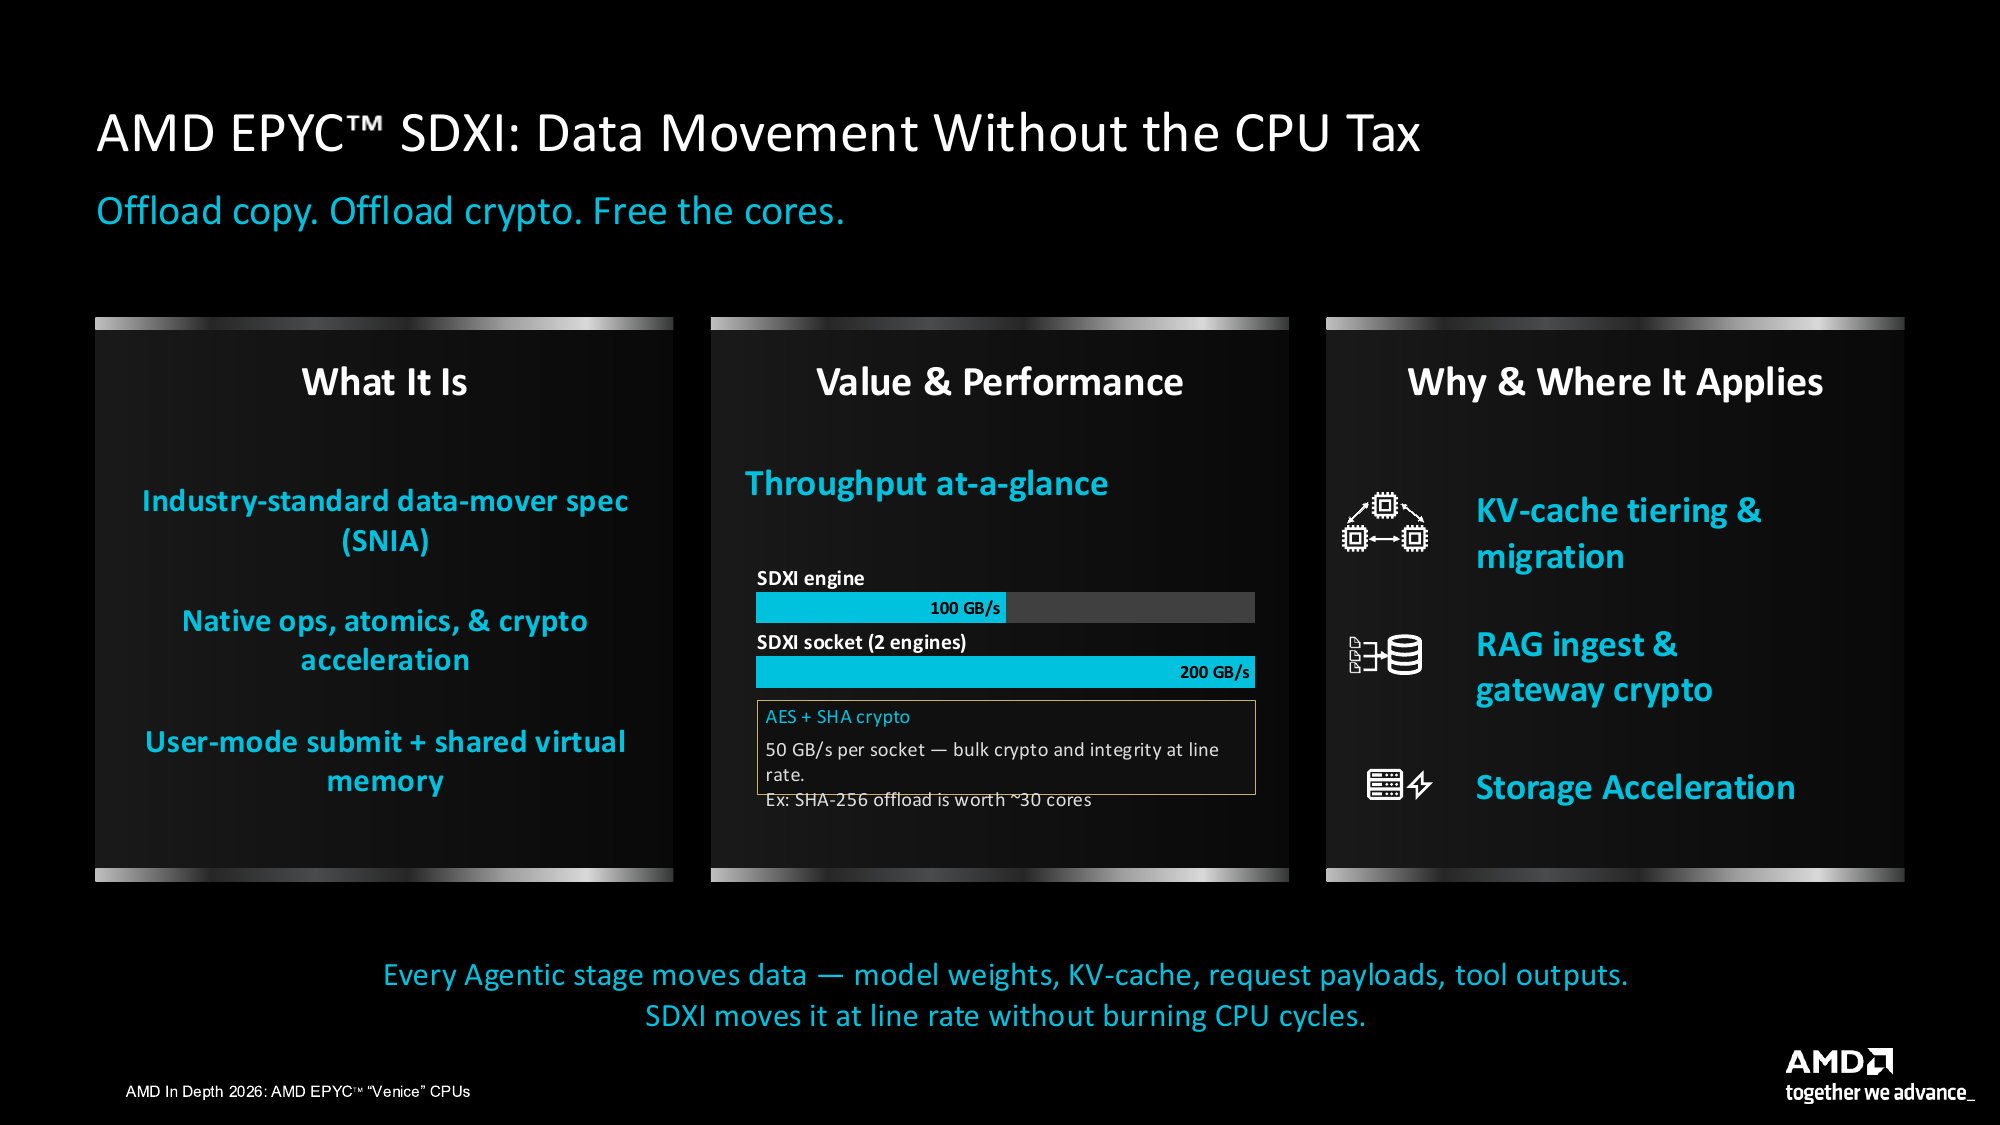
Aceleași benzi de 64Gb/s deservesc PCIe Gen6: un sistem SP7 cu un singur socket primește 96 de benzi Gen6 plus opt benzi PCIe Gen4 bonus, iar un sistem cu două socketuri primește până la 128 de benzi Gen6 plus 16 benzi Gen4. Legăturile se pot bifurca până la x16, x8, x4 sau x2. IOD-urile acceptă, de asemenea, Smart Data Cache Injection, care poate direcționa datele primite de pe dispozitiv direct în cache, și Smart Data Accelerator Interface pentru descărcarea copiilor din memorie.
LPDDR5X pe SOCAMM2 sosește odată cu Verano, unde AMD listează până la 1.5 TB per socket la aproximativ 0.8 TB/s și o putere de memorie cu 30% până la 40% mai mică decât modulele DDR5 RDIMM sau MRDIMM la aceeași lățime de bandă, așa că comparația cu Vera din această recenzie va avea un omolog direct AMD anul viitor.
Coerență și localitate a memoriei cache
Cu 1 GB de L3 în partea superioară, locul în care se află acea memorie cache începe să conteze la fel de mult ca și cât de multă există. Capacitatea mare L3 a memoriei Venice este distribuită pe CCD-urile sale, ceea ce face ca locația datelor partajate să fie o parte a ecuației de performanță. Coerența este garanția hardware că fiecare nucleu vede o valoare consistentă pentru o anumită adresă de memorie, chiar și atunci când copii ale acesteia se află în mai multe cache-uri.
Firele de execuție de pe un CCD pot reutiliza L3-ul local. La fel ca în cazul lui Turin, transmiterea datelor către un fir de execuție de pe un alt CCD adaugă un salt prin fabrică. Venice adaugă un salt suplimentar peste Infinity Fabric la celălalt IOD și apoi la CCD-ul țintă atunci când acel CCD este atașat la celălalt die I/O.
AMD descrie memoria cache L3 pe 16 căi a Zen 6c ca fiind o memorie cache exclusivă pentru victime, ceea ce înseamnă că deține în principal linii eliminate din L2 și nu duplică ceea ce conține deja L2, ceea ce extinde capacitatea efectivă a celor două niveluri combinate. Etichetele L2 duplicate din L3 ajută hardware-ul de coerență să localizeze datele din cache și să filtreze sondele, reducând solicitările inutile către cache-urile private și accelerând transferurile de la cache la cache. Ierarhia poate urmări 127 de erori restante de la L2 la L3 per nucleu și 1,280 de erori de la L3 la memorie per complex, permițând multor solicitări să progreseze în timp ce accesările anterioare încă așteaptă date.
Memoria cache de 164 MB la nivel de sistem a Verei este partajată între toate cele 88 de nuclee de pe un singur die de calcul, conectate prin structura sa coerentă on-die. Venice are mult mai multă memorie cache agregată de ultim nivel în partea de sus a gamei, împărțită între chipleturile sale, astfel încât software-ul care transmite în mod repetat date partajate între workeri trebuie să țină cont de acele domenii separate de memorie cache.
Pentru o aplicație de stocare, păstrarea unei cozi, a metadatelor acesteia și a lucrătorilor care o deservesc pe același CCD încurajează reutilizarea memoriei cache locale. Răspândirea acestor lucrători pe socket poate crește traficul între CCD-uri, deoarece acestea accesează aceleași structuri, iar plasarea memoriei adaugă un alt nivel, deoarece DRAM-ul unui thread se poate afla în spatele oricăreia dintre cele două matrițe I/O.
Moduri NPS și plasarea memoriei
Această configurație fizică este expusă software-ului prin NUMA, sau acces neuniform la memorie: sistemul de operare este informat care nuclee se află cel mai aproape de ce memorie, astfel încât să poată plasa munca în consecință. NPS, prescurtare de la NUMA nodes per socket (noduri NUMA per socket), determină modul în care Venice își prezintă domeniile de memorie sistemului de operare. AMD pune accent pe NPS2 pentru performanța SP7, NPS1 și suportul specific procesorului pentru NPS4 oferind alte modalități de organizare a socketului, iar fiecare rezultat Venice din această analiză a fost colectat în NPS2.
| mod | Domenii de memorie per socket | Canale per domeniu | CCD-uri asociate într-un pachet cu opt CCD |
|---|---|---|---|
| NPS1 | 1 | 16 | 8 |
| NPS2 | 2 | 8 | 4 |
| NPS4 | 4, unde este acceptat | 4 | 2 |
Numărul de CCD-uri din tabel descrie structura completă a celor opt CCD-uri; nucleele activate și modurile acceptate variază în funcție de procesor. NPS1 oferă sistemului de operare un domeniu de memorie și intercalează memoria pe toate cele șaisprezece canale, aceasta fiind cea mai simplă vizualizare pentru software, deși un acces trebuie să urmeze în continuare conexiunile fizice dintre CCD-ul său și IOD-ul care deservește adresa.
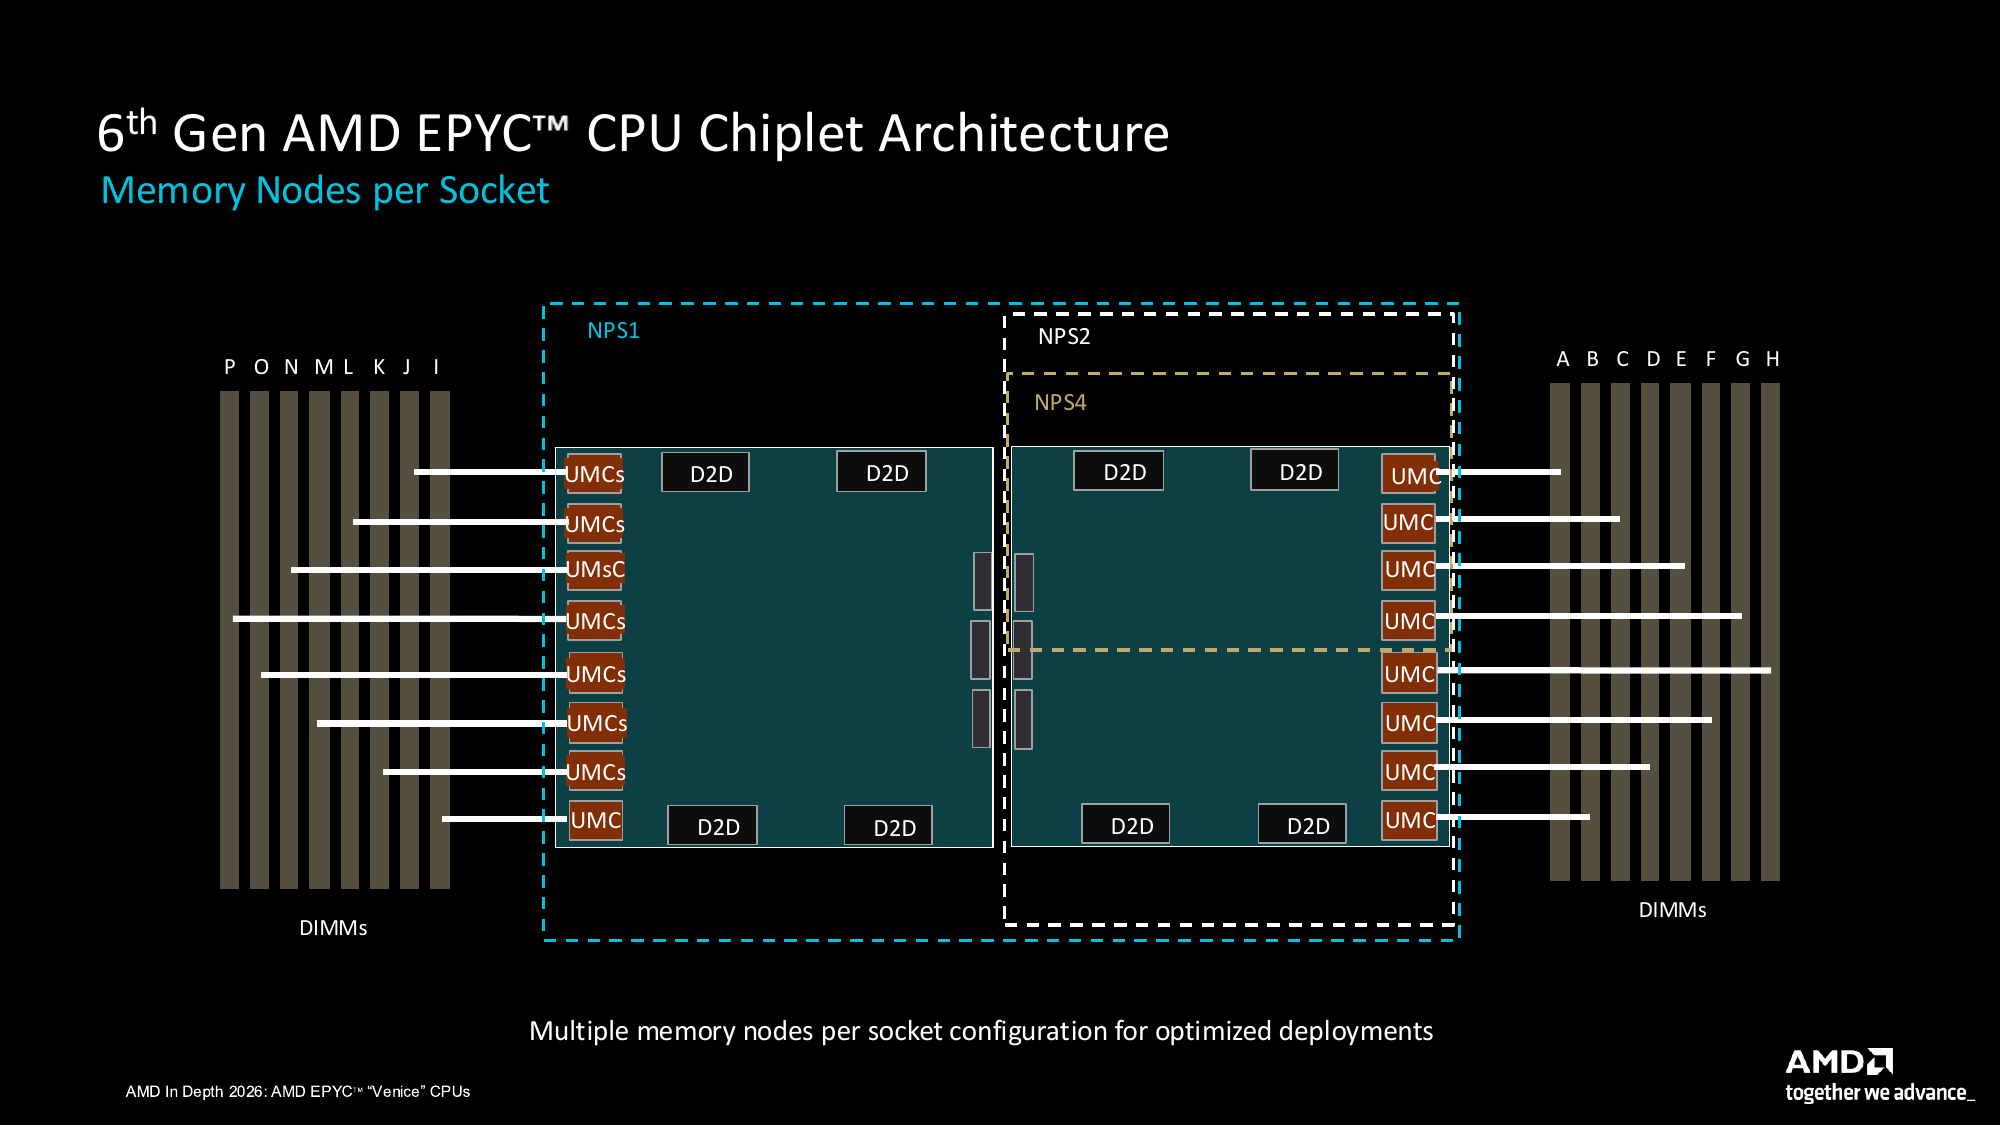
NPS2 urmează cele două jumătăți ale pachetului. Fiecare domeniu reunește cele opt controllere de memorie ale unui IOD și cele patru CCD-uri asociate. În procesoarele complet echipate prezentate aici, aceasta înseamnă 128 de nuclee per domeniu pe 9996 și 48 pe 9686F. Plasarea unui fir de execuție și a memoriei sale în același domeniu menține accesele DRAM pe acea parte a procesorului.
NPS4 împarte din nou resursele fiecărui IOD, oferind fiecărui domeniu patru canale de memorie și două CCD-uri asociate. Aceasta produce domenii cu 64 de nuclee în exemplul cu 256 de nuclee sau domenii cu 24 de nuclee în exemplul cu 96 de nuclee, unde procesorul acceptă acest mod. Software-ul obține un control mai fin asupra plasării, cu mai puține canale disponibile în interiorul fiecărui domeniu.
Aceste setări modifică intercalarea memoriei și informațiile de localitate expuse software-ului, în timp ce limitele fizice ale memoriei cache rămân neschimbate: patru CCD-uri dintr-un domeniu NPS2 au în continuare patru memorie cache L3 separate, iar traficul dintre ele utilizează în continuare structura structurală. Prin urmare, afinitatea firului de execuție și alocarea memoriei trebuie să fie în concordanță, deoarece fixarea unui worker la un domeniu în timp ce paginile sale sunt lăsate în altul menține acele accesări pe calea mai lungă. Dimensionarea mașinilor virtuale și alocarea la prima atingere, unde Linux plasează o pagină pe nodul firului de execuție care o scrie primul, merită aceeași atenție.
Vera simplifică acest lucru prin prezentarea unui singur domeniu NUMA per socket sau a două într-un sistem cu două socketuri. Fabric-ul său coerent gestionează comunicarea în cadrul matriței de calcul, iar NVLink-C2C transportă traficul către celălalt procesor, ceea ce oferă software-ului mai puține limite NUMA de gestionat în cadrul unui socket.
Conectivitate CPU-CPU între xGMI și Vera
Depășirea unui singur socket aduce în peisaj legăturile xGMI ale Venice. xGMI este versiunea coerentă socket-to-socket a Infinity Fabric de la AMD și partajează benzi fizice cu PCIe. AMD acceptă până la trei conexiuni x16 care rulează la 64Gb/s pe bandă, utilizând aceleași resurse de conectivitate de mare viteză utilizate pentru PCIe. Cu două legături xGMI x16 între procesoare, configurația generală de calcul a AMD lasă disponibile 128 de benzi PCIe Gen6 pe serverul cu două socketuri, iar trecerea la trei legături xGMI reduce totalul PCIe la nivel de sistem la 96 de benzi.
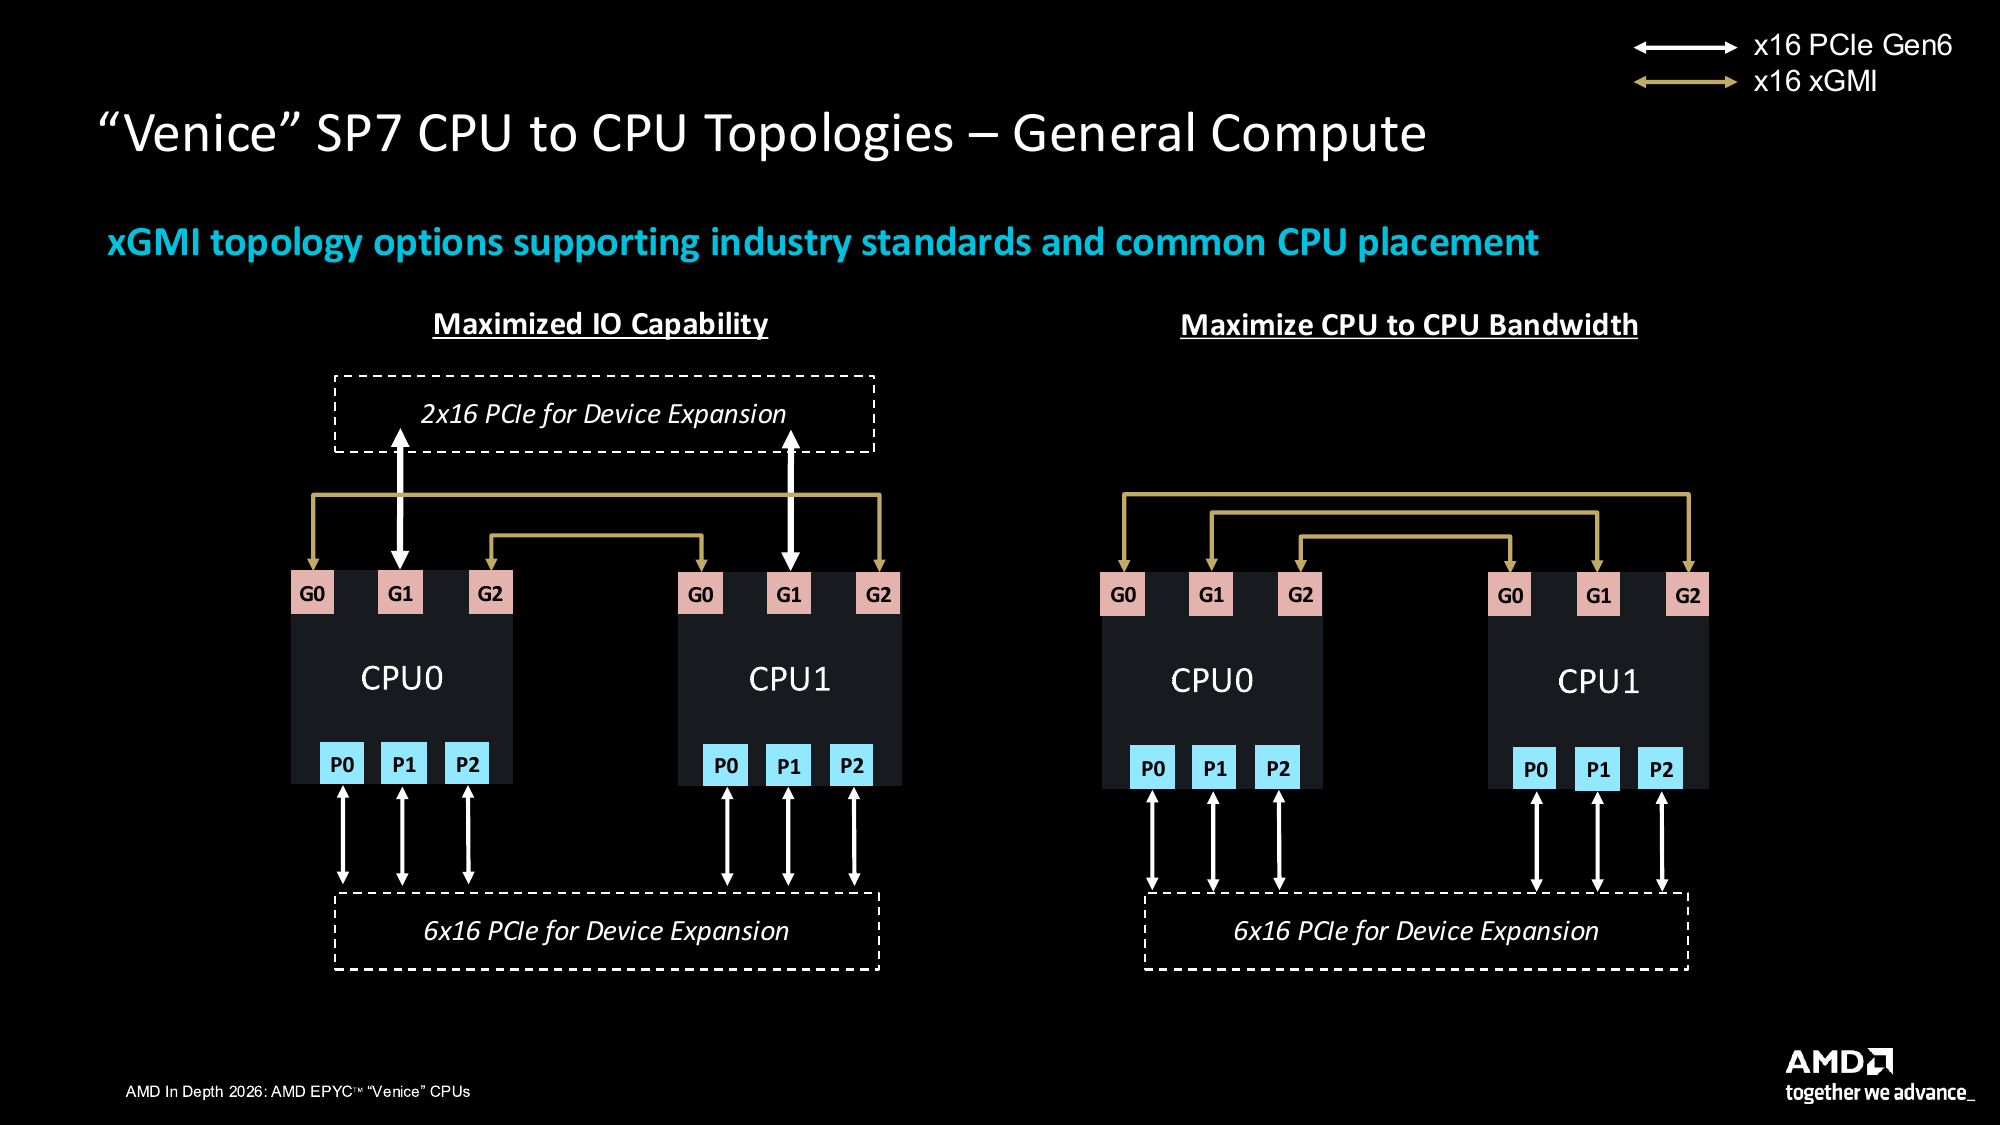
Fiecare legătură x16 xGMI are o viteză brută de 128 GB/s în fiecare direcție, înainte de costurile suplimentare ale protocolului. Două legături oferă 256 GB/s în fiecare direcție, în timp ce trei cresc această viteză la 384 GB/s, astfel încât adăugarea celei de-a treia legături cumpără cu 50% mai multă lățime de bandă între procesoare, cu prețul a 32 de benzi PCIe pe server.
NVIDIA depășește considerabil limitele cu a doua generație NVLink-C2C: conexiunea CPU-CPU a Vera este evaluată la 1.8 TB/s bidirecțională sau 900 GB/s în fiecare direcție, iar aceeași tehnologie de interconectare deservește conexiunea CPU-GPU strâns integrată a NVIDIA.
| Configurația legăturii CPU | Lățime de bandă pe direcție | Suma ambelor direcții |
|---|---|---|
| Veneția, două legături x16 xGMI | 256 GB/s brut, calculat | 512 GB/s brut, calculat |
| Veneția, trei legături x16 xGMI | 384 GB/s brut, calculat | 768 GB/s brut, calculat |
| Vera, NVLink-C2C | 900 GB/s, specificații ale furnizorului | 1,800 GB/s, specificații ale furnizorului |
Legăturile xGMI transportă mai mult decât traficul CPU; ele transportă și traficul generat de dispozitivele PCIe. O unitate NIC sau NVMe atașată la un CPU poate citi sau scrie buffere în memoria atașată la celălalt, trimițând acele transferuri DMA prin legătura socket. Păstrarea bufferelor locale pe dispozitiv necesită în continuare o intersecție dacă un worker de pe celălalt CPU consumă datele. Transferurile de accelerare care implică memoria gazdă la distanță creează aceeași cerere, iar toate acestea partajează xGMI cu accesele la memoria CPU la distanță, transferurile de cache-line și mesajele de coerență. Rezultatele noastre STREAM remote-socket de mai jos indică o cifră măsurată pentru acea legătură.
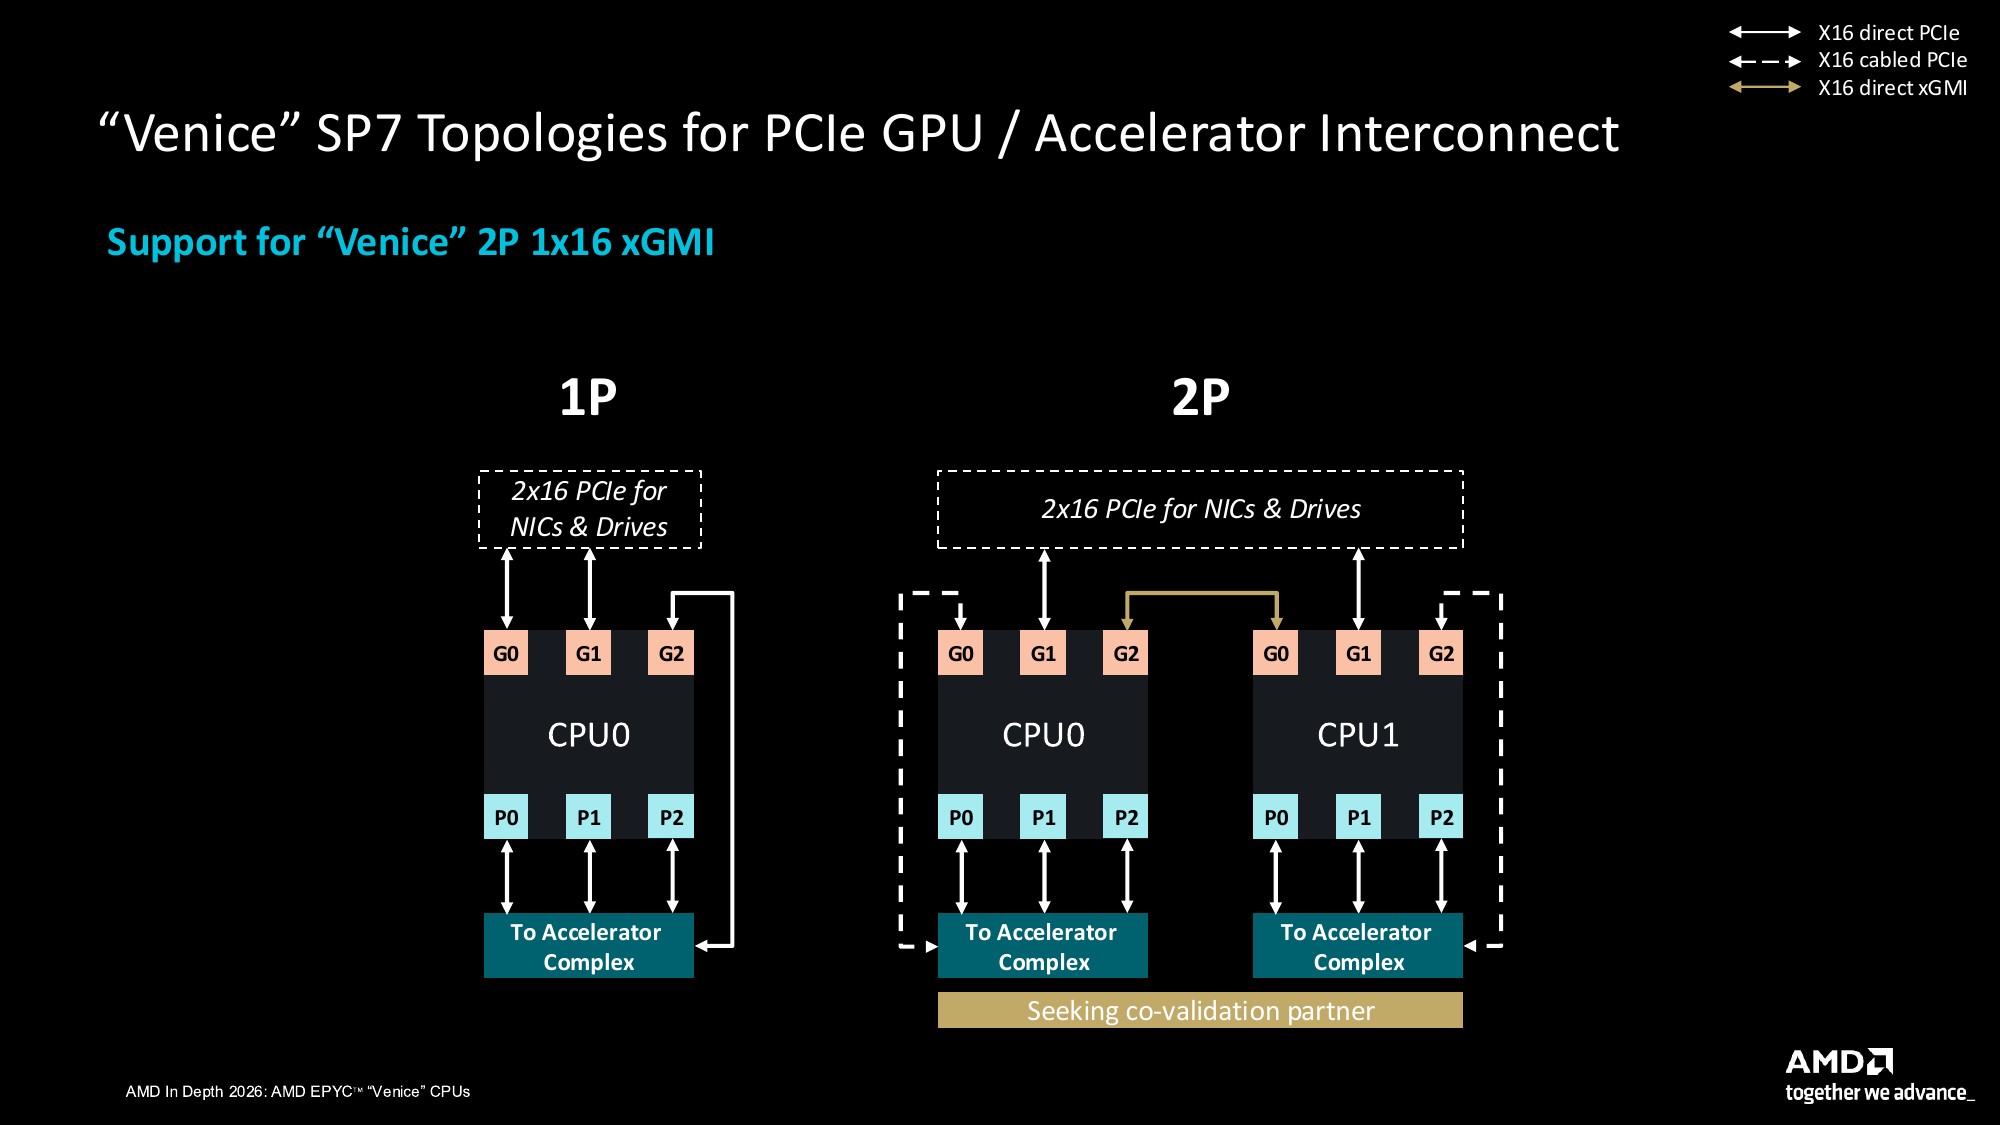
Veneția ca gazdă a inteligenței artificiale
Venice joacă, de asemenea, un rol cheie în rack-urile Helios de la AMD , unde un EPYC 9G76 cu 96 de nuclee găzduiește patru GPU-uri Instinct MI455X per tavă de calcul. În acest rol, procesorul este controlorul de trafic: acesta stochează datele, rulează software-ul care menține GPU-urile ocupate și se ocupă de rețea și stocare. Dezvăluirea detaliată a AMD confirmă aspectul discutat în articolul nostru Advancing AI : patru conexiuni x16, câte una pentru fiecare GPU.
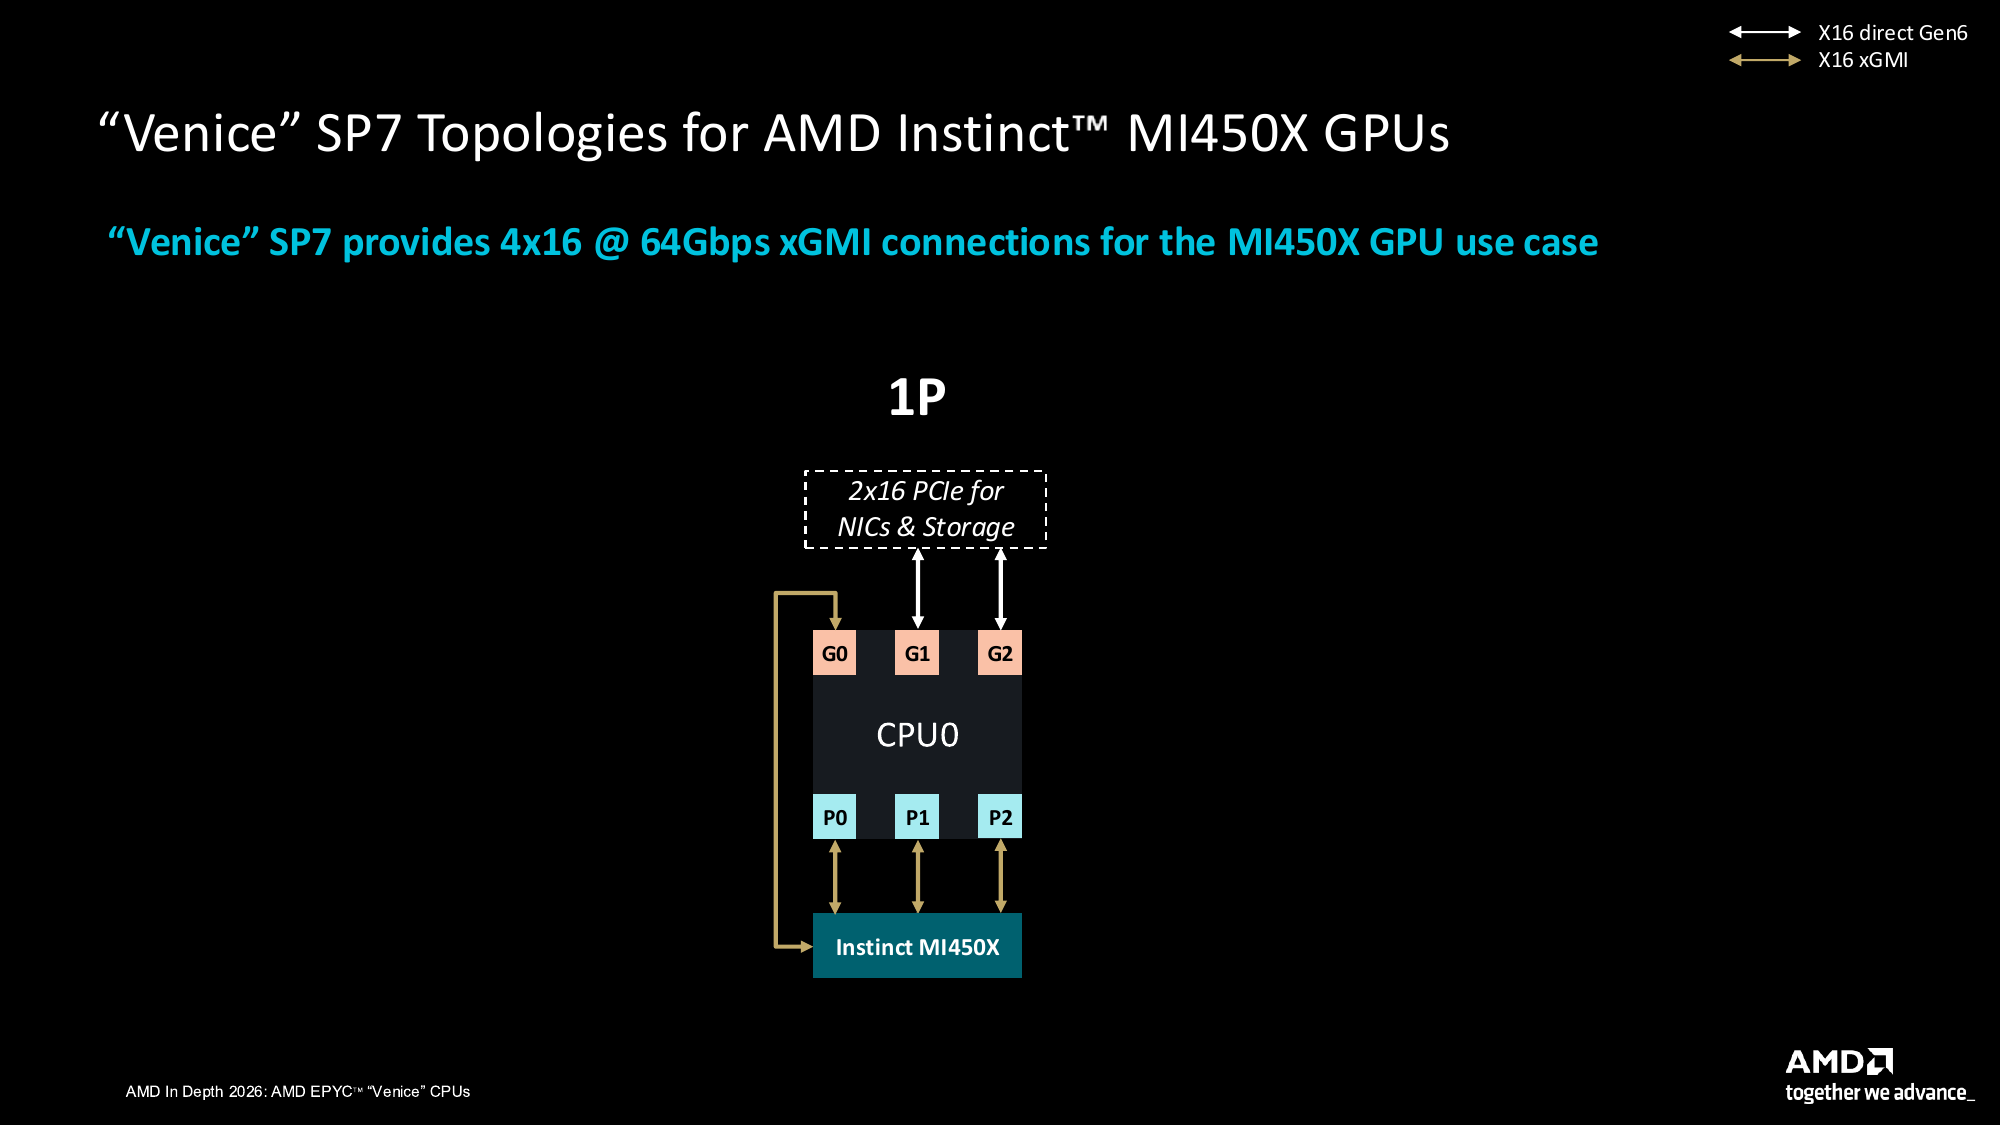
La o viteză de 64 Gb/s pe bandă, fiecare legătură este evaluată pentru 128 GB/s în fiecare direcție sau 256 GB/s bidirecțional, dublând lățimea de bandă a gazdei pentru conexiunea PCIe Gen5 x16 a MI355X. Pentru toate cele patru GPU-uri, aceasta ajunge la 512 GB/s în fiecare direcție sau 1.024 TB/s bidirecțional, iar procesorul păstrează două grupuri PCIe Gen6 x16 pentru rețea și stocare.
Aceste legături gazdă rulează Infinity Fabric coerent în locul PCIe simplu, oferind acces cache Venice la memoria GPU, astfel încât CPU-ul și GPU-ul pot partaja structuri de date fără copii explicite. NVLink-C2C de la NVIDIA oferă în continuare o lățime de bandă mai mare de la CPU la GPU și vom avea nevoie de sistemele Helios și NVL72 în laborator pentru a măsura cât de mult contează această diferență în antrenament și inferență. Bănuim că inferența este principalul obiectiv pentru Helios, care, în teorie, ar trebui să simtă un impact mai mic din cauza legăturilor mai lente de la CPU la GPU.
Performanță și Benchmark-uri
Testele de performanță examinează modul în care designul Venice se traduce în performanță, de la un singur fir de execuție fixat până la sarcini de lucru care încarcă fiecare nucleu dintr-un server cu două socketuri. Testele noastre acoperă lățimea de bandă și latența memoriei, calculul științific, analiza datelor, software-ul de uz general și bazele de date, arătând cum nucleele Venice și sistemul de memorie SP7 gestionează diferite cerințe.
Sisteme de testare
| Sistem și | Dell PowerEdge R9825 | Platforma de referință AMD Nigeria | Platforma de referință AMD Nigeria | NVIDIA MGX Vera C2 | Dell PowerEdge R7725 | Dell PowerEdge R770AP |
|---|---|---|---|---|---|---|
| Procesoare | ||||||
| Procesor | AMD EPYC 9996 | AMD EPYC 9686F | NVIDIA Vera | AMD EPYC 9965 | Intel Xeon 6978P | |
| Sockets | 2 | |||||
| Nuclee / Fire de execuție per CPU | 256 / 512 | 96 / 192 | 88 / 176 | 192 / 384 | 120 / 240 | |
| Ceas de bază | 2.55 GHz | 4.05 GHz | 2.25 GHz | 2.1 GHz | ||
| Ceas maxim | 4.1 GHz | 5.3 GHz | 3.4 GHz | 3.7 GHz | 3.9 GHz | |
| Memorie | ||||||
| Configuraţie | 32x 64GB | 16x 96GB Micron SOCAMM2 | 24x 128GB | 24x 64GB | ||
| Tip / Viteză | DDR5-8000 | MRDIMM-12800 | LPDDR5X-9600 | DDR5-6400 | ||
| Capacitate totală | 2TB | 1.5TB | 3TB | 1.5TB | ||
| Stocare | ||||||
| SSD | Solidigm D7-PS1030 12.8TB | Micron 9650 PRO 7.68TB | Solidigm D7-PS1010 7.68TB | Solidigm D7-PS1030 12.8TB | Solidigm D7-PS1010 7.68TB | |
| Legătură SSD | PCIe Gen5 x4 | PCIe Gen6 x4 | PCIe Gen5 x4 | PCIe Gen5 x2 | PCIe Gen5 x4 | |
| Firmware | ||||||
| BIOS-ul sistemului | 1.0.4 | RNIV1001H | NV_SBIOS 06.07.01.06 | 1.5.3 | 1.2.1 | |
| Profil BIOS | Performanţă | Mod implicit | Mod implicit | Mod implicit | Performanţă | |
| Stiva de software | ||||||
| OS | Ubuntu 26.04.1 LTS | Ubuntu 26.04 LTS | Ubuntu 26.04.1 LTS | Ubuntu 24.04.5 LTS | ||
| Nucleu | 7.0.0-42-generic | 7.2.0-rc5 | 7.2.0-rc5 | 7.0.0-2022-nvidia-bos | 6.8.0-142 / 6.8.0-146 | 6.8.0-138 |
| CGC | 15.2.0 | 13.3.0 | ||||
| glibc | 2.43 | 2.39 | ||||
| Deschideți MPI | 5.0.10 | 4.1.6 | ||||
| OpenJDK | 11.0.32 | |||||
Am comparat Venice cu trei sisteme testate cu aceeași suită: Vera de la NVIDIA, EPYC 9965 din Torino în PowerEdge R7725 de la Dell și Xeon 6978P în PowerEdge R770AP de la Dell. AMD a oferit acces de la distanță la Nigeria, serverul său de referință SP7 cu două socketuri, pentru rezultatele MRDIMM și EPYC 9686F, care sunt singurele rezultate din această recenzie care nu au fost colectate în laboratorul nostru.
Venice și Vera au rulat un pachet de software mai nou decât sistemele Turin și Xeon, așa cum este menționat mai sus, așa că GCC-ul mai vechi oferă sistemelor Turin și Xeon un mic handicap. Versiunile de benchmark, intrările și semnalizatoarele de compilare au fost în rest identice pe toate sistemele. Fiecare sistem Venice a rulat în NPS2, setarea recomandată de AMD pentru SP7, iar rezultatele sunt cu SMT dezactivat, cu excepția cazului în care se specifică altfel.
Memorie Bandwidth
Memoria este locul unde ar trebui să apară cele șaisprezece canale per socket ale SP7, așa că începem testele de acolo. Am testat STREAM Triad, rulat cu un fir OpenMP per nucleu fizic pe matrice de 16GiB. Rularea principală folosește fiecare nucleu din ambele socketuri, apoi o repetăm fixat la un socket, citind mai întâi memoria locală și apoi memoria socketului la distanță. Graficul de mai jos prezintă rezultatele Triad pentru întregul sistem și per socket cu SMT dezactivat.
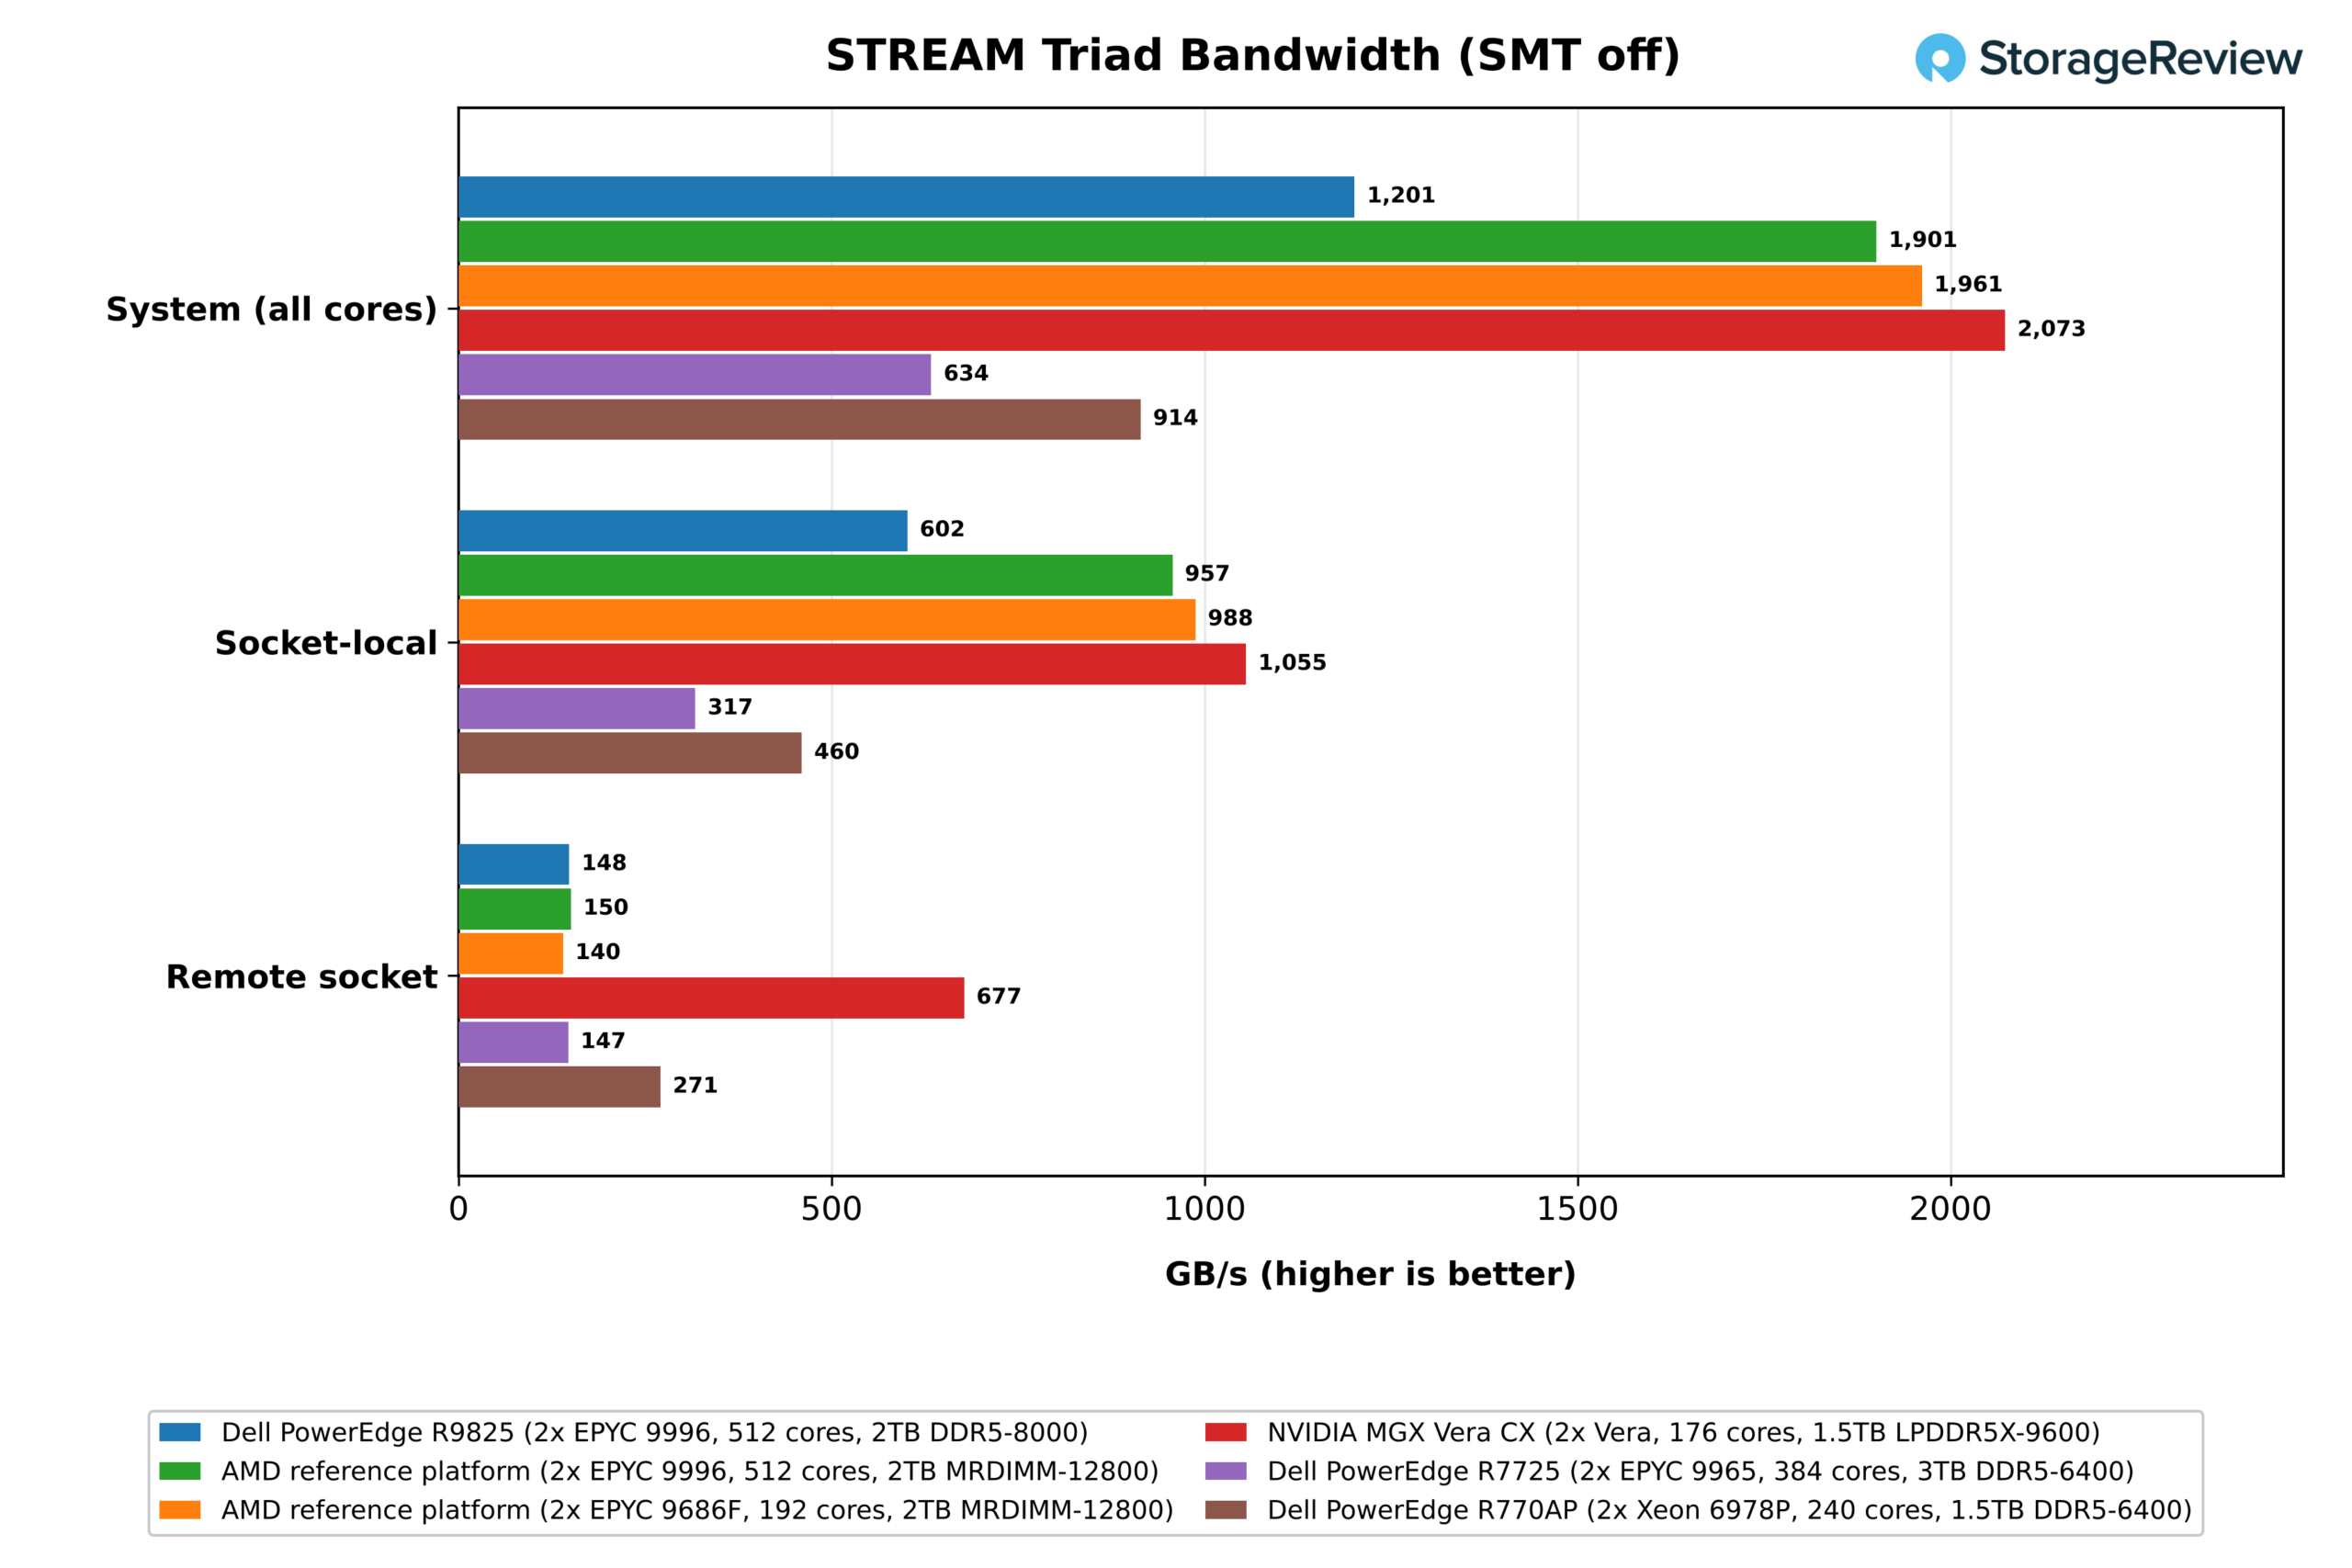
R9825 a susținut o viteză de 1,201 GB/s pe DDR5-8000, 59% din cei 2,048 GB/s pe care cei 32 de canale ale sale la 8,000 MT/s îi pot suporta pe hârtie. Aceasta este de 1.9 ori mai mare decât viteza de 634 GB/s a sistemului EPYC 9965 pe 24 de canale de DDR5-6400 și de 1.3 ori mai mare decât viteza de 914 GB/s a lui Xeon 6978P, dar este încă cu 42% mai mică decât viteza de 2,073 GB/s a lui Vera.
Viteza memoriei este factorul limitator la R9825, deoarece aceleași două procesoare de pe MRDIMM-12800 din platforma de referință AMD au atins 1,901 GB/s, un câștig de 58% doar datorită memoriei. 9686F cu 96 de nuclee pe aceleași MRDIMM-uri a atins o viteză ușor mai mare, la 1,961 GB/s, cu mai puțin de jumătate din numărul de nuclee care utilizează canalele. Pe MRDIMM-uri, Venice este cu 8% mai puțin decât Vera în ceea ce privește cifra STREAM brută.
Per nucleu, calculele aritmetice favorizează în continuare componentele mai mici. Repartizate pe 512 nuclee, 1,901 GB/s reprezintă 3.7 GB/s per nucleu pe 9996, față de 10.2 GB/s pe 9686F cu 192 de nuclee și 11.8 GB/s pe Vera cu 176 de nuclee, acesta fiind schimbul pe care un cumpărător îl face pentru 256 de nuclee într-un socket și motivul pentru care există 9686F.
O parte a decalajului față de Vera provine din modul în care STREAM numără traficul. Suita construiește STREAM cu GCC simplu, care nu emite memorii de streaming, astfel încât un memoriu care ratează memoria cache citește mai întâi linia de destinație din memorie. STREAM nu numără acea citire, ceea ce înseamnă că Triad subestimează traficul mutat cu aproximativ un sfert oriunde se întâmplă. Nucleele Zen de la AMD plătesc acest lucru la fiecare memoriu. Nucleele Arm, cum ar fi Grace-ul anterior de la NVIDIA, detectează scrierile pe linii complete și sar peste citire, iar procesoarele Xeon recente de la Intel pot sări peste cea mai mare parte a acesteia atunci când memoria este încărcată excesiv.
Ajustat pentru citirile necenzurate, R9825 s-a mișcat cu aproximativ 78% din vârful său teoretic. Aceeași corecție ridică octeții configurației MRDIMM 9996 peste 2,073 GB/s ai Vera, astfel încât diferența brută de 8% se inversează odată ce ambele sisteme sunt măsurate în funcție de traficul transportat de memoria lor. Cifra pentru Vera se situează mai aproape de traficul său real, ceea ce face ca cifrele de lățime de bandă pentru Veneția și Torino din această recenzie să fie conservatoare.
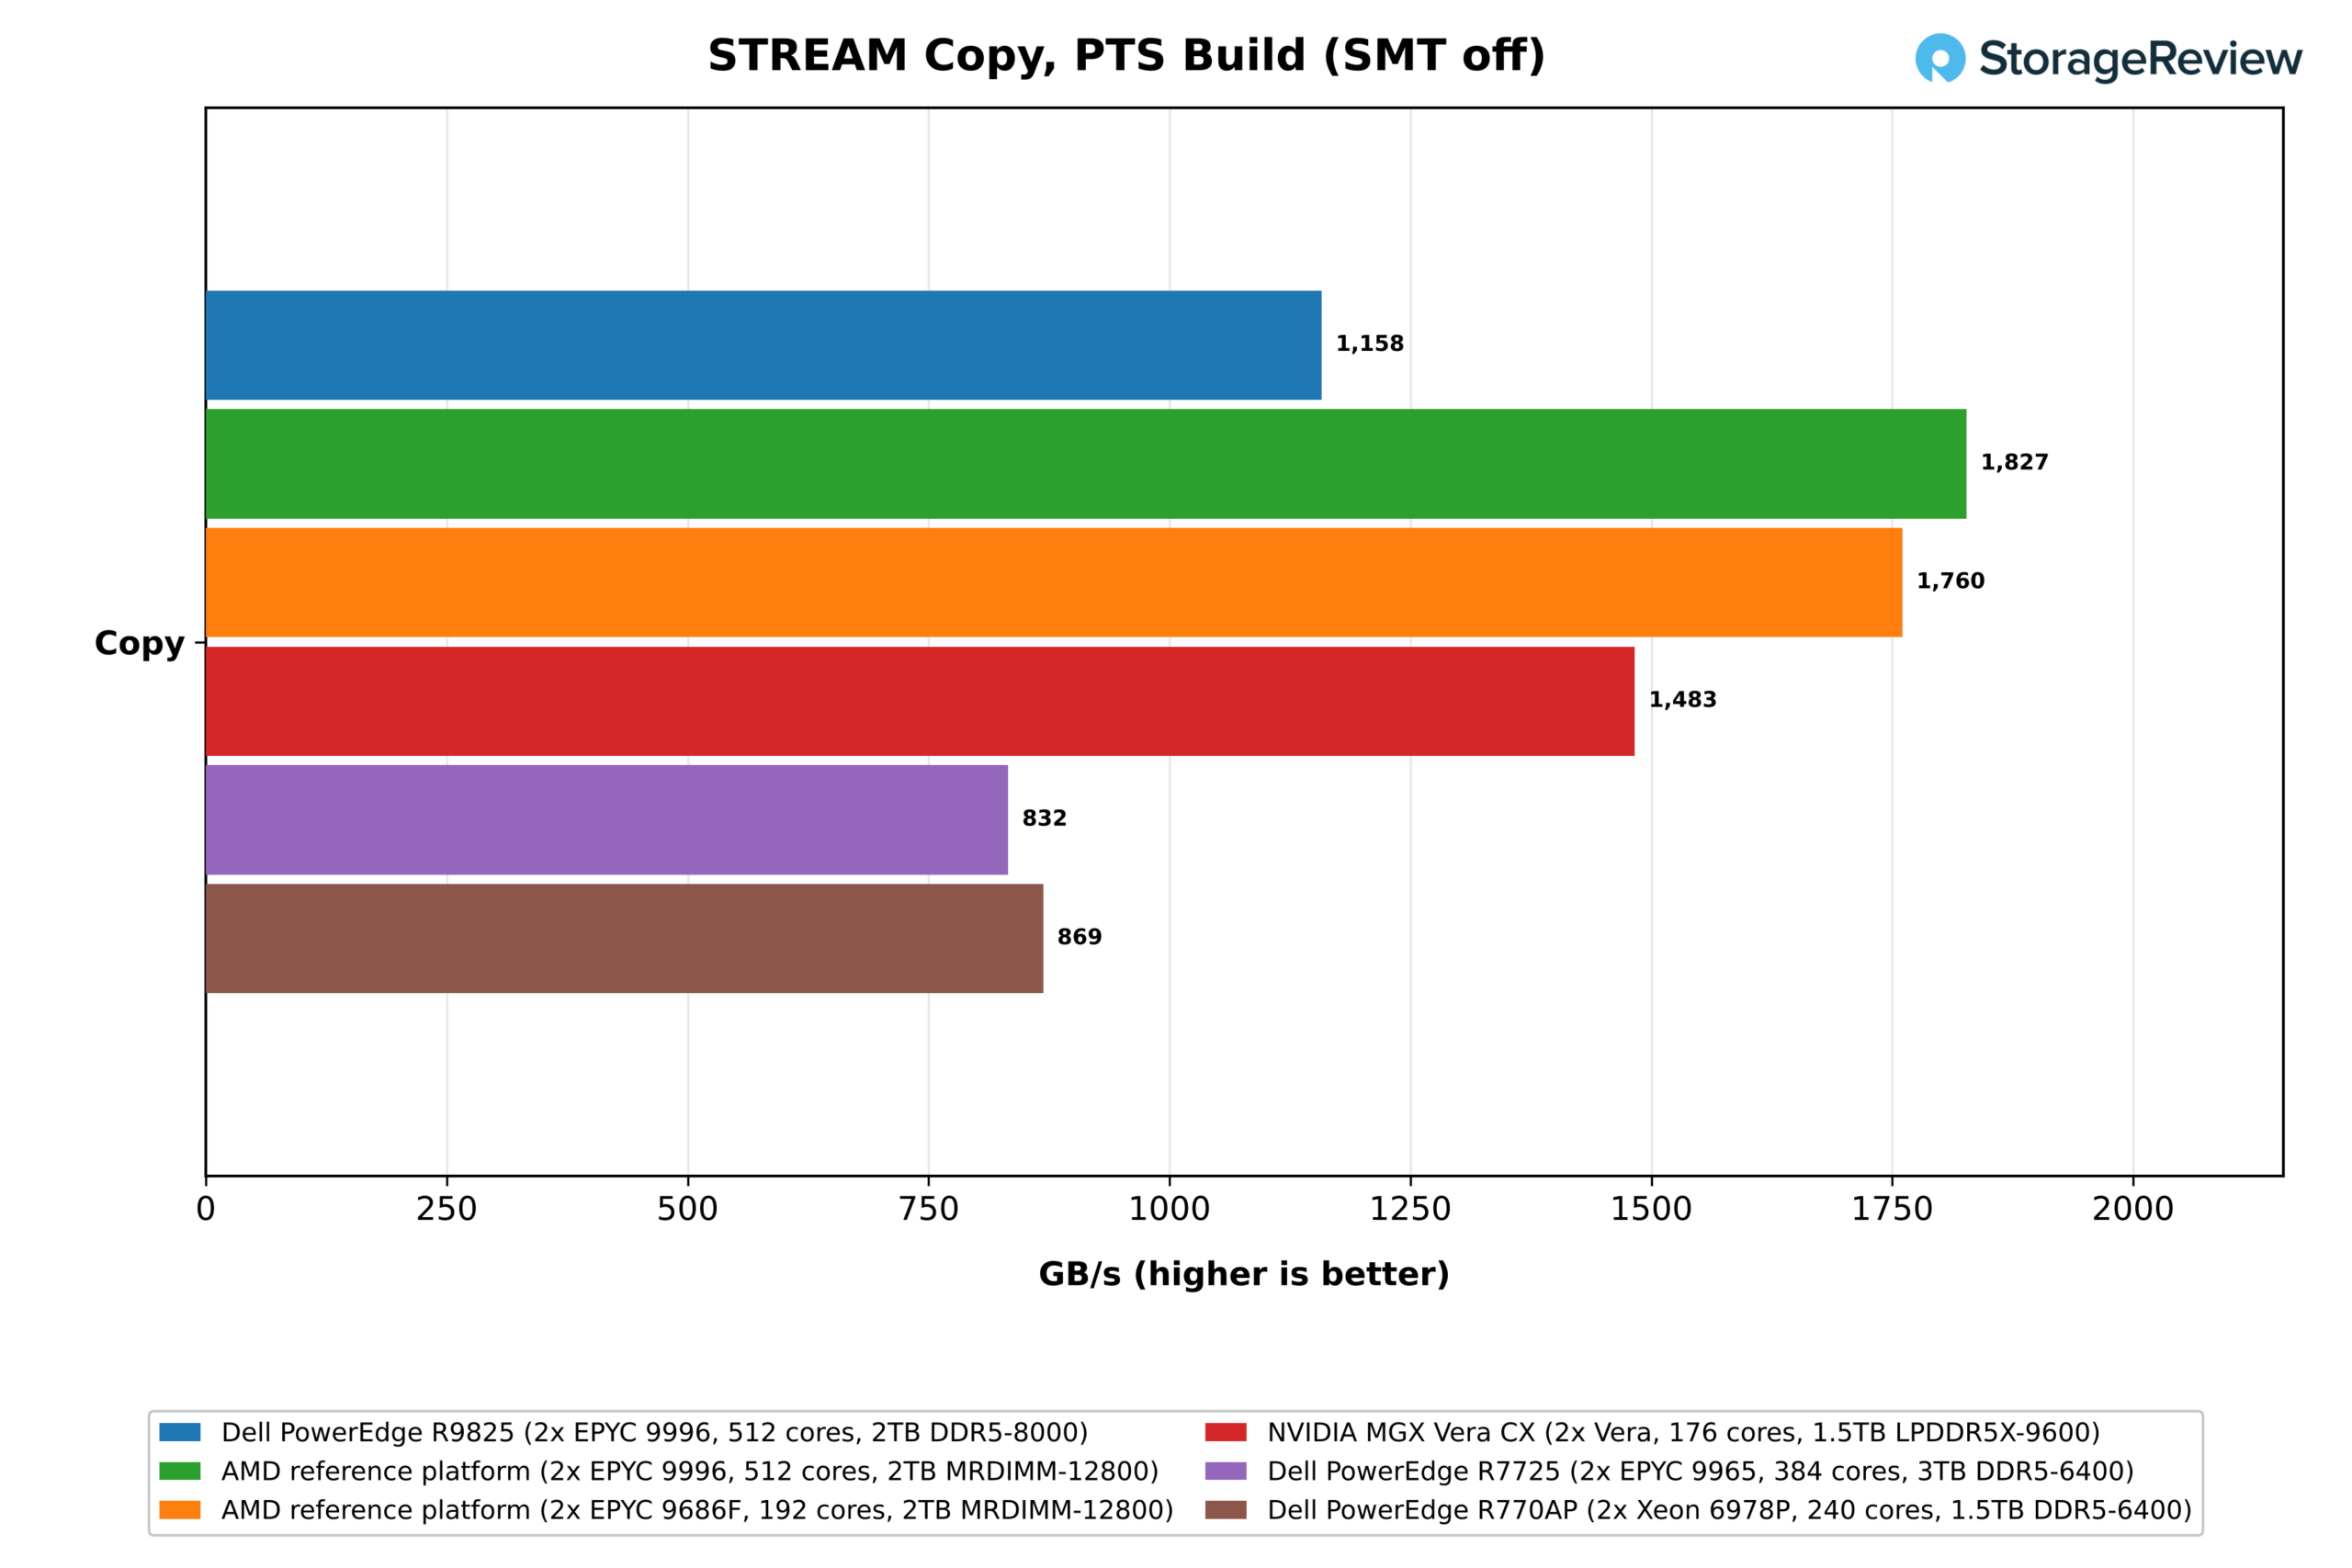
Având în vedere acest lucru, citiți cifra generațională de 1.9x și configurația MRDIMM de 3.0x pentru același server. Ambele se bazează pe rezultatul Triad de 634GB/s al EPYC 9965, despre care recenzia noastră Vera a constatat că este scăzut parțial din cauza acestor citiri necuvântate. Venice plătește aceleași citiri, deci nu umflă singure raportul, dar testul STREAM Copy al sistemului arată un decalaj generațional mai mic, cu 1,158GB/s pe R9825 față de 832GB/s pe 9965.
Acel test de copiere este o versiune separată a suitei de testare Phoronix a STREAM, cu o plasare diferită a thread-urilor și, de asemenea, reordonează partea de sus a graficului. Cu SMT dezactivat, cele două configurații MRDIMM au atins 1,827 GB/s și 1,760 GB/s, devansând Vera la 1,483 GB/s, în timp ce Xeon 6978P a aterizat la 869 GB/s.
Împărțirea testului pe socketuri arată cum gestionează structura datelor care nu sunt locale pentru nuclee. Un socket al R9825 care citește memoria locală a menținut 602 GB/s, iar aceleași nuclee care citesc xGMI către memoria celuilalt socket au menținut 148 GB/s, un raport de la distanță la local de 25%. Platforma MRDIMM a ridicat cifra locală la 957 GB/s pe 9996 și 988 GB/s pe 9686F, în timp ce lățimea de bandă la distanță a rămas la 150 GB/s și 140 GB/s. Prin urmare, memoria mai rapidă mărește decalajul, iar un thread care ajunge pe socketul greșit primește un sfert din lățimea de bandă locală la 8,000 MT/s și aproximativ o șesime la 12,800 MT/s.
Acest raport reprezintă costul măsurat al celor două legături x16 xGMI descrise anterior și este cea mai clară diferență arhitecturală față de Vera din întregul set de date. Socketul Vera citește 1,055 GB/s local și 677 GB/s de la distanță prin NVLink-C2C, un raport de 64%, iar Xeon 6978P gestionează 59% prin UPI. R7725 de la Turin a înregistrat aproape aceeași cifră la distanță ca și Venice, deci aceasta este o caracteristică Infinity Fabric preluată, iar plasarea NPS2 și software-ul compatibil NUMA contează mai mult pe Venice decât pe oricare dintre competitori.
Latență
Lățimea de bandă este doar jumătate din povestea memoriei. Latența decide cât timp așteaptă un nucleu de fiecare dată când ratează accesul în cache și contează cel mai mult pentru codul care urmărește pointerii prin memorie. O măsurăm cu tinymembench, care cronometrizează citirile aleatorii pe un buffer de 1GiB dintr-un singur thread pe socketul 0 și comparăm sistemele Venice cu Vera.
Când citește memoria locală, 9996 este mai rapid decât Vera. Cu pagini de 2MB, o citire locală a durat 87.6ns pe R9825 și 89.5ns pe platforma MRDIMM, față de 99.2ns pe Vera. Citirile la distanță au costat 200.8ns pe R9825 și 212.3ns pe platforma MRDIMM, față de 212.7ns la Vera, deci un acces cross-socket pe Venice este de 2.3x până la 2.4x față de cel local, în timp ce la Vera este de 2.1x.
Venice este, de asemenea, mai puțin sensibilă la dimensiunea paginii. Cu pagini de 4KB, unde ratele de traducere a adreselor se adaugă la fiecare citire, R9825 a citit la 106.9ns local și 225.9ns la distanță, față de 135.8ns și 308.4ns ale Vera. TLB-ul pe două niveluri al Zen 6c absoarbe penalizarea generată de pagini mici mai bine decât o face Olympus.
HPC
Lățimea de bandă și latența descriu sistemul de memorie în mod izolat. Aplicațiile științifice arată ce se întâmplă atunci când sistemul de memorie și nucleele trebuie să funcționeze împreună, iar cele două teste HPC ale noastre se bazează pe părți foarte diferite ale procesorului.
GROMACS, un cod de dinamică moleculară, își petrece cea mai mare parte a timpului în aritmetică vectorială, cu bucle fierbinți scrise manual pentru fiecare lățime SIMD. OpenFOAM, un solver de dinamică a fluidelor computațională, lucrează cu matrici rare mari și își petrece o mare parte din timp așteptând memoria. Cele două trag în direcții opuse pe majoritatea procesoarelor, iar Venice este prima platformă din setul nostru care conduce în ambele.
GROMACS
Am testat GROMACS 2025.3 cu benchPEP, un caz de 12 milioane de atomi rulat pe fiecare nucleu fizic al serverului. Versiunea a folosit AVX-512 pe fiecare sistem x86 și ARM_SVE pe Vera, iar intrările fixate ale suitei și reglarea PME dezactivată înseamnă că fiecare platformă a rulat aceeași lucrare.
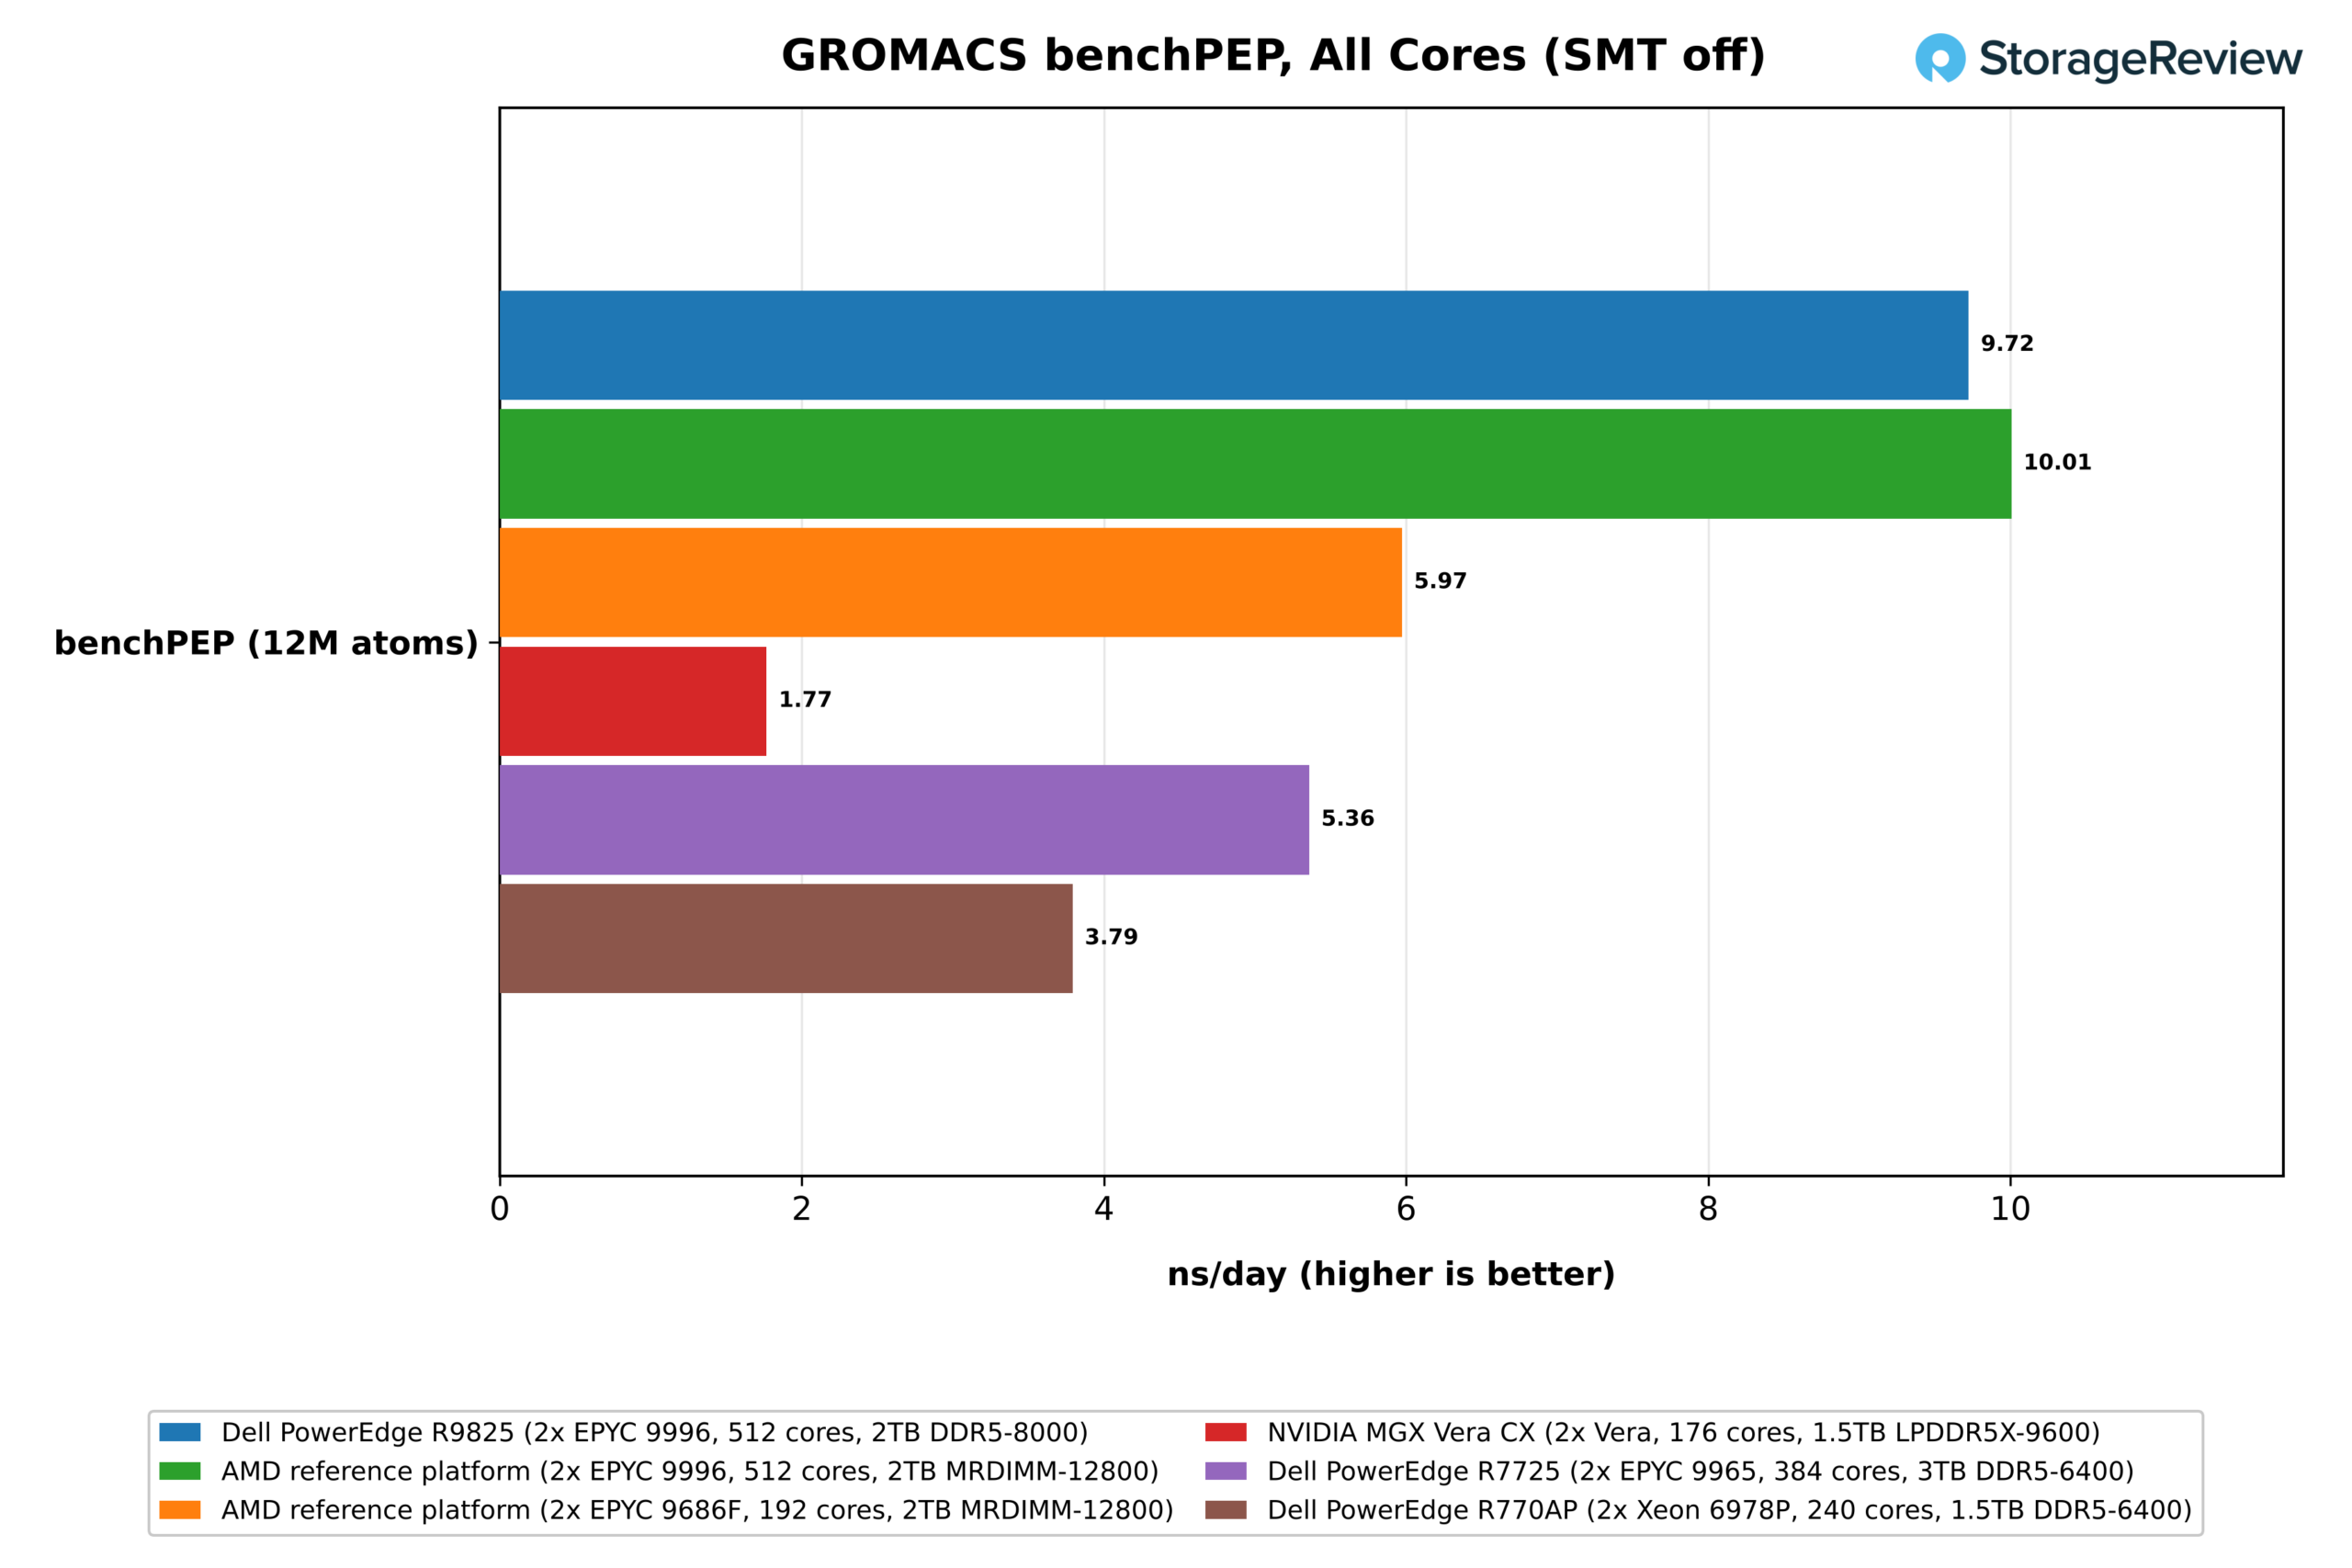
Cu SMT dezactivat, R9825 a terminat testul benchPEP la 9.72 ns/zi, de 1.8 ori mai mult decât serverul EPYC 9965, cu 5.36 ns/zi, pe 384 de nuclee, și de 2.6 ori mai mult decât Xeon 6978P, cu 3.79 ns/zi, pe 240 de nuclee. Platforma MRDIMM a adăugat 3% la 10.01 ns/zi, deci acest test este limitat la 512 nuclee. 9686F cu 192 de nuclee a atins 5.97 ns/zi, devansând modelul emblematic Turin cu 384 de nuclee, pe jumătate din nuclee, în timp ce cel mai bun rezultat al Vera, de 2.07 ns/zi, cu SMT activat, este de aproximativ o cincime din cifra obținută de R9825.
Normalizarea în funcție de numărul de nuclee arată cât din această diferență este legată de arhitectură. R9825 rezultă 0.0190 ns/zi per nucleu, față de 0.0140 pentru EPYC 9965 și 0.0158 pentru Xeon 6978P, un câștig de 36% per nucleu față de Zen 5c, care provine din nucleul mai rapid Zen 6c, L3-ul mai mare și canalele de memorie suplimentare împreună. 0.0311 per nucleu al lui 9686F arată ce se poate cumpăra cu 5.3 GHz și 384 MB de L3 pe 96 de nuclee cu acest cod.
SMT s-a schimbat puțin la Venice, deoarece cele două runde 9996 au atins un procent de 1.5% față de rezultatele lor fără SMT cu acesta activat, iar 9686F a câștigat 5% folosind o configurație de rang de 192×2.
Carcasa benchMEM izolează decalajul per nucleu prin rularea sistemului de 82,000 de atomi pe 16 nuclee fizice ale socketului 0 pe fiecare platformă, astfel încât numărul de nuclee nu este inclus în ecuație, iar rezultatul reflectă debitul vectorial, memoria cache și memoria locală.
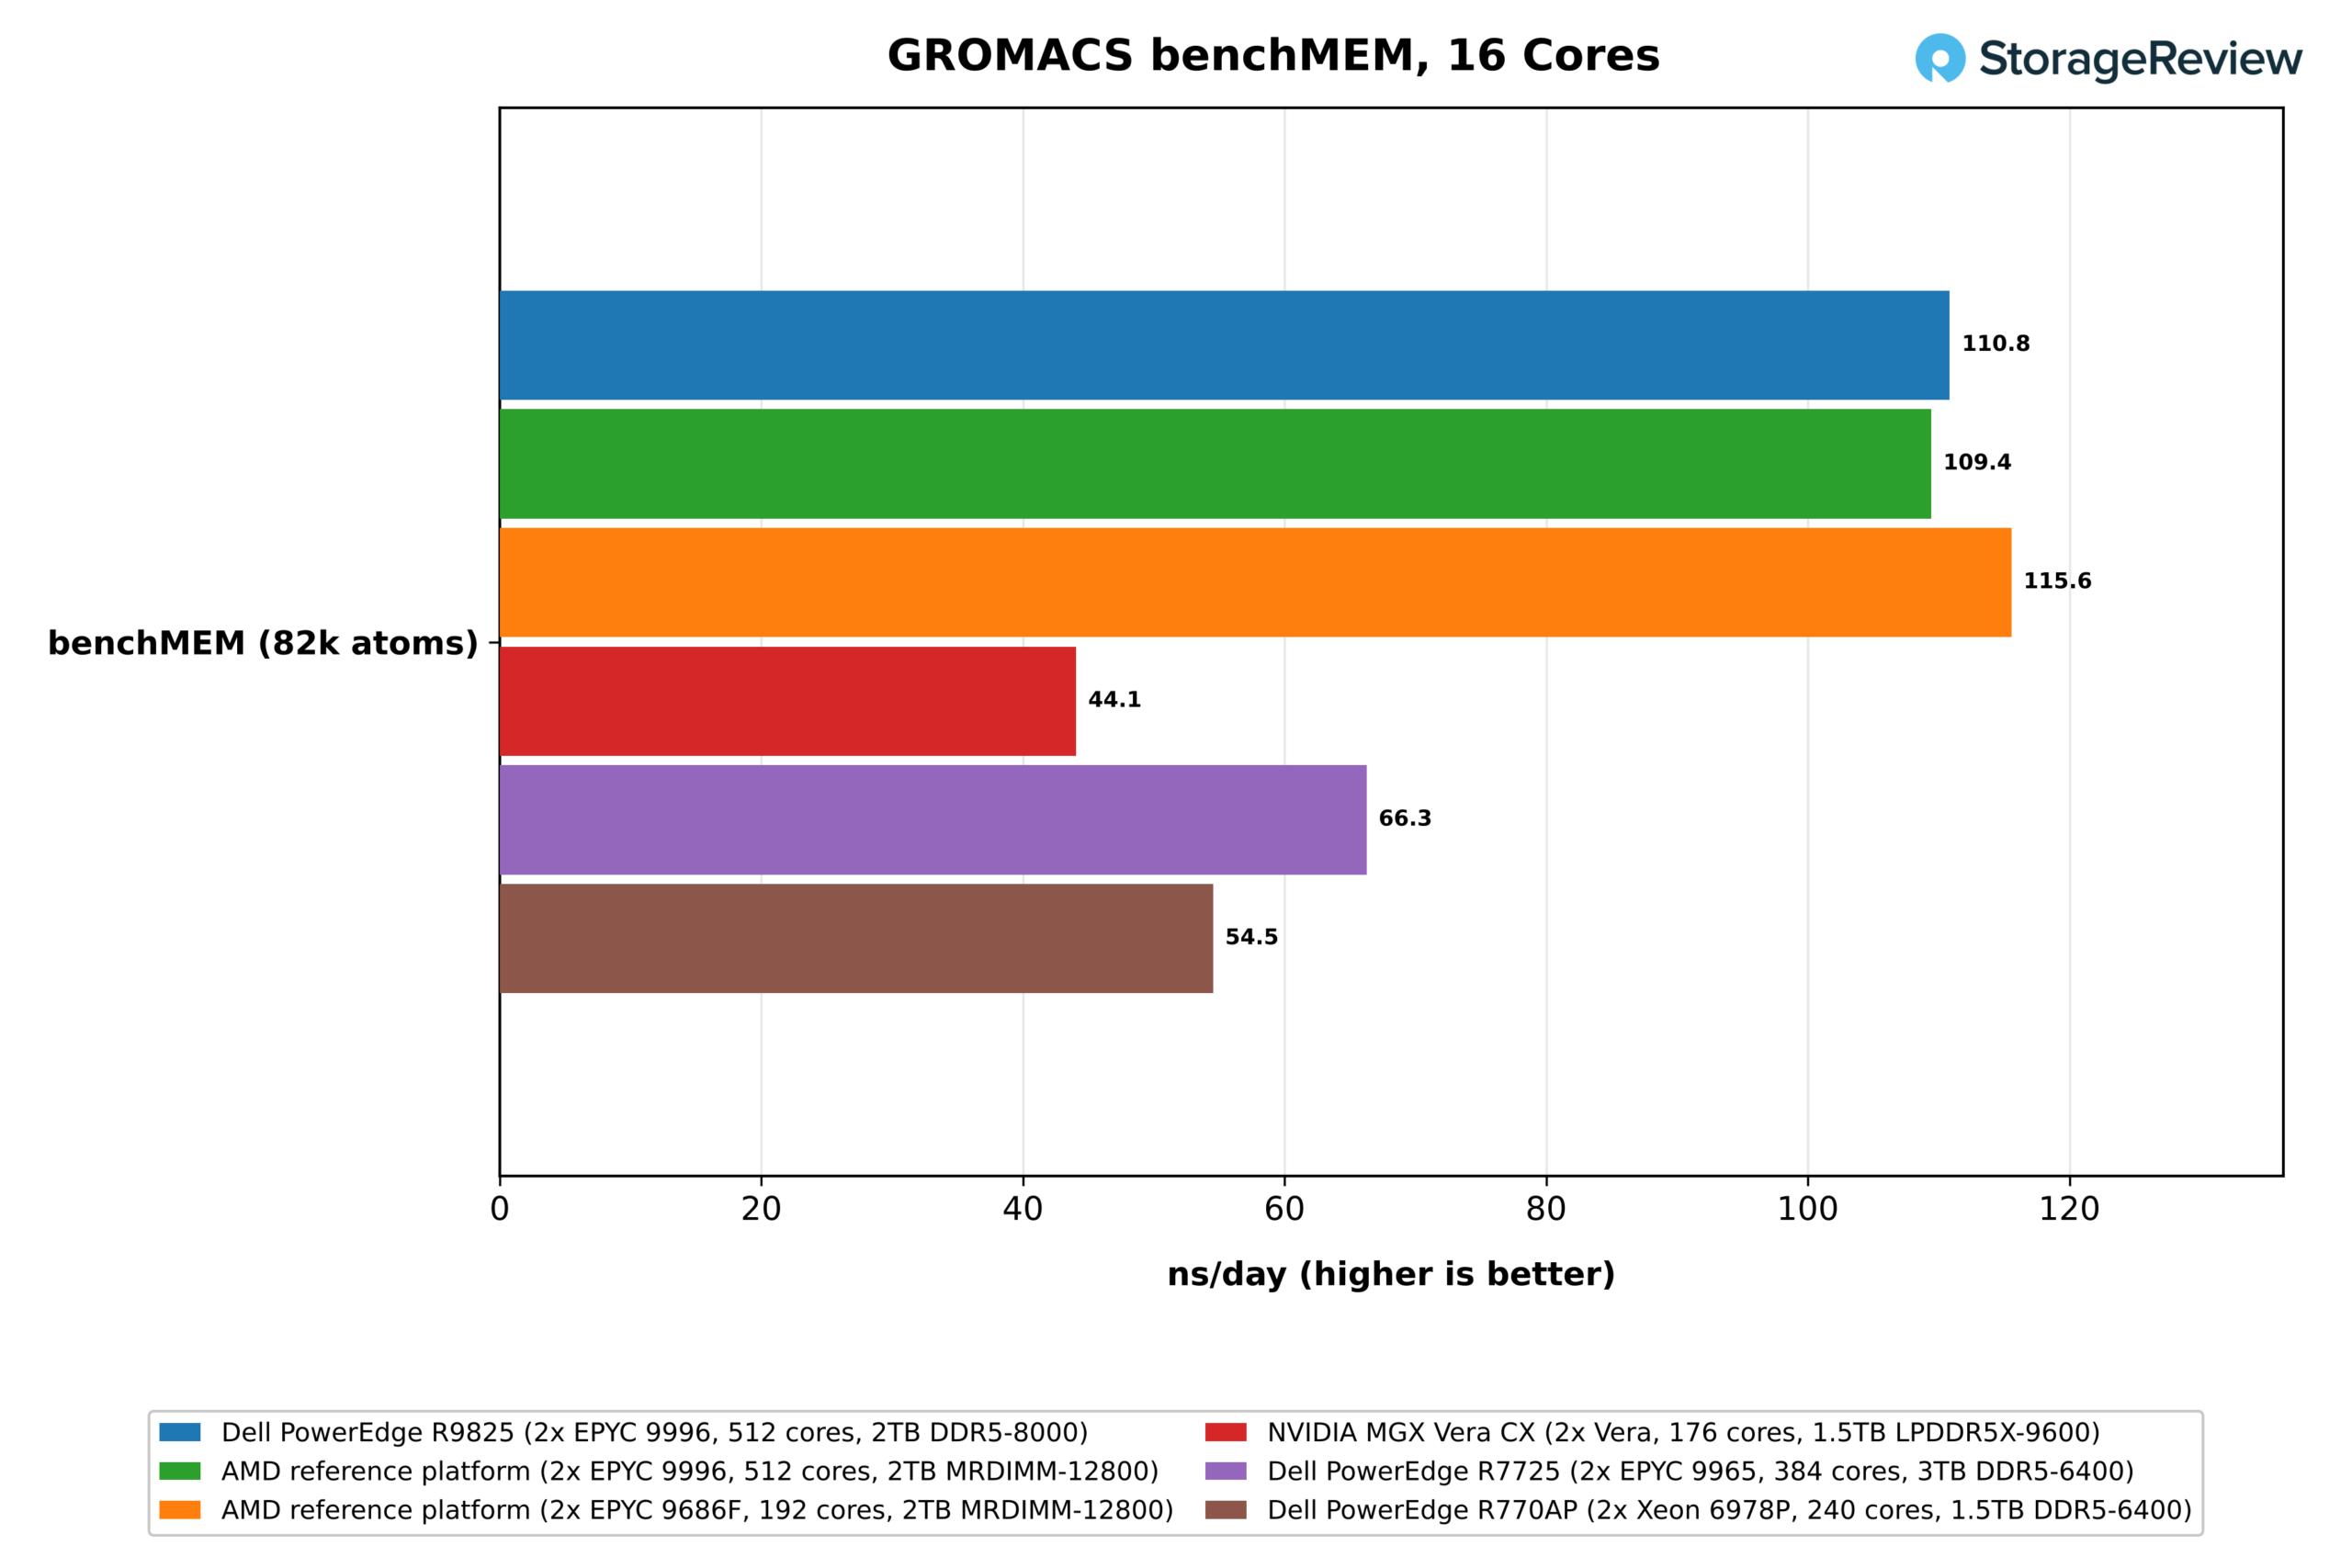
Aici, 16 nuclee Zen 6c de pe R9825 au înregistrat 110.8 ns/zi, MRDIMM 9996 la 109.4 și 9686F la 115.6. Șaisprezece nuclee Zen 5c de pe EPYC 9965 au atins 66.3, devansând Xeon 6978P la 54.5 și Vera la 44.1. Aceasta reprezintă un câștig de 67% per nucleu față de nucleul dens al lui Turin pe o sarcină de lucru pentru care cele două au seturi de instrucțiuni comune și o marjă de 2.5x față de cele șase pipe-uri SVE2 pe 128 de biți ale lui Olympus.
Setul de lucru de 82,000 de atomi încape într-o memorie L3 de 128MB a unui CCD Zen 6c, cu spațiu suplimentar, motiv pentru care cele trei configurații Venice se află la o diferență de 6% una față de cealaltă, o diferență mult mai mică decât diferența dintre oricare dintre ele și restul câmpului.
OpenFOAM
OpenFOAM mută presiunea de la unitățile vectoriale la sistemul de memorie, iar aici atât sistemul de memorie, cât și numărul de nuclee primesc un vot. Rulăm OpenFOAM 13 pe cazul de aerodinamică auto drivearFastback, cu un rang MPI per nucleu fizic, la două dimensiuni de plasă: o plasă medie de 2.98 milioane de celule și una mare de 22.6 milioane de celule.
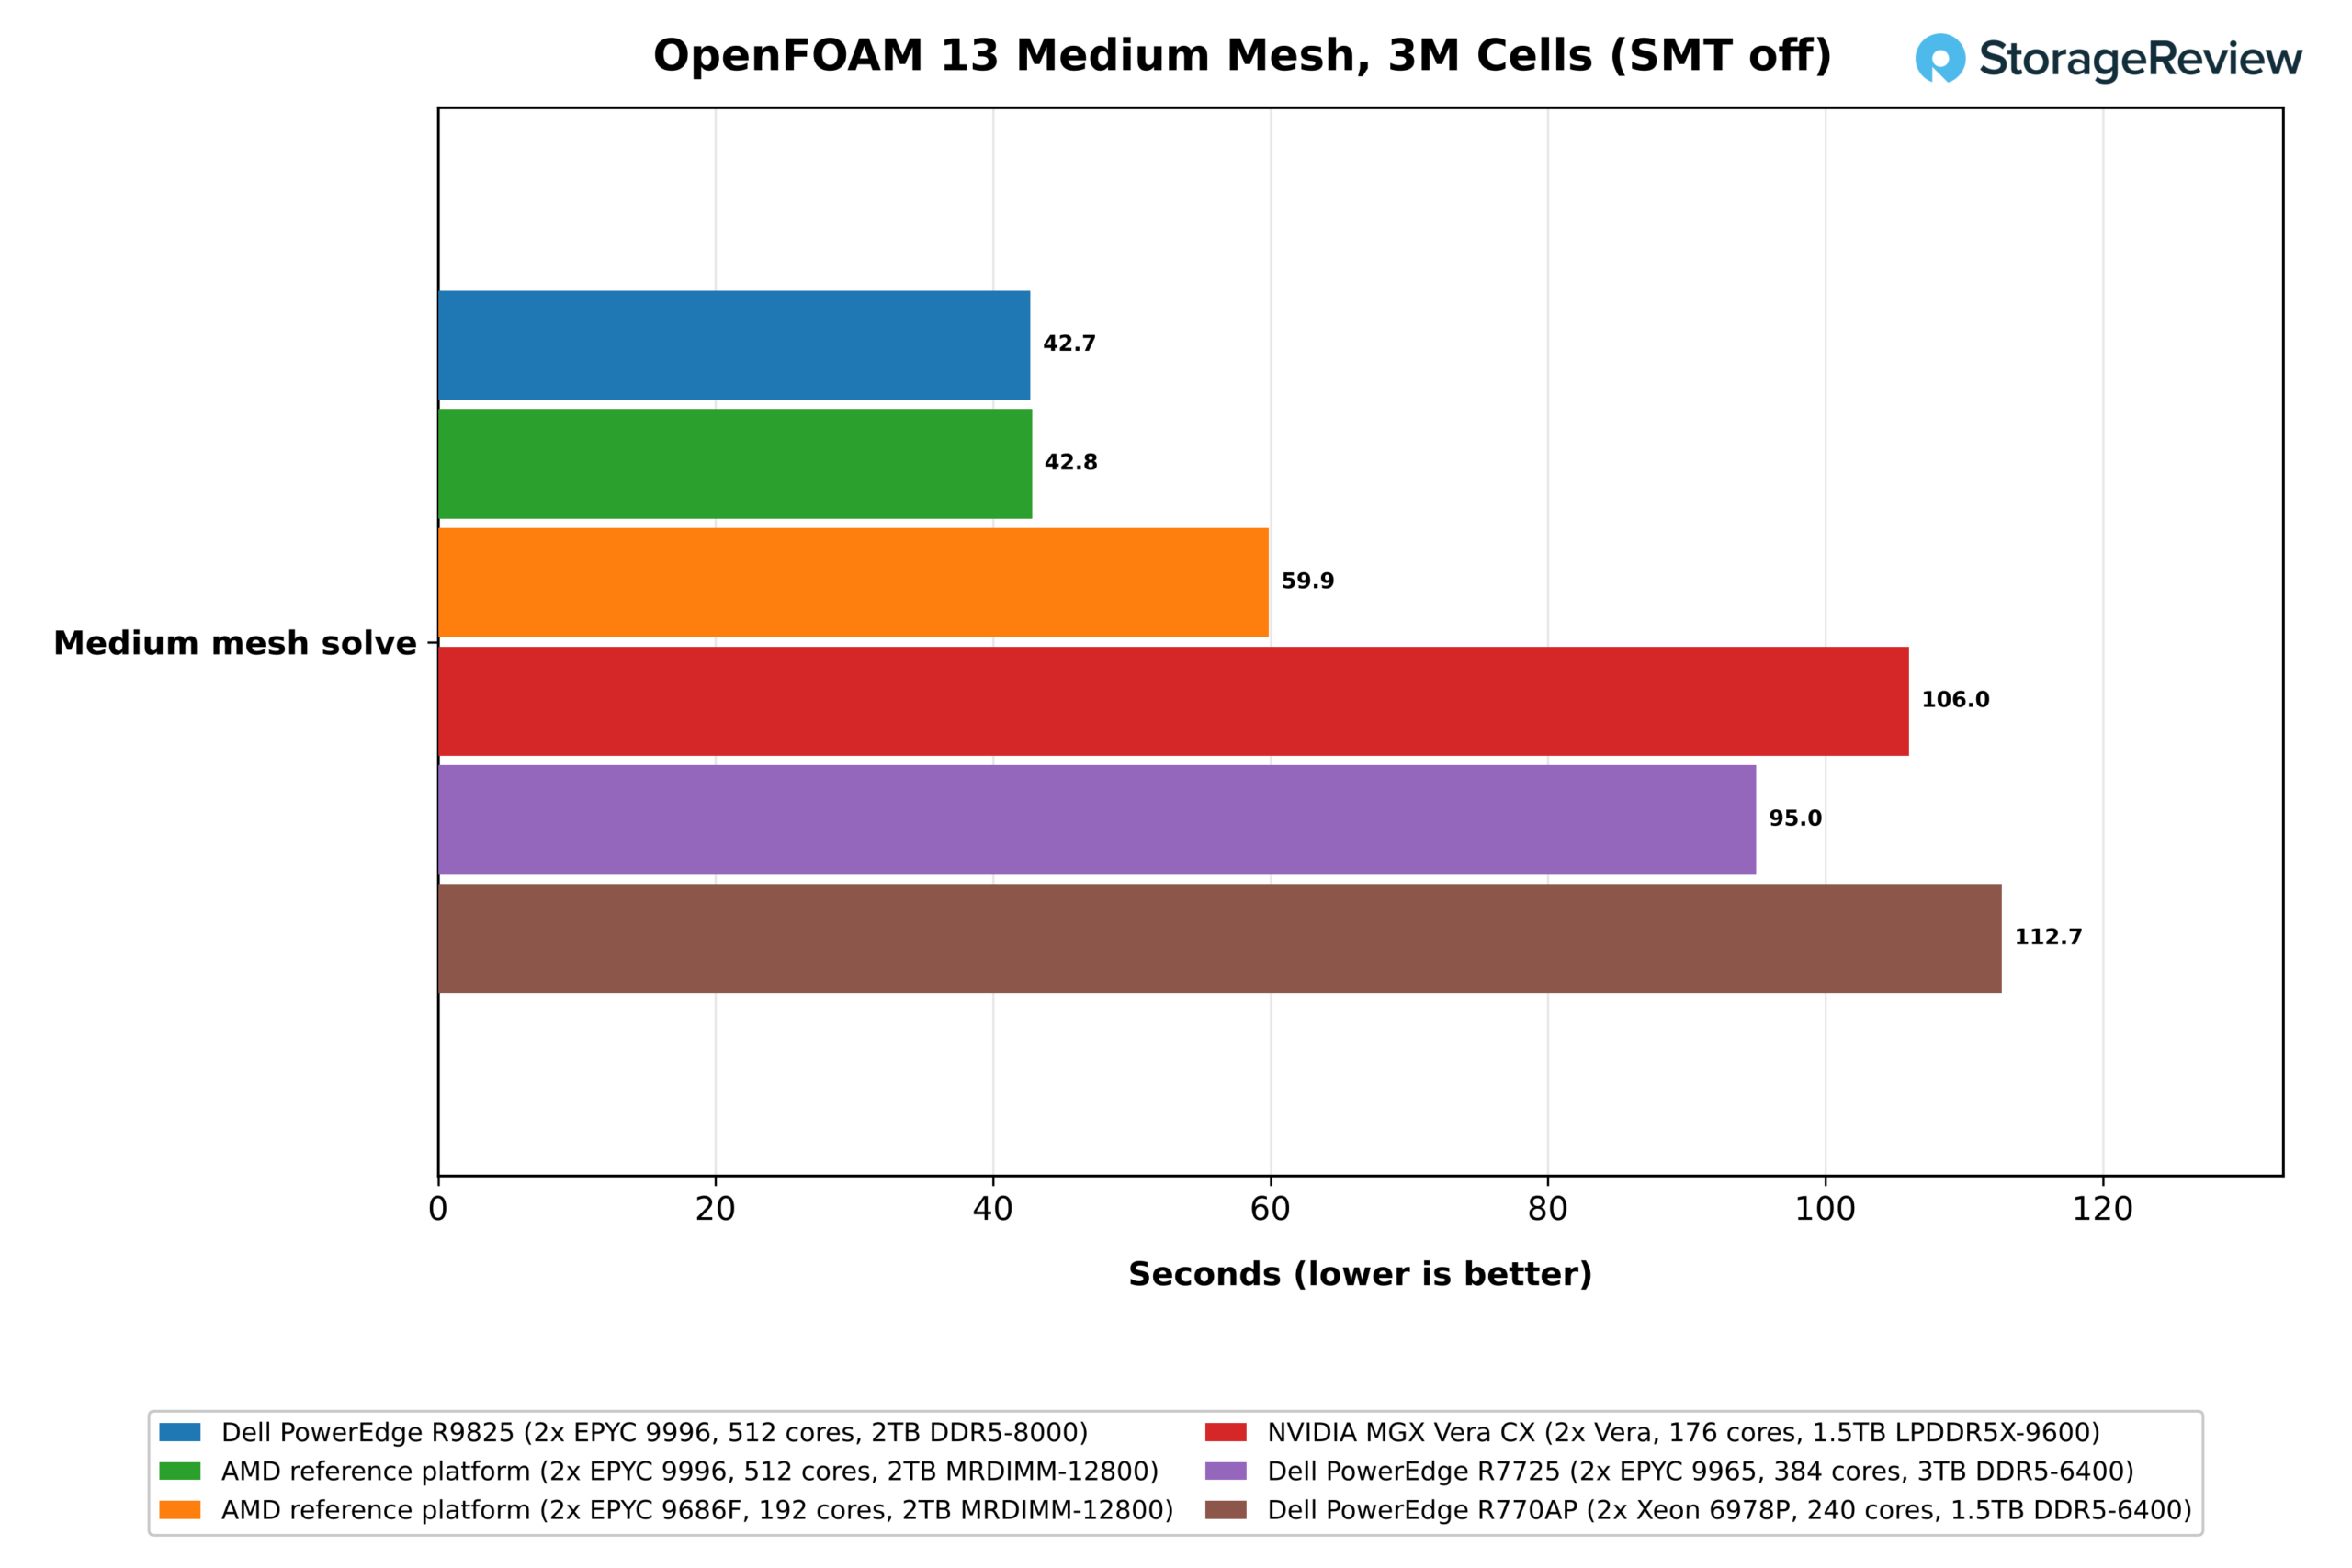
Mesh-ul mediu a fost rezolvat în 42.7 secunde pe R9825 și în 42.8 secunde pe platforma MRDIMM, de 2.2 ori mai rapid decât cele 95.0 secunde ale EPYC 9965 și de 2.5 ori mai rapid decât cele 106.0 secunde ale Vera. Rezultatul potrivirii pentru ambele tipuri de memorie arată că mica problemă este legată de numărul de nuclee și memoria cache la 512 ranguri. Cele 59.9 secunde ale 9686F pe 192 de nuclee confirmă acest lucru, deoarece partea cu 96 de nuclee a durat cu 40% mai mult decât sistemele 9996, terminând în același timp de 1.6 ori mai rapid decât Turin.
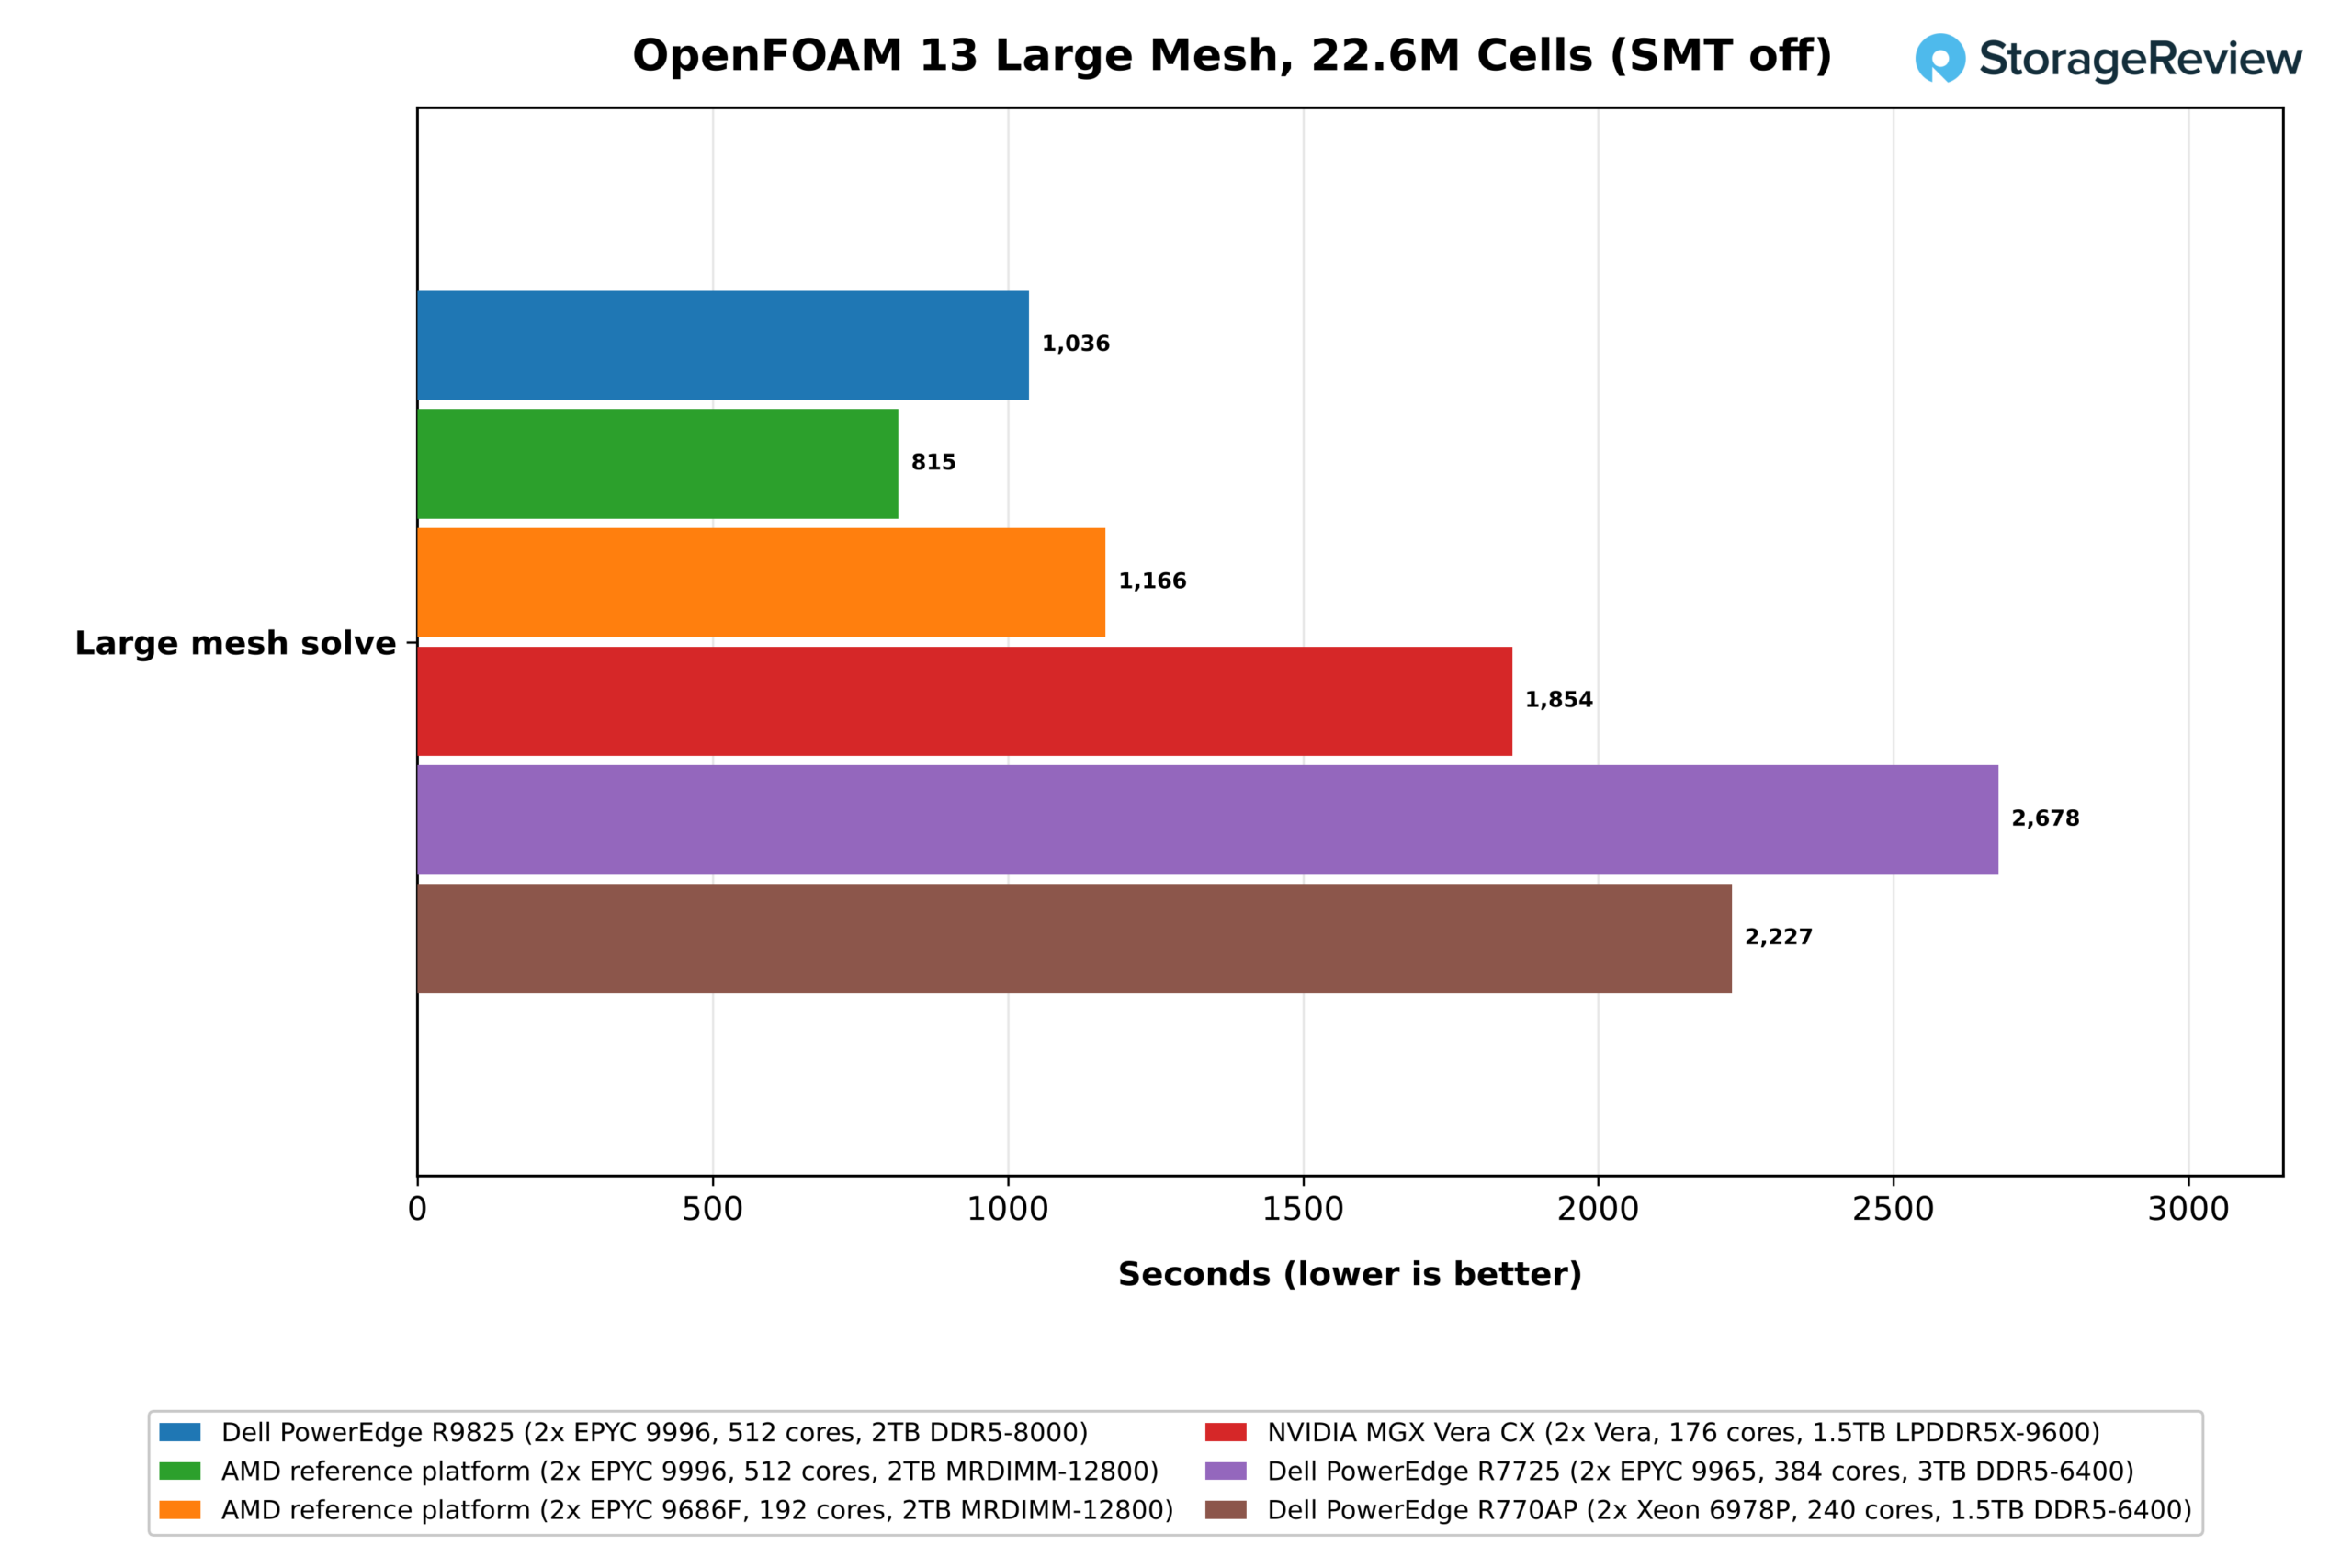
Tipul de memorie este plasa mare, unde se manifestă. R9825 a rezolvat problema în 1,036 de secunde, de 2.6 ori mai rapid decât cele 2,678 de secunde ale lui EPYC 9965 și de 1.8 ori mai rapid decât cele 1,854 de secunde ale lui Vera, iar aceleași procesoare de pe MRDIMM-12800 au terminat în 815 secunde, cu 21% mai repede.
Cele 1,166 de secunde ale modelului 9686F pe 192 de nuclee se situează în limita a 13% față de cele ale modelului R9825 cu 512 nuclee, ceea ce arată plafonul de lățime de bandă la lucru. La această dimensiune a mesh-ului, sistemul de 8,000 MT/s alimentează 256 de nuclee per socket, cu o lățime de bandă totală mai mică decât cea oferită de sistemul MRDIMM, care este de 96. Pe aceleași MRDIMM-uri, trecerea de la 96 la 256 de nuclee per socket reduce rezoluția cu 30%, iar MRDIMM-urile pe aceleași 256 de nuclee o reduc cu 21%, așadar pentru CFD, vreme și alte rezolvătoare cu memorie la dimensiuni de mesh de producție, alegerea memoriei contează la fel de mult ca numărul de nuclee.
Analiză și date în memorie
Rezultatele HPC au arătat ce fac nucleele și memoria Venice pentru rezolvatorii științifici. Serviciile de date pun același hardware la treabă diferit, iar cele două teste ale noastre îl utilizează din capete opuse. ClickBench rulează interogări analitice care scanează și agregă coloane mari de date, distribuind fiecare interogare pe un pool de thread-uri dimensionat pentru sistem. Valkey, furca Redis open-source, deservește cereri cheie-valoare mici și separă latența per nucleu de debitul agregat.
ClickBench
Am testat ClickBench cu 43 de interogări pe un tabel de analiză web cu 100 de milioane de rânduri pe ClickHouse 26.8. Suma sa la cald, în care fiecare interogare citește din memoria cache a paginii, este cea mai bună măsură unică din suita noastră pentru modul în care un procesor și memoria sa gestionează scanările și agregările în coloane. Suma la rece adaugă repornirile serverului și citirile SSD înainte de prima execuție a fiecărei interogări.
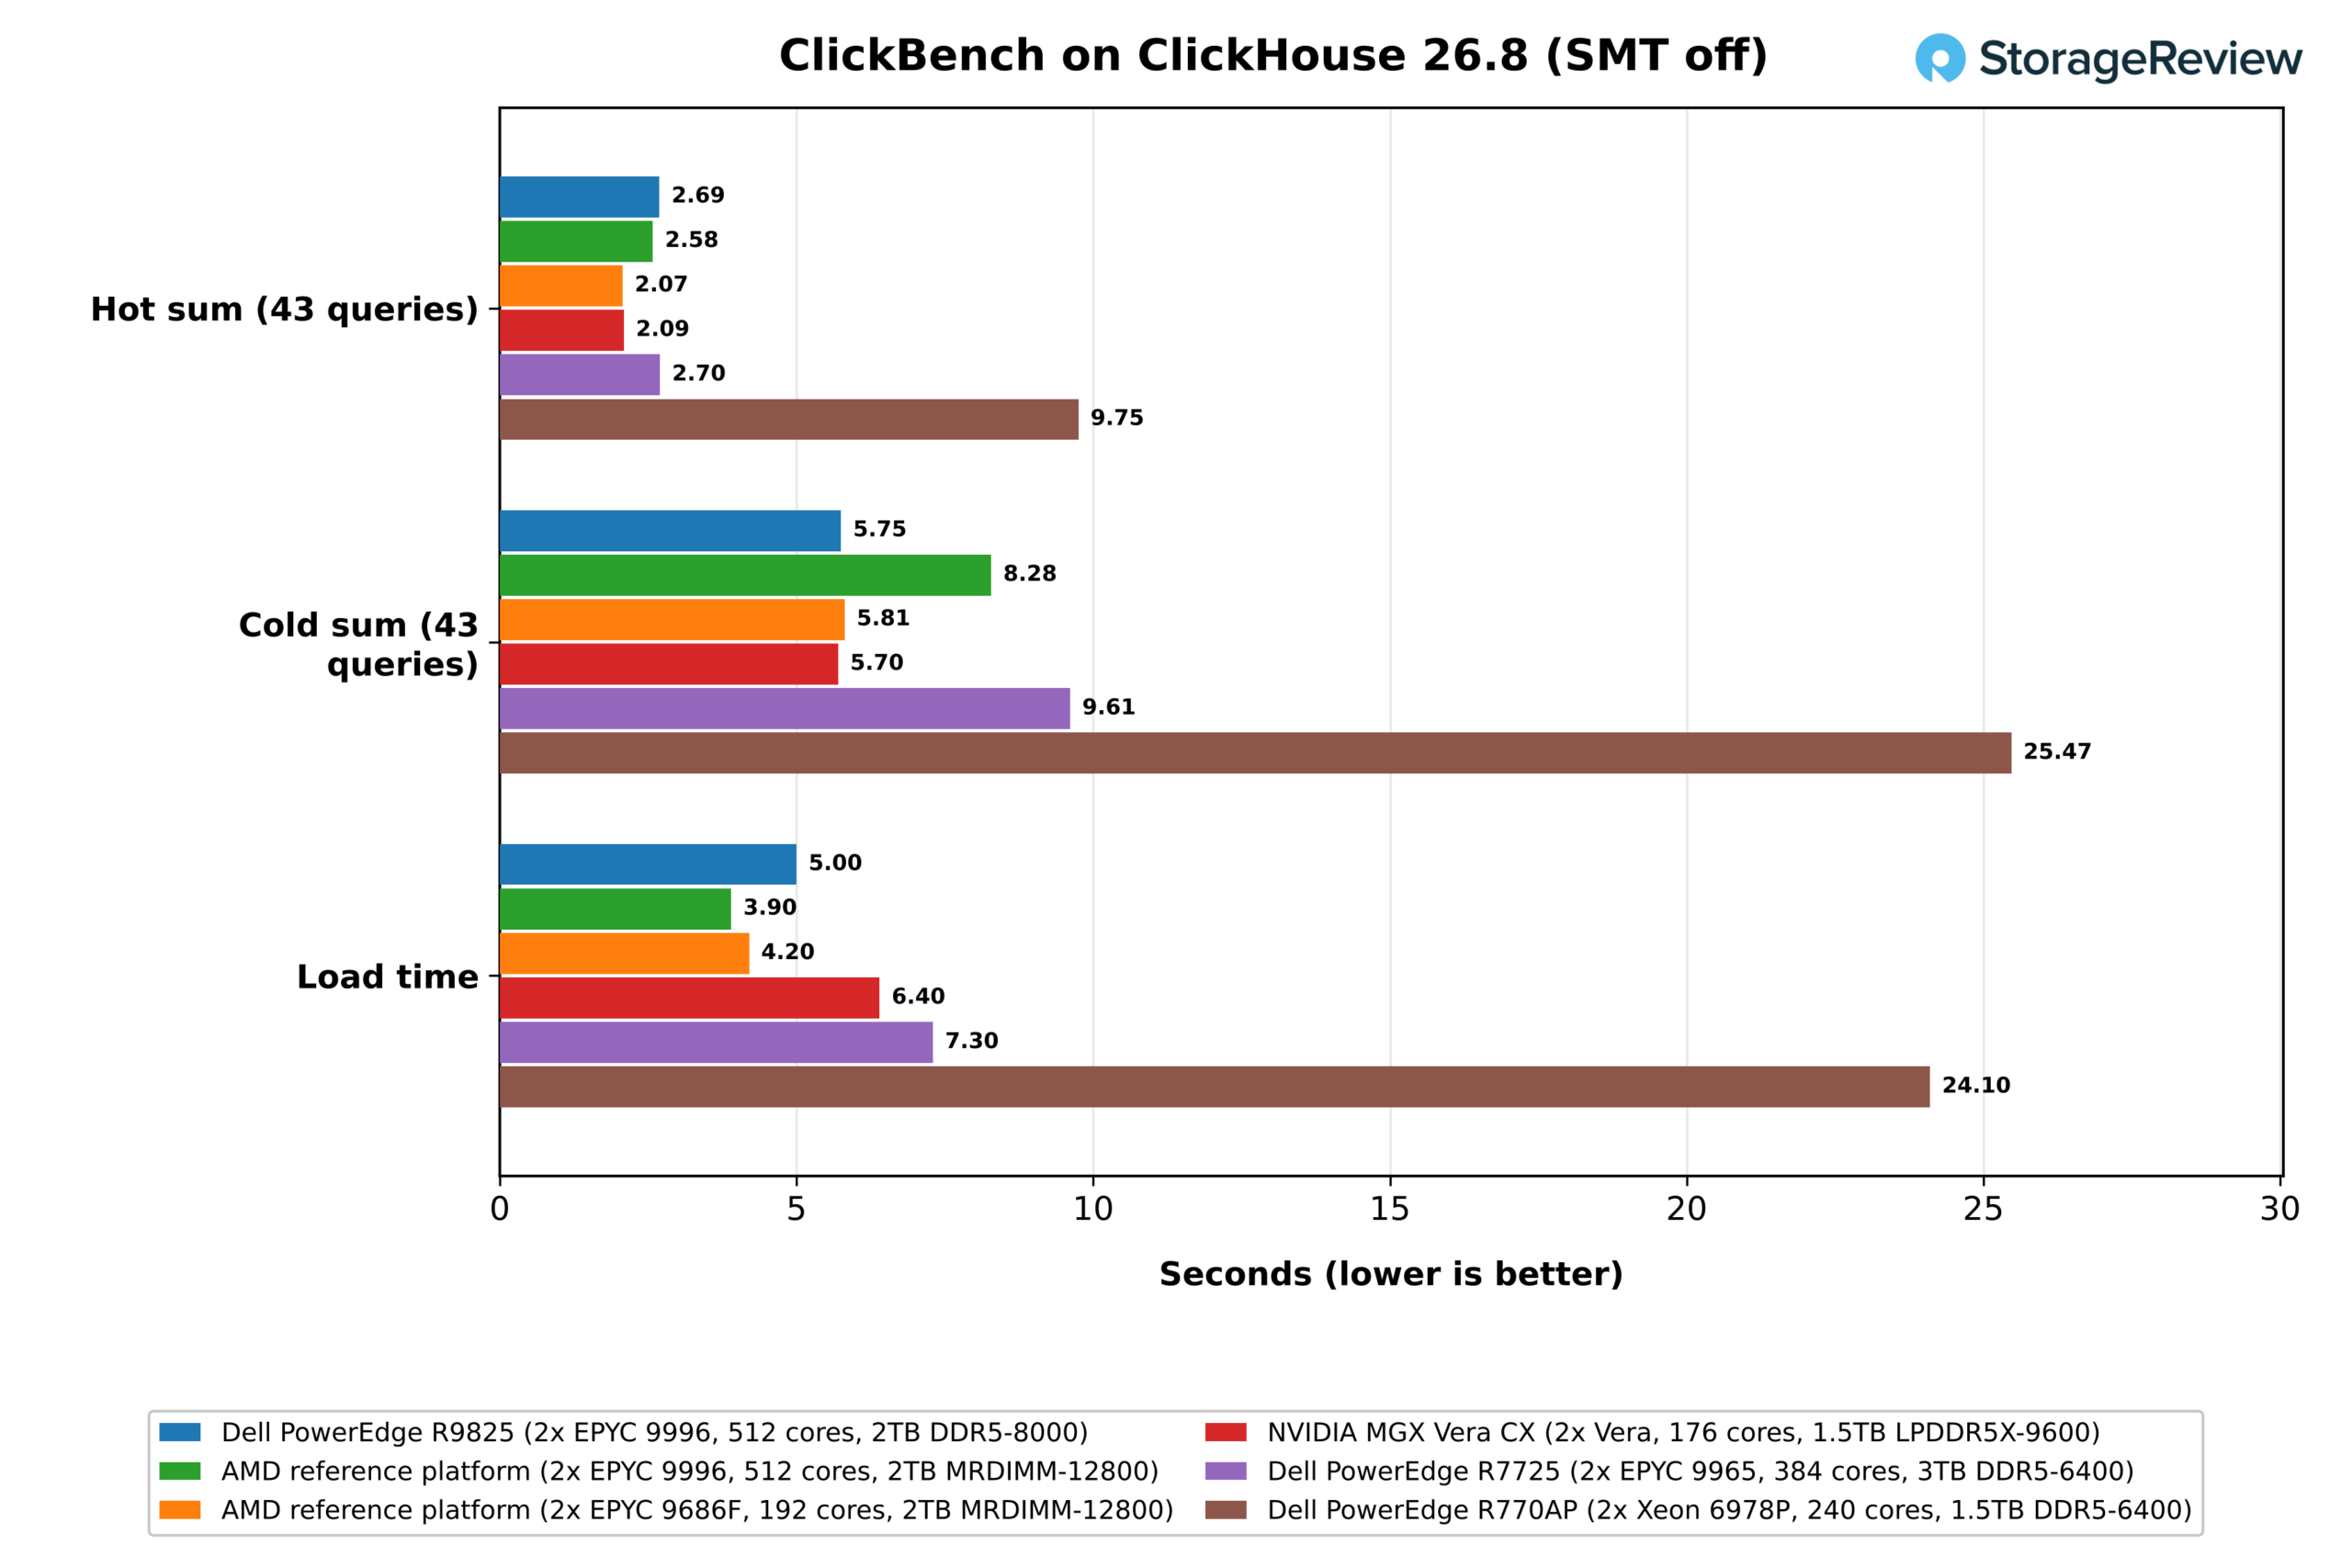
Cu SMT dezactivat, timpul median de rulare a memoriei la zi (hot sum) obținut de R9825 pe parcursul a trei rulări a fost de 2.69 secunde, la egalitate cu timpul de 2.70 secunde al EPYC 9965, în interiorul pragului de 7%, iar timpul de 2.58 secunde al platformei MRDIMM se încadrează, de asemenea, în această categorie. 9686F a rulat suita în 2.07 secunde, la egalitate cu timpul de 2.09 secunde al lui Vera și cel mai rapid rezultat x86 pe care l-am înregistrat. La 512 fire de execuție per sistem, planificarea și supraîncărcarea de fuziune a ClickHouse consumă nucleele suplimentare, în timp ce 96 de nuclee la 5.3 GHz cu 384 MB de L3 șterg cele 43 de interogări mai rapid decât 256 la 4.1 GHz.
Suma la rece se bazează mai mult pe stocare, iar unitățile de stocare diferă între laboratorul nostru și platforma AMD. R9825 a terminat la rece în 5.75 secunde, față de 5.70 secunde pentru Vera și 9.61 secunde pentru 9965, iar 9686F a ținut pasul cu 5.81 secunde. Configurația MRDIMM 9996 a durat 8.28 secunde pe platforma AMD, care rula o unitate diferită și kernelul Linux 7.2.0-rc5 pre-lansat de AMD. Testul repornește serverul înainte de fiecare interogare, așa că nu clasificăm acel rezultat.
R9825 a încărcat setul de date Parquet de 15 GB în 5.0 secunde, față de 3.9 și 4.2 secunde în cele două rulări pe platformă de referință, 6.4 pe Vera și 7.3 pe 9965. Suma la cald de 9.75 secunde și suma la rece de 25.47 secunde ale sistemului Xeon 6978P rămân nereconciliate din testele noastre anterioare, așa că le afișăm fără clasificare.
Activarea SMT a mutat suma de thread-uri la cald a R9825 la 2.67 secunde, iar suma de thread-uri la rece la 6.53, astfel încât cele 512 thread-uri suplimentare nu au schimbat nimic pe calea la cald și au adăugat timp pe cea rece. Vera a pierdut 10% din performanța sa de suma de thread-uri, thread-urile fiind dublate, ceea ce reflectă modul în care SMT-ul competitiv al Zen 6c și multithreading-ul spațial partiționat al NVIDIA gestionează un pool de thread-uri dimensionat pentru procesoare logice.
Valkey
Valkey execută comenzi pe o buclă cu un singur fir de execuție per instanță, așa că o analizăm în două moduri: ce livrează un server pe nucleele potrivite și ce livrează un socket atunci când este încărcat cu instanțe.
Profilul de harnașaj oferă unui server Valkey nouă nuclee fizice pe fiecare platformă și analizează adâncimea conductei și dimensiunea setului de lucru, astfel încât arată comportamentul per nucleu la numărul de nuclee potrivit. Graficul prezintă, de asemenea, rezultatul modului socket cu solicitări trimise una câte una, lucru pe care îl acoperim cu celelalte figuri ale socketurilor de mai jos.
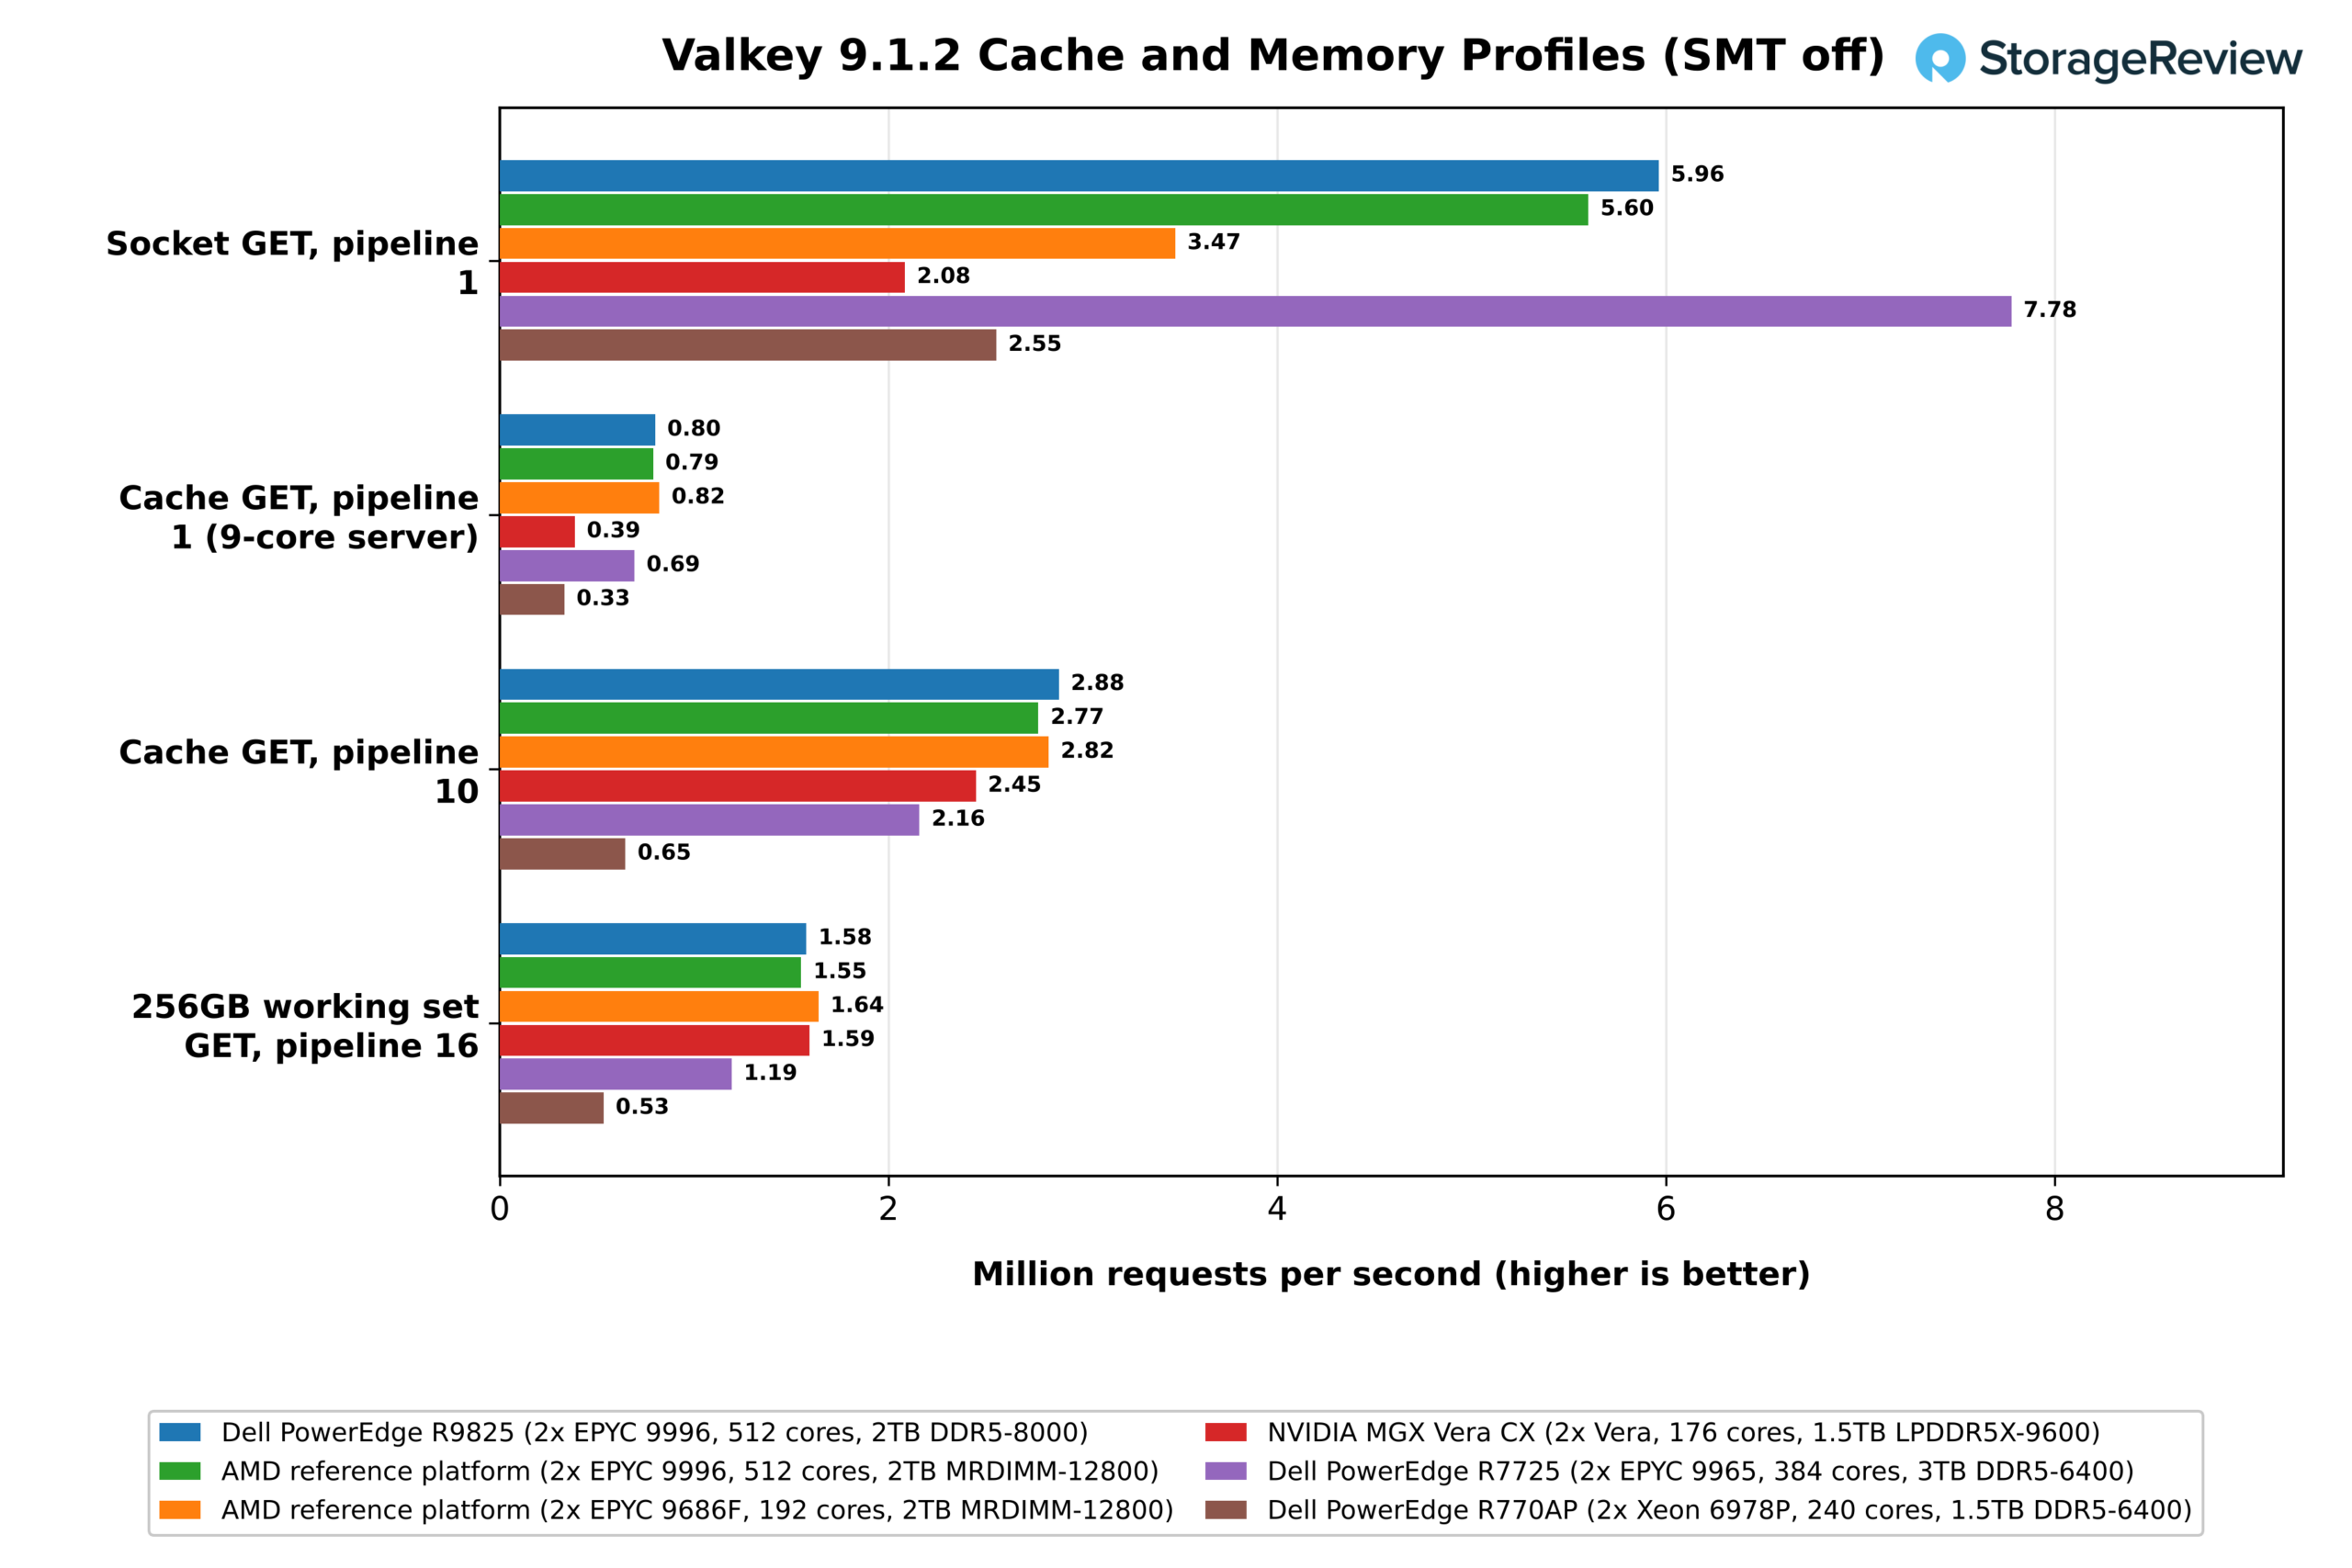
Trimise pe rând, cererile GET din cache au rulat cu 799,000 pe secundă pe R9825, cu un p99 de 0.84 ms, față de 692,000 și 1.08 ms pe 9965, 385,000 și 1.76 ms pe Vera și 332,000 pe Xeon 6978P, în timp ce 9686F a condus cu 821,000. În loturi de 10, R9825 a atins 2.88 milioane față de 2.16 milioane pentru 9965 și 2.45 milioane pentru Vera, un câștig generațional de 33% pentru AMD și un avans de 18% față de Olympus.
Setul de lucru de 256 GB depășește fiecare memorie cache, așa că rezultatul său urmărește latența memoriei și lățimea de bandă împreună, iar aici Venice și Vera au fost practic la egalitate, între 1.55 milioane și 1.64 milioane de cereri GET pe secundă. R9825 a deservit 1.58 milioane, MRDIMM 9996 1.55 milioane, 9686F 1.64 milioane și Vera 1.59 milioane, 9965 la 1.19 milioane și Xeon la 0.53 milioane. Valoarea de 1.76 milioane a Verei cu SMT activat este cea mai bună cifră individuală din acest test și singurul rezultat din setul Valkey în care sistemul de memorie Olympus prezintă un avantaj față de Zen 6c.
Modul Socket fixează instanțele serverului la socketul 0, câte una la fiecare patru sau opt nuclee, și le direcționează de la clienții de pe socketul 1 prin loopback, astfel încât rezultatul este un debit cheie-valoare al unui socket fără nicio placă de rețea în cale.
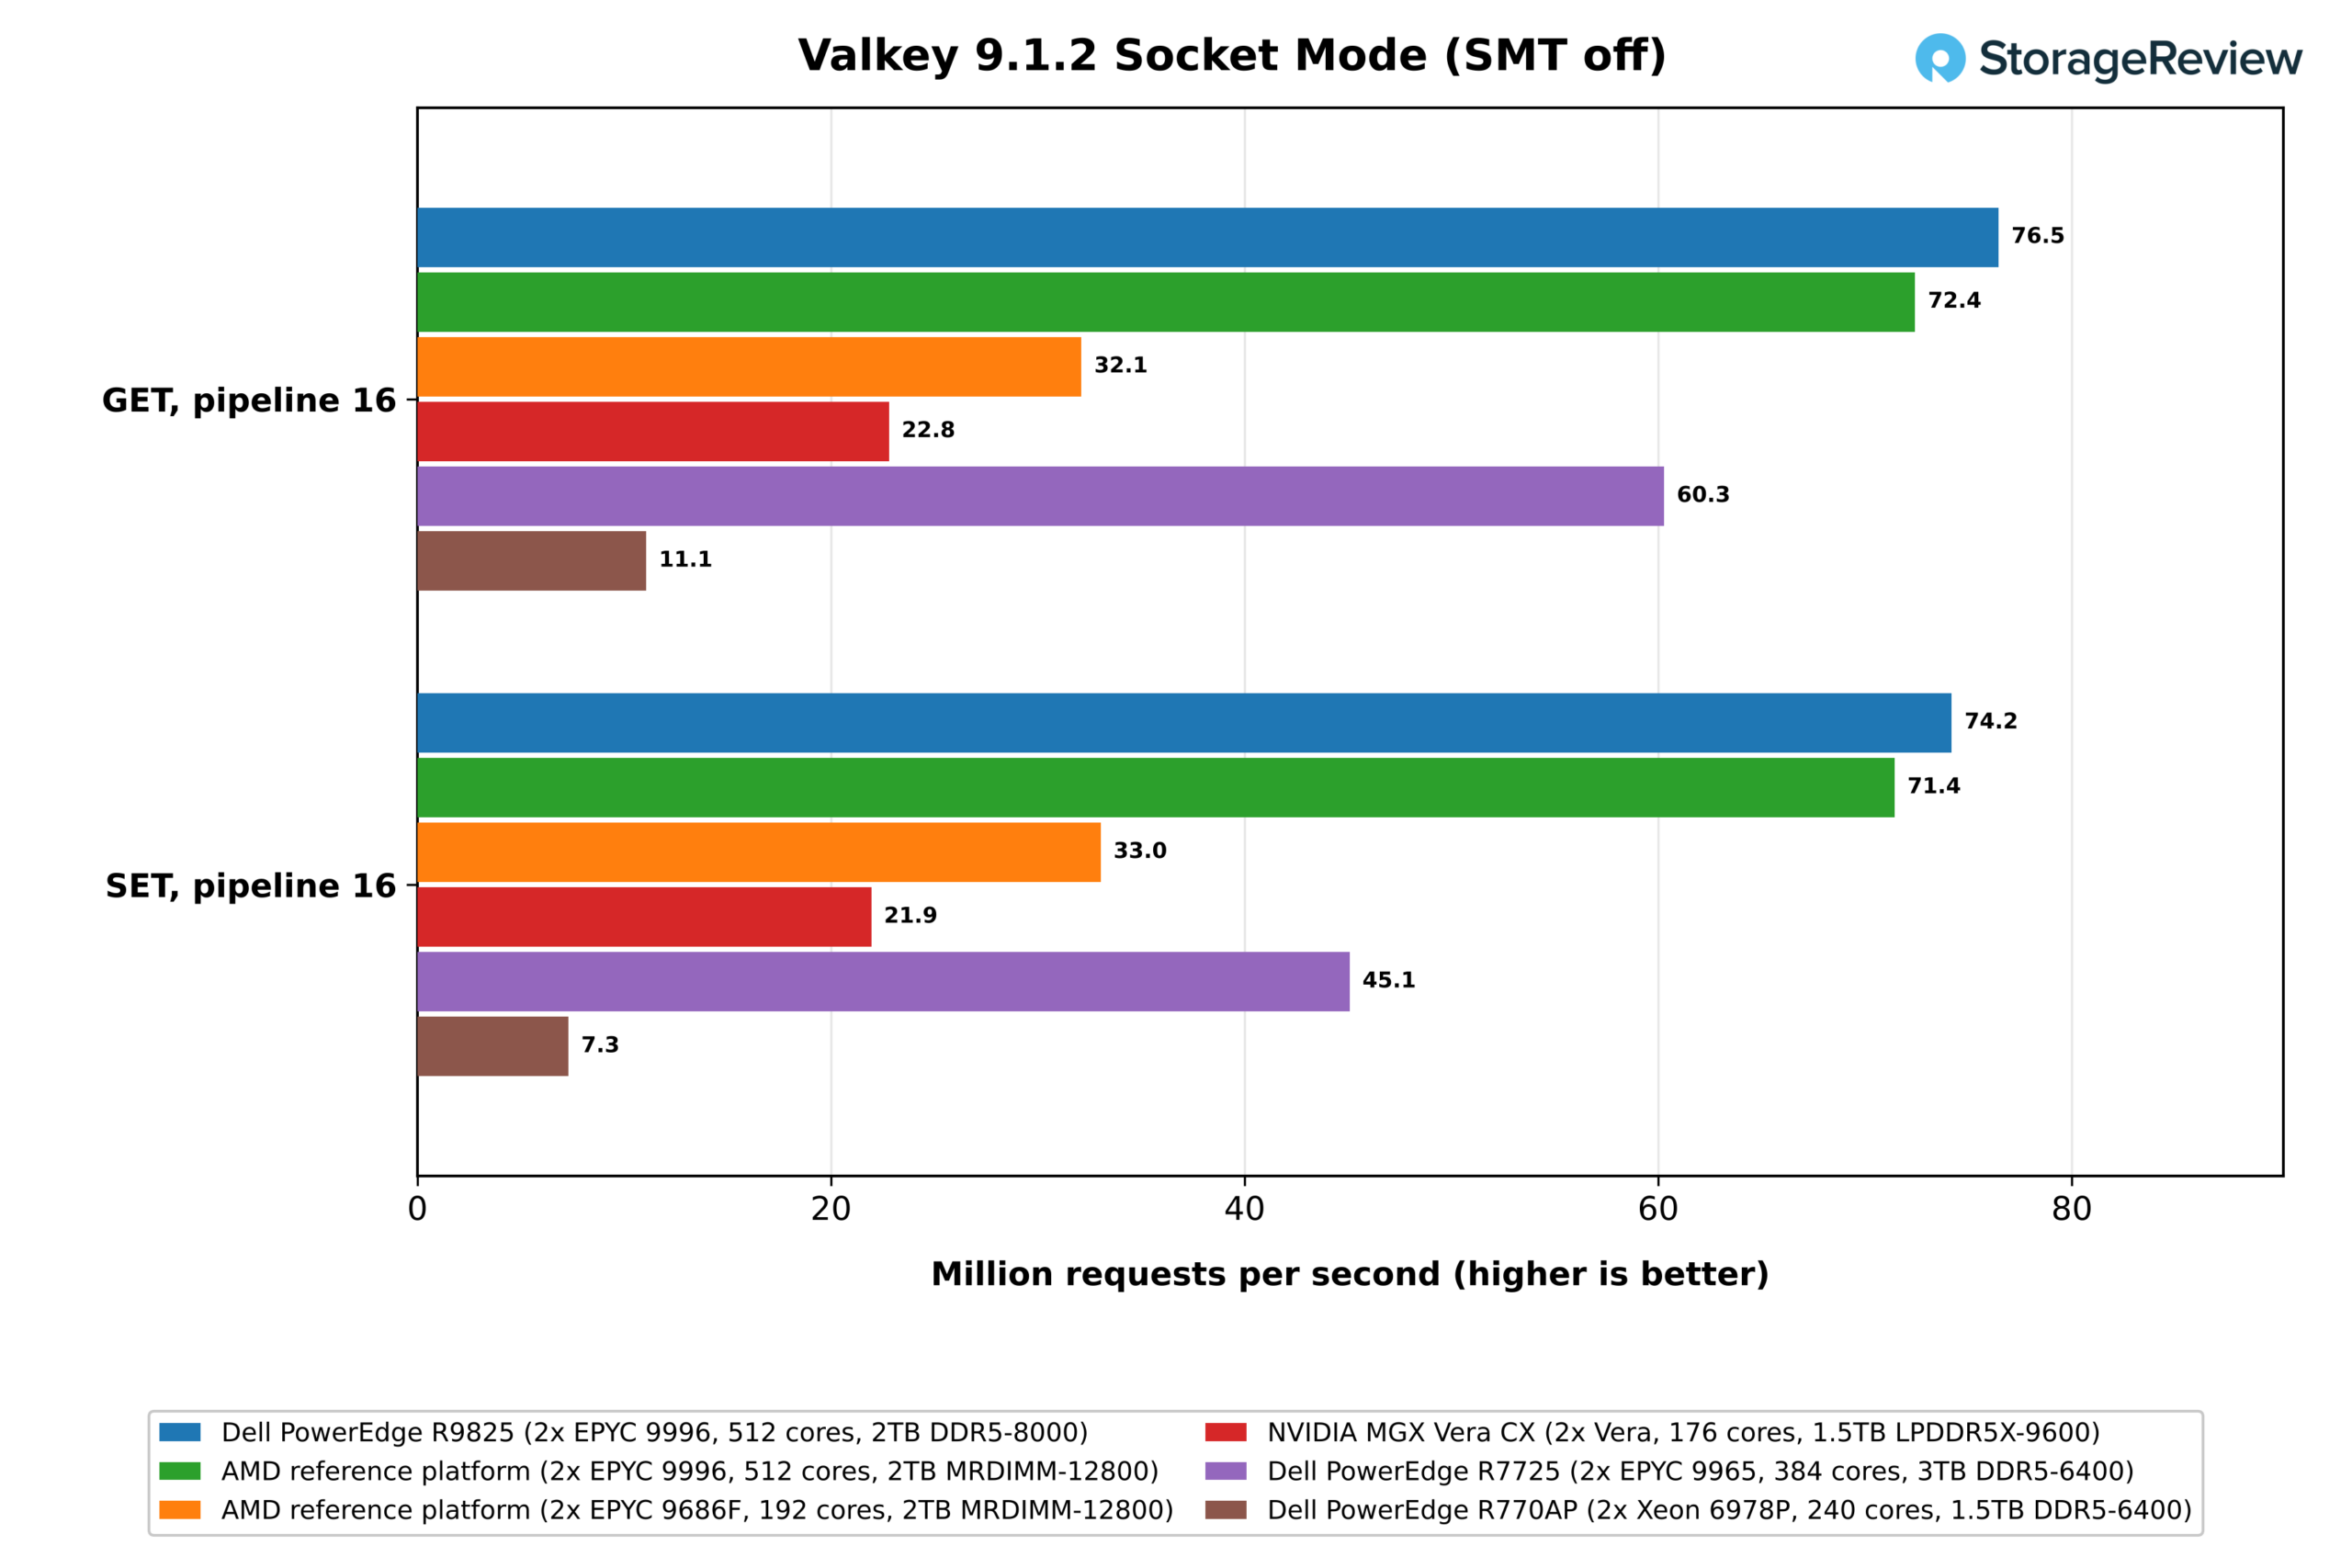
Cu loturi de 16, un socket cu 256 de nuclee al modelului R9825 a livrat 76.5 milioane de cereri GET și 74.2 milioane de cereri SET pe secundă cu configurația instanței cu 8 nuclee și 4 fire de execuție I/O. Aceasta este cu 27% și 65% mai mult decât cele 60.3 milioane și 45.1 milioane de cereri ale socketului EPYC 9965 cu 192 de nuclee și de 3.4 ori mai mult decât cele 22.8 milioane și 21.9 milioane de cereri ale Vera. Platforma MRDIMM a atins o rată de 6% față de cea a modelului R9825 la ambele comenzi, deci debitul în modul socket nu este limitat de memorie.
Per nucleu, procesorul 9686F cu 96 de nuclee a condus, atingând 32.1 milioane de cereri GET și 33.0 milioane de cereri SET pe secundă, sau 334,000 de cereri GET pe secundă per nucleu, față de 299,000 pentru 9996, 314,000 pentru 9965 și 259,000 pentru Vera.
În modul socket, cererile trimise una câte una, așa cum se arată în graficul de profil de mai sus, sunt singurul loc în care socketul lui Turin câștigă. Socketul R9825 a înregistrat 5.96 milioane de cereri GET pe secundă, față de 7.78 milioane pentru EPYC 9965, 3.47 milioane pentru 9686F, 2.55 milioane pentru Xeon 6978P și 2.08 milioane pentru Vera. Per nucleu, adică 23,300 pe 9996, 40,500 pe 9965, 36,200 pe 9686F și 23,700 pe Vera, așadar socketul dens Zen 6c din NPS2 șterge o singură buclă de comenzi la o rată similară cu cea a Olympus și mult sub Zen 5c.
Dispunerea instanțelor contează pe un socket atât de dens, iar noi nu am rulat încă suficiente configurații pentru a spune dacă domeniul NUMA de 128 de nuclee sau limita CCD de 32 de nuclee este variabila care decide cea mai bună dispunere. Plasarea este pe lista noastră pentru o continuare.
Fir unic și debit
Valkey și ClickBench s-au concentrat atât pe sistemul de memorie, cât și pe nuclee, iar această secțiune se concentrează pe nucleele în sine. Propunerea NVIDIA pentru Vera este performanța maximă pe un singur thread la scară largă, iar răspunsul AMD în această generație este o creștere de 4.1 GHz pentru partea cu 256 de nuclee și 5.3 GHz pentru 9686F cu 96 de nuclee. 7-Zip, OpenSSL și Python rulează fiecare ca un singur thread fixat, iar 7-Zip și OpenSSL rulează apoi din nou pe fiecare thread din sistem.
Sistemul de acționare rulează fiecare test cu pin pe procesorul cu cea mai mică cifră din nodul NUMA al socketului 0, care nu se află pe nucleul 0. Nucleul pin al lui R9825 a raportat un plafon de 4,115 MHz, cel al lui 9686F de 5,323 MHz, cel al lui Vera de 3,375 MHz, iar cel al lui EPYC 9965 de 3.7 GHz. Frecvența de ceas este doar o parte a poveștii, iar cele două rezultate 7-Zip de mai jos arată cum.
7-Zip
Compresia și decompresia LZMA din 7-Zip sunt cod întreg cu multe ramificații, iar cele două jumătăți ale testului răspund diferit la viteza de ceas.
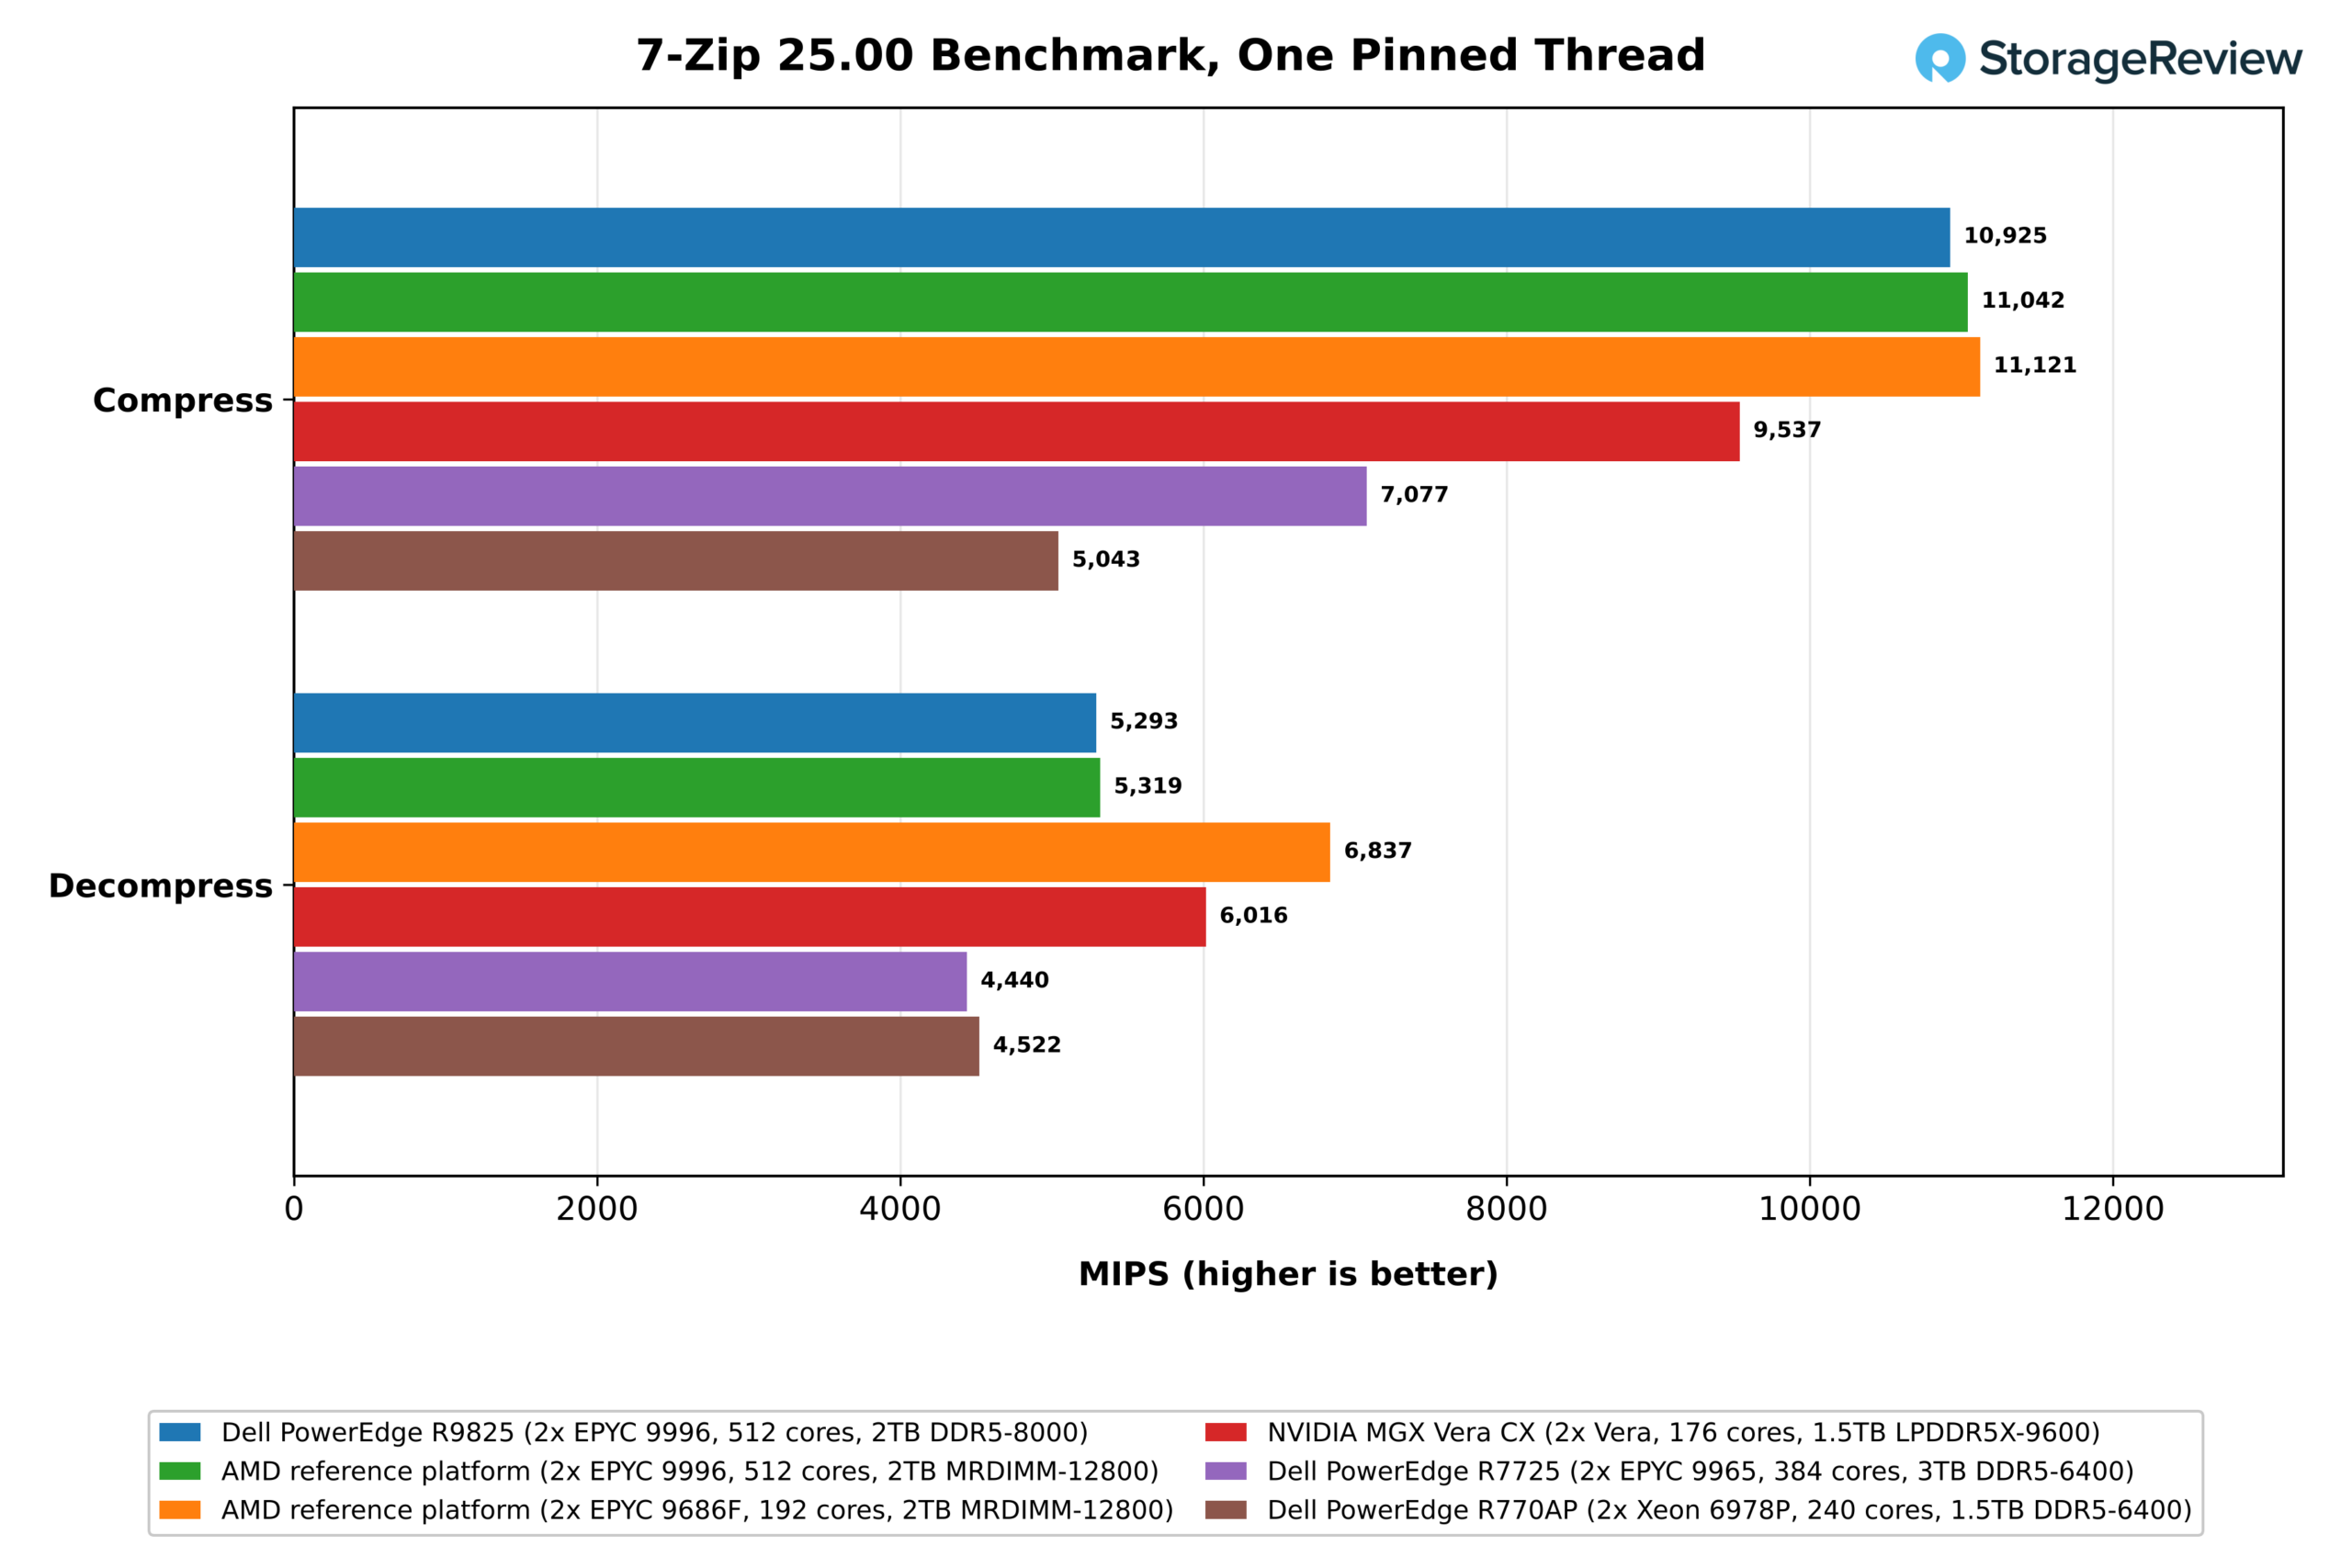
Pe un singur fir de execuție, nucleul Zen 6c al lui R9825 a avut o frecvență de comprimare de 11,068 MIPS, cu 16% înaintea Olympus la 9,537, cu 56% înaintea Zen 5c la 7,077 și de 2.2 ori mai mult decât 5,043 MIPS al lui Xeon 6978P. 9686F la 5.3 GHz a avut o frecvență de comprimare de 11,091 MIPS, aceeași cifră ca și 9996 la 4.1 GHz, deci compresia LZMA pe Zen 6c este legată de latența memoriei și comportamentul ramificării și nu de frecvența de ceas.
Decompresia a mers în direcția opusă, 9996 atingând 5,334 MIPS, sub cei 6,016 MIPS ai Verei, în timp ce cei 6,816 MIPS ai lui 9686F au reușit să se ridice la nivelul inițial cu un avantaj de 29% față de 9996 și au preluat conducerea. Per frecvență de ceas, Olympus la 3.4 GHz are în continuare cel mai bun rezultat la decompresie din set.
Parcurgerea fiecărui fir de execuție arată ce fac 1,024 de fire de execuție cu acea viteză per nucleu.
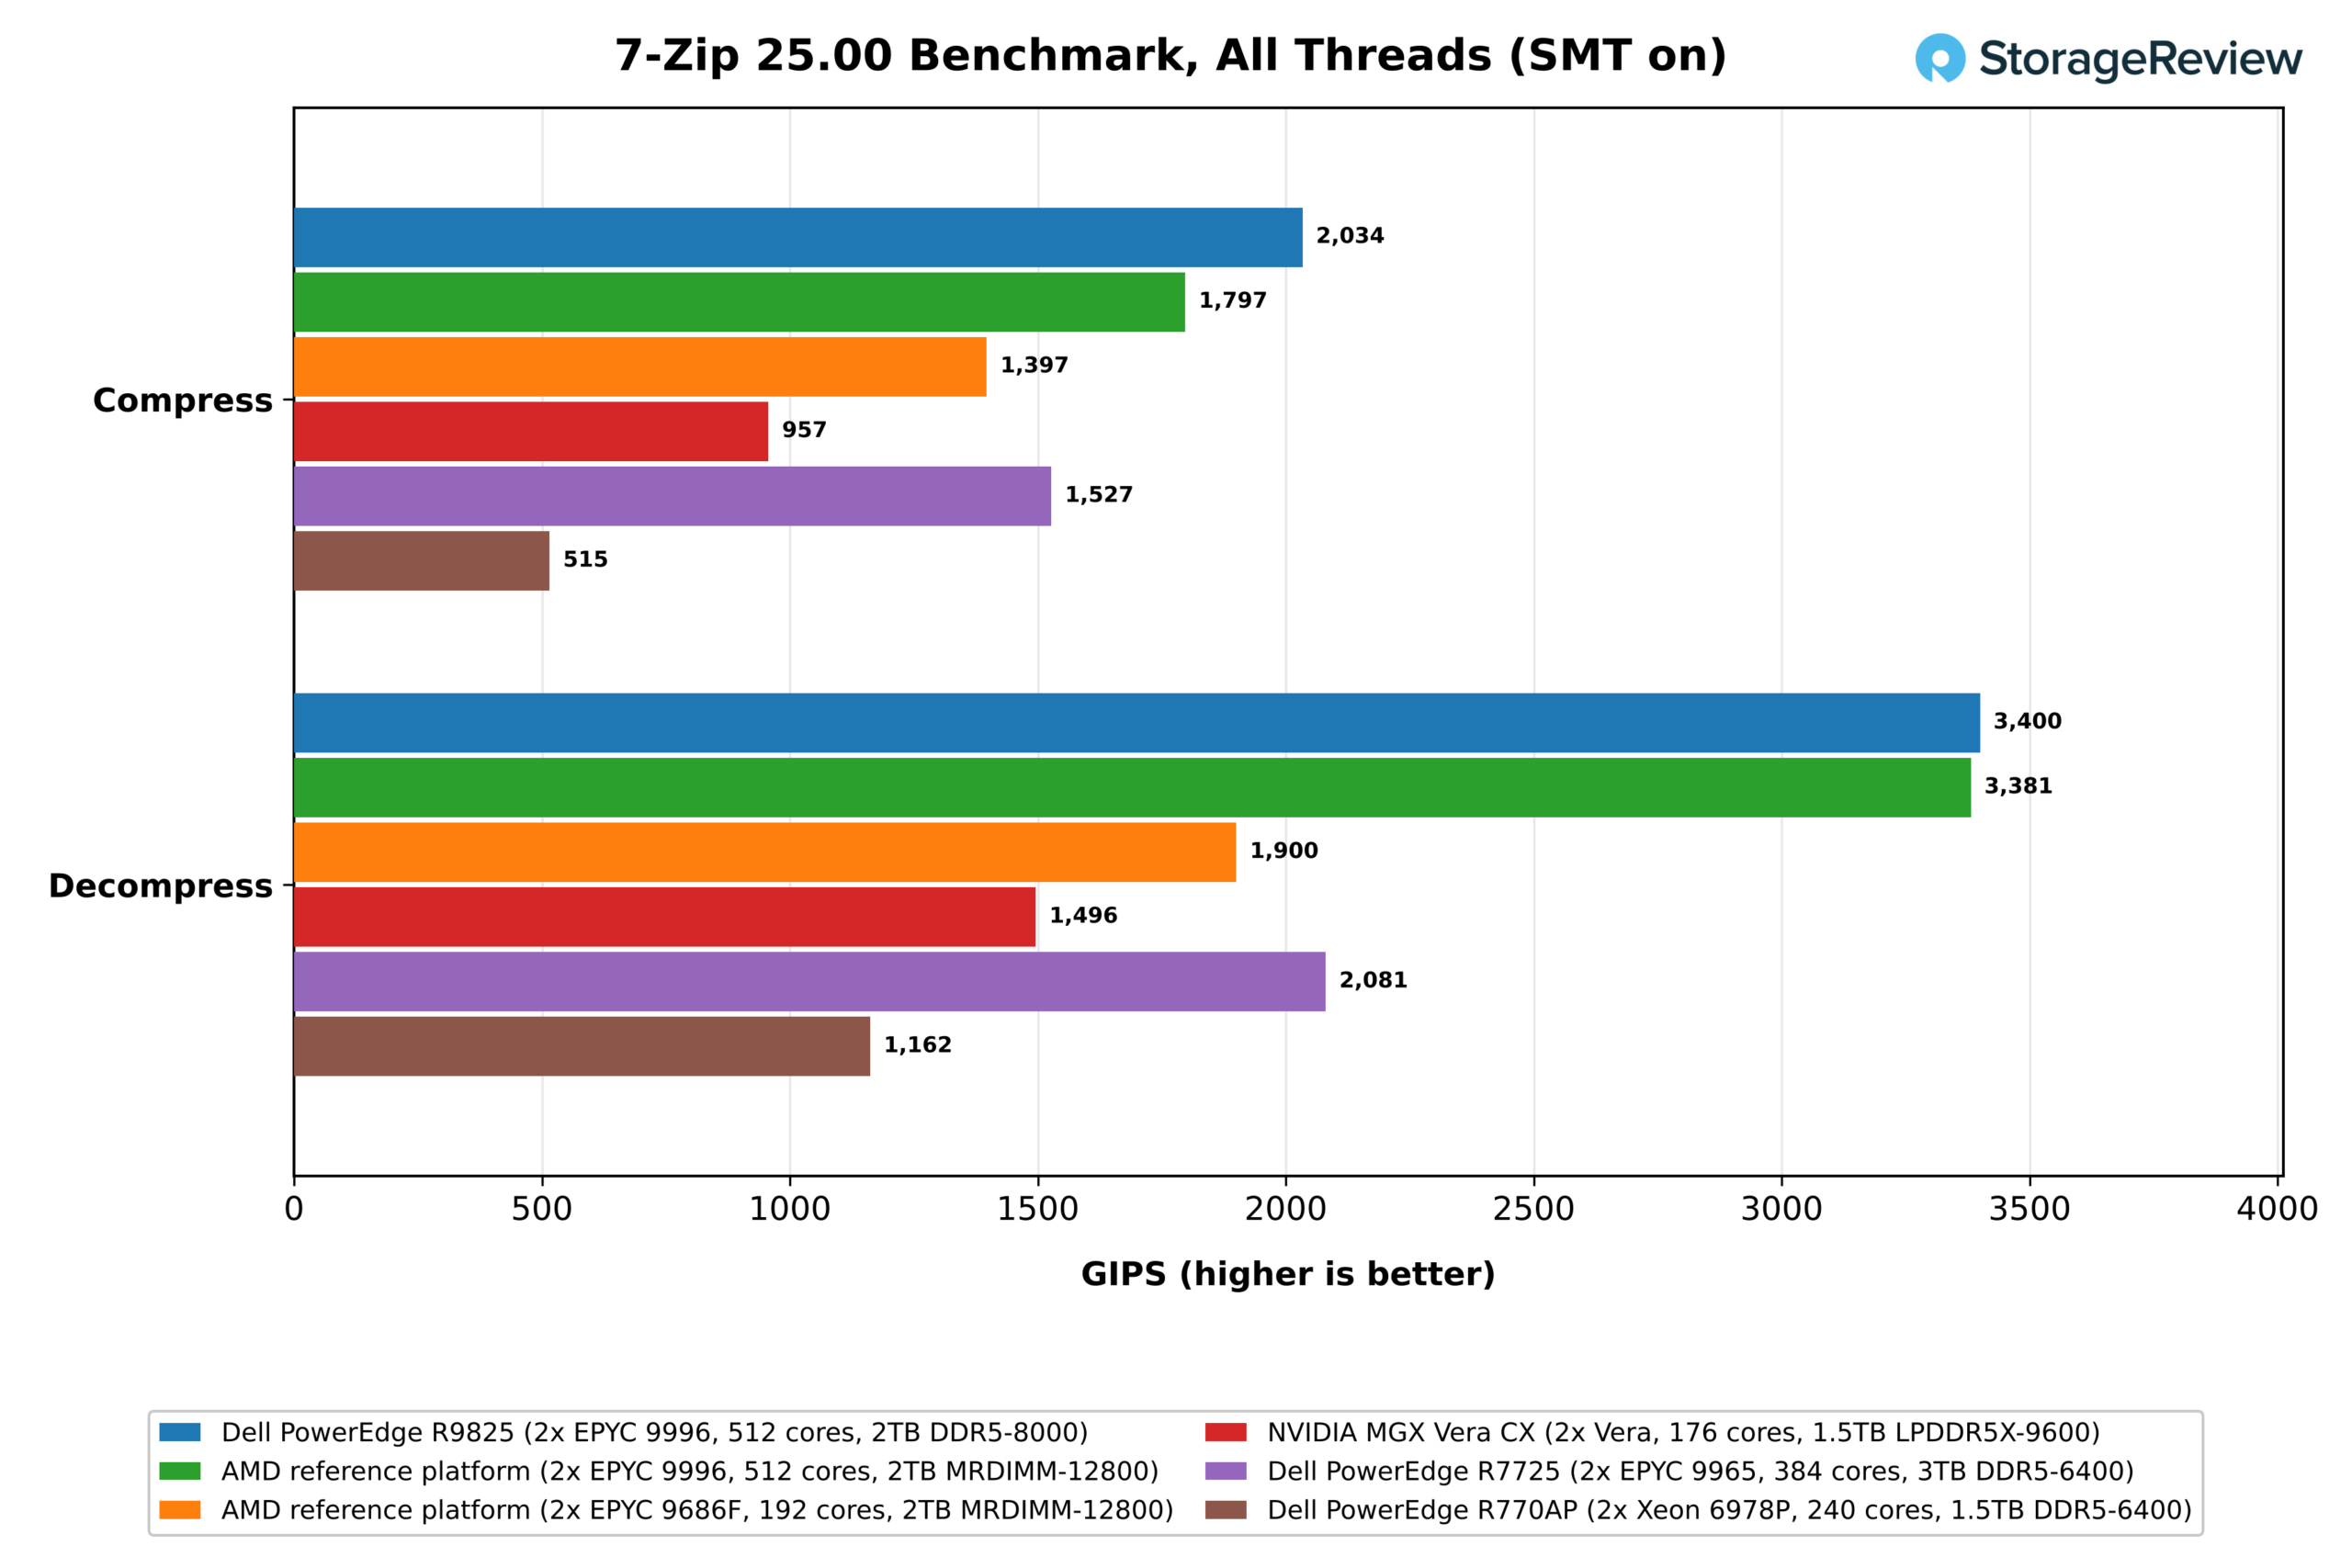
Cu SMT activat, R9825 a comprimat la 2,034 GIPS și a decomprimat la 3,400 GIPS, cu 33% și 63% mai mult decât serverul EPYC 9965 cu 768 de fire de execuție la 1,527 și 2,081, și cu 2.1x și 2.3x mai mult decât Vera 957 și 1,496. Platforma MRDIMM a egalat-o cu o rată de compresie de 12% și de decompresie de 1%.
Măsurată per nucleu fizic, compresia este la același nivel cu cea a lui Turin, la aproximativ 4.0 GIPS, așadar câștigul all-thread provine din numărul de nuclee, în timp ce cele 6.6 GIPS per nucleu ale decompresiei îi depășesc cu 23% pe cei 5.4 GIPS ai Zen 5c. Cele 1,397 și 1,900 GIPS ale modelului 9686F pe 192 de nuclee rezultă în 7.3 și 9.9 GIPS per nucleu, cele mai mari cifre de debit per nucleu din această recenzie.
OpenSSL
Testul AES-256-GCM al OpenSSL este cel în care lățimea setului de instrucțiuni contează cel mai mult. Componentele x86 rulează AES pe registre de 512 biți cu VAES, în timp ce Olympus are două pipe-uri criptografice de 128 biți.
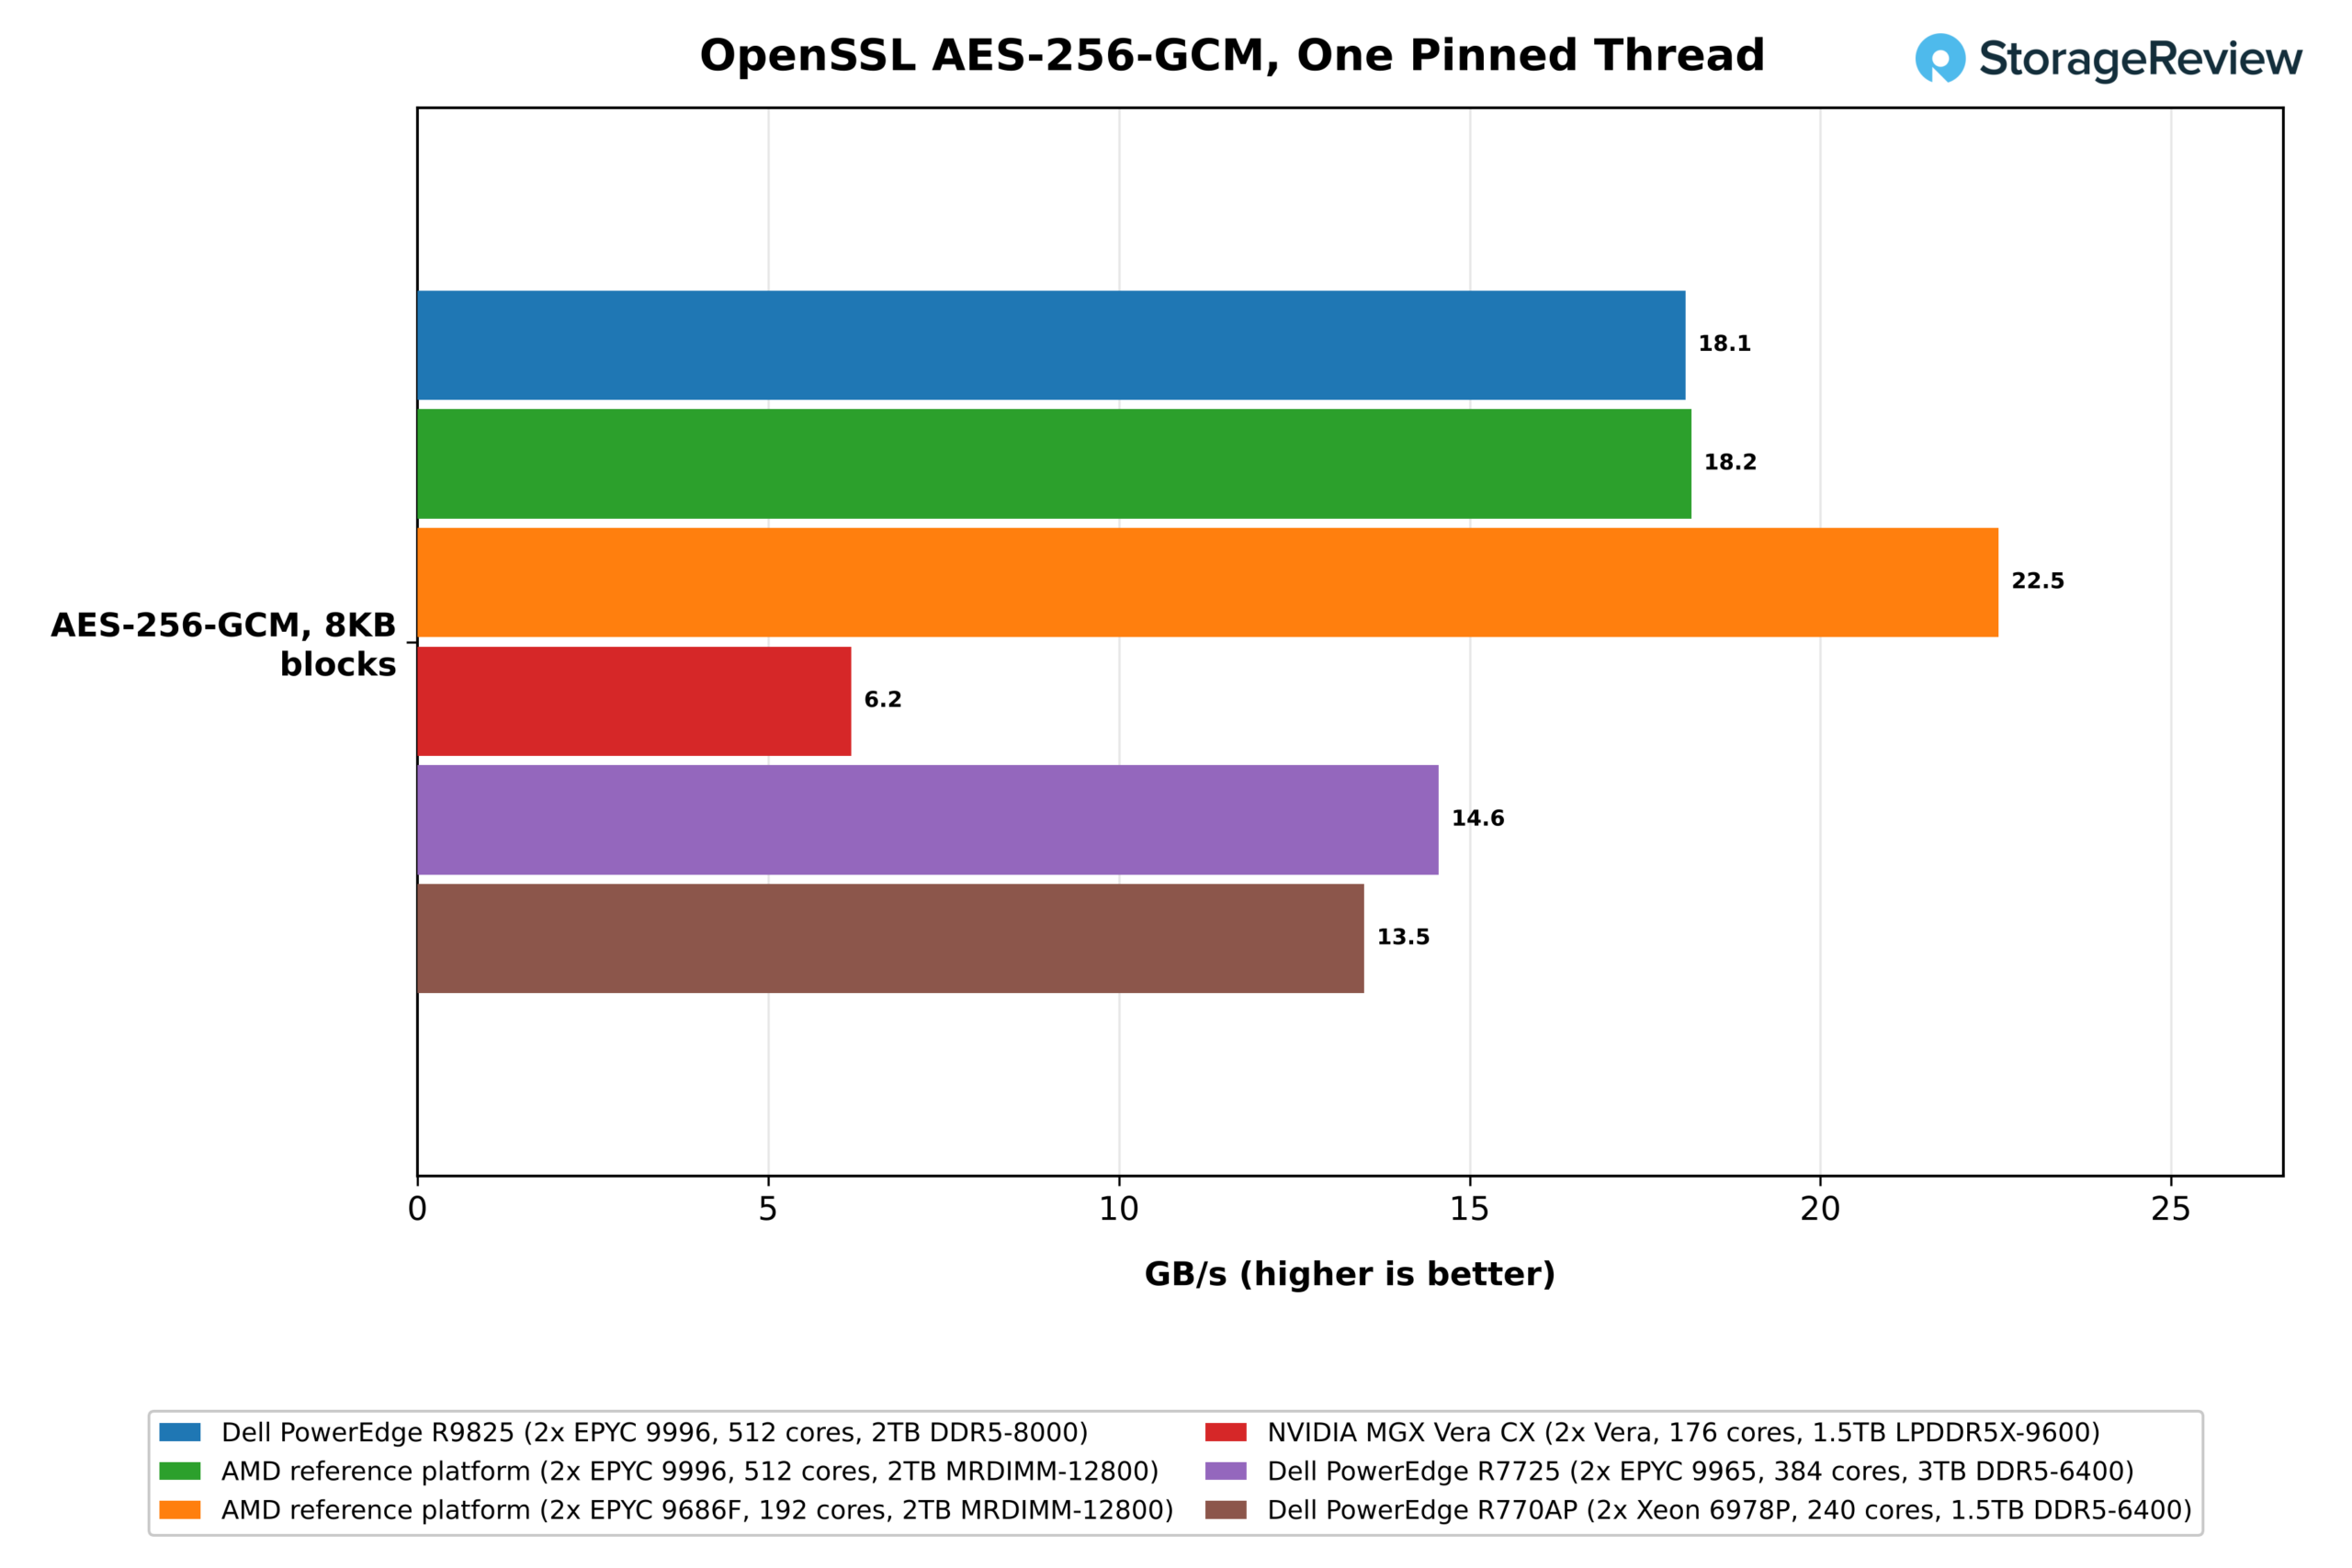
Decalajul este cel mai evident pe un singur fir de execuție. Un fir de execuție Zen 6c a criptat 18.1GB/s pe R9825, de 2.9 ori mai mult decât Olympus, 6.2GB/s, și cu 24% mai mult decât Zen 5c, care are 14.6GB/s, iar 9686F are 22.5GB/s, ceea ce reprezintă cea mai rapidă viteză pe un singur fir de execuție pe care am înregistrat-o.
În fiecare fir de acțiune, numărul de nuclee ale Veneției multiplică avantajul per nucleu.
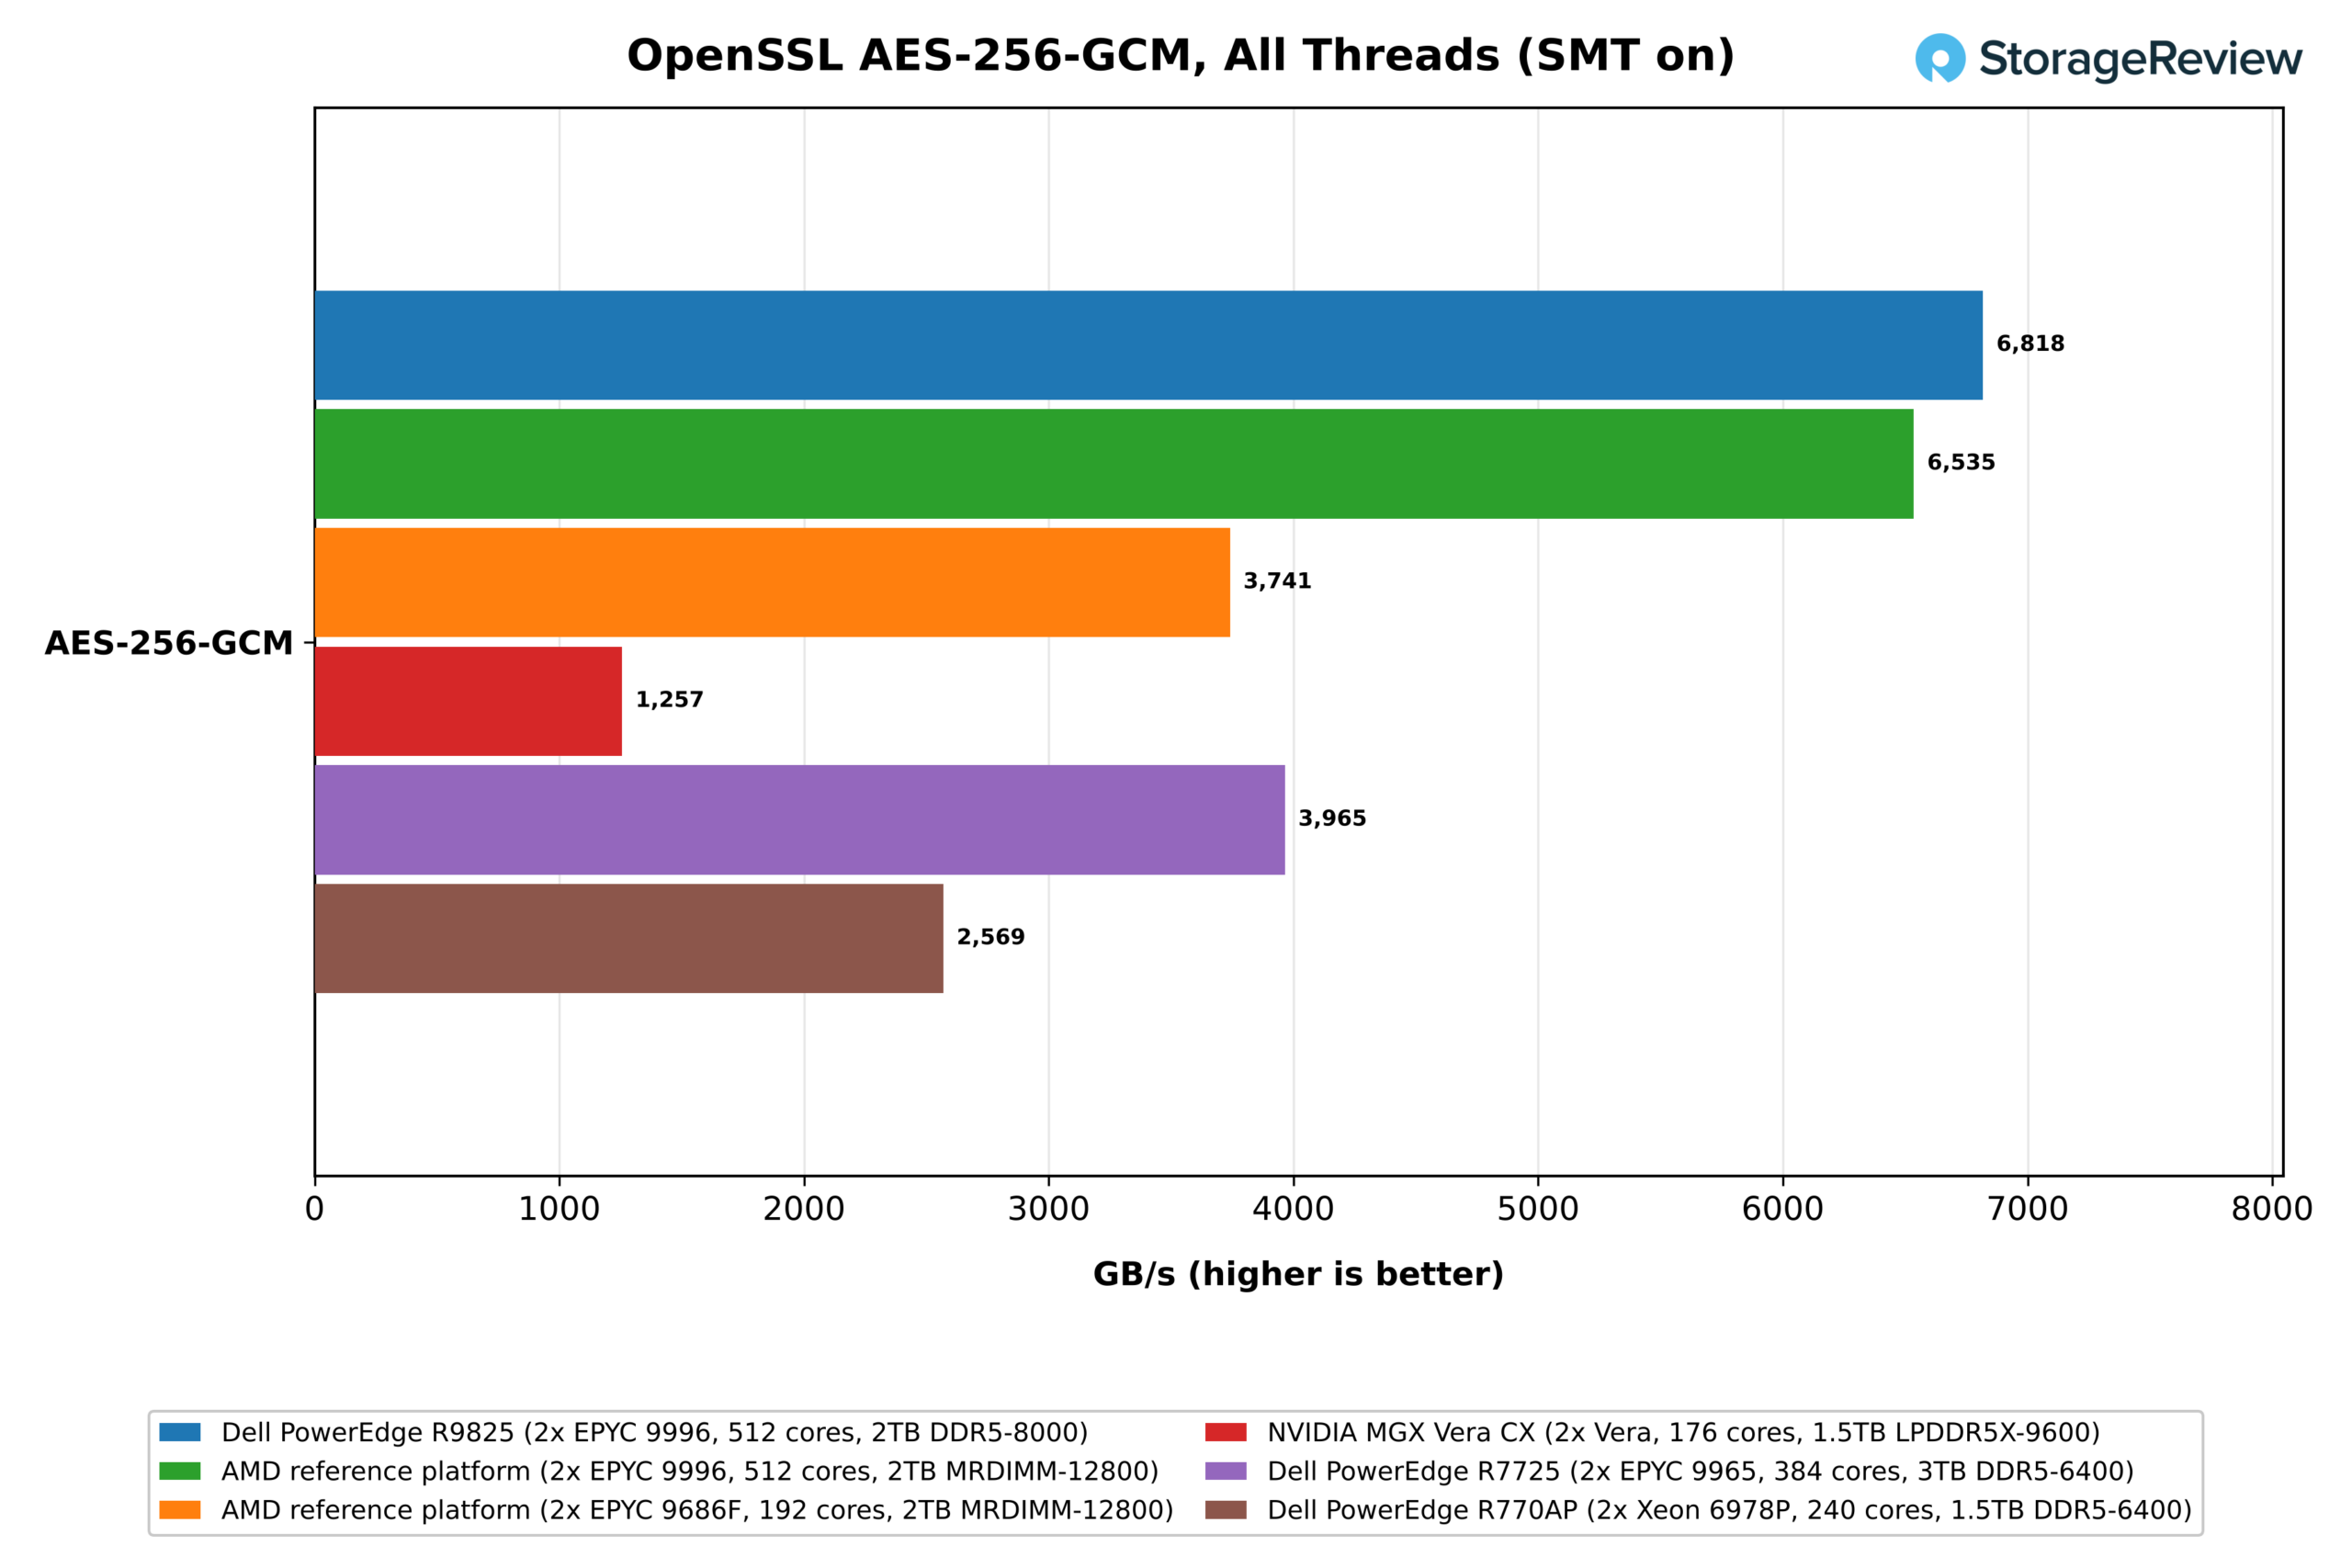
Cu SMT activat, R9825 a atins 6.8 TB/s, de 1.7 ori mai mult decât 3.96 TB/s față de EPYC 9965, de 2.7 ori mai mult decât 2.57 TB/s față de Xeon 6978P și de 5.4 ori mai mult decât 1.26 TB/s față de Vera. VAES pe registre de 512 biți pe 512 nuclee reprezintă o clasă diferită de debit criptografic în vrac față de două pipe-uri criptografice de 128 biți pe 176 nuclee, iar pentru terminarea TLS sau criptarea în repaus efectuată software, partea x86 a acestei comparații nu este apropiată.
Piton
Python este sarcina de lucru pe care NVIDIA o citează cel mai des pentru sandbox-urile de agenți, iar pyperformance ne oferă trei teste fixe pe un singur fir de execuție: go, o căutare în arborele de joc bazată pe obiecte; regex_compile, un compilator de expresii regulate; și nbody, o buclă n-body în virgulă mobilă. O diferență software se aplică aici: Venice și Vera au rulat Python 3.14.4 de pe Ubuntu 26.04, în timp ce comparațiile dintre Turin și Xeon au rulat 3.12.3, ceea ce le avantajează pe Venice și Vera cu câteva procente față de cele două.
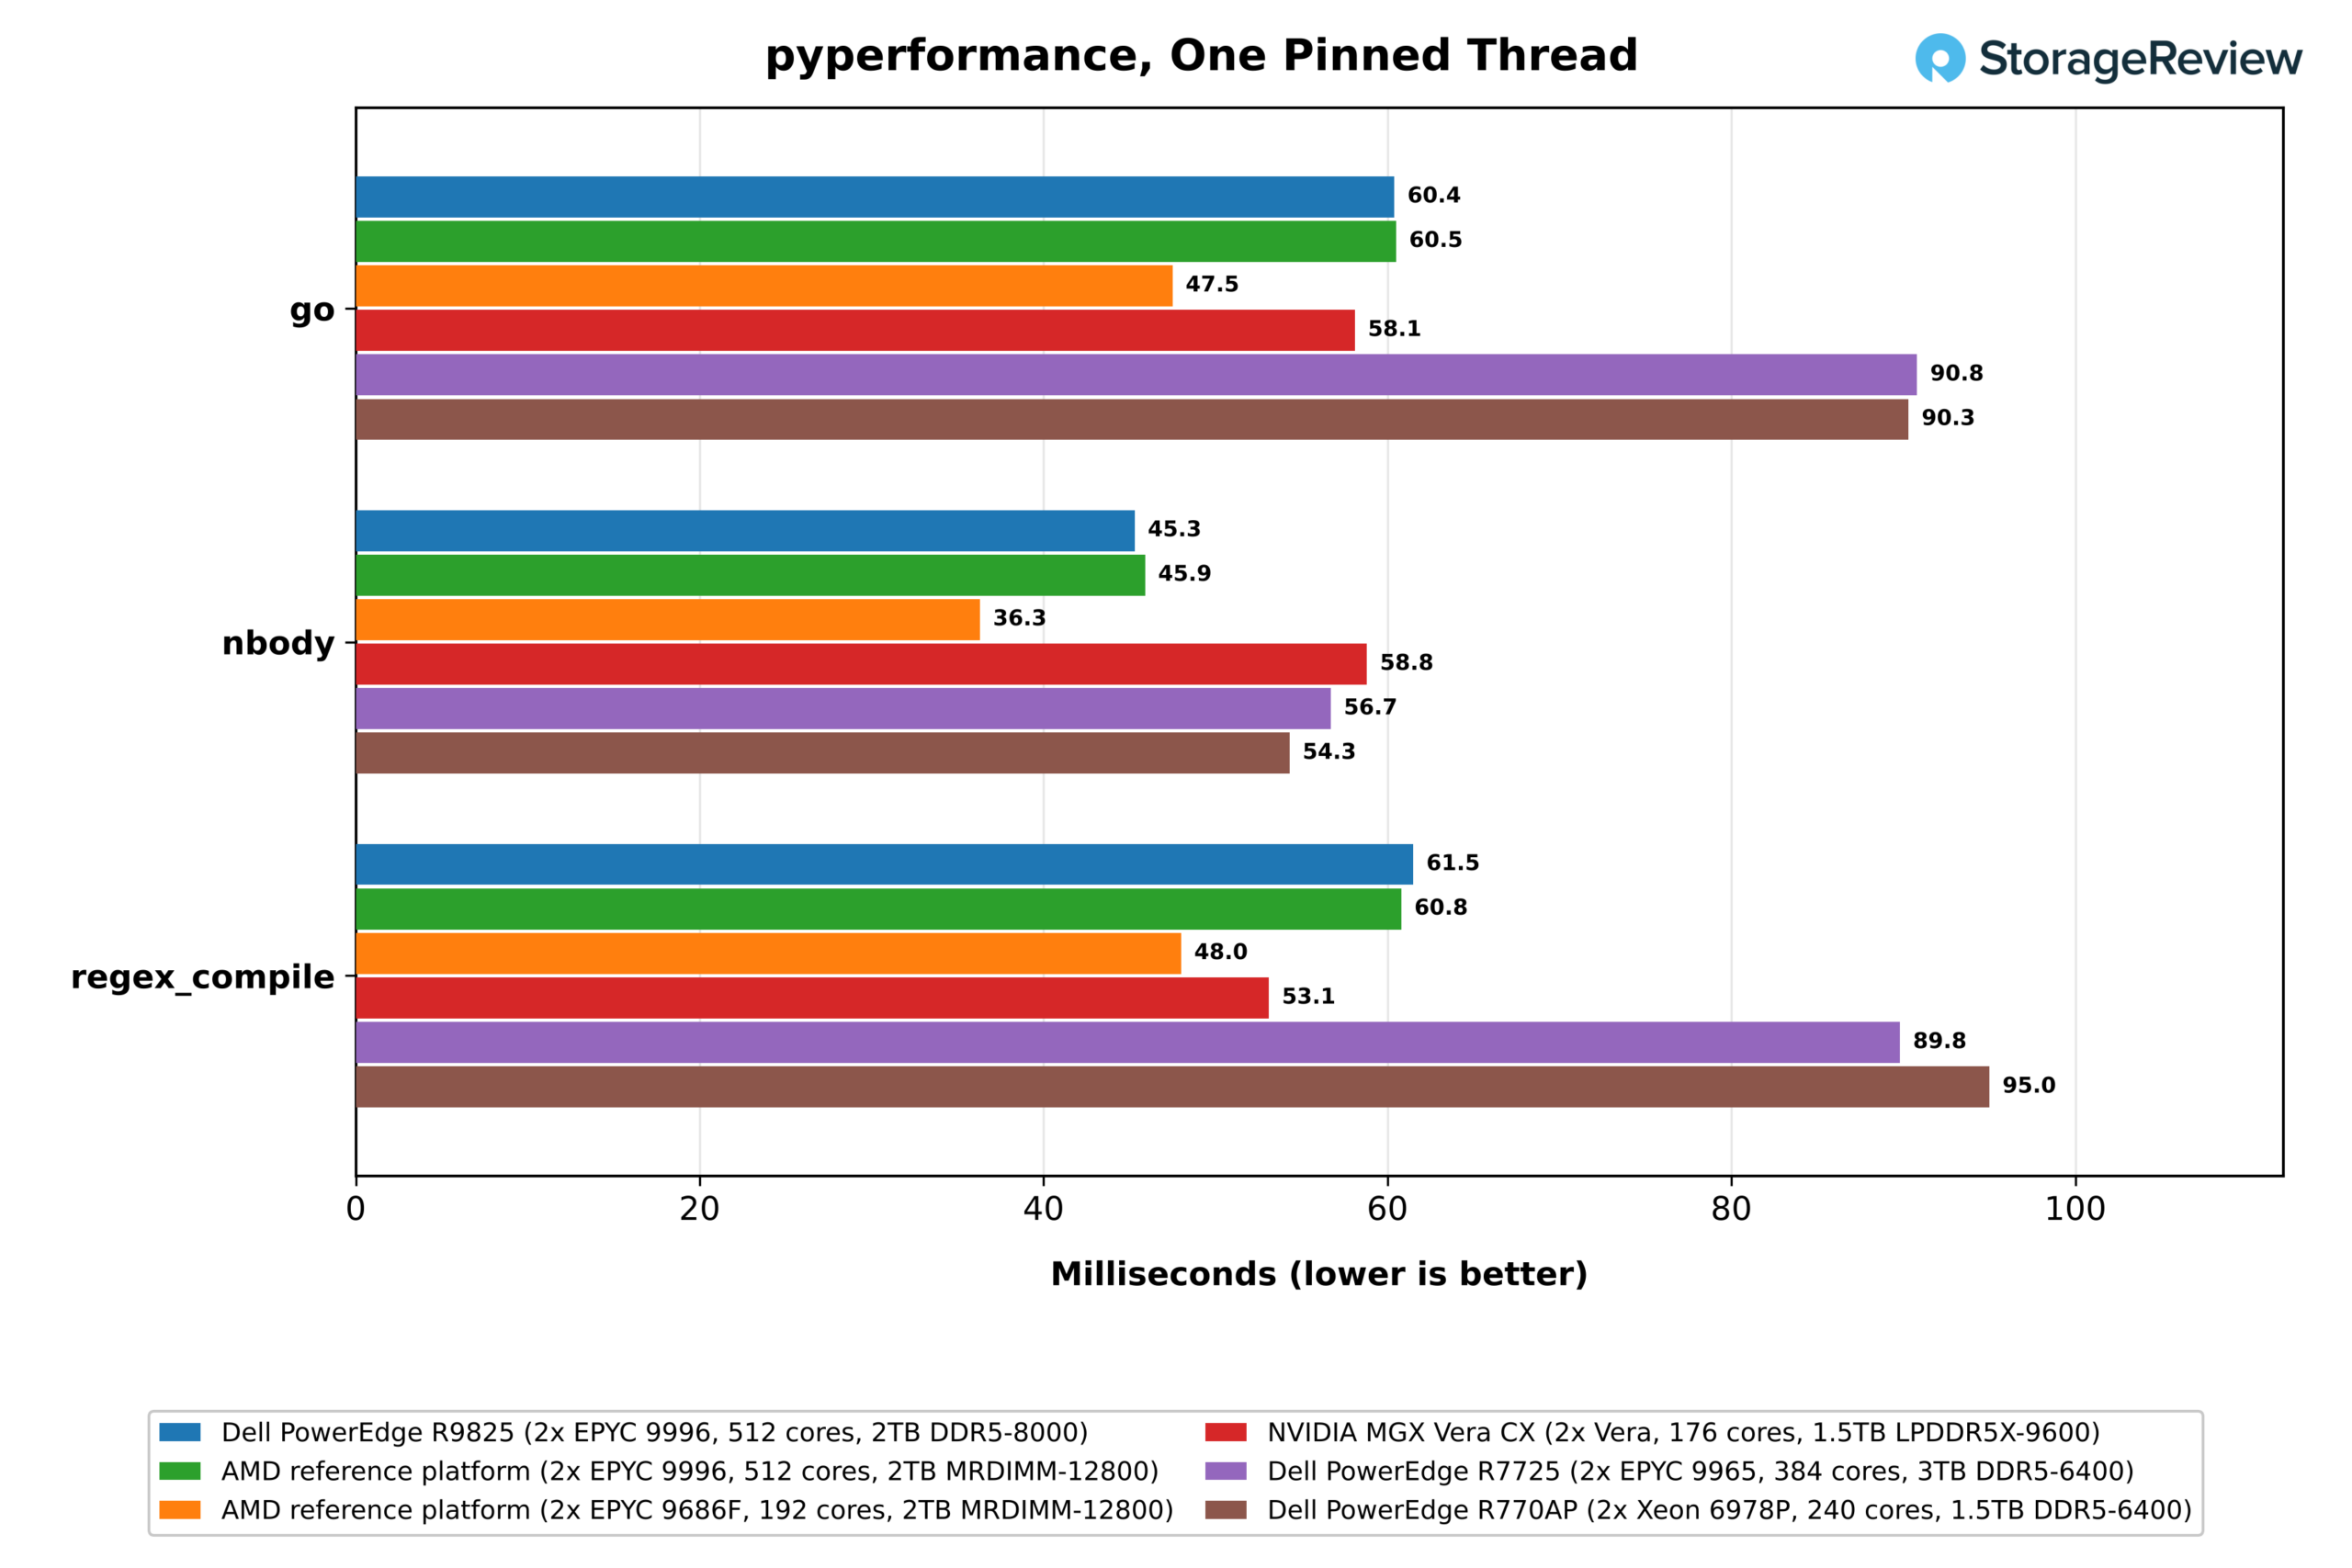
9996 împarte setul Python cu Vera, iar 9686F îl depășește. În mers, R9825 a rulat 60.4 ms față de cei 58.1 ms ai Verei, un avans de 4% al Verei care se află în interiorul zgomotului de la o rundă la alta, iar cei 47.5 ms ai 9686F au durat cu 18% mai puțin decât Olympus. Pe regex_compile, cei 53.1 ms ai Verei au durat cu 14% mai puțin decât cei 61.5 ms ai 9996, iar cei 48.0 ms ai 9686F au durat cu 10% mai puțin decât Vera. Pe nbody, bucla în virgulă mobilă, cei 45.3 ms ai 9996 au durat cu 23% mai puțin decât cei 58.8 ms ai Verei, iar cei 36.3 ms ai 9686F au durat cu 38% mai puțin.
Împotriva lui Turin, 9996 a redus timpul de execuție cu 33% în mișcare, cu 20% pe nbody și cu 32% pe regex_compile la o frecvență de ceas cu 400MHz mai mare, deci cea mai mare parte a acestui câștig provine din nucleu. Deoarece Venice avea și noul Python, acele margini ale lui Turin ar trebui interpretate ca limite superioare.
Rezultatele Python urmează un model consistent în toate cele trei teste. În cazul în care un test este limitat de latența memoriei pe un set funcțional după L2, așa cum sunt go și regex_compile, L2-ul de 2 MB și prefetcher-ul grafic de la Olympus îl mențin la același nivel cu sau înaintea unui nucleu Zen 6c de 4.1 GHz. În cazul în care testul este limitat de compute sau clock, așa cum este nbody, Zen 6c este în frunte, iar 9686F de 5.3 GHz este în fruntea tuturor celor trei.
Servirea web, JVM și latența planificatorului
Ultimul grup de teste de harnaș acoperă software-ul care înconjoară o aplicație: stiva web, mașina virtuală Java, planificatorul Linux și lanțul de instrumente al compilatorului. Mai multe dintre aceste rezultate depind la fel de mult de câte thread-uri rulează fiecare sistem, cât și de cât de repede rulează fiecare nucleu, așa că spun mai puține despre Zen 6c în sine decât o spun secțiunile anterioare.
Nginx
NGINX deservește cereri HTTPS către generatorul de încărcare Wrk care rulează pe aceeași mașină, astfel încât clientul și serverul concurează pentru aceleași nuclee. Rezultatul reflectă mai mult stiva TLS și HTTP decât numărul de nuclee și se stabilizează în jurul a 300,000 până la 400,000 de cereri pe secundă pe fiecare 2026 de servere pe care le-am rulat.
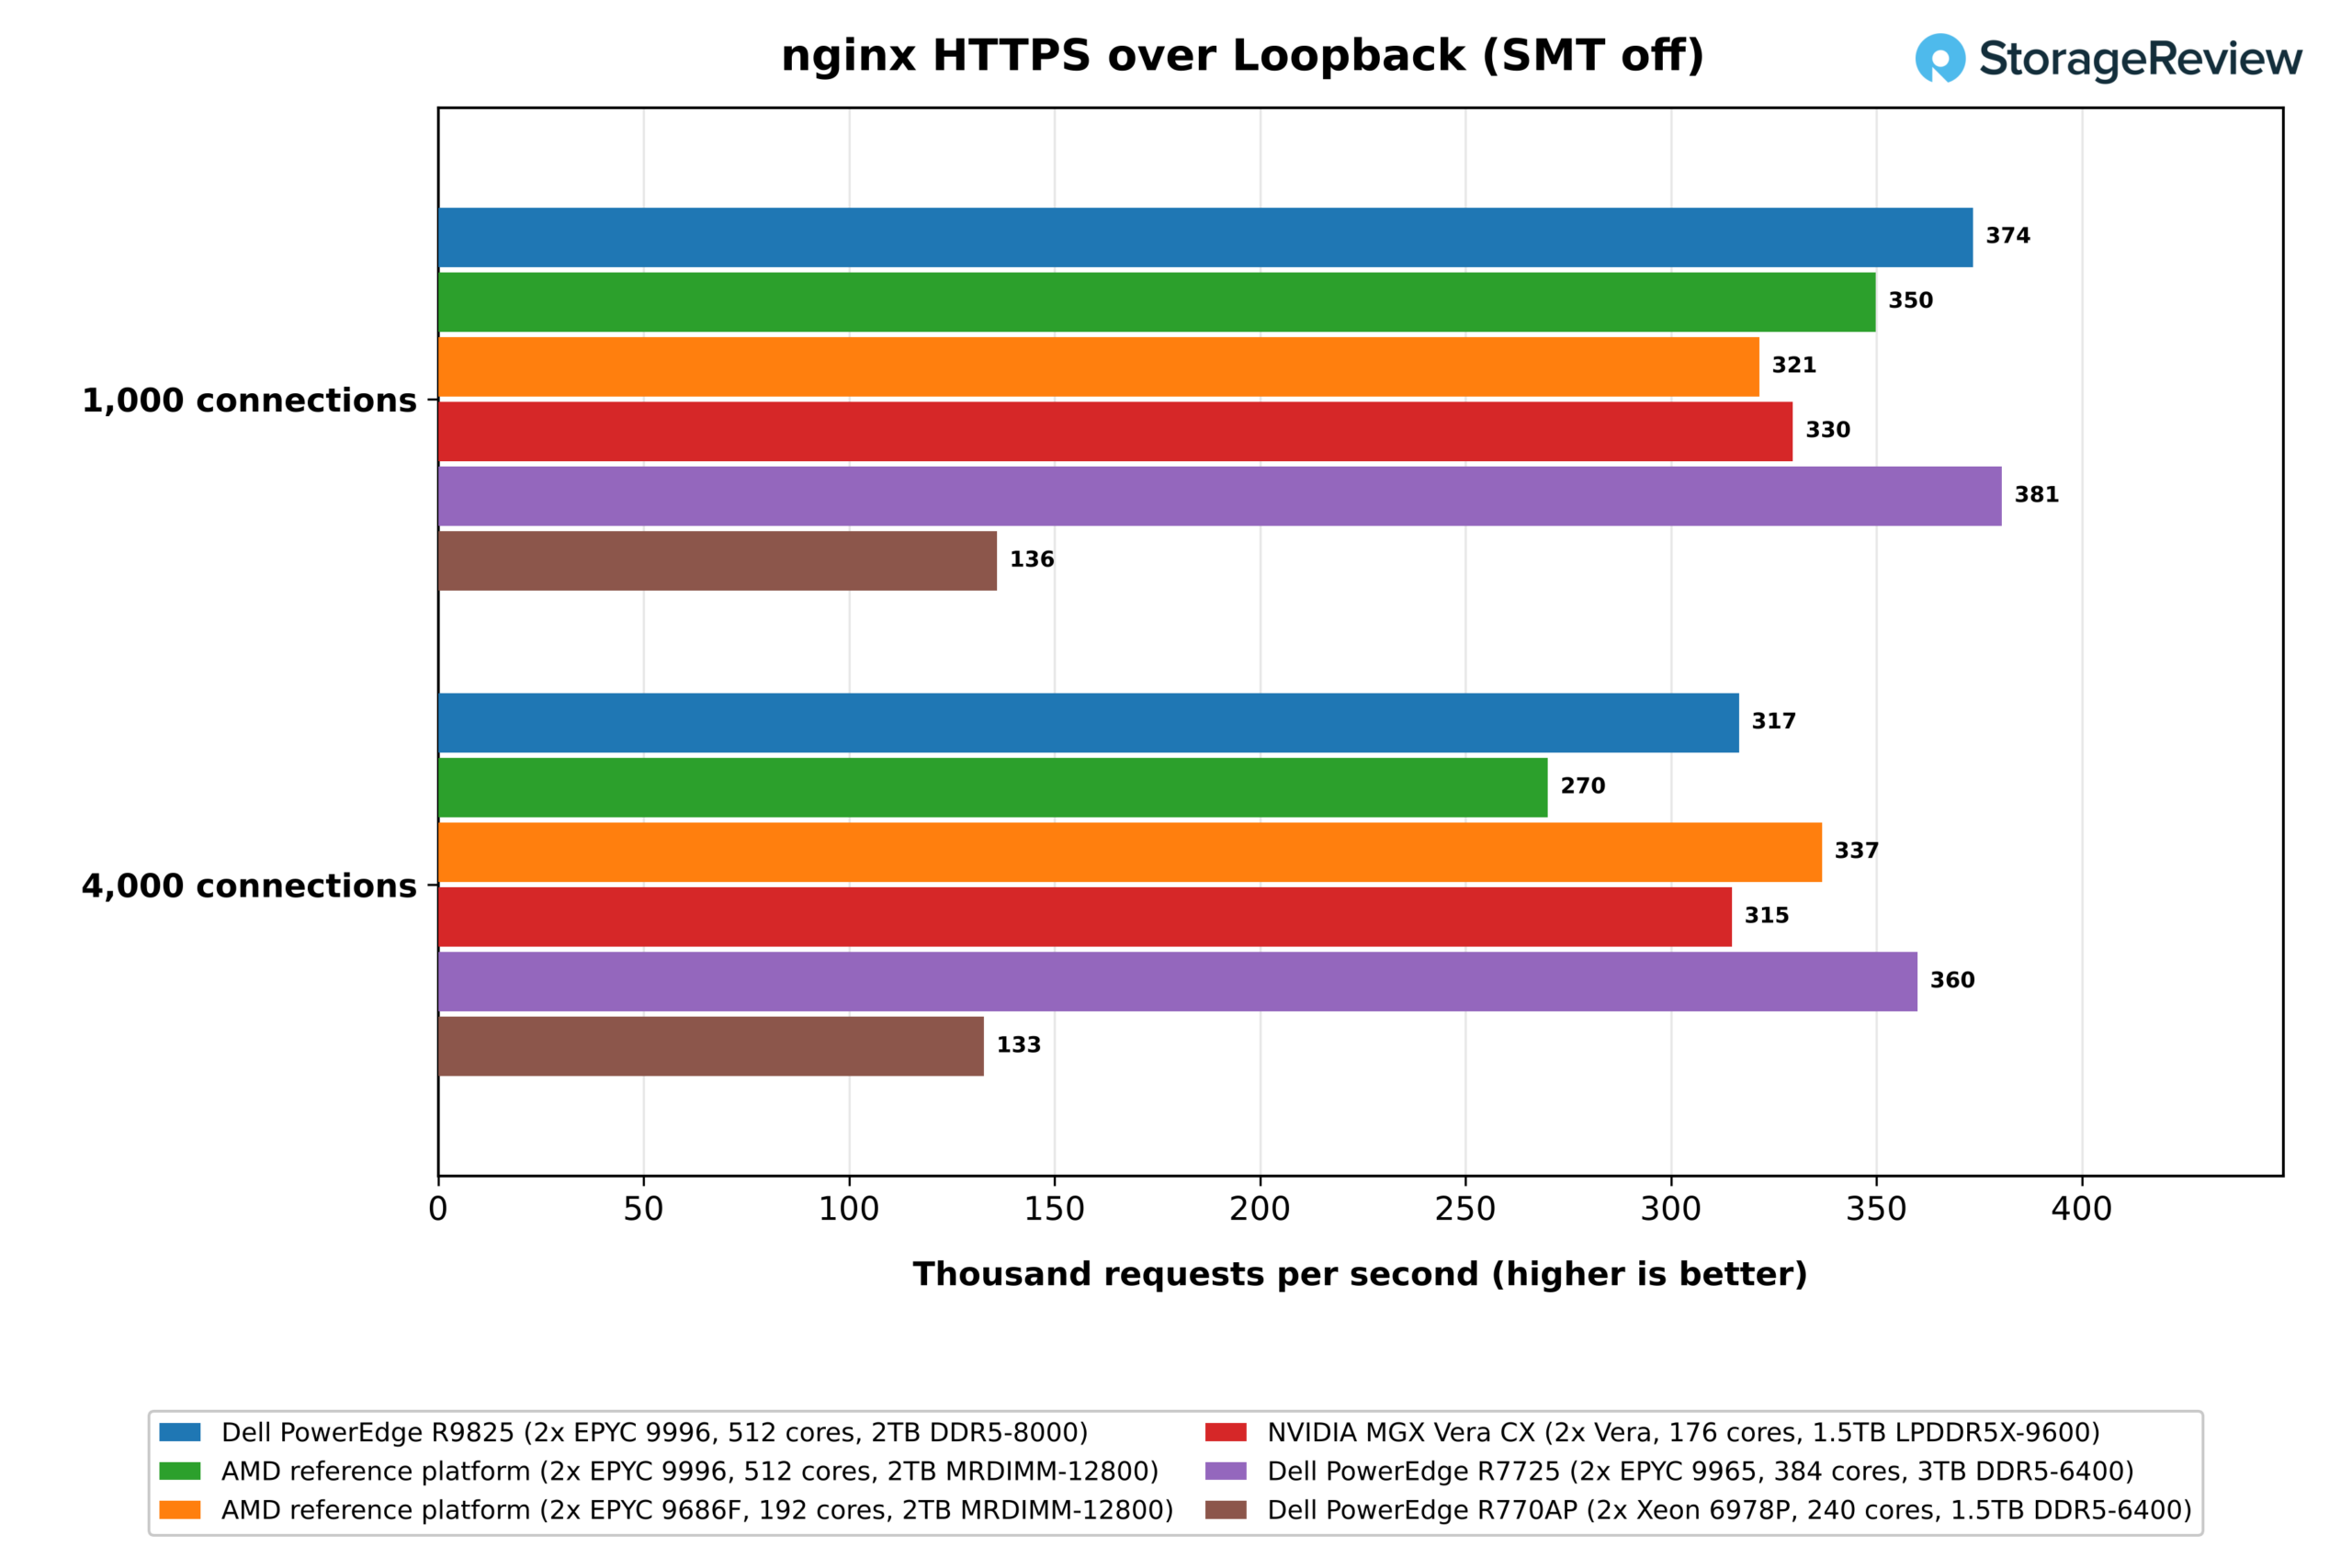
Cu SMT dezactivat, R9825 a gestionat 374,000 de cereri pe secundă la 1,000 de conexiuni și 317,000 la 4,000, față de 381,000 și 360,000 pentru EPYC 9965, 330,000 și 315,000 pentru Vera și 321,000 și 337,000 pentru 9686F. Toate acestea se situează pe platou, iar valorile de 136,000 și 133,000 pentru Xeon 6978P sunt valorile aberante. Testul confirmă că stiva de rețea Venice se comportă ca orice alt server x86, dar nu ne spune nimic despre numărul de nuclee.
Renaștere
Renaissance rulează sarcini de lucru Java pe OpenJDK 11: testul HTTP Finagle exersează o stivă de rețea Scala, testul Akka un framework de concurență actor-model, iar un al treilea testează un algoritm genetic. JVM programează lucrul pe fiecare CPU logic pe care îl vede, ceea ce pune un sistem cu 512 nuclee precum R9825 într-un dezavantaj structural, așa că enumerăm aceste rezultate pentru completitudine și nu le clasificăm.
| Testare | Dell R9825 (2x 9996) | Referință AMD (2x 9996, MRDIMM) | Referință AMD (2x 9686F) | NVIDIA Vera (2x 88c) | EPYC 9965 (2x 192c) | Xeon 6978P (2x 120c) |
|---|---|---|---|---|---|---|
| Renaissance 0.16 pe OpenJDK 11, milisecunde, SMT dezactivat (cu cât mai mic este mai bine) | ||||||
| Cereri HTTP Finagle | 13,949 | 14,423 | 5,135 | 4,298 | 8,218 | 54,612 |
| Copac Akka dezechilibrat cu pânze de păianjen | 150,034 | 146,208 | 32,396 | 44,557 | 56,163 | 103,649 |
| Algoritmul genetic (Jenetics + Futures) | 1,836 | 2,596 | 2,234 | 2,170 | 2,250 | 10,767 |
Cele două configurații 9996 înregistrează cei mai lenți timpi Finagle și Akka dintre sistemele AMD, deoarece testele actor-model și Scala se serializează pe sincronizare care crește cu 512 thread-uri. 9686F, cu 192 thread-uri la 5.3 GHz, înregistrează cel mai bun timp Akka din set și este depășit doar de Vera pe Finagle, în timp ce R9825 conduce algoritmul genetic cu 1,836 ms.
schbench
schbench măsoară cât de repede trezește planificatorul Linux firele de execuție (worker threads), rulând aproximativ un worker per CPU logic cu 4 fire de execuție (message threads) și aproximativ opt per CPU cu 32. Deoarece numărul de worker-i crește odată cu sistemul, serverele mai mari lucrează mai mult, așadar aceste rezultate descriu latența sub sarcină maximă pe fiecare mașină și nu reprezintă o comparație identică, așa că le lăsăm neclasificate.
| Testare | Dell R9825 (2x 9996) | Referință AMD (2x 9996, MRDIMM) | Referință AMD (2x 9686F) | NVIDIA Vera (2x 88c) | EPYC 9965 (2x 192c) | Xeon 6978P (2x 120c) |
|---|---|---|---|---|---|---|
| schbench, 4 fire de mesaje, microsecunde, SMT dezactivat (mai mic este mai bine) | ||||||
| p50 | 142 | 155 | 64 | 177 | 87 | 423 |
| p90 | 251 | 266 | 100 | 235 | 153 | 589 |
| p99.9 | 3,804 | 1,245 | 1,335 | 339 | 3,104 | 3,721 |
| schbench, 32 de fire de mesaje (supraabonate), microsecunde, SMT dezactivat (mai mic este mai bine) | ||||||
| p50 | 6,019 | 4,125 | 3,776 | 3,996 | 5,714 | 4,384 |
| p99.9 | 44,821 | 29,003 | 28,368 | 32,320 | 44,565 | 37,935 |
Latența p99.9 la patru fire de execuție necesită o mențiune suplimentară. Cei 3,804µs ai lui R9825 se compară cu cei 1,245µs de pe procesoarele identice de pe platforma AMD, o diferență de latență între cele două combinații de firmware și placă de bază pe care nu am izolat-o, deși medianele celor patru fire de execuție se potrivesc în limita a 10%.
Compilarea kernelului Linux
Compilarea allmodconfig a kernelului Linux este comparabilă pe sistemele x86, dar Vera compilează arborele kernelului arm64, care include un set diferit de module și drivere față de arborele x86-64, așa că îl omitem din grafic și nu îl clasificăm.
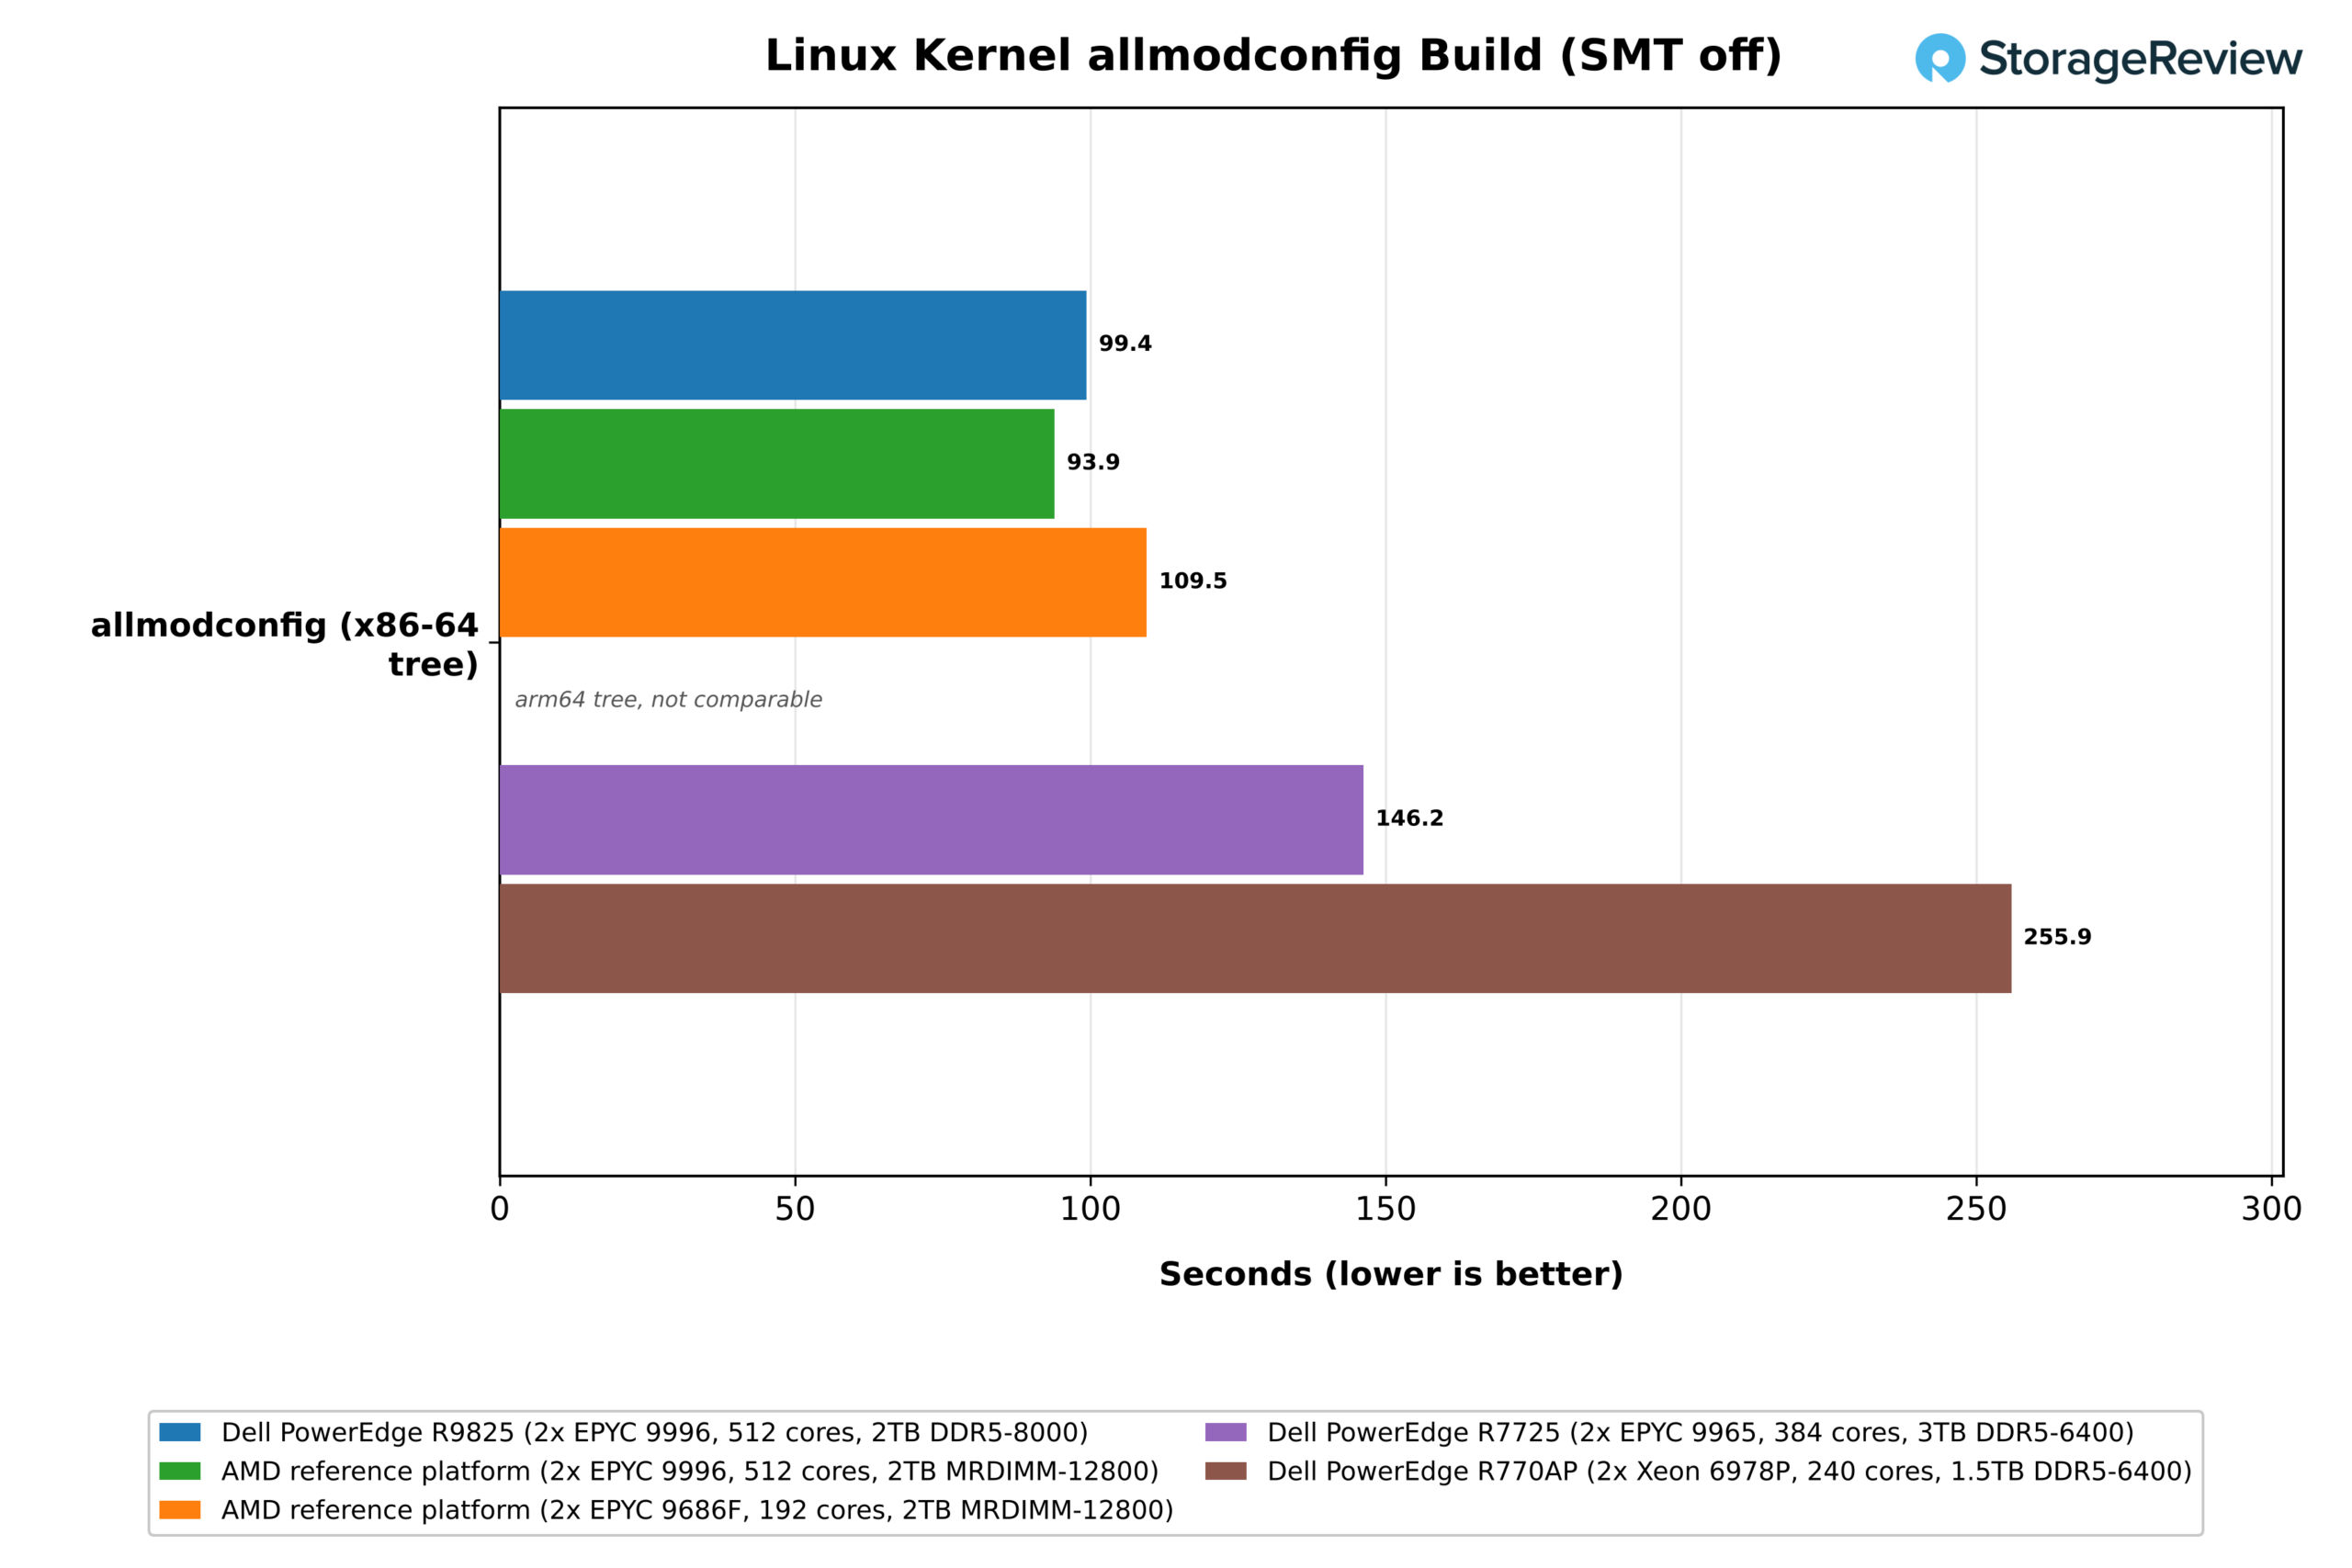
Cu SMT dezactivat, R9825 a construit kernelul în 99.4 secunde, cu 32% mai puțin timp decât cele 146.2 secunde ale EPYC 9965 și de 2.6 ori mai rapid decât cele 255.9 secunde ale Xeon 6978P. Configurația MRDIMM 9996 s-a finalizat în 93.9 secunde, iar 9686F în 109.5 secunde. Activarea SMT a încetinit R9825 la 103.1 secunde, iar MRDIMM 9996 la 101.3 secunde, așa că firele de execuție suplimentare nu au ajutat nici 9996 la construirea, în timp ce 9686F a îmbunătățit la 100.8 secunde, iar EPYC 9965 și Xeon 6978P au încetinit la 181.0 și 288.9 secunde. Vera, construindu-și arborele arm64, a avut nevoie de 180.7 secunde cu SMT oprit și 196.4 cu SMT activat.
Extensia HammerDB
Pentru testele bazei de date, l-am apelat din nou la Steve Shaw, creatorul și responsabilul de întreținere al HammerDB. În noiembrie, Shaw a rulat sarcina de lucru TPROC-C a HammerDB 6.1.1, un benchmark OLTP derivat din TPC-C, dar care nu este comparabil cu rezultatele TPC publicate, pe patru sisteme: Dell PowerEdge R9825, serverul Vera, un Dell PowerEdge R7725 cu două procesoare EPYC 9175F cu 16 nuclee și platforma de referință Nigeria de la AMD cu EPYC 9686F cu 96 de nuclee. El a testat câte patru motoare open-source pe fiecare: MariaDB 13.0.2, MySQL 26.10.0, VillageSQL 0.0.7 și PostgreSQL 18.6. Dimensiunea bazei de date a fost scalată la opt depozite de date per procesor logic online.
Shaw a rulat R9825 ca un singur socket EPYC 9996 cu toate cele 256 de nuclee online și SMT dezactivat la 2,048 de depozite, Vera ca socket cu 88 de nuclee cu SMT activat la 1,408 depozite, iar sistemul 9175F ca server cu 32 de nuclee și două socketuri la 512 depozite. El construiește profilurile cu un singur socket prin scoaterea din funcțiune a procesoarelor celui de-al doilea socket prin interfața hotplug a procesorului Linux, fără nicio modificare a BIOS-ului, deoarece niciunul dintre motoarele open-source nu se scalează pe două socketuri. O rulare pe două socketuri arată o concurență puternică de mutex și un vârf mai mic, o limitare pe care Oracle, SQL Server și Db2 au proiectat-o deja în jurul ei.
Deoarece numărul de depozite diferă între cele patru sisteme, vârful fiecărui motor este raportat la numărul de utilizatori virtuali și dimensiunea bazei de date care l-a produs, ca în runda din octombrie. Rezultatele din octombrie pentru socketul EPYC 9965 cu 192 de nuclee, rulat pe HammerDB 6.1 cu o lună mai devreme, se află în recenzia noastră Vera . Le facem referire aici doar acolo unde direcția este lipsită de ambiguitate, deoarece clientul a trecut la 6.1.1, iar MySQL a trecut de la 26.7 la 26.10 între runde, iar vârfurile Vera pe același hardware au oscilat între o scădere de 12% și un câștig de 4% în același interval.
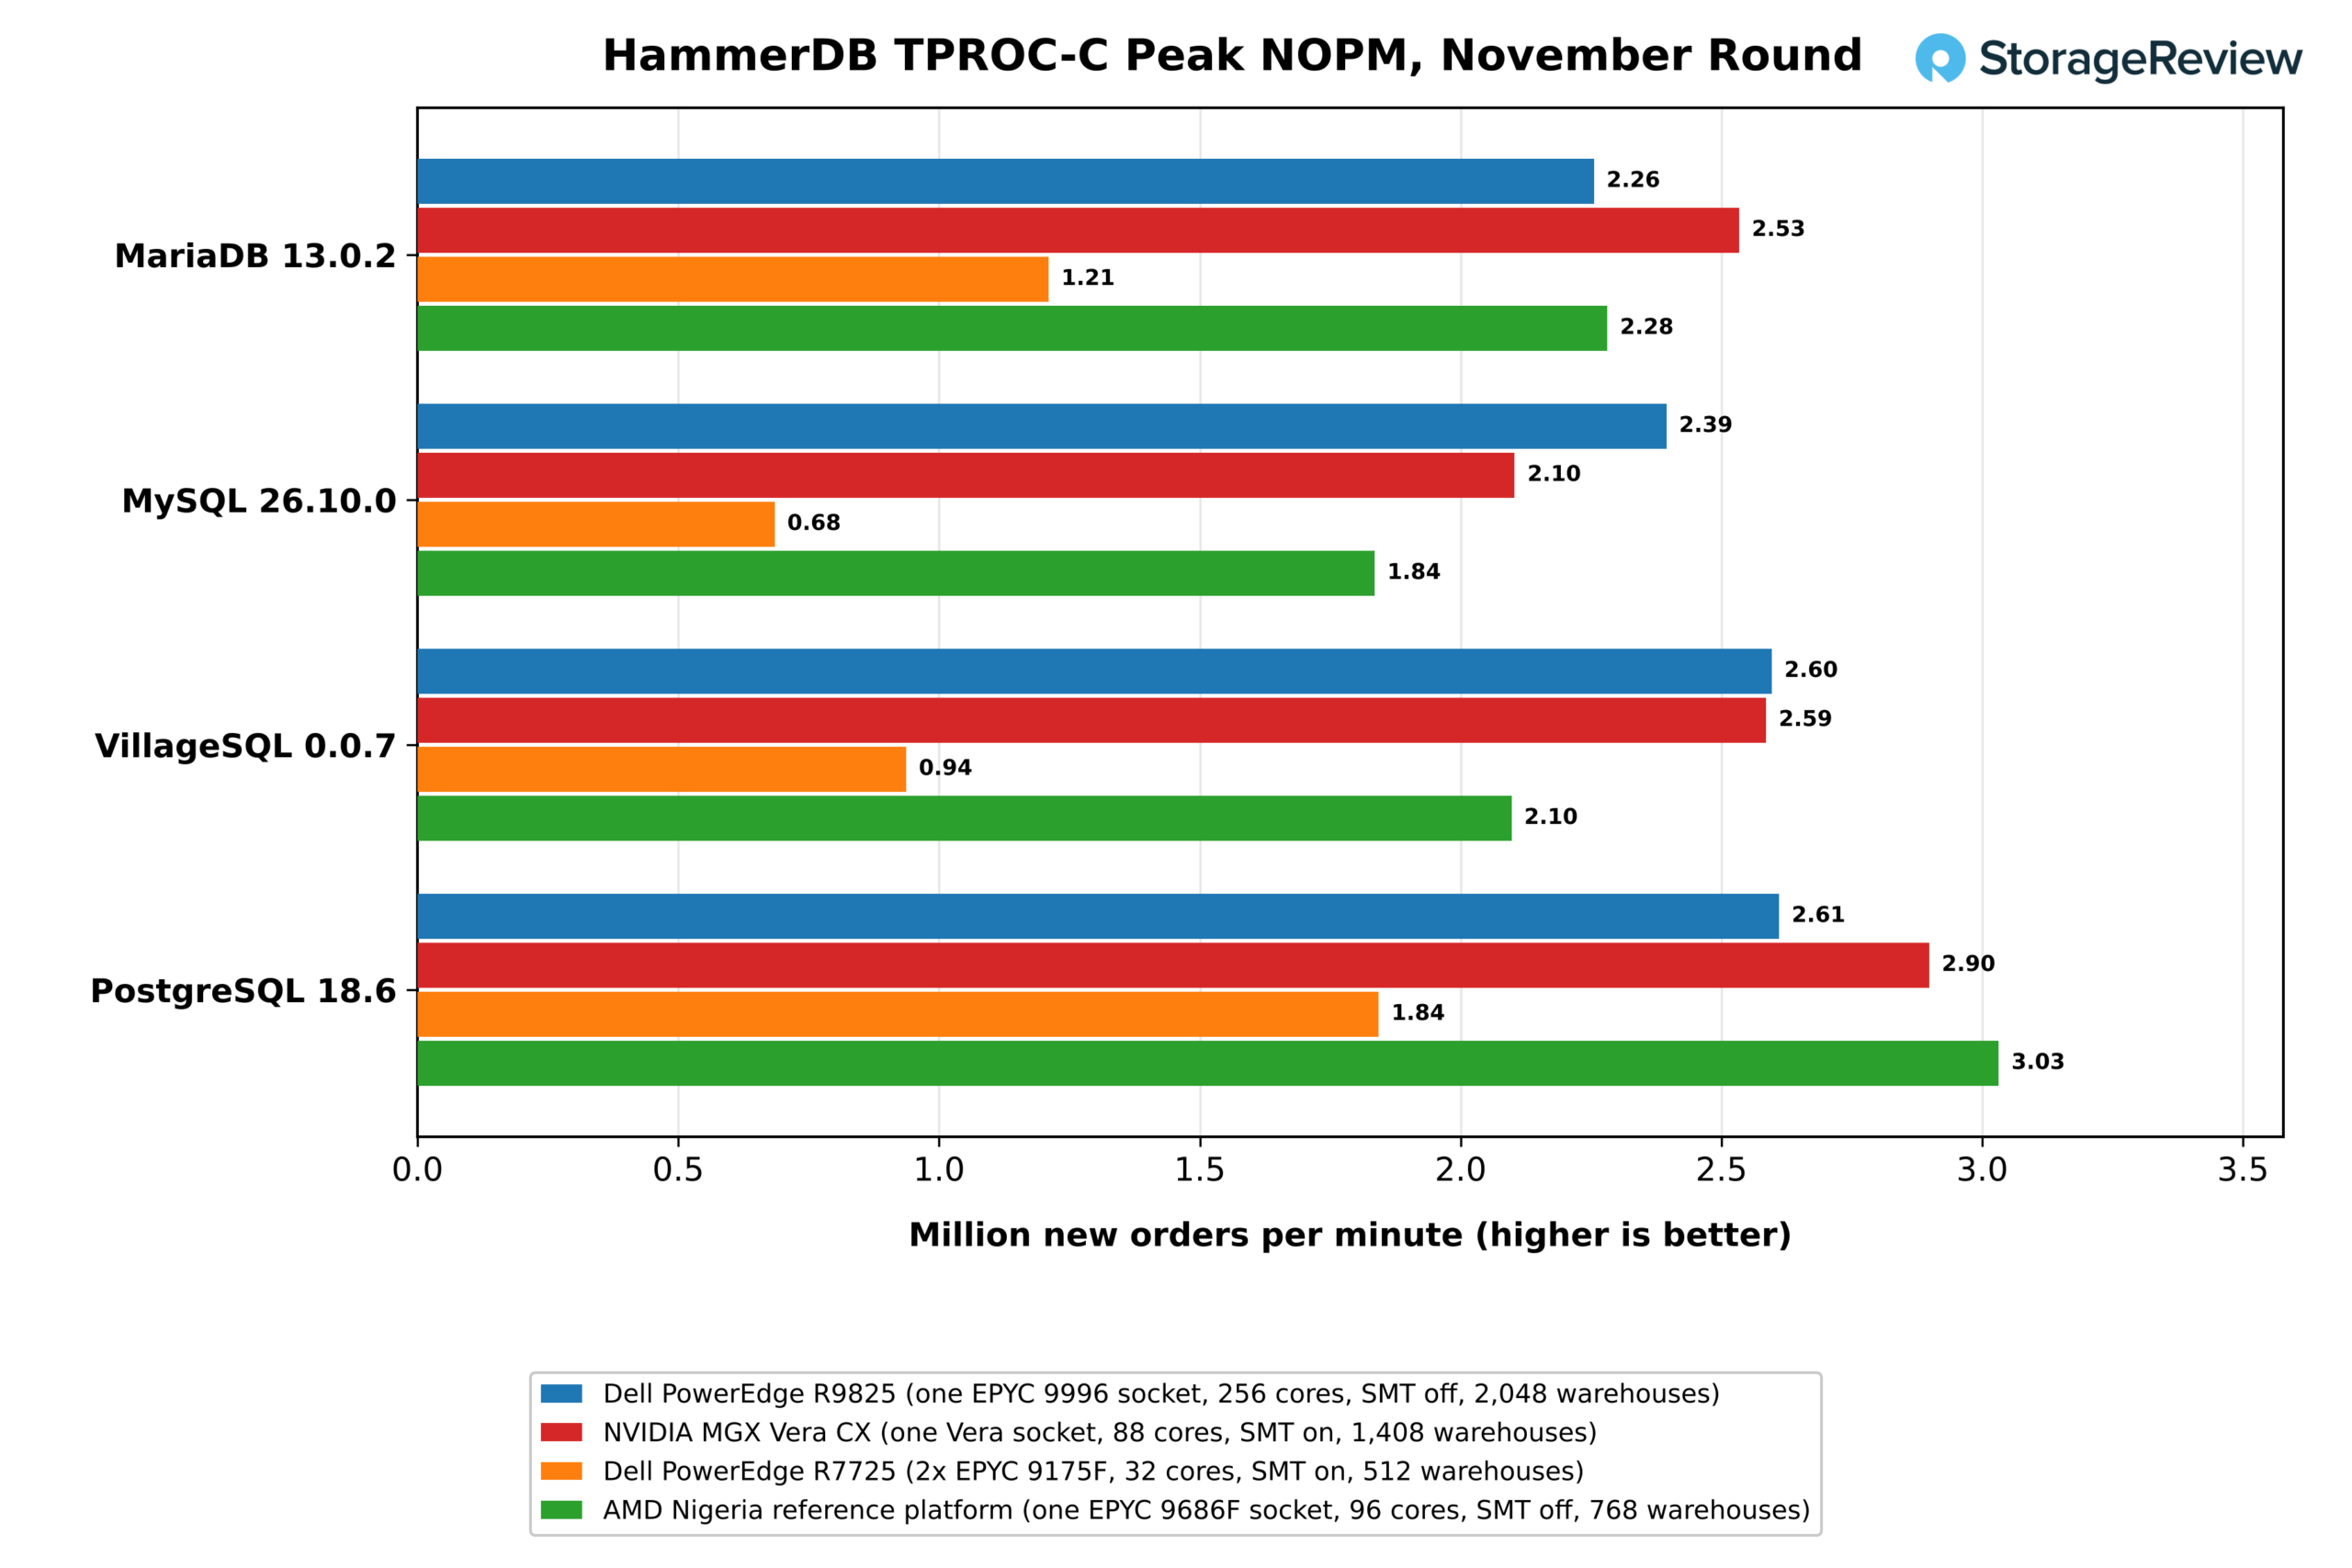
Pe un socket, cele 256 de nuclee Zen 6c și cele 88 de nuclee Olympus au împărțit cele patru motoare. Socketul R9825 a atins un vârf de 2.39 milioane de comenzi noi pe minut (NOPM) pe MySQL 26.10 față de 2.10 milioane pentru Vera, un avans de 14%, iar cele două au fost la egalitate pe VillageSQL cu 2.60 milioane și 2.59 milioane. Vera a menținut MariaDB 13.0.2 la 2.53 milioane față de 2.26 milioane, o marjă de 12%, și PostgreSQL 18.6 la 2.90 milioane față de 2.61 milioane, o marjă de 11%. Cele două procesoare 9175F au atins 1.21M, 0.68M, 0.94M și 1.84M pe MariaDB, MySQL, VillageSQL și PostgreSQL, iar acele 1.84M pe 32 de nuclee la 5.0 GHz reprezintă cel mai bun rezultat per nucleu al rundei.
Utilizarea procesorului la aceste vârfuri este cifra mai grăitoare. R9825 a atins vârful PostgreSQL la 144 de utilizatori virtuali cu socketul ocupat cu 18%, vârful MariaDB la 51%, iar vârfurile MySQL și VillageSQL la 74% și 75%. Vârfurile Vera au atins între 35% și 74% ocupare, iar 9175F cu 32 de nuclee a funcționat între 85% și 90% pe trei dintre cele patru motoare.
Niciunul dintre cele patru motoare nu a putut pune la treabă 256 de nuclee, acesta fiind plafonul de scalabilitate documentat de Shaw în fiecare rundă a acestei campanii. Motoarele open-source ating un maxim cu mult înainte de utilizarea socketului; transferul de tip lock în interiorul motorului stabilește vârful, iar procesorul așteaptă. Prin urmare, cifrele din baza de date R9825 măsoară cât de mult se scalează fiecare motor pe un singur socket și subestimează ceea ce pot face 512 nuclee cu implementări shardate sau cu instanțe multiple.
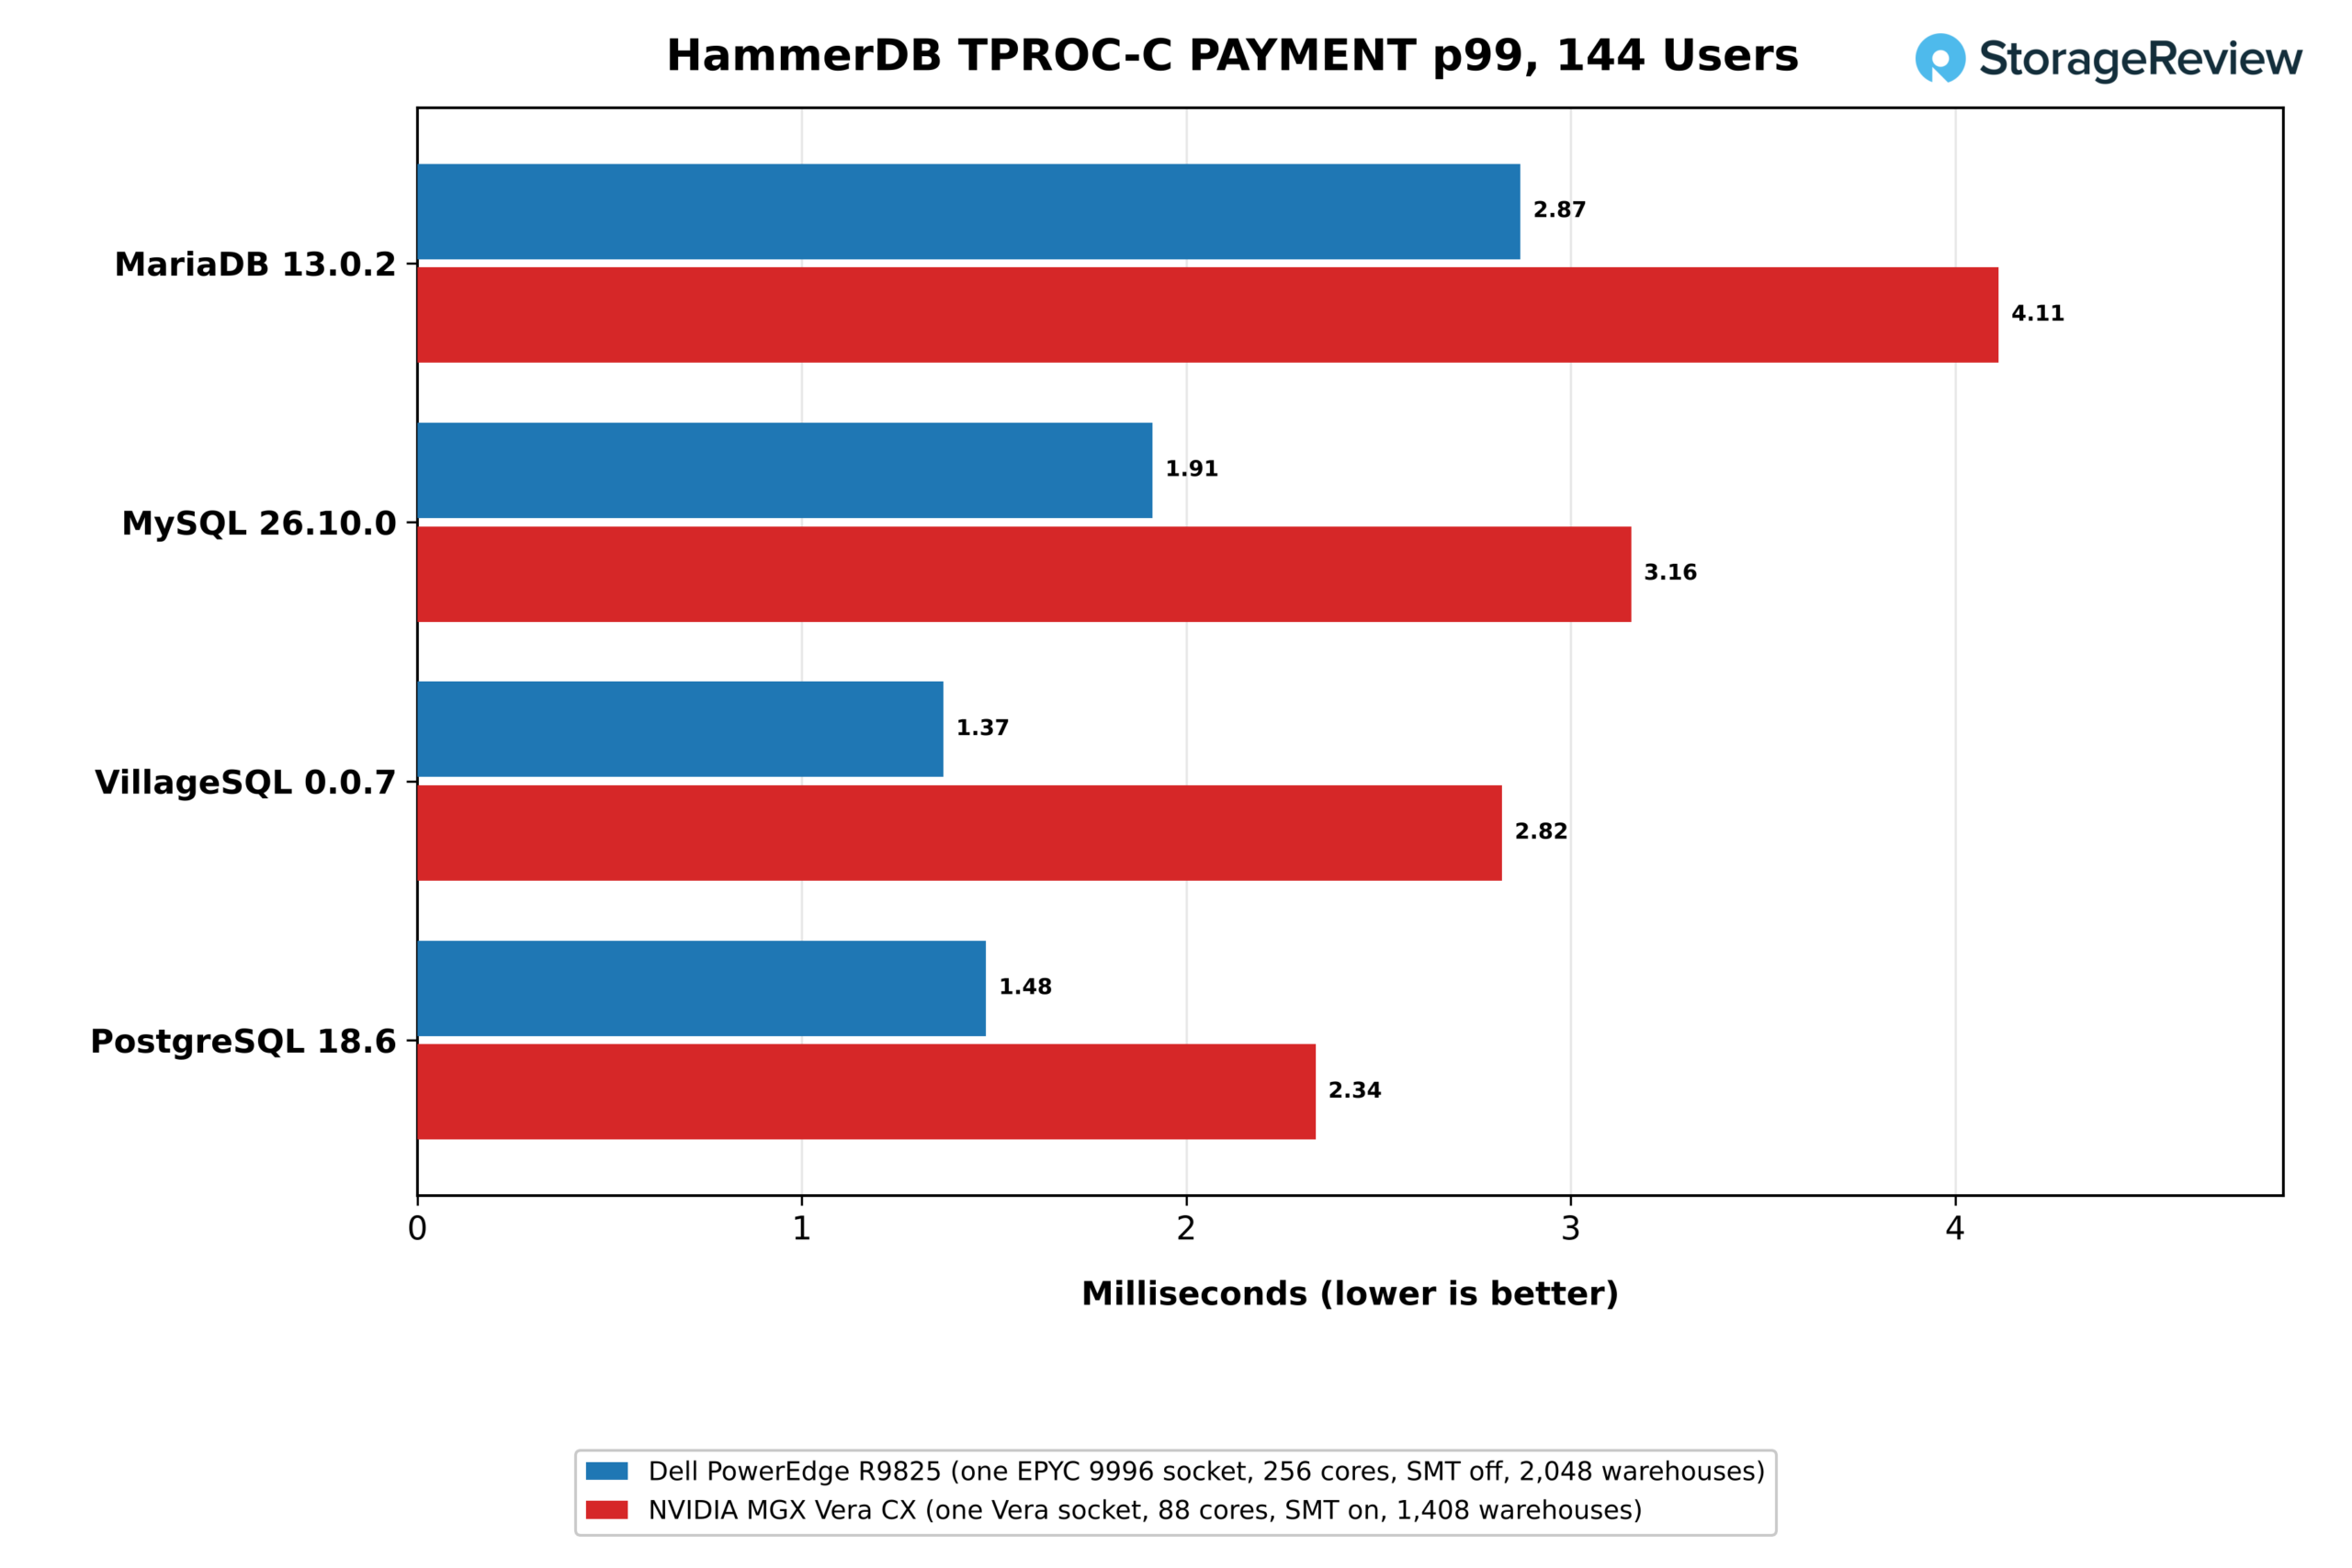
Latența finală la o sarcină corespondentă de 144 de utilizatori virtuali merge la Venice pe fiecare motor. Latența PAYMENT p99 pe R9825 a funcționat cu 2.87 ms pe MariaDB, 1.91 ms pe MySQL, 1.37 ms pe VillageSQL și 1.48 ms pe PostgreSQL, față de 4.11, 3.16, 2.82 și 2.34 ms pe Vera, astfel încât latența finală a Venice a fost cu 30% până la 51% mai mică. EPYC 9965 a înregistrat, de asemenea, latențe mai mici decât Vera pe majoritatea motoarelor în octombrie. 9175F la 32 de utilizatori a înregistrat 0.85, 1.35, 1.18 și 0.38 ms, ceea ce face un nucleu de 5.0 GHz cu 32 MB de L3 per nucleu pentru o latență OLTP.
Shaw a rulat, de asemenea, EPYC 9686F cu 96 de nuclee pe platforma AMD Nigeria ca un singur socket, cu 96 de nuclee online și SMT dezactivat la 768 de depozite de date. În profilul axat pe CPU, care se potrivește cu celelalte sisteme, PostgreSQL a atins un vârf de 3.03 milioane NOPM la 56 de utilizatori, cu socketul ocupat cu 38%, cel mai mare rezultat PostgreSQL din runda din noiembrie, devansând Vera, care a înregistrat 2.90 milioane, și socketul 9996, care a înregistrat 2.61 milioane. MariaDB a atins 2.28 milioane, VillageSQL 2.10 milioane, iar MySQL 1.84 milioane, cu o ocupare de 79% până la 89%.
Interpretarea lui Shaw este că partea de 5.3 GHz a fost sub așteptările sale și că, funcționând cu SMT dezactivat, recomandarea sa pentru socketul cu 256 de nuclee ar putea costa cel cu 96 de nuclee pe cele trei motoare din familia MySQL. De asemenea, a rulat socketul 9686F cu durabilitate completă, cu jurnalizare binară activată și WAL și fsync activate, aceasta fiind configurația pe care o rulează un sistem OLTP de producție și cea care pune stocarea în buclă.
MariaDB 13.0.2 a condus acel profil cu 1.43 milioane NOPM, devansând VillageSQL cu 1.39 milioane, PostgreSQL cu 1.30 milioane și MySQL cu 1.09 milioane, PostgreSQL împingând 5.5 GB/s către Micron 9650 pentru a ajunge acolo. Punerea în funcțiune a celui de-al doilea socket la 1,536 de depozite a redus vârful fiecărui motor între 1.43 milioane și 1.80 milioane, aceasta fiind disputa între socketuri descrisă de Shaw mai sus și motivul pentru care această secțiune compară socketurile individuale.
Cifrele din noiembrie ale Verei pentru firmware-ul actualizat de la NVIDIA sunt cu 5% sub cele din octombrie pe MariaDB și cu 12% sub cele din PostgreSQL la vârf, în timp ce au crescut cu 23% până la 24% la 16 utilizatori, ceea ce indică o schimbare a curbei de scalare. Evaluarea lui Shaw din octombrie, conform căreia Arm a ajuns ca un server de baze de date competitiv, se bazează pe aceste date. Runda din noiembrie adaugă că un socket Venice cu 256 de nuclee ține pasul cu socketul cu 88 de nuclee al Verei în ceea ce privește debitul și îl conduce în ceea ce privește latența, motoarele, nu siliciul, stabilind limita pentru ambele.
Concluzie
AMD EPYC de a 6-a generație se impune ca cea mai largă familie de procesoare pentru servere de pe piață, iar modelul emblematic SP7 pe care l-am testat resetează plafonul de debit pentru un server x86 cu două socketuri. Două procesoare EPYC 9996 din PowerEdge R9825 de la Dell au rulat GROMACS benchPEP de 1.8 ori mai rapid decât sistemul Turin cu 384 de nuclee, au rezolvat problema mesh-ului OpenFOAM de dimensiuni mari de 2.6 ori mai rapid și au criptat la 6.8 TB/s.
Aceste câștiguri depășesc cu mult creșterea de 33% a numărului de nuclee, deoarece nucleul Zen 6c în sine este mai rapid pe frecvență de ceas, transportă de patru ori mai mult L3 pe CCD și are acum șaisprezece canale în spate. Valkey este excepția printre rezultatele principale: un socket a transmis 76.5 milioane de cereri GET pe secundă, cu 27% mai mult decât Zen 5c și mai puțin decât creșterea numărului de nuclee, în timp ce debitul SET a crescut cu 65%.
Împotriva NVIDIA Vera, Venice câștigă majoritatea testelor noastre de calcul: 9996 conduce cu 2.5x per nucleu la matematica vectorială, de 5x per agregat la criptografia software și de 2x la debitul întreg pe toate firele de execuție, iar EPYC 9686F de 5.3 GHz învinge Olympus la fiecare test single-thread fixat din sistem, inclusiv testele Python cu latență limitată, unde Vera îl depășește pe 9996.
Vera este încă lider la capitolul lățime de bandă a memoriei brute: față de cei 2,073 GB/s pe STREAM Triad, Venice este în urmă cu 42% la DDR5-8000 a modelului R9825 și cu 8% la MRDIMM-uri, un decalaj care se inversează la MRDIMM-uri odată ce citirile pe care STREAM nu le ia în calcul sunt adăugate. De asemenea, deține un avans considerabil între socket-uri, unde NVLink-C2C oferă o lățime de bandă pentru socket-uri la distanță de 4.6 ori mai mare decât xGMI. Aceeași legătură NVLink-C2C conectează Vera direct la GPU-urile NVIDIA, iar la capitolul lățime de bandă CPU-GPU, Vera este de neegalat.
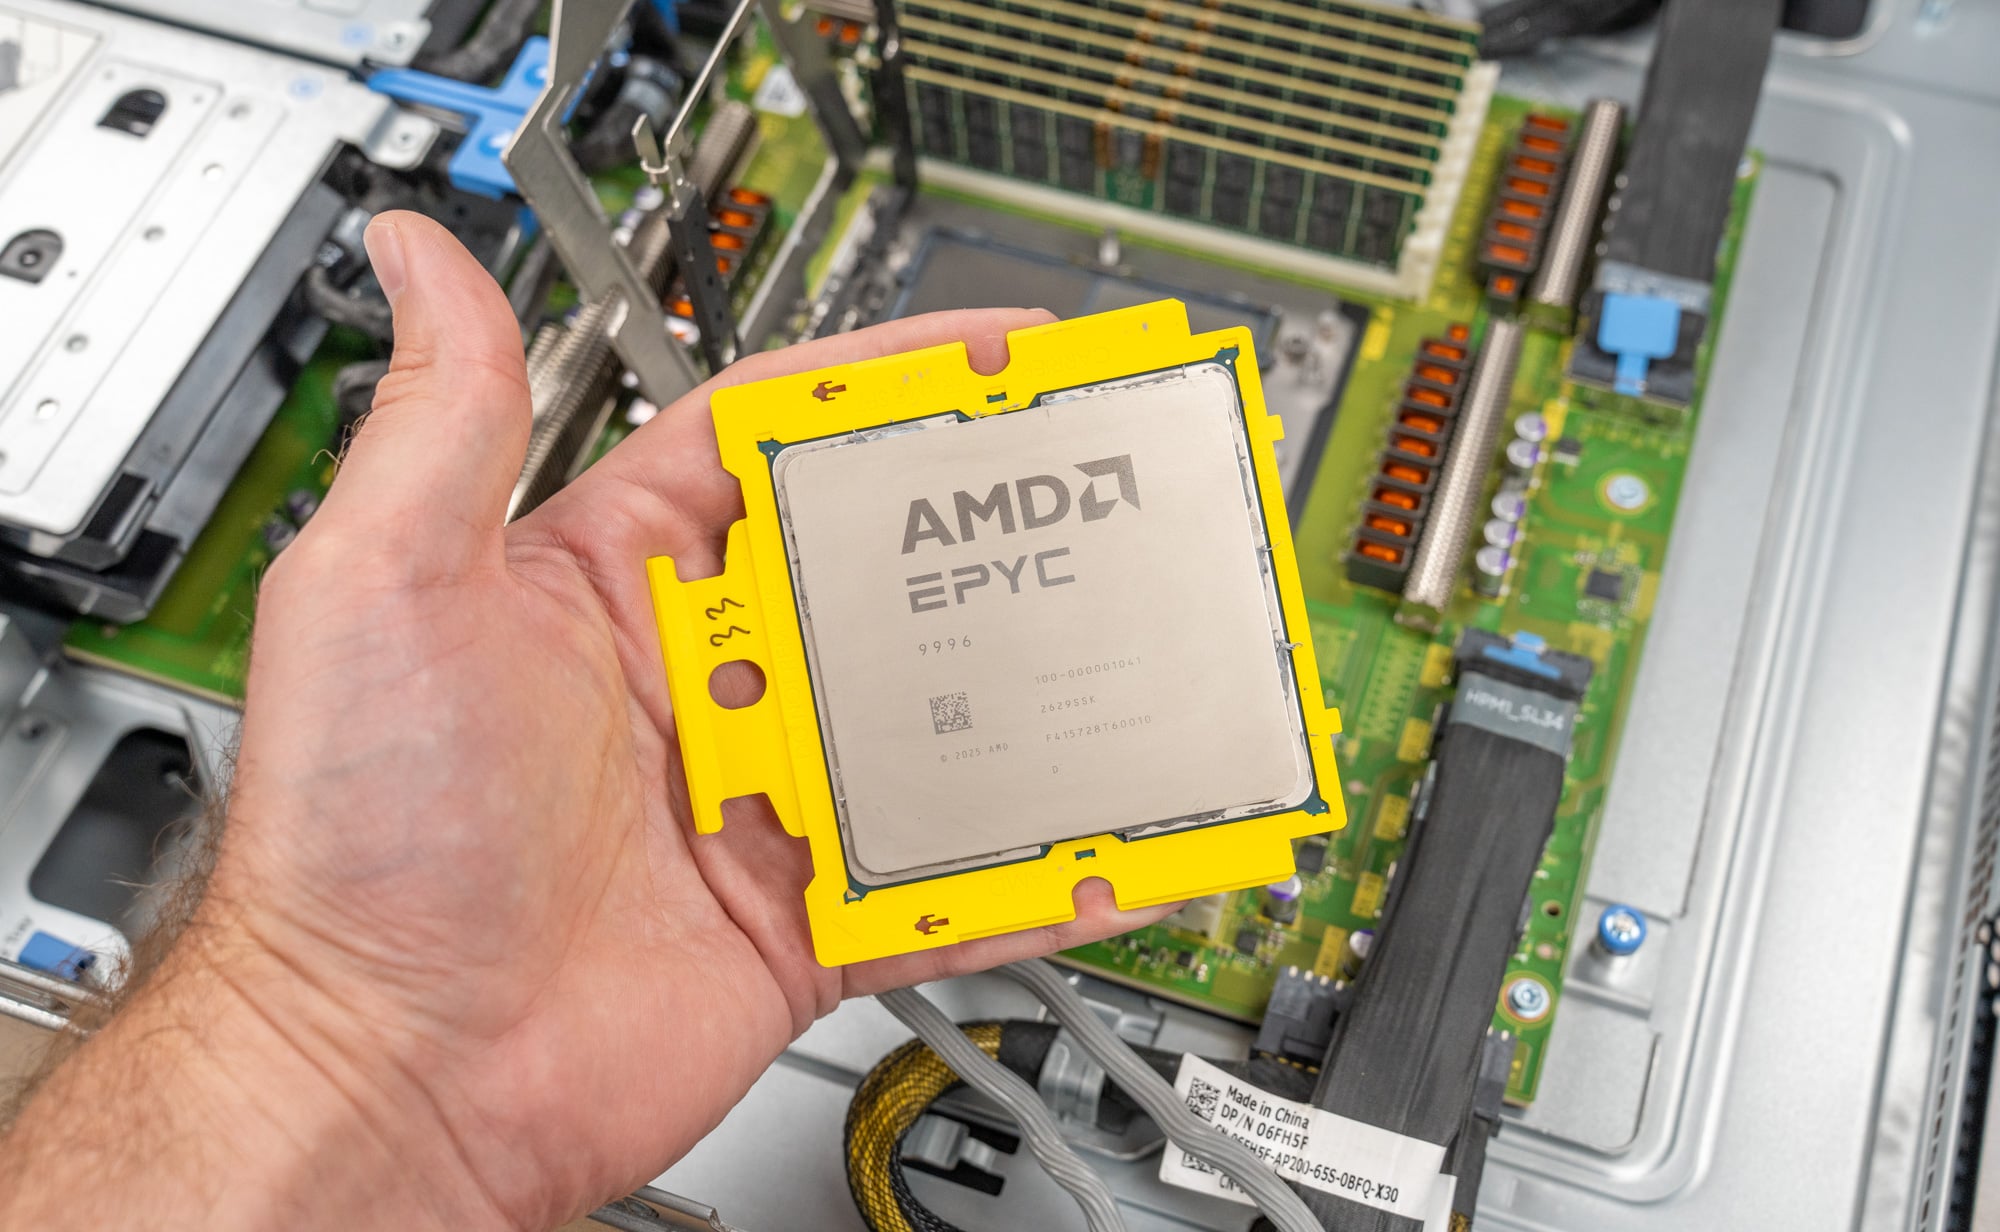
Pe piața actuală, memoria va fi cea mai mare problemă pentru cumpărători. Pe DDR5-8000 pe care a rulat-o R9825, 9996 oferă 1,201 GB/s și este atât de limitată de lățime de bandă pe rețeaua OpenFOAM mare încât o memorie 9686F cu 96 de nuclee pe MRDIMM-uri se situează la 13% din această valoare. MRDIMM-12800 ridică aceleași procesoare la 1,901 GB/s și reduce această viteză cu 21%, față de cele 30% pe care 256 de nuclee le câștigă față de 96 pe aceleași MRDIMM-uri, așa că pentru HPC cu memorie, alegerea memoriei contează la fel de mult ca numărul de nuclee. ClickBench a rămas în pragul de 7% pe memoria mai rapidă, iar setul de lucru Valkey de 256 GB nu s-a îmbunătățit.
Punctele slabe sunt specifice părții celei mai dense: un sistem cu 512 fire de execuție este mai lent decât unul cu 192 fire de execuție pe sarcini de lucru JVM care se sincronizează pe fiecare procesor logic, suma rapidă a datelor (hot sum) a ClickBench nu se îmbunătățește peste 192 de nuclee, iar calea de solicitare unică per nucleu a Valkey se situează la nivelul Olympus și sub cel al Zen 5c. Acestea sunt limitele de scalare și plasare la 256 de nuclee per socket, iar cumpărătorii ale căror sarcini de lucru arată astfel ar trebui să ia în considerare 9686F cu 96 de nuclee și 9756 cu 128 de nuclee, care este gama de procesoare din catalog pe care AMD o vinde împotriva unui competitor cu un singur SKU.
Pe HammerDB, un socket EPYC 9996 a reușit să schimbe motoarele de procesare cu socketul lui Vera, câștigând MySQL cu 14%, egalând VillageSQL și rămânând în urmă cu 11% până la 12% pe MariaDB și PostgreSQL, reducând în același timp latența PAYMENT cu 30% până la 51% la încărcare egală. Un socket 9686F cu 96 de nuclee a înregistrat cel mai mare rezultat PostgreSQL din rundă, de 3.03 milioane NOPM. Întrucât niciun motor nu a putut utiliza mai mult de trei sferturi din cele 256 de nuclee ale socketului 9996, rezultatele OLTP spun mai multe despre scalarea bazei de date decât despre procesor.
Serverul Dell care a găzduit testarea noastră principală EPYC 9996 a câștigat premiul pentru Cel mai bun server general în recenzia noastră PowerEdge R9825 , iar sistemele HPE ProLiant Gen13 Venice sunt livrate odată cu acesta, restul gamei OEM și platformele SP8 și Verano urmând în 2027. Pentru cumpărătorul de centre de date care alege astăzi un server cu două socketuri, EPYC 9996 este cel mai rapid procesor de uz general pe care l-am testat, iar 9686F este cel de ales atunci când sarcina de lucru necesită frecvențe de tact pe nuclee. Iar în continuare, o analiză aprofundată a performanței agențice, sarcina de lucru pentru care cumpărătorii de generație următoare își doresc o soluție.
Clasament: EPYC 9996 este motorul Dell PowerEdge R9825, care deține premiul „Cel mai bun server per total” în clasamentul nostru „Cele mai bune servere” , unde EPYC 9996 și 9686F apar și în tabelul nostru cu procesoare de servere măsurate.


 Amazon