

În cea mai mare parte a timpului petrecut în centrul de date, NVIDIA a tratat procesorul ca fiind puțin mai mult decât cipul care alimenta GPU-ul. Grace, primul său procesor de server, s-a încadrat în acest tipar. Acesta a folosit nucleele Neoverse V2 standard de la Arm și a fost livrat în mare parte ca jumătatea procesorului din supercipurile Grace Hopper și Grace Blackwell. Aceste supercipuri au introdus o componentă durabilă a platformei: NVLink-C2C, o legătură care oferă procesorului și GPU-ului acces coerent la memoria celuilalt, la o lățime de bandă mult mai mare decât PCIe.
Succesorul său, Vera, este mult mai ambițios. Este un design complet construit în jurul Olympus, nucleul Arm personalizat de NVIDIA. Olympus implementează Armv9.2, iar fiecare procesor Vera dispune de 88 de nuclee și 176 de fire de execuție. Alături de noile nuclee, subsistemul de memorie este celălalt punct culminant. Fiecare procesor suportă până la 1.5 TB de LPDDR5X pe module SOCAMM, cu o lățime de bandă maximă anunțată de 1.2 TB/s per socket, ceea ce îi conferă lui Vera eficiența energetică a DRAM-ului de clasă mobilă, menținând în același timp memoria înlocuibilă pe teren. Pe cele două socket-uri din serverul nostru de testare, această evaluare ajunge la 2.4 TB/s, iar am măsurat 2,073 GB/s pe STREAM Triad.
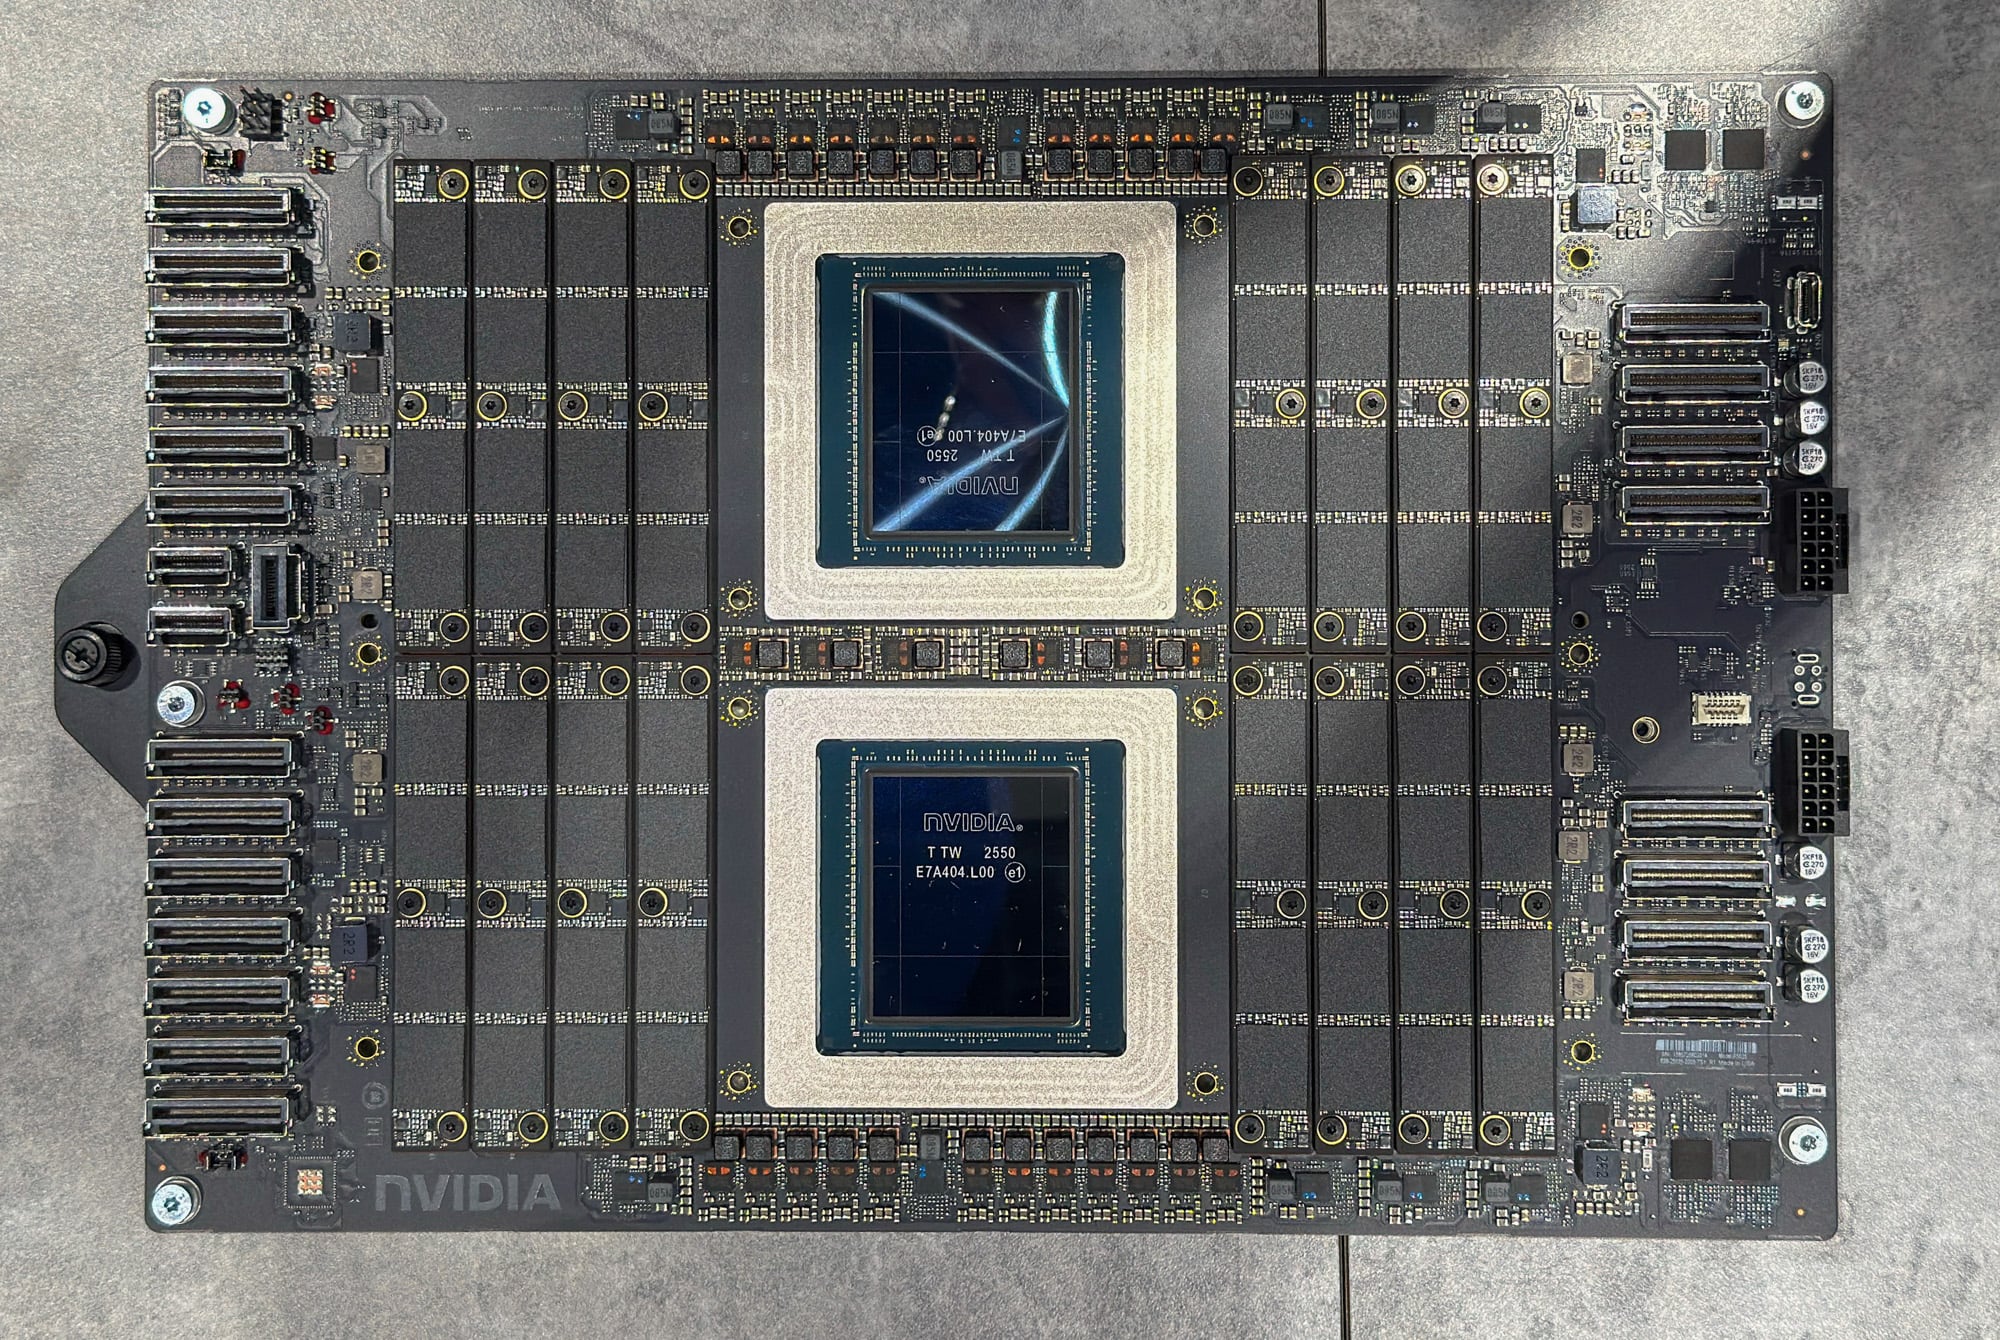
Această ambiție se extinde și la locul în care este implementat Vera. Acesta este încă inclus în supercipurile sistemelor Vera Rubin, dar NVIDIA l-a extins și la platforma sa de stocare BlueField-4 STX și la serverele CPU independente pentru sandbox-uri agentice. Vera câștigă, de asemenea, un sprijin larg din partea producătorilor de echipamente originale (OEM), a hiperscalatoarelor și a NCP-urilor: Dell, HPE și Supermicro au adăugat servere Vera la gamele lor, iar hiperscalatoarele și NCP-urile sunt pregătite să îl transforme într-o ofertă mainstream. Această disponibilitate largă este importantă deoarece, așa cum vor arăta rezultatele noastre, Vera este un concurent serios împotriva omologilor săi x86 și oferă organizațiilor un al treilea furnizor de CPU pentru a le ajuta să își diversifice lanțurile de aprovizionare.
Intrebari cu cheie
- Lățimea de bandă a memoriei este de peste două ori mai mare decât cea a fiecărui sistem x86. Două socket-uri Vera au susținut viteze de peste 2TB/s pe STREAM Triad, de 2.3 ori mai bun server DDR5 pe care l-am testat. Chiar și atunci când citea memoria celuilalt socket prin NVLink-C2C, nucleele Vera au consumat mai multă lățime de bandă decât orice socket x86 obține din memoria locală, iar latența locală cu pagini uriașe a fost cu 13% mai mică decât pe EPYC 9175F.
- Un cip bine echilibrat pentru segmentul de mijloc al pieței. Un nucleu Olympus de 3.4 GHz a avut o compresie cu 12% mai rapidă pe 7-Zip decât EPYC 9175F de 5.0 GHz și a câștigat două din trei teste Python cu un singur thread împotriva sa. La sarcină maximă, Vera a atins 63% până la 72% din debitul 7-Zip al EPYC 9965 cu mai puțin de jumătate din nuclee, rămânând aproape de specialistul per-core al AMD pe un thread și de specialistul său în debit pe întregul sistem.
- Funcționarea vectorială și criptografică este slăbiciunea evidentă. Șase pipe-uri SVE2 pe 128 de biți nu pot egala AVX-512 pe 512 biți pe codul scris special pentru acestea. Pe 16 nuclee potrivite, Vera a rulat GROMACS benchMEM la jumătate din viteza EPYC 9175F și la două treimi din viteza EPYC 9965, iar un singur nucleu a criptat AES-256-GCM la aproximativ o treime din viteza 9175F. Pe întregul sistem, EPYC 9965 cu 384 de nuclee a condus de aproximativ 3 ori atât pe GROMACS benchPEP, cât și pe AES.
- HPC cu memorie transformă lățimea de bandă în viteză. Pe rețeaua OpenFOAM mare, Vera a terminat de 1.44 ori mai rapid decât EPYC 9965 cu 384 de nuclee și de 1.20 ori mai rapid decât Xeon 6978P cu 240 de nuclee. Pe rețeaua mai mică, unde cache-urile x86 L3 mai mari prezintă o problemă mai mare, Vera s-a clasat pe locul al doilea, la o distanță de 12% de 9965.
- Bazele de date și analizele sunt deja competitive. În HammerDB TPROC-C pe un singur socket, 88 de nuclee Vera au depășit un socket EPYC 9965 cu 192 de nuclee cu 26% pe PostgreSQL și 8% pe MariaDB, în timp ce au fost în urmă cu 19% pe MySQL și 15% pe VillageSQL; Xeon 6787P a fost în urma lui Vera pe toate cele cinci motoare. De asemenea, Vera a finalizat run-ul ClickBench într-un timp cu 23% mai scurt decât EPYC 9965 și a deservit cu 34% mai multe cereri pe un set de lucru Valkey de 256 GB.
Specificații
| Specificație | Procesor NVIDIA Vera |
|---|---|
| Calcul și putere | |
| Nucleu | NVIDIA Olympus, Armv9.2 cu SVE2 și FP8 |
| Miezuri și filete per soclu | 88 de nuclee, 176 de fire de execuție (NVIDIA Spatial Multithreading) |
| Viteză ceas (măsurată) | 3.41GHz |
| TDP | Configurabil de la 250W la 450W |
| Răcire | Aer sau lichid |
| Cache | |
| Instrucțiune L1 | 64KB per nucleu |
| Date L1 | 96KB pe nucleu, pe 6 căi |
| L2 | 2 MB pe nucleu, privat |
| Cache la nivel de sistem (L3) | 164 MB per socket, partiționare Arm MPAM |
| Țesături | Țesătură de coerență scalabilă de a doua generație, bisecție de 3.4 TB/s |
| Memorie | |
| Tip | LPDDR5X pe 8 module SOCAMM2 per soclu |
| Controlere | 8x 128 biți (agregat de 1,024 biți) |
| Viteză | Până la 9,600 MT/s |
| Lățime de bandă | Până la 1.2 TB/s per socket (evaluare furnizor) |
| Capacitate | 256 GB până la 1.5 TB per soclu |
| I / O | |
| PCIe | Gen6, 88 de benzi per socket (platformă doar pentru CPU) bifurcația x16, x8, x4, x2 |
| CXL | 3.1, Extinderea și pooling-ul memoriei de tip 3 |
| NVLink-C2C | Criptare autentificată, coerentă, bidirecțională, de a doua generație, 1.8 TB/s |
| Securitate | |
| Calcul confidențial | Armați domeniile CCA, RME-DA și RME-CDA, TDISP, chei per-VM |
De ce NVIDIA vrea să intre în industria procesoarelor
Pentru a înțelege de ce Vera este importantă pentru NVIDIA, uitați-vă la modul în care a crescut compania. NVIDIA și-a construit poziția de centru de date în jurul GPU-ului, apoi s-a extins în infrastructura necesară pentru a menține aceste GPU-uri în funcțiune. Pe partea hardware, achiziția Mellanox din 2020 a adus tehnologia de rețea care conectează serverele și mută datele între ele. Pe partea software, CUDA, DOCA și stiva software mai largă au extins aria de acoperire a NVIDIA asupra modului în care acel hardware este programat și operat. Împreună, aceste componente au oferit companiei controlul asupra unei mari părți a platformei de calcul accelerat.
Însă platforma avea nevoie în continuare de un procesor de uz general. Ceva trebuia să ruleze sistemul de operare, să pregătească datele, să gestioneze aplicațiile și să coordoneze munca trimisă către acceleratoare. În timpul unei mari părți a expansiunii NVIDIA, Intel și AMD au îndeplinit acest rol. Acest lucru a plasat NVIDIA într-o poziție dificilă: putea furniza GPU-urile, rețeaua și o mare parte din software, depinzând în continuare de procesorul altei companii din centrul serverului.
Grace a fost primul pas major către schimbarea acestei situații. Construit în jurul nucleelor Arm Neoverse V2, acesta a oferit NVIDIA un procesor pentru centre de date și o modalitate de a conecta acel procesor mai strâns la GPU-urile sale prin NVLink-C2C. Cu toate acestea, Grace a lăsat un decalaj de performanță de eliminat. Lățimea de bandă a memoriei și eficiența l-au făcut competitiv ca procesor gazdă AI, dar procesoarele x86 de top au păstrat avantaje substanțiale în majoritatea celorlalte sarcini de lucru. Această performanță inegală a limitat argumentul pentru alegerea lui Grace ca înlocuitor general pentru un server EPYC sau Xeon.
Vera elimină o mare parte din acest decalaj prin înlocuirea nucleelor Neoverse V2 de la Grace cu designul personalizat Olympus de la NVIDIA și prin creșterea substanțială a lățimii de bandă și a capacității memoriei. Prin furnizarea unui procesor competitiv alături de GPU-urile, DPU-urile și rețelele sale, NVIDIA poate capta o cotă mai mare din cheltuielile pentru fiecare server. De asemenea, oferă companiei un control mai mare asupra ecosistemului său și asupra modului în care componentele funcționează împreună: nucleele procesorului, subsistemul de memorie, interconectarea și GPU-ul pot fi proiectate în jurul acelorași cerințe. Legătura coerentă CPU-GPU a Vera, acum evaluată la o viteză de până la 1.8 TB/s, este un exemplu concret al acestei integrări.
Captarea unei cantități mai mari din cheltuielile fiecărui sistem este doar o parte a imaginii. Învățarea prin consolidare (RL) și inteligența artificială agentială oferă NVIDIA un alt motiv pentru a oferi un sistem CPU independent. Un agent face mai mult decât să genereze un răspuns. Acesta apelează instrumente, preia informații, rulează cod și verifică rezultatele înainte de a decide ce să facă în continuare. O mare parte din această execuție are loc pe procesoare, iar atunci când următorul pas al modelului depinde de rezultatul unei sarcini CPU, execuția lentă întârzie întreaga secvență. Prin urmare, performanța per nucleu, latența memoriei și comportamentul previzibil sub sarcină devin importante pentru capacitatea de răspuns a agentului.
Nucleul Olimpului
Aceste cerințe se aliniază îndeaproape cu designul celor 88 de nuclee Olympus ale procesorului Vera, care sunt construite în jurul unei priorități clare: performanță puternică din fiecare nucleu, menținută atunci când întregul socket este ocupat. Olympus este implementarea de către NVIDIA a setului de instrucțiuni Armv9.2, înlocuind nucleele Neoverse V2 utilizate în Grace. Această distincție contează: Arm definește instrucțiunile pe care le execută procesorul, în timp ce NVIDIA a proiectat mecanismul care le preia, le programează și le execută. Acest control permite NVIDIA să ajusteze nucleul pentru obiectivul său: finalizarea rapidă a sarcinilor individuale, executând în același timp mai multe simultan.
Prima jumătate a acestui obiectiv începe cu instrucțiunile pe ciclu, sau IPC: câte instrucțiuni completează un nucleu, în medie, în fiecare ciclu de ceas. Viteza de ceas determină cât de des au loc aceste cicluri; microarhitectura determină câtă muncă utilă poate încăpea în ele. NVIDIA susține o îmbunătățire de 1.5x a IPC față de generația anterioară. Cea mai mare frecvență de ceas pe care am observat-o a fost de 3.41 GHz, dar arhitectura Vera pune accentul pe extragerea mai multor lucrări pe ciclu și menținerea acelui progres sub sarcină. Această subliniere contează deoarece, pentru un compilator, interpretor sau operațiune de bază de date cu o secvență lungă de pași dependenți, nucleele suplimentare nu pot face ca acea secvență să se termine mai repede.
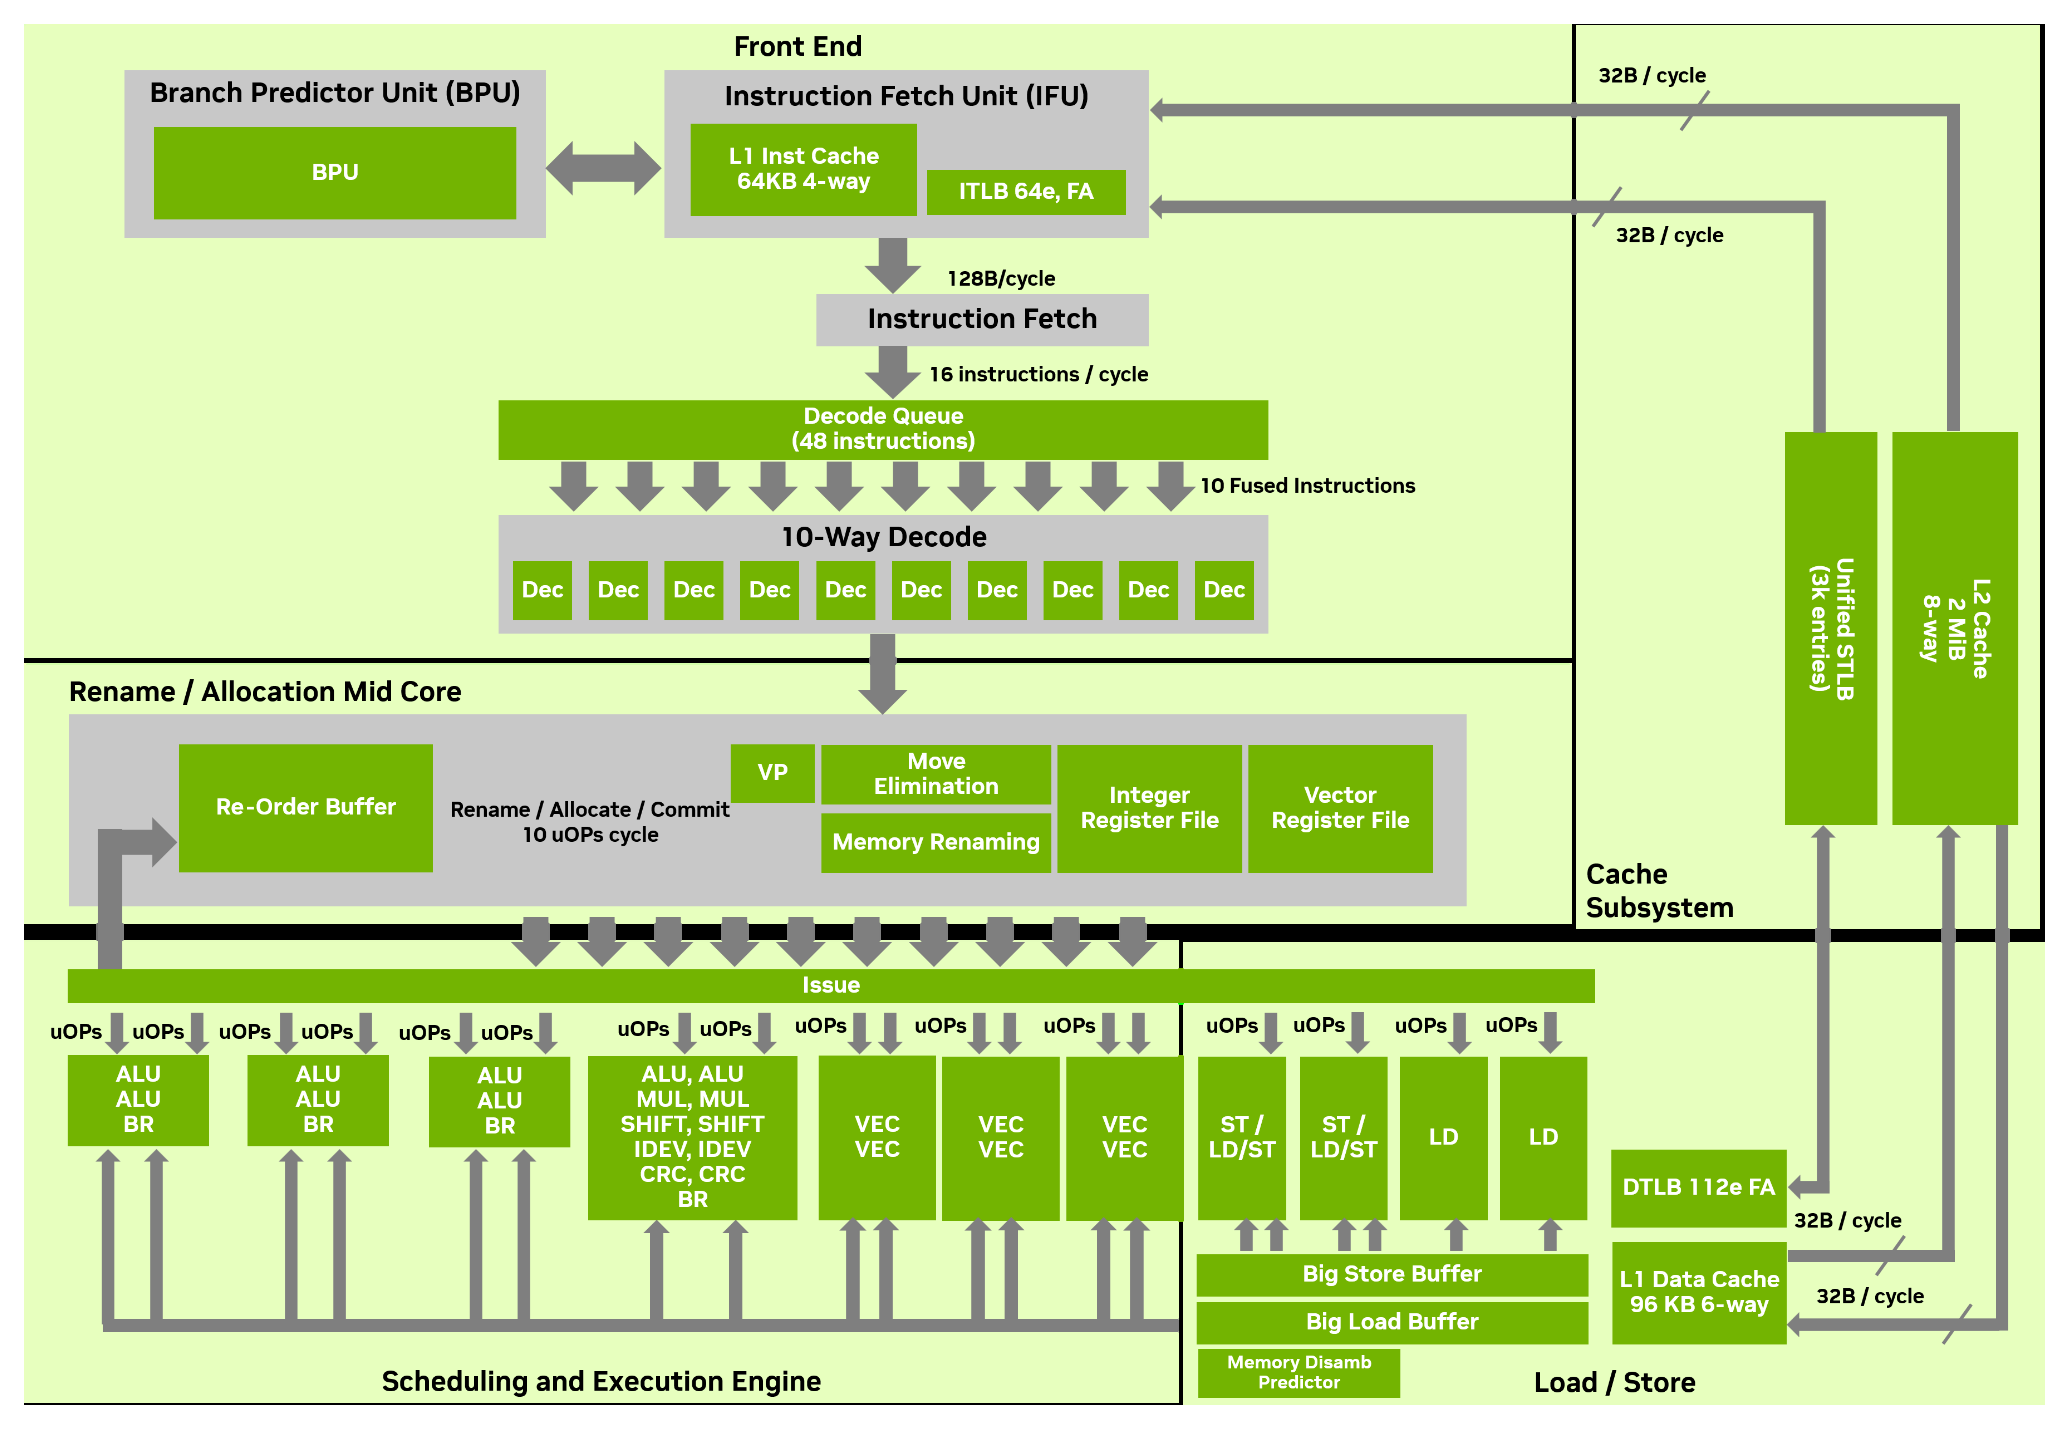
Realizarea acestui control interconectat (IPC) începe cu o sursă constantă de instrucțiuni utile. Partea frontală a Olympus, partea nucleului care preia și decodează instrucțiunile programului, poate decoda până la zece instrucțiuni pe ciclu. Această lățime contează doar dacă rămâne alimentată, ceea ce devine dificil atunci când software-ul se ramifică frecvent între căile de cod. Prin urmare, Olympus combină un predictor de ramificații neuronale cu alți predictori specializați și acceptă până la două ramificații preluate pe ciclu. O predicție mai bună ajută nucleul să preia instrucțiunile de care va avea nevoie, reducând timpul petrecut executând calea greșită și repornind după o eroare.
Odată ce aceste instrucțiuni sunt preluate și decodificate, Olympus folosește execuția în afara ordinii pentru a găsi o lucrare care poate continua în timp ce instrucțiunile anterioare așteaptă. De exemplu, dacă o operație așteaptă memorie, un calcul independent se poate executa înaintea ei. O fereastră mare de instrucțiuni oferă procesorului mai multe oportunități de a găsi acea lucrare independentă.
Chiar și așa, unele secvențe, precum lanțurile dependente descrise mai sus, rezistă acestei abordări deoarece fiecare pas are nevoie de rezultatul pasului anterior. Pentru acestea, Olympus folosește, de asemenea, predicția valorilor pentru a permite operațiilor dependente să înceapă cu o valoare prezisă, apoi verifică acea valoare atunci când rezultatul real devine disponibil. Predicțiile corecte pot reduce așteptarea efectivă de-a lungul acestor lanțuri de dependențe; predicțiile incorecte necesită corectarea și recalcularea muncii speculative.
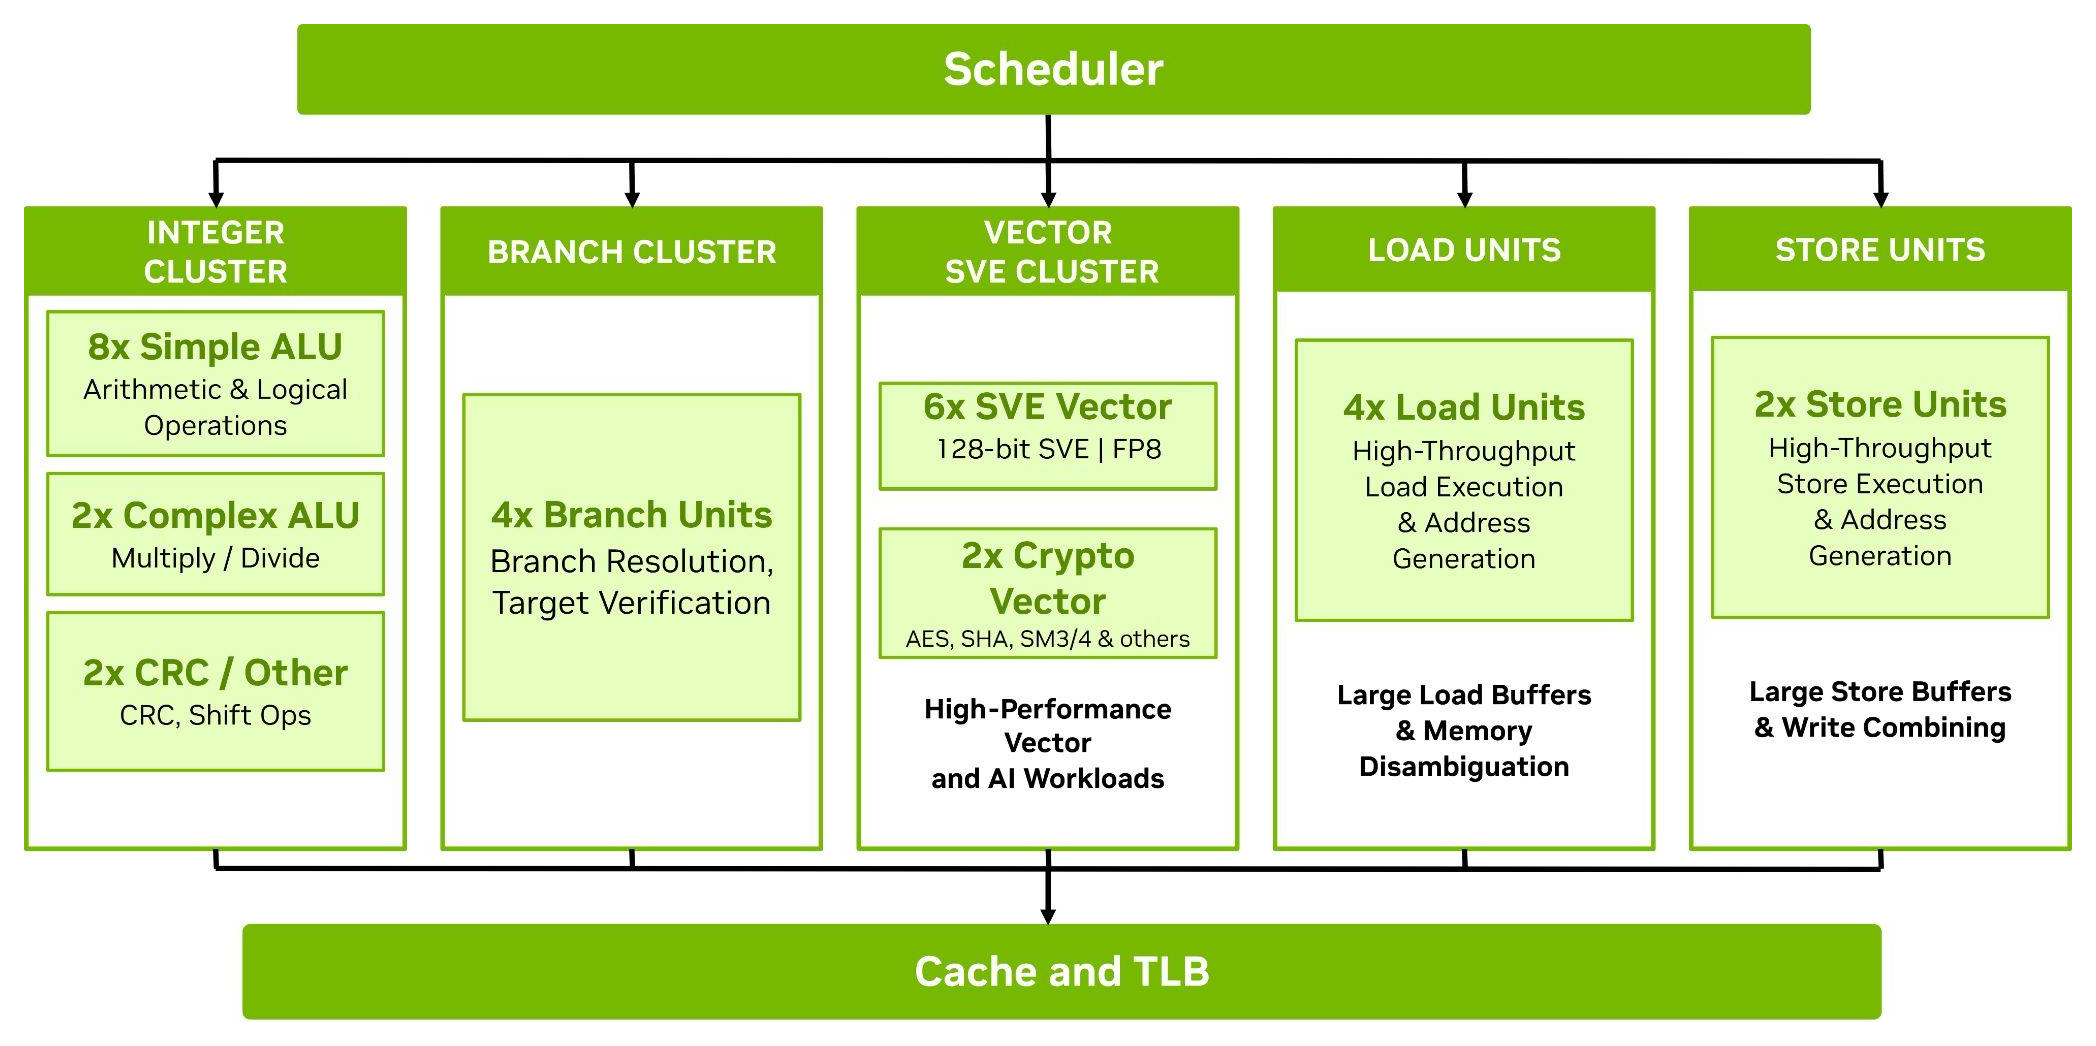
Motorul de execuție are nevoie apoi de suficientă capacitate pentru a transforma acea sursă de instrucțiuni în lucru finalizat. Olympus combină resurse largi de execuție a numerelor întregi cu unități de ramificare dedicate, patru conducte de încărcare și două conducte de stocare. Aceste resurse îndeplinesc cerințe diferite: unitățile întregi gestionează aritmetica, comparațiile și logica; unitățile de ramificare rezolvă fluxul de control; iar conductele de încărcare/stocare mută datele între nucleu și cache-urile sale. Echilibrul contează deoarece un decodor mai larg ar oferi puține beneficii dacă instrucțiunile ar fi pur și simplu salvate în spatele unui blocaj de execuție sau de memorie.
Pe lângă aceste resurse scalare, Olympus are șase conducte vectoriale pe 128 de biți care suportă SVE2, cu suport FP8 și capabilități criptografice în două conducte. Instrucțiunile vectoriale aplică o operație mai multor elemente de date, ceea ce le face utile pentru lucrul numeric, compresie și procesare a datelor.
Acesta este un aspect în care Olympus face un compromis clar: lățimea vectorială de 128 de biți este mai mică decât lățimea de 512 biți disponibilă prin AVX-512 pe procesoarele x86 concurente. Diferența este importantă pentru nucleele numerice optimizate și chiar pentru tokenizoare, deși performanța aplicației depinde și de randamentul instrucțiunilor specifice, de codul generat și de furnizarea de date. Prin urmare, aplicațiile științifice precum GROMACS rămân un test separat al punctelor forte ale designului.
Fiecare dintre aceste resurse de execuție, scalare sau vectoriale, depinde de datele care sosesc la timp, așa că păstrarea datelor utilizate frecvent aproape de motorul de execuție contează la fel de mult. Fiecare nucleu are o memorie cache de instrucțiuni de 64KB, o memorie cache de date de 96KB și o memorie cache L2 privată de 2MB. Memoriile cache de prim nivel, de dimensiuni reduse, oferă acces rapid la instrucțiunile și datele cele mai utile imediat; memoria L2, mai mare, păstrează o parte mai mare din setul de lucru al nucleului înainte ca un acces să fie nevoit să parcurgă o distanță mai mare prin procesor. Acordarea fiecărui nucleu a unei resurse L2 private substanțiale susține același obiectiv per nucleu: mai multă muncă poate fi deservită local, reducând presiunea asupra memoriei cache partajate și a memoriei principale.
Preîncărcarea completează aceste cache-uri prin introducerea datelor înainte ca o instrucțiune să le solicite. Alături de preîncărcările pentru modelele de acces obișnuite, Olympus include un preîncărcător de grafuri pentru accesări indirecte, cum ar fi A[B[i]], unde o căutare furnizează indexul pentru alta. După ce a învățat această relație, hardware-ul poate începe să preia a doua parte a datelor înainte ca programul să o solicite. Acest lucru ajută la rezolvarea unei probleme comune în procesarea grafurilor și în alte sarcini de lucru neregulate: procesorul are o capacitate amplă de execuție, dar progresul depinde de găsirea următoarei părți a datelor.
Ultima piesă a Olympus abordează cealaltă jumătate a obiectivului său: rularea mai multor sarcini simultan. Fiecare nucleu suportă două fire de execuție hardware, oferind Vera 176 de fire de execuție per socket. NVIDIA își numește schema Spatial Multithreading. Nucleul își poate dedica resursele unui singur fir de execuție activ sau le poate împărți între două fire de execuție active, oferind posibilitatea de a alege între concentrarea capacității de execuție pe un singur flux de instrucțiuni și suportarea mai multor lucrări concurente.
Obiectivul declarat al NVIDIA este de a reduce interferențele dintre cele două fire de execuție, făcând performanța mai previzibilă atunci când ambele sunt ocupate, aceeași predictibilitate de care depind sarcinile de lucru sub sarcină. Cele două fire de execuție au în continuare același nucleu fizic și sistemul de memorie mai amplu, astfel încât partiționarea resurselor nu garantează o latență fixă a aplicației.
Fabric, Memorie și I/O
Dincolo de nucleul individual, menținerea productivității a 88 de nuclee late necesită mai mult decât o conexiune rapidă la DRAM. Nucleele trebuie, de asemenea, să facă schimb de date, să acceseze memoria cache partajată și să comunice cu dispozitivele atașate. Vera conectează aceste resurse prin a doua generație de Scalable Coherency Fabric de la NVIDIA, o rețea internă care menține, de asemenea, coerența copiilor în cache ale datelor partajate. Nucleele, rețeaua și memoria cache de 164 MB la nivel de sistem se află pe un singur die de calcul, cu controlere de memorie și I/O pe chiplet-uri adiacente. NVIDIA evaluează rețeaua la o lățime de bandă de bisecție de 3.4 TB/s, o măsură a capacității de trafic în rețea, separată de lățimea de bandă a memoriei principale.
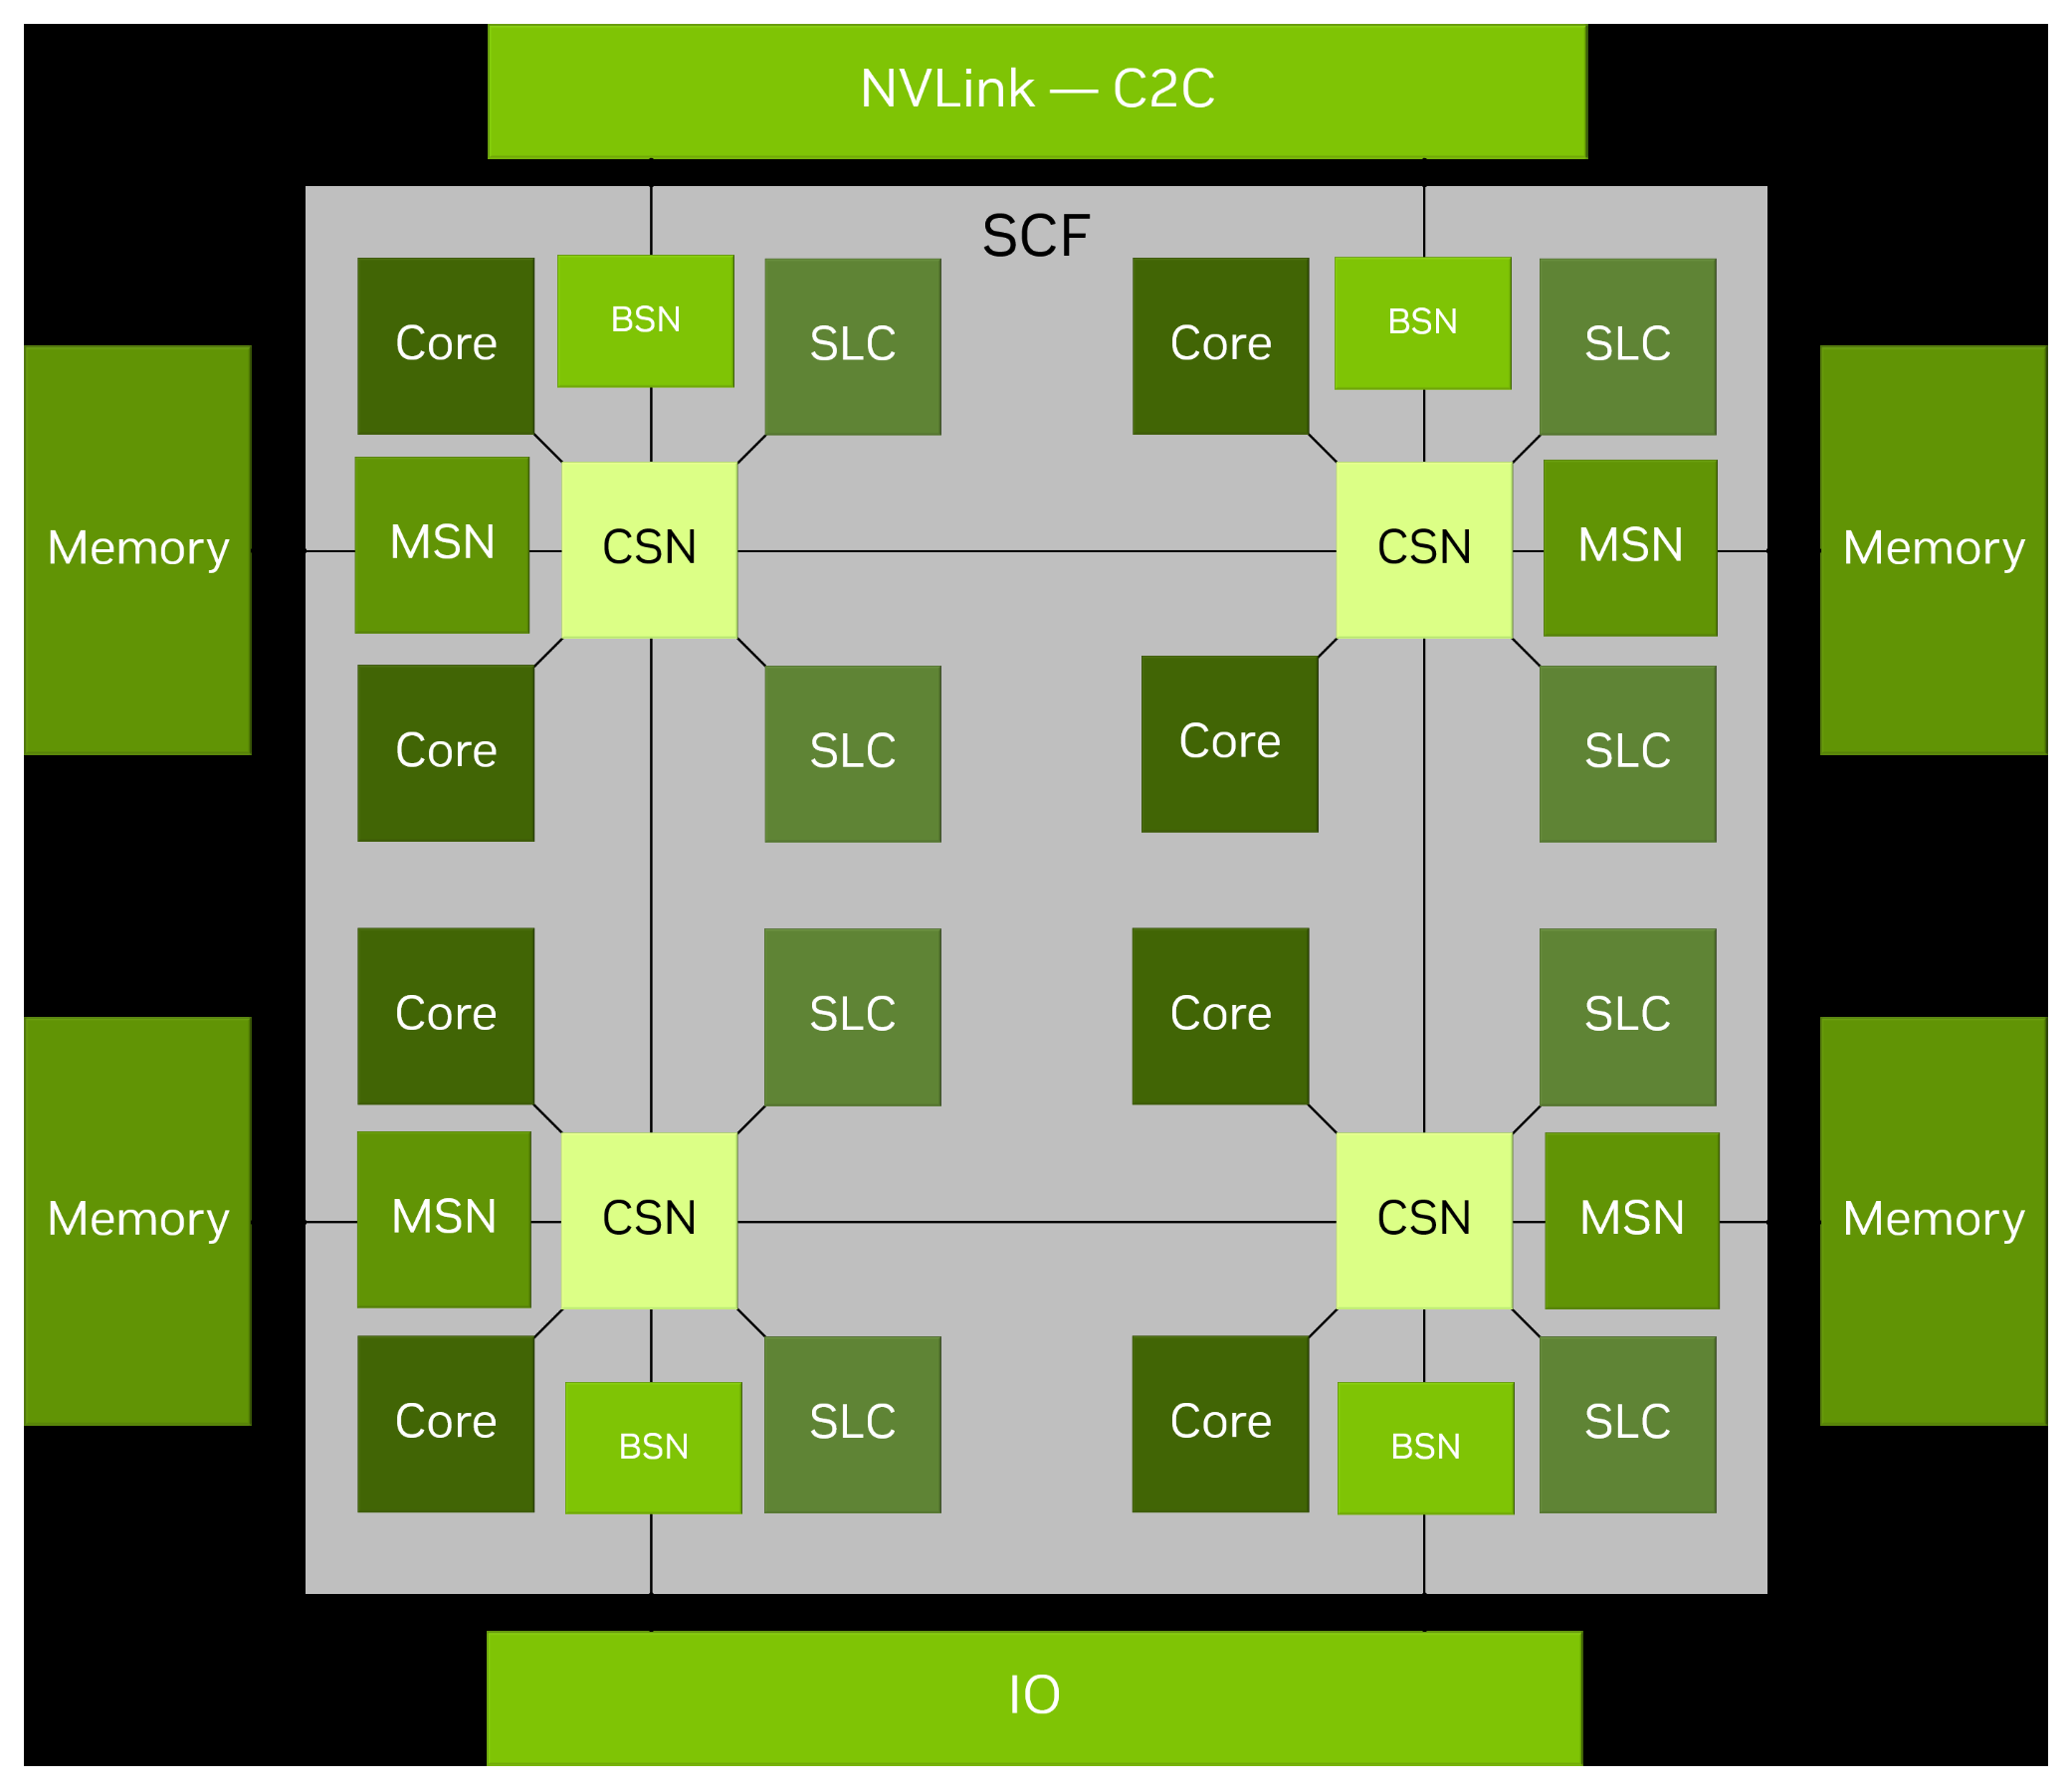
Această configurație cu un singur die evită transferurile între die-uri de calcul separate atunci când nucleele comunică sau accesează memoria cache partajată. Pentru software, Vera prezintă, de asemenea, un nod NUMA per socket: sistemul de operare vede fiecare socket ca un grup de nuclee și memorie atașată local. Acest lucru simplifică plasarea în cadrul socketului, deși nu înseamnă că fiecare cale prin rețeaua de rețea are o latență identică. Un server cu două socketuri are în continuare două noduri NUMA, iar accesarea memoriei celuilalt socket rămâne diferită de accesarea memoriei locale.
În fiecare socket, memoria cache partajată la nivel de sistem, sau L3, se află cu un nivel dincolo de memoria cache privată L2 descrisă anterior. Aceasta oferă nucleelor o altă șansă de a reutiliza datele fără a apela la DRAM și oferă o capacitate partajată accesibilă în tot socketul. Cei 164 MB sunt considerabili, dar unele procesoare concurente oferă considerabil mai mult L3. Acest lucru este important atunci când un set de lucru accesat în mod repetat este prea mare pentru L2-ul unui nucleu, dar se potrivește într-o memorie cache partajată mai mare. Lățimea de bandă DRAM mare ajută atunci când datele trebuie să provină din memorie; nu elimină beneficiul evitării acestui acces în primul rând.
Deoarece această capacitate este partajată, Vera este compatibilă și cu Arm MPAM, permițând software-ului de sistem să partiționeze capacitatea cache partajată și să gestioneze alocarea lățimii de bandă a memoriei între sarcinile de lucru.
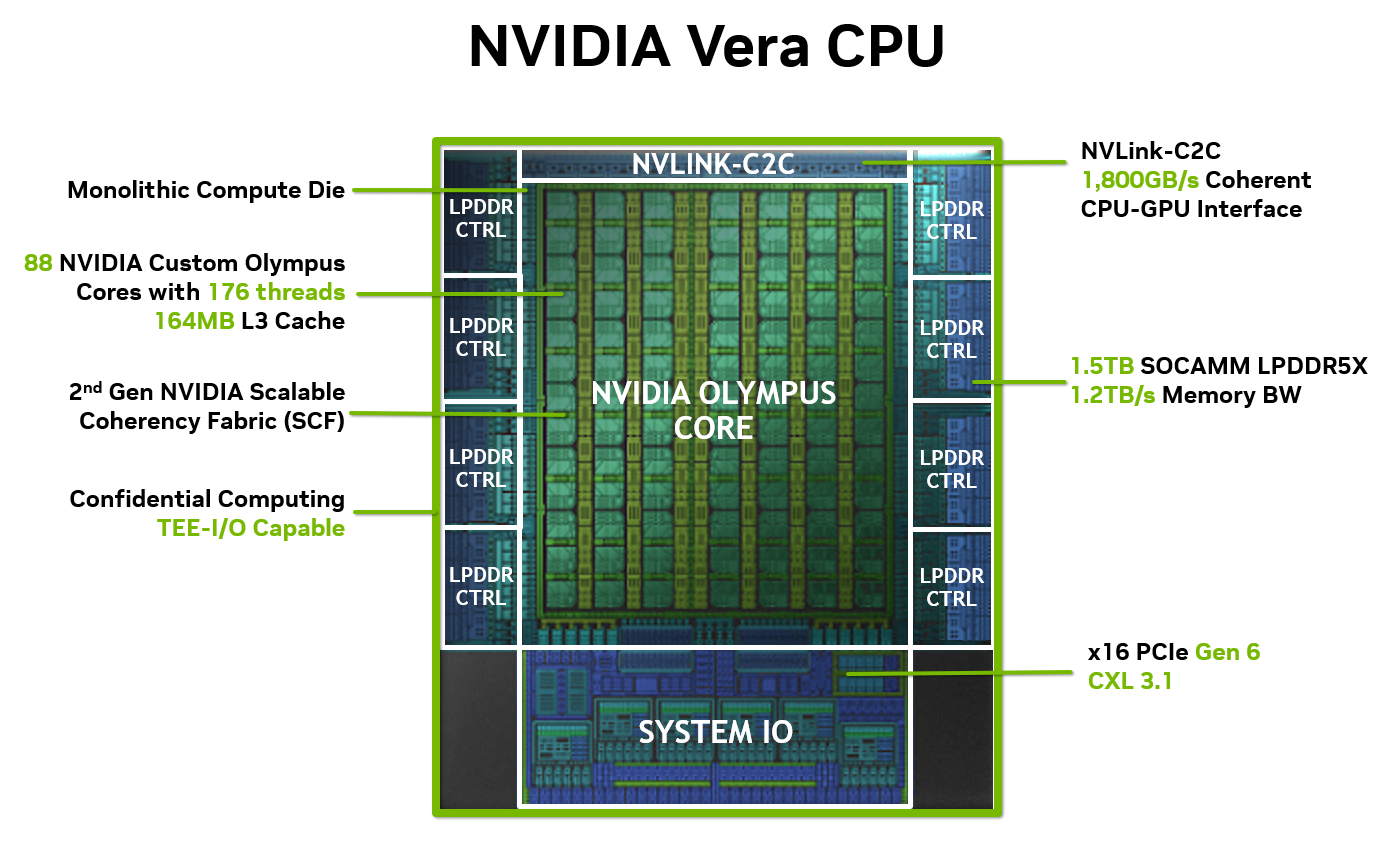
Când accesele ajung la memoria principală, Vera are o lățime de bandă considerabilă disponibilă. Opt controllere LPDDR5X pe 128 de biți oferă o interfață agregată de 1,024 de biți, cu memorie care rulează la o viteză de până la 9,600 MT/s pentru o viteză nominală de 1.2 TB/s per socket. Memoria se află pe opt module SOCAMM2 detașabile, combinând LPDDR5X cu module înlocuibile pe teren. Acest lucru oferă Vera o interfață de memorie largă și rapidă, fără a necesita memorie lipită.
Lățimea de bandă brută este însă doar o parte a imaginii. Relația mai utilă este cea dintre acea lățime de bandă și numărul de nuclee care o partajează. Împărțind viteza nominală de 1.2 TB/s la 88 de nuclee, se obțin aproximativ 13.6 GB/s per nucleu fizic. Aceasta este o modalitate de a descrie echilibrul procesorului, nu o alocare dedicată sau o garanție a ceea ce primește fiecare fir de execuție. Creșterea numărului de nuclee fără o creștere corespunzătoare a lățimii de bandă a memoriei ar reduce acest raport.
Împărțind lățimea de bandă STREAM măsurată la numărul de nuclee fizice, rezultă 11.8 GB/s pe nucleu pe Vera, comparativ cu 3.8 GB/s pe sistemul Xeon 6978P cu 240 de nuclee. Acesta este un exemplu concret al faptului că Vera oferă un debit de memorie substanțial în raport cu resursele sale de calcul.
Eficiența energetică face parte din aceeași alegere de design. NVIDIA estimează aproximativ 30W până la 40W pentru un subsistem de memorie LPDDR5X complet populat, în funcție de capacitate. Atractivitatea LPDDR5X este de a furniza această lățime de bandă, menținând în același timp contribuția memoriei la puterea totală a serverului la un nivel scăzut, lăsând o parte mai mare din bugetul de alimentare și răcire al sistemului disponibilă pentru calcul.
Lățimea de bandă și eficiența încă nu spun nimic despre cât de mult încape, iar capacitatea rămâne o considerație separată. NVIDIA specifică până la 1.5 TB de LPDDR5X atașat direct per socket sau 3 TB pe două socketuri. Pentru sarcinile de lucru care necesită ca setul lor de lucru să fie rezident în memorie, ratele de transfer mai mari nu pot compensa capacitatea insuficientă.
Acolo unde capacitatea atașată direct nu este suficientă, interfața I/O a Vera oferă o cale către mai multe conexiuni, împreună cu conexiuni pentru dispozitive. Platforma CPU independentă oferă 88 de benzi PCIe Gen6 per socket pentru rețele, stocare și acceleratoare, în timp ce configurația Vera Rubin expune 96. În ceea ce privește memoria, suportul CXL 3.1 include dispozitive de memorie de tip 3 și pooling de memorie, permițând extinderea capacității dincolo de modulele SOCAMM2. Această memorie extinsă utilizează o cale de acces diferită de cea a LPDDR5X atașată direct, așa că performanța sa trebuie evaluată separat.
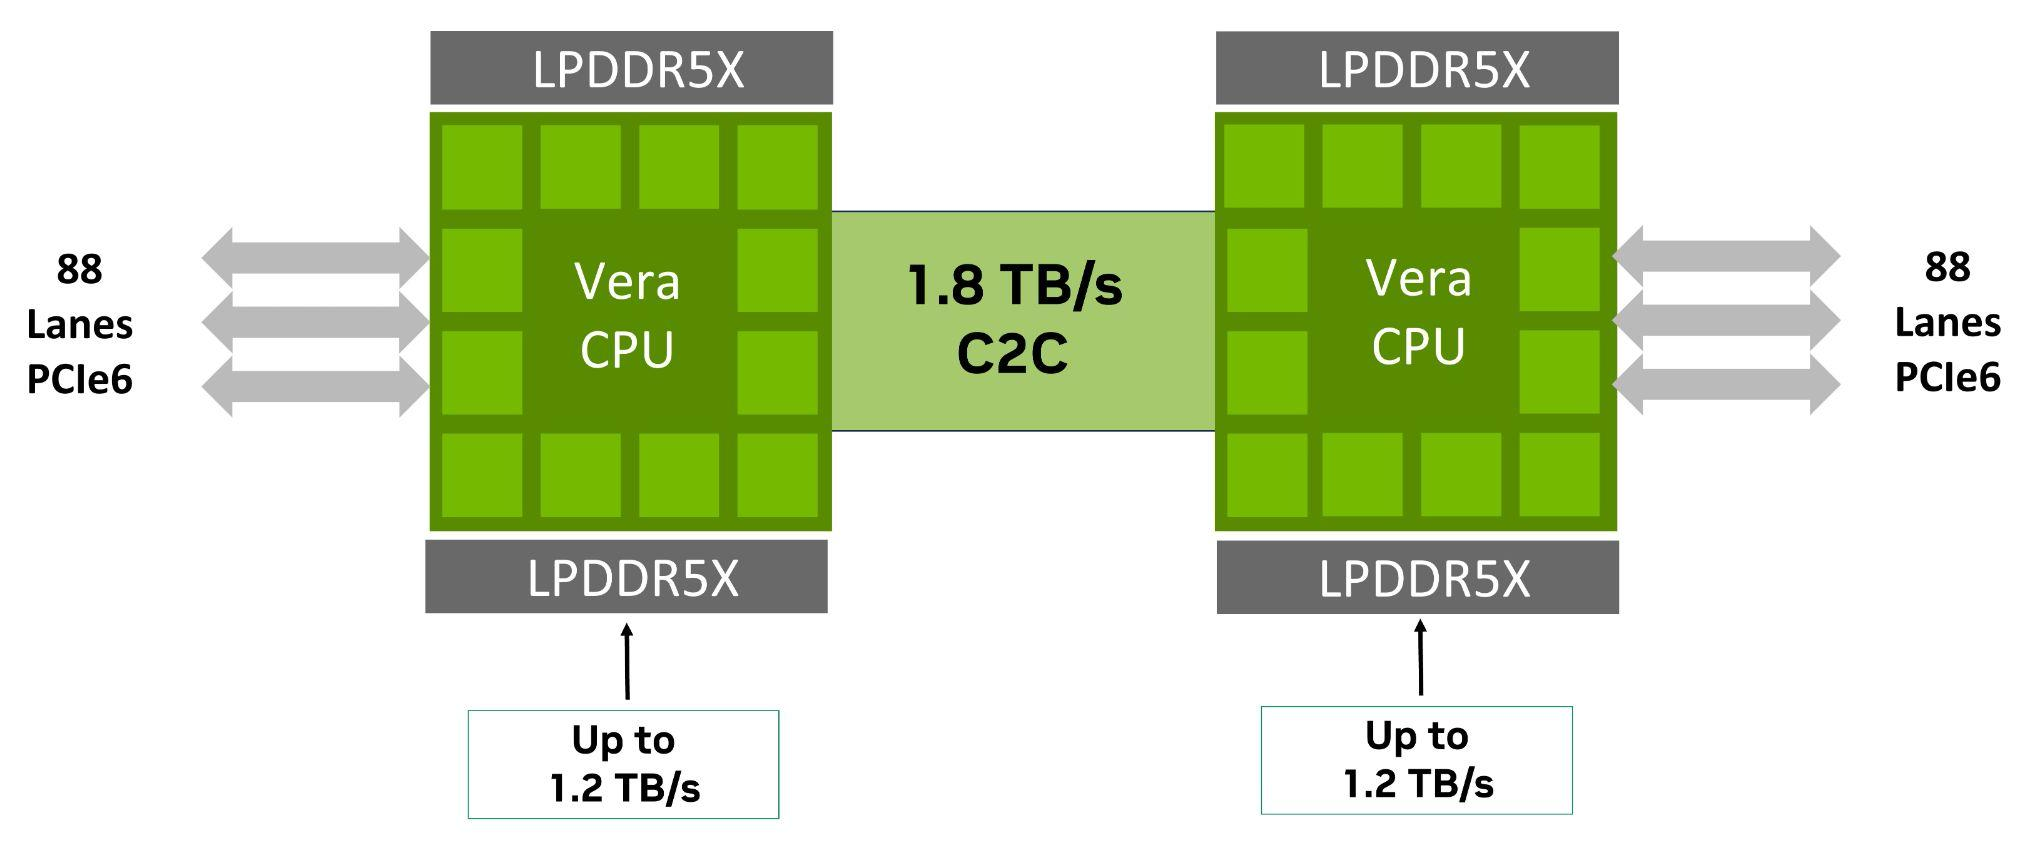
În cele din urmă, pentru comunicarea dintre procesoare, Vera utilizează NVLink-C2C de a doua generație, succesorul legăturii introduse odată cu supercipurile Grace. Conectează două procesoare Vera într-un server cu două socluri sau leagă Vera de GPU-uri Rubin într-un supercip. Legătura oferă o lățime de bandă bidirecțională agregată de până la 1.8 TB/s, sau 900 GB/s în fiecare direcție, și reflectă aceeași integrare strânsă CPU-GPU care a impulsionat inițiativa NVIDIA în domeniul procesoarelor.
În interiorul serverului de referință MGX Vera C2
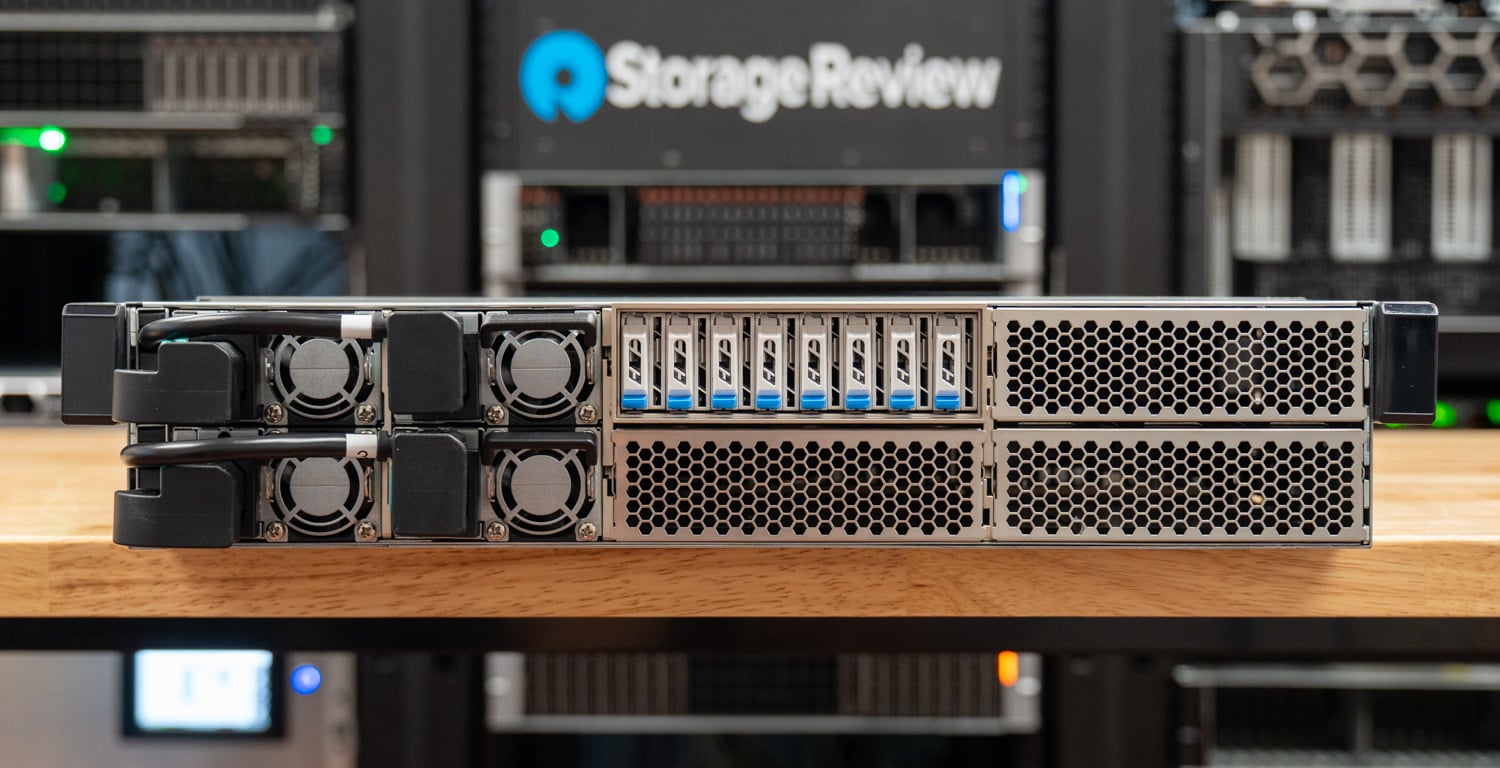
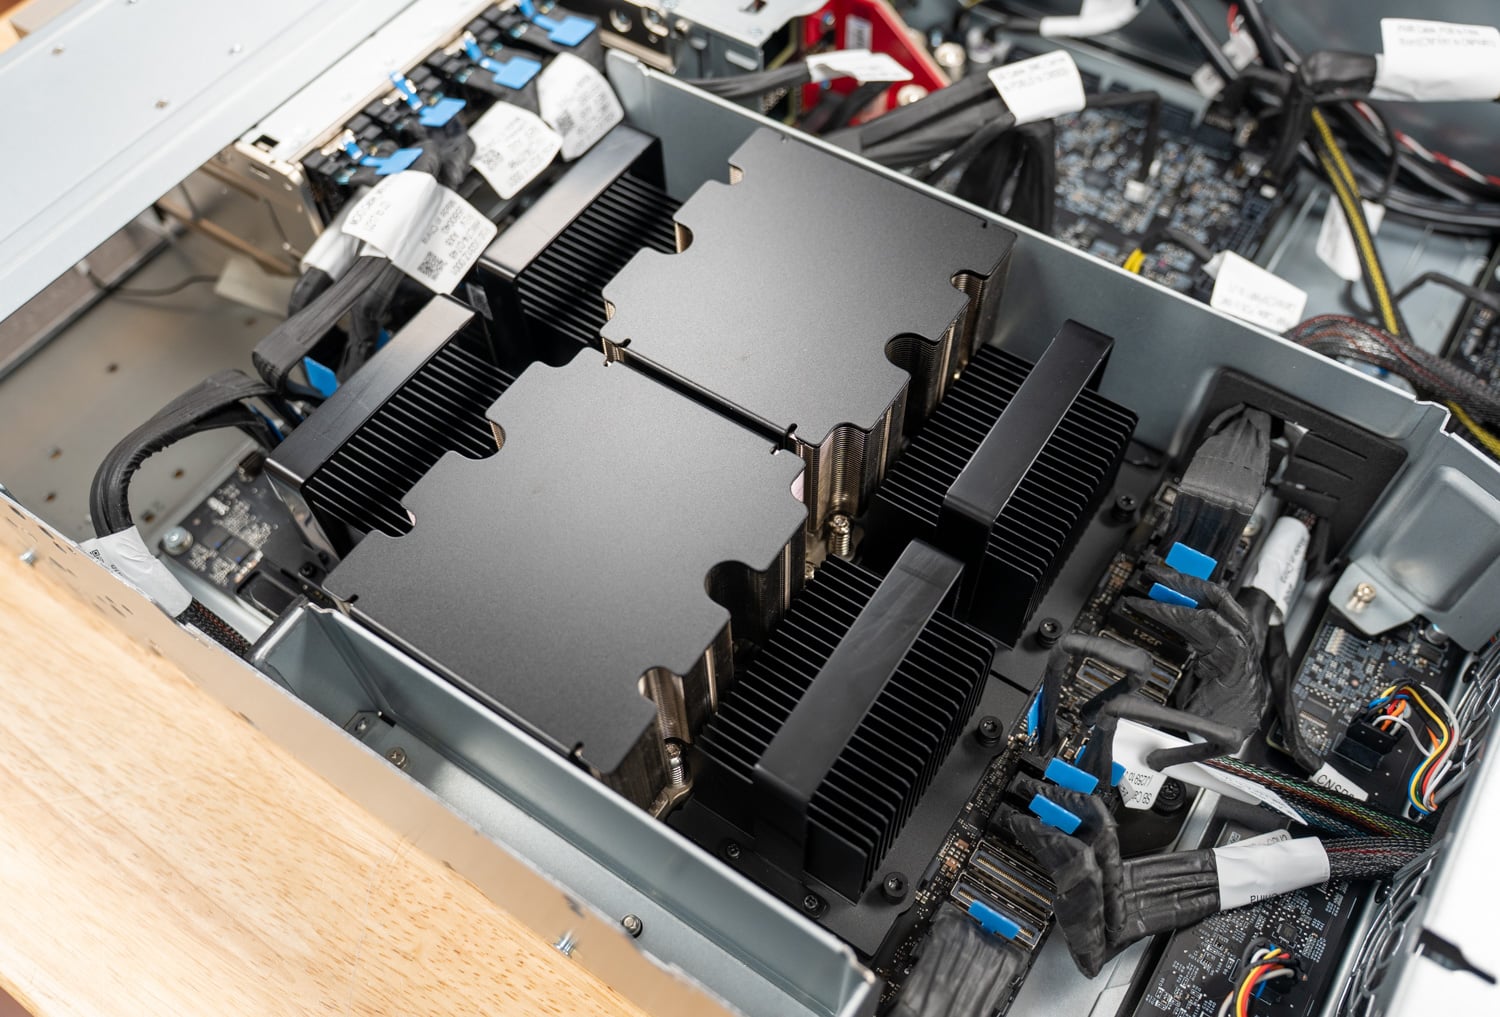
Unitatea noastră de testare este MGX Vera C2 de la NVIDIA, un server de referință 2U cu două socketuri, răcit cu aer, pe care partenerii NVIDIA îl folosesc ca bază pentru primele lor sisteme Vera. Opt compartimente E1.S se desfășoară în partea superioară a panoului frontal, lângă patru surse de alimentare Delta hot-swap, cu o admisie tip fagure care umple restul feței. Deoarece sursele de alimentare se încarcă din față, partea din spate rămâne liberă pentru cablarea I/O într-un rack și este dedicată riserelor PCIe și I/O de management.
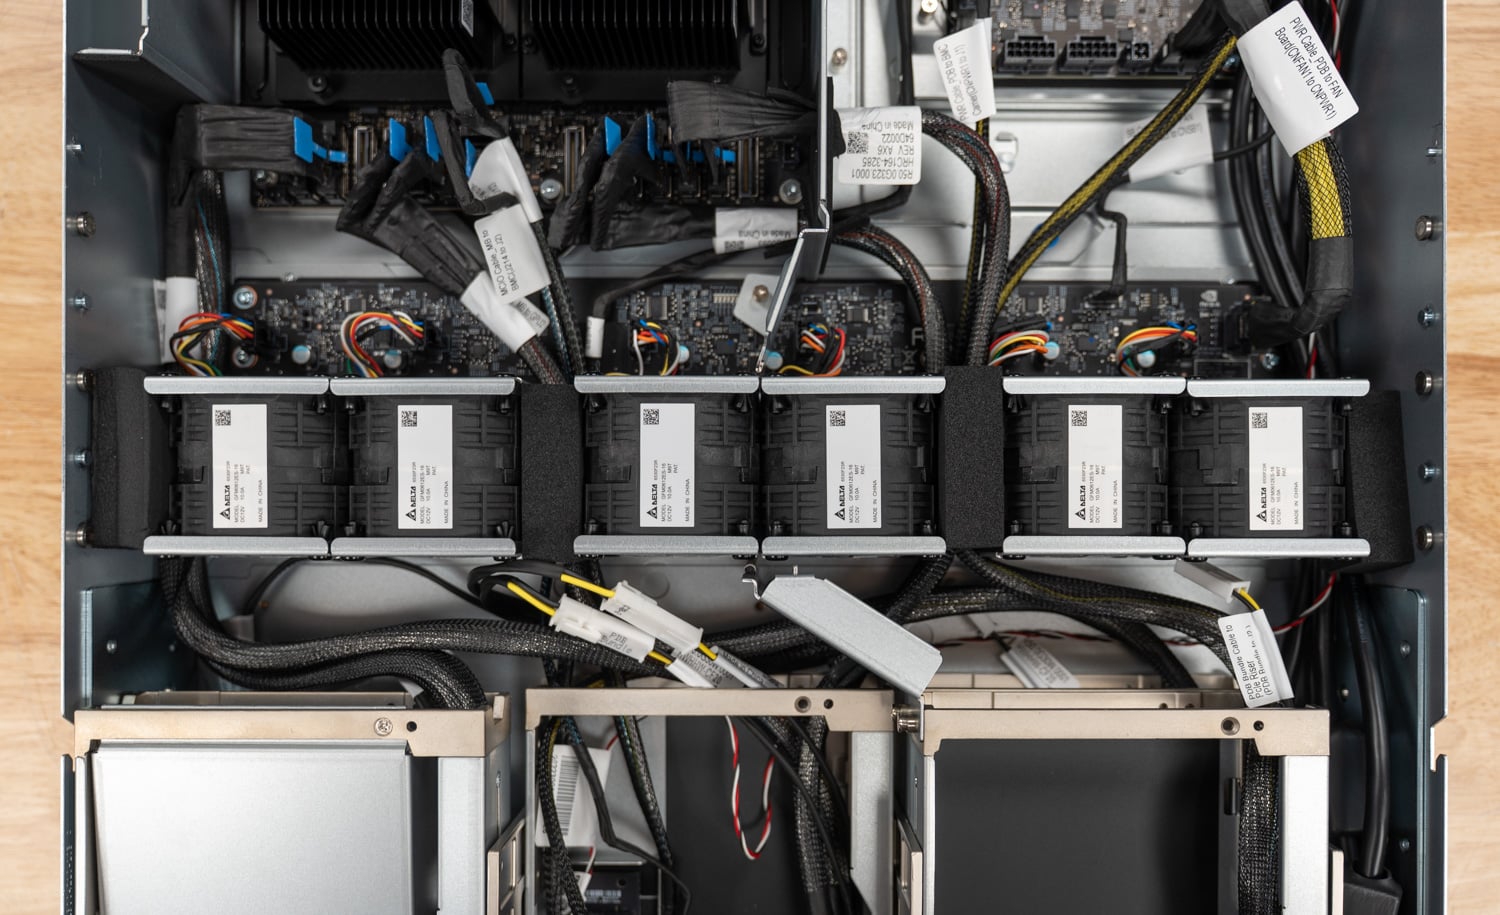
În interior, cele două procesoare Vera sunt amplasate unul lângă altul sub radiatoare pasive, cu module SOCAMM2 de-a lungul flancurilor. Un perete format din șase module de ventilatoare în centrul carcasei, chiar în spatele compartimentelor pentru unități, trage aerul prin ambele socluri, iar blocurile de spumă dintre fiecare pereche de ventilatoare direcționează fluxul de aer. Din punct de vedere al răcirii, aspectul este bine gândit.
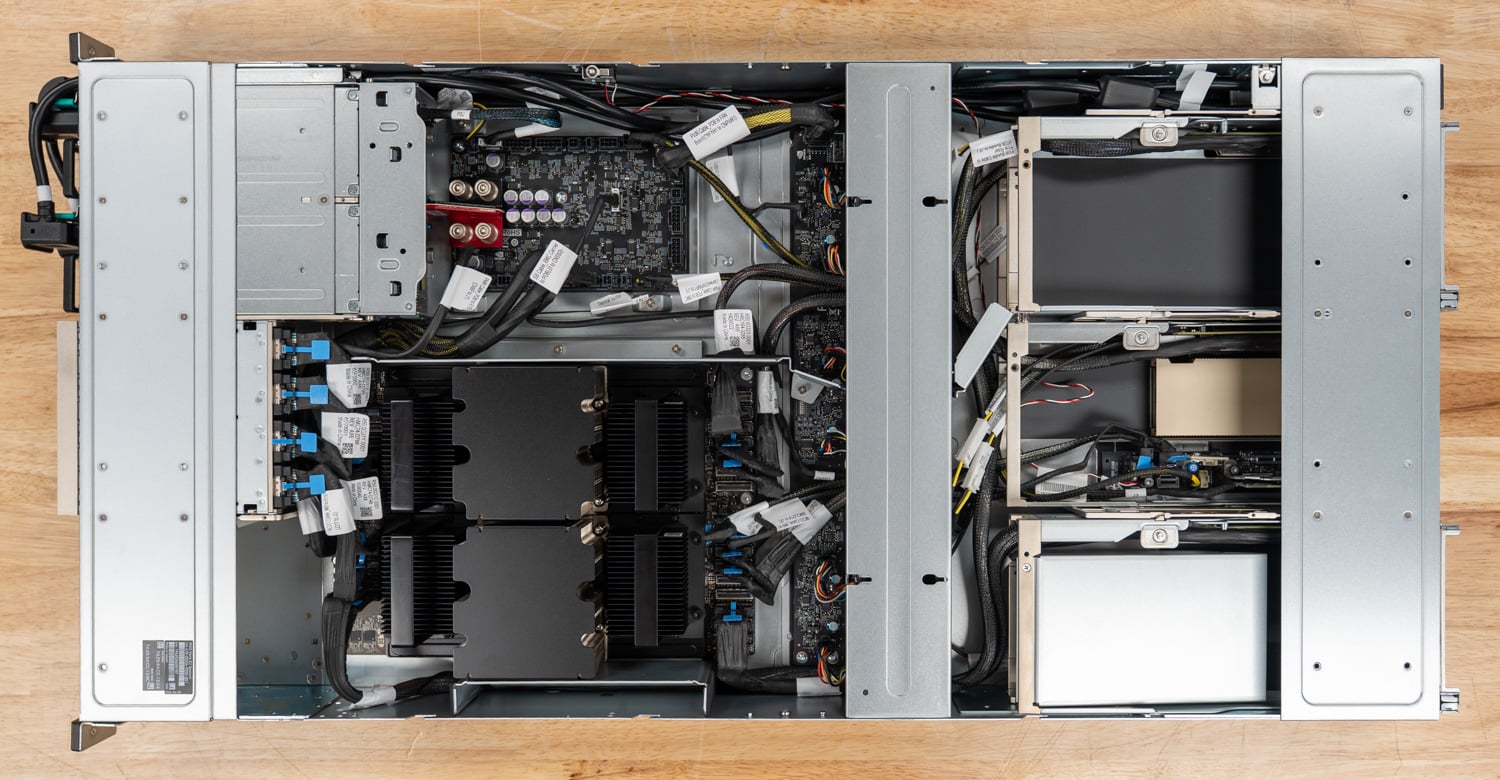
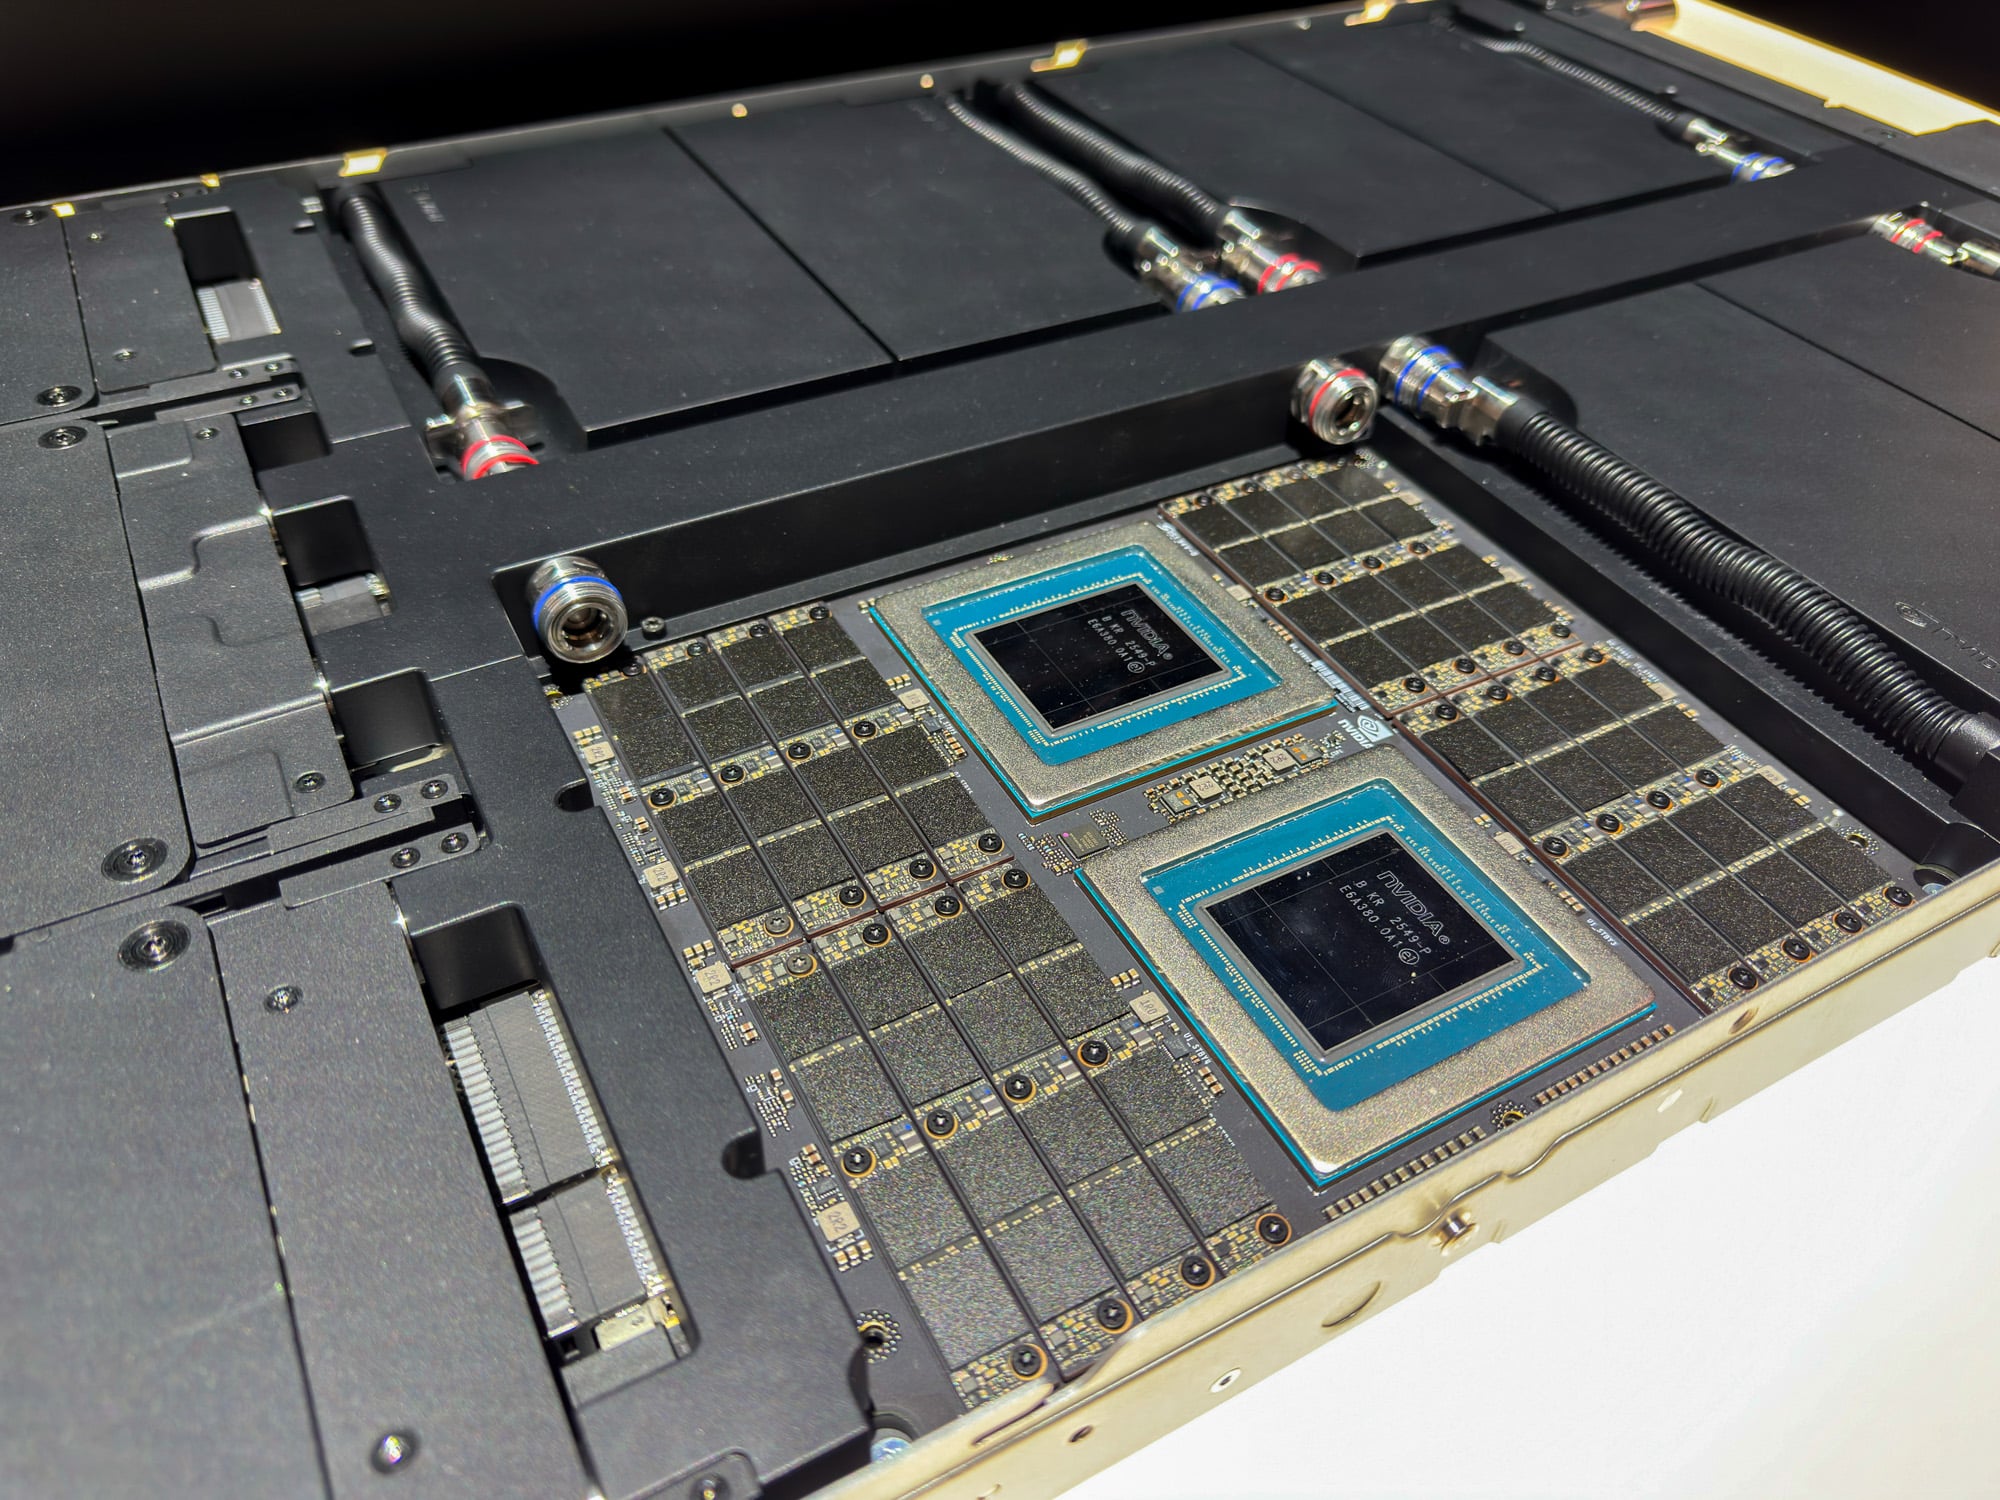
Ambele procesoare sunt montate direct pe PCB, fără soclu, în același mod în care NVIDIA livrează Vera în supercipurile sale. Cele 16 sloturi SOCAMM2 înconjoară cele două pachete, astfel încât memoria rămâne înlocuibilă pe teren, chiar dacă procesoarele nu sunt; înlocuirea unui procesor înseamnă schimbarea plăcii de bază. În timpul verii, am analizat și versiunea răcită cu lichid a aceleiași plăci de bază, care rulează conducte de răcire cu deconectare rapidă prin partea superioară a plăcii către plăcile de răcire ale procesorului, lăsând în același timp modulele SOCAMM2 răcite cu aer.
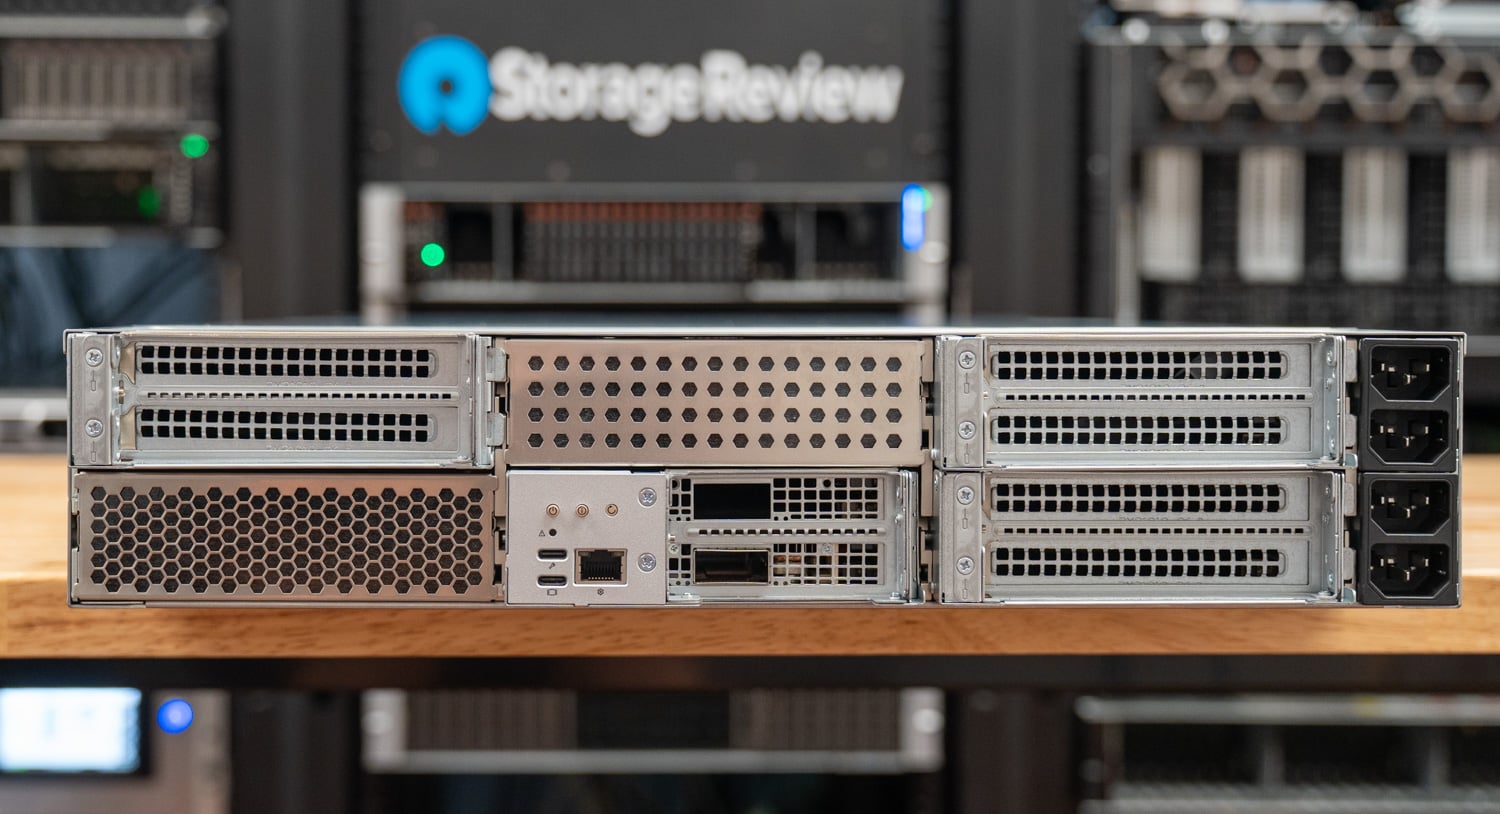
Riser-ul din mijloc găzduiește un adaptor NVIDIA ConnectX-8 pentru o rețea de până la 800G, iar panoul din spate dispune de porturi USB, DisplayPort și un port de rețea dedicat pentru gestionarea în afara benzii.
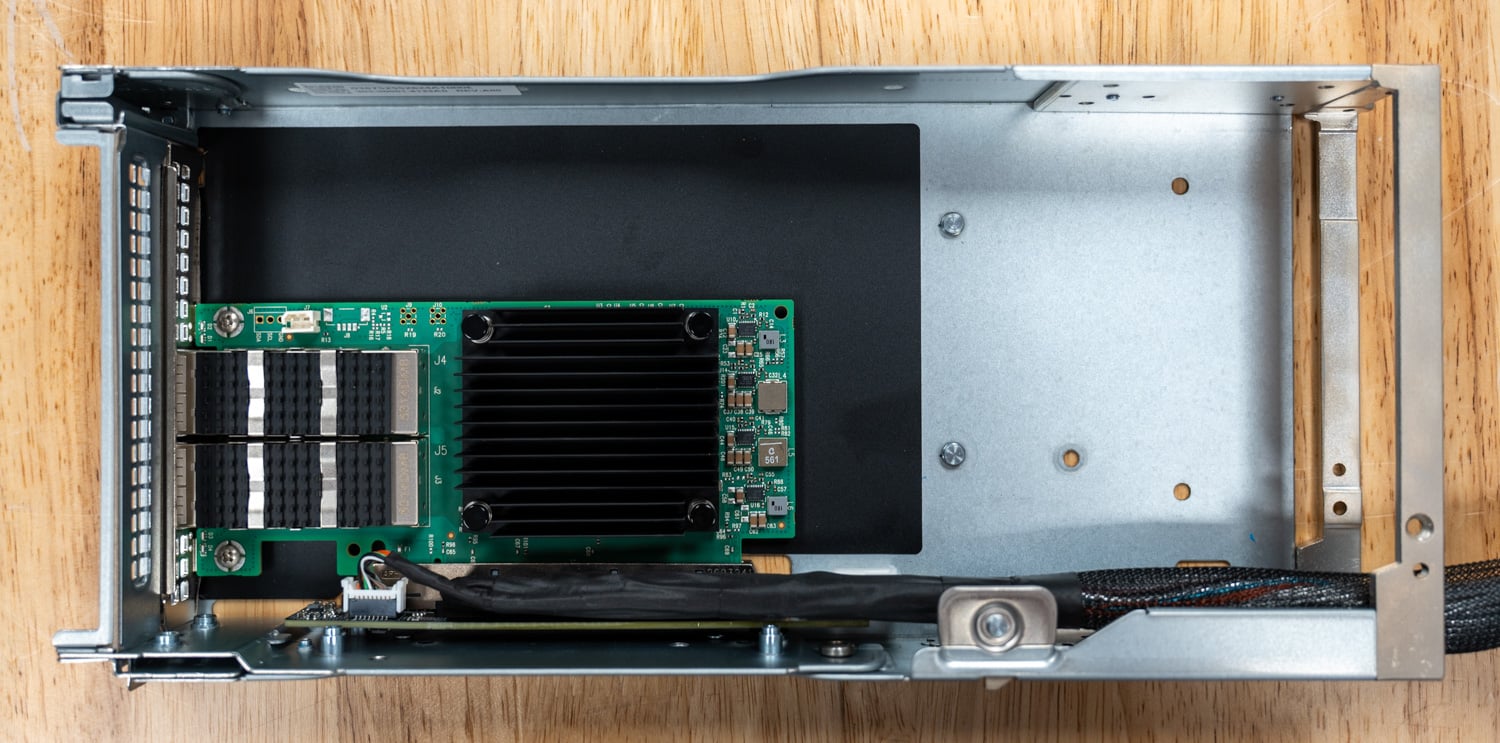
Platforma este extrem de modulară și acceptă o gamă largă de configurații de stocare și PCIe spate, dar această flexibilitate vine cu prețul timpului de service. Cele trei rise PCIe FHFL par ușor de întreținut la prima vedere. Într-un server tipic, schimbarea unei plăci înseamnă eliberarea riserului, scoaterea unei clapete de suport sau scoaterea unui șurub și glisarea plăcii în afară.
Pe serverul Vera, mai întâi scoateți capacul ventilatorului, scoateți unul sau mai multe dintre blocurile de spumă și deconectați și ridicați cablurile de alimentare și PCIe ale riser-ului. Abia apoi întregul ansamblu riser poate fi glisat afară prin spatele carcasei. Odată ce sania este liberă, aceasta trebuie dezasamblată pentru a ajunge la placă și apoi reasamblată după înlocuire. O sarcină care durează câteva secunde pe un server convențional durează între 5 și 10 minute per sanie aici.
În practică, service-ul în rack este imposibil, cu excepția cazului în care sunteți pregătit să vă mutați înainte și înapoi, așa că majoritatea schimbărilor de componente necesită mutarea serverului pe un banc de lucru pentru service.
Performanță și Benchmark-uri
Testele de performanță examinează modul în care designul Verei se traduce în performanță, de la thread-uri individuale la sarcini de lucru care utilizează întregul sistem. Testele noastre acoperă lățimea de bandă și latența memoriei, calcul științific, software de uz general și baze de date, arătând cum gestionează procesorul diferite cerințe asupra nucleelor și sistemului de memorie.
Sisteme de testare
| Sistem și | NVIDIA MGX Vera C2 | Dell PowerEdge R7725 | Dell PowerEdge R7725 | Dell PowerEdge R770AP | Dell PowerEdge R770 | Dell PowerEdge R760 |
|---|---|---|---|---|---|---|
| Procesoare | ||||||
| Procesor | NVIDIA Vera | AMD EPYC 9965 | AMD EPYC 9175F | Intel Xeon 6978P | Intel Xeon 6787P | Intel Xeon Platinum 8592+ |
| Sockets | 2 | |||||
| Nuclee / Fire de execuție per CPU | 88 / 176 | 192 / 384 | 16 / 32 | 120 / 240 | 86 / 172 | 64 / 128 |
| Ceas de bază | 3.4 GHz | 2.25 GHz | 4.2 GHz | 2.1 GHz | 2.0 GHz | 1.9 GHz |
| Ceas maxim | 3.4 GHz | 3.7 GHz | 5.0 GHz | 3.9 GHz | 3.8 GHz | 3.9 GHz |
| Memorie | ||||||
| Configuraţie | 16x 96GB Micron SOCAMM2 | 24x 128GB | 24x 64GB | 32x 64GB | 16x 64GB | |
| Tip / Viteză | LPDDR5X-9600 | DDR5-6400 | DDR5-5200 | DDR5-4800 | ||
| Capacitate totală | 1.5TB | 3TB | 1.5TB | 2TB | 1TB | |
| Stocare | ||||||
| SSD | Solidigm D7-PS1010 7.68TB | Solidigm D7-PS1030 12.8TB | Micron 9550 PRO 7.68TB | Solidigm D7-PS1010 7.68TB | Samsung PM1745 6.4TB | Solidigm D7-P5520 3.84TB |
| Legătură SSD | PCIe Gen5 x4 | PCIe Gen5 x2 | PCIe Gen5 x4 | PCIe Gen4 x4 | ||
| Firmware | ||||||
| BIOS-ul sistemului | NV_SBIOS 06.07.01.06 | 1.5.3 | 1.2.1 | 1.8.5 | 2.8.2 | |
| Profil BIOS | Mod implicit | Performanţă | ||||
| Stiva de software | ||||||
| OS | Ubuntu 26.04.1 LTS | Ubuntu 24.04.5 LTS | ||||
| Nucleu | 7.0.0-2022-nvidia-bos | 6.8.0-142 / 6.8.0-146 | 6.8.0-147 | 6.8.0-138 | 6.8.0-142 / 6.8.0-146 | 6.8.0-142 / 6.8.0-146 |
| CGC | 15.2.0 | 13.3.0 | ||||
| glibc | 2.43 | 2.39 | ||||
| Deschideți MPI | 5.0.10 | 4.1.6 | ||||
| OpenJDK | 11.0.32 | |||||
Am comparat Vera cu cinci configurații Dell PowerEdge cu configurație ideală de memorie și le-am testat cu aceeași suită, acoperind componentele EPYC cu cel mai mare număr de nuclee și optimizate din punct de vedere al frecvenței de la AMD, împreună cu procesoarele Xeon din generația actuală și anterioară.
Deoarece suportul pentru Olympus a apărut pentru prima dată în GCC 15, Vera a rulat o stivă de software mai nouă decât sistemele x86, așa cum este menționat mai sus. Versiunile de benchmark, intrările și semnalizatoarele de compilare erau în rest identice pe toate sistemele.
Memorie Bandwidth
Memoria este punctul în care Vera se diferențiază cel mai mult de x86, așa că începem testele de acolo. Am testat STREAM Triad, rulat cu un fir de execuție OpenMP per nucleu fizic pe matrice de 16GiB. Rularea principală folosește fiecare nucleu din sistem, datele fiecărui fir fiind plasate pe același socket. Apoi o repetăm cu nucleele socketului 0 citind mai întâi memoria locală și apoi memoria socketului la distanță, și cu fiecare nucleu citind pagini intercalate pe ambele socketuri. Graficul de mai jos prezintă rezultatele Triad pentru întregul sistem pentru fiecare server cu SMT dezactivat.
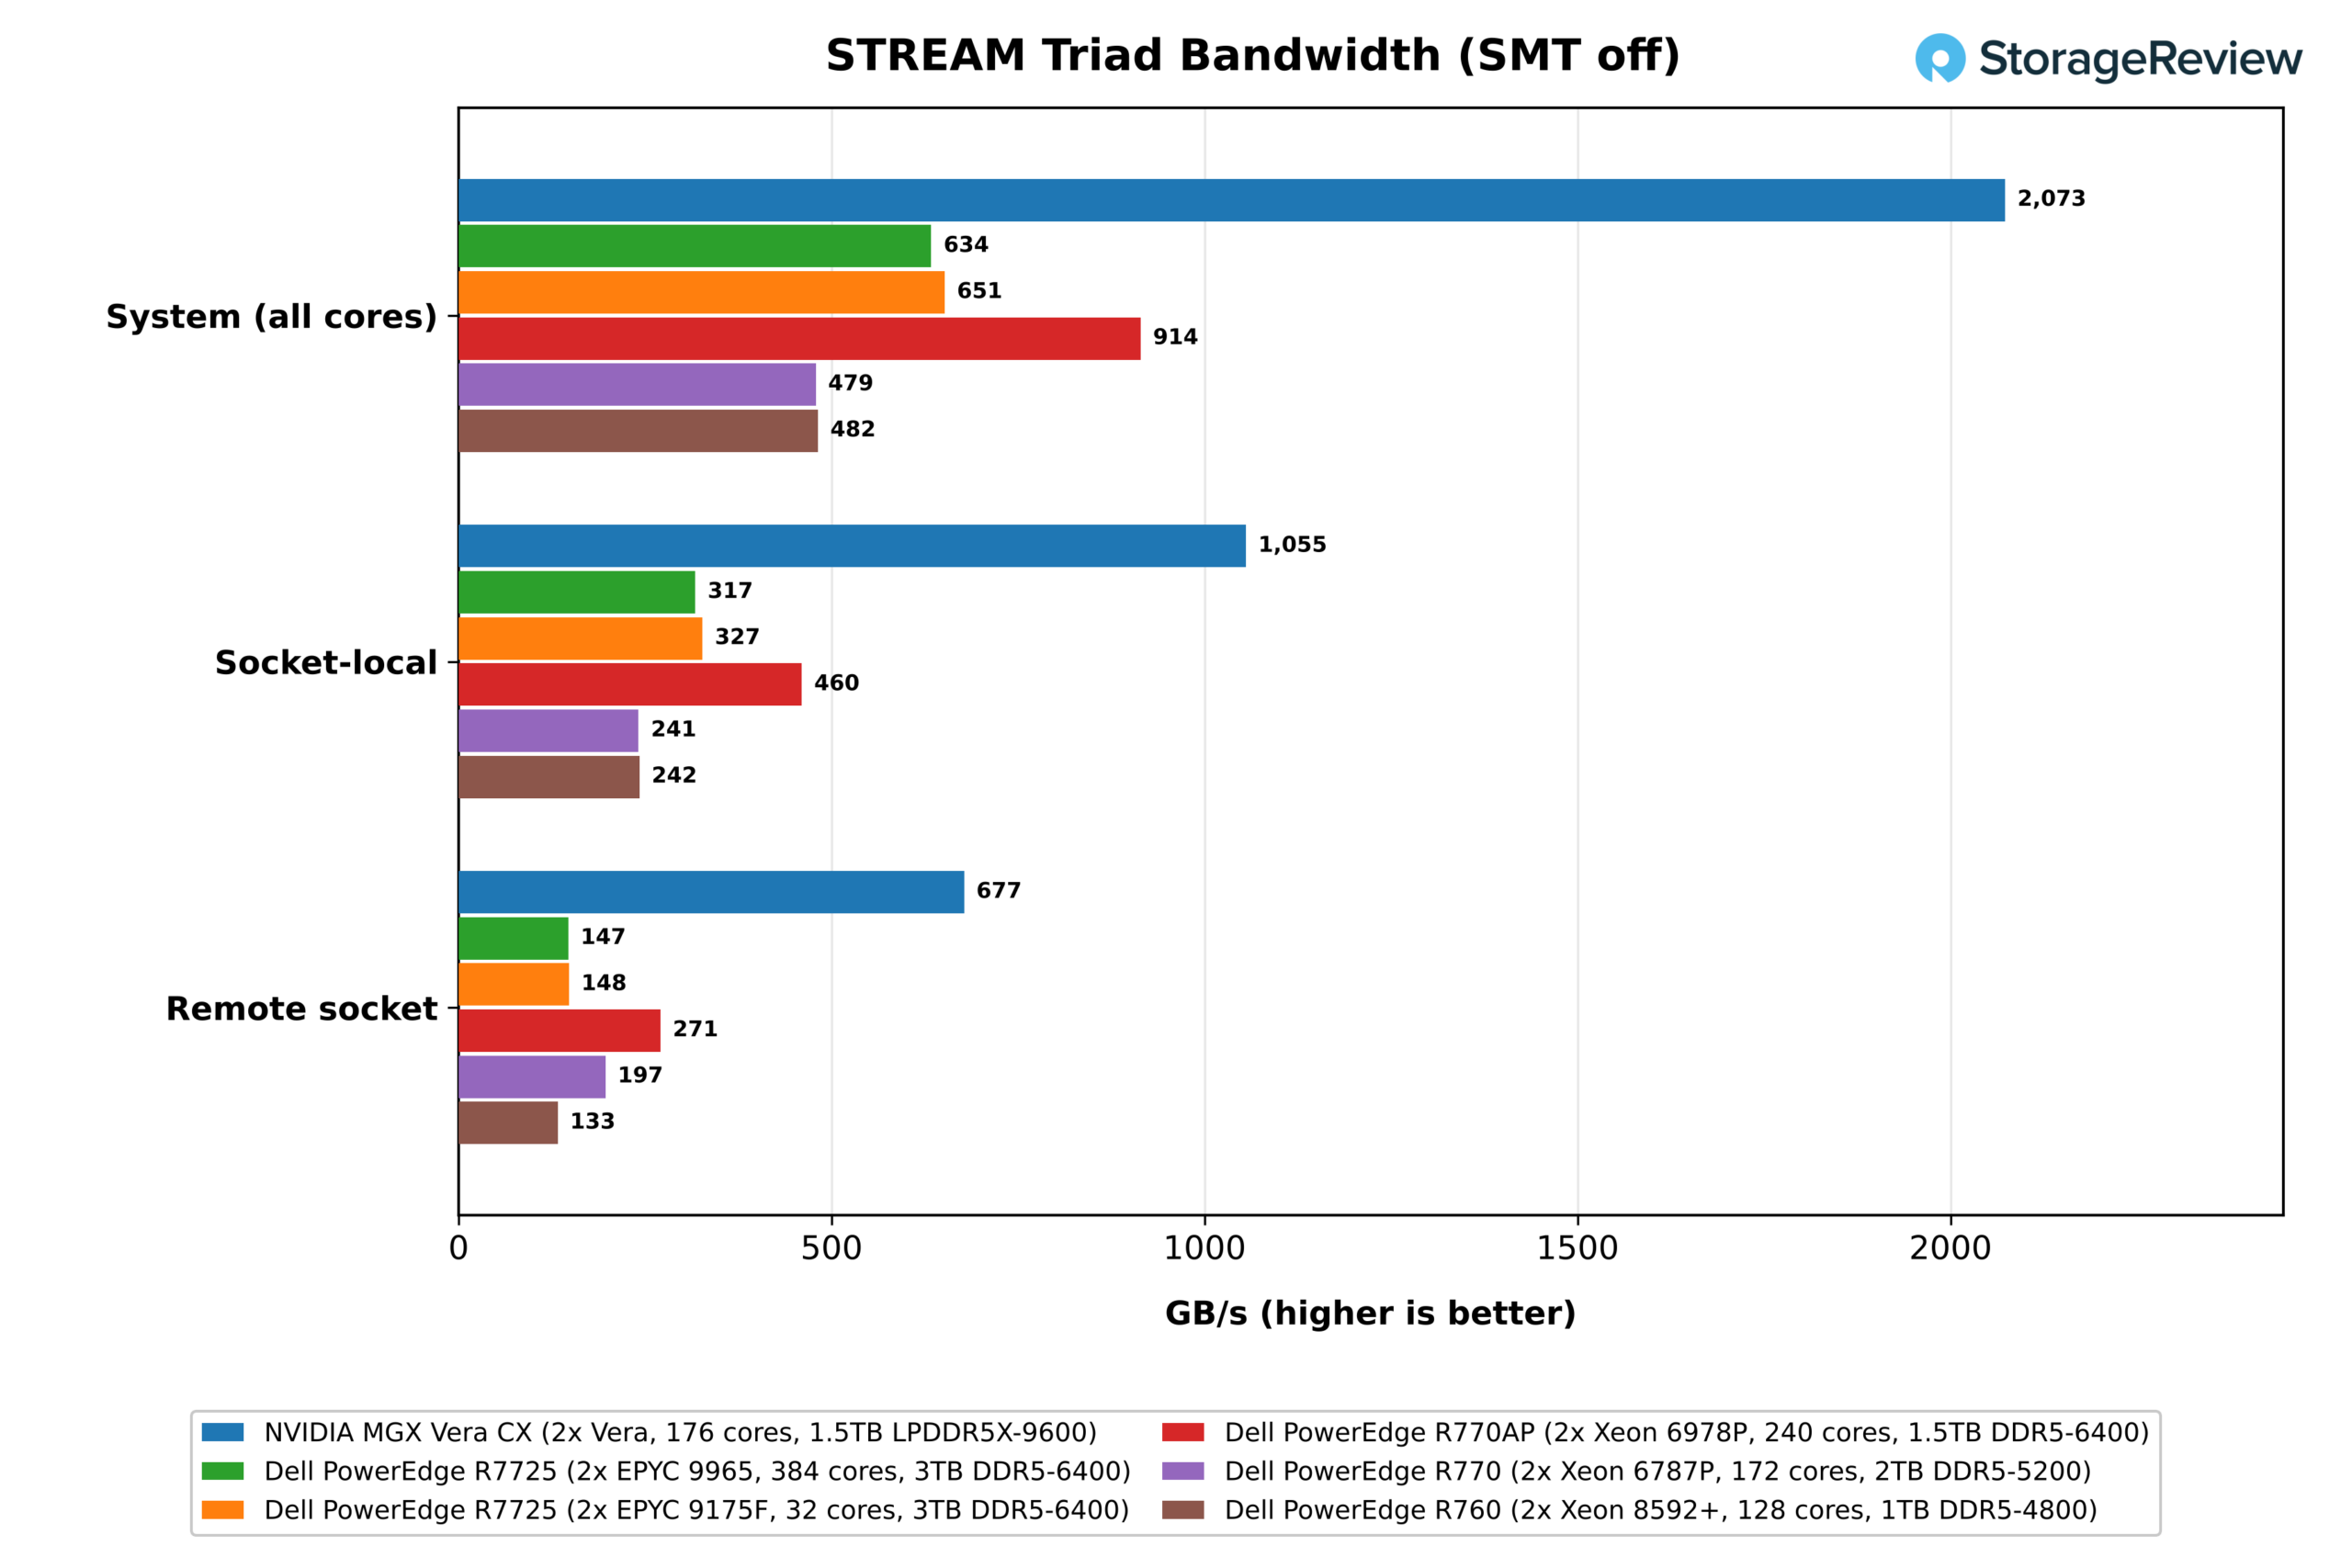
Vera a menținut o viteză de 2,073 GB/s, 86% din viteza sa de 2.4 TB/s pe două socketuri. Cel mai apropiat sistem x86 a fost Xeon 6978P, ale cărui 24 de canale de DDR5-6400 au oferit 914 GB/s, 74% din vârful teoretic de 1,229 GB/s, pentru un avans de 2.3x față de Vera. Cele două sisteme EPYC rulează aceleași 24 de canale de DDR5-6400, dar au atins un nivel mult sub acesta: 651 GB/s pentru 9175F cu 32 de nuclee și 634 GB/s pentru 9965 cu 384 de nuclee, doar 52% din vârf și un avans de 3.3x față de Vera. În cele din urmă, Xeon 6787P și 8592+ se află în urma plutonului, rulând pe DDR5-5200 și DDR5-4800 mai lente, atingând 479 GB/s și, respectiv, 482 GB/s.
O parte din deficitul EPYC provine din modul în care STREAM numără traficul. Suita construiește STREAM cu GCC simplu, care nu emite stocări de flux, astfel încât un stocator care ratează memoria cache citește mai întâi linia de destinație din memorie. STREAM nu numără acea citire, ceea ce înseamnă că Triad subestimează traficul mutat cu o 25% oriunde se întâmplă. Nucleele Zen de la AMD plătesc acest lucru la fiecare stocare. Nucleele Arm, cum ar fi Grace-ul anterior de la NVIDIA, detectează scrierile pe linii complete și sar peste citire, iar procesoarele Xeon recente de la Intel pot sări peste cea mai mare parte a acesteia atunci când memoria este încărcată puternic.
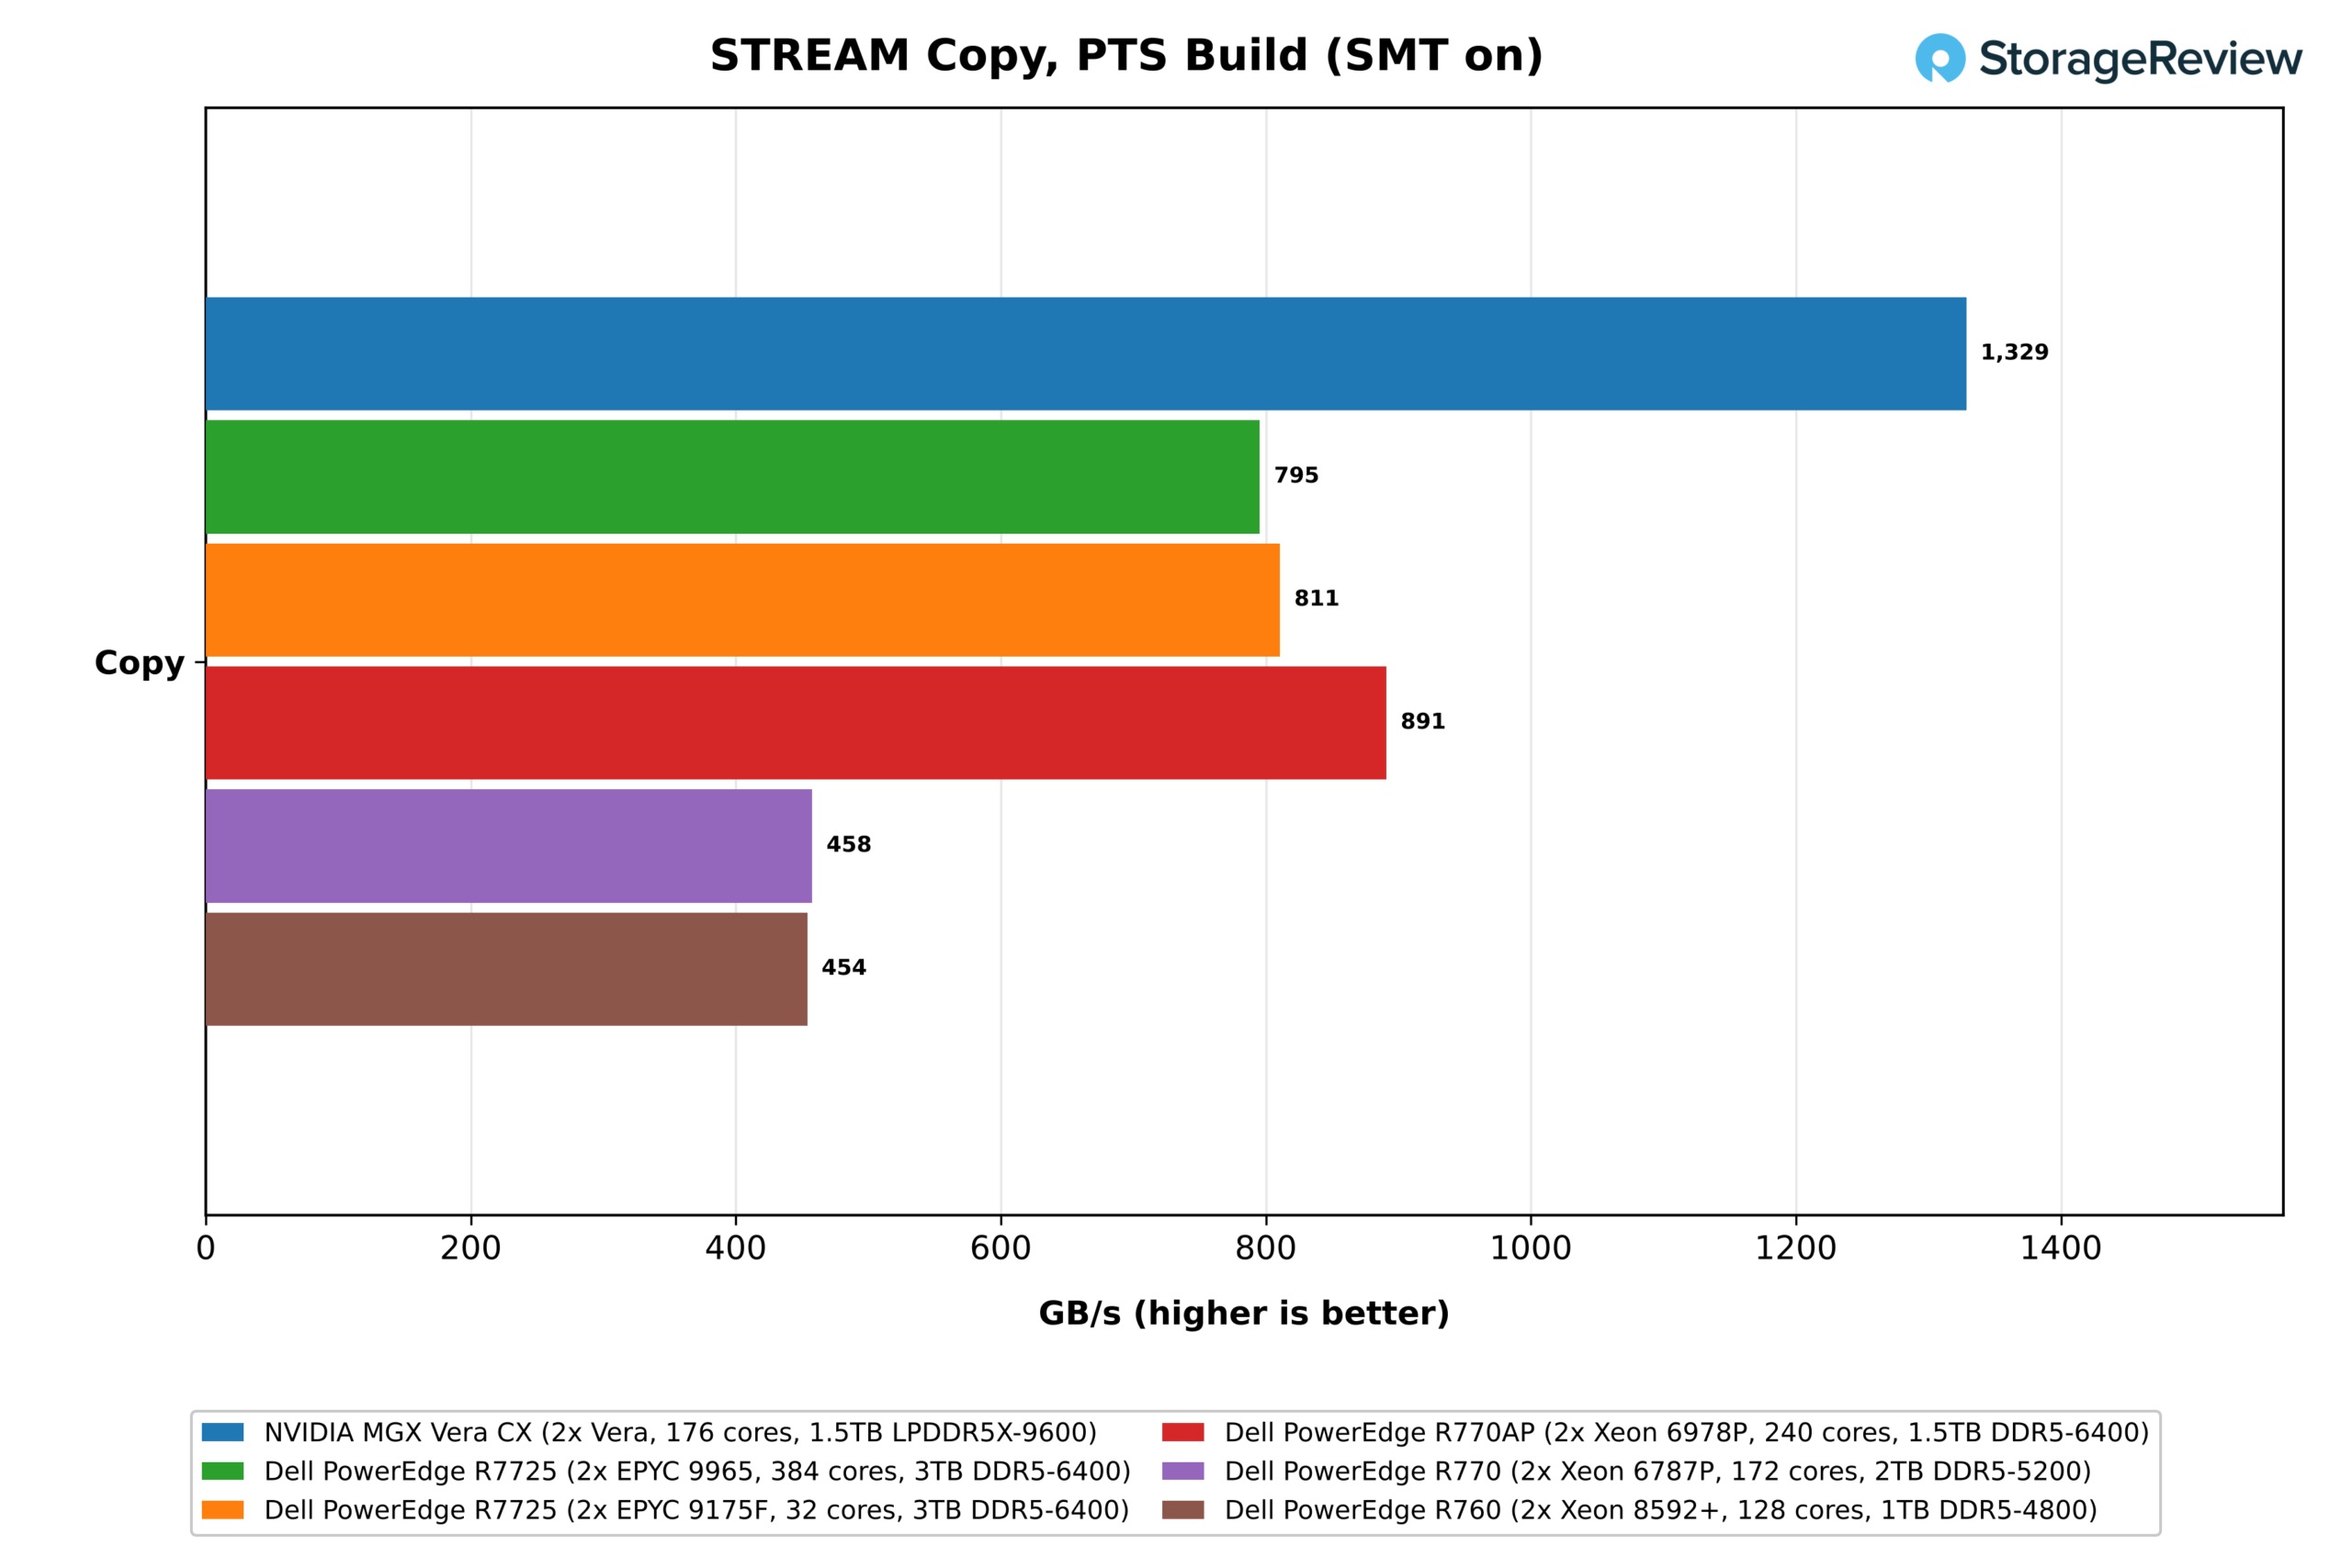
Versiunea separată Phoronix Test Suite a STREAM indică aceeași direcție. Cu SMT dezactivat, rezultatul Copy a atins 832GB/s pe 9965 și 873GB/s pe 9175F, aproximativ 1.5 ori mai mult decât vitezele de 551GB/s și 570GB/s ale versiunii suite și, în conformitate cu câștigul pe care Copy ar trebui să-l înregistreze odată ce citirea suplimentară este eliminată; pe Xeon-urile, cele două versiuni au ajuns la o diferență de 9% una față de cealaltă.
Ajustat pentru citirile necenzurate, 9965 s-a mișcat cu aproximativ 845 GB/s, aproximativ 69% din vârf, iar avansul Verei în ceea ce privește numărul de octeți mișcați se reduce la aproximativ 2.5x. 6978P necesită mult mai puține corecții, ceea ce face ca valoarea sa de 2.3x să fie cea mai conservatoare comparație din set.
Împărțirea testului în funcție de socket arată cum gestionează structura datelor care nu sunt locale pentru nuclee. Nucleele Socket 0 care citesc memoria locală au atins 1,055 GB/s, 88% din viteza de 1.2 TB/s per socket și mai mult decât orice server x86 din set. Citind memoria celuilalt socket prin NVLink-C2C, aceleași nuclee au menținut 677 GB/s, 64% din viteza locală, față de 59% pe Xeon 6978P și 45% pe EPYC 9175F (148 GB/s la distanță față de 327 GB/s local). Chiar și o sarcină de lucru plasată pe socket-ul greșit obține, prin urmare, mai multă lățime de bandă decât orice socket x86 care citește din memoria locală, care atinge un maxim de 460 GB/s pe 6978P.
Ca test final pentru Vera, am testat cu pagini intercalate STREAM Triad pe ambele socketuri, cazul pe care îl observă o aplicație care nu este compatibilă cu NUMA, ceea ce a dat pentru Vera 1,372 GB/s, de 1.5 ori mai mult decât rezultatul întregului sistem obținut de 6978P.
Latență
Lățimea de bandă este doar jumătate din povestea memoriei. Latența decide cât timp așteaptă un nucleu de fiecare dată când ratează accesul în cache și contează cel mai mult pentru codul care urmărește pointerii prin memorie. O măsurăm cu tinymembench, care cronometrizează citirile aleatorii pe un buffer de 1GiB dintr-un singur thread pe socketul 0. EPYC 9175F este singurul sistem x86 din setul nostru cu rezultate din acest test, așa că este comparația aici.
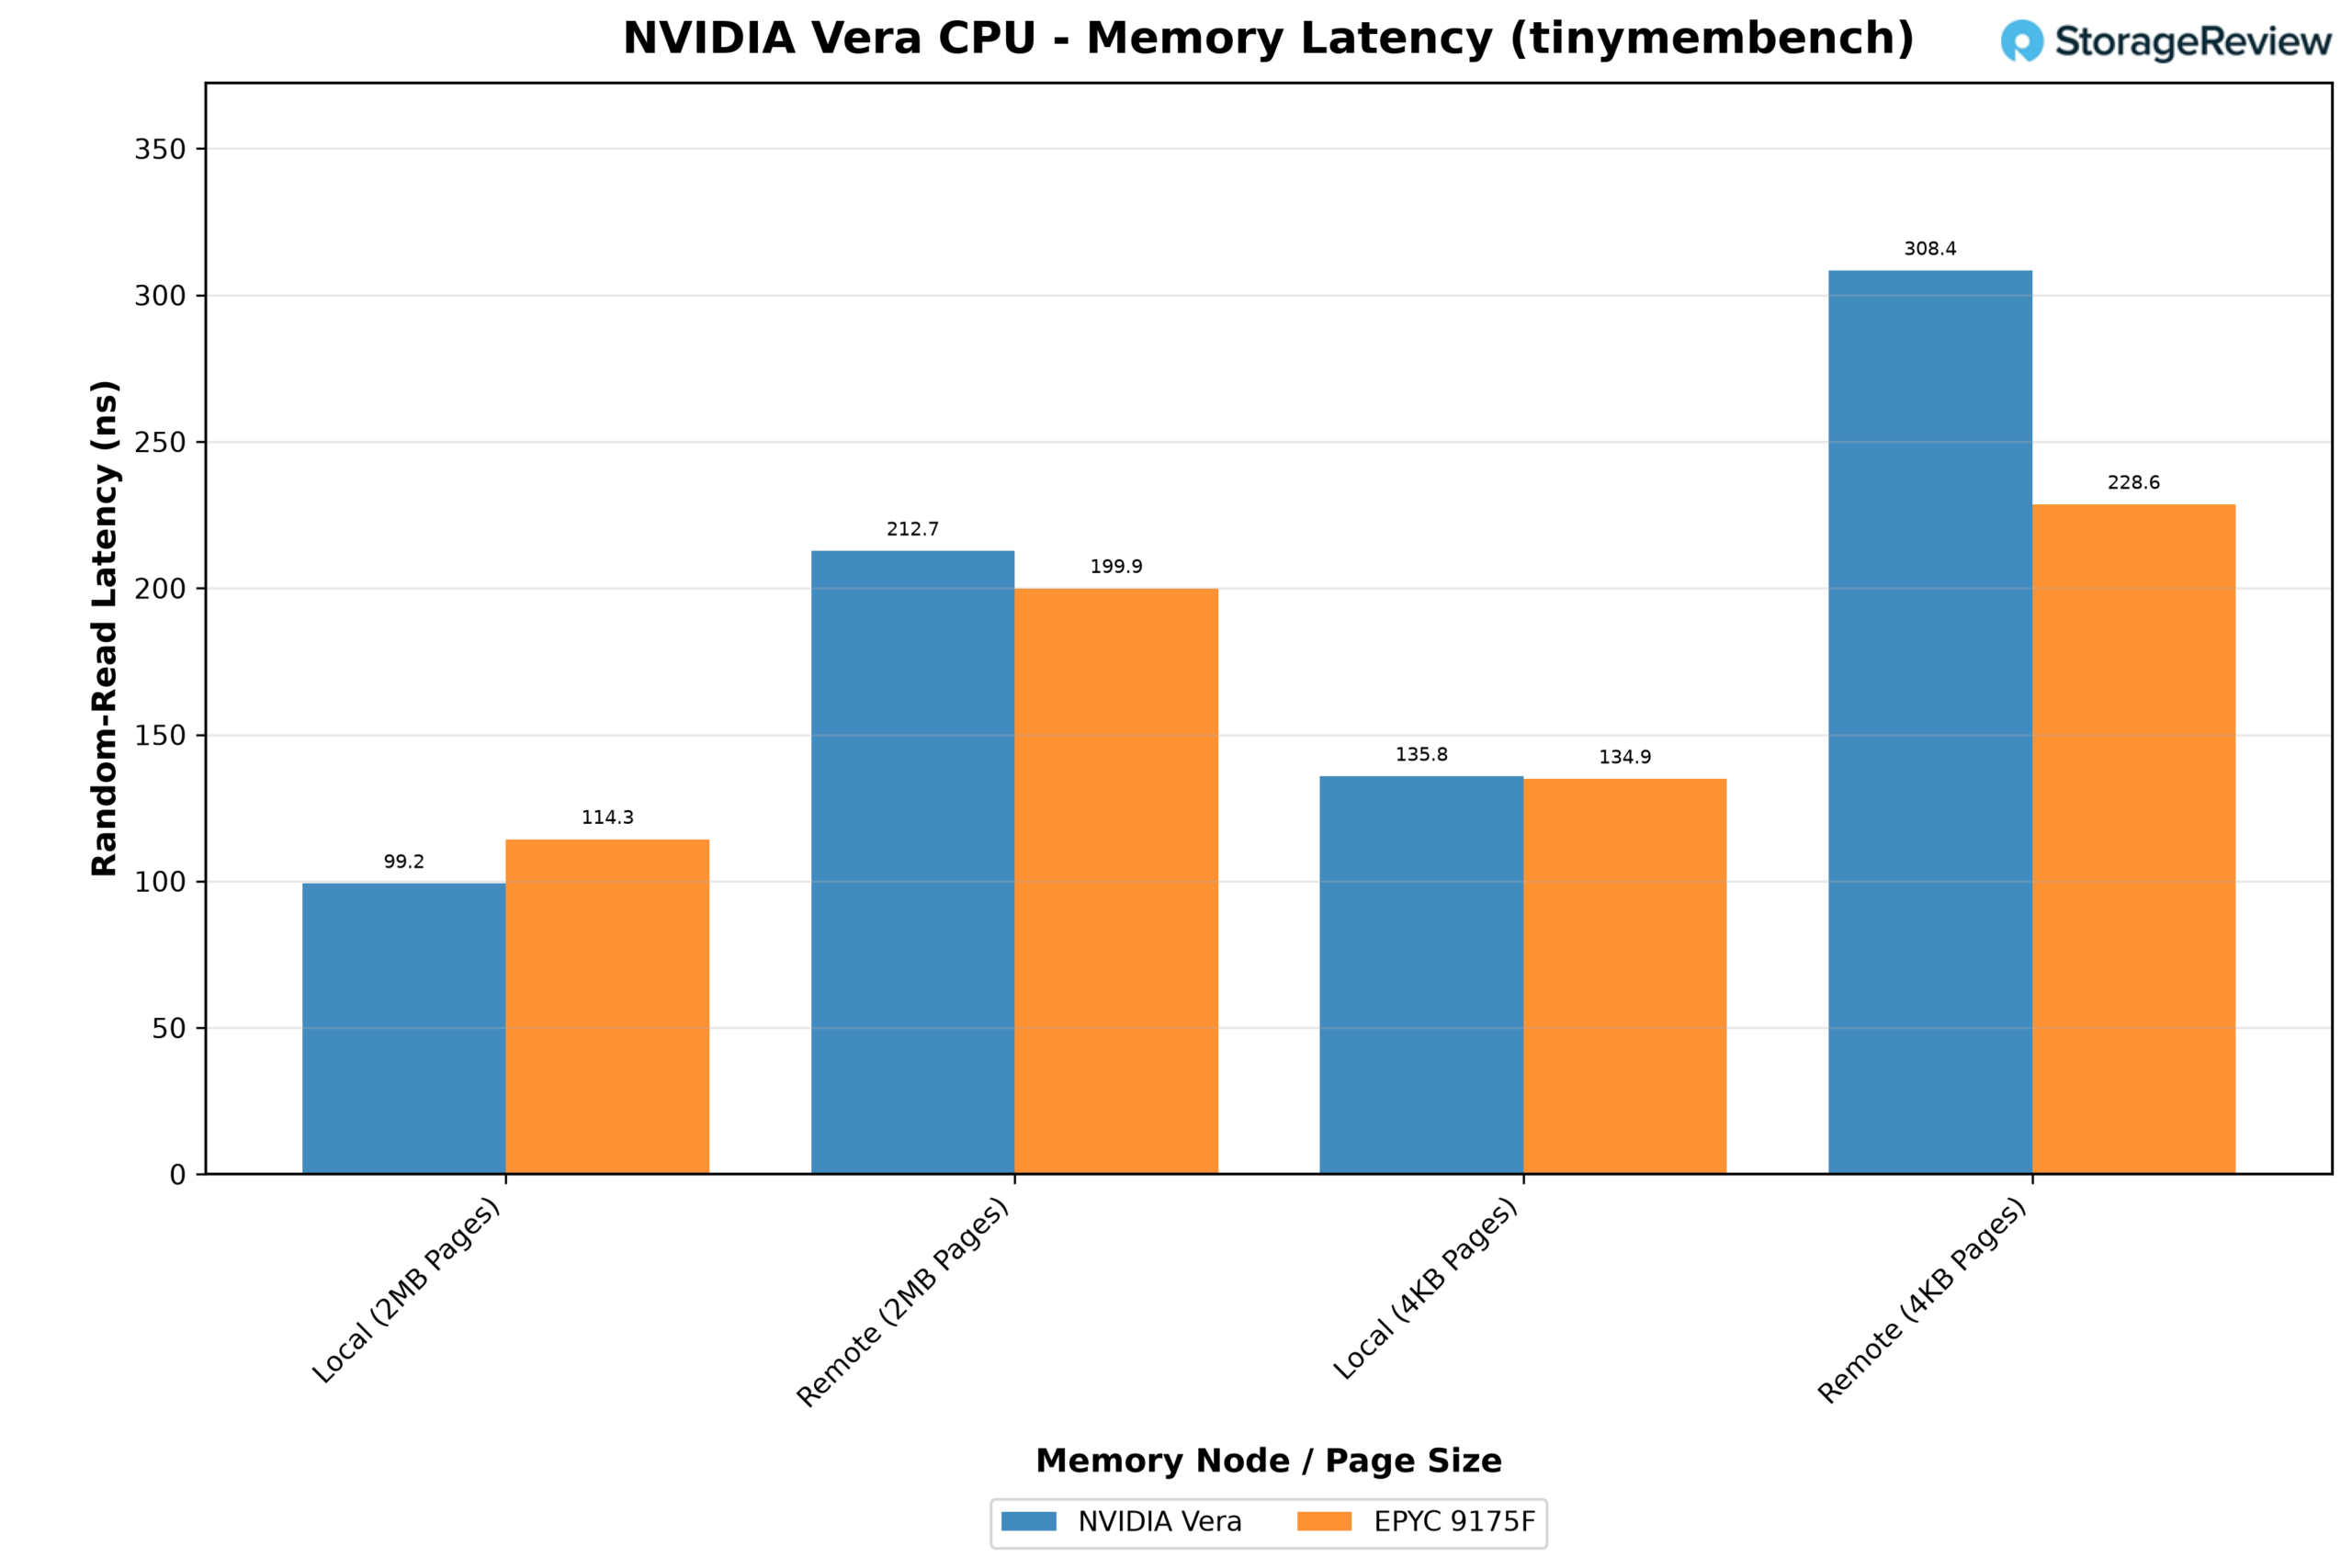
Când citește memoria locală, Vera este mai rapid decât EPYC. Cu pagini uriașe de 2 MB, o citire locală a durat 99.2 ns pe Vera față de 114.3 ns pe 9175F, cu 13% mai rapid; cu pagini standard de 4 KB, acestea au fost la aproximativ 135 ns. Costul NVLink-C2C se manifestă prin atingerea celuilalt socket. O citire la distanță a durat 212.7 ns pe Vera, aproximativ 2.1 ori mai repede decât ora locală, în timp ce 199.9 ns pentru EPYC a fost doar de 1.75 ori mai repede decât ora locală.
Vera este, de asemenea, mai sensibilă la dimensiunea paginii. Cu pagini de 4 KB, unde traducerile de adrese ratate se adaugă la fiecare citire, latența locală a crescut cu 37%, iar latența la distanță a ajuns la 308.4 ns, față de o creștere de 18% și 228.6 ns pe EPYC. Pe Vera, am rula pagini uriașe.
HPC
Lățimea de bandă și latența descriu sistemul de memorie în mod izolat. Aplicațiile științifice arată ce se întâmplă atunci când sistemul de memorie și nucleele trebuie să funcționeze împreună, iar cele două teste HPC ale noastre se bazează pe părți foarte diferite ale designului procesorului.
GROMACS, un cod de dinamică moleculară, își petrece cea mai mare parte a timpului în aritmetică vectorială, cu bucle fierbinți scrise manual pentru fiecare lățime SIMD. Acest lucru îl face cel mai direct test al compromisului descris în secțiunea Olympus: șase pipe-uri SVE2 pe 128 de biți împotriva unităților AVX-512 pe 512 de biți de pe componentele x86. OpenFOAM, un solver de dinamică a fluidelor computaționale, lucrează cu matrici rare mari și își petrece o mare parte din timp așteptând memoria, astfel încât arată dacă lățimea de bandă măsurată mai sus se transferă într-o aplicație reală.
GROMACS
Am testat GROMACS 2025.3 cu benchPEP, un caz de 12 milioane de atomi rulat pe fiecare nucleu fizic al serverului. Versiunea a folosit ARM_SVE pe Vera și AVX-512 pe fiecare sistem x86, iar intrările fixate ale suitei și reglarea PME dezactivată înseamnă că fiecare platformă a rulat aceeași lucrare.
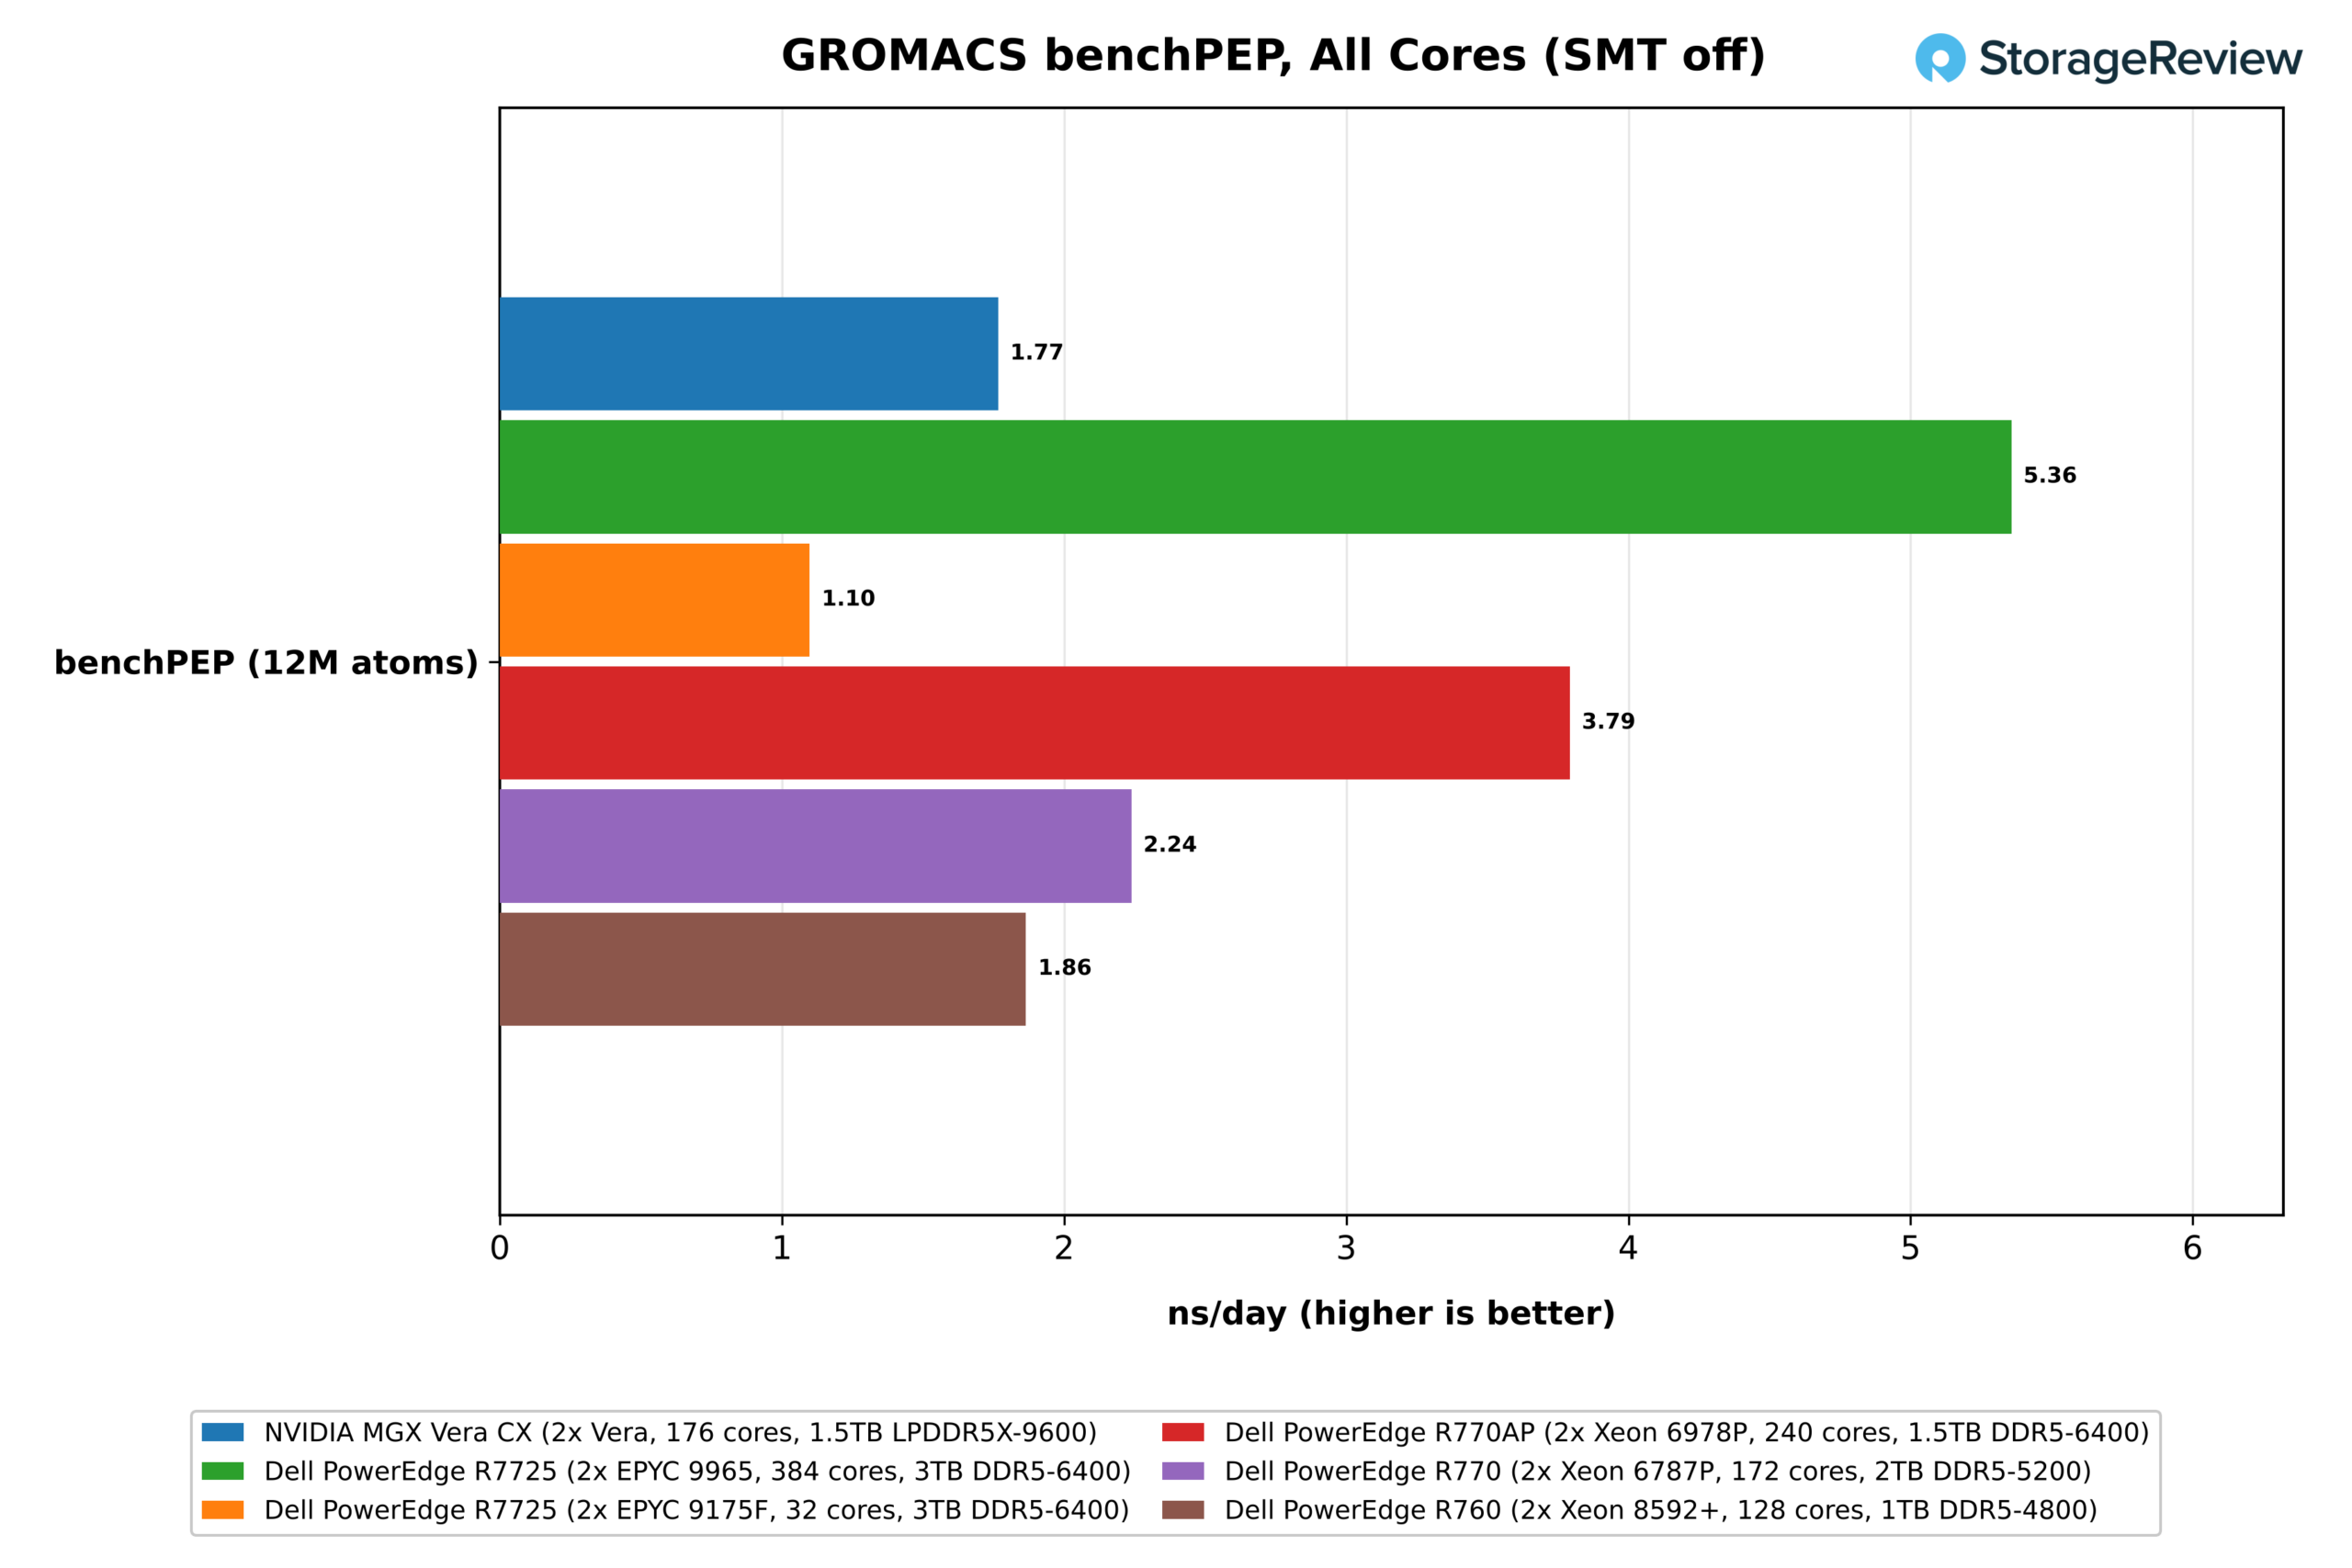
Cu SMT oprit, Vera a terminat benchPEP-ul la 1.77 ns/zi. EPYC 9965 cu 384 de nuclee a condus cu 5.36 ns/zi, de 3.0x Vera, urmat de Xeon 6978P cu 240 de nuclee cu 3.79 (2.1x) și Xeon 6787P cu 172 de nuclee cu 2.24 (1.27x). Xeon 8592+ cu 128 de nuclee a terminat, de asemenea, în frunte cu 1.87, lăsând în urma lui Vera doar EPYC 9175F cu 32 de nuclee, cu 1.10. Normalizarea după numărul de nuclee arată cât de mult din această diferență este reprezentată de arhitectură. Vera rezultă într-o viteză de 0.0100 ns/zi pe nucleu, față de 0.0130 pe 6787P, 0.0140 pe 9965, 0.0146 pe 8592+ și 0.0158 pe 6978P, deci deficitul față de componentele mari x86 este parțial numărul de nuclee și parțial debitul per nucleu.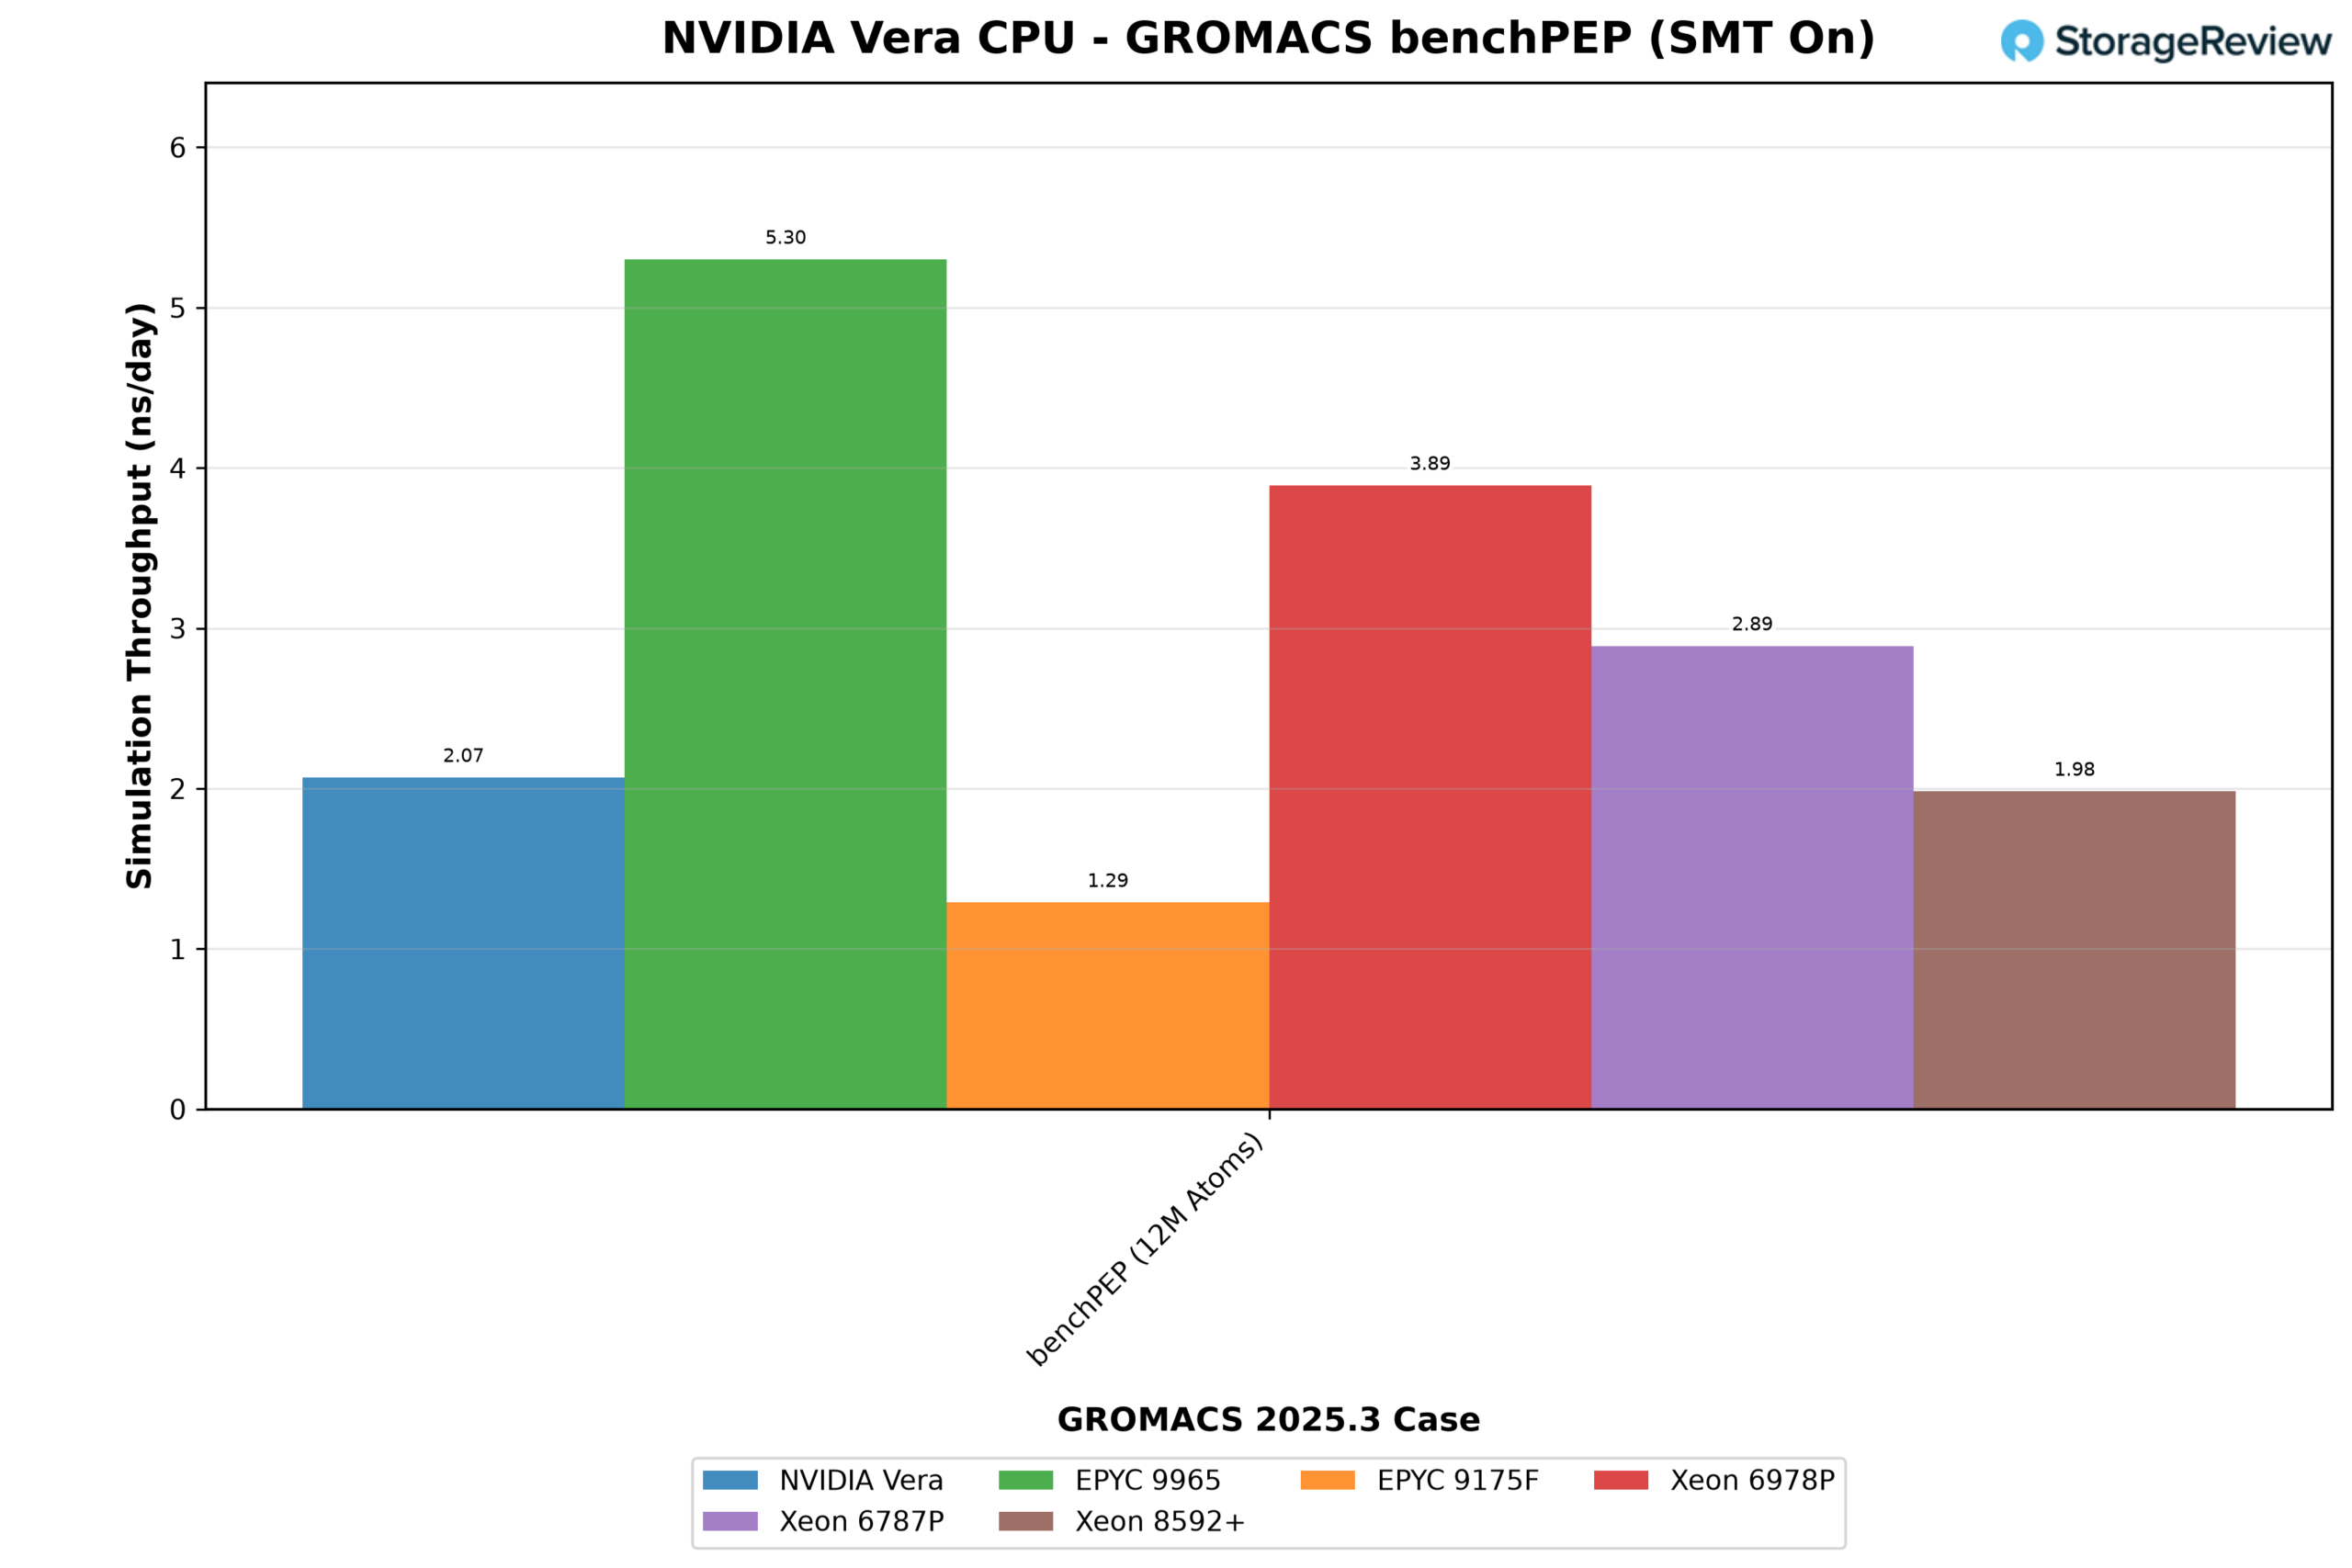
Multithreading-ul spațial recuperează o parte din acest teren, deoarece activarea acestuia a crescut rezultatul Verei cu 17% la 2.07 ns/zi, cel mai bun layout rulând toate cele 352 de thread-uri hardware ca ranguri MPI pentru thread-uri. Acesta este un câștig mai mare decât cel acordat de SMT pentru Xeon 6978P (3%) sau 8592+ (11%) în rulările noastre anterioare, iar EPYC 9965 a pierdut 3.5% cu acesta activat. Cu resursele împărțite între cele două thread-uri, fiecare rang primește o porțiune din nucleu, iar amestecul de matematică vectorială și blocaje de memorie al solverului pare să umple acele porțiuni mai bine decât un singur rang.
Carcasa benchMEM izolează decalajul per nucleu prin rularea sistemului de 82,000 de atomi pe 16 nuclee fizice ale socketului 0 pe fiecare platformă, astfel încât numărul de nuclee nu este inclus în ecuație, iar rezultatul reflectă debitul vectorial, memoria cache și memoria locală.
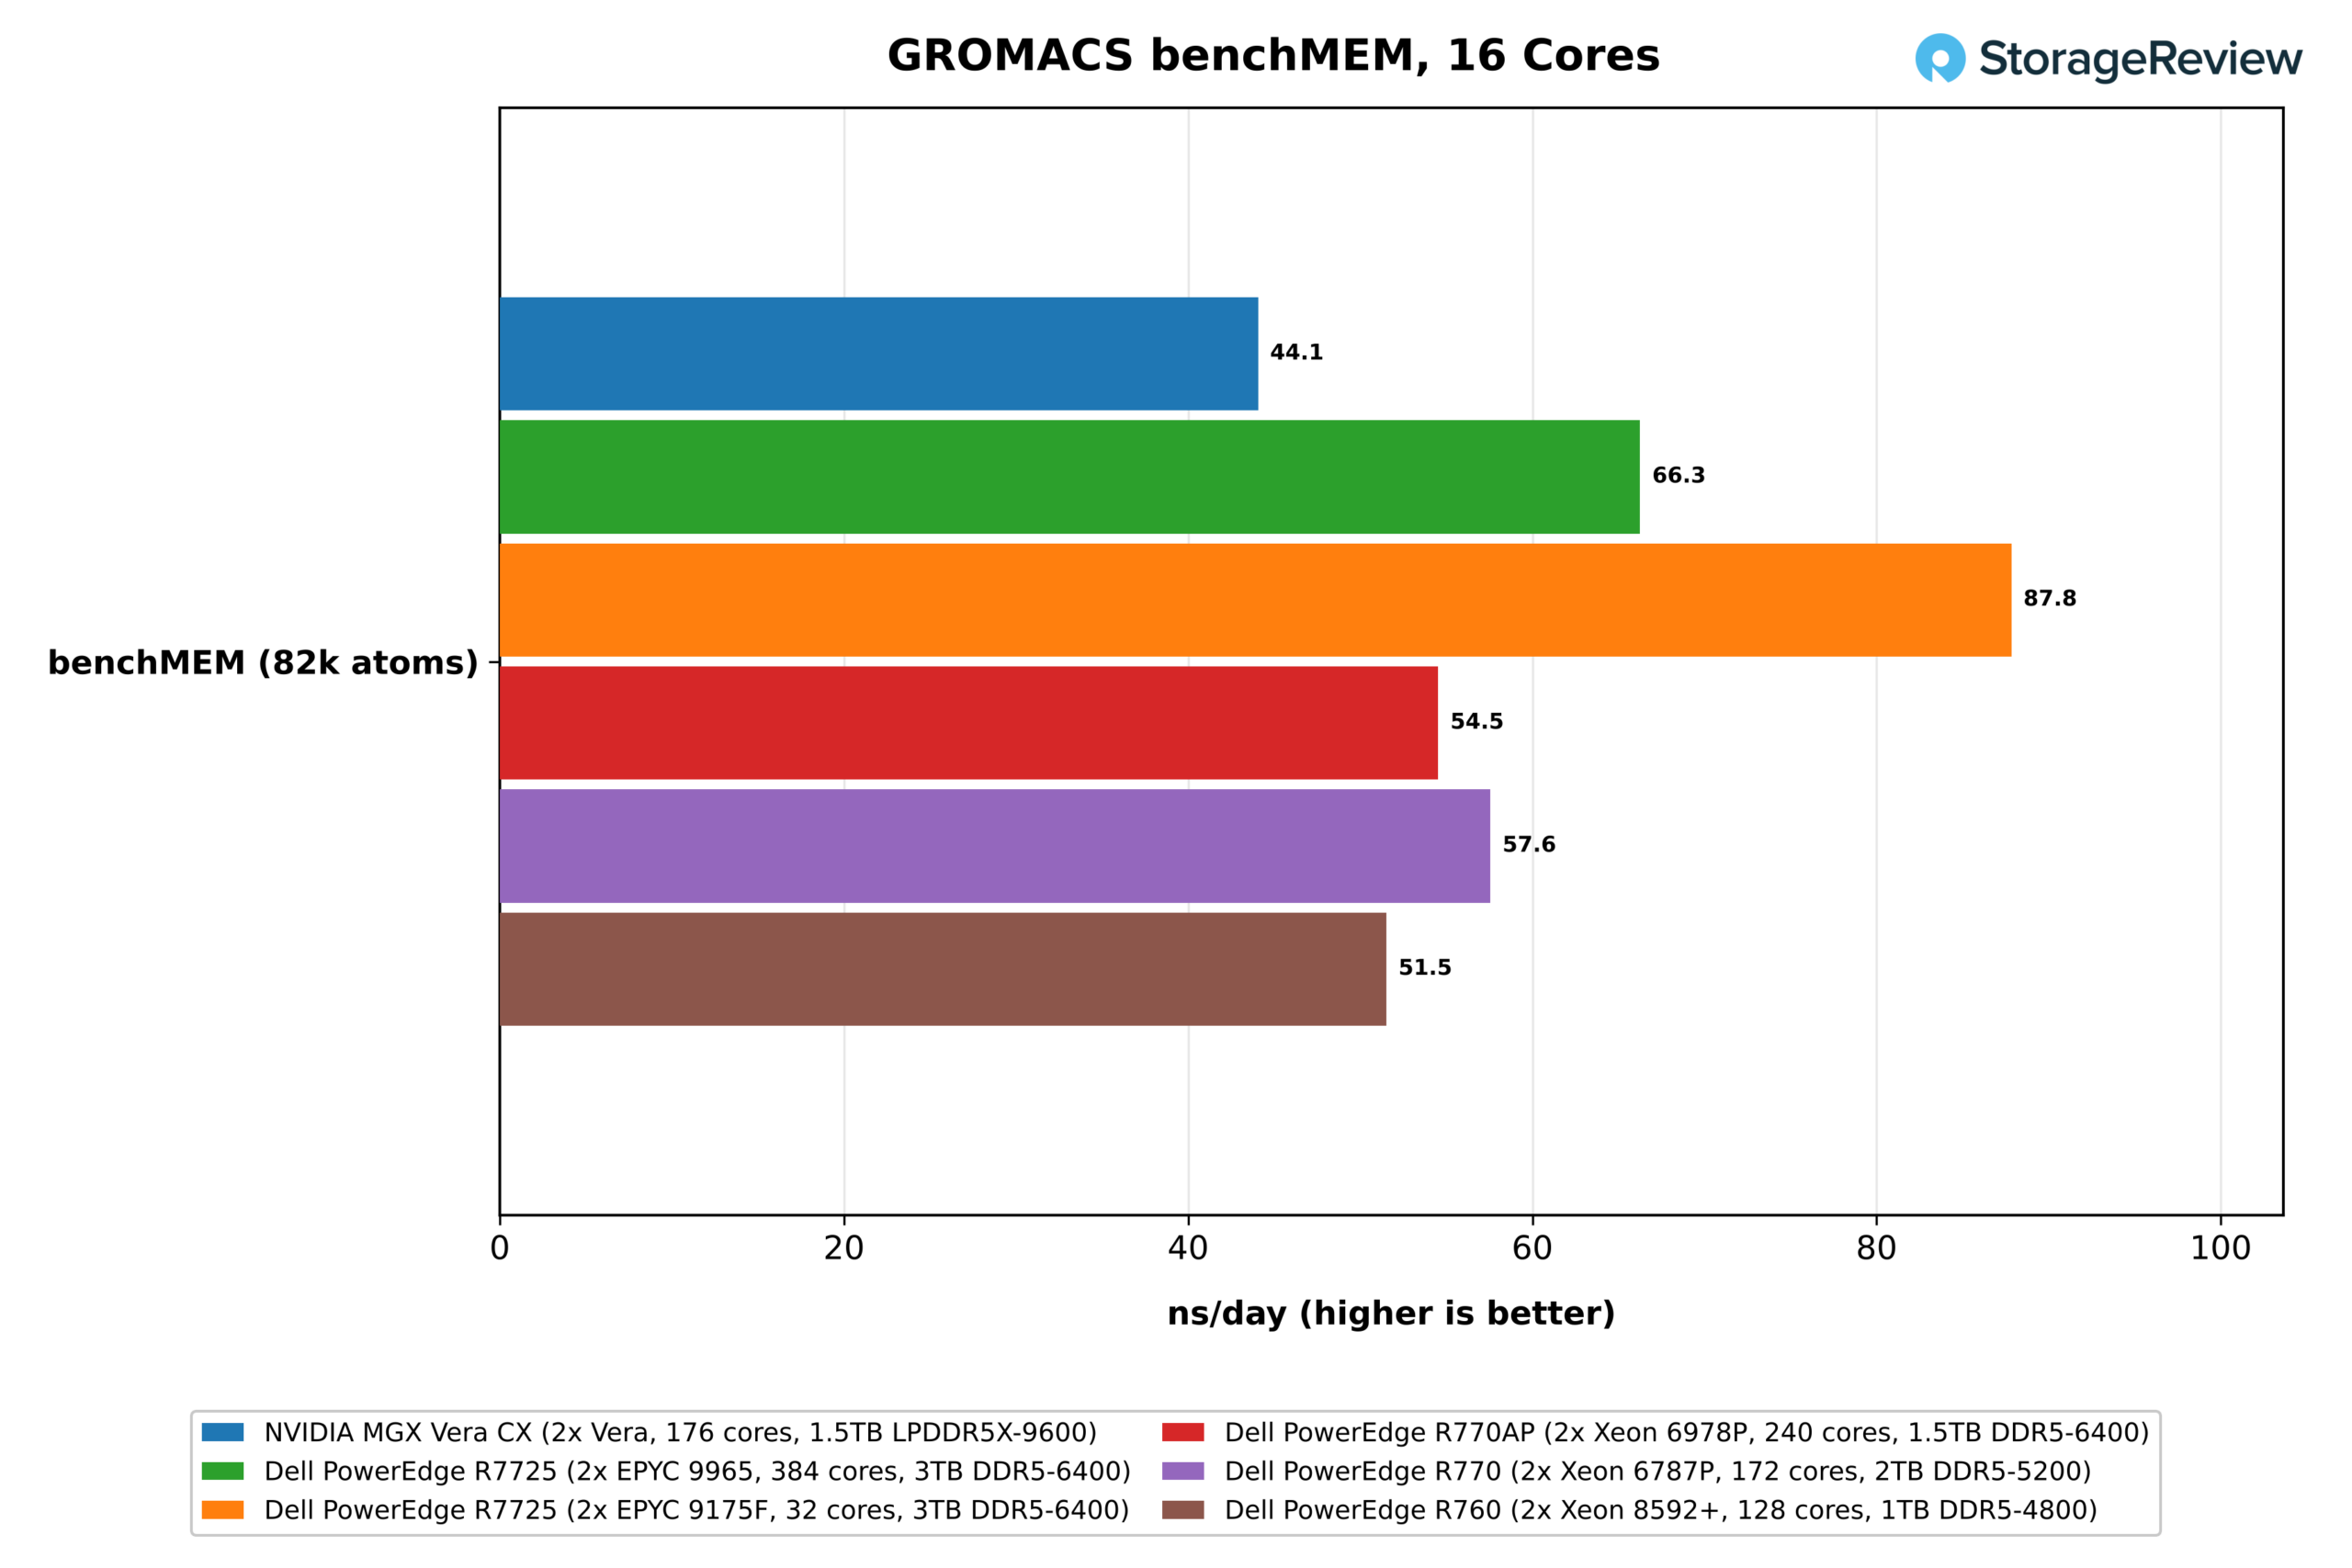
Aici, Vera a înregistrat 44.1 ns/zi. EPYC 9175F de 5.0 GHz a dublat această valoare, ajungând la 87.8, iar EPYC 9965 a atins 66.3, de 1.5 ori mai mult decât Vera, devansând Xeon 6787P la 57.6, 6978P la 54.5 și 8592+ la 51.5.
Prin urmare, o porțiune cu 16 nuclee de procesor Vera face aproximativ două treimi din munca unei porțiuni cu 16 nuclee de procesor Zen 5c, chiar dacă acele 16 nuclee de procesor Zen 5c partajează o singură memorie L3 de 32 MB, în timp ce procesorul Vera poate folosi memoria cache de 164 MB la nivel de sistem. Aceasta face ca aceasta să fie cea mai clară măsurătoare pe care o avem despre costul vectorilor de 128 de biți pentru codul scris pentru cei de 512 biți. Avansul suplimentar al lui 9175F față de 9965 este aproximativ în concordanță cu avantajul său în ceea ce privește frecvența de ceas, 5.0 GHz față de 3.7 GHz.
OpenFOAM
OpenFOAM mută presiunea de la unitățile vectoriale la sistemul de memorie. Rulăm OpenFOAM 13 pe cazul de aerodinamică auto driverFastback, cu un rang MPI per nucleu fizic, la două dimensiuni de plasă: o plasă medie de 2.98 milioane de celule și una mare de 22.6 milioane de celule.
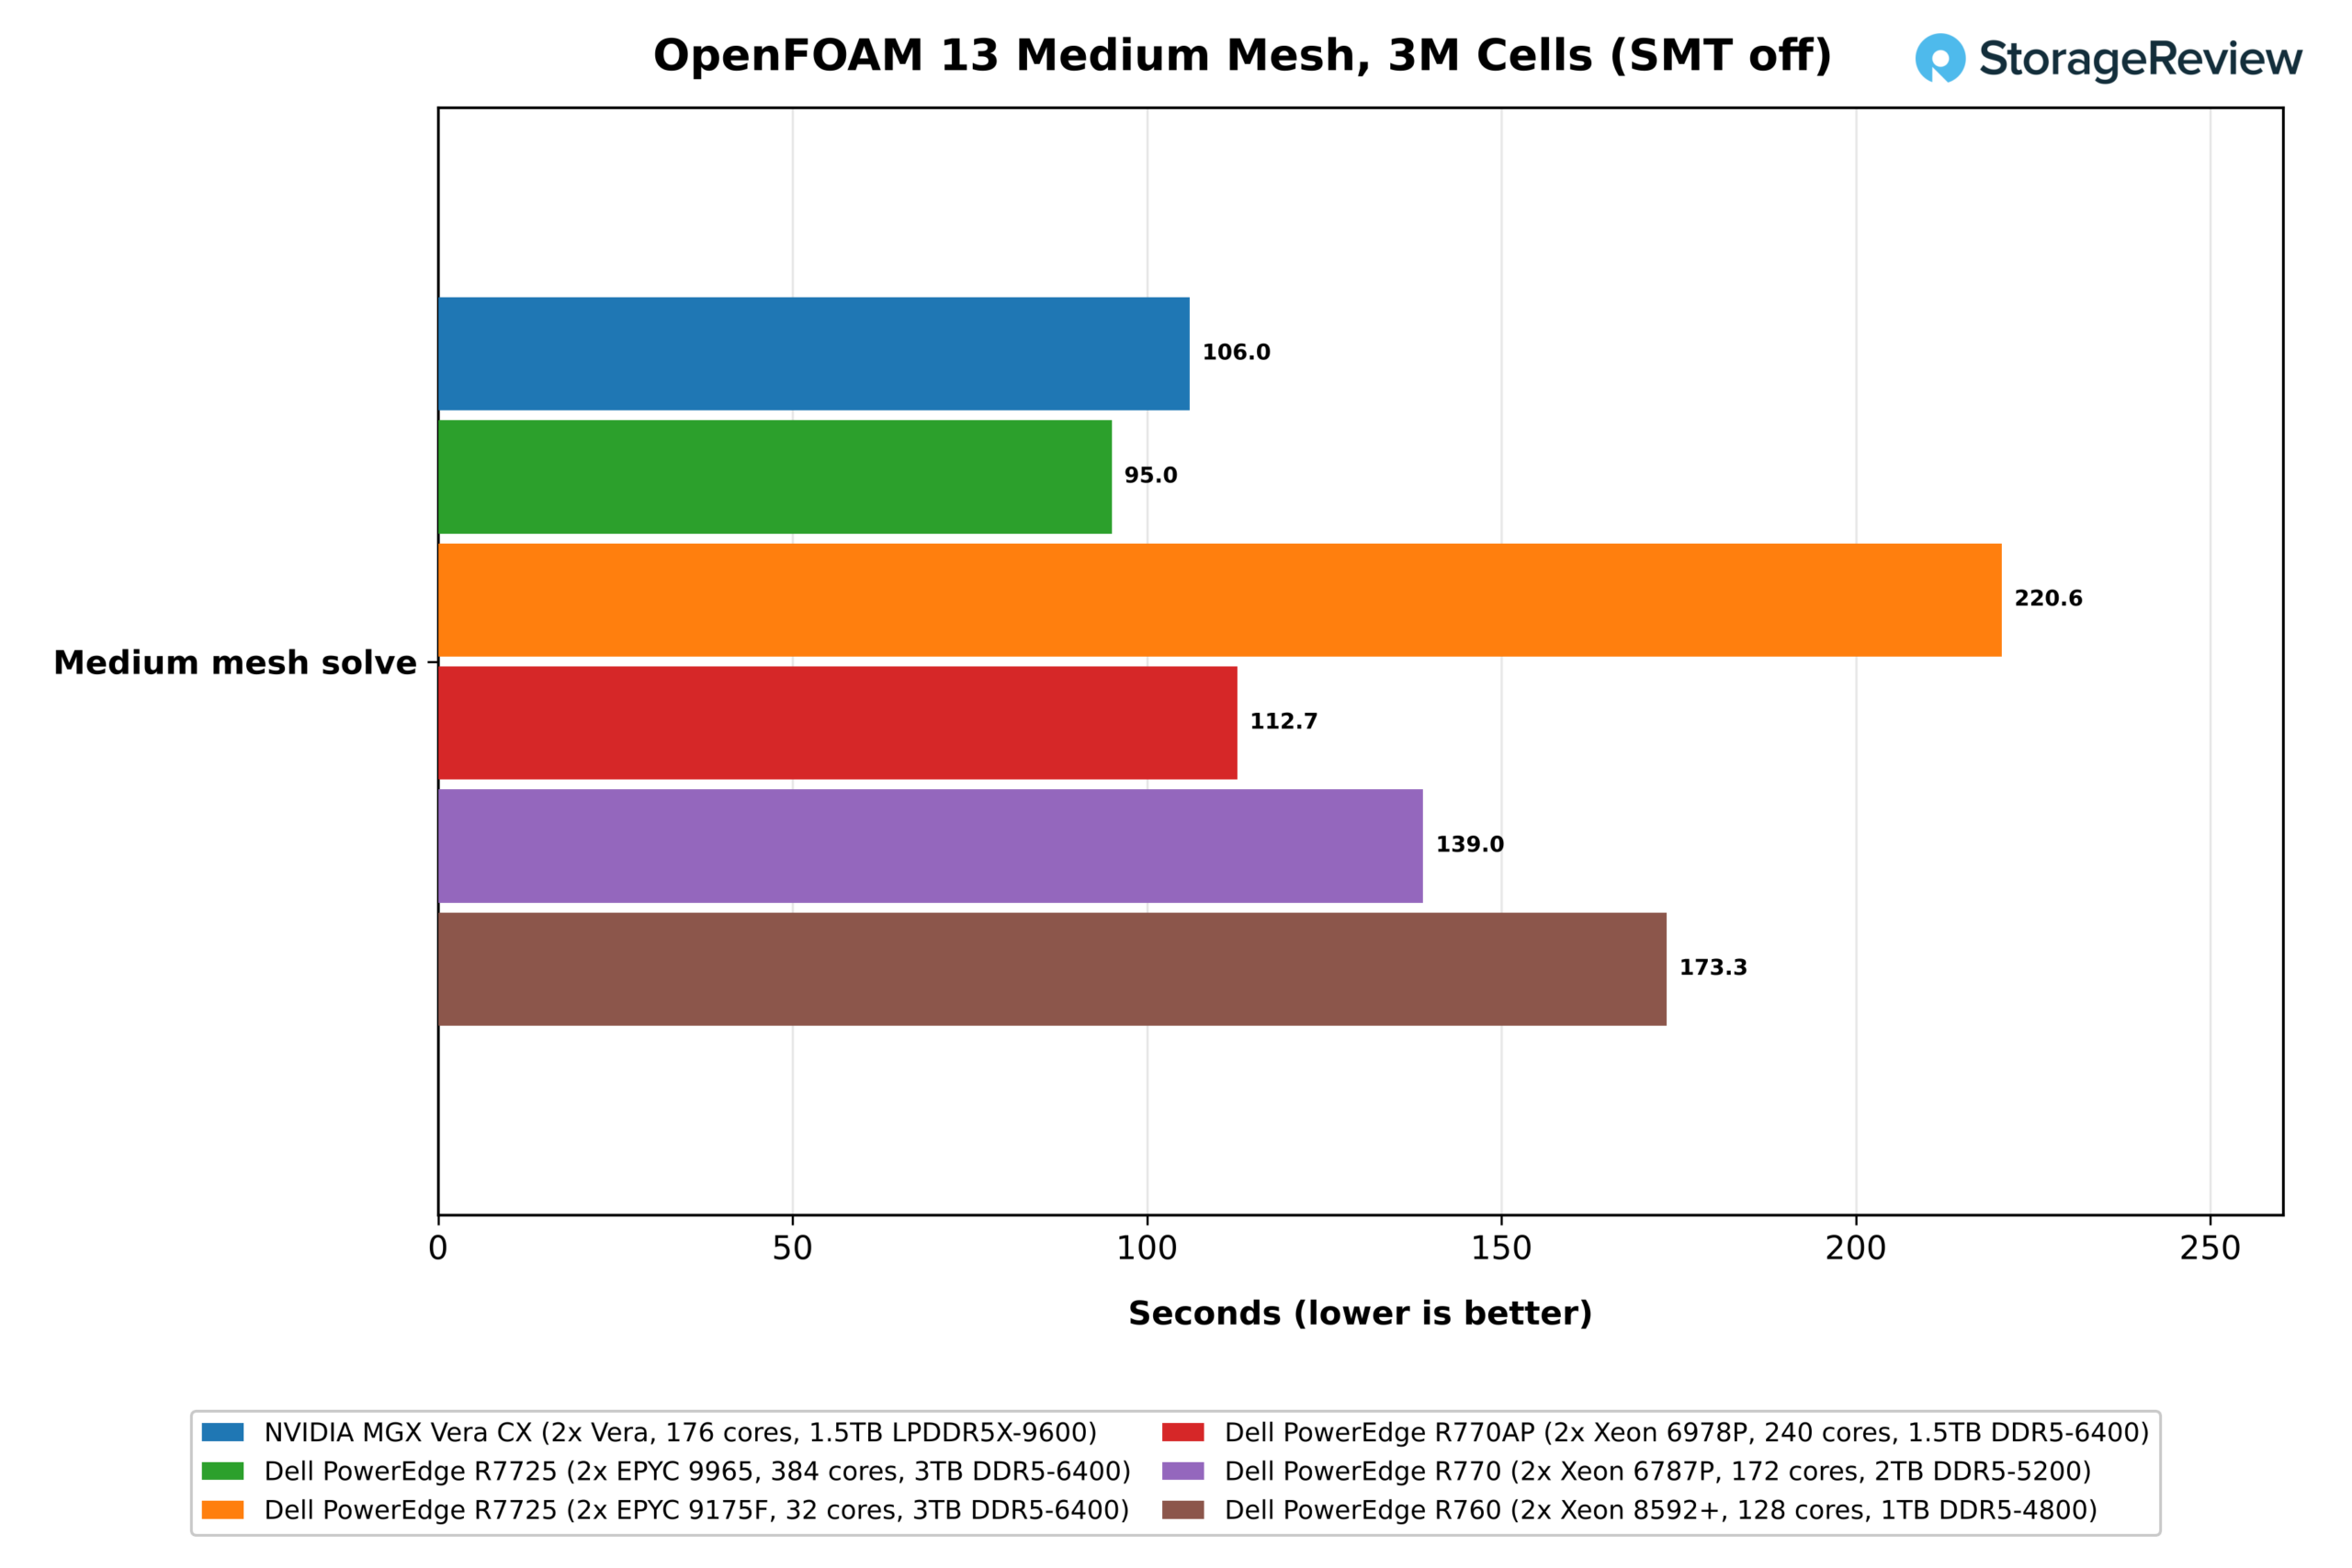
Mesh-ul mediu a fost rezolvat în 106.0 secunde pe Vera, față de 95.0 secunde pe EPYC 9965, 112.7 secunde pe Xeon 6978P, 139.0 secunde pe 6787P, 173.3 secunde pe 8592+ și 220.6 secunde pe 9175F cu 32 de nuclee. La această dimensiune, cele 384 de nuclee ale lui 9965 câștigă, iar Vera are nevoie de 12% mai mult timp, dar termină pe locul doi, cu 6% înaintea lui Xeon cu 240 de nuclee. Cu doar 3 milioane de celule, cache-urile L3 mai mari ale componentelor x86 dețin probabil o parte mai mare din problemă, ceea ce menține numărul de nuclee sub control.
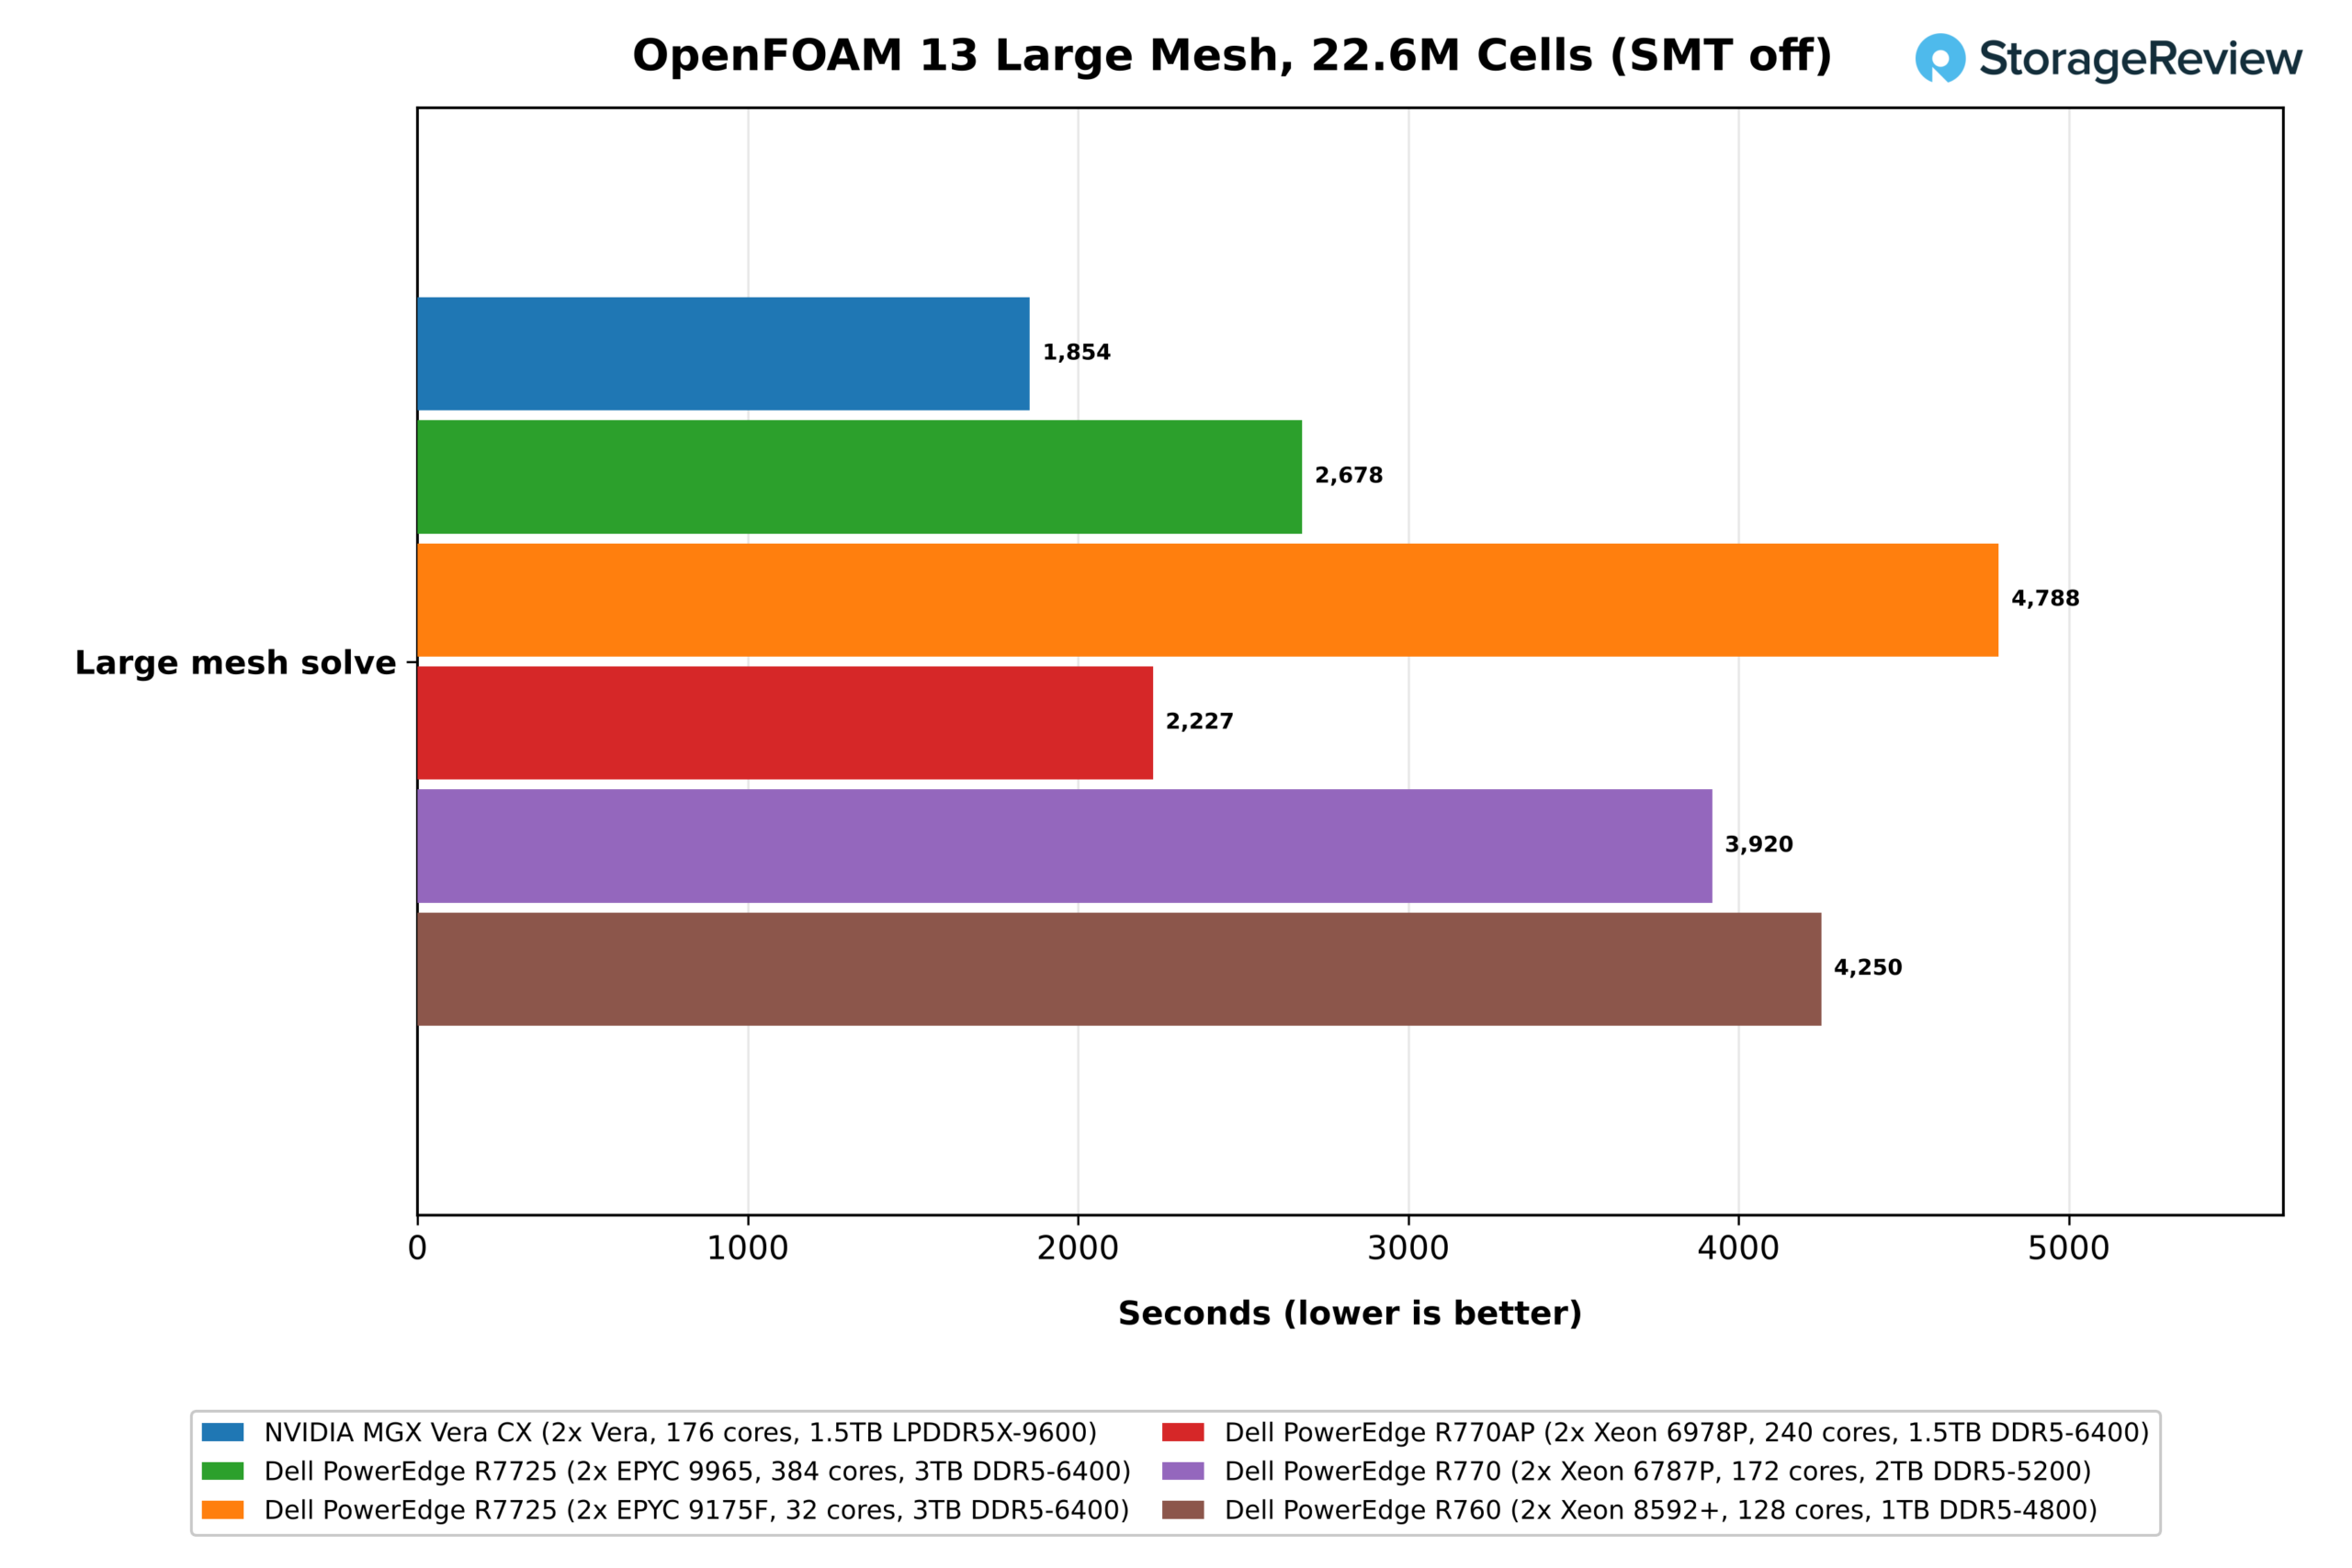
Plasa mare inversează ordinea, Vera rezolvând problema în 1,854 de secunde, față de 2,227 pentru Xeon 6978P, 2,678 pentru EPYC 9965, 3,920 pentru 6787P, 4,250 pentru 8592+ și 4,788 pentru 9175F, ceea ce îl face de 1.44 ori mai rapid decât serverul AMD cu 384 de nuclee și de 1.20 ori mai rapid decât cel Intel cu 240 de nuclee. De asemenea, Vera se încadrează într-un maxim nominal de 450 W per socket, comparativ cu cei 500 W ai modelului 9965.
Analiză și date în memorie
Rezultatele HPC au arătat ce face lățimea de bandă a Verei pentru un rezolvator științific. Serviciile de date pun același sistem de memorie la treabă diferit, iar cele două teste ale noastre îl utilizează din capete opuse. ClickBench rulează interogări analitice care scanează și agregă coloane mari de date, distribuind fiecare interogare pe fiecare nucleu, astfel încât recompensează un sistem care asociază mai multe nuclee cu lățimea de bandă necesară pentru a le alimenta. Valkey, un depozit cheie-valoare în memorie, gestionează milioane de cereri mici, fiecare citind sau scriind o singură valoare, deci depinde mai mult de cât de repede un nucleu individual procesează o cerere și, odată ce datele depășesc memoria cache, de latența și lățimea de bandă a memoriei.
ClickBench
Am testat ClickBench cu 43 de interogări pe un tabel de analiză web cu 100 de milioane de rânduri pe ClickHouse 26.8. Suma sa la cald, unde fiecare interogare citește din memoria cache a paginii, măsoară câte nuclee poate aduce un sistem la scanări și agregări în coloane și cât de bine le alimentează memoria sa. Suma la rece adaugă o repornire a serverului și citiri SSD înainte de prima execuție a fiecărei interogări.
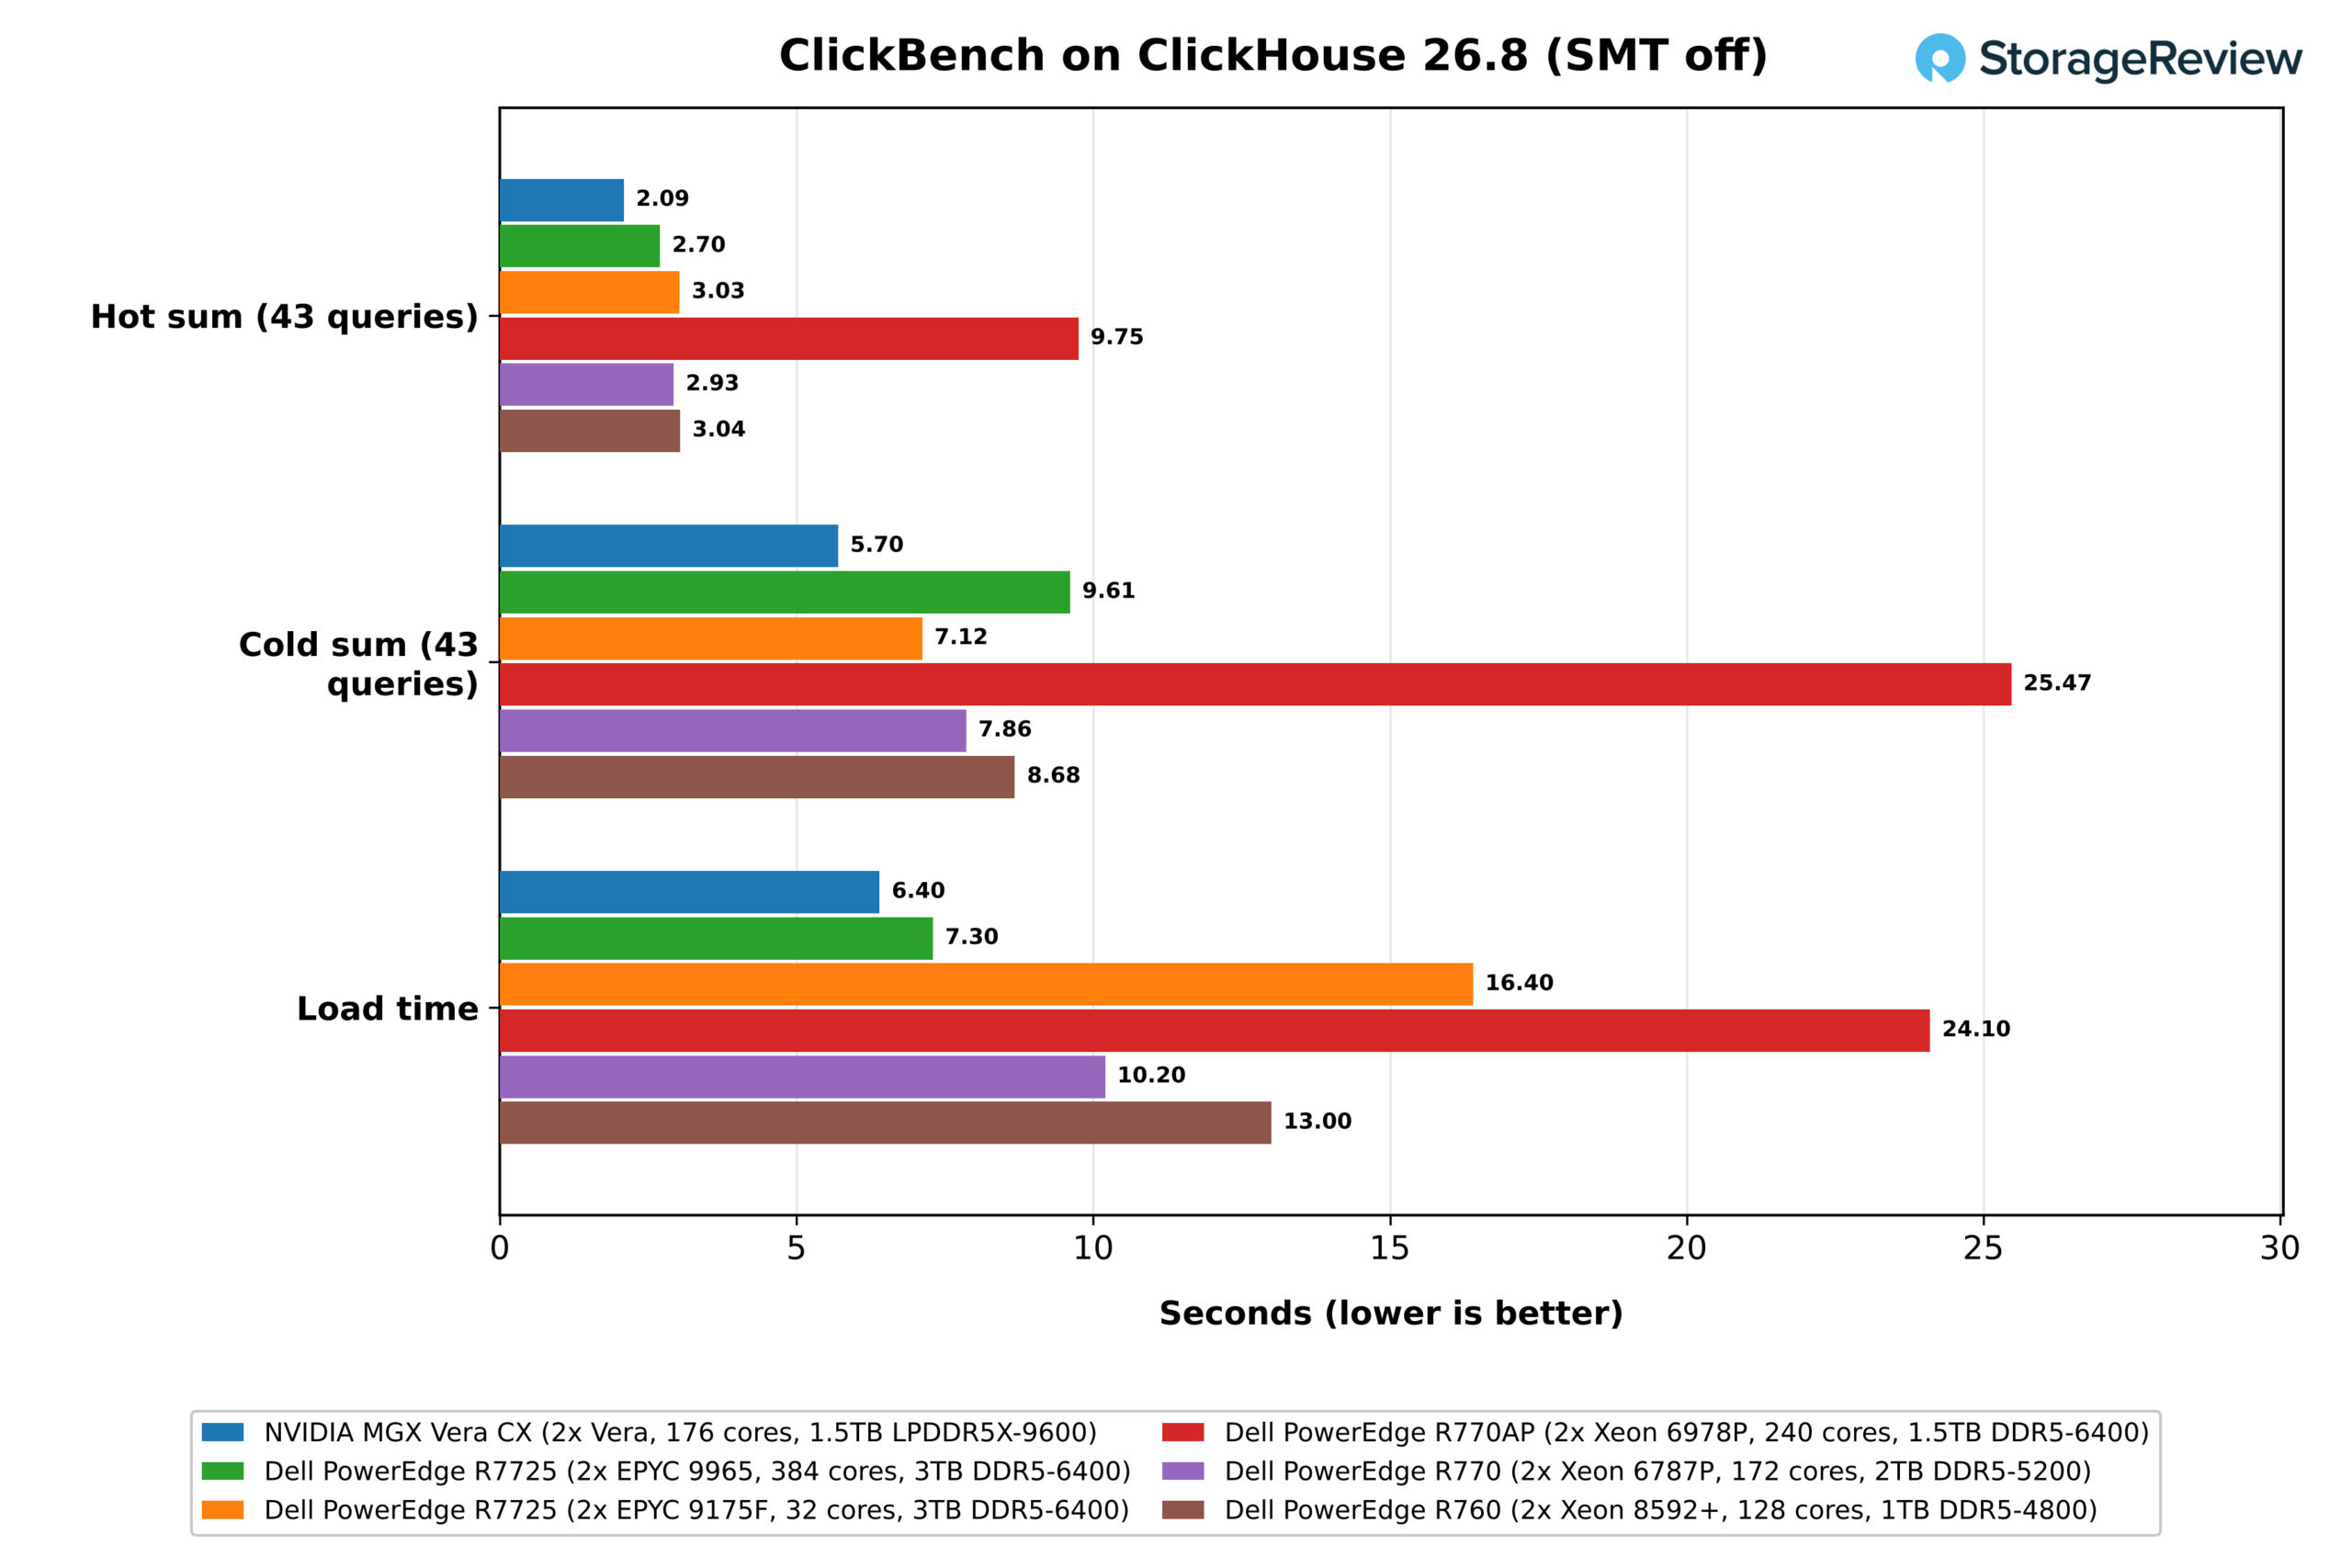
Cu SMT dezactivat, Vera a finalizat run-ul de încălzire în 2.09 secunde, cel mai rapid rezultat din setul nostru. EPYC 9965 a urmat cu 2.70 secunde, de 1.29 ori mai mult timp, în timp ce Xeon 6787P, EPYC 9175F și Xeon 8592+ au fost practic la egalitate între 2.93 și 3.04 secunde. Diferența reflectă echilibrul dintre nuclee și lățimea de bandă. 9965 cu 384 de nuclee are nuclee de rezervă, dar puțină lățime de bandă per nucleu; 9175F cu 32 de nuclee are inversul; iar Vera combină 176 de nuclee cu o lățime de bandă de peste trei ori mai mare decât oricare dintre ele.
Vera a condus și la încercarea la rece, cu un timp de 5.70 secunde, devansând modelul 9175F cu 7.12 secunde, modelul 6787P cu 7.86 secunde, modelul 8592+ cu 8.68 secunde și modelul 9965 cu 9.61 secunde. Timpul de stocare la rece se bazează mai mult pe stocare, iar legăturile dintre unități diferă: Gen5 x4 pe Vera și 6787P, x2 pe ambele sisteme EPYC și Gen4 pe 8592+.
Vera a încărcat, de asemenea, setul de date de 15 GB cel mai rapid, în 6.4 secunde, comparativ cu 7.3 secunde la 9965 și 10.2 până la 16.4 secunde la restul procesoarelor. Xeon 6978P, cu 9.75 secunde la încălzire și 25.47 secunde la rece, s-a situat mult în afara celorlalte procesoare Xeon din motive pe care nu le-am identificat, așa că l-am exclus din clasament.
Activarea Spatial Multithreading a încetinit Vera la 2.31 secunde la încărcare și 6.09 secunde la descărcare, o penalizare de 10% din suma la încărcare. Împărțirea resurselor fiecărui nucleu între două fire de execuție a costat scanările ClickHouse mai mult decât a câștigat.
Valkey
Valkey execută comenzi pe un singur fir principal, firele de execuție/ieșire ajutând doar până la un anumit punct, astfel încât implementările cresc prin adăugarea de shard-uri, deoarece oferirea mai multor nuclee unei instanțe nu are mare efect. Prin urmare, privim Valkey în două moduri: ce oferă un singur shard pe nucleele potrivite și ce oferă fiecare shard atunci când un socket este încărcat cu ele. În ambele teste, clienții rulează pe celălalt socket al aceleiași mașini, deci nu este implicată nicio placă de rețea.
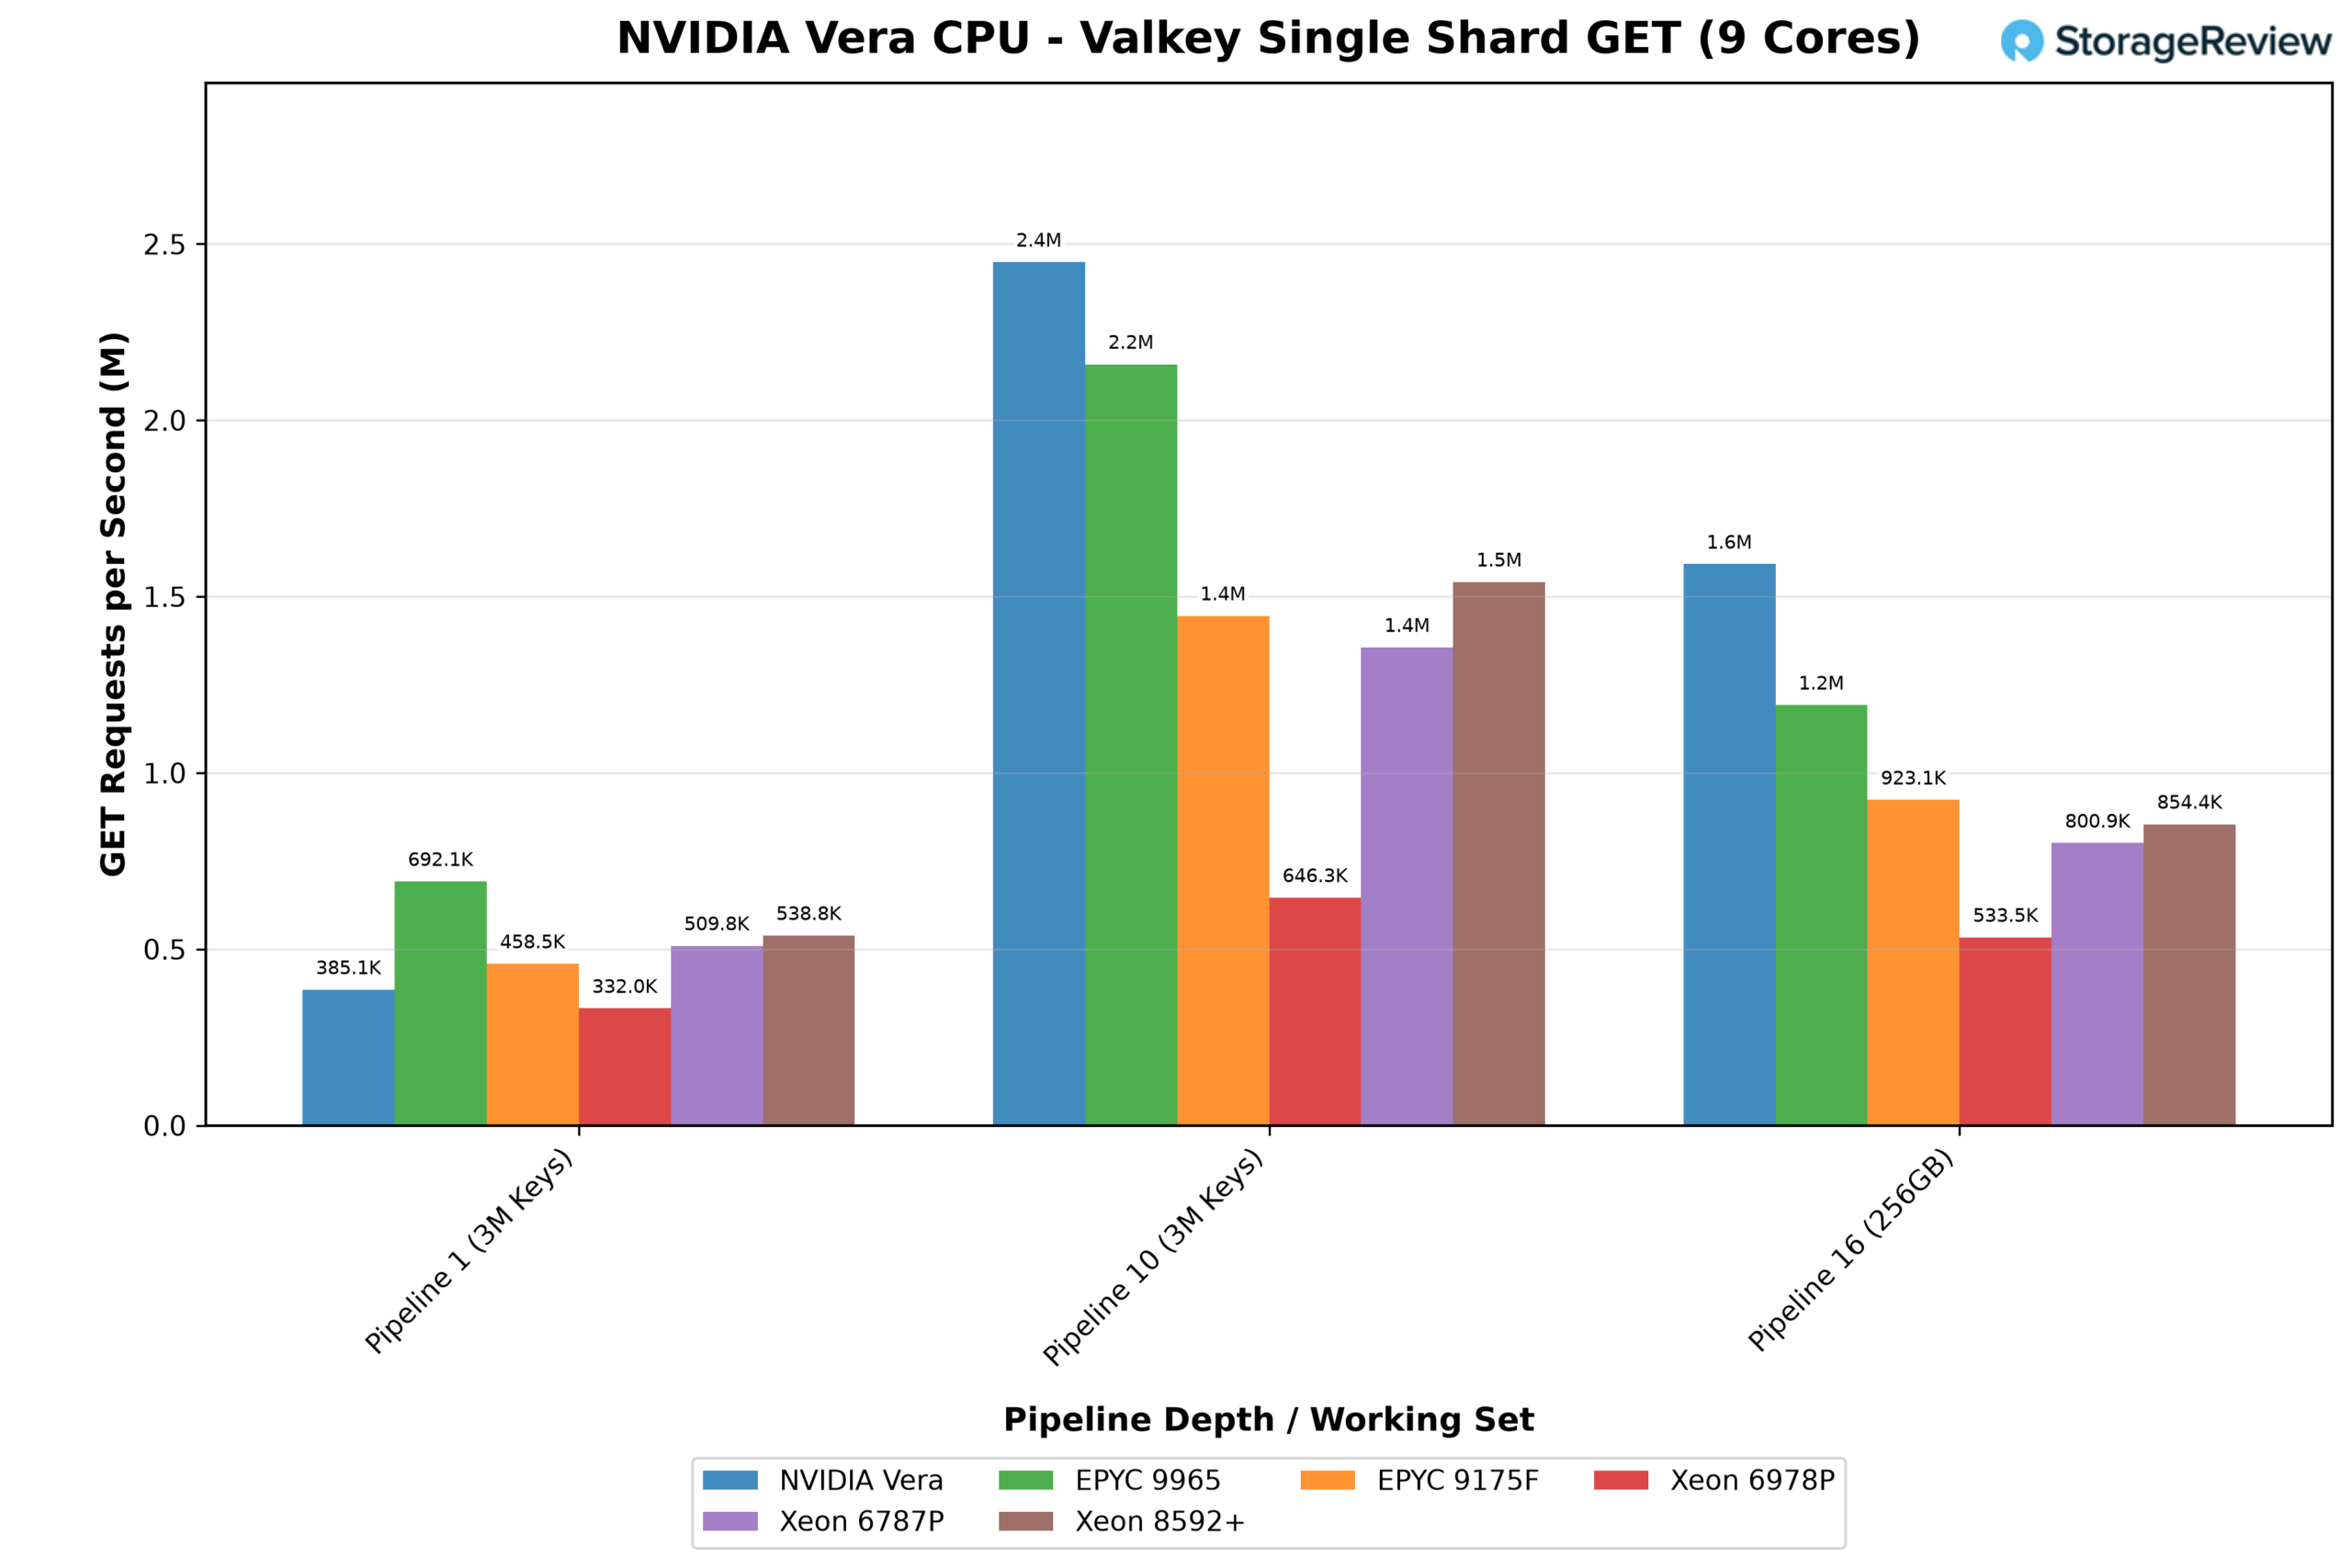
Testul cu un singur shard oferă unui server Valkey nouă nuclee fizice pe fiecare platformă. Acesta servește un set de date de 3 milioane de chei, cu cereri trimise una câte una, apoi în loturi de 10, și apoi servește un set de date de 256 GB, prea mare pentru orice memorie cache, în loturi de 16. Trimise una câte una, fiecare cerere trebuie să își finalizeze călătoria dus-întors înainte ca următoarea să fie trimisă, iar aici Vera este cel mai slab. Shard-ul său a servit 385,000 de cereri GET pe secundă, depășind doar Xeon 6978P, în timp ce EPYC 9965 a condus cu 692,000. Latența p99 a Verei a fost, de asemenea, mai mare, la 1.76 ms față de 1.08 ms pe 9965.
Tranzacționarea în loturi elimină cea mai mare parte a costului dus-întors, iar Vera trece în frunte. Cu loturi de 10, shard-ul său a gestionat 2.45 milioane de cereri GET pe secundă, cu 13% mai multe decât 9965 și cu mult înaintea oricărui Xeon. Setul de date de 256 GB a mărit și mai mult decalajul. Cu aproape fiecare cerere trimisă în memorie, Vera a deservit 1.59 milioane de cereri GET pe secundă, cu 34% mai multe decât 9965, în timp ce restul câmpului a variat între 0.53 milioane și 0.92 milioane. Rezultatele SET au urmat același model în ambele teste.
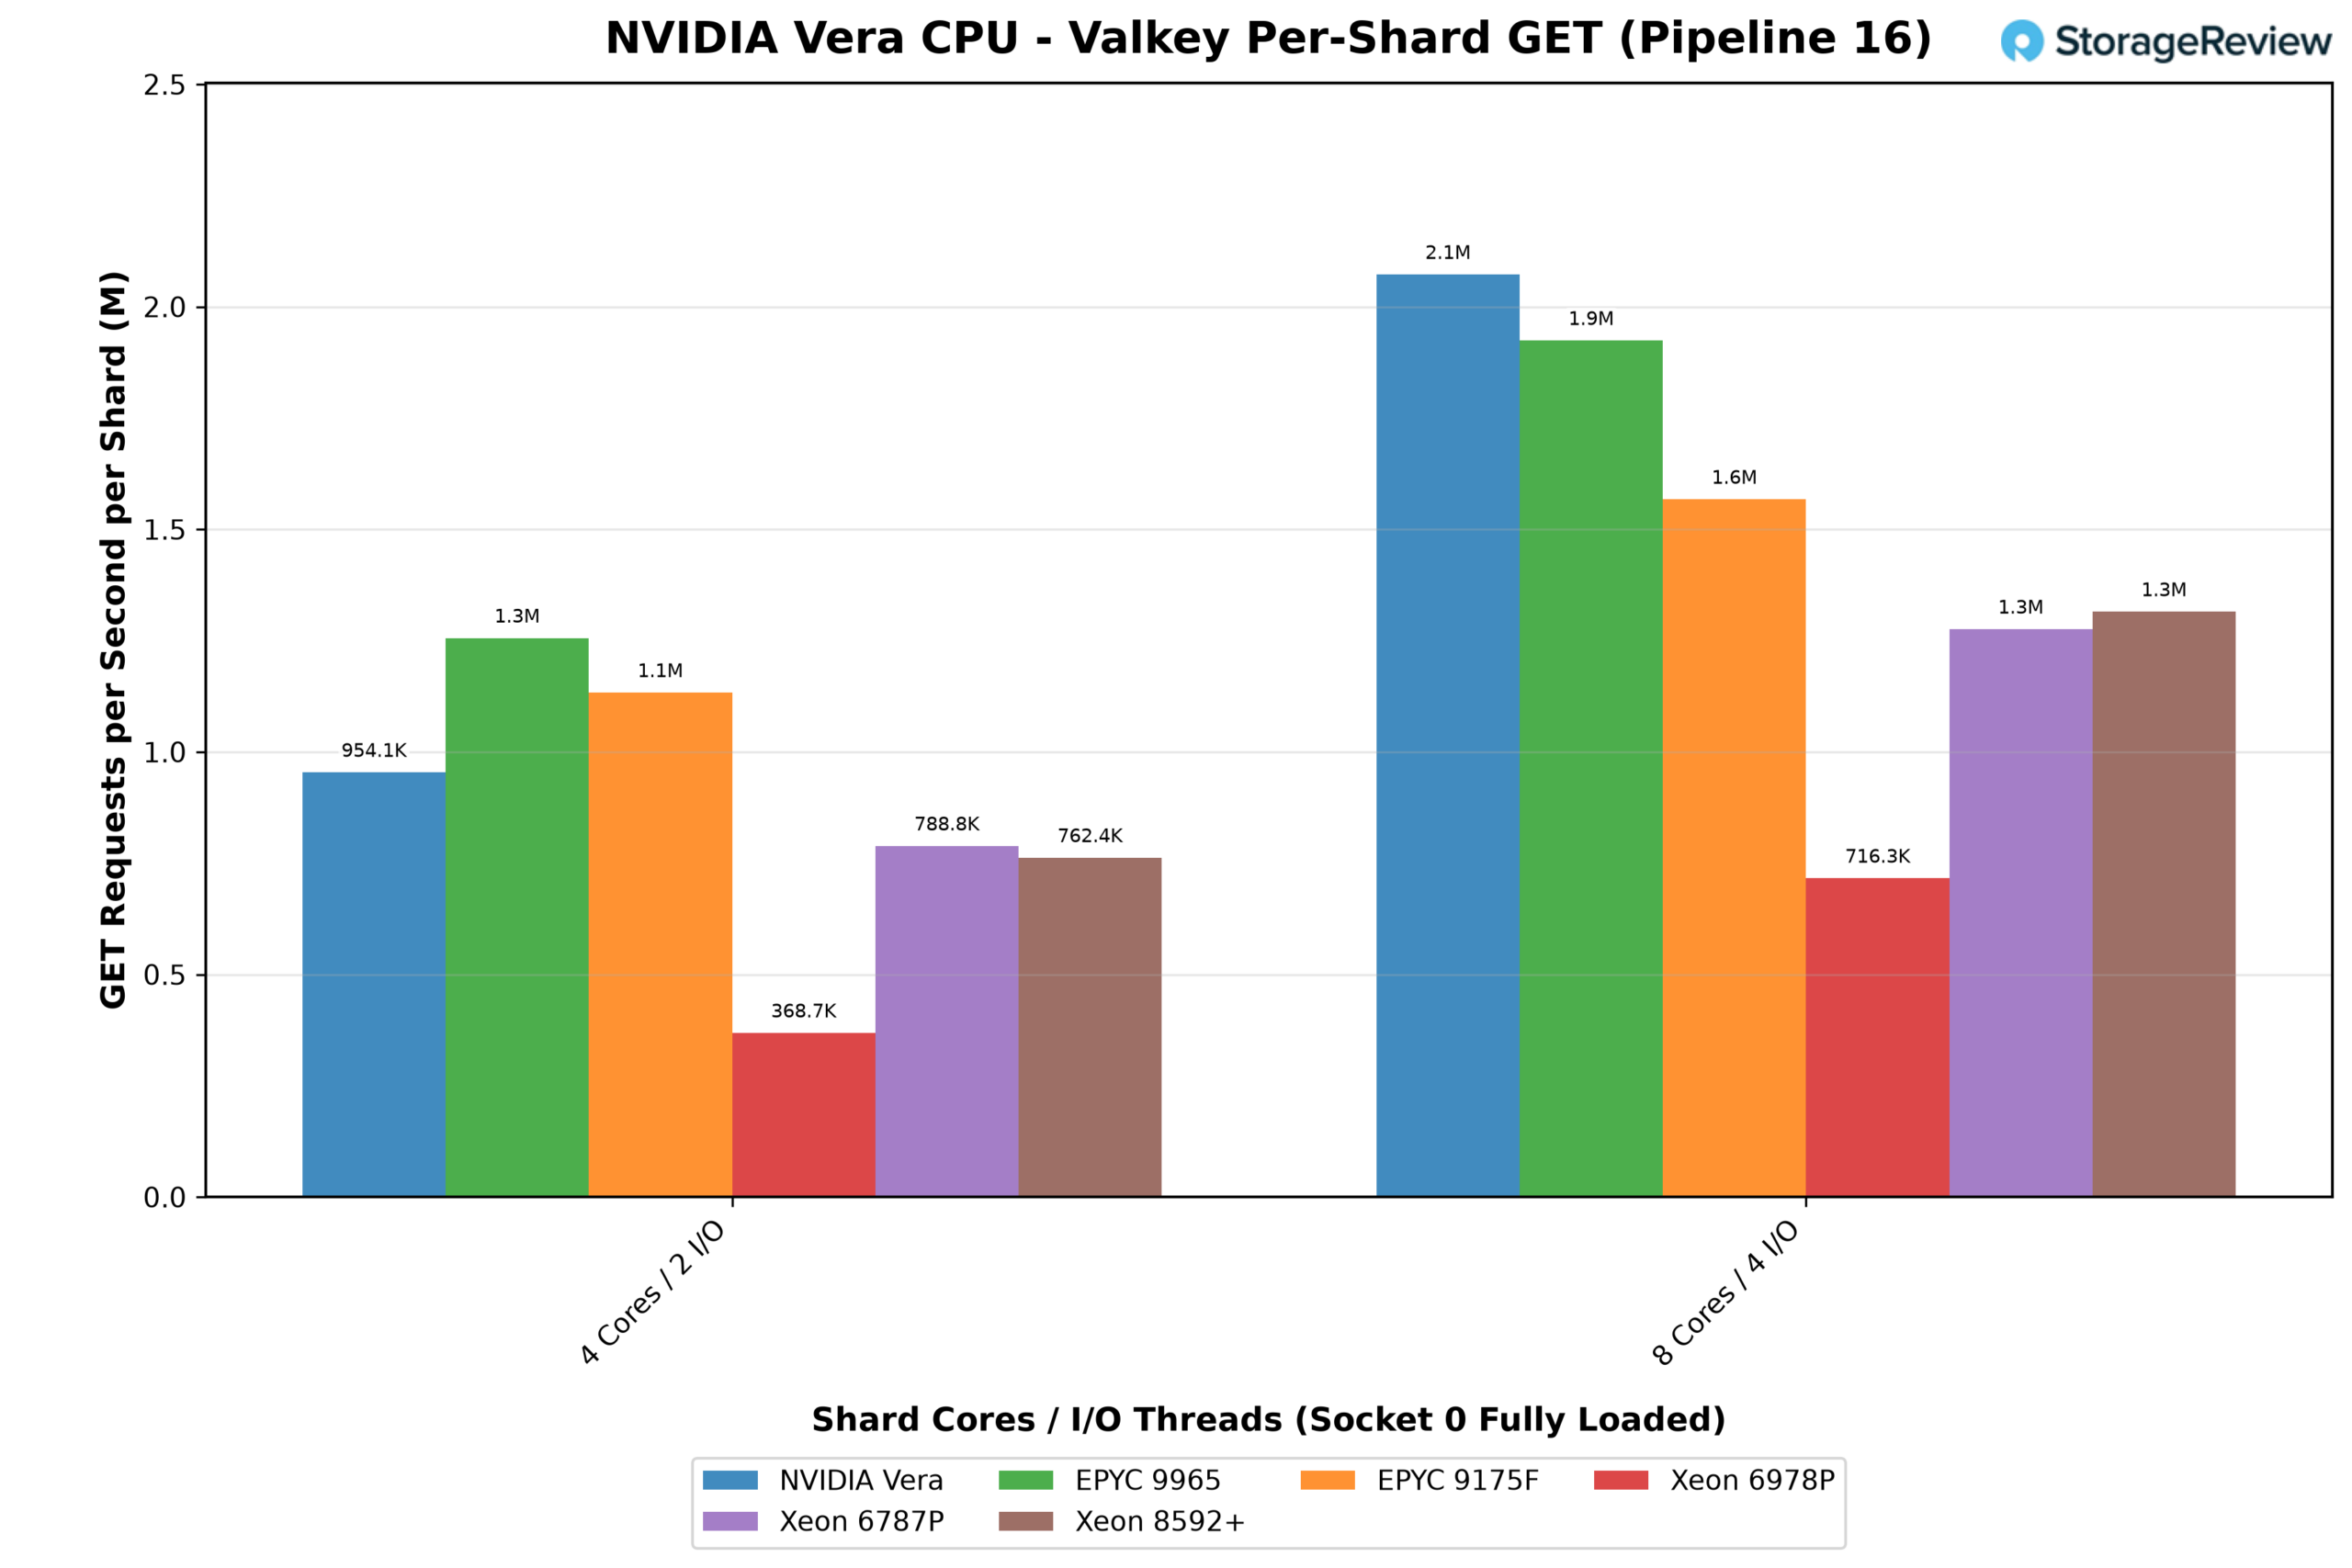
Modul Socket include socket-ul 0 cu shard-uri identice de patru sau opt nuclee, toate deservind trafic simultan, ceea ce este mai apropiat de modul în care funcționează o gazdă Valkey dedicată. Cu shard-uri cu 8 nuclee și loturi de 16, fiecare shard Vera a livrat 2.07 milioane de cereri GET pe secundă, înaintea celor 1.92 milioane ale modelului 9965 și de aproximativ 1.6 ori mai mult decât Xeon 6787P și 8592+, deși latența p99 a crescut la 2.2 ms față de aproximativ 0.5 ms la 9965.
Cu shard-uri mai mici cu 4 nuclee, AMD a ieșit în frunte: 9965 cu 1.26 milioane GET per shard față de 0.95 milioane ale Verei, deși Vera a continuat să conducă toate procesoarele Xeon. Cu solicitări trimise una câte una, shard-urile lui 9965 au fost de 1.5x până la 1.7x mai rapide decât cele ale Verei la ambele dimensiuni, iar 6787P și 8592+ au ieșit, de asemenea, în frunte la shard-uri cu 8 nuclee.
Densitatea decide numărul total de socketuri: un socket Vera conține 11 shard-uri cu opt nuclee și a deservit 22.8 milioane de cereri GET pe secundă, în timp ce cele 192 de nuclee ale modelului 9965 conțin 48 de shard-uri cu patru nuclee și au deservit 60.3 milioane. Vera oferă cele mai rapide shard-uri din setul nostru odată ce fiecare shard are opt sau mai multe nuclee, iar cererile sunt procesate în lot, dar 9965 încape de peste două ori mai multe shard-uri într-un socket.
Fir unic și debit
Valkey și ClickBench s-au concentrat atât pe sistemul de memorie, cât și pe nuclee. Această secțiune se concentrează pe nucleele în sine și pe cele două obiective din spatele Olympus descrise anterior: finalizarea rapidă a sarcinilor individuale și menținerea acelei viteze atunci când întregul socket este ocupat. 7-Zip, OpenSSL și Python rulează fiecare ca un singur fir de execuție fixat la un singur nucleu, arătând ce poate face un nucleu Olympus de unul singur. 7-Zip și OpenSSL rulează apoi din nou pe fiecare fir de execuție din sistem, arătând cât din acea viteză per nucleu supraviețuiește odată ce fiecare nucleu concurează pentru aceleași cache-uri și memorie.
7-Zip
Compresia LZMA din 7-Zip este un cod întreg cu ramificații intense și acces imprevizibil la memorie, tipul de muncă pentru care sunt proiectate interfața de 10" și prefetcherul grafic de la Olympus.
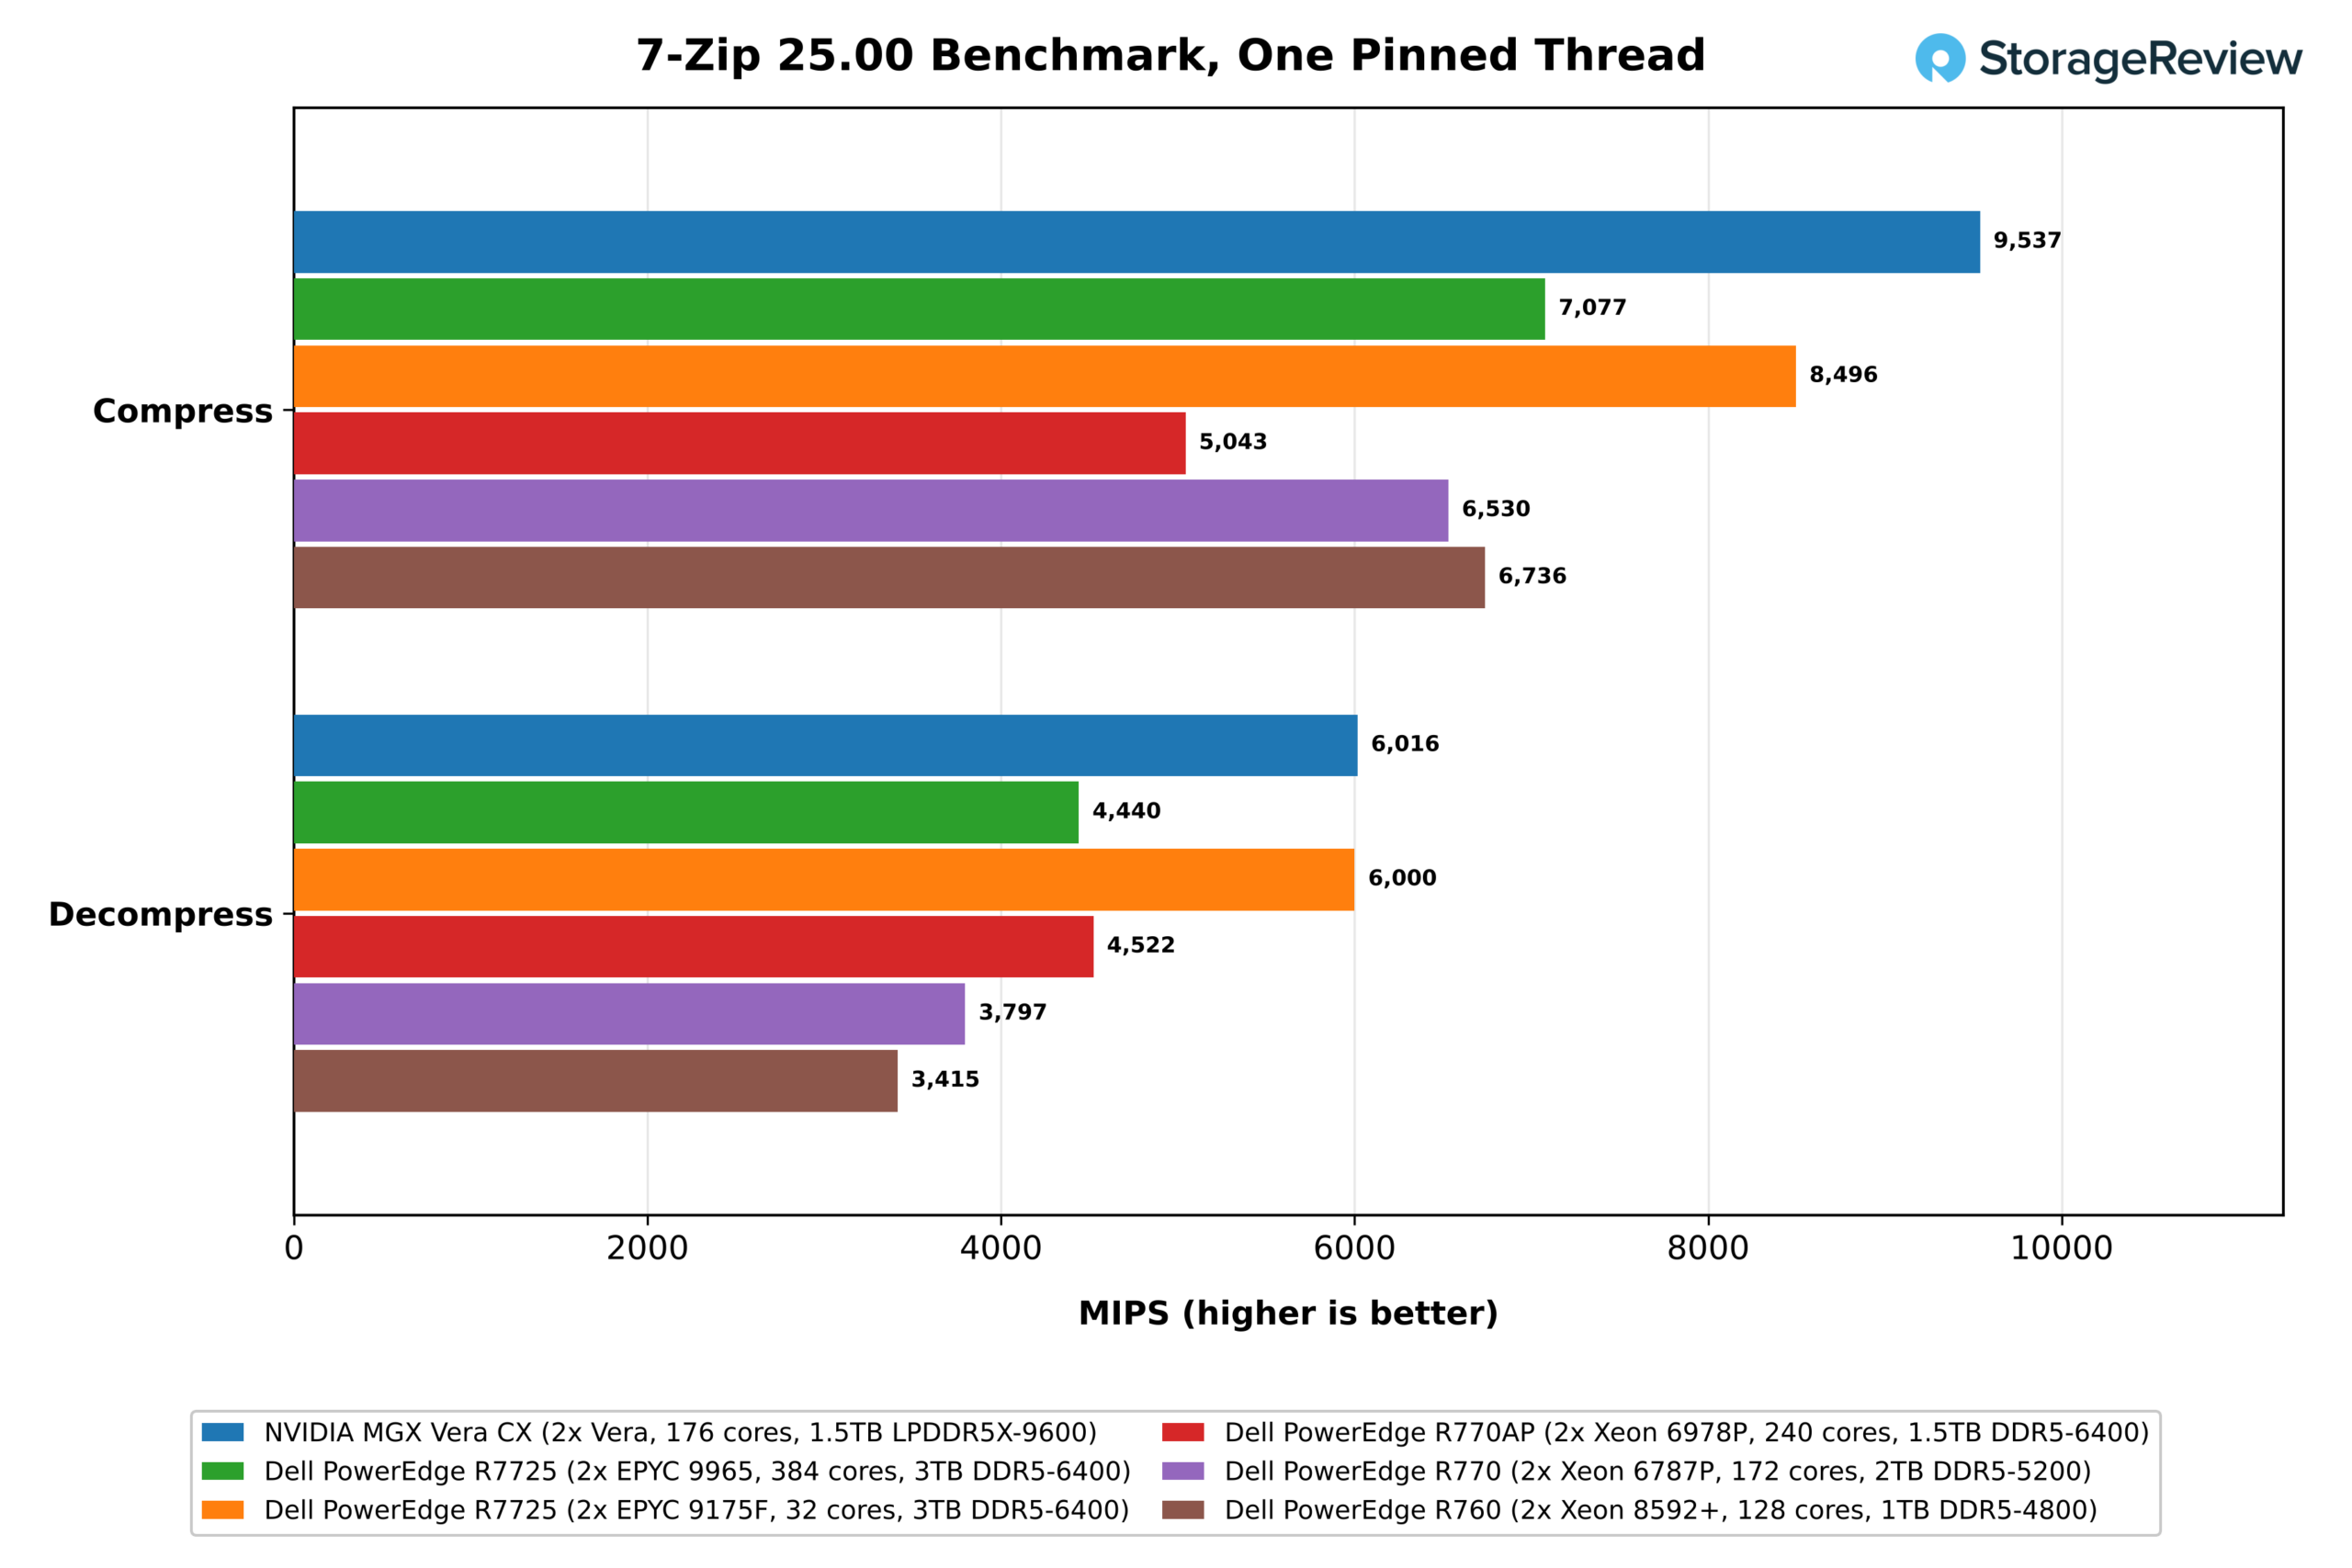
Pe un singur fir de execuție, Olympus a fost cel mai rapid compresor din setul nostru. A atins 9,537 MIPS, cu 12% înaintea EPYC 9175F de 5.0 GHz, cel mai rapid nucleu x86 de aici, și mult peste EPYC 9965 și fiecare Xeon. Decompresia a fost la egalitate între cele două: 6,016 MIPS pentru Vera și 6,000 pentru 9175F, fără niciun alt sistem la 20%.
Parcurgerea fiecărui fir de execuție arată cât din acel client potențial supraviețuiește atunci când întregul sistem este ocupat.
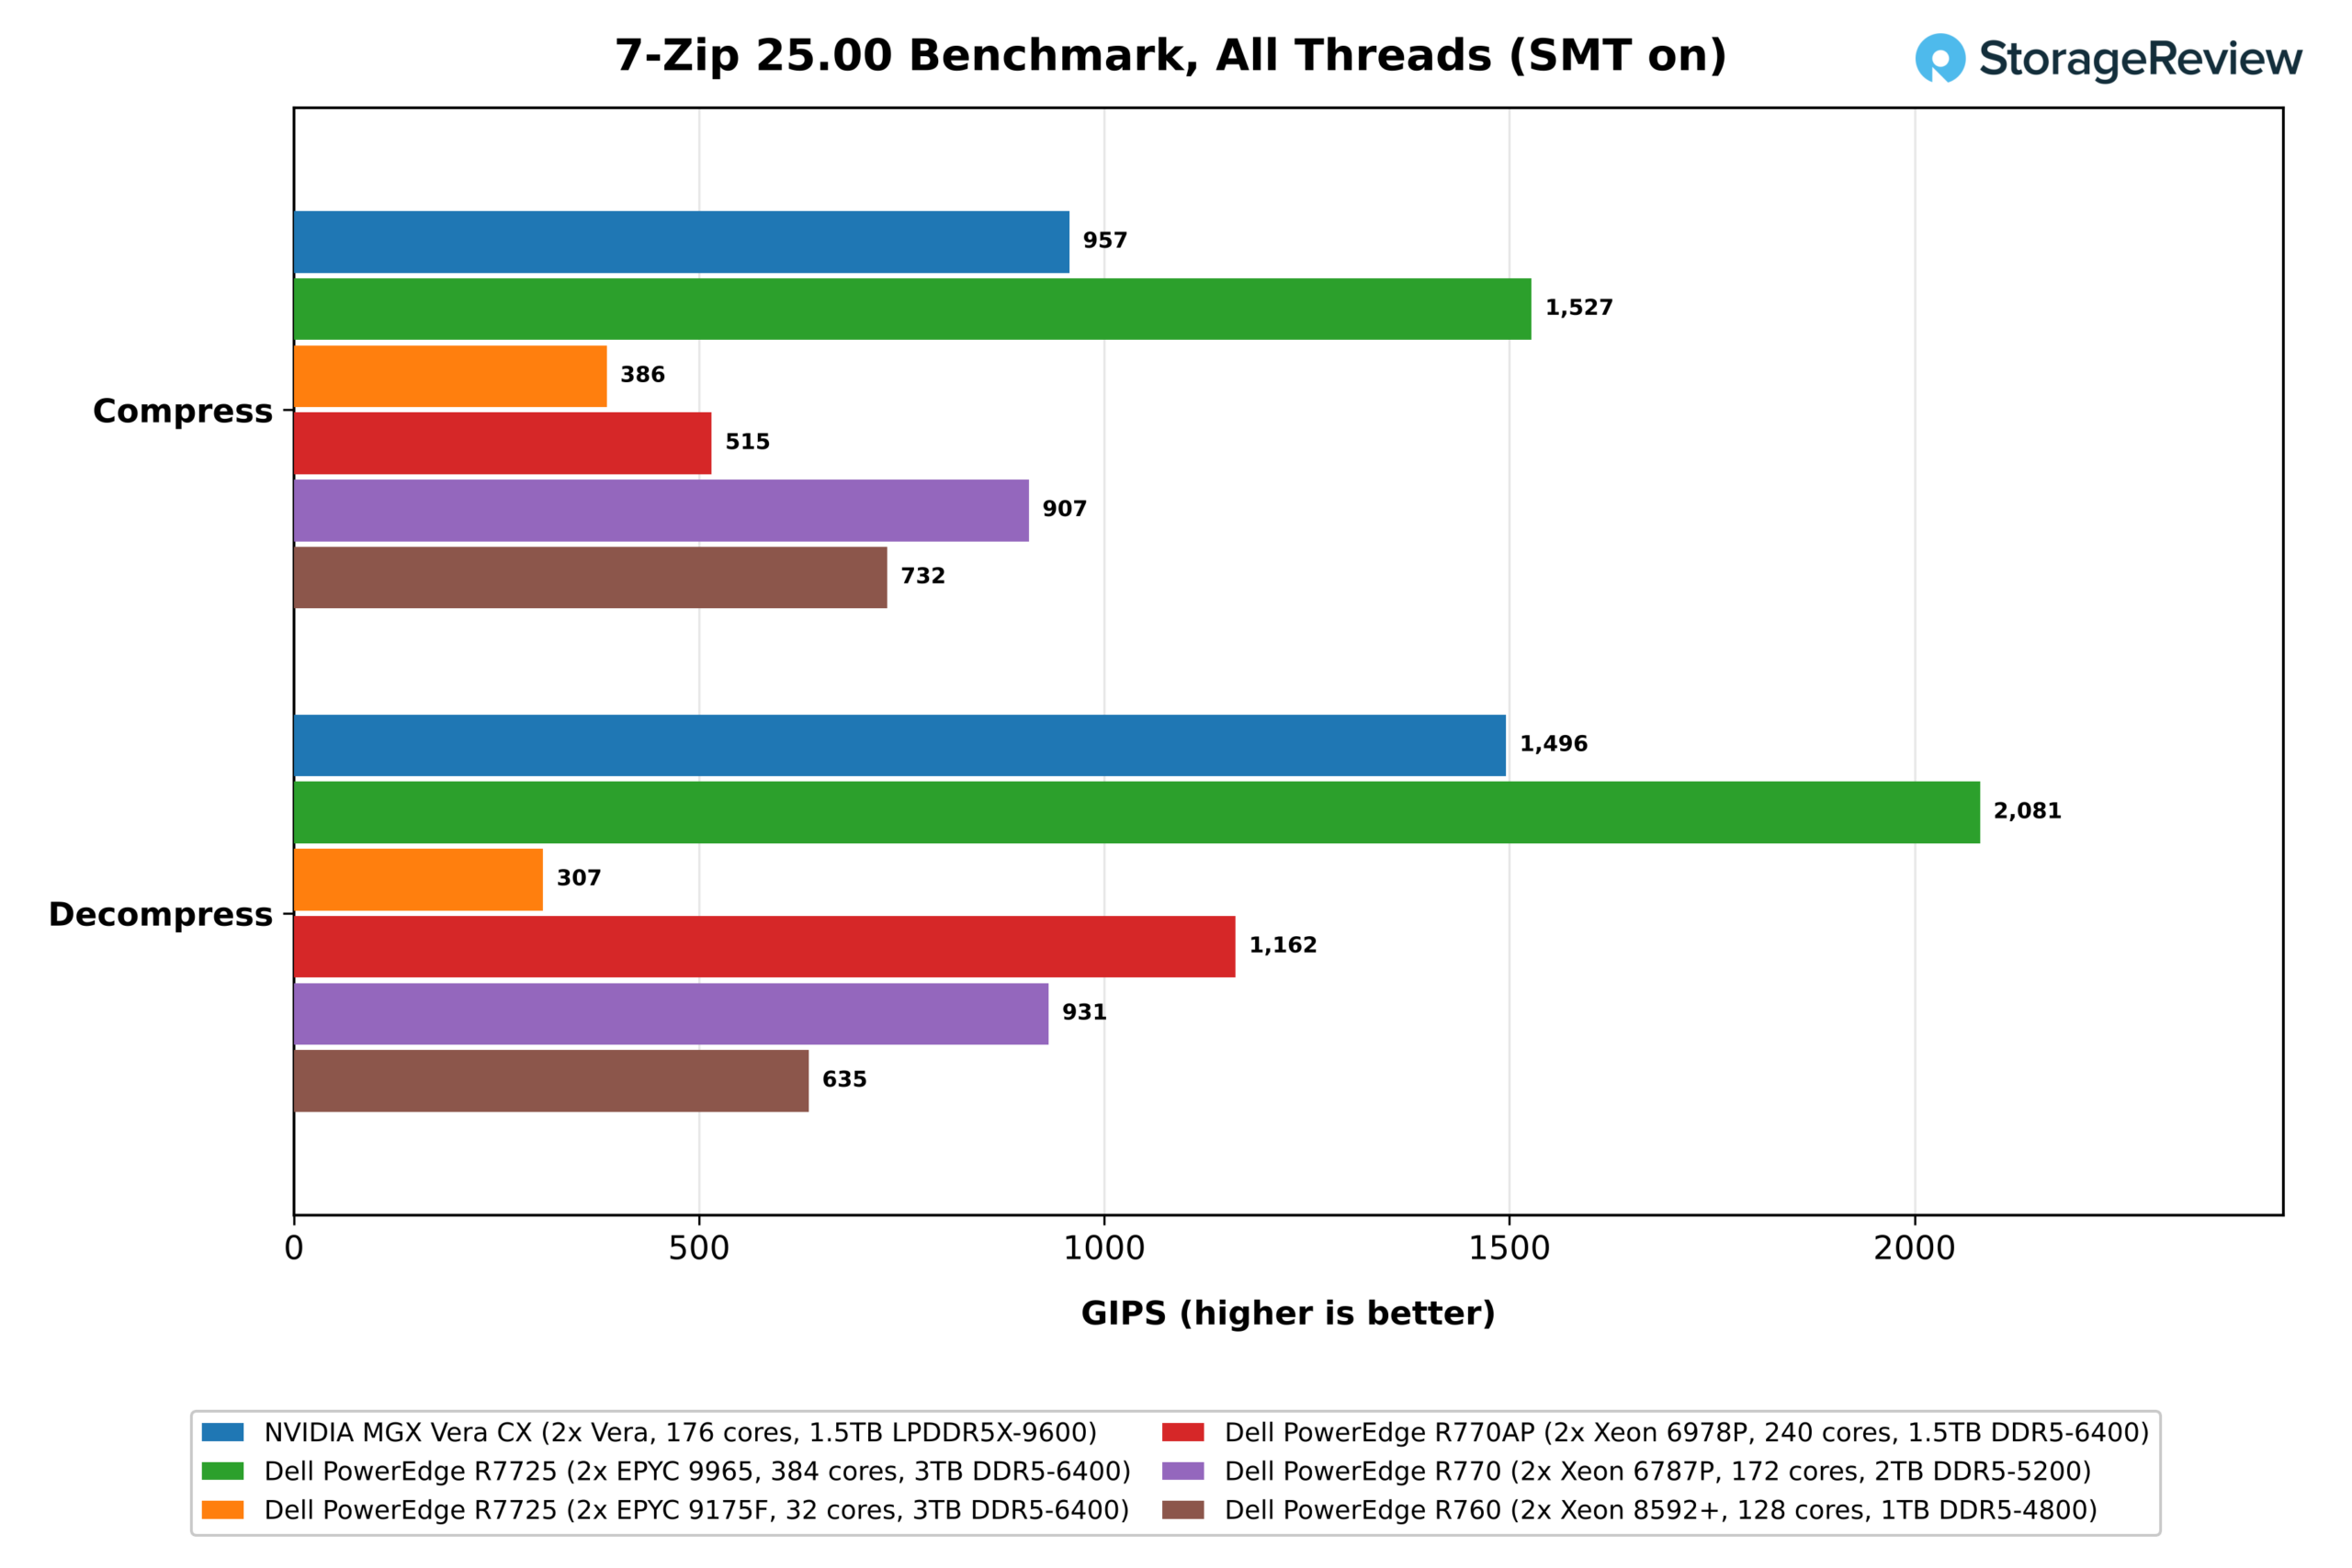
Cu fiecare fir de execuție ocupat, cele 768 de fire de execuție ale EPYC 9965 au ocupat primul loc, cu 1,527 GIPS la compresie și 2,081 GIPS la decompresie. Cele 352 de fire de execuție ale Vera s-au clasat pe locul doi, cu 957 și 1,496 GIPS, înaintea oricărui Xeon, 6787P fiind cel mai aproape, cu 907 și 931. Măsurat per nucleu fizic, Vera se menține bine. Cei 5.4 GIPS de compresie per nucleu se compară cu cei ai 6787P și 8592+ și îi depășesc pe cei 4.0 GIPS ai 9965, iar cei 8.5 GIPS de decompresie per nucleu sunt cu 57% mai mari decât cei ai 9965 și depășesc orice Xeon. Doar 9175F cu 32 de nuclee, cu mult mai puține nuclee care partajează cache-urile și memoria fiecărui socket, a făcut mai mult per nucleu pe ambele.
OpenSSL
Testul AES-256-GCM al OpenSSL este cel în care Vera cedează cel mai mult teren. Doar două dintre cele șase pipe-uri SVE2 pe 128 de biți ale Olympus pot executa instrucțiuni criptografice, în timp ce componentele x86 pot rula AES pe registre pe 512 biți cu VAES.
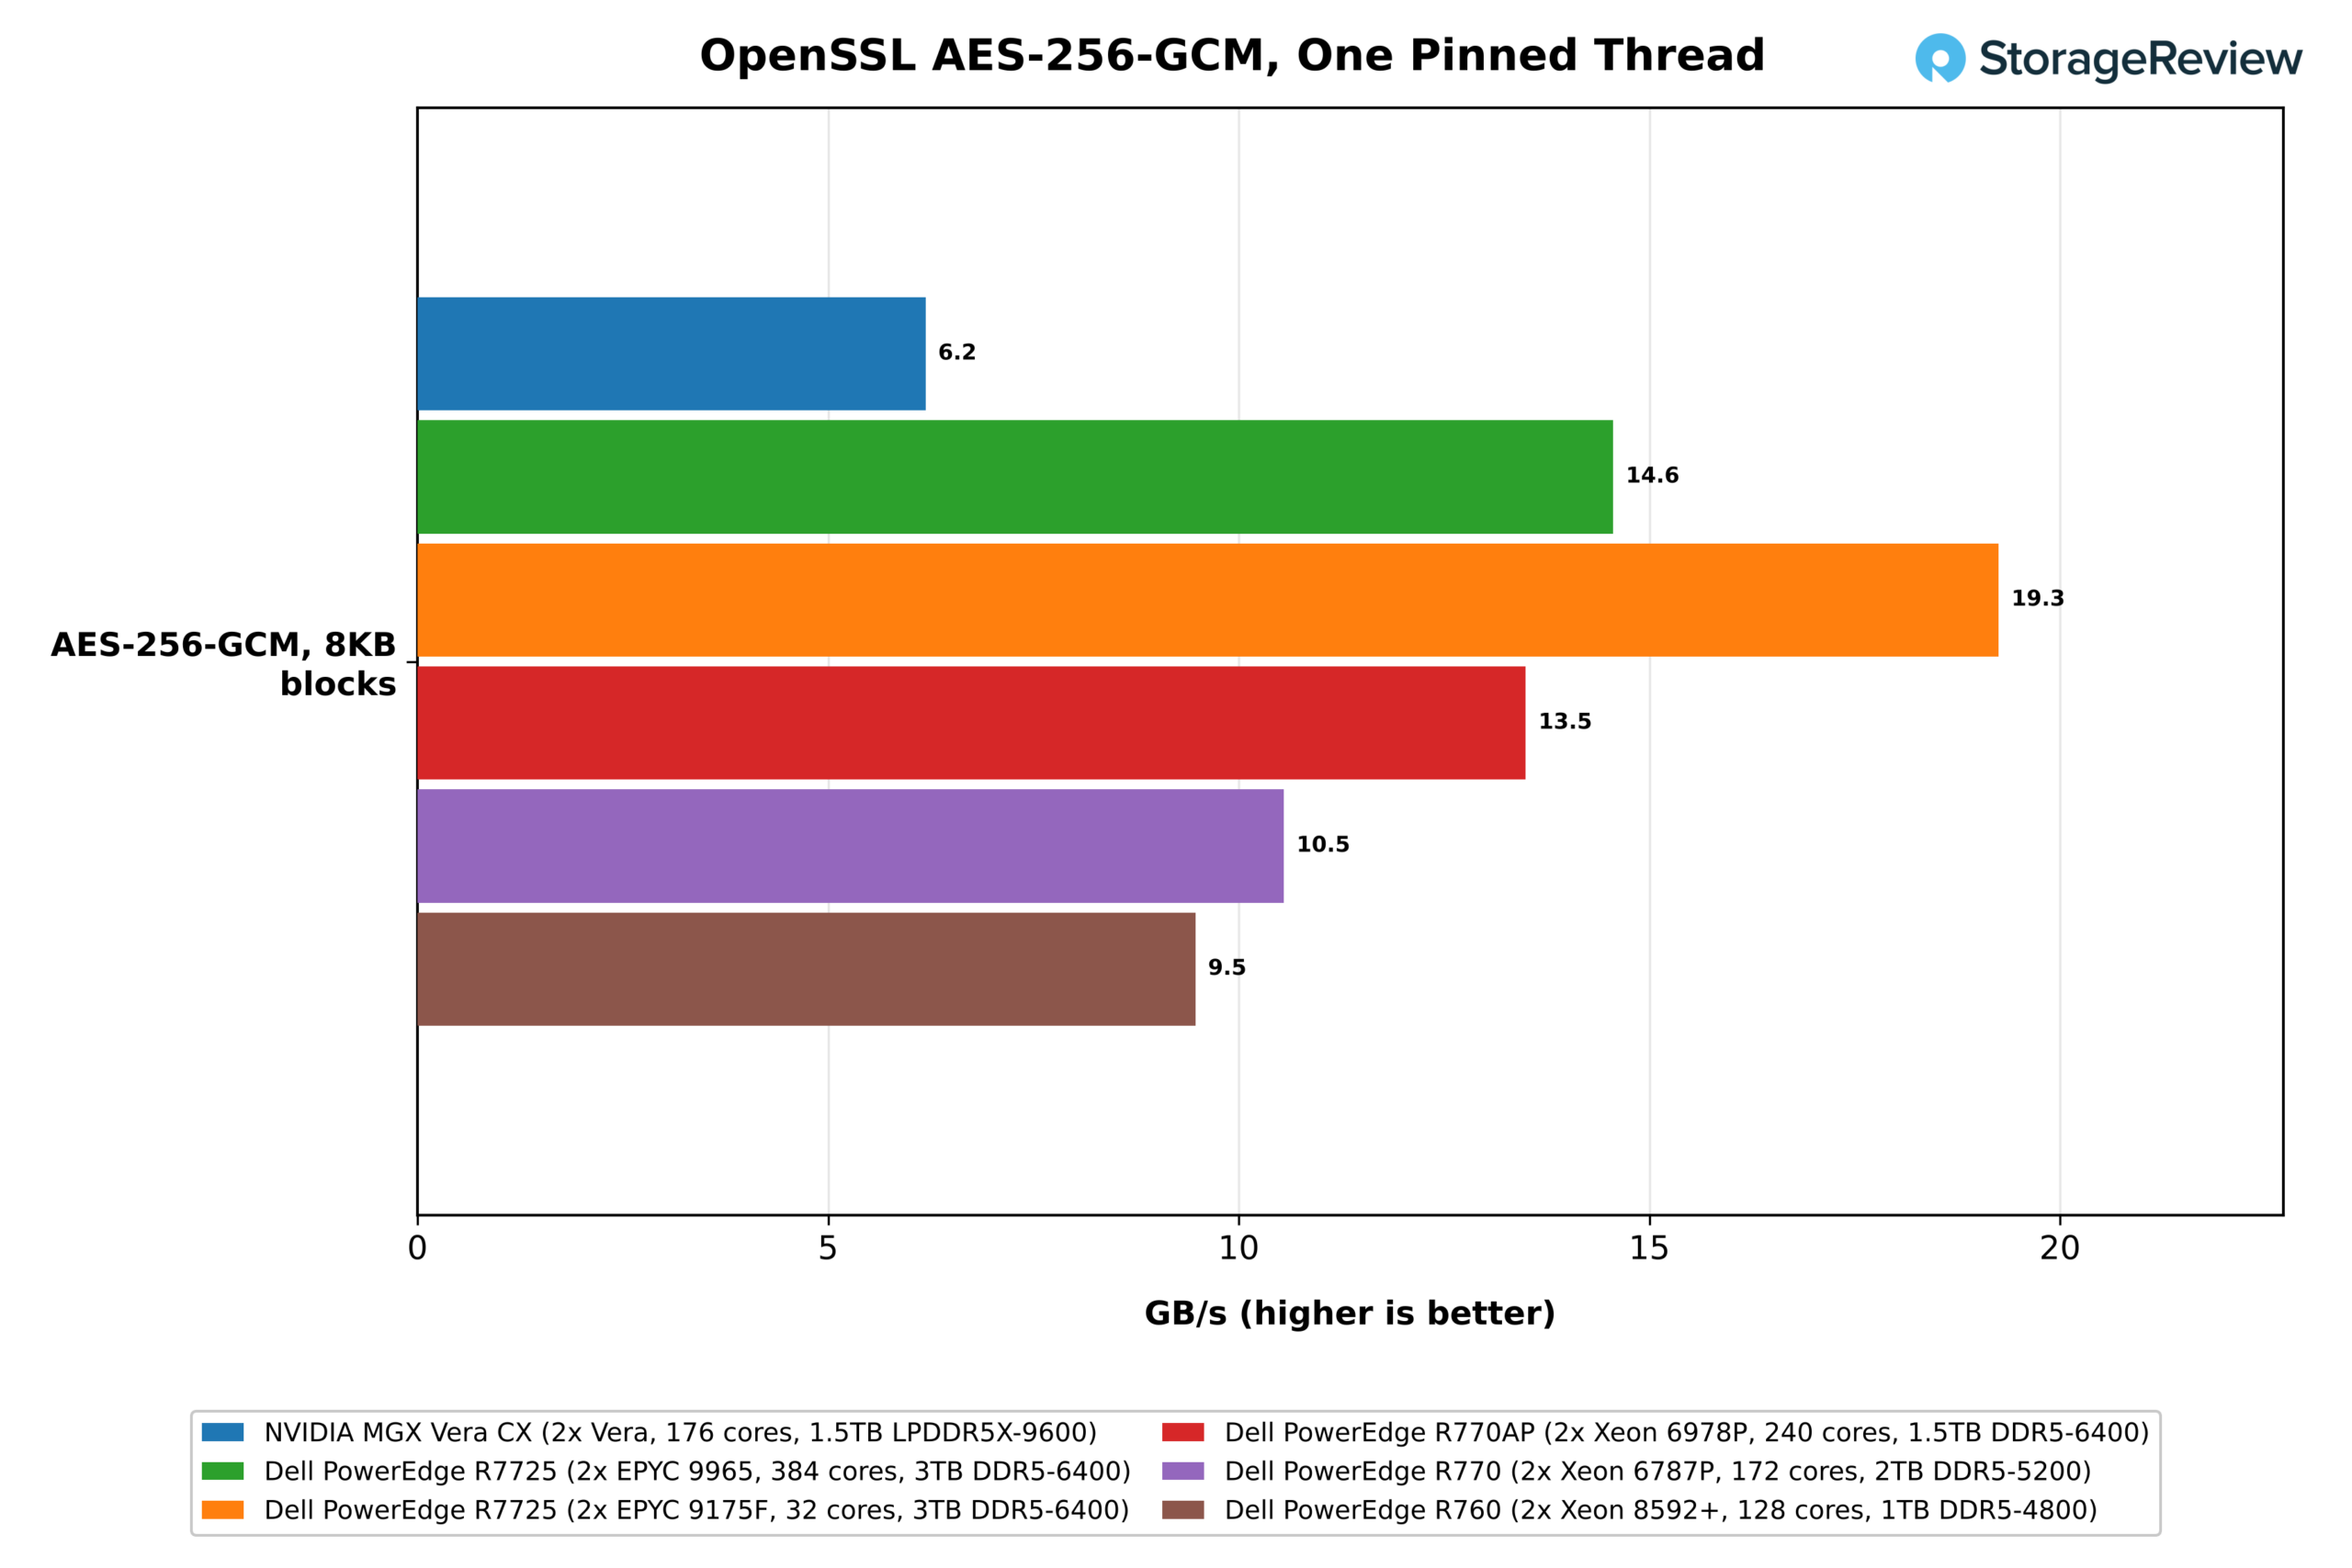
Decalajul este cel mai evident pe un singur fir de execuție. Un nucleu Olympus este criptat la 6.2 GB/s, aproximativ o treime din cei 19.3 GB/s de pe EPYC 9175F și mult în urma EPYC 9965 la 14.6 GB/s și a Xeon 6978P la 13.5 GB/s.
Pe fiecare fir de execuție, sistemele x86 se aliniază în funcție de numărul de nuclee, ceea ce arată unde lasă Vera deficitul per nucleu.
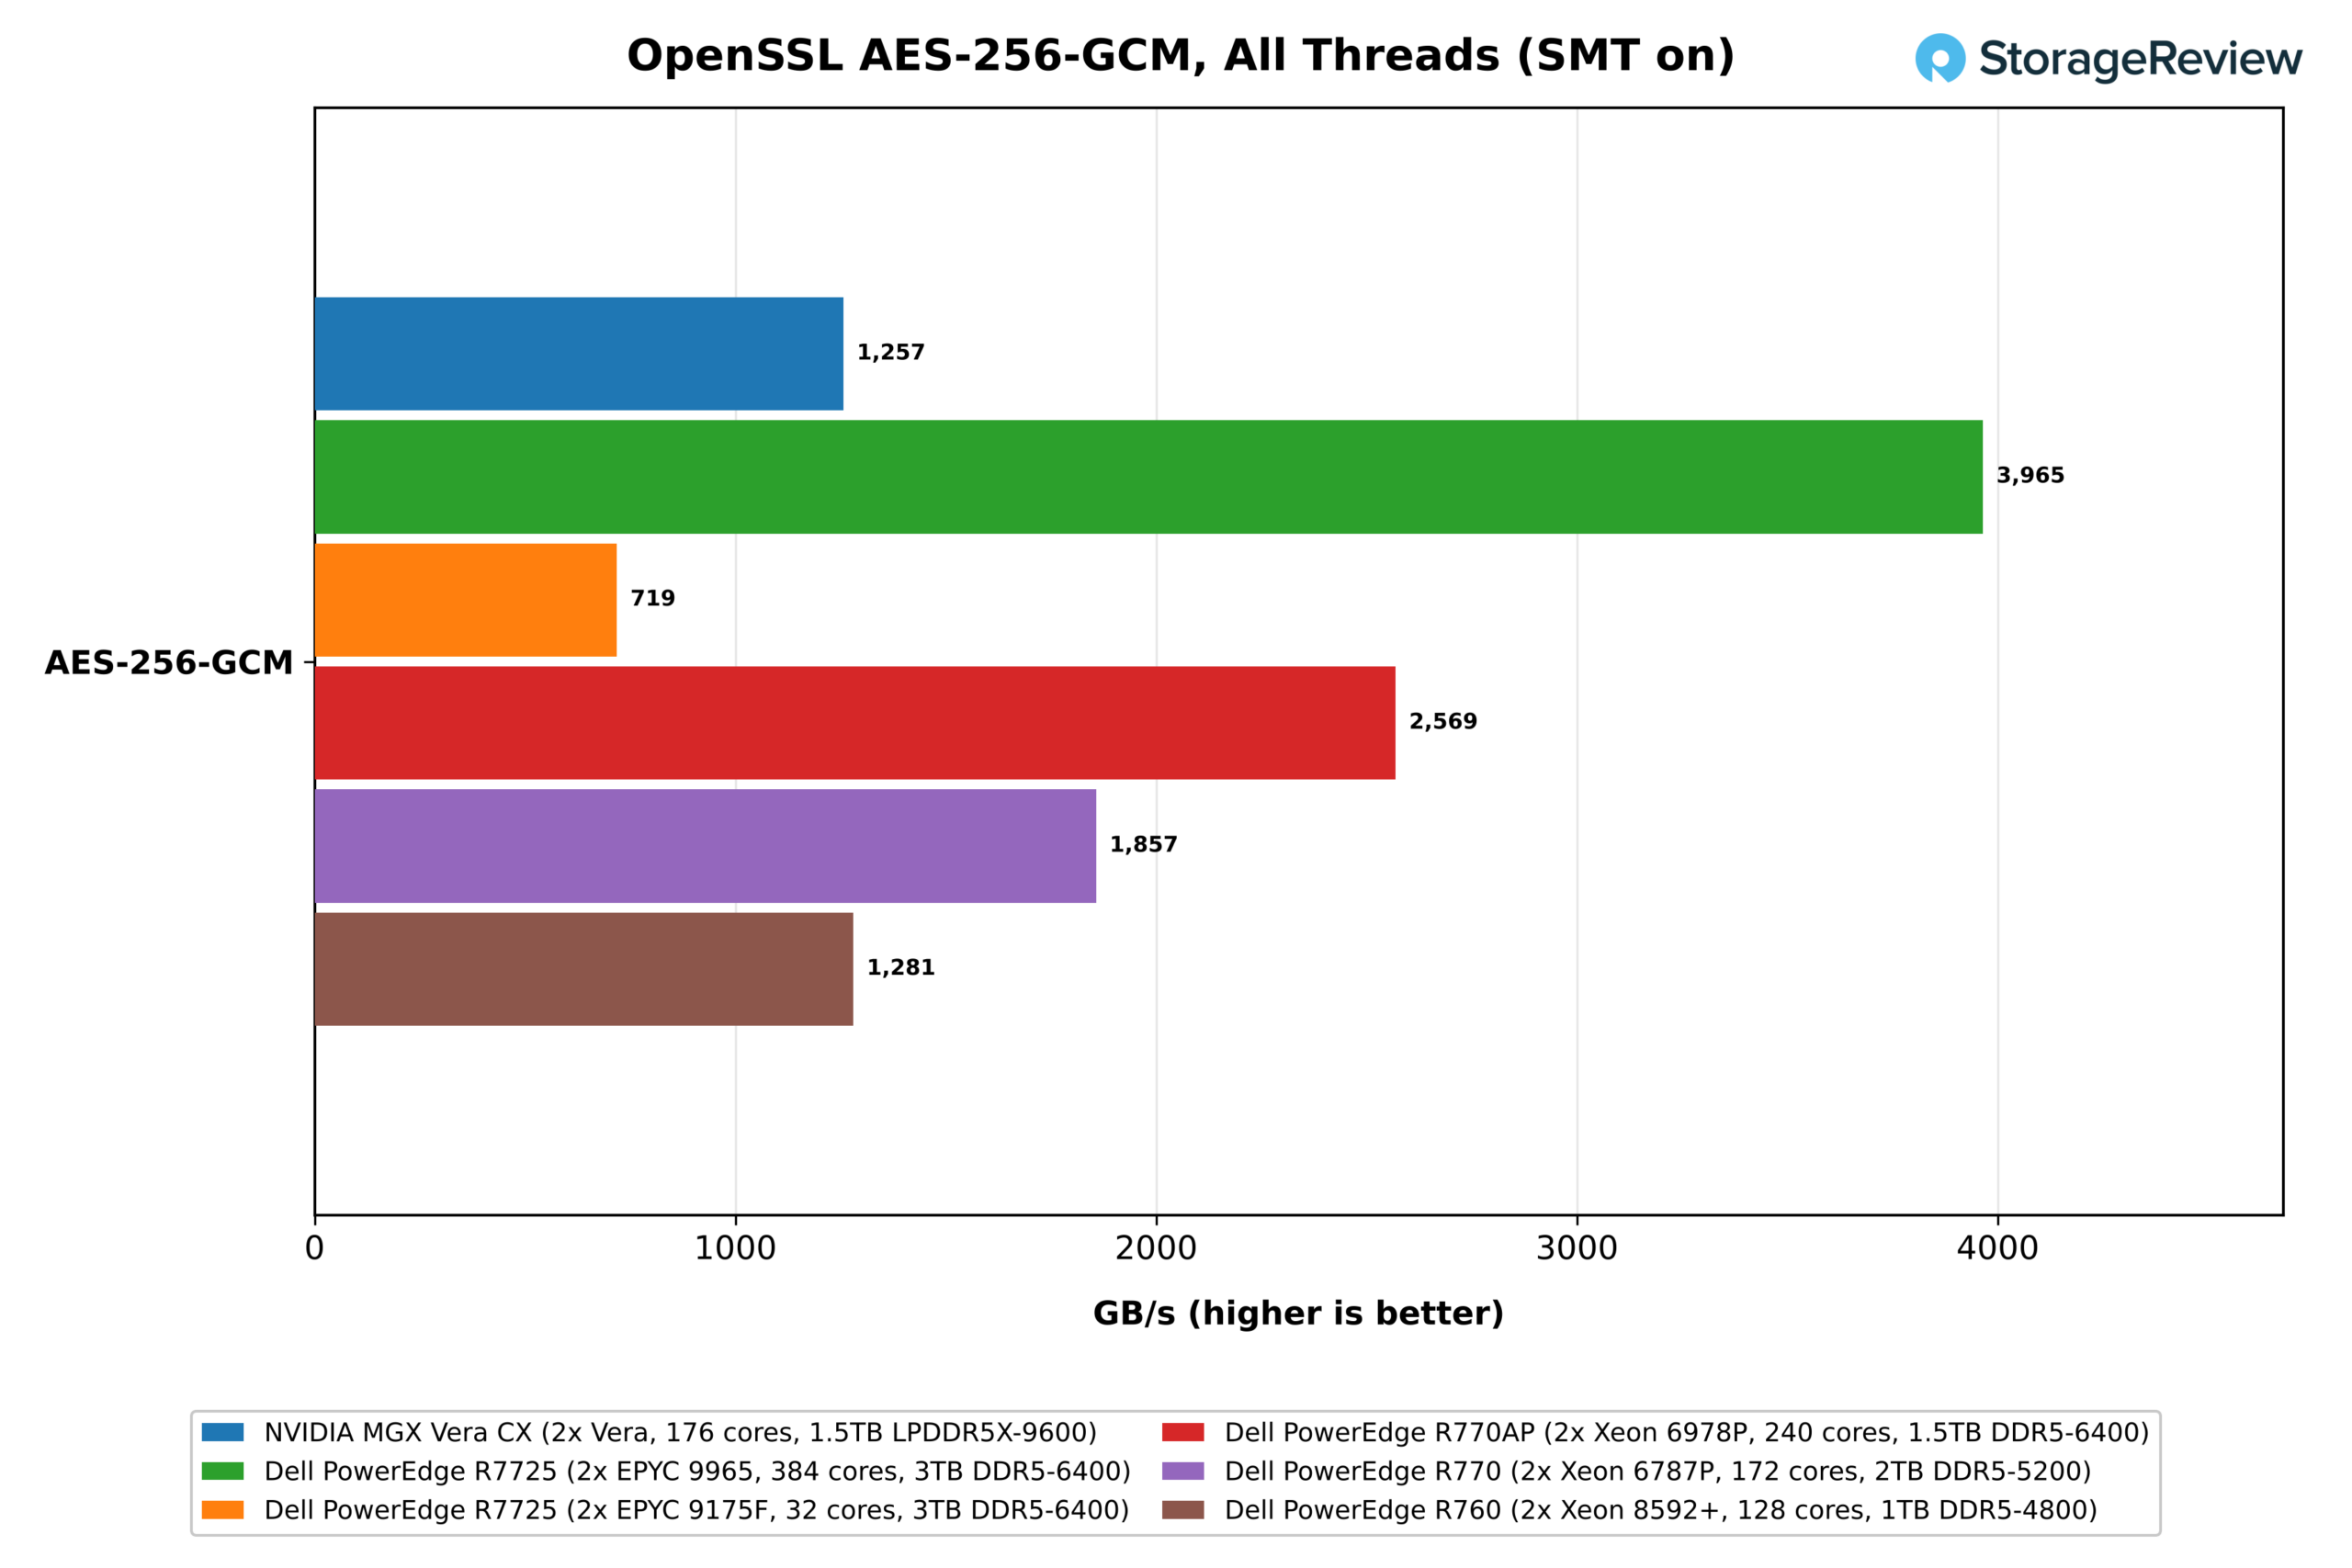
Cu toate cele 352 de thread-uri ocupate, Vera a atins 1.26 TB/s, la același nivel cu Xeon 8592+ cu 128 de nuclee la 1.28 TB/s și doar devansat de EPYC 9175F cu 32 de nuclee. EPYC 9965 a condus cu 3.96 TB/s, de aproximativ trei ori mai mare decât rezultatul lui Vera, urmat de Xeon 6978P cu 2.57 TB/s și 6787P cu 1.86 TB/s.
Piton
Python este esențial pentru sandbox-urile de agenți pe care NVIDIA le vizează cu Vera, iar pyperformance ne oferă trei teste fixe pe un singur fir de execuție: go, o căutare în arborele de joc bazată pe obiecte; regex_compile, care compilează expresii regulate; și nbody, o simulare fizică în virgulă mobilă. O diferență software se aplică aici: Vera a rulat Python 3.14.4 de pe Ubuntu 26.04, în timp ce sistemele x86 au rulat 3.12.3 de pe Ubuntu 24.04, iar versiunea mai nouă aduce îmbunătățiri ale interpretorului.
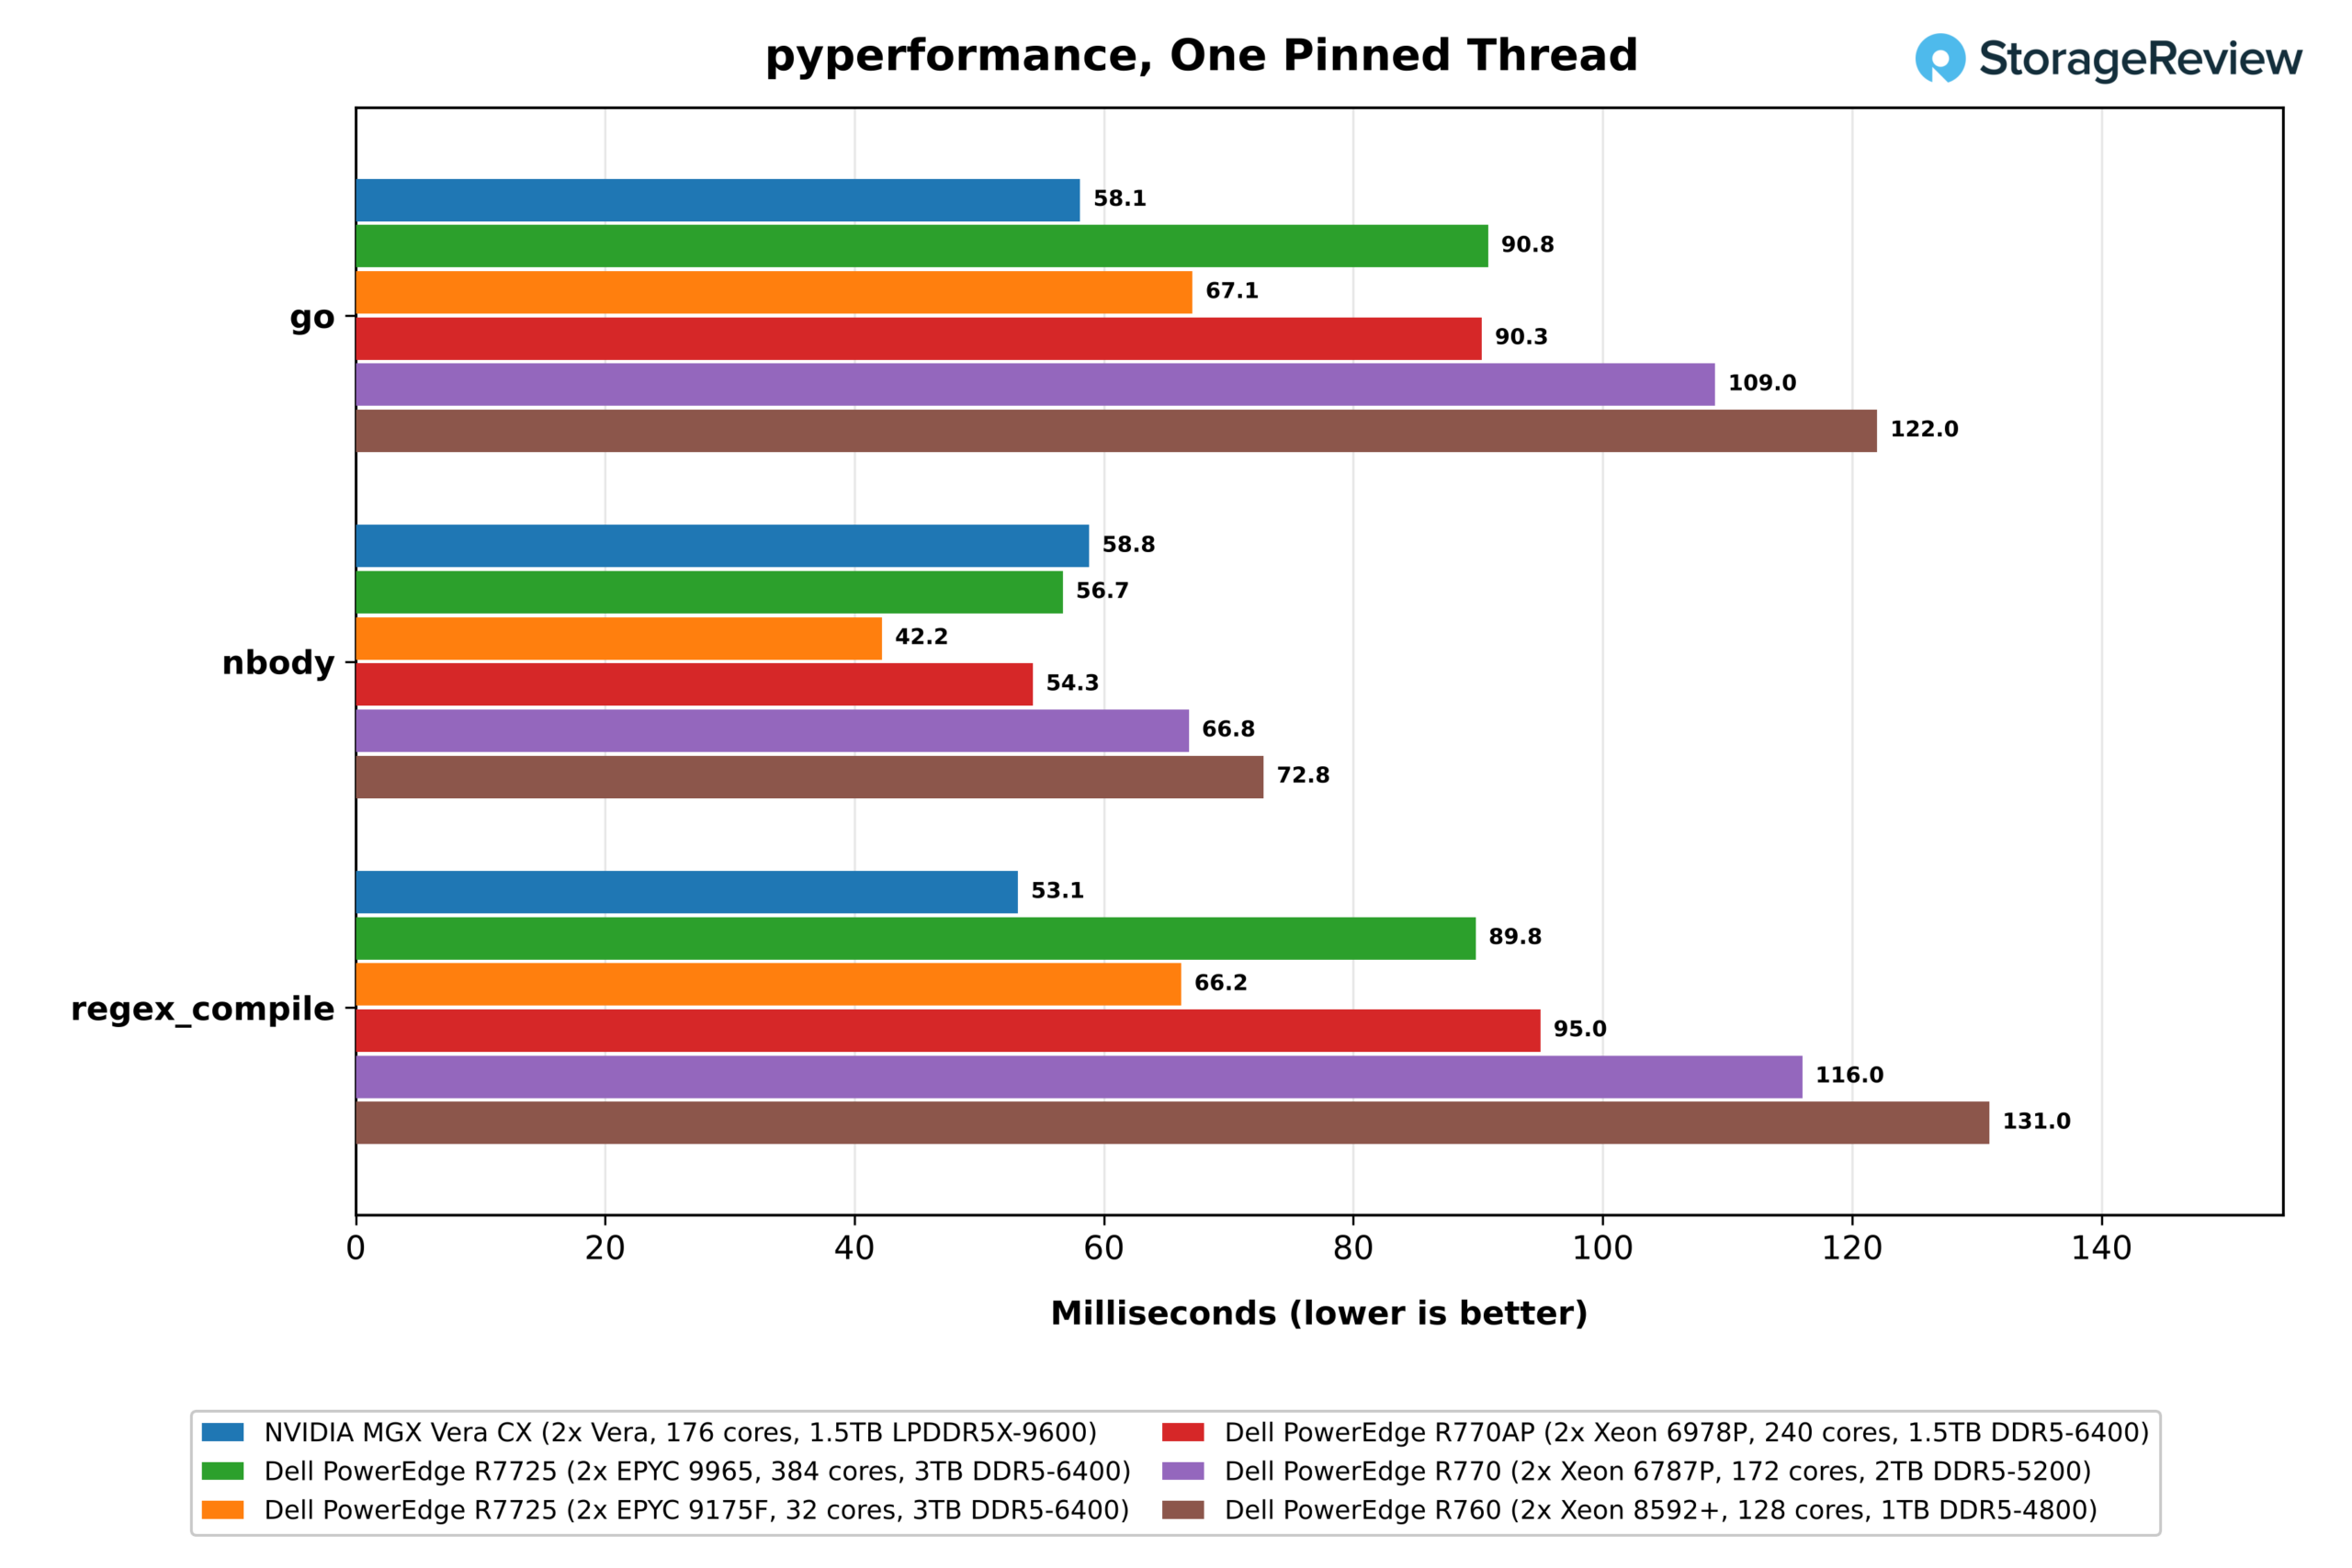
Vera a câștigat cele două teste construite pe cod ramificat, bogat în obiecte. go a terminat în 58.1 ms, cu 15% mai rapid decât EPYC 9175F, cel mai rapid nucleu x86 de aici, și de 1.6x până la 2.1x mai rapid decât restul competitorilor. regex_compile a arătat o marjă mai mare, terminând în 53.1 ms, cu 25% înaintea lui 9175F și cu 1.7x înaintea lui EPYC 9965. Deoarece Vera avea și noul Python, ambele margini au fost interpretate ca limite superioare.
Nimeni nu a mers în direcția opusă, deoarece bucla sa scurtă în virgulă mobilă și setul de lucru mic tind să favorizeze frecvențele de ceas ridicate, iar 9175F de 5.0 GHz a câștigat cu 42.2 ms, cu 39% mai rapid decât 58.8 ms al lui Vera. Xeon 6978P și EPYC 9965 au terminat, de asemenea, înaintea lui Vera, cu 54.3 ms și 56.7 ms, chiar și cu noul Python al lui Vera.
Servirea web, JVM și latența planificatorului
Ultimul grup de teste de harnaș acoperă software-ul care înconjoară o aplicație: stiva web, mașina virtuală Java, planificatorul Linux și lanțul de instrumente al compilatorului. Aceste rezultate depind la fel de mult de câte thread-uri rulează fiecare sistem, cât și de cât de repede rulează fiecare nucleu, așa că spun mai puțin despre Olympus în sine decât o spun secțiunile anterioare, dar arată cum se comportă un server Vera sub software de server obișnuit.
Nginx
NGINX deservește cereri HTTPS către generatorul de sarcină de lucru care rulează pe aceeași mașină, astfel încât clientul și serverul concurează pentru aceleași nuclee, iar rezultatul reflectă mai mult stiva TLS și HTTP decât numărul brut de nuclee.
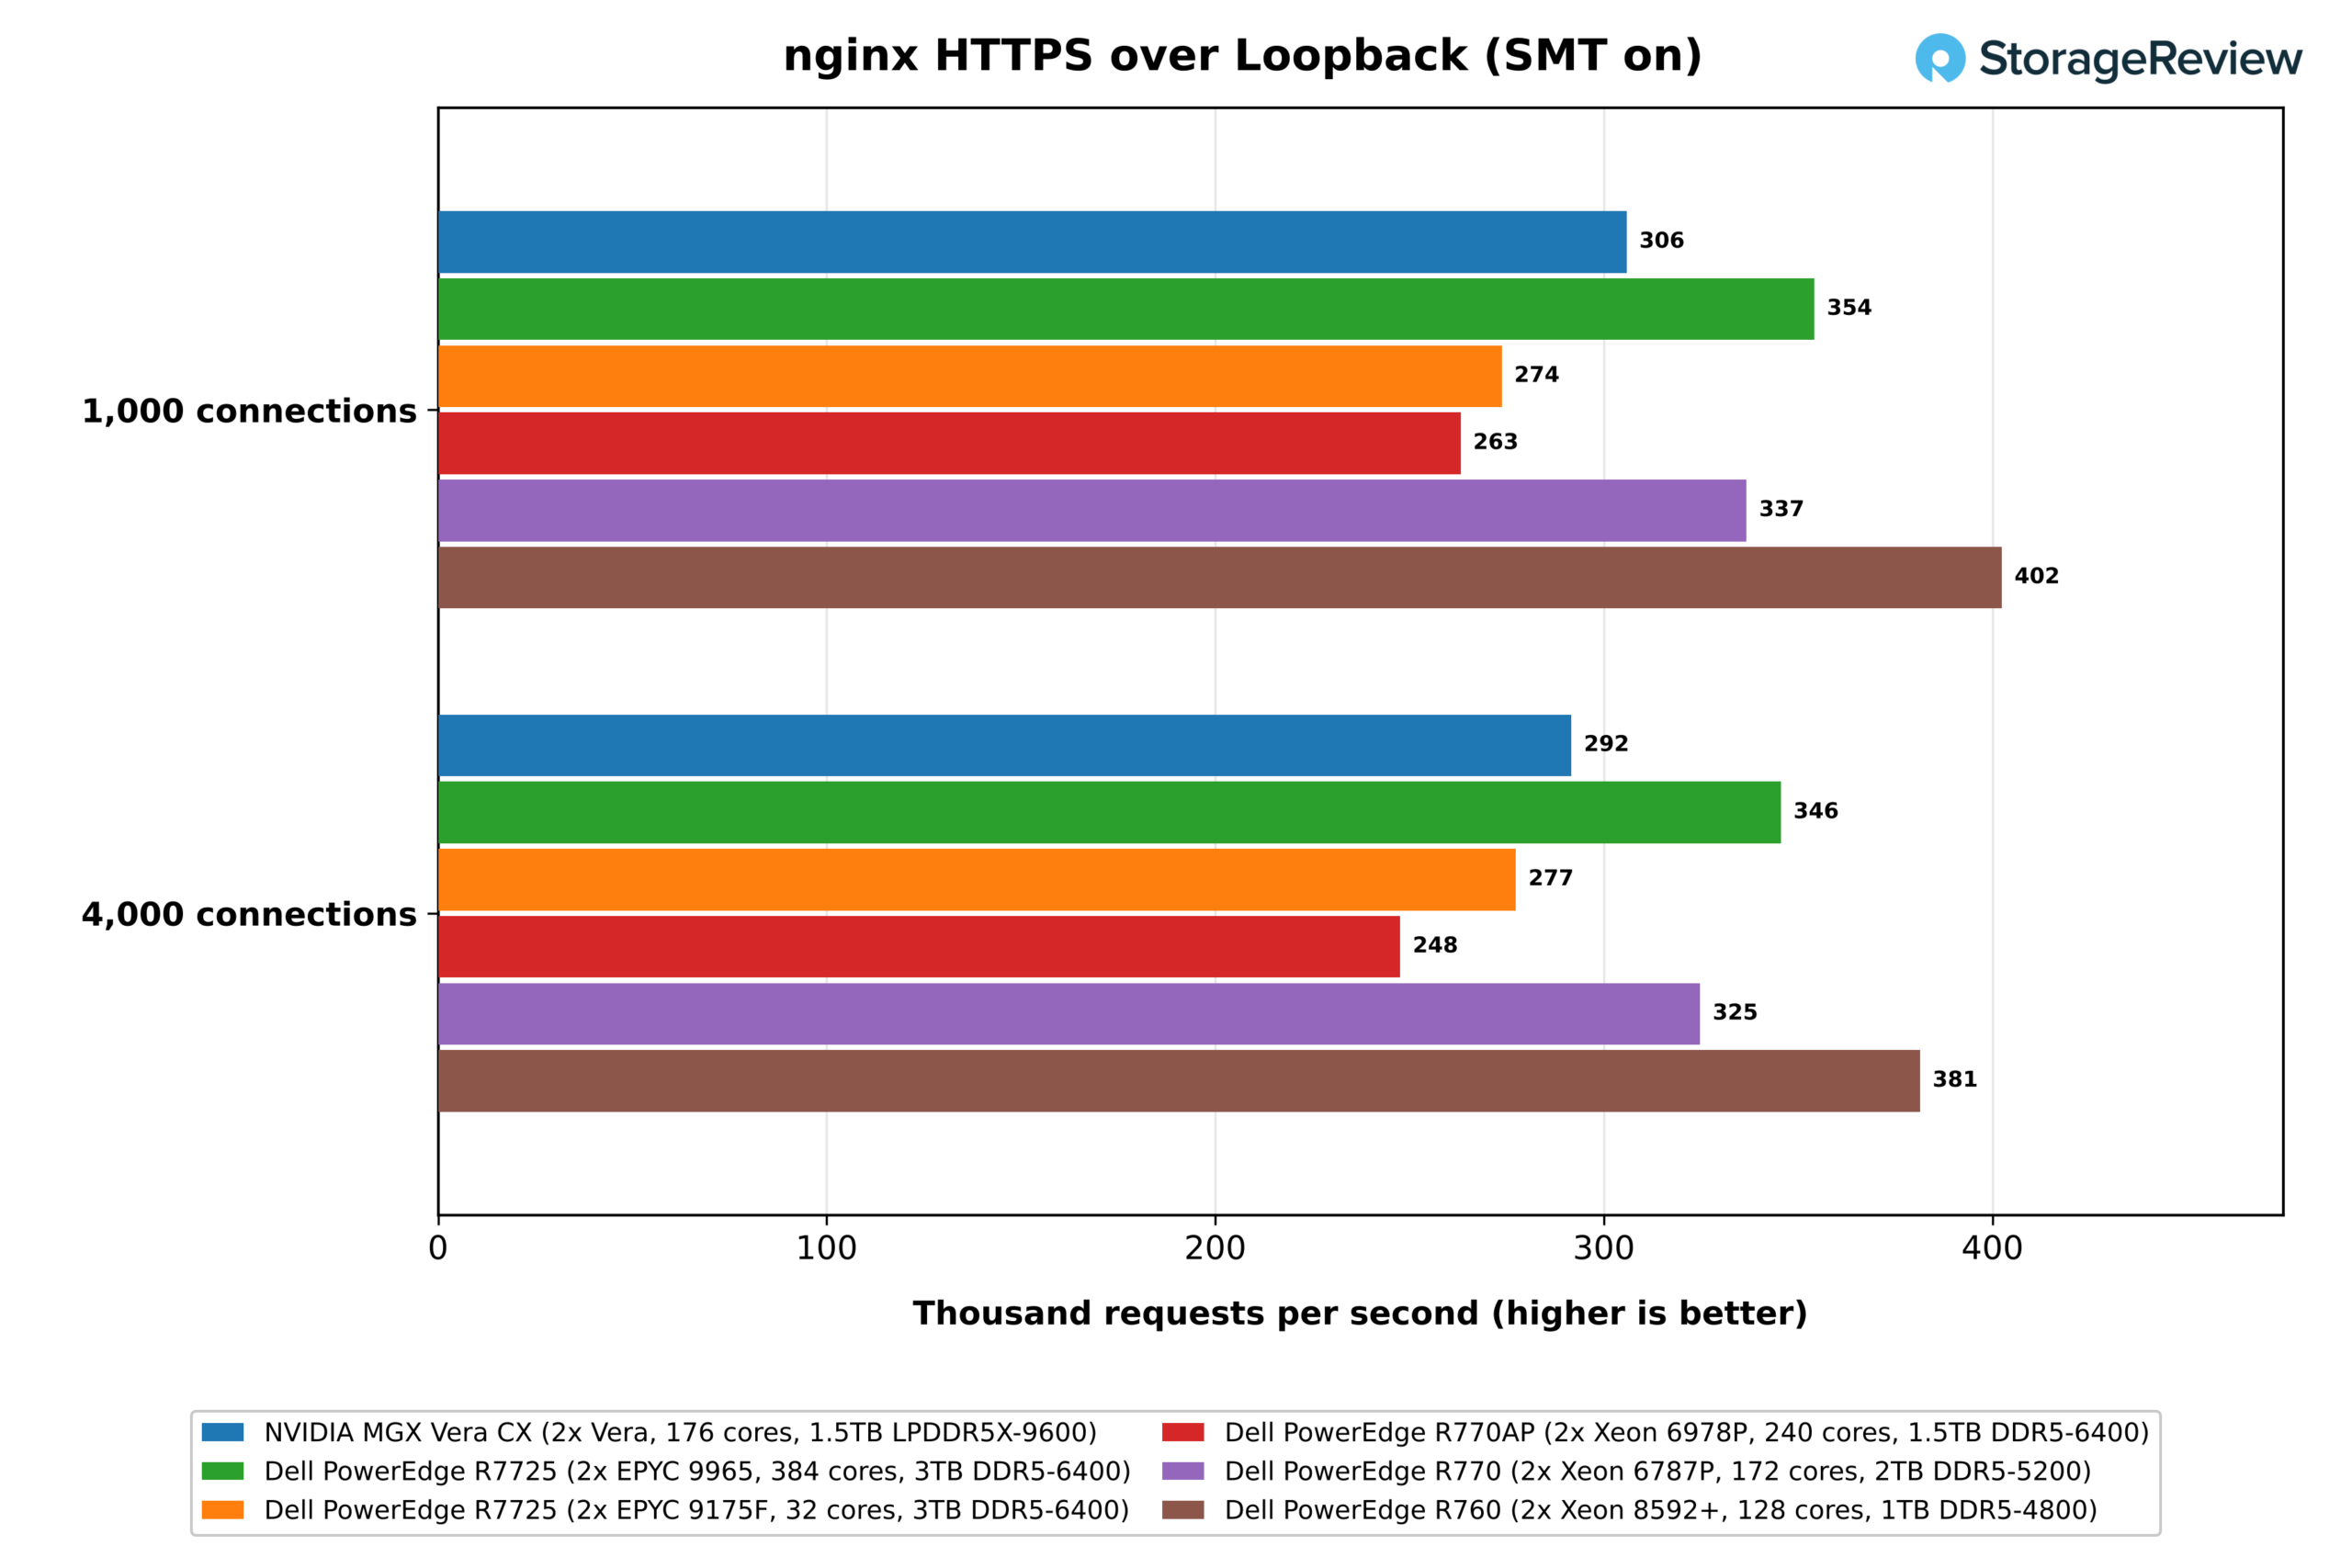
Cu SMT activat, Vera a gestionat 306,000 de cereri pe secundă la 1,000 de conexiuni și 292,000 la 4,000, în mijlocul unui câmp care a variat de la 263,000 pe Xeon 6978P la 402,000 pe Xeon 8592+. EPYC 9965 a atins 354,000, iar Xeon 6787P 337,000, iar dezactivarea SMT a ridicat Vera la 330,000. Stiva de rețea a Verei se află confortabil alături de sistemele x86.
Renaștere
Renaissance rulează sarcini de lucru Java pe OpenJDK 11. Testul HTTP Finagle exercită o stivă de rețea Scala, iar testul Akka un framework de concurență actor-model. Ambele distribuie munca pe fiecare procesor logic pe care JVM-ul îl poate vedea, așa că le-am rulat cu SMT activat și dezactivat.
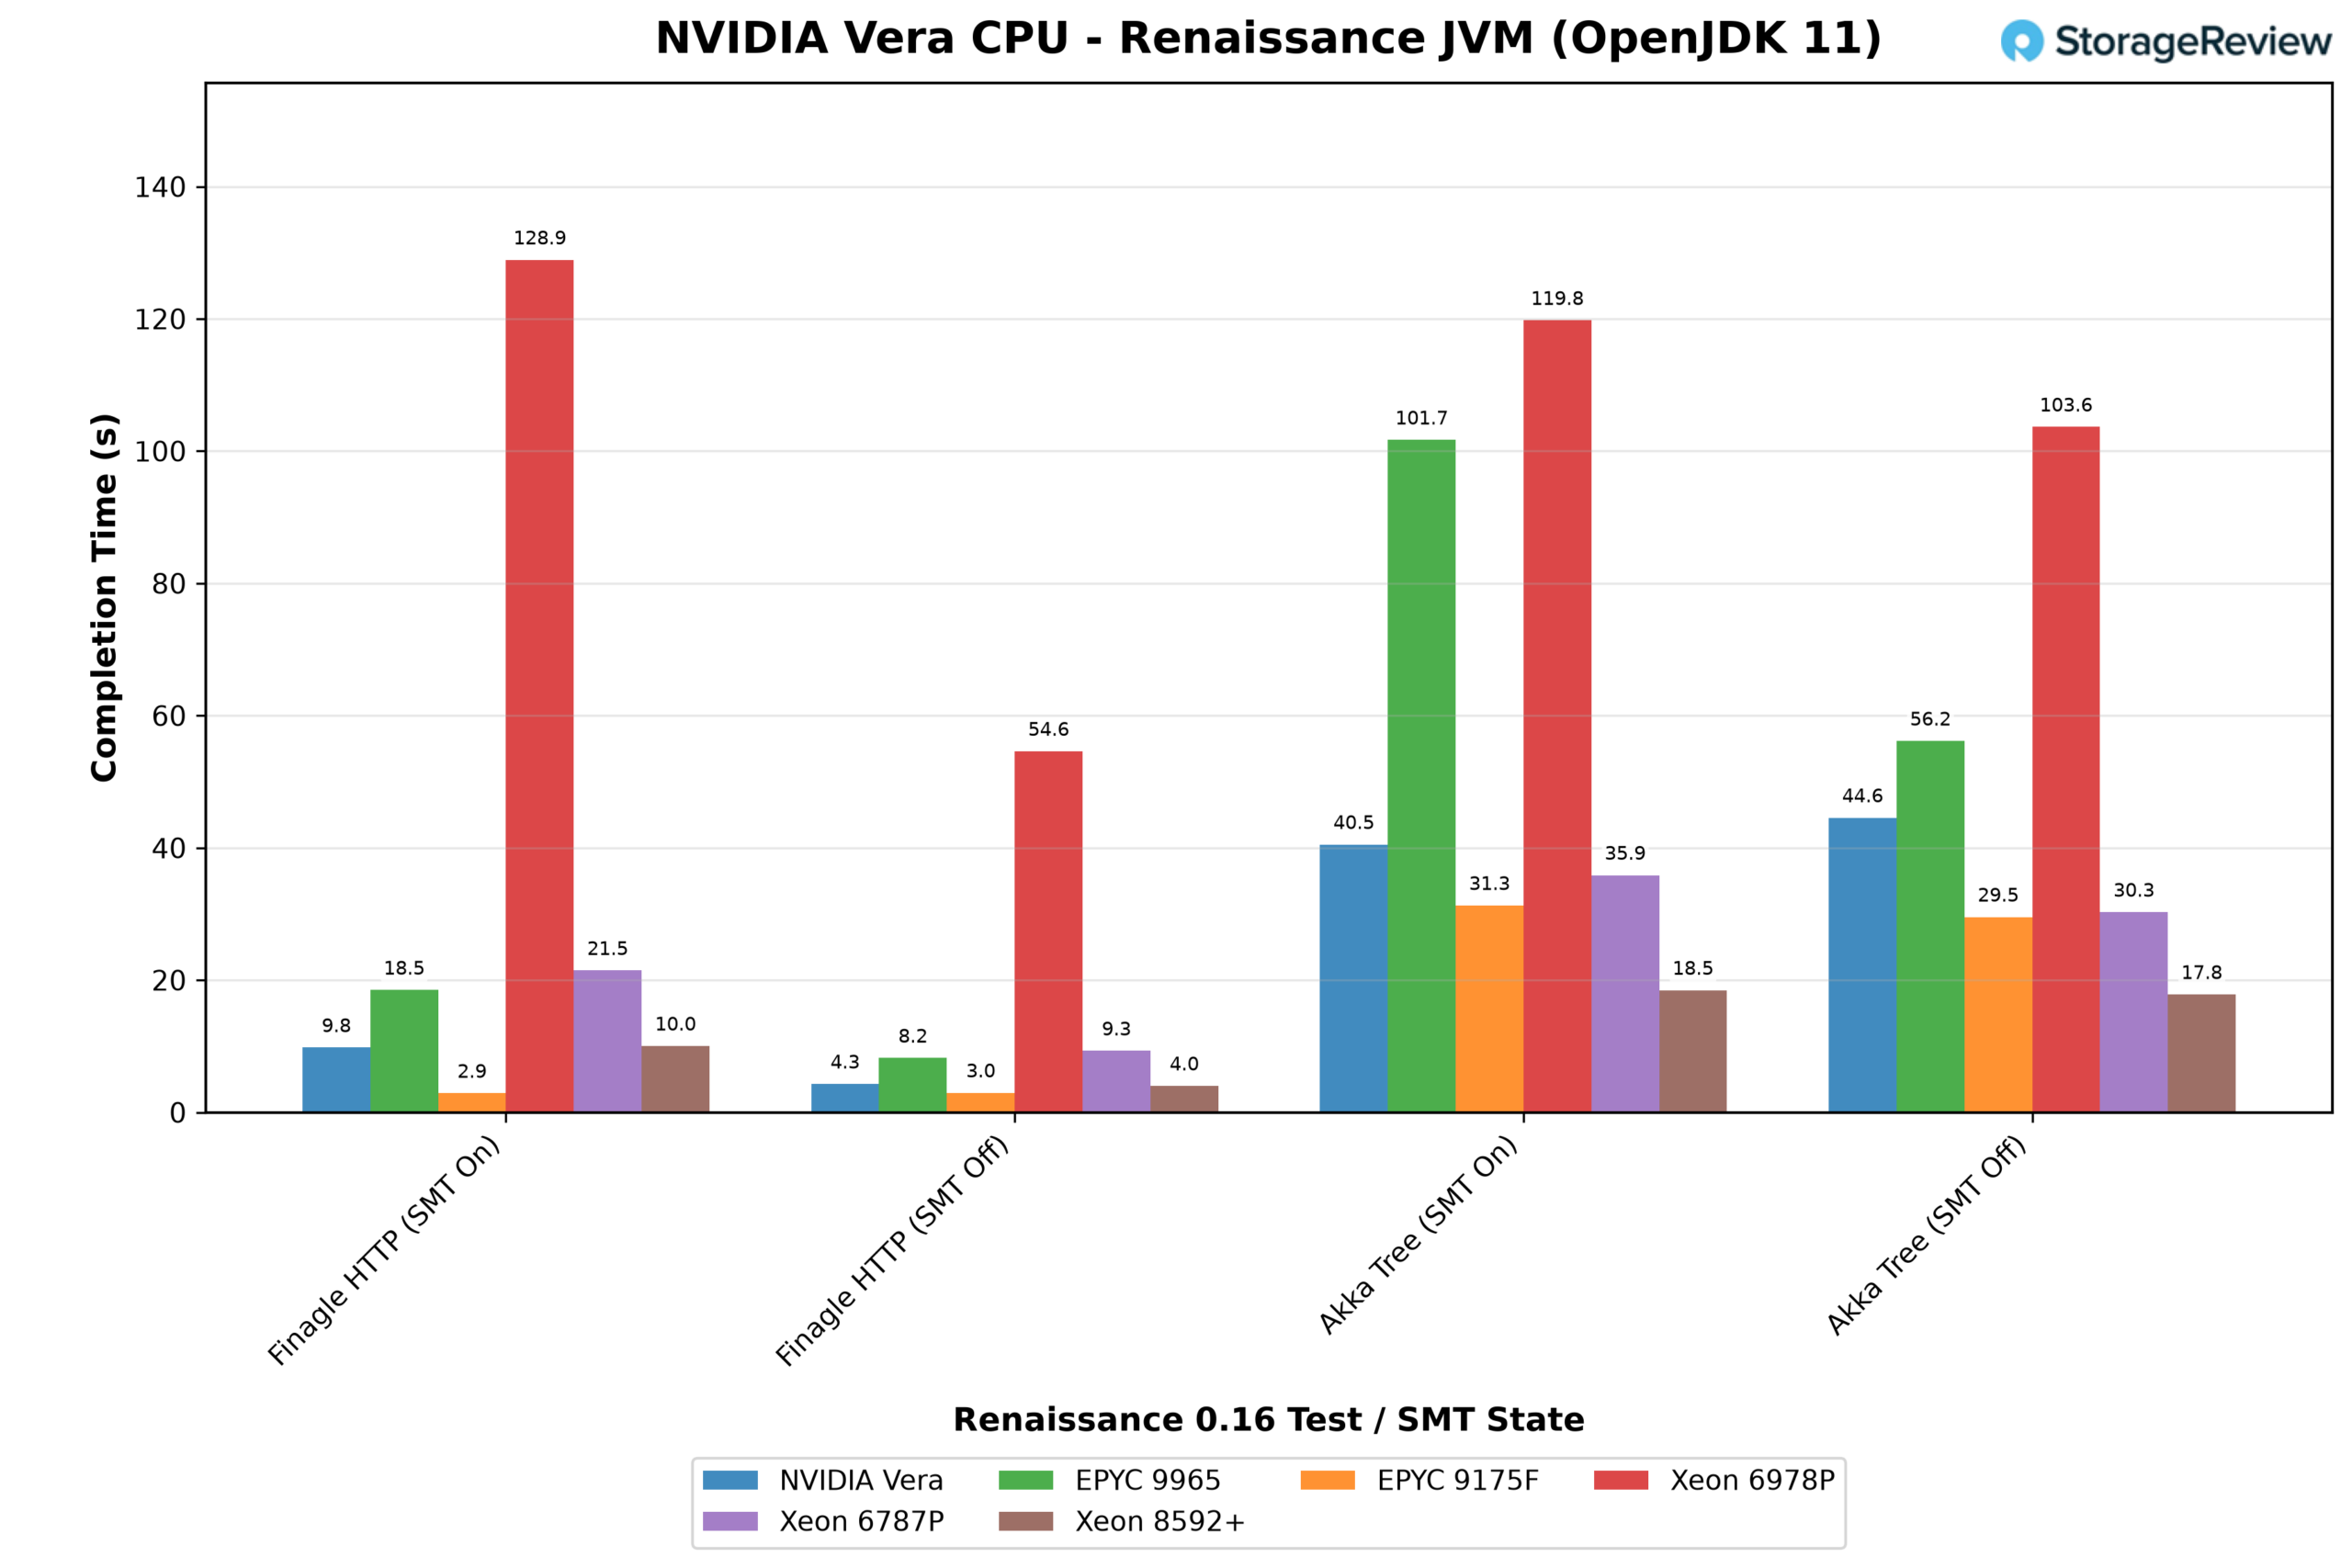
Finagle rulează mai rapid cu mai puține fire de execuție. Dezactivarea SMT, care reduce la jumătate numărul de fire de execuție, a redus timpul Verei de la 9.8 la 4.3 secunde, iar sistemele x86 mai mari s-au îmbunătățit cu un nivel similar de 2.3x până la 2.5x. EPYC 9175F cu 32 de nuclee, cu puține fire de execuție de la început, a condus în ambele direcții cu aproximativ 3 secunde.
Akka a preferat Xeon 8592+, care a terminat în aproximativ 18 secunde cu SMT activat sau dezactivat, în timp ce Vera a avut nevoie de 40.5 secunde cu SMT activat, iar cele mai mari două sisteme, EPYC 9965 și Xeon 6978P, au fost cele mai lente, cu 101.7 și, respectiv, 119.8 secunde. Al treilea test Renaissance, un algoritm genetic, a terminat în 1.6 până la 2.6 secunde cu SMT activat pe toate sistemele, cu excepția 6978P, unde Vera a înregistrat 2.6 secunde.
schbench
schbench măsoară cât de repede trezește planificatorul Linux firele de execuție (worker threads), rulând aproximativ un worker per CPU logic cu 4 fire de execuție (message threads) și aproximativ opt per CPU cu 32. Deoarece numărul de worker-i crește odată cu sistemul, serverele mai mari lucrează mai mult, așadar aceste rezultate descriu latența sub sarcină maximă pe fiecare mașină și nu reprezintă o comparație identică.
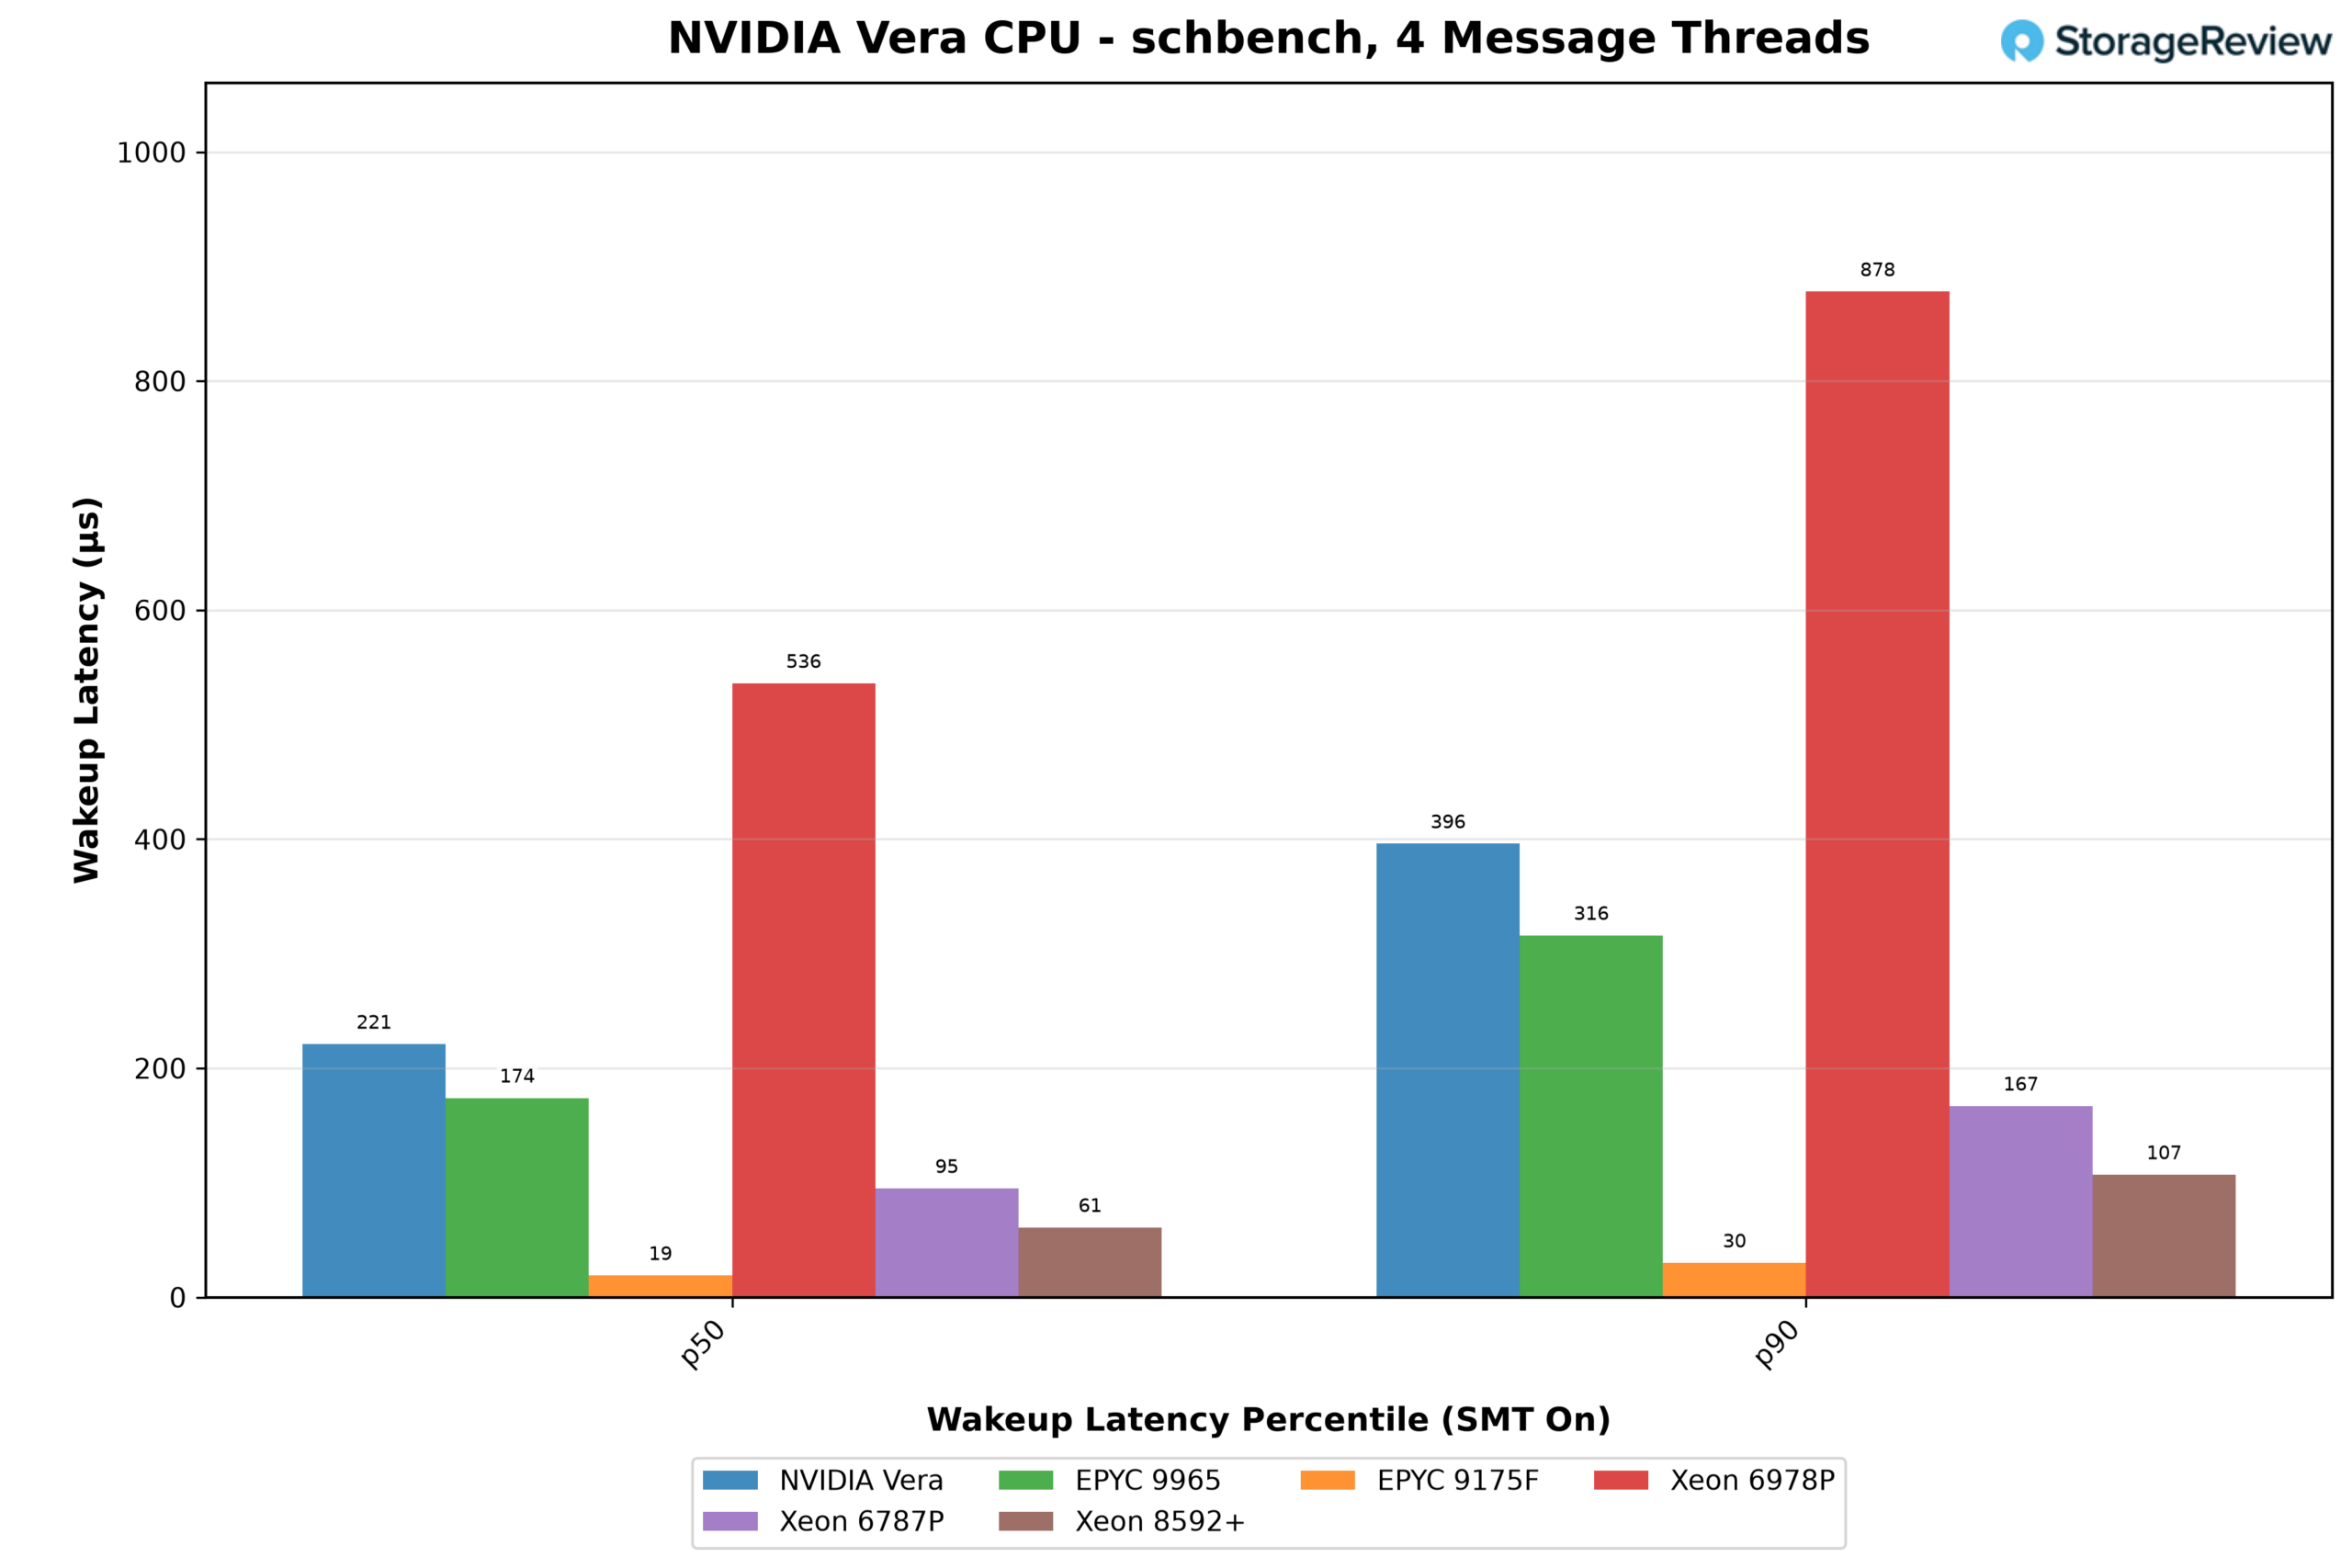
Cu 4 fire de execuție (thread-uri) de mesaje, latența mediană de activare a Verei a fost de 221µs, iar p90 de 396µs, mai mare decât a oricărui sistem, cu excepția Xeon 6978P, la 536µs și 878µs. Cele mai mici mașini și-au activat thread-urile cel mai rapid, EPYC 9175F cu 32 de nuclee la 19µs, iar Xeon 8592+ cu 128 de nuclee la 61µs.
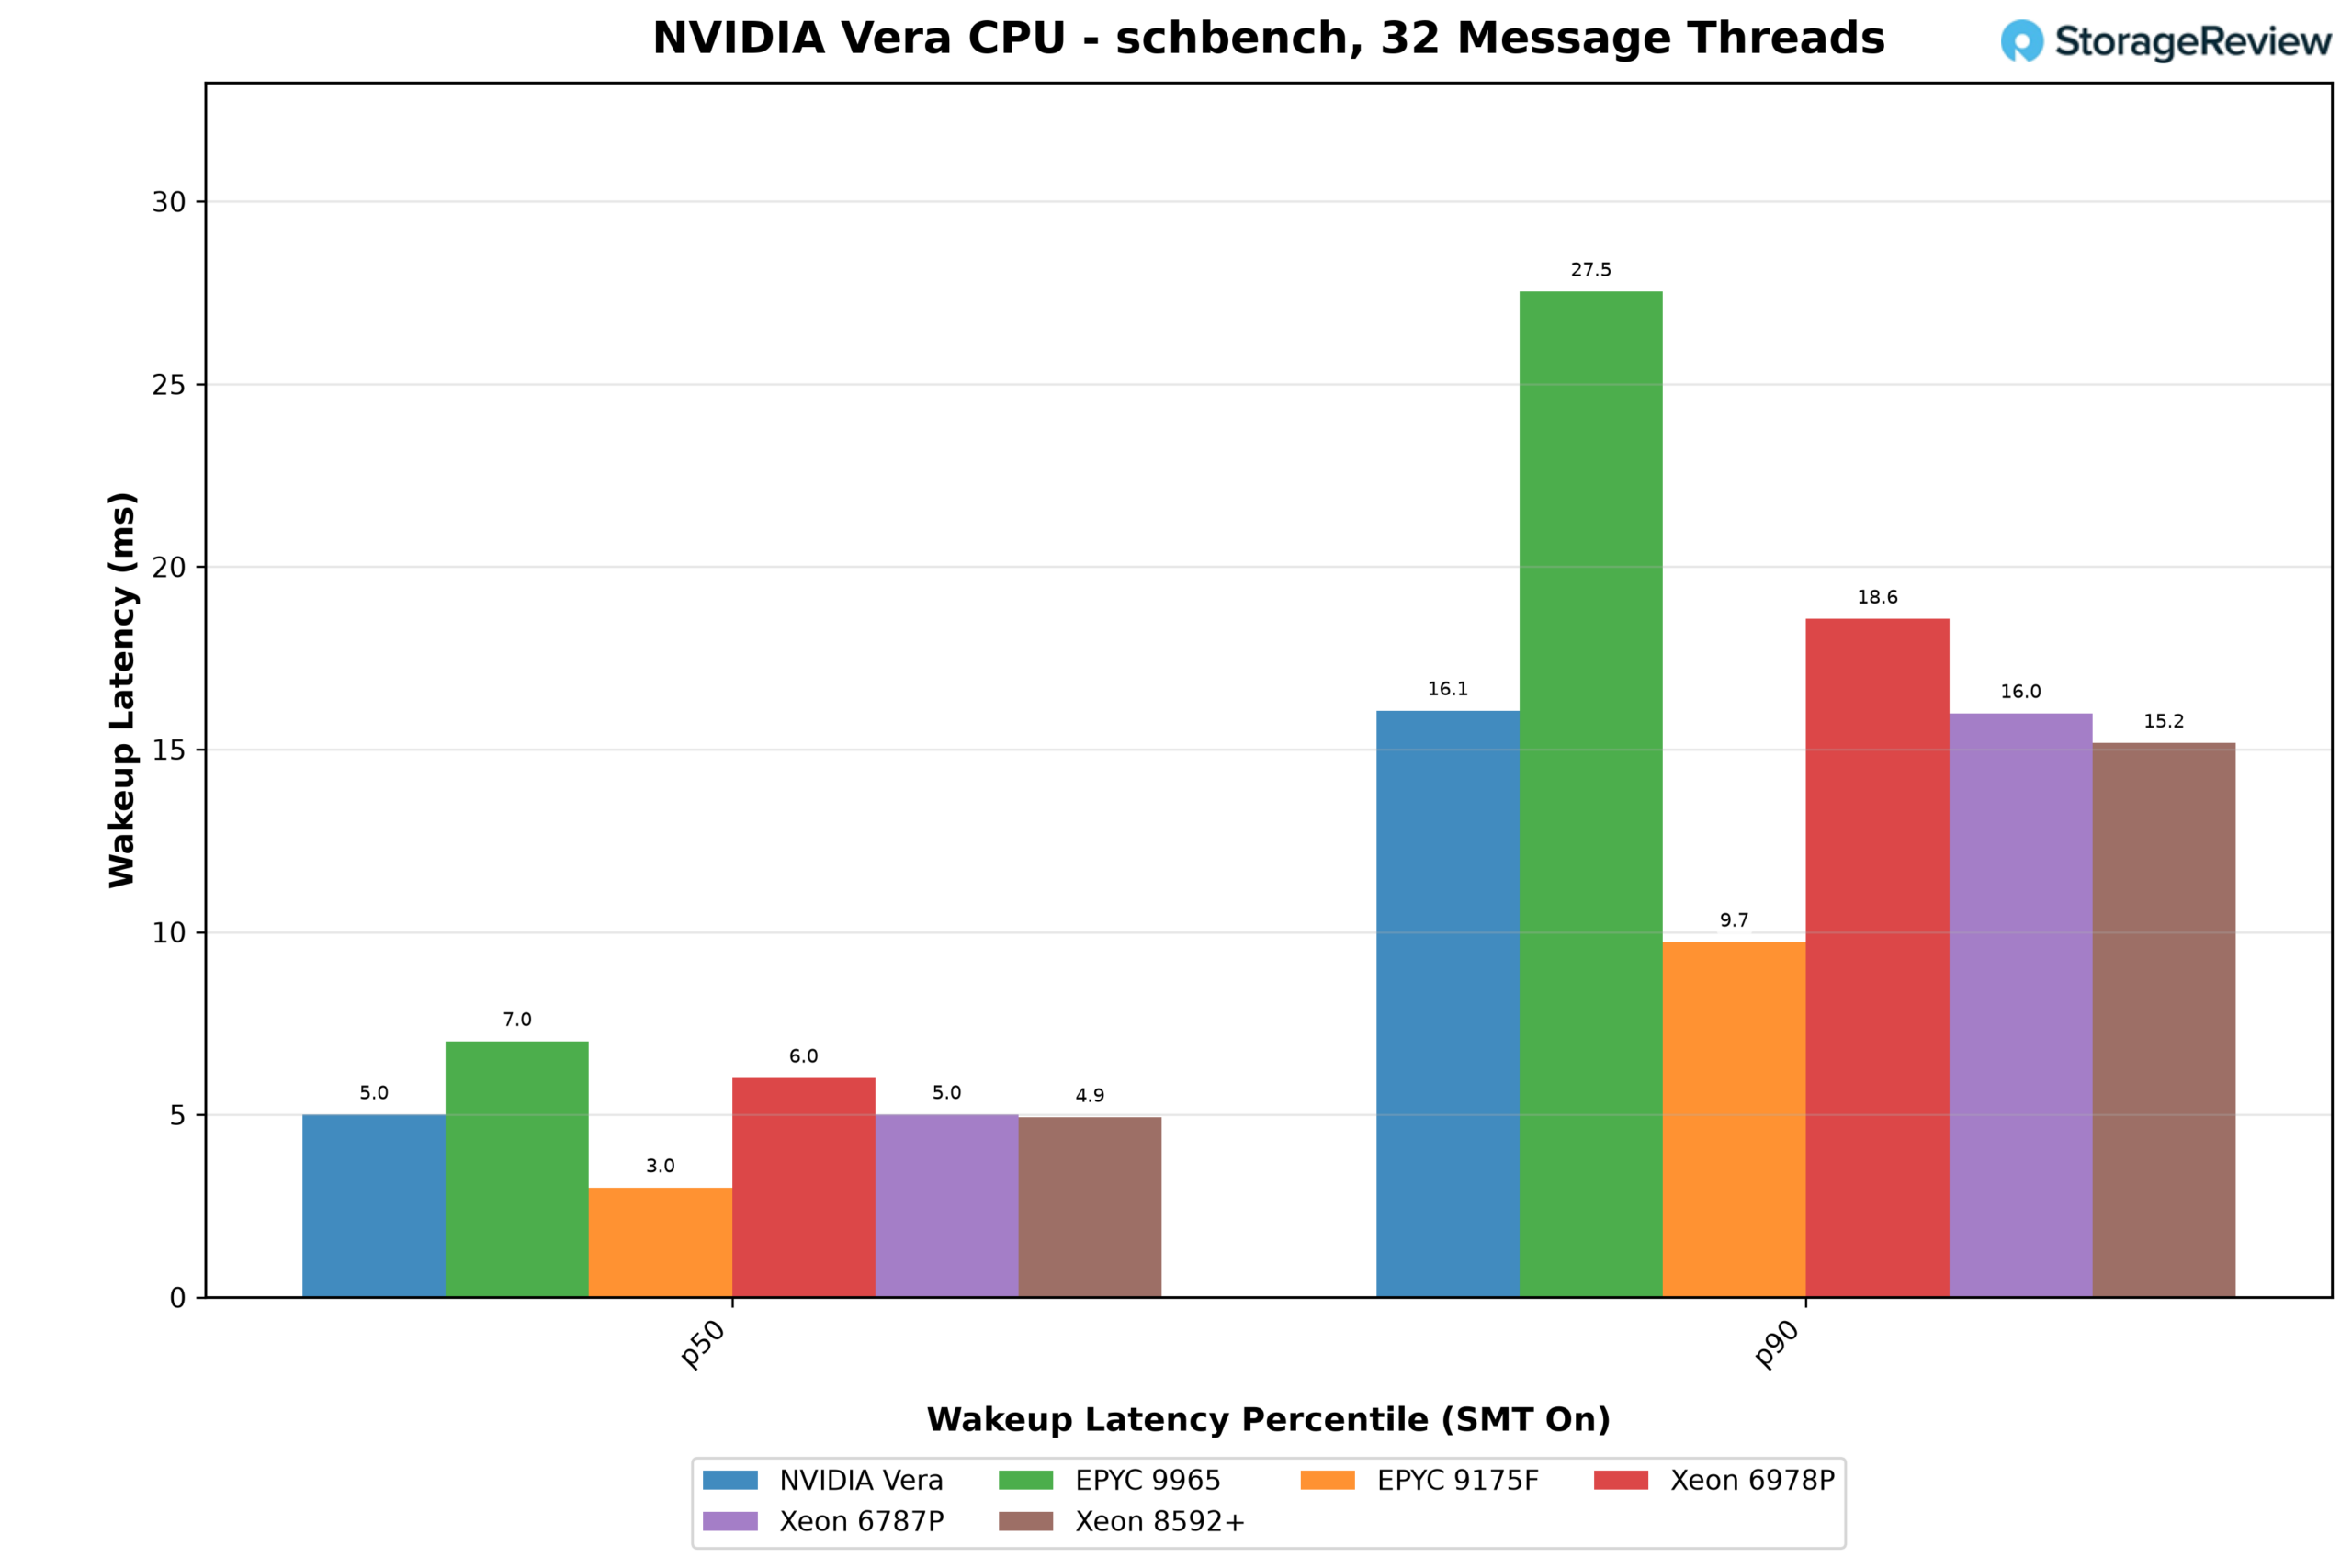
Suprasolicitat cu 32 de fire de mesaje, Vera s-a mutat la mijlocul plutonului. Mediana sa de 5.0 ms și p90 de 16.1 ms au fost la același nivel cu Xeon 6787P și 8592+ și înaintea atât a Xeon 6978P, cât și a EPYC 9965, care au atins 27.5 ms la p90. Doar 9175F a fost evident mai rapid, la 3.0 ms și 9.7 ms.
Compilarea kernelului Linux
Compilarea allmodconfig a kernelului Linux este singurul rezultat din această secțiune pe care nu îl clasificăm. Vera compilează arborele kernelului arm64, care include un set diferit de module și drivere față de arborele x86-64 al celorlalte sisteme compilate, și nu am încercat o compilare încrucișată.
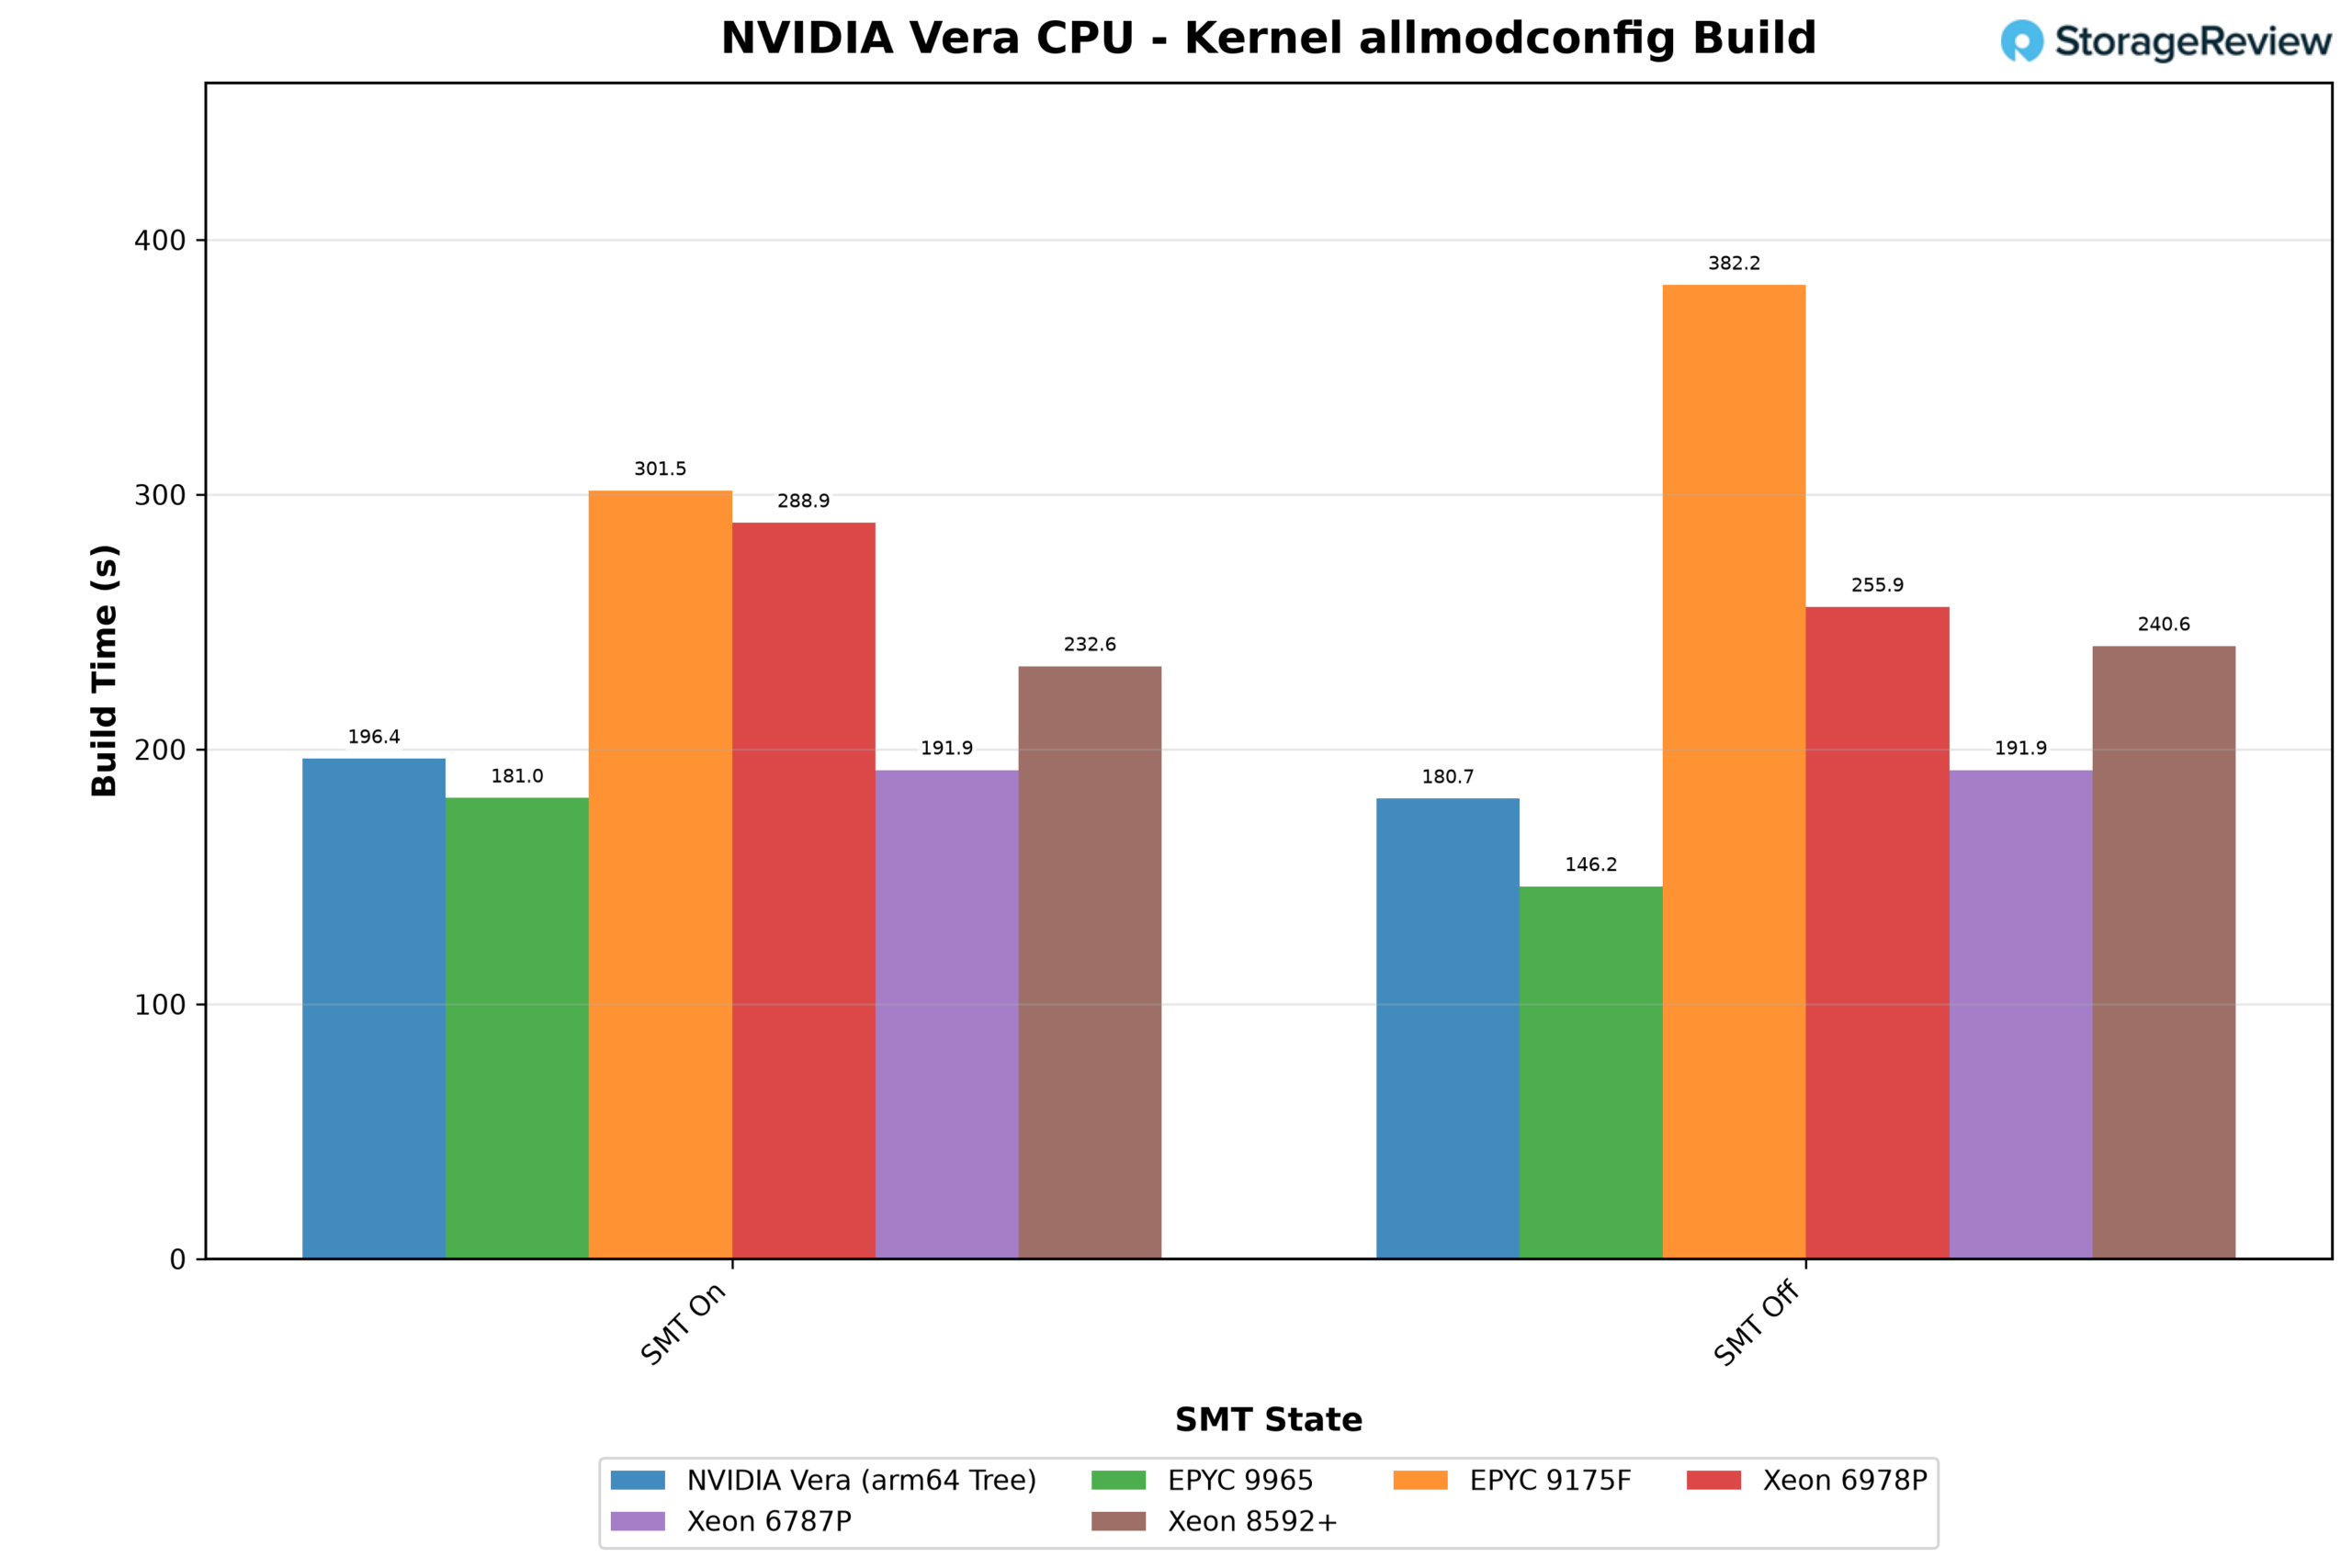
Vera și-a construit arborele în 180.7 secunde cu SMT dezactivat și în 196.4 secunde cu SMT activat, așa că firele de execuție suplimentare au încetinit construcția. Pe sistemele x86, fiecare construind un arbore nativ, timpii au variat de la 146.2 secunde pe EPYC 9965 cu SMT dezactivat la 382.2 secunde pe EPYC 9175F cu 32 de nuclee.
Extensia HammerDB
Pentru testele bazei de date, l-am adus pe Steve Shaw, creatorul și responsabilul de întreținere al HammerDB. Shaw a rulat sarcina de lucru TPROC-C a HammerDB, un benchmark OLTP derivat din TPC-C, dar care nu este comparabil cu rezultatele TPC publicate, pe serverul Vera, Dell PowerEdge R7725 cu EPYC 9965 și PowerEdge R770 cu Xeon 6787P. El a testat cinci motoare open-source pe fiecare: MariaDB 12.3.3 și 13.0.2, MySQL 26.7.0, VillageSQL 0.0.7 și PostgreSQL 18.6. Dimensiunea bazei de date a fost scalată în funcție de numărul de nuclee, ajungând la 16 depozite de date per nucleu fizic sau 1,408 pentru un singur socket Vera.
Fiecare motor a funcționat pe un socket și pe două, procesoarele celui de-al doilea socket fiind deconectate pentru rulările pe un singur socket, iar fiecare sistem s-a descurcat mai bine pe unul, tipic pentru performanța bazelor de date. În toate cele 15 perechi, adăugarea celui de-al doilea socket a redus debitul maxim cu 23% până la 47% și cu 29% până la 45% pe Vera. Shaw a constatat de mult timp că bazele de date open-source ating un plafon de scalare înainte de a rămâne fără nuclee. Dincolo de acest punct, menținerea coerenței cache-urilor pe două socketuri costă mai mult decât adaugă nucleele suplimentare. Prin urmare, ne concentrăm pe rezultatele pe un singur socket, prezentate în graficul de mai jos.
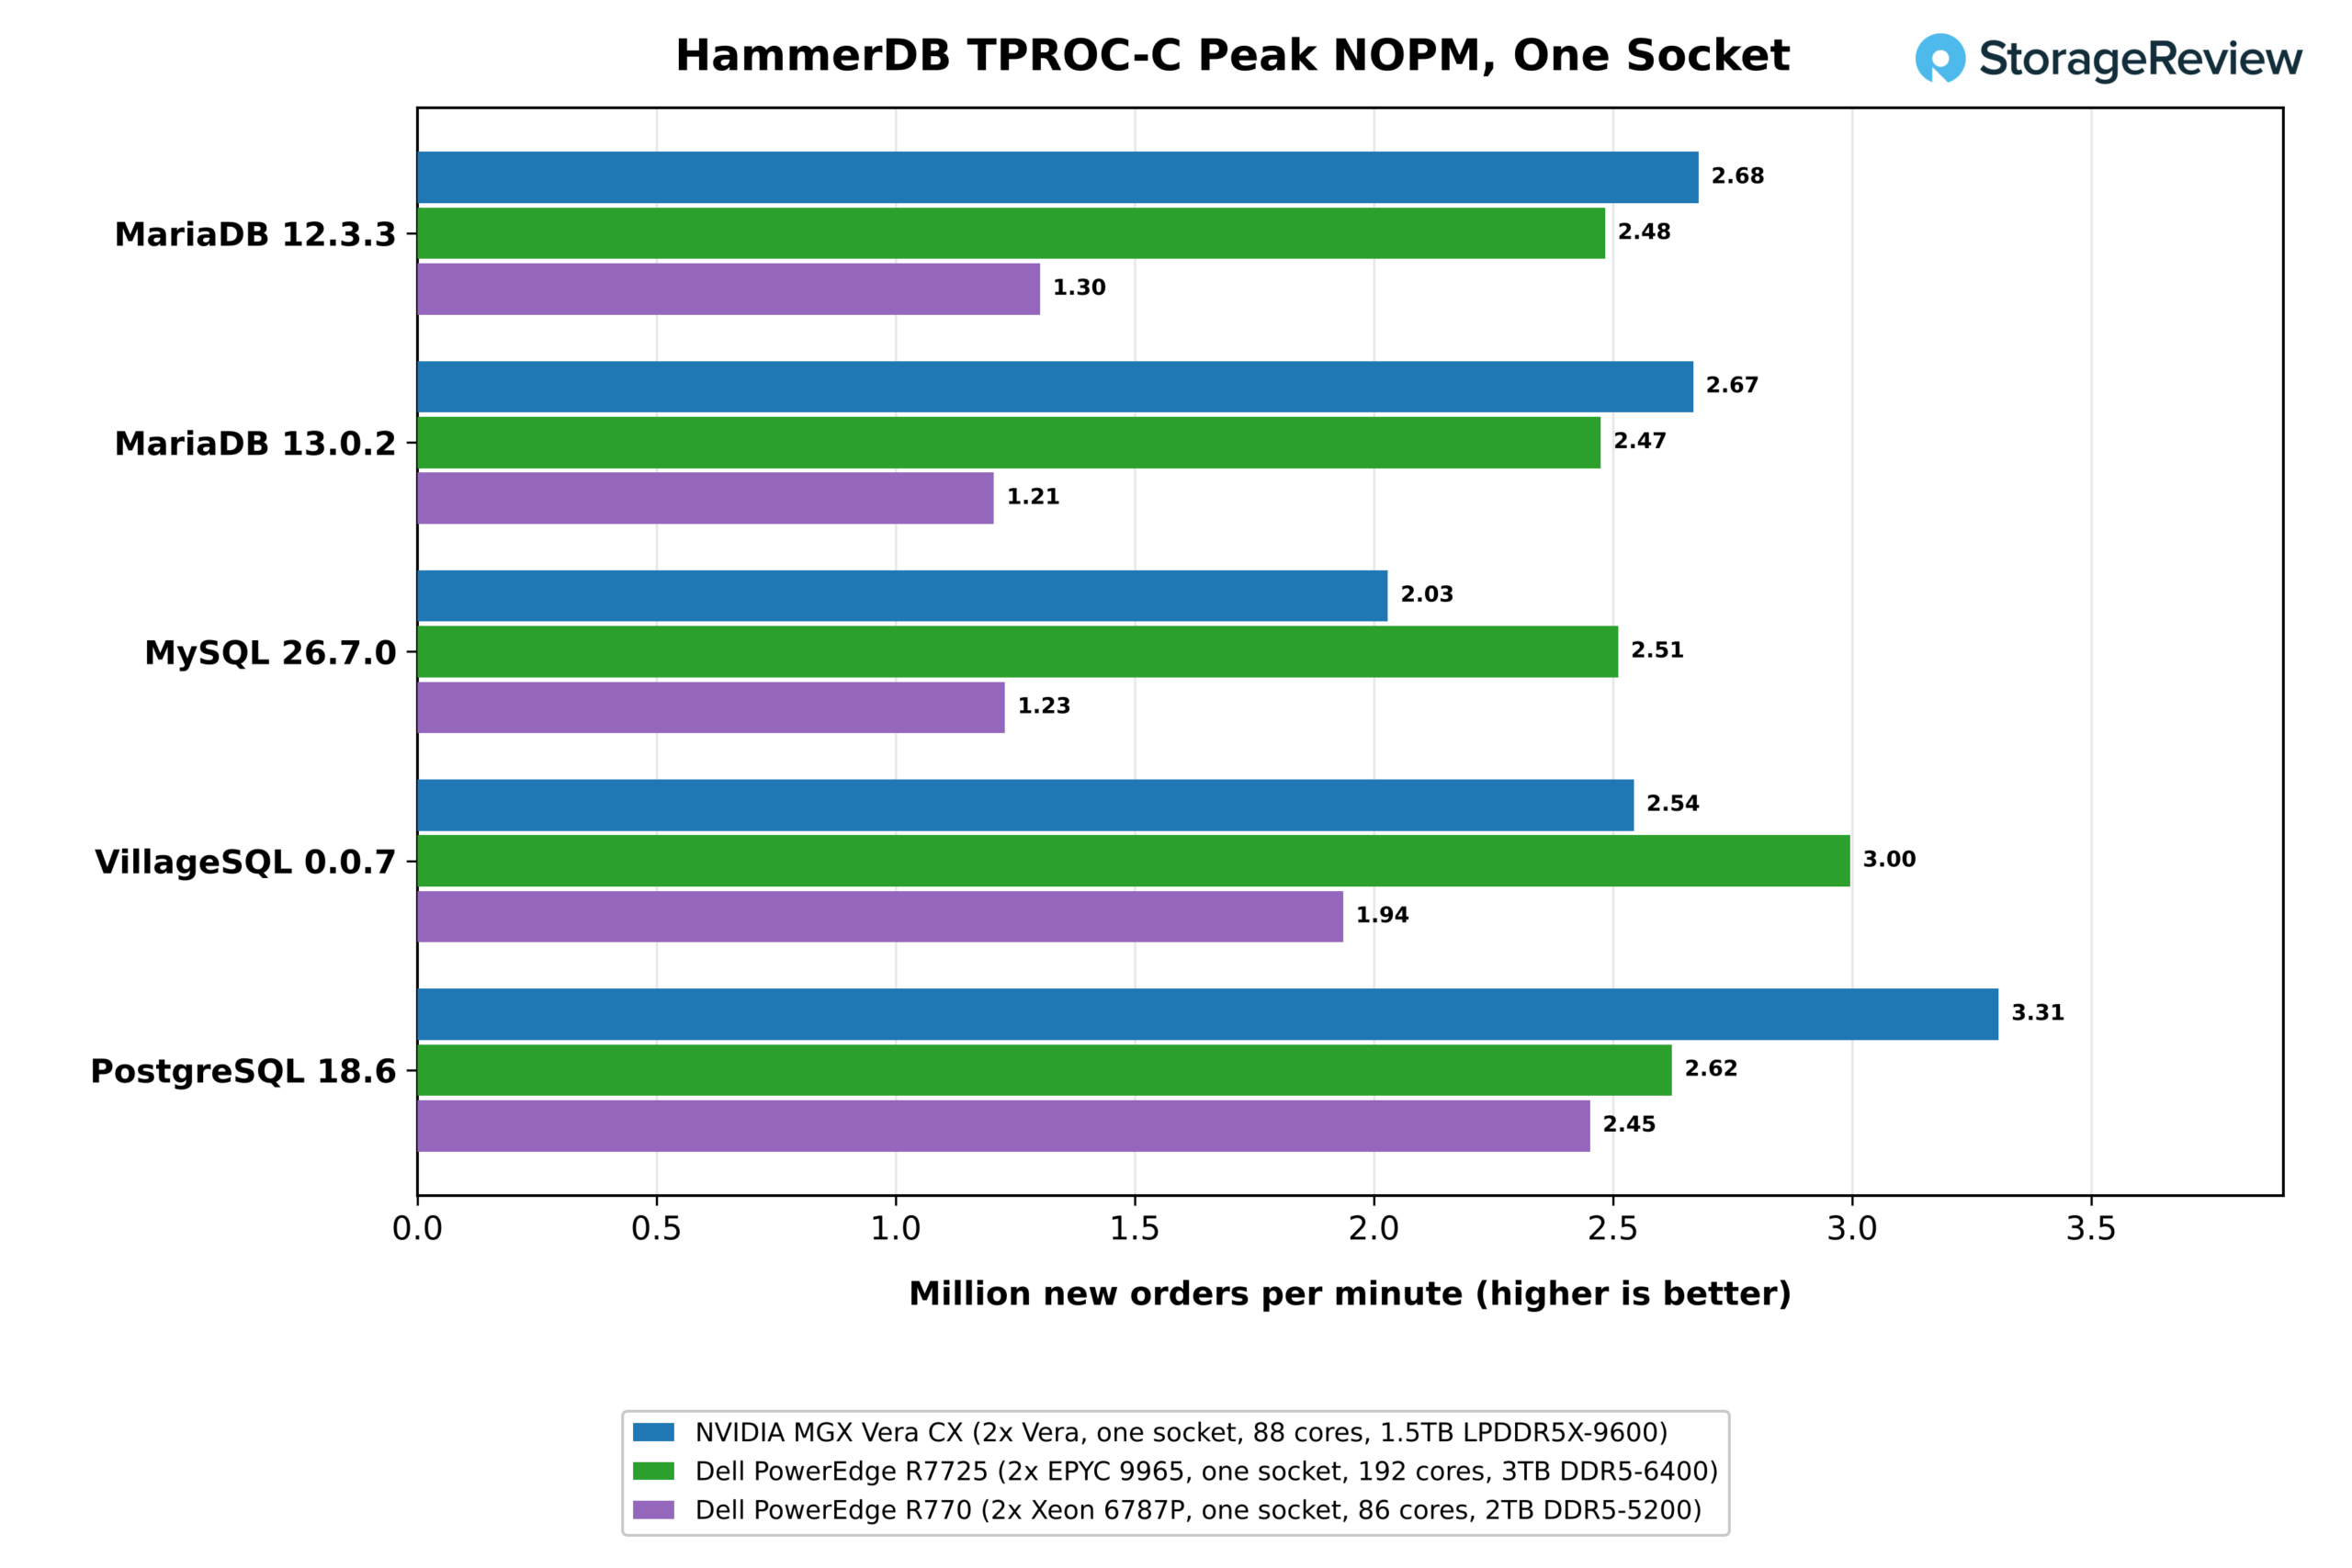
Pe un socket, 88 de nuclee Vera au condus pe trei dintre cele cinci motoare. PostgreSQL 18.6 a oferit Verei cea mai mare marjă, la 3.31 milioane de comenzi noi pe minut (NOPM) cu 128 de utilizatori virtuali, comparativ cu 2.62 milioane pe socketul EPYC 9965 cu 192 de nuclee și 2.45 milioane pe Xeon 6787P cu 86 de nuclee. Ambele versiuni MariaDB au fost, de asemenea, disponibile pentru Vera, cu 2.68 milioane și 2.67 milioane, comparativ cu 2.48 milioane și 2.47 milioane pe EPYC. AMD a menținut MySQL 26.7.0 la 2.51 milioane față de 2.03 milioane pentru Vera, iar VillageSQL la 3.00 milioane față de 2.54 milioane. Xeon a fost în urma tuturor celor cinci motoare cu 1.21 milioane până la 2.45 milioane, iar rezultatele MariaDB au fost mai puțin de jumătate din cele ale Verei.
Separarea este probabil rezultatul modului în care fiecare motor se scalează. Modelul proces-per-conexiune al PostgreSQL și InnoDB al MariaDB distribuie ambele munca pe mai multe nuclee cu trafic intens de memorie partajată, care se bazează pe lățimea de bandă locală de peste 1 TB/s pe care fiecare socket Vera o susține în STREAM. MySQL și VillageSQL au lovit mai devreme blocarea internă a platformei, așa că rezultatele lor depind mai mult de cât de repede fiecare nucleu șterge o secțiune critică, iar aici iese 9965 în avantaj. După runda din octombrie, Shaw a considerat Arm cea mai rapidă platformă per total, spunând că Arm „a ajuns cu siguranță ca un server de baze de date competitiv”, deși a adăugat că un EPYC cu 96 de nuclee și un singur socket pe care îl testase anterior ar putea să o depășească.
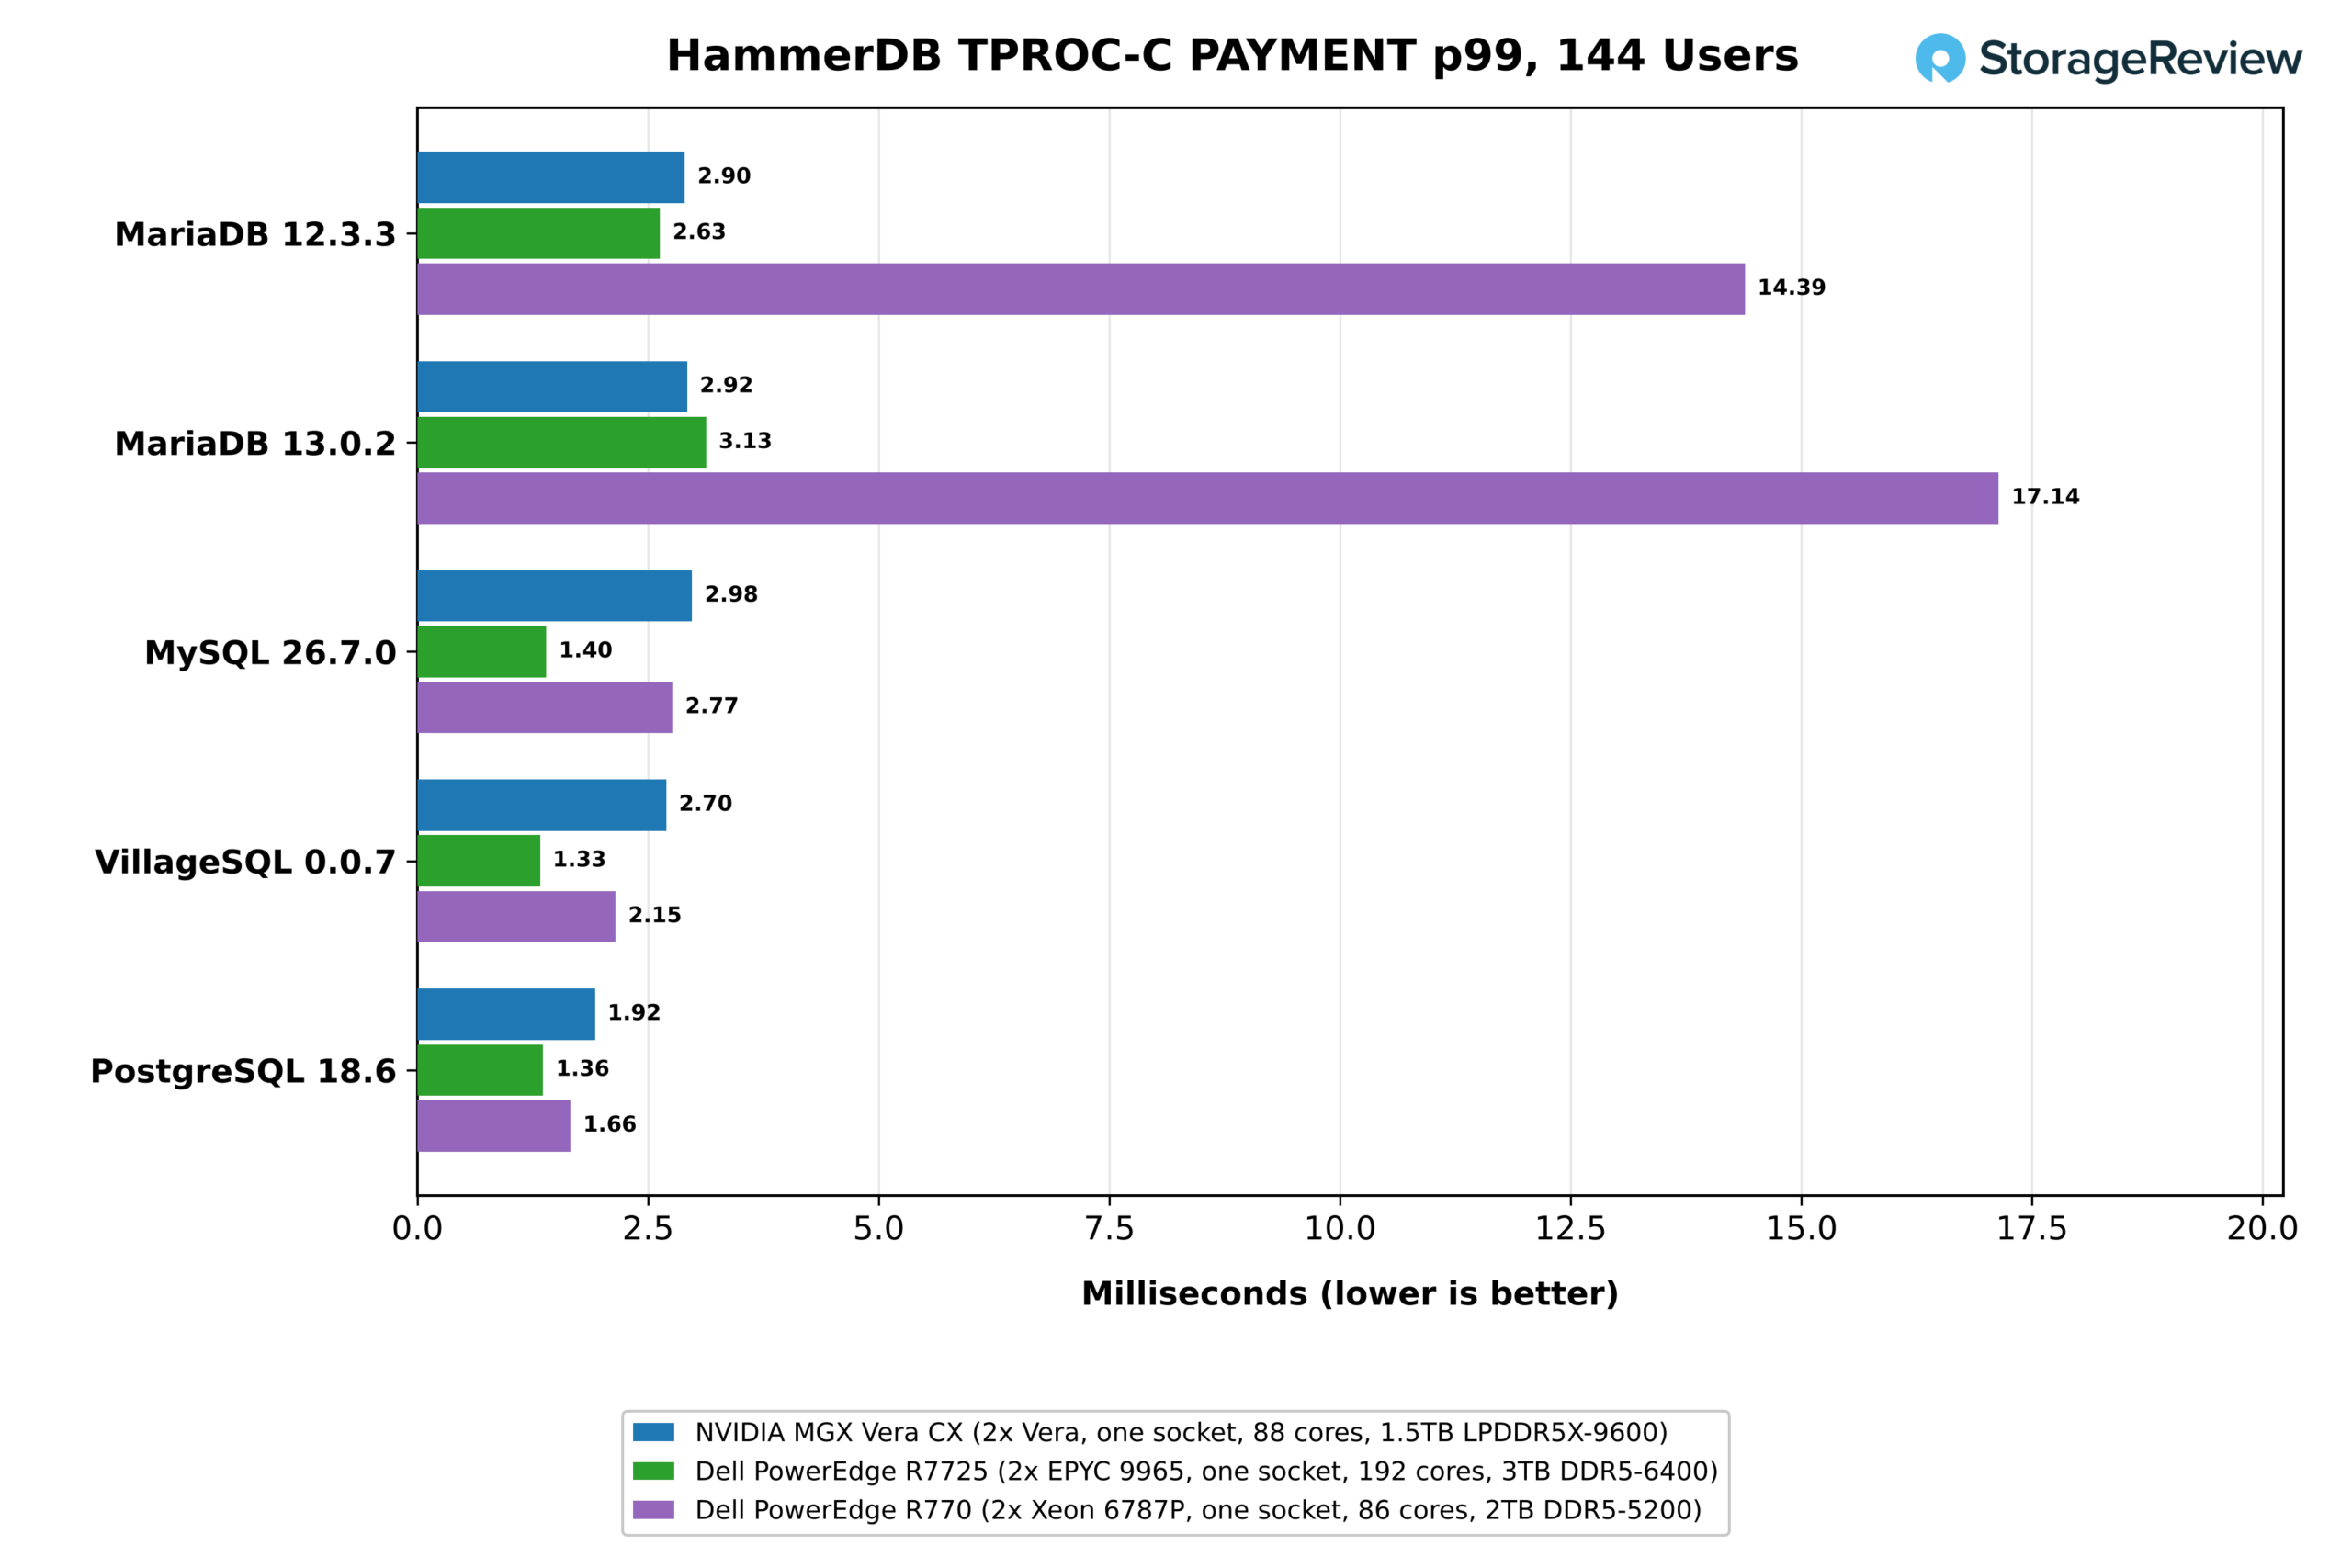
Latența finală la o sarcină corespondentă de 144 de utilizatori virtuali arată aceeași împărțire. Latența PAYMENT p99 a Verei a variat de la 1.92 ms pe PostgreSQL la 2.98 ms pe MySQL. EPYC 9965 a menținut MySQL, VillageSQL și PostgreSQL între 1.33 ms și 1.40 ms, cu 29% până la 53% mai mică decât Vera, dar cei 3.13 ms pe MariaDB 13.0.2 au fost în urma celor 2.92 ms ai Verei. Latența finală MariaDB a Xeon 6787P, la 14.4 ms și 17.1 ms, a fost de câteva ori mai mare decât a fiecăreia, în conformitate cu debitul său mult mai mic la aceeași sarcină. Transferul de tip lock handoff în interiorul motoarelor determină probabil la valorile mai mari ale latenței Verei, reflectând rezultatele Valkey, unde cererile trimise individual au favorizat, de asemenea, AMD.
Runda din noiembrie a pus la încercare intuiția lui Shaw. El a rulat aceeași sarcină de lucru pe un socket al noului AMD EPYC 9996 cu 256 de nuclee și pe un EPYC 9686F cu 96 de nuclee, cu socketul Vera în comparație. 9996 și Vera au schimbat motoarele, Vera menținând PostgreSQL și MariaDB, iar EPYC conducând la latență, iar partea cu 96 de nuclee a depășit Vera în clasamentul PostgreSQL. Rezultatele complete sunt în recenzia noastră AMD EPYC Venice.
„Am fost cu adevărat impresionat de performanța bazelor de date open-source pe NVIDIA Vera. Este minunat să vedem Arm concurând la vârful performanței bazelor de date și aducând o alternativă convingătoare pe piața întreprinderilor”, a declarat Steve Shaw, creatorul și administratorul HammerDB, după rundă.
Concluzie
Vera nu este cel mai rapid procesor din fiecare categorie, deoarece AMD răspunde fiecărei categorii de procesoare cu un component dedicat. EPYC 9175F, optimizat pentru frecvență, este construit pentru viteză per nucleu și totuși câștigă sarcini de lucru care recompensează un ceas rapid, de la nbody și AES single-thread din Python până la solicitări Valkey individuale. EPYC 9965 este construit pentru debit și câștigă munca care se scalează în funcție de numărul de nuclee, inclusiv GROMACS, 7-Zip și AES all-thread și numărul de fragmente Valkey care se potrivesc într-un socket.
Vera se diferențiază prin comparație și prin cât de aproape se apropie de fiecare dintre acești specialiști pe terenul lor. Pe un singur fir de execuție, a egalat sau a depășit 9175F la calculul numerelor întregi și la două dintre cele trei teste Python, comprimând cu 12% mai rapid pe 7-Zip și rulând go și regex_compile cu 15% și 25% mai rapid, în timp ce a rămas în urmă la codarea în virgulă mobilă și la crypto.
Pe întregul sistem, a atins 63% până la 72% din ratele 7-Zip all-thread ale modelului 9965 și a finalizat mesh-ul OpenFOAM mediu la 12% din aceasta, apoi a avansat odată ce memoria a preluat controlul, pe mesh-ul mare și pe ClickBench. Faptul că a rămas atât de aproape de liderul per-core pe un thread și de liderul de randament pe întregul sistem este ceea ce face din Vera un procesor de uz general atât de puternic. Pentru cumpărătorii care își doresc o platformă pentru segmentul de mijloc al pieței, fără a renunța la prea multe la niciuna dintre capete, este o ofertă extrem de puternică.
Vera oferă o lățime de bandă de memorie mult mai mare decât orice sistem x86 pe care l-am testat. Două socket-uri Vera au susținut 2,073 GB/s pe STREAM Triad, de 2.3 ori mai bun server DDR5 de aici, iar NVLink-C2C menține această lățime de bandă accesibilă între socket-uri: nucleele Vera citesc memoria celuilalt socket la 677 GB/s, mai mult decât orice socket x86 citește din memoria locală.
Au urmat sarcini de lucru limitate de memorie: rețeaua mare OpenFOAM a rezolvat probleme de 1.44 ori mai rapid decât pe EPYC 9965, rularea la cald a ClickBench s-a încheiat în 2.09 secunde față de 2.70, setul de lucru Valkey de 256 GB a rulat cu 34% mai rapid, iar pe un socket Vera a fost mai rapid decât HammerDB pe PostgreSQL și ambele versiuni MariaDB. Costul legăturii este latența: o citire la distanță durează de aproximativ 2.1 ori mai mult decât una locală, față de 1.75x pe EPYC 9175F, așadar plasarea cu funcție NUMA și paginile uriașe contează în continuare pe Vera.
Punctele slabe sunt surprinzător de mici și se datorează direct designului. Șase pipe-uri SVE2 pe 128 de biți nu se potrivesc cu unitățile AVX-512 pe 512 de biți din codul scris special pentru ele, așa că o porțiune de 16 nuclee de Vera a rulat GROMACS benchMEM la jumătate din rata lui 9175F și la două treimi din rata lui 9965. Având în vedere că doar două dintre aceste pipe-uri gestionau cripto, un singur nucleu Olympus a criptat AES-256-GCM la aproximativ o treime din rata lui 9175F.
Modul în care se va dezvolta Vera va depinde în mare măsură de partenerii OEM. Dell PowerEdge R8822 a început să fie livrat în octombrie, iar rack-ul CPU Vera M9882 va fi programat pentru primul trimestru al anului 2027, ProLiant Compute DL394 Gen12 de la HPE va sosi în această toamnă, Supermicro are rack-ul său Vera cu 256 de procesoare disponibil pentru ofertă, cu sisteme Vera 1U și 2U răcite cu aer în gamă, iar ASUS, ASRock Rack, QCT, GIGABYTE, MSI, Compal, Foxconn, Pegatron, Wistron și Lenovo au prezentat toate modele Vera. Oracle Cloud are instanțe Vera disponibile în general , urmate de CoreWeave, Nebius, Lambda și altele.
Vera este primul procesor de server Arm pe care l-am testat și care se încadrează în aceeași categorie ca flagship-urile x86 în ceea ce privește funcționalitățile de uz general și primul procesor de la orice furnizor care oferă o lățime de bandă de memorie de 2 TB/s într-o cutie cu două socketuri, răcită cu aer. Pentru segmentul de mijloc al pieței, este o opțiune credibilă astăzi, iar NVIDIA intră pe piața procesoarelor cu un subsistem de memorie pe care nimeni altcineva nu îl oferă. Pentru HPC cu vectori puternici și servicii criptografice, specialiștii x86 își mențin conducerea. Vom supune sistemele OEM prin aceeași suită pe măsură ce ajung în laborator, începând cu rolul de sandbox agentic pentru care NVIDIA a construit acest procesor.
De la această recenzie, AMD EPYC Venice a ajuns în laboratorul nostru, iar recenzia noastră AMD EPYC Venice SP7 și Dell PowerEdge R9825 au plasat EPYC 9996 cu 256 de nuclee în aceeași suită împotriva Vera, Vera având cel mai recent firmware.
Clasament: NVIDIA Vera deține premiul pentru cea mai bună implementare ARM în clasamentul nostru privind cele mai bune servere.


 Amazon