

Можно сказать, что процессоры AMD появились первыми: мини-ПК и ноутбуки Strix Halo поставлялись со 128 ГБ унифицированной памяти задолго до появления NVIDIA. Но категория настольных компьютеров для локального ИИ — это то, что NVIDIA фактически создала, поместив суперчип Grace Blackwell в литровый корпус и назвав его DGX Spark . Идея была проста: машина для разработчиков с достаточным объемом унифицированной памяти для хранения моделей, которая будет стоять на столе, а не использоваться в облаке. AMD Ryzen AI Halo — это ответ AMD на эту идею. AMD анонсировала его вместе с серией Ryzen AI Max PRO 400 в мае 2026 года; предварительные заказы открылись в июне эксклюзивно через Micro Center , а в магазинах он появился 10 июля. Ryzen AI Halo имеет схожие габариты, 128 ГБ унифицированной памяти, цену в 3,999 долларов и короткий список решений, которые делают его значительно отличающимся от Spark.
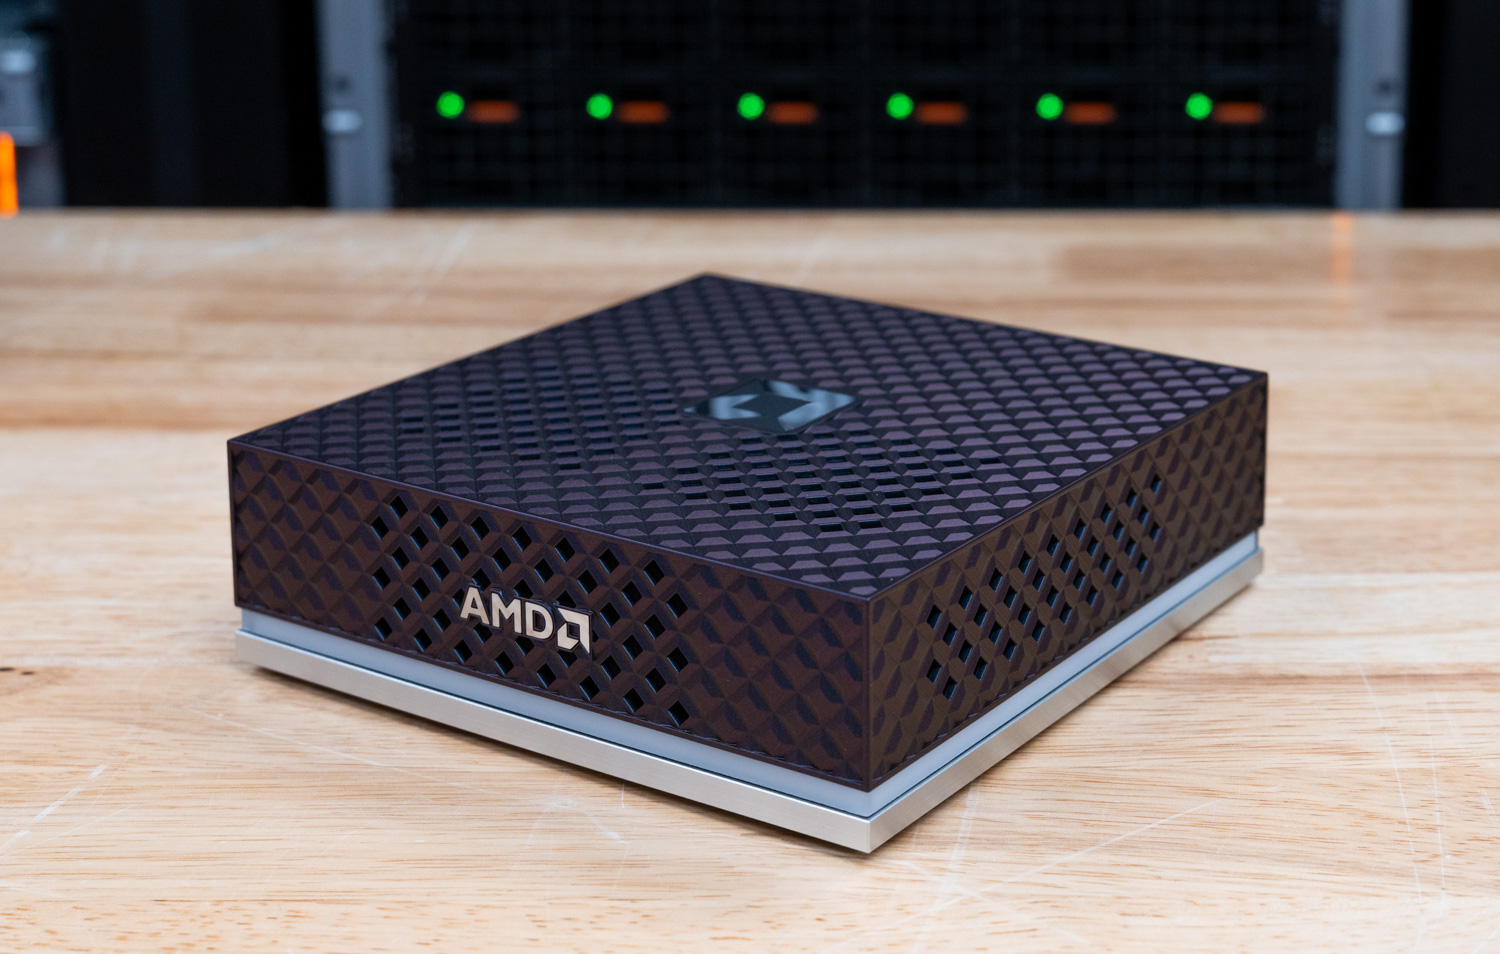
AMD позиционирует Halo как свою первую платформу для разработчиков ИИ, предоставляющую разработчикам быстрый и простой способ создания и запуска ИИ локально. Под капотом находится Ryzen AI Max+ 395, 16-ядерный 32-поточный процессор «Zen 5» с интегрированной графикой Radeon 8060S (40 вычислительных блоков RDNA 3.5) и нейронным процессором XDNA 2 с производительностью 50 TOPS, что в совокупности обеспечивает платформу, заявленную AMD как производительность ИИ до 126 TOPS. 128 ГБ памяти LPDDR5x работают на частоте 8000 МТ/с, обеспечивая пропускную способность 256 ГБ/с, а вся платформа питается от одного входа USB-C мощностью 120 Вт. AMD заявляет, что этого объема памяти достаточно для хранения моделей с количеством параметров до 200 миллиардов в памяти устройства. Это полноценная мини-рабочая станция x86, что и является ключевым отличием.
Разница заключается в Windows. На Spark работает только Linux-ориентированная ОС DGX от NVIDIA; Halo же загружает Windows 11 или образ Linux для разработчиков от AMD на том же оборудовании. Поддержка Windows была самым распространенным запросом от людей, присматривающихся к Spark, и это меняет целевую аудиторию устройства. Собственное позиционирование AMD подтверждает это: Windows и Linux против Spark, работающего только с Linux ( по крайней мере, на сегодняшний день ).
Еще три решения отличают Halo от Spark, и каждое из них устраняет недостатки предыдущей модели. Halo использует стандартный SSD M.2 2280, а не менее распространенный 2242, как в Spark, что открывает гораздо больший выбор вариантов замены накопителя, включая 8 ТБ, для тех, кто хочет его заменить. В обеих операционных системах предустановлен максимальный объем переменной графической памяти, поэтому большие модели загружаются без ручной настройки. Кроме того, корпус оснащен светящимся индикатором состояния, что является небольшим исправлением темных, не подсвеченных блоков Spark, которые получали некоторые покупатели в зависимости от производителя. Цена подхода AMD видна на задней панели, где отсутствует высокоскоростная коммутационная матрица, только 10 Гбит/с Ethernet, что ограничивает возможности многоузловой кластеризации. Это компромиссы, и они определяют рабочие нагрузки, для которых предназначена эта машина, еще до проведения каких-либо тестов.
Что касается цены, здесь важны нюансы. Halo с SSD на 2 ТБ стоит 3,999 долларов, что соответствует рыночной цене базовой системы класса Spark. Сравнение зависит от того, о какой именно модели Spark идёт речь. Собственная модель NVIDIA DGX Spark с более ёмким накопителем сейчас стоит около 4,700 долларов, что связано с дефицитом LPDDR5X и NAND-памяти. Базовые системы Grace Blackwell от ASUS и других производителей до сих пор продаются примерно за 4,000 долларов и сегодня представлены на Amazon (партнерская ссылка). По сравнению с базовыми моделями в своей категории, Halo находится на одном уровне с конкурентами, и его преимущества основаны скорее на вышеупомянутых решениях, чем на снижении цен на аналогичные продукты.
Мы протестировали Halo с помощью локального пакета программ StorageReview AI на Windows и Linux, и результаты представлены вместе с описанием конструкции и анализом программного обеспечения на протяжении всего обзора.
Основные выводы
- Альтернатива для архитектуры x86 с двумя ОС: Ryzen AI Halo — единственное устройство в категории Spark, которое загружает Windows 11 или Linux на полноценной платформе x86, и стоит оно 3,999 долларов с SSD на 2 ТБ, в то время как DGX Spark Founders Edition стоит 4,699 долларов.
- Память для хранения больших моделей: 128 ГБ унифицированной памяти LPDDR5x-8000 со скоростью 256 ГБ/с поддерживают модели с локальным количеством параметров до 200 миллиардов, а переменная графическая память предварительно настроена таким образом, что большие модели загружаются без ручной настройки.
- Самый мощный процессор Ryzen AI Max+ 395, который мы тестировали: Ноутбук Halo превзошел HP Z2 Mini G1a и ZBook Ultra G1a почти во всех тестах Windows, включая 37 316 баллов в многоядерном Cinebench R23, 184.2 GIPS в 7-Zip, а также лидирующие показатели в Procyon AI для генерации текста (Phi 1,192) и генерации изображений (SD 1.5 FP16 937).
- Победы процессора и поражения в задачах вывода результатов по сравнению со Spark: На Linux Halo превзошла DGX Spark по производительности процессора, сжимая файлы на 11% быстрее и распаковывая на 38% быстрее в 7-Zip, а также завершая компиляцию LLVM на 14% раньше, но отставала в 2-4 раза в большинстве сценариев обслуживания vLLM при высокой параллельности, достигая 8.8-кратного преимущества в работе с GPT OSS 120B, требующей интенсивного предварительного заполнения.
- Достаточное хранилище данных, скромные сетевые возможности: Стандартный отсек для M.2 2280 позволяет устанавливать накопители объемом до 8 ТБ, хотя платформа по своей конструкции понижает уровень встроенного Micron 4600 Gen5 до Gen4, а единственный порт 10GbE без высокоскоростной коммутационной матрицы исключает возможность создания многоузловых кластеров, которые обеспечивает технология ConnectX-7 200G в Spark.
Характеристики
| Параметр | Система AMD Ryzen AI Halo |
|---|---|
| процессор | |
| ЦП | Процессор AMD Ryzen™ AI Max+ 395 16 ядер / 32 потока (архитектура Zen 5) |
| GPU : | Интегрированная графика AMD Radeon™ 8060S 40 вычислительных блоков (архитектура RDNA™ 3.5) |
| НПУ | AMD XDNA™ 2 NPU |
| Память | |
| Тип памяти | LPDDR5x |
| Емкость памяти | 128GB |
| Скорость памяти | 8000 МТ / с |
| Пропускная способность памяти | 256GB / s |
| Память | |
| Память | Твердотельный накопитель M.2 NVMe SSD (SED) объемом 2 ТБ |
| Сеть и подключение | |
| Ethernet | 1 × 10GbE |
| Wi-Fi | Wi-Fi 7 |
| Блютуз | Bluetooth 5.4 |
| Ввода / вывода | |
| USB | 3 разъема USB-C, 1 разъем USB-C (вход питания) |
| Выходной сигнал дисплея | 1 × HDMI 2.1b |
| Система | |
| TDP | 120 Вт |
| Operating System | Linux или Windows 11 |
| Габаритные размеры: | 150 × 150 × 45.4 мм (5.9 × 5.9 × 1.79 дюймов) |
| Вес | Менее 1.2 кг (2.65 фунтов) |
Сборка и дизайн AMD Ryzen AI Halo
Система AMD Ryzen AI Halo использует компактный форм-фактор, похожий на «NVIDIA Spark», размером всего 150 × 150 × 45.4 мм и весом менее 1.2 кг (2.65 фунта). Алюминиевый корпус имеет агрессивный геометрический рисунок вентиляции сверху и спереди, что придает системе выразительный внешний вид и максимально увеличивает приток воздуха в систему охлаждения. Несмотря на свои небольшие габариты, платформа разработана как полноценная настольная рабочая станция для ИИ, способная обрабатывать рабочие приложения, локальный вывод LLM и задачи разработки ИИ.
Фронт
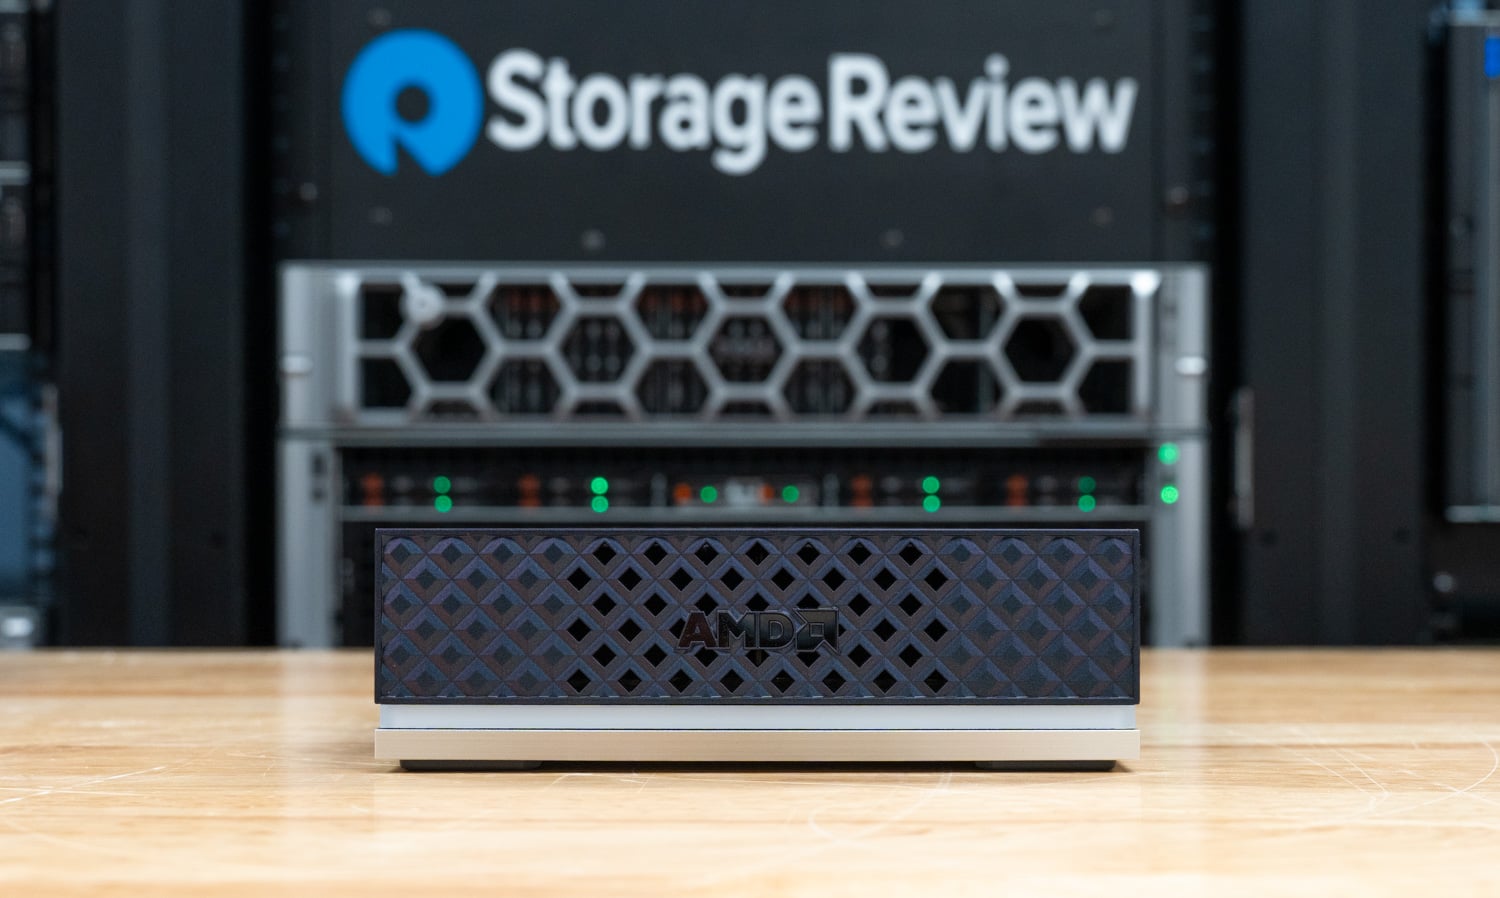
Передняя панель системы намеренно выполнена в минималистичном стиле, представляя собой почти исключительно большую сетчатую вентиляционную решетку, занимающую всю ширину корпуса. Вместо размещения портов на передней панели, AMD использует эту область для циркуляции воздуха, позволяя холодному воздуху поступать в систему через большой узорчатый воздухозаборник, при этом передняя панель остается свободной от лишних элементов. Серебристый акцент вдоль нижней части корпуса создает тонкий визуальный контраст с матовым черным корпусом.
Задний ввод-вывод
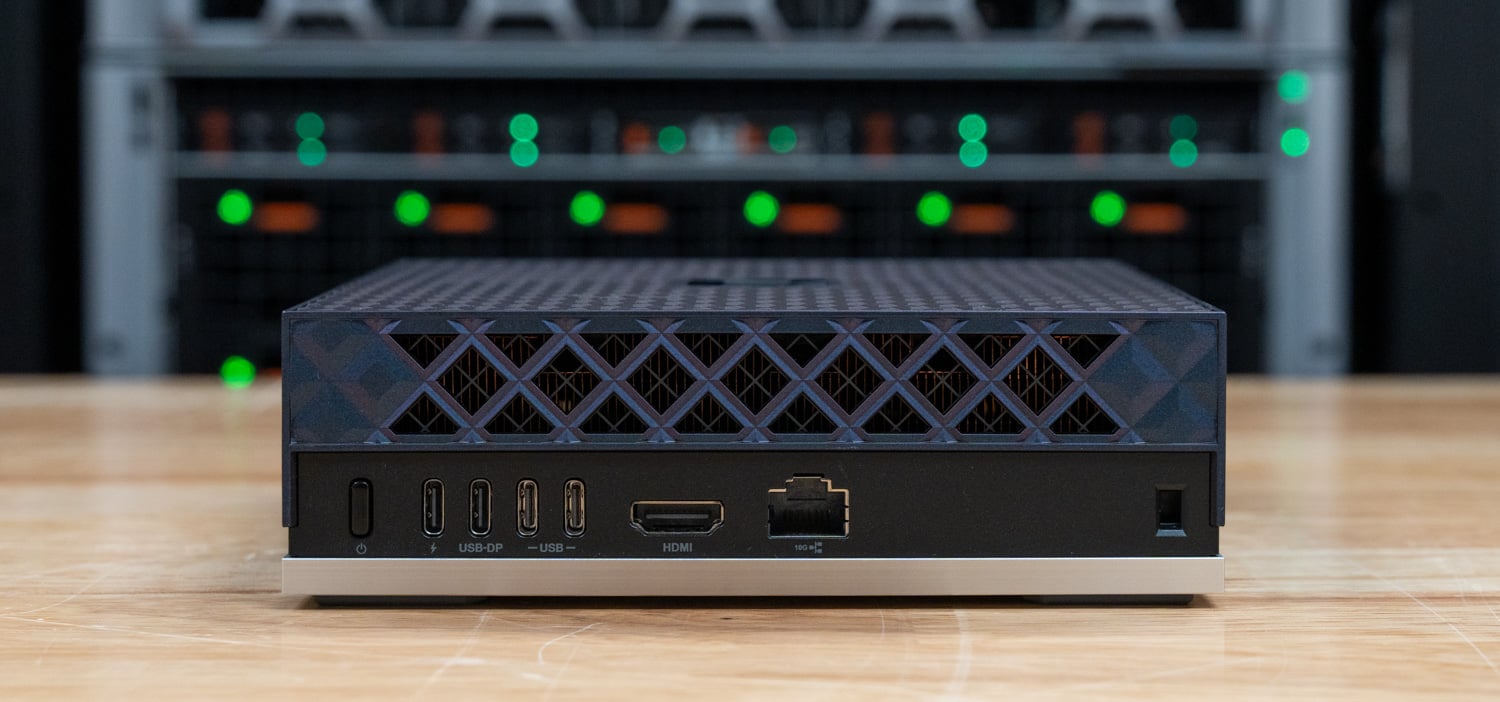
Все внешние разъемы расположены на задней панели системы. Слева направо на задней панели находятся следующие элементы:
- Вход питания USB-C
- Порт USB-C с поддержкой DisplayPort Alt Mode
- Два дополнительных порта USB-C
- Выход HDMI 2.1b
- 10GbE RJ45 Ethernet
- слот для замка безопасности Kensington
Система оснащена тремя портами USB-C для передачи данных, а также выделенным разъемом питания USB-C, что позволяет одновременно подключать несколько высокоскоростных периферийных устройств и дисплеев. HDMI 2.1b обеспечивает вывод изображения на экран, а встроенный интерфейс Ethernet 10GbE делает платформу хорошо подходящей для высокоскоростного подключения к сетевым хранилищам данных (NAS), передачи наборов данных для ИИ и локальных сред разработки.
Внутренний дизайн
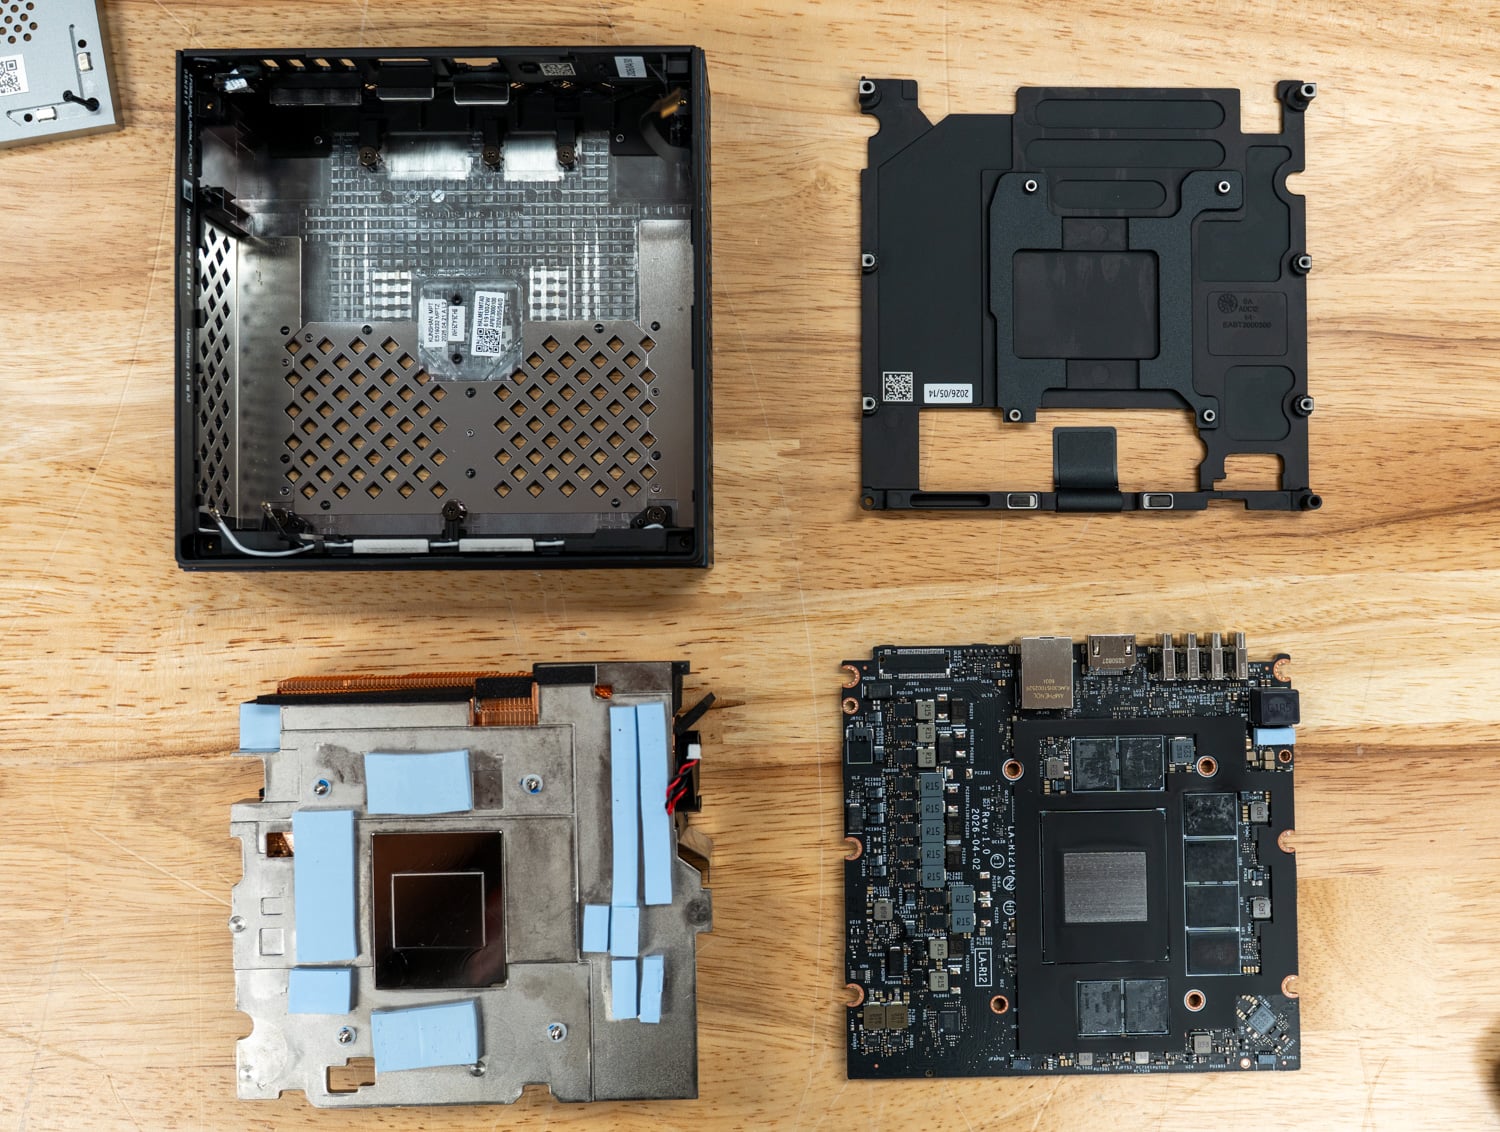
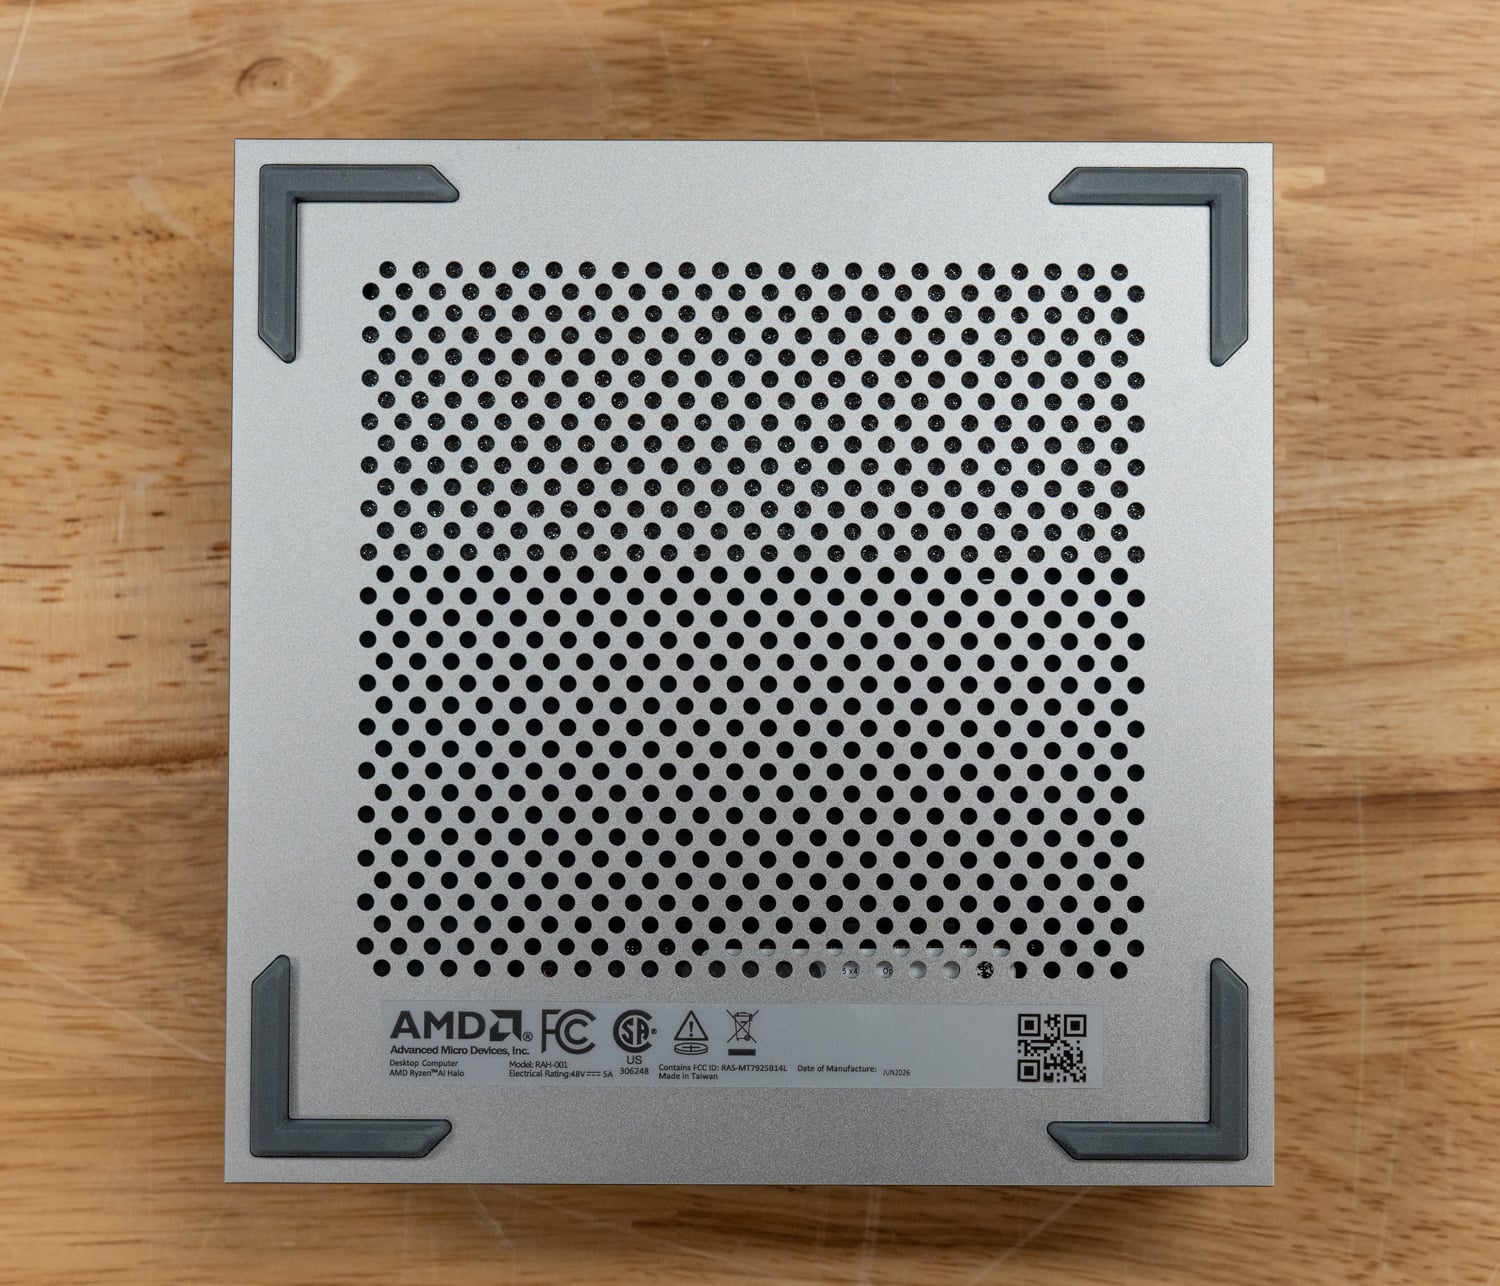
На нижней стороне материнской платы Ryzen AI Halo расположен большой перфорированный вентиляционный канал, который забирает воздух для охлаждения компонентов, установленных вдоль нижней части платы, а четыре резиновые ножки по углам обеспечивают устойчивость устройства на столе или полке.
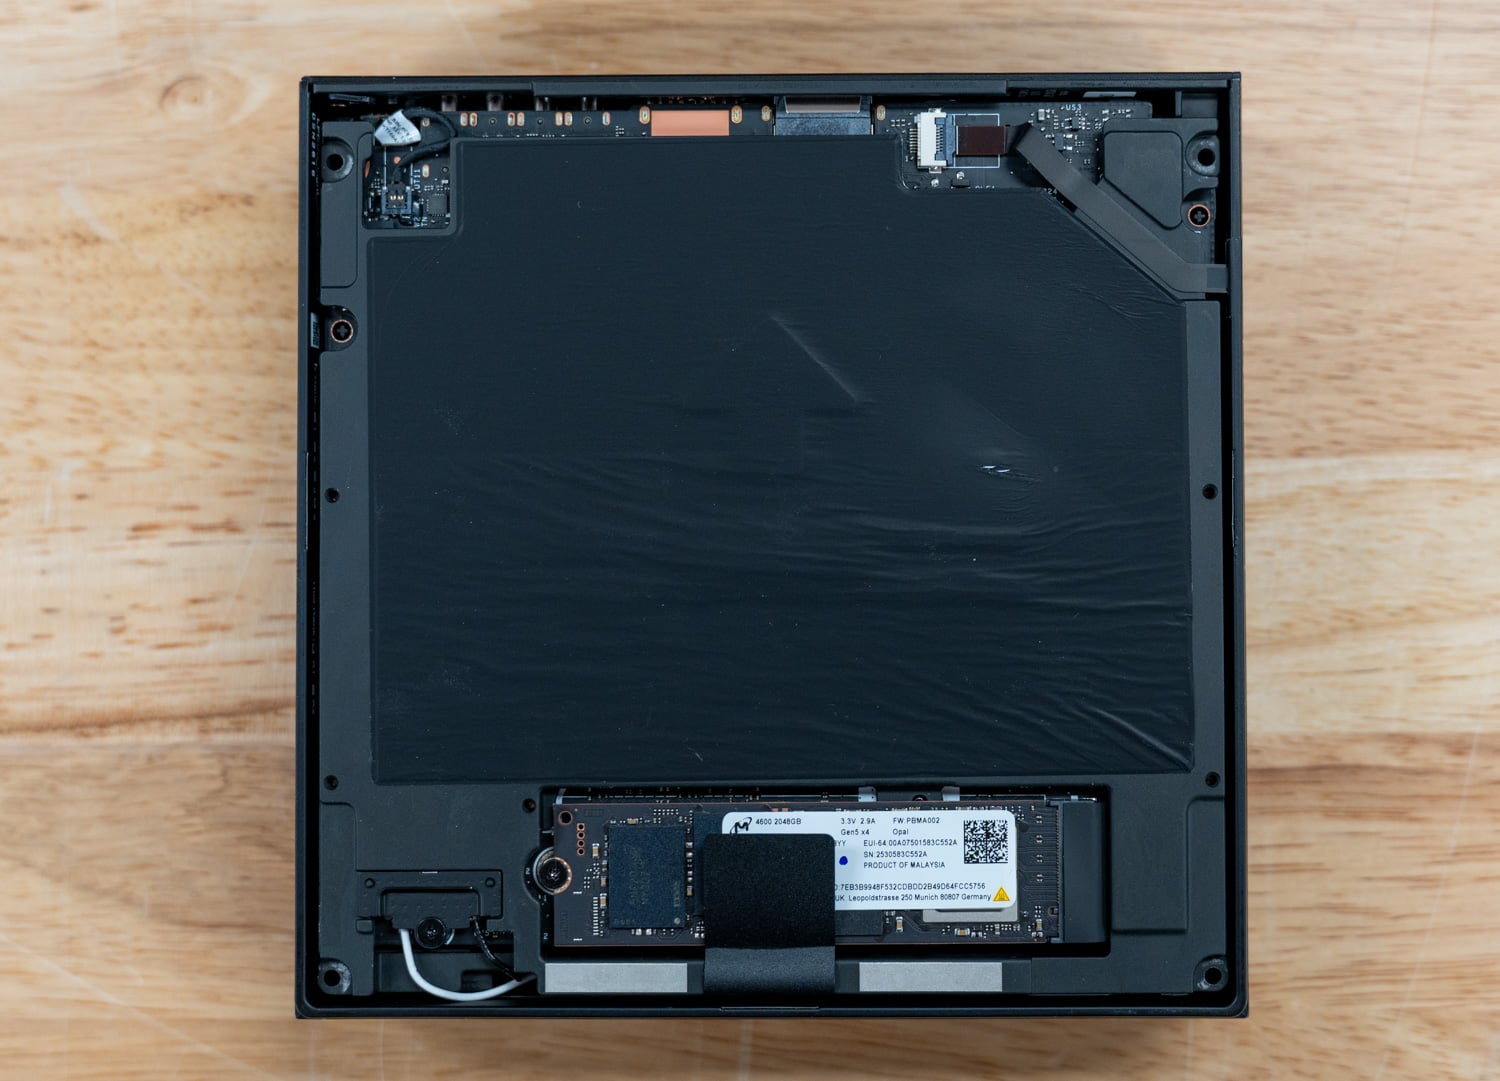
Открутив четыре винта, крепящие нижнюю панель, можно увидеть отсек для M.2 SSD и несколько компонентов нижней платы, включая разъем для карты Wi-Fi. В нашем тестовом образце в этот слот установлен SSD Micron 4600 2TB Gen5 x4, а остальную часть платы, открытую с нижней стороны, защищает черная клейкая пленка.
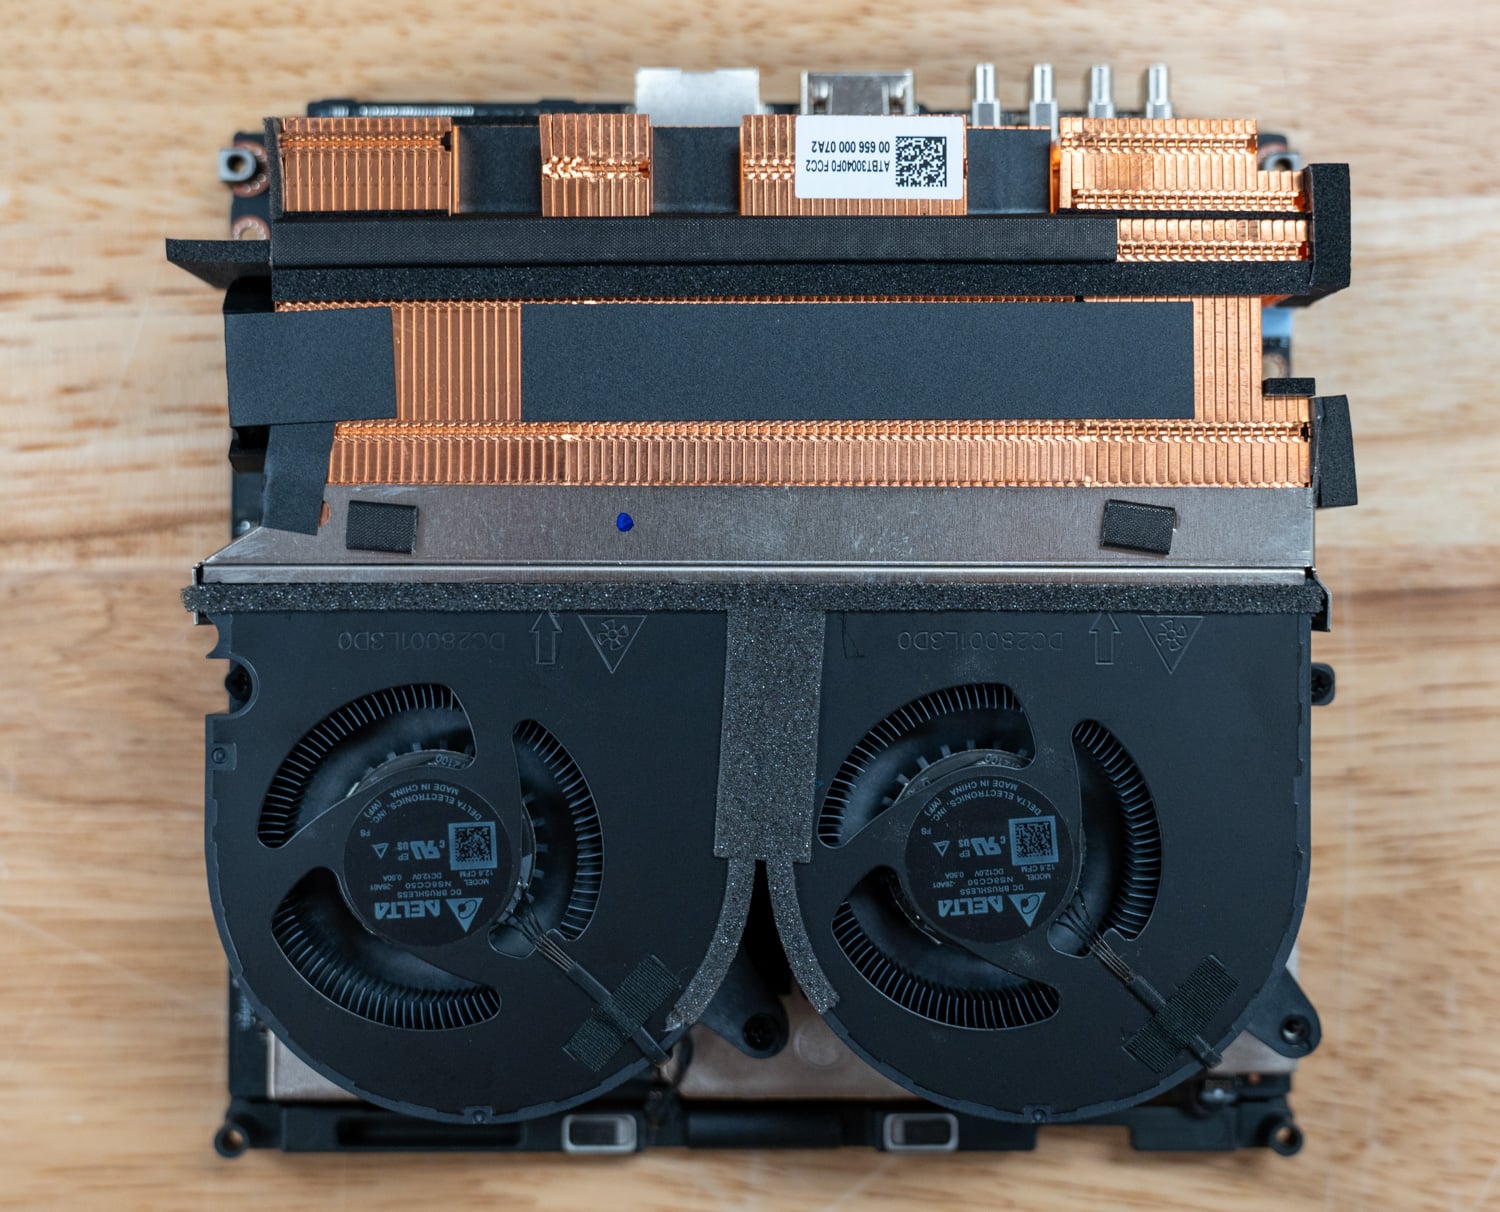
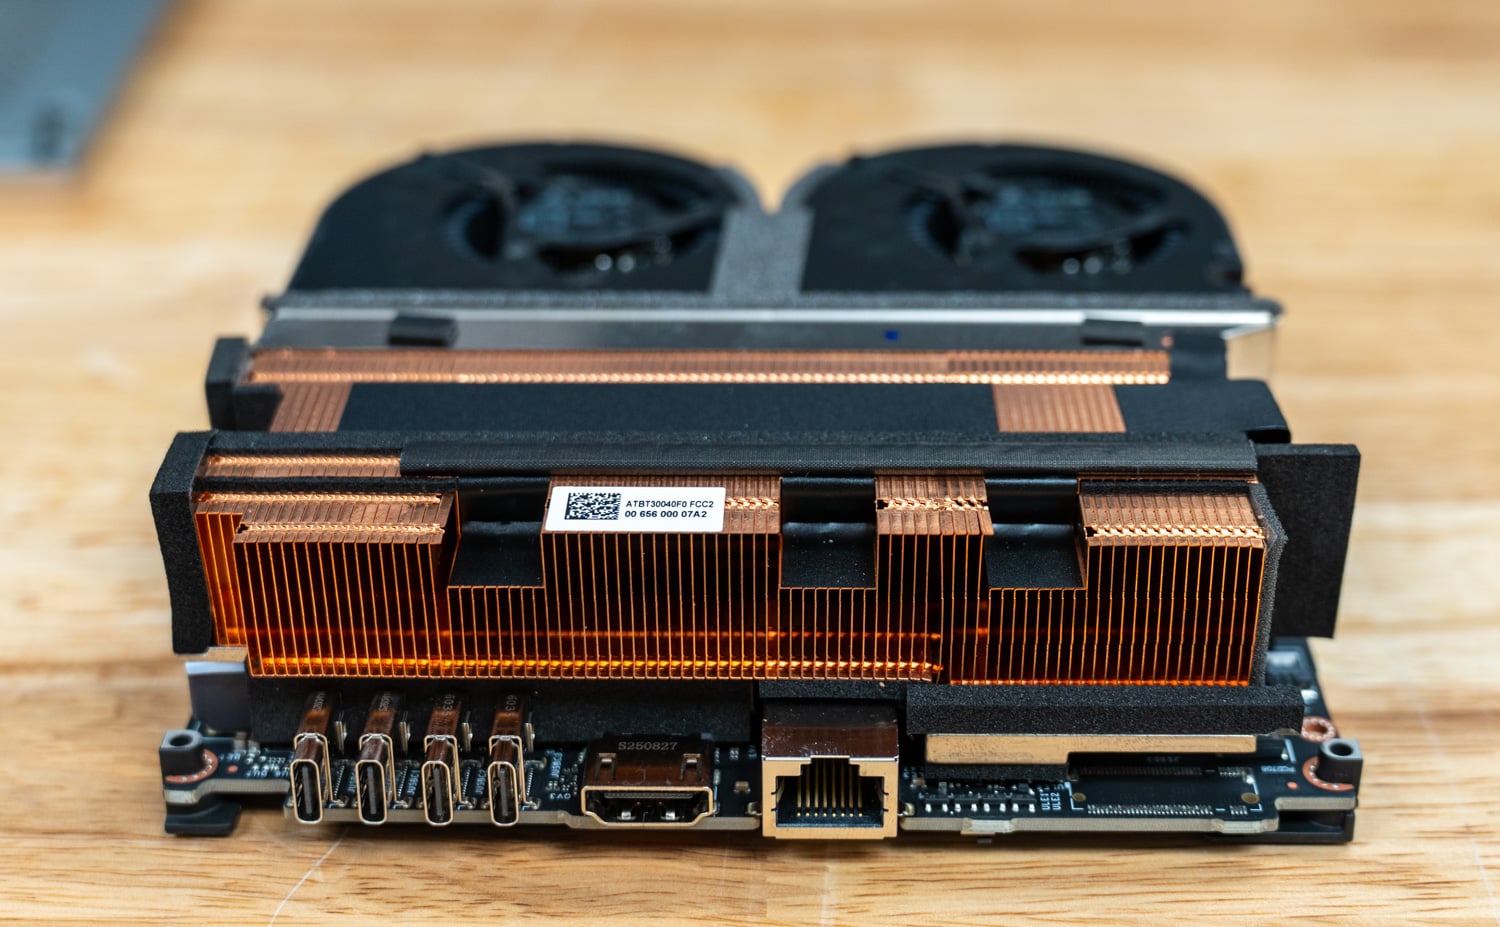
Для охлаждения AMD применила подход, аналогичный NVIDIA DGX Spark, используя два вентилятора, которые прокачивают воздух через ребристый радиатор и выводят его через заднюю часть корпуса.
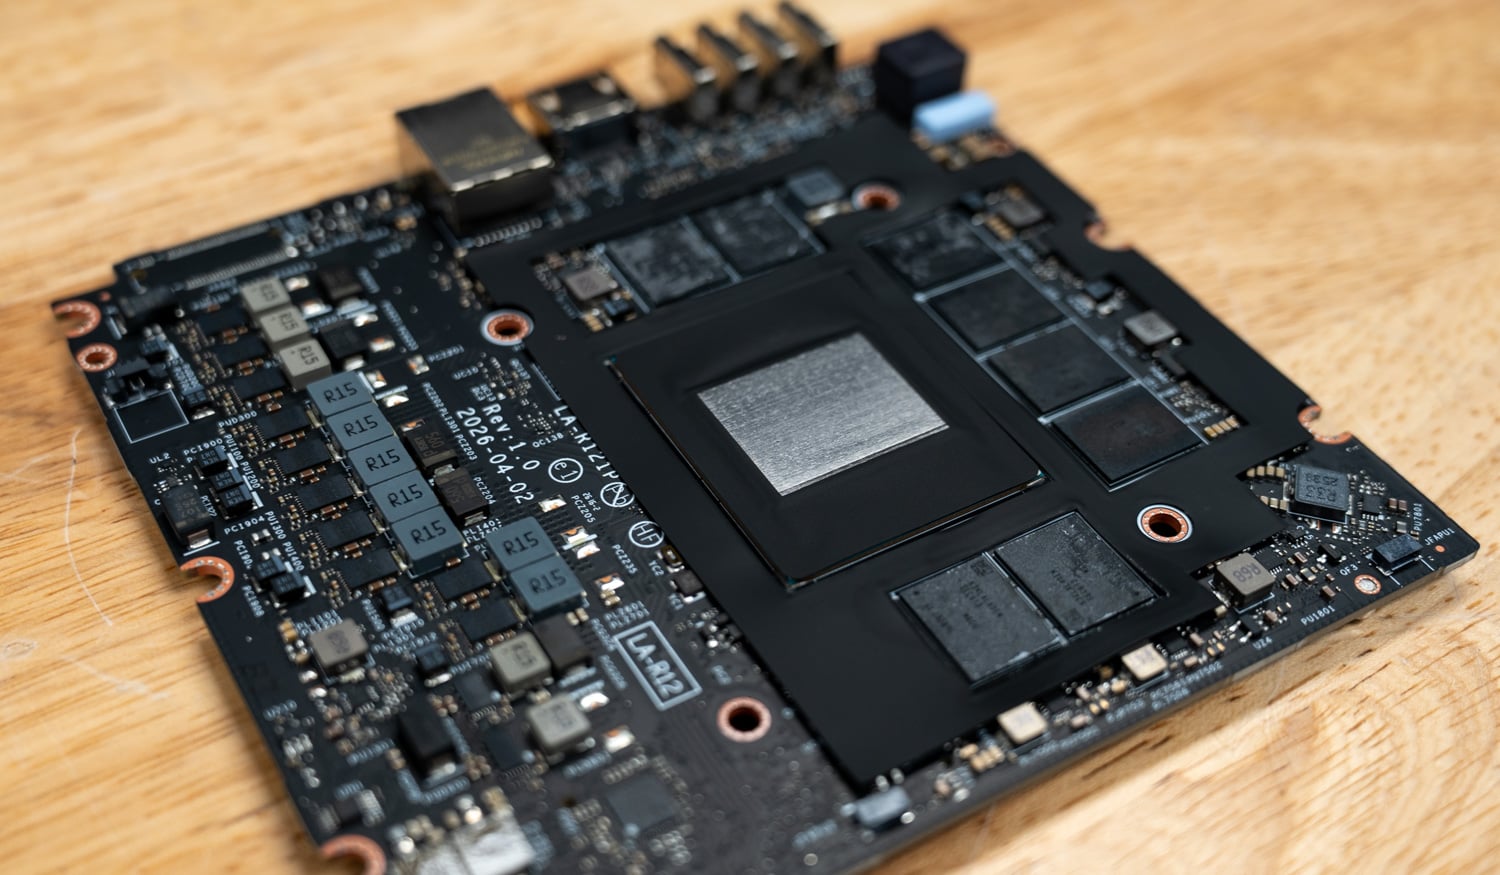
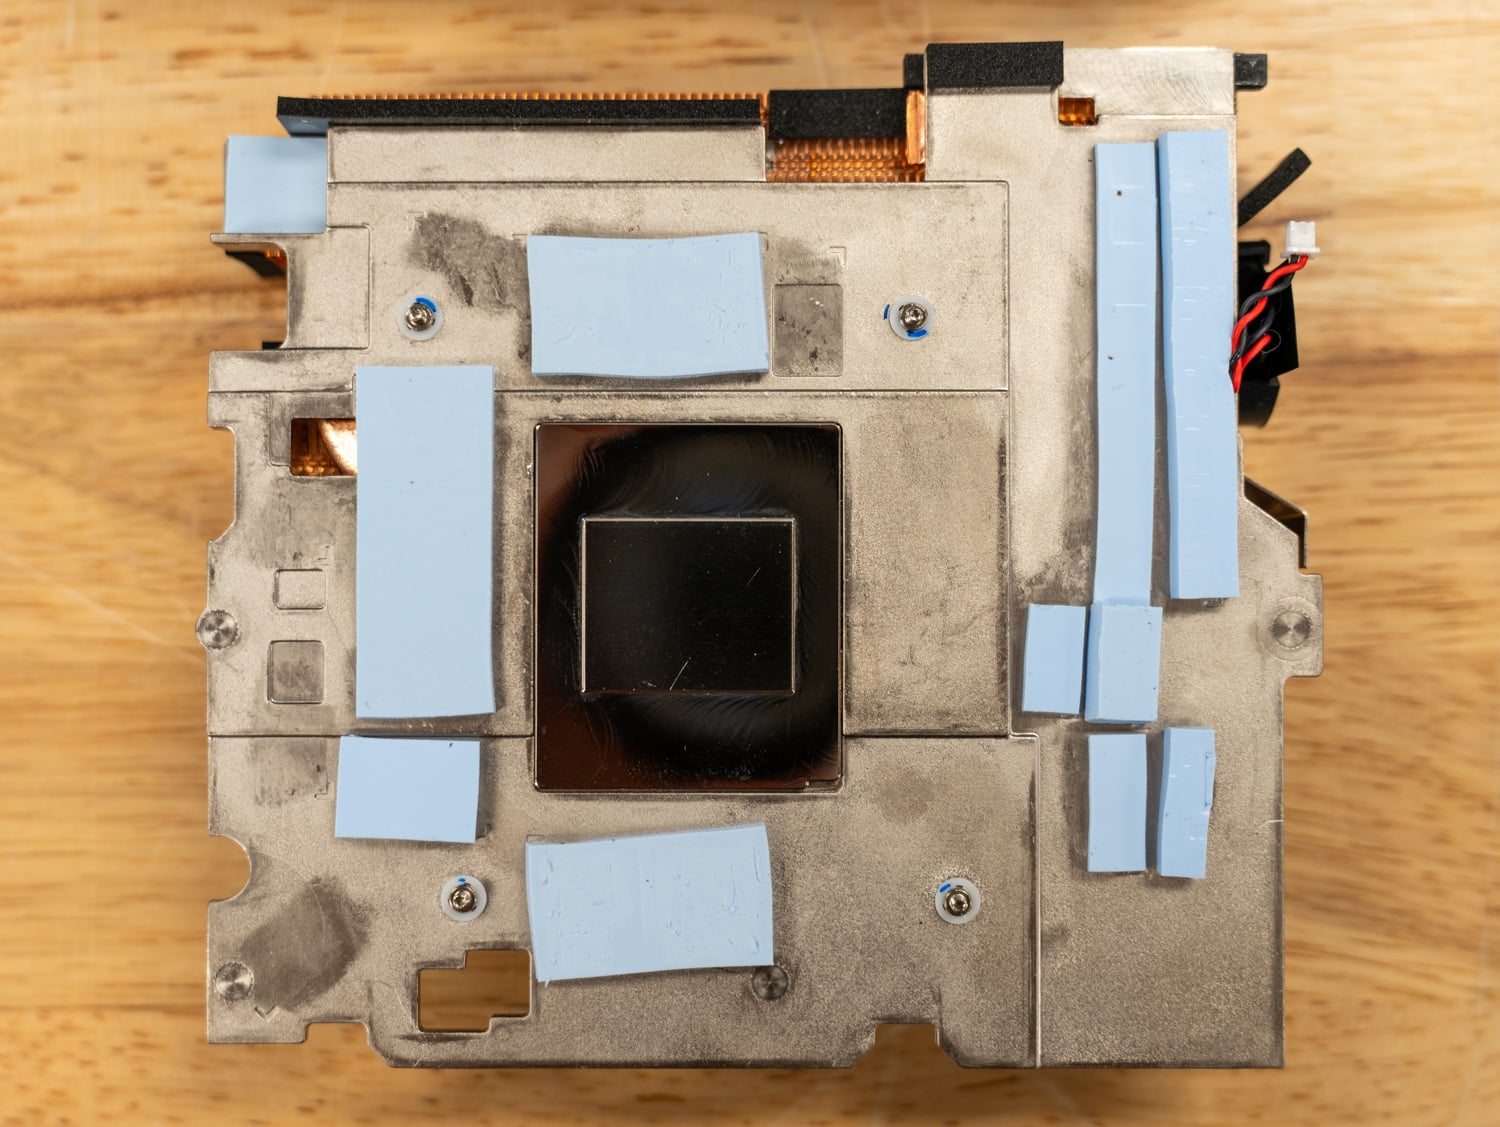
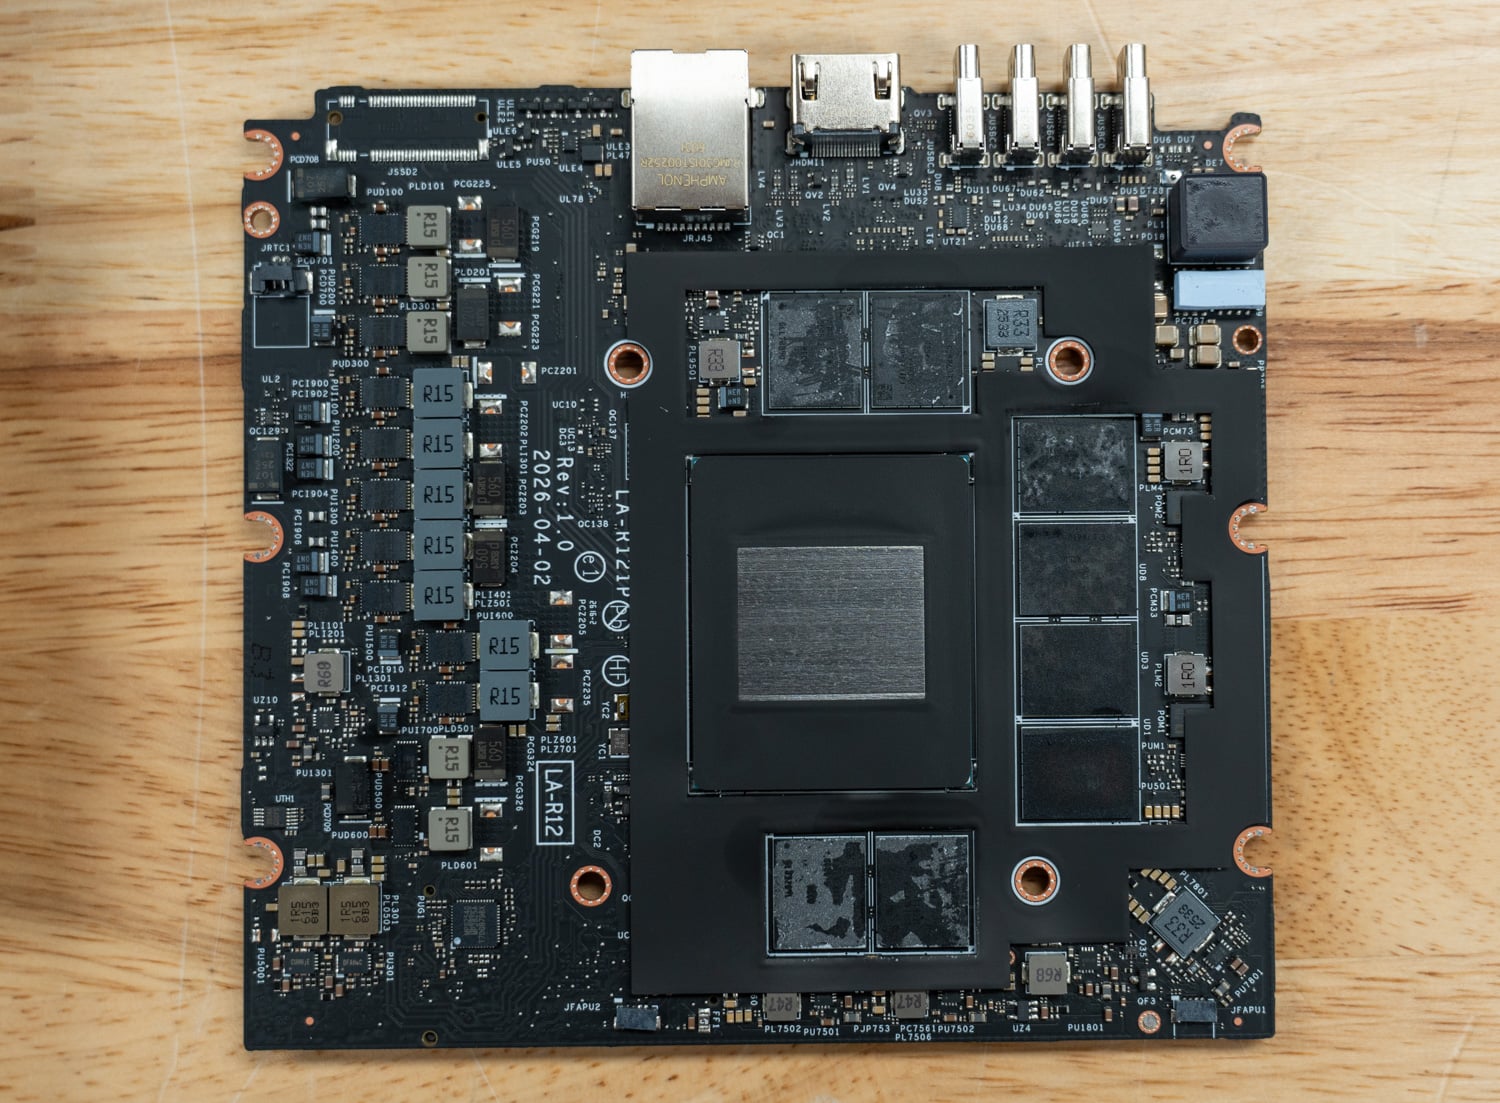
После снятия системы охлаждения открывается вид на материнскую плату, где в центре расположен кристалл APU, по бокам от которого находятся модули памяти, а вдоль левого края проходит схема VRM. Серебристый квадрат, видимый на кристалле, — это не жидкий металл или термопаста; это остатки твердой термопрокладки или покрытия, нанесенного AMD в качестве стыка кристалла и радиатора, что объясняет его равномерный, сухой вид, в отличие от влажного, размазанного вида, который обычно остается после нанесения пасты или жидкого металла.
Перевернув радиатор, можно увидеть нижнюю сторону его холодной пластины, где отполированная до зеркального блеска часть непосредственно контактирует с кристаллом. В то же время, окружающие зоны памяти и питания покрыты предварительно нанесенными термопрокладками различной толщины.
Тестирование производительности AMD Ryzen AI Halo
Мы протестировали платформу AMD Ryzen AI Halo на Windows и Linux, чтобы оценить её производительность в приложениях для рабочих станций и задачах, ориентированных на искусственный интеллект. Для тестирования под Windows система AMD Ryzen AI Halo сравнивалась с двумя коммерчески доступными системами на базе Ryzen AI Max+ PRO 395: компактной настольной рабочей станцией HP Z2 Mini G1a и мобильной рабочей станцией HP ZBook Ultra G1a 14 дюймов. Поскольку все три системы имеют одинаковую архитектуру процессора и интегрированную графику Radeon 8060S, эти сравнения показывают, как платформа Halo работает в различных температурных режимах и при разных конструкциях систем.
Для тестирования под Linux мы переключились на задачи разработки ИИ и хранения данных, сравнивая систему Ryzen AI Halo с NVIDIA DGX Spark. Эти тесты были сосредоточены на оценке производительности хранилища FIO и производительности вывода vLLM, сравнивая платформу для разработчиков на базе AMD Ryzen AI Halo со специализированной системой разработки ИИ от NVIDIA для локального вывода больших языковых моделей.
Протестированные устройства
UL Procyon: Компьютерное зрение на основе искусственного интеллекта
Бенчмарк Procyon AI Computer Vision предоставляет подробную информацию о том, как работают механизмы вывода ИИ на профессиональном уровне. Благодаря использованию механизмов от разных поставщиков, он выдает оценки производительности, точно отражающие возможности устройства. Бенчмарк оценивает современные модели нейронных сетей, сравнивая их производительность в ускорении ИИ на разных типах оборудования — включая CPU, GPU и NPU — что позволяет пользователям оценить относительную эффективность в различных рабочих нагрузках и условиях.
Чтобы отразить реальные задачи искусственного интеллекта, в бенчмарке используются шесть различных моделей нейронных сетей, каждая из которых выбрана с учетом ее соответствия современным задачам компьютерного зрения. MobileNet V3 — это компактная модель, ориентированная на мобильные устройства и предназначенная для идентификации объектов на изображениях, тогда как Inception V4 выполняет ту же задачу с более глубокой и сложной архитектурой.
YOLO V3 (You Only Look Once) специализируется на обнаружении объектов в реальном времени путем оценки вероятностей их появления. DeepLab V3, построенный на основе MobileNet V2, фокусируется на семантической сегментации изображений и кластеризации пикселей. Real-ESRGAN, наиболее ресурсоемкий тест, масштабирует изображения с разрешения 250×250 до 1,000×1,000. Наконец, ResNet 50 — это надежная модель классификации, позволяющая более эффективно обучать глубокие нейронные сети.
Платформа Ryzen AI Halo продемонстрировала стабильно высокую производительность в задачах вывода ИИ как на ЦП, так и на ГП. В тестах ЦП она показала общий результат 216, немного уступив HP Z2 Mini (227) и значительно опередив HP ZBook Ultra (186). Результаты в задачах ГП оказались еще более впечатляющими: система Halo получила наивысший общий балл — 553, опередив ZBook Ultra (528) и Z2 Mini (528). Она также показала самый быстрый вывод MobileNet V3 — 0.38 мс — и завершила ресурсоемкую задачу REAL-ESRGAN за 185.08 мс, по сравнению с 211.76 мс на Z2 Mini и 200.40 мс на ZBook Ultra.
| UL Procyon: Вывод данных в компьютерном зрении с помощью ИИ (чем ниже значение, тем лучше) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) | HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Время ЦП | |||
| Общий балл по компьютерному зрению в области ИИ (чем выше, тем лучше) | 216 | 227 | 186 |
| Мобильная сеть V3 | 0.73 мс | 0.75 мс | 1.09 мс |
| Ренет 50 | 6.02 мс | 5.99 мс | 6.84 мс |
| Начало V4 | 17.18 мс | 17.12 мс | 19.80 мс |
| DeepLab V3 | 29.21 мс | 21.20 мс | 28.27 мс |
| YOLO V3 | 35.60 мс | 36.58 мс | 41.64 мс |
| РЕАЛ-ЭСРГАН | 1,931.13 мс | 1,892.10 мс | 2,138.97 мс |
| Время работы графического процессора | |||
| Общий балл по компьютерному зрению в области ИИ (чем выше, тем лучше) | 553 | 528 | 583 |
| Мобильная сеть V3 | 0.38 мс | 0.42 мс | 0.46 мс |
| Ренет 50 | 4.04 мс | 3.85 мс | 3.27 мс |
| Начало V4 | 13.26 мс | 15.15 мс | 11.62 мс |
| DeepLab V3 | 12.72 мс | 10.98 мс | 10.72 мс |
| YOLO V3 | 11.17 мс | 12.64 мс | 10.57 мс |
| РЕАЛ-ЭСРГАН | 185.08 мс | 211.76 мс | 200.40 мс |
UL Procyon: Генерация текста с помощью ИИ
Тест производительности генерации текста с помощью ИИ от Procyon упрощает тестирование производительности моделей LLM, предоставляя краткий и согласованный метод оценки. Он позволяет проводить многократное тестирование на нескольких моделях LLM, минимизируя при этом сложность больших размеров моделей и переменных факторов. Разработанный совместно с ведущими производителями оборудования для ИИ, он оптимизирует использование локальных ускорителей ИИ для более надежной и эффективной оценки производительности. Приведенные ниже результаты были измерены с помощью TensorRT.
Референсная платформа Ryzen AI Halo превзошла все протестированные языковые модели в тесте Procyon AI Text Generation. Она достигла наивысшего общего балла Phi — 1,192, по сравнению с 965 у HP Z2 Mini и 922 у HP ZBook Ultra. Mistral показала аналогичную тенденцию с результатом 998, опередив 850 и 829, а Llama3 завершила тест с результатом 847, превзойдя конкурирующие системы с 766 и 756 соответственно. Платформа Halo также сократила время генерации первого токена во всех моделях, создав первый токен Phi всего за 0.996 секунды, что почти вдвое меньше задержки, чем у систем HP. Хотя пропускная способность генерации токенов иногда была выше у Z2 Mini, значительно меньшая задержка запуска платформы Halo привела к лучшим общим результатам в бенчмарке.
| UL Procyon: Генерация текста с помощью ИИ | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Общий балл Фи | 1,192 | 965 | 922 |
| Время вывода Phi до первого токена | (0.996%) | (1.898%) | (1.956%) |
| Выходные токены Phi в секунду | 55.271 токенов/с | 68.967 токенов/с | 64.986 токенов/с |
| Общая продолжительность Фи | (56.237%) | (52.666%) | (55.501%) |
| Общий балл Мистраля | 998 | 850 | 829 |
| Время выхода Мистраля до первого токена | (1.603%) | (2.734%) | (2.783%) |
| Выходная мощность Mistral (токены в секунду) | 35.027 токенов/с | 43.358 токенов/с | 41.992 токенов/с |
| Общая продолжительность Мистраля | (88.582%) | (81.716%) | (84.065%) |
| Общий балл Llama3 | 847 | 766 | 756 |
| Время вывода Llama3 до первого токена | (1.963%) | (2.545%) | (2.578%) |
| Вывод Llama3 в токенах в секунду | 34.630 токенов/с | 36.752 токенов/с | 36.243 токенов/с |
| Общая продолжительность Llama3 | (92.026%) | (91.987%) | (93.200%) |
| Общий балл Llama2 | ARCXNUMX | 936 | 929 |
| Время вывода Llama2 до первого токена | Н/д секунд | (3.813%) | (3.860%) |
| Вывод Llama2 в токенах в секунду | N/A токенов/с | 24.685 токенов/с | 24.619 токенов/с |
| Общая продолжительность Llama2 | Н/д секунд | (136.077%) | (136.720%) |
UL Procyon: Генерация изображений ИИ
Бенчмарк Procyon AI Image Generation предлагает стабильный и точный способ измерения производительности вывода ИИ на различных аппаратных платформах, от маломощных NPU до высокопроизводительных GPU. Он включает три теста: Stable Diffusion XL (FP16) для высокопроизводительных GPU, Stable Diffusion 1.5 (FP16) для GPU средней мощности и Stable Diffusion 1.5 (INT8) для маломощных устройств. Бенчмарк использует оптимальный механизм вывода для каждой системы, обеспечивая справедливые и сопоставимые результаты.
Генерация изображений оказалась одной из самых сложных задач для Ryzen AI Halo. В тесте Stable Diffusion 1.5 FP16 платформа Halo показала общий результат 937 баллов, по сравнению с 725 у Z2 Mini и 648 у ZBook Ultra, сократив время генерации до 106.7 секунд по сравнению с 137.8 и 154.2 секундами соответственно. В тесте Stable Diffusion XL также наблюдалось значительное преимущество: система Halo завершила работу за 878.5 секунд, что примерно на 174 секунды быстрее, чем Z2 Mini, и более чем на 450 секунд быстрее, чем ZBook Ultra. Платформа также успешно прошла тест Stable Diffusion 1.5 INT8 с общим результатом 9,158 баллов — задача, недоступная ни для одной из сравниваемых систем HP.
| UL Procyon: Генерация изображений с помощью ИИ | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Стабильная диффузия 1.5 (FP16) – Общий балл | 937 | 725 | 648 |
| Стабильная диффузия 1.5 (FP16) – Общее время | (106.7%) | (137.815%) | (154.203%) |
| Стабильная диффузия 1.5 (FP16) – скорость генерации изображения | 6.670 с/изображение | 8.613 с/изображение | 9.638 с/изображение |
| Стабильная диффузия 1.5 (INT8) – Общий балл | 9,158 | ARCXNUMX | ARCXNUMX |
| Стабильная диффузия 1.5 (INT8) – Общее время | (27.298%) | ARCXNUMX | ARCXNUMX |
| Стабильная диффузия 1.5 (INT8) – Скорость генерации изображения | 3.412 с/изображение | ARCXNUMX | ARCXNUMX |
| Стабильная диффузия XL (FP16) – Общий балл | 682 | 570 | 451 |
| Стабильная диффузия XL (FP16) – Общее время | (878.493%) | (1,052.468%) | (1,329.592%) |
| Стабильная диффузия XL (FP16) – скорость генерации изображения | 54.906 с/изображение | 65.779 с/изображение | 83.100 с/изображение |
Рабочая станция SPEC 4
Бенчмарк SPECworkstation 4.0 — это комплексный инструмент для оценки всех ключевых аспектов производительности рабочих станций. Он обеспечивает реальные показатели производительности ЦП, графики, ускорителя и диска, предоставляя специалистам данные, необходимые для принятия обоснованных решений об инвестициях в оборудование. Бенчмарк включает в себя специальный набор тестов, ориентированных на рабочие нагрузки ИИ и машинного обучения, такие как задачи анализа данных и тесты вывода на основе ONNX Runtime, что отражает растущую важность ИИ/машинного обучения в средах рабочих станций. Он охватывает семь отраслевых вертикалей и четыре аппаратные подсистемы, предоставляя подробную и актуальную оценку производительности современных рабочих станций.
Тест SPECworkstation 4 продемонстрировал сбалансированные возможности платформы Ryzen AI Halo в качестве рабочей станции. Она показала самые высокие результаты в категориях «Финансовые услуги» (2.92), «Медиа и развлечения» (2.97), «Дизайн продукции» (2.22) и «Производительность и разработка» (1.27), превзойдя в этих категориях как HP Z2 Mini, так и HP ZBook Ultra. Z2 Mini немного опередила конкурентов в категориях «Энергетика» (2.50 против 2.35) и «Биологические науки» (2.60 против 2.33). В целом, эталонная платформа Halo продемонстрировала высокую производительность во всех профессиональных рабочих нагрузках теста и осталась конкурентоспособной во всех протестированных категориях.
| SPECworkstation 4.0.0 (чем выше значение, тем лучше) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S)
|
HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Энергия | 2.35 | 2.50 | 2.20 |
| Финансовые услуги | 2.92 | 2.35 | 1.60 |
| Медико-биологическая промышленность | 2.33 | 2.60 | 2.20 |
| СМИ и развлечения | 2.97 | 2.22 | 1.90 |
| Дизайн продукта | 2.22 | 2.00 | 1.74 |
| Производительность и развитие | 1.27 | 1.00 | 1.03 |
Люксмарк
Luxmark — это бенчмарк для графических процессоров, использующий LuxRender, рендерер с открытым исходным кодом и трассировкой лучей, для оценки производительности системы при работе с высокодетализированными 3D-сценами. Этот бенчмарк полезен для оценки возможностей графического рендеринга серверов и рабочих станций, особенно для приложений визуальных эффектов и архитектурной визуализации, где точное моделирование освещения имеет решающее значение.
Результаты Luxmark показали минимальную разницу между тремя платформами Ryzen AI Max+ 395. Референсная система Halo показала наивысший результат в тесте Food — 4,158 баллов, опередив Z2 Mini (3,943) и ZBook Ultra (3,915). В тесте Hallbench она набрала 8,014 баллов, немного отстав от Z2 Mini (8,477), но опередив ZBook Ultra (7,833). В целом, результаты показывают, что системы на базе Radeon 8060S обеспечивают очень схожую производительность трассировки лучей независимо от форм-фактора.
| Люксмарк (Чем выше, тем лучше) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Скамейка в зале | 8,014 | 8,477 | 7,833 |
| Еда - Food | 4,158 | 3,943 | 3,915 |
Сжатие 7-Zip
Тест производительности 7-Zip Compression Benchmark оценивает производительность процессора во время сжатия и распаковки, измеряя производительность в GIPS (гигаинструкциях в секунду) и загрузку процессора. Более высокие значения GIPS и эффективное использование процессора указывают на превосходную производительность.
Платформа Ryzen AI Halo лидировала по всем основным показателям в бенчмарке 7-Zip. Она достигла показателя сжатия 176.7 GIPS, по сравнению с 139.3 GIPS у HP Z2 Mini и 139.6 GIPS у ZBook Ultra. Производительность декомпрессии осталась столь же высокой — 191.6 GIPS, превзойдя 164.0 GIPS у Z2 Mini и 174.0 GIPS у ZBook Ultra. В совокупности платформа Halo достигла наивысшего общего показателя — 184.2 GIPS, превзойдя конкурирующие системы примерно на 20% и продемонстрировав отличную пропускную способность для целочисленных операций при создании и извлечении архивов.
| Тест на сжатие 7-Zip (чем выше значение, тем лучше) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) | |||
|---|---|---|---|---|---|---|
| сжимающий | ||||||
| Текущая загрузка ЦП | 2,741% | 2,734% | 2,868% | |||
| Текущий рейтинг/использование | 6.370 ГИПС | 5.136 ГИПС | 4.883 ГИПС | |||
| номинал тока | 174.589 ГИПС | 140.405 ГИПС | 140.061 ГИПС | |||
| Результат – использование ЦП | 2,751% | 2,718% | 2,855% | |||
| Итоговая оценка/использование | 6.424 ГИПС | 5.126 ГИПС | 4.890 ГИПС | |||
| Итоговый рейтинг | 176.742 ГИПС | 139.298 ГИПС | 139.617 ГИПС | |||
| Декомпрессия | ||||||
| Текущая загрузка ЦП | 2,568% | 2,343% | 2,904% | |||
| Текущий рейтинг/использование | 7.670 ГИПС | 6.805 ГИПС | 6.029 ГИПС | |||
| номинал тока | 196.986 ГИПС | 159.451 ГИПС | 175.104 ГИПС | |||
| Результат – использование ЦП | 2,469% | 2,414% | 2,887% | |||
| Итоговая оценка/использование | 7.766 ГИПС | 6.793 ГИПС | 6.028 ГИПС | |||
| Итоговый рейтинг | 191.645 ГИПС | 163.969 ГИПС | 174.046 ГИПС | |||
| Общий рейтинг | ||||||
| Общее использование ЦП | 2,610% | 2,566% | 2,871% | |||
| Общий рейтинг/Использование | 7.095 ГИПС | 5.959 ГИПС | 5.459 ГИПС | |||
| Общий рейтинг | 184.194 ГИПС | 151.634 ГИПС | 156.832 ГИПС | |||
Тест Блендера
Blender — это приложение для 3D-моделирования с открытым исходным кодом. Данный тест производительности проводился с помощью утилиты Blender Benchmark. Результат измеряется в количестве выборок в минуту, при этом более высокие значения указывают на лучшую производительность.
Рендеринг на ЦП — еще одна область, где Ryzen AI Halo показал себя превосходно. В сцене Monster он достиг 244.7 сэмплов в минуту, опередив HP Z2 Mini (224.3) и HP ZBook Ultra (189.3). В сцене Junkshop он показал 159.4 сэмпла в минуту по сравнению с 149.5 и 129.4 соответственно, а в сцене Classroom — 131.6 сэмпла в минуту, опередив Z2 Mini (116.3) примерно на 13% и ZBook Ultra (94.1) почти на 40%. Эти результаты демонстрируют, что Ryzen AI Max+ 395 обеспечивает превосходную производительность многопоточного рендеринга, несмотря на свои компактные размеры рабочей станции.
| Тест производительности процессора в Blender (количество сэмплов в минуту, чем выше показатель, тем лучше) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| монстр - Monster | 244.7 образцов/м | 224.3 образцов/м | 189.29 образцов/м |
| Магазин старых вещей | 159.4 образцов/м | 149.5 образцов/м | 129.42 образцов/м |
| Класс | 131.6 образцов/м | 116.3 образцов/м | 94.14 образцов/м |
Результаты рендеринга на GPU были значительно ближе на разных системах. Референсная платформа Halo отрендерила сцену с монстром со скоростью 704.2 сэмпла в минуту, уступив Z2 Mini (745.6), но опередив ZBook Ultra (661.5). В Junkshop результаты практически сравнялись между платформой Halo (366.6) и Z2 Mini (366.5). В то же время система Halo показала самый высокий результат в режиме Classroom — 361.5 сэмпла в минуту, немного опередив Z2 Mini (359.0) и ZBook Ultra (333.3). Результаты показывают, что Radeon 8060S обеспечивает удивительно стабильную производительность рендеринга на GPU в разных реализациях.
| Тест производительности Blender для графических процессоров (количество сэмплов в минуту, чем выше показатель, тем лучше). | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| монстр - Monster | 704.2 образцов/м | 745.55 образцов/м | 661.50 образцов/м |
| Магазин старых вещей | 366.6 образцов/м | 366.54 образцов/м | 341.92 образцов/м |
| Класс | 361.51 образцов/м | 359.01 образцов/м | 333.26 образцов/м |
у-кранчер
y-cruncher — это многопоточная масштабируемая программа, способная вычислять число Пи и другие математические константы с точностью до триллионов знаков после запятой. С момента своего запуска в 2009 году она стала популярным инструментом для бенчмаркинга и стресс-тестирования среди оверклокеров и энтузиастов аппаратного обеспечения.
Результаты теста y-cruncher различаются в зависимости от объема вычислений. При обработке 1 миллиарда и 2.5 миллиарда цифр все три системы показали результаты с разницей всего в несколько десятых секунды, при этом системы HP немного опередили конкурентов. По мере увеличения нагрузки Halo вырвалась вперед, завершив вычисления с 5 миллиардами цифр за 71.948 секунды, по сравнению с 75.021 секундой для Z2 Mini и 78.19 секундой для ZBook Ultra. При обработке 10 миллиардов цифр Halo завершила работу за 151.409 секунды, примерно на 6% опередив Z2 Mini и на 12% для ZBook Ultra, что говорит о том, что настольные компьютеры лучше справляются с высокой многопоточной нагрузкой по мере увеличения времени выполнения.
| Y-Cruncher (общее время вычислений) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| 1 млрд | (13.193%) | (12.965%) | (12.93%) |
| 2.5 млрд | (34.578%) | (34.533%) | (34.91%) |
| 5 млрд | (71.948%) | (75.021%) | (78.19%) |
| 10 млрд | (151.409%) | (160.252%) | (171.72%) |
Geekbench 6
Geekbench 6 — это кроссплатформенный бенчмарк, измеряющий общую производительность системы.
Тест Geekbench 6 подтвердил сбалансированный профиль производительности платформы Halo. Она показала наивысший результат в одноядерном режиме — 2,986 баллов, опередив HP Z2 Mini (2,862) и ZBook Ultra (2,825). Многоядерная производительность также лидировала в сравнении с результатом 18,068 баллов. Radeon 8060S показала наивысший результат в тестах OpenCL GPU — 92,883 балла, немного опередив Z2 Mini (91,591) и значительно превзойдя ZBook Ultra (85,337). Стабильное лидерство в тестах CPU и GPU демонстрирует сбалансированную производительность платформы Ryzen AI Max+ 395.
| Geekbench 6 (чем выше, тем лучше) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Одноядерный процессор | 2,986 | 2,862 | 2,825 |
| Многоядерный процессор | 18,068 | 17,210 | 17,562 |
| GPU OpenCL | 92,883 | 91,591 | 85,337 |
Cinebench R23
Cinebench R23 — это широко признанный бенчмарк для оценки производительности процессора в задачах 3D-рендеринга. Основанный на движке Cinema 4D, он измеряет, насколько хорошо процессор справляется с однопоточными и многопоточными задачами, предоставляя информацию об общей быстродействии и возможностях параллельной обработки.
В тесте Cinebench R23 наблюдалась очень напряженная борьба между двумя настольными версиями Ryzen AI Max+ 395. Референсная платформа Halo показала результат в многоядерном режиме 37 316 баллов, опередив HP Z2 Mini (37 156), а обе платформы с большим отрывом превзошли HP ZBook Ultra (29 112 баллов). Производительность в одноядерном режиме показала аналогичную картину: платформа Halo набрала 2,047 баллов, Z2 Mini — 2,020, а ZBook Ultra — 1,984. Хотя разница с Z2 Mini была невелика, система Halo стабильно занимала первое место в тесте.
| Cinebench R23 (чем выше значение, тем лучше) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Многоядерные | 37,316 | 37,156 | 29,112 |
| Одноядерный | 2,047 | 2,020 | 1,984 |
Cinebench 2024
Cinebench 2024 развивает идеи R23, вводя тесты рендеринга на основе графического процессора, но при этом сохраняя акцент на производительности центрального процессора. В этом разделе мы рассматриваем только результаты тестов ЦП, которые дают обновленное представление о том, насколько хорошо каждая система справляется с современными задачами 3D-рендеринга.
Новый бенчмарк Cinebench 2024 повторил результаты R23. Ryzen AI Halo показал наивысший результат в многоядерном режиме — 1,916 баллов, немного опередив HP Z2 Mini (1,906) и сохранив значительное преимущество над HP ZBook Ultra (1,579). В одноядерном режиме платформа Halo также показала лучшие результаты: 116 баллов против 112 у Z2 Mini и 111 у ZBook Ultra. Хотя различия между настольными системами остались небольшими, результаты подтверждают способность Ryzen AI Max+ 395 обеспечивать стабильно высокую производительность рендеринга.
| Cinebench 2024 (чем выше значение, тем лучше) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Многоядерные | 1,916 | 1,906 | 1,579 |
| Одноядерный | 116 | 112 | 111 |
Тесты производительности Phoronix
Phoronix Test Suite — это платформа для автоматизированного тестирования производительности с открытым исходным кодом, поддерживающая более 450 тестовых профилей и более 100 тестовых наборов через OpenBenchmarking.org. Она берет на себя все этапы — от установки зависимостей до запуска тестов и сбора результатов, что делает ее идеальной для сравнения производительности, проверки оборудования и непрерывной интеграции. Мы рассмотрим производительность в тестах Stream, 7-Zip и LLVM.
Анализируя набор бенчмарков Phoronix, мы наблюдали довольно равномерное распределение результатов между платформой AMD Ryzen AI Halo и NVIDIA DGX Spark. Система Ryzen AI Halo стабильно лидировала в задачах, ориентированных на ЦП, превосходя DGX Spark на 11% в сжатии 7-Zip, на 38% в распаковке 7-Zip и завершая тест компиляции LLVM на 14% быстрее. DGX Spark, с другой стороны, показала более высокую устойчивую пропускную способность памяти, лидируя в тестах STREAM Scale, Triad и Add на 17%, 13% и 15% соответственно. Halo сохранила 18%-ное преимущество в тесте STREAM Copy, что показывает, что, хотя обе системы обладают высокой производительностью, платформа Ryzen AI Halo отдает предпочтение вычислительным задачам общего назначения, в то время как DGX Spark демонстрирует более высокую пропускную способность в задачах, ориентированных на пропускную способность памяти.
| Тест | AMD Ryzen AI Halo | NVIDIA DGX Spark | победитель |
|---|---|---|---|
| 7-Zip-сжатие (MIPS) | 186,921 | 169,052 | Гало (+11%) |
| 7-Zip декомпрессия (MIPS) | 146,109 | 106,084 | Гало (+38%) |
| Потоковое воспроизведение (МБ/с) | 145,363 | 123,730 | Гало (+18%) |
| Масштаб потока (МБ/с) | 110,611 | 128,970 | Искра (+17%) |
| Потоковое воспроизведение Triad (МБ/с) | 107,105 | 121,433 | Искра (+13%) |
| Добавить потоковое воспроизведение (МБ/с) | 107,022 | 122,815 | Искра (+15%) |
| Компиляция LLVM (Make, секунды) | 431.8 | 504.3 | Halo (на 14% быстрее) |
FIO Performance Benchmark
Для измерения производительности хранилища по общепринятым отраслевым показателям мы используем fio. В нашем традиционном тесте SSD каждый накопитель предварительно заполняется дважды в качестве дополнительного накопителя; здесь же мы тестировали каждый накопитель непосредственно в системе, через файловую систему. Ранее мы тестировали системы NVIDIA с помощью GDSIO, но AMD не предлагает сопоставимого теста хранилища непосредственно на GPU, поэтому запуск fio на уровне файловой системы на обеих платформах уравнивает их возможности, что важнее, чем тестирование накопителей по отдельности.
И NVIDIA DGX Spark (Founders Edition), и AMD Ryzen AI Halo поставляются с накопителем PCIe Gen5, поэтому теоретически обе платформы имеют одинаковые пределы пропускной способности накопителя. Однако на практике накопитель Halo работает на скоростях канала PCIe Gen4 в этой системе, что ограничивает доступную пропускную способность значительно ниже возможностей самого накопителя. Это ограничение скорости канала стоит учитывать на протяжении всего раздела, поскольку оно составляет значительную часть разницы в пропускной способности между двумя платформами.
В этом разделе мы сосредоточимся на следующих тестах FIO:
- 128K Последовательный
- 64K Случайный
- 16K Последовательный
- 16K Случайный
- 4K Случайный
128K последовательное чтение
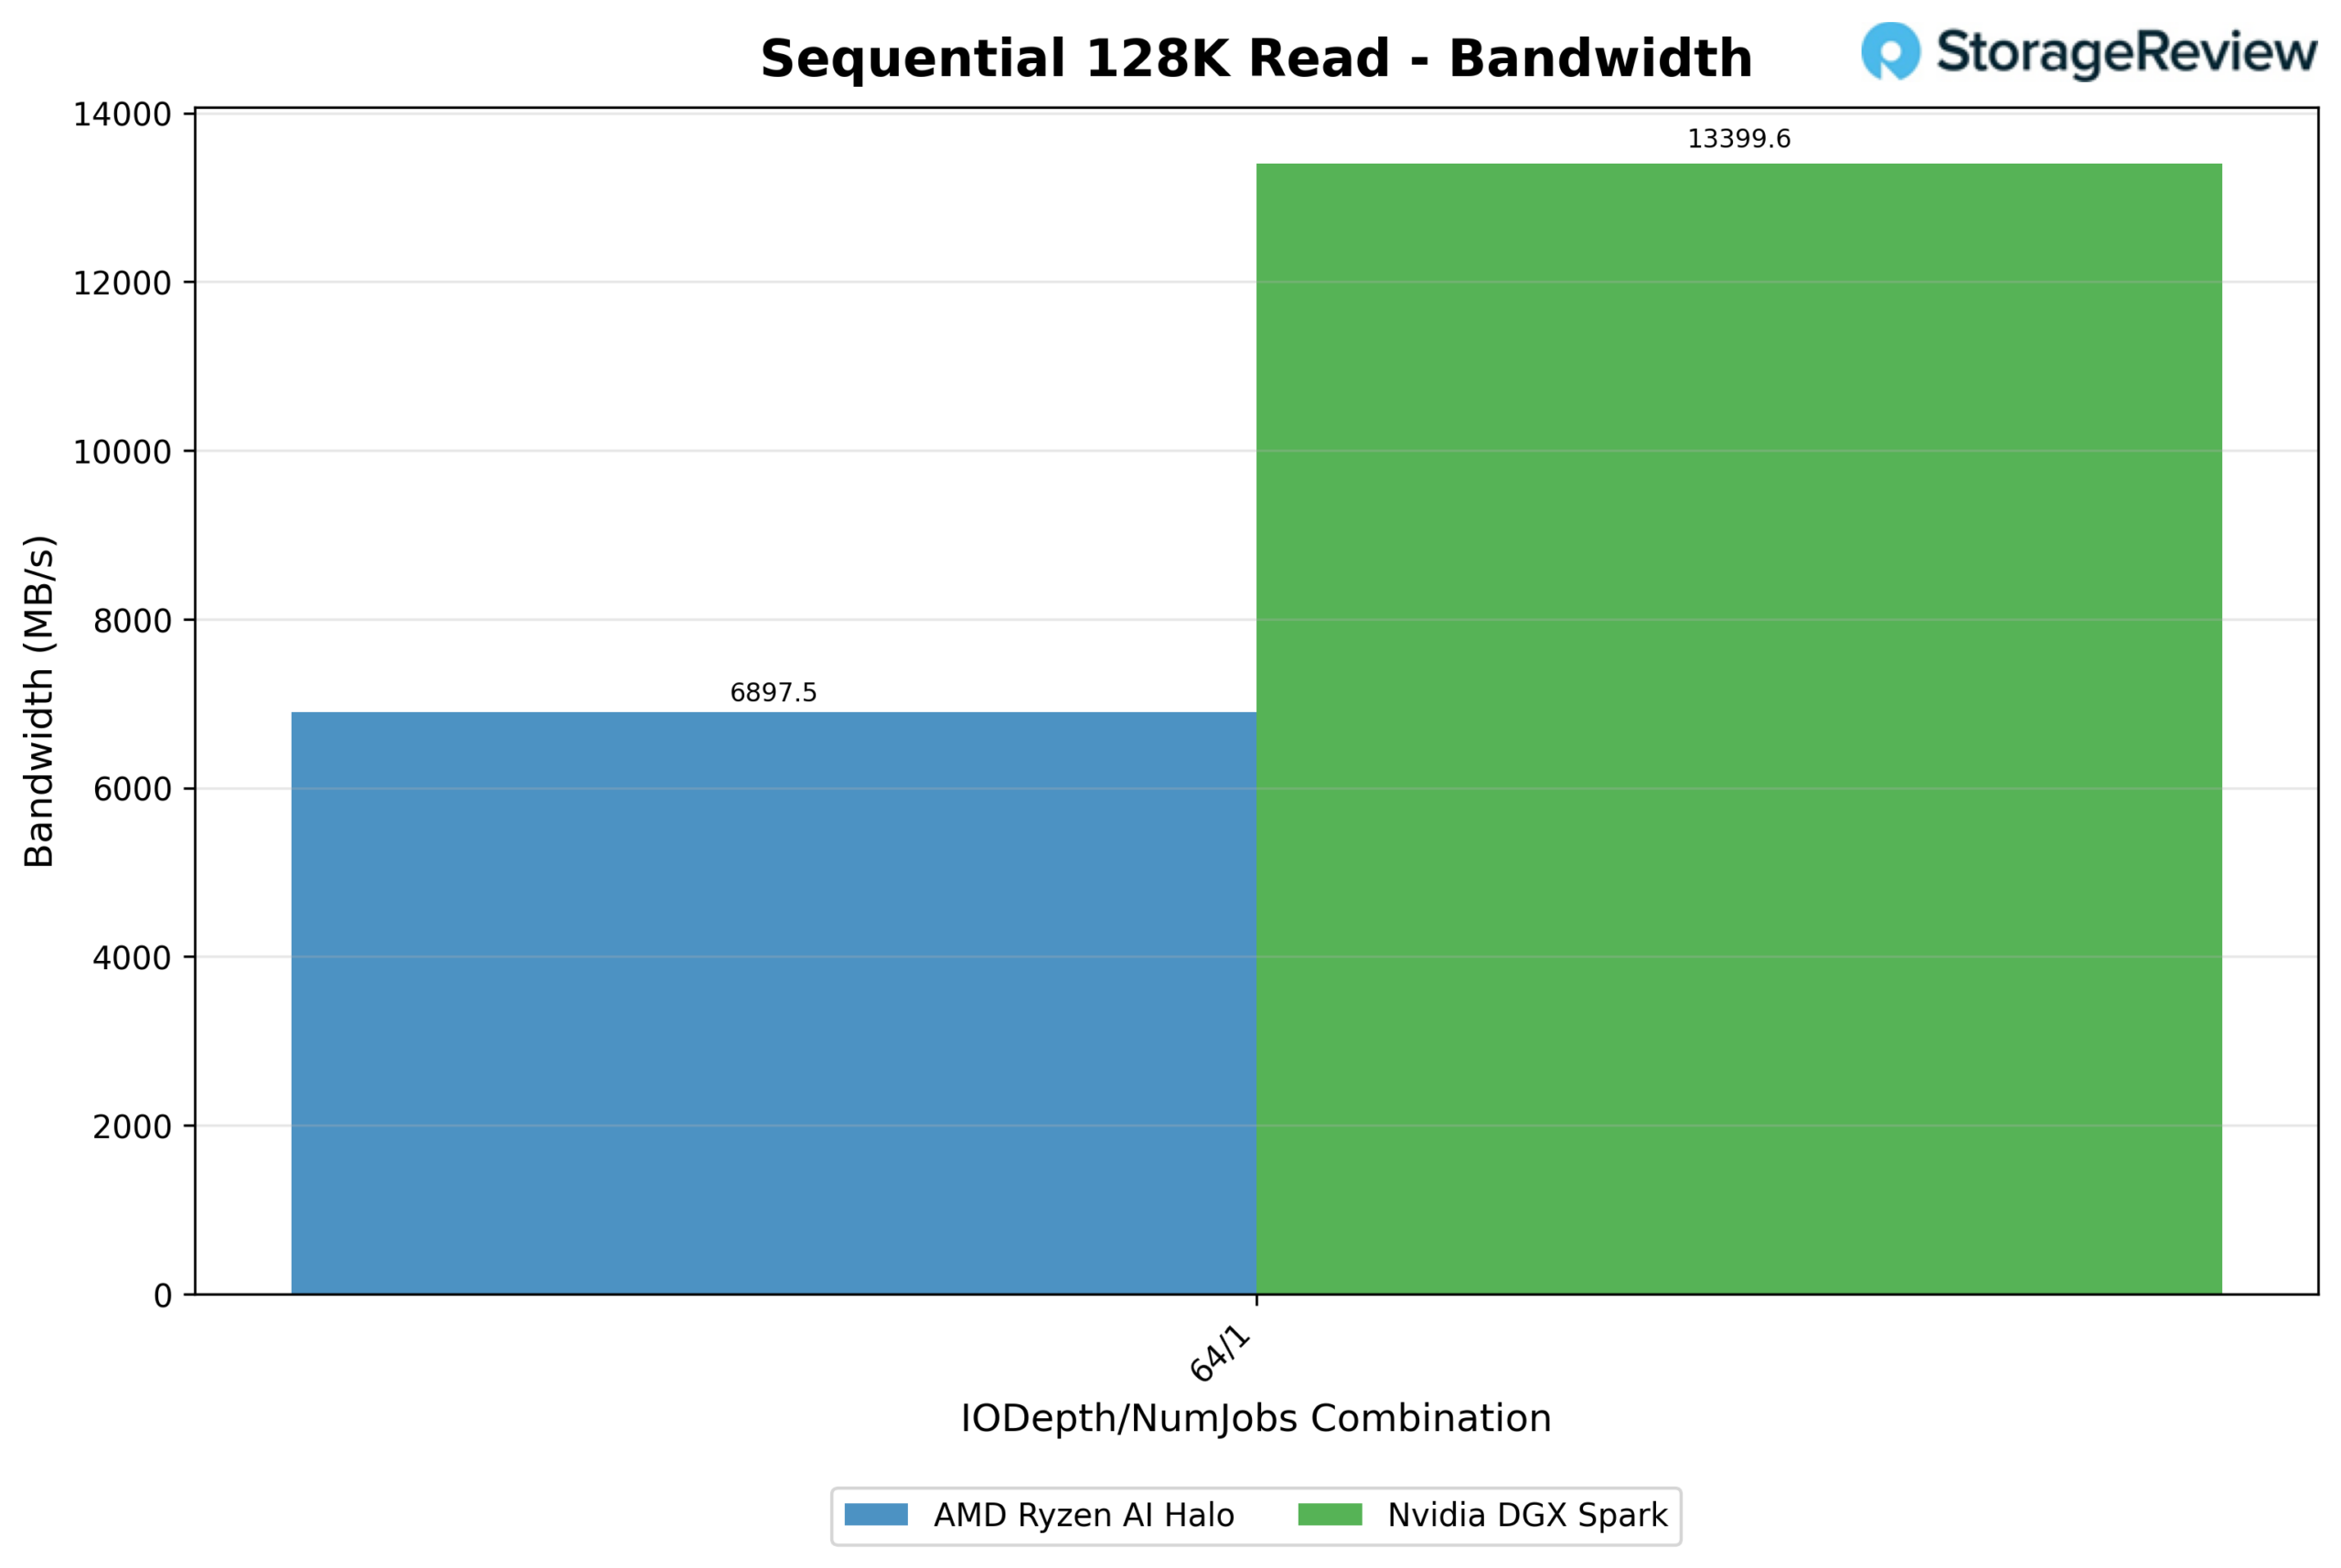
При однопоточном последовательном чтении с глубокой очередью 128 КБ (64/1) NVIDIA DGX Spark показала скорость 13 399,6 МБ/с, что почти вдвое больше, чем у AMD Ryzen AI Halo (6 897,5 МБ/с). Задержка следовала той же закономерности: средняя задержка Spark на этой глубине составила 0.597 мс, в то время как Halo отставала с показателем 1.159 мс, почти вдвое медленнее на запрос, несмотря на перемещение вдвое большего объема данных. Это наиболее явный разрыв за весь период тестирования, что говорит о том, что стек хранения Spark рассчитан на более высокую устойчивую последовательную пропускную способность при таком размере блока.
Последовательная запись 128K
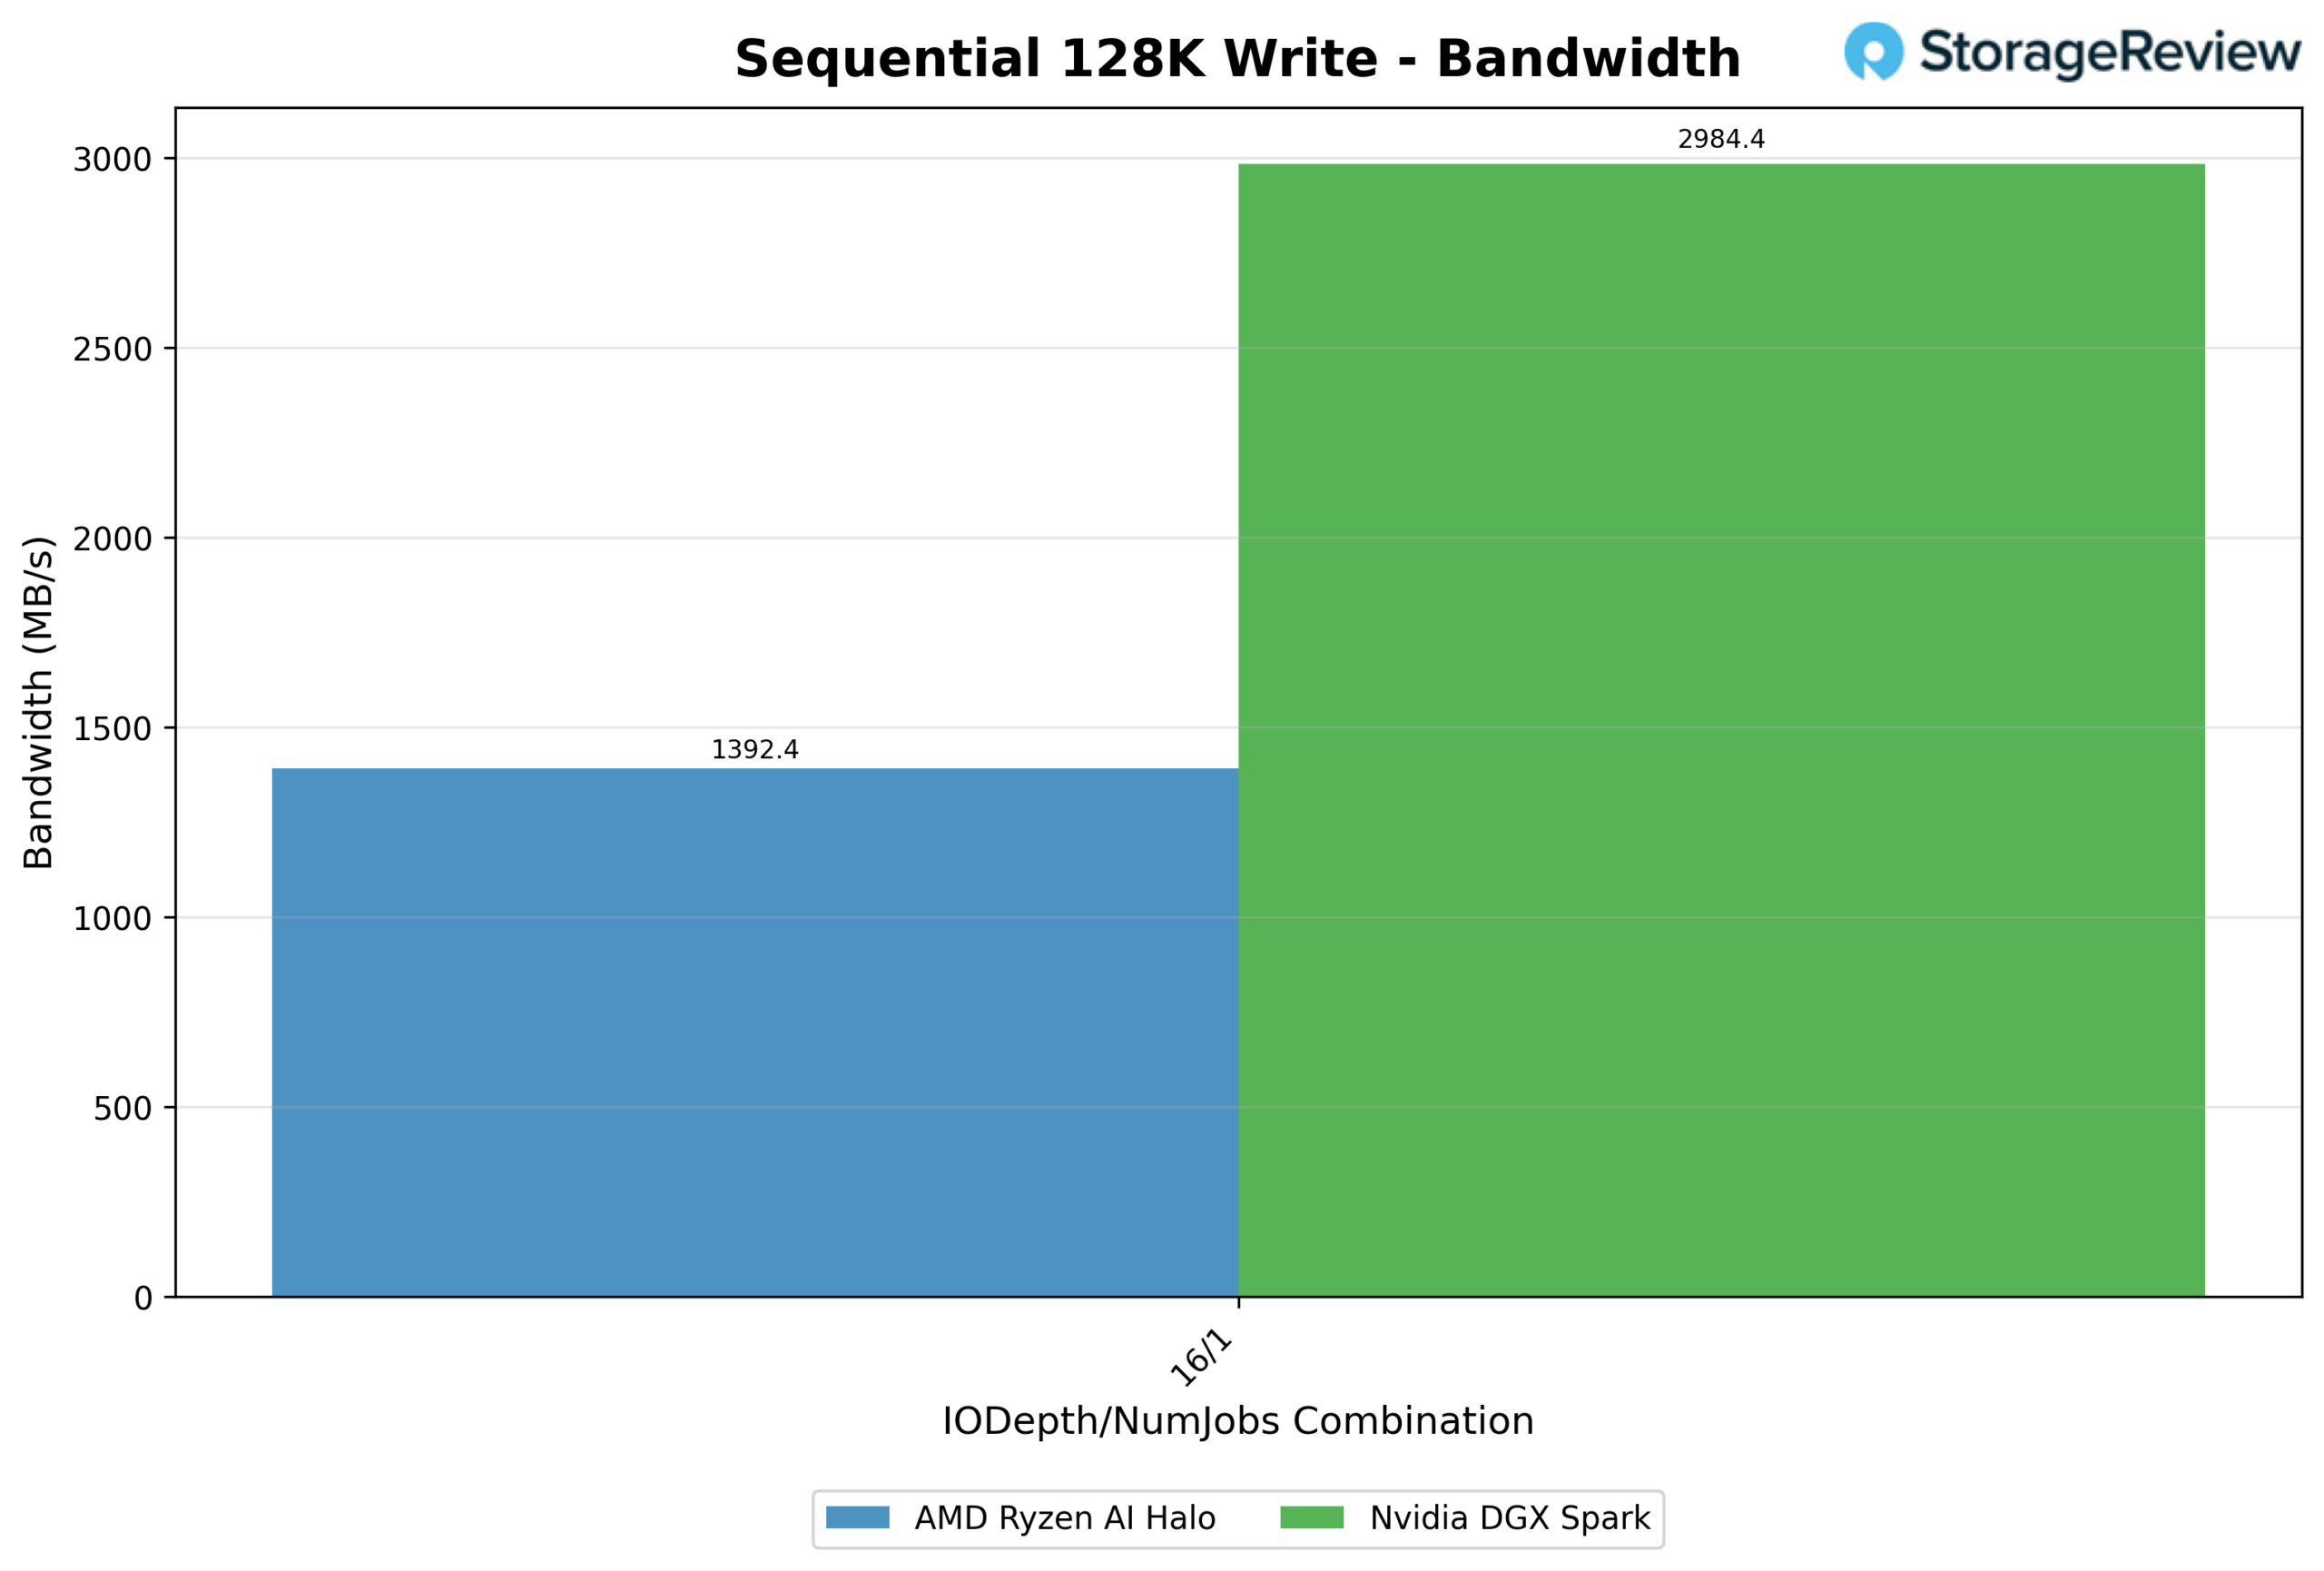
Результаты записи показывают аналогичную картину. При глубине памяти IODepth 16/1 Spark достиг скорости 2,984.4 МБ/с, по сравнению с 1,392.4 МБ/с у Halo, что на 114% больше, чем у NVIDIA. Задержка также оказалась в пользу Spark: 0.67 мс против 1.436 мс у Halo. В сочетании с результатами чтения, последовательная скорость чтения 128 КБ — это, безусловно, лучший показатель Spark по сравнению с Halo.
64K Произвольное чтение
Именно здесь проявляется преимущество Halo в отношении задержки при малой глубине очереди. При глубине очереди 1/1 Halo ответил всего за 0.051 мс, в то время как Spark — за 0.275 мс, что более чем в 5 раз быстрее для одного незавершенного запроса. Эта разница сохраняется при малой и средней глубине очереди: Halo показывает время ответа значительно меньше 0.2 мс, в то время как Spark на протяжении большей части исследования колеблется в диапазоне 0.2–0.45 мс.
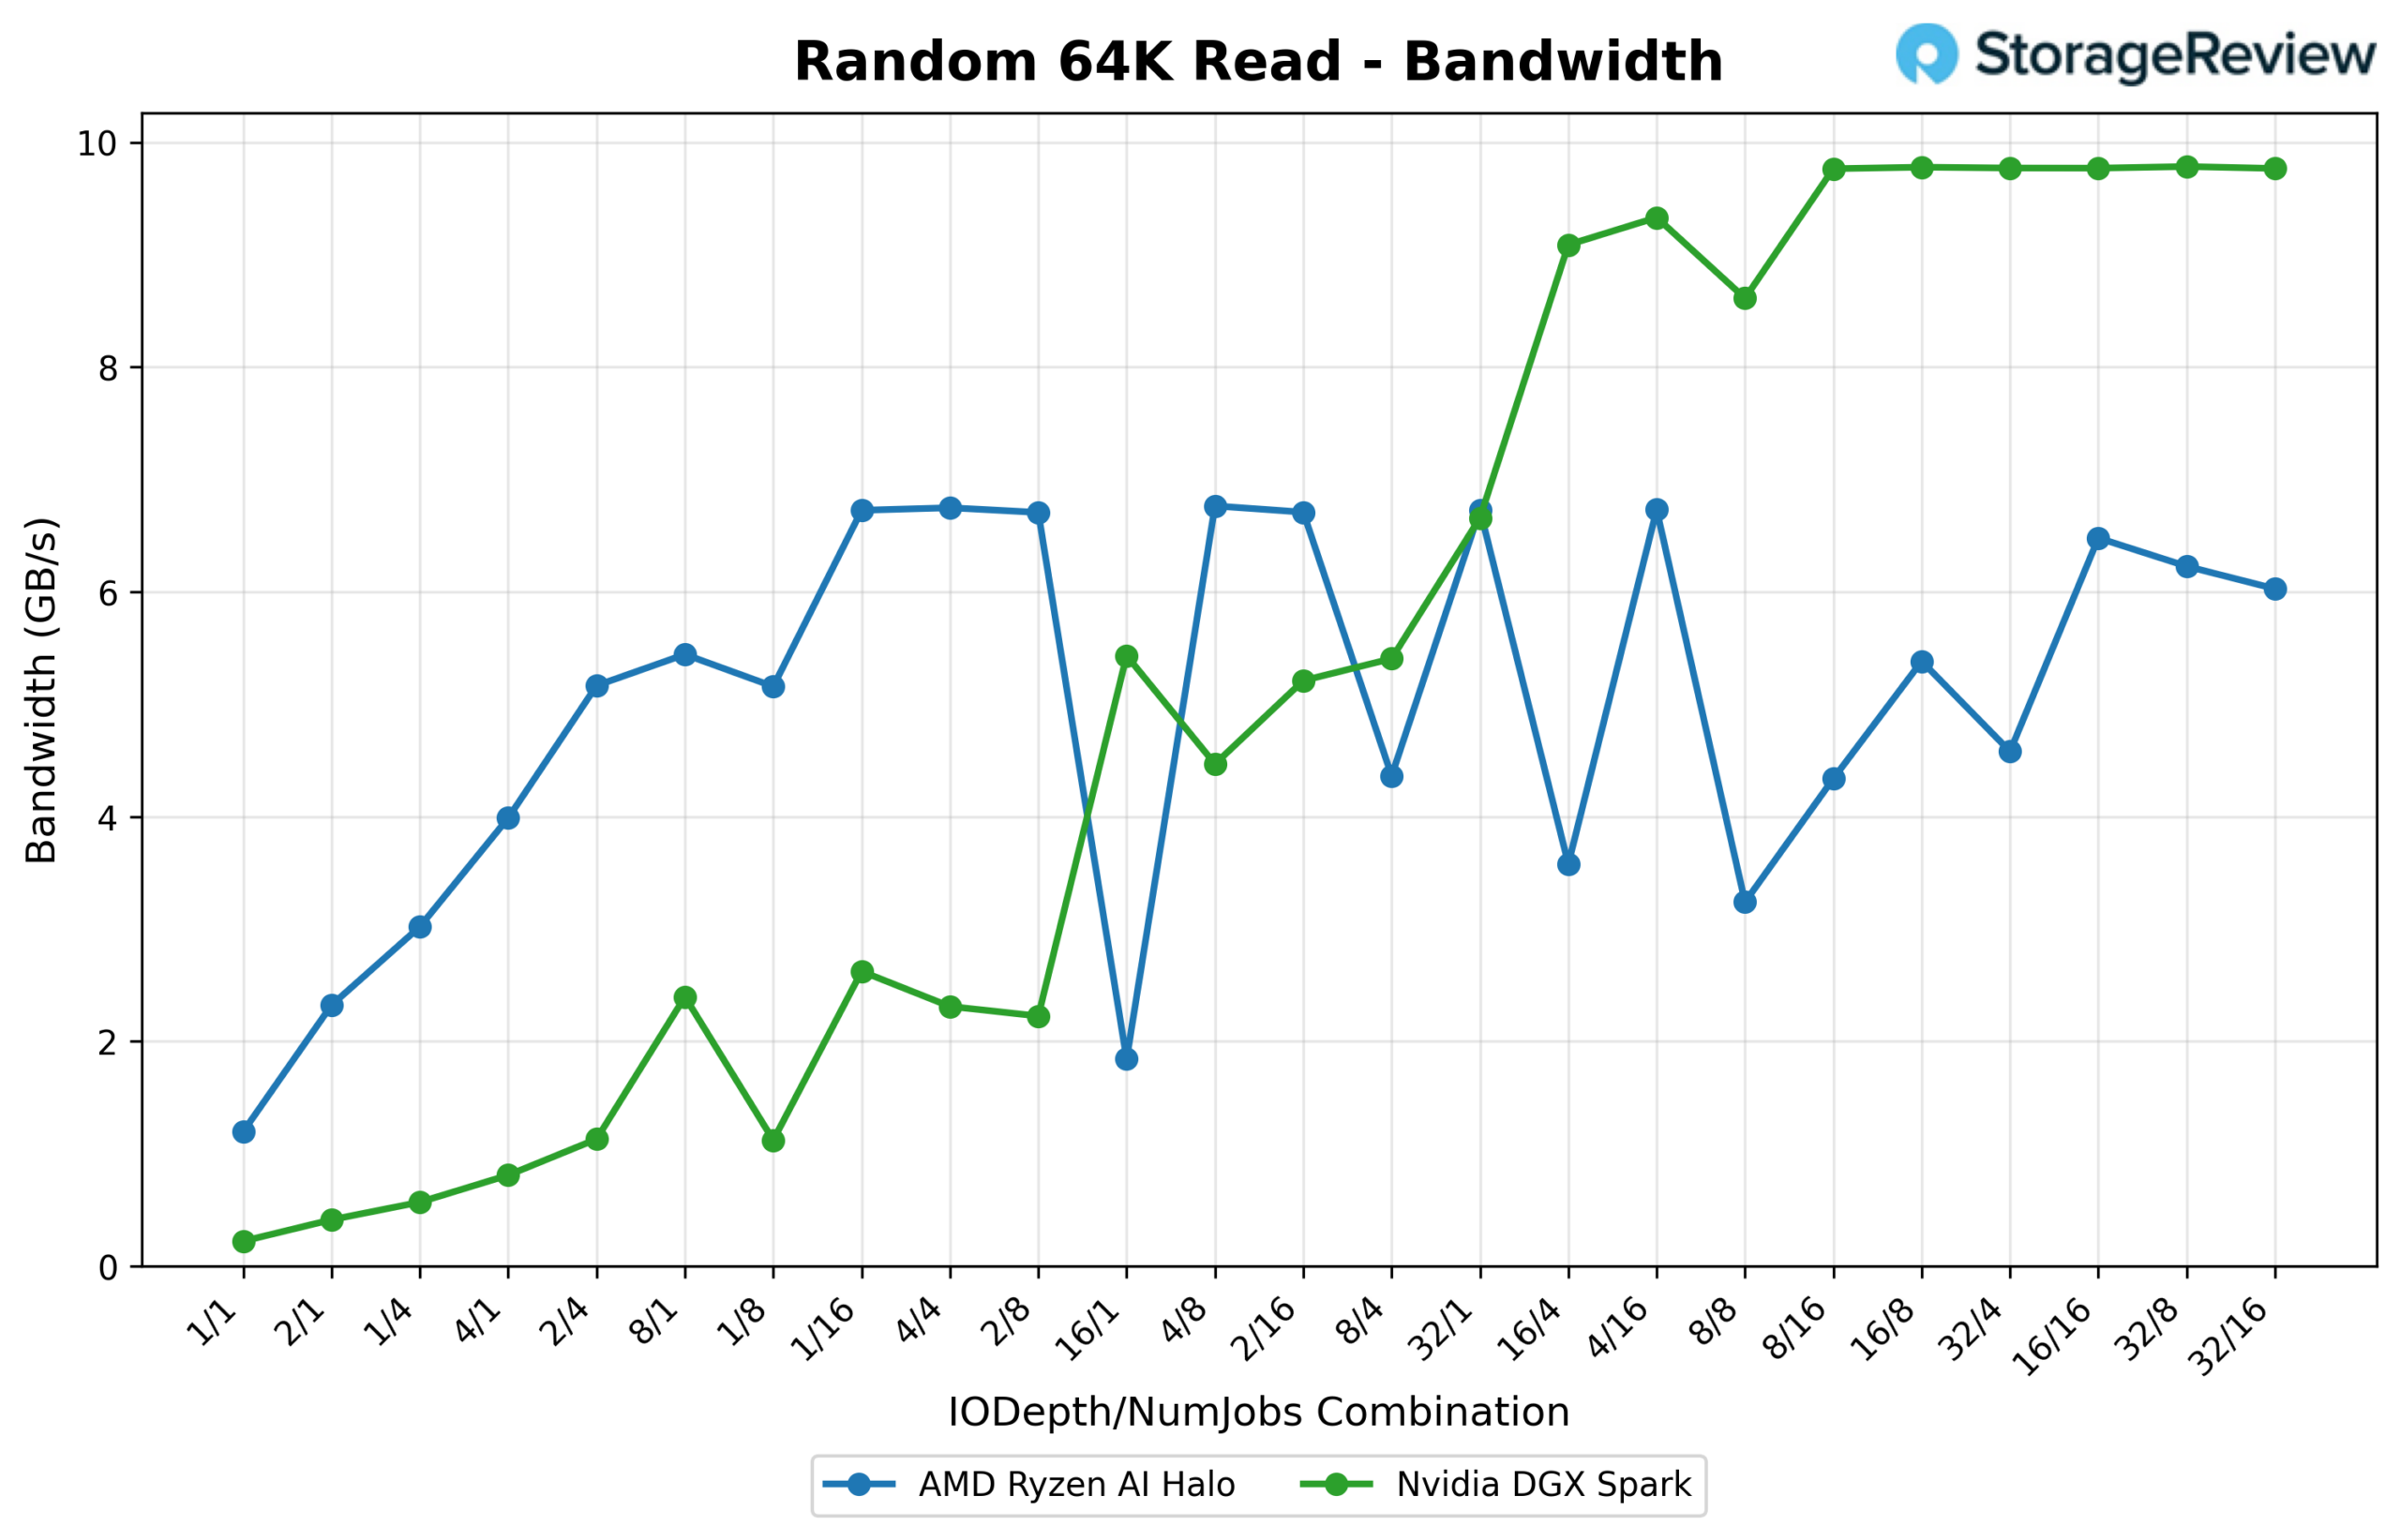
Однако при увеличении масштаба ситуация меняется. По мере того, как глубина очереди и количество потоков превышают примерно 16/4, пропускная способность Spark резко возрастает и стабилизируется на уровне около 9.8 ГБ/с, начиная с 8/16, достигая пика в 10 019,1 МБ/с (160.3 тыс. IOPS) при 32/8. Halo никогда не достигает этого потолка: его пропускная способность насыщается в диапазоне 6.0–6.9 ГБ/с, достигая пика в 6,926.5 МБ/с (110.8 тыс. IOPS) при 4/8. Кривая пропускной способности заметно более нестабильна, колеблясь между примерно 2 и 6.8 ГБ/с в зависимости от комбинации глубины/количества потоков, вместо того, чтобы плавно расти.
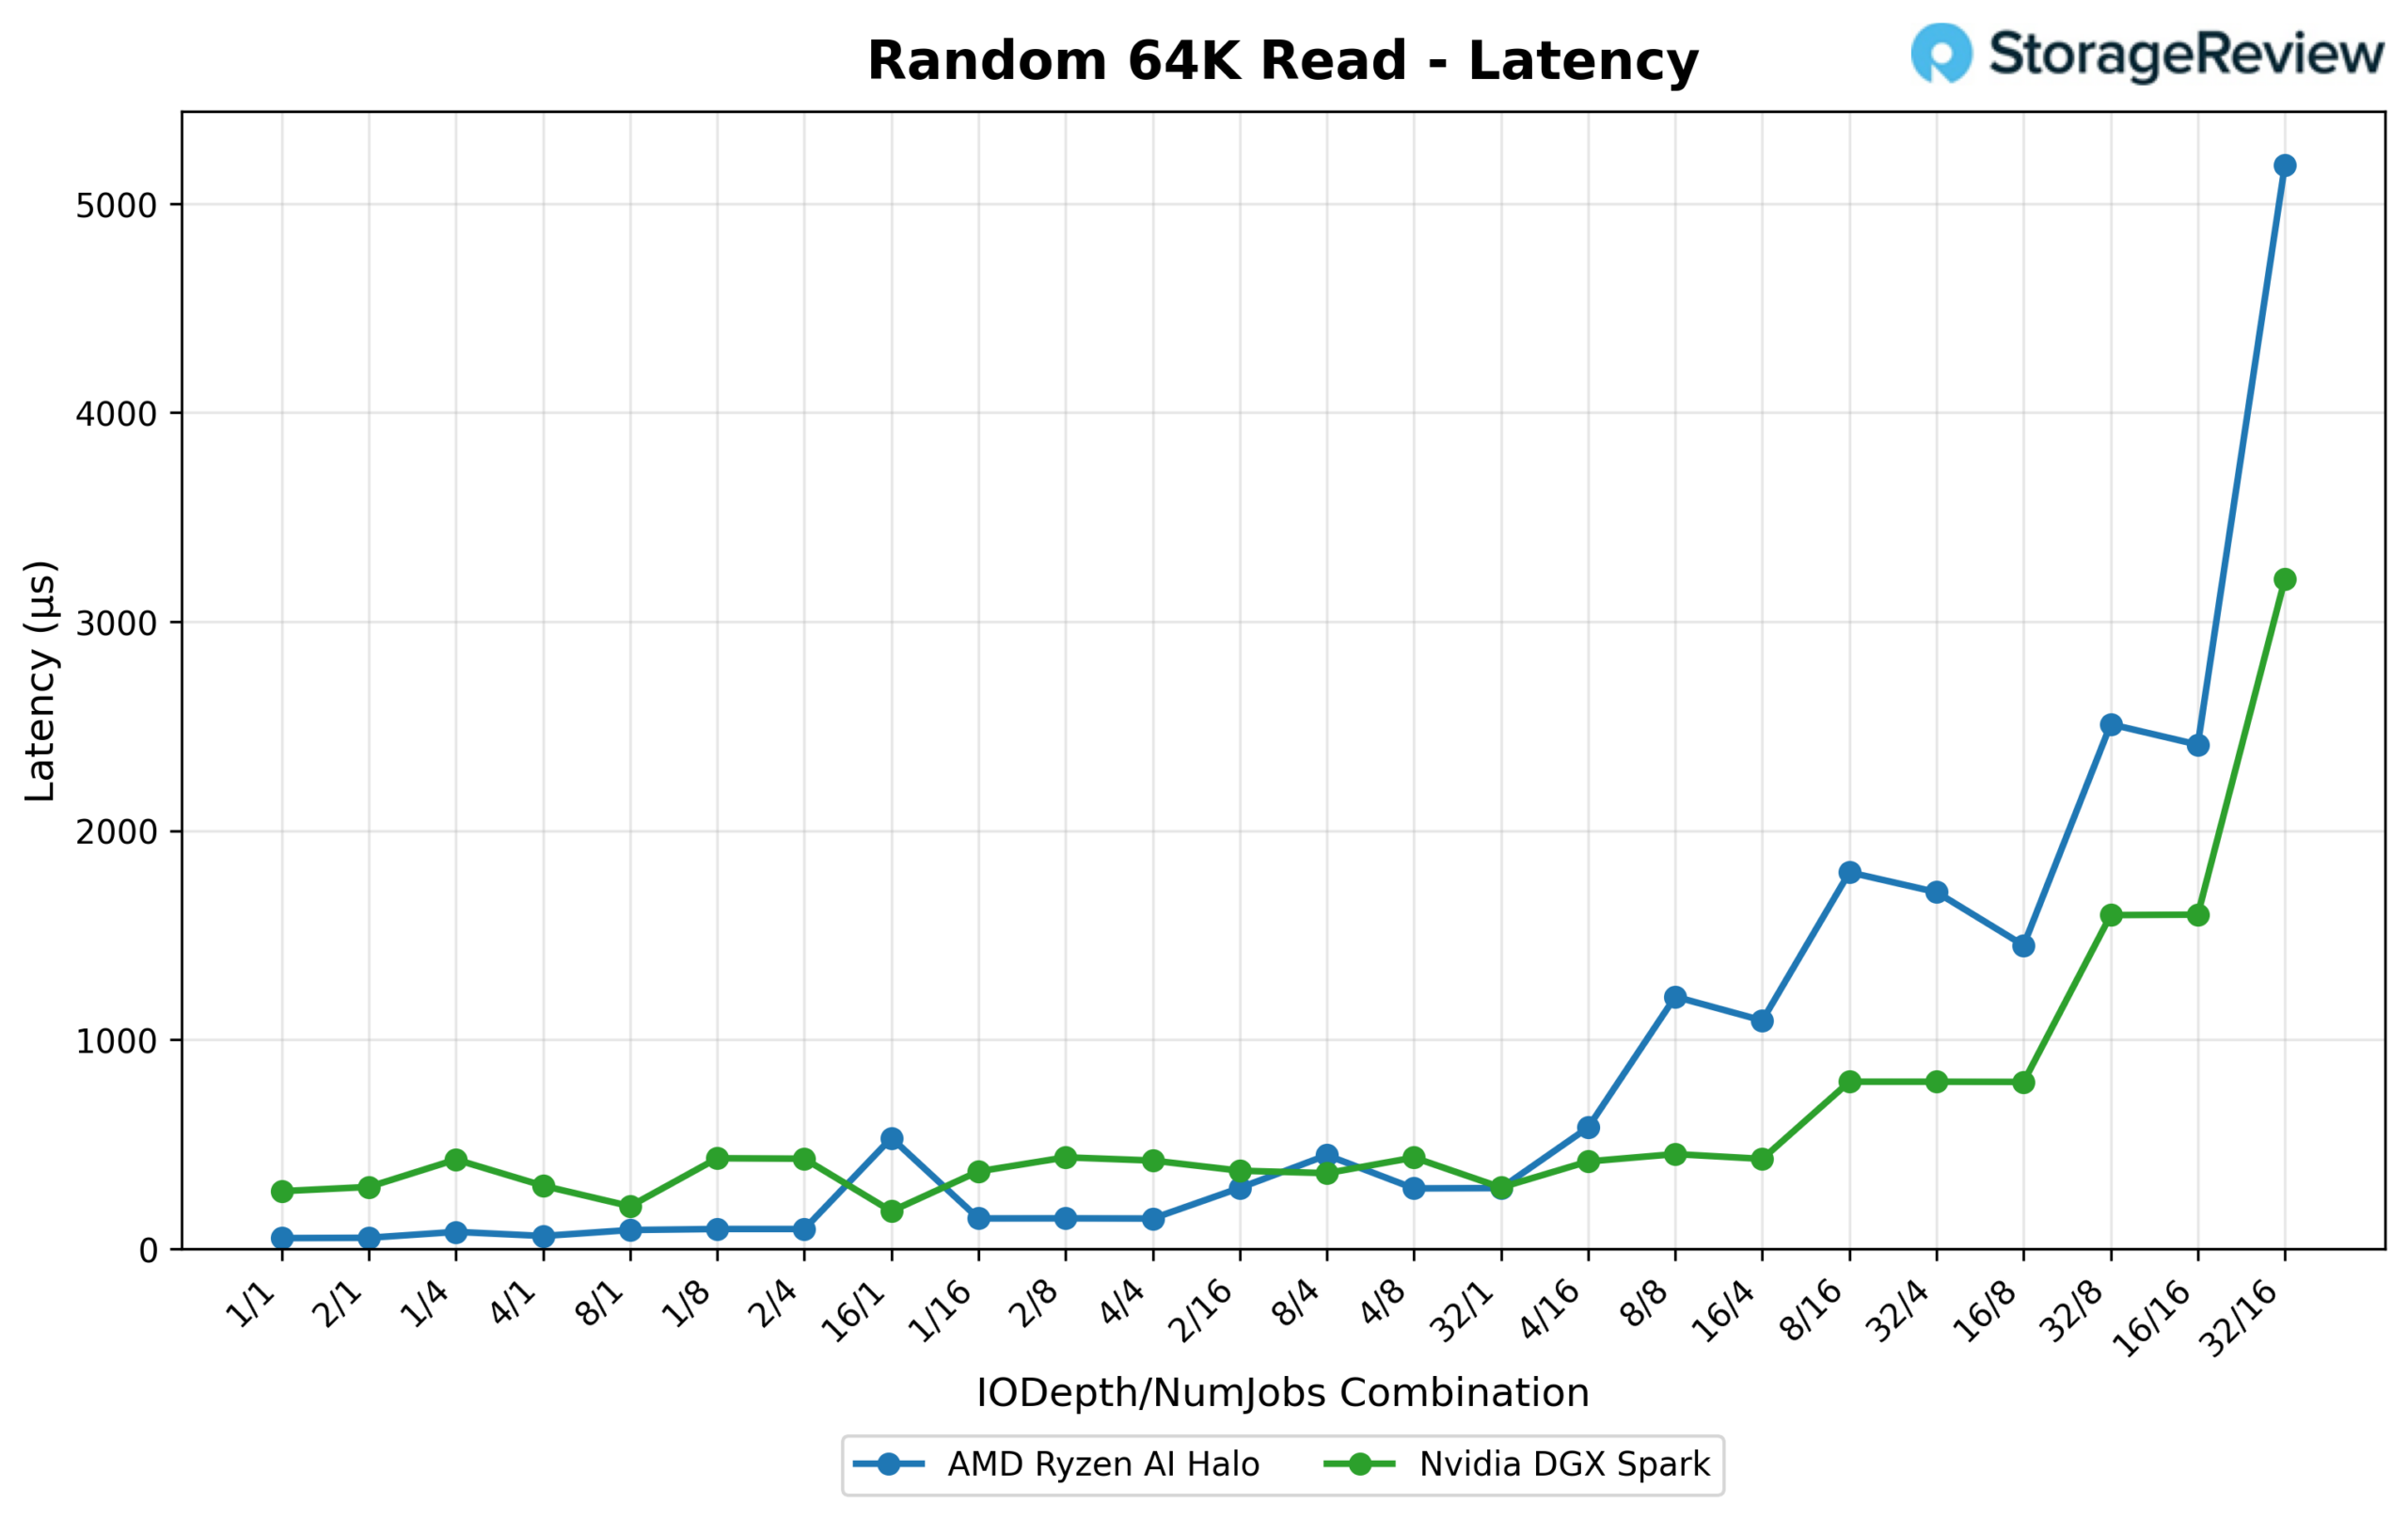
Задержка при полной загрузке также играет на руку Spark: при 32/16 средняя задержка Halo увеличивается до 5.185 мс по сравнению с 3.204 мс у Spark, что означает, что Halo расплачивается за низкую скорость отклика в очереди худшим поведением в конце очереди после ее полной загрузки.
64K Случайная запись
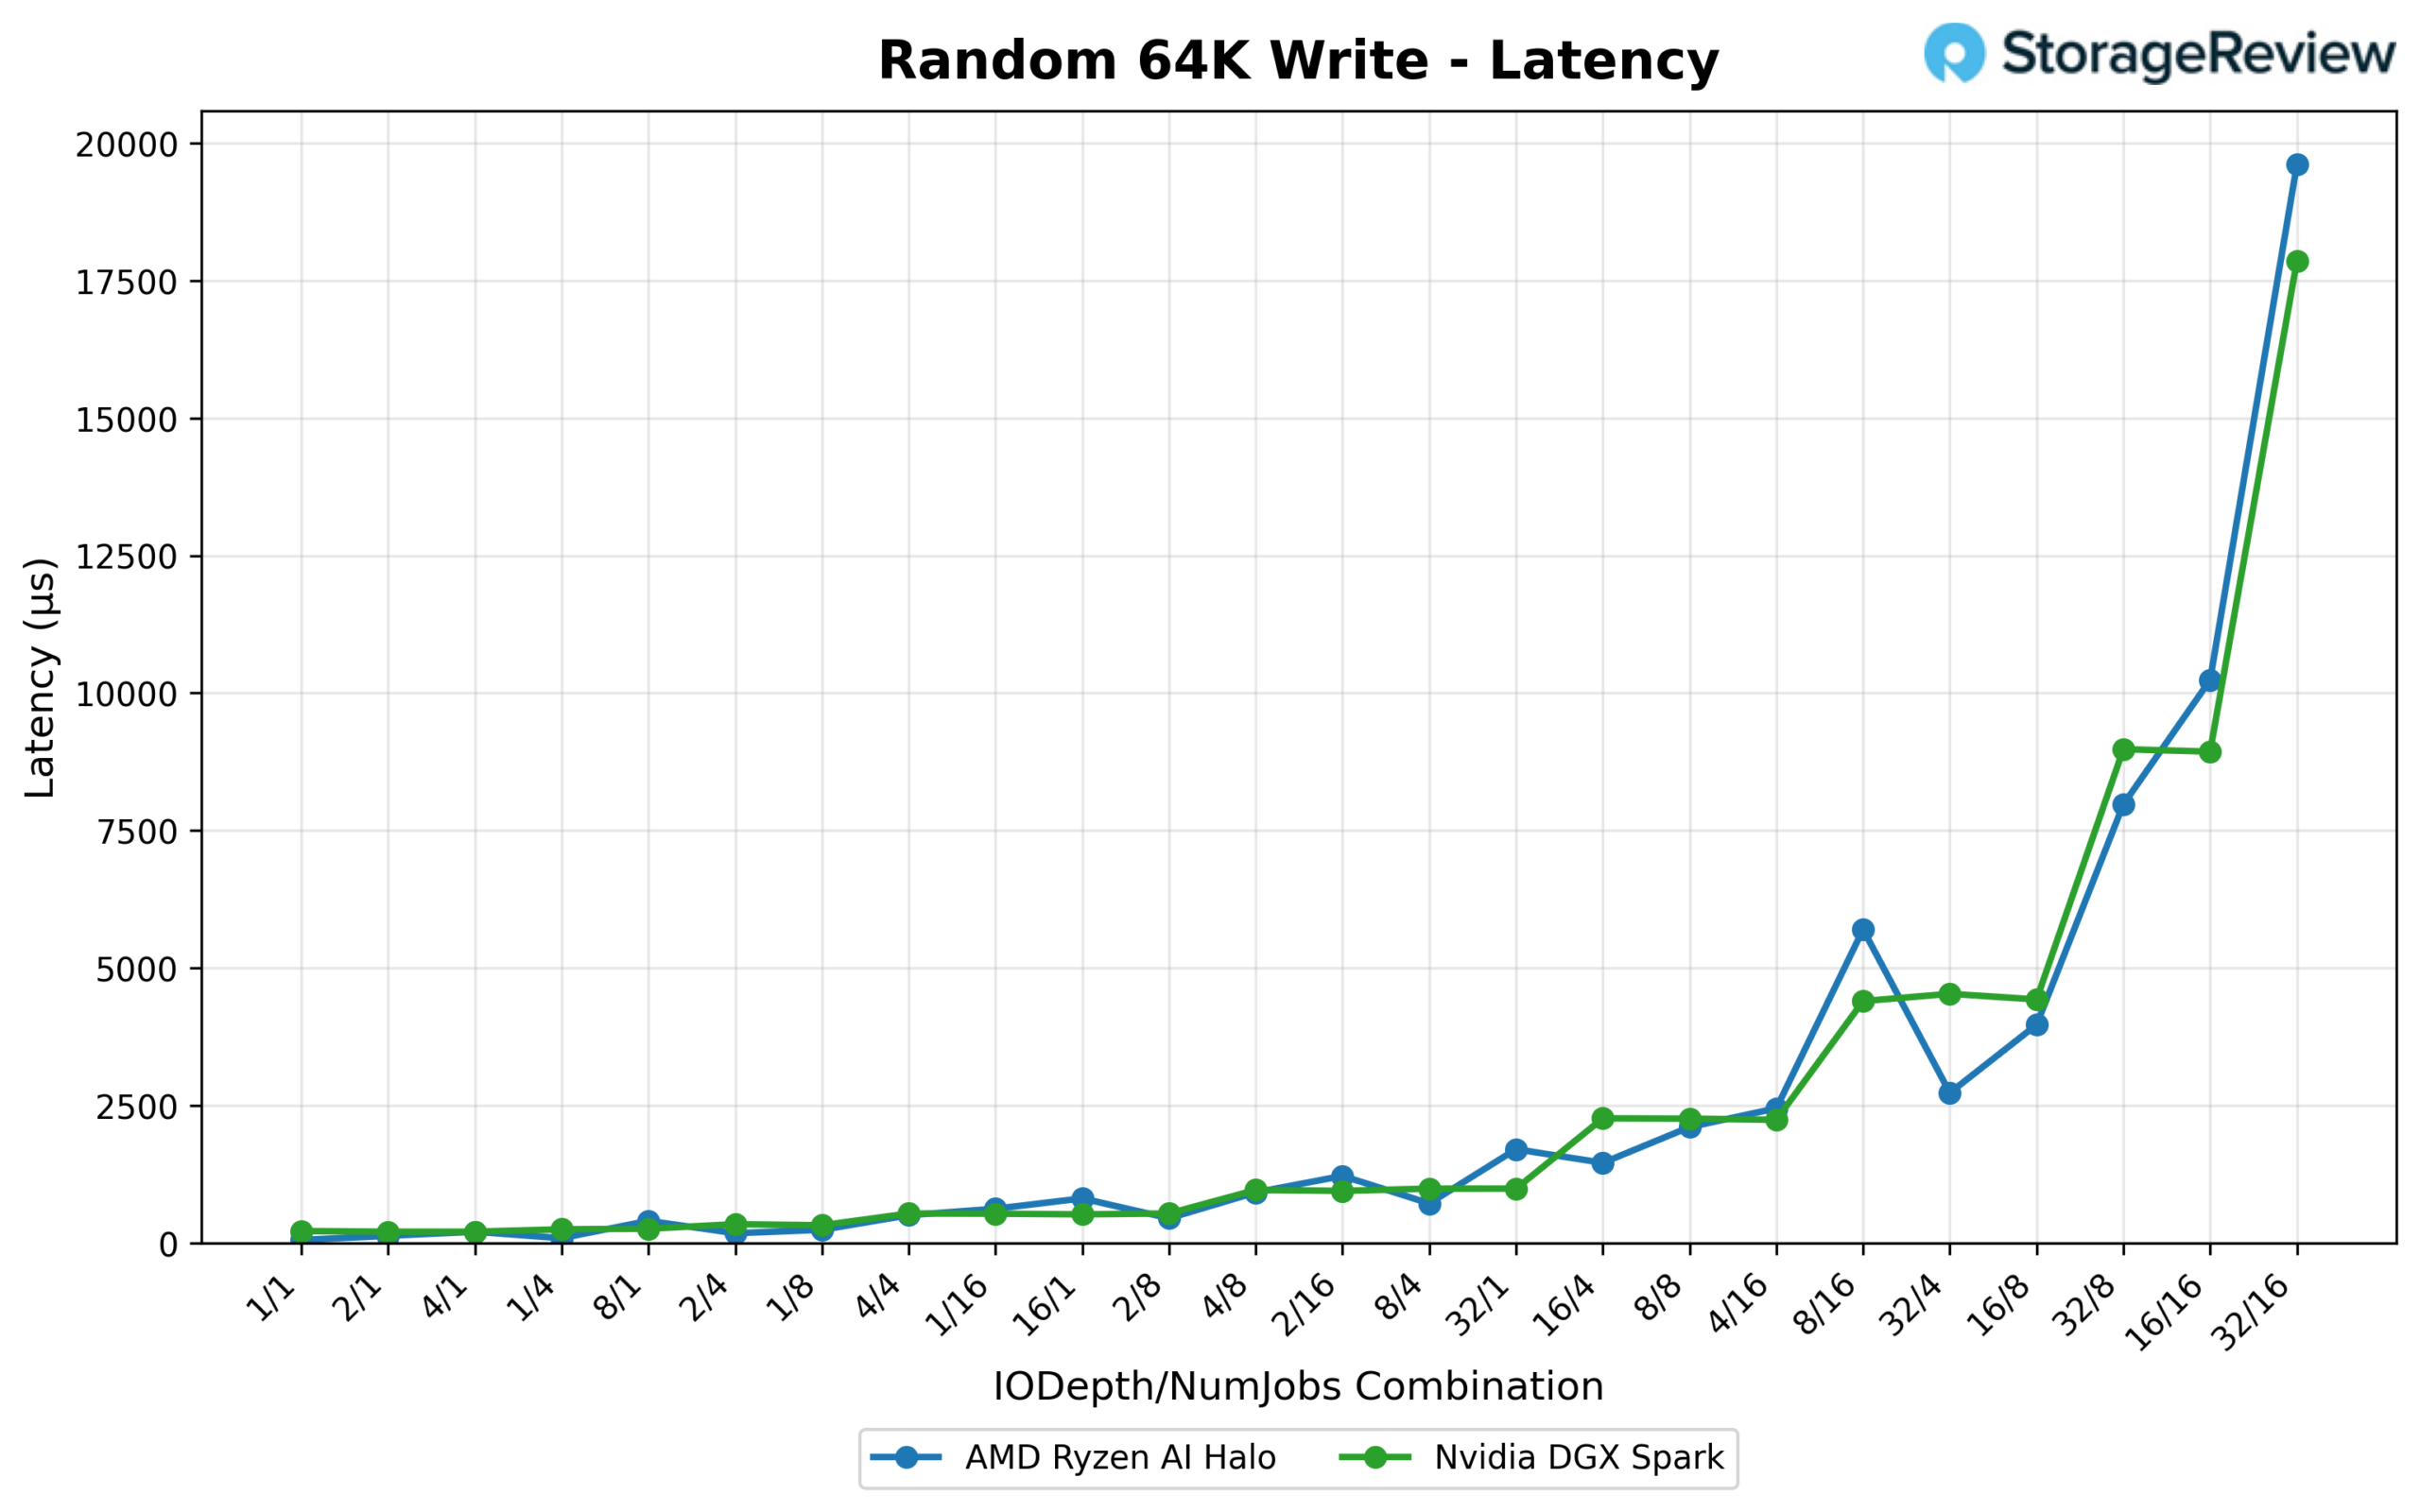
Пропускная способность при случайной записи 64K на двух платформах ближе друг к другу, чем при чтении, хотя форма кривых сильно различается. Пропускная способность Halo более скачкообразно высока: она неоднократно превышает 2.5 ГБ/с (достигая пика в 2,929.1 МБ/с / 46.9 тыс. IOPS при 32/4), прежде чем снова упасть до диапазона 1.1–1.5 ГБ/с на смежных комбинациях. Spark сравнительно стабилен, стабилизируясь в диапазоне 1.7–2.0 ГБ/с на протяжении большей части измерения и достигая пика в 2,106.6 МБ/с (33.7 тыс. IOPS) при 2/16.
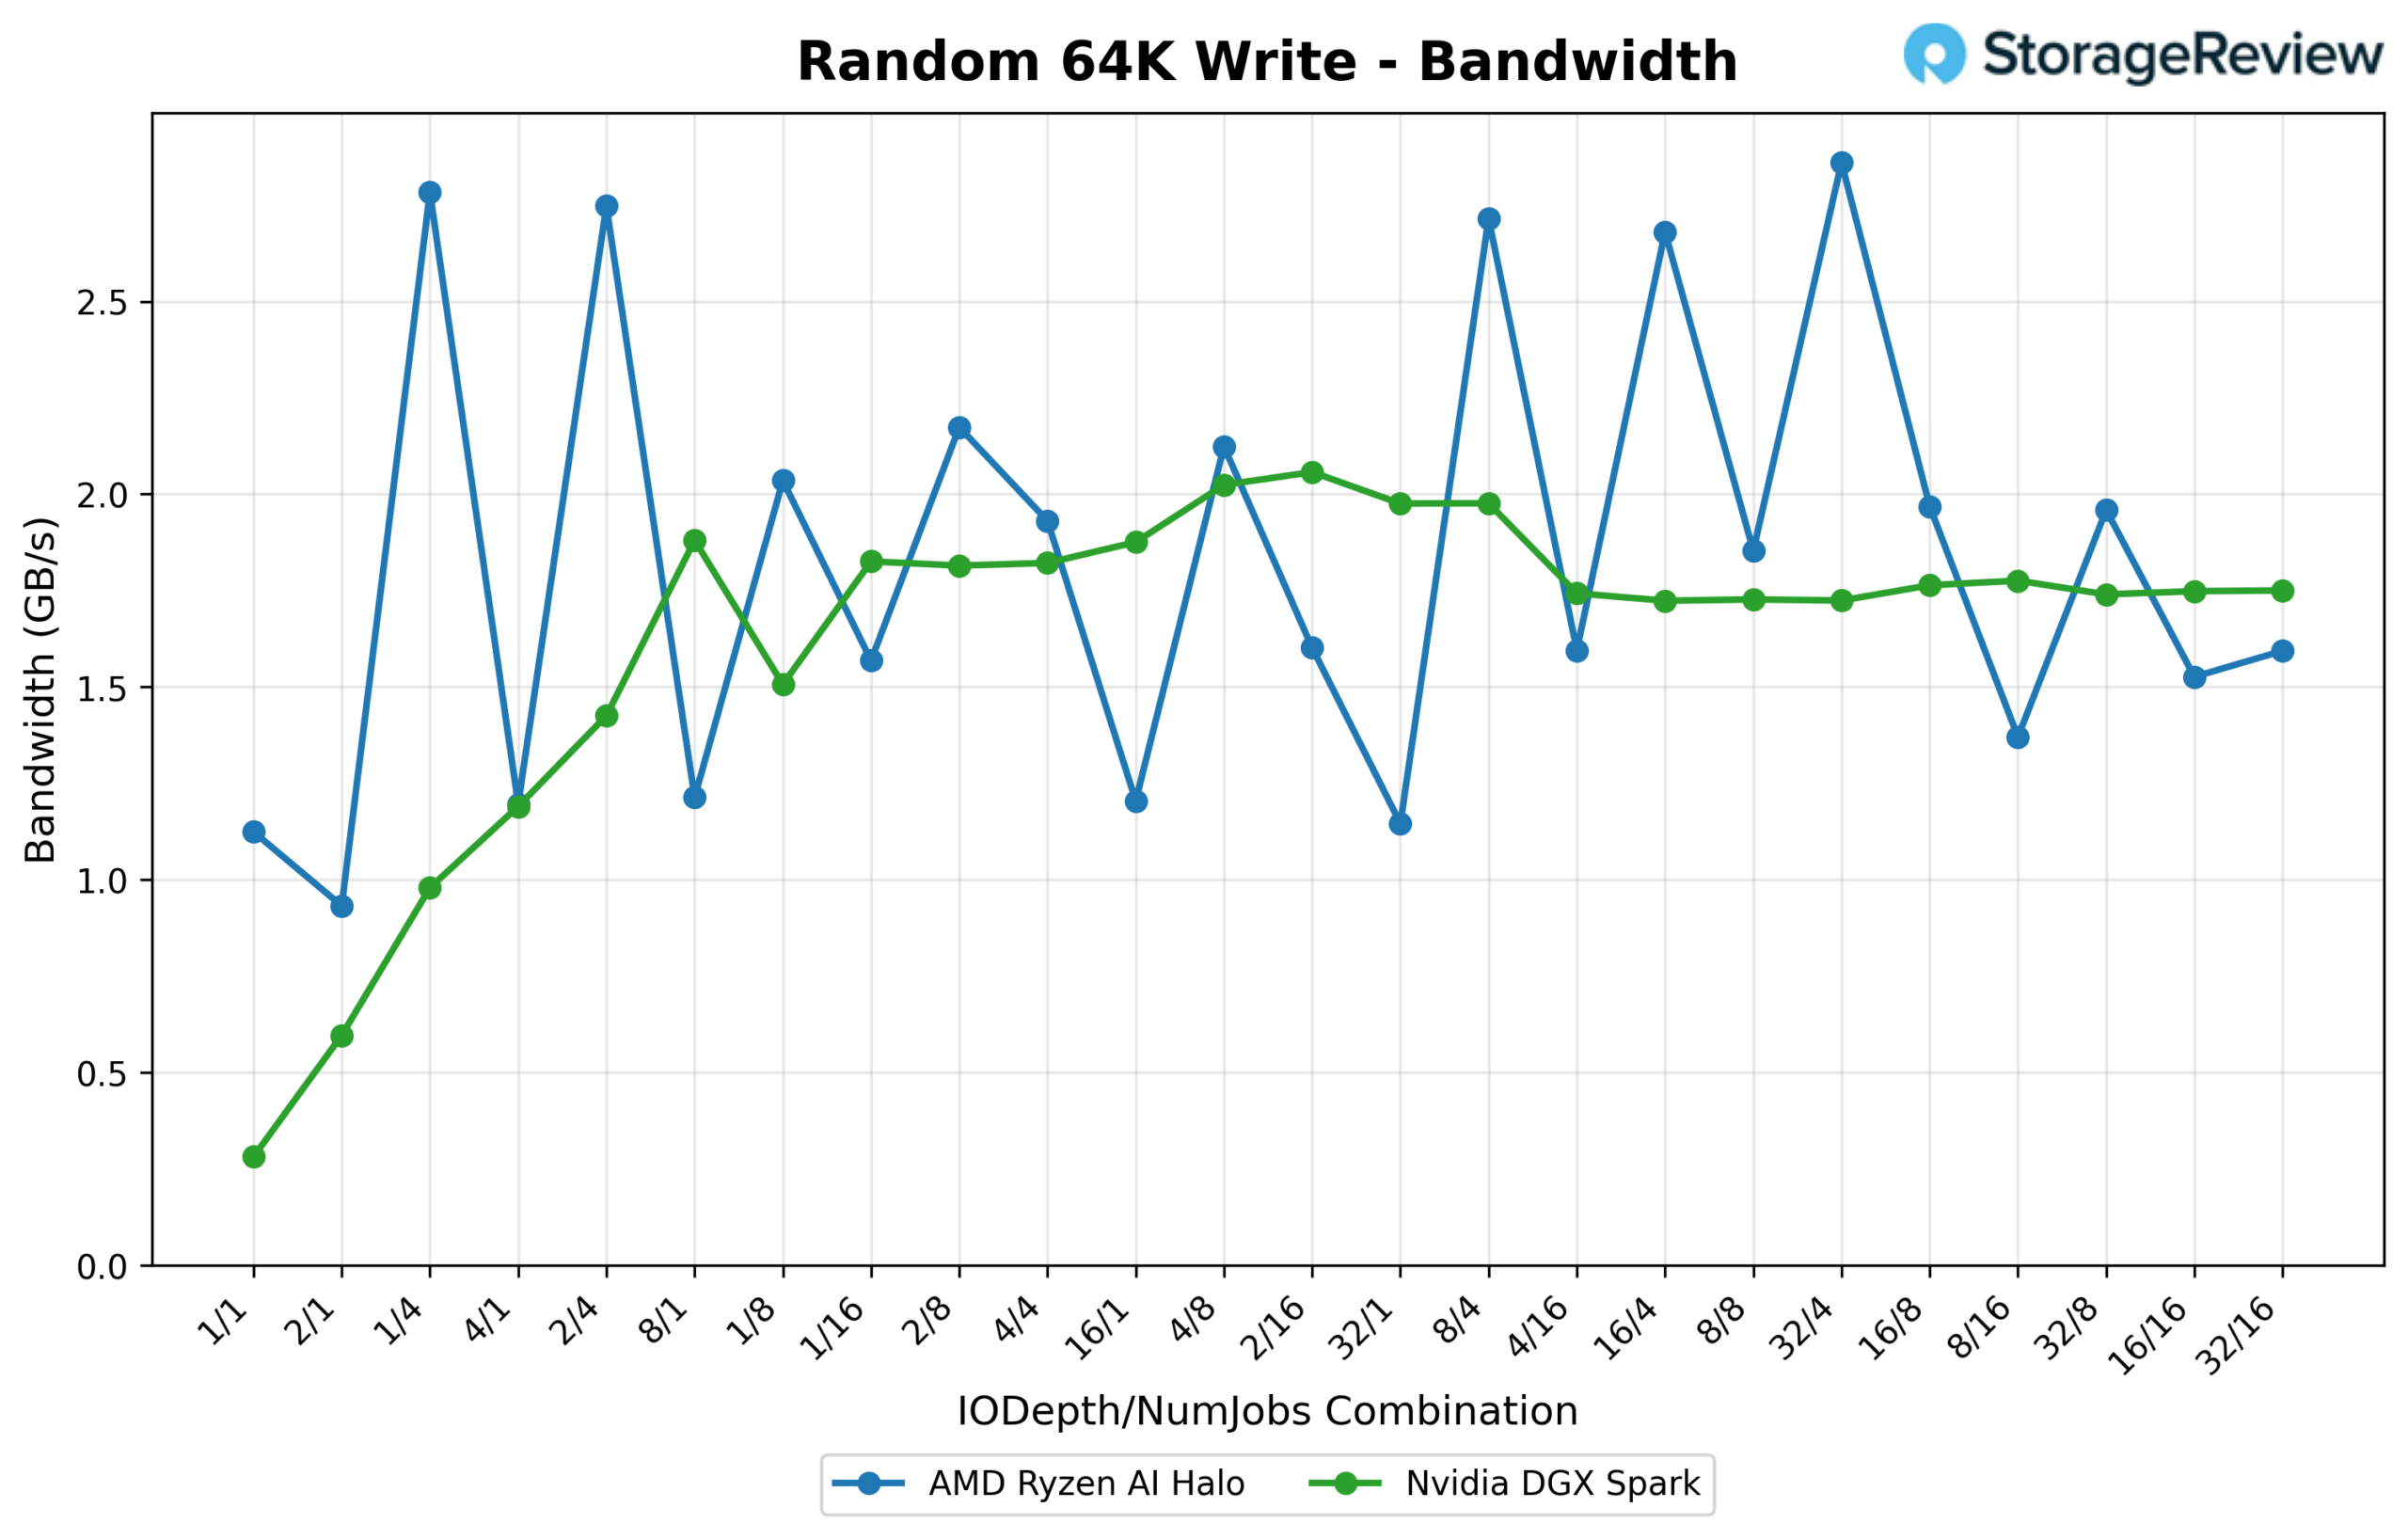
Задержка отражает закономерность чтения 64K: Halo значительно быстрее при малой глубине очереди (0.054 мс при 1/1 против 0.217 мс у Spark), и оба накопителя резко ухудшают свои показатели по мере увеличения глубины очереди и количества потоков до двузначных значений. При полной загрузке (32/16) задержка Halo достигает 19.611 мс по сравнению с 17.857 мс у Spark. Оба накопителя явно испытывают сильную нагрузку из-за усиления записи в этот момент, при этом Halo снова немного хуже в самом верху кривой.
16K последовательное чтение
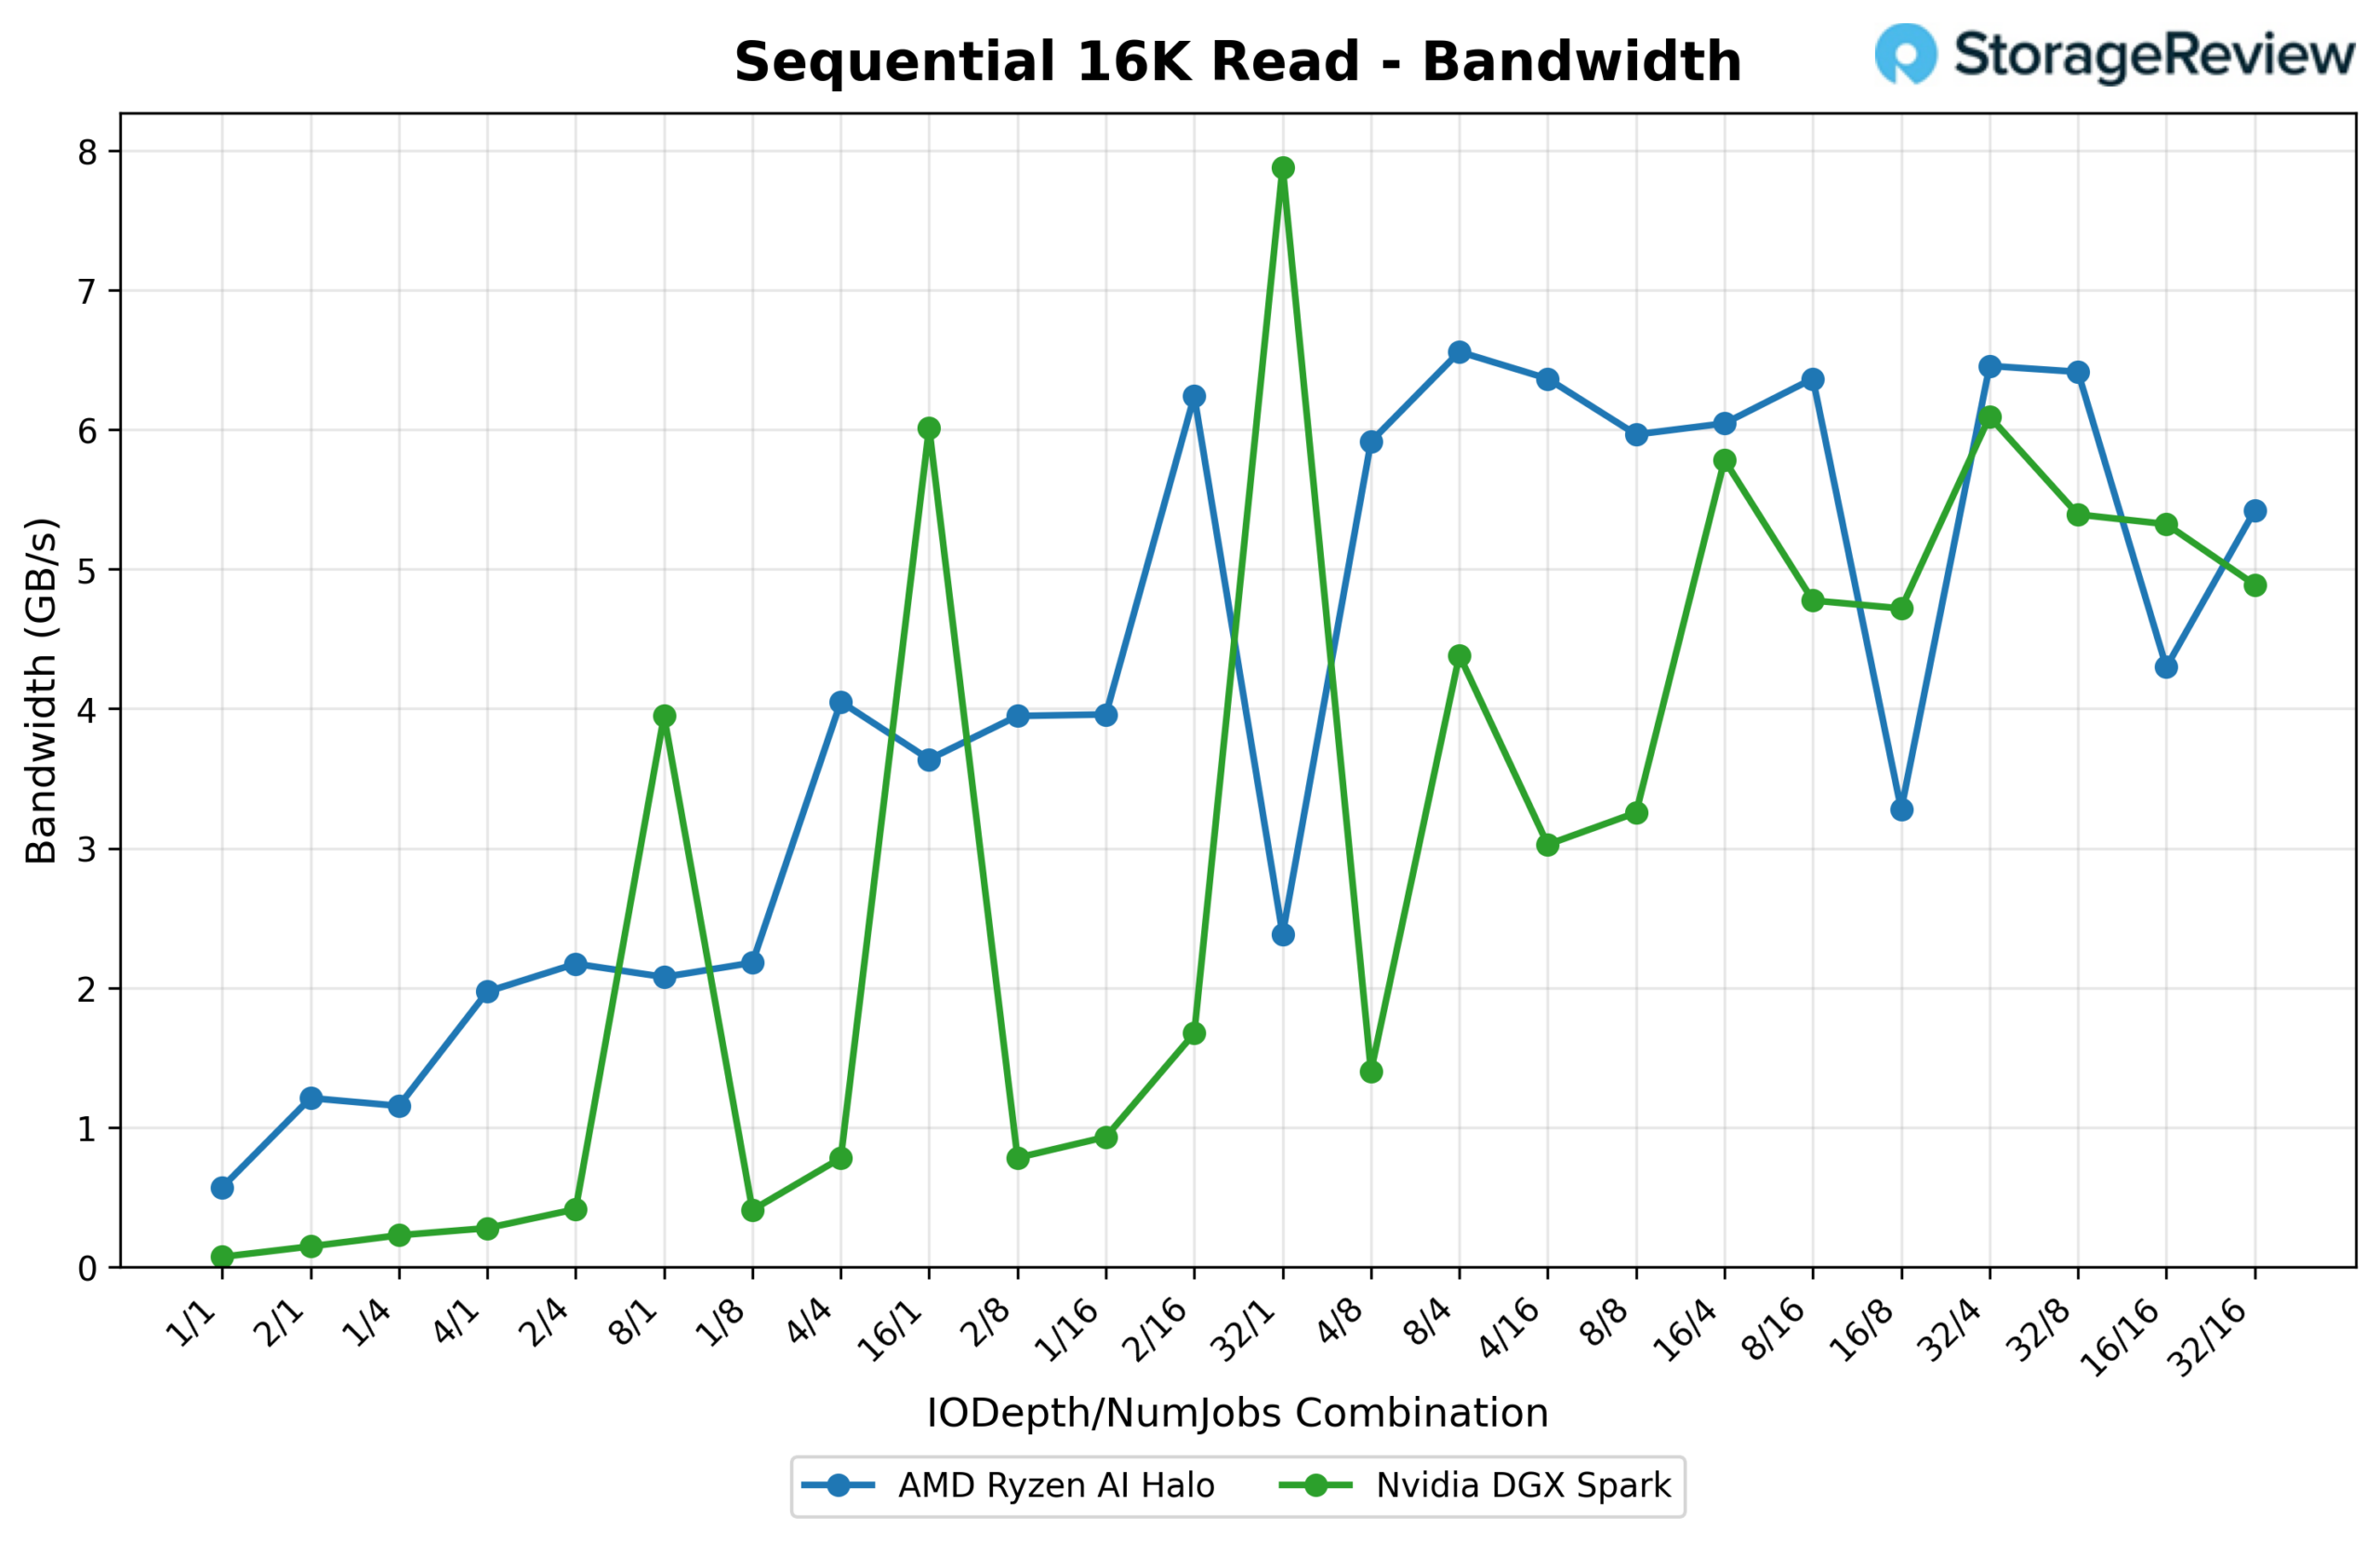
Пропускная способность остается высокой на протяжении большей части теста, при этом оба накопителя демонстрируют пилообразные колебания в диапазоне примерно от 1 до 8 ГБ/с в зависимости от комбинации глубины/потоков. Spark немного превосходит конкурента по пиковой скорости, достигая 8,069.3 МБ/с (516.4 тыс. IOPS) при соотношении 32/1, в то время как Halo достигает максимума в 6,715.8 МБ/с (429.8 тыс. IOPS) при соотношении 8/4.
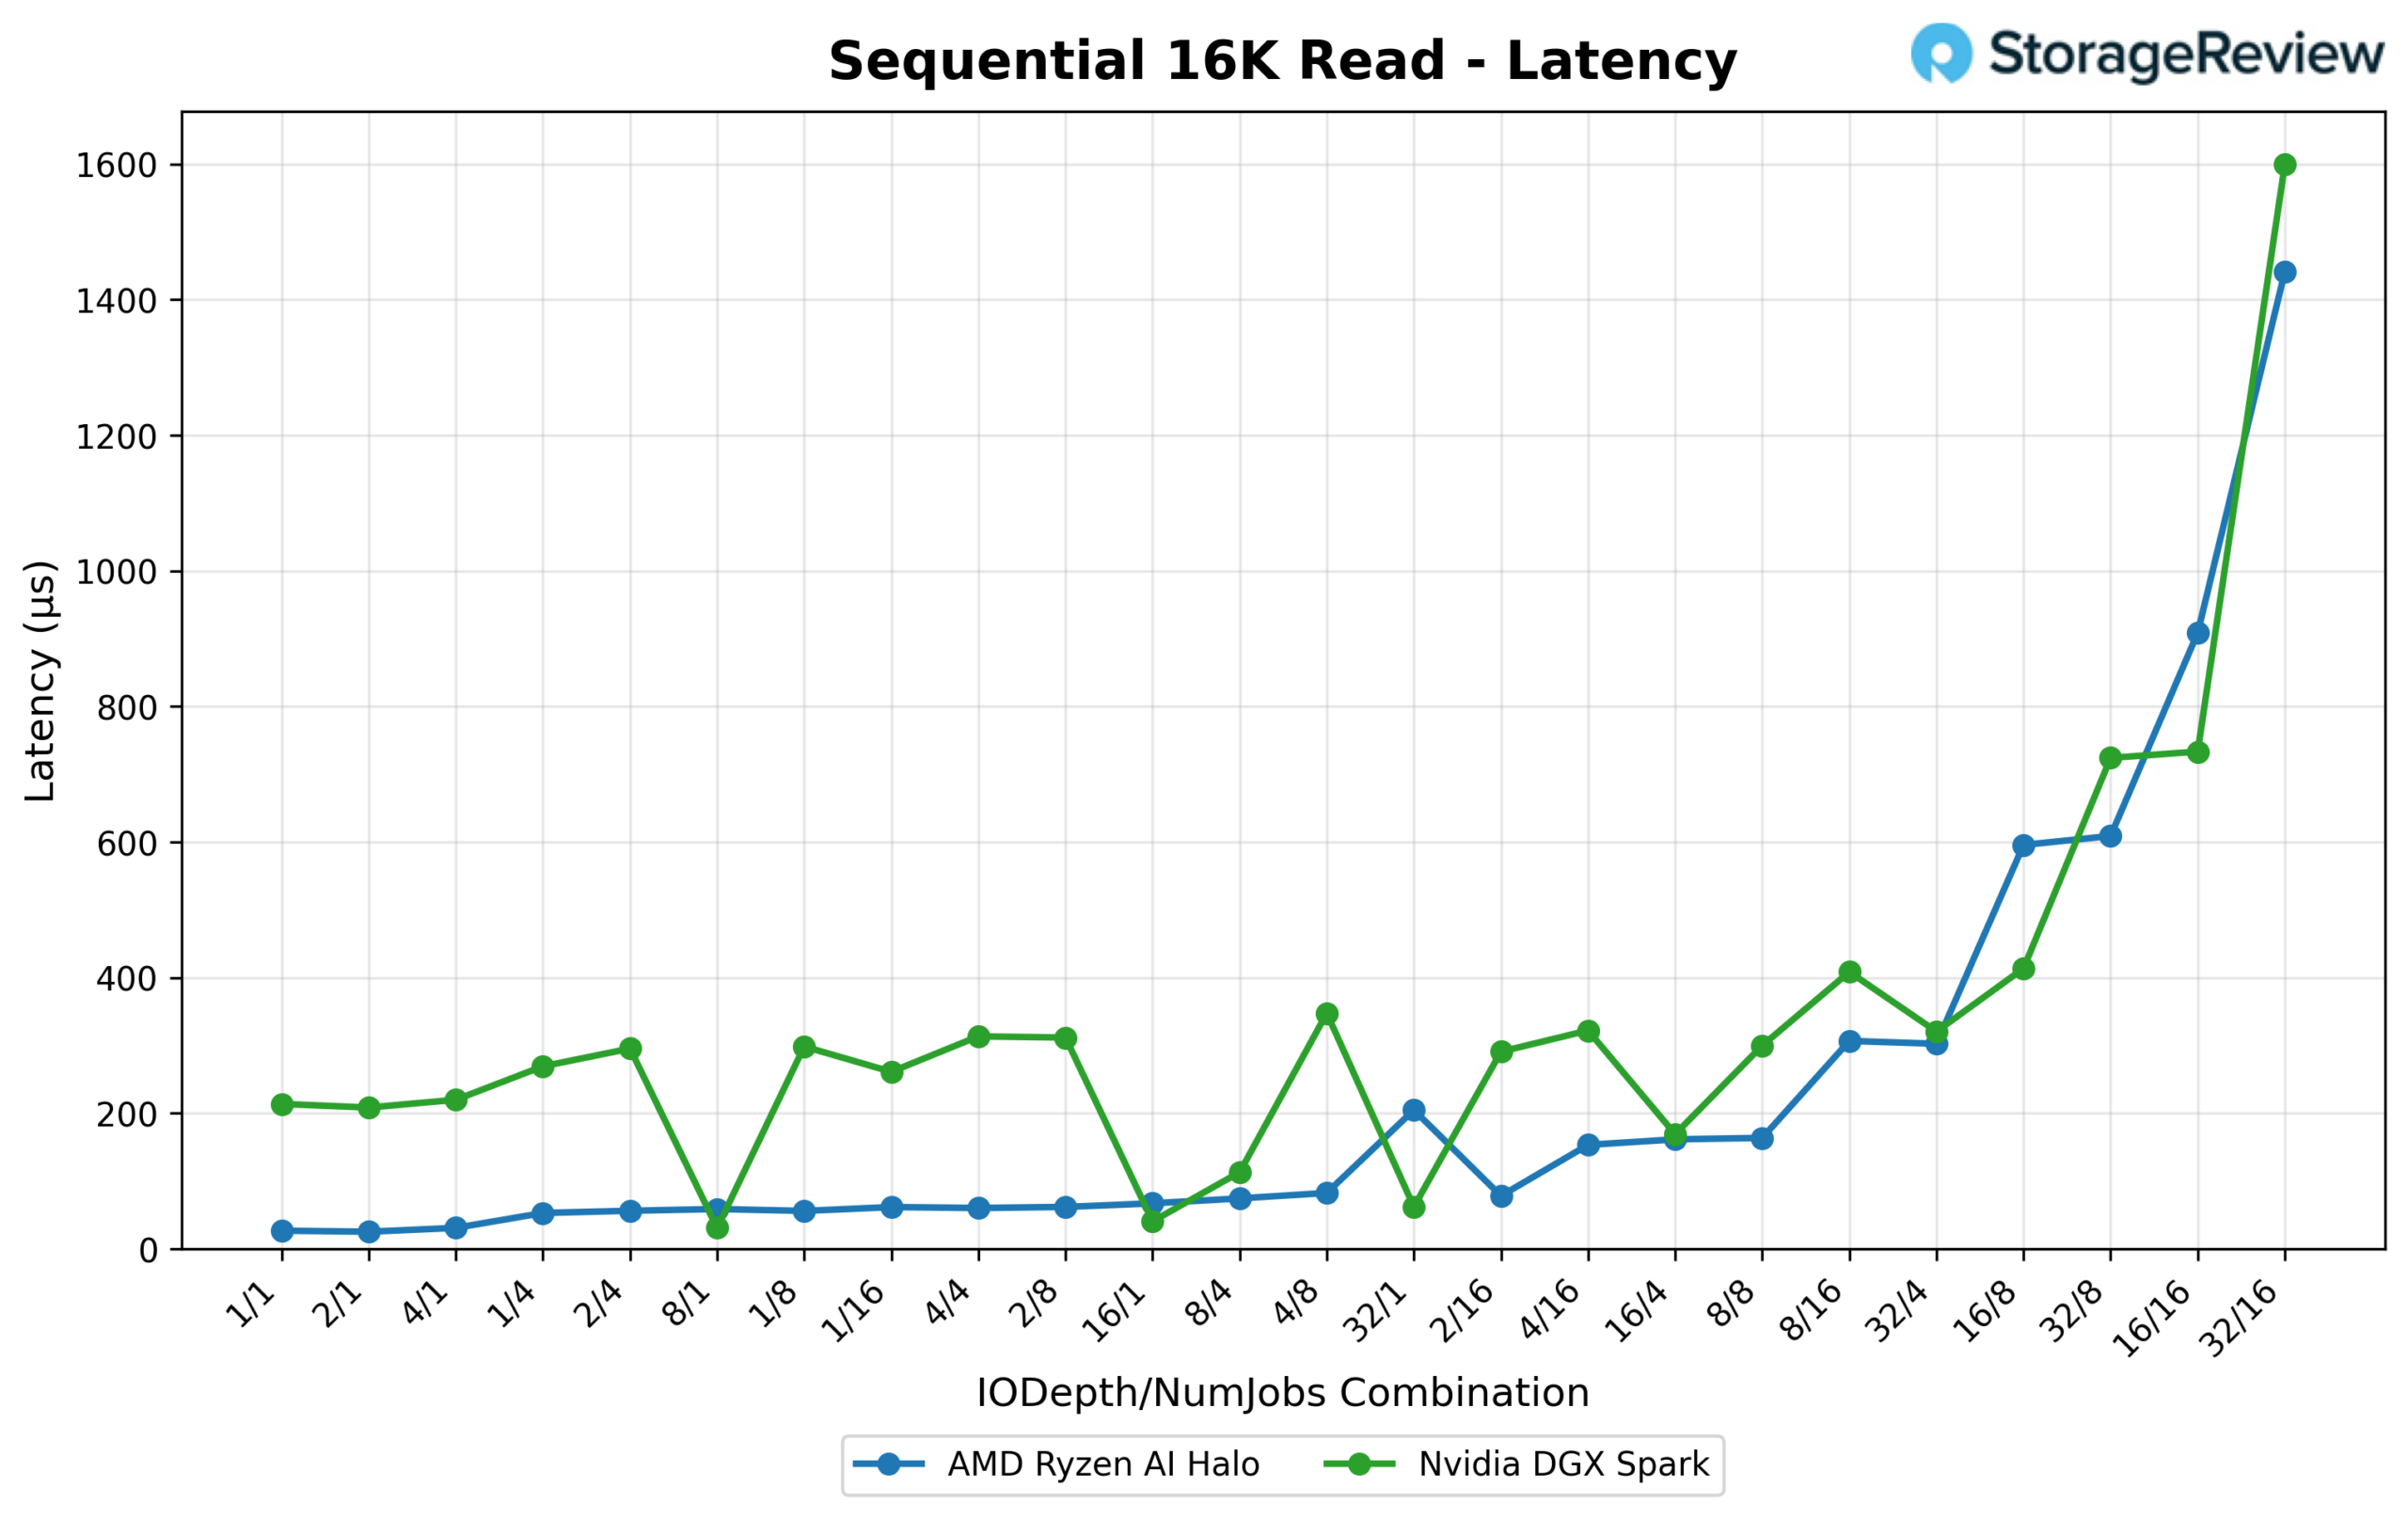
Задержка снова оказывается в пользу Halo везде, кроме самого верха очереди. При соотношении 1/1 Halo отвечает за 0.027 мс против 0.214 мс у Spark, и Halo сохраняет более низкую задержку на протяжении большей части сканирования. Разница сокращается только при самых глубоких комбинациях. При соотношении 32/16 средняя задержка Halo составляет 1.441 мс, что немного меньше, чем у Spark (1.599 мс), что делает эту точку одной из немногих, где кривая задержки Halo не превышает кривую Spark при насыщении.
Последовательная запись 16K
Пропускная способность здесь также близка: пиковая скорость Spark составляет 2,141.6 МБ/с (137.1 тыс. операций ввода-вывода в секунду) при соотношении 16/1, а Halo не сильно отстает, достигая 1,970.9 МБ/с (126.1 тыс. операций ввода-вывода в секунду) при соотношении 1/8.
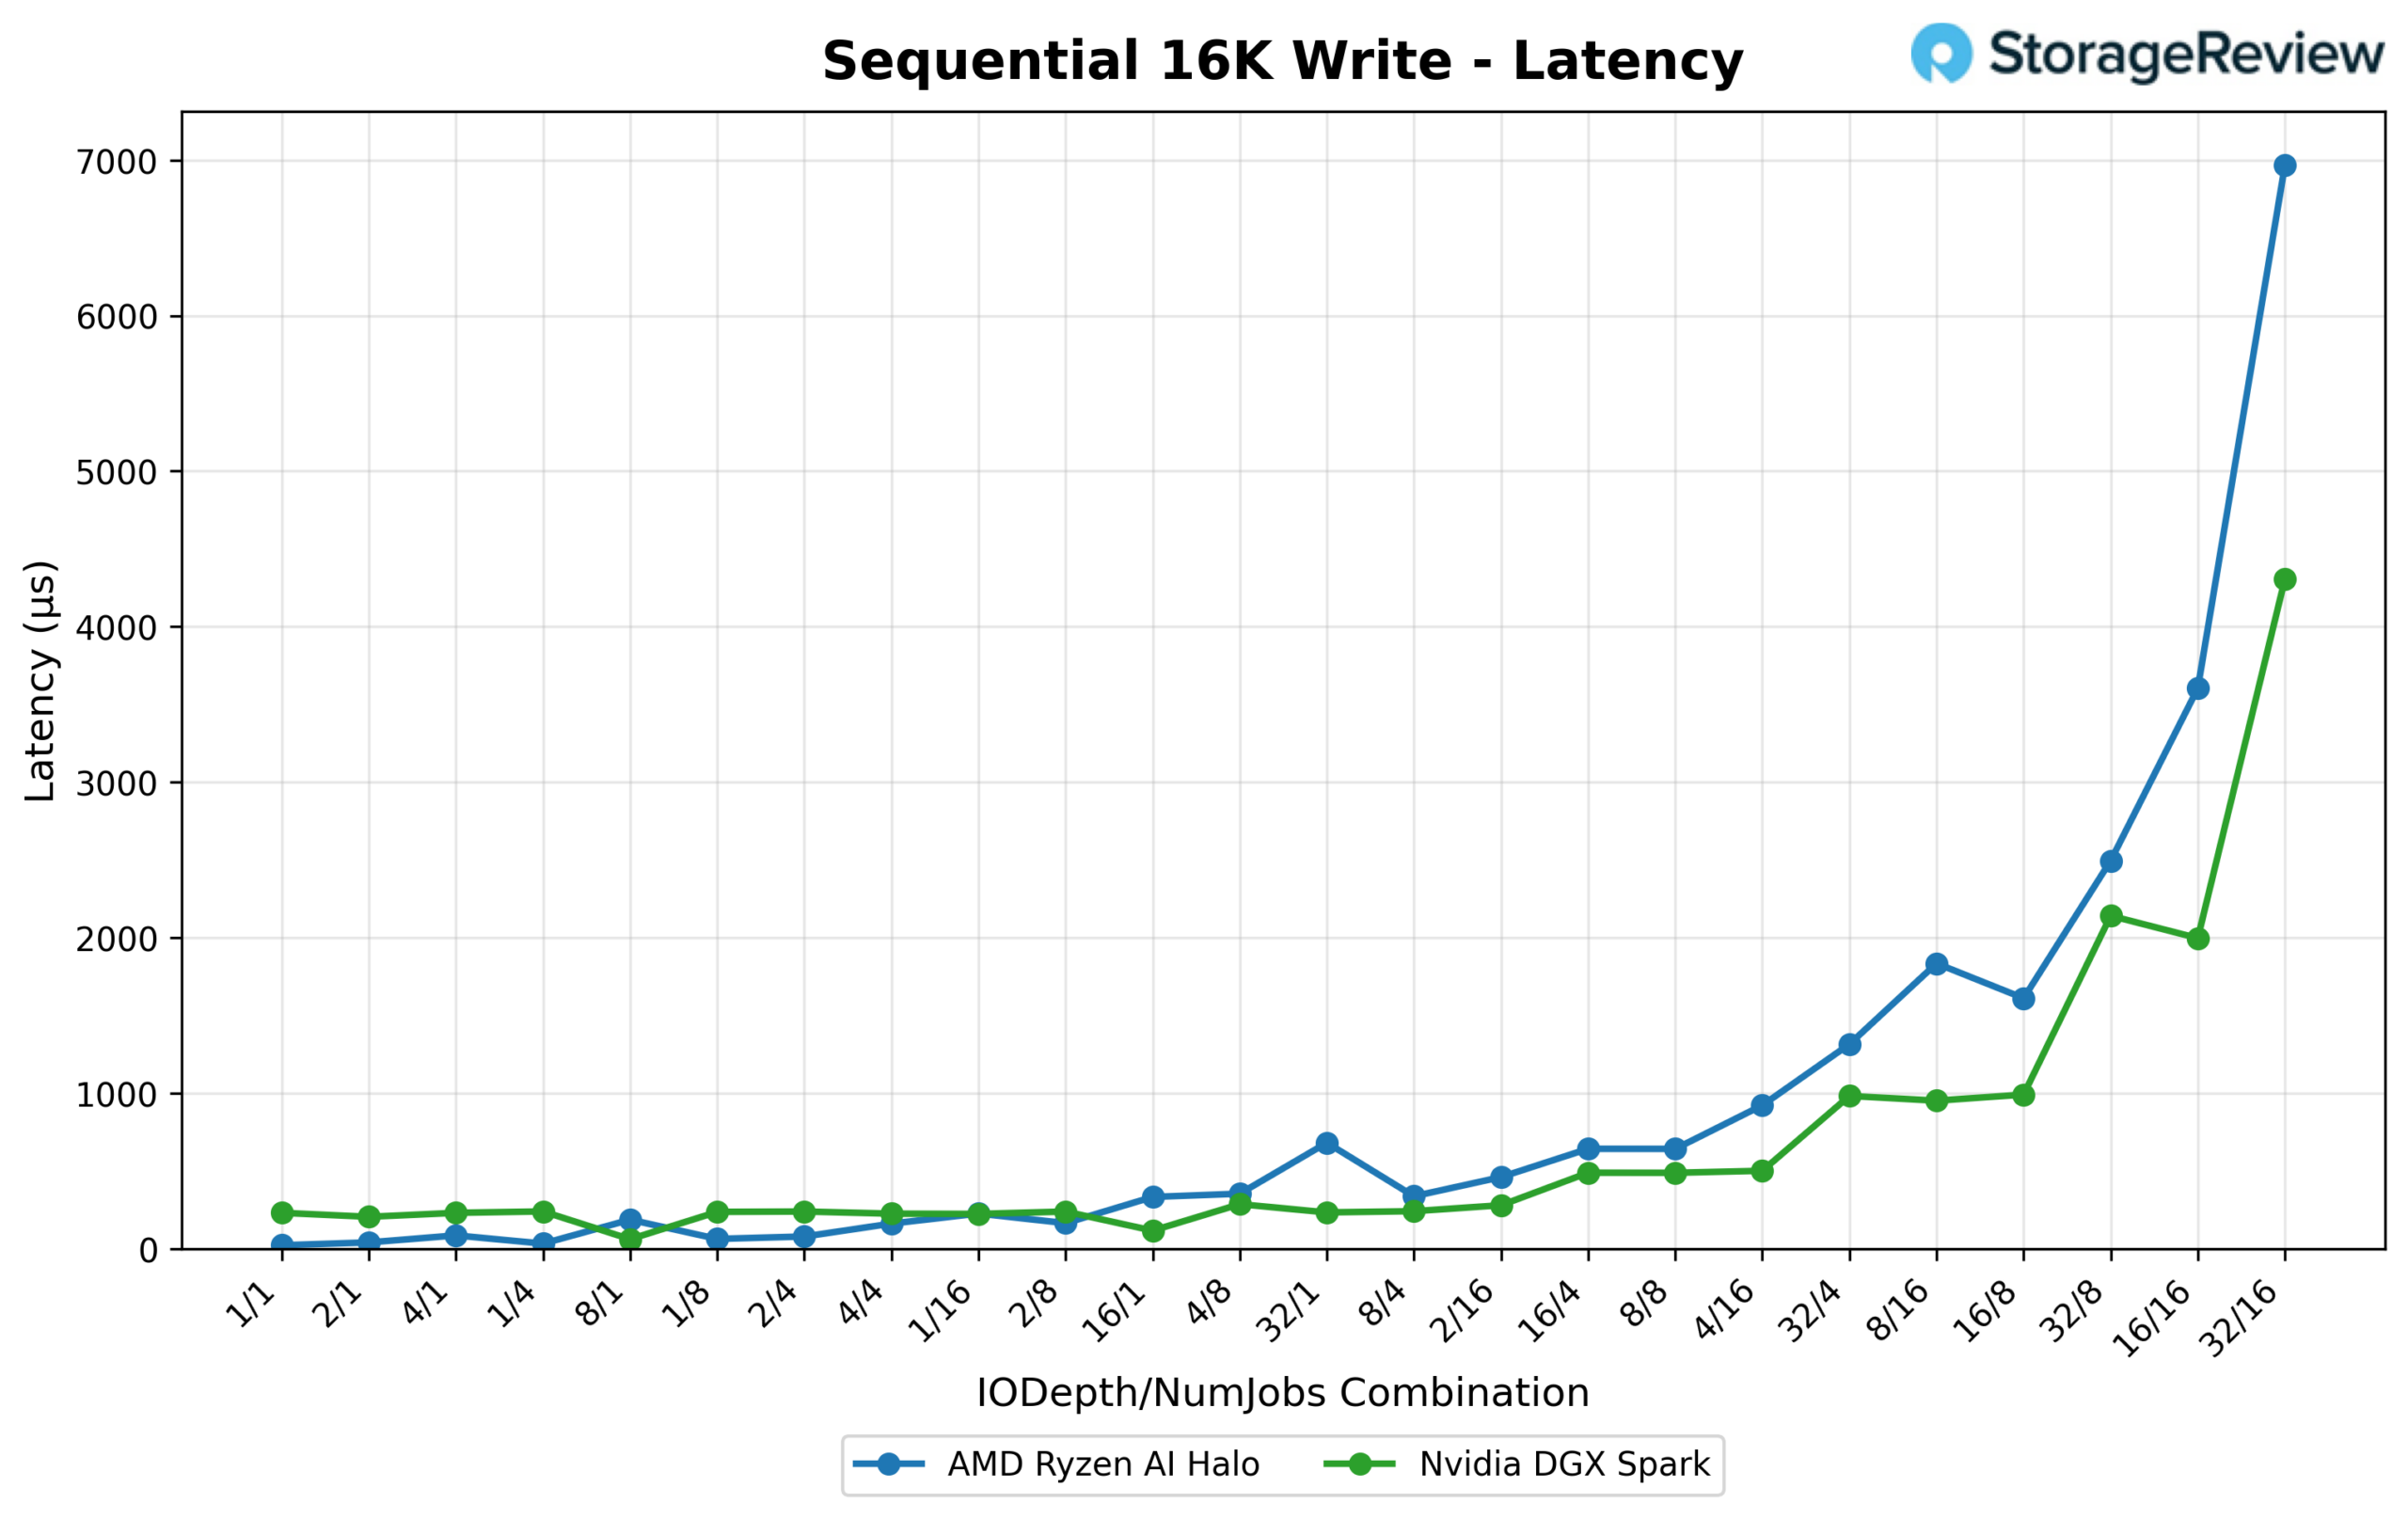
Разница между двумя устройствами резко возрастает в отношении задержки. Halo значительно опережает конкурентов при малой глубине очереди (0.022 мс при соотношении 1/1 против 0.231 мс у Spark), но кривая задержки резко возрастает по мере заполнения очереди. К 32/16 средняя задержка Halo достигает 6.967 мс, что значительно превышает показатель Spark в 4.306 мс на том же этапе. Кривая задержки Halo также гораздо менее предсказуема на протяжении всего процесса, с резкими скачками при нескольких средних значениях, в то время как у Spark она остается сравнительно стабильной.
16K Произвольное чтение
Это один из лучших результатов Halo. Фактически, пиковая пропускная способность составляет 6,609.4 МБ/с (423.0 тыс. IOPS) при 32/16, по сравнению с 6,082.6 МБ/с (389.3 тыс. IOPS) у Spark при той же комбинации.
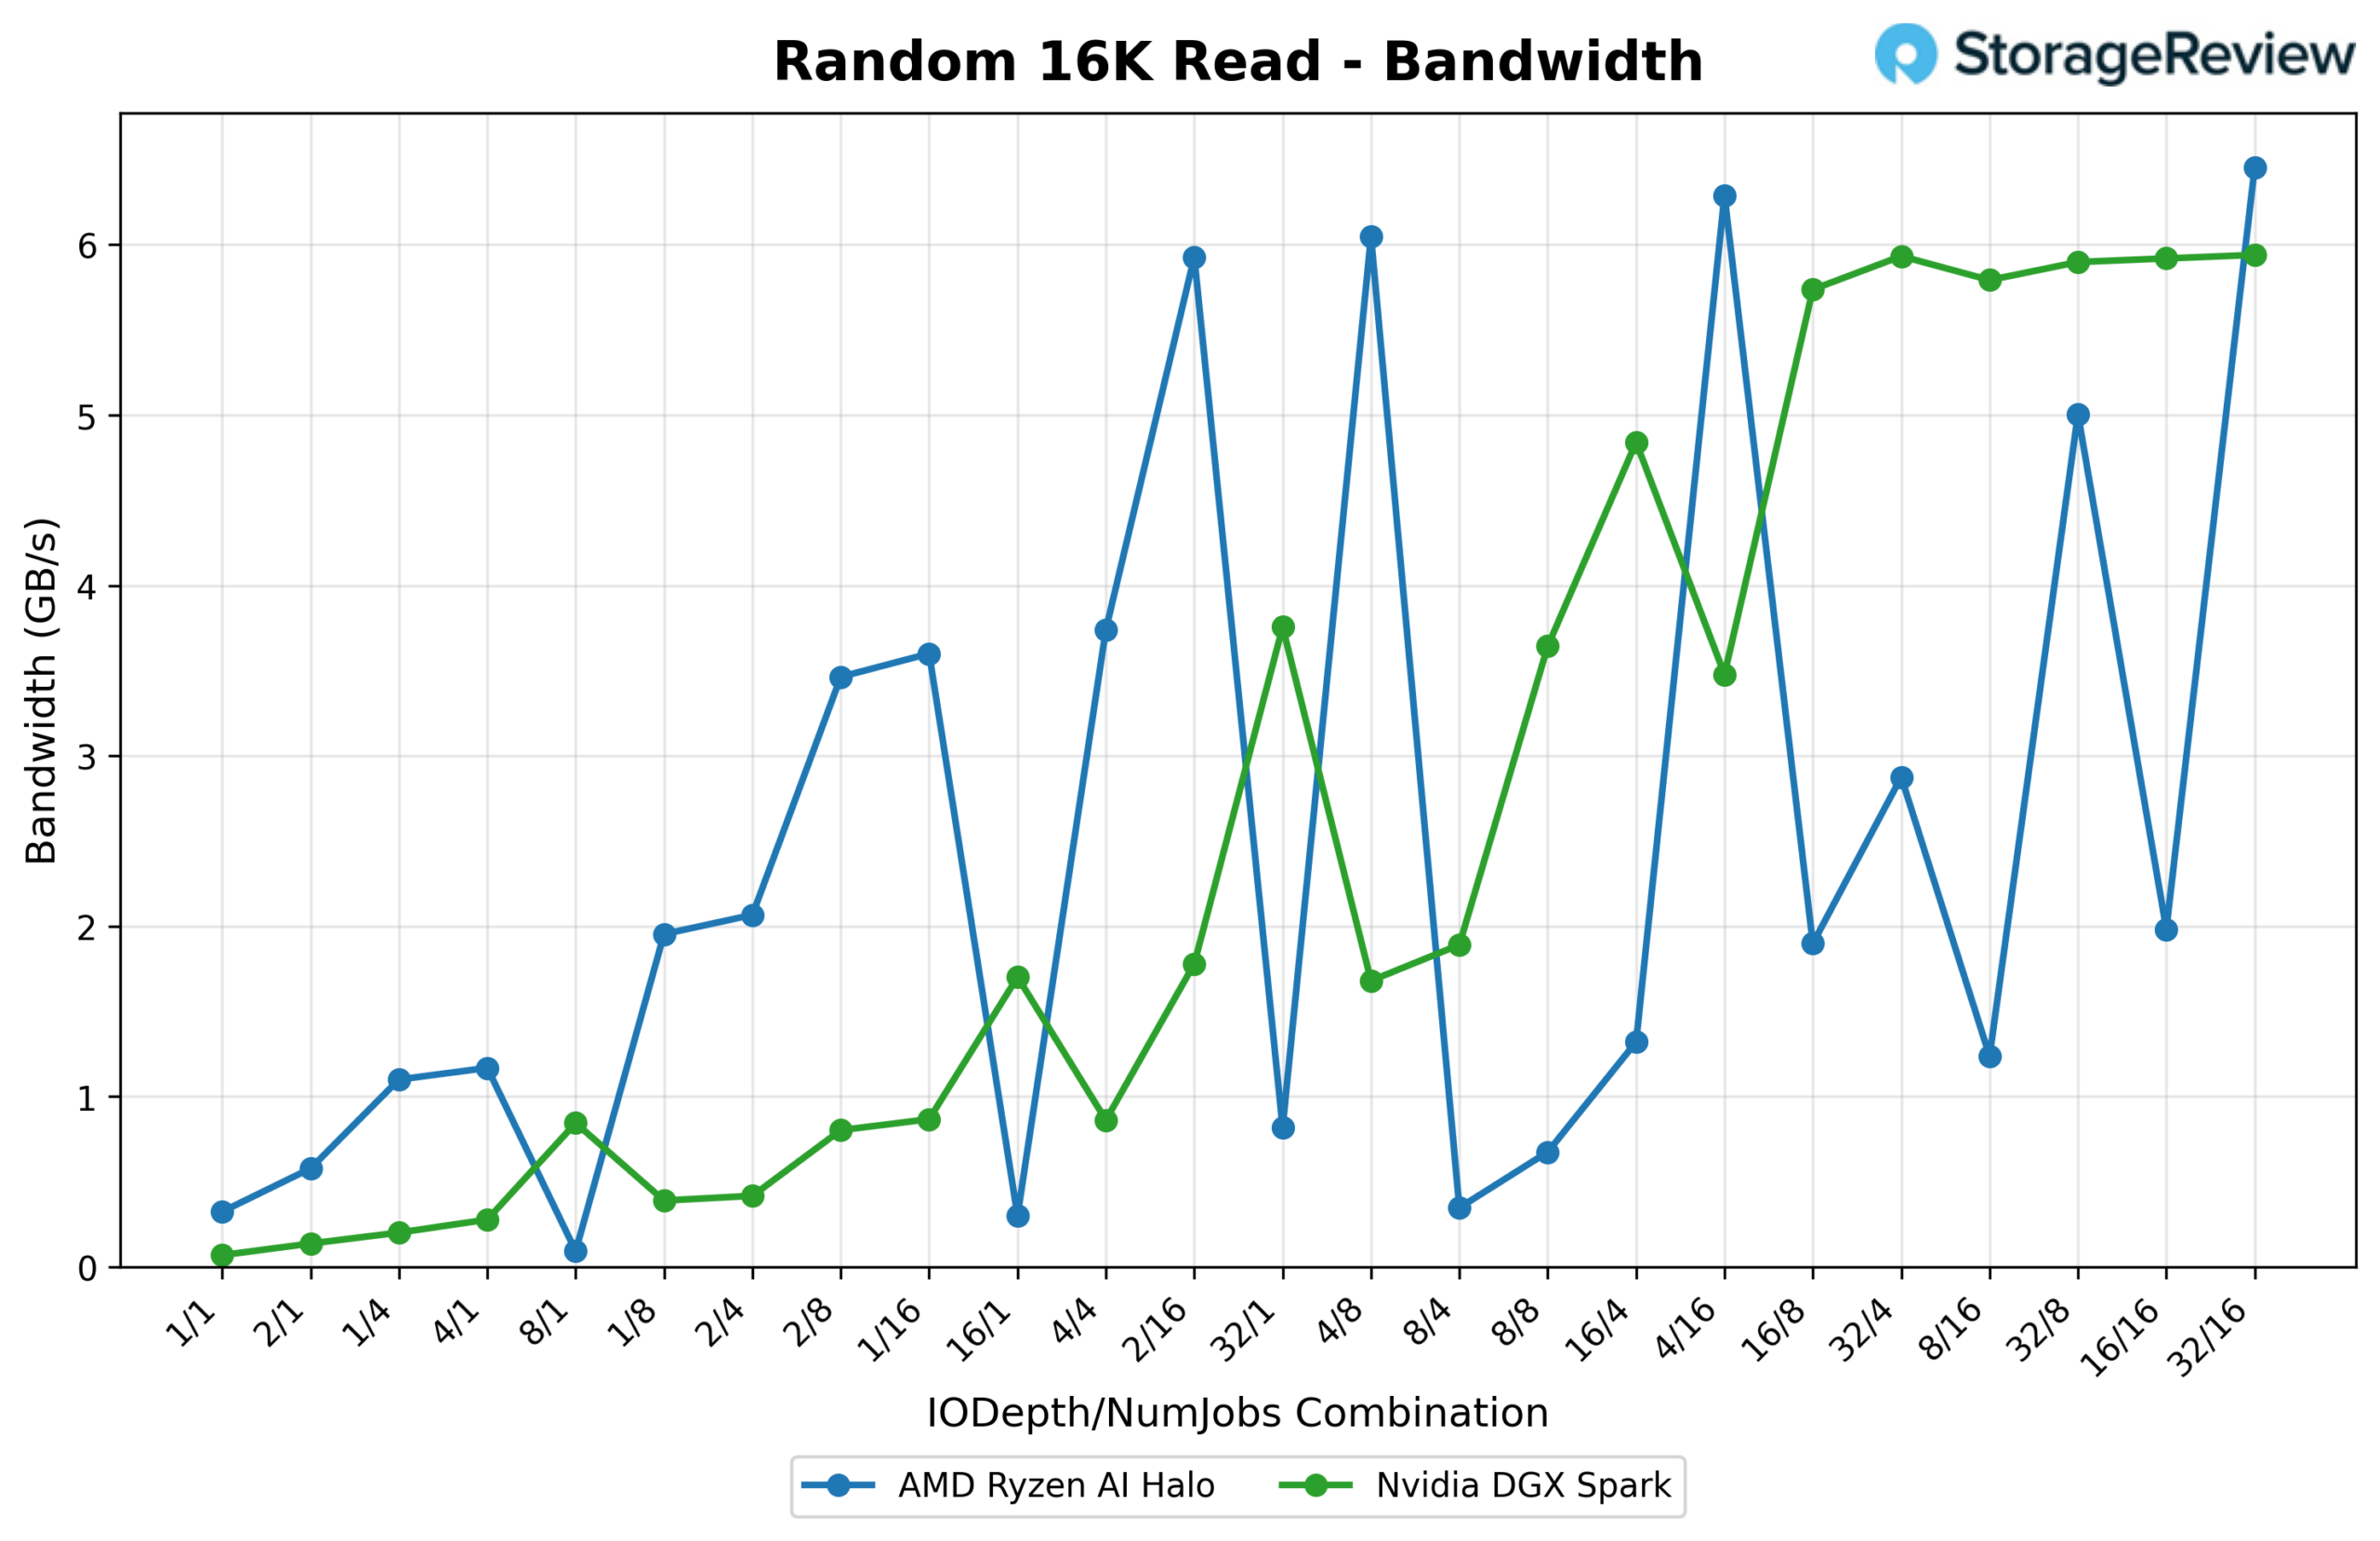
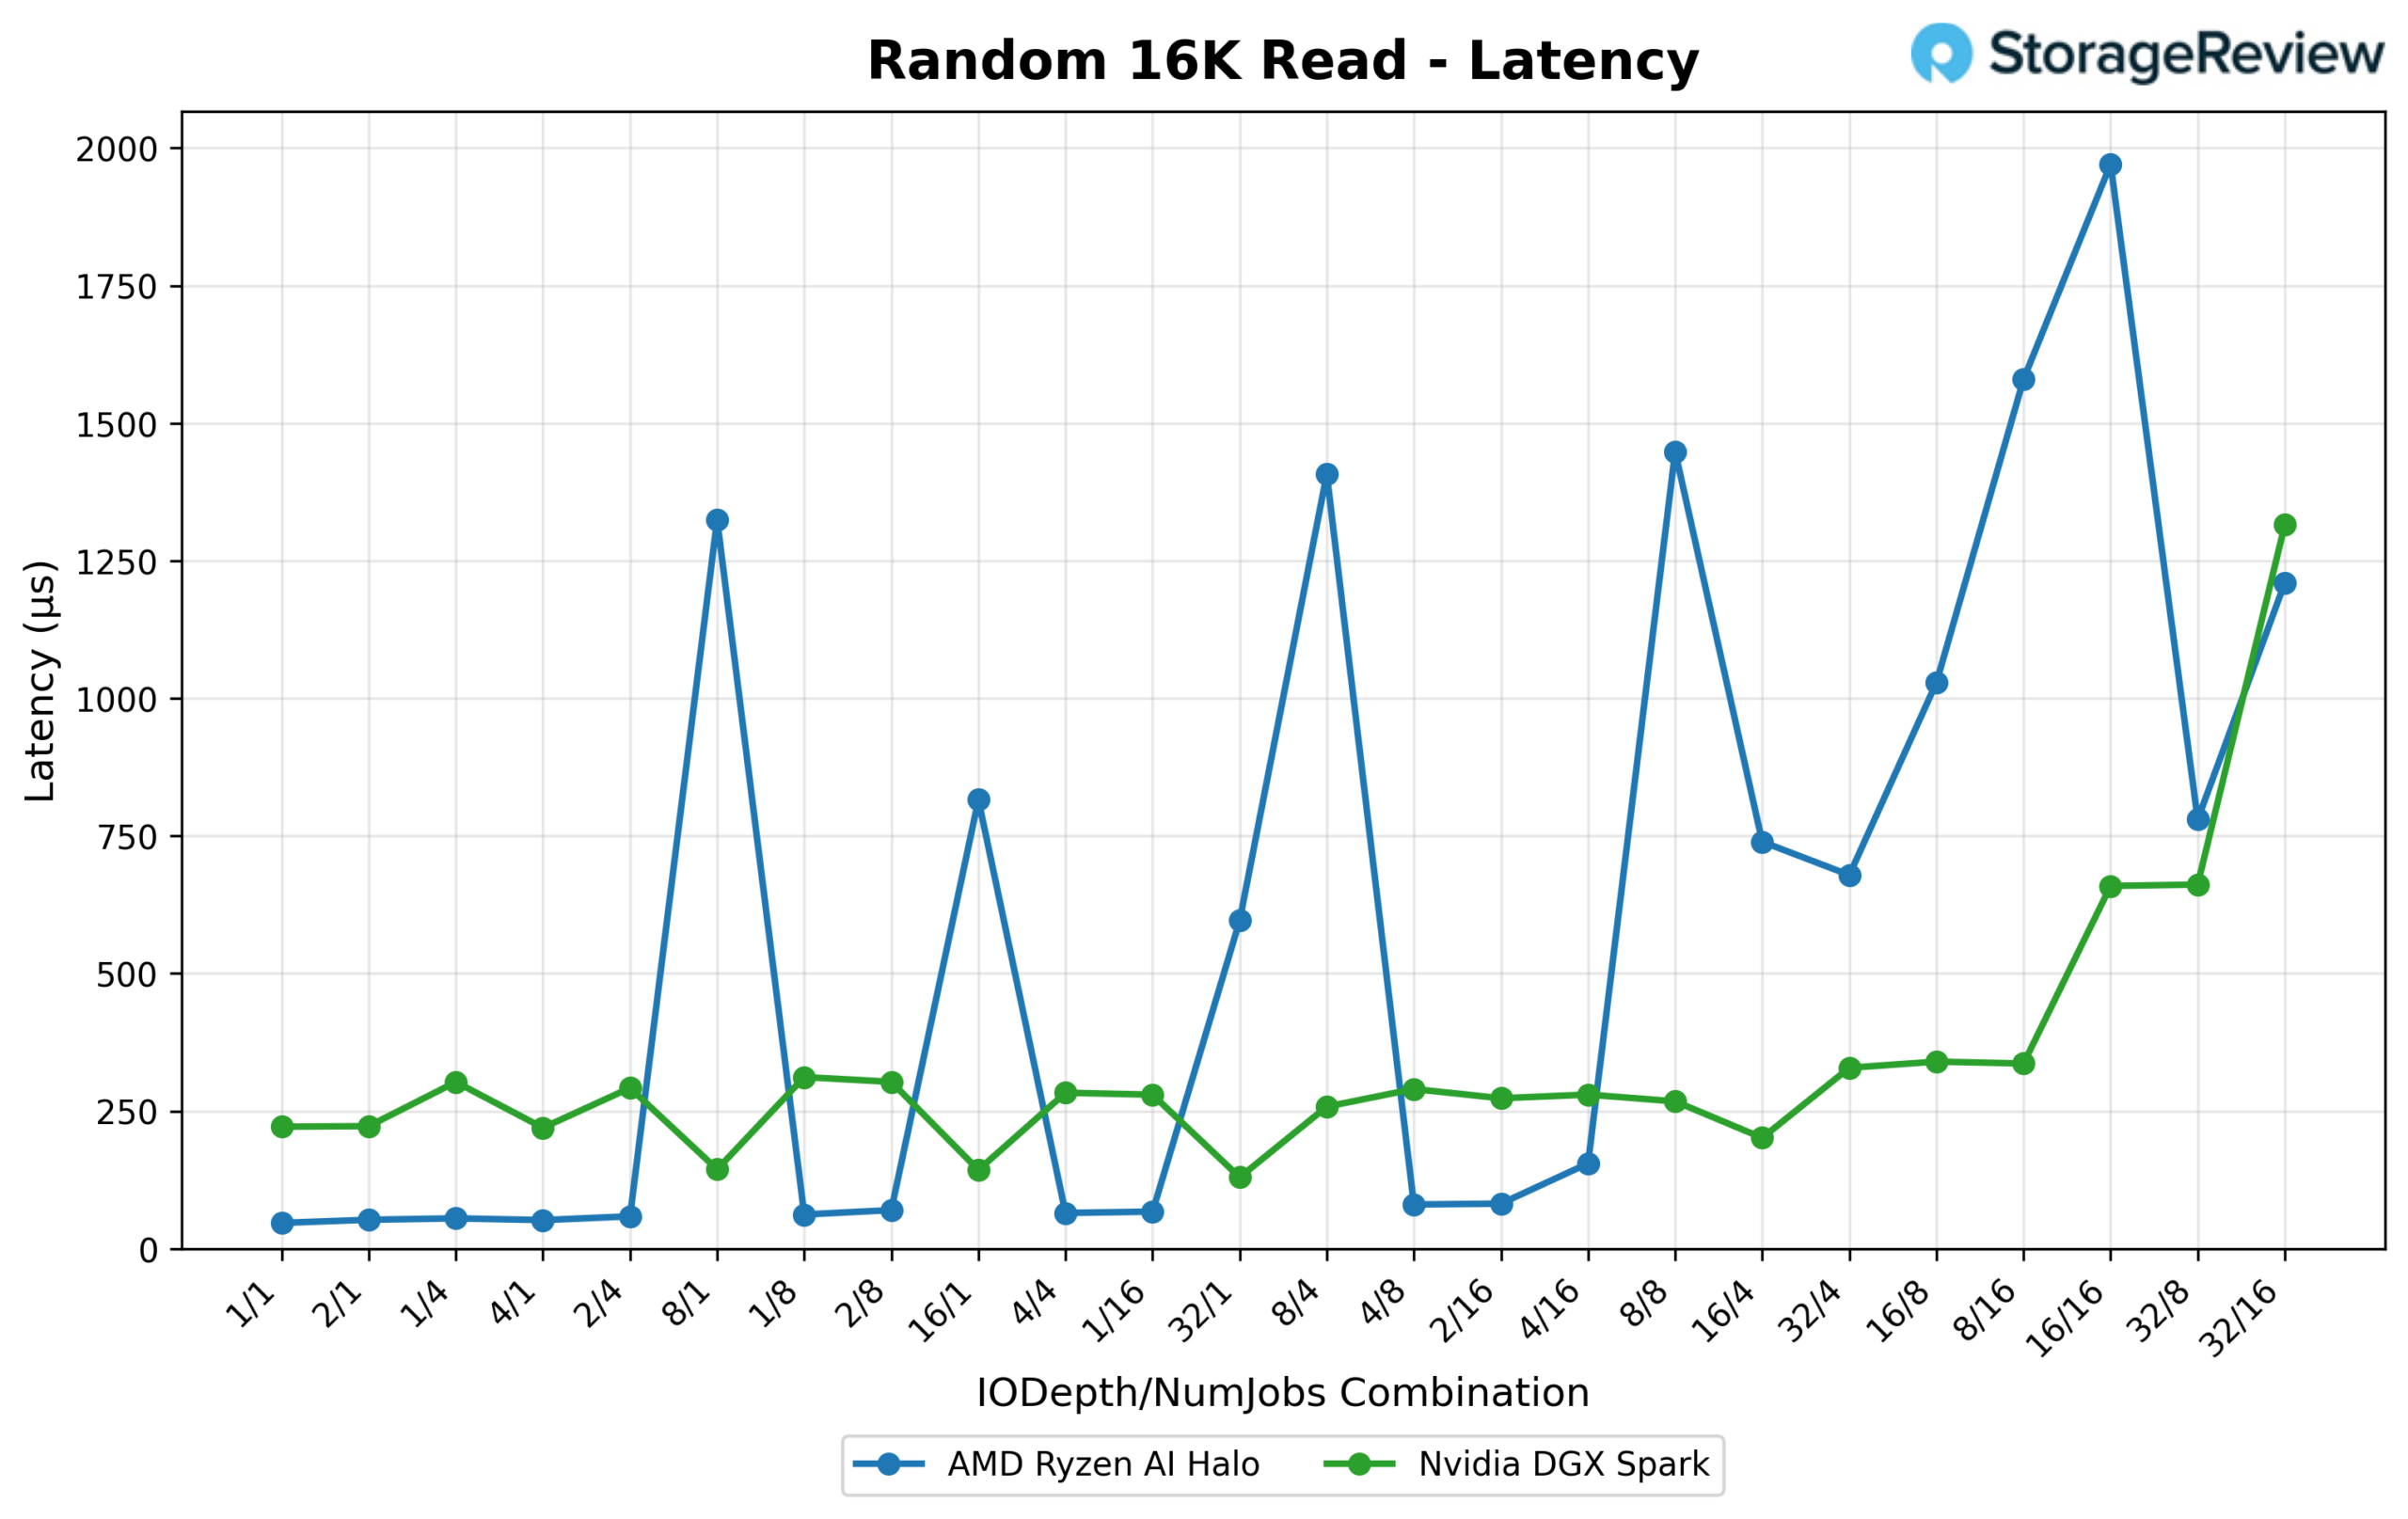
Задержка снова значительно превосходит показатели Halo (0.047 мс при 1/1 против 0.222 мс у Spark). Тем не менее, кривая задержки Halo гораздо более изменчива на протяжении всего диапазона, с резкими скачками при 8/1, 16/1, 8/4 и 8/8, которые значительно превышают сравнительно плавную (хотя и более высокую базовую) кривую Spark. В самом верху очереди пиковая задержка Halo в 1.971 мс (при 16/16) превышает пиковую задержку Spark в 1.315 мс (при 32/16), поэтому Halo жертвует стабильностью ради высокой скорости при малой глубине очереди.
16K Случайная запись
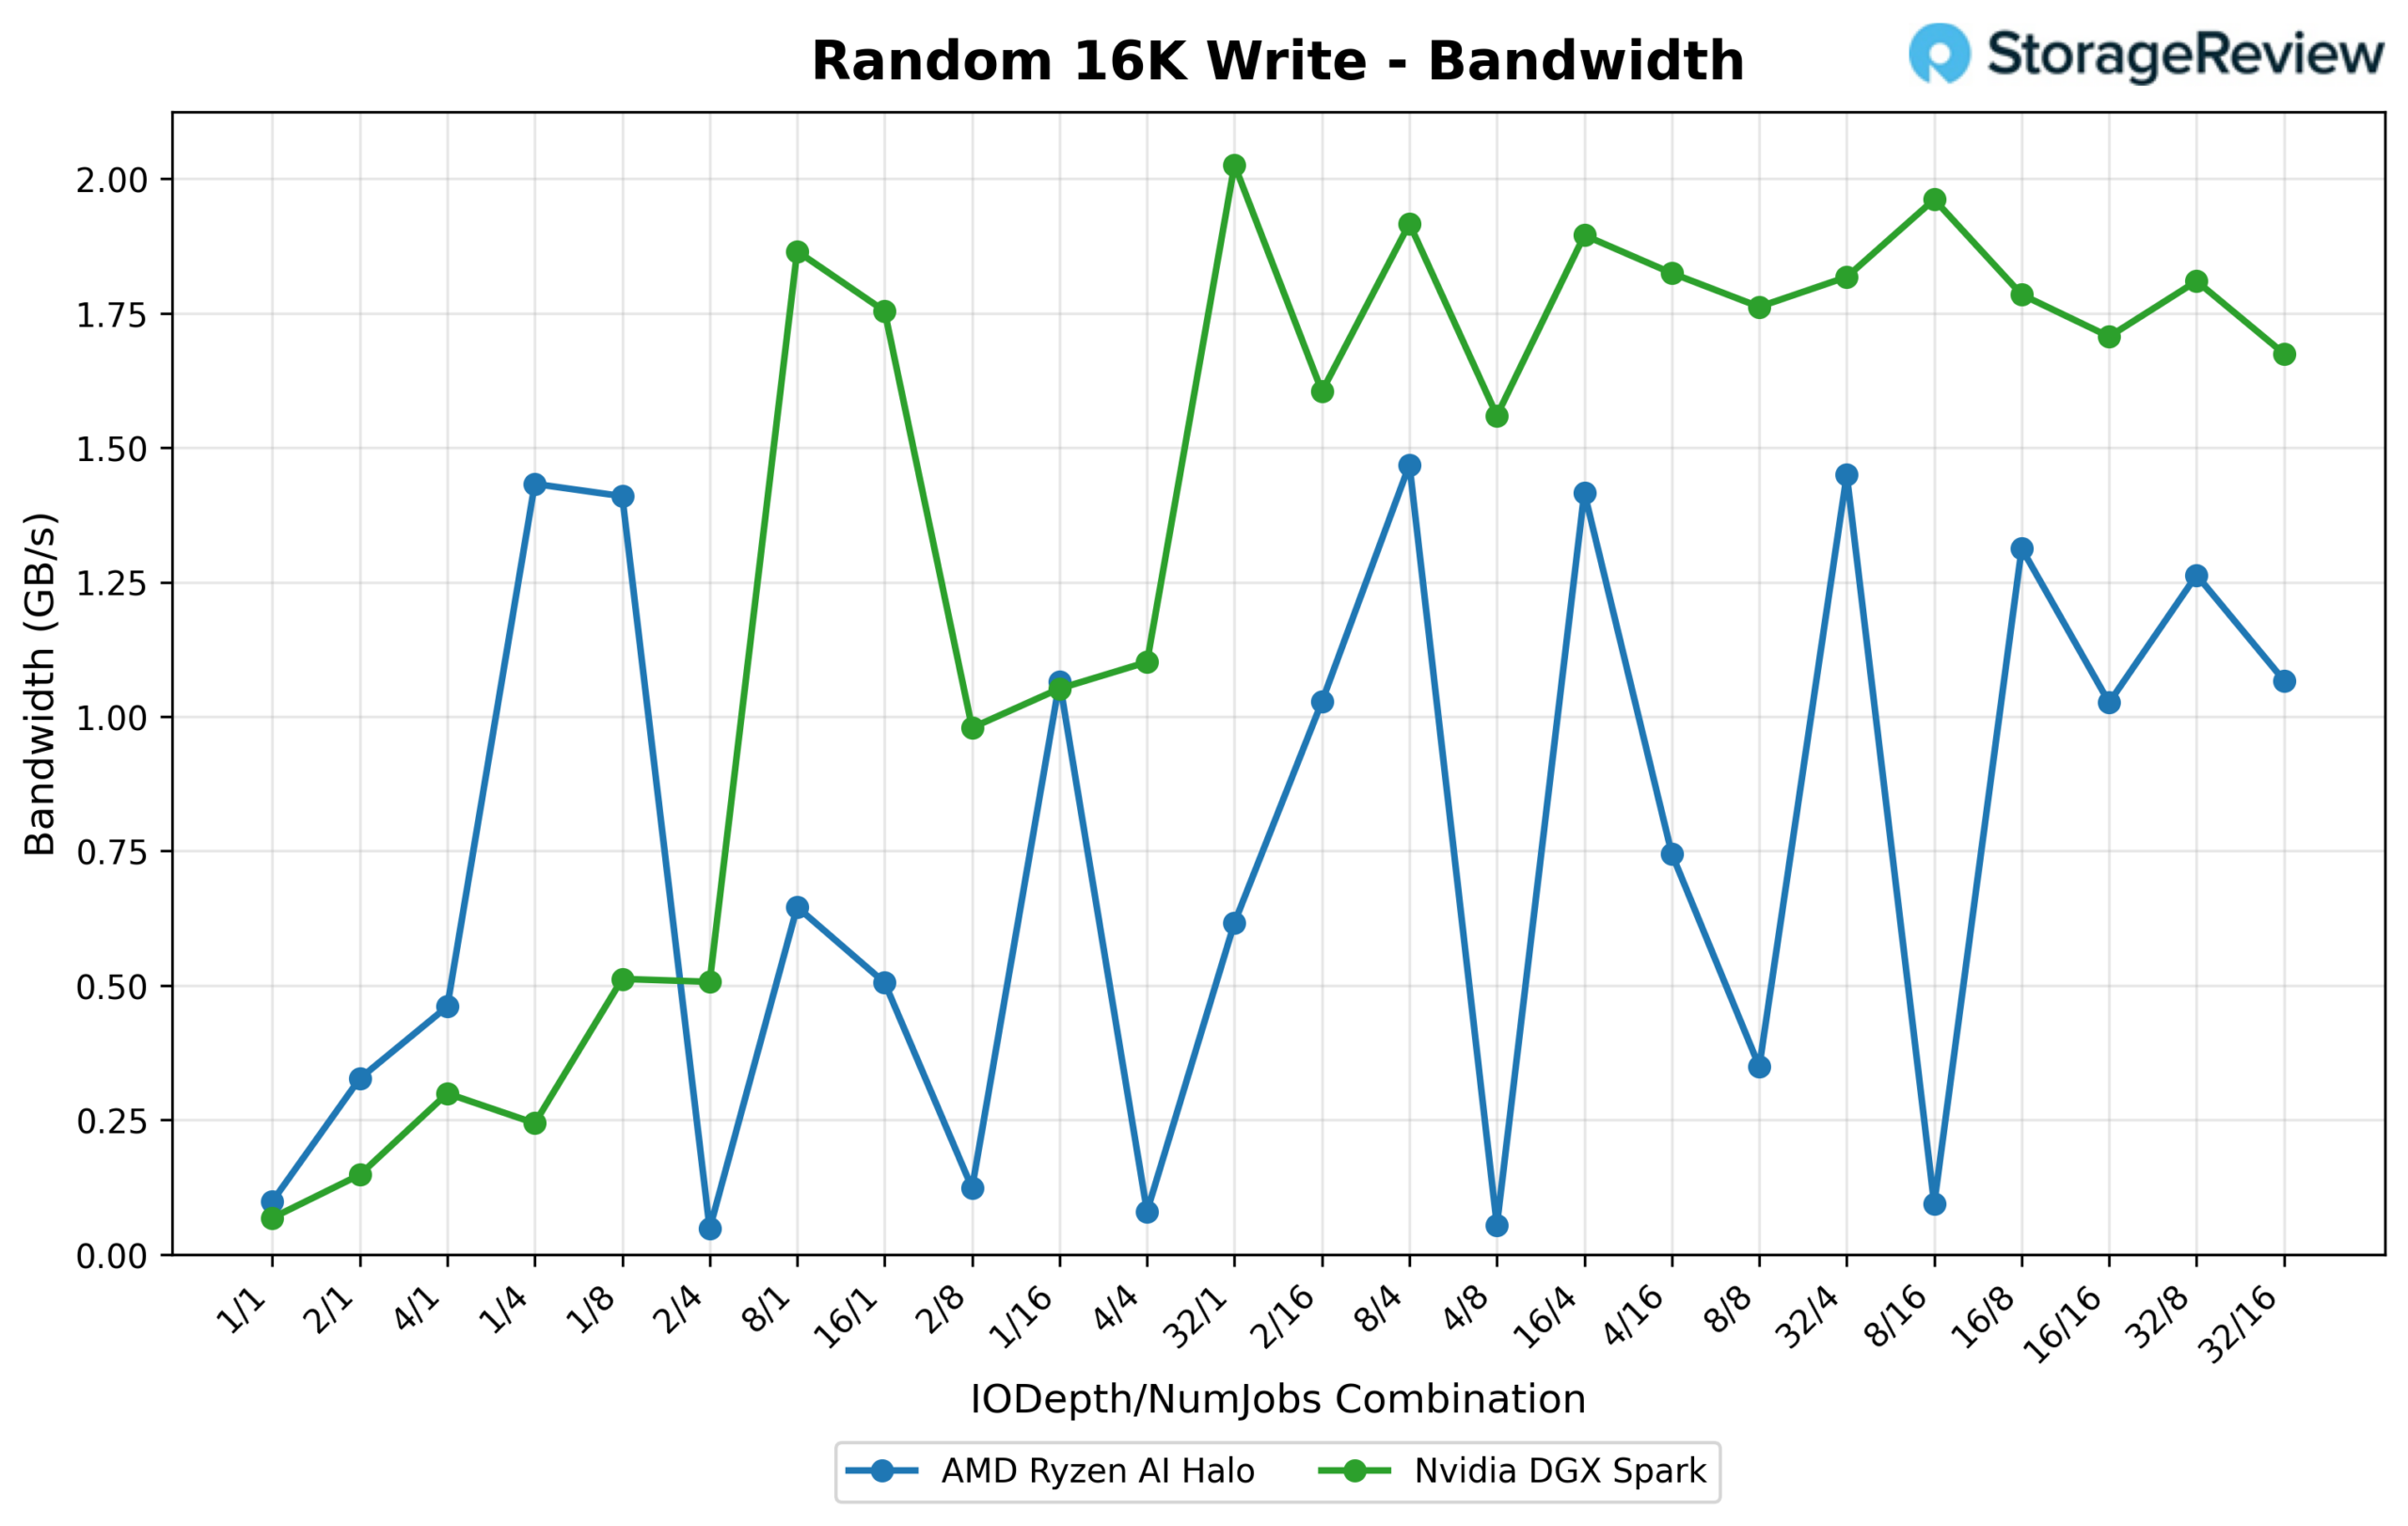
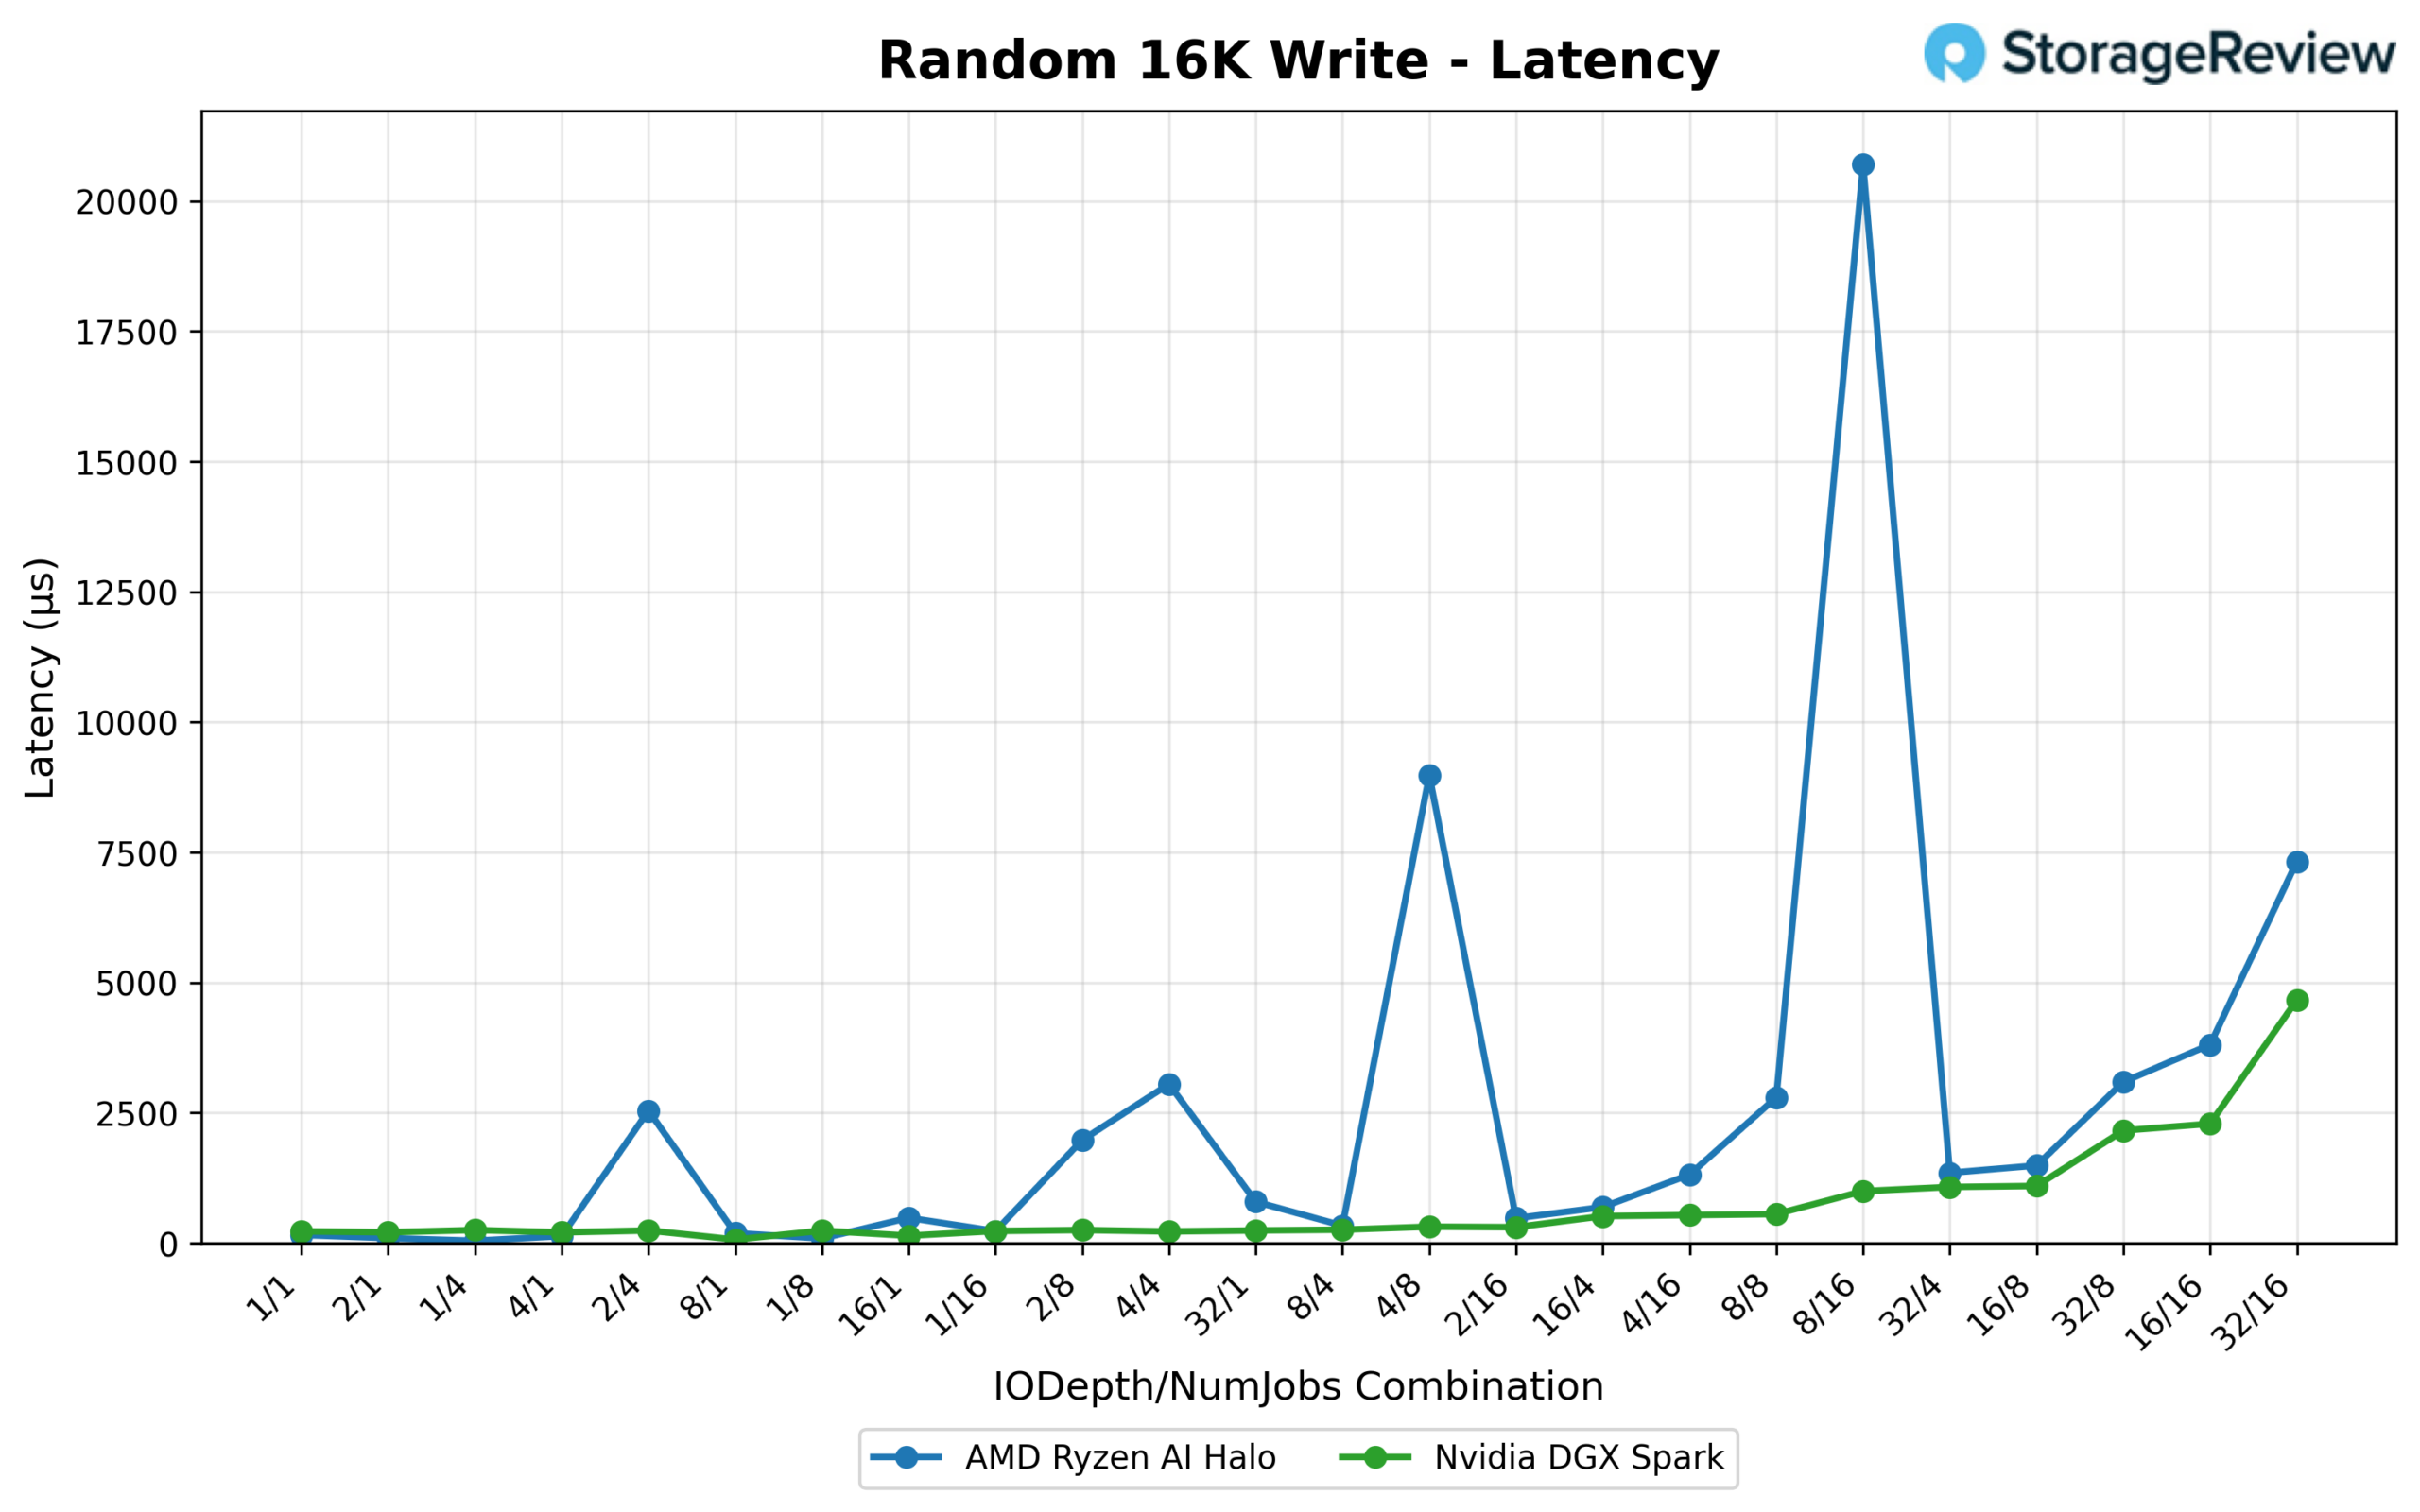
В этом отношении пропускная способность Spark выше: при соотношении 32/1 она достигает 2,074.1 МБ/с (132.7 тыс. операций ввода-вывода в секунду), тогда как у Halo — 1,503.5 МБ/с (96.2 тыс. операций ввода-вывода в секунду) при соотношении 8/4. Кривая пропускной способности Spark также значительно более стабильна, оставаясь в диапазоне 1.6–2.0 ГБ/с на протяжении большей части диапазона после начального нарастания. В сравнении с этим, у Halo наблюдаются резкие колебания скорости от примерно 0.1 до 1.5 ГБ/с в зависимости от комбинации.
Задержка — вот что выделяет этот тест: Halo изначально показывает более низкие значения при 1/1 (0.154 мс против 0.224 мс), но при 8/16 средняя задержка резко возрастает до экстремальных 20.698 мс, что почти в 4.5 раза превышает худший показатель Spark в 4.664 мс на всем протяжении теста. За исключением этого единственного скачка, задержка Halo в остальном приемлема, но это существенное отклонение, на которое стоит обратить внимание при любой рабочей нагрузке, которая может потребовать именно такой глубины/количеств потоков.
4K Произвольное чтение
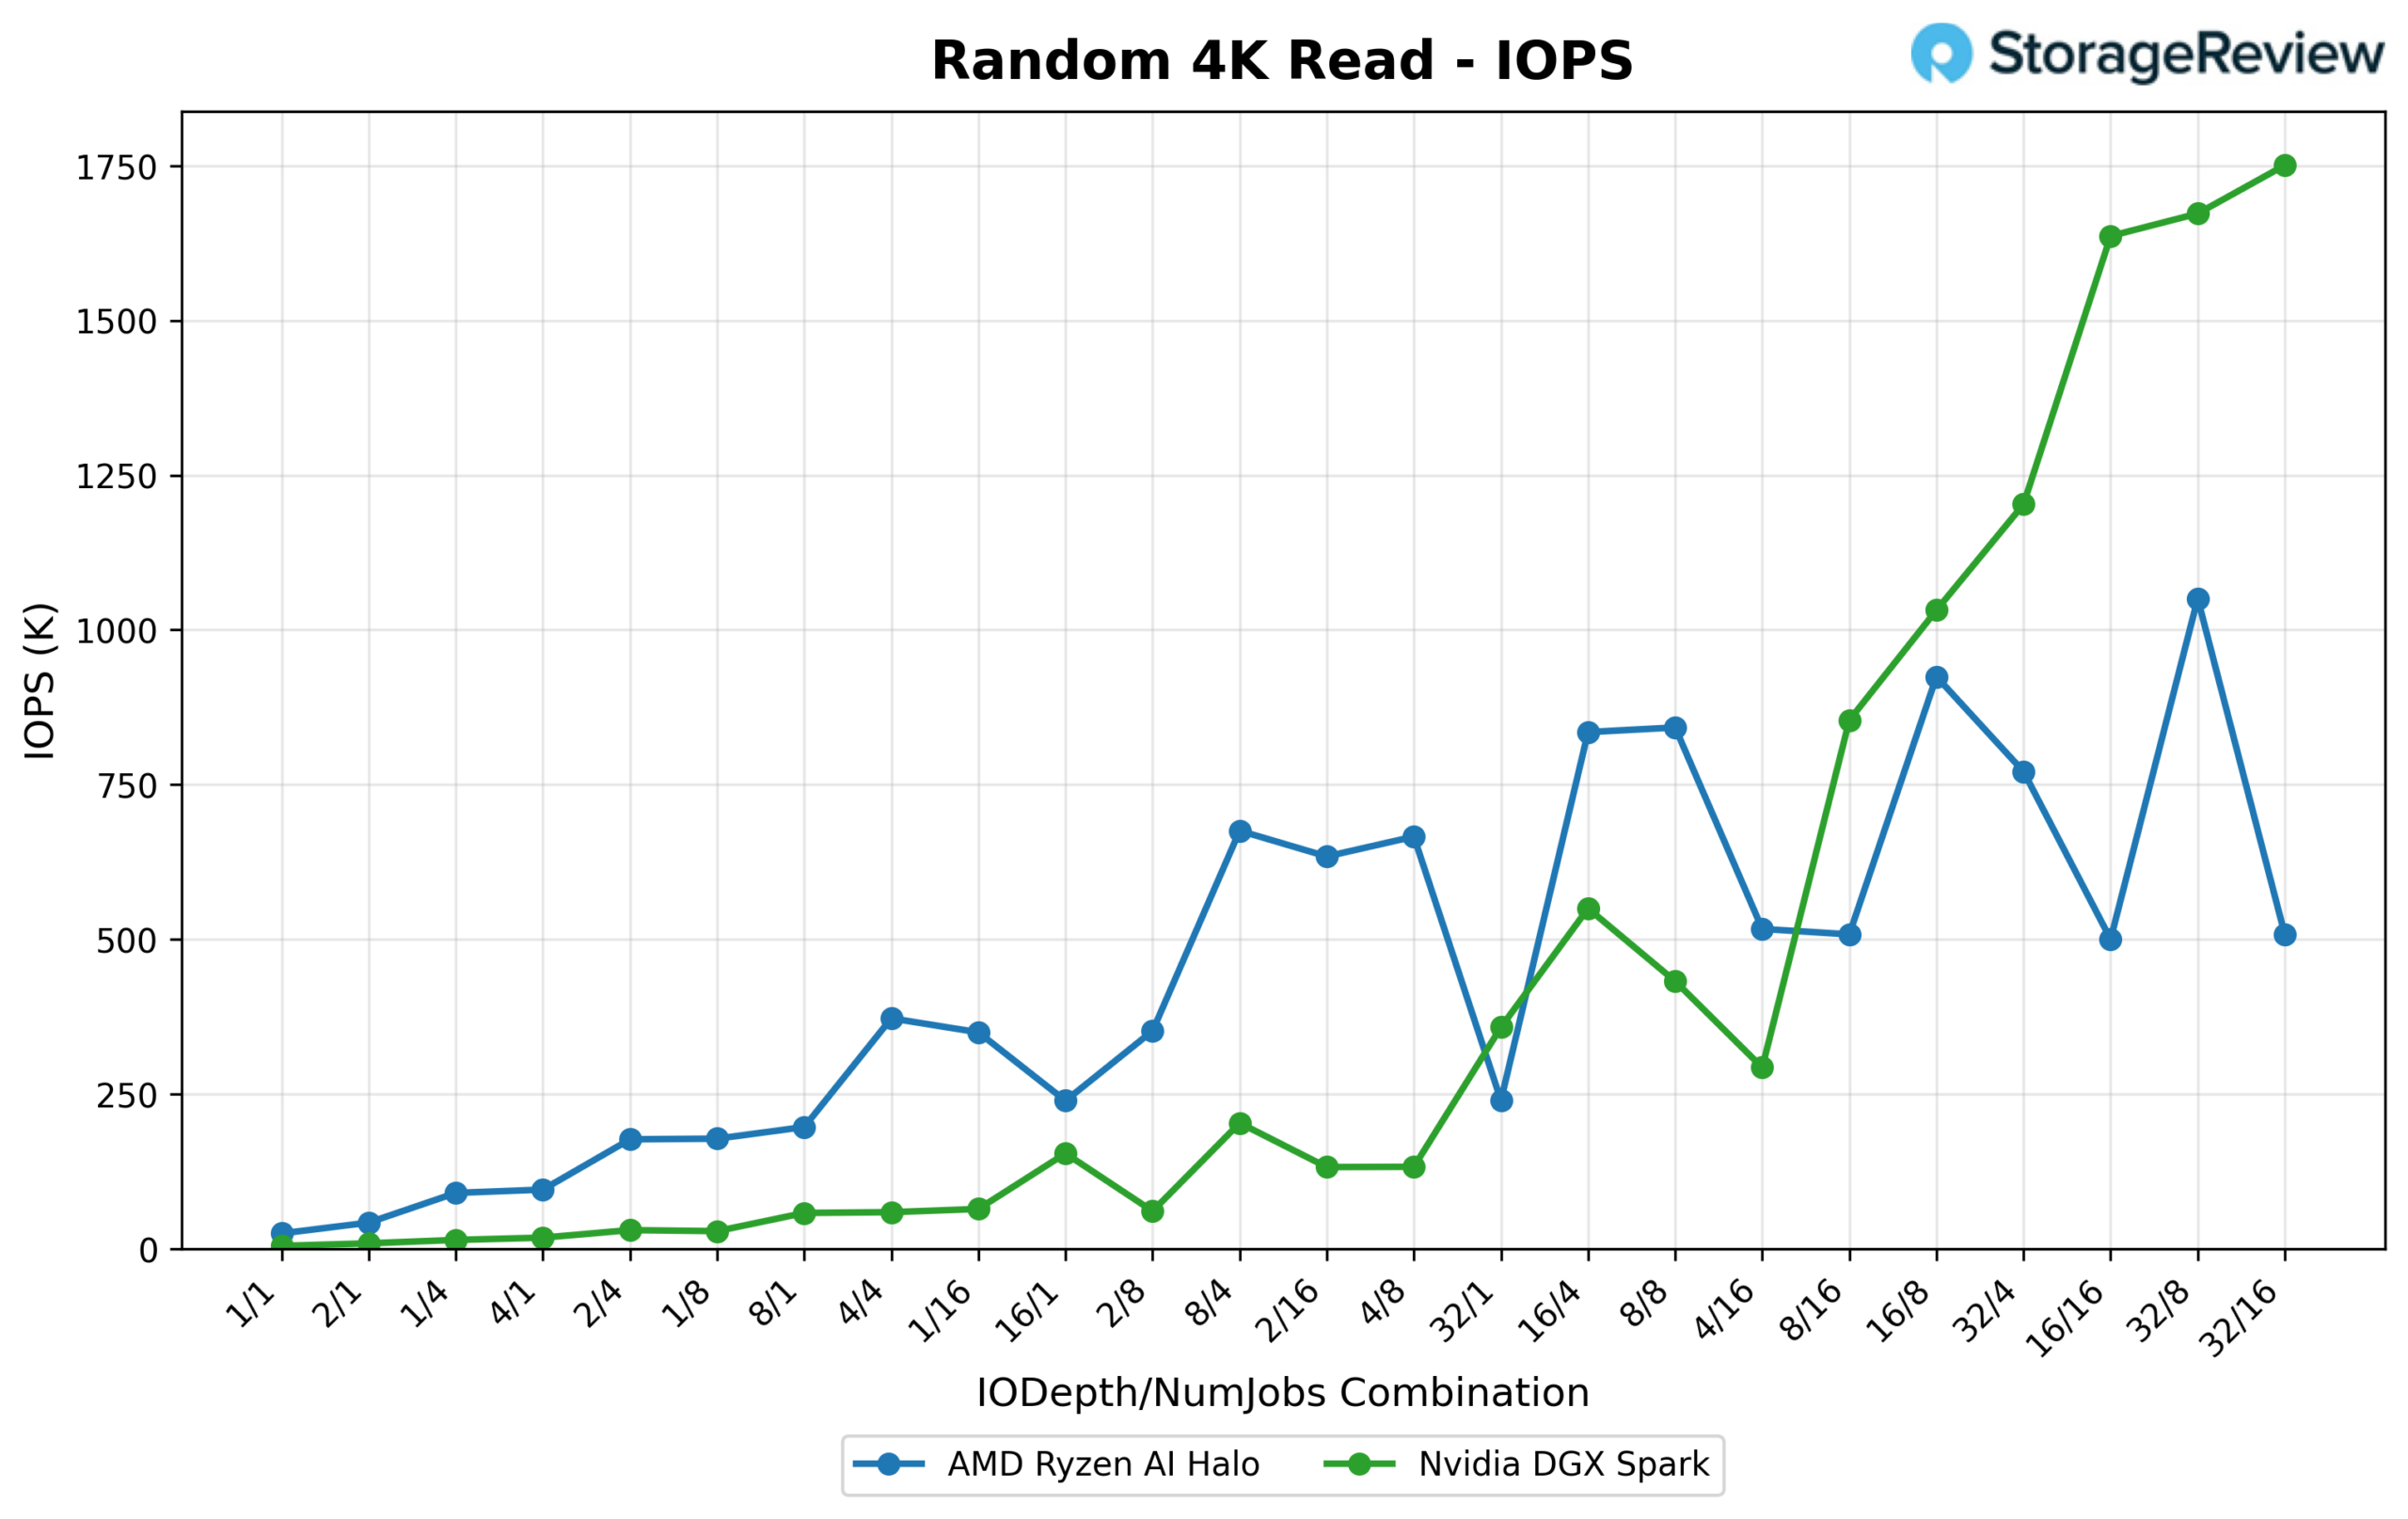
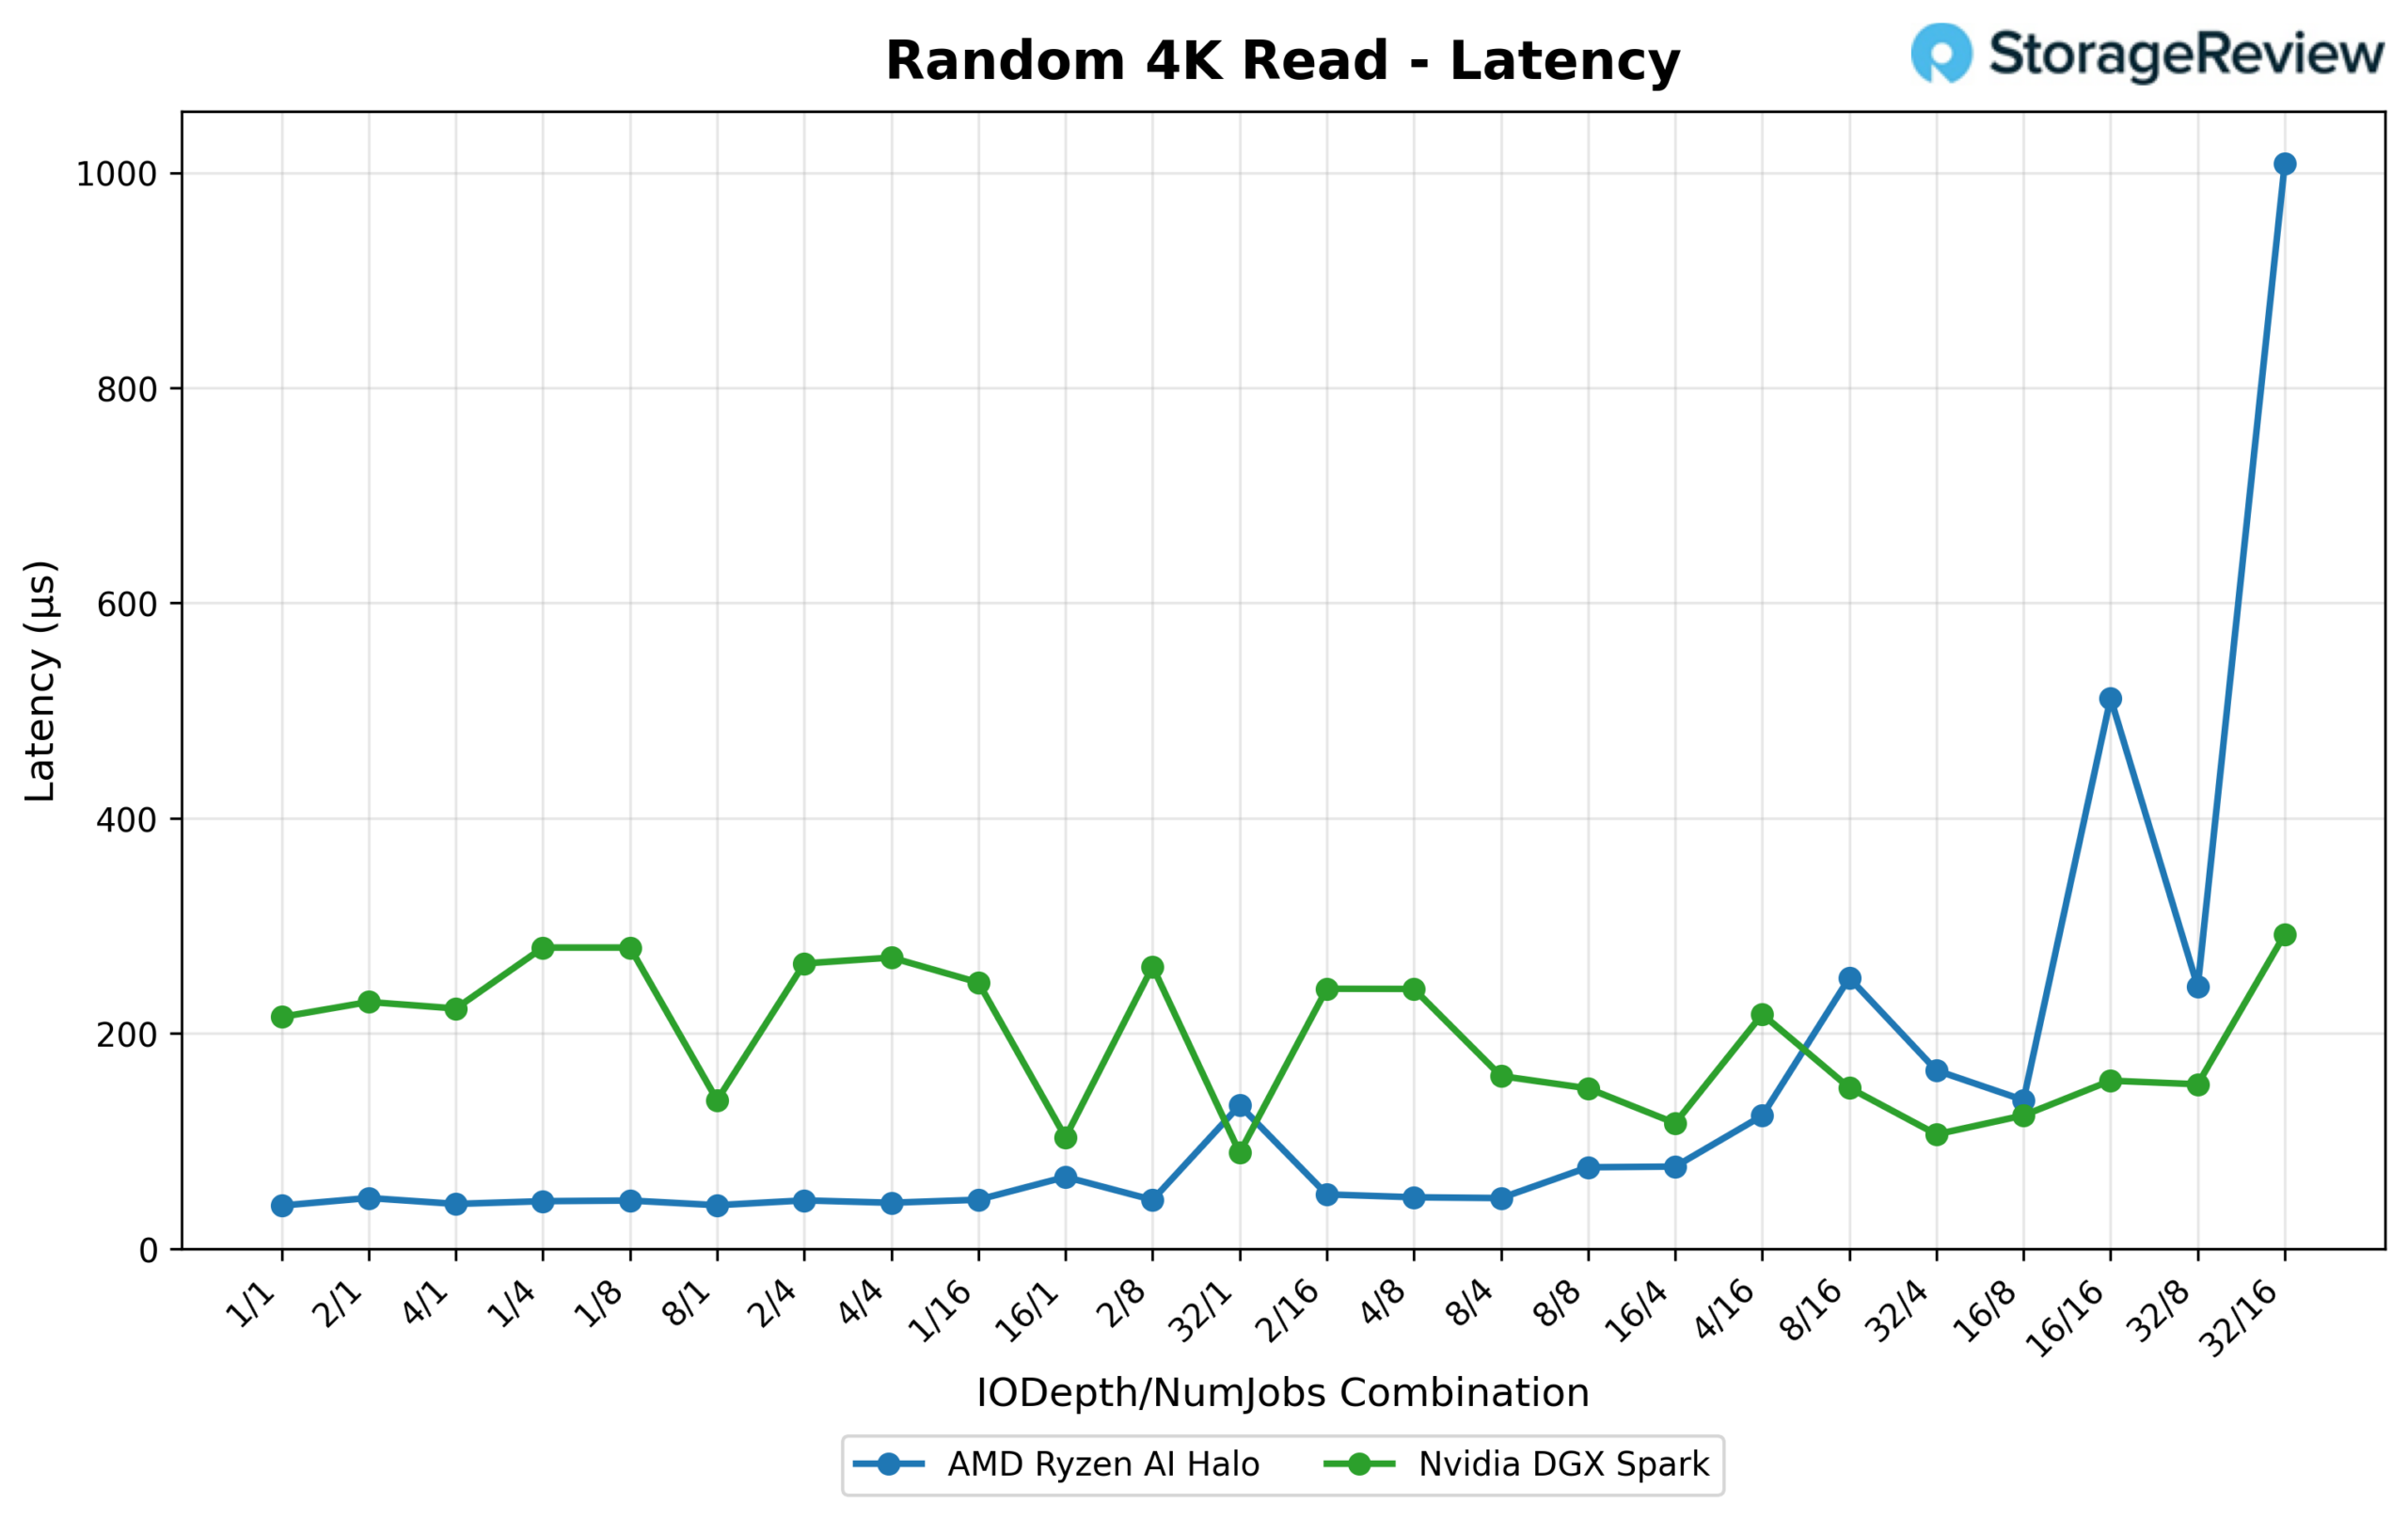
При малой глубине очереди Halo реагирует значительно быстрее (0.04 мс при 1/1 против 0.215 мс у Spark) и сохраняет преимущество в задержке на протяжении большей части диапазона низких и средних значений. Но Spark значительно опережает его по пропускной способности в масштабе: его пиковое значение IOPS достигает 1,750.7 тыс. (6,838.8 МБ/с) при 32/16, что значительно превосходит пиковое значение Halo в 1,050.4 тыс. IOPS (4,103.2 МБ/с) при 32/8.
Интересно, что картина задержки меняется на противоположную при большой глубине очереди. Кривая задержки Spark остается относительно стабильной даже при увеличении глубины и количества потоков, достигая пика всего в 0.292 мс. Halo, напротив, резко возрастает при 16/16 (0.513 мс) и снова при 32/16 (1.009 мс), превышая свой базовый уровень в установившемся режиме более чем в 3 раза, что означает, что его превосходная отзывчивость при малой глубине очереди не сохраняется до полной насыщенности.
4K Случайная запись
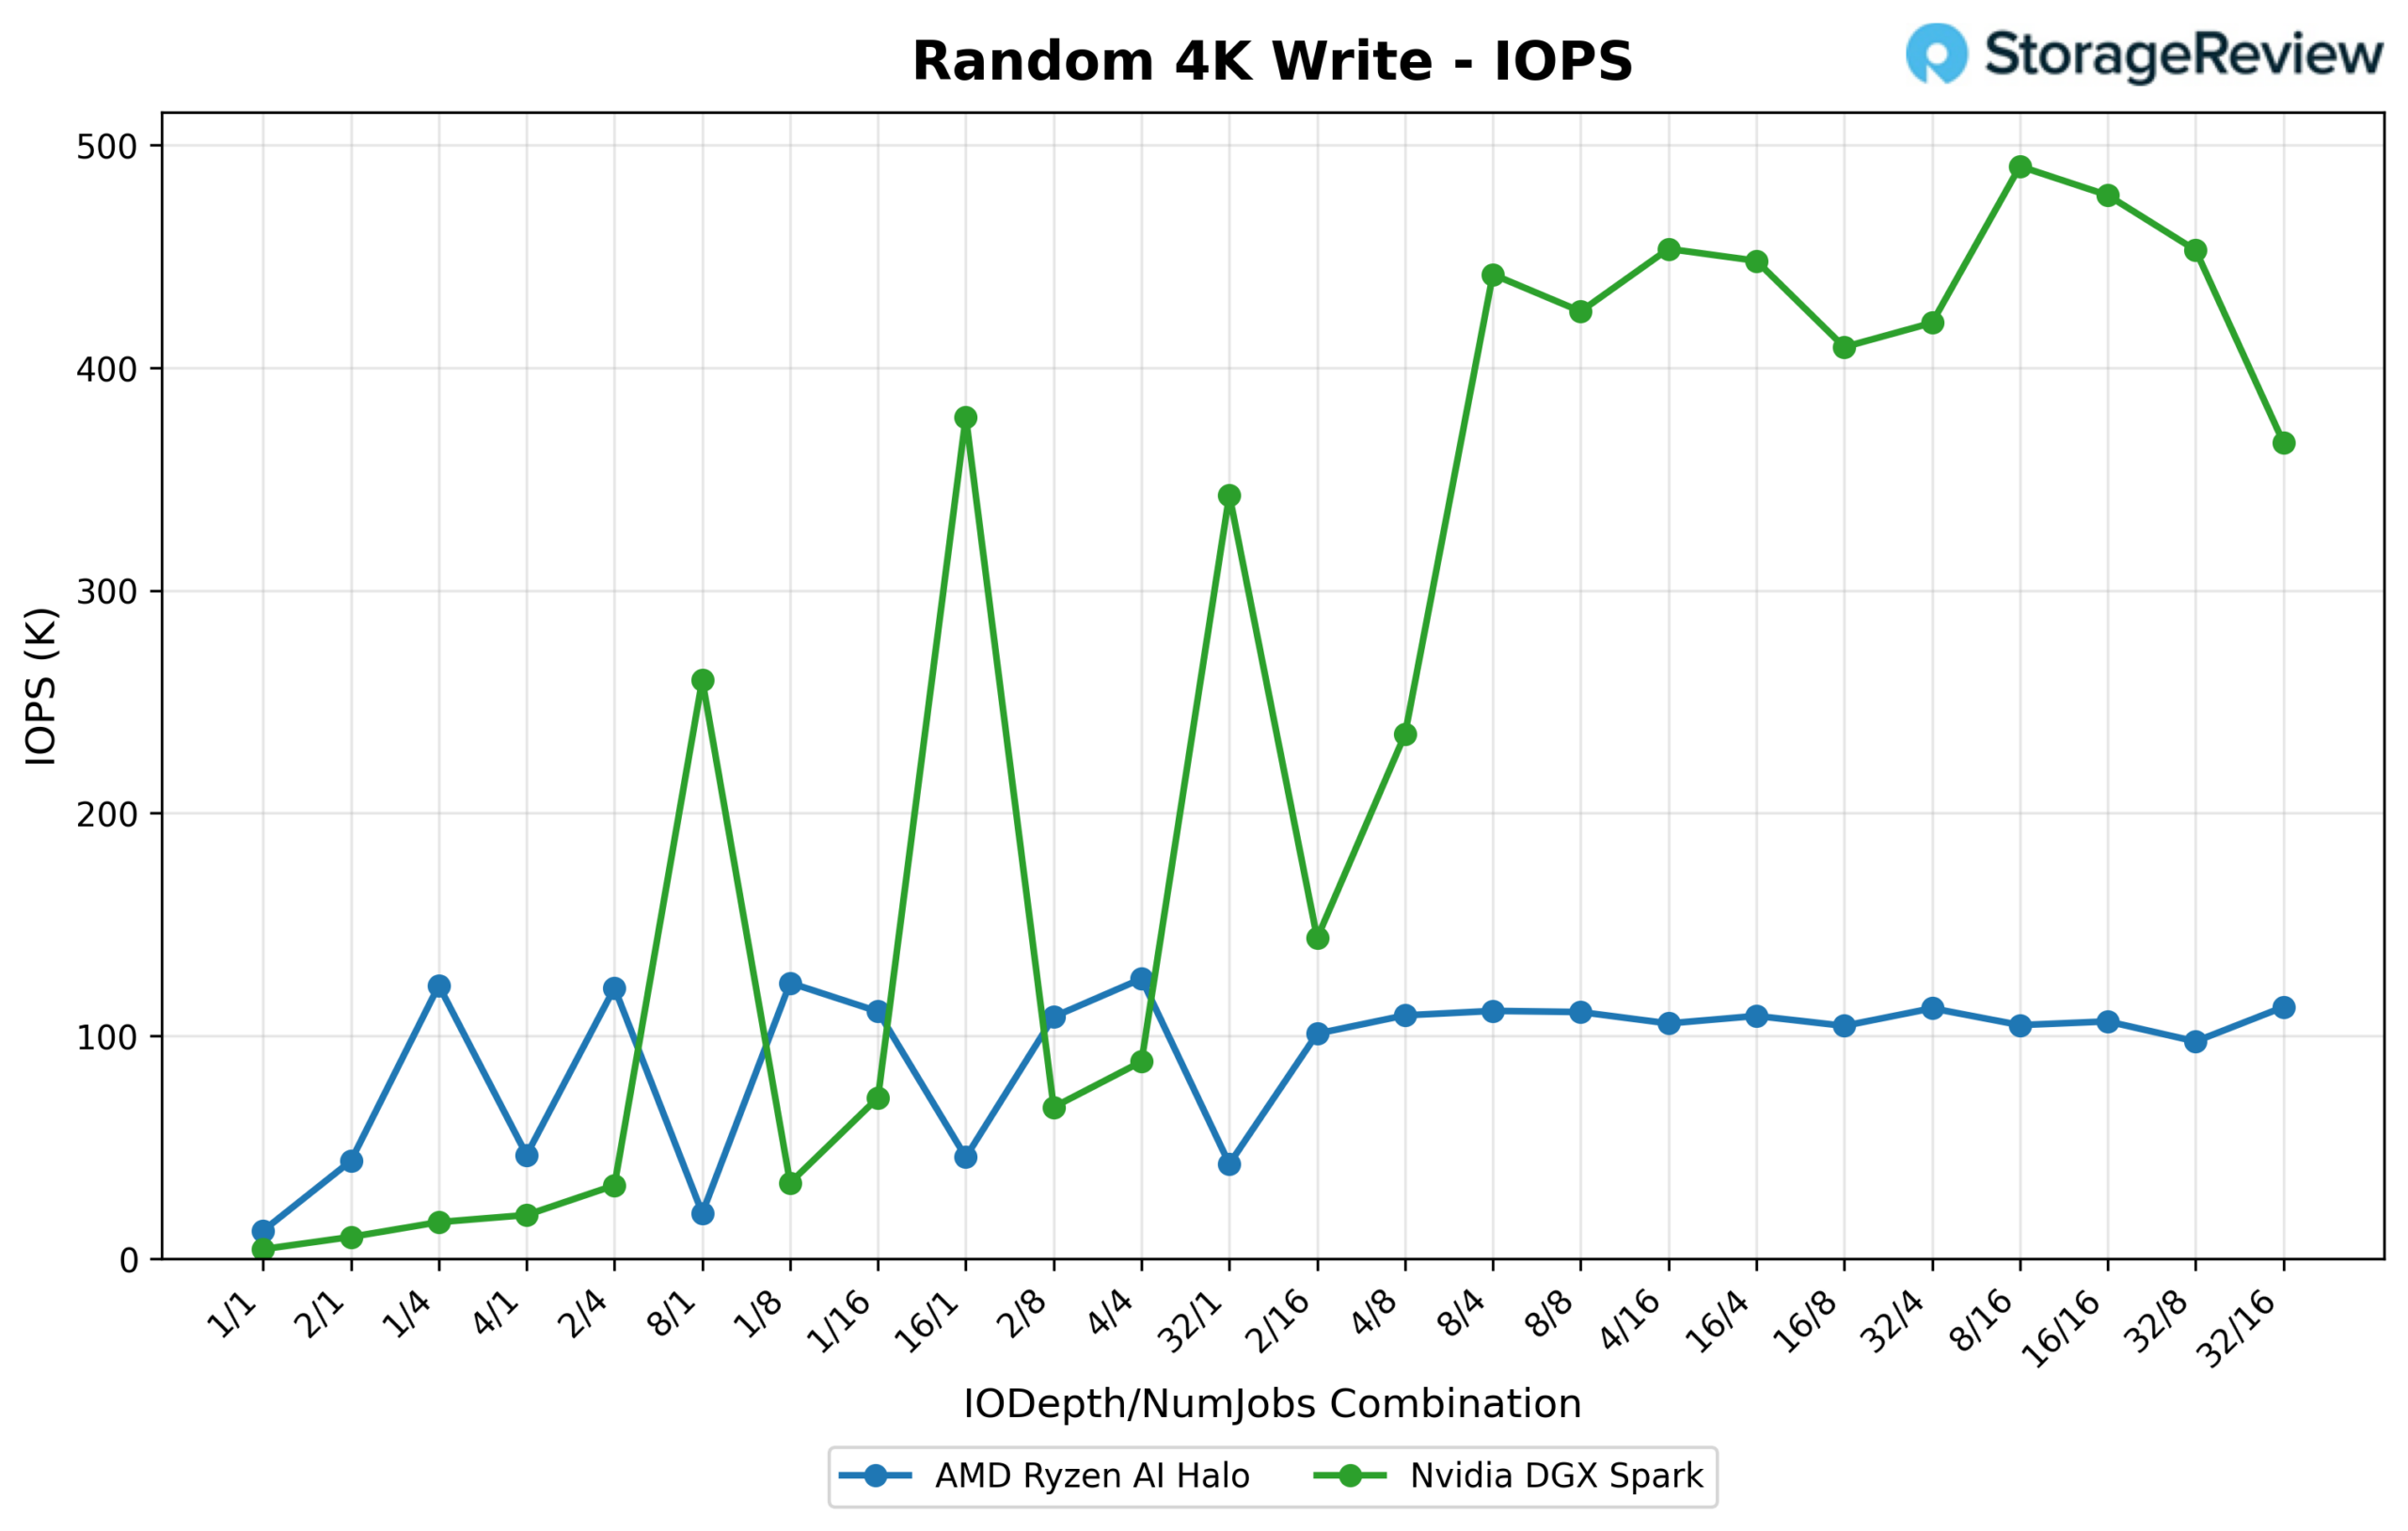
Это самый большой разрыв в IOPS за весь период тестирования. Производительность Spark при случайной записи 4K резко возрастает с увеличением глубины очереди и количества потоков, достигая 490.4 тыс. IOPS (1,915.6 МБ/с) на уровне 8/16. Halo, тем временем, достигает плато гораздо раньше и на гораздо более низком уровне, достигая максимума в 125.6 тыс. IOPS (490.7 МБ/с) на уровне 4/4 и никогда не превышая примерно 110–115 тыс. IOPS до конца тестирования. В этом случае Spark работает почти в 4 раза быстрее, чем Halo.
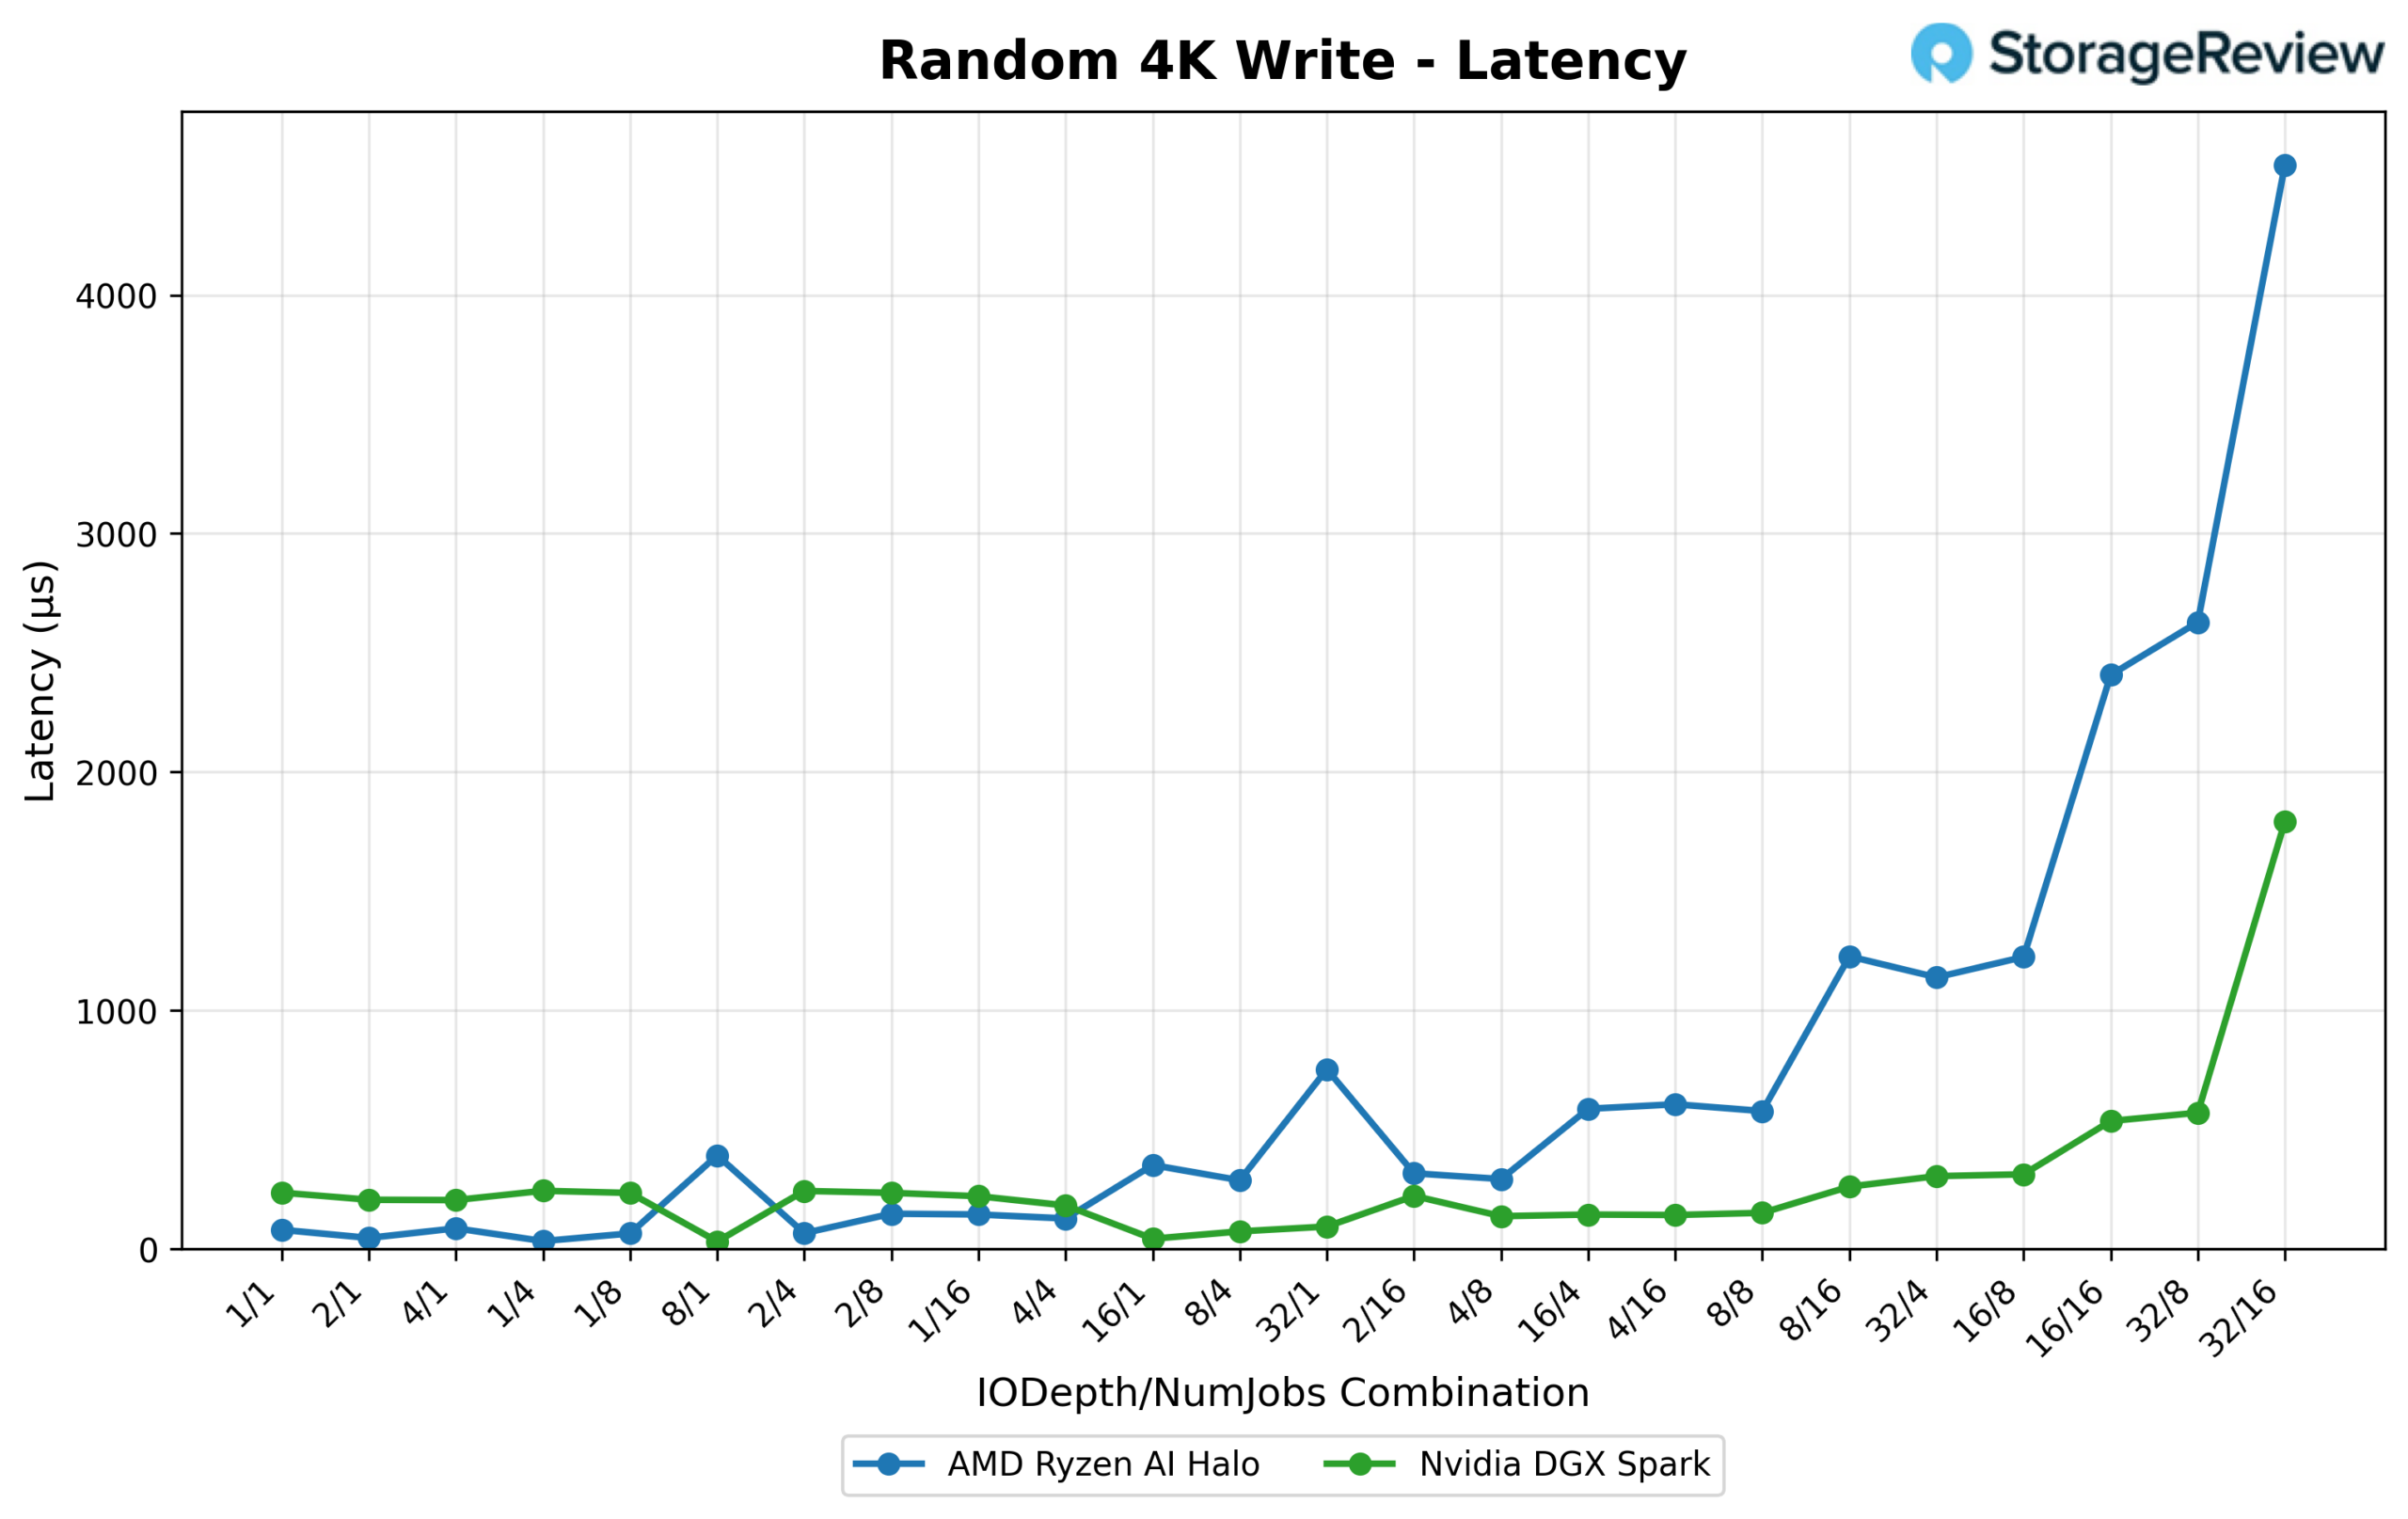
Задержка снова оказывается в пользу Halo при малой глубине очереди (0.079 мс против 0.235 мс при 1/1). К 32/16 средняя задержка Halo выросла до 4.546 мс, в то время как у Spark она остается сравнительно стабильной на уровне 1.792 мс. В сочетании с разницей в IOPS это тест, где преимущество Spark наиболее выражено и наиболее стабильно на протяжении всего анализа глубины/потока.
Онлайн-сервис vLLM – Производительность вывода данных LLM
vLLM — один из самых популярных высокопроизводительных механизмов вывода и обслуживания для LLM-систем. Онлайн-бенчмарк vLLM оценивает реальную производительность этого механизма вывода при одновременном запросе. Он имитирует производственные нагрузки, отправляя запросы на работающий сервер vLLM с настраиваемыми параметрами, такими как скорость запросов, длина входных и выходных данных, а также количество одновременно работающих клиентов. Бенчмарк измеряет ключевые показатели, включая пропускную способность (токены в секунду), время до получения первого токена и время на один выходной токен (TPOT), помогая пользователям понять, как vLLM работает в различных условиях нагрузки.
Мы протестировали производительность вывода на основе широкого набора моделей, охватывающих различные архитектуры, масштабы параметров и стратегии квантования, чтобы оценить пропускную способность при различных профилях параллельного выполнения.
ГПТ ОСС 120Б
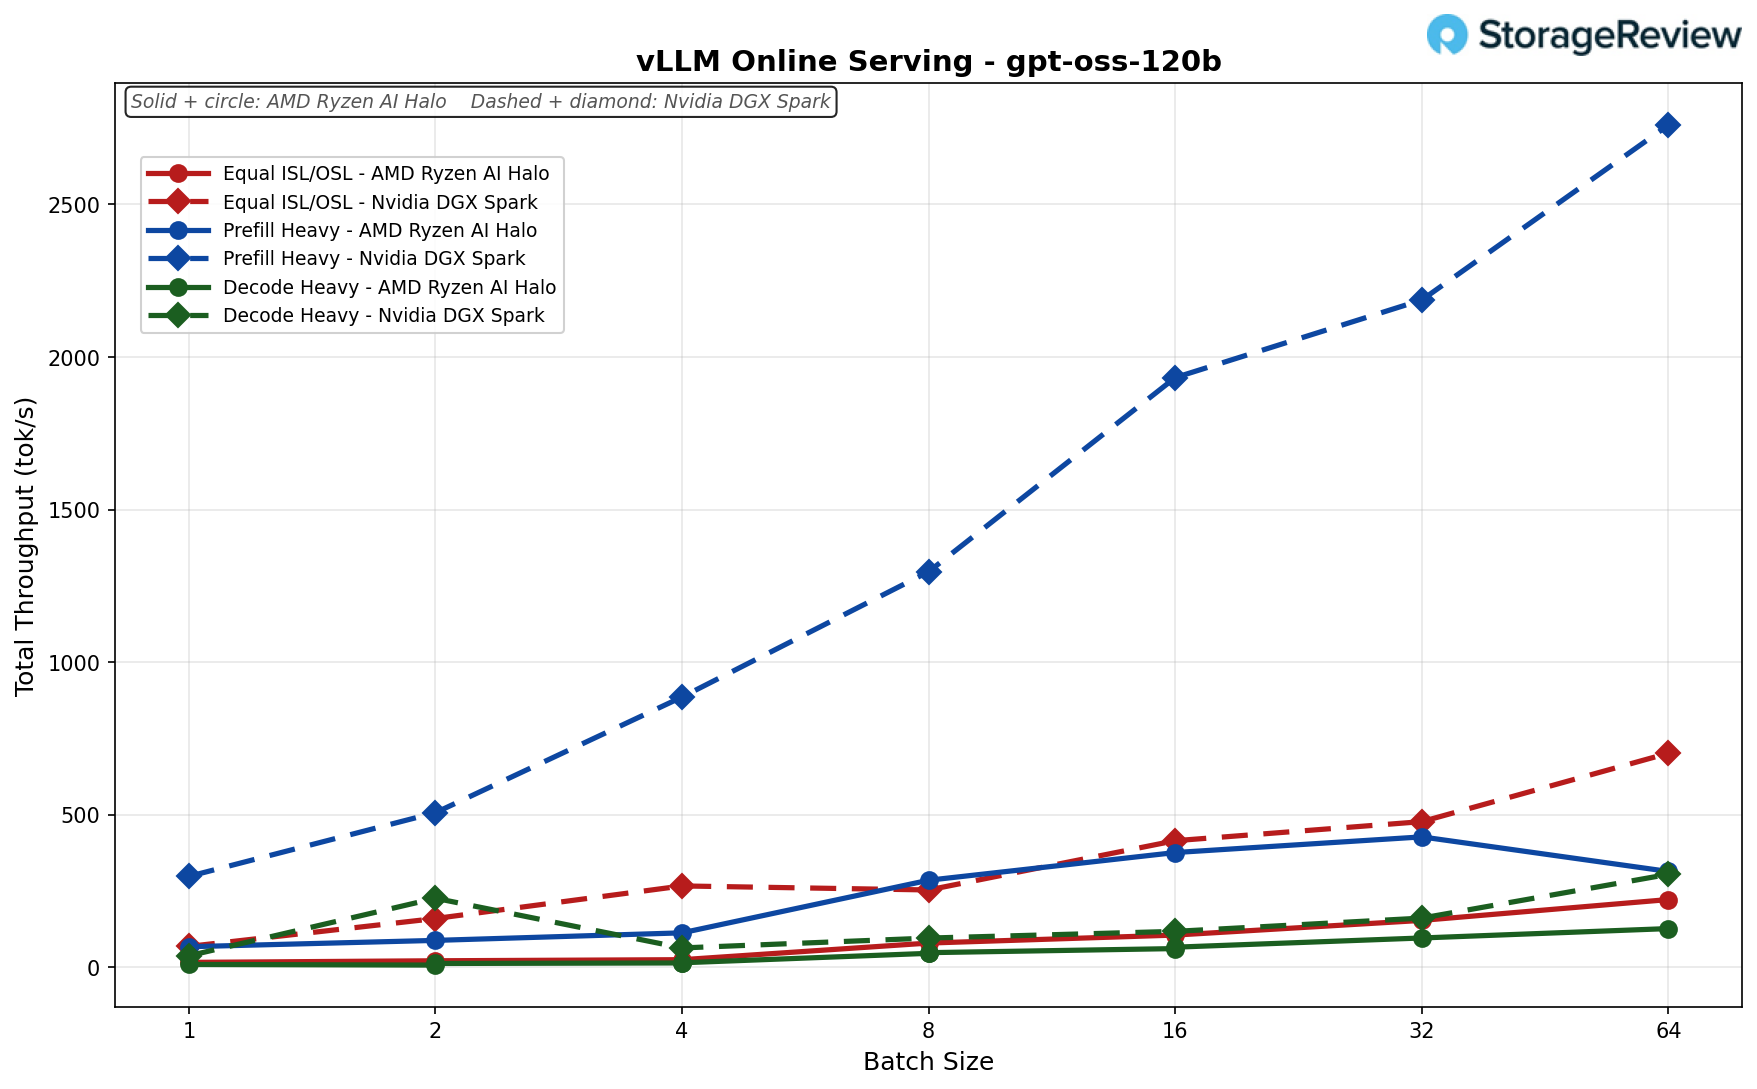
Равные показатели ISL/OSL (256/256): Halo достигла производительности 222 ток/с при размере партии 64, в то время как Spark достигла 701 (примерно в 3.2 раза меньше).
Тяжелый предварительный заправщик (8k/1k): Производительность Halo достигла пика на 32-й партии (427 токов/с), затем упала до 314 на 64-й партии, в то время как Spark резко увеличила производительность до 2,760 (примерно в 8.8 раза) — самый большой разрыв в этом наборе.
Decode Heavy (1k/8k): Halo достигла скорости 127 токенов в секунду, по сравнению с 305 токенов в секунду у Spark при размере партии 64 (примерно в 2.4 раза выше).
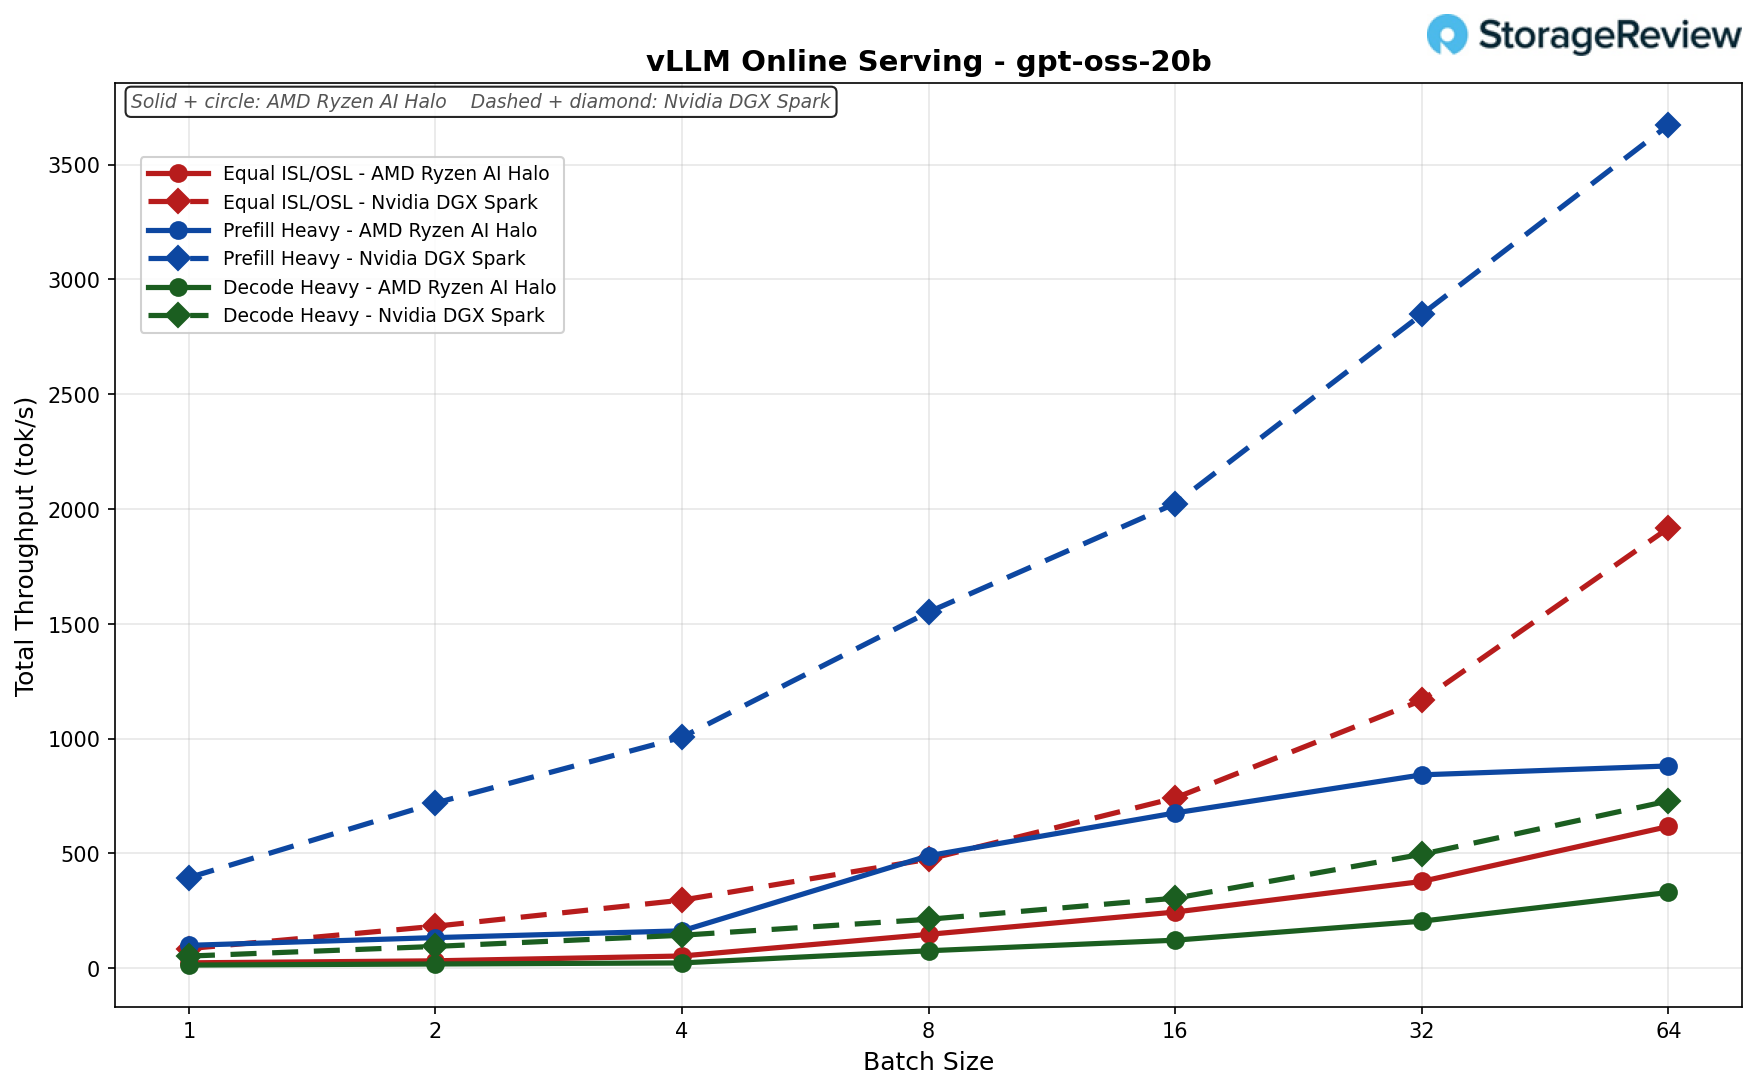
ГПТ ОСС 20Б
Равные значения ISL/OSL (256/256): Spark лидировал в каждой партии, достигнув производительности 1,917 против 617 токов/с в 64-й партии (Spark примерно в 3.1 раза опережал конкурента).
Предварительное заполнение Heavy (8 тыс./1 тыс.): Spark демонстрирует самый большой отрыв, достигнув показателя 3,672 против 881 токен/с при размере партии 64 (Spark примерно в 4.2 раза опережает конкурента).
Decode Heavy (1k/8k): Spark опережает всех, достигая 728 против 330 токена/с на 64-м пакете (Spark примерно в 2.2 раза опережает).
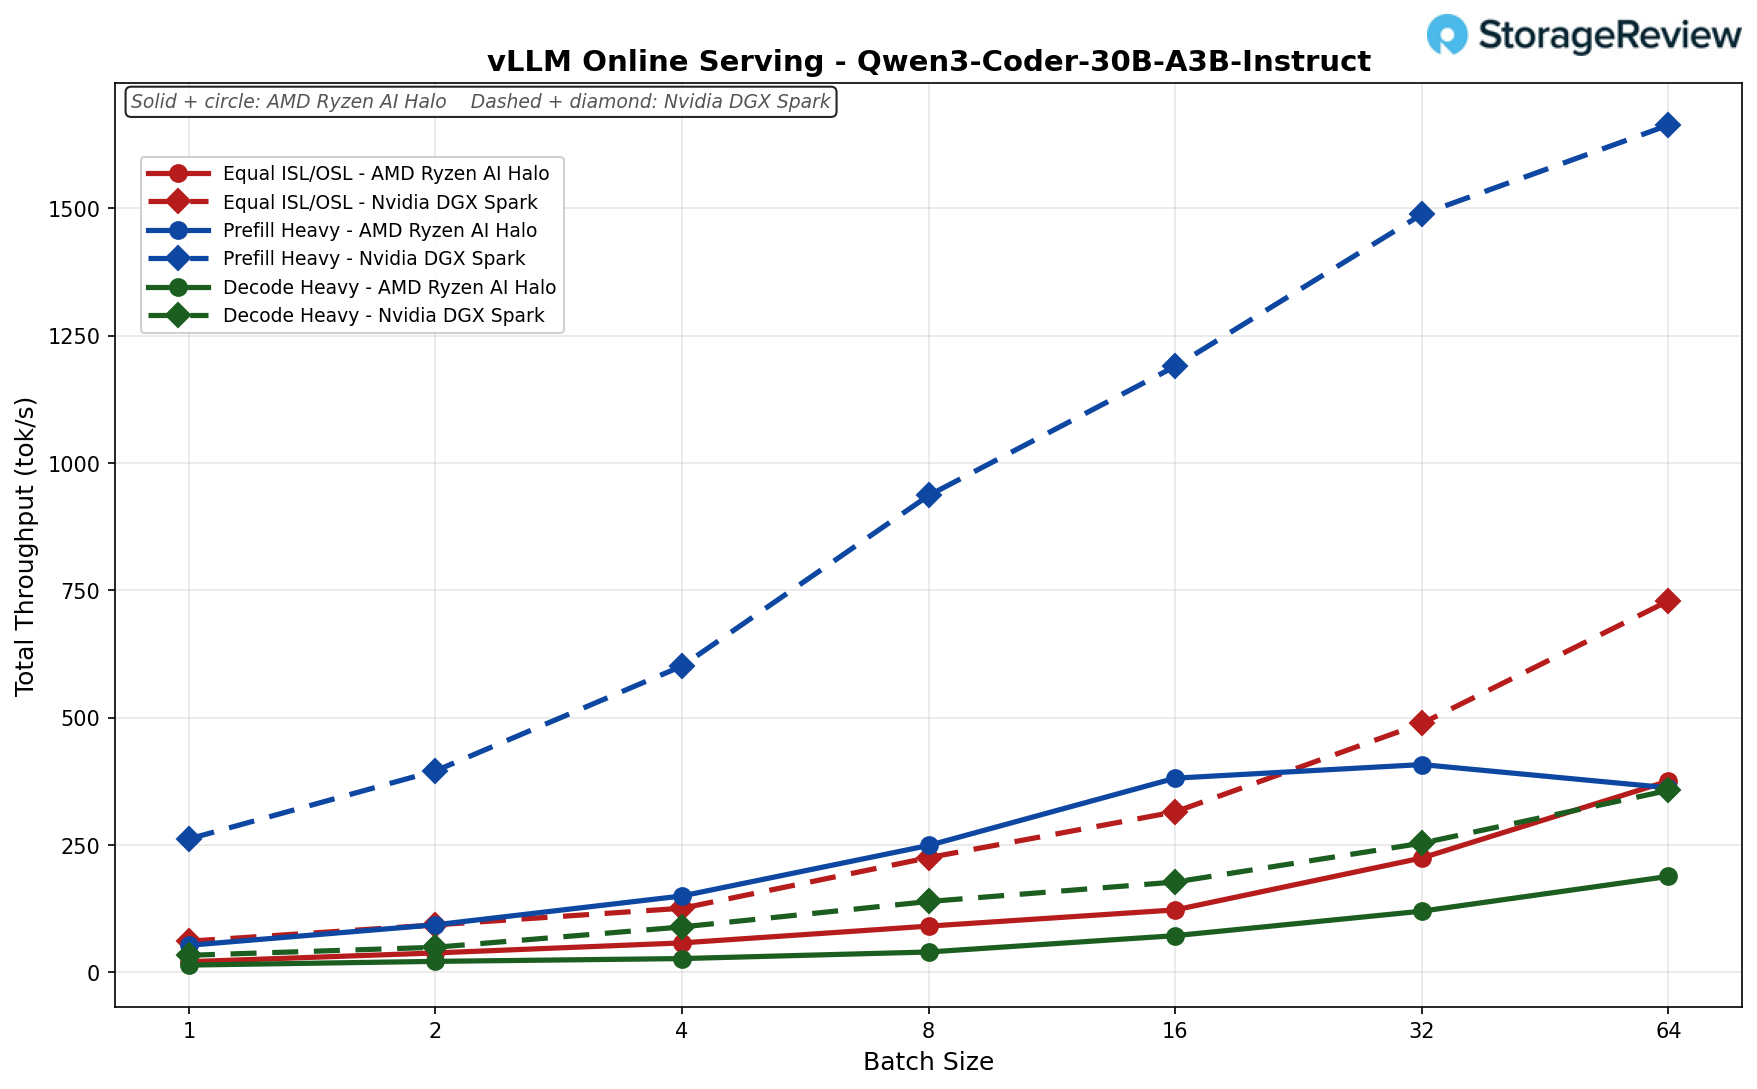
Инструкция по кодеру Qwen3 30B A3B
Равные значения ISL/OSL (256/256): Halo показала производительность 376 токенов/с при размере партии 64, что примерно вдвое меньше, чем у Spark (729 токенов/с, примерно в 1.9 раза выше) — один из самых близких результатов по показателю Equal ISL/OSL.
Предварительная заправка Heavy (8k/1k): пик производительности Halo пришелся на 32-ю партию (408 токов/с), затем он снизился до 362 на 64-й партии, уступая показателю Spark в 1,663 (примерно в 4.6 раза).
Decode Heavy (1k/8k): Halo достигла скорости 188 токов/с, по сравнению с 357 у Spark при размере пакета 64 (примерно в 1.9 раза выше).
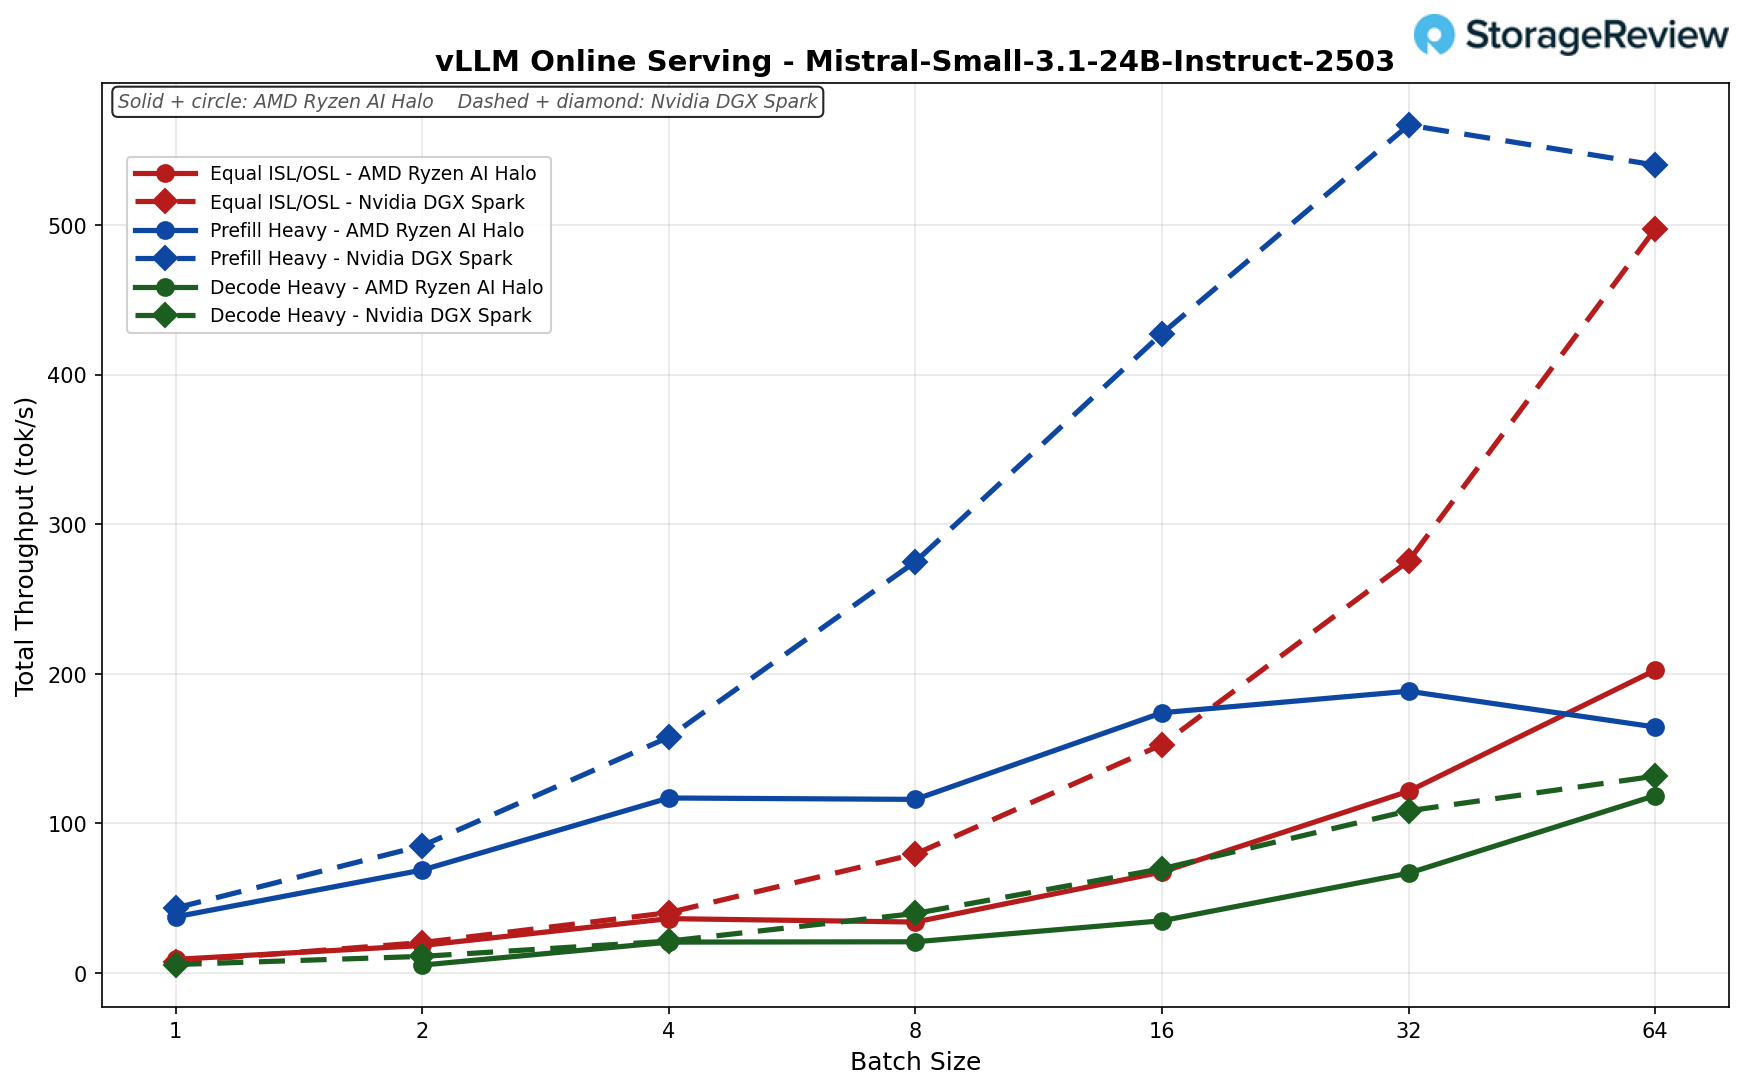
Mistral Small 3.1 24B Инструкция
Равные показатели ISL/OSL (256/256): Halo фактически лидировал в первой партии (9 против 8 ток/с), затем стабилизировался на уровне 202 ток/с в 64-й партии, в то время как Spark показал 498 (примерно в 2.5 раза отставая).
Предварительная заправка Heavy (8k/1k): Halo достигла пика производительности на 32-й партии (188 токов/с) и немного снизилась до 164 на 64-й партии, уступив показателю Spark в 540 (примерно в 3.3 раза).
Decode Heavy (1k/8k): Практически равные показатели на протяжении всего боя, Halo достигла 119 токена в секунду против 132 у Spark на 64-й партии (разница примерно 11%).
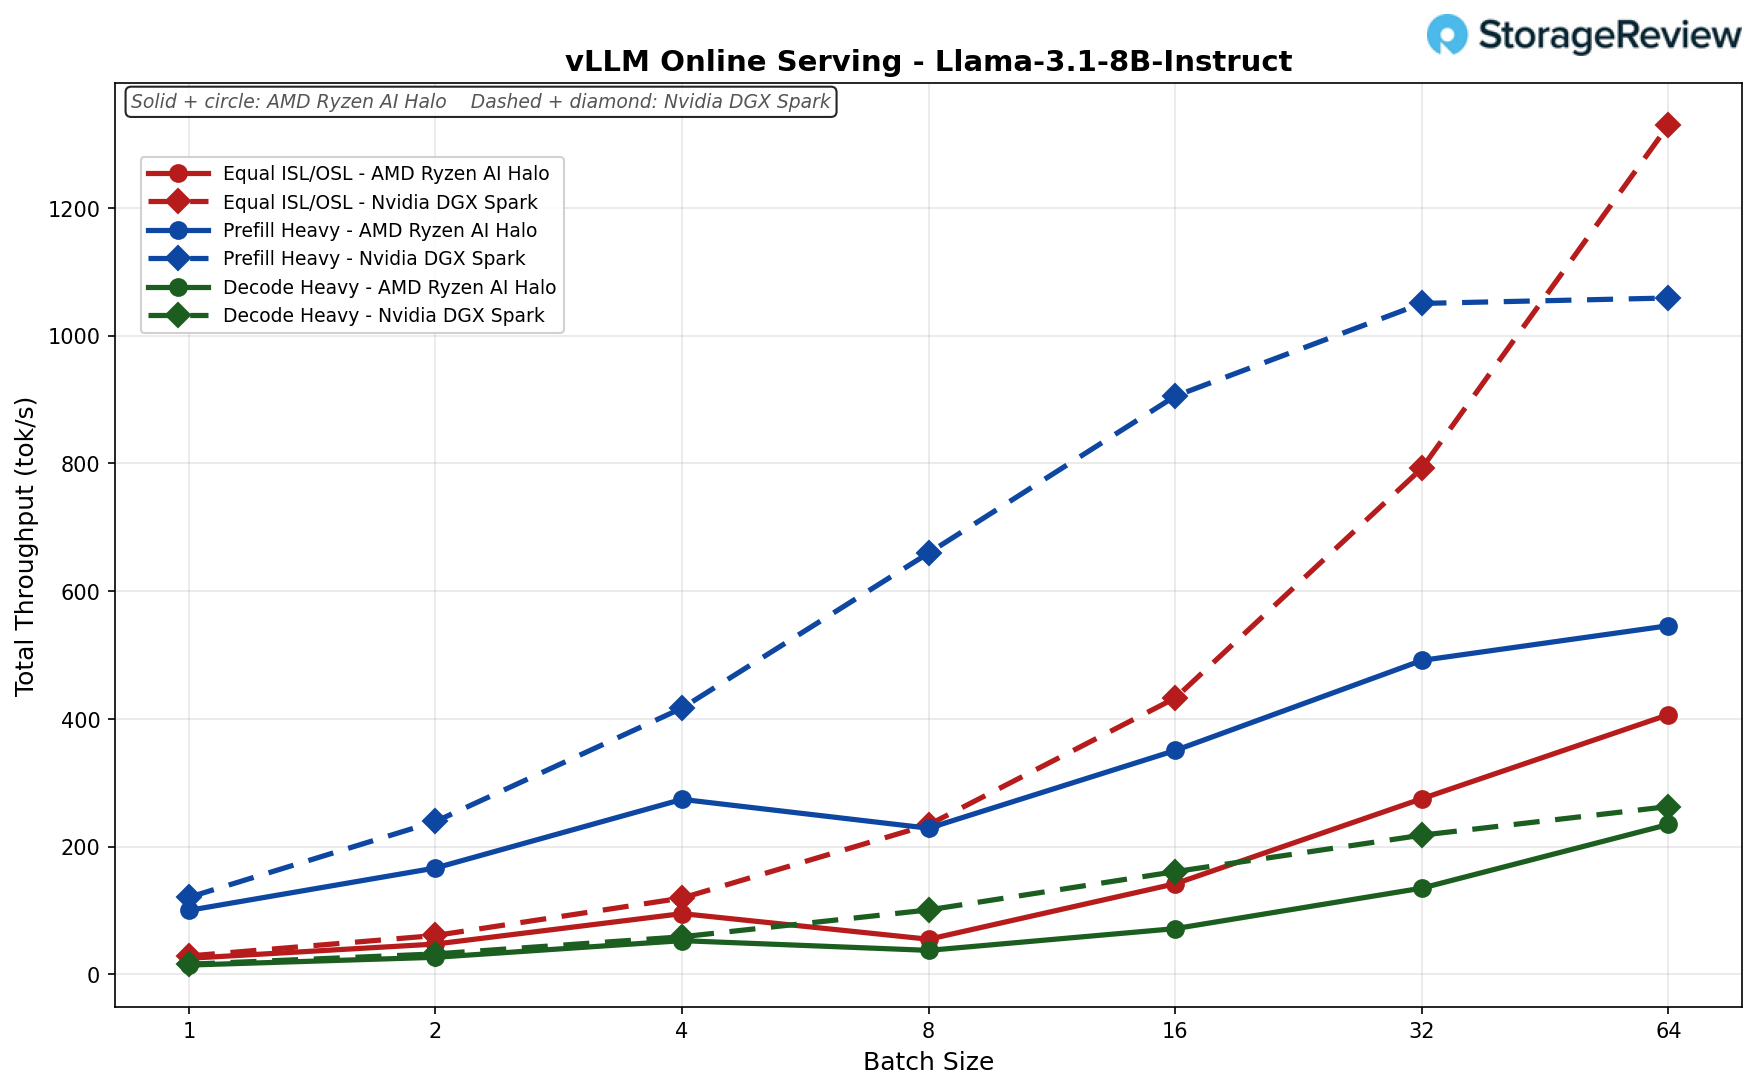
Лама 3.1 8Б Инструктировать
Равные показатели ISL/OSL (256/256): Halo плавно масштабировался от 25 ток/с в первой партии до 407 ток/с в 64-й партии, точно следуя за Spark до 4-й партии, после чего Spark вырвался вперед, достигнув 1,330 (Halo отставал примерно в 3.3 раза на пике).
Предварительная заправка Heavy (8k/1k): Halo достигла производительности 546 токи/с при размере партии 64, что примерно вдвое меньше, чем у Spark (1,059).
Decode Heavy (1k/8k): Самый конкурентоспособный сценарий в Halo, достигающий 235 токов/с против 263 у Spark при размере партии 64 (разница примерно 12%).
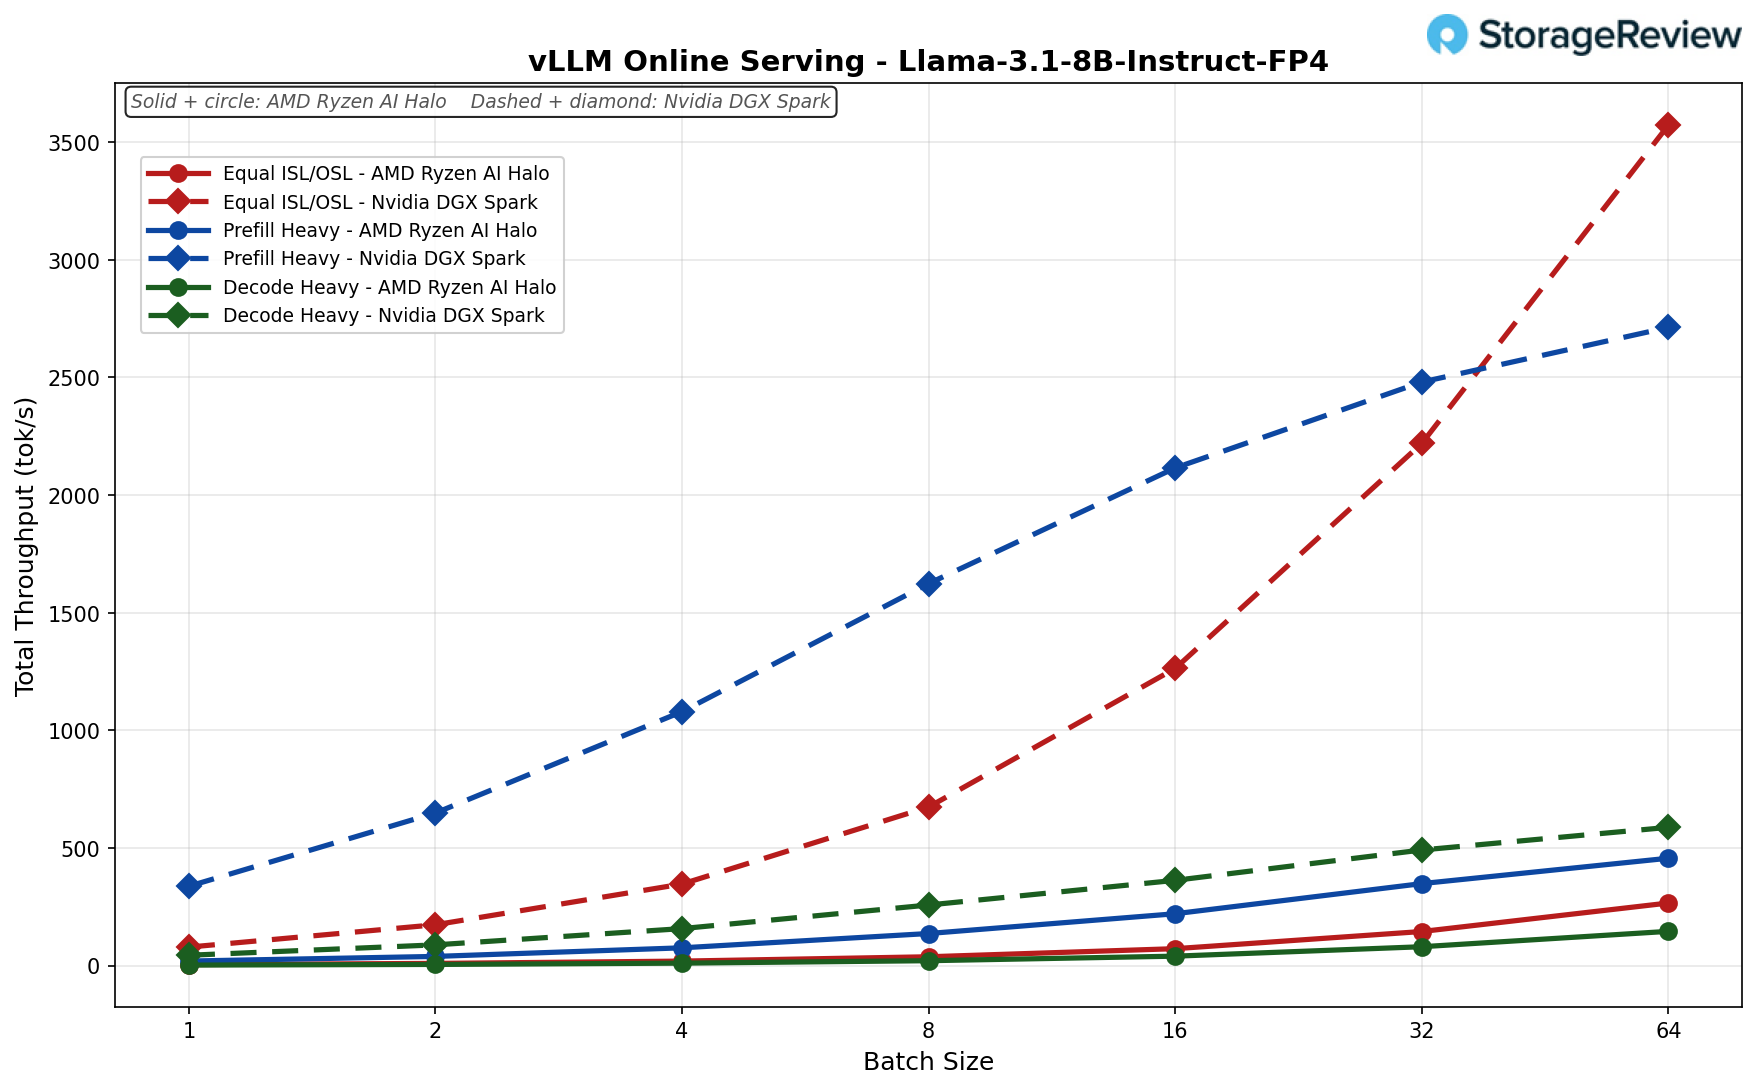
Лама 3.1 8B Инструкция FP4
Равные показатели ISL/OSL (256/256): пиковая скорость Halo составила 267 ток/с при размере партии 64, что значительно меньше, чем у Spark (3,573) — наибольший разрыв (примерно в 13.4 раза) наблюдается в FP4.
Предварительная заправка Heavy (8k/1k): Halo достигла производительности 457 токи/с при размере партии 64, по сравнению с 2,713 у Spark (примерно в 5.9 раза).
Decode Heavy (1k/8k): Halo показал производительность 146 ток/с, по сравнению с 588 ток/с у Spark при размере пакета 64 (примерно в 4 раза больше).
Заключение
Процессор AMD Ryzen AI Halo входит в категорию, фактически созданную NVIDIA с помощью DGX Spark, и не пытается превзойти Spark в его собственной игре. В наших тестах vLLM Spark показал преимущество в пропускной способности в 2-4 раза в большинстве сценариев при высокой параллельности, достигая 8.8-кратного преимущества в работе с GPT OSS 120B с интенсивным заполнением и сокращаясь примерно до 10% только в паре запусков с интенсивным декодированием, а его подсистема хранения данных выиграла почти все тесты fio при насыщении. Вместо этого Halo предлагает те же 128 ГБ унифицированной памяти и потолок в 200 миллиардов параметров в аналогичном форм-факторе, по цене 3,999 долларов против 4,699 долларов у Spark Founders Edition (хотя некоторые OEM-производители предлагают их по цене ниже 4,000 долларов), в полноценной x86-машине, которая загружает Windows 11 или Linux, а не только DGX OS.
Если не брать в расчет Spark, то Halo — это самая мощная из протестированных нами реализаций Ryzen AI Max+ 395. Она показала лучшие результаты по сравнению с HP Z2 Mini G1a и ZBook Ultra G1a почти во всех тестах Windows: 37 316 баллов в Cinebench R23 для многоядерных систем, 184.2 GIPS в 7-Zip против 151.6 и 156.8 у HP, самые высокие показатели генерации текста и изображений с помощью Procyon AI, а также самые быстрые результаты в y-cruncher при обработке 5 и 10 миллиардов цифр. В Linux, в сравнении со Spark, она безоговорочно выиграла тесты Phoronix, зависящие от процессора, сжимая данные на 11% быстрее в 7-Zip и завершая компиляцию LLVM на 14% раньше. Это прежде всего компактная рабочая станция, в которой роль разработчика ИИ не заменяет собой, а дополняет функциональность.
Разработчикам, которым требуется максимальная локальная скорость передачи данных в секунду или которые планируют кластеризовать узлы по высокоскоростной сети, всё же стоит приобрести Spark; возможности Halo по обеспечению 10GbE и vLLM значительно превосходят аналогичные. Для разработчиков, работающих с ROCm, команд, которым необходима поддержка Windows, или для тех, кто хочет использовать один компьютер для профессиональных задач и локальной работы с моделями, Halo подойдёт лучше, а стандартный отсек для M.2 2280 и предварительно настроенная переменная графическая память устраняют две наиболее распространённые проблемы, на которые жаловались владельцы Spark. AMD также заявила, что в третьем квартале платформа будет поставляться с процессорами Ryzen AI Max PRO 400 Series с объёмом унифицированной памяти до 192 ГБ, поэтому покупатели, стремящиеся к более мощным моделям, имеют чёткий путь развития без смены платформы.
Страница продукта – AMD Ryzen AI Halo
В рейтинге лучших настольных компьютеров для локального ИИ AMD Ryzen AI Halo занимает первое место как лучшая альтернатива x86.



 Amazon