

AMD, Spectro Cloud och Supermicro har presenterat AMD Instinct Coder, en validerad företagsinferensplattform avsedd för AI-kodningsarbetsbelastningar. Lösningen kombinerar AMD Instinct GPU-acceleratorer, Supermicro AI-infrastruktur och Spectro Clouds PaletteAI Inference Launchpad för att tillhandahålla ett paketerat alternativ för att driftsätta privata och hybrida AI-inferensmiljöer.
Arkitekturen är utformad för företag, molnleverantörer och suveräna AI-operatörer som behöver balansera lokal bearbetning, åtkomst till frontiermodeller, operativ styrning och tokenförbrukning. Istället för att dirigera alla kodningsagentförfrågningar till externa stora språkmodeller använder AMD Instinct Coder policybaserad routing för att avgöra om en begäran hanteras av en lokalt distribuerad modell eller vidarebefordras till en extern frontiermodellslutpunkt.
Denna metod riktar sig mot arbetsbelastningar där rutinkodning, kodgenerering, sammanfattning och liknande uppgifter kan hanteras lokalt, medan mer komplexa resonemang eller specialiserade funktioner förblir tillgängliga via externa modeller. Plattformen är avsedd att minska beroendet av en enda modellleverantör samtidigt som känslig kod, prompter och kontextuell data hålls inom kontrollerad infrastruktur där så är lämpligt. Partnerna hävdar att arrangemanget kan minska kostnaderna för AI-kodningstoken med upp till 70 %, där AMD:s eget material ramar in samma siffra som den totala ägandekostnaden och anger återbetalningstid på så lite som sex månader. Ingen av siffrorna har verifierats oberoende.
Tillkännagivandet kommer samtidigt som organisationer skalar upp AI-kodningsverktyg över utvecklingsteam och automatiserade arbetsflöden. Gartner uppgav i sin rapport från den 24 juni 2026, Gartner Predicts AI Coding Costs Will Surpass Average Developer's Salary by 2028 as Token Consumption Surges , att tokenkostnaderna skulle kunna överstiga produktivitetsökningarna utan en strukturerad driftsmodell. AMD Instinct Coder tar itu med den oron genom modellrouting, mätning, kvoter och arbetsbelastningspolicyer.
Den initiala konfigurationen förväntas använda AMD Instinct MI325X GPU:er. Varje MI325X-accelerator inkluderar 256 GB HBM3E-minne och upp till 6 TB/s maximal minnesbandbredd, med inriktning på minnesintensiva generativa AI-inferensarbetsbelastningar. AMD positionerar plattformen kring sin Instinct-acceleratorportfölj och ROCm-programvaruekosystem, med målet att stödja lokalt driven inferens utan att organisationer behöver montera och validera hela hårdvaru- och programvarustacken oberoende av varandra. Lokal inferens kör en GLM-5.2-modell optimerad genom AMD Inference Microservices, och plattformen exponerar tokenkvoter, revisionsspår och kostnadssynlighet genom Grafana- och Prometheus-instrumentpaneler.
Specifikationer
| Specifikation | AMD Instinct Coder Referenskonfiguration |
|---|---|
| hårdvara | |
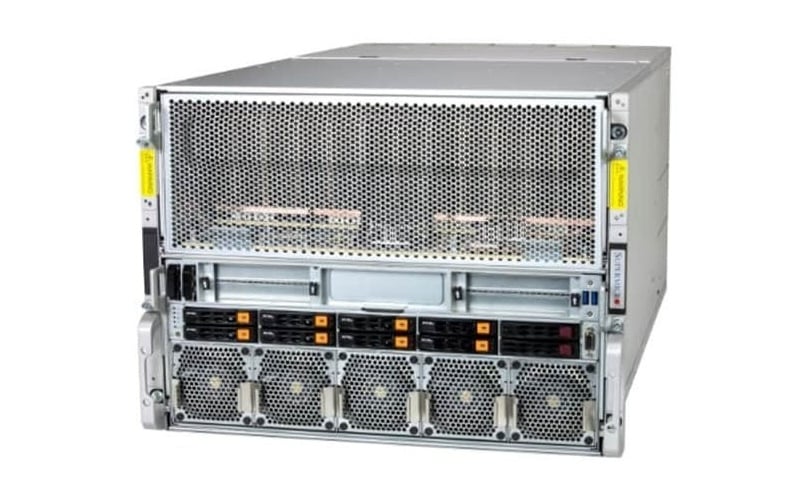
| server | Supermicro AS-8126GS-TNMR |
| CPU: er | 2 x AMD EPYC 9575F, 64 kärnor, 3.3 GHz |
| GPUs | 8 x AMD Instinct MI325X |
| Minne | 3 TB (24 x 128 GB) DDR5 RDIMM 6400 ECC |
| Boot Storage | 2 x 960 GB NVMe PCIe Gen4 V6 M.2 |
| Datalagring | 8 x 7.68 TB PCIe Gen5 TLC U.2 SSD |
| nätverk | 2 x AMD Pensando Pollara 400 HHHL PCIe-nätverkskort, 400 GbE |
| Effekt | 6 x 5250W redundanta (3+3-konfiguration) högeffektiva nätaggregat i titannivå |
| Mjukvara | |
| plattform | Spectro Cloud Palette AI Inference Launchpad |
| Capabilities | Fullstack-hantering av AI-livscykel Företagsstyrning i stor skala Intelligent lokalt-först-modellrouting, gränslinje när det är motiverat Fullständig insyn och kontroll över AI-användning och kostnader |
| AI-modeller | |
| Lokala | AMD Inference Microservices-modell GLM-5.2 |
| Gräns (när det är berättigat) | Antropisk Claude OpenAI GPT Google Tvillingarna |
| Utvecklingsverktyg | |
| IDE:er/verktyg som stöds | Claude Code Markör Visual Studio Code |
| Support | |
| Mjukvara | Omfattande fullstack-programvarusupport från Spectro Cloud |
| hårdvara | 3 års leverans nästa arbetsdag på plats från Supermicro |
| Skala | |
| Kapacitet | Upp till 50 utvecklare per nod, 30 samtidigt |
Supermicro tillhandahåller den underliggande AI-infrastrukturen för företag. Deras stödda system inkluderar luft- och vätskekylda plattformar med åtta grafikkort, kompatibla med acceleratorerna AMD Instinct MI325X och MI350-serien . Supermicros bidrag inkluderar förvalidering, rackintegration och systemkvalificering, som syftar till att minska komplexiteten i driftsättningen och förkorta övergången från levererad infrastruktur till produktionsinferens.
Spectro Cloud PaletteAI Inference Launchpad tillhandahåller det operativa programvarulagret. Plattformen stöder routing mellan lokala och frontiermodeller, arbetsbelastningsspecifik policytillämpning, tokenmätning, förbrukningskvoter och separation mellan flera hyresgäster för team och användare. Programvaran är utformad för att upprätthålla lokal exekvering för lämpliga arbetsbelastningar samtidigt som reservanslutning till externt hostade frontiermodeller bibehålls.
Den resulterande arkitekturen använder nivåindelad inferens, där modellens slutpunkter tilldelas baserat på erforderlig prestanda, känslighet, modellkapacitet, kostnadsmål och tillgänglig infrastrukturkapacitet. För plattformsteam skapar detta ett sätt att standardisera hur efterfrågan på AI-kodning tillhandahålls och styrs mellan interna användare och applikationer. Dan McNamara, senior vice president och general manager för Compute and Enterprise AI på AMD, beskrev skiftet som att AI-kodning går från ett individuellt utvecklarverktyg till ett beslut om företagsplattformen. BMC är bland de tidiga användarna, och Tom Davies, vice president för SaaS-verksamhet, beskriver AMD Instinct Coder som ett kostnadseffektivt, högpresterande inferenslager för företagets Helix Agentic Engineering-arbete.
Den initiala AMD Instinct Coder-konfigurationen förväntas levereras på Supermicro-system som använder AMD Instinct MI325X GPU:er, och partnerna demonstrerar plattformen på Ai4 i Las Vegas denna vecka. Slutliga produktkonfigurationer, tillgänglighet, regional support och prissättning är fortfarande föremål för partnervalidering och godkännande, så specifikationerna ovan beskriver referensversionen snarare än en leverans-SKU med publicerade priser. Organisationer som är intresserade av utvärdering kan kontakta Spectro Cloud via deras Kom igång-sida.


 Amazon