

Updated November 3, 2026: The AMD Instinct MI350P joins Also Tested from our first look at 450W, and its two-card results join Scale-Out Configurations; it ranks once it completes the Ministral 3 ladder at 600W. Published October 14, 2026. Five PCIe accelerators ranked on one vLLM container and one model set, with the H100 NVL and the MI350P in Also Tested; the H200 NVL carries a power note explained below.
Varje accelerator som rankas på den här sidan har gått igenom StorageReview-labbet som ett enda PCIe-kort. Marknaden för företags-GPU är uppdelad mellan HGX- och OAM-modulerna som fyller AI-fabriker och tilläggskorten som ingår i de 2U- och 4U-servrar som de flesta datacenter redan kör, och den här sidan täcker endast den andra gruppen: datacenter-GPU:n som du kan beställa i en vanlig serverkonfigurator och placera i ett rack du redan har.
Det är marknaden för företagsinferens, och företagsinferens är den arbetsbelastning som varje kort här rankas på. Varje val länkar till recensionen som innehåller data, och rankningen kommer från samma test på varje kort.
Det testet är vLLM online-serving, den stack som mest företagsinferens körs på, driven från 1 till 32 samtidiga strömmar på varje kort, och till 128 på de två Hopper-korten, på fyra modeller i samma NGC vLLM 26.08-container (vLLM 0.27.1 på CUDA 13.4.1) och samma 595.71.05-drivrutin.
Fem av de sex korten kördes i vår Dell PowerEdge R770 med den effekt som servern levererar till en GPU-plats; RTX PRO 6000 kördes i vår Dell Pro Max Tower T2 på samma behållare och drivrutin. Ordningen du ser nedan gällde för varje modell och båda de begärandeformerna vi körde, så rankningen är inte bara ett toppresultat.
Minne avgör mer än beräkningsförmågan i den här klassen. Ett 24 GB eller 32 GB kort hanterar små och medelstora modeller vid chattlängd och får slut på KV-cache när långa uppmaningar staplas; ett 48 GB eller 96 GB kort hanterar medelstora modeller med plats för samtidighet mellan flera hyresgäster, och 94 GB och 141 GB HBM-korten är där en modell i 70B till 120B-bandet stannar kvar på en GPU. Valen är organiserade kring den uppdelningen, och FAQ:n längst ner besvarar de jämförelsefrågor som köpare ställer oftast, från RTX PRO 6000 mot H100 till vad 450W mot 600W är värt i ett 2U-kort.
Kortfattat
Utdatatokens per sekund kommer från Ministral 3 14B Instruct FP8 vid 32 samtidiga strömmar, den tyngsta punkten varje kort slutfört, på chattformen 512-in, 512-ut och dokumentformen 8 192-in, 1 024-ut. FP8 är det maximalt uppnåeliga MAMF-matmulresultatet i TFLOPS, en ihållande tät GEMM-mätning, inte leverantörstoppen.
| Kategori | Accelerator | Minne / Bandbredd | Spår/strömförsörjning enligt test | Chatt 512/512 (tok/s) | Dokument 8K/1K (tok/s) | MAMF FP8 (TFLOPS) | Full Review |
|---|---|---|---|---|---|---|---|
| Bästa PCIe AI-acceleratorn totalt sett | NVIDIA H200 NVL* | 141 GB HBM3e / 4.8 TB/s | Dubbeluttag / 450W* | 3,435 | 1,038 | 1,262 | ET900N G3 Recension (H200 NVL-data) |
| Bästa företagsinferens-GPU | NVIDIA RTX PRO 6000 Blackwell Server Edition | 96 GB GDDR7 / 1.6 TB/s | Dubbeluttag / 600W (450W-uttag har även testats) | 2,283 | 608 | 774 | RTX PRO 6000 Recension |
| Bästa GPU med en enda plats | NVIDIA RTX PRO 4500 Blackwell Server Edition | 32 GB GDDR7 / 800 GB/s | Enkelport / 165W | 1,107 | 190 | 280 | RTX PRO 4500 SE Recension |
| Bästa Mainstream Inference GPU som fortfarande levereras | NVIDIA L40S | 48 GB GDDR6 / 864 GB/s | Dubbeluttag / 350W | 995 | 230 | 369 | RTX PRO 4500 SE recension (L40S-data) |
| Bästa kort med kortplats för 1U och Edge | NVIDIA L4 | 24 GB GDDR6 / 300 GB/s | Enkel HHHL / 72W | 364 | 42 | 116 | L4-recension |
*H200 NVL testades vid 450 W, det mesta en Dell PowerEdge R770 GPU-plats levererar. Kortet är klassat för 600 W, och vi har inte kört det där, så siffrorna på den här sidan är ett minimum. Siffrorna för RTX PRO 6000 kommer från Workstation Edition; NVIDIA klassar båda utgåvorna till 600 W, och de profilerar identiskt i våra tester, och Server Edition är det passiva, headless-kortet med samma GPU och minne.
Valen
Bästa PCIe AI-acceleratorn totalt sett: NVIDIA H200 NVL
H200 NVL är det snabbaste tilläggskortet vi har mätt, och det är det enda på den här sidan som fortsätter att skala bortom 32 strömmar. Vid 32 samtidiga strömmar på Ministral 3 14B FP8 levererade det 3 435 utdatatokens per sekund mot 3 096 för H100 NVL och 2 283 för RTX PRO 6000, och gapet ökade i takt med att samtidigheten ökade: 7 336 tokens per sekund vid 128 strömmar, där RTX-korten redan hade slutat. På dokumentformen med 8 192 tokens fick 141 GB HBM3e aldrig brist på, och kortet slutade 21 till 23 procent före H100 NVL på alla modeller vid matchad samtidighet.
Försprånget mot Blackwell-kortet är större än vad specifikationsbladen antyder. Vid 32 strömmar låg H200 50 till 81 procent före RTX PRO 6000 bland de tre FP8- och BF16-modellerna, och vid 8K-ingång klarade den 1 038 tokens per sekund på 14B-modellen jämfört med RTX-kortets 608, eftersom 4.8 TB/s HBM-flöden avkodas på ett sätt som 1.6 TB/s GDDR7 inte kan.
Två eller fyra kort bryggar över NVLink med 900 GB/s, vilket inget annat kort här erbjuder. Våra H200 NVL-siffror visas bredvid RTX PRO 6000 och GB300 DGX Station i ET900N G3-recensionen, där Stationen nådde 22 041 utdatatokens per sekund på GPT-OSS-20B vid 128 strömmar jämfört med 6 022 för detta kort.
För en 2U-köpare är det viktigt att notera att det här kortet kördes på de 450 W som en PowerEdge R770-plats tillåter, och dess 600 W-klassning är fortfarande oprövad i vårt labb. Den enda arbetsbelastningen där det inte visar någon fördel är NVFP4-versionen av Qwen3.8-27B, där kortet inte har någon FP4-hårdvara och vLLM dekvantiserar i farten, och landar på 467 tokens per sekund jämfört med 616 för RTX PRO 6000. Köp det för minne och bandbredd, vilket är vad en 70B till 120B-distribution behöver.
Läs recensionen av ASUS ET900N G3, som innehåller våra resultat för H200 NVL
Bästa företagsinferens-GPU: NVIDIA RTX PRO 6000 Blackwell Server Edition
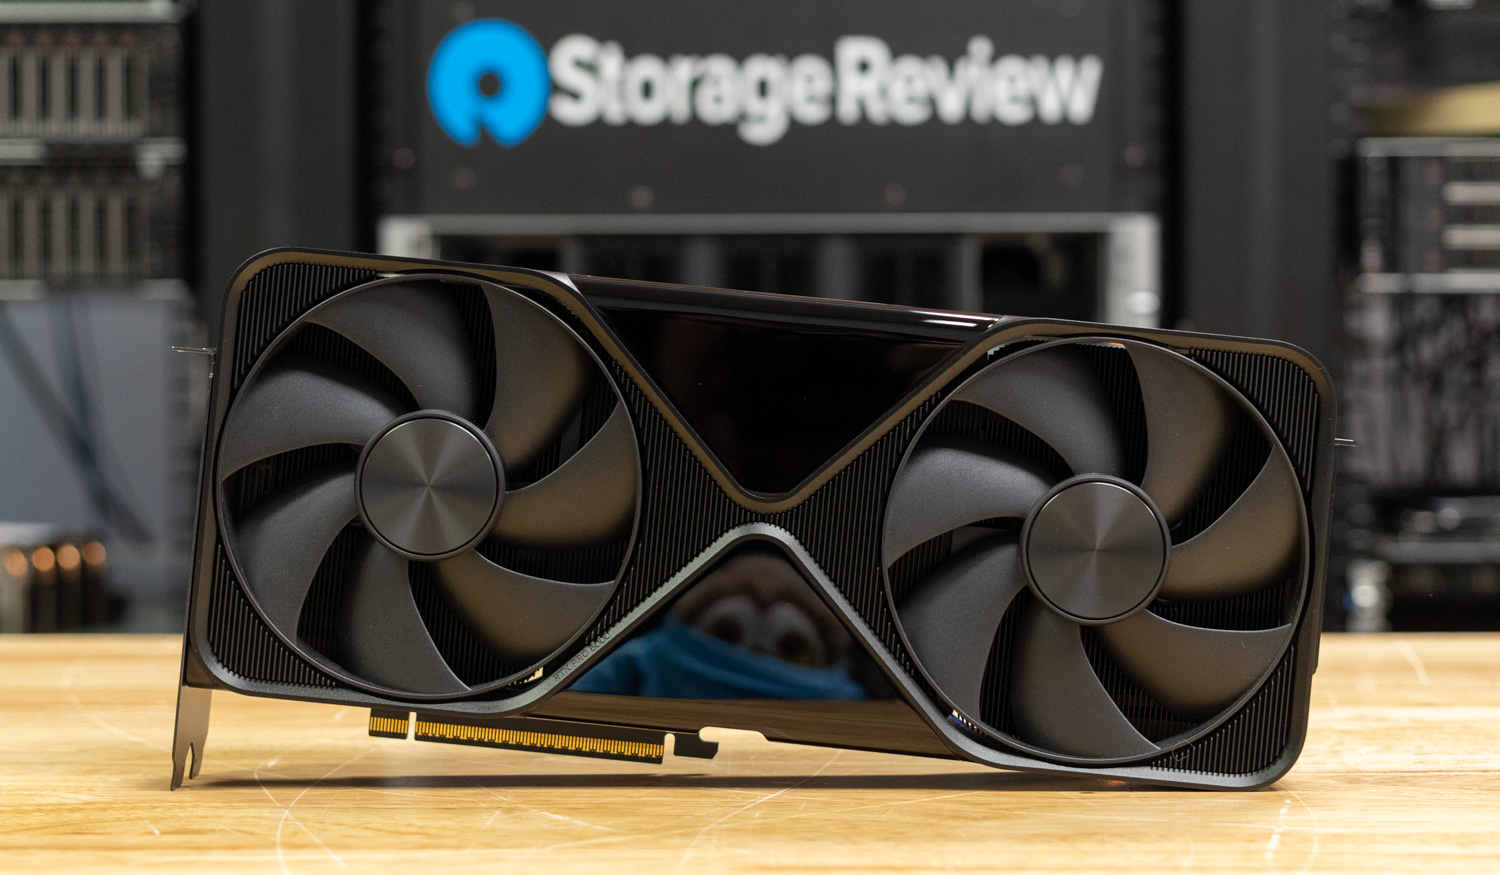
RTX PRO 6000 är företags-inferens-GPU:n på den här sidan: Blackwell-kortet som är byggt för de 2U- och 4U-inferensservrar som företag köper nu, med den största bildbufferten under HBM-nivån och den bredaste funktionsuppsättningen av alla kort här. Vid 600W levererade den 2 283 utdatatokens per sekund vid 32 strömmar på Ministral 3 14B FP8, 2 139 på 8B-modellen och 4 155 på 3B, ungefär dubbelt så mycket som RTX PRO 4500 vid kort kontext och 2.7x till 3.5x vid 8K-ingång, där dess 96 GB fortsätter att klättra till 32 strömmar medan 32 GB- och 48 GB-korten plattas ut.
I MAMF nådde den 774 TFLOPS i FP8 och 1 481 i NVFP4, den högsta FP4-siffran på sidan.
450W-gränsen visar en 2U-köpare vad de sista 150W är värda. Hållet på 450W, det mesta en PowerEdge R770-kortplats levererar, gav kortet upp 2 till 5 procent vid kort kontext och 4 till 9 procent vid lång kontext, och dess FP8 MAMF-resultat förändrades inte. Vid gränsen levererar det 4.8 utdatatokens per sekund per nominell watt på 14B-modellen jämfört med 3.8 vid 600W, vilket är anledningen till att en 2U-köpare förlorar lite på att köra den där.
Det är också det enda kortet på den här sidan med RT-kärnor, fyra kodare och avkodare, samt skärmutgångar, så en server som blandar inferens med rendering, transkodning eller virtuella arbetsstationer under vGPU får ett kort för allt. Våra siffror kommer från Workstation Edition i en Dell Pro Max Tower T2; NVIDIA betygsätter båda utgåvorna till 600W, de profilerar identiskt i våra tester, och Server Edition är den passiva, headless-versionen med samma GB202 GPU och 96 GB GDDR7 med ECC.
Även i vårt labb: fyra Server Edition-kort i HPE ProLiant DL380a Gen12 , två och fyra kort i Dell PowerEdge XE7740 i ET900N G3-granskningen , det enda kortet i Dell Pro Max Tower T2 som producerade siffrorna ovan, både 300W Max-Q- och 600W-korten i Dell Pro Precision 9 T2 , där 600W-kortet kostade Xeon 4 till 5 procent på all-core CPU-arbete, åtta kort och 768 GB i Comino Grando , och dubbla Max-Q-kort i Dell Precision 7875 och HP Z8 Fury G6i.
Läs hela recensionen av NVIDIA RTX PRO 6000
Bästa GPU med en enda plats: NVIDIA RTX PRO 4500 Blackwell Server Edition

RTX PRO 4500 Server Edition levererar L40S-dataflöde från ett 165W-kort med en enda plats, vilket är den lösning som de flesta vanliga servrar har väntat på. Vid 32 strömmar på chattformen matchade eller överträffade den L40S på alla FP8- och BF16-modeller: 1 107 mot 995 tokens per sekund på Ministral 3 14B FP8 och 2 006 mot 1 988 på 3B-modellen, från ett kort som var klassat till 47 procent av L40S kraft och hälften av dess kortplatser. Jämfört med L4-kortet som den ersätter var det 2.8x till 3.6x snabbare med 2.3x kortets kraft, och ett 2U-chassi som rymmer fyra kort med dubbla kortplatser rymmer åtta av dessa.
Gränsen är 32 GB: vid inmatning av 8 192 tokens låg kortet 17 till 33 procent efter L40S, och dess kurvor planade ut vid åtta strömmar, där 48 GB-kortet fortsatte att klättra till 16, eftersom KV-cachen, inte beräkningskapaciteten, tog slut. Det är också ett moderkort i fullhöjd och full längd med en 16-pinskontakt, så L4:ans 1U- och halvhöjdsmodeller klarar inte det utan ett chassi byggt för FHFL-kort.
NVFP4 är den andra nackdelen, som delas av alla kort vi testade på denna vLLM-version: på Qwen3.8-27B producerade 4500 320 tokens per sekund vid 32 strömmar medan dess FP4-hårdvara nådde 569 TFLOPS i MAMF, så FP4-fördelen finns på GEMM-nivå och har ännu inte nått serverstacken. Två 16 GB MIG-partitioner, konfidentiell databehandling och vGPU 20 kompletterar en datacenterfunktionsuppsättning som Workstation Edition av samma kort inte har.
Även i vårt labb: samma kort mot L4 inuti en HPE ProLiant DL145 Gen11 , den edgeserver-recension som föregick denna.
Läs hela recensionen av NVIDIA RTX PRO 4500 Blackwell Server Edition
Bästa Mainstream Inference GPU som fortfarande levereras: NVIDIA L40S

L40S har varit standardkortet för vanliga inferenser i två år, och 48 GB är anledningen till att det fortfarande får en plats på en sida från Blackwell-eran. På chattformen levererade den 995 utdatatokens per sekund med 32 strömmar på Ministral 3 14B FP8, 1 005 på 8B-modellen och 1 988 på 3B.
Det är inom 12 procent av RTX PRO 4500 överallt, och före det på 8K-dokumentformatet med 230 mot 190 på 14B-modellen, 277 mot 185 på 8B och 475 mot 384 på 3B. Dess kurvor fortsätter att klättra till 16 strömmar vid lång kontext, där 32 GB-kortet slutar vid åtta.
Kostnaden för det minnet är ett 350W kort med dubbla kortplatser på PCIe 4.0, och ingen FP4-hårdvara; på NVFP4-versionen av Qwen3.8-27B nåddes 480 tokens per sekund genom dekvantisering, vilket slog 4500 med 1.5x i denna mjukvaruversion. Dess MAMF-tak är 220 TFLOPS i BF16 och 369 i FP8, strax under hälften av RTX PRO 6000. För en flotta som redan körs på L40S och vars arbetsbelastningar ligger på lång kontext är det inte ett kort att ersätta ännu; för en ny 2U gör 4500 med en kortplats samma chatlängdsarbete med hälften så många kortplatser och strömförbrukning.
Även i vårt labb: en enda L40S i Lenovo ThinkSystem SR650 V4 , och kortets grafiksida i vår L40S för Omniverse -modell.
Läs våra L40S-resultat i RTX PRO 4500 Server Edition-recensionen
Bästa kort med kortplats för 1U och Edge: NVIDIA L4
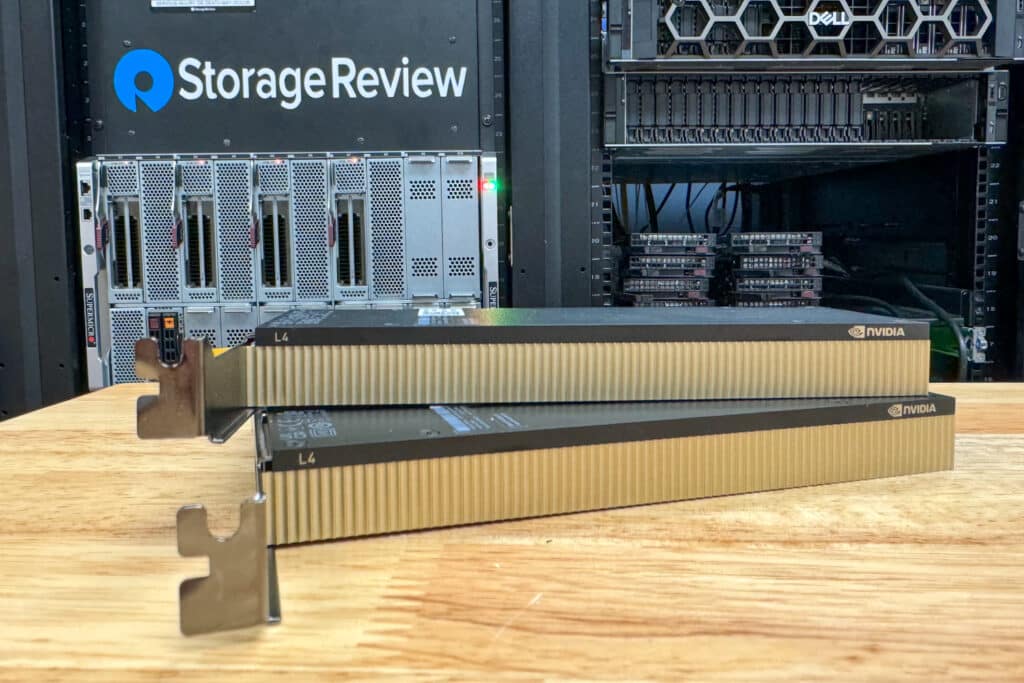
L4 är det enda kortet på den här sidan som drar sin ström från kortplatsen och passar i en halvhöjdsfack, vilket gör att det kan sitta kvar i 1U-servrar och edge-boxar där inget nyare kan komma in. Vid 72W levererade den 364 utdatatokens per sekund vid 32 strömmar på Ministral 3 14B FP8, 279 på 8B-modellen och 704 på 3B, och dess 5.1 utdatatokens per sekund per nominell watt på 14B-modellen slår L40S på 2.8 och RTX PRO 6000 på 600W på 3.8.
Dess MAMF-tak på 50 TFLOPS i BF16 och 116 i FP8 är de lägsta här, och den har ingen FP4-väg, så 27B NVFP4-modellen fick inte plats med dess 24GB.
Lång kontext är där det slutar: på 8 192-token-formen var L4-kortet platt från fyra strömmar på varje modell, med 34 till 130 tokens per sekund, eftersom 24 GB och 300 GB/s rymmer väldigt få 8K-kontexter samtidigt. RTX PRO 4500 Server Edition körs 2.8x till 3.6x snabbare, men den behöver en FHFL-plats och en 16-pins kabel, så en L4-flotta i ett 1U- eller halvhögt chassi får inte en drop-in-ersättning. Vår RTX PRO 4500 edge-recension mätte båda korten inuti en HPE ProLiant DL145 Gen11, där 4500 levererade 2.7x L4.
Även i vårt labb: L4 vid kanten i Dell PowerEdge XR7620 , fyra L4:or i Dell PowerEdge T560 och kortet mot RTX PRO 4500 i HPE ProLiant DL145 Gen11.
Läs hela NVIDIA L4-recensionen
Även testad
NVIDIA H100 NVL
H100 NVL körde samma stege i samma R770 och finns med i Also Tested endast för att den inte har någon Hopper-motsvarighet på den här sidan att hålla en kategori mot. För en generation sedan var den fortfarande 36 till 61 procent snabbare än RTX PRO 6000 vid matchad samtidighet på FP8- och BF16-modellerna vi körde.
I samma R770, på samma container, levererade den 3 096 utdatatokens per sekund med 32 strömmar på Ministral 3 14B FP8, 3 449 på 8B-modellen och 5 873 på 3B, och den skalade till 128 strömmar likt sin efterföljare och nådde 6 038 på 14B-modellen. Dess MAMF-resultat på 1 047 TFLOPS i FP8 ligger 35 procent över RTX PRO 6000:s 774.
94 GB HBM3 med 3.9 TB/s är anledningen. Dokumentmässigt klarade 14B-modellen 859 tokens per sekund vid 32 strömmar, 41 procent före RTX PRO 6000 med 600 W, med samma kurvform som H200 visar med 21 till 23 procent lägre höjd. Två kort bryggar över NVLink med 600 GB/s, den konfiguration som vår Comino Grando H100-recension täcker, och kortet drar 350 till 400 W, konfigurerbart i ett passivt paket med dubbla kortplatser som passar samma riserkort som en L40S.
Där den inte når upp till förväntningarna är samma punkt som H200: på NVFP4-kontrollpunkterna saknar den hårdvara. För en köpare som behöver HBM-kapacitet och har en offert på H100 NVL i handen, visar data att det fortfarande är det näst snabbaste tilläggskortet vi har testat, efter endast H200 NVL ovan.
Även i vårt labb: samma par H100 NVL-kretsar i vår R770 matade Graid SupremeRAID AE GPU Direct Storage-testerna.
Läs hela recensionen av Comino Grando H100
AMD Instinct MI350P

The MI350P is AMD’s first new PCIe Instinct card in four years, and it sits in Also Tested because it has not yet run the ranking ladder above. That ladder uses the NGC container and the Ministral 3 model set; our first look ran the card on stock vLLM for ROCm at 450W in a 2U PowerEdge R7725, against a 600W rating. It carries 144GB of HBM3E at 4TB/s, the most memory of any PCIe accelerator we have tested, 3GB above the H200 NVL.
On the tests that overlap, it lands between the two NVIDIA cards. MAMF reached 1,120 TFLOPS in FP8 and 2,228 in block-scaled FP4 at 450W, 36 to 38 percent above the 600W RTX PRO 6000 at every precision in that review’s runs and behind the H200 NVL in BF16 and FP8. On GPT-OSS-120B at 128 streams on the chat shape, one card served 5,057 output tokens per second against 3,064 for the RTX PRO 6000 and 3,376 for the H200 NVL, and on 512-token prompts it beat the RTX PRO 6000 by 35 to 65 percent on every FP8, BF16, and GPT-OSS model.
The H200 NVL stays 4 to 18 percent ahead on the dense FP8 and BF16 models at 128 streams on chat prompts, and on 8,192-token prompts the MI350P trails it by 25 to 58 percent on the same models and flattens by 16 streams on Llama 3.1 8B and MiniMax M2.7. Its two-card results, where a pair holds MXFP4 builds of MiniMax M3 and GLM-5.2 that take four RTX PRO 6000s, ran on ROCm 7.2.3 and appear under Scale-Out Configurations.
It ranks once it completes the Ministral 3 ladder at 600W in a PowerEdge XE7745, which Dell supports with eight MI350Ps. Until then, for a buyer whose models sit between 96GB and 144GB, it is one of two PCIe cards that keep them on a single GPU, and the only one past 141GB.
Read the AMD Instinct MI350P first look
Skalbara konfigurationer
Ett kort får sin rangordning på den här sidan som ett enda kort. Resultat från flera kort rapporteras här som konfigurationer, utan rangordning, eftersom de kör olika modelluppsättningar och programvaruuppsättningar och inte kan sorteras mot varandra eller mot den enkla kortstegen ovan. Varje rad innehåller det uppmätta resultatet och den recension det kommer ifrån.
| konfiguration | Host | Uppmätt resultat | Stack | Källa |
|---|---|---|---|---|
| 4x NVIDIA RTX PRO 6000 Blackwell Server Edition (384 GB) | Dell PowerEdge XE7740 | MiniMax M3 NVFP4: 1 181 utdatatokens/s vid 16 strömmar, 759 vid 32 (512/512) | NGC vLLM 26.08, spekulativ avkodning av MTP | ET900N G3 Recension |
| 4x NVIDIA RTX PRO 6000 Blackwell Server Edition (384 GB) | HPE ProLiant DL380a Gen12 | GPT-OSS-120B NVFP4, TP4: 4 016 totala tokens/s vid batch 64, 3 956 vid batch 32; Llama 3.2 90B Vision: 1 372 totala tokens/s vid batch 128 | vLLM online-servering | DL380a Gen12 Recension |
| 2x NVIDIA RTX PRO 6000 Blackwell Server Edition (192 GB) | Dell PowerEdge XE7740 | MiniMax M2.7 NVFP4: 1 932 utdatatokens/s vid 128 strömmar (512/512), 511 på 8K/1K | NGC vLLM 26.08 | ET900N G3 Recension |
| 4x Intel Gaudi 3 PCIe (512 GB HBM) | Dell PowerEdge XE7740 | Llama 3.1 70B, TP4: cirka 3 600 tokens/s totalt vid 128 samtidiga förfrågningar (1 024/1 024); FP8-sökvägar långsammare än BF16 i denna version | Intel vLLM-fork 2.7.1 på Gaudi Docker 1.22.2 | XE7740 Recension (sponsrad av Dell) |
| 2x AMD Instinct MI350P (288GB), 450W per card | Dell PowerEdge R7725 | MiniMax M3 MXFP4: 998 output tokens/s at 16 streams, 1,509 at 32 (512/512); DeepSeek-V4-Flash FP8: 1,081 output tokens/s at 32 streams (512/512), 621 on 8K/1K | vLLM on ROCm 7.2.3 | MI350P First Look |
Intels vLLM-gaffel hade ännu inte optimerat sina FP8-vägar vid testtillfället, och FP8 körde långsammare än BF16. Resultatet från MiniMax M3 visar taket för PCIe-skalbarhet på en modell som knappt får plats med 384 GB, där fyra kort drog sig före en enda GB300 DGX Station vid 16 strömmar och sjönk vid 32 när de långa prompterna förbrukade cachen.
Bortom spelautomaten
En modell som växer ur 141 GB på ett kort, eller en serverbelastning som behöver dussintals strömmar på en kontrollpunkt i 400B-klassen, har lämnat marknaden för tilläggskort. GB300 DGX Station-klassen rankas på vår lista över bästa stationära datorer för lokal AI , där en enda Blackwell Ultra GPU med 252 GB HBM3e ligger bredvid H200 NVL i samma lista, och systemen HGX B200 och AMD Instinct MI350X från våra Supermicro JumpStart-recensioner hör hemma på listan över bästa servrar . Dessa system mäts som system, inte som kort, och de rankas inte här.
Hur vi rankar
Tre regler styr varje StorageReview-topplista, och den första är att endast laboratorietestade kort rankas: allt vi inte har jämfört kan nämnas, men det kan inte ha en kategori. För det andra testas kort som enskilda kort i en värd som stöder dem, med den effekt som värden levererar, och den effekten anges för varje post; H200 NVL-noten ovan är det enda fallet där betyget och den testade effekten skiljer sig åt.
För det tredje är arbetsstationskort exkluderade från den här sidan, med ett angivet undantag: där NVIDIA säljer samma kisel som serverdel och de två profilerna identiskt, står arbetsstationskortet i rätt ordning, och det anges i posten.
Rankningar härrör från vLLM:s online-serverdataflöde, företagets inferensarbetsbelastning, vid matchad samtidighet på en delad modelluppsättning, med dokumentformen på 8 192 tokens och MAMF-beräkningsresultat som bryter banden, och minneskapaciteten anger lönsamhetsnivån. Leverantörer ser inte rankningar före publicering, ingen placering på denna sida betalas, och där en sponsrad artikel citeras identifieras den som sådan. Nya kort läggs till när de slutför samma test på samma container, och ändringsloggen högst upp registrerar varje ändring.
Software stacks change every few weeks, so each figure on this page comes from the run that set the ranking, and later reviews may report newer runs of the same card. We re-rank when a newer run changes the order, not when a number moves.
Vanliga frågor om företags-GPU
Vilken är den bästa GPU:n för företagsinferens?
För de 2U- och 4U-inferensservrar som de flesta företag köper är RTX PRO 6000 Blackwell Server Edition, eftersom den kombinerar 96 GB, den högsta FP4-beräkningsförmågan vi har uppmätt i ett PCIe-kort, MIG, vGPU samt grafik- och videomotorer i ett kort som bara förlorar 2 till 9 procent av sin dataflöde vid de 450 W som en vanlig kortplats levererar.
H200 NVL är det snabbare kortet när minne och bandbredd avgör arbetsbelastningen, och det var det som ledde varje modell vi körde, så en implementering byggd kring 70B till 120B-modeller med hög samtidighet bör börja där. RTX PRO 4500 Server Edition är valet när kortplatsen är enkelbredd eller strömförbrukningen är 165W.
RTX PRO 6000 vs H100 NVL: vilket är snabbare för inferens?
H100 NVL är 36 till 61 procent snabbare vid matchad samtidighet på FP8- och BF16-modellerna som vi körde i samma vLLM-container, och 41 till 52 procent snabbare på dokumentformen med 8 192 tokens, eftersom 94 GB HBM3 vid 3.9 TB/s-flöden avkodas snabbare än 96 GB GDDR7 vid 1.6 TB/s. RTX PRO 6000 vinner på NVFP4-kontrollpunkter, där H100 inte har någon FP4-hårdvara, och den är den enda av de två med grafik-, video- och visningskapacitet. Köp H100 NVL för dataflöde på FP8- och BF16-modellerna; köp RTX PRO 6000 för en blandad arbetsbelastning eller för en FP4-färdplan.
H100 NVL vs H200 NVL: är uppgraderingen värd det?
H200 NVL låg 10 till 12 procent före H100 NVL vid 32 strömmar i chattformatet och 21 till 23 procent före vid 128 strömmar och i dokumentformatet med 8 192 tokens, med 141 GB mot 94 GB minne och 4.8 TB/s mot 3.9 TB/s. Dessa siffror är från H200 vid 450 W, det mesta en 2U R770-kortplats levererar, och dess 600 W-klassificering är oprövad i vårt labb, så skillnaden är ett golv. Kapacitetsskillnaden är avgörande för de flesta köpare: en modell i 120B-klassen i FP8 som får plats med 141 GB behöver två H100 NVL:er.
L40S vs RTX PRO 6000: vad kostar det större kortet?
Kortfattat levererade RTX PRO 6000 2.1x till 2.3x L40S genomströmning vid 32 strömmar på Ministral-kortet, och vid 8 192-token-ingångar ökade förhållandet till 2.2x till 2.6x då 48 GB-kortet fick slut på KV-cache vid 16 strömmar medan 96 GB-kortet fortsatte att skalas. 6000 har också FP4-hårdvara, PCIe 5.0 och MIG med fyra 24 GB-partitioner, vid 600 W mot 350 W. För arbete med långa kontexter eller flera hyresgäster är det ett bättre köp; för chattlängdsserverande med L40S kraft är RTX PRO 4500 med en enda plats den närmare matchen.
L4 vs RTX PRO 4500: bör en L4-flotta uppgraderas?
RTX PRO 4500 Server Edition körde 2.8x till 3.6x högre dataflöde än L4:ans dataöverföringshastighet vid kort kontext i vår R770 och 2.7x högre i en HPE ProLiant DL145 Gen11, med 165W mot 72W och med 32GB mot 24GB. Haken är fysisk: 4500 är ett kort i fullhöjd och full längd med en 16-pinskontakt, och L4 är ett kort i halvhöjd och med kortplatser, så 1U-servrar och små edge-boxar byggda runt L4 tar inte 4500. Uppgradera där chassit har en FHFL-kortplats; behåll L4 där den inte har det.
RTX PRO 6000 Server Edition vs Workstation Edition: vad är skillnaden?
Samma GB202 GPU, 96 GB GDDR7 med ECC och 600W; NVIDIA betygsätter dem identiskt, och de profilerar sig likadant i våra tester, vilket är anledningen till att Workstation Editions data står för Server Edition på den här sidan. Server Edition är passiv och headless, byggd för chassiets luftflöde, med datacenterfunktionerna MIG, konfidentiell databehandling och vGPU; Workstation Edition kyls aktivt med fyra DisplayPort-utgångar. En serverköpare vill ha Server Edition; siffrorna är desamma i båda fallen.
Vad är skillnaden mellan ett PCIe-GPU och en SXM- eller HGX-modul?
En PCIe-accelerator är ett tilläggskort som ansluts till en standardkortplats och drar 72 W till 600 W, vilket är anledningen till att det passar 2U- och 4U-servrar som redan finns i ett rack, och kommunikation mellan flera kort går via PCIe eller en NVLink-brygga. SXM- och OAM-moduler löds fast på ett baseboard i specialbyggda system som HGX B200- eller MI350X-plattformar, körs med 700 W till 1 400 W per GPU och länkas över ett komplett NVLink- eller Infinity Fabric-nät. Den här sidan rangordnar den första typen; den andra behandlar våra server- och lokala AI-skrivbordskort.
Hur mycket GPU-minne behöver en inferensserver?
Det beror på modell och kontext. På den här sidan fungerade 24 GB och 32 GB-kort bekvämt för modeller med 3 GB till 14 GB i chattlängd och utjämnades med fyra till åtta strömmar vid inmatning av 8 192 tokens; 48 GB fortsatte att klättra till 16 strömmar, 96 GB blev aldrig bristfälligt på samma modeller, och 141 GB H200 NVL höll GPT-OSS-120B på ett enda kort i våra ET900N G3-tester. Budgetera vikterna först, sedan KV-cachen för den samtidighet du förväntar dig, och behandla arbete i långa kontexter eller med flera hyresgäster som ett krav på 48 GB och uppåt.
Spelar 450W kontra 600W någon roll i en 2U-server?
Less than the rating gap suggests, on the one card we have measured both ways. Capped to 450W, the most a PowerEdge R770 slot delivers, the RTX PRO 6000 gave up 2 to 5 percent of output throughput at short context and 4 to 9 percent at long context, and its FP8 MAMF result did not change, which returned 25 percent of its power budget for a 2 to 9 percent cost. The H200 NVL on this page was tested at 450W for the same reason, and its full 600W result has not yet been measured. The AMD Instinct MI350P in our first look also ran at 450W in a 2U PowerEdge R7725, against a 600W rating, and we will measure the difference in a PowerEdge XE7745.


 Amazon