

AMD har släppt sina MLPerf Inference v6.0-resultat, som positionerar Instinct MI355X GPU som en skalbar inferensplattform för distributioner med en enda nod, flera noder och heterogena enheter. Resultatet sträcker sig bortom stegvisa vinster genom att lägga till nya arbetsbelastningar, demonstrera ett dataflöde i klusterskala som överstiger 1 miljon tokens per sekund och validera reproducerbarhet över ett växande partnerekosystem.
CDNA 4-arkitekturen riktar sig mot högkapacitetsinferens
Instinct MI355X GPU är baserad på AMD:s CDNA 4- arkitektur byggd på en TSMC 3nm | 6nm FinFET-process (den använder en dubbelprocess-chipletdesign: beräkningskretsarna (XCD) använder TSMC:s 3nm-nod medan I/O-kretsarna använder 6nm), integrerar 185 miljarder transistorer och stöder FP4- och FP6-dataformat. Det är värt att notera att detta gäller hela multichiplet-paketet, inte en monolitisk krets. Varje GPU innehåller upp till 288 GB HBM3E-minne, vilket möjliggör stöd för modeller upp till 520 miljarder parametrar på en enda enhet. AMD positionerar denna kombination av beräkningstäthet och minneskapacitet som avgörande för stormodellinferens utan överdriven modellpartitionering.
Plattformen finns tillgänglig i UBB8-konfigurationer med både luftkylda och direktvätskekylda alternativ, vilket anpassar sig till kraven för datacenterimplementering.
Multinodgenomströmning överstiger 1 miljon tokens per sekund
Ett viktigt resultat från den här rundan är att AMD överträffar 1 miljon tokens per sekund på klusternivå. Med hjälp av Instinct MI355X GPU:er uppnådde AMD denna tröskel på Llama 2 70B i både server- och offline-scenarier, och på GPT-OSS-120B i offline-scenarier.
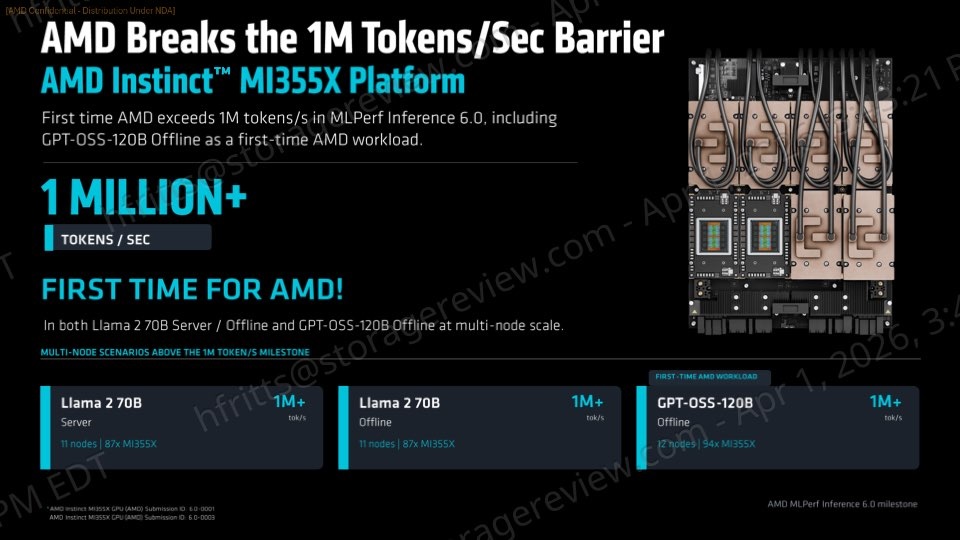
Dessa resultat återspeglar en förskjutning mot att utvärdera inferensprestanda på klusternivå snarare än per accelerator. Aggregerad dataflöde och time-to-serv används i allt högre grad för att fastställa produktionsberedskap för storskaliga AI-distributioner.
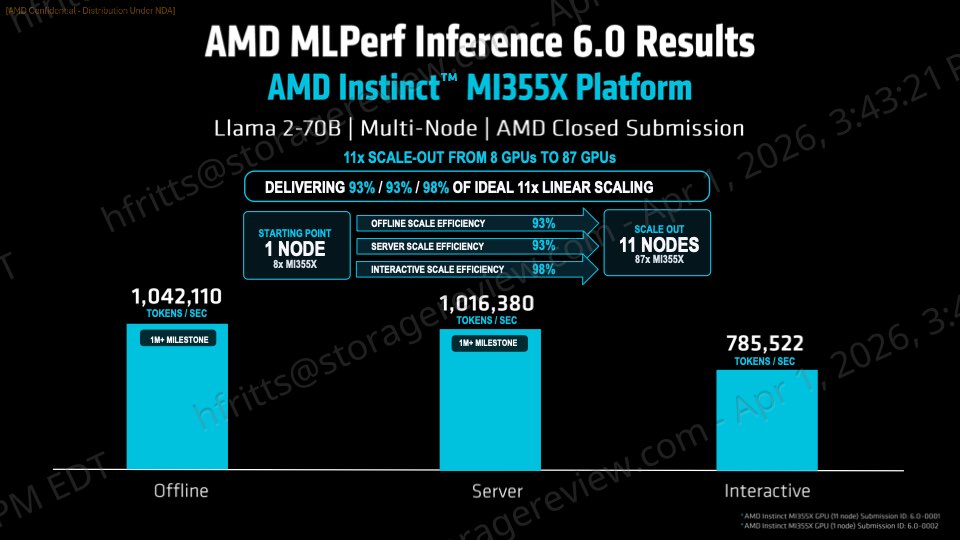
AMD demonstrerade också effektiv skalning. På Llama 2 70B nådde en konfiguration med 11 noder och 87 GPU:er över 1 miljon tokens per sekund i offline-, server- och interaktiva scenarier, med en skalningseffektivitet från 93 % till 98 %. På GPT-OSS-120B uppnådde ett kluster med 12 noder och 94 GPU:er liknande dataflöde med en skalningseffektivitet på över 90 %. Dessa resultat indikerar att prestandavinster effektivt översätts när distributioner expanderar bortom ett enda system.
Generationsvinster och konkurrenskraftig prestanda för en enda nod
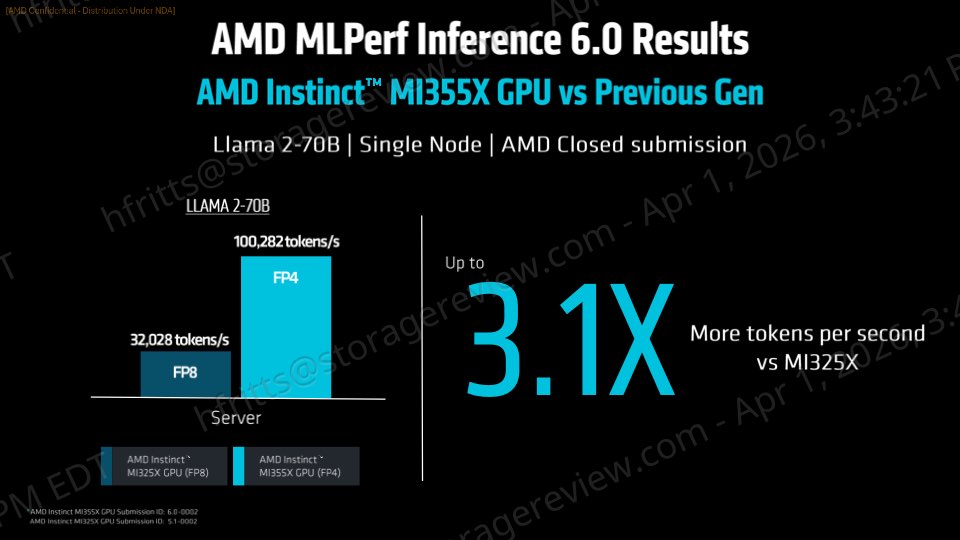
AMD rapporterade en prestandaökning på 3.1 gånger på Llama 2 70B Server jämfört med den tidigare generationen av Instinct MI325X, och nådde 100 282 tokens per sekund. Förbättringen återspeglar både arkitekturförändringar och ROCm-programvaruoptimeringar. Offline-poäng förbättrades med 4.4 gånger och serverpoäng förbättrades med 4.8 gånger jämfört med tidigare omgångar. Dessa vinster tillskrivs främst kvantisering i FP4.
I jämförelser med enskilda noder visade MI355X konkurrenskraftig positionering gentemot NVIDIAs plattformar. På Llama 2 70B matchade AMD NVIDIA B200 i offline-genomströmning, nådde nästan paritet i serverprestanda och överträffade interaktiv prestanda. Jämfört med Nvidias B300 levererar AMDs GPU 92 % i offline-läge, 93 % i serverläge och överträffar det med 104 % i interaktivt läge.
Förstagångsmodellaktivering utökar täckningen
MLPerf Inference v6.0 innehåller flera nya arbetsbelastningar, och AMD använde denna runda för att demonstrera snabb modellaktivering. GPT-OSS-120B, en expertblandningsmodell, introducerades för första gången och uppnådde konkurrenskraftiga resultat jämfört med NVIDIA-system i både offline- och serverscenarier.
AMD skickade även in resultat för Wan-2.2 text-till-video-generering, vilket markerar deras inträde inom multimodal och generativ videoinferens. Medan den officiella inlämningen fokuserade på Single Stream-latens, var resultaten konkurrenskraftiga med resultaten från befintliga plattformar. Justering efter inlämningen förbättrade prestandan ytterligare, vilket indikerar utrymme för optimering allt eftersom programvaran mognar.
Dessa tillägg belyser AMDs fokus på att expandera bortom traditionella LLM-riktmärken för att stödja nya AI-arbetsbelastningar.
ROCm-programvara möjliggör skalning och heterogen inferens
AMD tillskriver mycket av prestandan och skalbarheten till sin ROCm-programvarustack. Förbättringarna inkluderar optimerad FP4-exekvering, förbättrad GPU-till-GPU-kommunikation för distribuerad inferens och stöd för dynamisk arbetsbelastningsfördelning över heterogena miljöer.
Den initiala heterogena MLPerf-inlämningen utvecklades med tre AMD Instinct GPU-modeller: MI300X, MI325X och MI355X. Konfigurationen, som skickades in av Dell och MangoBoost, uppnådde 141 521 tokens per sekund på Llama 2 70B Server och 151 843 tokens per sekund på Llama 2 70B Offline.
Värt att notera är att AMD Instinct MI355X-plattformen var placerad i Dells laboratorium i USA, medan Instinct MI300X- och MI325X-plattformarna fanns i Korea. Detta visar förmågan att koordinera system över olika geografiska platser.
Ekosystemtillväxt och reproducerbarhet
AMDs partnerekosystem expanderade i denna MLPerf-runda, med nio företag som lämnade in resultat från flera generationer av Instinct GPU. Deltagande leverantörer inkluderade Cisco, Dell, Giga Computing, HPE, MangoBoost, MiTAC, Oracle, Supermicro och Red Hat.
Partnerbidragen stämde väl överens med AMD:s interna resultat, vanligtvis inom 4 % och i vissa fall inom 1 %. Denna konsekvens indikerar att prestandan är reproducerbar över OEM- och molnplattformar, vilket minskar distributionsrisken och ökar förtroendet för verkliga resultat.


 Amazon