

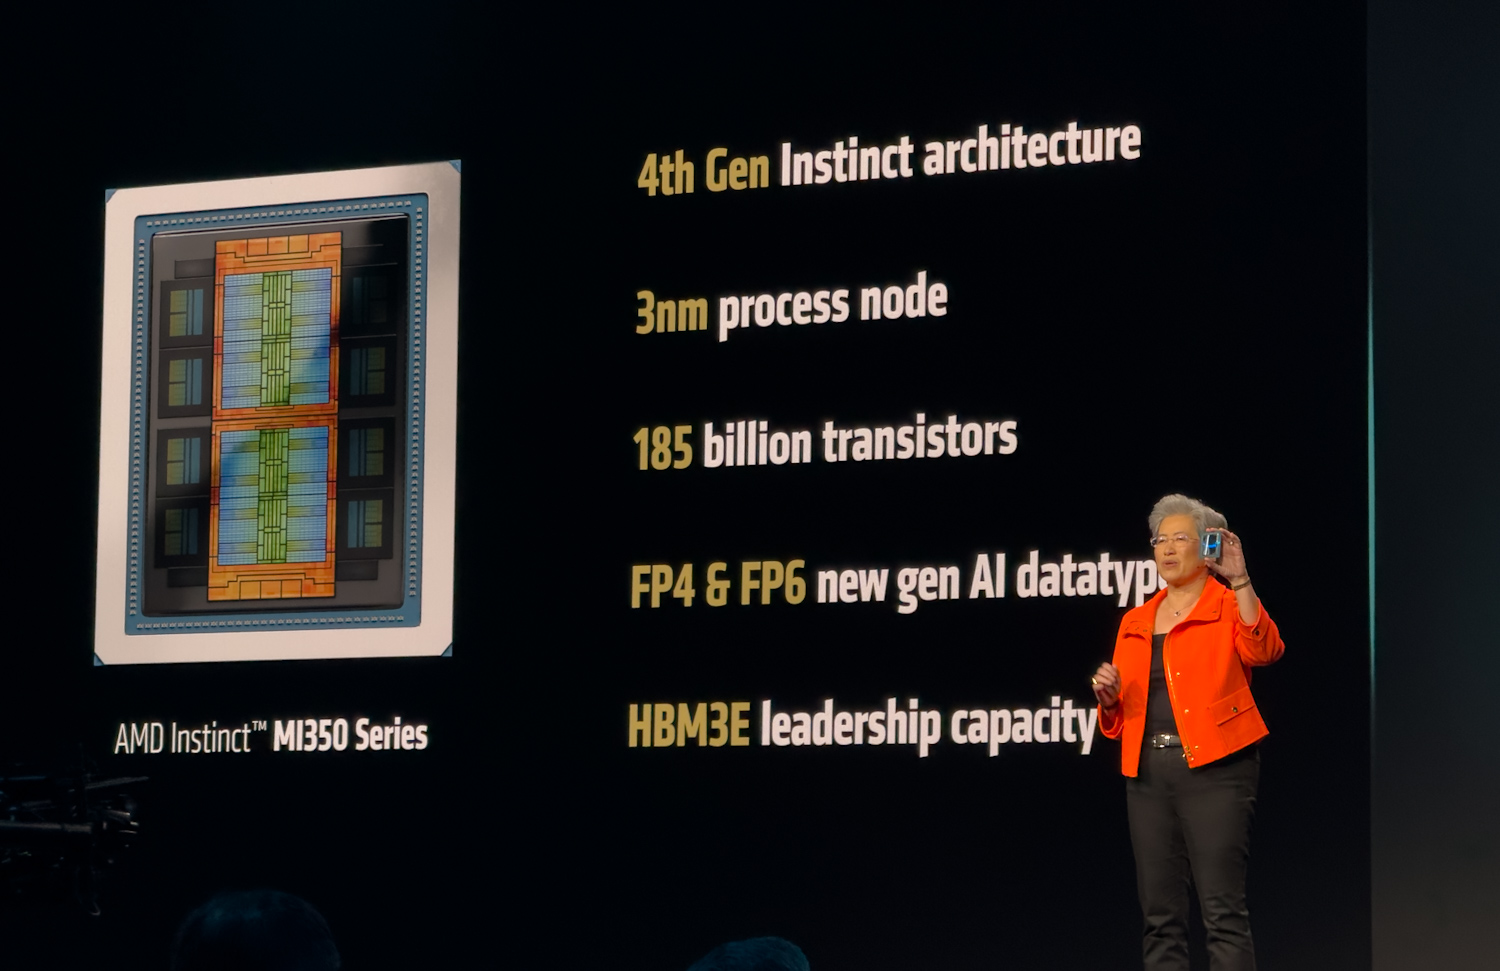
Vid sitt Advancing AI-evenemang i San Jose presenterade AMD Instinct MI350-serien, sin senaste generation av GPU:er, tillsammans med en aggressiv färdplan för framtida AI-acceleratorplattformar. MI4-serien, som bygger på den avancerade CDNA350-arkitekturen, lovar betydande prestandaökningar för krävande AI-arbetsbelastningar. Tillkännagivandet inkluderade också en förhandsvisning av den framtida Instinct-serien, vilket understryker AMDs engagemang för kontinuerlig innovation inom AI-hårdvara.
AMD Instinct MI350-serien
AMD Instinct MI350-serien , som drivs av den nya CDNA4-arkitekturen, representerar ett betydande steg framåt inom AI-beräkning. CDNA4-arkitekturen är specifikt utformad för AI-arbetsbelastningar och introducerar förbättrade matrismotorer, stöd för nya dataformat och kritiska förbättringar av energieffektiviteten.
Avancerad paketering och chipletarkitektur: Grunden för MI350
MI350-serien bygger på AMDs avancerade 3D-chiplet-kapslingsteknik, som utvecklats från MI300-serien med viktiga förbättringar.
Chipletdesign och tillverkning
I grund och botten innehåller GPU-paketet åtta Accelerator Compute Chiplets (XCD), de primära beräkningsmotorerna. Dessa XCD:er är tillverkade med en avancerad 3nm Node 3+ nodprocess, en uppgradering från 5nm-tekniken som används i MI300-serien, vilket bidrar avsevärt till förbättrad energieffektivitet. Varje XCD innehåller fyra shadermotorer, där varje motor innehåller åtta aktiva CDNA4-beräkningsenheter, vilket resulterar i 32 CU:er per XCD och totalt 256 CU:er för acceleratorn.

XCD-kretsarna kompletteras av två IO-kretsar (IOD), en minskning från de fyra IOD-kretsarna i MI300-serien. Dessa IOD-kretsar, tillverkade med en 6nm-process, hanterar minnesåtkomst, I/O-operationer och kommunikation mellan kretsar. Denna strömlinjeformade design med två IOD-kretsar, i kombination med bredare interna sammankopplingar, upprätthåller bandbreddsmålen samtidigt som strömförbrukningen minskar.
Fysisk integration och logisk enhet
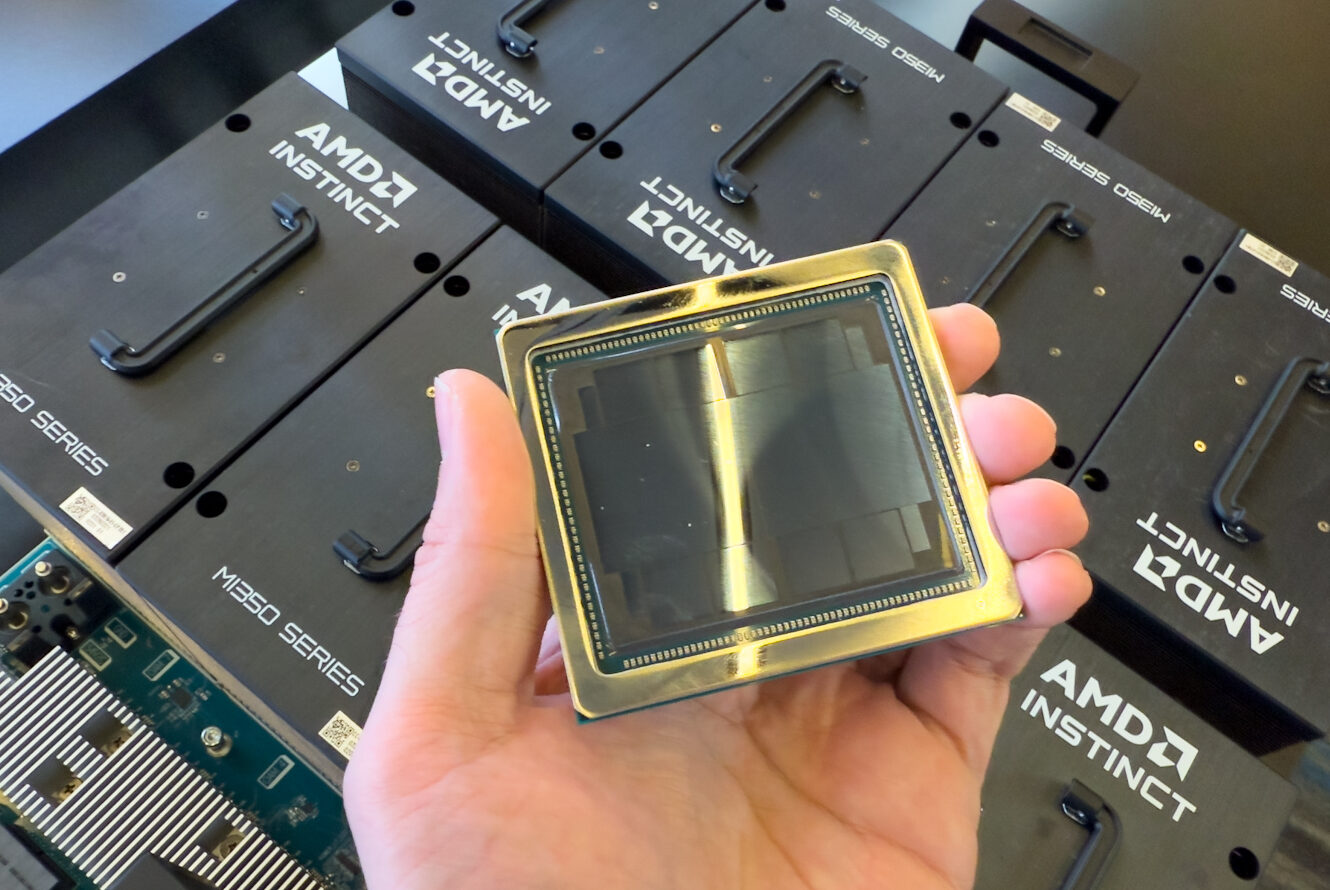
Den fysiska monteringen innebär att XCD- och HBM3E-minnesstackarna monteras på ett Chip-on-Wafer-on-Substrate (COOS)-mellanlägg. En kritisk aspekt av denna design är hybridbindningen av XCD- och IOD-kretsarna som sitter under dem. Denna 3D-hybridbindningsteknik skapar exceptionellt täta sammankopplingar med hög bandbredd mellan beräknings- och I/O-chiplets, vilket vida överträffar traditionella 2.5D-konstruktioner, vilket är avgörande för att effektivt leverera data till de strömslukande XCD-kretsarna. Dessutom bidrar denna avancerade 3D-integration till ett mindre totalt GPU-fotavtryck, vilket kan förbättra tillverkningsutbytet och driftssäkerheten.
Trots sin komplexa chiplet-konstruktion fungerar MI350 logiskt sett som en enda, enhetlig GPU. Varje XCD utgör ett Accelerator Compute Complex, utrustat med globala resurser, inklusive en kommandoprocessor och en 4 MB L2-cache.
Förbättrat minnesundersystem
För att tillräckligt försörja de kraftfulla CDNA4-kärnorna har MI350-serien ett väsentligt uppgraderat minnessystem. Den är utrustad med åtta stackar HBM3E-minne, vilket ger en total kapacitet på 288 GB per GPU. Varje stack på 36 GB, bestående av 12 enheter med en maximal kapacitet på 24 Gbit/s, arbetar med full HBM3E-pinhastighet på 8 Gbps per pin.
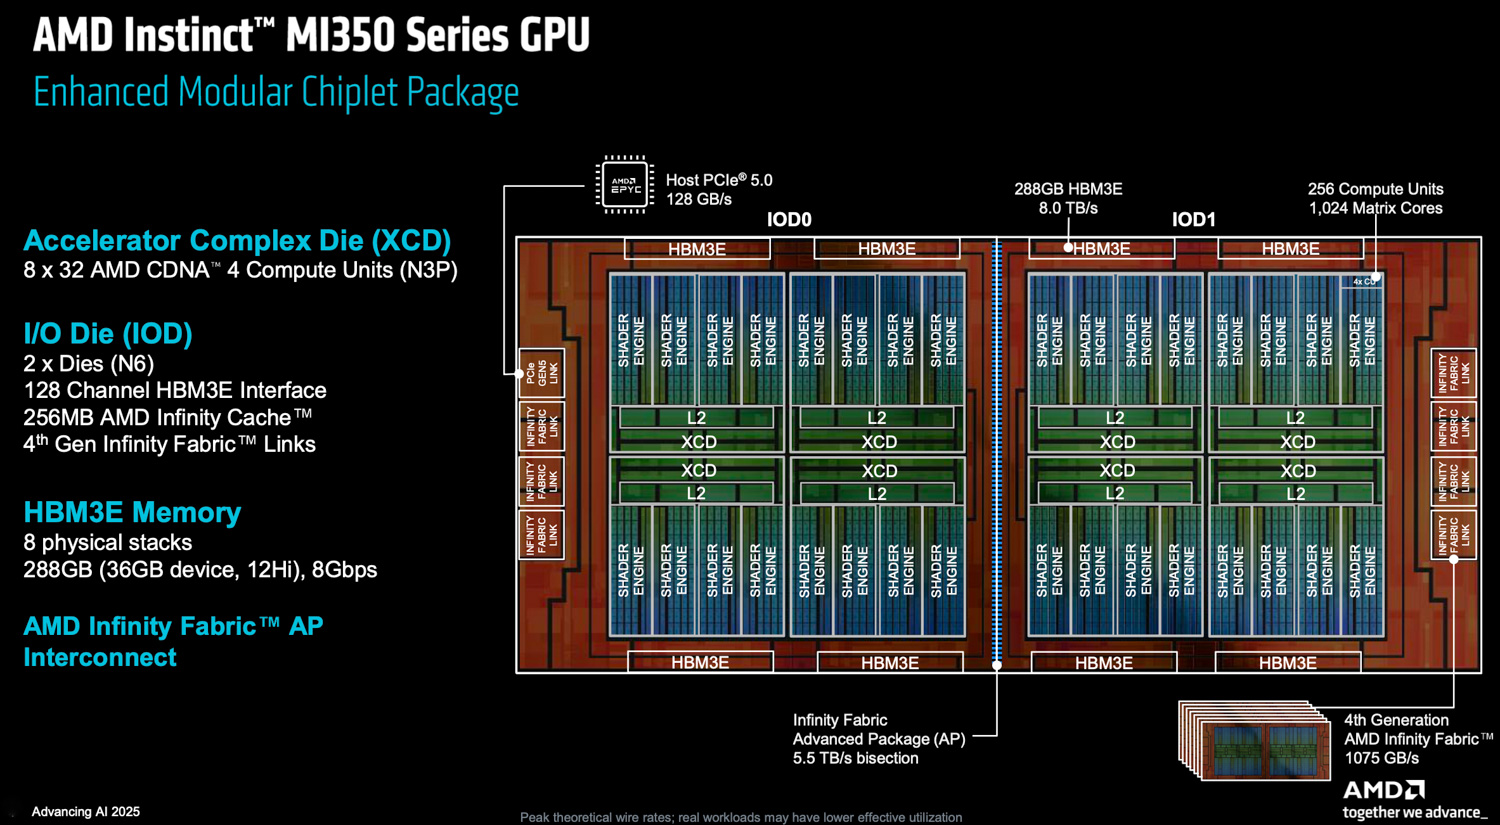
Arkitekturen behåller även AMD:s Infinity Cache, en viktig minnessidescache placerad mellan HBM- och Infinity Fabric/L2-cachen. Denna cache består av 128 kanaler, var och en backad av 2 MB cache, för totalt 256 MB för GPU:n. För att förbättra bandbreddsleveranseffektiviteten vid lägre effekt har AMD breddat nätverksbussarna på dien inom IOD:erna och driver dem med en lägre spänning. Denna optimering minskar energiförbrukningen per bit, vilket gör att MI350-serien kan uppnå cirka 1.3 gånger högre minnesbandbredd per watt jämfört med sin föregångare, MI300-serien.
För att effektivt hantera det expansiva fysiska minnet på 288 GB har dessutom Universal Translation Caches (UTC) analogt med CPU Translation Lookaside Buffers (TLB) förbättrats avsevärt. MI350-serien introducerar mer detaljerade sidstorlekskontroller i både UTC L1 och L2, tillsammans med ökad kapacitet. Dessa förbättringar möjliggör större TLB-räckvidd och effektivare hantering av virtuellt minne.
Infinity Fabric-förbättringar
AMDs Infinity Fabric-teknik är fortfarande central för MI350:s skalbarhet och kommunikationsprestanda mellan grafikkorten. Den bisektionella bandbredden för Infinity Fabric AP-länken som förbinder de två IOD:erna har ökats avsevärt till 5.5 TB/s, vilket underlättar effektiv dataöverföring mellan grafikkortets två halvor.
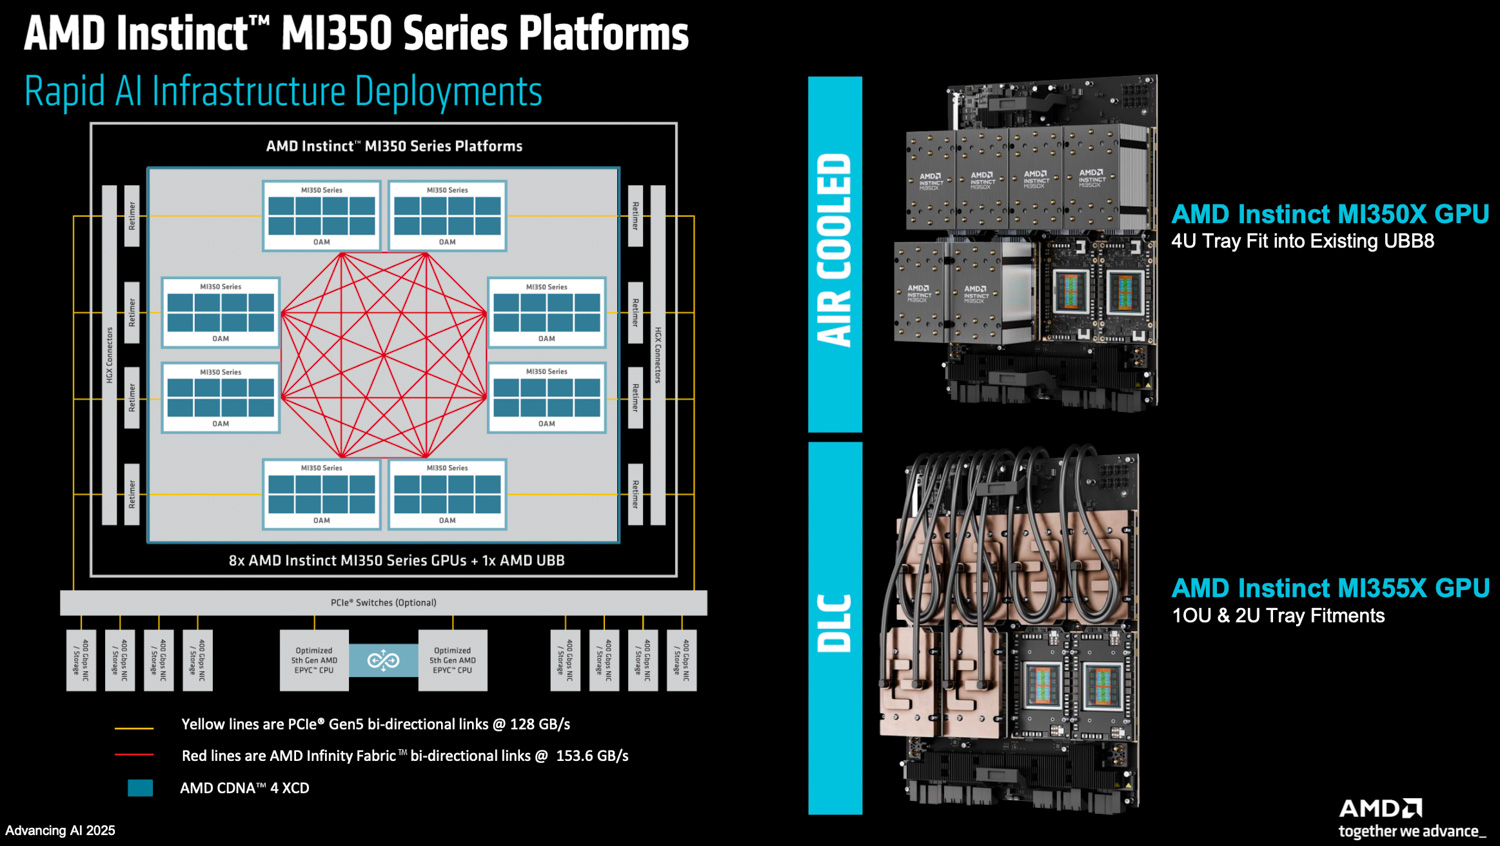
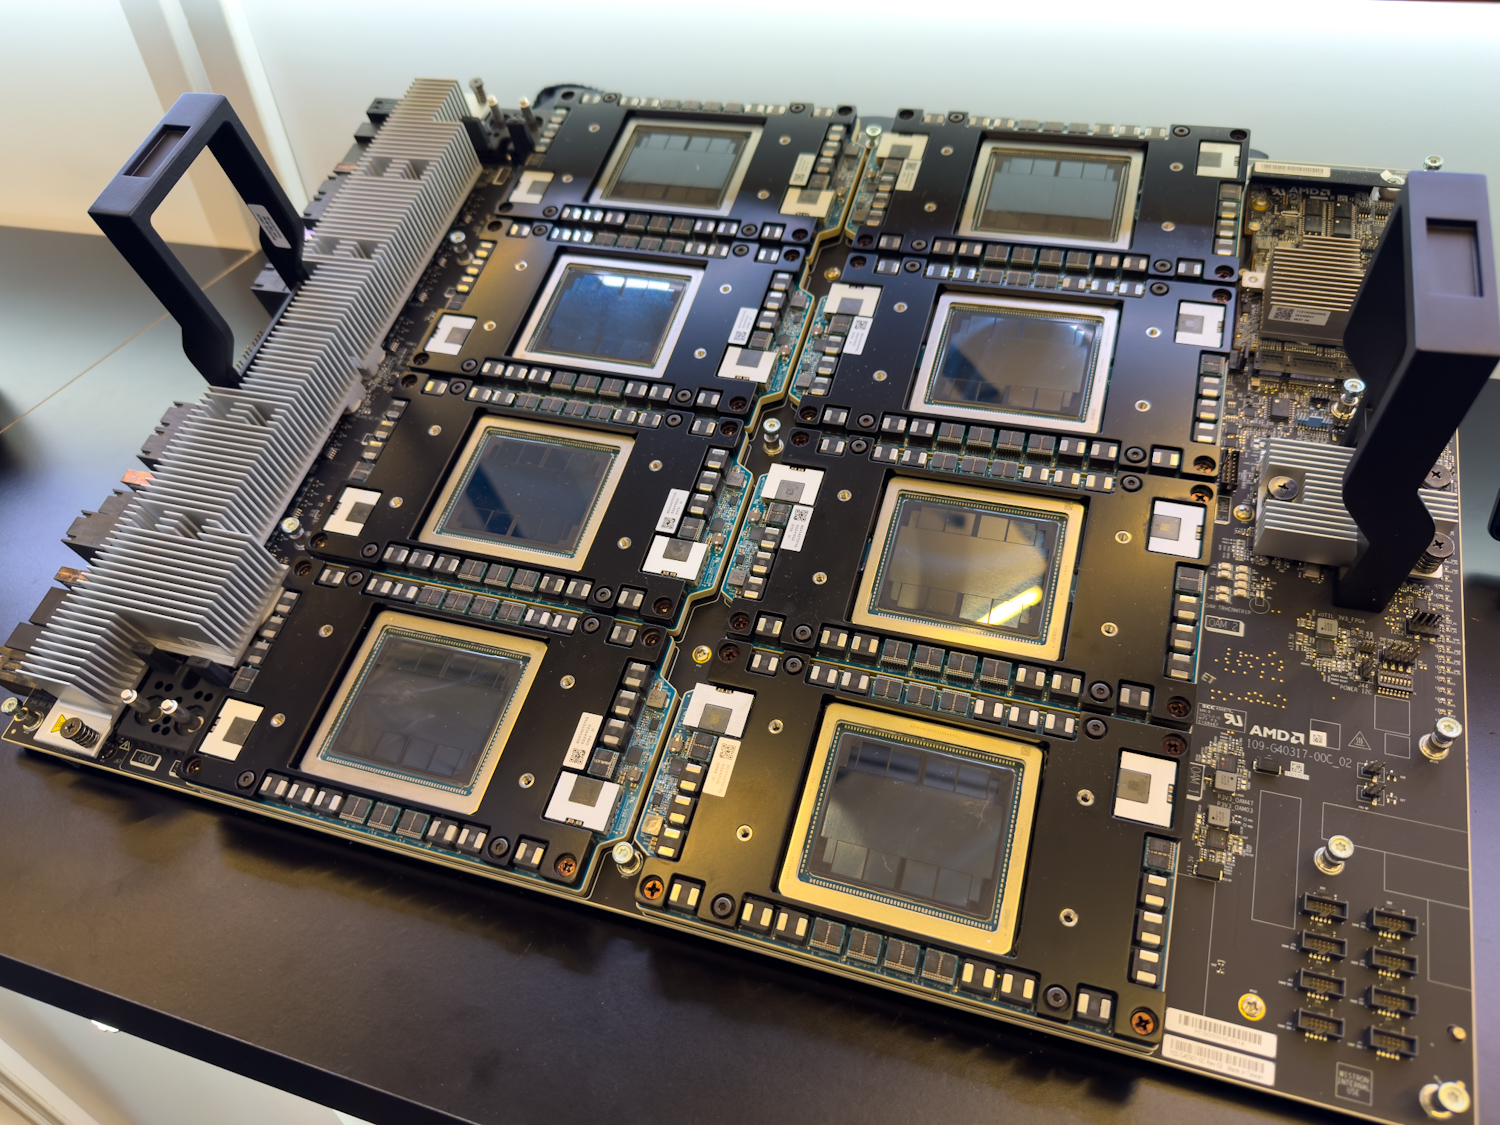
För extern kommunikation har varje MI350 GPU sju Infinity Fabric-länkar, vilket möjliggör direkt GPU-till-GPU-anslutning i konfigurationer som en 8-GPU UBB 2.0-plattform. Dessa länkar fungerar med 38.4 Gbps per pin. I en 8-GPU OAM-installation levererar denna konfiguration en bisektionsbandbredd på cirka 153.6 GB/s i varje riktning per länk. AMD har också förfinat datapacknings- och komprimeringstekniker över dessa externa länkar för att öka den effektiva levererade bandbredden. Internt säkerställer Infinity Fabric att alla XCD:er har fullständig, finkornig sammanflätad åtkomst till hela HBM3E-minnesutrymmet över båda IOD:erna, vilket presenterar minnet som en enda, platt, enhetlig resurs för beräkningsenheterna.
CDNA4 Compute Core-arkitektur
I hjärtat av MI350:s processorkraft har CDNA4-beräkningsenheten genomgått en betydande omarkitektur skräddarsydd för AI.
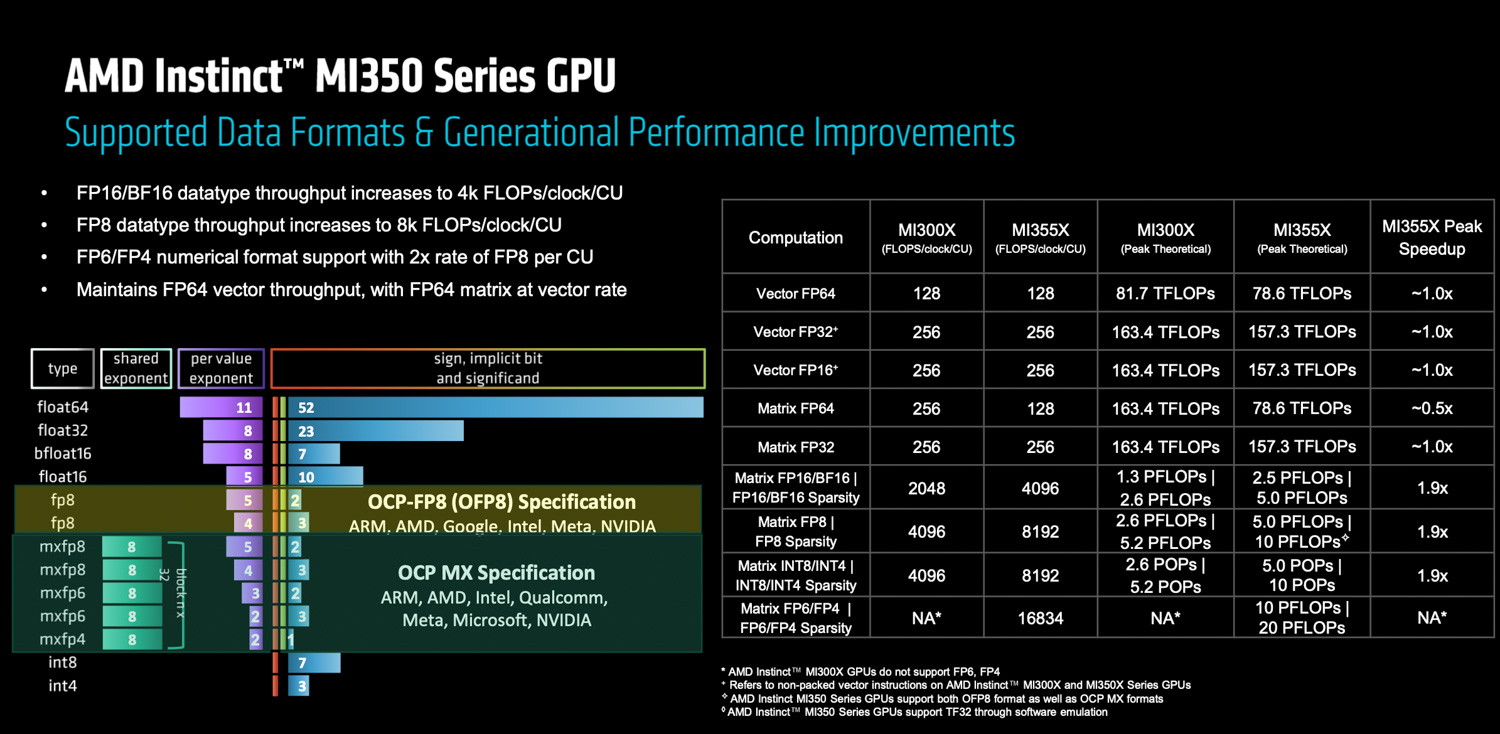
Matrismatematikens kapacitet ökar avsevärt: MI350 CU:er levererar en dubbel ökning av dataflödet per CU för 2-bitars (BF16, FP16) och 16-bitars (FP8, INT8) operationer jämfört med sina MI8-motsvarigheter. MI300-serien introducerar också hårdvarustöd för OCP MX-specificerade mikroskaleformat, specifikt FP350 och FP6, som skalar proportionellt från FP4. Det är värt att notera att AMD:s implementering gör det möjligt för FP8 att arbeta med samma beräkningshastighet som FP6. Detta strategiska beslut positionerar AMD för ledarskap inom FP4, ett framväxande format med potential för AI-träning. Dessutom har en ny vektor-ALU lagts till, som stöder 6-bitars operationer och kan ackumulera BF2-resultat till FP16, vilket förbättrar dataflödet för vissa lågprecisionsvektoroperationer.
För att stödja dessa förbättrade tensordataflöden har storleken på Local Data Share (LDS) per CU ökats, och nya funktioner förbättrar bandbredden för att ladda data från globalt minne till LDS. Genomströmningen för transcendenta funktioner har också ökats i takt med förbättringarna av tensorkärnan, eftersom man inser potentiella flaskhalsar i operationer som softmax och uppmärksamhetsmekanismer.
Flera andra arkitektoniska förbättringar bidrar till prestanda och flexibilitet:
- Hårdvarubaserad stokastisk avrundning: Minskar bias vid nedkastning från FP32 till format med lägre precision genom att injicera entropi.
- Instruktion för Logisk operator 3 (LUT3): Erbjuder programmerare större flexibilitet för att implementera anpassade logiska operationer med tre ingångar.
- Nya Min-Max-operatorer: Gör det möjligt för programmerare att kontrollera NaN-utbredning under jämförelser, vilket gör att de antingen kan sprida NaN-värden eller välja flyttalssystemet som inte är NaN, vilket bidrar till robust AI-datahantering.
Även om AI är det primära fokuset, behåller MI350-serien stöd för 64-bitars flyttal (FP64) i både vektor- och matrisenheter. En viktig skillnad från MI300 är dock att på MI350 körs matris-FP64-operationer med samma hastighet som vektor-FP64-enheterna, vilket i praktiken är hälften av FP64-matrishastigheten hos MI300.
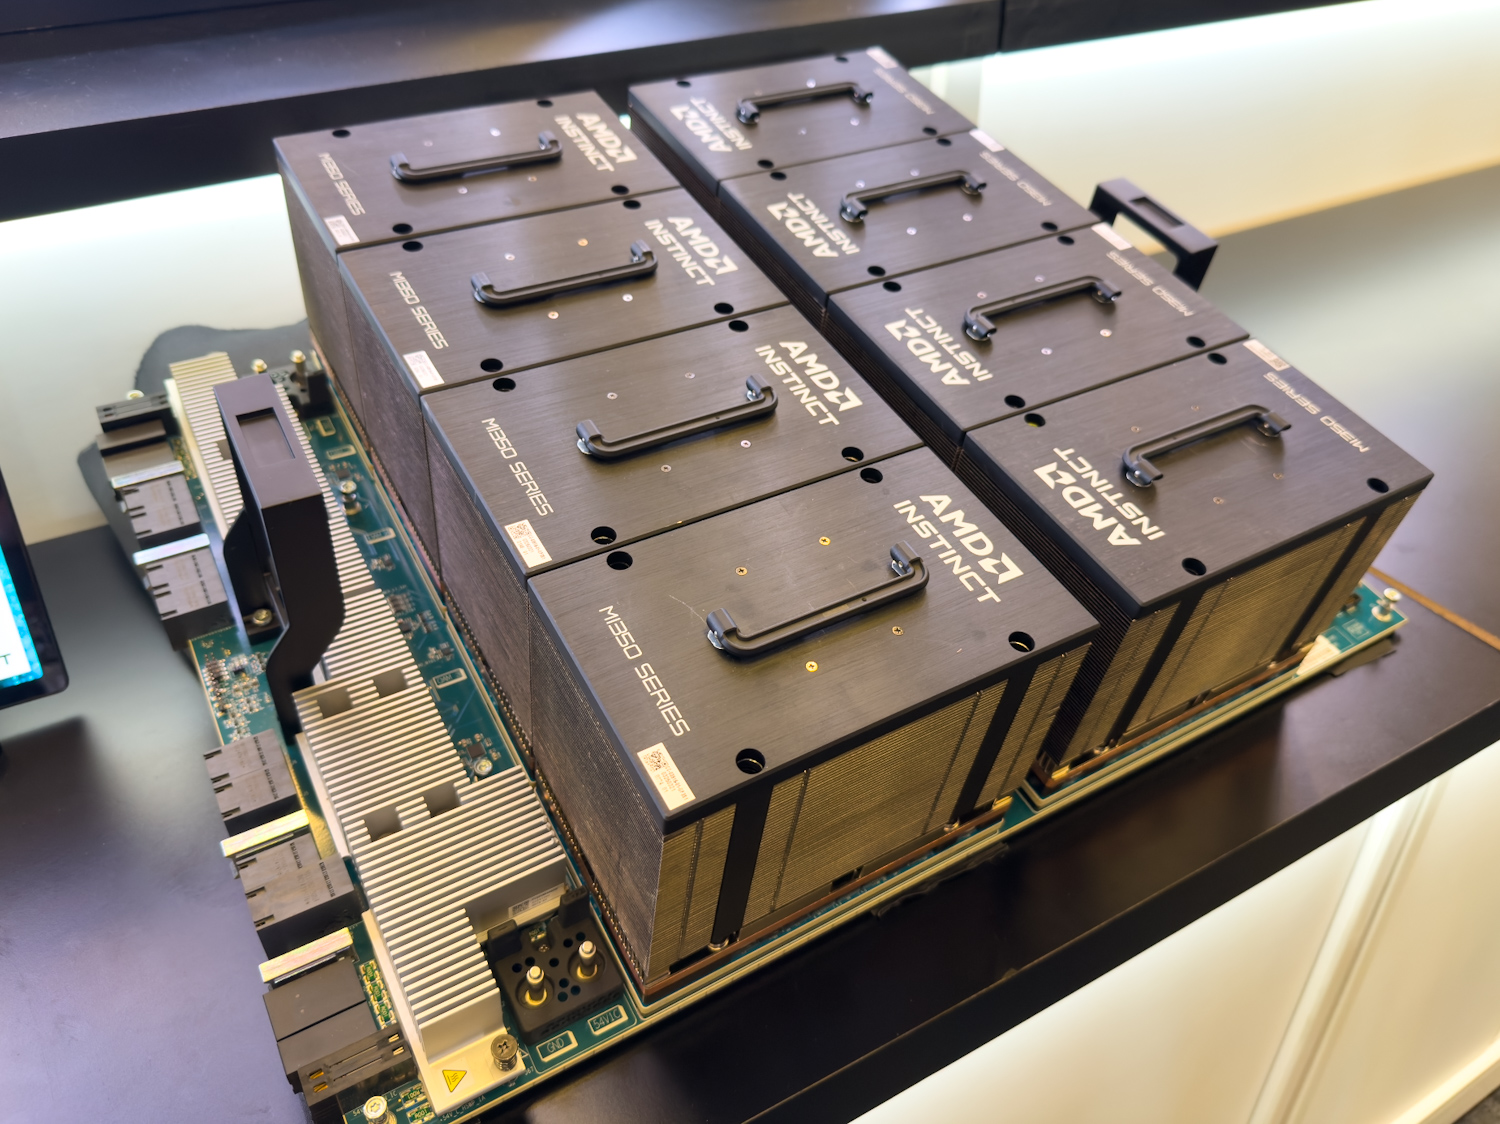
Slutligen innebär kombinationen av högre HBM3E-bandbredd och ett något minskat antal CU (256 på MI350X/355X jämfört med 304 på MI300X) att varje CU i MI350-serien drar nytta av ökad global minnesbandbredd per klockfrekvens. Detta är avgörande för att accelerera både GEMM-tunga (General Matrix Multiply) operationer och bandbreddsbunden vektoraritmetik.
Partitionering för flexibilitet: NPS- och beräkningspartitionering
AMD MI350-serien har förbättrade partitioneringsfunktioner och erbjuder mycket flexibel allokering av sina betydande resurser för att maximera utnyttjande och effektivitet över olika arbetsbelastningar.
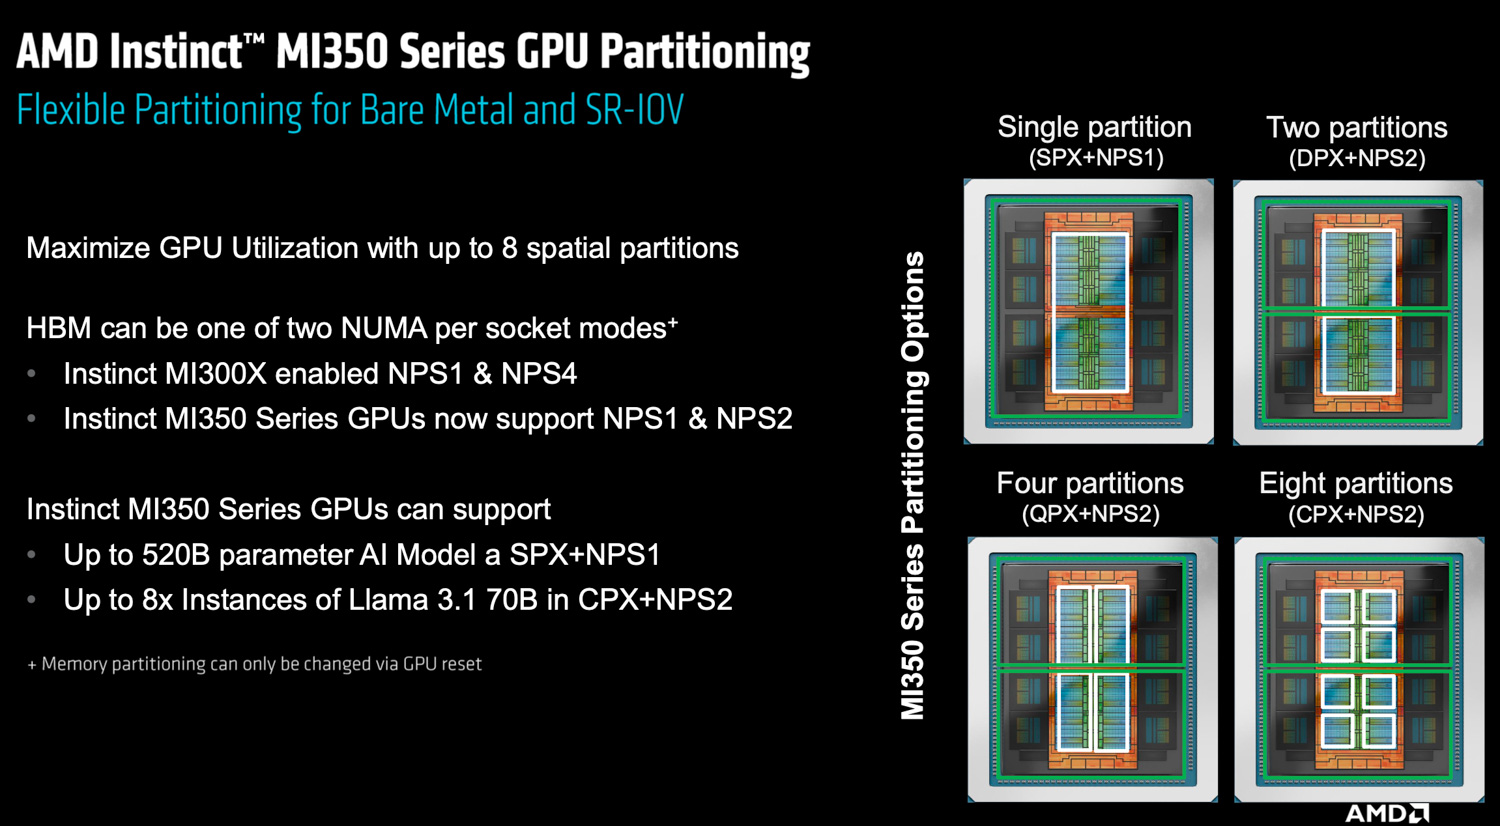
För minneshantering tillhandahåller MI350 två primära NUMA-lägen (Non-Uniform Memory Access):
- NPS1: Behandlar hela 288 GB HBM3E-minnet som en enda, enhetlig NUMA-domän genom att sammanfoga dataåtkomst över alla åtta HBM-stackar.
- NPS2: Delar upp minnet i två separata NUMA-domäner, som var och en motsvarar en av de två IOD:erna och dess fyra tillhörande HBM-stackar. Medan minnesåtkomsten inom varje IOD i NPS2-läge förblir finkornig och sammanflätad, blir den grovkornig över IOD:erna. Detta läge, särskilt i kombination med beräkningspartitionering, kan möjliggöra optimeringar för spatial lokalitet.
Det är värt att notera att AMD har valt att inte stödja ett NPS4-läge på MI350 (vilket var tillgängligt på MI300). Beslutet härrör från den tätare minneskopplingen inom var och en av de två IOD:erna i den nyare arkitekturen, vilket minskade de potentiella prestandafördelarna med ytterligare minnesuppdelning.
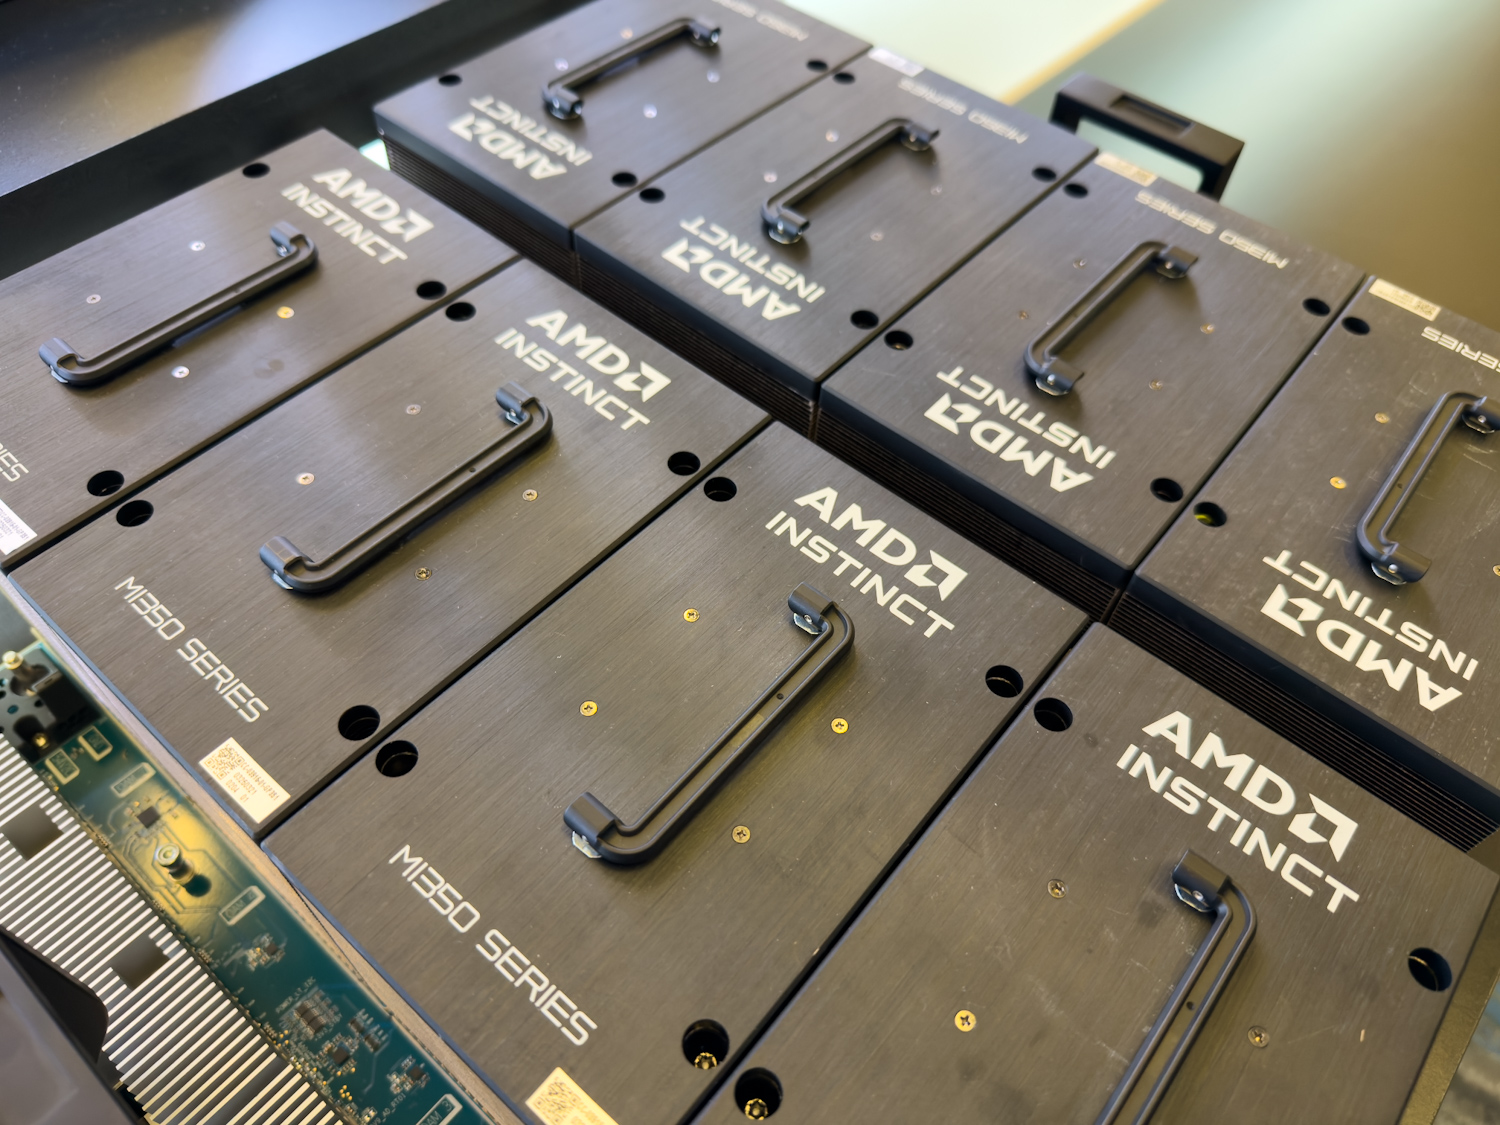
På beräkningssidan kan GPU:n konfigureras för att fungera i flera lägen:
- SPX (Single Partition Execution): GPU:n fungerar som en enda, kraftfull motor, vanligtvis används med NPS1-minnesläge.
- DPX, QPX, OPX (Dual, Quad, Octal Partition Execution): GPU:n kan delas in i två, fyra eller till och med åtta oberoende beräkningspartitioner.
Dessa beräkningspartitioner kan paras ihop med antingen NPS1- eller NPS2-minneskonfigurationer, med begränsningen att beräkningspartitionens granularitet måste vara minst lika fin som, eller finare än, minnespartitionen (t.ex. är SPX-läge inkompatibelt med NPS2-minnespartitionering).
Dessa mångsidiga partitioneringsalternativ stöds både i bare-metal-distributioner och via SR-IOV (Single Root I/O Virtualization), vilket gör dem idealiska för virtualiserade miljöer med flera hyresgäster. Till exempel, i moln- eller datacentermiljöer, kan en enda MI350 GPU logiskt segmenteras för att betjäna flera användare eller applikationer samtidigt. Varje hyresgäst får en dedikerad mängd minne och beräkningsresurser, vilket säkerställer servicekvalitet och säkerhet, vilket är särskilt värdefullt i scenarier där olika virtuella maskiner kräver isolerad åtkomst till GPU-hårdvara.
MI350X vs. MI355X: Skräddarsydd för olika implementeringar
MI350-serien introduceras med två huvudvarianter, som tillgodoser olika driftsättningsbehov och termiska skal:
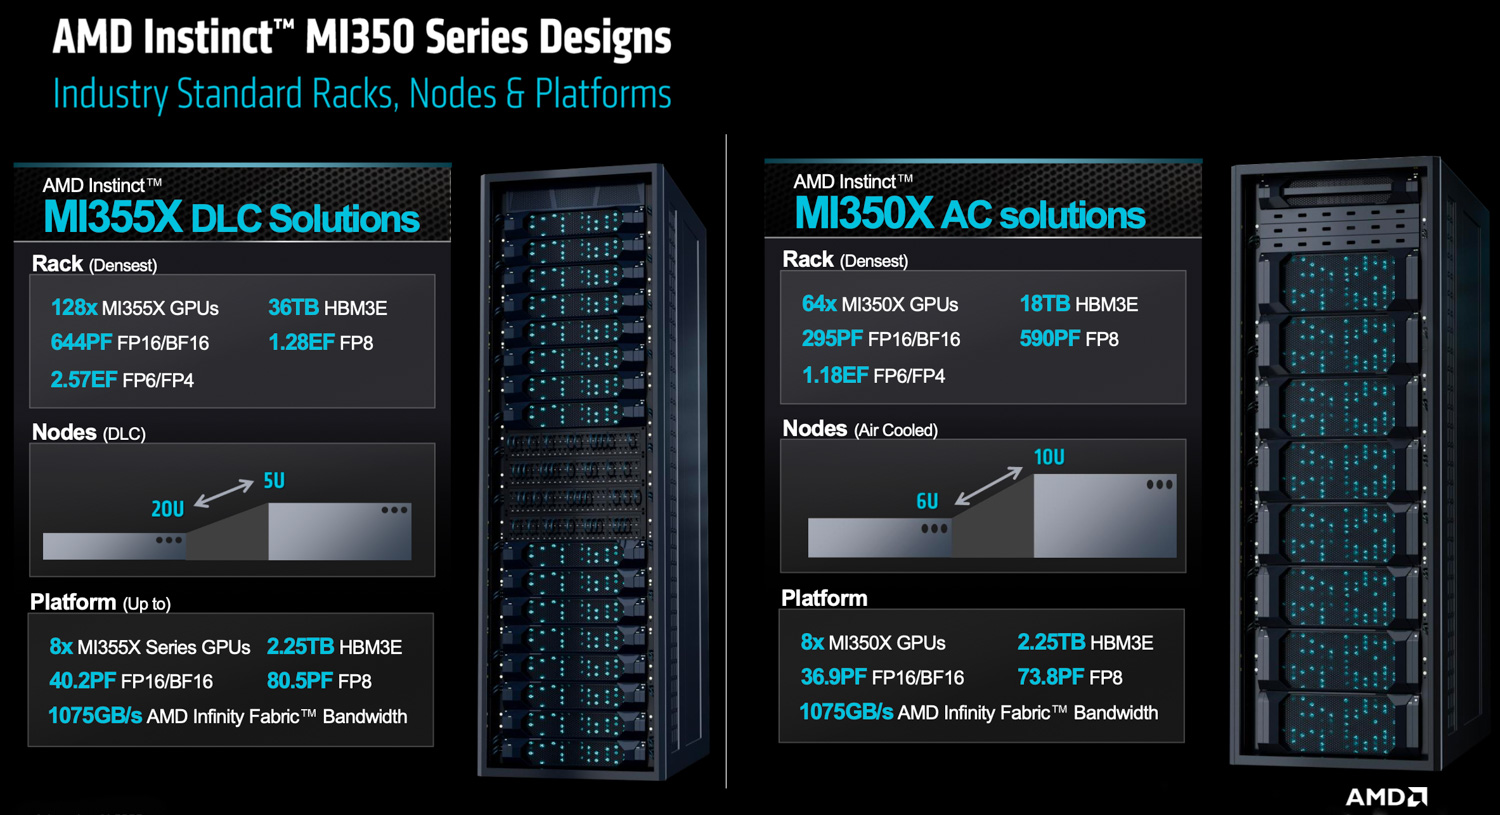
- MI350X: Denna variant är utformad för lägre strömförbrukning, med en termisk designeffekt (TDP) på upp till en kilowatt. Den stöder luftkylda installationer och erbjuder bredare kompatibilitet inom befintliga datacenterinfrastrukturer.
- MI355X: Med en högre systemeffekt på upp till 1.4 kilowatt TDP är MI355X främst avsedd för vätskekylda driftsättningar, vilket gör att den kan leverera maximal prestanda.
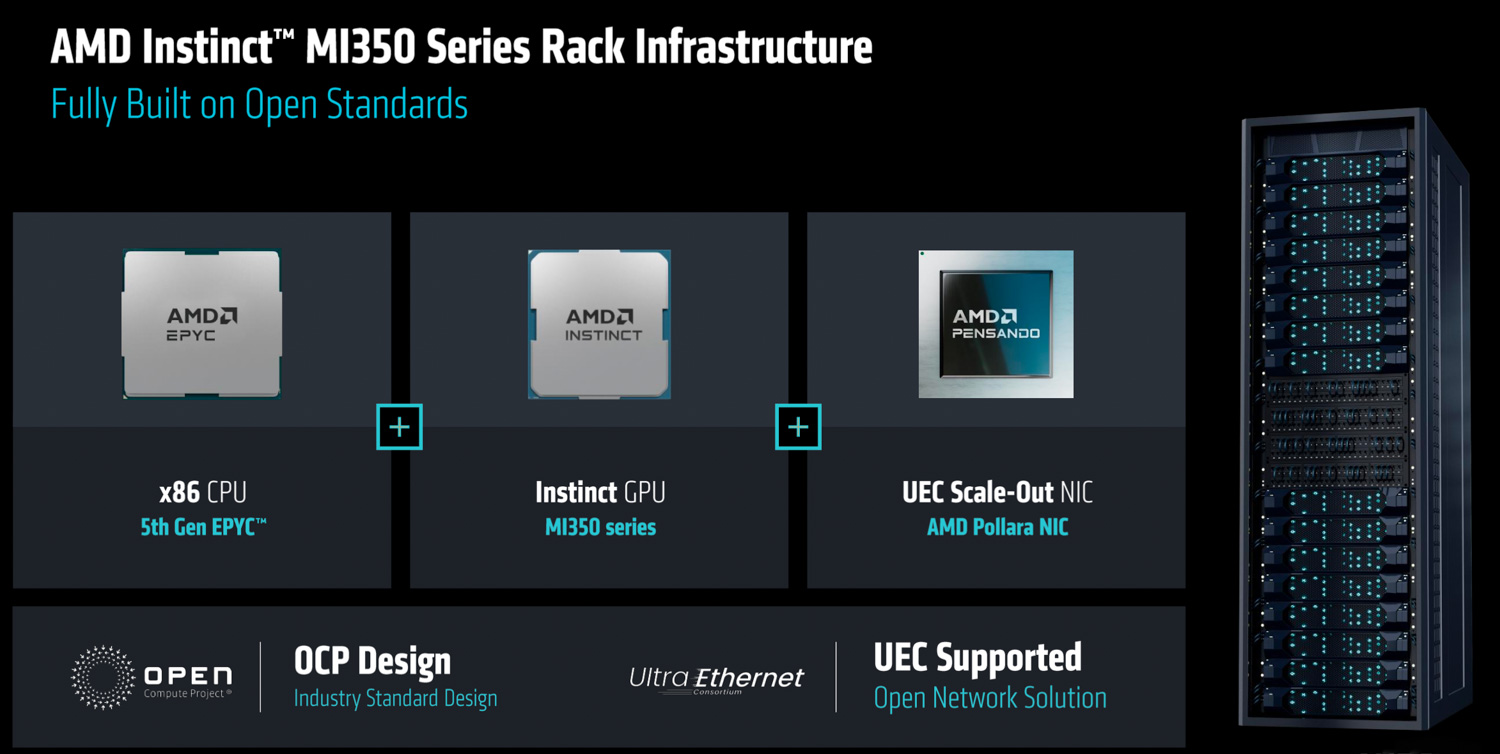
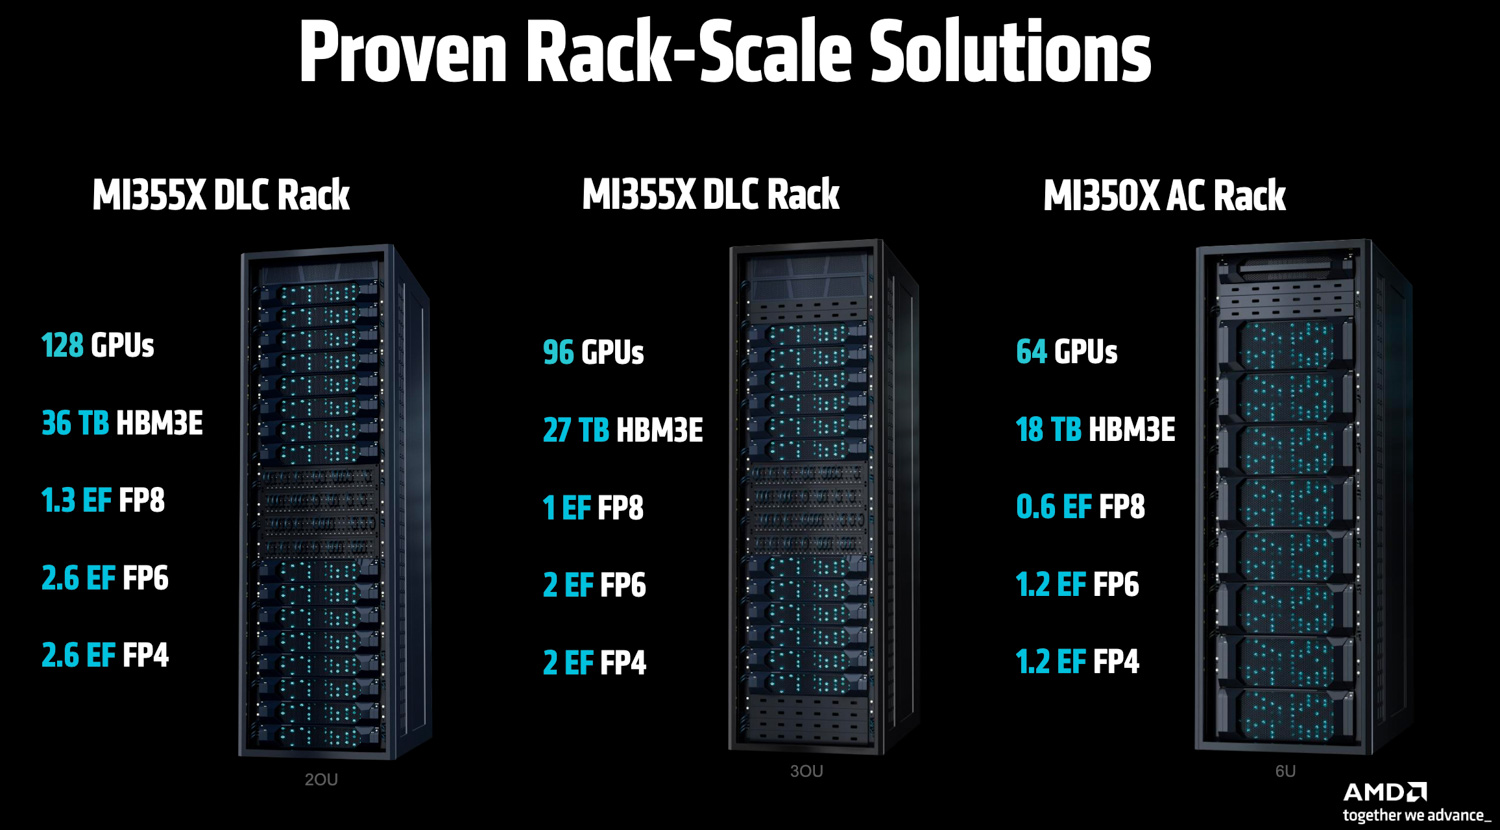
Även om båda varianterna är byggda på samma grundläggande hårdvara, möjliggör MI355X:s högre driftseffekt högre, ihållande klockfrekvenser. Detta innebär en prestandafördel på cirka 20 % i verkliga, heltäckande arbetsbelastningar jämfört med MI350X. Dessa finns tillgängliga i tre validerade rackkonfigurationer.
AMD Pensando Pollara nätverk
Utöver de nya grafikkorten gav AMD en djupgående titt på sina Pollara Networking-lösningar, och visade upp betydande arkitektoniska framsteg utformade för att möta de eskalerande kraven från storskaliga artificiella intelligenssystem. Pollara 400 AI NIC, byggt på teknik från AMDs förvärv av Pensando, introducerar en ny nivå av programmerbarhet och intelligens till AI-nätverksstrukturer.

Kärnan i Pollaras innovation ligger i dess programmerbara arkitektur. Till skillnad från hårdvara med fast funktion har Pollara NIC en P4-programmerbar MPU-kärna. Denna design är avgörande eftersom kraven på AI-nätverk är i ständig förändring, med nya protokoll, transportmekanismer och telemetribehov som snabbt uppstår. Programmerbarheten gör det möjligt för Pollara NIC att anpassa sig genom programuppdateringar, vilket möjliggör implementering av anpassade trafikhanteringsscheman, nya lastbalanseringsalgoritmer och skräddarsydda mekanismer för överbelastningskontroll utan att hårdvarubyte krävs. Denna flexibilitet är avgörande för att framtidssäkra AI-datacenter och snabbt reagera på de föränderliga egenskaperna hos arbetsbelastningar.
Pollara introducerar multicast för att åtgärda vanliga flaskhalsar i nätverk. För GPU-till-GPU-kommunikation kan data från en enda anslutning distribueras över flera fysiska nätverkslänkar samtidigt. Denna metod förbättrar den totala nätverksutnyttjandet och dataflödet genom att förhindra överbelastning på en enskild väg. Nätverkskortet hanterar själv komplexiteten i denna distribution, inklusive omordning av paket som kan anlända till destinationen i fel ordning.
Nätverkseffektiviteten förbättras genom selektiv bekräftelse för omsändningar. I traditionella nätverk kan förlust av ett enda paket utlösa omsändning av en omfattande datasekvens. Pollara implementerar också en mer exakt metod där endast förlorade paket skickas om. Detta minskar redundant data i nätverket avsevärt, vilket förbättrar den effektiva bandbredden. Pollaras nätverkslösning är också konstruerad för robust drift i olika nätverksmiljöer, inklusive de med förlustbringande anslutningar. Den innehåller sofistikerad, programmerbar och sökvägsmedveten överbelastningskontroll. Denna funktion minskar beroendet av perfekt förlustfria nätverksstrukturer, vilka kan vara komplexa och kostsamma att implementera och underhålla i de massiva skalor som krävs av moderna AI-kluster.

AMD är också en aktiv deltagare i Ultra Ethernet Consortium och bidrar till och implementerar dess standarder. UEC strävar efter att definiera nästa generations Ethernet optimerat för AI, med fokus på effektiv lastbalansering, förbättrad tillförlitlighet och AI-specifik överbelastningskontroll. Efterlevnad av dessa öppna standarder främjar interoperabilitet och främjar ett bredare ekosystem.
Slutligen är Pollara-tekniken utformad för synergistisk drift inom AMD:s bredare plattform, vilket möjliggör saminnovation mellan CPU-, GPU- och NIC-komponenter. Detta inkluderar funktioner som kollektiv driftavlastning, där NIC:et hanterar specifika nätverksintensiva kommunikationsuppgifter (de som inte kräver GPU-beräkning). Detta frigör GPU-resurser för deras primära bearbetningsuppgifter.
ROCm 7: Ett öppet programvaruekosystem för avancerad AI
Grunden för dessa hårdvaruinnovationer är tillkännagivandet av ROCm 7, den senaste utvecklingen av AMDs öppna programvaruplattform, konstruerad för att maximera prestanda och tillgänglighet. ROCm 7, som är planerad för en offentlig förhandsvisning idag inför den fullständiga lanseringen i augusti, rapporterar AMD att den levererar en häpnadsväckande 3x till 3.5x förbättring i både inferens- och träningsprestanda på befintlig hårdvara jämfört med sin föregångare.
För företagskunder lanserar AMD ROCm AI Enterprise, en omfattande svit som erbjuder klusterhantering, MLOps och applikationsbyggande verktyg för storskaliga distributioner. Samtidigt möjliggör AMD åtkomst för enskilda utvecklare med ett nytt utvecklarmoln, komplett med gratis GPU-krediter för att uppmuntra experimenterande. Denna strävan efter tillgänglighet sträcker sig ännu längre, med ROCm 7 som officiellt utökar stödet till klientenheter, inklusive bärbara datorer och arbetsstationer som kör Windows, vilket säkerställer att utvecklare kan bygga och testa AI-applikationer sömlöst över hela AMD:s ekosystem.
Vägen framför
AMD är dedikerade till en snabb, årlig innovationscykel, med en produktplan som sträcker sig bortom deras MI350-serie.

Med siktet inställt på en lansering under 2026 utvecklar AMD MI400-serien, som kommer att vara kärnan i en helt integrerad racklösning med kodnamnet Helios. Denna plattform är specifikt konstruerad för att träna banbrytande AI-modeller och hantera storskaliga distribuerade inferensuppgifter. Helios-systemet kommer att vara en integrerad AMD-plattform som inkluderar framtida EPYC-processorer med kodnamnet Venice, Instinct MI400 GPU:er och nästa generations Pensando-nätverk, specifikt Vulcano 800G AI NIC. En omfattande ROCm-programvarustack, inklusive en dedikerad Fabric Manager för automatiserad distribution och hantering, kommer också att ingå i denna lösning. Med betoning på öppna standarder kommer Helios-racket att uppfylla OCP-specifikationer. Det kommer att utnyttja Ultra Ethernet (UEC) för att skala ut nätverk mellan rack och introducera Ultra Accelerator Link (UAL 1.0) för att skala upp kommunikationen inom ett enda rack.

Själva Instinct MI400 GPU:n är specialbyggd för extremskaliga AI-applikationer. Preliminära specifikationer indikerar imponerande kapacitet, inklusive 40 PetaFLOPS FP4-prestanda och 20 PetaFLOPS FP8-prestanda. Varje GPU förväntas ha 432 gigabyte HBM-minne, vilket ger cirka 20 TB/s HBM-minnesbandbredd, och kommer att erbjuda 300 Gigabit per sekund skalbar bandbredd. Som ett komplement till GPU:n kommer Vulcano 800G AI NIC att vara UEC-redo och stödja UAL tillsammans med PCIe Gen6, där UAL ger dubbelt så stor bandbredd som PCIe Gen6. Detta NIC förväntas erbjuda upp till åtta gånger mer skalbar bandbredd per GPU jämfört med den tidigare Polara-generationen. AMD har ambitiösa prestandamål för Helios racklösning och beräknar att den ska leverera upp till tio gånger mer AI-prestanda på de mest avancerade frontmodellerna jämfört med MI355. Jämfört med Vera Rubin år 2026 siktar Helios på att erbjuda konkurrenskraftiga råa FLOPS, 50 % mer HBM-kapacitet, 50 % mer HBM-minnesbandbredd och upp till 50 % mer skalbar bandbredd.
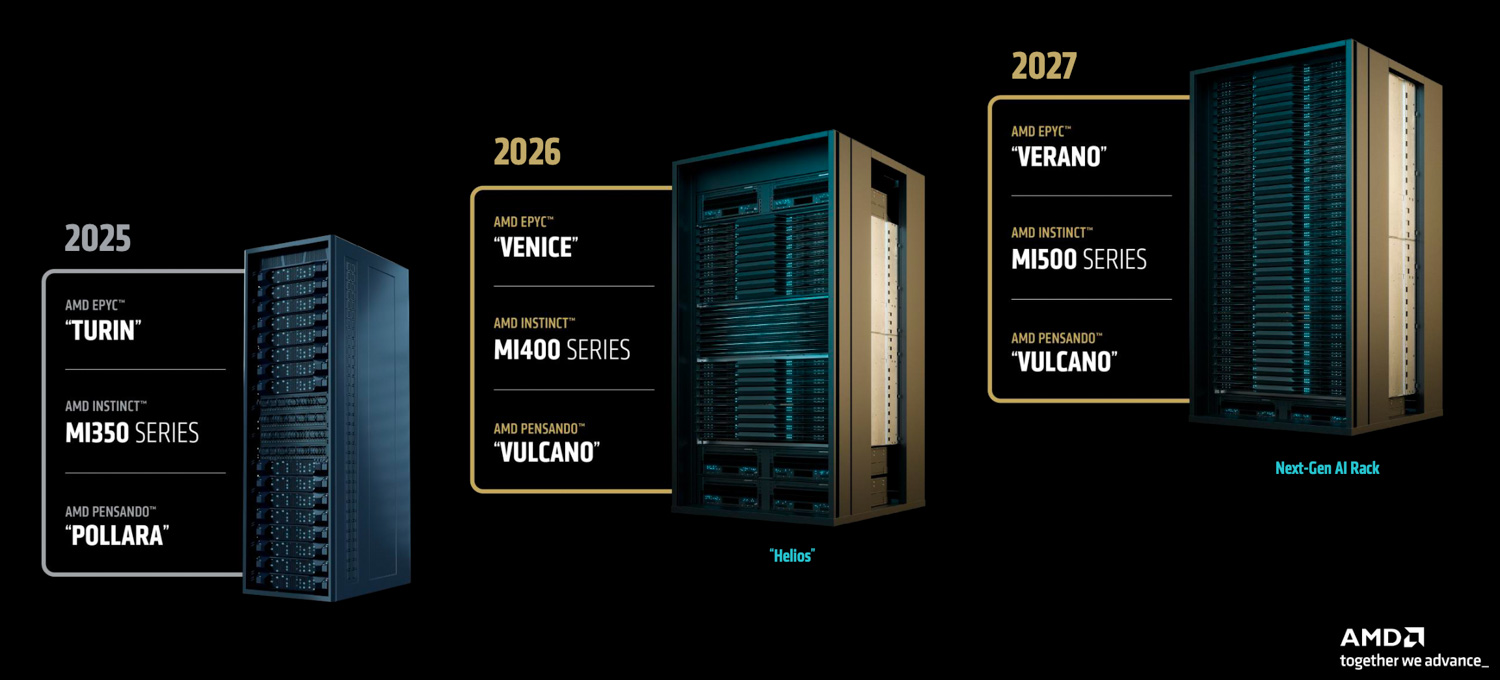
AMDs färdplan sträcker sig ännu längre, med utveckling redan i full gång för MI500-serien och efterföljande rackarkitekturer planerade för 2027 och framåt. Dessa framtida plattformar kommer att integrera MI500-serien, tillsammans med nästa generations EPYC-processorer med kodnamnet Verano, och ytterligare framsteg inom Pensando-nätverksteknik. Ytterligare information avslöjades dock inte vid evenemanget.


 Amazon