

AMD ROCm 10.1, som släpptes den 5 oktober, lägger sin vikt på vägen mellan lagring och GPU:n. Kontrollpunktsfiler, nyckelvärdescacher och modellvikter växer nu rutinmässigt ur acceleratorminnet, och när de gör det börjar tiden som läggs på att flytta data styra iterationstiden mer än matematiken gör. Utgåvan bygger ut AMD Infinity Storage, direktlagringsstacken som kom i ROCm 7.14, genom att koppla lagringsåtkomst till HIP-körtiden och lägga till NUMA-medvetet värdminne, så att data når GPU:n utan en omväg genom CPU-minnet.
Direkta GPU-lagringspipelines och NUMA-medvetet minne
hipFILE-biblioteket i AMD Infinity Storage får en asynkron snabbsökvägs-backend. Läs- och skrivförfrågningar körs direkt på en HIP-ström, vilket hoppar över värdminnes-stagingsteget som den traditionella sökvägen kräver, och AMD säger att resultatet är lägre latens för kontrollpunktsmotorer och KV-cache-avlastning samtidigt som bibehållen bandbredd hålls uppe. Versionsinformationen nämner anropen: hipFileReadAsync() och hipFileWriteAsync() stöder nu den snabba sökvägen.
Ett batch-I/O-API skickar flera filförfrågningar samtidigt och sprider dem över en intern pool av arbetstrådar, vilket håller lagringsköerna fulla när ett träningsjobb hämtar en stor datamängd. Telemetri växer med det: hipFileGetStatsL1, L2 och L3 returnerar successivt mer detaljerad I/O-statistik, och dessa räknare matar ROCm-profilerarna så att en operatör kan avgöra om en pipeline är begränsad av beräkning, minne eller dataleverans.
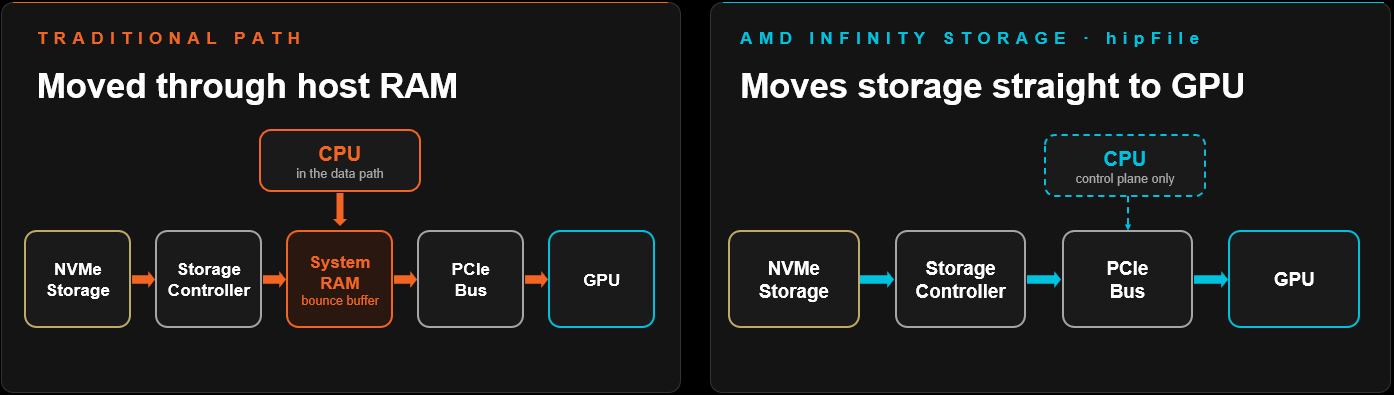
På värdar med två socklar betalar en buffert som allokeras på fel sockel en inter-socket-straffavgift vid varje överföring. ROCm 10.1 utökar HIP:ernas API:er för hantering av virtuellt minne med hipMemLocationTypeHostNuma och hipMemLocationTypeHostNumaCurrent, så att värdminne kan placeras på en specifik NUMA-nod genom hela livscykeln för skapande, reservering, mappning och nedmontering. Bibliotek som RCCL kan bygga NUMA-lokala kommunikationsbuffertar utan kopior ovanpå detta och hålla trafik mellan värd och enhet borta från sockelanslutningen.
ROCm CLI v1.0.0 och arbetsflöden för AI-agenter
ROCm CLI når v1.0.0 som en enda binärfil för Linux, Windows och WSL2 som installerar, konfigurerar och kör lokala AI-arbetsbelastningar på AMD-GPU:er. Den detekterar flash-atti- och amd-aiter-hjulen som vLLM behöver, stöder den uppdaterade ROCm 10- paketlayouten och lägger till en flagga för helt icke-interaktiva installationer i skript- eller CI-miljöer. En helskärms TUI-instrumentpanel visar live GPU-telemetri bredvid modellvisning och ett lokalt chattfönster för att kontrollera att en slutpunkt svarar.
AMD Skills, de paketerade integrationerna för kodningsagenter som Claude Code och Codex, tar upp ytterligare två. quark-install konfigurerar AMD Quark med en matchande PyTorch-version, och quark-torch-llm-ptq kör kvantisering efter träning på PyTorch och Hugging Face LLM med scheman som FP8 och INT4.
Profilering och modernisering av telemetri
ROCprofiler-SDK lägger till kärnuppspelning, i beta. GPU-hårdvara exponerar ett begränsat antal prestandaräknare per dispatch, så att samla in en fullständig räknaruppsättning innebar tidigare att hela applikationen kördes om en gång per räknargrupp. Kärnuppspelning kör varje dispatch på plats, återställer GPU-minne mellan körningar och samlar in hela uppsättningen i en enda körning. SDK:et låter också profilering starta och stoppa när som helst i en körning för PyTorch Kineto och Triton Proton, och levererar en PC-samplingsagentfärdighet som guidar en kodningsassistent genom rocprofv3 PC-sampling för att hitta beräkningsstopp.
ROCm Compute Profilers taklinjerapport är nu en interaktiv HTML-sida, så att en ingenjör kan isolera en enskild kärna och växla den aritmetiska intensitetsaxeln mellan cachenivåer. PC-samplingsrapporter per kärna, ner till samplings- och stallantal på individuella instruktioner, och en ny guide täcker profilering av vLLM. ROCm Systems Profiler lägger till Linux-spårning för Gorgon Point 1, 2 och 3 APU:er (gfx1150, gfx1152 och gfx1153), och ROCm Optiq visualiserar nu rocprofv3-profiler tillsammans med Systems Profiler-spår och Compute Profiler-analys.
AMD SMI (amd-smi) tar över från ROCm SMI, som har tagits bort från standardversionen i den här utgåvan. Den täcker AMD GPU:er, CPU:er och APU:er på Linux och Windows, både bare metal och virtualiserade, med ett CLI, ett C-bibliotek (amd_smi_lib) och bindningar för Python, Go och Rust. Containermedvetenhet omfattar containerd, CRI-O, Podman, LXC och LXD, inklusive Kubernetes-podar, så att en klusteradministratör kan matcha GPU-processer och användning med containern som kör dem.
Uppdateringar av kärnkompilatorer, bibliotek och runtime-stöd
Verktygskedjan flyttas från LLVM 23 till LLVM 24, och makrot clang_major rapporterar nu 24, vilket alla som fäster kompilatorversioner eller länkar mot libLLVM bör kontrollera innan de uppgraderar. Stegvisa byggen blir snabbare genom cachning av de partitioner som länktidsoptimering för enhetskoden skapar, så oförändrade partitioner återanvänds i nästa byggprocess.
Composable Kernel snabbar upp uppmärksamheten på Radeon GPU:er och lägger till fler kvantiserade matrismultiplikationstyper till sin dispatcher. MIGraphX byter sin backend-kompilator från rocMLIR till rocMLIRTriton, vilket AMD säger förbättrar inferensprestanda och ofta förkortar modellkompileringstider samtidigt som kompilatorn hålls i takt med uppströms Triton. rocSPARSE kör triangulära lösningar direkt på matriser lagrade i ELLPACK (ELL)-formatet, utan något första konverteringssteg.
hipThreads, ett nytt verktyg i ROCm Core SDK:s trådbibliotek, ger AMD-grafikprocessorer på Linux och Windows standardiserade trådkoncept i C++. Poängen är att accelerera befintlig CPU-trådad kod på grafikprocessorn utan att behöva skrivas om till HIP-kärnor och synkroniseringsprimitiver.
Windows Subsystem för Linux 2 går in i teknisk förhandsvisning, där standard Linux-paket installeras i gäst- och GPU-paravirtualiseringsdrivrutinen och arbetet lämnas över till Windows värddrivrutin. Förhandsvisningen täcker .deb-paket och Python-hjul men inte RPM:er, och profilering, felsökning och KFD-beroende verktyg fungerar ännu inte i WSL2. På virtualiseringssidan stöds KVM SR-IOV nu med Ubuntu 26.04 LTS som både värd och gäst, i kombination med version 9.3.0.K av AMD:s GIM-virtualiseringsdrivrutin.
Listan över stödda hårdvaror lägger till Radeon AI PRO R9600 tillsammans med Instinct MI355X, MI350X och MI350P, MI300- och MI200-serien, resten av Radeon AI PRO R9700-familjen och Ryzen AI-processorer.


 Amazon