

Cerebras Systems har officiellt introducerat CS-4 , den fjärde generationen av sin waferskala AI-superdatorplattform, designad för frontlinjeträning och arbetsbelastningar med hög samtidighet. Systemet är konstruerat kring tre nyutvecklade Wafer Scale Engine 3 (WSE-3) Turbo-processorer, inrymda i en helt ny design som kallas Nexus rackskalaplattform. Cerebras hävdar att systemet levererar upp till 30 gånger högre inferensprestanda än GPU-baserade lösningar, en siffra som företaget baserar på GPT-OSS-120B , där de anger mer än 4 400 tokens per sekund per användare, tillsammans med en 10-faldig ökning av dataflödet per watt jämfört med föregående generation CS-3.
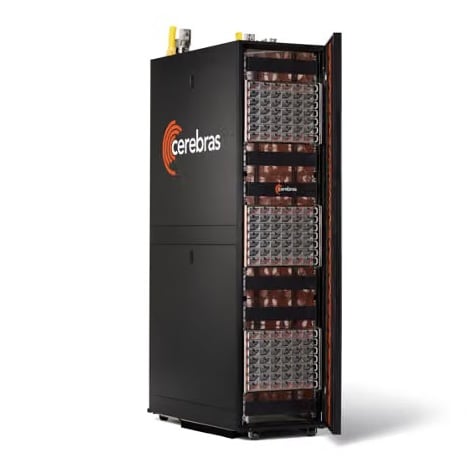
CS-4 är utformad för att hantera de systemiska skalningsbegränsningar som är inneboende i diskreta GPU-kluster med flera noder, där kommunikation mellan chip, effektförluster och termiska begränsningar ofta stryper bibehållen beräkningseffektivitet. Cerebras positionerar plattformen för att betjäna båda extremerna av inferensarbetsbelastningsspektrumet, och levererar de svarstider på under en millisekund som krävs för komplexa agentiska arbetsflöden och interaktivt resonemang, samtidigt som den tillhandahåller den aggregerade kapacitet som hyperskalare behöver för att maximera beräkningstätheten per gigawatt.
Förbättringar av sammankopplingsstrukturen är centrala för plattformens skalningsmöjligheter för flera processorer. CS-4 minskar latensen för sammankoppling mellan wafers till så låg som 2 mikrosekunder, vilket gör att multiwaferstrukturer kan fungera med nästan monolitisk kohesion. Denna struktur med ultralåg latens gör det möjligt för CS-4 att upprätthålla genereringshastigheter på över 1 000 tokens per sekund på modeller med mer än 10 biljoner parametrar, vilket minskar det historiska prestandagapet där uppskalning av parameterantalet allvarligt äventyrade leveranshastigheterna för interaktiva tokens.

Nexus Rack-arkitektur och waferskala-ryggsäcken
En viktig teknisk övergång i CS-4 är Cerebras Nexus Platform Architecture, en modulär rackimplementering byggd kring oberoende beräknings-, strömförsörjnings- och I/O-domäner. Beräkningstätheten förankras av en nydesignad, bakmonterad Wafer-Scale Backpack som ansluts vertikalt till den primära strömförsörjningsmatrisen. Varje backpack är en fristående enhet som innehåller direkt-till-chip-vätskekylningsgrenrör, point-of-load-strömomvandlingssteg, höghastighetsnätverksvägar och inbyggd styrelektronik placerad direkt bakom kiselskivan. Genom att isolera kärnberäkningslagret från bulkströmfördelningsramen minskade Cerebras antalet systemkomponenter med 50 procent, ökade automatiserad montering med 60 procent och komprimerade tidslinjerna för datacenterdistribution till bara några timmar.

Effektiviteten i strömförsörjningen har förbättrats genom att flytta DC-till-DC-spänningsregleringsmodulerna 100 gånger närmare kiselgränsen än i typiska serverkortsimplementeringar. Detta point-of-load-arrangemang minskar förluster i resistiva strömfördelningsnätverk (PDN) och gör att Nexus-ramen kan leverera dubbelt så mycket effekt till varje WSE-3 Turbo-processor, vilket möjliggör högre, ihållande klockfrekvenser utan termisk strypning.

I/O-delsystemet har också utökats med en programmerbar Wafer I/O-modul som fördubblar bandbredden för hela nätstrukturen samtidigt som den minskar transitlatensen. Systemnätverk fungerar i två lägen: standard RoCE v2 (RDMA over Converged Ethernet)-gränssnitt för låglatensanslutning av nätstrukturen till äldre företagsnätverk och tredjepartsacceleratornoder, och proprietära Direct Wafer Links som tillhandahåller direkta, switchfria sammankopplingsvägar mellan angränsande system inom och mellan rack.
Specifikationer för CS-4 och WSE-3 Turbo
| CS-4-SYSTEMET | |
| arkitektur | Aktivt kraftrack med tre modulära datorryggsäckar |
| Waferskalamotorer | 3x WSE-3 Turbos per system |
| AI Compute | 750 PFLOPS* |
| minnesbandbredd | 129.6 PB/s |
| Bandbredd för tyg på chip | 160.5 PB/s |
| I/O-bandbredd | 7.2 Tbit / s |
| I/O-latens | 2 mikrosekunder |
| WSE-3 TURBO (PER WAFER) | |
| Transistorer / Kisel | 4 biljoner transistorer; 46 225 mm2, TSMC 5nm |
| AI-kärnor / Inbyggt SRAM | 900 000 kärnor; 44 GB SRAM |
| AI Compute | 250 PFLOPS* |
| minnesbandbredd | 43.2 PB/s |
| Bandbredd för tyg på chip | 53.5 PB/s |
| I/O-bandbredd | 2.4 Tbit / s |
| *AI-beräkning visas som gles FP16 | |
Disaggregerad inferens och tillgänglighet
Arkitektoniskt sett är CS-4 byggd med inbyggt stöd för disaggregerade inferenstopologier. I företags- och molnmiljöer kan operatörer frikoppla beräkningsfaserna i inferensen genom att använda specialiserade externa förfyllningsacceleratorer, såsom AMD Helios eller AWS Trainium, för att mata in promptkontexter och bygga modelltillstånd. Den beräkningsbundna KV-cachen dirigeras sedan via höghastighetslänkar till CS-4:s massiva SRAM-struktur för autoregressiv tokengenerering med ultralåg latens.
Cerebras bekräftade att de första produktionsimplementeringarna och leveranserna av CS-4-plattformen kommer att påbörjas under detta kvartal.


 Amazon