

MSI XpertStation WS300 är byggd på NVIDIAs senaste DGX Station-arkitektur, den hittills mest kapabla generationen, och placerar en komplett GB300 Grace Blackwell Ultra-nod bredvid ditt skrivbord. Huvudsiffran är 20 petaFLOPS FP4-beräkning, levererad av en enda Blackwell Ultra GPU kopplad till en 72-kärnig Grace-processor via en 900 GB/s NVLink-C2C-länk. Båda processorerna använder en koherent minnespool på 748 GB; 252 GB HBM3e parat med 496 GB LPDDR5X, tillräckligt för att hålla en modell med biljoner parametrar lokalt.
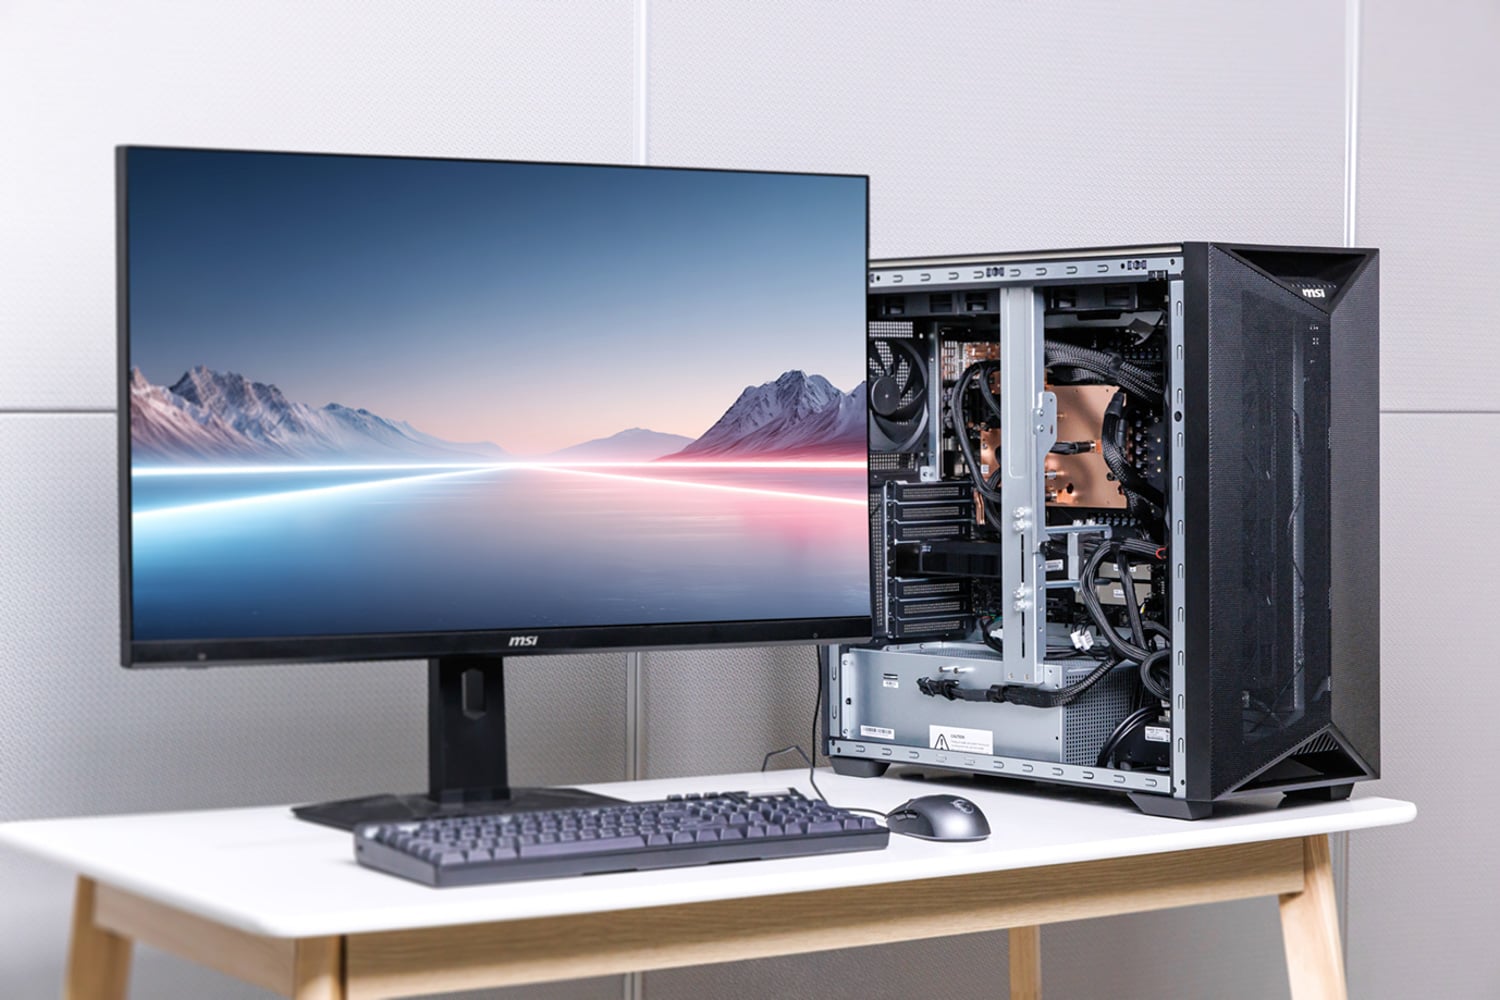
DGX Station stöder även klusterbildning av flera enheter med hjälp av sin ConnectX-8 SuperNIC, som exponerar två 400 GbE-portar för 800 Gb/s infrastruktur. Resultatet är en maskin i datacenterklass som kan köras i ett hem eller kontor snarare än i en serverhall.
NVIDIA DGX Station Tekniska specifikationer
XpertStation WS300 är MSIs implementering av NVIDIAs GB300 DGX Station-plattform. NVIDIA levererar Grace Blackwell Ultra-baskortet och programvarumiljön, medan MSI levererar chassit, vätskekylningen, strömförsörjningen, lagringslayouten, externa I/O-enheter och servicemodellen som förvandlar plattformen till ett komplett skrivbordssystem. Eftersom Grace-processorn, Blackwell Ultra GPU, NVLink-C2C-interconnect och ConnectX-8-nätverket är fasta, ligger den verkliga OEM-differentieringen i hur effektivt det omgivande systemet upprätthåller, hanterar och exponerar den hårdvaran. MSI konfigurerade detta system med fyra 2TB Micron 4600 Gen5 M.2 SSD-diskar för testning. Två SSD-diskar konfigurerades i RAID1 för startlagring, medan de andra två var separata SSD-diskar för scratchutrymme eller andra användningsområden.
| Specifikation | Detaljer |
|---|---|
| arkitektur | |
| CPU | NVIDIA Grace, 72-kärnig Arm Neoverse V2 |
| GPU | NVIDIA Blackwell Ultra (B300) |
| Tensorkärnor | 5th Generation |
| CPU-GPU Interconnect | NVLink-C2C, 900 GB/s dubbelriktad |
| Minne | |
| Koherent minne | Upp till 748 GB |
| GPU-minne | Upp till 252 GB HBM3e |
| GPU-minnes bandbredd | 7.1 TB / s |
| CPU-minne | Upp till 496 GB LPDDR5X (4 x SOCAMM) |
| CPU-minnesbandbredd | 396 GB / s |
| lagring | |
| Starta enheter | 2 x M.2 2280 PCIe 5.0 x4 NVMe (CPU-ansluten), utrustat med 2 x 2 TB Micron 4600 Gen5 i RAID 1 |
| Expansionsenheter | 2 x M.2 2280 PCIe 5.0 x4 NVMe (ConnectX-8-ansluten), utrustade för testning med 2 x 2 TB Micron 4600 Gen5 |
| nätverk | |
| NIC | NVIDIA ConnectX-8 SuperNIC, 2 x 400G QSFP112 (800 Gb/s totalt) |
| ethernet | 1 x 10GBase-T RJ45 (Marvell AQC113) |
| Förvaltningsport | 1 x 1000Base-T RJ45 (dedikerad out-of-band) |
| trådlös | M.2 2230 Key-E-kortplats, PCIe 2.0 x1 (Wi-Fi 6E / Wi-Fi 7, Bluetooth) |
| Expansion | |
| PCIe-kortplatser | 1 x PCIe 5.0 x16 FHFL dubbelbred; 2 x PCIe 5.0 x16 FHFL enkelbred (x8-signaler) |
| Tilläggs-GPU:er som stöds | NVIDIA RTX PRO 2000 Blackwell, RTX PRO 4000 Blackwell SFF, RTX PRO 6000 Blackwell Workstation / Max-Q |
| Främre/Övre I/O | |
| USB | 2 x USB 3.2 Gen 2 typ-A; 2 x USB 3.2 Gen 2 typ-C (5V/3A) |
| Audio | 2 x uttag (linjeutgång/mikrofon) |
| Bakre I / O | |
| USB | 4 x USB 10 Gbps typ-A; 1 x Micro-USB COM (seriell konsol) |
| Skärmar | 1 x Mini DisplayPort (BMC-video, max 1024 x 768, ingen DP++) |
| Audio | 3 x uttag (linjeingång / linjeutgång / mikrofon) |
| Hantering och säkerhet | |
| BMC | ASPEED AST2600 med AMI MegaRAC-firmware, IPMI 2.0 och Redfish, lokal eMMC-lagring |
| Säkerhet | TPM 2.0, chassiintrång, Microchip CEC1736 hårdvarubaserad förtroendekod (ERoT) |
| Kylning | |
| Flytande kylning | Vätskekylningsmodul klassad för 1400W CPU + GPU, med block på GPU, CPU, minne och ConnectX-8 |
| Radiatorer / Fläktar | 2 x 360 mm radiatorer; 1 x 12025 systemfläkt |
| Effekt | |
| Strömförsörjning | 1 x 1600W ATX, 80 PLUS Platinum (150 x 86 x 210 mm) |
| AC Input | 100–114 V AC, 15 A, 47–63 Hz (max 1300 W uteffekt); 115–240 V AC, 15–8 A, 47–63 Hz (max 1600 W uteffekt) |
| Formfaktor | |
| Mått | 245.7 x 529.0 x 570.4 mm (9.67 x 20.83 x 22.46 tum), B x H x D |
Design och bygga
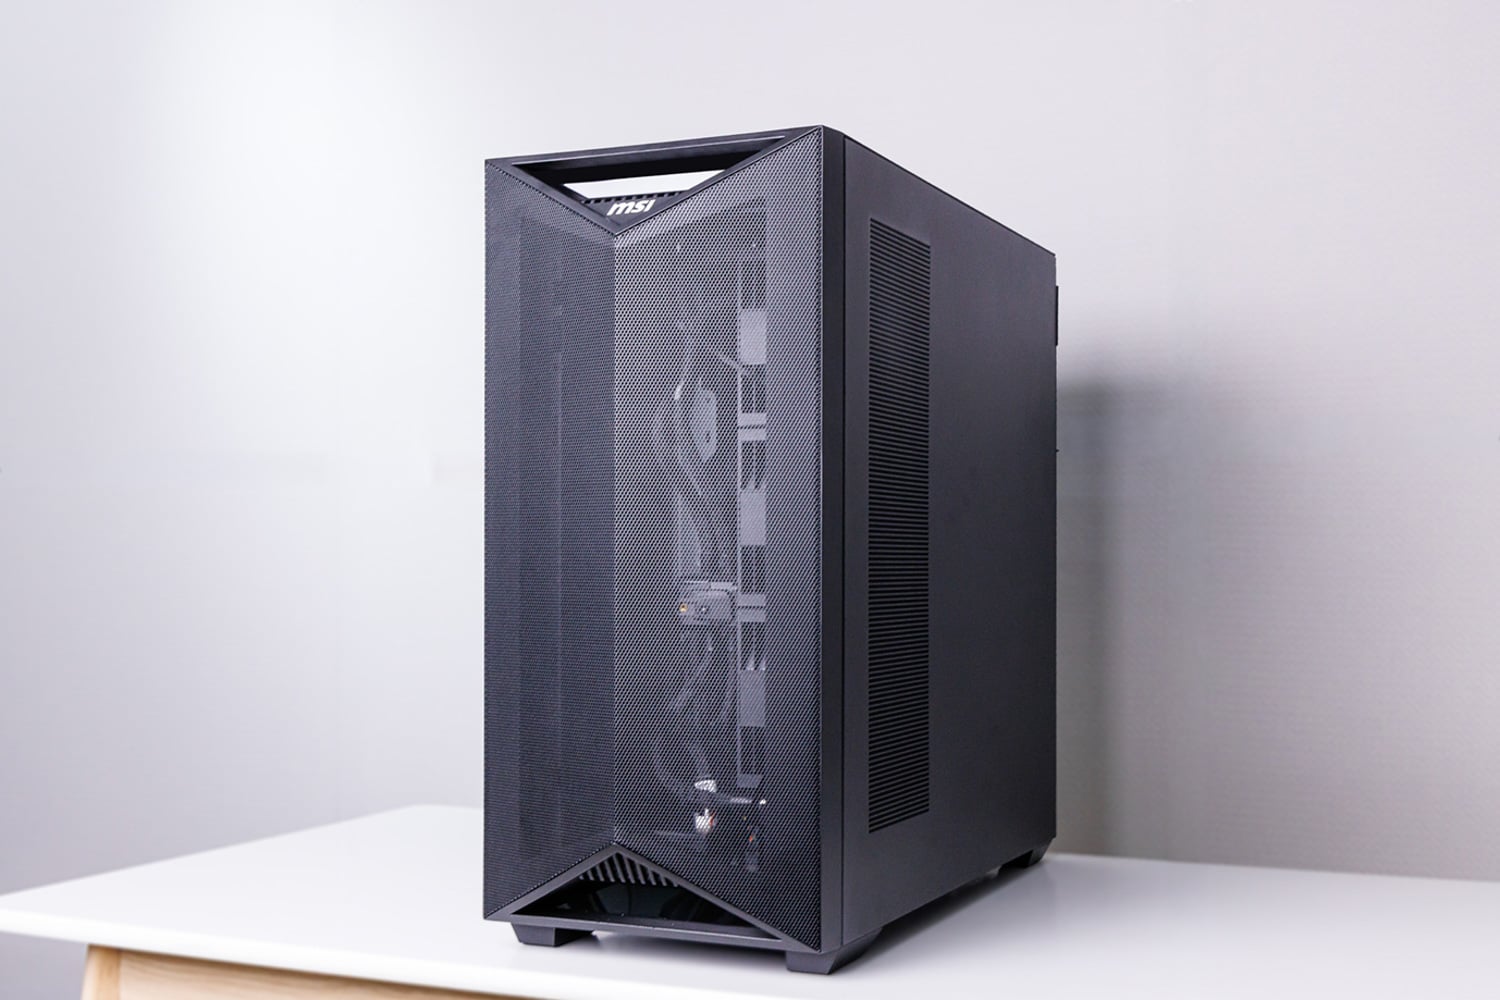
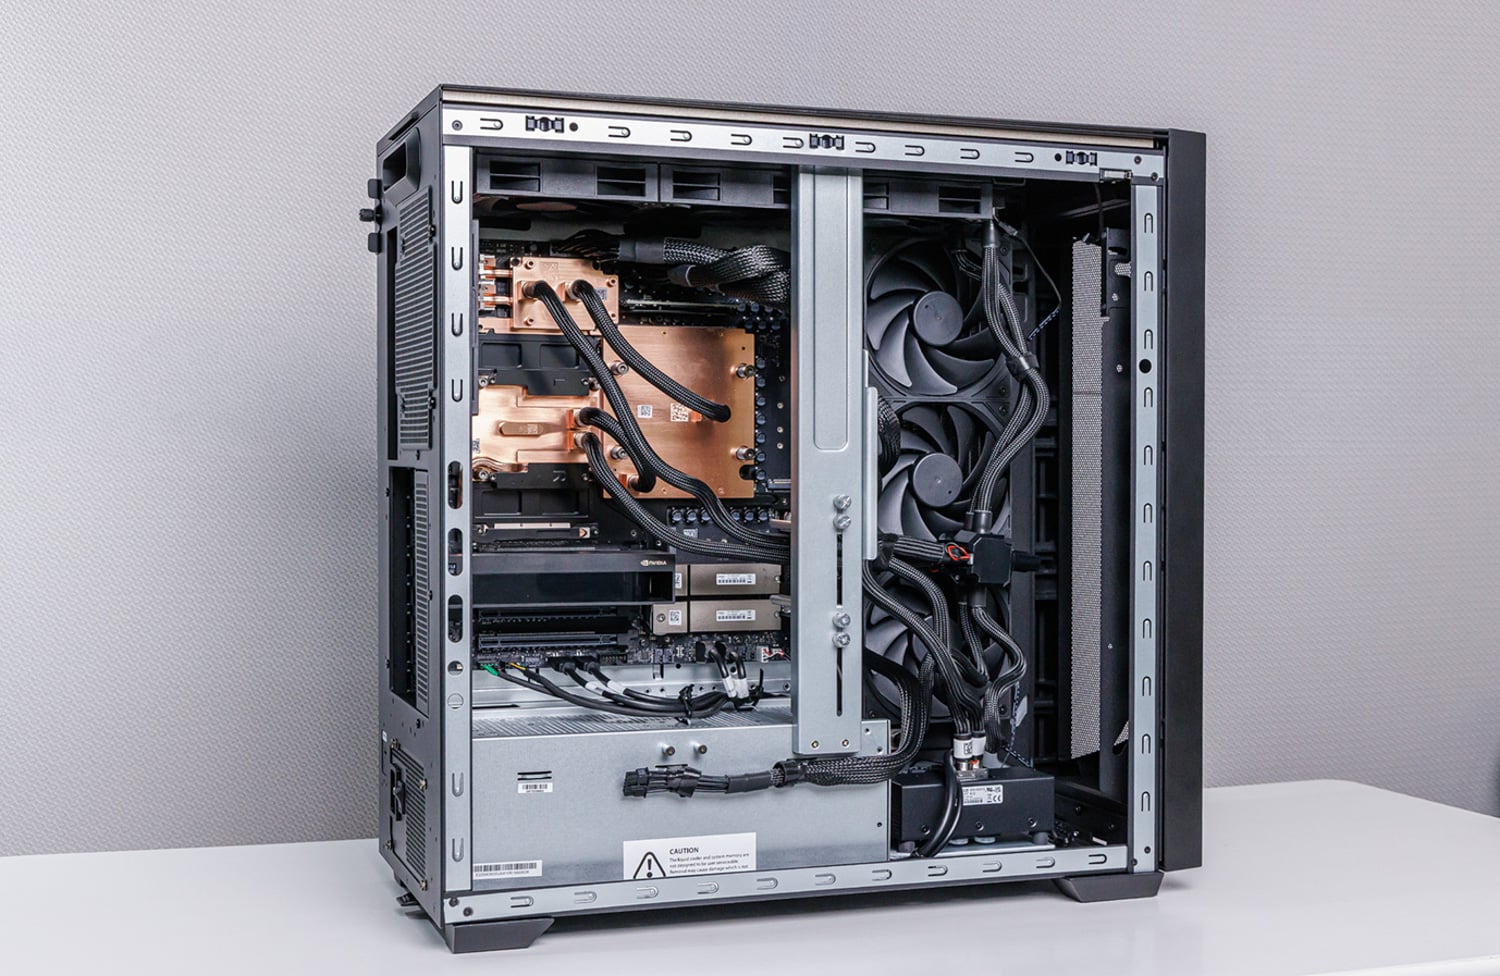
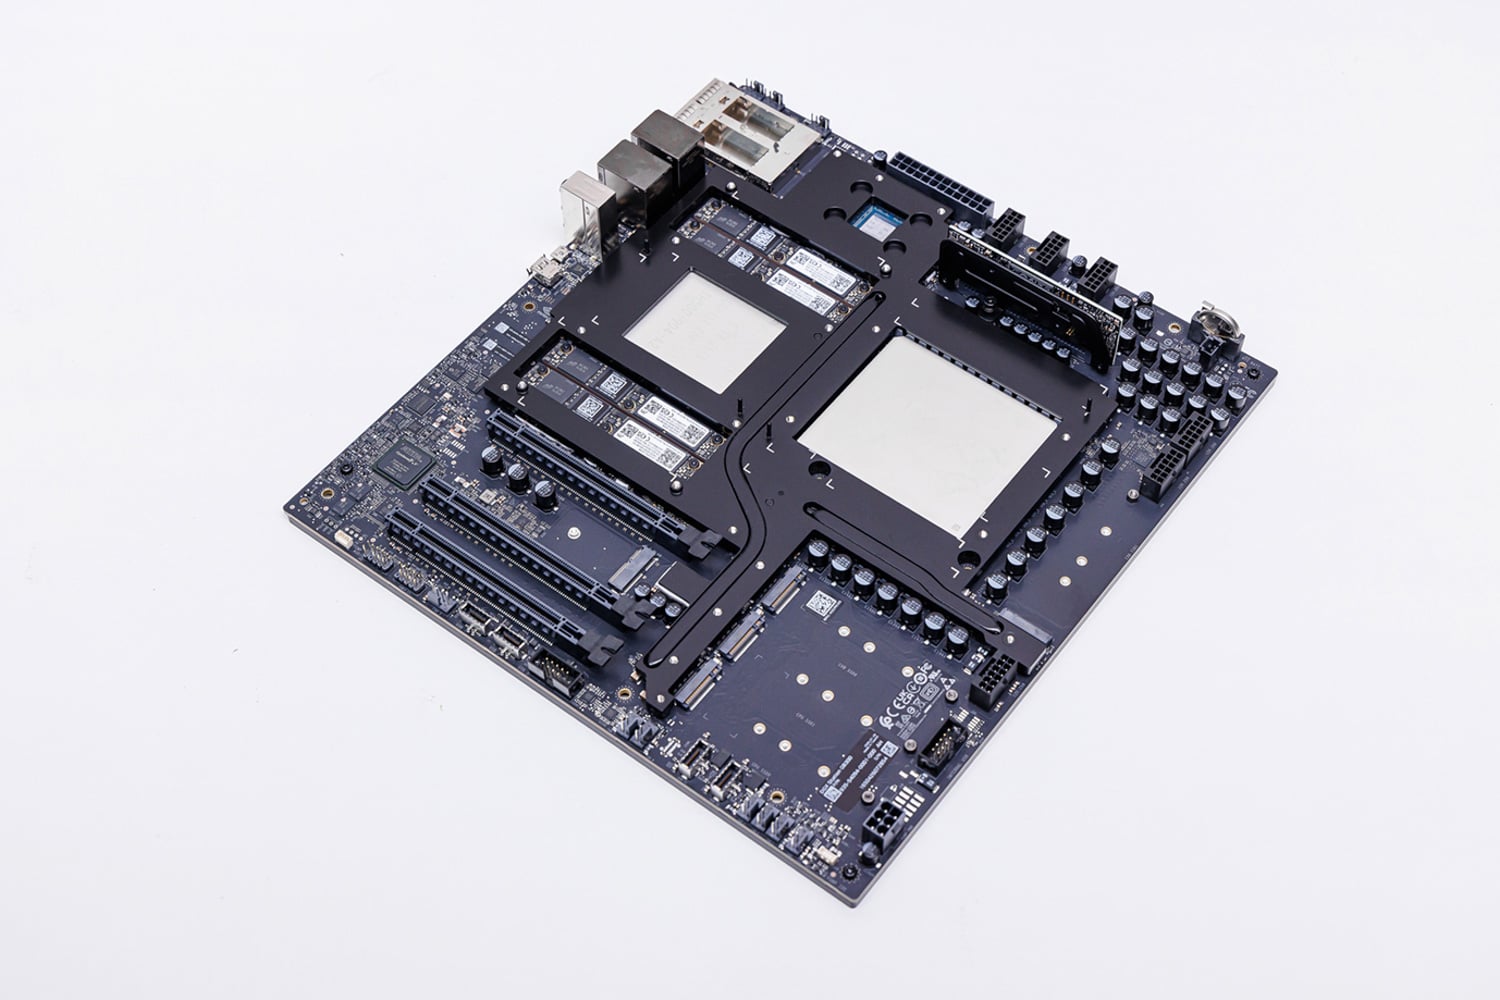
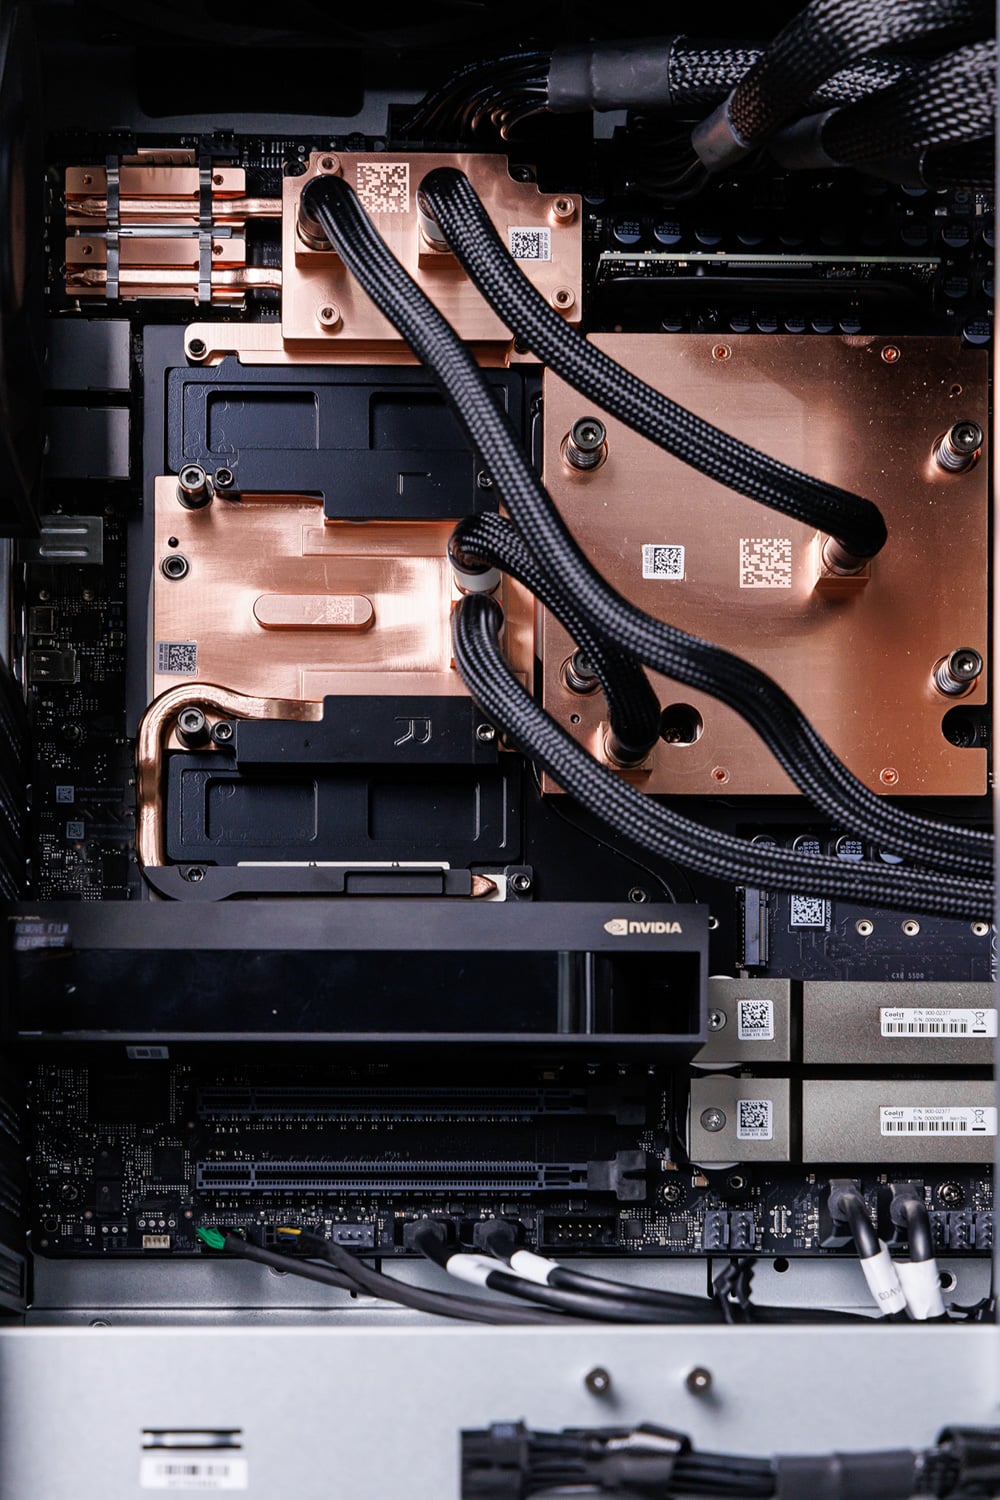
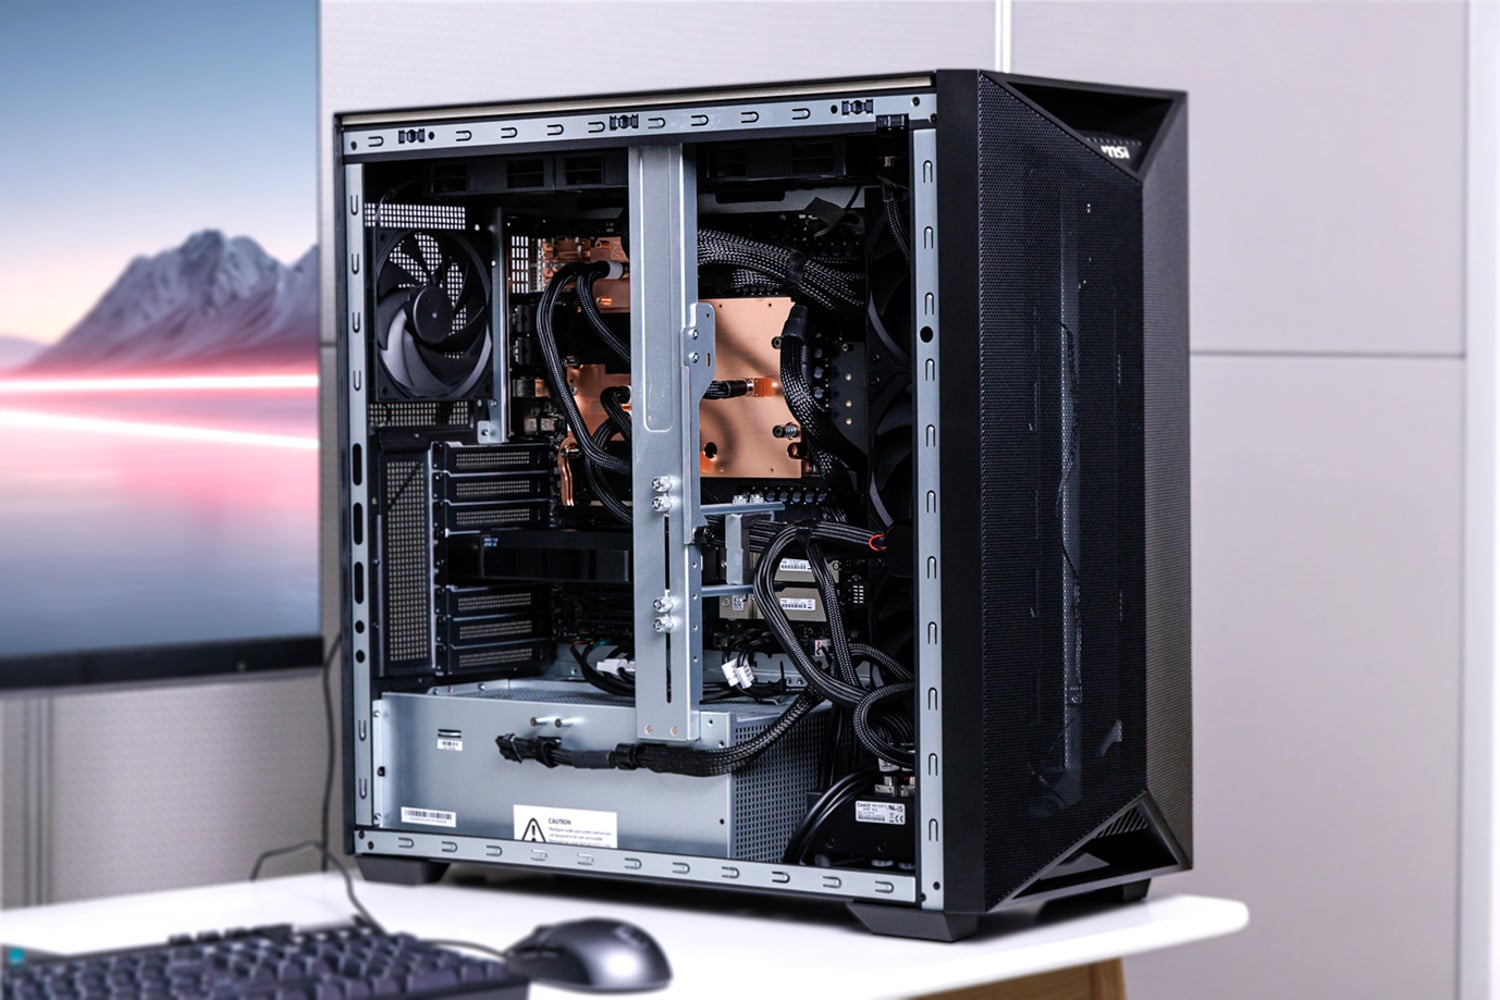
Vid första anblicken ser XpertStation ut som en vanlig modern arbetsstation med en elegant professionell design. Ta bort sidopanelen, och likheten slutar där.
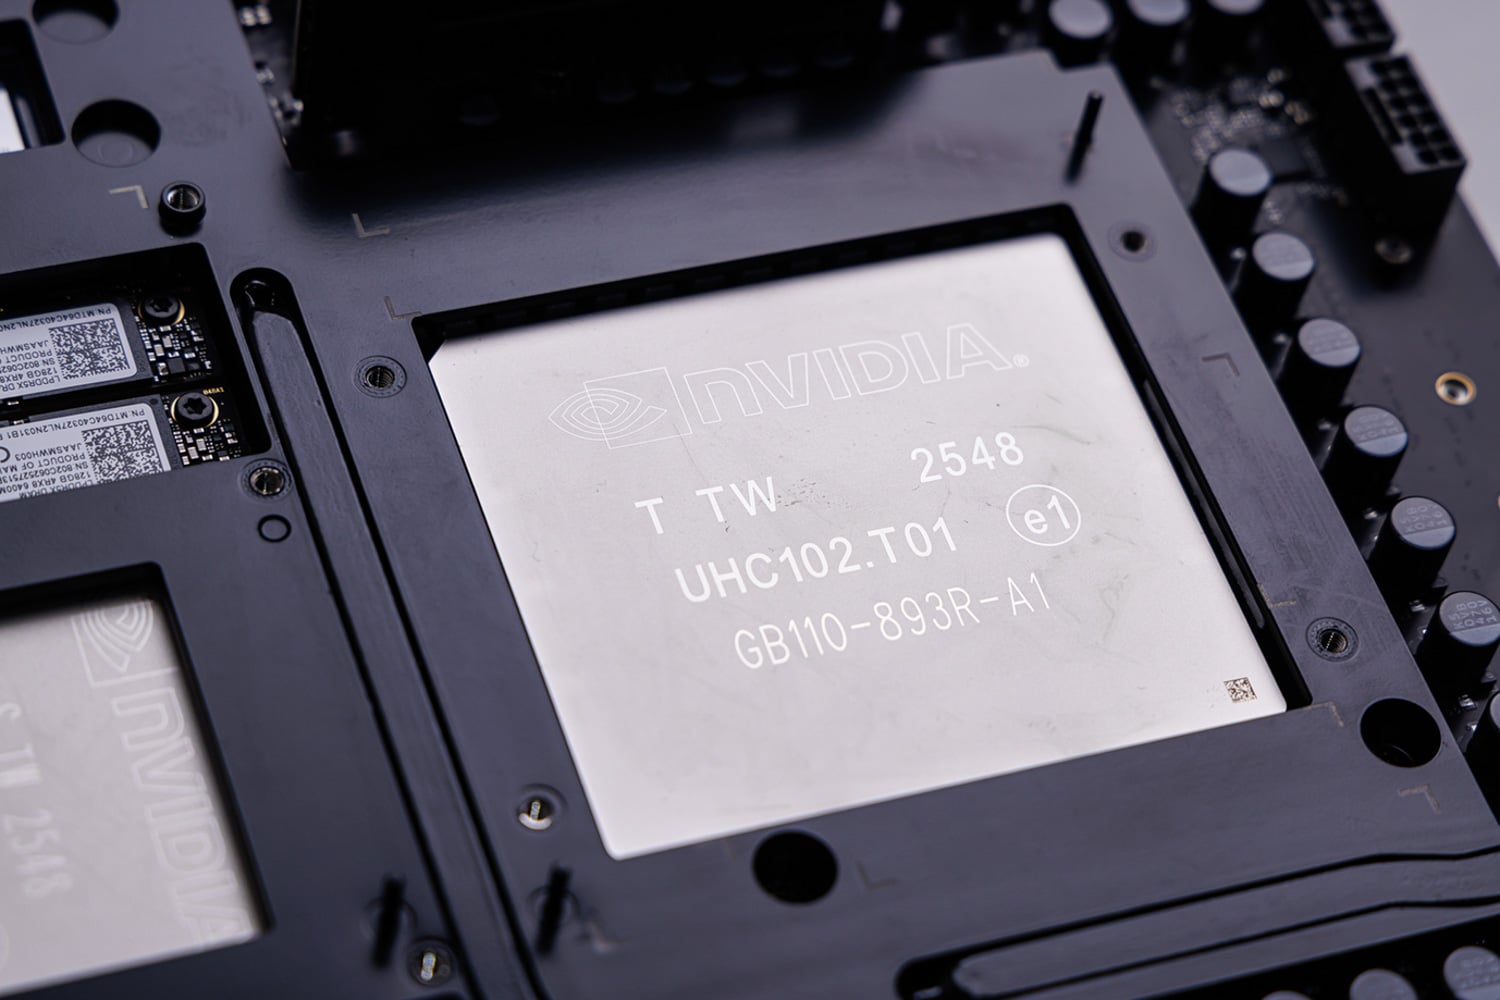
GB300 Grace Blackwell Ultra Desktop Superchip
I mitten av WS300 finns vår stjärna: NVIDIAs B300 GPU, byggd på Blackwell Ultra-arkitekturen.
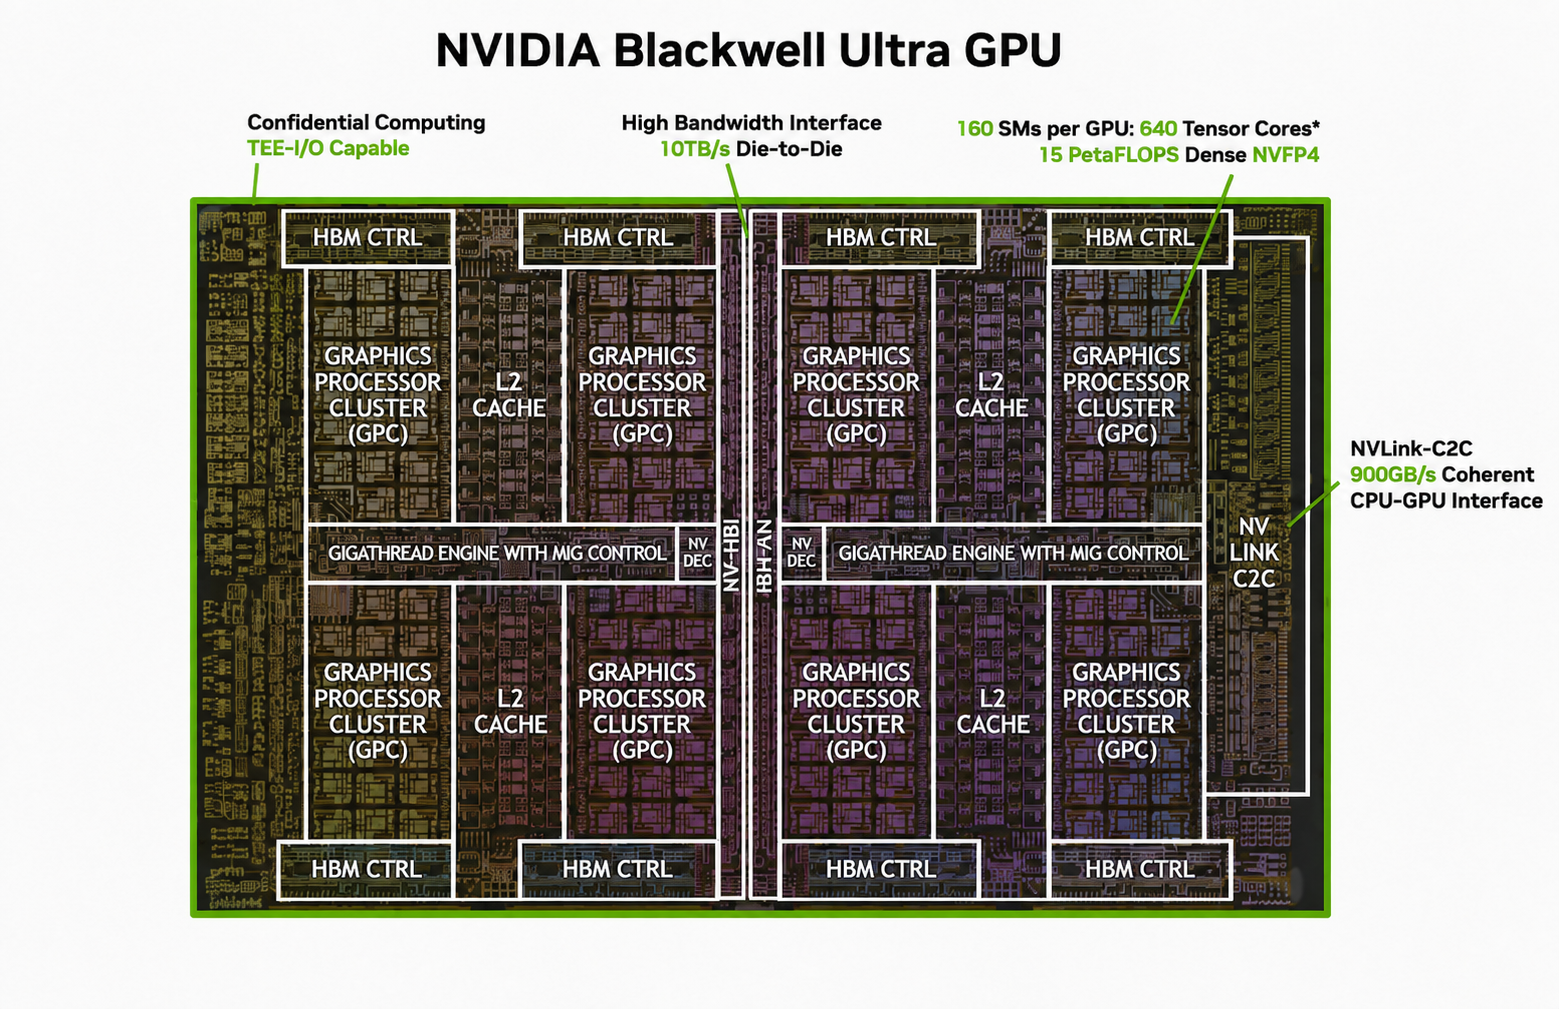
Källa: NVIDIA, kommenterad av StorageReview
B300 är en av de mest avancerade grafikprocessorerna som finns tillgängliga idag, med en dubbelriktad design byggd på TSMC:s 4NP-process. De två kretsarna är sammankopplade av NVIDIA:s 10TB/s NV-HBI krets-till-krets-gränssnitt, vilket gör att grafikprocessorn kan fungera som en enda CUDA-accelerator. B300 som används i DGX Station är baserad på Blackwell Ultra-designen med 208 miljarder transistorer, med upp till 160 SM och 640 femte generationens Tensor-kärnor. Den har också 252 GB HBM3e med 7.1 TB/s minnesbandbredd. Som en datacenterkomponent saknar B300 normal skärmutgång och NVENC-hårdvarukodare. Den inkluderar dock sju NVDEC-motorer och sju nvJPEG-avkodare. Grafikprocessorn stöder också MIG, vilket gör att den kan partitioneras i så många som sju isolerade instanser. Sett till beräkningar erbjuder B300:
| Precision | Peak Performance |
|---|---|
| B300 Beräkningsprestanda | |
| NVFP4 Tensorkärna | 20 PFLOPS gles / 15 PFLOPS tät |
| FP8 / FP6 Tensorkärna | 10 PFLOPS |
| INT8 Tensor Core | 330 TOPS |
| FP16 / BF16 Tensorkärna | 5 PFLOPS |
| TF32 Tensor Core | 2.5 PFLOPS |
| FP32 | 80 TFLOPS |
| FP64 / FP64 Tensorkärna | 1.3 TFLOPS |
| Toppfrekvenser baseras på GPU-boostklocka. Tensor Core-specifikationer använder sparsity om inget annat anges. | |
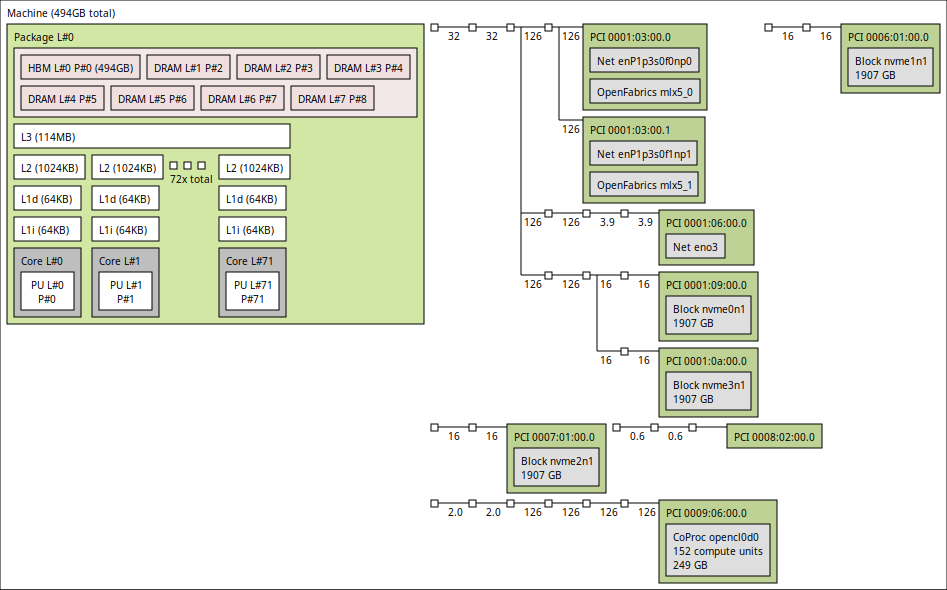
Tillsammans med B300 finns Grace, NVIDIAs första datacenter-CPU. Den använder 72 Arm Neoverse V2-kärnor, men den omgivande processorn är NVIDIAs egen design, inklusive cachehierarkin, minneskontroller, system-I/O, Scalable Coherency Fabric och NVLink-C2C-gränssnittet. Grace exponerar 72 kärnor och 72 hårdvarutrådar, där varje kärna implementerar Armv9 med kryptografiska tillägg och fyra 128-bitars SVE2-vektorenheter. Kärnan har en sexvägs instruktionsavkodare som kan skicka upp till åtta instruktioner per klocka, sex skalära ALU:er, 64KB vardera av L1-instruktions- och datacache, och 1MB privat L2. Över hela kretskortet delar processorn 114 MB L3-cache.
Kärnorna och L3-cacheskivorna är anslutna via NVIDIAs Scalable Coherency Fabric, en mesh-koppling med 3.2 TB/s bisektionsbandbredd. Strukturen ansluter även CPU-kärnorna till minne, system-I/O och NVLink-C2C-gränssnittet, vilket ger Grace den dataförflyttningsbandbredd som behövs för att hålla B300 matad. I WS300 hanterar Grace CPU-sidans arbete kring acceleratorn: GPU-kärnstarter, datainläsning, förbehandling, tokenisering och modellorkestrering. Topologivyn nedan ger en tydlig titt på single-socket-designen, med en 72-kärnig Grace-processor och plattformsenheterna anslutna runt den.
Grace är parat med 496 GB LPDDR5X-minne, vilket ger 396 GB/s bandbredd. Istället för att löda minnet direkt på baskortet använder DGX Station fyra SOCAMM-moduler. SOCAMM, eller System-on-Chip Advanced Memory Module, paketerar LPDDR5X i ett kompakt, avtagbart format. Detta gör att plattformen kan behålla bandbredds- och energieffektivitetsfördelarna hos LPDDR5X samtidigt som minnet blir servicebart. En trasig modul kan bytas ut utan att hela baskortet behöver bytas ut.
Grace och B300 kopplas samman av NVIDIAs NVLink-C2C-gränssnitt, en sammankoppling på paketnivå som levererar 900 GB/s dubbelriktad bandbredd, ungefär sju gånger så mycket som en PCIe Gen5 x16-anslutning. Den viktigaste skillnaden är minneskoherens. I en konventionell arbetsstation upprätthåller processorn och den separata grafikprocessorn separata minnesutrymmen, där data kopieras mellan dem via PCIe. Med NVLink-C2C delar Grace och B300 ett koherent adressutrymme, vilket gör att varje processor kan komma åt minne som är anslutet till den andra processorn direkt.
Resultatet är ett koherent adressutrymme på 748 GB, inte ett block av HBM på 748 GB. B300 har 252 GB HBM3e som levererar 7.1 TB/s, medan Grace bidrar med 496 GB LPDDR5X med 396 GB/s. Data som lagras i Grace-minnet måste fortfarande korsa C2C-länken, så HBM är fortfarande den bästa platsen för ofta åtkomna modellvikter, tensorer och buffertar. Grace-minnet fungerar istället som en högkapacitetsnivå, vilket gör att arbetsbelastningar som överstiger B300:s 252 GB lokala minne kan finnas kvar på ett system istället för att delas upp över flera GPU:er. Vi kommer att mäta prestandapåverkan av att korsa till den andra minnesnivån senare i testavsnittet.
Systemtopologi
Med utgångspunkt från GB300-paketet visar MSIs blockdiagram hur resten av systemet ansluts runt Grace. Processorn sitter i mitten av I/O-topologin, med två PCIe 5.0 x4 M.2-kortplatser direkt anslutna till den. MSI fyller dessa med ett par 2TB Micron 4600 SSD-diskar konfigurerade i RAID 1 för operativsystemet och NVIDIA-programvarustacken. De tre fullängds-expansionskortplatserna kommer också direkt från Grace, med en PCIe 5.0 x16-länk och två PCIe 5.0 x8-länkar.
MSI har också förberett chassit för ett stort tilläggs-GPU. En förkopplad 12VHPWR-strömkabel är lätt att nå på chassits framsida, vilket gör att man slipper dra ytterligare en kabel genom systemet. Det vertikala metallstödet som förstärker chassit har också ett anti-sag-fäste för att stödja långa, tunga RTX PRO-kort.
En USB-kontroller på Grace-sidan hanterar systemets huvudsakliga främre och bakre USB-portar, tillsammans med ljudkodeken. Grace ansluts också till ASPEED AST2600 BMC, som har en dedikerad 1GbE-hanteringsport, en Mini DisplayPort-utgång begränsad till 1024 x 768 och en Micro-USB-seriell konsol. Mini DisplayPort är avsedd för initial installation och felsökning, inte som systemets primära bildskärmsutgång. Alla som planerar att använda WS300 som en vanlig stationär dator behöver fortfarande ett av de valfria RTX PRO-tilläggskorten.
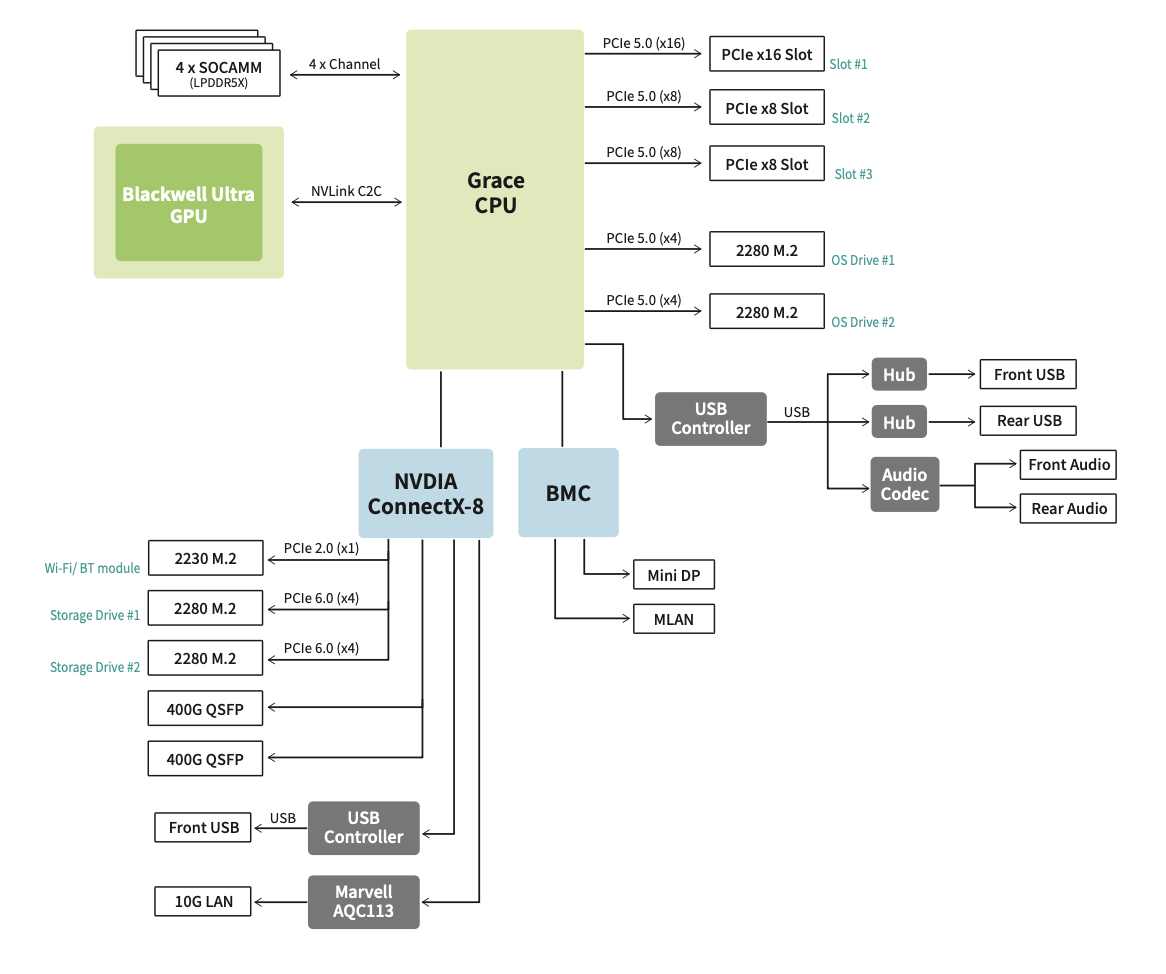
Den andra stora grenen är NVIDIAs ConnectX-8 SuperNIC. Dess mest synliga funktion är paret med 400GbE QSFP112-portar på bakpanelen, vilket ger upp till 800Gb/s aggregerad nätverksbandbredd. ConnectX-8 inkluderar också en integrerad PCIe-switch med 48 banor; dess uppströmslänk är PCIe Gen6-kompatibel, men nedströmsportarna som den exponerar för enheter körs på PCIe 5.0, vilket gör att MSI kan använda den som en sekundär I/O-hubb snarare än bara ett nätverkskort.
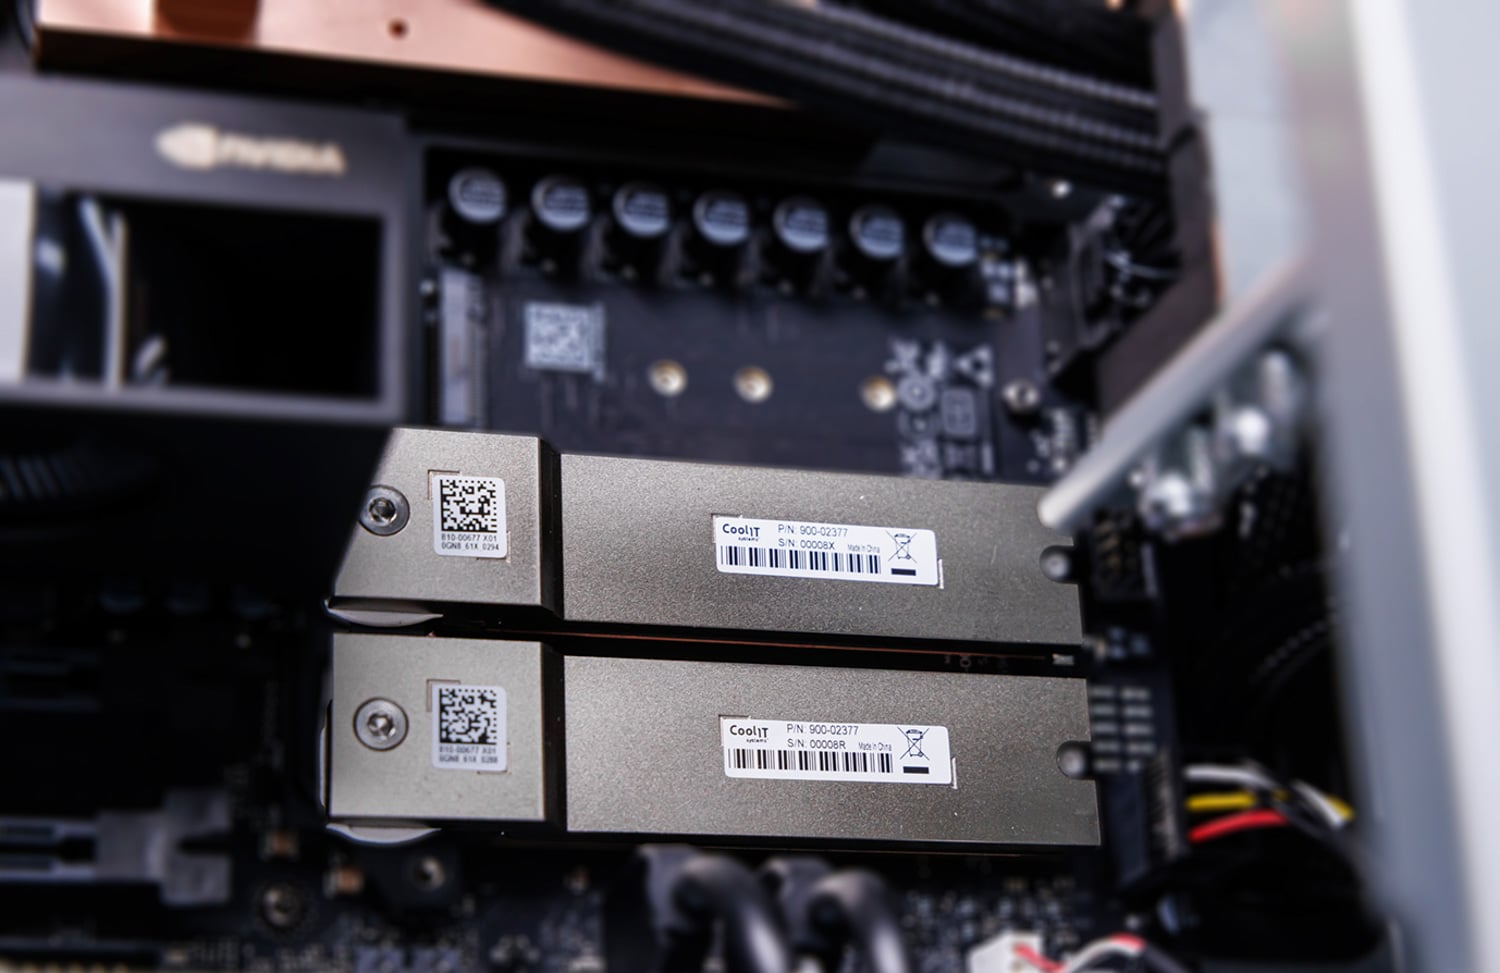
Två PCIe 5.0 x4-länkar från ConnectX-8 matar de återstående M.2 2280-kortplatserna, som MSI lämnar öppna för expansion. Samma gren ansluter även M.2 2230 Wi-Fi- och Bluetooth-kortplatsen via PCIe 2.0 x1, Marvell AQC113-kontrollern för 10GBase-T-porten och en andra USB-kontroller som betjänar en ytterligare USB-väg på frontpanelen.
Kraft och kyla
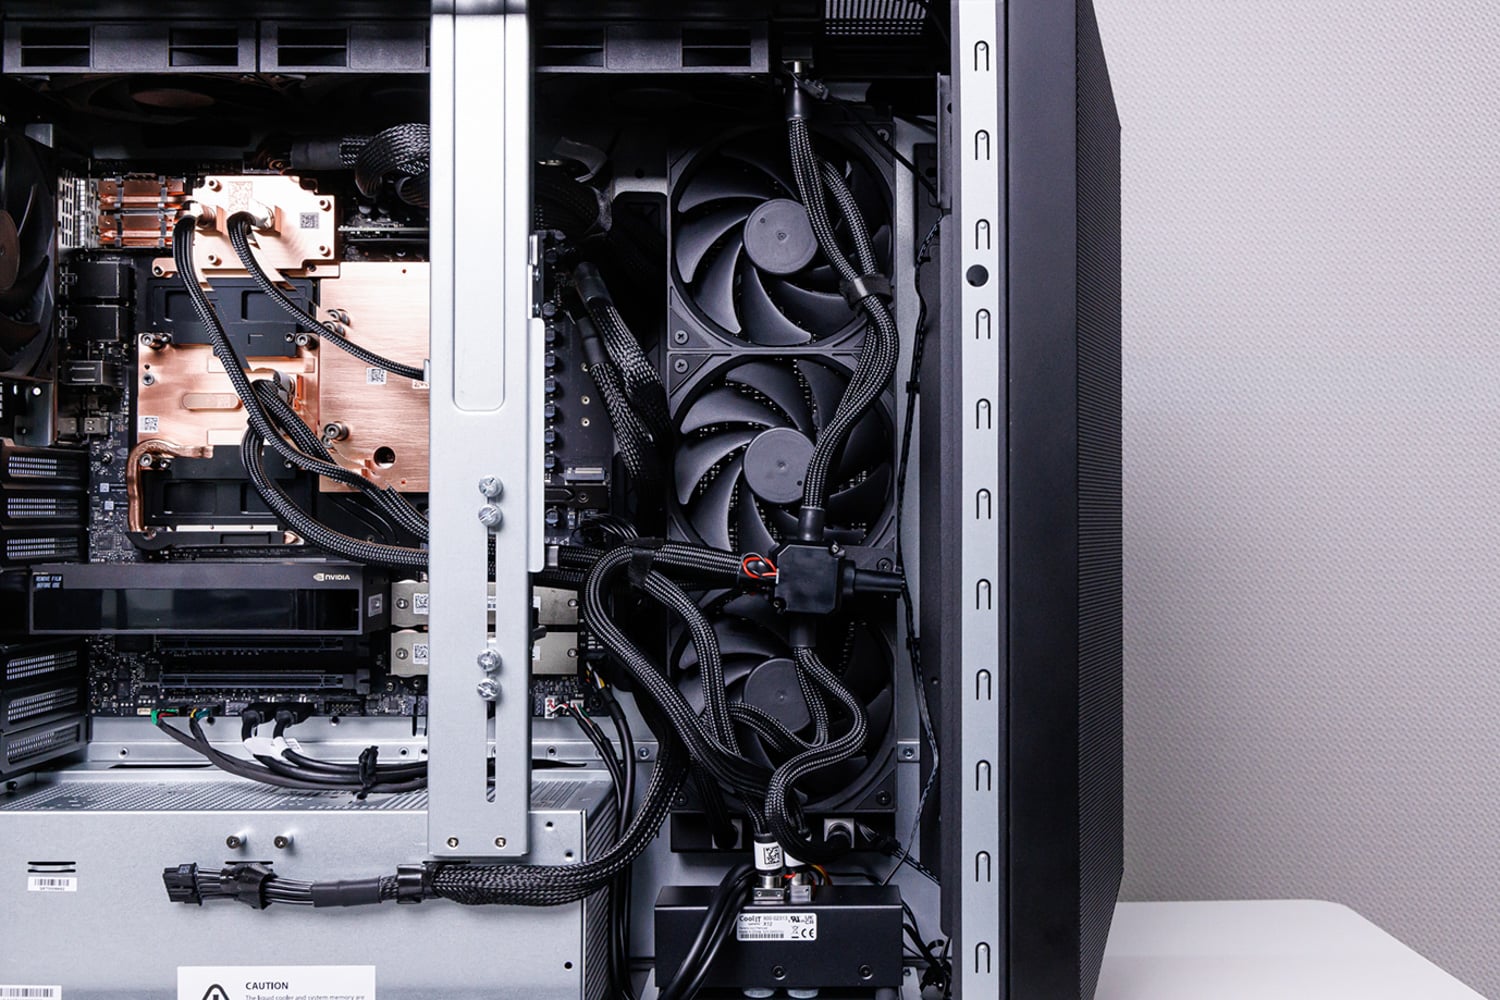
WS300 drivs av ett enda 1 600 W 80 PLUS Platinum ATX-nätaggregat med en C19-ingång. För nordamerikanska installationer kräver DGX Station en dedikerad 20A-krets för att förse systemet med sin fulla effekt.
1 600 W-effekten är maxeffekten för hela systemet. Grace, B300, lagring, pumpar, fläktar och eventuella valfria RTX PRO-kort använder alla samma strömförsörjning. Att lägga till ett kraftfullt grafikkort utökar WS300:s kapacitet, men det använder inte en annan strömkälla. När både B300 och RTX-kortet är belastade måste de dela på det som redan finns tillgängligt, vilket kan minska prestandan hos B300 GPU.
MSI hanterar den resulterande termiska belastningen med en specialanpassad vätskeslinga som täcker B300, Grace-processorn, SOCAMM-minnet och ConnectX-8, inklusive de optiska burarna. Värme skickas genom två 360 mm radiatorer, medan en separat 120 mm fläkt flyttar luft genom resten av chassit. MSI klassar kylaggregatet för upp till 1 400 W över processorn och grafikkortet. Under våra tester nådde B300:s temperatur en topp på 71 °C medan processorn aldrig blev varmare än 65 °C vid en strömförbrukning på 1 292 W för grafikkortet.
Kraftskvalpande
NVIDIA hanterar den delade budgeten via vsloshd-tjänsten. I sitt dynamiska standardläge övervakar tjänsten strömförbrukningen i realtid för GB300-modulen och ett valfritt RTX PRO-kort, och flyttar tillgängligt headroom mellan dem istället för att hålla varje enhet till en fast gräns. Enligt den nuvarande policyn prioriteras RTX-kortet, så när det behöver mer ström sänker systemet först GB300:s strömgräns innan det höjer RTX-gränsen. Utan något RTX-kort installerat förblir hela policybudgeten tillgänglig för GB300-modulen.
Det betyder att det valfria RTX PRO 6000-kortet inte bara ger extra prestanda utöver B300. När båda grafikkorten är upptagna tas strömmen som tilldelas RTX-kortet direkt från GB300:s budget och kan minska B300:s klockfrekvens och prestanda.
Plattformen inkluderar även en hårdvarubaserad strömbroms för fall där systemet upptäcker försämrad strömförsörjning. Vi såg detta under vårt praktiska arbete när lösa strömkontakter fick WS300 att sänka sin strömgräns istället för att stänga av eller fortsätta att dra full ström via en komprometterad anslutning. Maskinen förblev online i reducerat strömläge tills anslutningsproblemet var åtgärdat.
Anslutningar
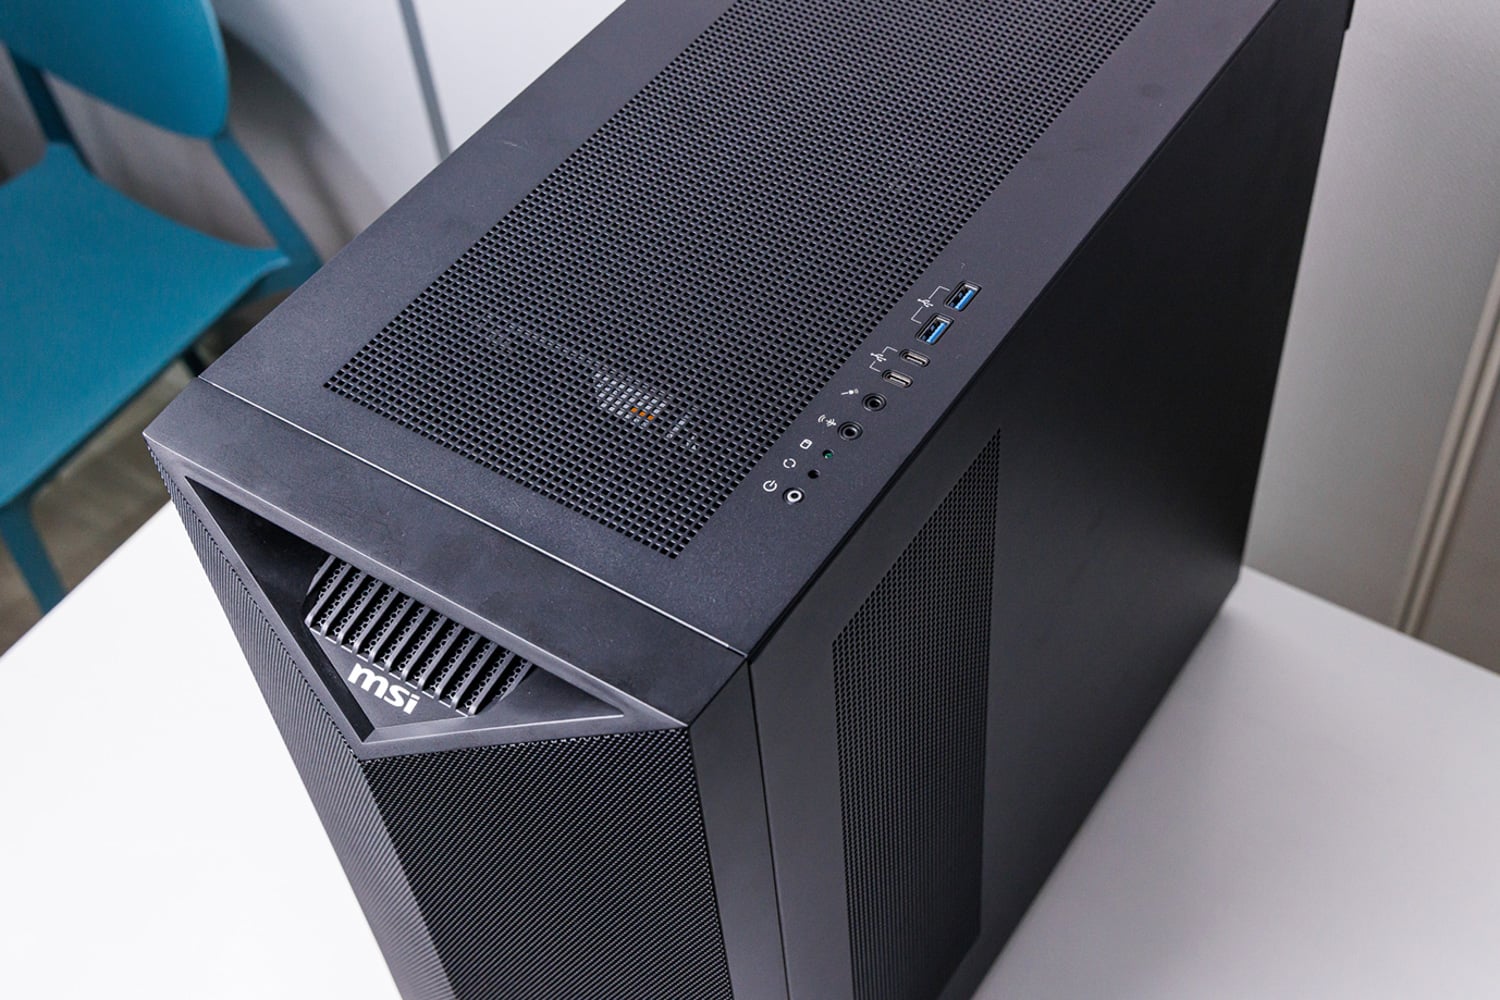
Innan vi går vidare från chassit är de främre och bakre I/O-portarna värda en snabb titt. De främre I/O-portarna består av två USB 3.2 Gen 2 Type-A-portar, två USB 3.2 Gen 2 Type-C-portar, separata linjeutgångar och mikrofonuttag samt ström- och återställningskontroller.
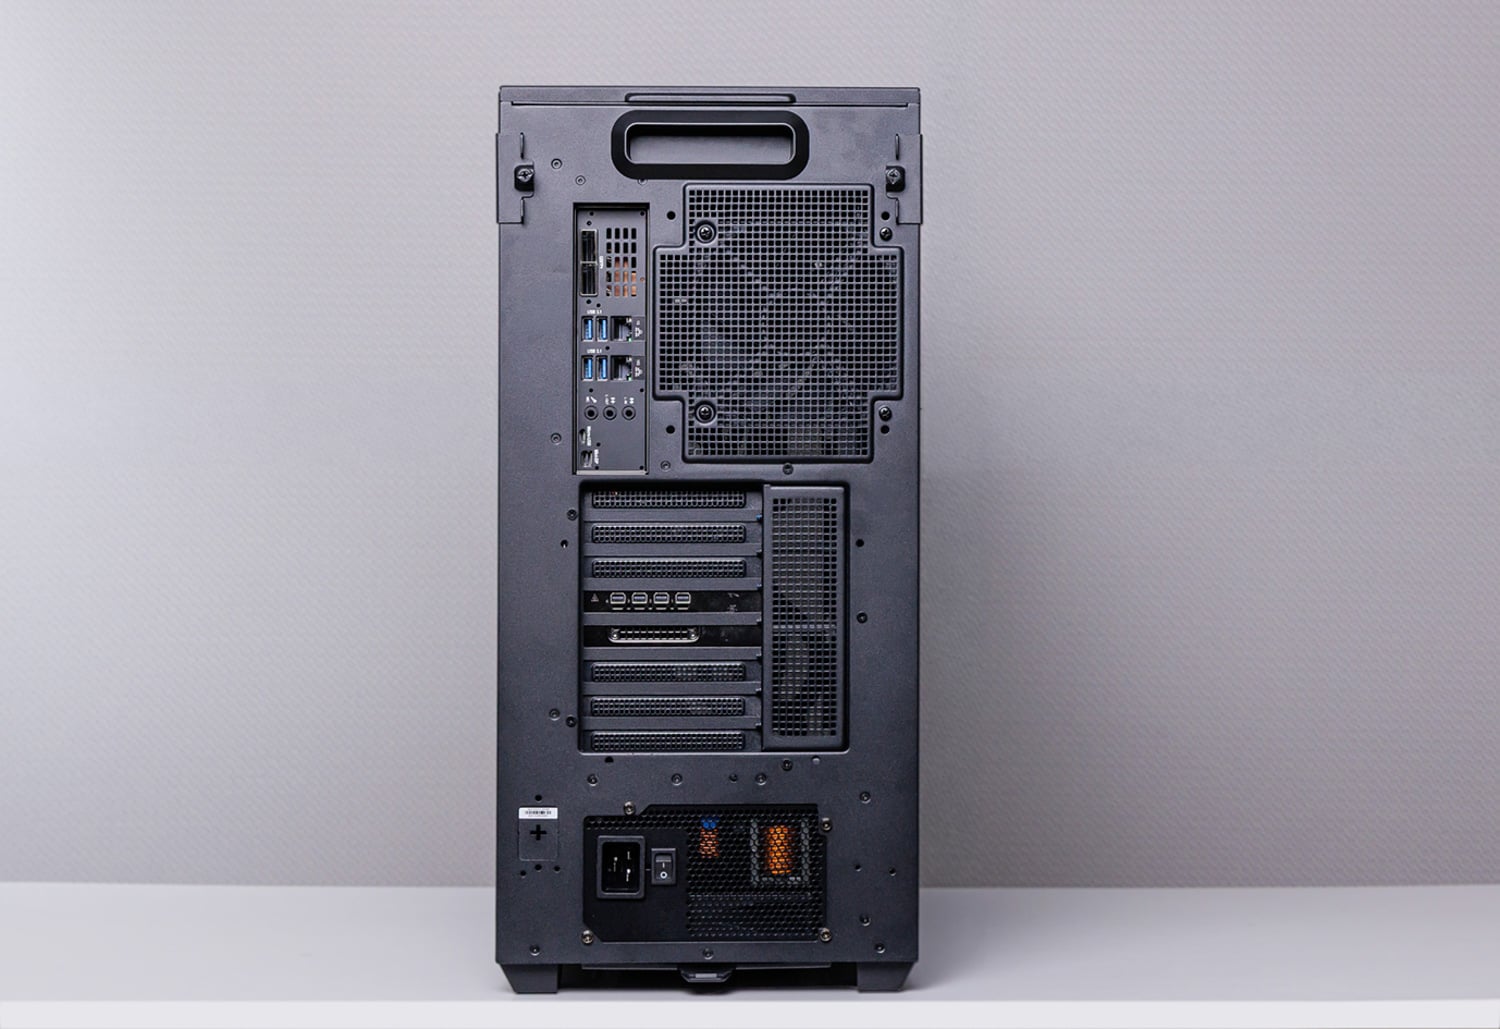
Bakpanelen är uppdelad mellan arbetsstationsanslutning och serverhårdvaran under. ConnectX-8 har två 400GbE QSFP112-portar, medan en separat 10GBase-T-port hanterar normal värdnätverkshantering och en dedikerad 1GbE-port ansluts till BMC. Fyra 10Gbps USB Type-A-portar och tre ljuduttag täcker lokala kringutrustningar. BMC har också en Micro-USB-seriekonsol och en Mini DisplayPort. C19-strömintaget sitter längst ner på chassit, och Wi-Fi 6E eller Wi-Fi 7 med Bluetooth kan läggas till via den interna M.2 2230 Key-E-porten.
Datacenterarbetsbelastningar på skrivbordet
Allt hittills har beskrivit vad DGX Station är; den mer användbara frågan för köpare är vad XpertStation gör det möjligt för ett team att göra. Värdet av WS300 blir tydligare när man behandlar den som en utvecklingsplattform snarare än bara ett högkapacitetsinferenssystem. Dess B300 GPU, Grace CPU, MIG-stöd, valfri RTX PRO-grafik och datacenterprogramvarustack samlar flera arbetsflöden som normalt skulle vara beroende av delad klusterhårdvara på en enda lokal nod.
MIG som ett utvecklingsverktyg
Tänk dig att köra flera helt separata jobb på en GPU samtidigt, vart och ett avskilt från de andra. Det är vad Multi-Instance GPU (MIG) gör: den segmenterar B300 rumsligt i hårdvaran i så många som sju lika stora skivor, eller instanser. Varje instans får sin egen fasta andel av SM, HBM, cache och minnesbandbredd, bär sin egen enhetsidentitet och visas för CUDA som en separat GPU.
Detta gör det möjligt att utveckla, testa och validera arbetsbelastningar med flera GPU:er; träna skript; och utveckla för verktyg som Dynamo, LLM-D, etc.
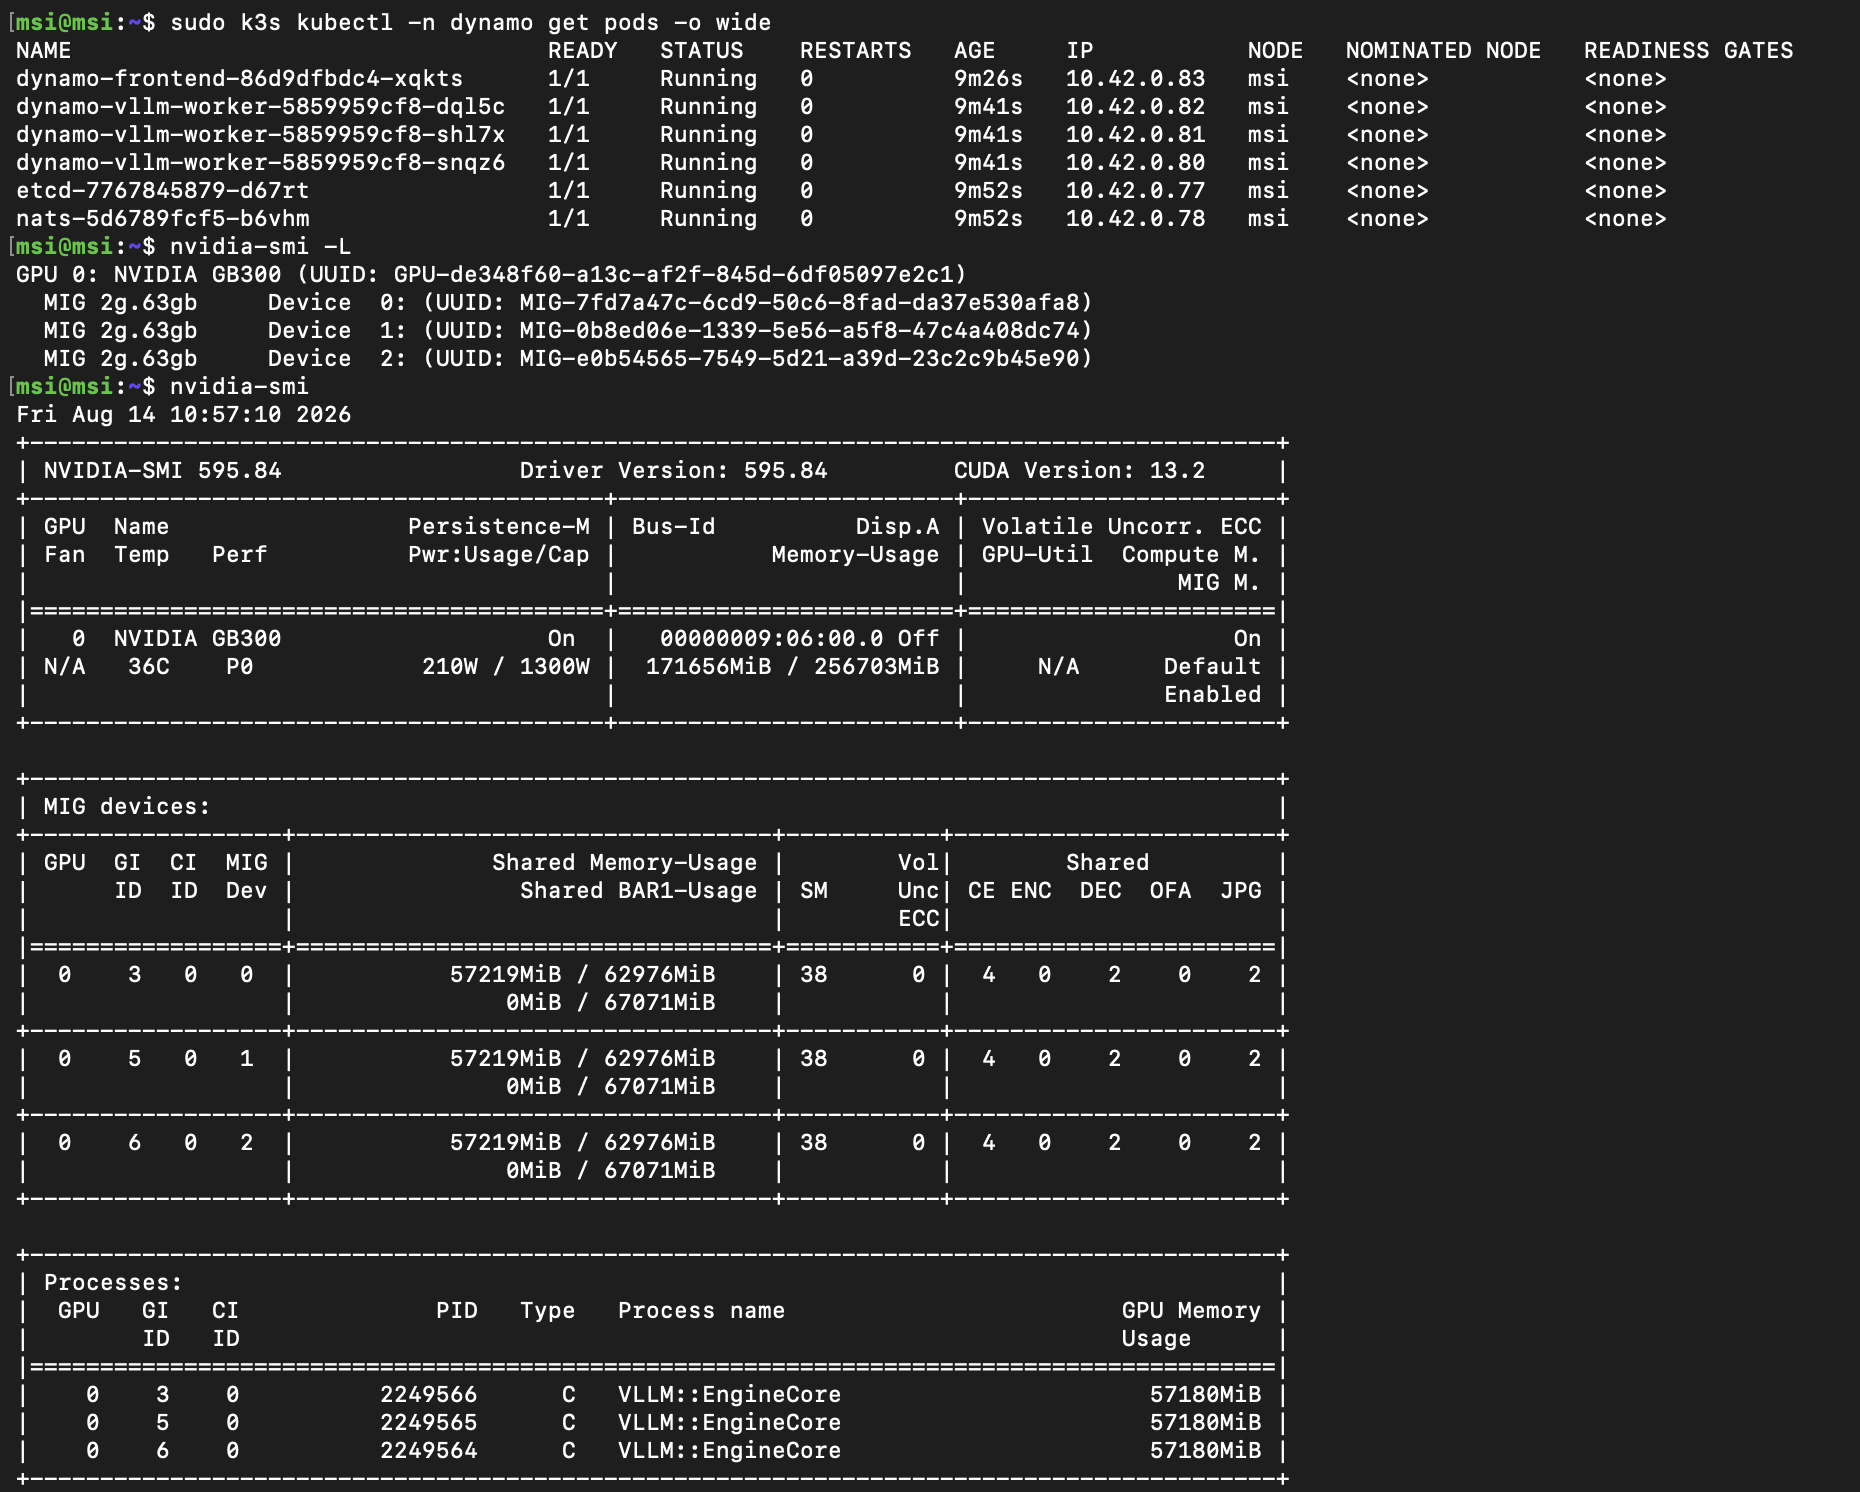
För våra tester konfigurerade vi B300 med 3x MIG-instanser och använde dem för att starta NVIDIA Dynamo-komponenter på separata CUDA-synliga enheter. Detta speglar hur mycket av våra egna benchmarkverktyg byggs: att validera att de beter sig exakt som avsett innebär att man itererar mot riktig hårdvara om och om igen. Att ha en lokal B300 som vi kan dela upp och konfigurera om, utan att schemalägga tid på en delad server, och utan strömförbrukning, värme och buller från ett rack i rummet, eliminerar en förvånansvärt stor mängd omkostnader från den typen av iterativt arbete.
Isaac GR00T och den fysiska AI-slingan
Ett annat arbetsflöde som passar DGX Station särskilt bra är fysisk AI.
Vi har testat den här typen av arbetsflöde tidigare , men det krävde flera system utrustade med olika klasser av grafikkort. DGX Station sammanför dessa tidigare separata steg i en enda bordsmaskin.
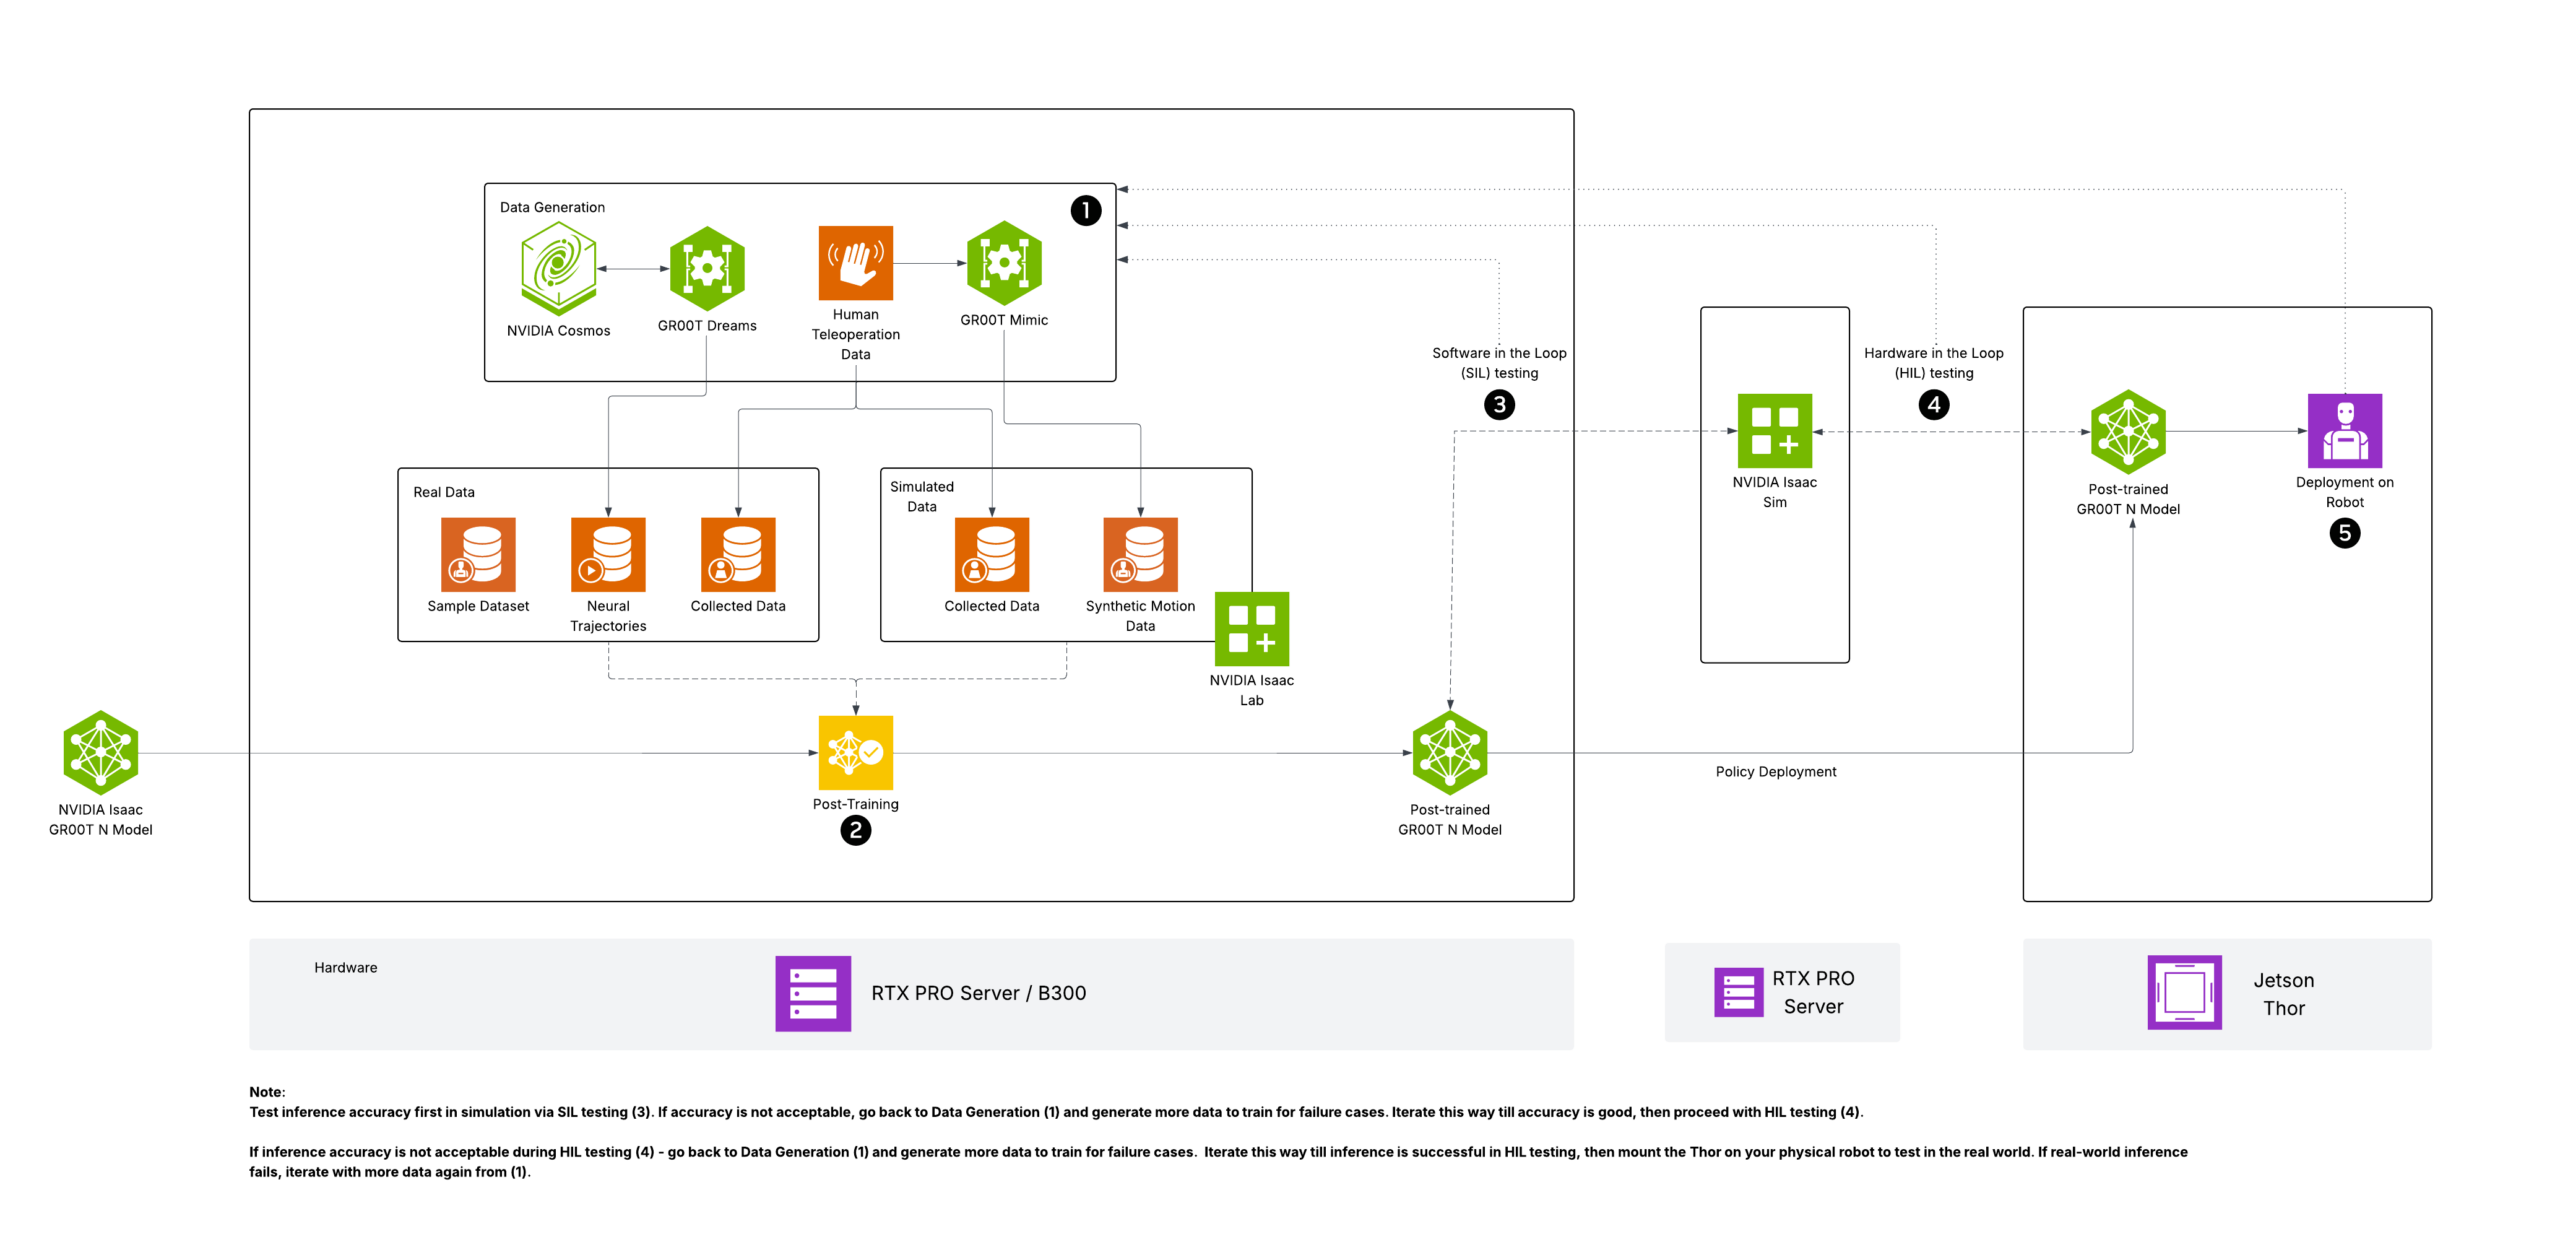
Processen börjar med teleoperation: en operatör guidar roboten genom en uppgift för att fånga en liten uppsättning verkliga demonstrationer. Dessa exempel matas sedan in i Isaac GR00T:s arbetsflöde. Den valfria RTX PRO GPU hanterar grafik- och strålspårningskraven från Isaac Sim, medan Isaac Lab och GR00T-Mimic utökar de ursprungliga demonstrationerna till en mycket större samling av fysiskt rimliga syntetiska banor. Slutligen finjusterar B300 GR00T-modellen med hjälp av den kombinerade verkliga och syntetiska datamängden.
Källa: NVIDIA
Efter finjustering kan den resulterande policyn valideras i simulering innan den distribueras till roboten för verklig utvärdering. Det skapar en snäv utvecklingsloop: spela in en verklig demonstration, reproducera och variera den i simulering, omträna modellen och testa den uppdaterade policyn på hårdvaran. För team med begränsad tillgång till robotar, operatörer eller datainsamlingsfönster kan konsolidering av simulering, generering av syntetiska data och modellträning i ett enda skrivbordssystem avsevärt minska friktionen vid varje iteration.
Blackwell Ultra-kärnutveckling
Det bästa användningsfallet för DGX Station är dock utan tvekan kärnoptimering. När ett team skriver CUDA- eller Triton-kärnor för Blackwell Ultra finns det inget alternativ till att köra på målarkitekturen. WS300 ger utvecklaren en B300 och 252 GB HBM3e, vilket gör det möjligt att profilera verkliga arbetsbelastningar, inspektera minnesbeteende, finjustera Tensor Core-sökvägar, säkra operationer och iterera utan att boka tid på en server med åtta GPU:er eller ett racksystem.
Större system är fortfarande viktiga, men de kan reserveras för arbete som kräver dem: NVLink-skalning, NCCL-kollektiv, kommunikationskärnor, multi-GPU-inferens och slutgiltig dataflödesvalidering. WS300 hanterar arbetet med en enda GPU-kärna lokalt, vilket håller dessa dyra delade system tillgängliga för uppskalad testning. För ett team som fokuserar på Blackwell Ultra-optimering är detta ungefär en så direkt utvecklingsmaskin som marknaden erbjuder.
Om DGX Station hade levererats tillsammans med de första Blackwell Ultra-systemen misstänker vi att det ursprungliga utbudet nästan omedelbart skulle ha försvunnit till AI-labb, kompileringsteam, utvecklare av inferensmotorer och andra grupper som kämpar för att finjustera programvara för B300. Även nu kan direktåtkomst till mål-GPU:n vara den tydligaste anledningen för en organisation att köpa en.
Prestanda
Testinformation: Testningen utfördes på distans på ett MSI-hostat system, där StorageReview kontrollerade hela programvarumiljön under hela utvärderingsfönstret. Systemet testades utan ett RTX PRO GPU eller andra PCIe-tilläggskort installerade. Detta lämnade GB300 Superchip med systemets fulla tillgängliga acceleratorkraftbudget under hela testningen.
Maximalt uppnåeliga Matmul FLOPS (MAMF)
För att sätta B300:s beräkningsmodell i ett sammanhang körde vi MAMF på tre Blackwell-generations system. MAMF (Maximum Achievable Matmul FLOPS) är ett praktiskt prestandamått utformat för att mäta de realistiska toppflyttalsoperationerna per sekund som kan uppnås på maskininlärningsacceleratorer under matrismultiplikationsoperationer, vilket erbjuder ett mer exakt riktmärke än de teoretiska toppflyttalsoperationer som ofta annonseras i hårdvaruspecifikationer.
För detta test sveper vi över vart och ett av de tre systemen i BF16, FP8 och NVFP4, och vi rapporterar det bästa ihållande (täta) resultatet per precision.
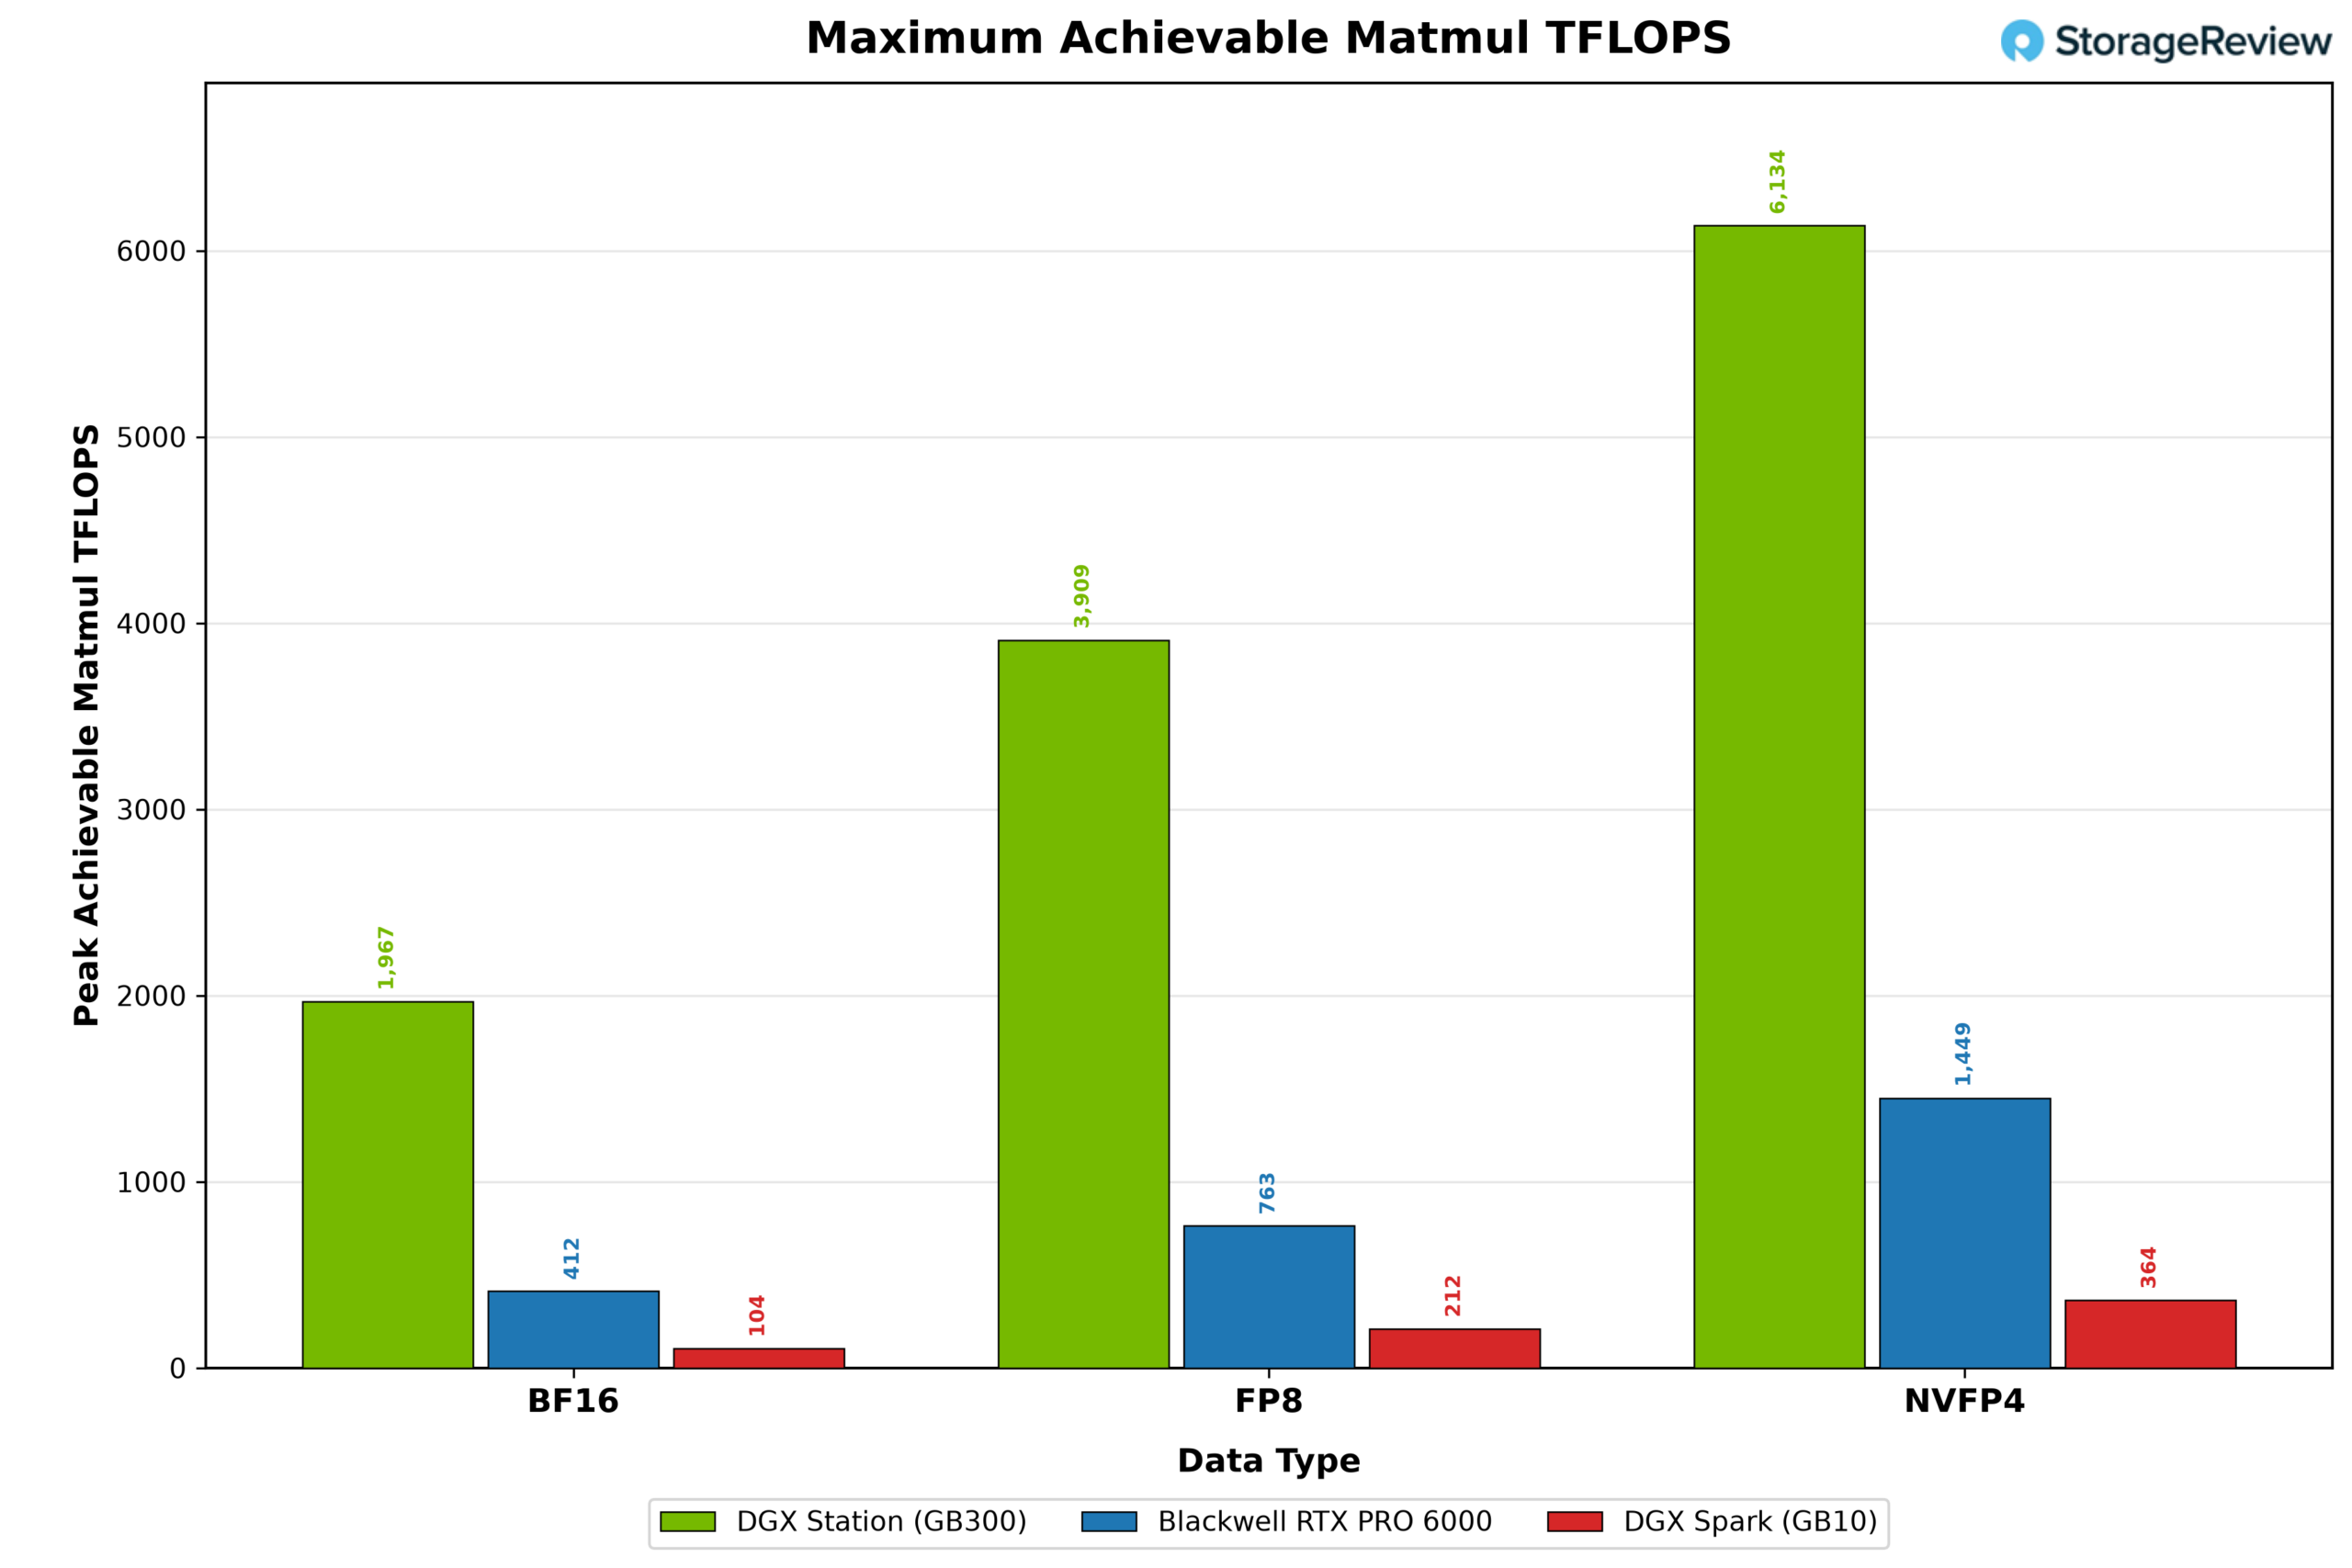
GB300 leder i alla precisioner. I BF16 når den 1 967 TFLOPS mot 412 på RTX PRO 6000 och 104 på DGX Spark . FP8 följer samma mönster: 3 909, 763 och 211. NVFP4 ger GB300 6 134 TFLOPS, med RTX PRO 6000 på 1 449 och Spark på 364. Förhållandena är anmärkningsvärt stabila över alla tre precisioner: GB300 har en fördel på 4 till 5 gånger jämfört med RTX PRO 6000 och 17 till 19 gånger jämfört med Spark, medan RTX PRO 6000 bibehåller ungefär 4 gånger jämfört med Spark.
NVBandbredd
Rå dataflöde för beräkningar är bara användbart om acceleratorn kan hålla sina exekveringsenheter försedda med data. Detta är särskilt viktigt för AI-inferens, där tokengenerering under avkodningsfasen ofta begränsas mer av minnesbandbredd än av tillgängliga FLOPS.
På GB300 Superchip omfattar den hierarkin B300:s lokala HBM3e, Graces LPDDR5X-minne och NVLink-C2C-kopplingen som förbinder dem. NVIDIAs NVBandwidth-verktyg mäter de olika kopieringsvägarna över dessa komponenter och visar både den tillgängliga bandbredden inuti GPU:n och kostnaden för att flytta data mellan GPU:ns och CPU:ns minnesdomäner.
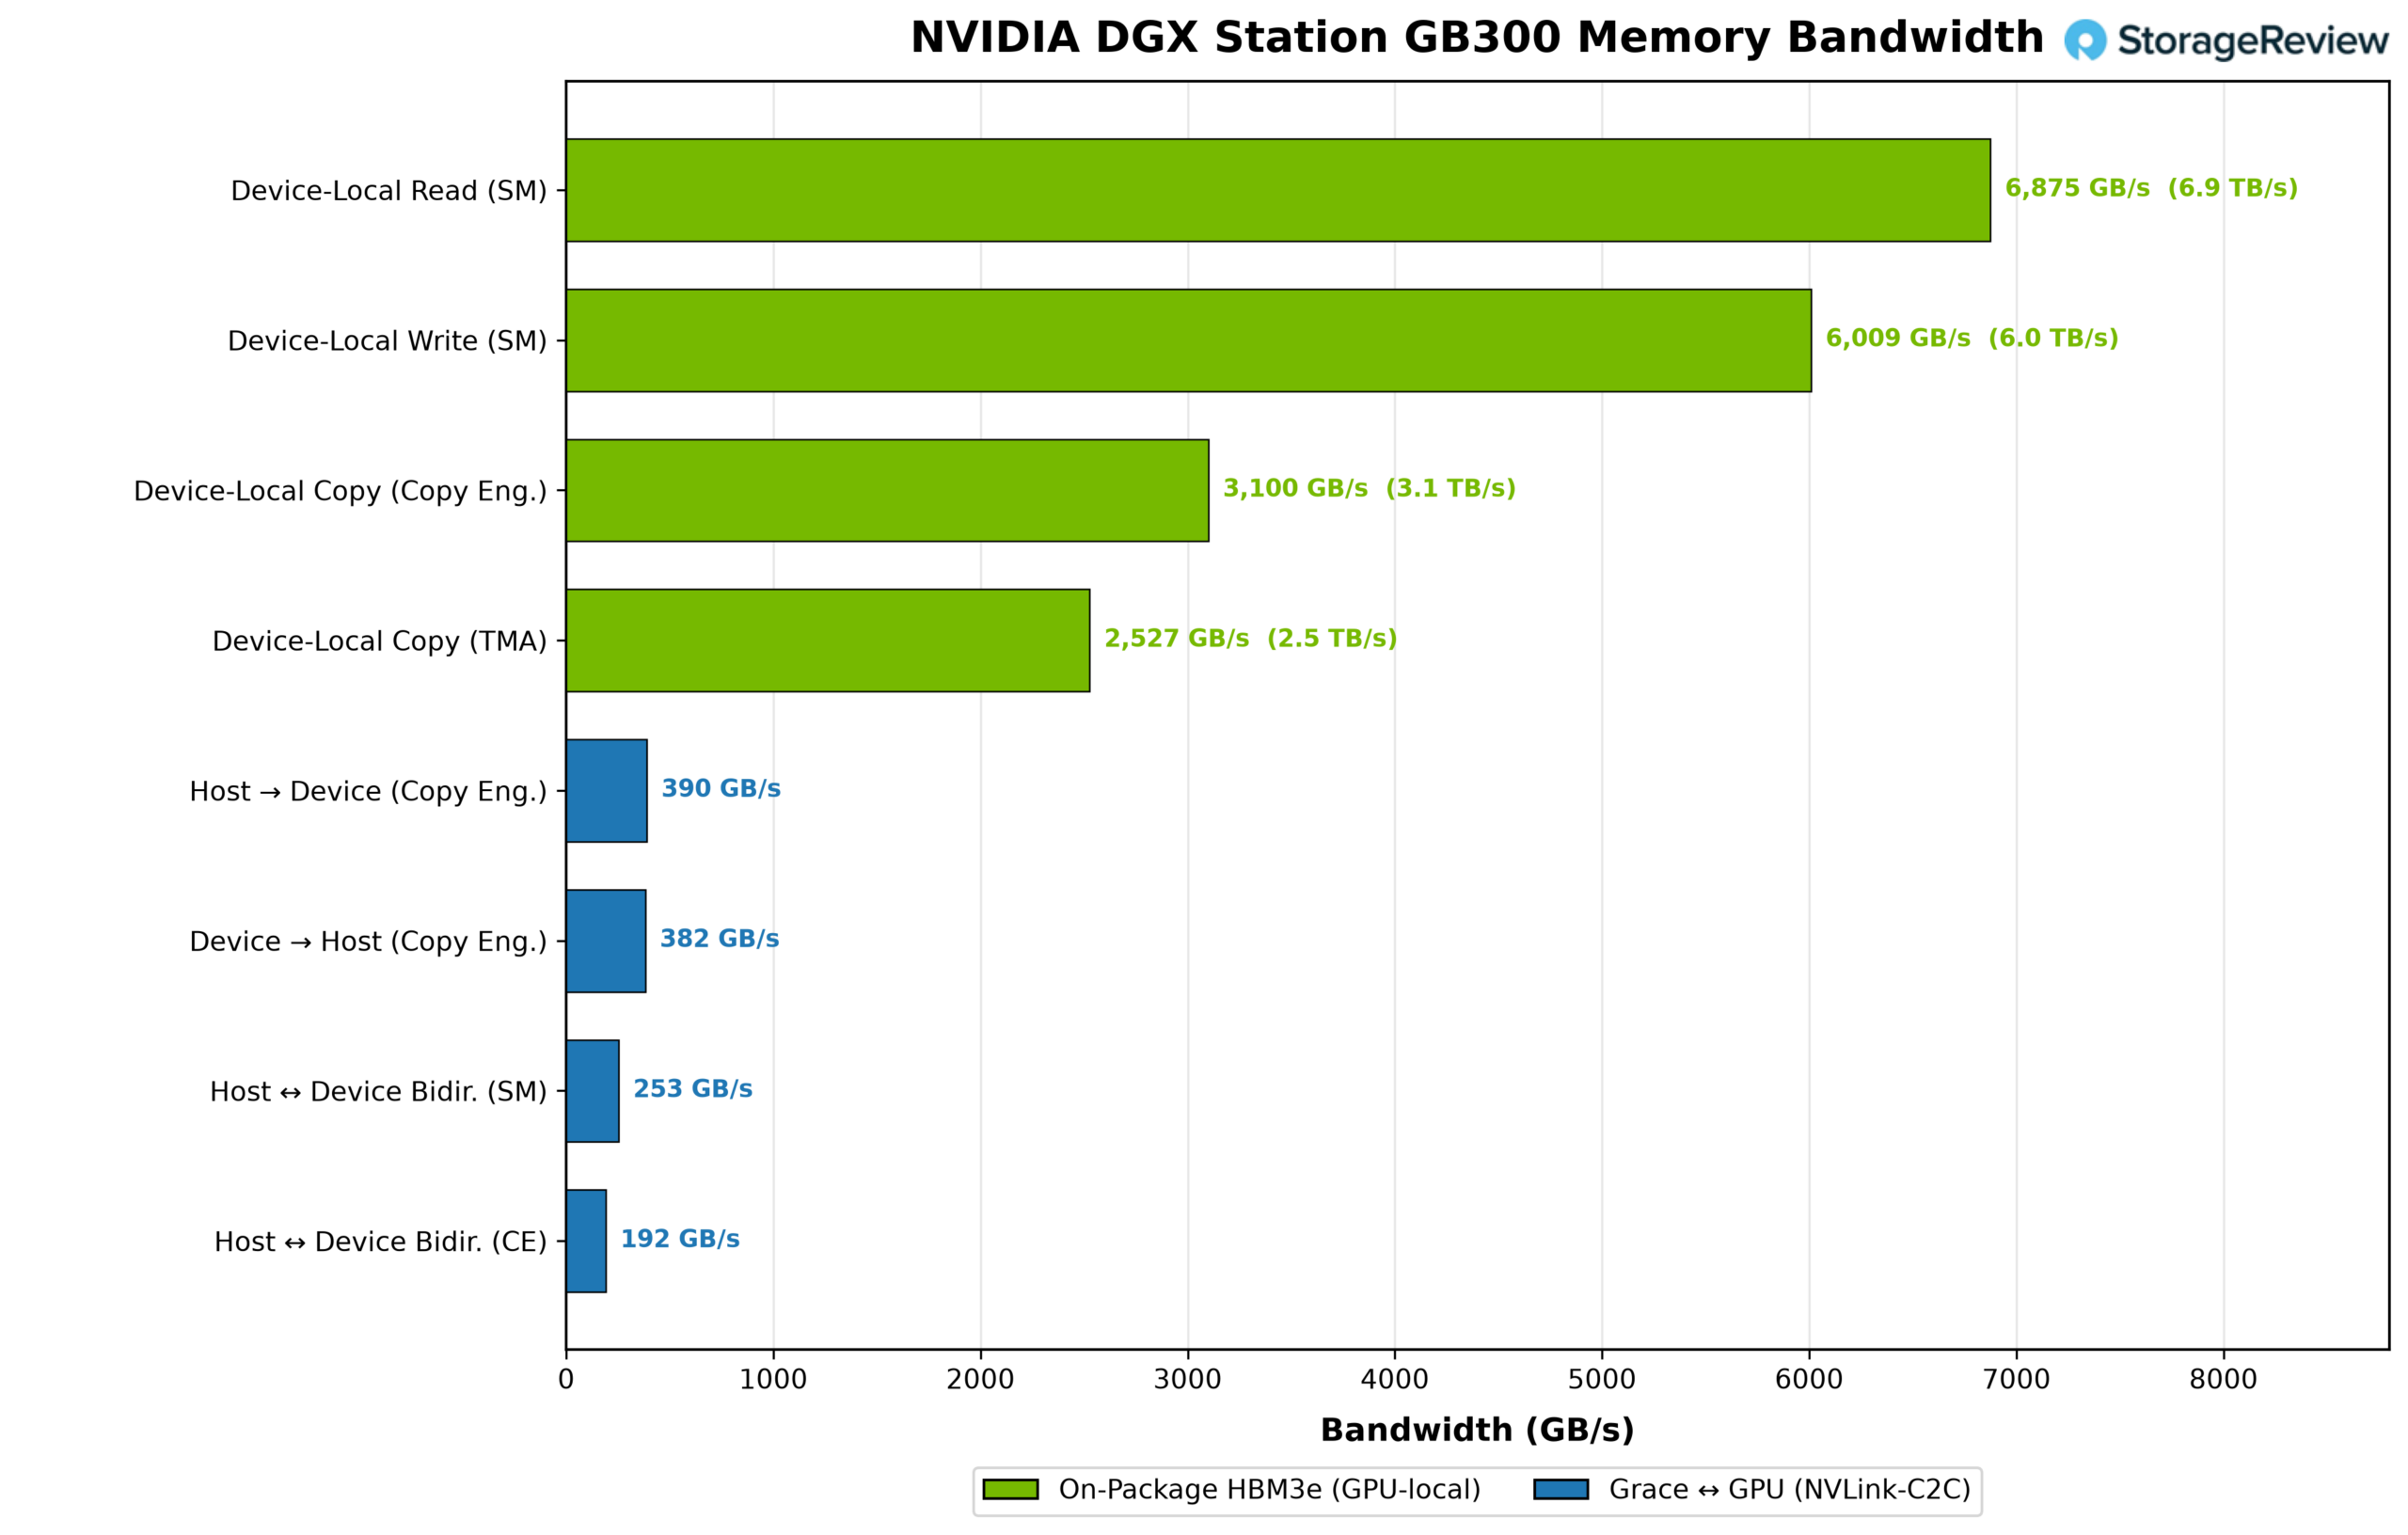
De fyra första testerna mäter dataförflyttning inom B300:s 252 GB HBM3e. Enhetslokala läsningar når 6 875 GB/s, eller cirka 6.9 TB/s, vilket placerar resultatet inom några få procent av GPU:s nominella minnesbandbredd på 7.1 TB/s. Enhetslokala skrivningar når 6 009 GB/s.
Kopieringsoperationer från HBM till HBM är lägre eftersom varje kopia förbrukar bandbredd två gånger: en gång för att läsa källan och en gång för att skriva till destinationen. De dedikerade kopieringsmotorerna når 3 100 GB/s, medan Tensor Memory Accelerator registrerar 2 527 GB/s.
De återstående testerna korsar NVLink-C2C och använder Graces 496 GB LPDDR5X-minne. Överföringar från Grace-minne till B300 HBM når 390 GB/s, medan överföringar i motsatt riktning når 382 GB/s. Även om NVLink-C2C tillhandahåller upp till 900 GB/s koherent bandbredd mellan processor och grafikkort, begränsas de uppmätta överföringarna av Graces LPDDR5X-minnesbandbredd på 396 GB/s. Dubbelriktade överföringar exponerar ytterligare den begränsningen. Samtidig trafik når 253 GB/s med SM-baserade kopior och 192 GB/s genom kopieringsmotorerna.
Slutledning
När lågnivåtesterna är täckta går vi vidare till LLM-inferens. Här flyttas fokus från toppantal till tokens per sekund, tid till första token och latens under belastning, vilket ger oss en bättre bild av hur WS300 beter sig som ett serversystem.
Låt oss börja med GB300 Superchips definierande kapacitet: att betjäna modeller på båda sidor om B300:s kapacitetsgräns på 252 GB HBM3e. Det är här dess koherenta minnespool på 748 GB spelar störst roll. De fem kontrollpunkterna går från två modeller som passar bekvämt i HBM, till en som nominellt passar men lämnar för lite utrymme för runtime- och KV-cache, och slutligen till två som måste avlasta betydande delar av sina vikter till Grace-minne.
Obs: Där det nämnts kördes modeller med spekulativ avkodning för högre avkodningsgenomströmning, med mängden påtvingad acceptanstoken inställd på mängden spekulativ avkodningstoken. Resultaten visar därför bästa tänkbara prestanda; vid verklig servering är genomströmningen dynamisk och beror på kvaliteten på spekulativa avkodningstokens.
Modeller som passar helt i HBM
DeepSeek v4 Flash (0731)
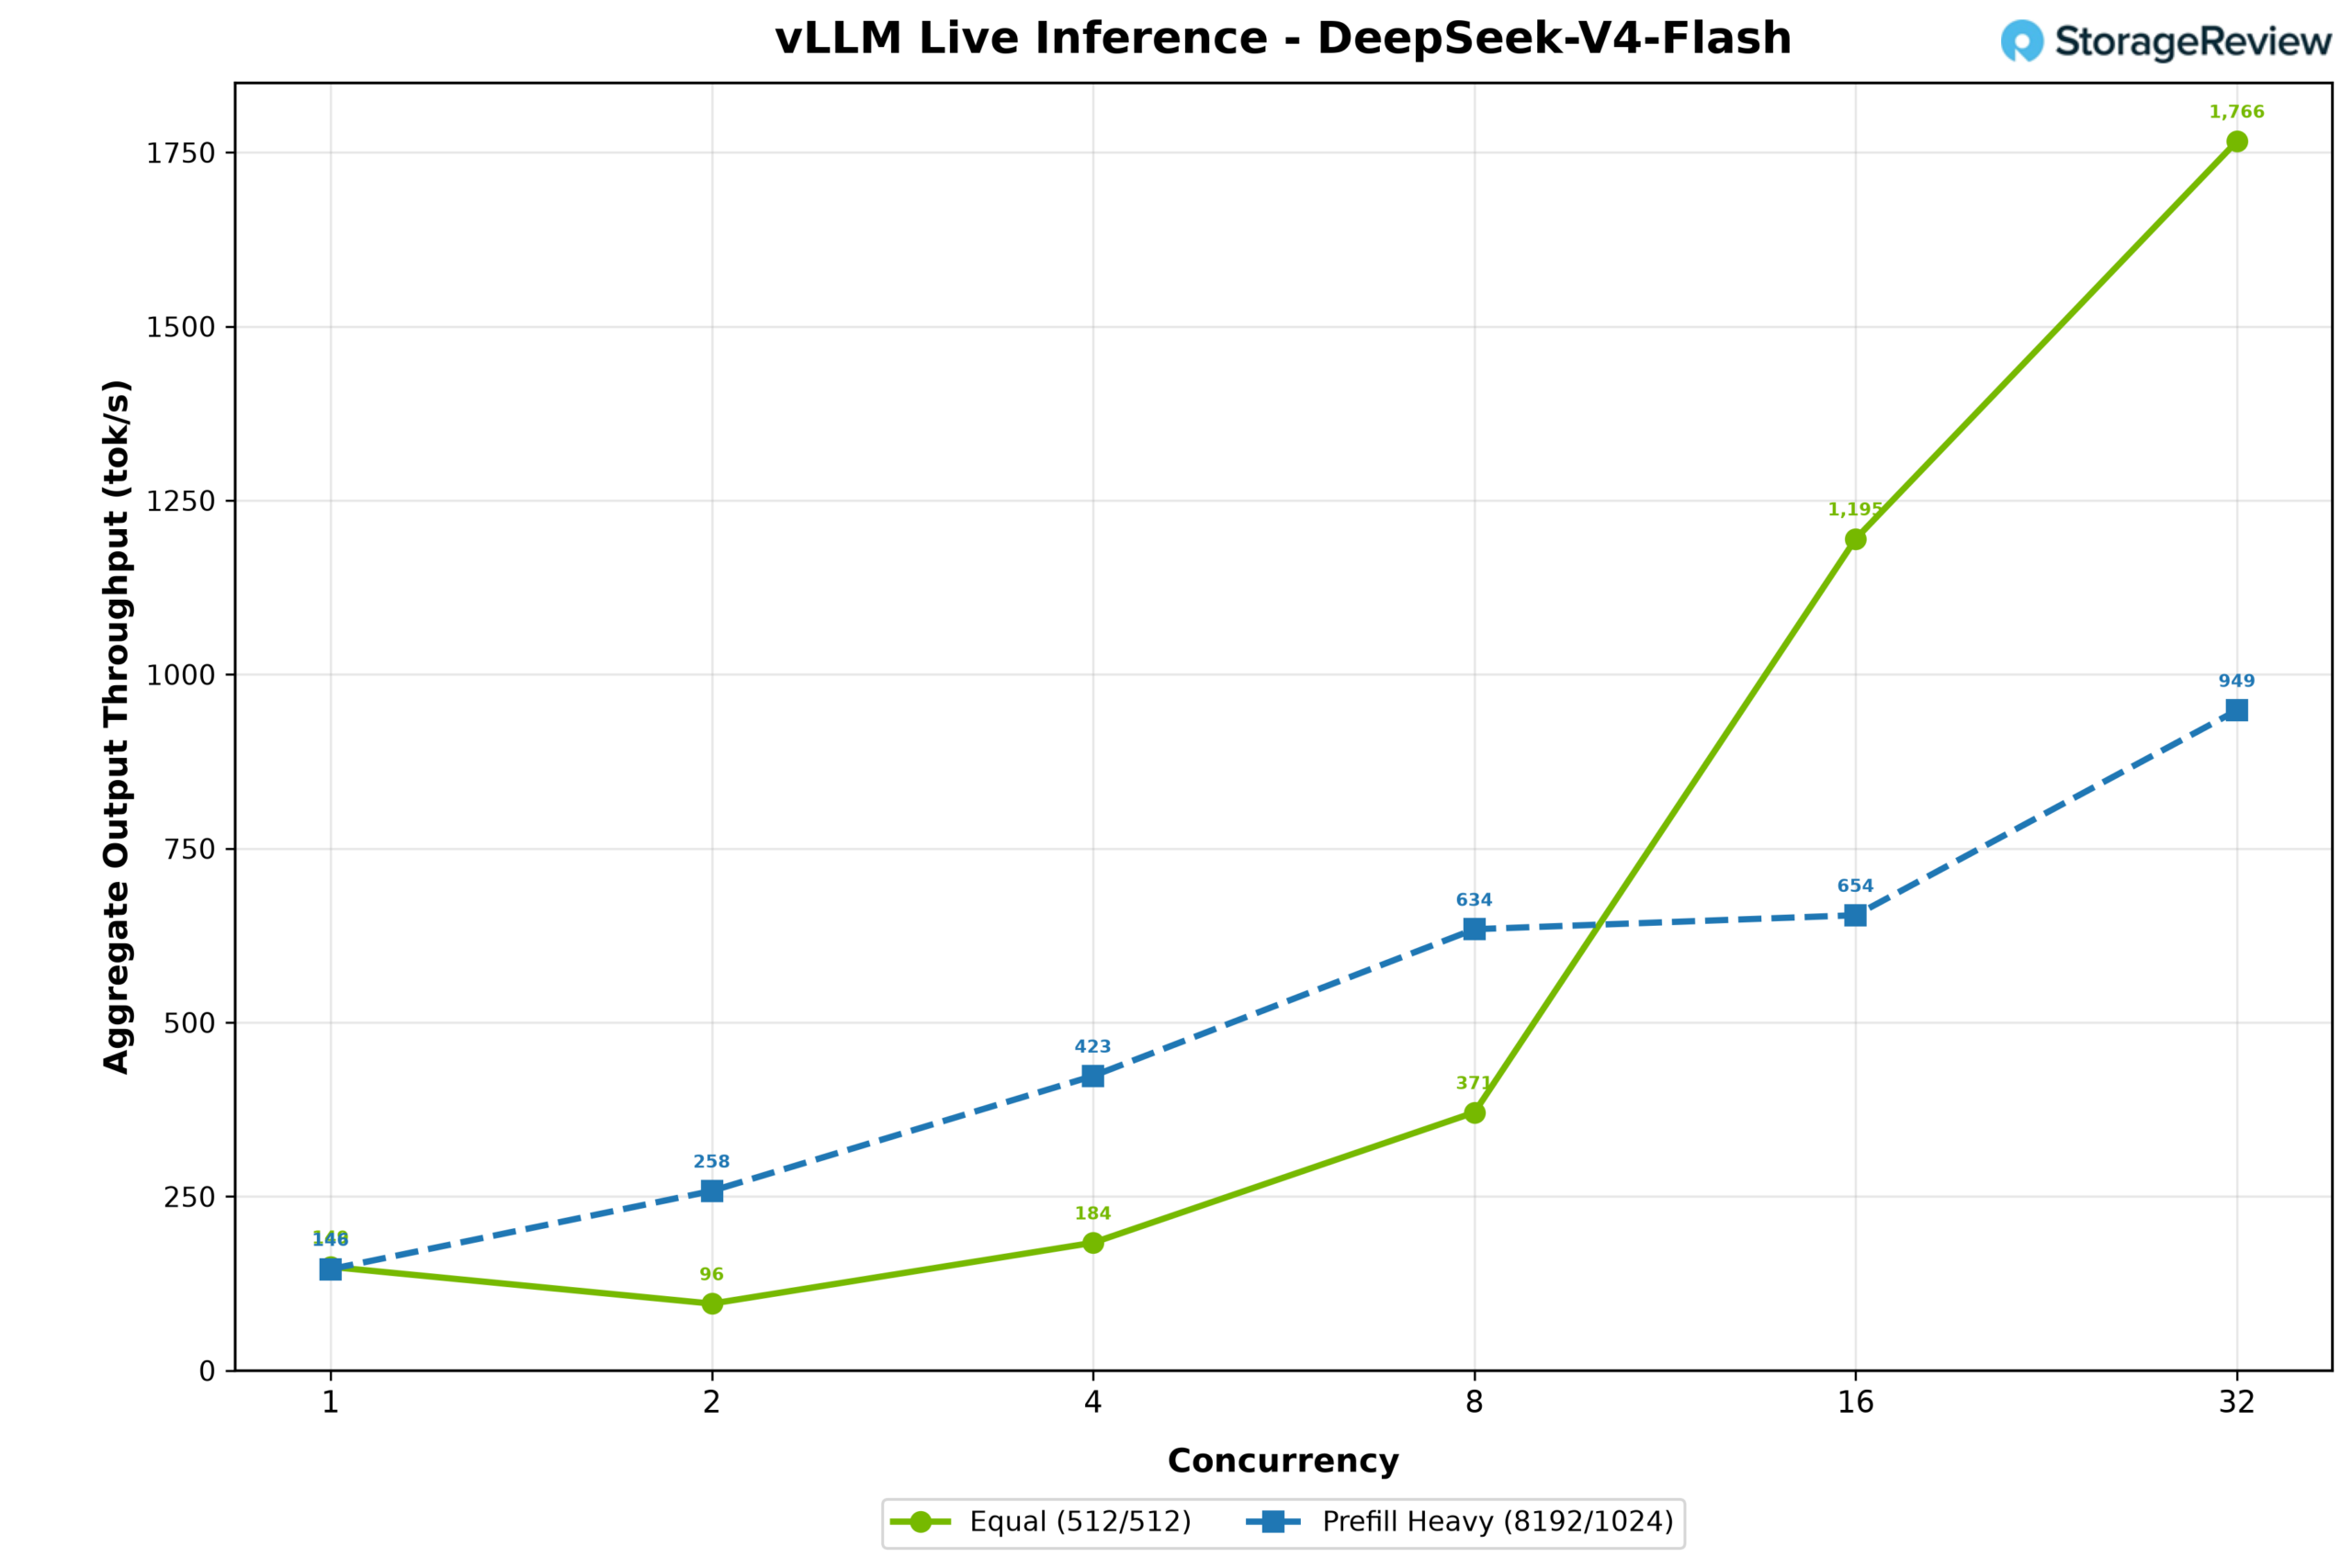
Först ut var den otroligt populära DeepSeek v4 Flash (0731), som förbrukar 14+6 GB minne som en inbyggd FP8-kontrollpunkt. Denna modell är känd för att vara mycket effektiv och lättanvänd, vilket är vad vi upplevde på DGX Station. I 512/512-arbetsbelastningen började utdataflödet på 149 tokens per sekund vid samtidighet 1, och steg snabbt till 1 766 vid samtidighet 32. Den förfyllningstunga arbetsbelastningen skalades från 146 till 949 tokens per sekund.
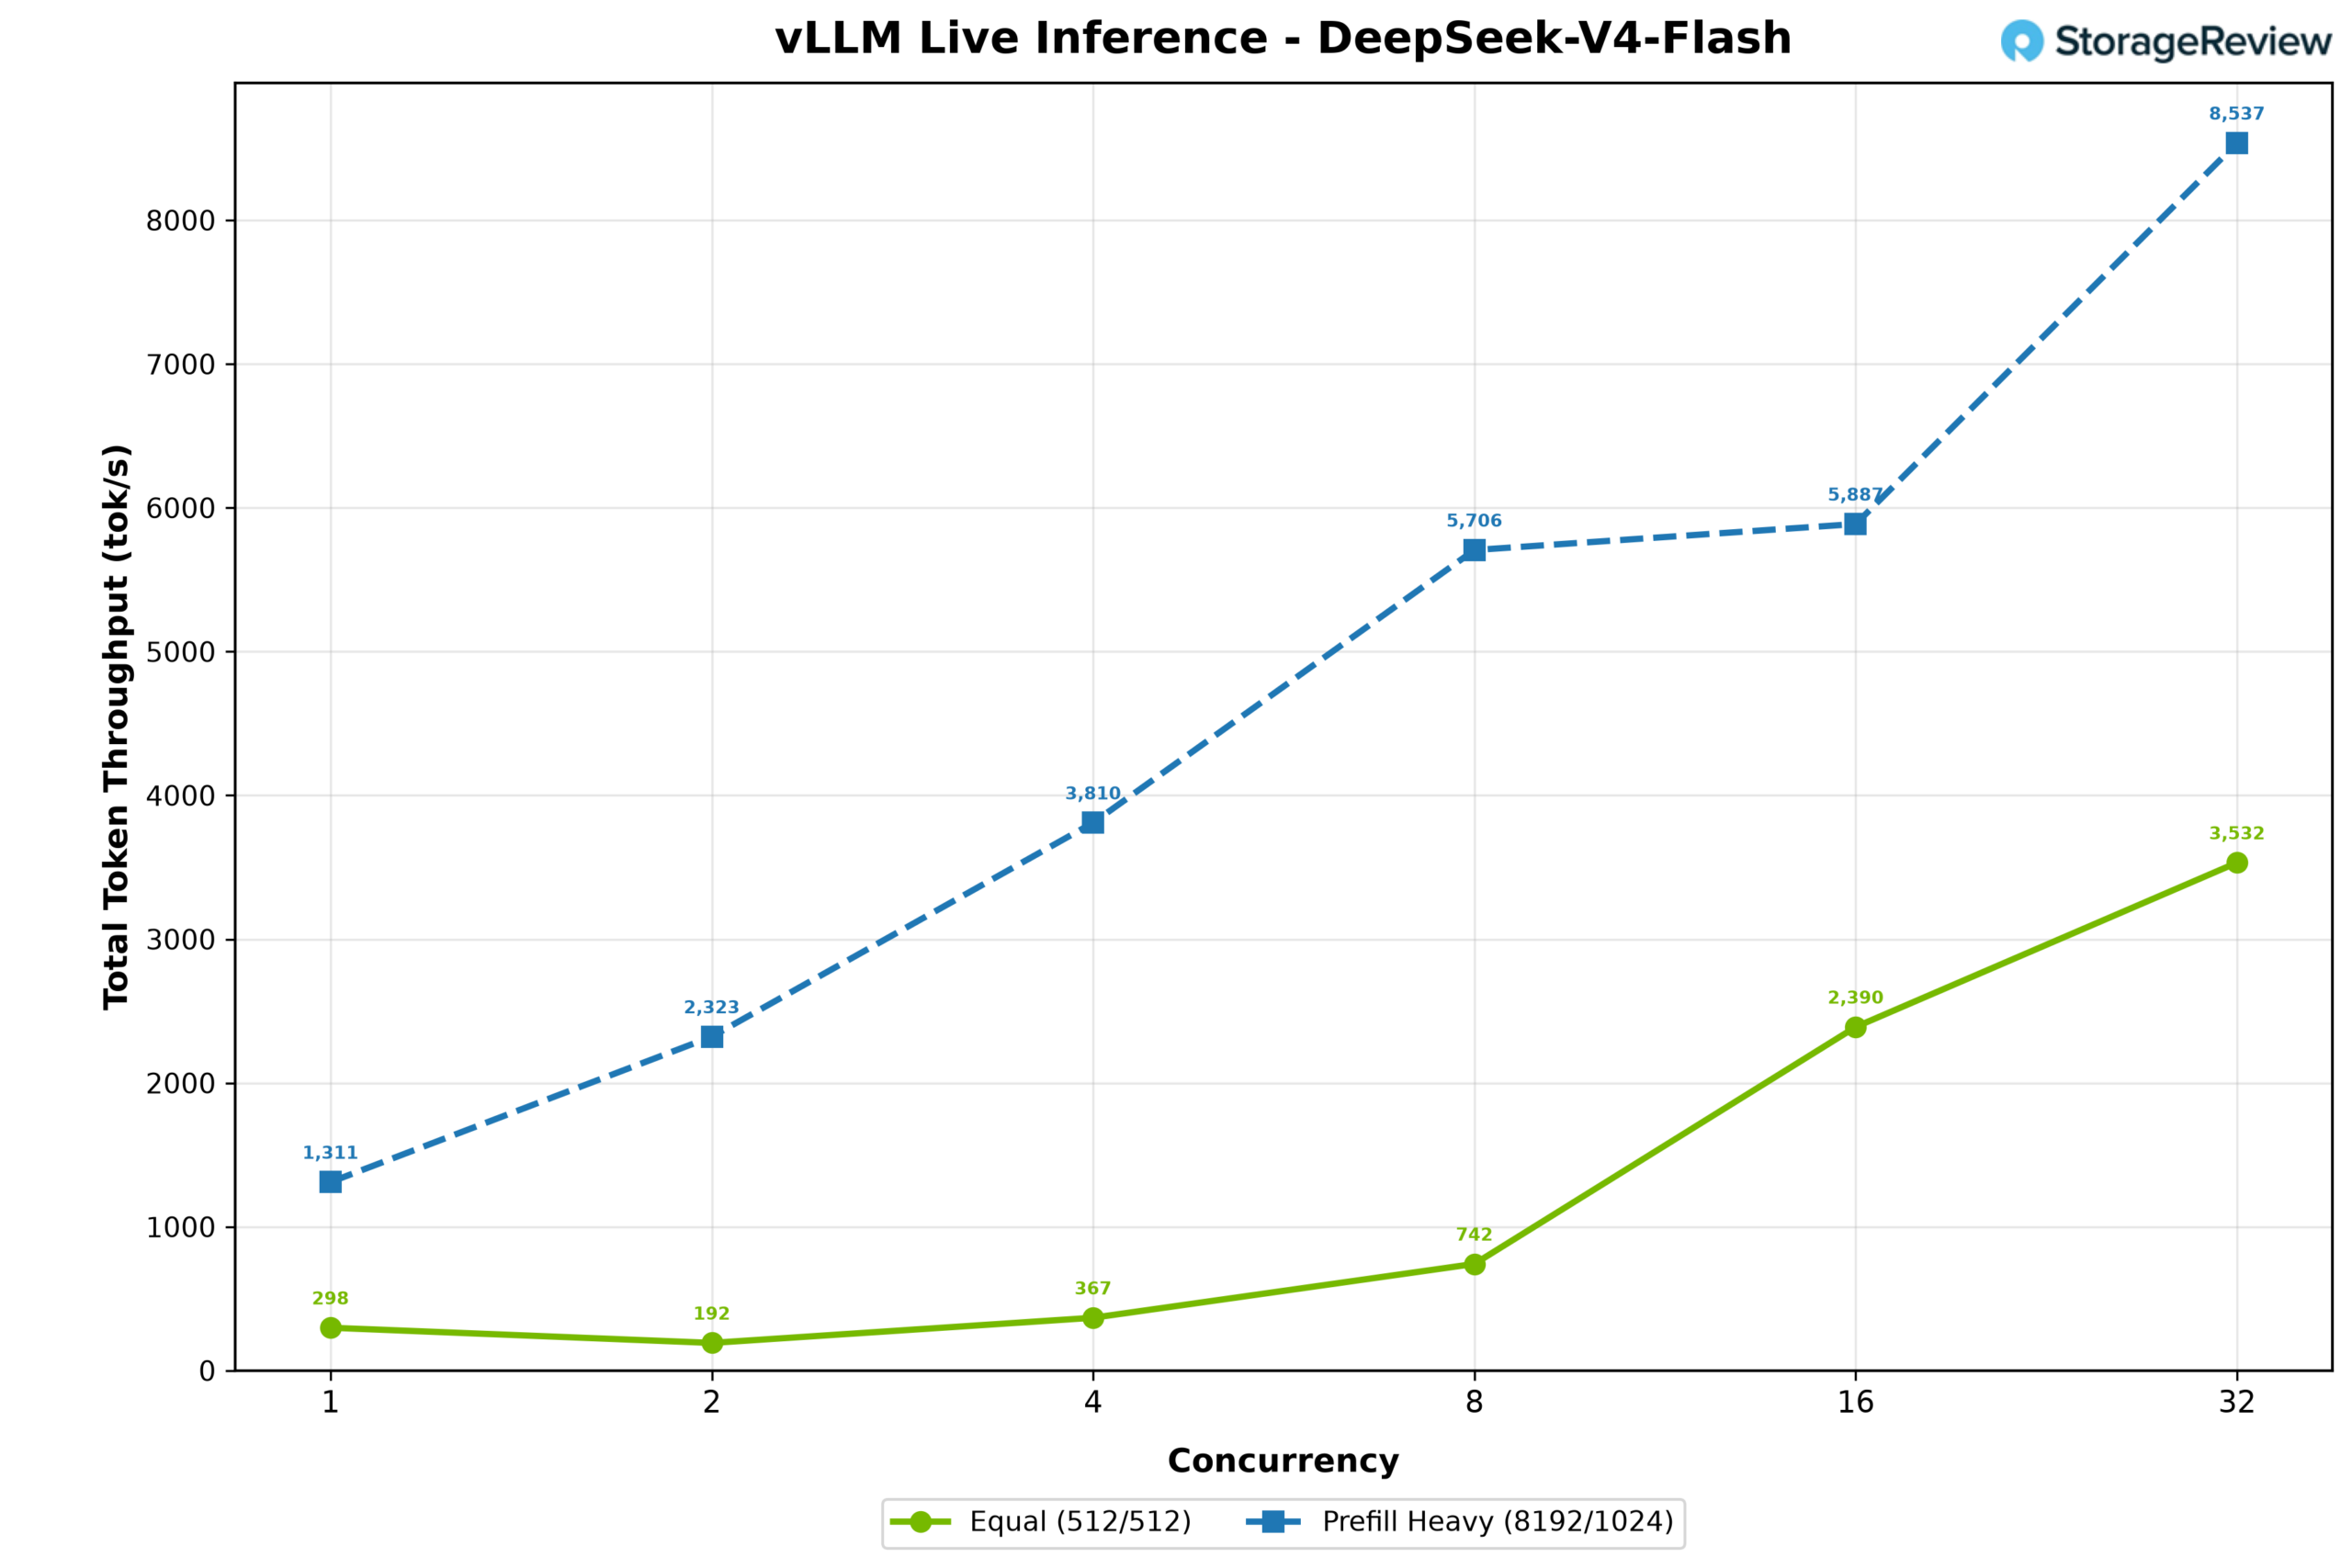
Total tokengenomströmning skalades i takt, där 512/512-arbetsbelastningen klättrade från 298 till 3 532 tokens per sekund och den förfyllningstunga arbetsbelastningen ökade från 1 311 till 8 537
MiniMax M2.7 (NVFP4)
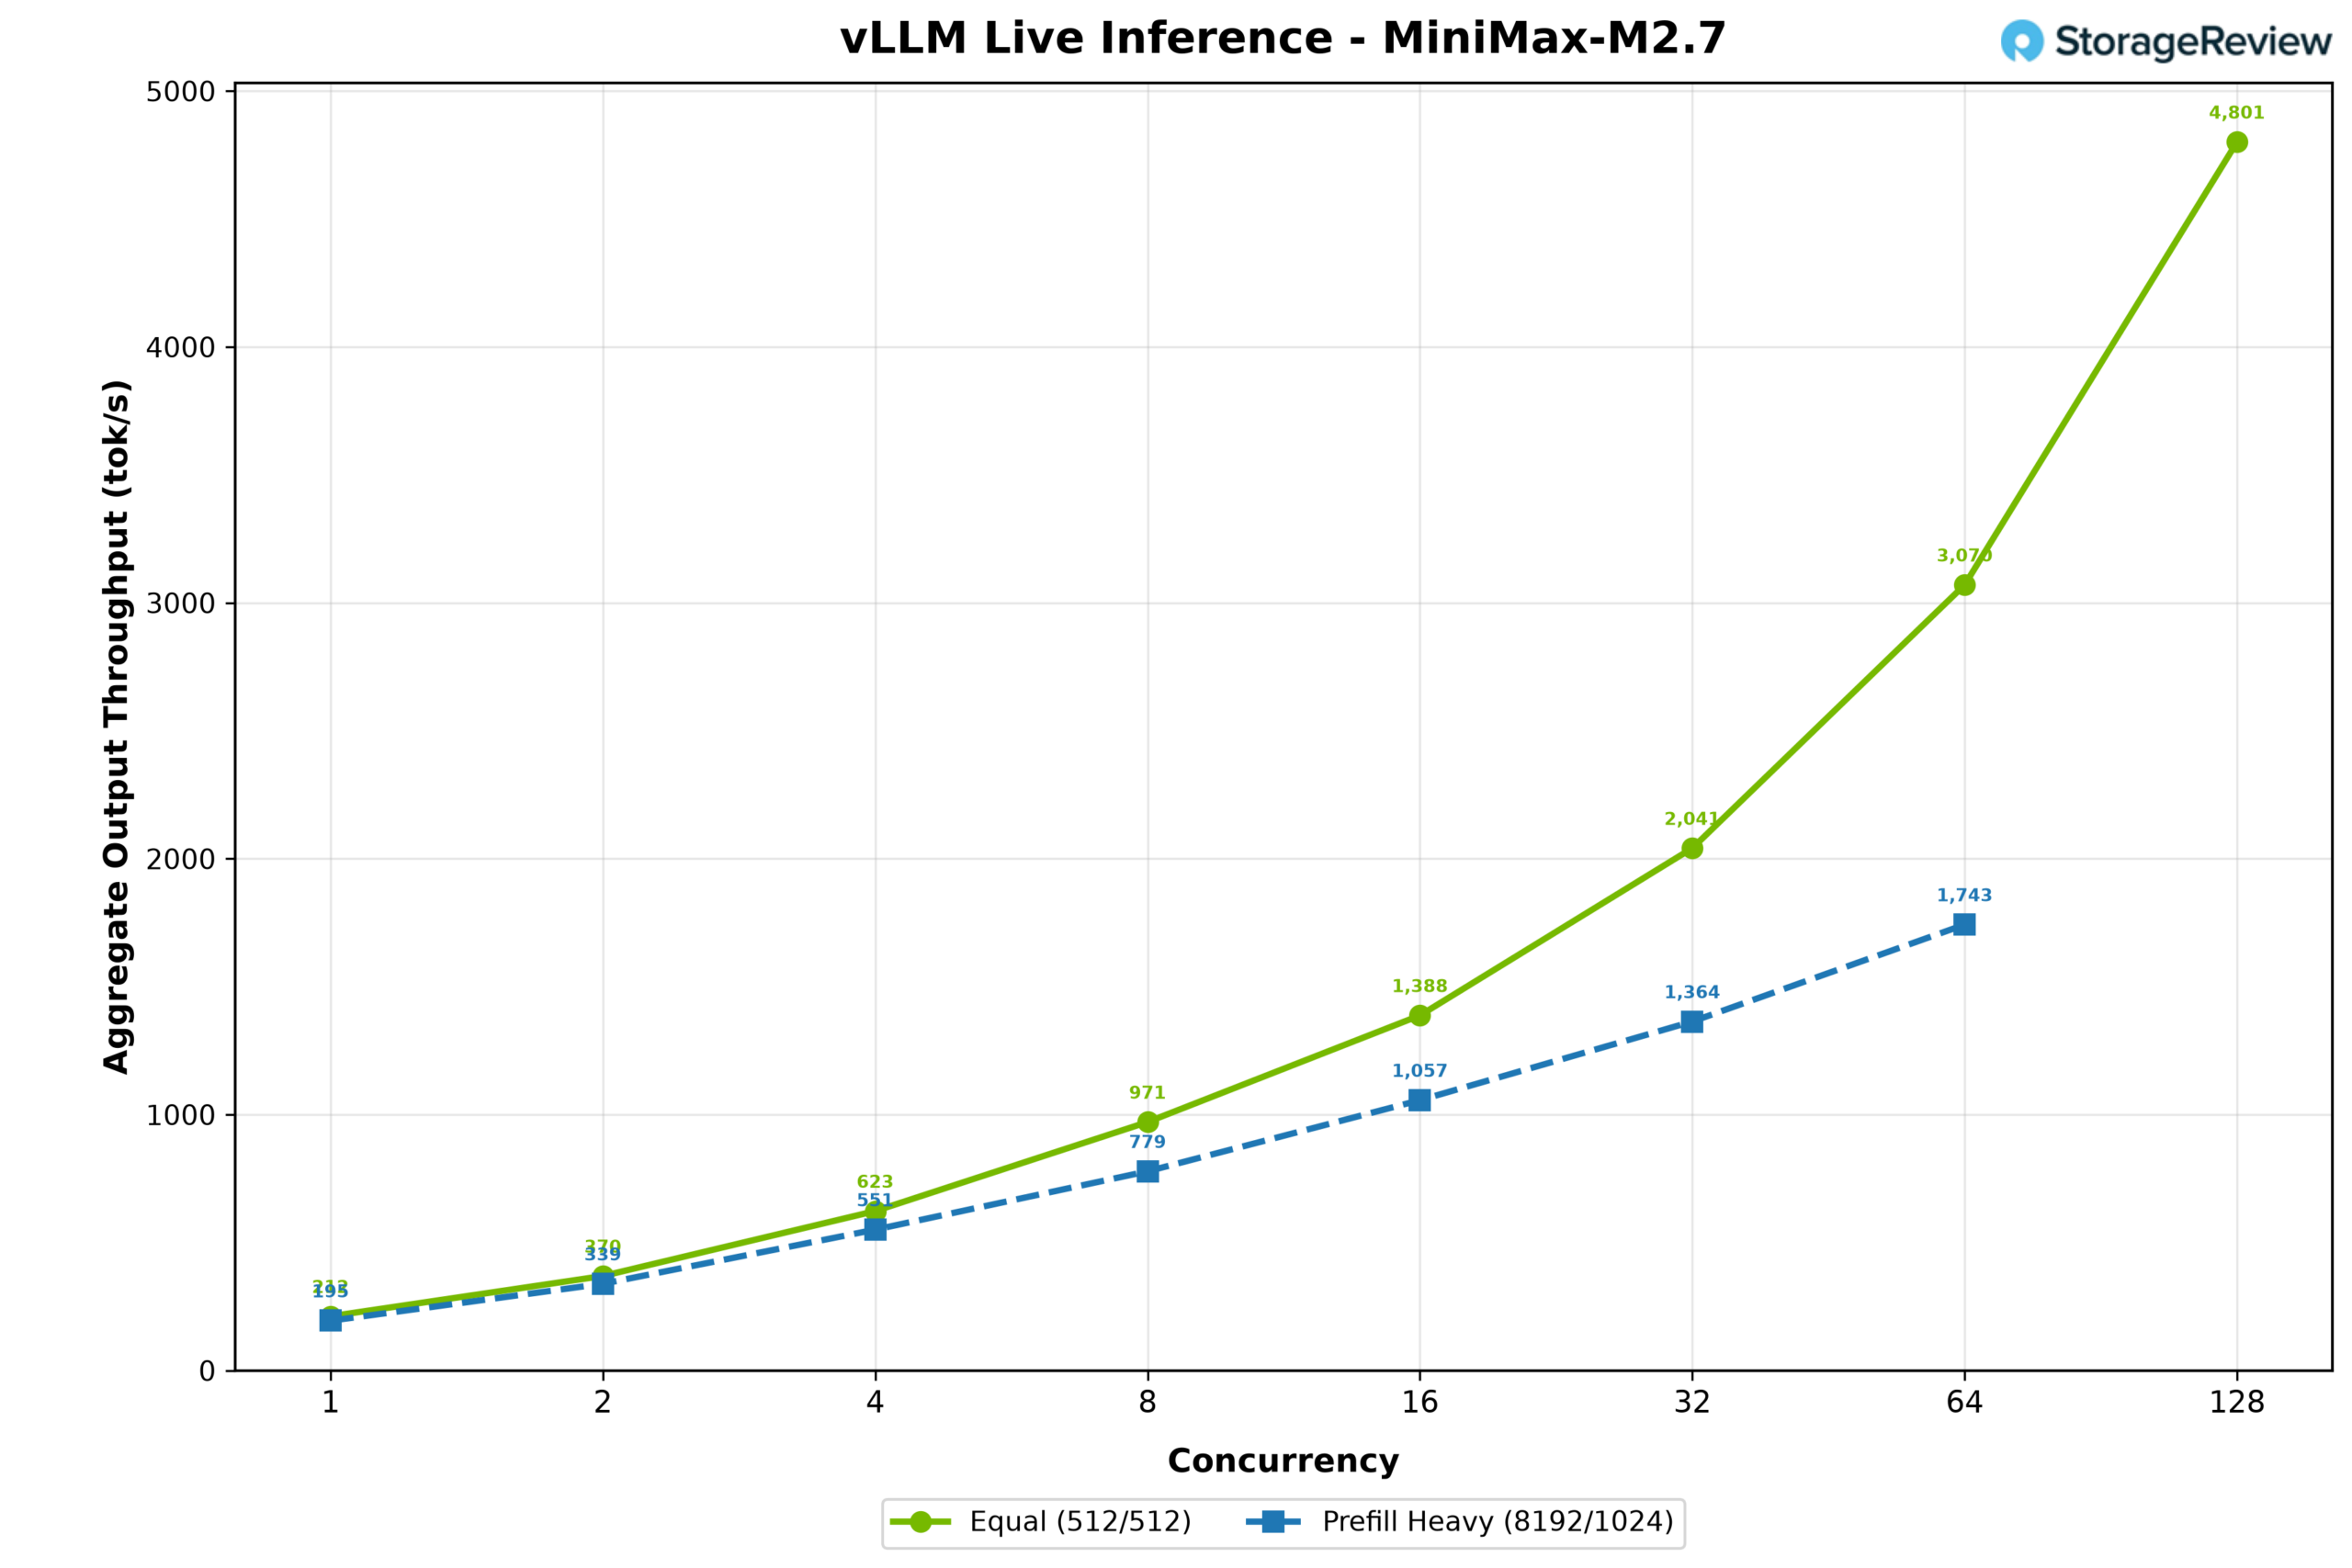
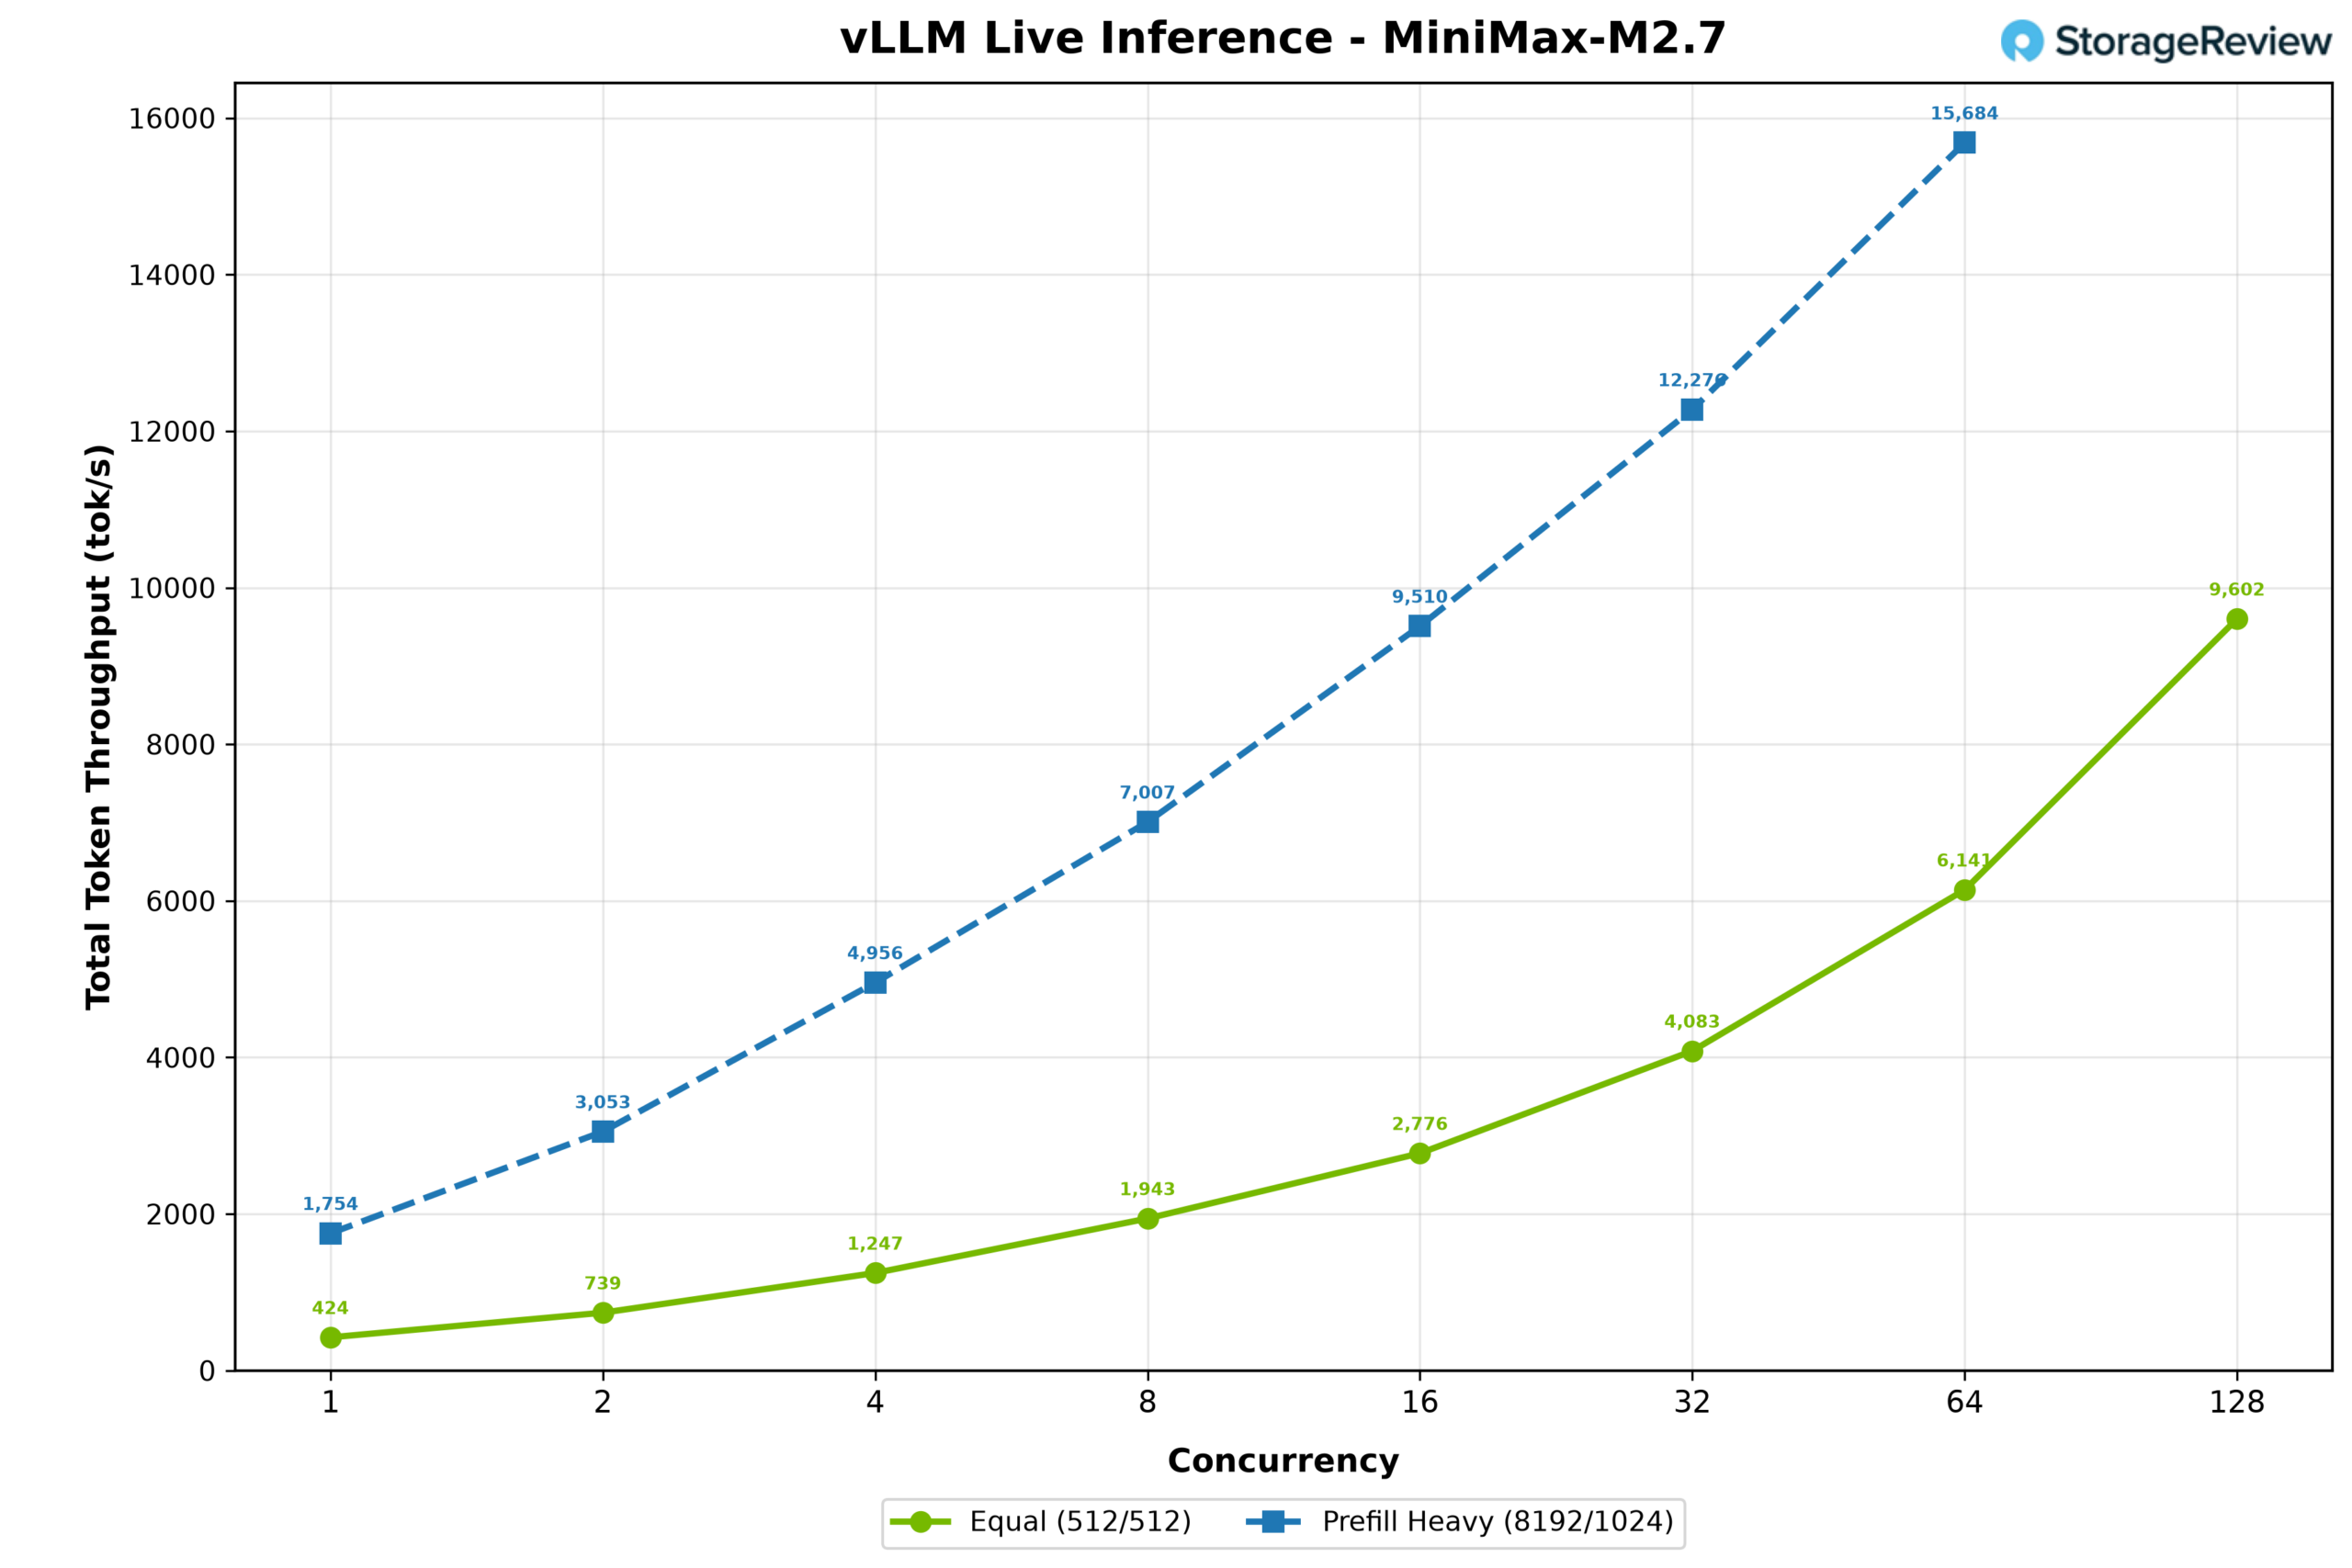
Nästa ut är MiniMax M2.7, en av våra favoritmodeller, testad med NVIDIAs NVFP4-minne, som upptar 125 GB VRAM. I 512/512-arbetsbelastningen började dataflödet vid 193 tokens per sekund vid samtidighet 1 och skalades snabbt till 4 801 tokens per sekund vid samtidighet 128. Den förfyllda arbetsbelastningen ökade från 195 tokens per sekund vid samtidighet 1 till 1 743 tokens per sekund vid samtidighet 64. Den totala token-dataflödet visade motsatt trend, med den förfyllda arbetsbelastningen som steg från 1 754 till 15 684 tokens per sekund fram till samtidighet 64, medan 512/512-arbetsbelastningen skalades från 424 till 9 602 tokens per sekund vid samtidighet 128.
Den totala tokengenomströmningen visade motsatt trend, där den förfyllningstunga arbetsbelastningen steg från 1 754 till 15 684 tokens per sekund genom samtidighet 64, medan arbetsbelastningen 512/512 skalades upp från 424 till 9 602 tokens per sekund vid samtidighet 128.
Modeller som knappt får plats i HBM
MiniMax M3 (NVFP4)
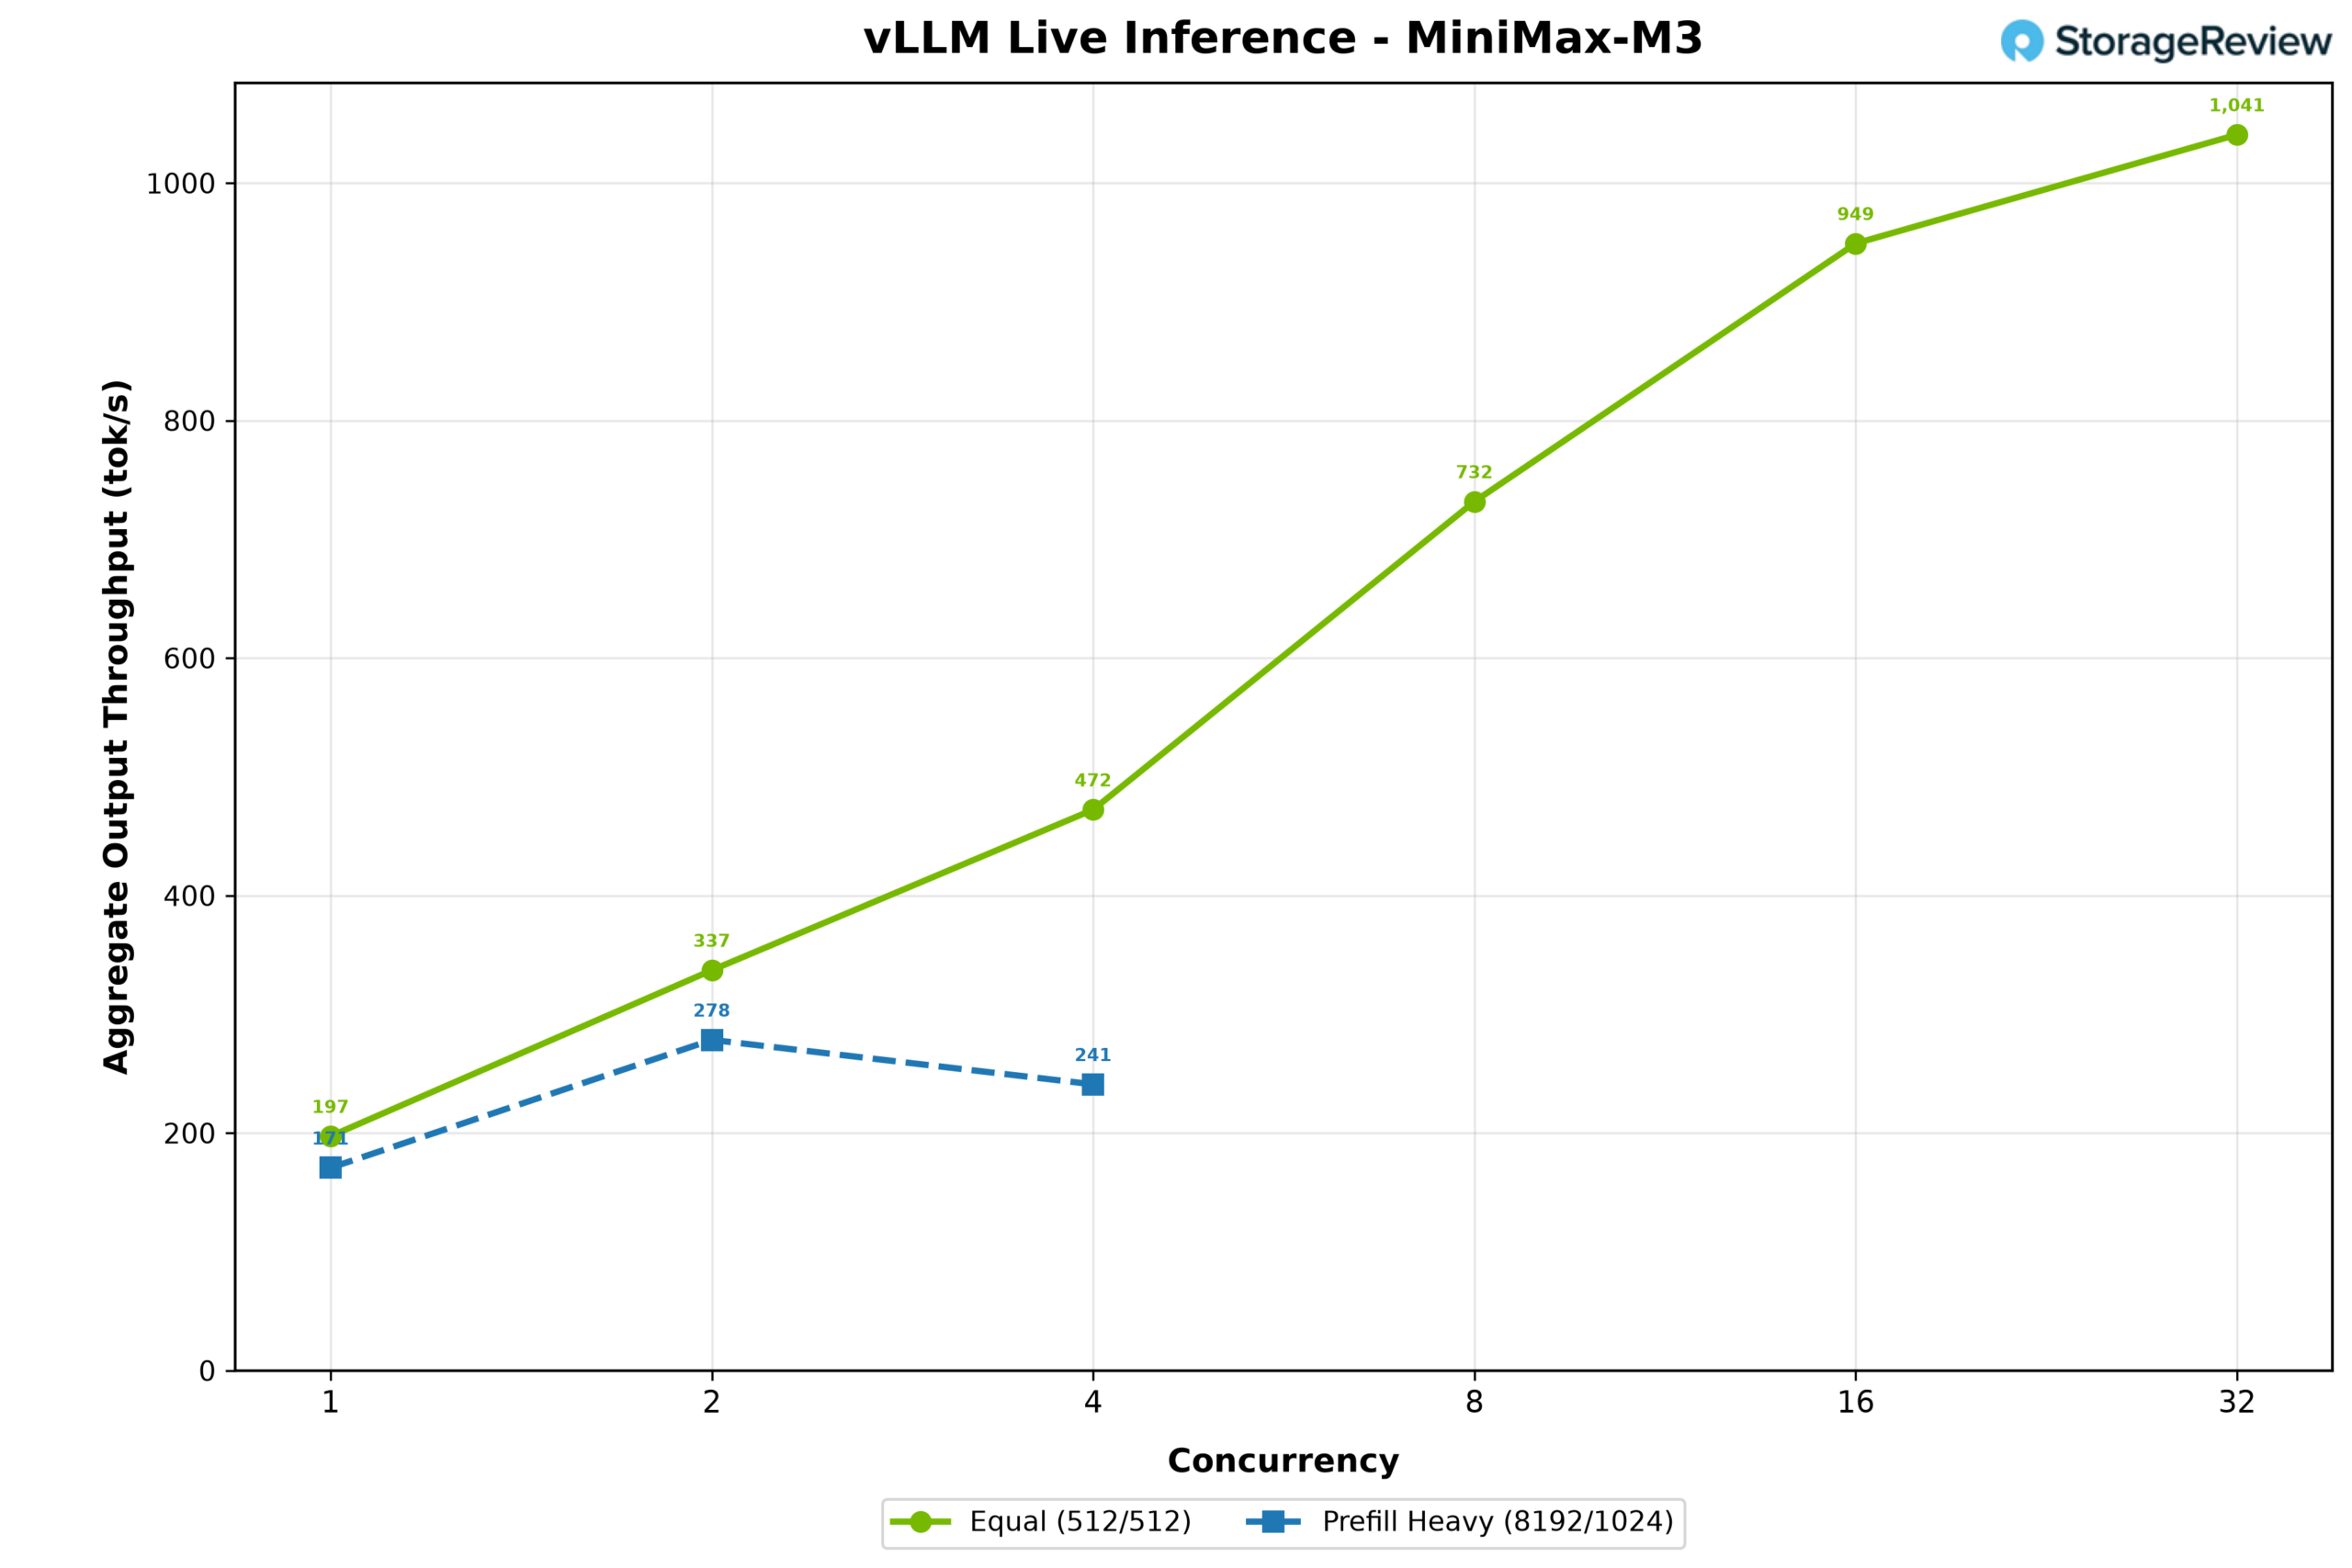
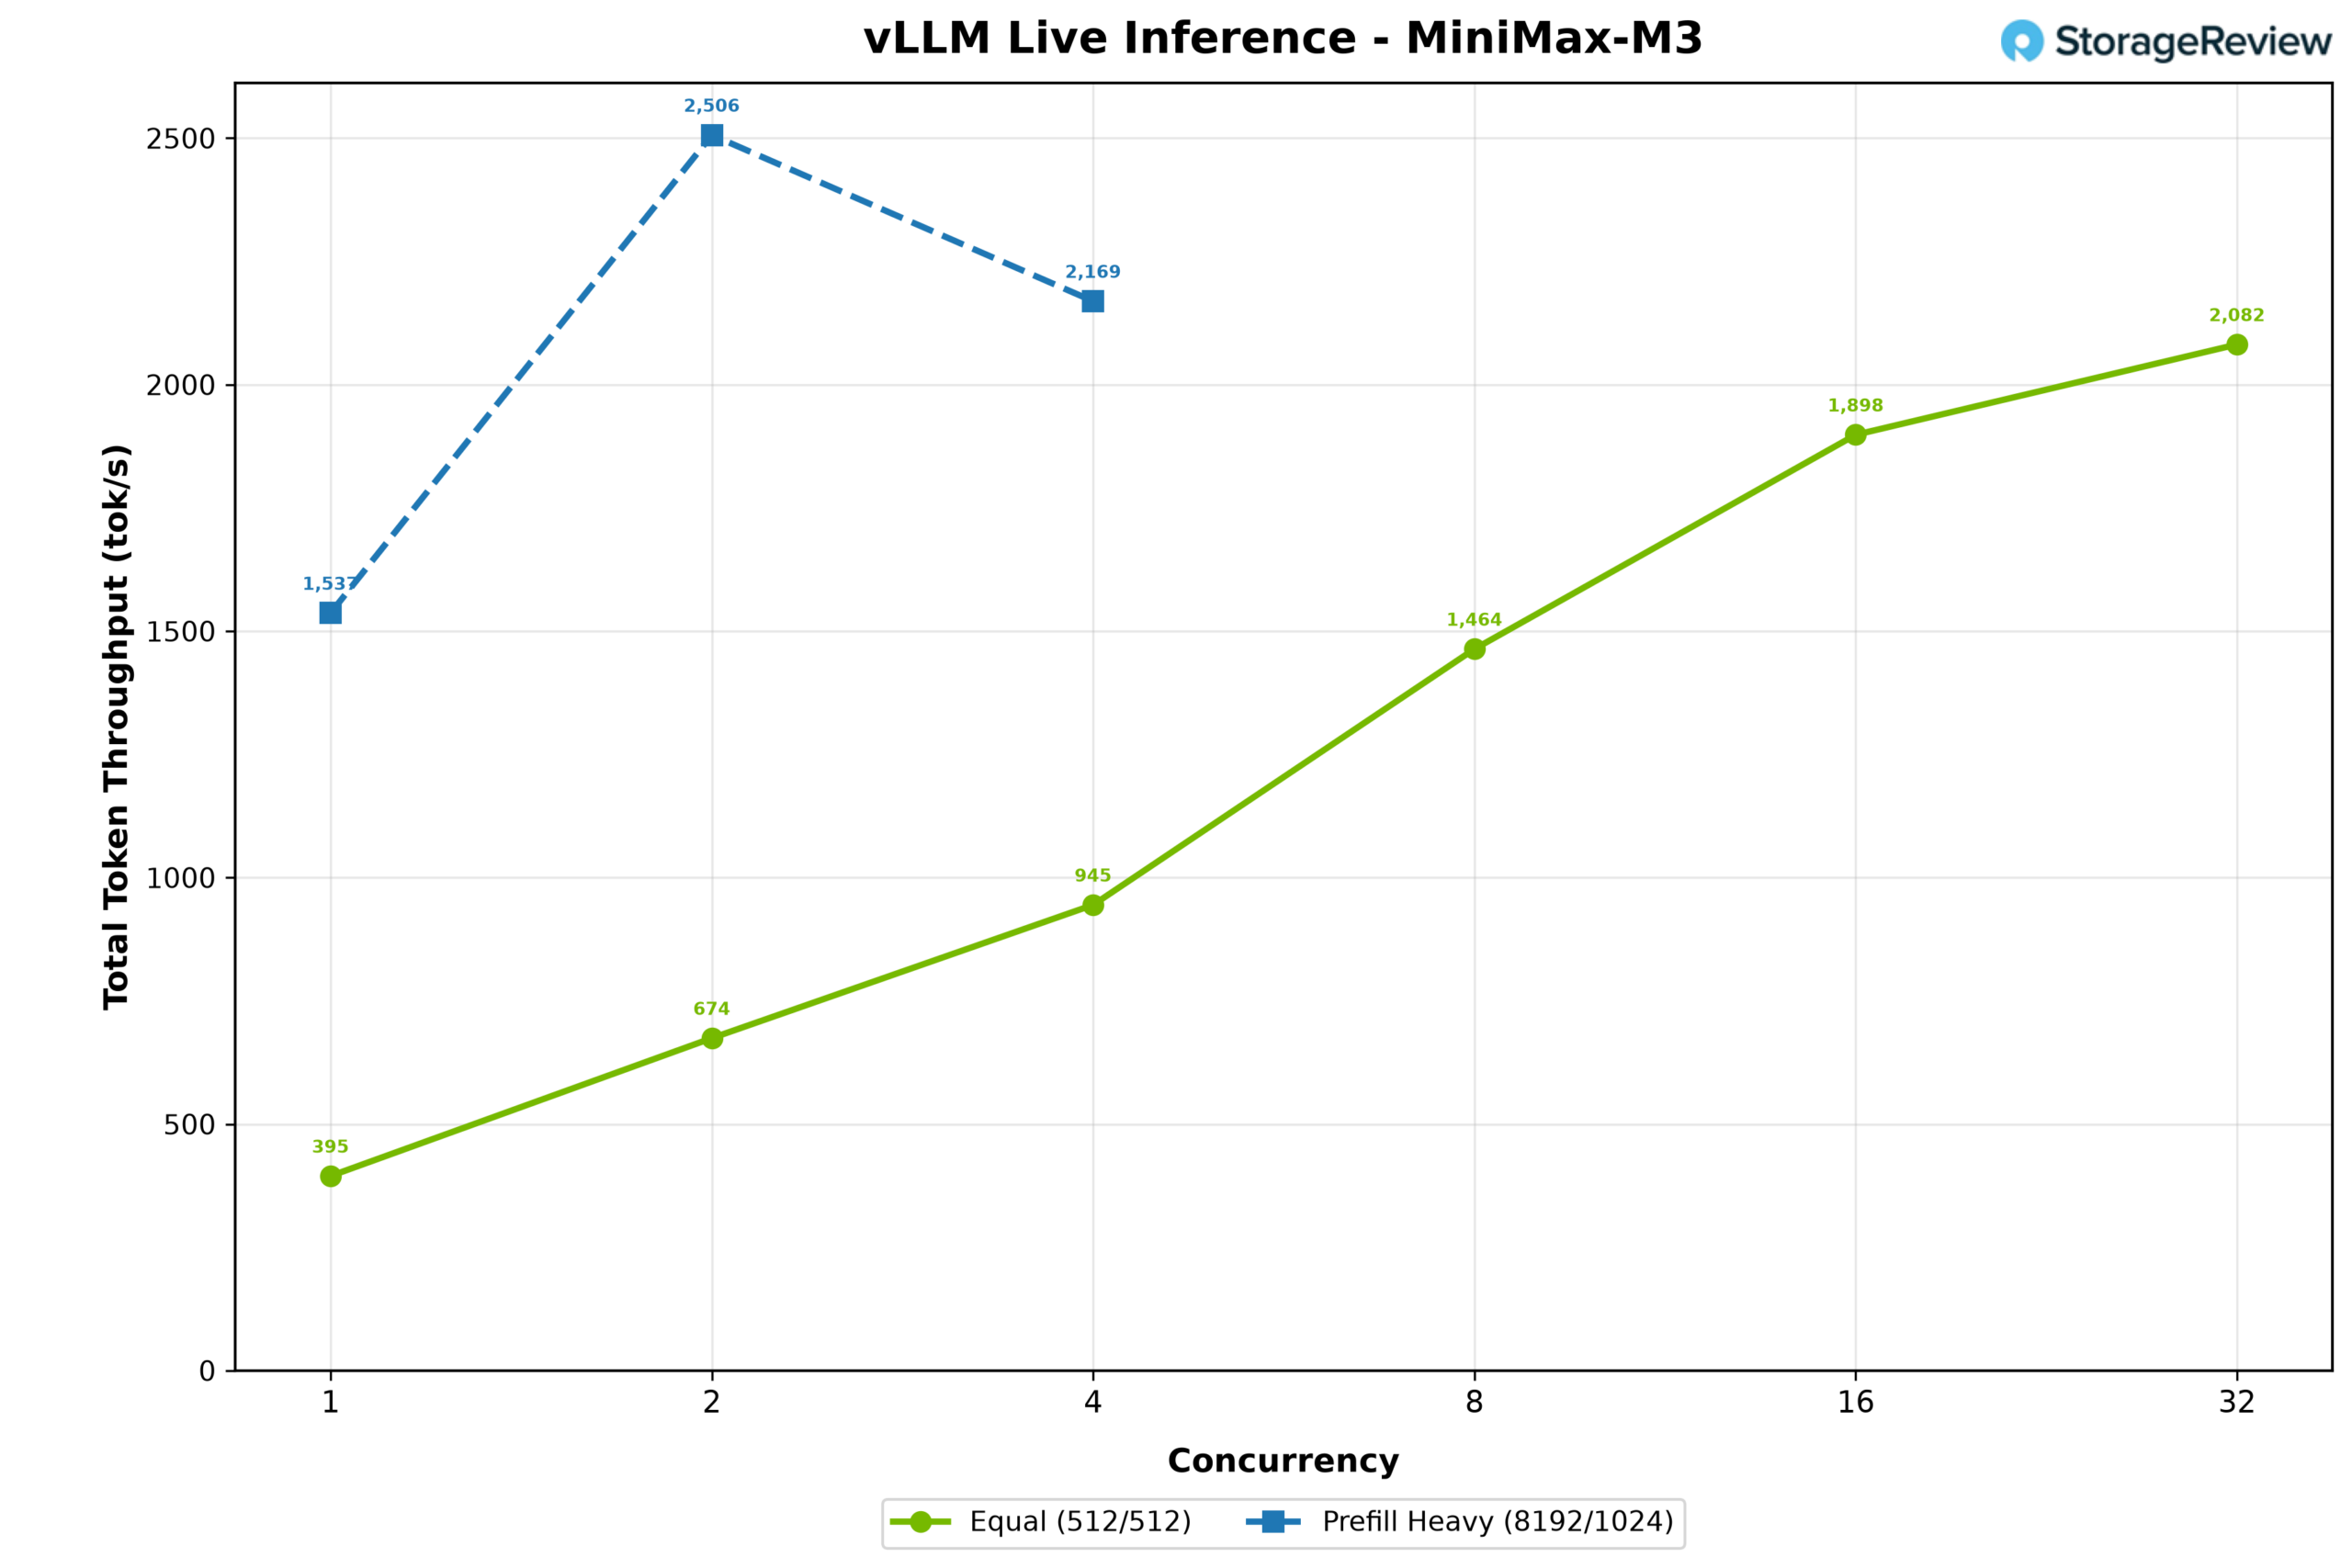
MiniMax M3 visar hur knappt passande ser ut i praktiken. Dess 233 GB NVFP4-kontrollpunkt är mindre än B300:s 252 GB HBM, men modellen behöver fortfarande plats för runtime- och KV-cache. Den upptog slutligen 223 GB HBM, med 21 GB experter avlastade till Grace. Spekulativ avkodning med EAGLE3-GQA användes med en syntetisk acceptanslängd på 3 tokens. I 512/512-arbetsbelastningen började utdataflödet på 197 tokens per sekund vid samtidighet 1 och skalades stadigt till 1 041 tokens per sekund vid samtidighet 32. Den förfyllningstunga arbetsbelastningen ökade från 171 tokens per sekund vid samtidighet 1 till en topp på 278 vid samtidighet 2 innan den minskade till 241 vid samtidighet 4.
Den totala tokengenomströmningen följde ett liknande mönster, där 512/512-arbetsbelastningen ökade från 395 till 2 082 tokens per sekund, medan den förfyllningstunga arbetsbelastningen nådde sin topp på 2 506 tokens per sekund vid samtidighet 2 innan den sjönk till 2 169 vid samtidighet 4.
Modeller som inte passar i HBM
GLM-5.2 (NVFP4)
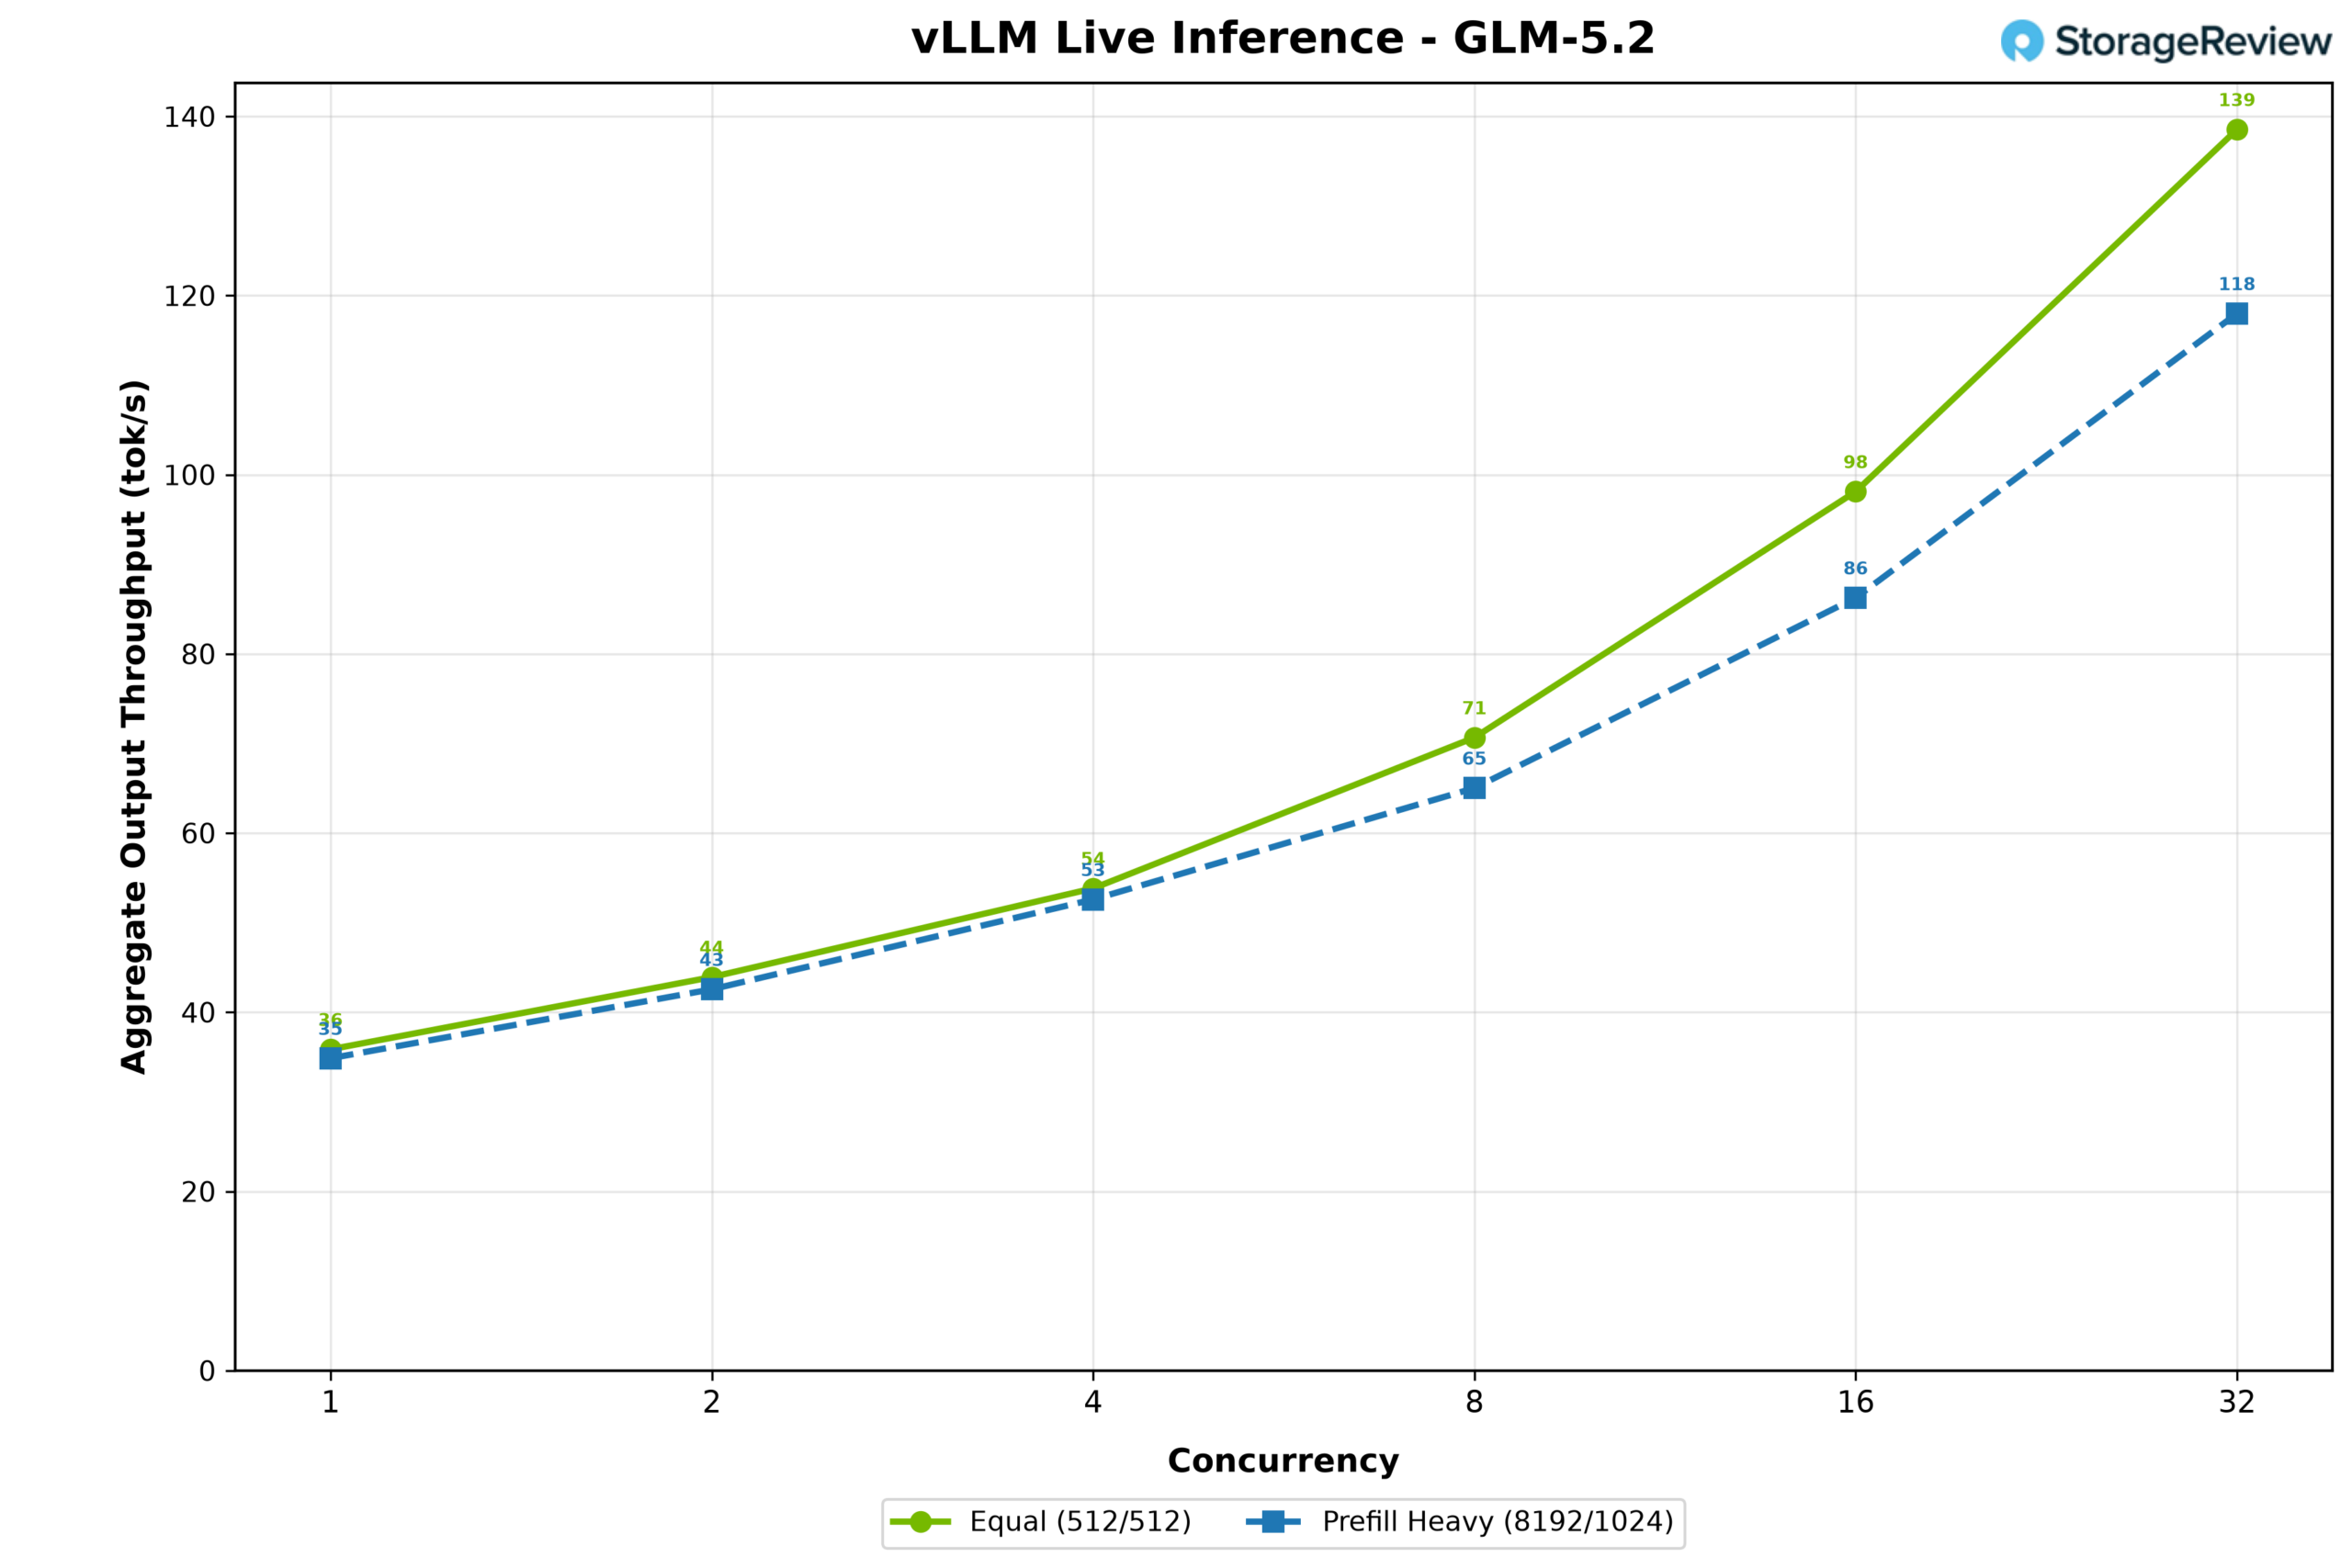
GLM-5.2 testades med NVIDIAs NVFP4-kvantum. Dess kontrollpunkt på 433 GB använde 218 GB HBM, med 216 GB expertvikter avlastade till Grace-minne. Spekulativ MTP-avkodning användes med en syntetisk acceptanslängd på 3 tokens. Utdataflödet i 512/512-arbetsbelastningen ökade från 36 tokens per sekund vid samtidighet 1 till 139 vid samtidighet 32. Arbetsbelastningen 8 192/1 024 följde tätt och ökade från 35 till 118 tokens per sekund. De liknande resultaten mellan de två profilerna visar att genereringen förblev begränsad främst genom att flytta de avlastade experterna mellan Grace-minnet och GPU:n. Svepet slutade vid samtidighet 32 eftersom det inte fanns tillräckligt med HBM kvar för ytterligare kontext.
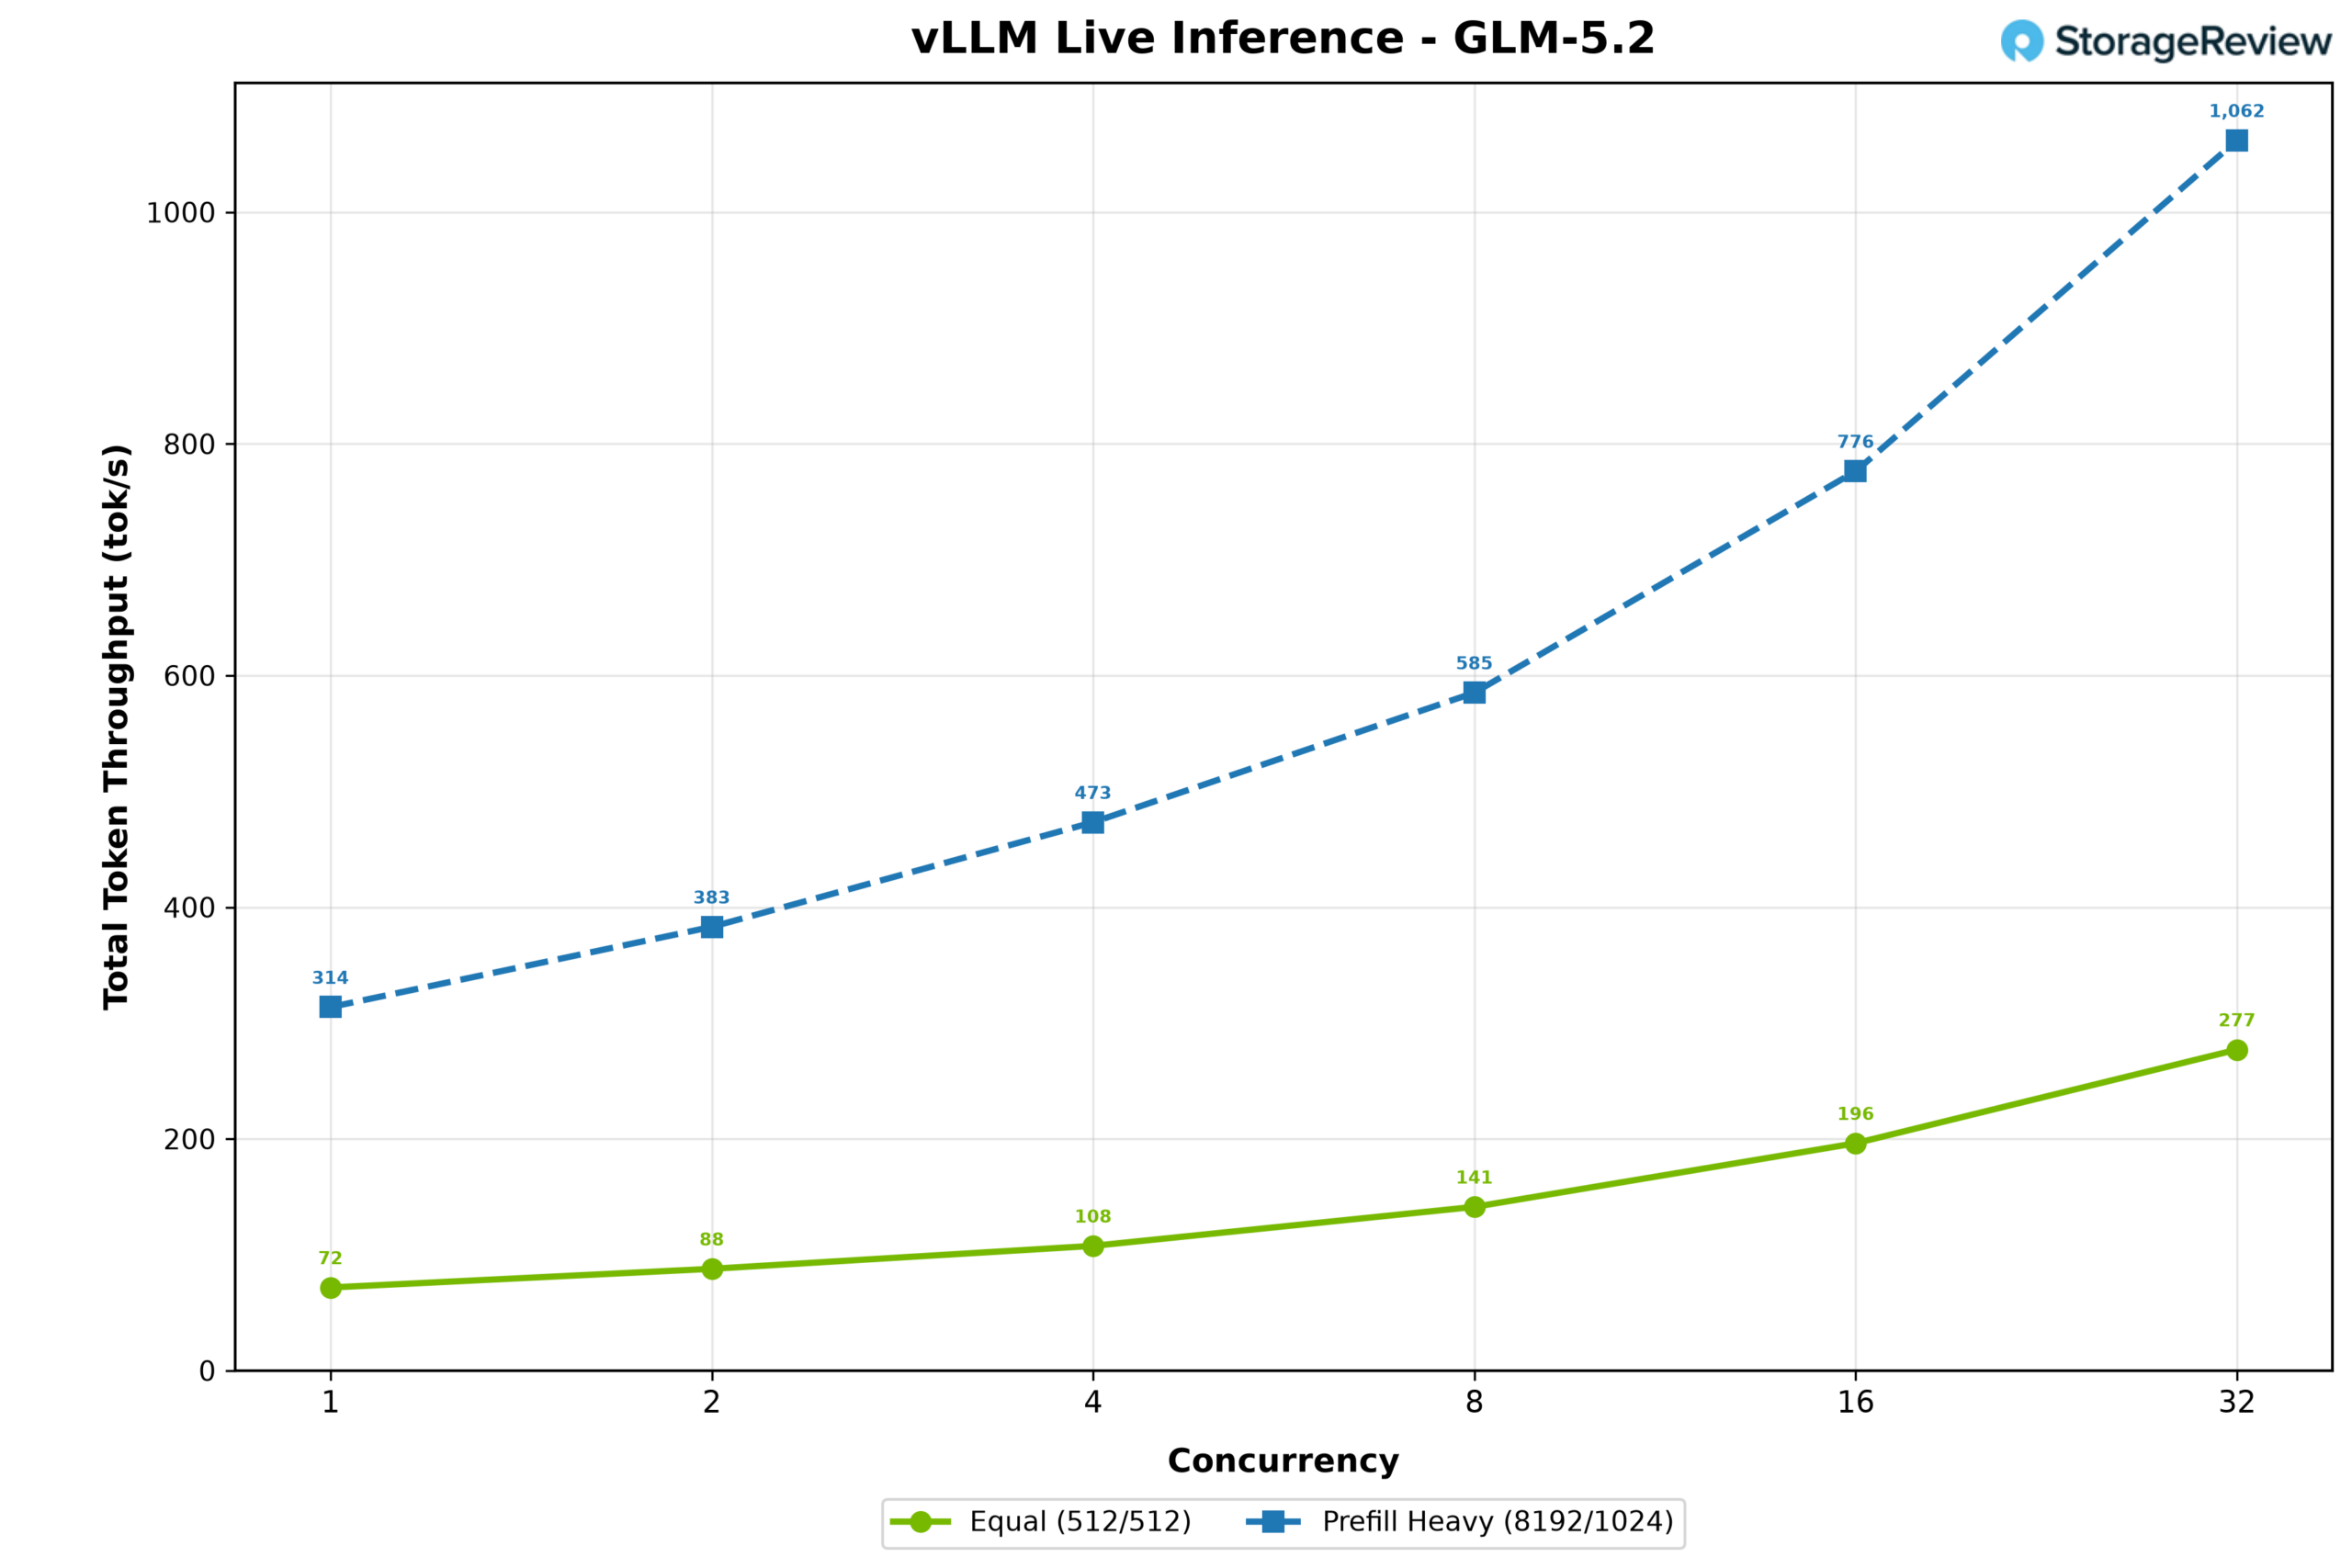
Den totala tokengenomströmningen följde samma mönster, där 512/512-arbetsbelastningen ökade från 72 till 277 tokens per sekund och den förfyllda arbetsbelastningen klättrade från 314 till 1 062; här separerar de längre prompterna slutligen de två profilerna, eftersom själva förfyllningstokenen räknas mot totalen.
Nemotron-3-Ultra 550B (NVFP4)
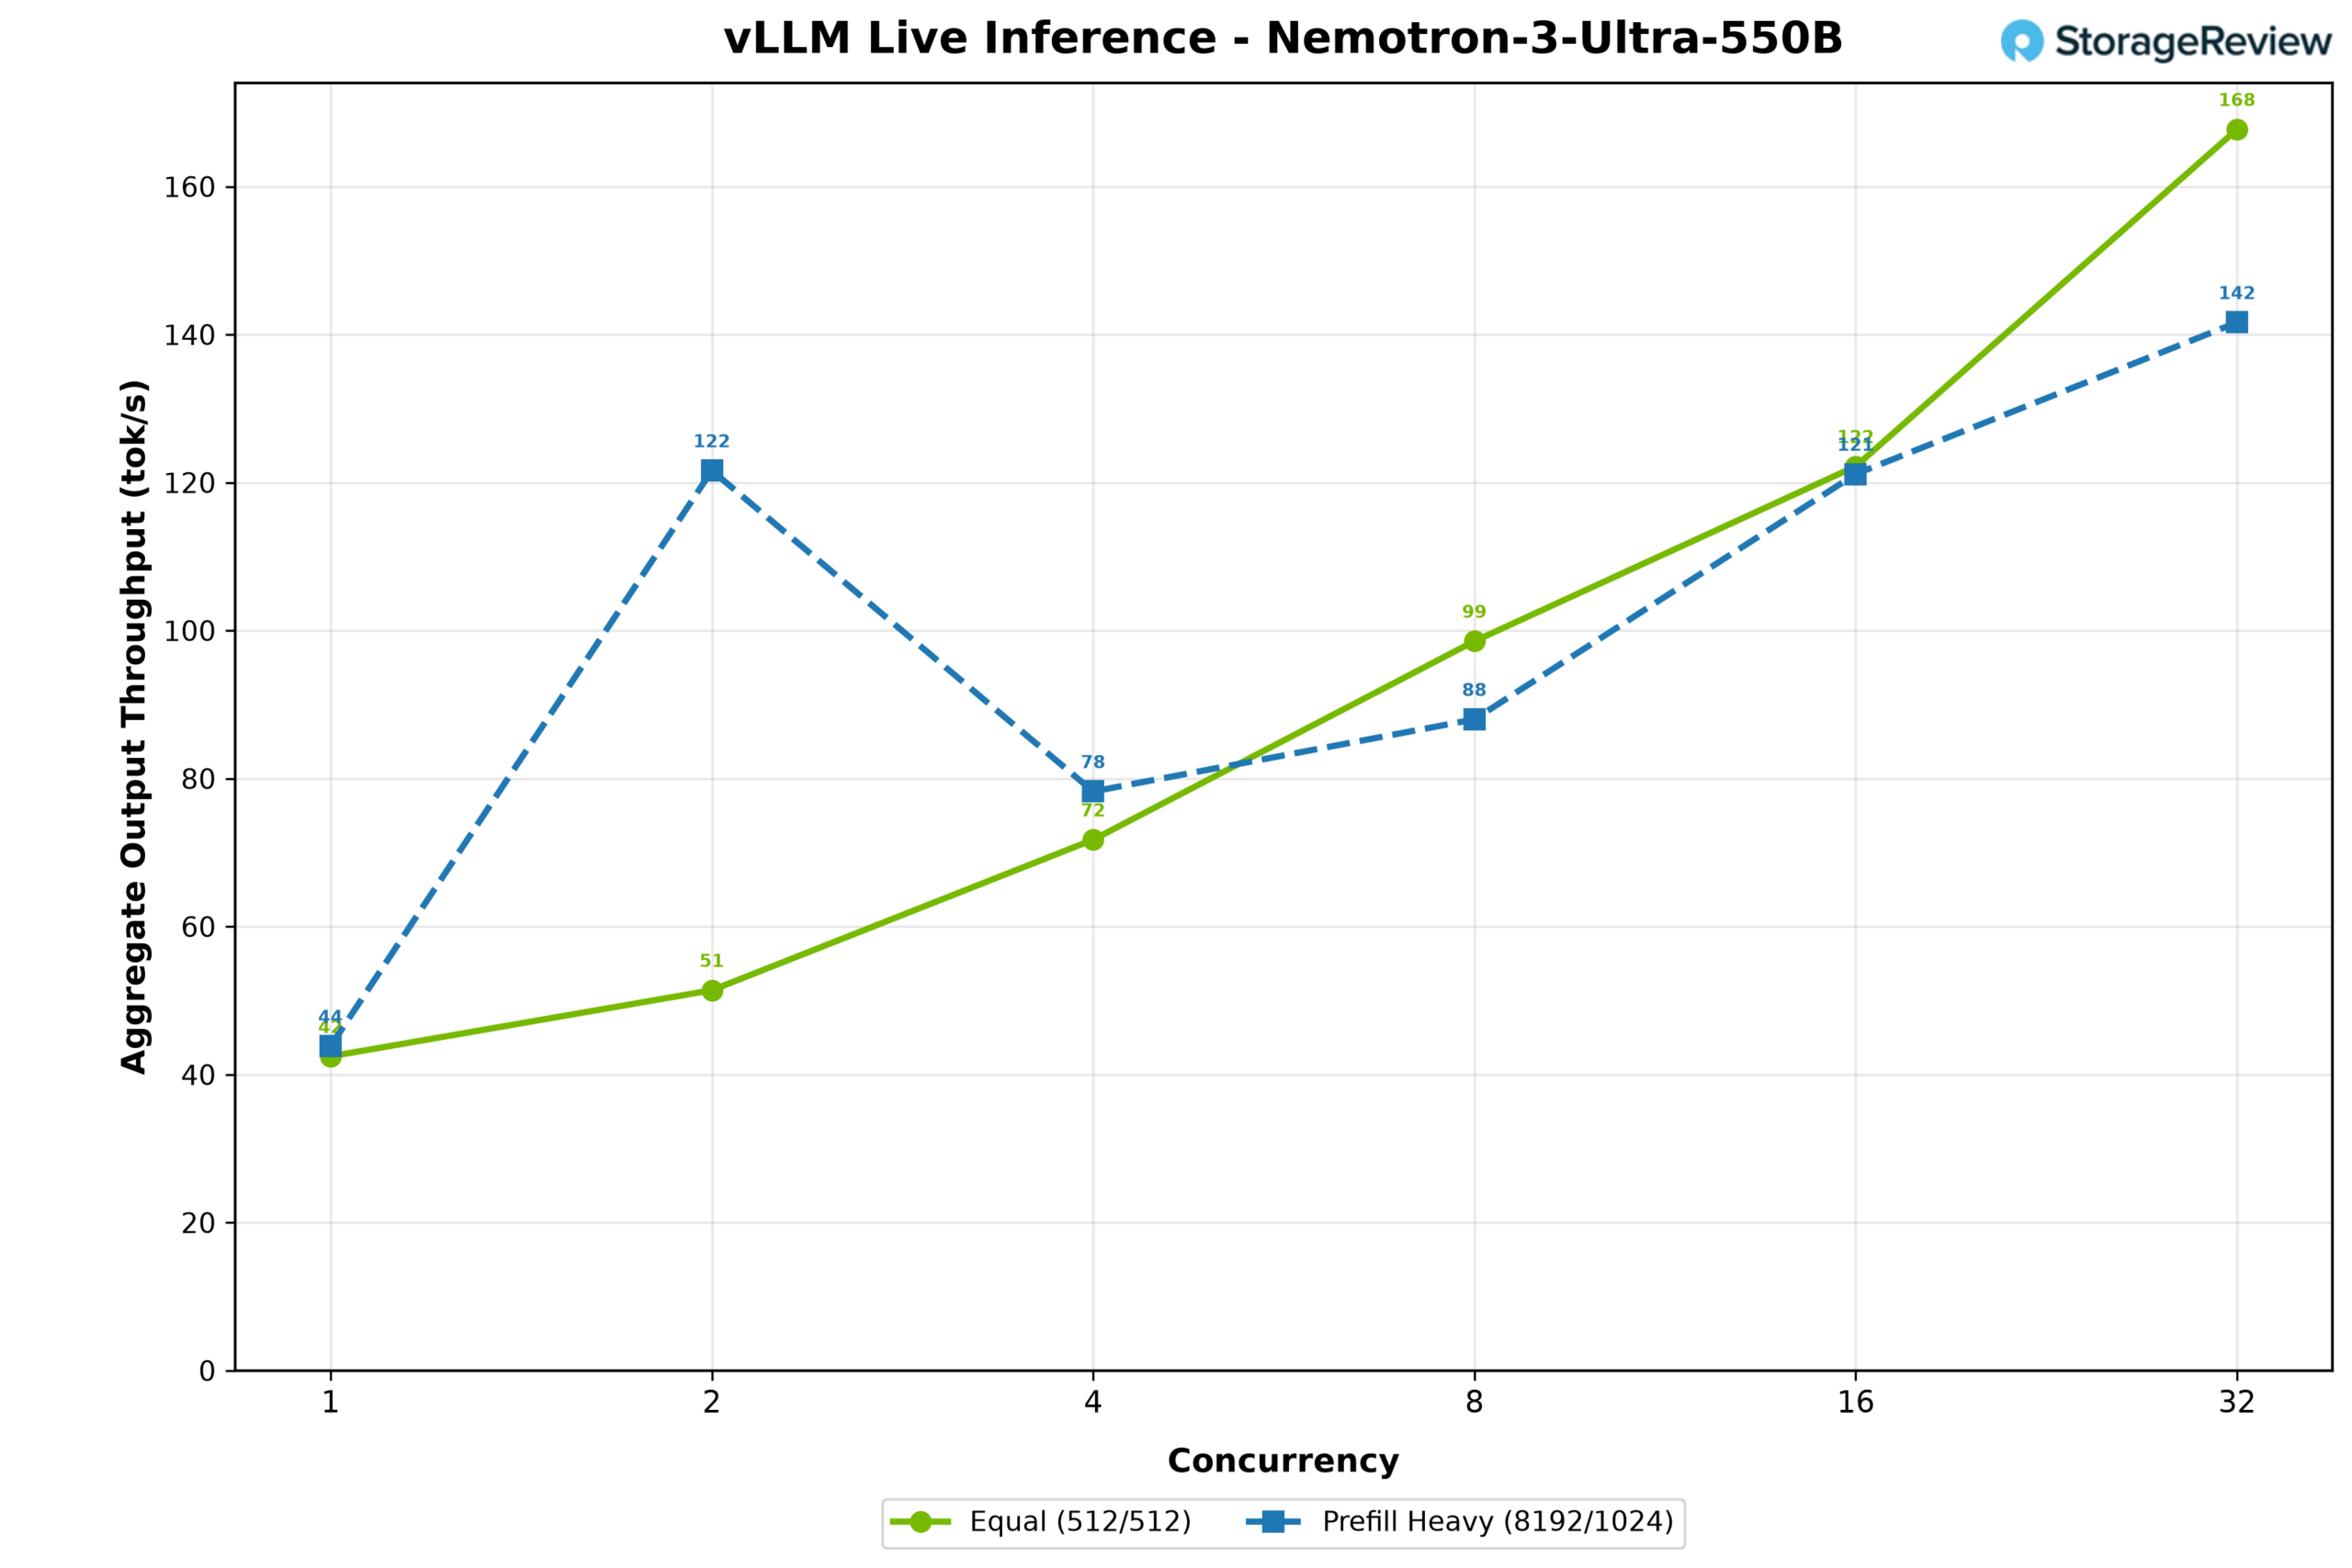
Nemotron-3-Ultra 550B är den största modellen vi körde, och den som mest direkt använder hela den koherenta poolen. Det är en 307 GB NVFP4 hybrid Transformer-Mamba-modell, alldeles för stor för enbart HBM, med 114 GB av dess vikter avlastade till Grace-minne. MTP-spekulativ avkodning användes med en syntetisk acceptanslängd på 5 tokens. Utdataflödet i 512/512-arbetsbelastningen började på 43 tokens per sekund vid samtidighet 1 och klättrade till 168 vid samtidighet 32. Den förfyllningstunga arbetsbelastningen berättade en mer intressant historia: dataflödet ökade från 44 tokens per sekund vid samtidighet 1 till en topp på 122 vid samtidighet 2, men sjönk sedan tillbaka till 78 vid samtidighet 4 när de långa prompterna fyllde den begränsade KV-cachen. Precis som med GLM-5.2 följer de två profilerna varandra noggrant, vilket återigen pekar på expertmigrering mellan Grace och GPU:n som den begränsande faktorn snarare än beräkning. Svepet avslutades vid samtidighet 32 av samma anledning: det fanns inte tillräckligt med HBM kvar för ytterligare kontext.
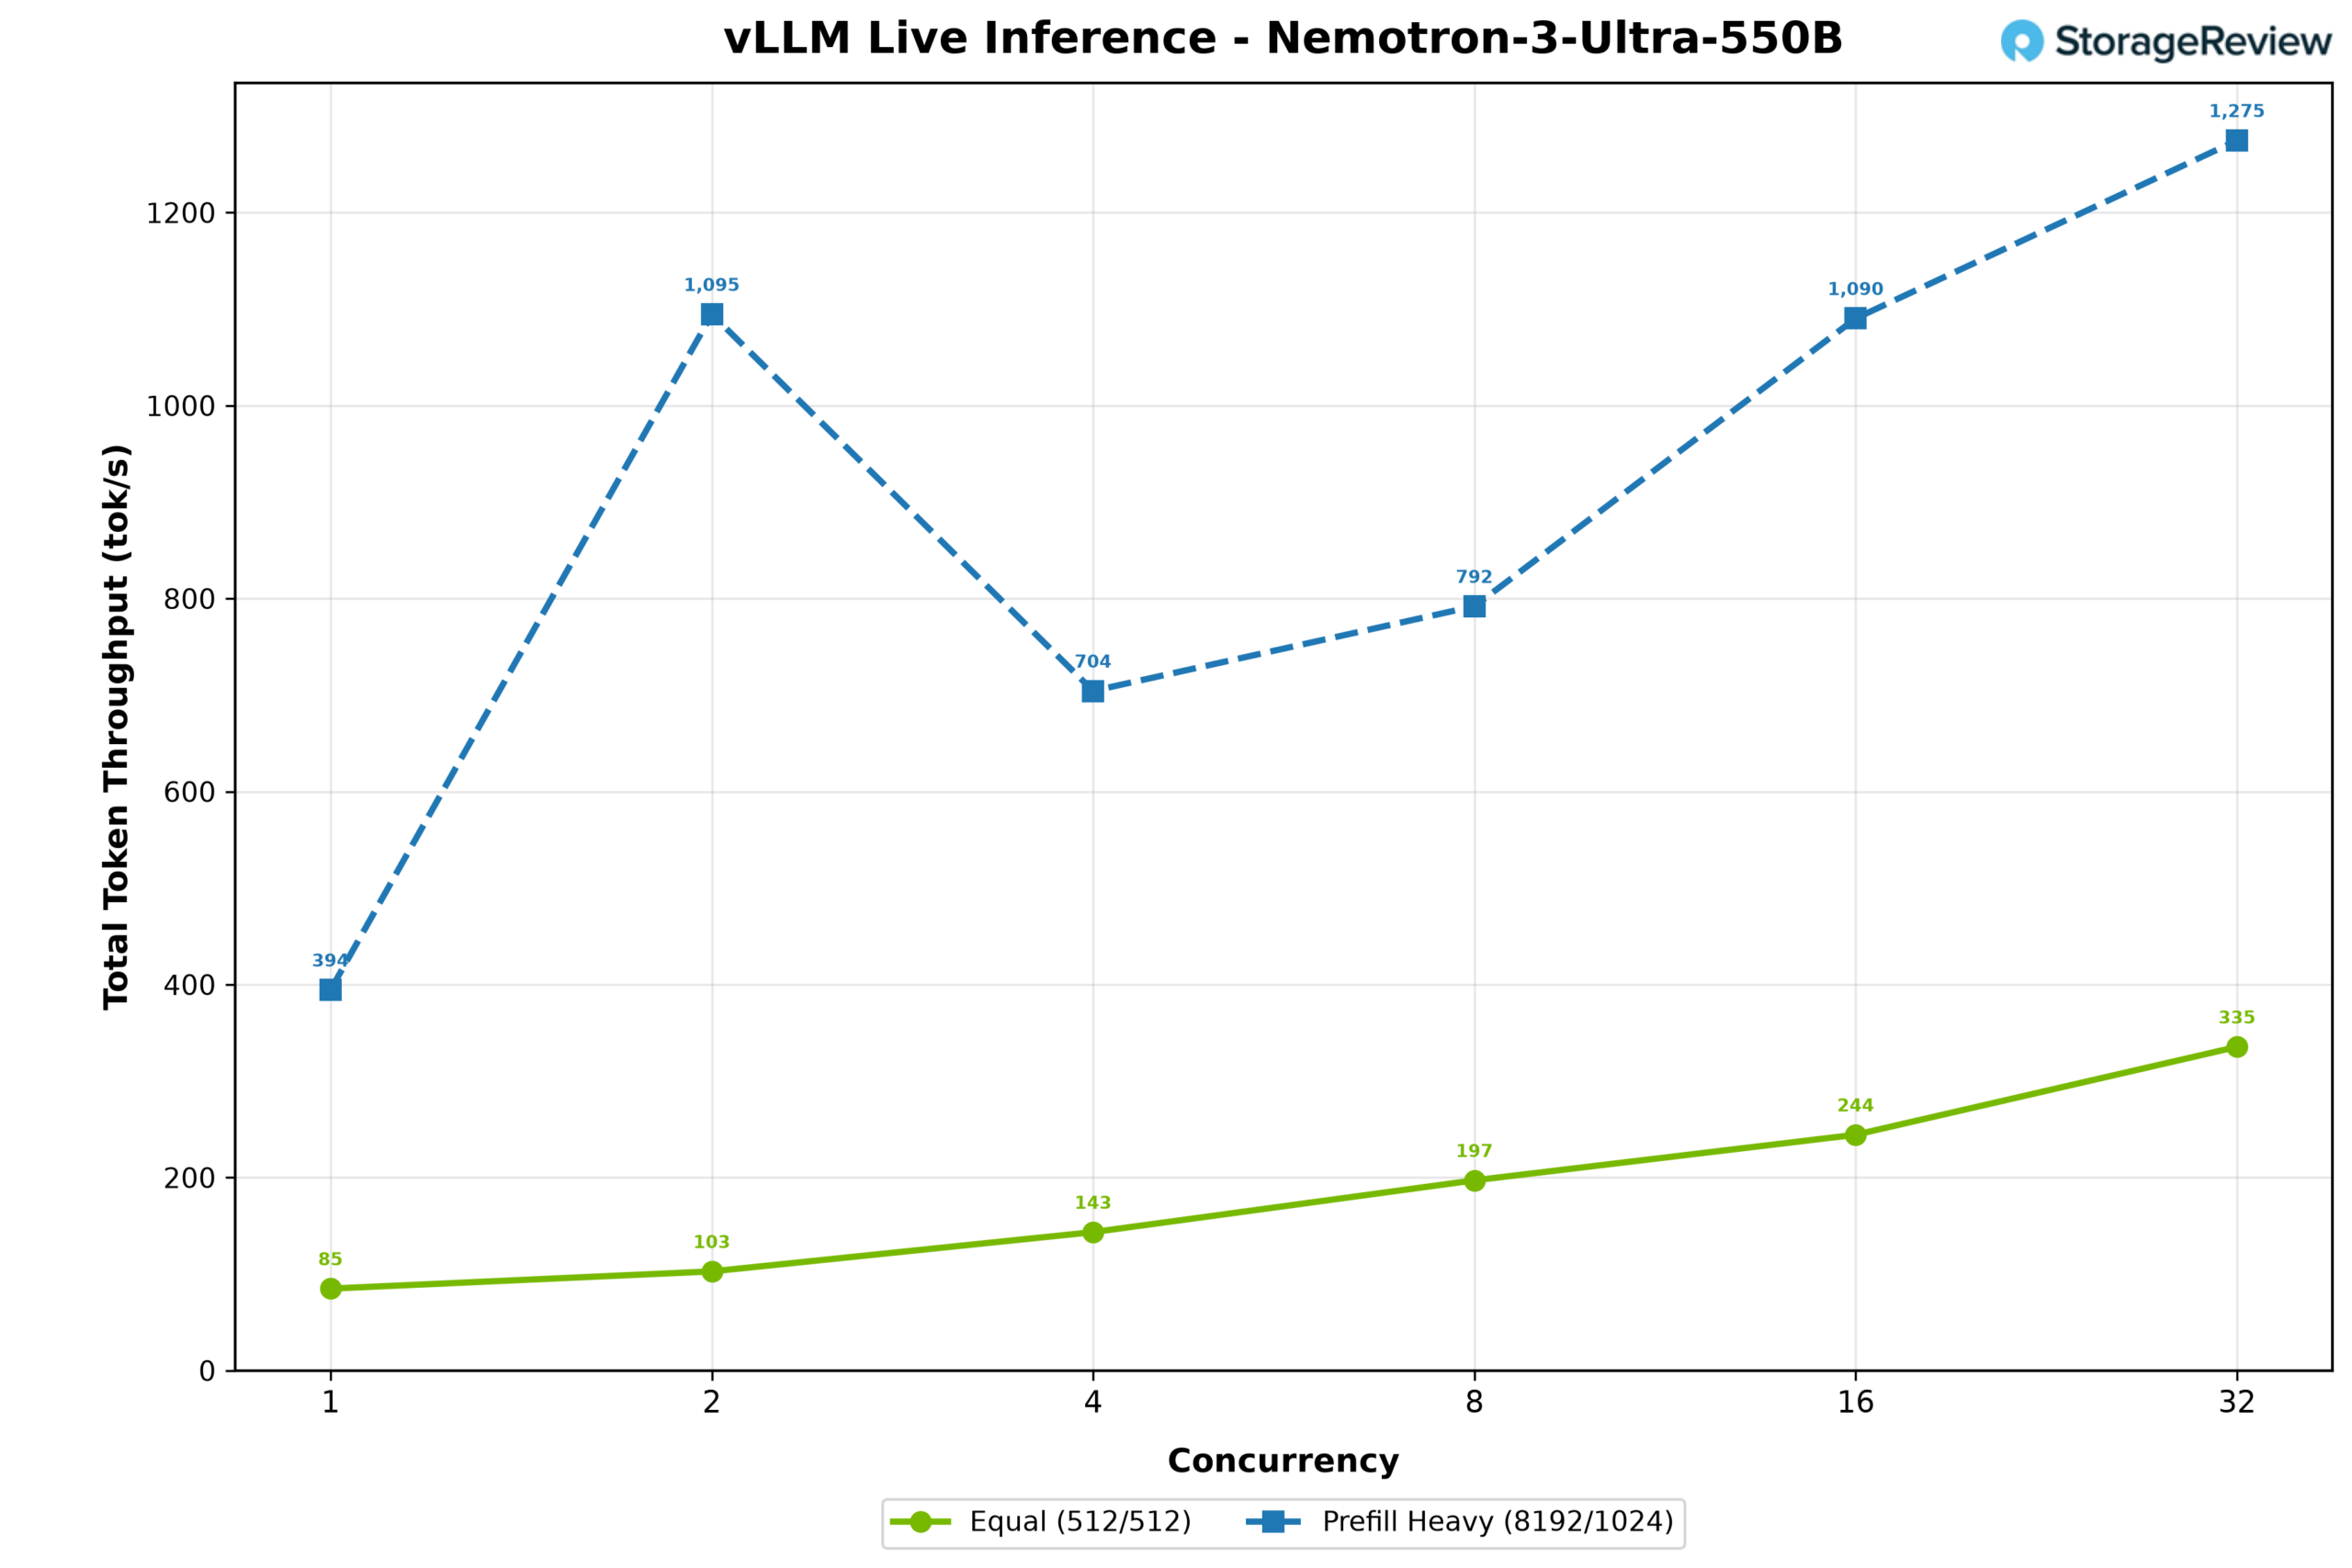
Den totala genomströmningen av tokens följde, med den förfyllningstunga arbetsbelastningen som toppade på 2 506 tokens per sekund vid samtidighet 2 innan den minskade till 2 169 vid samtidighet 4, medan arbetsbelastningen för 512/512 skalades från 85 till 336 tokens per sekund.
WS300 jämfört med Blackwell RTX PRO 6000 jämfört med DGX Spark
Den här halvan av våra inferenstester sätter WS300 mot de två andra sätten att få Blackwell på eller nära ett skrivbord: Blackwell RTX PRO 6000, NVIDIAs 600W-arbetsstationskort, som finns i Dell Pro Max Tower T2 som vi recenserade tidigare, och den GB10-baserade DGX Spark, här representerad av Acer Veriton GN100 . Varje system körde samma vLLM-live-inferensarbetsbelastningar under två scenarier, en lika stor arbetsbelastning med 512 indata- och 512 utdata-tokens och en förfylld tung arbetsbelastning med 8 192 indata- och 1 024 utdata-tokens, på samtidighetsnivåer från 1 till 128. Vi kartlade aggregerad utdata och total dataflöde för varje modell som alla tre system kan hantera gemensamt: GPT-OSS-20B och GPT-OSS-120B i deras nativa MXFP4, Llama 3.1 8B vid BF16, FP8 och NVFP4, och Mistral Small 24B och Qwen3 Coder 30B vid BF16 och FP8.
GPT-OSS-20B
GPT-OSS-20B är det användarvänligaste testet i setet, en kontrollpunkt som enkelt passar alla tre systemen. Med lika stor arbetsbelastning skalade WS300 snyggt till 22 161 utdatatokens per sekund vid 128 samtidiga strömmar, ungefär 2.5 gånger RTX PRO 6000 vid 9 000 och 15 gånger DGX Spark vid 1 469. Resultat från en enda ström berättar samma historia i miniatyr: 530 tokens per sekund på Stationen, 244 på kortet och 50 på Spark.
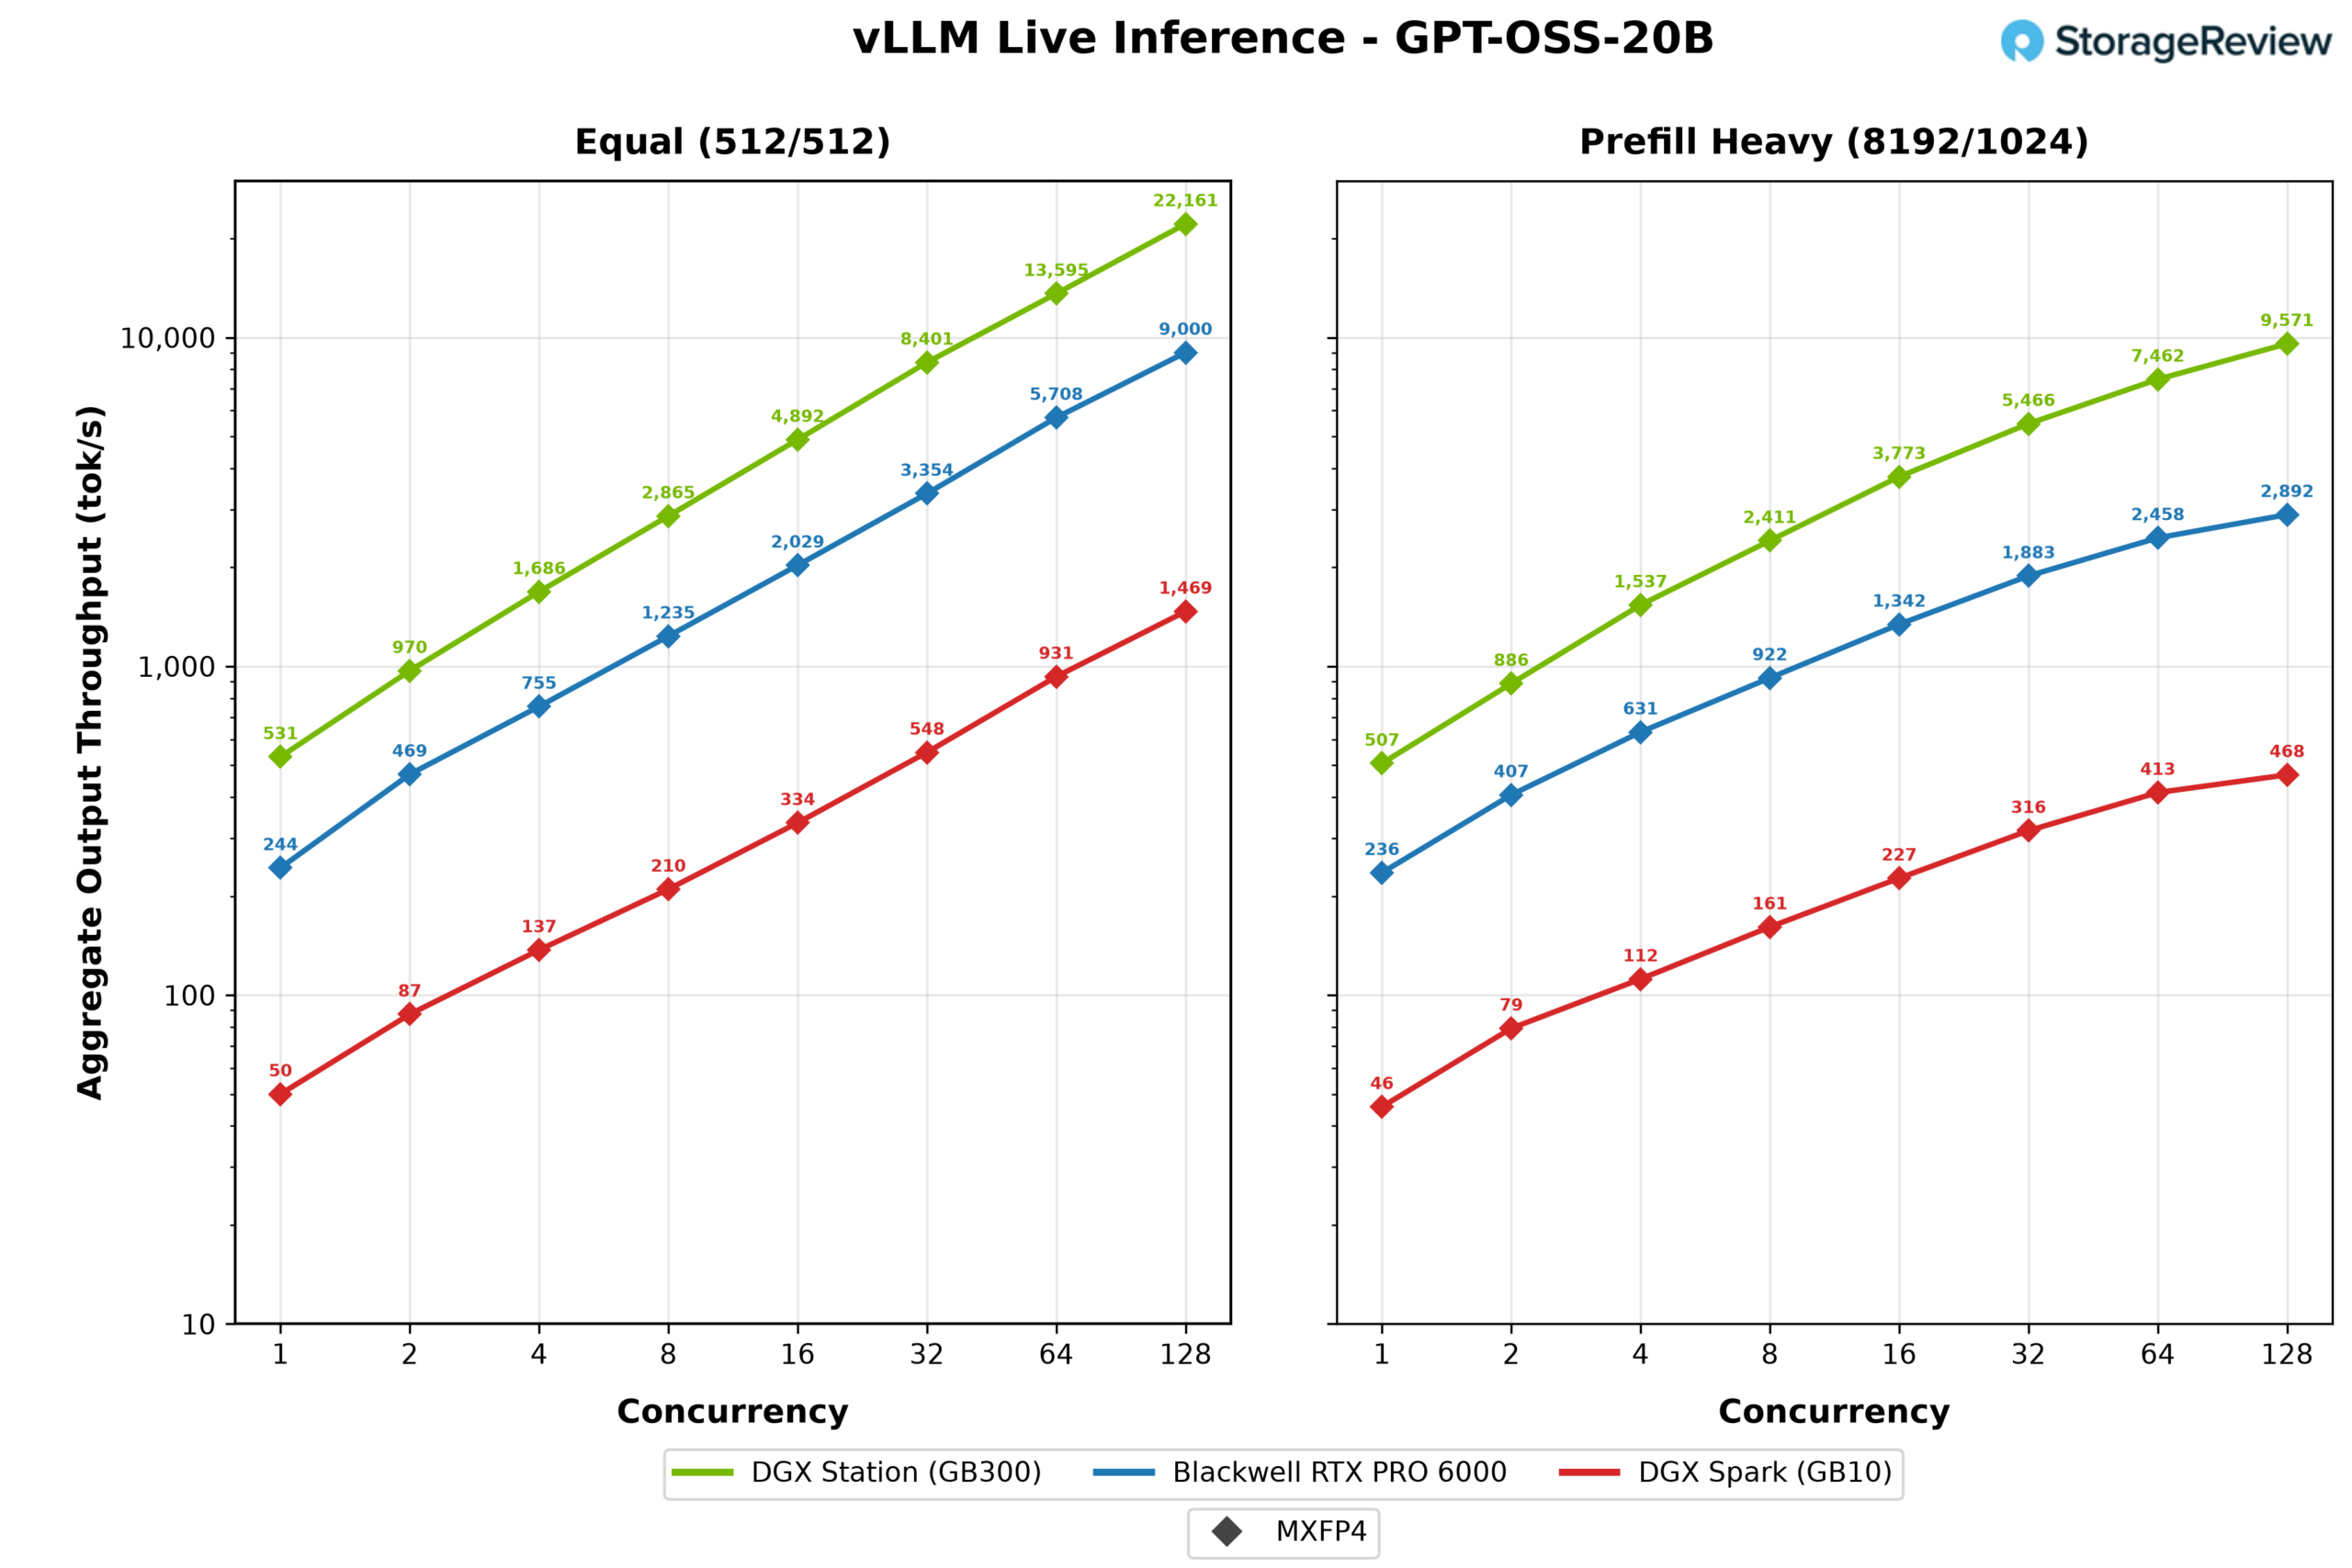
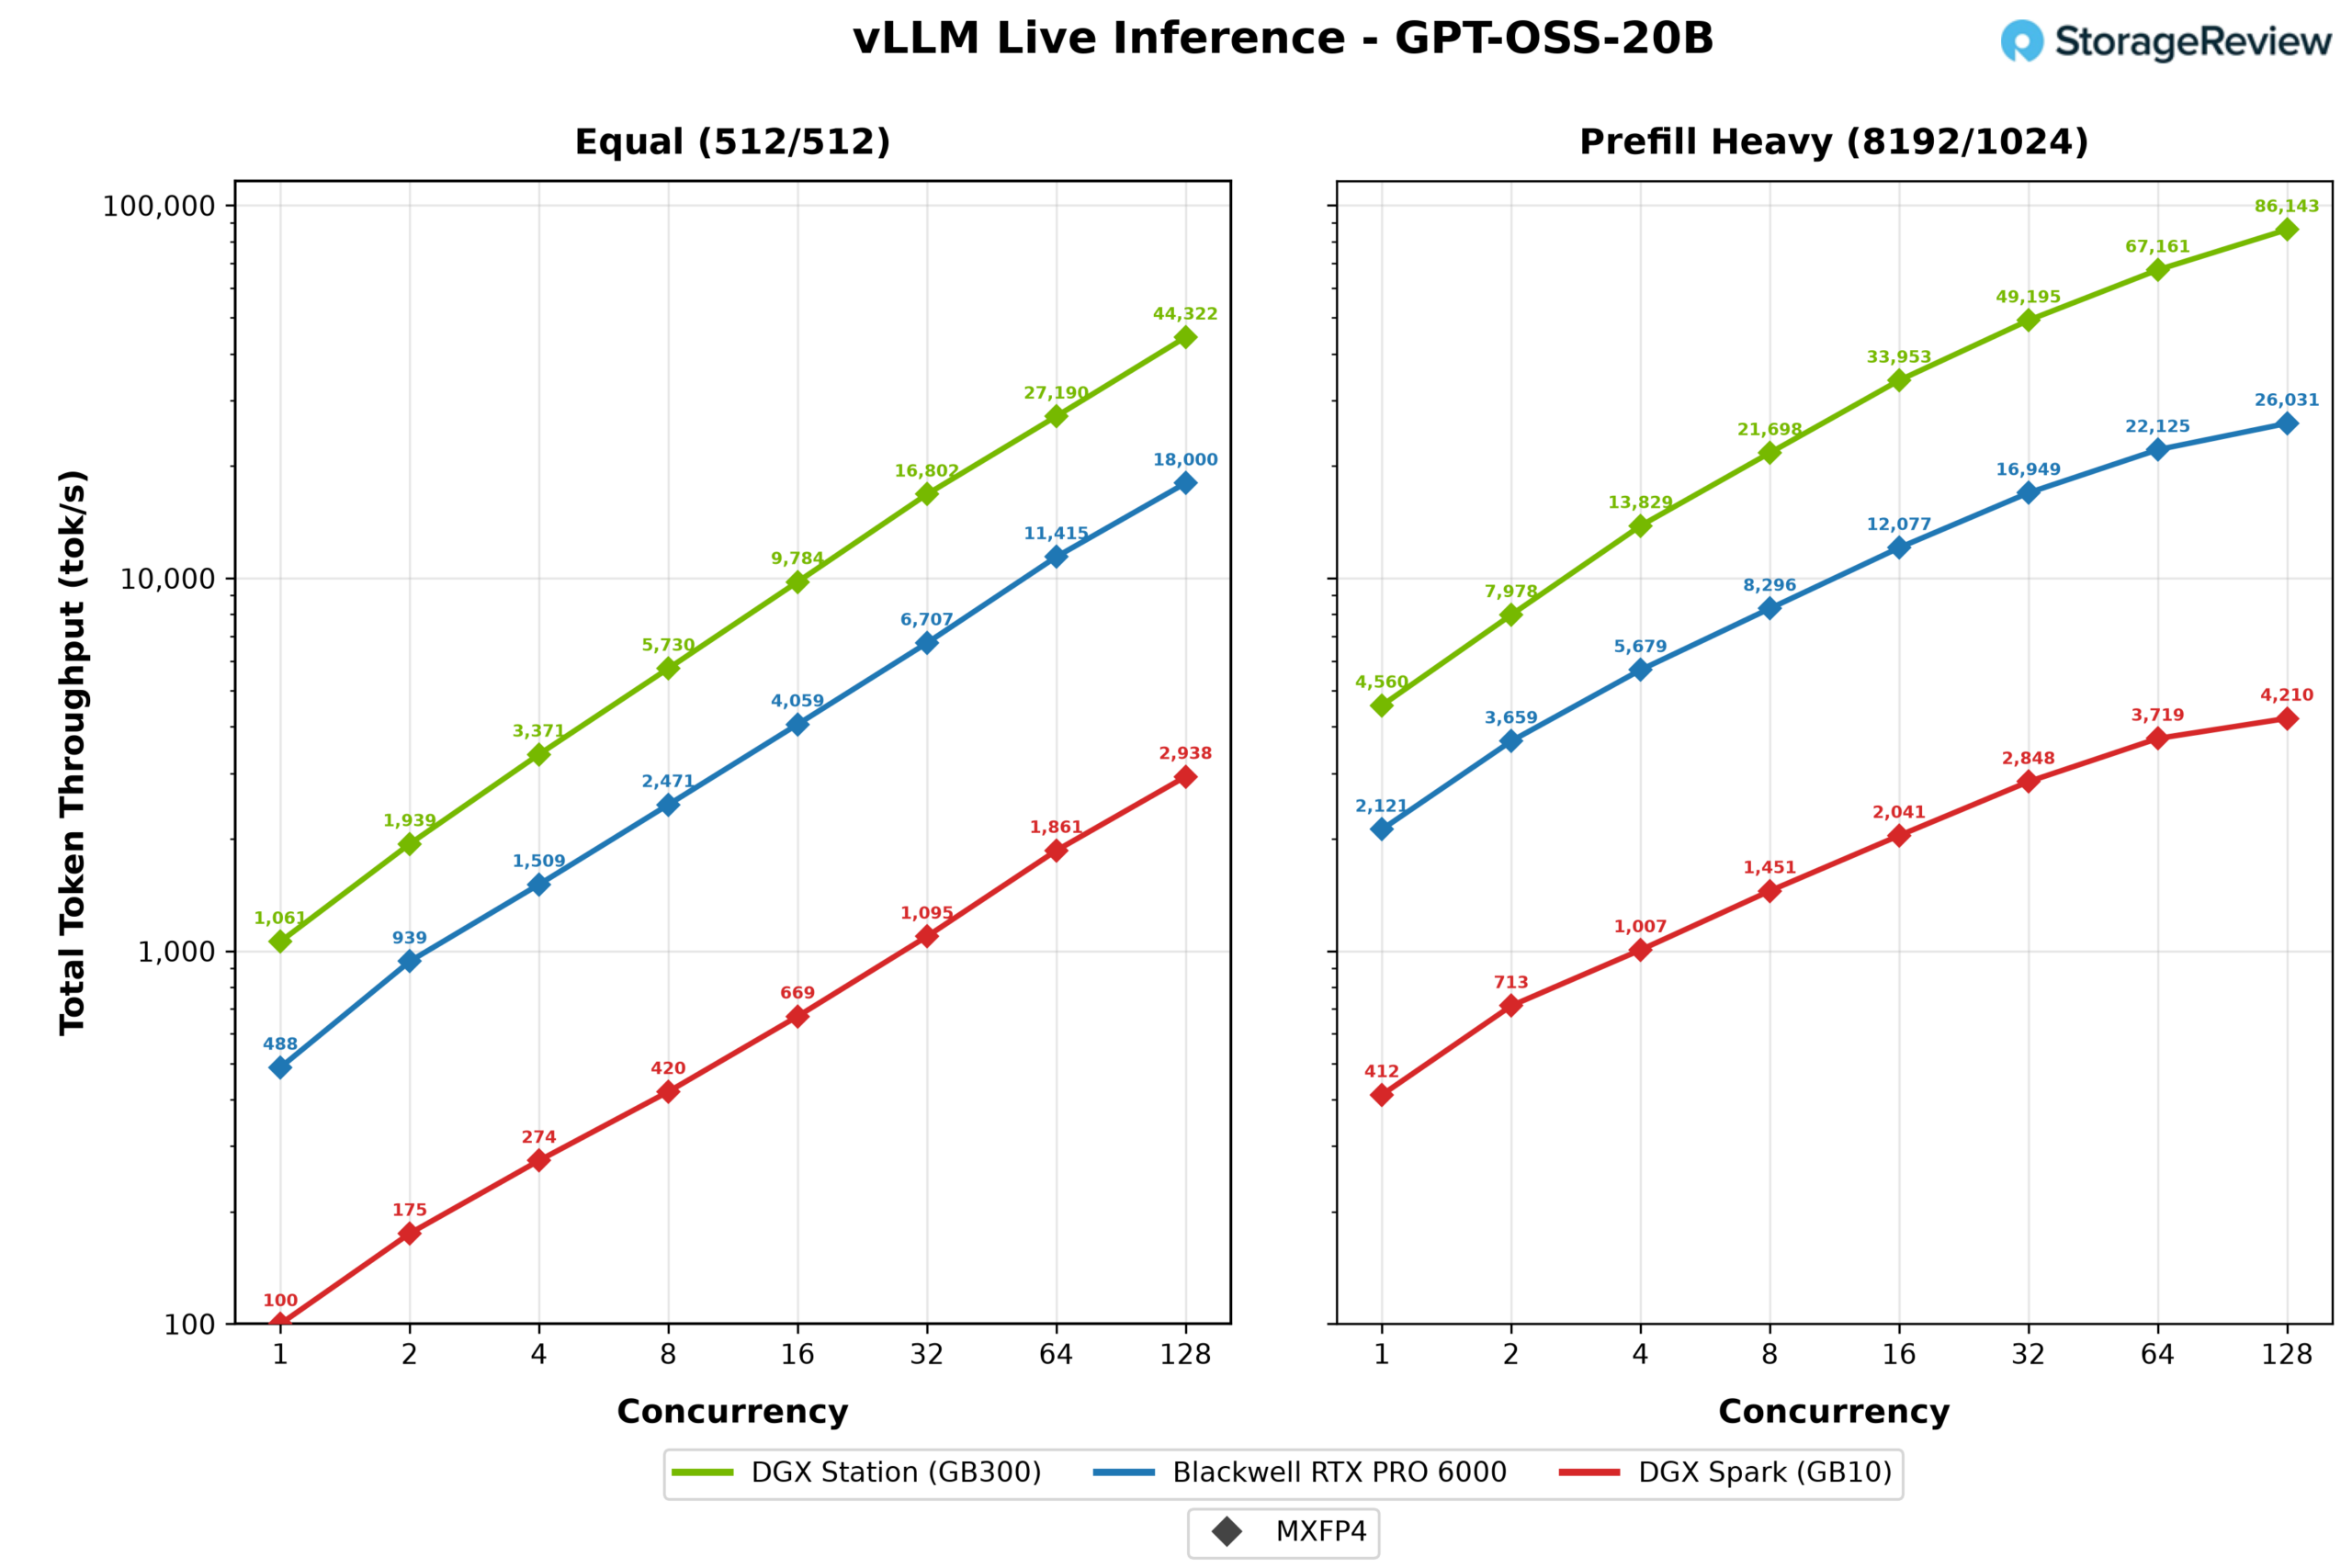
Scenariot med hög förfyllning skiljer fältet ytterligare åt. Med 8 192 token-prompter levererade WS300 fortfarande 9 572 utdatatokens per sekund som mest, vilket motsvarar mer än 86 000 tokens per sekund när förfyllningen räknas, medan RTX PRO 6000 nådde sin topp på 2 892 och Spark på 468.
GPT-OSS-120B
Om man uppgraderar till GPT-OSS-120B kan alla tre system fortfarande ladda modellen, men minneshierarkin börjar spela roll. WS300 nådde en topp på 9 294 utdatatokens per sekund under samma arbetsbelastning, 2.7 gånger RTX PRO 6000 på 3 384 och nästan 19 gånger DGX Spark på 500.
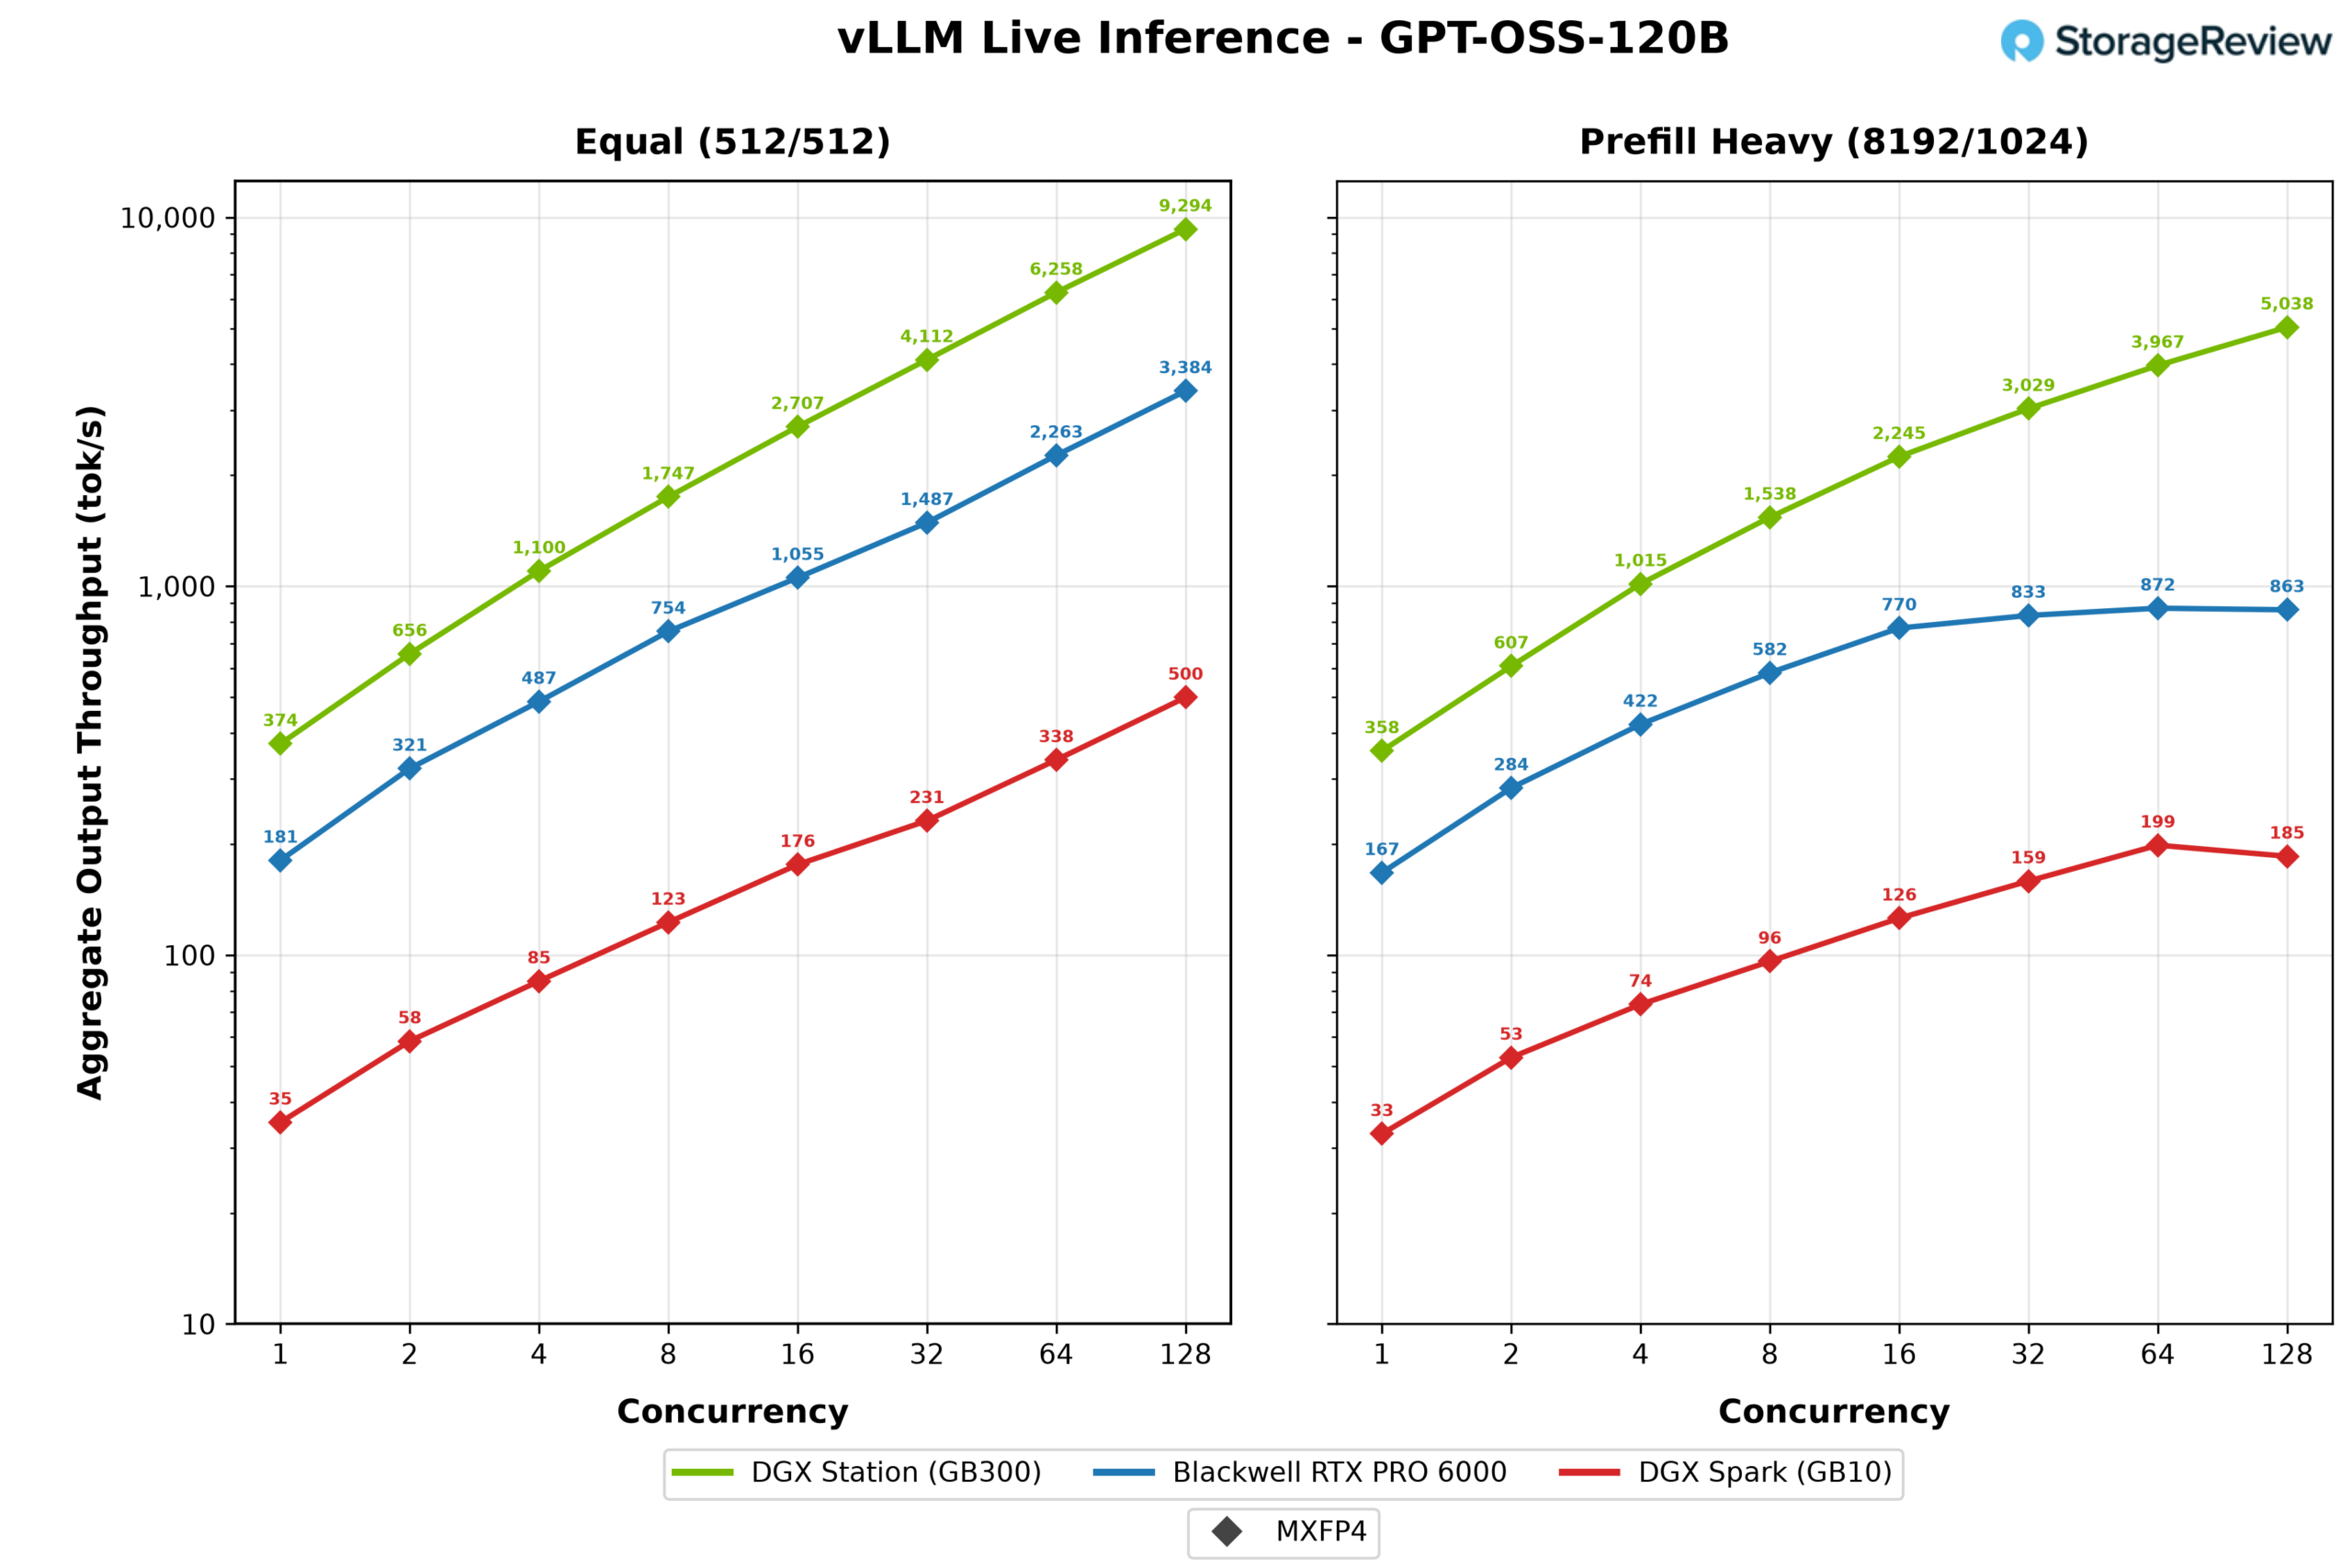
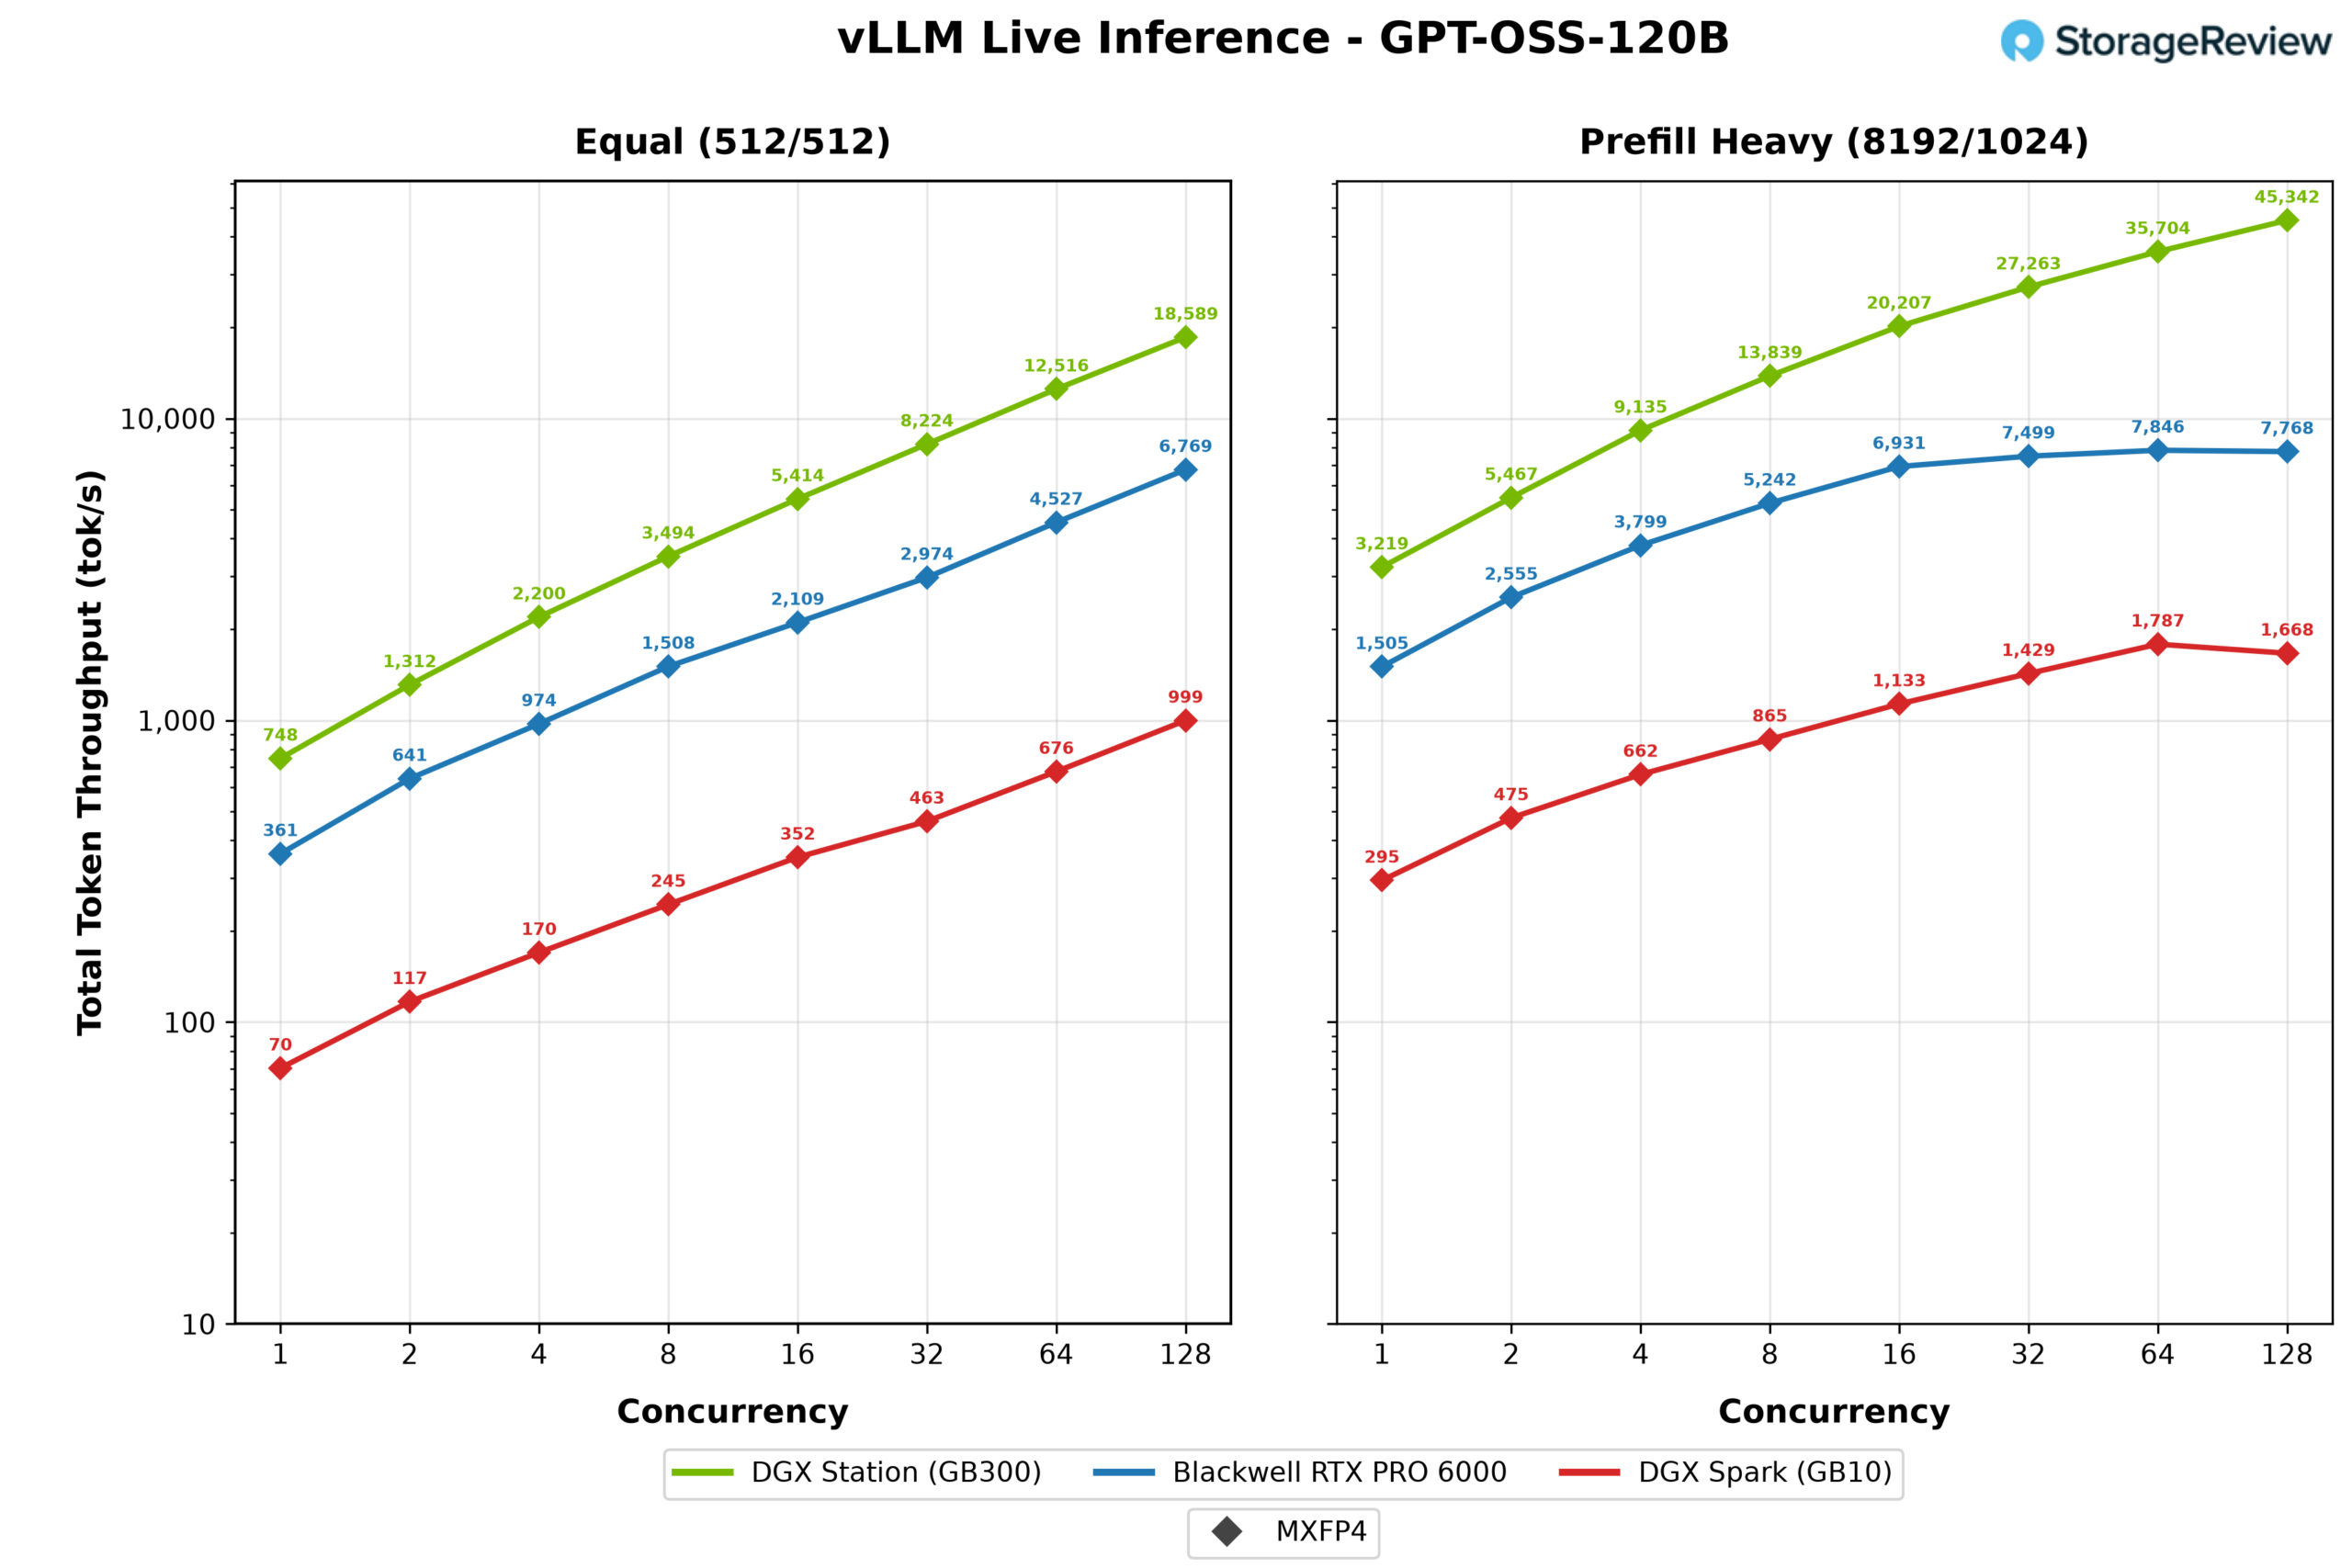
Det är vid förfyllningsintensiv körning som de mindre systemen når sina gränser. RTX PRO 6000 planade ut vid 872 utdatatokens per sekund med 64 samtidiga strömmar, och Spark vid 199, medan WS300 fortfarande klättrade vid 128 strömmar och slutade på 5 038, ett gap på nästan 6 gånger kortet. Långa prompter sväller KV-cachen, och system med mindre minnesutrymme får slut på utrymme för batchning långt före Station.
Lama 3.1 8B
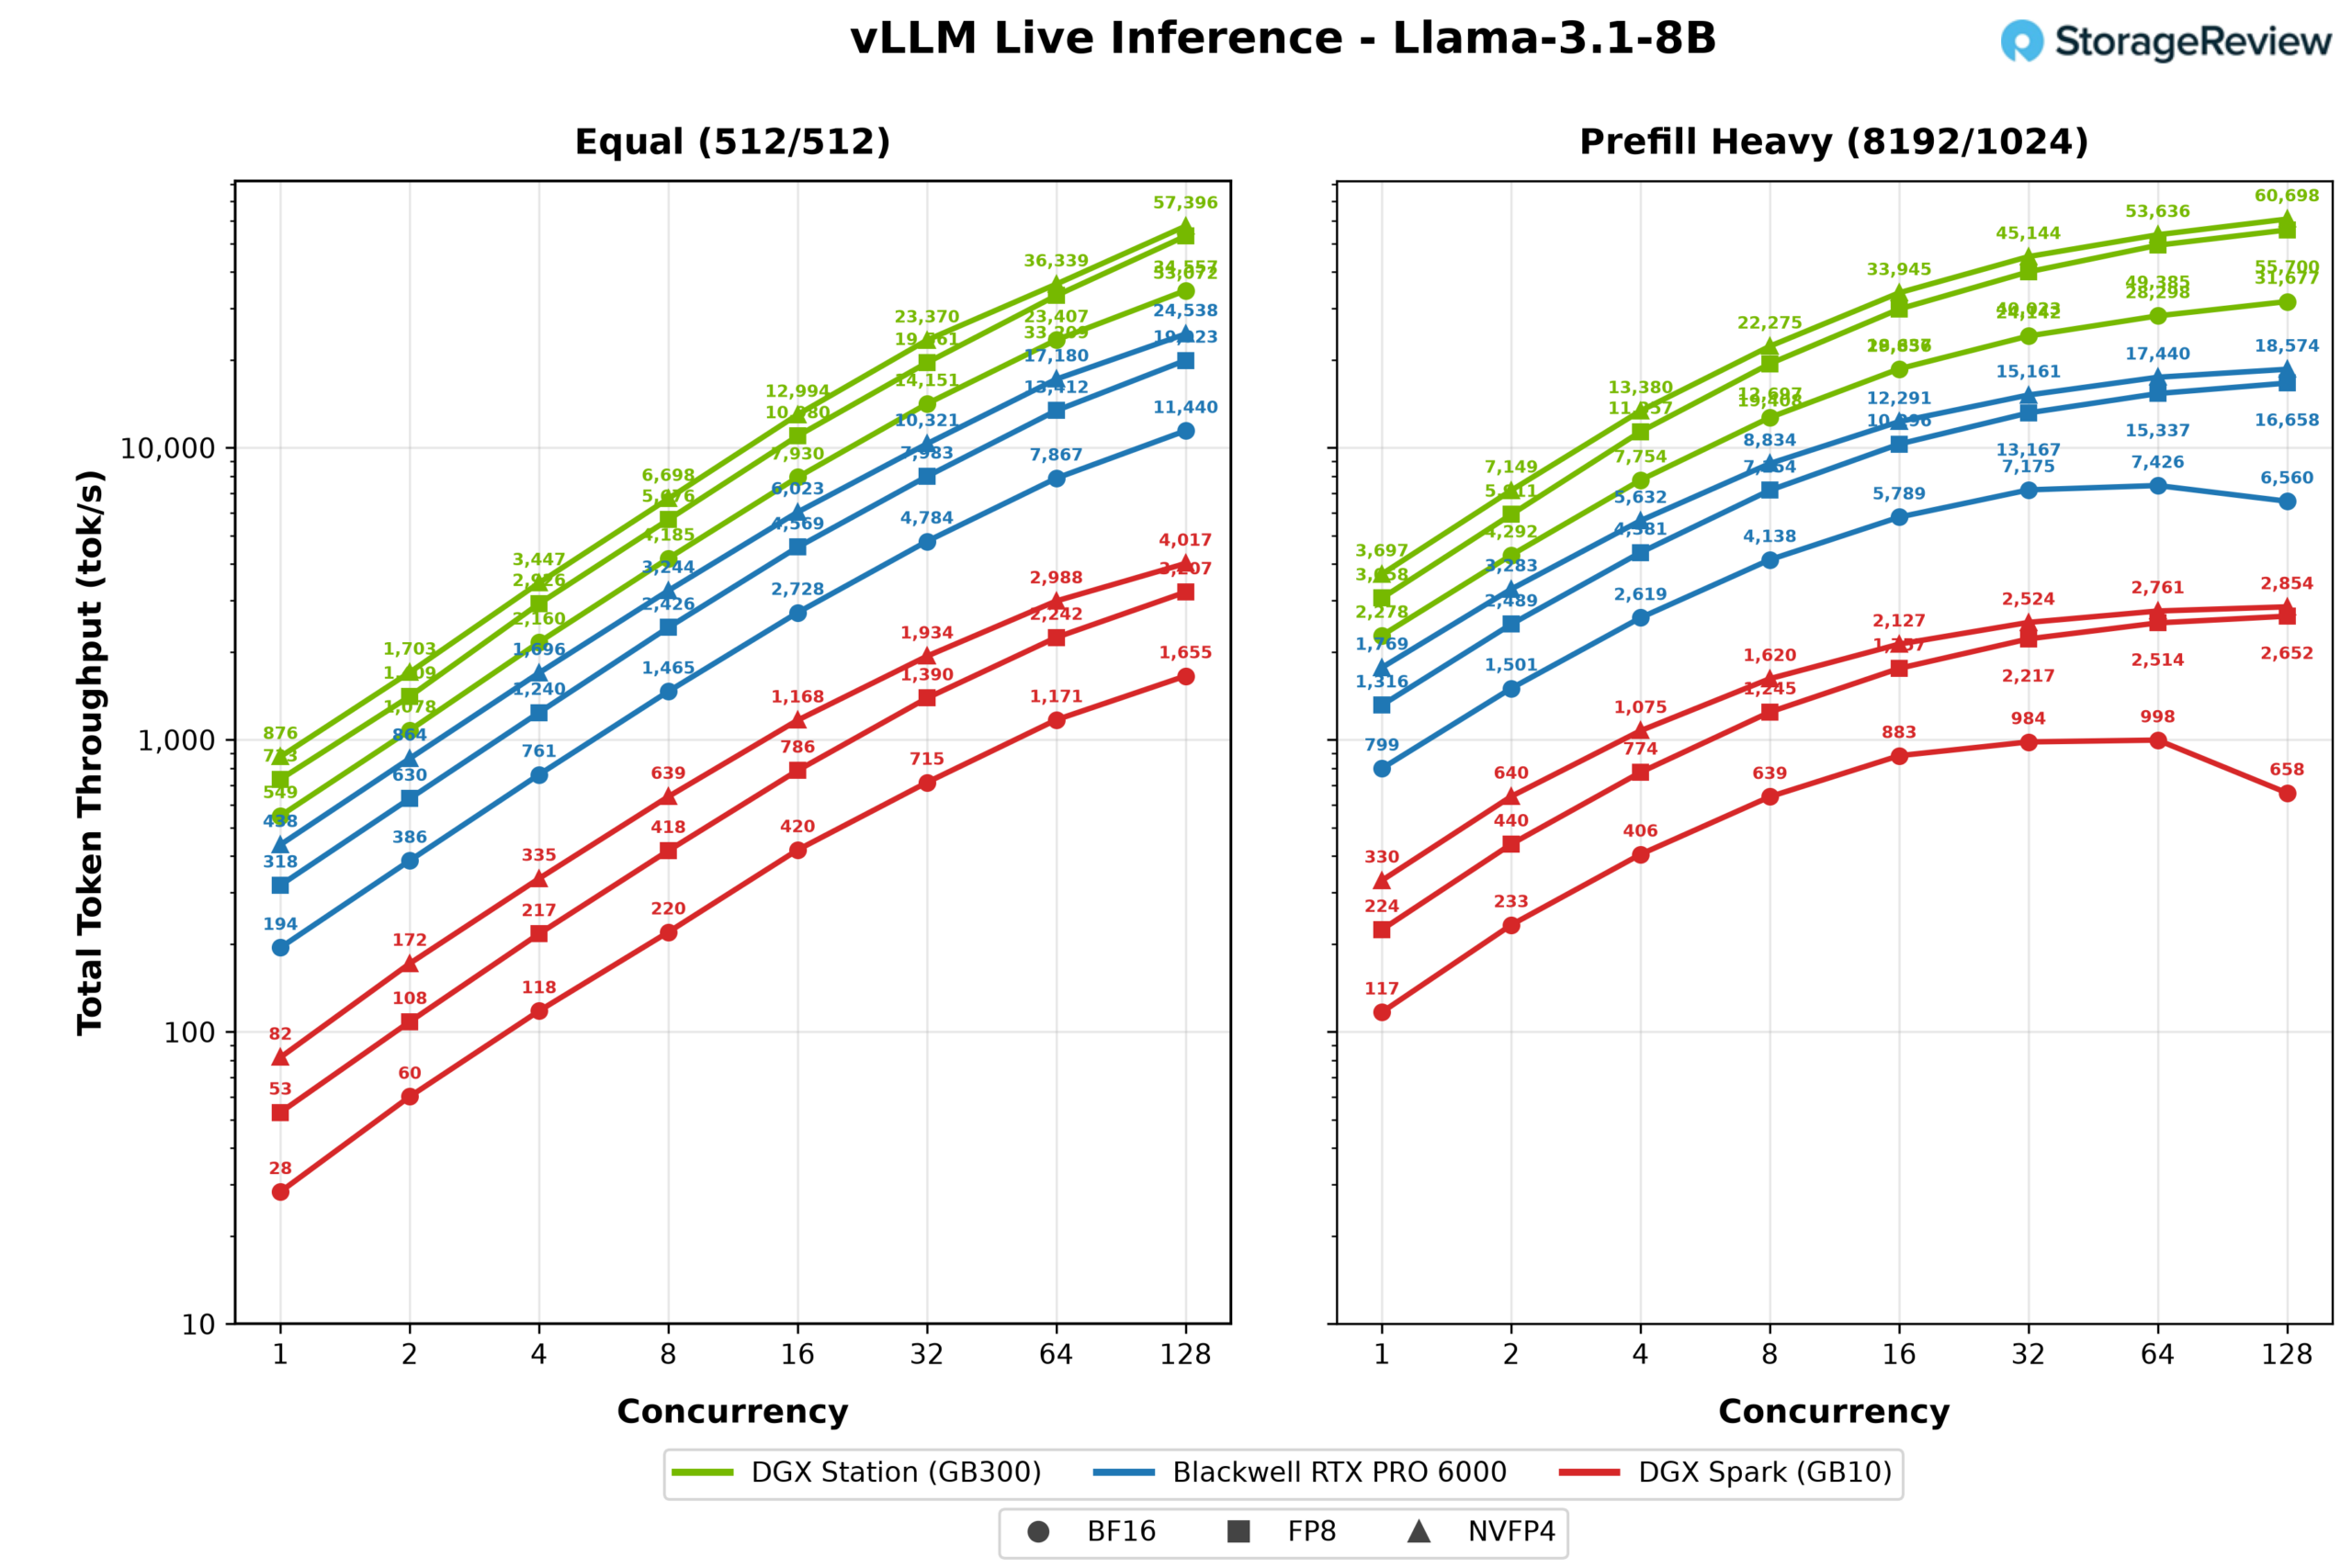
Llama 3.1 8B är tillräckligt liten för att vi skulle kunna köra den på BF16, FP8 och NVFP4 på alla system, vilket gör den till den renaste bilden av vad kvantisering ger på varje maskin. Vid 128 samtidiga strömmar under samma arbetsbelastning gick WS300 från 17 278 utdatatokens per sekund vid BF16 till 28 698 vid NVFP4, en ökning på 66 procent. RTX PRO 6000 ökade med 114 procent från samma ökning, från 5 720 till 12 269, och DGX Spark ökade med 143 procent, från 828 till 2 009. Mönstret är värt att komma ihåg: ju mindre maskinen är, desto mer lönar sig kvantisering.
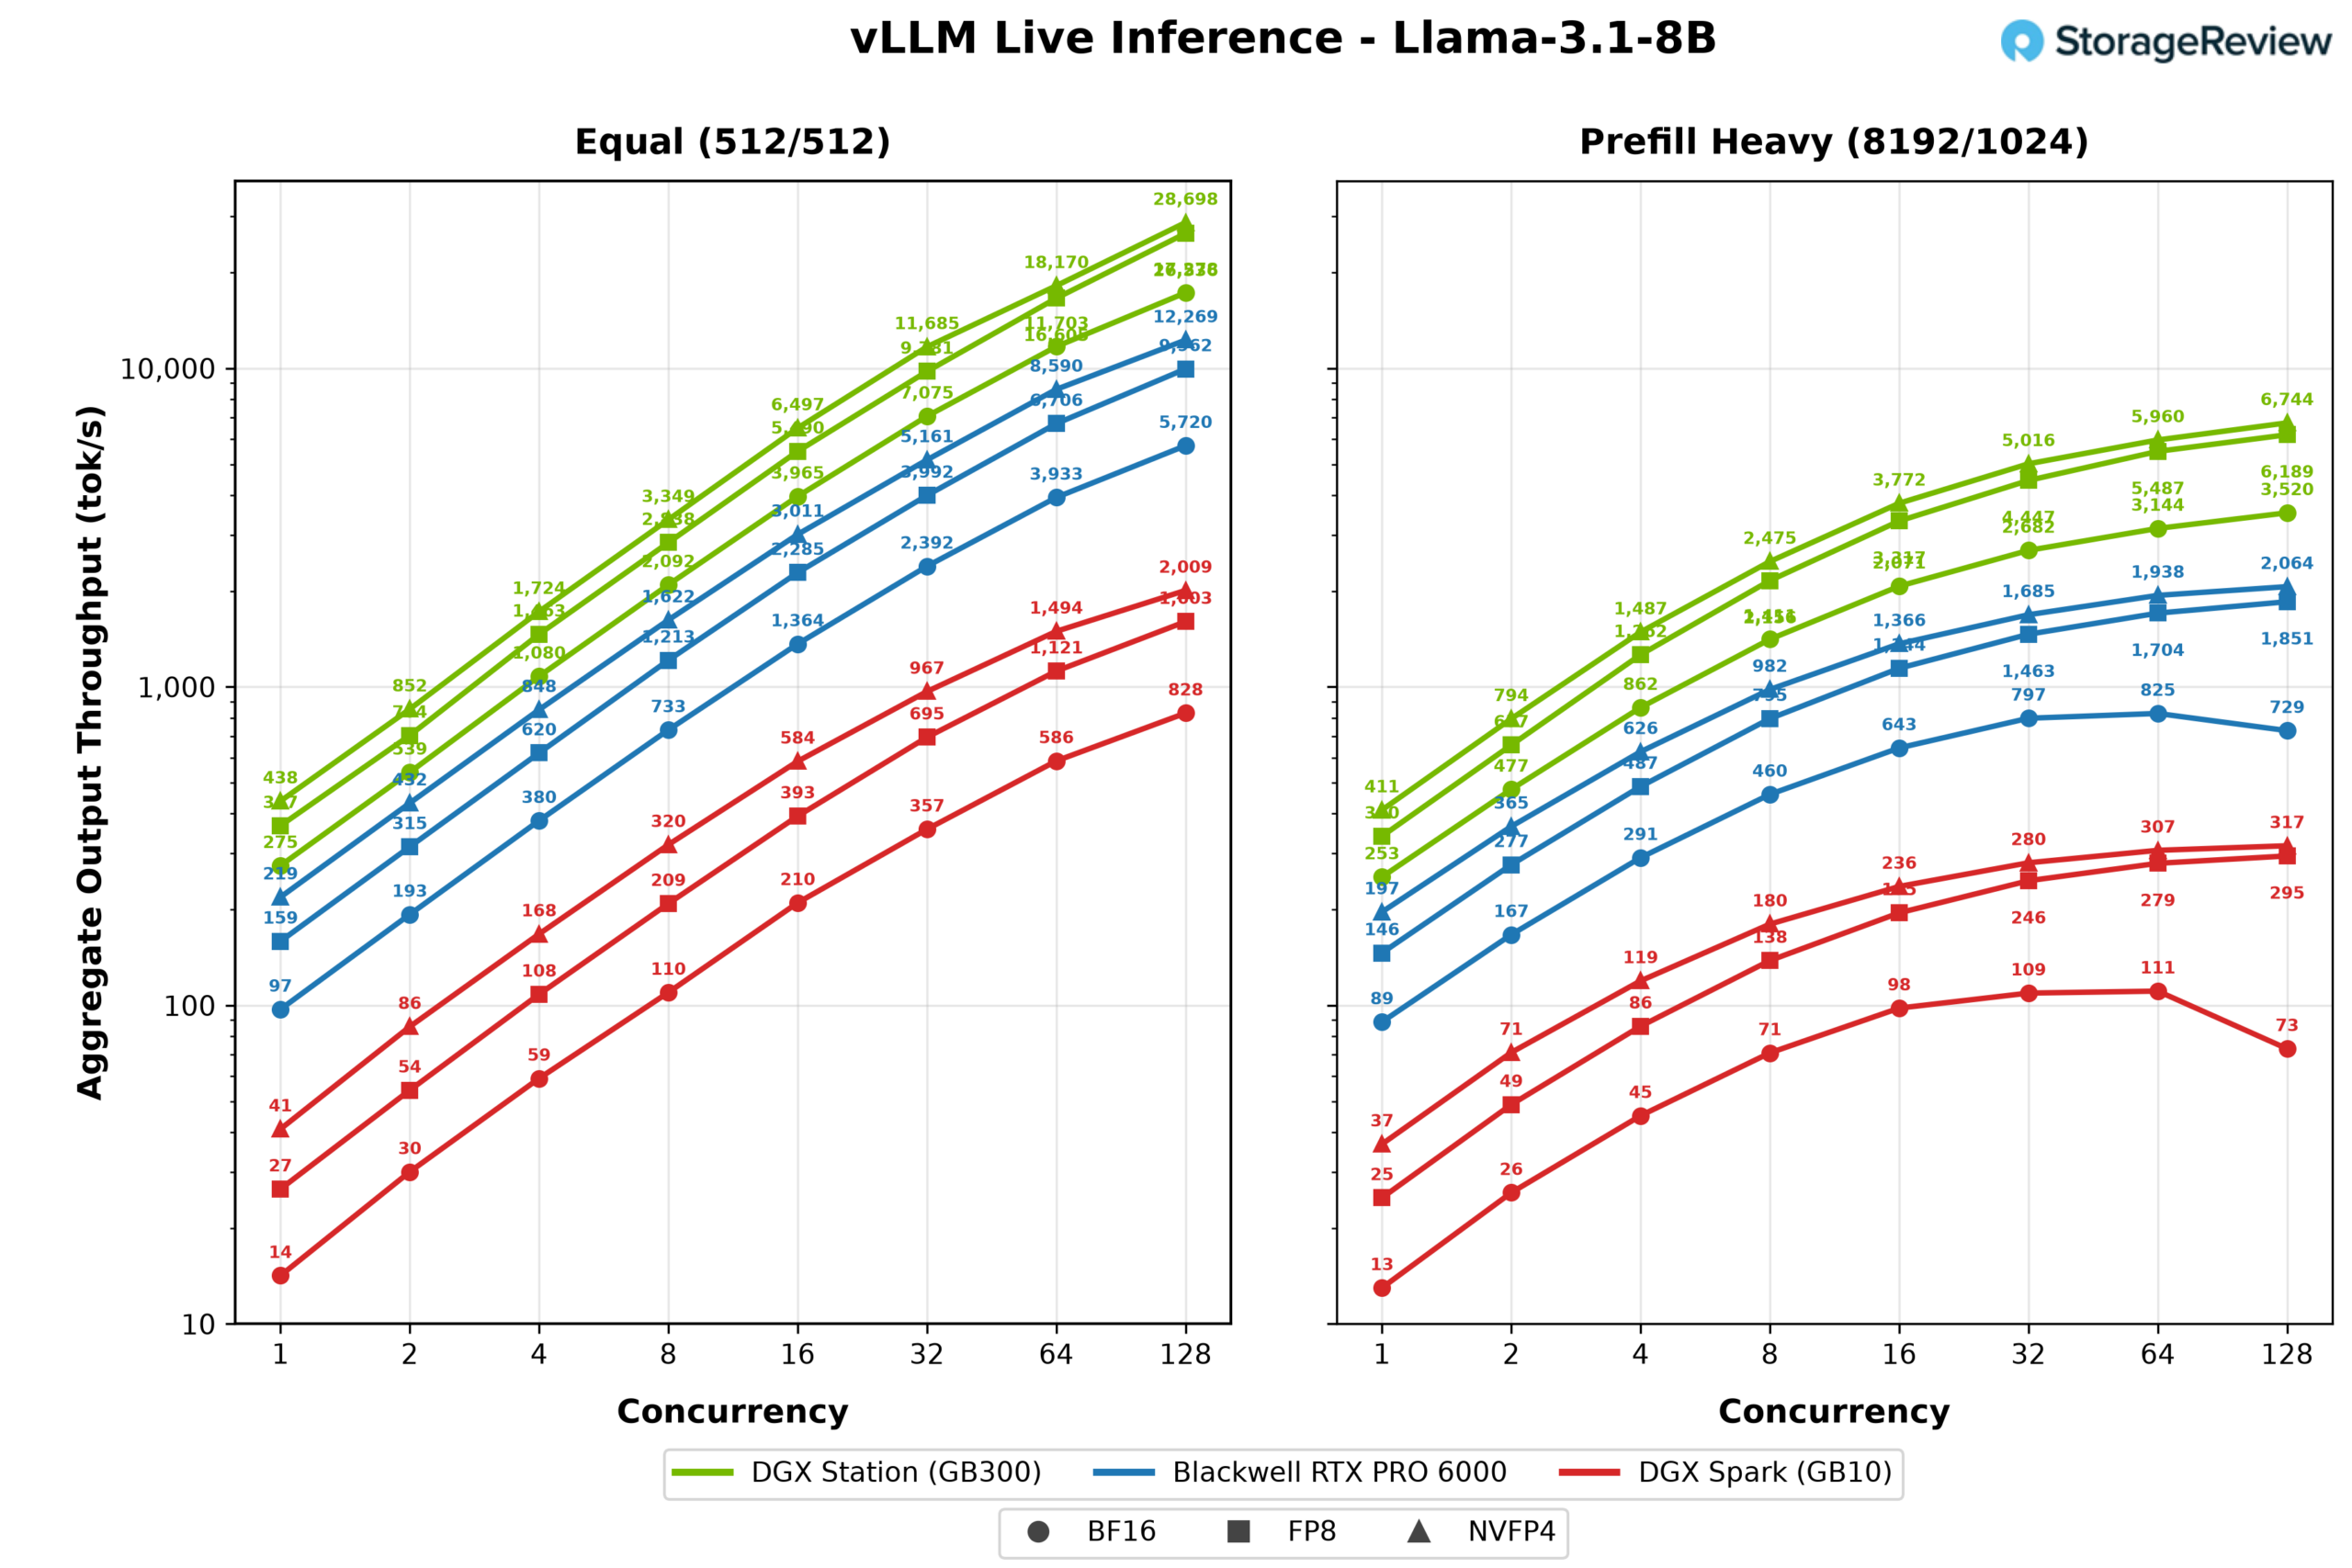
Resultat med hög förfyllning komprimerar hela fältet, där WS300:s NVFP4-körning når en topp på 6 744 utdatatokens per sekund jämfört med 2 064 för kortet och 317 för Spark.
Mistral Small 24B
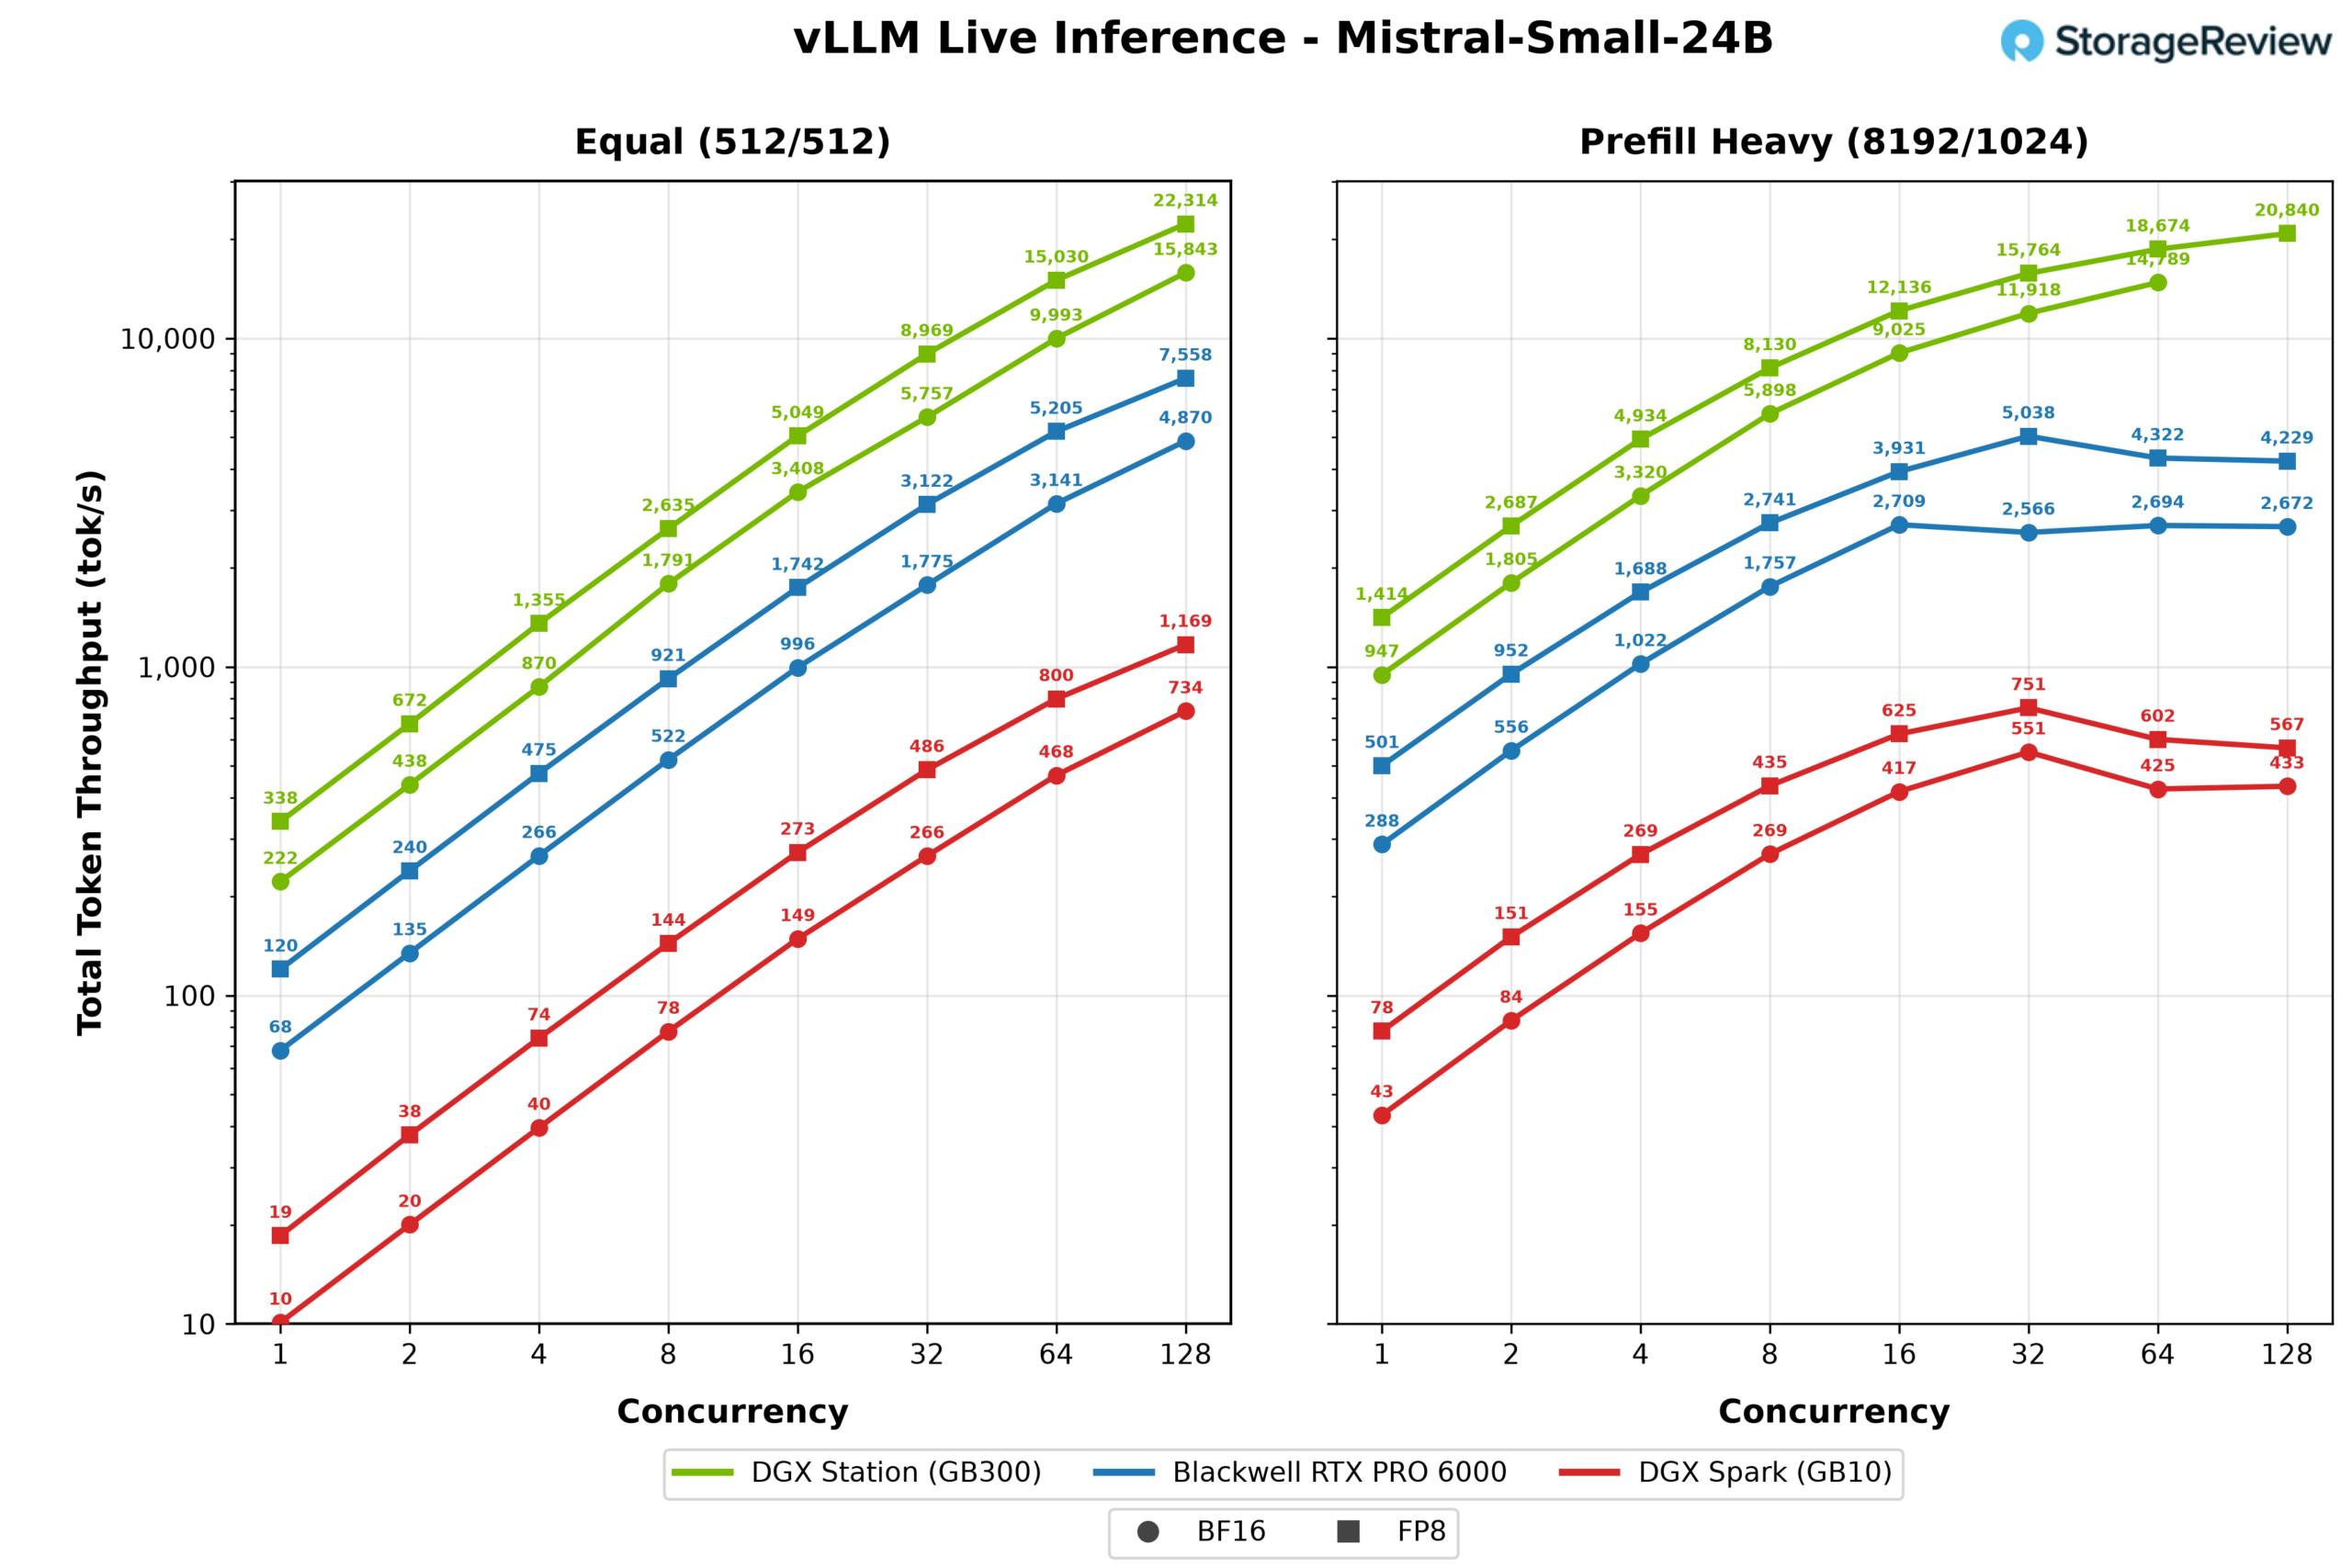
Mistral Small 24B producerade de största luckorna i setet. Vid FP8 under samma arbetsbelastning nådde WS300 en topp på 11 157 utdatatokens per sekund, tre gånger RTX PRO 6000 på 3 779 och 19 gånger DGX Spark på 585. Med en enda ström är Stationens 169 tokens per sekund mycket närmare interaktiv komfort än Sparks 9.
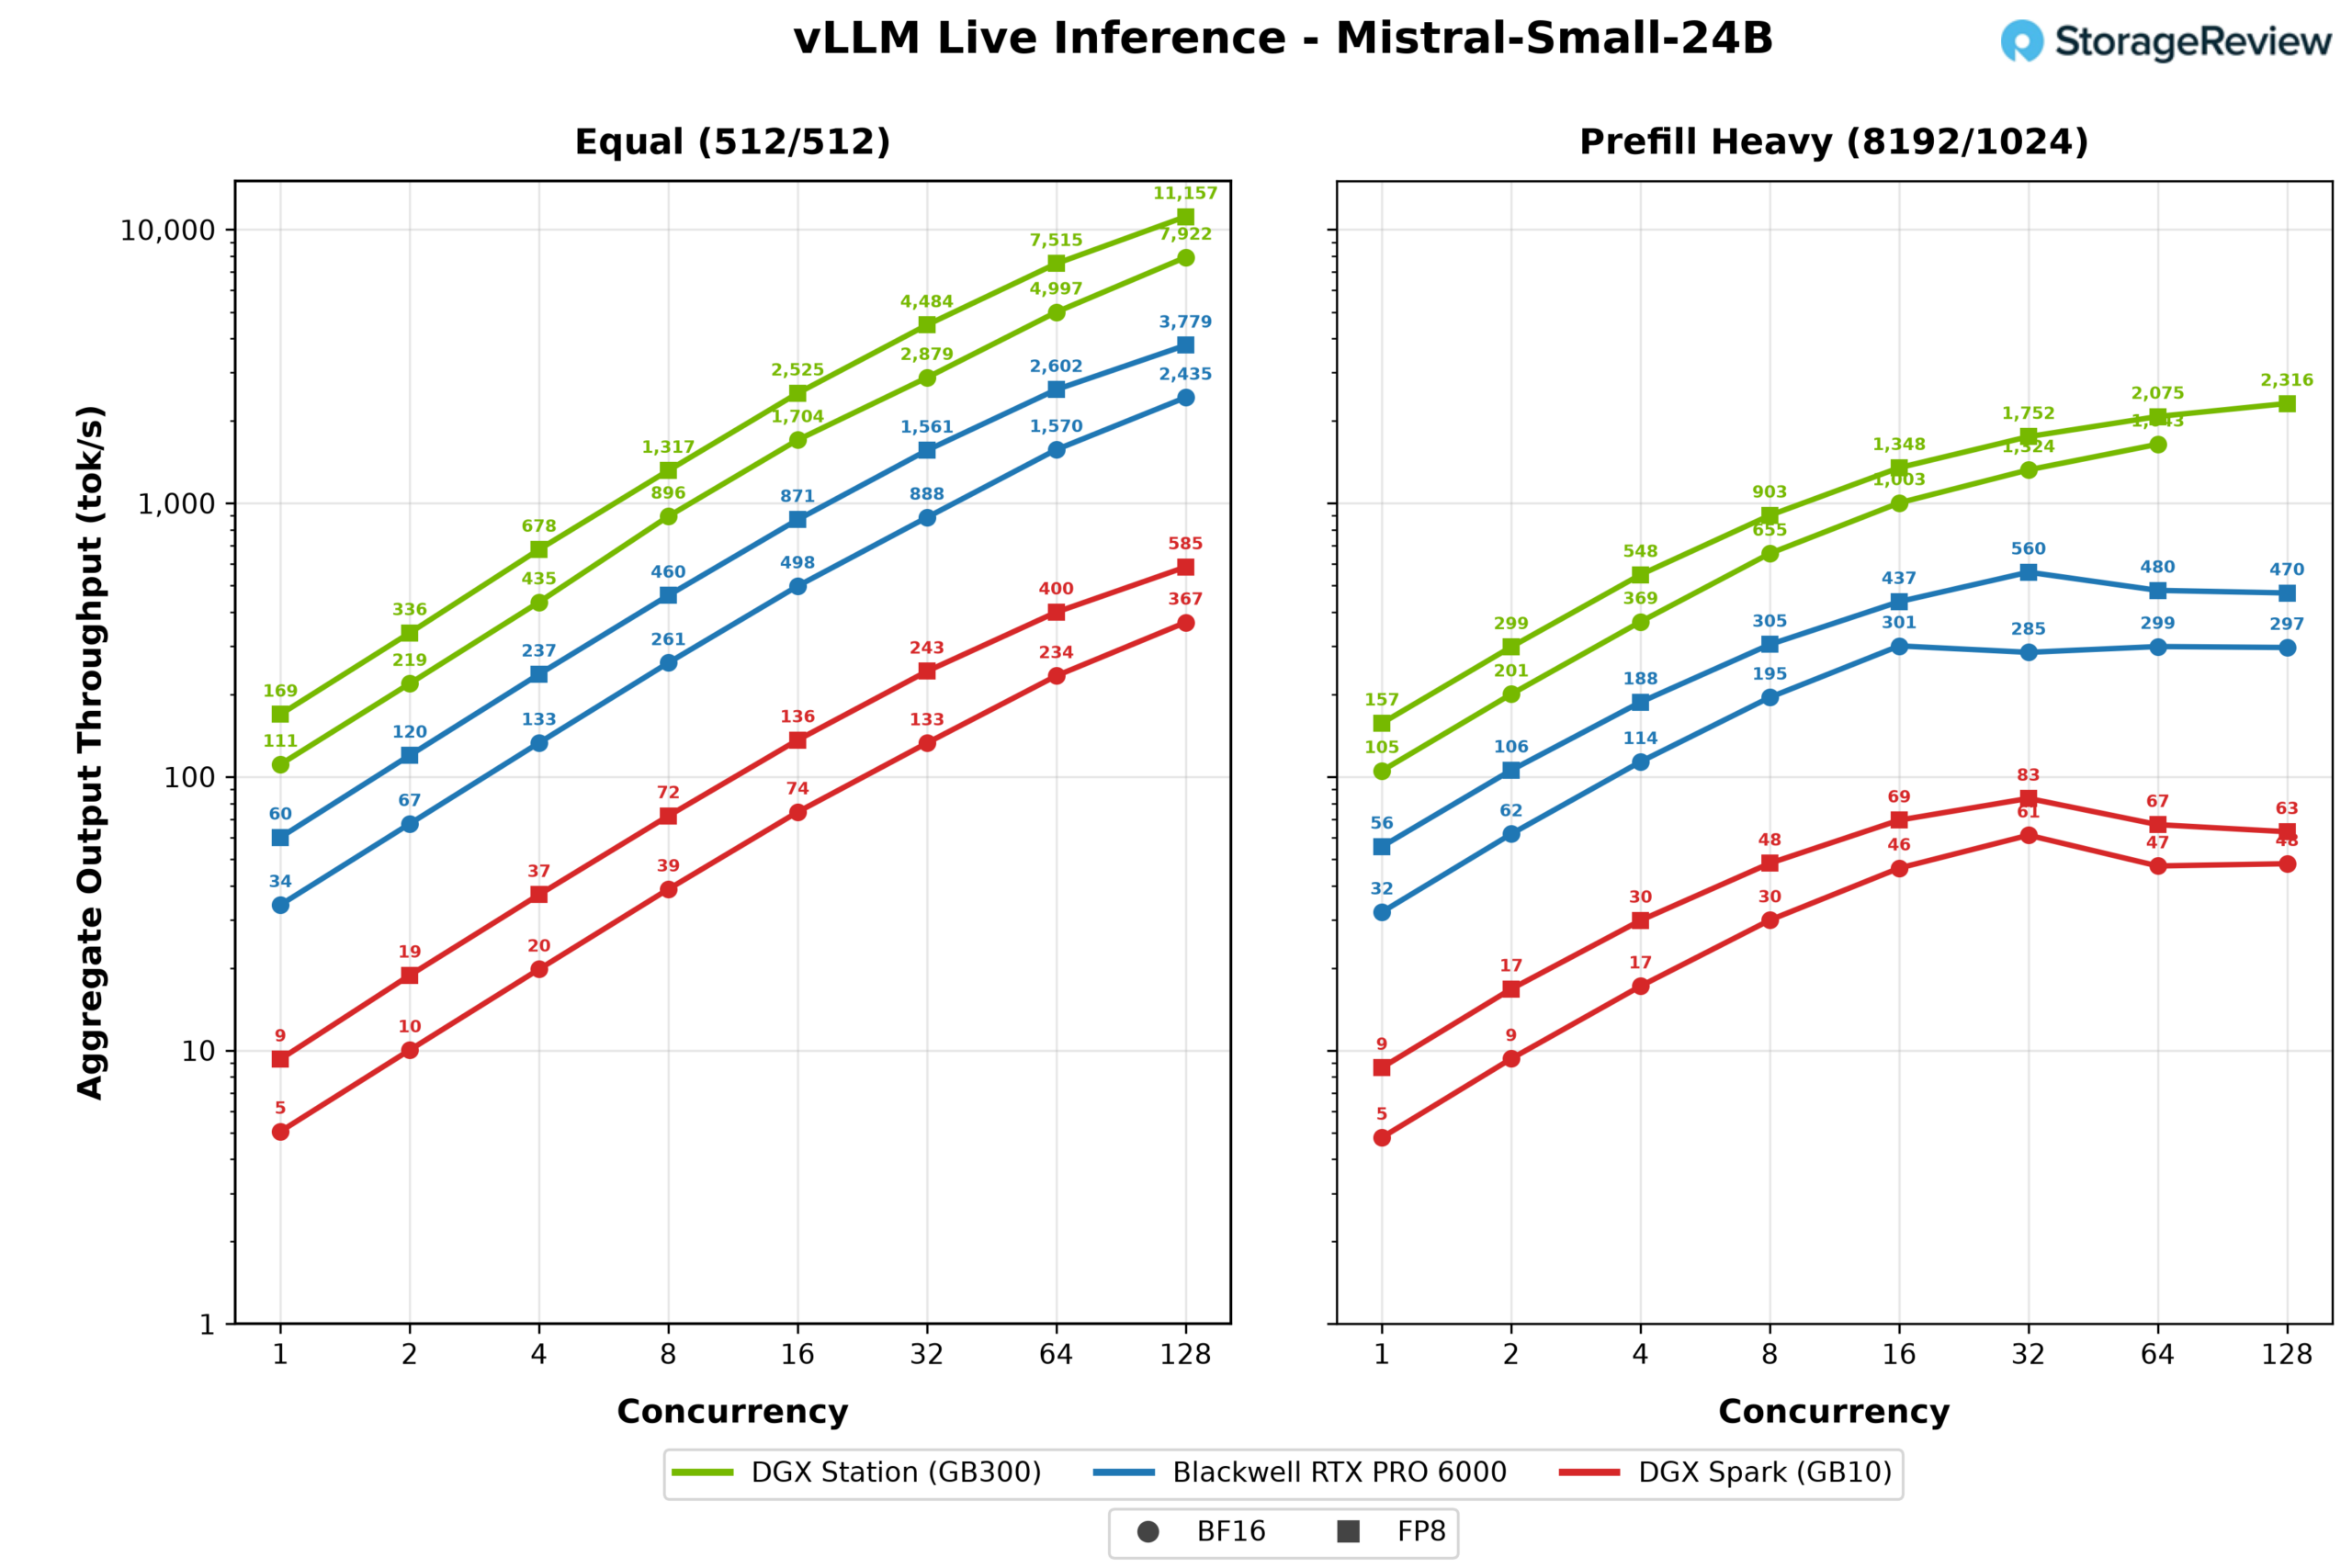
Under tung förfyllningsbelastning nådde RTX PRO 6000 en topp på bara 32 samtidiga strömmar och 560 utdatatokens per sekund innan den sjönk, medan WS300 fortsatte till 2 316 med 128 strömmar.
Qwen3-kodare 30B
Qwen3 Coder 30B, en blandning av expertmodeller med ett litet antal aktiva parametrar, är det enda testet där de mindre systemen minskar gapet mellan enskilda strömmar. Vid en samtidig begäran under samma arbetsbelastning levererade RTX PRO 6000 208 utdatatokens per sekund till WS300:s 310, det närmaste resultatet i denna jämförelse kommer Stationen, och till och med Spark lyckades med användbara 55. Batchning återställer den vanliga ordningen: vid 128 strömmar är Stationens 12 425 utdatatokens per sekund vid FP8 2.4 gånger kortets och nästan 16 gånger Spark.
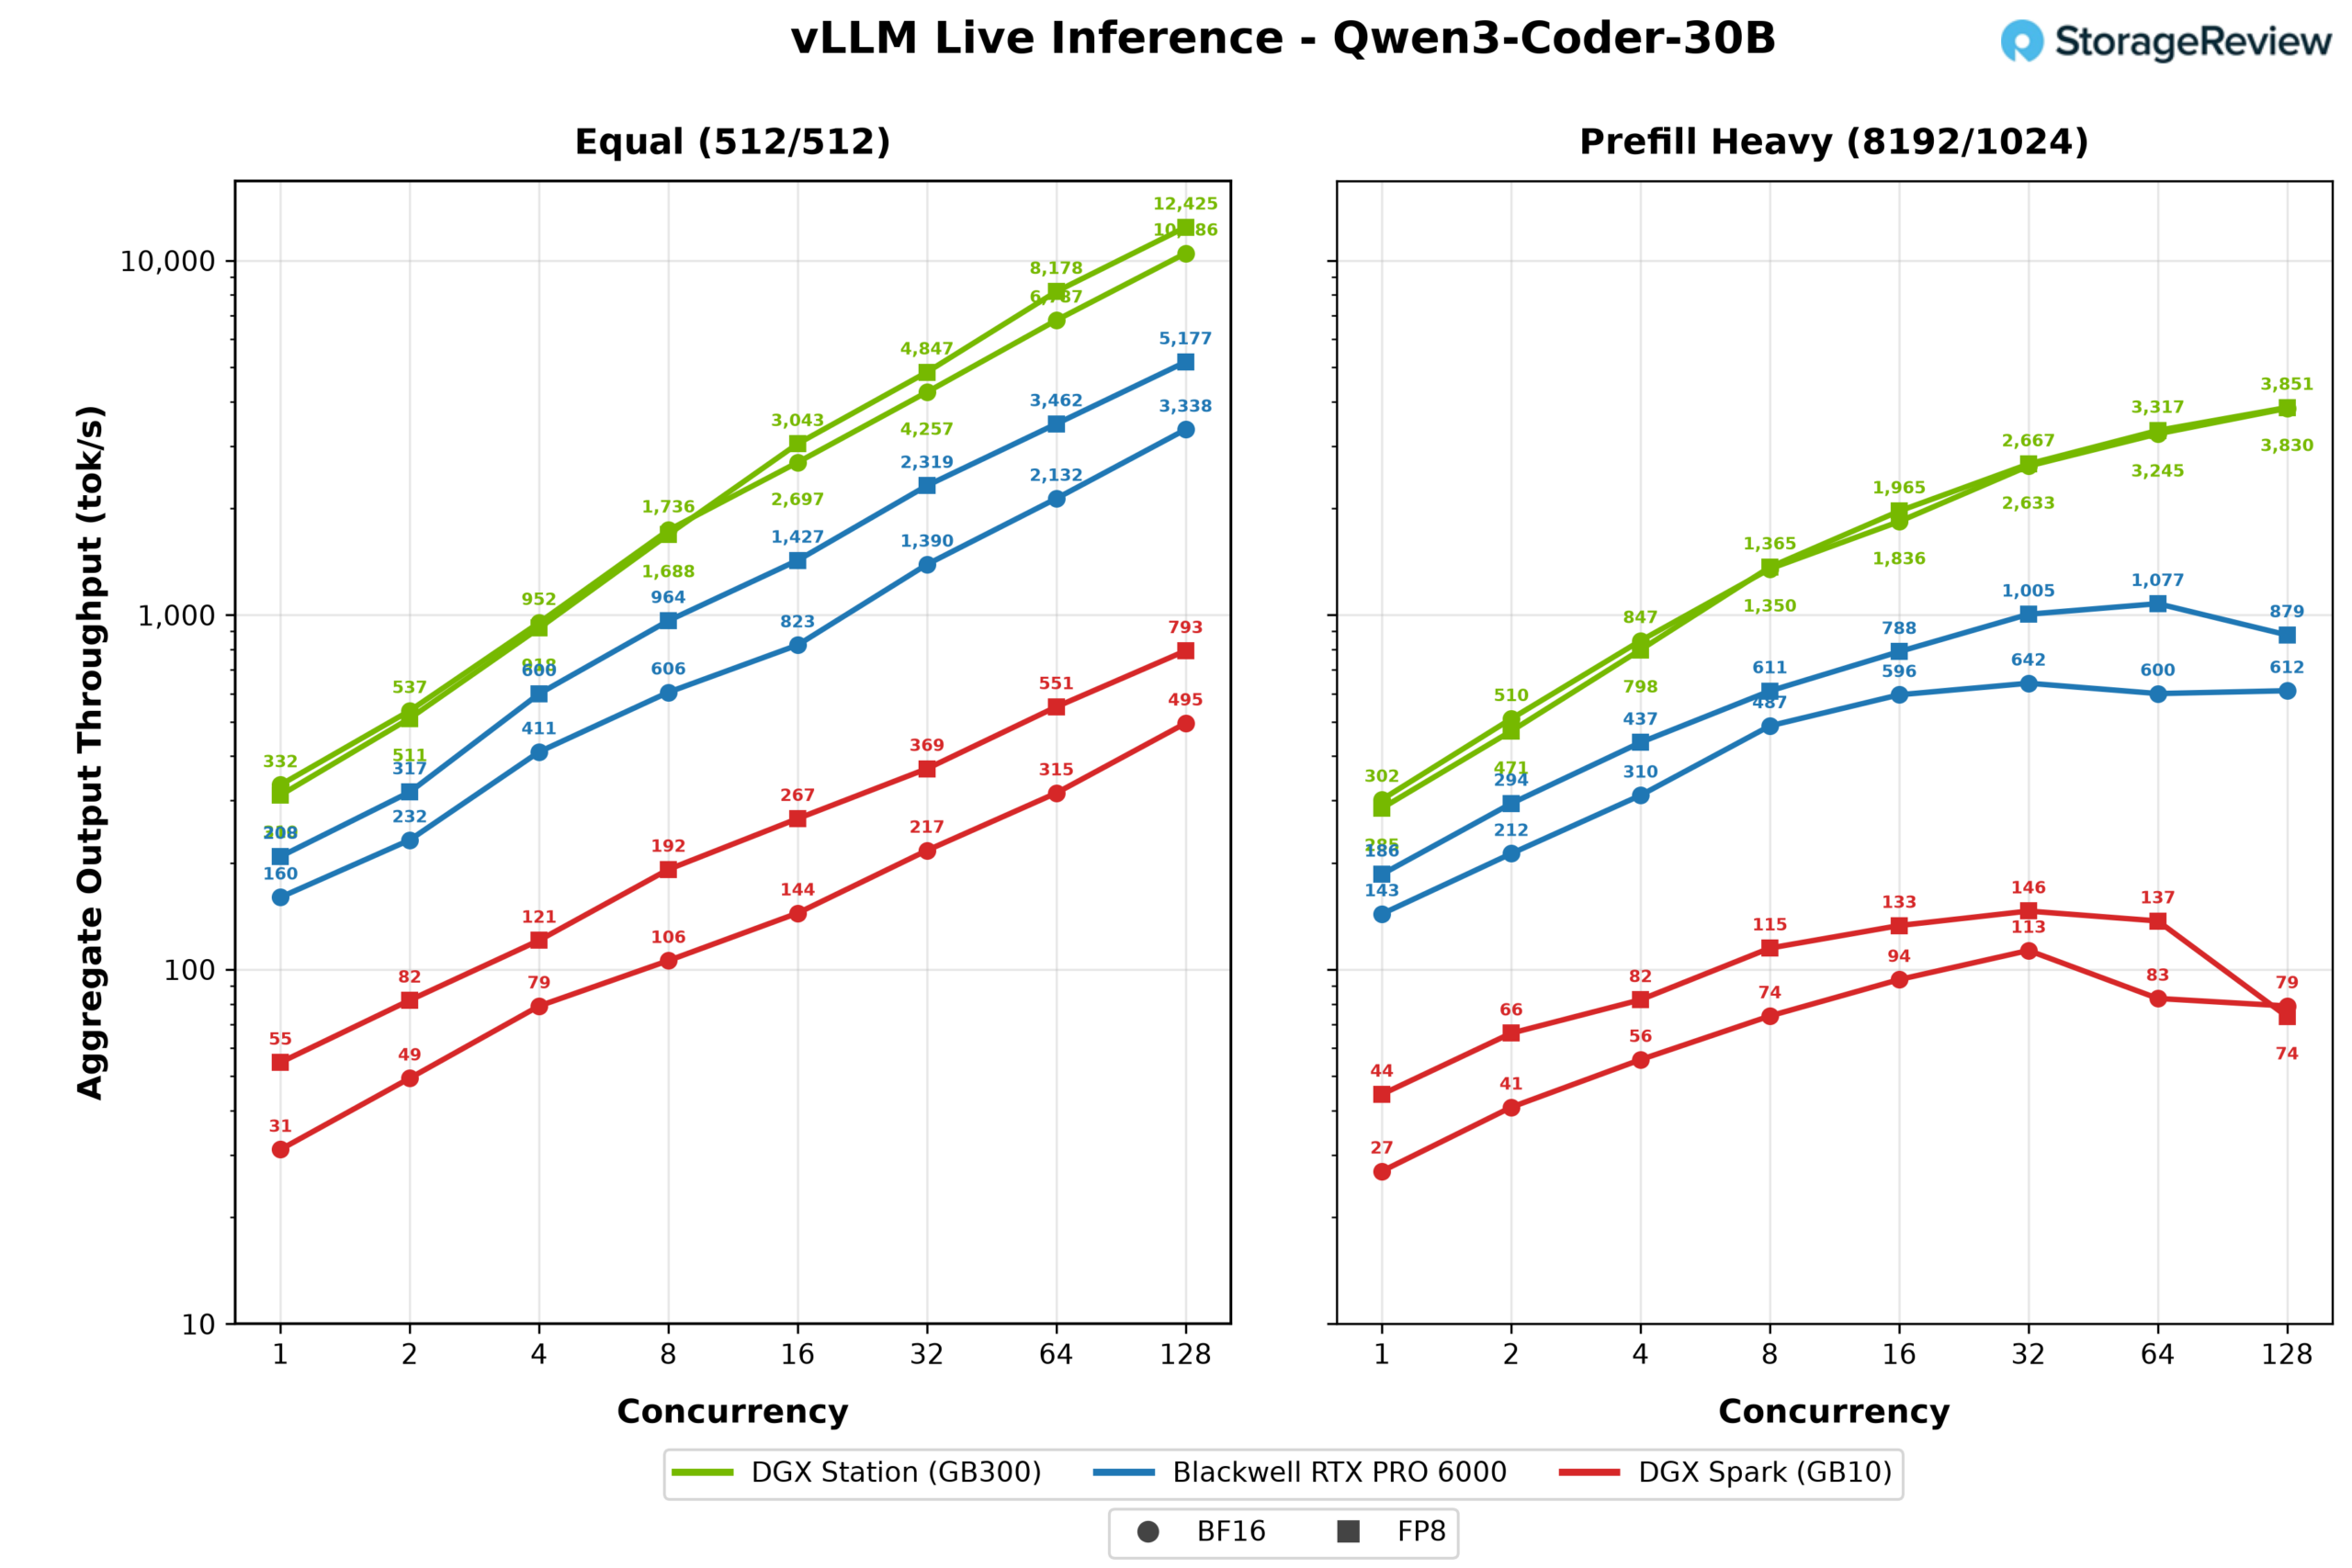
Förfyllningshastigheten följde det etablerade mönstret, där WS300 nådde 3 851 utdatatokens per sekund medan kortet nådde sin topp på 1 077 och Spark på 146.
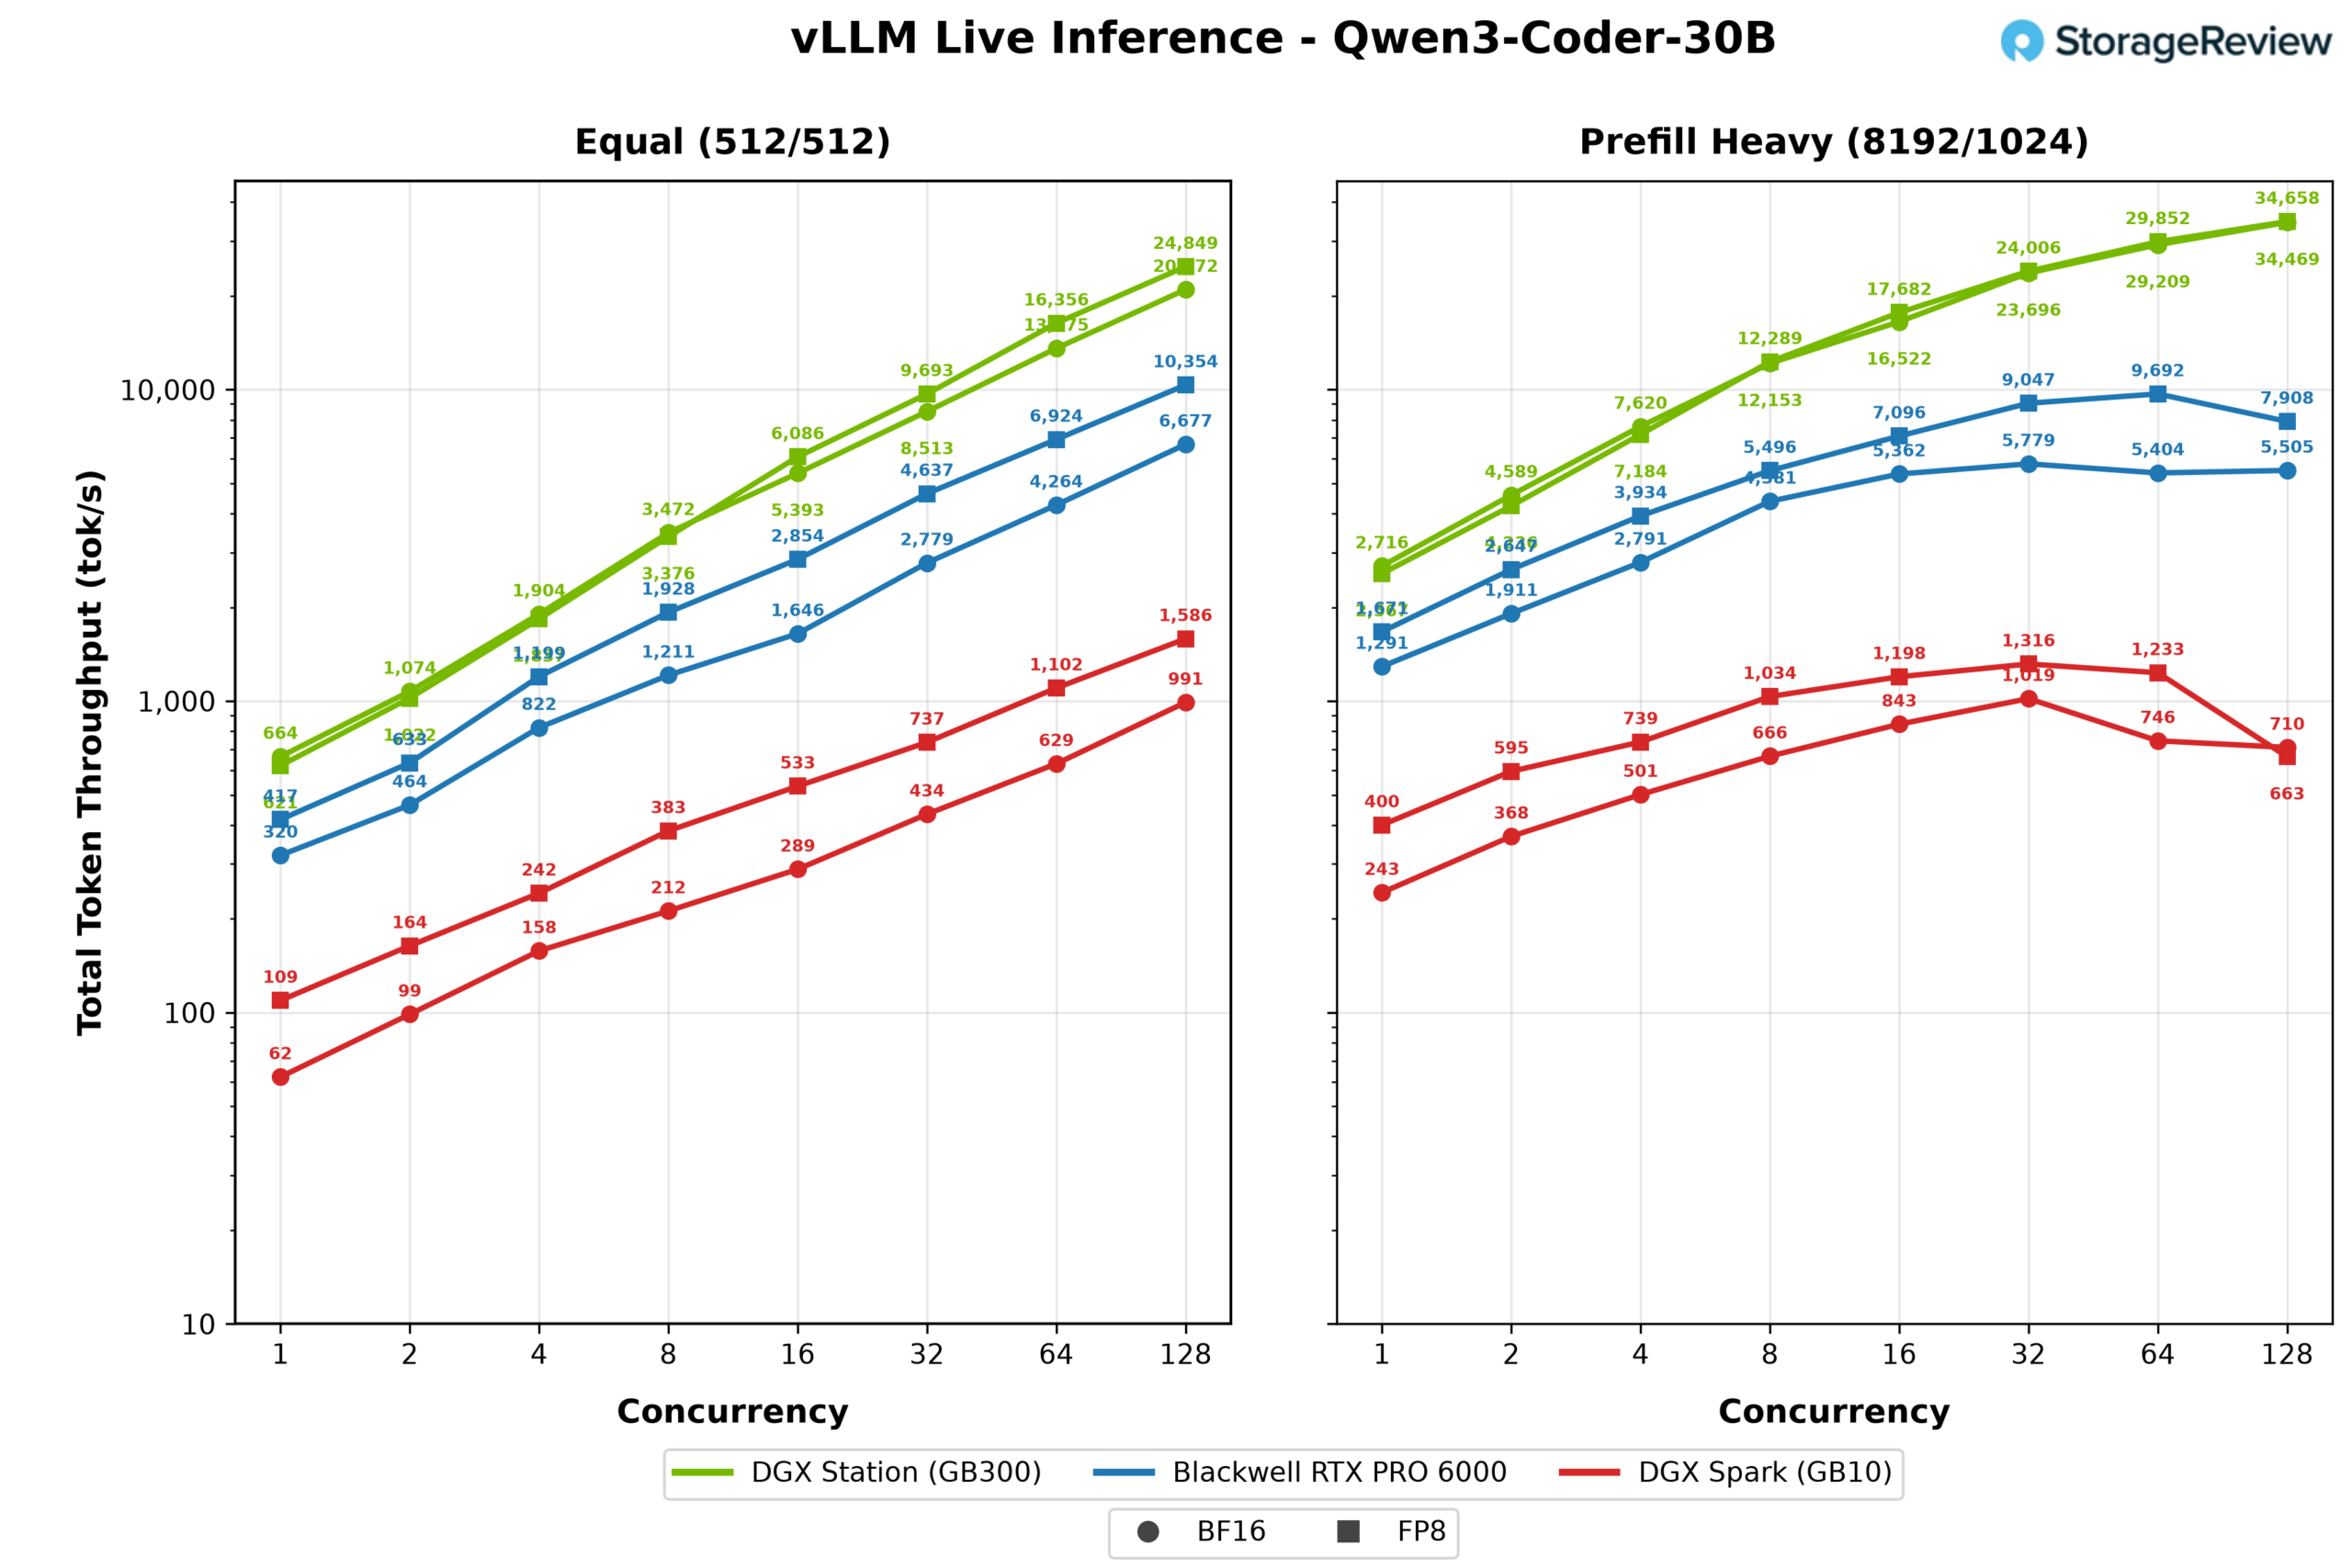
Över de fem delade modellerna landade WS300 mellan 2.3 och 3 gånger högre dataflöde än Blackwell RTX PRO 6000 och 14 till 19 gånger högre än DGX Spark vid full samtidighet, med en marginal som vidgas mot 6x över kortet när långa prompter belastar KV-cachen. Alla tre maskinerna kör samma CUDA-stack och samma kvantiseringsvägar; det Stationen köper är minneskapacitet och bandbredd, vilket här visas som samtidighetsutrymme och lång kontexttolerans. Lika viktigt är vad dessa diagram inte kan visa: ingen av frontier-modellerna i avsnitten ovan kommer ens att laddas på de andra två systemen.
GDSIO
Moderna AI-arbetsbelastningar är beroende av att flytta databatchar, modellvikter och kontrollpunkter från lagring till GPU-minne tillräckligt snabbt för att hålla acceleratorn sysselsatt. NVIDIA GPUDirect Storage tar bort den traditionella tvåkopierade sökvägen där data först läses från en SSD till systemminnet och sedan kopieras till GPU-minnet.
GB300 DGX Station implementerar detta annorlunda än en konventionell PCIe GPU-server. Micron 4600 som användes för vårt test är ansluten till PCIe-switchen som är integrerad i ConnectX-8. ConnectX-8 ansluter uppströms till Grace-processorn, medan B300 GPU ansluter till Grace via NVLink-C2C. SSD:n och GPU:n sitter inte under samma PCIe-switch. Lagringstrafik passerar istället genom ConnectX-8-switchen, går in i Grace PCIe-rotkomplexet, passerar Grace-koherensstrukturen och korsar NVLink-C2C för att nå B300:s HBM3e.
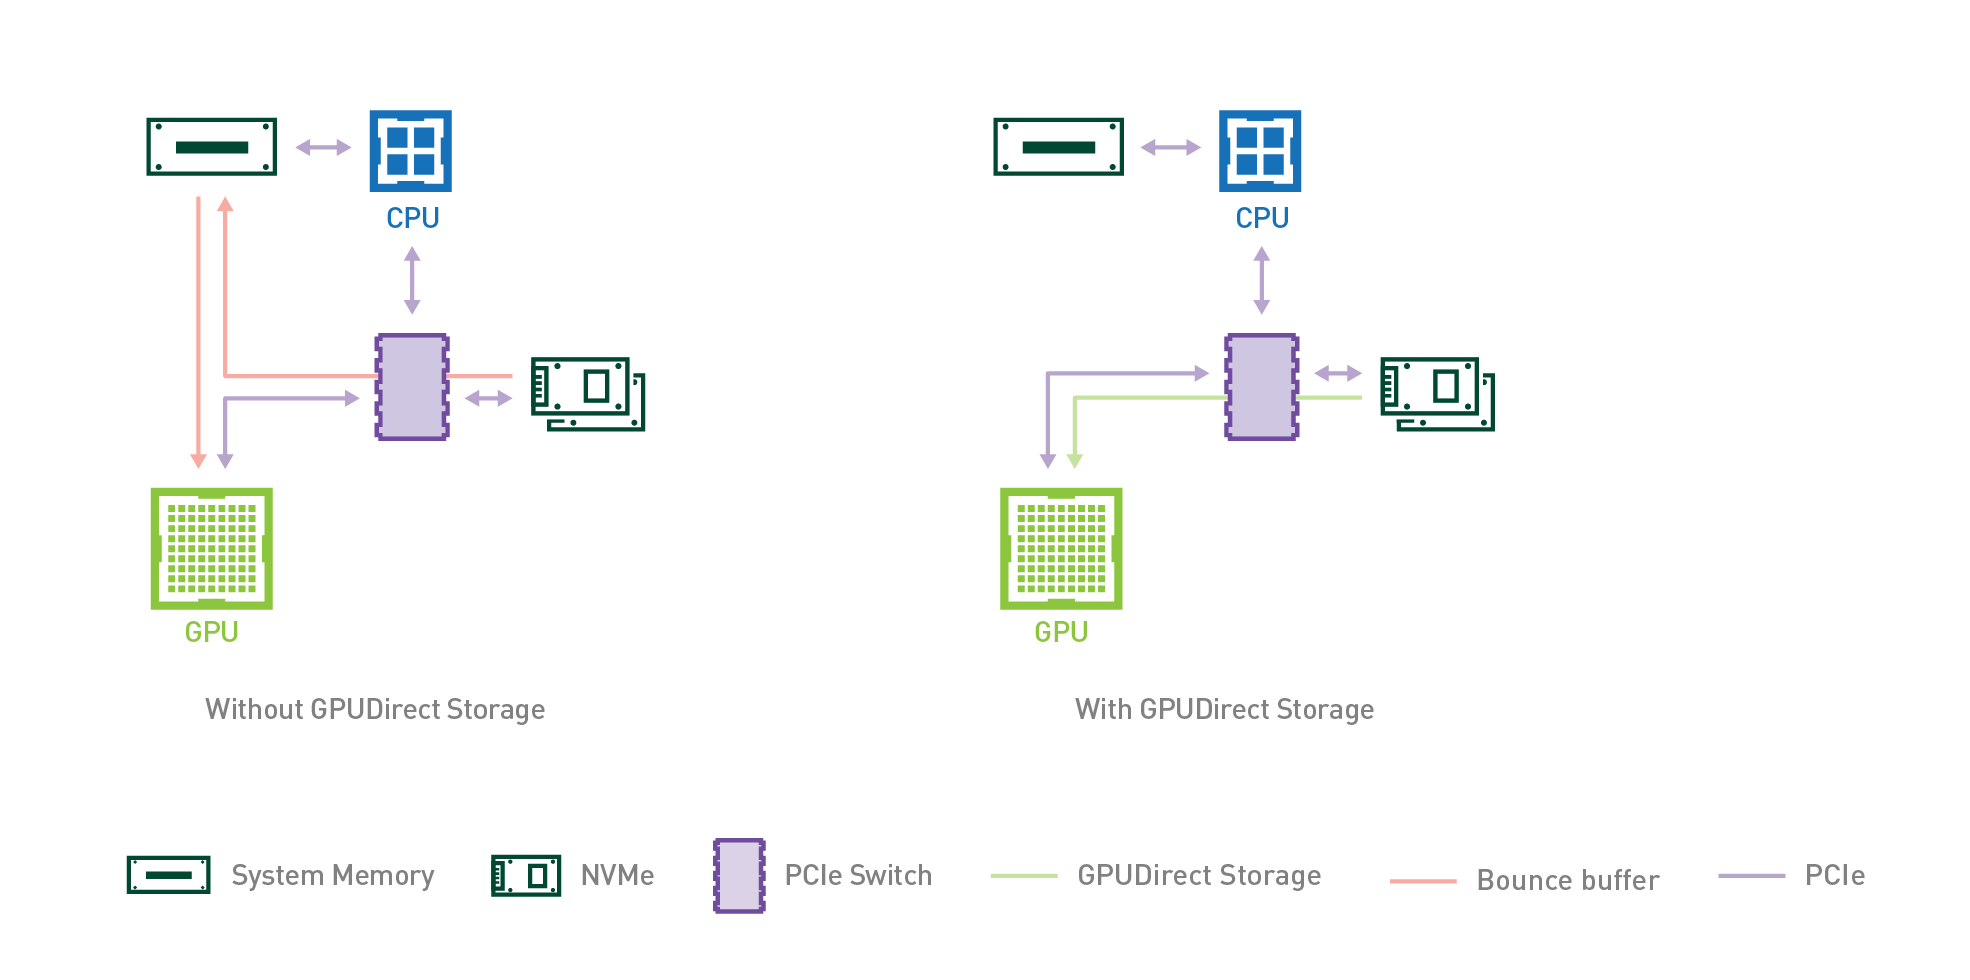
Med GPUDirect Storage registrerar cuFile en buffert allokerad i B300 HBM3e som källa eller destination för lagrings-I/O. Vid en läsning använder Micron 4600:s styrenhet DMA för att placera data i HBM3e; vid en skrivning hämtar den data från HBM3e. Båda operationerna följer Grace- och NVLink-C2C-sökvägen som beskrivs ovan utan att stage nyttolasten i Graces LPDDR5X-minne. Grace hanterar fortfarande filsystemet och NVMe-kontrollplanet, inklusive kommandoinlämning och adressöversättning, men kopierar inte data. GPUDirect Storage tar därför bort systemminnesstagingsteget även om trafiken fortfarande passerar genom Grace på sin väg mellan SSD:n och B300-minnet. För AI-arbetsbelastningar motsvarar sekventiella läsningar strömning av dataset, modellinläsning och återställningar av kontrollpunkter, medan sekventiella skrivningar motsvarar sparningar av kontrollpunkter och andra överföringar tillbaka till lagring. För att testa GDSIO-prestanda mätte vi lagringsprestanda med hjälp av en fristående sekundär SSD.
GDSIO-testkonfiguration
- Startlagring: 2 x Micron 4600 2TB i RAID1
- Sekundärlagring: 2 x Micron 4600 2TB
Om man tittar på GDSIO Sequential Read-prestanda skalar enheten konsekvent över både trådantal och blockstorlek. Vid 16K ökar dataflödet från 16MiB/s vid 1 tråd till 250MiB/s vid 16 trådar, och når 2.0GiB/s vid 128 trådar. Större blockstorlekar ökar mycket snabbare, med 256K som når 11.8GiB/s vid 64 trådar och toppar på 12.9GiB/s vid 128 trådar. De starkaste resultaten visas vid 512K och 1M, där dataflödet når sin topp på 13.1GiB/s, där arbetsbelastningen på 1M når den nivån vid bara 32 trådar och bibehåller den genom 128 trådar.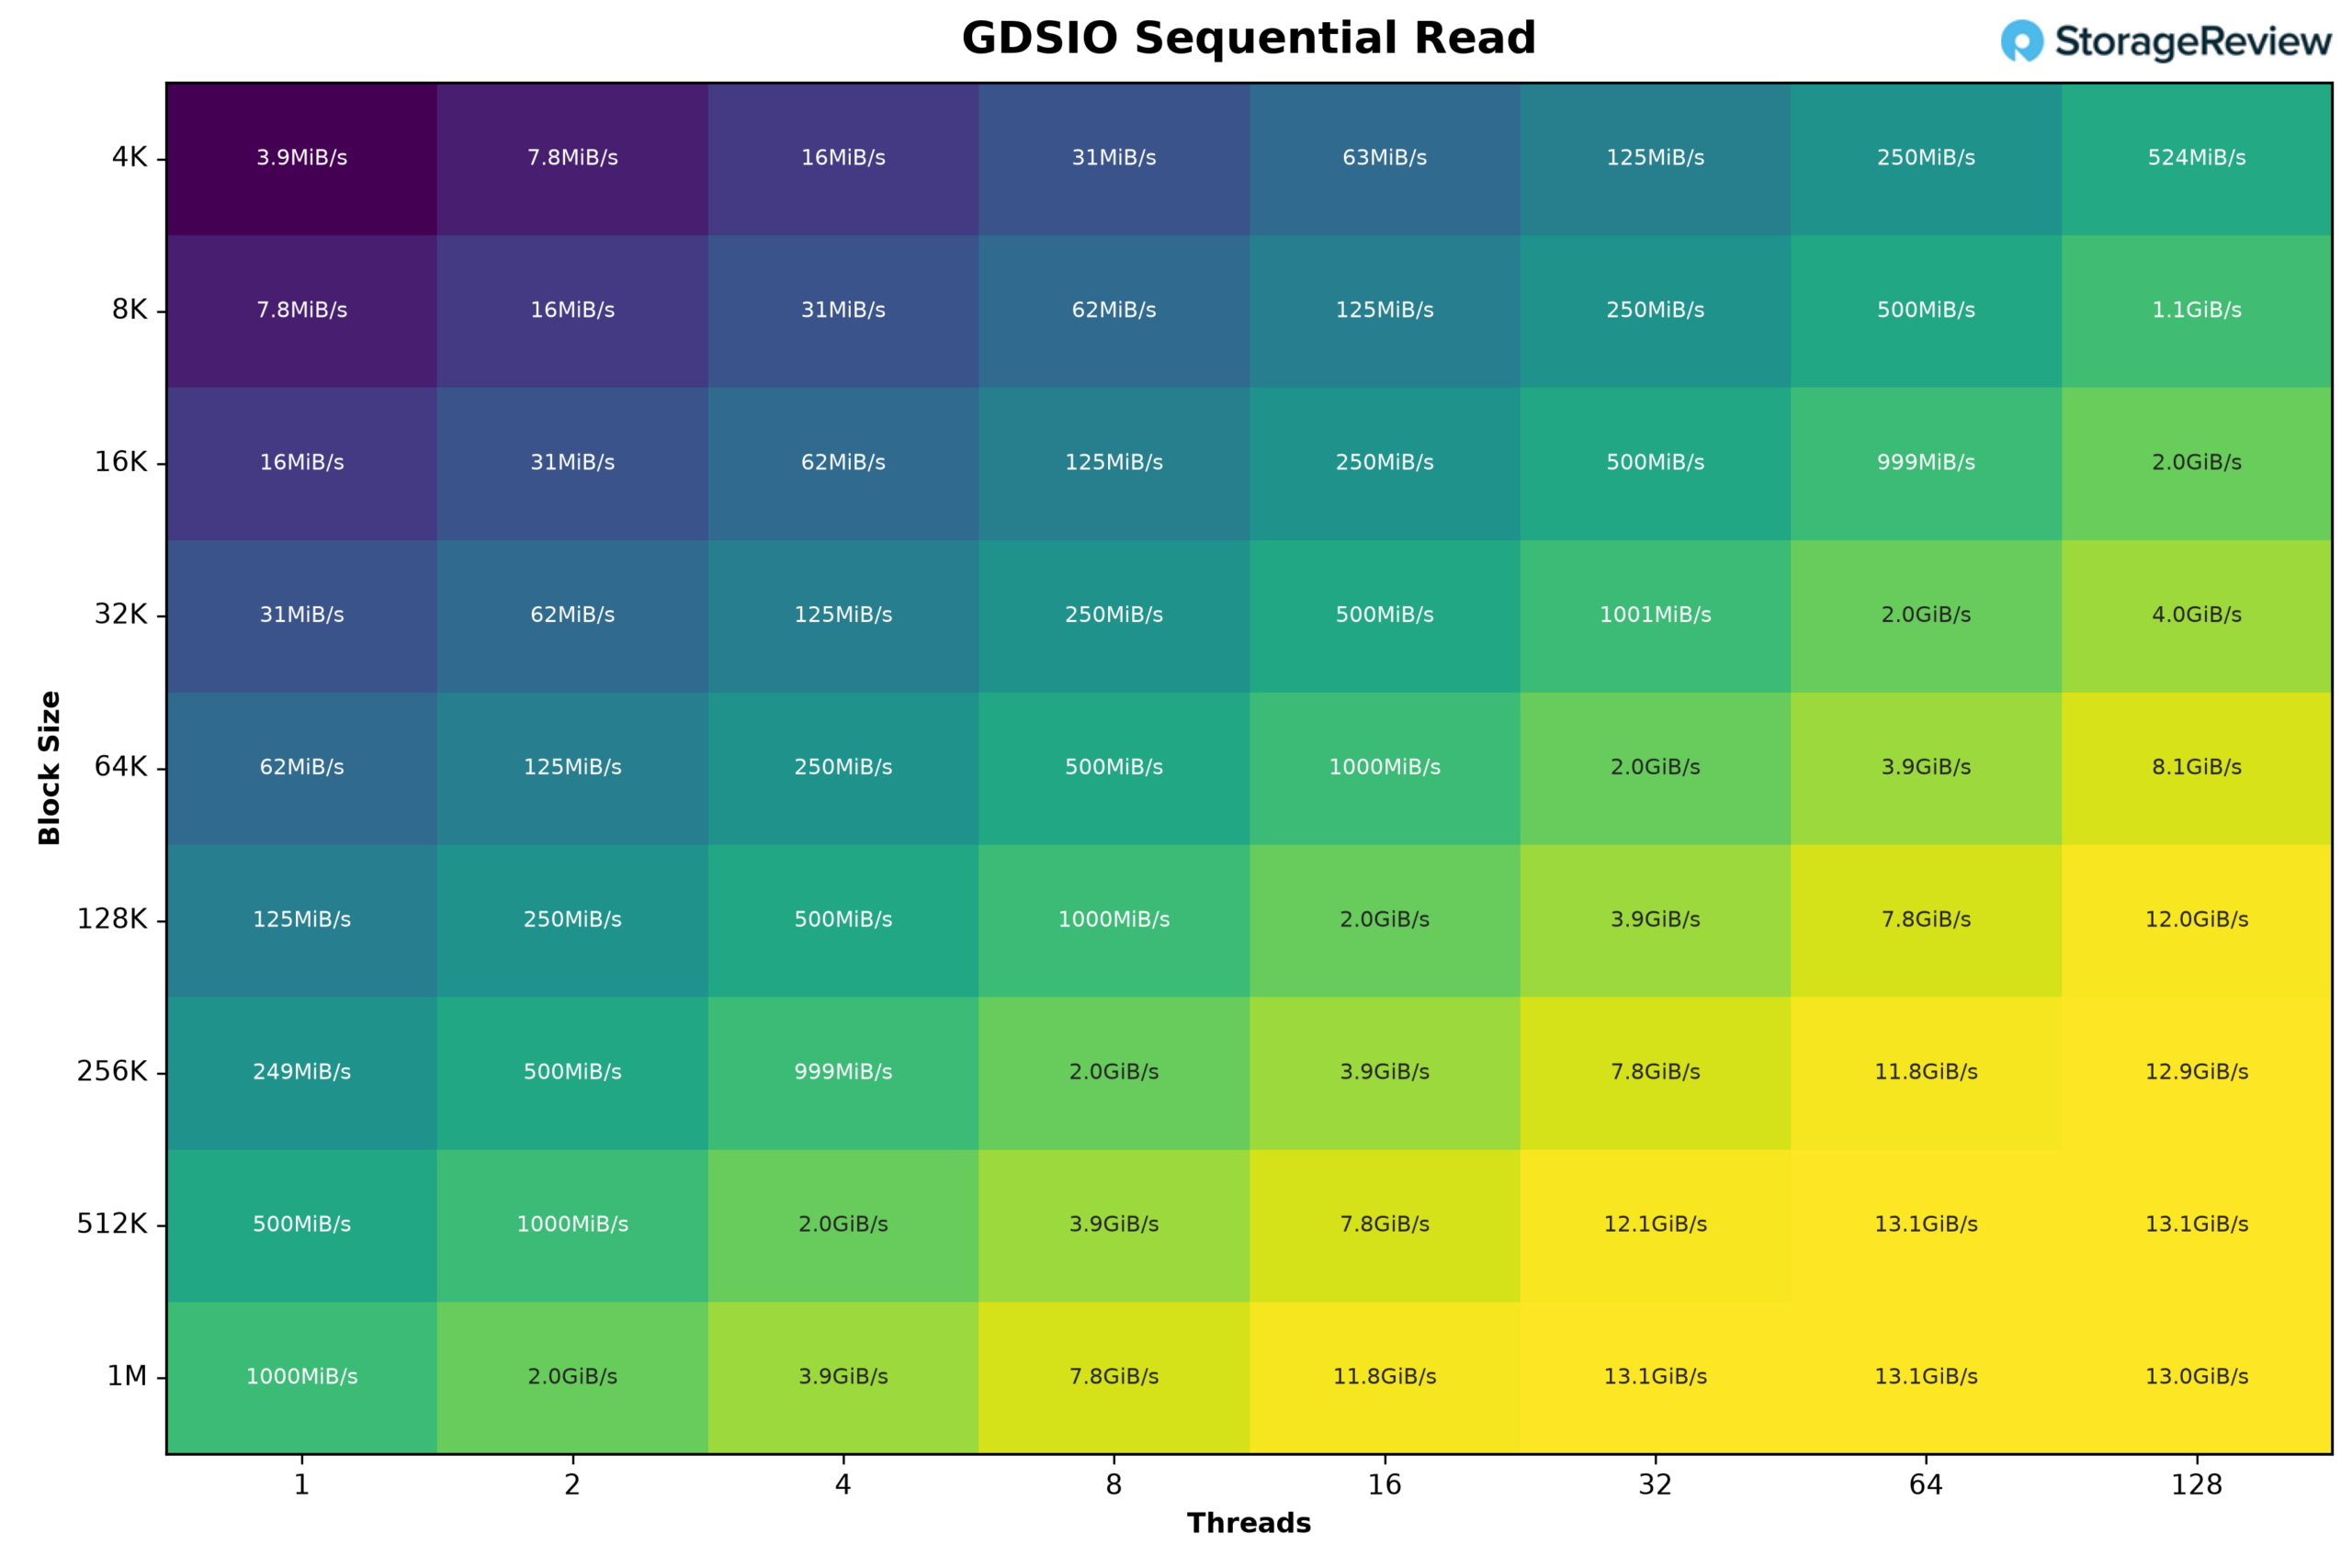
När det gäller prestanda för GDSIO Sequential Write skalas enheten konsekvent över både trådantal och blockstorlek. Vid 16K ökar dataflödet från 16MiB/s vid 1 tråd till 250MiB/s vid 16 trådar, och når 2.0GiB/s vid 128 trådar. Större blockstorlekar ökar mycket snabbare, med 256K som når 7.5GiB/s vid 32 trådar och 12.0GiB/s vid 64 trådar. Det starkaste resultatet kommer från arbetsbelastningen på 1M, som når taket på 12.0GiB/s vid bara 16 trådar och bibehåller den prestandan genom 128 trådar. 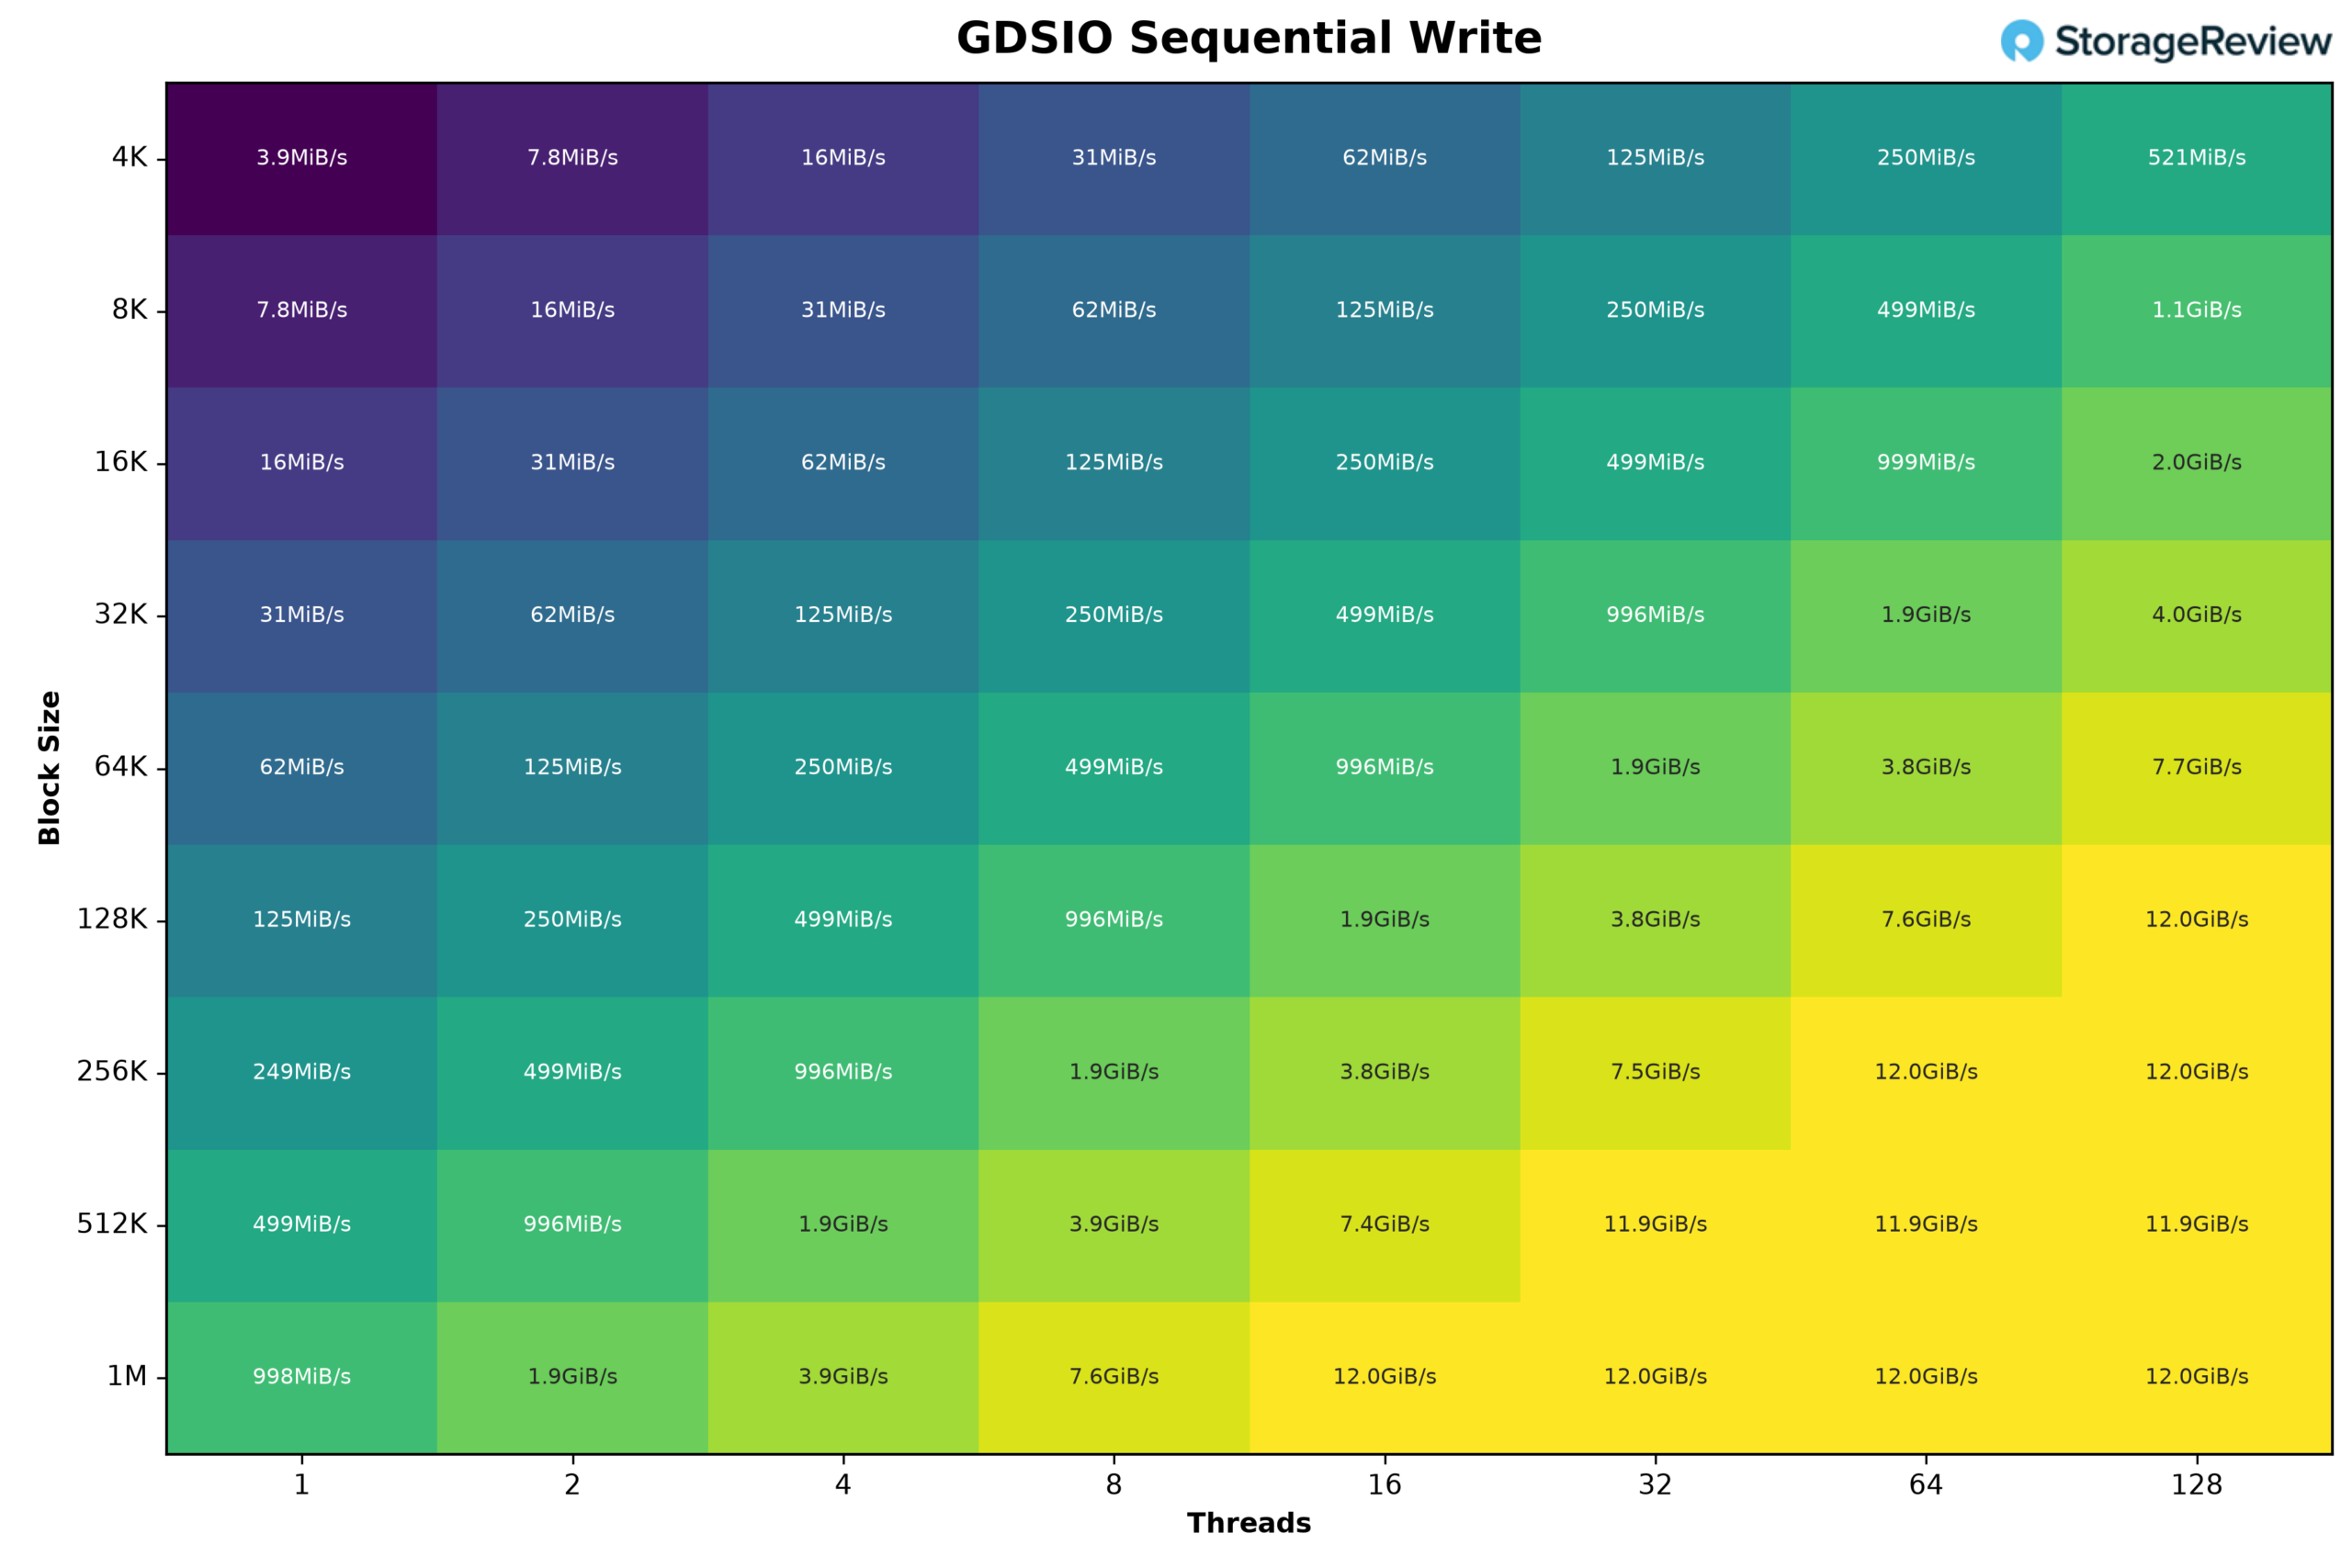
Vem är MSI XpertStation WS300 avsedd för?
WS300 är för organisationer som behöver direktåtkomst till Blackwell Ultra men inte vill att varje experiment ska börja med en klusterreservation eller molnförfrågan. AI-labb, utvecklare av inferensmotorer, ramverks- och kompileringsteam, robotgrupper och AI-team inom stora företag kan använda den som en lokal utvecklingsnod för arbetsflödena ovan. MIG låter utvecklare testa och utveckla för en multi-GPU-installation, och BMC gör systemet hanterbart på distans.
Det är också logiskt för erfarna AI-utvecklare som behöver ett system som levereras redo att användas. Värdet ligger inte bara i B300. Det är den kompletta plattformen runt den: 252 GB HBM3e, Grace och 496 GB LPDDR5X, ConnectX-8, speglad startlagring, vätskekylning, fjärrhantering och MSI-stöd i ett enda torn. De praktiska begränsningarna är Arm-värden, kravet på en dedikerad 20A-krets och den delade budgeten på 1 600 W när ett stort RTX PRO-kort är installerat.
Att få ut det mesta av WS300 beror också på den omgivande programvaran. NVIDIA tillhandahåller en bred samling handböcker och driftsättningsguider som är utformade för att hjälpa team att få systemet online och snabbt få sina resurser att fungera. Vi kommer att utforska flera av dessa verktyg i framtida rapporter, inklusive Brev, som kan förenkla delad åtkomst till arbetsstationen och förbättra utnyttjandet så att en så dyr resurs inte står overksam.
När det gäller pris har MSI inte publicerat något, och maskiner i den här klassen har sällan ett listpris; detta är en viktig diskussion med ett säljteam, inte en knapp för att lägga till i varukorgen. Den ärliga jämförelsen görs inte mot andra arbetsstationer utan mot vad ett AI-team redan betalar för: reserverad klustertid, åtaganden för molnbaserade GPU:er och schemaläggningskostnaden för att vänta på delad hårdvara.
Slutsats
MSI XpertStation WS300 är den mest kapabla arbetsstationen vi någonsin har recenserat, och den sällsynta produkt som förändrar vad en enskild utövare kan försöka sig på. Kontrollpunkter i gränsområdet som normalt ligger bakom en klusterreservation, GLM-5.2 på 433 GB, Nemotron-3-Ultra på 550 miljarder parametrar, laddas och serveras på en låda bredvid skrivbordet, privat och alltid tillgänglig. Det är källan till vår entusiasm för det här systemet.
DGX Station riktar sig till utvecklare: kärnutvecklare som riktar sig till Blackwell Ultra, inferensmotor- och ramverksteam, robotgrupper som kör hela Isaac-loopen och generellt användare som är frustrerade över att schemalägga experiment kring delad hårdvara. Utanför den nischen är argumenten för att köpa dessa system ganska begränsade. Arm-värden kommer att utesluta vissa verktygskedjor; 20A-kretsen är ett installationskrav på 120V-kretsar; det finns ingen skärmutgång utan ett tilläggskort; och en RTX PRO 6000-arbetsstation kostar mycket mindre och täcker arbete för en enda användare på modeller som får plats med dess 96 GB.
Ekonomin begränsar också rätt distributionsstorlek. En WS300 är lätt att rättfärdiga mot reserverad klustertid, och ett par per team är det fortfarande. Att stapla ytterligare datorer slutar vara meningsfullt vid en viss punkt: när en organisation till exempel köper fyra GB300-torn, är samma pengar inom räckhåll för en åttavägs B300-server med mer minne per GPU, tätare MIG-partitionering och NVLink mellan varje GPU. Den optimala lösningen är en på skrivbordet, kanske två i labbet, vilket kompletterar datacenterinvesteringen.
NVIDIA tillhandahåller baskortet, så skillnaden mellan OEM-tillverkare handlar om implementeringen, och MSIs utförande här är solidt. En vätskeslinga på 1 400 W kyler B300, Grace, SOCAMM och ConnectX-8, och plattformen förblev stabil under hela testningen. Den djupare titten är nu publicerad: vår djupdykning av WS300-termiska data parar ihop MSIs kylplatta och radiatordata med en 2.8-timmars instrumenterad körning som visar att chipen hölls vid 60 °C och en platt 2.07 GHz klockfrekvens vid full belastning. Effektbudgeten på 1 600 W fördelas automatiskt över komponenterna, och när vi testade hårdvaruströmbromsen med en komprometterad anslutning strypte den snarare än stängdes av. En förkopplad 12VHPWR-kabel och ett anti-sag-fäste stöder RTX PRO-expansionsvägen. Efter att ha testat den första GB300 DGX Station som nådde oss kan vi säga att XpertStation WS300 sätter en hög ribba för plattformen.
XpertStation WS300 har nu platsen för bästa GB300-system på vår topplista över bästa stationära datorer för lokal AI , och den förankrar minnesdiskussionen i vår guide om RAM, GPU och lagring för Agentic AI .


 Amazon