

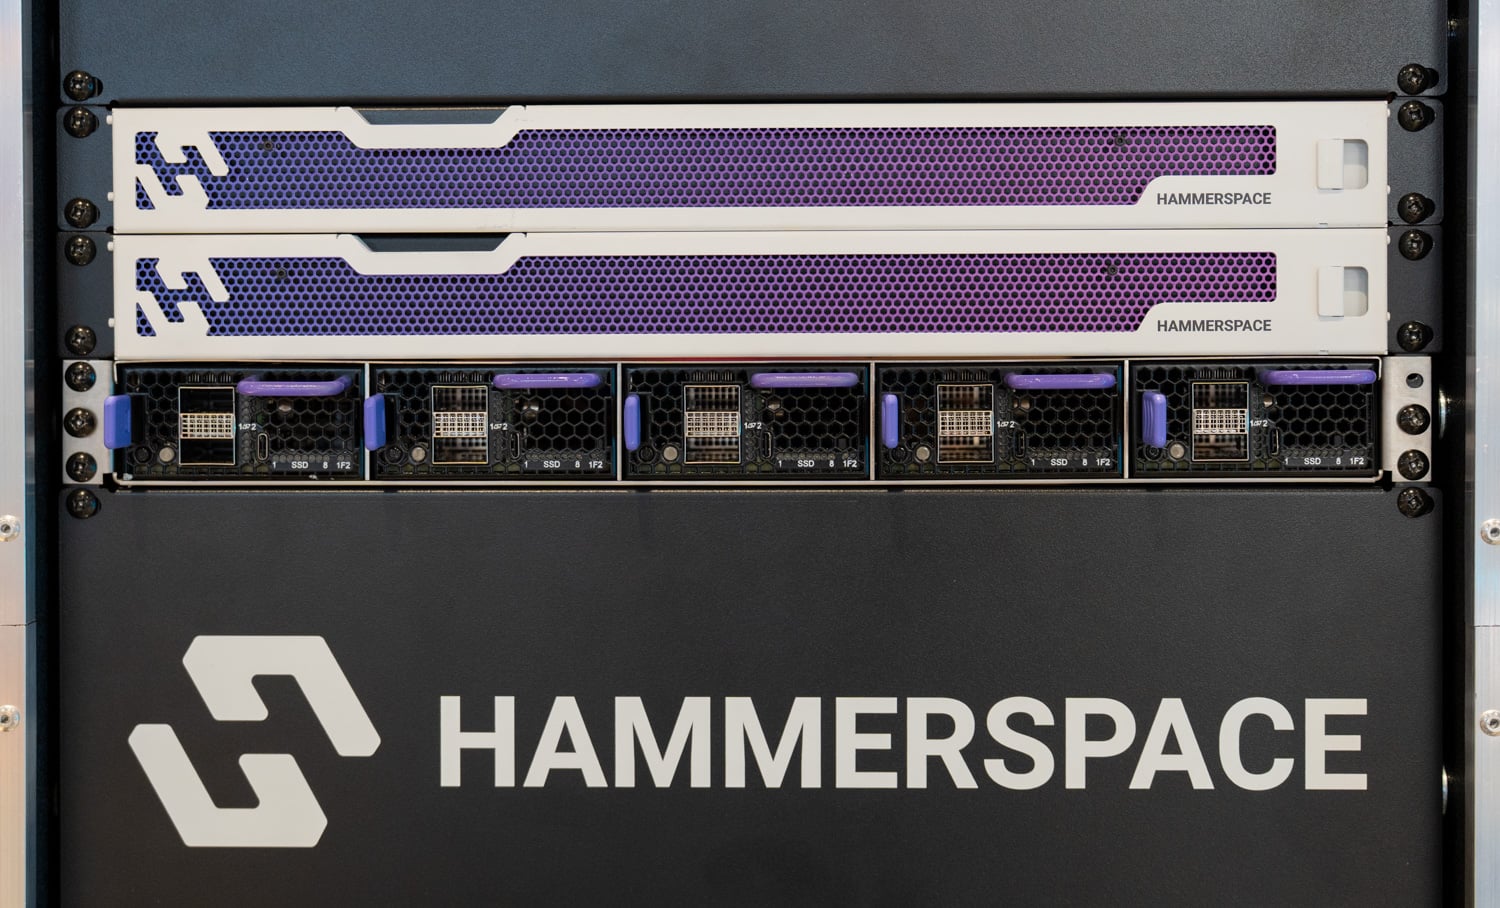
Hammerspace har förvandlat sin programvarudefinierade dataplattform till Hammerspace Data System och kommer för första gången att sälja den som ett komplett system med hårdvara. Kärnan är Hammerspace Open Flash Platform (OFP), en 1U-bricka som rymmer fem DPU-baserade flashnoder utan x86-lagringsserver, betygsatt av företaget till 390 GB/s skrivningar och 15 miljoner IOPS per rackenhet och upp till 9.83 PB råminne. Lanseringen lägger också till ett dataintelligenslager och en KV-cacheroll för GPU-lokal NVMe. OFP finns tillgänglig för offert nu och levereras under första halvåret 2027.
Från dataplattform till datasystem
Hammerspaces kärnprodukt är ett parallellt globalt filsystem som separerar metadata från datasökvägen och presenterar befintlig NAS-, objekt- och molnlagring som ett namnutrymme över pNFS, NFS, SMB och S3. Klienter når det via NFSv4.2-klienten som är inbyggd i vanliga Linuxdistributioner, utan proprietär agent, med hjälp av Flex Files-layouten som Hammerspace säger att de konstruerat för NFS-specifikationen. Företaget beskriver Data System som en utökning av den programvaran, organiserad kring fem funktioner: dataförening, intelligens, orkestrering, acceleration och lagring, av vilka intelligens och lagring är nya.
Den kommersiella förändringen är att hela systemet kan köpas från Hammerspace, med programvara, metadatanoder och lagring installerade och supporterade av företaget. Metadatanoderna, som Hammerspace kallar Anvils, är 1U x86-servrar i standard- och stora M-seriekonfigurationer med två 100 GbE-dataportar, distribuerade som ett högtillgänglighetspar på varje plats för att köra kontrollplanet som hanterar namnrymden och exekverar placeringspolicyer. Programvarubaserad distribution på kundens hårdvara fortsätter, liksom Hammerspace Ready Nodes från Dell, Supermicro och Hitachi Vantara, och marknadsplatsavbildningar på AWS, Azure, Google Cloud och Oracle Cloud.
Systemalternativet svarar på ett mönster som Hammerspace har sett inom försäljning, där programvaran vann den tekniska utvärderingen, och kunden ändå köpte en integrerad produkt från en annan leverantör för det enklare köpet. Programvaran licensieras som en prenumeration prissatt efter kapacitet under hantering. Hammerspace-lagring tas vanligtvis in när ett nytt GPU-kluster behöver högpresterande lagring medan kundens befintliga data finns på NetApp-, PowerScale- eller objektsystem som namnrymden kan ta över på plats.
Varje plats kluster parar ihop dessa städ med en uppsättning datatjänstnoder, och klustren sammanfogas till ett globalt filsystem. Metadata replikeras kontinuerligt mellan platser, med ungefär en sekunds fördröjning mellan avlägsna platser, medan själva data bara flyttas när en policy eller en åtkomstbegäran kräver det. Jobbschemaläggare kan starta den rörelsen via API:et och nativa kopplingar. Företaget gav exemplet med kunder inom life science som matar in instrumentdata över SMB, bearbetar den över pNFS och hanterar den över S3 från samma system.
Utvärderingar körs vanligtvis som ett koncepttest, med molnavbildningar av typen "bring-your-own-licence" som självbetjäningsväg. Diskkapacitet kommer från JBOD:er och lagringsservrar byggda av hårddiskleverantörer; OFP är en Hammerspace-design byggd av en kontraktstillverkare, och återförsäljare och integrationspartners levererar systemen. En blockmatris ansluter sig endast till namnrymden när den kan monteras över NFS.
”Att bara lägga till mer lagringsutrymme är inte lösningen”, säger David Flynn, grundare och VD för Hammerspace. Flynn beskrev lanseringen som att den konsolidering som AI-fabriksdesigner innebar för databehandling har inneburit.
Inuti den öppna Flash-plattformen
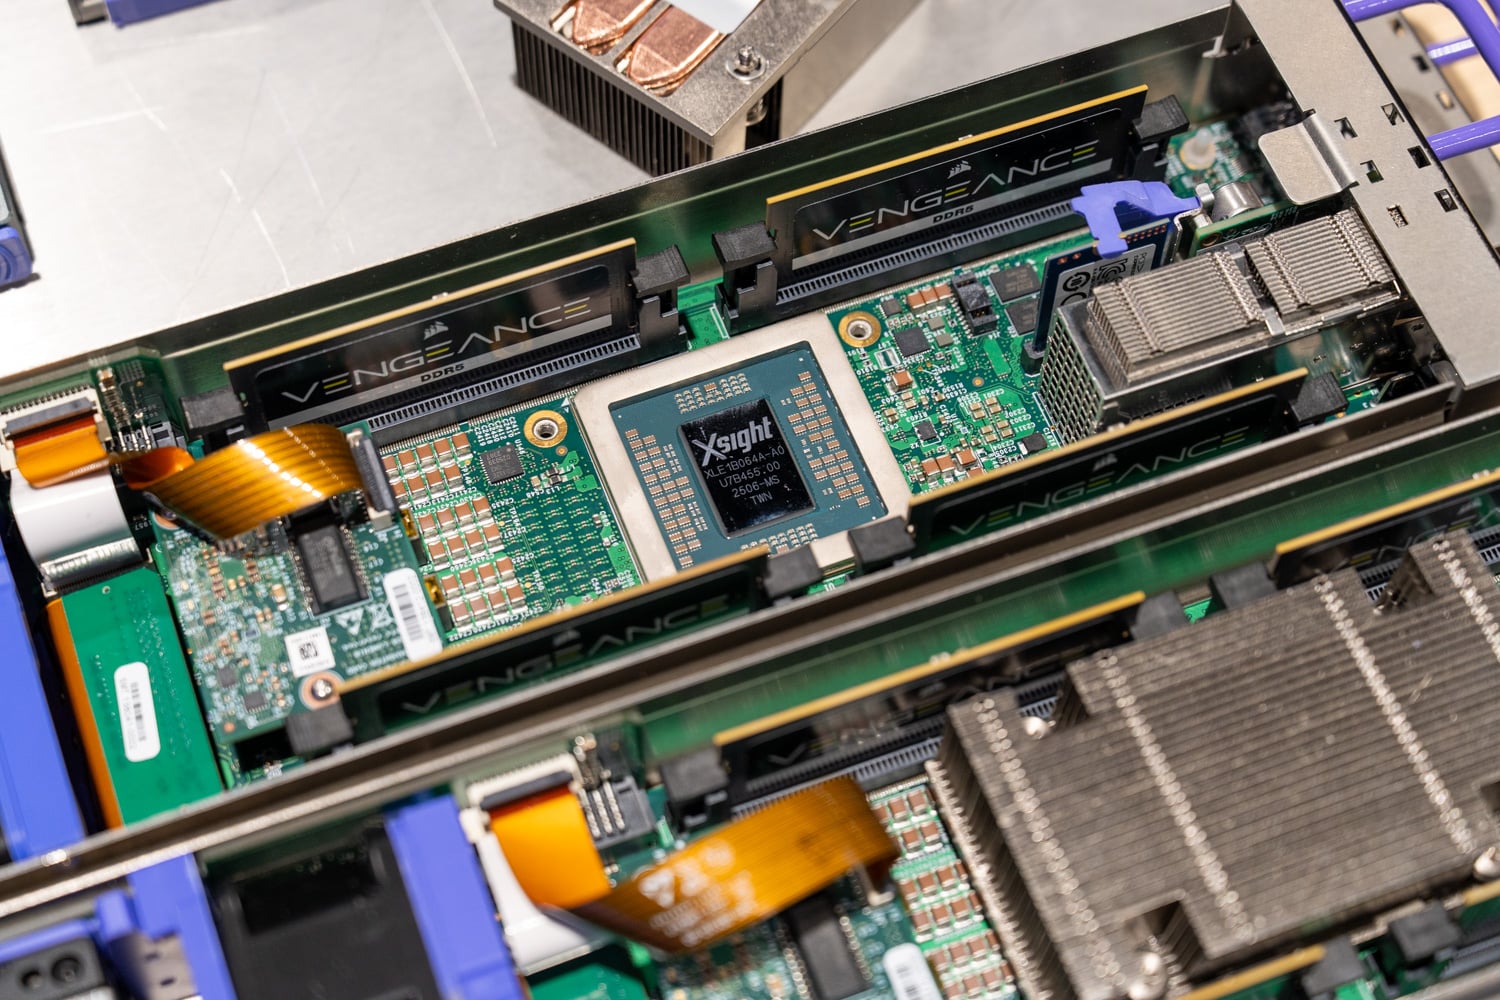
Varje OFP-sled är en komplett lagringsnod, en femtedel av en rackenhet bred, med åtta U.2- eller U.3 NVMe SSD-diskar i två flyttbara paket med fyra diskar, två 400 GbE QSFP-DD-portar och en 64-kärnig Arm DPU istället för ett x86-moderkort. DPU:n är Xsight Labs E1, som Xsight bygger på TSMC:s 5nm-process med 64 Arm Neoverse N2-kärnor, två 400 G MAC-datorer, PCIe Gen5 och en typisk effekt på 70 W. Den kör standard Linux, och varje sled visas som en NFS-server för Hammerspace-filsystemet.
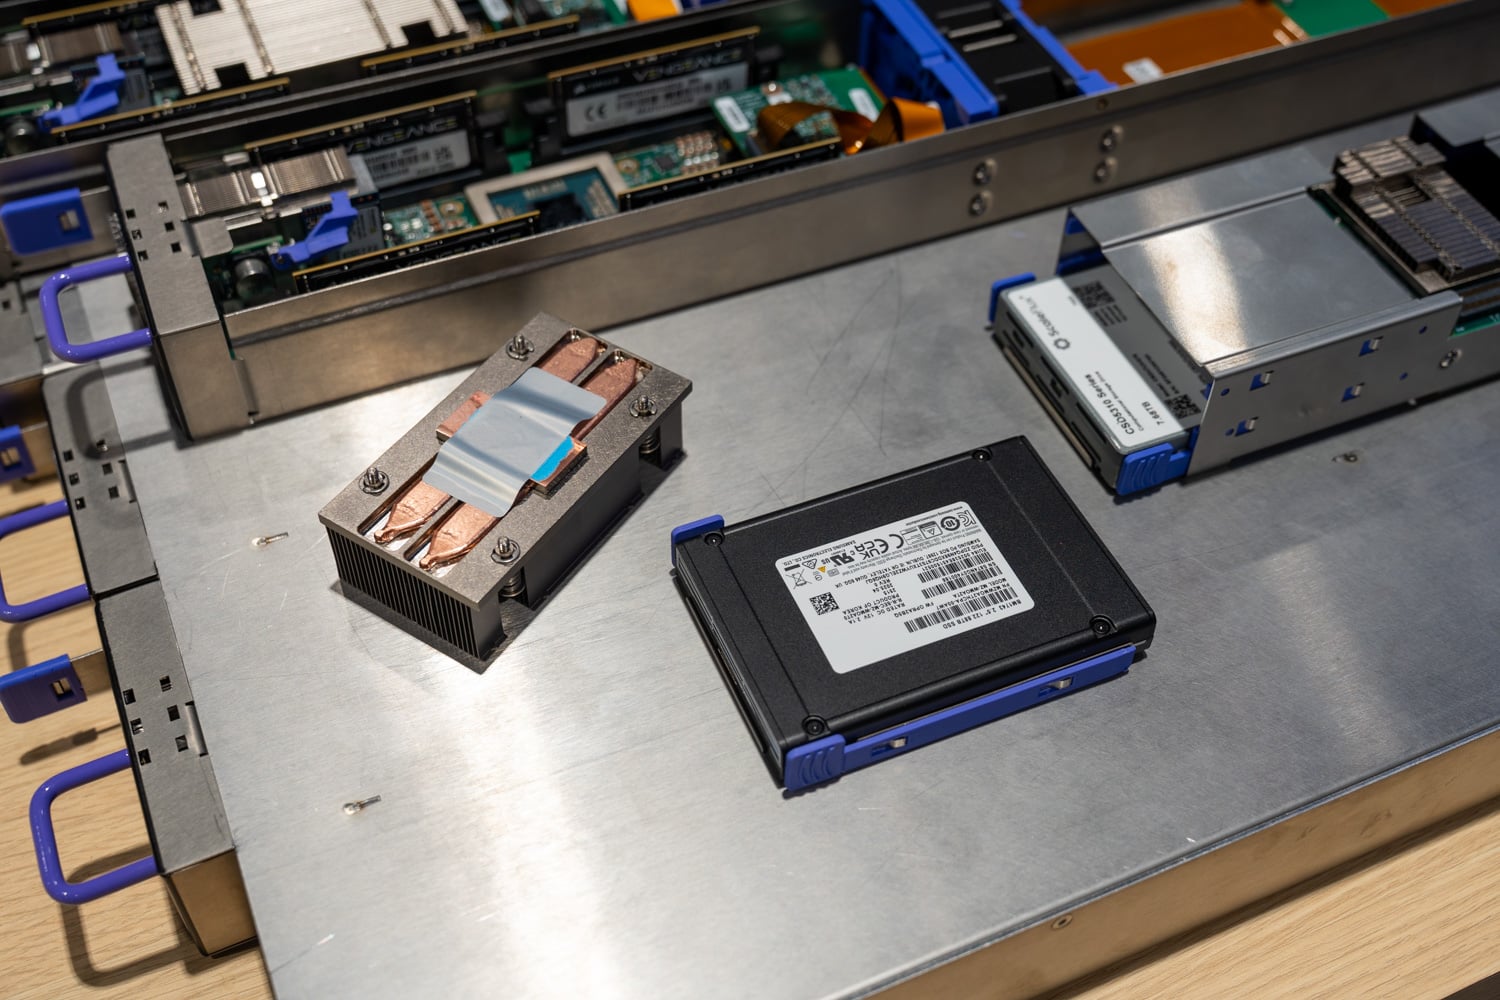
Ett 1U-fack rymmer en till fem sleds, för upp till 40 hårddiskar, 320 Arm-kärnor och tio 400 GbE-portar per rackenhet. Hammerspace listar maximalt 360 W per sled och 1 800 W per fack på dubbla 2 160 W Titanium-nätaggregat, med verktygslös service för sleds och hårddiskpaket samt IPMI och Redfish för hantering. Facket är 106.64 cm djupt och kräver ett 1 200 mm rack, vilket utesluter grundare företagsskåp. Hammerspace anger en hårddiskdensitet på 3.3 gånger högre än för en typisk 2U NVMe-server med 24 fack, vid 160 SSD-diskar i 4U jämfört med 48.
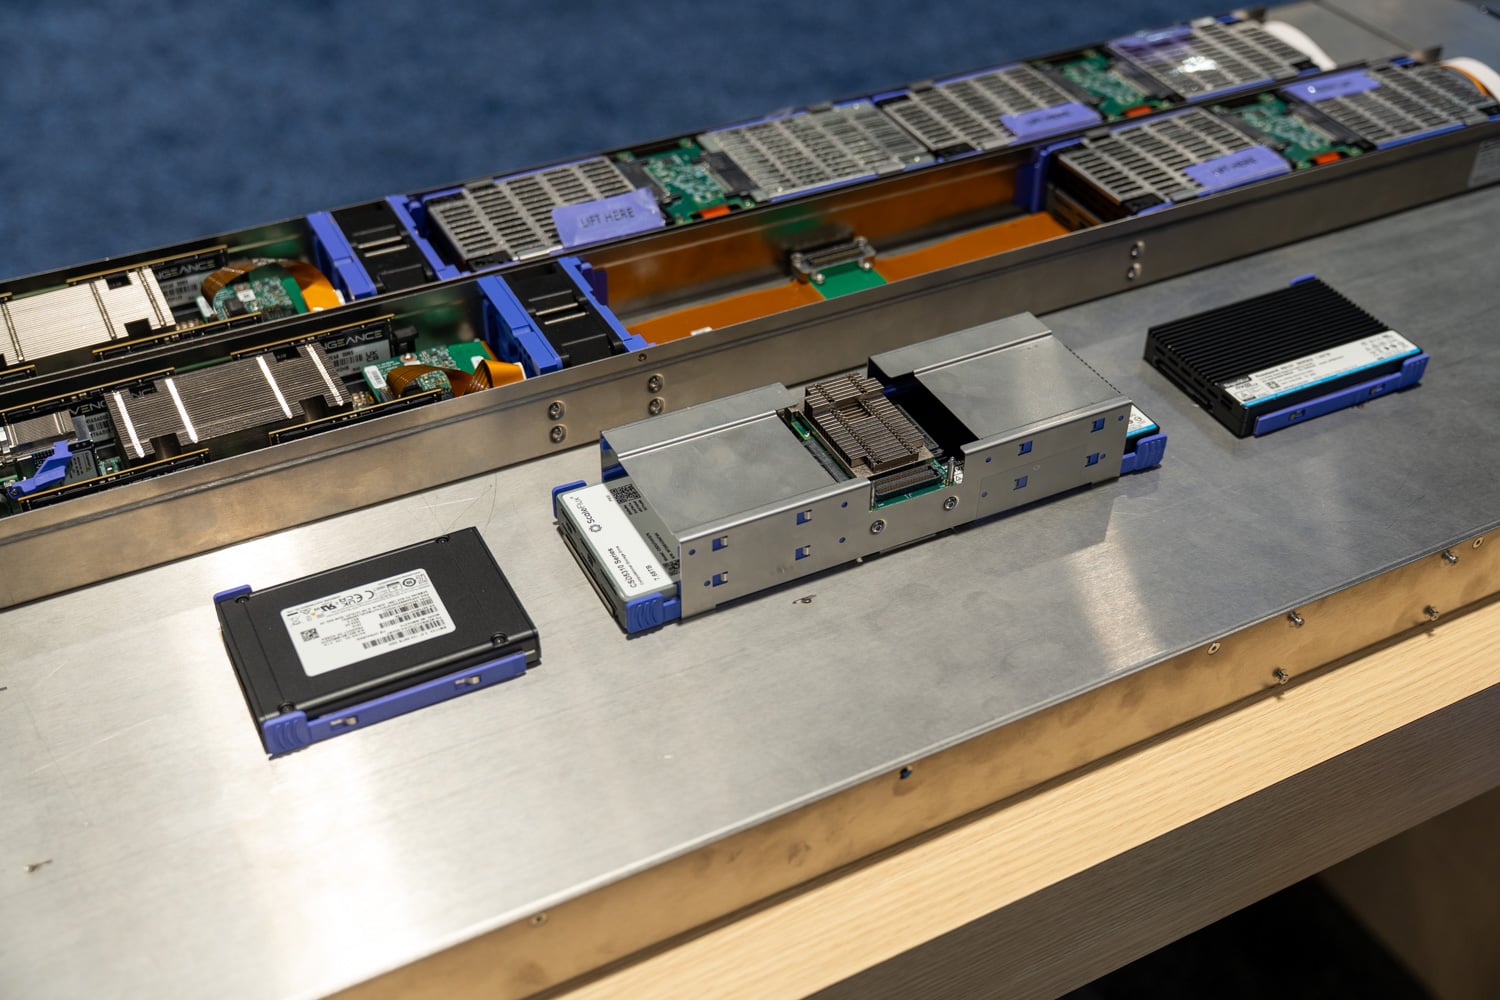
Med åtta QLC SSD-diskar på 245.76 TB, de största Hammerspace-listorna och kapaciteten hos hårddiskar som KIOXIA LC9 , rymmer en sled 1.97 PB rålagring och ett helt fack rymmer 9.83 PB. Vid fackets maximala effekt på 1 800 W motsvarar det cirka 183 W per petabyte rålagring. Sled-diskar accepterar TLC- eller QLC-diskar på PCIe Gen5 eller tidigare, och Hammerspace placerar TLC för prestanda och QLC för kapacitet. Ett 42U-rack fyllt med fack skulle rymma cirka 413 PB och dra upp till 75.6 kW.
Designen kan spåras tillbaka till Open Flash Platform-initiativet som Hammerspace startade 2025, med Xsight Labs och Los Alamos National Laboratory bland de namngivna deltagarna. I oktober 2025 meddelade Hammerspace att produktionssystem skulle vara tillgängliga i början av 2026, så schemat har flyttats med ungefär ett år. Släden använder U.2- och U.3-enheter eftersom de levereras i stora volymer nu, och Hammerspace utformade designen med tätare formfaktorer i åtanke. Hammerspace och Xsight har beskrivit en väg till en exabyte per rack, mer än dubbelt så mycket som hela 42U av de största nuvarande enheterna skulle rymma.
Hammerspace sa att prototyparbetet på släden började för ungefär två år sedan, och att den tidiga implementeringen har kommit från hyperskalare som placerar en eller två fack högst upp i varje GPU-rack och värdesätter rack- och prestandatätheten över energibesparingarna. I den layouten mappar Hammerspace NVMe inuti GPU-servrar till NVIDIA-etiketternas nivå G3 och ett TLC-fyllt OFP-fack i varje rack till G4.
Prestandakrav och testförhållanden
Hammerspace klassar ett fem-sled-fack till 390 GB/s skrivgenomströmning utan spegling och 15 miljoner 4K slumpmässiga läs-IOPS. De angivna villkoren är NFSv4.2 med pNFS över TCP på en 400 GbE-struktur med Enterprise Gen5 TLC SSD-diskar. Läshastigheter är klassade till upp till 80 GB/s per sled, eller 400 GB/s per fack. Det är ungefär 40 GB/s genom var och en av en sleds två 400 GbE-portar, vilket i huvudsak mättar länkarna när protokolloverhead räknas, så nätverksportarna sätter taket för läsgenomströmning.
Skyddet sker genom spegling, vilket ställs in per fil eller katalog via policy och kan ändras online. Skrivhastigheten faller till 195 GB/s per fack med tvåvägsspegling och 130 GB/s med trevägsspegling, och tvåvägsspegling halverar också den användbara kapaciteten, till cirka 4.9 PB på ett fullt befolkat QLC-fack. Hammerspace föreslår att man kör utan speglar för data som kan regenereras, såsom KV-cache. Företaget hävdar att prestandan per rackenhet är två till fem gånger högre än en namnlös närmaste konkurrent. De har inte publicerat latens, klientantal eller IO500- och MLPerf-lagringsresultat för OFP, och vi har inte kört eller granskat dessa tester.
| Specifikation | Hammerspace Open Flash-plattform |
|---|---|
| Plattformöversikt | |
| arkitektur | DPU-baserade flashlagringsnoder utan x86-lagringsserver |
| Kälke | 8 x U.2/U.3 NVMe SSD-diskar i två paket med 4 diskar 64-kärnig Arm DPU (Xsight Labs E1) 2 x 400 GbE QSFP-DD |
| 1U-bricka | 1 till 5 slädar Upp till 40 XNUMX SSD-diskar Upp till 320 Arm-kärnor Upp till 10 x 400 GbE |
| Drive Support | Kvalificerade U.2/U.3 SSD-diskar, PCIe Gen5 eller tidigare TLC eller QLC |
| Maximal råkapacitet | 1.97 PB per släde 9.83 PB per bricka Baserat på 245.76 TB QLC SSD-diskar |
| Protokoll | NFSv4.2 med pNFS |
| Dataskydd | Spegling efter policy per fil eller katalog: ingen, 2-vägs eller 3-vägs |
| Prestanda (Hammerspace-siffror, Gen5 TLC SSD-diskar, 400 GbE, TCP) | |
| Läs genomströmning | 80 GB/s per släde 400 GB/s per fack |
| Skrivdataflöde, ingen spegling | 78 GB/s per släde 390 GB/s per fack |
| Skrivdataflöde, 2-vägsspegel | 39 GB/s per släde 195 GB/s per fack |
| Skrivdataflöde, 3-vägsspegel | 26 GB/s per släde 130 GB/s per fack |
| 4K slumpmässig läsning | 3 miljoner IOPS per släde 15 miljoner IOPS per fack |
| Kraft och fysisk | |
| Maximal effekt | 360W per släde 1 800 W per bricka |
| Nätaggregat | Dubbla 2 160 W titanium per bricka |
| Formfaktor | 1U-bricka, 106.64 cm djup Kräver ett 1 200 mm rack |
| Kylning | Luft, maximal inloppstemperatur 40°C vid havsnivå |
| Verksamhetsledningen | IPMI, rödfisk |
| Tillgänglighet | Citerar nu Frakt under första halvåret 2027 |
Nivå 0 och KV-cache
Hammerspace positionerar OFP som Tier 1, bakom en Tier 0 gjord av NVMe som redan finns inuti GPU-servrar, vilken exporteras via NFS och aggregeras till en delad, klusteromfattande nivå utan klient eller agent på beräkningsnoderna. Data som skrivs där speglas över klustret för skydd och flyttas till andra nivåer enligt policy, och Hammerspace säger att ett vanligt mönster är att skriva träningskontrollpunkter lokalt och låta systemet flytta äldre till objektlagring. Hammerspace anger 4.4 gånger den sekventiella bandbredden och 56 procent lägre latens för Tier 0 jämfört med extern delad lagring, utan att publicera testkonfigurationen.
KV-cacherollen använder samma nivå, med motiveringen att en inferensserver som kan ladda om den beräknade kontexten för en konversation från delad lagring inte behöver beräkna om dessa tokens på GPU:n. Hammerspace fungerar inte som cachehanterare, och presenterar den poolade nivå 0 NVMe, med OFP bakom, som POSIX-lagring för inferensprogramvarans cachehanterare att använda.
Dataintelligens: Katalog-, DeepScan- och Natural-Language Queries
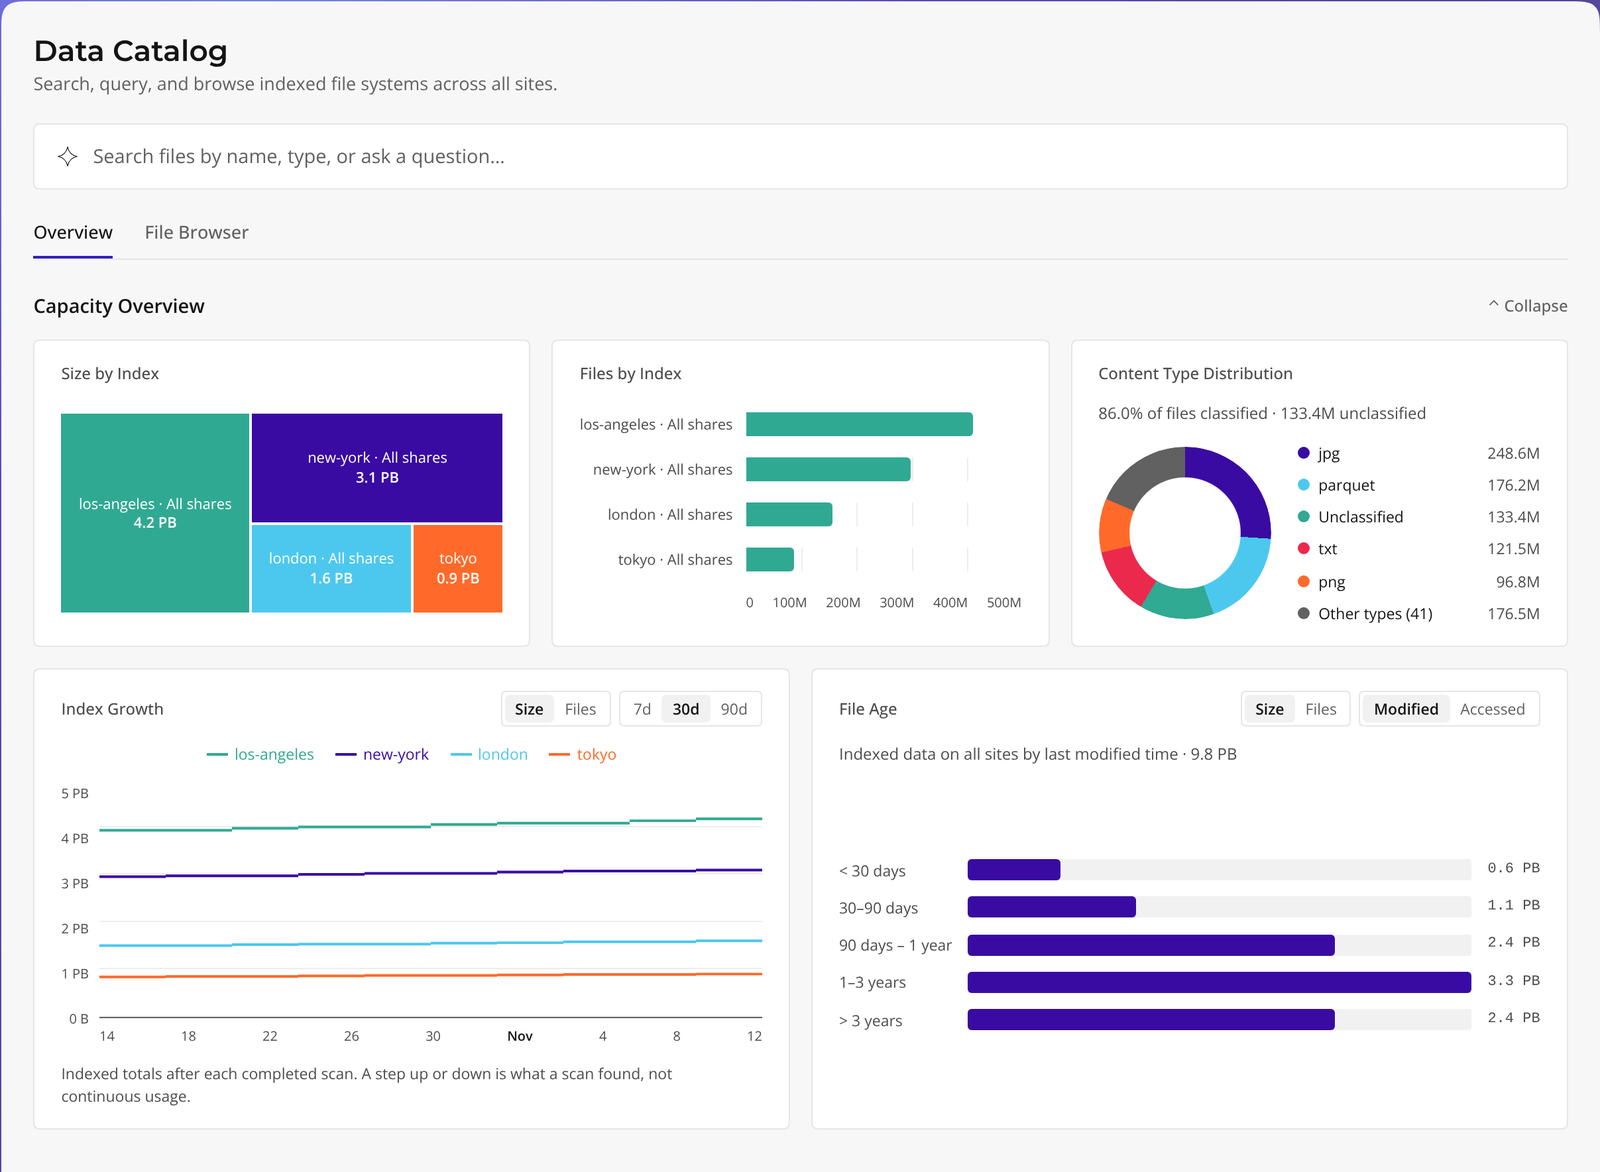
Dataintelligenslagret börjar med en katalog som indexerar fil- och objektmetadata över varje lagringssystem i namnrymden utan att flytta data. En andra nivå, DeepScan, öppnar filer för att söka efter personlig, finansiell och skyddad hälsoinformation på begäran eller enligt ett schema, och dess resultat blir sökbara taggar. Frågor kan skrivas på naturligt språk genom en LLM som kunden väljer. Resultaten matar den befintliga policymotorn, som Hammerspace kallar mål, så att en administratör kan hitta varje fil som är taggad som utbildningsklar eller begränsad till ett land och ställa in en placeringsregel för den uppsättningen.
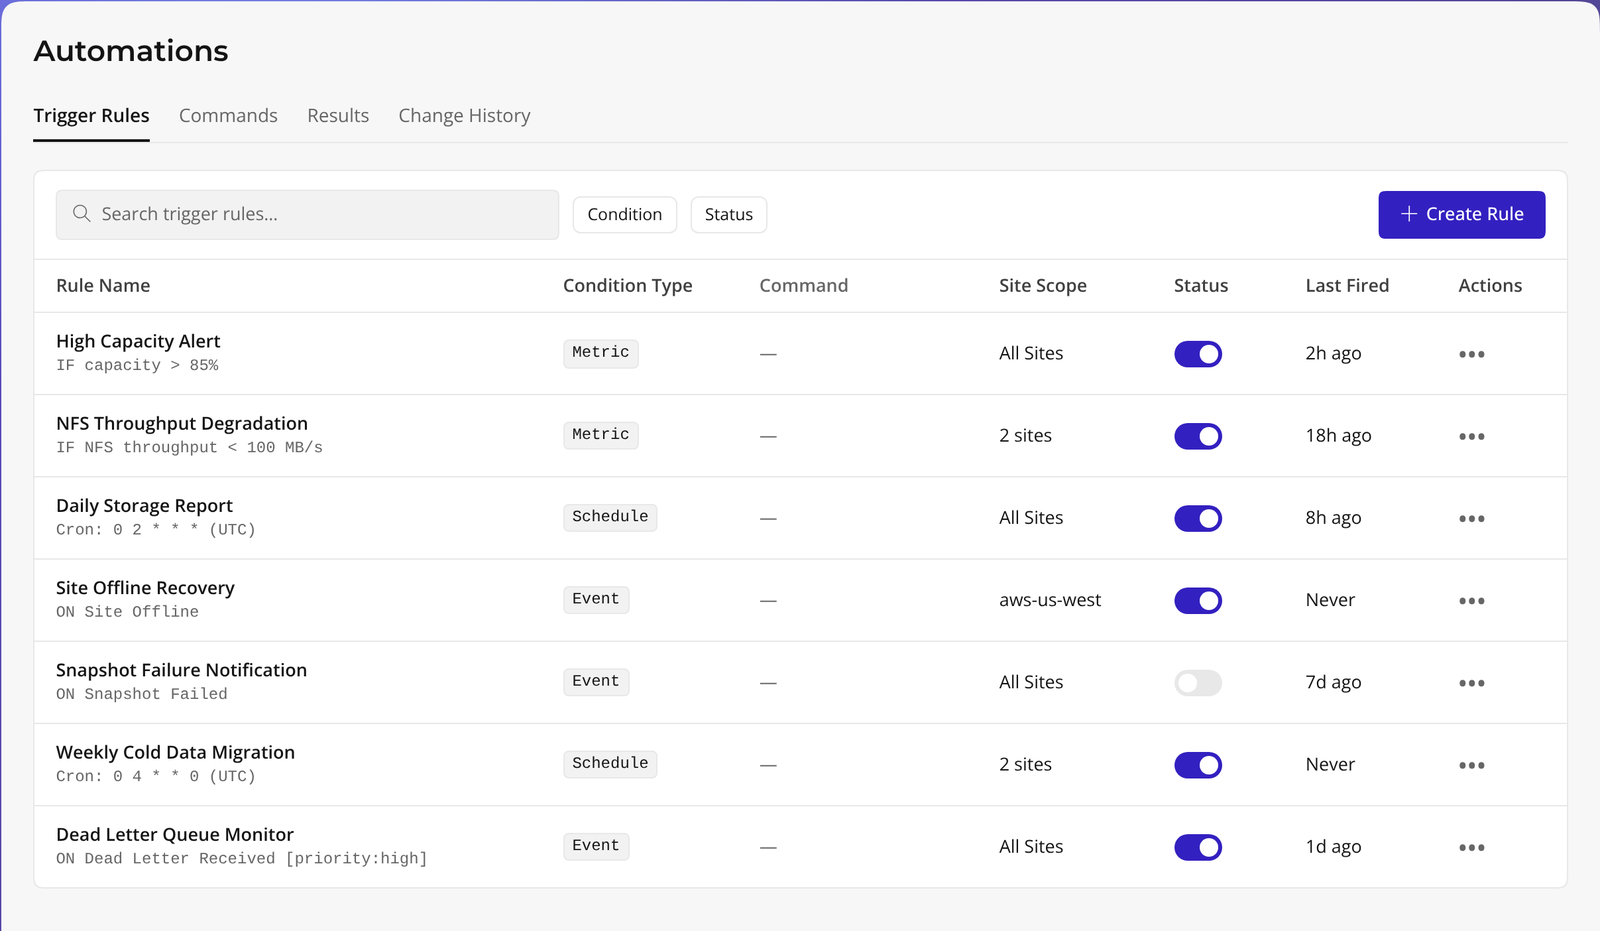
Mål är deklarativa regler som är kopplade till en delning, volym, katalog eller fil, till exempel att flytta data orörda i 30 dagar eller behålla tre kopior på tre platser. Nya automatiseringar utlöser dem från villkor som inkluderar kapacitetströsklar, scheman och händelser, med ett förhandsgranskningssteg innan ändringar godkänns. Taggar ärver ner i katalogträdet och följer filer mellan lagringssystem och moln. Programvaran täcker fil- och objektlager från alla leverantörer och hanterar inte strukturerad data.
Tidiga kunder och framtidsutsikter
Referenskunden vid lanseringen är Kaiko, ett kliniskt AI-företag med kontor i Amsterdam och Zürich som utbildar modeller på bild- och patologidata. Kaiko kör Hammerspace över Microsoft Azure och Nebul- och Nebius GPU-moln som ett namnområde, använder NVMe i sina GPU-noder som Tier 0 för träning och har kontrollpunkter placerade på Azure Blob Storage enligt policy. Hammerspace säger att alla Kaikos ML-teknikarbetsflöden på dessa tre kluster har flyttats till systemet. Fallstudien involverar inte OFP-hårdvara.
Hammerspace berättade för oss att Kaiko antog systemet samtidigt som de växte från cirka 128 GPU:er till fler än 1 000 på Nebius, och att deras befintliga all-flash NAS i Nebul-molnet integrerades i namnrymden på plats. Företaget beskrev också ett namnlöst hyperskaligt AI-forskningslabb som ersatte Amazon FSx för Lustre med ett 30PB Hammerspace-kluster i AWS efter ett år då Lustre var deras största källa till supportärenden, och utökar nu namnrymden till ett lokalt datacenter. Hammerspace nämner ungefär tre gånger snabbare storfilsoperationer där.
OFP ansluter sig till andra designer som placerar en DPU där lagringsserverns processor brukade vara, inklusive referensarkitekturen BlueField-4 STX som NVIDIA introducerade på GTC, och Hammerspaces version skiljer sig genom att para ihop den med ett filsystem som också körs utan sin hårdvara. Hammerspace demonstrerar hårdvaran på SC26 och har inte publicerat några priser.
Vi filmade en genomgång av OFP-släden och -brickan med Hammerspace på SC26, och vi kommer att lägga till videon i den här artikeln när den publiceras.


 Amazon