

Meta beskrev den snabba utvecklingen av sitt Meta Training and Inference Accelerator (MTIA)-program. Det beskrev fyra generationer av chip som skapats under ungefär två år. Dessa chip löser ett viktigt infrastrukturproblem som Meta anser vara avgörande för AI världen över: snabb anpassning till föränderliga modellarkitekturer till låg kostnad, utan att vara beroende av långa kiselutvecklingscykler. MTIA är en del av en bredare kiselstrategi, och Meta bekräftade sitt samarbete med Broadcom för att utveckla dessa chip.
Enligt Meta har de redan driftsatt hundratusentals MTIA-enheter i produktion och har integrerat flera interna modeller. Valideringsarbetet inkluderar testning av stora språkmodeller som Llama. Företaget har tidigare publicerat tekniska detaljer om de två första MTIA-generationerna, MTIA 100 och MTIA 200, i ISCA-forskningsartiklar. Nu utökar de plattformen med MTIA 300, 400, 450 och 500. Dessa nya komponenter utökar täckningen från ranking- och rekommendationsinferens (R&R) till R&R-utbildning och, i allt högre grad, till allmänna GenAI-arbetsbelastningar, särskilt inferens, med driftsättningar pågående eller planerade för 2026 och 2027.
Iteration som designprincip
Ett centralt tema är kadens. Meta menar att modellutvecklingen är snabbare än traditionell chiputveckling, som kan ta två år från design till produktion. Meta bygger MTIA-chip på den öppna källkodsarkitekturen RISC-V, där Taiwan Semiconductor Manufacturing Corporation (TSMC) hanterar tillverkningen. Svaret är en iterativ, modulär designmetod. Varje generation bygger på återanvändbara chiplets och finjusteras med hjälp av de senaste insikterna om operatörer och serveringar. Företaget betonade också vikten av återanvändning utöver själva chipet. MTIA 400, 450 och 500 delar samma chassi-, rack- och nätverksinfrastruktur. Detta möjliggör snabba uppgraderingar, vilket minskar tiden från kiselberedskap till datacenterdistribution.
MTIA 300: Nätverkande och kollektiv inbyggda i kiseln
MTIA 300 utgör grunden för den nya färdplanen. Den optimerades initialt för R&R-träning, Metas primära arbetsbelastning före GenAI:s uppkomst. Arkitekturen inkluderar inbyggda nätverkschiplets, dedikerade meddelandemotorer för effektiv kollektiv kommunikation och nära-minnesberäkning för att minska belastningen på kollektiva operationer. Även om de fokuserar på R&R, stöder dessa kommunikationskomponenter även GenAI-träning och inferenseffektivitet i senare versioner.
På blocknivå beskrev Meta MTIA 300 som en multichiplet-design med en beräkningschiplet, två nätverkschiplets och flera HBM-stackar. Beräkningsblocket är arrangerat som ett rutnät av bearbetningselement (PE), med extra PE för att öka utbytet. Varje PE inkluderar två RISC-V-vektorkärnor, en punktproduktmotor för matrisoperationer, en specialiserad funktionsenhet för aktiveringar och elementvisa operationer, en reduktionsmotor för ackumulering och PE-till-PE-kommunikation, och en DMA-motor för lokal dataöverföring.
MTIA 400: En pivot mot GenAI med konkurrenskraftiga dataflödeskrav
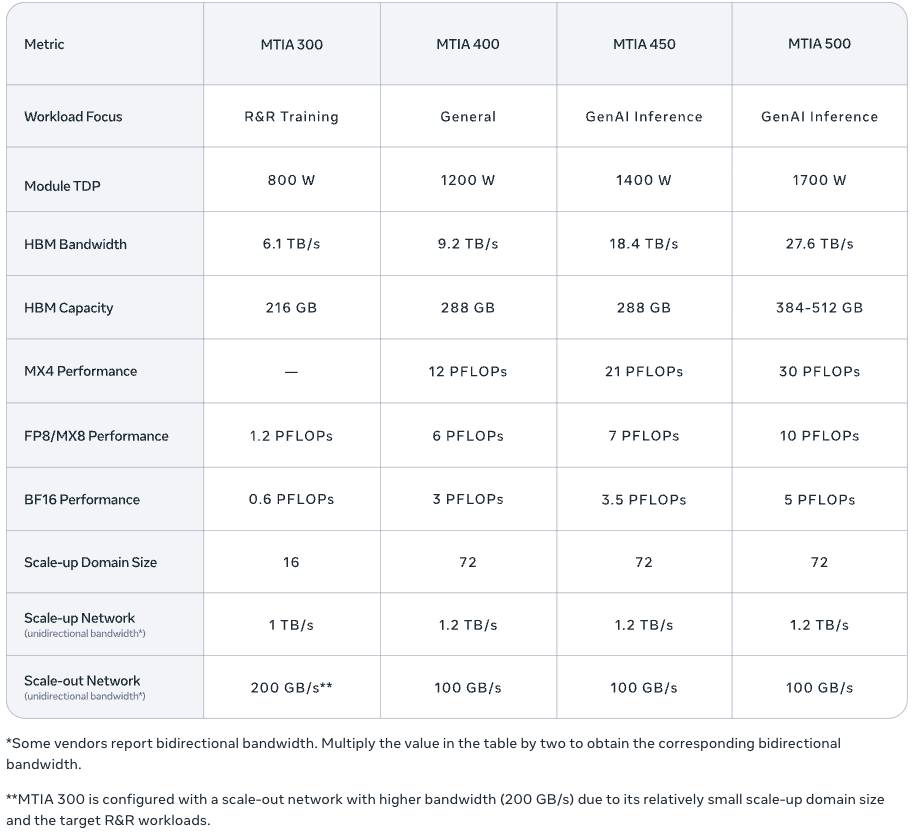
MTIA 400 uppgraderar MTIA 300 för att bättre stödja GenAI samtidigt som R&R-funktioner bibehålls. Meta beskriver MTIA 400 som en större uppgradering och rapporterar 400 % högre FP8 FLOPS och 51 % högre HBM-bandbredd än MTIA 300. Arkitektoniskt kombinerar MTIA 400 två beräkningschiplets för att öka beräkningstätheten och lägger till stöd för förbättrade MX8- och MX4-lågprecisionsformat, vilket Meta anser vara avgörande för effektiv GenAI-inferens.

Systemdesign är fortfarande ett centralt fokus. Meta beskrev en rackstor driftsättning där 72 MTIA 400-enheter ansluts via ett switchat bakplan och bildar en enda skalbar domän. För flexibla driftsättningar nämnde Meta luftassisterade vätskekylningsrack (AALC) för att påskynda installationen i befintliga datacenter. De noterade också att plattformen kan stödja vätskekylningslösningar.
MTIA 450: GenAI-inferensoptimering börjar med minnesbandbredd
MTIA 450 är en förbättrad version av MTIA 400, fokuserad på inferens och driven av ökad efterfrågan på GenAI-inferens. Meta identifierade HBM-bandbredd som den främsta faktorn som begränsar inferensprestanda och fördubblade den från MTIA 400 till MTIA 450. Företaget rapporterade också en 75% ökning av MX4 FLOPS för att förbättra mixed-of-experts-beräkningar, tillsammans med hårdvaruacceleration för att minska vanliga flaskhalsar i attention- och feed-forward-operationer, särskilt i beteendet hos Softmax och FlashAttention.
Meta lyfte fram sitt arbete med datatyper som en viktig faktor. MTIA 450 går längre än FP8 och MX8 och uppnår MX4-genomströmning med sex gånger högre hastighet än FP16/BF16. Chipet stöder blandade lågprecisionsberäkningar utan att kräva programvarukonverteringar. Det har anpassade innovationer för datatyper utformade för att bevara modellkvaliteten samtidigt som FLOPS ökas med minimal areapåverkan. MTIA 450 är planerad för massdistribution i början av 2027.
MTIA 500: Mer bandbredd, mer kapacitet, ytterligare chiplet-nedbrytning
MTIA 500 fortsätter fokus på inferens med ytterligare förbättringar inom minne och beräkning. Meta uppgav att MTIA 500 ökar HBM-bandbredden med 50 % jämfört med MTIA 450, höjer HBM-kapaciteten med upp till 80 % och ökar MX4 FLOPS med 43 %. Chiplet-designen utvecklas med en 2×2-konfiguration av mindre beräkningschiplets, omgivna av flera HBM-stackar och två nätverkschiplets. Den inkluderar också en System-on-Chip (SoC)-chiplet för PCIe-anslutning till värd-CPU:n och skalbara nätverkskort. Meta nämnde ytterligare hårdvaruacceleration och ändringar av datatyper för att åtgärda flaskhalsar i inferens.
MTIA 500 är planerad för massutplacering 2027.
Enkel adoption
Meta anpassar MTIA med målet att enkelt kunna implementera det, med betoning på branschstandardverktyg snarare än ett specialiserat ramverk. Företaget beskrev MTIA som PyTorch-nativt, som fungerar sömlöst med PyTorch 2.x-kompileringsprocesser och stöder både Eager- och grafkörning. I grafläge kan utvecklare använda torch.compile och torch.export för att optimera grafer utan att behöva skriva om MTIA-specifika modeller, vilket möjliggör parallell distribution över GPU:er och MTIA.
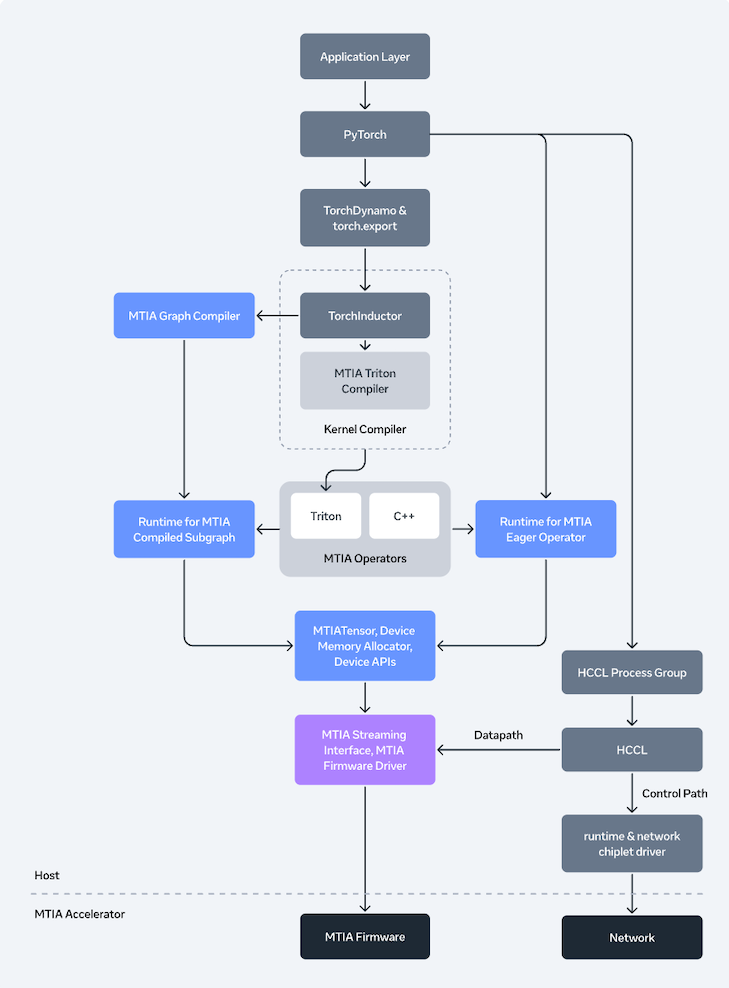
Bakom kulisserna har Meta detaljerat presenterat en MTIA-kompilatorstack byggd på Torch FX IR och TorchInductor. De lägre lagren använder Triton, MLIR och LLVM, tillsammans med MTIA-specifika optimeringar, inklusive förbättringar av kärnfusion och tillägg för prestandakritiska delar. Autojustering är en viktig funktion för att välja mellan olika kompileringsstrategier.
För distribuerad exekvering introducerade Meta sitt Hoot Collective Communications Library (HCCL). Detta bibliotek liknar GPU-kollektiva stackar men är optimerat för MTIA:s inbyggda nätverkschiplets och meddelandemotorer. Det använder nära-minnesberäkning för att accelerera reduktionsoperationer. Meta stöder också compute-collective fusion för att sänka latensen och har en transportstack utformad för att hantera datavägen och minska värdkostnaden.
Vid körning demonstrerade Meta en enhetskörning som hanterar minne, schemaläggning och koordinering mellan Eager- och Graph-lägen. Den introducerade också en Rust-baserad användarutrymmesdrivrutin, vilket skilde sig från den traditionella Linux-drivrutinen i kärnan. Den inbyggda programvaran är skriven i bare-metal Rust, med betoning på låg latens och säkerhet.
För GenAI-servern beskrev Meta sin vLLM-integration med hjälp av ett plugin-system. Detta ersätter nyckeloperatorer som FlashAttention och fused LayerNorm med MTIA-specifika kärnor. Det möjliggör också grafläge via en anpassad torch.compile-backend. Dessutom nämnde Meta verktyg för att hantera stora MTIA-distributioner, inklusive övervakning, profilering, felsökning och observerbarhet över värdar och enheter.
Vad kommer härnäst
Metas uppdaterade MTIA-färdplan betonar ekonomin bakom GenAI-inferens, med fokus på HBM-bandbredd och lågprecisionsformat som nyckelfaktorer. Om Meta uppfyller sina tidsfrister för distribution kommer MTIA 450 och 500 att fungera som de första storskaliga testerna för att avgöra om en inferensbaserad acceleratorstrategi, baserad på snabba chiplet-iterationer och standardiserad programvara, kan bibehålla fördelar jämfört med vanliga GPU-plattformar för att leverera GenAI-tjänster.


 Amazon