

Computex 2026 har dragit igång i Taipei, och som vanligt satte NVIDIA tonen med ett Jensen Huang-anförande som sträckte sig över hela företagets färdplan. En stor del av det handlade om datacenter-GPU-förträffligheten vi redan sett, med Vera Rubin nu i full produktion och det numera bekanta budskapet om agenter som omformar varje lager av datoranvändning. Vi kommer inte att upprepa allt detta här.
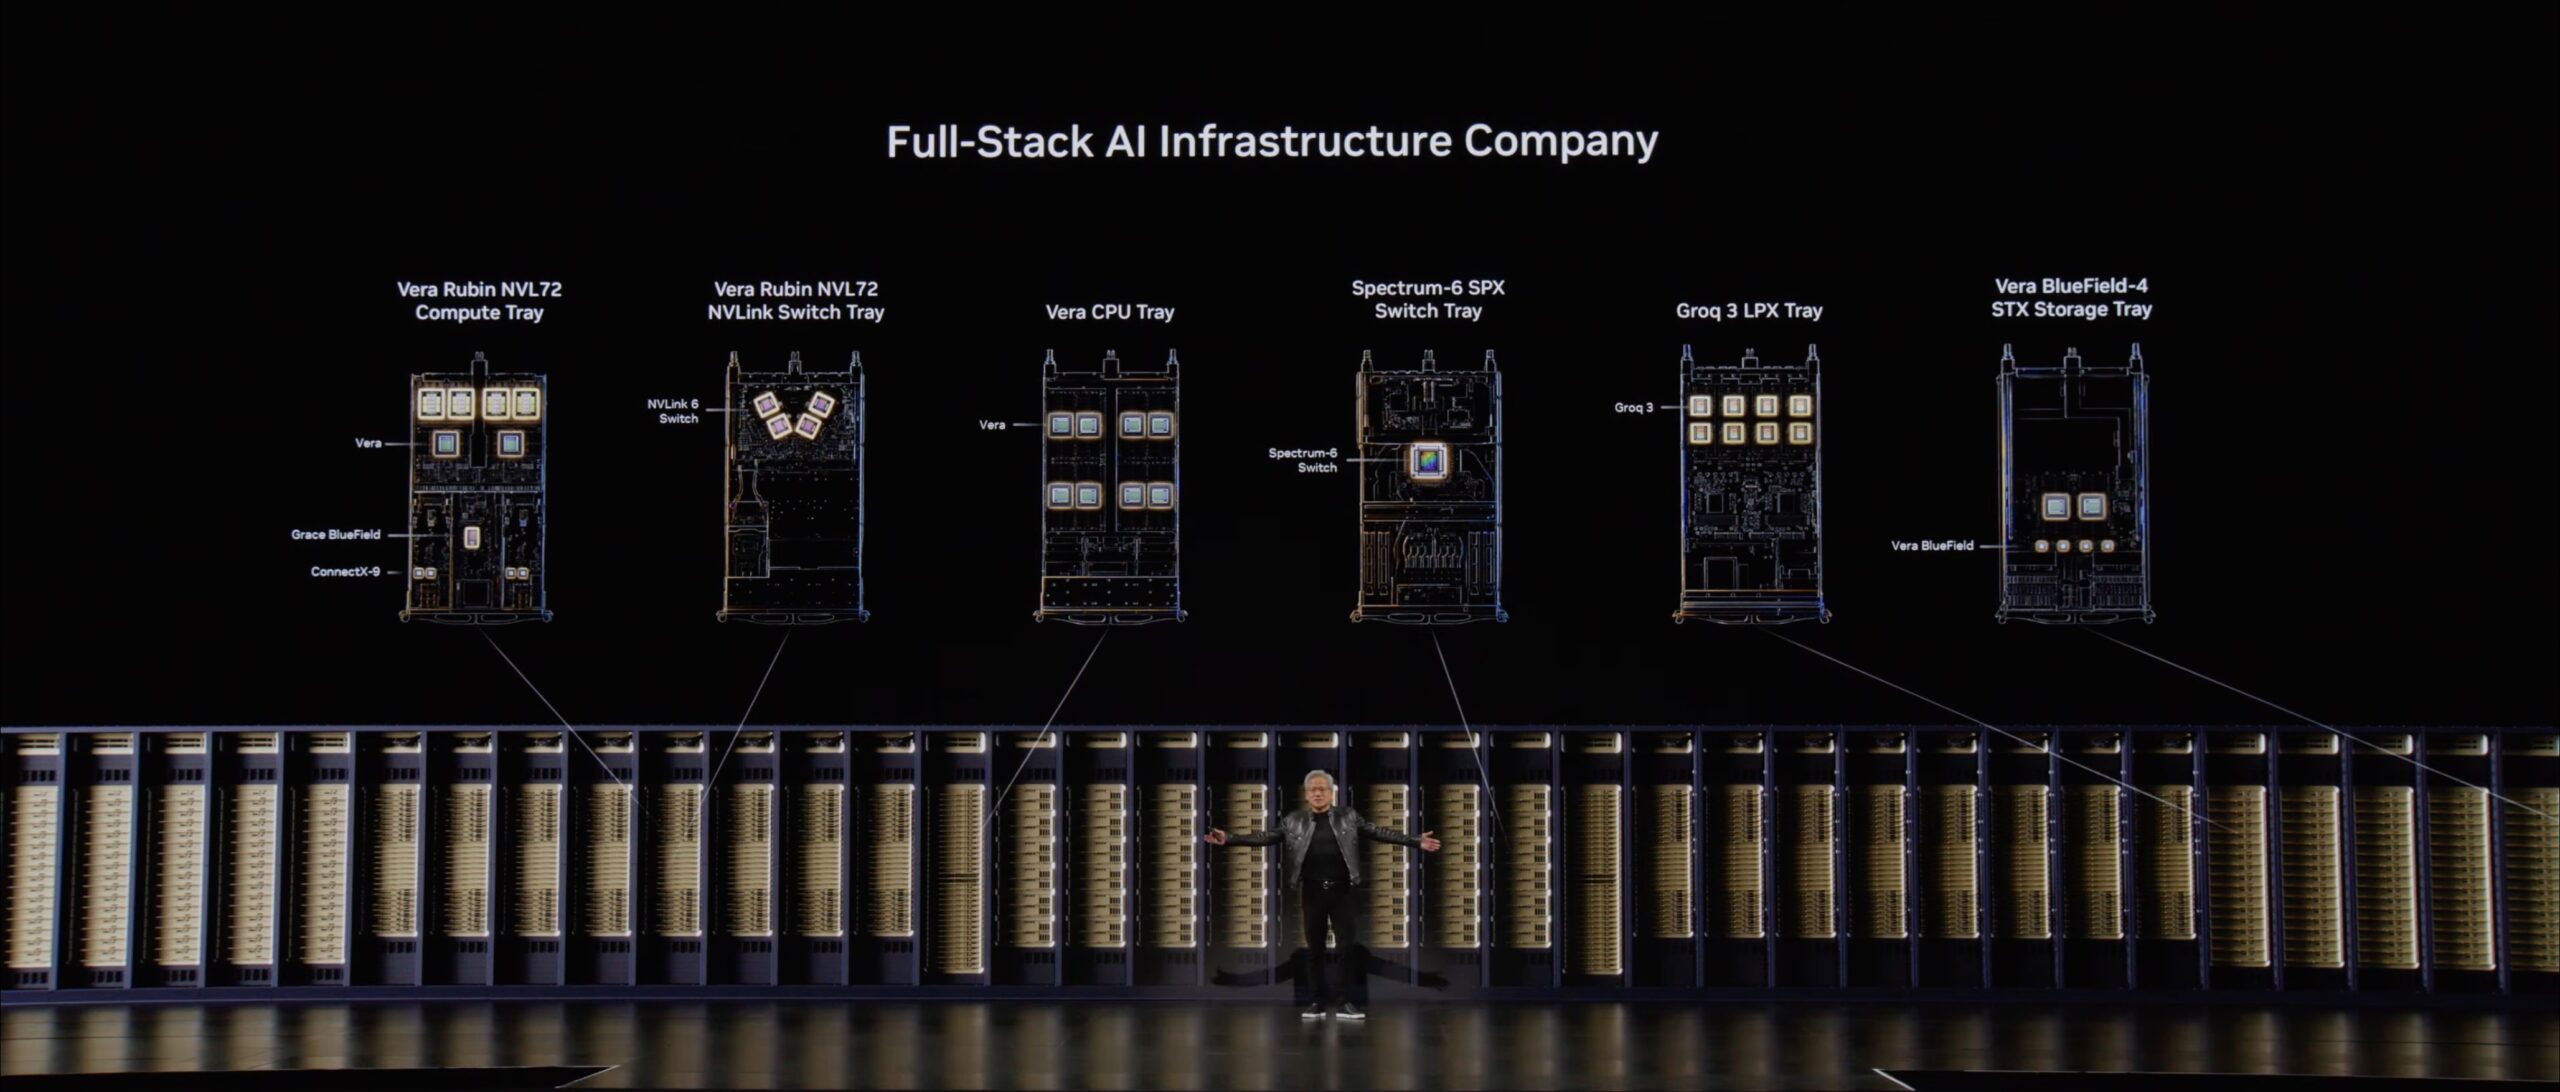
Det genuint nya materialet, och anledningen till att detta huvudanförande var viktigt för alla som lever på klientsidan, var datorn. NVIDIA och Microsoft använde Computex för att tillkännage en ny version av Windows-maskinen, och gjorde det över en hel produktfamilj snarare än en enda enhet. Innan vi går in på det är dock en del av datacenterhistorien värd att titta närmare på.
En närmare titt på LPX-racket
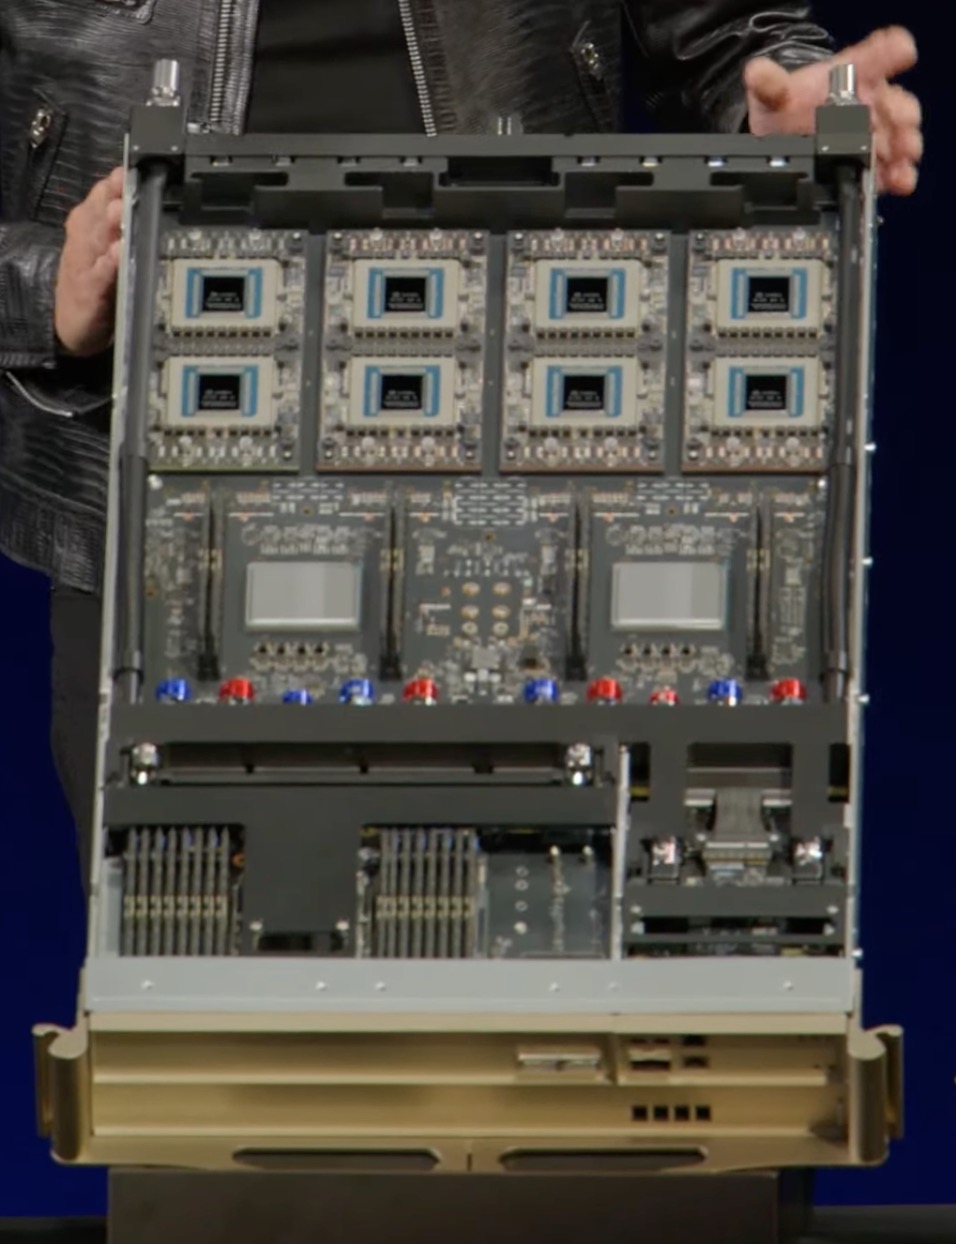
En sak i datacentret fångade vår uppmärksamhet. LPX-racket har ändrats. Systemen verkar ha gått från 1 OU till 2 OU, och de fyra Groq C2C-länkarna ser också fysiskt annorlunda ut än vår tidigare LPX-täckning . NVIDIA gav oss en ännu närmare titt på racket den här gången. Utöver dessa två förändringar var det inget annat som uppenbart annorlunda på utsidan, vilket gör oss väldigt nyfikna på vad det andra lagret faktiskt innehåller.
En treskiktad datorfamilj
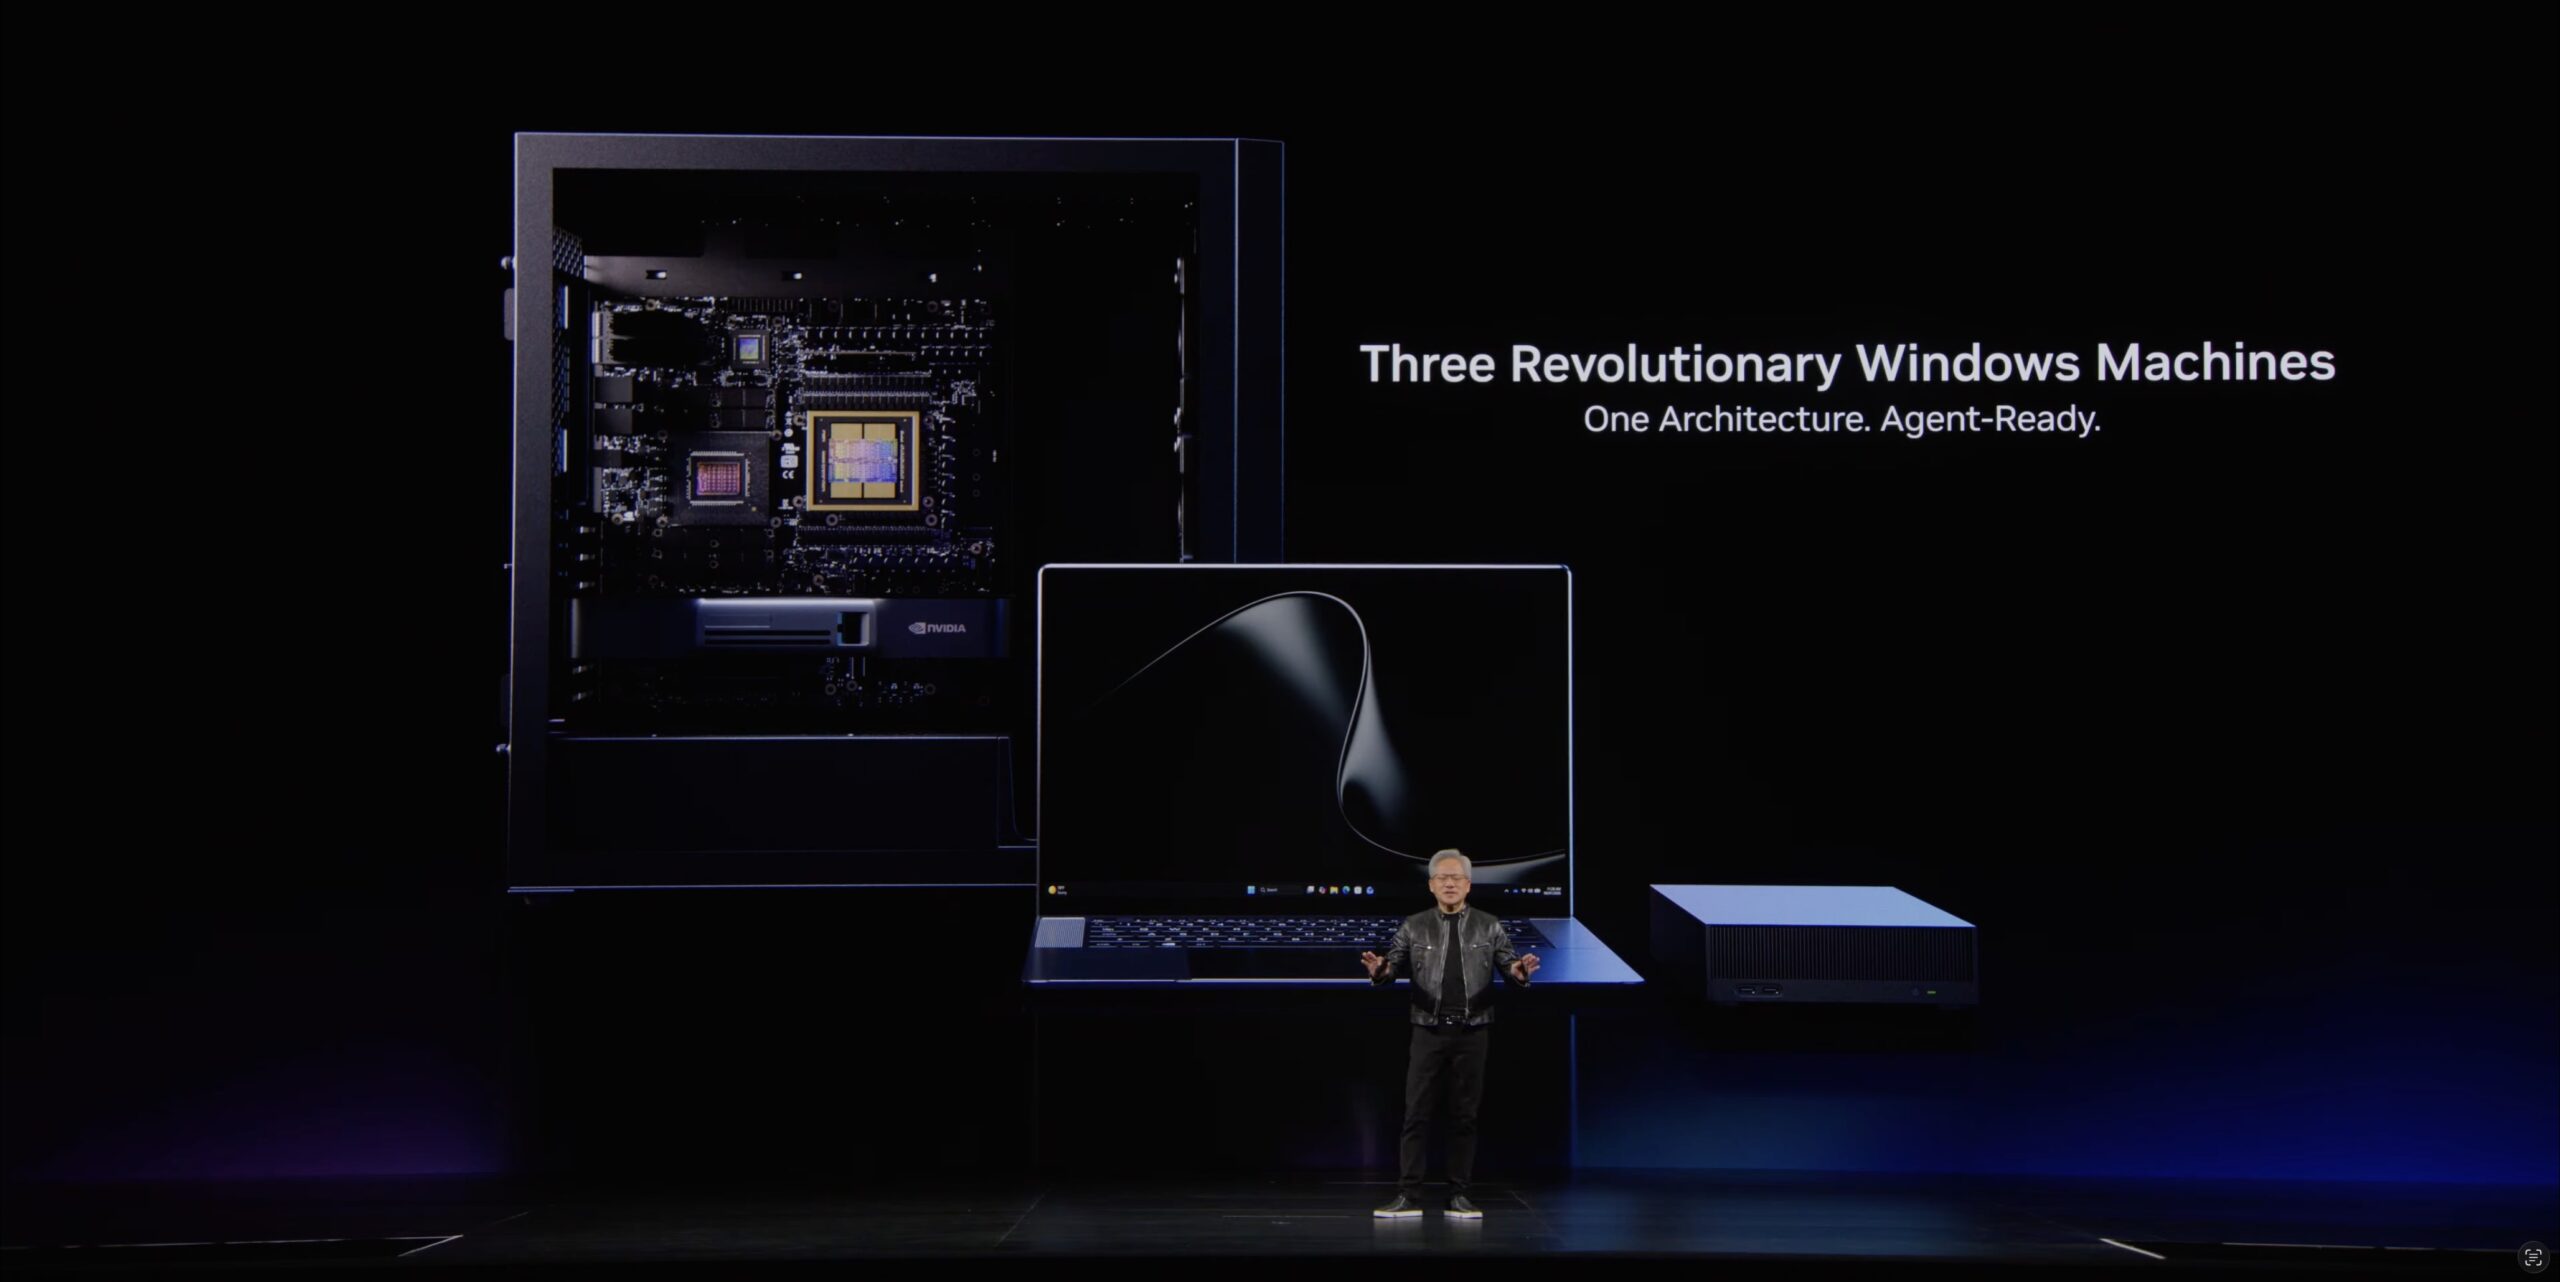
NVIDIA tillkännagav en familj av klientmaskiner: en bärbar dator, en stationär dator och en arbetsstation, alla byggda på samma Spark- och Blackwell-grund, och även inriktade på att stödja Windows. Jensen utformade den som den första helt omkonstruerade serien av PC-datorer på 40 år. Oavsett om du köper ramverket eller inte är strukturen värd att förstå, eftersom varje nivå riktar sig till en helt annan köpare. Vi tar dem i ordning.
RTX Spark-bärbara datorer
I mitten av bärbara datorerna finns superchippet RTX Spark, som NVIDIA visade upp på scenen under kodnamnet N1X och byggt i samarbete med MediaTek. Det är en del på 70 miljarder transistorer i en TSMC 3nm-process som sammanfogar två chiplets till en SoC. GPU-sidan är en stor Blackwell-design med 6 144 CUDA-kärnor och femte generationens Tensor-kärnor med FP4-precision, klassade till 1 petaflop FP4 AI-prestanda. Den ansluts via NVLink-C2C med 600 GB/s (NVIDIAS siffra är ungefär 5x PCIe Gen 5, med mycket lägre effekt) till en 20-kärnig Grace-processor. Minnet når upp till 128 GB enhetligt minne med 300 GB/s bandbredd.
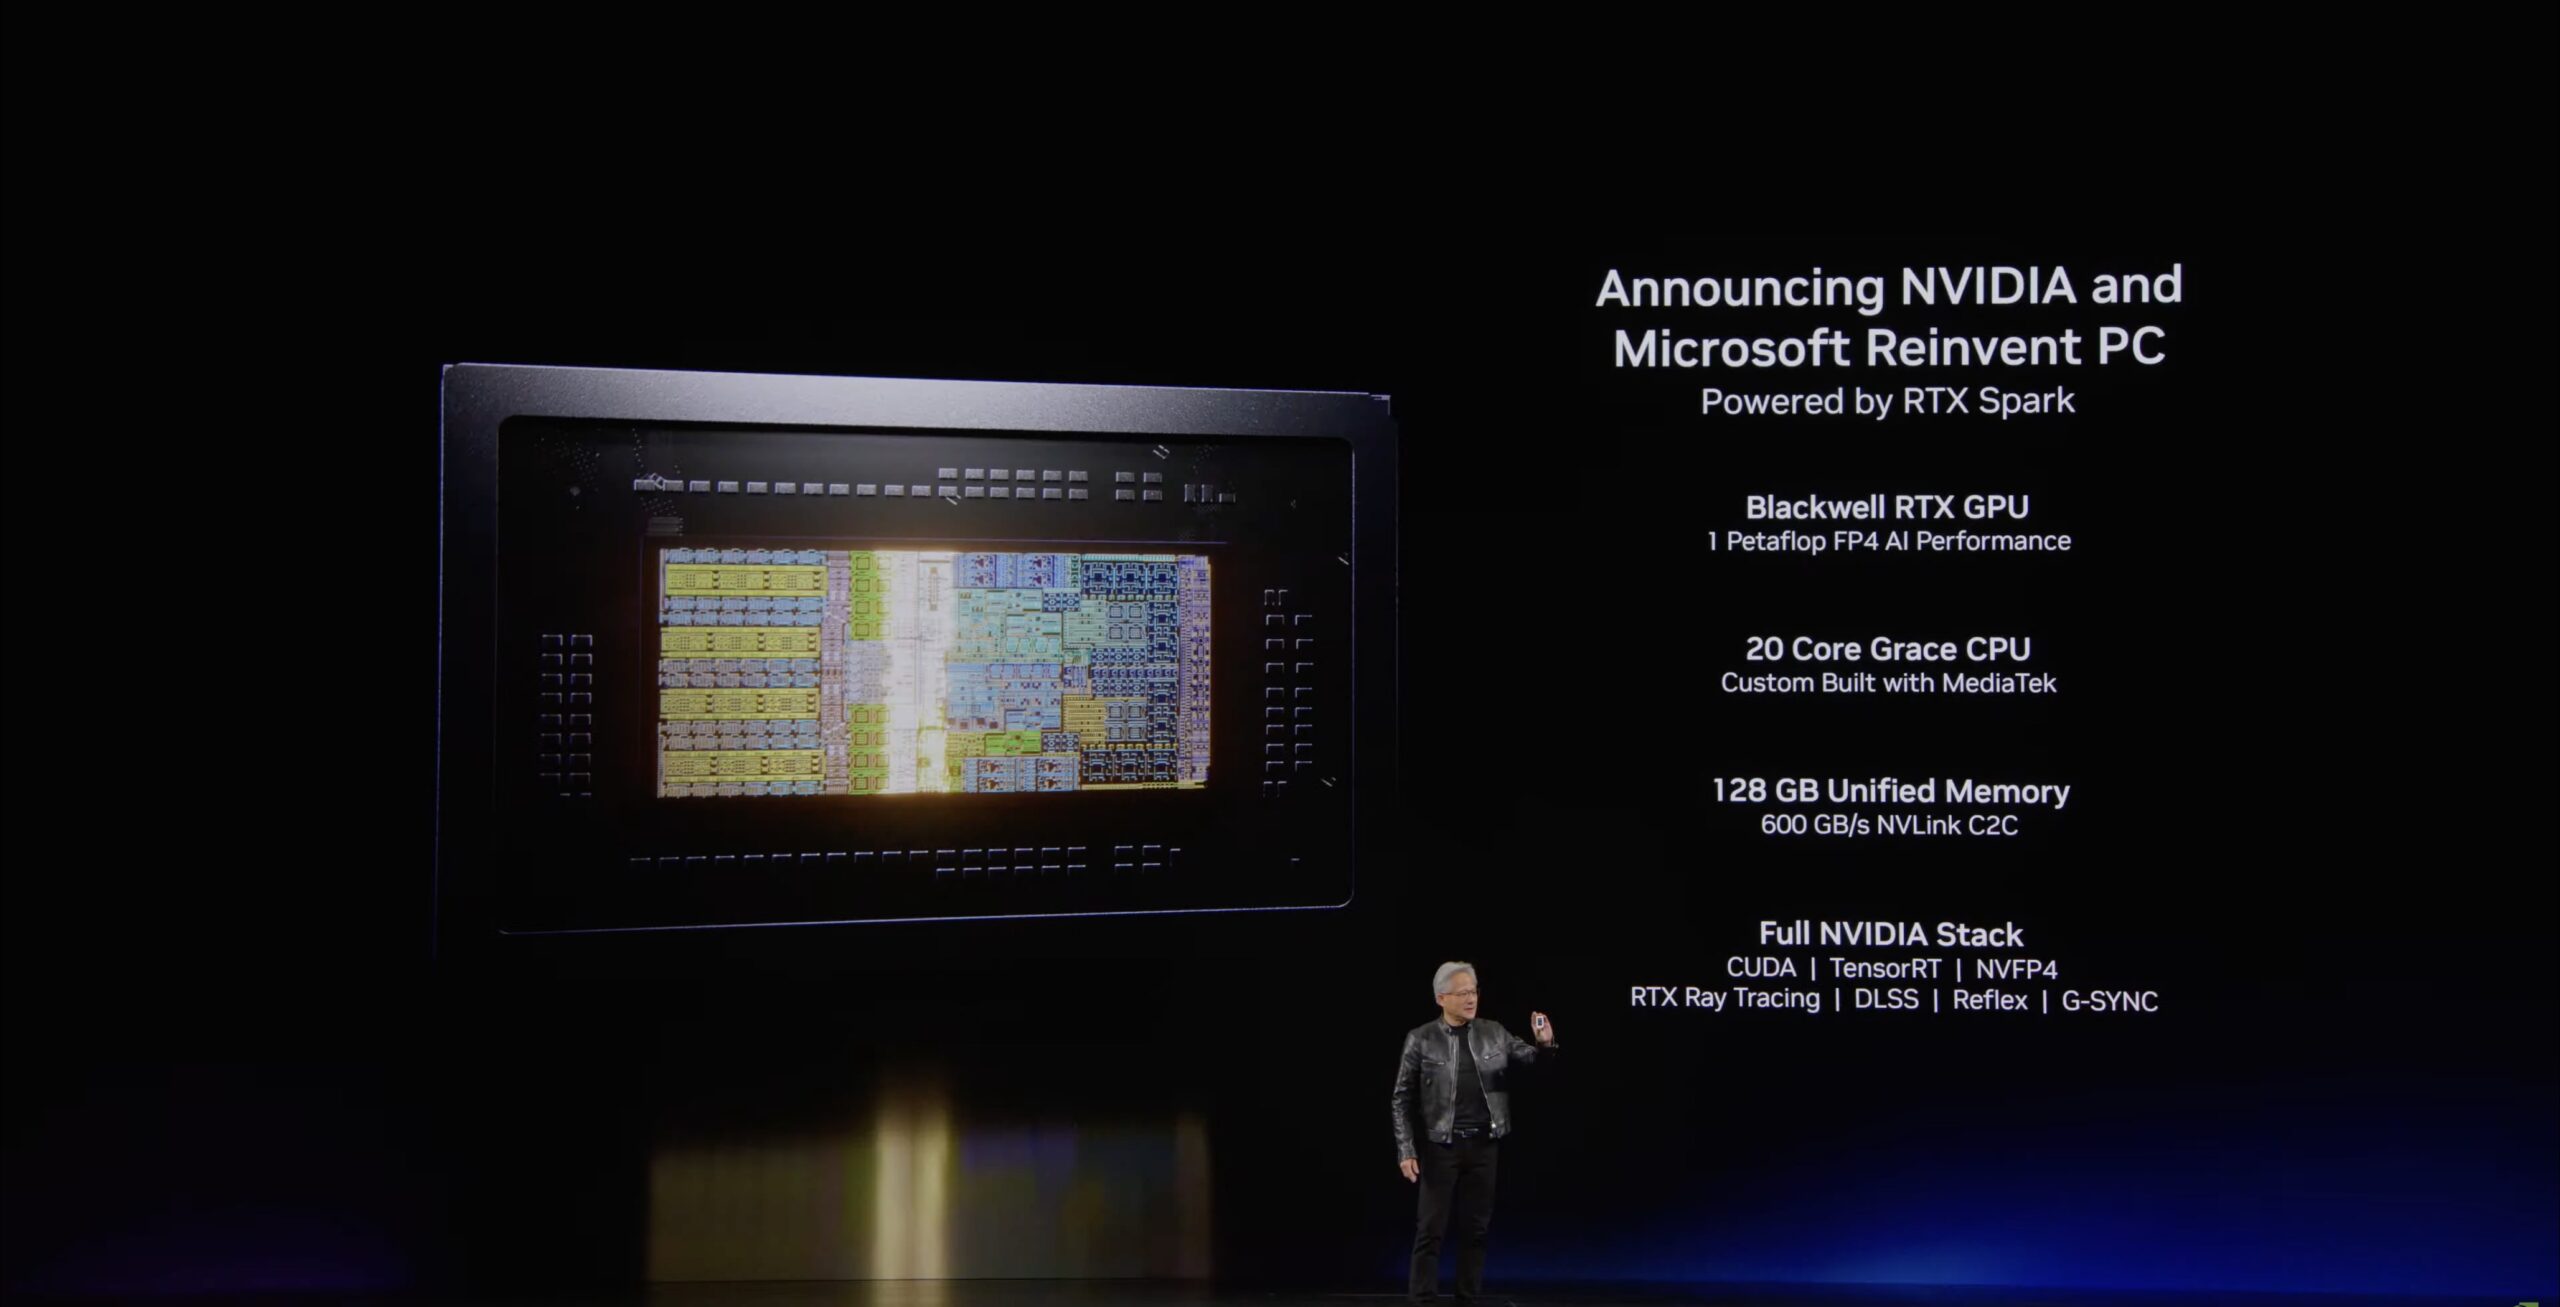
Om det låter som ett DGX Spark-specifikationsblad, så är det nästan för att det är det. NVIDIA sa det under pressens frågestund och svar och kallade fullspecifikationschippet "baserat på samma system" som DGX Spark men optimerat för en annan plattform både vad gäller hårdvara och mjukvara. Grunden är att DGX Spark är byggt för Linux- och AI-utvecklare, medan RTX Spark är en Windows-först-produkt som lagerar RTX-spel- och skapandestacken ovanpå samma kisel. NVIDIA beskriver prestanda som "i samma klass som en RTX 5070-bärbar GPU", med den stora förbehållet att jämförelsen varierar beroende på arbetsbelastning, eftersom en SoC med enhetligt minne beter sig väldigt annorlunda än en separat GPU över PCIe. Det är här vår DGX Spark-upplevelse gör oss mest nyfikna, och där vi förväntar oss att den här lanseringen kommer att skilja sig från den förra. I våra DGX Spark-tester var ett av de mest konsekventa resultaten hur nära de olika OEM-designerna landade varandra. Vissa implementeringar var bättre konstruerade än andra, men eftersom varje enhet byggdes på i huvudsak samma NVIDIA-referensplattform med samma kraft och termiska hölje, var verklighetens prestanda tätt klustrade.
Vi förväntar oss inte att det ska hålla i sig här. RTX Spark satsar på bärbara datorer, vissa så tunna som 14 mm och så lätta som 3 kg. NVIDIA bekräftade att dessa chip kommer att köra allt från ensiffriga watt upp till ungefär 80 W i toppen för de största konfigurationerna, där varje OEM fritt kan välja sin egen kylmetod, från ångkammare till avancerade värmerör. I ett så tunt chassi kommer chipet nästan säkert att vara effektbegränsat, vilket i sin tur gör det termiskt och frekvensbegränsat. Det är inte en nackdel. Det är fysik. Men det betyder att den OEM som bygger den bättre termiska lösningen, ger chipet en högre hållbar strömförbrukningsbudget och justerar sina fläktkurvor väl, skulle kunna öppna ett verkligt, hållbart prestandagap jämfört med en tunnare, tystare konkurrent som kör identiskt kisel. Två bärbara datorer med samma chip och samma minne skulle kunna leverera märkbart olika hållbar dataflöden, och att lista ut vilken OEM som faktiskt låter chipet sträcka på benen är precis den typ av testning vi lever för. RTX Spark spänner också över en hel familj av chip. NVIDIA har gjort det klart att det kommer att finnas flera SKU:er, med fullspecifikationsdelen (20 processorkärnor, upp till 128 GB) högst upp. I den bredare familjen kommer minnet att variera från 16 GB till 128 GB, och NVIDIA förväntar sig över 30 bärbara datorer och långt över 10 stationära datorer enbart i den första omgången, från alla större OEM-tillverkare, inklusive namngivna designer som Dell XPS 16 Creator Edition, HP OmniBook och Microsofts Surface Laptop Ultra.
Två hårdvarudetaljer gör oss optimistiska. Den första är nätverk, eller snarare bristen på det. DGX Spark levererades med NVIDIAs ConnectX-7-nätverk och 200 GbE-anslutning inbyggd, vilket var utmärkt för en utvecklarklusterbox men förbrukade kortutrymme, ström och kostnad. NVIDIA bekräftade att RTX Spark-bärbara datorer inte kommer att ha CX7-paketet. För en konsumentbärbar Windows-bärbar dator är det rätt val, och med det frigjorda kortutrymmet och strömförbrukningen vill vi se mycket bättre lagringsutrymme i dessa enheter. DGX Sparks lagring var användbar, men aldrig stjärnan i showen, och en konsumentbärbar dator utan nätverkskisel att mata har all anledning att leverera snabbare och större NVMe. Den andra är I/O. Eftersom varje DGX Spark använde samma referenskort, levererades varje enhet med samma portar. Med DGX Sparks enhetlighet skulle en verklig I/O-variation per OEM vara välkommen.
Batteritid är den sista frågan om bärbara datorer, och den våra riktmärken är byggda för. NVIDIA lovade ett batteri som räcker hela dagen för produktivitet och surfning, samtidigt som vi är ärliga att spel eller fullfjädrad AI kommer att tömma vilken bärbar dator som helst på 45 minuter till en timme. Det vi inte kan vänta med att kvantifiera är batteritiden medan man utför faktiskt AI-arbete. En agent som körs även när användaren inte gör det är en bra idé, men lokal inferens om batteri är en riktig dragningskraft, och skillnaden mellan att e-posta hela dagen och att köra en 120B-modell hela dagen kan vara enorm. Vi har en komplett uppsättning anpassade personliga AI-beräkningsriktmärken redo för just den här typen av plattform, och vi planerar att mäta den verkliga produktivitetsökningen snarare än att ta marknadsföringssiffrorna för nominellt värde.
RTX Spark-stationär dator
NVIDIA bekräftade att stationära RTX Spark-datorer med liten formfaktor kommer i höst tillsammans med bärbara datorer, och visade upp en från MSI på scenen. Ärligt talat ser den vid första anblicken ut som en DGX Spark, och det är ungefär allt vi vet om den. Den industriella designen verkar skilja sig från den hos DGX Spark-enheten vi recenserade, men utöver det delade NVIDIA väldigt lite med sig av.
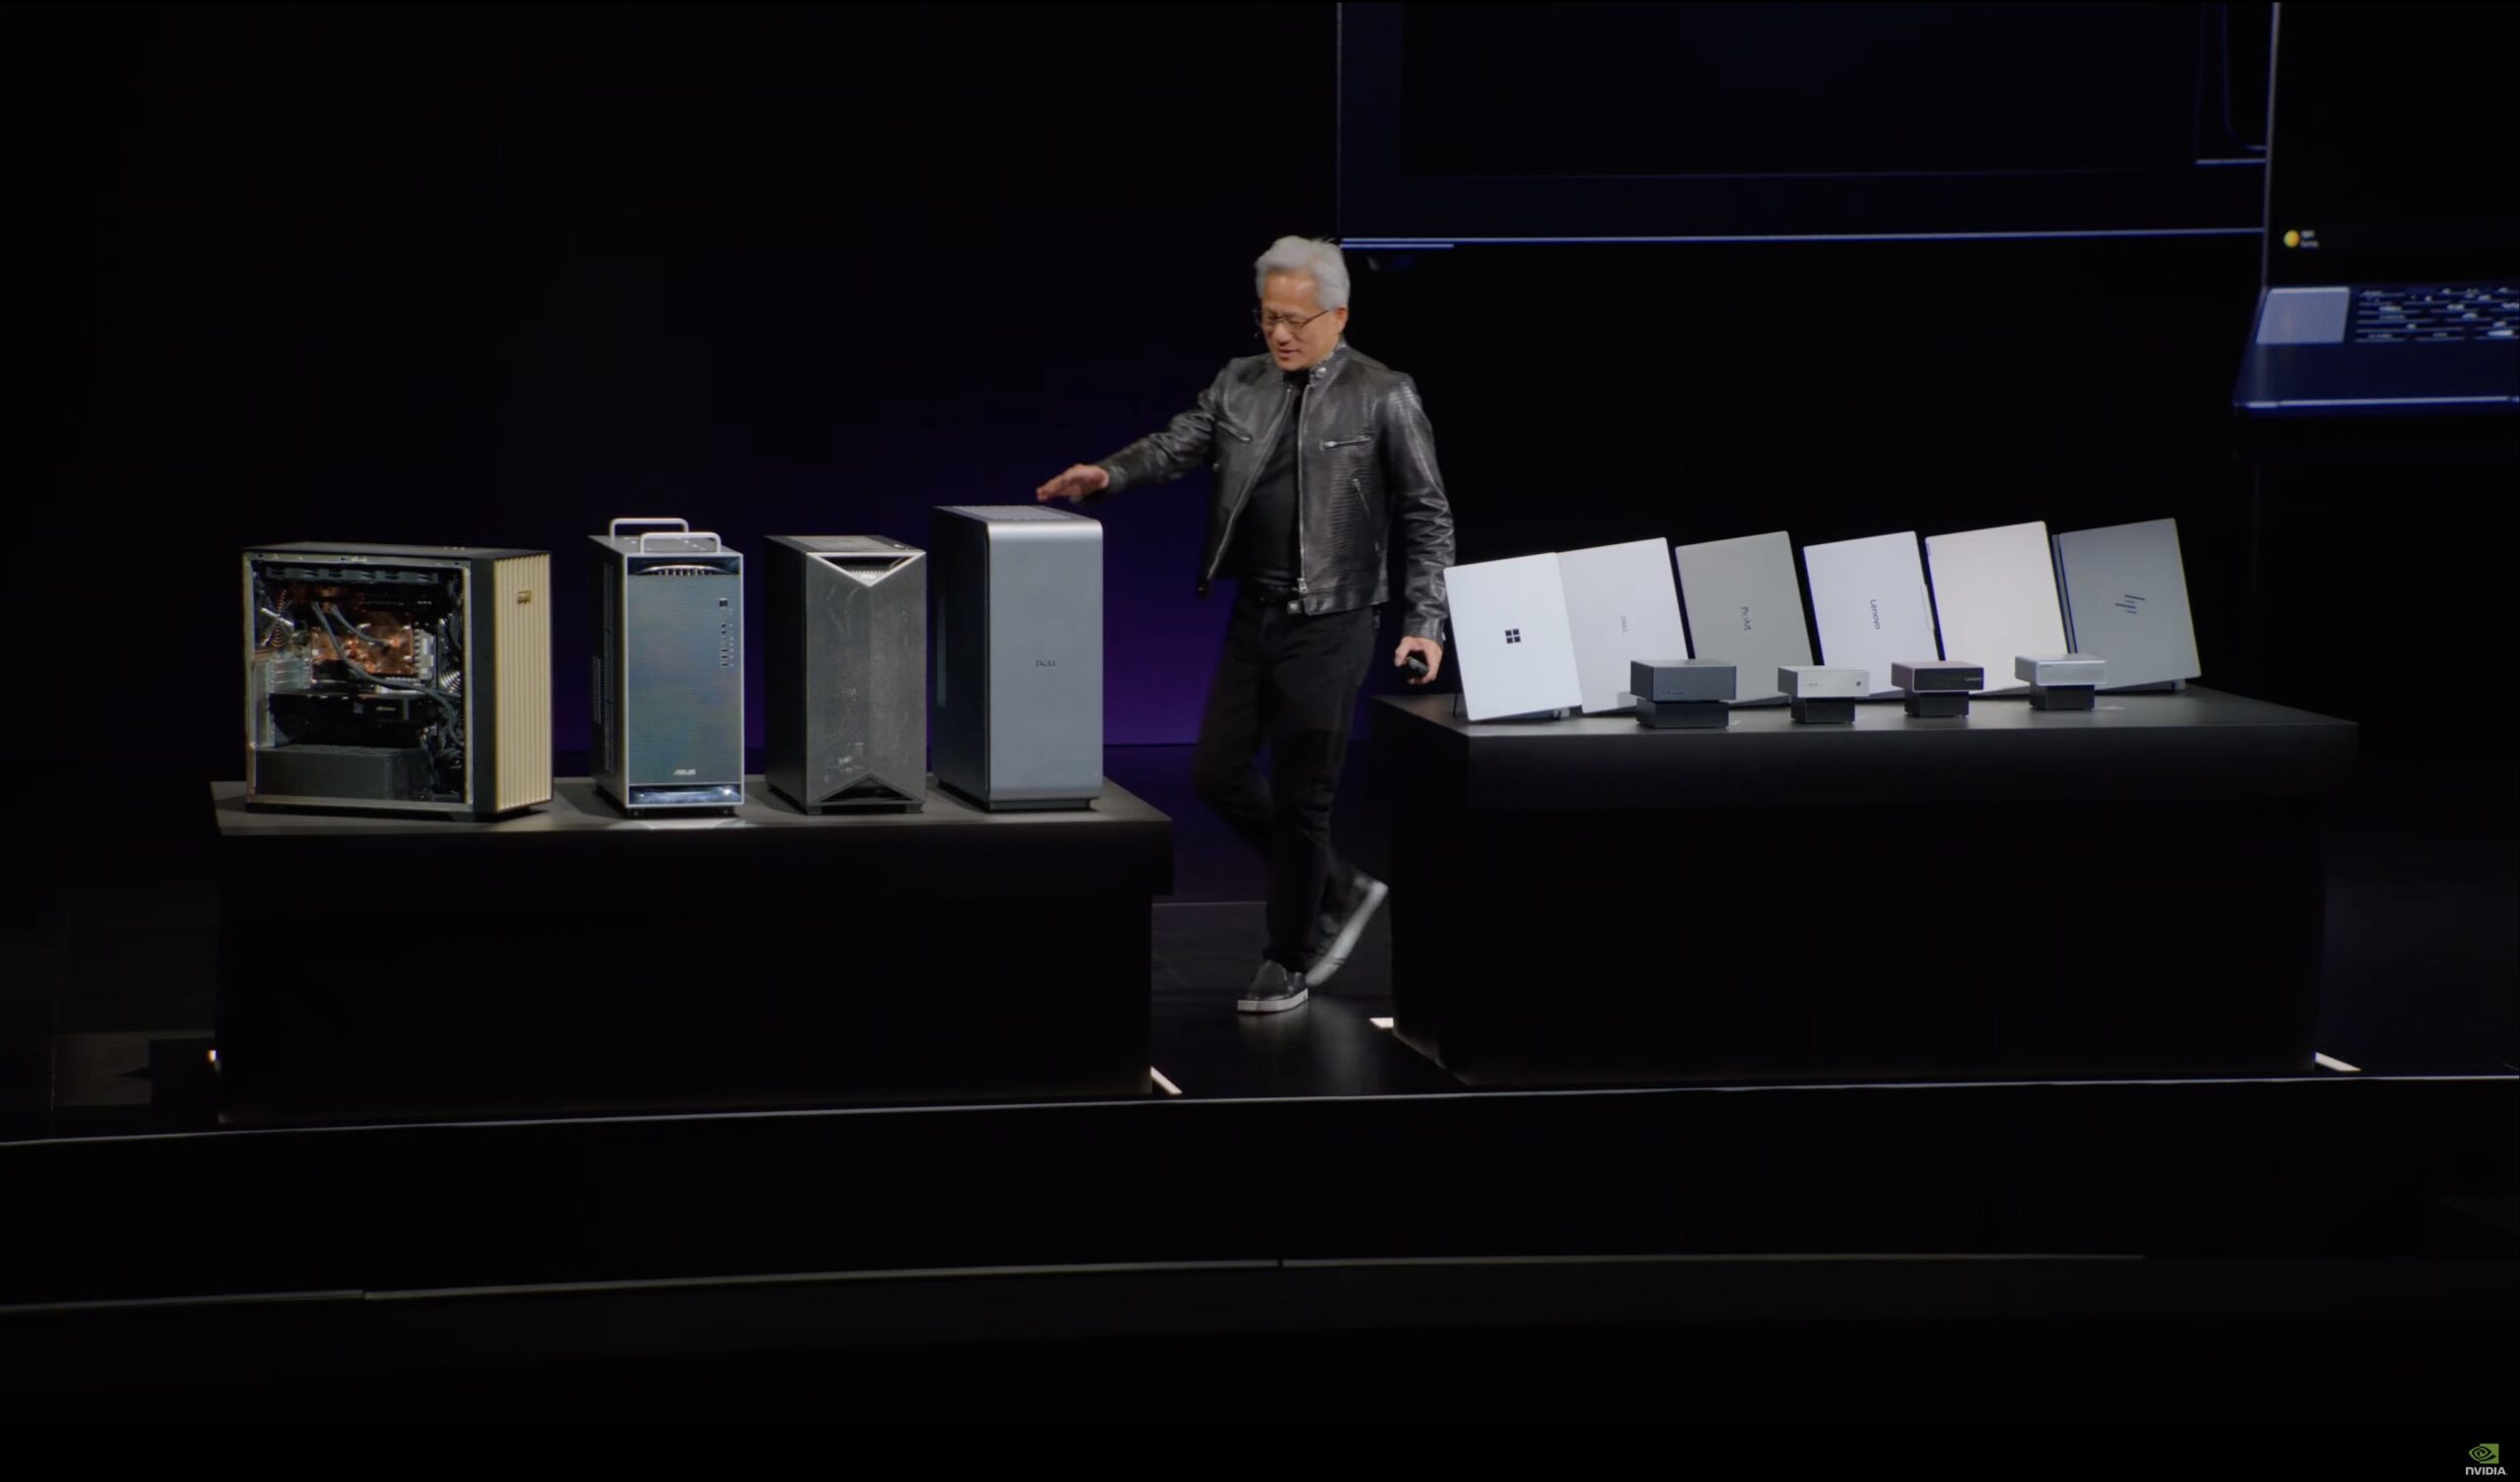
Våra frågor är uppenbara, och de får vänta tills vi får hårdvara på bänken. Hur står sig den stationära datorns hållbara prestanda i jämförelse med både de bärbara datorerna och DGX Spark, med tanke på att den borde ha betydligt mer termiskt utrymme än en 14 mm bärbar dator? Och behåller den stationära datorn 200G-nätverket som definierade DGX Spark, eller slopar den CX7-paketet, precis som de bärbara datorerna, för att nå ett lägre konsumentpris?
DGX Station
Den tredje nivån är den stora, och det är en maskin vi redan känner till. NVIDIA har visat upp DGX Station offentligt tidigare, och vi hade nyligen förmånen att testa en. Vi kommer inte att gå in på så mycket detaljer här, eftersom de viktigaste specifikationerna har varit offentliga ett tag, och vi kommer att ha mycket mer att säga i vår recension som kommer snart.
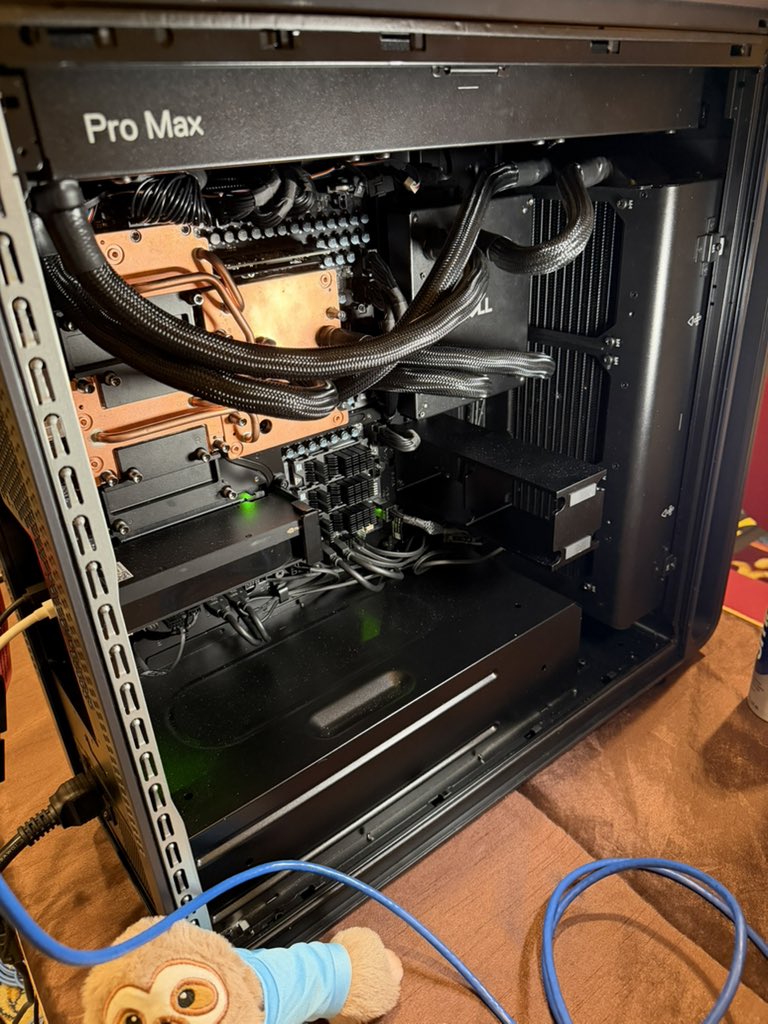
Kortversionen: DGX Station för Windows är byggd på GB300 Grace Blackwell Ultra Desktop Superchip, och kombinerar en Blackwell Ultra GPU med en 72-kärnig Grace-processor. Den har upp till 748 GB koherent minne och upp till 20 petaflops FP4, tillräckligt för att köra biljonparametermodeller lokalt och, med NVIDIAs ord, hundratals agenter samtidigt. Till skillnad från Spark-datorerna för konsumenter har den här snabb nätverksfunktion med en ConnectX-8 SuperNIC som klarar upp till 800 Gb/s, plus en valfri RTX PRO 6000 Blackwell-arbetsstations-GPU.
Den stora asterisken: kan Microsoft klara av detta?
Låt oss vara tydliga med var vi står. DGX Spark var en stor succé för NVIDIA, och vi är mycket optimistiska om hela den här familjen. Hårdvarusången träffar rätt toner, effektiviteten finns där, och NVIDIA har redan bevisat kiseln. Vi är skeptiska till Microsofts förmåga att stödja dessa enheter.
Microsoft har varit i rubrikerna av fel anledningar på sistone, med växande användarmissnöje över Windows riktning. Vissa användare har börjat kalla det "Microslop". Klagomålen är bekanta: Copilots aggressiva satsning på varje hörn av operativsystemet, den vertikala integrationen av AI över hela stacken och långvariga metoder som att effektivt tvinga OneDrive på människor. Dessutom är Windows on Arm inte en plattform som någon skulle kalla mogen. NVIDIA satsar starkt på att den här gången är annorlunda och hänvisar till åratal av gemensamt arbete med Prism-emulatorn och samarbete med alla större anti-fusk-leverantörer. Företagets svar på "Varför kommer Windows on Arm att lyckas nu?" är i princip "för att alla äntligen lägger hela sin vikt bakom det". Det kan mycket väl vara sant. Det är också mer eller mindre vad vi hörde förra gången.
Personligen hejar jag på att Microsoft levererar, för fördelarna är verkliga. RTX Spark är en kapabel spelmaskin, ungefär i RTX 5070-klassen. Om emulerings- och drivrutinshistorien håller ihop kan den bli det billigare och effektivare alternativet till spel på NVIDIAs egna bärbara datorer med separata grafikkort. Det finns också en Linux-vinkel som vi inte kan ignorera. Kisel är kisel, så RTX Spark borde ärva samma starka Linux-stöd som gjorde DGX Spark till en så kapabel liten maskin, och vi är väldigt nyfikna på om spel- och grafikfunktionen som går in i Windows-stacken också syns som spelvinster på Linux. Om Microsoft misslyckas med en så här bra plattform, betyder den Linux-stamfattringen att detta kan vara lanseringen som äntligen sparkar igång året för Linux-skrivbordet för massorna.
Den större överraskningen för oss var NVIDIAs val att överhuvudtaget installera Windows på DGX Station. När produkten först tillkännagavs 2025 tyckte många av våra vänner på andra publikationer och vi att det var ett genialt drag. Programvarusupport har historiskt sett halkat efter ny hårdvara, ofta med år, innan kärnan och verktygen mognat tillräckligt för att verkligen dra nytta av vad kiseln kan göra. En DGX Station var den maskin som topplabb, forskare och organisationer inom AI kunde köpa för att börja utveckla den senaste arkitekturen, långt innan datacentren skapades kring den. Problemet är att produkten är ett år försenad. Och även om vi verkligen njöt av vår tid med systemet, bortsett från förproduktionsegendomligheter (ett par av dem gav mig nattskräck), kan vi inte riktigt rättfärdiga att installera Windows på en maskin som är så här tydligt byggd för hardcore AI. B300 har inga RT-kärnor, så många av NVIDIAs egna arbetsstationsarbetsbelastningar skulle förlita sig på det valfria separata RTX PRO-kortet, vilket lämnar B300 enbart för AI-uppgifter. Vi är väldigt nyfikna på hur Windows-stödet på DGX Station faktiskt håller, och ärligt talat skeptiska till att Microsoft kan leverera en bra upplevelse här och verkligen utnyttja B300- och 800G ConnectX-8-nätverket på en enda värd.
En ny produktfamilj, varje generation
Den detalj från huvudtalet som fastnade mest i oss var inte en specifikation.
Jensen presenterade denna PC-serie som en permanent produktfamilj och lovade en stationär dator, bärbar dator och arbetsstation för varje framtida arkitekturgeneration, med vad han hävdar är 100 % av PC-industrin ombord.
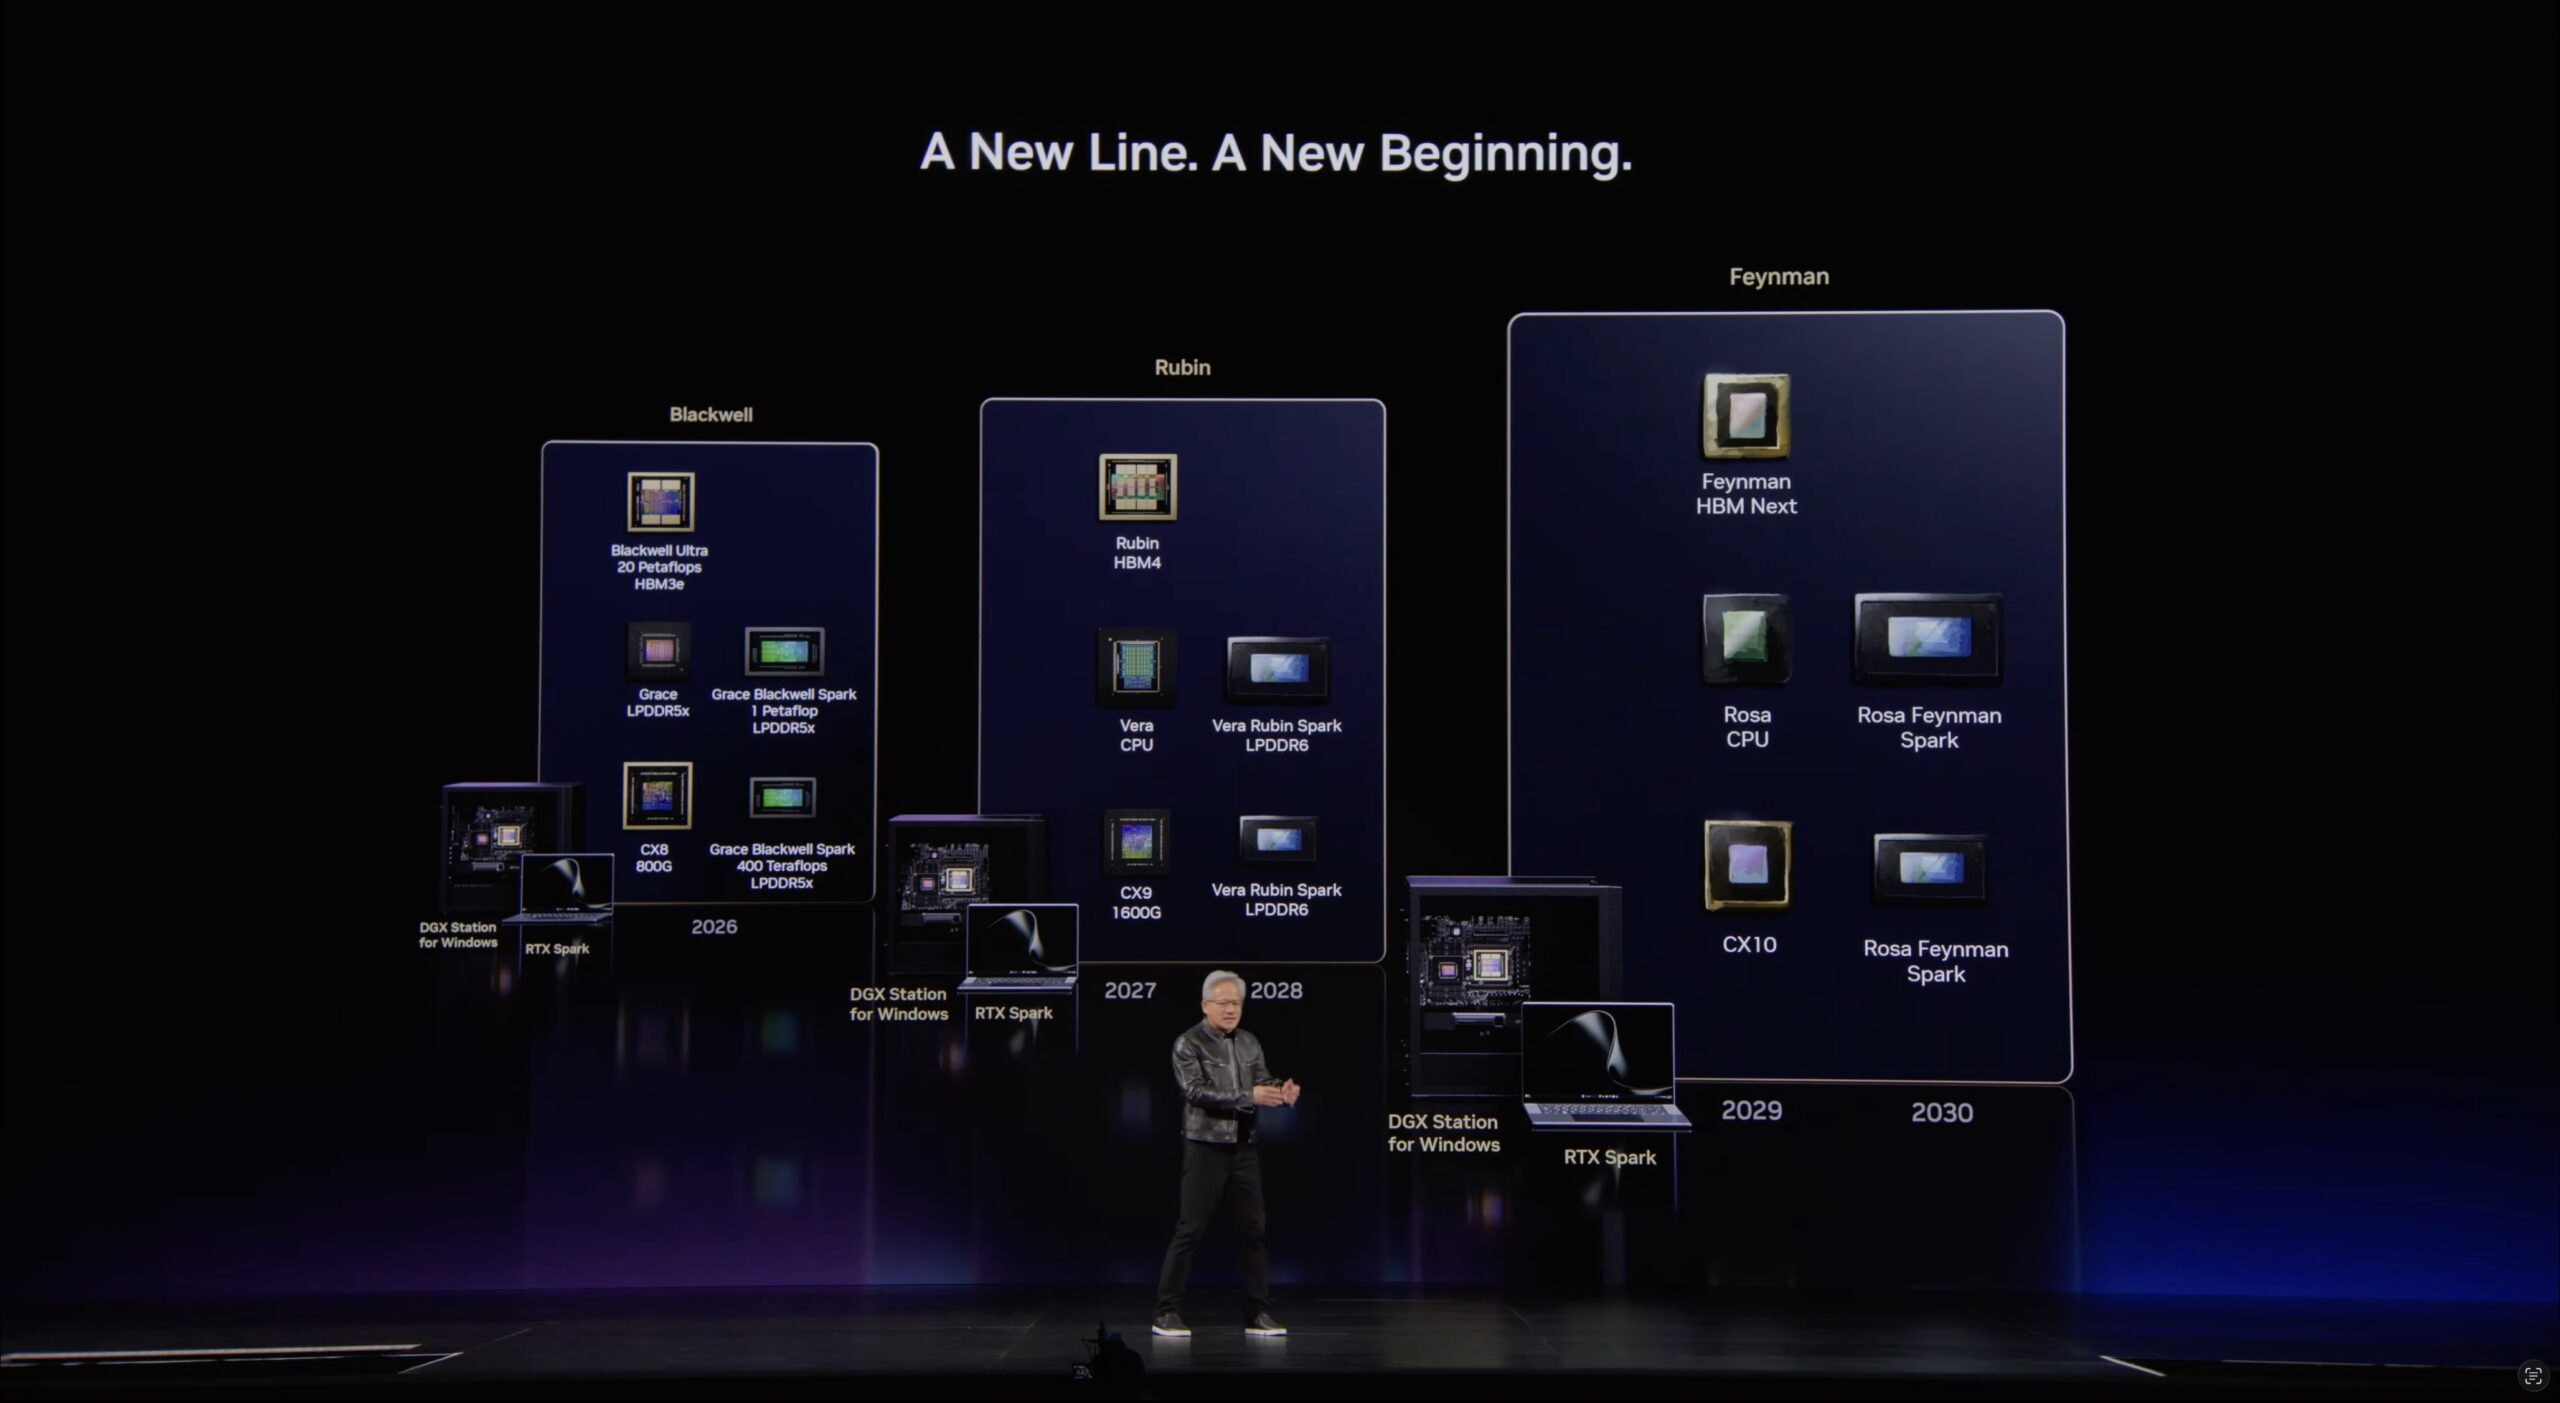
Bara som en sidoanteckning, vi såg äntligen det mindre 400 TFlop N1 Grace Blackwell Spark Superchip nämnas här. Det ska bli intressant att se vilken typ av enheter som kommer att ha detta chip.
Bortom datorn: Fysisk AI
Den sista halvan av huvudanförandet fokuserade starkt på fysisk AI. Det är en annan värld än klienthårdvaran ovan, men det kompletterar Computex-bilden. NVIDIA använde också mässan för att öppna källkoden för en stor samling verktyg och färdigheter för fysiska AI-agenter, publicerade på github.com/NVIDIA/skills, inklusive färdigheter för syntetisk data som neural rekonstruktion, videoförstärkning och defektbildsgenerering som tillverkningspartners, inklusive TSMC, Foxconn och SK hynix, redan kör i fabrikslinjer. De viktigaste plattformarna visas nedan.
Isaac GR00T Referens Humanoid Robot
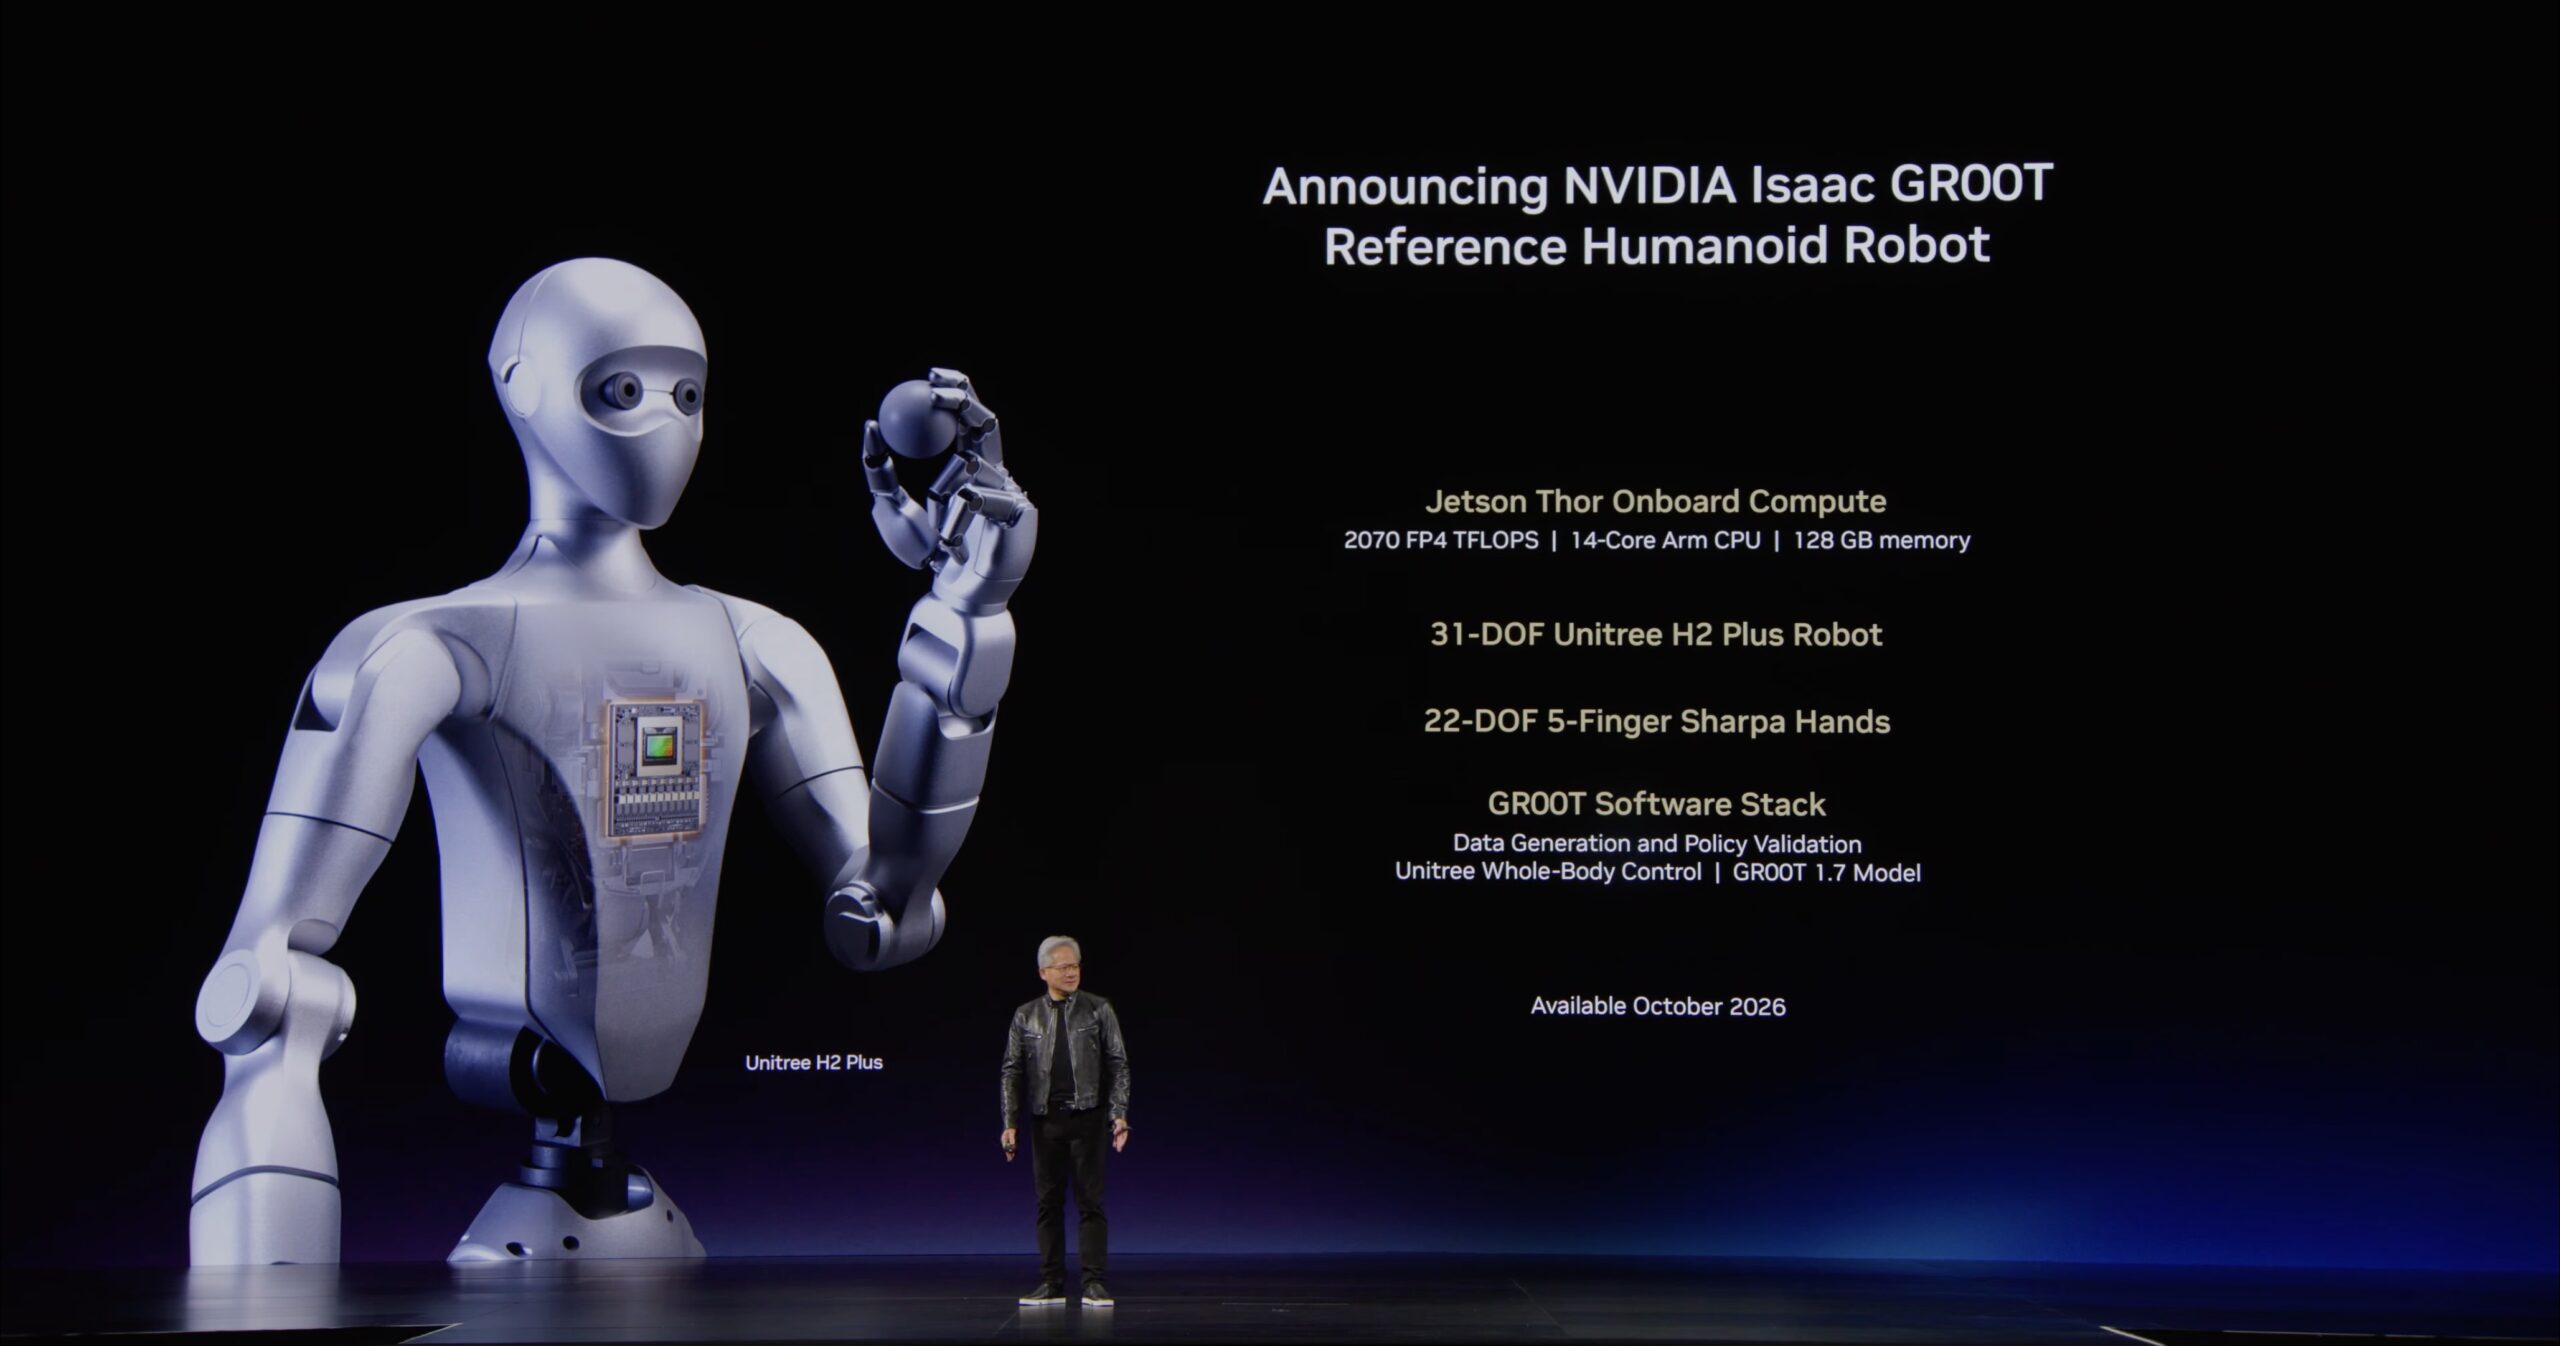
NVIDIA släppte en öppen referensdesign för en humanoid robot, byggd på ett Unitree H2 Plus-chassi som är nästan 1,8 meter högt och väger 65 kg, med totalt 75 frihetsgrader, tack vare dubbla Sharpa Wave taktila femfingershänder. Ställdonen är seriösa, med upp till 120 Newtonmeter armvridmoment, upp till 360 vid benen och en nominell nyttolast på 7 kg som toppar på 15 kg. För avkänning bär den en huvudmonterad stereokamera med ett 140-graders horisontellt synfält, handledskameror för manipulation, en tröghetsmätningsenhet och den vanliga Wi-Fi 6- och Bluetooth 5.2-anslutningen. Hjärnan är NVIDIAs Jetson AGX Thor T5000, med en Blackwell GPU på 2 070 FP4-teraflops, en 14-kärnig Arm-processor och 128 GB enhetligt minne, som drar konfigurerbara 40 till 130 watt och körs på ett batteri på ungefär 1 kWh som räcker i cirka tre timmar. Hela stacken, från Isaac Teleop för datainsamling via Isaac Sim och Isaac Lab till GR00T-grundmodellerna och Isaac ROS-mellanprogramvaran för driftsättning, är öppen, och forskare behåller kontrollen över sina egna data. Stanford, ETH Zurich, UC San Diego och Ai2 är bland de tidiga användarna, med hårdvara tillgänglig från Unitree i slutet av 2026 och ett Unitree G1-referensarbetsflöde som snart kommer att släppas på GitHub och Hugging Face. Jensen satsade i karakteristiskt stora termer och kallade humanoida robotar för en "ekonomisk möjlighet värd flera biljoner dollar".
Cosmos 3
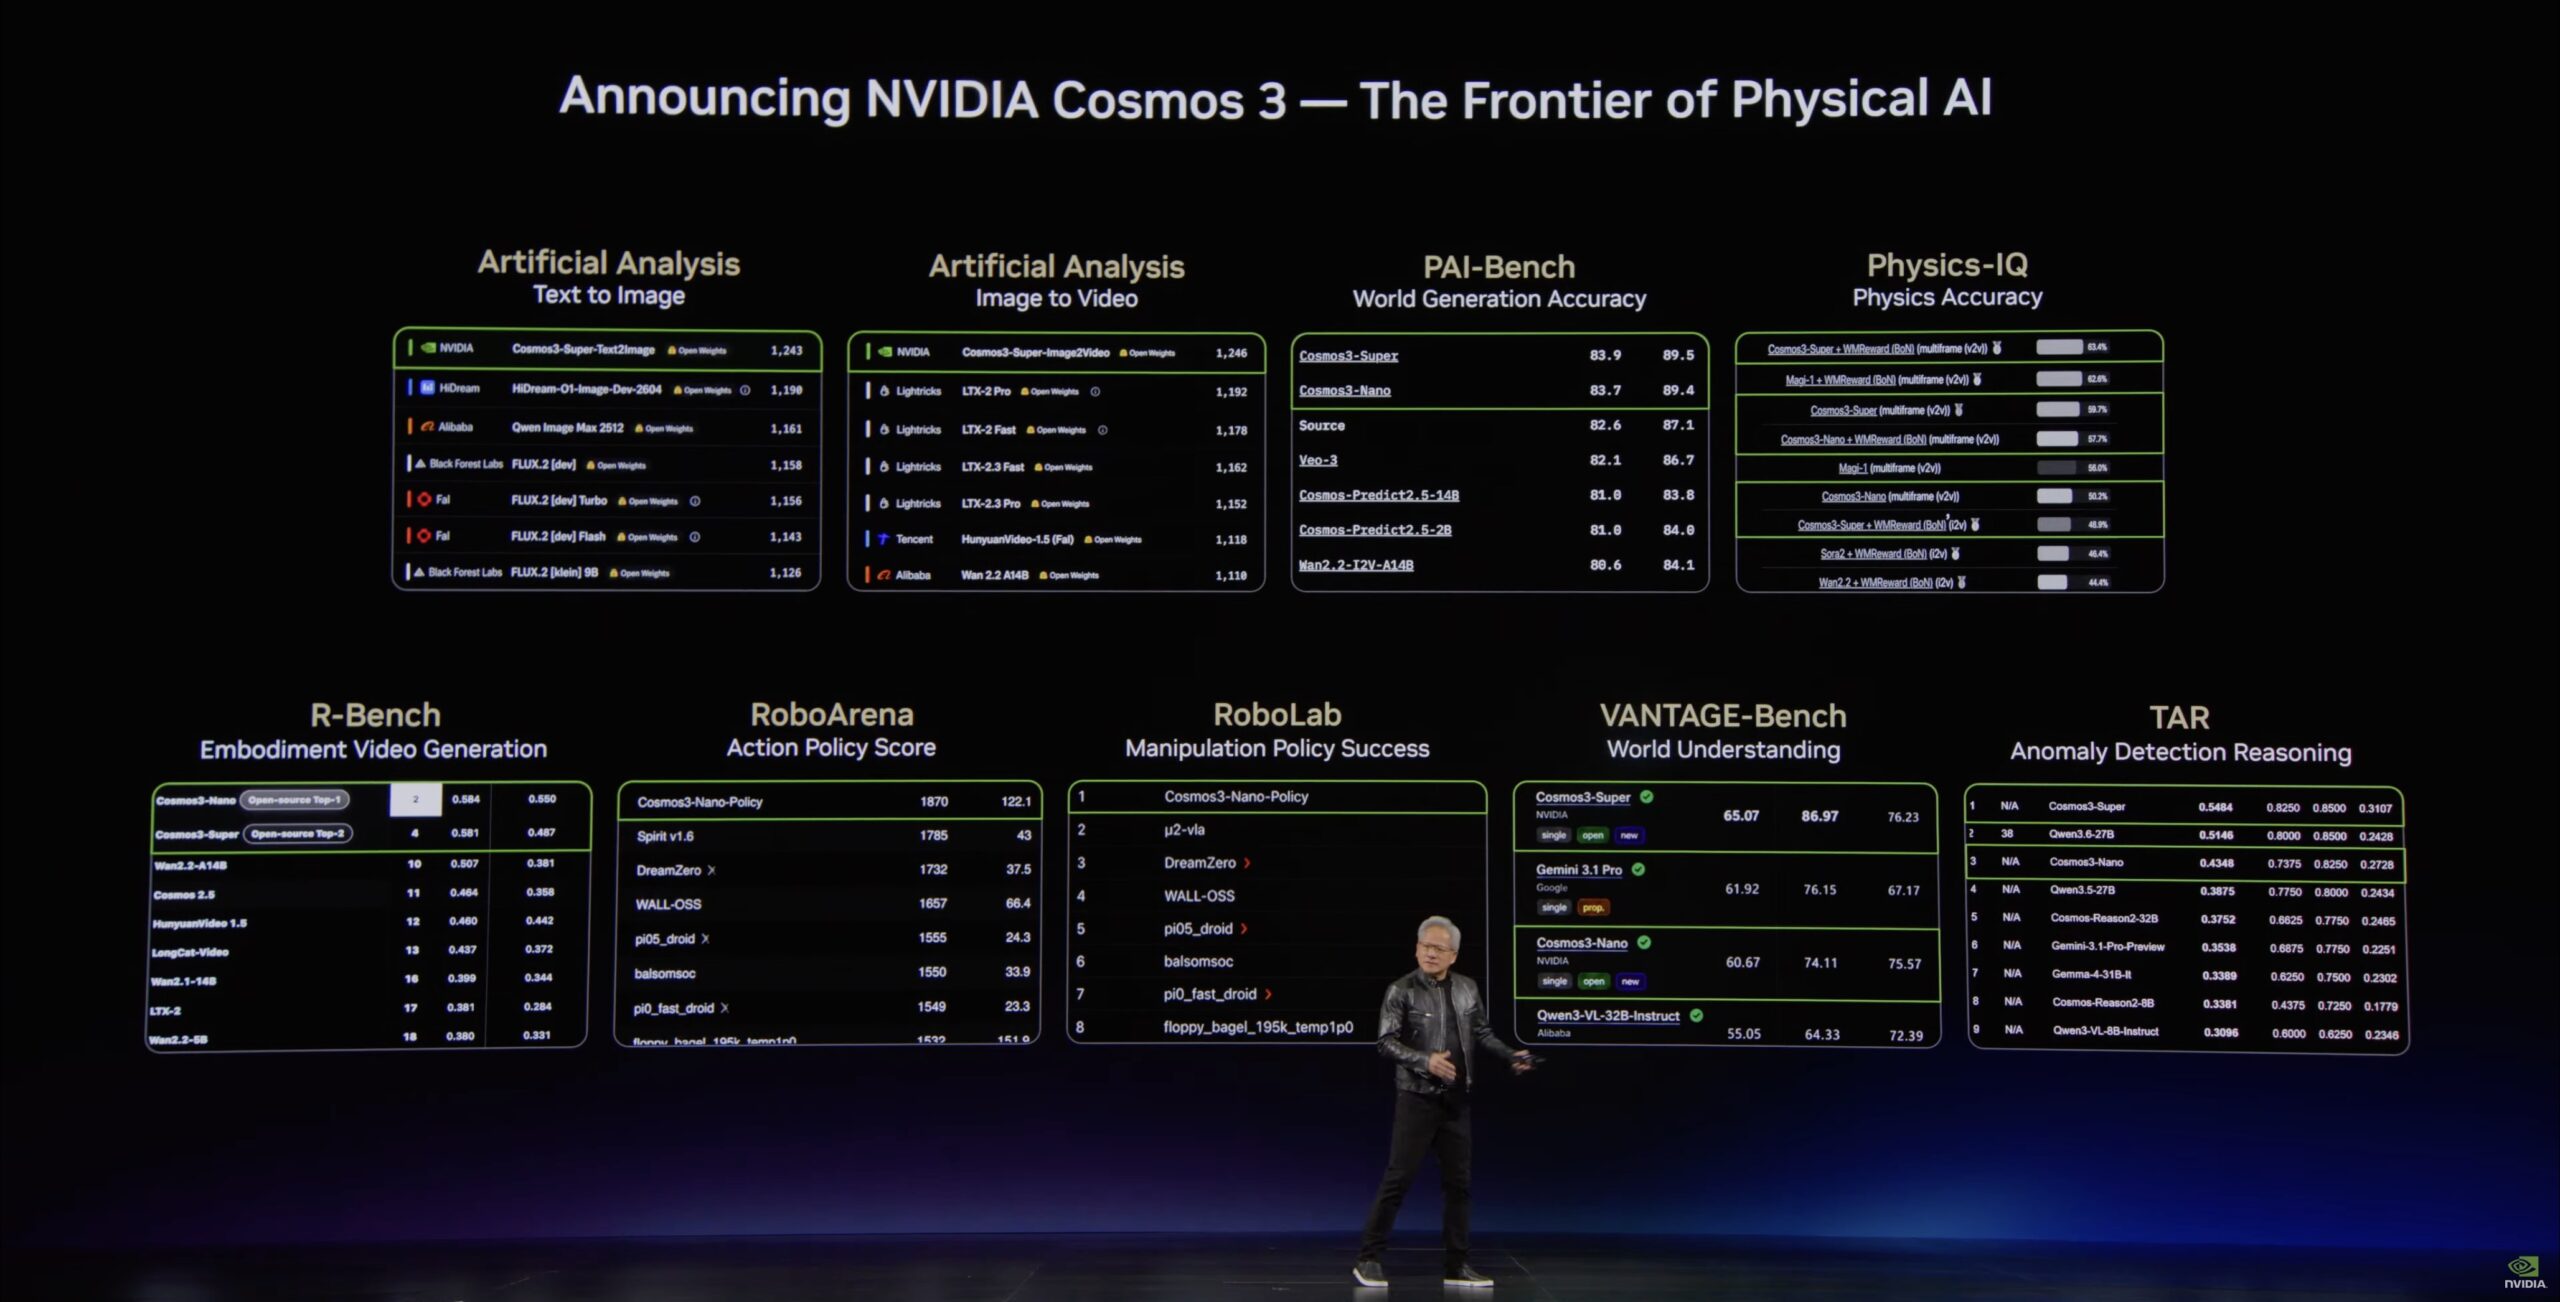
Cosmos 3 är NVIDIAs öppna grundmodell för fysisk AI. Denna blandning av transformatorer, en omnimodell som hanterar text, bilder, video, omgivande ljud och handlingar i en enda stack, tränad på miljarder multimodala samplingar. Den spelar tre roller: en visionsspråksmodell för multimodalt resonemang, en världsmodell för att simulera fysiska miljöer och en ryggrad för de världshandlingsmodeller som tränar robotar på specifika uppgifter. Den kommer som Cosmos 3 Super för högprecisionsrobotar och efterträning av AV, Cosmos 3 Nano för snabbt video- och handlingsresonemang, och Cosmos 3 Edge för inferens i realtid, kommer snart. NVIDIA säger att de leder fältet med öppna modeller på en lång lista med riktmärken, inklusive Physics-IQ och R-Bench för världsgenerering, RoboLab och RoboArena för handlingspolicy, och VANTAGE-Bench för visionsförståelse, och att den kan minska fysisk AI-tränings- och utvärderingscykler från månader till dagar. Den är tillgänglig på Hugging Face, GitHub och build.nvidia.com som NIM-mikrotjänster, med en koalition runt den som inkluderar Agile Robots, Black Forest Labs, Runway och Skild AI, och användare som Samsung, LG Electronics, Li Auto och Doosan Robotics.
Alpamayo 2 Super
För autonom körning introducerade NVIDIA Alpamayo 2 Super. Det är en öppen resonemangs-, vision-språk-handlingsmodell med 32 miljarder parametrar, byggd på Cosmos World Foundation-modeller, som resonerar, planerar och agerar över hela drivstacken för nivå 4-utveckling. Den skalar upp från de tidigare versionerna med 10 miljarder parametrar och expanderar till fullständig 360-graders surrounduppfattning. Den producerar också både makrodrivande beslut och kausalitetskedjor som förklarar dem, och dess automatiska resonemangsmärkning kan komprimera annoteringscykler från månader till dagar. NVIDIA positionerar den som en lärarmodell som destillerar till mindre nätverk för driftsättning i fordon på DRIVE AGX Thor, och parar ihop den med stödverktyg i AlpaGym för sluten förstärkningsinlärning, OmniDreams för generativ scenarieskapande och Neural Reconstruction byggd på Omniverse NuRec för att omvandla flottdata till 3D-scener. Tidigare versioner av Alpamayo laddades ner nästan 400 000 gånger. Den nya modellen vann ett COMPUTEX Best Choice-pris och förväntas bli tillgänglig på GitHub och Hugging Face i sommar.
DRIVE Hyperion
Om Alpamayo är hjärnan, så är det DRIVE Hyperion som kör den. Vi har tidigare beskrivit Hyperion, så vi kommer inte att återuppta plattformen här, förutom att det är NVIDIAs nivå 4-klara referens byggd på säkerhetssystemet Halos och DriveOS, med DRIVE AGX-beräkning. Den mer intressanta historien den här gången är vem som står bakom den. Uber integrerar flera Hyperion-drivna flottor, inklusive ett robottaxiprogram i München som lanseras senare i år. Foxconn och Foxtron siktar på en robottaxilansering i Taiwan 2028, med start i Kaohsiung och expansion över hela Asien. VinFast tar nivå 4-fordon till Sydostasien, Autobrains samarbetar med både VinFast och Uber, och HUMAIN tar det till Saudiarabien. Den partnerlistan, mer än någon enskild specifikation, är det som gör Hyperion värd att hålla ögonen på.
Utgående Tankar
NVIDIA har kiseln och marknadsför den nu överallt, från en 14 mm bärbar dator till en stationär GB300 till en människoliknande bröstkorg, och den delen tror vi på. Vad ett specifikationsblad inte kan säga oss är om Microsoft kan göra Windows on Arm värt hårdvarukostnaden, om OEM-tillverkare låter Spark-chippet sträcka på benen eller strypa det i ett för tunt chassi, och om påståendena om petaflop och batteri håller när vi väl kan mäta dem. Vi är optimistiska om hårdvaran och skeptiska till programvaran (Microsoft, inte Linux), och vi kommer att hålla båda positionerna tills maskinerna når labbet. När de gör det kommer riktmärkena att vara klara.


 Amazon