

LPU, eller Language Processing Unit, är en anpassad AI-inferensaccelerator designad och byggd av Groq, Inc. Groq grundades 2016 av Jonathan Ross, en tidigare Google-ingenjör som anses vara en av de ursprungliga uppfinnarna av TPU, och spenderade år på att utveckla en deterministisk, programvarudefinierad processorarkitektur från grunden. Till skillnad från GPU:er, som förlitar sig på dynamisk hårdvaruschemaläggning och flernivåcachehierarkier, har LPU en radikalt annorlunda strategi: den eliminerar alla reaktiva hårdvarukomponenter och placerar hela kontrollplanet i kompilatorn, vilket möjliggör helt förutsägbar exekvering ända ner till klockcykeln.
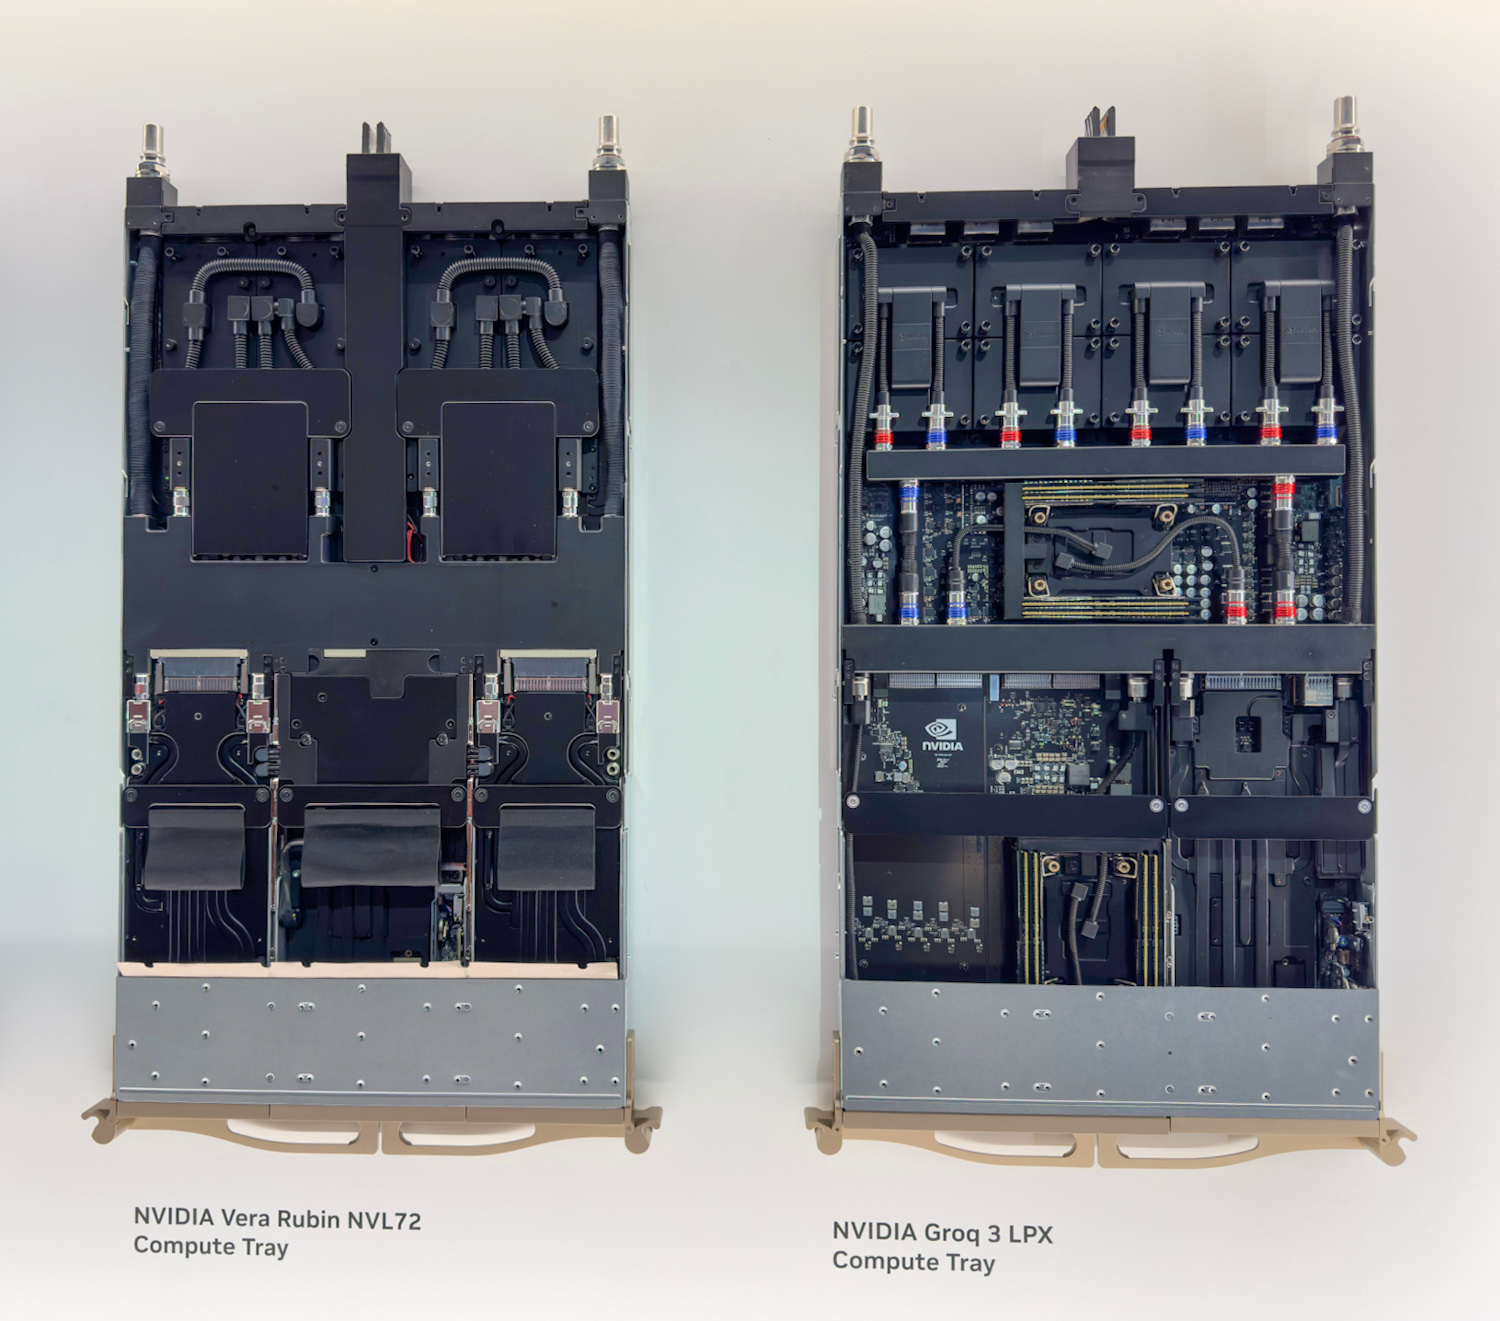
I december förra året förvärvade NVIDIA Groq, vilket innebär att LPU-arkitekturen togs under NVIDIAs paraply. Förvärvet var enormt populärt i branschen och utlöste omedelbara spekulationer om hur NVIDIA skulle integrera Groqs teknik i sitt datacenterekosystem. Dessa frågor besvarades slutligen på GTC 2026, där NVIDIA presenterade Groq 3 LPX som det sjunde chipet i Vera Rubin-plattformen, som parar ihop 256 LPU-acceleratorer i ett racksystem tillsammans med Vera Rubin NVL72.
Vad hände med CPX?
Förra året, på AI Infra Summit, tillkännagav NVIDIA även CPX-racket i ett par konfigurationer utformade för att accelerera långkontextinferensfrågor. Efter vår första bevakning av det tillkännagivandet väckte det flera frågor hos oss om CPX:s faktiska funktion. Vid första anblicken, även om det var ett intressant arkitektoniskt koncept, verkade CPX inte erbjuda något väsentligt utöver själva Rubin GPU:n, förutom kanske ytterligare acceleration för uppmärksamhetsoperationer. Sedan kom Groq-förvärvet, vilket utlöste spekulationer om hur NVIDIA skulle integrera Groqs LPU-teknik i den bredare Vera Rubin-plattformen.
Nåväl, NVIDIA klargjorde luften på GTC 2026 med LPX-tillkännagivandet. Av det som presenterades verkar det som att CPX-rackkonceptet har utvecklats till Groq 3 LPX Rack, där den ursprungliga CPX:ens fokus på kontextbehandling har gett vika för en fundamentalt annorlunda avkodningsaccelerationsarkitektur byggd kring Groqs kisel. LPX Rack är helt vätskekyld, byggd på MGX-infrastruktur och kommer att finnas tillgänglig under andra halvan av 2026, samtidigt som den bredare Vera Rubin-utrullningen. NVIDIA hävdar upp till 35 gånger högre inferensdataflöde per megawatt och upp till 10 gånger fler intäktsmöjligheter för biljonparametermodeller med detta nya tillskott.
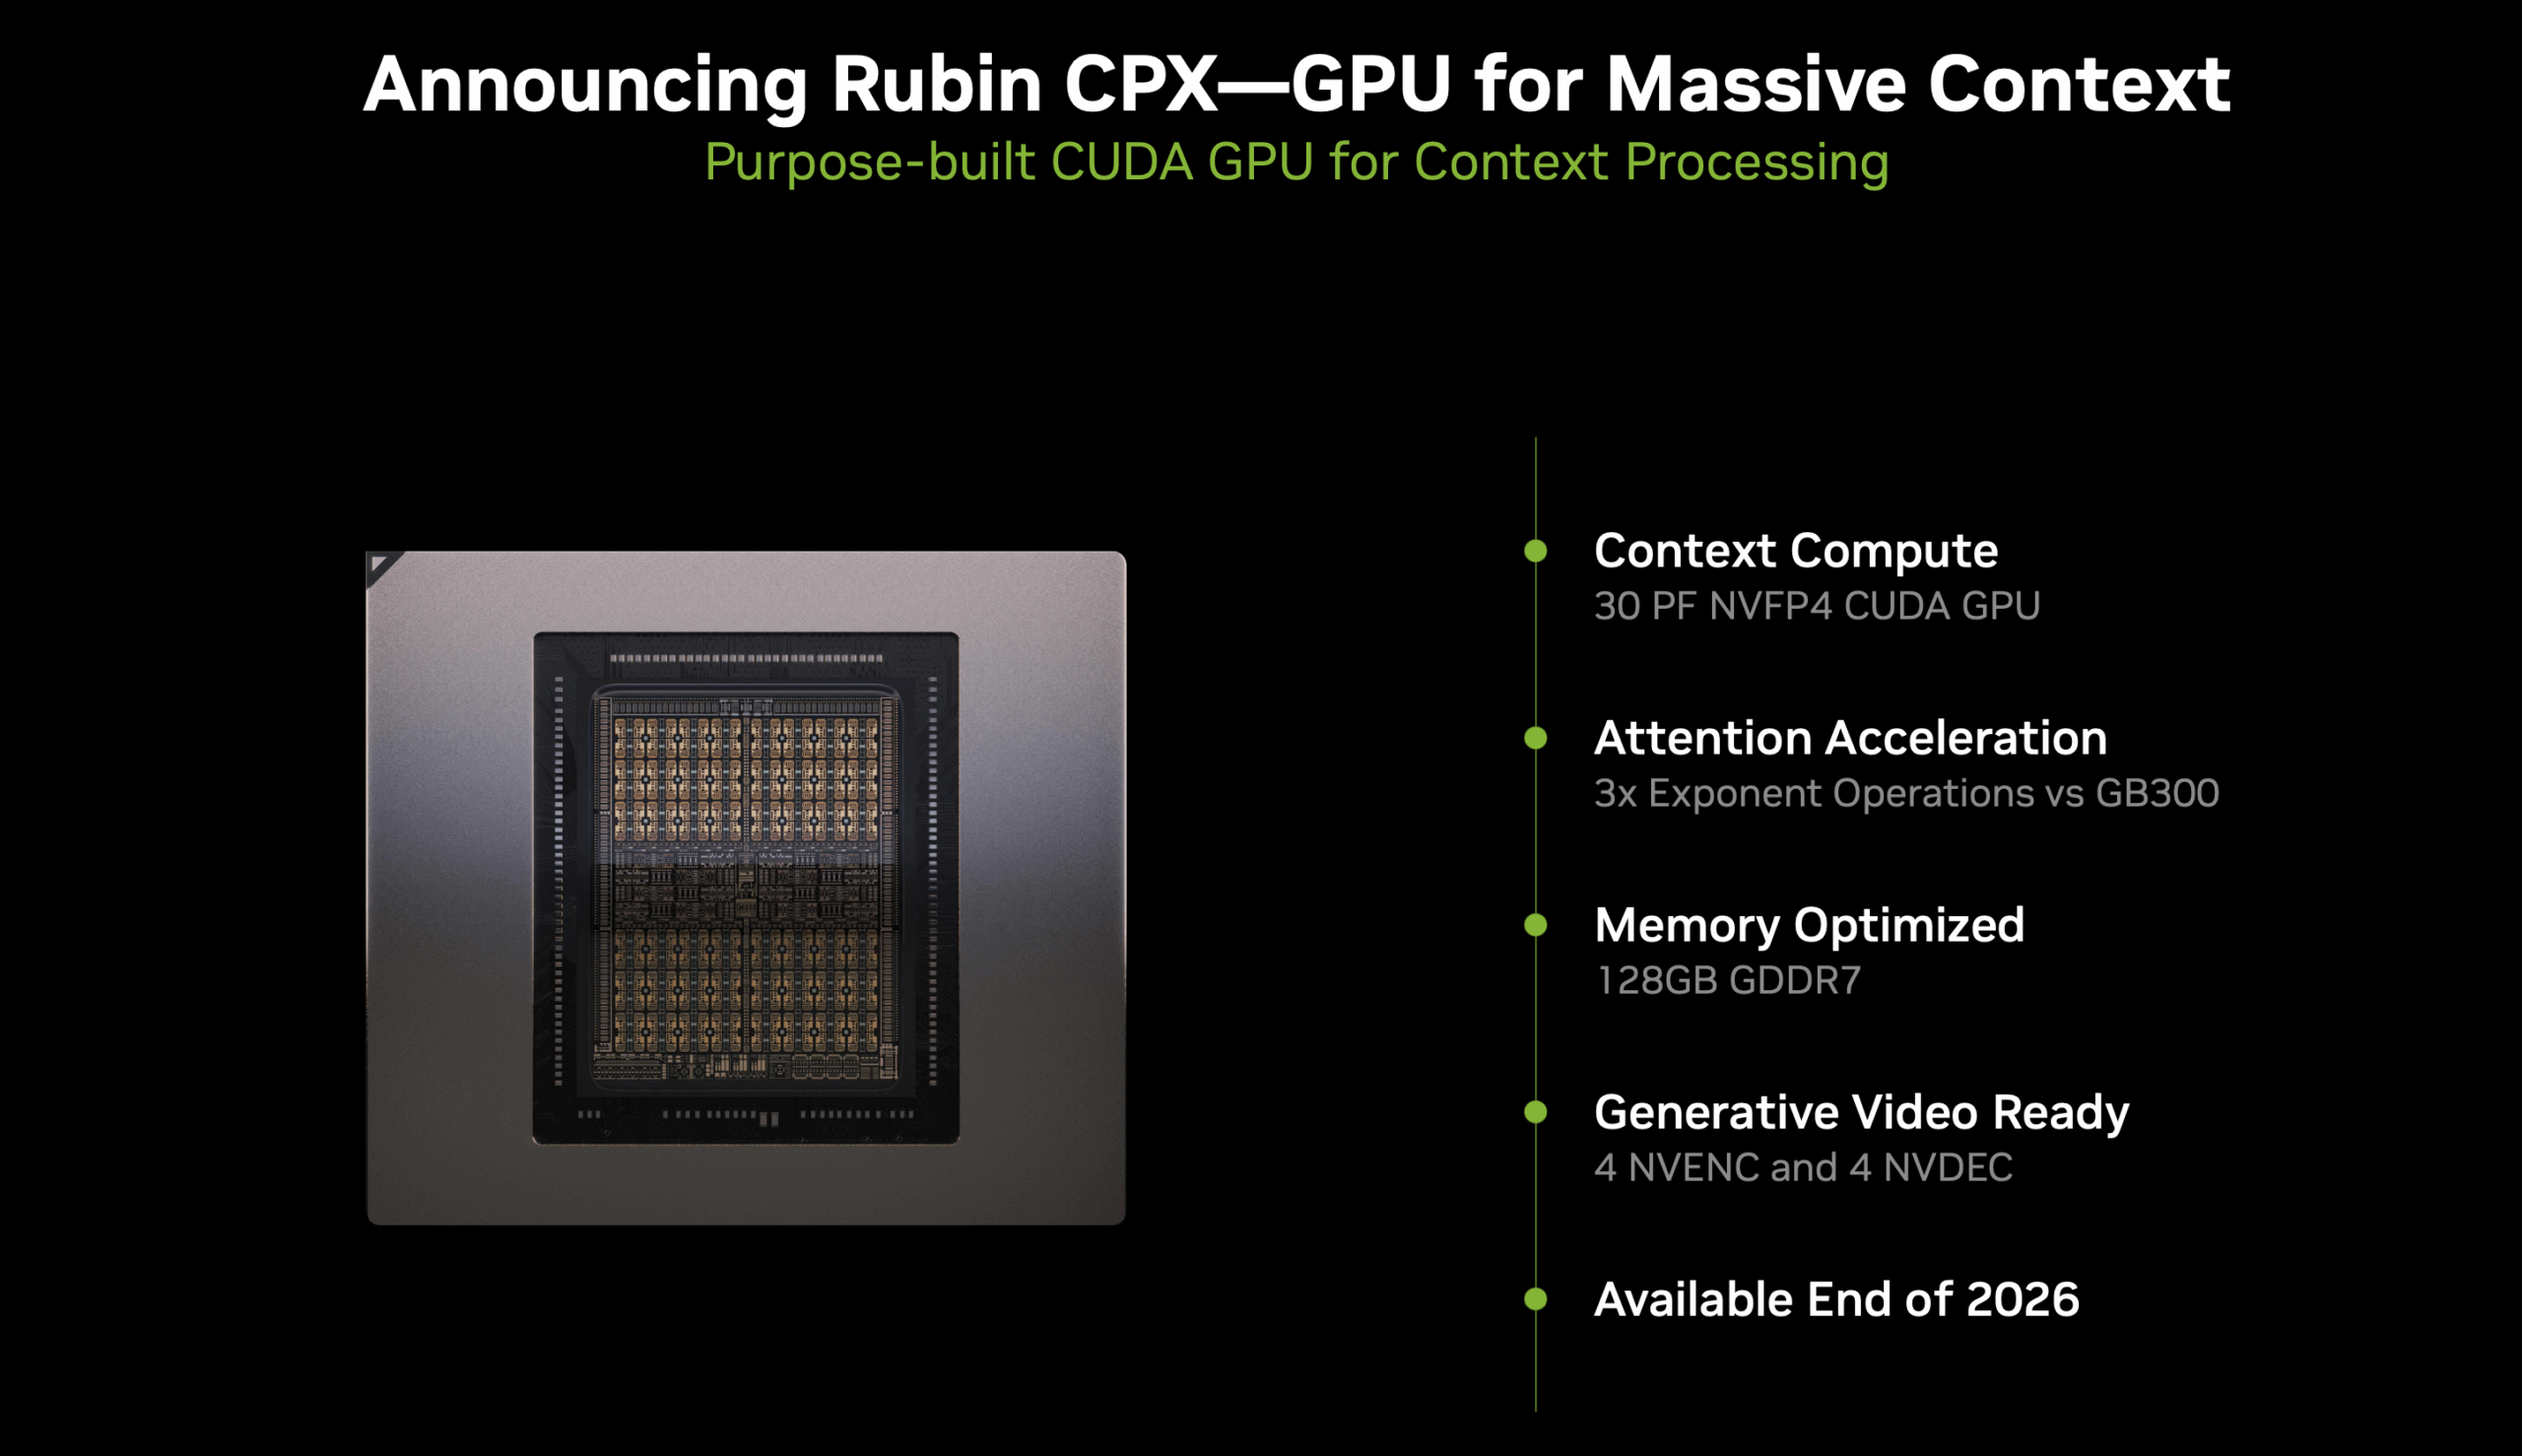
Men ännu viktigare är att NVIDIA bekräftade att LPU:n fungerar som en accelerator inom den befintliga CUDA-stacken som körs på Vera- och NVL72-plattformarna, med beräkningar som avlastas transparent per token. Under GTC Q&A beskrev NVIDIA LPU:n som en "avkodningsmodellförstärkare" och förklarade att de kommer att arbeta nära AI-labb och frontlinjemodellbyggare som distribuerar biljonparametermodeller för att möjliggöra nästa generations premiummodellvisning.
Med CPX-frågan avgjord är den naturliga uppföljningsfrågan: vad är det egentligen för LPU som NVIDIA bygger ett helt racksystem kring?
Vad är en LPU?
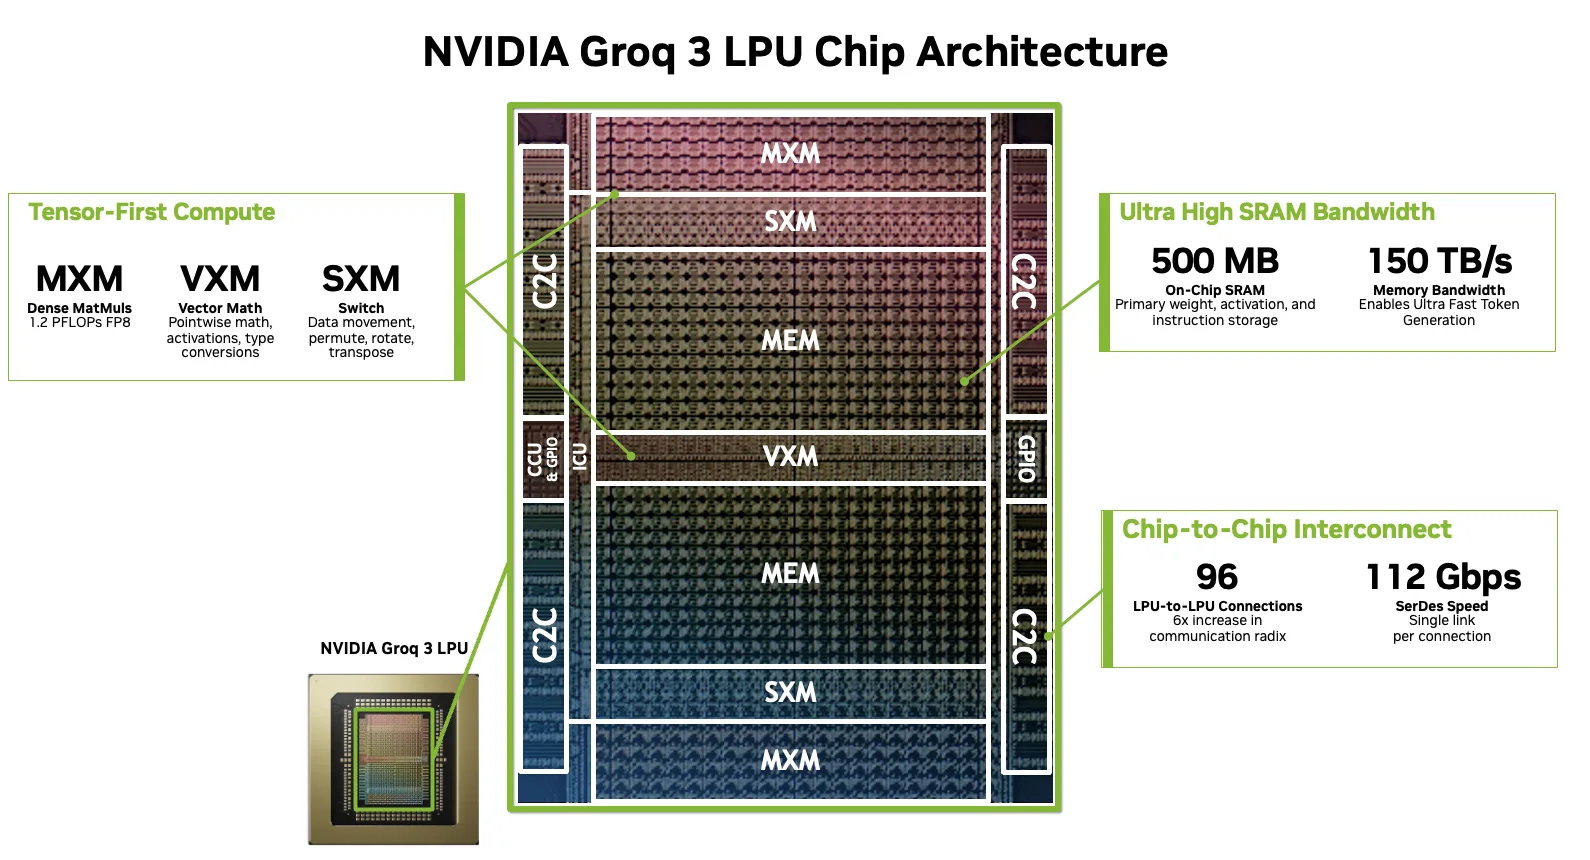
I grund och botten är LPU:n en mycket stor vektorprocessor. Den grundläggande enheten för både beräkning och kommunikation är en vektor med 320 element bestående av 320 byte vid INT8 och 640 byte vid FP16. Varje operation på chipet, oavsett om det är aritmetik, minnesåtkomst, dataomformning eller överföring mellan chips, fungerar på dessa vektorer med fast storlek.
Källa: Nvidia
Arkitekturen är uppbyggd från en enda grundläggande byggsten: en SIMD-funktionell enhet i kombination med en lätt instruktionsavsändningsenhet. Groq behandlar detta som en basklass som specialiseras i fyra distinkta typer, var och en optimerad för en specifik kategori av operationer:
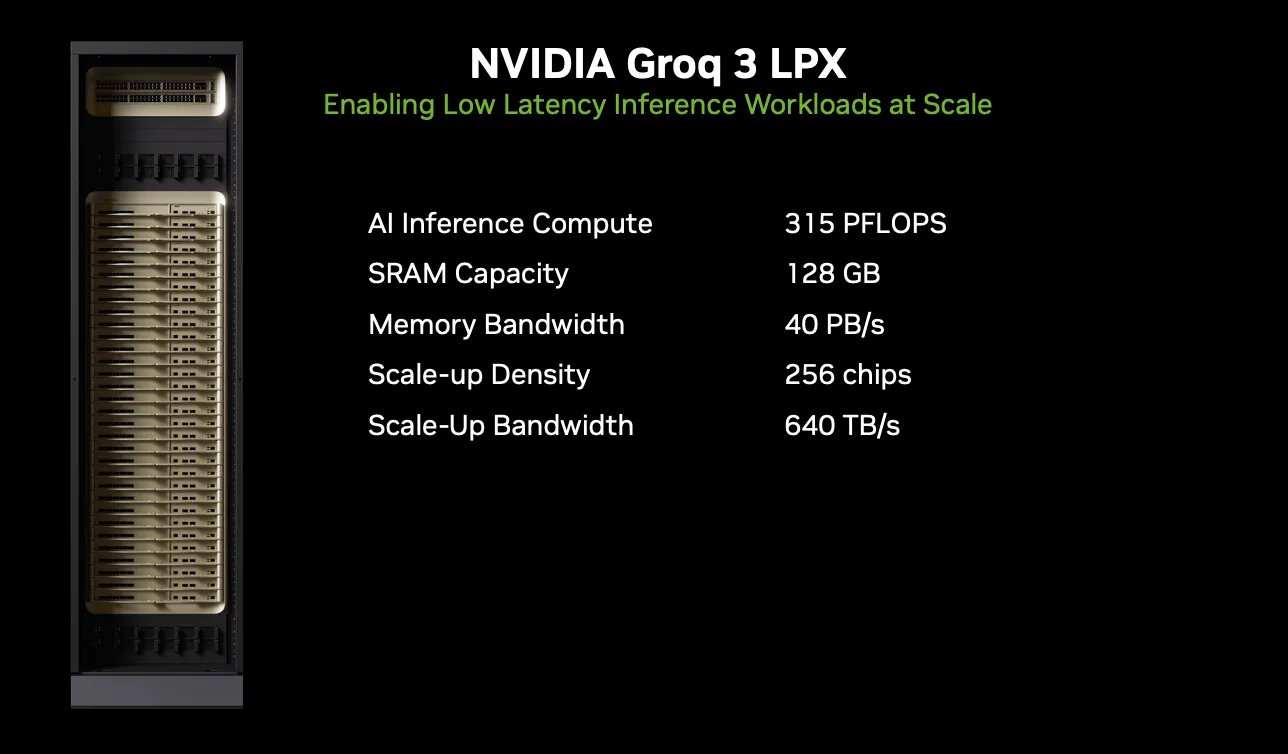
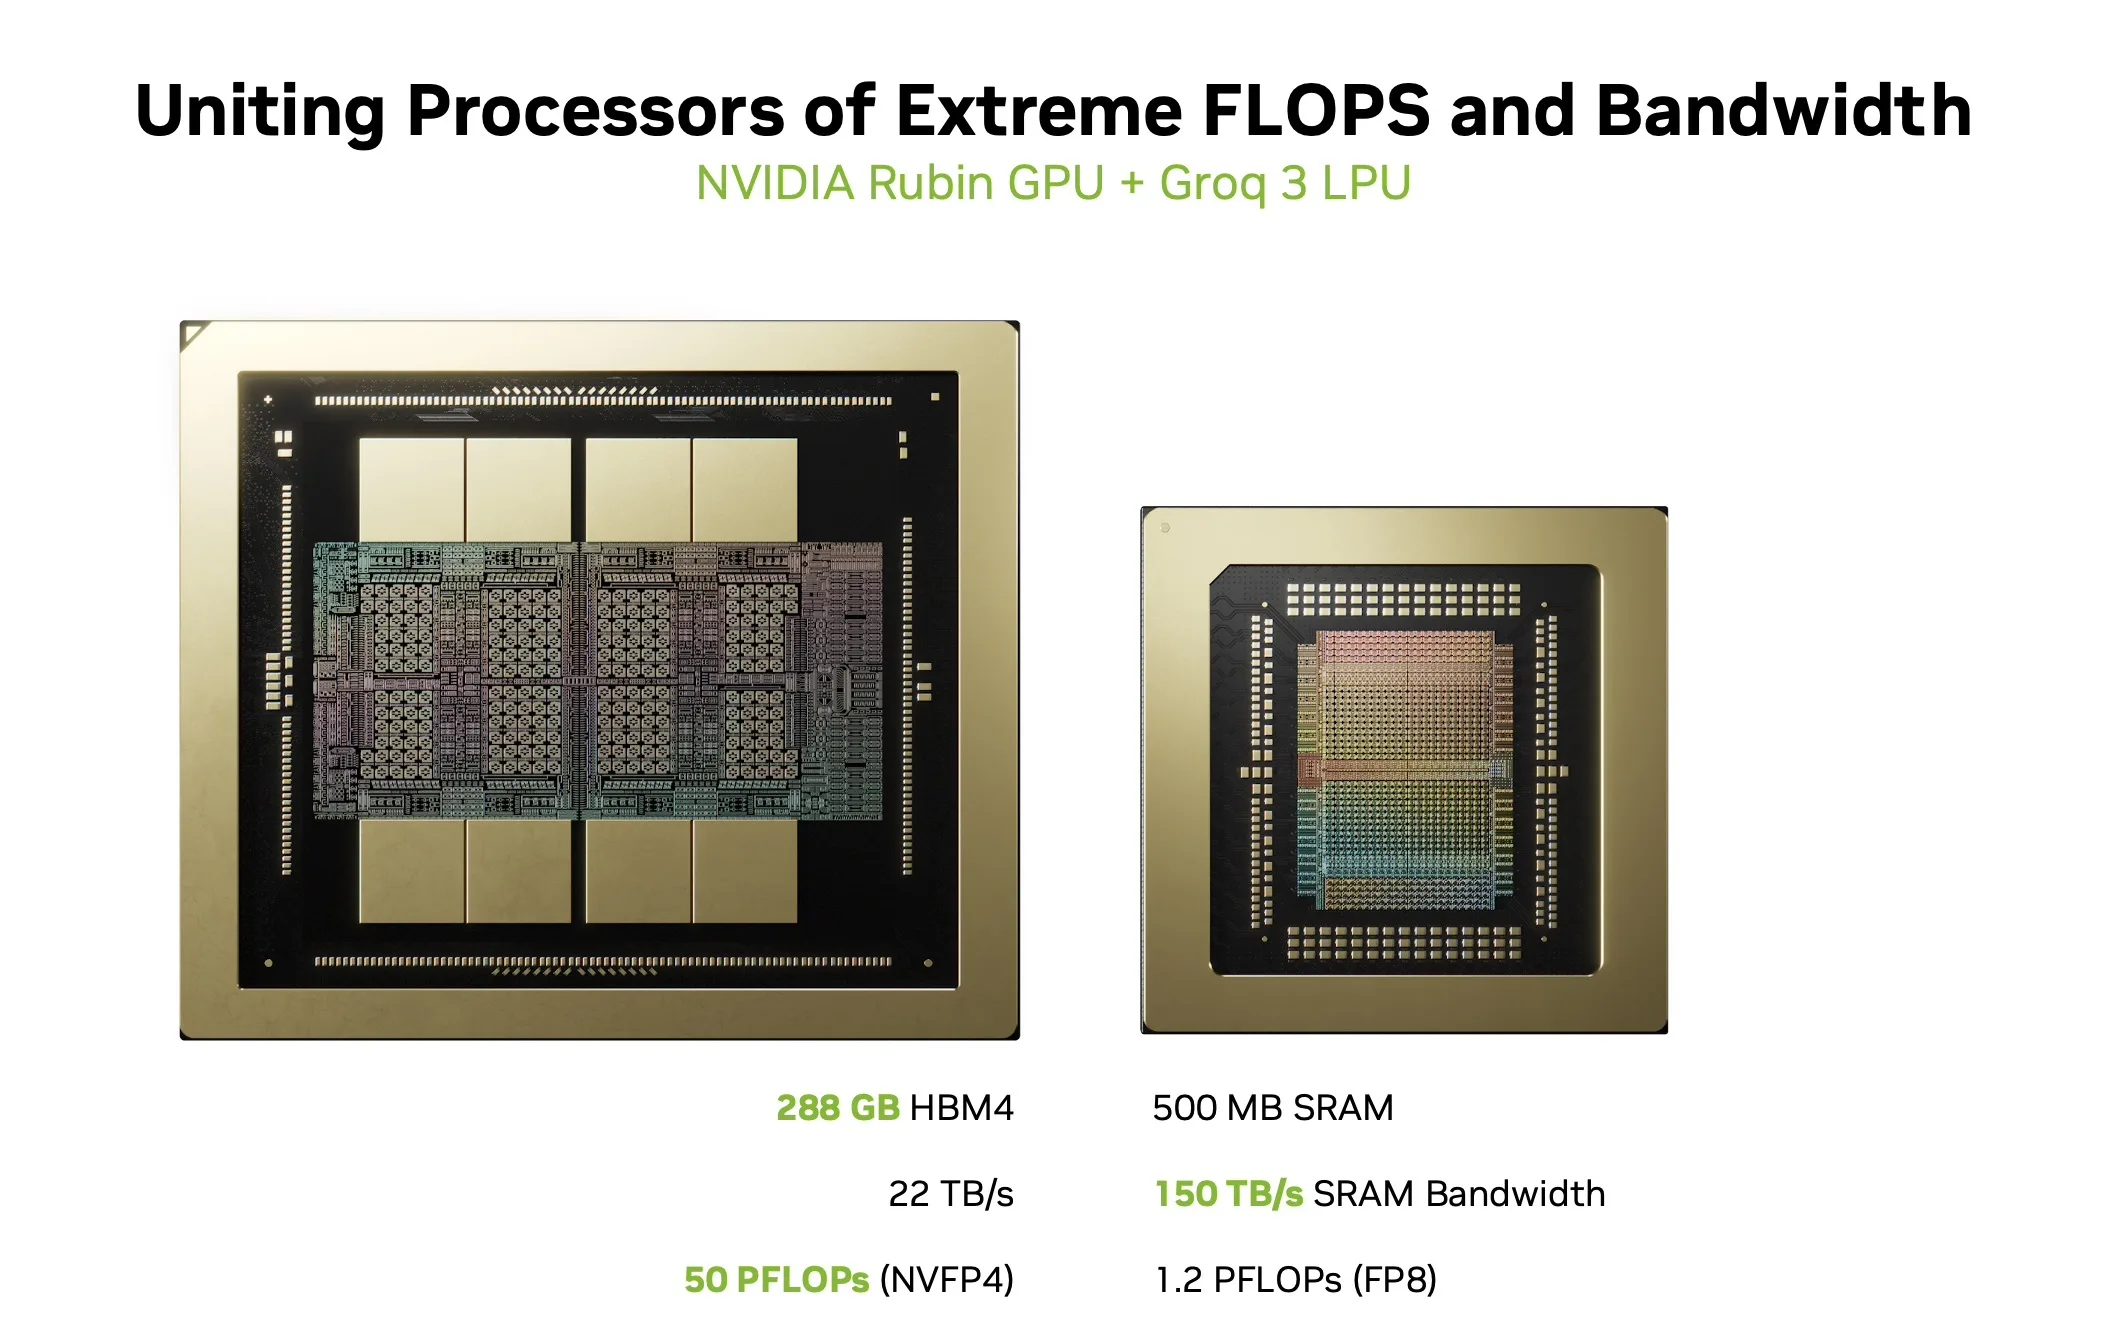
Matrix Execution Modules (MXM): Den primära beräkningsarbetshästen, som ger tät multiplikations-ackumuleringskapacitet för matris-vektor- och matris-matrisoperationer. Var och en av de 8 Groq 3 LP30-kretsarna i NVIDIAs LPX-rack levererar 1.2 PFLOPS FP8-beräkning per krets, totalt 9.6 PLOPS FP8-beräkning per LPX-bricka.
Vektorexekveringsmoduler (VXM): Hanterar punktvis aritmetik, logiska operationer, typkonverteringar och aktiveringsfunktioner. VXM innehåller en array av ALU:er som kompilatorn automatiskt kedjar samman för att bilda sammansatta operationer (till exempel reduktion följt av bias-add, följt av aktivering, följt av type cast) i ett enda svep.
Switch Execution Modules (SXM): Utför strukturerad dataförflyttning, inklusive permutation, rotation, distribution och transposition av vektorer.
Minnesenheter (MEM): En platt, SRAM-först baserad minnesarkitektur utan cacher, ingen hierarki och inget koncept för cachemissar. Groq 3 LP30 tillhandahåller 500 MB SRAM på chipet med en bandbredd på 150 TB/s. Kompilatorn adresserar direkt fysiska bankplatser och känner till den exakta positionen för all data under hela programkörningen.
Flera kopior av varje funktionell enhetstyp stämplas över chipets horisontella dimension. Instruktioner flödar från toppen och botten till mitten medan dataströmmar flödar österut till väster och korsar de funktionella enheterna för att utföra operationer.
1D-sammankopplingen, strömningsregister och determinism
Strömregister och 1D-sammankopplingen
Kommunikation mellan funktionella enheter på LPU:n sker via strömregister, en avsiktligt enkel endimensionell sammankoppling. Det finns två kommunikationsvägar, en som flyter österut och en västerut, där varje strömregister representerar ett enda hopp. Data rör sig med exakt ett hopp per klockcykel, vilket innebär att kompilatorn kan resetiden mellan två funktionella enheter genom att utföra en enkel addition eller subtraktion baserat på deras fysiska positioner på chiplayouten.
Det finns inga köer och inga konkurrensmekanismer inom sammankopplingen. Detta förenklar schemaläggningsproblemet från ett komplext 2D-binpackningsproblem till ett mycket mer hanterbart 1D-problem. Igor Arsovski, Groqs chefsarkitekt, beskriver det bäst: kompilatorn vet exakt var en dataenhet kommer att befinna sig om 10 cykler, eftersom den kommer att vara exakt 10 hopp bort. Det finns ingen tvetydighet, ingen spekulation och ingen hårdvara som fattar oberoende routingbeslut.
Determinism
Det definierande kännetecknet för en LPU är determinism. Till skillnad från konventionella processorer, där dynamisk schemaläggning, cachebeteende och minnesåtkomstkonflikt introducerar varians vid körning, körs LPU:er med noll varians, och varje funktionell enhet arbetar i låst steg.
Denna determinism uppnås genom att ta bort funktioner som hårdvaruinterlocks och flytta allt beslutsfattande till kompilatorn; hårdvaran kör helt enkelt det resulterande schemat. Andra fördelar med denna metod är att allt fungerar med exakt samma latens, och även strömförbrukningen är förutsägbar vid varje tidpunkt.
Determinism sträcker sig även till den numeriska domänen genom vad Groq kallar TruePoint-teknik, där arkitekturens garanterade operationsordning möjliggör noggrannhet på FP32-nivå från FP16-ingångar via en sammansmält punktprodukt med 320 element med ett enda avrundningssteg. Detaljerna om varför numerisk determinism är viktig för LLM-inferens, och varför icke-deterministisk hårdvara producerar subtilt olika utdata över körningar, utforskas ingående i Thinking Labs whitepaper "Defeating Nondeterminism in LLM Inference" . Det är inte fokus för den här artikeln, men läsare som är intresserade av implikationerna för numerisk noggrannhet kan hitta relevant analys i Groqs tekniska TruePoint-dokumentation, länkad i slutet.
Hur LPU:er ansluts: RealScale, monteringslinjen och racktopologi
Monteringsbandet: Hur data rör sig
På den enklaste nivån fungerar dataförflyttning mellan LPU:er som ett löpande band. När en modell kompileras för systemet partitionerar kompilatorn den i steg och mappar varje steg rumsligt till en grupp LPU-chip. Varje grupp lagrar de viktparametrar den behöver i lokalt SRAM på chipet. Under inferens är den enda data som färdas mellan grupper av chip den mellanliggande aktiveringsutgången från föregående steg. Data flödar från chip till chip som en produkt som rör sig längs ett transportband, där varje station utför sin tilldelade beräkning och skickar resultatet till nästa. Detta skiljer sig fundamentalt från GPU:er, där varje beräkningssteg kräver att hela viktuppsättningen hämtas från HBM-minne utanför chipet och resultaten skrivs tillbaka. På LPU:n finns vikterna redan i SRAM vid varje station; endast aktiveringstensorerna rör sig.
En anmärkning om C2C-länkar: RealScale, inte NVIDIA C2C
Innan vi går in på detaljerna kring topologin är det viktigt att klargöra en potentiell källa till förvirring. Chip-till-chip (C2C)-länkarna som används i hela LPX-systemet är Groqs RealScale C2C-sammankoppling. Dessa är inte samma sak som NVIDIAs C2C-teknik, som används på andra ställen i NVIDIA-ekosystemet. De två teknikerna är arkitektoniskt olika:
- NVIDIA C2C är en cache-koherent sammankoppling utformad för att ansluta två olika chiptyper inom en tätt kopplad modul, till exempel en CPU-till-GPU-länk. Den använder ett koherent protokoll med snabbare SerDes och är utformad för heterogen chip-till-chip-kommunikation inom ett enda paket eller en enda modul.
- Groq RealScale C2C är en mjukvaruschemalagd, deterministisk punkt-till-punkt-sammankoppling. Nätverkslänkar är explicit flödesstyrda av kompilatorn och schemalagda som förstklassiga funktionella enheter, precis som MXM- eller VXM-beräkningsenheterna. Det finns ingen hårdvaruarbitrering eller adaptiv routing, och paketen har inga käll- eller destinationsrubriker. Länkarna är fasjusterade och fungerar som ledningar med hög bandbredd och fast latens mellan chip. Ett plesiokront protokoll tar deterministiskt hänsyn till naturlig klockdrift över chip, vilket exponerar en enda gemensam tidsdomän för kompilatorn över hela nätverket.
Varje C2C-anslutning i LPX-racket, oavsett om det är inom ett fack, över fack via ryggraden eller mellan rack via portarna på frontpanelen, använder RealScale. Detta är samma grundläggande sammankopplingsteknik som Groq har använt sedan den ursprungliga GroqNode, uppskalad i länkhastighet (från 30 Gbps till 112 Gbps per fil) men arkitekturmässigt oförändrad.
Obs: Nästa avsnitt som förklarar anslutningen är baserat på vår förståelse av arkitekturen baserat på Groqs dokumentation (länkad i slutet), NVIDIAs blogginlägg och förklaringen av racket som vi fick i GTC-montern:
- C2C-länkarna som används av LPX-rackenheterna är Groqs teknik och är inte samma som C2C-länkarna som används i andra racksystem från NVIDIA.
- De fyra C2C-länkarna på framsidan av varje LPX-rackenhet används för att ansluta till intilliggande rackenheter på samma nivå.
- Inom ett rack finns det all-to-all-kommunikation mellan LPU:er
- Processorn i LPX-racket är x86
Intra-fack-anslutning
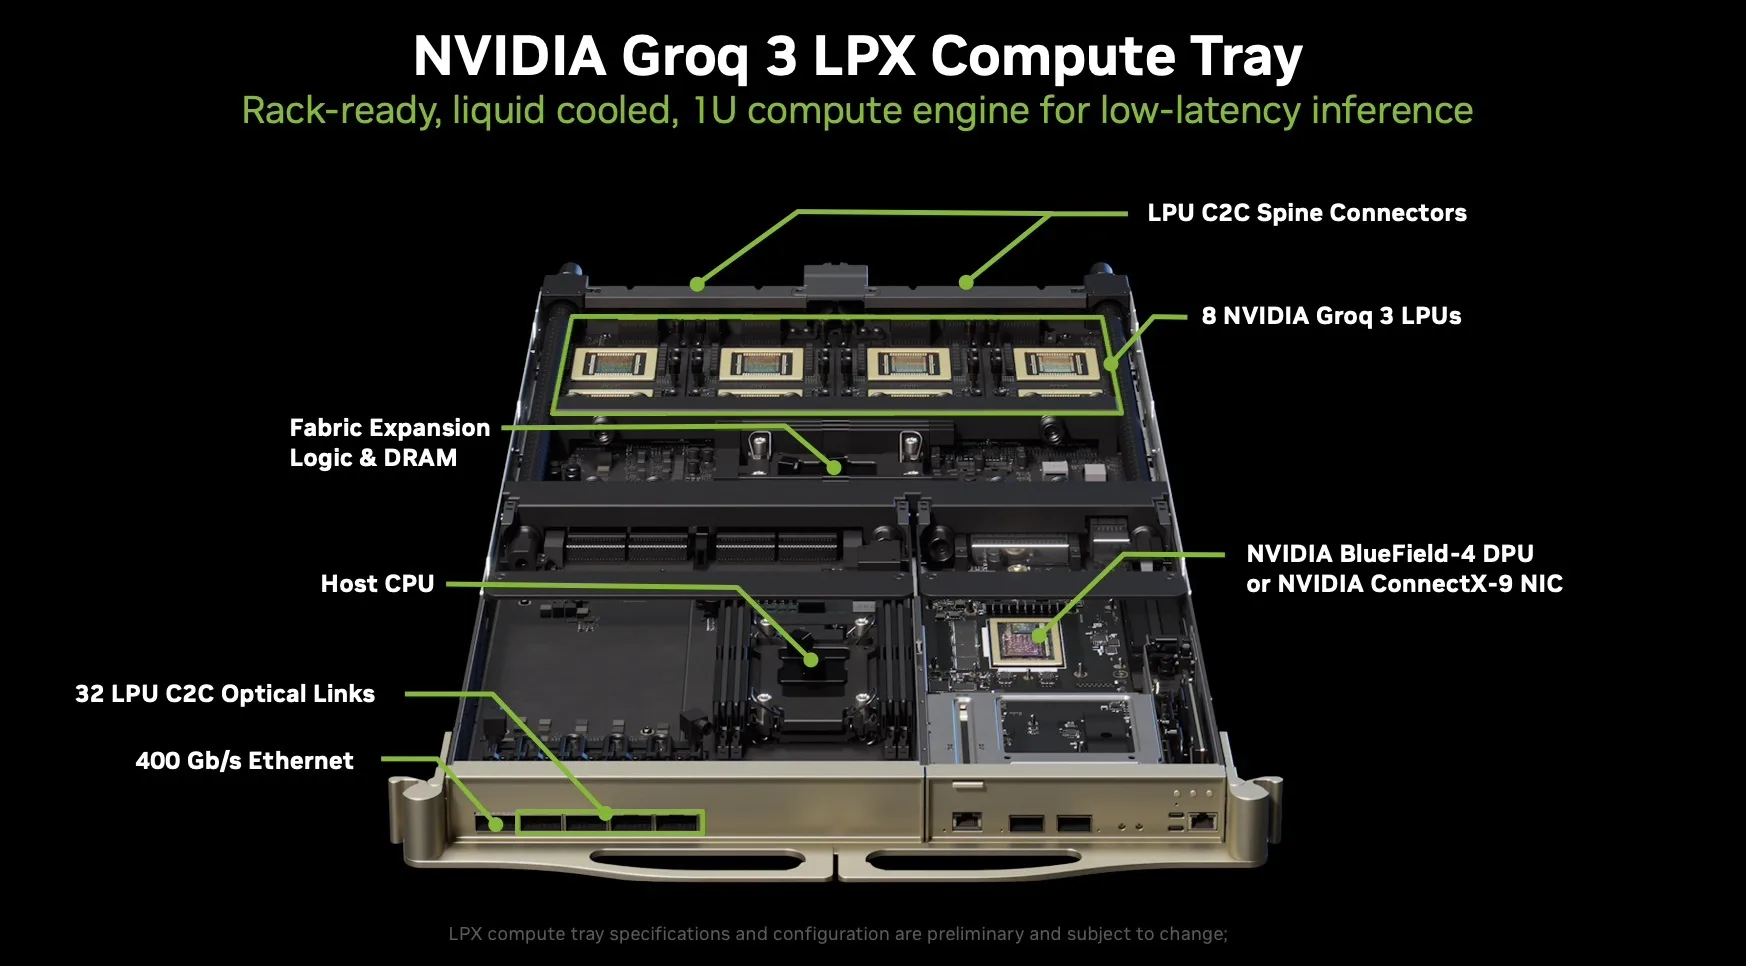
Den grundläggande byggstenen i Groqs nätverkstopologi har inte ändrats från den ursprungliga GroqNode till NVIDIA Groq 3 LPX. Varje 1U-beräkningsbricka innehåller exakt åtta LP30-chip, tätt sammankopplade i en komplett graf (all-to-all), där varje chip kan kommunicera direkt med alla andra chip i samma hastighet.
Källa: Nvidia
Varje LP30-chip har 96 C2C-länkar, som var och en körs med 112 Gbps, vilket ger 2.5 TB/s dubbelriktad bandbredd per chip. I en komplett graf med 8 chip har varje chip 7 grannar. Antalet unika chip-till-chip-kanter inom en bricka är C(8,2) = 28. En del av varje chip's 96 länkar är dedikerade till dessa all-till-all-anslutningar inom bricka, medan de återstående länkarna dirigeras till bakplanet (för rackryggraden) och frontpanelen (för mellan rack). NVIDIA:s publicerade specifikation listar 20 TB/s total bandbredd för uppskalning per bricka, vilket representerar den kombinerade bandbredden inom bricka och ryggraden. Vi kan verifiera detta: varje bricka har 8 chip × 96 länkar = 768 länkar totalt. Om man subtraherar de 32 mellan-rack-banorna på frontpanelen blir det 736 länkar kvar för uppskalning. Vid 112 Gbps per länk blir det 736 × 112 Gbps = 82 432 Gbps, eller ungefär 10.3 TB/s per riktning, vilket motsvarar ungefär 20.6 TB/s dubbelriktad. Detta stämmer väl överens med NVIDIAs angivna 20 TB/s per tray.
Denna allt-till-all-grupp med 8 chip bildar den "lokala gruppen" i en trollsländenätverkstopologi. Den ursprungliga GroqChip 1 hade 11 C2C-länkar per kort, var och en med 30 Gbps per fil (fyra filer per länk), för totalt 330 GB/s per kort. Groq 3 LP30:s 96 länkar med 112 Gbps representerar ett massivt generationssprång i I/O-bandbredd per chip samtidigt som samma topologiska struktur bevaras.
Intra-rack-anslutning
Inom ett enda LPX-rack är 32 beräkningsbrickor (totalt 256 chip) sammankopplade via fyra ETL-ryggar i bakplanet. Dessa ryggar transporterar RealScale C2C-trafik mellan brickorna, vilket skapar rackskala-uppskalningsdomänen. Den sammanlagda bandbredden för uppskalning över hela racket är 640 TB/s (32 brickor × 20 TB/s per bricka). Fördelat över de fyra ryggarna bär varje rygg cirka 160 TB/s dubbelriktad bandbredd.
Anslutning mellan rack
Varje 1U-beräkningsbricka har fyra QSFP C2C-portar på frontpanelen, vilket ger totalt 32 banor (8 banor per port) för kommunikation mellan rack. Dessa portar ansluts till intilliggande rack i ett symmetriskt mönster: två portar (16 banor) ansluter till det vänstra intilliggande racket och två portar (16 banor) ansluter till det högra intilliggande racket. Varje U-position ansluter till motsvarande U-position i det intilliggande racket (det första U:et i rack A ansluter till det första U:et i rack B, det andra till det andra, och så vidare).
Källa: Nvidia
Vid 112 Gbps per fil ger varje fackets 32 interrack-filer 32 × 112 Gbps = 3 584 Gbps, eller cirka 448 GB/s per riktning per fack bandbredd mellan rack. Över hela racket ger de 32 facken 32 × 32 = 1 024 interrack-filer. Det blir 1 024 × 112 Gbps = 114 688 Gbps, eller cirka 14.3 TB/s per riktning till varje intilliggande rack (jämnt fördelat: ~7.2 TB/s per riktning till vänster granne och ~7.2 TB/s per riktning till höger granne).
Denna bandbredd mellan rack är konstruerad för att vara glesare än bandbredden inom racket. Inom racket ger uppskalningsdomänen på 640 TB/s tät, all-to-all-nåbarhet genom ryggraden. Mellan racken ger länkarna på frontpanelen de glesare globala anslutningarna i trollslände-topologin. Detta är samma arkitekturmönster som i det ursprungliga GroqRack, där fyra externa C2C-länkar per chip kopplade samman lokala grupper (noder) för att bilda multiracksystem med låg nätverksdiameter (maximalt tre hopp i en 264-chips-distribution).
Att sätta ihop det: Samma arkitektur, 4 gånger högre densitet
Den ursprungliga GroqRack-installationen med fyra rack innehöll 264 GroqChip-processorer. Ett enda LPX-rack rymmer 256 LP30-chip i ett MGX ETL-rack, ungefär 4 gånger så hög chipdensitet i ett enda rack med vätskekylning och ett kabellöst bakplan. Den lokala allt-till-all-gruppen med åtta chip, trollslände-topologin och det mjukvaruschemalagda routingparadigmet fortsätter alla intakt. Den grundläggande Groq-nätverkstekniken har inte förändrats; den har skalats upp.
För modeller som överstiger SRAM-kapaciteten för ett enda rack (totalt 128 GB fördelat på 256 chip) kan flera LPX-rack eller rader av rack sammankopplas via C2C-portarna på frontpanelen för att ytterligare förlänga monteringslinjen. Mer om vad detta innebär för verkliga modellstorlekar finns i nästa avsnitt.
Varför FFN-lager? Att förstå vad NVIDIA avlastar
Varför avkodning blir svårare att betjäna
Innan vi går in på detaljerna kring vad NVIDIA lägger till på LPX och varför, är det bra att förstå de bredare trenderna, som NVIDIA påpekar, som gör detta arkitektoniska beslut nödvändigt. AI-inferens är inte en enda, enhetlig arbetsbelastning. Inom en enda begäran ställer förfyllningsfasen (mata in prompten och bygga KV-cachen) och avkodningsfasen (generera tokens en i taget) mycket olika krav på hårdvaran, och dessa krav förändras med batchstorlek, kontextlängd och modellstruktur.
Allt eftersom modeller producerar längre resonemangsutdata och flerstegskedjor av tankemönster, övergår en större andel av varje begäran till den sekventiella avkodningsfasen. Samtidigt minskar tekniker som prefixcachning kostnaden för förifyllning genom att återanvända delat prompttillstånd över förfrågningar, vilket bara gör den relativa kostnaden för avkodning mer framträdande. Kontextfönster växer också till hundratusentals tokens, vilket sätter ökande press på minnesbandbredden under uppmärksamhetsberäkning. Och i agentiska arbetsflöden ökar latensen över många modellanrop, verktygsinteraktioner och verifieringsslingor. Den kumulativa effekten är att avkodningslatens i allt högre grad är den flaskhals som användarna upplever, och hårdvara som är optimerad enbart för maximal aggregerad dataflöde är inte alltid den bästa lösningen för arbetsbelastningar som kräver snabb, förutsägbar tokengenerering för varje enskild begäran.
Dessutom, som sett med Anthropics Fast Mode -lansering, driver lägre latens och högre token-genomströmning högre intäkter, där Anthropics snabba inferenserbjudande kostar 6 gånger så mycket som vanliga förfrågningar.
Med detta LPX-tillkännagivande vet vi att NVIDIA vill avlasta den största avkodningsflaskhalsen till LPU:erna: feed-forward-nätverkslagren (FFN). För att förstå varför FFN är målet och för att uppskatta den stora omfattningen av vad det betyder, analyserade vi FFN-parameterantal för dagens mest populära modeller med öppen källkod.
Vad är FFN-lager och varför dominerar de?
Varje transformatorlager har två huvudblock: ett uppmärksamhetsblock och ett feed-forward-block (FFN). Uppmärksamhetsblocket låter tokens titta på och blanda information från andra tokens i sekvensen. FFN-blocket arbetar på varje token oberoende av varandra: det projicerar tokens representation uppåt i ett högre dimensionellt rum, tillämpar en icke-linjäritet och projicerar den tillbaka nedåt. Man kan tänka på det som modellens kunskapslagring, där faktiska associationer och inlärda transformationer finns.
MoE- eller Mixture of Experts-arkitekturen har framstått som den dominerande arkitekturen bland dagens ledande stora språkmodeller med öppen källkod: DeepSeek R1, Kimi K2, Qwen3-235B, GLM-5, MiniMax M2.5 och OpenAI:s GPT-OSS 120B.
Inom dessa MoE-modeller är det specifikt FFN-blocket som replikeras till hundratals mindre oberoende kopior som kallas experter, medan uppmärksamheten förblir delad. En lätt inlärd routingfunktion väljer dynamiskt en liten delmängd av experter att aktivera per token. Resultatet är en modell som lagrar ett enormt totalt antal parametrar men bara aktiverar en bråkdel per token, vilket ger kvalitetsfördelarna med skalning utan den proportionella beräkningskostnaden.
Men som du säkert har insett innebär detta ytterligare en utmaning: FFN-lagren står för merparten av modellens vikter. Specifikt för MoE-modeller kan detta vara så mycket som 90 % av modellens vikter.
Inuti DeepSeek R1: Ett fungerande exempel
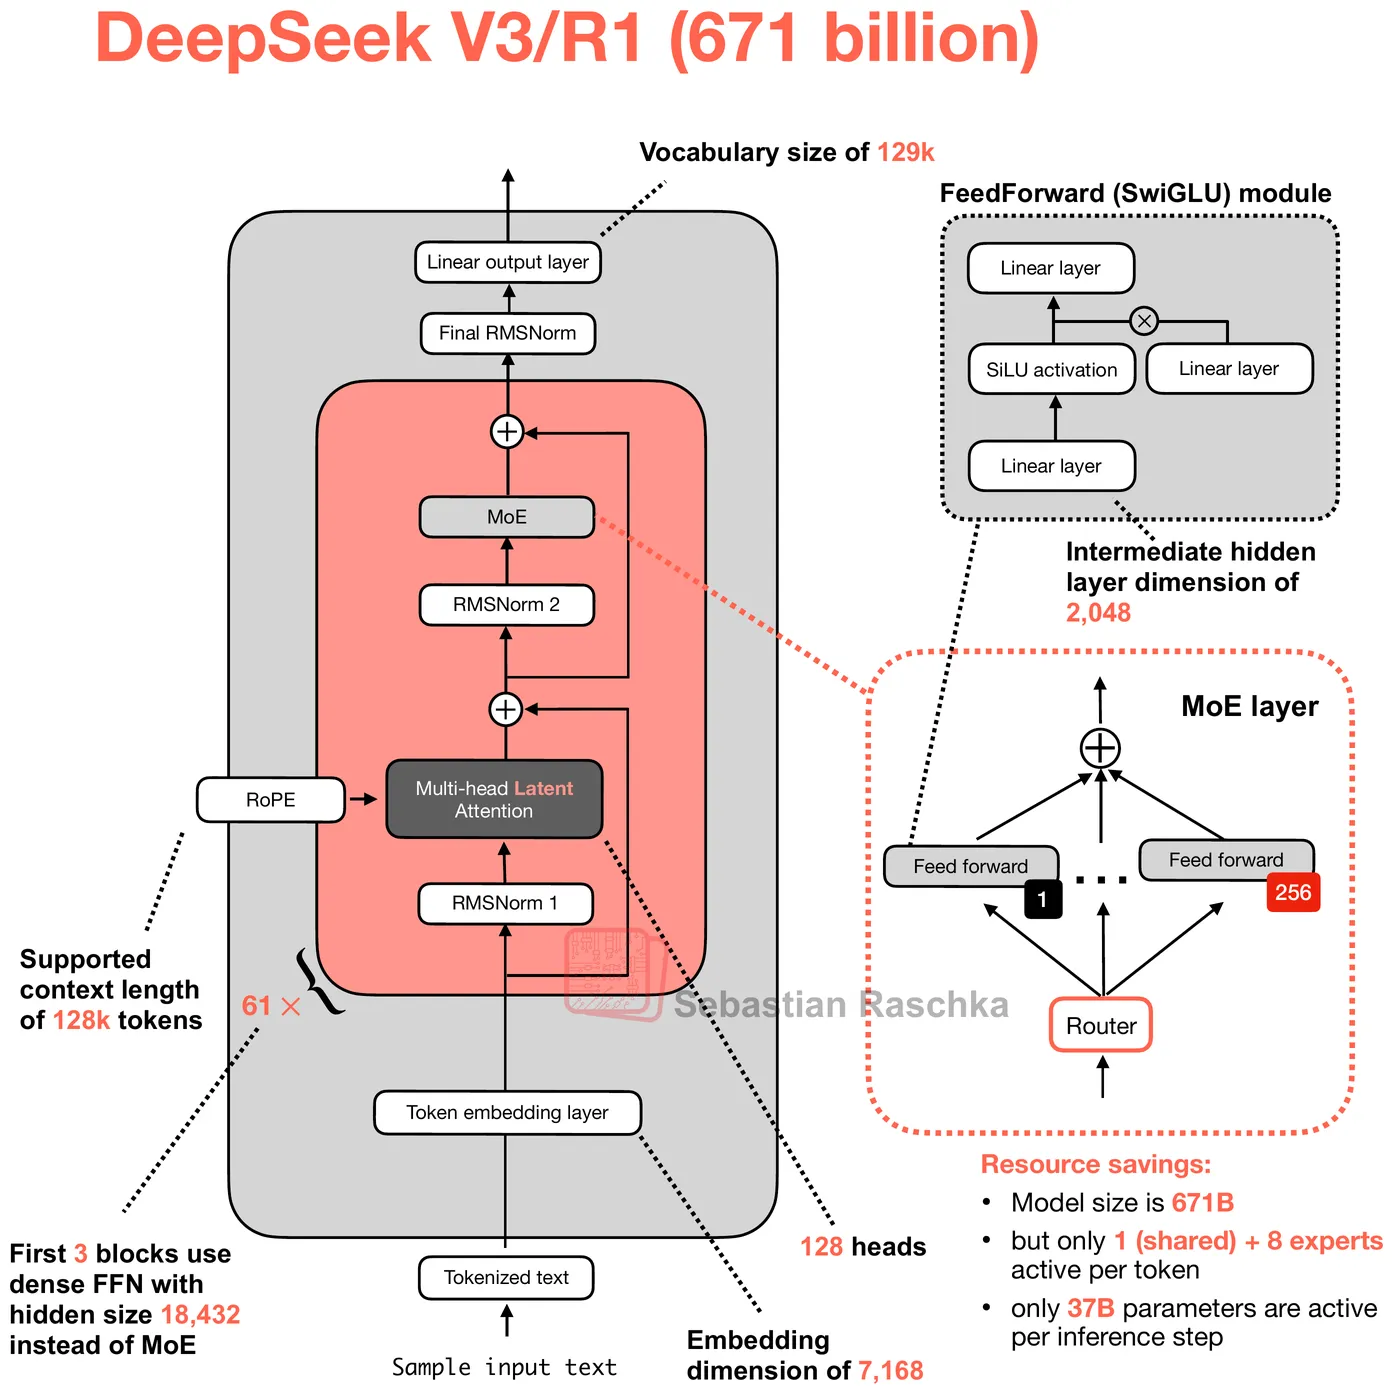
För att illustrera, låt oss zooma in på DeepSeek R1. Modellen har 61 Transformer-lager med en dold dimension (H) på 7 168. De första 3 lagren använder ett standard tätt FFN, medan de återstående 58 använder MoE (plus 1 ytterligare MTP-lager med egna experter, för totalt 59 MoE-lager). Moderna LLM:er använder en variant som kallas SwiGLU, som har tre viktmatriser istället för två. Framåtpassningen beräknar w2(SiLU(w1(x)) ⊙ w3(x)), där w1 (grindprojektionen) och w3 (uppprojektionen) båda expanderar den dolda dimensionen från H till en mellanliggande storlek I, och w2 (nedprojektionen) komprimerar den tillbaka. ⊙ är elementvis multiplikation mellan de grindade och icke-grindade banorna. Ingen av dessa matriser har biastermer, så varje SwiGLU FFN-block innehåller exakt 3 × H × I-parametrar.
Källa: Sebastian Raschka
För DeepSeek R1:s täta lager (de första 3) är den mellanliggande dimensionen 1.8 432, vilket ger 3 × 7 168 × 18 432 = 396.4 miljoner parametrar per lager. För MoE-lagren är var och en av de 256 routade experterna ett komplett SwiGLU-block med en mindre mellanliggande dimension på 2 048, så varje expert har 3 × 7 168 × 2 048 = 44.0 miljoner parametrar. Multiplicera med 256 experter, så får du 11.27 miljarder parametrar enbart i routade experter, per lager. Utöver det har varje MoE-lager en delad expert (samma 44M-parameter SwiGLU-block, alltid aktiverat för varje token), en routergate (en linjär projektion av formen [256, 7,168] = 1,8M parametrar) och en liten biasvektor med 256 FP32-värden som används för lastbalansering under routing.
Den fullständiga FFN-filen har ungefär 669.1 miljarder parametrar. I FP8 E4M3-format (1 byte per vikt) motsvarar det ungefär 623.1 GB FFN-data. Det är 97.7 % av modellens uppskattade totala storlek på disken. De återstående ~2.3 % är uppmärksamhetsvikter, inbäddningar, utdatahuvudet, lagernormer och FP8-skalningsmetadata.
Avkoda disaggregering
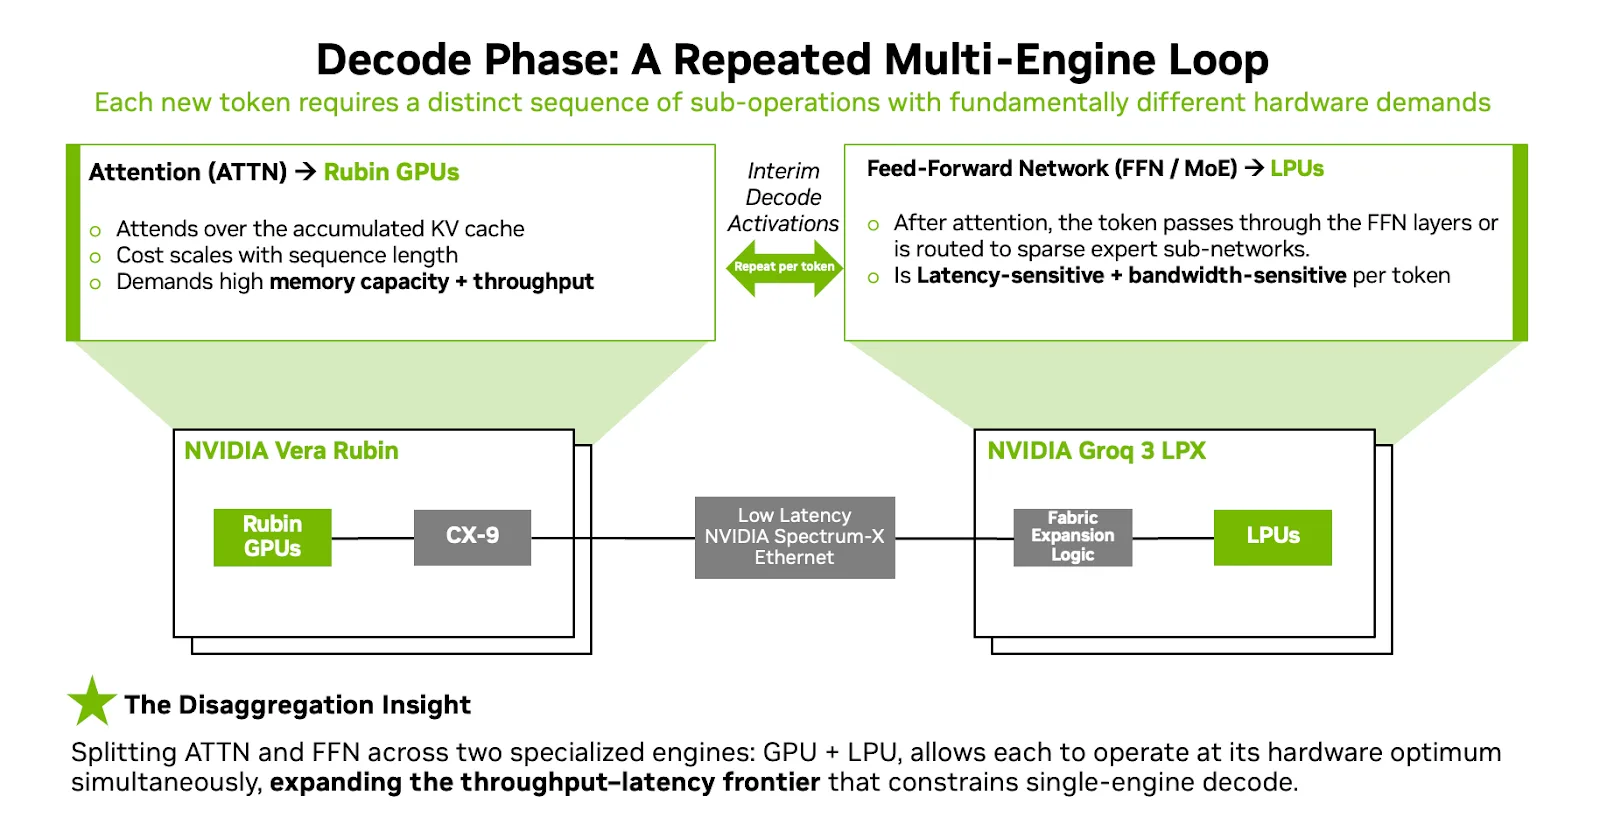
NVIDIA ramar nu in avkodningsfasen inte som en monolitisk operation utan som en upprepad loop per token där olika delar belastar olika hårdvaruflaskhalsar. Förfyllningsfasen domineras av att mata in stora indata och bygga KV-cachen, en arbetsbelastning som drar nytta av tät parallell beräkning och stor minneskapacitet. Vera Rubin NVL72 hanterar detta effektivt, särskilt för långkontextuella arbetsbelastningar där prompten kan vara massiv och mycket variabel.
Källa: Nvidia
Avkodning är annorlunda. För varje ny token måste systemet utföra uppmärksamhet över hela den ackumulerade KV-cachen och sedan köra FFN/MoE-beräkningen på uppmärksamhetsutgången. I NVIDIAs Attention-FFN Disaggregation (AFD)-arkitektur är dessa två steg uppdelade på två motorer. Rubin GPU:er hanterar avkodningsuppmärksamhet: läsning av KV-cachen från HBM, beräkning av uppmärksamhetspoängen och produktion av den mellanliggande aktiveringen. Den aktiveringstensorn (vad NVIDIA refererar till som "interimtensortillstånd") överlämnas sedan till LPX, som kör FFN- eller MoE-expertberäkningen med extrem bandbredd och deterministisk latens innan resultatet returneras till GPU:n för att fortsätta tokengenereringen.
Denna överlämning sker för varje enskild token. Aktiveringstensorerna som utväxlas mellan GPU och LPU är små i förhållande till viktdata, vilket är just i det område där LPU:ns nätverk med nära noll overhead utmärker sig. Uppdelningen spelar på varje processors grundläggande styrkor: GPU:er tillhandahåller den HBM-kapacitet och flexibla exekvering som behövs för variabel längduppmärksamhet över stora KV-cacher, medan LPU:er tillhandahåller den SRAM-bandbredd och deterministiska schemaläggning som behövs för de bandbreddsbundna, statiskt schemalagda FFN-vikterna.
Källa: Nvidia
Det finns en subtil men viktig skalningsegenskap som är värd att nämna här. Allt eftersom kontextlängden växer, skalas även beräknings- och minneskraven för uppmärksamhetsoperationen med den: KV-cachen expanderar linjärt med varje ytterligare kontexttoken, och varje nytt avkodningssteg måste ta hand om hela den ackumulerade cachen. FFN växer dock inte alls med kontexten. FFN-viktmatriserna (w1, w2, w3 i SwiGLU) är fasta konstanter i modellarkitekturen. De har samma storlek oavsett om kontexten är 1 000 tokens eller 1 000 000 tokens, och varje token passerar genom dem oberoende. Detta innebär att i AFD-arkitekturen, allt eftersom kontextfönstren fortsätter att växa, absorberar GPU-sidan den ökande kostnaden (mer HBM för KV-cache, mer beräkning för uppmärksamhet), medan LPX-sidan förblir helt statisk. Antalet LPX-rack som krävs för att betjäna en modells FFN bestäms helt av modellens arkitektur, inte av serveringkonfigurationens kontextlängd. Detta löser på ett snyggt sätt det som historiskt sett var en av de största utmaningarna för SRAM-only-acceleratorer: att växande kontextkrav så småningom överstiger den fasta minneskapaciteten på chipet. I AFD-uppdelningen stannar det kontextberoende arbetet kvar på hårdvara med expanderbar HBM, och LPU:n hanterar endast det kontextoberoende arbete som passar naturligt i fast SRAM.
NVIDIA Dynamo gör heterogen avkodning operativ
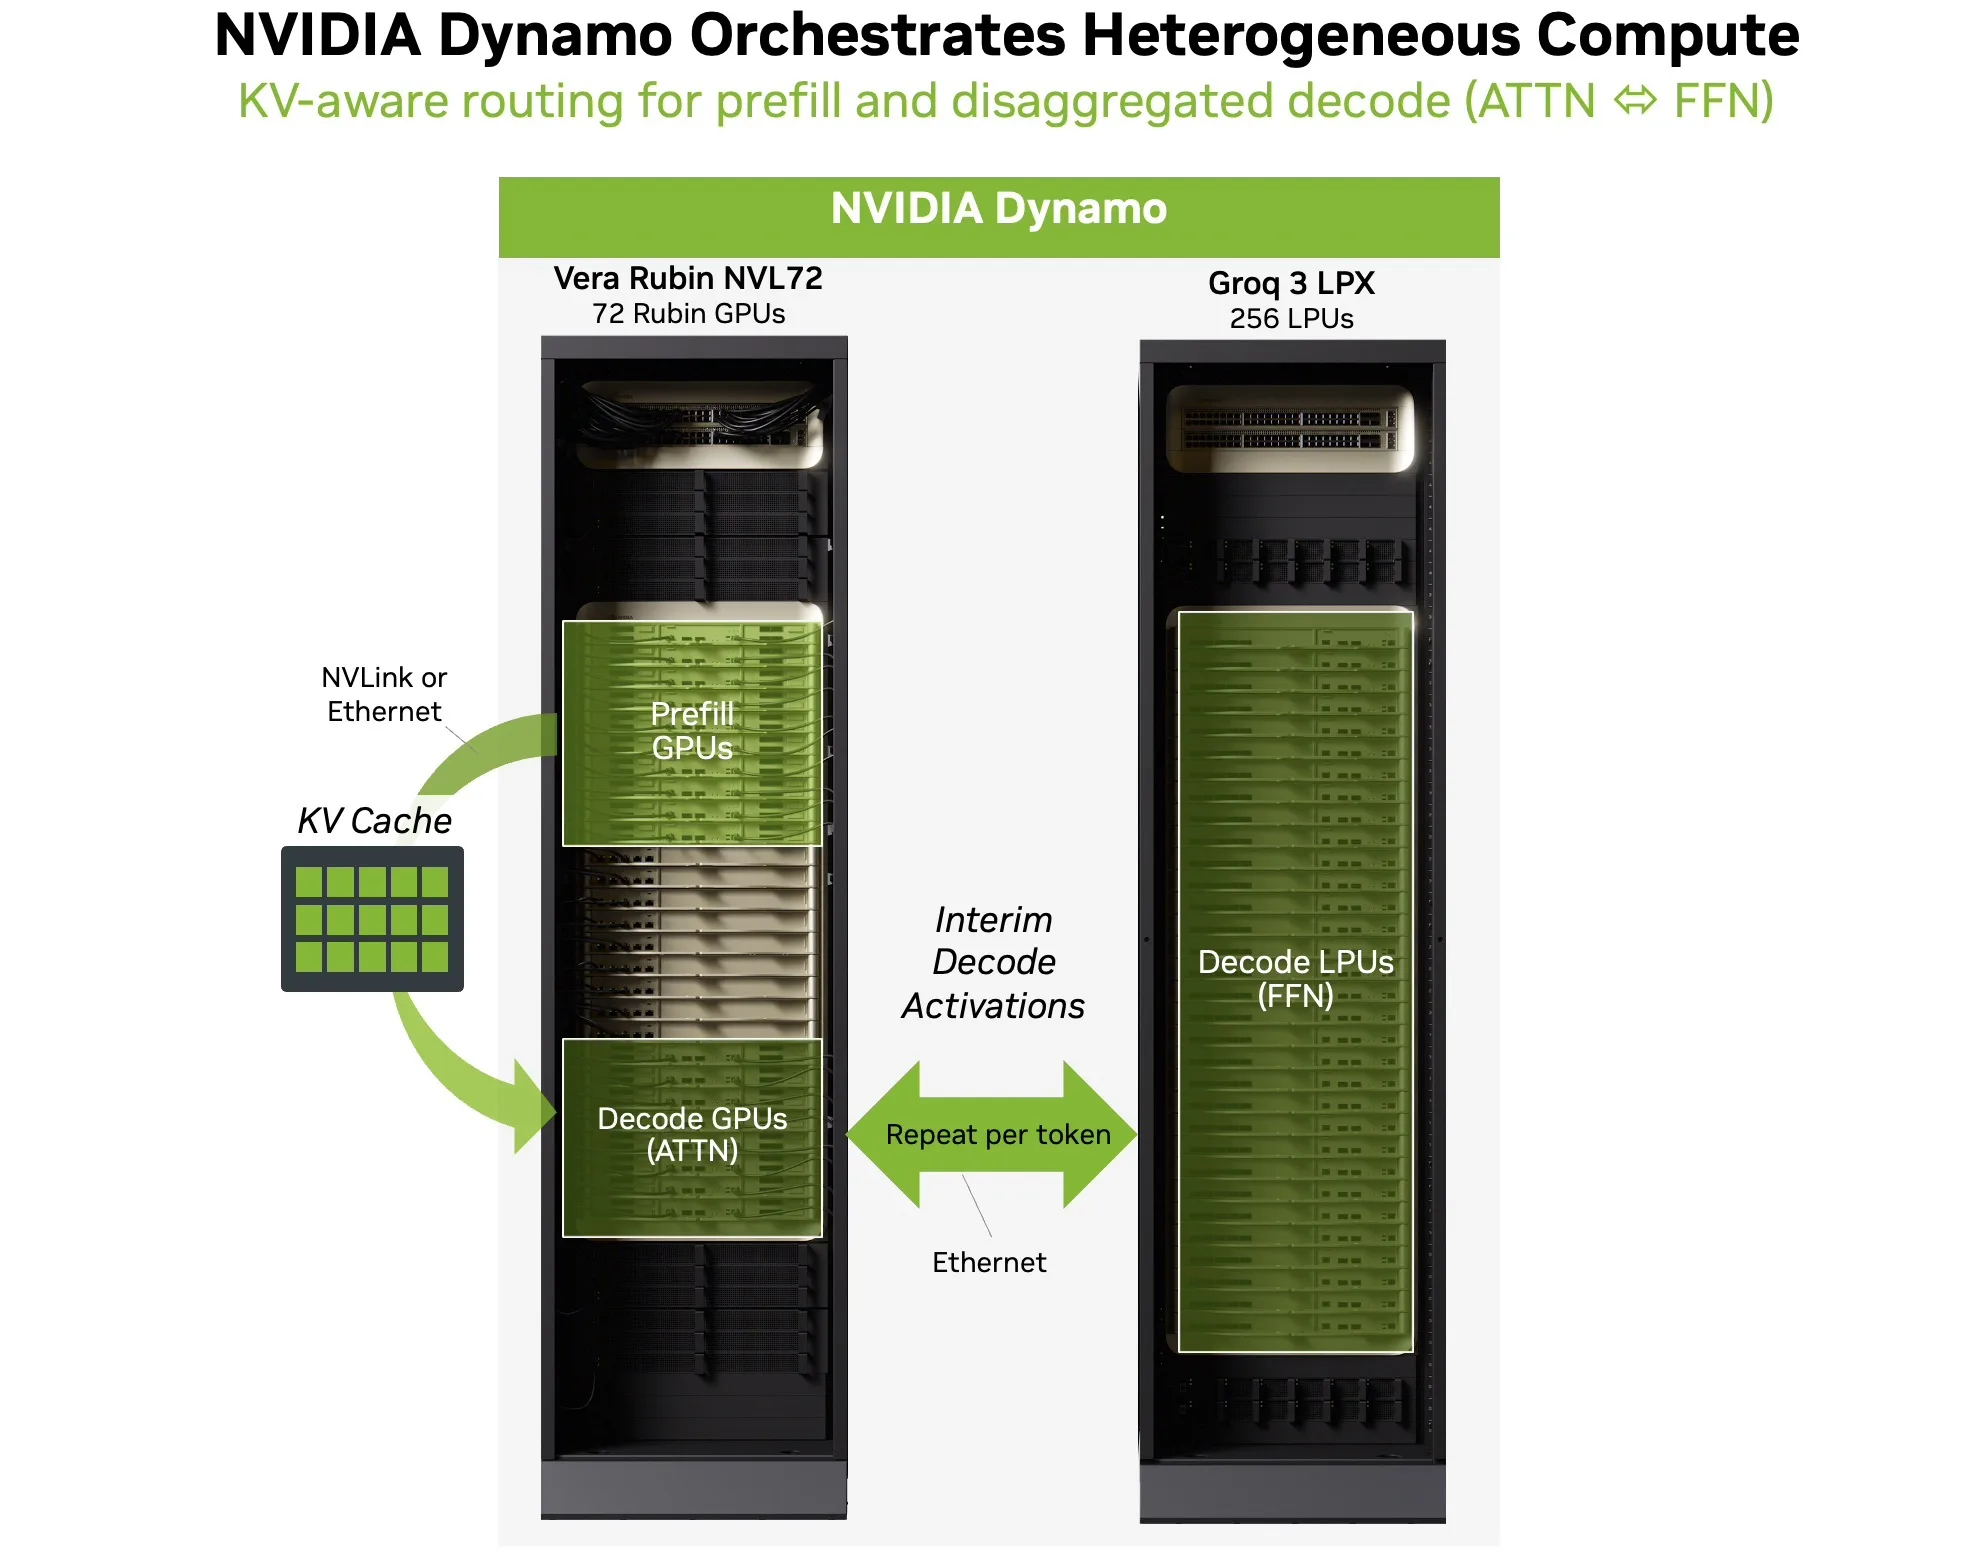
Att få denna tvåmotoriga loop att fungera i produktion kräver mer än bara hårdvara. NVIDIAs Dynamo-orkestreringslager är det som gör heterogen avkodning praktisk. Dynamo koordinerar disaggregerad servering över GPU- och LPU-backends och hanterar klassificering, routing och aktiveringsöverföring per token som krävs av AFD.
Källa: Nvidia
I praktiken dirigerar Dynamo förfyllning till GPU-arbetare för att bearbeta indata och bygga KV-cachen. Under avkodningen orkestrerar Dynamo AFD-slingan: GPU:er styr den ackumulerade KV-cachen, mellanliggande aktiveringar överlämnas till LPU:er för FFN/MoE-körning, och utdata återgår till GPU:erna för att fortsätta tokengenereringen. Resultatet är en enda sammanhängande serveringsväg snarare än två frånkopplade system.
Dynamo tillhandahåller även KV-medveten routing (så att förfrågningar hamnar på arbetare som redan har relevant KV-cache), latensmålsdriven schemaläggning (så att interaktiva sessioner undviker långa köer) och överföringshantering med låg overhead. Dessa funktioner är viktiga eftersom orkestreringsskiktet, under verklig produktionstrafik med varierande kontextlängder, blandade förfrågningstyper och bursty-samtidighet, håller svansfördröjningen stabil och förhindrar att jitter mellan hyresgäster försämrar användarupplevelsen.
FFN-storlekar för alla större modeller med öppen källkod och LPX-storlekar
Nu när vi förstår hur LPX fungerar och vad det försöker lösa, låt oss titta på vad det innebär när det gäller hårdvarukrav.
Vi beräknade antalet parametrar och FFN-storleken på disken för populära modeller med hjälp av config.json och model.safetensors.index.json som finns tillgängliga på Huggingface.
| Modell | FFN-parametrar | FFN-storlek (på disk) | FFN-procent | Dtyp | Experter |
|---|---|---|---|---|---|
| DeepSeek R1 och DeepSeek V3.2 | 669.1B | 623.1 GB | 97.7% | FP8 | 256 |
| Kimi K2 | 1.02T | 948.0 GB | 98.9% | FP8 | 384 |
| Kimi K2.5 | 1.02T | 474.0 GB | 98.5% | INT4 | 384 |
| MiniMax M2.5 | 224.7B | 209.3 GB | 97.7% | FP8 | 256 |
| OpenAI GPT-OSS 120B | 114.7B | 53.4 GB | 95.4% | MXFP4 | 128 |
| GLM 5 | 738.1B | 1,374.8 GB | 98.0% | BF16 | 256 |
| Qwen3 235B-A22B | 227.2B | 423.1 GB | 96.6% | BF16 | 128 |
Mönstret bekräftar det vi undersökte tidigare: för varje modell i denna analys står FFN-parametrar för 95 % till 99 % av den totala modellstorleken på disken. Kimi K2 är det mest extrema fallet, med 384 routade experter per lager vilket driver FFN till över 1 biljon parametrar och nästan 99 % av totalen. Även den minsta modellen i uppsättningen, OpenAI:s GPT-OSS 120B med 128 experter lagrade i MXFP4, har fortfarande FFN som representerar 95.4 % av totalen. Storleken på disken varierar från blygsamma 53 GB för GPT-OSS 120B (tack vare 4-bitars kvantisering) upp till nästan 1.4 TB för GLM 5 (lagrad i BF16 utan kvantisering).
Dessa siffror hjälper oss att förstå LPX-storleken. Ett enda LPX-rack ger 128 GB totalt SRAM fördelat på sina 256 chip. För en modell som OpenAI:s GPT-OSS 120B vid 53 GB FFN får FFN-vikterna bekvämt plats i ett enda rack med gott om plats. DeepSeek R1 vid 623 GB skulle kräva ungefär fem LPX-rack, medan GLM 5 vid 1.4 TB i BF16 skulle behöva över tio (även om kvantisering till FP8 skulle halvera det ungefär). Det är just därför C2C-portarna på frontpanelen mellan racken krävs: de gör det möjligt att kedja ihop flera LPX-rack, vilket förlänger monteringslinjen för att rymma större modeller.
Accelerera spekulativ avkodning med LPX
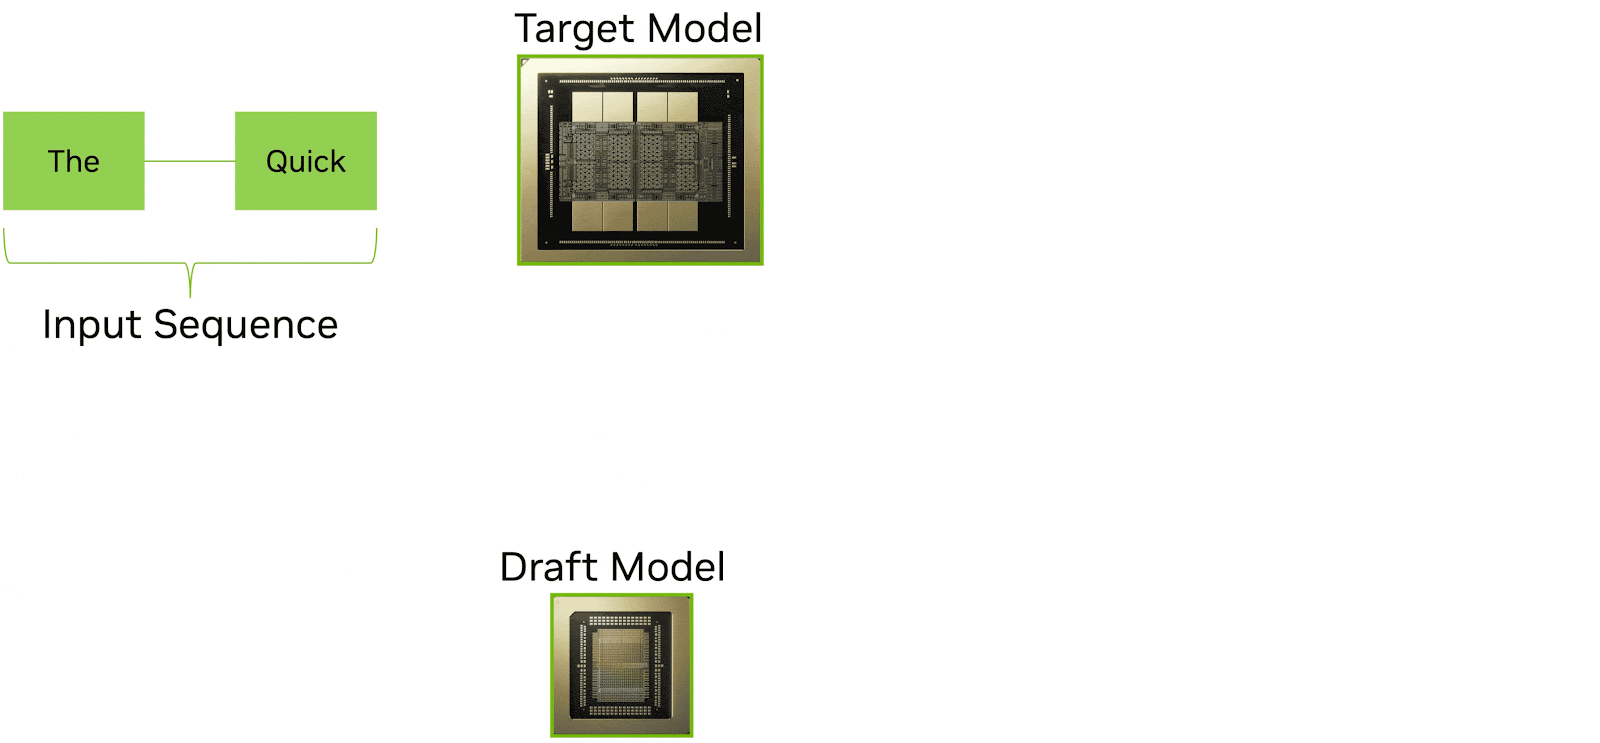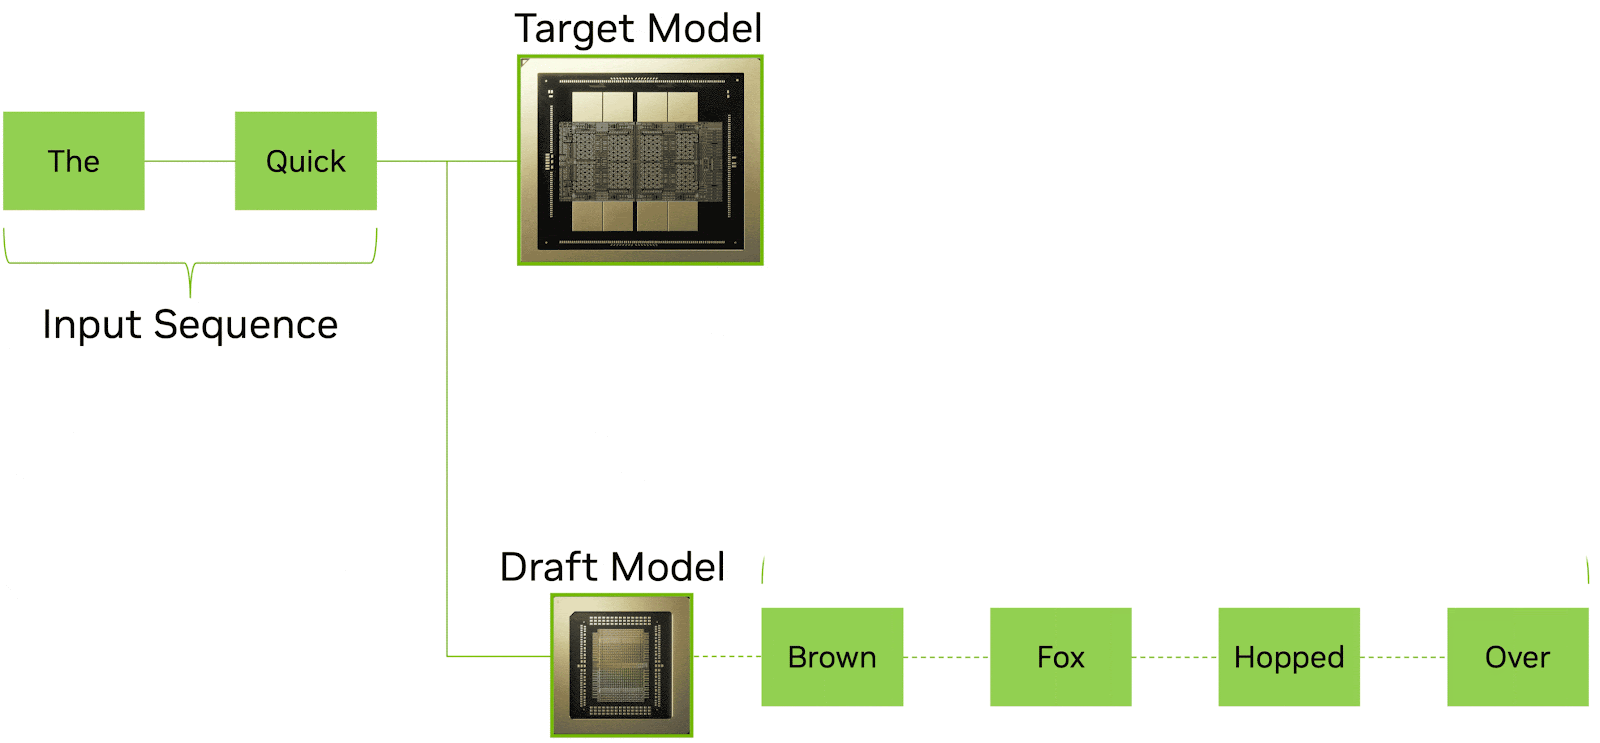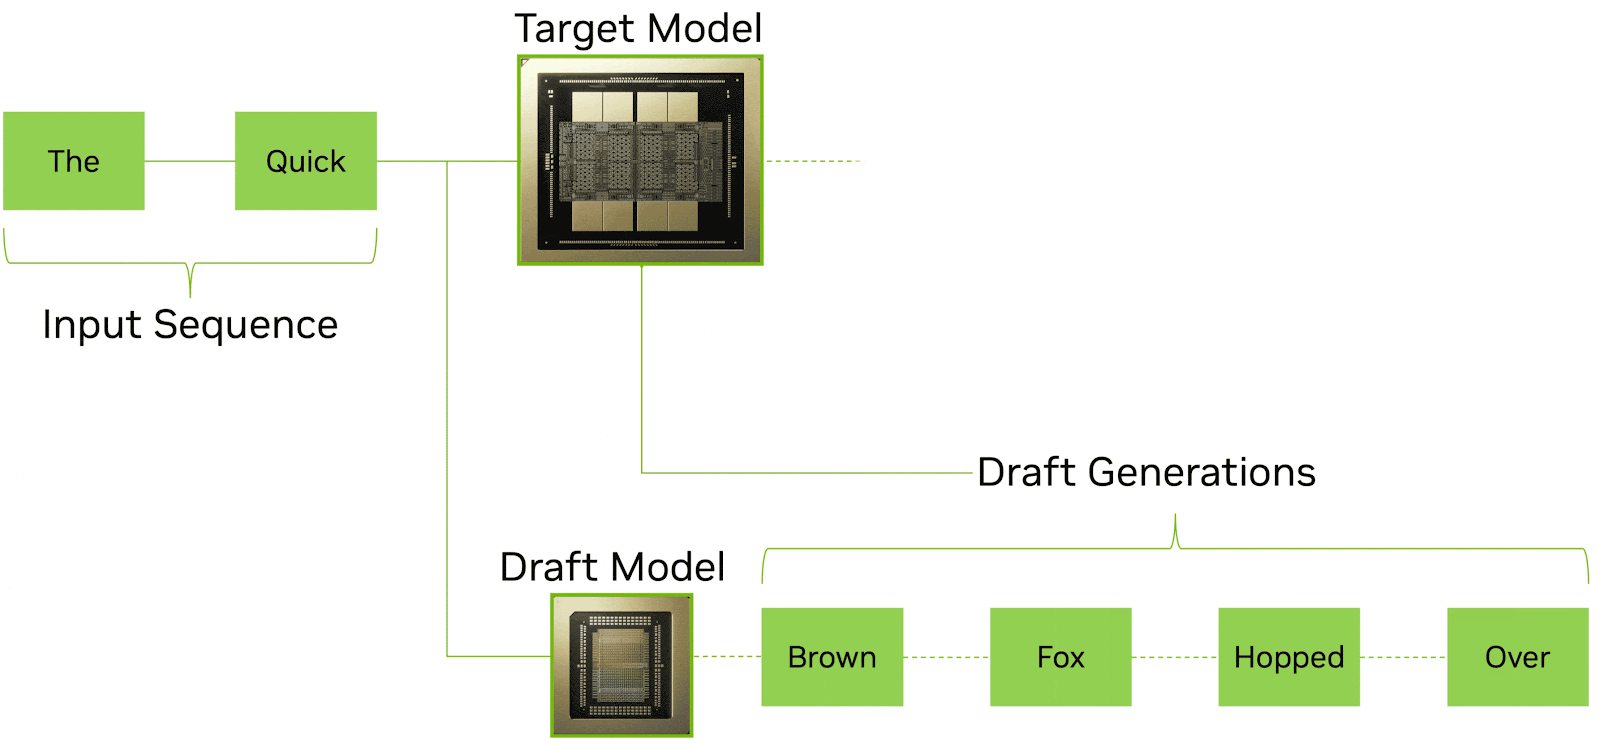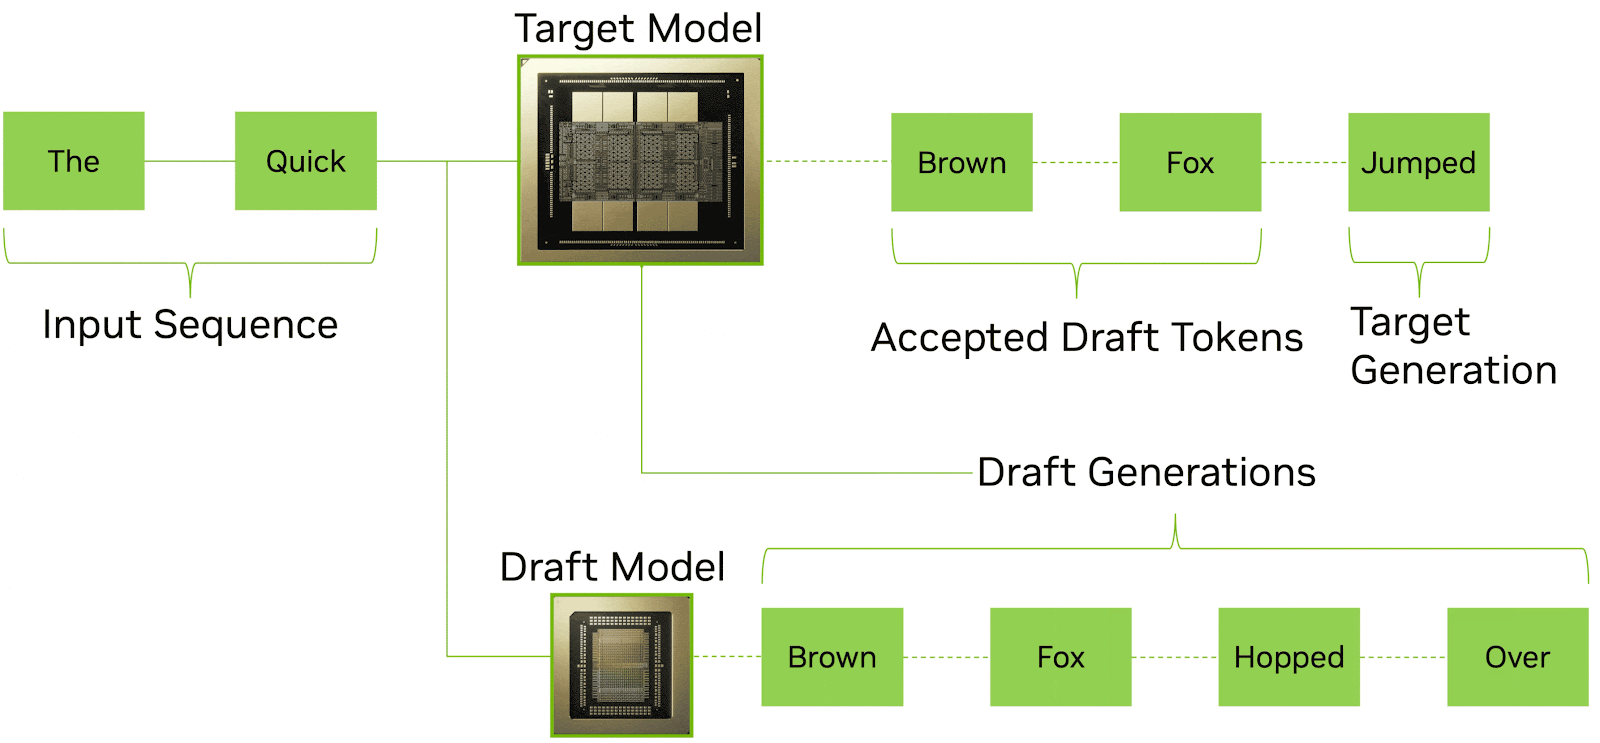
Utöver AFD-avkodningsslingan identifierar NVIDIA ett andra viktigt användningsfall för LPX: att fungera som utkastgenereringsmotor vid spekulativ avkodning.
Spekulativ avkodning är en allt viktigare teknik för att minska latens i LLM-inferens. Idén är enkel: en mindre, snabbare utkastmodell genererar flera kandidattokens i förväg, medan en större målmodell verifierar och accepterar dem parallellt. När utkastmodellens förutsägelser är korrekta (vilket de ofta är för rutinmässig text) kan flera tokens committas samtidigt i ett enda verifieringssteg. Resultatet är betydligt högre effektiva tokens per sekund och lägre upplevd latens för slutanvändaren.
Källa: Nvidia
Utmaningen är att spekulativ avkodning kräver att utkastmodellen körs extremt snabbt. Varje millisekund som utkastmodellen lägger på att generera kandidater är en millisekund som verifieraren väntar. I en konventionell GPU-enbart system konkurrerar både utkastmodellen och målmodellen om samma hårdvaruresurser, och utkastmodellens hastighet begränsas av samma HBM-bandbreddsbegränsningar som påverkar allt annat.
LPX är väl lämpad för denna roll. Den deterministiska exekveringsmodellen och LP30:s extrema SRAM-bandbredd på chipet möjliggör mycket snabb och förutsägbar generering av drafttokens. En mindre draftmodell passar bekvämt i SRAM-minnet i ett enda LPX-fack eller ett litet antal fack, och den deterministiska schemaläggningen säkerställer att draftgenereringen körs med en jämn och förutsägbar hastighet utan den variation som skulle göra det svårt att pipelinea med verifieraren.
I den här konfigurationen parar systemet ihop de två processorerna för kompletterande roller: LPX genererar utkasttokens snabbt med sin arkitektur med låg latens, medan Rubin-GPU:er verifierar och slutför tokens effektivt med hjälp av sin höga dataflödeskapacitet och stora HBM-kapacitet. Denna separation gör att spekulativ avkodning kan köras över heterogena processorer snarare än att båda modellerna måste dela en enda GPU, vilket potentiellt förbättrar utkasthastigheten och verifieringsgenomströmningen jämfört med en homogen installation.
NVIDIA har lyft fram spekulativ avkodning, vid sidan av AFD, som en viktig arbetsbelastning för LPX och antyder att de ser detta som en betydande del av systemets värdeerbjudande. I takt med att frontiermodeller fortsätter att växa och resonemangskedjor förlängs, kan möjligheten att generera och verifiera tokens parallellt på specialiserad hårdvara bli en viktig hävstång för att upprätthålla interaktiv respons.
Sluttankar: Extrem hårdvaru-/programvarudesign
En av de saker som sticker ut med NVIDIAs tillvägagångssätt med Vera Rubin-plattformen och LPX är hur exakt varje komponent är riktad. Inom konsumentvärlden stöter vi regelbundet på produkter som försöker lösa problem som ingen egentligen har, från företag som inte förstår sina kunders behov på djupet. NVIDIAs strategi här står i skarp kontrast. Det är brutalt uppenbart att de förstår inferenspipelinens problem på en extremt detaljerad nivå, och de optimerar varje segment av den pipelinen för att hjälpa sina kunder att maximera sin avkastning på hårdvaran.
Uppdelningen av uppmärksamhet/FFN är inte ett marknadsföringskoncept. Det är ett direkt svar på den uppmätta flaskhalsprofilen för MoE-modeller med biljoner parametrar. Beslutet att avlasta FFN specifikt (och inte uppmärksamhet) och utveckla CPX-racket till LPX-racket återspeglar en exakt förståelse för vilka operationer som är bandbreddsbundna kontra kapacitetsbundna, vilka som är statiskt schemalagda kontra dynamiskt variabla, och vilken processorarkitektur som är bäst lämpad för var och en. Dynamo-orkestreringsskiktet, den transparenta CUDA-integrationen och den kabellösa MGX-rackdesignen pekar alla på en ingenjörsorganisation som har tänkt igenom hela implementeringslivscykeln.
Det finns fortfarande många okända faktorer gällande LPX och NVIDIAs nya frontierprodukter. En av de stora kvarvarande frågorna för oss är vad syftet med "Fabric Expansion Logic and DRAM" är, vilken typ av kisel som används för det, och eftersom många redan har upptäckt x86-sockeln, från investeringen i Intel förra året och kylflänsens retention-design är det troligtvis en Intel-processor, men vilken del är fortfarande en stor okänd.
LPX-distributionen kommer initialt att fokusera på modellbyggare och tjänsteleverantörer snarare än bred tillgänglighet. Och verklig prestanda under produktionstrafikmönster, med varierande kontextlängder, blandade förfrågningstyper och bursty-samtidighet, och energieffektiviteten behöver valideras oberoende. Vi ser fram emot att få tillgång till dessa system för oberoende testning.
Refererade källor:
Groq: Vad är en språkbehandlingsenhet?
Groq: Groq LPU, AI-inferensteknik, ger mer energieffektivitet…
Groq: RealScale chip-till-chip-sammankopplingsteknik
Groq: Låg latens för AI och HPC i realtid
Groq: Determinism och Tensor-strömningsprocessorn
Nvidia: Inuti Nvidia Groq 3 LPX…
Aleksa Gordić – AI-uppenbarelsen: Hur fungerar Groq LPU? (med chefen för Silicon Igor Arsovski!)


 Amazon