

Under GTC 2026 visade VDURA upp uppdateringar till sin dataplattform som förbättrar GPU-utnyttjande och lagringseffektivitet i AI-miljöer. Tillkännagivandet inkluderar den allmänna tillgängligheten av Remote Direct Memory Access (RDMA), en förhandsvisning av deras kontextmedvetna nivåindelningsteknik och validerade infrastrukturinställningar baserade på AMD EPYC Turin-processorer och NVIDIA ConnectX-7-nätverk.
Uppdateringarna syftar till att eliminera flaskhalsar i dataförflyttning mellan GPU-kluster och lagring och att optimera dataplacering över lagringsnivåer för storskaliga AI-tränings- och inferensarbetsbelastningar. RDMA möjliggör GPU-direkta datavägar.
VDURA har lagt till RDMA-stöd över hela sin plattform, vilket gör det möjligt för GPU-servrar att komma åt lagring direkt över nätverket utan CPU-inblandning. Detta möjliggör dataöverföringar mellan GPU och lagring som kringgår traditionella kärn- och CPU-medierade vägar, vilket minskar latensen och ökar dataflödet.
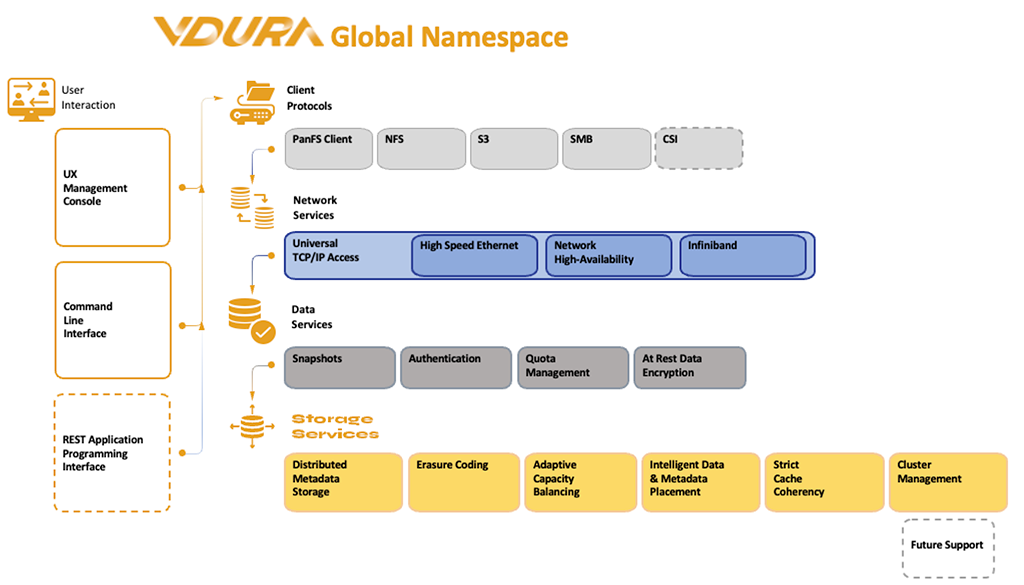
Implementeringen integreras med VDURA DirectFlow, företagets dataflyttningslager, för att säkerställa att all GPU-servertrafik använder RDMA. Genom att eliminera CPU-overhead i datavägen förblir beräkningsresurser dedikerade till modellträning och inferensuppgifter. Denna metod är avsedd att upprätthålla högre GPU-utnyttjandegrader samtidigt som pipeline-latens i distribuerade AI-kluster minimeras.
Kontextmedveten nivåindelning riktar in sig på effektiv dataplacering
VDURA redogjorde också för den första fasen av sin kontextmedvetna nivåindelningsfunktion, som är planerad att släppas senare i år. Den här funktionen introducerar automatiserad dataplacering över lagringsnivåer baserat på arbetsbelastningsbeteende och åtkomstmönster.
Den inledande fasen utökar DirectFlow-bufferten till lokala NVMe SSD-diskar, vilket gör att data som används ofta kan lagras närmare beräkningsresurser. Detta minskar beroendet av delad eller nätverksansluten lagring för het data och förbättrar svarstiderna för aktiva arbetsbelastningar.
Plattformen introducerar även KVCache-återskrivningskontroller, som selektivt sparar endast kritisk inferensdata till varaktig lagring. Detta minskar onödig skrivaktivitet samtidigt som de beständighetsgarantier som krävs av produktionsinferenspipelines bibehålls.
Dessutom implementerar VDURA ett enhetligt ramverk för Context Cache Tiering som omfattar DRAM och lokal SSD. Detta möjliggör höghastighetsläsning och skrivåtkomst i linje med LMCache-klassens prestanda, vilket stöder användningsfall som långkontext-LLM-inferens och generering med utökad hämtning.
VDURA indikerade att framtida faser av kontextmedveten nivåindelning kommer att utökas till applikationsmedveten dataplacering, förbättrad cachekoherens mellan noder och stöd för nya infrastrukturkomponenter som NVIDIA BlueField-4 DPU:er.
Företaget introducerade även optimerade plattformskonfigurationer som kombinerar AMD EPYC Turin-processorer med NVIDIA ConnectX-7 nätverkskort. Dessa konfigurationer är utformade för att komplettera RDMA-aktiverade datavägar och stödja kommunikation med hög datakapacitet och låg latens mellan GPU-kluster och lagringssystem.
Fokus på fullstack AI-datapipeline
VDURAs VD Ken Claffey lyfte fram företagets AI-lagringsplattform, som spänner över hela datahierarkin från minne till långtidslagring, och betonade dess prestanda. Han sa att plattformen använder RDMA för direkt, CPU-fri dataåtkomst och har kontextmedveten nivåindelning för att positionera data över lagringsnivåer. Claffey noterade att dessa innovationer hjälper organisationer att stödja större modeller, hantera fler inferensförfrågningar och skala AI-infrastruktur samtidigt som de uppfyller produktionskraven för AI-tillförlitlighet.
Den kombinerade metoden är avsedd att stödja större modellstorlekar, öka inferensdataflödet och förbättra infrastrukturens effektivitet samtidigt som tillförlitlighetskraven för AI-distributioner i produktion bibehålls.
Tillgänglighet
RDMA är nu tillgängligt på plattformarna VDURA V5000 och V7000. Kontextmedveten nivåindelning fas 1 förväntas bli allmänt tillgänglig senare under 2026, och tidiga åtkomstprogram pågår för närvarande.


 Amazon