

NVIDIA presenterade Minerva på GTC Berlin, en AIOps-plattform som hämtar telemetri från GPU:er, nätverk, lagring, schemaläggare och de AI-arbetsbelastningar som körs på dem, och sedan tillämpar maskininlärning för att hitta en försämrad komponent innan den saktar ner ett träningsjobb. Dell Technologies, Lenovo och Supermicro kommer att erbjuda det i sina AI-fabriksportföljer, IREN kör det redan, och IBM, Jio, Lambda, Quake AI, Tesla, Aolani och Bitdeer AI planerar att driftsätta det. NVIDIA har inte publicerat priser eller ett datum för allmän tillgänglighet.
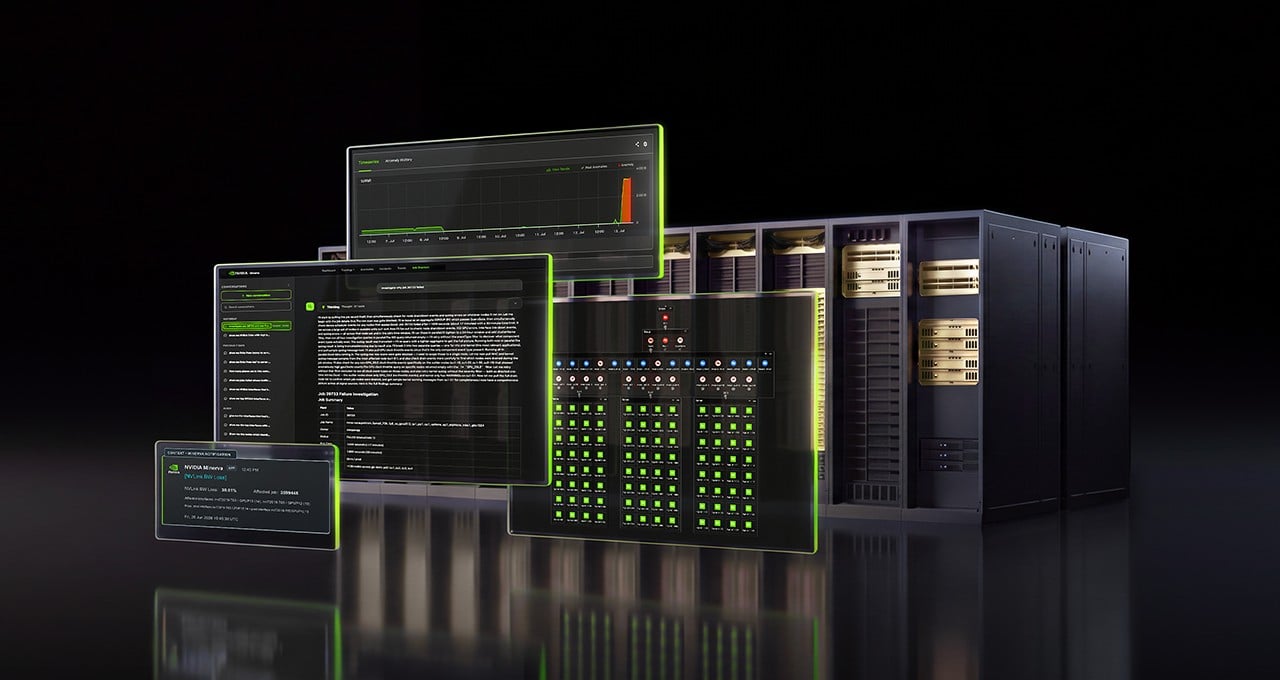
Problemet Minerva siktar på är ett som alla stora klusteroperatörer känner till: tusentals GPU:er på en höghastighetsstruktur beter sig som en enda maskin, så en enskild del som får slut på specifikationer drar med sig hela jobbet. NVIDIAs exempel är en GPU som blir varmare än sina grannar och en NVMe-disk som förlorar prestanda under belastning, den typ av datasignal som idag finns i ett nätverksverktyg, ett beräkningsverktyg och ett ML-teams instrumentpanel, var och en med en separat vy av samma kluster.
Vad Minerva tittar på
Minerva bygger en dynamisk kunskapsgraf som kartlägger GPU:er, SuperNIC:er, switchar, kablar och de jobb som är schemalagda på dem, och analyserar sedan vad NVIDIA beskriver som miljarder datapunkter per timme med övervakad och oövervakad maskininlärning. Modellerna lär sig normalt beteende för fabriken, flaggar avvikelser som de inte sett tidigare, förutspår fel som utvecklas och korrelerar relaterade händelser med hjälp av topologin, så att ett långsamt träningsjobb kan spåras till den ansvariga komponenten över fabriker med NVIDIA-storlekar på hundratusentals GPU:er.
Utdata är organiserad som incidenter, med relaterade händelser grupperade i ett enda objekt och en sannolik rotorsak kopplad, vilket NVIDIA säger ersätter en flod av varningar med ett åtgärdbart objekt. En inbyggd assistent svarar på frågor på naturligt språk mot live-telemetrin och rekommenderar en åtgärd, och plattformen ansluter till externa agentverktyg. Operatörer väljer om en person tillämpar åtgärden eller om Minerva överlåter den till automatisering via infrastruktur-API:er och externa system.
NVIDIA ramar in utdelningen som AI-fabriksavkastning, vilket de mäter i GPU-timmar, goodput, klusterdrifttid och tokenproduktion. De påstådda resultaten är längre intervall mellan avbrott, snabbare reparationer och färre varningar att prioritera, där driftteamet går från reaktivt till proaktivt underhåll. Det är leverantörspåståenden utan bifogade siffror; NVIDIA har inte publicerat genomsnittlig tid till reparation eller drifttid för Minerva.
Var den sitter i stapeln
NVIDIA säljer redan driftprogramvara för sina referensdesigner. Mission Control , som introducerades i mars 2025, hanterar klusterprovisionering via Base Command Manager, arbetsbelastningshantering via Run:ai, telemetri och autonom jobbåterställning för DGX SuperPOD-system. Samma vecka som Minerva lade NVIDIA till tre DSX OS-komponenter med öppen källkod i utvecklarförhandsvisningen för AI-fabrikslivscykelhantering: Config Manager för nätverkskonfiguration, Rack Management Service för hantering av strömförsörjning, lager, firmware och switchar på racknivå, och Cluster Readiness Engine för validering av GPU-kluster med distribuerade arbetsbelastningar.
Omfattningen av problemet som Minerva siktar på visades i Metas Prometheus-artikel förra veckan. Meta kör varje NVL72-domän som en 64-GPU-skiva med de övriga åtta GPU:erna som reservdelar i racket, håller cirka 2 procent av racken i reserv och sätter alla reparerade system i karantän tills de godkänns som validering. Ett år av arbete med rotorsakssökning med NVIDIA-ingenjörer på plats minskade avbrotten med 99 procent och drev den genomsnittliga tiden mellan avbrott över 54 000 GPU-timmar, med ett mål på 100 000.
Det är en hyperscaler som kör en specialbyggd telemetri-pipeline och ett gemensamt triage-team med NVIDIA. Minerva ser ut som en paketerad version av den disciplinen, något mer färdigt för ett företag eller neocloud som vill ha hyperscaler-klassad insyn i GPU, fabric och lagringshälsa, och det reserv-och-omstart-arbetsflöde som följer med det, levererat genom samma OEM-tillverkare som säljer racken.
NVIDIA har inte sagt hur Minerva förhåller sig till Mission Control eller DSX OS, om det levereras som programvara, en apparat eller en värdbaserad tjänst, eller hur OEM-förpackningen från Dell, Lenovo och Supermicro kommer att se ut. Produktens dokumentationssida hänvisar kunder till deras NVIDIA-kontoteam för användarhandboken. Kundreferensen är IREN, som NVIDIA säger använder Minerva för att optimera sina AI-fabriker idag.
”NVIDIA Minerva ger vårt driftsteam en överblick över nätverket, GPU:erna och de jobb som körs på dem”, säger Denis Skrinnikoff, teknikchef på IREN, som menar att det har lett till att teamets tid har riktats mot proaktivt underhåll.
För lagringssidan av systemet är det intressanta påståendet att hårddiskbeteende under belastning är en indata vid sidan av GPU- och fabric-telemetri, eftersom en NVMe-enhet som saktar ner sällan dyker upp i GPU-användningen förrän en kontrollpunkt eller ett datainläsningssteg stannar. Hur djupt den lagringstelemetrin går, och vilka OEM- och arrayplattformar som matar den, är detaljer som kommer att bli intressanta att dyka in i när vi ser den här lösningen komma ut på marknaden.



 Amazon