

Historiskt sett har varje lagringsenhet som lästs av en GPU passerat värdprocessorn, som hanterar filsystemet, skickar kommandon och returnerar data. Denna overhead är försumbar för stora sekventiella överföringar men blir en begränsande faktor när man hanterar miljontals 512-byte-operationer per sekund. Vid FMS 2026 i Santa Clara tillkännagav NVIDIA ny programvara och ett branschinitiativ för att eliminera denna flaskhals.
Det centrala tillkännagivandet är cuFile, ett API som låter GPU:er läsa från och skriva till lagring direkt. NVIDIA använder öppen källkod för cuFile och dess fullständiga stödjande programvaruuppsättning, med koden värd i den nya XIO-SIG-organisationen på GitHub. Grundare och utvecklare inkluderar Google, Intel, Meta och NVIDIA. Dessutom lanserade NVIDIA formellt Storage-Next, ett initiativ som diskuterats offentligt sedan åtminstone GTC 2025. Storage-Next inkluderar nu över 40 lagrings- och flash-leverantörer, såsom DDN, KIOXIA och Micron, samt styrenhetstillverkare, kylningsspecialister och standardiseringsorganisationer. Dessa deltagare definierar tillsammans hur lagringsenheter ska bete sig när en GPU, snarare än en processor, är klienten.
Problemet: Värdmedierad I/O
GPU-system har traditionellt fungerat under en värdcentrerad I/O-modell. CPU:n schemalägger GPU-uppgifter, stadier data och initierar alla överföringar mellan GPU:n och nätverket eller lagringen. Varje operation följer en sekvens: GPU-kärnan slutförs, kontrollen återgår till CPU:n, CPU:n konfigurerar överföringen och nästa kärna startas. Kostnaden per operation, främst kärnstart och CPU-GPU-synkroniseringsoverhead, mäts i mikrosekunder. Även om denna overhead är försumbar för bulköverföringar blir den betydande för finjusterade operationer.
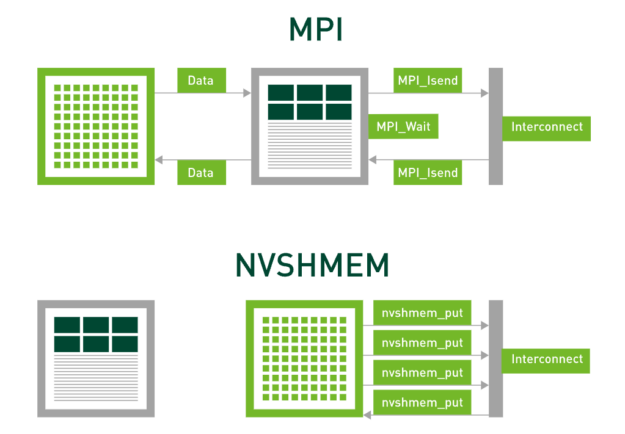
För GPU-till-GPU-kommunikation eliminerade NVIDIA värdens inblandning via NVSHMEM, vilket gör att enhetskod kan initiera överföringar direkt och överlappa dem med beräkning. Effekten är betydande: när GROMACS övergick sin halo-exchange-kommunikation från MPI till NVSHMEM, togs kommunikationen bort från den kritiska vägen och blev helt överlappad med beräkning.
Lagringen behöll den värdmedierade modellen. En läsning från en NVMe-enhet återför fortfarande kontrollen till processorn, kör filsystemet och väntar på att den ska vara klar. Träning tolererar detta eftersom dess läsningar är stora och oregelbundna. Inferens gör inte det. Att visa KV-cacheposter, inbäddningar och vektorsökningsresultat genererar miljontals små slumpmässiga läsningar per sekund, med processorn i sökvägen för var och en.
GPU-initierad I/O och SCADA
SCADA (skalad, accelererad dataåtkomst) tillämpar NVSHMEM-modellen på lagring, vilket gör det möjligt för GPU:n att initiera och hantera sin egen lagrings-I/O.
Den underliggande forskningen är BaM, eller Big Accelerator Memory, publicerad på ASPLOS 2023 av NVIDIA, IBM, University of Illinois och University at Buffalo. BaM demonstrerade en GPU som hanterar NVMe-enheter direkt, sammanfogar och cachar de små förfrågningar som genereras över dess trådar för att upprätthålla diskmättande ködjup utan värdens inblandning. På identisk hårdvara körde BaM dataanalysarbetsbelastningar 5.3 gånger snabbare än CPU-initierad åtkomst och exekverade grafarbetsbelastningar från flashminne till upp till 21.7 gånger lägre hårdvarukostnad än att lagra samma data i värdminnet.
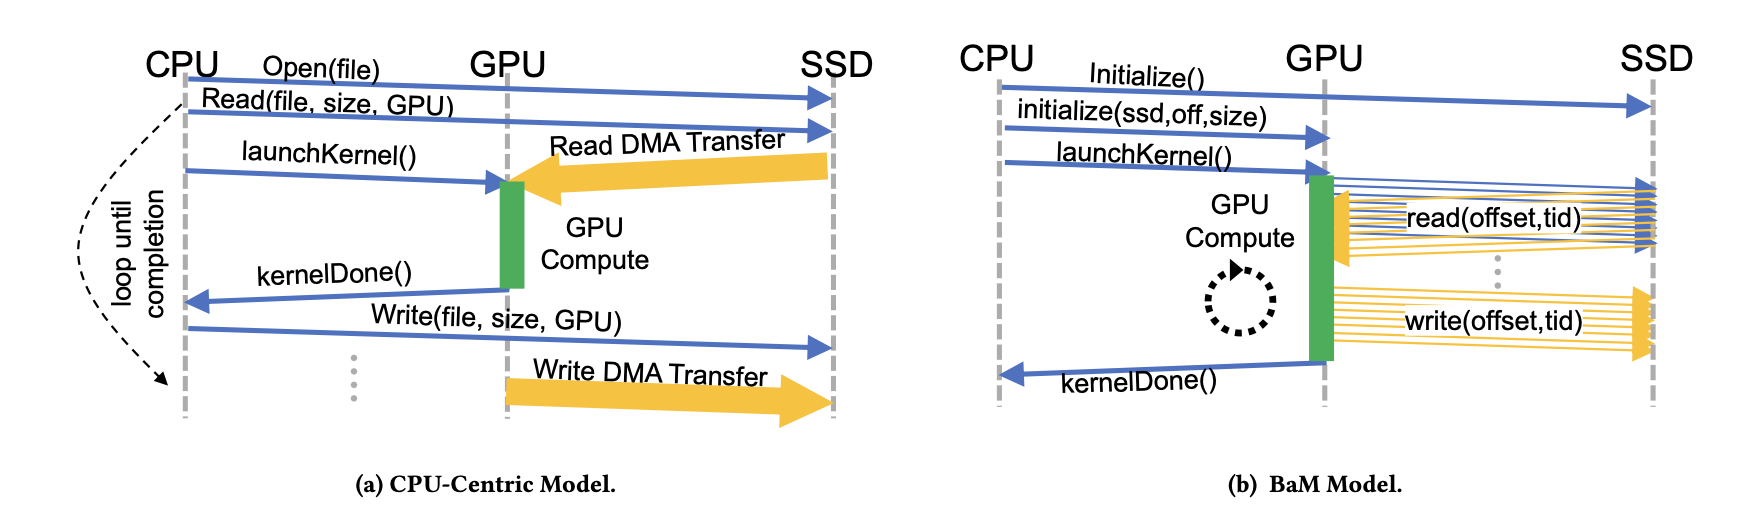
SCADA är den produktifierade formen. En runtime på GPU:n sitter mellan kärnans trådar och lagring. Den sammanfogar spridda små förfrågningar till läsningar som serveras från en cache på GPU:n eller utfärdas till hårddiskar, vilket kan vara lokal NVMe eller en fjärrlagringsserver.
Direkt enhetsåtkomst måste begränsas eftersom rå åtkomst till en delad enhet kan låta en applikation läsa eller korrumpera en annans data. NVIDIAs design separerar behörighetsnivåer. Prestandakritiska delar av en applikation körs oprivilegierade, utanför den betrodda datorbasen. En privilegierad komponent konfigurerar skyddad åtkomst mellan varje applikation och endast dess godkända lagring vid installationen, med hjälp av standard Linux-säkerhetsmekanismer. NVIDIA anger denna uppdelning och Linux-baserade interoperabilitet som anledningen till att stacken släpps som öppen källkod snarare än en sluten CUDA-komponent.
Hur SCADA skiljer sig från GPUDirect-lagring
Varje lagringsoperation har en datasökväg (de flyttade byten) och en kontrollsökväg (förfrågningskonstruktion, inlämning och hantering av slutförande). GPUDirect Storage (GDS), introducerat 2019 och levererat sedan 2021, tog bort processorn från datasökvägen: genom cuFile flyttas data via DMA mellan hårddisken och GPU-minnet utan studsbuffert i värd-RAM. NVIDIAs lanseringsmaterial satte gränsen för processorsökvägen på en DGX-2 till 50 GB/s, där GDS kan kombinera sökvägar för en övre gräns som närmar sig 200 GB/s, och DDN, VAST, WEKA, Pure Storage och de andra stora AI-lagringsleverantörerna certifierade mot den. Kontrollsökvägen stannade kvar på processorn: värdprogramvaran bestämmer fortfarande vad som ska hämtas och utfärdar varje begäran, och GPU:n är DMA-målet snarare än initieraren.
Vid stora överföringsstorlekar är denna uppdelning okej. En läsning på 1 MB amorterar kontrollvägskostnaden till ingenting. Vid 512 byte inverteras förhållandet. Den fasta kostnaden per begäran dominerar, och processorn mättas långt före hårddiskarna. SCADA flyttar kontrollvägen till GPU:n, som absorberar latens per operation på samma sätt som den absorberar minneslatens, genom att hålla hundratusentals operationer igång.
De två samexisterar: cuFile för bulköverföringar, SCADA för stora volymer av små slumpmässiga läsningar.
Storage-Next och 512-byteproblemet
SCADA täcker GPU-sidan. Storage-Next hanterar hårddisksidan, som för närvarande är optimerad för en annan arbetsbelastning.
Företags-SSD-diskar har finjusterats för 4KB slumpmässiga läsningar i ett decennium, vilket matchar åtkomstmönster för databaser och virtualiseringar. De flesta styrenheter gör ungefär samma arbete för att hantera en 512-byte-läsning som en 4KB-läsning, så sub-4K-förfrågningar körs till en 4K-kostnad. Inferensåtkomstmönster är mindre: inbäddningar körs några hundra byte och KV-cacheblock är långt under en kilobyte. Att hantera dem från 4K-inställda hårddiskar kräver 8x läsförstärkning, vilket slösar bort bandbredd och styrenhetscache. Vid tiotals terabyte av små objekt avgör den förstärkningen om flashminne är användbart som minnesnivå.
Storage-Next är ett försök att omprogrammera hårddiskar, styrenheter och system kring den mindre enheten. Det presenterades offentligt på GTC 2025, som redan var igång, med ett uttalat mål att maximera 512-byte IOPS per GPU under begränsningar av strömförbrukning och latens. På FMS bifogade NVIDIA ett medlemsnummer, fler än 40 lagrings- och flashleverantörer och utsåg SCADA som ramverk att bygga mot.
Referensresultatet är Microns SC25-demonstration av 230 miljoner 512-byte slumpmässigt lästa IOPS från en enda server under SCADA-programmeringsmodellen: 44 Micron 9650 PCIe Gen6 SSD-diskar bakom tre Broadcom PEX90000 Gen6-switchar, drivna av tre H100-diskar i ett H3 Platform Falcon 6048-chassi. Siffran motsvarar ungefär 95 % av de 44 diskarnas kombinerade 5.5 miljoner IOPS-värden.
Sammansättningen av det antalet spelar roll. 230 miljoner 512-byte-läsningar motsvarar ungefär 118 GB/s nyttolast, vilket fyra eller fem av dessa hårddiskar skulle kunna leverera sekventiellt. Prestationen är antalet operationer. Att upprätthålla det via värdprogramvara skulle förbruka dussintals CPU-kärnor enbart vid inlämning och slutförandehantering, men demons enda CPU var i princip inaktiv. Fördelat över en GPU:s hundratusen plus trådar är belastningen några tusen operationer per tråd per sekund.
SSD-kapacitet är nu den avgörande faktorn. Microns 9650, den första PCIe Gen6 SSD:n, är klassad till 28 GB/s sekventiell och rekordhöga 5.5 miljoner slumpmässigt lästa IOPS. Micron rapporterar linjär skalning från 1 till 44 hårddiskar i demon. Kioxias GP-serie, en XL-Flash SSD byggd för 512-byte-åtkomst , utvecklas under Storage-Next. NVIDIAs Storage-Next-färdplan kräver PCIe Gen7 SSD:er som klarar 100 miljoner IOPS vardera, ett mål för kontrollerleverantörer, inklusive Marvell, som nu utformar mot. För att nå dessa siffror krävs omdesign av kontroller, felkorrigering som dimensioneras för små nyttolaster och standarder som definierar GPU-nativa hårddiskbeteende.
Mappning till träning och inferens
De två vägarna motsvarar två åtkomstmönster. Träningen är bandbreddsbunden. Den strömmar stora sekventiella shards och skriver regelbundet kontrollpunkter på flera terabyte under vilka GPU:er är inaktiva. CPU-overhead är försumbar vid dessa överföringsstorlekar, så GDS och den nyligen öppna cuFile-stacken förblir det korrekta gränssnittet, mätt i GB/s per GPU och kontrollpunktsvaraktighet.
Inferensen är IOPS-bunden. KV-cachen, uppmärksamhetstillståndet för varje token som redan bearbetats i en konversation, växer med kontextlängden. Agentiska distributioner kör tusentals samtidiga konversationer. Den överskrider snabbt GPU-minnet, och att omberäkna borttagna poster kostar mer GPU-tid än att läsa tillbaka dem. Standarddesignen är en nivåindelad cache som spills från GPU-minne till systemminne till flashminne, påfylld genom stora volymer av små slumpmässiga läsningar. Vektorsökning och inbäddningssökningar producerar samma mönster. Detta är den åtkomstform som SCADA riktar sig till, och anledningen till att NVIDIA anger 512-byte IOPS snarare än bandbredd. Att servera KV-cachen från flashminne snarare än minne ökar kontexten och antalet samtidiga användare som varje GPU stöder, vilket sätter serveringskostnaden per användare.
Hårdvaran: Vera BlueField-4 STX och CMX
Plattformslagret är NVIDIA Vera BlueField-4 STX , den rackbaserade lagringsarkitekturen som introducerades på GTC 2026 och utökades denna vecka. STX kombinerar Vera Rubin-plattformen med BlueField-4-lagringsprocessorer, som var och en kombinerar Vera Arm-kärnor med 800 Gb/s integrerat nätverk och ungefär 6 gånger beräkningshastigheten jämfört med BlueField-3.
På FMS publicerade NVIDIA ett riktmärke för dessa kärnor. En tvåstegs komprimerings- och krypteringspipeline, representativ för de inline-datatjänstlagringssystem som gäller för all trafik, kördes med upp till 3.21 gånger dataflödet för en x86-processor på Vera. Det underförstådda påståendet är att kryptering, komprimering och verifiering, som för närvarande förbrukar x86-kärnor i lagringskontroller, kan flyttas till Vera-kisel med lägre effekt. DOCA, NVIDIAs programvaruramverk för BlueField, upprätthåller säkerhetspolicy i datavägen. CMX Context Memory Storage , byggt på STX, poolar flashminne bakom BlueField-4 som en delad KV-cachenivå för långkontextinferens. Partnersystem från DDN, Dell, HPE, IBM, VAST Data, WEKA och andra förväntas under andra halvan av 2026.
Utgående Tankar
Den strategiska strukturen är tydlig: NVIDIA publicerar gränssnittet som GPU:er kommer att använda för att nå lagring, öppnar upp implementationen och organiserar fler än 40 leverantörer för att standardisera hårdvarubeteendet under det. Att öppna cuFile avviker från NVIDIAs praxis att hålla detta lager inuti CUDA. Men ett GPU-initierat lagringsgränssnitt lönar sig bara om leverantörer av hårddiskar, styrenheter och arrayer bygger efter det. Att Intel går med som underhållare är en anmärkningsvärd signal. En ledande leverantör av x86-kisel i nuvarande lagringssystem stöder programvara som är utformad för att ta bort det kislet från I/O-vägen.
Microns demonstration fastställer genomförbarhet. Tre GPU:er drev 44 Gen6-hårddiskar till ungefär 95 % av sin kombinerade nominella gräns vid en blockstorlek som branschen har behandlat som en eftertanke. Det som återstår är exekvering: koden landar på GitHub, SCADA som mognar från ramverk till stödd CUDA-komponent och leverantörer som levererar SSD-diskar optimerade för små läsningar i volym. Siffrorna ovan är NVIDIAs och dess partners, inte oberoende mätningar. Vi kommer att testa dem när STX-systemen når labbet under andra halvåret.


 Amazon