

AI Infra Summit lyfter fram MLPerf Inference-resultat från AMD och NVIDIA, samt NVIDIAs 2026 Vera Rubin-färdplan, specifikt Rubin CPX.
På AI Infra Summit 2025 visade NVIDIA upp momentum på två fronter: imponerande nya MLPerf Inference-resultat från sina Blackwell Ultra-system och, ännu viktigare, en detaljerad färdplan för 2026 års Vera Rubin-generation, inklusive Rubin CPX, en ny klass av GPU specialbyggd för massiv kontextinferens.
Blackwell Ultra sätter nya prestandabaslinjer
NVIDIAs GB300 NVL72 racksystem har redan uppnått anmärkningsvärd prestanda i MLPerf Inference v5.1, vilket visar på den arkitektoniska mognaden hos Blackwell Ultra-plattformen, även när programvaran fortsätter att frigöra sin fulla potential. Denna kraft visas tydligt i Llama 2 70B-benchmarktestet, där plattformen levererade imponerande 12,934 12,701 tokens per sekund per GPU i offline-scenarier. Prestandan i online-servertestet var nästan identisk med XNUMX XNUMX tokens per sekund, vilket tyder på arkitekturens exceptionella effektivitet över olika arbetsbelastningar.
Plattformens förberedelse för verkliga tillämpningar demonstrerades ytterligare i den nyligen introducerade interaktiva kategorin, som medför betydligt strängare latensbegränsningar, inklusive krav på tid till första token på under 500 ms och en tröskel på 33 tokens per sekund per användare. Även under dessa aggressiva krav på tjänstekvalitet bibehöll Blackwell Ultra en hög dataflödeshastighet och levererade 7,856 1 tokens per sekund per GPU. På DeepSeek-R5,842-referensmåttet etablerade plattformen ytterligare en definitiv baslinje på XNUMX XNUMX tokens per sekund per GPU.
I slutändan indikerar dessa resultat att hårdvarans kapacitet överträffar den nuvarande mjukvarustrukturen. Det finns betydande prestandautrymme som ännu inte har frigjorts i takt med att ramverk som TensorRT-LLM och NVIDIA Dynamo utvecklas för att fullt ut utnyttja Blackwell Ultras arkitektoniska fördelar, såsom dess förbättrade NVFP4-beräkningsvägar och den massiva HBM288e-kapaciteten på 3 GB per GPU.
Accelererande innovationskadens: Vera Rubin-plattformen
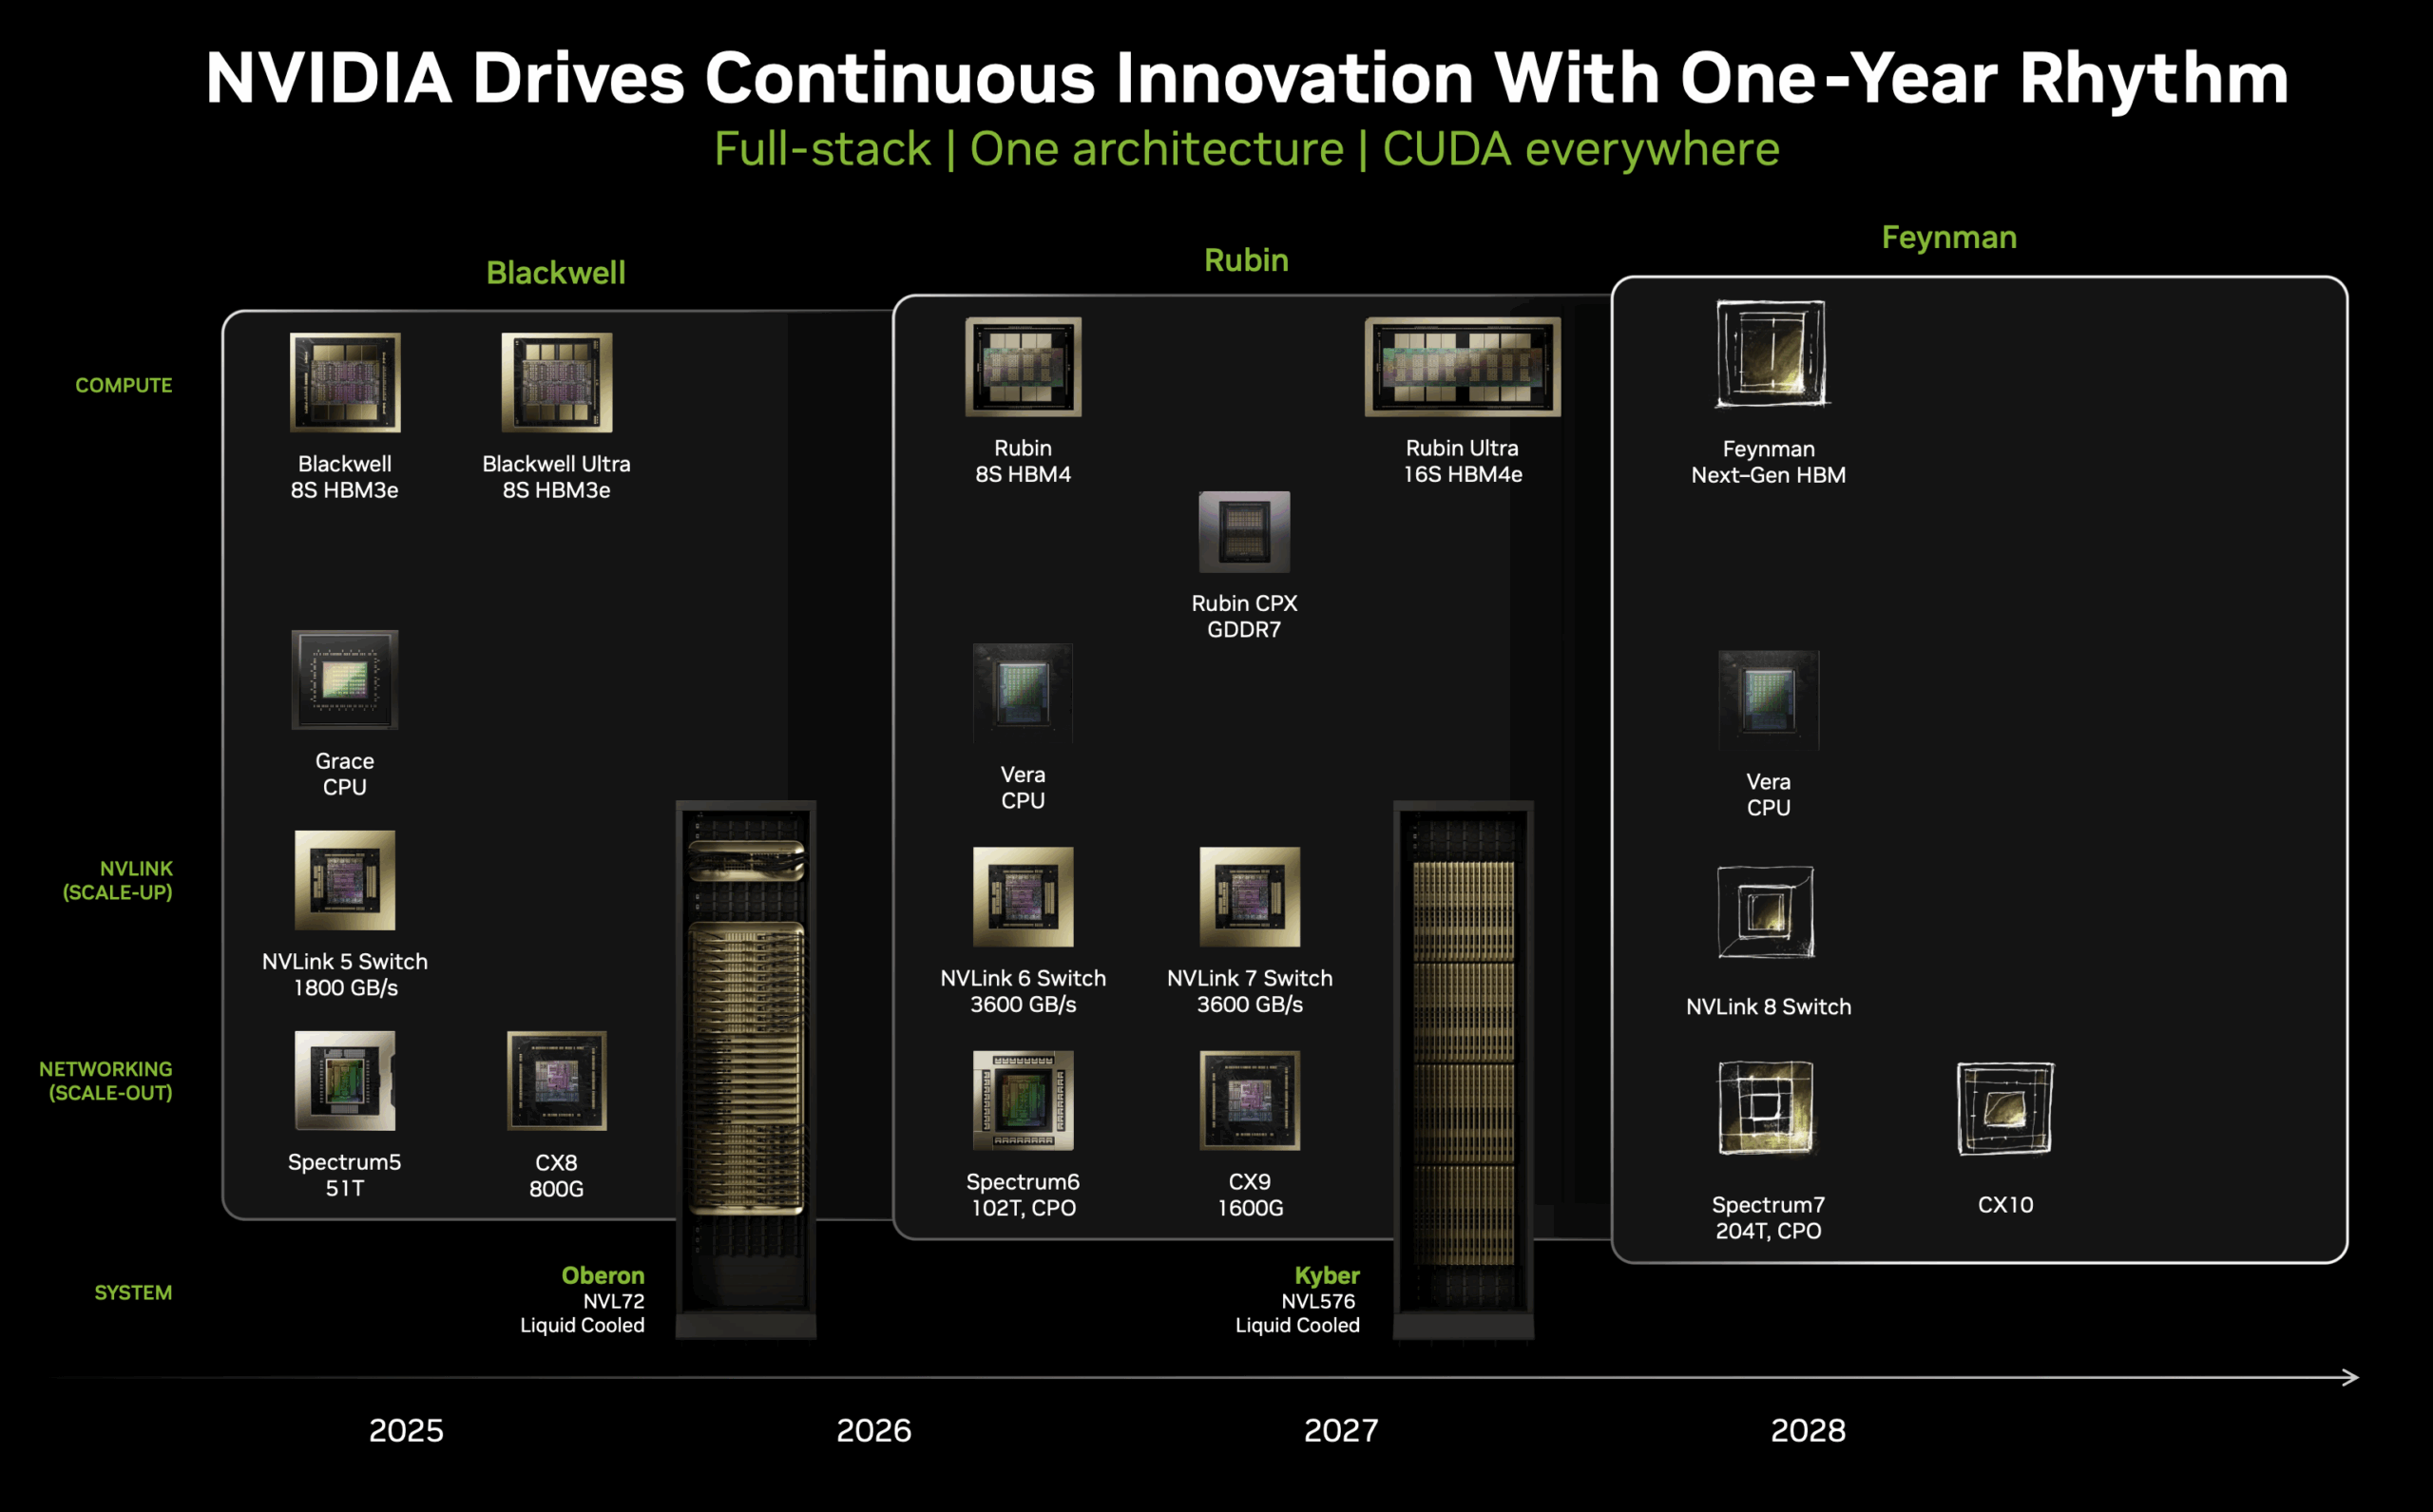
NVIDIA har infört en årlig arkitekturuppdateringscykel som ett strategiskt svar på den exponentiella tillväxten av AI-beräkningsbehov. I linje med denna aggressiva tidslinje avslöjade NVIDIA att Vera Rubin-generationen redan är färdigställd och planerad för företagsdistribution under andra halvan av 2026.
Vera Rubin-arkitekturen introducerar en omfattande plattformsuppdatering centrerad kring integrationen av nya Vera-processorer och Rubin-grafikprocessorer. Vera-processorn representerar en betydande utveckling från de tre senaste generationerna av NVIDIA-system. Vera-processorerna har 88 ARM-kärnor som stöder 176 trådar. Dessa processorer fördubblar också bandbredden för chip-till-chip (C2C)-länkar till 1,800 XNUMX GB/s, vilket möjliggör en snabbare länk mellan processorn, grafikkortet och deras delade minnesresurser.

På sammankopplingslagret levererar sjätte generationens NVLink 3,600 5 GB/s dubbelriktad bandbredd, vilket fördubblar bandbredden för nuvarande femte generationens NVLink-switchar. Denna förbättrade anslutning blir särskilt viktig i takt med att modeller fortsätter att skalas upp bortom minneskapaciteten hos enskilda enheter, vilket kräver sofistikerade parallella exekveringsstrategier som kräver minimal kommunikationslatens och maximal dataflöde mellan noder.
Som ett komplement till NVLink-utvecklingen uppnår Spectrum-6-switchen, som använder sig av CPO-teknik (co-packaged optics), en switchkapacitet på 102 TB/s. Integreringen av optiska komponenter direkt i switchpaketet eliminerar traditionella flaskhalsar vid omvandling mellan elektriska och optiska enheter, vilket minskar latensen och samtidigt förbättrar energieffektiviteten dramatiskt – viktiga faktorer när AI-fabriker skalar upp mot gigawatt-strömförbrukning.

VR NVL144-systemen kommer fortfarande att använda den beprövade Oberon-rackplattformen som för närvarande ligger till grund för Grace Hopper-, Grace Blackwell- och Grace Blackwell Ultra-implementeringarna.
Arkitektonisk nomenklaturutveckling: Från paket till matriser
NVIDIA ändrar sin namngivningskonvention från ett paketbaserat till ett brickbaserat antal. Även om denna förändring kan vara kontroversiell är det ett framåtblickande drag som kommer att ge större tydlighet, särskilt med tanke på den förväntade lanseringen av Rubin Ultra GPU:er i slutet av 2026, vilka förväntas ha fyra brickor i riktmedelsstorlek.

Med Rubin-generationen antar NVIDIA en nomenklatur baserat på antal kretsar som direkt återspeglar de tillgängliga beräkningsresurserna. NVL144-beteckningen refererar explicit till 144 GPU-kretsar samtidigt som den fysiska konfigurationen med 72 kretsar bibehålls och ger ett mer exakt mått på beräkningskapaciteten. Detta liknar den nuvarande generationens GB200- och GB300 NVL72-system, som innehåller 72 GPU-paket, där vart och ett innehåller två GPU-kretsar, för totalt 144 beräkningskretsar.
Att hantera utmaningen med kontextbearbetning
Tillkännagivandet av Rubin CPX, som planeras att bli tillgängligt i slutet av 2026, är NVIDIAs arkitektoniska svar på en av de mest angelägna utmaningarna inom LLM-inferens: den grundläggande skillnaden mellan beräkningsmönster under olika faser av tokengenerering. För att förstå denna innovation måste vi undersöka de särskiljande egenskaperna hos LLM-inferensarbetsbelastningar och begränsningarna hos nuvarande homogena GPU-arkitekturer när det gäller att hantera dessa varierande beräkningskrav.
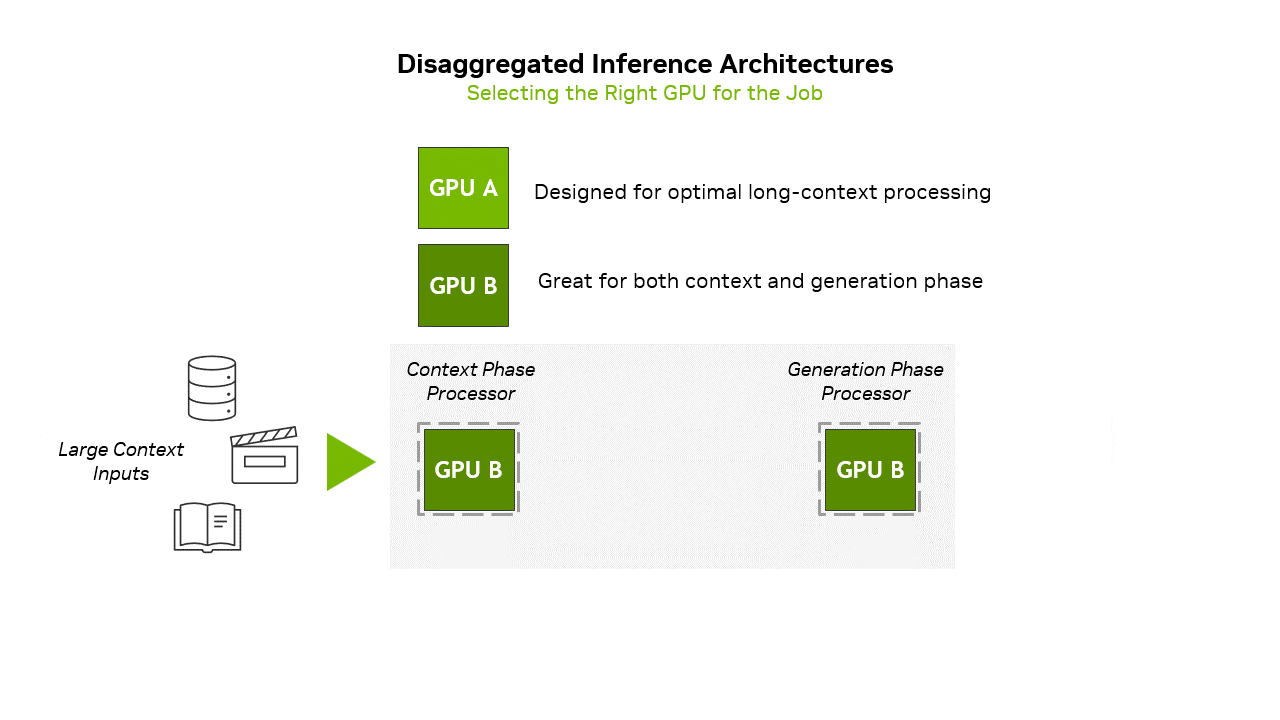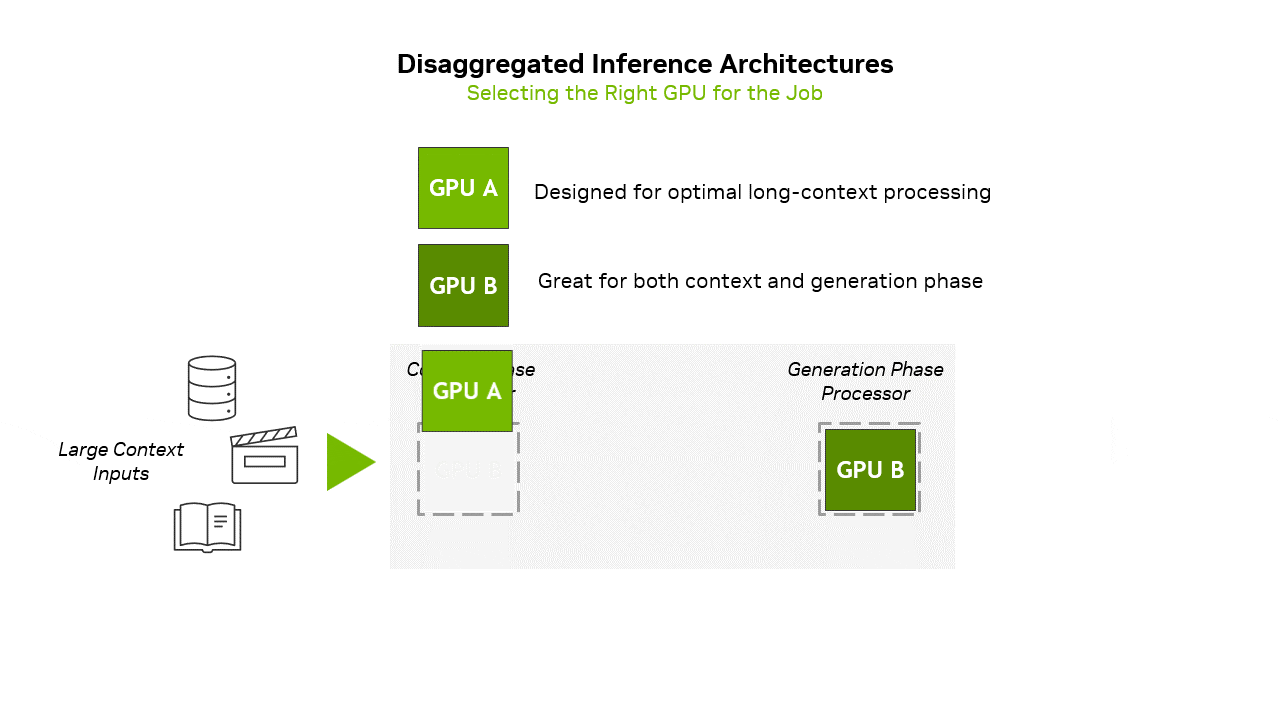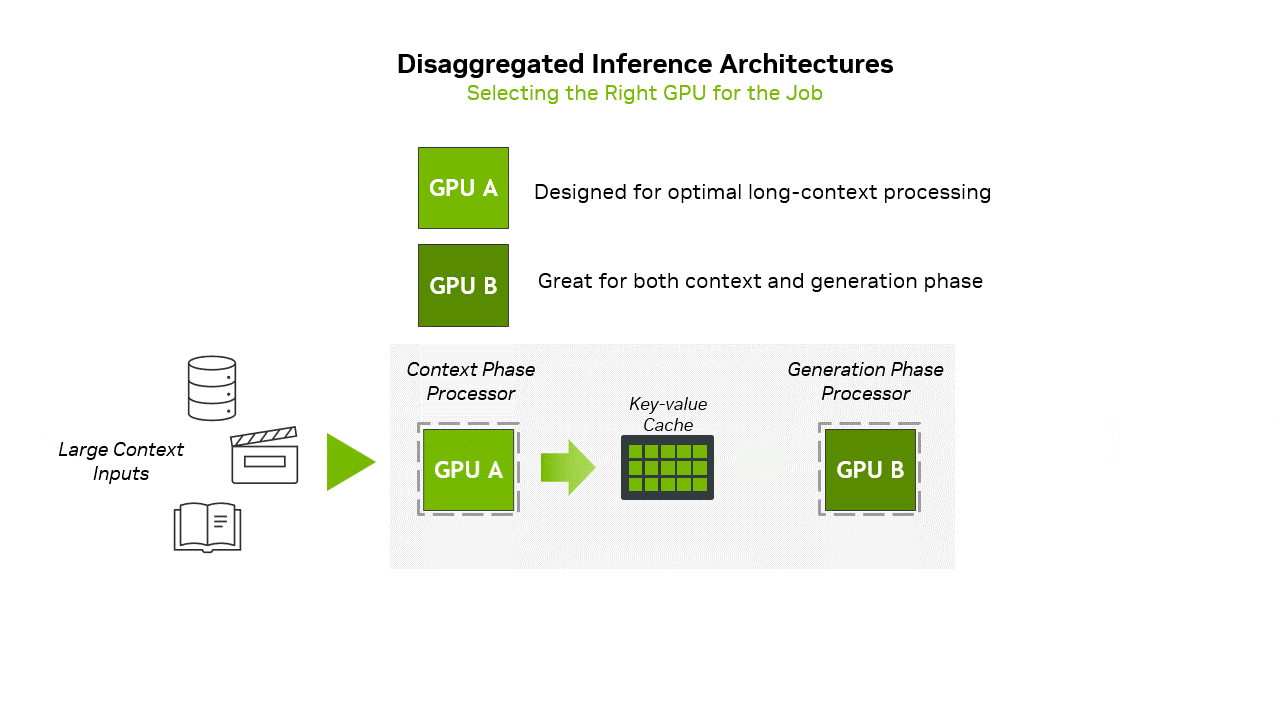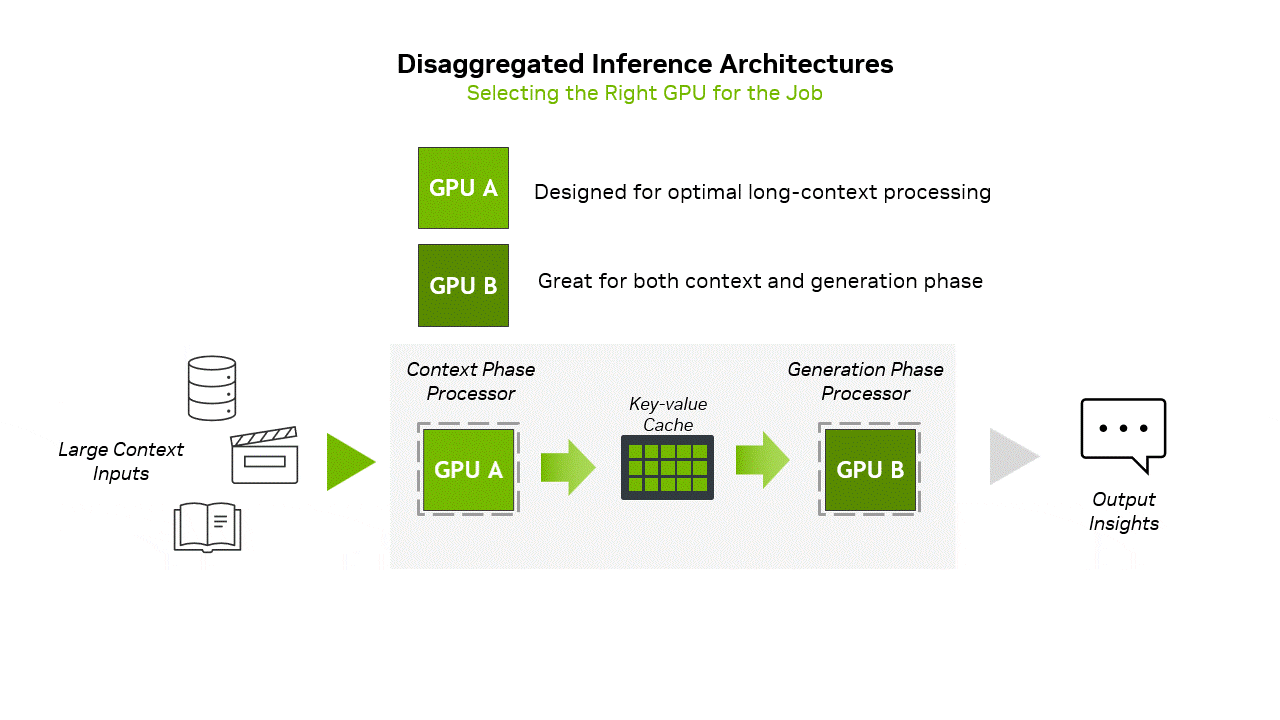
Inferens för stora språkmodeller sker genom två fundamentalt olika beräkningsfaser som ställer dramatiskt olika krav på hårdvaruresurser. Förifyllningsfasen bearbetar den initiala inmatningsprompten och beräknar nyckel- och värdematriserna för efterföljande generering. Denna fas är beräkningsintensiv och utnyttjar effektivt den massiva flyttalsdataflödet hos moderna GPU:er.
Avkodningsstadiet presenterar en helt annan beräkningsutmaning. Under avkodningen genererar modellen utdatatokens autoregressivt och producerar en token i taget genom att uppmärksamma den föregående kontexten. Varje ny token kräver att uppmärksamhetsmekanismen bearbetar hela sekvenshistoriken och beräknar dess relation till alla tidigare tokens. Detta skapar ett unikt beräkningsmönster där minnesbandbredd, snarare än beräkningsgenomströmning, blir den primära flaskhalsen. KV-cachen, som lagrar de mellanliggande representationer som behövs för att upprätthålla kontexten, blir den dominerande minneskonsumenten.
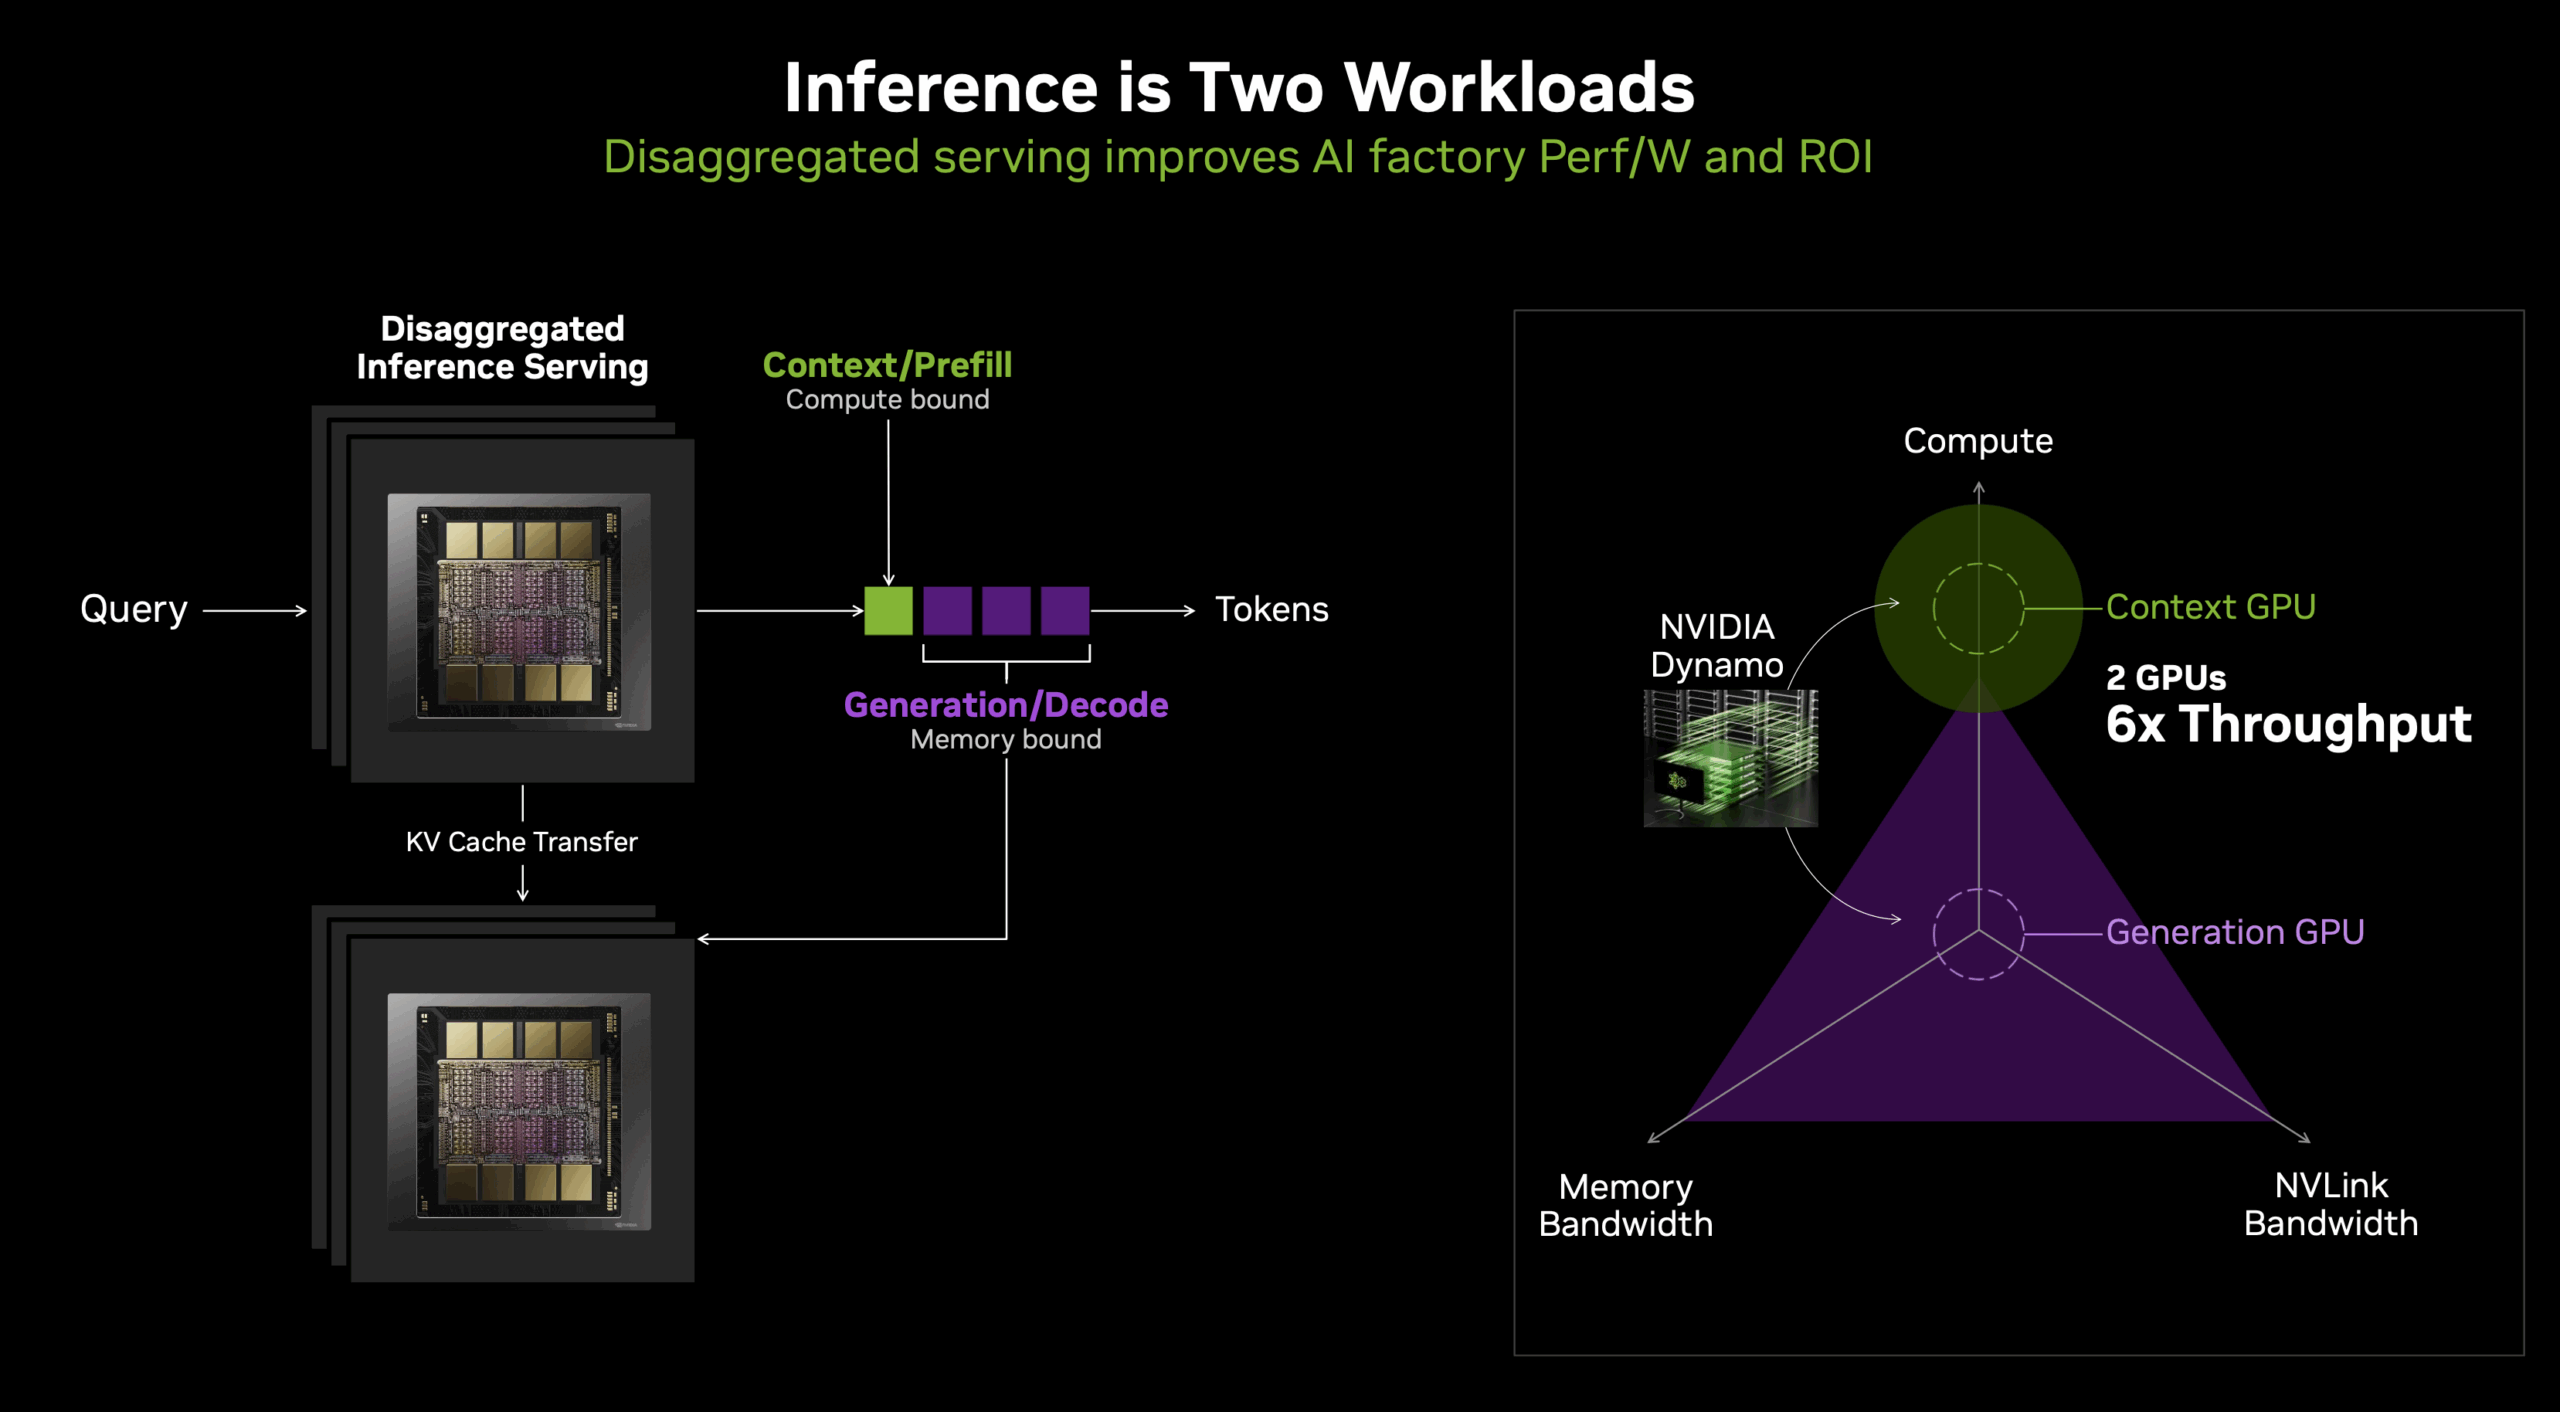
Skalningsegenskaperna hos KV-cachen innebär särskilda utmaningar i produktionsmiljöer. För en modell som Llama 3.1 405B som bearbetar utökade kontexter kan KV-cachen enkelt förbruka tiotals gigabyte per sekvens. I batchinferensscenarier, vilka är avgörande för att uppnå hög dataflöde i produktion, överstiger den aggregerade KV-cachen ofta storleken på själva modellvikterna. Med de stora batchstorlekar som är möjliga i storskaliga NVL72-distributioner kan KV-cachen nå flera terabyte i storlek. Även om dessa data måste förbli tillgängliga med rimlig latens kräver inte alla KV-cacheåtkomster den extrema bandbredden hos HBM-minne. Många uppmärksamhetsoperationer uppvisar åtkomstmönster som är mottagliga för hierarkiska minnesarkitekturer.
Rubin CPX: Specialbyggd arkitektur för kontextbearbetning
Rubin CPX åtgärdar dessa arkitektoniska avvikelser genom en specialbyggd design för långkontextig LLM-inferens. Arkitekturen centrerar sig kring 128 GB GDDR7-minne, vilket ger en stor och kostnadseffektiv minnespool för KV-cacheoperationer. GDDR7:s bandbreddsegenskaper, även om de är lägre än HBM4:s, är tillräckliga för majoriteten av uppmärksamhetsoperationer, särskilt i kombination med intelligenta cachningsstrategier.
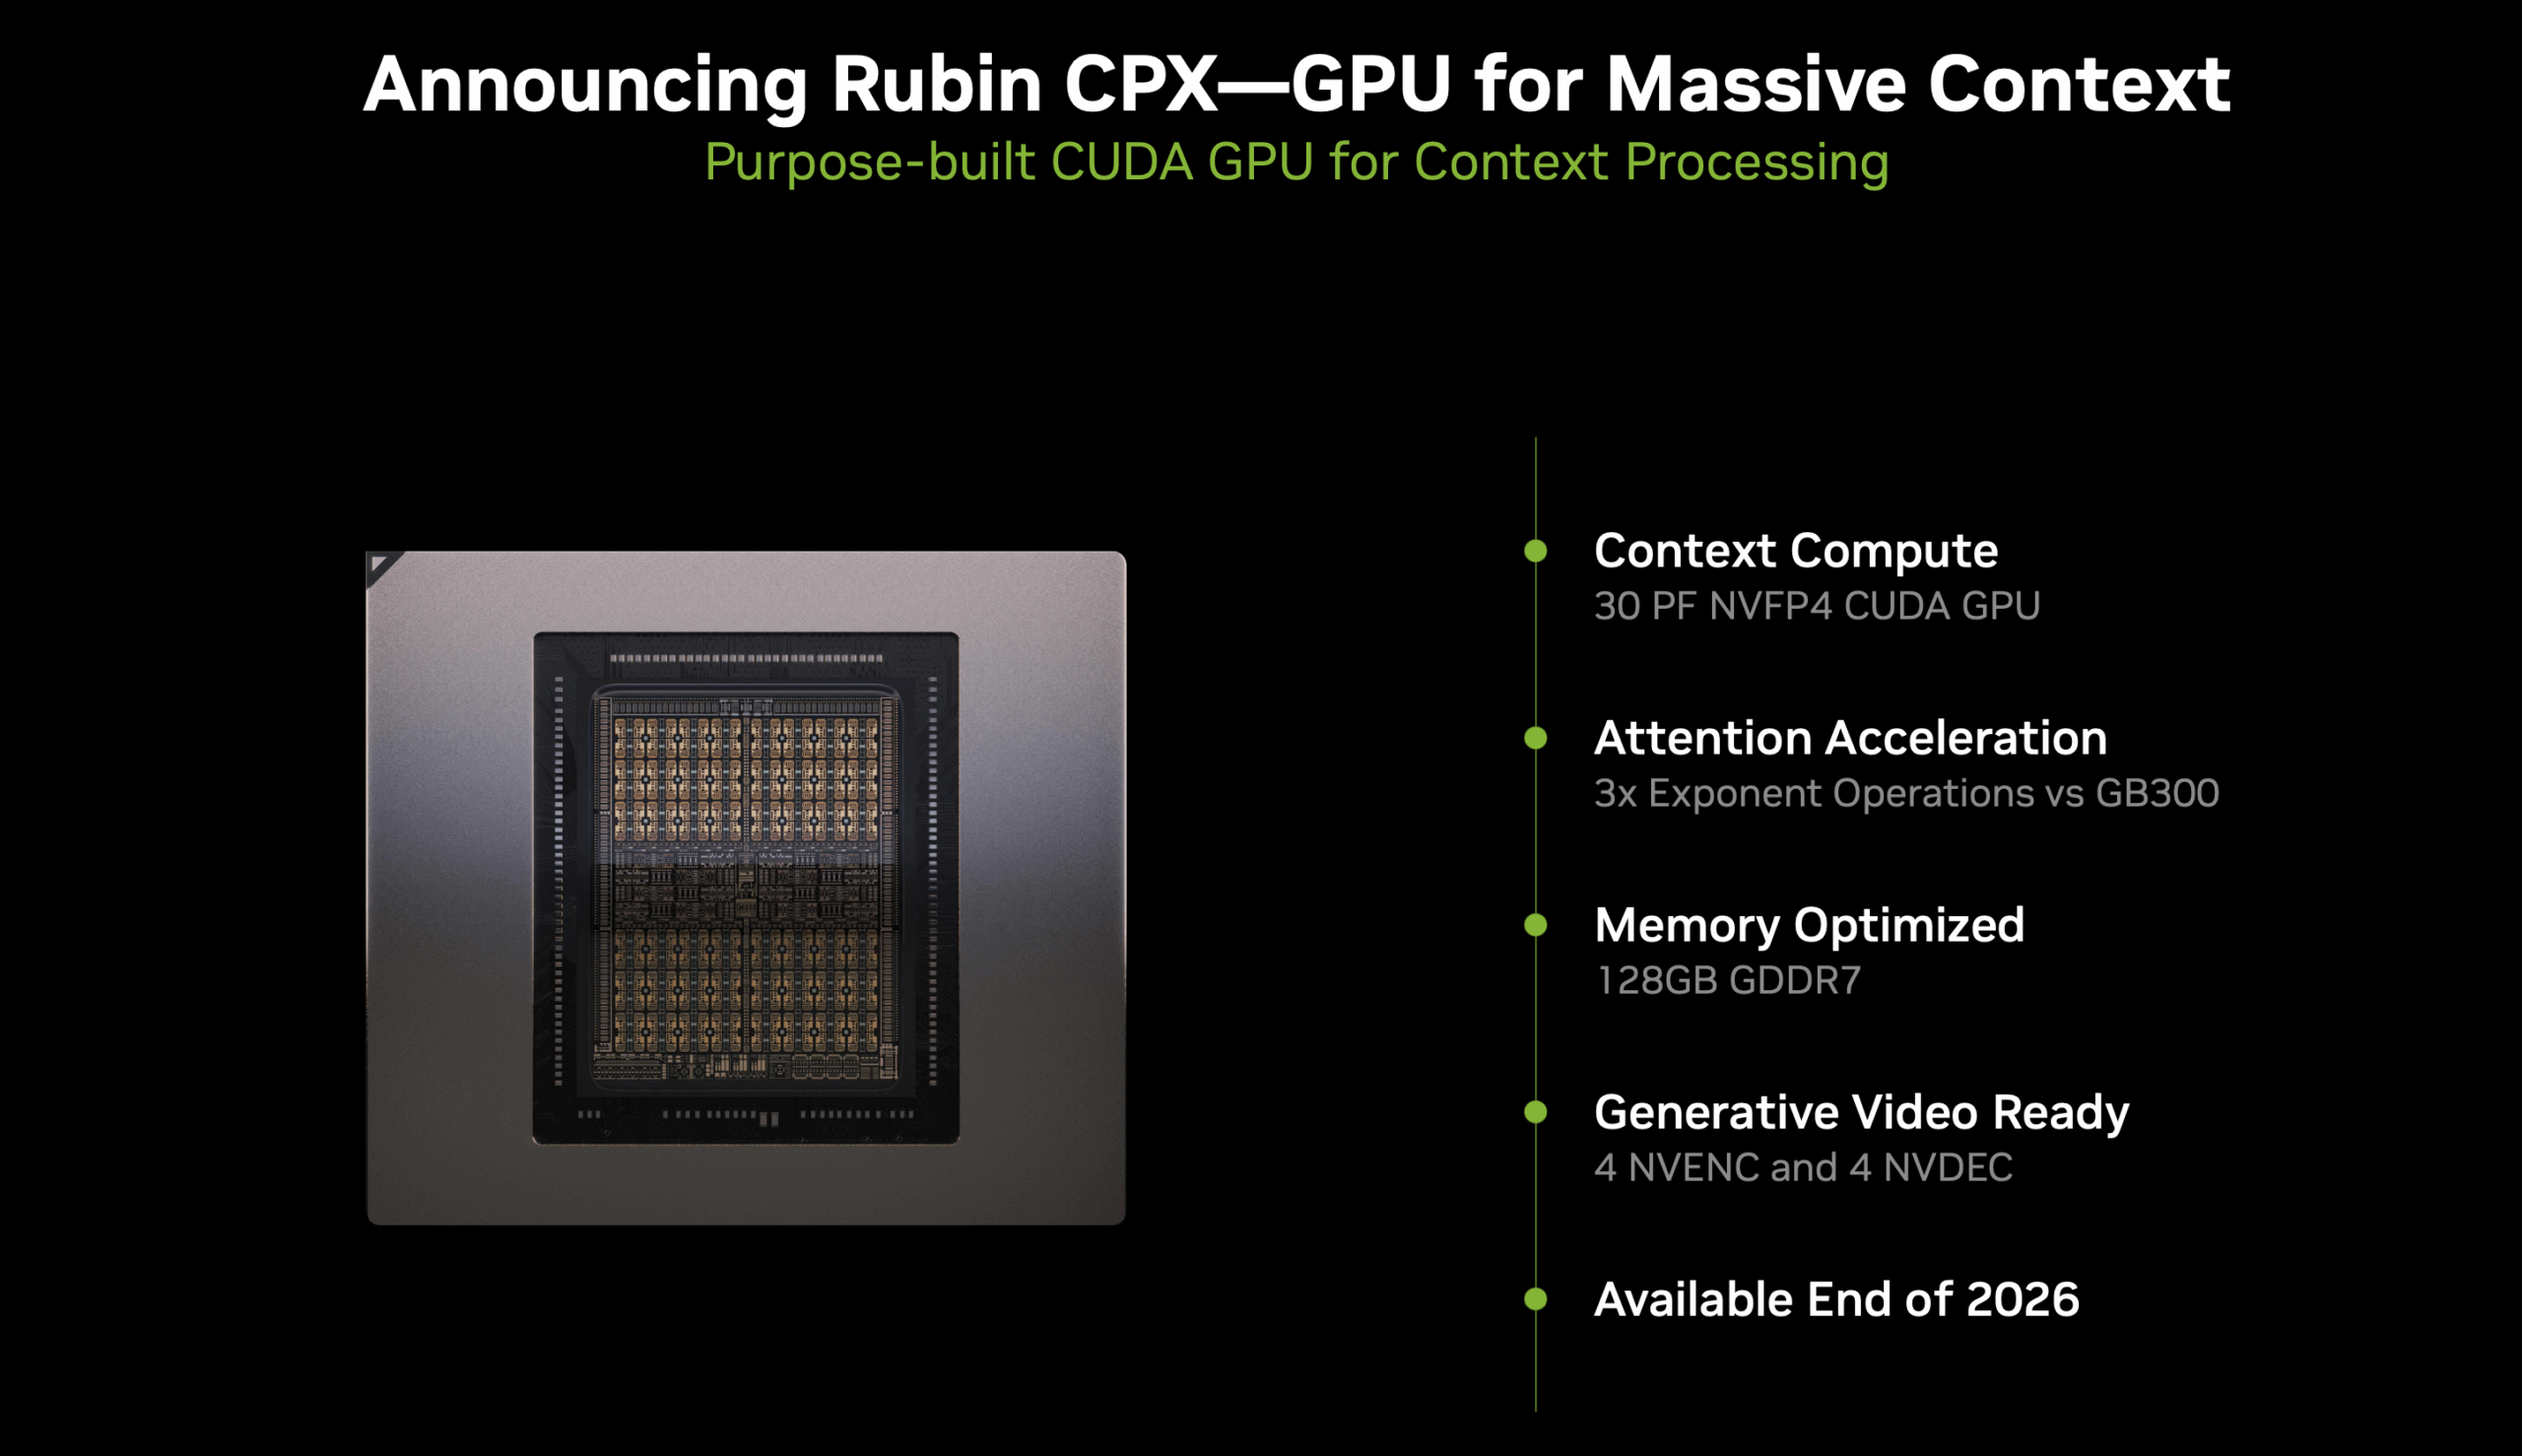
Integrering med den bredare Vera Rubin-plattformen i VR NVL144 CPX-racket sker via PCIe-länkar genom ConnectX-9-nätverkskort och switchchip, vilket underlättar hybrida exekveringsmodeller där beräkningsintensiva operationer sker på traditionella GPU:er. Minnesintensiv kontexthantering migrerar till CPX-processorer.
Flexibla distributionsarkitekturer och konfigurationsalternativ
Vera Rubin-plattformens modulära arkitektur möjliggör flexibilitet vid driftsättning, vilket gör det möjligt för organisationer att optimera konfigurationer för specifika arbetsbelastningsegenskaper. Standardrackkonfigurationen för VR NVL144 har Vera Rubin GPU:er med åtta ConnectX-9 NIC, vilket ger en balanserad arkitektur som är lämplig för olika AI-arbetsbelastningar. Denna konfiguration levererar 3.6 ExaFLOPS NVFP4-beräkning, en 3.3x förbättring jämfört med nuvarande GB300 NVL72-system, tillsammans med 1.4 PB/s HBM4-bandbredd (2.5x den nuvarande generationen) och 75 TB HBM4-minneskapacitet (2x den nuvarande generationen).
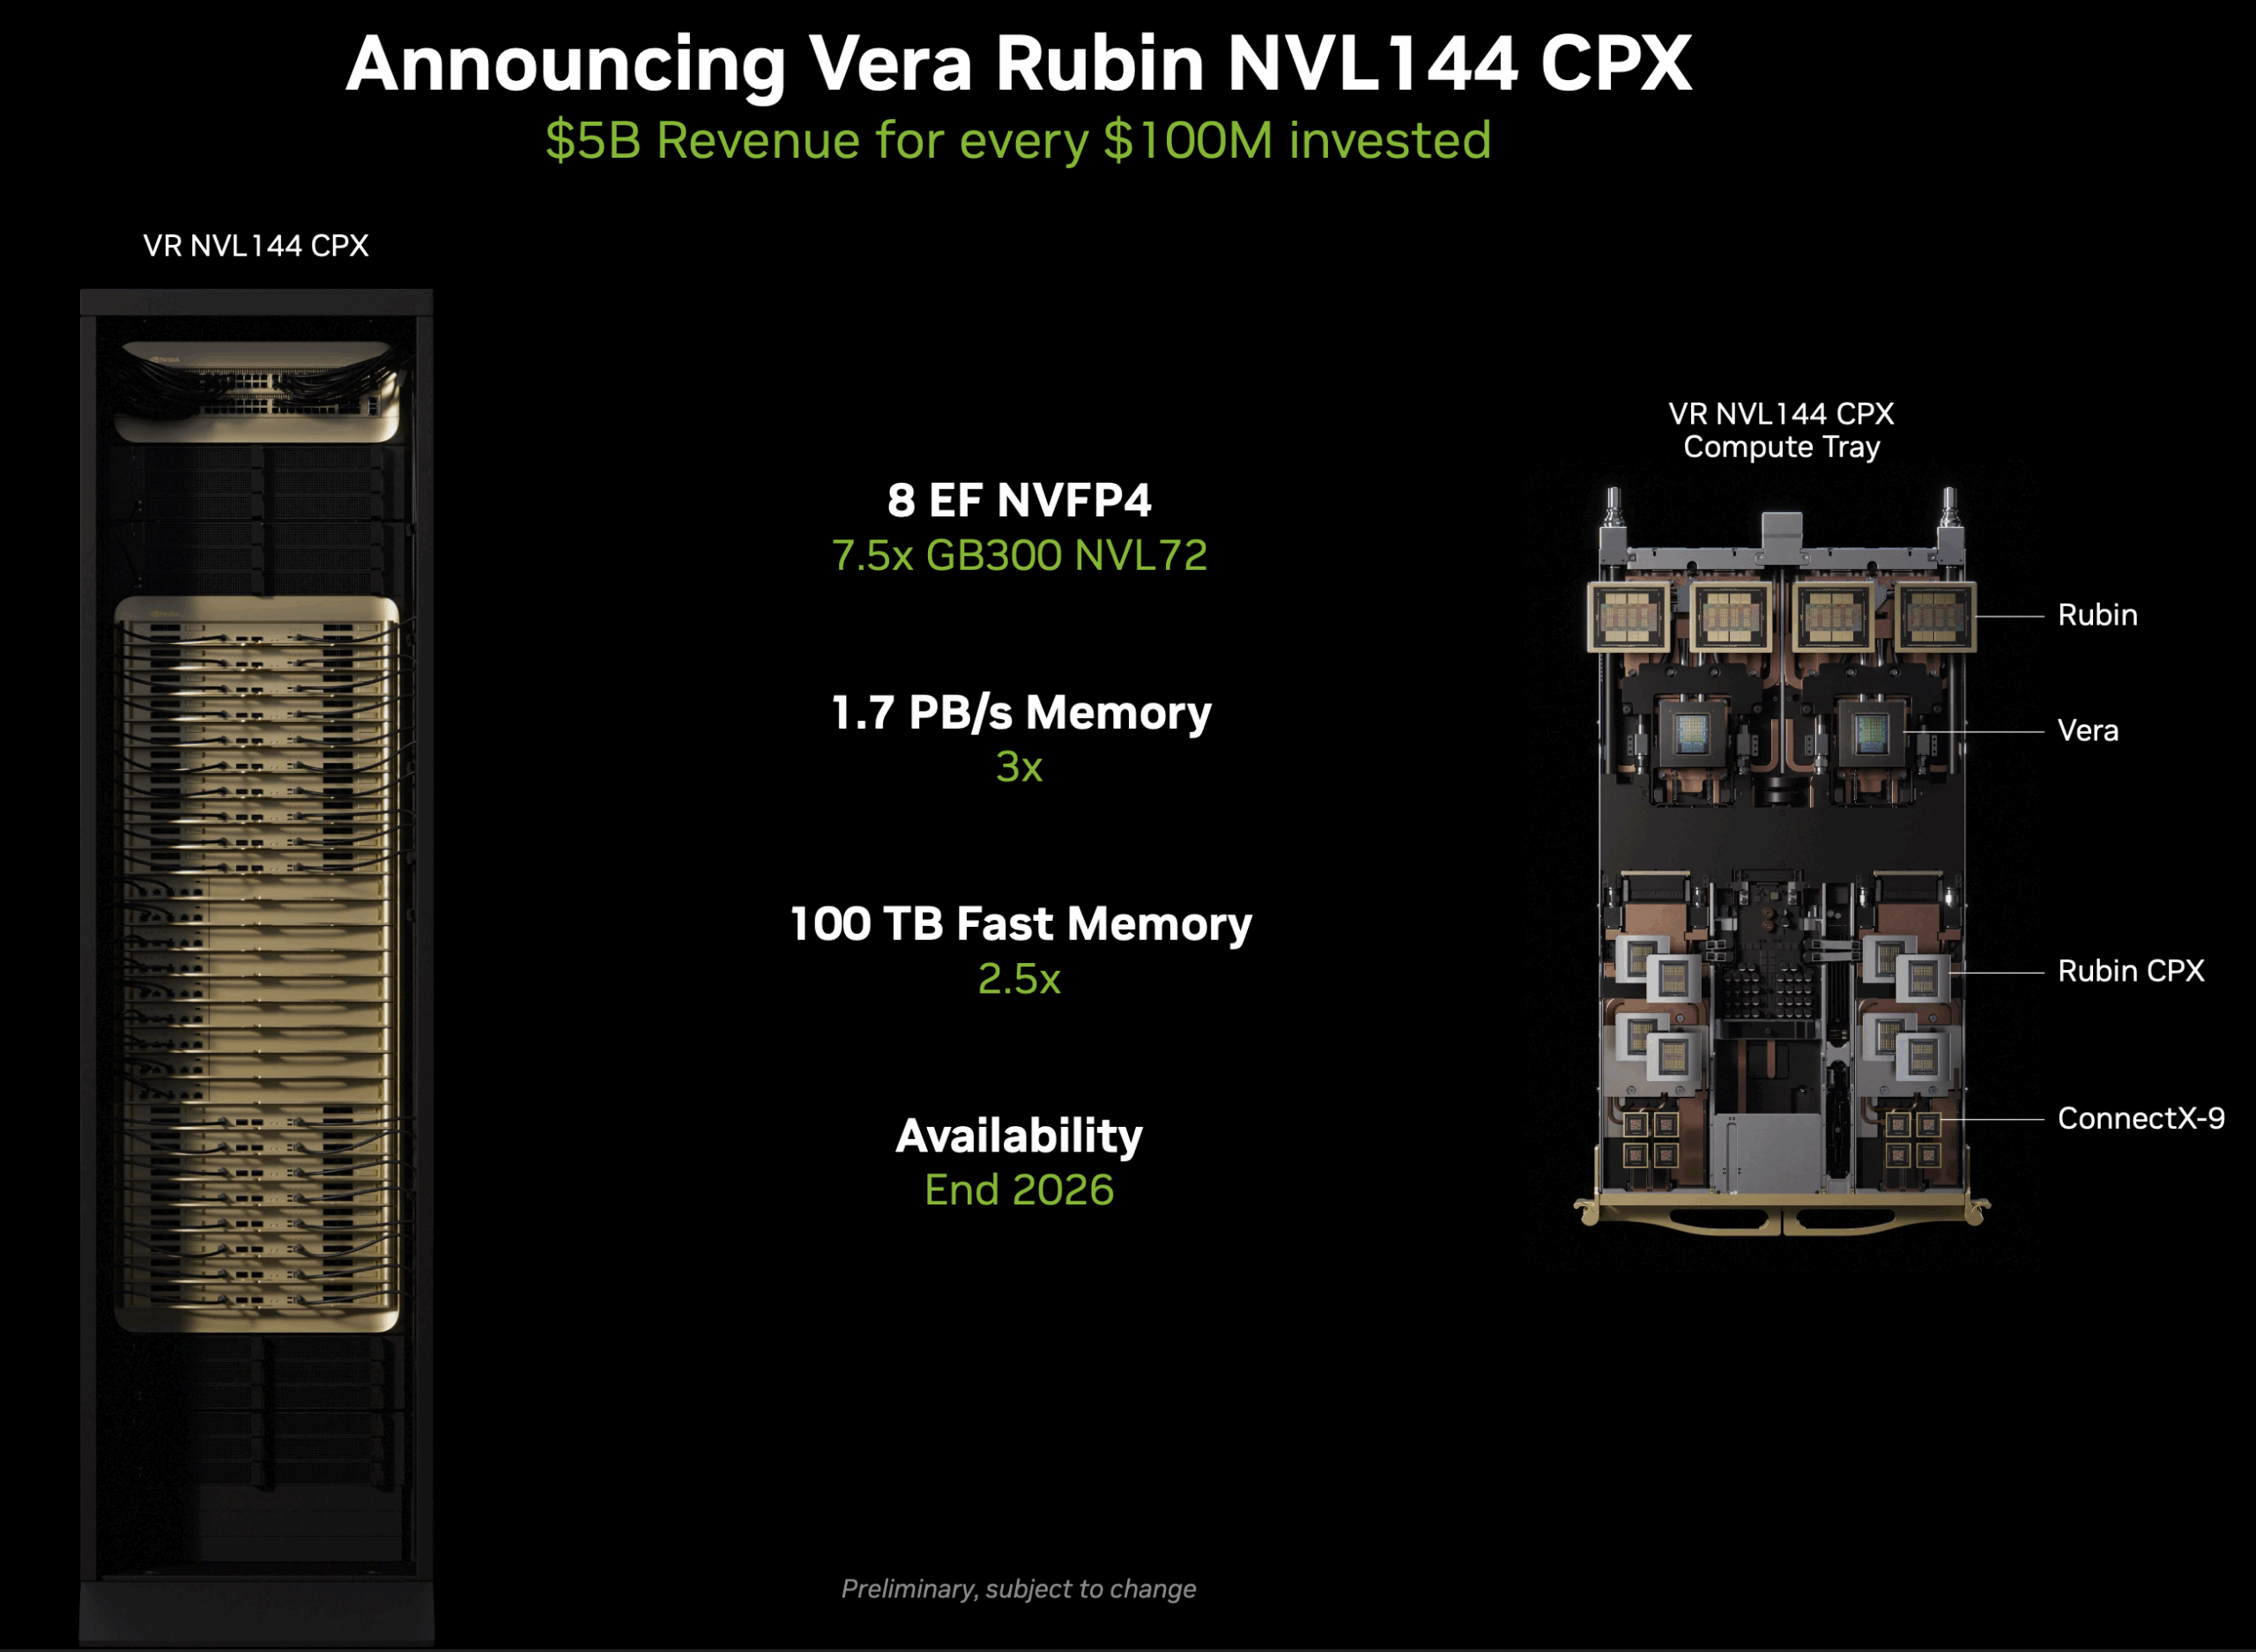
För organisationer som optimerar för inferens och långkontext-RL-efterträning finns det ultratäta beräkningsfacket VR NVL144 CPX tillgängligt. Varje fack innehåller fyra VR GPU-paket, som var och en innehåller åtta GPU-chips, vilket bibehåller beräkningstätheten hos standardkonfigurationen, samtidigt som åtta Rubin CPX GPU:er läggs till. De åtta ConnectX-9 NIC/switch-chipsen säkerställer det sömlösa dataflödet som är avgörande för distribuerad inferens.
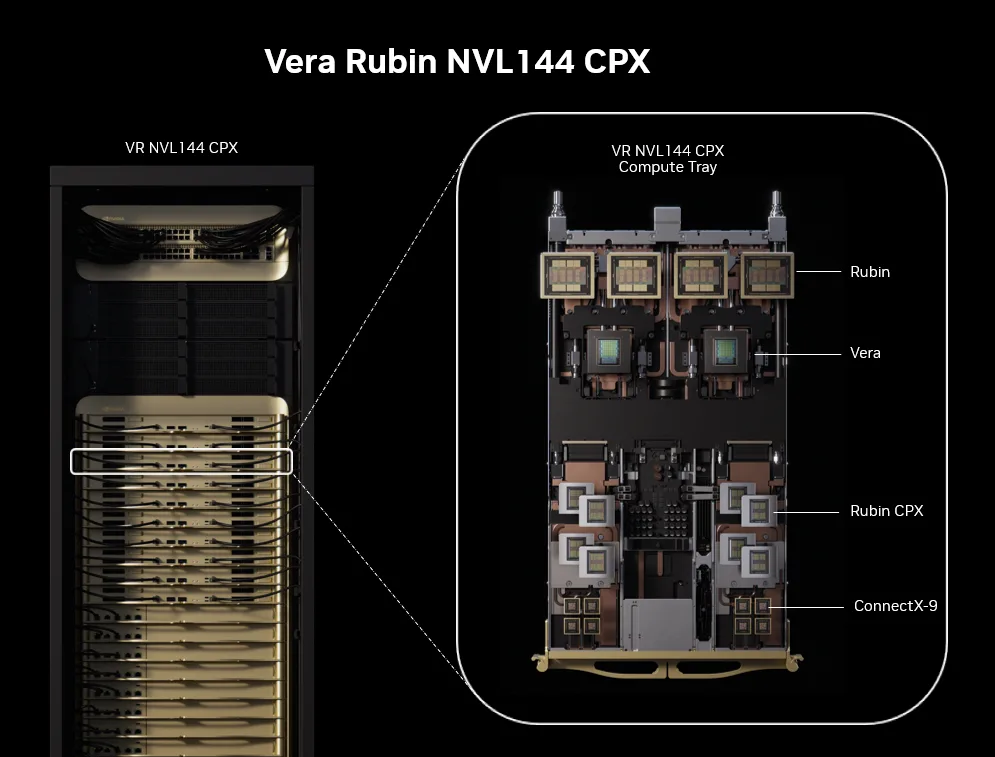
Arkitekturens modulära natur möjliggör exceptionellt flexibla driftsättningsstrategier. Organisationer kan initialt driftsätta standardiserade VR NVL144-rack och därefter utöka dem med dedikerade Rubin CPX-rack allt eftersom deras krav på kontextbehandling växer. Denna metod gör det möjligt för infrastrukturen att utvecklas i takt med modellens funktioner, vilket undviker överprovisionering.
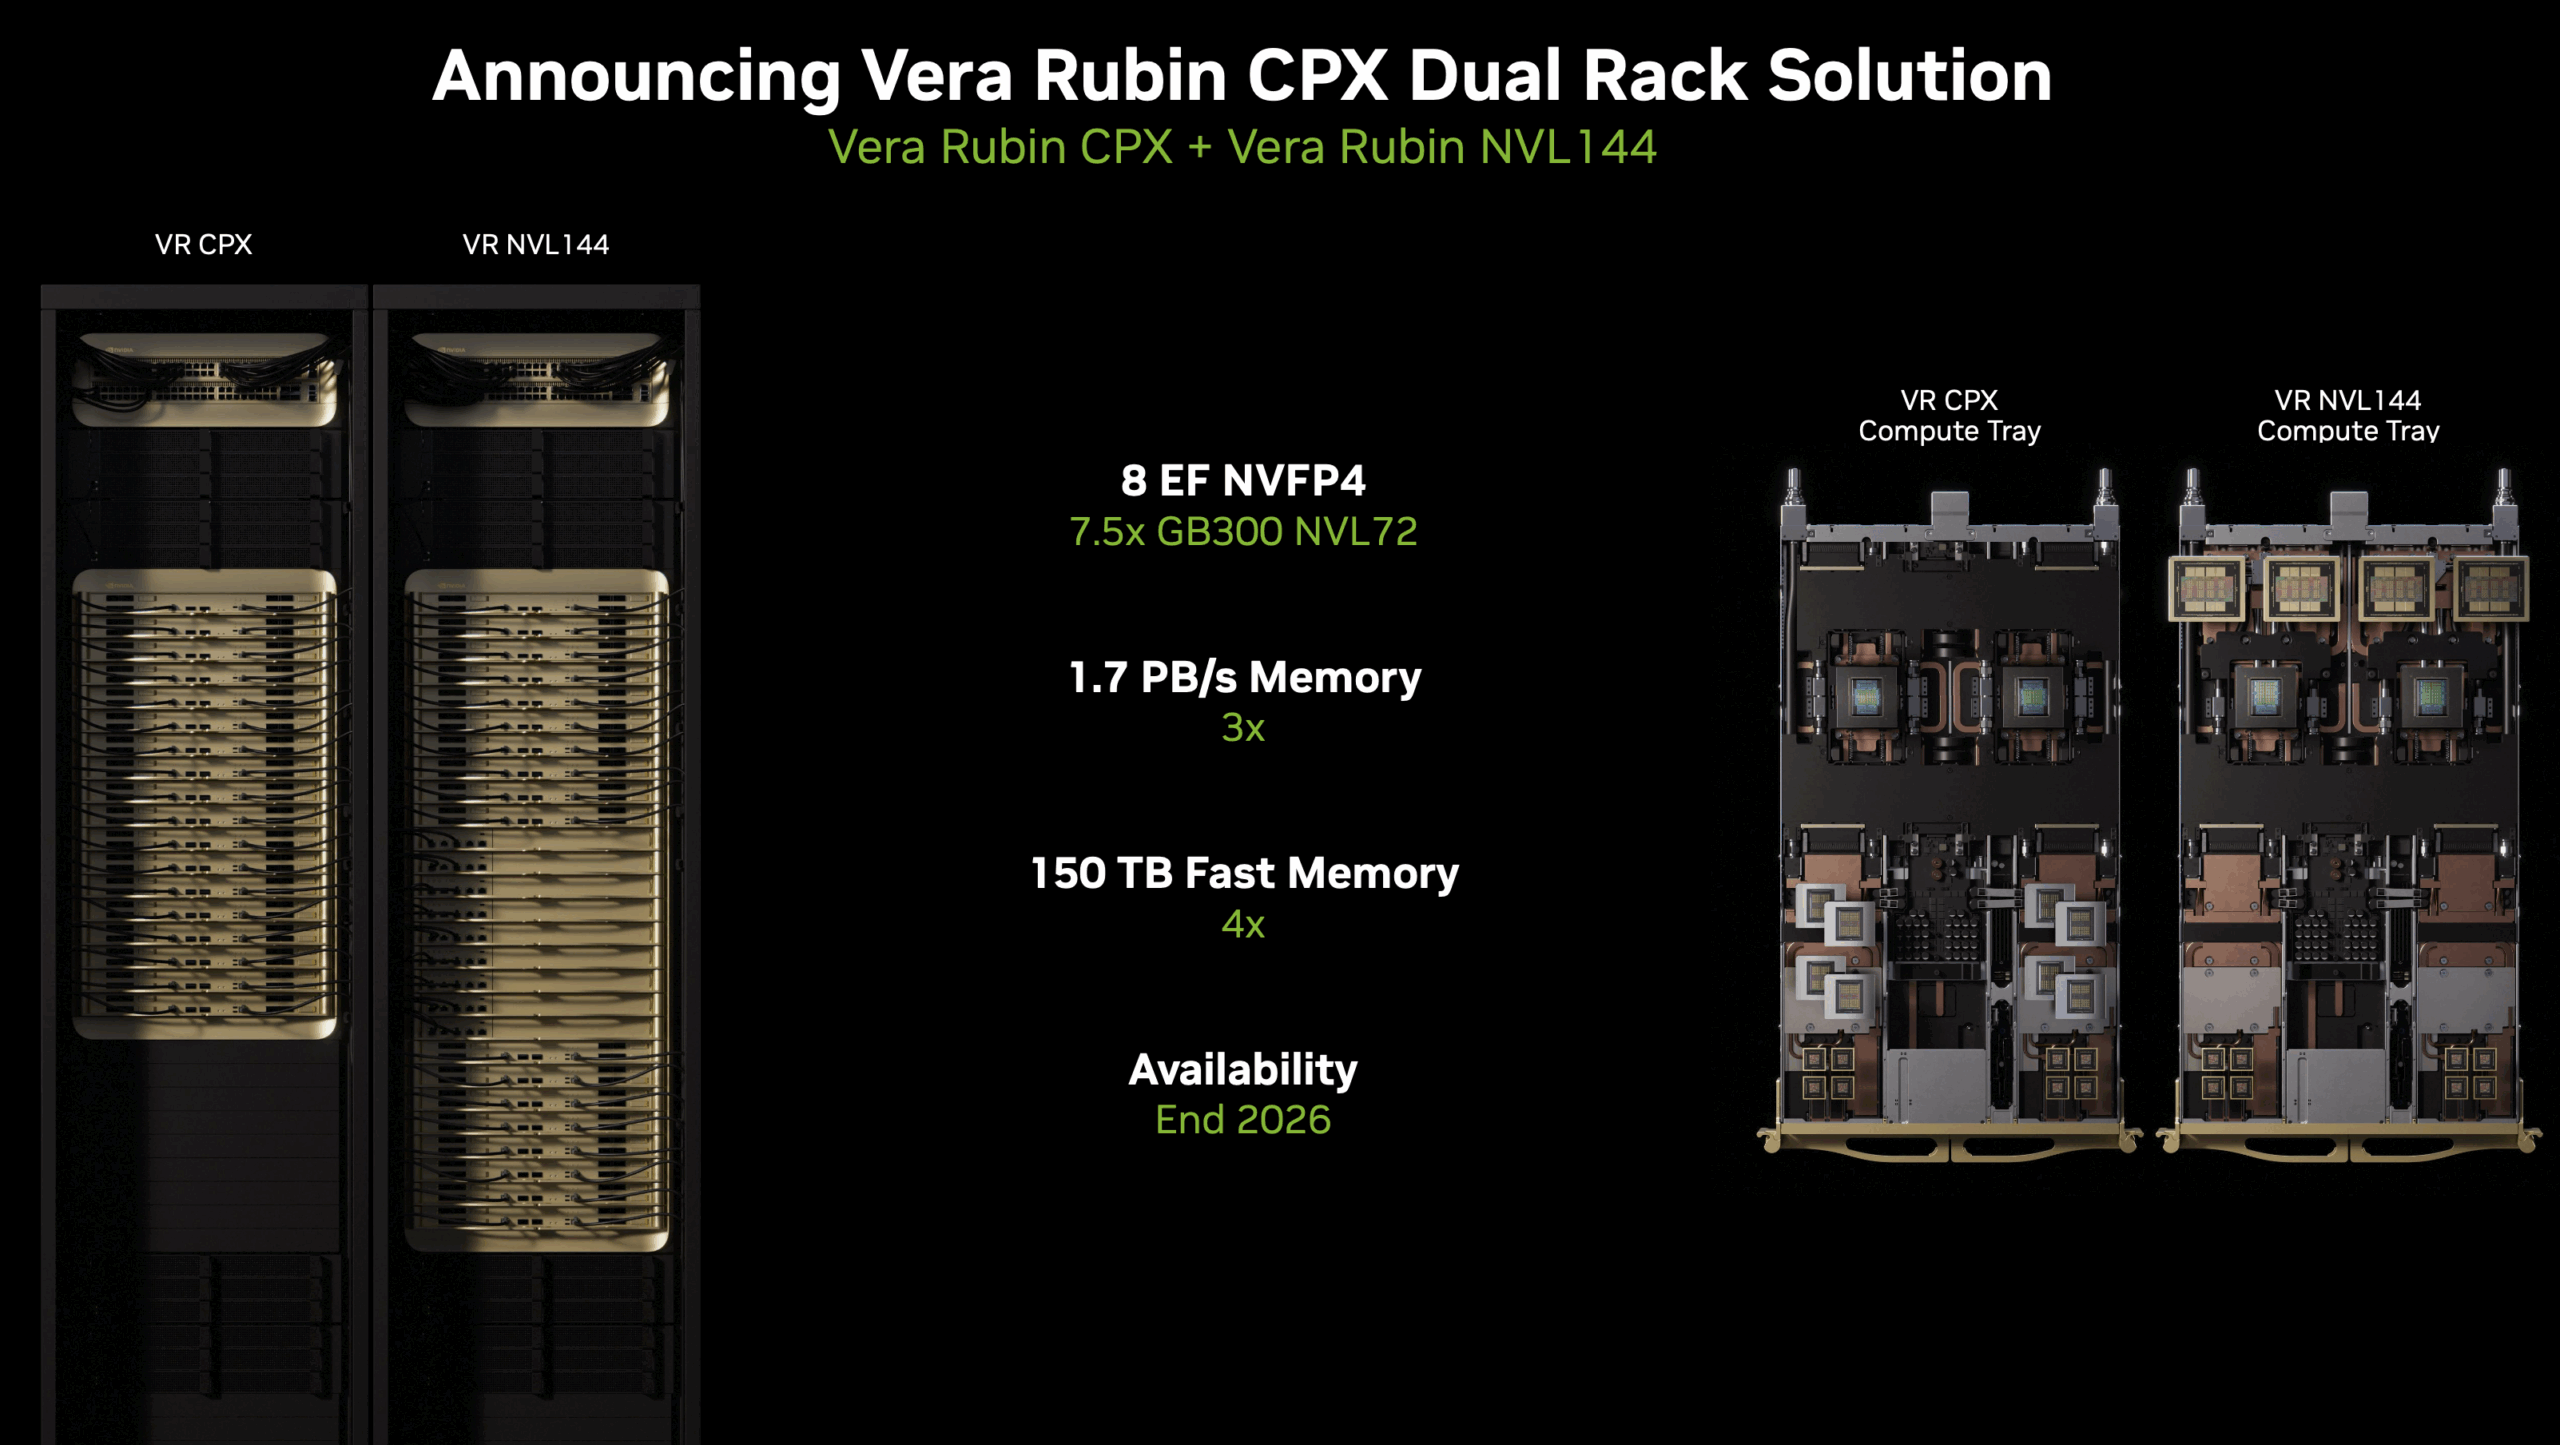
Den kompletta VR NVL144 CPX-konfigurationen etablerar en ny baslinje för beräkningskraft. Systemet levererar 8 ExaFLOPS NVFP4-beräkning, en 7.5x förbättring jämfört med nuvarande generationens GB300 NVL72-system. Denna massiva beräkningskapacitet kombineras med 1.7 PB/s aggregerad minnesbandbredd, vilket utnyttjar både HBM4 och GDDR7 för att uppnå tre gånger så hög minnesgenomströmning som nuvarande system. Den totala minneskapaciteten når 100 TB, vilket ger 2.5 gånger så många minnesresurser som nuvarande generationens plattformar.
NVIDIA siktar på tillgänglighet i slutet av 2026. Detta kommer att möjliggöra nya kategorier av AI-applikationer och göra kontextfönster med miljoner tokens praktiska för produktion, vilket gör det möjligt för AI-system att bearbeta hela kodbaser eller långa dokument i ett enda svep. Dessa innovationer gör det också möjligt för organisationer att stödja större batchstorlekar, vilket sänker inferenskostnaden och skapar en mer gynnsam OPEX-beräkning.
Plan för infrastruktur i gigawattskala
Utöver enskilda systeminnovationer presenterade NVIDIA även referensarkitekturer för AI-fabriker i gigawattskala. Dessa ritningar, som utvecklats i samarbete med infrastrukturpartners som Jacobs, Schneider Electric, Siemens Energy och Vertiv, adresserar hela infrastrukturen, från kraftproduktion till beräkningsbaserad leverans. Referensdesignerna bekräftar att nästa generations AI-implementeringar kräver en holistisk optimering som sträcker sig långt bortom själva beräkningskomponenterna.
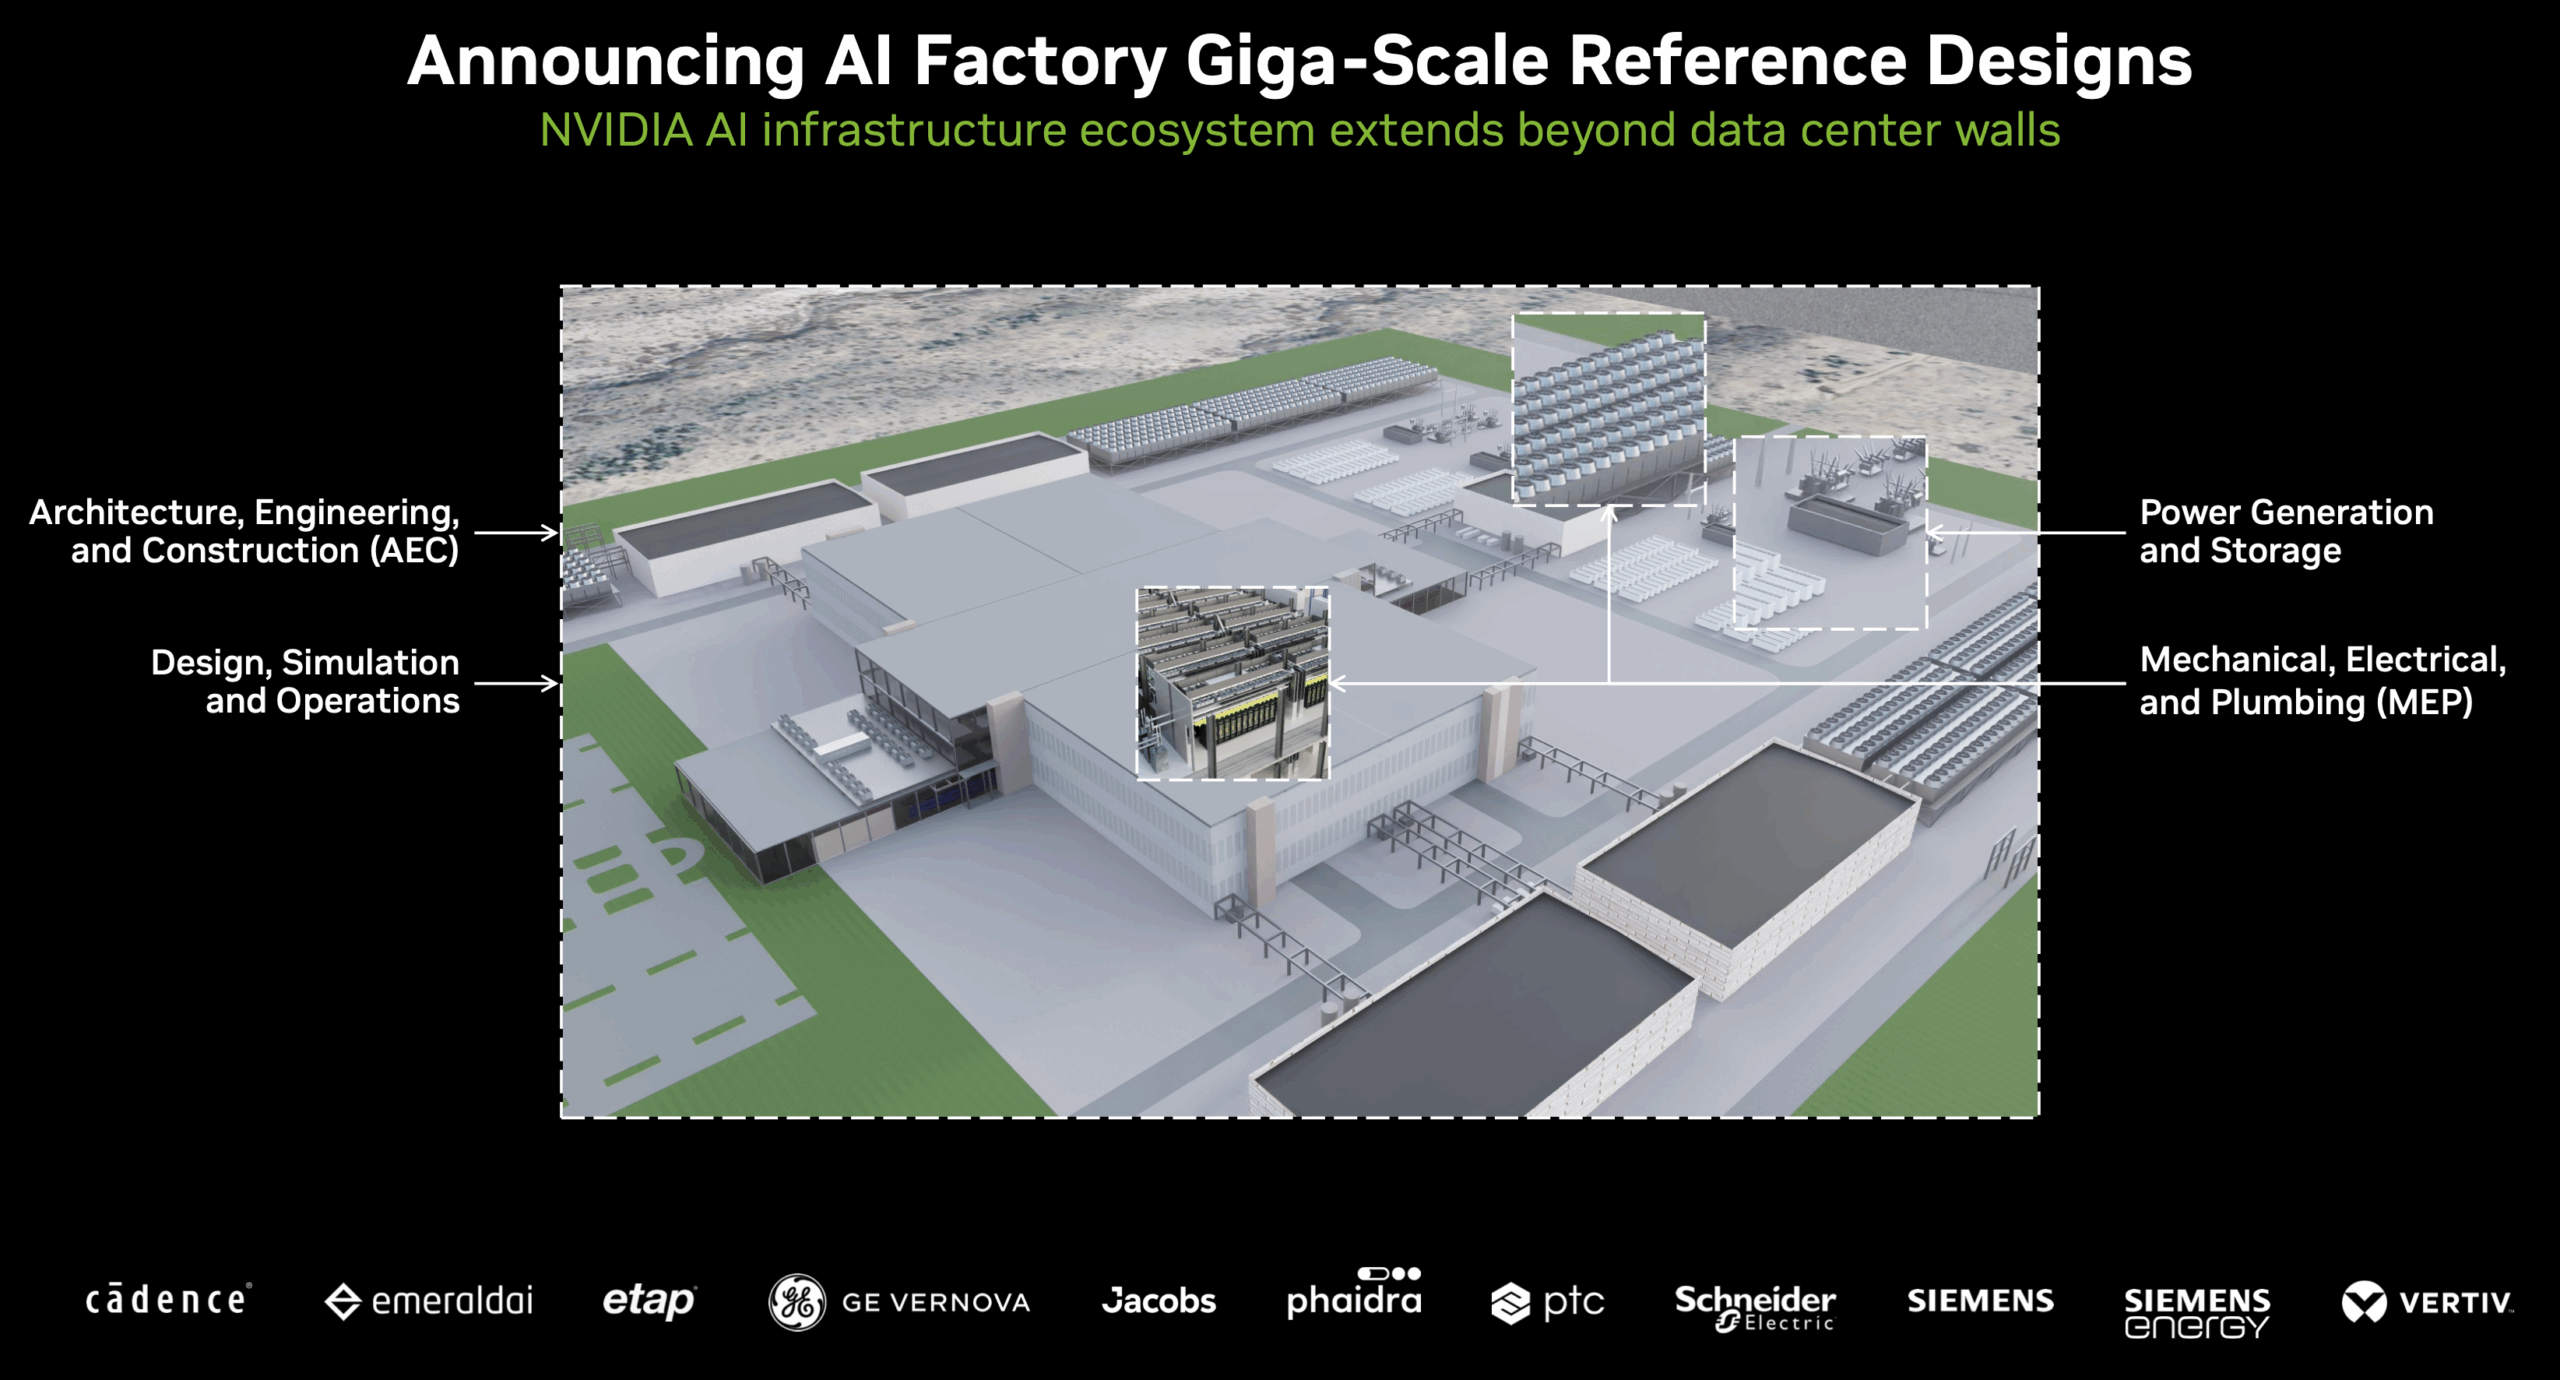
Dessa arkitekturritningar använder NVIDIA Omniverse digitala tvillingar för att underlätta omfattande anläggningssimulering före fysisk driftsättning. Organisationer kan modellera kraftdistribution, kylsystem och beräkningsarbetsbelastningar i enhetliga simuleringar, och identifiera och åtgärda flaskhalsar innan de satsar på fysisk infrastruktur.
Slutsats
NVIDIA fortsätter att leda AI-infrastrukturområdet med ett framåttänkande, utvecklarcentrerat tillvägagångssätt som direkt adresserar de problemområden som organisationer och AI-labb står inför. Övergången från generell acceleration till arbetsbelastningsspecifika arkitekturer, exemplifierad av Rubin CPX:s riktade tillvägagångssätt för kontextbehandling, indikerar att framtida AI-system i allt högre grad kommer att bestå av heterogena beräkningsresurser optimerade för varje fas av AI-arbetsflöden. Denna arkitekturutveckling kräver att organisationer som planerar fleråriga investeringar i AI-infrastruktur inte bara beaktar rå beräkningskapacitet utan också anpassningen mellan hårdvarufunktioner och utvecklande modellarkitekturer.
Den accelererade innovationskadensen, från Blackwell Ultra via Vera Rubin till Rubin CPX inom en komprimerad tidslinje, är verkligen imponerande. En sådan snabb takt kräver att organisationer utformar system som kan integrera nya arkitektoniska paradigmer allt eftersom de uppstår, och undviker den inlåsning som kännetecknade tidigare generationer av datacenterinfrastruktur. För att möta denna utmaning tillhandahåller NVIDIAs AI Factory-referensdesigner och Omniverse digitala tvillingar de viktiga ritningarna och simuleringsverktygen för att framtidssäkra dessa kritiska investeringar. I takt med att AI-modeller fortsätter sin bana mot biljonparameterskalor och miljontoken-kontexter, ger de arkitektoniska innovationer som presenterades vid AI Infrastructure Summit den viktiga grunden för denna framtid inom beräkning. De etablerar de ramverk och teknologier som kommer att definiera företagens AI-kapacitet under hela årtiondet.
Refererade artiklar: Nvidia GTC25 Nyheter
Alla bilder och bilder kommer från Nvidia


 Amazon