

Qumulo presenterade Cloud AI Accelerator, en ny arkitektur utformad för att förbättra effektiviteten i företags AI-infrastruktur genom att eliminera flaskhalsar i dataförflyttning. Plattformen presenterar distribuerade datamängder till GPU-resurser i realtid över regioner, moln och hybridmiljöer utan att replikering eller staging krävs.
Utgåvan bygger på en väl dokumenterad ineffektivitet i företags AI-infrastruktur. Qumulo hänvisar till Cast AI:s rapport om optimering av Kubernetes från 2026 och pekar på en genomsnittlig GPU-användning på cirka 5 procent i företag, medan de återstående 95 procenten av accelererad beräkning ligger inaktiva eftersom data måste stages, replikeras och flyttas på plats innan arbetsbelastningar kan börja. Qumulos VD Doug Gourlay formulerade problemet i tillkännagivandet: "Varje företag vi pratar med fokuserar på GPU-tillgänglighet, men tillgänglighet är bara halva problemet. Det djupare problemet är utnyttjandet, och boven i dramat är datagravitationen."
Omprövning av dataplacering för AI-arbetsbelastningar
Traditionella metoder för AI-infrastruktur samlokaliserar lagring med GPU-kluster, ofta med högpresterande flashsystem som är tätt kopplade till beräkning. Även om den här modellen är effektiv under aktiv träning eller inferens, hanterar den inte perioder av vila på grund av dataförberedelse. Den skapar också fragmenterade lagringssilos när företag replikerar datamängder över olika miljöer för att hålla dem nära beräkningen.
Qumulos tillvägagångssätt förändrar modellen genom att frikoppla dataplats från beräkningsplats. Istället för att flytta data till GPU:er gör Cloud AI Accelerator det möjligt för GPU:er att komma åt data på plats. Detta uppnås genom en distribuerad datastruktur som ger konsekvent åtkomst till datamängder i realtid, oavsett deras fysiska plats.
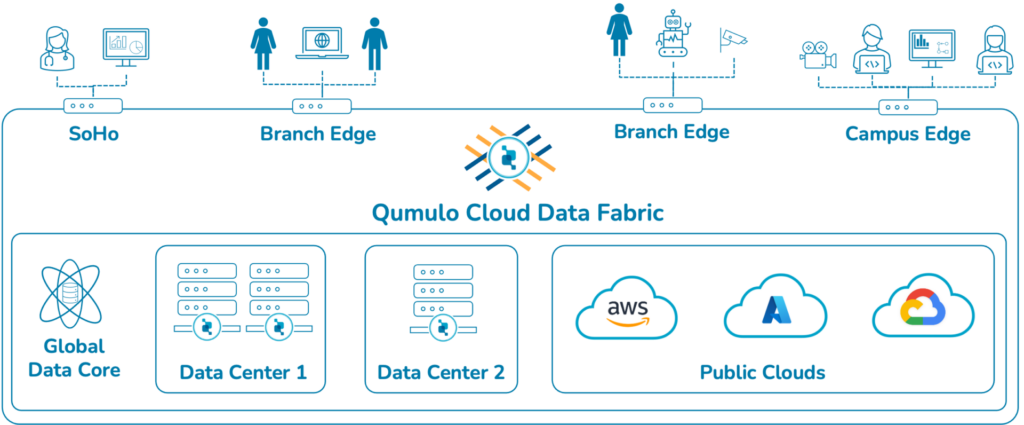
Företaget beskriver denna funktion som att möjliggöra "GPU-likviditet", vilket gör att arbetsbelastningar kan schemaläggas baserat på tillgänglig beräkningskapacitet snarare än begränsningar av datalokalitet. I praktiken gör detta det möjligt för företag att använda GPU-resurser över flera moln eller regioner utan att förpositionera data.
Arkitektur: Data Fabric och cachningslager
Cloud AI Accelerator är en integration av tre Qumulo-produkter som tidigare levererades separat. Cloud Native Qumulo (CNQ) är Qumulos filsystem som körs direkt på AWS, Azure, Google Cloud och Oracle Cloud Infrastructure. Cloud Data Fabric (CDF), som lanserades i februari 2025, tillhandahåller ett centralt fil- och objektarkiv med sammanhängande cacher i kanten. NeuralCache, som lades till i CDF i april 2025, tillämpar maskininlärning för prediktiv läs- och skrivcachelagring, och Qumulo hävdar att det minskar GPU-dataladdningstider med upp till 64 procent. Cloud AI Accelerator i sig dök först upp i november 2025; versionen den 26 maj lägger till direkt anslutning till Microsoft AI Foundry, AWS Bedrock och Google Vertex AI, formaliserar positioneringen "GPU-likviditet" och parar ihop produkten med Cisco för hybriddistributioner.
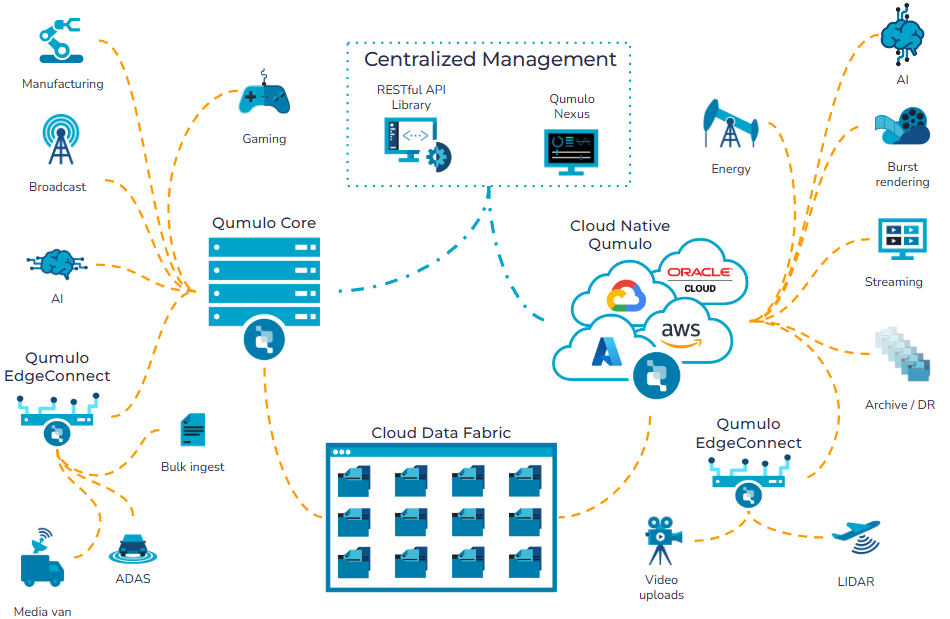
Datasökvägen går på blocknivå från källplatser (lokala kluster, molnregioner, repliker över flera regioner eller CNQ S3-baserad lagring) till acceleratorns CPU DRAM-cache och sedan direkt till grafikprocessorerna. Arkitekturen upprätthåller en enda sanningskälla i lokala miljöer, edge-miljöer och multimolnmiljöer och undviker massreplikering, vilket minskar både lagringskostnader och synkroniseringskomplexitet.
Denna design stöder även integration med hanterade AI-tjänster. Företag kan ansluta befintliga datamängder direkt till plattformar som Microsoft AI Foundry, AWS Bedrock och Google Vertex AI utan att kopiera data till dessa miljöer.
Operativ påverkan: Minska tomgångstid och komplexitet
Den primära operativa fördelen är elimineringen av förseningar i datalagring. I många AI-arbetsflöden kan dataförberedelse ta dagar eller veckor, vilket försenar modellträning och minskar effektiv GPU-användning. Genom att möjliggöra omedelbar åtkomst till datamängder gör Cloud AI Accelerator att arbetsbelastningar kan startas så snart beräkningen är tillgänglig.
Detta minskar också behovet av att underhålla flera lagringsmiljöer. Istället för att skapa separata datasilos för varje GPU-kluster eller molnregion kan organisationer arbeta utifrån en enda logisk datamängd. Detta förenklar datahanteringen och minskar infrastrukturspridningen.
Ur ett kostnadsperspektiv riktar sig modellen mot inaktiva GPU-utgifter. Genom att eliminera behovet av att förladda data till GPU-ansluten lagring kan företag minska den tid GPU:er väntar på data, vilket förbättrar den totala avkastningen på investeringen för accelererad beräkning.
Cisco-integration för hybrid AI-infrastruktur
Cisco är den gemensamma marknadspartnern för hybriddistributionen, där Cisco UCS tillhandahåller det lokala beräkningsavtrycket och Cisco-nätverk och säkerhet omsluter datastrukturen. Tillsammans positionerar Qumulo och Cisco erbjudandet som en infrastruktur som anpassar sig på några minuter till förändrad GPU-tillgänglighet, vilket de menar är det som gör GPU-likviditet praktisk i företagsskala.
Parkopplingen är avgörande i båda riktningarna. Den ger Qumulo en validerad väg in i Cisco UCS-miljöer och förser Cisco med en lagringslösning för hybrid-AI-kunder som vill att data ska förbli lokalt medan beräkningar skalas över hyperskalare. Nätverk med hög genomströmning och låg latens är det bärande elementet här, eftersom dataåtkomst på plats är beroende av konsekvent transport mellan platser.
Tillgänglighets- och distributionsmodell
Qumulo Cloud AI Accelerator finns nu tillgänglig på AWS, Microsoft Azure, Google Cloud och Oracle Cloud Infrastructure, med stöd för hybriddistribution i Cisco UCS-miljöer. Qumulo och Cisco kommer att finnas på Cisco Live 2026 i Las Vegas, i monter #4018, från 31 maj till 4 juni, där det gemensamma erbjudandet kommer att visas upp.
Lanseringen återspeglar ett bredare skifte inom AI-infrastrukturdesign mot datacentrerade arkitekturer. I takt med att den accelererade beräkningskapaciteten fortsätter att överstiga den infrastruktur som matar den, kommer förbättrad utnyttjandegrad att bero på att minska den tid GPU:er väntar på data. Qumulos satsning är att det är mer hållbart att göra datamängden universellt tillgänglig, snarare än mobil, än att lägga till mer flashminne i varje GPU-kluster.


 Amazon