

Vissa servrar utökar det som redan finns, medan andra återställer förväntningarna. Dell PowerEdge R7725xd tillhör den andra kategorin. I våra senaste tester, konfigurerade med 24 Micron 9550 PRO PCIe Gen5 NVMe SSD-diskar och fyra 2x 200GbE NIC-kort, uppnådde denna 2U-server högre rå lagringskapacitet än något system vi har mätt tidigare. Internt klarade plattformen över 300 GB/s över NVMe-poolen. Över nätverket levererade den 160 GB/s med standard RDMA, utan ytterligare komplexitet.
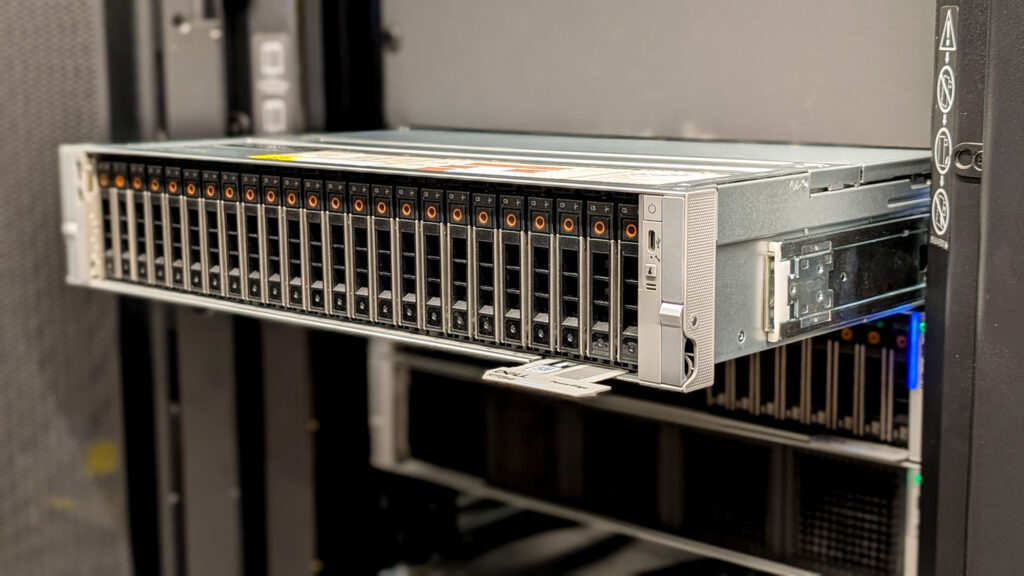
Det här är inte bara en snabbare lagringsserver. Det är ett system som förändrar hur dataintensiv databehandling är utformad. Moderna AI-tränings- och inferenspipelines begränsas ofta inte av GPU:ns kraft, utan av hur snabbt data kan stagas, strömmas, blandas och kontrolleras. Stora GPU-noder kommer att stå inaktiva om lagringen inte kan hålla jämna steg. Team åtgärdar dessa begränsningar genom att använda cacher, överdimensionering och komplex nivåindelning för att säkerställa att acceleratorer tar emot data tillräckligt snabbt för att motivera sina kostnader.
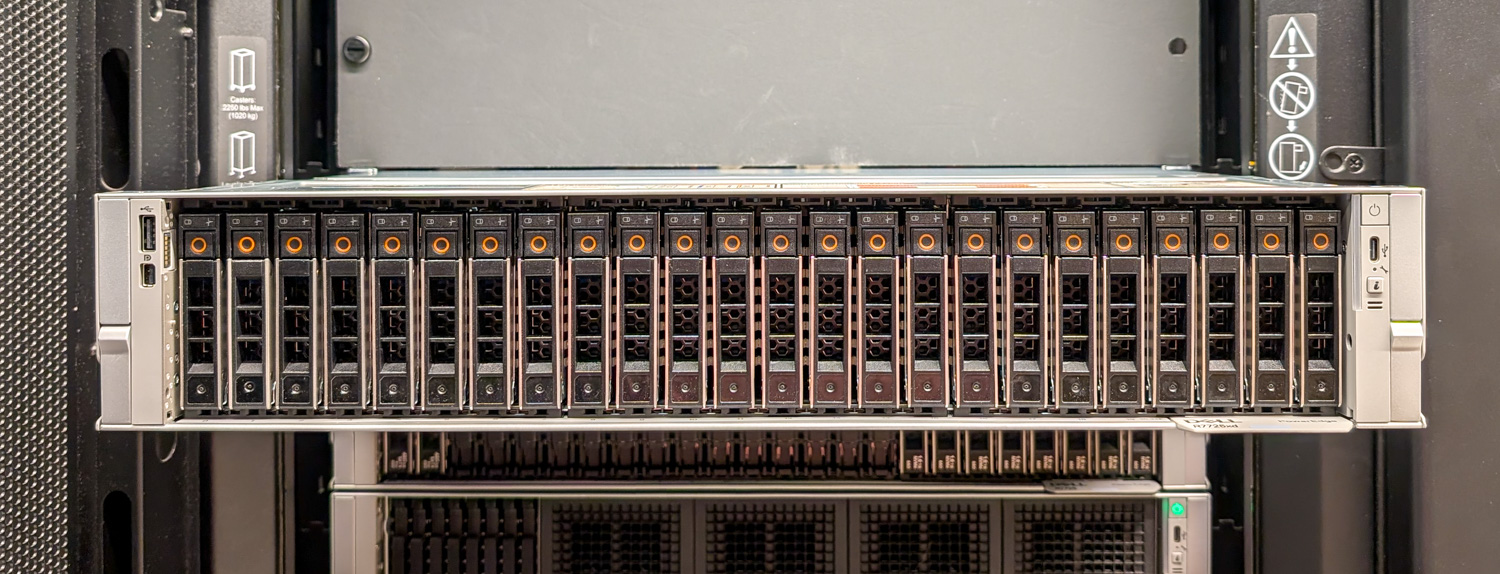
Dell PowerEdge R7725xd åtgärdar flaskhalsen vid källan. Servern är byggd kring ett U.2-bakplan med 24 fack, där varje enhet får en dedikerad PCIe Gen5 x4-länk direkt till AMD EPYC CPU-komplexet. Det finns ingen bandbreddsutjämning och ingen mellanplansexpander används för att minska samtidighet. Prestandan skalas upp smidigt eftersom hårdvaran är utformad för att aggregera dataflödet utan konkurrens. I en traditionell 2-sockelkonfiguration är processorerna anslutna med fyra XGMI-länkar för kommunikation mellan socklar. I R7725xd är en av dessa länkar omvandlad till ytterligare 16 banor med PCIe Gen5 per processor, vilket ger servern totalt 160 banor med PCIe Gen5 (96 för de främre SSD-diskarna och 64 för de fyra bakre PCIe-kortplatserna). I kombination med Microns 9550 PRO SSD-diskar, som är utformade för ihållande skrivbelastningar och hög uthållighet, blir systemet en datamotor med hög genomströmning som kan stödja kontrollpunktsintensiva och kontinuerliga strömmande arbetsbelastningar.
Vi lade PEAK:AIO ovanpå denna arkitektur för att utnyttja parallella inlämningsvägar och bibehålla effektiviteten allt eftersom samtidigheten ökade. Resultatet blev inte bara topprestanda utan även bibehållen prestanda under belastning. Plattformen kan fungera som en lokal exekveringsnod för förbehandling, träning eller transformation, eller så kan den hantera lagring med hög bandbredd över flera GPU-system över nätverket. Om du känner dig äventyrlig kan du göra båda samtidigt.
Key Takeaways
- Oöverträffad dataflöde i en enda nod: R7725xd klarade över 300 GB/s intern bandbredd och 160 GB/s över NVMe-oF RDMA, vilket konkurrerade med lagringskluster med flera noder i ett 2U-chassi.
- Sann Gen5-arkitektur, inga switchar, ingen fläktuttag: Alla 24 Micron 9550 PRO SSD-diskar får dedikerade x4 PCIe Gen5-banor direkt från CPU-komplexet, vilket möjliggör skalning av linjehastighet utan konkurrens.
- Drivs av AMD EPYC 9005-serien: Dubbla AMD EPYC 9575F-processorer ger det antal filer, den minnesbandbredd och den NUMA-topologi som krävs för hållbar I/O med hög samtidighet.
- Utformad för AI, analys och kontrollpunktstunga arbetsbelastningar: Systemet eliminerar I/O-flaskhalsar som stoppar moderna GPU-pipelines, vilket möjliggör kontinuerlig dataleverans med hög bandbredd.
- PEAK:AIO låser upp full parallellism: PEAK:AIOs programvarustack håller köstrukturerna mättade under belastning och levererar företagsprestanda till ett övertygande förhållande mellan dollar och GB.
Specialbyggd för NVMe-genomströmning
I den senaste generationen servrar har Dell slutat använda PCIe-switchar i lagringstäta serverkonfigurationer. Modeller som PowerEdge R770 eller R7725 erbjuder PCIe Gen5 x4-fack, som stöder upp till 16 SSD-konfigurationer, och växlar till x2-fack i större lagringsbakplanskonfigurationer. Servrar av tidigare generationer, som PowerEdge R760, skulle inkludera en PCIe-switch i NVMe-konfigurationer med 24 fack. För att förenkla byggen och ta bort den komplexitet som en PCIe-switch introducerade, antog nya servrar en strategi att minska antalet PCIe-banor i lagringstäta byggen. Det vill säga, fram till R7725xd.
Skillnaden mellan standardmodellen R7725 och R7725xd handlar om hur plattformarna allokerar PCIe-root-komplexa resurser. Basmodellen R7725 distribuerar PCIe-banor över lagring, GPU-expansion och generell I/O. Varianten 'xd' omallokerar den budgeten så att NVMe-undersystemet blir den primära konsumenten av PCIe-bandbredd. De 24 U.2-facken är kopplade direkt till processorns PCIe Gen5-rötter, där varje SSD får sin egen x4-slutpunkt, inte en delad upplänk som exponeras via en PCIe-switch eller ett re-timer-träd. Detta ger varje enhet oberoende köstrukturer och oberoende DMA-vägar tillbaka till minneskontrollern.
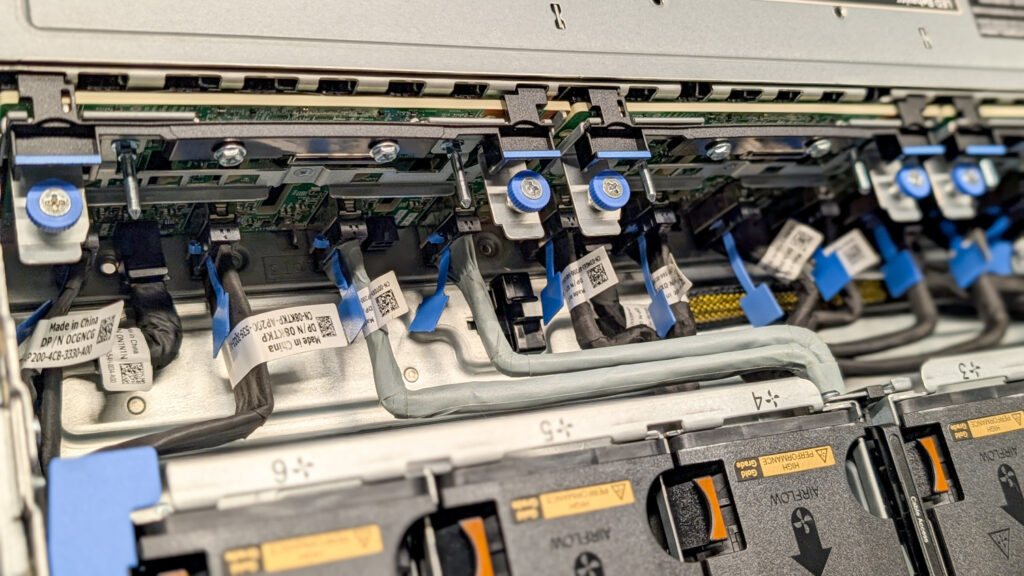
Bakplanet och riser-topologin återspeglar detta engagemang. Dell grupperar NVMe-kontakterna och PCIe-kortplatserna över båda AMD EPYC-socklarna, så varje processor har direkt äganderätt till en del av hårddiskuppsättningen. I praktiken skapar detta två symmetriska NVMe-domäner, var och en med lokala latensegenskaper och fullständig läs-/skrivsamtidighet. När vi installerade fyra Broadcom 200GbE-nätverkskort med dubbla portar som tilläggskort, tillät kortplatsplaceringen att varje nätverkskort landade i en PCIe-domän som var anpassad till motsvarande NVMe-grupp. Med NVMe-över-RDMA innebar detta att nätverkstrafiken förblev lokal för sockeln som hanterade den associerade hårddisk-I/O, vilket undvek Infinity Fabric-hoppet mellan socklarna som vanligtvis ökar latensen och förbrukar bandbredd under belastning.
Termiskt beteende stöder också bibehållen dataöverföringshastighet. U.2 är fortfarande fördelaktigt i täta Gen5-konfigurationer eftersom det ger en definierad luftflödeskanal och förutsägbar kylflänsyta för varje enhet. R7725xds fläktmoduler för högt statiskt tryck och chassikanaler upprätthåller ett jämnt luftflöde över alla 24 fack, vilket gör att arbetsbelastningar för hela hårddisken kan köras kontinuerligt utan strypning. Den mekaniska designen kompletterar den elektriska: varje hårddisk kan bibehålla full prestanda eftersom plattformen är byggd för att kyla 24 samtidiga Gen5-enheter vid belastning.
Denna kombination av rotkomplexjustering, konsekvent NUMA-fillayout (non-uniform memory access), sockelmedveten placering av nätverkskort och termiskt stabil U.2-kapsling gör att systemet kan uppnå I/O med linjehastighet i stor skala. Arkitekturen undviker flaskhalsar och optimerar prestandan.
Översikt över Dell PowerEdge R7725xd iDRAC 10
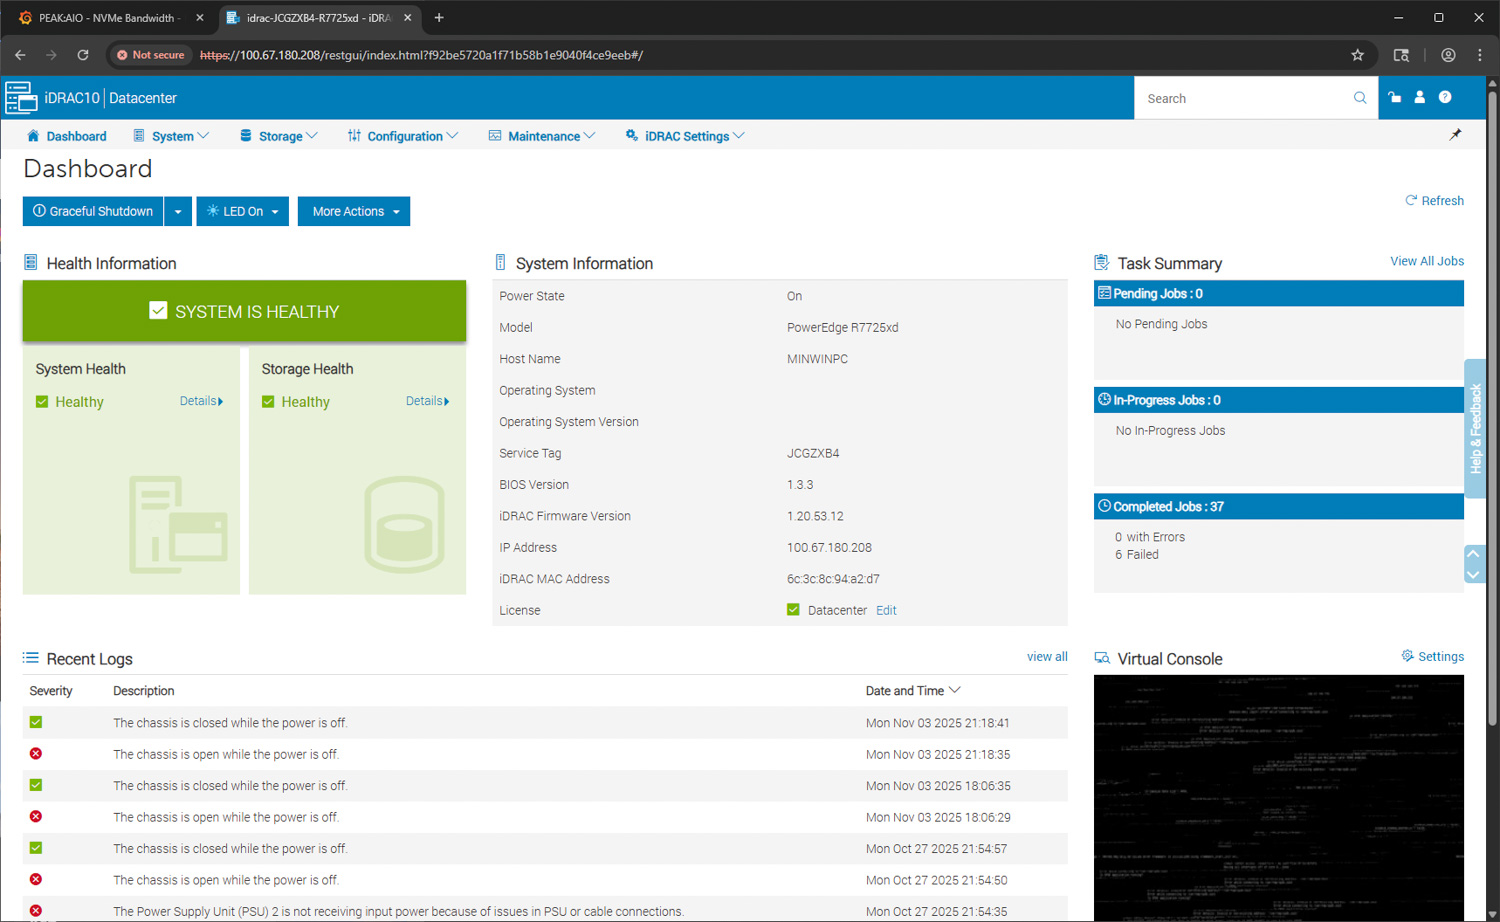
Denna generation av R7725xd, liksom många andra 17:e generationens plattformar som vi har utvärderat, har Dells nya iDRAC 10-plattform, som fungerar som central punkt för fjärrhantering, hälsoövervakning och out-of-band-kontroll. Instrumentpanelen ger en omedelbar sammanfattning av systemets övergripande hälsa, lagringsstatus och senaste aktivitet. För vår testenhet är system- och lagringshälsorapporten grön, vilket bekräftar att servern fungerar normalt. Viktiga systemdetaljer som modell, värdnamn, BIOS-version, iDRAC-firmwarenivå, IP-adress och licensinformation visas på höger sida av gränssnittet.
Instrumentpanelen innehåller också en panel för sammanfattning av uppgifter som visar slutförda, väntande och pågående åtgärder. Nedanför denna lista över de senaste loggar samlar in händelser gällande chassitintrång och meddelanden om strömförsörjning, vilket ger snabb inblick i förändringar i hårdvarans tillstånd utan att behöva navigera till djupare menyer. Den virtuella konsolpanelen finns i det nedre högra hörnet för fullständig fjärrkontroll av KVM.
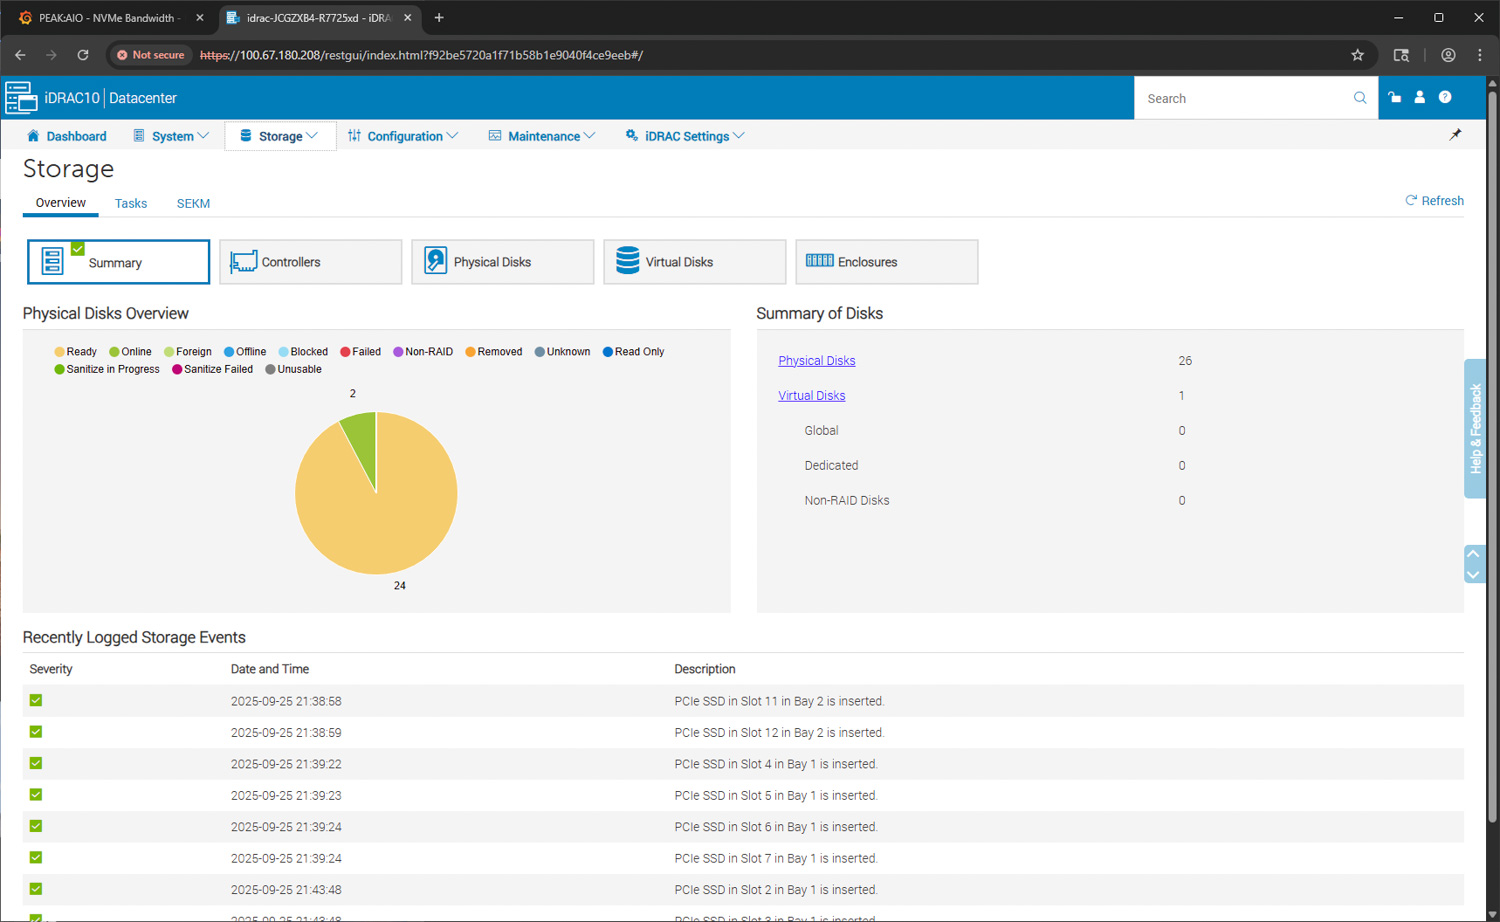
Lagringsavsnittet i iDRAC 10 presenterar en komplett översikt över alla fysiska diskar som är installerade i R7725xd. Sammanfattningspanelen visar en översikt över alla anslutna diskar, tillsammans med ett visuellt cirkeldiagram som illustrerar disktillstånden. I den här konfigurationen är 24 NVMe SSD-diskar aktiva och rapporterar som redo, med två ytterligare startenheter i systemet, separata från den primära främre NVMe-banken.
Till höger delar panelen Sammanfattning av diskar upp dessa i fysiska diskar och eventuella tillhörande virtuella diskar. Eftersom R7725xd använder en direkt NVMe-arkitektur utan traditionella RAID-styrenheter rapporteras alla diskar som icke-RAID och individuellt adresserbara, vilket överensstämmer med systemets design för stora NVMe-pooler och SDS-plattformar.
Under statussammanfattningen listar området Nyligen loggade lagringshändelser insättningsloggar för varje PCIe SSD, organiserade efter fack och kortplats. Denna post bekräftar korrekt identifiering över alla enhetsfack och hjälper till att identifiera eventuella problem med placering, kablage eller hot-swap-aktivitet. För stora distributioner är dessa loggar användbara vid spårning av enhetsprovisionering eller verifiering av att kapaciteten har fyllts som förväntat.
Den sista skärmdumpen visar den detaljerade NVMe-enhetsvyn i iDRAC10. Varje NVMe-enhet som är installerad i systemet listas med status, kapacitet och fackplacering. Om du väljer en enskild enhet får du en fullständig översikt över dess egenskaper.
I det här exemplet visar informationspanelen för hårddisken den fullständiga modellsträngen, enhetsprotokollet, formfaktorn och de förhandlade PCIe-inställningarna. NVMe-enheterna körs med en länkhastighet på 32 GT/s med en förhandlad x4-anslutning, vilket bekräftar att hårddiskarna arbetar med full bandbredd på systemets PCIe Gen5-bakplan. Informationsavsnittet rapporterar även uthållighetsprocent, status för tillgängliga reservminnen och protokolltyp, vilket hjälper administratörer att övervaka hårddiskens hälsa och livscykelförväntningar.
Denna detaljerade enhetsrapportering är värdefull i NVMe-konfigurationer med hög densitet där länkbredd, förhandlad hastighet och mediehälsa direkt påverkar arbetsbelastningens beteende och lagringsprestanda.
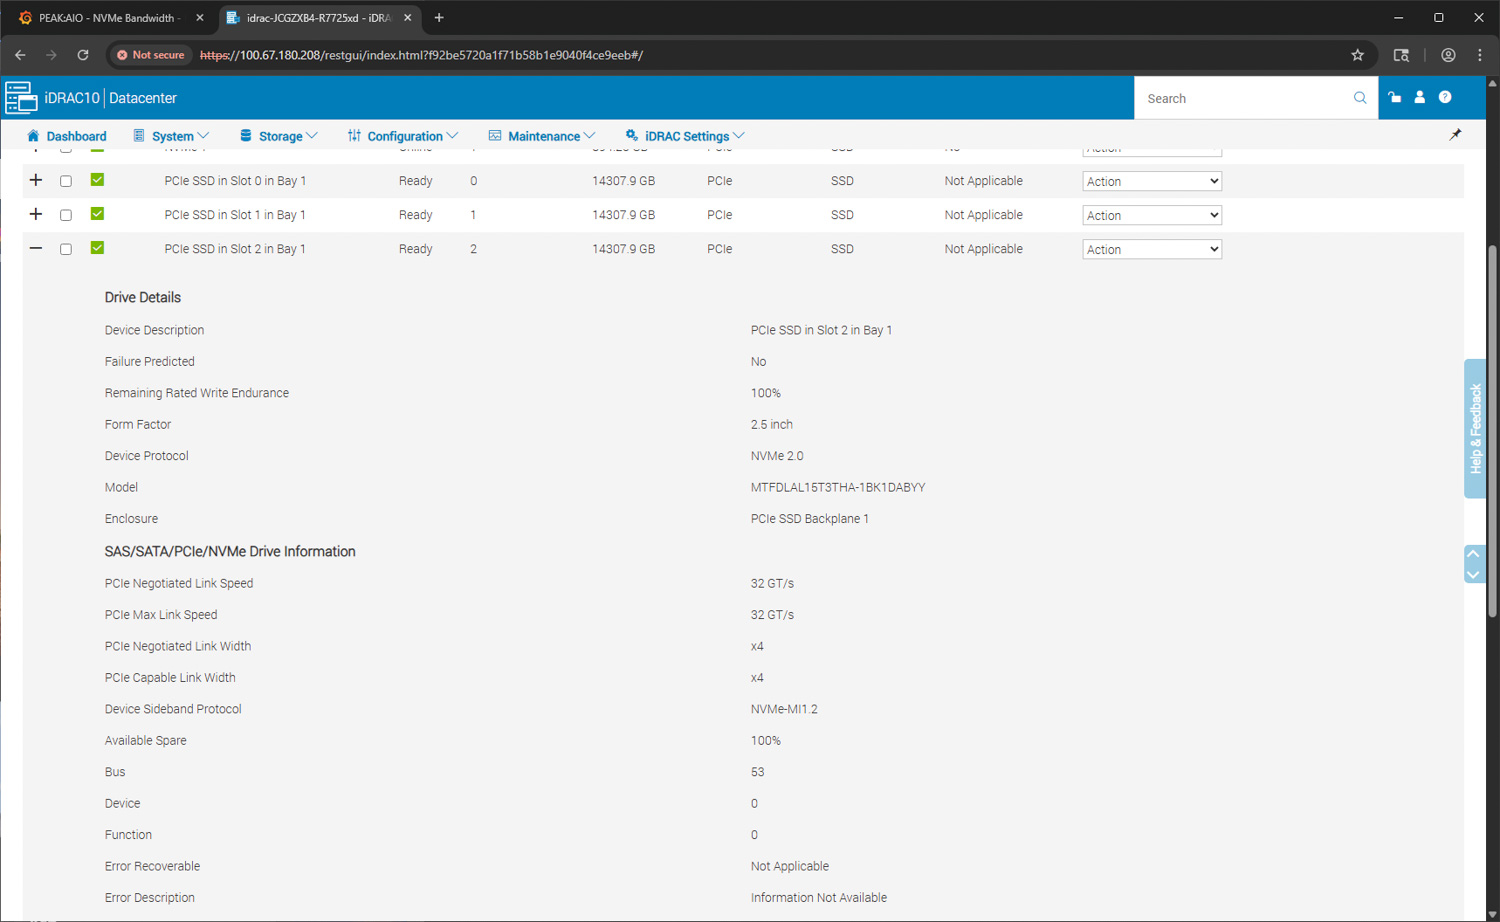
Sammantaget ger iDRAC 10-gränssnittet en tydlig, hårdvarucentrerad bild av R7725xds NVMe-lagringsarkitektur, vilket möjliggör enkel validering av länkhälsa, hårddiskstatus och systemintegritet med en snabb blick.
Dell PowerEdge R7725xd-prestanda
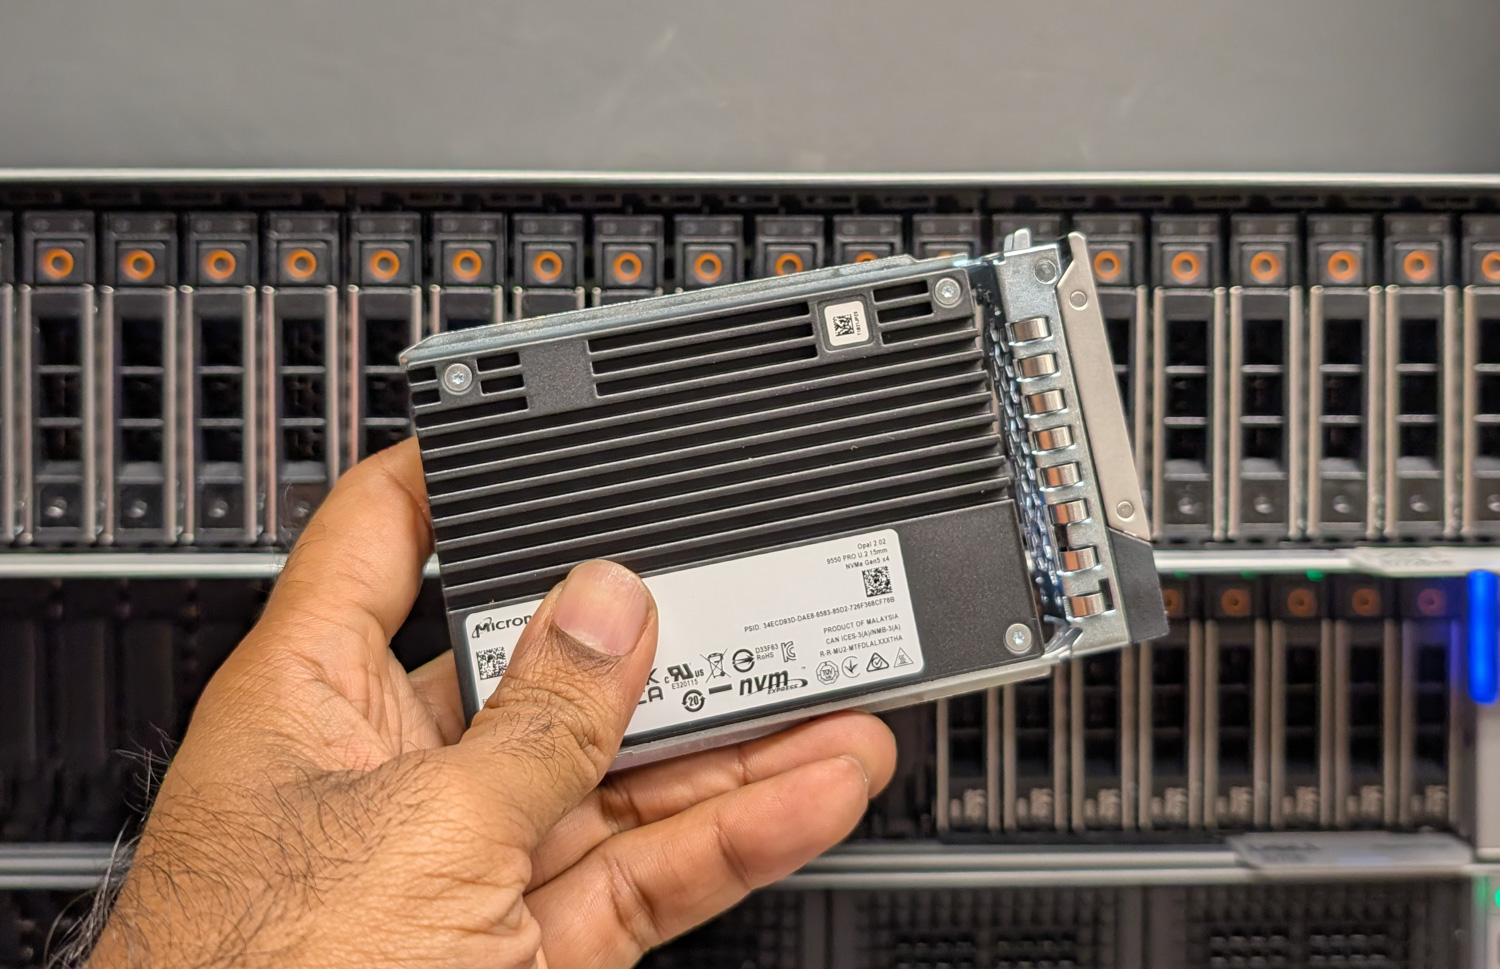
Innan testningen konfigurerades vårt system med en balanserad men högpresterande belastning. Systemet är utrustat med två AMD EPYC 9575F-processorer, vardera med 64 högfrekventa kärnor, och parat med 24 32 GB DDR5 DIMM-minnen som arbetar med 6400 MT/s. För lagring är chassit fullt utrustat med 24 15.36 TB Micron 9550 PRO U.2 NVMe SSD-enheter, var och en ansluten via en dedikerad PCIe Gen5 x4-länk. Detta ger en total råkapacitet på 368.64 TB, och Micron 9550 PRO-enheterna levererar sekventiella läshastigheter på upp till 14 000 MB/s och sekventiella skrivhastigheter på upp till 10 000 MB/s. Nätverk hanteras av fyra Broadcom BCM57608-adaptrar som levererar totalt åtta 200 GB-portar, tillsammans med ett BCM57412 OCP NIC som erbjuder ytterligare två 10-gigabit-portar.
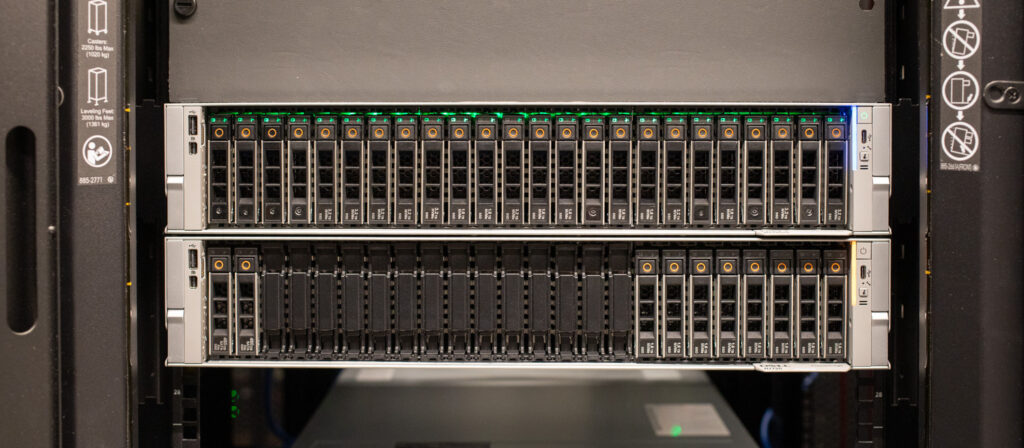
Testsystemspecifikationer
- CPU: 2x AMD EPYC 9575F 64-kärniga högfrekventa processorer
- Minne: 24x 32 GB DDR5 @ 6400 MT/s
- Förvaring: 24x 15.36 TB Micron 9550 PRO U.2-hårddiskar (anslutna till 4x PCIe Gen5-banor vardera); stöder upp till 128 TB hårddiskar idag med högre kapaciteter i sikte
- Nätverk: 4x Broadcom BCM57608 2x200G nätverkskort, 1x BCM57412 2x10Gb OCP nätverkskort
- Växla: Dell PowerSwitch Z9664
FIO-prestandamåttstock
För att mäta lagringsprestanda för PowerEdge R7725xd använde vi branschstandardmätvärden och FIO-verktyget. I det här avsnittet fokuserar vi på följande FIO-riktmärken:
- Slumpmässig 4K – 1M
- Sekventiell 4K – 1M
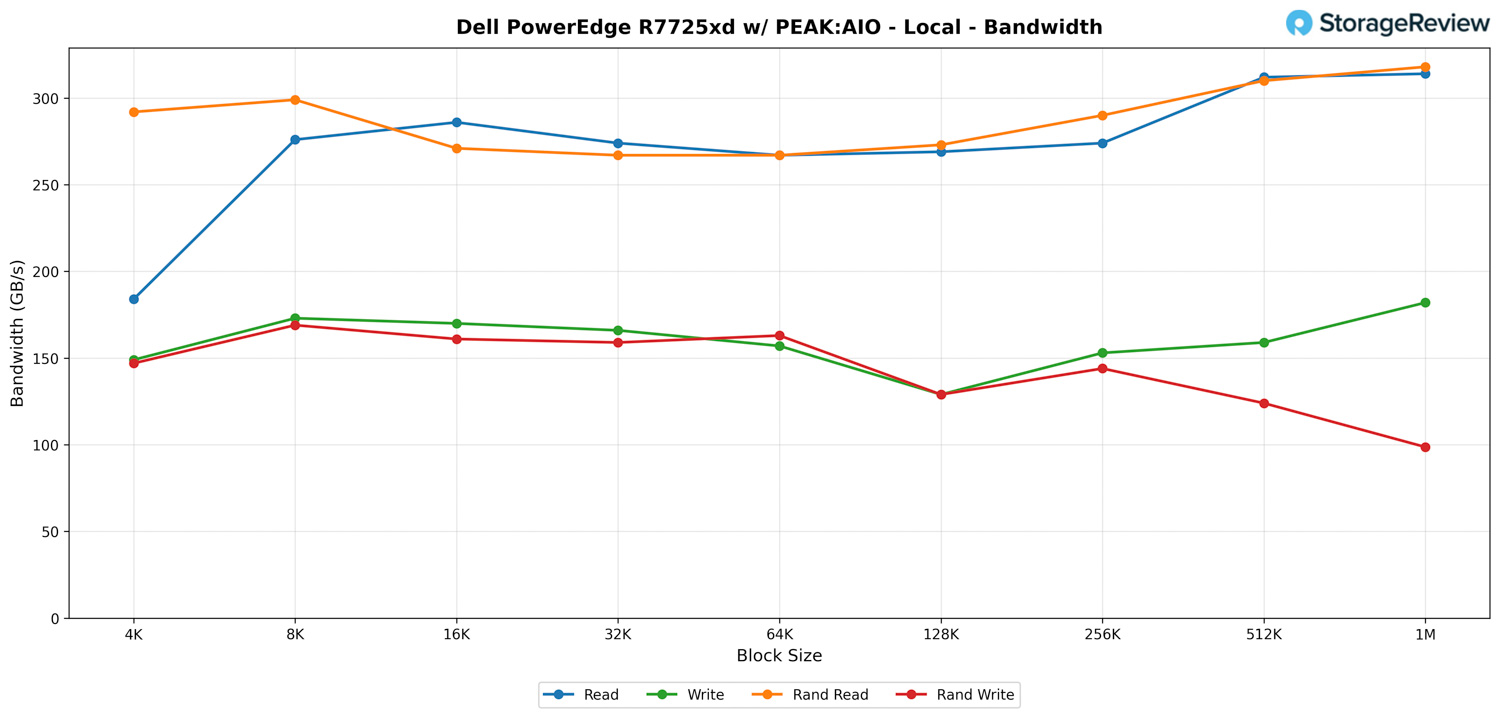
FIO – Lokal – Bandbredd
När man testar lokal åtkomst till de 24 PCIe Gen5 NVMe-enheterna inuti Dell PowerEdge R7725xd, visar systemet exakt vad man kan förvänta sig av en plattform där varje enhet är ansluten till processorerna med en fullständig x4-lane PCIe Gen5-länk. Utan något nätverkslager involverat är detta den rena, interna dataflödet för Dells Gen5-lagringslayout och AMD EPYC-plattformens PCIe-bandbredd som fungerar utan begränsningar.
Sekventiella läsningar börjar vid 184 GB/s med 4K-block och skalas snabbt upp allt eftersom blockstorleken ökar. Från 512K till 1M upprätthåller servern en konsekvent hastighet på 312 till 314 GB/s, vilket är en stark indikation på hur väl systemet kan aggregera alla 24 × 4 Gen5-banor till en bibehållen läsbandbredd utan några flaskhalsar i styrenheten.
Sekventiella skrivningar följer en annan kurva men håller sig stadigt inom det förväntade intervallet. Med en början på 149 GB/s stiger resultaten till mitten av 100-talet och når 182 GB/s vid 1 miljon. Detta överensstämmer med skrivbeteendet hos Micron 9550 PRO SSD-diskar och den overhead som är inneboende i högparallella NVMe-skrivningar över så många oberoende enheter.
Slumpmässig läsningsprestanda är en annan höjdpunkt. Systemet uppnår hastigheter på nästan 300 GB/s vid de minsta blockstorlekarna, sjunker något i mellanregistret och återhämtar sig sedan till de övre 200-talet och låga 300-talet vid större blockstorlekar. Vid 1 MB når slumpmässiga läsningar maximalt 318 GB/s, vilket visar plattformens förmåga att fördela blandade operationer jämnt över alla 24 hårddiskar.
Slumpmässiga skrivningar sker med en lägre hastighet, vilket är typiskt för spridda metadata och skrivallokeringsuppgifter över en bred NVMe-uppsättning. Resultaten ligger kvar i intervallet 140 till 160 GB/s under större delen av testet och minskar till strax under 100 GB/s vid 1 M.b.
FIO – Lokal – IOPS
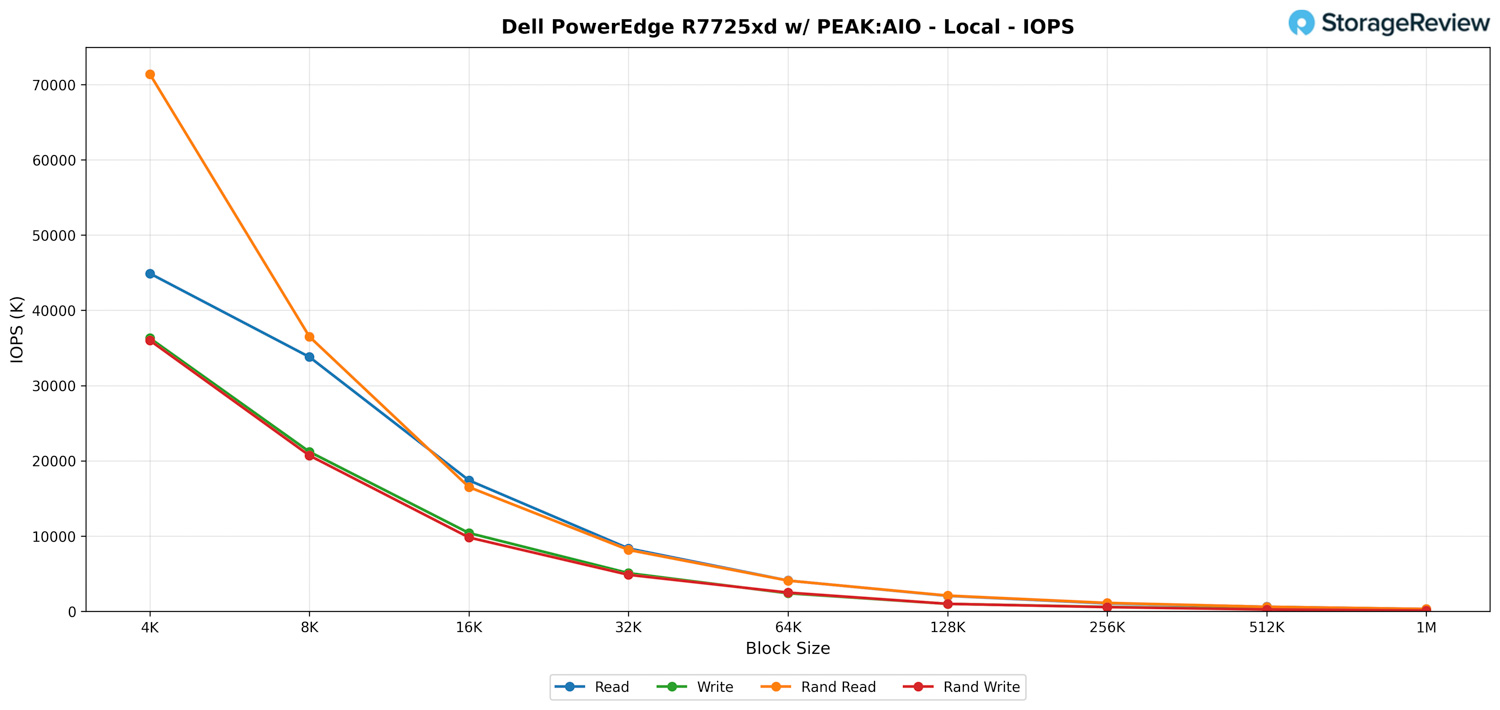
När man granskar IOPS-sidan uppvisar R7725xd robust prestanda för små block, med förfrågningsfrekvenser som når upp till tiotals miljoner innan större blockstorlekar flyttar arbetsbelastningen mot en bandbreddsdriven profil.
Vid 4K når läsningarna 44.9 miljoner IOPS och skrivningarna 36.3 miljoner. Slumpmässiga läsningar når ännu högre nivåer på 71.4 miljoner IOPS, vilket visar systemets förmåga att effektivt distribuera arbetsbelastningar med hög kö över alla hårddiskar. Dessa värden minskar naturligtvis allt eftersom blockstorlekarna ökar, men utvecklingen förblir konsekvent genom 8K-, 16K- och 32K-intervallen.
Vid 16 000 och 32 000 block stabiliseras läsningarna på 17.4 miljoner och 8.35 miljoner IOPS, med slumpmässiga läsningar som matchar varandra på 16.5 miljoner och 8.15 miljoner. Skrivningarna följer det förväntade mönstret, och ligger lägre men är stabila över både sekventiella och slumpmässiga åtkomstmönster.
När vi går mot 64K och uppåt övergår testet från ren IOPS till ett mer bandbreddsbundet scenario. IOPS hamnar i intervallet låga miljoner och så småningom upp i hundratusentals. Vid en blockstorlek på 1M landar läs-IOPS runt 300K, skrivningar på cirka 174K, och slumpmässiga operationer slutförs i samma område.
Sammantaget visar de lokala IOPS-resultaten tydligt systemets förmåga att hantera mycket höga ködjup i arbetsbelastningar över små block, med förutsägbar skalning allt eftersom överföringar växer och bandbredd blir den dominerande faktorn.
PEAK:AIO: Varför Dell PowerEdge R7725xd passar den här arbetsbelastningen
PEAK:AIO är utformad för miljöer som kräver extremt snabb åtkomst till stora datamängder med låg latens, vanligtvis för AI-träning, inferenspipelines, finansiell modellering och realtidsanalys. Plattformen bygger på tät NVMe-lagring, balanserad PCIe-bandbredd och förutsägbar latens i stor skala. För att uppfylla dessa krav måste den underliggande hårdvaran leverera en hållbar dataöverföring samtidigt som den bibehåller konsekvent och repeterbar prestanda under samtidiga tunga belastningar.
Det är här Dell PowerEdge R7725xd passar naturligt in i PEAK:AIO. Systemets arkitektur är utformad för att maximera PCIe Gen5-resurser, vilket exponerar hela bandbredden för dess 24 frontmonterade U.2 NVMe-fack direkt till processorerna, utan att förlita sig på traditionella RAID-kontroller. Denna layout ger PEAK:AIO den parallellitet och latensprofil som den förväntar sig av moderna NVMe-baserade datapipelines. Systemkonfigurationen delade upp NVMe SSD-diskarna i två RAID0-grupper.
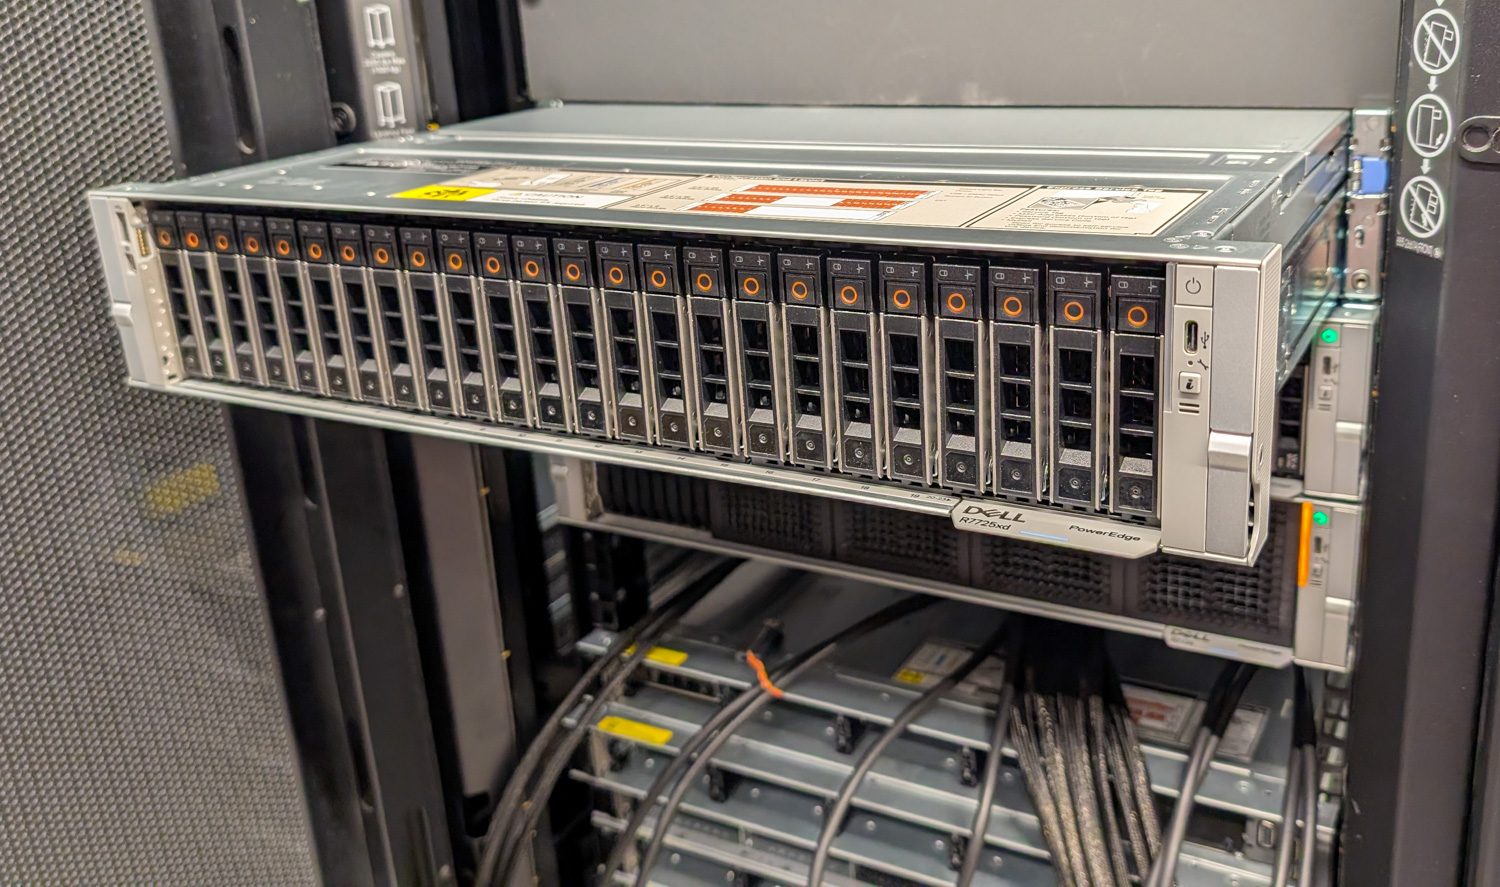
I det testade scenariot använde vi två klientsystem anslutna till R7725xd, vart och ett utrustad med Broadcom BCM57608 2x 200G NIC. Det skapade totalt fyra 200G-upplänkar som matar in varje klient, vilket gav R7725xd en realistisk högpresterande konfiguration som speglar vad PEAK:AIO-distributioner ser i produktion. Denna nivå av nätverksbandbredd gav oss utrymme att fullt ut belasta NVMe-delsystemet, PCIe-topologin och CPU-anslutningarna utan flaskhalsar på NIC-lagret.
Resultatet är en plattform som effektivt anpassar sig till PEAK:AIO-arbetsbelastningar. R7725xd erbjuder kompakt NVMe-kapacitet, PCIe Gen5-dataflöde, dubbla AMD EPYC 9005-processorer för parallellitet och nätverkskapacitet för att hantera datainmatning från flera klienter med hundratals gigabit per klient. Alla dessa egenskaper är grundläggande för att uppnå PEAK:AIOs prestandaförväntningar.
PEAK:AIO – NVMe-oF RDMA – Bandbredd
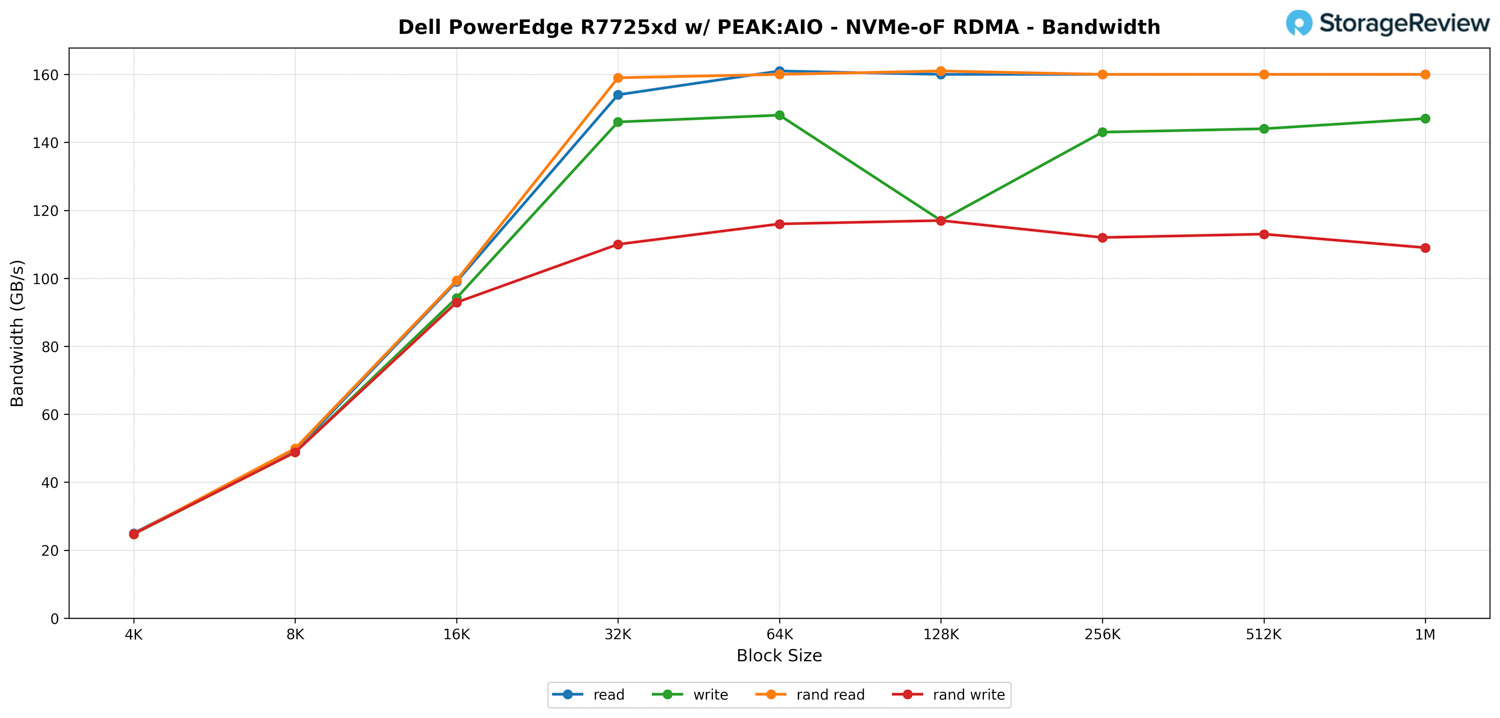
Om man undersöker NVMe-oF RDMA-bandbreddsresultaten på PowerEdge R7725xd med PEAK:AIO, är den övergripande trenden precis vad vi förväntar oss av ett system med så här mycket PCIe- och nätverksbandbredd. Allt eftersom blockstorleken ökar ökar dataflödet snabbt tills det planat ut nära plattformens praktiska gräns.
Vid små blockstorlekar börjar prestandan i mitten av 20 GB/s-intervallet för både läsning och skrivning, vilket är normalt eftersom 4K- och 8K-överföringar pressar IOPS-vägen mycket hårdare än dataflödesvägen. När vi kommer in i 16K- och 32K-blocken öppnas pipelinen upp. Läsningarna hoppar till cirka 154 GB/s vid 32K och fortsätter att klättra till 160 GB/s-intervallet, vilket är precis där vi skulle förvänta oss att en dubbelklientinstallation över fyra 200 Gb/s-länkar skulle landa.
Prestandan för slumpmässig läsning speglar den sekventiella prestandan nästan perfekt. PEAK:AIO gör ett bra jobb med att hålla kommandoköerna matade, så bandbredden för slumpmässig läsning följer i princip sekventiell läsning hela vägen upp och ligger på ungefär 159 till 161 GB/s från 32K till 1M. Detta indikerar att lagringsstacken inte är flaskhalsar under blandade åtkomstmönster, och R7725xds PCIe-topologi fördelar belastningen jämnt över de 24 Gen5 NVMe-diskarna.
Skrivprestandan följer en liknande kurva, även om den toppar något lägre än läsprestandan. Sekventiella skrivningar ligger kvar i intervallet 140 till 148 GB/s genom de medelstora blocken, och sjunker till cirka 117 GB/s vid 128K men återhämtar sig allt eftersom blockstorleken ökar. Slumpmässiga skrivningar beter sig annorlunda och planar ut närmare 110-117 GB/s, vilket är normalt för arbetsbelastningar med blandade köer som introducerar ytterligare overhead.
Den viktigaste slutsatsen från detta avsnitt är att R7725xd inte har några problem med att upprätthålla extremt hög bandbredd över NVMe-oF, även med flera klienter som driver systemet till dess gränser. När blockstorlekarna når 32K eller högre mättar servern konsekvent sin tillgängliga nätverks- och lagringsbandbredd. Det är precis den typ av prestanda som PEAK:AIO är utformad för att utvinna, vilket gör dessa resultat till en stark validering av plattformens förmåga att skalas under verkliga förhållanden.
PEAK AIO – NVMe-oF RDMA IOPS
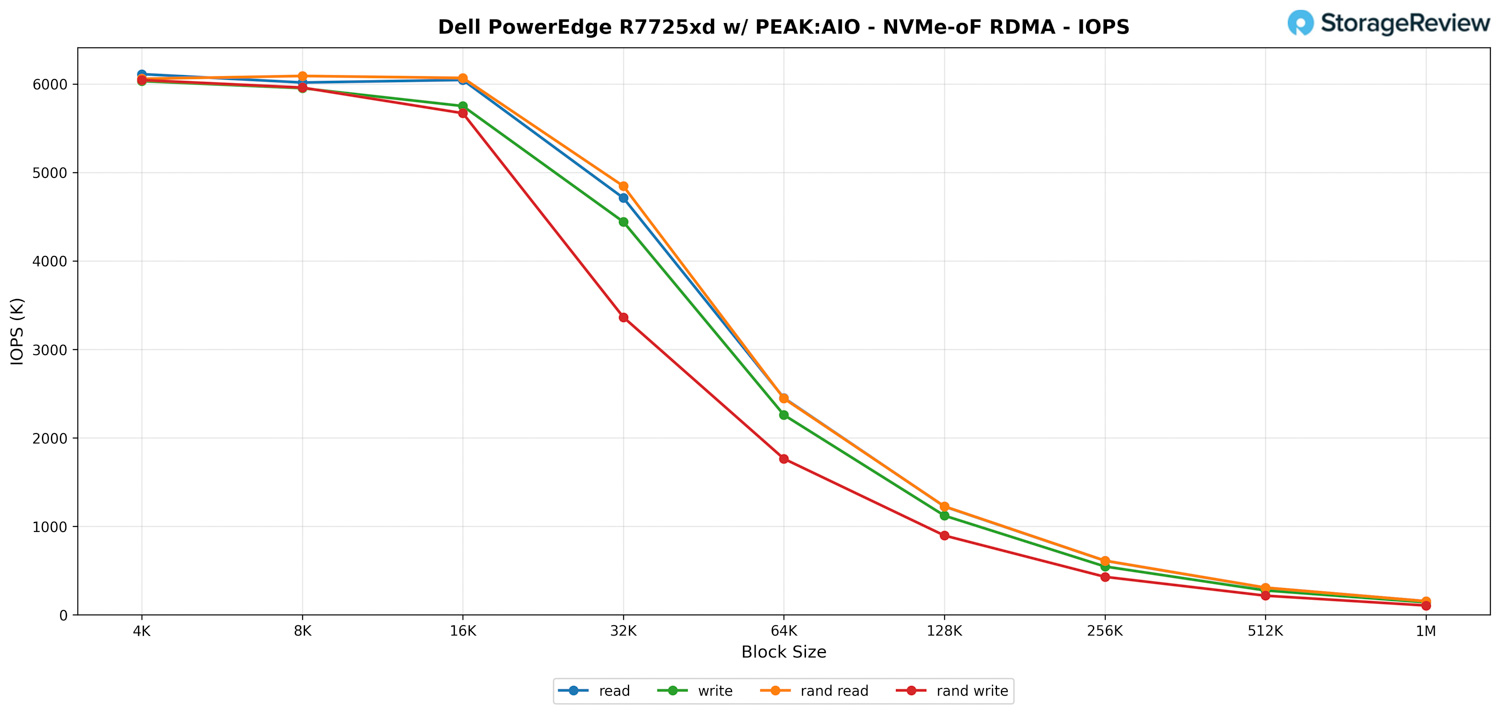
På IOPS-sidan uppvisar PowerEdge R7725xd stark prestanda för små block, även om vi initialt observerade lägre siffror än väntat; detta problem förväntas åtgärdas med förbättrat stöd för nätverksdrivrutiner i framtiden. Även med det i spel ser den övergripande skalningstrenden ut precis som NVMe-oF RDMA vanligtvis beter sig när blockstorleken ökar.
Vid den minsta blockstorleken kan systemet leverera mer än 6 miljoner IOPS över både sekventiella och slumpmässiga arbetsbelastningar. Läsning, skrivning, slumpmässig läsning och slumpmässig skrivning ligger alla i ungefär samma intervall vid 4K och 8K, vilket indikerar att frontend-klienterna, PCIe-infrastrukturen och NVMe-enheterna själva inte har några problem med att hålla jämna steg med förfrågningshastigheten.
Allt eftersom blockstorlekarna växer börjar den förväntade minskningen av IOPS. Vid 32K landar läsningarna runt 4.7 miljoner IOPS, medan skrivningar halkar efter något på cirka 4.4 miljoner. Slumpmässiga skrivningar drabbas hårdast här och faller till ungefär 3.3 miljoner IOPS, vilket överensstämmer med den extra kö- och CPU-overhead som introduceras av mixed-access-mönster.
När vi rör oss in i de stora blocken fortsätter IOPS att minska på ett förutsägbart linjärt sätt. När vi når överföringar på 256 000 och 512 000 blir dataflödet det dominerande måttet, och IOPS sjunker naturligtvis till mitten av hundratusentals. Vid en blockstorlek på 1 miljoner dollar konvergerar alla arbetsbelastningar till 140 000–153 000 IOPS, vilket överensstämmer med bandbreddssiffrorna vi såg i föregående avsnitt.
GPUDirect-lagringsprestanda
Ett av testerna vi utförde på R7725xd var Magnum IO GPUDirect Storage (GDS)-testet. GDS är en funktion utvecklad av NVIDIA som gör det möjligt för GPU:er att kringgå processorn vid åtkomst till data lagrad på NVMe-enheter eller andra höghastighetslagringsenheter. Istället för att dirigera data genom processorn och systemminnet möjliggör GDS direkt kommunikation mellan GPU:n och lagringsenheten, vilket avsevärt minskar latensen och förbättrar dataflödet.
Hur GPUDirect-lagring fungerar
Traditionellt sett, när en GPU bearbetar data som lagras på en NVMe-enhet, måste informationen först passera genom processorn och systemminnet innan den når GPU:n. Denna process introducerar flaskhalsar, eftersom processorn blir en mellanhand, vilket ökar latensen och förbrukar värdefulla systemresurser. GPUDirect Storage eliminerar denna ineffektivitet genom att göra det möjligt för GPU:n att komma åt data direkt från lagringsenheten via PCIe-bussen. Denna direkta väg minskar dataförflyttningskostnaden, vilket möjliggör snabbare och effektivare dataöverföringar.
AI-arbetsbelastningar, särskilt de som involverar djupinlärning, är mycket dataintensiva. Att träna stora neurala nätverk kräver bearbetning av terabyte data, och eventuella fördröjningar i dataöverföringen kan leda till underutnyttjade GPU:er och längre träningstider. GPUDirect Storage hanterar denna utmaning genom att säkerställa att data levereras till GPU:n så snabbt som möjligt, vilket minimerar inaktivitetstid och maximerar beräkningseffektiviteten.
Dessutom är GDS särskilt fördelaktigt för arbetsbelastningar som involverar streaming av stora datamängder, såsom videobearbetning, naturlig språkbehandling eller realtidsinferens. Genom att minska beroendet av CPU:n påskyndar GDS datarörelsen och frigör CPU-resurser för andra uppgifter, vilket ytterligare förbättrar den övergripande systemets prestanda.
Utöver rå bandbredd levererar GPUDirect med NVMe-oF (TCP/RDMA) även I/O med ultralåg latens. Detta säkerställer att GPU:er aldrig svälter på data, vilket gör systemet idealiskt för AI-inferens i realtid, analyspipelines och videouppspelning.
GDSIO Läs sekventiell
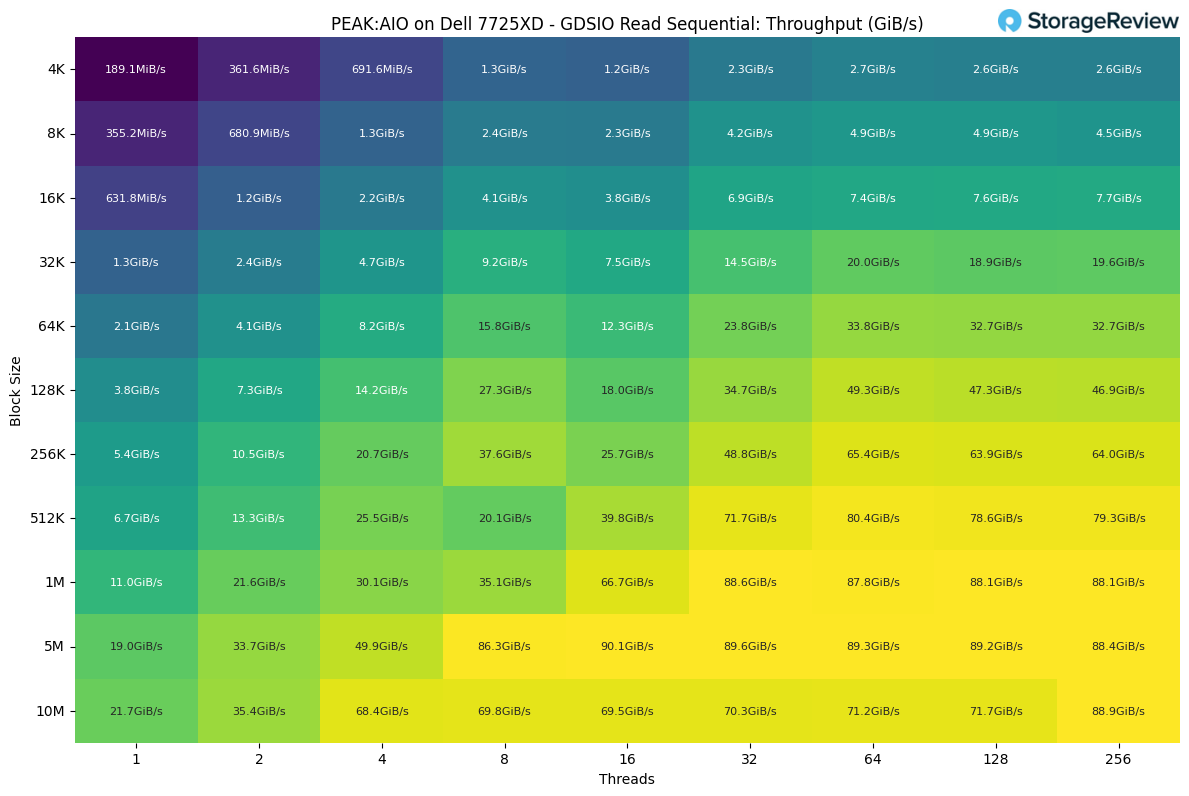
När man undersöker PEAK:AIO med en klient som använder GDSIO, uppvisar läsdataflödet ett tydligt skalningsmönster då både blockstorlek och trådantal ökar. Denna enda klient var ansluten via två 400G-länkar, vilket begränsade dess totala potential till 90 GB/s.
Vid de minsta blockstorlekarna och låga trådantal är prestandan blygsam, med 4K-läsningar som börjar runt 189 MiB/s vid en enda tråd. Så fort vi ökar trådparallelliteten svarar systemet omedelbart, och når 691 MiB/s vid fyra trådar och bryter in i multi-GiB/s-intervallet när vi går in i större block.
Blockstorlekarna i mellanregistret visar den starkaste känsligheten för trådantal. Vid 32K växer dataflödet från 1.3 GiB/s vid en enda tråd till nästan 20 GiB/s vid 64 trådar, med endast en liten avsmalning utöver det. Ett liknande mönster syns vid 64K och 128K, där systemet övergår från låga ensiffriga GiB/s vid låg parallellitet till över 30 GiB/s allt eftersom arbetsbelastningen skalas upp.
När vi når de större blockstorlekarna börjar dataflödet plana ut när systemet närmar sig sitt prestandatak för en enskild klient. Vid 1 MiB klättrar prestandan från 11 GiB/s vid en tråd till cirka 88 GiB/s vid höga trådantal. Överföringarna på 5 MiB och 10 MiB visar samma platå, och toppar runt 89–90 GiB/s oavsett om testet körs med 64, 128 eller 256 trådar.
GDSIO Skriv sekventiell
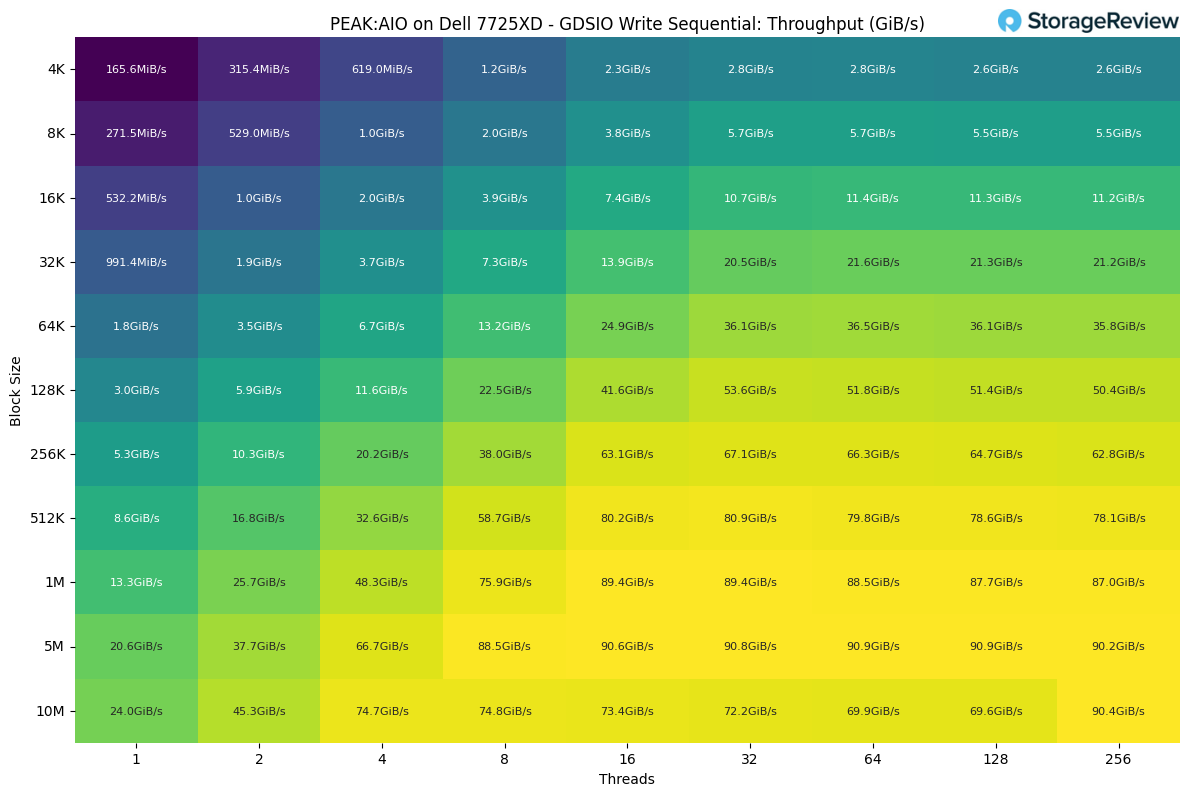
På skrivsidan följer skalningsbeteendet ett liknande mönster som för läsningar, men med något lägre prestanda över de flesta blockstorlekar, vilket förväntas för sekventiella skrivbelastningar. Vid de minsta blockstorlekarna börjar dataflödet vid 165 MiB/s för en enda tråd vid 4K och ökar stadigt allt eftersom parallelliteten ökar. Vid fyra trådar växer det till drygt 619 MiB/s innan det klättrar förbi 1 GiB/s vid åtta trådar.
Blockstorlekar i mellanklassen visar starkare vinster när trådantalet ökar. Vid 32K börjar dataflödet på strax under 1 GiB/s och skalas upp till över 21 GiB/s vid högre trådnivåer. 64K- och 128K-intervallen fortsätter trenden och går från låga ensiffriga GiB/s till mitten av 30 GiB/s och 50 GiB/s när arbetsbelastningen blir mer parallell.
Större överföringar sker när systemet återgår till sitt naturliga skrivhastighetstak. Vid 1 MiB ökar prestandan från 13.3 GiB/s vid en enda tråd till strax under 90 GiB/s vid höga trådantal. Testerna på 5 MiB och 10 MiB följer ett liknande mönster, med resultat som toppar runt 90 GiB/s oavsett om systemet körs med 64, 128 eller 256 trådar.
Omdefiniera prestanda i Gen5-eran
Dell PowerEdge R7725xd är mer än en lagringsserver; den representerar ett skifte i hur bandbredd levereras inuti racket. Genom att eliminera PCIe-switchar och ge varje NVMe-enhet en direkt väg till processorn, skapade Dell ett system där dataflödet skalas upp smidigt, temperaturen förblir förutsägbar och samtidighet blir en tillgång snarare än en utmaning.
I kombination med Microns 9550 PRO SSD-diskar och PEAK:AIO:s parallella I/O-programvara förvandlas R7725xd från ett kompakt NVMe-chassi till en riktig datamotor. Den kan mätta sin lokala PCIe-struktur, mata GPU:er över RDMA med linjehastighet eller fungera som både beräknings- och lagringsenhet samtidigt, allt inom ett 2U-hölje.
Dell PowerEdge R7225xd
I praktiken levererar den här konfigurationen mer än 300 GB/s lokal dataflöde och 160 GB/s över nätverket, vilket konkurrerar med prestandan hos lagringskluster med flera noder till en bråkdel av komplexiteten och kostnaden. Det är en demonstration av vad som händer när varje lager i stacken, från kisel till programvara, är inriktat på effektivitet och bibehållen bandbredd.
R7725xd sätter en ny standard för prestanda för lagring med en enda nod i Gen5-eran. För organisationer som bygger nästa generations AI-pipelines, höghastighetsanalys eller kontrollpunktstunga träningsmiljöer är det en glimt av vad som är möjligt när flaskhalsarna designas bort helt från systemet.
Den här rapporten är sponsrad av Dell Technologies. Alla åsikter och åsikter som uttrycks i denna rapport är baserade på vår opartiska syn på produkten/de produkter som övervägs.


 Amazon