

Comino skickade oss nyligen den senaste versionen av Comino Grando för recension, konfigurerad med åtta NVIDIA RTX PRO 6000 Blackwell-kort, vart och ett med 96 GB VRAM, för totalt 768 GB GPU-minne. Vi recenserade Comino år 2024, konfigurerad med 6x RTX 4090 , som erbjuder 144 GB totalt GPU-minne, samt en version med NVIDIA H100 . Den senaste uppdateringen markerar ett betydande generationssprång i både rå minneskapacitet och utbudet av arbetsbelastningar som plattformen kan hantera.
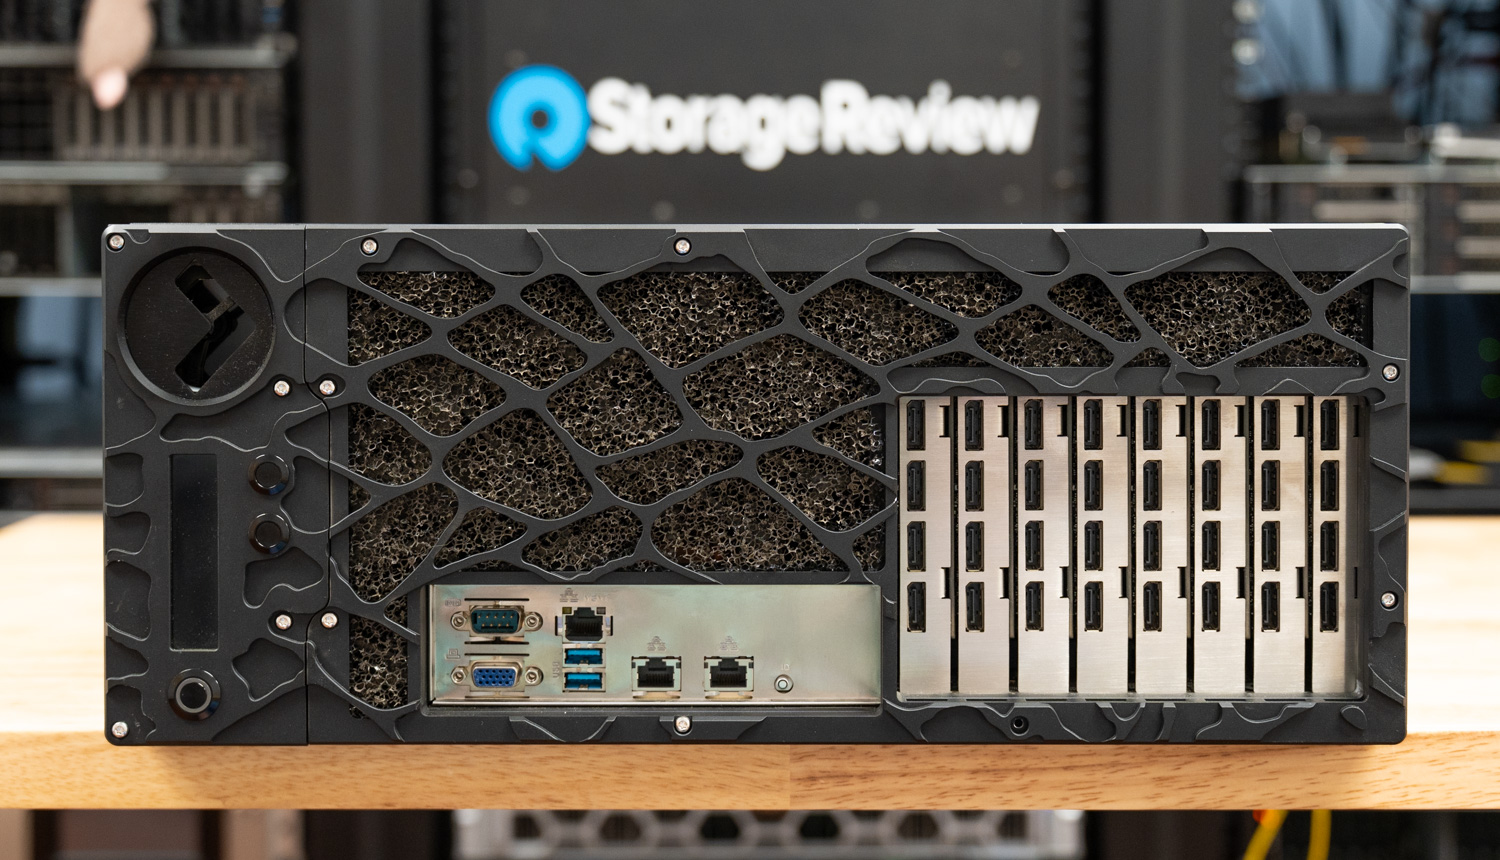
Grando är en specialbyggd 4U-plattform utformad för att lösa den kritiska konflikten mellan högdensitets-GPU-beräkning och kylhantering. Medan vanliga luftkylda chassin faller sönder under de ihållande 600W+ TDP-kraven som moderna professionella kort ställer, har Grando en fundamentalt annorlunda strategi, byggd från grunden kring en vätskekyld arkitektur som kan avleda hela 6.5 kW kontinuerlig värme. Detta är inte en eftermontering eller en eftertanke; hela chassit, från dess inverterade moderkortslayout till dess färgkodade snabbkopplingssystem, har konstruerats kring kylkretsen.
Resultatet är en plattform som kan hantera åtta professionella grafikkort med full TDP i ett enda 4U-chassi, som körs dygnet runt i omgivande miljöer på 3–38 °C, utan termisk strypning, utan den akustiska attacken från högvarvtalsluftkylning och utan att kompromissa med servicevänligheten. För organisationer som distribuerar AI-inferens, maskininlärningsträning eller högpresterande simuleringsarbetsbelastningar i stor skala, erbjuder Grando något verkligt ovanligt: en server som inte ber dig att välja mellan densitet, temperatur och tillförlitlighet.
Comino Grando Specifikationer
Tabellen nedan visar de fysiska specifikationerna och de hårdvarukonfigurationer som stöds för Comino Grando-plattformen.
| Specifikation / Funktion | Comino Grando |
|---|---|
| Comino Grando server- och rackbar arbetsstation | |
| Kylkapacitet | 6.5 kW (Max 6 500 W vid 20 °C insugningsluft T) |
| Moderkort | Upp till EATX och EBB |
| GPU:er (server) | Upp till 8; NVIDIA: RTX A6000, RTX 6000 ADA, RTX PRO 6000, A40, L40, L40S, A100, H100, H200 |
| GPU:er (rackbara arbetsstationer) | Upp till 6; NVIDIA: 3090, 4090, 5080, 5090, RTX A6000, RTX 6000 ADA, RTX PRO 6000, A40, L40, L40S, A100, H100, H200; AMD: W7800, W7900 |
| CPU: er | Upp till 2; Enkel sockel: Intel Xeon W-2400/2500 och 3400/3500, Intel Xeon Scalable 4:e generationen, 5:e generationen, XEON 6, AMD Threadripper PRO 5000WX, 7000WX, 9000WX, AMD EPYC 9004/9005 Dubbel sockel: Intel Xeon Scalable 4:e generationen och 5:e generationen, XEON 6, AMD EPYC 9004/9005 |
| RAM | Upp till 2TB |
| M2-enheter | Upp till 8x NVME |
| lagring | Bakpanelens hot-swap-burar: upp till 4 hot-swap SSD-diskar (4x 7 mm eller 2x 15 mm) och upp till 4 fler (4x 7 mm eller 2x 15 mm) istället för ett fjärde nätaggregat; Intern 3.5″ bur upp till 4x 3.5″ eller 4x 2.5″ 15mm eller 12x 2.5″ 7mm; Interna 2.5-tumsplatser: upp till 4x 2.5-tums SSD 7 mm |
| Strömförsörjning och driftspänning | Upp till 4x 2000W Hot Swap CRPS vid 180-264V Upp till 4x 1000W Hot Swap CRPS vid 90-140V Redundanslägen: 4+0, 3+1, 2+2 |
| Ljudnivå | 39dB-70dB |
| Lan | Upp till 2x 10 Gbit/s på mainboardet och upp till 400 Gbit/s i PCIe |
| OS | Ubuntu / Windows 11 (Pro/Home) / Windows Server |
| Fysiska och kylande specifikationer | |
| Vätskekylning | CPU med VRM och GPU med GDDR och VRM |
| Reservoar | Comino specialanpassad 450ml med integrerade pumpar |
| Fläktar | 3x Ultra High Flow 6200 RPM (hög ljudnivå) eller 3x högt flöde 3000 varv/min (låg ljudnivå) |
| Installation | 19-tums rackmonterbar eller fristående som arbetsstation |
| Nödvändigt rackutrymme | 4U |
| Storlek | 439 x 681 x 177 mm (utan handtag och utskjutande delar) |
| Vikt | 4 grafikkort: 49 kg (netto), 67 kg (brutto) 6 grafikkort: 52 kg (netto), 70 kg (brutto) 8 grafikkort: 55 kg (netto), 72 kg (brutto) |
| Drifts- och förvaringstemperaturintervall | Förvaring: -5..50°C / 23..122°F Drift: 3..38°C / 38..100°F |
| Comino övervakningssystem (CMS) | |
| Översikt | Styrkort med sensorer och programvara för realtidsövervakning |
| Viktiga fördelar | Kylsystem och CPU/GPU-övervakning, webbgränssnitt, kylsystemlogg, centraliserad övervakning för arbetsgrupper |
| Sensorer och anslutna enheter | Temperatur (luft och kylvätska), % luftfuktighet, spänning, kylvätskeflöde, kylvätskenivå i behållaren, fläktar, pumpar, moderkort, display och knappar |
| Integrationsmöjligheter | Upprätta övervakning via ett REST API och skicka sensordata till övervakningsprogramvara (t.ex. Zabbix, Grafana) eller databaser (t.ex. InfluxDB). |
| Tekniska krav för CMS | |
| OS | Windows 11 / 10 Ubuntu 22.04/20.4 (Beroende för Ubuntu: målsystemet måste ha nvidia-smi och sensorverktyg installerade) |
| Webbläsare | Mozilla Firefox, Google Chrome, Chromium, Apple Safari, Microsoft Edge (Obs! Internet Explorer 11 stöds inte) |
| Hårddisk | 300MB |
| Styrenhetens firmwareversion | 1.0.6 eller nyare |
| Styrenhetskretskortsversion | 2.xx.xx |
Design, byggnation och GPU-densitet
Chassilayout och driftsättning
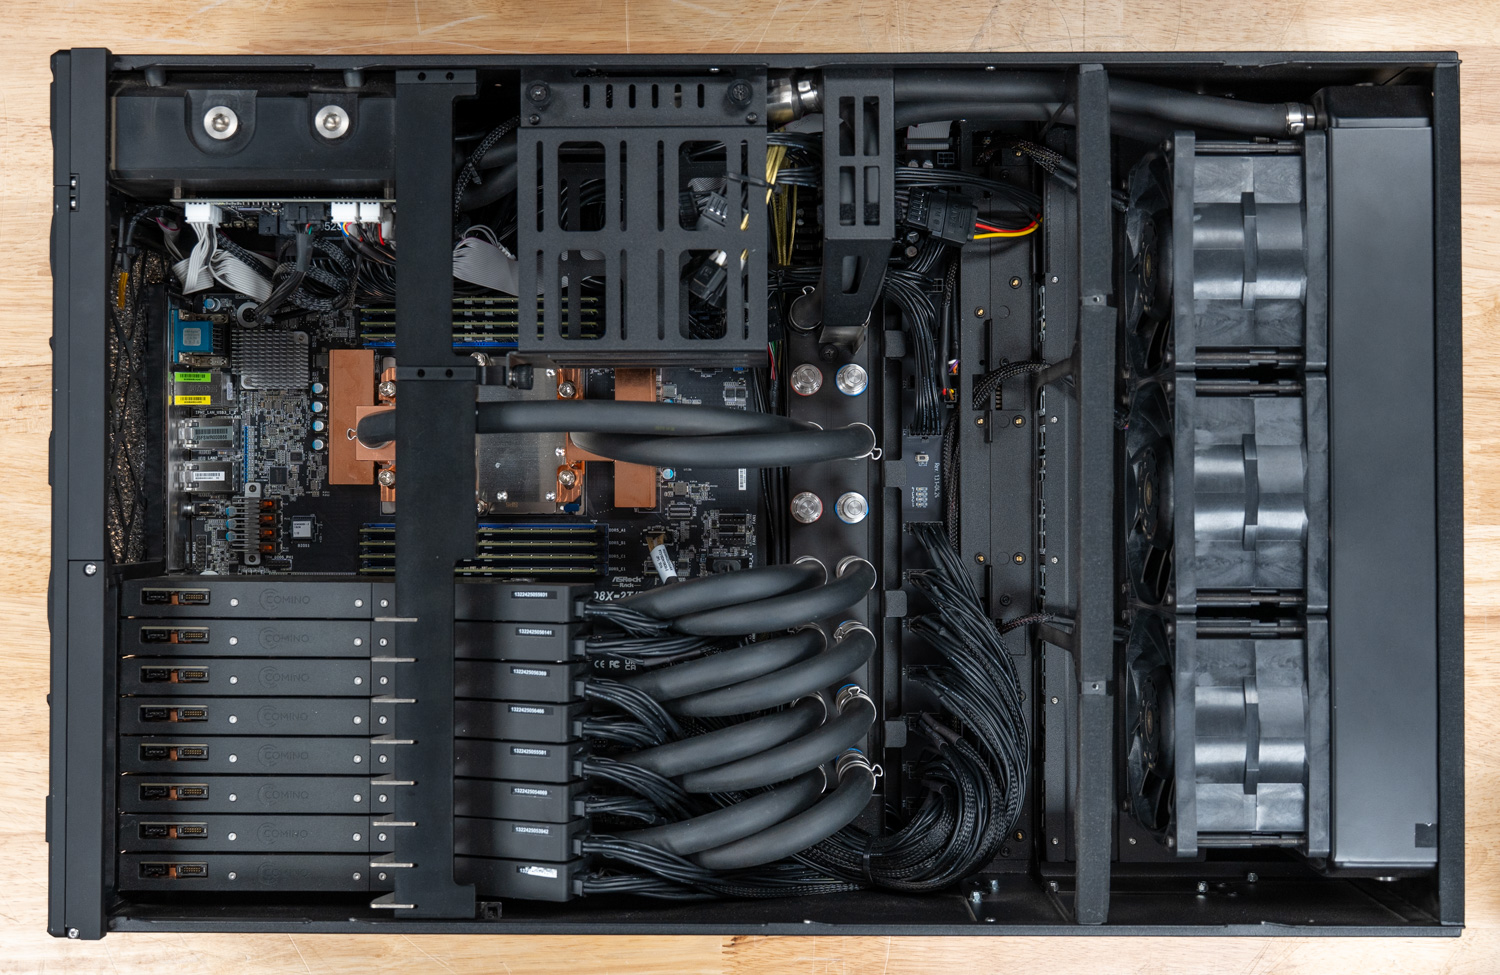
Grando Server är en mästerklass inom utrymmesoptimering och mäter 17.3 x 26.8 x 6.97 tum (4U). Till skillnad från traditionella servrar placerar den moderkortets baksida framför chassit, vilket inverterar den konventionella interna layouten. Detta säkerställer att luftkylda komponenter, såsom RAM-moduler och VRM-minnen, får den kallaste möjliga insugsluften innan den når vätskekylningsradiatorn på baksidan.
Själva chassit är byggt enligt samma exakta standard, med en solid stålkonstruktion med en matt svart pulverlackering på insidan och utsidan. Detta medvetna val sträcker sig även till rör, kablar, kylare och lödmask för kretskort, vilket återspeglar en tydlig avsikt att ha en ren och professionell estetik rakt igenom. Dessutom stöder systemet mångsidig implementering och fungerar sömlöst som antingen en 19-tums rackmonterbar enhet eller en fristående stationär enhet. Beroende på konfigurationen väger den mellan 148 och 159 kg.
GPU-kylplattor och vattenblock
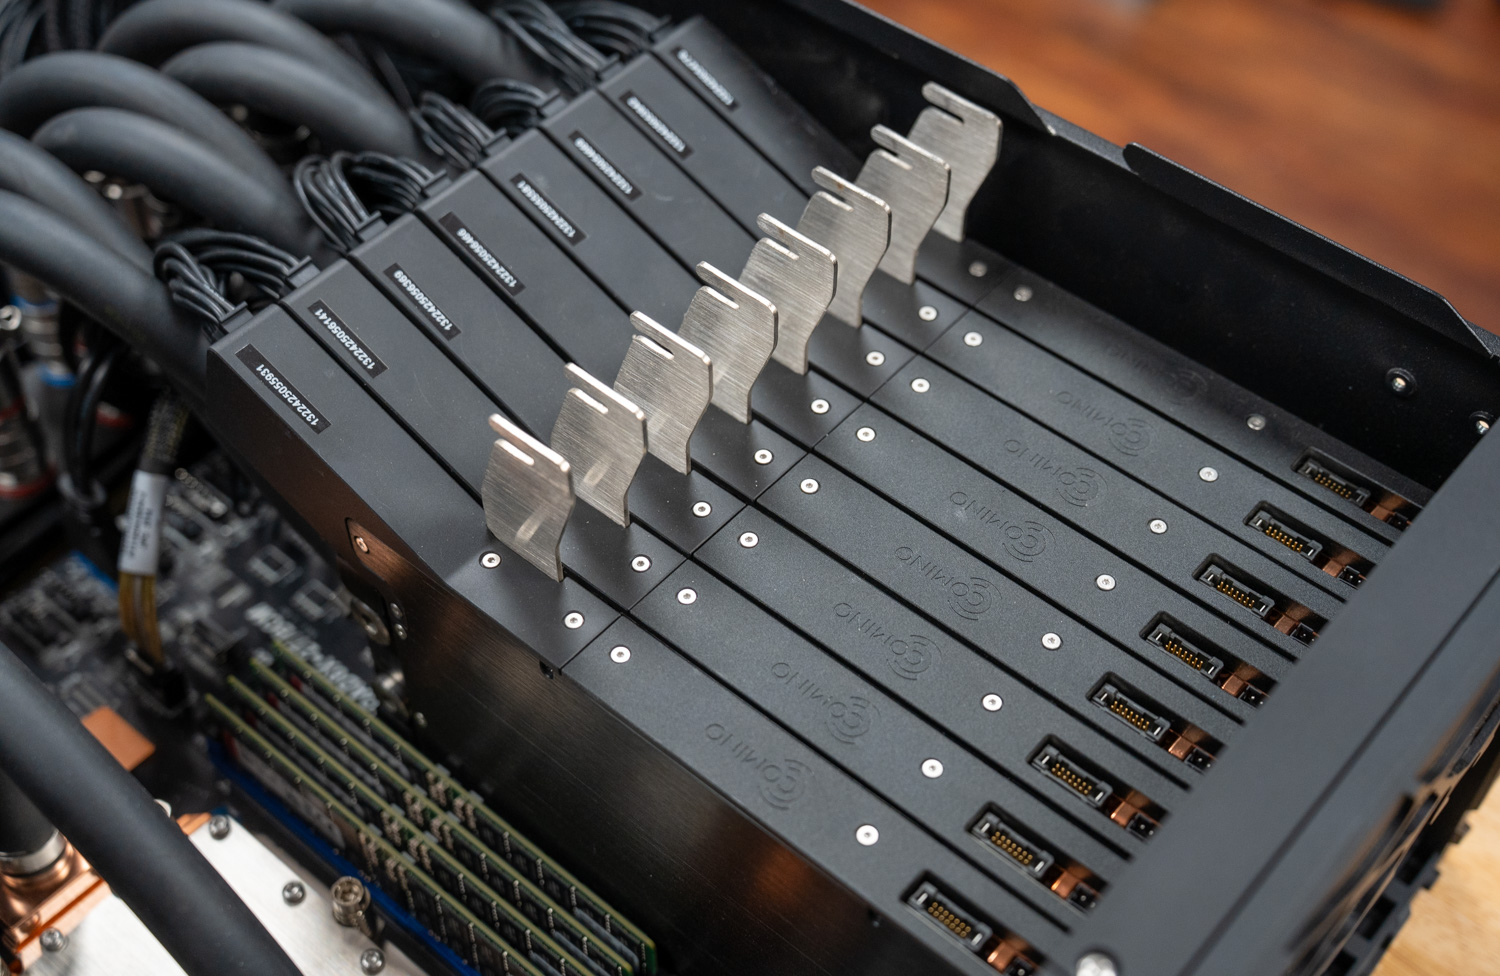
De egenutvecklade vattenblocken i koppar utgör kärnan i Grandos densitet och kyler inte bara GPU-chipet utan även andra komponenter som minne och spänningsregulatorer. Varje GPU levereras som ett standardkort, på vilket Comino monterar en specialbyggd kylplatta. I praktiken reducerar denna tunnprofildesign varje kort till en enda plats, vilket gör att sex eller till och med åtta professionella GPU:er kan placeras sida vid sida i ett enda 4U-chassi. Vår testenhet levererades med åtta NVIDIA RTX PRO 6000 Blackwell-kort, vart och ett med en TDP på 600 W, vilket resulterar i ett totalt kylbehov på 4 800 W under full belastning.
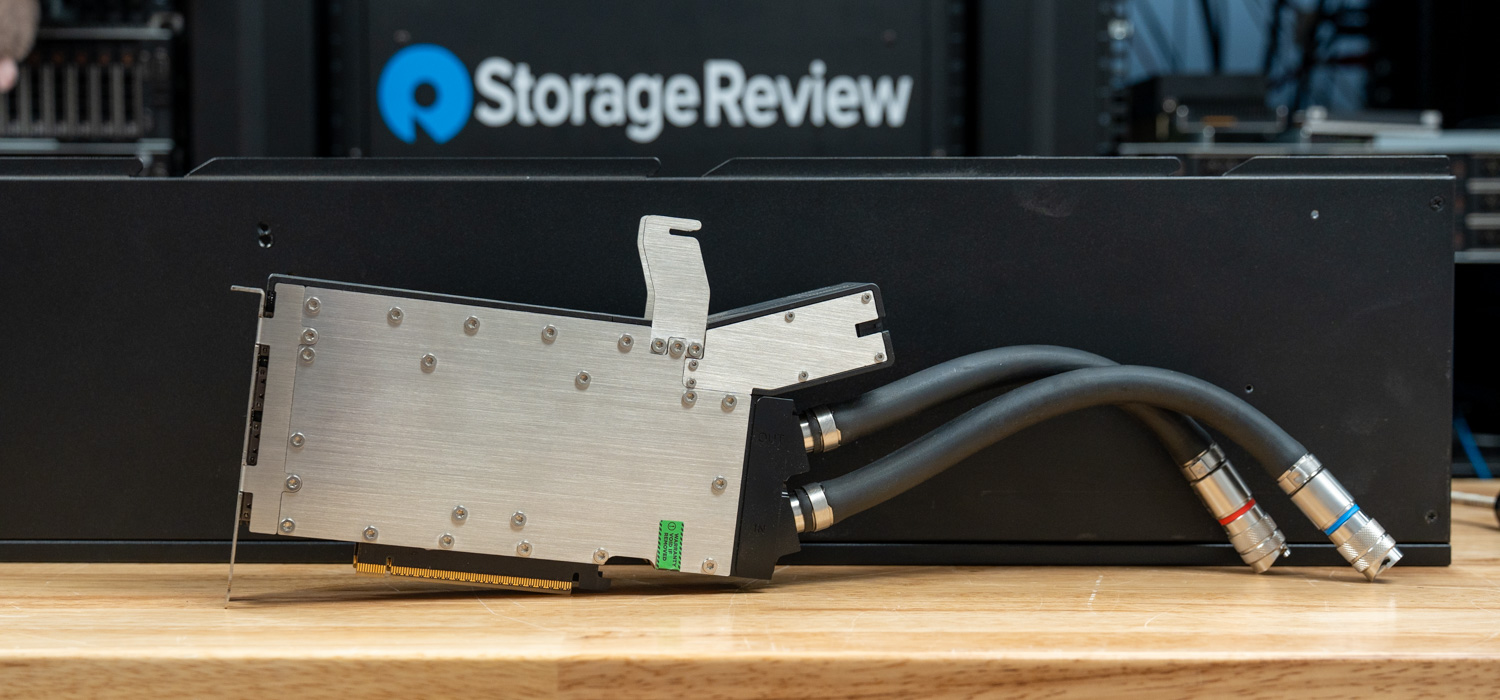
Att uppnå Cominos GPU-densitet med 8 enstaka kortplatser skulle vara nästan omöjligt med luftkylning, eftersom NVIDIA RTX PRO 6000-kort i originalutförande upptar två kortplatser vardera och kräver betydande luftflöde. Däremot upptar dessa specialkylda kort bara en kortplats vardera. Kylplattorna är solida, vilket ger varje kort märkbar vikt, men den vikten återspeglar den kvalitet och kylprestanda som krävs på denna nivå.
Varje par grafikkort är anslutna genom ett dedikerat delgrenrör som konsoliderar båda korten till en enda inlopps- och utloppsanslutning till huvudkylvätskegrenröret. Denna parade metod förenklar den övergripande looparkitekturen, minskar antalet anslutningar vid huvudgrenröret och gör det möjligt för en tekniker att koppla bort ett enda par snabbkopplingar för att ta bort två kort samtidigt, vilket ytterligare effektiviserar underhållet.
Vattendistribution och grenrör
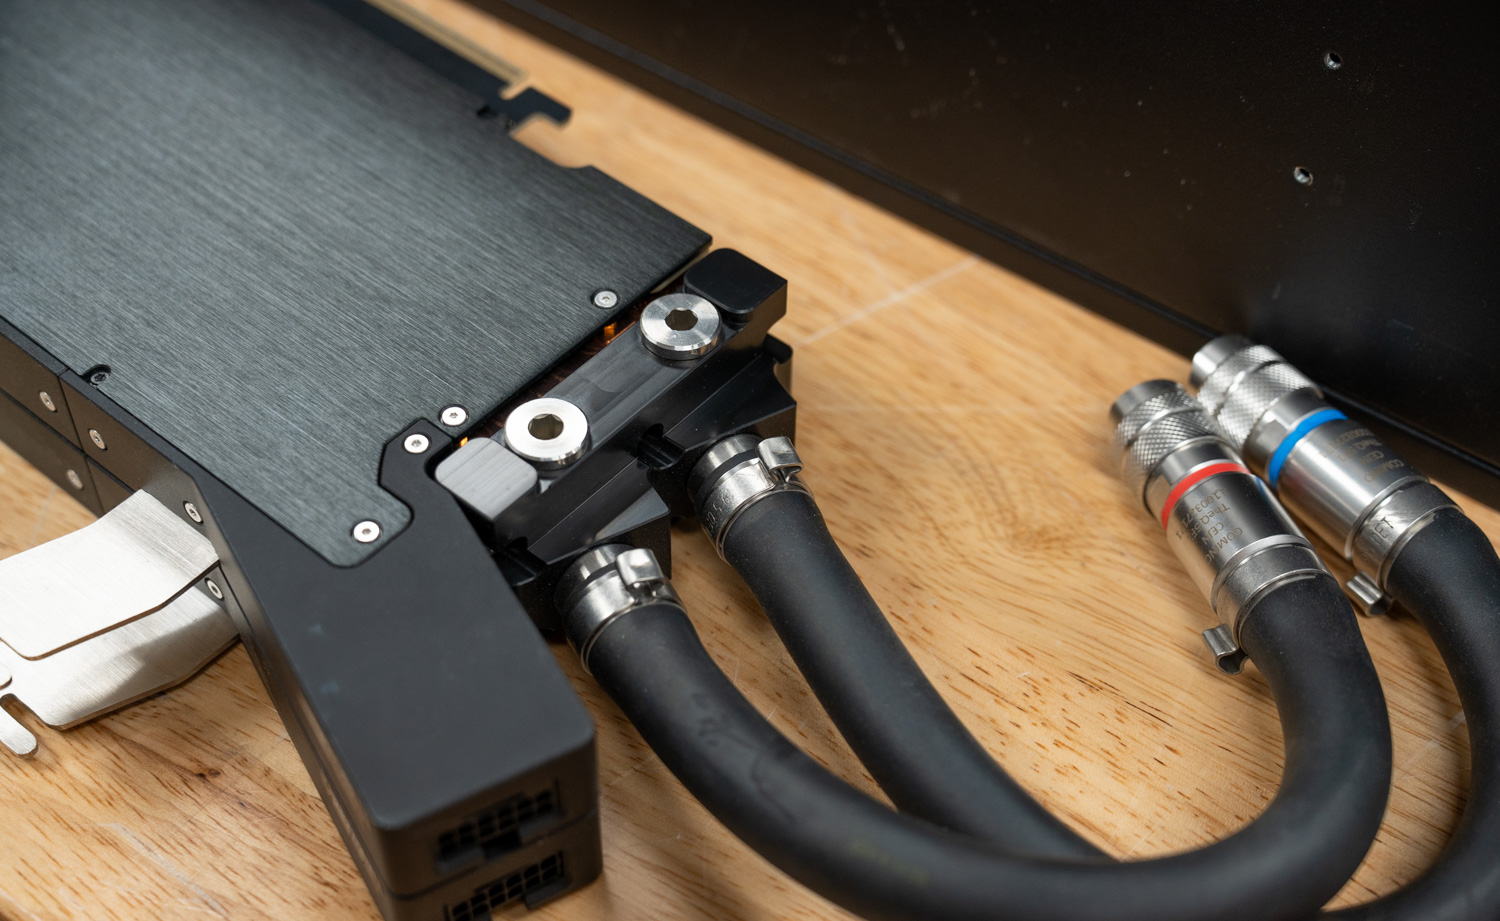
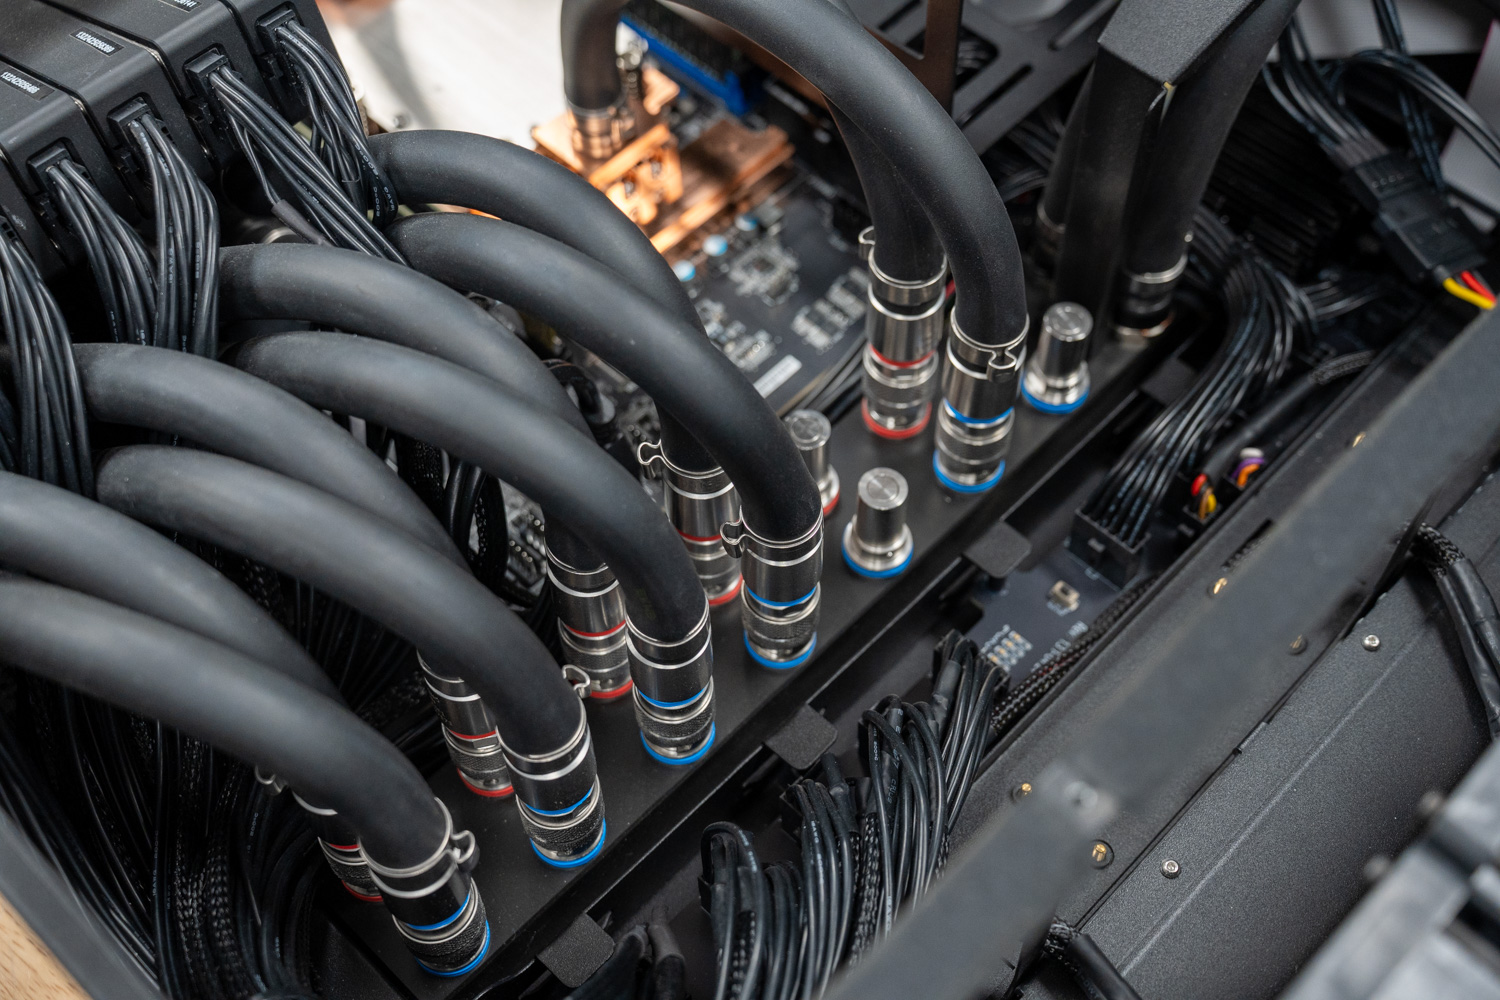
I mitten av systemet sitter ett stort vattenfördelningsgrenrör som tillför kall vätska till varje GPU- och CPU-kylplatta och fungerar som returväg till kylaren. Alla anslutningar mellan grenröret och GPU:erna och CPU:erna använder Cominos "TheQ" snabbkopplingar. Dessa droppfria kopplingar i rostfritt stål är färgkodade med röda och blå ringar för att tydligt identifiera de varma och kalla sidorna av slingan, vilket eliminerar eventuella tvetydigheter under installation eller service.
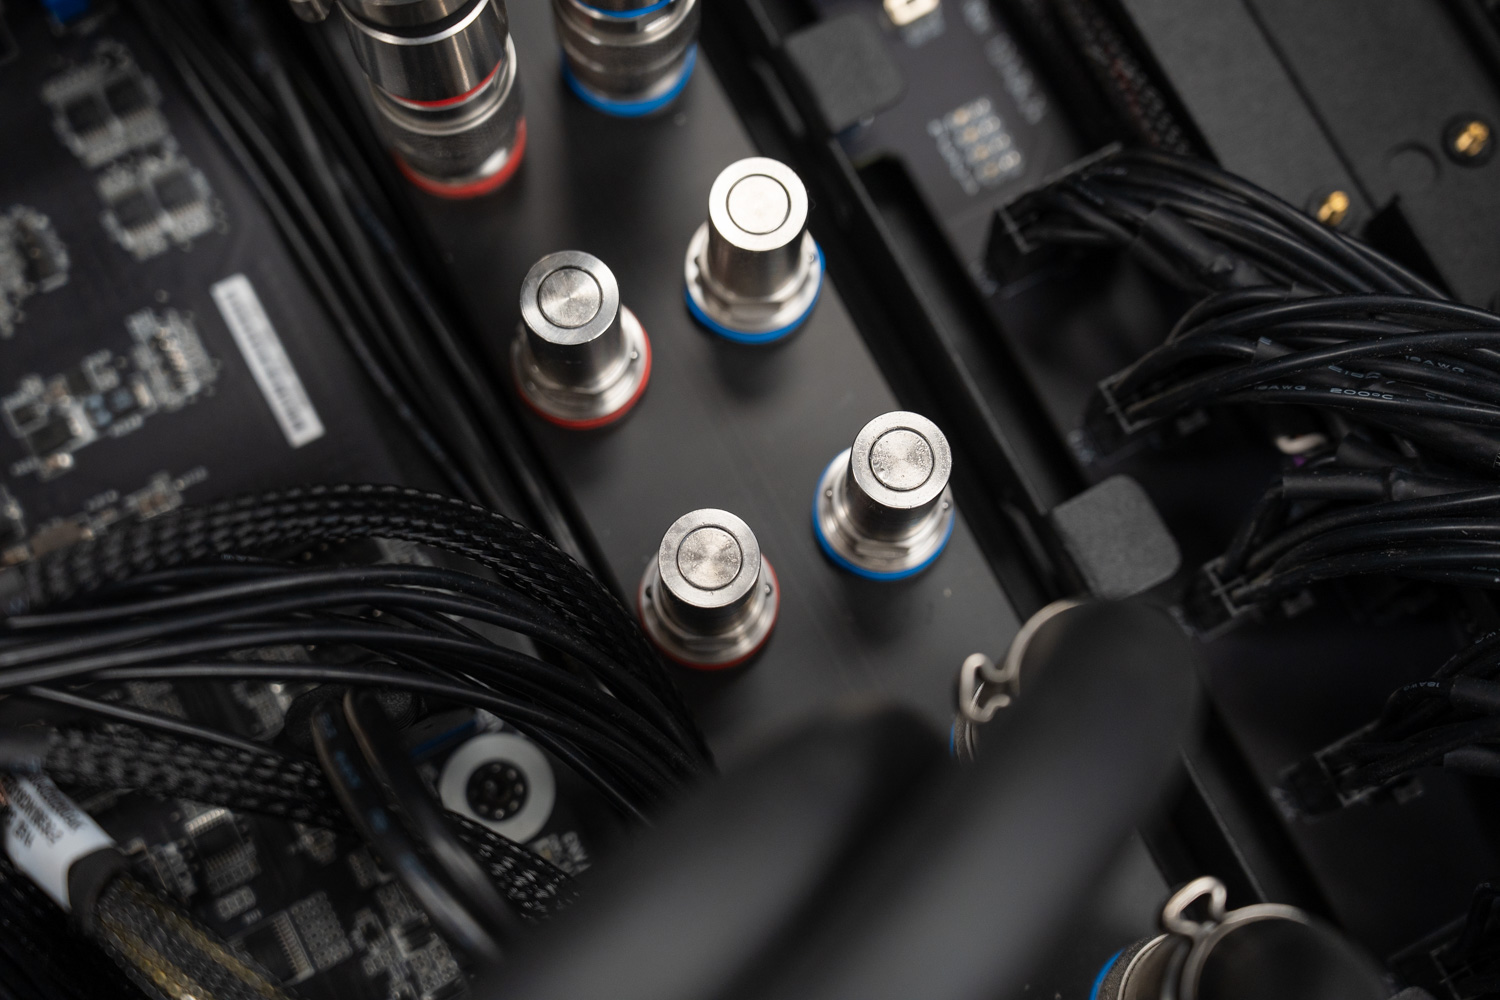
De lämnar minimala rester på anslutningsytan när de kopplas bort, vilket gör det möjligt för tekniker att ta bort eller byta ut enskilda grafikkort eller processorn utan att tömma 450 ml-behållaren eller resten av slingan. På så sätt ger Grando den enkla underhållsupplevelsen hos luftkylda system till en högpresterande vätskekyld plattform.
CPU-kylning och minne
CPU:n och dess spänningsregulatorer drar också nytta av en dedikerad kylplatta som är direkt ansluten till kylvätskekretsen, vilket förhindrar att processorn blir en flaskhals under intensiva arbetsbelastningar med flera grafikkort. Vår testenhet levererades med ett AMD Turin/Genoa-kort med en enda AMD EPYC 9474F 48-kärnig processor. Kylplattan speglar kvaliteten på kortets kylplattor, bearbetade av solid koppar och säkrade med hårdvara i rostfritt stål.
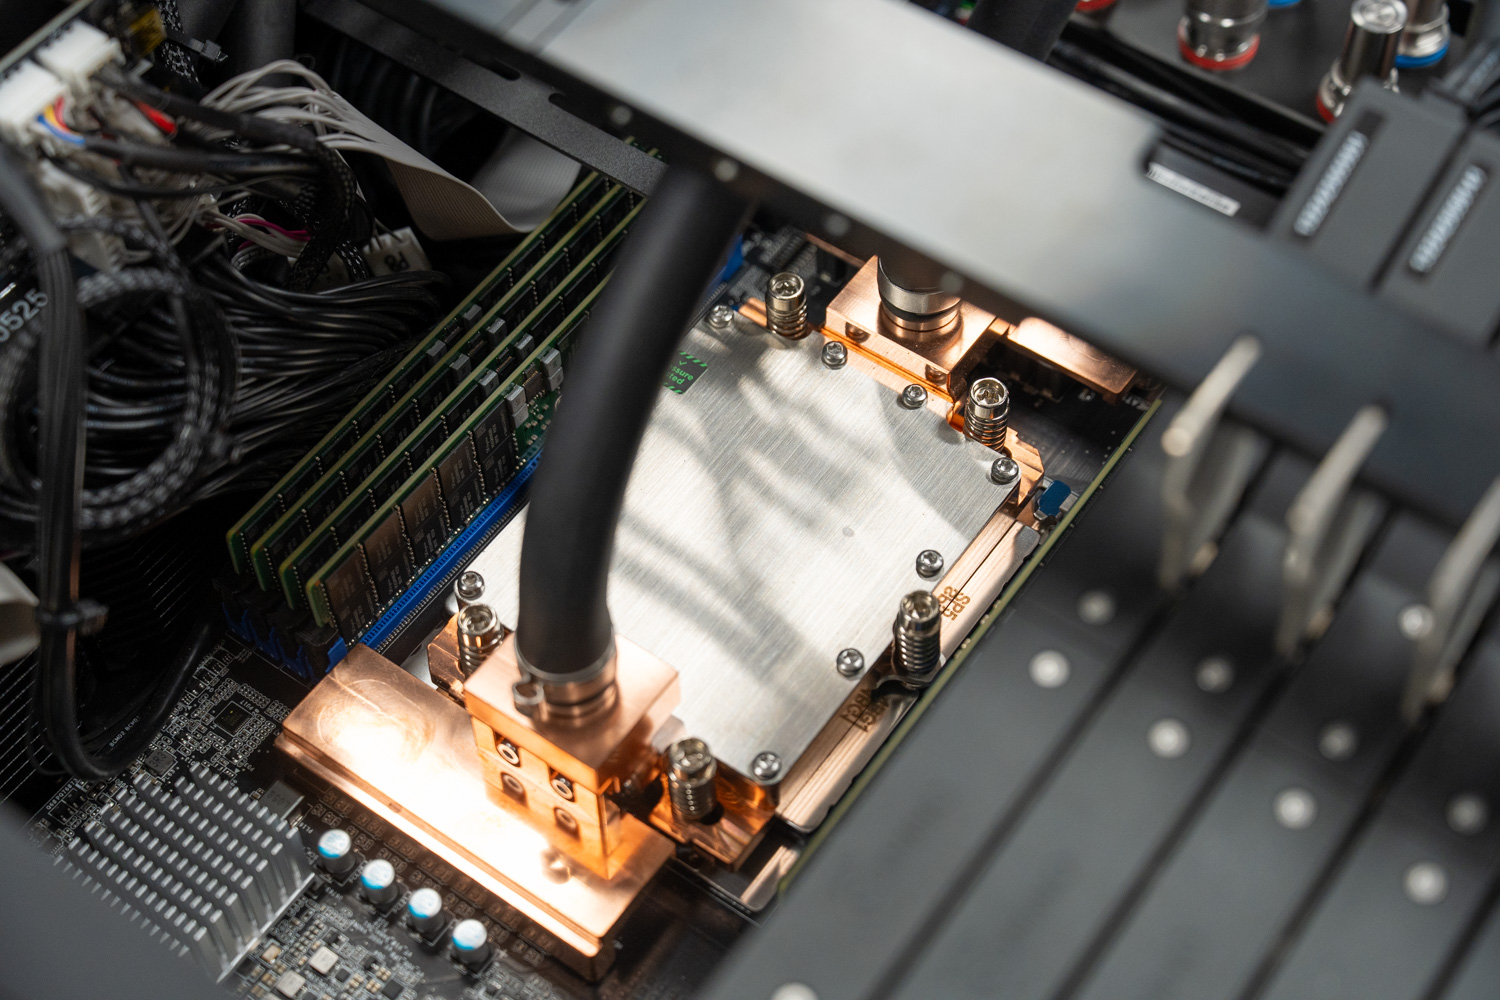
På båda sidor omger processorn åtta fullt utrustade DRAM-platser som stöder konfigurationer upp till 2 TB RAM. Vår testenhet var utrustad med 512 GB DDR5 RAM. En stödstång sträcker sig ovanför GPU- och CPU-området i chassit, vinkelrätt mot dem, vilket säkrar känsliga komponenter som GPU:erna och bibehåller chassits styvhet under transport.
Kylare och fläktar
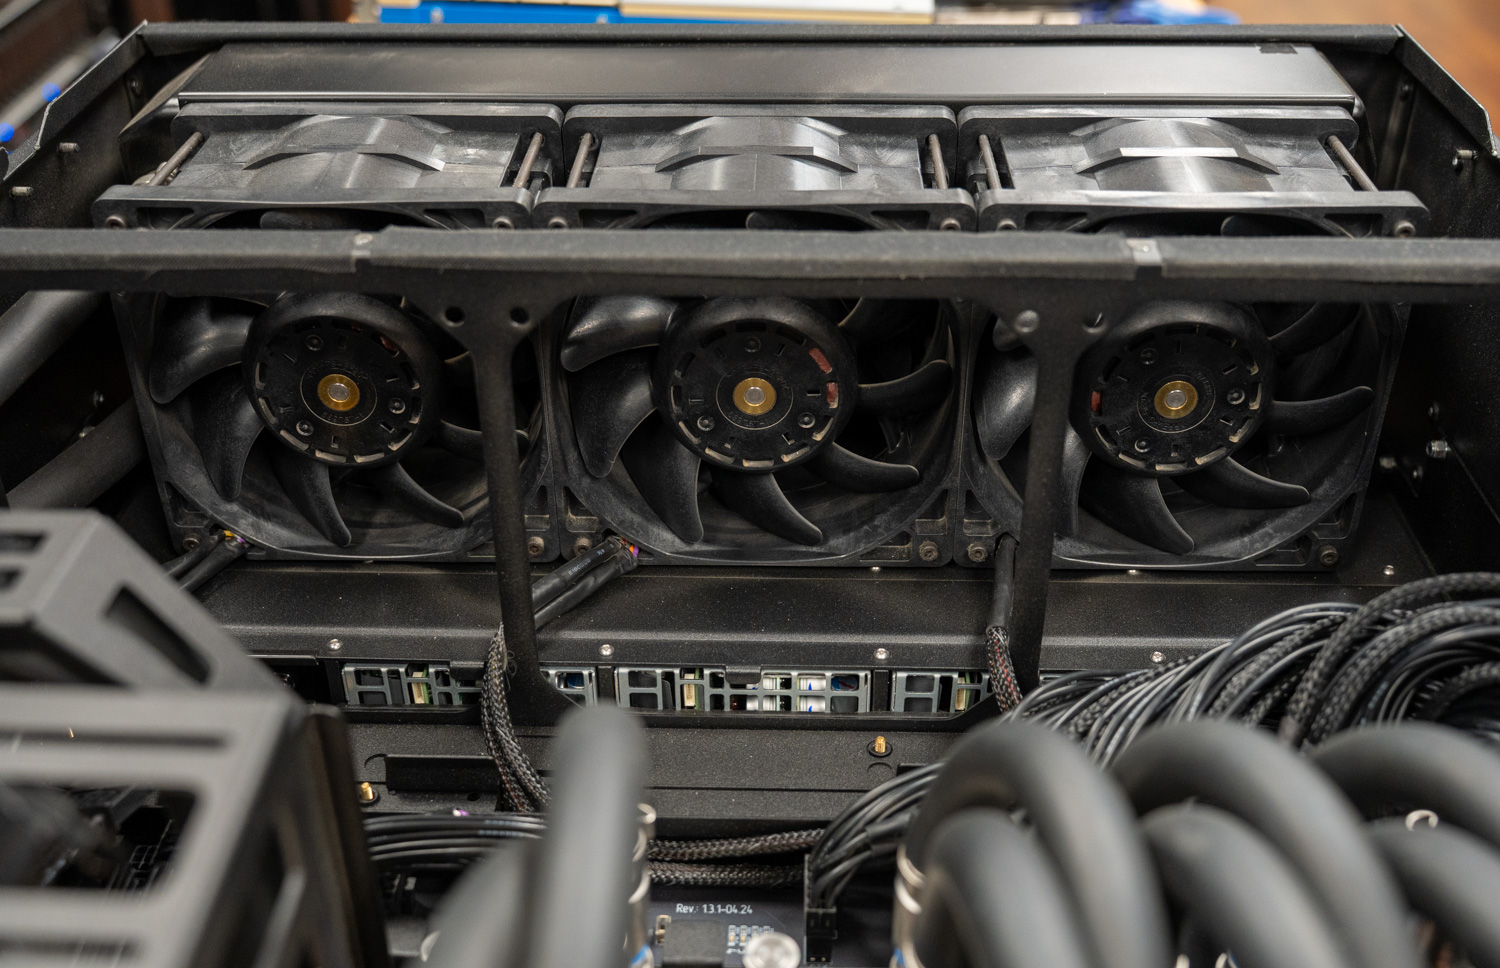
Kylningen hanteras av en stor trippel 140 mm-radiator monterad på baksidan av chassit, i kombination med tre snabba 140 mm-fläktar som kan nå 6 200 varv/min och leverera upp till 1 000 m³/h luftflöde. Den täta flänsstrukturen som den tjocka radiatorn ger understryker det termiska utrymmet som är utformat i plattformen, som är byggd för att avleda upp till 6.5 kW ihållande värme i vår konfiguration.
Det kanske mest förvånande är att trots den arbetsbelastningen och de fläkthastigheterna lyckas enheten hålla sig inom ett tolerabelt ljudområde, med ljudnivåer på över 70 dB vid full lutning. Det är högt för arbetsstationsstandarder men anmärkningsvärt begränsat för ett system som avleder värmeeffekten från en liten elektrisk ugn, vilket talar för hur effektivt Cominos vätskeslinga överför värme bort från komponenterna.
Frontpanel och telemetridisplay
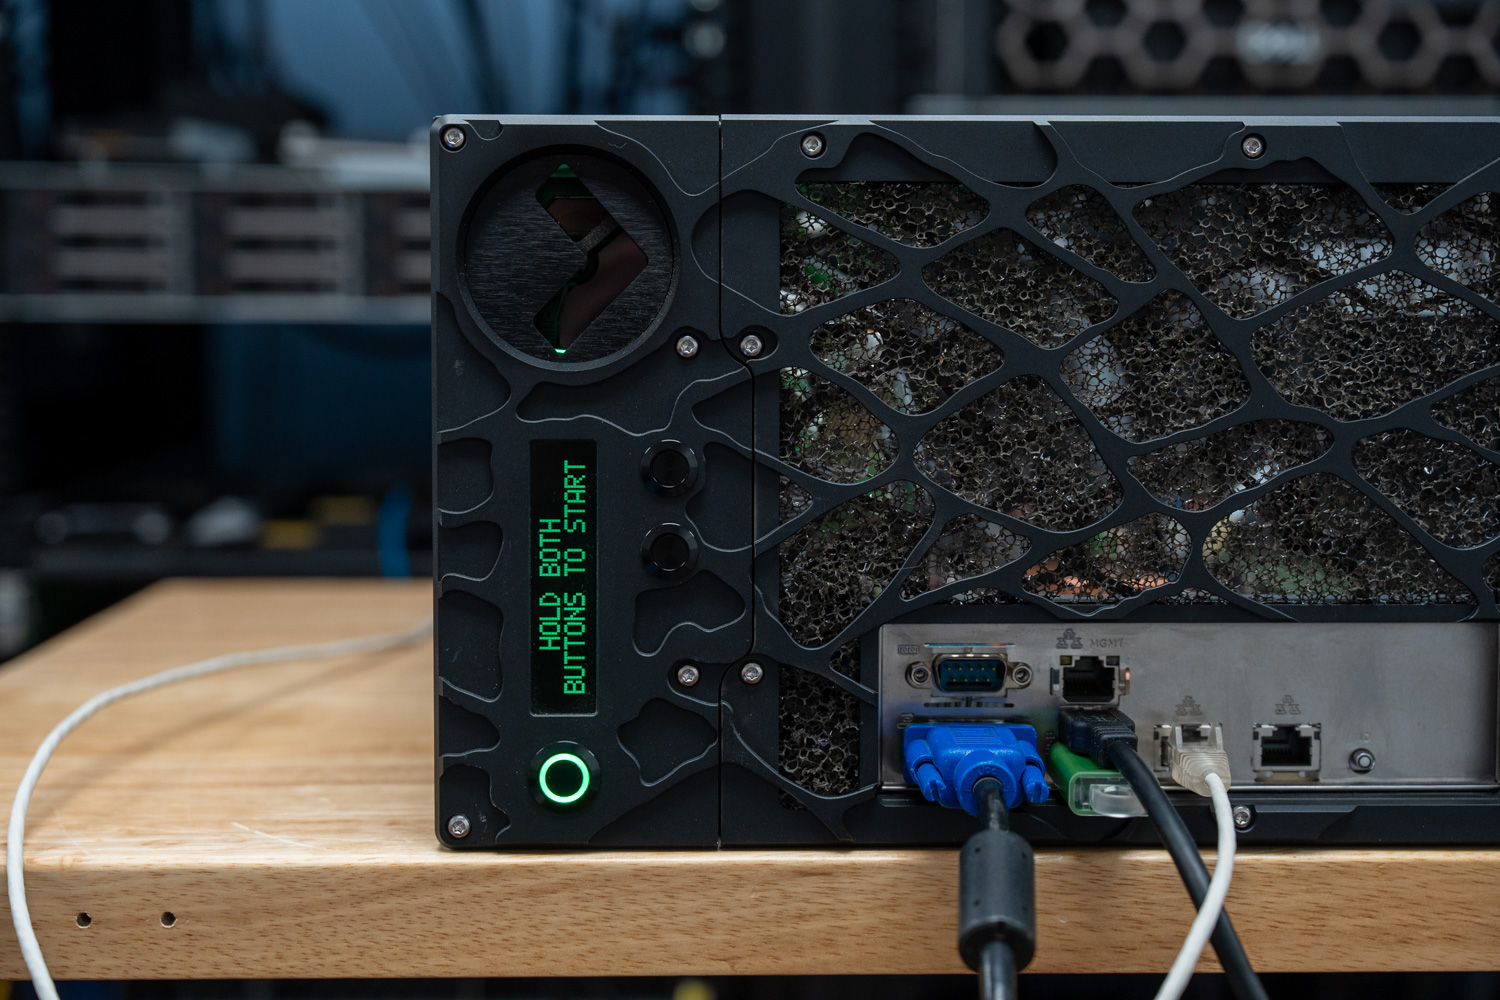
På frontpanelen visar en LED-display viktig telemetridata i realtid, inklusive pumpstatus, omgivningstemperatur, kylvätsketemperatur och fläkthastighet. Användare navigerar i menyn med hjälp av upplysta knappar på kylmodulen, och bläddrar igenom tillgängliga data med korta tryck. Ett långt tryck på PB2-knappen öppnar ytterligare menygren, inklusive kommandon, serviceinställningar och en händelselogg. Dessutom har den främre I/O-panelen en VGA-port för skärmutgång, tillsammans med en seriell port, flera USB-portar och nätverksanslutningar för anslutning av kringutrustning och enheter.
Kraft- och lagringsarkitektur
Strömförsörjning och redundans
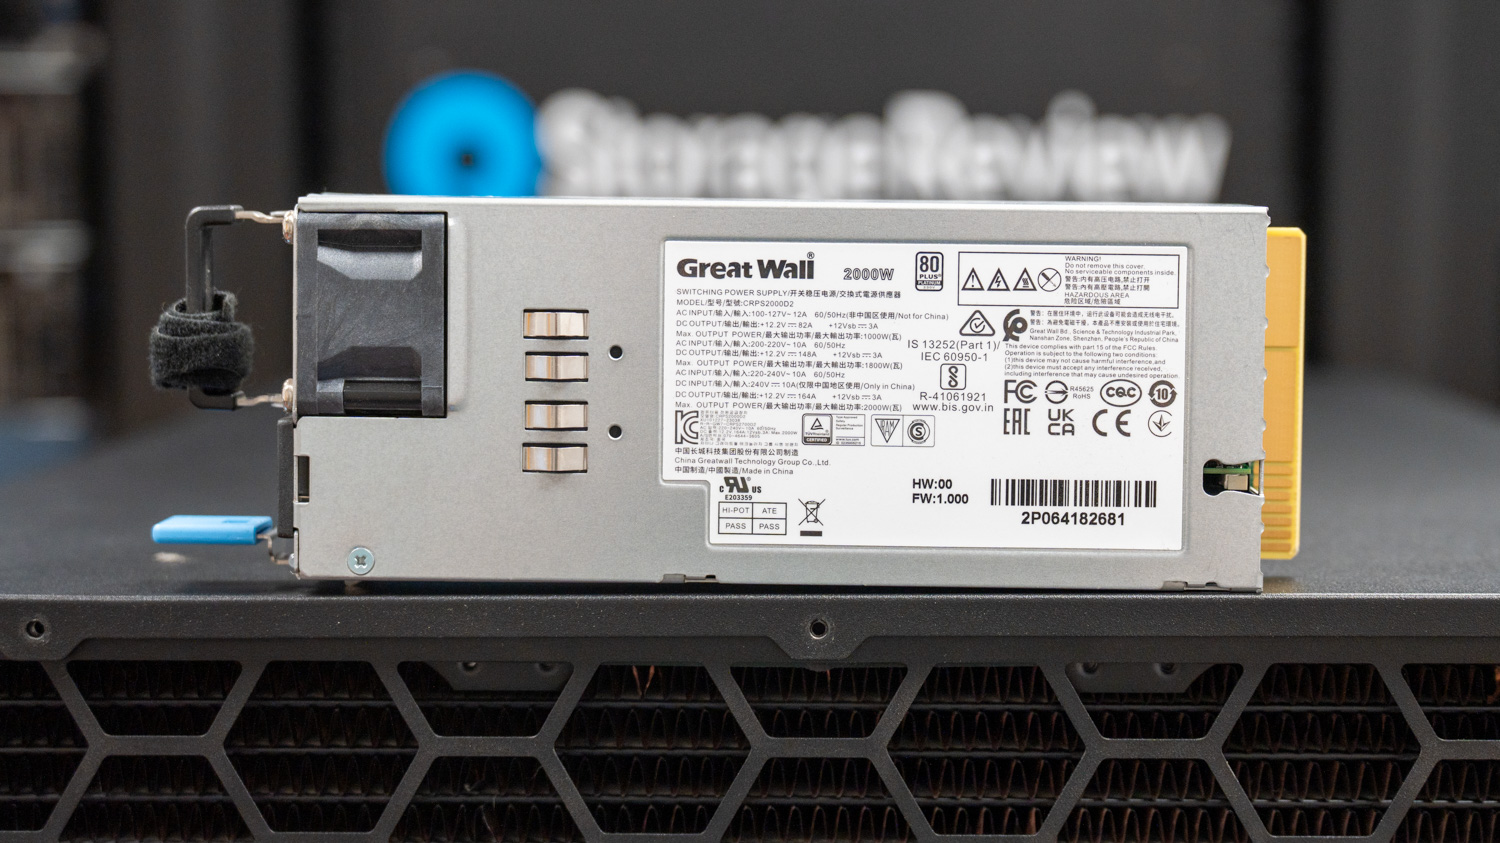
Att stödja denna beräkningsnivå kräver lika robust strömförsörjning. Grando stöder upp till fyra hot-swap 1000W eller 2000W CRPS-moduler i en redundant konfiguration, som levererar upp till 8.0 kW vid 180–264 V. Med stöd för redundanslägen 4+0, 3+1 och 2+2 kan systemet tolerera nätaggregatsfel samtidigt som det upprätthåller kontinuerlig drift för 24/7 AI- och HPC-arbetsbelastningar.
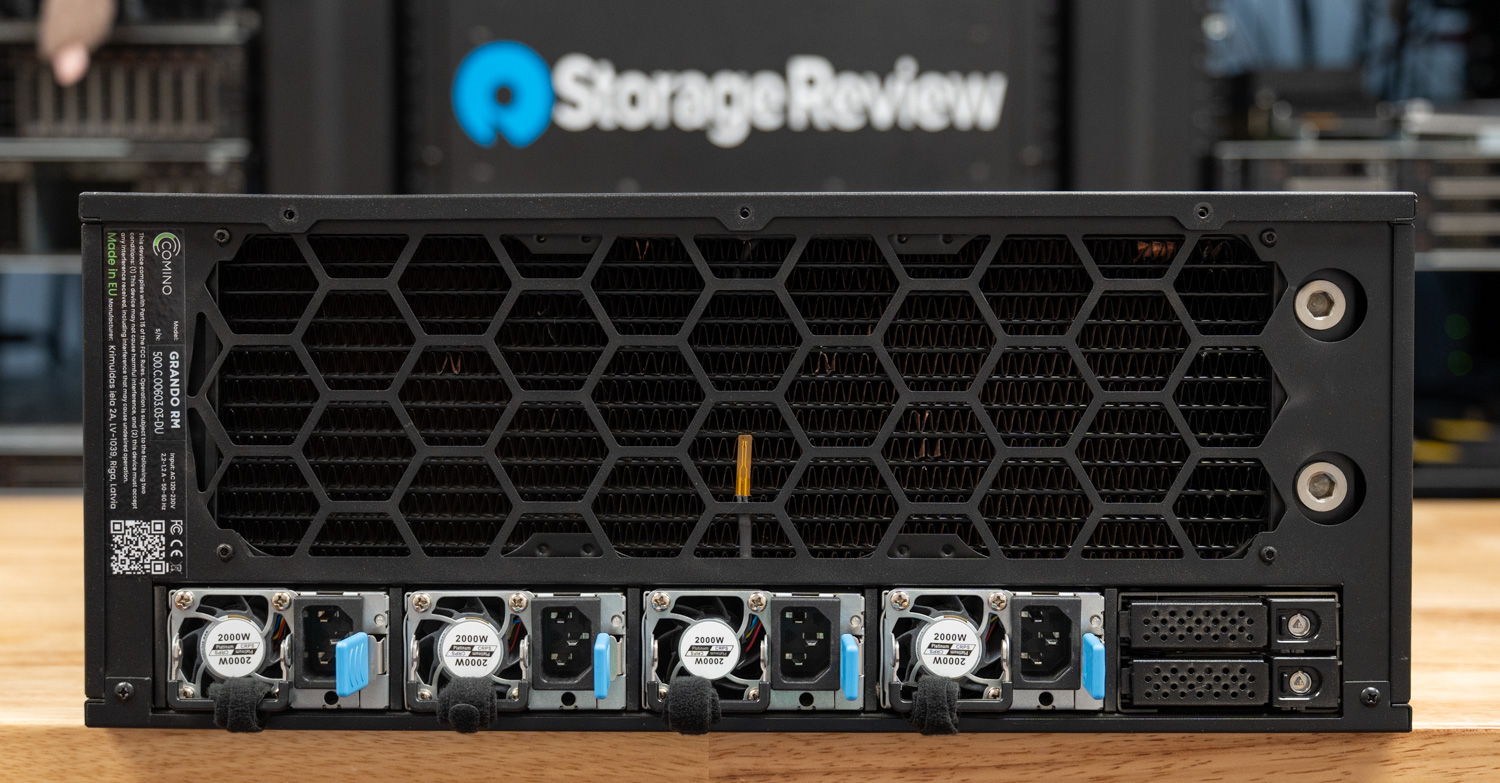
Vår testenhet levererades med fyra Great Wall 2000W 80 Plus Platinum hot-swap-nätaggregat, vilket bildade hela 8.0 kW-konfigurationen.
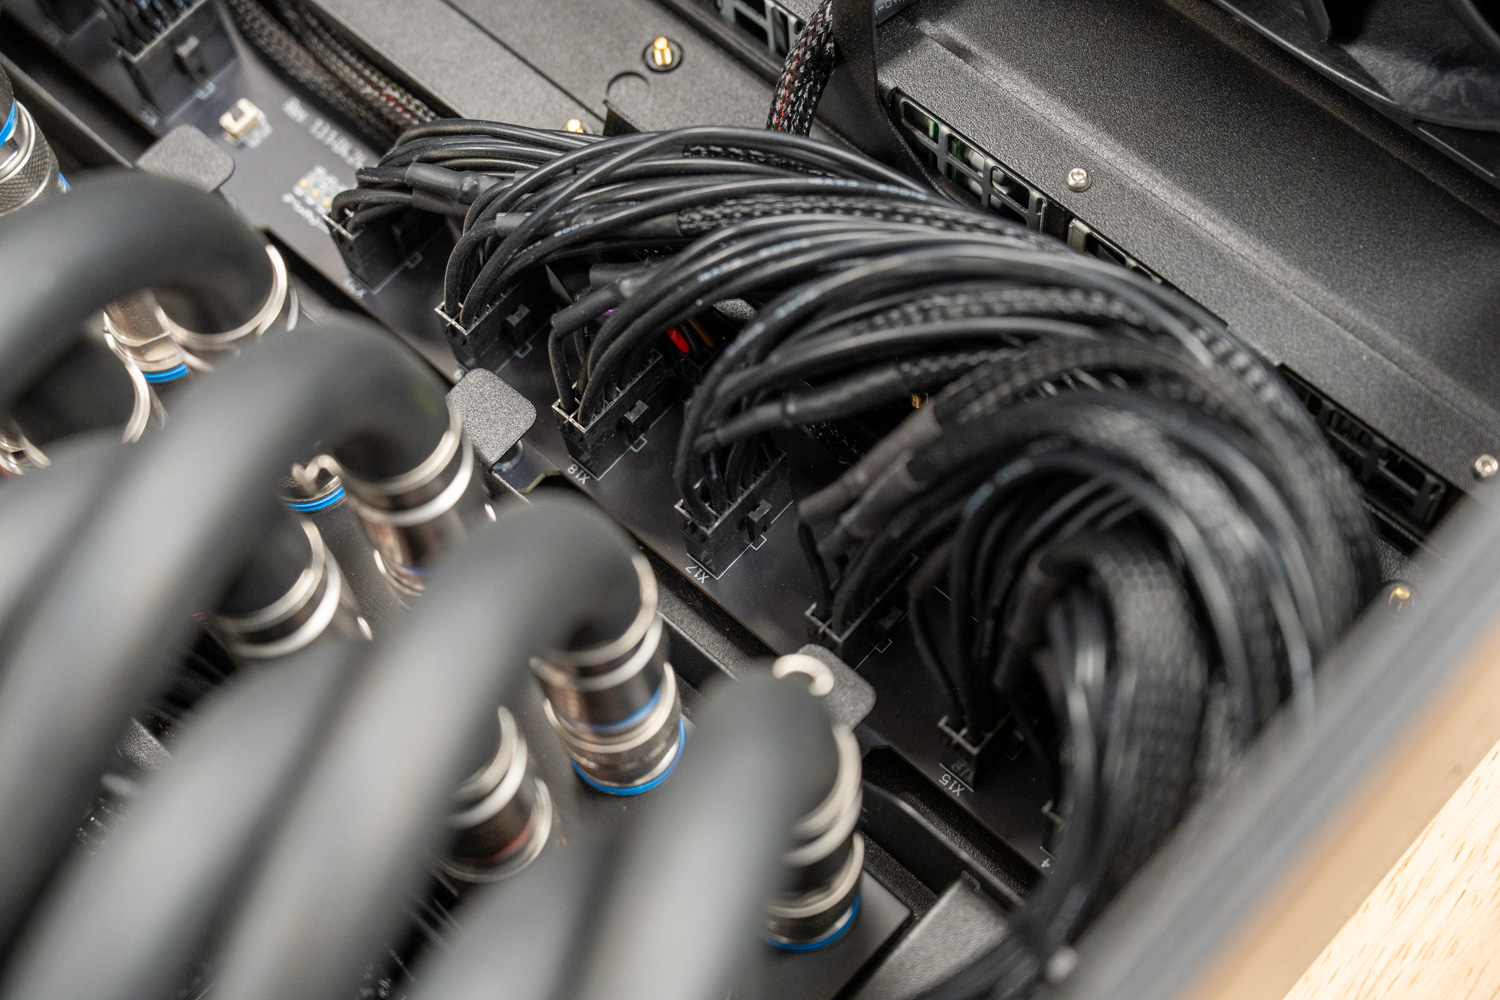
Strömförsörjningen till varje GPU går genom ett centraliserat 12-poligt strömfördelningskort monterat mellan GPU-matrisen och huvudkabeldragningen. Grando använder detta distributionskort för att konsolidera inkommande strömförsörjning och sedan förgrena den till varje GPU på ett organiserat och utrymmeseffektivt sätt.
PCIe, lagring och nätverk
Grando stöder bekvämt sex GPU:er utan att kompromissa med bandbredden för kortplatser, och chassit skalar till en full åtta-kortskonfiguration för maximal densitet. Cominos ASRock Rack GENOAD8X-2T/BCM-moderkort har sju x16- och en x8 PCIe Gen 5-kortplats, vilket innebär att sju av de åtta GPU:erna körs med full x16-bandbredd medan det åttonde kortet arbetar med x8. Detta är en avvägning mellan antalet PCIe-banor som en processor med en sockel kan stödja och Cominos ovilja att lägga till storleken, kostnaden och komplexiteten hos en PCIe-switchplatta. Att byta till ett moderkort med dubbla socklar skulle ge fler PCIe-banor men erbjuda ännu färre kortplatser, eftersom den andra sockeln skulle uppta utrymme som annars skulle användas av PCIe-kortplatser i den utrymmesbegränsade formfaktorn.
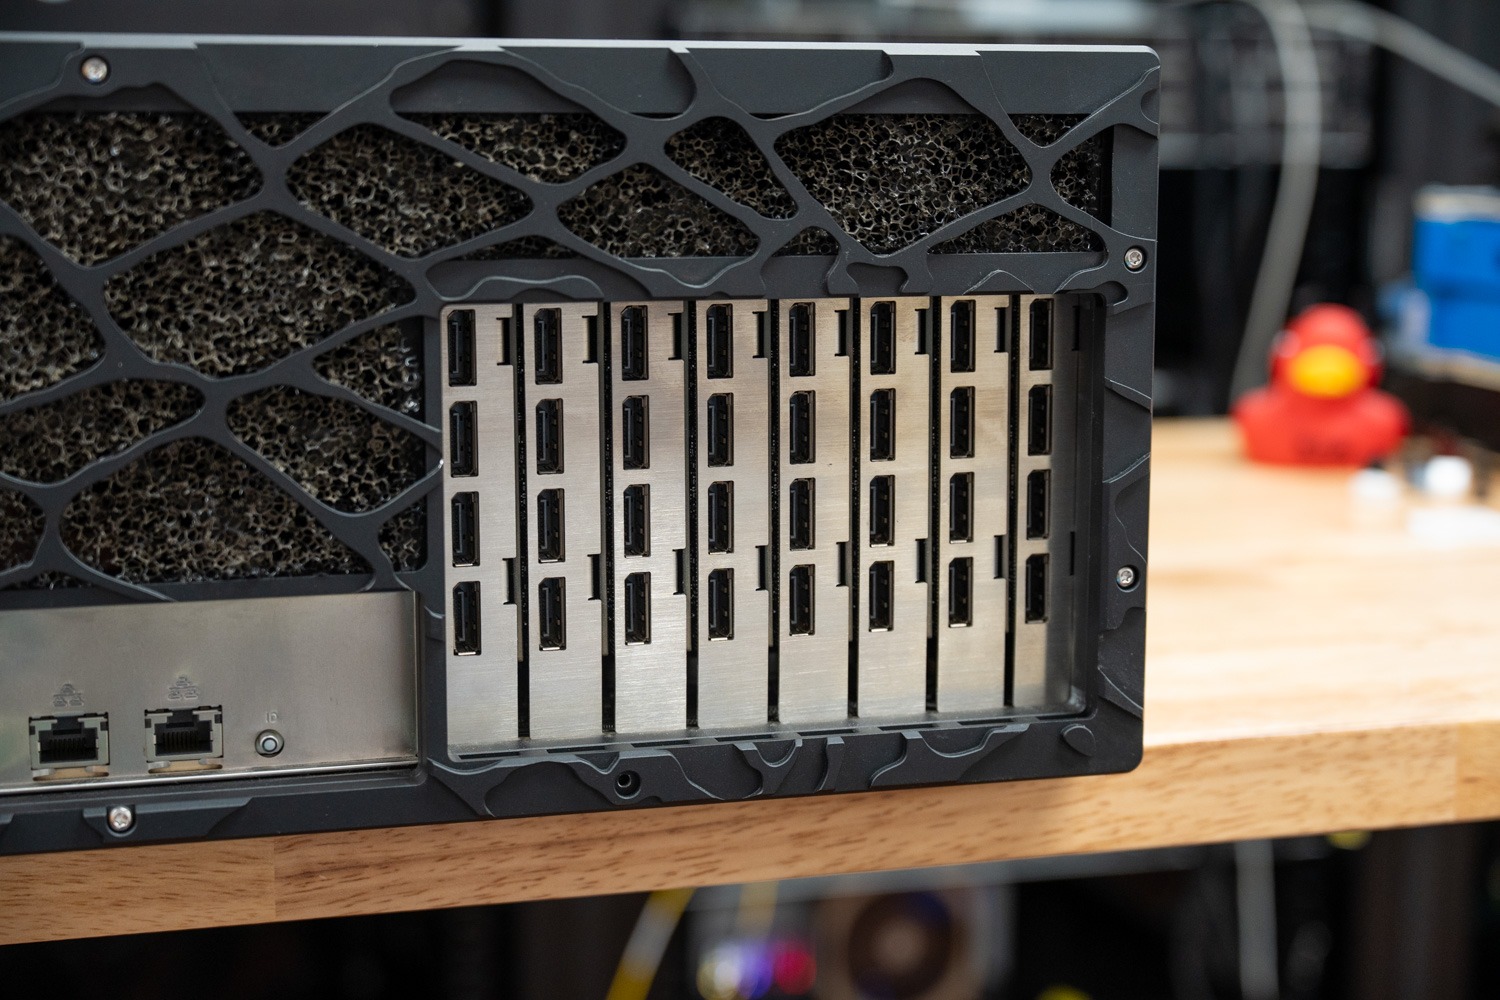
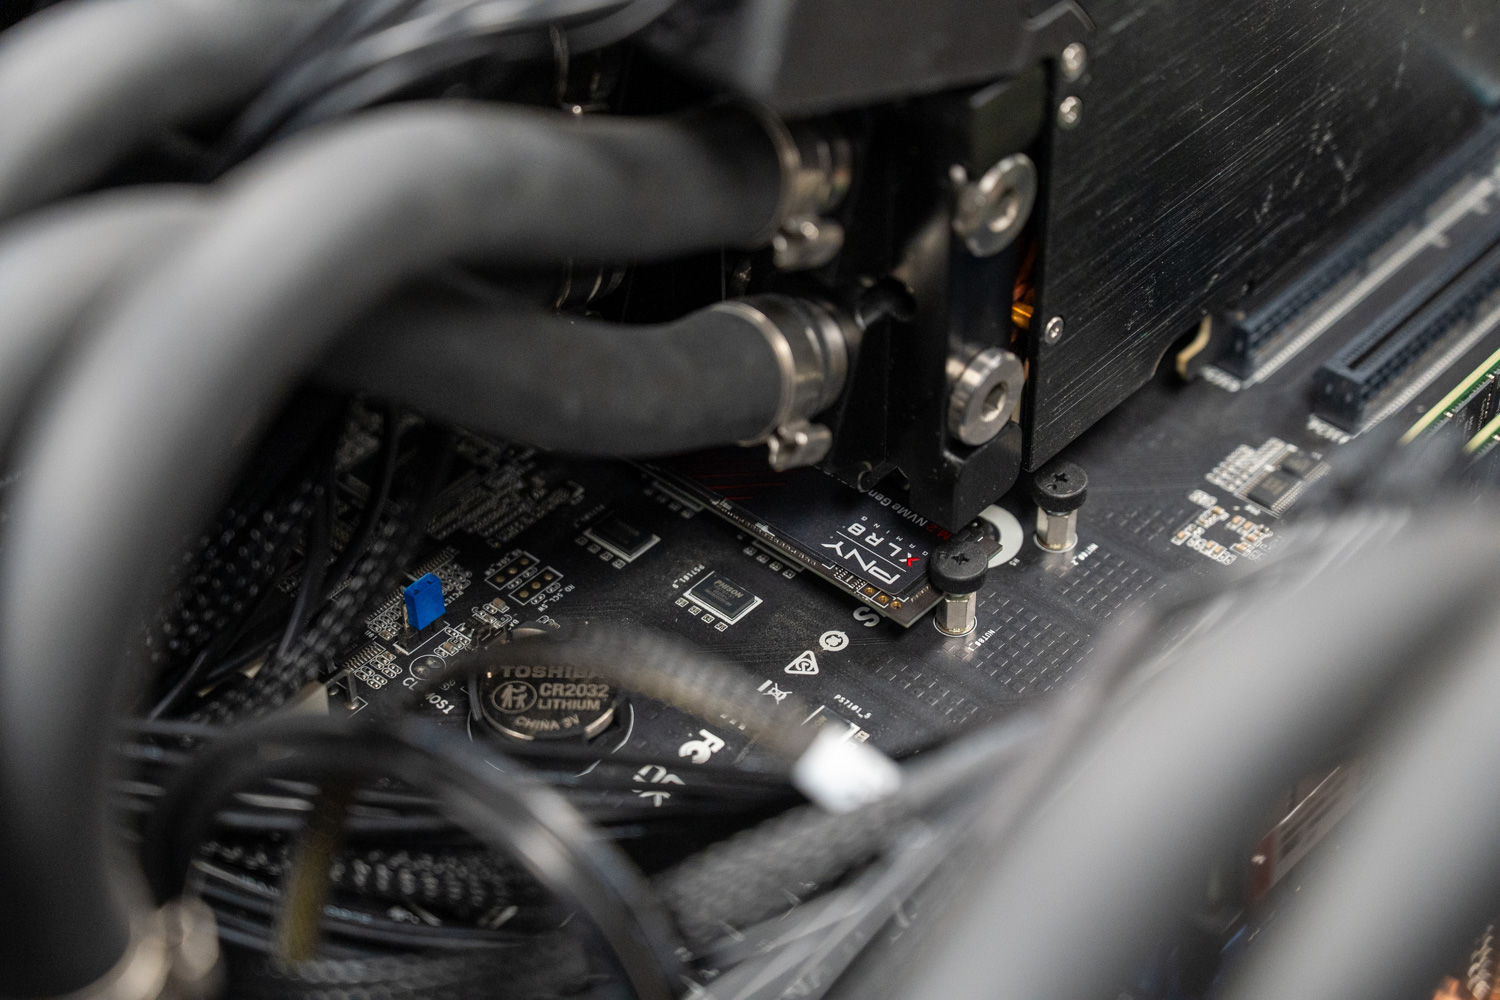
Att köra åtta GPU:er i ett system med en sockel förbrukar lejonparten av tillgängliga PCIe-banor, och det kommer med avvägningar. Vår testenhet, baserad på AMD Genoa, har totalt 128 PCIe Gen 5-banor tillgängliga. Med åtta GPU:er som förbrukar 120 av dessa banor är de återstående 8 banorna delade x4 till varje M.2 SSD-kortplats, så det är inte möjligt att samtidigt köra åtta GPU:er och en komplett uppsättning NVMe-enheter på baksidan av chassit anslutna via de två MCIO-kontakterna. I vår fullständiga konfiguration med 8 GPU:er fanns endast 2 M.2-kortplatser tillgängliga för lagring. Administratörer som behöver ytterligare NVMe-kapacitet utöver maximal GPU-densitet bör vara medvetna om att lägga till bakre hot-swap NVMe-lagring via bakpanelens burar kommer att förbruka ytterligare PCIe-banor och inaktivera en del av GPU-kapaciteten i deras system.
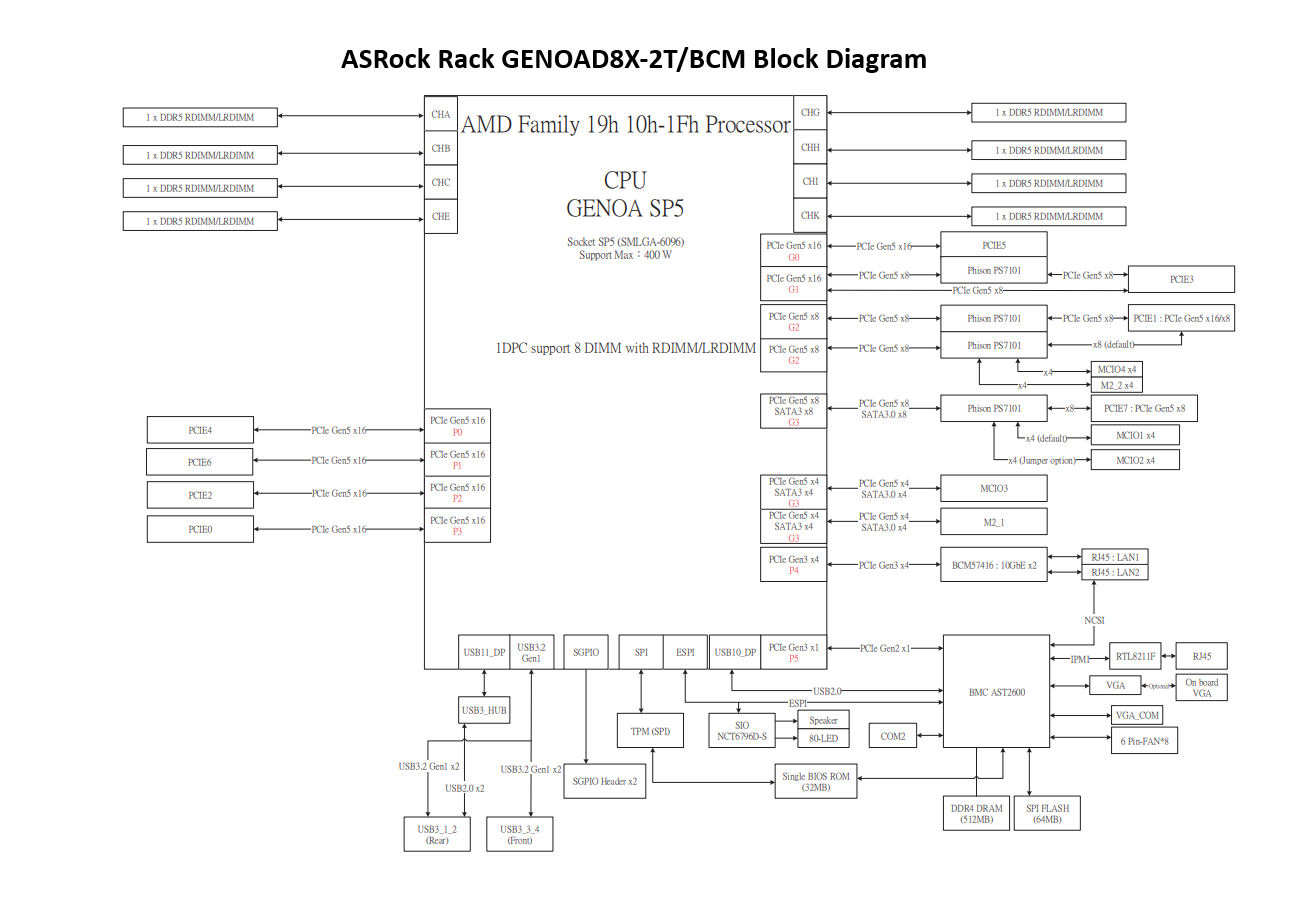
Blockschema för ASRock Rack GENOAD8X-2T/BCM moderkort som visar CPU, PCIe Gen 5-kortplatser, DIMM-kanaler, M.2-kortplatser, BMC, USB, SATA och nätverksanslutningar.
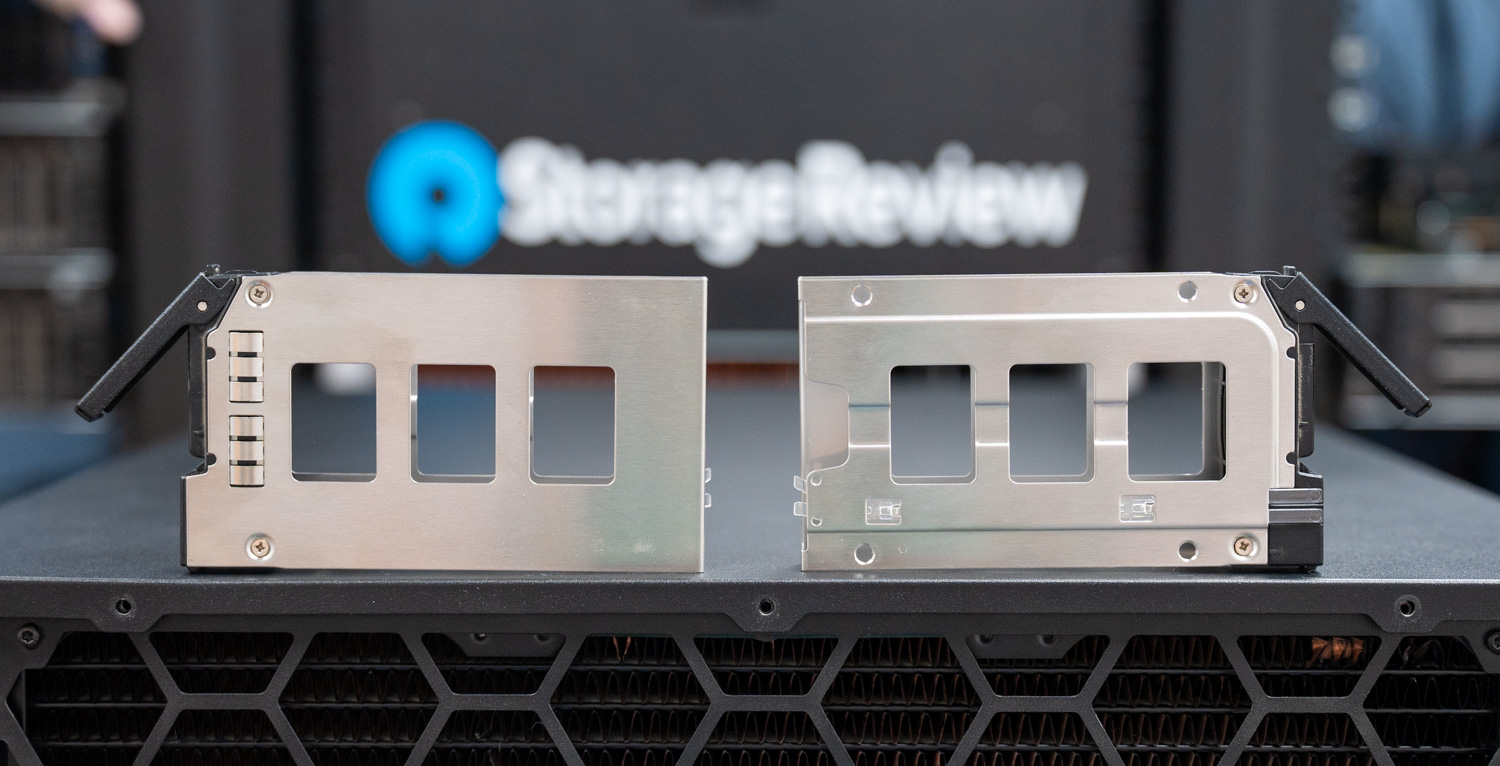
Med det sagt är lagringen lika modulär som expansiv, även om konfigurationen påverkar PCIe-filbudgeten för GPU:er, vilket är värt att planera kring för det avsedda användningsfallet. Bakpanelen på vår testenhet har en 2.5-tums hårddiskbur som stöder upp till fyra 2.5-tums SSD-diskar i antingen 4x 7 mm eller 2x 15 mm konfigurationer, med en valfri andra uppsättning på upp till fyra tillgängliga istället för den fjärde nätaggregatsplatsen. Eftersom vår testenhet krävde alla fyra nätaggregatsfacken för att stödja hela 8-GPU-konfigurationen, hade vi bara tillgång till den första av de två hot-swap-facken. Internt kan chassit stödja en 3.5-tumsbur som rymmer upp till fyra 3.5-tumsdiskar, fyra 2.5-tums 15 mm-diskar eller upp till tolv 2.5-tums 7 mm-diskar, plus fyra ytterligare interna 2.5-tums 7 mm SSD-facken om sådana är konfigurerade.
För nätverkshantering är två inbyggda RJ45 10 Gb/s-portar som drivs av Broadcom BCM57416 standard på moderkortet, tillsammans med en dedikerad Gigabit Ethernet IPMI-hanteringsport. Administratörer kan ytterligare öka bandbredden genom att installera PCIe-nätverkskort som stöder upp till 400 Gb/s för högbandbreddsanslutning, men observera att ytterligare PCIe-nätverkskort upptar GPU-platser, vilket minskar det maximala antalet GPU:er som systemet kan vara värd för.
Fjärrhantering och systemintelligens
För att skydda hårdvaran och optimera prestandan inkluderar systemet Comino Monitoring System (CMS). Ett separat, autonomt styrkort driver CMS och fungerar som serverns "hjärna", oberoende av huvudoperativsystemet. I praktiken avläser denna styrenhet en omfattande uppsättning sensorer som spårar luft- och kylvätsketemperaturer, fuktighetsnivåer, kylvätskeflöden och reservoarnivåer i realtid. Avgörande är att denna autonoma design gör det möjligt för CMS att utföra självdiagnos och utlösa nödavstängningar vid upptäckt av en läcka eller ett pumpfel, vilket skyddar den dyra interna hårdvaran från skador.
Ett webbaserat grafiskt gränssnitt hanterar den dagliga hanteringen och ger administratörer tydlig insyn i kylprestanda, drifttid och energiförbrukning i realtid för processor och grafikkort. För distributioner i företagsskala ansluter CMS även till centraliserade övervakningsverktyg via REST API:er, som Zabbix, Grafana och InfluxDB. Tillsammans hjälper dessa funktioner administratörer att upprätthålla en 3-årig serviceperiod och hålla servern igång med maximal effektivitet utan termisk strypning, även i miljöer med hög omgivningstemperatur.
Bortom AI: Kreativa och tekniska tillämpningar
Medan våra tester fokuserade på arbetsbelastningar för AI-inferens, fyller Grando en lika praktisk roll för kreativa yrkesverksamma och ingenjörer som behöver betydande lokal GPU-beräkning. 768 GB aggregerat VRAM fördelat på åtta RTX PRO 6000-kort låser upp funktioner som konventionella arbetsstationskonfigurationer inte kan matcha.
FX-artister och proffs inom rörlig grafik kan rendera komplexa scener med massiva texturuppsättningar helt i VRAM, vilket eliminerar de flaskhalsar med diskbyte som plågar produktioner med 8K-film eller miljöer med många polygoner. CAD-ingenjörer som kör beräkningsmässig fluiddynamik eller struktursimuleringar kan hantera sammansättningar av oöverträffad komplexitet utan att partitionera sina modeller i flera körningar. Videoredigerare som arbetar med multistream 8K RAW-tidslinjer, färgläggare som tillämpar ML-baserad brusreducering i full upplösning och 3D-artister som renderar banspårade slutresultat lokalt istället för att vänta på att molnfarmen ska vara tillgänglig, alla drar nytta av denna densitet av GPU-minne och beräkningsförmåga.
Grando kräver inte en fullständig konfiguration med åtta grafikkort. Comino erbjuder plattformen i konfigurationer med fyra, sex och åtta grafikkort, med alla varianter tillgängliga för omedelbar leverans. Mindre studior, oberoende kreatörer och ingenjörsteam kan anpassa sin investering till aktuella behov samtidigt som de behåller en tydlig uppgraderingsväg allt eftersom arbetsbelastningen växer.
Plattformsavvägningar: Densitet kontra expansionsförmåga
Grandos kompakta design ger exceptionell GPU-densitet och värmehantering inom ett standard 4U-fotavtryck, men den densiteten innebär arkitektoniska avvägningar som är värda att förstå före driftsättning.
Chassit rymmer moderkort med EATX- och EEB-formfaktorer, men inte utökade serverkort som finns i traditionella plattformar med dubbla socklar. Detta begränsar det totala antalet PCIe-banor som är tillgängliga för kringutrustning utöver GPU-matrisen. I vår konfiguration med åtta GPU:er förbrukas AMD EPYC-processorns 128 PCIe Gen 5-banor nästan helt av GPU:erna, vilket lämnar lite bandbredd för ytterligare NVMe-lagring eller höghastighetsnätverk utöver de inbyggda 10GbE-portarna.
Detta står i kontrast till de åtta-GPU-plattformar som vi har granskat från Dell, HPE och Supermicro. Dessa system använder större chassin, konfigurationer med dubbla socklar och PCIe-switchtopologier för att stödja betydligt mer kringutrustningsanslutning. De rymmer vanligtvis fyra till åtta ytterligare nätverkskort eller DPU:er utöver det fullständiga GPU-paketet, plus åtta eller fler hot-swap NVMe-fack, vilket gör dem väl lämpade för distribuerade inferensarbetsbelastningar som kräver fabric-sammankopplingar med hög bandbredd.
Den utökade kapaciteten har dock en betydande kostnad. Effektförbrukningen överstiger 8 kW. Termiska belastningar kräver dedikerad kylinfrastruktur för datacenter. Bullernivåer utesluter driftsättning utanför specialbyggda maskinrum. Och ledtiderna sträcker sig ofta mellan sex och arton månader på grund av ihållande leveransbegränsningar på företags-GPU-plattformar.
Grando intar en annan position. För organisationer som prioriterar snabb driftsättning, hanterbara driftsmiljöer och inferens- eller kreativa arbetsbelastningar framför storskalig distribuerad utbildning är avvägningarna ofta gynnsamma. Team som behöver sin hårdvara nu, i en miljö de faktiskt kan arbeta med, kan finna Grandos tillvägagångssätt för densitet mer praktiskt än att vänta i kö på en plattform som de realistiskt sett inte kan driftsätta när den väl anländer.
Resultat av Comino Grandos prestandatest
Systemkonfiguration
- Chassi: Comino Grando
- Moderkort: ASRock-rack GENOAD8X-2T/BCM
- CPU: AMD EPYC 9474F 48C
- Minne: 512 GB DDR5
- GPU: 8 x NVIDIA RTX PRO 6000
- Förvaring: M.2 SSD
Claude Code-servering – MiniMax M2.5
Utöver traditionella råa LLM-inferensmått ville vi utvärdera hur bra denna hårdvara presterar i ett agentiskt kodningsarbetsflöde, specifikt genom att hantera flera samtidiga Claude Code-sessioner med hjälp av en lokalt hostad modell. Detta användningsfall kopplas direkt till utvecklingsteamets produktivitet: hur många ingenjörer kan samtidigt använda en AI-kodningsassistent som hanteras från en enda nod innan upplevelsen försämras?
För att testa detta byggde vi en benchmark-harness som genererar en datamängd med måttligt svåra kodningsproblem (som att implementera en LRU-cache, bygga en CLI todo-applikation, skriva en markdown-konverterare och konstruera ett REST API) och kör varje Claude Code-session i en separat Docker-container mot den lokala vLLM-servern. En transparent proxy sitter mellan sessionerna och inferensslutpunkten och samlar in mätvärden per begäran för varje Claude Code-instans. Modellen som användes var MiniMax M2.5, som serveras via vLLM på systemets åtta NVIDIA RTX PRO 6000 GPU:er. Även om det inte är den högst rankade kodningsmodellen på offentliga topplistor, är M2.5 en kapabel modell som många användare, inklusive våra utvecklarvänner, kör lokalt.
Som en baslinjereferens använder vi Anthropics Claude Opus 4.6 genomsnittliga genomströmning via OpenRouter.ai, en av de mest populära routingtjänsterna för åtkomst till produktions-API:er. Den baslinjen ligger på cirka 37 tokens per sekund och API-förfrågan.
Vi mätte två viktiga mätvärden: genomsnittliga utdatatokens per sekund per Claude Code-session (vad varje utvecklare upplever) och aggregerade utdatatokens per sekund över alla sessioner (det totala arbete som servern producerar).
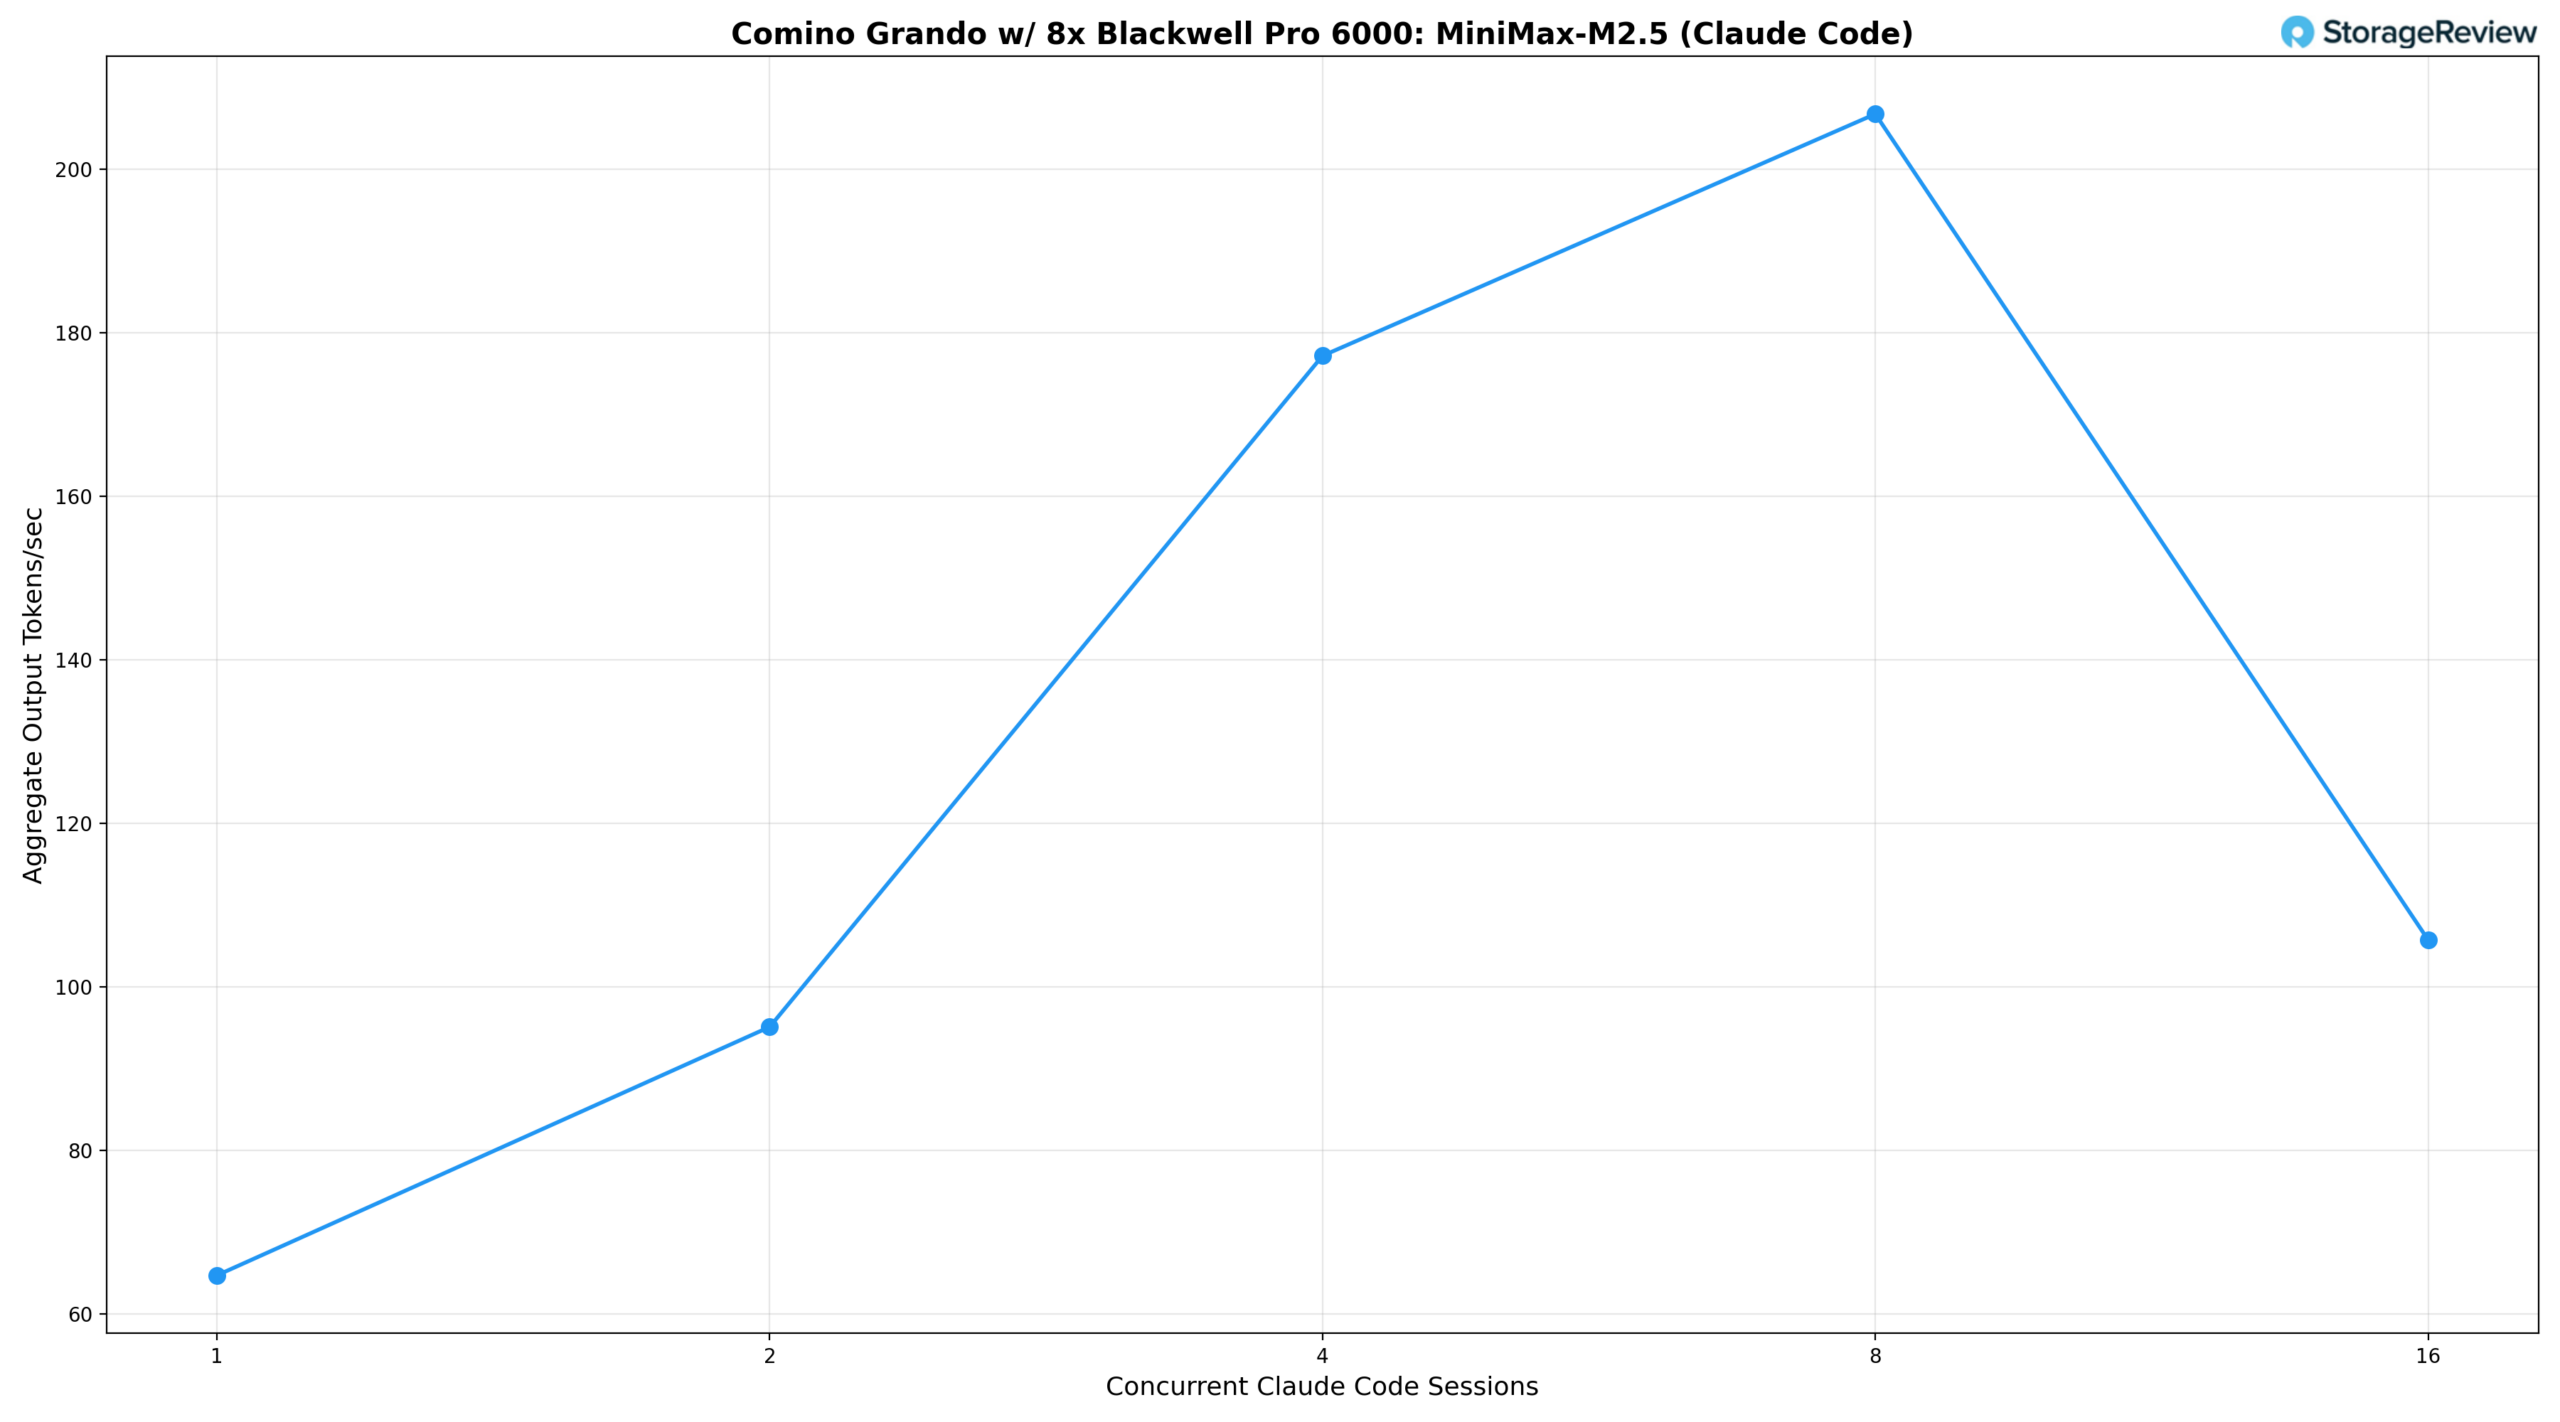
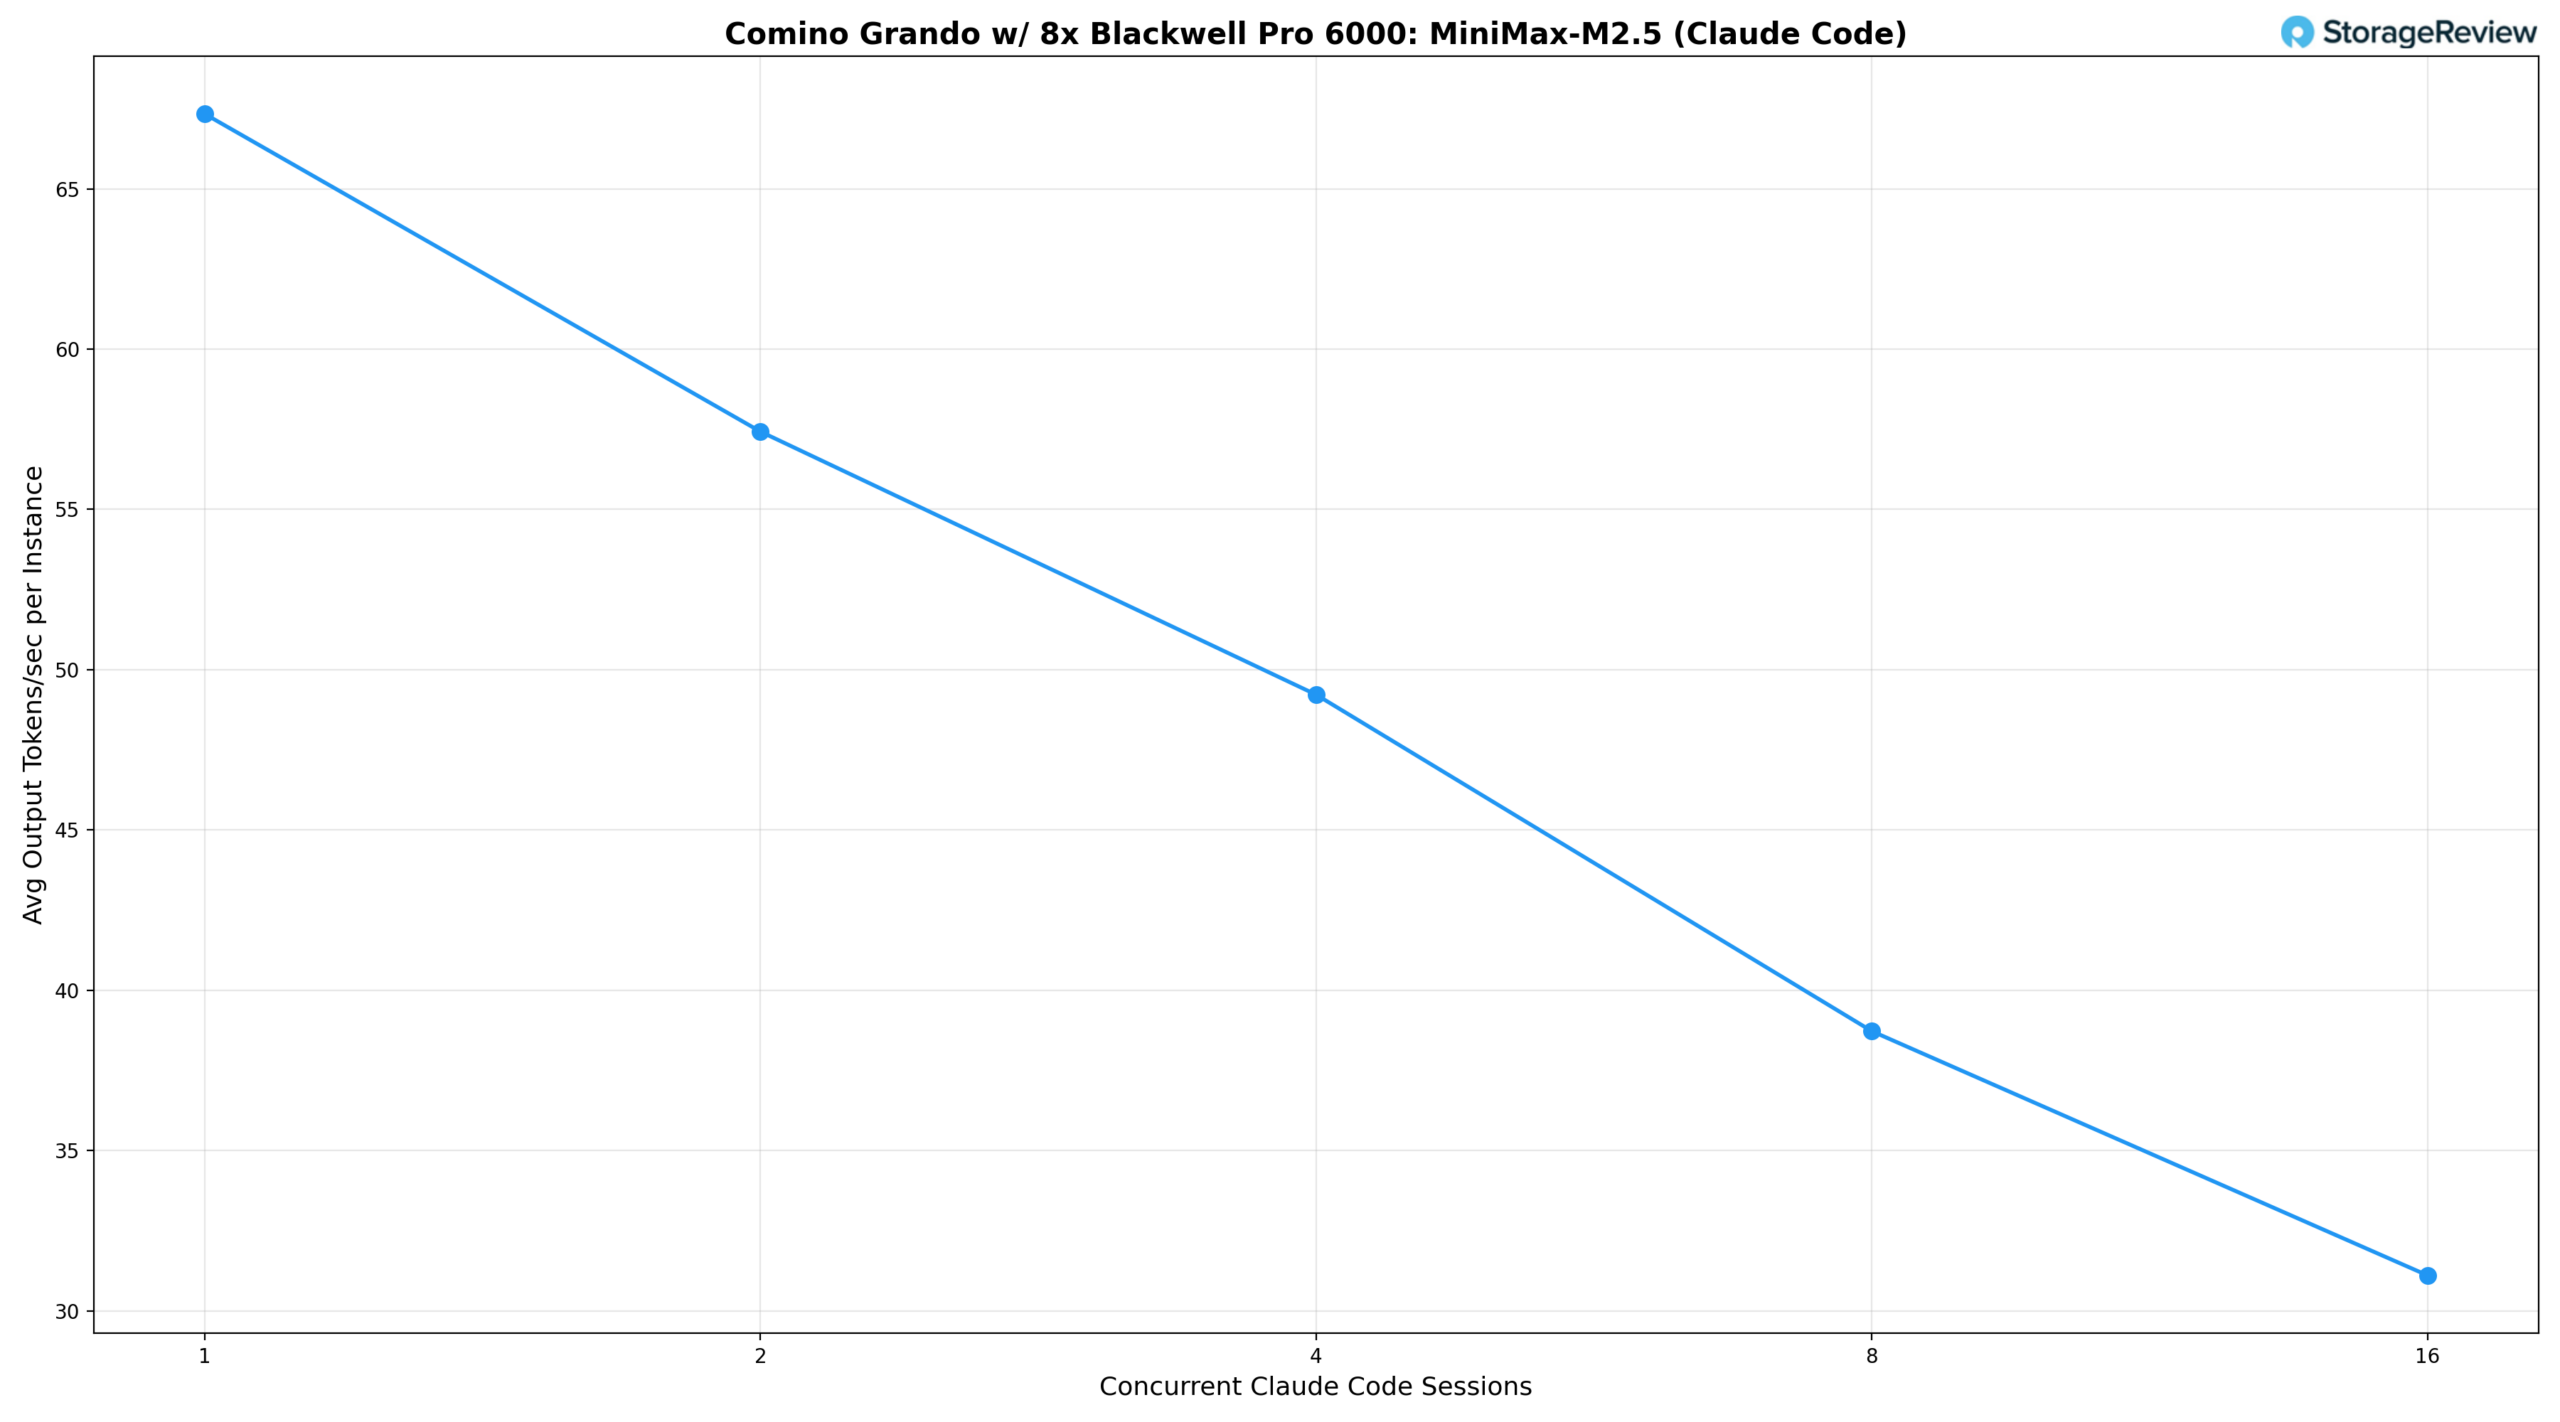
Baserat på resultaten levererar en enda samtidig Claude Code-session 67.3 tok/s per användare och en aggregerad utdata på 64.7 tok/s. Vid två sessioner sjunker genomströmningen per instans något till 57.4 tok/s, medan den aggregerade utdatan klättrar till 95.1 tok/s när vLLM:s batchning börjar amortera overhead. Fyra samtidiga sessioner bibehåller 49.2 tok/s per användare, fortfarande en mycket responsiv upplevelse för interaktiva kodningsarbetsflöden, medan den aggregerade genomströmningen når 177.2 tok/s. Åtta sessioner representerar den optimala nivån för aggregerad utdata, med en topp på totalt 206.7 tok/s, medan genomströmningen per instans stabiliseras på 38.7 tok/s, en nivå som förblir behaglig för kodgenerering och iteration i realtid.
Vid 16 samtidiga sessioner uppvisar systemet den klassiska batch-avvägningen: dataflödet per instans sjunker till 31.1 tok/s, och den sammanlagda utdata faller till 105.8 tok/s. Detta tyder på att 230B MiniMax M2.5-modellen, på denna samtidighetsnivå, tänjer på gränserna för vad åtta GPU:er kan klara utan att introducera meningsfull latens för varje användare. Den sammanlagda nedgången från 8 till 16 sessioner återspeglar minnesbandbreddskraven för en stor MoE-arkitektur under tung samtidig avkodningsbelastning, snarare än en schemaläggningsineffektivitet.
För organisationer som utvärderar egenhostad AI-infrastruktur för utvecklarverktyg är Grando ett starkt argument. Med en 230B-modell i frontlinjen kan den bekvämt hantera upp till åtta samtidiga Claude Code-sessioner med dataflödesnivåer som känns genuint interaktiva, med hastigheter per användare som överstiger 38 tok/s vid maximal aggregerad produktion. Team på fyra till åtta ingenjörer kan arbeta med nästan optimal dataflöde utan märkbar försämring av svarstiden.
Den vätskekylda arkitekturen gör även denna beräkningsnivå praktisk i miljöer där traditionella GPU-servrar inte kan fungera. Systemet körs tillräckligt tyst för att stå i ett startup-kontor, ett litet maskinrum eller ett dedikerat hörn i en öppen arbetsyta. Luftkylda system med liknande GPU-densitet når vanligtvis 90 dB eller högre, vilket är tillräckligt högt för att kräva dedikerat datacenterutrymme eller, som ett minimum, en sluten servergarderob med seriös akustisk behandling. Grando kan samexistera med teamet som använder den. Kombinerat med fullständig datalokalitet, inga API-kostnader per token och fullständig kontroll över modellval, erbjuder den en självhostad process som skalar med ett växande utvecklingsteam utan att kräva datacenterinfrastruktur eller ökade kostnader i olika steg.
vLLM Online-servering – LLM-inferensprestanda
vLLM är en av de mest populära inferens- och serveringssystemen med hög genomströmning för LLM:er. vLLM:s online-serveringsbenchmark utvärderar den verkliga serveringsprestandan för denna inferensmotor under samtidiga förfrågningar. Den simulerar produktionsarbetsbelastningar genom att skicka förfrågningar till en aktiv vLLM-server, med konfigurerbara parametrar som förfrågningshastighet, in- och utmatningslängder och antalet samtidiga klienter. Benchmarket mäter viktiga mätvärden, inklusive genomströmning (tokens per sekund), tid till första token och tid per utmatningstoken (TPOT), vilket hjälper användare att förstå hur vLLM presterar under olika belastningsförhållanden.
Vi testade inferensprestanda över en omfattande uppsättning modeller som spänner över olika arkitekturer, parameterskalor och kvantiseringsstrategier för att utvärdera dataflödet under olika samtidighetsprofiler.
Sammanfattning av resultaten
| Modell | Precision | Lika (256/256) | Förfyllning - Tung (8k/1k) | Avkodningstung (1k/8k) |
|---|---|---|---|---|
| Comino Grando med 8× RTX PRO 6000 Blackwell — vLLM-inferensresultat (tok/s, topp vid BS=256) | ||||
| GPT-OSS 20B | ep_dp1 | 17,280 | 32,061 | 11,187 |
| GPT-OSS 120B | ep_dp1 | 11,726 | 21,636 | 7,570 |
| Llama 3.1 8B Instruktion | FP8 | 12,109 | 20,137 | 7,353 |
| Llama 3.1 8B Instruktion | FP4 | 11,954 | 20,206 | 7,239 |
| Llama 3.1 8B Instruktion | BF16 | 11,752 | 17,346 | 6,155 |
| Qwen3-kodare 30B A3B | FP8 | 10,985 | 16,659 | 4,907 |
| Qwen3-kodare 30B A3B | BF16 | 10,588 | 16,680 | 4,829 |
| Mistral Small 3.1 24B | BF16 | 8,925 | 11,846 | 4,975 |
| MiniMax M2.5 (230B) | ep_dp1 | 5,753 | 7,357 * | 2,555 |
| Alla värden i tok/s, maximal genomströmning vid BS=256. *MiniMax M2.5 prefill-heavy nådde sin topp vid BS=128 (7 357 tok/s); BS=256 var 7 141 tok/s. | ||||
GPT-OSS 120B och 20B
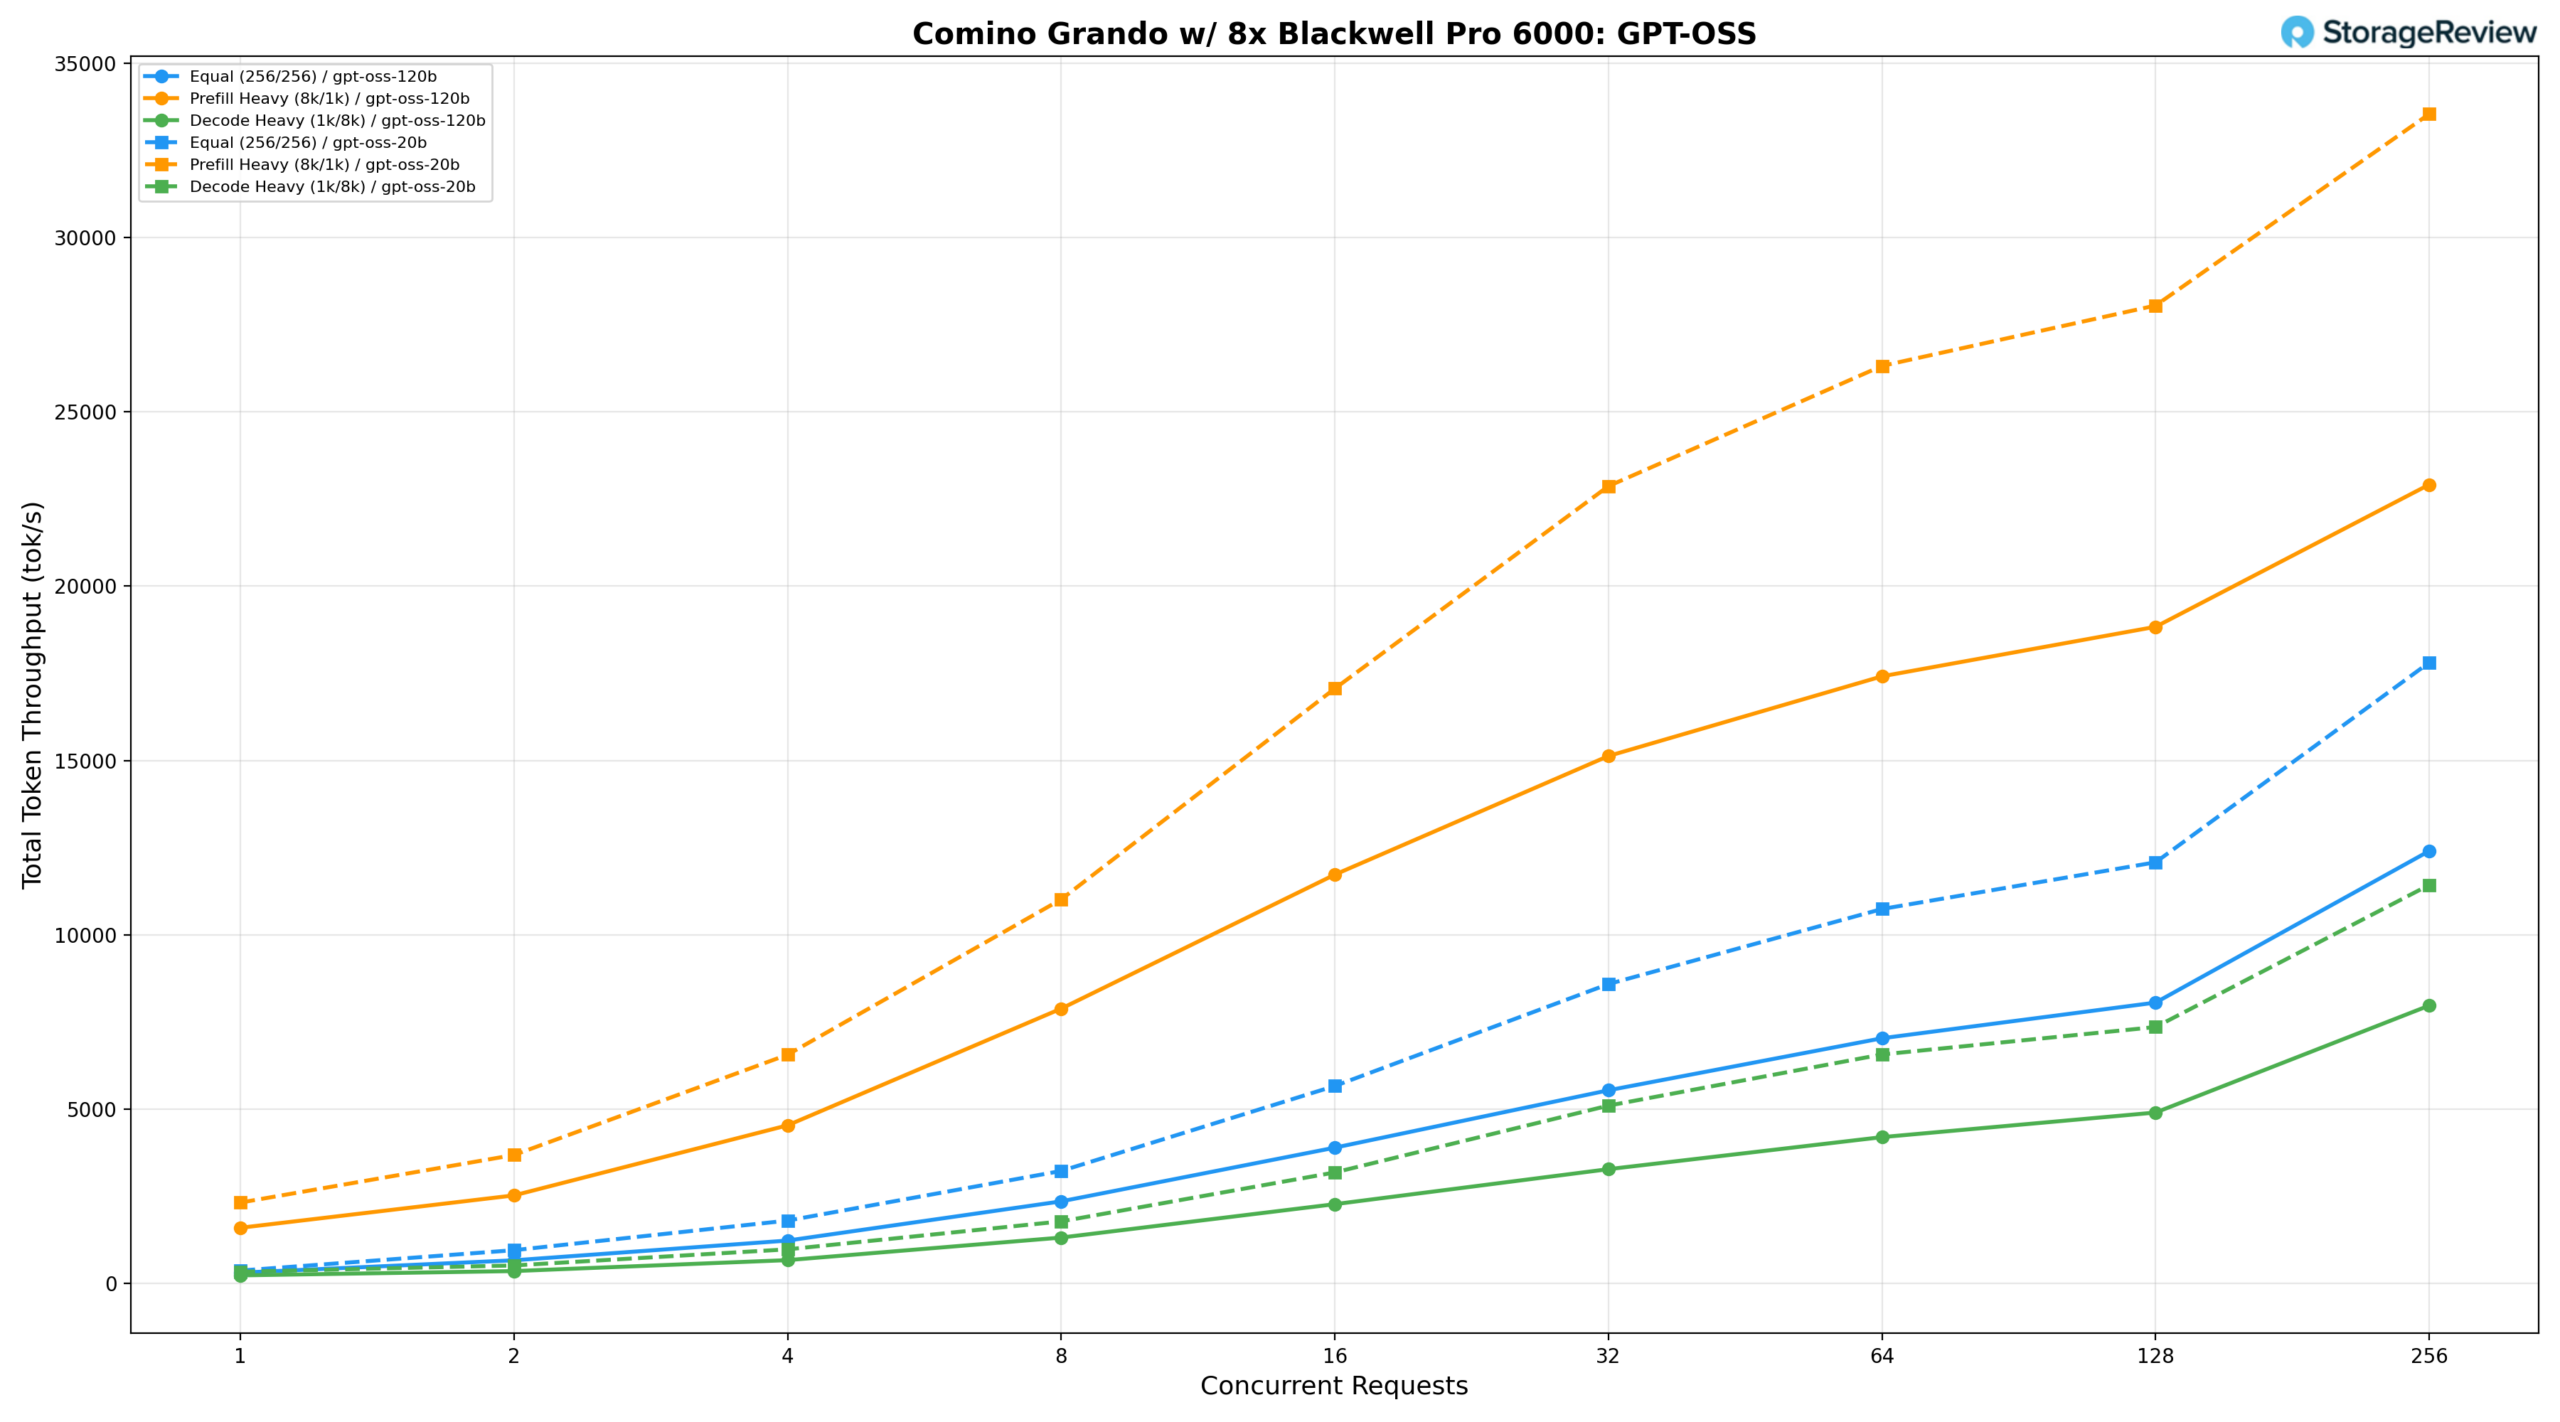
GPT-OSS-modellfamiljen testades i både 120B- och 20B-konfigurationer på Comino Grando.
GPT-OSS 120B
Under lika stor arbetsbelastning (256/256) levererar 120B-modellen 268.85 tok/s vid BS=1, når 6 666,23 tok/s vid BS=64 och når sin topp på 11 726,04 tok/s vid BS=256. Förfyllningstung (8k/1k) börjar vid 1 375,69 tok/s, klättrar till 16 374,19 tok/s vid BS=64 och 17 944,55 tok/s vid BS=128 och når sin topp på 21 636,41 tok/s vid BS=256. Avkodningstung (1k/8k) växer från 196.28 tok/s vid BS=1 till 7 569,97 tok/s vid BS=256, med välkontrollerad latens vid lägre samtidighetsnivåer.
GPT-OSS 20B
20B-modellen levererar 334.80 tok/s vid BS=1 under lika stor arbetsbelastning, når 10 303,56 tok/s vid BS=64 och når en topp på 17 280,12 tok/s vid BS=256. Förfyllningshastigheten börjar vid 2 007,90 tok/s, klättrar till 24 990,46 tok/s vid BS=64 och 26 866,25 tok/s vid BS=128, och når en topp på 32 060,72 tok/s vid BS=256, den högsta absoluta förfyllningskapaciteten som registrerats för båda modellstorlekarna. Avkodningshastigheten ökar från 286.08 tok/s vid BS=1 till 11 187,36 tok/s vid BS=256, vilket ger ungefär 1.5 gånger avkodningsgenomströmningen för 120B vid maximal samtidighet, samtidigt som den bibehåller en snävare latens hela tiden.
Qwen3-kodare 30B A3B-instruktioner och FP8-instruktioner
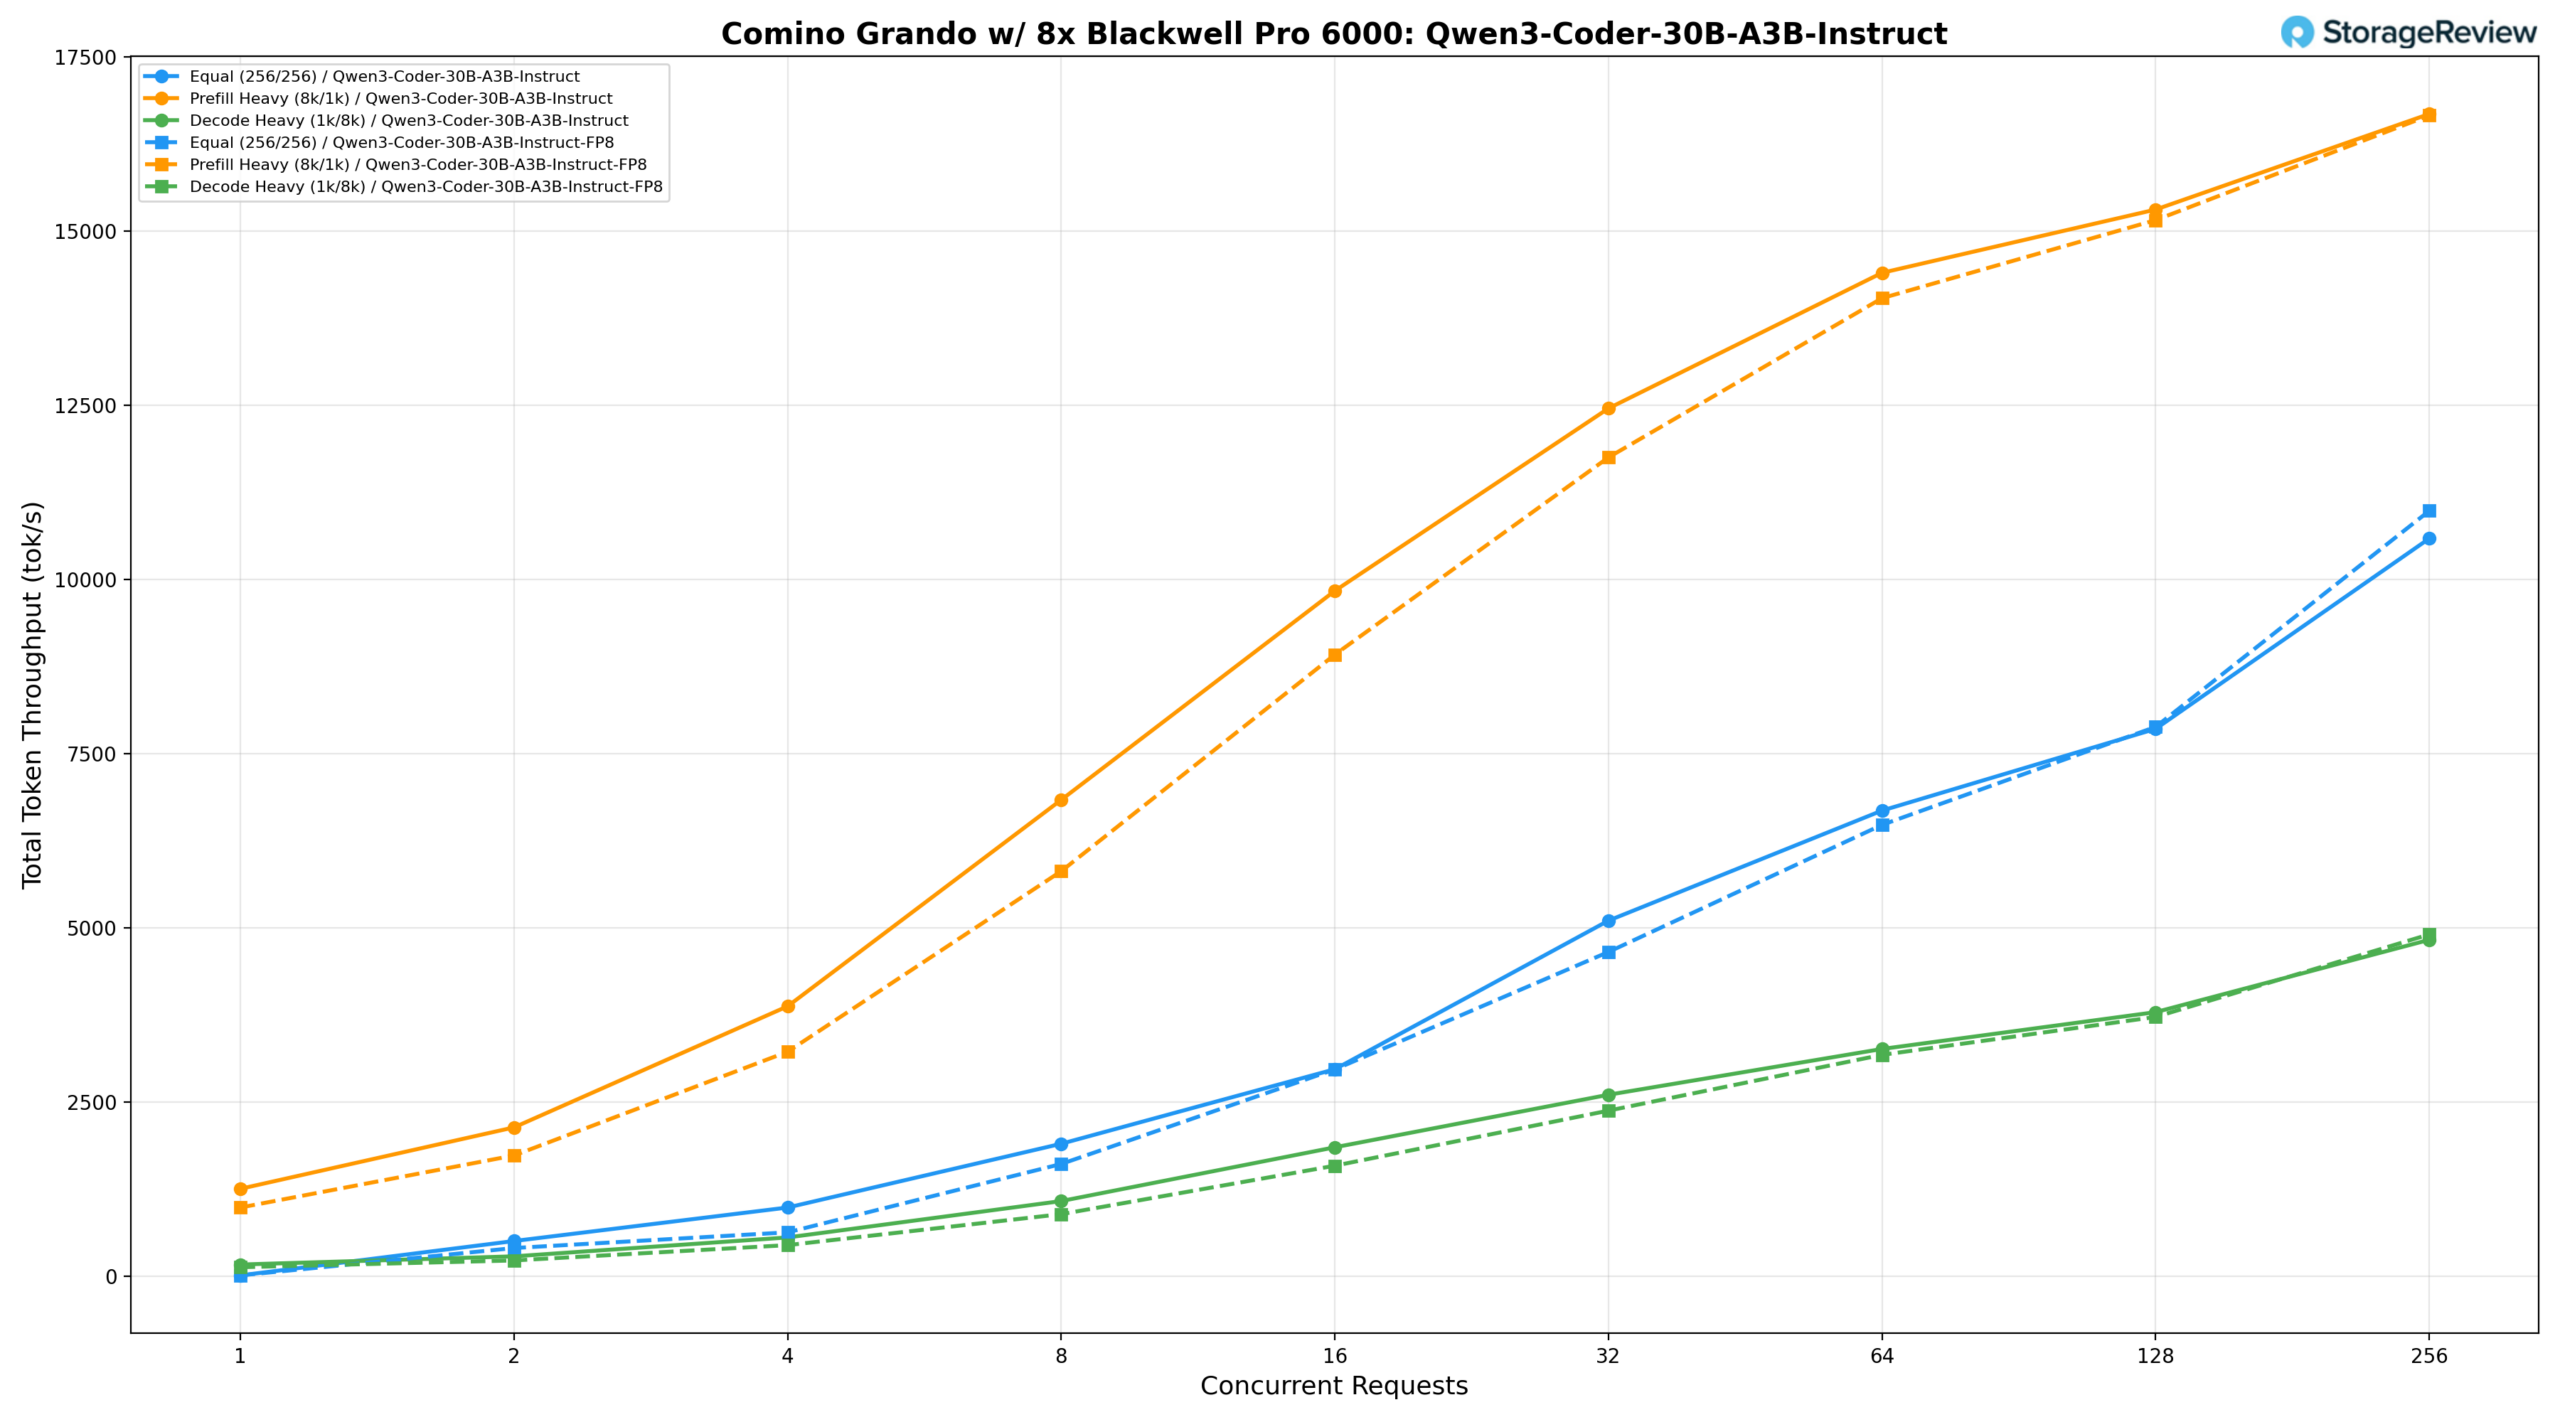
Modellen Qwen3-Coder-30B-A3B-Instruct testades med både BF16- och FP8-precision.
Qwen3-Coder-30B-A3B-Instruct (BF16)
Under en lika stor arbetsbelastning (256/256) levererar BF16-modellen 1 902,32 tok/s vid BS=8, når 6 683,58 tok/s vid BS=64 och når sin topp vid 10 587,56 tok/s vid BS=256. Förfyllningstung (8k/1k) börjar vid 1 256,03 tok/s vid BS=1, klättrar till 14 400,57 tok/s vid BS=64 och 15 308,35 tok/s vid BS=128 och når sin topp vid 16 679,52 tok/s vid BS=256. Avkodningstung (1k/8k) växer från 169.19 tok/s vid BS=1 till 4 828,82 tok/s vid BS=256, med välkontrollerad latens vid lägre samtidighetsnivåer.
Qwen3-Coder-30B-A3B-Instruct (FP8)
FP8-modellen levererar ett dataflöde jämförbart med BF16 i de flesta scenarier, med en arbetsbelastning på 6 478,54 tok/s vid BS=64 och en topp på 10 984,61 tok/s vid BS=256, en liten förbättring jämfört med BF16 vid maximal samtidighet. Förfyllningsintensivt dataflöde börjar vid 987.48 tok/s vid BS=1, klättrar till 14 036,46 tok/s vid BS=64 och 15 156,69 tok/s vid BS=128, och når en topp på 16 658,98 tok/s vid BS=256. Avkodningstung tillväxt från 130.70 tok/s vid BS=1 till 4 906,51 tok/s vid BS=256, vilket marginellt överträffar BF16 vid maximal samtidighet, medan de två konfigurationerna förblir nära matchade i resten av samtidighetsintervallet.
Mistral Small 3.1 24B Instruct 2503
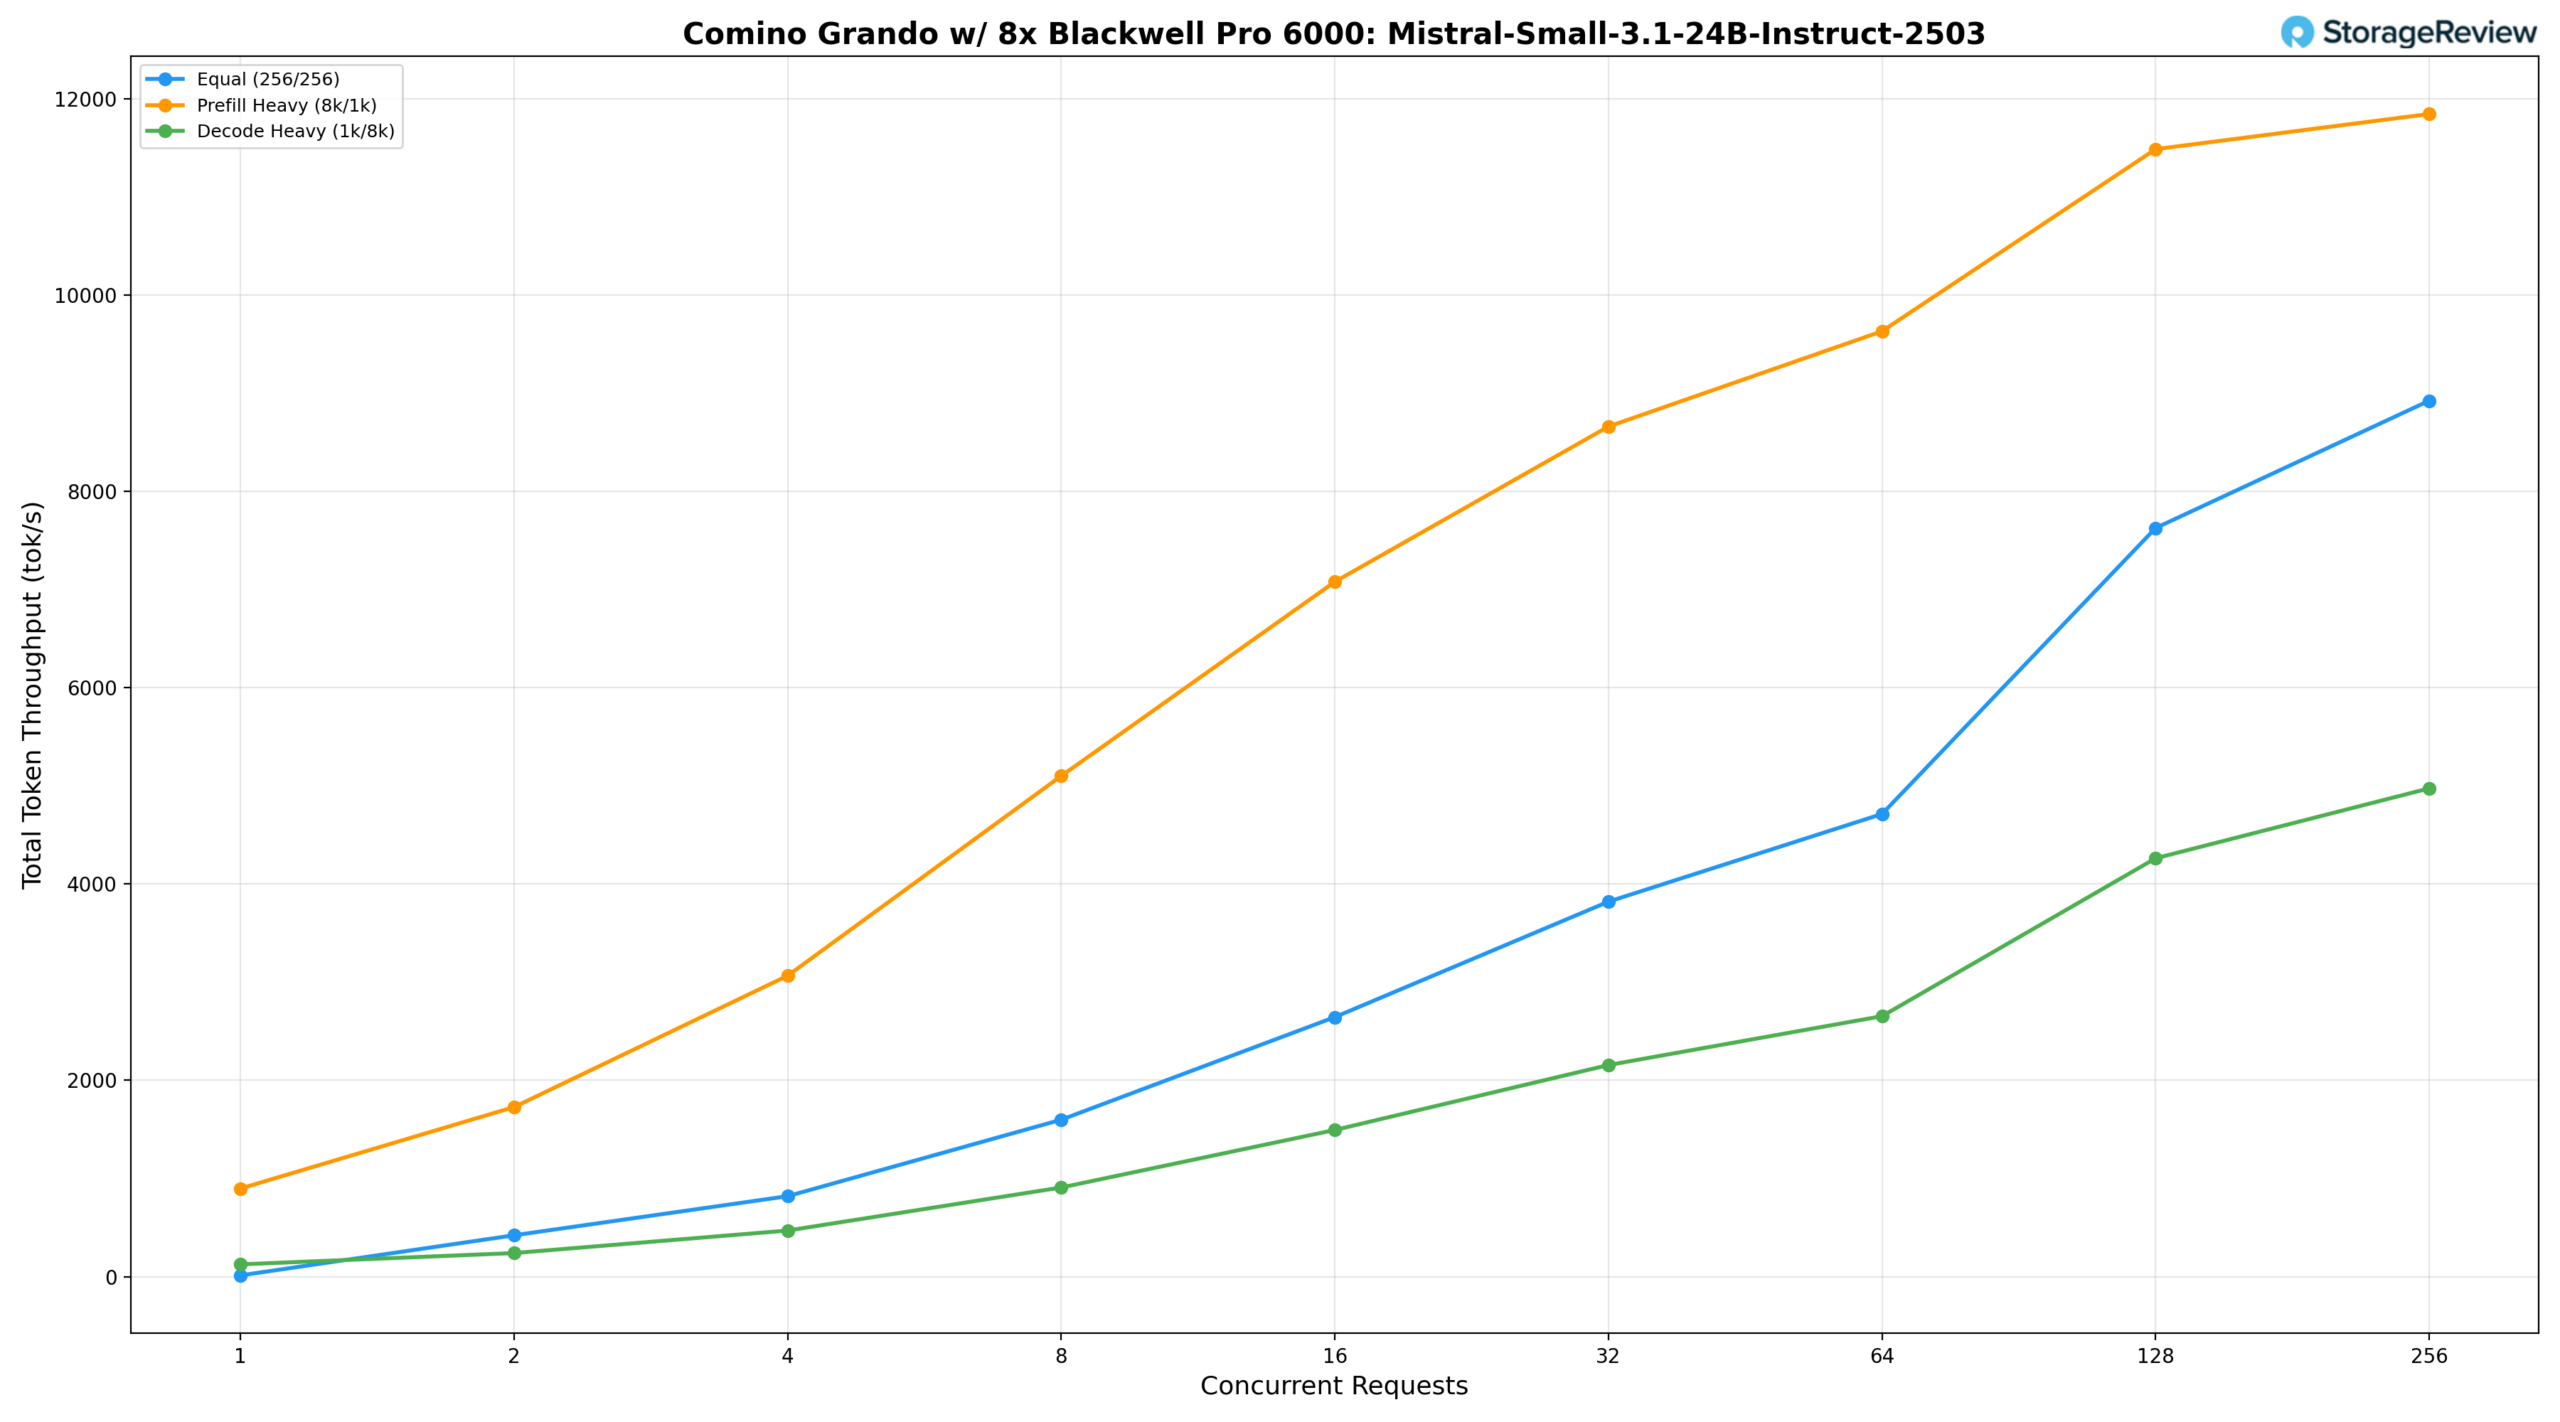
Under en lika stor arbetsbelastning (256/256) levererar modellen 1 598,79 tok/s vid BS=8, når 4 713,84 tok/s vid BS=64 och skalar kraftigt till 8 925,12 tok/s vid BS=256. Förfyllningstung (8k/1k) börjar vid 897.84 tok/s vid BS=1, klättrar till 9 632,58 tok/s vid BS=64 och 11 488,13 tok/s vid BS=128, med en topp på 11 846,15 tok/s vid BS=256. Avkodningstung (1k/8k) växer från 124.98 tok/s vid BS=1 till 2 653,82 tok/s vid BS=64, och accelererar sedan märkbart vid högre samtidighetsnivåer, når 4 262,53 tok/s vid BS=128 och toppar vid 4 975,06 tok/s vid BS=256, vilket återspeglar modellens förmåga att upprätthålla stark avkodningskapacitet när samtidighetsskalor sker.
Llama 3.1 8B Instruktion
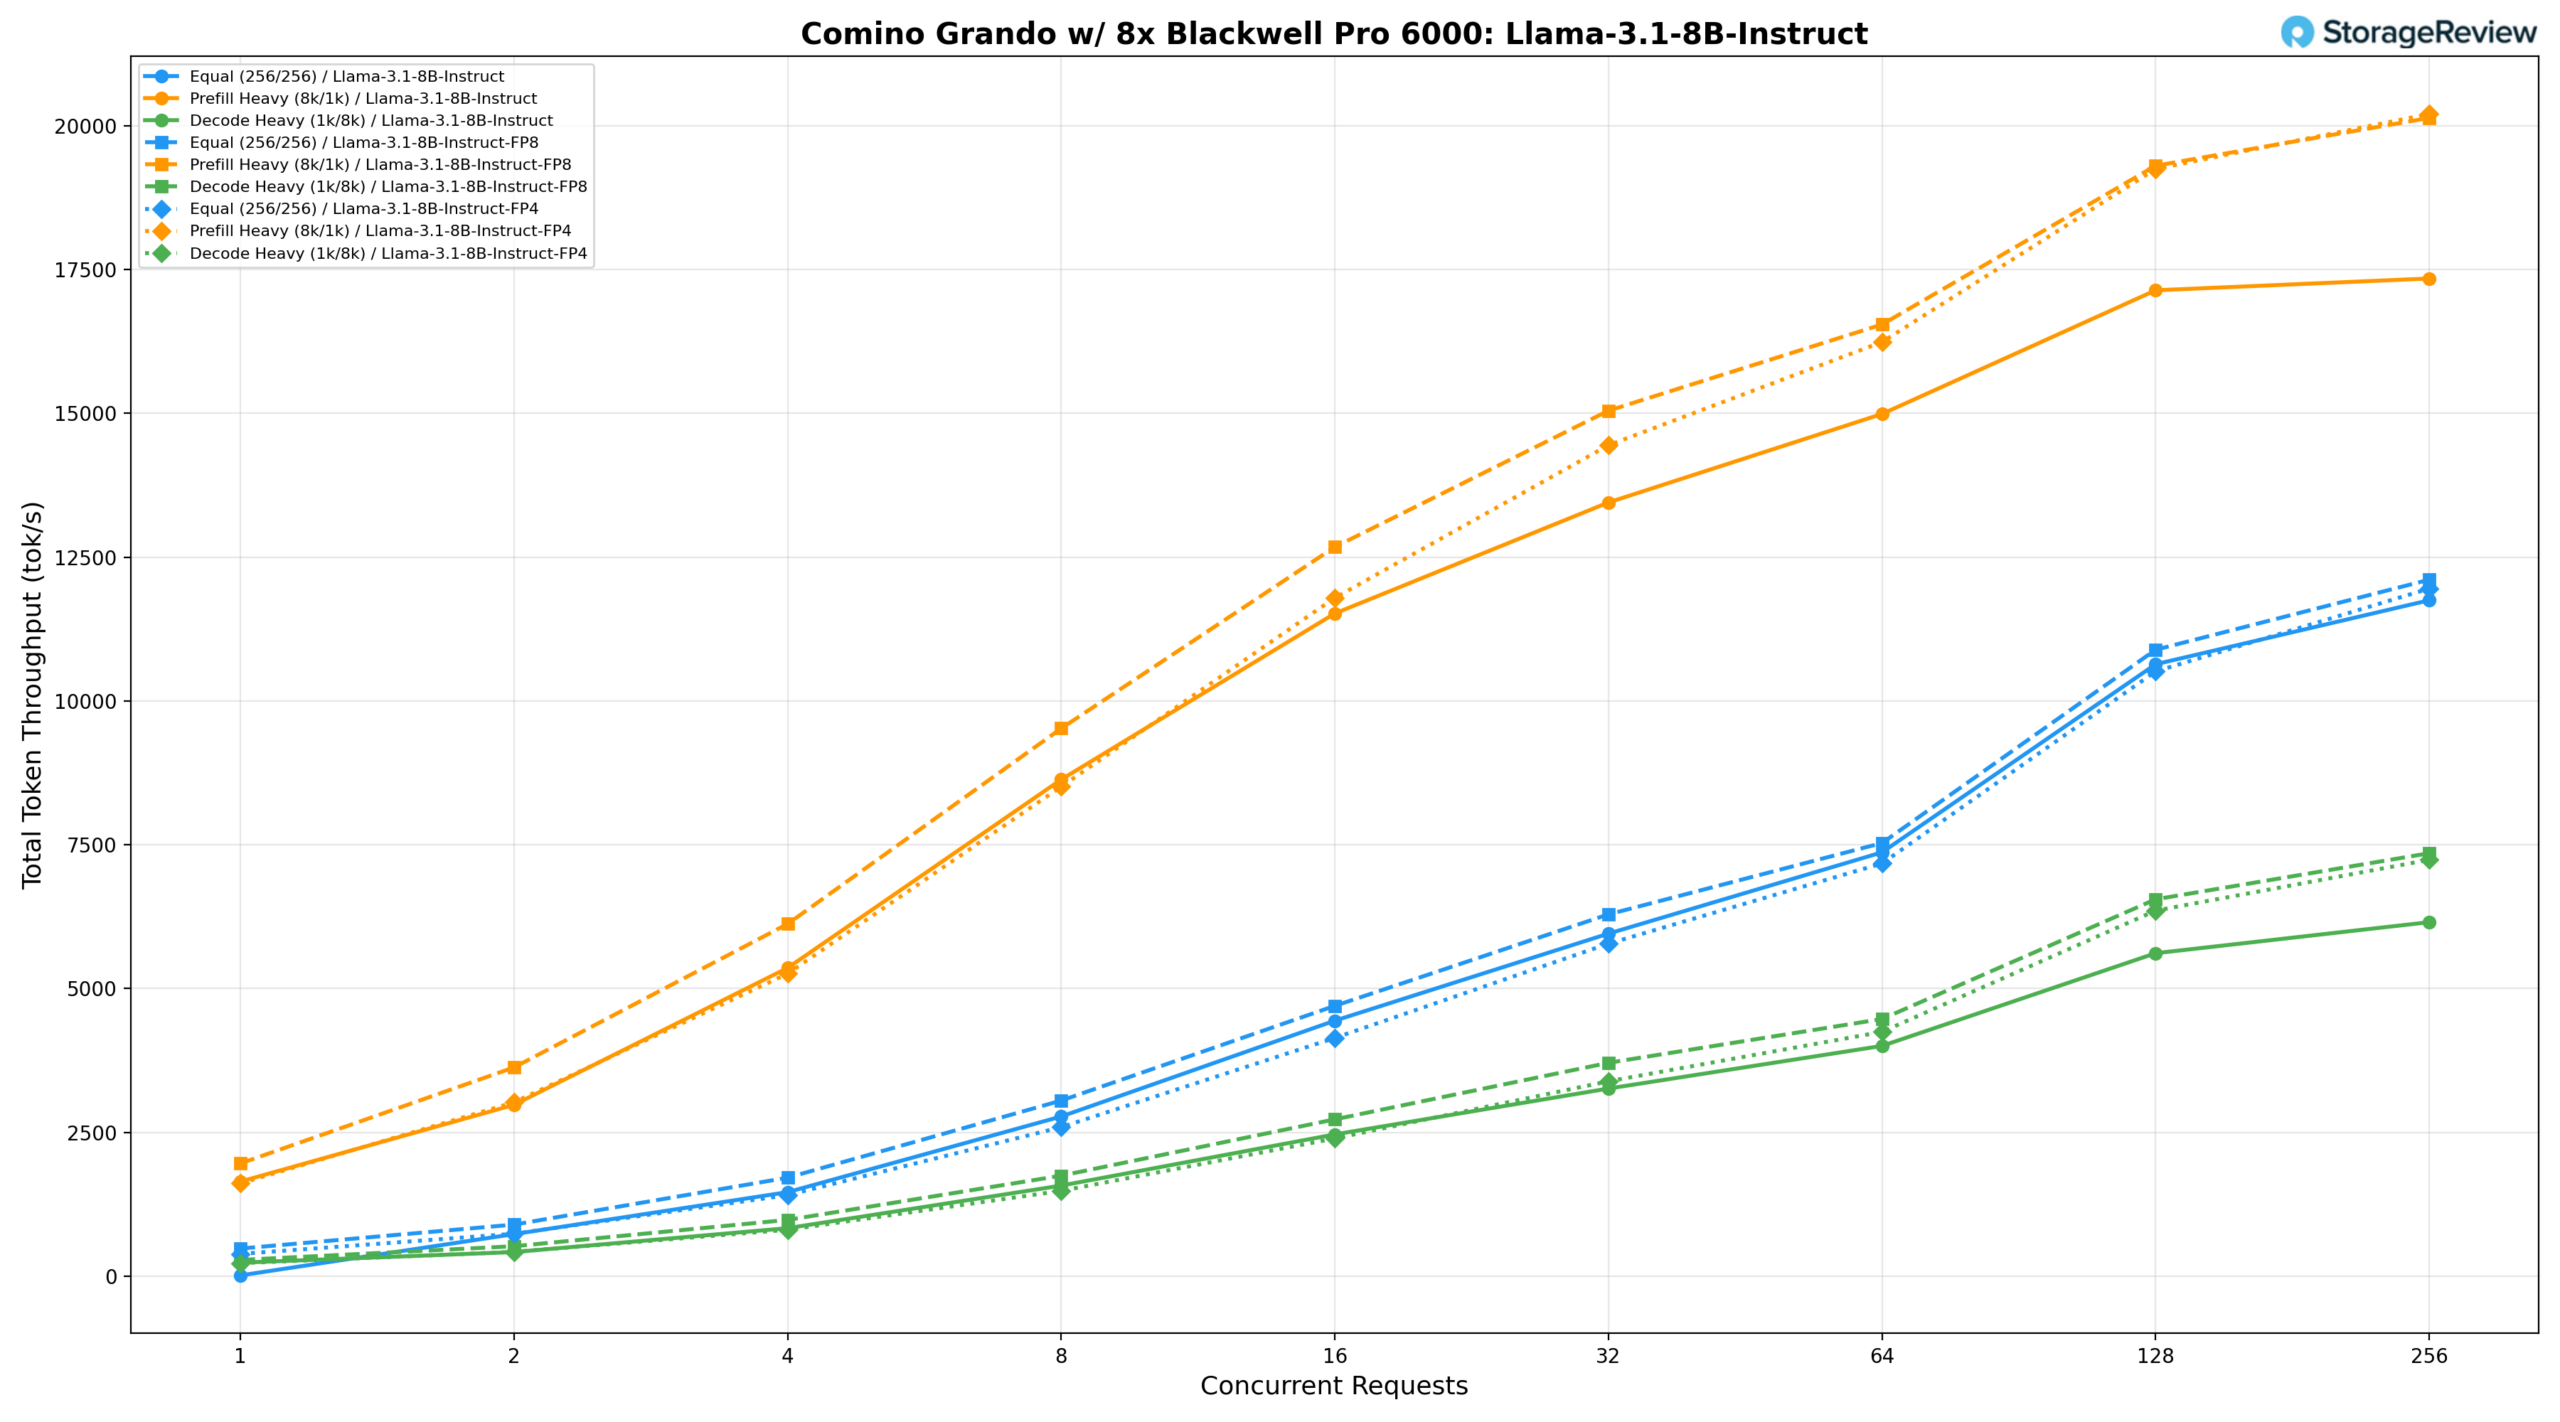
Llama-3.1-8B-Instruct-modellen testades med tre precisionskonfigurationer på Comino, vilket gav en tydlig bild av hur kvantisering påverkar dataflödet för denna modellstorlek.
Llama 3.1 8B Instruktion BF16
Under en lika stor arbetsbelastning (256/256) levererar BF16-modellen 2 776,42 tok/s vid BS=8, når 7 369,01 tok/s vid BS=64 och når sin topp på 11 751,56 tok/s vid BS=256. Förfyllningstung (8k/1k) börjar vid 1 645,29 tok/s vid BS=1, klättrar till 14 990,47 tok/s vid BS=64 och 17 140,71 tok/s vid BS=128 och når sin topp på 17 345,80 tok/s vid BS=256. Avkodningstung (1k/8k) växer från 234.78 tok/s vid BS=1 till 6 154,73 tok/s vid BS=256.
Llama 3.1 8B Instruktion FP8
FP8-kvantisering ger en meningsfull ökning över alla scenarier. Den lika stora arbetsbelastningen når 7 530,39 tok/s vid BS=64 och når sin topp vid 12 108,98 tok/s vid BS=256. Förfyllningstung arbetsbelastning klättrar till 16 546,53 tok/s vid BS=64 och 19 306,49 tok/s vid BS=128, med en topp på 20 137,35 tok/s vid BS=256, ungefär en ökning på 16 % jämfört med BF16 vid maximal samtidighet. Avkodningstung arbetsbelastning når sin topp vid 7 353,40 tok/s vid BS=256, ungefär 19 % före BF16.
Llama 3.1 8B Instruktion FP4
FP4 levererar ett dataflöde som är nära konkurrenskraftigt med FP8 vid högre samtidighetsnivåer, även om det halkar efter något vid lägre batchstorlekar. Den lika stora arbetsbelastningen når sin topp på 11 954,40 tok/s vid BS=256, och förfyllningstunga arbetsbelastningar når sin högsta punkt på 20 205,57 tok/s vid BS=256, vilket knappt överträffar FP8 vid maximal samtidighet. Avkodningstunga arbetsbelastningar når sin topp på 7 239,29 tok/s vid BS=256 och ligger inom några få procent av FP8 genomgående, vilket gör FP4 till ett övertygande alternativ när minneseffektivitet är en prioritet utan en betydande uppoffring av dataflödet.
MiniMax M2.5
MiniMax-M2.5 230B, testad på Comino Grando, var den största och mest krävande modellen vi använde.
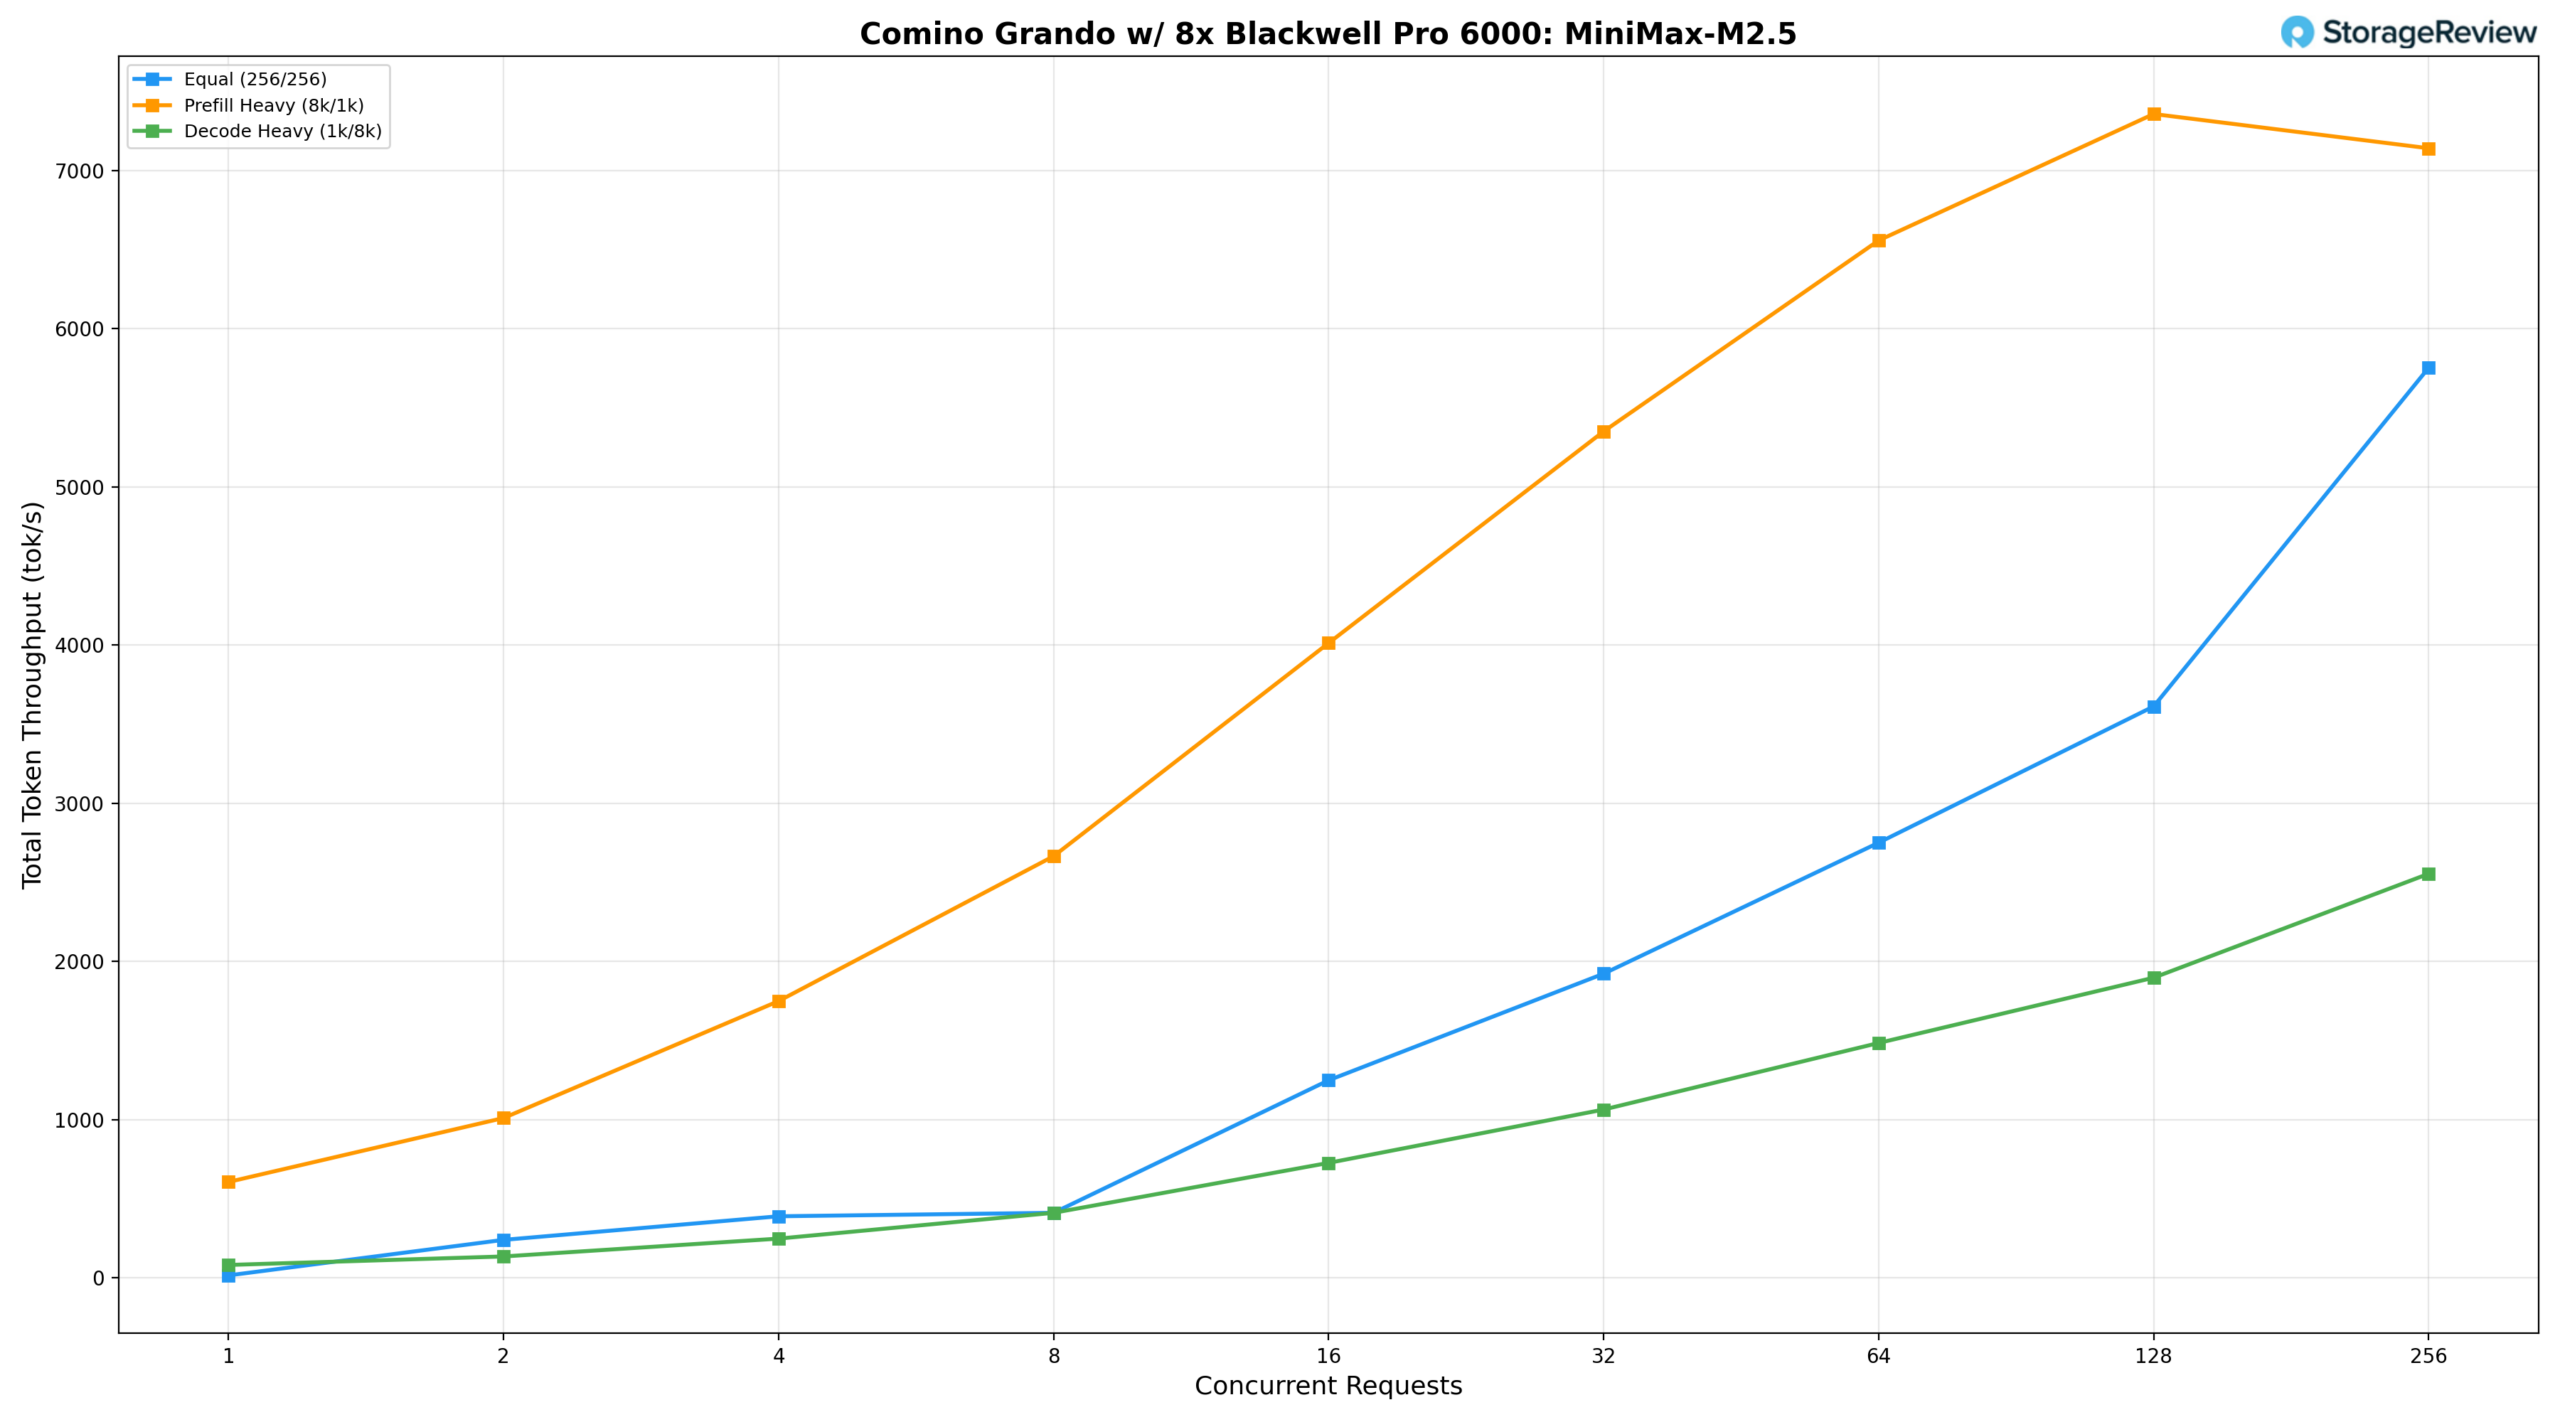
Under en lika stor arbetsbelastning (256/256) börjar modellen vid 16.35 tok/s vid BS=1, når 2 751,25 tok/s vid BS=64 och skalar kraftigt vid högre samtidighet, med en topp på 5 753,24 tok/s vid BS=256. Förfyllningstung (8k/1k) börjar vid 606.97 tok/s vid BS=1, klättrar stadigt till 5 351,02 tok/s vid BS=32 och 6 557,92 tok/s vid BS=64, och når sin topp vid 7 357,26 tok/s vid BS=128 innan den avtar något till 7 140,74 tok/s vid BS=256, vilket tyder på att modellen närmar sig mättnad i förfyllningsgenomströmning bortom BS=128. Avkodningstung (1k/8k) växer konsekvent från 82.21 tok/s vid BS=1 till 1 485,28 tok/s vid BS=64, med en topp på 2 554,87 tok/s vid BS=256, vilket återspeglar de förväntade minnesbandbreddskraven för en 230B MoE-arkitektur under ihållande avkodningsarbetsbelastningar.
Slutsats
Comino Grando förstås bäst som ett system specialbyggt för att frigöra den fulla potentialen hos åtta NVIDIA RTX PRO 6000 GPU:er. Varje större designbeslut, från den inverterade moderkortslayouten till kylslingan och den integrerade övervakningsstacken, är avsett att säkerställa att dessa GPU:er kan arbeta kontinuerligt med full 600W TDP utan termiska eller strömförbrukningsbegränsningar.
Det som gör Grando övertygande är inte någon enskild funktion i sig, utan hur hela systemet sammanhänger. Vätskekylningen är inte ett tillägg; det är arkitekturen. Strömförsörjningen är redundant, kan bytas under drift och skalas till 4 800 W-belastningen för åtta 600 W-kort med extra utrymme. Övervakningssystemet går utöver att rapportera temperaturer; det skyddar automatiskt hårdvaran när något går fel. Ingenting här känns som en eftertanke.
Prestandasiffrorna förstärker den sammanhållningen. Över en mångsidig uppsättning modeller, från Llama 3.1 8B till 230B MiniMax M2.5, levererade Grando dataflödessiffror som håller måttet för en självhostad plattform. Claude Codes samtidighetstestning förstärkte det praktiska värdet: åtta ingenjörer kan köra samtidiga agentiska kodningssessioner mot en lokalt hostad 230B-modell med interaktiva hastigheter, med en dataflöde per användare som överstiger 38 tok/s vid maximal aggregerad produktion. Team på fyra till åtta kan arbeta med nästan optimal dataflöde utan märkbar försämring.
Värdet av denna konfiguration sträcker sig bortom AI-inferens. Med 96 GB VRAM per GPU och tät multi-GPU-skalning är plattformen lika väl lämpad för avancerade kreativa och tekniska arbetsbelastningar, inklusive VFX-rendering, storskalig simulering och komplexa CAD-pipelines. Systemet skalar ner till konfigurationer med fyra och två GPU:er, vilket gör denna prestandanivå tillgänglig för mindre studior och team som fortfarande kräver densitet i arbetsstationsklass.
Det som skiljer Grando mest från de åtta-GPU-företagsplattformar som vi har granskat är i praktisk implementering. Dessa system erbjuder mer PCIe-filutrymme, fler NIC-platser och djupare lagringsanslutning, men de kräver också dedikerad datacenterinfrastruktur, drar långt över 8 kW och har ledtider som kan sträcka sig över ett år. Grando byter en del av den kringutrustningsmöjligheterna mot ett system som körs tillräckligt tyst för att dela ett rum med sina användare, avleder mindre värme till omgivningen och levereras nu. För organisationer som prioriterar snabb implementering och hanterbara driftsmiljöer framför maximal fabric-anslutning är avvägningen gynnsam.
Produktsida – Comino Grando
Comino-konfigurator – Sida
Topplista: Comino Grando RTX PRO 6000 har platsen för Extreme Pick på vår topplista över bästa stationära datorer för lokal AI .


 Amazon