

Intels Project Battlematrix representerar ett övertygande erbjudande inom tillgänglig AI-infrastruktur, som ger arbetsstationschassin betydande GPU-minneskapacitet genom en design med flera GPU:er. Byggd kring den professionella GPU:n med kodnamnet Battlemage Arc Pro B60, riktar sig denna plattform till organisationer som vill distribuera stora språkmodeller lokalt utan molnabonnemangskostnader eller oro för dataskydd. Med upp till 192 GB VRAM fördelat på åtta GPU:er i ett enda system positionerar sig Battlematrix som ett relativt kostnadseffektivt alternativ till andra professionella GPU-ekosystem för AI-inferensarbetsbelastningar.
Visa det här inlägget på Instagram
Det som skiljer Battlematrix från traditionella arbetsstationskonfigurationer är Intels kortdesign med dubbla GPU-enheter, som placerar två kompletta B60-GPU:er på ett enda kretskort vilket kräver PCIe-bifurkationsstöd. Denna densitetsoptimerade metod möjliggör konfigurationer som annars skulle kräva servermoderkort, medan Arc Pro B60:s 24 GB GDDR6 per GPU gör den särskilt väl lämpad för minnesintensiva transformatormodeller. Tidiga tester visar lovande potential, även om programvaruoptimering fortfarande släpar efter hårdvarans kapacitet.
Disclosure
Testning utfördes med tidiga programvaru- och drivrutinsrevisioner, inklusive utvecklingsgrenar av Intel LLM Scaler. Dessutom använder vår testplattform AMD EPYC-processorer snarare än Intels Xeon-plattform. Intel positionerar Battlematrix som en heltäckande Intel-lösning med Xeon 6-processorer, och produktionssystem med Intel-processorer kan uppvisa högre prestanda än våra resultat antyder. Läsare bör betrakta dessa resultat som preliminära, med förståelsen att programvarumognad och plattformsoptimering bör förbättras under 2026.
Specifikationer och arkitektur
| Specifikation | Detalj |
|---|---|
| Produktkollektion | Intel® Arc™ Pro B-seriens grafik |
| Kodnamn | Battle |
| GPU Arkitektur | Xe2 (TSMC N5) |
| Xe-färger | 20 |
| Rendera skivor | 5 |
| Ray Tracing Units | 20 |
| XMX-motorer | 160 |
| Xe Vector Engines | 160 |
| Grafisk klocka | 2400 MHz |
| Grafikklocka (LP-läge) | 2000 MHz |
| GPU FP32-prestanda | 12.28 TFLOPS |
| GPU Peak TOPS (INT8) | 197 |
| Total Board Power (TBP) | 200 W |
| Minne | 24 GB GDDR6 |
| Minnesgränssnitt | 192-bitars |
| minnesbandbredd | 456 GB / s |
| Minneshastighet | 19 Gbps |
| PCIe-gränssnitt | PCIe 5.0 x8 |
| Skärmar som stöds | 4 |
| Grafikutgång | HDMI 2.1 | DP2.1 (UHBR 13.5) | DP2.1 (UHBR 10) |
| Maximal upplösning (HDMI) | 7680 x 4320 @ 120Hz |
| Maximal upplösning (DP) | 7680 x 4320 @ 60Hz |
| HDMI variabel uppdateringsfrekvens | Ja |
| VESA Adaptive Sync | Ja |
| H.264 / H.265 / AV1 Kodning/Avkodning | Ja |
| Stöd för strålspårning | Ja |
| oneAPI-stöd | Ja |
| Support för OpenVINO | Ja |
| Intel IPEX-stöd | Ja |
| Intel XeSS-stöd | Ja |
Ocuco-landskapet Intel Arc Pro B60 delar sin kiselfundament med den spelfokuserade Intel Arc B580, båda använder samma chipp tillverkad med TSMC:s 5nm-process. Detta 272 mm² stora chip innehåller 19.6 miljarder transistorer och integrerar 20 Xe2-kärnor, som marknadsförs för att leverera 12.28 TFLOPS FP32-beräkning och 197 TOPS INT8 AI-prestanda per GPU. Den avgörande skillnaden ligger i minneskonfigurationen: medan B580 levereras med 12 GB GDDR6, fördubblar B60 kapaciteten till 24 GB.
Varje B60 GPU arbetar med 2 400 MHz över ett 192-bitars minnesgränssnitt, vilket ger 456 GB/s bandbredd per GPU. Arkitekturen har 160 XMX (Xe Matrix Extensions) AI-motorer per GPU, specialbyggda för att accelerera matrisoperationer vid AI-inferens.
Dubbel GPU-design och PCIe-bifurkation
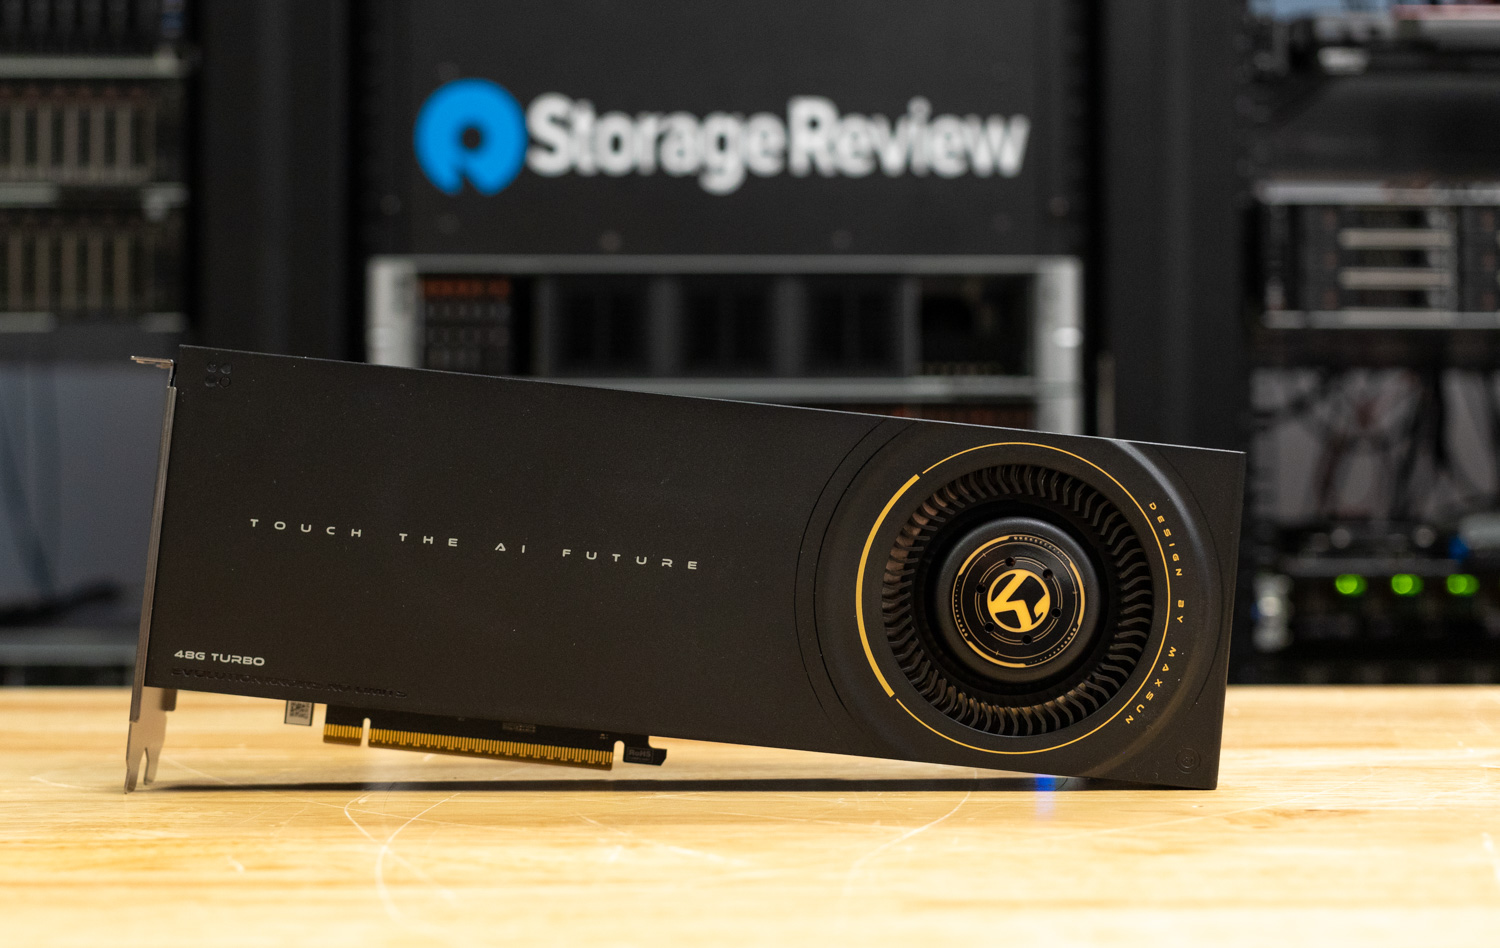
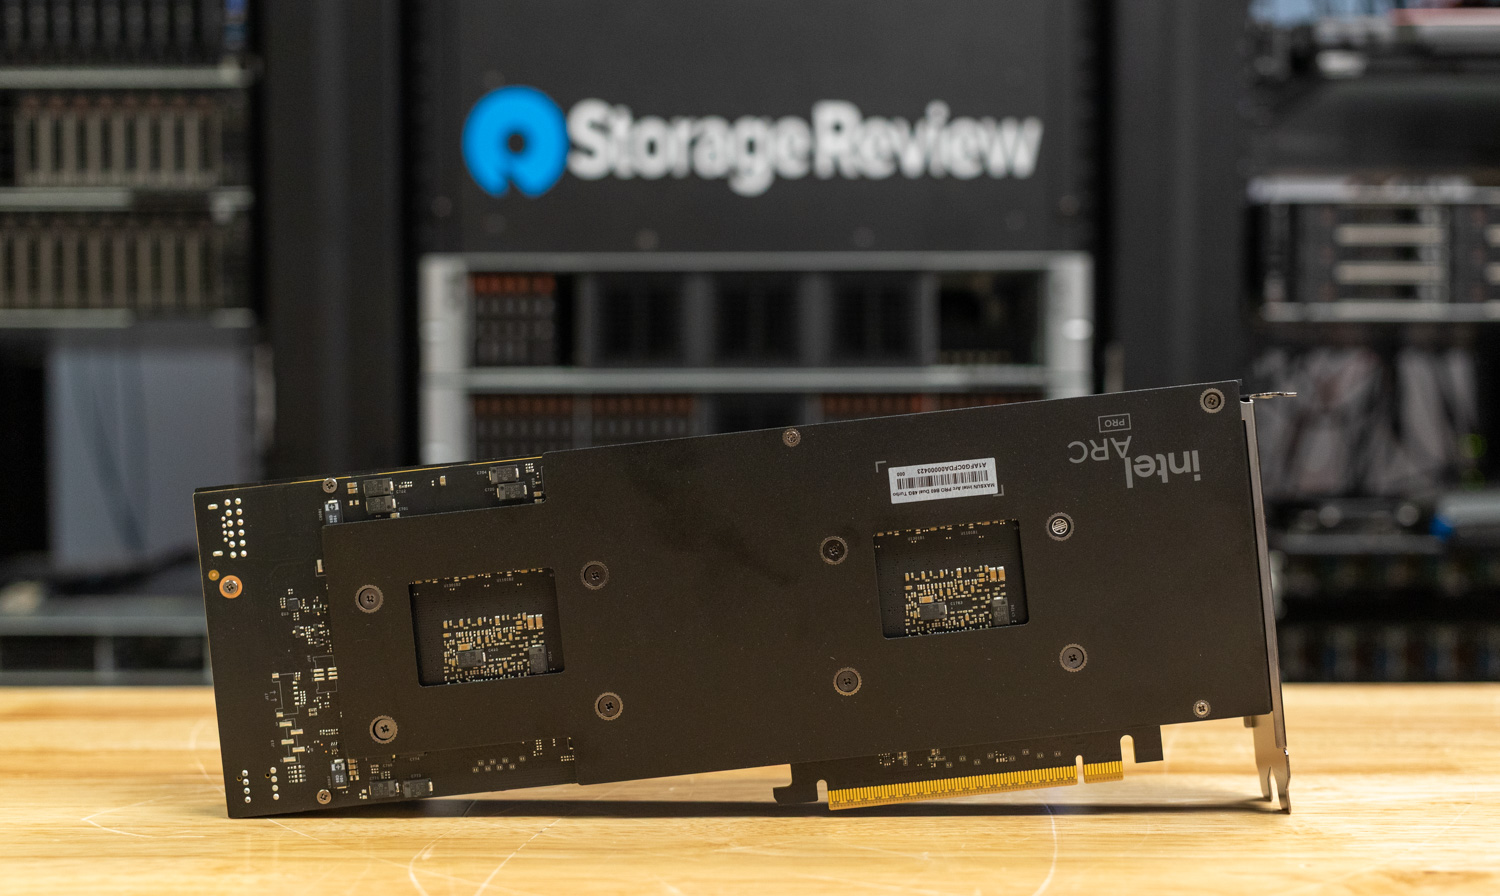
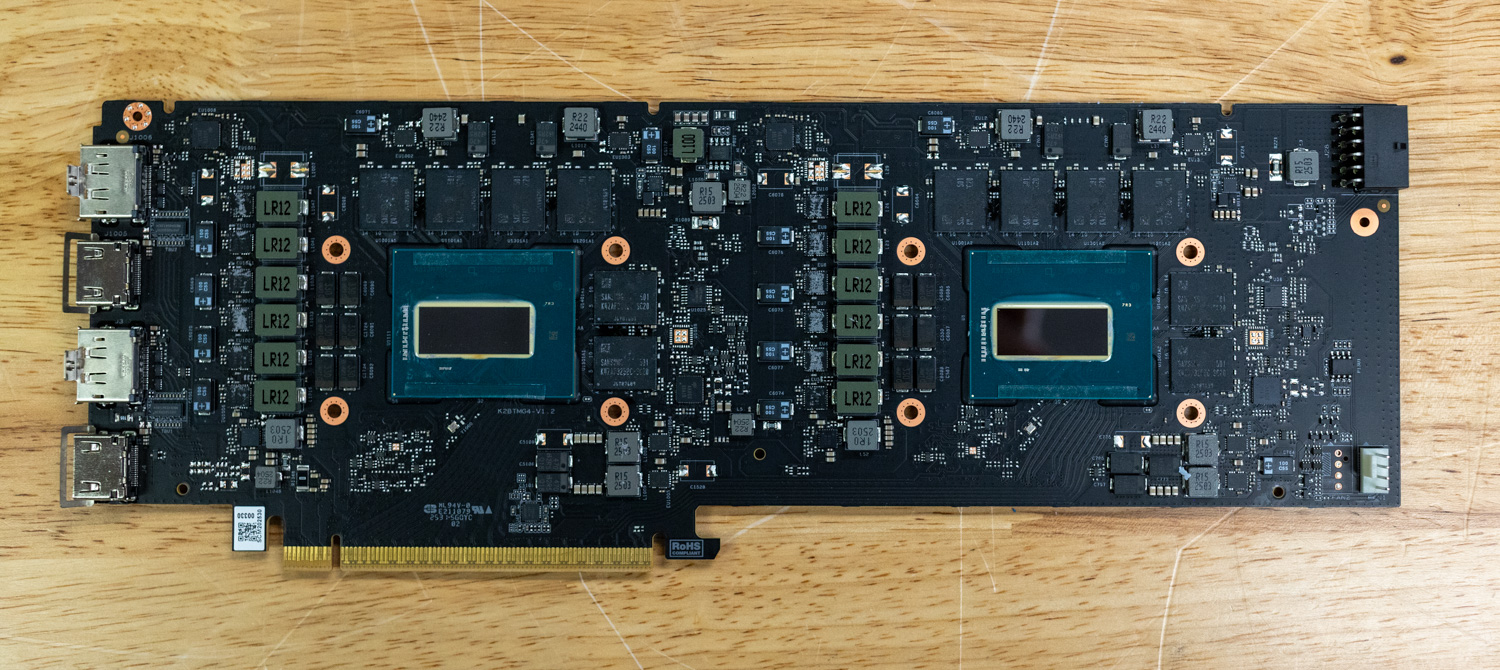
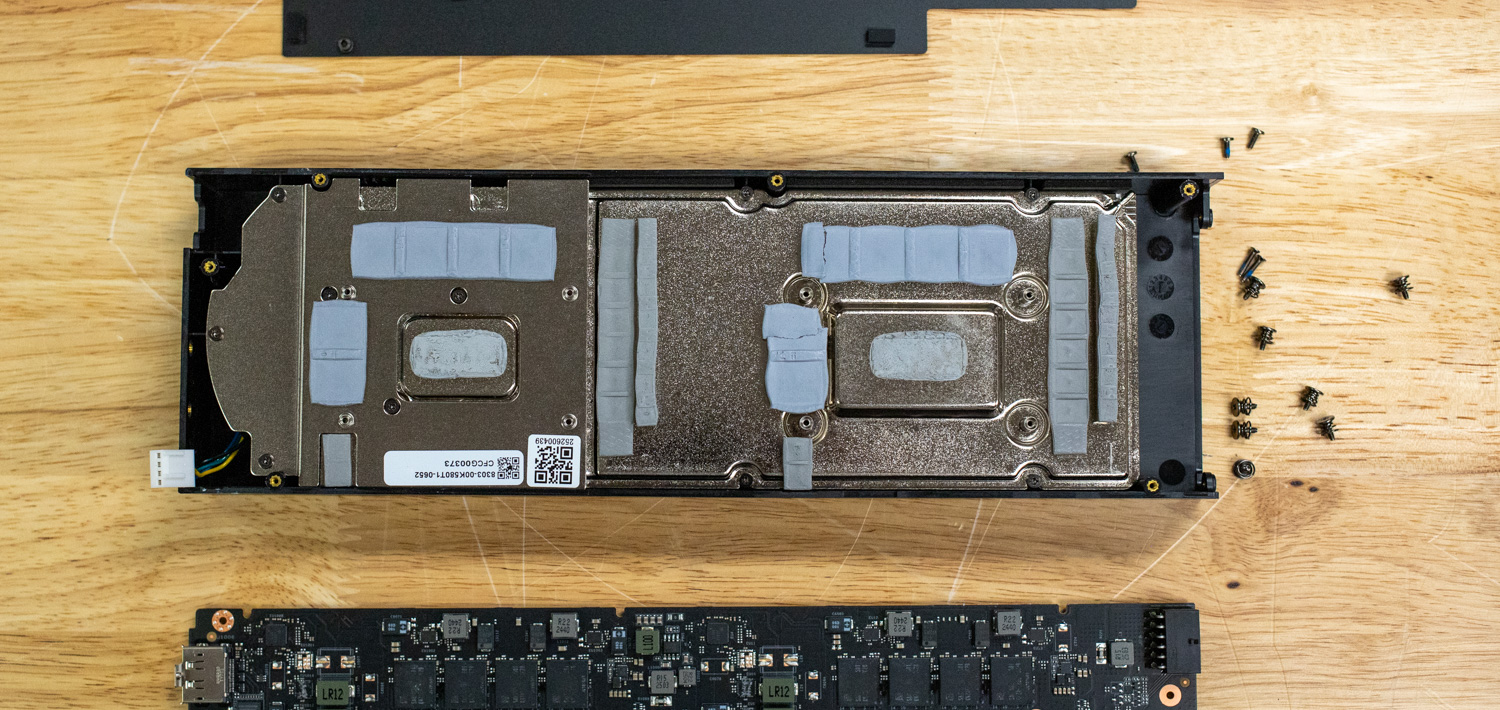
Maxsun Arc Pro B60 Dual 48G Turbo exemplifierar Intels densitetsstrategi: två kompletta GPU:er monterade på ett enda kort med dubbla kortplatser, anslutna oberoende via PCIe 5.0 x8-gränssnitt. Till skillnad från traditionella designer med dubbla GPU:er som bryggar kretsar för att fungera som en enda GPU, presenteras varje B60 GPU som en separat enhet i systemet, vilket kräver moderkortsstöd för PCIe x8/x8-bifurkation. En enda x16-kortplats delas elektriskt i två x8-anslutningar, där varje GPU får dedikerad bandbredd.
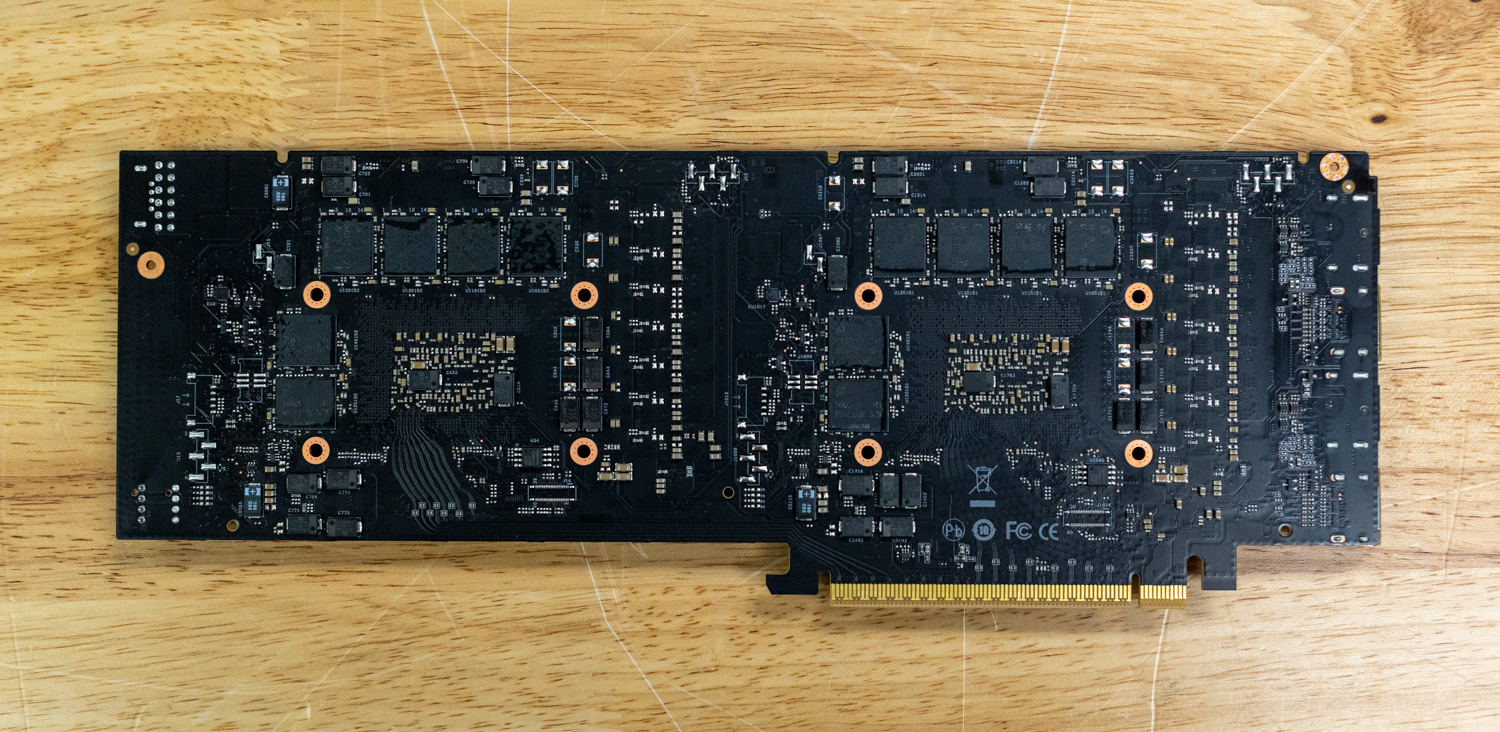
PCIe 5.0 x8 levererar 128 GB/s dubbelriktad bandbredd per GPU, vilket matchar PCIe 4.0 x16. Konfigurationen med dubbla kort mäter 300 mm i längd, upptar två platser med fläktkylning och drar 400 W total moderkortseffekt via en enda 12V-2×6-kontakt klassad för 600 W.
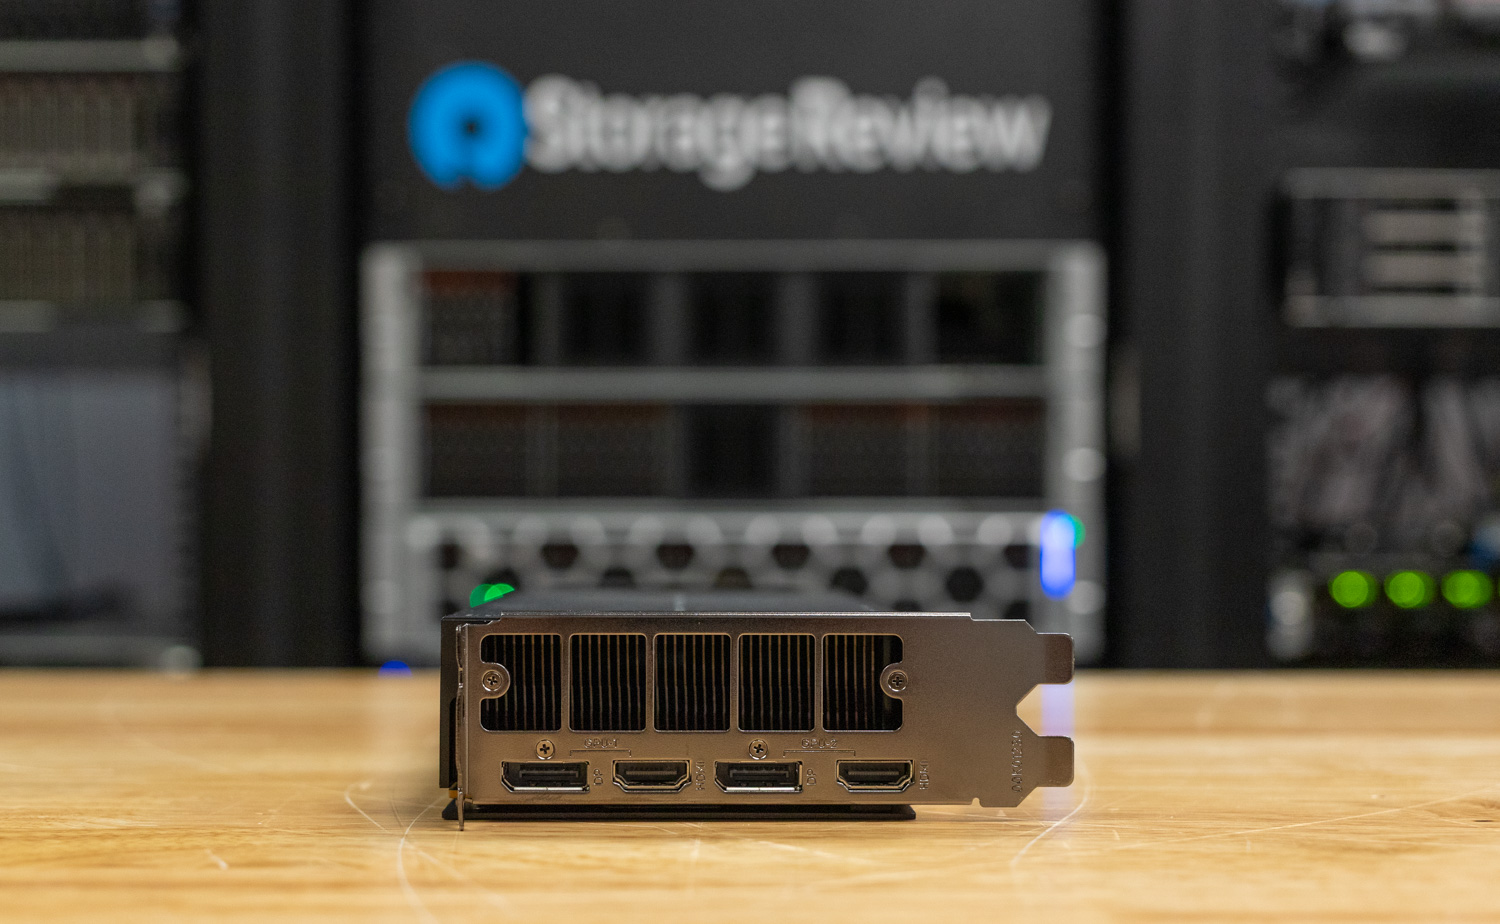
Varje dubbelkort har fyra skärmutgångar: två DisplayPort 2.1 UHBR20- och två HDMI 2.1a-portar, en uppsättning per GPU, vilket möjliggör separata videoutgångskonfigurationer för virtualiserade skrivbordsmiljöer eller fleranvändarsystem. En viktig punkt att notera är att endast en av de två skärmutgångarna kan användas åt gången för varje GPU.
Visa det här inlägget på Instagram
Åtta GPU Battlematrix-konfiguration
Intels referensspecifikation för Battlematrix stöder upp till åtta Arc Pro B60-grafikkort i ett arbetsstationschassi, vilket uppnås genom att använda fyra kort med dubbla grafikkort. Denna konfiguration levererar:
- 192 GB totalt system-VRAM (8 × 24 GB)
- 1 280 XMX AI-motorer
- 1,576 INT8 TOPP aggregerad beräkning
- 3.6 TB/s kombinerad minnesbandbredd
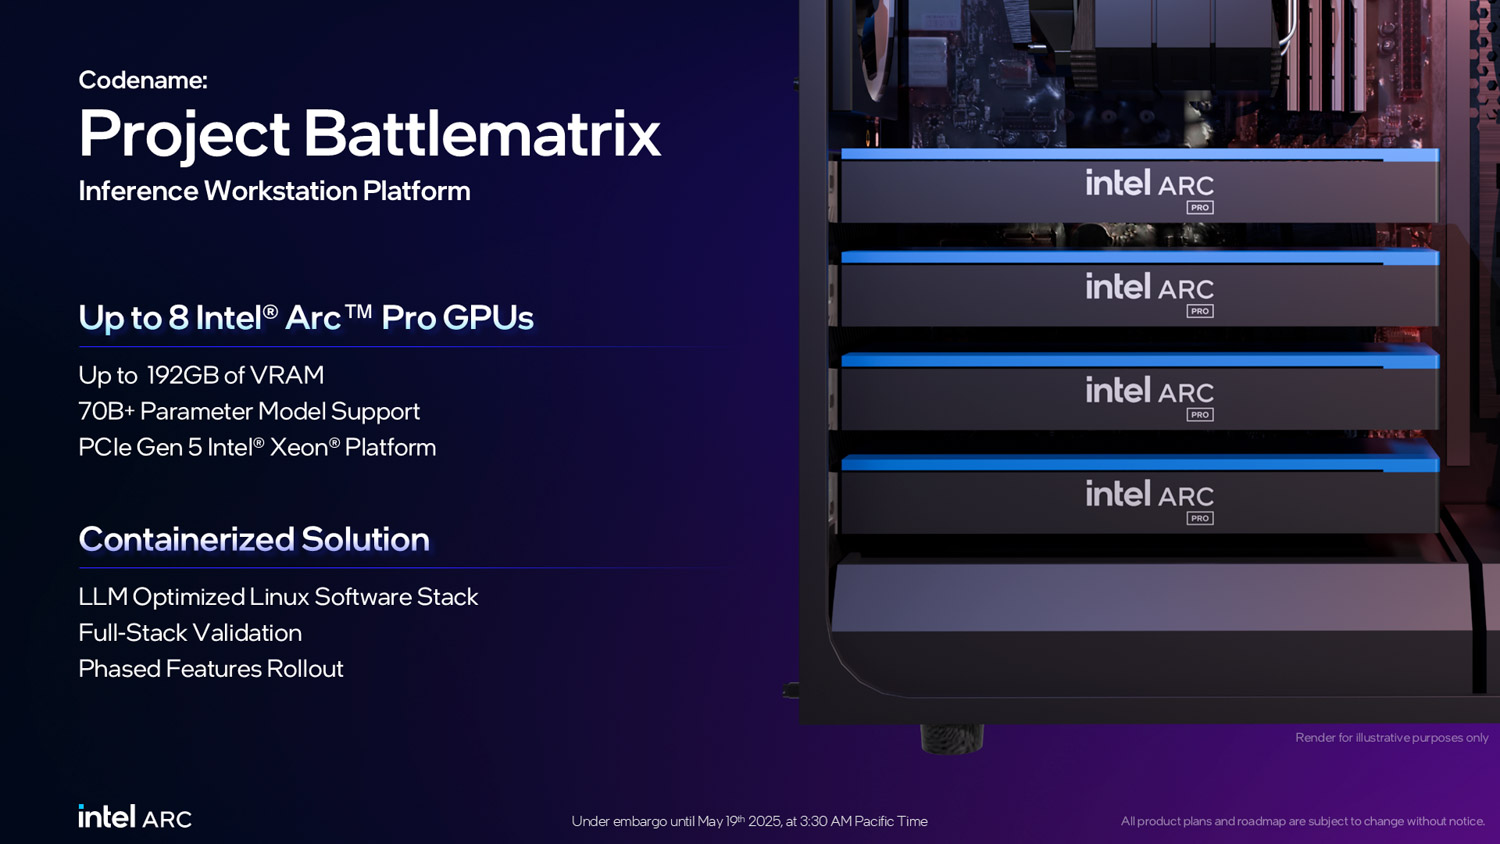
Plattformen kräver moderkort med fyra PCIe 5.0 x16-kortplatser som stöder bifurcation, och Battlematrix-specifikationen kommer även att inkludera en Xeon 6-processor; ytterligare information om Battlematrix-konfigurationen är dock för närvarande inte tillgänglig.
Användningsfall och värdeerbjudande
Målgrupp
Intels Project Battlematrix riktar sig till tre marknadssegment: AI-utvecklingsteam som behöver lokal infrastruktur, programvaruutvecklingsorganisationer som implementerar AI-assisterade arbetsflöden med känsliga kodbaser och organisationer som söker kostnadseffektiva alternativ till molnbaserade inferenstjänster. Plattformens kärnvärde är centrerat kring datasuveränitet och fördelar med total ägandekostnad jämfört med fleråriga molnabonnemang.
Privat AI och agentutveckling
Battlematrix-plattformens främsta styrka ligger i att stödja utvecklingsarbetsflöden för stora språkmodeller som kräver omfattande kontextfönster och betydande parameterantal.
Utvecklingsteam som bygger agentiska system drar särskilt nytta av det tillgängliga minnesutrymmet. RAG-agentimplementeringar underhåller vanligtvis flera komponenter samtidigt i GPU-minnet: basspråksmodellen, inbäddningsmodeller för vektorsökning och omrankningsmodeller. Dessutom utför agentiska arbetsflöden flerstegsresonemang, verktygsanvändning och självkorrigering, vilket genererar betydande kontextfönster genom iteration. En kodningsagent som analyserar en stor kodbas kan ackumulera 100 000+ tokens under sin operativa livscykel.
Framtidens VDI och virtualiserat spelande
Intels färdplan inkluderar att aktivera stöd för SR-IOV (Single Root I/O Virtualization) på Arc Pro B60 GPU:er, vilket omvandlar hårdvaran till en grafikplattform för flera användare. SR-IOV möjliggör uppdelning av en fysisk GPU i flera virtuella GPU:er, som var och en kan tilldelas separata virtuella maskiner med direkt hårdvaruåtkomst och isolerade minnesutrymmen.
Den här funktionen låser upp licensfria scenarier med virtuella skrivbordsinfrastrukturer där ett enda Battlematrix-system med åtta GPU:er stöder dussintals samtidiga användare med dedikerad GPU-acceleration för CAD-applikationer, videoredigering eller måttliga spel. Traditionella VDI-lösningar kräver dyra licensavgifter utöver hårdvarukostnader, vilket ofta kräver dyrare professionella GPU:er eller GPU:er för datacenter. Intels engagemang för licensfri virtualisering eliminerar denna driftskostnad.
Prissättning och värdeförslag
Intel meddelade att Arc Pro B60 kommer att kosta runt 600 dollar per grafikkort. För initial testning och utveckling erbjuder konfigurationer med ett eller två kort (600 till 1 200 dollar) tillgängliga instegsmöjligheter. Ett enda kort med två grafikkort och 48 GB VRAM ger tillräcklig kapacitet för kvantiserade modeller och täcker en betydande del av populära LLM-applikationer med öppen källkod.
Maxsun Dual Arc Pro B60 Dual 48G Turbo-konfigurationen som vi testade kostar 1 200 dollar direkt från Maxsun, i linje med Intels ursprungliga tillkännagivande. De senaste fluktuationerna i minnespriserna kan dock påverka detta.
Exceptionellt värde till ingångspris
Konfigurationerna med ett eller två kort erbjuder övertygande ekonomi för små team, enskilda utvecklare och hemmalabbor. Med ett pris på 600 dollar för 24 GB GPU-minne och 1 200 dollar för 48 GB underprisar denna plattform professionella GPU-alternativ avsevärt, som vanligtvis kostar minst dubbelt så mycket.
Detta värdeerbjudande är särskilt relevant för organisationer som utforskar AI-integration utan att binda företagsbudgetar.
vLLM Online-visningsprestanda
vLLM är den mest populära högkapacitetsinferens- och serveringmotorn för LLM:er. vLLM:s onlineserving benchmark är ett prestandautvärderingsverktyg som mäter verklig serveringsprestandan under samtidiga förfrågningar. Det simulerar produktionsarbetsbelastningar genom att skicka förfrågningar till en körande vLLM-server med konfigurerbara parametrar som förfrågningshastighet, in-/utmatningslängder och antal samtidiga klienter. Benchmarket mäter viktiga mätvärden, inklusive dataflöde (tokens per sekund), tid till första token (TTFT) och tid per utmatningstoken (TPOT), vilket hjälper användare att förstå hur vLLM presterar under olika belastningsförhållanden.
Testplattform:
- Server: Supermicro AS-4125GS-TNRT
- processorer: AMD EPYC 9374F
- Minne: 512 GB Samsung 4800 MT/s DDR5
- Grafikkort: 4x Maxsun MS-Intel ARC Pro B60 Dual 48G Turbo
Kvantiseringsstöd och begränsningar
Dessa GPU:er bör utmärka sig vid lågprecisionsinferens med inriktning på INT4-kvantisering för optimal prestanda. På grund av den mycket tidiga utvecklingsversionen av Intels LLM Scaler som vi testade, fungerade dock endast de GPT OSS-modeller som initialt tränades med MXFP4-mikroskalningsformatet korrekt. Andra kvantiseringsformat, inklusive standard INT4, FP8 och AWQ, misslyckades med att starta helt. Denna begränsning begränsade avsevärt vår förmåga att noggrant testa dessa GPU:er, även om vi förväntar oss bredare stöd för kvantisering allt eftersom programvarustacken mognar.
Vi testade de flesta modellerna med två konfigurationer: den fullständiga Battlematrix-konfigurationen med åtta GPU:er och det minsta antalet GPU:er som krävs för att få plats med modellen i minnet. Denna jämförelse avslöjar intressanta skalningsegenskaper, särskilt kring kommunikationskostnader vid lägre batchstorlekar.
Mikroskalningsdatatyper
Mikroskalning representerar en avancerad kvantiseringsmetod som tillämpar finkorniga skalningsfaktorer på små viktblock snarare än enhetlig kvantisering över stora parametergrupper. MXFP4-formatet implementerar denna teknik med hjälp av en blockerad flyttalrepresentation, där varje mikroskaleblock delar en gemensam exponent som skalningsfaktor, vilket bevarar numerisk precision samtidigt som 4-bitars precision uppnås. En viktig fördel med MXFP4-datatypen är att kvantisering av modeller till INT4 inte försämrar svarskvaliteten avsevärt, till skillnad från kvantisering från format med högre precision som BF16. GPT OSS-modellerna körs med INT4-kvantisering på B60:orna eftersom de inte har nativt stöd för MXFP4.
OpenAI GPT-OSS 20B
20B-parametermodellen visar tydligt fenomenet med kommunikationsoverhead. Vid en batchstorlek på 1 levererar en enda GPU 49.22 tok/s per användare, jämfört med bara 22.83 tok/s när den fördelas över alla åtta GPU:er. Konfigurationen med en enda GPU presterar mer än 2x bättre. Konfigurationen med åtta GPU:er utmärker sig dock vid högre samtidighet och uppnår en total dataflöde på 511.99 tok/s vid en batchstorlek på 16.
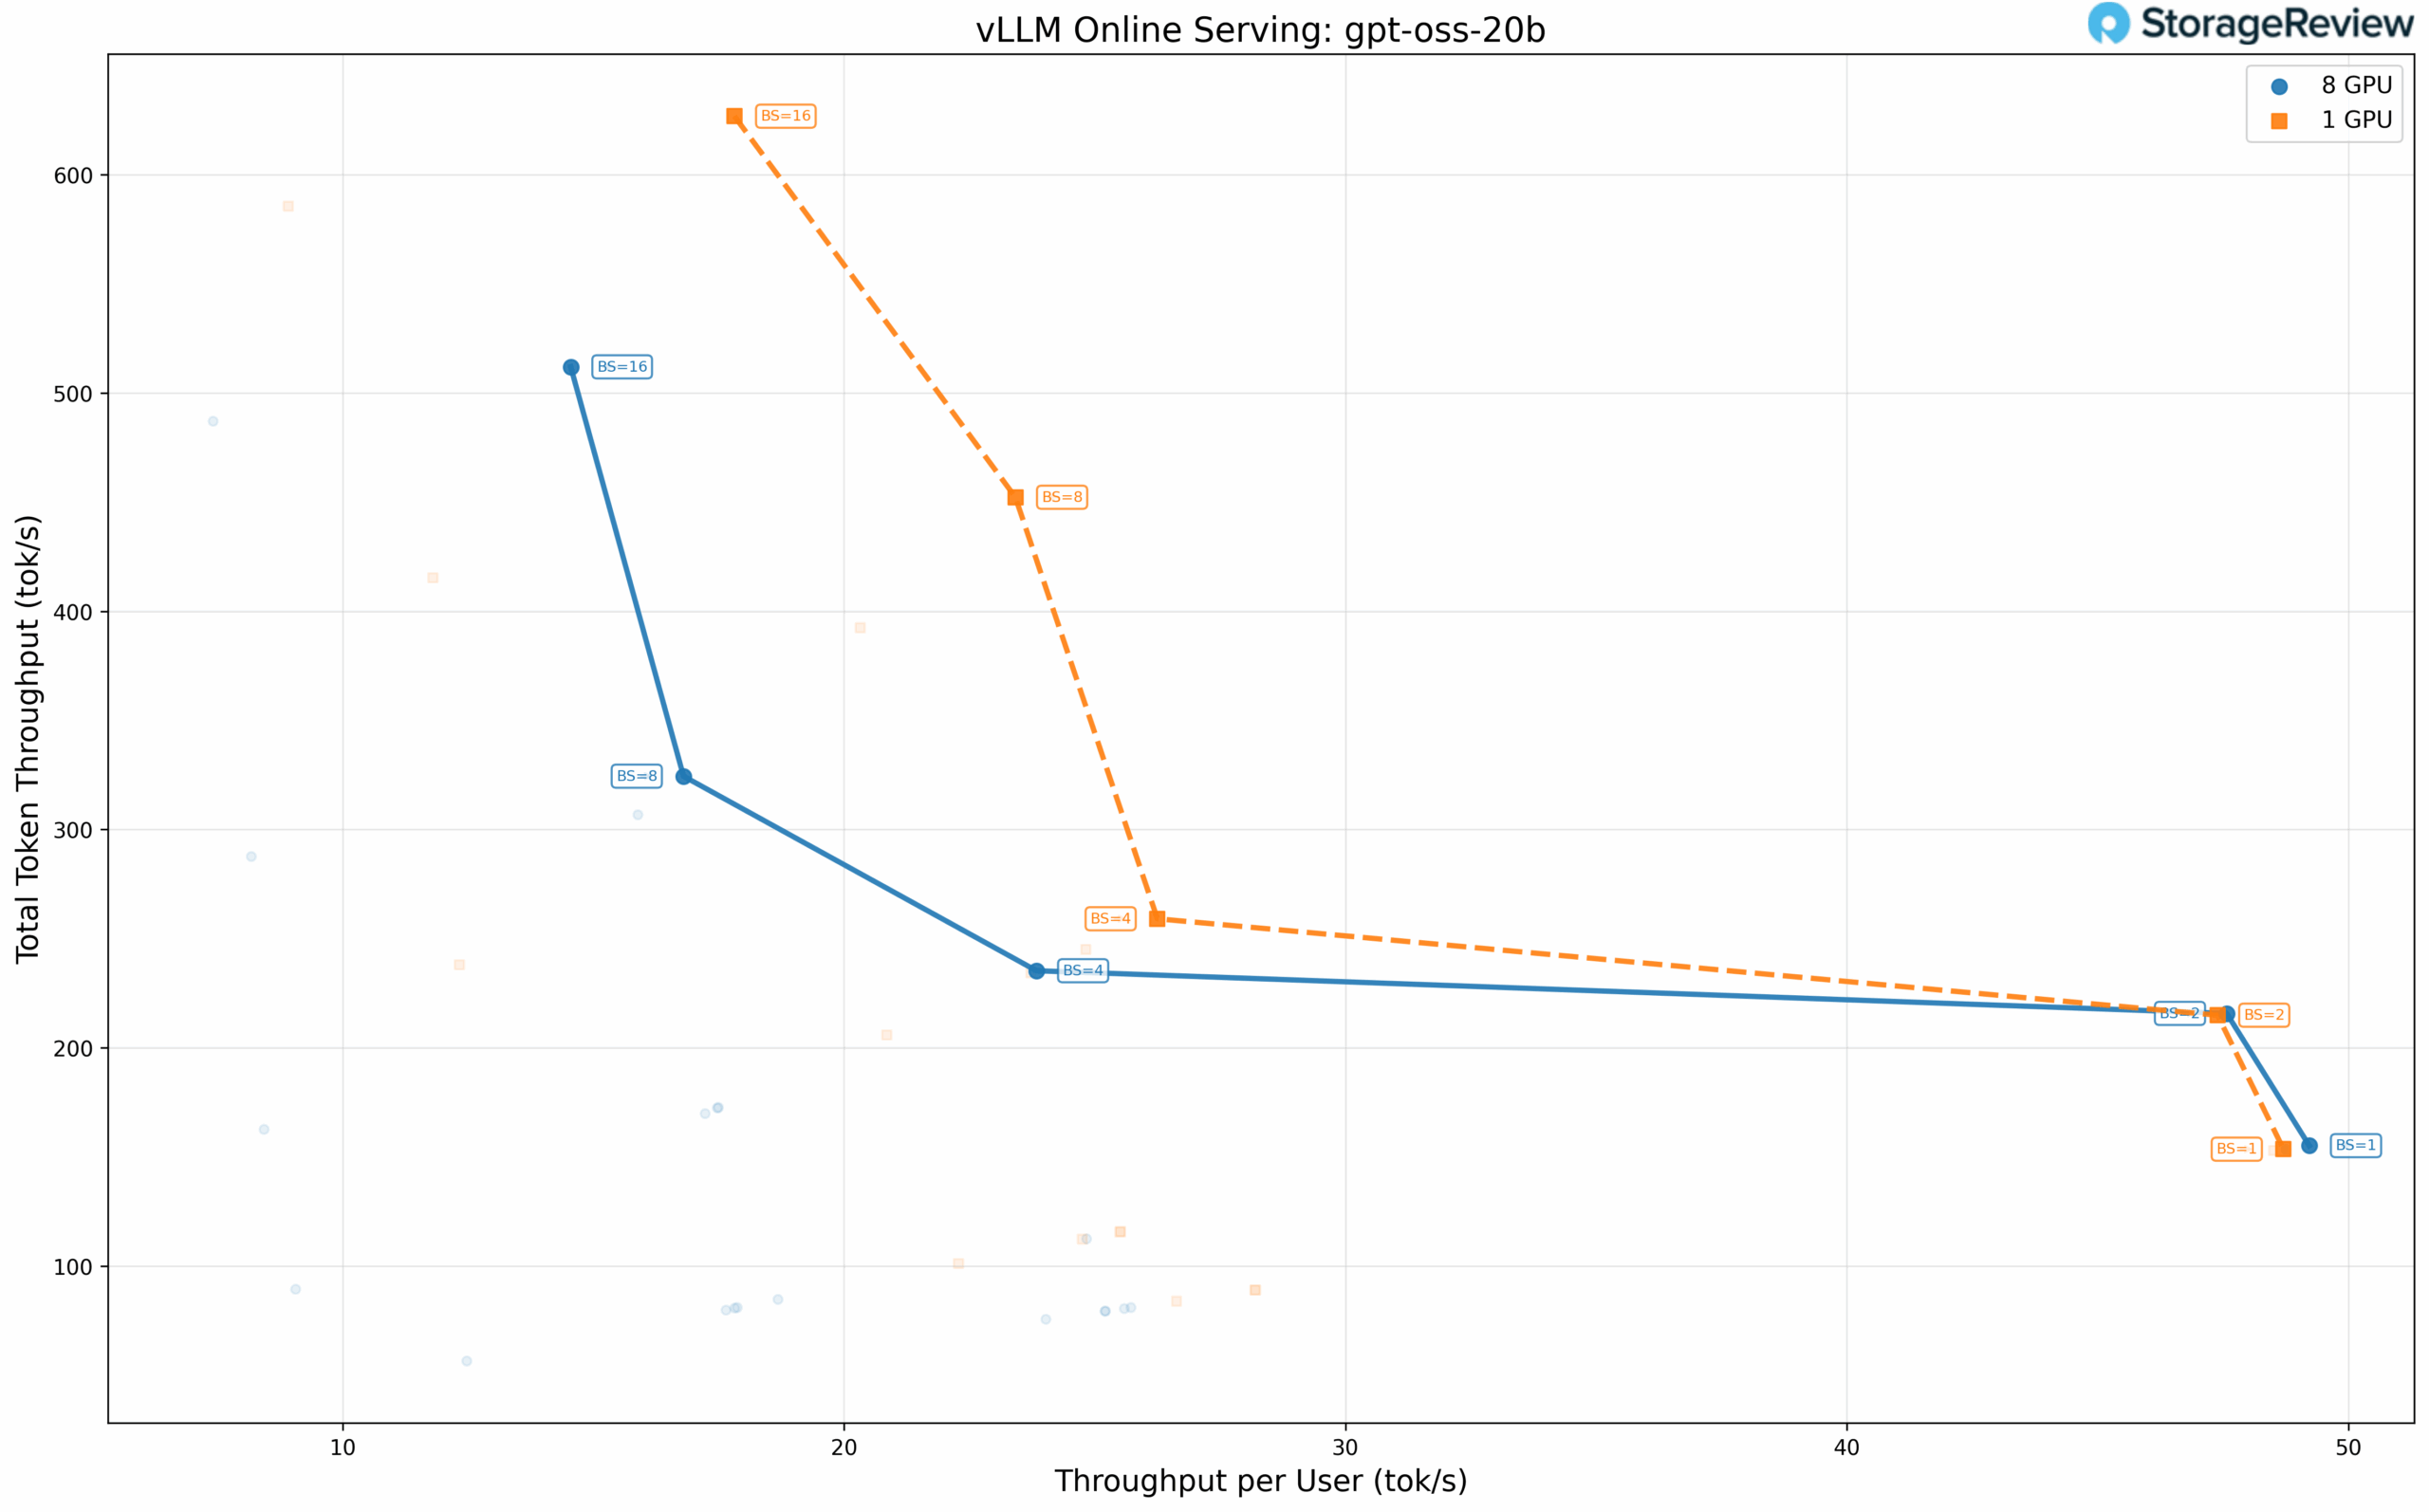 Den lägsta GPU-konfigurationen uppnår faktiskt högre total dataflöde vid batchstorlek 16: 626.84 tok/s med TP=4 jämfört med 511.99 tok/s med TP=8. Detta kontraintuitiva resultat understryker att för modeller och kontextlängder som bekvämt passar färre GPU:er, introducerar tillägg av mer hårdvara kommunikationsoverhead utan proportionella prestandavinster.
OpenAI GPT-OSS 120B
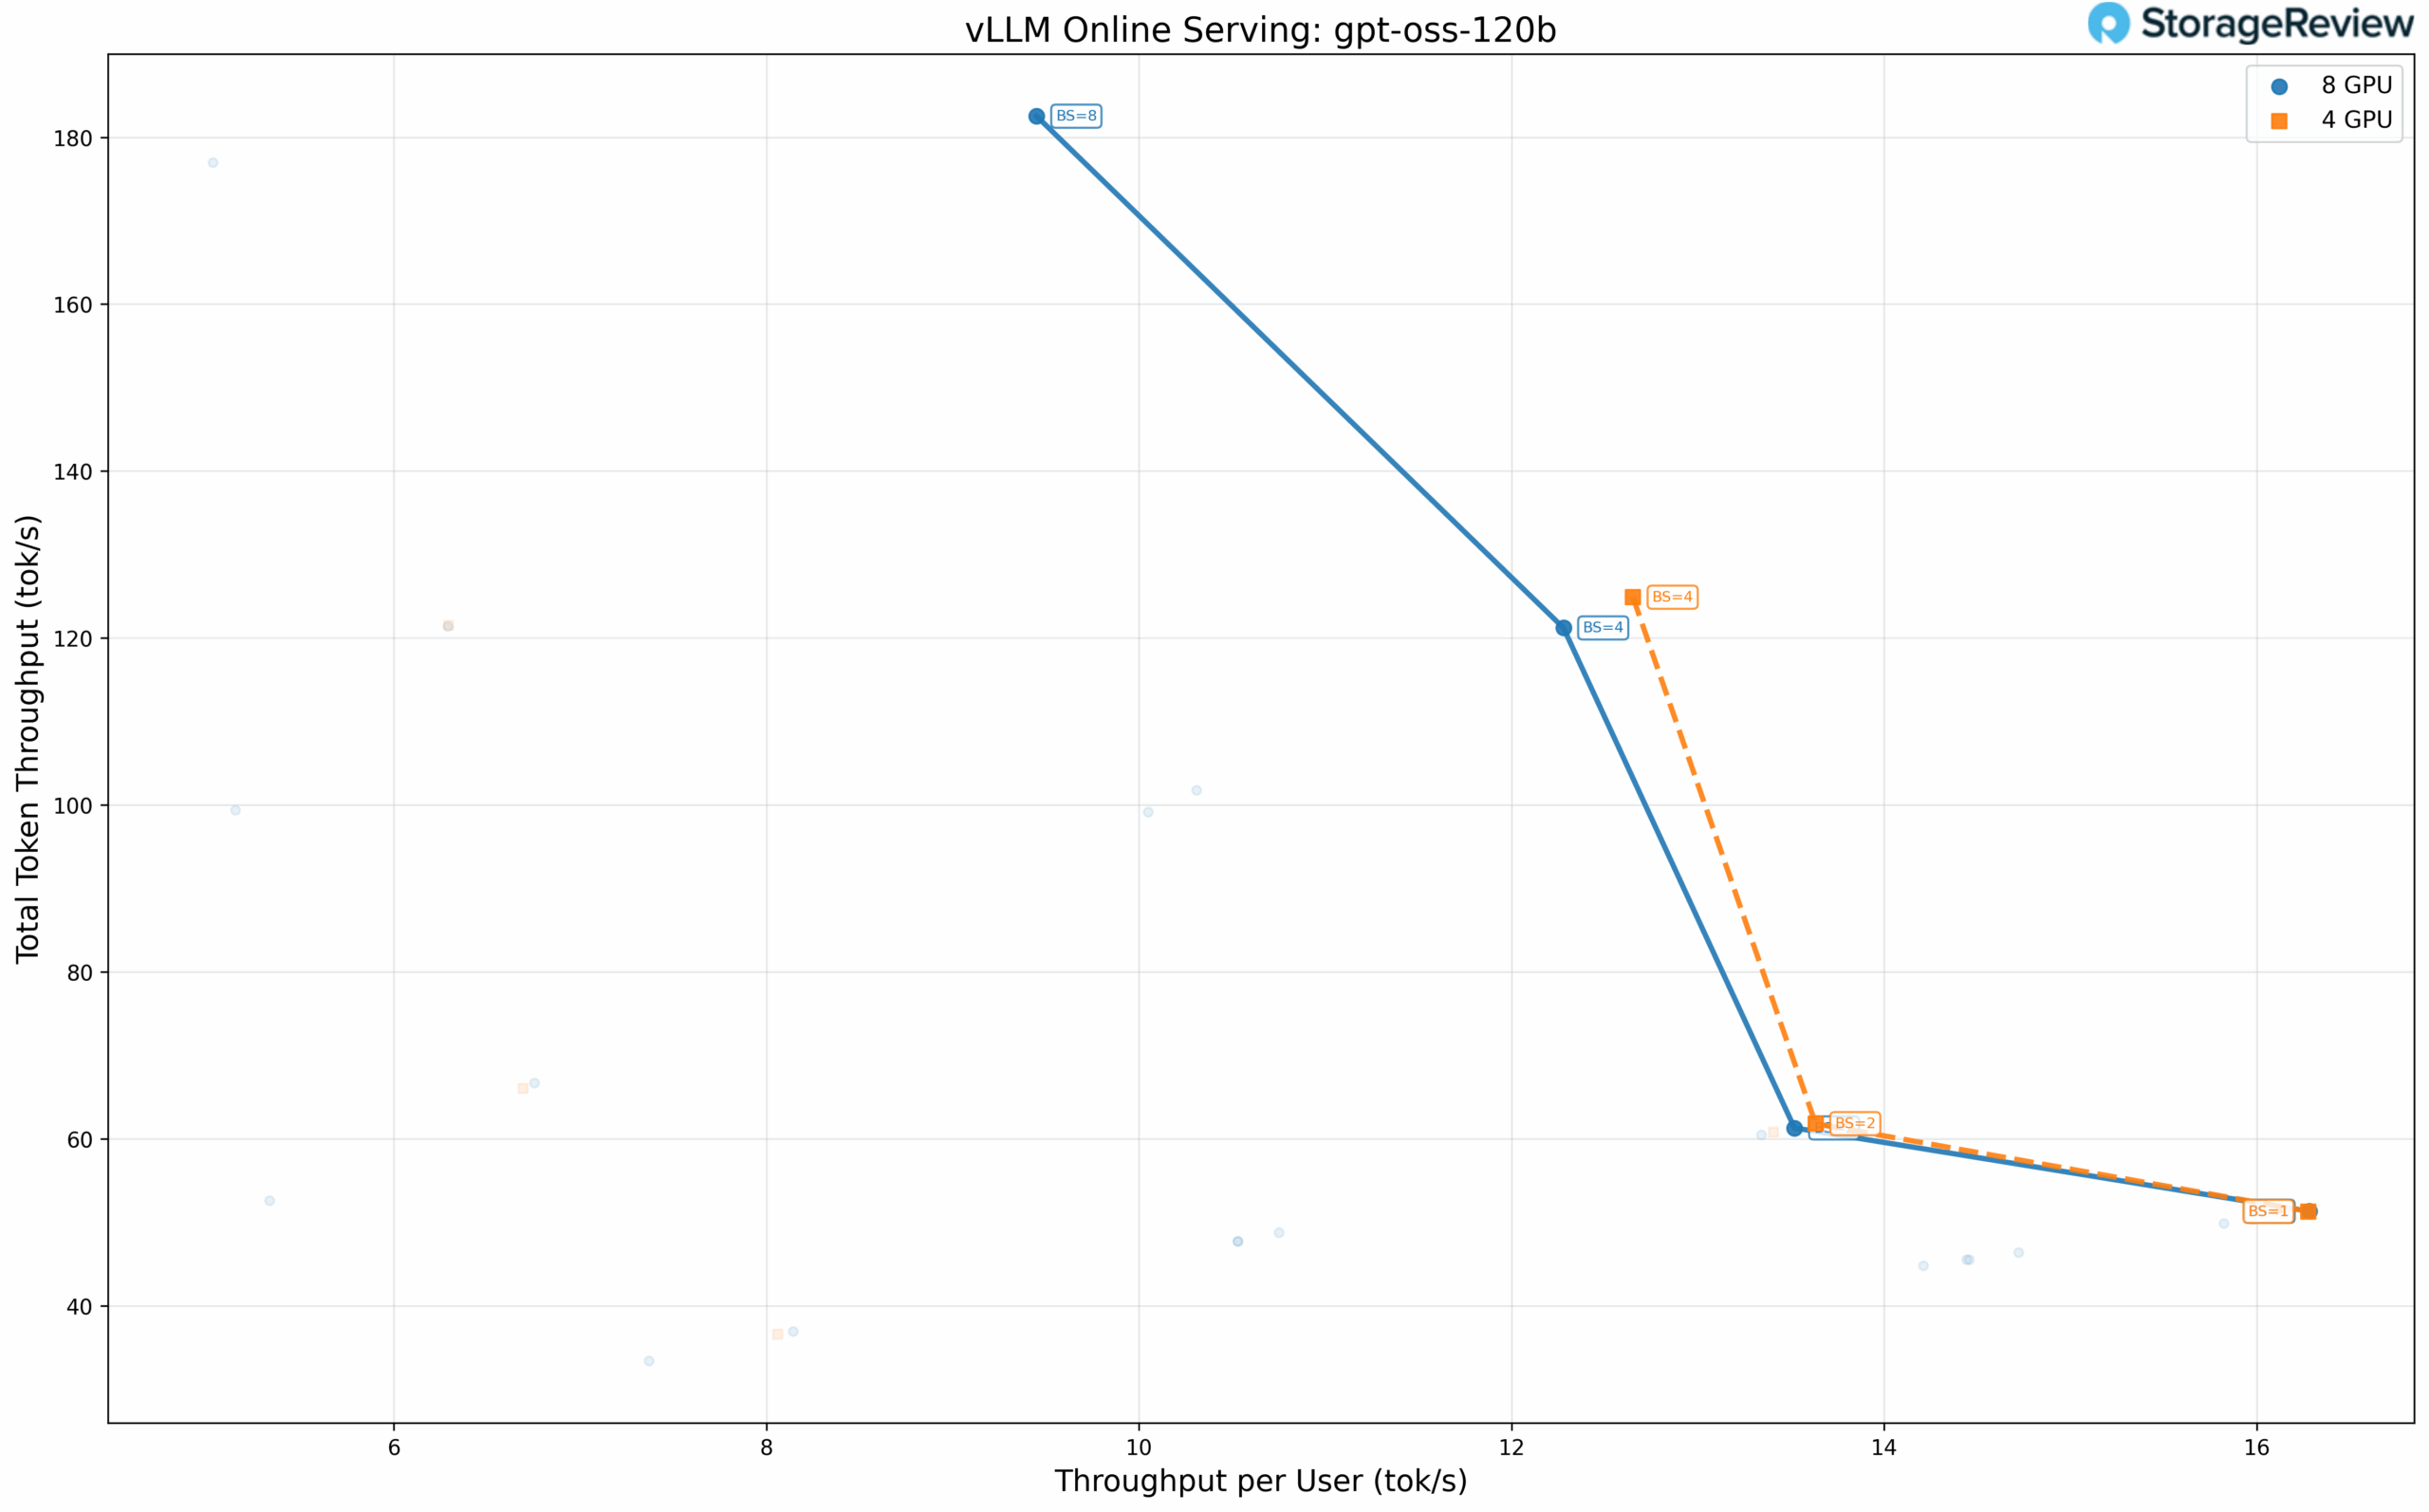
Den större 120B-modellen kräver minst fyra grafikkort, vilket eliminerar jämförelsen med ett enda grafikkort. Prestandan mellan fyra och åtta grafikkortskonfigurationer konvergerar närmare, med ett dataflöde per användare som är nästan identiskt vid batchstorlek 1 (16.28 tok/s för båda). Konfigurationen med åtta grafikkort ger blygsamma vinster vid högre batchstorlekar genom dataparallellism.
Expertblandning: Qwen3 Coder 30B-A3B
Glesa MoE-arkitekturer bibehåller ett stort antal parametrar samtidigt som de endast aktiverar en delmängd under inferens. Qwen3 Coder 30B-A3B aktiverar cirka 3 miljarder parametrar per token från sin fullständiga parameterpool på 30 miljarder, vilket gör den populär för lokala kodningsassistentdistributioner.
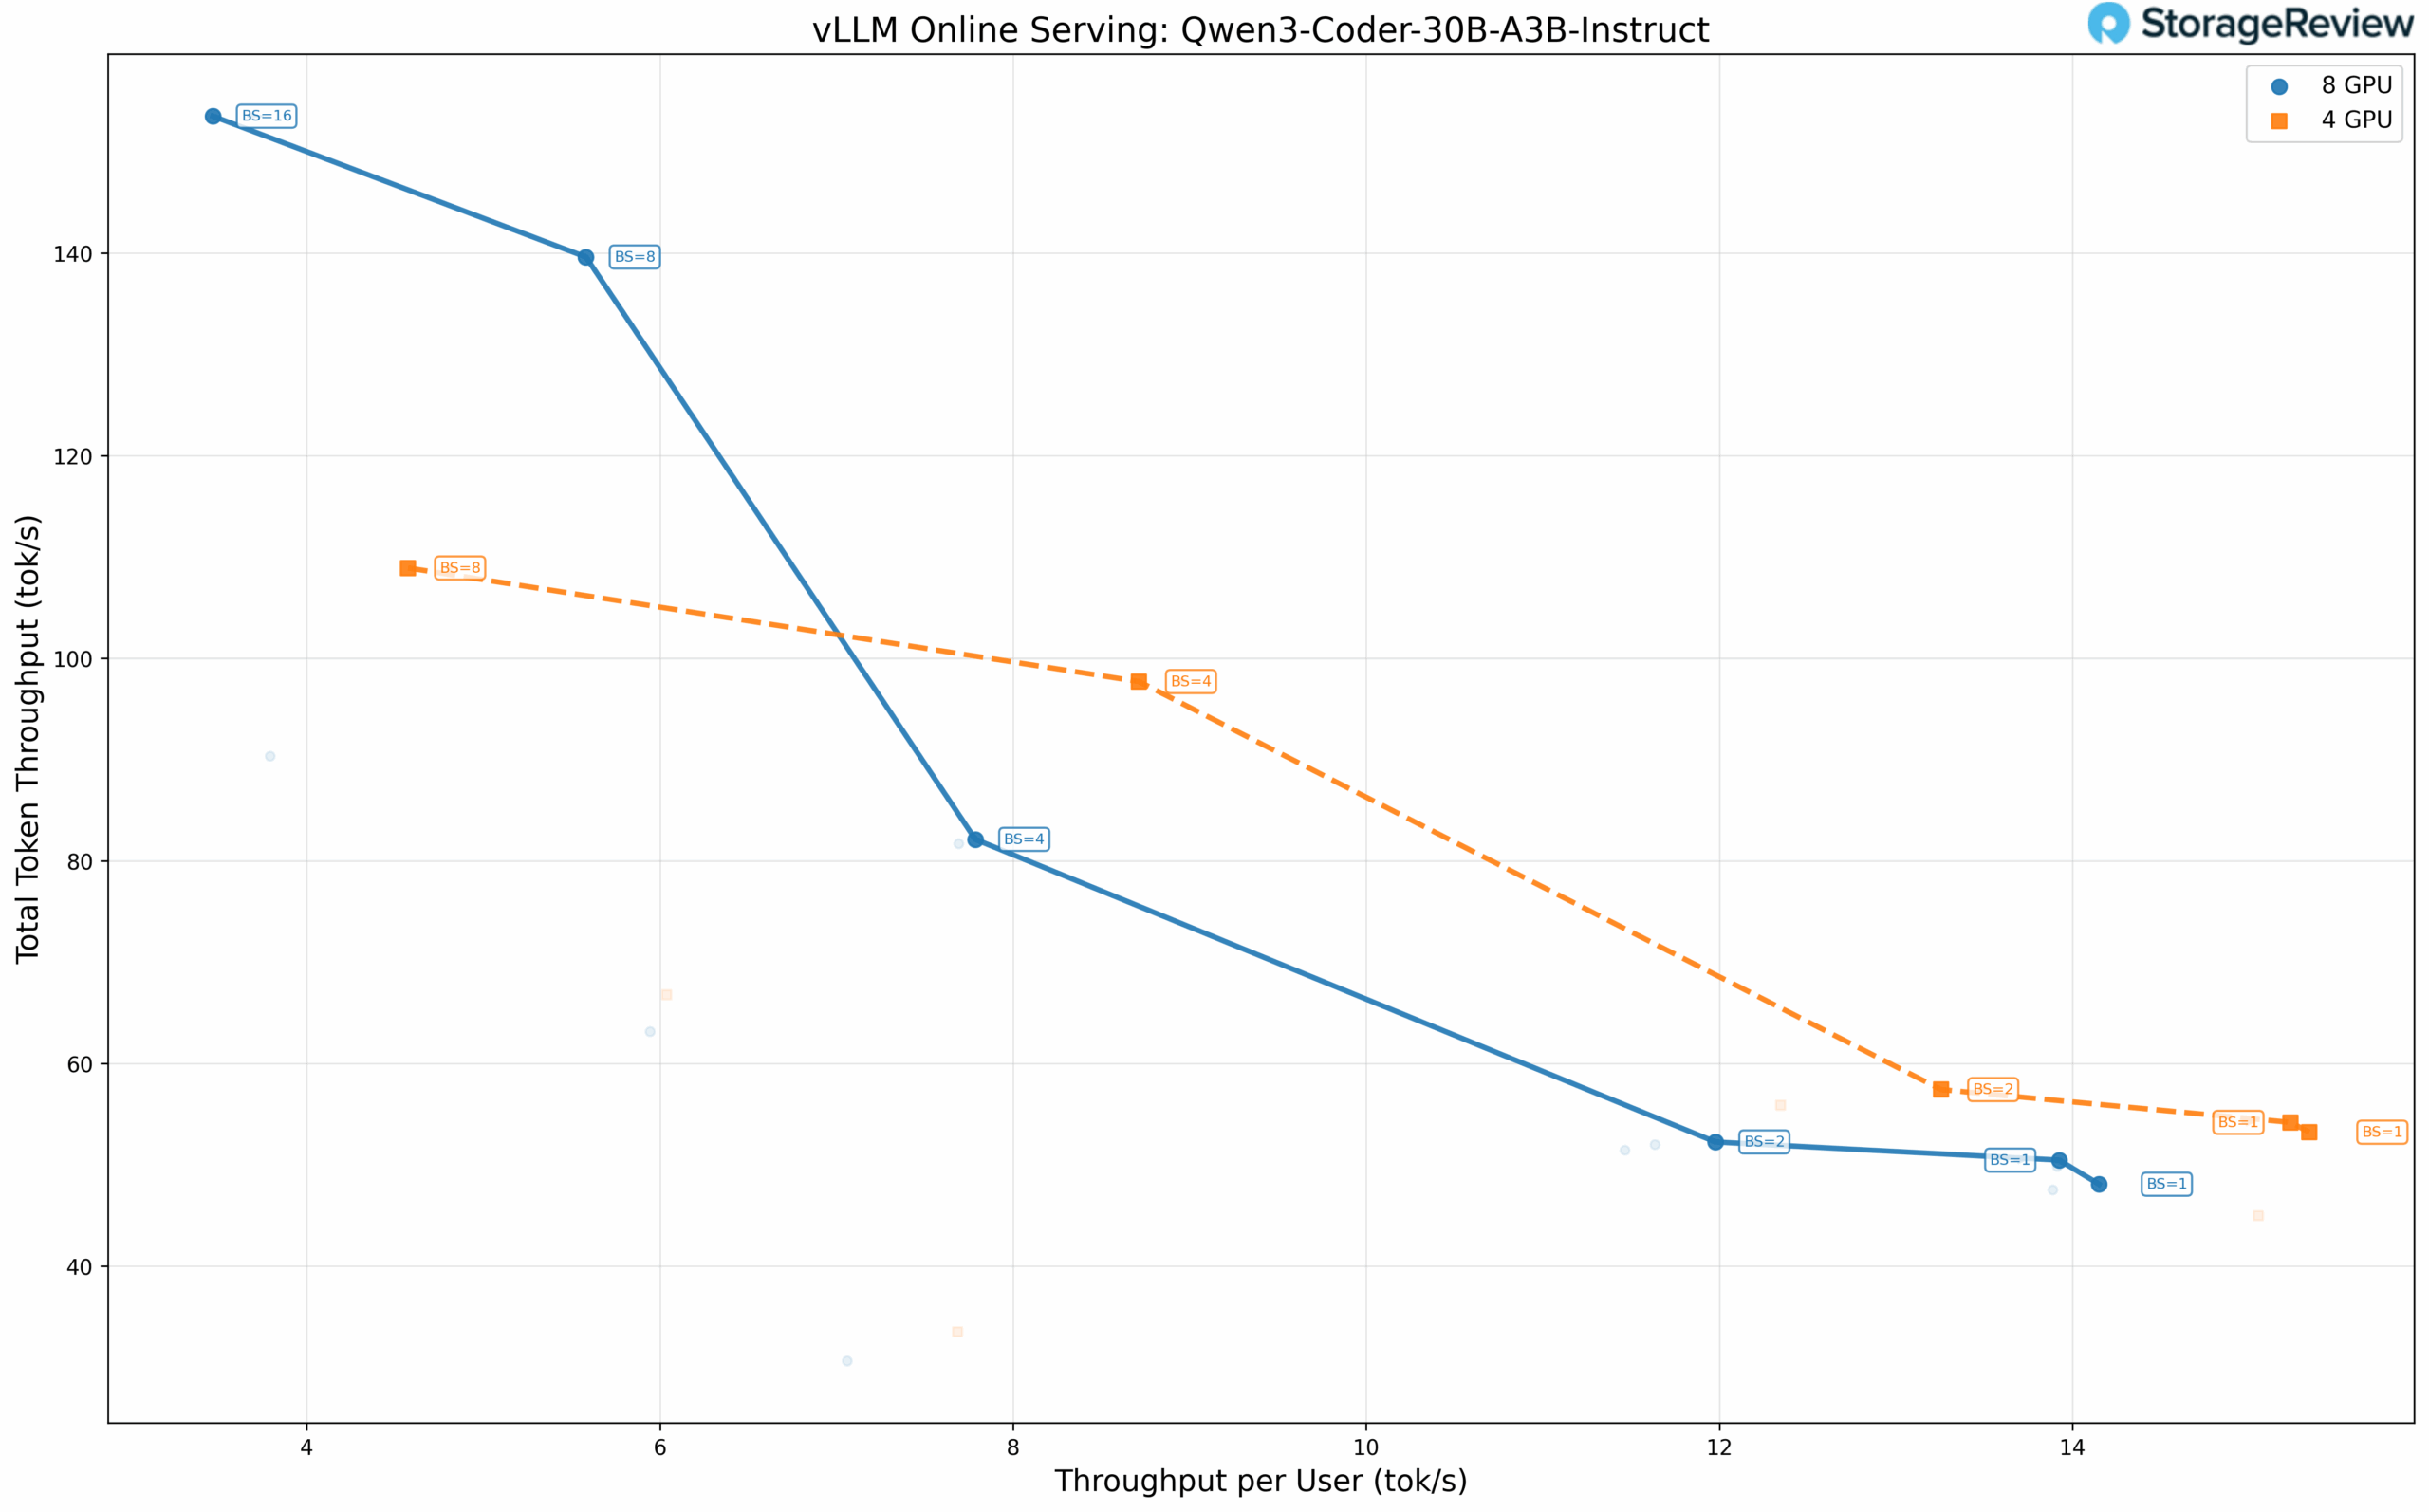
Vid testning med BF16-precision visar konfigurationen med fyra GPU:er återigen fördelar vid lägre batchstorlekar. Dataflödet per användare når 15.34 tok/s med TP=4, jämfört med 14.15 tok/s med TP=8, vid en batchstorlek på 1.
Täta modeller
Täta modeller följer den konventionella LLM-arkitekturen, där alla parametrar och aktiveringar används under inferens, vilket resulterar i mer beräkningsintensiv bearbetning än deras glesa motsvarigheter. Utan att använda INT4-kvantisering under vårt testfönster kördes dessa modeller med BF16-precision.
Llama 3.1 8B Instruktion
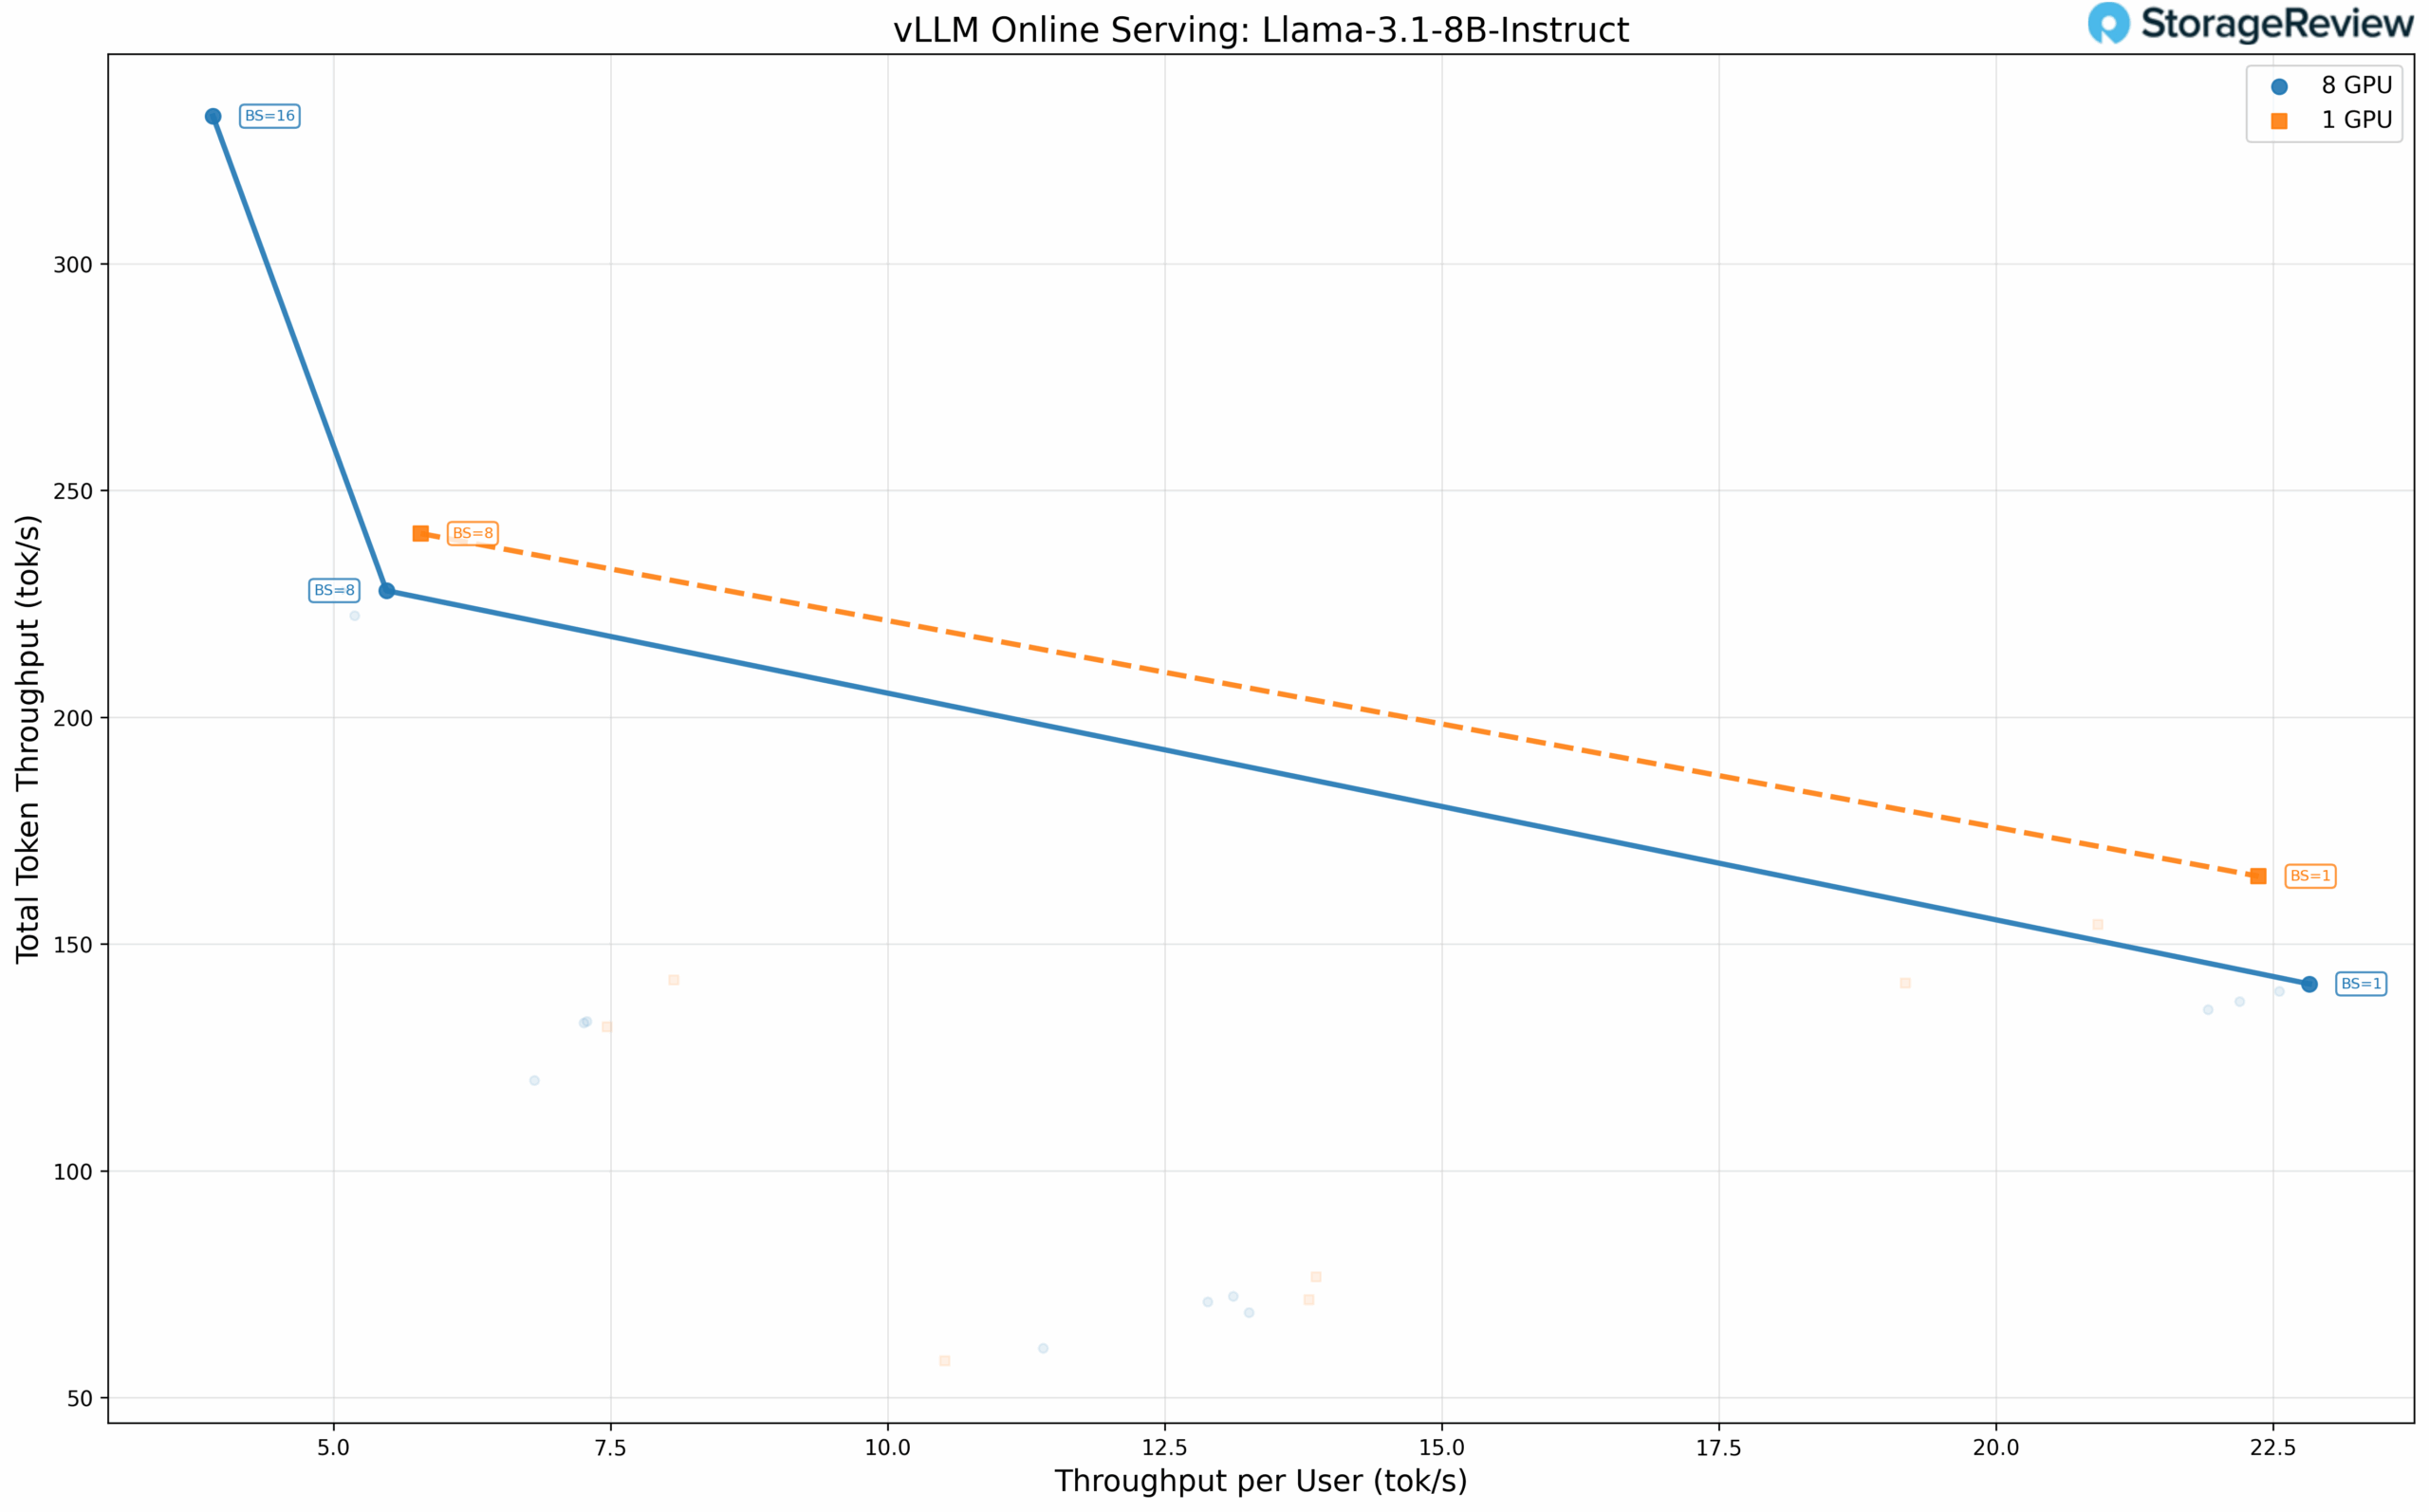
Den kompakta 8B-modellen passar bekvämt på en enda GPU men har testats i flera konfigurationer för att karakterisera skalningsbeteendet. Resultaten bekräftar mönstret: fyra GPU:er levererar en total dataflödeshastighet på 240.48 tok/s vid batchstorlek 8 jämfört med 227.90 tok/s med åtta GPU:er vid samma batchstorlek. Dataflödet per användare vid batchstorlek 1 förblir nästan identiskt (22.37 tok/s vs. 22.83 tok/s).
Mistral Small 3.1 24B Instruktion
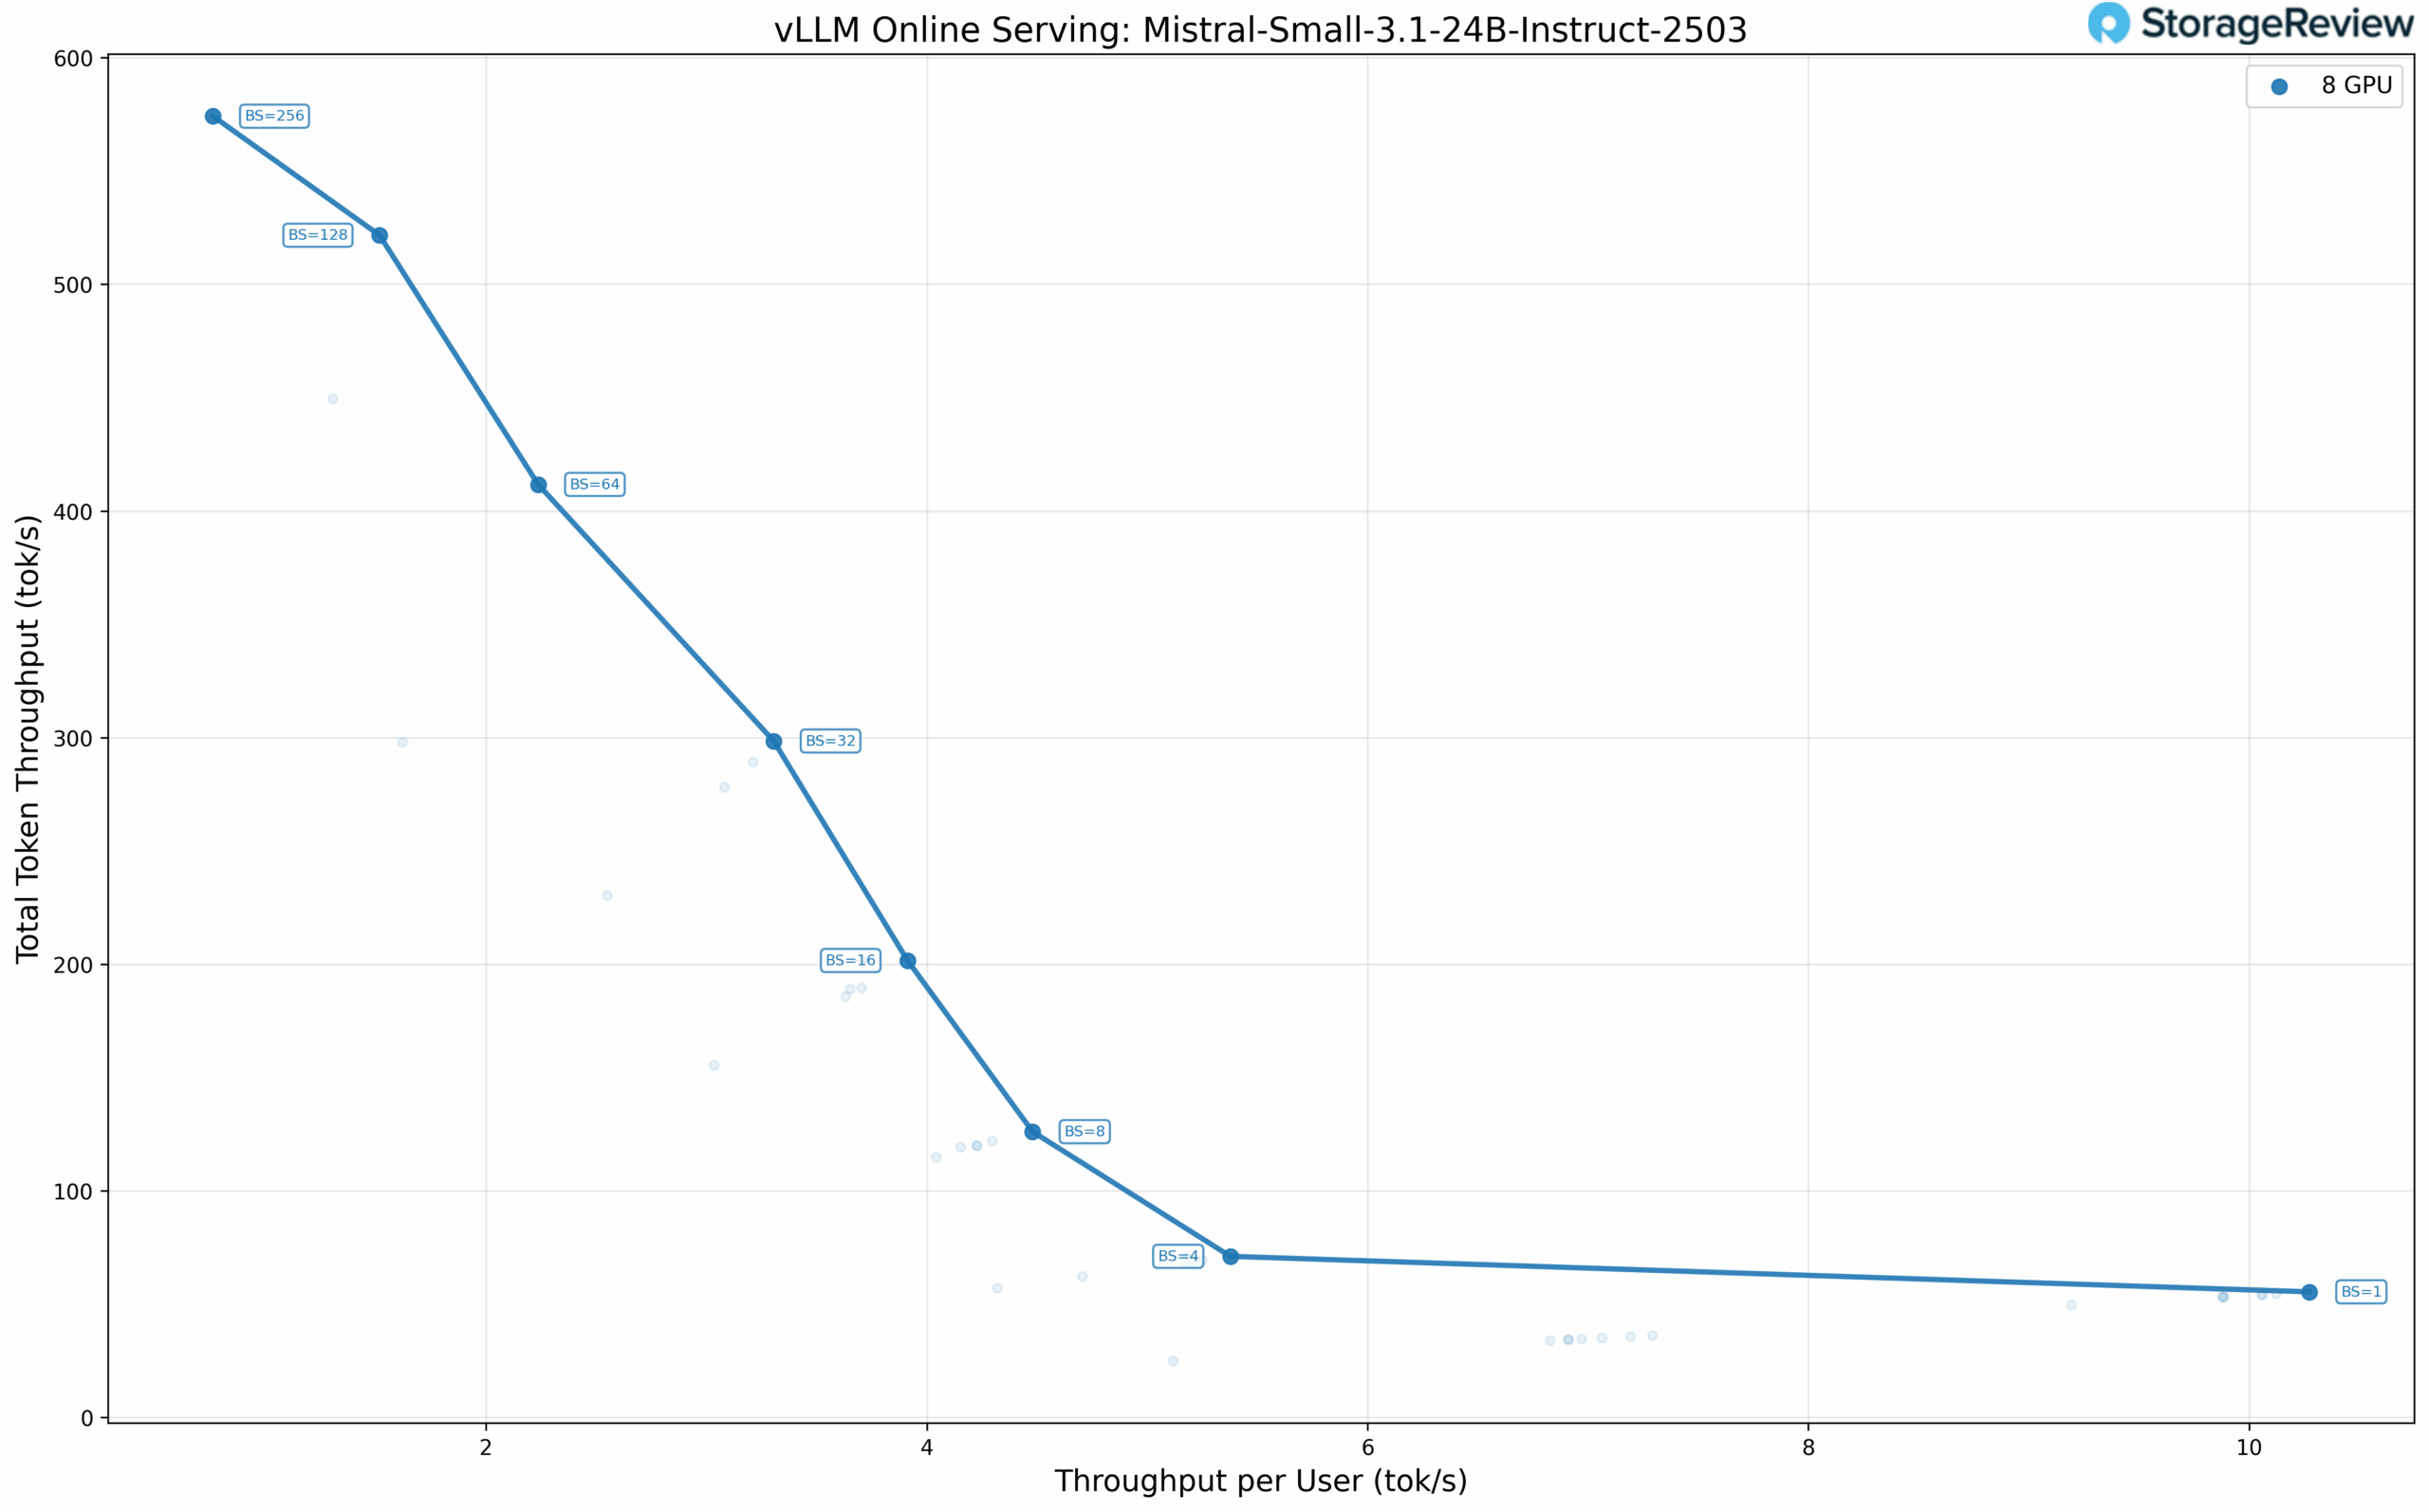
Mistral-modellen med 24B-parametrar representerar en mer krävande arbetsbelastning. Vid BF16-precision uppnår modellen stark dataflödesskalning vid högre batchstorlekar och når 574.16 tok/s vid en batchstorlek på 256 över alla åtta GPU:er.
Resultat
Ett konsekvent mönster framträder i alla testade modeller: vid låga batchstorlekar med vår konfiguration med 256 input/output-tokens ger användning av det minsta antal GPU:er som krävs för att passa modellen bättre prestanda per användare än att distribuera över alla åtta GPU:er . Kommunikationskostnaden mellan GPU:erna via PCIe, även vid PCIe 5.0-hastigheter, introducerar latens som överstiger parallelliseringsfördelarna för scenarier med en enda användare eller låg samtidighet.
Denna upptäckt har praktiska konsekvenser för distributionsplanering. Organisationer som kör kodningsassistenter med en enda användare eller arbetsflöden för agenter med låg samtidighet kan komma undan med mindre GPU-konfigurationer och fortfarande få acceptabel prestanda. Den fullständiga Battlematrix-konfigurationen med åtta GPU:er är mest fördelaktig för batchinferensarbetsbelastningar, generering av syntetisk data eller scenarier med hög samtidighet där det totala dataflödet är viktigare än latensen per begäran, särskilt när man använder större modeller som kräver mer minne.
Erfarenhet av Arc Pro B60s
I de begränsade tester vi utförde var upplevelsen anmärkningsvärt smärtfri. Det var enkelt att få igång korten, och det visade sig vara lika enkelt att installera LLM-Scaler, utvecklingsgrenen av vLLM med stöd för Battlemage. Programvaran är dock fortfarande i ett tidigt utvecklingsstadium. När vi började testa kunde vi inte hämta någon GPU-statistik, och utöver tensorparallellism hade vi ingen tur med andra parallellismstrategier, såsom expertparallellism eller pipelineparallellism, för skalning över flera system. Med det sagt förväntade vi oss att dessa begränsningar skulle träda i kraft, med tanke på programvarustackens tillstånd före utgivning.
Kylningen genererade en hel del diskussion efter vår första YouTube-kortfilm , där många kommentatorer uttryckte oro för att korten skulle kunna överhettas i vår öppna testbädd. Utan tillgänglig temperaturövervakning flyttade vi slutligen korten till ett serverchassi för att säkerställa tillräckligt luftflöde. Vi har för avsikt att testa kylprestandan i arbetsstationskonfigurationen för vår fullständiga recension, eftersom den slutliga Battlematrix-versionen, som visas i Intels marknadsföringsrenderingar ovan, placerar dessa kort i ett arbetsstationschassi staplat tätt tillsammans.
När det gäller formfaktor är dessa kort något längre än vanliga arbetsstations-GPU:er, vilket kan skapa utmaningar med chassinkompatibilitet. De passar dock utan problem i serverchassin, eftersom de flesta serverkabinett har extra utrymme mot kortets framkant för stödfästen.
Framtida testplaner
Vi planerar att se över Intel Battlematrix och göra en mer omfattande granskning efter att B60 har släppts fullständigt och blivit allmänt tillgänglig. Vi kommer att utvärdera LLM-inferensprestanda genom ytterligare vLLM-tester över ett brett spektrum av modeller och distributionskonfigurationer. Även om det inte visas i denna förhandsvisning observerade vi att dessa GPU:er, i sitt nuvarande programvarutillstånd, presterar bättre på förfyllning än på avkodning. Den fullständiga granskningen kommer att fördjupa sig i förfyllningstunga och avkodningstunga inferensarbetsbelastningar för att karakterisera detta beteende.
Homelab-communityn uttryckte intresse för att använda dessa GPU:er för en av de mest populära Homelab-arbetsbelastningarna: medieservrar. Vi planerar att testa dessa med Plex och eventuellt Jellyfin med medlemmar i vår Discord . Professionella arbetsbelastningar finns också på vår radar, inklusive SolidWorks och Autodesk för CAD-prestandatestning. Vi planerar också att titta på SR-IOV med Proxmox för att driftsätta en VDI-server för flera användare för Discord-medlemmar för att utvärdera samtidig skrivbordstäthet och molnspel.
Slutsats
Intels Arc Pro B60 Battlematrix är en spännande plattform som gör högkapacitets-GPU-minne tillgängligt till prisvärda arbetsstationer. Designen med dubbla GPU-kort hanterar densitetsbegränsningar, allokeringen på 24 GB per GPU passar LLM-inferensarbetsbelastningar och prisstrukturen skapar övertygande alternativ till etablerade professionella GPU-ekosystem. För organisationer som prioriterar datasuveränitet och kostnadseffektivitet framför banbrytande prestanda är plattformen värd att överväga.
Programvarans mognad är fortfarande den primära begränsningen. Intels investering i ramverksoptimering via LLM Scaler och kontinuerlig drivrutinsförfining indikerar ett engagemang för att bibehålla Arc-serien av GPU:er som ett betydande värde.
Det är okänt hur populär Battlematrix-konfigurationen med åtta grafikkort kommer att bli jämfört med den otroliga prestandan som levereras av NVIDIA DGX Spark . Den verkliga historien kan vara konfigurationerna med ett och två kort, där instegspriserna på 600–1 200 dollar dramatiskt sänker hindren för utforskning av privat AI-infrastruktur.
Vi kommer att fortsätta utöka våra tester allt eftersom drivrutinsuppdateringar anländer och programvaruramverk mognar. Om du vill testa dessa själv kan du gå med i vår Discord-server , där vi har en communityserver med begränsad B60-åtkomst.


 Amazon