

NVIDIA DGX Spark representerar en vändpunkt inom tillgänglig AI-infrastruktur. År 2017 publicerades den banbrytande artikeln "Attention is All You Need", som introducerade Transformer-arkitekturen, baserat på en P100-serverkonfiguration med åtta GPU:er, förbrukade tiotals kilowattimmar och upptog betydande datacenteryta. Idag levererar DGX Spark överlägsen beräkningsprestanda i ett kompakt 240-watts stationärt format. Denna dramatiska utveckling av energieffektivitet och formfaktorkomprimering gör tidigare datacenter-exklusiva AI-funktioner tillgängliga för enskilda forskare, små team och distribuerade utvecklingsorganisationer.
Det som skiljer Spark från tidigare AI-lösningar för skrivbordsmiljöer är dess omfattande tillvägagångssätt för hela utvecklingscykeln. Istället för att tvinga fram kompromisser mellan experiment, finjustering och driftsättning, erbjuder Spark genuin kapacitet i alla faser. Den enhetliga minnesarkitekturen på 128 GB möjliggör fullständig parameterfinjustering av modeller som skulle kräva molnresurser på konventionella arbetsstationer, samtidigt som den levererar hundratals tokens per sekund, lämpliga för batchinferensarbetsbelastningar, inklusive generering av syntetisk data. Inkluderingen av ConnectX-7-nätverk med 200 GB fabric-kapacitet innebär att organisationer kan klustra flera Spark-system för ännu större modellutforskning, men som vi kommer att demonstrera visar sig även en enda enhet vara anmärkningsvärt kapabel.
Key Takeaways
Datacenterkraft i en stationär dator : GB10 Grace Blackwell i en 1.13-liters 240W-låda, prissatt till 3 999 dollar, som ger upp till 1 petaFLOP FP4-prestanda.
Minne som förändrar arbetsflöden : 128 GB enhetligt minne möjliggör fullständig parameterfinjustering av 8B-modeller lokalt och högkapacitetsinferens. I tester såg vi att Llama 3.1 8B FP4 nådde ~924 tok/s vid 128 samtidighet, och Qwen3 Coder 30B-A3B FP8 nådde ~483 tok/s vid batch 64.
Klar att skalas upp och ansluta snabb lagring : Integrerad ConnectX-7 tillhandahåller 200G-struktur för kluster eller NVMe-oF. Den interna 2242 Gen5 NVMe är praktisk men begränsad för tung I/O, så extern NVMe-oF över RDMA är den bättre vägen för hållbart dataflöde.
Programvarumognad från första dagen : Levereras med DGX OS, CUDA, cuDNN, TensorRT, AI Workbench, containrar och arbetsflödeshandböcker så att team kan köra riktiga arbetsbelastningar direkt.
Bevisad prestanda i verkligheten : MAMF mätte ~99.8 TFLOPs BF16 och ~207.7 TFLOPs FP8. GDSIO-läsningar nådde en intern topp på ~11.4 GiB/s, med ett högre maximum som förväntas över 200G-strukturen.
Vad är DGX Spark, och vem bör överväga det?
NVIDIA DGX Spark är i grunden en komplett AI-utvecklingsplattform snarare än bara en GPU-komponent. Kärnan är GB10 Grace Blackwell Superchip, som integrerar en Blackwell-arkitektur-GPU med femte generationens Tensor-kärnor med en 20-kärnig Arm-CPU (10× Cortex-X925 + 10× Cortex-A725) ansluten via NVLink-C2C. Denna koherenta sammankopplingsarkitektur, enligt NVIDIA, möjliggör upp till 5× högre bandbredd jämfört med PCIe Gen 5, vilket skapar en enhetlig beräkningsstruktur snarare än diskreta processordomäner.
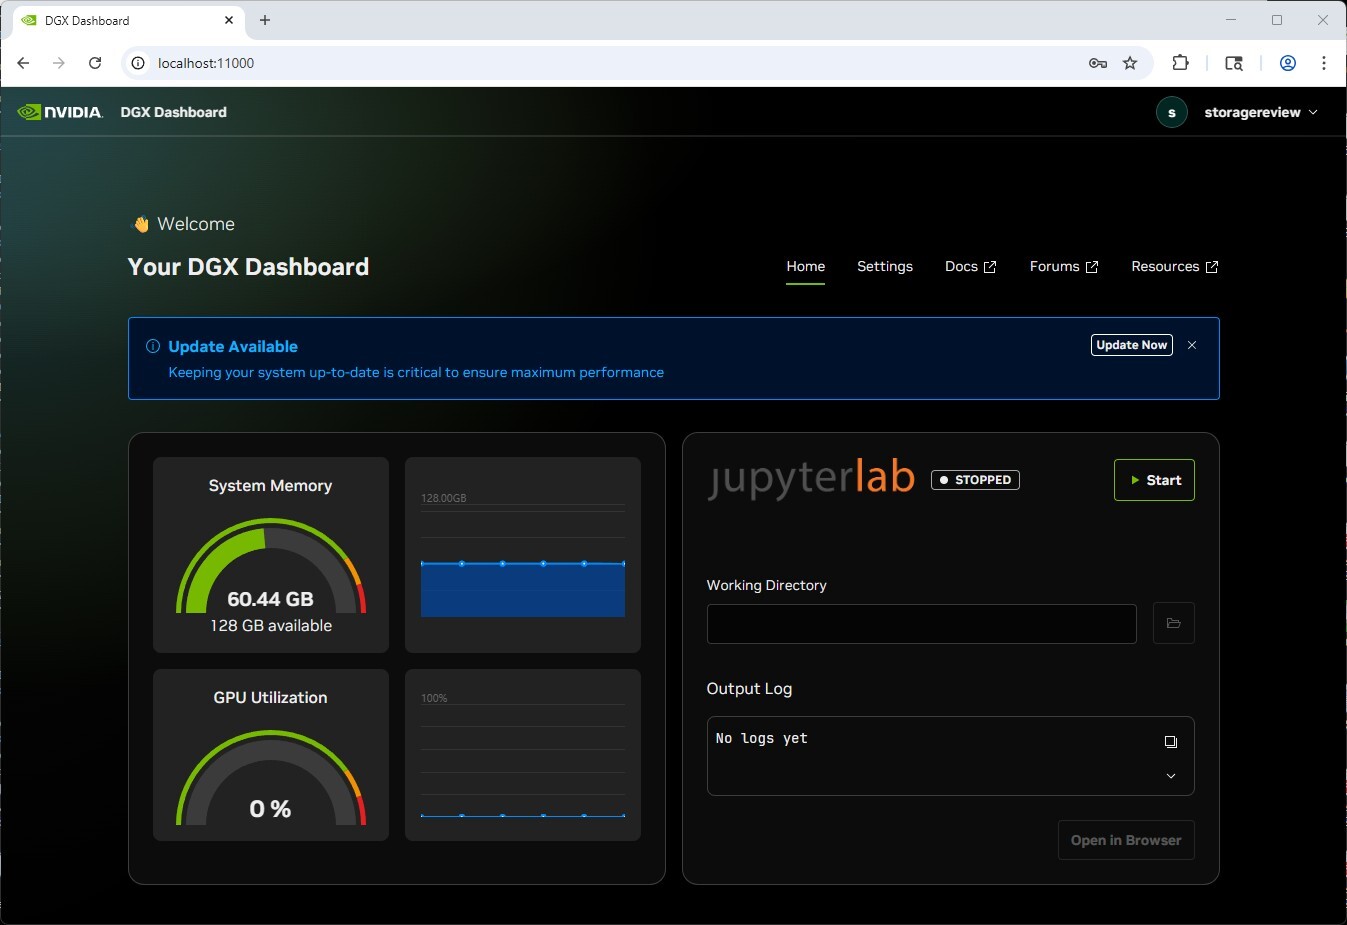
För att hjälpa användarna att komma igång levererar NVIDIA DGX OS byggt på Ubuntu Desktop med den kompletta AI-programvarustacken förkonfigurerad, inklusive CUDA, cuDNN, TensorRT, NVIDIA Container Runtime och AI Workbench, vilket eliminerar de typiska drivrutinsutmaningarna och miljökonfigurationskostnaderna som plågar anpassade arbetsstationsbyggen. Systemet erbjuder flexibla distributionsparadigmer: anslut kringutrustning och använd det som en kompakt arbetsstation med den fullständiga Ubuntu-skrivbordsupplevelsen, eller distribuera det som en headless nätverksapparat åtkomlig via NVIDIA Sync, vilket ger sömlös integration med JupyterLab, VS Code, Cursor IDE och SSH-terminaler.
Detta är en specialbyggd infrastruktur för AI-utövare, forskare som finjusterar språkmodeller, datavetare som accelererar RAPIDS-arbetsflöden, utvecklare som implementerar agentiska system eller team som experimenterar med arkitekturer med ablativa modeller i liten skala. Spark riktar sig till yrkesverksamma som behöver seriös AI-beräkningskapacitet utan datacenterkomplexitet.
NVIDIA DGX Spark Tekniska Specifikationer
| Specifikation | Detaljer |
|---|---|
| arkitektur | |
| GPU | NVIDIA Blackwell-arkitektur |
| CPU | 20-kärnig arm (10x Cortex-X925 + 10x Cortex-A725) |
| Tensorkärnor | 5th Generation |
| RT Cores | 4th Generation |
| NVENC / NVDEC | 1× / 1× |
| Minne | |
| Systemminne | 128 GB LPDDR5X (enhetligt systemminne) |
| Minnesgränssnitt | 256-bitars |
| minnesbandbredd | 273 GB / s |
| Prestanda | |
| FP4 | upp till 1 petaFLOP (med Sparsity) |
| lagring | |
| lagring | 1 TB eller 4 TB NVMe M.2 (självkrypterad) |
| Anslutningar | |
| USB | 4× Typ-C USB 3.2 Gen 2×2 (20 Gbps) |
| ethernet | 1× 10GbE RJ-45 |
| NIC | ConnectX-7 Smart NIC – 2x 200G QSFP (Tillåter maximalt 200G bandbredd) |
| trådlös | Wi-Fi 7, Bluetooth 5.3 |
| Ljudutgång | HDMI flerkanalig ljudutgång |
| Skärmanslutningar | 1× HDMI 2.1a |
| Mekanisk | |
| Mått | 150 × 150 × 50.5 mm (5.9 × 5.9 × 1.98 tum) |
| Vikt | 1.2 kg |
| Energiförbrukning | 240 W |
NVIDIA DGX Spark Design & Bygg
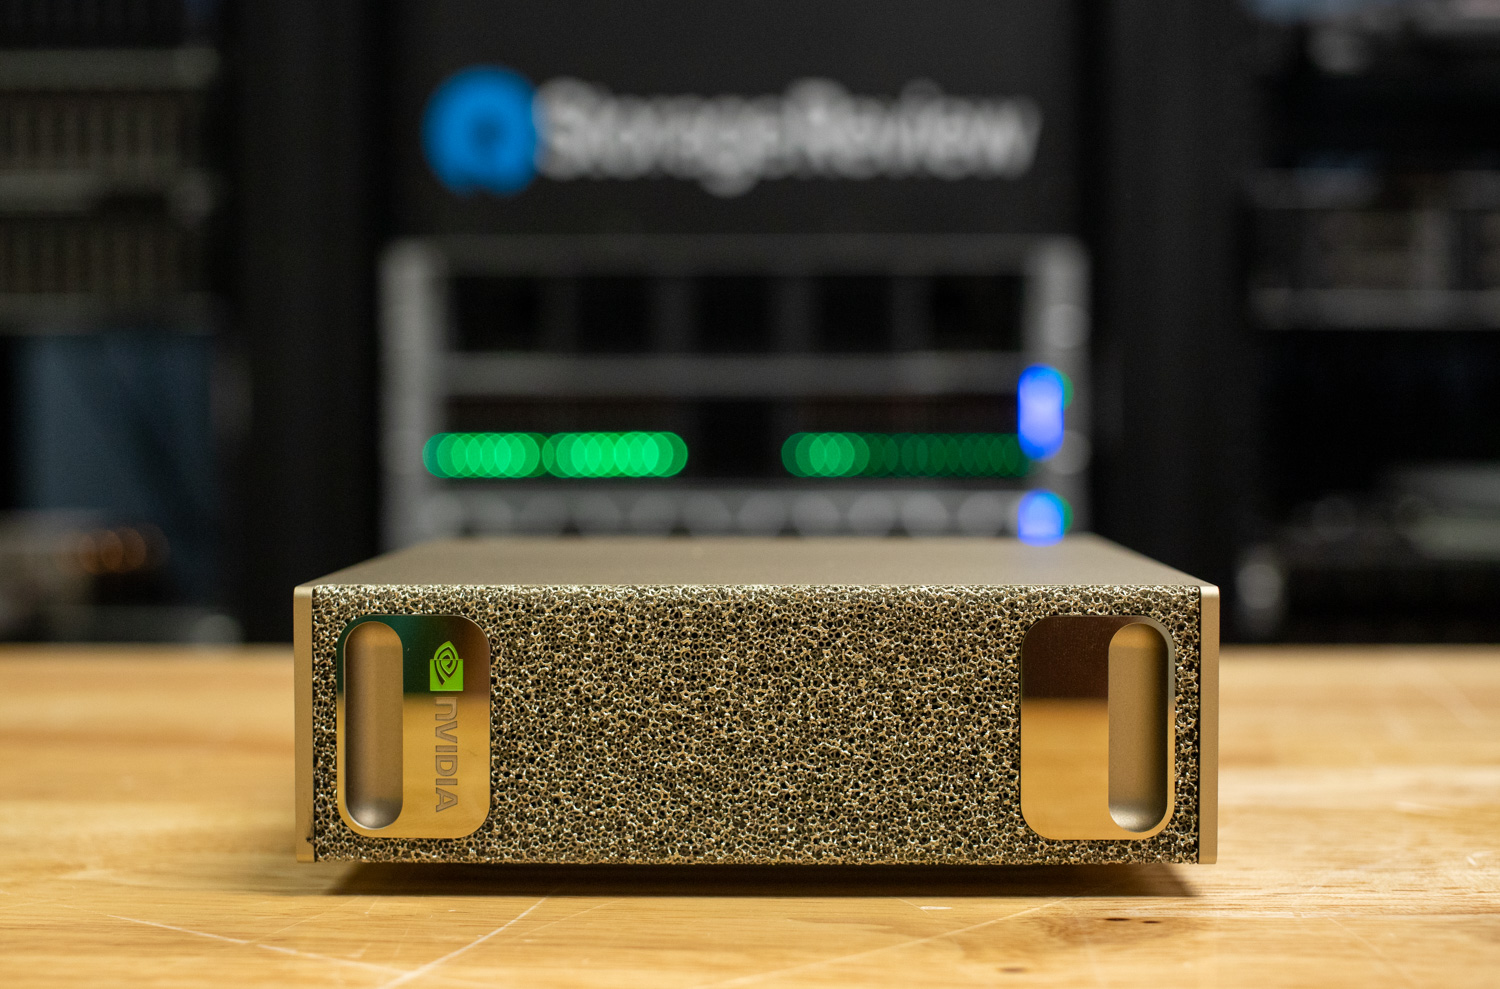
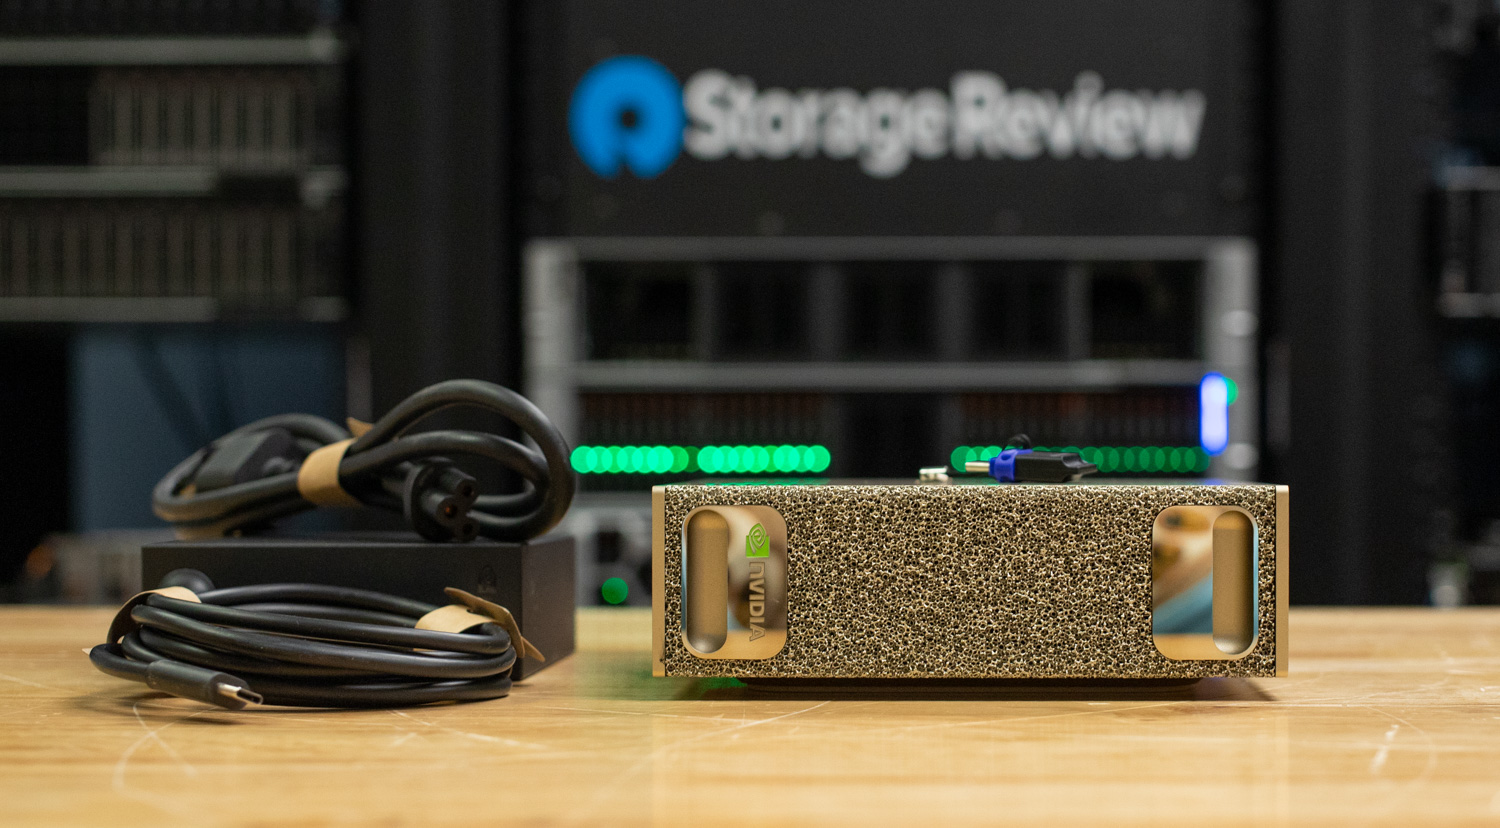
NVIDIA DGX Spark fortsätter NVIDIAs omisskännliga industriella designspråk med ett kompakt chassi som speglar utseendet och känslan hos deras större DGX-system. Frontpanelen har miniatyrutskärningar för handtag, en anspelning på de ursprungliga DGX-enheternas handtag i full storlek och en guldfärgad metallfinish som ger en raffinerad, premiumstruktur, accentuerad av NVIDIAs ikoniska gröna logotyp.
Fysiskt sett mäter DGX Spark 5.9 × 5.9 × 1.98 tum (150 × 150 × 50.5 mm) och väger 2.6 pund (1.2 kg), vilket ger den en total intern volym på 1.13 liter. Detta placerar den definitivt i klassen för 1-liters små PC-datorer. Trots sitt minimala format känns systemet tätt och robust tack vare ett skal i helmetalllegering som också fungerar som en passiv värmespridare, vilket bibehåller fokus på både form och funktion.
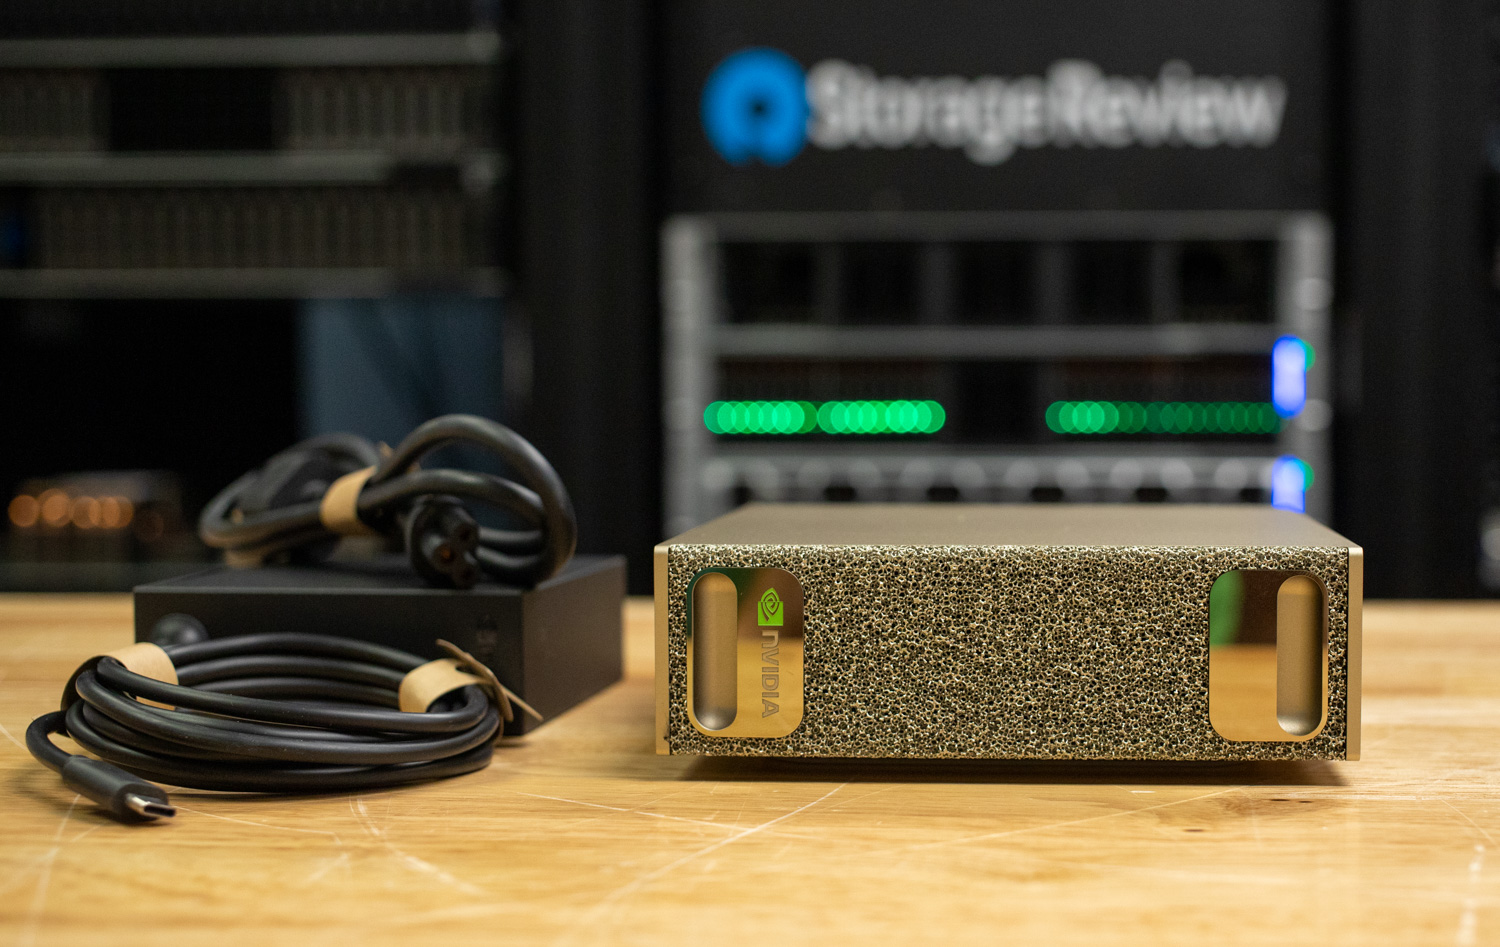
Strömförsörjningen sker via en extern USB-C-strömkälla på 240 W, som syns bredvid huvudenheten på bilden. Strömkällan är kompakt och välbyggd, med en standard C5-kontakt (klöverbladskontakt) för nätingång och matchar DGX Sparks rena och effektiva design.
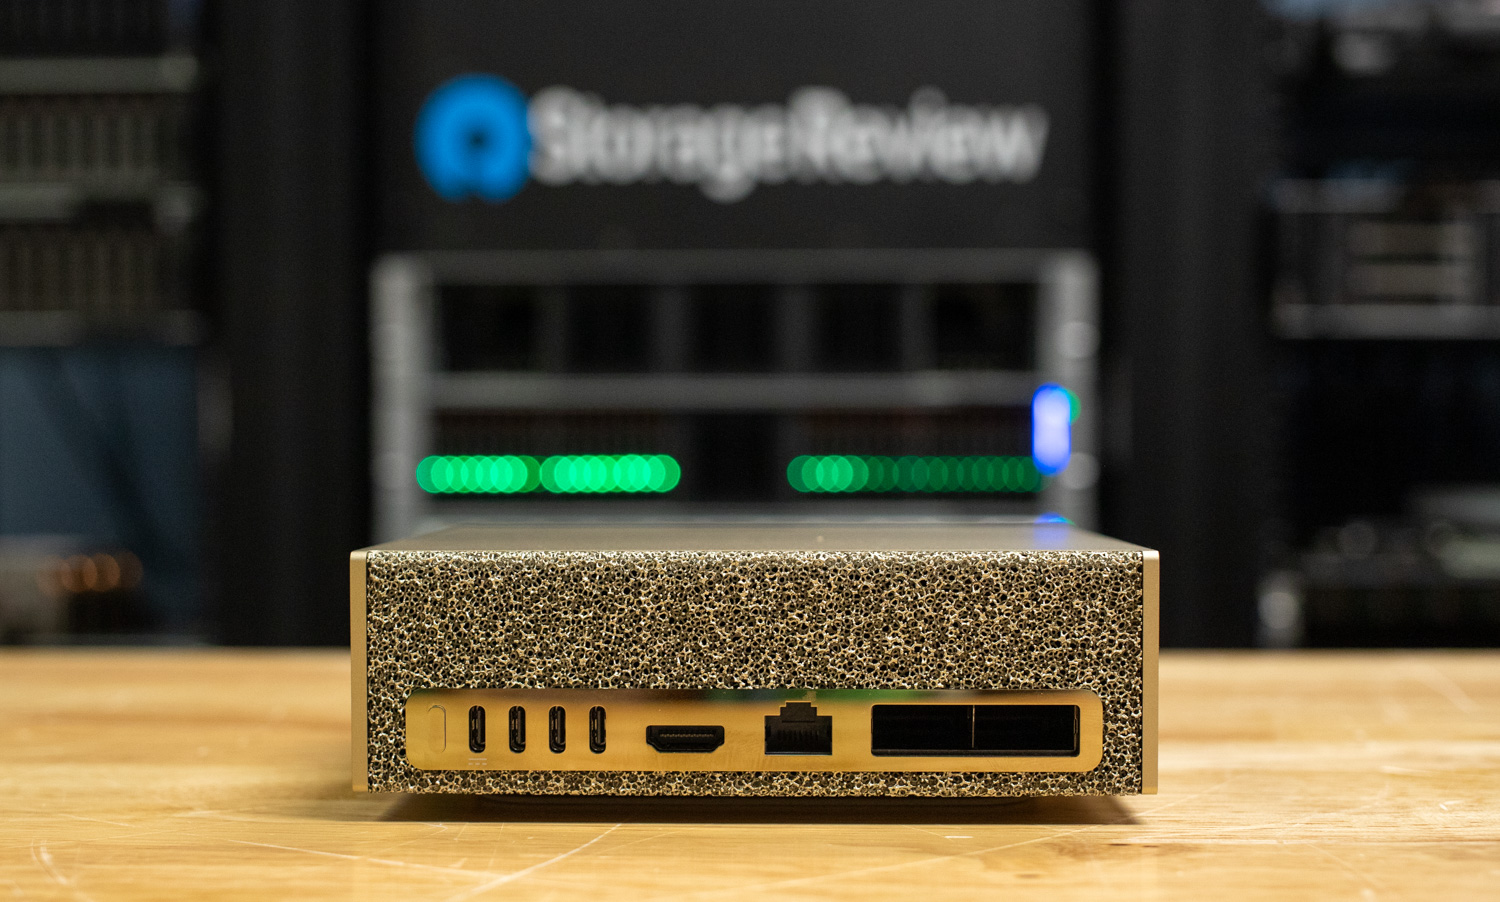
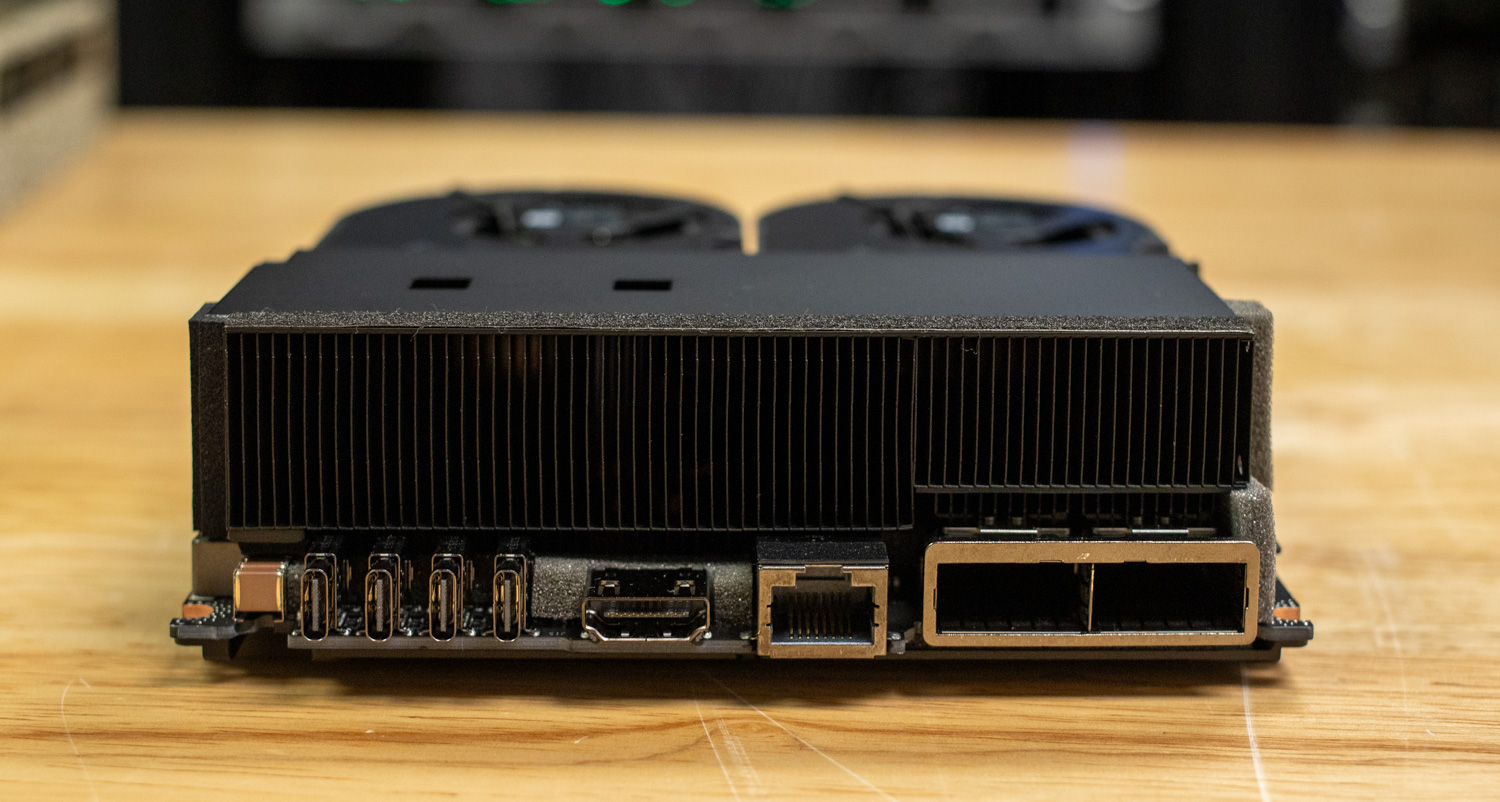
Bakifrån har DGX Spark samma guldfärgade texturerade finish som på framsidan, vilket bibehåller en sammanhängande design i hela chassit. Från vänster sitter strömbrytaren bredvid fyra USB-C-portar, varav en ger strömförsörjning till enheten. Dessa följs av en enda HDMI 2.1a-utgång, en 10 GbE RJ-45-port, och det som gör den här enheten intressant är de dubbla 200 GbE QSFP56-gränssnitten som drivs av ett integrerat NVIDIA ConnectX-7 SmartNIC.
Vid första anblicken kan man anta att Spark möjliggör 400G anslutning; tyvärr, på grund av PCIe-begränsningar, kan Spark bara erbjuda 200G anslutning. För att veta mer grävde vi djupare i Sparks topologi:
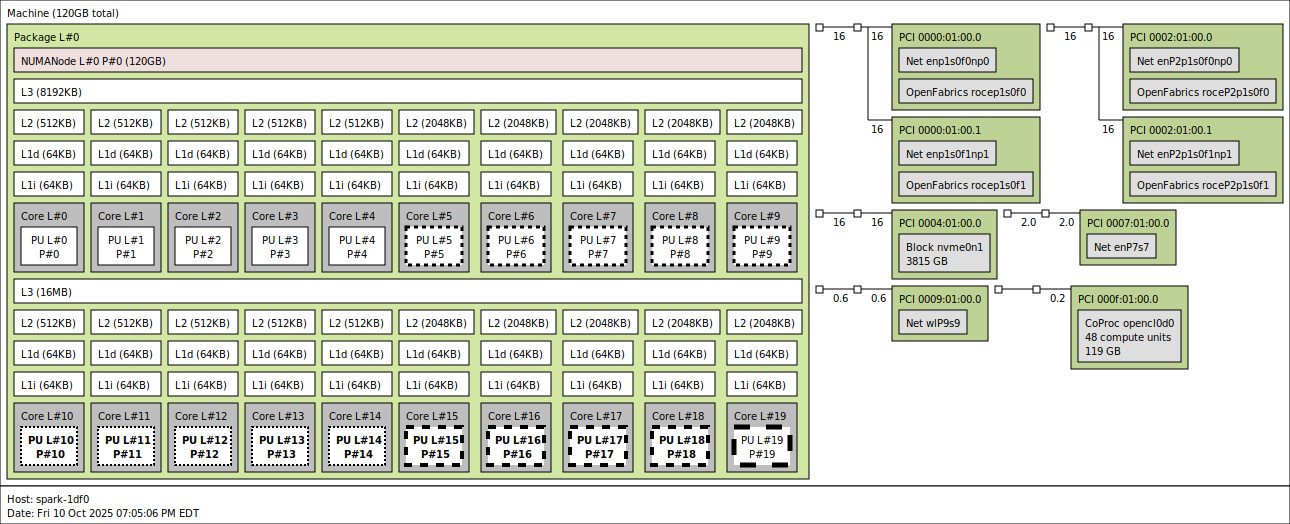
Med hjälp av lstopo observerar vi de två sammankopplingarna från CX7-nätverket. Elektriskt är CX7 ansluten via två Gen5 x4-länkar. Inom operativsystemet visas dessa anslutningar som fyra gränssnitt, som vart och ett stöder en maximal bandbredd på 200G. På grund av begränsad testtid kunde vi inte upptäcka alla nätverksegenskapligheter hos denna plattform utanför våra NVMe-oF-tester, som beskrivs senare i artikeln. Vi planerar dock att utforska denna plattform ytterligare och kommer att släppa framtida artiklar som fördjupar sig i dess funktioner, som att klustra flera gnistor tillsammans för ett minikluster.
Om man tittar på andra anslutna enheter är nästa steg den lilla 2242-formfaktorn M.2 SSD ansluten med Gen5 x4, följt av Realtek RJ45 10GbE-kontrollern ansluten med PCIe Gen4 x1-länk och MediaTek Wi-Fi-kontrollern ansluten med en PCIe Gen3 x1-länk.
Om man dyker ner i processorn innehåller Spark en 20-kärnig Arm-processor med en heterogen liten arkitektur, liknande Intels senaste processorer, bestående av 10 Cortex-A725-effektivitetskärnor och 10 Cortex-X925-prestandakärnor uppdelade på två L3-cachekluster. Det första klustret (8 MB L3) innehåller processorerna 0-4 (Cortex-A725, max 2808 MHz) och processorerna 5-9 (Cortex-X925, max 3900 MHz), medan det andra klustret (16 MB L3) innehåller processorerna 10-14 (Cortex-A725, max 2860 MHz) och processorerna 15-19 (Cortex-X925, max 3978-4004 MHz). Varje kärna har privata L1-datacacher på 64 kB och L1-instruktionscacher på 64 kB, men L2-cachen skiljer sig avsevärt åt beroende på kärntyp: Cortex-A725-kärnorna med hög effektivitet har 512 kB L2-cacher, medan Cortex-X925-kärnorna med hög prestanda har betydligt större L2-cacher på 2 MB (4× större). De snabbaste kärnorna är processorerna 15-19, som drar nytta av både den större L3-cachen på 16 MB och högre frekvenser, där processor 19 är kärnan med högsta prestanda vid 4004 MHz. Dessa olika effekt-/frekvensnivåer indikeras av de streckade linjerna på kärnan i topologin som visas ovan.
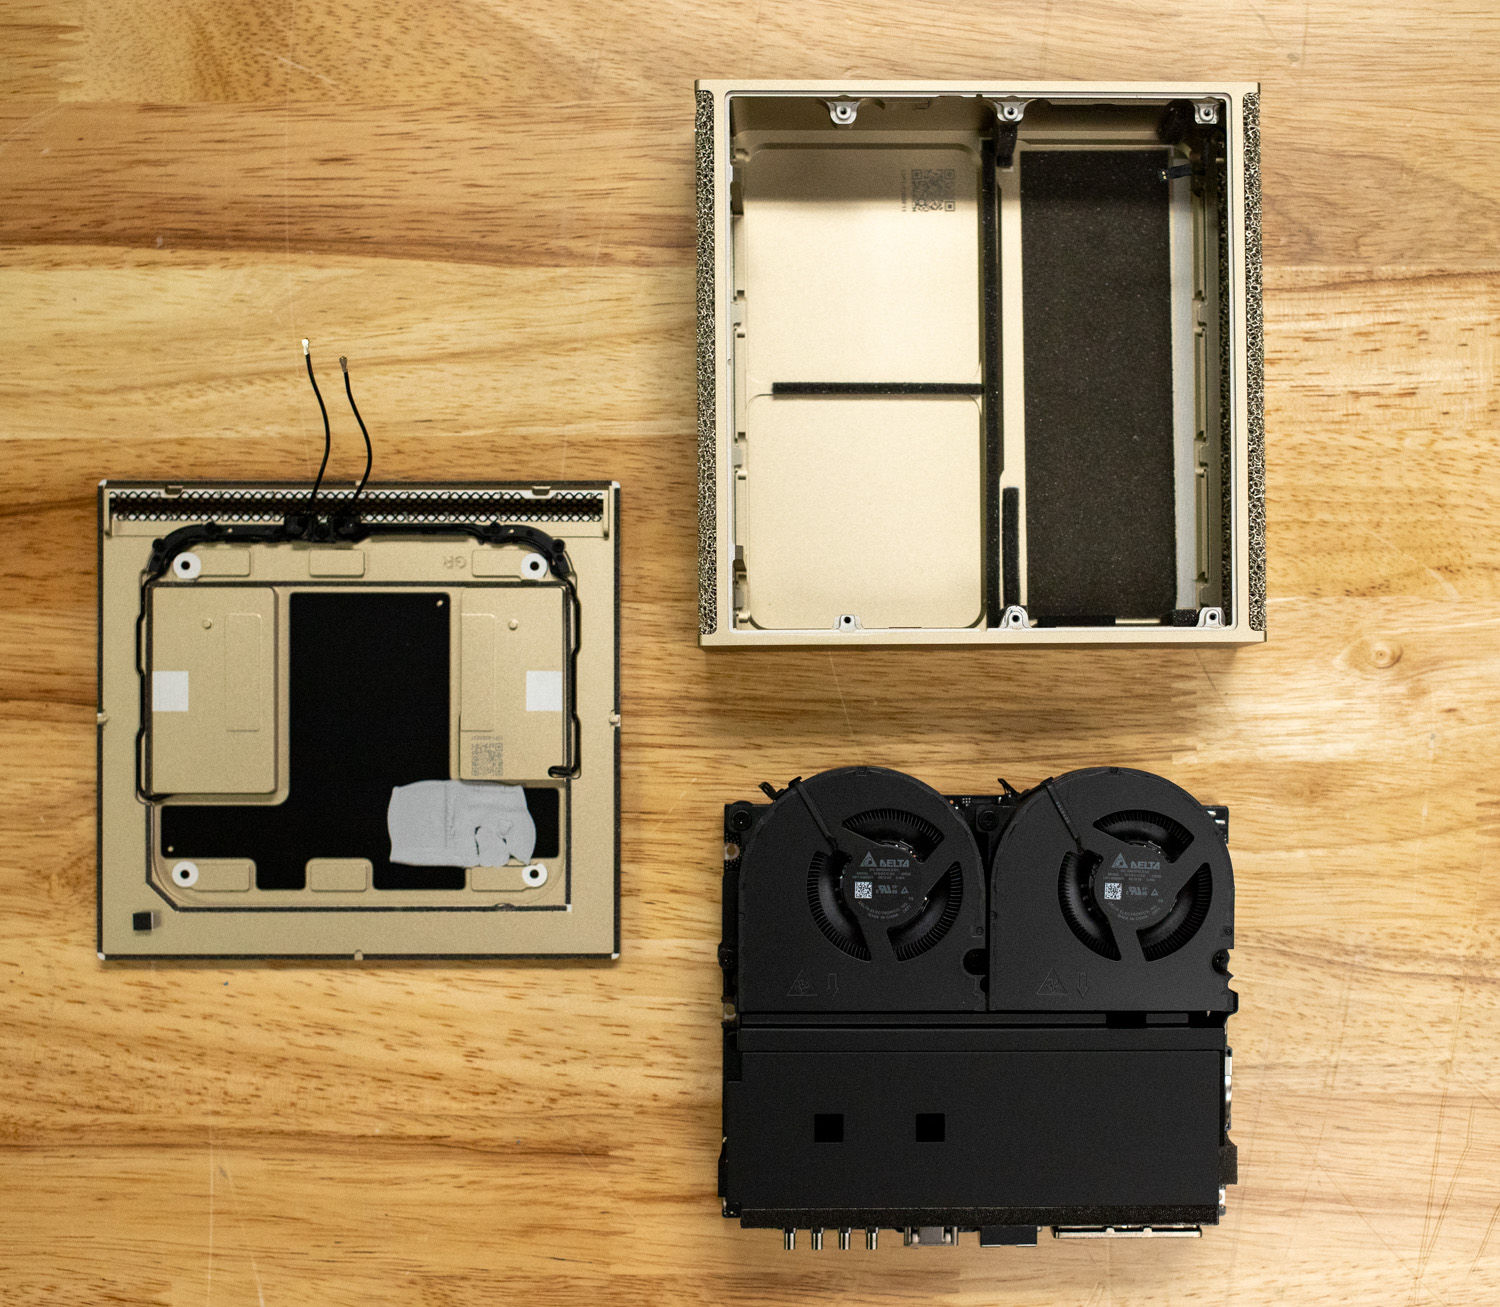
Vi zoomar ut igen och vänder på DGX Spark; den enda synliga plastkomponenten är baskåpan, som fästs magnetiskt på chassits undersida. Denna design håller utsidan ren samtidigt som den möjliggör snabb åtkomst till insidan. När den magnetiska basen har tagits bort syns fyra skruvar, vilket ger åtkomst till det huvudsakliga inre facket.
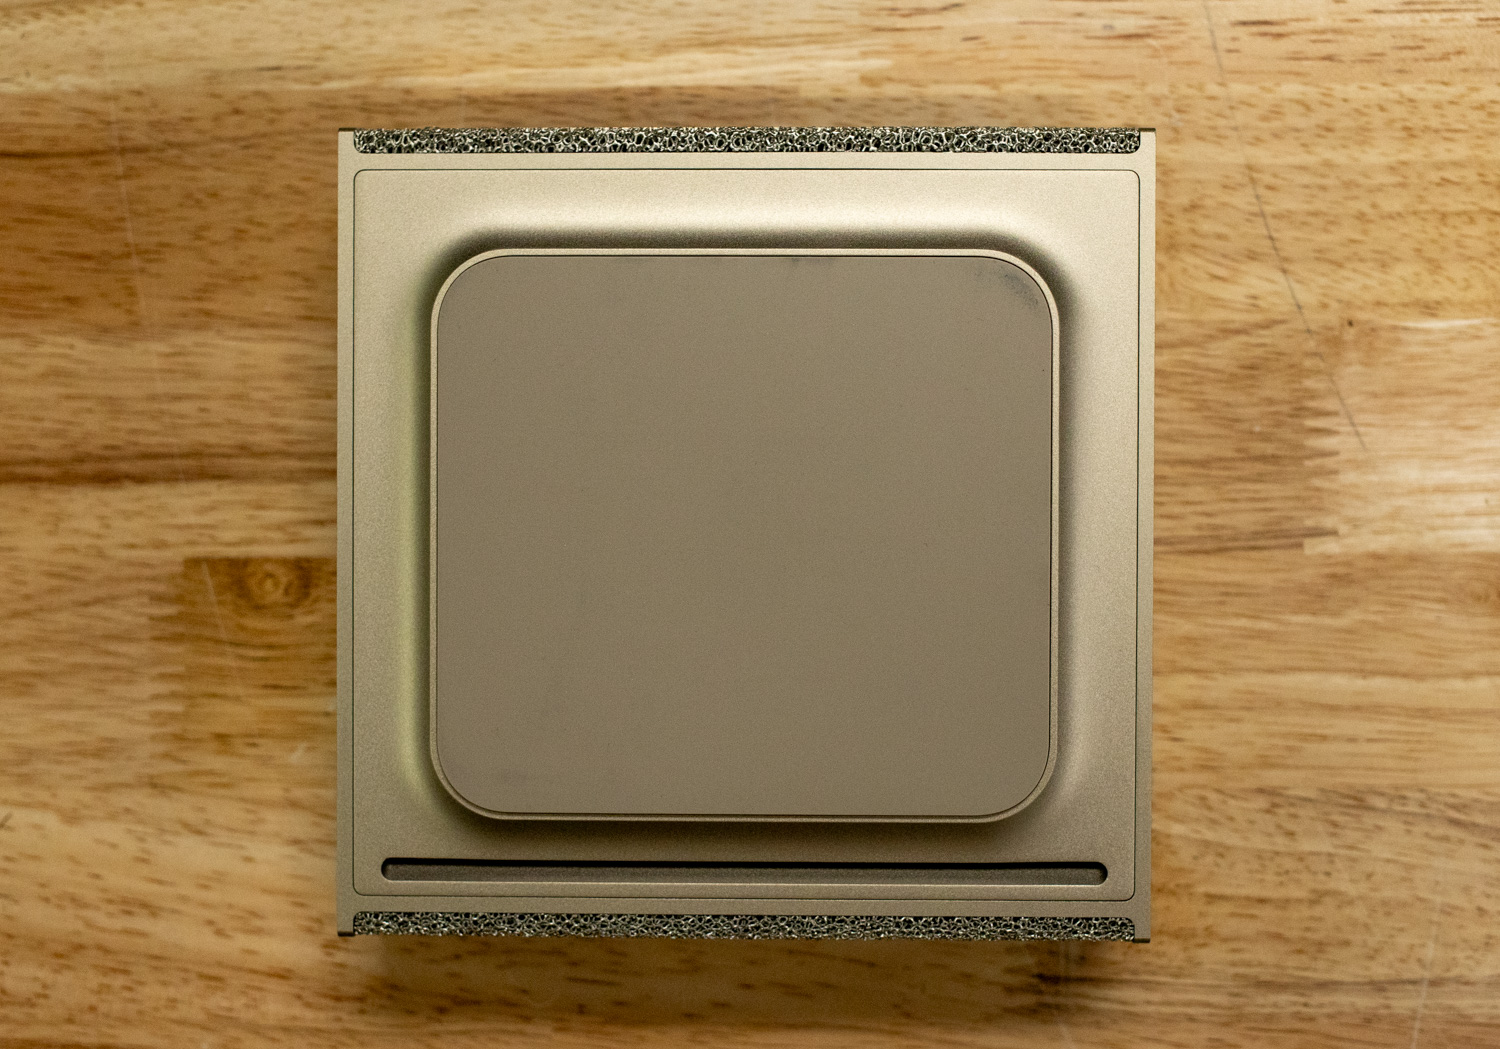
Inuti kan vi se antennkablarna dragna mot enhetens övre del, vilket bekräftar att Wi-Fi 7 och Bluetooth 5.3 är tillgängliga. Detta ger flexibla nätverksalternativ, särskilt användbara för mobila installationer eller laboratorieinstallationer där trådbunden åtkomst kanske inte är tillgänglig.
Enhetens lagringslösning, en PCIe Gen5 2242 M.2 SSD, syns också, vilket är en mindre vanlig formfaktor för sådan högpresterande hårdvara. Konfigurationen som visas här inkluderar en 4TB Samsung NVMe-hårddisk i vår konfiguration.
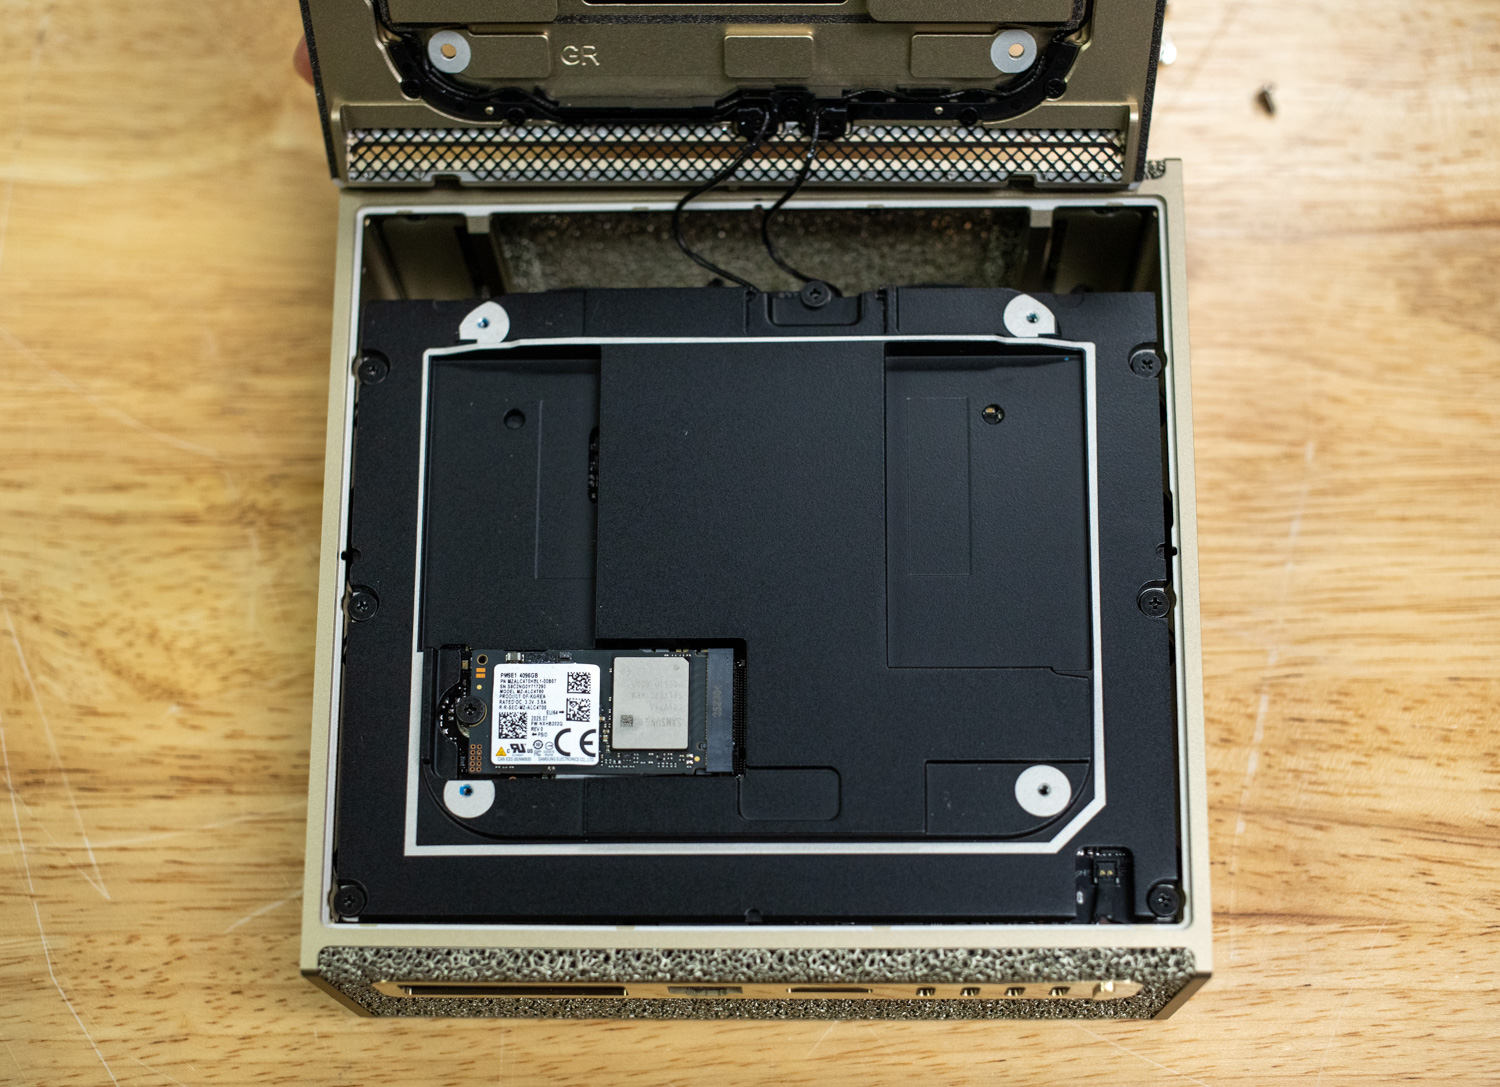
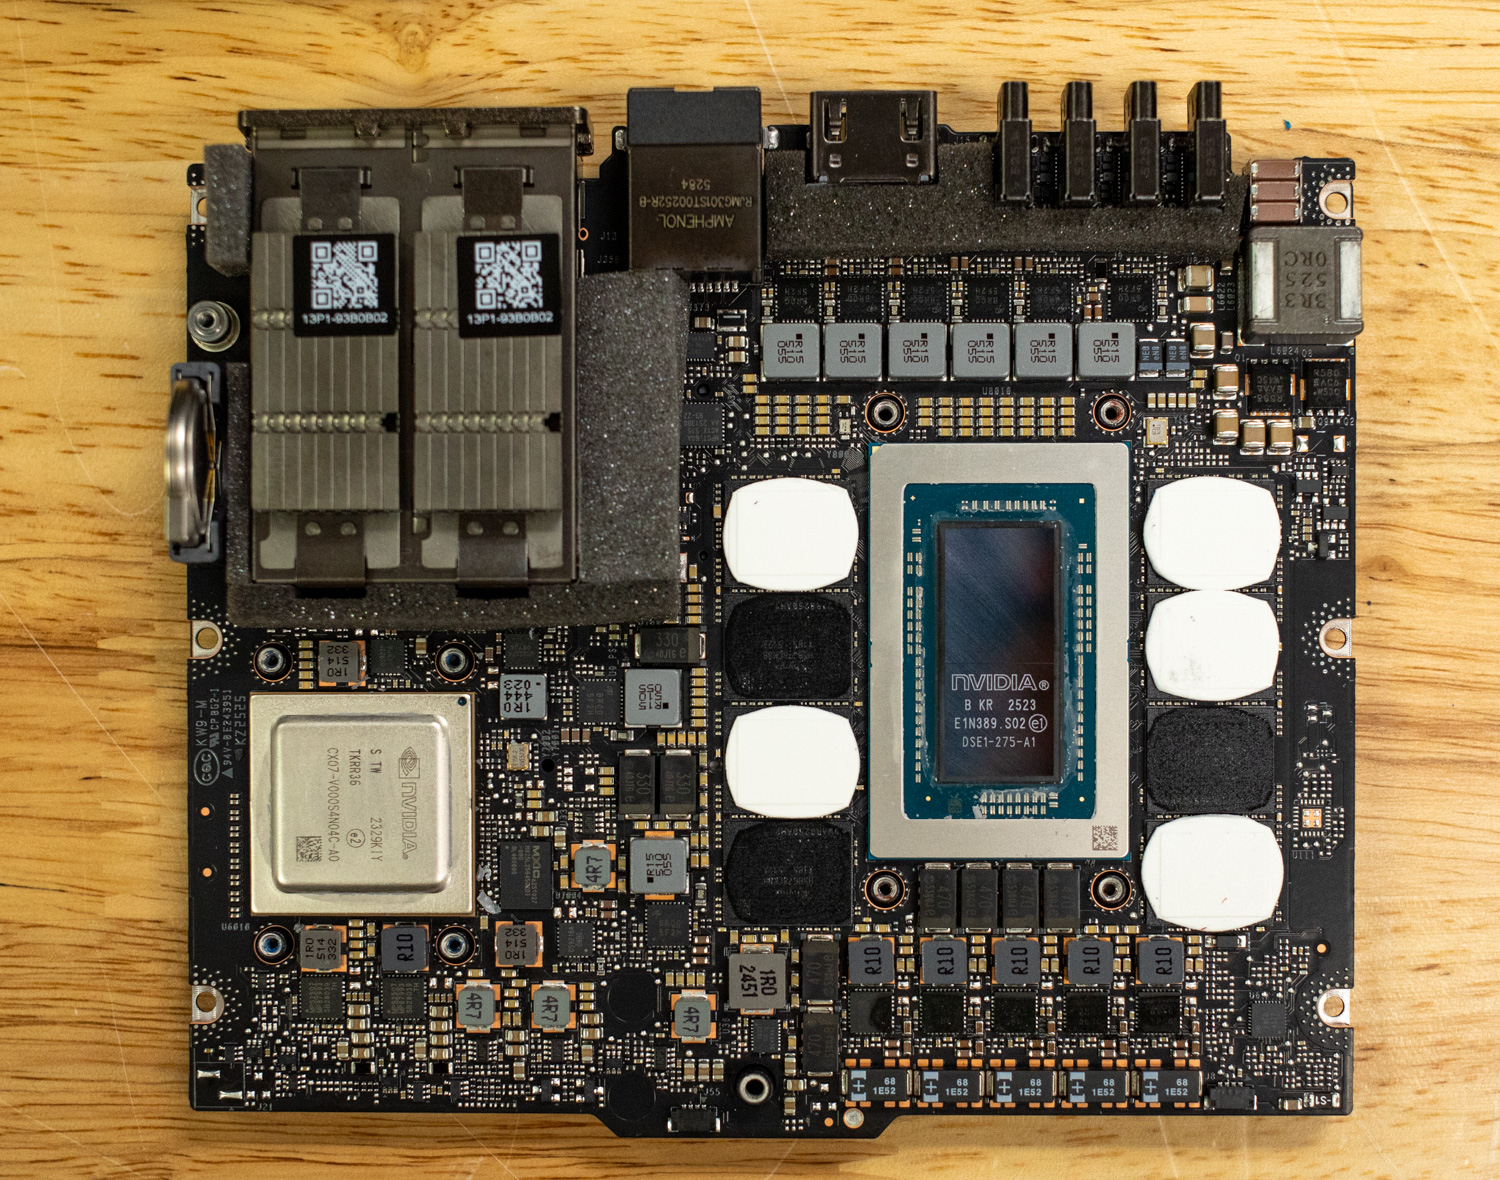
Om man dyker djupare in i DGX Spark avslöjar man systemets hjärta, NVIDIA Grace Blackwells GB10 Superchip. Bakom GB10 Superchip finns det åtta lödda LPDDR5X-systemminnet som levererar 273 GB/s bandbredd, vilket säkerställer snabb dataåtkomst över både CPU- och GPU-operationer.
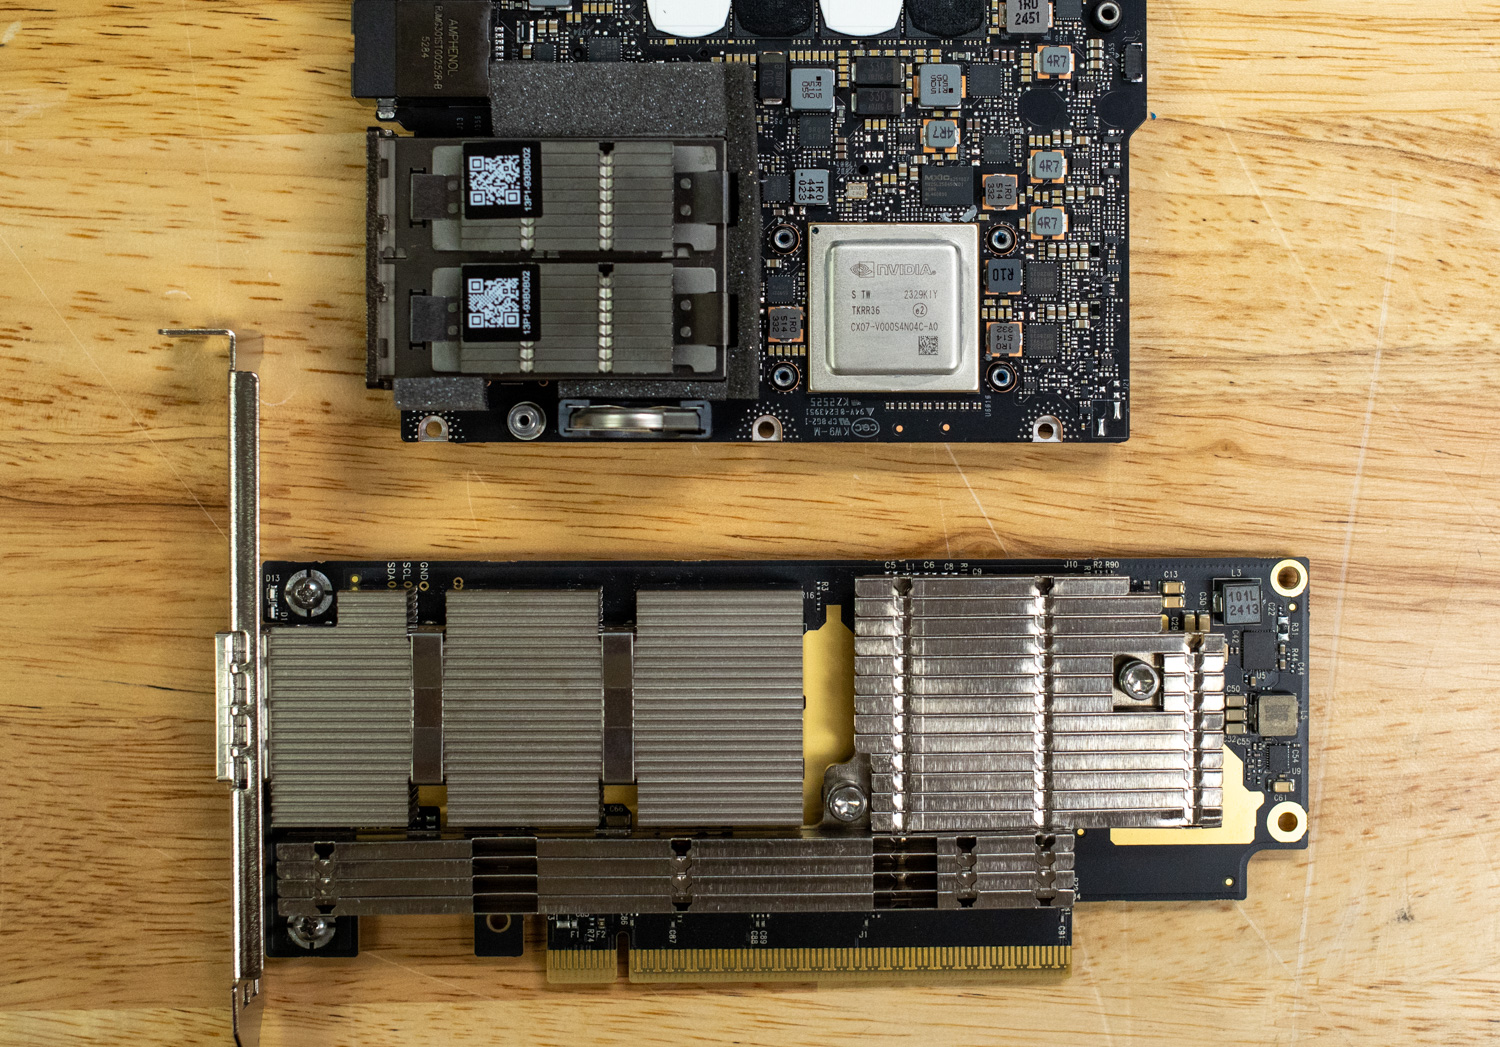
Precis bredvid chipet sitter CX7-nätverket, vilket, som tidigare nämnts, ger 200G anslutning. Detta gör det möjligt för användare att ansluta Spark till höghastighetslagring eller till och med klustra flera instanser av Spark tillsammans. NVIDIA har validerat och säljer ett kluster av två Sparks som kan anslutas direkt för att stödja ännu större AI-modeller.
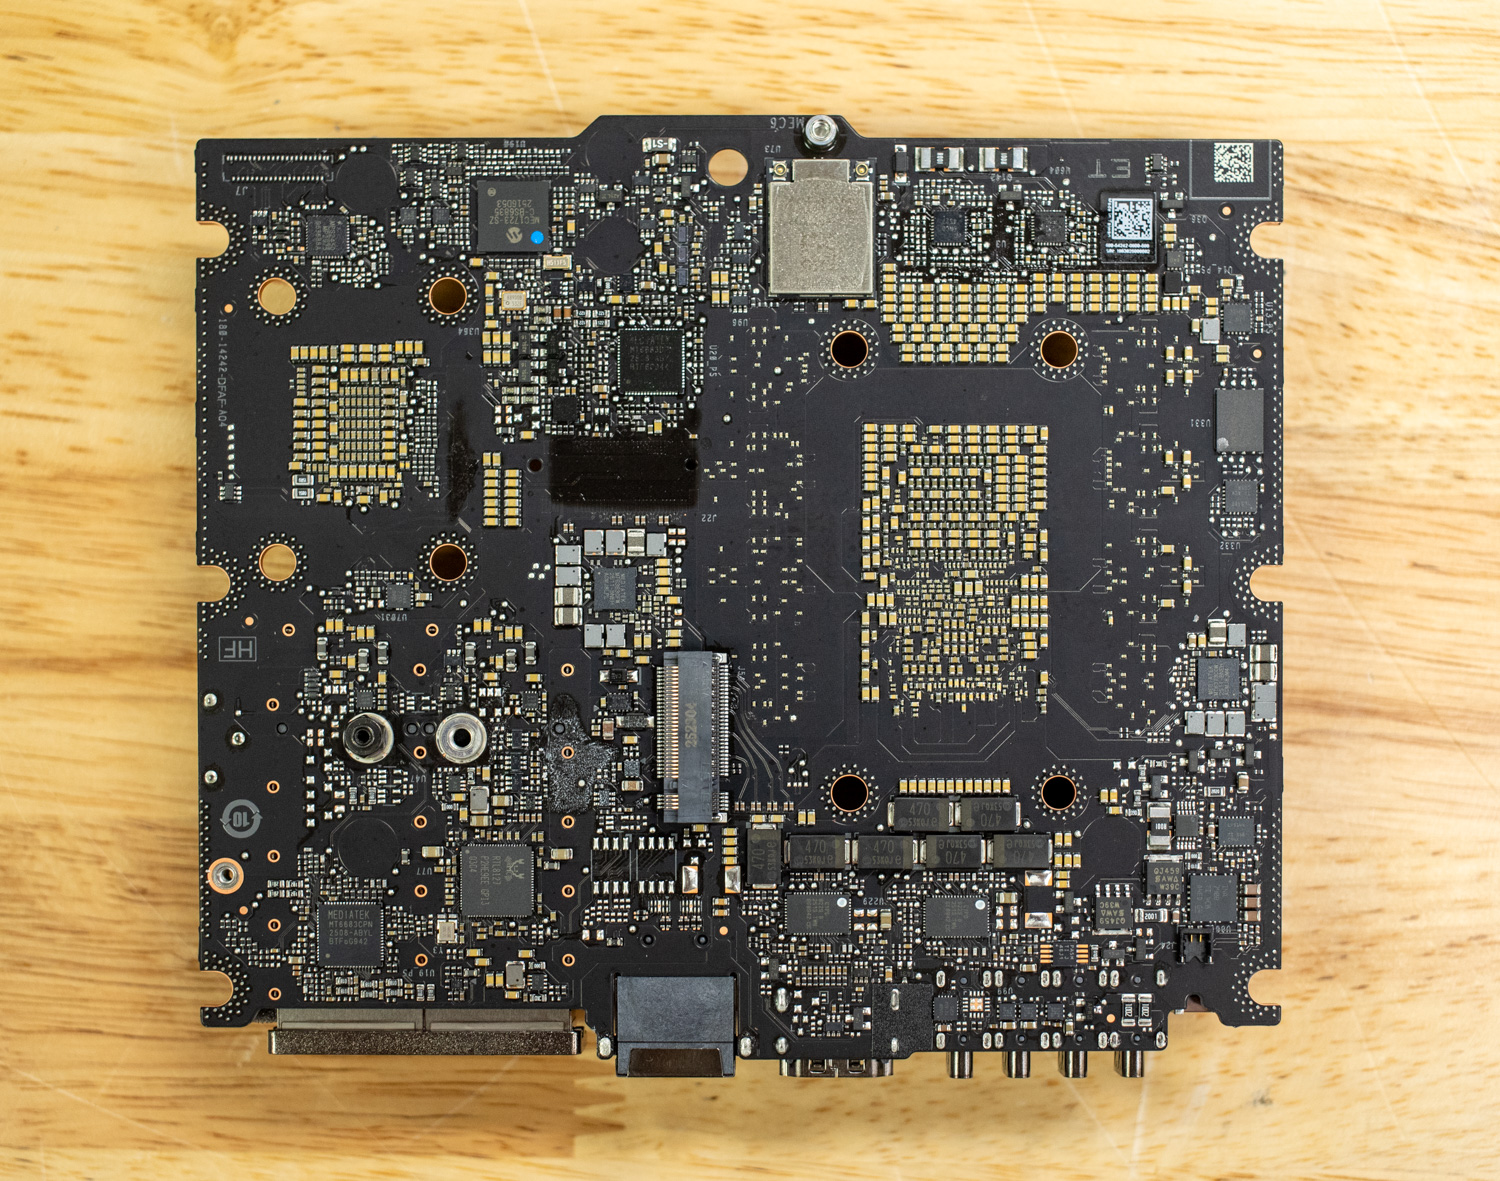
Slutligen, när man vänder på kortet visas alla PCIe-anslutningar, inklusive PCIe Gen5 x4 2242 M.2 SSD och PCIe Gen3x1 MediaTek Wi-Fi-adaptern.
Där Spark blir oumbärlig: Den moderna AI-utvecklingsenheten
DGX Spark visar sig vara särskilt övertygande i flera olika professionella sammanhang, där var och en drar nytta av sin unika kombination av enhetligt minne, kompakt formfaktor och omfattande programvaruintegration.
Data Science Acceleration: Från Pandor till Produktion
För dataforskare representerar NVIDIA DGX Spark en stor förbättring av arbetsflödeshastighet och upplevelse. ConnectX-7-nätverket som levererar 200 Gbps bandbredd, i kombination med CUDA X-accelererade bibliotek, transformerar dataförbehandling. AI och datavetenskap bygger på grunden bra data in, bra data ut. Traditionellt sett är den mest tidskrävande fasen i alla konventionella ML-projekt datarensning och funktionsutvinning. Konventionella arbetsflöden innebär vanligtvis att man laddar datamängder i verktyg som Pandas och utför transformationer på CPU-kärnor, vilket i allmänhet är långsamt. Manuell utforskning och funktionsutveckling kan också vara ett betydande hinder. Spark möjliggör end-to-end GPU-acceleration genom RAPIDS.
Ett typiskt scenario för företagsdatavetenskap involverar funktionsutveckling på datamängder i intervallet 40–80 GB: sammankoppling av flera tabeller, beräkning av aggregeringar över temporala fönster, hantering av kategorisk kodning och normalisering av fördelningar. På CPU-infrastruktur kan denna förbehandling ta timmar. Med RAPIDS cuDF som laddar hela datamängden till Sparks 128 GB enhetliga minne slutförs dessa operationer på minuter med 10× eller högre acceleration. Den efterföljande modellträningen gynnar lika mycket oavsett om det gäller klassisk ML med cuML eller djupinlärning med PyTorch, vilket eliminerar den traditionella flaskhalsen där dataforskare väntar på infrastruktur snarare än att iterera på hypoteser.
Generering av syntetisk data: Robotik och simulering
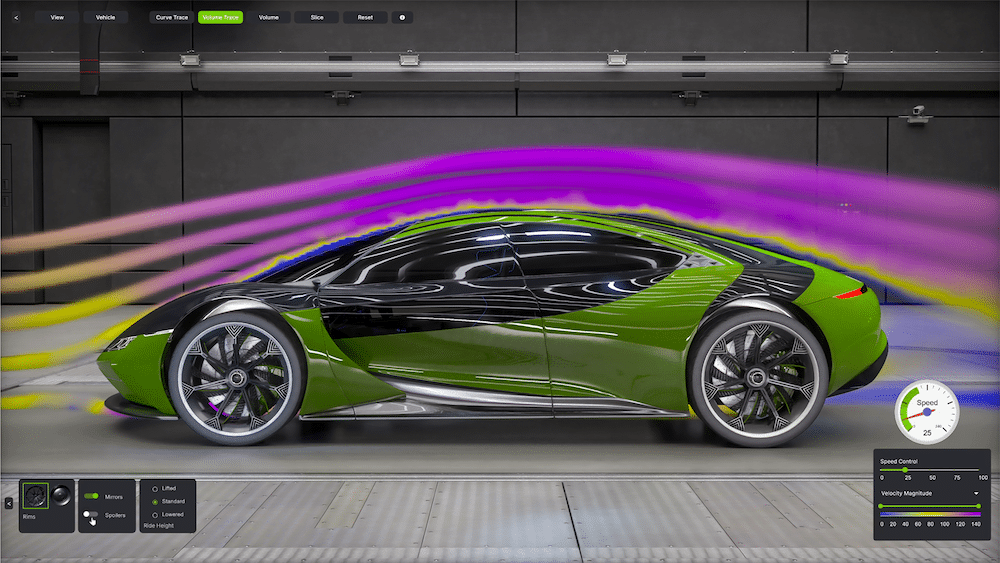
Inkluderingen av fjärde generationens RT-kärnor positionerar Spark unikt för ett framväxande arbetsflöde: syntetisk datagenerering för träning av världsmodeller. Att träna robusta manipulationspolicyer kräver traditionellt tiotusentals verkliga demonstrationer, vilket är oöverkomligt dyrt och tidskrävande. Fotorealistisk simulering i plattformar som Isaac Sim eller Omniverse erbjuder ett alternativ, men rendering av strålspårade bilder med fysiskt korrekt belysning, reflektioner och material krävde historiskt sett dyra arbetsstations-GPU:er som NVIDIAs L40S och RTX 6000 Ada.
Källa: NVIDIA
Spark konsoliderar detta arbetsflöde. RT-kärnor gör det möjligt för OpenUSD-arbetsbelastningar att hantera generering av syntetisk data, medan Tensor-kärnor används för AI-inferens i en ritning/ett arbetsflöde. Tidigare kunde organisationer driftsätta flera maskiner för rendering och en separat inferensoptimerad server. Nu är detta möjligt i en enda 240W-enhet. För robotstartups, universitetslaboratorier eller biltillverkare som utforskar autonom manipulation minskar denna integration avsevärt utvecklingstidslinjer och kapitalutgifter.
Vi har tidigare undersökt liknande pipelines för syntetisk datagenerering med hjälp av dedikerade L40S-renderingssystem i kombination med H100 för inferens i vår tidigare bevakning av NVIDIA L40S. GB10:s arkitektoniska konsolidering av dessa funktioner till en enhetlig utvecklingsenhet representerar en övertygande utveckling av detta arbetsflöde. Vi planerar att genomföra ytterligare tester av Sparks RT Core-prestanda mot dessa diskreta konfigurationer i kommande analyser, där vi undersöker rendering och andra arbetsbelastningar för representativa scenarier för robotmanipulation.
Vibe-kodningsrevolutionen
Andrej Karpathy, tidigare Teslas AI-chef och OpenAIs grundare, myntade termen "vibe coding" för att beskriva en framväxande metod för snabb mjukvaruutveckling med AI-hjälp. Istället för att noggrant skriva kod rad för rad, utnyttjar vibe coding juridiktekniker som interaktiva parprogrammerare: beskriver funktionalitet i naturligt språk, genererar implementeringsställningar, itererar genom konversationsförfining och prototyperar snabbt funktioner. Detta arbetsflöde omvandlar kodning från avsiktlig konstruktion till guidad konversation med en AI som förstår kontext, API:er och arkitekturmönster, vilket gör det möjligt för enskilda utvecklare att bygga anmärkningsvärt sofistikerade system med oöverträffad hastighet.
Omfattningen av AI-assisterad kodning bevisas av OpenRouters användningsrankningar , där kodningsfokuserade modeller konsekvent dominerar inferensvolymen. Tekniska yrkesverksamma, den primära demografiska gruppen för kodning, fungerar vanligtvis som avancerade användare och kör flera kodningsagenter parallellt i olika sammanhang. Och i takt med att öppna modeller i allt högre grad matchar proprietära alternativ på viktiga riktmärken , utforskar utvecklare lokala inferensdistributioner för att eliminera hastighetsbegränsningar, säkerställa tillgänglighet under kritiska utvecklingsfönster och upprätthålla kodsekretess för proprietära projekt.
r/LocalLLaMA-communityn visar upp verkligt imponerande specialbyggen, allt från arbetsstationer med flera grafikkort till servrar som är tejpade ihop och kör lokala modeller, distribuerad inferens över konsumenthårdvara och avancerade kyllösningar som möjliggör hållbar generering med hög datakapacitet. Dessa konfigurationer presenterar dock betydande hinder: kapitalutgifter som ofta överstiger tiotusentals dollar, betydande strömförbrukning, utmaningar med värmehantering som kräver dedikerade utrymmen snarare än vanliga kontorsmiljöer, och avsevärd teknisk expertis för konfiguration, optimering och felsökning.
Spark förändrar detta värdeerbjudande fundamentalt. För 3 999 dollar med 128 GB enhetligt minne levererar den imponerande modellinferensprestanda i en tyst, kompakt och energieffektiv enhet som bara drar 240 W. Användare som vill etablera en lokal infrastruktur för kodningsassistenter behöver inte längre avancerade hemmalabbar som förbrukar kilowattimmar och genererar betydande värmeeffekt. Den validerade enhetsmetoden med förkonfigurerat DGX OS eliminerar konfigurationskomplexiteten som tidigare begränsade lokal LLM-distribution till användare med djupgående Linux- och CUDA-expertis.
Utöver att eliminera infrastrukturfriktion tar Spark itu med kritiska problem kring kodsekretess och modellanpassning. Molnbaserade kodningsassistenter överför nödvändigtvis källkod till fjärrservrar, vilket är en icke-start för organisationer som hanterar proprietära algoritmer, säkerhetskritisk infrastruktur eller reglerad data. Lokal inferens på Spark säkerställer att kod aldrig lämnar utvecklingsmiljön. Dessutom möjliggör minneskapaciteten på 128 GB fullständig parameterfinjustering av kodningsmodeller, vilket gör det möjligt för erfarna utvecklare att specialisera modeller på interna kodbaser. Denna funktion är särskilt värdefull för organisationer med domänspecifika språk, anpassade ramverk eller arkitekturmönster som inte är tillräckligt representerade i offentliga träningsdata.
Finjustering med NVIDIA NeMo på DGX Spark
DGX Sparks 128 GB enhetliga minne möjliggör fullständig parameterfinjustering av 8B-modeller som traditionellt krävde dyra molnkonfigurationer med flera GPU:er. Fullständig finjustering av Qwen3 8B med standard Adam-optimering kräver cirka 132 GB (16 GB modellvikter, 96 GB optimeringstillstånd, 16 GB gradienter plus aktiveringar), vilket överstiger dubbla H100 80 GB-konfigurationer. Med hjälp av minneseffektiv 8-bitars Adam minskas kraven till cirka 70 GB, beroende på batchstorlek, vilket bekvämt passar in i Sparks minnespool. Detta är viktigt eftersom fullständig finjustering ger 4–6 % bättre noggrannhet än LoRA på komplexa resonemangsuppgifter. Medan molnbaserade 2× H100 80 GB-konfigurationer kostar cirka 5 dollar i timmen med distribuerad träningskomplexitet, tillhandahåller Spark träning för ett enda system till en engångsinvestering på 3 999 dollar.
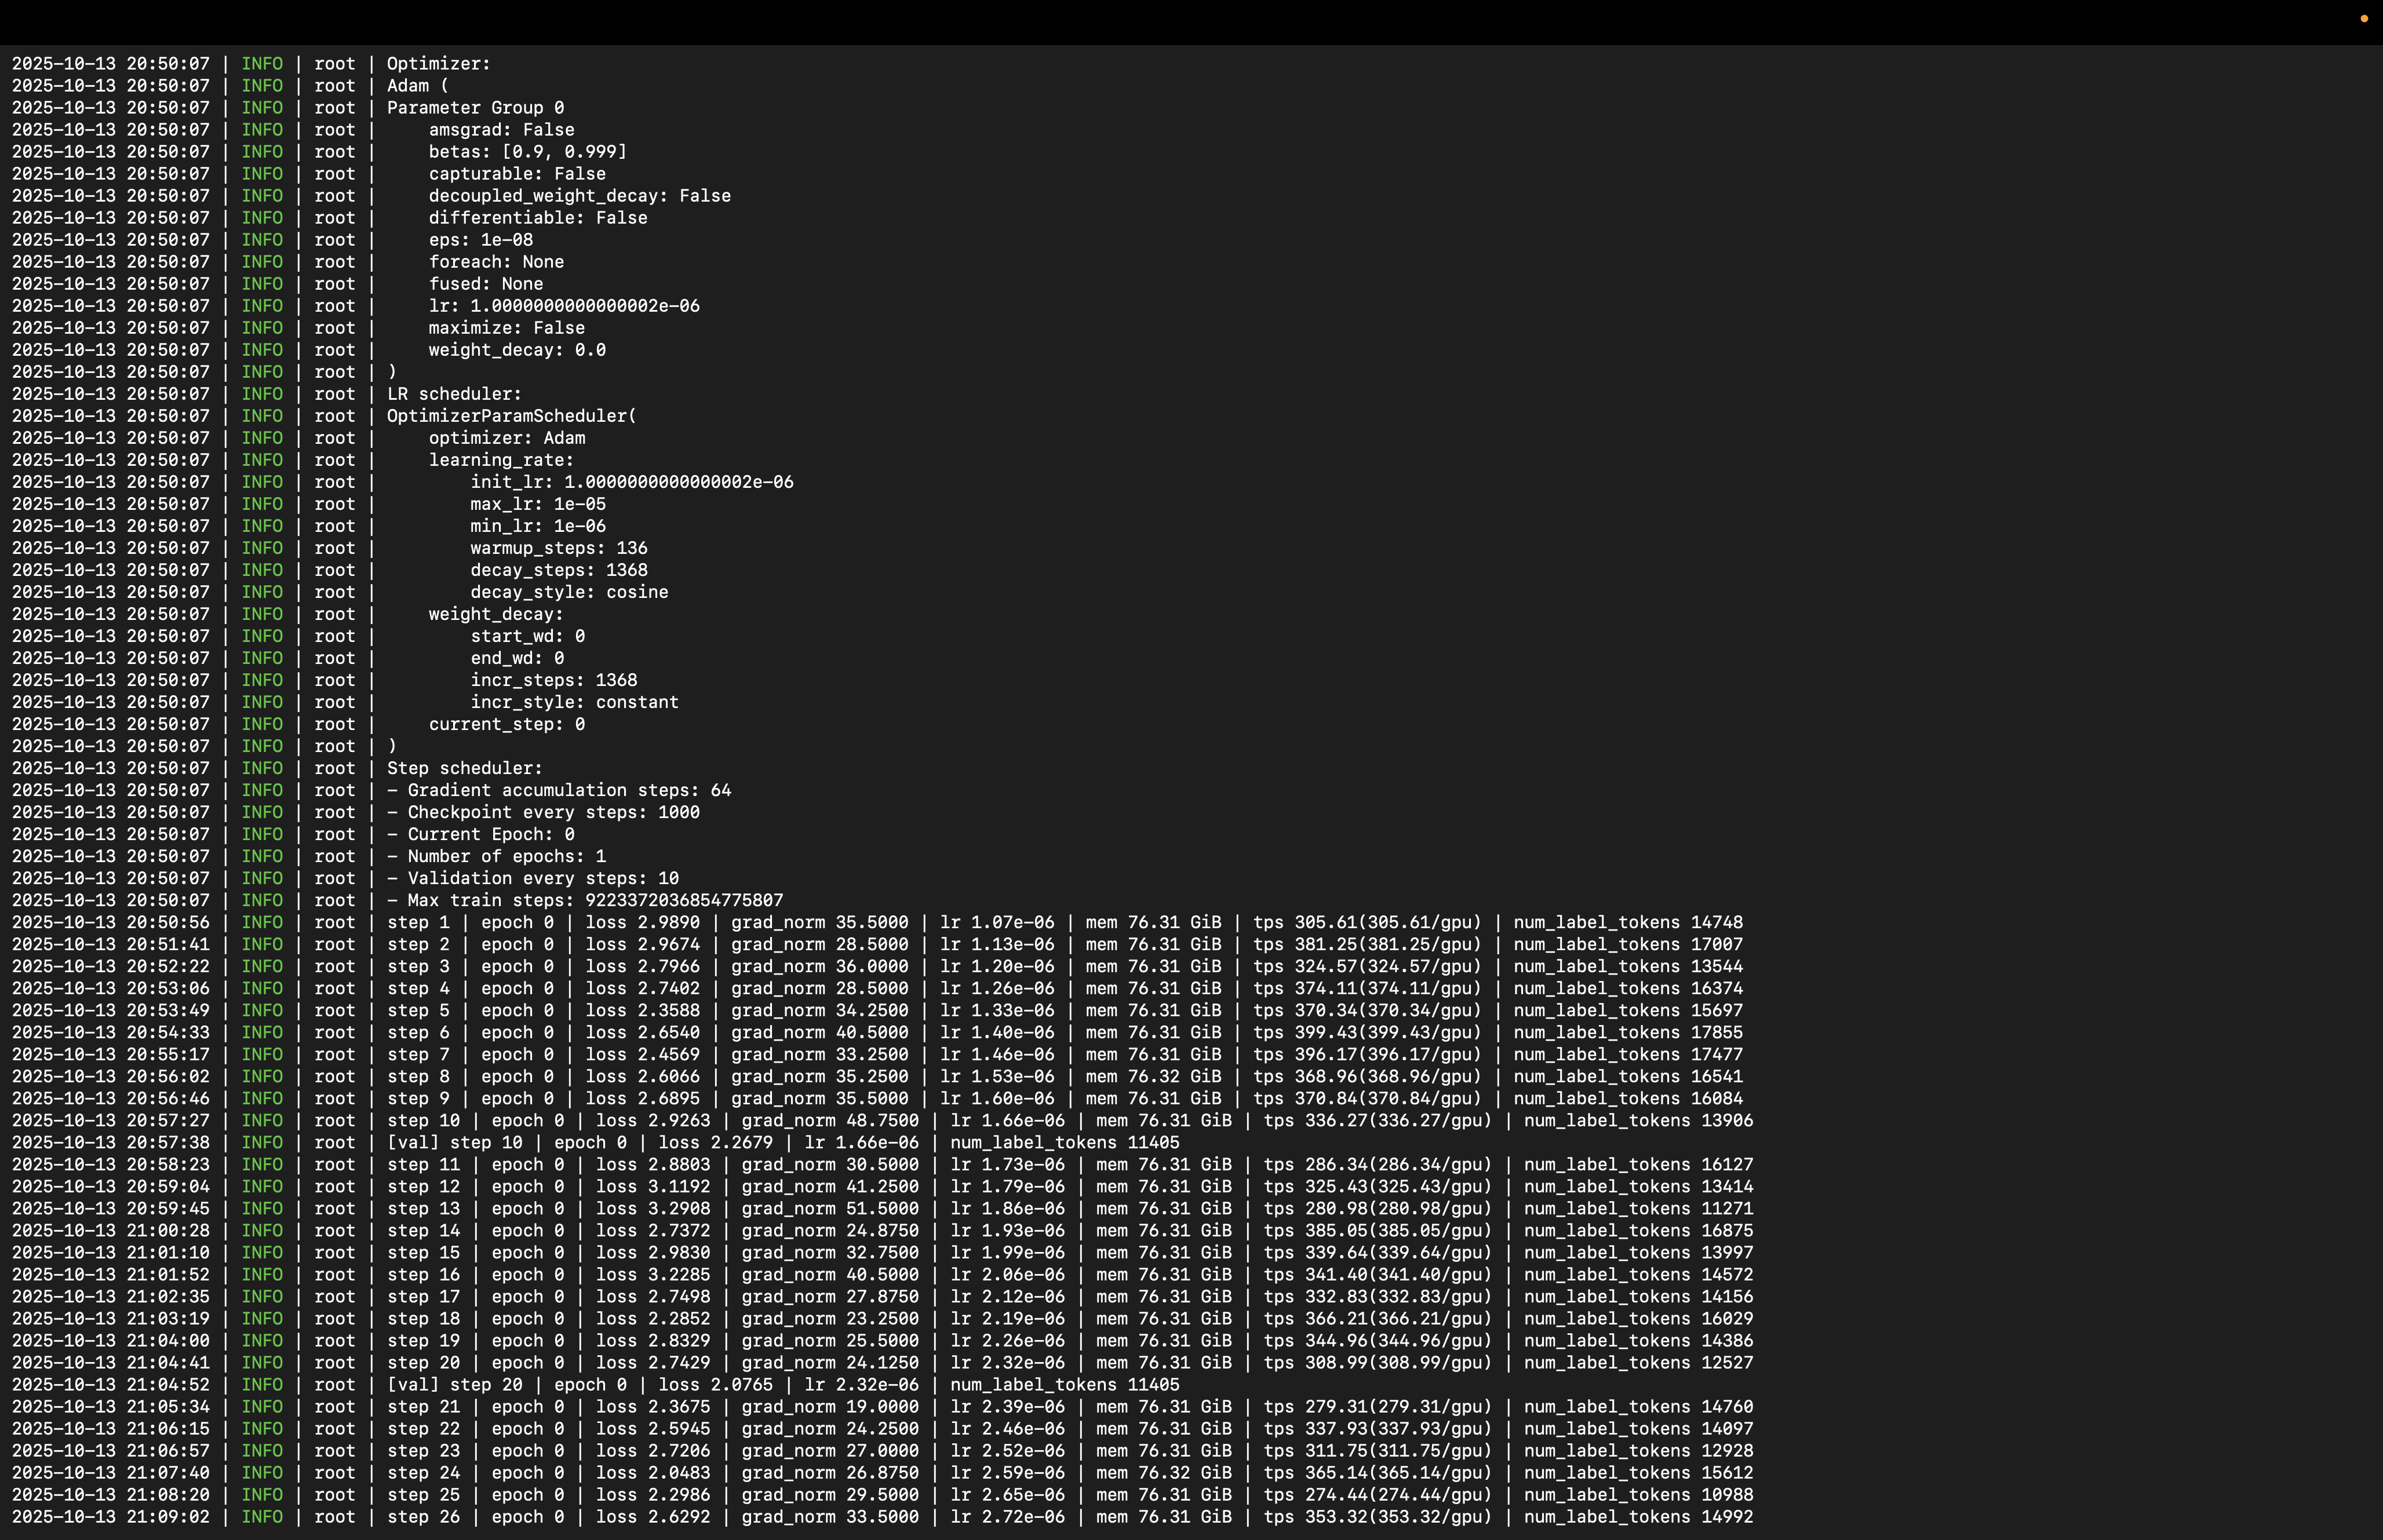
NVIDIA NeMo Automodel eliminerar friktion med företagsutbildningsramverk genom att tillhandahålla Day-0-stöd för alla Hugging Face-modeller utan kontrollpunktskonvertering. Ladda Qwen3 8B direkt från HuggingFace Hub och konfigurera finjustering via YAML-filer som specificerar datakällor, optimeringsinställningar och LoRA-mål. NeMo automatiserar distribuerad kontrollpunktshantering med safetensor-kompatibilitet, implementerar sammanslagna CUDA-kärnor för 2–5× hastighetsökningar och hanterar gradientackumulering.
Bildgenerering med bekvämt användargränssnitt
ComfyUI tillhandahåller ett nodbaserat grafiskt gränssnitt som omvandlar Stable Diffusion och relaterade diffusionsmodeller till mycket anpassningsbara kreativa pipelines. Till skillnad från traditionella webbaserade gränssnitt som abstraherar komplexitet bakom förenklade parameterreglage, använder ComfyUI en visuell grafarkitektur där användare konstruerar arbetsflöden genom att ansluta diskreta funktionella noder, som var och en representerar specifika operationer som modellinläsning, promptkodning, latent diffusionssampling, VAE-avkodning eller uppskalningstransformationer. Denna modulära design möjliggör detaljerad kontroll över hela genereringspipelinen, vilket gör varje beräkningssteg transparent och justerbart. Det gör det också möjligt för användare att länka flera modeller, implementera anpassade samplingsscheman eller integrera avancerade tekniker som ControlNet-vägledning, vilket skulle vara omöjligt i förenklade gränssnitt.
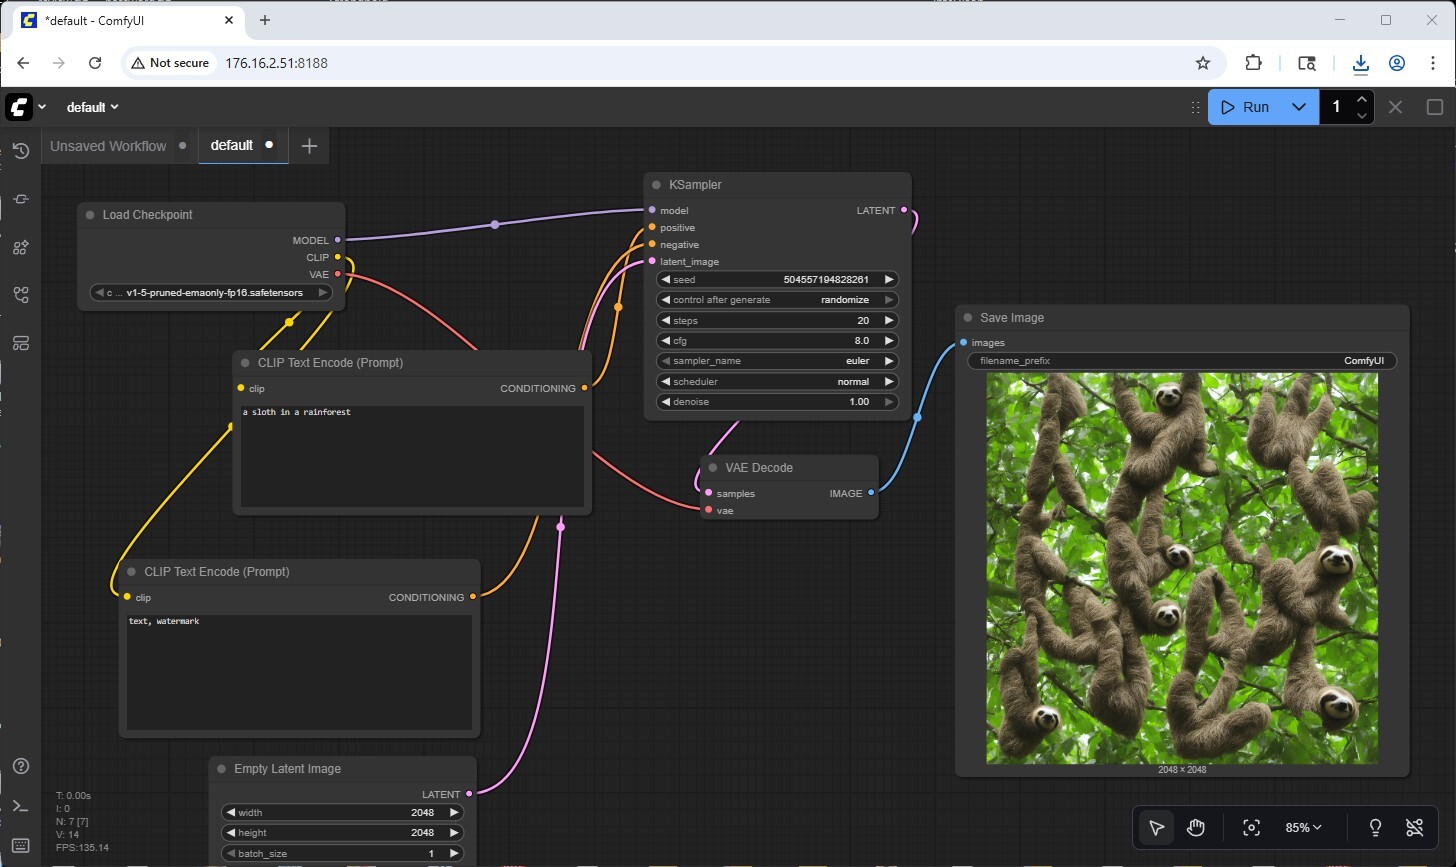
På DGX Spark utnyttjar ComfyUI Blackwell GPU:s Tensor Cores för accelererad diffusionssampling, vilket vanligtvis slutför generationer på 15–30 sekunder beroende på samplingskomplexitet. Den enhetliga minnesarkitekturen på 128 GB visar sig vara särskilt fördelaktig, eftersom den upprätthåller flera kontrollpunktsmodeller, LoRA-adaptrar och VAE-avkodare i minnet samtidigt, vilket eliminerar den omlastningsoverhead som plågar VRAM-begränsade system. Användare kan generera effektivt obegränsat med AI-konstverk lokalt, fritt från API-hastighetsbegränsningar, molnkostnader per generation och integritetsproblem i samband med proprietära kreativa arbetsflöden. Arbetsflödespersistensmodellen ger operativt värde: kompletta pipelines serialiseras till JSON-filer som kan versionskontrolleras, delas mellan team eller bäddas in direkt i genererade bilder som metadata, vilket möjliggör reproducerbarhet som är avgörande för organisationer som bygger syntetiska datapipelines eller upprätthåller konsekventa konstnärliga stilar över genererade tillgångar.
NVIDIA DGX Spark prestandatestning
vLLM Online-servering – LLM-inferenstest
vLLM är den mest populära inferens- och servingsmotorn med hög genomströmning för LLM:er. vLLM:s onlineserving benchmark är ett prestandautvärderingsverktyg utformat för att mäta den verkliga servingskapaciteten hos denna inferensmotor vid hantering av samtidiga förfrågningar. Den simulerar produktionsarbetsbelastningar genom att skicka förfrågningar till en körande vLLM-server med konfigurerbara parametrar, såsom förfrågningshastighet, in-/utmatningslängder och antal samtidiga klienter. Benchmarket mäter viktiga mätvärden, inklusive genomströmning, dvs. tokens per sekund, tid till första token och tid per utmatningstoken, vilket hjälper användare att förstå hur vLLM presterar under olika belastningsförhållanden.
Vi testade inferensprestanda över en omfattande uppsättning modeller som representerar de mest populära arkitekturerna och modelltyperna i produktionsdistributioner idag.
Blandning av expertmodeller
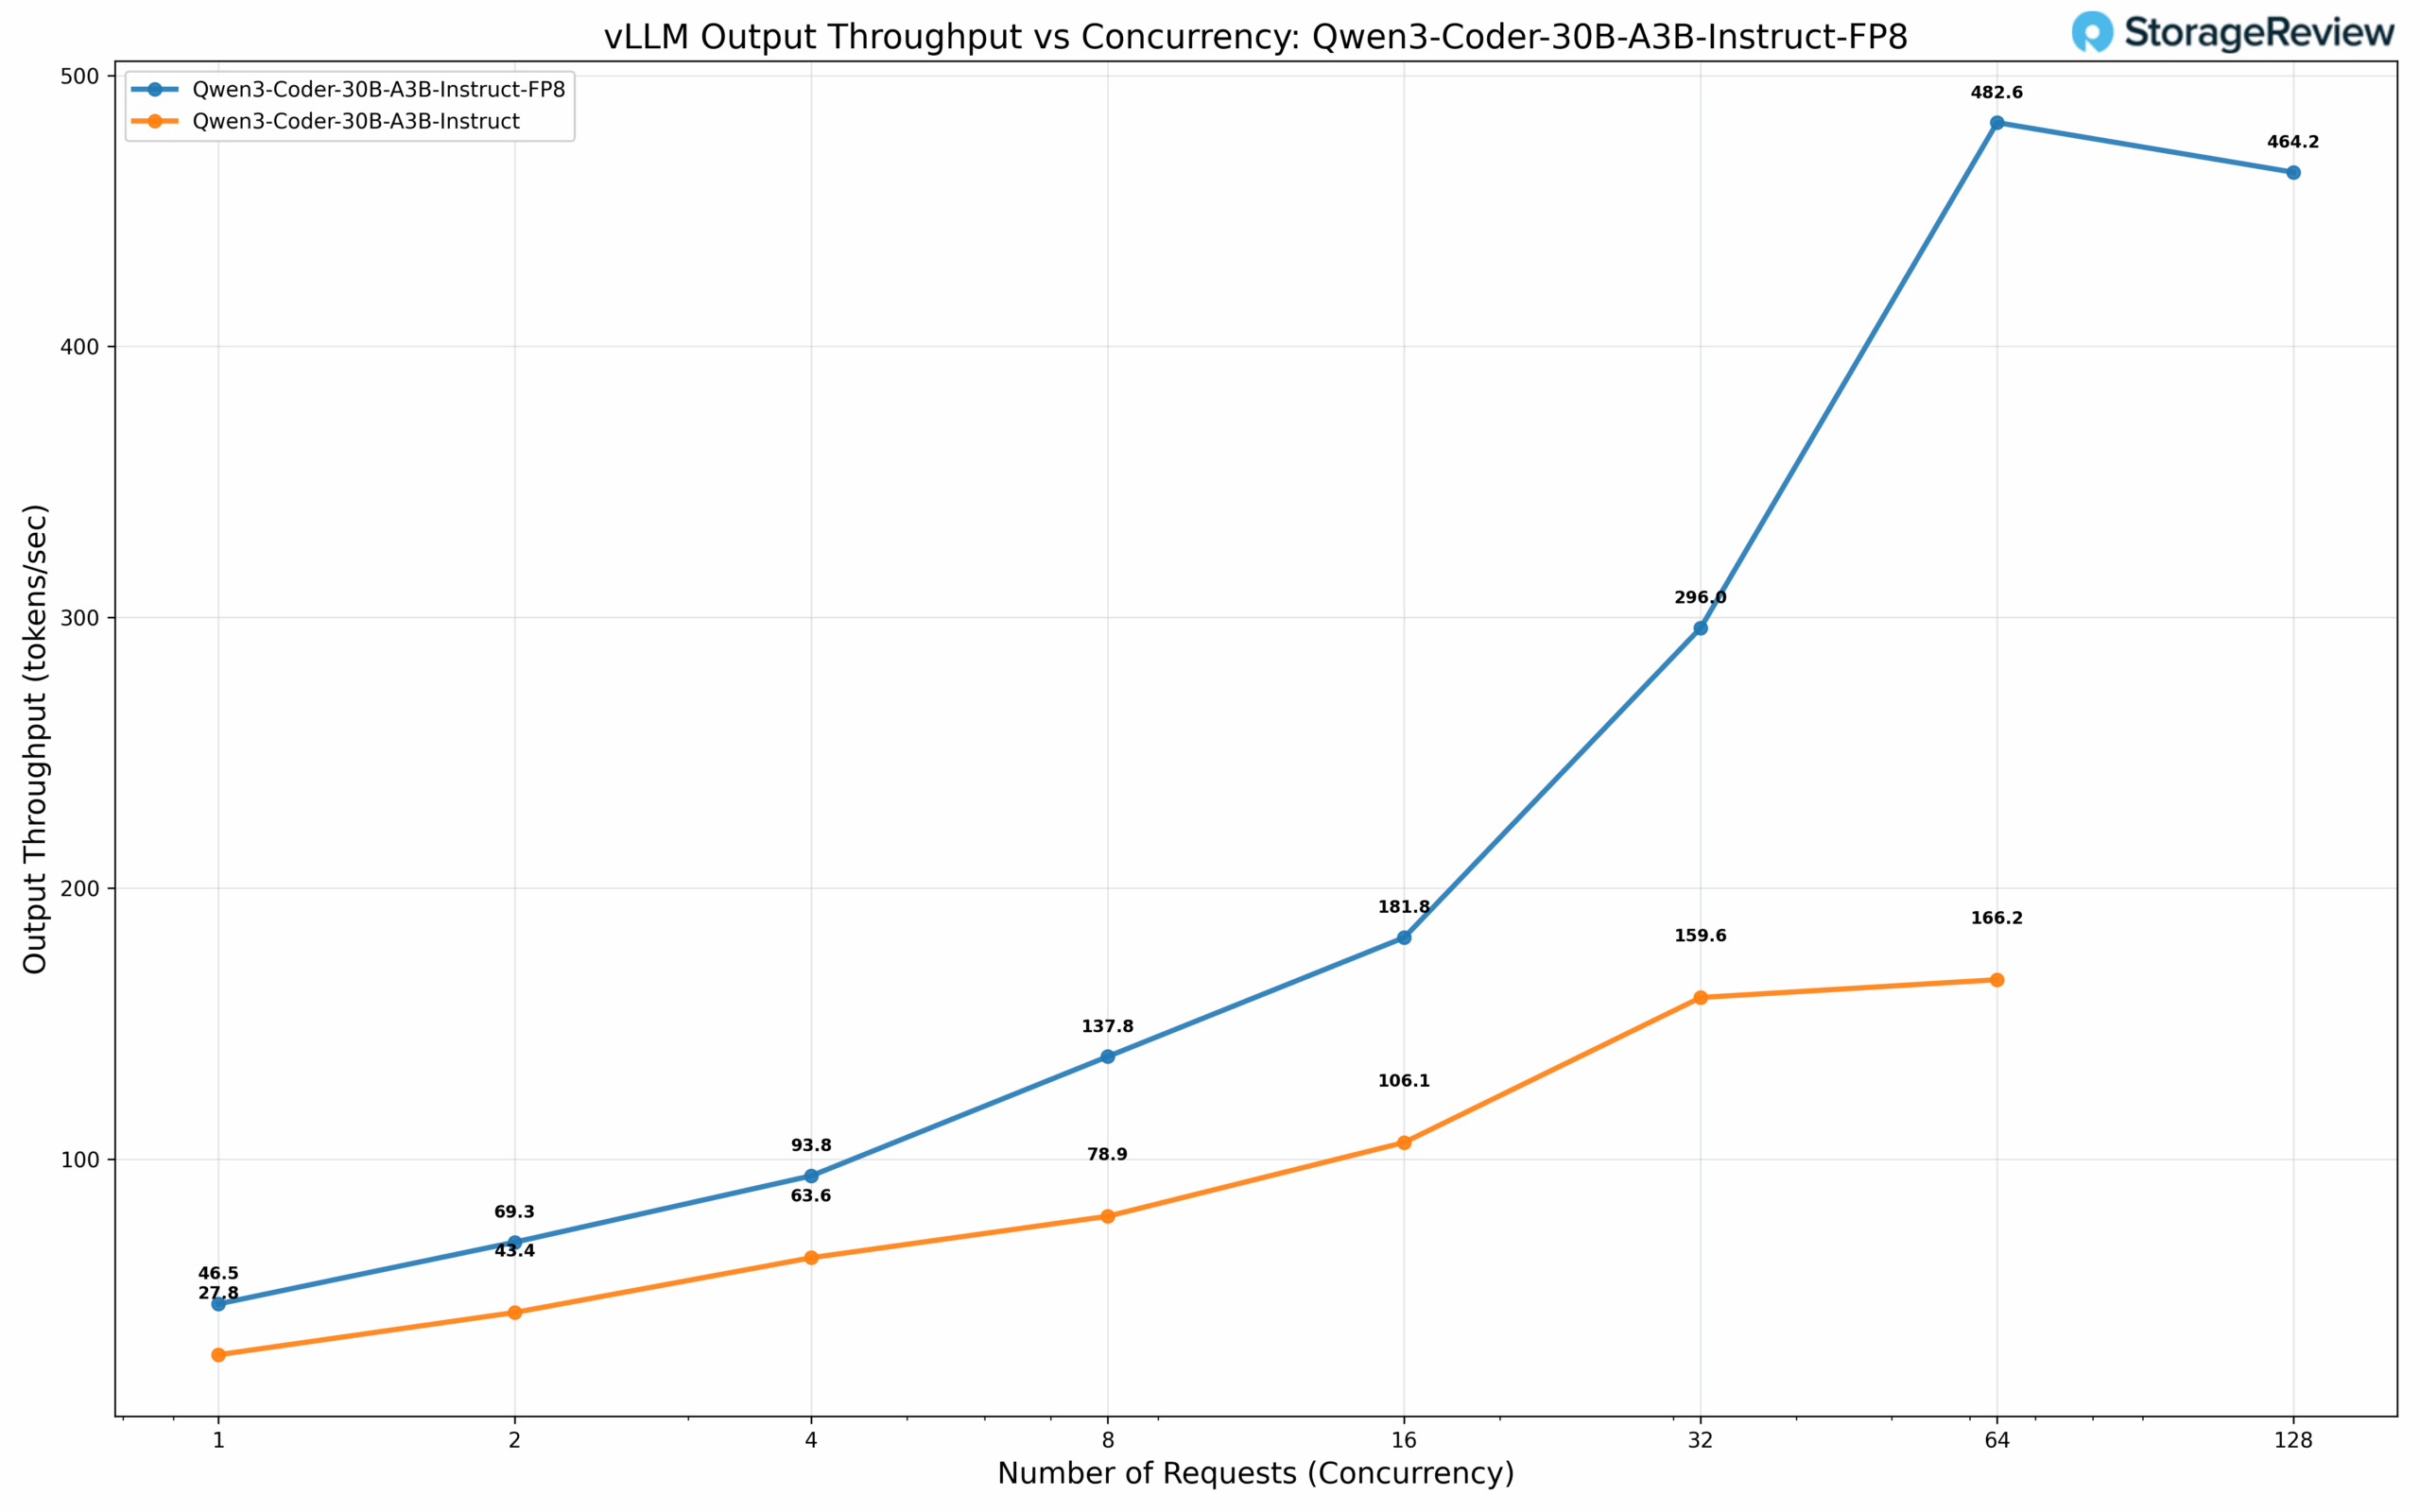
Vi utvärderade Qwen3 Coder 30B-A3B, en av de mest populära kodningsmodellerna för lokala inferensdistributioner. Denna glesa arkitektur bibehåller en full modellstorlek på 30B parametrar med BF16-precision samtidigt som den endast aktiverar 3B parametrar per genererad token. Vi jämförde både standardmodellen och en FP8-kvantiserad variant från Qwen. Den FP8-kvantiserade modellen visar betydande prestandavinster: den uppnår 46.5 tok/s vid samtidighet 1, och skalar till imponerande 482.6 tok/s vid batchstorlek 64. Standardmodellen BF16 levererar 27.8 tok/s vid samtidighet 1 och når 166.2 tok/s vid batchstorlek 64, en nästan 3x prestandaskillnad.
Täta modeller
Täta modeller representerar den konventionella LLM-arkitekturen där alla parametrar och aktiveringar aktiveras under inferens, vilket resulterar i mer beräkningsintensiv bearbetning jämfört med deras glesa motsvarigheter. För att heltäckande utvärdera prestandaegenskaper över modellskalor och kvantiseringsstrategier, jämförde vi fem täta modellkonfigurationer.
Vår testsvit inkluderade Mistral Small 3.1 24B från Mistral AI med BF16-precision, tillsammans med en dynamiskt kvantiserad variant av Mistral Small 3.1 24B FP8 från RedHat AI. Dynamisk kvantisering använder selektiva viktkvantiseringstekniker för att optimera prestanda-noggrannhetsavvägningen, vilket strategiskt minskar precisionen samtidigt som modellförsämringen minimeras. Vi kompletterade dessa större, täta modeller med Meta Llama 3.1 8B-utvärderingar i tre precisionsformat: originalkonfigurationen av BF16, plus kvantiserade versioner av FP8 och FP4 från NVIDIA. Denna modellvalsstrategi möjliggör direkt prestandajämförelse över modellskalor samtidigt som den isolerar effekten av progressiv kvantisering på inferensdataflödet.
Prestandanalys: Stora täta modeller
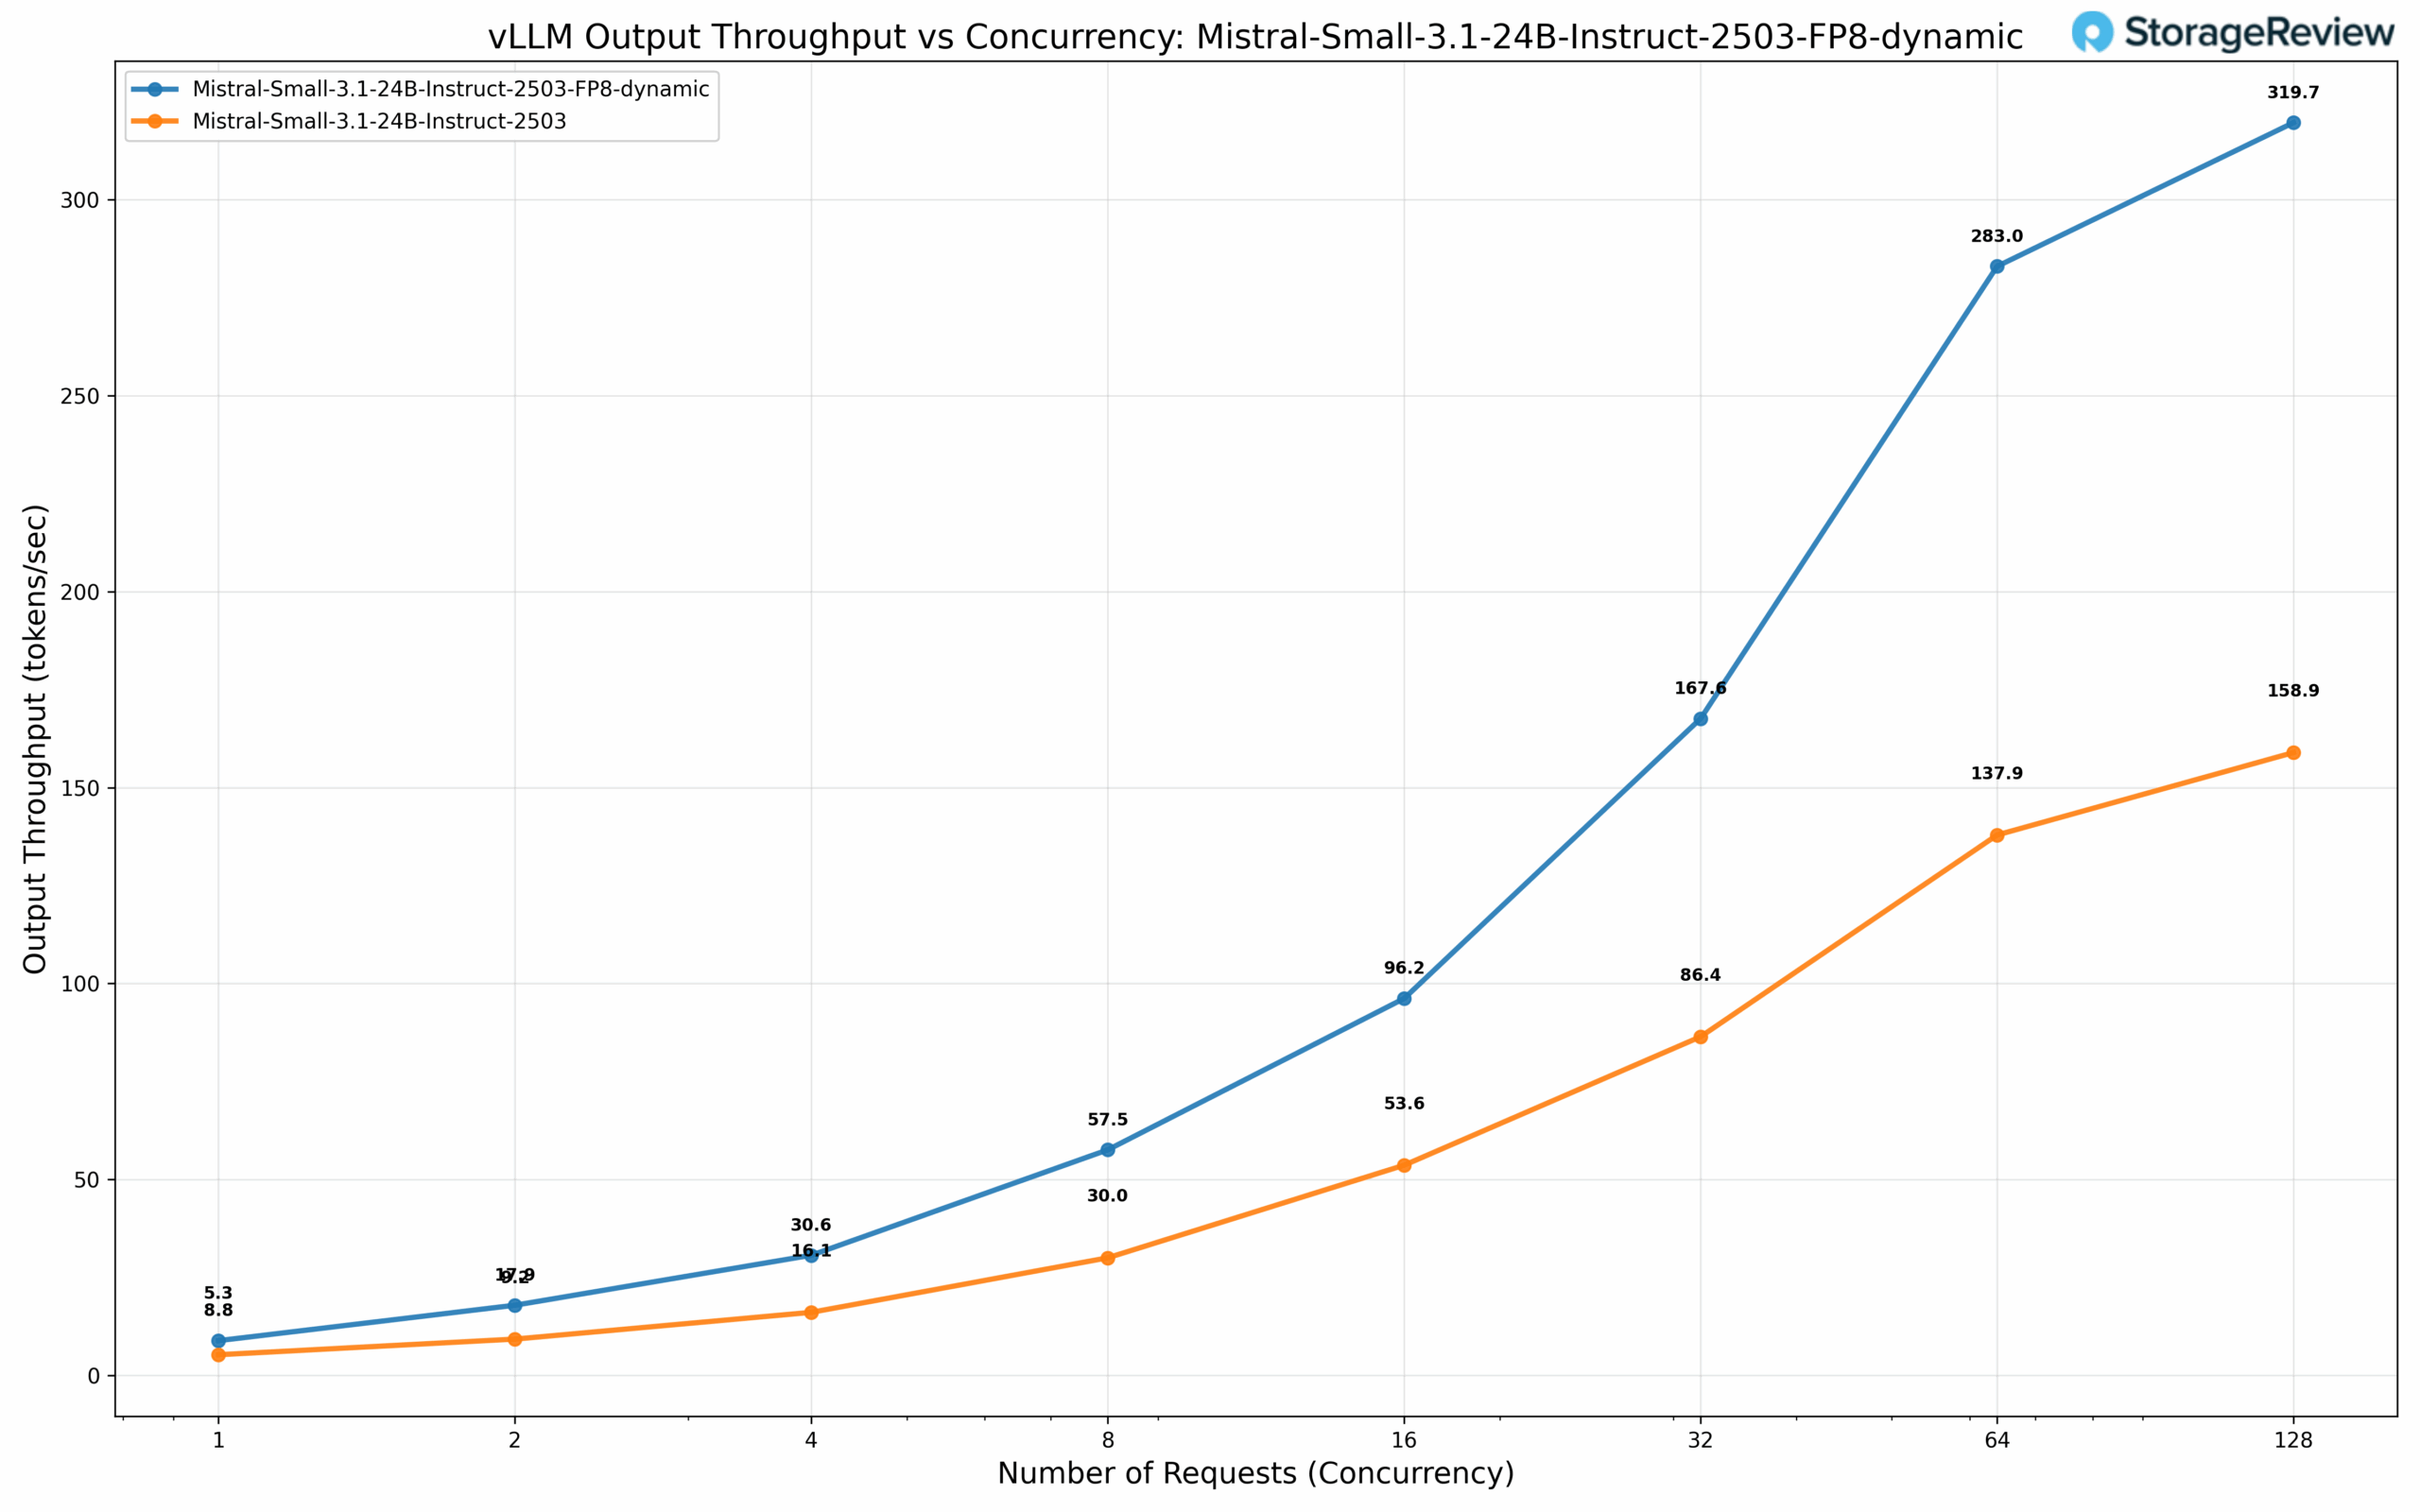
Mistral Small 3.1 24B uppvisar vid BF16-precision en baslinjegenomströmning på 5.3 tok/s vid samtidighet 1, och skalar upp till betydande 158.9 tok/s vid 128 samtidiga förfrågningar. Den dynamiskt kvantiserade FP8-varianten uppvisar blygsamma vinster vid lägre samtidighet med 8.8 tok/s, men levererar en övertygande 2x prestandamultiplikator i skala och uppnår 319.7 tok/s vid 128 samtidighet – vilket understryker effektiviteten av dynamisk kvantisering för scenarier med hög genomströmning.
Prestandanalys: Kompakta, täta modeller
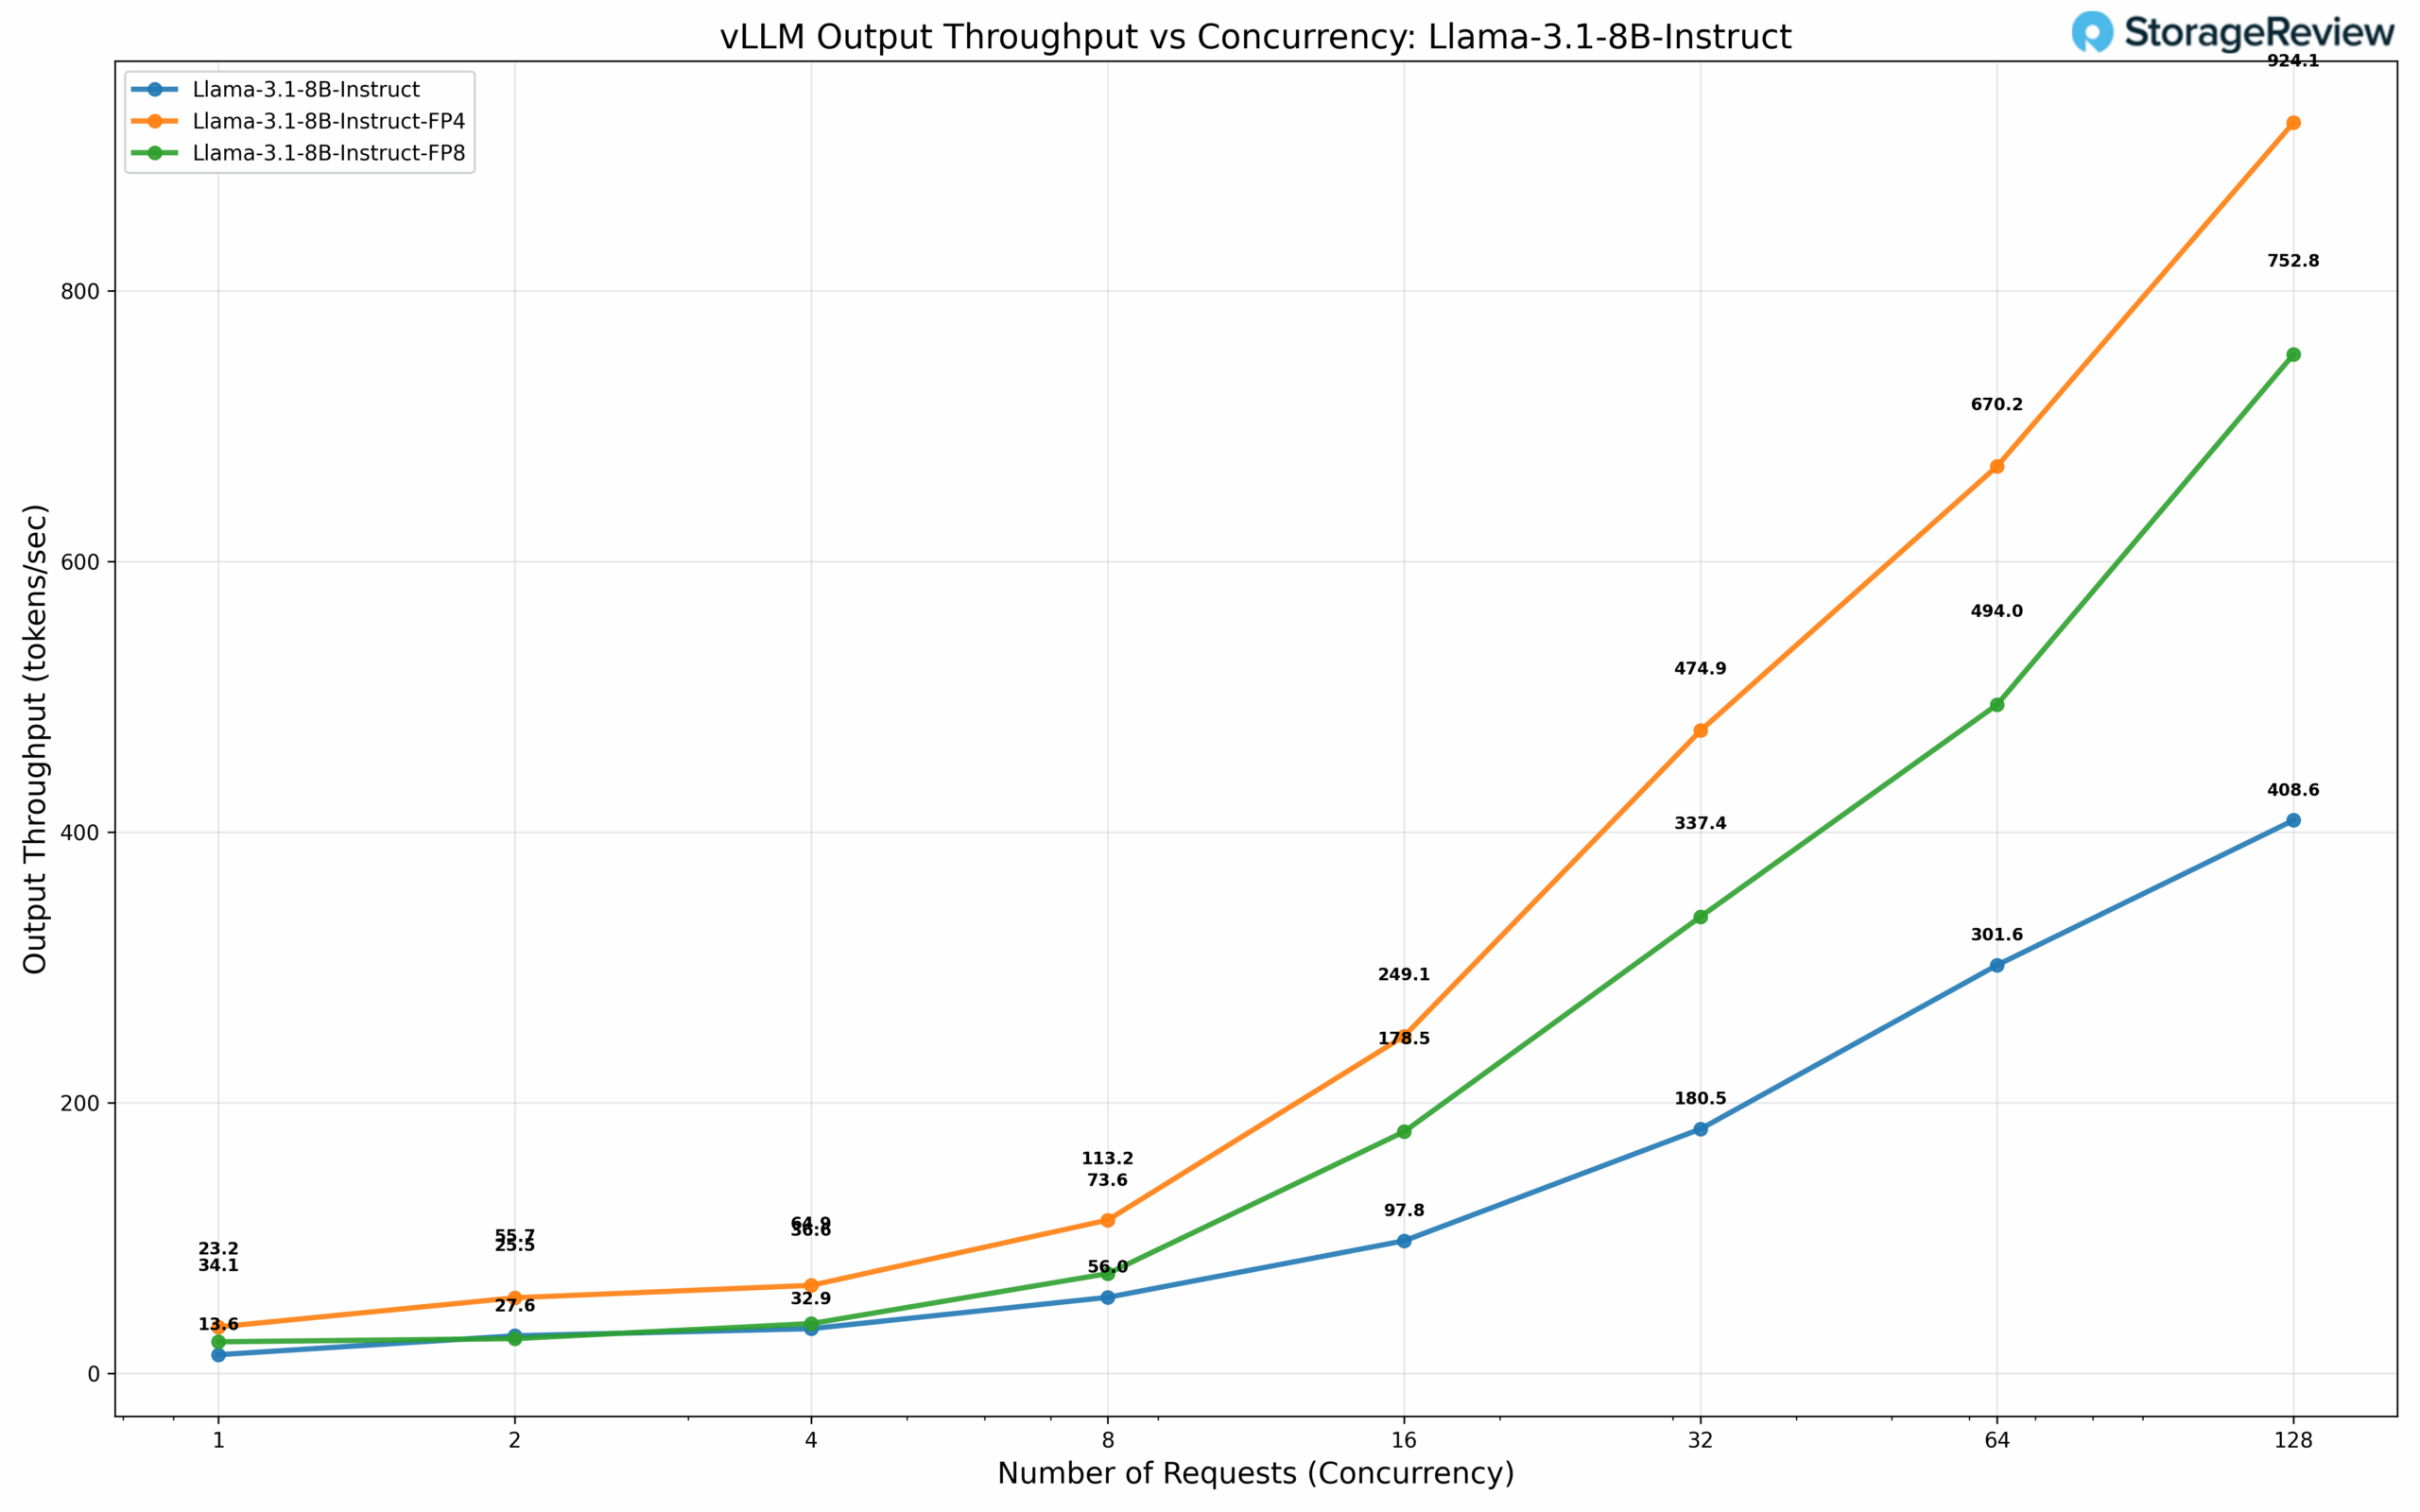
Llama 3.1 8B-arkitekturen uppvisar markant olika prestandaegenskaper mellan kvantiseringsstrategier. Vid BF16-precision levererar modellen 13.6 tok/s vid samtidighetsnivå 1, och utökas till 408.6 tok/s vid 128 samtidiga förfrågningar. Övergång till FP8-kvantisering ger 23.2 tok/s respektive 752.8 tok/s vid samtidighetsnivå 1 respektive 128 – vilket motsvarar en förbättring av dataflödet med 84 % i stor skala. FP4-konfigurationen ökar prestandan ytterligare och uppnår 34.1 tok/s respektive 924.1 tok/s vid samma samtidighetsnivåer, vilket visar att aggressiva kvantiseringsstrategier kan leverera 2.3x prestandavinster jämfört med baslinjeprecisionen samtidigt som acceptabel modellkvalitet bibehålls för många produktionsarbetsbelastningar.
Mikroskalningsdatatyp
Mikroskalning representerar en avancerad kvantiseringsmetod som tillämpar finkorniga skalningsfaktorer på små viktblock snarare än enhetlig kvantisering över stora parametergrupper. NVIDIAs NVFP4-format implementerar denna teknik genom en blockerad flyttalrepresentation där varje mikroskaleblock med 8–32 värden delar en gemensam exponent som skalningsfaktor. Denna granulära metod bevarar numerisk precision samtidigt som den uppnår 4-bitarsrepresentation, vilket bibehåller det dynamiska omfång som är avgörande för transformatorarkitekturer. Formatet integreras med NVIDIAs Tensor Core-arkitektur, vilket möjliggör effektiv blandad precisionsberäkning med dekompression under matrisoperationer.
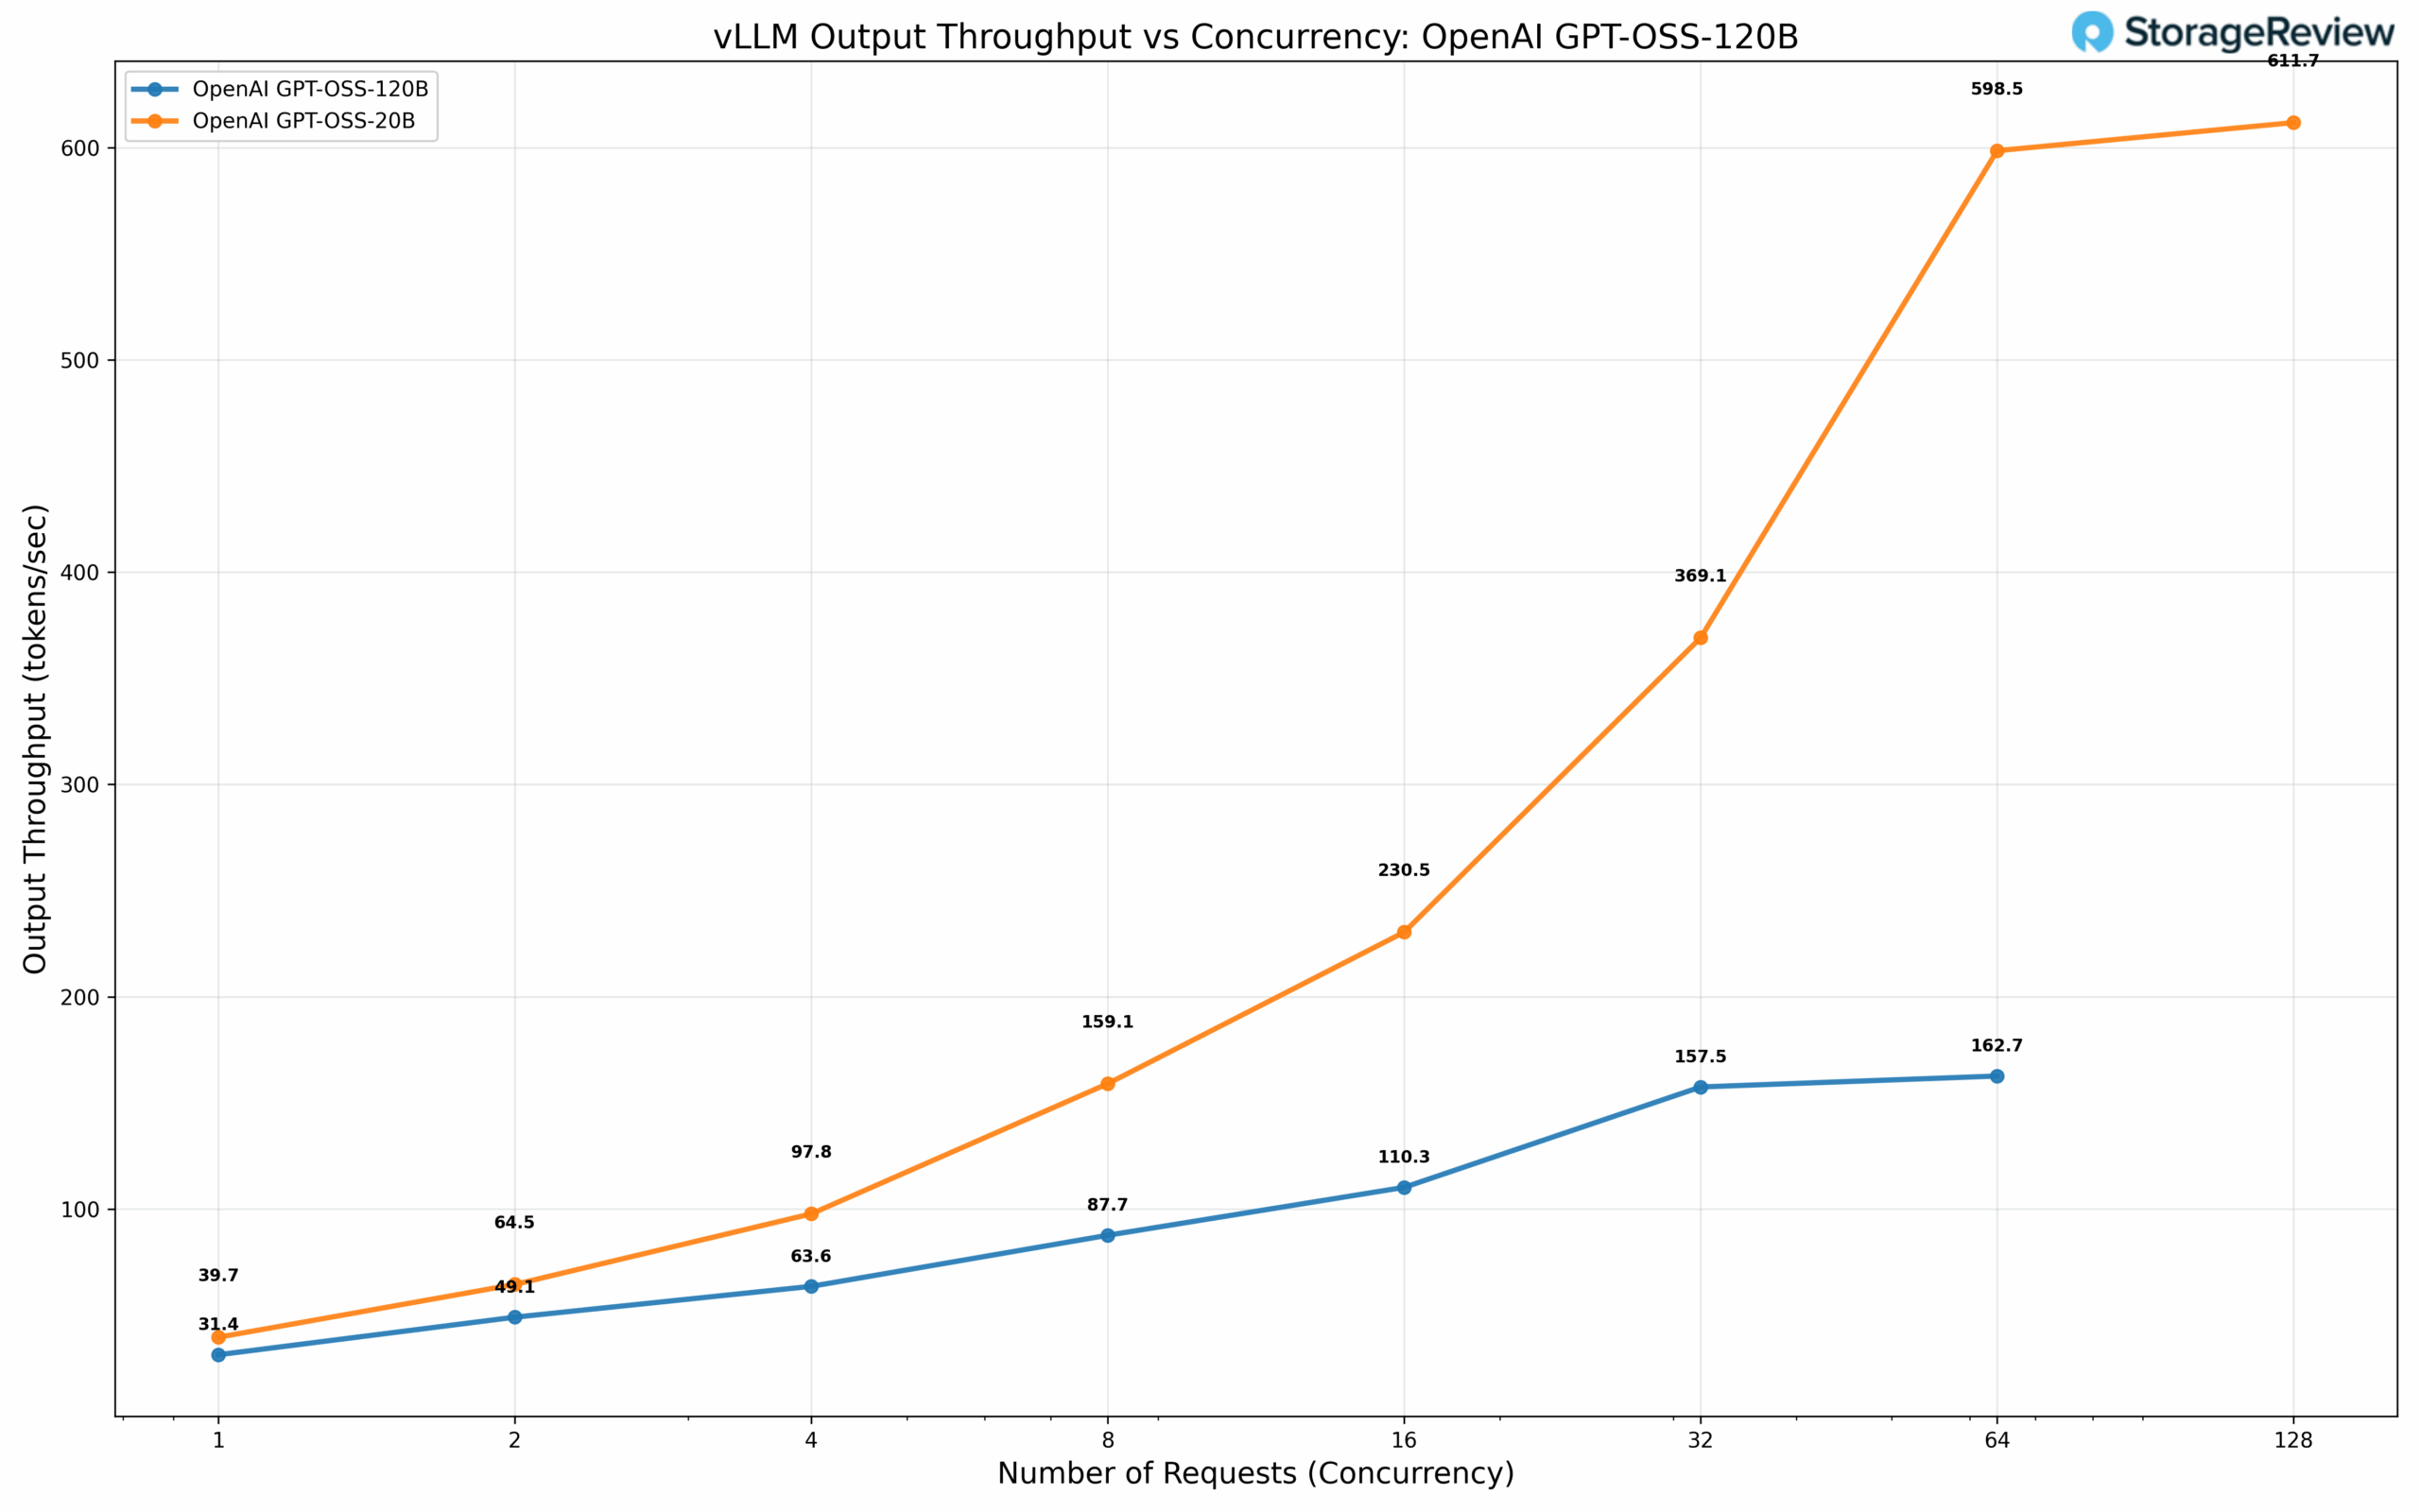
Vi utvärderade OpenAI:s GPT OSS-modeller vid parameterskalor på 20B och 120B med hjälp av NVFP4-kvantisering. 20B-parametermodellen uppnår 39.7 tok/s vid samtidighet 1, och skalar till 611.7 tok/s vid 128 samtidiga förfrågningar. Parametervarianten 120B levererar 31.4 tok/s vid samtidighet 1 och 162.7 tok/s vid 64 samtidiga förfrågningar.
Obs: Utdataflödet är dataflödet mellan förfrågningar och inte dataflödet per begäran.
På grund av begränsad tid kunde vi inte slutföra våra TensorRT-tester. Håll utkik efter uppföljningsartiklar med The Spark där vi kommer att utforska prestanda på fler inferensramverk.
Förfyll och avkoda tung inferens
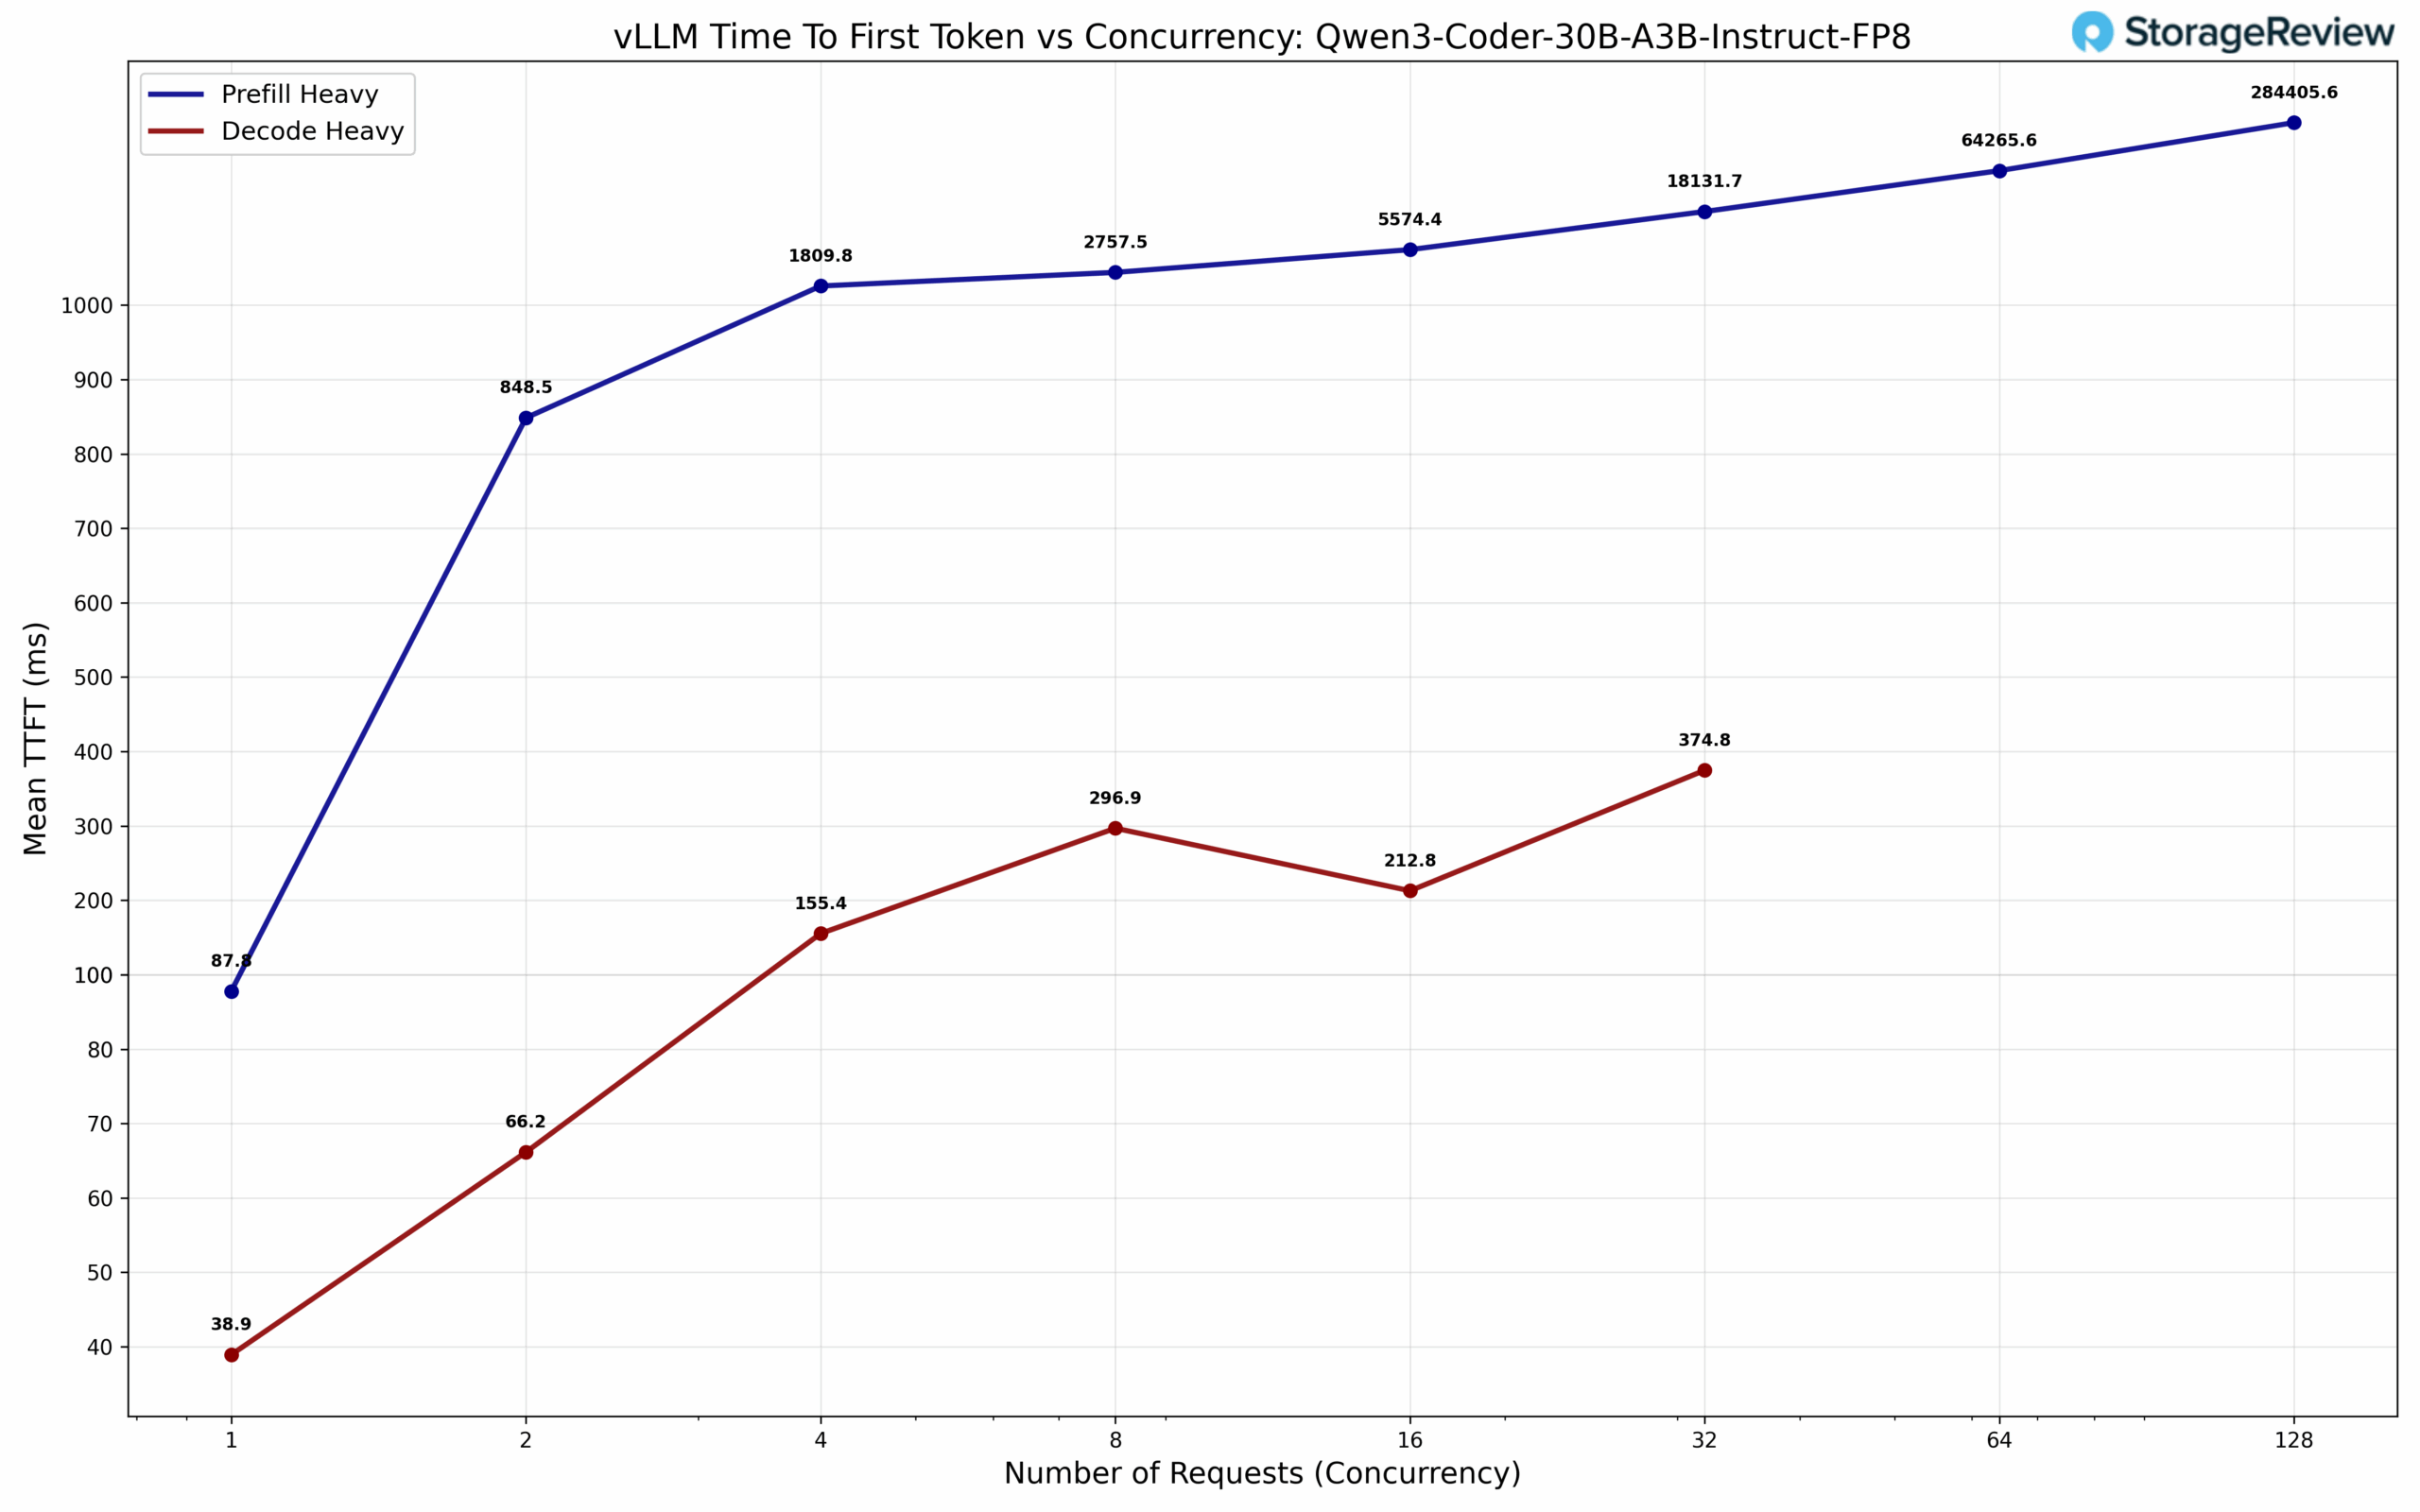
LLM-inferens kan fundamentalt delas upp i två distinkta beräkningsfaser, som var och en uppvisar markant olika prestandaegenskaper och resursutnyttjandemönster. Förfyllningsfasen bearbetar hela inmatningsprompten i en enda parallell operation och beräknar uppmärksamhetsmekanismer över alla inmatningstokens samtidigt – en beräkningsintensiv operation som helt mättar tensorkärnor och beräkningsenheter. Omvänt genererar avkodningsfasen utmatningstokens autoregressivt och producerar en token i taget genom sekventiella operationer som uppvisar lägre beräkningsintensitet men ställer betydande krav på minnesbandbredd eftersom modellen upprepade gånger måste komma åt vikter och den växande nyckel-värde-cachen. Detta skapar fundamentalt olika flaskhalsprofiler: förfyllningsoperationer är vanligtvis beräkningsbundna, medan avkodningsoperationer blir minnesbandbreddsintensiva, vilket gör dem särskilt känsliga för begränsningar i minnesundersystem.
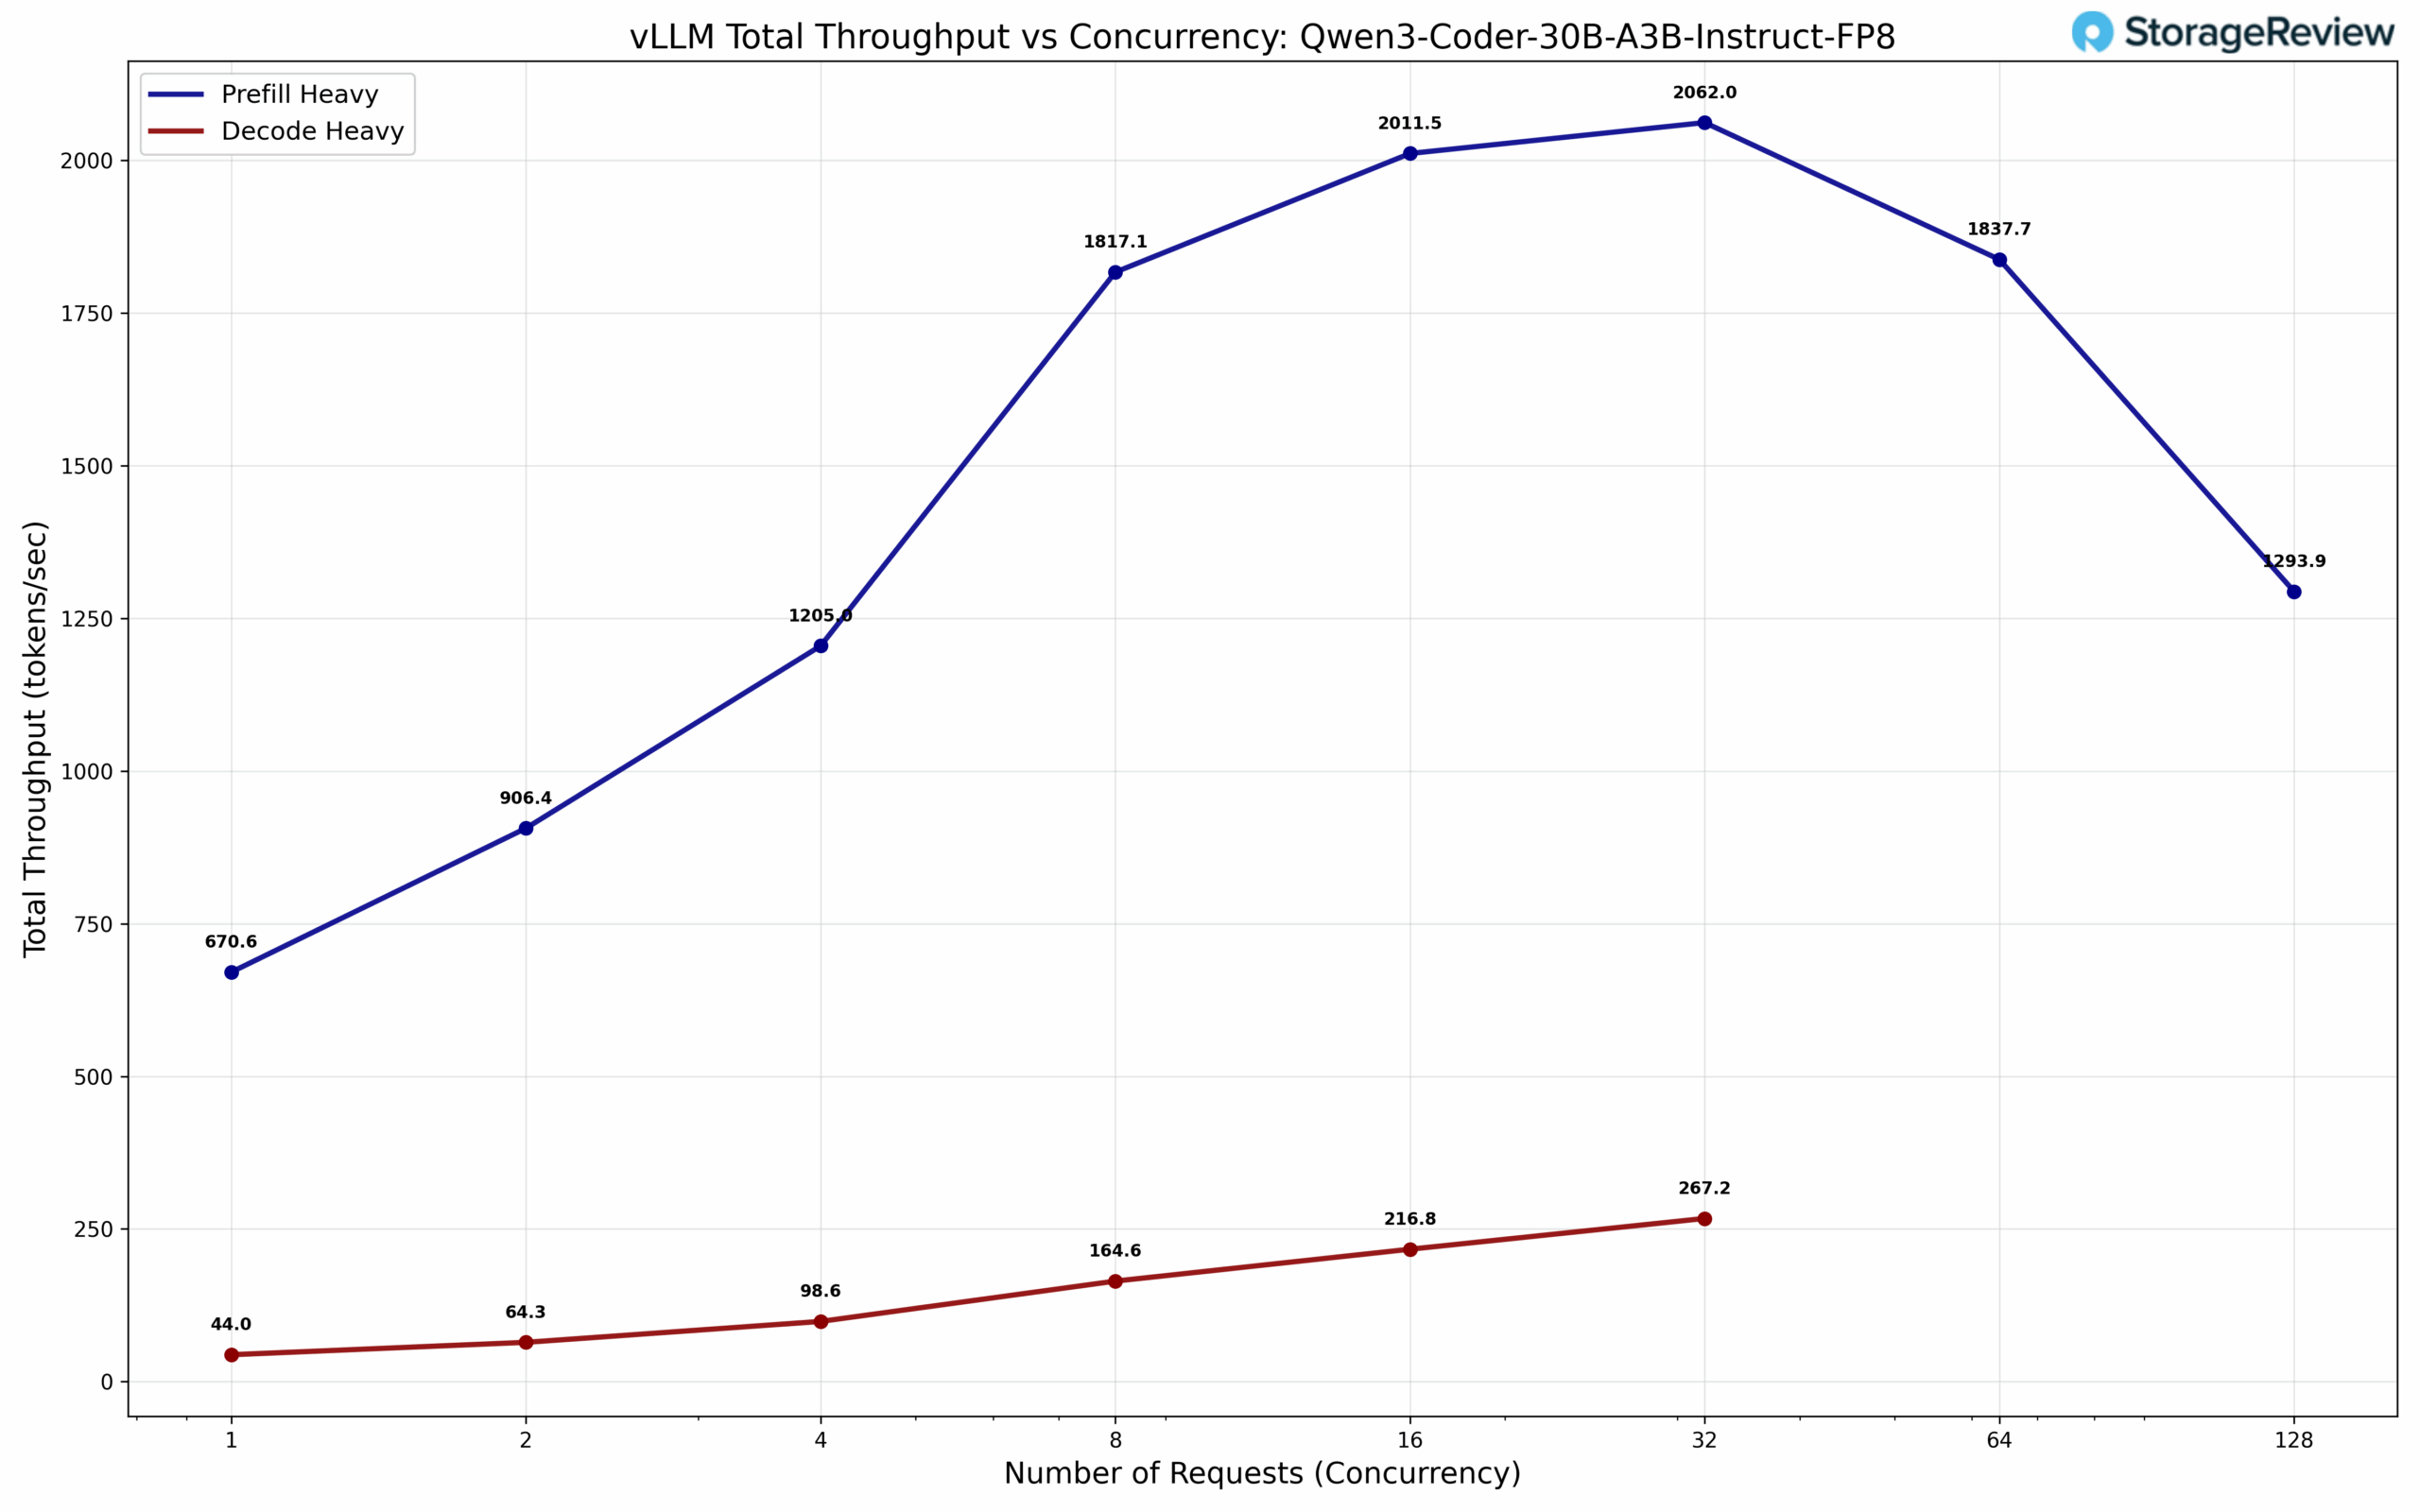
Vi genomförde omfattande tester över två distinkta arbetsbelastningsprofiler: avkodningsintensiv inferens med 512 inmatningstokens och 8 192 utmatningstokens, och förfyllningsintensiv inferens med 8 192 inmatningstokens och 512 utmatningstokens. Prestandakarakteriseringen avslöjar förväntade arkitektoniska avvägningar: Spark uppvisar konkurrenskraftig dataflöde på förfyllningsintensiva arbetsbelastningar där beräkningsresurser fortfarande är den primära flaskhalsen, men uppvisar minskad prestanda i avkodningsintensiva scenarier. Denna prestandaskillnad överensstämmer exakt med minnesbandbreddsbegränsningarna. Avkodningsoperationers sekventiella natur och intensiva minnesåtkomstmönster exponerar direkt de bandbreddsbegränsningar som är inneboende i Sparks arkitektur. Dessa resultat ger ett kritiskt sammanhang för att tolka MAMF-mätningarna i nästa avsnitt, eftersom båda benchmarksviterna konsekvent identifierar minnesbandbredd som den grundläggande prestandabegränsande faktorn i verkliga inferensdistributioner.
Maximalt uppnåeliga Matmul FLOPS (MAMF)
MAMF (Maximum Achievable Matmul FLOPS) är ett praktiskt prestandamått utformat för att mäta de realistiska toppflyttalsoperationerna per sekund som kan uppnås på maskininlärningsacceleratorer under matrismultiplikationsoperationer, vilket erbjuder ett mer exakt riktmärke än de teoretiska toppflyttalsoperationer som ofta annonseras i hårdvaruspecifikationer. Vi använder mamf-finder-riktmärket av Stas Beckman.
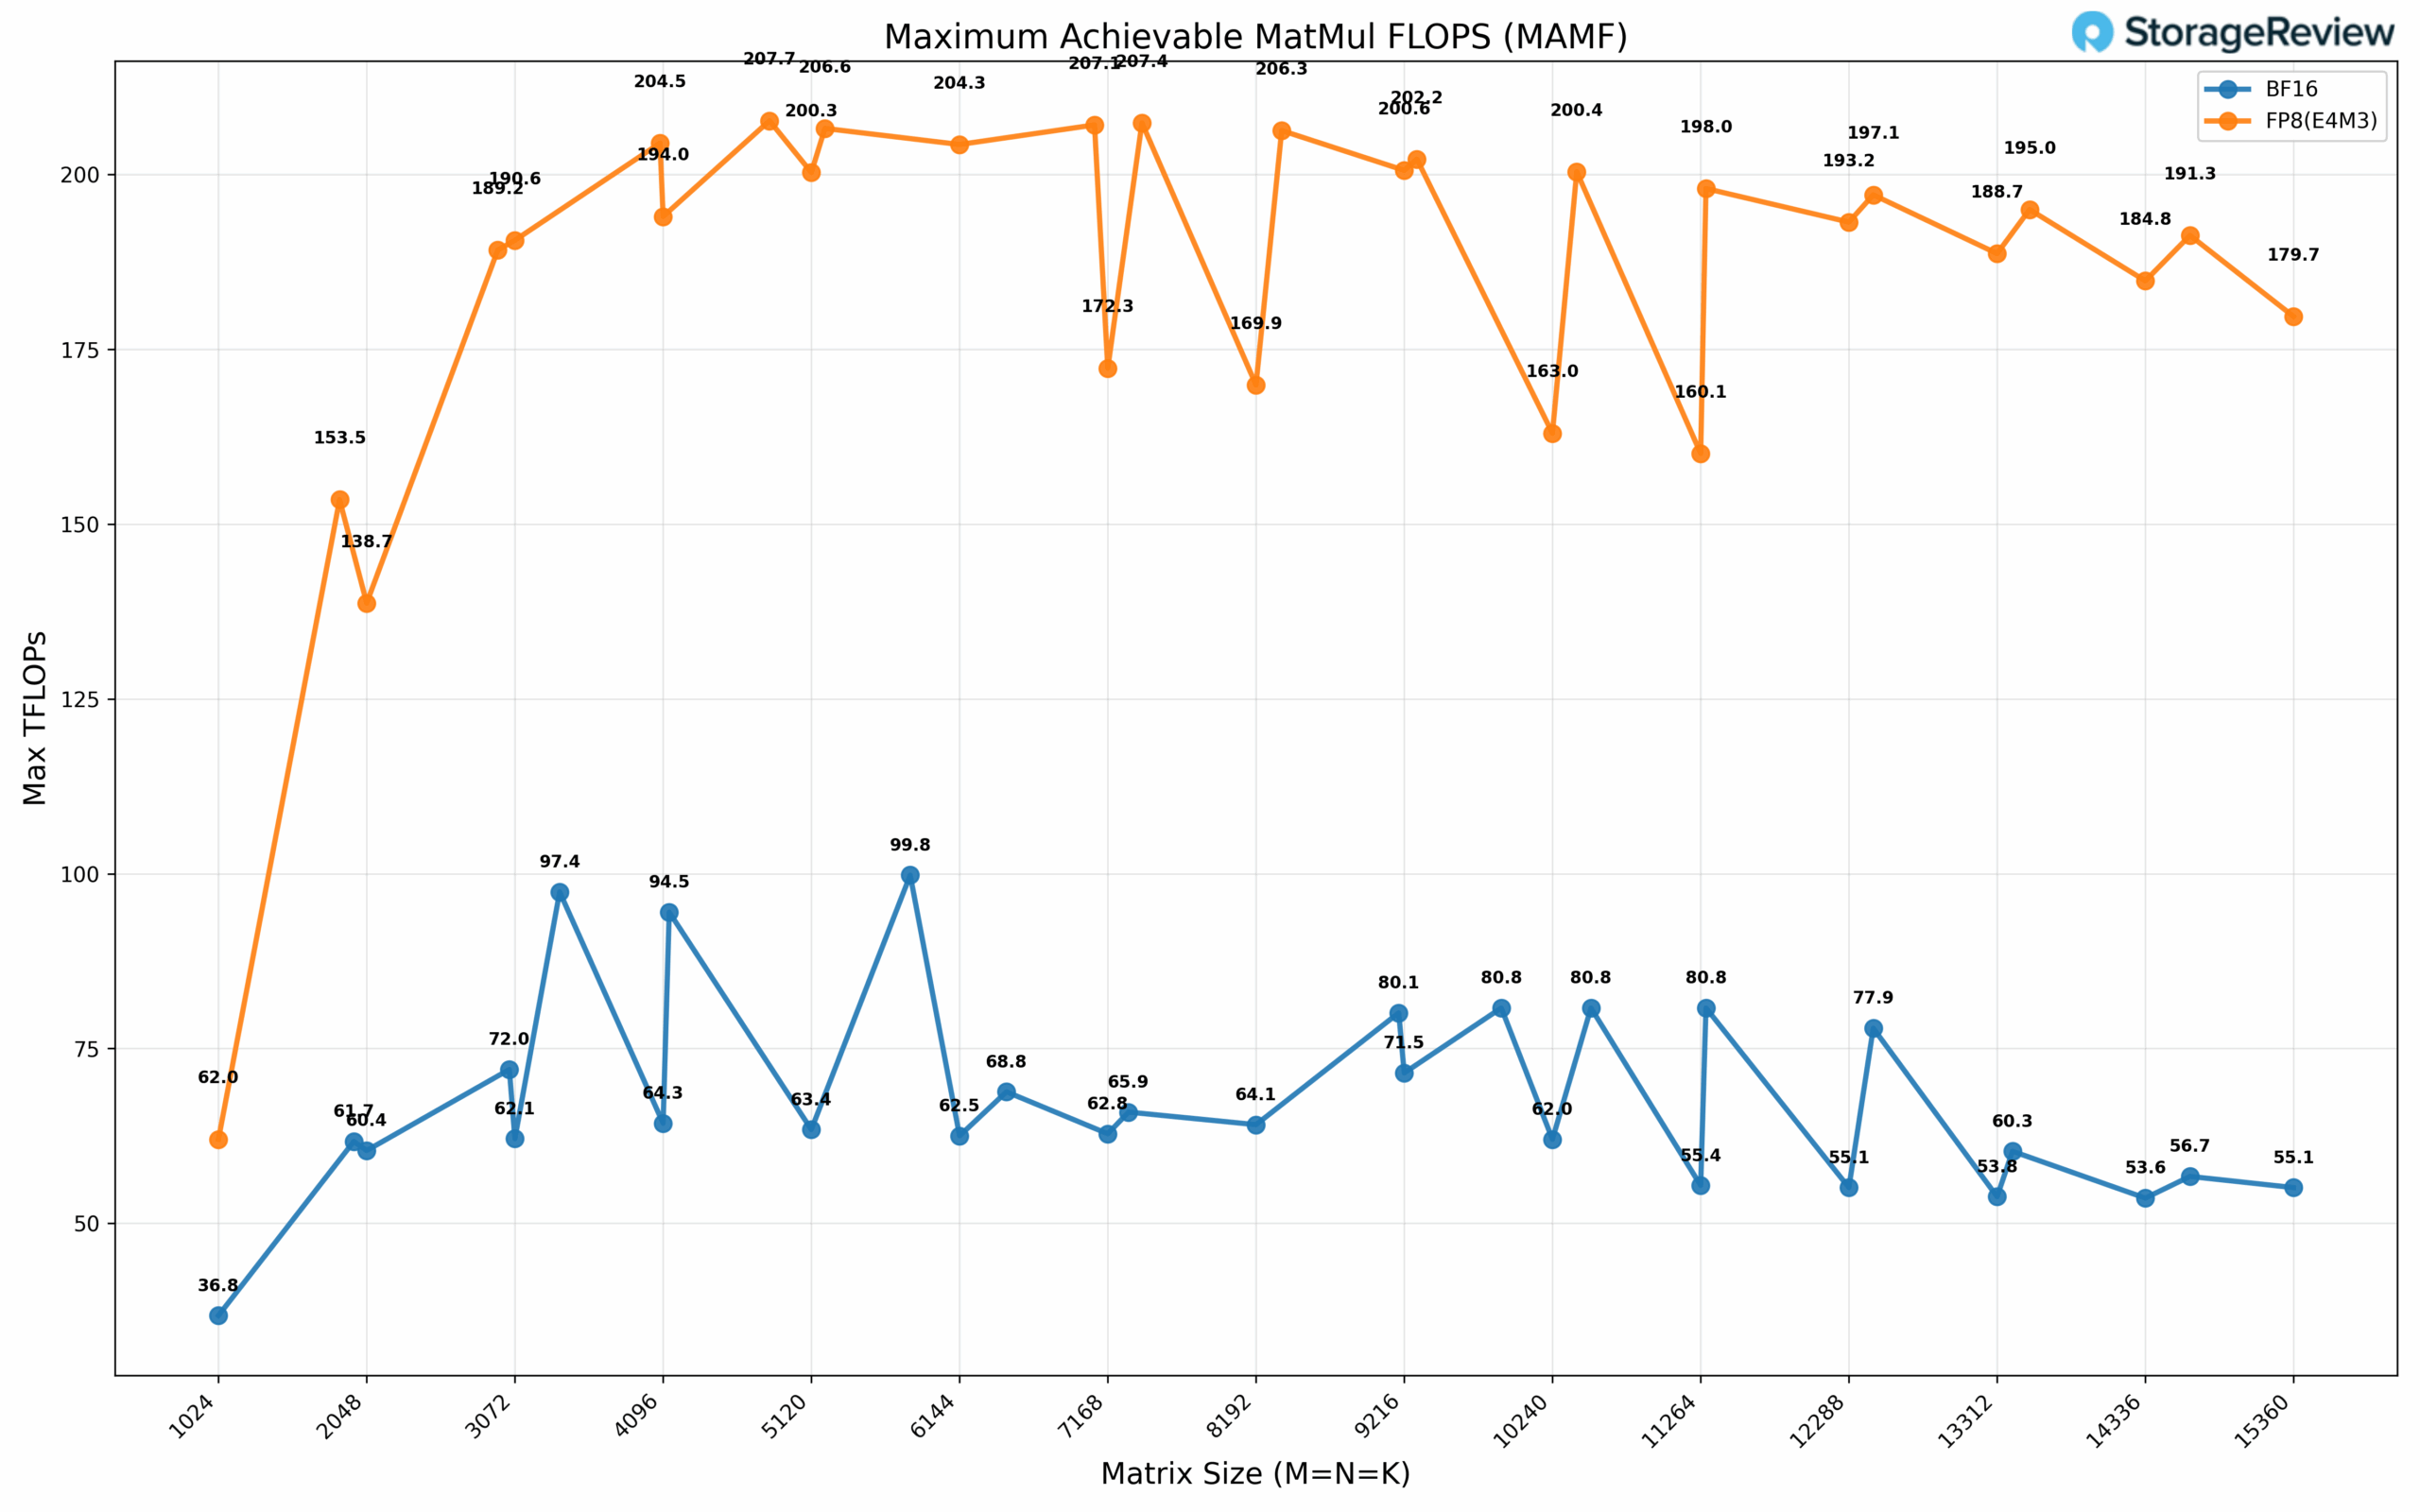
Vid BF16-precision observerar vi en MAMF på 99.8 TFLOP, medan FP8 (E4M3) uppvisar en MAMF på 207.7 TFLOP. På grund av tidsbegränsningar kunde vi inte genomföra en omfattande FP4 MAMF-karakterisering; men genom att extrapolera från observerade precisionsbaserade skalningsmönster förväntar vi oss en ytterligare 2× prestandavinst jämfört med FP8, vilket ger cirka 400 TFLOP för täta FP4-operationer. När man tar hänsyn till 2:1 strukturerad gleshetsoptimering motsvarar detta ungefär 80 % av den teoretiska FP4-prestandakapaciteten, vilket uppnår cirka 800 TFLOP under glesa beräkningsbelastningar. Det är viktigt att notera att dessa MAMF-mätningar kan falla under de teoretiskt annonserade specifikationerna av många anledningar som vi inte kommer att gå in på i denna recension.
GPU direkt lagring
Ett av testerna vi utförde på Spark var MagnumIO GPU Direct Storage (GDS)-testet. GDS är en funktion utvecklad av NVIDIA som gör det möjligt för GPU:er att kringgå processorn vid åtkomst till data lagrad på NVMe-enheter eller andra höghastighetslagringsenheter. Istället för att dirigera data genom processorn och systemminnet möjliggör GDS direkt kommunikation mellan GPU:n och lagringsenheten, vilket avsevärt minskar latensen och förbättrar dataflödet.
Hur GPU Direct Storage fungerar
Traditionellt, när en GPU bearbetar data lagrad på en NVMe-enhet, måste data först färdas genom CPU:n och systemminnet innan de når GPU:n. Denna process introducerar flaskhalsar, eftersom CPU:n blir en mellanhand, lägger till latens och förbrukar värdefulla systemresurser. GPU Direct Storage eliminerar denna ineffektivitet genom att göra det möjligt för GPU:n att komma åt data direkt från lagringsenheten via PCIe-bussen. Denna direkta väg minskar de omkostnader som är förknippade med datarörelser, vilket möjliggör snabbare och mer effektiva dataöverföringar.
AI-arbetsbelastningar, särskilt de som involverar djupinlärning, är mycket dataintensiva. Att träna stora neurala nätverk kräver bearbetning av terabyte med data, och varje fördröjning i dataöverföringen kan leda till underutnyttjade GPU:er och längre träningstider. GPU Direct Storage hanterar denna utmaning genom att säkerställa att data levereras till GPU:n så snabbt som möjligt, vilket minimerar vilotiden och maximerar beräkningseffektiviteten.
Dessutom är GDS särskilt fördelaktigt för arbetsbelastningar som involverar streaming av stora datamängder, såsom videobearbetning, naturlig språkbehandling eller realtidsinferens. Genom att minska beroendet av CPU:n påskyndar GDS datarörelsen och frigör CPU-resurser för andra uppgifter, vilket ytterligare förbättrar den övergripande systemets prestanda.
GDSIO – Intern 4 TB M.2
NVIDIA DGX Spark har ett intressant val för lagring. Av storleksskäl i det lilla chassit valde NVIDIA den mindre vanliga Gen5 2242 M.2 SSD:n. För läsare som inte är bekanta med den här typen av SSD är det en kortare 42 mm-version jämfört med 80 mm som är vanligare för stationära datorer. Det finns färre alternativ för hårddiskar, där 4 TB är den högsta kapaciteten i denna storlek. Det största problemet är dock prestanda. Små SSD-diskar, som 2242- och 2230-modellerna, prioriterar storlek, medan hårddiskhastigheter spelar en sekundär roll. De är vanliga i bärbara spelkonsoler, surfplattor och vissa bärbara datorer.
Det finns inte mycket utrymme på 2230- och 2242-SSD-kretskorten, vilket resulterar i mindre utrymme för styrenheter, DRAM-minne och NAND-kapslar. Vi observerade några av dessa avvägningar under våra tester. När vi använde vår GDSIO-arbetsbelastning i ett format på 1 TB eller 128 GB låste SSD:n sig och krävde en ny avbildning av Spark. Genom att sänka testformatet till 64 GB, samt att sänka det högre trådantalet, kringgick vi detta problem. Dessa problem uppstår vanligtvis inte med vanligare högpresterande 80 mm SSD-diskar.
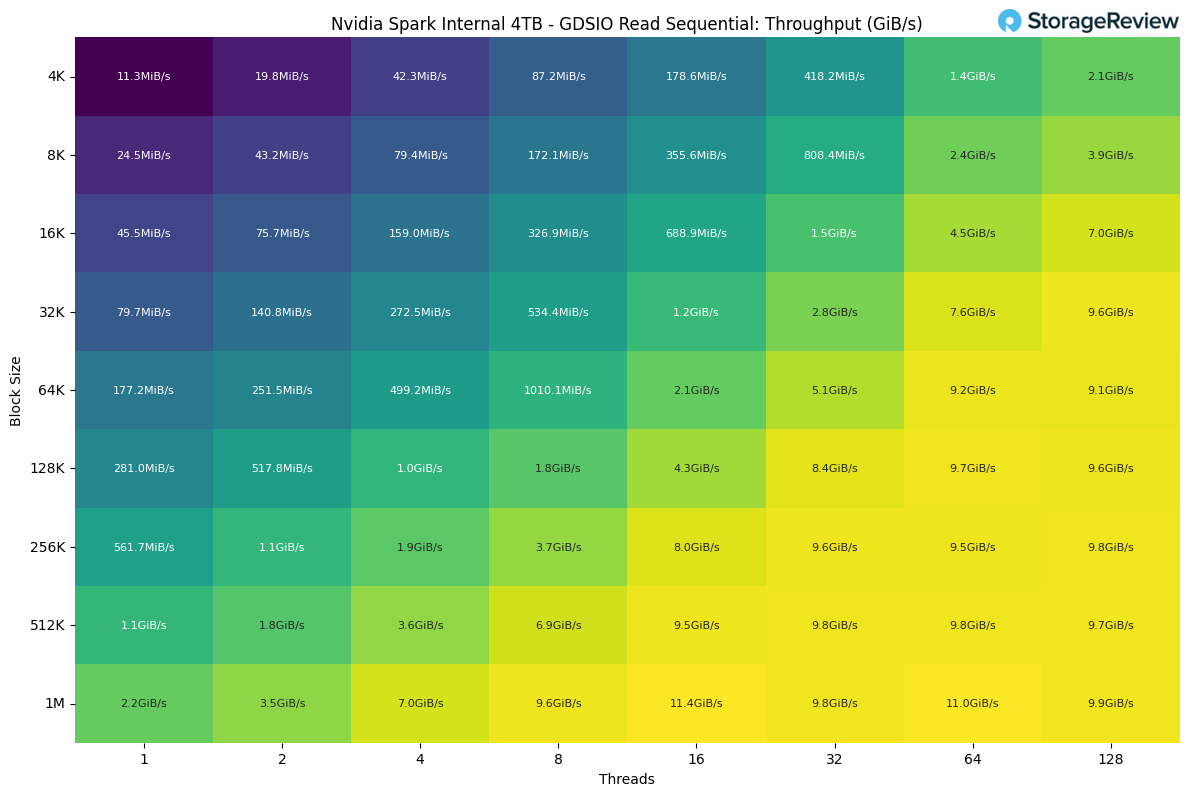
Om vi tittar på den interna hårddiskens prestanda för sekventiell läsning ser vi den högsta dataflödet vid 1M blockstorlek med 16 trådar, vilket uppnår 11.4 GiB/s.
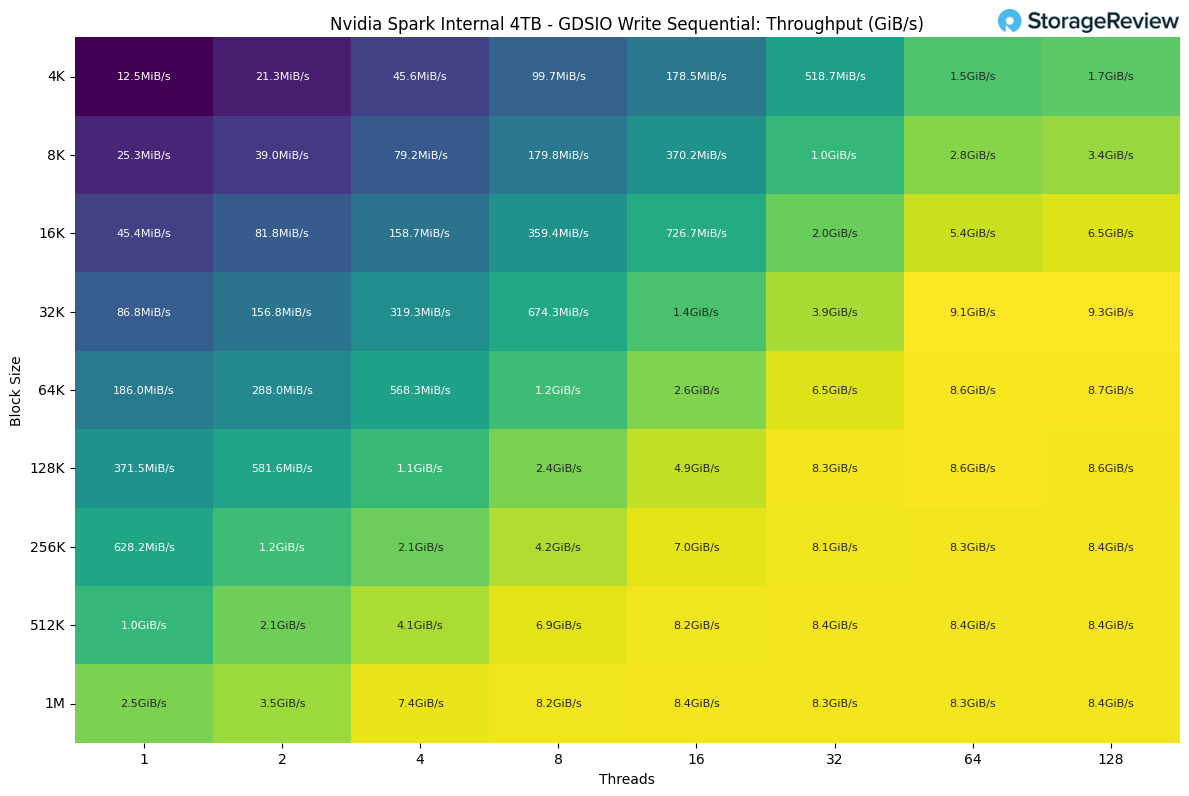
När man tittar på prestandan för sekventiell skrivning uppnår hårddisken den högsta dataöverföringen vid en blockstorlek på 32k med 128 trådar. Vid större blockstorlekar verkar prestandan plana ut, med ett genomsnitt på runt 8.3 GiB/s.
För köpare som vill köpa NVIDIA DGX Spark för tyngre utvecklingsarbete, särskilt företag som kan tänkas skapa små kluster av dem, rekommenderar vi starkt att utnyttja det inbyggda 200 GB NVIDIA ConnectX-7 NIC.
GDSIO – NVMe-oF över RDMA
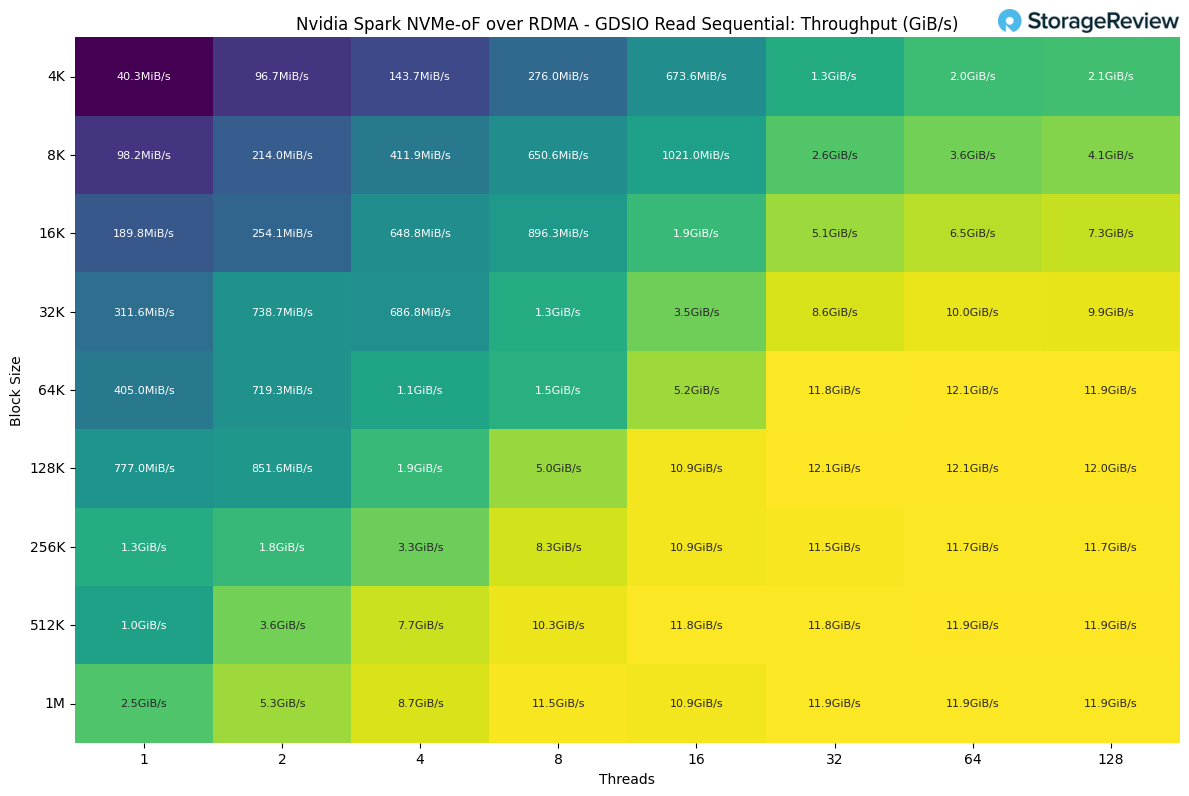
För NVMe-oF RDMA-testning med NVIDIA DGX Spark använde vi PEAK:AIO:s programvara för att skapa ett NVMe-oF-mål på en Dell PowerEdge R770 med sex Micron 9550 3.84 TB SSD-diskar och anslutna via RDMA. Som vi tidigare nämnt har Sparks CX7 NIC sina egenheter, och på grund av tidsbrist kunde vi bara testa Spark med 100G-anslutning. Både Spark och PEAK:AIO kan uppnå betydligt högre siffror. Vi kommer att utföra ytterligare lagrings- och nätverkstester med Spark i senare avsnitt.
Om vi tittar på den interna hårddiskens prestanda för sekventiell läsning ser vi den högsta dataflödet vid en blockstorlek på 128k med 32 trådar, vilket uppnår 12.1 GiB/s.
När man tittar på prestandan för sekventiell skrivning uppnår hårddisken den högsta dataöverföringen vid en blockstorlek på 128k med 16 trådar. Vid större blockstorlekar verkar prestandan plana ut, med ett genomsnitt på runt 11.3 GiB/s.
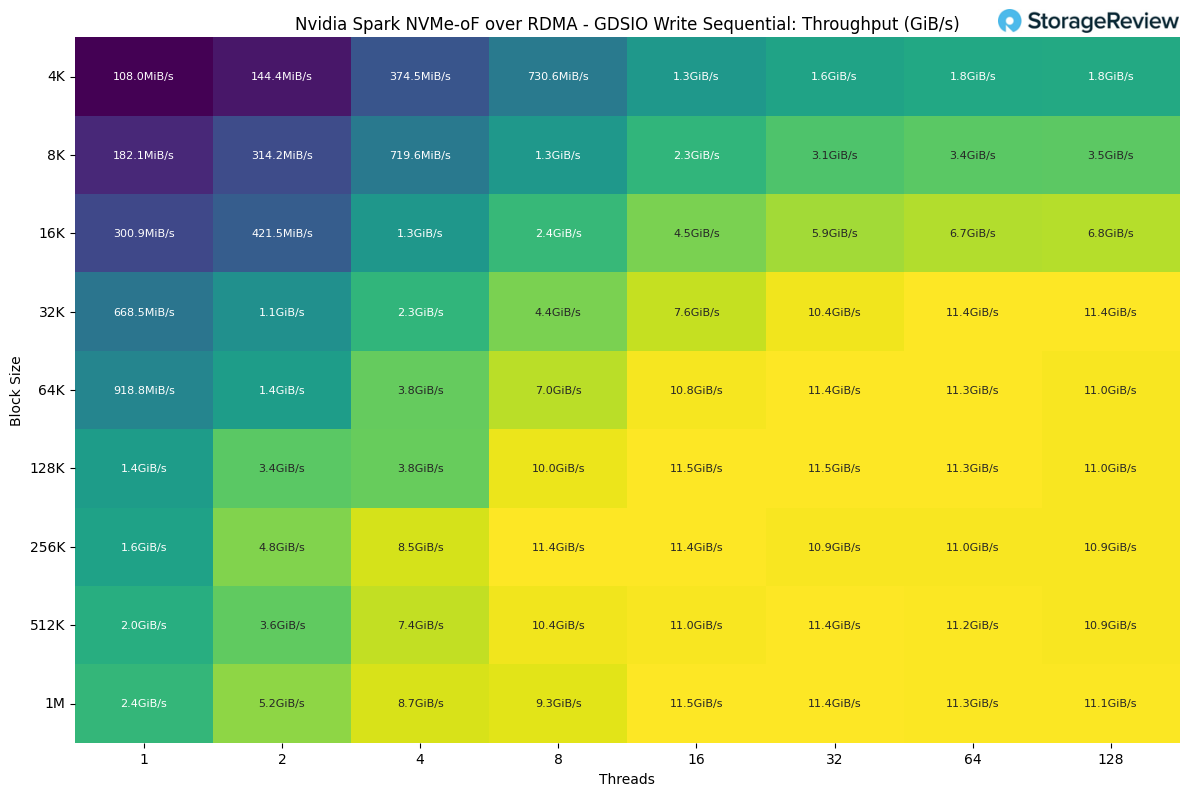
Det finns många nyanser i dessa resultat, vi ser bara hälften av det teoretiska maximumet på grund av tidigare nämnda tidsrelaterade och nätverksrelaterade skäl. Dessutom påverkas den högsta dataflödet vid 128k blockstorlek av flera faktorer som vilka företagshårddiskar vi använde eller hur PEAK:AIO hanterar denna IO. Din körsträcka kan variera och vi avser att göra mer genom att testa med Spark i framtiden.
Programvaruekosystem från dag ett
NVIDIA och andra leverantörer har investerat avsevärt i mjukvaruberedskap, vilket är en tydlig skillnad från typiska hårdvarulanseringar där tidiga användare navigerar ofullständig dokumentation och saknade verktyg. Spark lanseras med omfattande handböcker som täcker vanliga arbetsflöden: ComfyUI för diffusionsmodeller, TRT-LLM för optimerad inferens, Ollama med Open WebUI för lokal modellvisning, Unsloth för finjustering och multiagentarkitekturer med LangGraph.
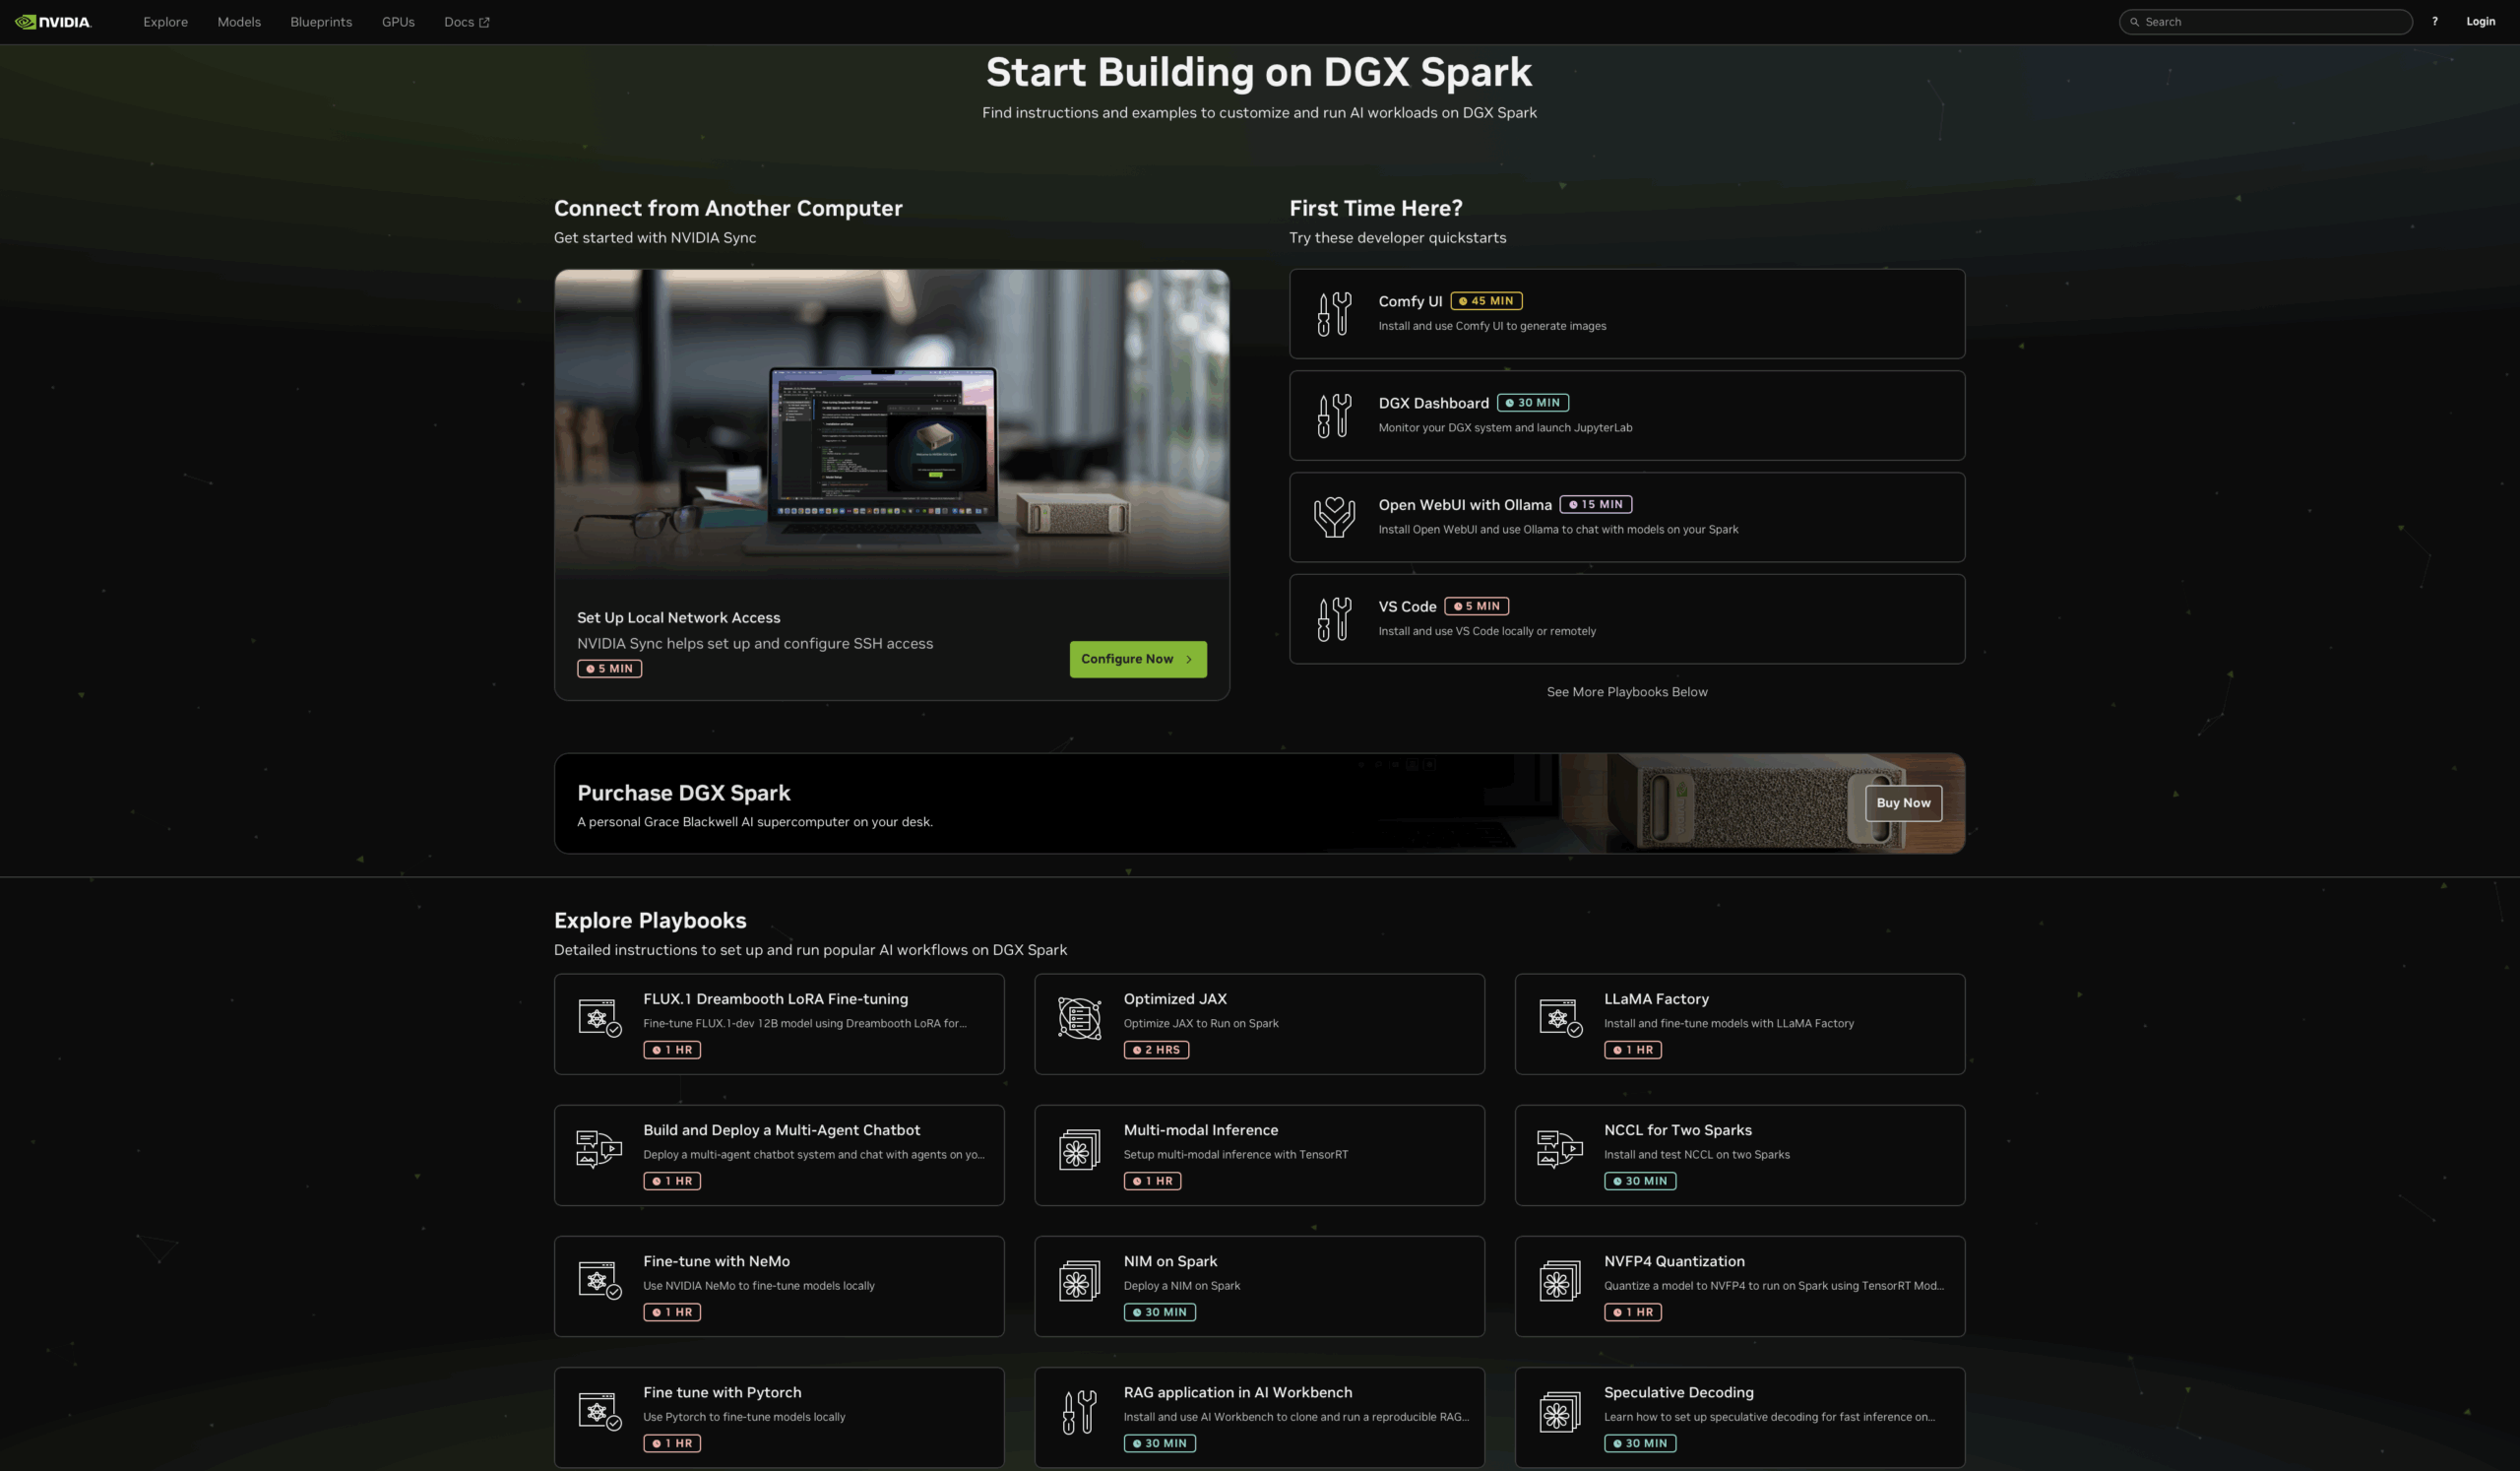
Denna mjukvarumognad förändrar utvärderingsupplevelsen. Istället för att lägga dagar på att konfigurera miljöer kan utvecklare omedelbart bedöma om Spark uppfyller deras krav genom att köra representativa arbetsbelastningar. Handböckerna tillhandahåller inte bara instruktioner utan även containerbaserade miljöer, exempeldataset och förväntade prestandamått.
Tillgänglighet och OEM-system
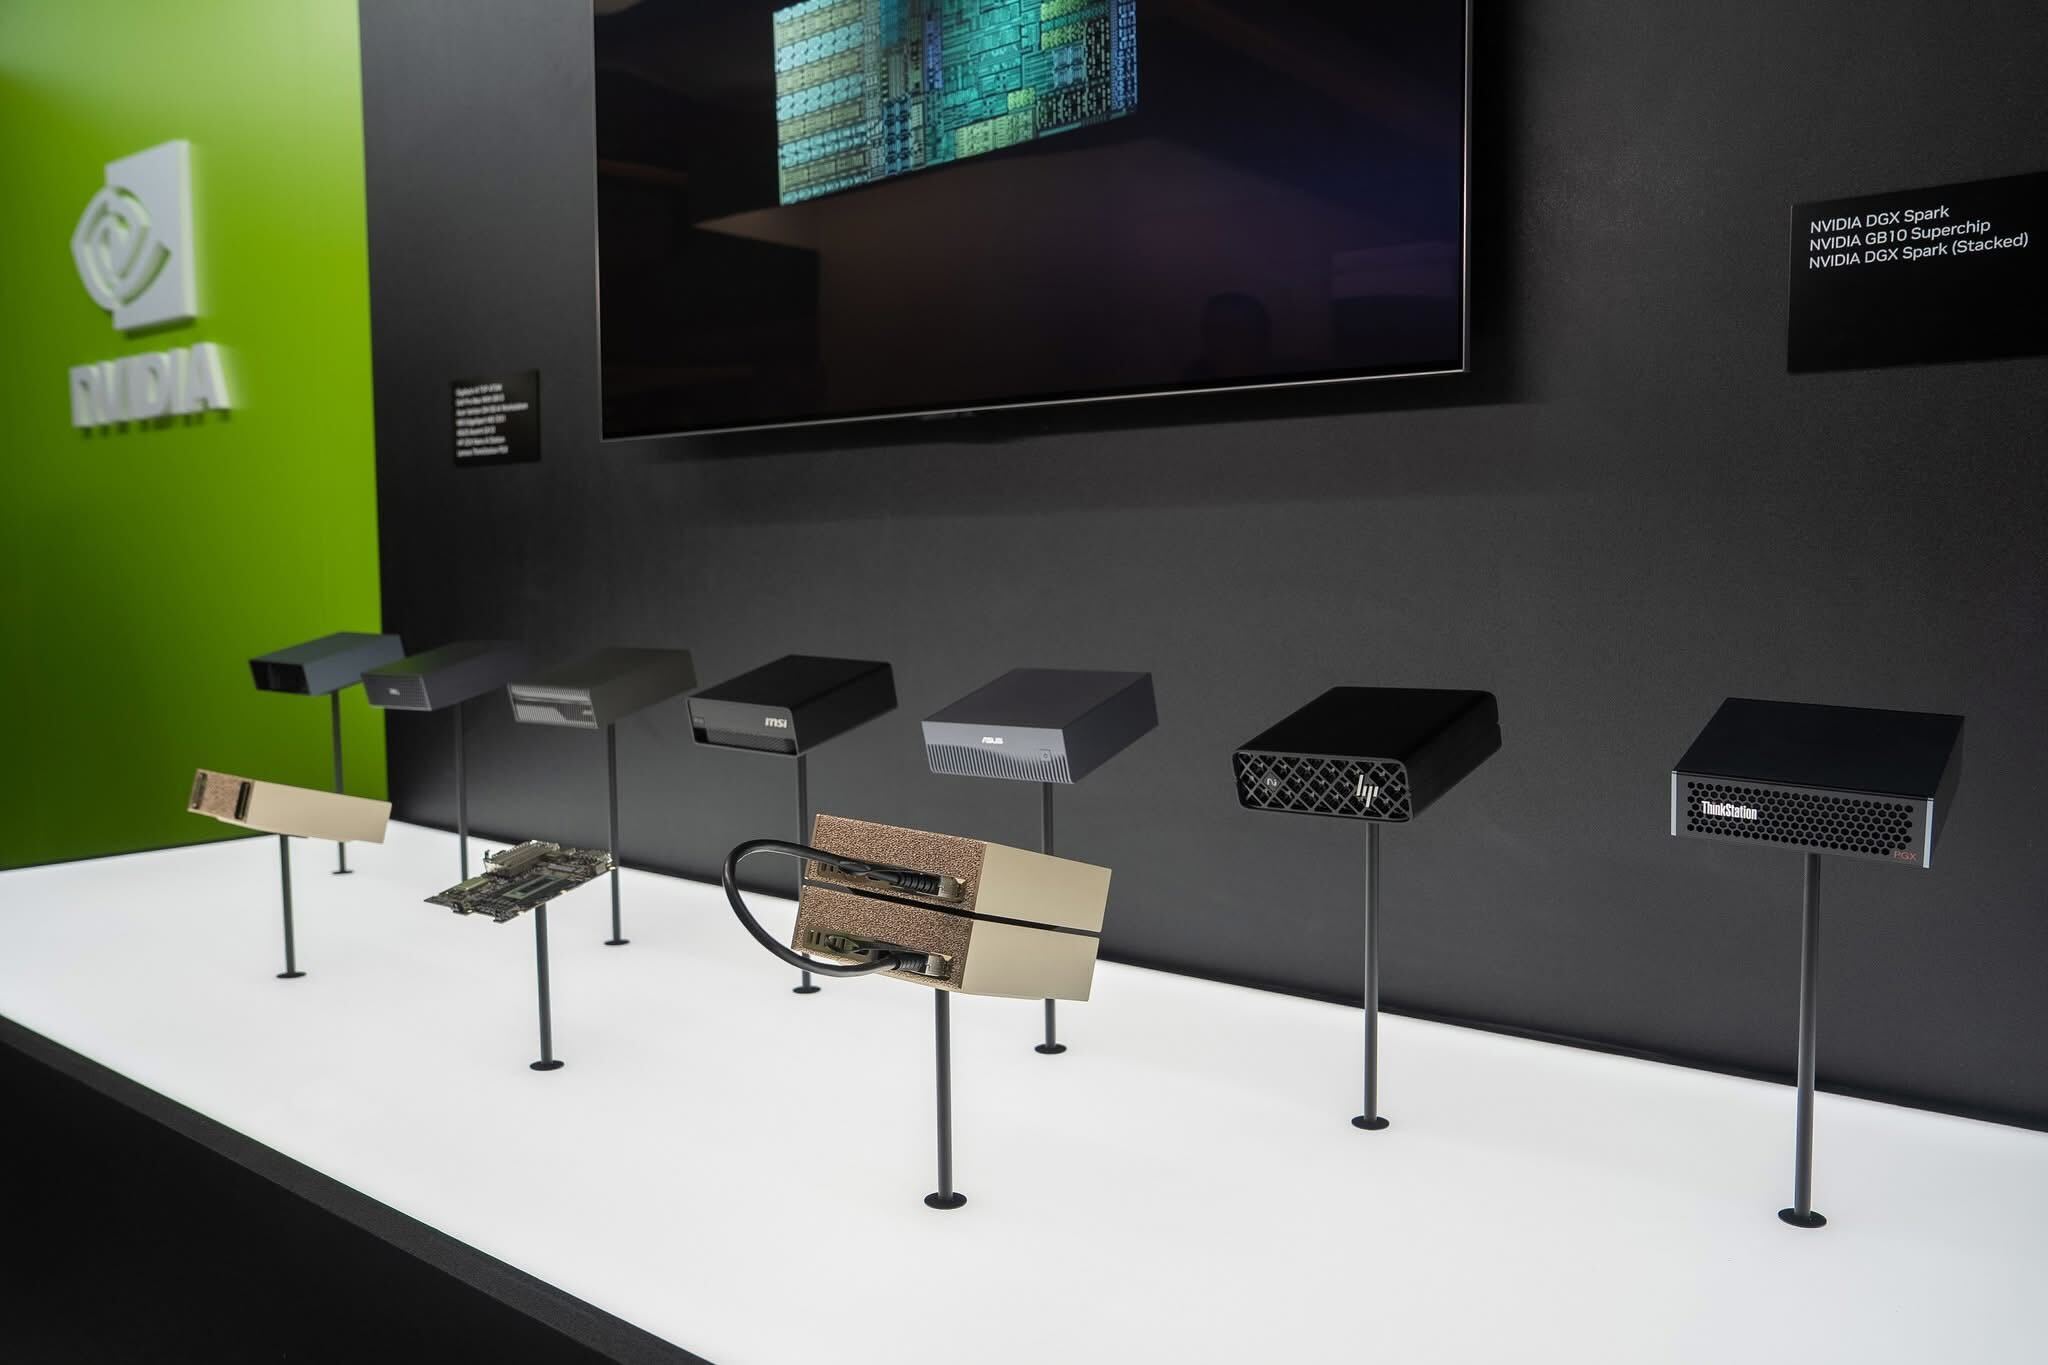
NVIDIAs Founders Edition finns att beställa för 3 999 dollar för 4TB-konfigurationen, och den allmänna tillgängligheten börjar den 15 oktober. Förutom NVIDIAs egen enhet kommer flera GB10-stationära datorer från de stora OEM-tillverkarna. Kärnhårdvaran kommer att vara ganska likartad hos alla OEM-tillverkare, men det kan finnas lite utrymme för dem att differentiera sig, även om det mesta av prisskillnaden sannolikt kommer att komma från lagringsvalet. Vi har redan sett många tillkännagivanden, inklusive Dell Pro Max med GB10, Lenovo ThinkStation PGX, Acer Veriton GN100 och ASUS Ascent GX10.
Källa: Nvidia
Slutsats
NVIDIA DGX Spark representerar en grundläggande vändpunkt i tillgänglighetsparadigmet för avancerad AI-beräkningsinfrastruktur. Genom att konsolidera GB10 Grace Blackwell Superchips kapacitet: 128 GB enhetligt minne, 1 petaFLOP sparse FP4-prestanda, fjärde generationens RT-kärnor och ConnectX-7-nätverk i en 240W, 1.13-liters apparat till ett pris av 3 999 dollar, har NVIDIA effektivt rivit de barriärer som historiskt sett separerade AI-kapacitet i datacenterklass från enskilda forskare och små utvecklingsteam.
Den validerade apparatmetoden adresserar en ihållande friktionspunkt i implementeringen av AI-infrastruktur: den operativa omkostnaden för att underhålla anpassade konfigurationer. Organisationer som driftsätter Spark-enheter drar nytta av NVIDIAs omfattande testning och validering av hela stacken, inklusive DGX OS, CUDA-verktygssats, ramverksbehållare och hårdvarufirmware, vilket eliminerar den konfigurationsskuld som plågar anpassade arbetsstationsbyggen. DGX Dashboards integrerade uppdateringshantering, systemövervakning och JupyterLab-provisionering minskar ytterligare den operativa bördan, medan NVIDIA Syncs automatiska SSH-nyckeldistribution och tunnelhantering gör fjärråtkomst verkligt friktionsfri. För skalande organisationer innebär detta mätbart snabbare onboarding: nya forskare får standardiserad hårdvara, ansluter till befintlig infrastruktur via den validerade tvånodsklusterkonfigurationen och börjar produktivt arbete inom några timmar snarare än dagar efter felsökning av drivrutinskonflikter eller nätverksstrukturkonfiguration.
DGX Spark levererar redan verklig AI-kraft i en kompakt och tyst apparat, och våra tidiga resultat visar varför det är viktigt för team som vill ha seriös kapacitet utan datacenteroverhead. Historien har bara börjat. Vi planerar att utöka våra tester med 200G-strukturen, NVMe-oF-mål och klustring med flera noder för att utforska skalningseffektivitet, större modellytor och arkitekturer för delad lagring. I takt med att mjukvaran och partnerekosystemet mognar förväntar vi oss att Spark-distributioner kommer att utvecklas från kraftfulla konfigurationer med en enda nod till tätt integrerade minikluster med hög genomströmning som ytterligare förbättrar denna plattform.
Topplista: NVIDIA DGX Spark innehar platsen för bästa stationära AI-system totalt sett på vår topplista över bästa stationära datorer för lokal AI .
Topplista: Storleksguide för den här systemklassen finns i vår guide om RAM, GPU och lagring för Agentic AI .


 Amazon