

L40S fyller en kritisk lucka i datacenters GPU-ekosystem. Medan beräkningsfokuserade AI-tränings-GPU:er som Nvidia H100 prioriterar rå prestanda men utelämnar grafikacceleration helt, saknar traditionella professionella visualiseringskort vanligtvis de AI-beräkningsfunktioner som krävs av moderna inferensarbetsbelastningar och framväxande AI-drivna grafikapplikationer. Denna positionering gör den särskilt värdefull för generering av syntetisk data, multimodal AI-utveckling och Omniverse-applikationer där både beräknings- och grafikprestanda är avgörande.
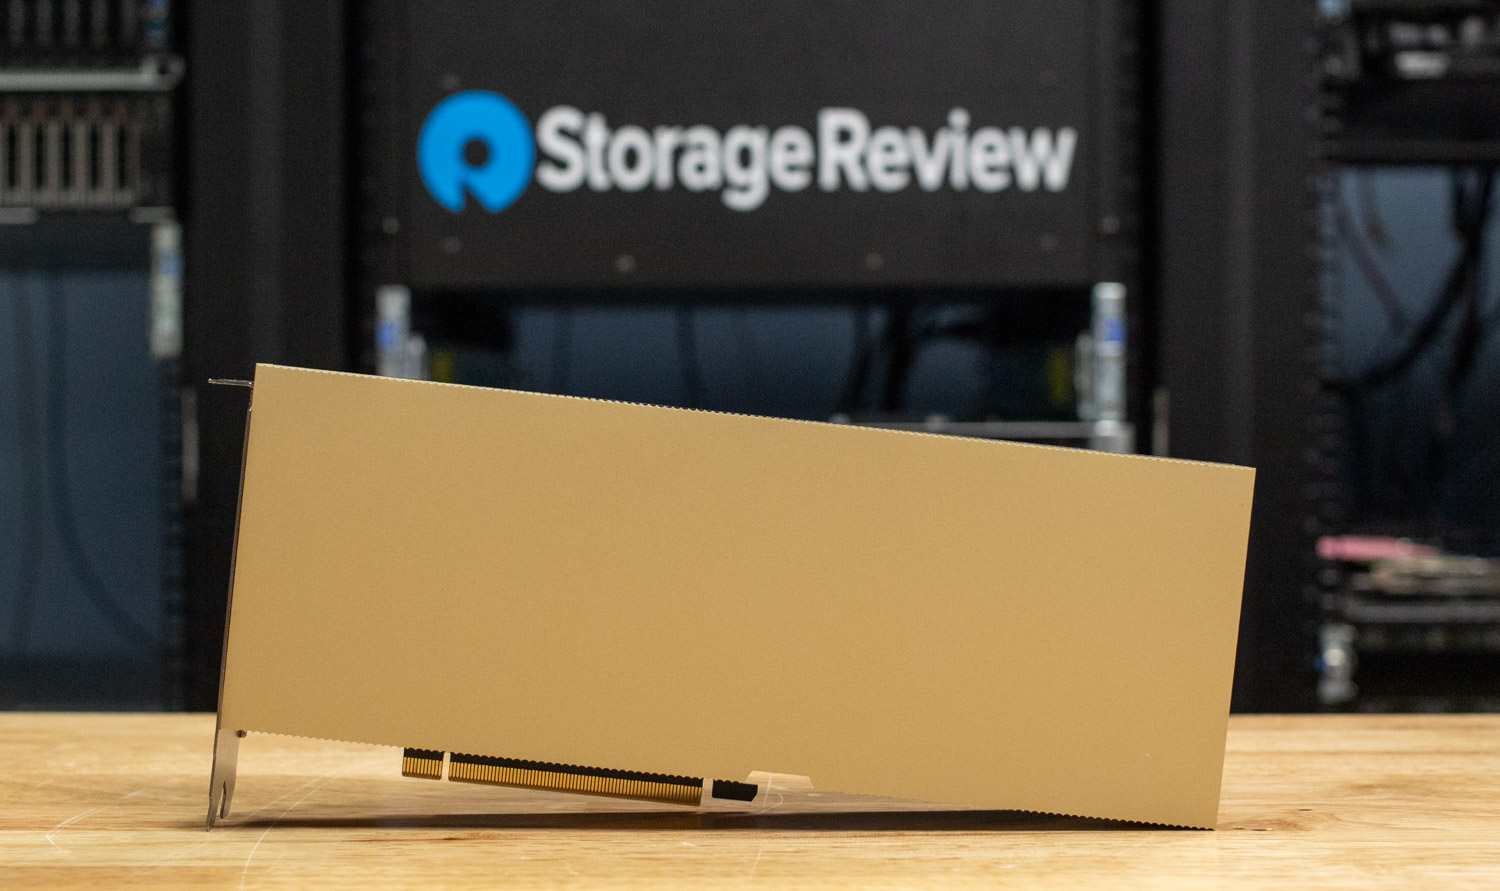
NVIDIA L40S-specifikationer
| Specifikation | L40 | L40S | H100 80G PCIe |
| GPU Arkitektur | Ada Lovelace | Ada Lovelace | Ficka |
| GPU-chip | AD102 | AD102 | GH100 |
| CUDA Cores | 18,176 | 18,176 | 14,592 |
| Tensorkärnor | 568 (4:e generationen) | 568 (4:e generationen) | 456 |
| RT Cores | 142 (3:e generationen) | 142 (3:e generationen) | - |
| GPU-minne | 48GB GDDR6 med ECC | 48GB GDDR6 med ECC | 80 GB HBM2e |
| minnesbandbredd | 864 GB / s | 864 GB / s | 2 TB / s |
| Minnesgränssnitt | 384-bitars | 384-bitars | 5120-bitars |
| Max Strömförbrukning | 300W | 350W | 350W |
| Formfaktor | 4.4 cm H x 10.5 cm L: Dubbelt hål | 4.4 cm H x 10.5 cm L: Dubbelt hål | 4.4 cm H x 10.5 cm L: Dubbelt hål |
| Termisk lösning | Passiv | Passiv | Passiv |
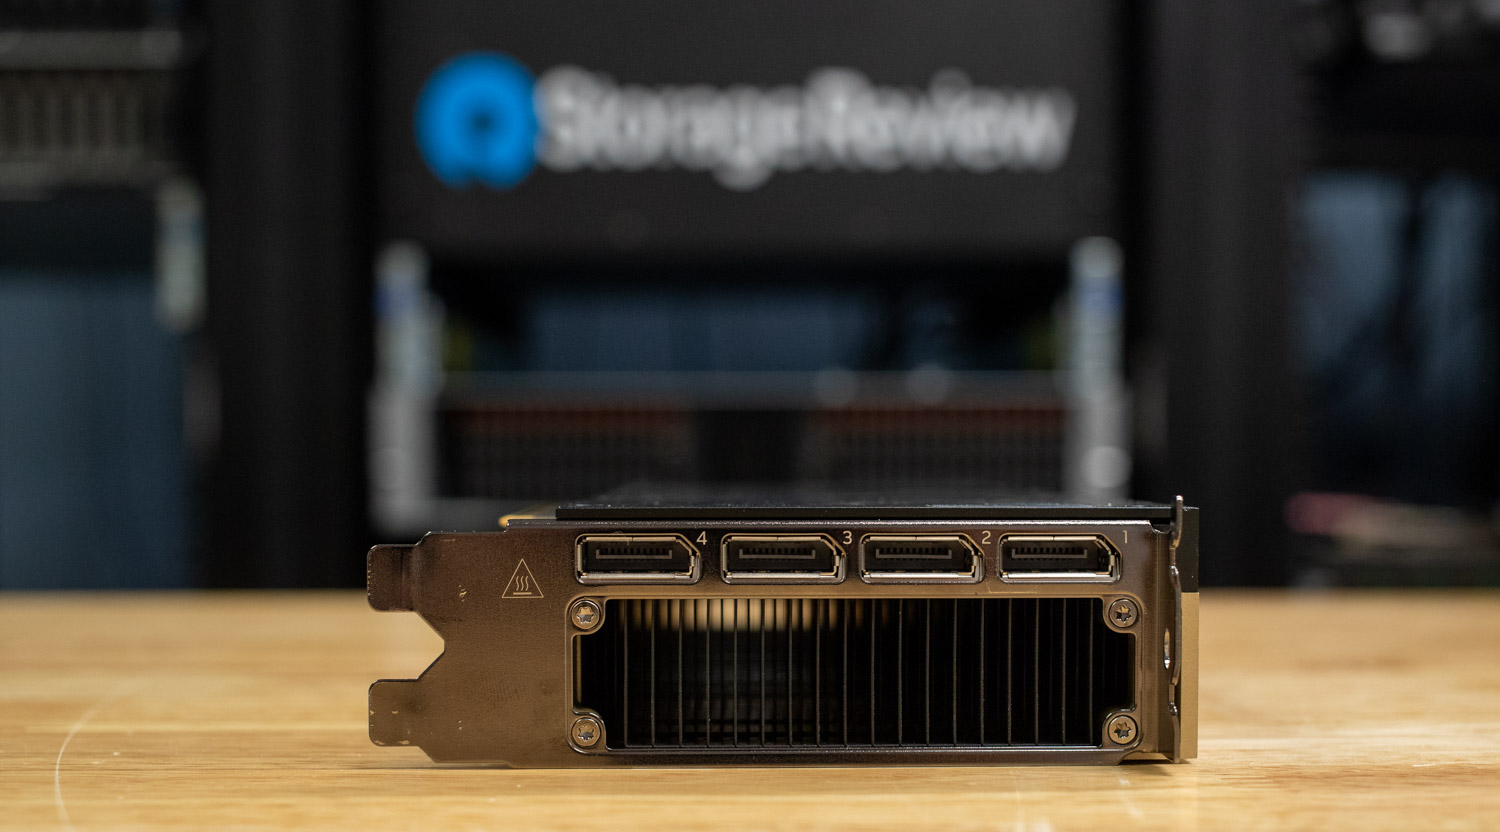
| Skärmanslutningar | 4x DisplayPort 1.4a | 4x DisplayPort 1.4a | - |
| PCIe-gränssnitt | Gen4 x16 | Gen4 x16 | Gen5 x16 |
| Strömkontakt | 16-pin | 16-pin | 16-pin |
| vGPU-stöd | Ja | Ja | Nej |
| Multi-instans GPU (MiG) | Nej | Nej | Ja |
| NVLink-support | Nej | Nej | Nej |
Prestandaspecifikationer
| metrisk | L40-prestanda | L40S-prestanda | H100-prestanda |
| FP32-prestanda | 90.5 TFLOPS | 91.6 TFLOPS | 51.2 TFLOPS |
| TF32 Tensor Core | 362.1 TFLOPS | 366 TFLOPS | 756 TFLOPS |
| FP16 Tensor Core | 724 TFLOPS | 733 TFLOPS | 1513 TFLOPS |
| FP8 Tensor Core | 1,448 TFLOPS | 1,466 TFLOPS | 3026 TFLOPS |
| Peak INT8 Tensor TOPS | 1,448 TFLOPS | 1,466 TFLOPS | 3026 TOPS |
| RT Core Performance | 209 TFLOPS | 212 TFLOPS | - |
(Prestandasiffrorna är med gleshet)
NVIDIA L40S jämfört med H100
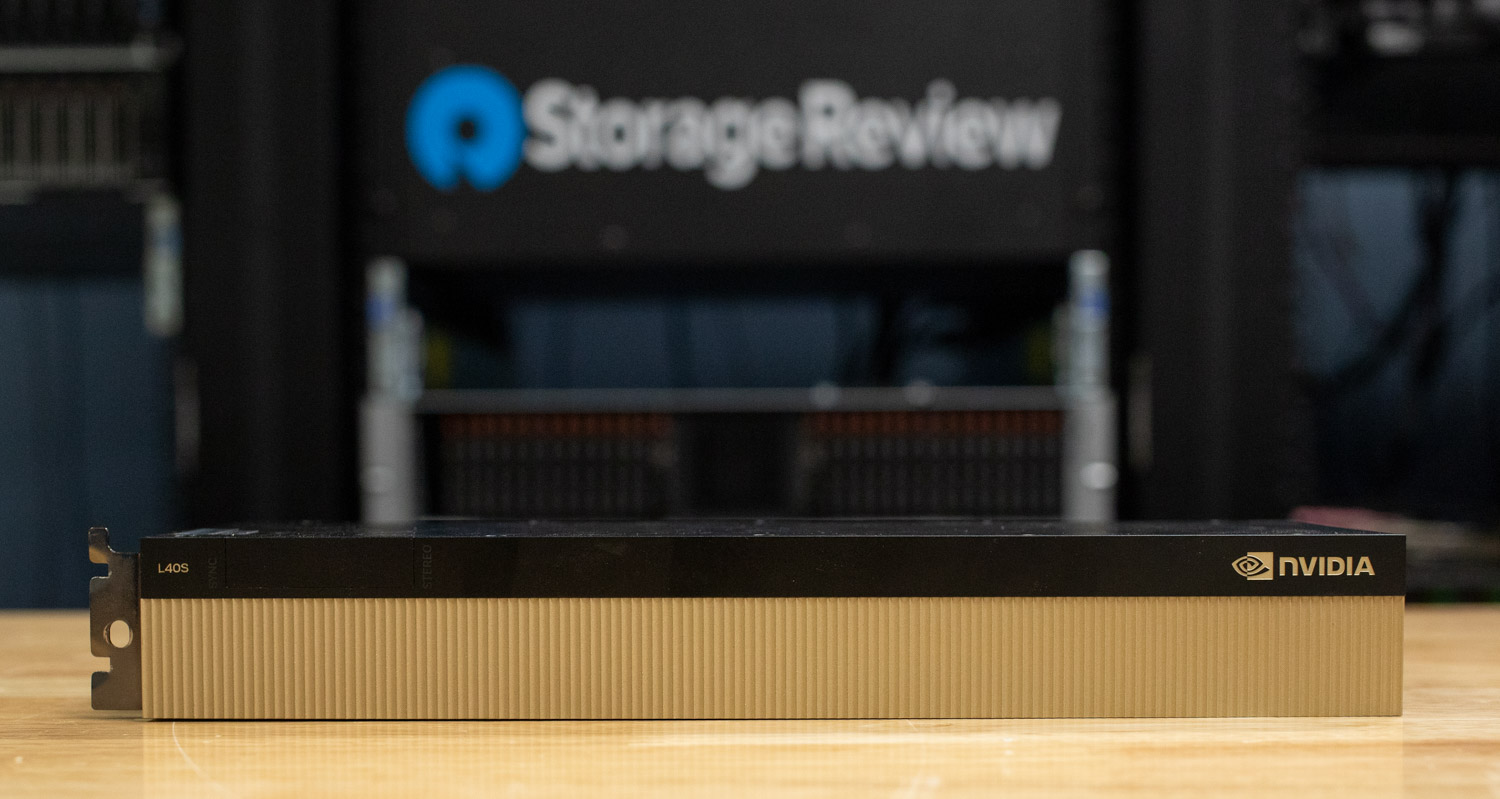
En detaljerad titt på specifikationerna avslöjar de distinkta designfilosofierna bakom NVIDIA L40S och H100. L40S är byggd på Ada Lovelace-arkitekturen, med samma AD102-chip som finns i NVIDIAs avancerade grafikkort för arbetsstationer. Detta arv ger den ett massivt antal på 18,176 32 CUDA-kärnor, vilket leder till utmärkt single-precision FP100-prestanda, vilket är en hörnsten i traditionell grafikrendering och vetenskaplig databehandling. Däremot är H100:s Hopper-arkitektur och GHXNUMX-chip specialbyggda för AI- och HPC-arbetsbelastningar framför allt annat.
Den mest framträdande skillnaden är kärnkonfigurationen. L40S inkluderar 142 tredje generationens RT-kärnor och 568 fjärde generationens Tensor-kärnor. RT-kärnorna är specialiserad hårdvara för att accelerera strålspårning, en funktion som helt saknas hos H100, vilket gör L40S unikt kapabel till fotorealistisk rendering. Medan H100 har färre Tensor-kärnor är de snabbare och mer avancerade, optimerade för nya AI-dataformat som FP8, vilket ger den en ledande ledning inom rå AI-prestanda.
Denna avvägning är även tydlig i minnesundersystemen. H100 använder 80 GB dyrt HBM2e-minne, vilket ger en häpnadsväckande bandbredd på 2 TB/s. Detta är avgörande för att hålla SM:erna matade under storskalig AI-modellträning och inferens. L40S använder ett mer konventionellt 48 GB GDDR6-minne, vilket ger 864 GB/s bandbredd. Även om det är mindre än hälften av H100:s, är detta fortfarande en betydande mängd, helt tillräcklig för att ladda stora 3D-scener, högupplösta texturer och ansenliga AI-modeller för inferens.
Slutligen beskriver funktionerna deras avsedda roller. L40S har fyra DisplayPort 1.4a-utgångar och robust vGPU-stöd, vilket gör den idealisk för virtualiserade arbetsstationer, renderingsfarmar och molnbaserade speldistributioner. H100, som saknar skärmutgångar eller vGPU-funktioner, erbjuder istället Multi-Instance GPU (MiG)-teknik, vilket gör att den kan partitioneras i flera mindre, isolerade GPU-instanser för att hantera flera beräkningsintensiva arbetsbelastningar samtidigt. Den delade dubbla kortplatsen, den passiva termiska designen och 350W-effekthöljet hos L40S och PCIe H100 möjliggör flexibilitet vid distribution i ett brett utbud av branschstandardservrar.
När man jämför L40S med NVIDIAs flaggskepp H100 blir skillnaderna i deras avsedda roller tydliga. H100 är den obestridda ledaren inom rå AI-träningsprestanda för den generationen av GPU:er, men denna jämförelse berättar bara en del av historien. Det är värt att notera att L40 också ingår i NVIDIAs sortiment, med en lägre TDP på 300 W jämfört med L40S 350 W effekt, vilket erbjuder liknande funktioner med minskad strömförbrukning.
H100-familjen vi undersöker här är den ursprungliga 80 GB PCIe-versionen med HBM2e-minne. NVIDIA har sedan dess utökat denna modell med varianter som H100 NVL, som ersätter den ursprungliga 80 GB PCIe-modellen och erbjuder 94 GB minne och en högre TDP på 400 W, samtidigt som den har lagt till NVLink-stöd för konfigurationer med dubbla GPU:er. H100-familjen utökas även till SXM-konfigurationer med 8 GPU:er och den nyare H200, som delar samma GPU-chip men levererar förbättrad prestanda i både PCIe- och SXM-formfaktorer.
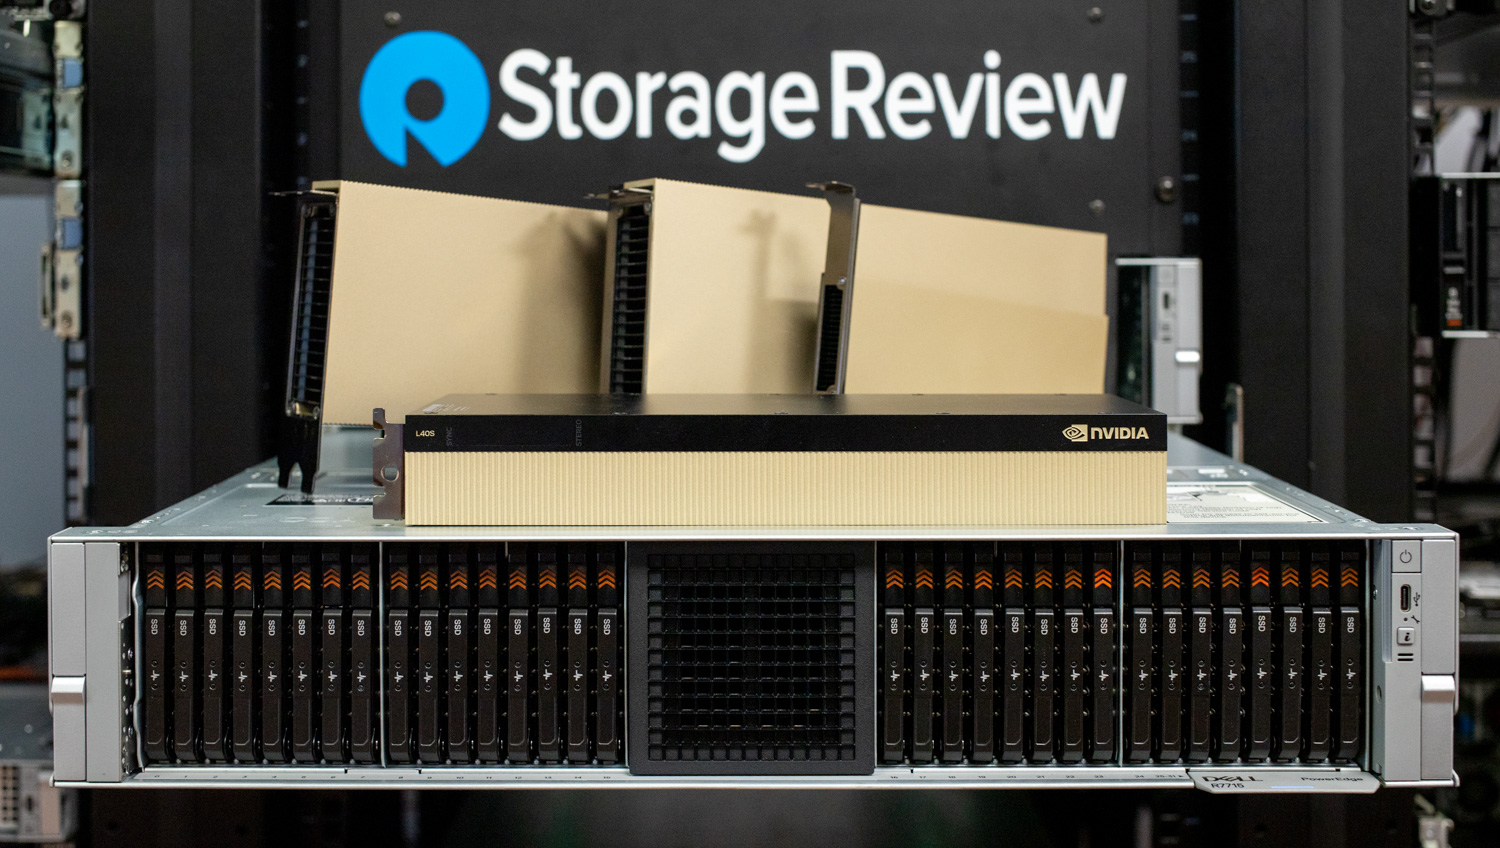
Skillnaden mellan L40S och H100 belyser en strategisk skillnad i designen av GPU:er för datacenter. H100 är ett rent beräkningsfokuserat kort, optimerat exklusivt för AI och högpresterande datorbelastningar. Målet är storskalig AI-träning, där maximal beräkningskapacitet är det primära målet. Varje aspekt av dess design, från den massiva HBM2e-minnesbandbredden till de specialiserade Tensor-kärnorna, är konstruerad för de mest krävande träningsscenarierna för neurala nätverk.
L40S är däremot en universell GPU designad för mångsidighet, med fokus på AI-inferens vid sidan av grafikintensiva arbetsbelastningar och NVIDIA vGPU-distributioner. Även om den fungerar som en kompetent och kostnadseffektiv lösning för AI-inferens, ligger dess verkliga styrka i att stödja en mängd olika grafikintensiva applikationer som H100 helt enkelt inte är byggd för.
Grafikintensiva arbetsbelastningar och professionella applikationer
L40S utmärker sig inom ett flertal grafikintensiva områden som kräver både beräkningskraft och avancerade renderingsfunktioner. Inom 3D-rendering och animering förlitar sig studior på L40S för komplex scenrendering, där dess RT-kärnor accelererar strålspårningsberäkningar som skulle vara omöjliga på GPU:er som endast bygger på beräkningar. Film- och tv-produktionsbolag använder dessa funktioner för förvisualisering i realtid, vilket gör det möjligt för regissörer och filmfotografer att se fotorealistiska renderingar av CGI-scener under filmning, vilket dramatiskt minskar tid och kostnader för efterproduktion.
Arkitekt- och ingenjörsföretag använder L40S för arkitektonisk visualisering och produktdesign i realtid, där kunder kan gå igenom fotorealistiska byggnadsrenderingar eller undersöka detaljerade produktprototyper innan den fysiska konstruktionen påbörjas. Kortets professionella grafikfunktioner gör det också idealiskt för CAD-arbetsstationer, där ingenjörer behöver både beräkningskraften för komplexa simuleringar och grafikaccelerationen för smidig och högkvalitativ visningsprestanda.
Inom media- och underhållningssektorn driver L40S renderingsanläggningar som bearbetar animationsbildrutor av slutgiltig kvalitet. Samtidigt möjliggör dess vGPU-funktioner molnbaserade kreativa arbetsflöden där artister kan få åtkomst till kraftfulla grafikarbetsstationer på distans. Videoredigerings- och postproduktionsanläggningar använder L40S för realtidseffektbearbetning, färggradering och kompositionsarbetsflöden som kräver både grafikacceleration och betydande beräkningsresurser.
Marknaden för virtuell skrivbordsinfrastruktur (VDI) representerar ett annat viktigt tillämpningsområde, där L40S vGPU-teknik gör det möjligt för flera användare att dela GPU-resurser för grafikaccelererade virtuella skrivbord. Detta gör professionella grafikfunktioner tillgängliga i företagsmiljöer utan att dedicera individuella GPU:er till varje användare.
Utvecklingen mot fysikbaserad AI-träning
Ännu viktigare är att L40S erbjuder funktioner som H100 helt saknar. Den viktigaste skillnaden ligger i L40S:s 142 RT-kärnor av tredje generationen, vilka möjliggör strålspårning i realtid och fotorealistisk rendering. Även om H100 inte har några RT-kärnor och inte kan utföra grafikacceleration, gör L40S:s RT-kärnor den till det självklara valet för applikationer som kräver både AI-beräkning och avancerad grafik.
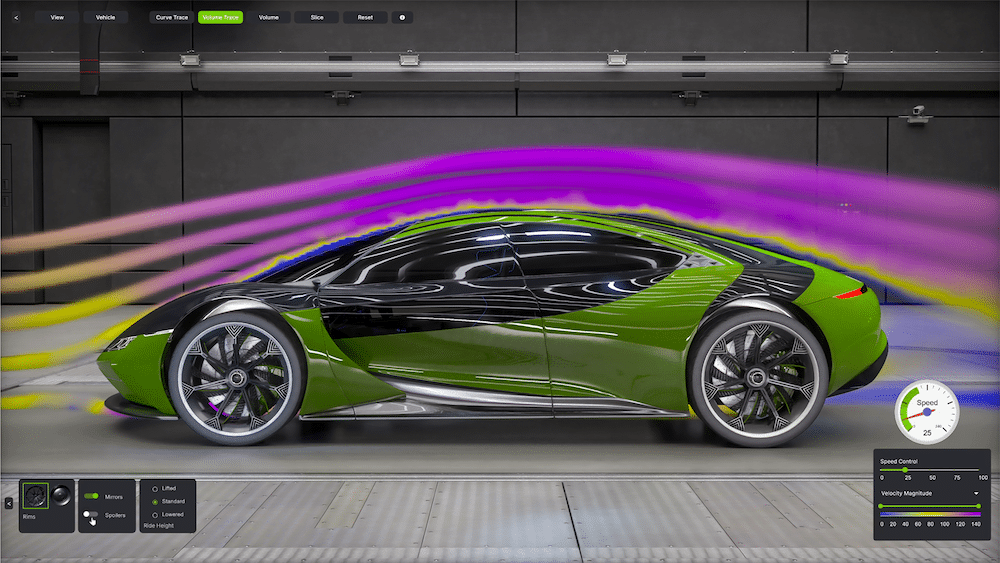
Källa: Nvidia
Denna distinktion blir allt viktigare i takt med att vi bevittnar den ökande populariteten för AI-genererad 3D-modellering, digitala tvillingsimuleringar och arbetsflöden för Universal Scene Description (OpenUSD). Nästa gräns inom artificiell intelligens handlar inte bara om att träna större språkmodeller; det handlar om att utveckla världsmodeller som förstår fysik, rumsliga relationer och verkliga interaktioner. Denna utveckling kräver en grundläggande förändring i hur vi närmar oss generering av träningsdata.
Medan träning av traditionella AI-modeller i hög grad förlitar sig på NVIDIAs flaggskepps-GPU:er för beräkningar, kräver träning av nästa generations fysiskt jordade världsmodeller en annan metod. Dessa avancerade AI-system behöver stora mängder träningsdata som inte bara fångar visuell information, utan även fysiska egenskaper, ljusbeteende, materialinteraktioner och rumsliga relationer. GPU:er som L40S blir viktiga för storskalig generering av träningsdata, där deras RT-kärnor möjliggör skapandet av fysiskt noggranna syntetiska miljöer som fungerar som grund för träning av mer sofistikerade AI-modeller.
Denna förmåga till avancerad grafikrendering, driven av dedikerade RT-kärnorna, är just det som gör L40S till den ideala motorn för NVIDIAs Omniverse-plattform och det bredare ekosystemet för fysikbaserad AI-utveckling.
Omniversum
Omniverse är en utvecklingsplattform med API:er, SDK:er och tjänster som gör det möjligt för utvecklare att bygga applikationer och arbetsflöden baserade på Universal Scene Description (OpenUSD). Den är utformad för att skapa och ansluta fysiskt noggranna virtuella 3D-världar i realtid. Detta uppnås genom att integrera NVIDIAs RTX-teknik för fotorealistisk, strålspårad rendering direkt i industriella och robotbaserade simuleringsarbetsflöden. L40S, med sina kraftfulla RT-kärnor, ger den nödvändiga hårdvaruaccelerationen för att driva dessa krävande RTX-renderingsarbetsbelastningar, vilket gör det möjligt för utvecklare att simulera ljus, material och fysik med fantastisk realism.
Omniverse är mer än bara ett visualiseringsverktyg, det är en plattform för att utveckla nästa generations fysiska AI. Genom att skapa dessa verklighetstrogna virtuella världar, eller "digitala tvillingar", kan utvecklare simulera komplexa industrianläggningar, testa hela robotflottor och validera autonoma fordon i en säker, virtuell miljö innan de driftsätts i verkligheten. Avgörande är att dessa högkvalitativa simuleringar blir grunden för att generera stora mängder fysiskt baserad syntetisk data; en kritisk resurs för att träna de kraftfulla AI-modeller som körs på beräkningsfokuserade GPU:er.
Generering av syntetisk manipulationsrörelser för robotik
NVIDIA Isaac GR00T-ritningen för rörelsegenerering med syntetisk manipulation ger ett ramverk för robotträning och demonstrerar hur L40S RT Core-funktioner möjliggör skapandet av stora datamängder från minimala mänskliga demonstrationer. Detta arbetsflöde tar itu med en av de viktigaste utmaningarna inom robotutveckling: den tidskrävande och dyra processen att samla in tillräckligt med högkvalitativa träningsdata för robotmanipulationsuppgifter.
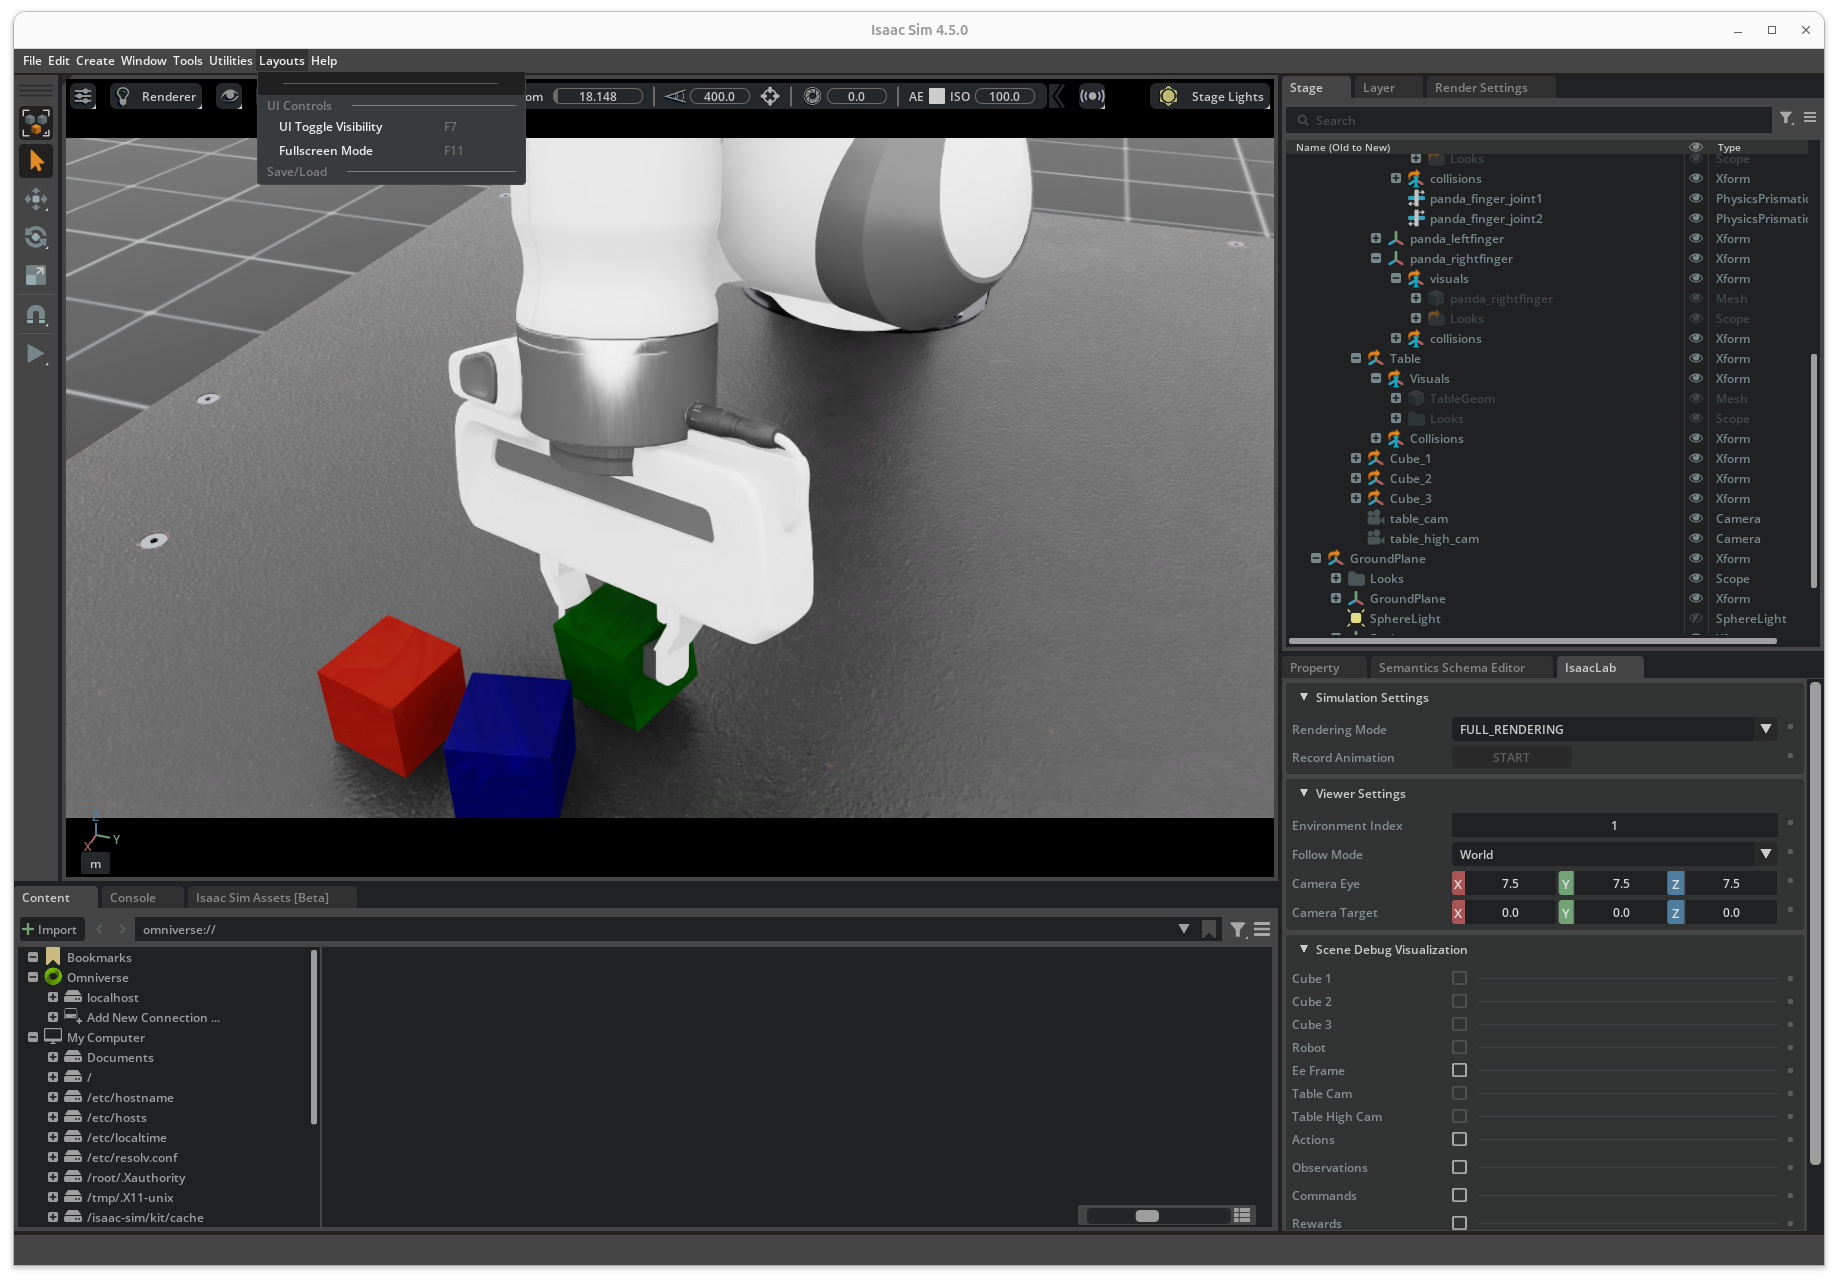
Traditionell robotutbildning förlitar sig i hög grad på övervakat eller imitationsinlärning, där robotar förvärvar nya färdigheter genom att observera och härma experters mänskliga demonstrationer. Att skapa perfekta demonstrationer är dock utmanande, och att samla in omfattande, högkvalitativa datamängder i den verkliga världen är mödosamt, tidskrävande och dyrt. En korrekt utbildad mänsklig operatör tar vanligtvis ungefär en minut på sig att spela in en enda högkvalitativ demonstration, vilket är svårt att skala på grund av den betydande mänskliga ansträngning som krävs och risken för fel.
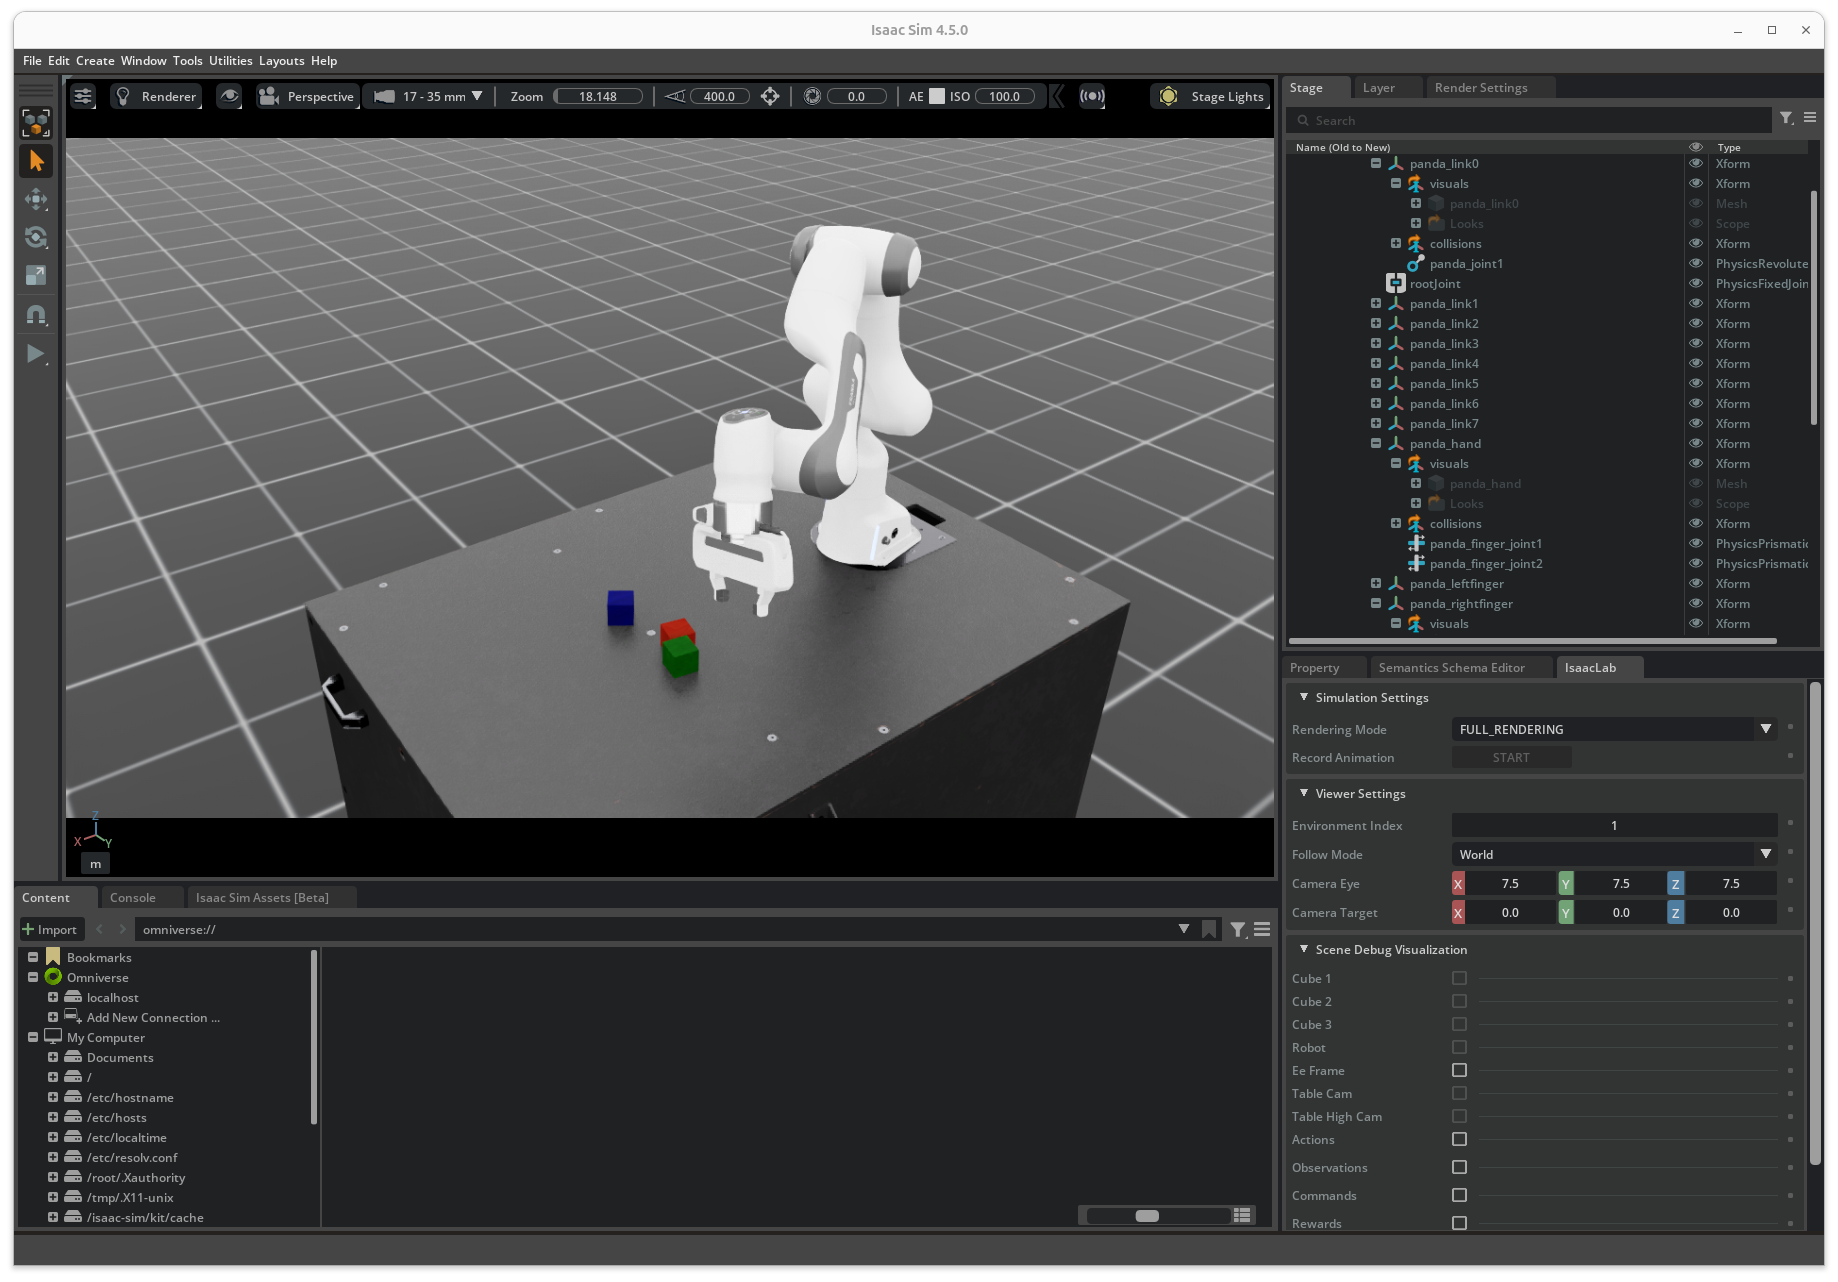
Isaac GR00T-ritningen tar sig an denna utmaning genom att utnyttja syntetiska data genererade från fysiskt noggranna simuleringar för att påskynda datainsamlingsprocessen. Organisationer kan samla in exponentiellt mer data från bara ett par timmars mänskliga demonstrationer.
Isaac GR00T -ritningen består av tre nyckelkomponenter som arbetar tillsammans för att skapa en omfattande pipeline för generering av syntetisk data:
- GR00T-Teleop gör det möjligt för skickliga mänskliga operatörer att styra virtuella robotar med hjälp av rumsliga beräkningsenheter som Apple Vision Pro. Detta system gör det möjligt för operatörer att demonstrera komplexa manipulationsuppgifter i fotorealistiska virtuella miljöer, och fånga inte bara rörelsebanorna utan även miljökontexten och objektinteraktioner. Apple Vision Pro strömmar handspårningsdata till Isaac Lab, som samtidigt strömmar en uppslukande vy av robotens omgivning tillbaka till enheten, vilket möjliggör intuitiv och interaktiv styrning av roboten.
- GR00T-Efterliknande tar de inspelade demonstrationerna och multiplicerar dem till större syntetiska datamängder med hjälp av avancerade simuleringstekniker. Denna komponent använder de inspelade demonstrationerna som indata för att generera ytterligare syntetiska rörelsebanor i Isaac Lab, vilket stöder både manipulation av enarmade och tvåmanuella humanoida robotar. Processen innebär att kommentera viktiga punkter i demonstrationerna och använda interpolering för att säkerställa att de syntetiska banorna är smidiga och kontextuellt lämpliga.
- GR00T-Gen utnyttjar NVIDIA Omniverse- och Cosmos-plattformarna för att utöka syntetiska datamängder genom 3D-uppskalning och domänrandomisering. Denna komponent ger ytterligare mångfald genom att slumpmässigt sortera bakgrund, ljus och andra variabler i scenen. Den förstärker de genererade bilderna genom NVIDIA Cosmos Transfer, vilket uppnår fotorealism som hjälper till att minska gapet mellan simulering och verklighet.
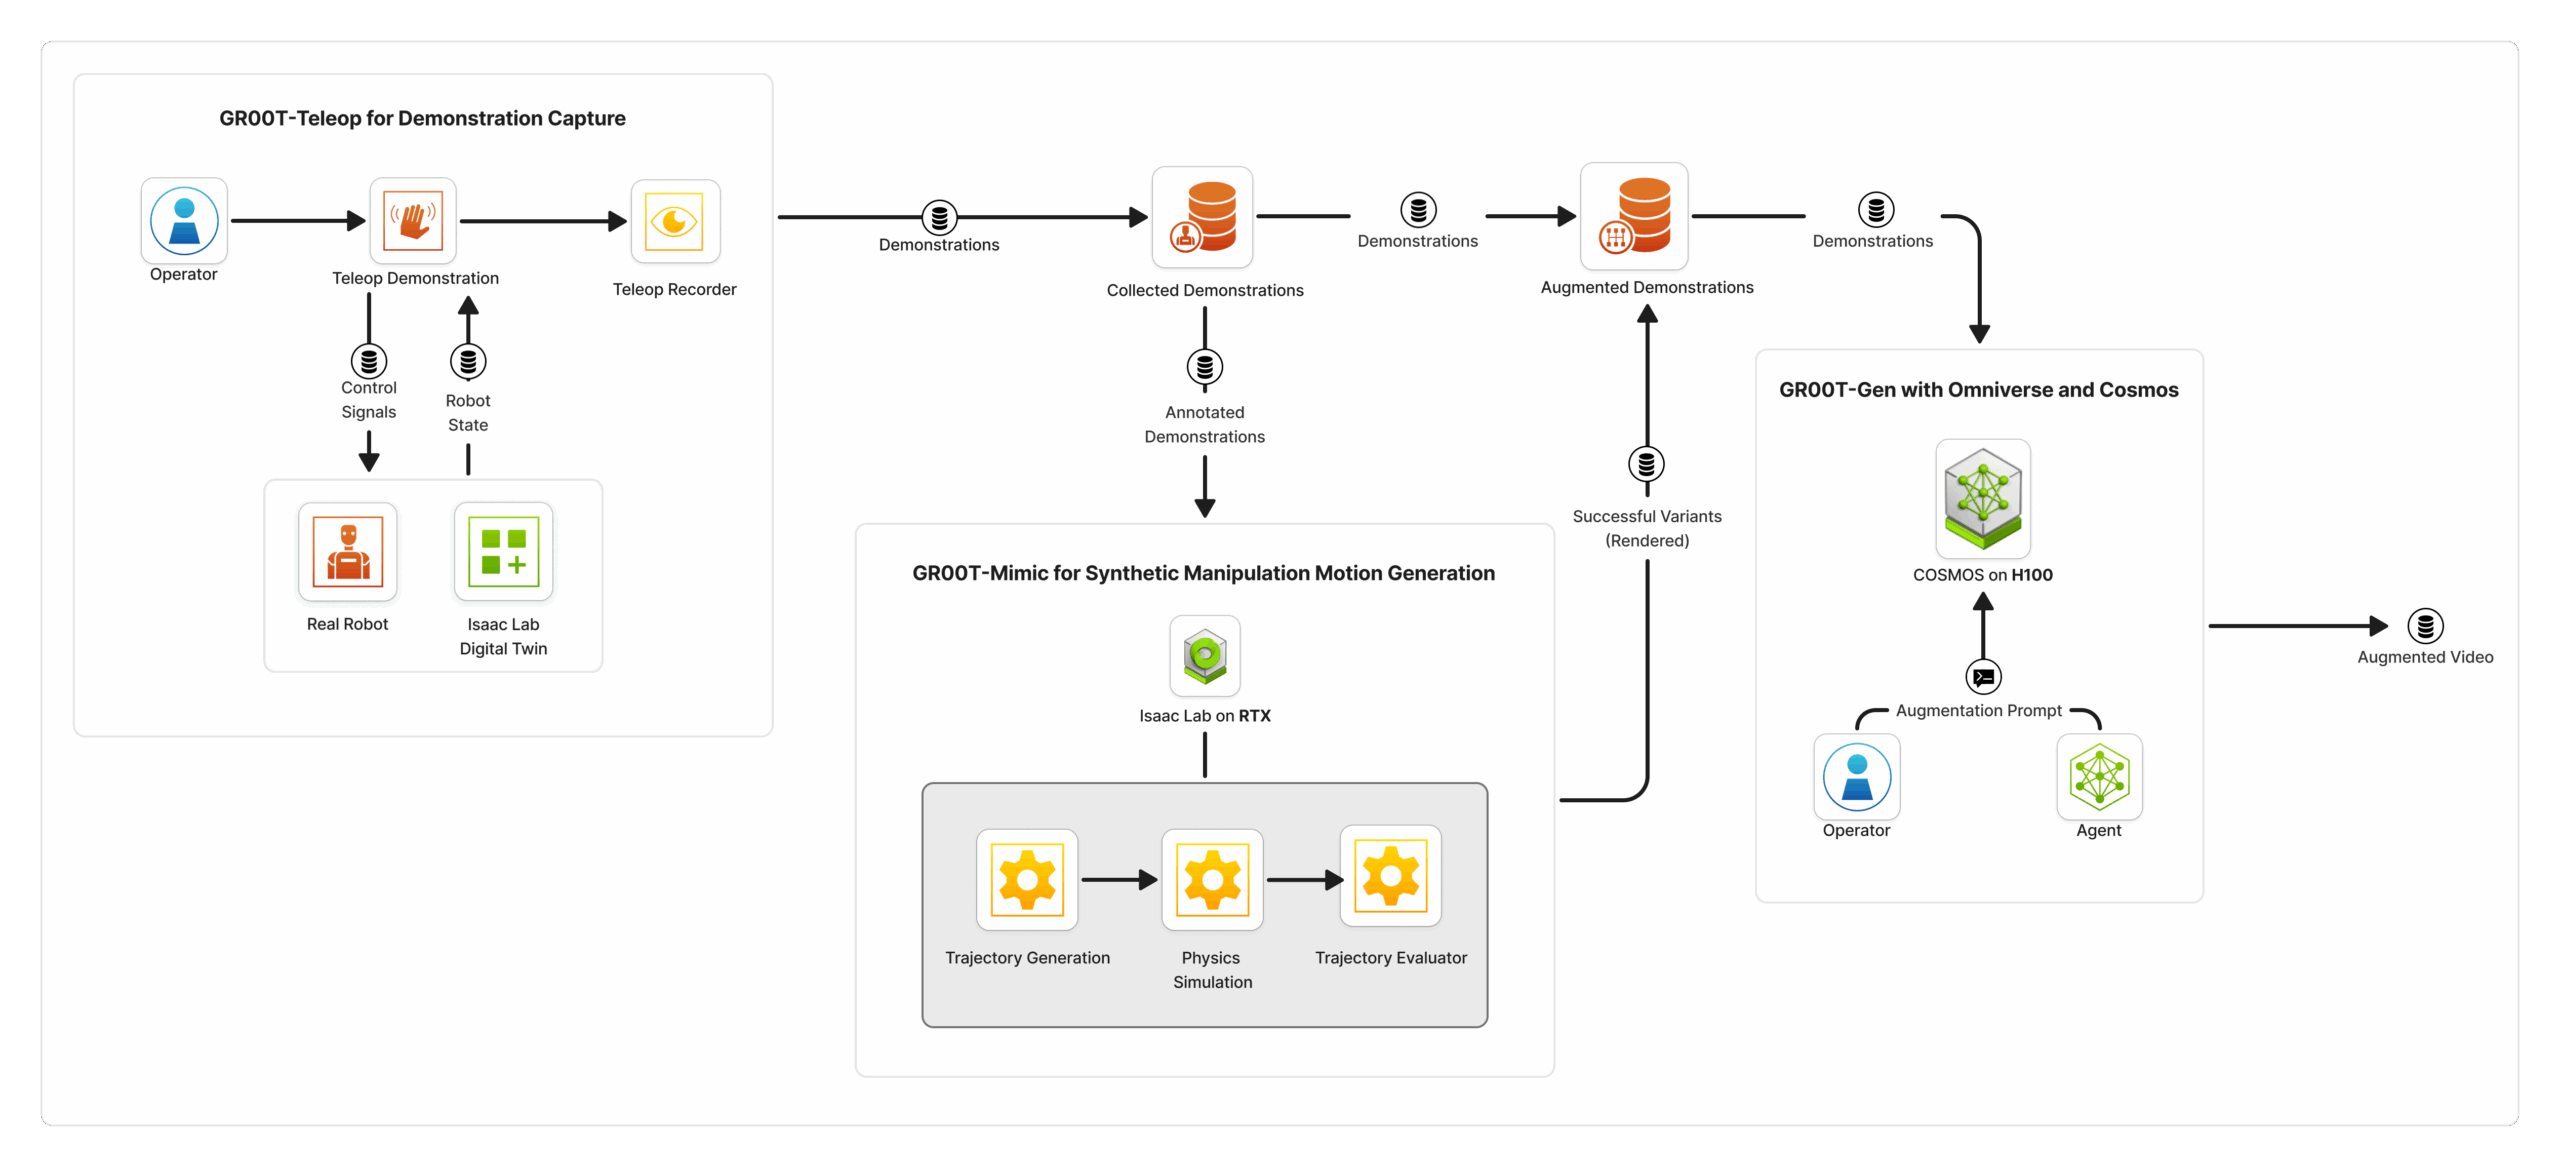
Denna pipeline illustrerar perfekt de specialiserade, kompletterande rollerna hos moderna datacenter-GPU:er. L40S, med sina dedikerade RT-kärnor, fungerar som världsbyggaren. Den är oumbärlig för de inledande stegen av datagenerering, där den hanterar den fysiskt baserade rendering, realtidsstrålspårning och domänrandomisering som behövs för att skapa en fotorealistisk och mångsidig virtuell miljö.
Denna högkvalitativa virtuella värld blir sedan arbetsytan för nästa generationssteg. Generativa AI-modeller, som de i NVIDIA Cosmos , körs på beräkningscentrerade GPU:er som H100 för att producera den slutliga träningsdatan. H100 utnyttjar den realistiska miljön som skapats av L40S för att generera miljontals dynamiska, fysiskt medvetna scenarier.
AI-inferensprestandamått
Ett annat användningsfall där kort som L40S är populära är för kostnadseffektiv inferens. För att utvärdera L40S verkliga AI-inferensfunktioner jämfört med H100, jämförde vi LLM-prestanda med hjälp av vLLM som körde Nvidias Open Reasoning Nemotron 14B-parametermodell vid BF16 med max 32K tokenlängd.
vLLM-benchmarkresultat
H100 visar tydlig prestandatitl och levererar ungefär 4.2 gånger högre dataflöde än L40S. Denna fördel härrör direkt från H100:s fördubblade Tensor Core-prestanda och mer än fördubblade minnesbandbredd (2 TB/s jämfört med 864 GB/s).
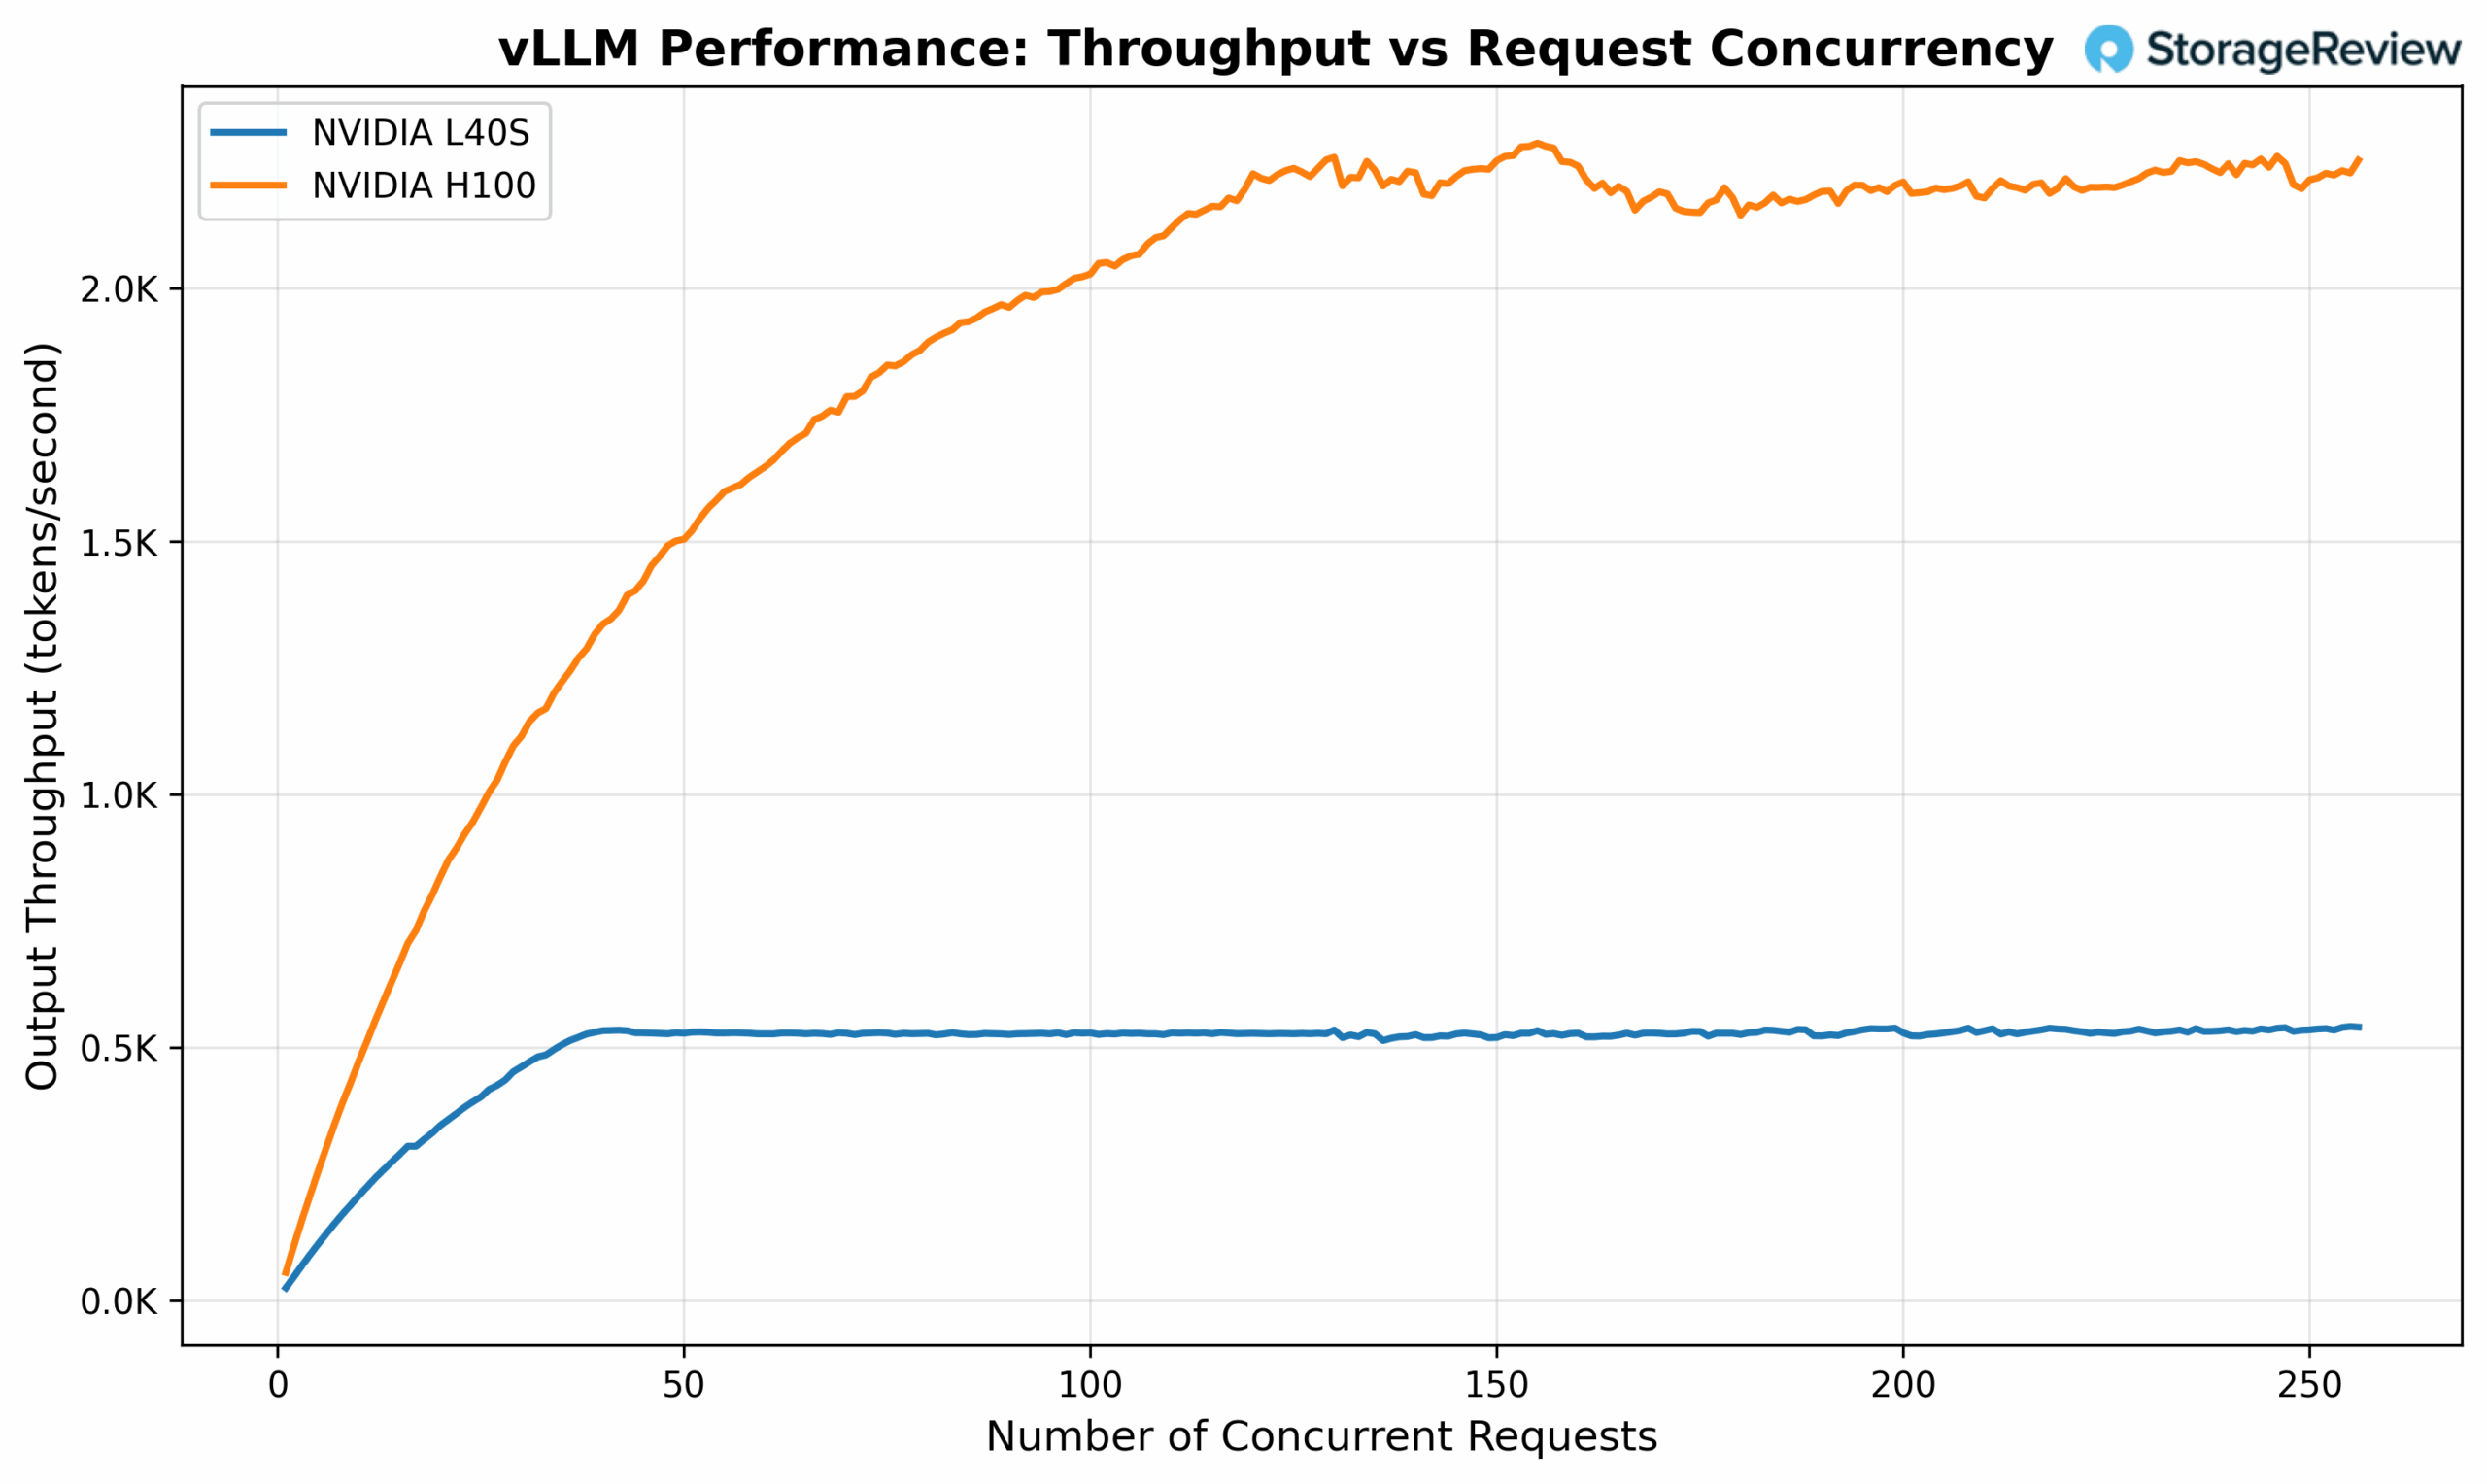
Prestanda per dollar visar dock en annan sak. L40S kostar vanligtvis mindre än en tredjedel av priset för en H100, vilket gör den mer kostnadseffektiv för många inferensarbetsbelastningar. Organisationer som kör inferenstjänster där absolut topprestanda inte är avgörande tycker ofta att L40S ger bättre total ägandekostnad.
Om vi dubbelklickar på sektionen med linjär prestanda ser vi att L40S levererar en mycket acceptabel prestandanivå, med förmågan att hantera 16 samtidiga förfrågningar med ~52 ms TPOT (Time Per Output Token) SLO.
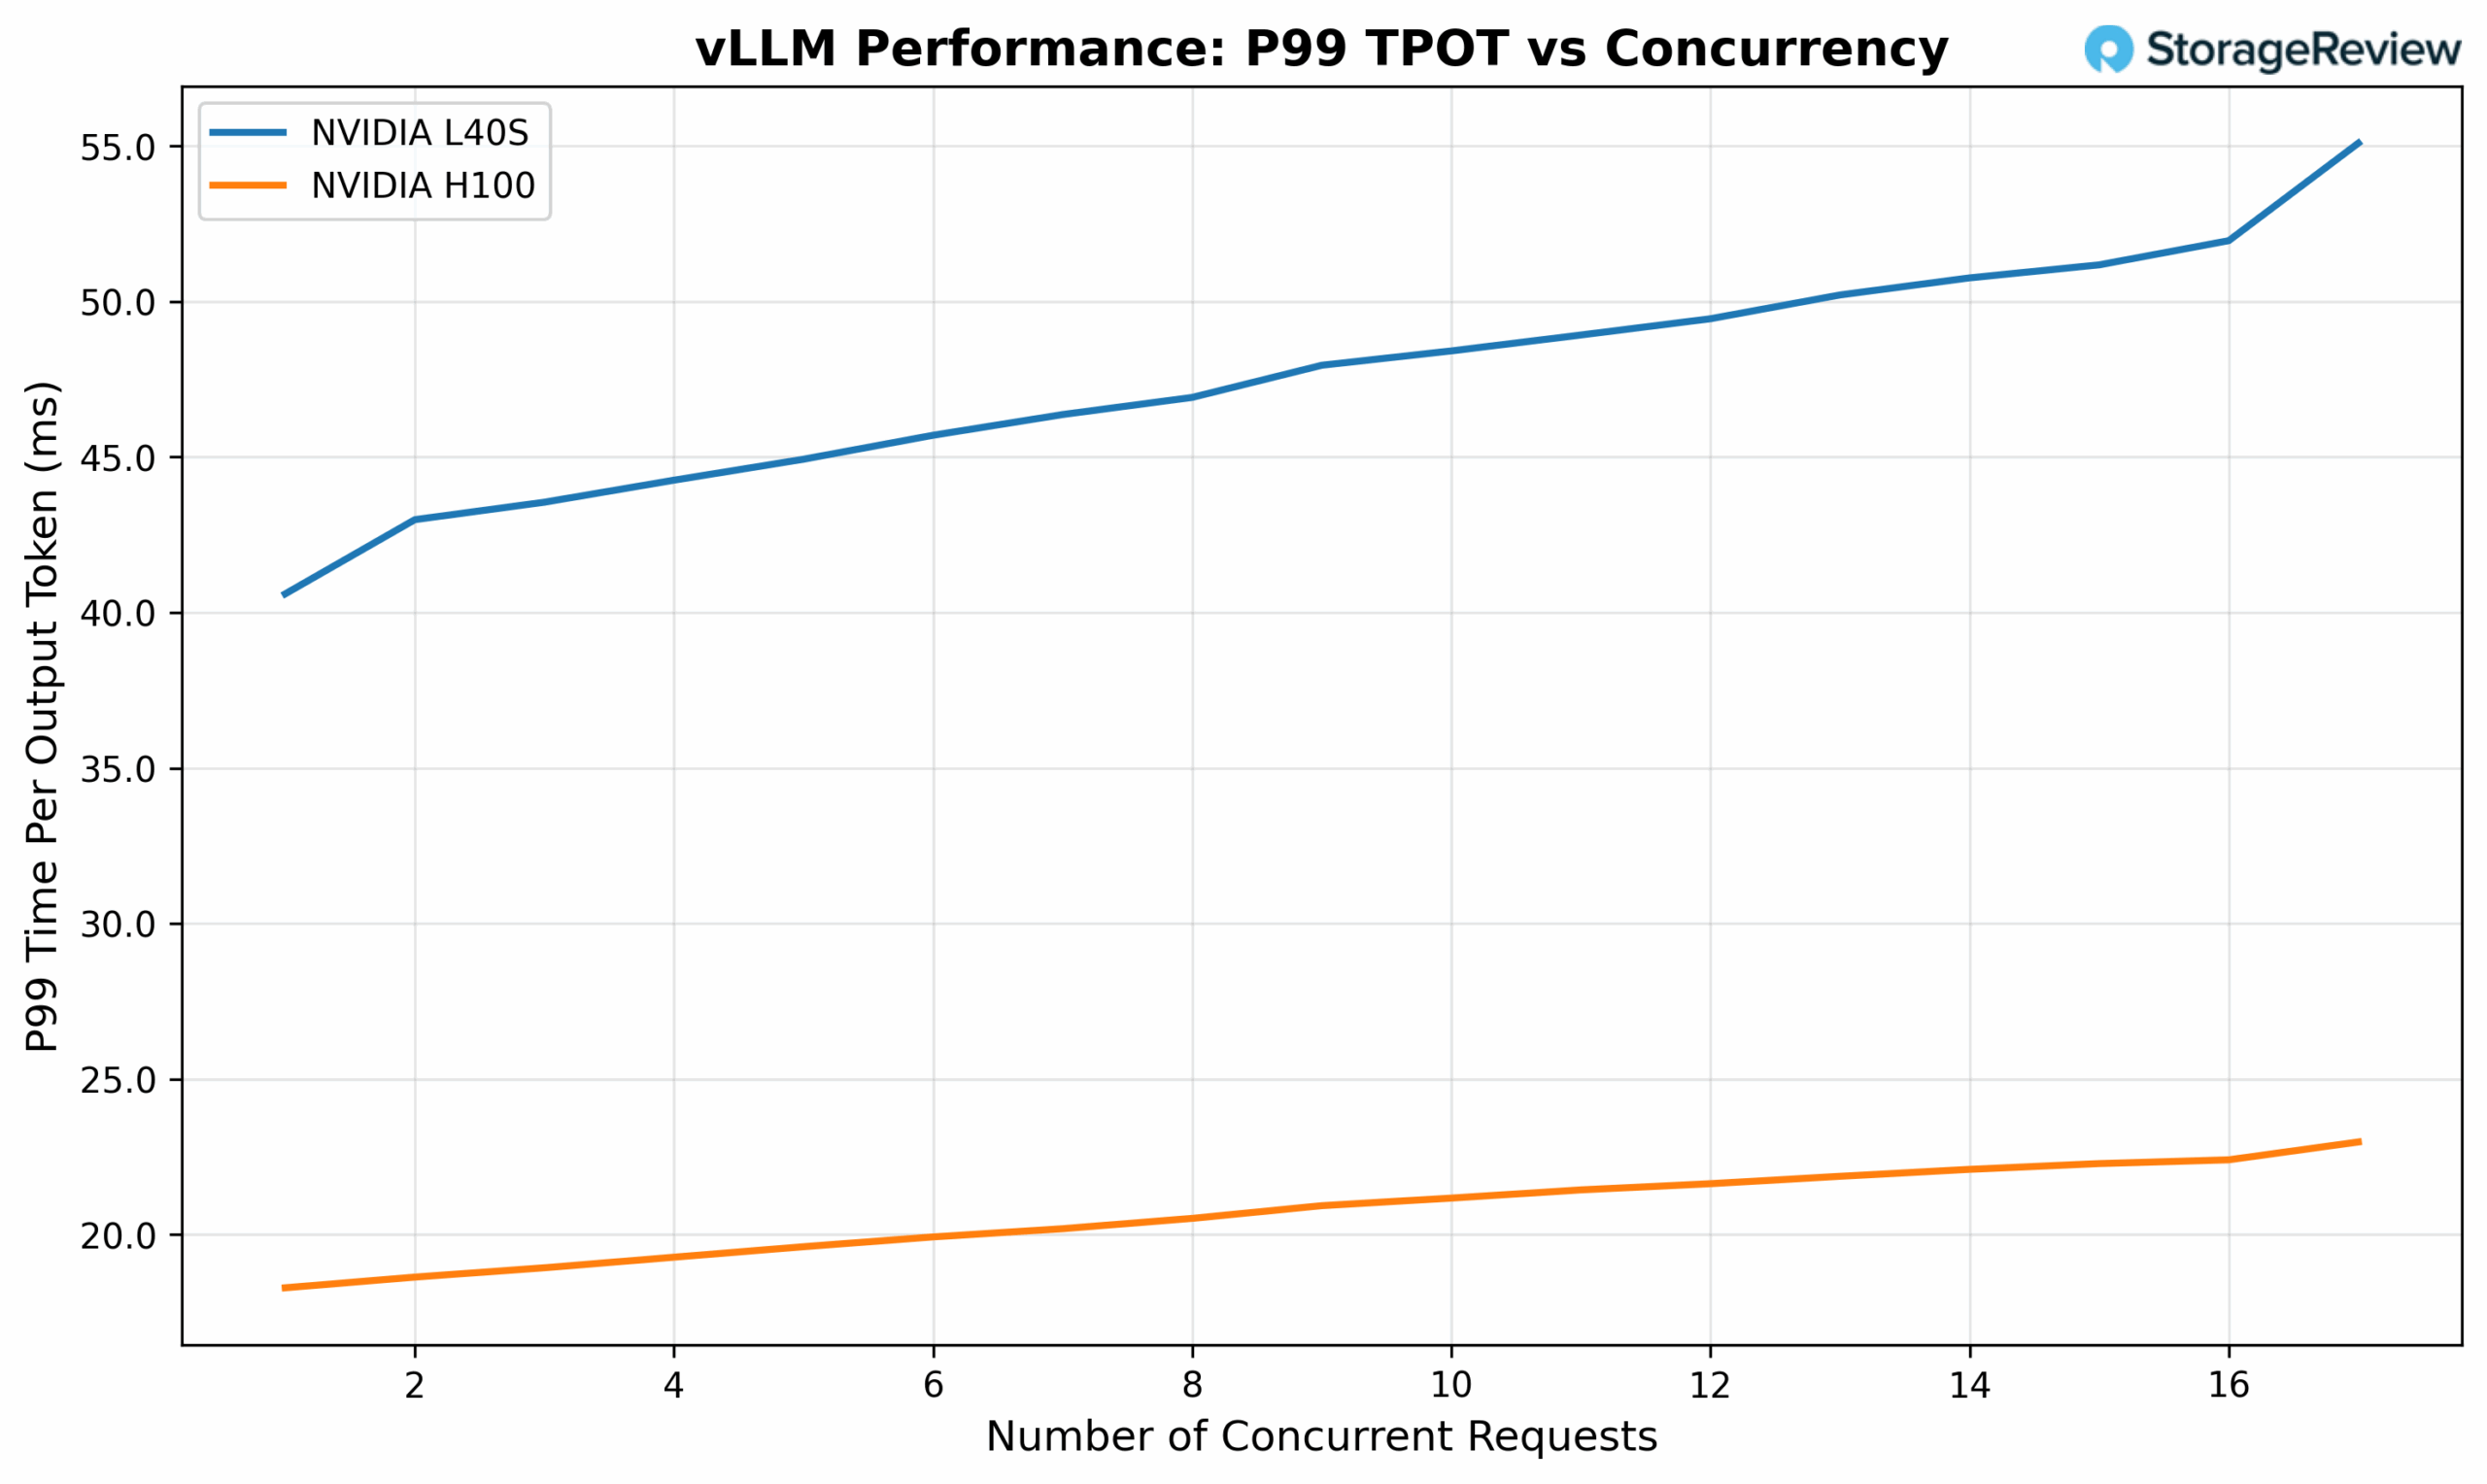
En viktig faktor att notera är att AI-inferens, särskilt avkodningsfasen vid textgenerering, i grunden är en minnesbandbreddsintensiv operation. Under inferensen måste modellen upprepade gånger komma åt vikter lagrade i GPU-minnet för att generera varje ny token, vilket gör minnesgenomströmningen till en kritisk prestandaflaskhals. Denna egenskap förklarar varför H100, med sin överlägsna minnesbandbredd och förbättrade Tensor Core-prestanda, naturligt uppnår högre inferensgenomströmning.
För distributionsscenarier som kräver både AI-inferens och grafikacceleration, såsom realtidsrendering med AI-förbättrade effekter och interaktiva applikationer med AI-drivna funktioner, blir dock L40S det enda gångbara alternativet.
Slutsats
NVIDIA L40S och de senaste efterföljarna till Blackwell RTX Pro 6000 framstår som en strategiskt positionerad GPU som möter de ständigt föränderliga kraven från moderna datacenter, där AI-beräkning och avancerade grafikfunktioner i allt högre grad konvergerar. Medan GPU-klasserna H100 och B200 fortfarande är de obestridda ledarna för ren AI-träning och inferensarbetsbelastningar, skapar L40S en distinkt och värdefull nisch som en universell GPU som överbryggar klyftan mellan beräkningsfokuserade AI-kort och traditionella professionella visualiseringslösningar.
L40S unika värdeerbjudande blir tydligast i scenarier som kräver både AI-inferensfunktioner och grafikacceleration. Dess 142 tredje generationens RT-kärnor möjliggör applikationer som helt enkelt är omöjliga på beräkningsbaserade GPU:er som H100, från realtidsstrålspårning i professionella arbetsflöden till fotorealistisk syntetisk datagenerering för nästa generations AI-träning. Denna dubbla funktion gör den oumbärlig för nya applikationer inom digital tvillingutveckling, fysikbaserad AI-träning och det växande Omniverse-ekosystemet.
Ur ett ekonomiskt perspektiv erbjuder L40S ett övertygande värde för organisationer som inte kräver H100:s absoluta topprestanda inom AI. Med en kostnad på ungefär en tredjedel av kostnaden för en H100 levererar L40S respektabel inferensprestanda samtidigt som den tillhandahåller grafikfunktioner som ger enorm mångsidighet till datacenterinstallationer. För många organisationer gör denna kombination av kostnadseffektivitet och mångsidighet L40S till ett mer praktiskt val än att investera i separata AI- och grafiklösningar.


 Amazon