

Under större delen av sin tid i datacentret behandlade NVIDIA processorn som inte mycket mer än chippet som matade grafikkortet. Grace, deras första serverprocessor, passade in i den mallen. De använde Arms standard Neoverse V2-kärnor och levererades mestadels som processorhalvan i superchipsen Grace Hopper och Grace Blackwell. Dessa superchips introducerade en bestående del av plattformen: NVLink-C2C, en länk som ger processorn och grafikkortet koherent åtkomst till varandras minne med mycket högre bandbredd än PCIe.
Dess efterföljare, Vera, är betydligt mer ambitiös. Det är en ren design byggd kring Olympus, NVIDIAs specialbyggda Arm-kärna. Olympus implementerar Armv9.2, och varje Vera-processor har 88 kärnor och 176 trådar. Vid sidan av de nya kärnorna är minnesundersystemet den andra höjdpunkten. Varje processor stöder upp till 1.5 TB LPDDR5X på SOCAMM-moduler, med en annonserad maximal bandbredd på 1.2 TB/s, vilket ger Vera energieffektiviteten hos mobilklass-DRAM samtidigt som minnesfältet är utbytbart.
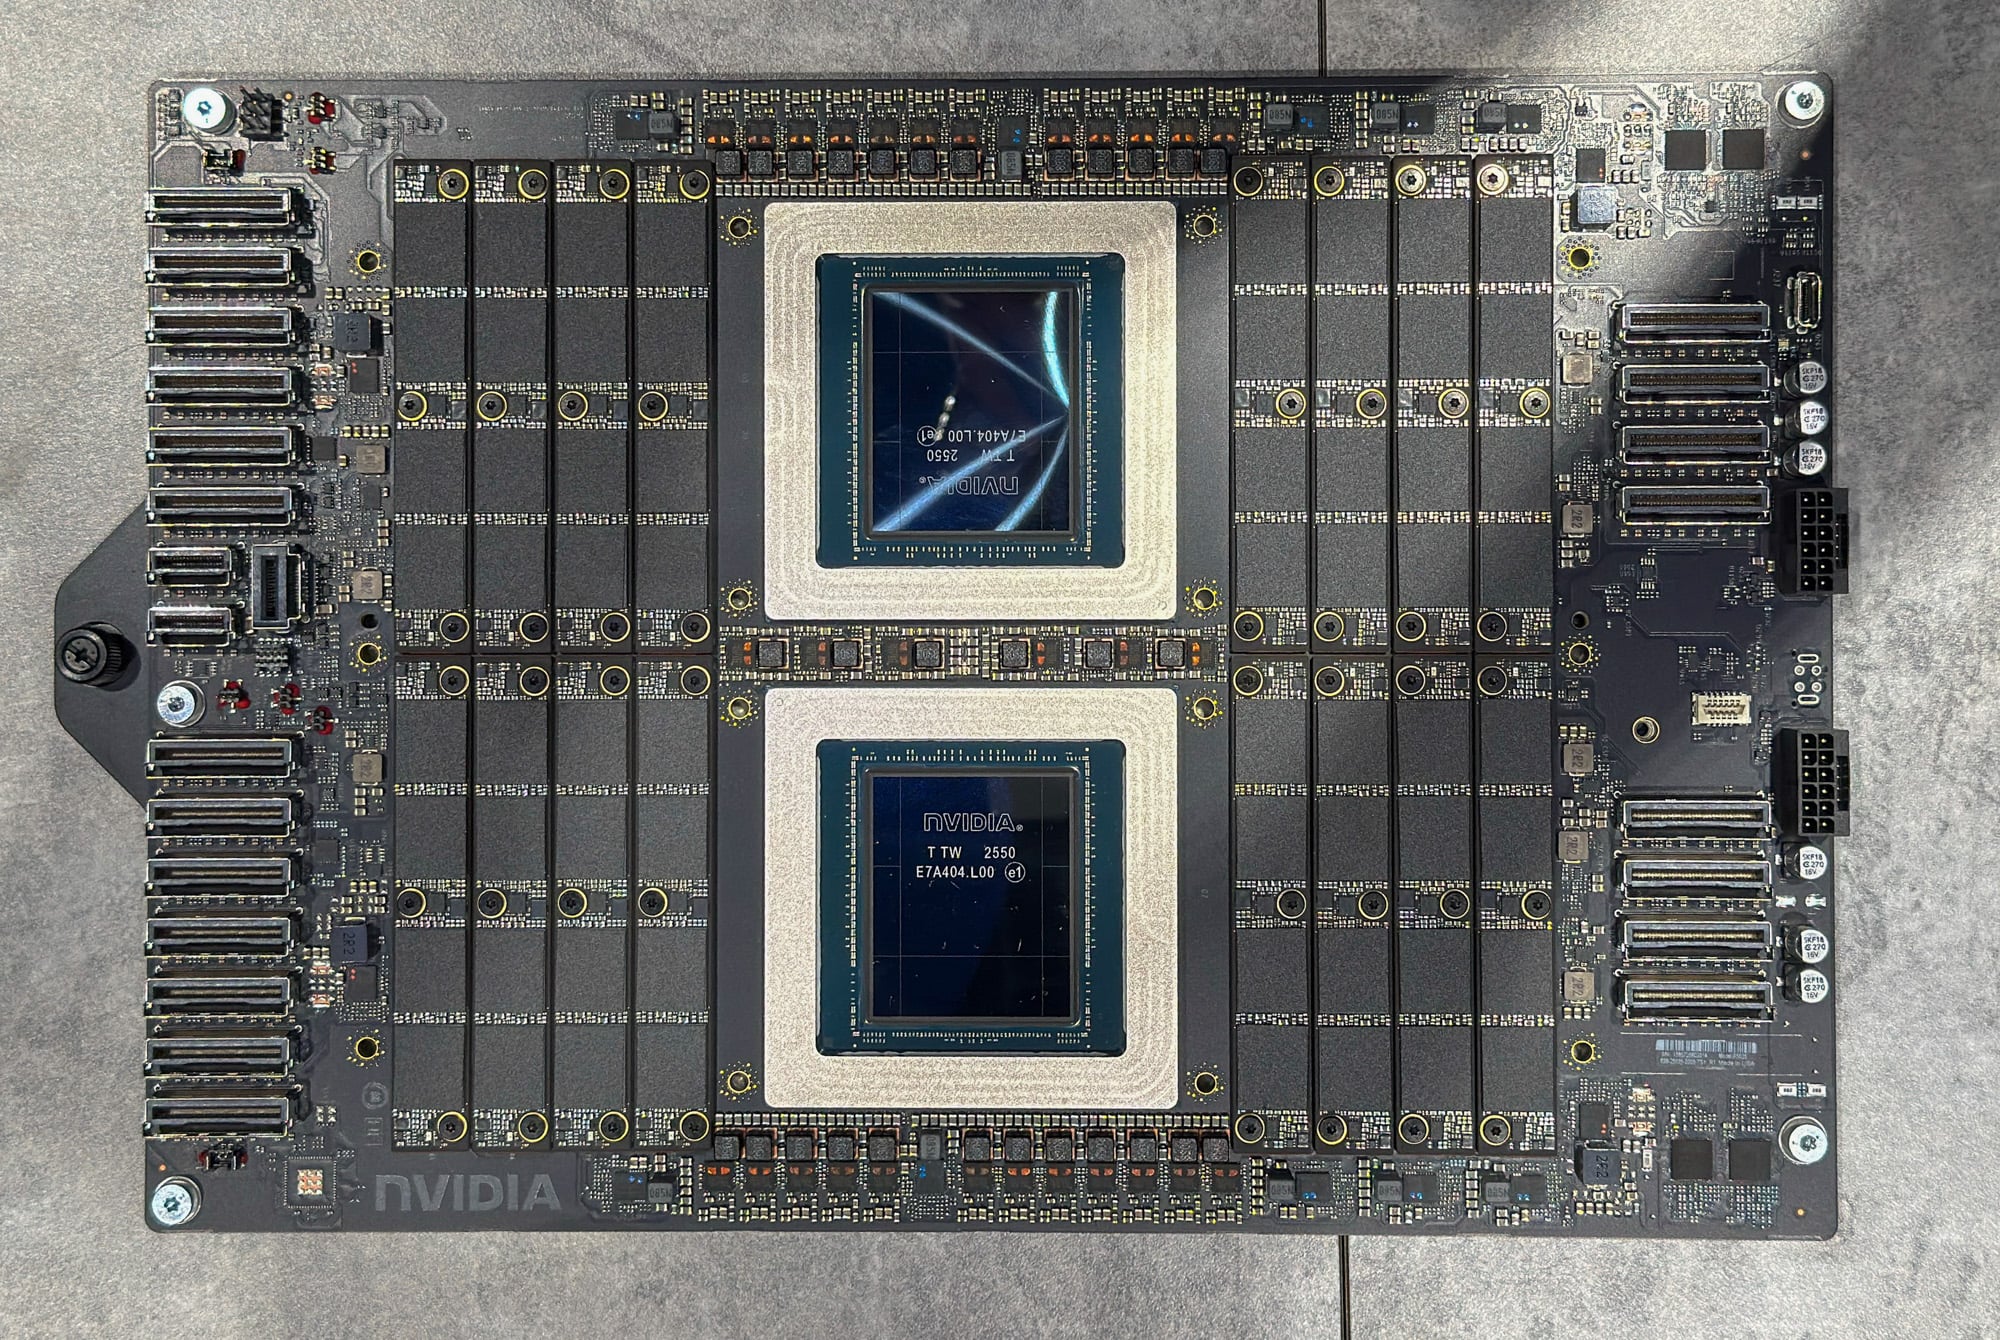
Den ambitionen sträcker sig även till var Vera distribueras. Det levereras fortfarande som en del av superchippet i Vera Rubin-system, men NVIDIA har också utökat det till sin BlueField-4 STX-lagringsplattform och till fristående CPU-servrar för agentiska sandlådor. Vera får också brett stöd från OEM-tillverkare, hyperskalare och NCP:er: Dell, HPE och Supermicro har lagt till Vera-servrar i sina sortiment, och hyperskalare och NCP:er är redo att göra det till ett vanligt erbjudande. Den breda tillgängligheten är viktig eftersom, som våra resultat kommer att visa, Vera är en seriös utmanare mot sina x86-motsvarigheter, och det ger organisationer en tredje CPU-leverantör som hjälper till att diversifiera sina leveranskedjor.
Key Takeaways
- Minnesbandbredden mer än fördubblas för varje x86-system. Två Vera-socklar klarade över 2 TB/s på STREAM Triad, 2.3 gånger den bästa DDR5-servern vi testade. Även när man läste den andra sockelns minne över NVLink-C2C drog Veras kärnor mer bandbredd än någon x86-socket får från lokalt minne, och den lokala latensen med hugepages var 13 % lägre än på EPYC 9175F.
- Ett välbalanserat chip för den breda mellanklassen. En 3.4 GHz Olympus-kärna komprimerades 12 % snabbare på 7-Zip än 5.0 GHz EPYC 9175F och vann två av tre entrådiga Python-tester mot den. Vid full belastning nådde Vera 63 % till 72 % av EPYC 9965:s 7-Zip-genomströmning med färre än hälften så många kärnor, och låg därmed nära AMD:s specialist på processorer per kärna på en tråd och deras specialist på genomströmning över hela systemet.
- Vektor- och kryptoarbete är den tydliga svagheten. Sex 128-bitars SVE2-pipes kan inte matcha 512-bitars AVX-512 i den kod som skrivits för den. På matchande 16 kärnor körde Vera GROMACS benchMEM med halva EPYC 9175F:s hastighet och två tredjedelar av EPYC 9965:s, och en enda kärna krypterad AES-256-GCM med ungefär en tredjedel av 9175F:s hastighet. Över hela systemet ledde 384-kärniga EPYC 9965 med ungefär 3 gånger både på GROMACS benchPEP och AES.
- Minnesbunden HPC omvandlar bandbredd till hastighet. På den stora OpenFOAM-meshen slutförde Vera 1.44 gånger snabbare än 384-kärniga EPYC 9965 och 1.20 gånger snabbare än 240-kärniga Xeon 6978P. På den mindre meshen, där större x86 L3-cacher har mer av problemet, kom Vera på andra plats, inom 12 % av 9965.
- Databaser och analyser är redan konkurrenskraftiga. I HammerDB TPROC-C på en sockel slog 88 Vera-kärnor en 192-kärnig EPYC 9965-socket med 26 % på PostgreSQL och 8 % på MariaDB, medan den låg efter med 19 % på MySQL och 15 % på VillageSQL; Xeon 6787P låg efter Vera på alla fem motorerna. Vera slutförde också ClickBench-hot run på 23 % kortare tid än EPYC 9965 och hanterade 34 % fler förfrågningar på ett 256 GB Valkey-arbetsset.
Specifikationer
| Specifikation | NVIDIA Vera-processor |
|---|---|
| Beräkning och kraft | |
| Kärna | NVIDIA Olympus, Armv9.2 med SVE2 och FP8 |
| Kärnor och gängor per hylsa | 88 kärnor, 176 trådar (NVIDIA Spatial Multithreading) |
| Klockhastighet (uppmätt) | 3.41GHz |
| TDP | 250W till 450W konfigurerbar |
| Kylning | Luft eller vätska |
| Cache | |
| L1-instruktion | 64KB per kärna |
| L1-data | 96 KB per kärna, 6-vägs |
| L2 | 2 MB per kärna, privat |
| Systemnivåcache (L3) | 164 MB per sockel, Arm MPAM-partitionering |
| Tyg | Andra generationens skalbar koherensstruktur, 3.4 TB/s bisektion |
| Minne | |
| Typ | LPDDR5X på 8x SOCAMM2-moduler per sockel |
| controllers | 8x 128-bitars (1 024-bitars aggregerat) |
| Fart | Upp till 9,600MT/s |
| Bandbredd | Upp till 1.2 TB/s per sockel (leverantörsklassificering) |
| Kapacitet | 256 GB till 1.5 TB per sockel |
| I / O | |
| PCIe | Gen6, 88 banor per sockel (endast CPU-plattform) x16, x8, x4, x2 förgrening |
| CXL | 3.1, Typ 3 minnesutbyggnad och poolning |
| NVLink-C2C | 2:a generationens, 1.8 TB/s dubbelriktad, koherent, autentiserad kryptering |
| Säkerhet | |
| Konfidentiell databehandling | Aktivera CCA-sfärer, RME-DA och RME-CDA, TDISP, nycklar per VM |
Varför NVIDIA vill gå in i CPU-branschen
För att förstå varför Vera är viktigt för NVIDIA, titta på hur företaget har vuxit. NVIDIA byggde sin datacenterposition kring GPU:erna och expanderade sedan till den infrastruktur som behövs för att hålla dessa GPU:er igång. På hårdvarusidan introducerade Mellanox-förvärvet 2020 nätverkstekniken som kopplar samman servrar och flyttar data mellan dem. På mjukvarusidan utökade CUDA, DOCA och den bredare mjukvarustacken NVIDIAs räckvidd till hur hårdvaran programmeras och drivs. Tillsammans gav dessa delar företaget kontroll över en stor del av den accelererade datorplattformen.
Men plattformen behövde fortfarande en processor för allmänt bruk. Något var tvunget att köra operativsystemet, förbereda data, hantera applikationer och koordinera arbetet som skickades till acceleratorerna. Under en stor del av NVIDIAs expansion fyllde Intel och AMD den rollen. Det placerade NVIDIA i en besvärlig position: de kunde leverera grafikkorten, nätverket och mycket av programvaran samtidigt som de fortfarande var beroende av ett annat företags processor i mitten av servern.
Grace var det första stora steget mot att ändra på det. Byggt kring Arm Neoverse V2-kärnor gav det NVIDIA en datacenter-CPU och ett sätt att ansluta den processorn närmare sina GPU:er via NVLink-C2C. Grace lämnade dock ett prestandagap att täcka. Dess minnesbandbredd och effektivitet gjorde den konkurrenskraftig som en AI-värd-CPU, men ledande x86-processorer behöll betydande fördelar i de flesta andra arbetsbelastningar. Den ojämna prestandan begränsade argumentet för att välja Grace som en generell ersättning för en EPYC- eller Xeon-server.
Vera täcker en stor del av den luckan genom att ersätta Graces Neoverse V2-kärnor med NVIDIAs specialdesignade Olympus och avsevärt öka minnesbandbredden och kapaciteten. Genom att leverera en konkurrenskraftig processor vid sidan av sina GPU:er, DPU:er och nätverk kan NVIDIA ta en större andel av utgifterna för varje server. Det ger också företaget större kontroll över sitt ekosystem och hur komponenterna fungerar tillsammans: CPU-kärnorna, minnesundersystemet, sammankopplingen och GPU:n kan utformas kring samma krav. Veras sammanhängande CPU-till-GPU-länk, nu klassad till upp till 1.8 TB/s, är ett konkret exempel på den integrationen.
Att fånga upp mer av varje systems utgifter är bara en del av bilden. Förstärkningsinlärning (RL) och agentbaserad AI ger NVIDIA ytterligare en anledning att erbjuda ett fristående CPU-system. En agent gör mer än att generera ett svar. Den anropar verktyg, hämtar information, kör kod och kontrollerar resultaten innan den bestämmer vad den ska göra härnäst. Mycket av den exekveringen sker på processorer, och när nästa modellsteg beror på resultatet av en CPU-uppgift försenar långsam exekvering hela sekvensen. Prestanda per kärna, minneslatens och förutsägbart beteende under belastning blir därför viktiga för agentens respons.
Olympuskärnan
Dessa krav stämmer väl överens med designen av Veras 88 Olympus-kärnor, som är byggda kring en tydlig prioritet: stark prestanda från varje kärna, som upprätthålls när hela sockeln är upptagen. Olympus är NVIDIAs implementering av instruktionsuppsättningen Armv9.2 och ersätter Neoverse V2-kärnorna som används i Grace. Den skillnaden är viktig: Arm definierar instruktionerna som processorn kör, medan NVIDIA designade maskineriet som hämtar, schemalägger och exekverar dem. Den kontrollen låter NVIDIA finjustera kärnan för sitt mål: att slutföra enskilda uppgifter snabbt samtidigt som många körs samtidigt.
Den första halvan av det målet börjar med instruktioner per cykel, eller IPC: hur många instruktioner en kärna slutför i genomsnitt under varje klockcykel. Klockhastigheten avgör hur ofta dessa cykler inträffar; mikroarkitekturen avgör hur mycket användbart arbete som får plats i dem. NVIDIA hävdar en 1.5x IPC-förbättring jämfört med sin tidigare generation. Den högsta klockfrekvensen vi observerade var 3.41 GHz, men Veras arkitektur betonar att extrahera mer arbete per cykel och bibehålla den utvecklingen under belastning. Den betoningen är viktig eftersom ytterligare kärnor ensamma, för en kompilator-, tolk- eller databasoperation med en lång sekvens av beroende steg, inte kan få den sekvensen att slutföras snabbare.
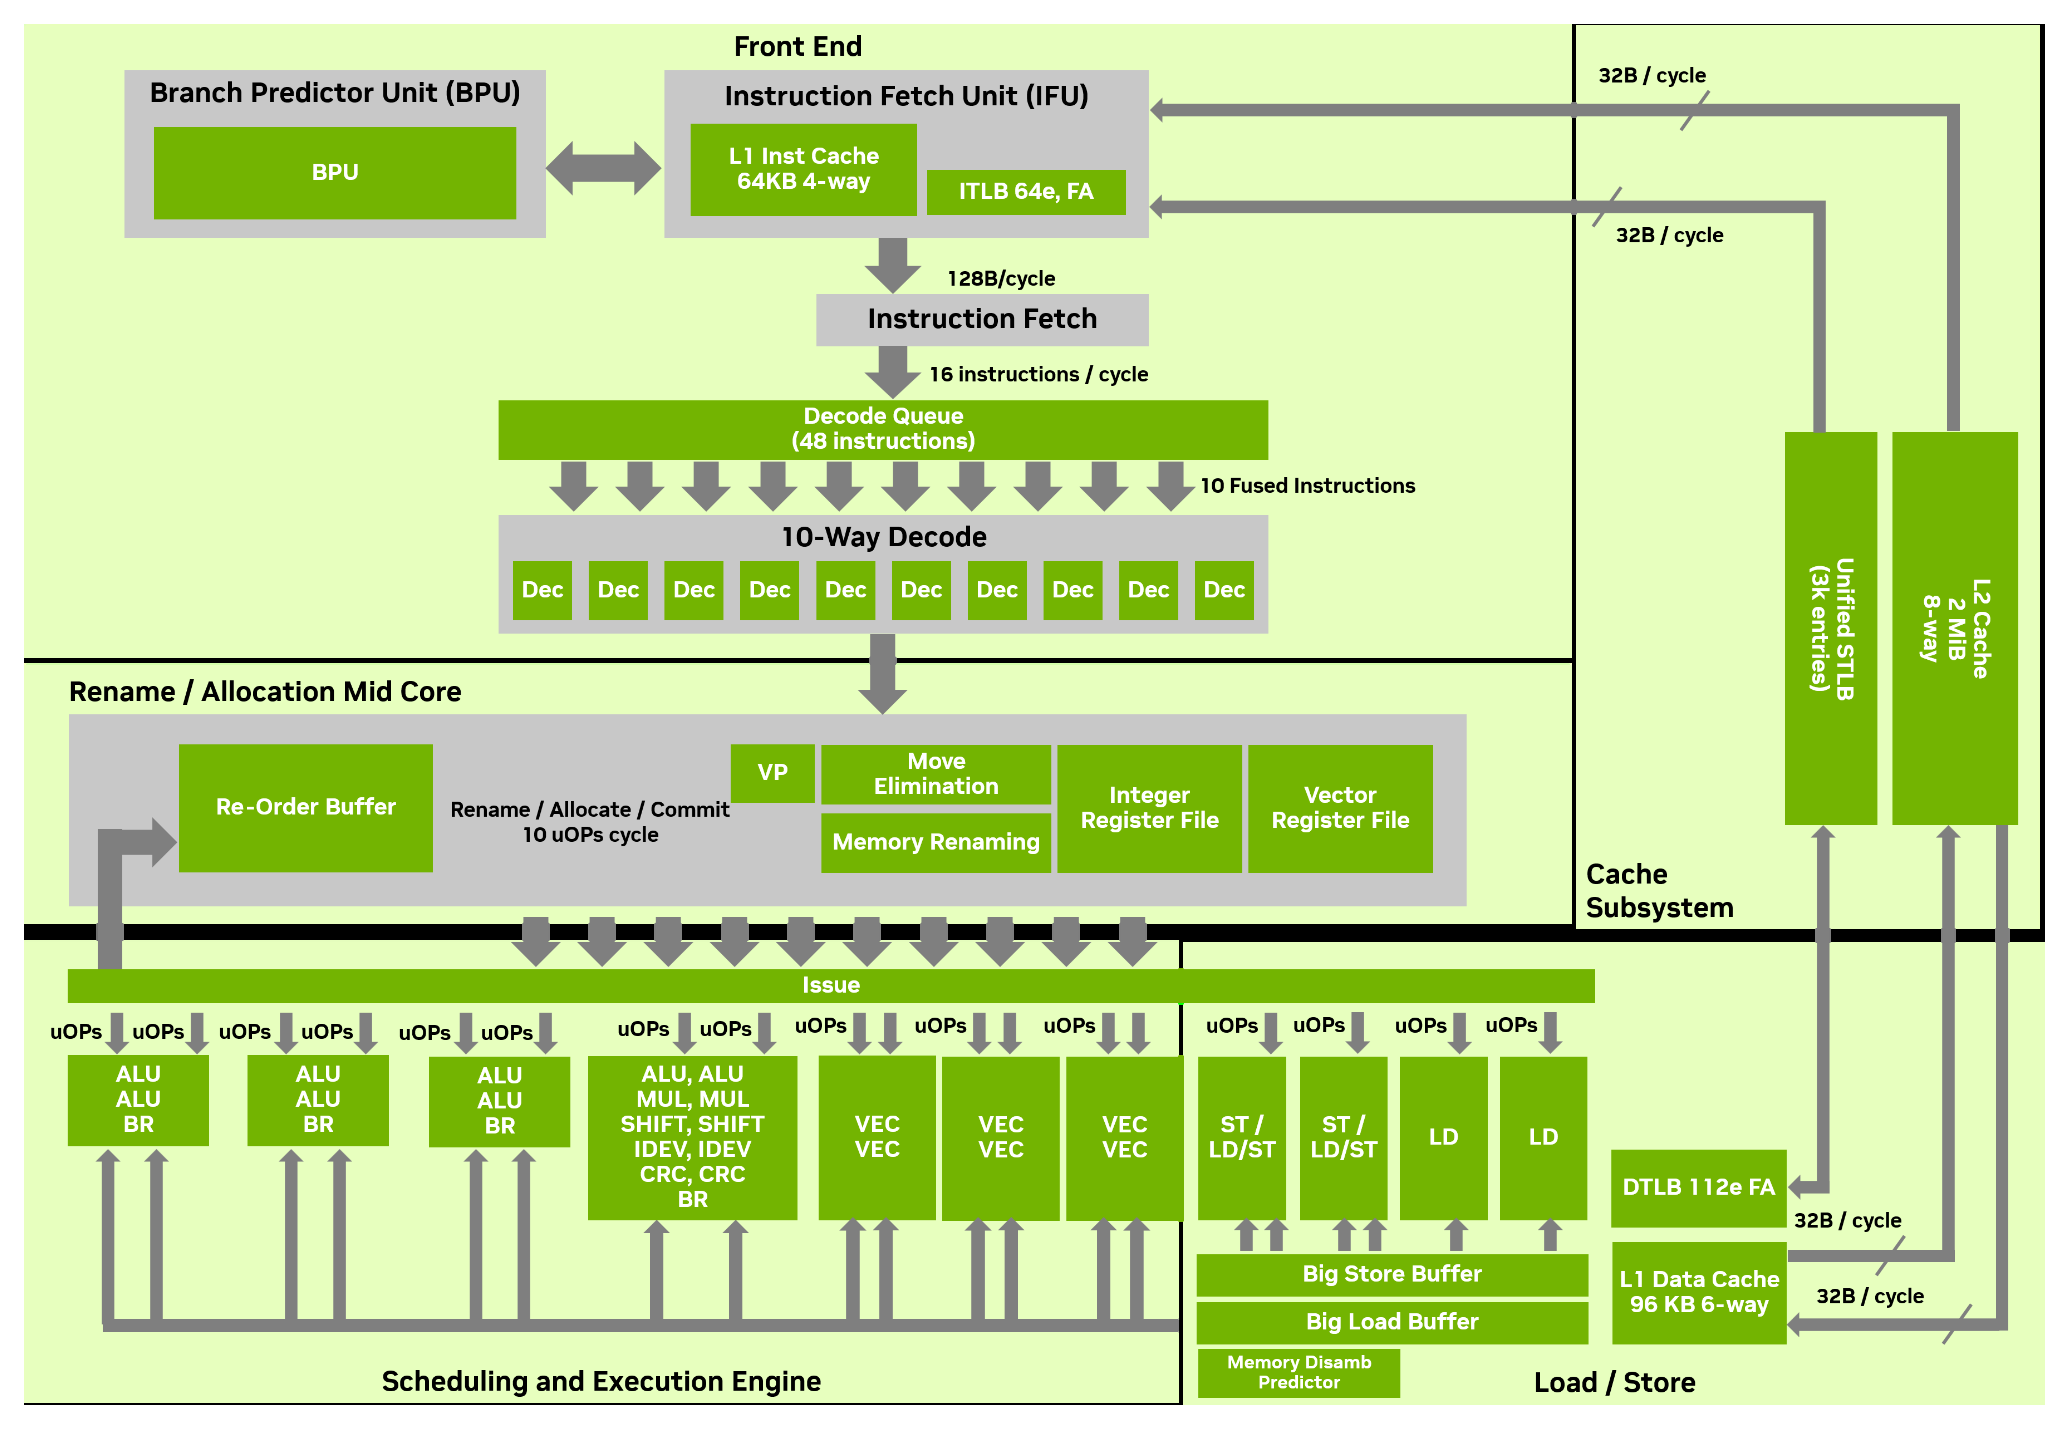
Att uppnå den IPC:n börjar med en stadig tillgång på användbara instruktioner. Olympus frontend, den del av kärnan som hämtar och avkodar programinstruktioner, kan avkoda upp till tio instruktioner per cykel. Den bredden spelar bara roll om den fortsätter att matas, vilket blir svårt när programvara ofta förgrenar sig mellan kodvägar. Olympus kombinerar därför en neural grenprediktor med andra specialiserade prediktorer och stöder upp till två tagna grenar per cykel. Bättre prediktion hjälper kärnan att hämta de instruktioner den behöver, vilket minskar tiden som går åt till att köra fel väg och starta om efter ett misstag.
När dessa instruktioner har hämtats och avkodats använder Olympus exekvering i fel ordning för att hitta arbete som kan fortsätta medan tidigare instruktioner väntar. Om till exempel en operation väntar på minne kan en oberoende beräkning exekveras före den. Ett stort instruktionsfönster ger processorn fler möjligheter att hitta det oberoende arbetet.
Trots detta motstår vissa sekvenser, som de beroende kedjor som beskrivs ovan, denna metod eftersom varje steg behöver resultatet från föregående steg. För dessa använder Olympus också värdeprediktion för att låta beroende operationer börja med ett förutsagt värde och sedan kontrollera det värdet när det faktiska resultatet blir tillgängligt. Korrekta förutsägelser kan minska den effektiva väntetiden längs dessa beroendekedjor; felaktiga förutsägelser kräver att det spekulativa arbetet korrigeras och beräknas om.
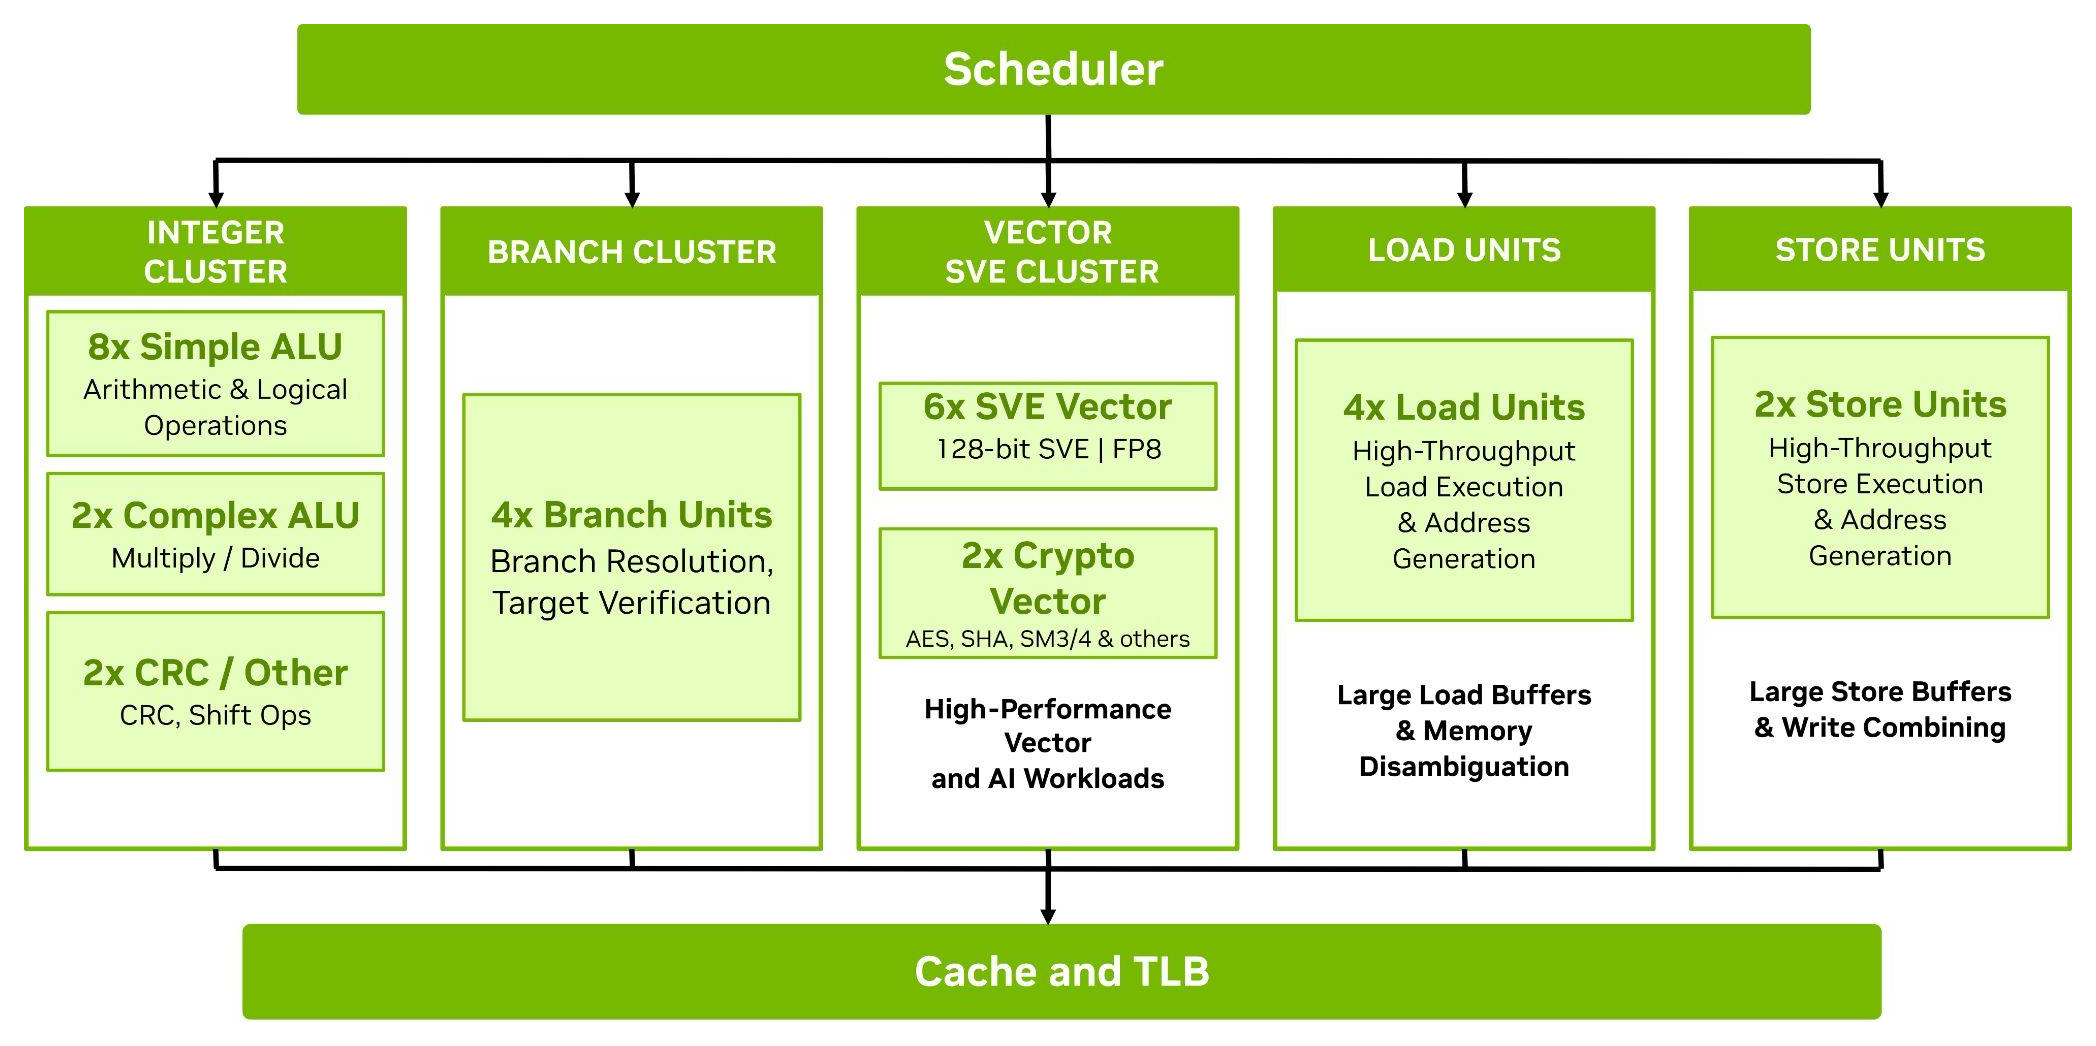
Exekveringsmotorn behöver sedan tillräckligt med kapacitet för att omvandla den instruktionstillförseln till färdigt arbete. Olympus kombinerar breda heltalsexekveringsresurser med dedikerade grenenheter, fyra laddningspipelines och två lagringspipelines. Dessa resurser uppfyller olika krav: heltalsenheter hanterar aritmetik, jämförelser och logik; grenenheter löser kontrollflöde; och laddnings-/lagringspipelines flyttar data mellan kärnan och dess cachar. Balansen spelar roll eftersom en bredare avkodare skulle erbjuda liten nytta om instruktionerna helt enkelt säkerhetskopieras bakom en exekverings- eller minnesflaskhals.
Vid sidan av dessa skalära resurser har Olympus sex 128-bitars vektorpipelines som stöder SVE2, med FP8-stöd och kryptografiska funktioner i två pipelines. Vektorinstruktioner tillämpar en operation på flera dataelement, vilket gör dem användbara för numeriskt arbete, komprimering och databehandling.
Detta är ett område där Olympus gör en tydlig avvägning: dess 128-bitars vektorbredd är mindre än den 512-bitars bredd som är tillgänglig via AVX-512 på konkurrerande x86-processorer. Skillnaden är viktig för optimerade numeriska kärnor och till och med tokenizers, även om applikationens prestanda också beror på dataflödet för de specifika instruktionerna, den genererade koden och datatillförseln. Vetenskapliga tillämpningar som GROMACS förblir därför ett separat test av designens styrkor.
Var och en av dessa exekveringsresurser, skalära eller vektorbaserade, är beroende av att data anländer i tid, så det är lika viktigt att hålla ofta använda data nära exekveringsmotorn. Varje kärna har en instruktionscache på 64 kB, en datacache på 96 kB och en privat L2-cache på 2 MB. De små cacharna på första nivån ger snabb åtkomst till de mest omedelbart användbara instruktionerna och data; den större L2-nivån behåller mer av kärnans arbetsmängd innan en åtkomst måste färdas längre genom processorn. Att ge varje kärna en betydande privat L2 stöder samma mål per kärna: mer arbete kan hanteras lokalt, vilket minskar trycket på delad cache och huvudminne.
Förhämtning kompletterar dessa cacher genom att hämta data innan en instruktion begär den. Vid sidan av förhämtningsfunktioner för vanliga åtkomstmönster inkluderar Olympus en grafförhämtare för indirekta åtkomster som A[B[i]], där en sökning tillhandahåller indexet för en annan. Efter att ha lärt sig det sambandet kan hårdvaran börja hämta den andra datadelen innan programmet begär det. Detta hjälper till att åtgärda ett vanligt problem vid grafbearbetning och andra oregelbundna arbetsbelastningar: processorn har gott om exekveringskapacitet, men framstegen beror på att hitta nästa datadel.
Den sista delen av Olympus tar itu med den andra halvan av sitt mål: att köra många uppgifter samtidigt. Varje kärna stöder två hårdvarutrådar, vilket ger Vera 176 trådar per sockel. NVIDIA kallar sitt schema Spatial Multithreading. Kärnan kan dedikera sina resurser till en aktiv tråd eller dela resurser mellan två aktiva trådar, vilket ger ett val mellan att koncentrera exekveringskapaciteten på en instruktionsström och stödja mer samtidigt arbete.
NVIDIAs uttalade mål är att minska störningar mellan de två trådarna, vilket gör prestandan mer förutsägbar när båda är upptagna, vilket är samma förutsägbarhet som agentarbetsbelastningar är beroende av under belastning. De två trådarna delar fortfarande en fysisk kärna och det bredare minnessystemet, så partitionering av resurser garanterar inte en fast applikationslatens.
Struktur, minne och I/O
Utöver den enskilda kärnan kräver det mer än en snabb anslutning till DRAM för att hålla 88 breda kärnor produktiva. Kärnorna behöver också utbyta data, komma åt delad cache och kommunicera med anslutna enheter. Vera kopplar samman dessa resurser genom andra generationen av NVIDIAs Scalable Coherency Fabric, ett internt nät som också håller cachade kopior av delad data koherenta. Kärnorna, nätet och 164 MB systemnivåcache sitter på en enda datorkrets, med minneskontroller och I/O på angränsande chiplets. NVIDIA betygsätter nätet till 3.4 TB/s bisektionsbandbredd, ett mått på trafikkapacitet över nätet, separat från huvudminnesbandbredden.
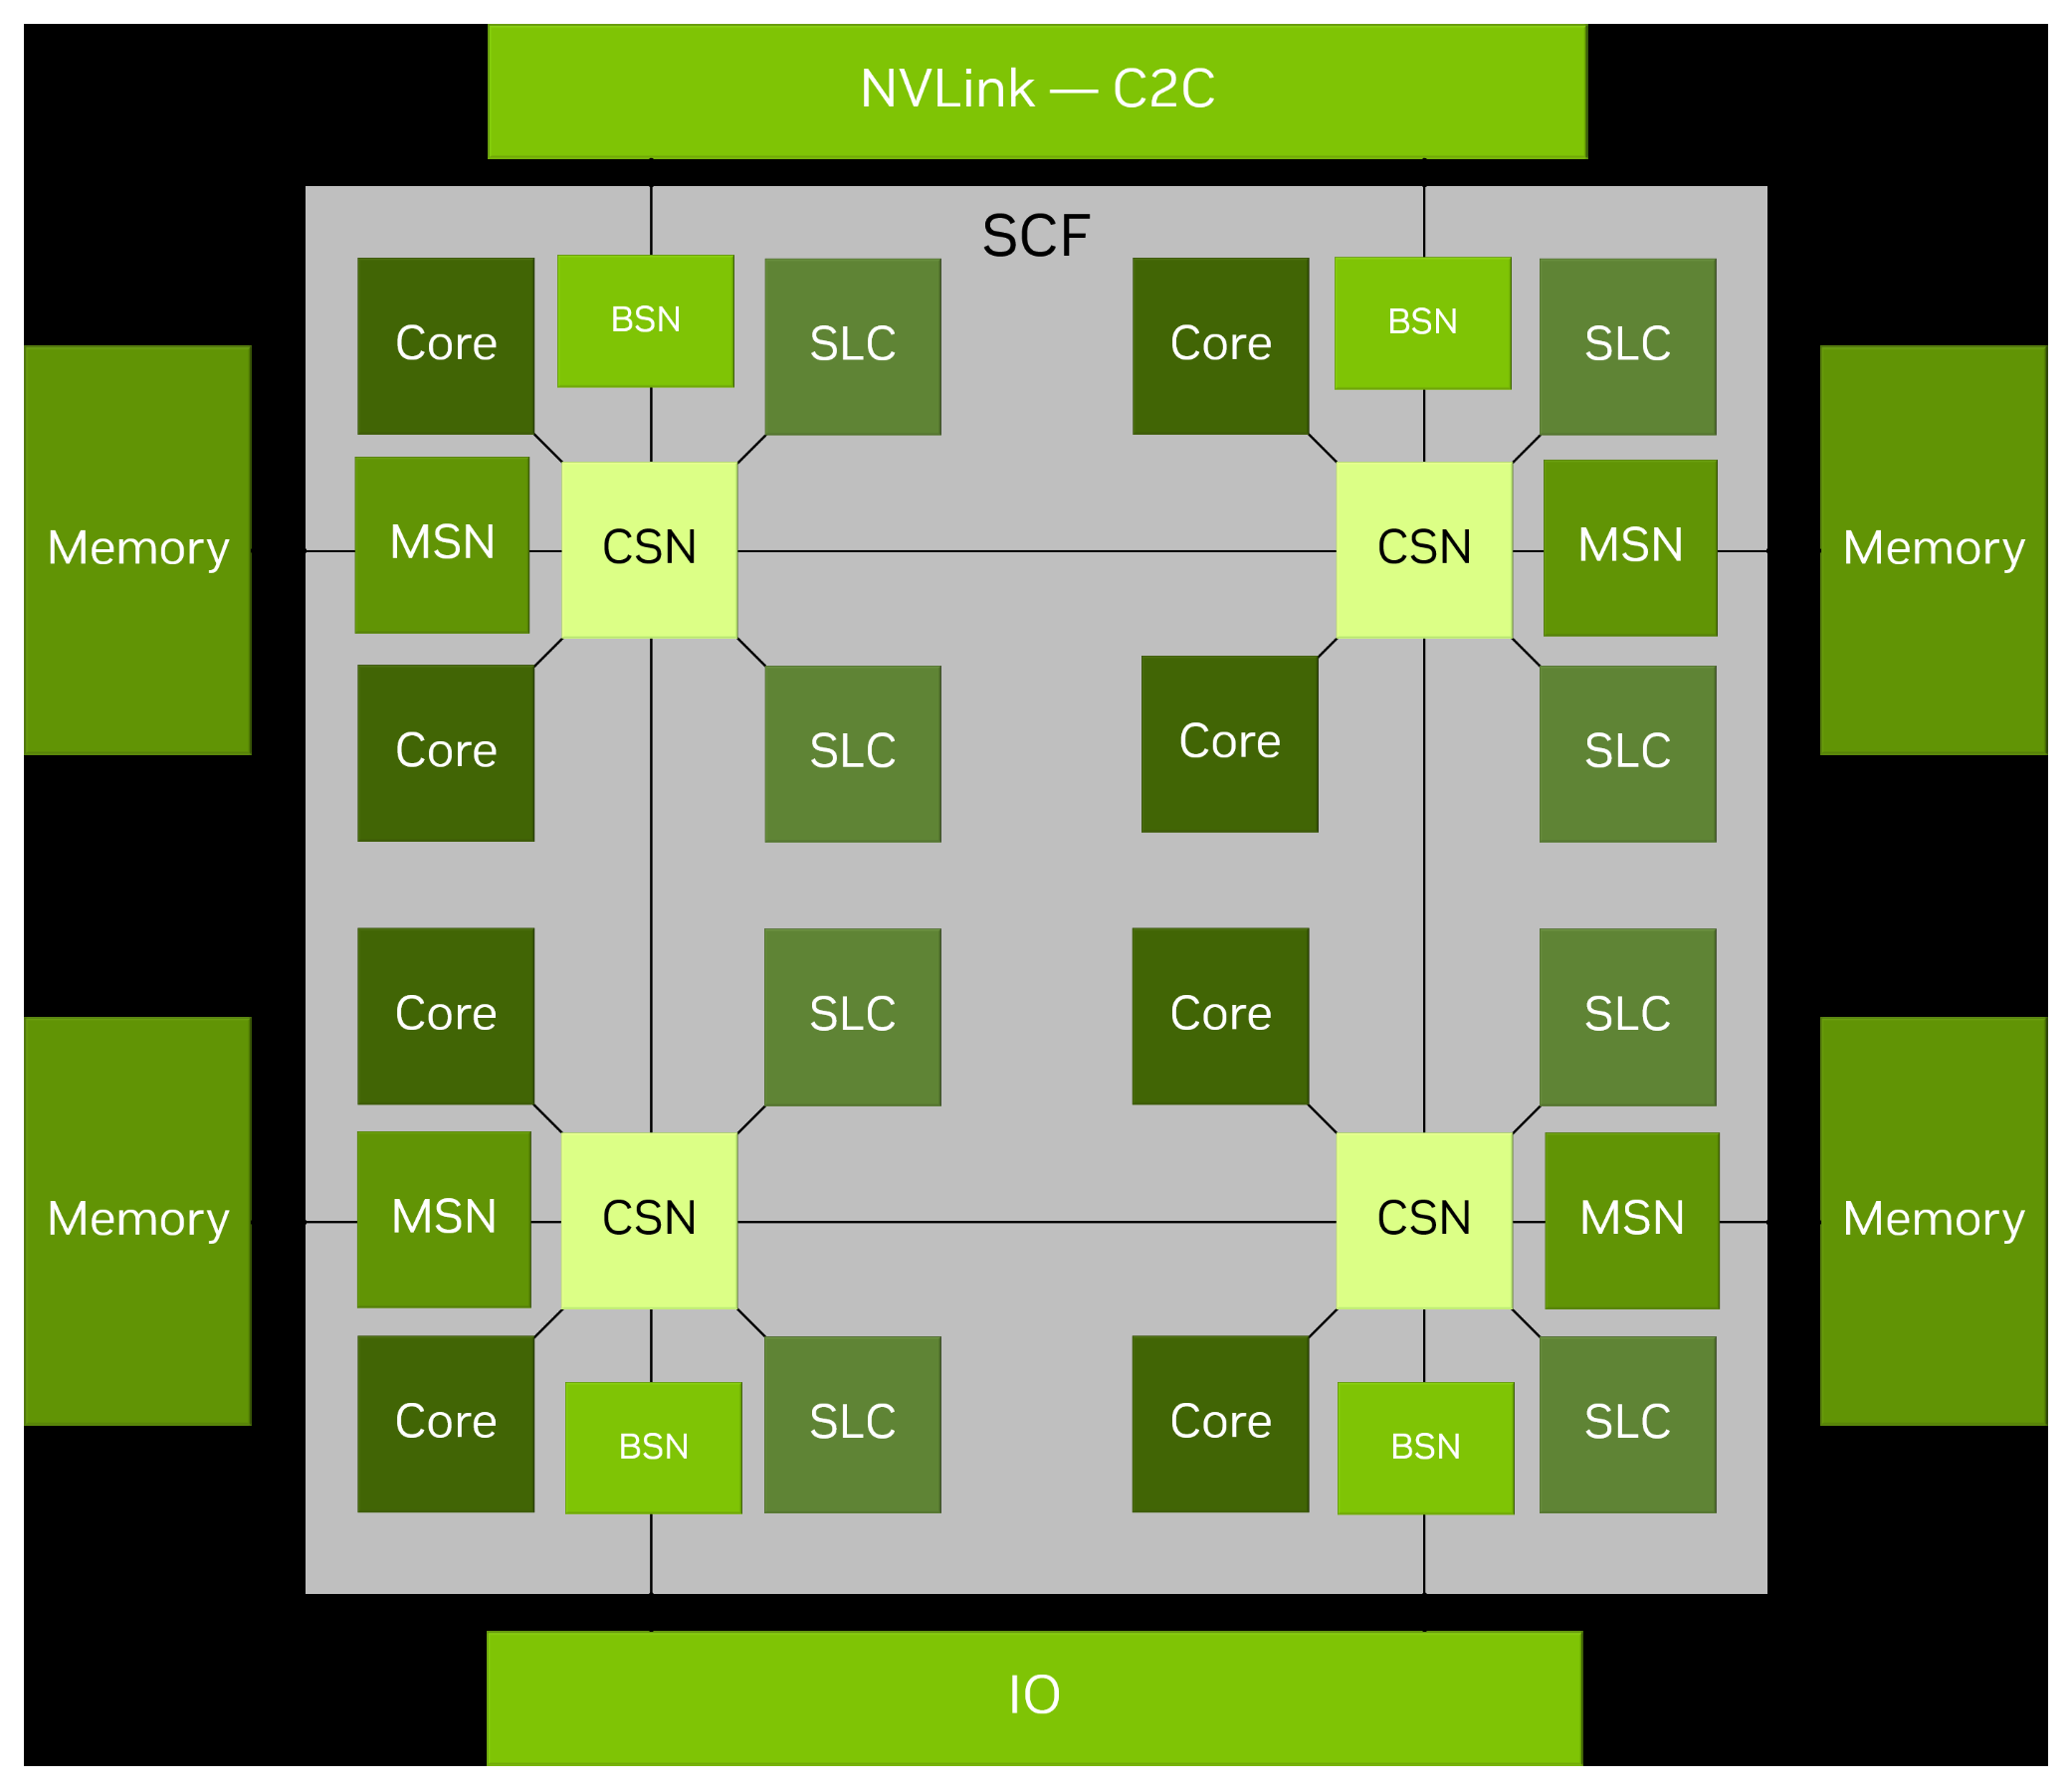
Den där layouten med en enda krets undviker överföringar mellan separata beräkningskretsar när kärnor kommunicerar eller har åtkomst till delad cache. För programvara presenterar Vera också en NUMA-nod per socket: operativsystemet ser varje socket som en grupp kärnor och lokalt anslutet minne. Detta förenklar placeringen i socketen, även om det inte betyder att varje väg genom meshen har identisk latens. En server med två sockets har fortfarande två NUMA-noder, och åtkomsten till den andra sockets minne förblir annorlunda än åtkomsten till lokalt minne.
Inom varje sockel ligger den delade systemnivåcachen, eller L3, en nivå utöver de privata L2-cacher som beskrivits tidigare. Det ger kärnorna ytterligare en chans att återanvända data utan att gå till DRAM och tillhandahåller delad kapacitet som är tillgänglig över sockeln. Dess 164 MB är betydande, men vissa konkurrerande processorer erbjuder betydligt mer L3. Det spelar roll när en upprepade gånger åtkomlig arbetsuppsättning är för stor för en kärnas L2 men får plats i en större delad cache. Hög DRAM-bandbredd hjälper när data måste komma från minnet; det tar inte bort fördelen med att undvika den åtkomsten från första början.
Eftersom den kapaciteten delas stöder Vera även Arm MPAM, vilket gör det möjligt för systemprogramvara att partitionera delad cachekapacitet och hantera minnesbandbreddsallokeringar mellan arbetsbelastningar.
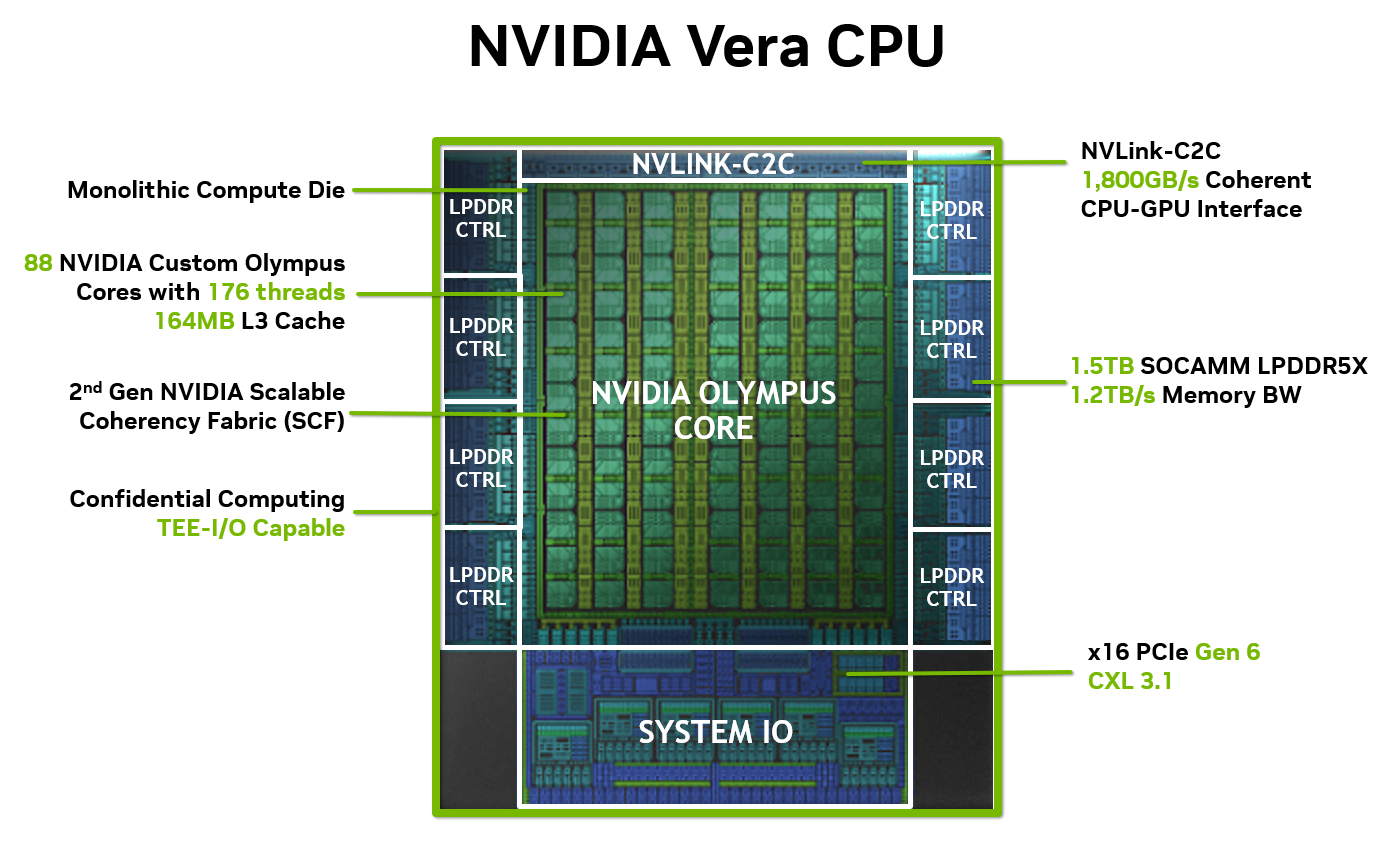
När åtkomster når huvudminnet har Vera avsevärd bandbredd tillgänglig. Åtta 128-bitars LPDDR5X-styrenheter ger ett aggregerat gränssnitt på 1 024 bitar, med minne som körs med upp till 9 600 MT/s för en nominell hastighet på 1.2 TB/s per sockel. Minnet sitter på åtta flyttbara SOCAMM2-moduler, som kombinerar LPDDR5X med moduler som kan bytas ut på plats. Detta ger Vera ett brett och snabbt minnesgränssnitt utan att behöva fastlödt minne.
Rå bandbredd är dock bara en del av bilden. Det mer användbara förhållandet är mellan den bandbredden och antalet kärnor som delar den. Att dividera de nominella 1.2 TB/s med 88 kärnor ger cirka 13.6 GB/s per fysisk kärna. Detta är ett sätt att beskriva processorns balans, inte en dedikerad allokering eller en garanti för vad varje tråd får. Att öka antalet kärnor utan en motsvarande ökning av minnesbandbredden skulle minska det förhållandet.
Om vi dividerar vår uppmätta STREAM-bandbredd med antalet fysiska kärnor får vi 11.8 GB/s per kärna på Vera, jämfört med 3.8 GB/s på Xeon 6978P-systemet med 240 kärnor. Det är ett konkret exempel på hur Vera levererar en betydande minnesgenomströmning i förhållande till sina beräkningsresurser.
Energieffektivitet är en del av samma designval. NVIDIA uppskattar ungefär 30 W till 40 W för ett fullt utrustat LPDDR5X-minnessystem, beroende på kapacitet. Det attraktiva med LPDDR5X är att leverera denna bandbredd samtidigt som minnets bidrag till serverns totala effekt hålls lågt, vilket lämnar mer av systemets effekt- och kylningsbudget tillgänglig för beräkning.
Bandbredd och effektivitet säger fortfarande ingenting om hur mycket data som får plats, och kapaciteten förblir en separat faktor. NVIDIA specificerar upp till 1.5 TB direktansluten LPDDR5X per sockel, eller 3 TB över två socklar. För arbetsbelastningar som behöver deras arbetsuppsättning i minnet kan högre överföringshastigheter inte kompensera för otillräcklig kapacitet.
Där den direktanslutna kapaciteten inte räcker till, erbjuder Veras I/O en väg till mer, tillsammans med anslutningar för enheter. Den fristående CPU-plattformen tillhandahåller 88 PCIe Gen6-banor per sockel för nätverk, lagring och acceleratorer, medan Vera Rubin-konfigurationen exponerar 96. På minnessidan inkluderar CXL 3.1-stödet typ 3-minnesenheter och minnespoolning, vilket gör att kapaciteten kan sträckas bortom SOCAMM2-modulerna. Det utökade minnet använder en annan åtkomstväg än den direktanslutna LPDDR5X, så dess prestanda måste utvärderas separat.
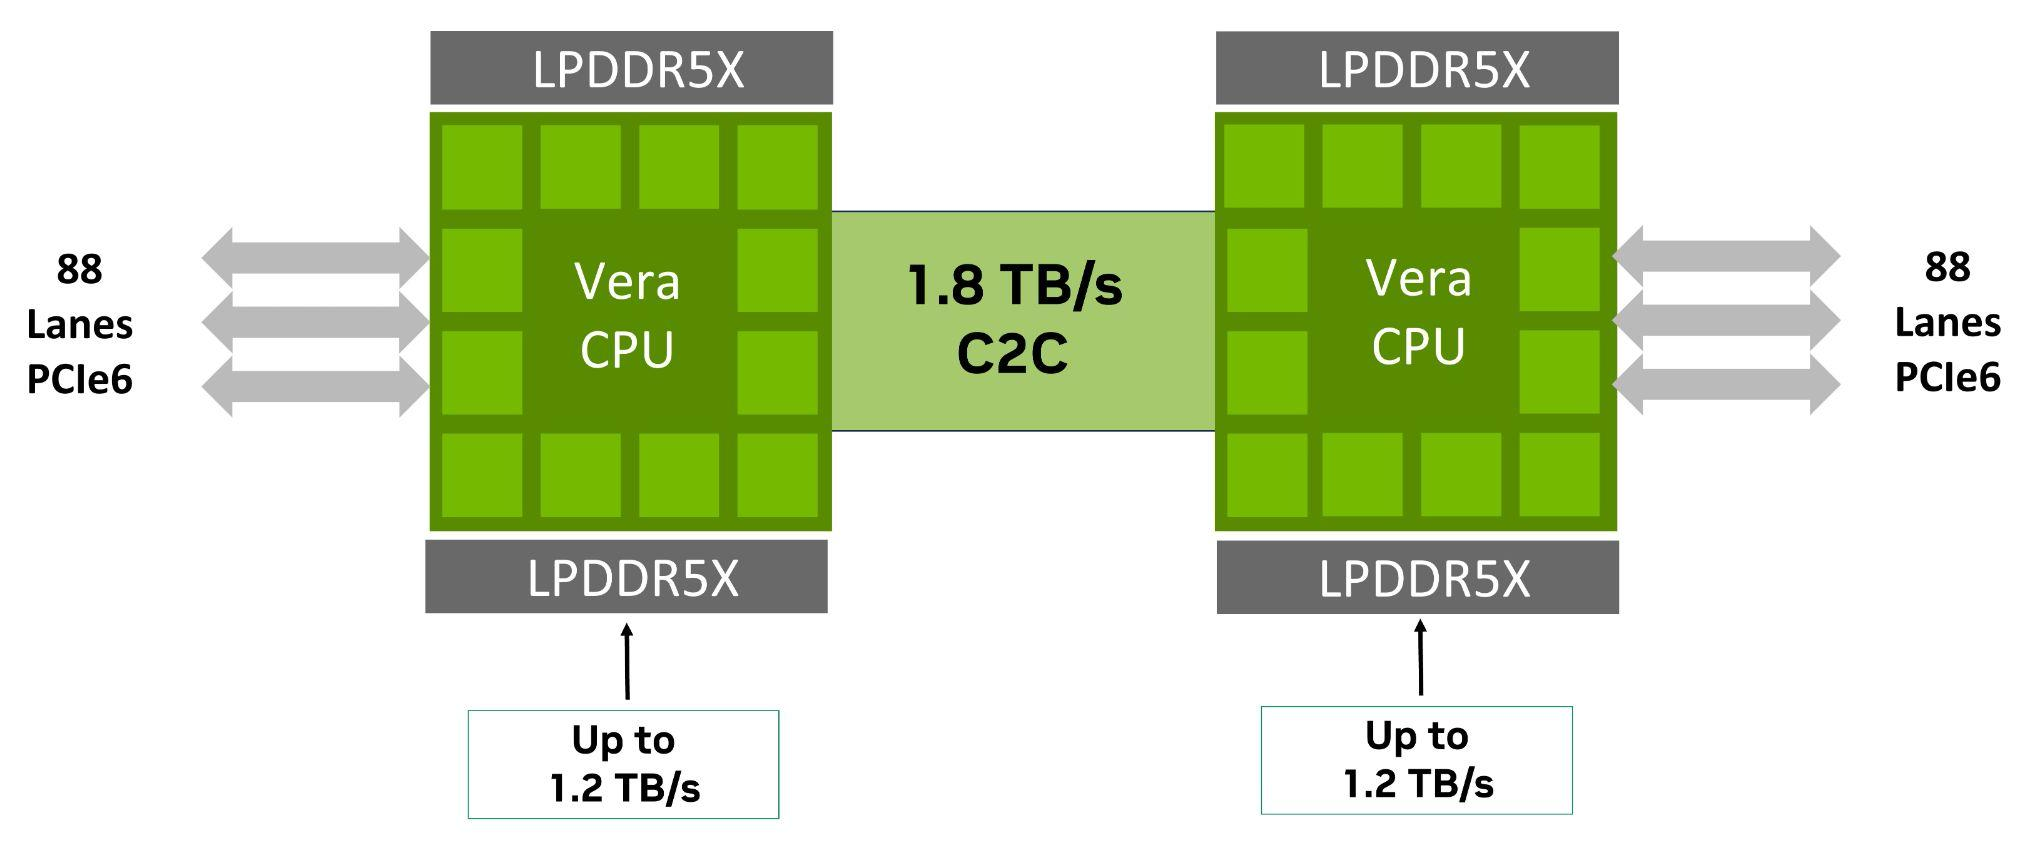
Slutligen, för kommunikation mellan processorer, använder Vera andra generationens NVLink-C2C, efterföljaren till länken som introducerades med Graces superchips. Den kopplar samman två Vera-processorer i en server med dubbla socklar eller länkar Vera till Rubin-grafikprocessorer i ett superchip. Länken ger upp till 1.8 TB/s aggregerad dubbelriktad bandbredd, eller 900 GB/s i varje riktning, och den återspeglar samma täta CPU-GPU-integration som driver NVIDIAs satsning på CPU-branschen från första början.
Inuti MGX Vera C2-referensservern
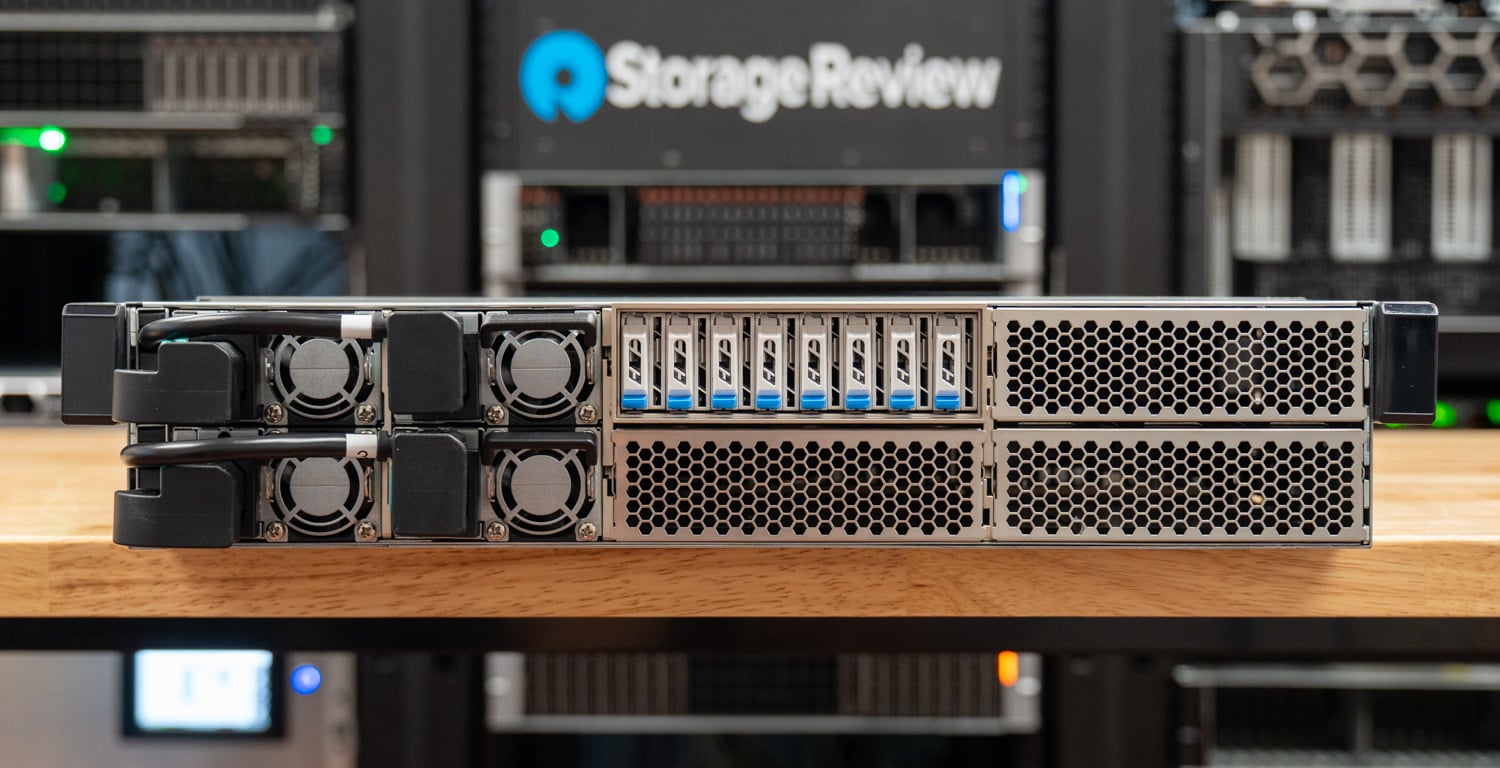
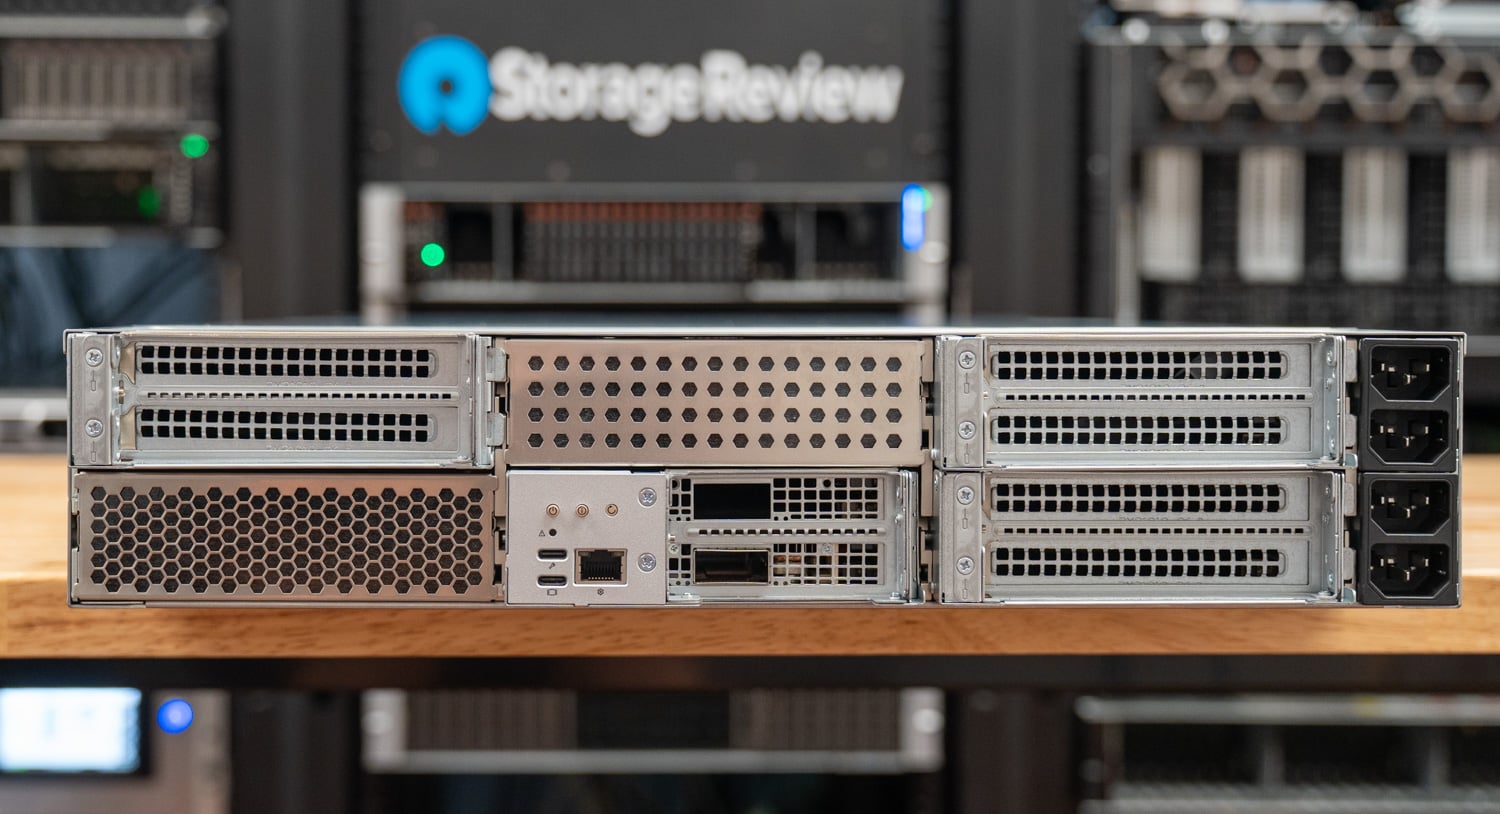
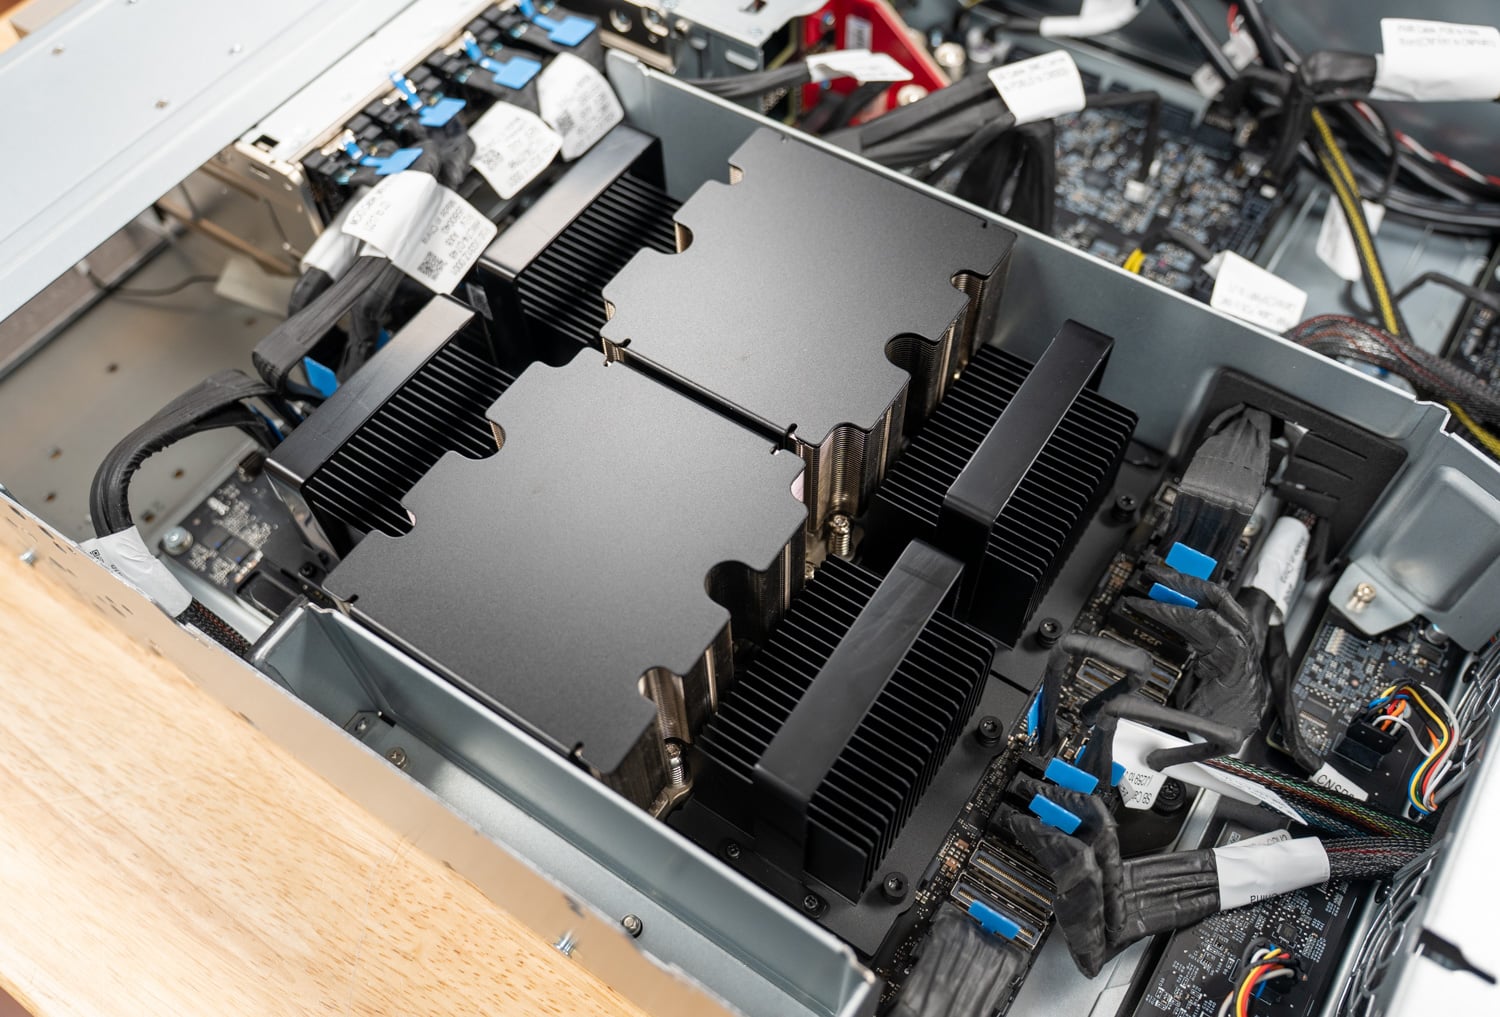
Vår testenhet är NVIDIAs MGX Vera C2, en luftkyld 2U-referensserver med dubbla socklar som NVIDIAs partners använder som bas för sina första Vera-system. Åtta E1.S-fack löper över frontpanelens ovansida bredvid fyra hot-swap-nätaggregat med Delta-uttag, med bikakeformade intag som fyller resten av frontpanelen. Eftersom nätaggregaten laddas framifrån förblir baksidan fri för I/O-kablar i ett rack och används för PCIe-risers och management-I/O.
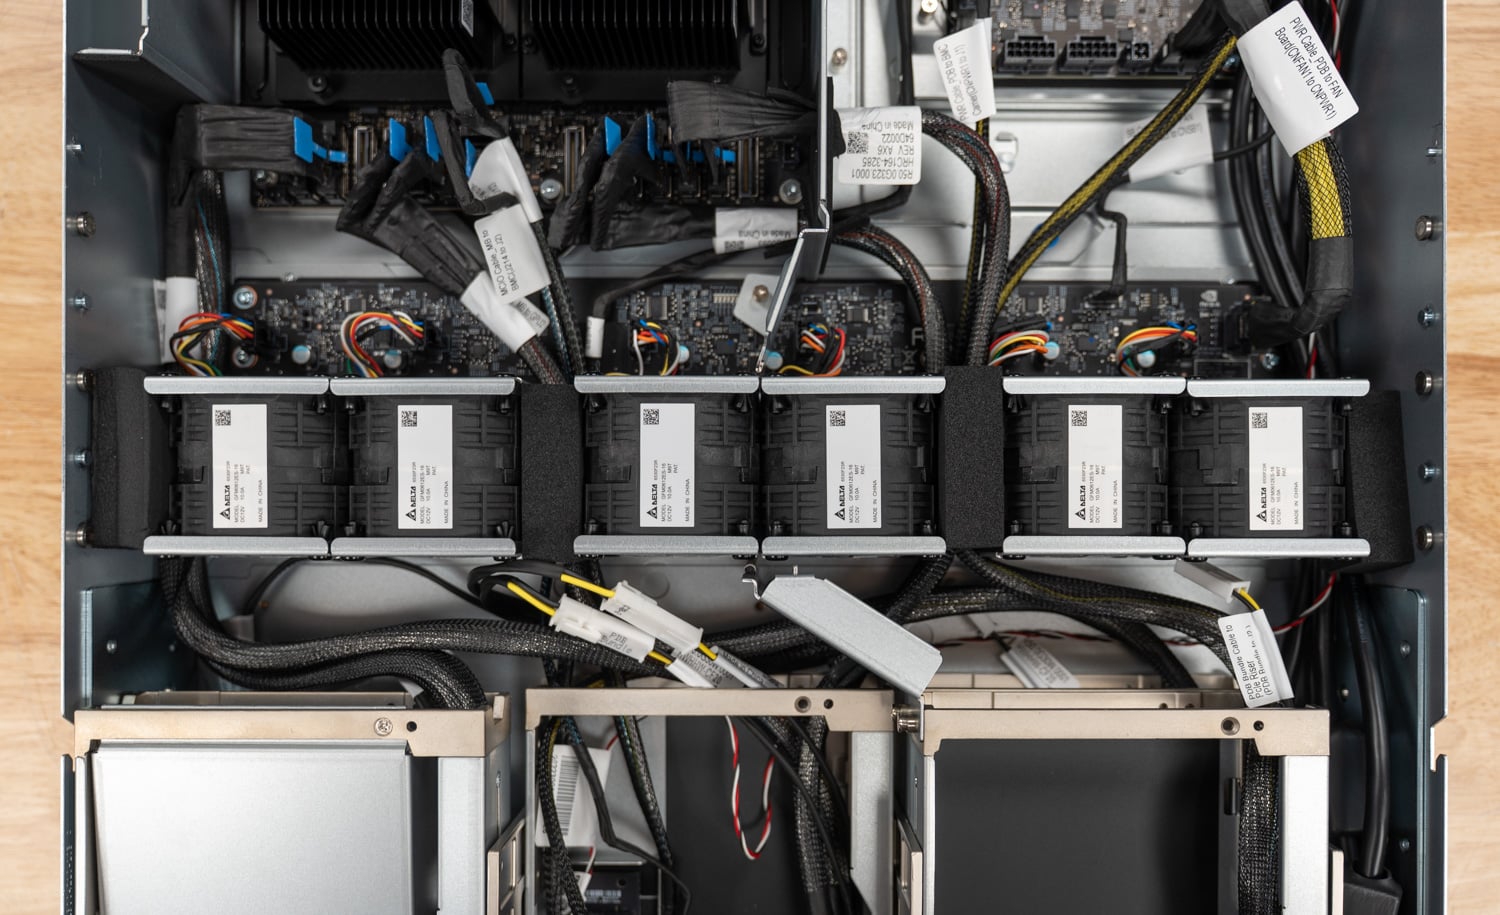
Inuti sitter de två Vera-processorerna sida vid sida under passiva kylflänsar, med SOCAMM2-moduler längs sina flanker. En vägg med sex fläktmoduler i mitten av chassit, precis bakom enhetsfacken, drar luft över båda socklarna, och skumblock mellan varje fläktpar styr luftflödet. Ur kylningssynpunkt är layouten väl genomtänkt.
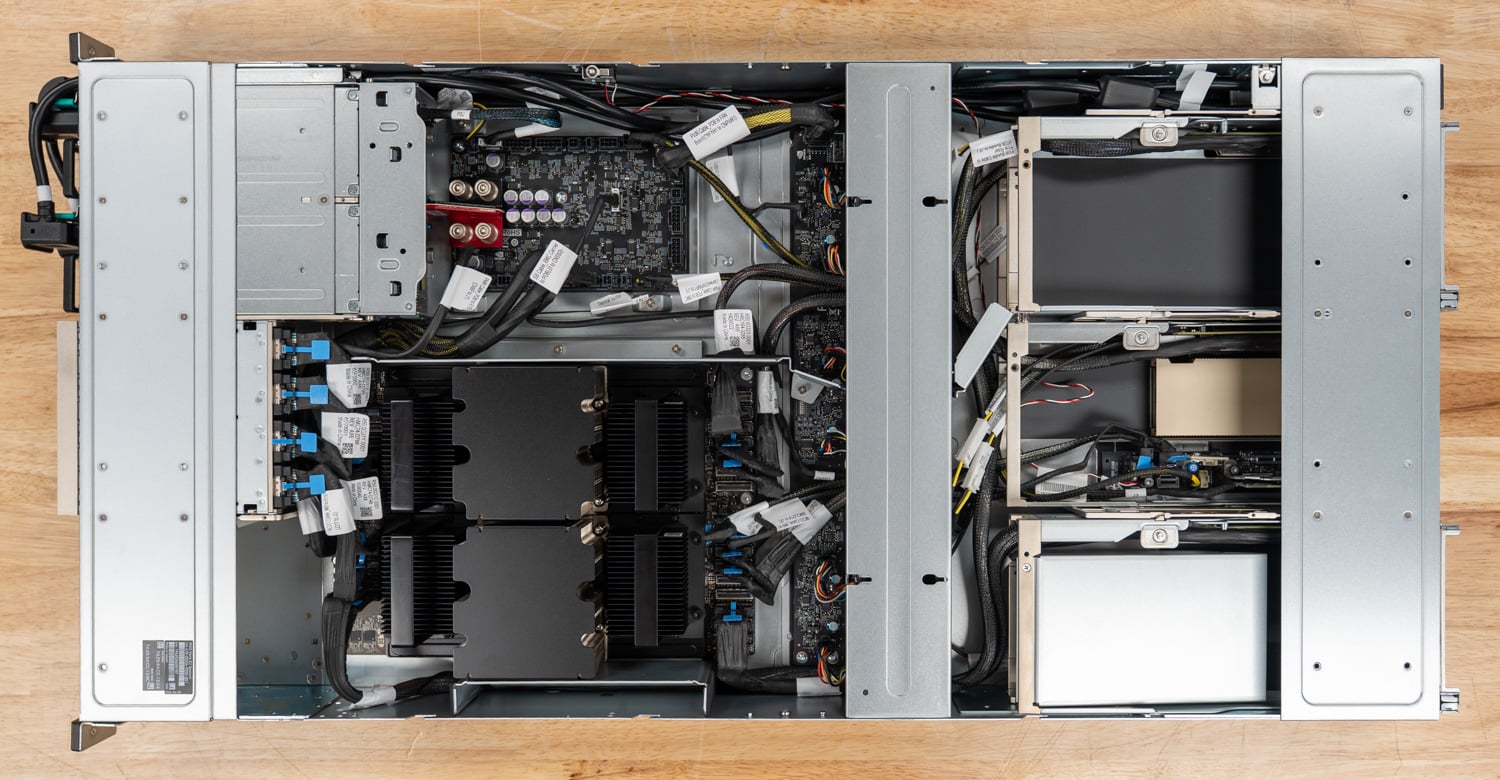
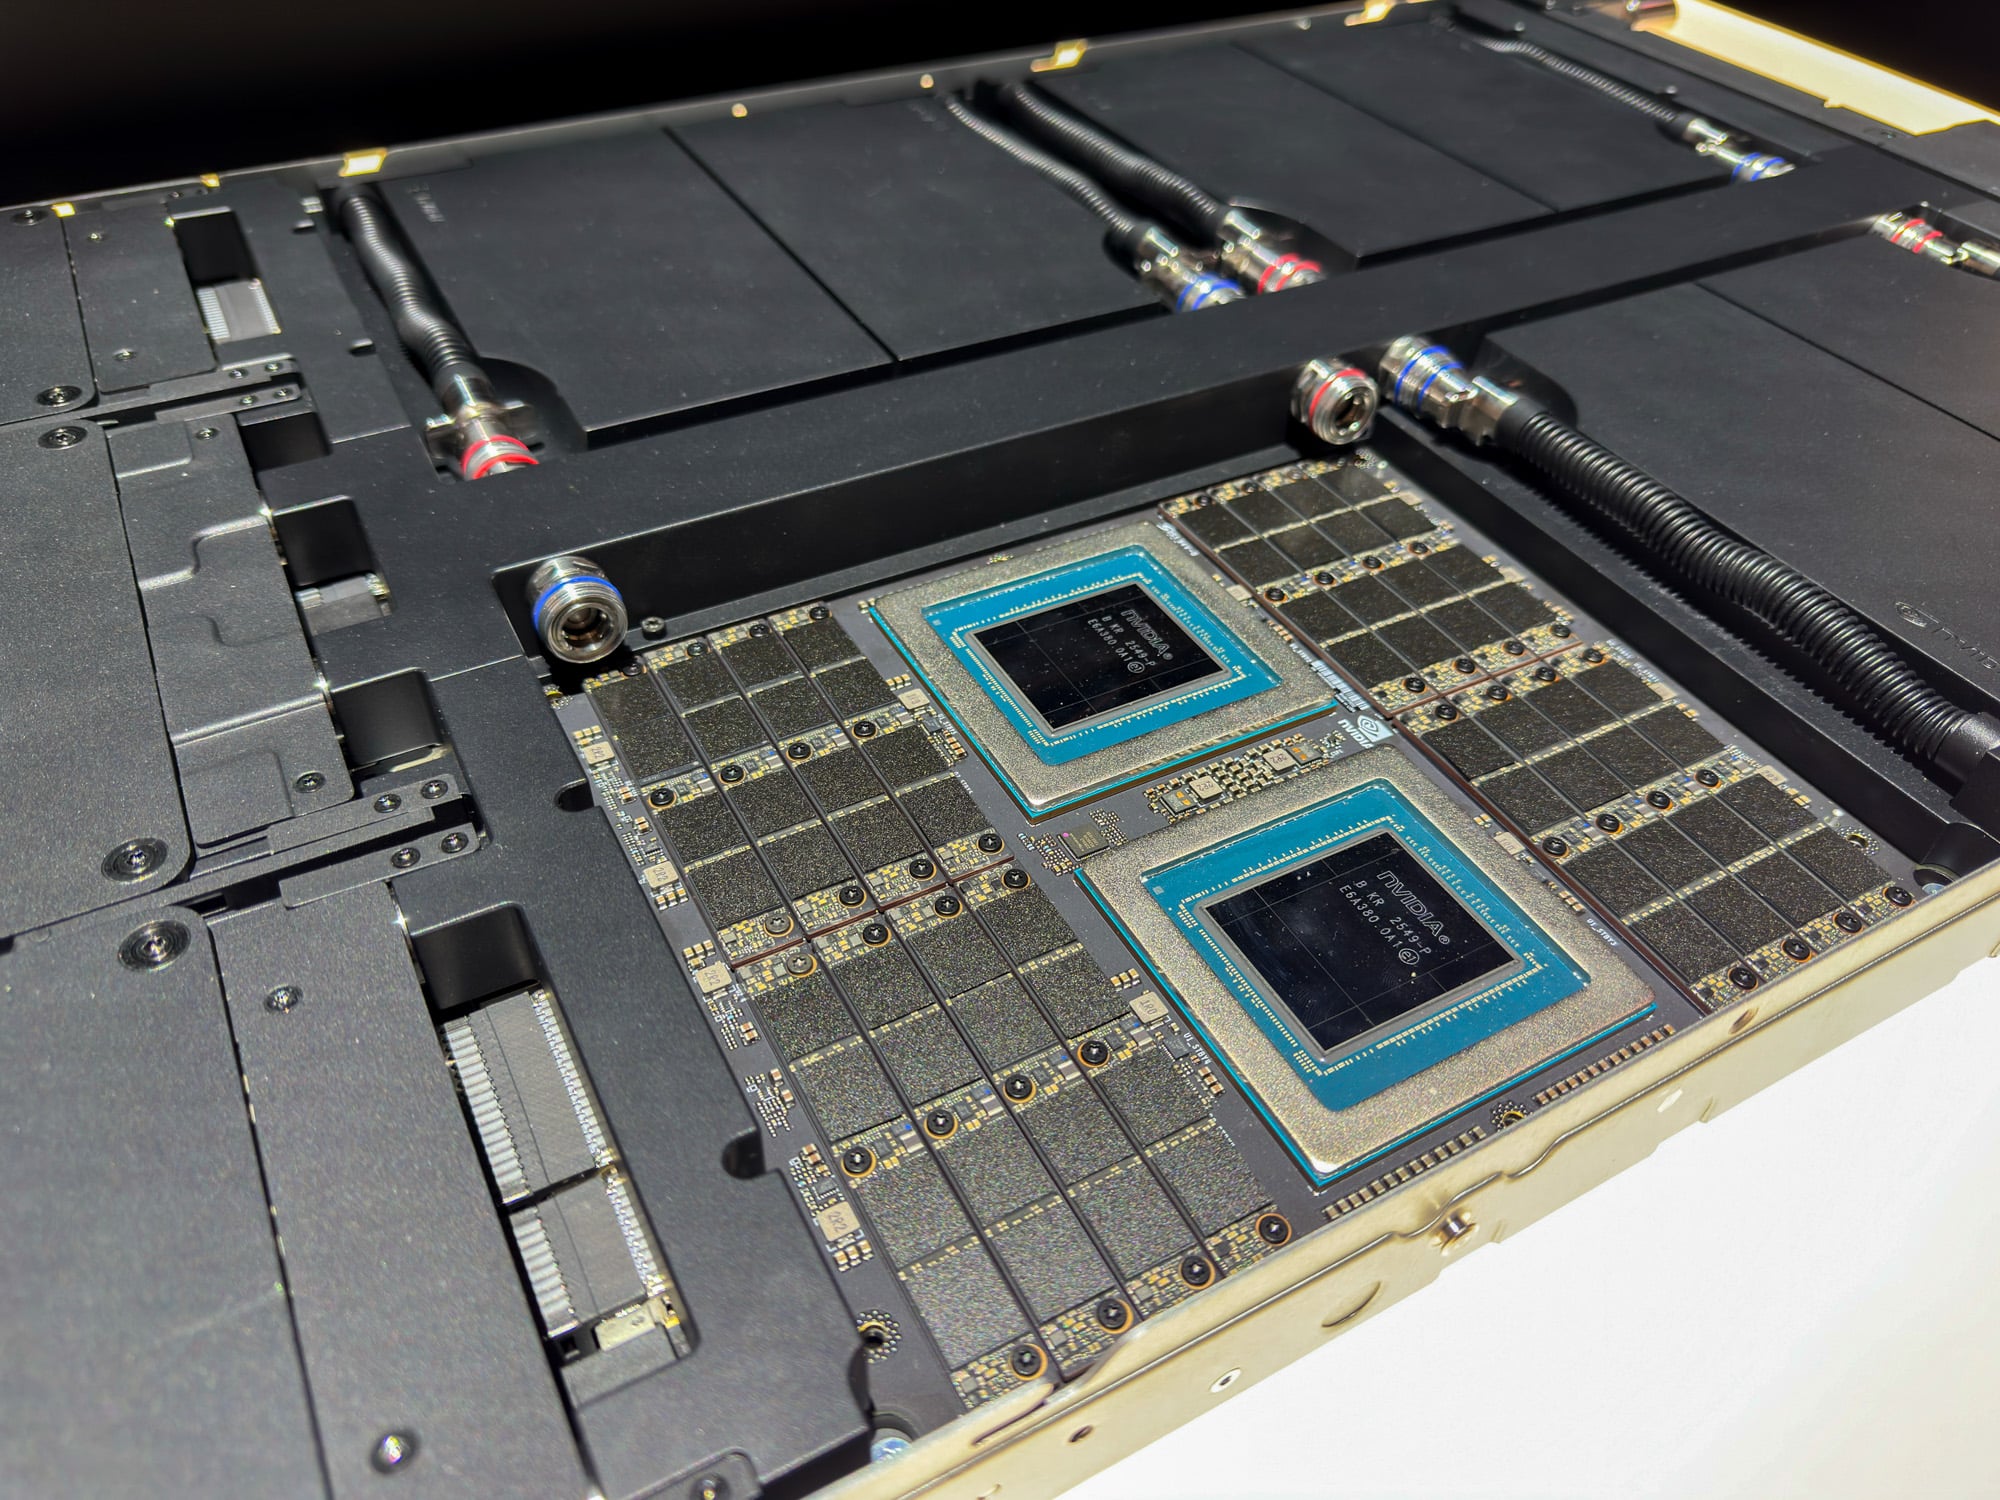
Båda processorerna är monterade direkt på kretskortet utan sockel, på samma sätt som NVIDIA levererar Vera i sina superchips. De 16 SOCAMM2-kortplatserna omger de två kapslingarna, så minnet kan fortfarande bytas ut även om processorerna inte är det; att byta ut en processor innebär att byta ut kortet. Under sommaren tittade vi också på den vätskekylda versionen av samma kort, som drar snabbkopplingsledningar för kylvätska över kortet till processorns kylplattor samtidigt som SOCAMM2-modulerna är luftkylda.
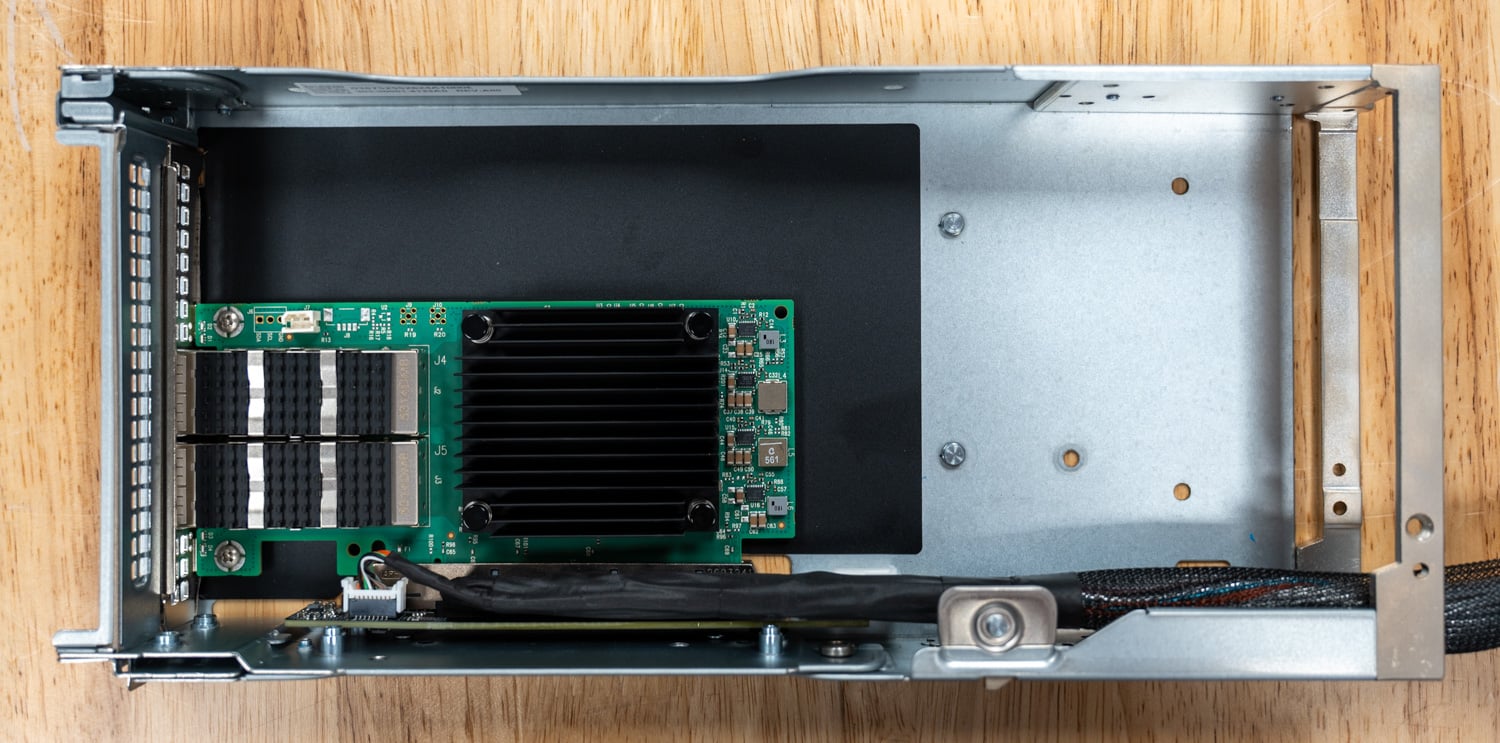
Mellanrisern har en NVIDIA ConnectX-8-adapter för upp till 800G-nätverk, och bakpanelen har USB, DisplayPort och en dedikerad nätverksport för out-of-band-hantering.
Plattformen är mycket modulär och stöder en rad olika lagrings- och bakre PCIe-konfigurationer, men den flexibiliteten kommer på bekostnad av servicetid. Dess tre FHFL PCIe-risers ser lätta ut att serva vid första anblicken. I en typisk server innebär kortbyte att lossa risern, fälla ut en stödflik eller ta bort en skruv och skjuta ut kortet.
På Vera-servern lyfter du först bort fläktkåpan, tar bort ett eller flera av skumblocken och kopplar bort och lyfter ut riserns ström- och PCIe-kablar. Först då kan hela riserenheten glida ut genom chassits baksida. När sleden är fri måste den demonteras för att nå kortet och sedan monteras ihop igen efter bytet. Ett jobb som tar några sekunder på en vanlig server tar 5 till 10 minuter per sled här.
I praktiken är service i racket omöjligt om du inte är beredd att flytta fram och tillbaka, så de flesta komponentbyten kräver att servern flyttas till en bänk för service.
Prestanda och benchmarks
Riktmärkena undersöker hur Veras design omsätts i prestanda, från enskilda trådar till arbetsbelastningar med hela systemet. Våra tester täcker minnesbandbredd och latens, vetenskaplig beräkning, programvara för allmänt bruk och databaser, och visar hur processorn hanterar olika krav på sina kärnor och minnessystem.
Testa system
| Systemkrav | NVIDIA MGX Vera C2 | Dell PowerEdge R7725 | Dell PowerEdge R7725 | Dell PowerEdge R770AP | Dell PowerEdge R770 | Dell PowerEdge R760 |
|---|---|---|---|---|---|---|
| Processorer | ||||||
| CPU | NVIDIA Vera | AMD EPYC 9965 | AMD EPYC 9175F | Intel Xeon 6978P | Intel Xeon 6787P | Intel Xeon Platinum 8592+ |
| sockets | 2 | |||||
| Kärnor/trådar per processor | 88 / 176 | 192 / 384 | 16 / 32 | 120 / 240 | 86 / 172 | 64 / 128 |
| Basklocka | 3.4 GHz | 2.25 GHz | 4.2 GHz | 2.1 GHz | 2.0 GHz | 1.9 GHz |
| Maxklocka | 3.4 GHz | 3.7 GHz | 5.0 GHz | 3.9 GHz | 3.8 GHz | 3.9 GHz |
| Minne | ||||||
| konfiguration | 16x 96 GB Micron SOCAMM2 | 24x 128GB | 24x 64GB | 32x 64GB | 16x 64GB | |
| Typ / Hastighet | LPDDR5X-9600 | DDR5-6400 | DDR5-5200 | DDR5-4800 | ||
| Total kapacitet | 1.5TB | 3TB | 1.5TB | 2TB | 1TB | |
| lagring | ||||||
| SSD | Solidigm D7-PS1010 7.68 TB | Solidigm D7-PS1030 12.8 TB | Micron 9550 PRO 7.68 TB | Solidigm D7-PS1010 7.68 TB | Samsung PM1745 6.4TB | Solidigm D7-P5520 3.84TB |
| SSD-länk | PCIe Gen5 x4 | PCIe Gen5 x2 | PCIe Gen5 x4 | PCIe Gen4 x4 | ||
| firmware | ||||||
| system-BIOS | NV_SBIOS 06.07.01.06 | 1.5.3 | 1.2.1 | 1.8.5 | 2.8.2 | |
| BIOS-profil | Standard | Prestanda | ||||
| Programvara Stack | ||||||
| OS | Ubuntu LTS 26.04.1 | Ubuntu LTS 24.04.5 | ||||
| Kärna | 7.0.0-2022-nvidia-bos | 6.8.0-142 / 6.8.0-146 | 6.8.0-147 | 6.8.0-138 | 6.8.0-142 / 6.8.0-146 | 6.8.0-142 / 6.8.0-146 |
| GCC | 15.2.0 | 13.3.0 | ||||
| glibc | 2.43 | 2.39 | ||||
| Öppna MPI | 5.0.10 | 4.1.6 | ||||
| OpenJDK | 11.0.32 | |||||
Vi jämförde Vera mot fem Dell PowerEdge-konfigurationer med ideal minneskonfiguration och testade dem med samma svit, som täckte AMD:s EPYC-komponenter med högsta kärnantal och frekvensoptimerade prestanda, tillsammans med nuvarande och föregående generationers Xeon-processorer.
Eftersom Olympus-stöd först kom i GCC 15, körde Vera en nyare programvarustack än x86-systemen, som listas ovan. Benchmarkversioner, indata och byggflaggor var annars identiska över alla system.
minnesbandbredd
Minne är där Vera avviker mest från x86, så vi börjar våra tester där. Vi testade STREAM Triad, körd med en OpenMP-tråd per fysisk kärna på 16GiB-arrayer. Huvudkörningen använder varje kärna i systemet, med varje tråds data placerad på samma sockel. Vi upprepar sedan den med sockel 0:s kärnor som först läser sitt lokala minne och sedan fjärrsockettens minne, och med varje kärna som läser sidor sammanflätade över båda socklarna. Diagrammet nedan visar Triad-resultat för hela systemet för varje server med SMT avstängt.
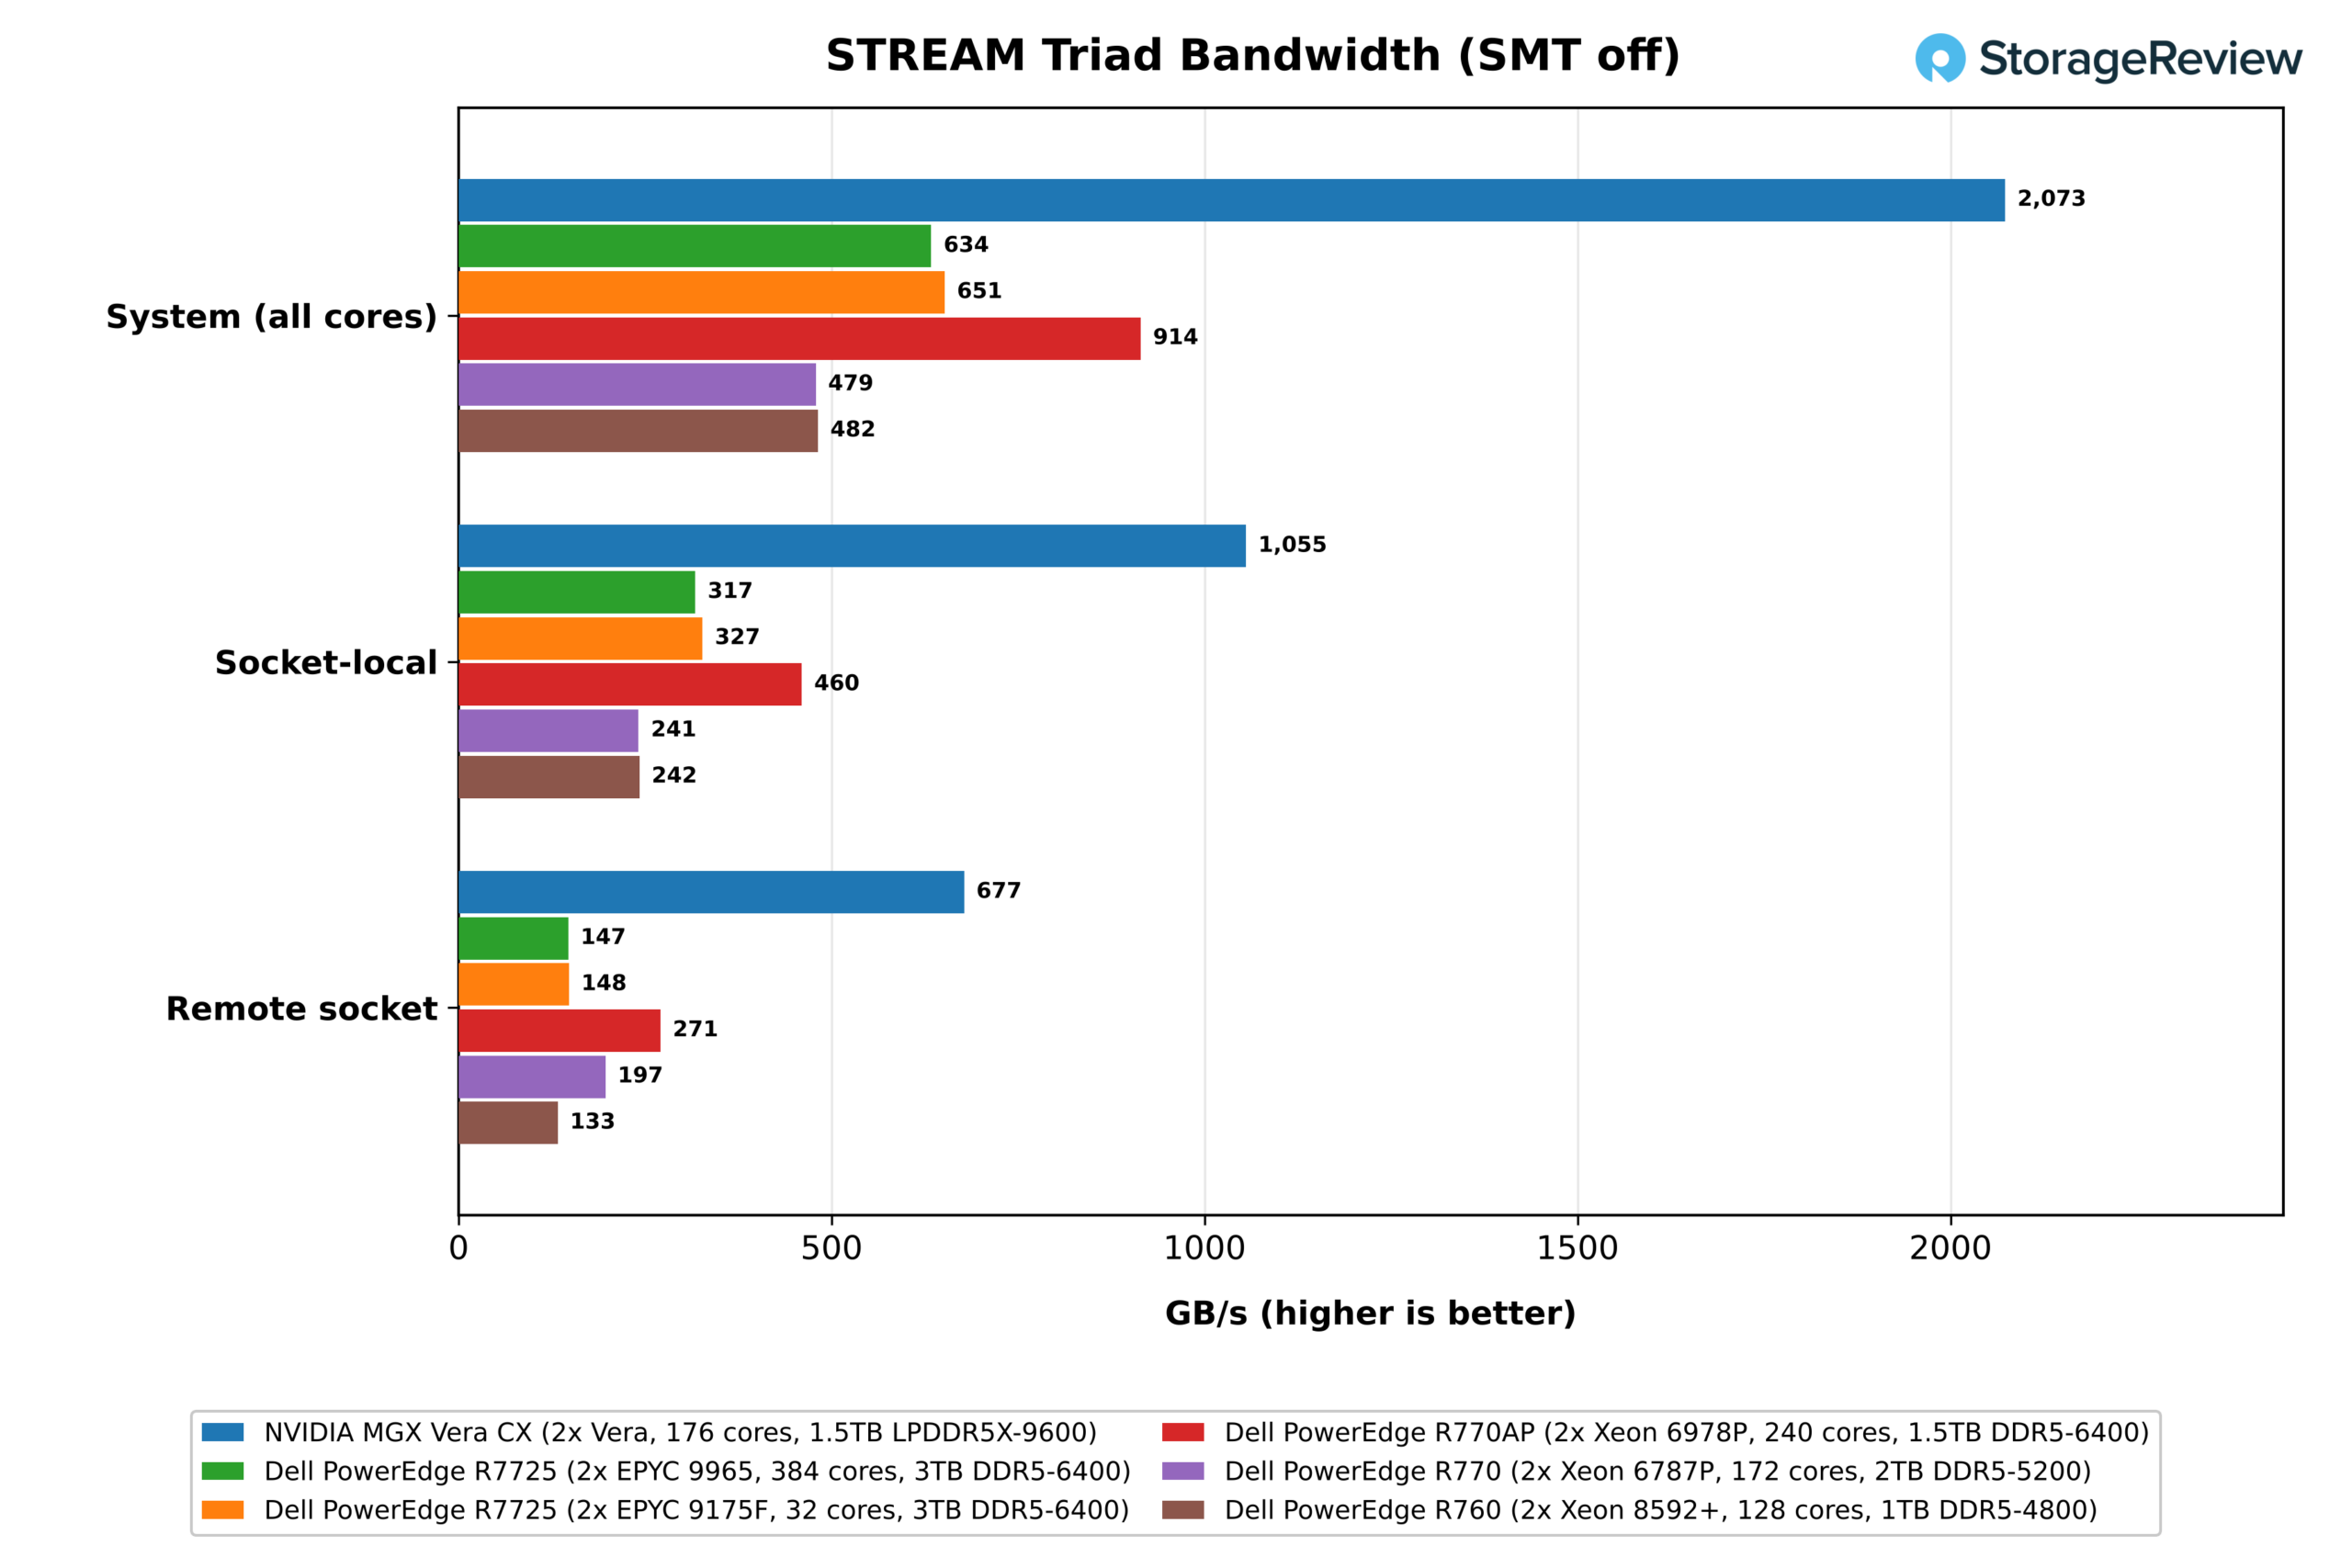
Vera höll 2 073 GB/s, 86 % av dess 2.4 TB/s-kapacitet med två socklar. Det närmaste x86-systemet var Xeon 6978P, vars 24 kanaler DDR5-6400 levererade 914 GB/s, 74 % av dess teoretiska topp på 1 229 GB/s, vilket ger en 2.3x Vera-ledning. De två EPYC-systemen kör samma 24 kanaler DDR5-6400 men landade långt under det: 651 GB/s för 32-kärnig 9175F och 634 GB/s för 384-kärnig 9965, bara 52 % av toppen och en 3.3x Vera-ledning. Slutligen släpar Xeon 6787P och 8592+ efter med långsammare DDR5-5200 och DDR5-4800, och når 479 GB/s respektive 482 GB/s.
En del av EPYC-underskottet kommer från hur STREAM räknar trafik. Programsviten bygger STREAM med vanlig GCC, som inte genererar strömmande minne, så ett minne som missar cache läser först sin destinationsrad från minnet. STREAM räknar inte den läsningen, vilket innebär att Triad underskattar trafiken som flyttas med en fjärdedel var den än sker. AMD:s Zen-kärnor betalar för varje minne. Arm-kärnor som NVIDIA:s tidigare Grace upptäcker fullständiga radskrivningar och hoppar över läsningen, och Intels senaste Xeons kan hoppa över det mesta när minnet är hårt belastat.
Den separata Phoronix Test Suite-versionen av STREAM pekar åt samma håll. Med SMT avstängt nådde dess Copy-resultat 832 GB/s på 9965 och 873 GB/s på 9175F, ungefär 1.5 gånger suite-versionens 551 GB/s och 570 GB/s, och i linje med den förstärkning Copy bör se när den extra läsningen är borta, landade de två versionerna på Xeon-modellerna inom 9 % av varandra.
Justerat för oräknade läsningar rörde sig 9965 cirka 845 GB/s, ungefär 69 % av toppen, och Veras ledning i byte minskar till cirka 2.5x. 6978P behöver betydligt mindre korrigering, vilket gör dess 2.3x till den mest konservativa jämförelsen i uppsättningen.
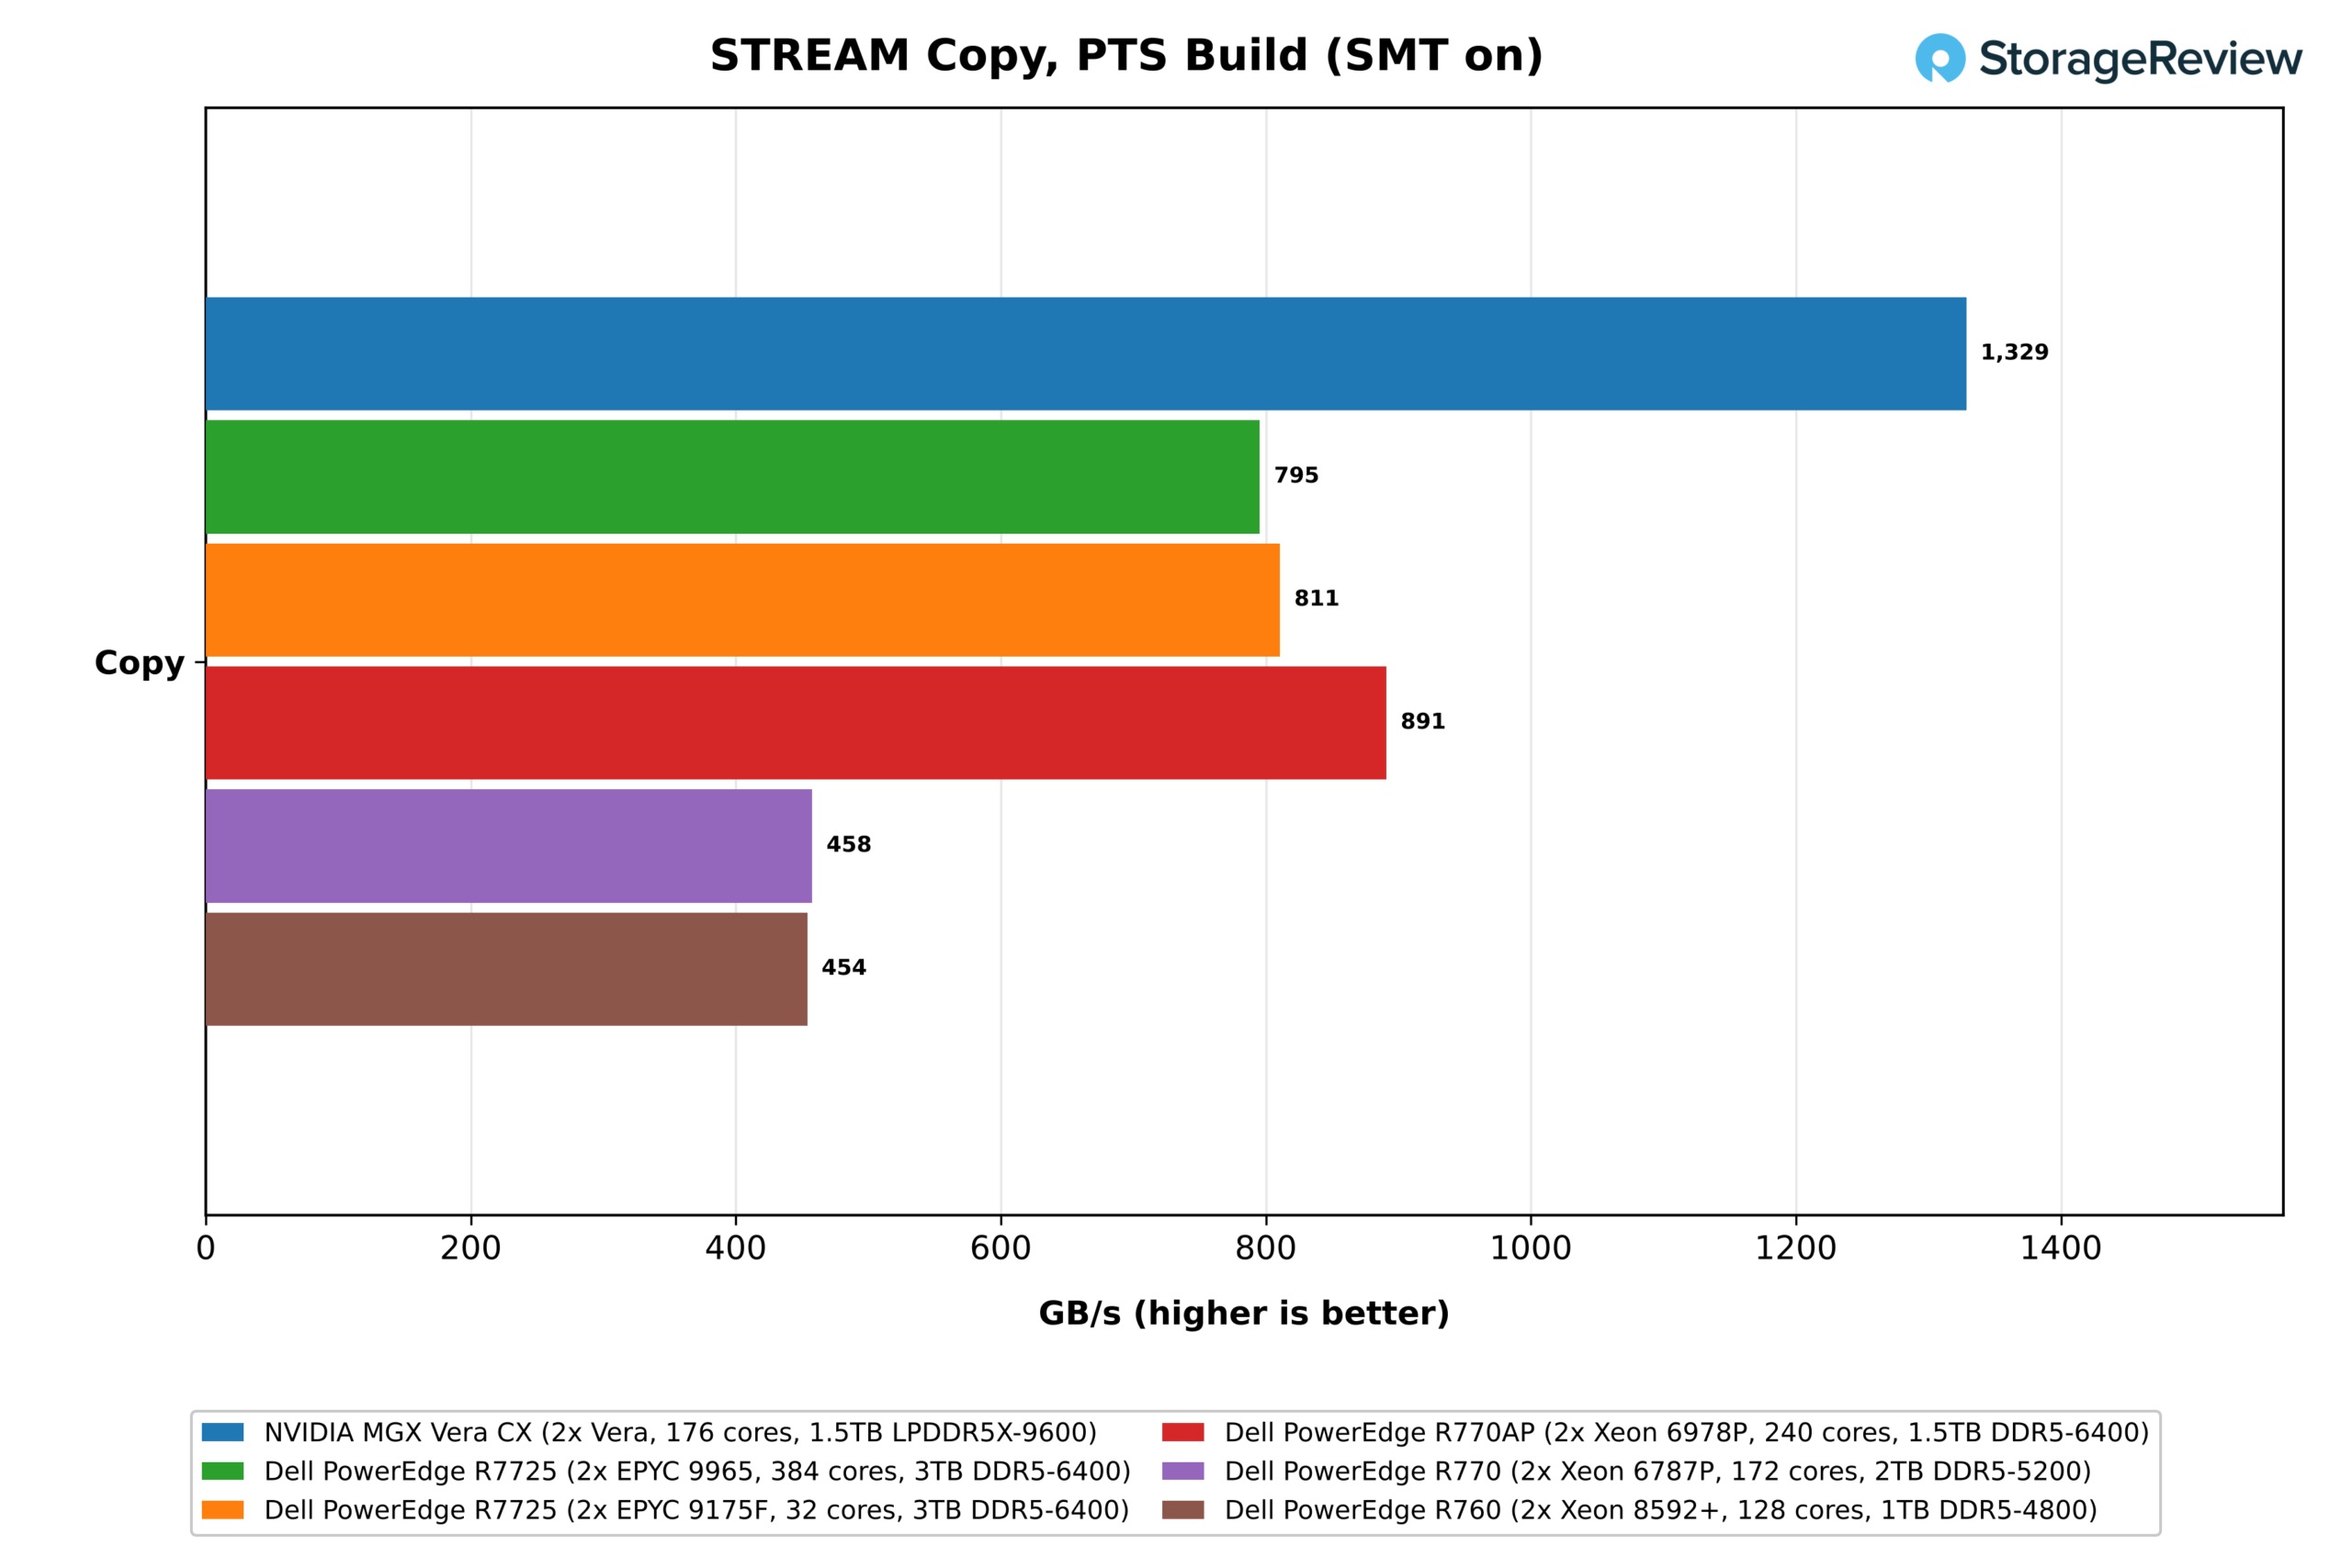
Genom att dela upp testet per socket visas hur tygstrukturen hanterar data som inte är lokal för kärnorna. Kärnorna i Socket 0 läser lokalt minne och når 1 055 GB/s, 88 % av 1.2 TB/s per socket-gränsen, vilket är mer än någon annan hel x86-server i serien. Vid läsning av den andra sockets minne via NVLink-C2C klarade samma kärnor 677 GB/s, 64 % av den lokala siffran, jämfört med 59 % på Xeon 6978P och 45 % på EPYC 9175F (148 GB/s på distans mot 327 GB/s lokalt). Även en arbetsbelastning som placeras på fel socket får därför mer bandbredd än någon x86-socket som läser från lokalt minne, vilket når upp till 460 GB/s på 6978P.
Som ett sista test för Vera testade vi med STREAM Triad sammanflätade sidor över båda socklarna, det fall som en icke-NUMA-medveten applikation ser, vilket gav Vera 1 372 GB/s, 1.5 gånger 6978P:s resultat för hela systemet.
Latens
Bandbredd är bara hälften av minneshistorien. Latens avgör hur länge en kärna väntar varje gång den missar cachen, och det spelar störst roll för kod som jagar pekare genom minnet. Vi mäter det med tinymembench, som tidbestämmer slumpmässiga läsningar över en 1GiB-buffert från en enda tråd på socket 0. EPYC 9175F är det enda x86-systemet i vår uppsättning med resultat från detta test, så det är jämförelsen här.
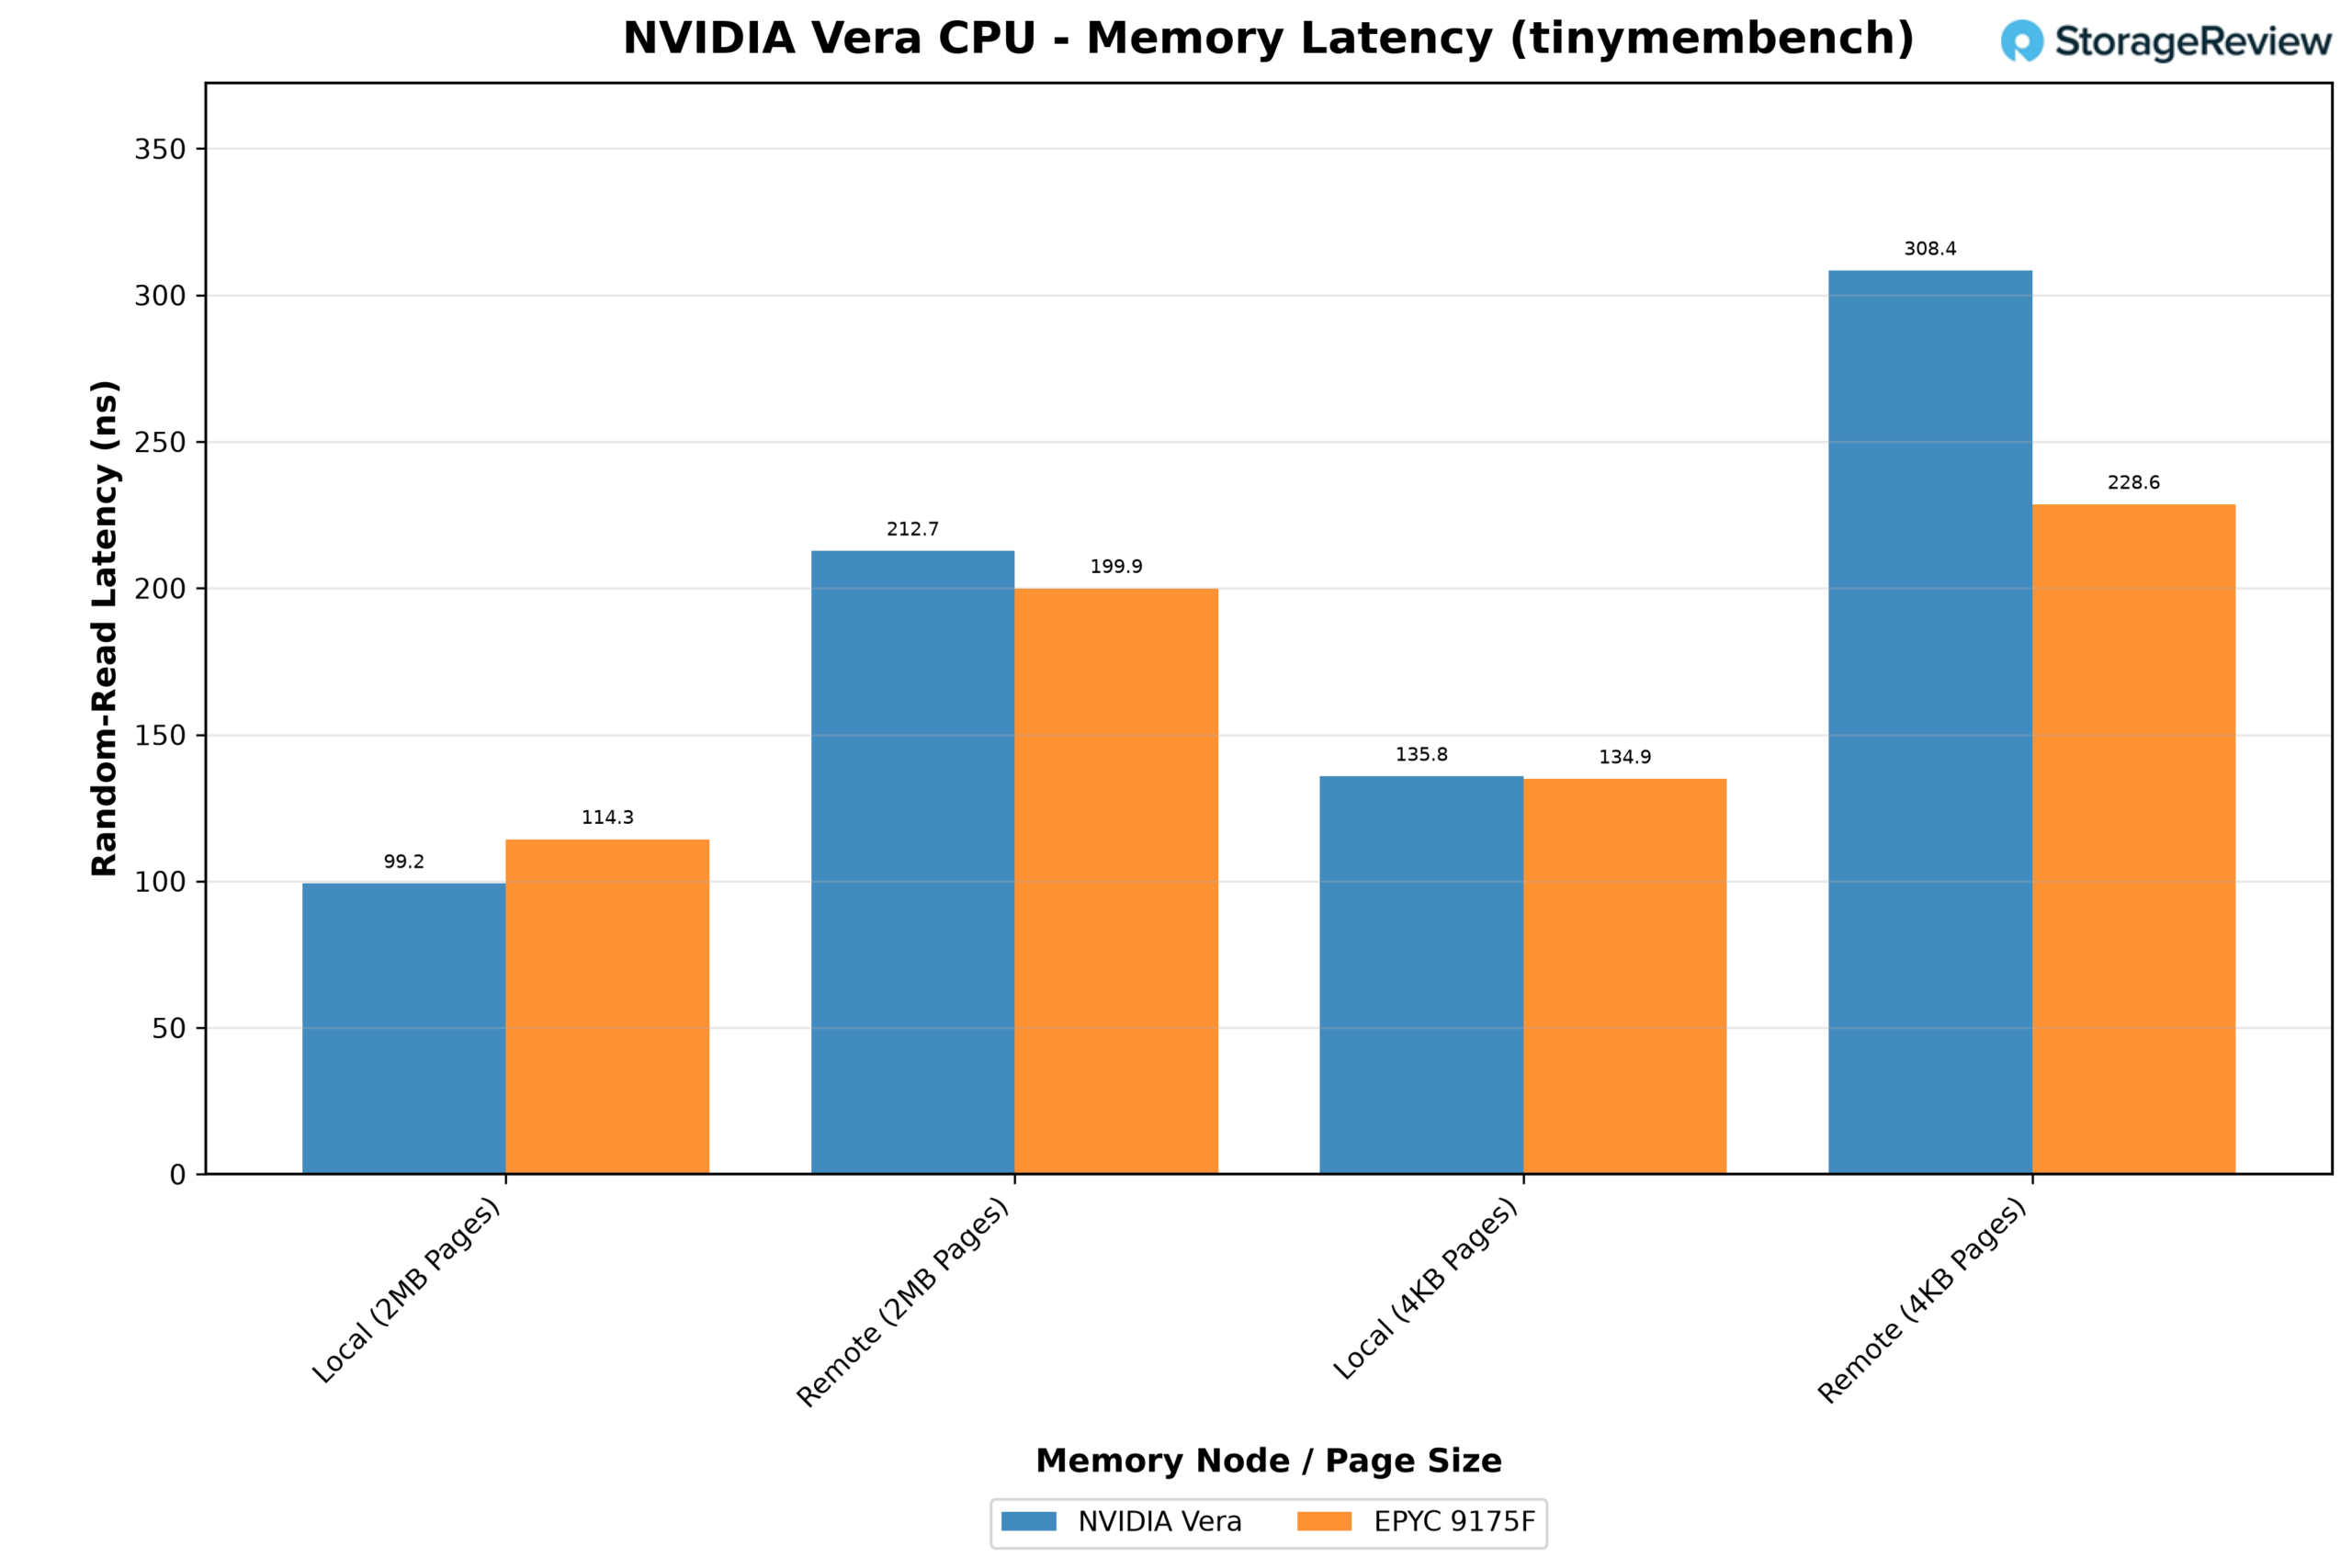
När Vera läser lokalt minne är den snabbare än EPYC. Med 2 MB stora sidor tog en lokal läsning 99.2 ns på Vera jämfört med 114.3 ns på 9175F, 13 % snabbare; med vanliga 4 KB-sidor var de i nivå med cirka 135 ns. När man sträcker sig över till den andra sockeln visar NVLink-C2C sin kostnad. En fjärrläsning tog 212.7 ns på Vera, cirka 2.1 gånger lokal tid, medan EPYC:s 199.9 ns bara var 1.75 gånger lokal tid.
Vera är också mer känslig för sidstorlek. Med 4KB-sidor, där missade adressöversättningar ökar vid varje läsning, ökade dess lokala latens med 37 % och dess fjärrlatens nådde 308.4 ns, jämfört med en ökning på 18 % och 228.6 ns på EPYC. På Vera körde vi hugepages.
HPC
Bandbredd och latens beskriver minnessystemet isolerat. Vetenskapliga tillämpningar visar vad som händer när minnessystemet och kärnorna måste arbeta tillsammans, och våra två HPC-tester lutar sig mot väldigt olika delar av CPU-designen.
GROMACS, en molekylärdynamikkod, spenderar större delen av sin tid i vektoraritmetik, med handskrivna heta loopar för varje SIMD-bredd. Det gör det till det mest direkta testet av den avvägning som beskrivs i Olympus-avsnittet: sex 128-bitars SVE2-rör mot 512-bitars AVX-512-enheter på x86-delarna. OpenFOAM, en beräkningsbaserad fluiddynamiklösare, arbetar genom stora glesa matriser och spenderar mycket av sin tid med att vänta på minne, så den visar om bandbredden som mätts ovan överförs till en verklig applikation.
gromacs
Vi testade GROMACS 2025.3 med benchPEP, ett fall med 12 miljoner atomer som körs över varje fysisk kärna i servern. Byggnaden använde ARM_SVE på Vera och AVX-512 på varje x86-system, och svitens fästa ingångar och inaktiverade PME-justering innebar att varje plattform körde samma arbete.
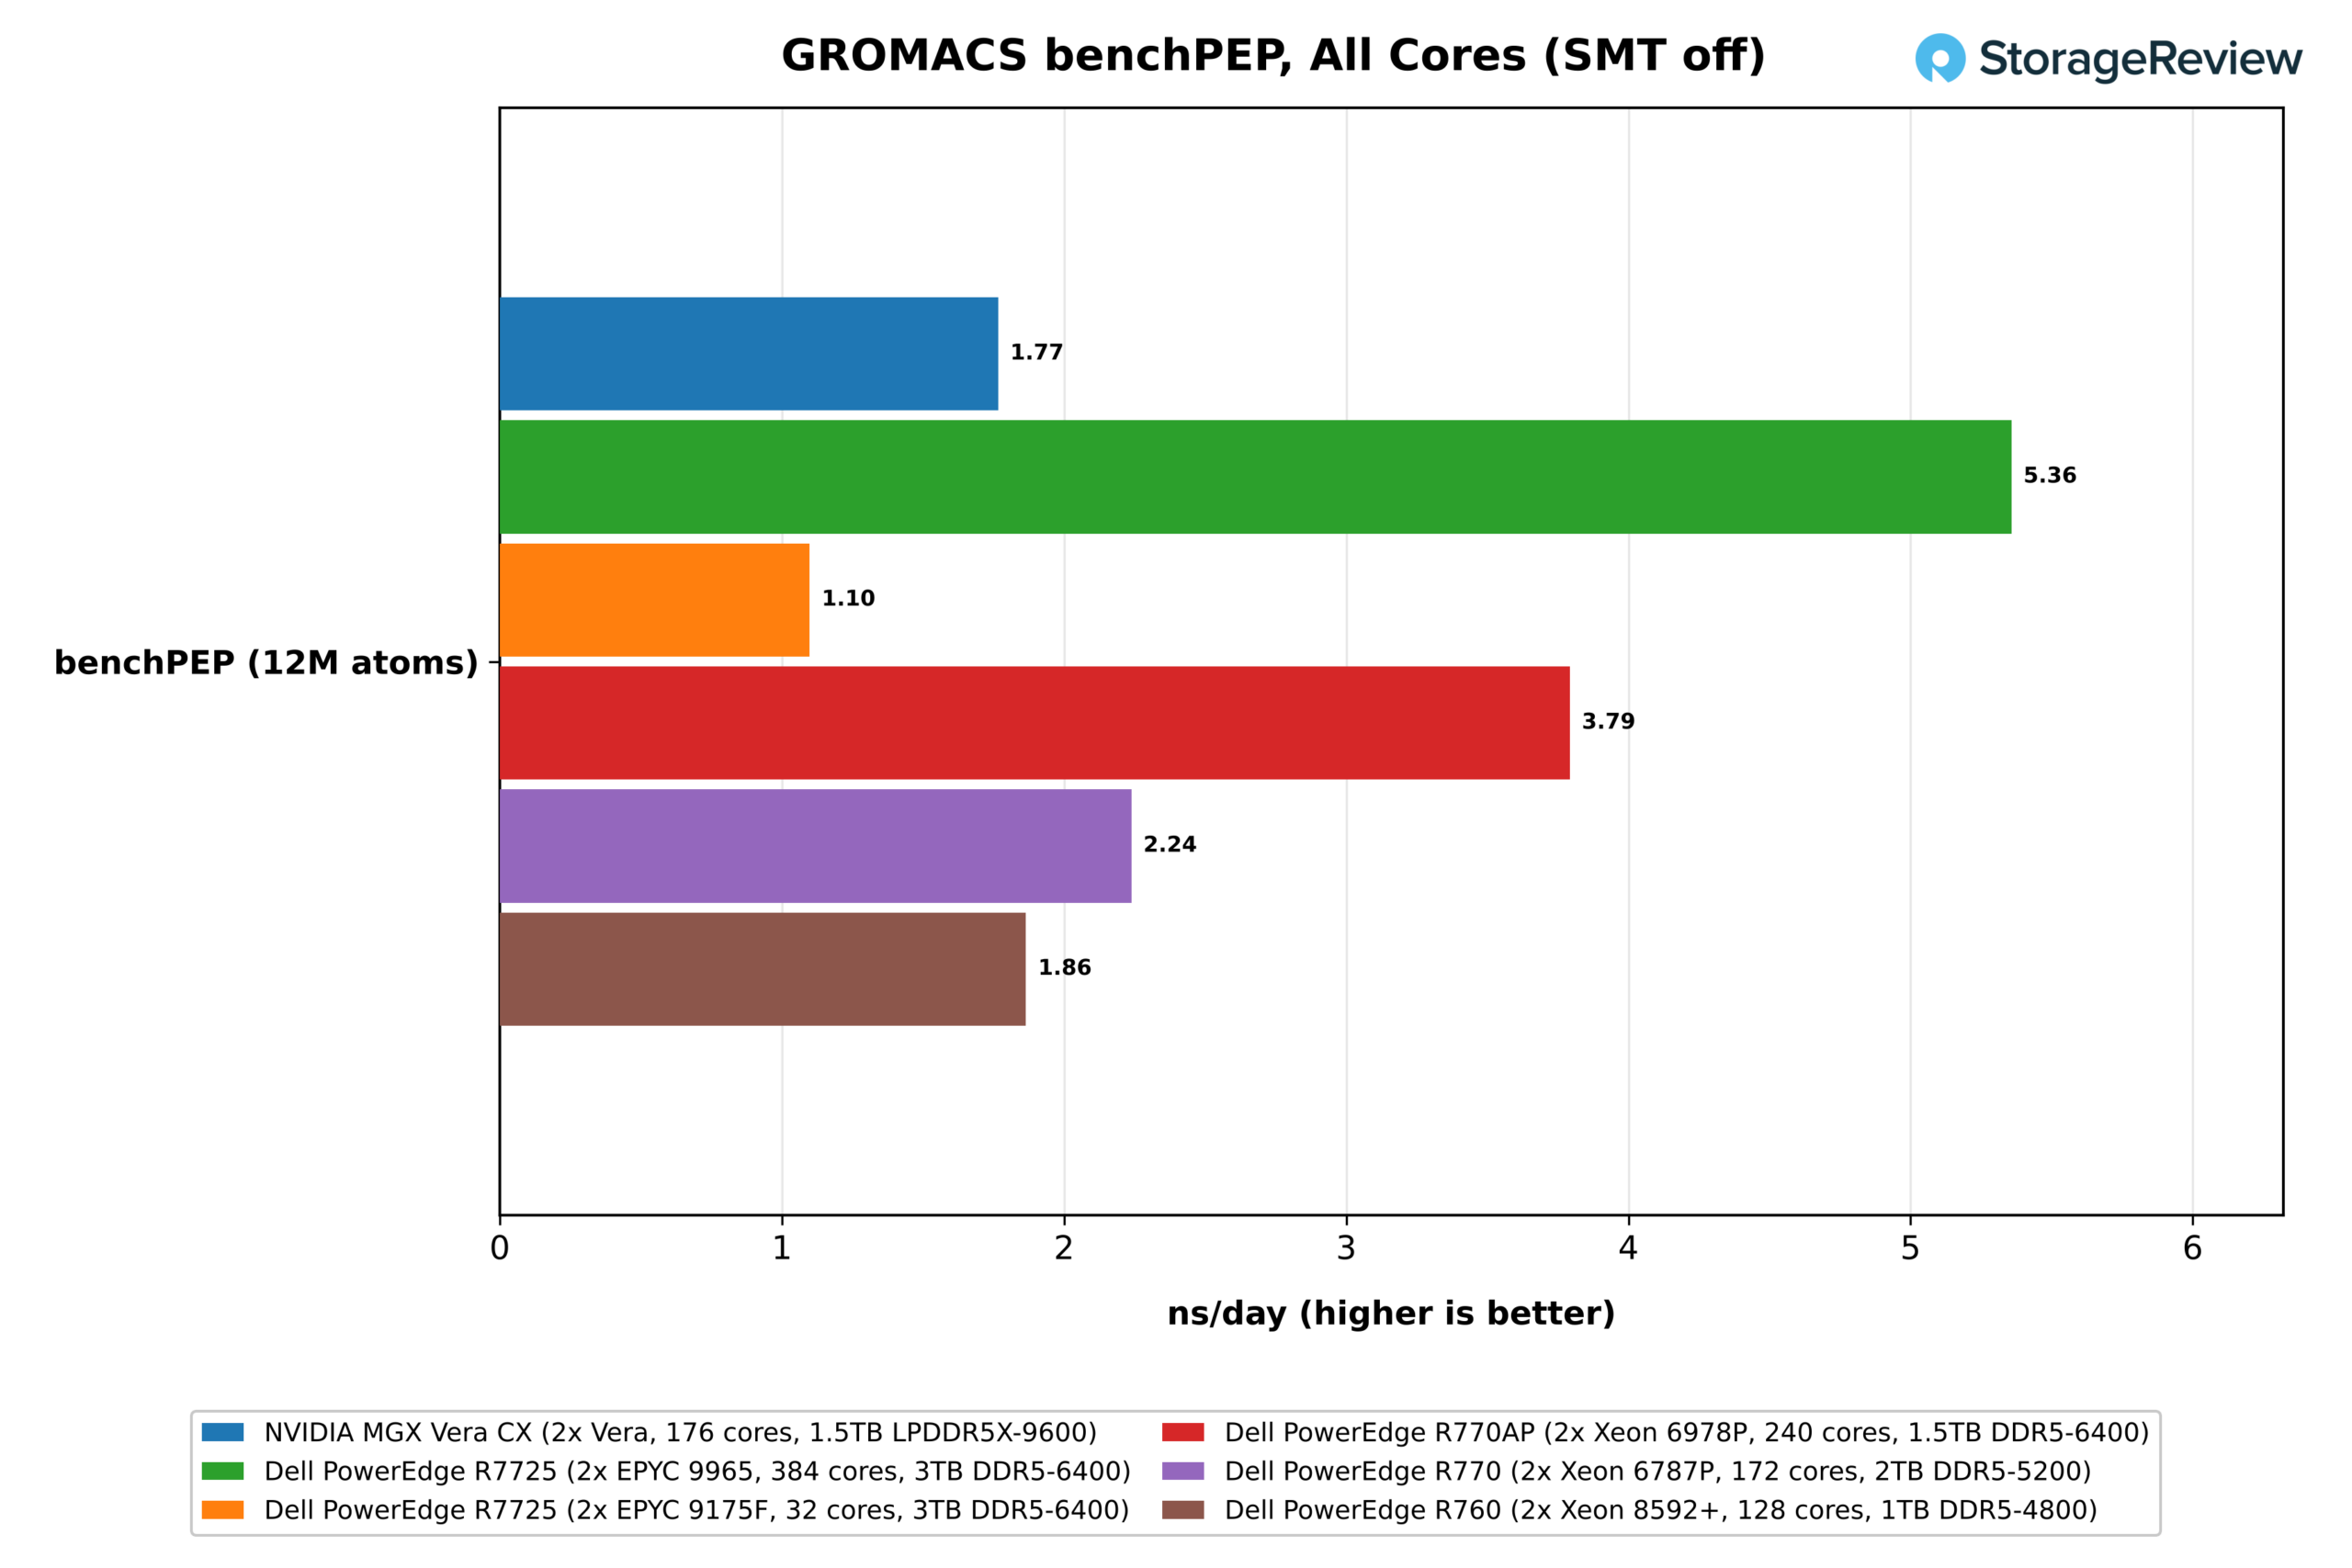
Med SMT avstängd avslutade Vera benchPEP på 1.77 ns/dag. 384-kärnig EPYC 9965 ledde på 5.36 ns/dag, 3.0x Vera, följt av 240-kärnig Xeon 6978P på 3.79 (2.1x) och 172-kärnig Xeon 6787P på 2.24 (1.27x). 128-kärnig Xeon 8592+ slutade också före på 1.87, vilket bara lämnade 32-kärnig EPYC 9175F, på 1.10, efter Vera. Normalisering efter kärnantal visar hur mycket av det gapet som är arkitektur. Vera blir 0.0100 ns/dag per kärna, jämfört med 0.0130 på 6787P, 0.0140 på 9965, 0.0146 på 8592+ och 0.0158 på 6978P, så underskottet till de stora x86-komponenterna är delvis kärnantal och delvis dataflöde per kärna.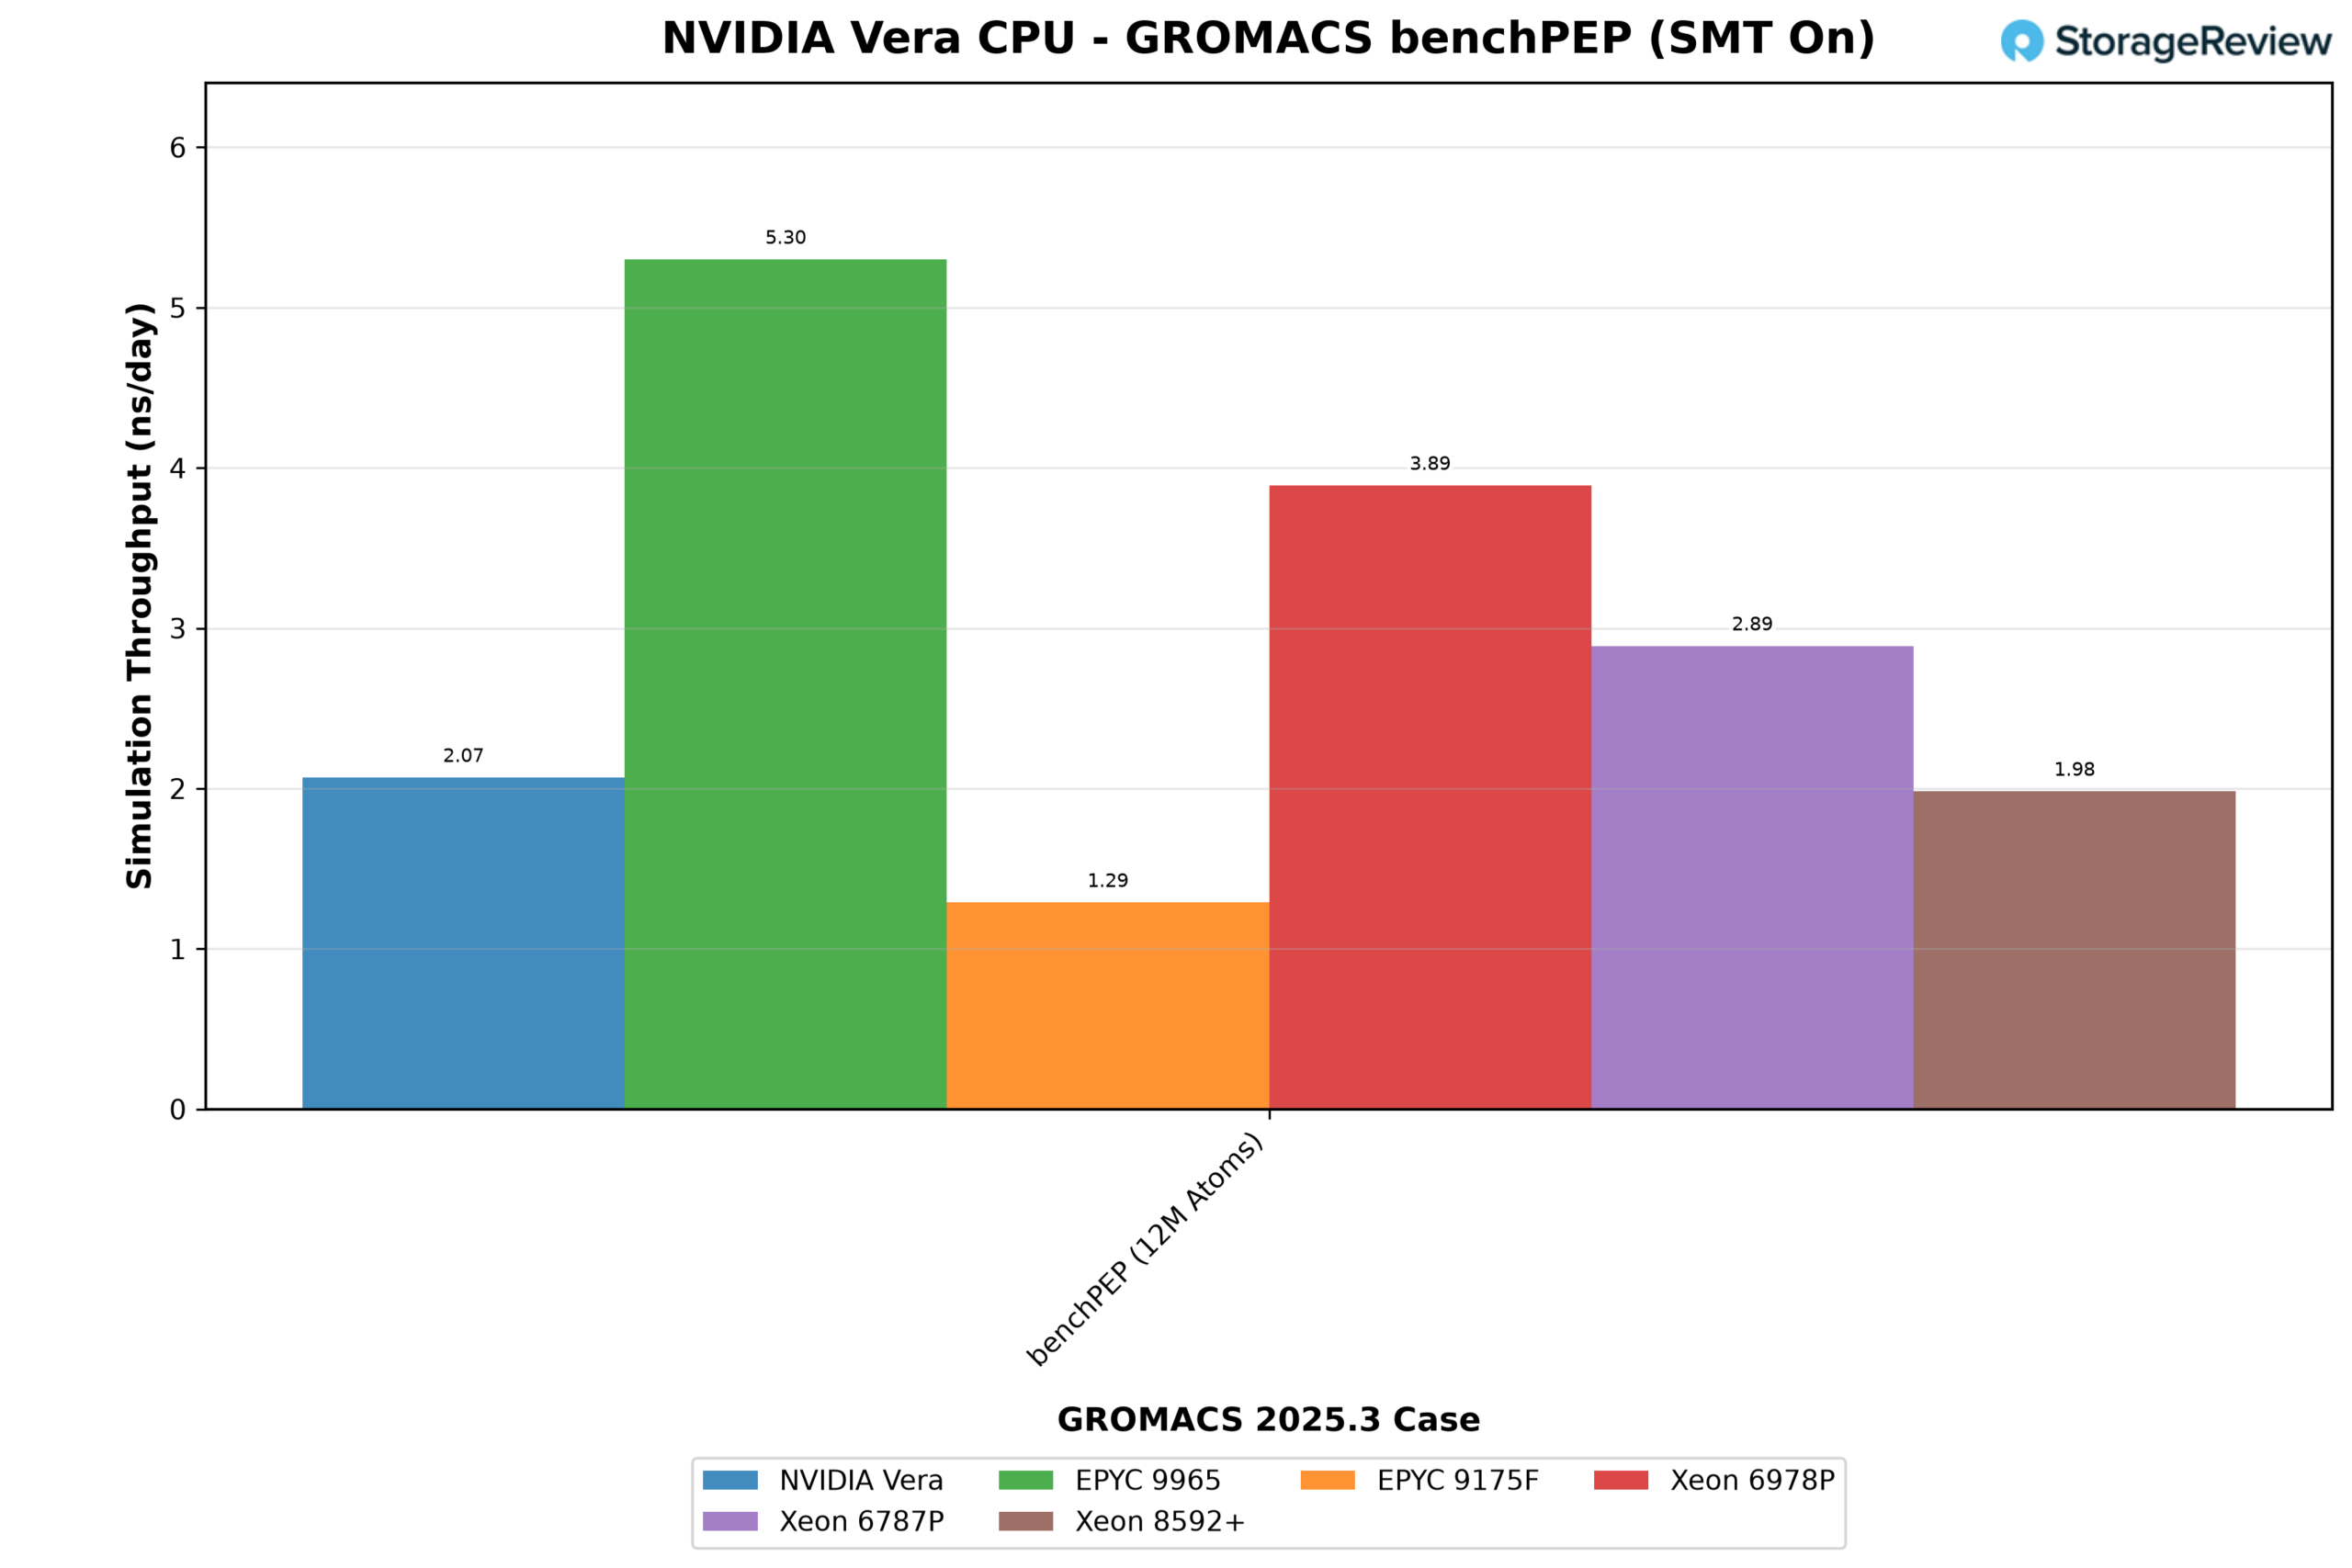
Spatial Multithreading återhämtar sig en del av den marken, då det ökade Veras resultat med 17 % till 2.07 ns/dag, med den bästa layouten som körde alla 352 hårdvarutrådar som tråd-MPI-rankningar. Det är en större vinst än vad SMT gav Xeon 6978P (3 %) eller 8592+ (11 %) i våra tidigare körningar, och EPYC 9965 förlorade 3.5 % med den aktiverad. Med resurser fördelade mellan de två trådarna får varje rank en bit av kärnan, och lösarens blandning av vektormatematik och minne stannar av verkar fylla dessa bitar bättre än en enda rank.
BenchMEM-fallet isolerar gapet per kärna genom att köra 82 000-atomsystemet på 16 fysiska kärnor i socket 0 på varje plattform, så antalet kärnor är utanför ekvationen, och resultatet återspeglar vektorgenomströmning, cache och lokalt minne.
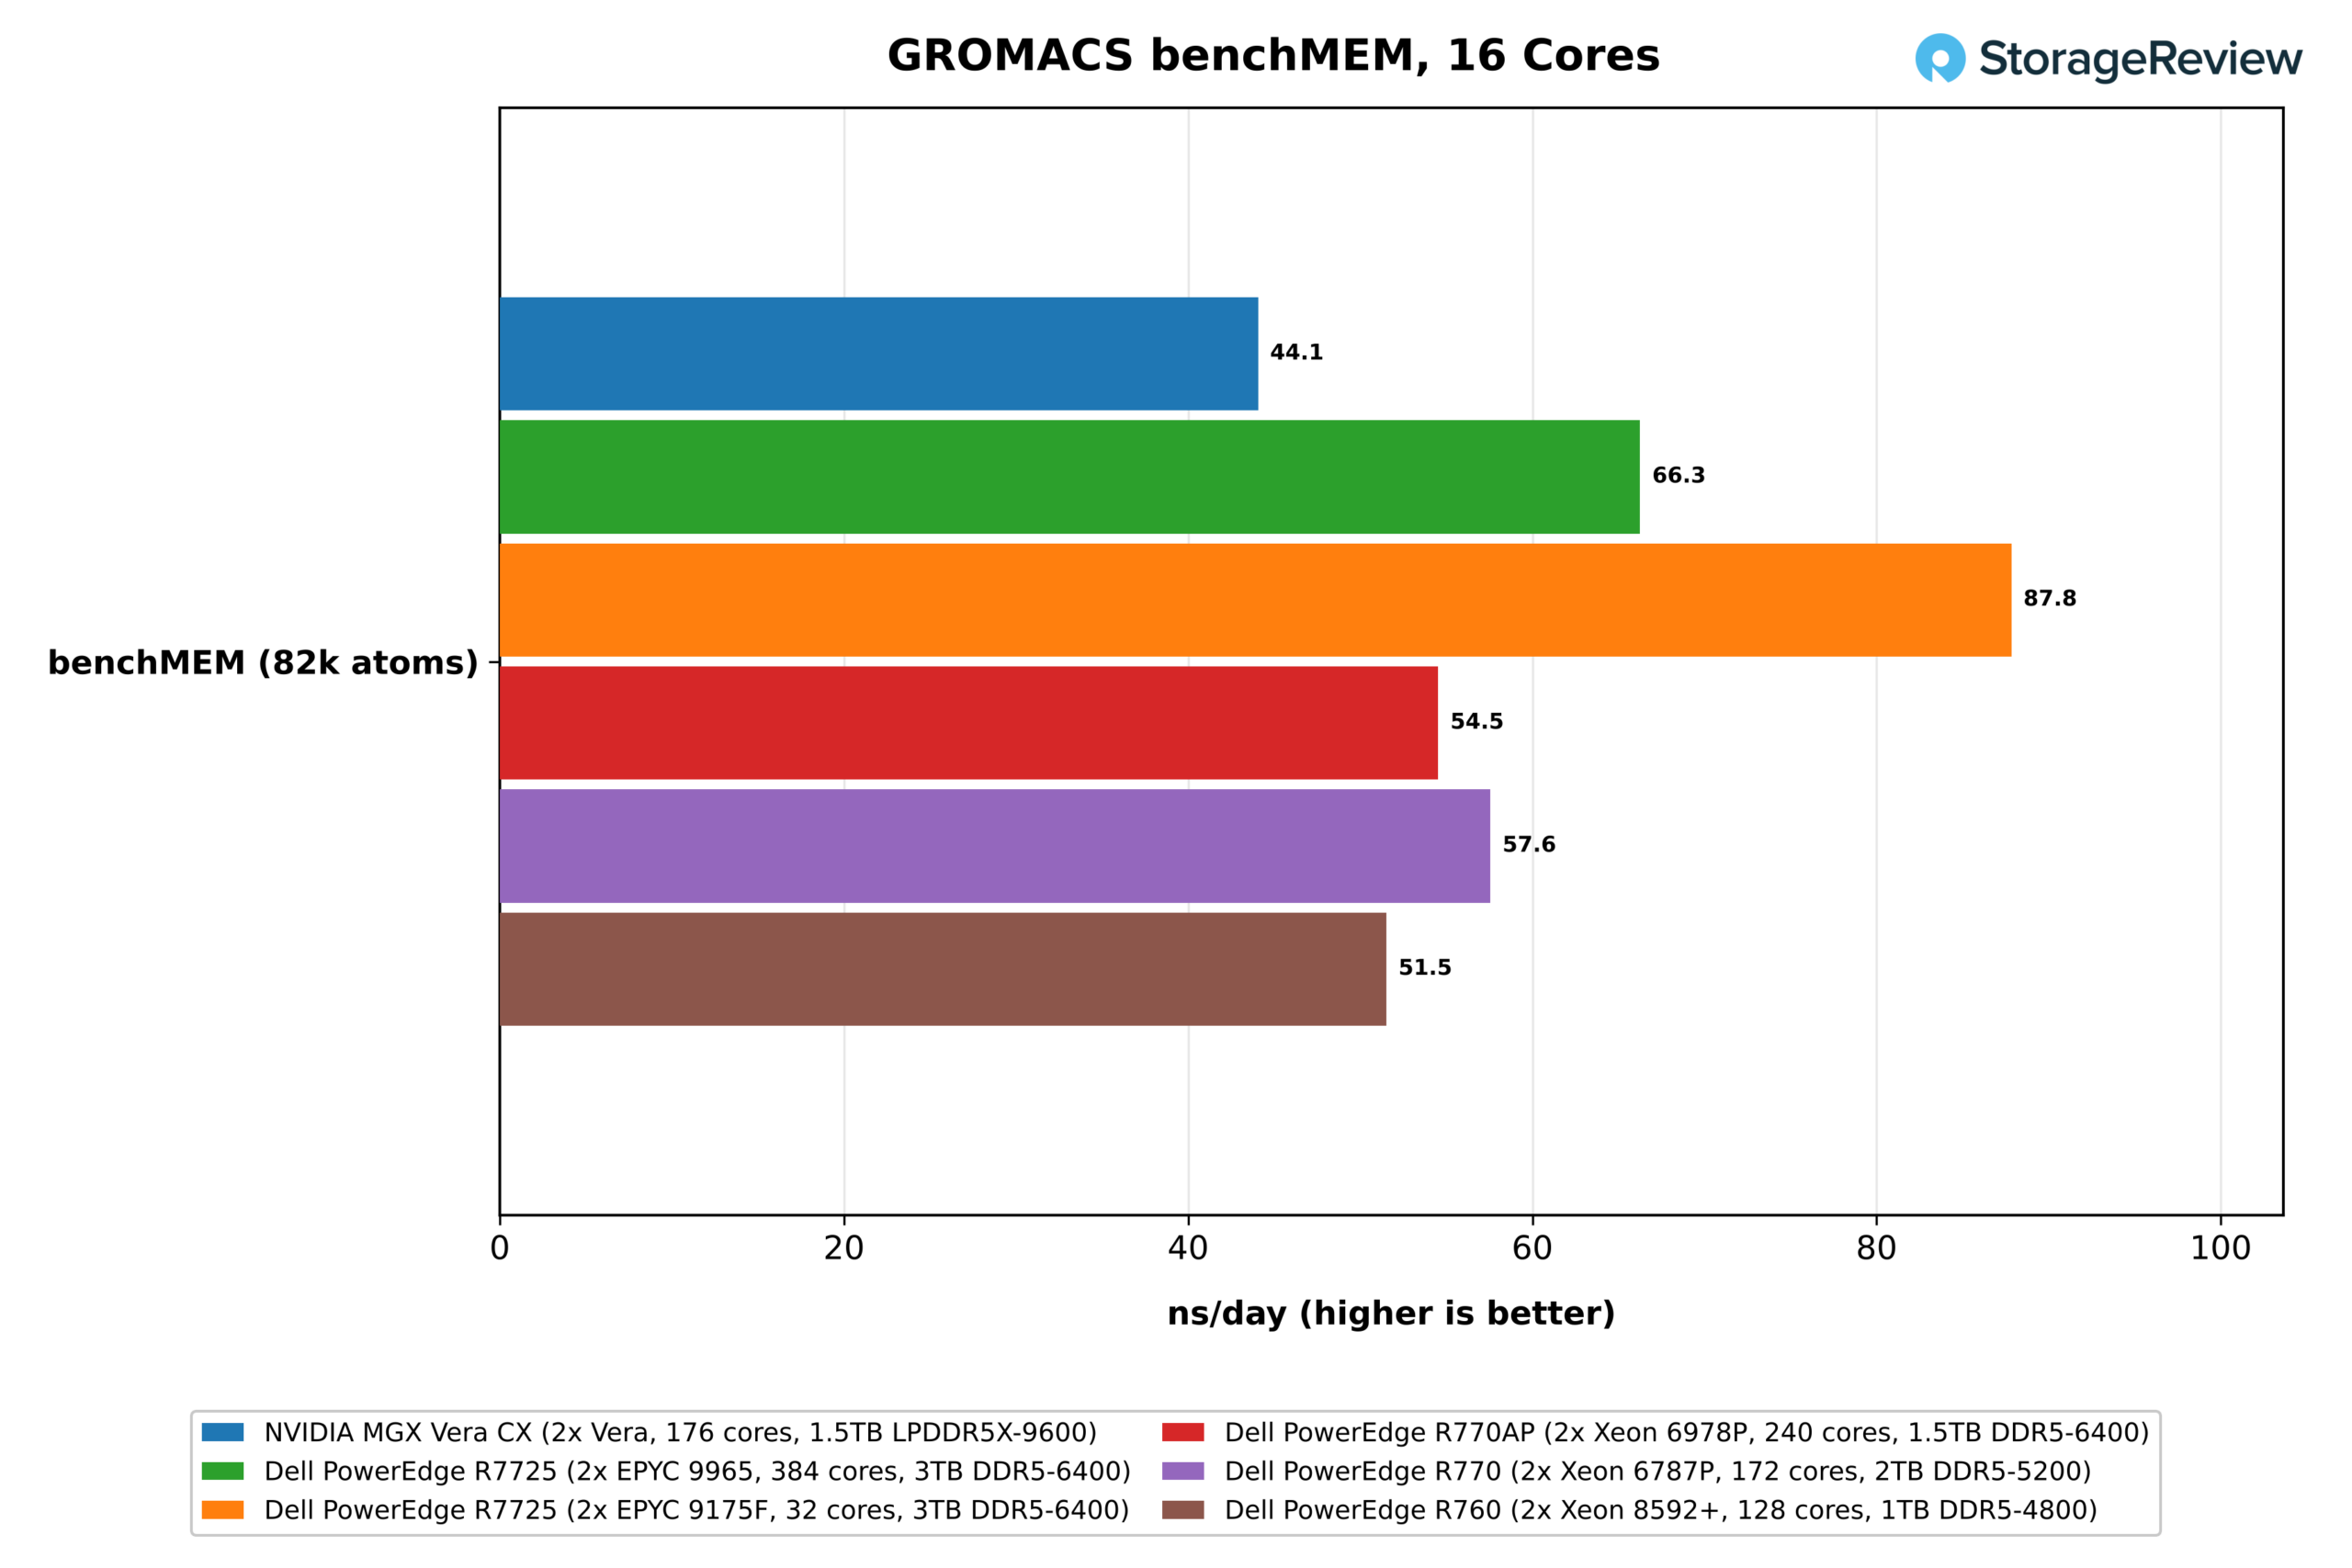
Här nådde Vera 44.1 ns/dag. 5.0 GHz EPYC 9175F fördubblade det vid 87.8, och EPYC 9965 nådde 66.3, 1.5x Vera, före Xeon 6787P vid 57.6, 6978P vid 54.5 och 8592+ vid 51.5.
En 16-kärnig skiva av Vera gör därför ungefär två tredjedelar av arbetet som en 16-kärnig skiva av en Zen 5c-del, även om dessa 16 Zen 5c-kärnor delar en enda 32 MB L3 medan Veras kan dra nytta av dess 164 MB systemnivåcache. Det gör detta till den tydligaste mätningen vi har av vad 128-bitarsvektorer kostar på kod skriven för 512-bitarsvektorer. 9175F:s ytterligare ledning jämfört med 9965 är ungefär i linje med dess klockfördel, 5.0 GHz mot 3.7 GHz.
OpenFOAM
OpenFOAM flyttar trycket från vektorenheterna till minnessystemet. Vi kör OpenFOAM 13 på driverFastback-fallet för bilaerodynamik, med en MPI-rankning per fysisk kärna, vid två maskstorlekar: en medellång maskstorlek på 2.98 miljoner celler och en med 22.6 miljoner celler.
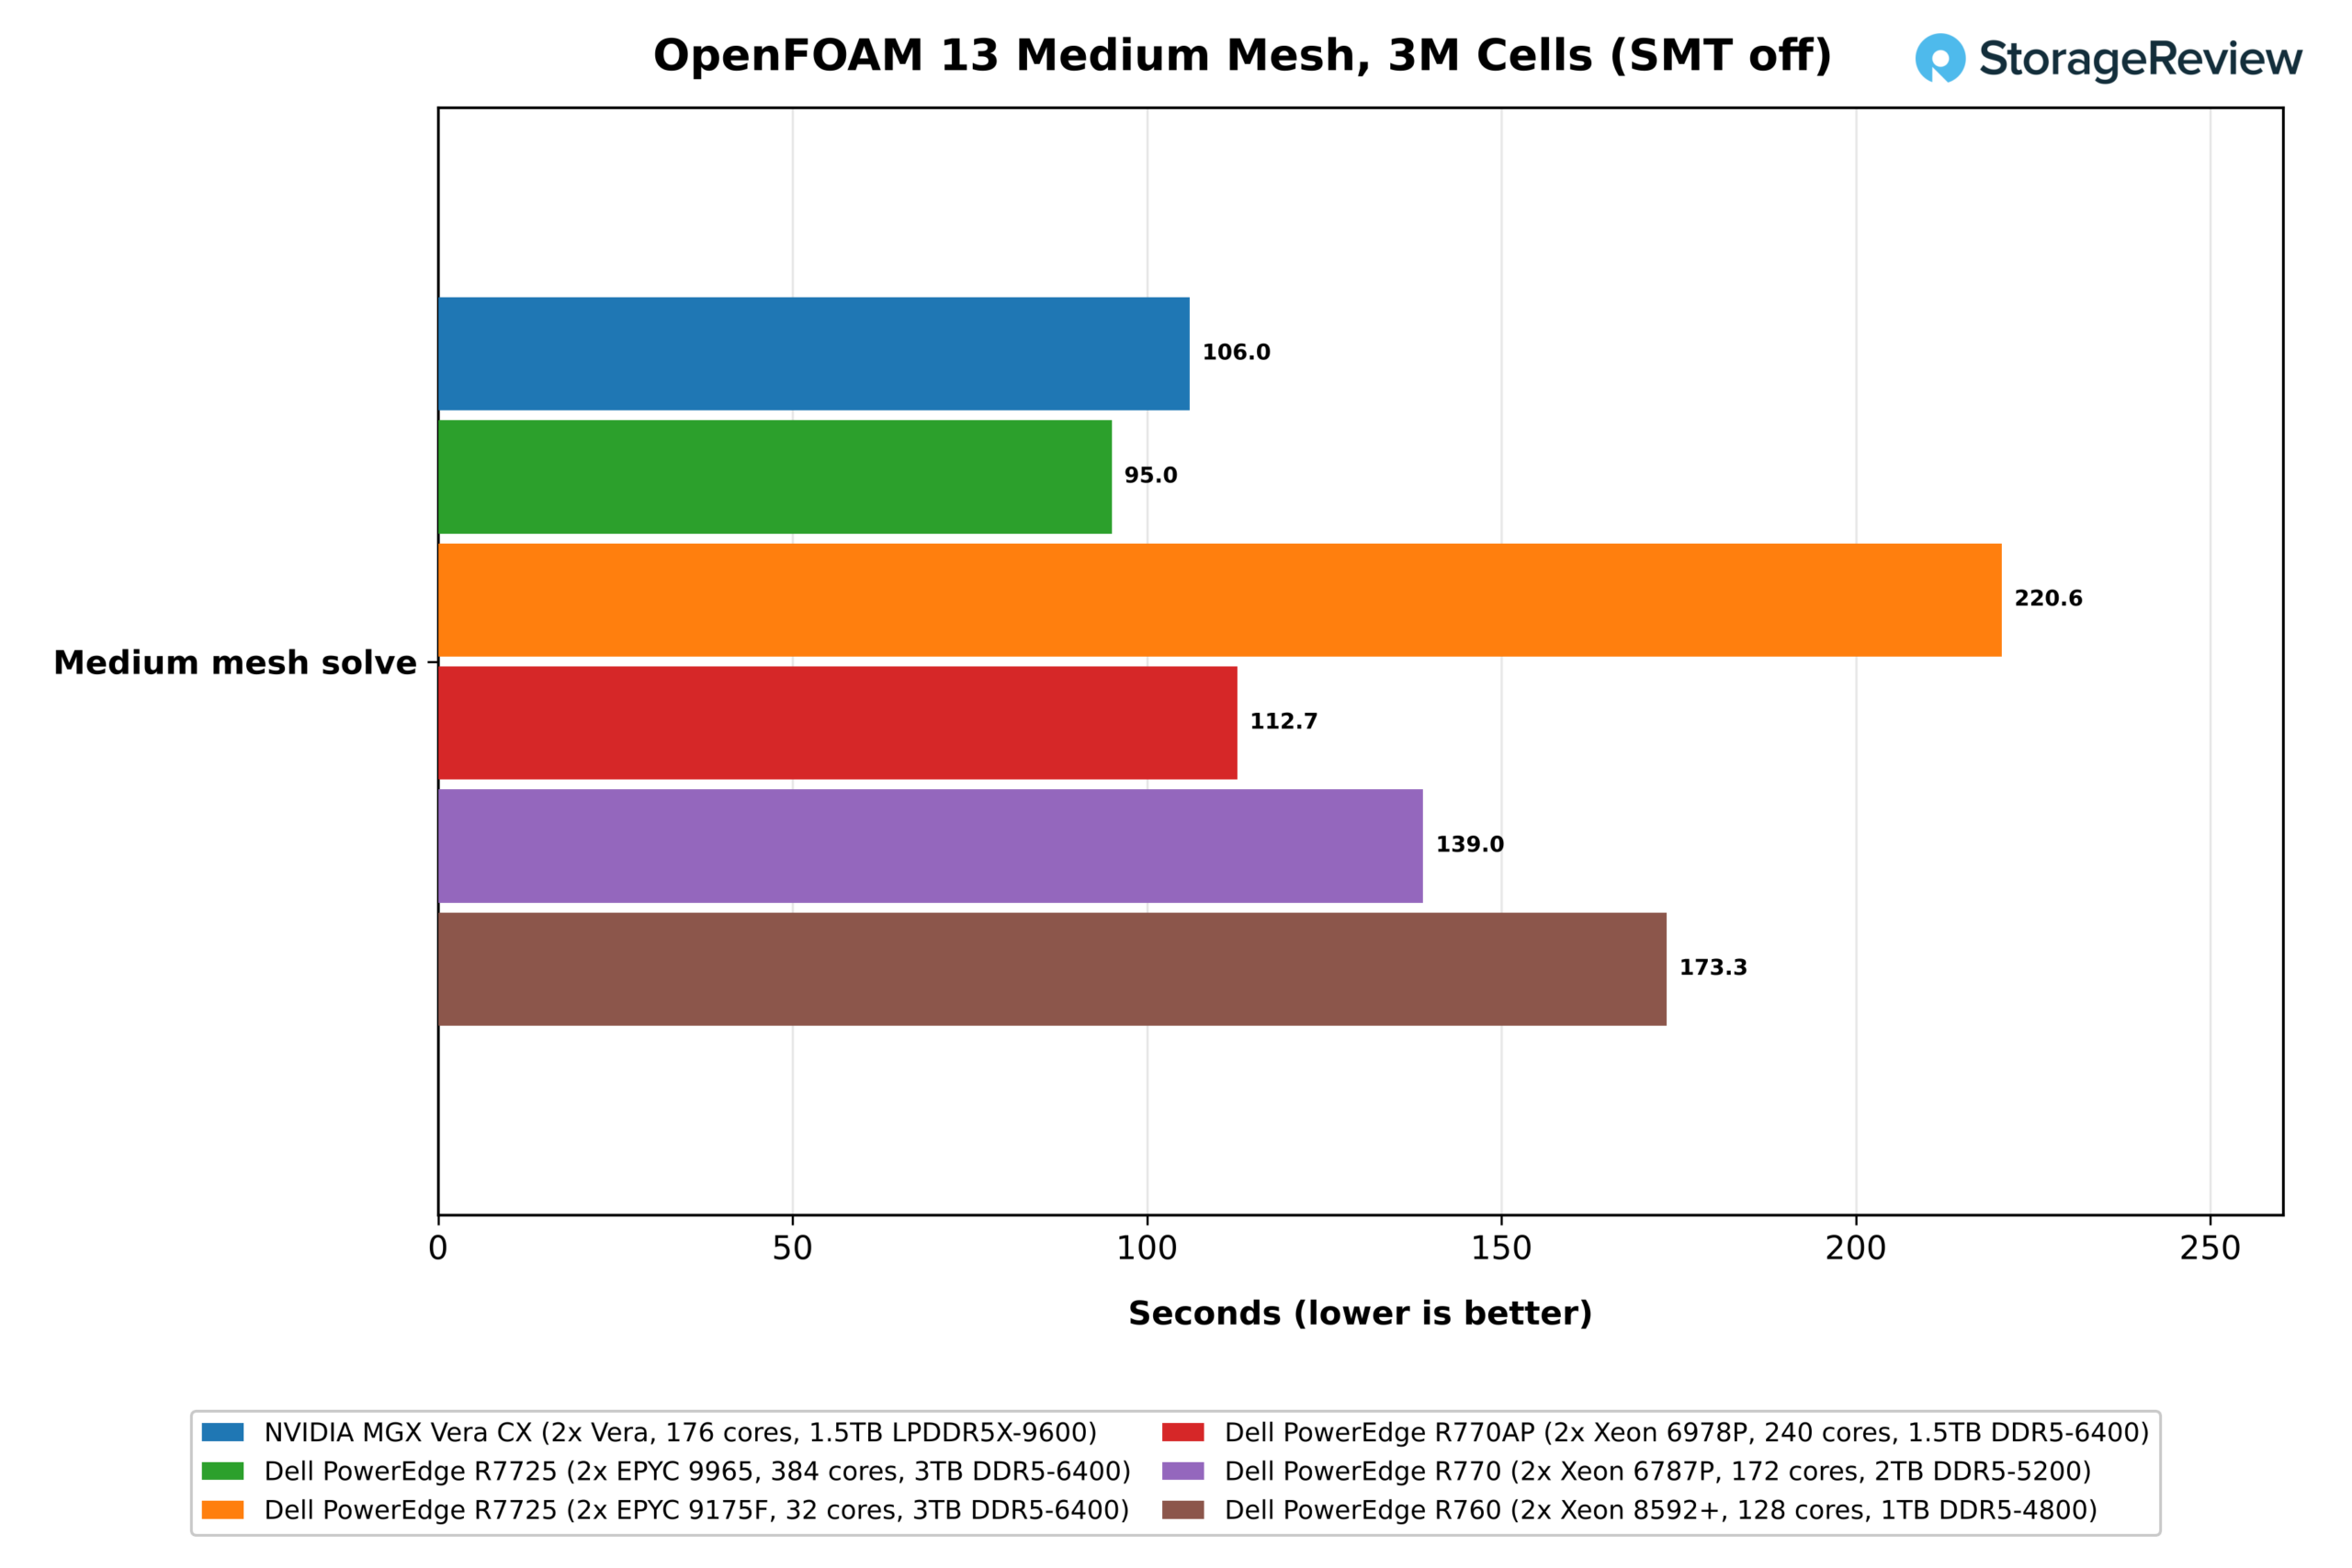
Medelstora mesh-problem löstes på 106.0 sekunder på Vera, jämfört med 95.0 på EPYC 9965, 112.7 på Xeon 6978P, 139.0 på 6787P, 173.3 på 8592+ och 220.6 på 32-kärniga 9175F. I denna storlek vinner 9965:ans 384 kärnor, och Vera tar 12 % längre tid men slutar tvåa, 6 % före 240-kärniga Xeon. Med bara 3 miljoner celler är x86-komponenternas större L3-cacher sannolikt orsaken till mer av problemet, vilket håller kärnantalet i schack.
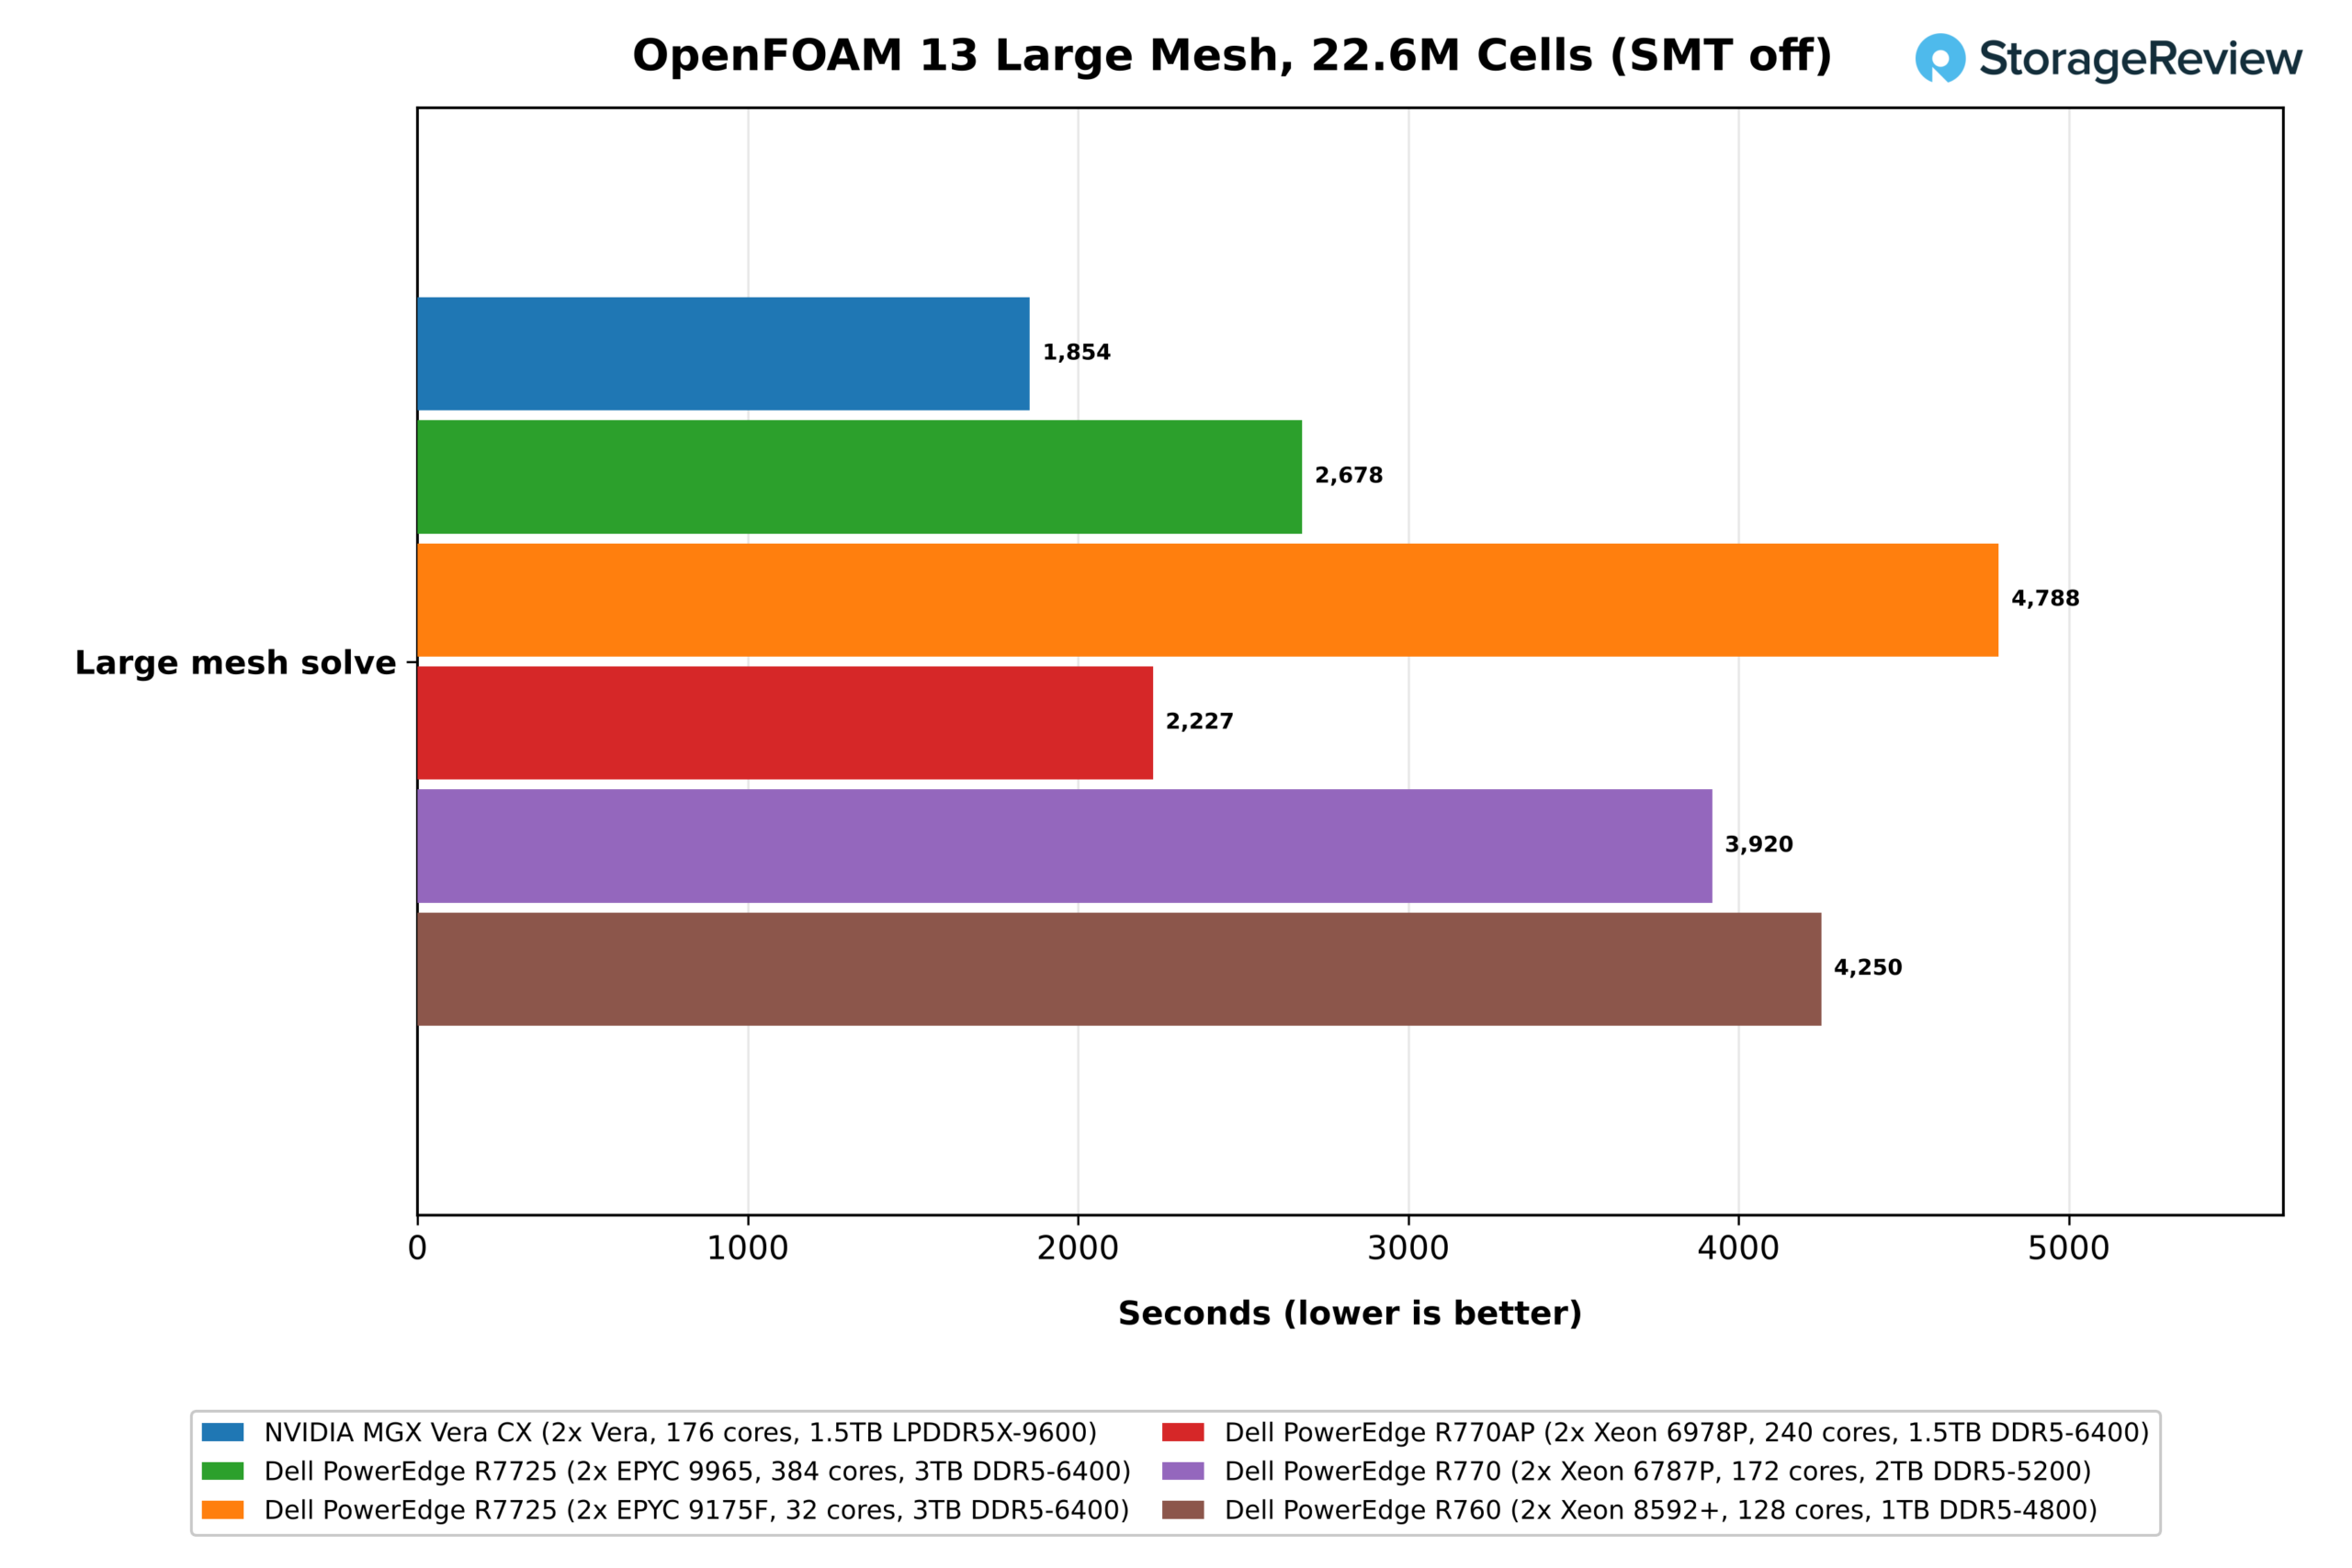
Den stora mesh-funktionen vänder på ordningen, där Vera löser det på 1 854 sekunder, jämfört med 2 227 sekunder för Xeon 6978P, 2 678 sekunder för EPYC 9965, 3 920 sekunder för 6787P, 4 250 sekunder för 8592+ och 4 788 sekunder för 9175F, vilket gör den 1.44 gånger snabbare än AMD-servern med 384 kärnor och 1.20 gånger snabbare än Intel-servern med 240 kärnor. Vera håller sig också inom ett nominellt maximum på 450 W per sockel, jämfört med 9965:ans 500 W.
Analys och minnesdata
HPC-resultaten visade vad Veras bandbredd gör för en vetenskaplig lösare. Datatjänster får samma minnessystem att fungera på olika sätt, och våra två tester använder det från motsatta ändar. ClickBench kör analytiska frågor som skannar och aggregerar stora kolumner med data och sprider varje fråga över varje kärna, så det belönar ett system som parar ihop många kärnor med bandbredden för att mata dem. Valkey, ett nyckel-värde-lager i minnet, hanterar miljontals små förfrågningar, där varje läser eller skriver ett enda värde, så det beror mer på hur snabbt en enskild kärna hanterar en förfrågan och, när datan växer ur cachen, på minneslatens och bandbredd.
ClickBench
Vi testade ClickBench med 43 frågor mot en webbanalystabell med 100 miljoner rader på ClickHouse 26.8. Dess heta summa, där varje fråga läser från sidcachen, mäter hur många kärnor ett system kan ta med sig till kolumnära skanningar och aggregeringar och hur väl dess minne håller dem matade. Den kalla summan lägger till en serveromstart och SSD-läsningar innan varje fråga körs första gången.
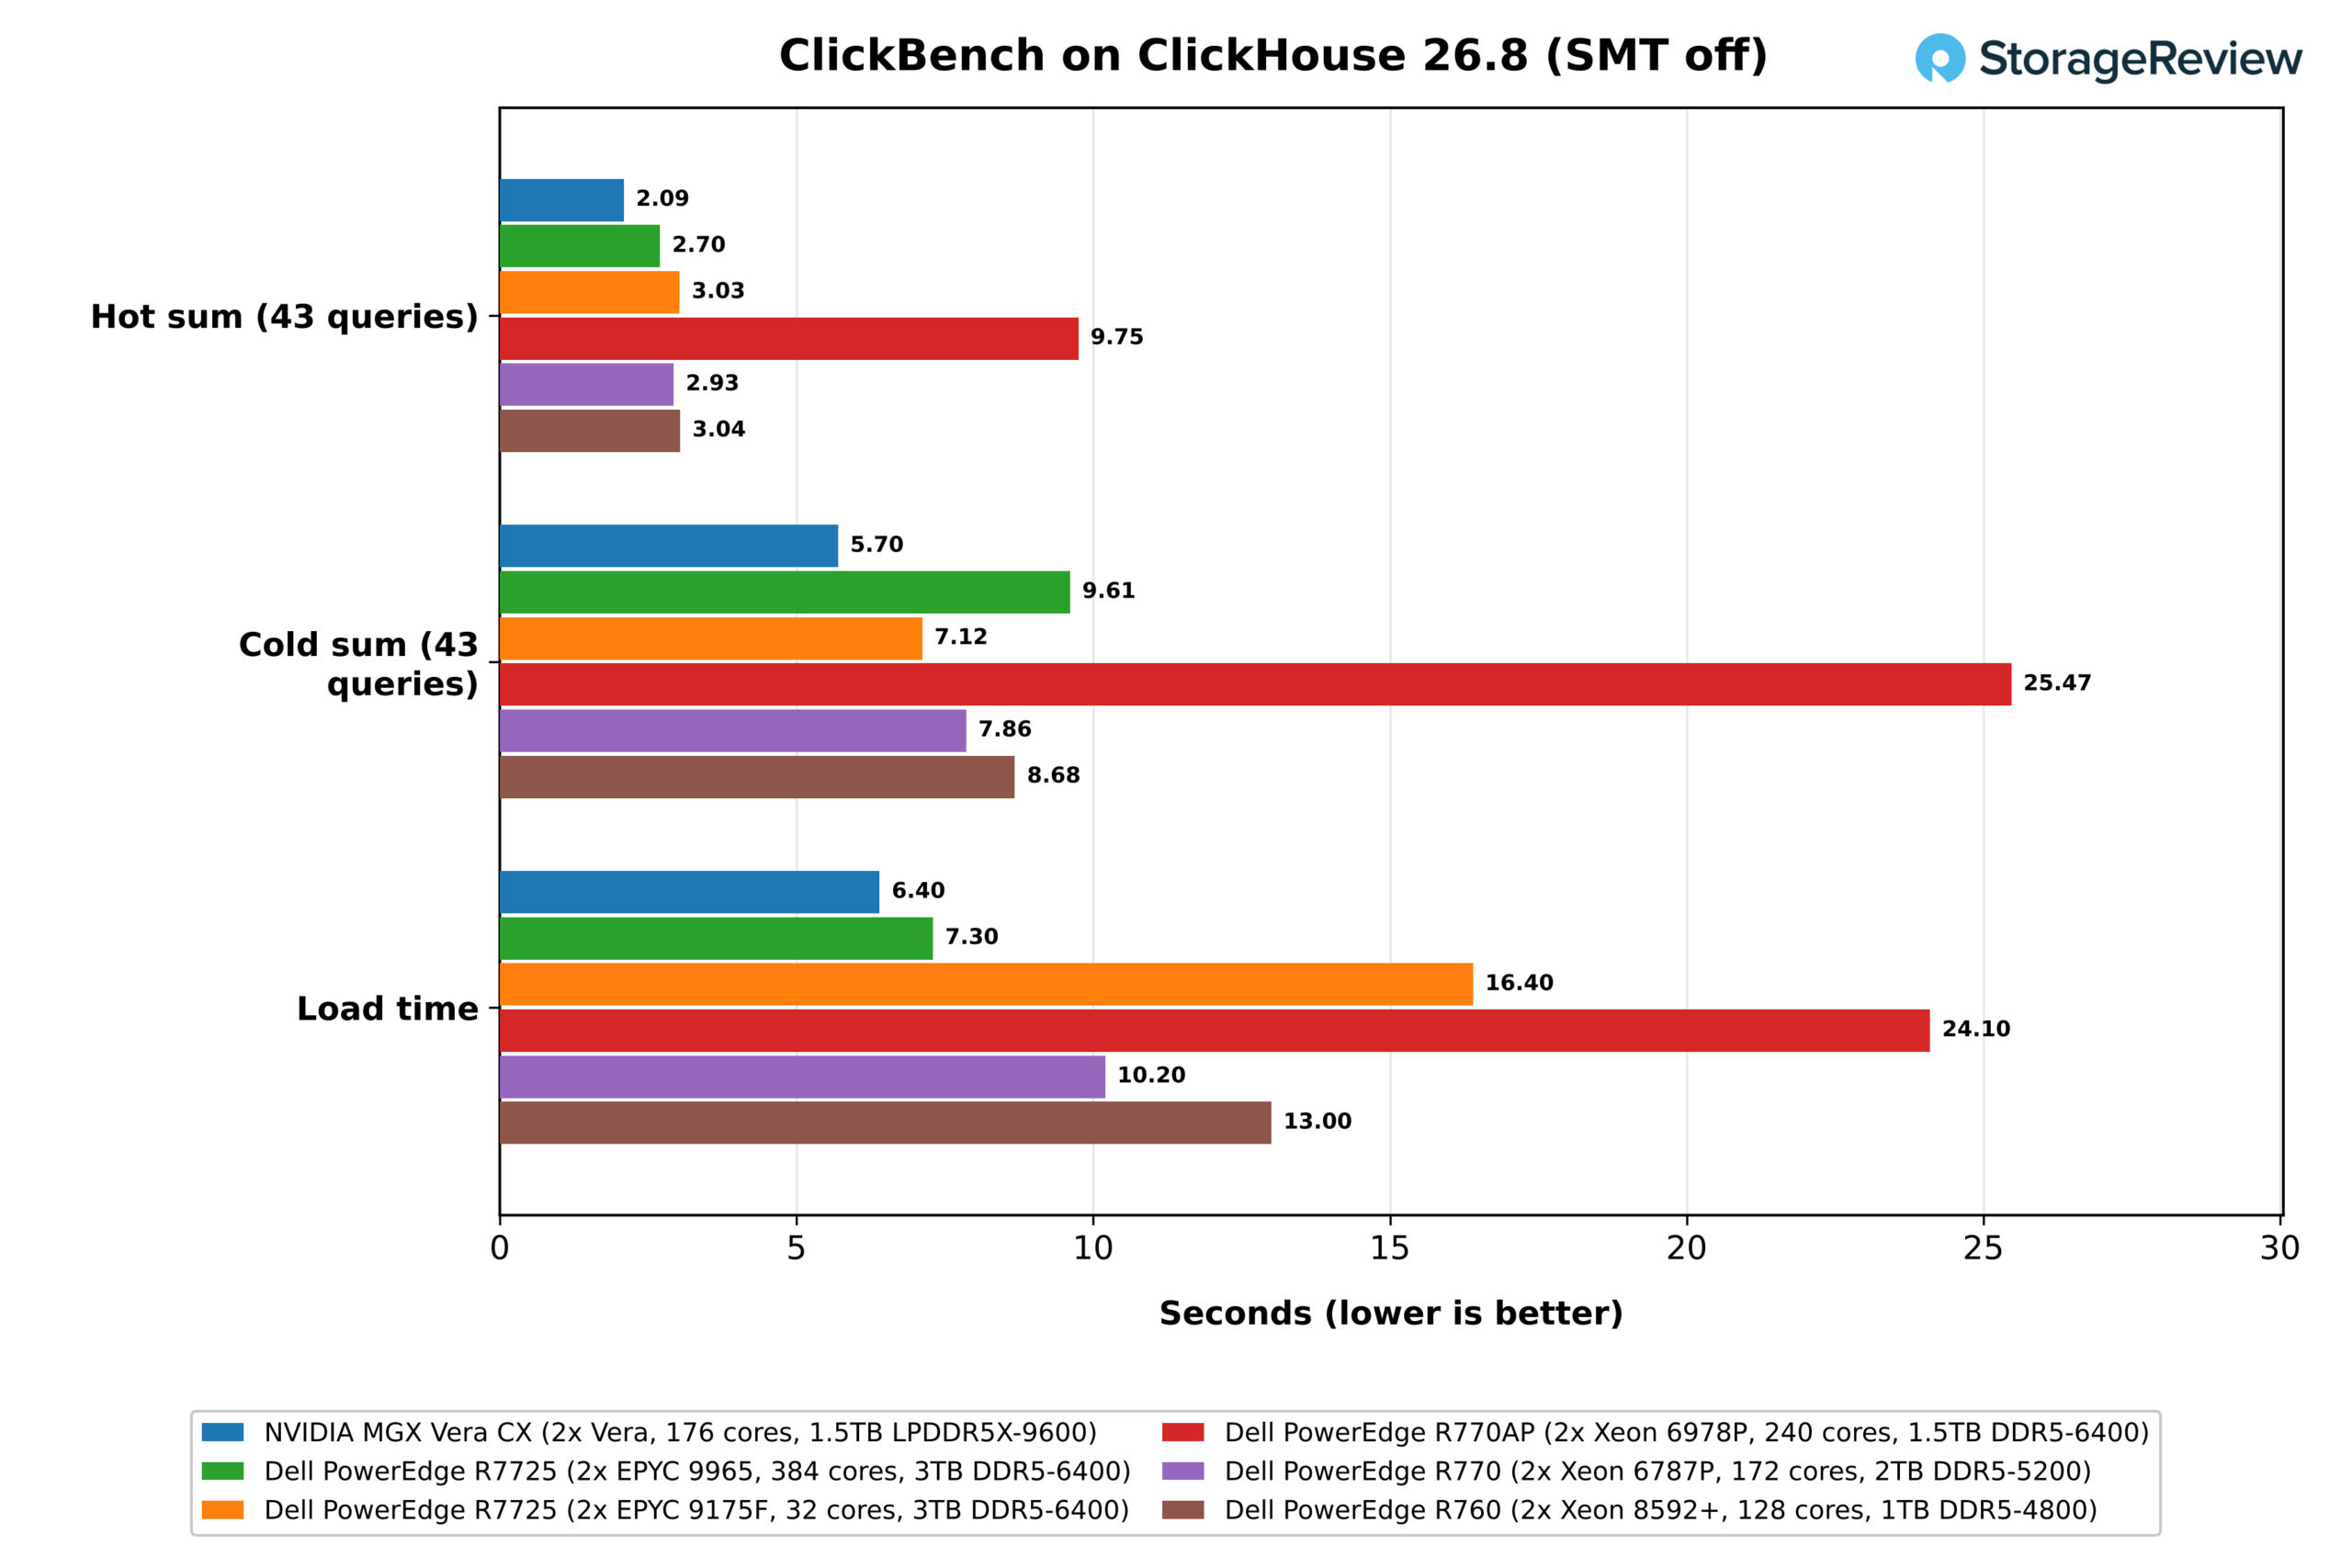
Med SMT avstängd slutförde Vera den snabba körningen på 2.09 sekunder, det snabbaste resultatet i vår uppsättning. EPYC 9965 kom härnäst med 2.70 sekunder, vilket tog 1.29 gånger så lång tid, medan Xeon 6787P, EPYC 9175F och Xeon 8592+ låg i praktiken på lika kort mellan 2.93 och 3.04 sekunder. Skillnaden återspeglar balansen mellan kärnor och bandbredd. 9965 med 384 kärnor har kärnor att avvara men liten bandbredd per kärna; 9175F med 32 kärnor har det motsatta; och Vera parar ihop 176 kärnor med mer än tre gånger bandbredden jämfört med båda.
Vera ledde även den kalla körningen med tiden 5.70 sekunder, före 9175F med tiden 7.12, 6787P med tiden 7.86, 8592+ med tiden 8.68 och 9965 med tiden 9.61. Den kalla körningen lutar mer åt lagring, och drivlänkarna skiljer sig åt: Gen5 x4 på Vera och 6787P, x2 på båda EPYC-systemen och Gen4 på 8592+.
Vera laddade också 15 GB-datasetet snabbast, på 6.4 sekunder, jämfört med 7.3 sekunder på 9965 och 10.2 till 16.4 sekunder på resten. Xeon 6978P, med 9.75 sekunder varm och 25.47 sekunder kall, hamnade långt utanför de andra Xeon-processorerna av skäl som vi inte har identifierat, så vi lämnar den utanför rankningen.
Att slå på Spatial Multithreading saktade ner Vera till 2.31 sekunder i drift och 6.09 sekunder i kall drift, en straffavgift på 10 % av den totala drifttiden. Att dela upp varje kärnas resurser mellan två trådar kostade ClickHouses skanningar mer än vad den tjänade.
Valkey
Valkey kör kommandon på en enda huvudtråd, där I/O-trådar bara hjälper till upp till en viss punkt, så distributioner växer genom att lägga till shards, eftersom det inte gör mycket att ge en instans fler kärnor. Vi tittar därför på Valkey på två sätt: vad en enskild shard levererar på matchade kärnor, och vad varje shard levererar när en socket är packad med dem. I båda testerna körs klienterna på den andra socketen på samma maskin, så inget nätverkskort är inblandat.
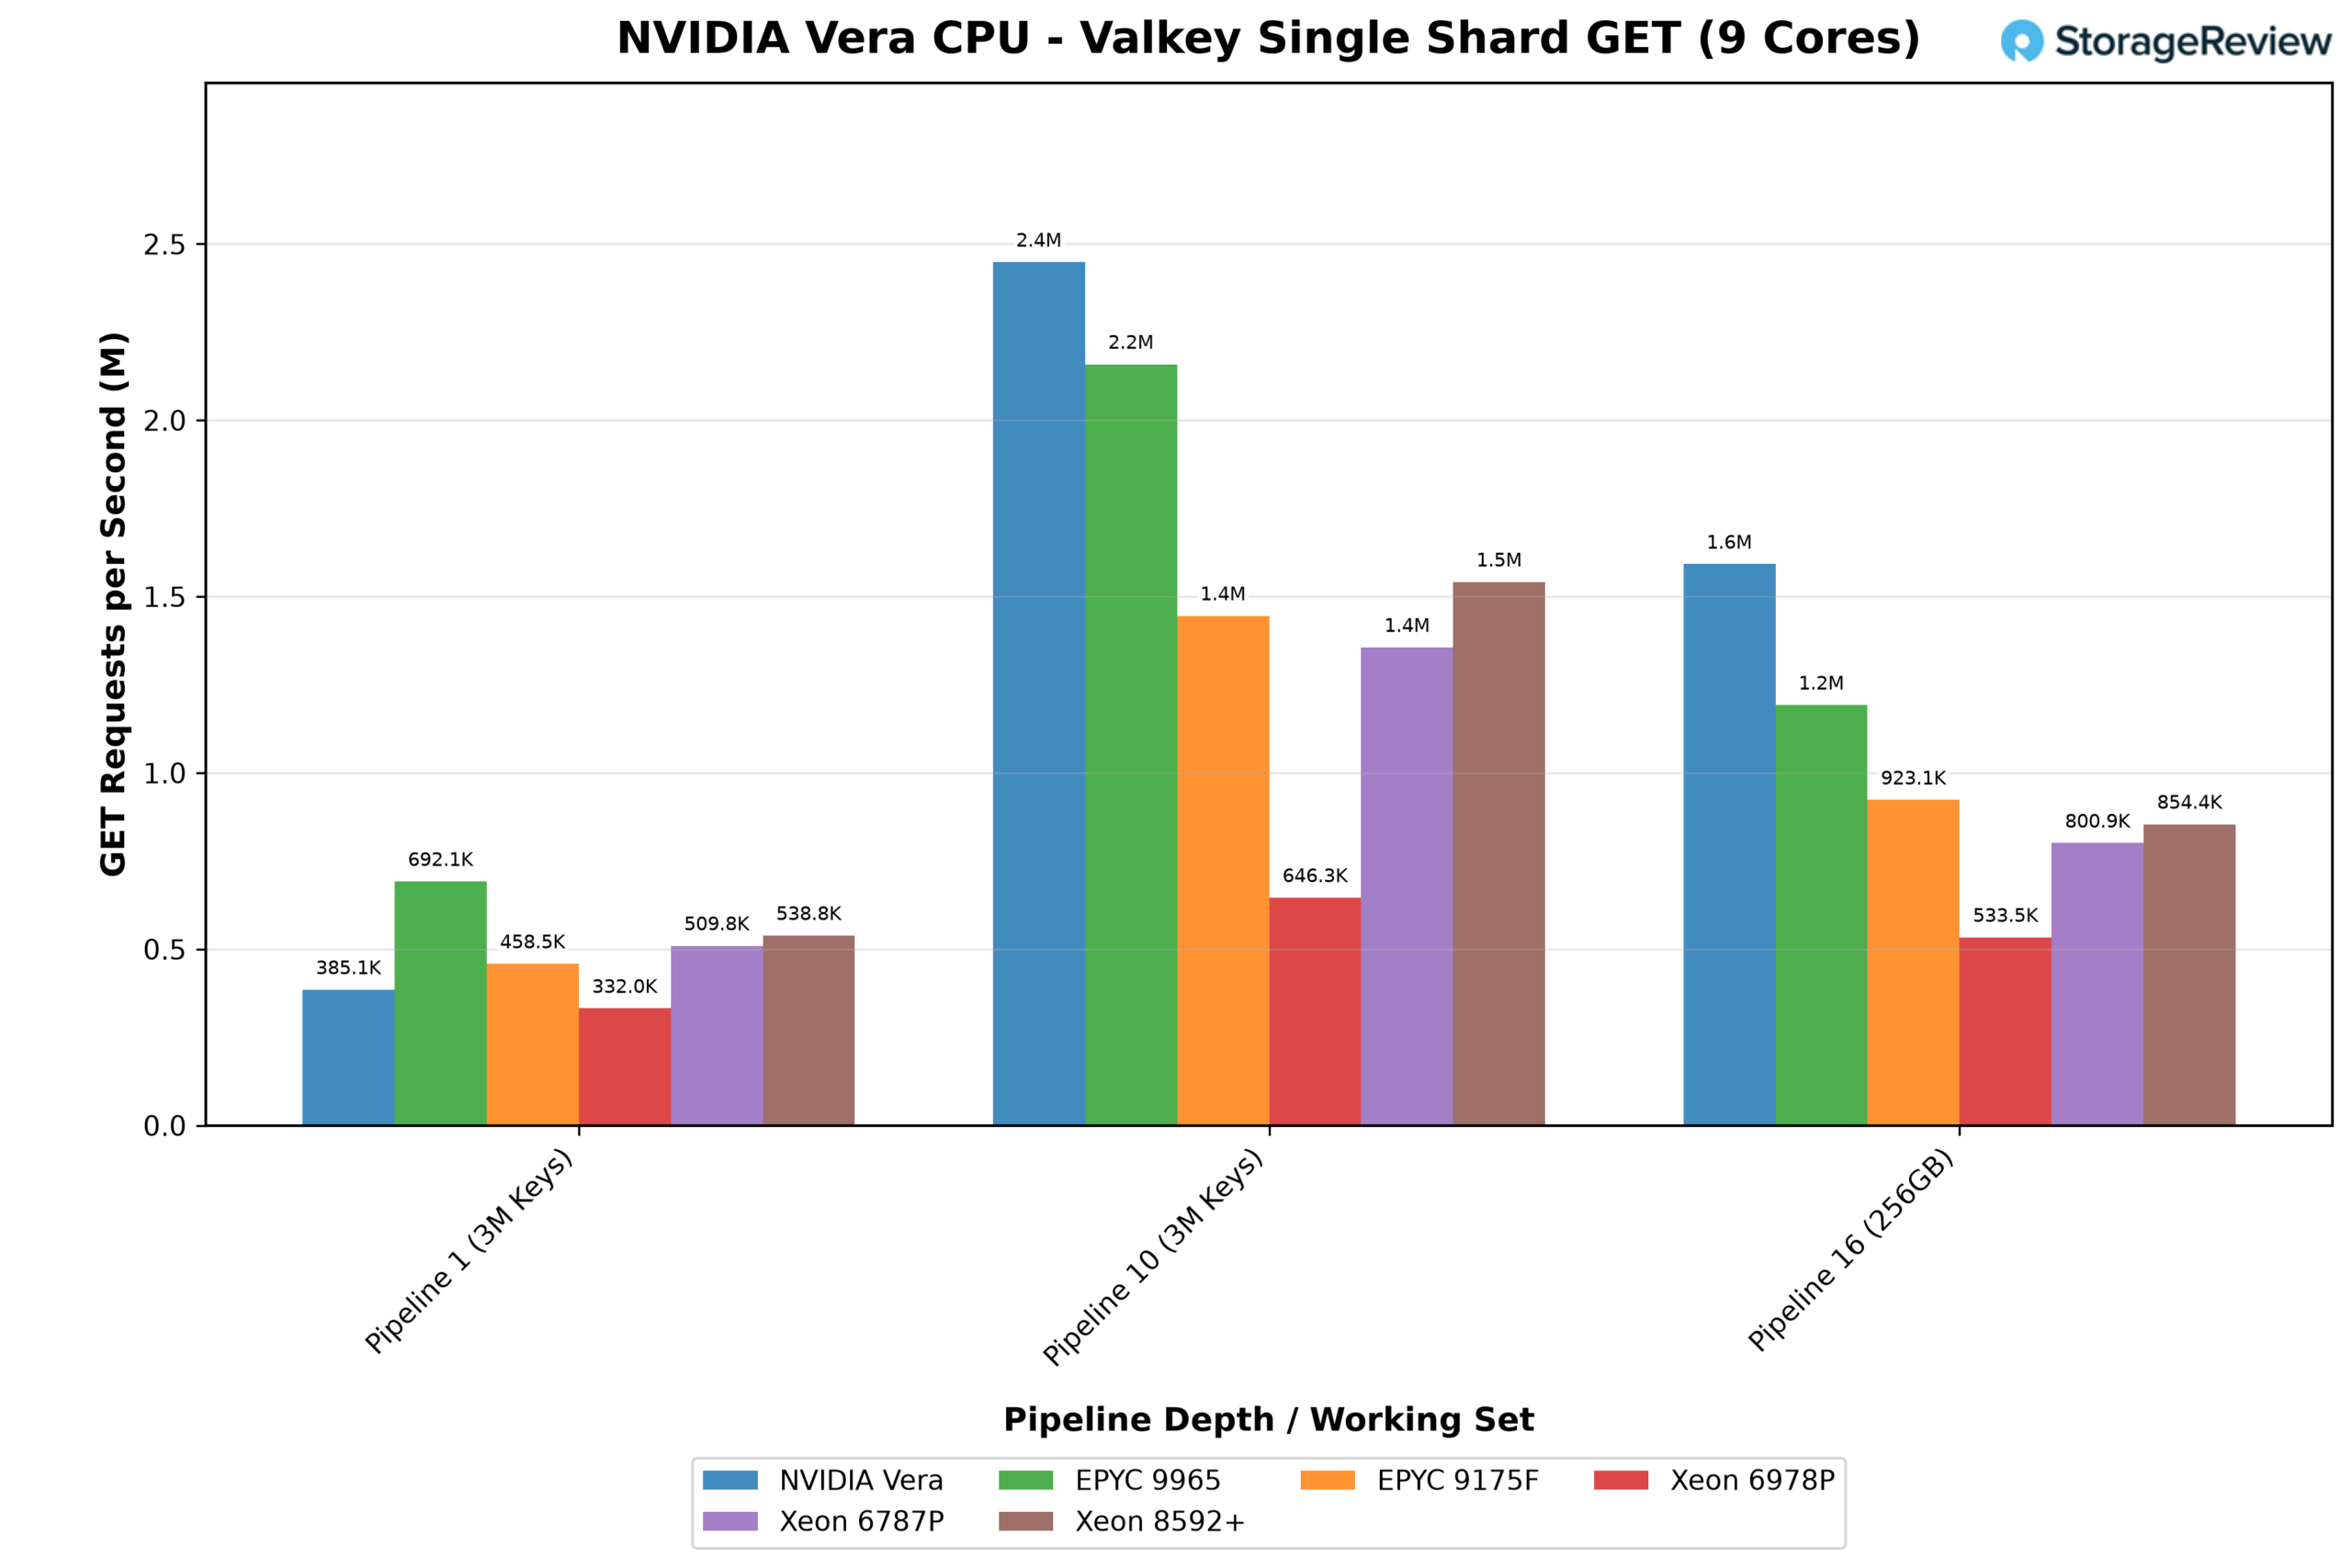
Single-shard-testet ger en Valkey-server nio fysiska kärnor på varje plattform. Den hanterar en datamängd på 3 miljoner nycklar, där förfrågningar skickas en i taget, sedan i batcher om 10, och hanterar sedan en datamängd på 256 GB, för stor för någon cache, i batcher om 16. När förfrågningarna skickas en i taget måste varje förfrågan slutföra sin tur och retur innan nästa skickas ut, och det är här Vera är svagast. Dess shard hanterade 385 000 GET-förfrågningar per sekund, före endast Xeon 6978P, medan EPYC 9965 ledde med 692 000. Veras p99-latens var också högre, på 1.76 ms jämfört med 1.08 ms på 9965.
Batchning eliminerar det mesta av den tur-retur-kostnaden, och Vera flyttar framåt. Med batcher om 10 hanterade deras shard 2.45 miljoner GET-förfrågningar per sekund, 13 % mer än 9965 och långt före alla Xeon-processorer. Datauppsättningen på 256 GB vidgade gapet ytterligare. Med nästan varje förfrågan som gick till minnet hanterade Vera 1.59 miljoner GET-förfrågningar per sekund, 34 % mer än 9965, medan resten av fältet varierade från 0.53 miljoner till 0.92 miljoner. SET-resultaten följde samma mönster i båda testerna.
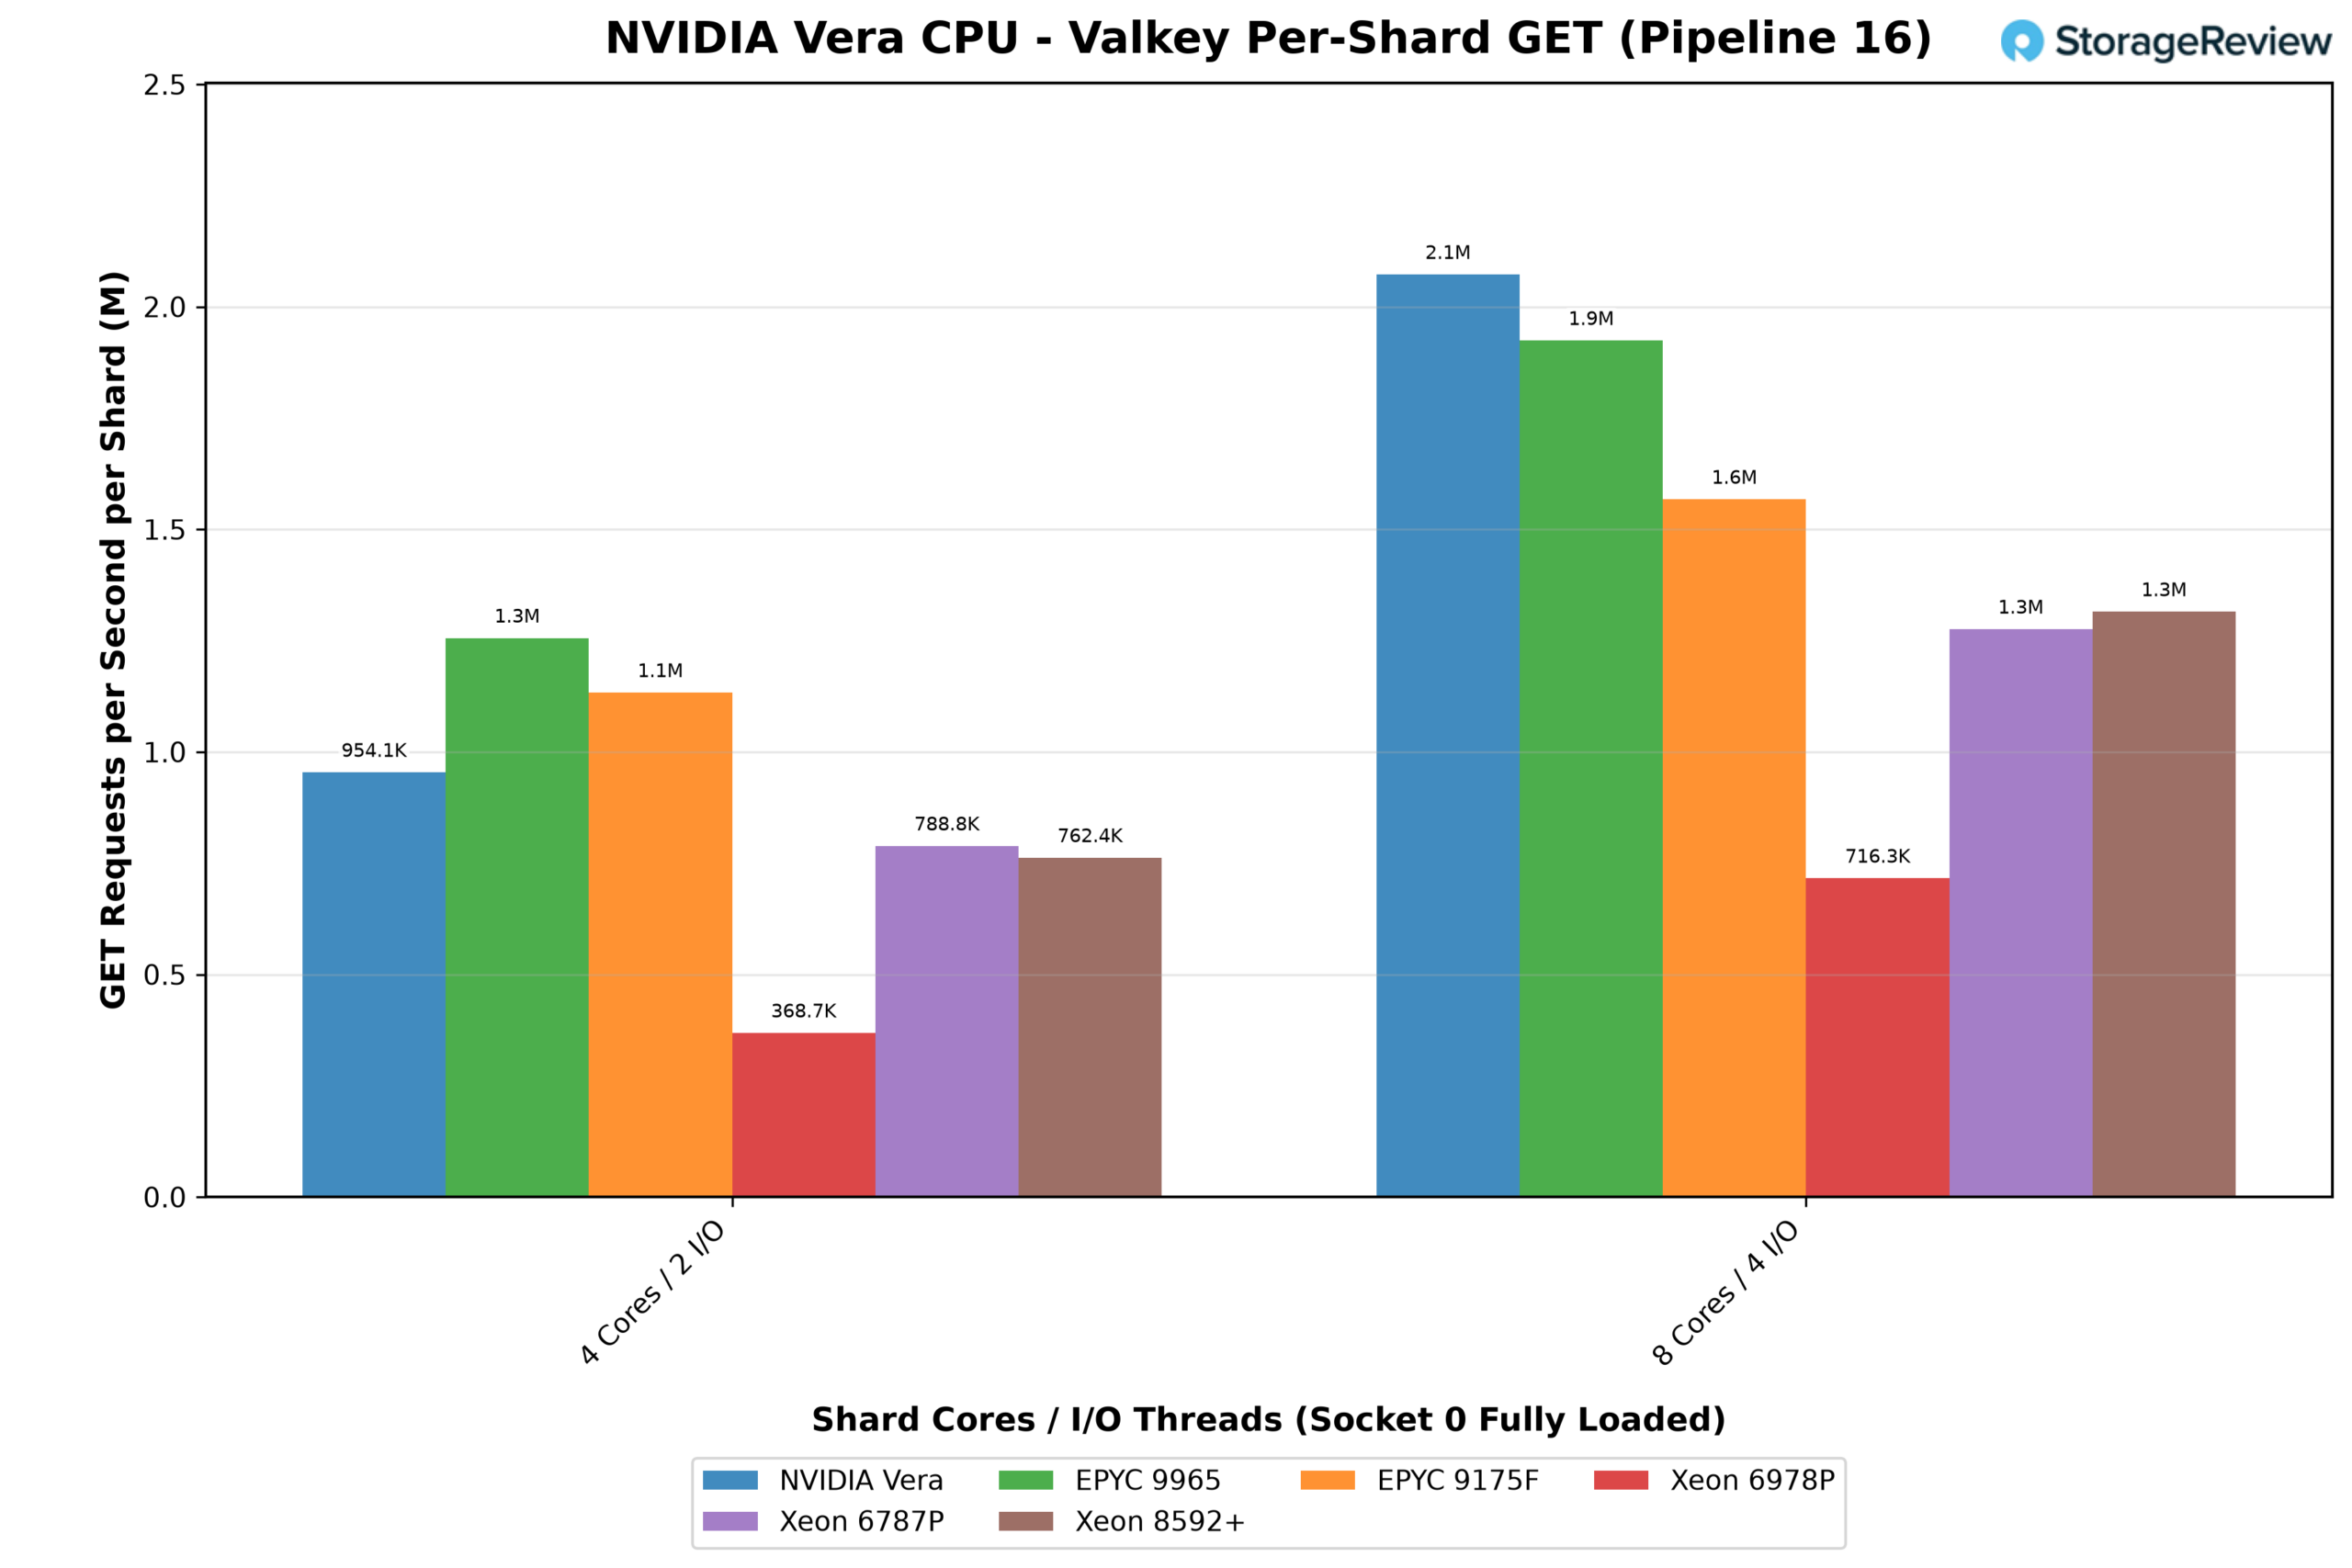
Socket-läge packar socket 0 med identiska shards på fyra eller åtta kärnor, som alla hanterar trafik samtidigt, vilket är närmare hur en dedikerad Valkey-värd körs. Med 8-kärniga shards och batcher på 16 levererade varje Vera-shard 2.07 miljoner GET-förfrågningar per sekund, vilket är högre än 9965:ans 1.92 miljoner och cirka 1.6 gånger högre än Xeon 6787P och 8592+, även om dess p99-latens ökade till 2.2 ms jämfört med cirka 0.5 ms på 9965.
Med mindre 4-kärniga shards kom AMD ut i ledningen: 9965 med 1.26 miljoner GET per shard mot Veras 0.95 miljoner, även om Vera fortfarande ledde alla Xeon. Med förfrågningar skickade en i taget var 9965:s shards 1.5x till 1.7x snabbare än Veras i båda storlekarna, och 6787P och 8592+ drog också före på 8-kärniga shards.
Densiteten avgör det totala antalet sockets: en Vera-socket rymmer 11 åttakärniga shards och hanterade 22.8 miljoner GET-förfrågningar per sekund, medan 9965:ans 192 kärnor rymmer 48 fyrkärniga shards och hanterade 60.3 miljoner. Vera levererar de snabbaste shards i vår uppsättning när varje shard har åtta eller fler kärnor och förfrågningar batchas ihop, men 9965 får plats med mer än dubbelt så många shards i en socket.
Enkeltråd och genomströmning
Valkey och ClickBench lutade sig lika mycket mot minnessystemet som mot kärnorna. Det här avsnittet handlar om själva kärnorna och de två målen bakom Olympus som beskrivits tidigare: att slutföra enskilda uppgifter snabbt och bibehålla den hastigheten när hela sockeln är upptagen. 7-Zip, OpenSSL och Python körs var och en som en enda tråd fäst vid en kärna, vilket visar vad en Olympus-kärna kan göra på egen hand. 7-Zip och OpenSSL körs sedan igen över varje tråd i systemet, vilket visar hur mycket av den hastigheten per kärna som överlever när varje kärna konkurrerar om samma cachar och minne.
7-Zip
7-Zips LZMA-komprimering är grentung heltalskod med oförutsägbar minnesåtkomst, den typ av arbete som Olympus 10-breda frontend och grafförhämtare är designade för.
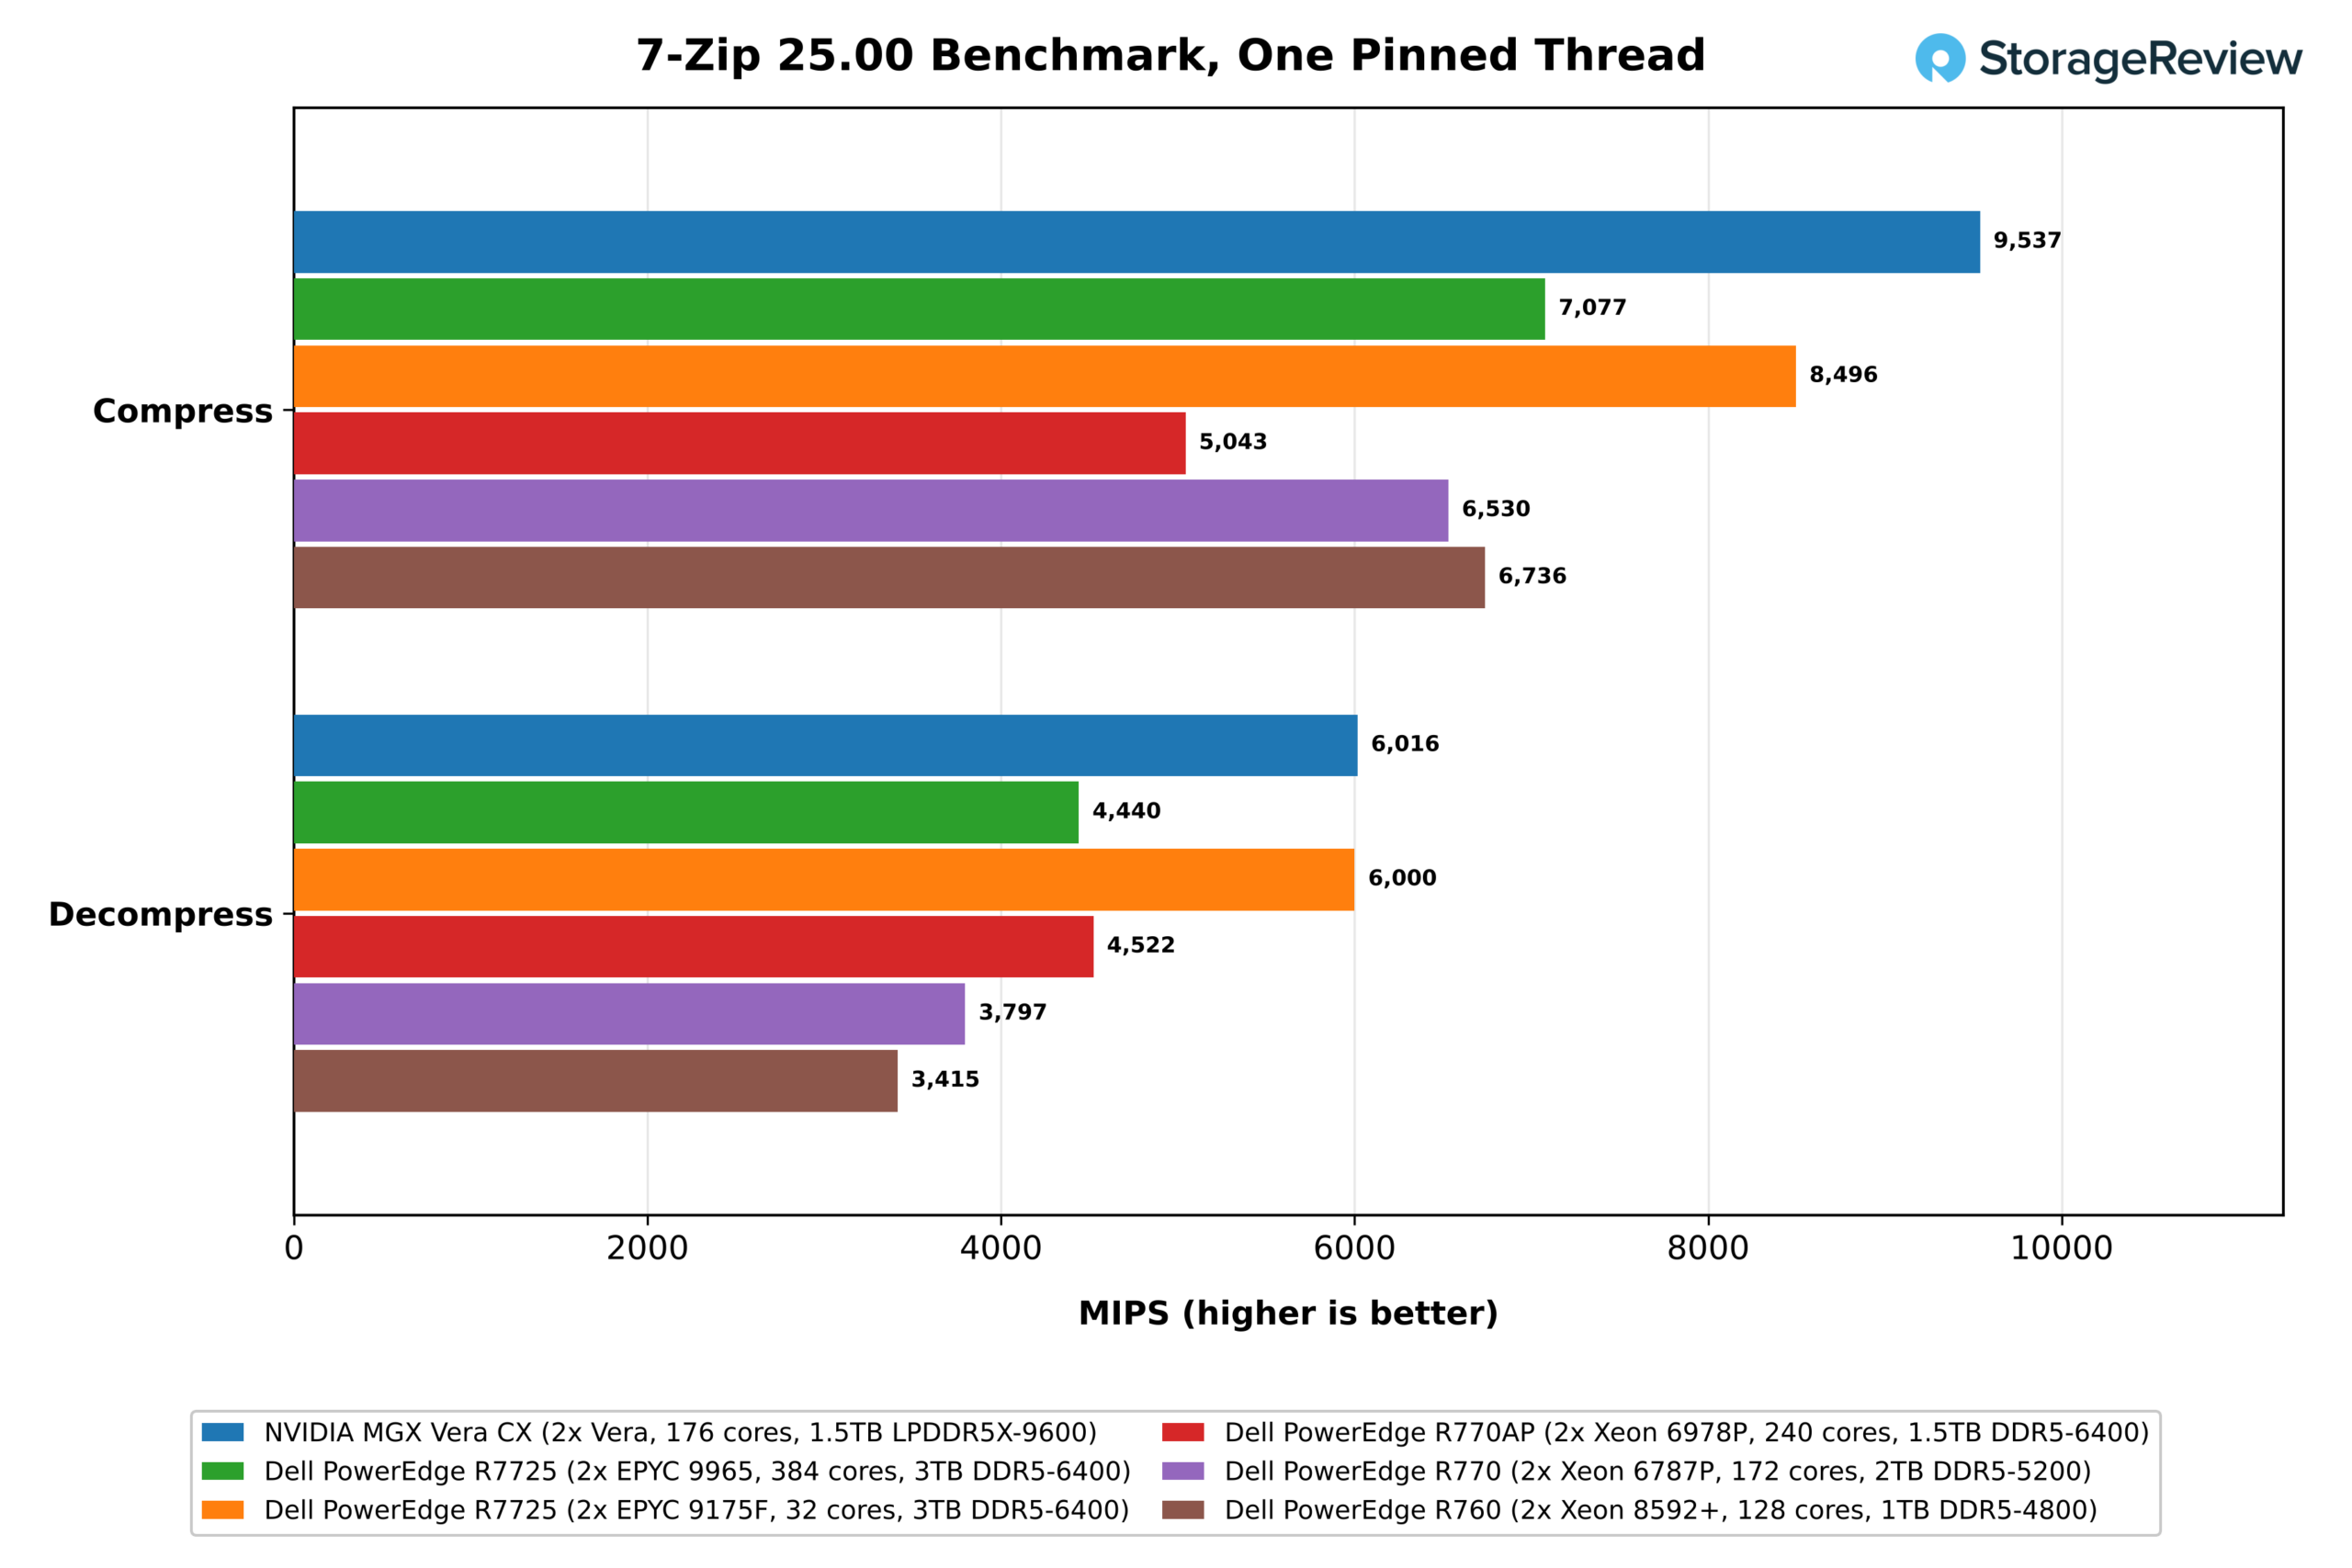
På en enda tråd var Olympus den snabbaste kompressorn i vår uppsättning. Den nådde 9 537 MIPS, 12 % före 5.0 GHz EPYC 9175F, den snabbaste x86-kärnan här, och långt före EPYC 9965 och alla Xeon. Dekompressionen var en likvärdig skillnad mellan de två: 6 016 MIPS för Vera och 6 000 för 9175F, utan något annat system inom 20 %.
Att löpa genom varje tråd visar hur mycket av den där ledningen överlever när hela systemet är upptaget.
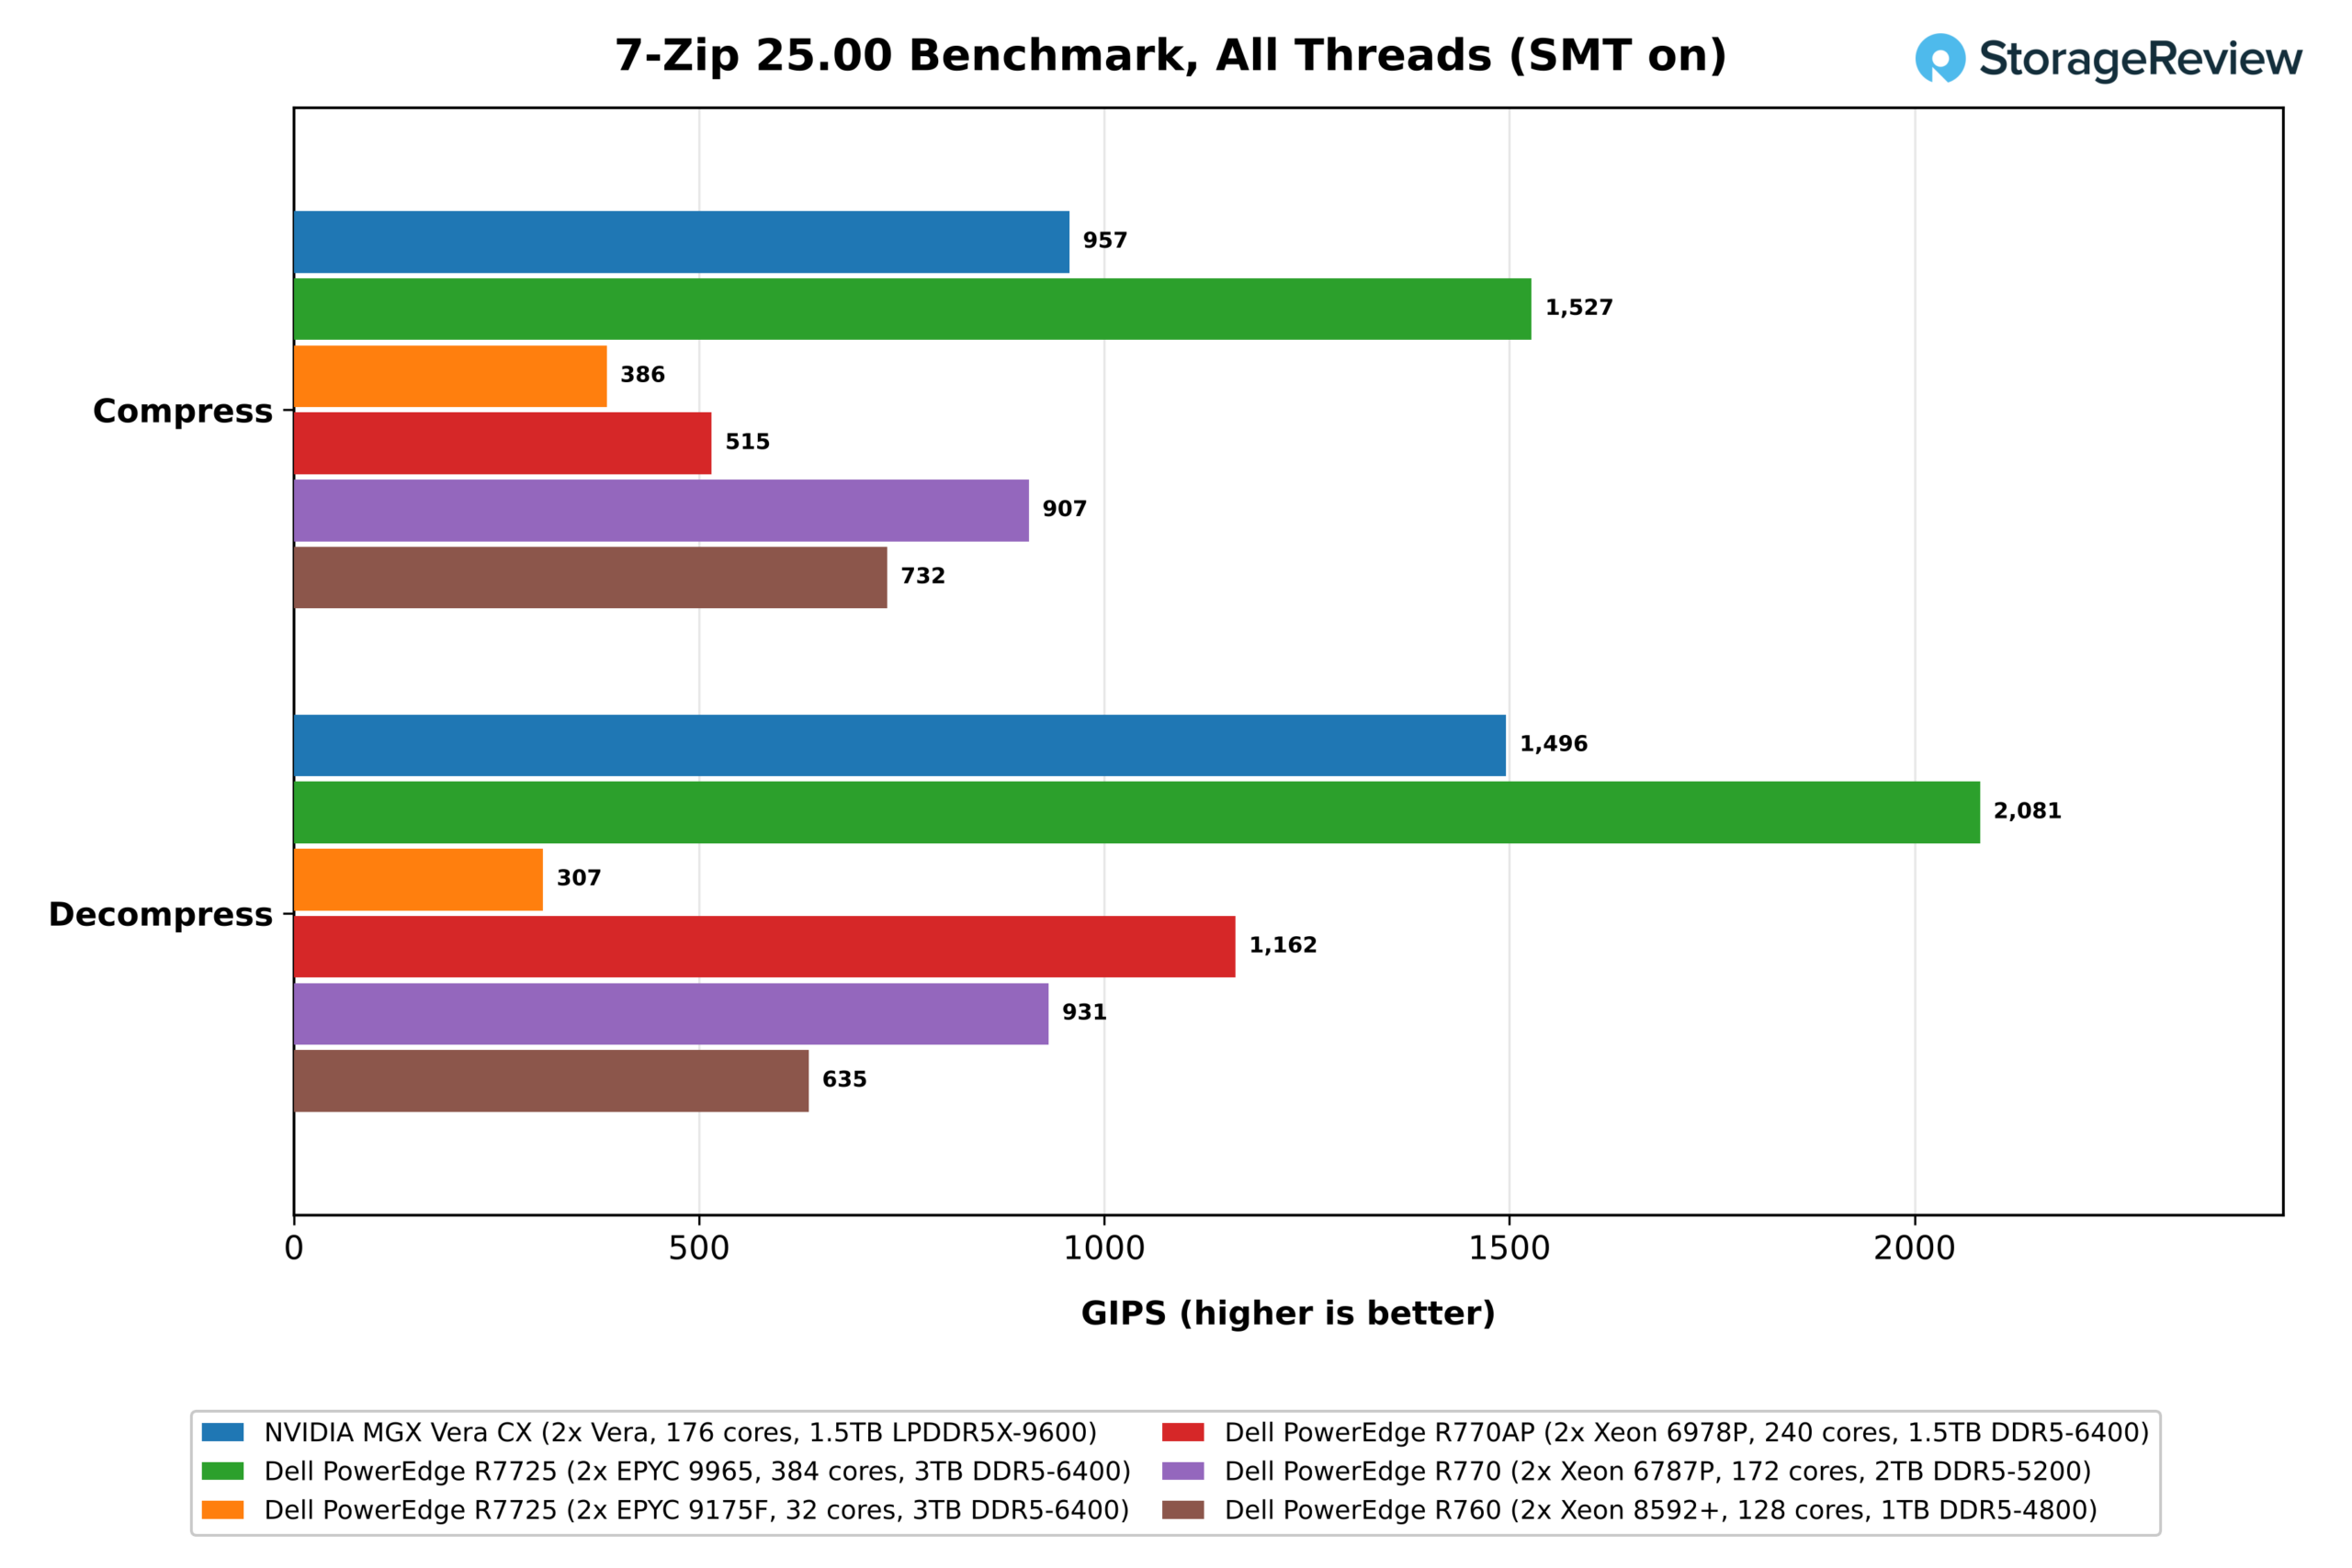
Med varje tråd upptagen tog EPYC 9965:s 768 trådar topplaceringen med 1 527 GIPS-komprimering och 2 081 GIPS-dekomprimering. Veras 352 trådar kom tvåa med 957 och 1 496 GIPS, före alla Xeon-processorer, med 6787P närmast med 907 och 931. Mätt per fysisk kärna håller Vera sig bra. Dess 5.4 GIPS-komprimering per kärna matchar 6787P och 8592+ och slår 9965:s 4.0, och dess 8.5 GIPS-dekomprimering per kärna är 57 % högre än 9965 och slår alla Xeon-processorer. Endast 32-kärniga 9175F, med betydligt färre kärnor som delar varje sockels cacheminne och minne, gjorde mer per kärna på båda.
OpenSSL
Det är i OpenSSLs AES-256-GCM-test som Vera ger upp mest. Endast två av Olympus sex 128-bitars SVE2-rör kan exekvera kryptoinstruktioner, medan x86-delarna kan köra AES på 512-bitars register med VAES.
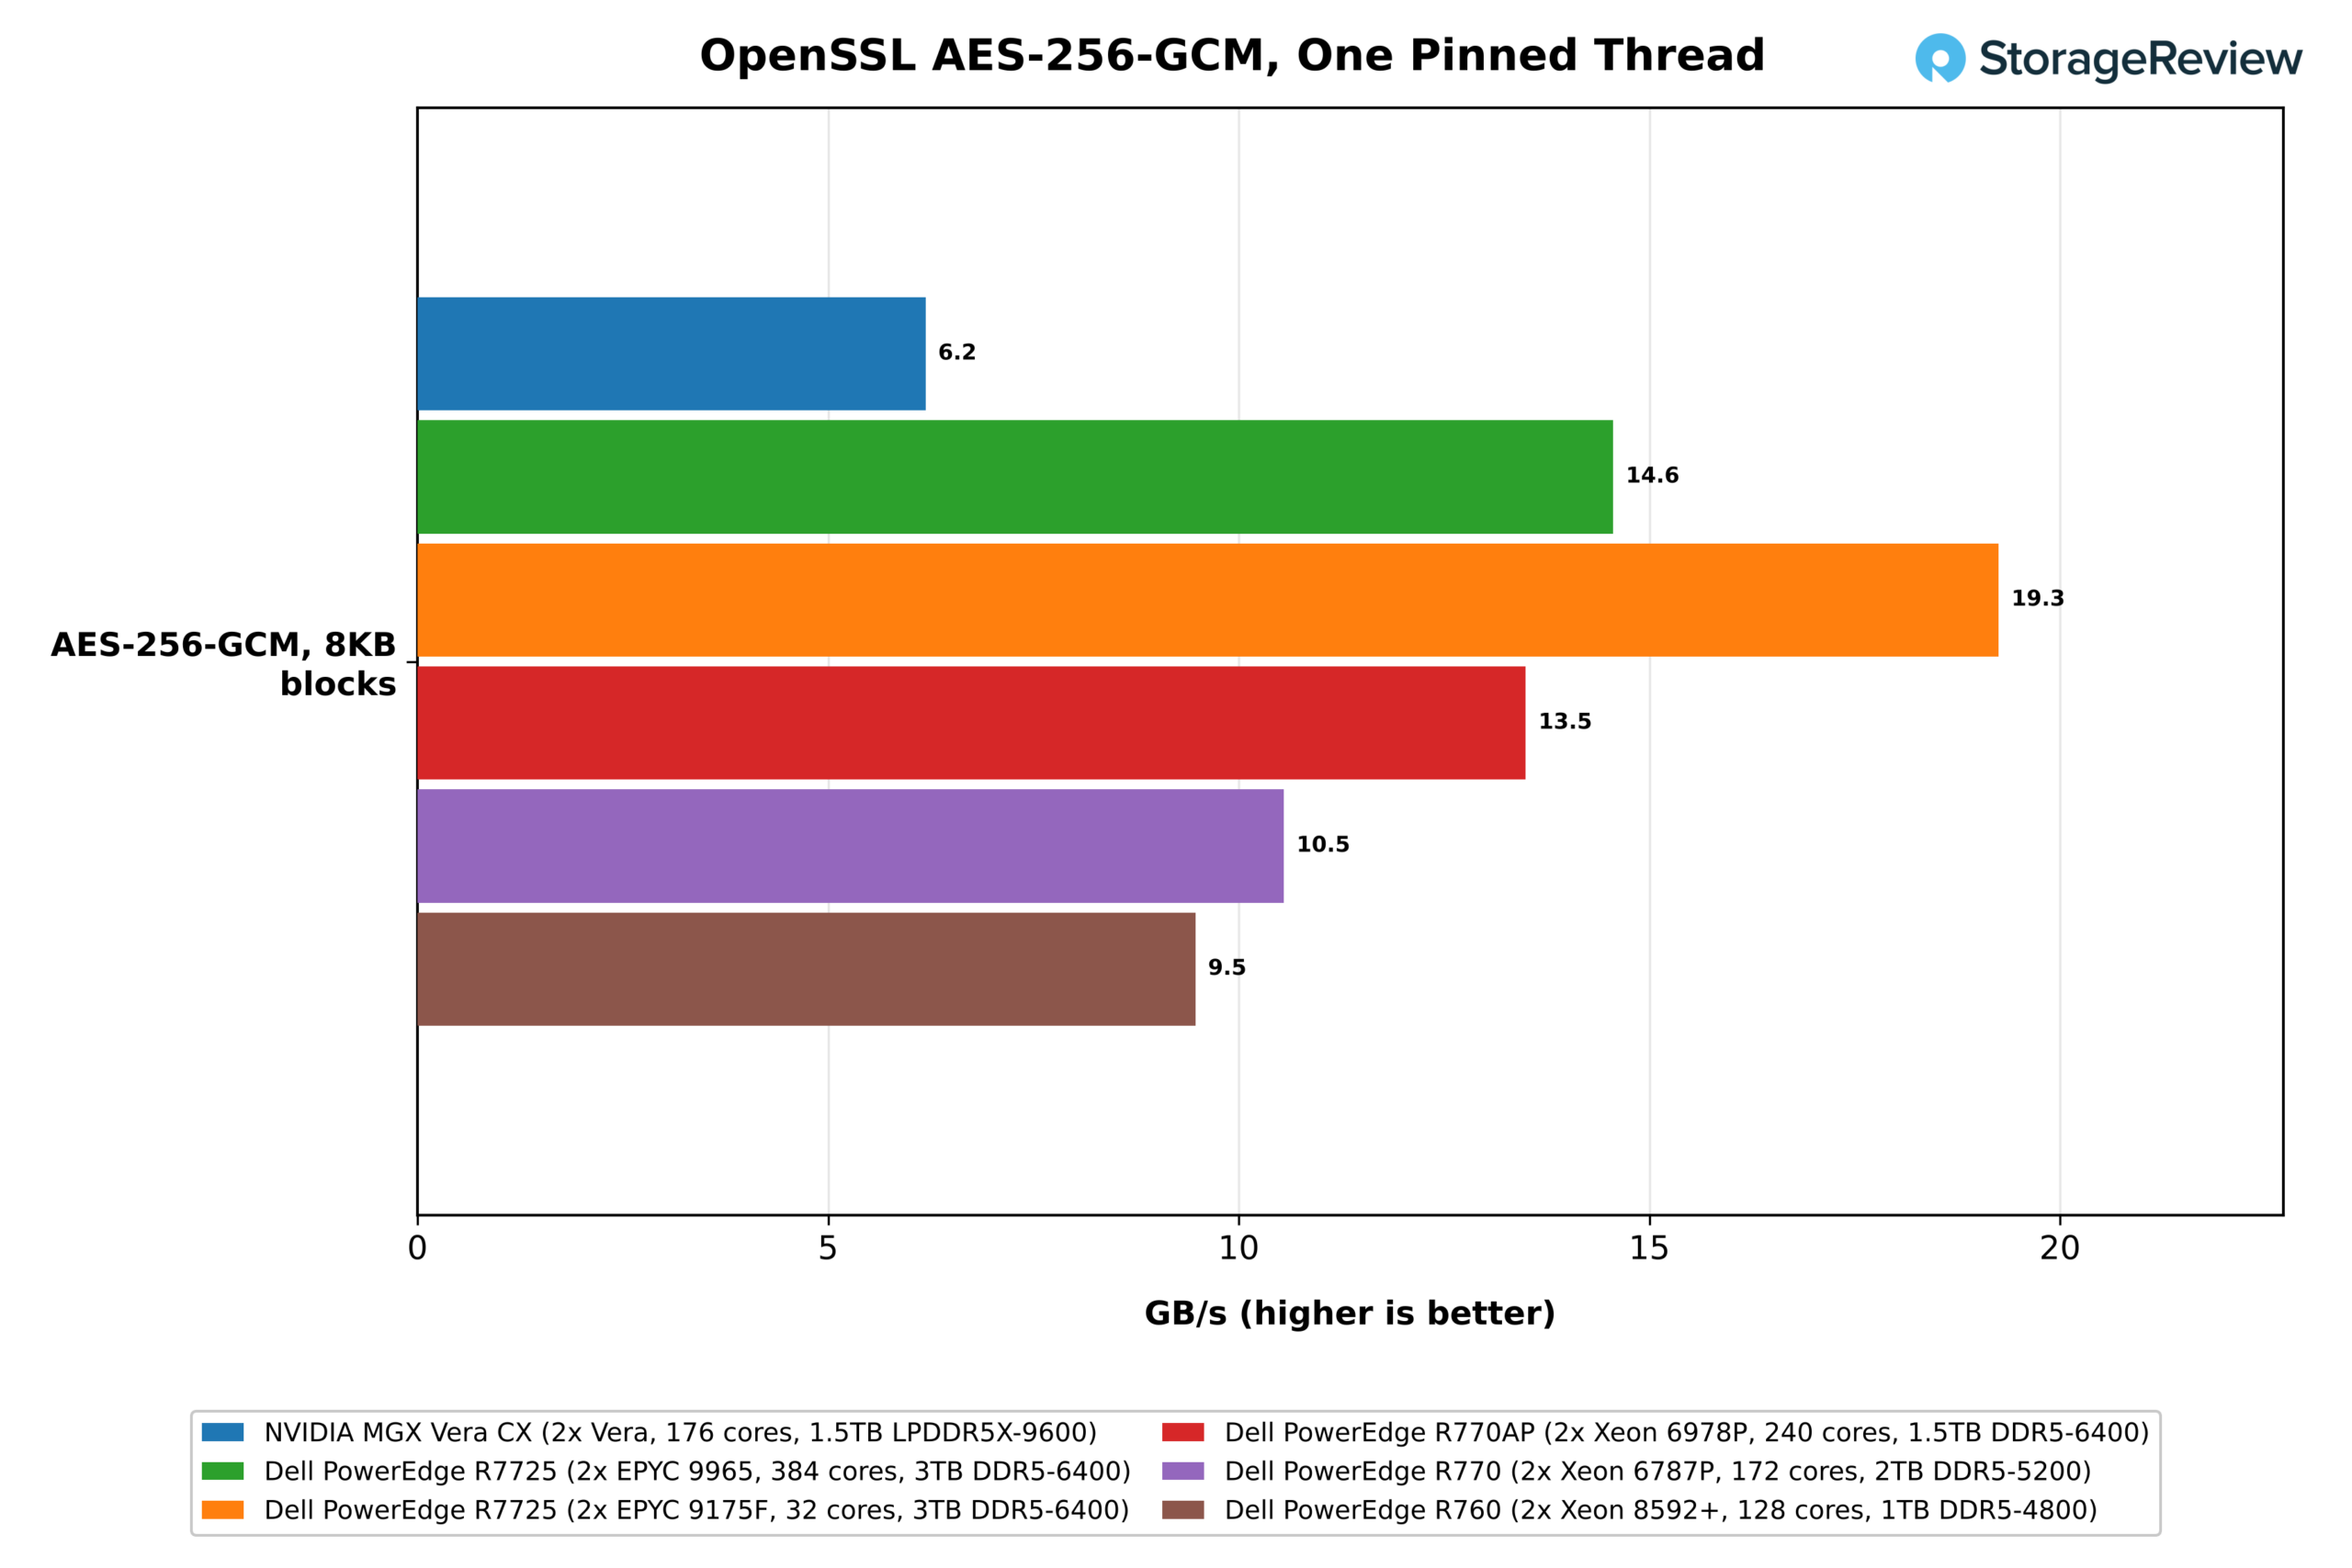
Gapet är tydligast på en enda tråd. En Olympus-kärna krypterad med 6.2 GB/s, ungefär en tredjedel av de 19.3 GB/s som finns på EPYC 9175F, och långt efter EPYC 9965 med 14.6 GB/s och Xeon 6978P med 13.5 GB/s.
Över varje tråd radas x86-systemen upp efter kärnantal, vilket visar var det underskottet per kärna lämnar Vera.
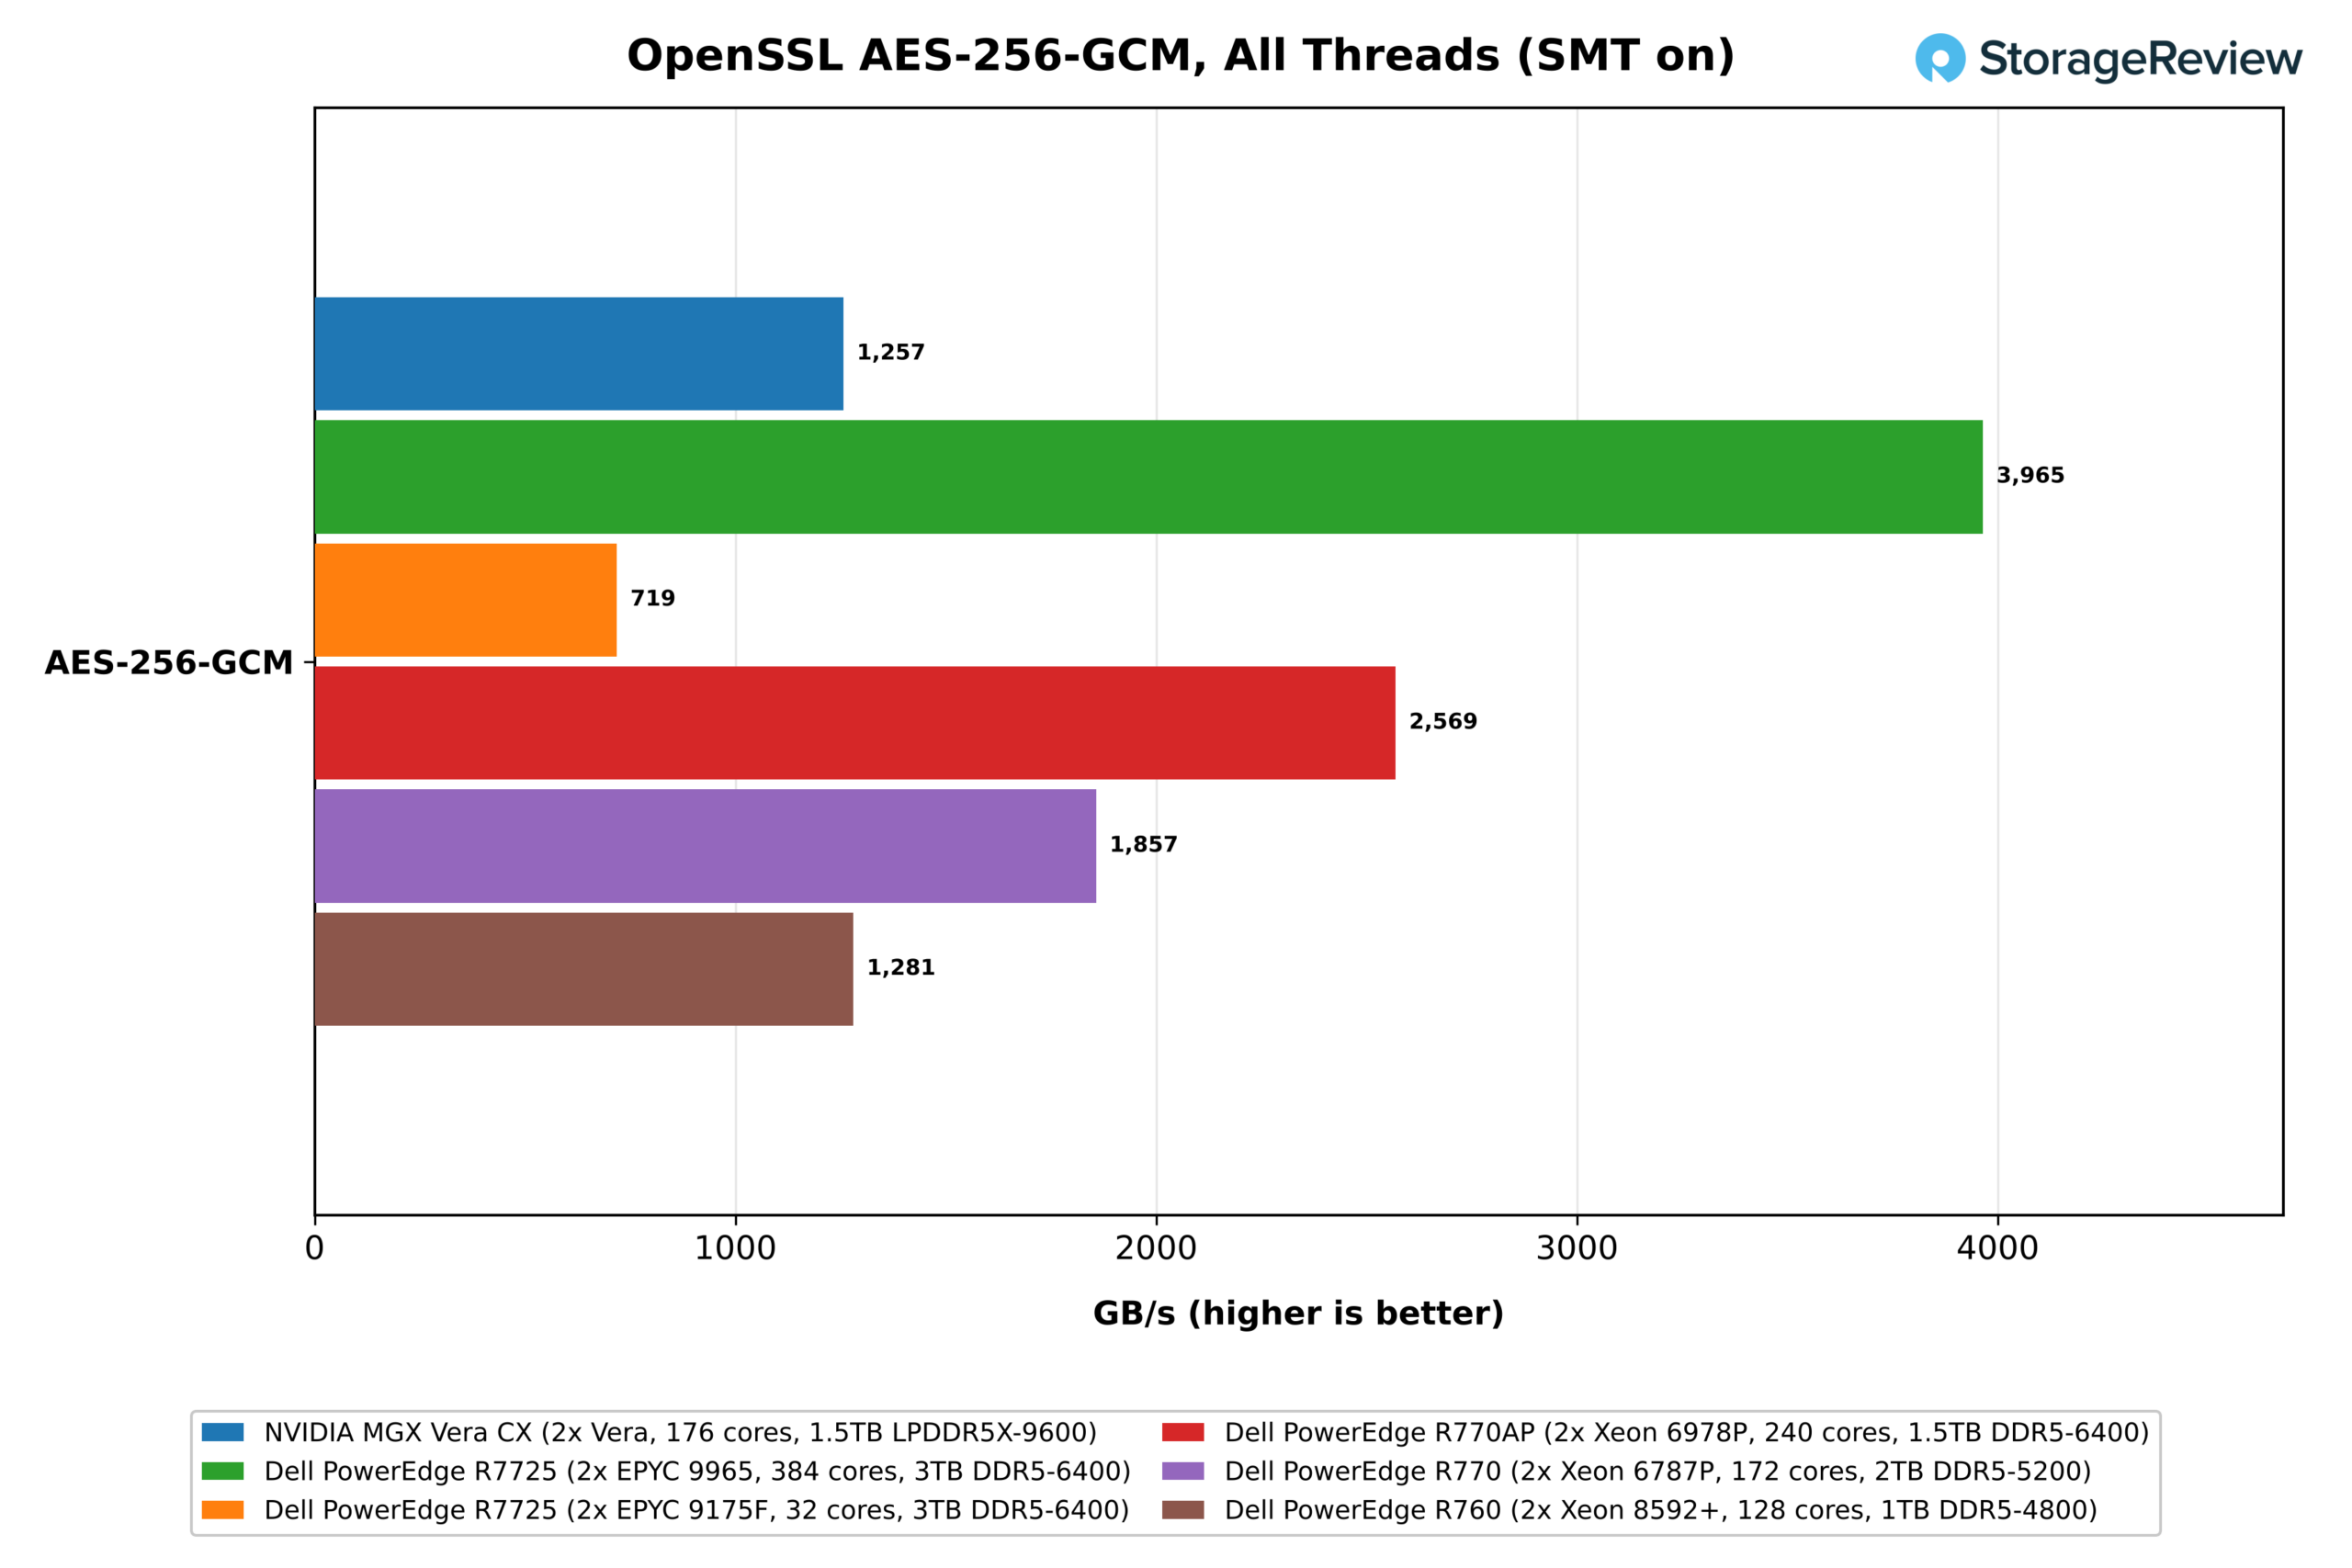
Med alla 352 trådar upptagna nådde Vera 1.26 TB/s, i nivå med 128-kärniga Xeon 8592+ på 1.28 TB/s och före endast 32-kärniga EPYC 9175F. EPYC 9965 ledde med 3.96 TB/s, ungefär tre gånger Veras resultat, följt av Xeon 6978P på 2.57 TB/s och 6787P på 1.86 TB/s.
Python
Python är centralt för de agent-sandlådor som NVIDIA riktar in sig på med Vera, och pyperformance ger oss tre fästa entrådstester av det: go, en objekttung spelträdsökning; regex_compile, som kompilerar reguljära uttryck; och nbody, en flyttalsfysiksimulering. En skillnad i programvaran gäller här: Vera körde Python 3.14.4 från Ubuntu 26.04, medan x86-systemen körde 3.12.3 från Ubuntu 24.04, och den nyare versionen ger snabbare tolkning.
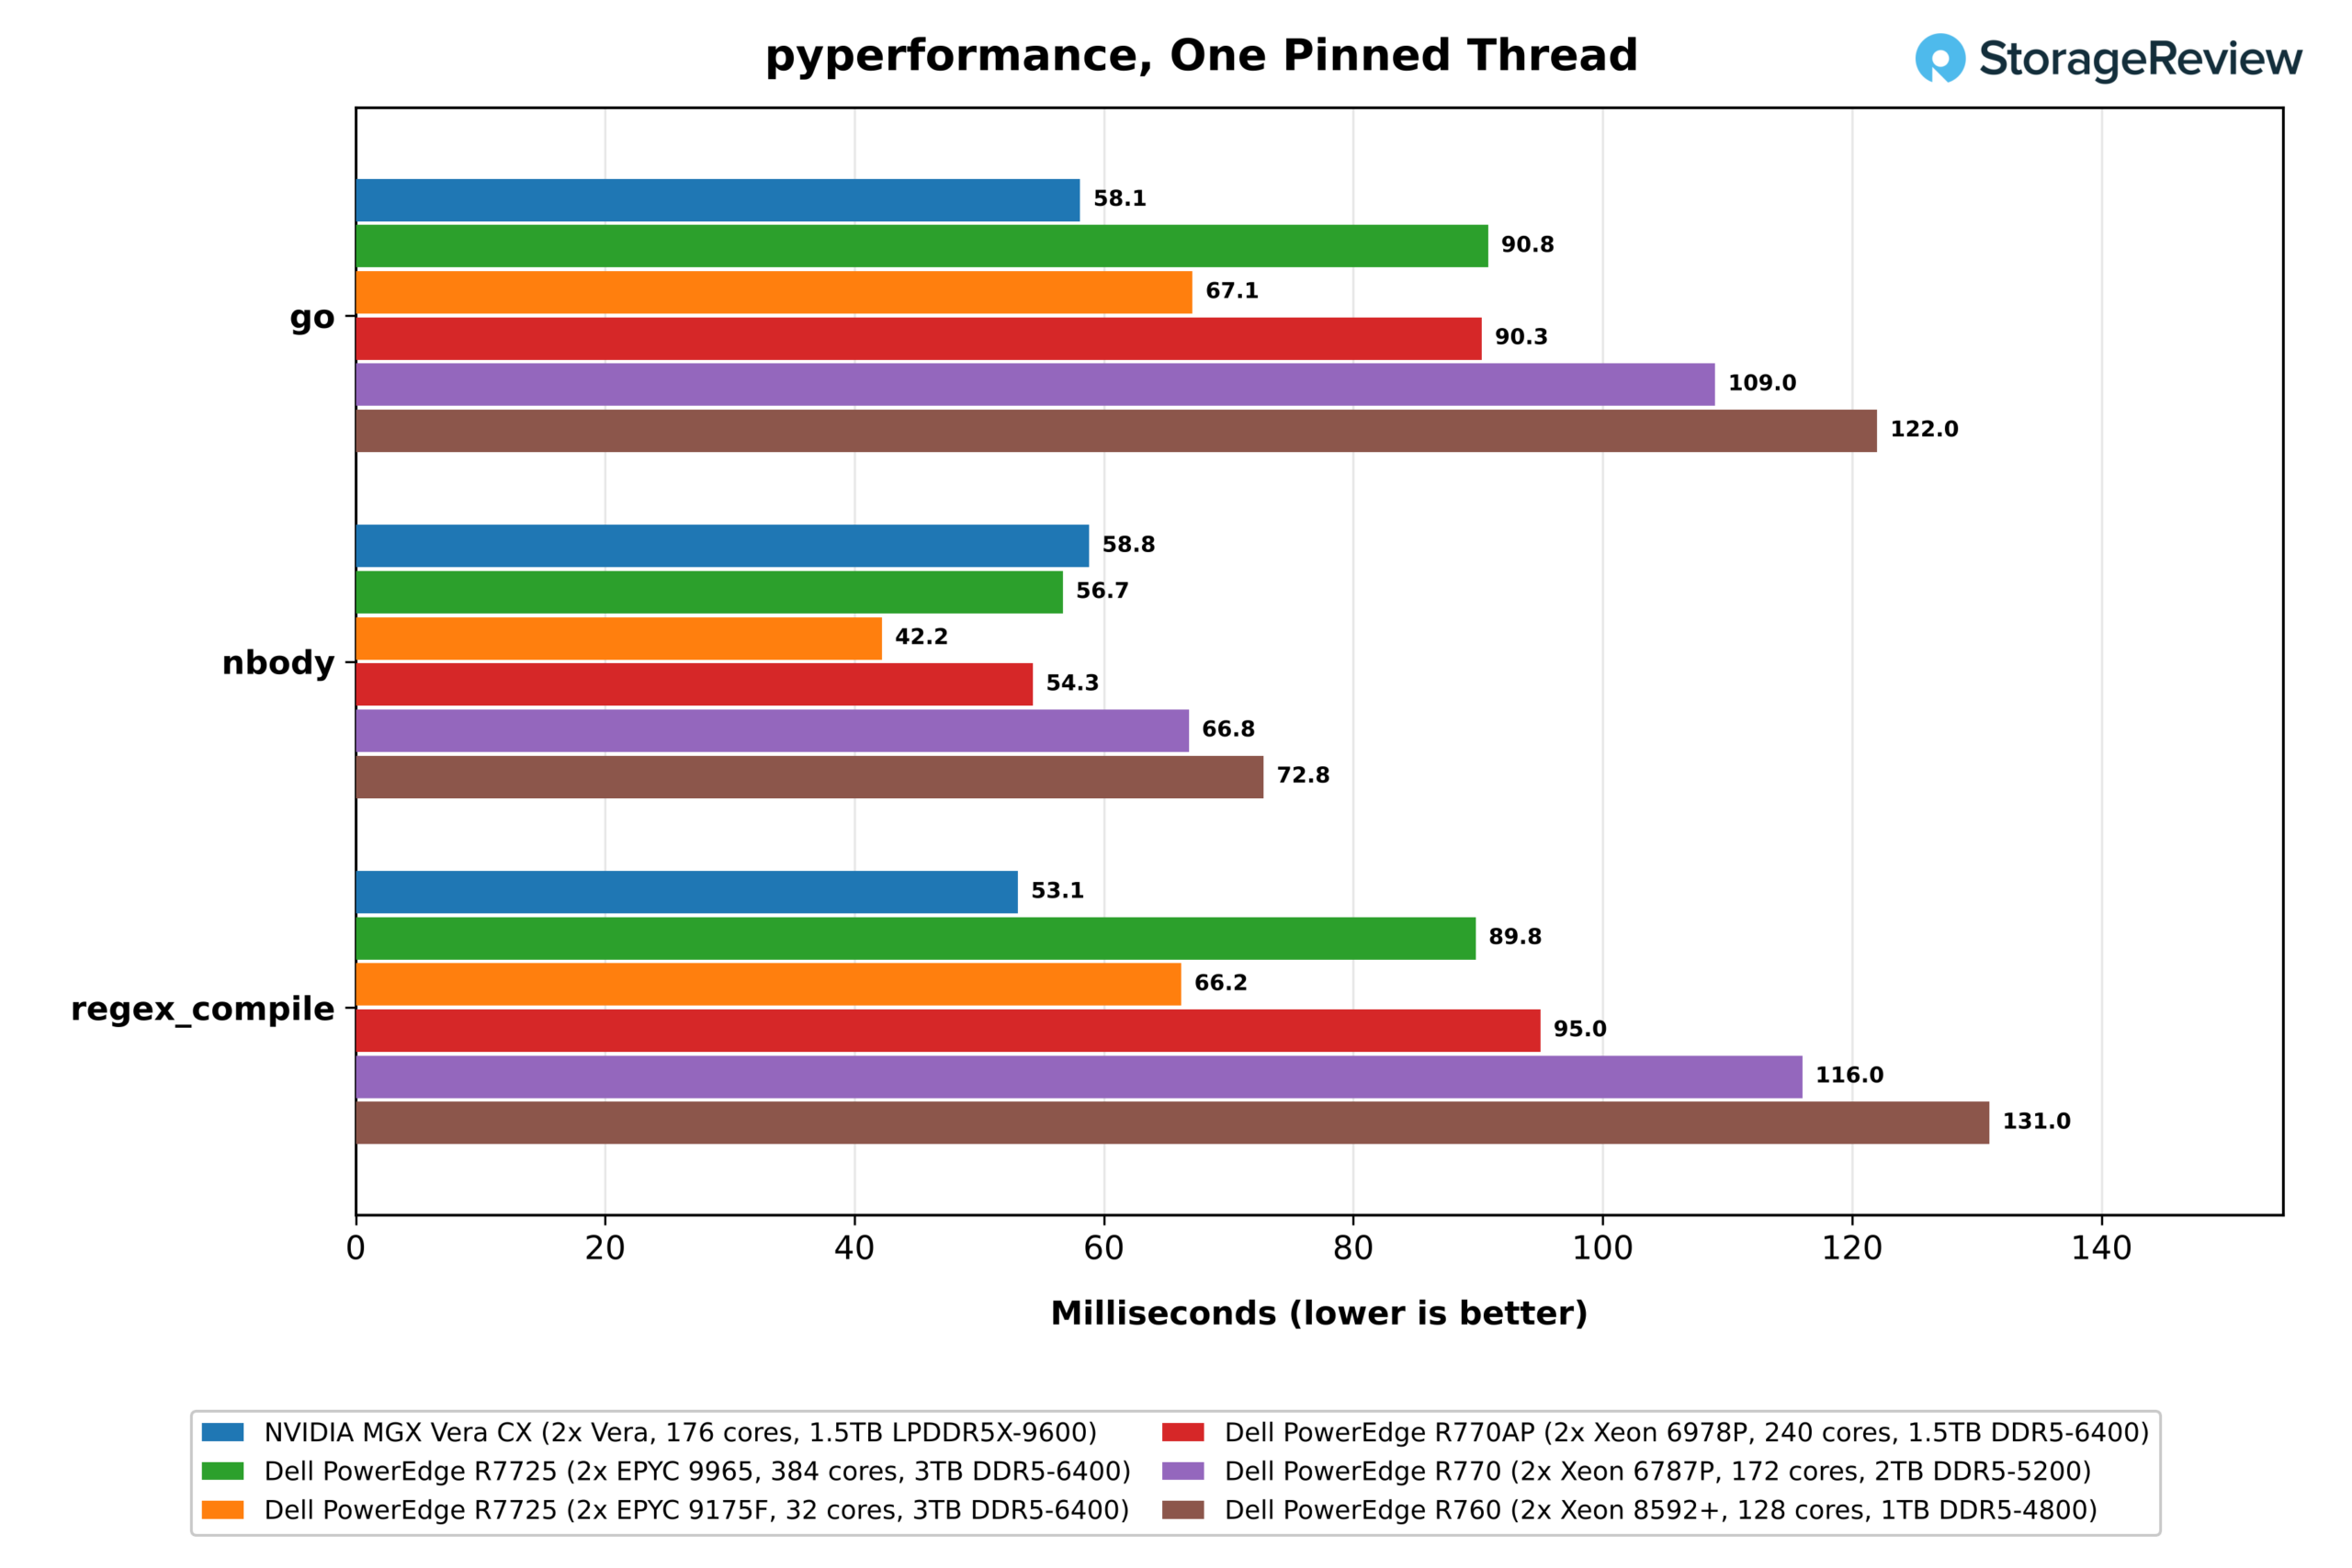
Vera vann de två testerna som byggdes på förgrenad, objekttung kod. go slutfördes på 58.1 ms, 15 % snabbare än EPYC 9175F, den snabbaste x86-kärnan här, och 1.6x till 2.1x snabbare än resten av fältet. regex_compile visade en större marginal och slutade på 53.1 ms, 25 % före 9175F och 1.7x före EPYC 9965. Eftersom Vera också hade den nyare Python, läs båda marginalerna som övre gränser.
Ingen gick åt andra hållet, eftersom dess korta flyttal och lilla arbetsuppsättning tenderar att gynna höga klockfrekvenser, och 5.0GHz 9175F vann med 42.2ms, 39% snabbare än Veras 58.8ms. Xeon 6978P och EPYC 9965 slutade också före Vera, med 54.3ms och 56.7ms, även med Veras nyare Python.
Latens för webbserver, JVM och schemaläggare
Den sista gruppen av harness-tester täcker programvaran som omger en applikation: webbstacken, den virtuella Java-maskinen, Linux-schemaläggaren och kompilatorns verktygskedja. Dessa resultat beror lika mycket på hur många trådar varje system kör som på hur snabb varje kärna är, så de säger mindre om Olympus självt än de tidigare avsnitten gör, men de visar hur en Vera-server beter sig under vanlig serverprogramvara.
nginx
NGINX skickar HTTPS-förfrågningar till wrk-belastningsgeneratorn som körs på samma maskin, så klient och server konkurrerar om samma kärnor, och resultatet återspeglar TLS- och HTTP-stacken mer än det råa kärnantalet.
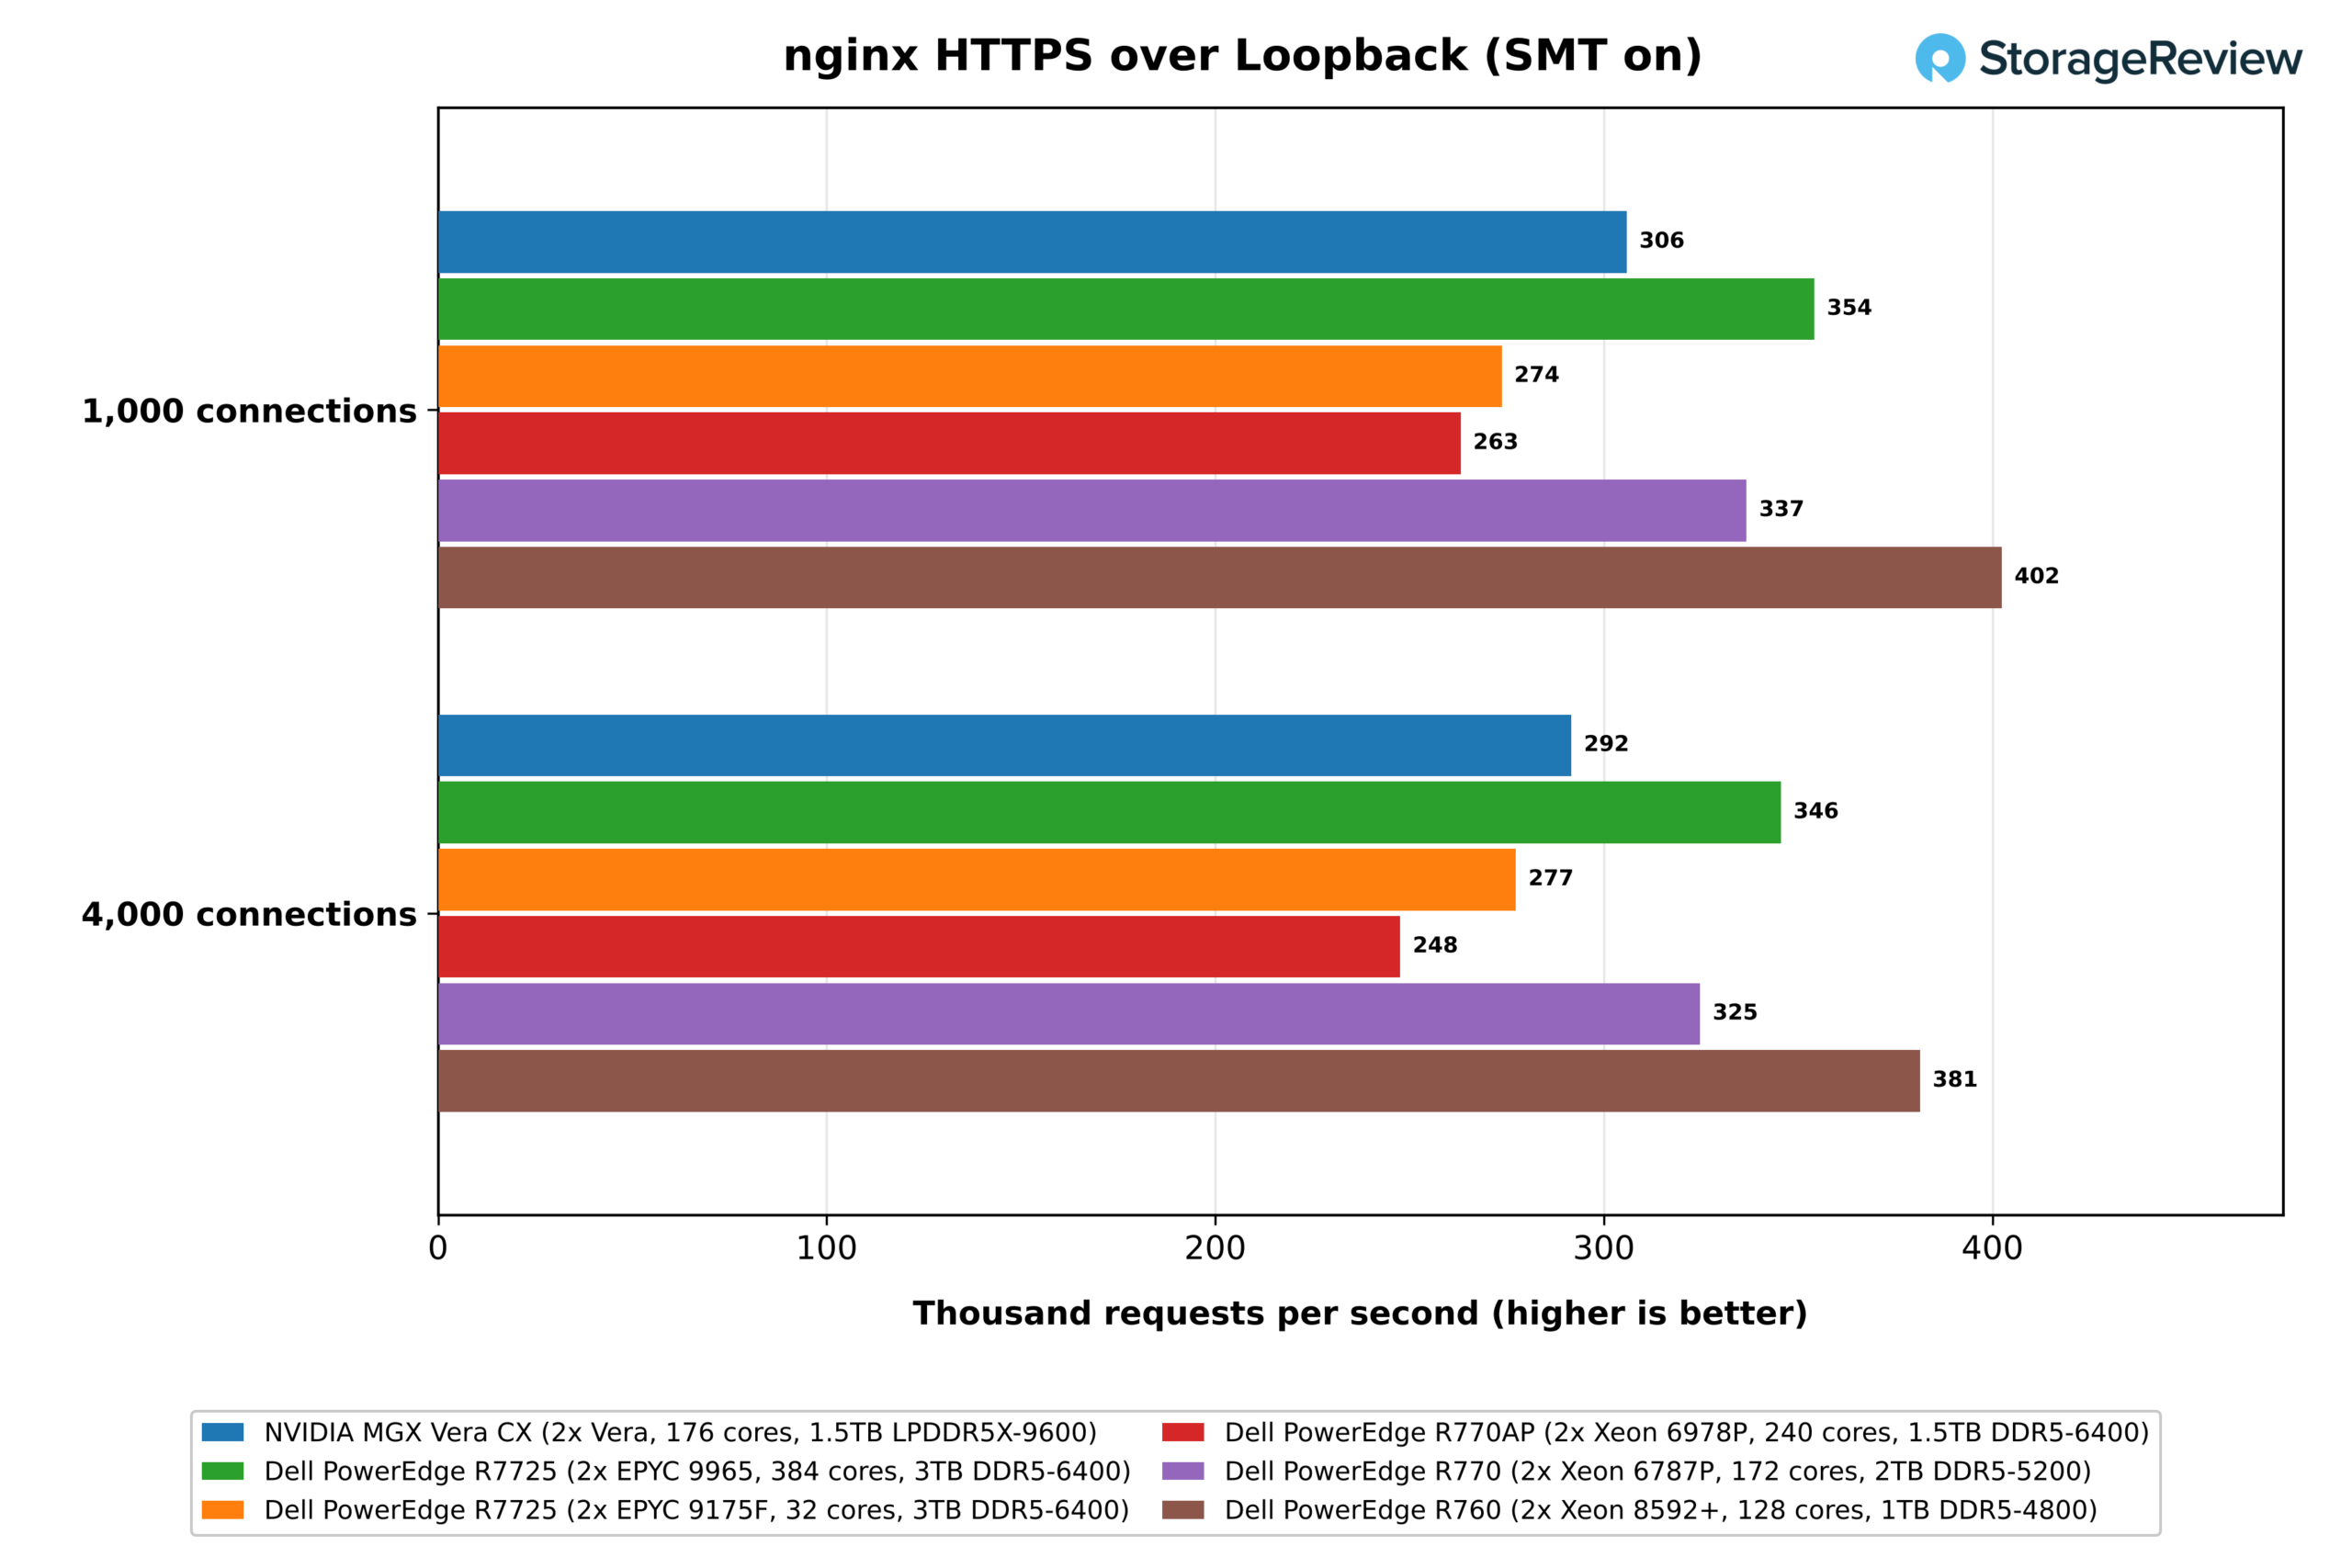
Med SMT aktiverat hanterade Vera 306 000 förfrågningar per sekund vid 1 000 anslutningar och 292 000 vid 4 000, mitt i ett fält som sträckte sig från 263 000 på Xeon 6978P till 402 000 på Xeon 8592+. EPYC 9965 nådde 354 000 och Xeon 6787P 337 000, och genom att stänga av SMT ökade Vera till 330 000. Veras nätverksstack passar utmärkt tillsammans med x86-systemen.
Renässans
Renaissance kör Java-arbetsbelastningar på OpenJDK 11. Dess Finagle HTTP-test använder en Scala-nätverksstack och dess Akka testar ett aktörsmodell-samtidighetsramverk. Båda sprider arbete över varje logisk processor som JVM kan se, så vi körde dem med SMT på och av.
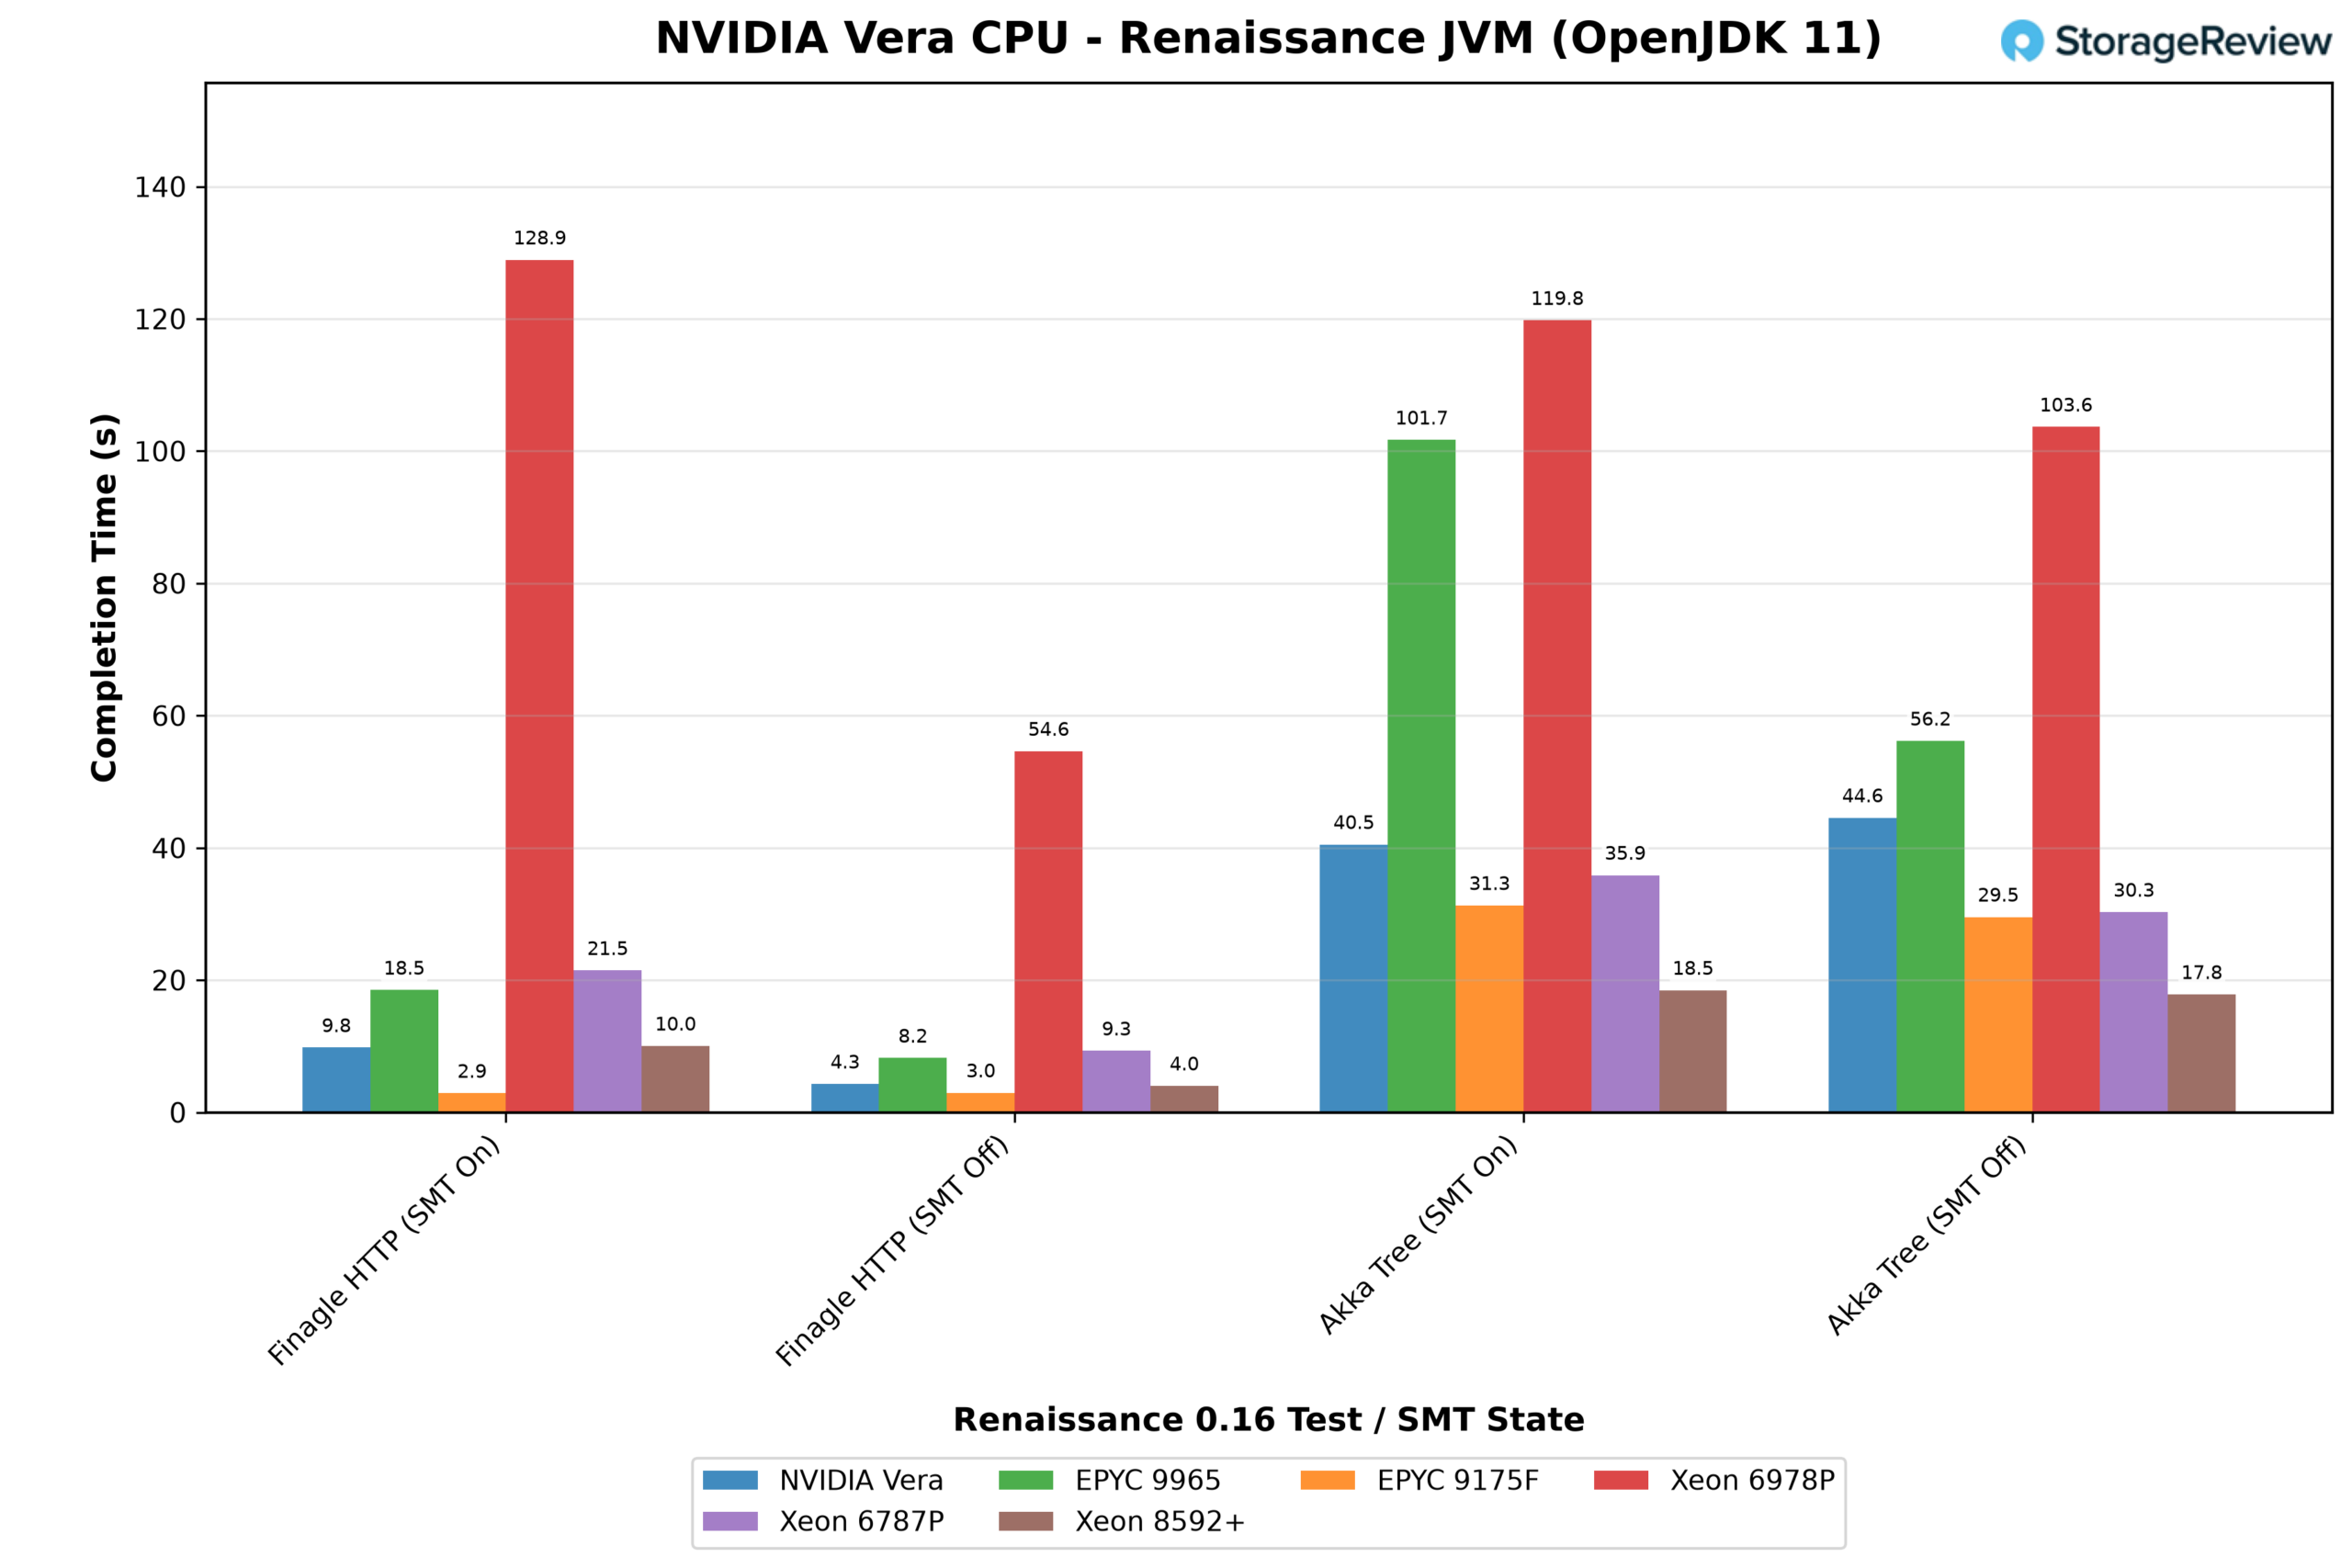
Finagle körs snabbare med färre trådar. Genom att stänga av SMT, vilket halverar trådantalet, minskade Veras tid från 9.8 till 4.3 sekunder, och de större x86-systemen förbättrades med liknande 2.3x till 2.5x. 32-kärniga EPYC 9175F, med få trådar till en början, ledde åt båda hållen med cirka 3 sekunder.
Akka föredrog Xeon 8592+, som klarade testet på cirka 18 sekunder med SMT på eller av, medan Vera tog 40.5 sekunder med SMT på, och de två största systemen, EPYC 9965 och Xeon 6978P, var långsammast med 101.7 och 119.8 sekunder. Det tredje Renaissance-testet, en genetisk algoritm, klarade testet på 1.6 till 2.6 sekunder med SMT på i alla system utom 6978P, med Vera på 2.6.
schbänk
schbench mäter hur snabbt Linux-schemaläggaren väcker arbetstrådar, och kör ungefär en arbetare per logisk processor med 4 meddelandetrådar och cirka åtta per processor med 32. Eftersom antalet arbetare växer med systemet utför större servrar mer arbete, så dessa resultat beskriver latens under full belastning på varje maskin och är inte en jämförelse mellan olika enheter.
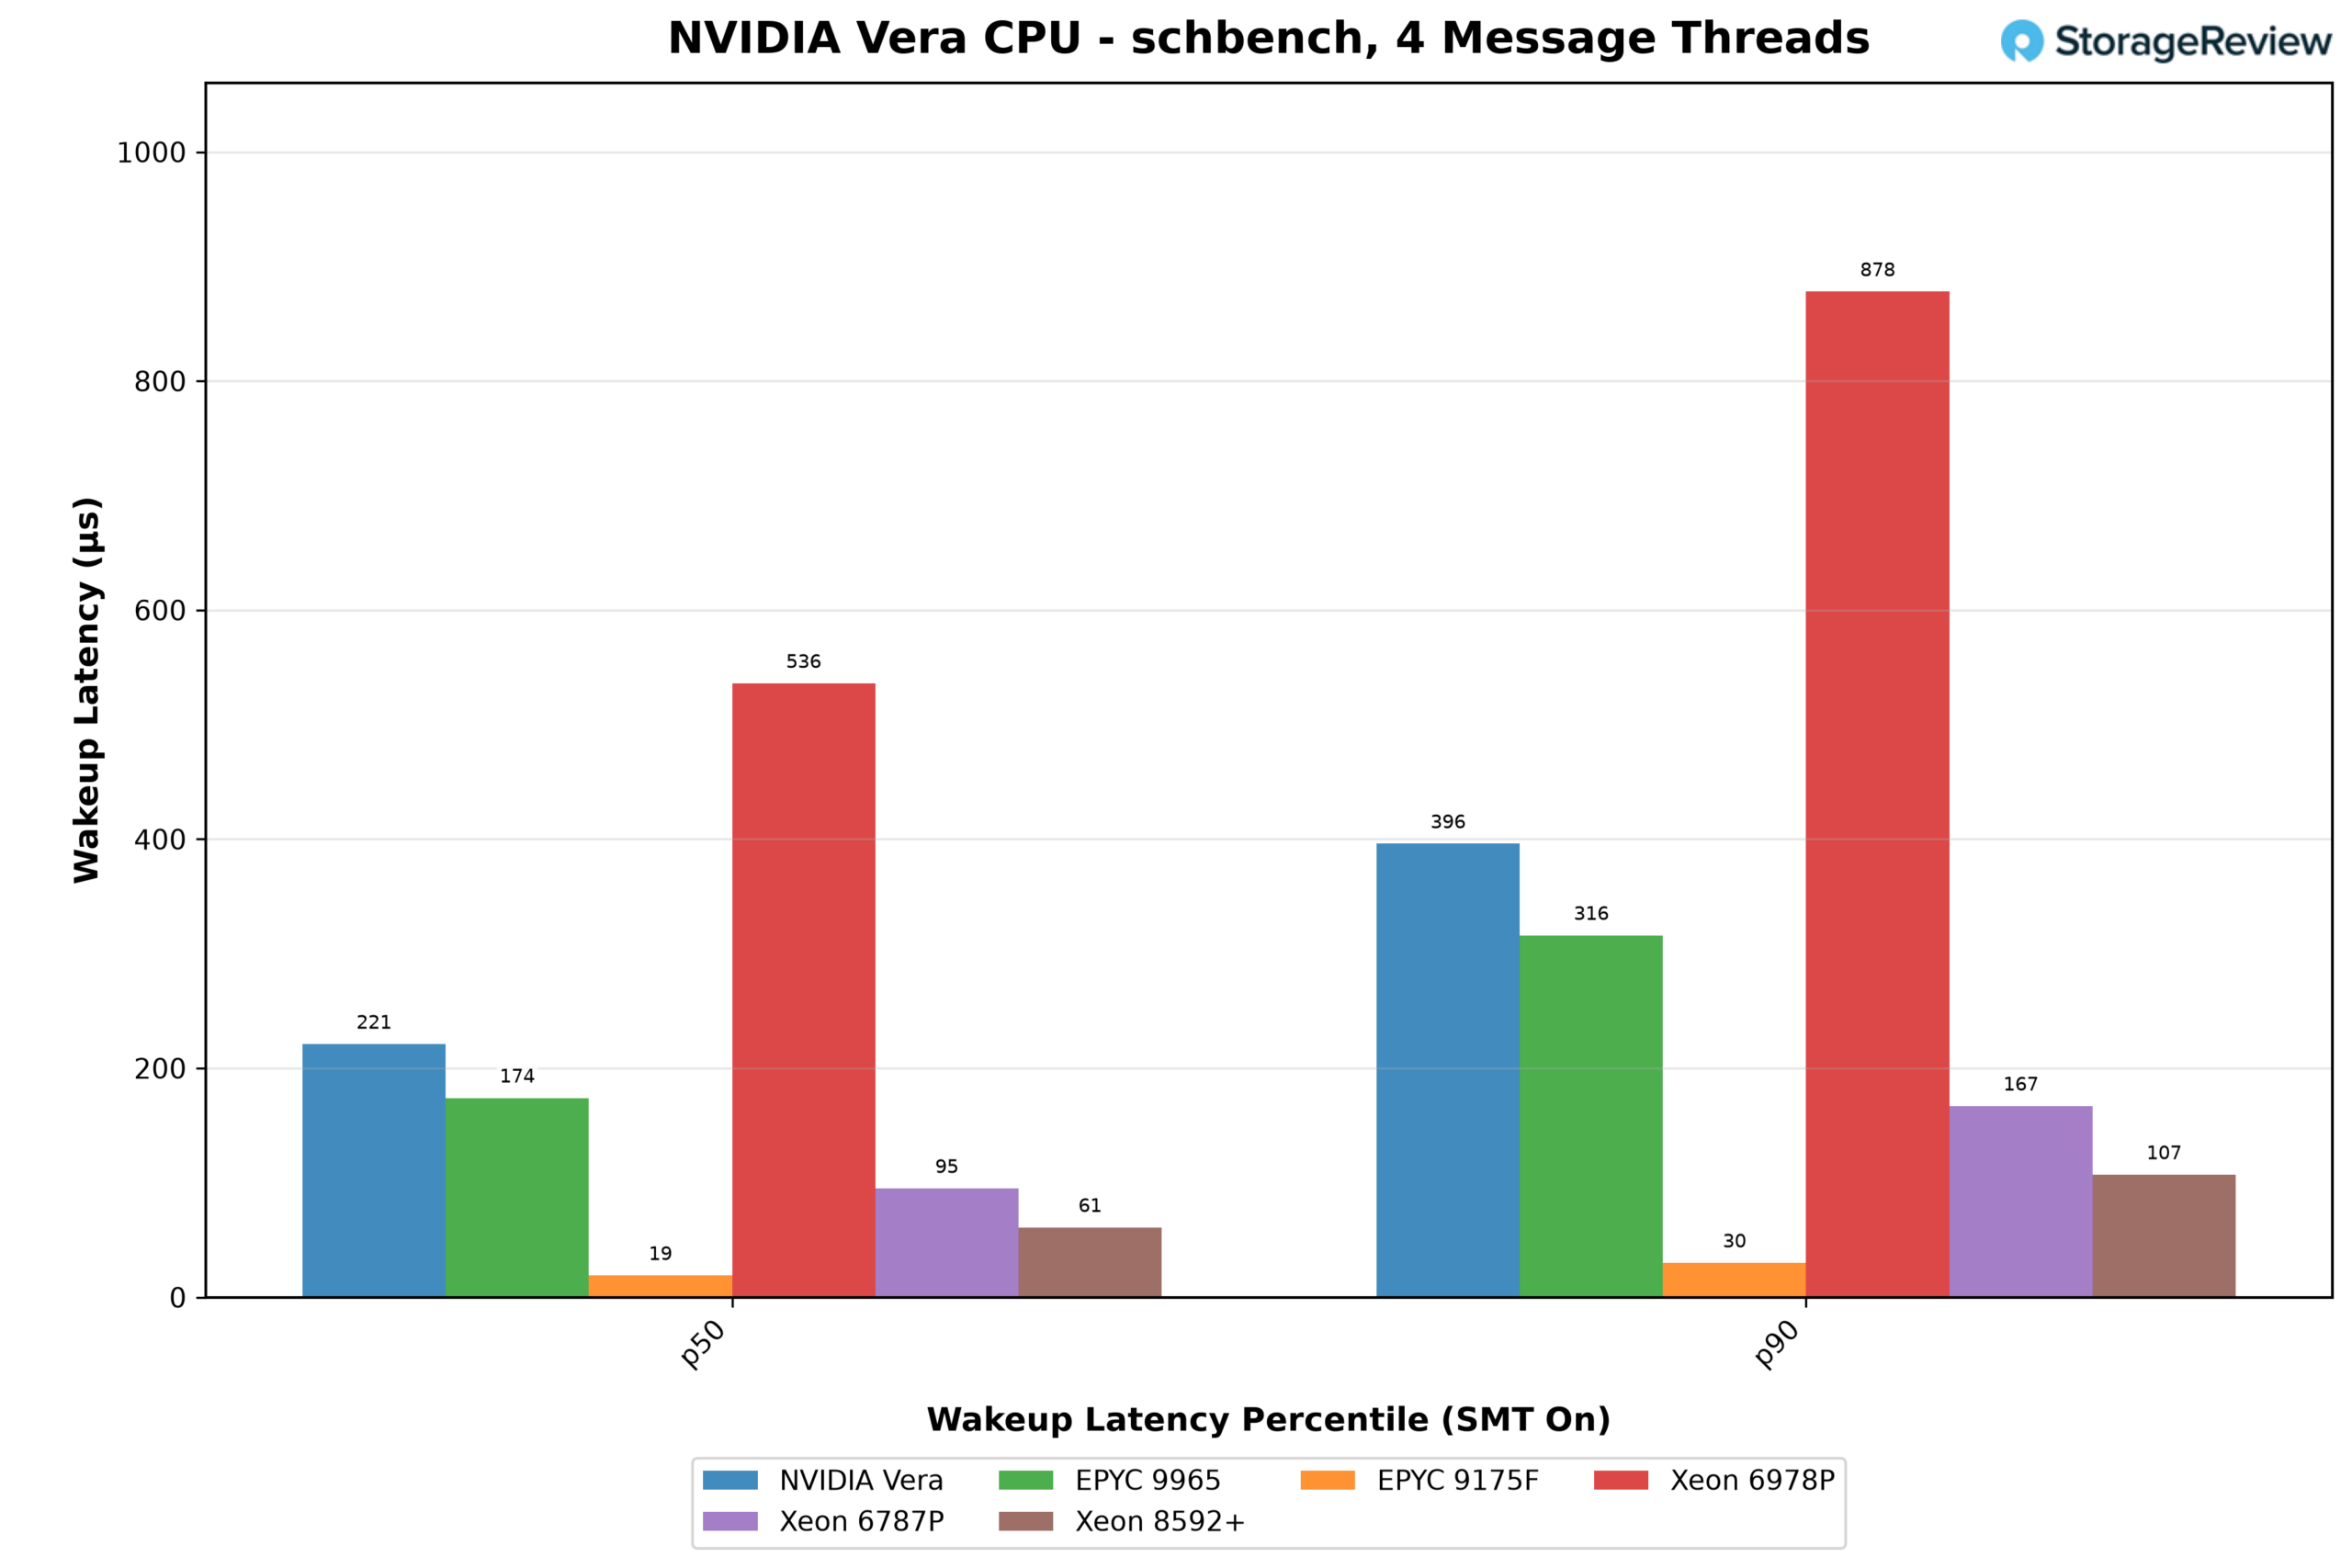
Med fyra meddelandetrådar var Veras medianuppvakningslatens 221 µs och dess p90 396 µs, högre än alla system förutom Xeon 6978P vid 536 µs och 878 µs. De minsta maskinerna väckte sina trådar snabbast, med 32-kärnig EPYC 9175F vid 19 µs och 128-kärnig Xeon 8592+ vid 61 µs.
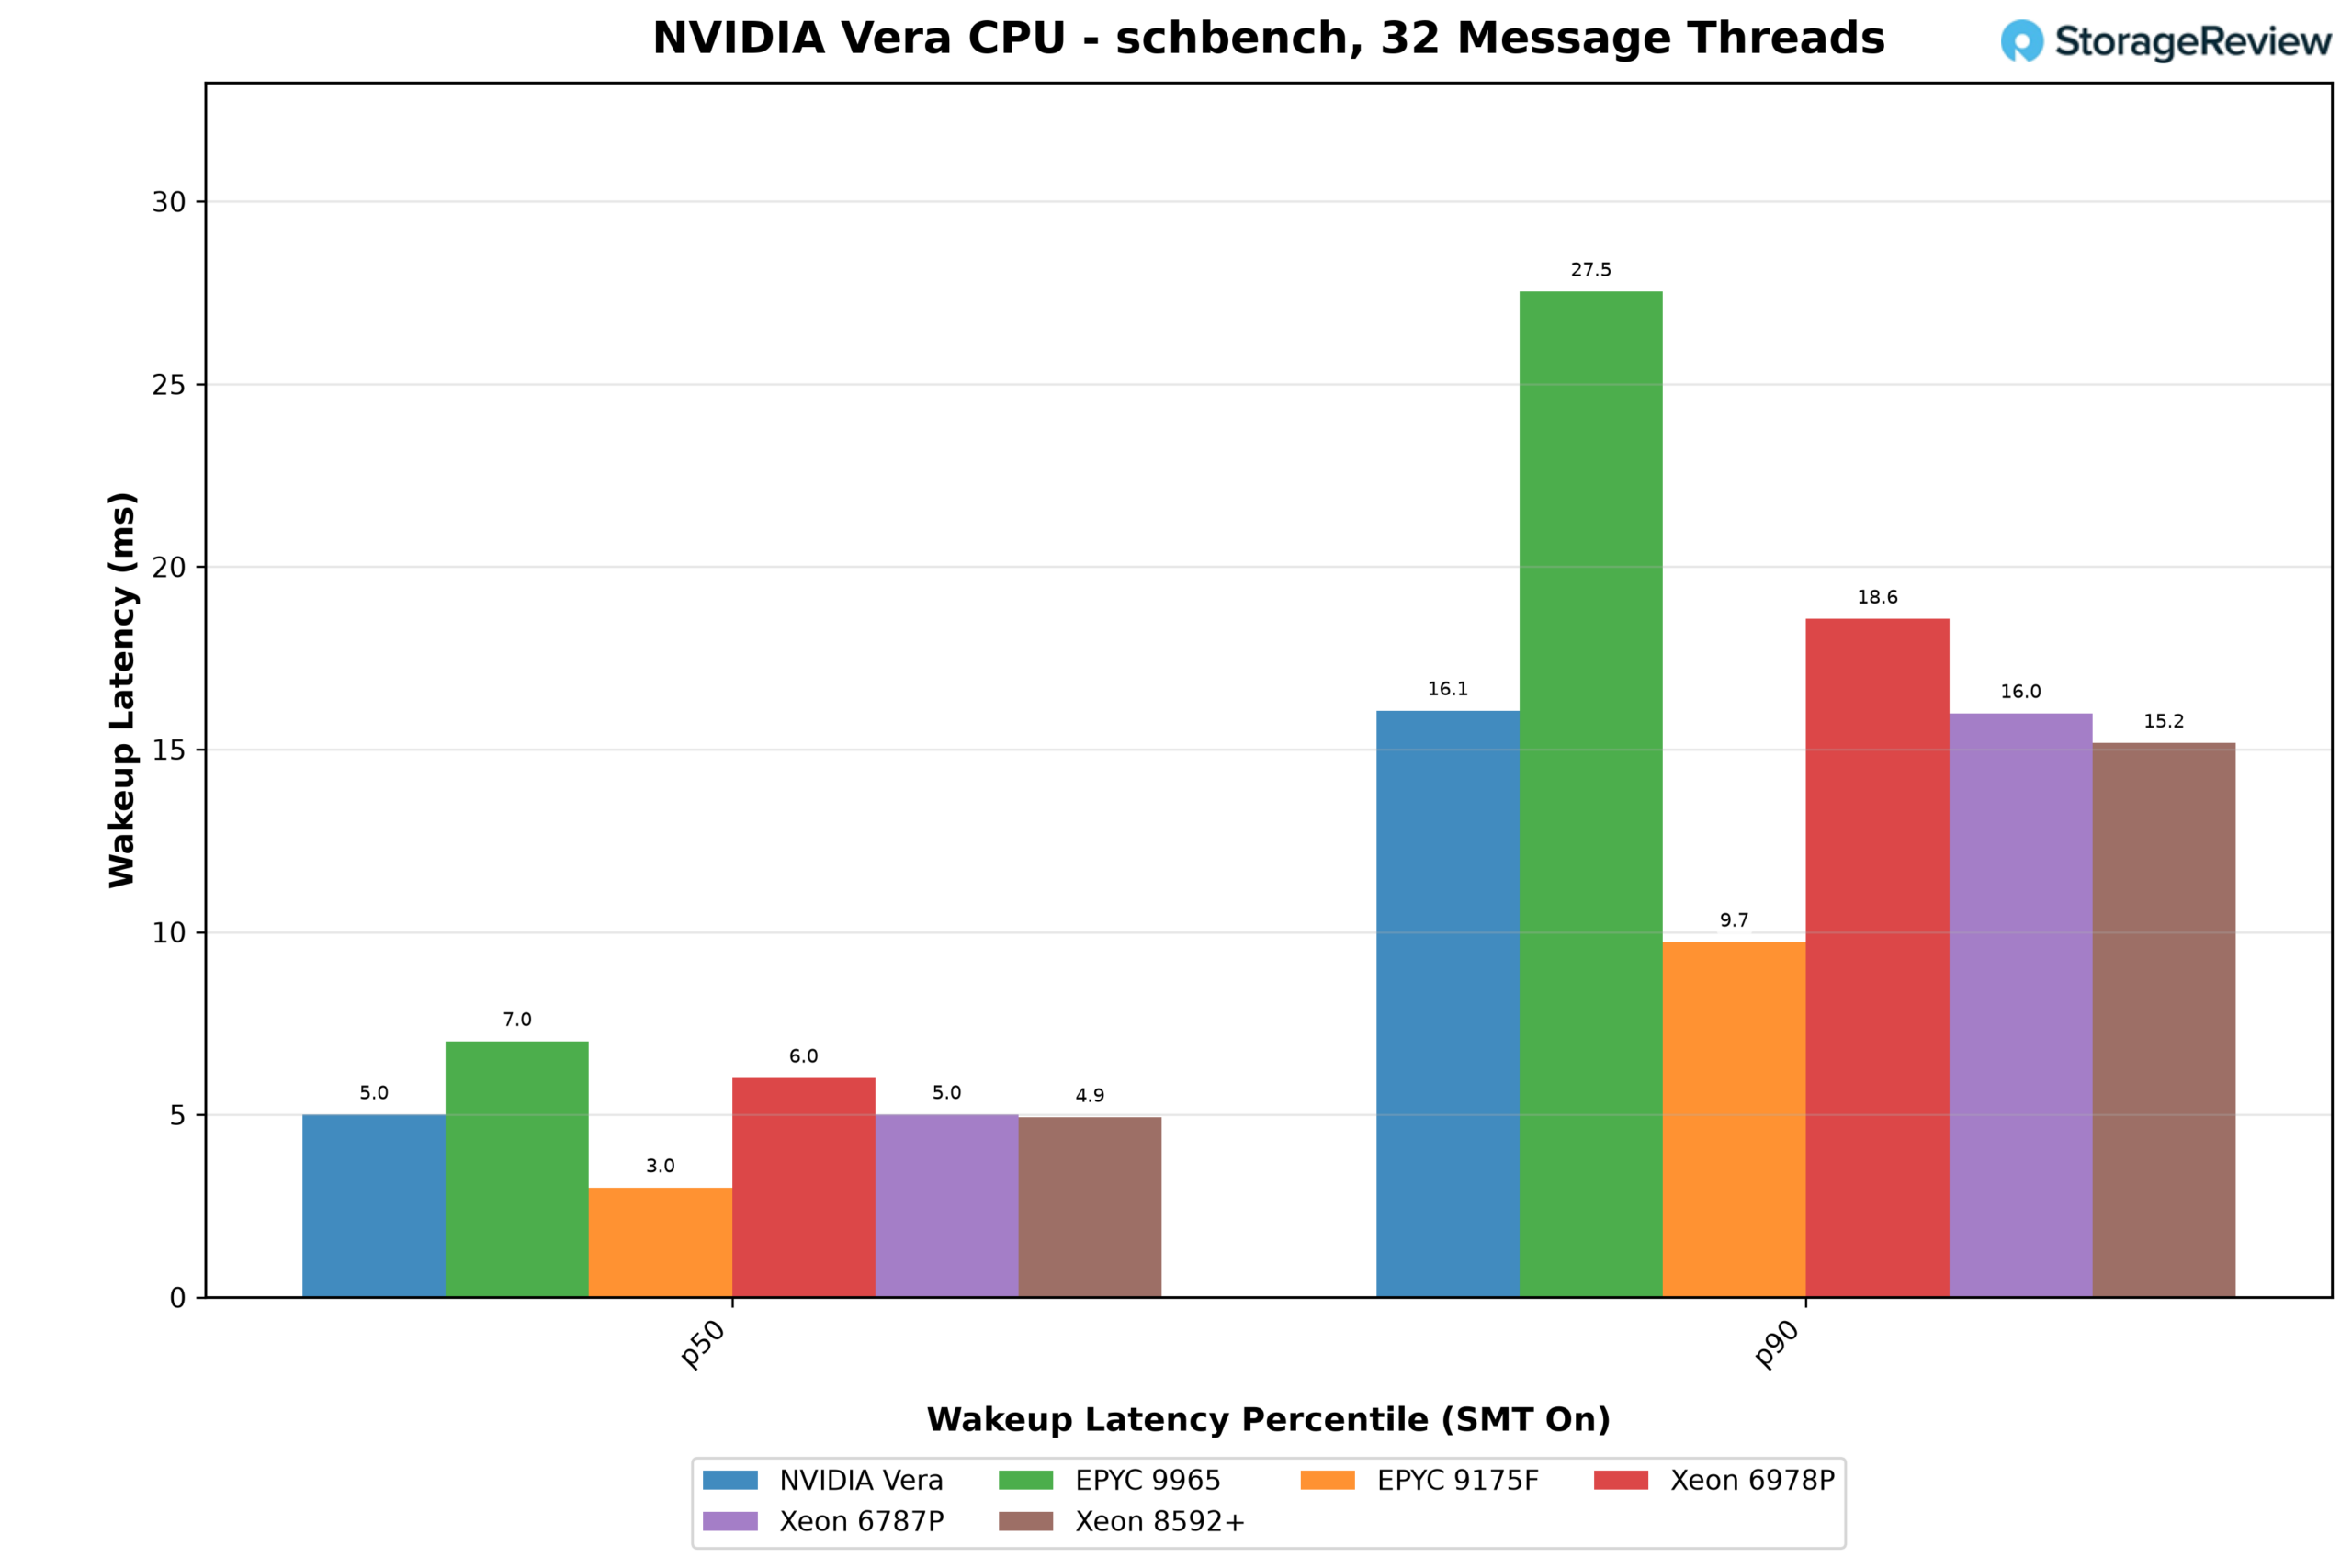
Med 32 övertecknade meddelandetrådar placerade sig Vera i mitten. Dess medianhastighet på 5.0 ms och 16.1 ms p90 var i nivå med Xeon 6787P och 8592+ och före både Xeon 6978P och EPYC 9965, som nådde 27.5 ms vid p90. Endast 9175F var betydligt snabbare, med 3.0 ms och 9.7 ms.
Linux-kärnbygge
Linuxkärnans allmodconfig-byggprocess är det enda resultat i det här avsnittet som vi inte rangordnar. Vera kompilerar arm64-kärnträdet, vilket innehåller en annan uppsättning moduler och drivrutiner än x86-64-trädet som de andra systemen bygger, och vi försökte inte korskompilera.
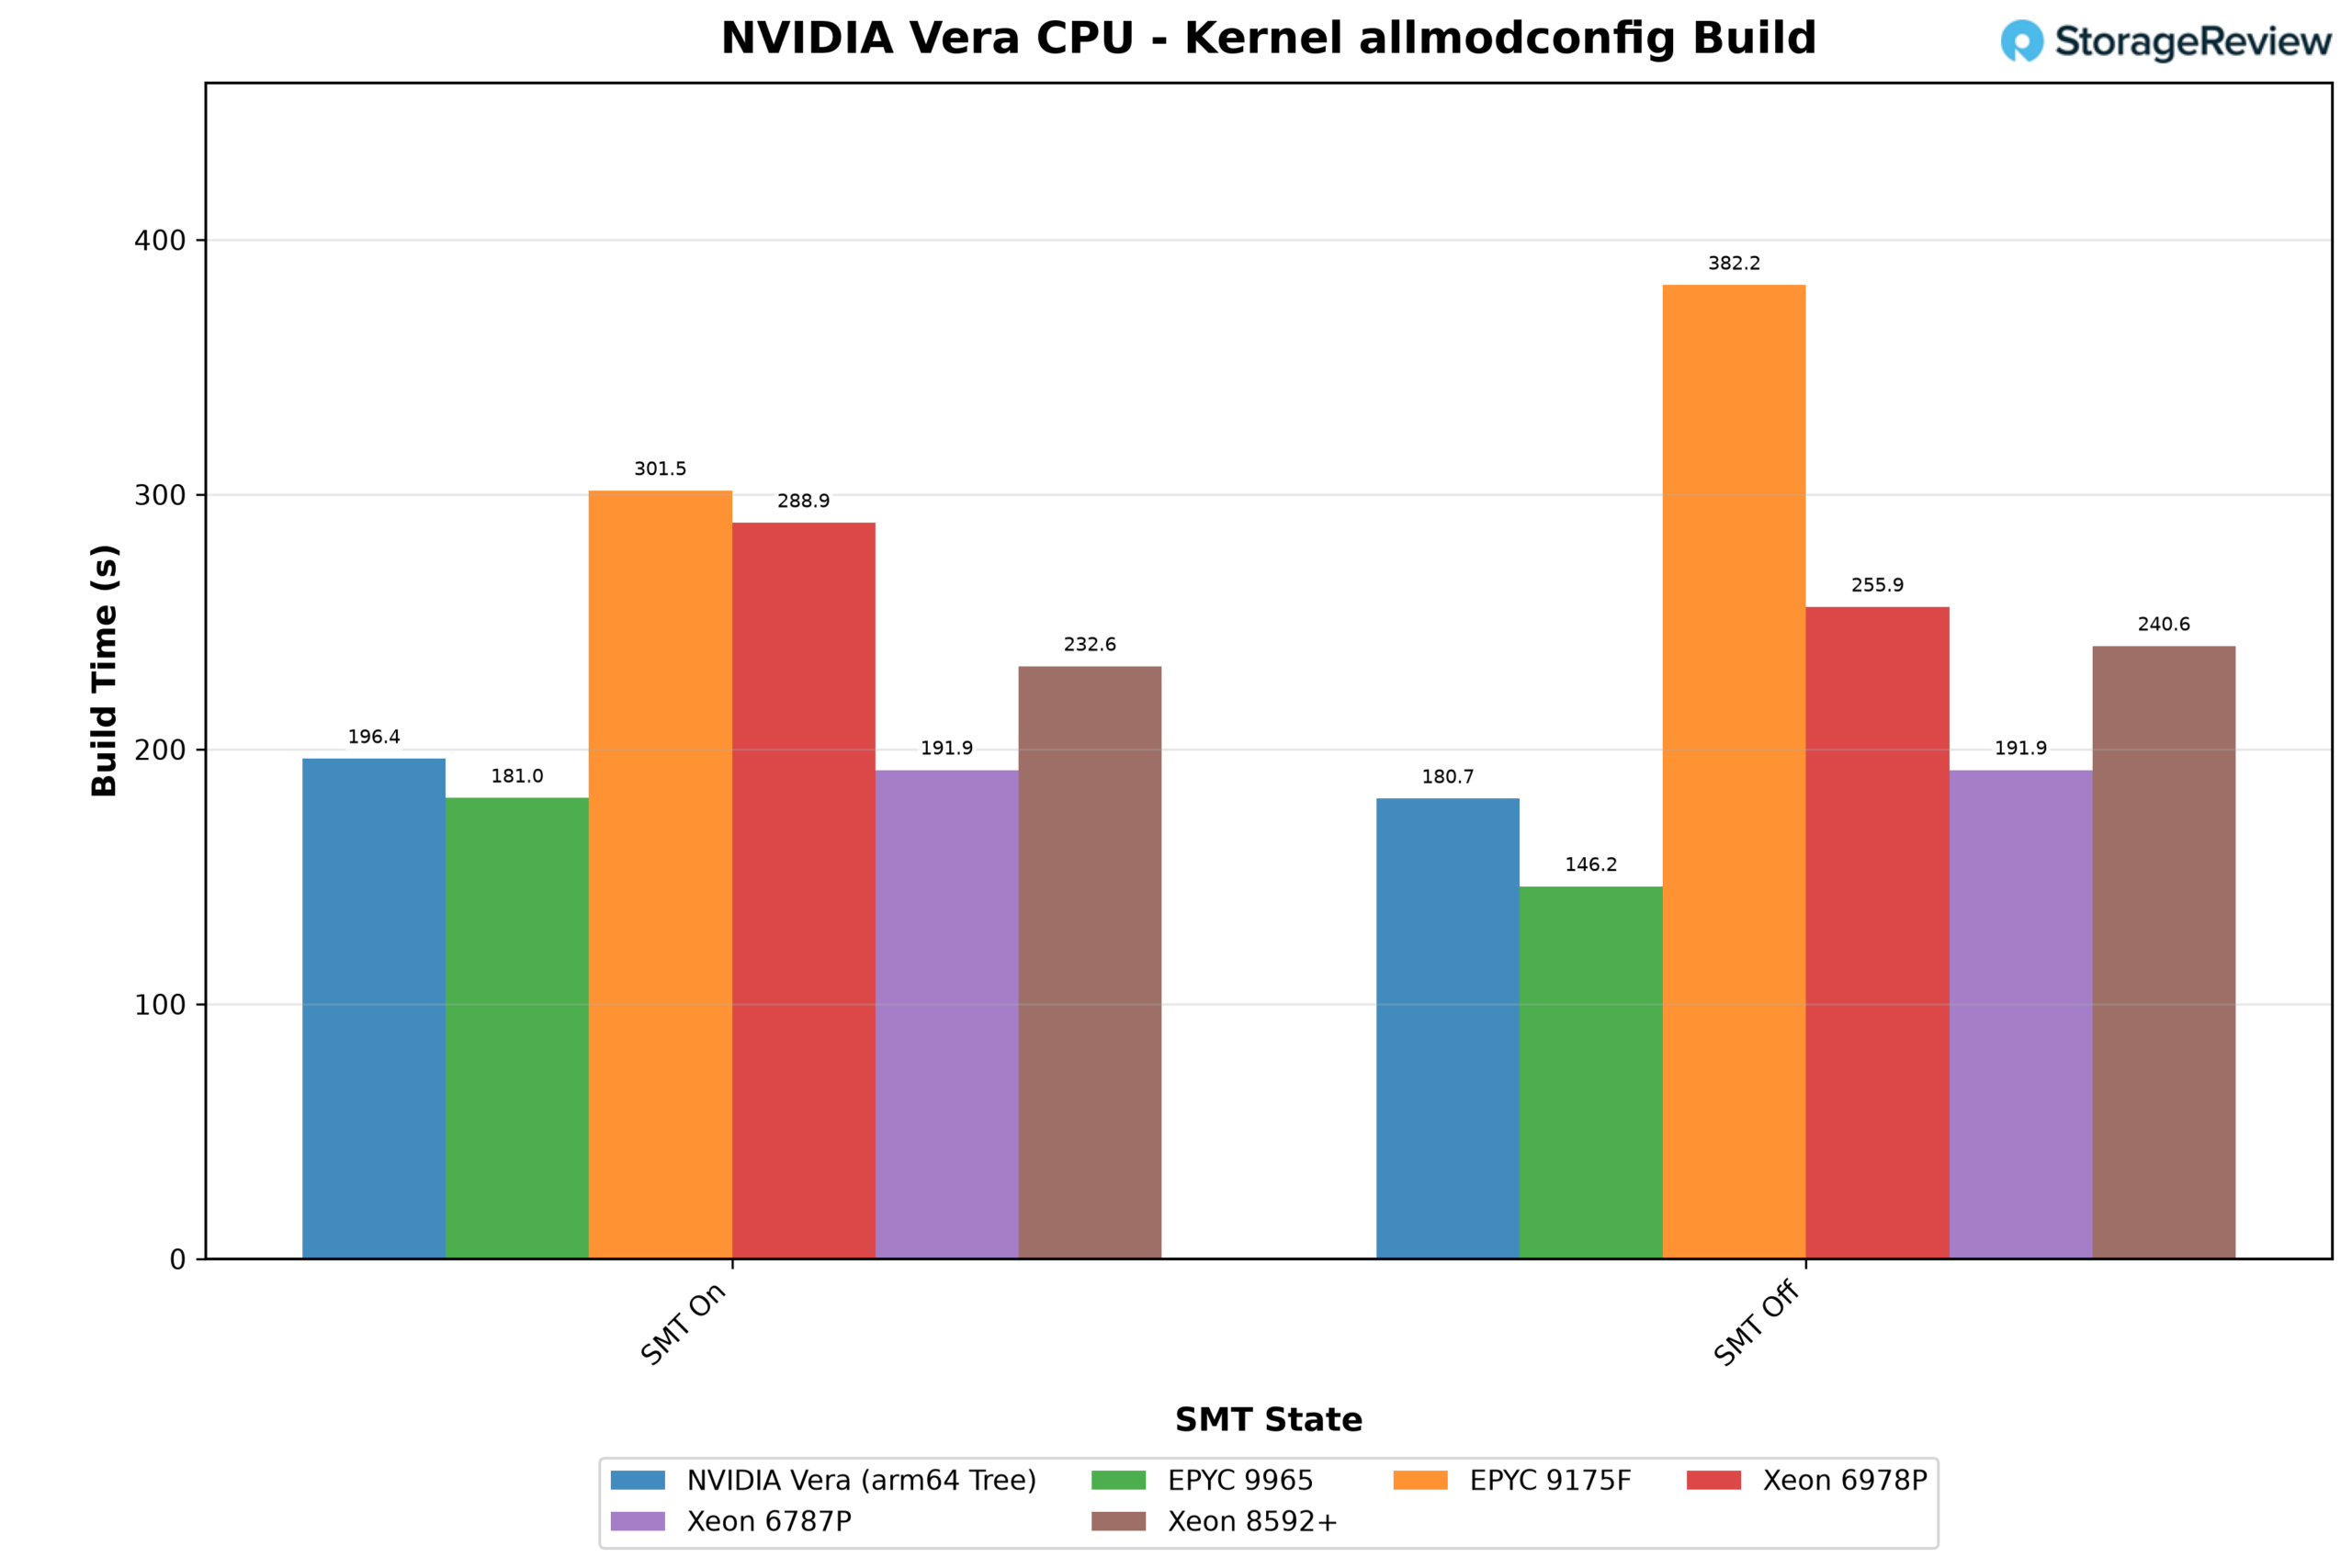
Vera byggde sitt träd på 180.7 sekunder med SMT av och 196.4 sekunder med SMT på, så de extra trådarna saktade ner bygget. För x86-systemen, där varje system byggde ett eget träd, varierade tiderna från 146.2 sekunder på EPYC 9965 med SMT av till 382.2 sekunder på 32-kärniga EPYC 9175F.
HammerDB
För databastesterna anlitade vi Steve Shaw, HammerDBs skapare och underhållare. Shaw körde HammerDBs TPROC-C-arbetsbelastning, ett OLTP-riktmärke härlett från TPC-C men inte jämförbart med publicerade TPC-resultat, på Vera-servern, Dell PowerEdge R7725 med EPYC 9965 och PowerEdge R770 med Xeon 6787P. Han testade fem motorer med öppen källkod på varje: MariaDB 12.3.3 och 13.0.2, MySQL 26.7.0, VillageSQL 0.0.7 och PostgreSQL 18.6. Databasstorleken skalades med kärnantal till 16 lagerställen per fysisk kärna, eller 1 408 för en enda Vera-socket.
Varje motor kördes på en sockel och på två, där den andra sockelns processorer togs offline för körningar med en enda sockel, och varje system presterade bättre på en, vilket är typiskt för databasprestanda. För alla 15 par minskade tillägget av den andra sockeln toppdataflödet med 23 % till 47 %, och med 29 % till 45 % för Vera. Shaw har länge funnit att databaser med öppen källkod når ett skalningstak innan de får slut på kärnor. Utöver den punkten kostar det mer att hålla cacheminnen koherenta över två sockelringar än vad de extra kärnorna lägger till. Vi fokuserar därför på resultaten med en enda sockel, som visas i diagrammet nedan.
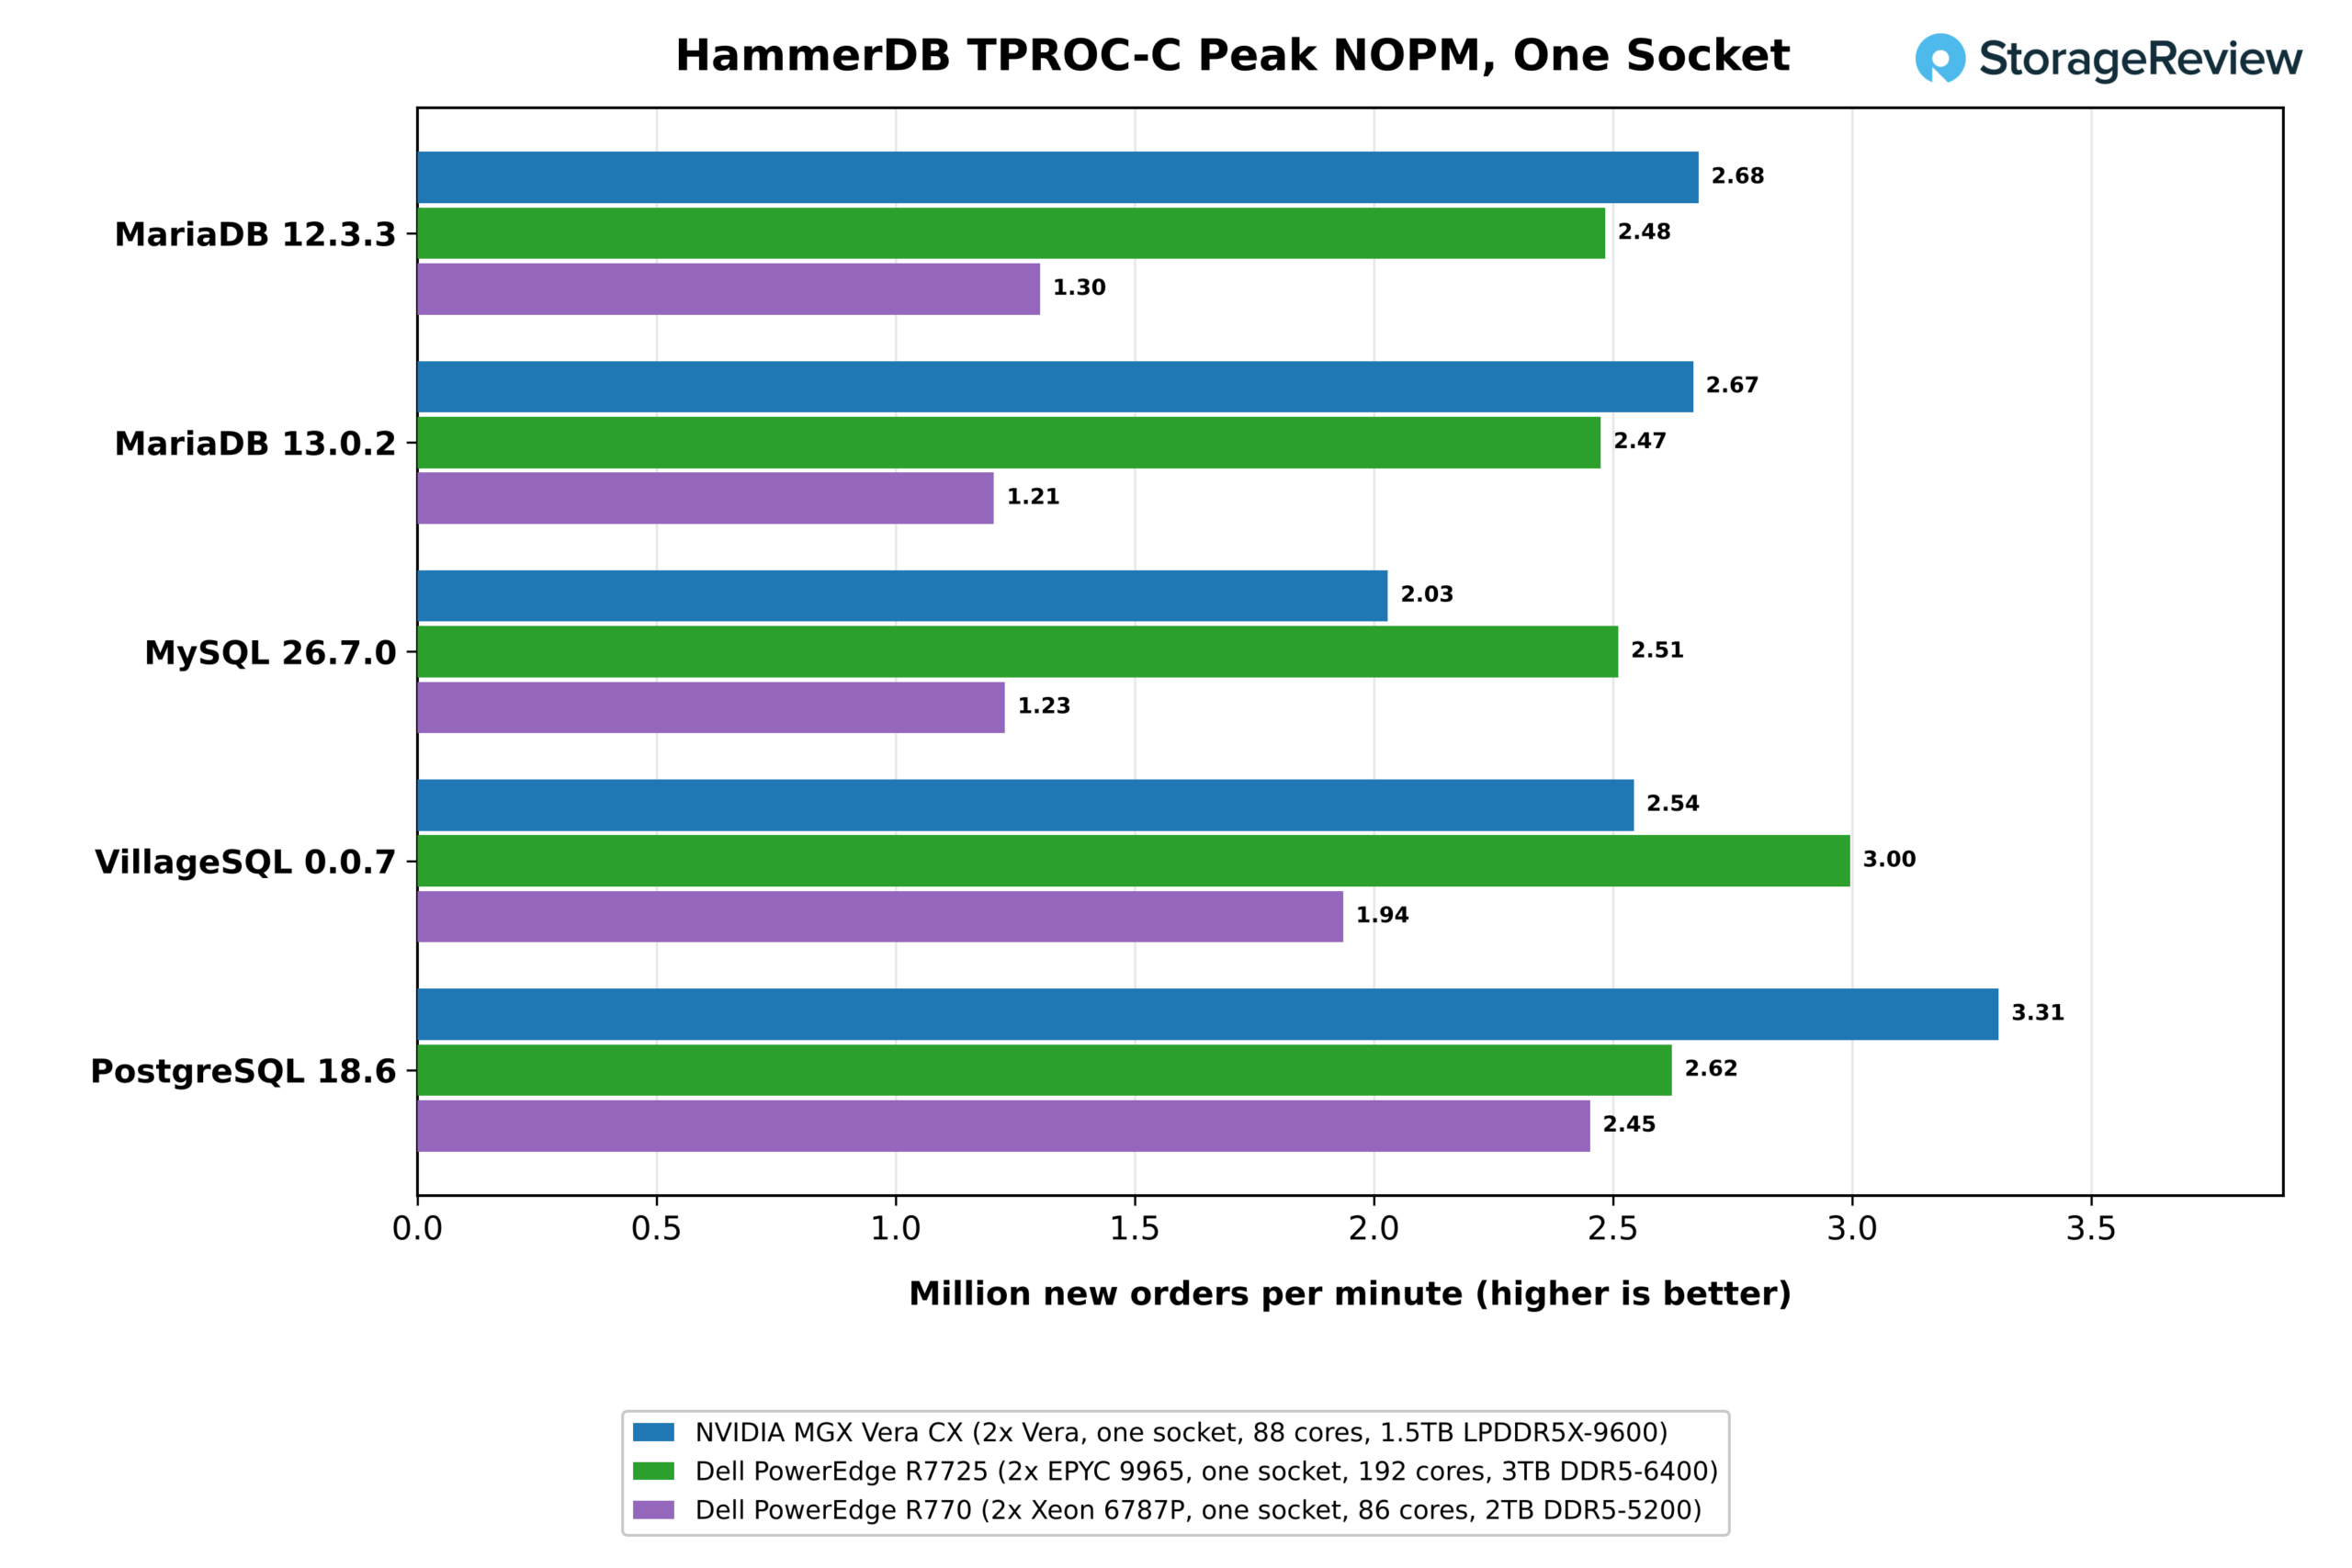
På en sockel ledde 88 Vera-kärnor på tre av de fem motorerna. PostgreSQL 18.6 gav Vera sin största marginal, med 3.31 miljoner nya ordrar per minut (NOPM) med 128 virtuella användare, jämfört med 2.62 miljoner på EPYC 9965-socketten med 192 kärnor och 2.45 miljoner på Xeon 6787P med 86 kärnor. Båda MariaDB-utgåvorna gick också till Vera, med 2.68 miljoner och 2.67 miljoner, jämfört med 2.48 miljoner och 2.47 miljoner på EPYC. AMD behöll MySQL 26.7.0 på 2.51 miljoner mot 2.03 miljoner för Vera, och VillageSQL på 3.00 miljoner mot 2.54 miljoner. Xeon låg efter på alla fem motorerna med 1.21 miljoner till 2.45 miljoner, och dess MariaDB-resultat var mindre än hälften av Veras.
Uppdelningen följer sannolikt hur varje motor skalas. PostgreSQLs process-per-anslutningsmodell och MariaDBs InnoDB sprider båda arbete över många kärnor med tung delad minnestrafik, vilket spelar på den mer än 1 TB/s lokala bandbredd som varje Vera-socket klarade i STREAM. MySQL och VillageSQL drabbas av intern låskonkurrens tidigare, så deras resultat beror mer på hur snabbt varje kärna klarar en kritisk sektion, och det är där 9965 sticker ut. Efter oktoberrundan bedömde Shaw Arm som den snabbaste plattformen totalt sett och sa att Arm "definitivt har anlänt som en konkurrenskraftig databasserver", även om han tillade att en EPYC med en enda sockel och 96 kärnor som han testat tidigare kan komma att överträffa den.
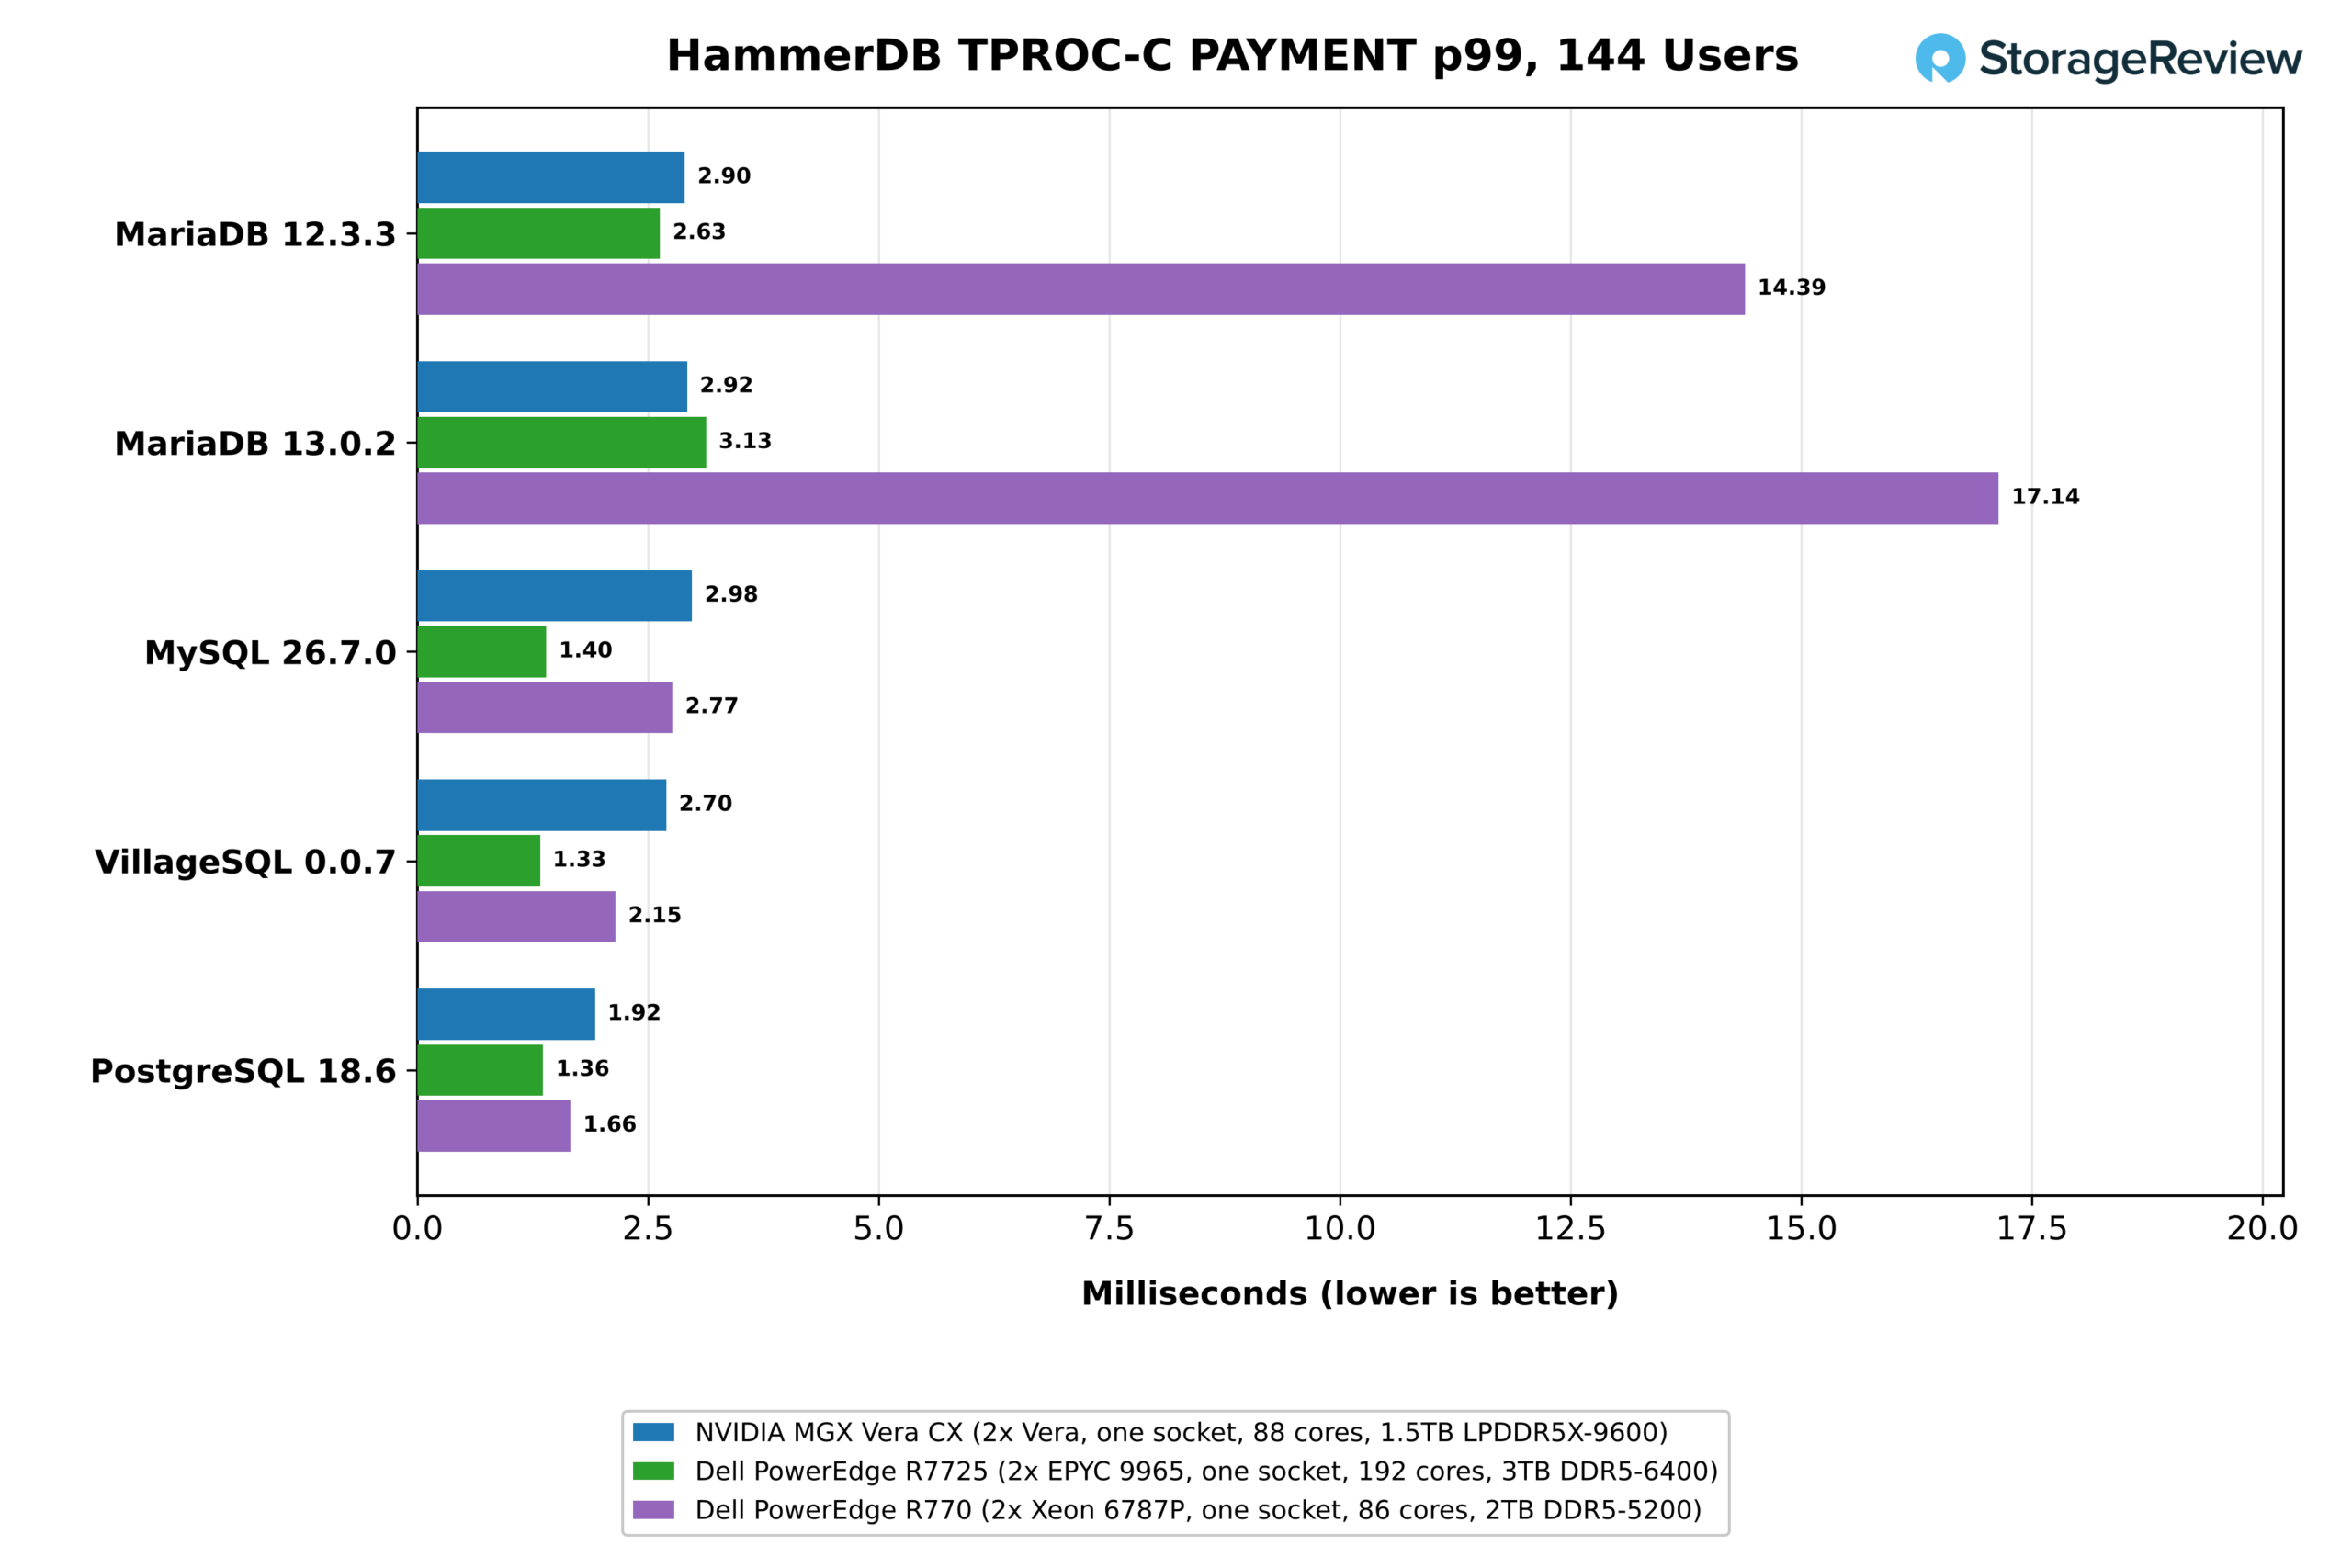
Svansfördröjningen vid en matchad belastning på 144 virtuella användare visar samma fördelning. Veras PAYMENT p99-latens varierade från 1.92 ms på PostgreSQL till 2.98 ms på MySQL. EPYC 9965 höll MySQL, VillageSQL och PostgreSQL mellan 1.33 ms och 1.40 ms, 29 % till 53 % lägre än Vera, men dess 3.13 ms på MariaDB 13.0.2 låg efter Veras 2.92 ms. Xeon 6787P:s MariaDB-svansar, på 14.4 ms och 17.1 ms, var flera gånger högre än någon av dem, i linje med dess mycket lägre dataflöde vid samma belastning. Låshandoff inuti motorerna driver sannolikt Veras högre svansar, vilket återspeglar Valkey-resultaten, där förfrågningar som skickades en i taget också gynnade AMD.
Novemberrundan satte Shaws magkänsla på prov. Han körde samma arbetsbelastning på en sockel av AMD:s nya 256-kärniga EPYC 9996 och på en 96-kärnig EPYC 9686F, med Veras sockel i jämförelsen. 9996 och Vera utbytte motorer, där Vera behöll PostgreSQL och MariaDB och EPYC ledde på svansfördröjning, och 96-kärniga delen gick före Vera på PostgreSQL. De fullständiga resultaten finns i vår AMD EPYC Venice-recension.
”Jag var genuint imponerad av prestandan hos databaser med öppen källkod på NVIDIA Vera. Det är fantastiskt att se Arm konkurrera i toppen av databasprestanda och erbjuda ett övertygande alternativ till företagsmarknaden”, sa Steve Shaw, skaparen och utvecklaren av HammerDB, efter rundan.
Slutsats
Vera är inte den snabbaste processorn i alla kategorier eftersom AMD tillgodoser alla behov på marknaden med en dedikerad del. Den frekvensoptimerade EPYC 9175F är byggd för hastighet per kärna och vinner fortfarande arbetsbelastningar som belönar en snabb klockfrekvens, från Pythons nbody och single-thread AES till Valkey-förfrågningar med en enda tråd i taget. EPYC 9965 är byggd för dataflöde och vinner det arbete som skalas med kärnantal, inklusive GROMACS, all-thread 7-Zip och AES, och antalet Valkey-shards som får plats i en socket.
Där Vera sticker ut är i mitten, och i hur nära den kommer var och en av dessa specialister på hemmaplan. I en enda tråd matchade eller slog den 9175F på heltalsarbete och två av de tre Python-testerna, komprimerade 12 % snabbare på 7-Zip och körde go och regex_compile 15 % respektive 25 % snabbare, medan den låg efter på flyttal och krypto.
Över hela systemet nådde den 63 % till 72 % av 9965:s all-thread 7-Zip-hastigheter och avslutade den medelstora OpenFOAM-meshen inom 12 % av den, för att sedan gå vidare när minnet tog över, på den stora meshen och på ClickBench. Att den ligger så nära ledaren per kärna på en tråd och ledaren på dataflödet över hela systemet är det som gör Vera till en så stark processor för allmänt bruk. För köpare som vill ha en plattform för den breda mittenmarknaden utan att ge upp mycket i någon ände, är det ett extremt starkt erbjudande.
Vera levererar betydligt mer minnesbandbredd än något annat x86-system vi testat. Två Vera-socklar klarade 2 073 GB/s på STREAM Triad, 2.3 gånger den bästa DDR5-servern här, och NVLink-C2C håller den bandbredden inom räckhåll över socklarna: Veras kärnor läser den andra sockelns minne med 677 GB/s, mer än någon annan x86-socket läser från lokalt minne.
Minnesbundna arbetsbelastningar följde: det stora OpenFOAM-nätet löstes 1.44 gånger snabbare än på EPYC 9965, ClickBenchs hot run slutfördes på 2.09 sekunder mot 2.70, Valkey-arbetsuppsättningen på 256 GB kördes 34 % snabbare, och på en socket ledde Vera HammerDB på PostgreSQL och båda MariaDB-utgåvorna. Länkkostnaden är latens: en fjärrläsning tar ungefär 2.1 gånger så lång tid som en lokal, mot 1.75 gånger på EPYC 9175F, så NUMA-medveten placering och hugepages spelar fortfarande roll på Vera.
Svagheterna är förvånansvärt små och kan spåras direkt till designen. Sex 128-bitars SVE2-pipes matchar inte 512-bitars AVX-512-enheter i den kod som skrivits för dem, så en 16-kärnig skiva av Vera körde GROMACS benchMEM med hälften så hög hastighet som 9175F och två tredjedelar så hög som 9965. Med bara två av dessa pipes som hanterade krypto, krypterade en enda Olympus-kärna AES-256-GCM med ungefär en tredjedel av 9175F:s hastighet.
Hur Vera utvecklas beror till stor del på OEM-partnerna. Dells PowerEdge R8822 började levereras i oktober och M9882 Vera CPU Rack väntas under första kvartalet 2027. HPEs ProLiant Compute DL394 Gen12 anländer i höst. Supermicro har sitt Vera-rack med 256 processorer tillgängligt för offert med luftkylda 1U- och 2U Vera-system i sortimentet. ASUS, ASRock Rack, QCT, GIGABYTE, MSI, Compal, Foxconn, Pegatron, Wistron och Lenovo har alla visat Vera-designer. Oracle Cloud har Vera-instanser allmänt tillgängliga , med CoreWeave, Nebius, Lambda och andra som följer.
Vera är den första Arm-serverprocessorn vi har testat som hör hemma i samma kategori som x86-flaggskeppen för allmänt bruk, och den första processorn från någon leverantör som har 2 TB/s minnesbandbredd i en luftkyld tvåsockellåda. För den breda mellanklassen är det ett trovärdigt alternativ idag, och NVIDIA går in på CPU-marknaden med ett minnesundersystem som ingen annan levererar. För vektortung HPC och kryptobundna tjänster behåller x86-specialisterna sin ledning. Vi kommer att låta OEM-systemen gå igenom samma svit när de når labbet, med början i agentic-sandbox-rollen som NVIDIA byggde denna processor för att fylla.
Topplista: NVIDIA Vera har utnämnts till bästa armimplementering på vår topplista för bästa servrar .


 Amazon