

I takt med att AI-infrastrukturen utvecklas blir datapipelines snabbare, mer omfattande och alltmer komplexa. Från träning av stora modeller till realtidsinferens i stor skala är lagringsundersystemet avgörande för att säkerställa att GPU:er kontinuerligt får nödvändig data. I takt med att lagring blir allt viktigare i AI-kluster, omprövar organisationer hur de ska leverera hög dataflöde, förutsägbar prestanda och motståndskraft, särskilt i miljöer där dataförlust eller driftstopp helt enkelt är oacceptabla.
Utmaningen blir ännu mer uttalad i takt med att AI-modeller fortsätter att växa exponentiellt i storlek. Moderna stora språkmodeller och grundmodeller kräver frekventa kontrollpunkter för att bibehålla träningsframsteg. I takt med att modellstorlekarna ökar från miljarder till biljoner parametrar, skalas lagringskraven för dessa kontrollpunkter proportionellt. Detta skapar ett akut behov av stora, enhetliga lagringsnamnrymder som kan hantera massiva kontrollpunktsfiler, samtidigt som de bibehåller extremt snabb skriv- och läsprestanda. Traditionella lagringsarkitekturer kämpar för att tillhandahålla både den kapacitet och hastighet som krävs för dessa krävande arbetsbelastningar.
Nuvarande metoder för kontrollpunktshantering, såsom asynkron kontrollpunktshantering som dumpar modellvikter till CPU-minne för att tillåta GPU:er att fortsätta träna, möter betydande begränsningar allt eftersom modellerna växer. Den tillfälliga lagringen av dessa kontrollpunkter i systemminnet blir alltmer slösaktig och dyr, vilket kräver enorma mängder RAM som driver upp systemkostnader och strömförbrukning. Ännu viktigare är att i takt med att modellstorlekarna fortsätter att expandera kan denna metod bli helt opraktisk på grund av den stora datamängden som skulle behöva lagras tillfälligt i minnet.
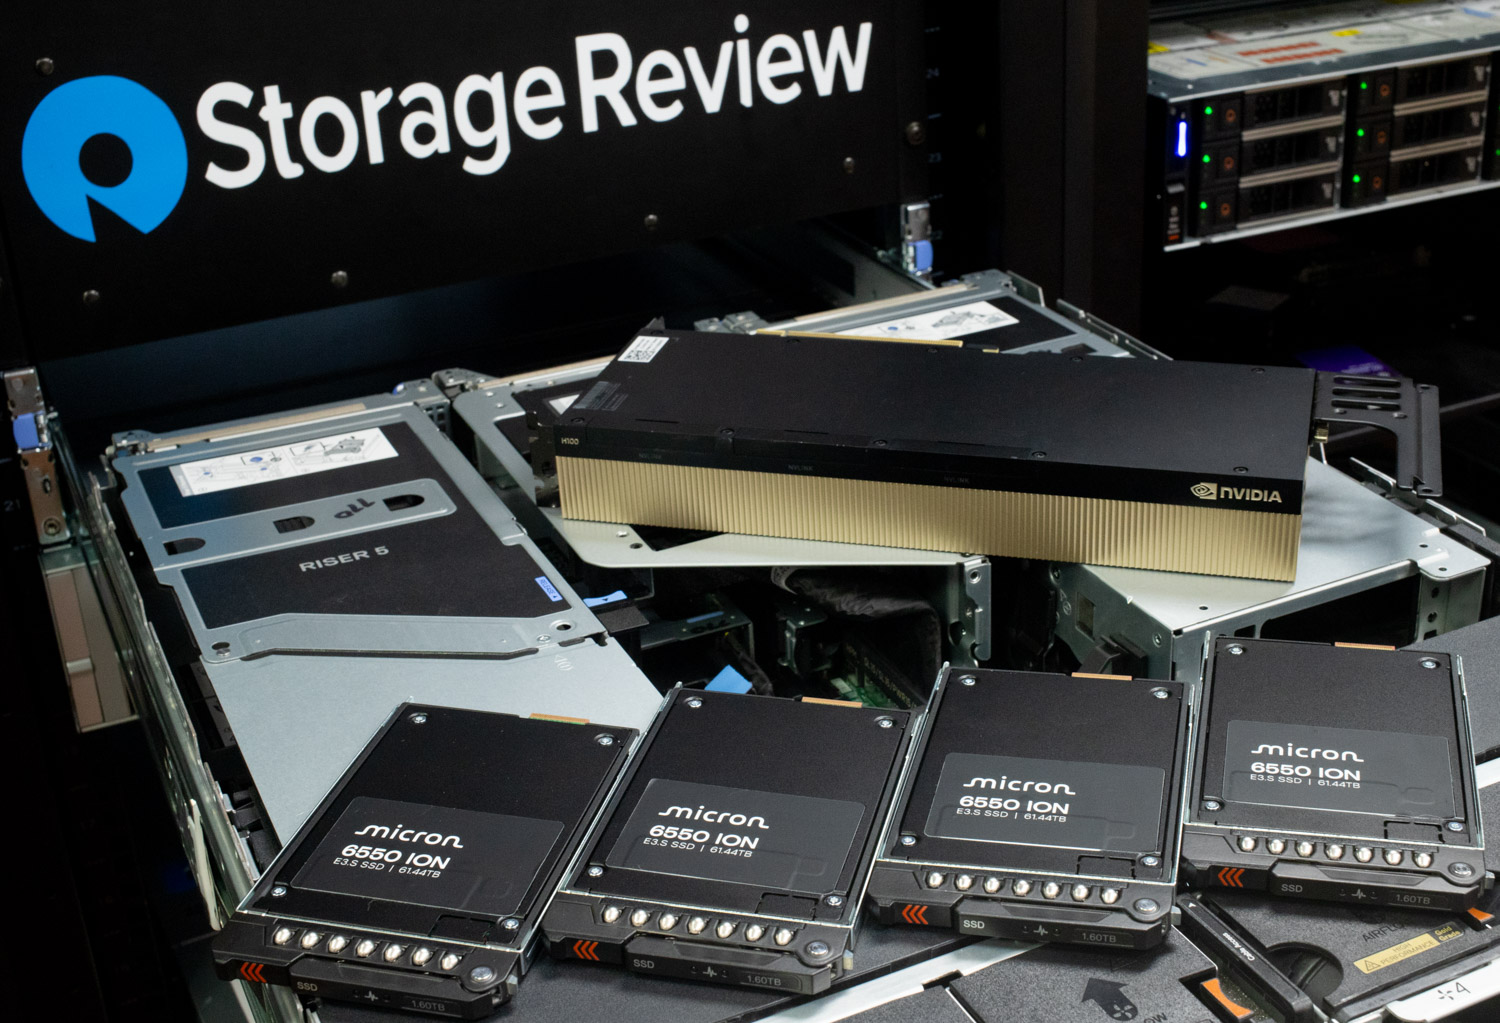
Graid Technology har introducerat en ny metod som är specifikt skräddarsydd för att hantera dessa utmaningar. Byggande på den programvarudefinierade modellen som etablerats i tidigare lösningar som SupremeRAID SR1010 , ger Graids nya SupremeRAID AE (AI Edition) företags-RAID-funktionalitet till AI-arbetsbelastningar med minimala infrastrukturförändringar. Istället för ett dedikerat hårdvaru-RAID-kort eller en anpassad enhet levereras AE som en programvarulicens och använder endast en liten andel av en befintlig NVIDIA GPU. Detta innebär att organisationer kan uppnå lagringsprestanda och tillförlitlighet i företagsklass utan att 1) förbruka ytterligare PCIe-kortplatser, 2) göra infrastrukturförändringar eller 3) uppleva en betydande inverkan på GPU-prestanda för tränings- och inferensarbetsbelastningar.
Key Takeaways
- Hög prestanda i stor skala: SupremeRAID AE uppnår läshastigheter på upp till 183.60 GB/s och skrivhastigheter på upp till 54.23 GB/s, vilket uppfyller höga AI-krav.
- Minimal GPU-overhead: Introducerar minimal overhead (~4 %) under GPU-intensiv inferens, vilket bibehåller stark övergripande systemprestanda.
- Namnrymd för massivt enhetligt lagringsutrymme: Stöder upp till 32 NVMe SSD-diskar per array, vilket ger nästan 1 PB lagringsutrymme i ett enda enhetligt namnutrymme.
- Avancerade integrationsfunktioner: Integreras helt med NVIDIA GPUDirect Storage och ledande AI-fokuserade filsystem (BeeGFS, Lustre, Ceph).
- Förenklad infrastruktur: Eliminerar dedikerad RAID-hårdvara, vilket minskar komplexitet, kostnader och driftskostnader avsevärt.
Optimerad lagring och motståndskraft för avancerade AI-arbetsbelastningar
SupremeRAID AE stöder upp till 32 NVMe SSD-diskar i en enda array och aggregerar dem till ett enhetligt namnutrymme. Denna struktur gör det möjligt för AI-arbetsbelastningar att effektivt komma åt stora datamängder samtidigt som de bibehåller motståndskraft, vilket är särskilt viktigt för miljöer som kör långvariga träningsjobb. Vid ett hårddiskfel förblir arrayen tillgänglig och kontrollpunktsbaserade framsteg bevaras. Det skyddet minimerar risken för dataförlust eller tidskrävande omstarter, vilket är en betydande fördel för team som hanterar stora modeller eller inferenspipelines med hög volym.
De intelligenta resurshanteringsfunktionerna i SupremeRAID AE erbjuder ytterligare optimeringsmöjligheter för AI-arbetsbelastningar. Även om våra tester visar minimal overhead under samtidiga operationer, kan effekten minskas ytterligare genom smart schemaläggning. Kontrollpunktsoperationer körs vanligtvis inte samtidigt med aktiv träning på samma nod; det finns vanligtvis en tillfällig paus i träningen under kontrollpunktsfaser. Under dessa intervall kan SupremeRAID AE utnyttja ytterligare oanvända GPU-resurser för att påskynda slutförandet av kontrollpunkter.
SupremeRAID AE stöder även NVIDIA GPUDirect Storage. Detta möjliggör direkta vägar mellan lagring och GPU-minne, vilket resulterar i minskad latens och förbättrad I/O-effektivitet. Det integreras med AI-centrerade filsystem, som BeeGFS, Lustre och Ceph, och inkluderar intelligent dataavlastning, tillsammans med orkestreringsklara API:er för automatisering. Sammantaget erbjuder SupremeRAID AE ett förenklat – men kraftfullt – sätt att integrera RAID-fördelar i moderna AI-arbetsflöden.
Utöver träningsarbetsbelastningar tillgodoser SupremeRAID AE kritiska krav för moderna AI-inferensscenarier. I takt med att organisationer skalar upp inferensoperationer förlitar de sig i allt högre grad på avancerade strategier som persistent KV-cachehantering, optimering av förfyllning och avkodning och nivåindelade minnesarkitekturer. Dessa tekniker kräver ofta att KV-cacher avlastas till lagring när de överskrider VRAM-kapaciteten. Lösningar som NVIDIA Dynamo, Red Hats LLM-D och vLLM-produktionsstack innehåller alla nivåindelade KV-cacheintegrationer som är beroende av snabb lagring med hög kapacitet. I dessa scenarier blir det avgörande att ha stora, prestandafulla lagringspooler för att upprätthålla inferens med låg latens, och SupremeRAID AE:s förmåga att tillhandahålla både massiv kapacitet och exceptionell hastighet gör den till en idealisk grund för dessa avancerade inferensarkitekturer.
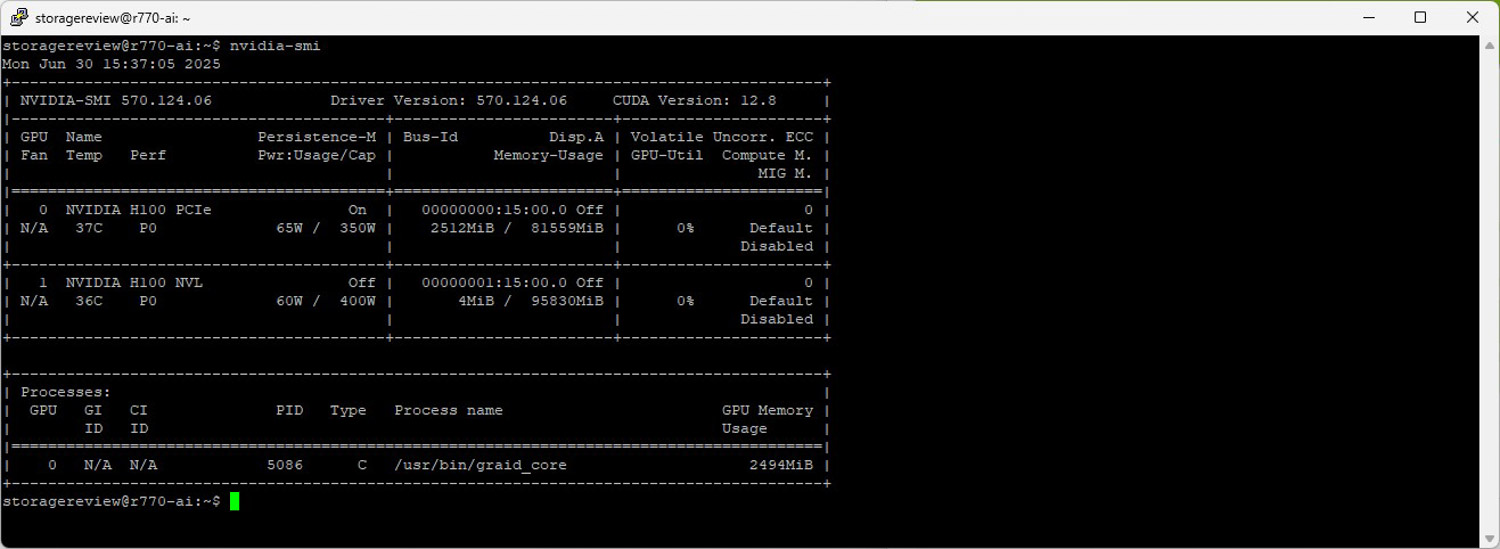
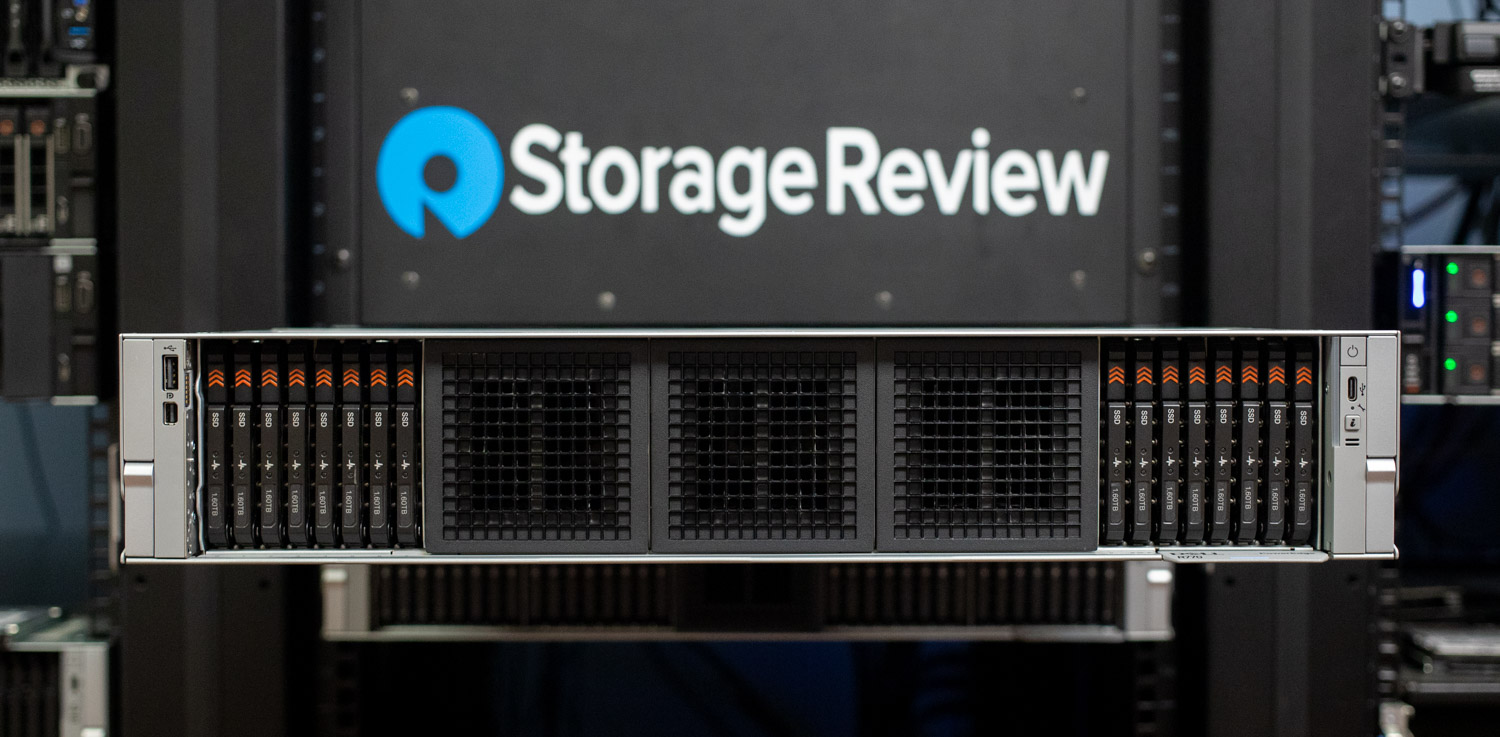
I den här analysen utvärderar vi SupremeRAID AE som körs på vår Dell PowerEdge R770-plattform, som har dubbla NVIDIA H100 GPU:er och 16 Micron 6550 61.44TB Gen5 NVMe SSD:er. Vi utforskar prestanda under RAID 5 med hjälp av GDSIO- och FIO-verktyg och undersöker hur Graid AE påverkar GPU-beteendet under en live LLM-inferensarbetsbelastning. Målet är att förstå hur den här lösningen integreras i AI-miljöer i företagsklass, där prestanda, kapacitet, motståndskraft och enkelhet måste skalas tillsammans.
Siffrorna: Djupdykning i SupremeRAID AE-prestanda
För att testa prestandan hos Graid SupremeRAID AE konfigurerade vi en Dell PowerEdge R770 med dubbla NVIDIA H100-grafikkort och 16 E3.S-fack i fronten. Systemet, som är byggt på Intels senaste Xeon 6-plattform, konfigurerades med två Intel Xeon 6787P-processorer, som var och en erbjuder 86 kärnor för att hantera mycket parallella arbetsbelastningar i AI-, HPC- och datatunga miljöer.
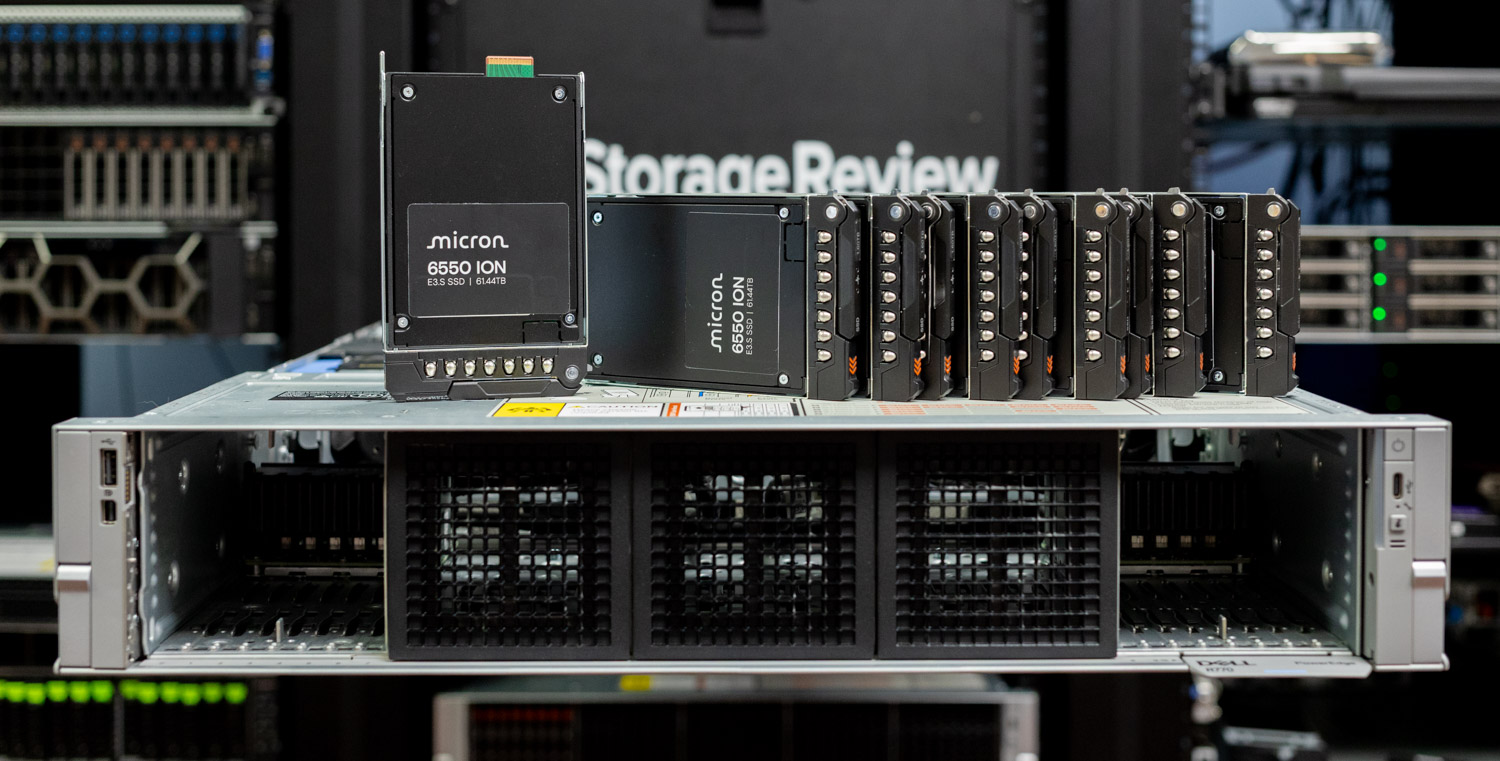
R770 konfigurerades med 16 E3.S-fack, och lagringen var fullt utrustad med Micron 6550 ION 61.44TB Gen5 NVMe TLC SSD-diskar, vilka är utformade för att leverera konsekvent prestanda över ett brett spektrum av arbetsbelastningar. Micron SSD-diskarna ger en idealisk balans mellan exceptionell prestanda och massiv kapacitet, vilket gör att AI-arbetsbelastningar kan bibehålla hög dataflöde samtidigt som AI-infrastrukturen drastiskt förenklas. Med en petabyte lagringsutrymme på bara 16 diskar kan organisationer effektivt hantera omfattande datamängder och storskaliga modellkontrollpunkter inom en enda server, vilket avsevärt minskar komplexiteten och infrastrukturkostnaden.
Testsystemspecifikationer
- Plattform: Dell PowerEdge R770
- CPU: 2x Intel Xeon 6787P (86 kärnor vardera)
- Minne: 32x Micron 64 GB Dual-Rank DDR5 6400 MT/s Totalt minne: 2TB
- Nätverk: DELL BRCM 4P 25G SFP 57504S OCP NIC
- GPU 1: NVIDIA H100 (80 GB VRAM)
- GPU 2: NVIDIA H100NVL (96 GB VRAM)
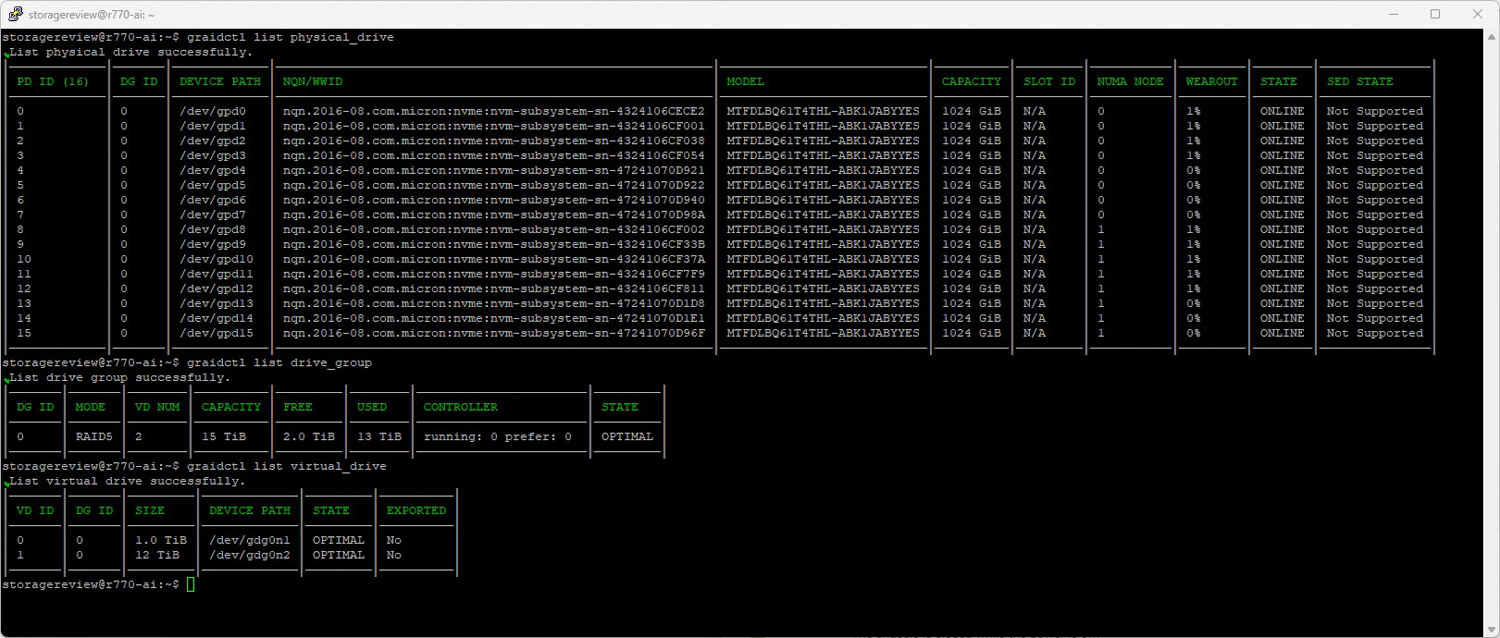
- Förvaring: 16 x 61TB Micron ION 6550 SSD-diskar (915 TB RAID 5-pool)
Som en del av denna prestandatestning konfigurerades Micron SSD-diskarna i en enda RAID 5-pool med SupremeRAID AE. Denna layout valdes för att utvärdera hur väl SupremeRAID AE kan balansera prestanda och feltolerans i en AI-driven miljö som kräver lagring med hög kapacitet. RAID 5 distribuerar paritet över alla diskar, vilket skyddar mot fel på enskilda diskar samtidigt som användbar lagringskapacitet bibehålls.
Innan vi går in på prestandatesterna är det viktigt att notera skillnaderna mellan GDSIO och FIO när man mäter lagringsprestanda med Graid. I våra tidigare bedömningar av Graids prestanda är en viktig observation att det inte finns några flaskhalsar (som ett hårdvaru-RAID-kort) som begränsar maximal bandbredd. Hårdvaru-RAID-kort hanterar de lagringsenheter som är anslutna till dem, och PCIe-kortplatsen kan bli en flaskhals i denna process. Graid använder en GPU för RAID-operationer, men all data behöver inte passera genom den. Som ett resultat begränsar inte GPU:n bandbredden.
FIO-lagringsriktmärket mäter lagringsprestanda genom att använda processorn för att komma åt lagring och begränsas endast av lagringslösningen. GDSIO, å andra sidan, mäter prestandan för GPU Direct Storage, där GPU:n kan vara den begränsande faktorn. NVIDIA H100 har till exempel ett PCIe Gen5 x16-gränssnitt och klarar cirka 63 GB/s bandbredd in eller ut. När man diskuterar GPU-prestandaflaskhalsar i detta sammanhang är problemet relaterat till bandbredden som GPU:n kan stödja med GPU Direct Storage, inte en Graid-flaskhals.
NVIDIA GPU direktlagring
Ett av testerna vi genomförde på denna testbänk var Magnum IO GPU Direct Storage (GDS)-testet. GDS är en funktion utvecklad av NVIDIA som gör att GPU:er kan kringgå CPU:n när de kommer åt data lagrade på NVMe-enheter eller andra höghastighetslagringsenheter. Istället för att dirigera data genom processorn och systemminnet, möjliggör GDS direkt kommunikation mellan GPU:n och lagringsenheten, vilket avsevärt minskar latensen och förbättrar datagenomströmningen.
Hur GPU Direct Storage fungerar
Traditionellt, när en GPU bearbetar data lagrad på en NVMe-enhet, måste data först färdas genom CPU:n och systemminnet innan de når GPU:n. Denna process introducerar flaskhalsar, eftersom CPU:n blir en mellanhand, lägger till latens och förbrukar värdefulla systemresurser. GPU Direct Storage eliminerar denna ineffektivitet genom att göra det möjligt för GPU:n att komma åt data direkt från lagringsenheten via PCIe-bussen. Denna direkta väg minskar de omkostnader som är förknippade med datarörelser, vilket möjliggör snabbare och mer effektiva dataöverföringar.
AI-arbetsbelastningar, särskilt de som involverar djupinlärning, är mycket dataintensiva. Att träna stora neurala nätverk kräver bearbetning av terabyte med data, och varje fördröjning i dataöverföringen kan leda till underutnyttjade GPU:er och längre träningstider. GPU Direct Storage hanterar denna utmaning genom att säkerställa att data levereras till GPU:n så snabbt som möjligt, vilket minimerar vilotiden och maximerar beräkningseffektiviteten.
Dessutom är GDS särskilt fördelaktigt för arbetsbelastningar som involverar streaming av stora datamängder, såsom videobearbetning, naturlig språkbehandling eller realtidsinferens. Genom att minska beroendet av CPU:n påskyndar GDS datarörelsen och frigör CPU-resurser för andra uppgifter, vilket ytterligare förbättrar den övergripande systemets prestanda.
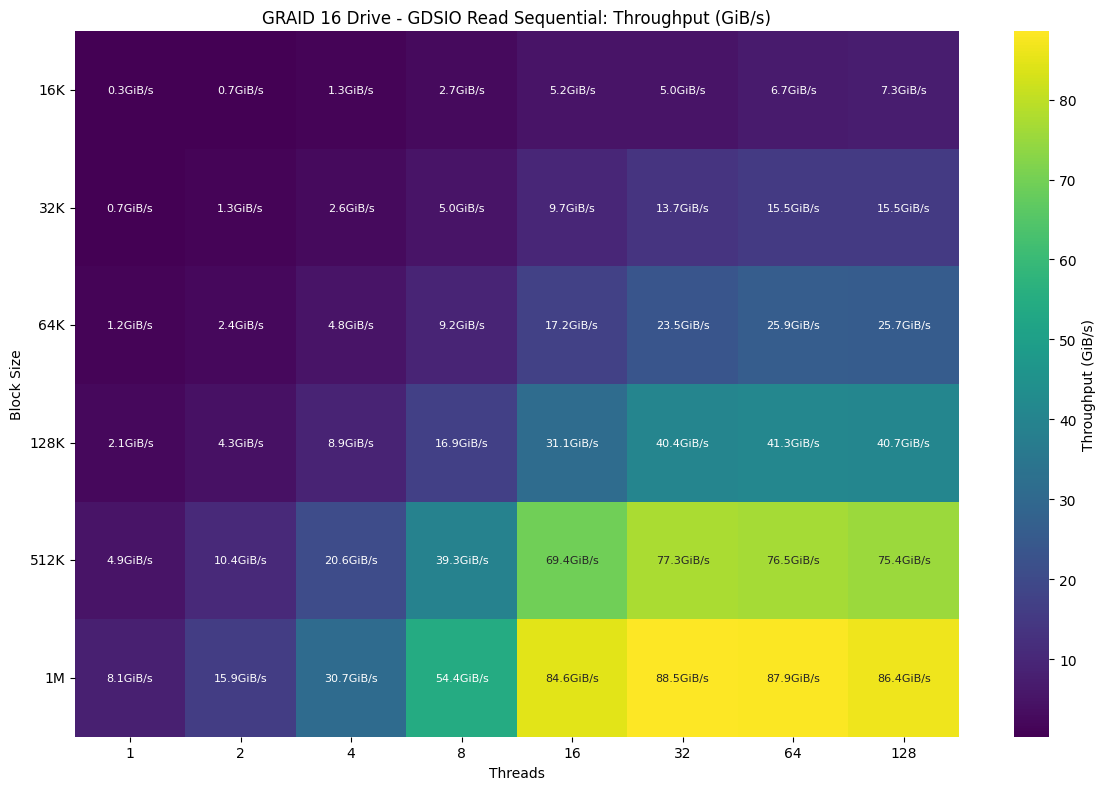
GDSIO 16-enhetens slumpmässiga läsdataflöde
Innan vi dyker in på prestandasiffrorna är det viktigt att notera att den begränsande faktorn för läs- och skrivprestanda med GDSIO-siffror är GPU:n. Testet är utformat för att mäta den maximala lagringsprestanda som kan pushas eller dras från GPU:n. Du kommer så småningom att stöta på en flaskhals i PCIe-kortplatsen, vilket för PCIe Gen5 x16 är cirka 63 GB/s.
När det gällde slumpmässig läsning av GDSIO levererade arrayen sina starkaste resultat med större blockstorlekar och högre trådantal, samtidigt som den hade svårt att skala effektivt i den lägre delen. Vid 16K / 128 trådar började saker och ting förbättras mer märkbart och nådde 7.3 GiB/s, men verklig dataflödesacceleration kom inte in förrän 32K och uppåt, där arrayen nådde 15.5 GiB/s med 64 trådar. Betydande vinster observerades vid 64K, klättrande till 25.9 GiB/s, och prestandan tog fart från 128K, vilket nådde 41.3 GiB/s vid 64 trådar och förblev över 40 GiB/s genom 128 trådar. Maximal dataflöde uppnåddes vid 1M blockstorlek med 32 trådar, där arrayen nådde 88.5 GiB/s och bibehöll den nivån över de högsta trådantalen.
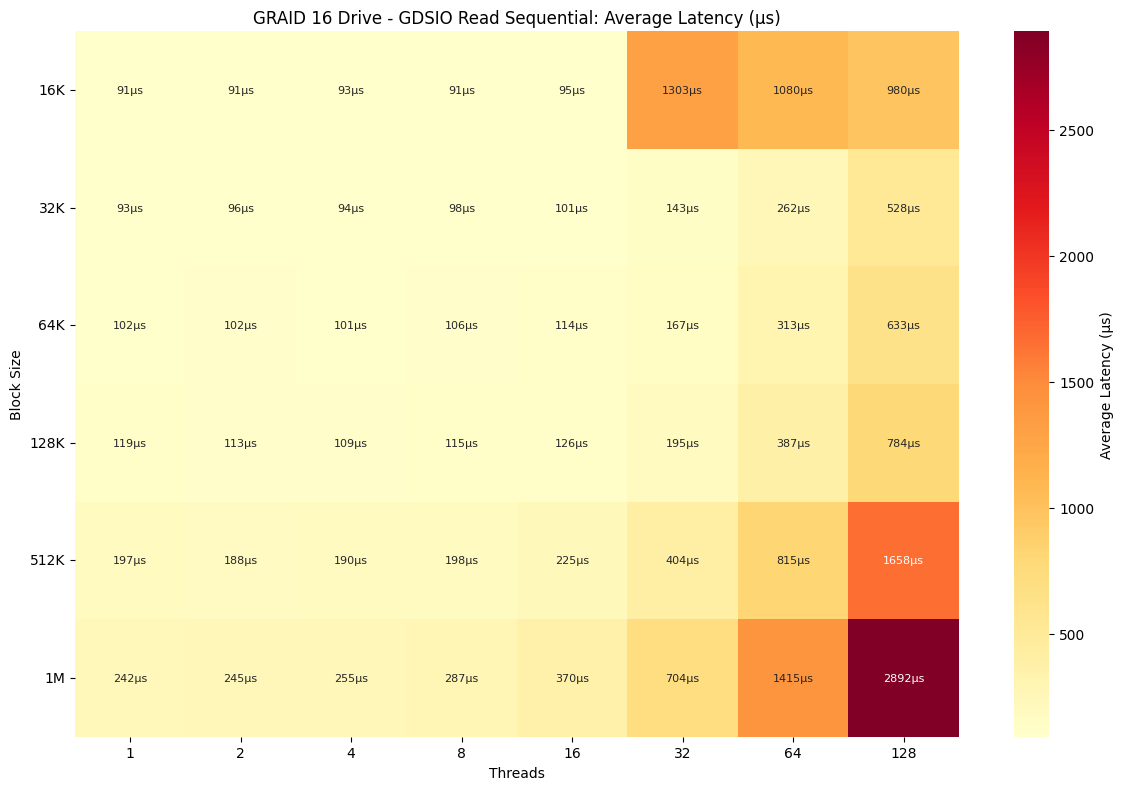
GDSIO 16-diskens slumpmässiga läsfördröjning
Som en uppföljning av dataflödesresultaten återspeglade latensprofilen för slumpmässig läsning för arrayen det skalningsbeteende som observerats tidigare. Latensen förblev exceptionellt låg över alla blockstorlekar och trådantal upp till 16 trådar, med värden under 0.1 ms för allt upp till 128K. Även större block, som 128K, låg runt 0.13 ms till 0.20 ms. Utöver 16 trådar ökade dock latensen märkbart. Vid 16k / 32 trådar fortsatte latensen att öka och nådde så småningom 980 ms vid 128 trådar. På liknande sätt ökade 1 miljon läsningar, som hade den högsta dataflödet, från 0.242 ms vid en tråd till 2.892 ms vid 128 trådar. Trenden var konsekvent över alla storlekar då latensen förblev oförändrad under måttlig samtidighet, men ökade kraftigt när trådantalet ökade bortom 32, särskilt med större blockstorlekar.
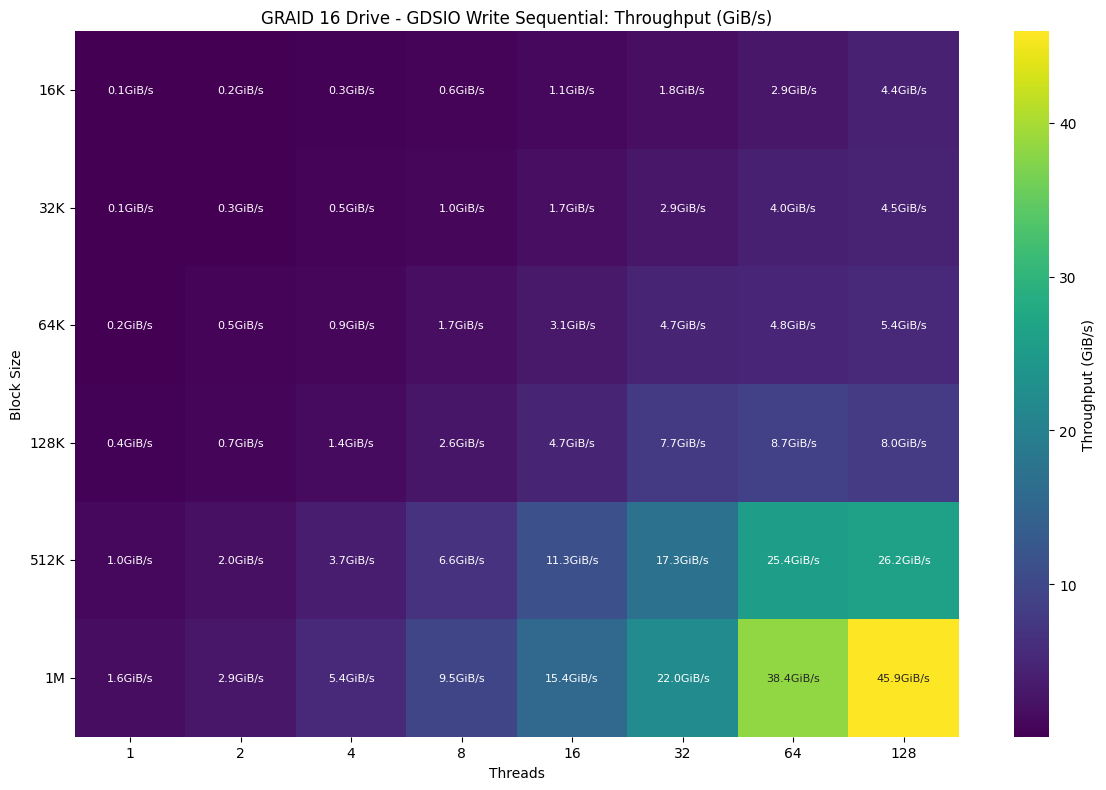
GDSIO 16-enhetens slumpmässiga skrivdataflöde
När det gäller GDSIO-skrivgenomströmning visade arrayen återigen stark prestanda vid större blockstorlekar samtidigt som den skalades mer gradvis överlag jämfört med läsningar. Prestandan började förbättras mer betydande från och med 32K, där genomströmningen passerade 5.9 GiB/s, och särskilt vid 64 trådar och högre, där 512K och 1M block levererade ihållande vinster långt in i höga trådantal. Vid 64 trådar och högre nådde 512K skrivningar 25.4 GiB/s och 1M nådde en topp på 38.4 GiB/s, medan 128M skrivningar fortsatte att skalas till en maximal topp på 1 GiB/s vid 45.9 trådar. Blockstorlekarna på 512K och 128K förblev också stabila vid hög samtidighet och planade ut runt 26.2 GiB/s respektive 8.0 GiB/s.
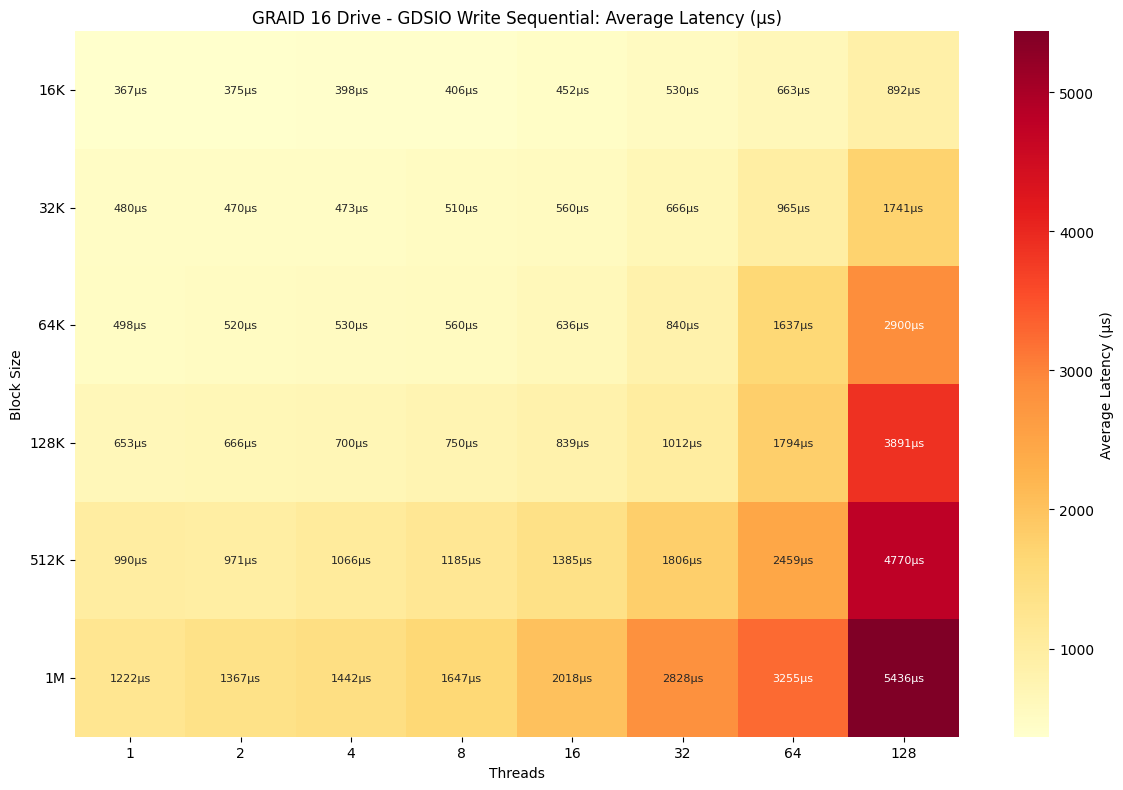
GDSIO 16-diskens slumpmässiga skrivfördröjning
Efter den starka skalningen av skrivdataflödet uppvisade latensprofilen för slumpmässiga skrivningar på arrayen en stadig ökning i takt med att blockstorleken och trådantalet ökade. Även vid låga trådantal var skrivlatensen betydligt högre än läslatensen, med början vid 0.367 ms och klättring med varje blockstorlek upp till 1.222 ms vid 1 MB. Allt eftersom samtidigheten ökade ökade latensen gradvis upp till 16 trådar, för att sedan accelerera mer aggressivt. Vid 64 trådar nådde skrivningarna 0.663 ms, medan 1 MB skrivningar ökade till 3.255 ms. Vid 128 och 256 trådar ökade latensen avsevärt, särskilt med stora blockstorlekar. Till exempel nådde 512 4.770 skrivningar 128 ms vid 512 trådar, och 1 5 och 5.436 MB korsade 1 ms-gränsen, med en topp på XNUMX ms vid XNUMX MB.
Fio Prestandabenchmark
Härnäst går vi över till att mäta FIO-prestanda över den enskilda RAID5-poolen. Medan GDSIO i slutändan beror på prestandan hos de GPU:er som är installerade i systemet och deras PCIe-bandbredd, kan FIO bli högre baserat på SSD-diskarnas prestanda samt själva RAID-lösningen.
Hela disksystemet genomgår en konsekvent testprocess, som börjar med en förkonditioneringsfas bestående av två fullvolymsfyllningar med en sekventiell skrivbelastning, följt av våra sekventiella och slumpmässiga arbetsbelastningar. Detta säkerställer att hårddiskarna når ett stabilt tillstånd innan prestandamätningen börjar.
För varje ny arbetsbelastningstyp återinitierade vi förkonditioneringen med motsvarande överföringsstorlek för att bibehålla noggrannhet och konsekvens i resultaten.
Det här avsnittet belyser följande riktmärken för slumpmässig skrivning/läsning av FIO som tillämpats på Graid 16 SSD RAID 5-arrayen:
- 1M Slumpmässig skrivning/läsning
- 64K slumpmässig skrivning/läsning
- 16K slumpmässig skrivning/läsning
- 4K slumpmässig skrivning/läsning
1M slumpmässig läs-/skrivbandbredd
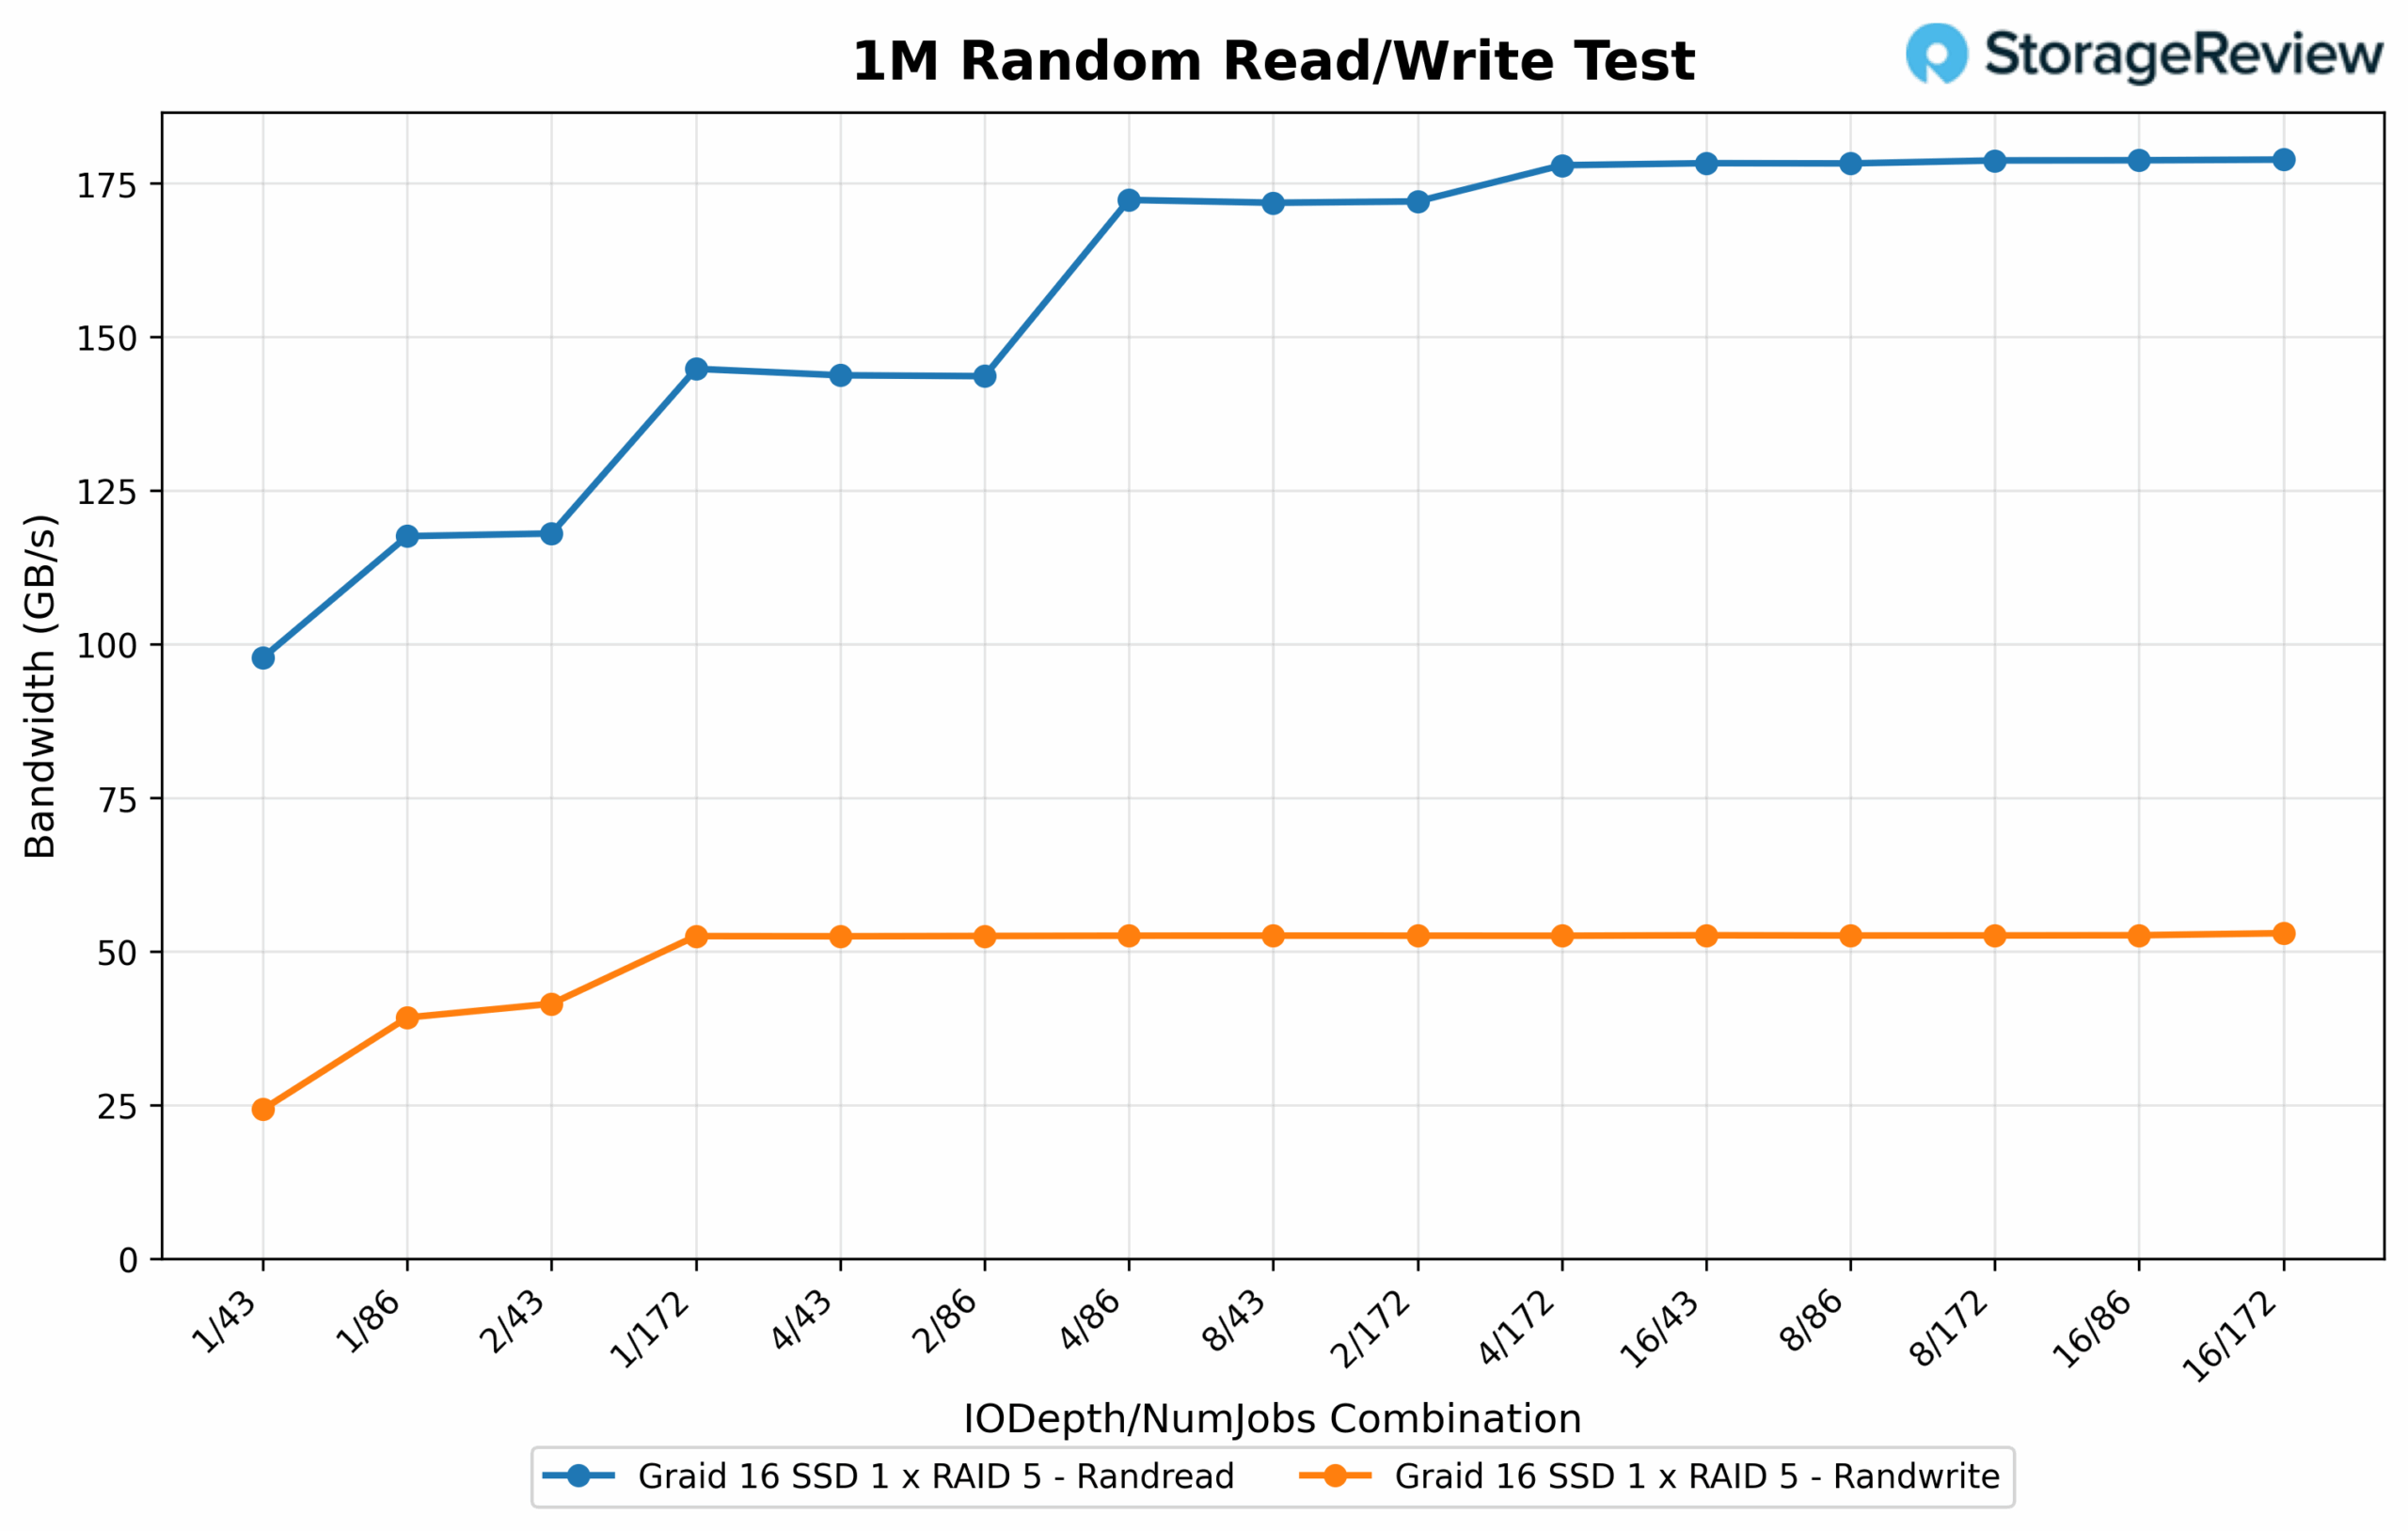
Vid övergång till slumpmässiga 1M-operationer ledde läsbandbredden prestandakurvan med en topp på 183.60 GB/s med ett IO-djup på 16 med 172 jobb, den mest aggressiva testade konfigurationen. Liknande resultat för hög dataflöde registrerades vid 8/172 och 4/172, båda överstigande 182 GB/s, vilket belyser arrayens förmåga att skala med ökande jobbantal och djup. Även mellanregisterkonfigurationer som 4/86 och 16/43 höll sig starka och höll över 147 GB/s, vilket visade konsekvent läsprestanda över olika nivåer av samtidighet. Vid övergång till skrivningar nådde slumpmässig 1M-bandbredd en topp på 54.233 GB/s vid 8/172, med nästan identiska 53.77 GB/s vid 2/86, vilket validerade effektiv skrivskalning under parallella arbetsbelastningar. Prestandan skalades ner smidigt i kombinationer med lägre trådar som 1/43 och 2/43, vilket producerade 24.88 GB/s respektive 42.48 GB/s, vilket fortfarande återspeglar en stark mättnadskurva även vid måttliga samtidighetsnivåer.
1M slumpmässig läs-/skrivlatens
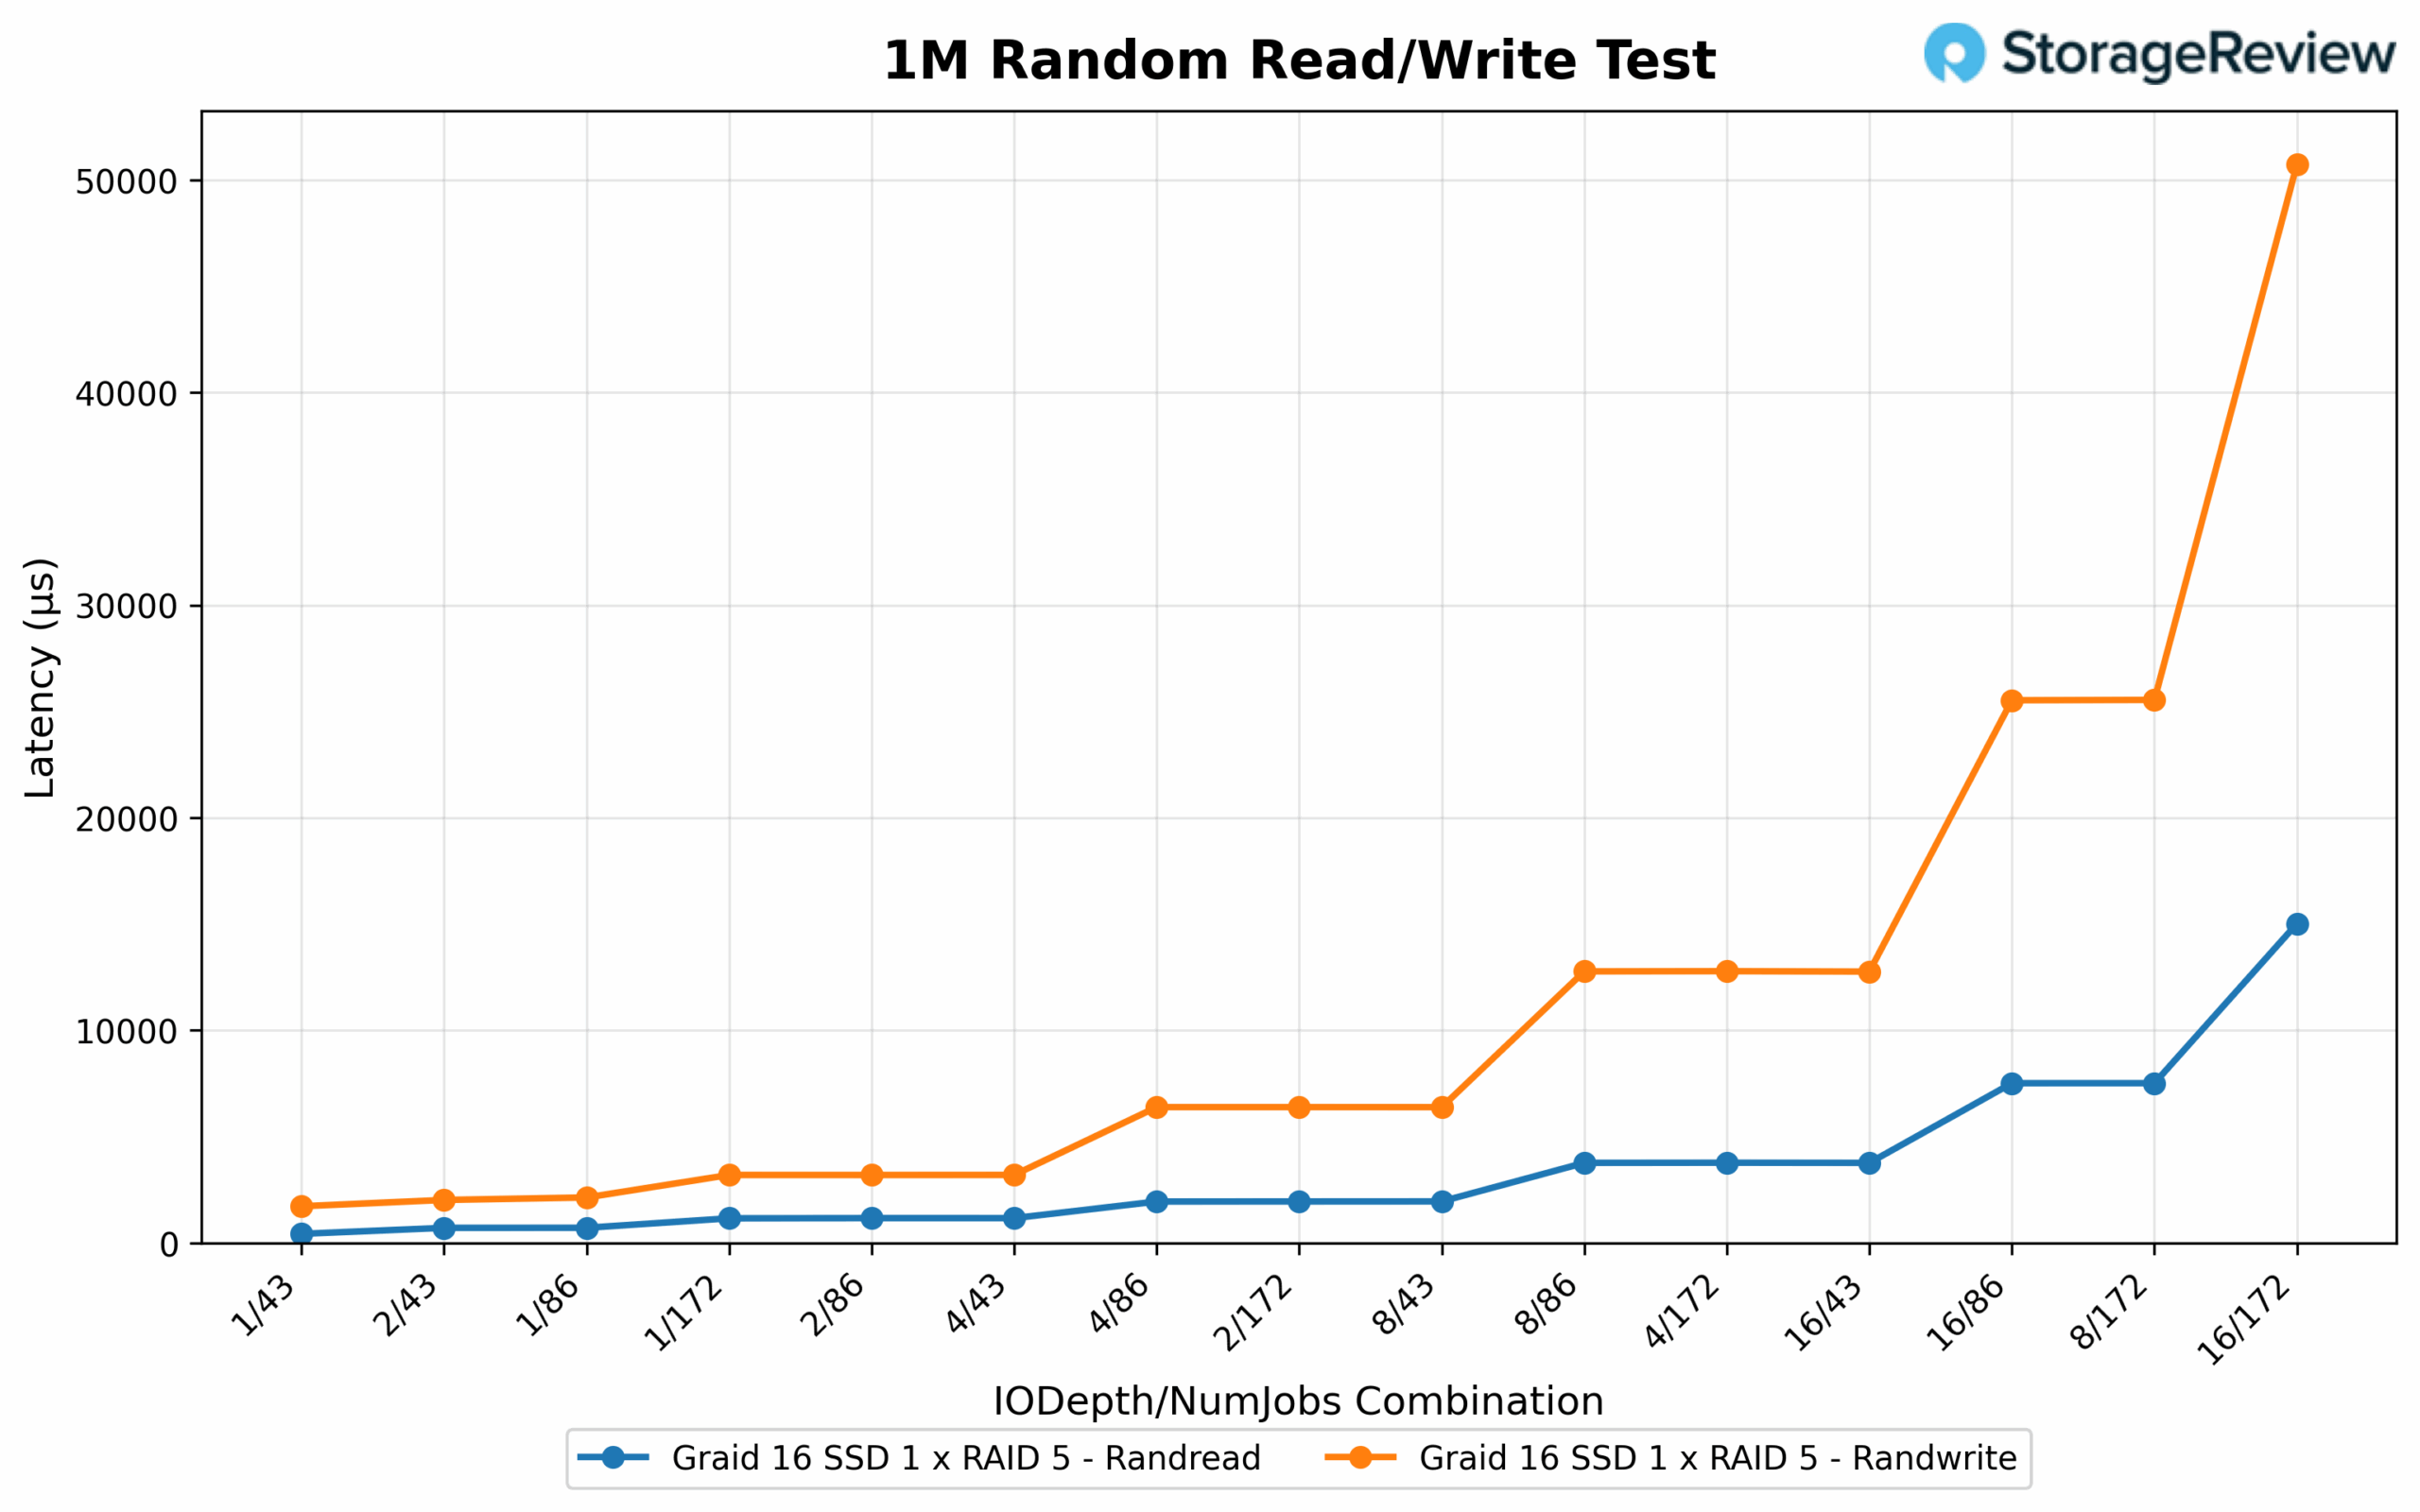
Latensen förblev kontrollerad för läsningar genom hela testintervallet. Den lägsta observerade latensen var 0.714 ms vid både 2/86 och 4/86, medan belastningar med högre djup som 8/172 och 4/172 låg under 2 ms. Konfigurationen som producerade den högsta läsdataflödet, 16/172, hade den högsta latensen på 7.516 ms – en tydlig avvägning då djupare köer ökade svarstiderna. På skrivsidan följde latensen ett liknande mönster. Den lägsta skrivlatensen mättes till 1.727 ms med 1/43. En stark balans mellan dataflöde och latens uppnåddes vid 2/86 med 3.197 ms. Alternativ med högre samtidighet som 8/43 registrerade 6.389 ms, och konfigurationen 16/172, som levererade maximal skrivprestanda, registrerade den högsta latensen på 50.741 ms, vilket understryker det välbekanta inversa förhållandet mellan dataflöde och responsivitet på extrema djup.
64K slumpmässig läs-/skrivbandbredd
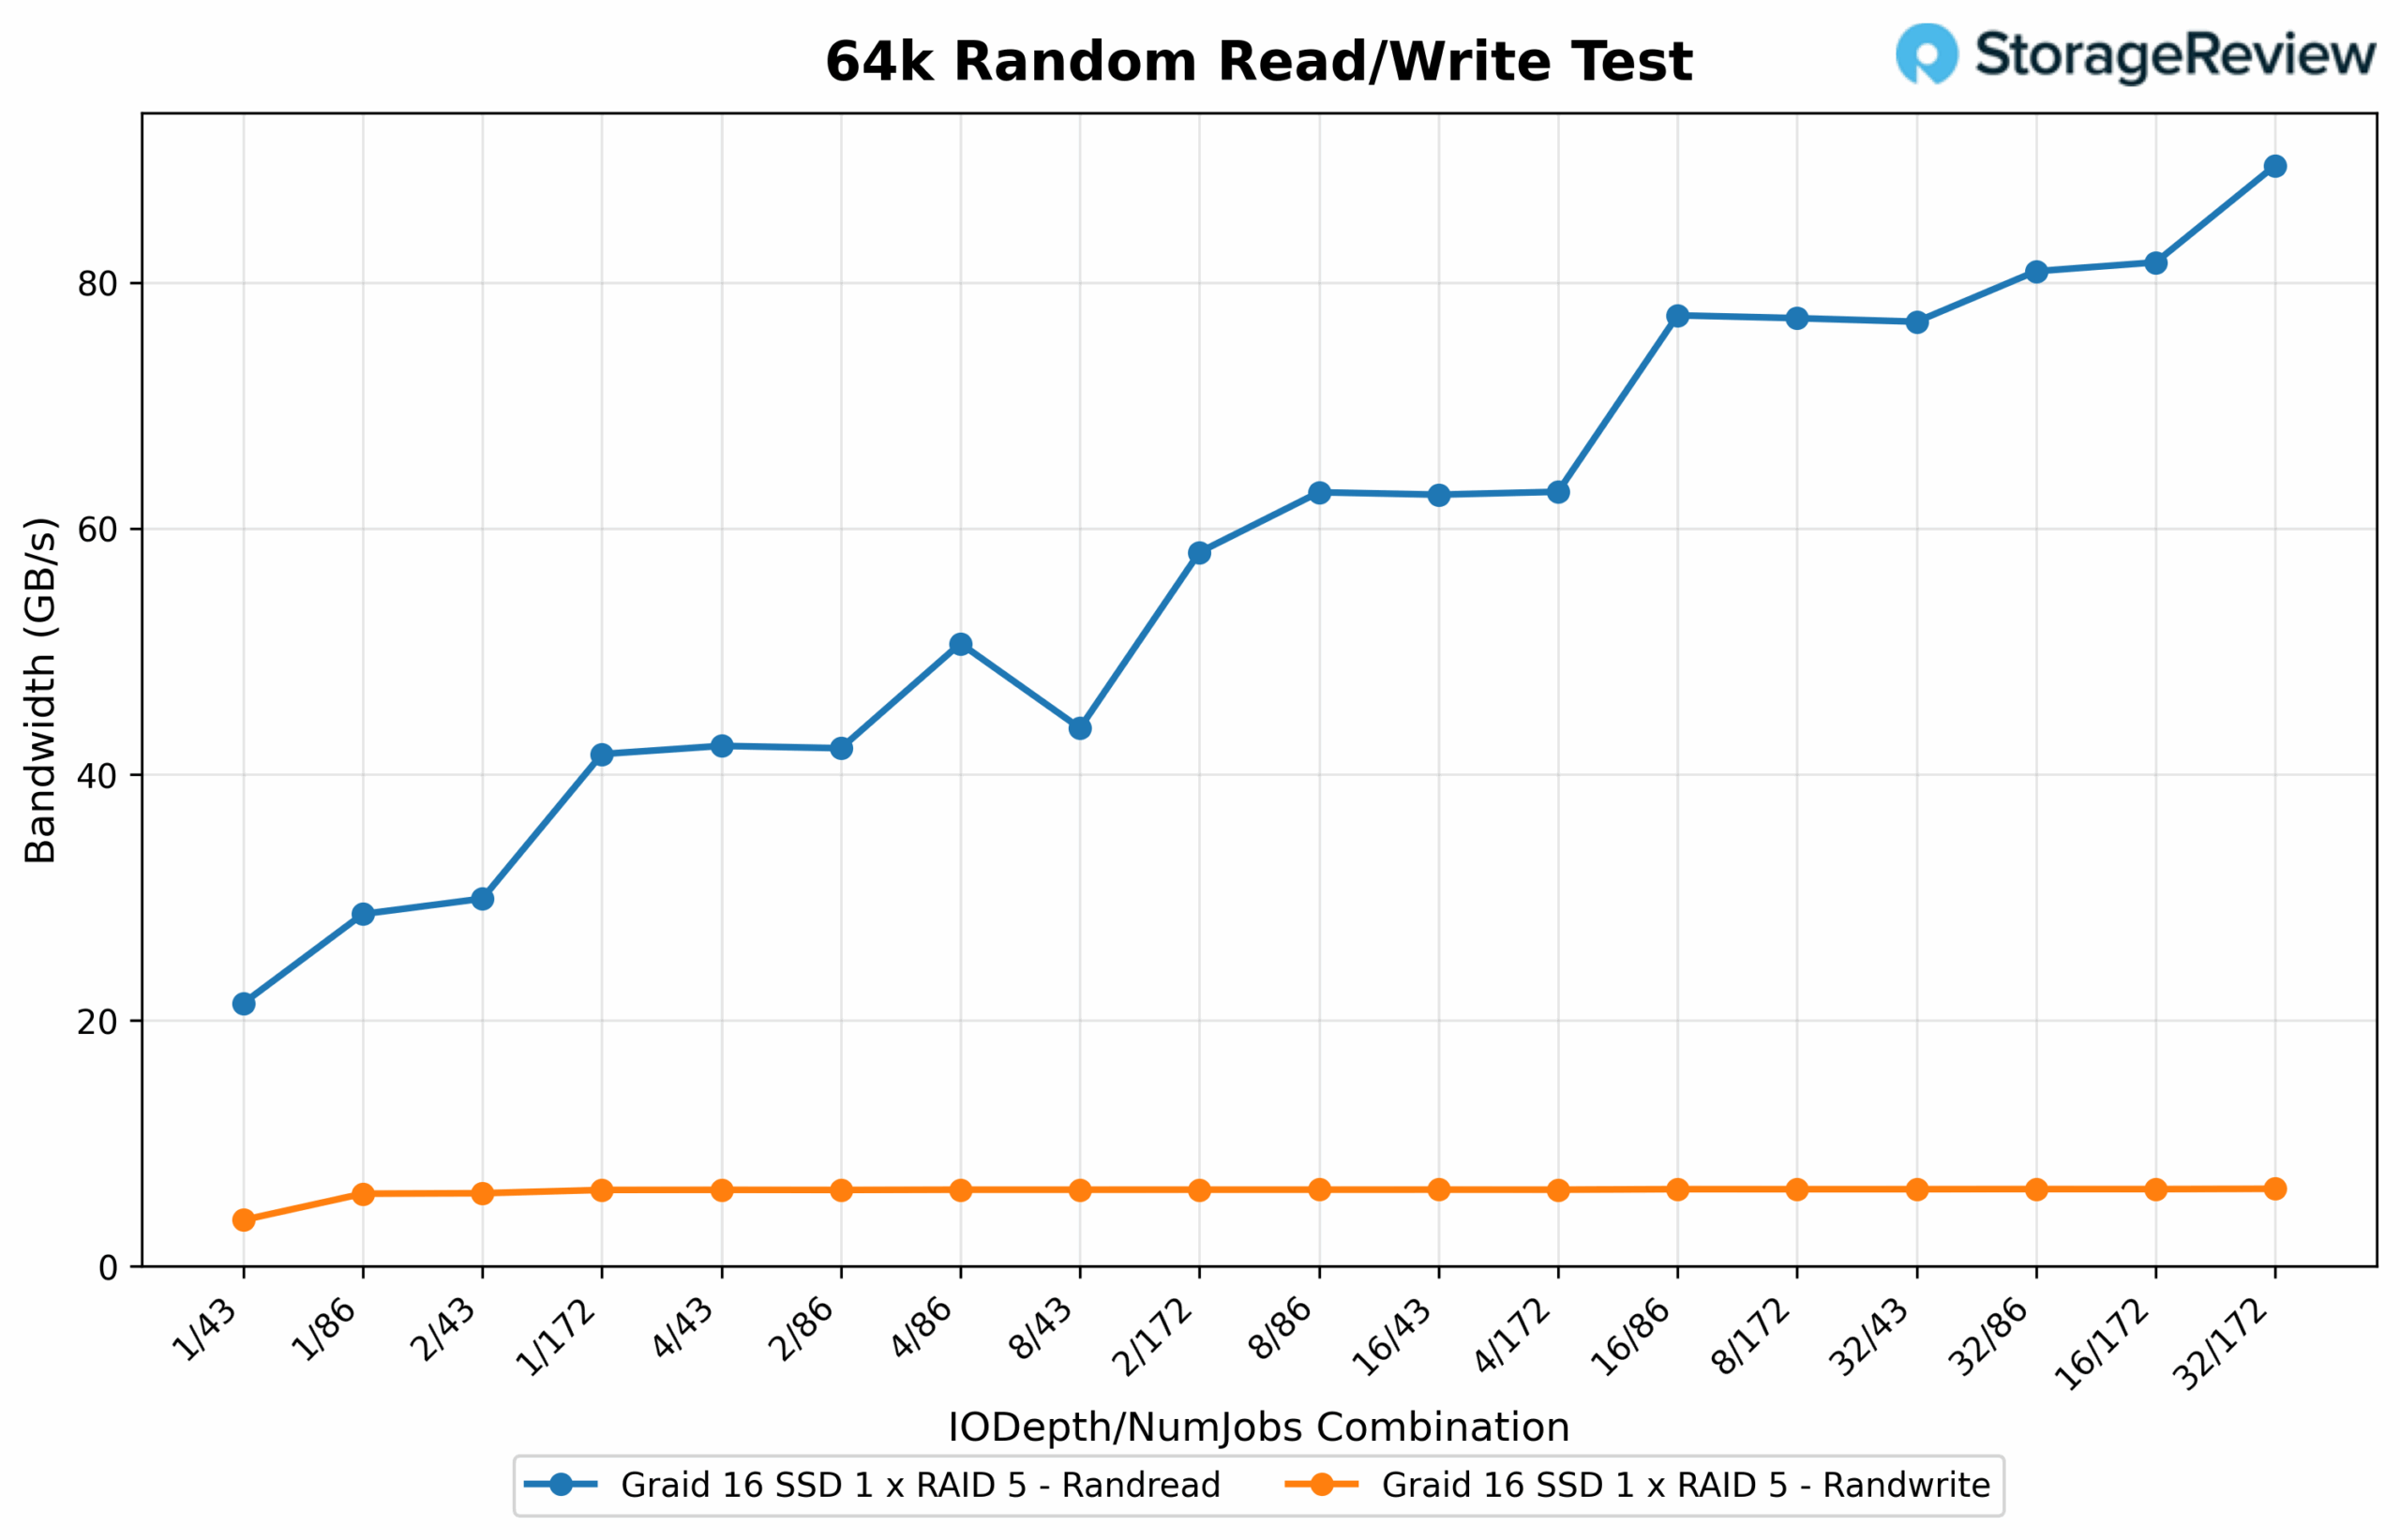
Vid övergången till slumpmässiga 64K-operationer förbättrades läsbandbredden avsevärt med högre ködjup och jobbantal, och nådde en topp på 91.65 GB/s vid 32 IO-djup med 172 jobb. Flera andra konfigurationer följde tätt, inklusive 16/172 vid 83.59 GB/s och 32/86 vid 82.85 GB/s, vilket belyser konsekventa prestandaförbättringar allt eftersom arbetsbelastningen skalades upp. Mellanstora konfigurationer som 8/172 och 16/86 bibehöll starka resultat mellan 78 GB/s och 79 GB/s. Däremot producerade kombinationer med lägre samtidighet, som 1/43 och 1/172, minskade dataflödesnivåer från 21.89 GB/s till 42.63 GB/s, vilket illustrerar arrayens beroende av parallellitet för maximal prestanda. På skrivsidan nådde 64K slumpmässig bandbredd en topp på 6.44 GB/s med 32/86. Andra toppresterande konfigurationer, inklusive 32/172 och 16/86, låg nära i linje med 6.41 GB/s respektive 6.36 GB/s. De flesta testpunkterna låg mellan 6.3 GB/s och 6.4 GB/s, vilket visade stabil konsistens över varierande ködjup. Lätta konfigurationer som 1/43 visade lägst skrivprestanda på 3.83 GB/s, vilket fortfarande förstärker trenden med progressiva förbättringar under tyngre arbetsbelastningar.
64K slumpmässig läs-/skrivlatens
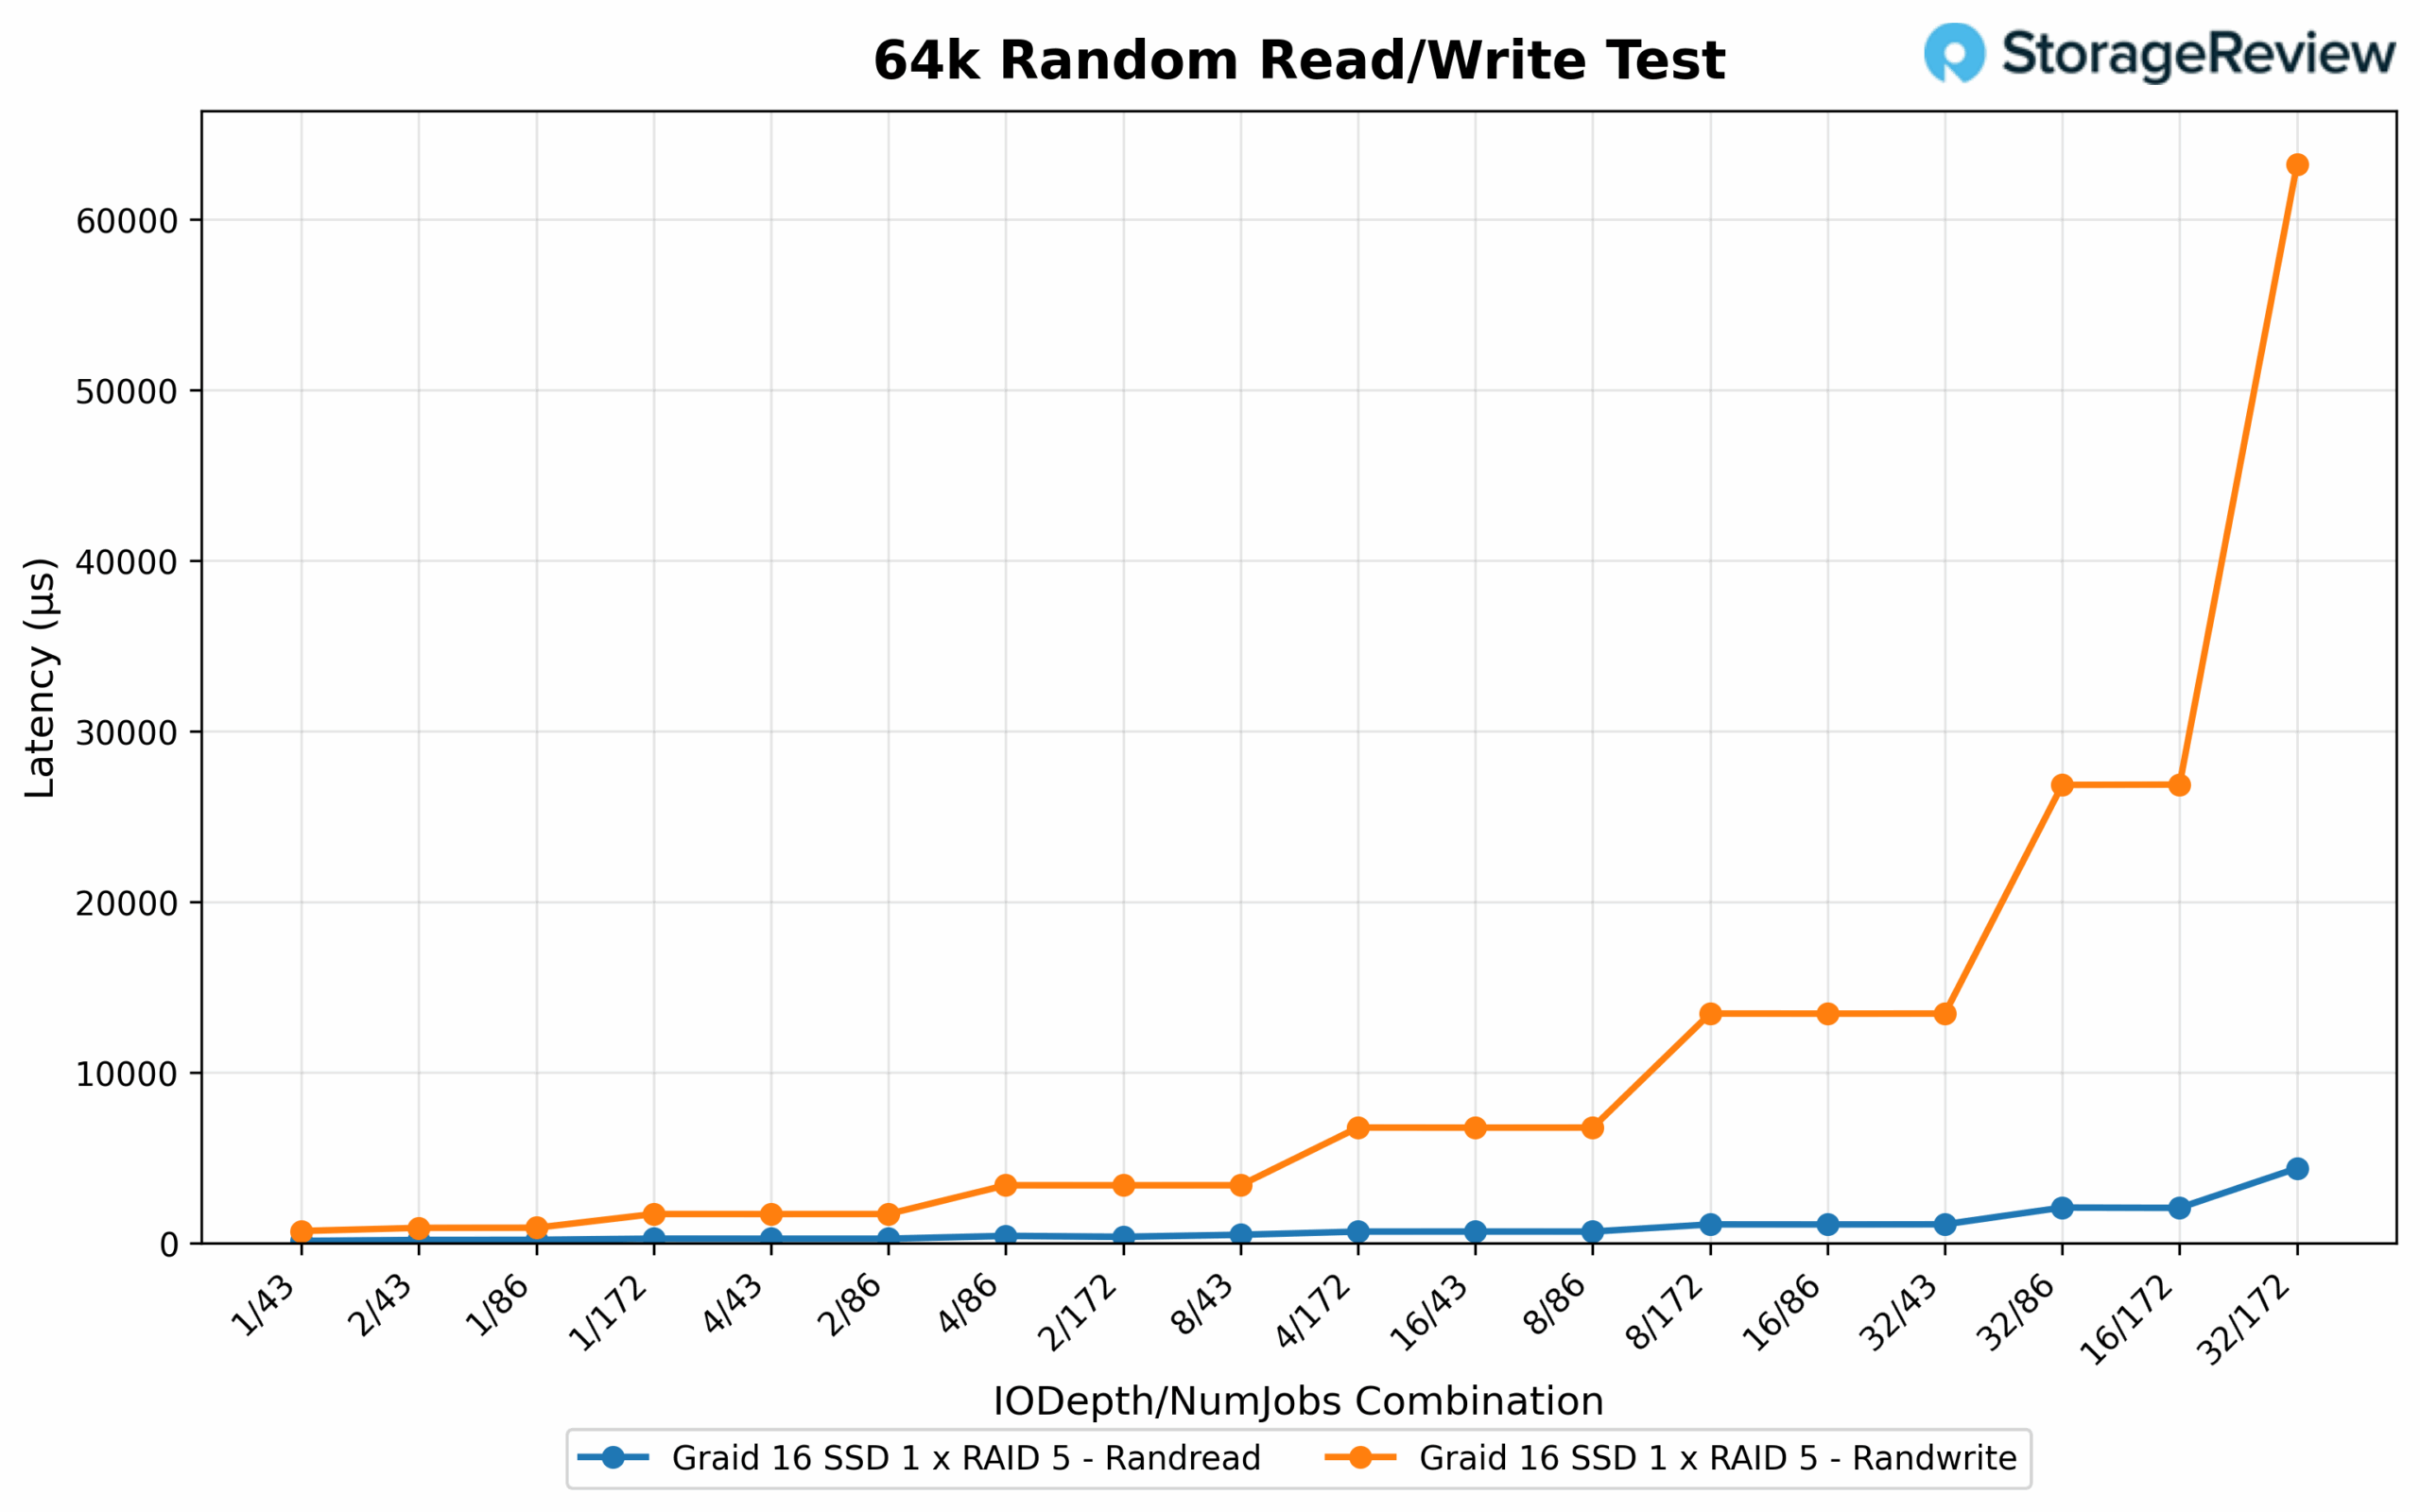
Den slumpmässiga 64K-läslatensen förblev genomgående låg i de flesta testfall. Den lägsta latensen var 0.123 ms vid 1/43, följt av 0.175 ms vid 1/86. Allt eftersom dataflödet skalades uppåt, höll sig latensen inom ett kontrollerat intervall: 4/172 nådde 0.666 ms, medan 16/172 nådde 2.057 ms. Även under tyngre belastningsförhållanden förblev svarstiden effektiv, med 32/86 som registrerade 2.076 ms trots att de levererade ett av de bästa bandbreddsresultaten. På skrivsidan skalades latensen skarpare med djup och jobbantal. Den lägsta latensen kom från 2/43 vid 0.887 ms, med 4/43 och 2/86 tätt efter vid 1.694 ms respektive 1.697 ms. Tyngre konfigurationer visade tydliga tecken på kompromisser med svarstiden: 8/172 registrerade 13.445 ms, 16/172 steg till 26.862 ms och 32/172 nådde en topp på 63.201 ms, vilket betonade den ökade köbelastningen i takt med att arbetsbelastningen intensifierades.
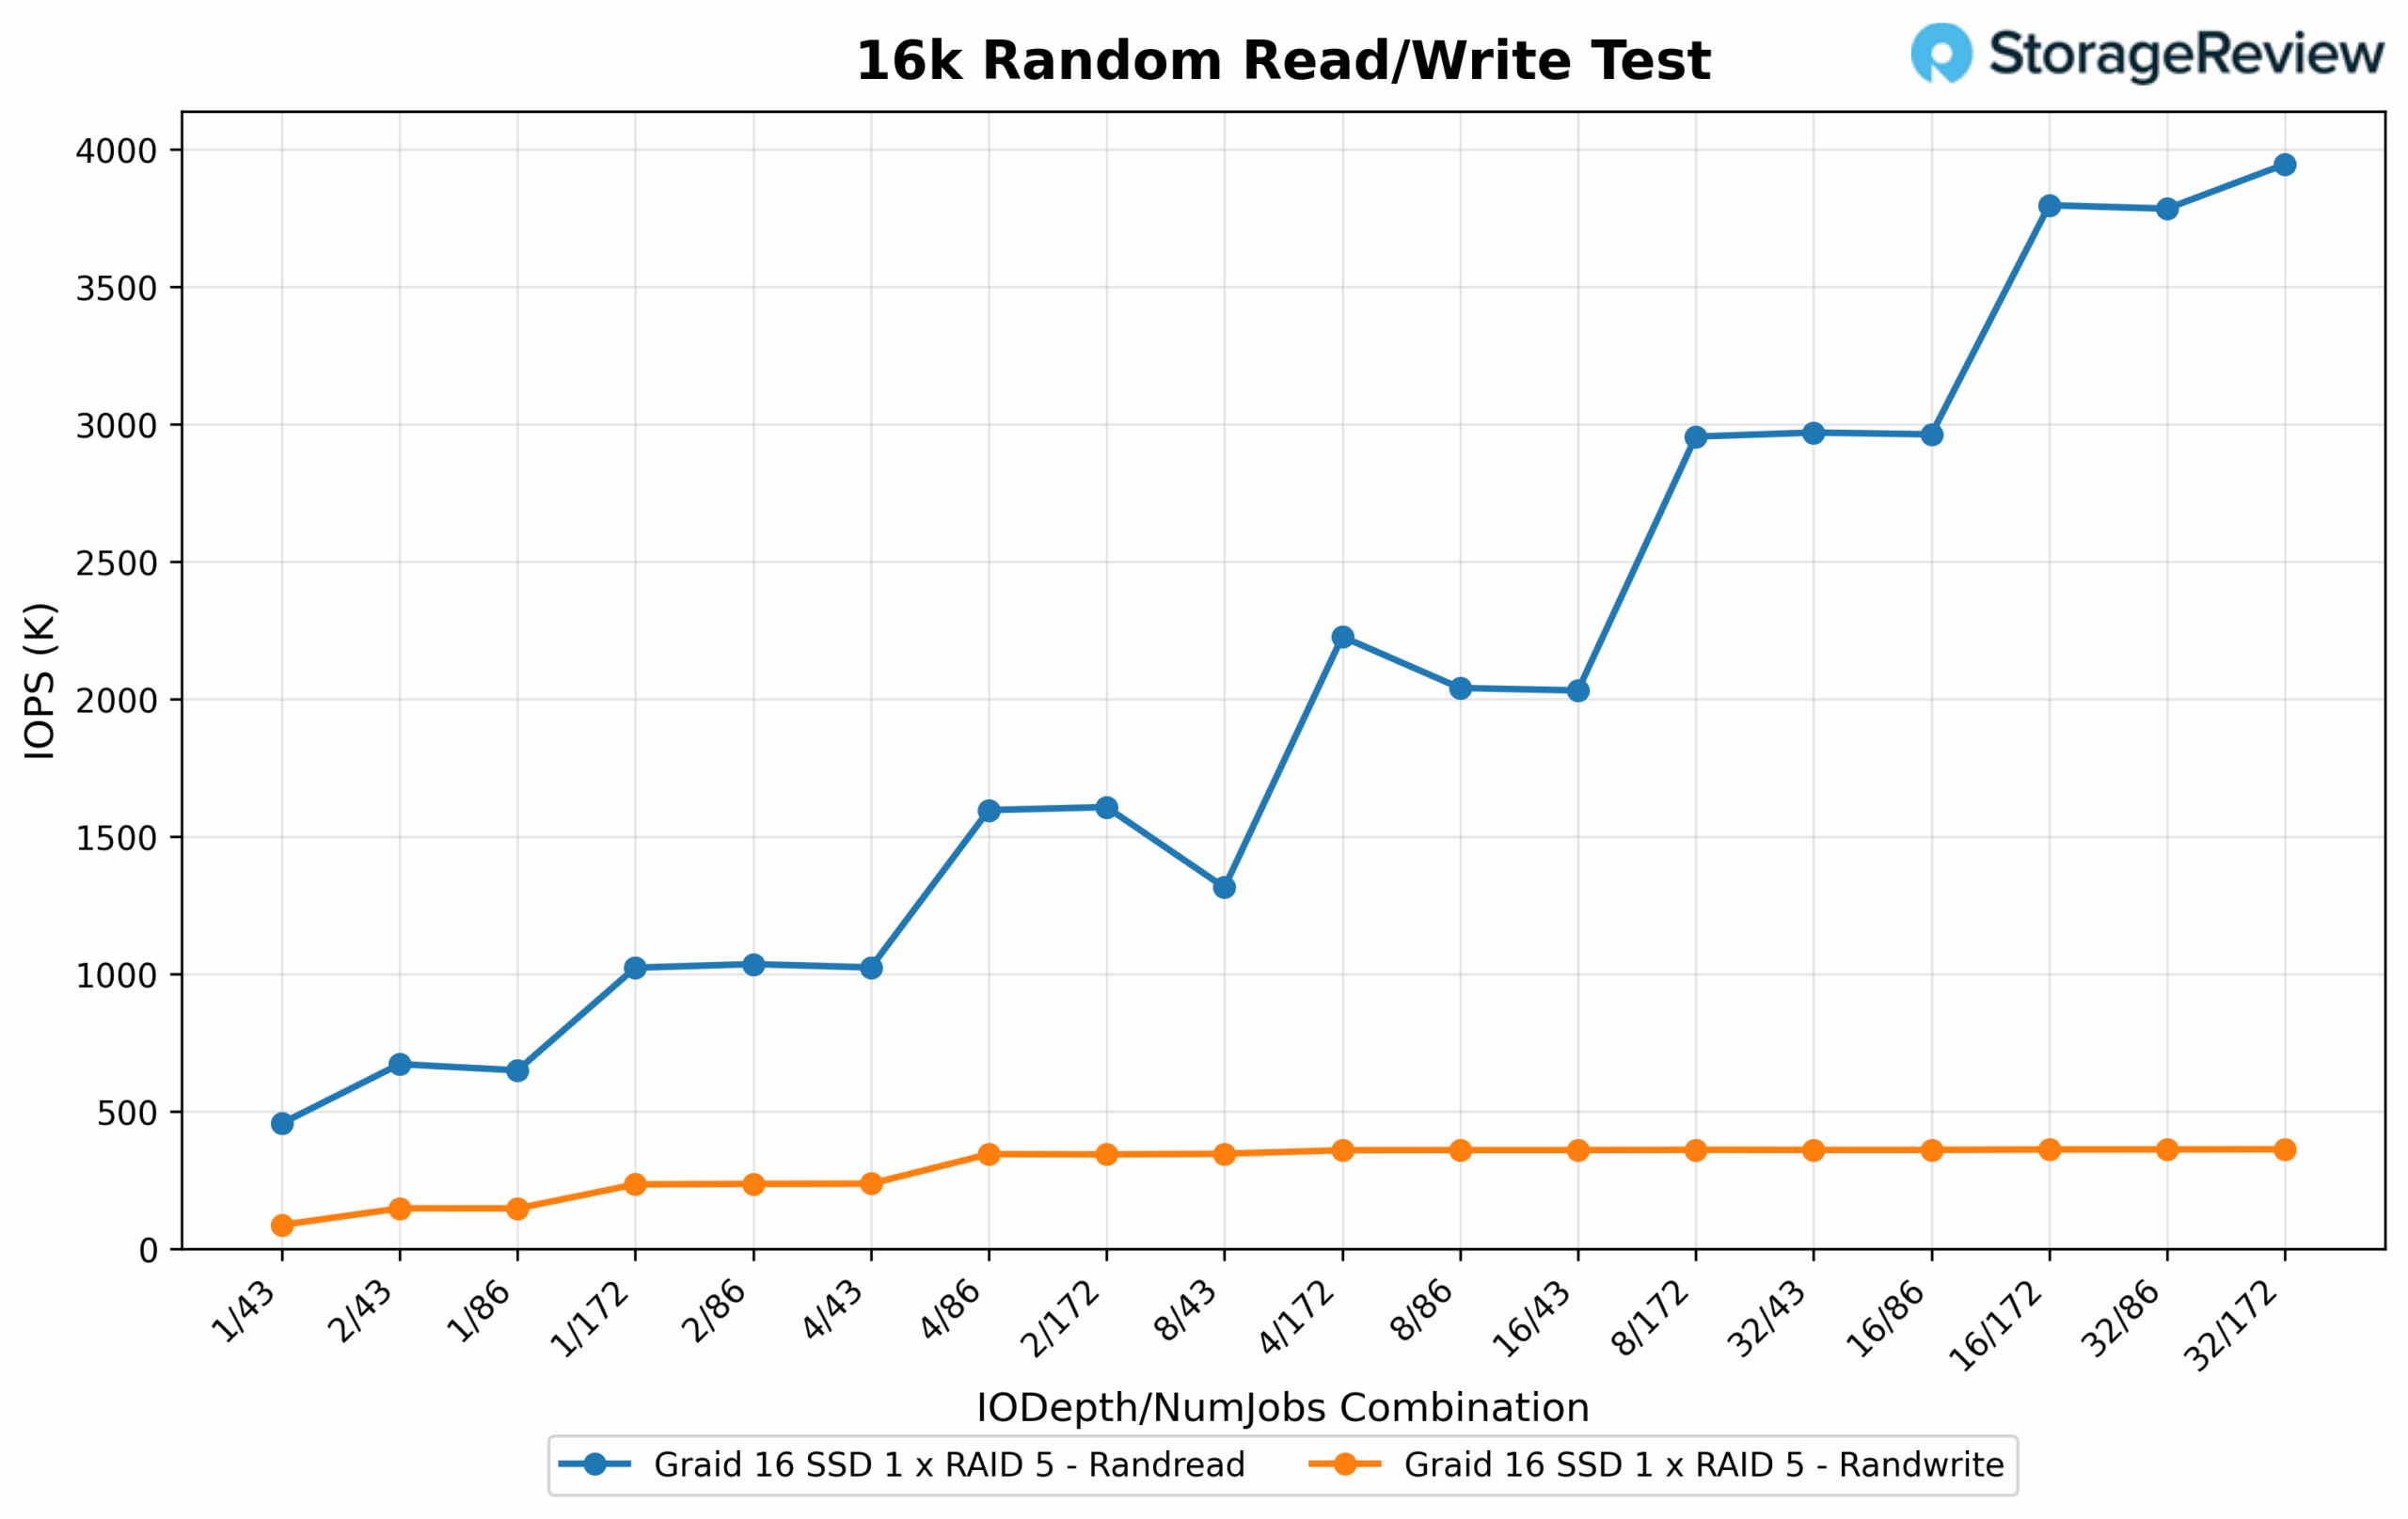
16K slumpmässiga läs-/skriv-IOPS
Den slumpmässiga 16K-läslatensen förblev låg även vid maximala IOPS. Den bästa responsen sågs i lättare konfigurationer, där 1/43 bara uppnådde 0.087 ms och 1/86 0.114 ms. Kombinationer med högre samtidighet som 4/86 och 8/86 mätte 0.236 ms respektive 0.420 ms. Även de högst presterande konfigurationerna bibehöll rimlig latens, där 16/172 uppnådde 1.143 ms och 32/172 2.372 ms, vilket visar effektiv skalning med en hanterbar inverkan på svarstiden. För slumpmässiga 16K-skrivningar registrerades den lägsta latensen vid 2/43 med 0.848 ms, följt av 1.253 ms vid 4/43 och 1.415 ms vid 1/43. Allt eftersom djupet och antalet jobb ökade ökade latensen gradvis: 8/172 nådde 5.574 ms, medan 16/172 och 32/172 steg till 10.455 ms respektive 22.958 ms, vilket belyser den förväntade avvägningen i takt med att kömättnaden ökade.
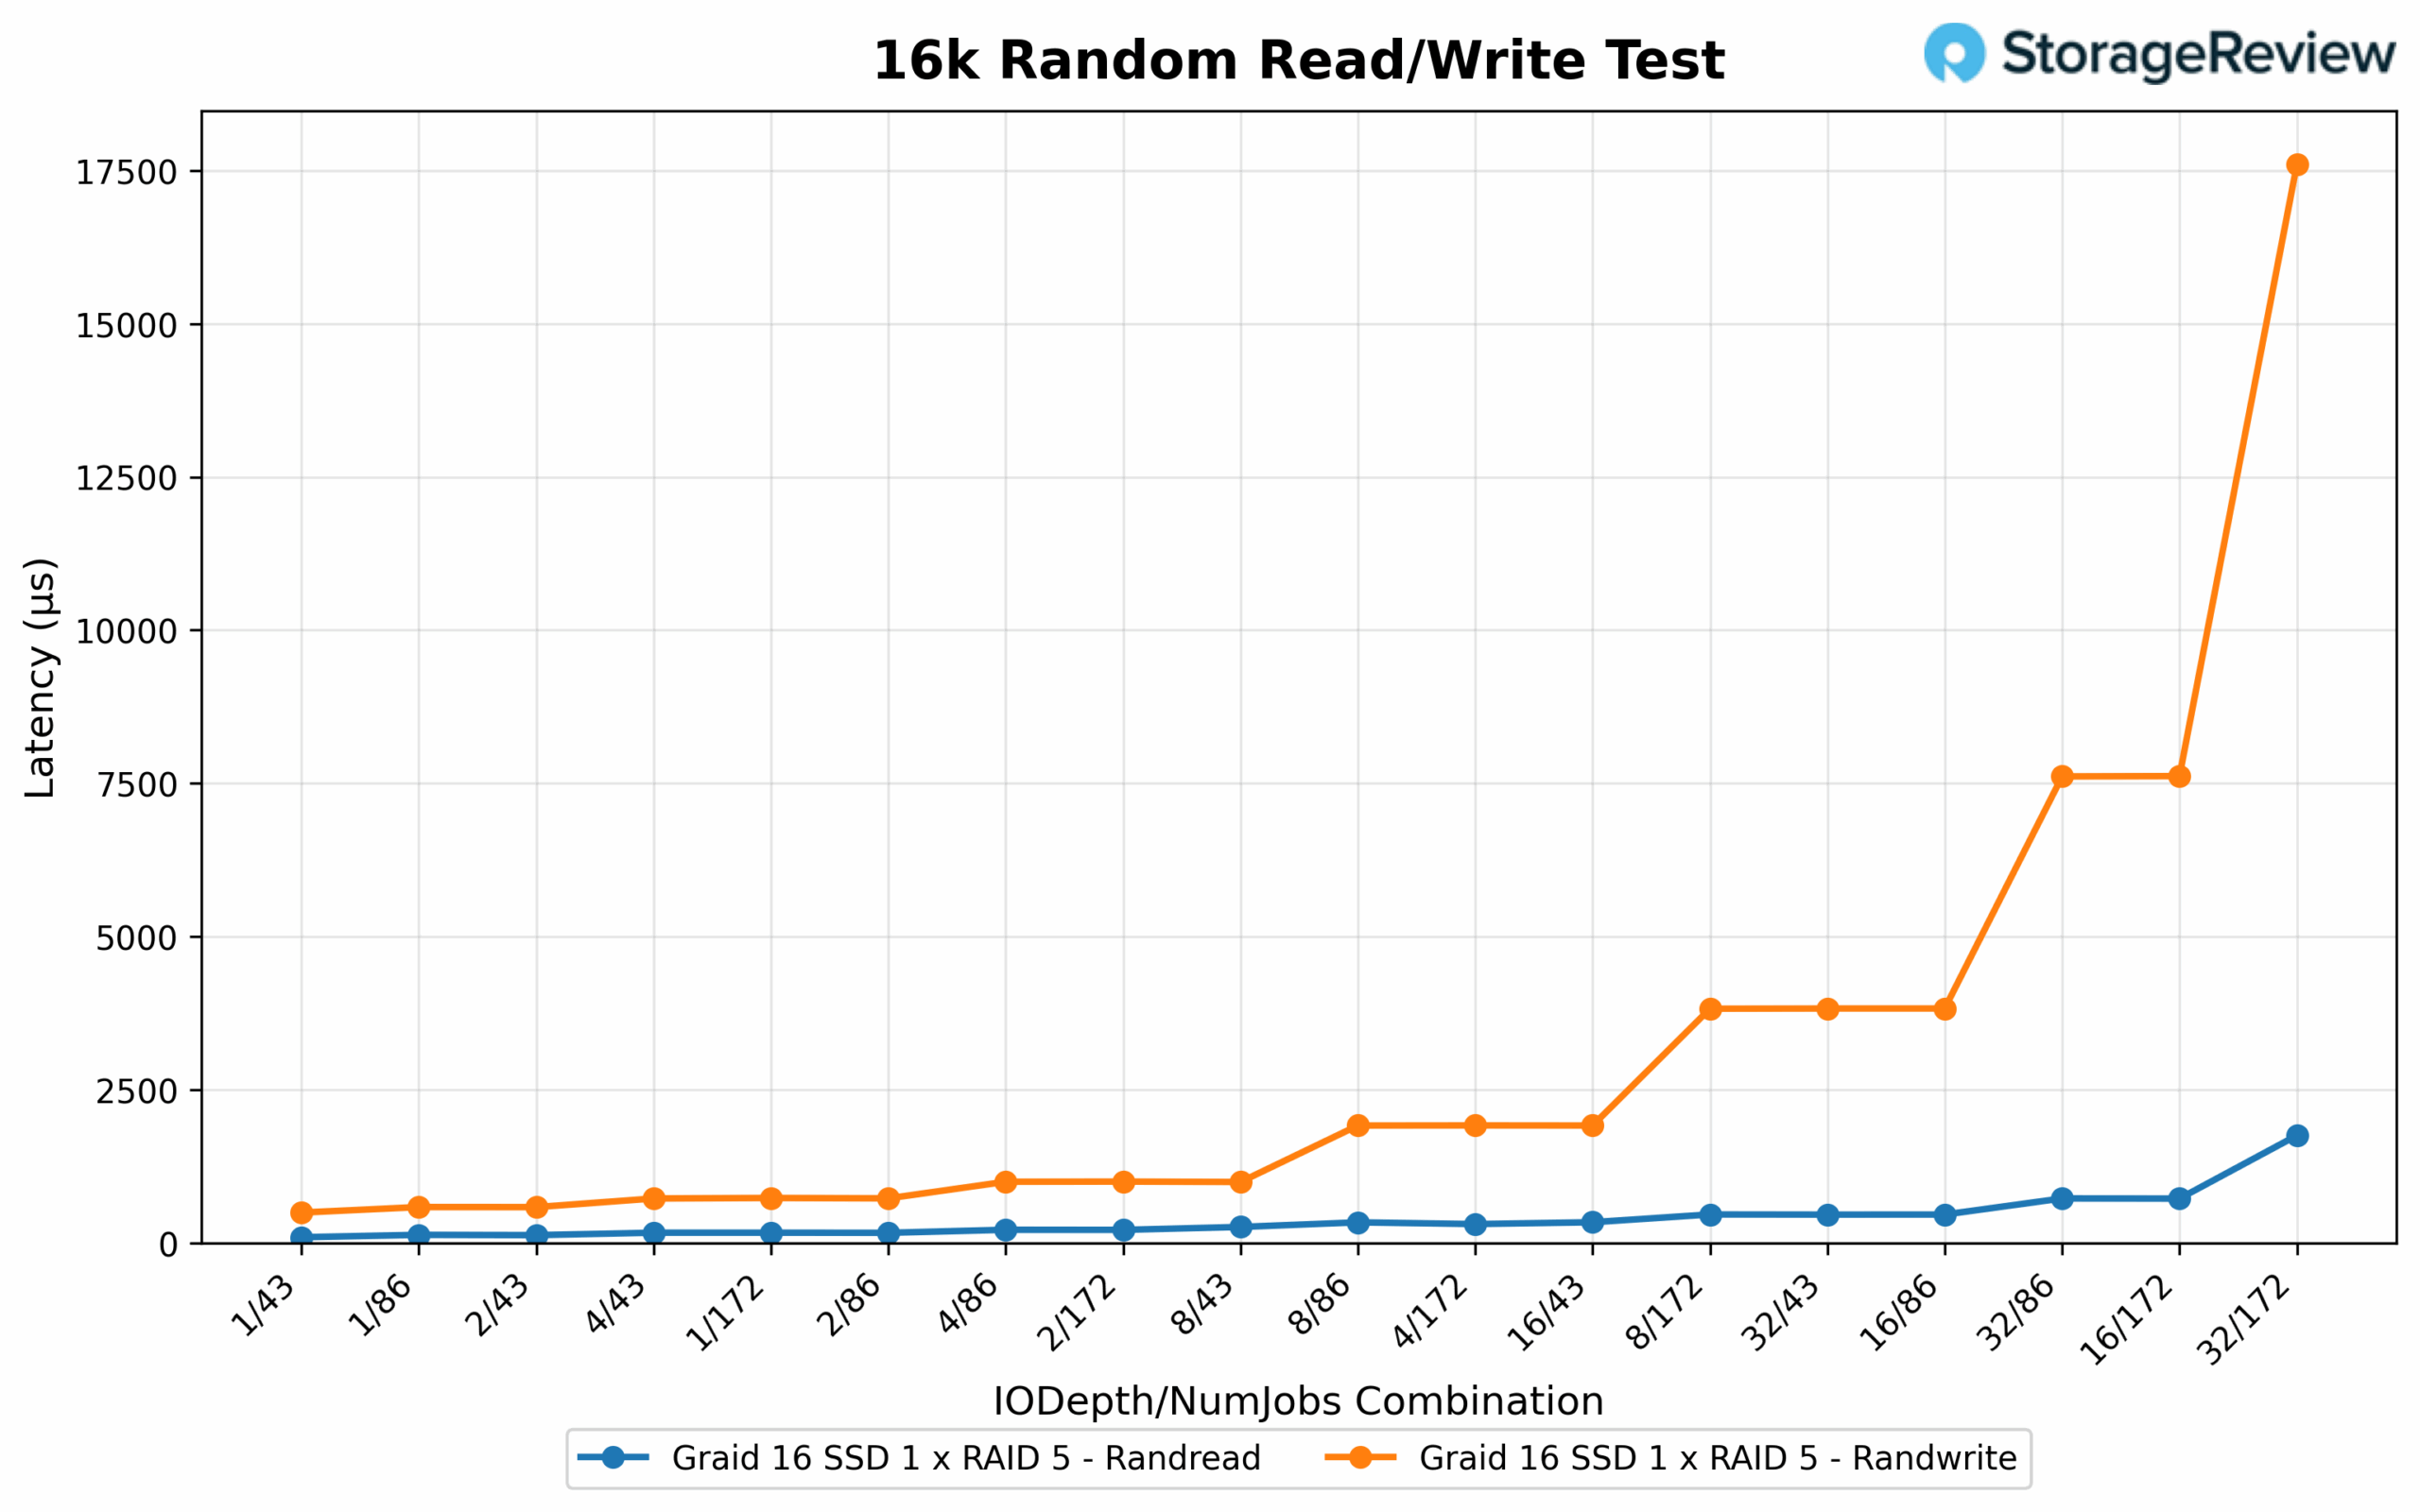
16K slumpmässig läs-/skrivlatens
Den slumpmässiga 16K-läslatensen förblev genomgående låg över hela linjen. Den mest responsiva konfigurationen var 1/43 vid 0.123 ms, tätt följt av 1/86 vid 0.175 ms. Även under maximal belastning höll konfigurationer som 32/172 och 16/172 latensen under 2.1 ms, vilket visar att arrayen bibehöll snabba svarstider samtidigt som den hanterade förhöjda IOPS. Däremot uppvisade den slumpmässiga 16K-skrivlatensen bredare varians. Den lägsta latensen var 0.496 ms vid 1/43, med ytterligare effektiva körningar som 2/86 och 4/43 som höll sig under 1 ms-gränsen. Allt eftersom samtidighet och djup ökade ökade latensen i enlighet därmed: 16/172 registrerade 7.017 ms och 32/172 nådde 17.246 ms, vilket förstärkte den förväntade avvägningen mellan maximal dataflöde och responsivitet vid maximal mättnad.
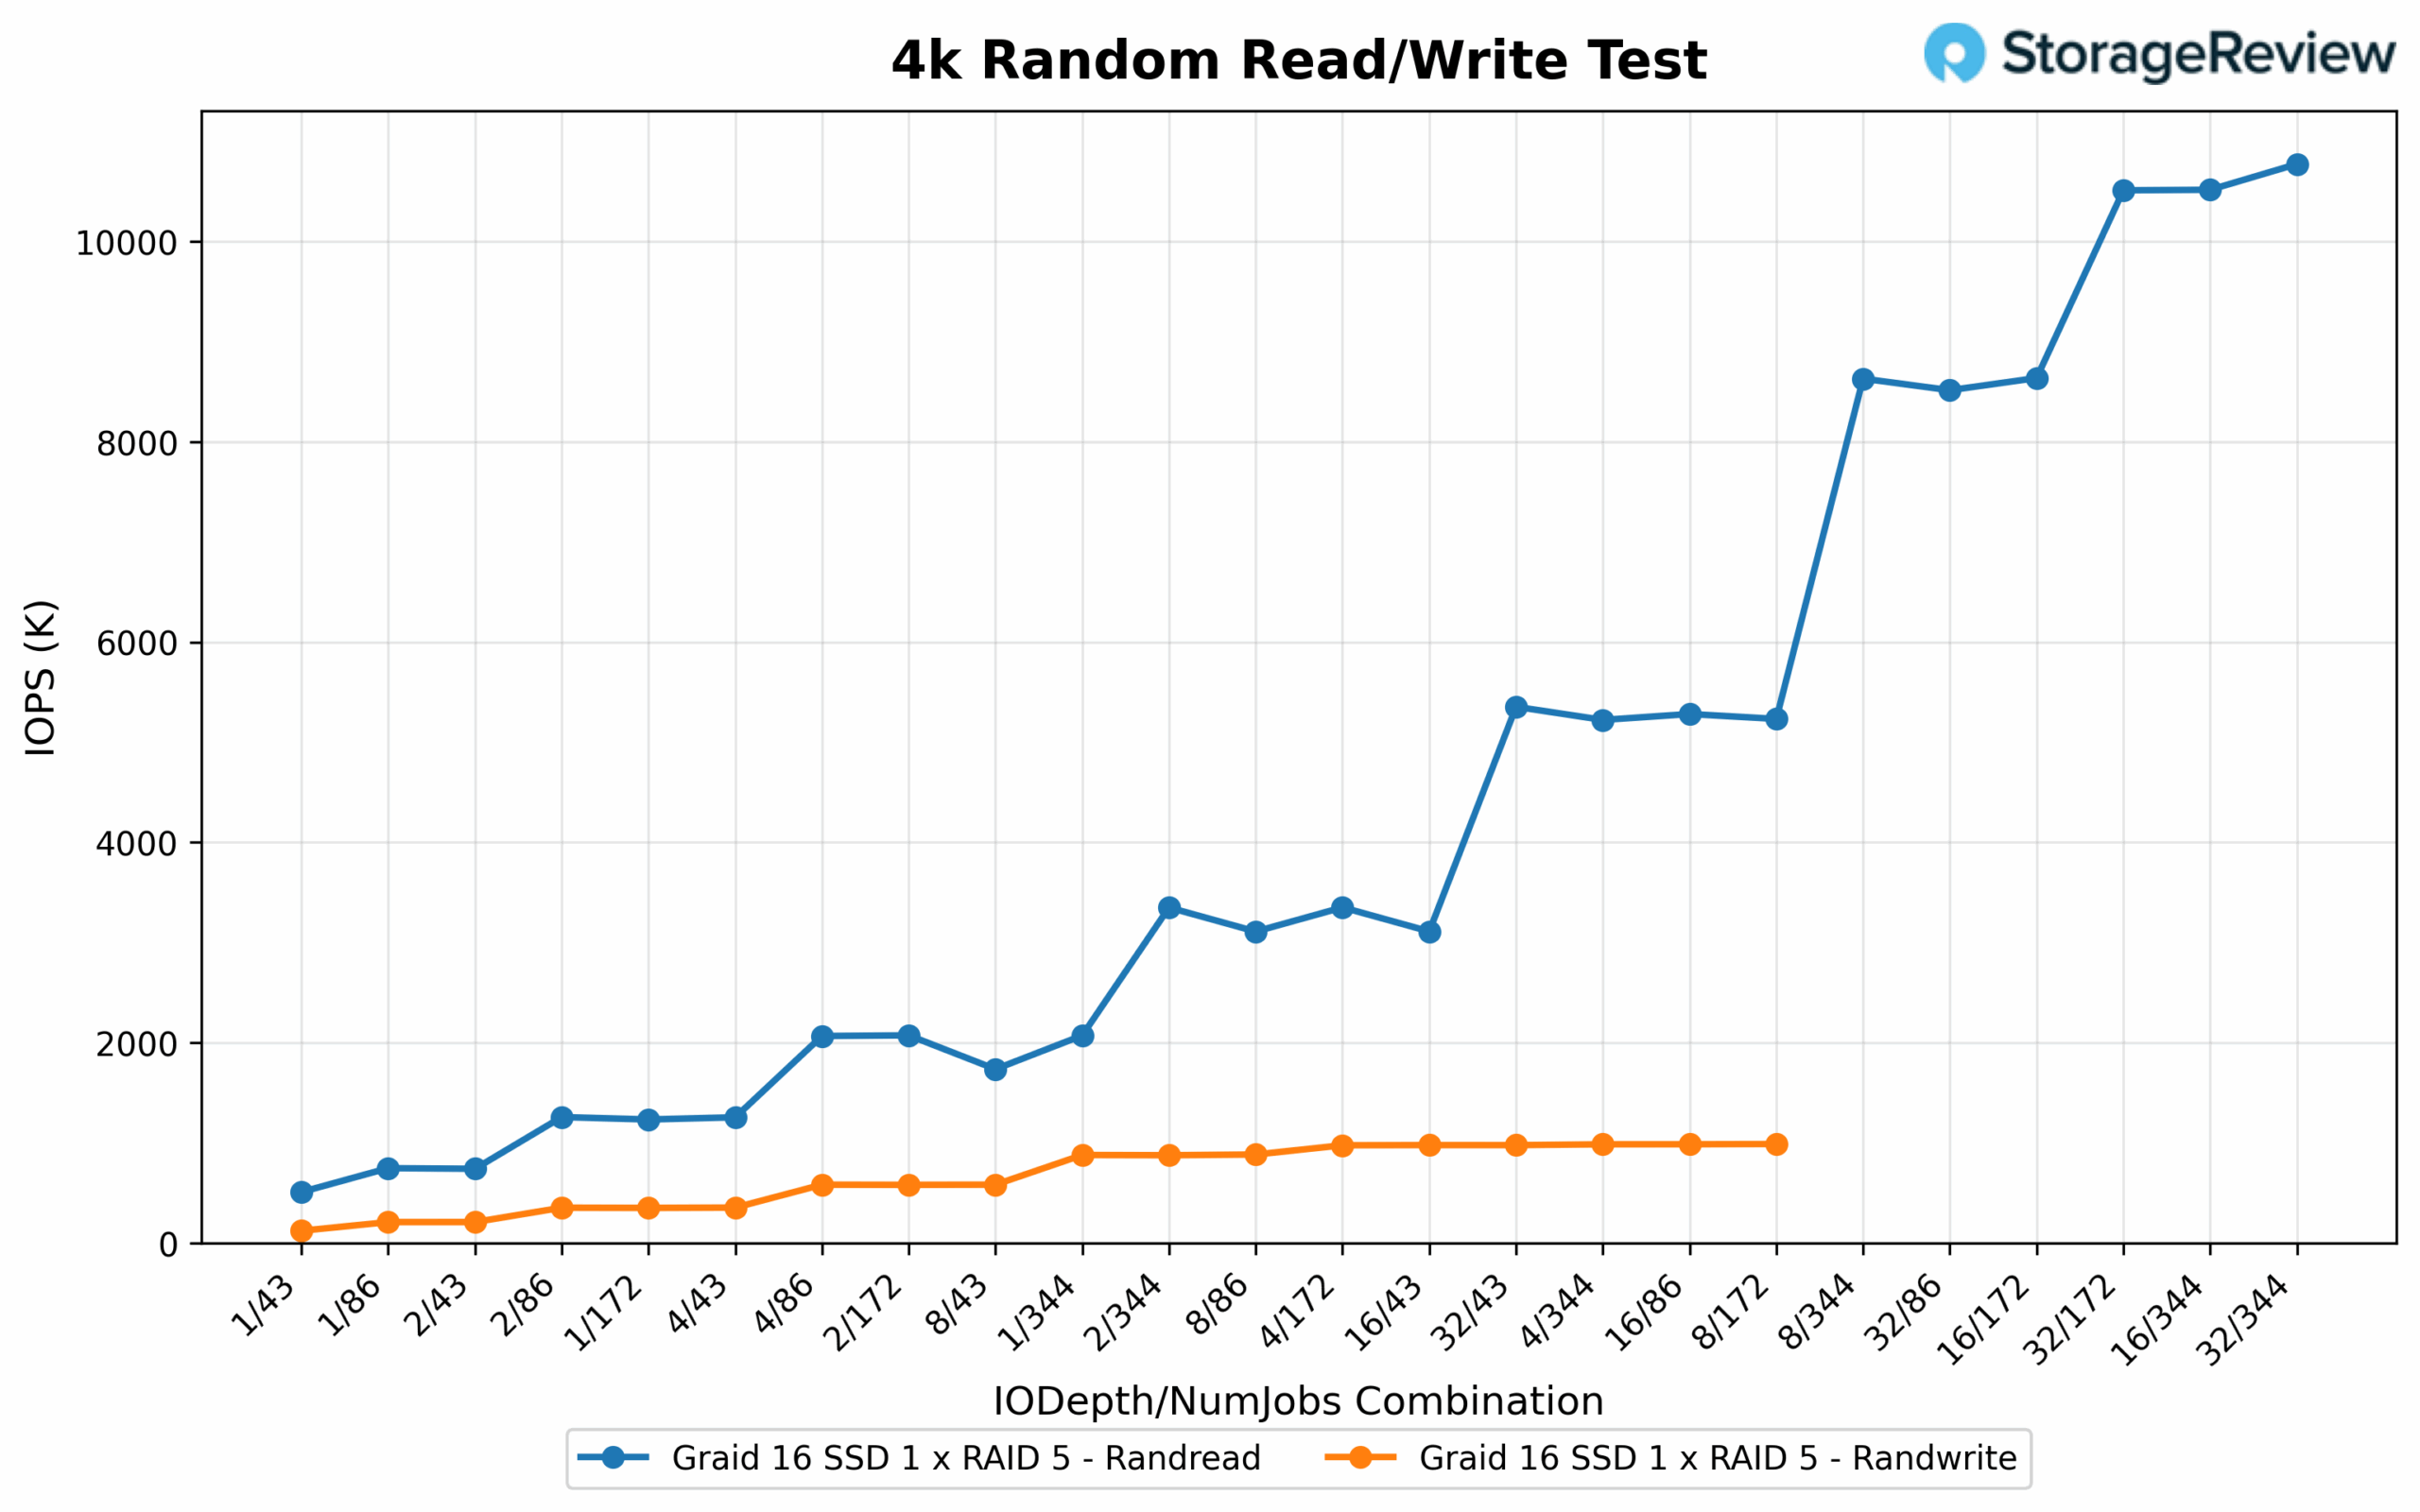
4K slumpmässiga läs-/skriv-IOPS
Under en högre samtidighetsbelastning nådde slumpmässiga 4K-läs-IOPS en imponerande topp på 10.77 miljoner med ett IO-djup på 32 med 344 jobb. Andra konfigurationer följde tätt, inklusive 16/344 vid 10.52M, 4/344 vid 10.51M och 8/344 vid 10.42M, alla med exceptionell skalning med aggressiva kombinationer av köer och jobbdjup. Även alternativ med reducerat djup, som 8/172 och 16/172, upprätthöll en stark dataflödeshastighet mellan 5.23M och 5.35M IOPS, vilket ytterligare belyser arrayens förmåga att hantera krävande parallella arbetsbelastningar. På skrivsidan nådde 4K IOPS en topp på 987.9K med 32/172. Liknande högeffektiva konfigurationer inkluderade 32/86 vid 985.1K, 16/172 vid 985.6K och 8/172 vid 976.9K. Ytterligare kombinationer från 8/86 till 16/86 bibehöll prestanda i intervallet 875K till 977K, vilket förstärkte arrayens konsekvens och tillförlitlighet när den var helt mättad med samtidiga skrivoperationer.
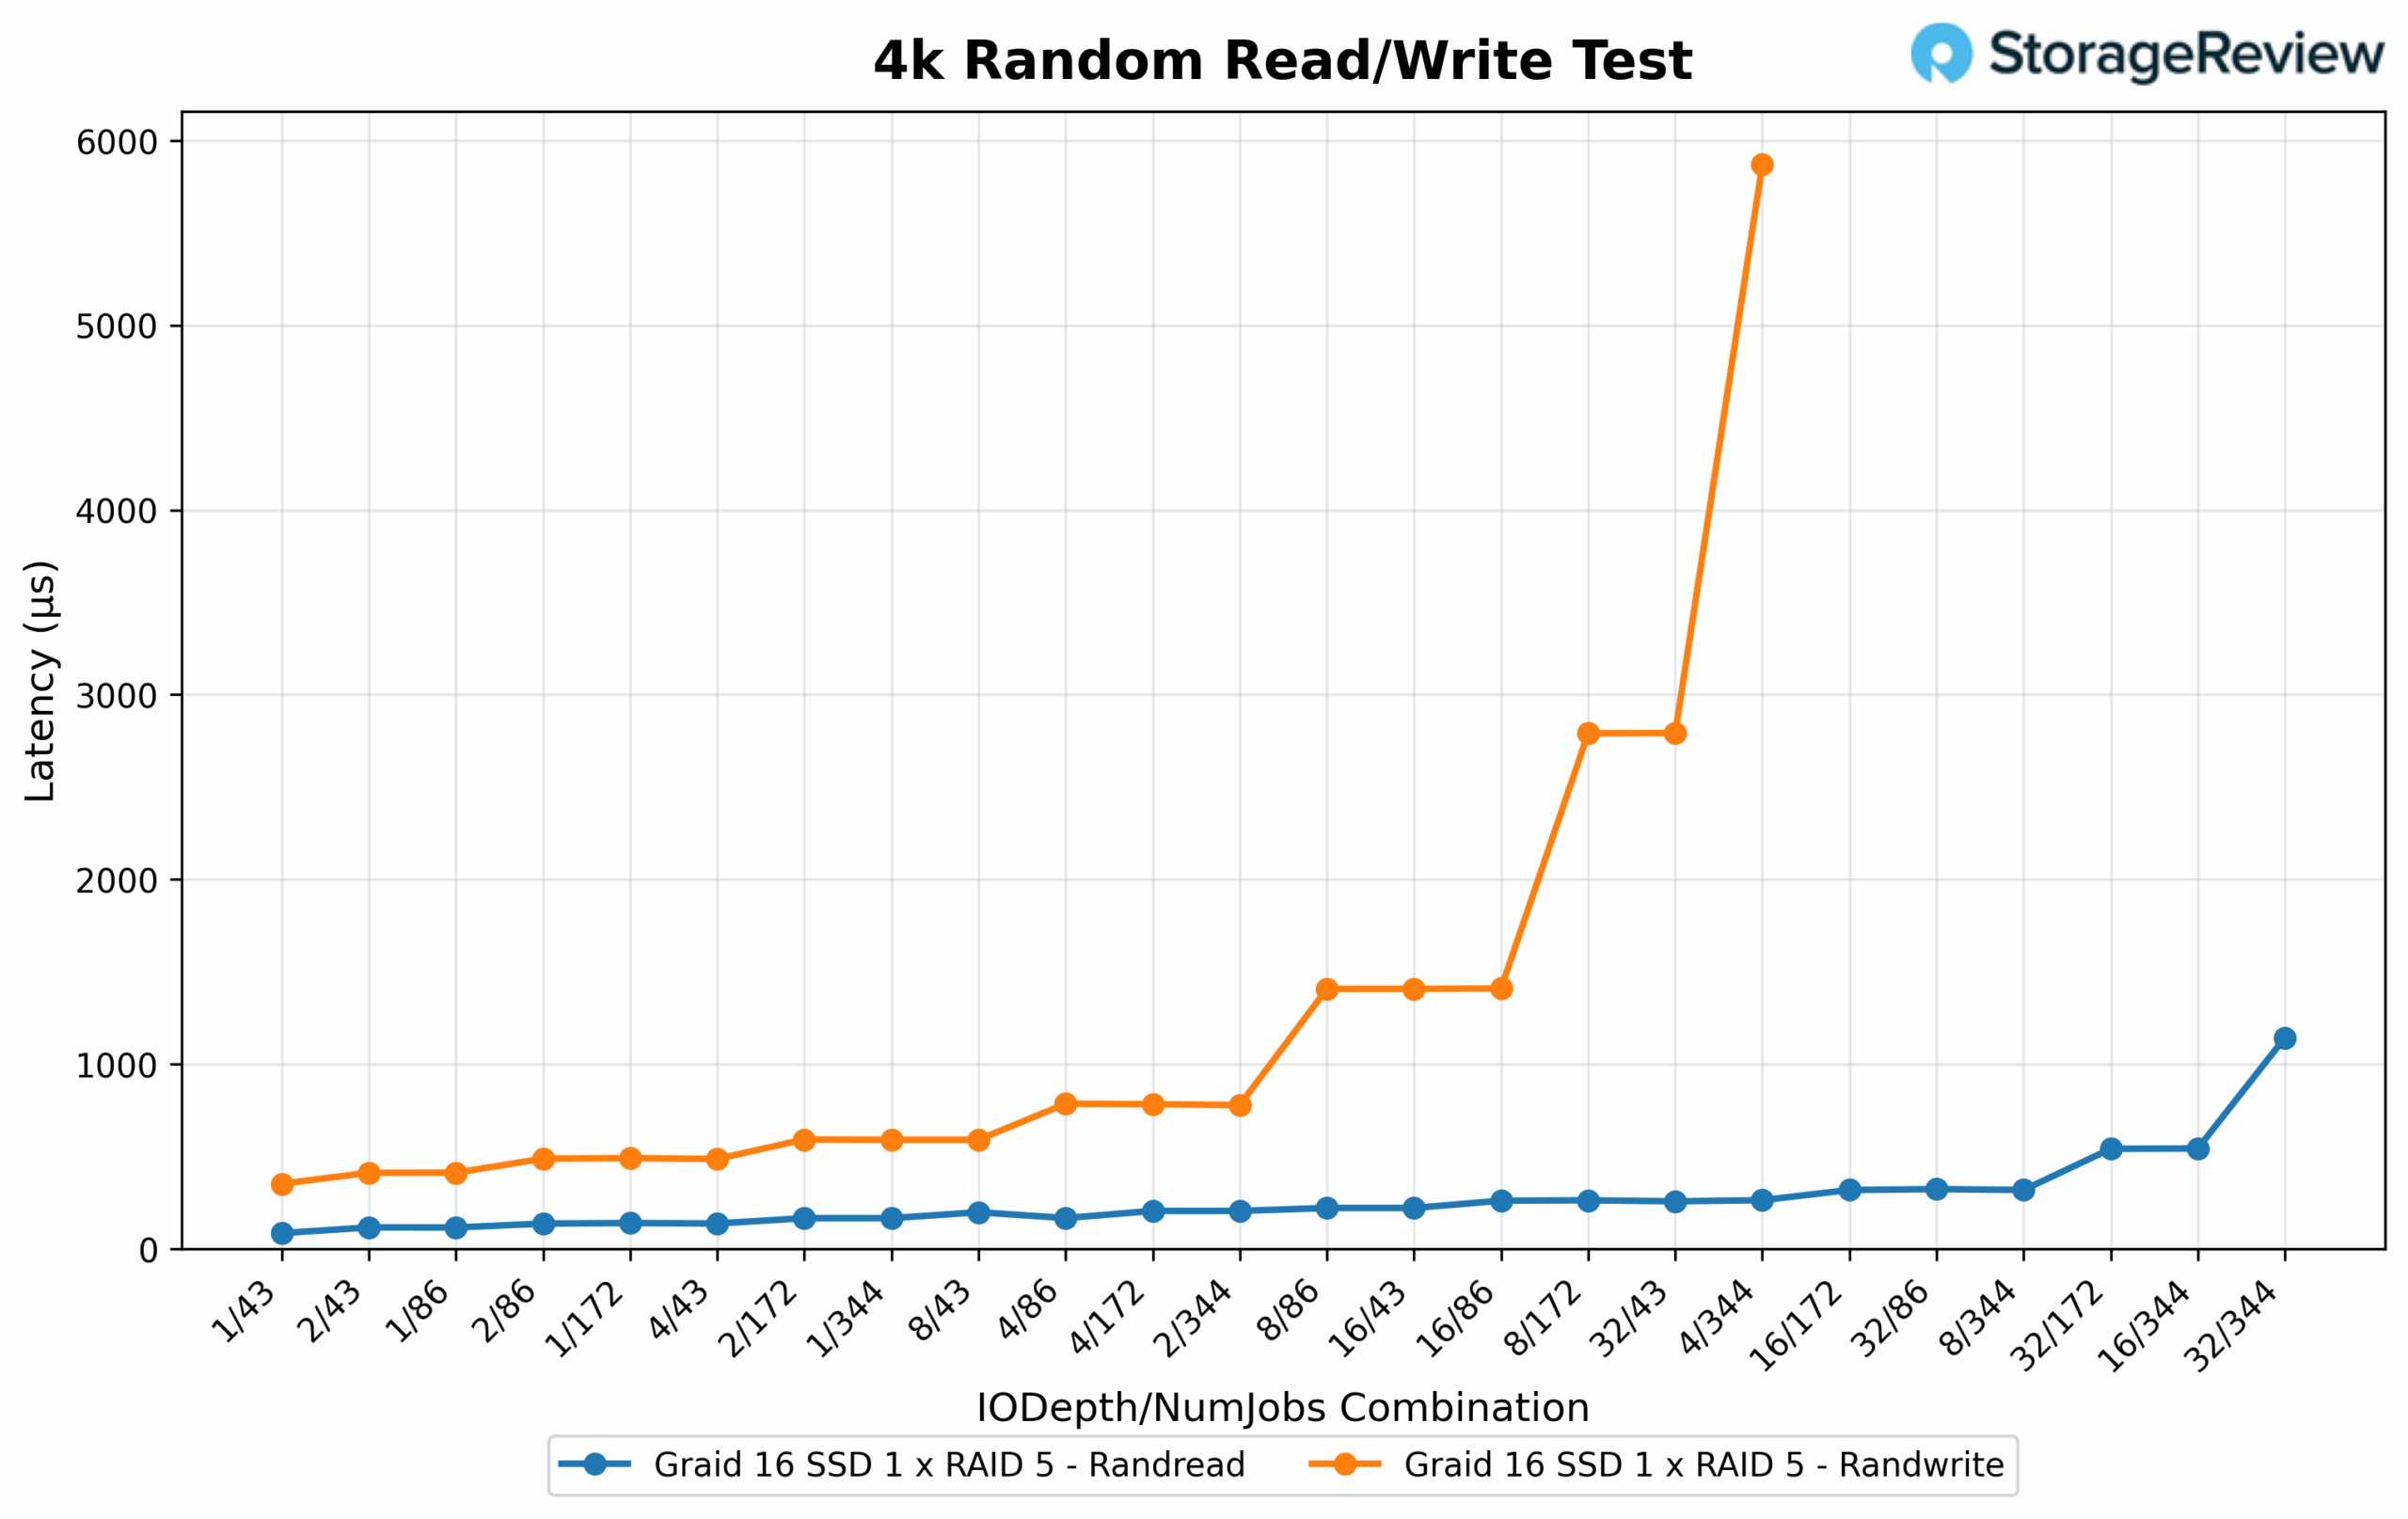
4K slumpmässig läs-/skrivlatens
Den slumpmässiga 4K-läslatensen förblev extremt låg överlag. Den snabbaste svarstiden var 0.084 ms vid 1/86, medan flera andra konfigurationer – inklusive 1/43, 2/43 och 4/43 – alla låg under 0.12 ms. Även vid maximal IOPS förblev latensen välkontrollerad, med den bäst presterande 32/344-konfigurationen som bara låg på 1.142 ms. Detta återspeglar utmärkt respons, även när arrayen pressade sin maximala dataflödespotential. På skrivsidan hanterades även den slumpmässiga 4K-latensen väl. Det lägsta registrerade värdet var 0.352 ms vid 1/43, medan andra mycket effektiva konfigurationer som 1/86, 2/43 och 4/43 alla låg under 0.6 ms. Högkapacitetskonfigurationer som 32/172 och 32/86 såg en måttlig ökning av latensen till mellan 2.79 ms och 5.87 ms, vilket låg inom ett acceptabelt intervall med tanke på de ihållande skrivmättnadsnivåerna.
Measuring Graid SupremeRAID AE GPU Overhead
När vi undersöker Graids SupremeRAID AE-lagringsprestanda är det viktigt att beakta hur SupremeRAID, som delar GPU-resurser, kan påverka arbetsbelastningar som också använder samma GPU:er. I tidigare implementeringar av SupremeRAID var GPU:n i systemet dedikerad till Graid. Med den här lösningen distribuerar du den på en plattform som redan innehåller GPU:er som Graid kan använda och dela resurser. För att mäta effekten av overhead byggde vi ett LLM-inferensscenario med hjälp av vLLM. Vi mätte arbetsbelastningens baslinjeprestanda med Graid i viloläge, och sedan igen med Graid som läste 172 GB över RAID 5-poolen. Detta simulerar inferensarbetsbelastningen och förallokerar nästa arbetsbelastning medan en körs. Med vLLM som pressar GPU:erna till 100 % utnyttjande kommer alla Graid-operationer att påverka tokenhastigheter och latens.
För AI-arbetsbelastningen körde vi inferens med vLLM med hjälp av Llama 3.3 70B-modellen med full precision (BF16) och en cachestorlek på 16K KV. Detta utnyttjade nästan helt VRAM på båda korten (78G på 80G-kortet och 86G på 94G-kortet). Vi körde sedan vLLM:s benchmarkingskript med en maximal utdatalängd på 256 tokens. Varje test körde 256 frågor med en maximal samtidighet på 32 förfrågningar, med kontinuerlig batchning för att simulera ett realistiskt förfrågningsmönster. De mätvärden vi samlade in är Tok/s, Time to First Token (TTFT), Time per Output Token (TPOT) och Inter Token Latency (ITL). FIO-arbetsbelastningen vi initierade under inferenstestet bestod av 172 16K slumpmässiga läsjobb, där vart och ett läste 1GB.
Genomströmningen minskade blygsamt överlag. Genomströmningen för förfrågningar minskade från 1.86 till 1.78 förfrågningar per sekund, en minskning med 4.3 %. Genomströmningen för utgående tokens minskade från 225.44 till 215.94 tokens per sekund, vilket motsvarar en minskning med 4.2 %. Den totala tokengenomströmningen minskade från 2029.77 till 1944.30 tokens per sekund, vilket motsvarar en liknande minskning med 4.2 %. Detta tyder på att överföringen medförde viss omkostnad som påverkade prestandan något.
Latensstatistiken visade blandade resultat. Den genomsnittliga TTFT ökade med 3.6 %, från 6,704 6,945 ms till 1.5 99 ms, medan median-TTFT steg med 2.8 %. Intressant nog förbättrades P14,199 TTFT och minskade med 13,803 % från 5.3 0.65 ms till 99 24.6 ms, vilket indikerar bättre prestanda i slutskedet inom den mätningen. För TPOT ökade medelvärdet med 127.69 %, medan medianen förblev relativt oförändrad med en ökning på 159.15 %. P5.1 TPOT ökade dock kraftigt med 99 %, från 2.2 ms till XNUMX ms, vilket visar att den värsta tänkbara tiden för tokengenerering påverkades avsevärt. Inter-token latency (ITL) uppvisade liknande trender, där medelvärdet ökade med XNUMX %, medianen förblev i stort sett oförändrad och PXNUMX ökade med XNUMX %.
Graids SupremeRAID AE, som kördes parallellt med vår vLLM-arbetsbelastning, introducerade en liten men konsekvent minskning av dataflödet (cirka 4 %), tillsammans med måttliga ökningar av genomsnittlig latens och märkbar försämring av P99-prestanda för tokengenerering. Med dessa effekter förblev systemet helt stabilt och responsivt, vilket visar att hög samtidighetsinferens med stora modeller, som Llama 3.3 70B, fortfarande kan fungera tillförlitligt tillsammans med Graid SupremeRAID AE.
| Metrisk (kortare duration / Högre tok/s är bättre) | Baslinje | Med 172 GB FIO-läsfunktion |
| Framgångsrika förfrågningar | 256 | 256 |
| Riktmärkesvaraktighet (s) | 137.68 | 143.73 |
| Totalt antal inmatningstokens | 248,414 | 248,414 |
| Totalt antal genererade tokens | 31,037 | 31,037 |
| Begärandataflöde (req/s) | 1.86 | 1.78 |
| Utdata för token (tok/s) | 225.44 | 215.94 |
| Total tokengenomströmning (tok/s) | 2029.77 | 1944.30 |
| Tid till första token (TTFT) (lägre latens är bättre) | ||
| Genomsnittlig TTFT (ms) | 6,704.43 | 6,945.72 |
| Median TTFT (ms) | 6,469.88 | 6,569.80 |
| P99 TTFT (ms) | 14,199.21 | 13,803.62 |
| Tid per utdatatoken (TPOT, exkl. 1:a token) (lägre latens är bättre) | ||
| Genomsnittlig TPOT (ms) | 81.44 | 85.72 |
| Median TPOT (ms) | 80.38 | 80.90 |
| P99 TPOT (ms) | 127.69 | 159.15 |
| Inter-token Latency (ITL) (lägre latens är bättre) | ||
| Genomsnittlig ITL (ms) | 79.94 | 83.99 |
| Median ITL (ms) | 49.75 | 49.78 |
| P99 ITL (ms) | 539.07 | 550.73 |
Utgående Tankar
Graid SupremeRAID AE levererar en praktisk och effektiv lösning för organisationer som bygger eller skalar upp AI-infrastruktur. Genom att ersätta traditionell hårdvaru-RAID med en GPU-driven, programvarudefinierad metod förenklar SupremeRAID AE driftsättningen samtidigt som vanliga flaskhalsar som stoppar moderna AI-arbetsflöden tas bort.
Våra tester visade dess förmåga att förena upp till 32 NVMe SSD-diskar till ett enda, robust namnutrymme, vilket ger nästan 1 PB kapacitet i en server med exceptionell prestanda. Toppresultat på 183 GB/s läshastighet och 54 GB/s skrivhastighet, i kombination med minimal GPU-overhead under live-inferens, validerar dess förmåga att möta de dubbla kraven på massiv modellkontrollpunktning och inferens med låg latens i stor skala.
Genom att eliminera kostnaden och komplexiteten hos dedikerad RAID-hårdvara samtidigt som den integreras sömlöst med tekniker som NVIDIA GPUDirect Storage och AI-fokuserade filsystem, skapar SupremeRAID AE en framtidsklar lagringsgrund. För organisationer som fokuserar på att effektivisera inferens och minska driftsrisker, ger SupremeRAID AE den prestanda, enkelhet och motståndskraft som krävs för AI-produktionsmiljöer.


 Amazon