

宏碁 Veriton GN100 AI 迷你工作站是我們正在評估的幾款基於 Spark 的系統之一,它們都採用 NVIDIA 的 GB10 Grace Blackwell 超級晶片。與其他系統一樣,GN100 的設計目標是將資料中心級的 AI 運算能力融入緊湊的桌面設備中,使開發人員和研究人員能夠在本地運行和優化模型,而無需完全依賴雲端基礎設施。
在此配置中,GN100 搭載了 20 核心 Arm 架構的 GB10 處理器和整合式 Blackwell 顯示卡,可提供高達 1 petaFLOP 的 FP4 AI 效能。它配備 128GB LPDDR5x 統一記憶體和 4TB PCIe Gen5 NVMe SSD,能夠提供大型語言模型、生成式 AI 工作流程和資料密集型實驗所需的記憶體頻寬和儲存吞吐量。
與該系列的其他 Spark 系統一樣,GN100 支援本地 AI 執行,同時可透過整合的 NVIDIA ConnectX-7 智慧網路卡實現系統間擴充。兩台設備可以連接起來,以支援超出單一設備規模的大型模型工作負載。
該系統預先安裝了 NVIDIA DGX 作業系統和完整的 AI 軟體堆疊,可立即部署到開發和研究環境中。
宏碁 Veriton GN100 AI 規格
| 規格 | 宏碁 Veriton GN100 AI (GB10) |
|---|---|
| 尺寸和重量 | |
| 高度 | 2在 |
| 信號寬度 | 5.9在 |
| 深度 | 5.9在 |
| 重量 | 2.65磅 |
| 處理器 | |
| 處理器類型 | NVIDIA GB10(Grace Blackwell Superchip)(20 核心) |
| 集成顯卡 | NVIDIA Blackwell GPU(整合式顯示卡) |
| 記憶體應用 | |
| 內存類型 | LPDDR5x(統一系統記憶體) |
| 內存配置 | 128 GB LPDDR5x 統一系統內存 |
| 內存帶寬 | 273 GB/s (8533 MT/s) |
| 操作系統 | |
| 支持的操作系統 | NVIDIA DGX 作業系統 |
| 外部連接埠和插槽 | |
| 網絡端口 | 一個 RJ45 (10GbE) NVIDIA ConnectX-7 網路卡(200G × 2 QSFP) |
| USB端口 | 三個 USB 3.2 Gen 2×2 Type-C (20Gbps) 一個支援PD的USB 3.2 Gen 2×2 Type-C接口 |
| 視訊連接埠 | 一個 HDMI 2.1a 接口 |
| 電源適配器端口 | USB Type-C(PD 輸入) |
| 安全槽 | 肯辛頓鎖一號 |
| 無線應用 | |
| WiFi | WiFi 7(AW-EM637,2×2) |
| 藍牙 | 藍牙5.4 |
| 儲存 | |
| 儲存選項 | 最高支援 4 TB NVMe SSD(PCIe Gen5) |
| 電源適配器 | |
| 類型 | 240W 外置轉接器(USB Type-C) |
宏碁 Veriton GN100 AI 建造與設計
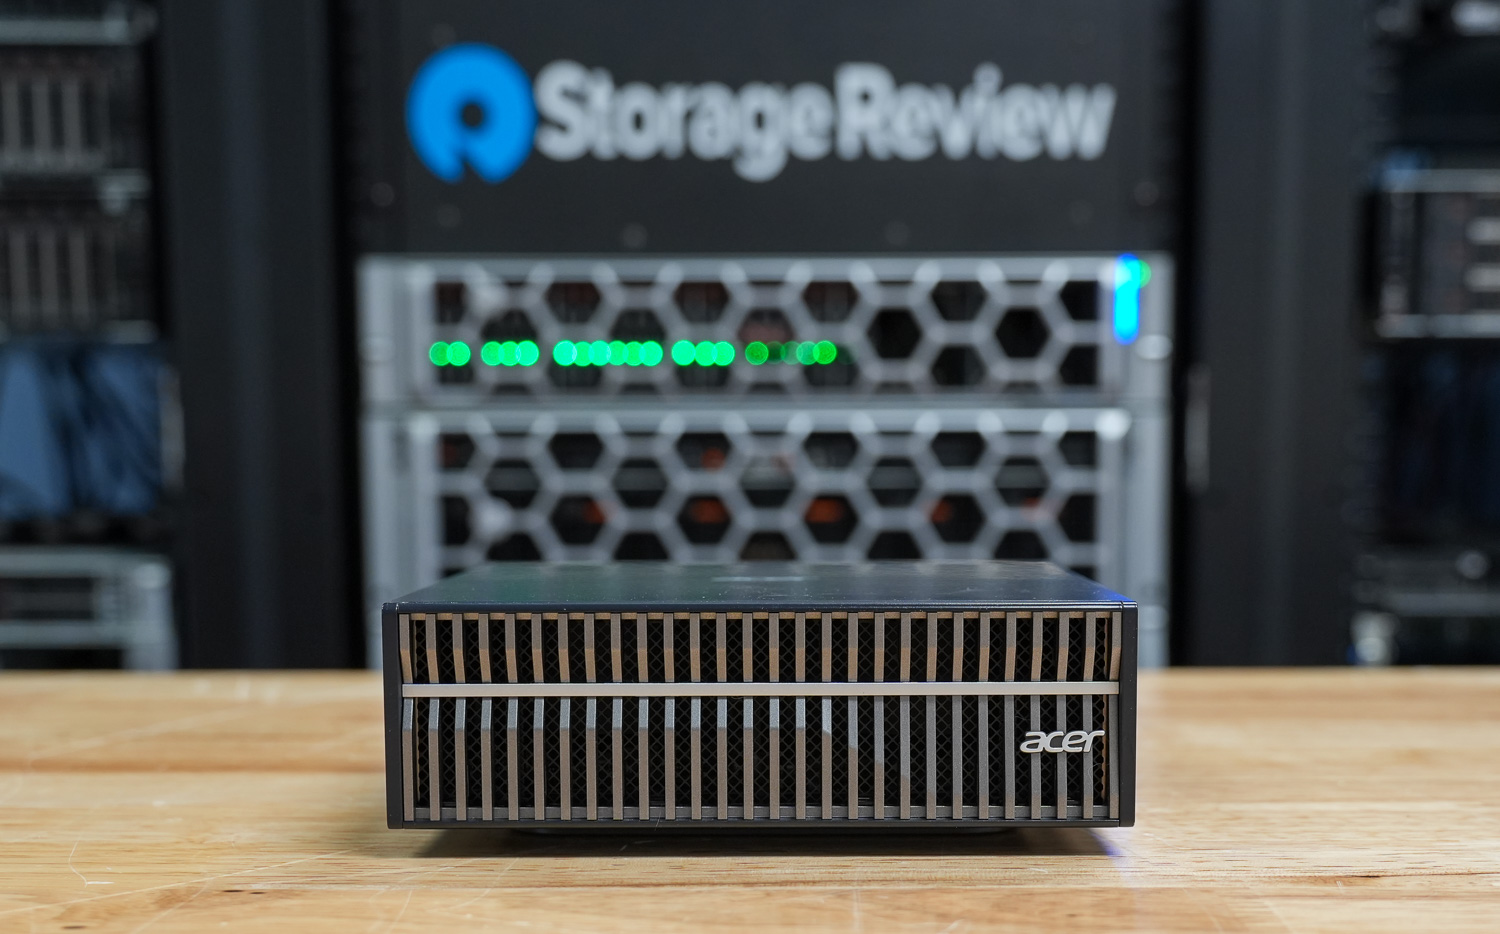
Veriton GN100 的正面最引人注目的是一排橫跨整個機身寬度的垂直格柵。一條水平裝飾線貫穿格柵,使其外觀與我們先前評測過的其他基於 Spark 的系統相比獨具特色。
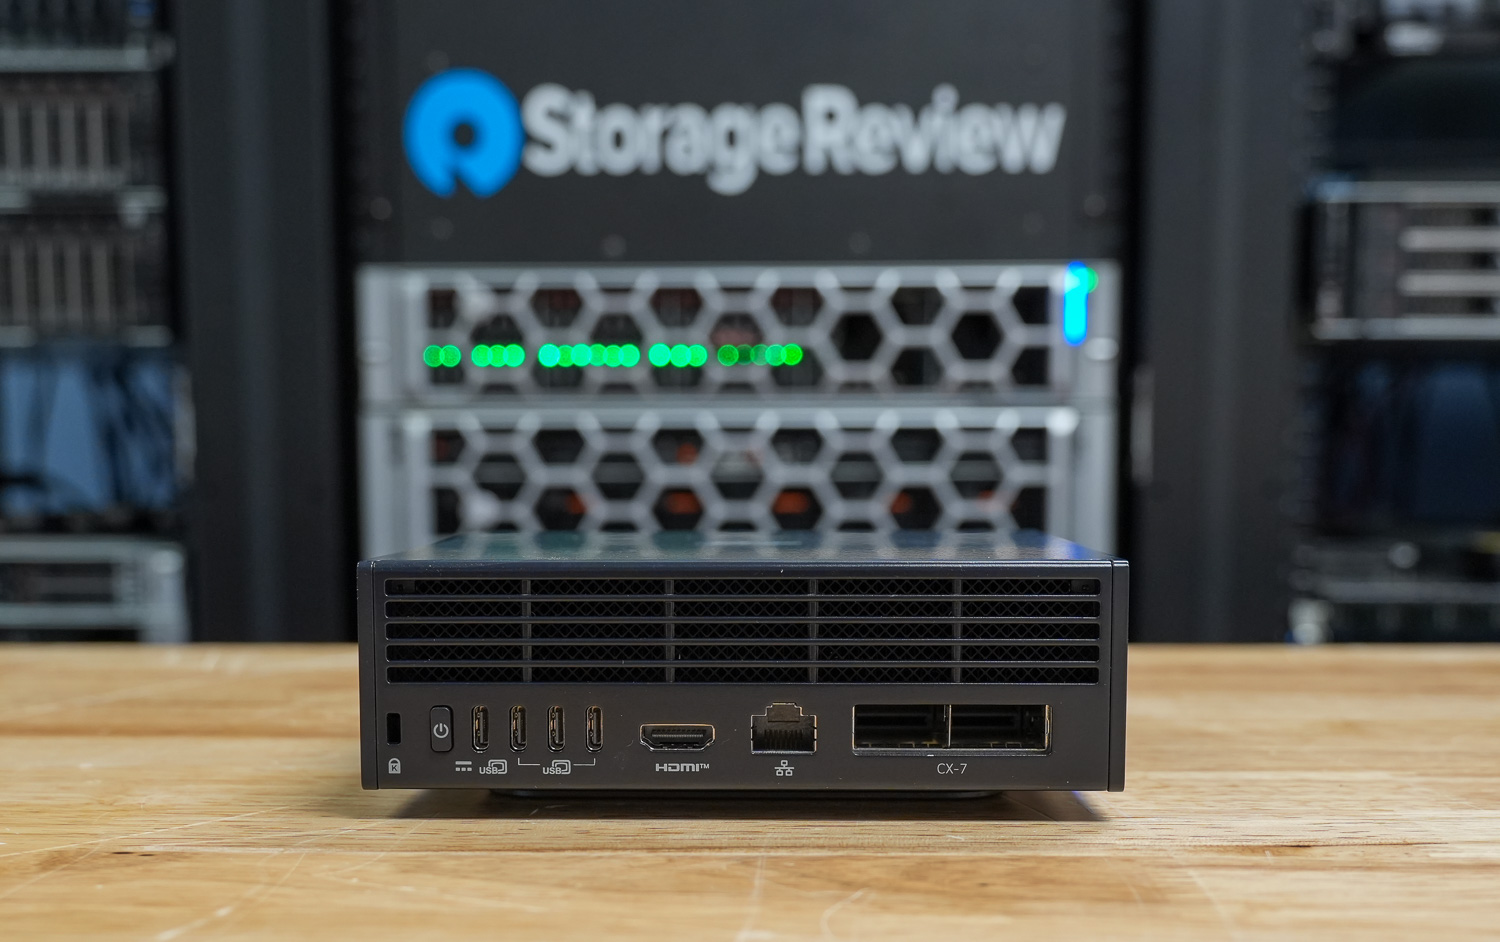
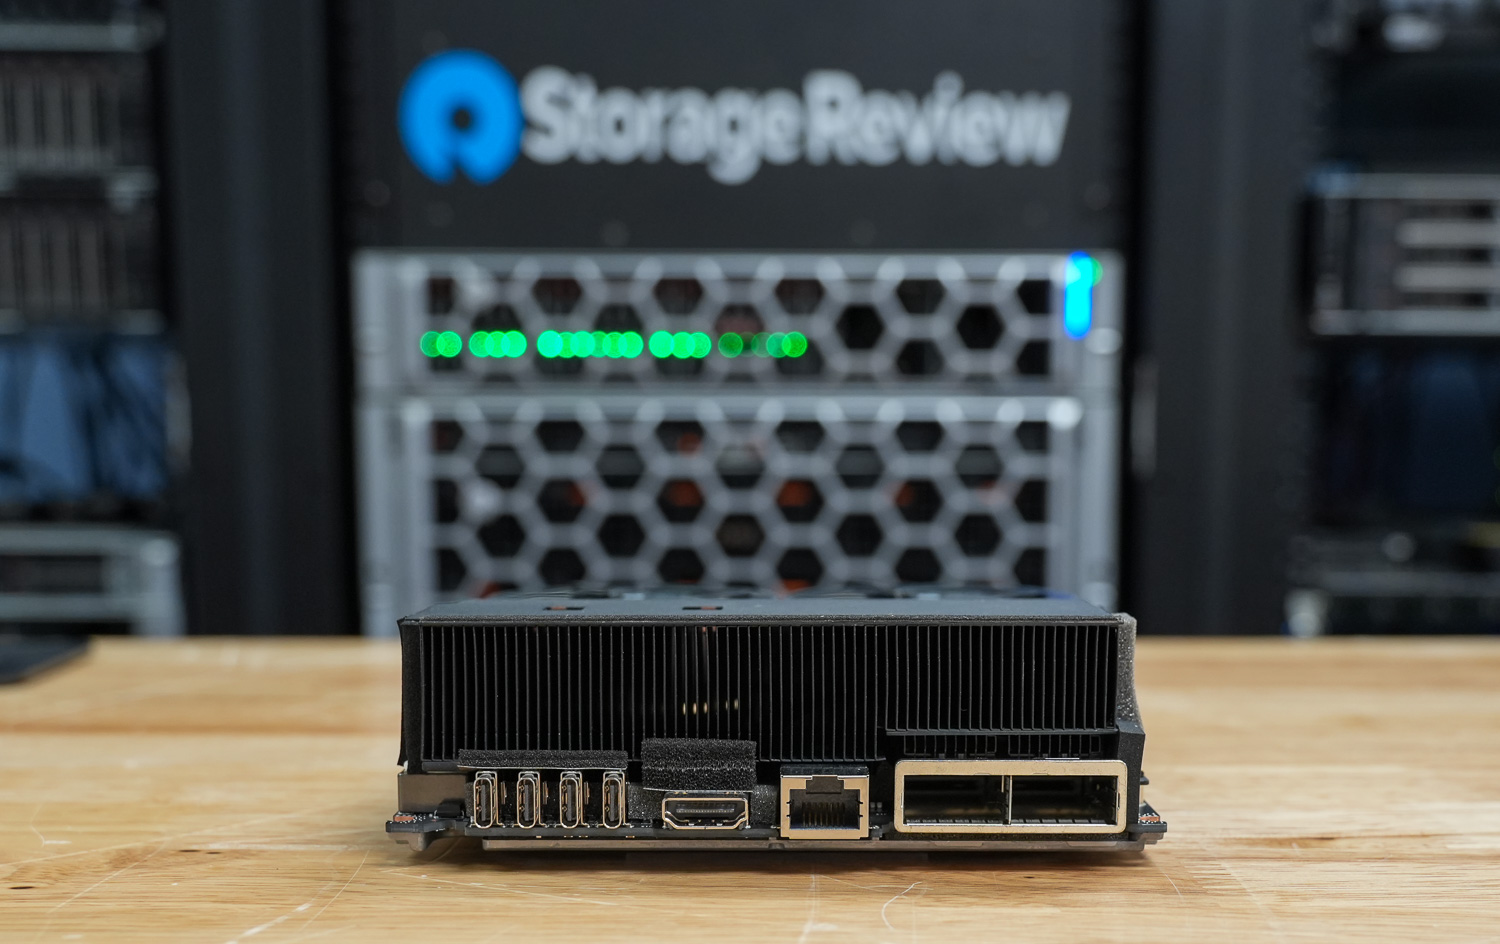
所有主要I/O介面均位於系統後方。宏碁配備了四個USB 3.2 Type-C接口,其中一個支援供電,以及一個用於顯示輸出的HDMI 2.1b接口。網路方面,配備了一個RJ-45乙太網路介面和一個NVIDIA ConnectX-7智慧網路卡,可實現高頻寬連接和系統互聯。無線連線方面,支援Wi-Fi 7和藍牙5.1或更高版本。此外,還配備了Kensington鎖槽,用於物理安全防護。
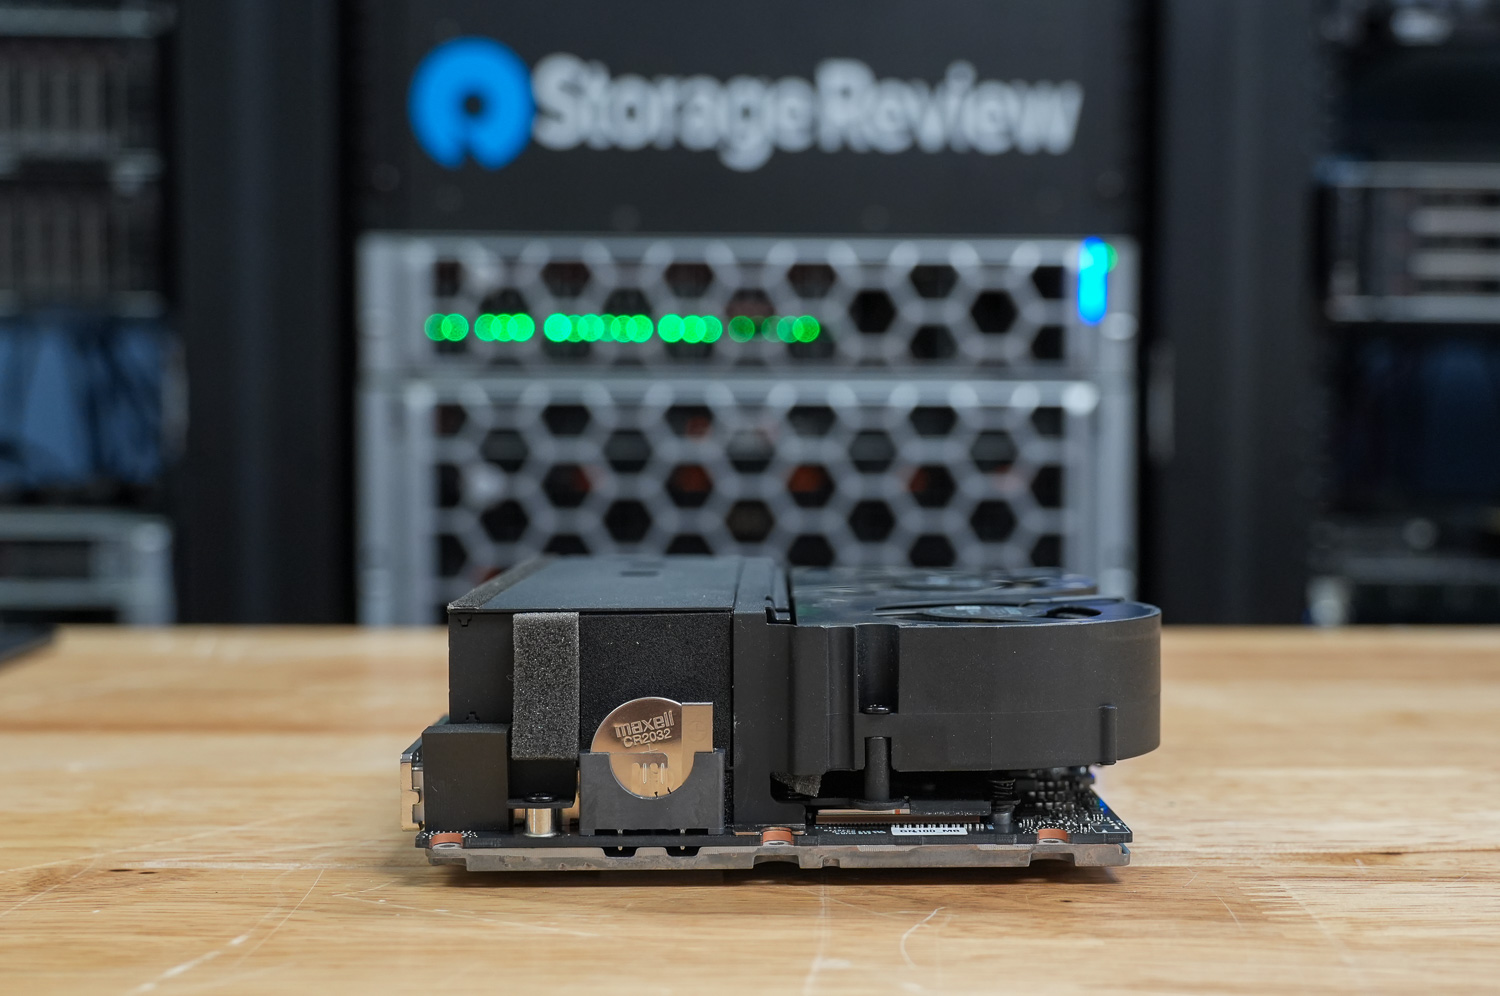
這裡可以看到覆蓋整個機殼的金屬屏蔽罩和結構板,它既起到加固框架的作用,也起到散熱片的作用。左下角是一個方便使用的 M.2 2242 NVMe SSD 插槽,用一顆螺絲固定,部分隱藏在金屬板下方。
若要打開宏碁主機底部,請旋下周圍的螺絲,即可輕鬆取下底板。打開後,內部佈局簡潔明了,散熱組件、儲存區域和主機板組件一目了然。底板本身厚實堅固,有助於提昇機殼的整體剛性。
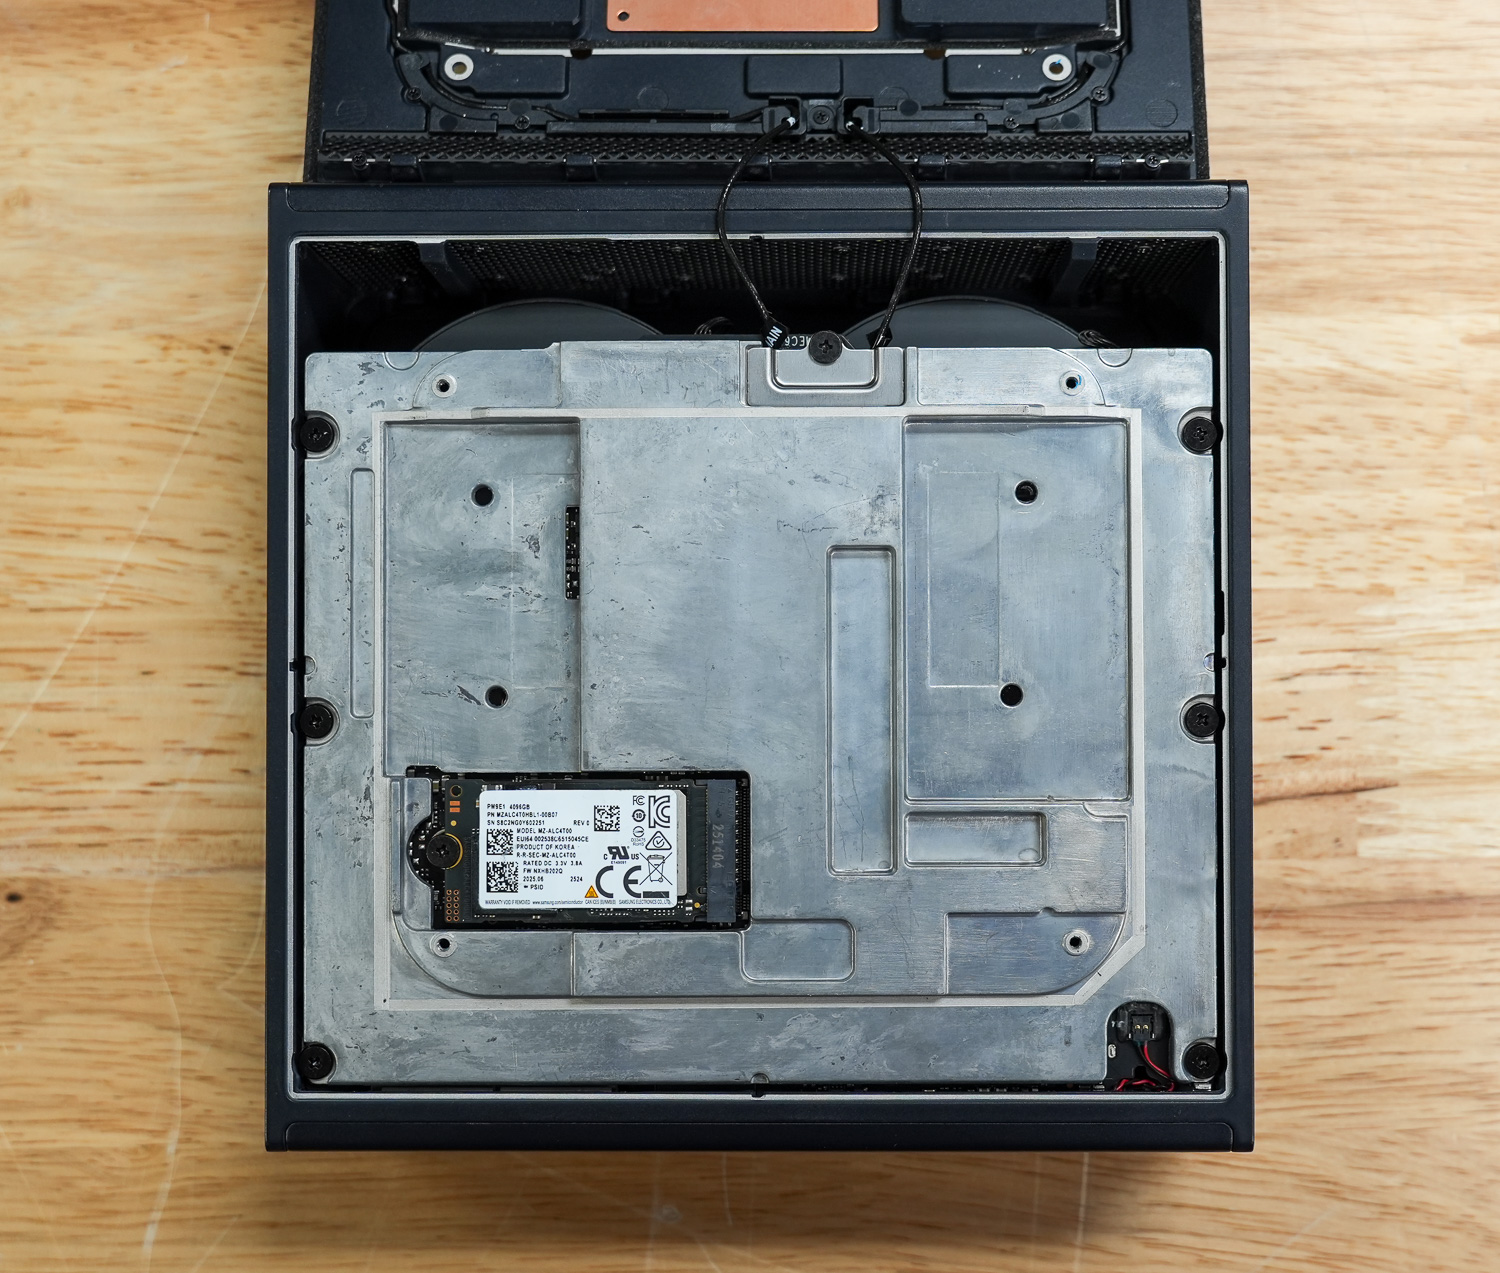
與我們評測過的其他 Spark 系統相比,宏碁這次採用了略有不同的設計。它沒有採用 Founders Edition 和一些 OEM 版本上常見的精緻噴漆金屬底板,而是使用了未經處理的鑄造金屬底板。雖然表面處理略顯粗糙,鑄造紋理清晰可見,但底板依然厚實且結構穩固。從功能上看,它仍然起到加固框架和輔助散熱片的作用,但這種製造工藝的選擇顯然體現了不同的設計和成本理念。
宏碁 Veriton GN100 AI 散熱測試
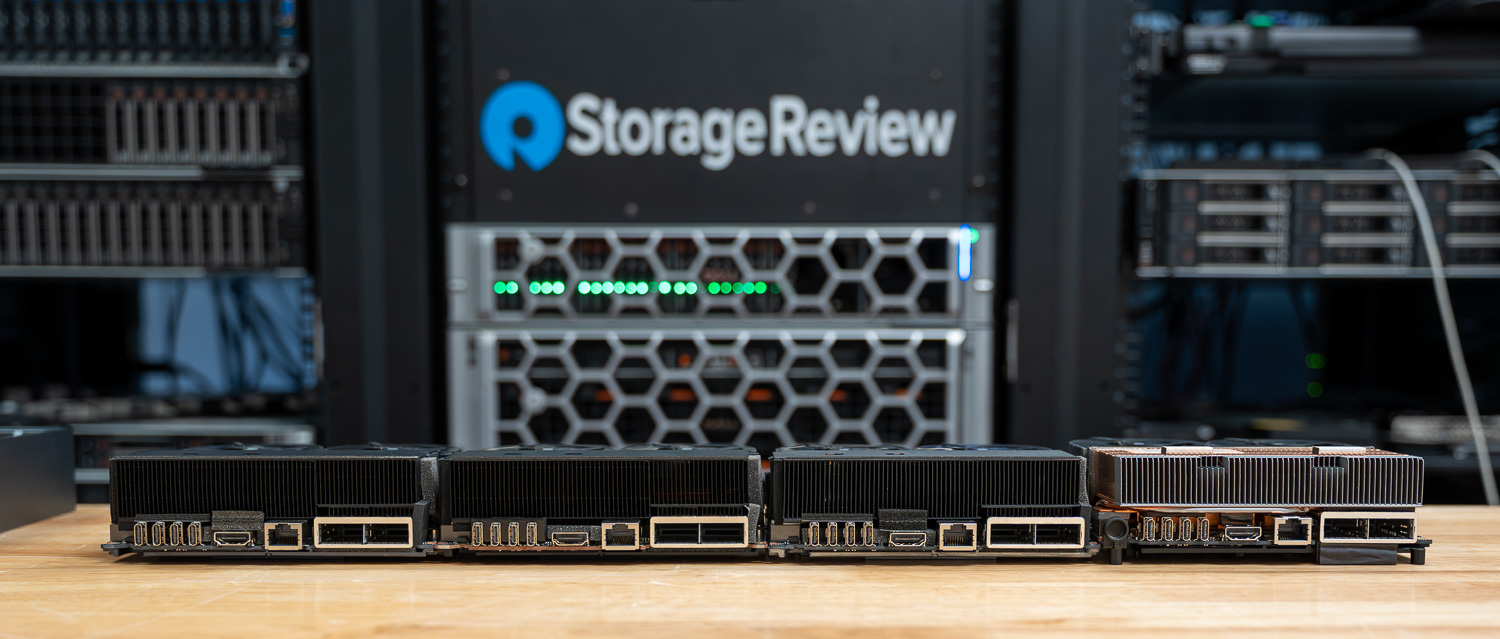
為了測試宏碁 Veriton GN100 AI 的散熱性能,我們將其與 Founders Edition 版本以及戴爾、華碩和技嘉等 OEM 廠商的產品進行了比較。我們在Spark 散熱測驗論文中對此進行了更深入的探討。
我們對整個技術堆疊進行了監控,在給定的時間段內,工作負載分為三個階段,利用率在大約一小時內逐步提升。這使我們能夠觀察設備在長時間使用和不同工作負載階段的效能。我們監控了 CPU、GPU、網路、NVMe 的溫度以及總功耗。
CPU溫度
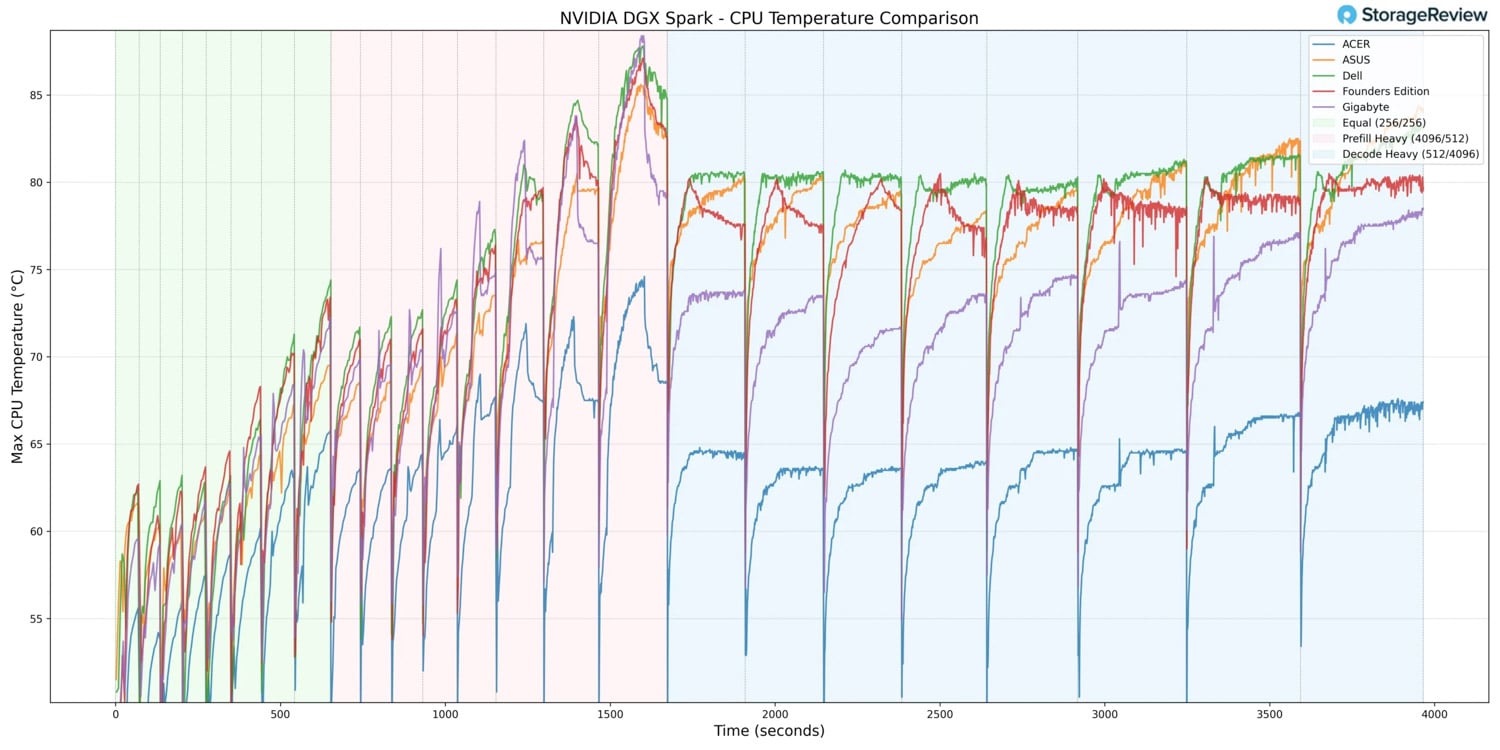
在CPU散熱測試中,宏碁系統執行高強度預填充操作時,最高溫度達到74.7°C。這是對照組中觀察到的最低最高CPU溫度之一,顯示其散熱設計非常保守或有效率。
隨著工作負載過渡到 ISL/OSL 平衡模式以及持續的解碼密集階段,CPU 溫度始終保持在良好控制範圍內,沒有出現劇烈的升溫。與某些競品系統常見的 80°C 以上高溫不同,宏碁這款產品保持了較低的持續運行溫度,這體現了其在長時間運算負載下強大的散熱能力。
在低負載情況下,CPU 的最低溫度為 37.8°C。此基準溫度與整個處理器系列的基準溫度相符,並進一步證實了宏碁的散熱解決方案在待機和負載狀態下均能有效運作。
總體而言,Acer 在峰值功率和持續功率階段都提供了同組產品中最涼爽的 CPU 散熱性能之一。
GPU溫度
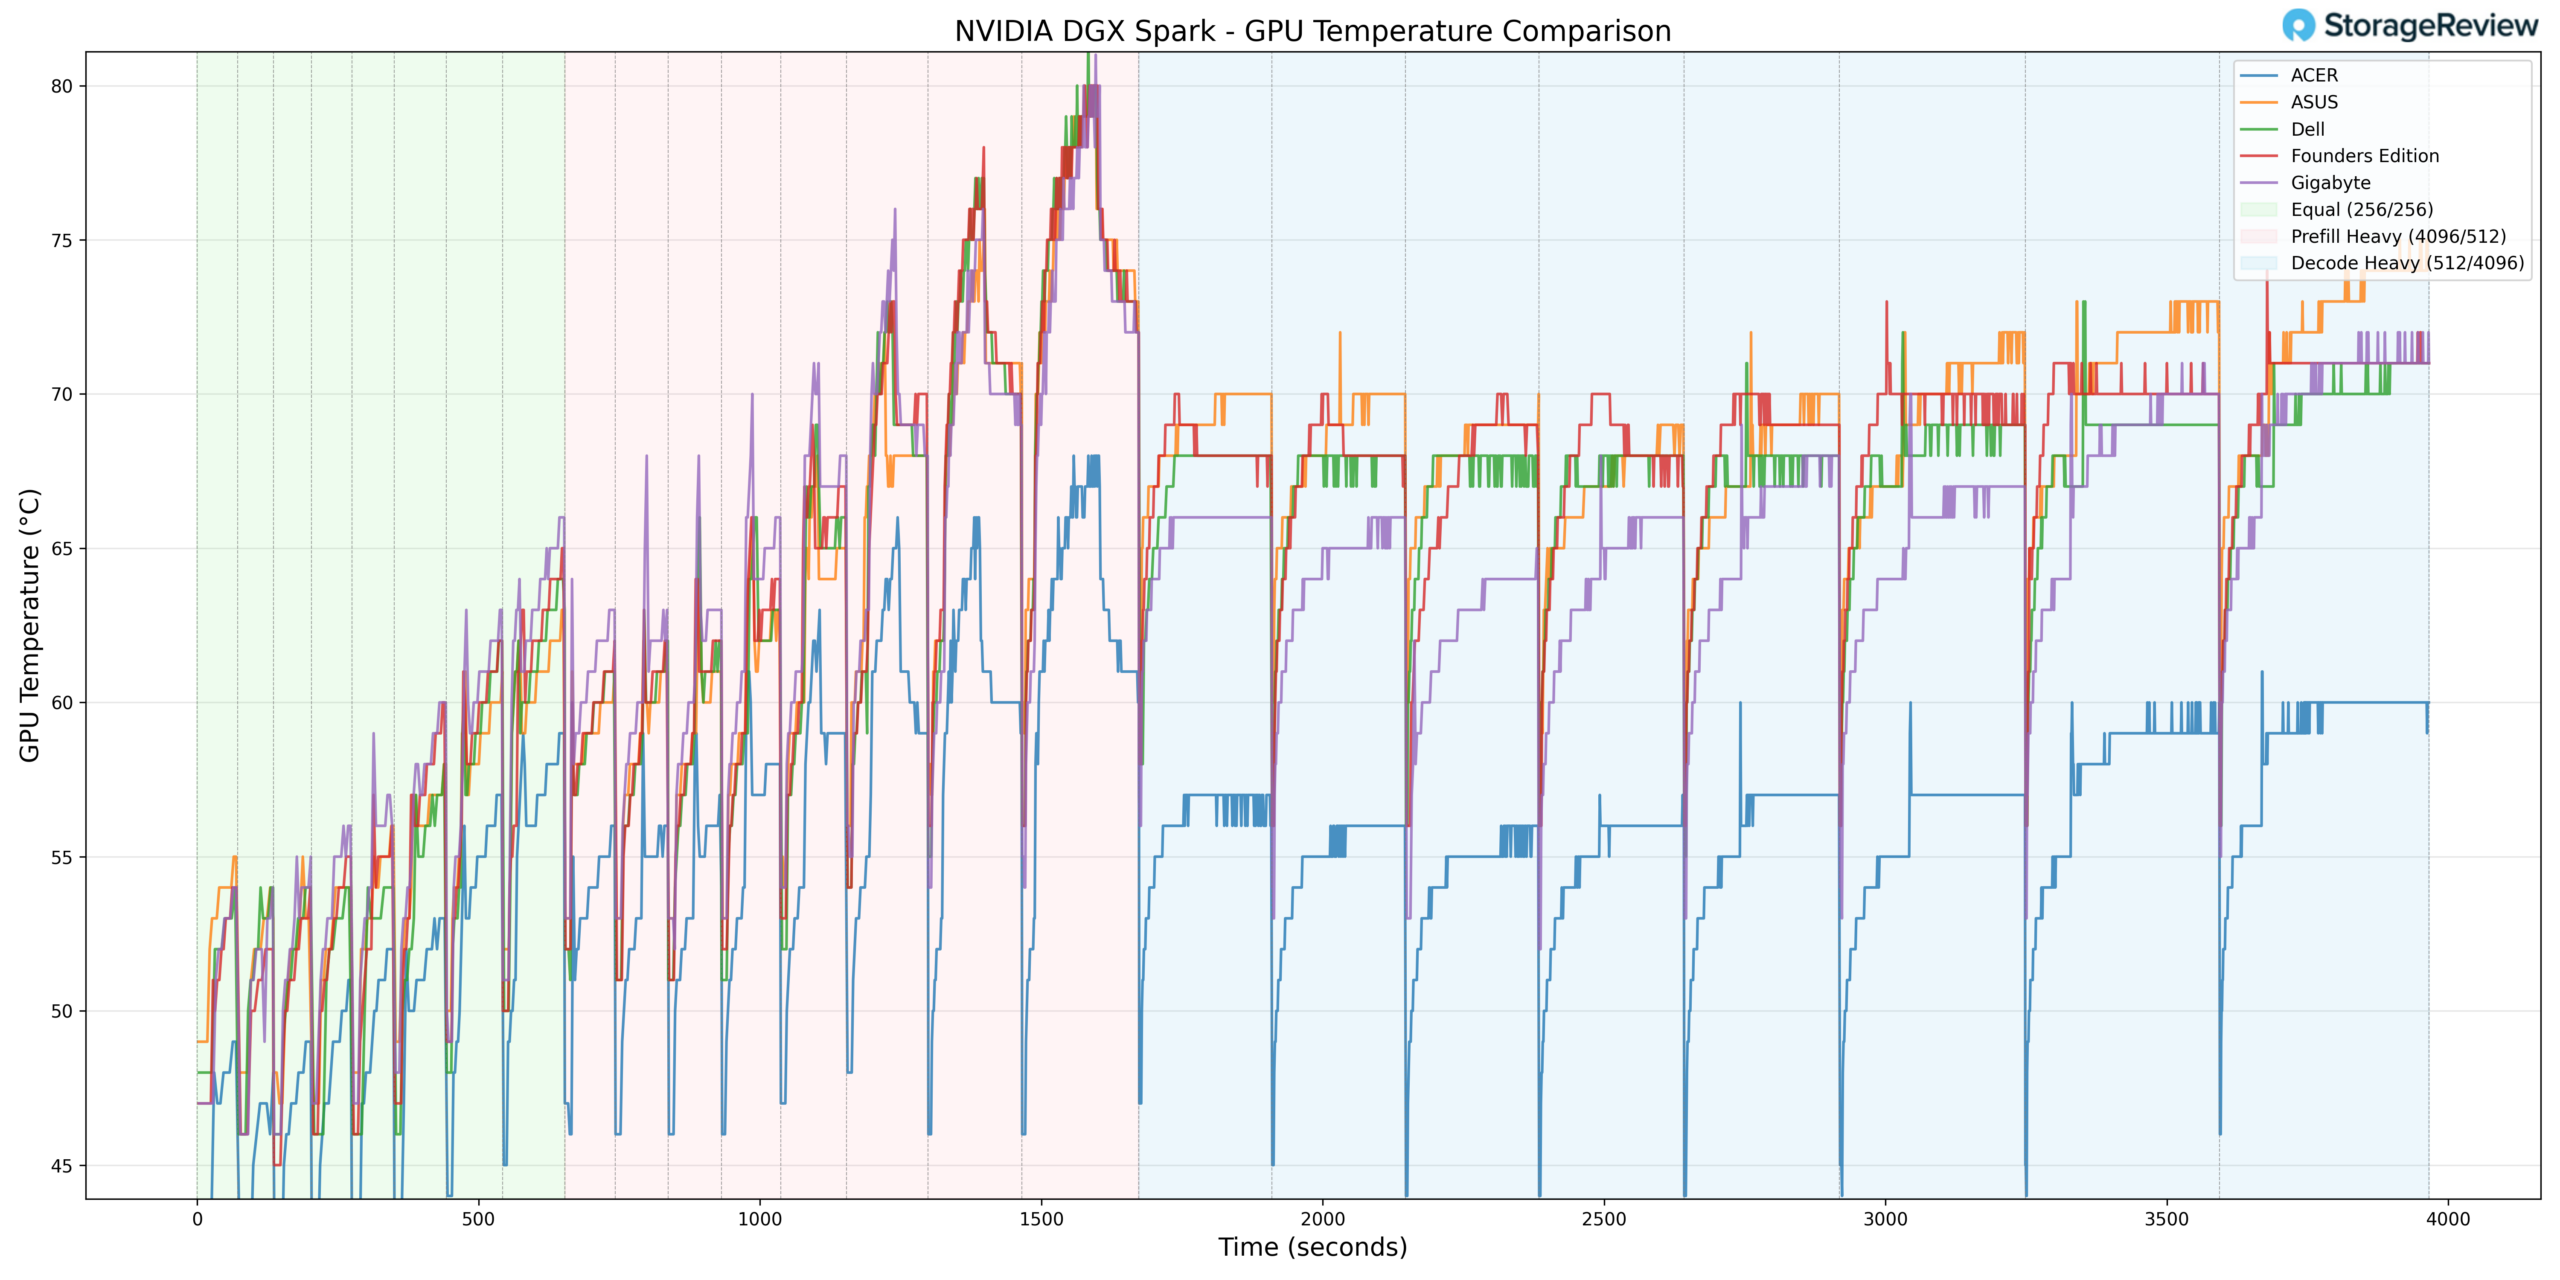
GPU 溫度也呈現類似的穩定趨勢。在預填充重加速期間,GPU 最高溫度達到 69°C,顯著低於幾款競品在突發運作時的溫度。
隨著工作負載進入均衡ISL/OSL和解碼密集型階段,GPU溫度穩定在一個可控範圍內,沒有出現明顯的溫度峰值。系統在持續解碼下表現出良好的穩定性,始終遠低於運行上限。
在較輕的階段,記錄到的最低 GPU 溫度為 35°C,是該堆疊中最低的空閒基線之一。
綜合來看,Acer 在突發負載和持續負載下都展現了最出色的 GPU 實作之一。
NVMe溫度
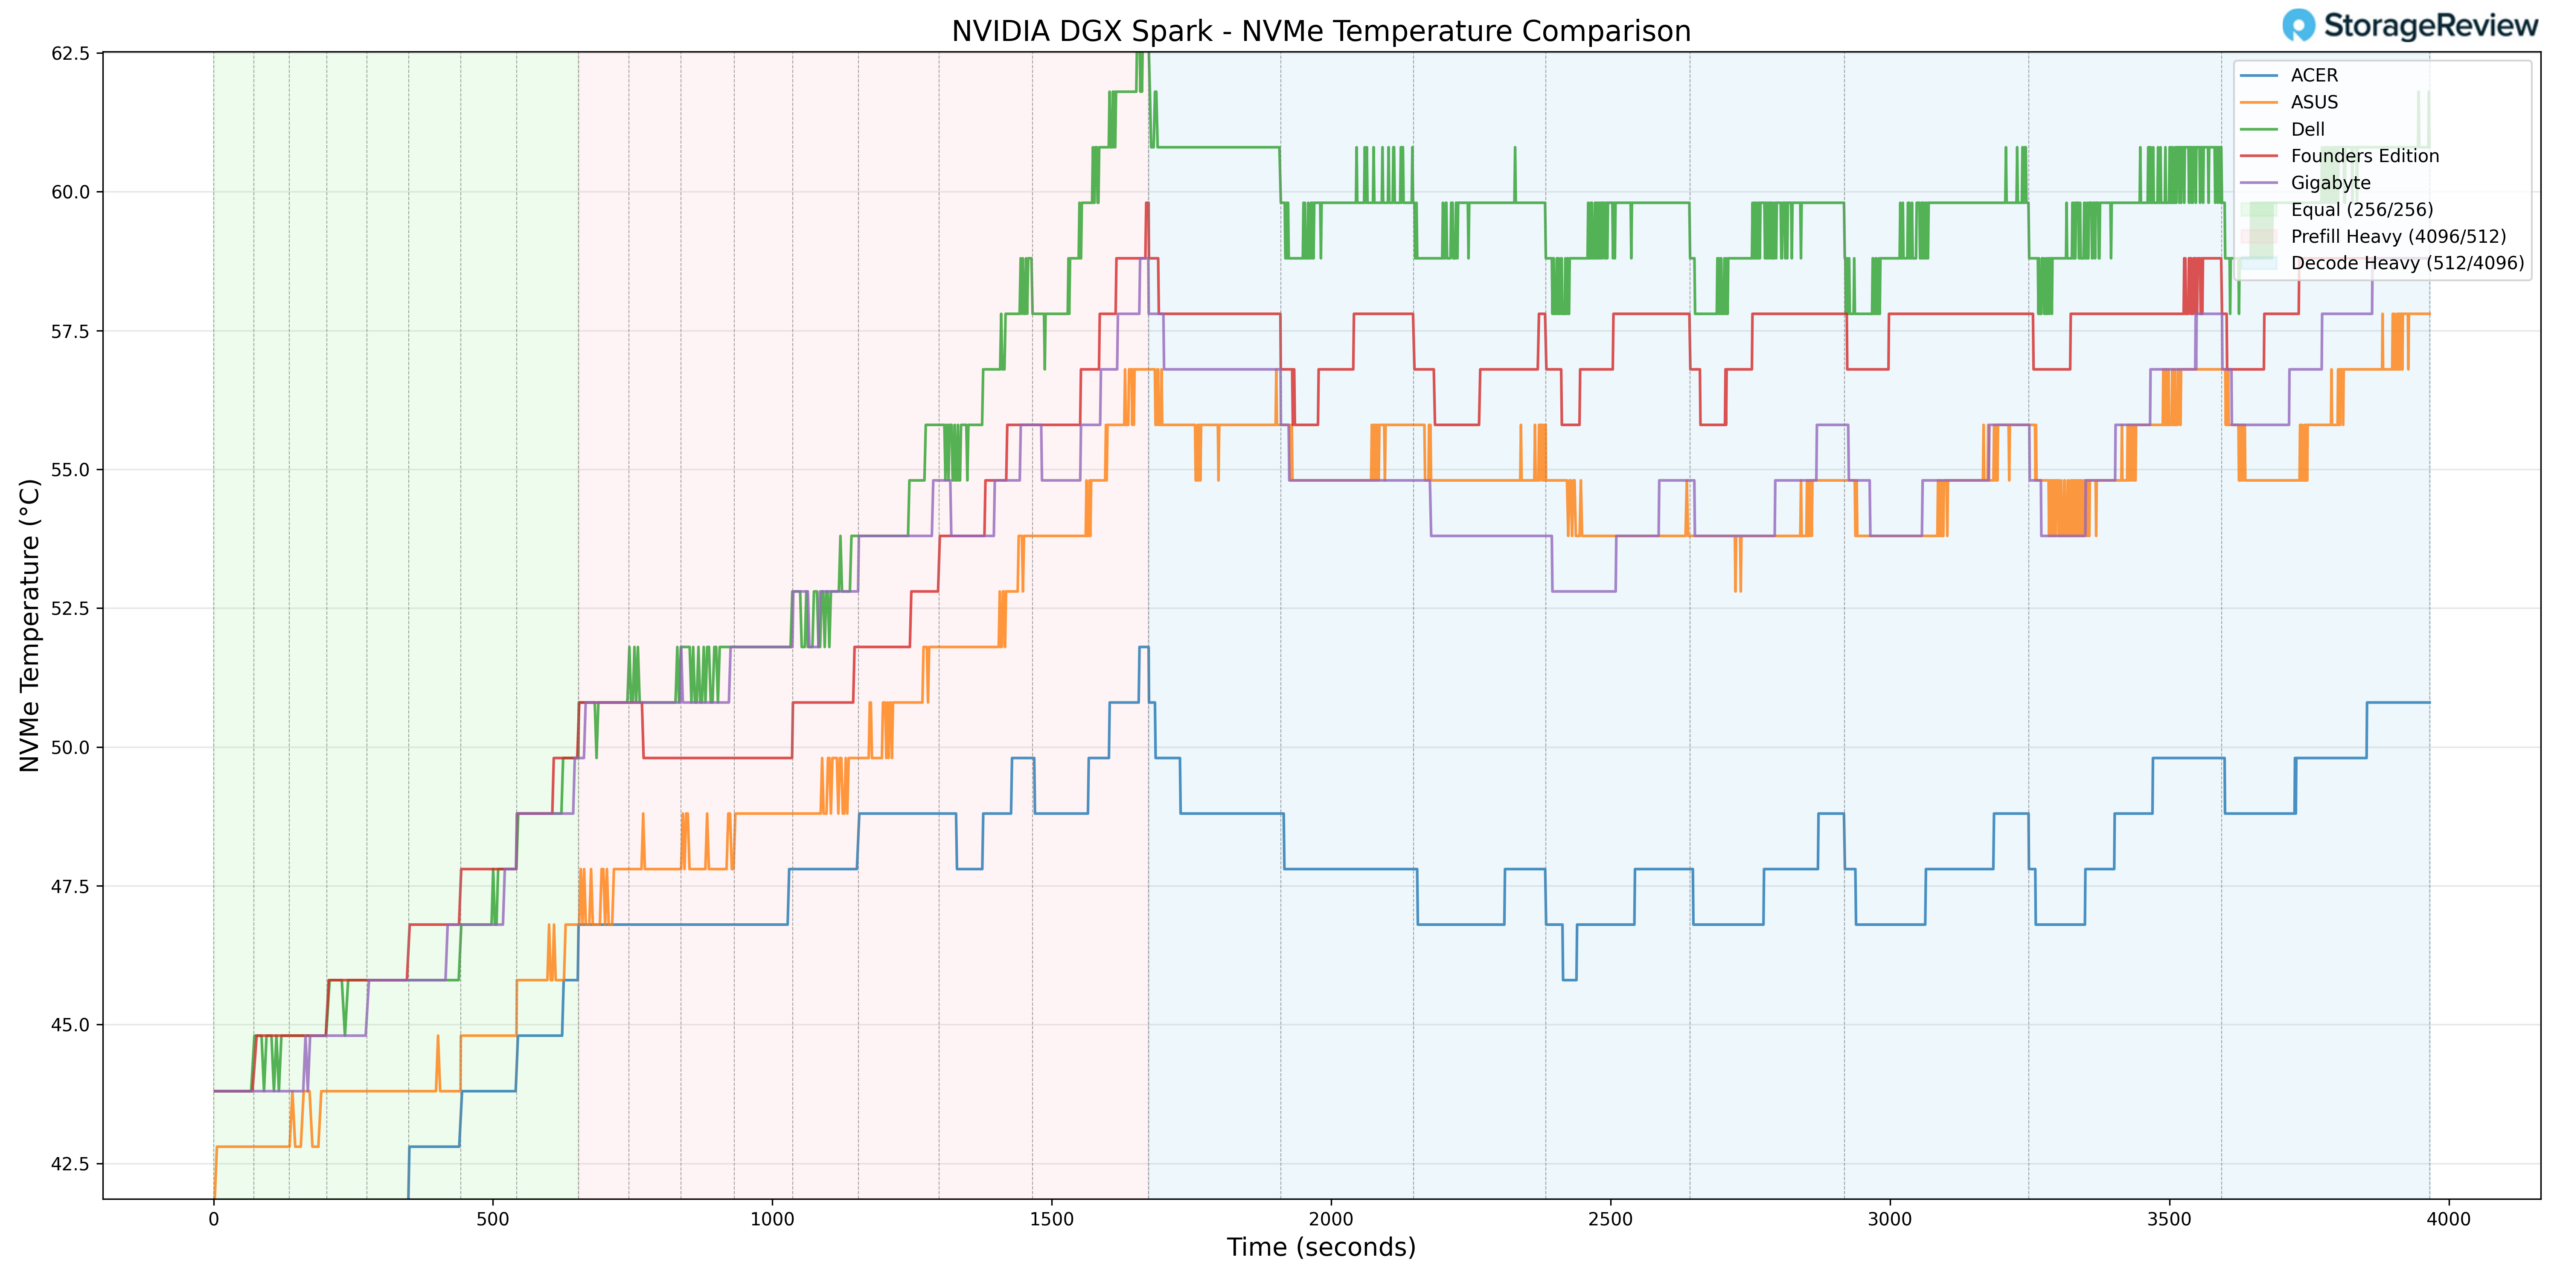
測試過程中,儲存設備的溫度始終保持在規格範圍內。在負載較高的階段,NVMe 固態硬碟的最高溫度為 56.8°C,遠低於常見的降頻閾值,與該組其他儲存裝置較為溫和的測試結果相符。
在空閒或輕度使用時,NVMe 溫度降至 36.8°C,表示儲存子系統在低負載下不受熱限制。
整體而言,宏碁保持了具有競爭力的 NVMe 散熱性能,在確保較低持續溫度的同時,也實現了穩定的基準性能。
NIC 溫度
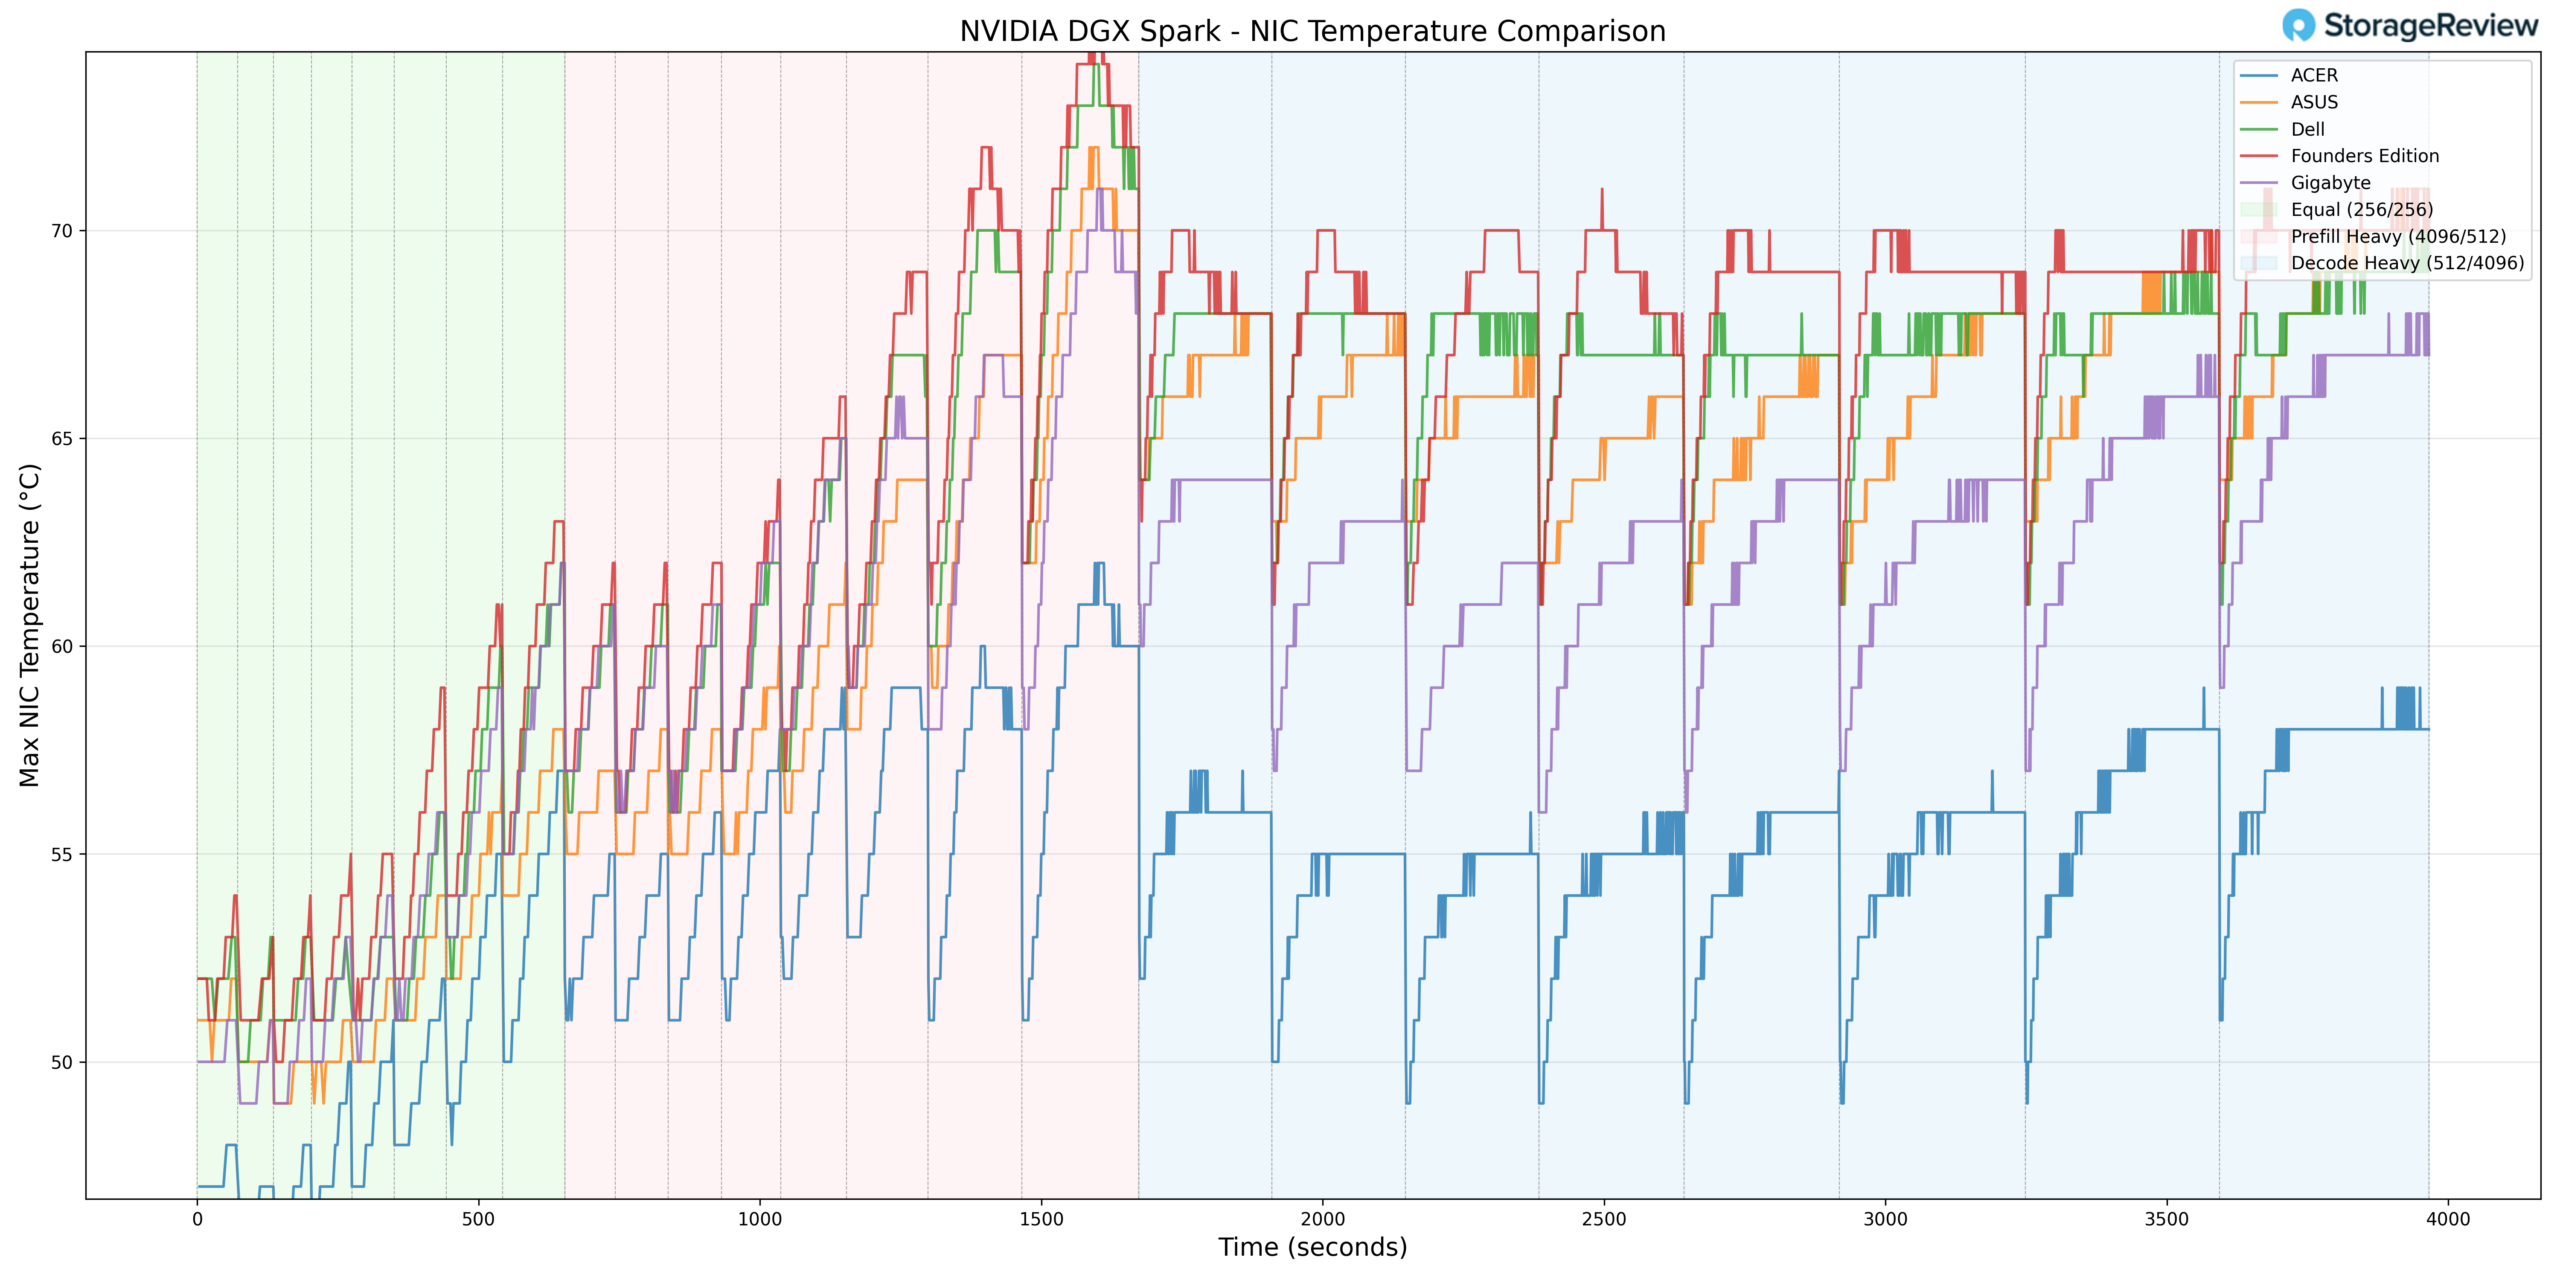
在負載較高階段,網卡溫度高峰達到 61°C。這是對照組中觀察到的網卡最高溫度較低的情況之一,顯示機箱內部氣流流通良好或組件佈局合理。
在光照較強的階段,記錄到的最低 NIC 溫度為 39°C,再次反映了其較強的基線熱行為。
在整個測試過程中,網路控制器與工作負載需求成比例地進行跟踪,沒有過度擴展。
GPU功耗
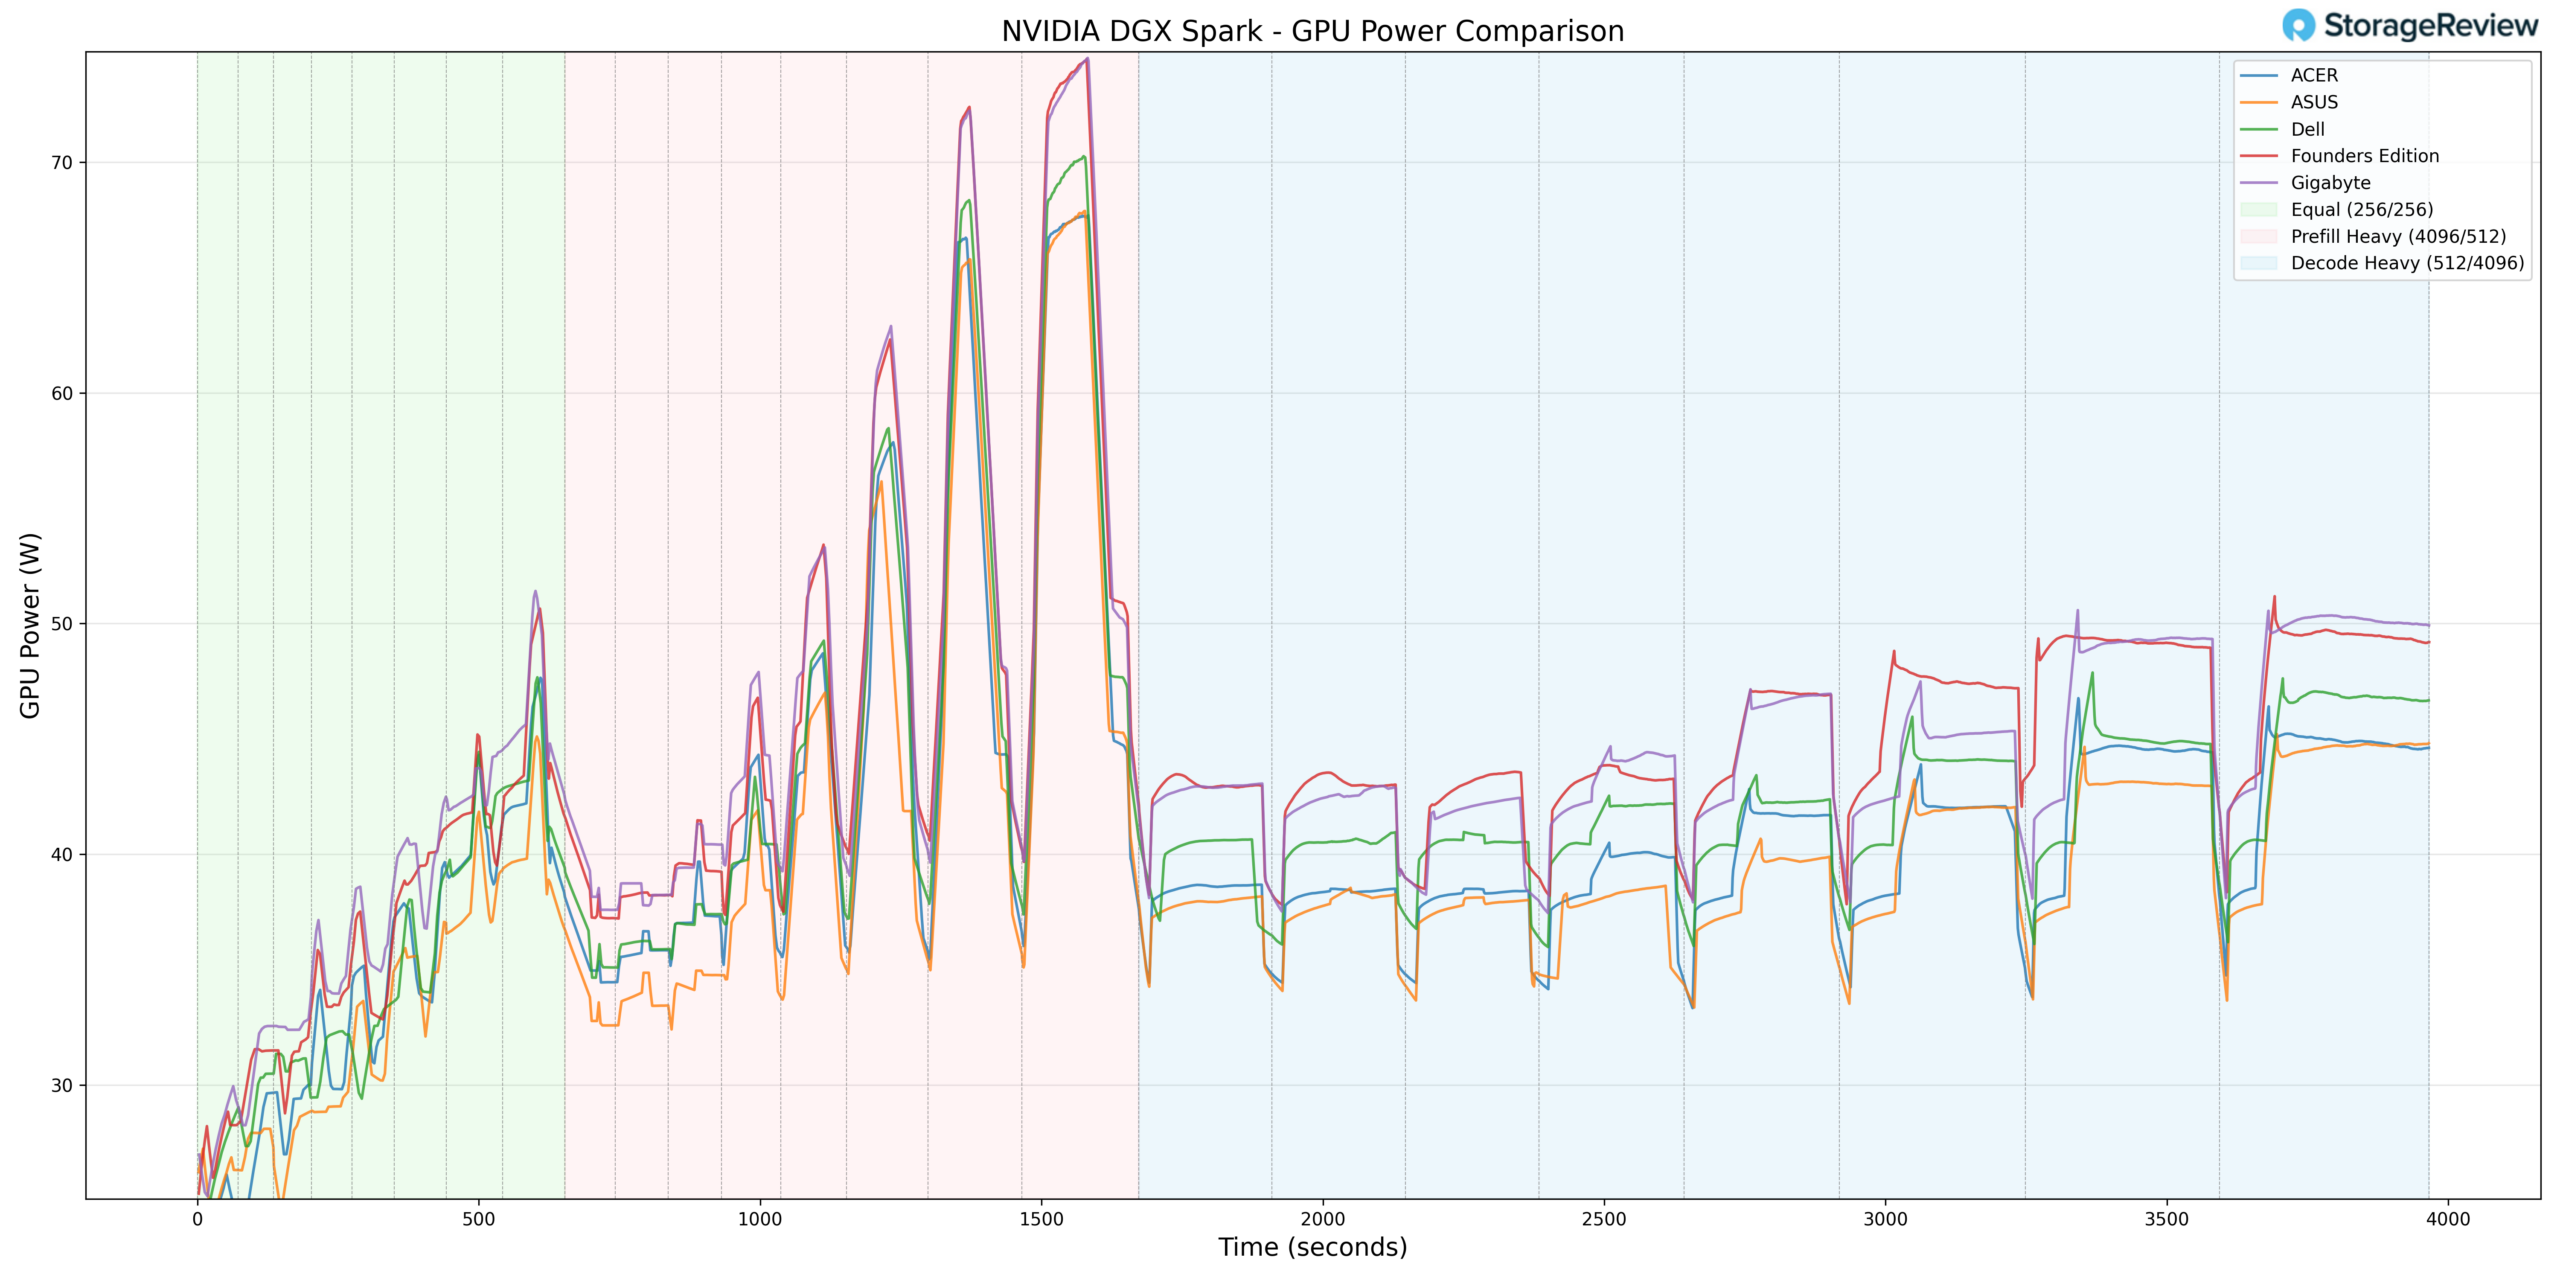
在預填充重載轉換期間,GPU 功耗峰值達到 69.18W。這使得 Acer 的功耗略低於 GB10 系列處理器中觀察到的最高功耗上限。
較低的峰值功率分配與宏碁較涼爽的GPU散熱特性直接相關。宏碁並沒有一味追求功率上限,而是在性能和散熱效率之間尋求平衡,從而在峰值功率輸出階段保持較低的組件溫度。
在持續解碼工作負載期間,功耗會根據工作負載需求趨於穩定,並保持可預測性。
熱力總結
在對 CPU、GPU、NVMe 和網卡進行全面溫度監測後,Acer GB10 在對比組中展現出最佳的整體散熱性能。在負載尖峰時段,CPU 最高溫度為 74.7°C,GPU 最高溫度為 69°C,而 NVMe 溫度始終低於 57°C,網卡最高溫度為 61°C。 GPU 最高功耗為 69.18W,略低於其他機型的最高值。
整體而言,宏碁的實現方案優先考慮散熱效率和持續穩定性,在激烈的工作負載轉換過程中保持充足的餘裕,同時在長時間負載下提供穩定的效能。
宏碁 Veriton GN100 性能測試
為了評估宏碁 Veriton GN100,我們使用 vLLM Online Serving 基準測試對 Spark 單元進行了測試。 vLLM Online Serving 基準測試是目前應用最廣泛的大型語言模式高吞吐量推理和服務引擎。此基準測試透過向運行中的 vLLM 伺服器發送並發請求來模擬真實生產環境中的工作負載,並測量關鍵指標,包括總令牌吞吐量(每秒令牌數)、首令牌到達時間和每個輸出令牌的產生時間,並考察不同負載條件下的效能。
我們的測試涵蓋了從密集架構到微擴展資料類型的各種模型。測試評估了三種工作負載場景下的效能:均衡 ISL/OSL、預填密集型和解碼密集型。這些場景代表了不同的實際服務模式,從均衡的輸入輸出負載到計算密集型的提示符號處理和記憶體頻寬受限的令牌產生。
除了宏碁 Veriton GN100 之外,我們還以 NVIDIA Founders Edition Spark 作為參考基準,同時測試了來自華碩、戴爾和技嘉的 OEM 系統。這使我們能夠將宏碁的測試結果置於更廣泛的競爭格局中,並了解其在不同型號和工作負載類型中處於領先地位、與競爭對手並駕齊驅或落後於競爭對手的程度。
GPT-OSS-120B
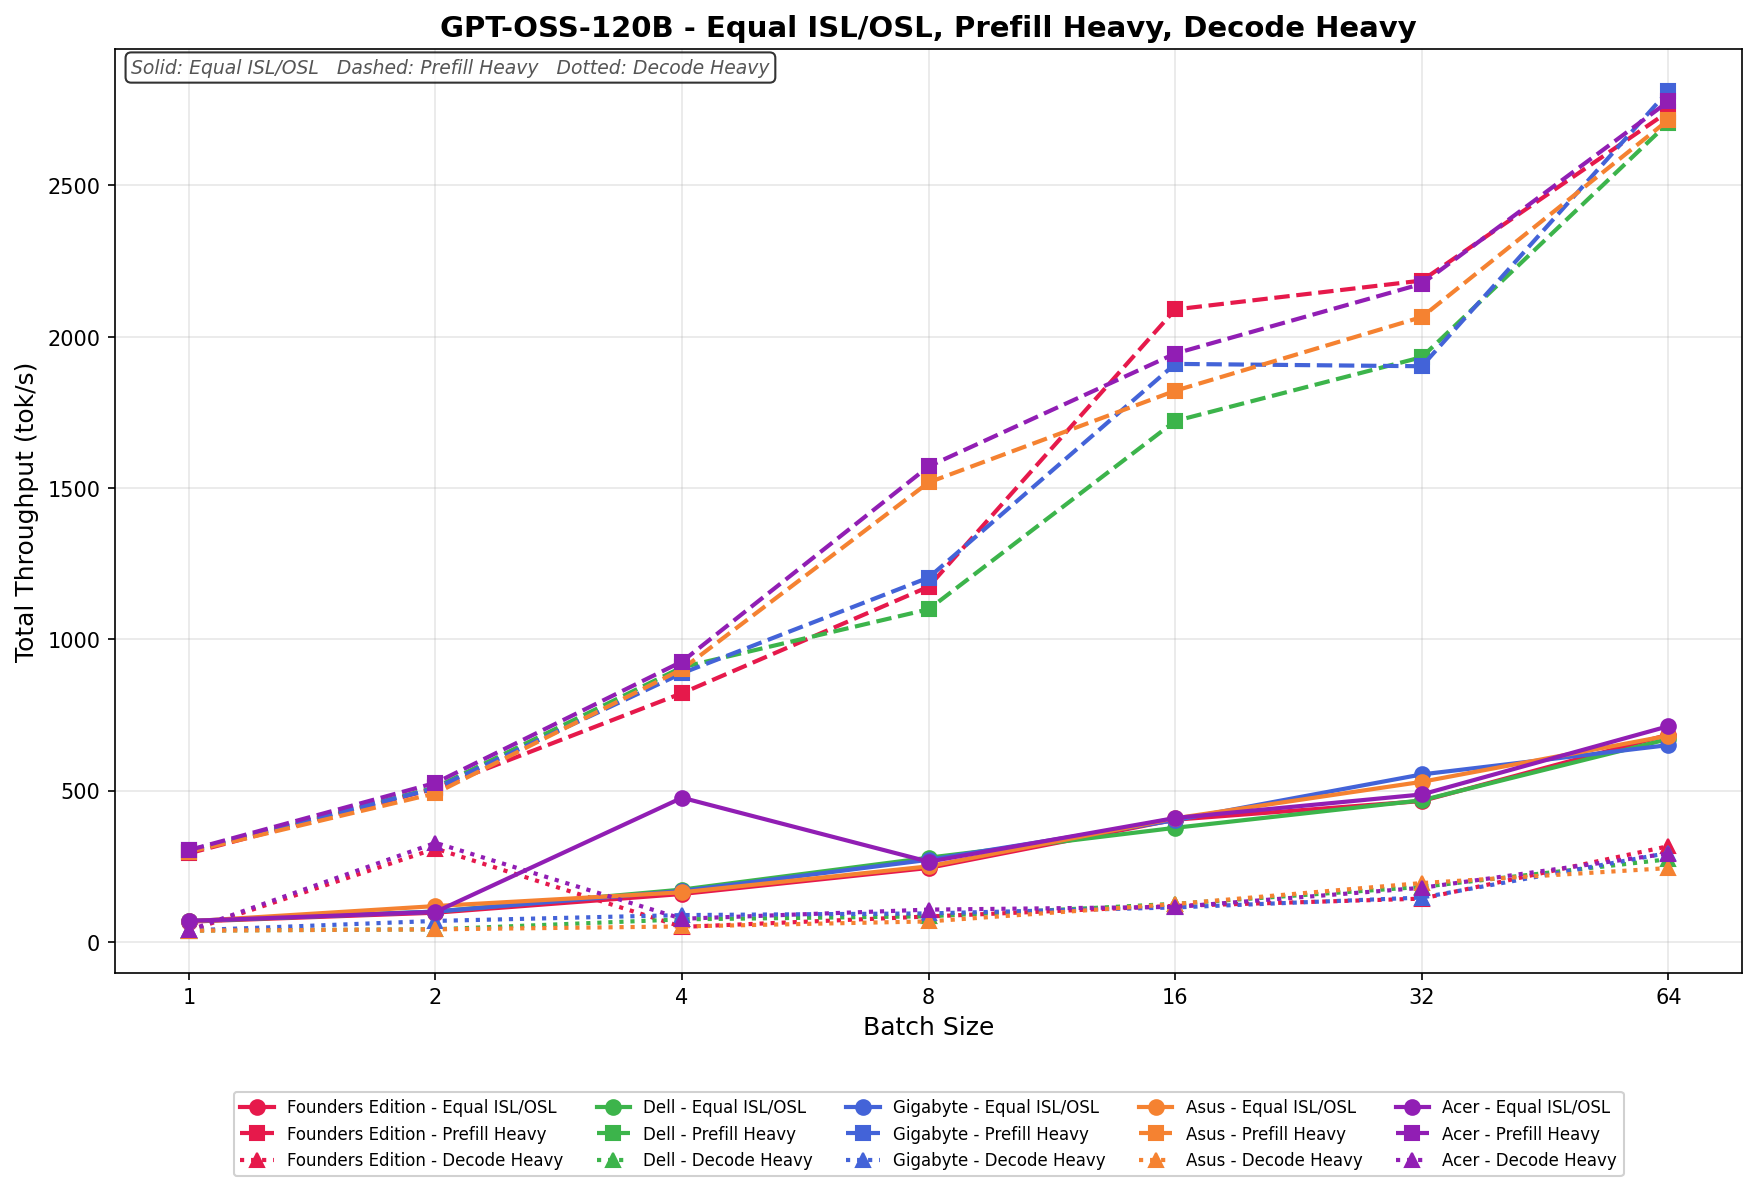
在 ISL/OSL 相等的情況下,Acer 處理器在整個批次掃描過程中吞吐量從 69.65 提升至 713.18 tok/s。在批次較小時,吞吐量存在一定波動,之後趨於穩定,並從第 8 批次開始持續增長,直至第 64 批次。
預填充重型設備從 303.61 tok/s 開始,到批次大小 64 時攀升至 2,777.56 tok/s。整個製程規模成長強勁且穩定提升,尤其是在第 8 個批次時成長尤為迅猛,並且在更大的批次規模下持續成長。
解碼重任務的處理速度範圍為 38.38 至 292.41 tok/s,在整個批次掃描過程中呈現漸進且穩定的成長。較小的批次大小在吞吐量穩定之前會出現一些波動,並從第 16 個批次開始穩步增長。
GPT-OSS-20B
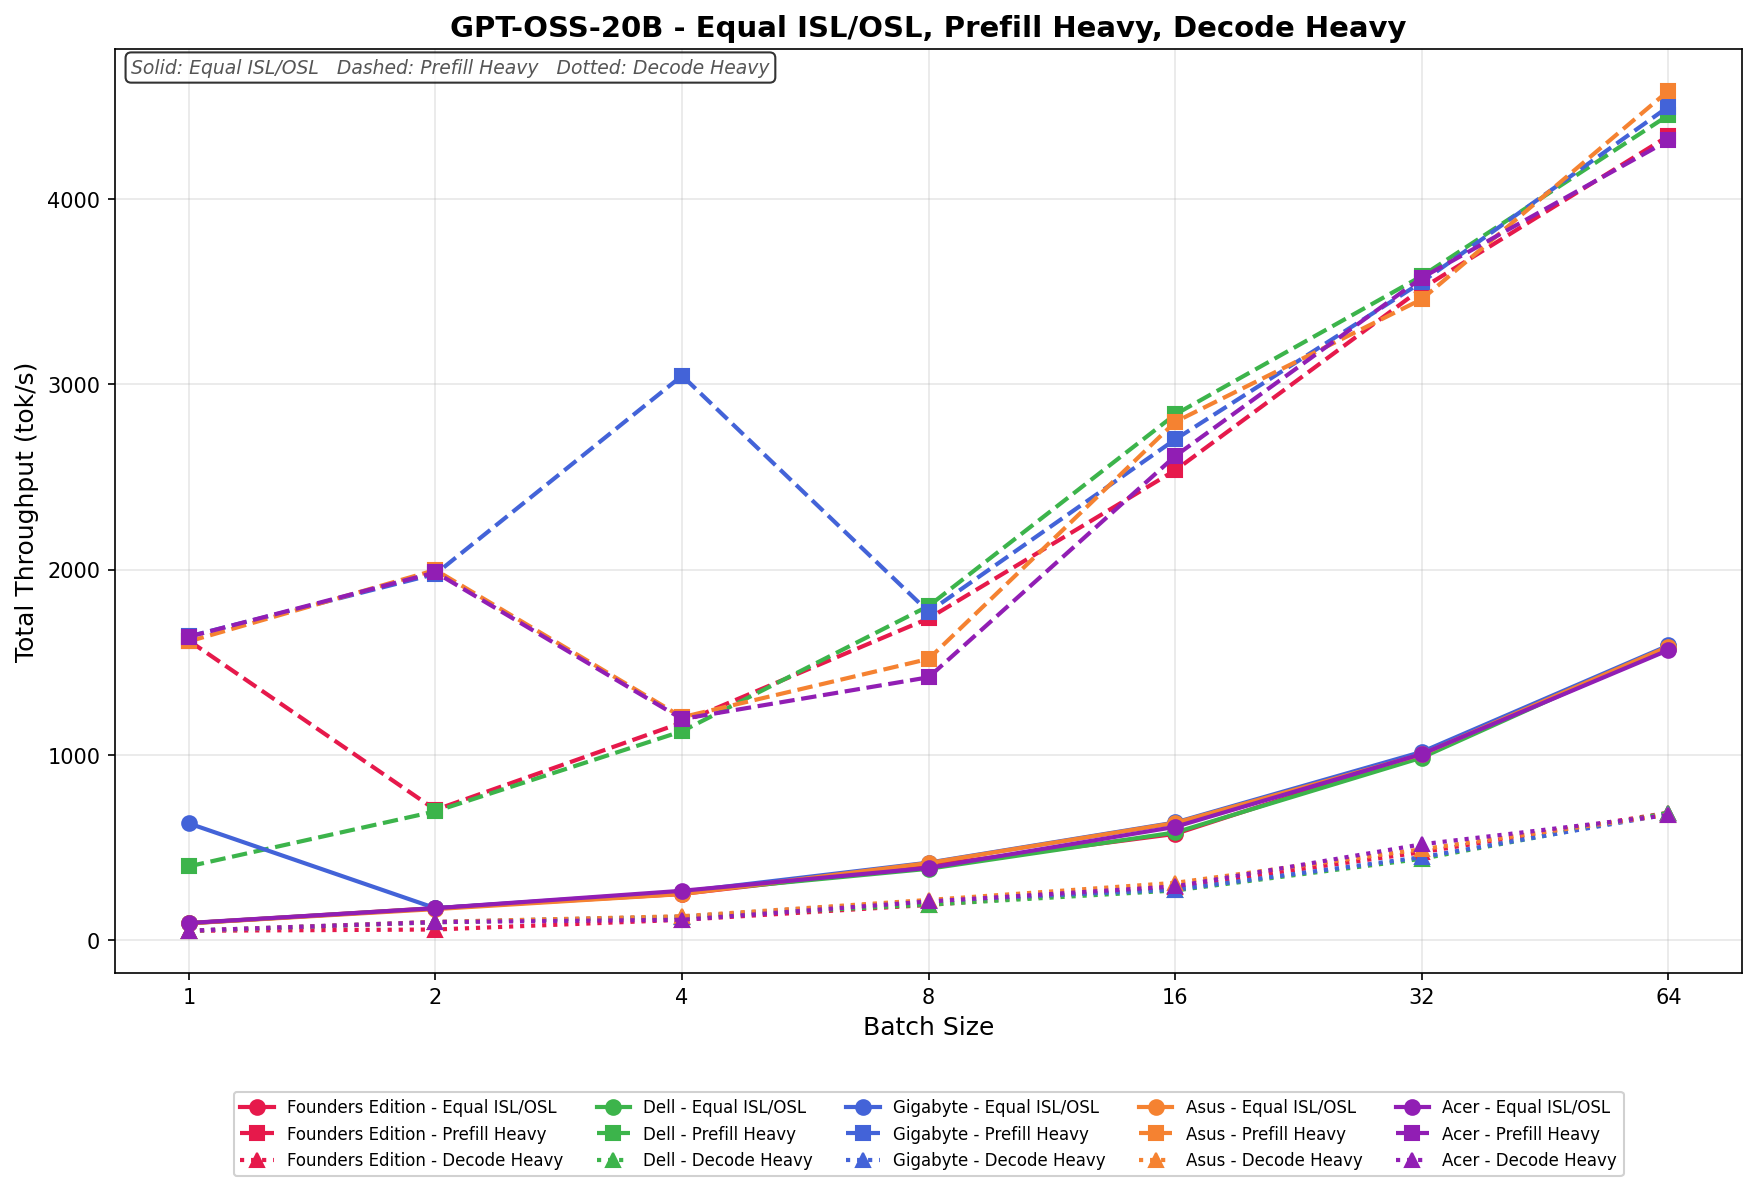
在 ISL/OSL 相等的測試條件下,Acer 處理器的處理能力從 91.91 tok/s 提升至 1,565.62 tok/s,在整個批次掃描過程中均保持強勁且穩定的增長。吞吐量從第 1 批次到第 4 批次大約翻了一番,然後在第 32 批次和第 64 批次繼續攀升。
Prefill Heavy 從 1,637.72 tok/s 開始,隨著批次大小增加到 64,攀升至 4,317.73 tok/s。成長在第 2 批次時強勁,在中期趨於平緩,然後在第 32 批次和第 64 批次時再次加速。
解碼重任務的速度範圍為 50.55 至 674.26 tok/s,在整個批次掃描過程中,速度逐漸且穩定地提升。
Qwen3 程式設計師 30B A3B FB8
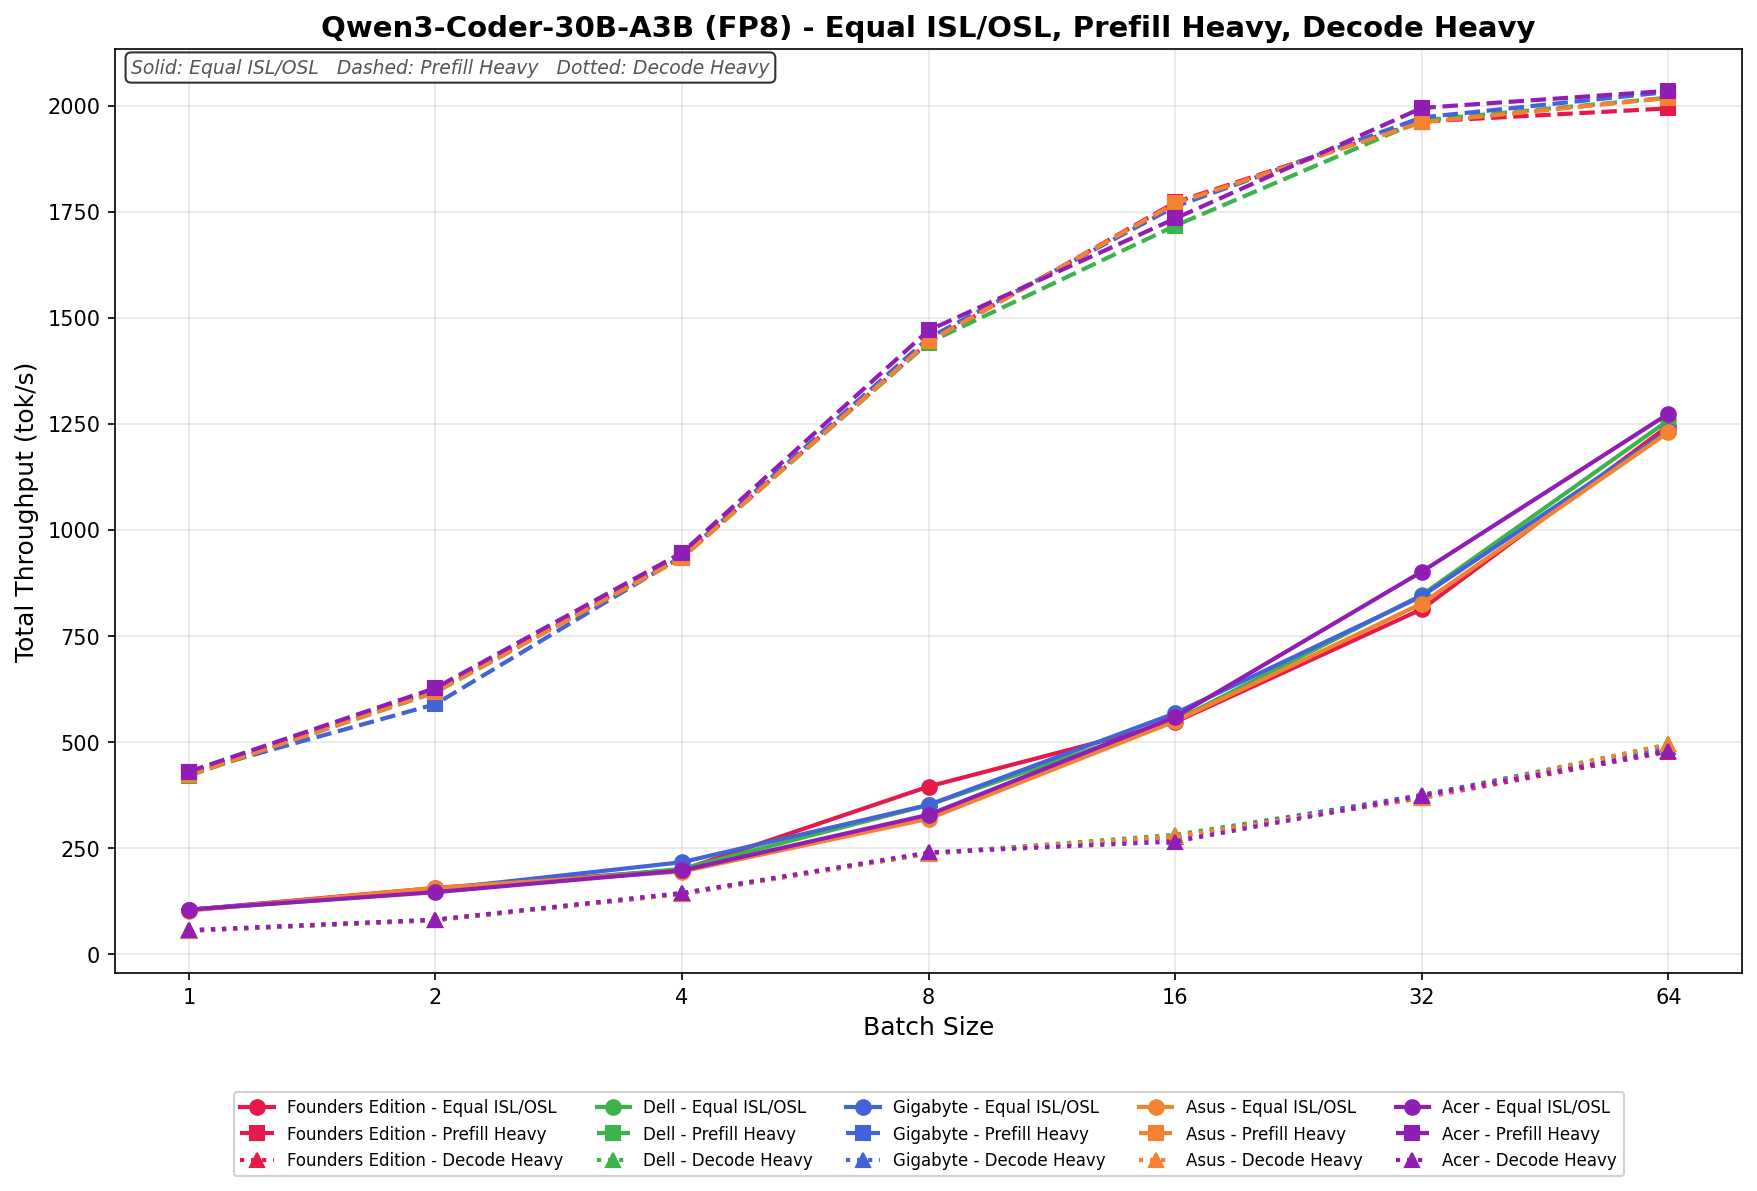
在 ISL/OSL 相等的情況下,Acer 處理器的處理能力從 104.64 tok/s 提升至 1,273.47 tok/s,並在整個批次掃描過程中保持穩定成長。處理能力在第 16 個批次之前每一步都大約翻一番,然後在第 32 個和第 64 個批次中繼續攀升。
預填充重型設備從 429.86 tok/s 開始,到批次大小 64 時增長到 2,034.76 tok/s。擴展性在第 8 批次之前很強,然後隨著工作負載在第 32 批次和第 64 批次接近平台期而趨於緩和。
解碼重任務的速度範圍為 55.94 至 478.59 tok/s,在整個批次掃描過程中,速度逐漸且穩定地提升。
Qwen3 編碼器 30B A3B 基地
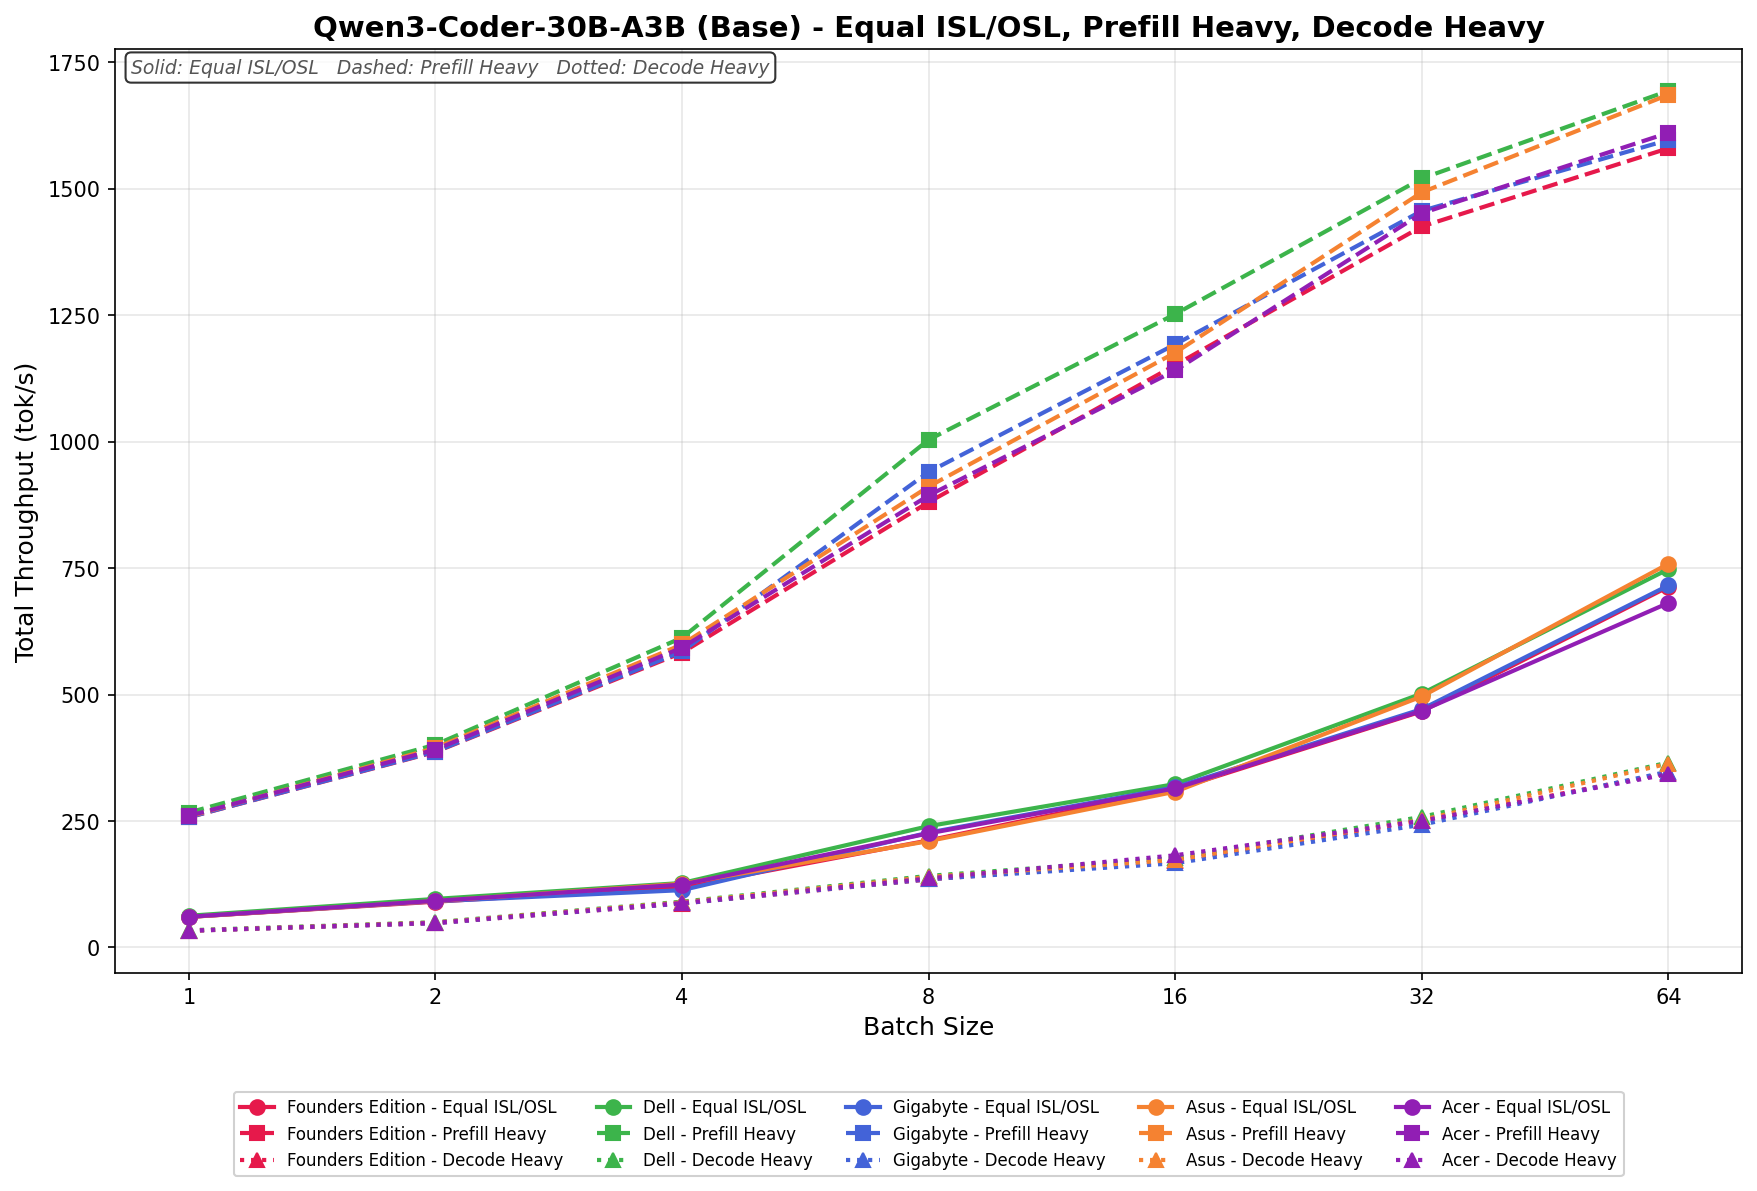
在 ISL/OSL 相等的情況下,Acer 的吞吐量從 60.71 到 681.18 tok/s 不等,在所有批次大小下,其吞吐量都明顯低於 FP8 版本。雖然在整個測試過程中吞吐量保持穩定成長,但隨著批次大小的增加,與 FP8 的差距也隨之擴大。
Prefill Heavy 的初始吞吐量為 260.11 tok/s,批量大小為 64 時,吞吐量攀升至 1,610.56 tok/s。在整個掃描過程中,吞吐量保持穩定,但無論批次大小,吞吐量都遠低於 FP8 的對應吞吐量。
解碼重碼的速度範圍為 33.31 至 342.79 tok/s,在整個掃描過程中,其輸出低於 FP8 變體。所有批次大小的成長都較為平緩且穩定。
Llama 3.1 8B 指令 FP4
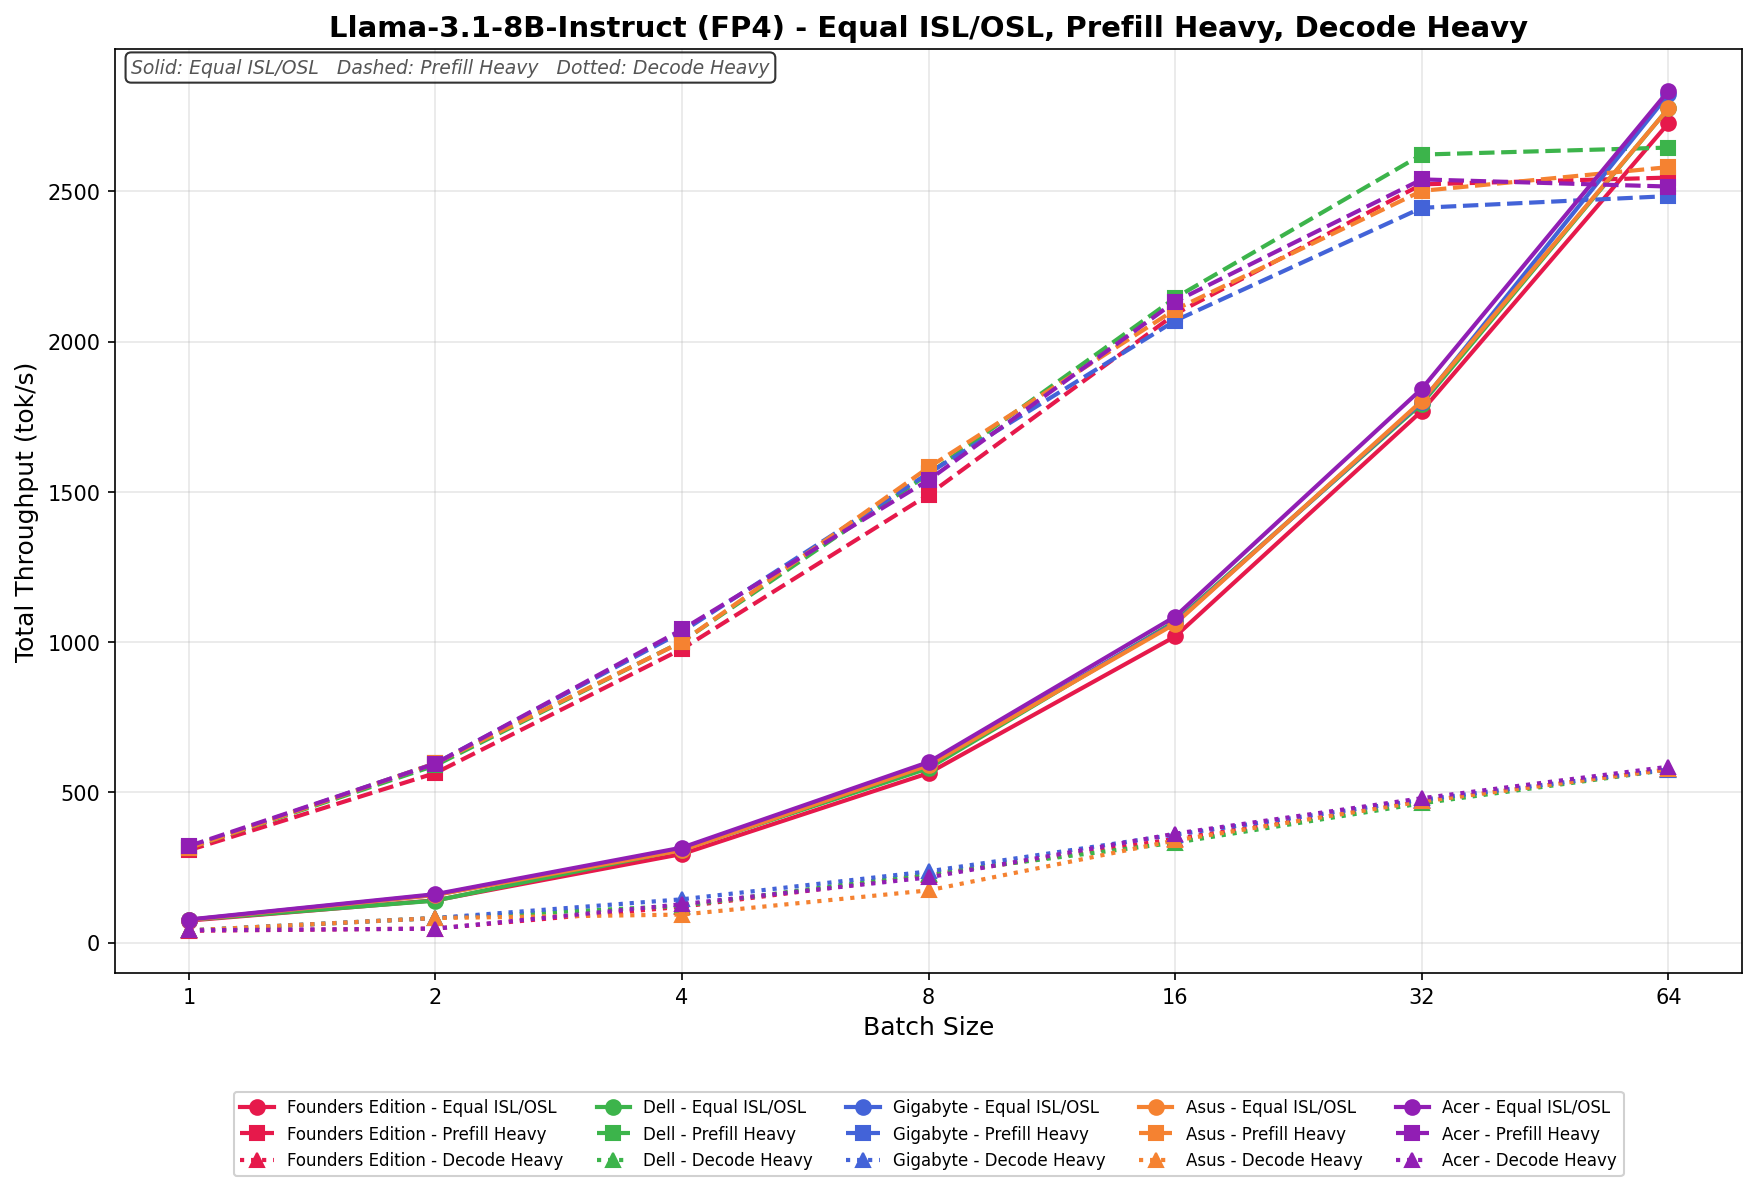
在 ISL/OSL 相等的情況下,Acer 的效能從 77.15 tok/s 提升至 2,834.70 tok/s,在所有批次大小下均比 FP8 版本具有明顯的吞吐量優勢。效能提昇在第 32 批次之前平滑線性,並在第 64 批次時繼續保持強勁增長。
預先填充重型設備從 321.54 tok/s 開始,在第 32 批次時攀升至 2,539.85 tok/s,然後在第 64 批次時略微穩定在 2,516.13 tok/s。在中等和較大批次規模下,FP4 型號的吞吐量均高於其 FP8 型號。
解碼重碼的速率範圍為 41.21 至 585.63 tok/s,在所有批次大小下,其輸出均顯著高於 FP8 變體。整個掃描過程中,速率成長保持穩定。
Llama 3.1 8B 指令 FP8
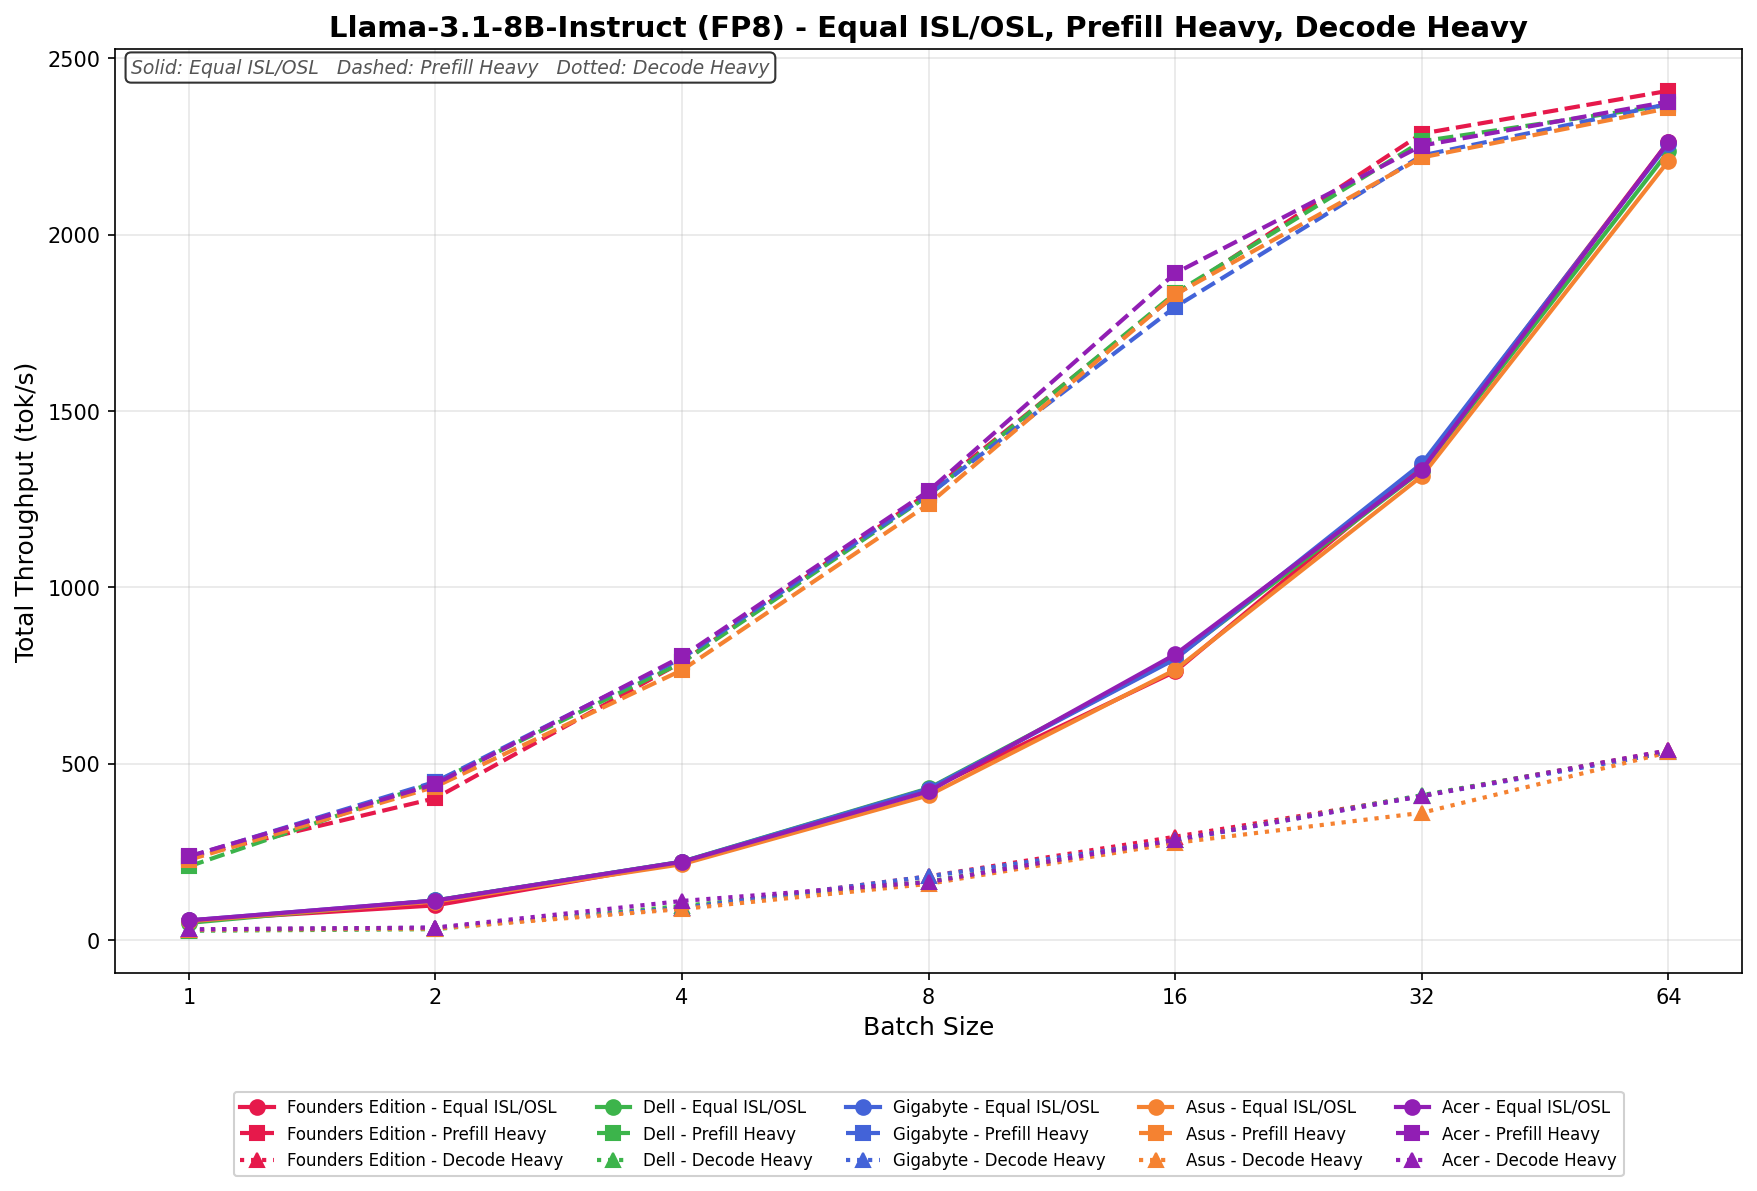
在 ISL/OSL 相等的測試環境中,Acer 處理器在整個批次掃描過程中吞吐量從 55.93 tok/s 提升至 2,262.73 tok/s,且每一步都保持穩定成長。吞吐量從第 1 批次到第 8 批次幾乎翻了一番,並在第 32 批次和第 64 批次中持續攀升,未出現飽和跡象。
預填充重型物料的初始吞吐量為 237.62 tok/s,批量大小為 64 時,吞吐量成長至 2,376.88 tok/s。整個批次掃描過程中,吞吐量持續成長,且擴展性強勁。
解碼重任務的速度範圍為 30.39 至 538.18 tok/s,在整個批次掃描過程中持續成長。
GPU直接儲存
我們在 Spark 上進行的測試之一是 MagnumIO GPU 直接儲存 (GDS) 測試。 GDS 是 NVIDIA 開發的功能,可讓 GPU 在存取儲存在 NVMe 磁碟機或其他高速儲存裝置上的資料時繞過 CPU。 GDS 無需透過 CPU 和系統記憶體路由數據,而是支援 GPU 和儲存設備之間的直接通信,從而顯著降低延遲並提高數據吞吐量。
宏碁 Veriton GN100 AI 內部使用了 4TB 三星 PM9E1 Gen5 SSD,這是我們迄今為止在市場上見過的速度最快的 2242 M.2 硬碟。
GPU 直接儲存的工作原理
傳統上,當GPU處理儲存在NVMe磁碟機上的資料時,資料必須先經過CPU和系統記憶體才能到達GPU。由於CPU充當中間人,這個過程會造成效能瓶頸,增加延遲並消耗寶貴的系統資源。 GPU直接儲存(GPU Direct Storage)透過允許GPU直接透過PCIe匯流排存取儲存裝置中的數據,消除了這種低效率。這種直接路徑減少了資料傳輸的開銷,從而實現了更快、更有效率的資料傳輸。
人工智慧工作負載,尤其是涉及深度學習的工作負載,是高度資料密集的。訓練大型神經網路需要處理 TB 級的數據,資料傳輸中的任何延遲都可能導致 GPU 利用率不足和訓練時間更長。 GPU 直接儲存透過確保資料盡快傳輸到 GPU、最大限度地減少空閒時間並最大限度地提高運算效率來解決這一挑戰。
此外,GDS 對於涉及串流大型資料集的工作負載特別有利,例如視訊處理、自然語言處理或即時推理。透過減少對 CPU 的依賴,GDS 可以加速資料移動並釋放 CPU 資源用於其他任務,從而進一步增強整體系統效能。
GDSIO 讀取吞吐量 16k
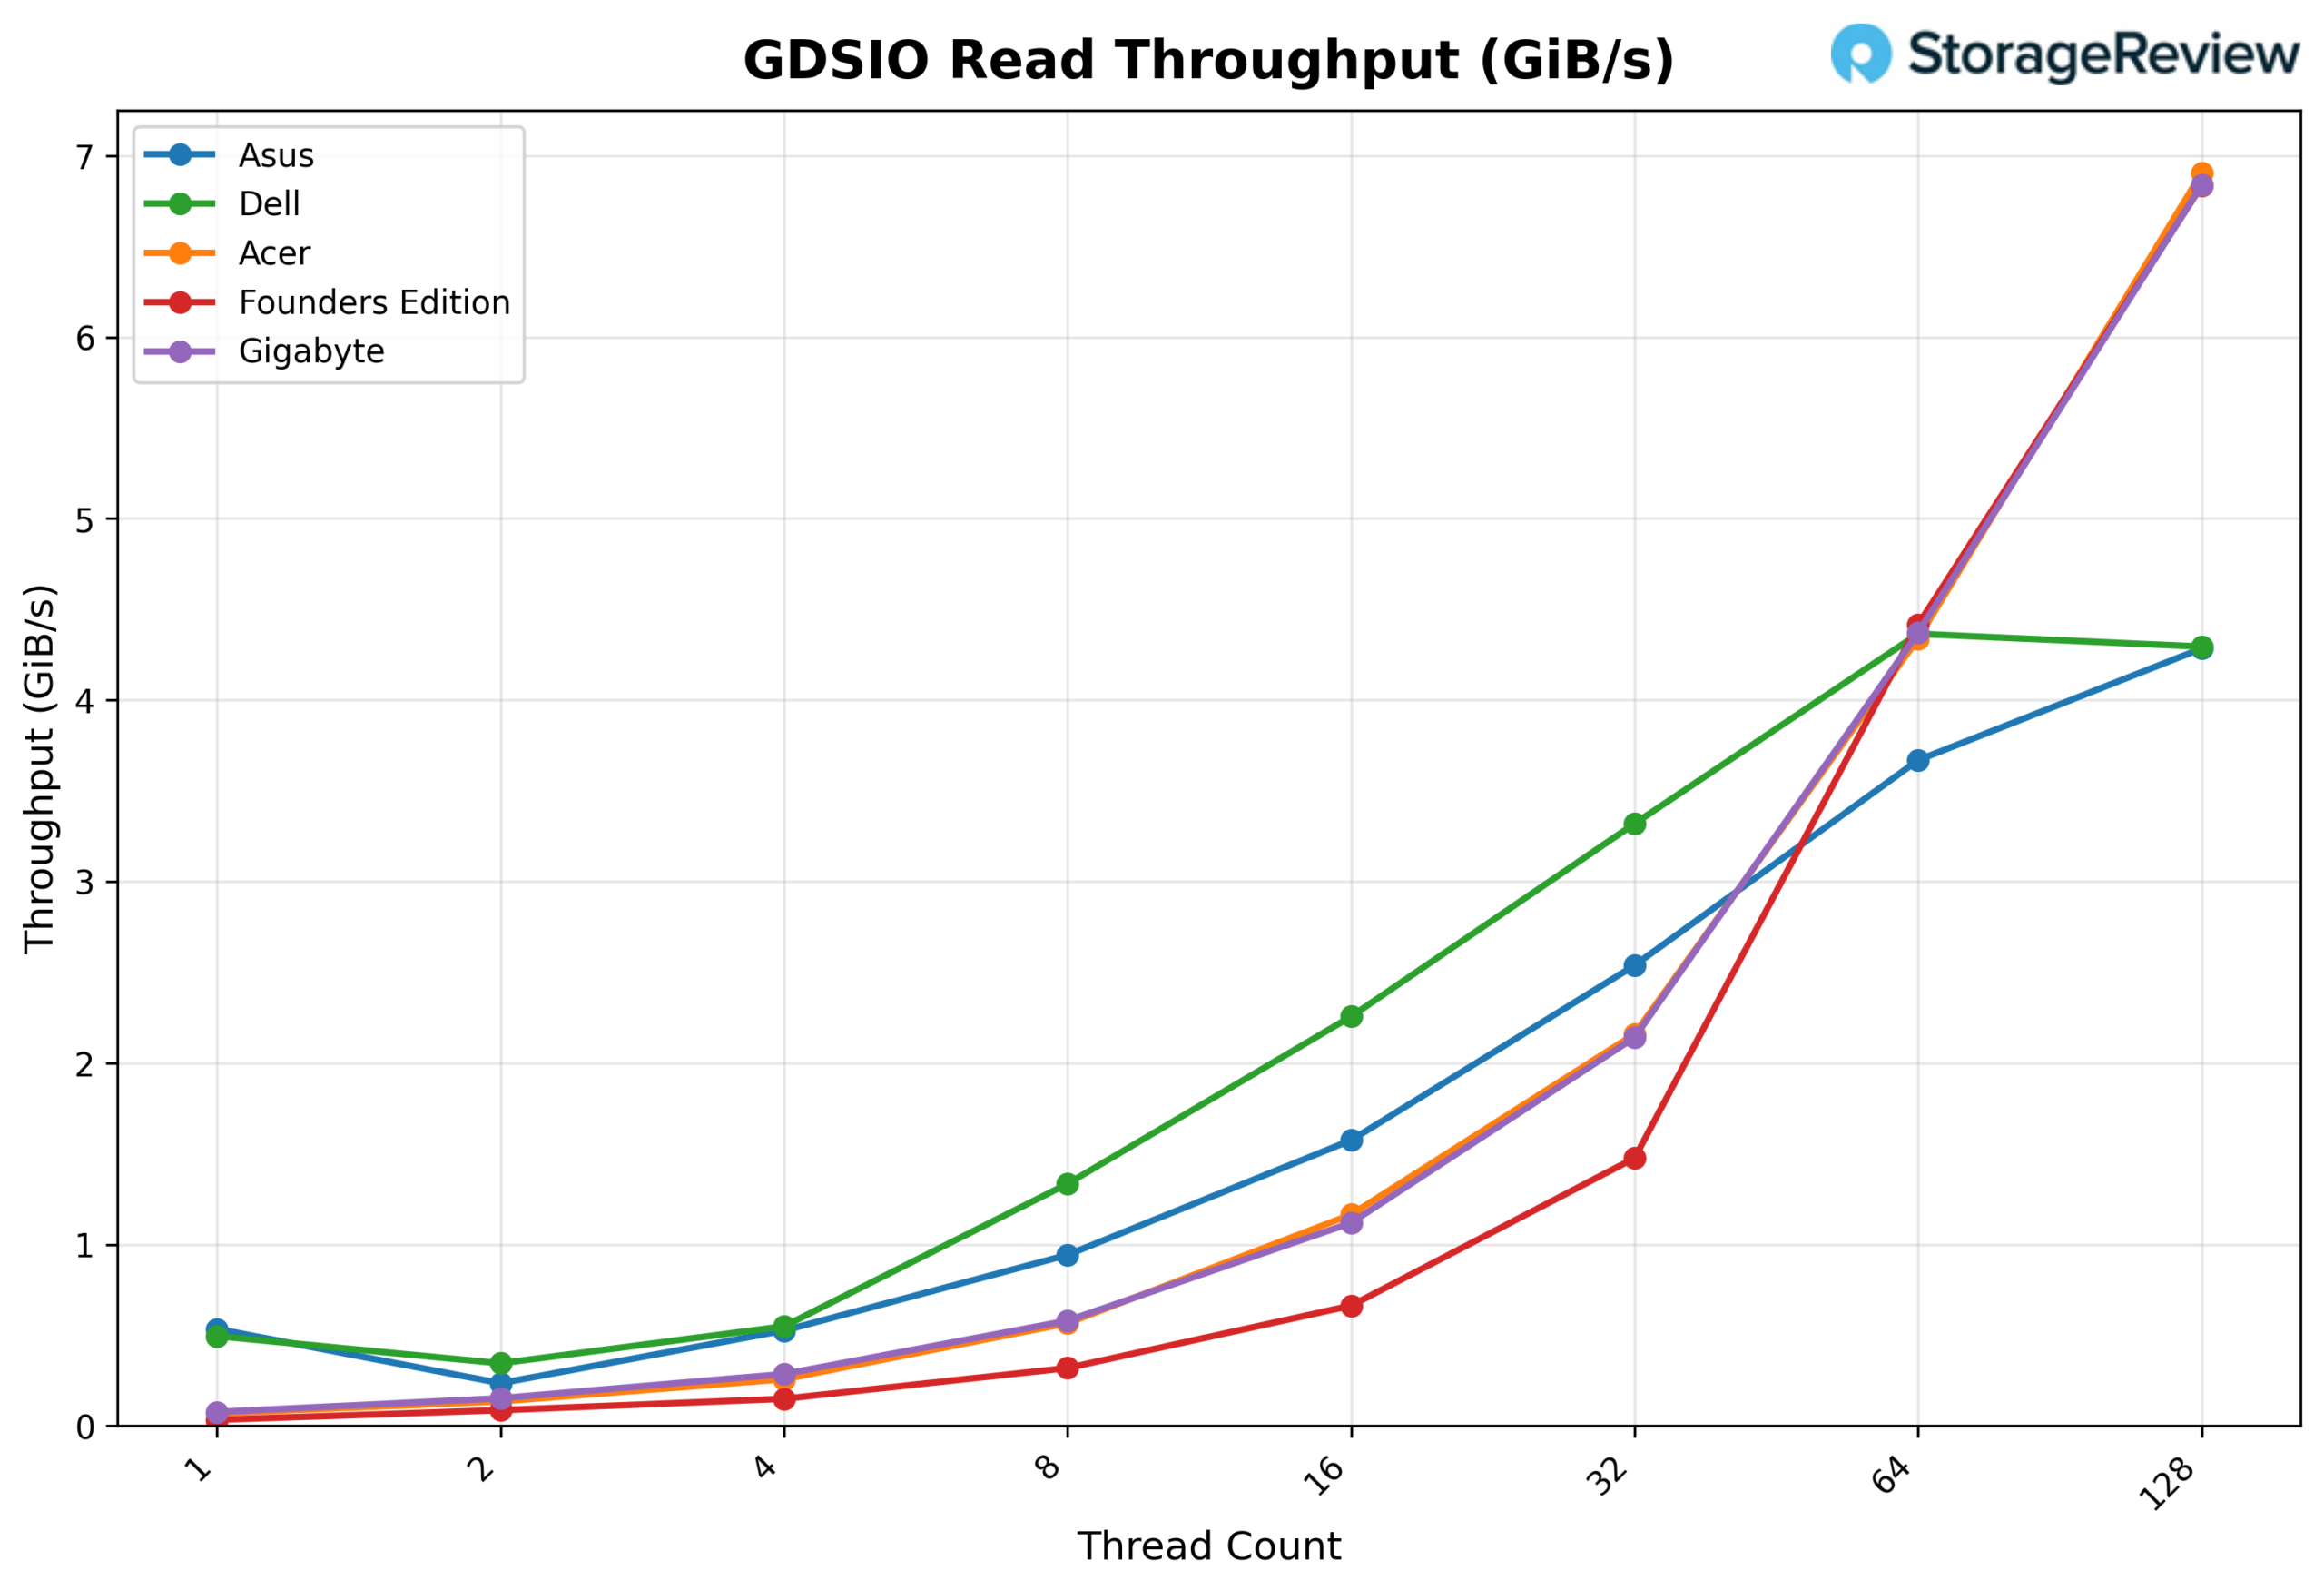
從 GDSIO 16K 讀取吞吐量來看,Acer 平台在單線程時吞吐量為 0.07 GiB/s,並隨著線程數的增加呈線性增長,雙線程(0.13 GiB/s)、四線程(0.26 GiB/s)和八線程(0.57 GiB/s)的吞吐量也隨之增加。在 16 個線程(1.16 GiB/s)、32 個線程(2.16 GiB/s)和 64 個線程(4.34 GiB/s)時,吞吐量繼續攀升。在 128 個執行緒時,吞吐量達到 6.91 GiB/s,這是本次測試中觀察到的最高值,且沒有明顯的飽和點,顯示該平台在小 I/O 規模下仍能保持良好的效能。
GDSIO 讀取平均延遲 16K
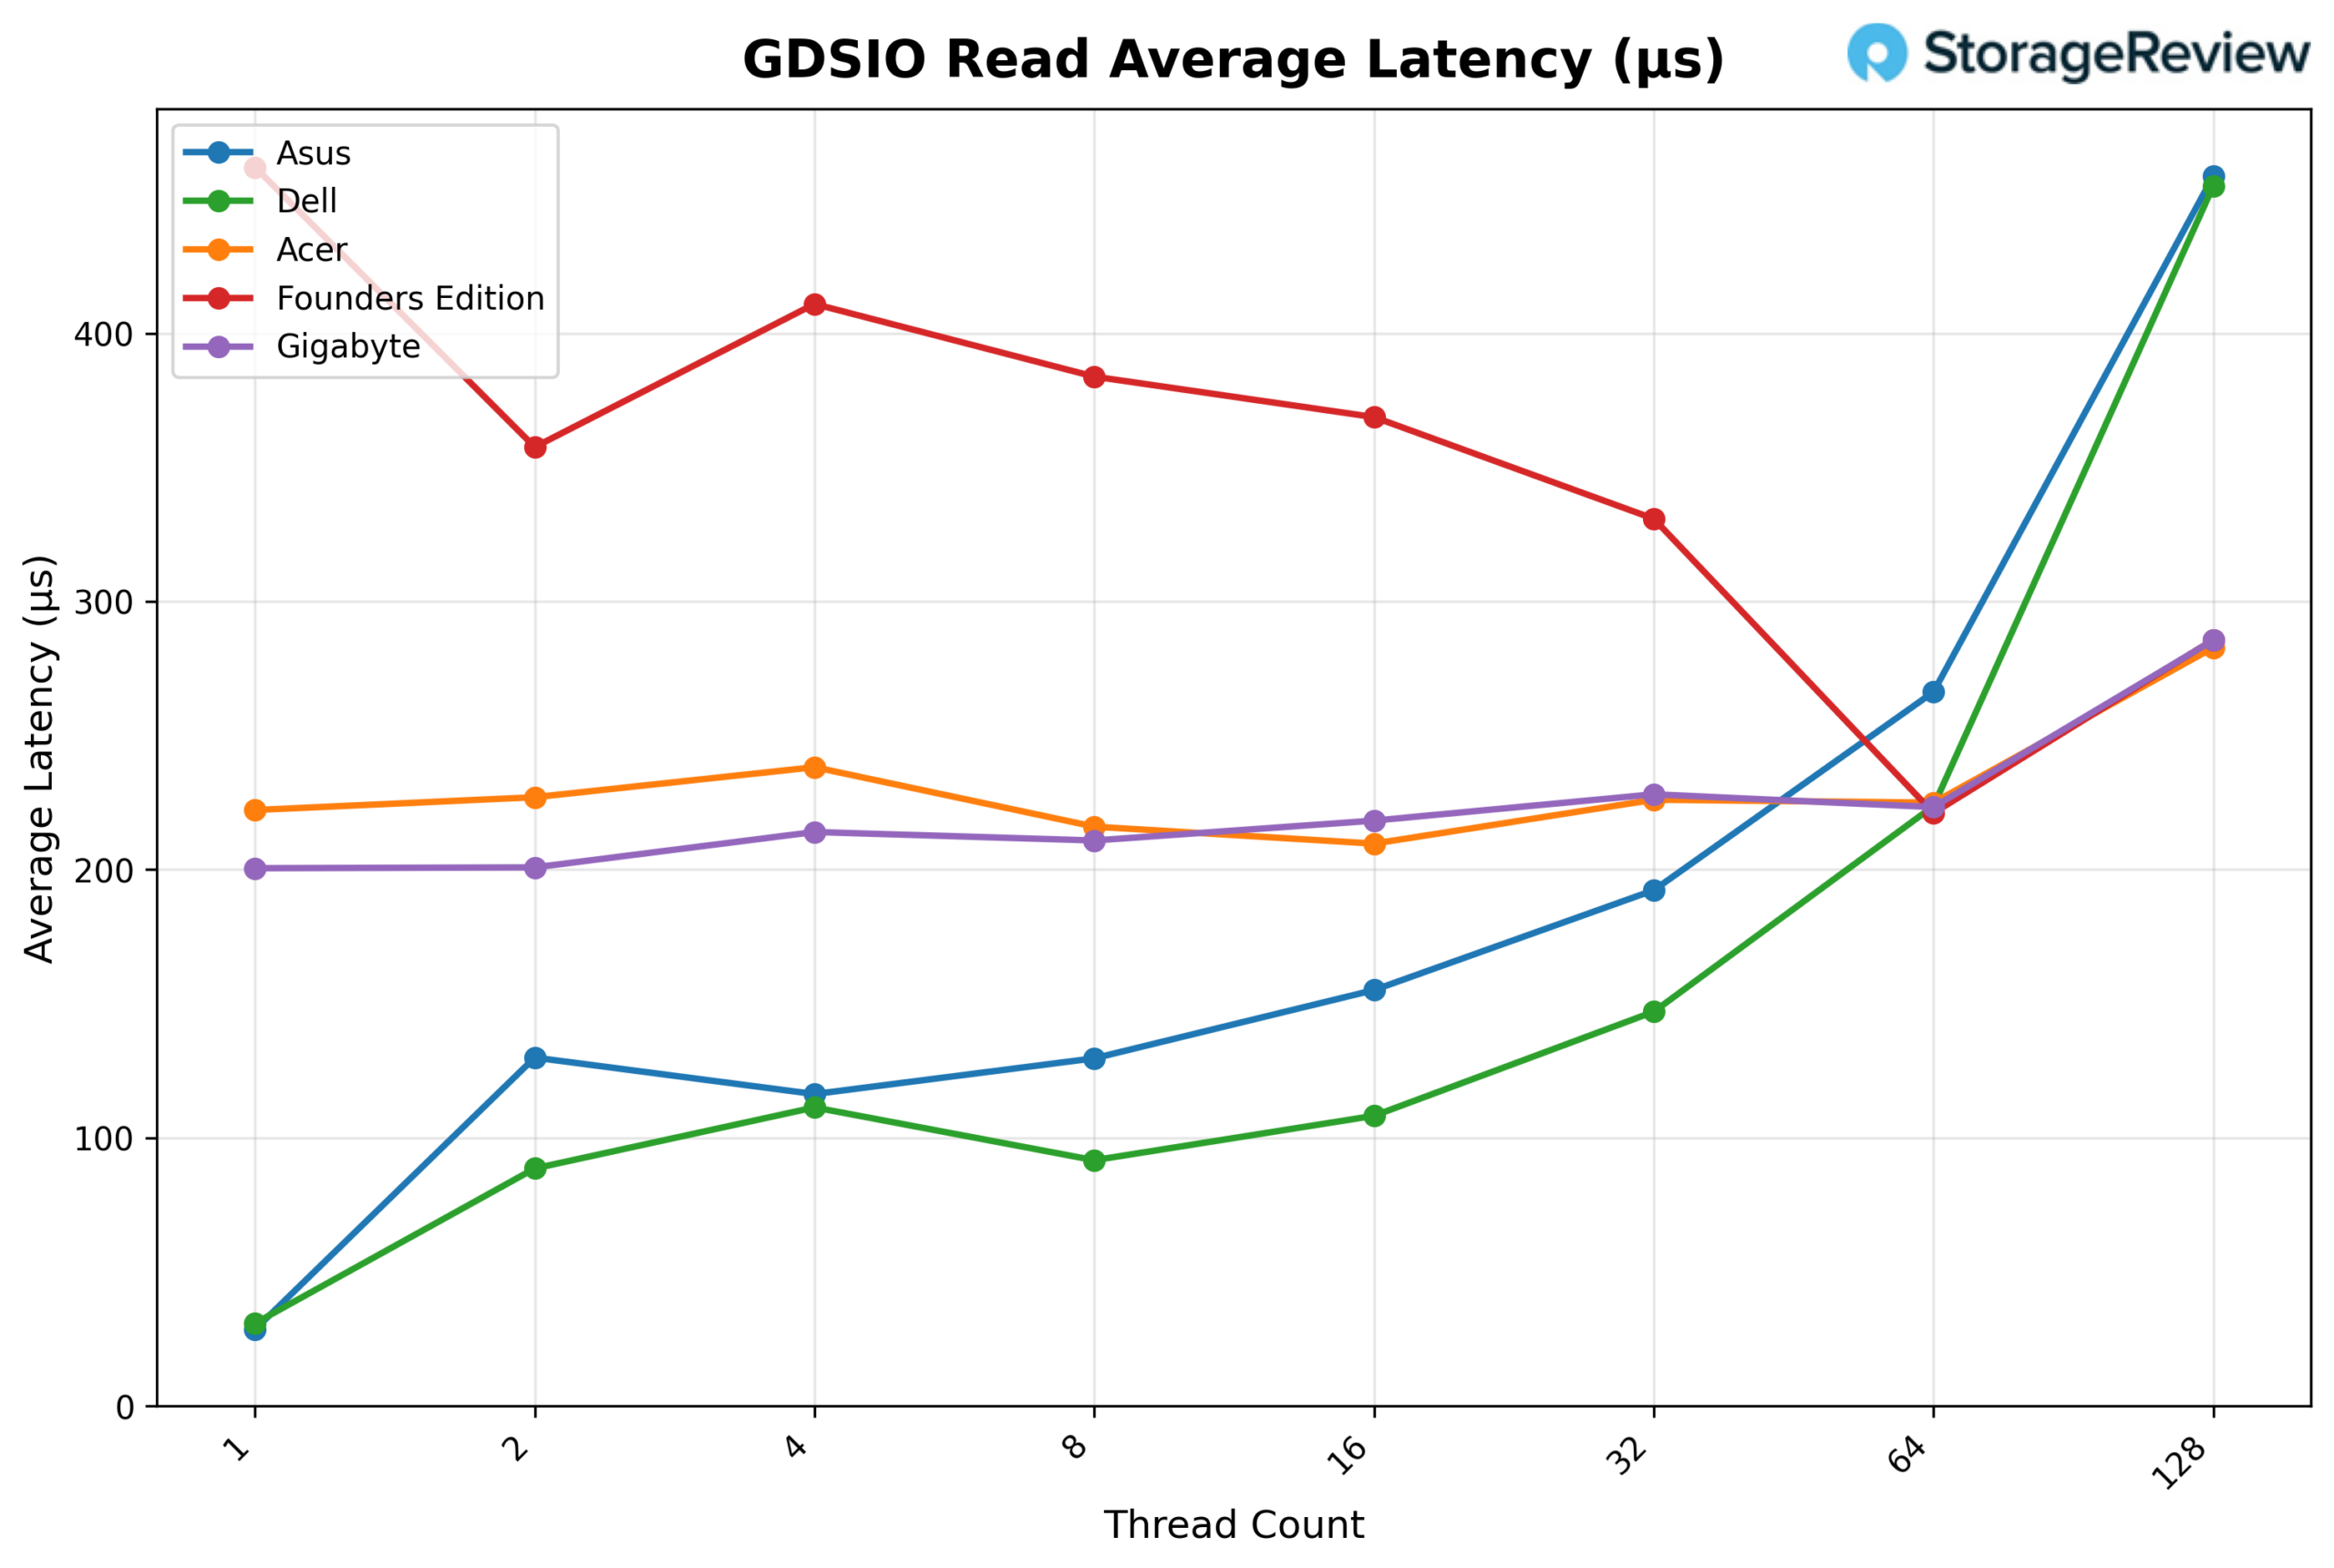
從 GDSIO 讀取平均延遲 (16K) 來看,Acer 的延遲在 1 個執行緒時約為 0.22 毫秒,並在整個測試過程中保持了驚人的穩定性:2 個執行緒時為 0.23 毫秒,4 個執行緒時為 0.24 毫秒,8 個執行緒時為 0.22 毫秒。延遲在 16 個執行緒 (0.21 毫秒)、32 個執行緒 (0.23 毫秒) 和 64 個執行緒 (0.22 毫秒) 時也保持相對平穩,直到 128 個執行緒時才略微上升至 0.28 毫秒。這種在所有執行緒數下都保持近乎平穩的延遲特性,反映了吞吐量持續的擴展性。
GSDIO 寫入吞吐量 16K
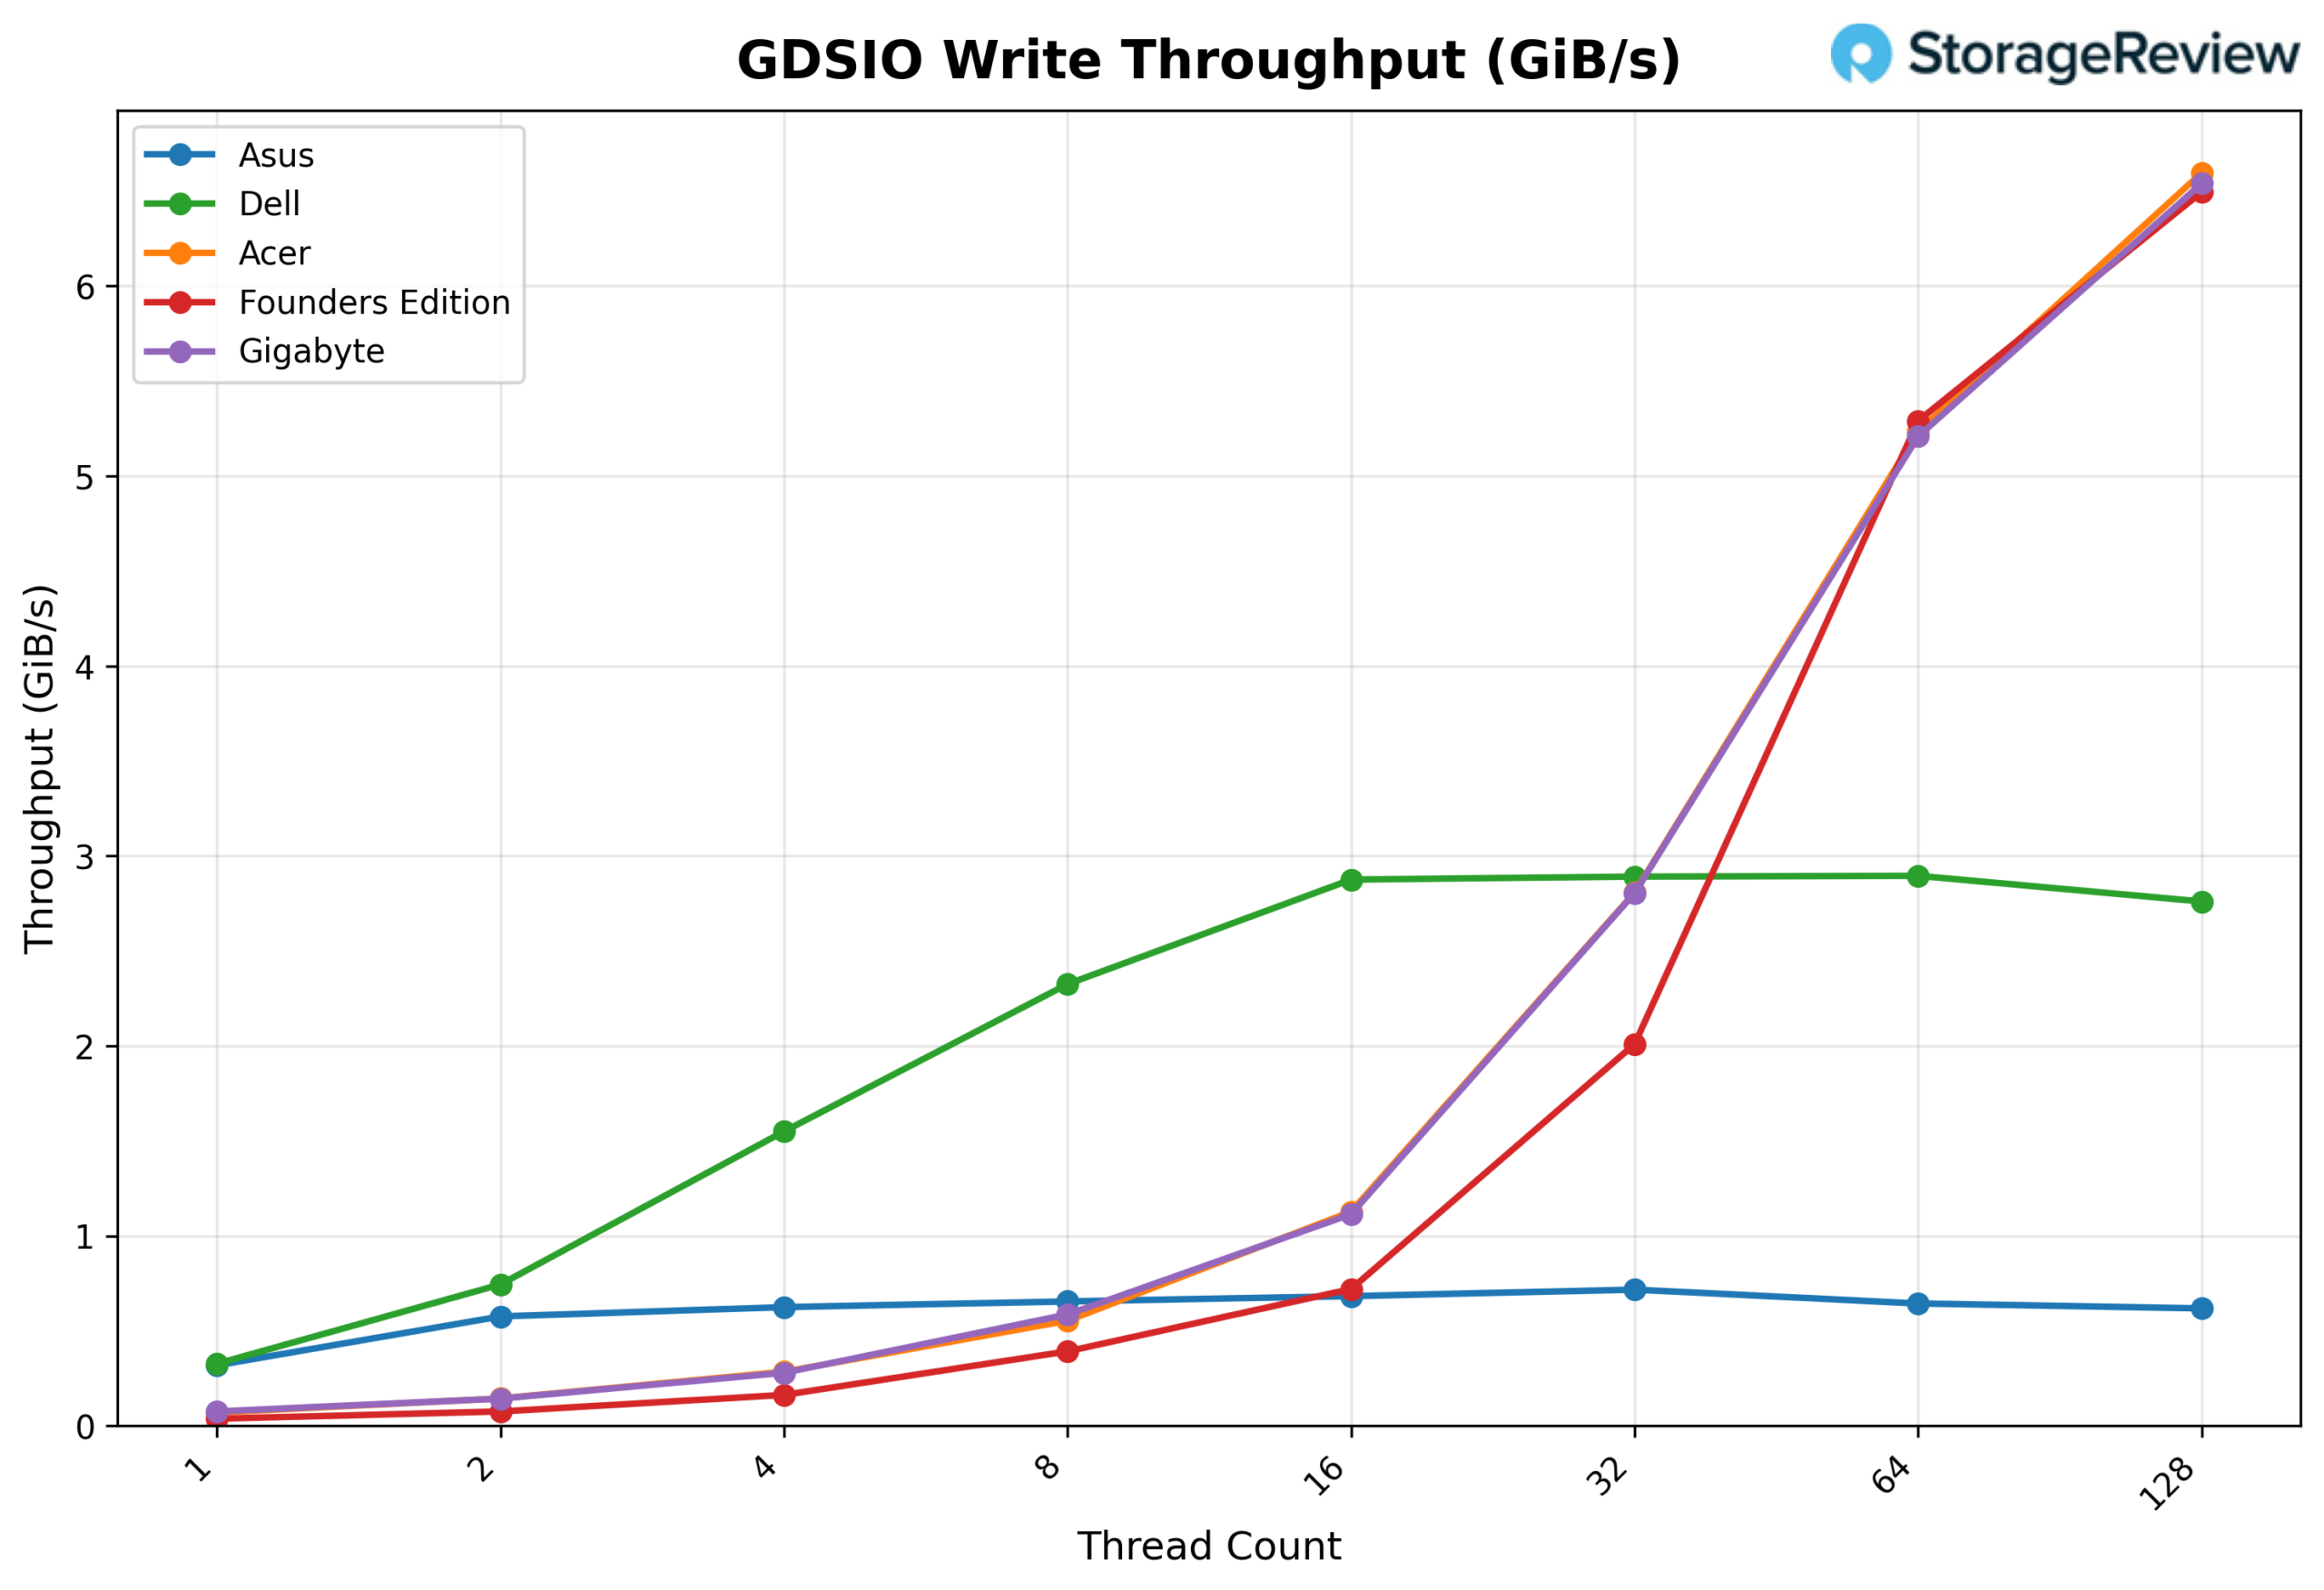
從 GDSIO 16K 寫入吞吐量來看,Acer 的吞吐量在 1 執行緒時為 0.07 GiB/s,隨著執行緒數的增加,在 2 個執行緒(0.14 GiB/s)、4 個執行緒(0.28 GiB/s)和 8 個執行緒(0.55 GiB/s)時有所提升。在 16 執行緒(1.13 GiB/s)、32 執行緒(2.81 GiB/s)和 64 執行緒(5.23 GiB/s)時,吞吐量成長速度加快。在 128 個執行緒時,吞吐量達到峰值 6.60 GiB/s,再次顯示吞吐量沒有明顯的飽和現象,並且在小資料塊大小下仍能持續提升。
GDSIO 寫入平均延遲 16K
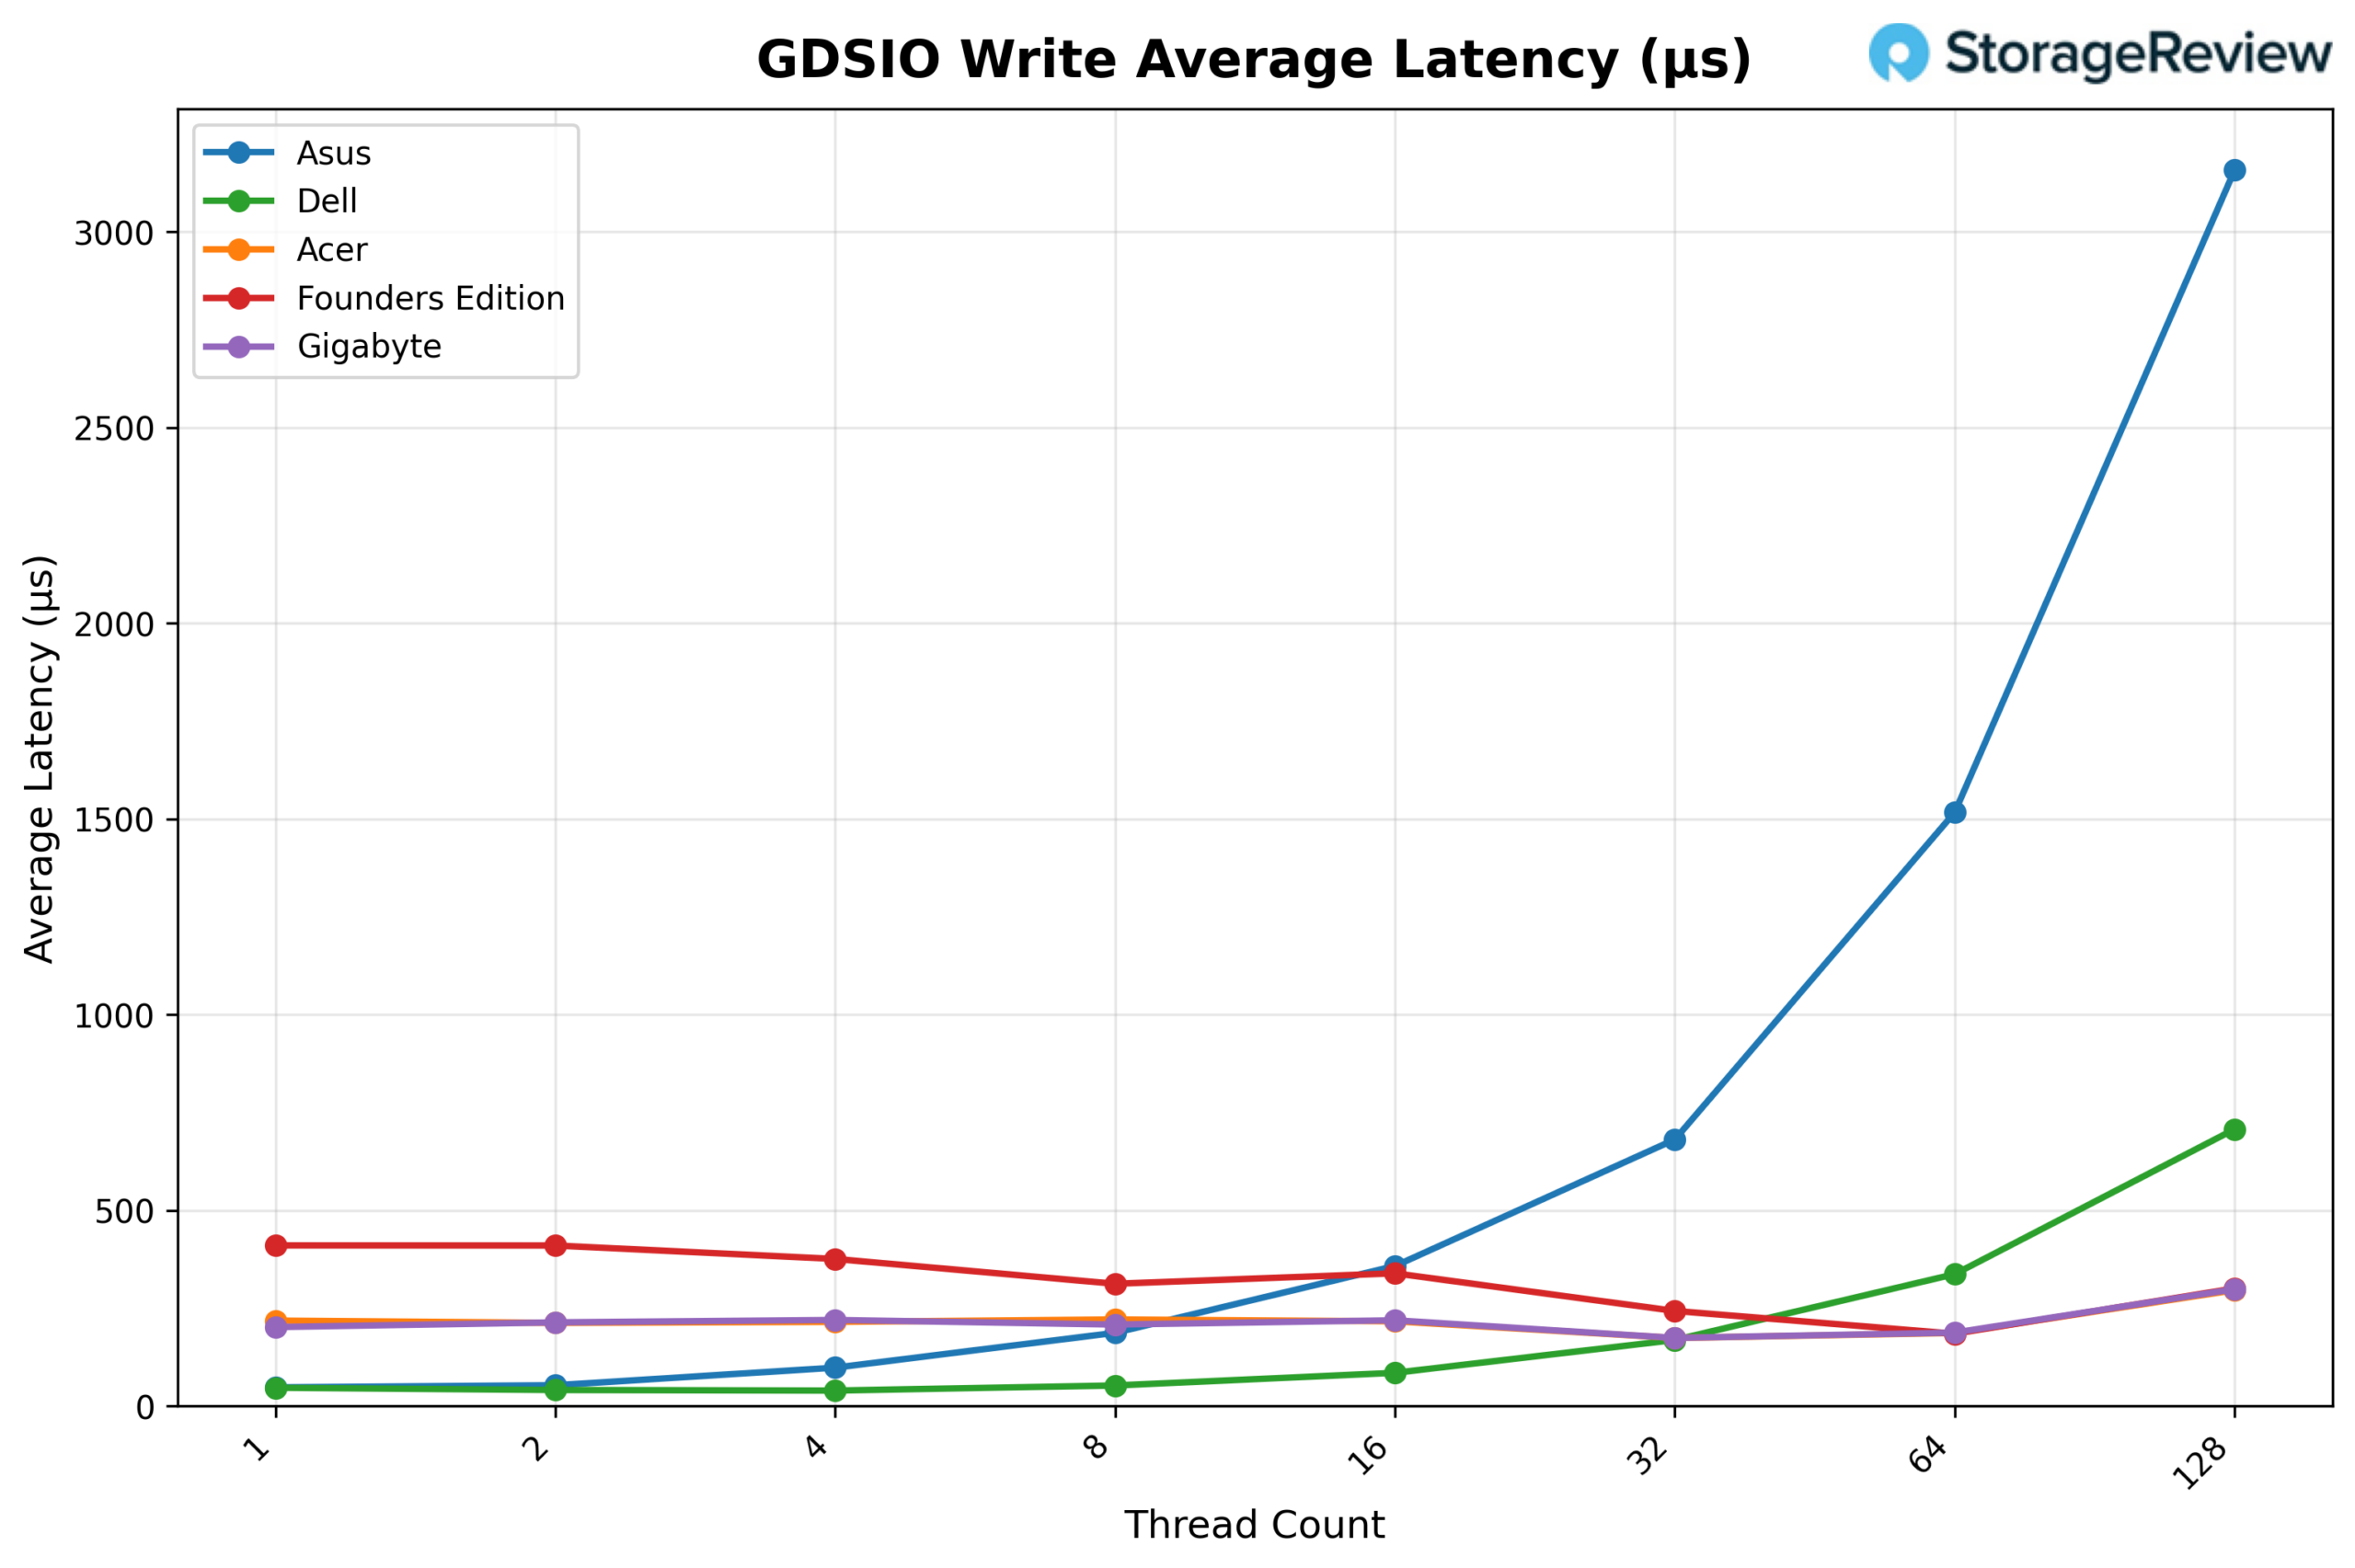
從 GDSIO 寫入平均延遲(16K)來看,Acer 的延遲在 1 個執行緒時約為 0.22 毫秒,在 2 個執行緒(0.21 毫秒)、4 個執行緒(0.22 毫秒)和 8 個執行緒(0.22 毫秒)時保持穩定。在 32 個執行緒時,延遲略微下降至 0.17 毫秒,然後在 64 個執行緒時小幅上升至 0.19 毫秒。在 128 個執行緒時,延遲攀升至 0.30 毫秒,與 1M 的結果相比仍然相對較低,這與在這種較小的 I/O 規模下持續的擴展特性一致。
GDSIO 讀取吞吐量 1M
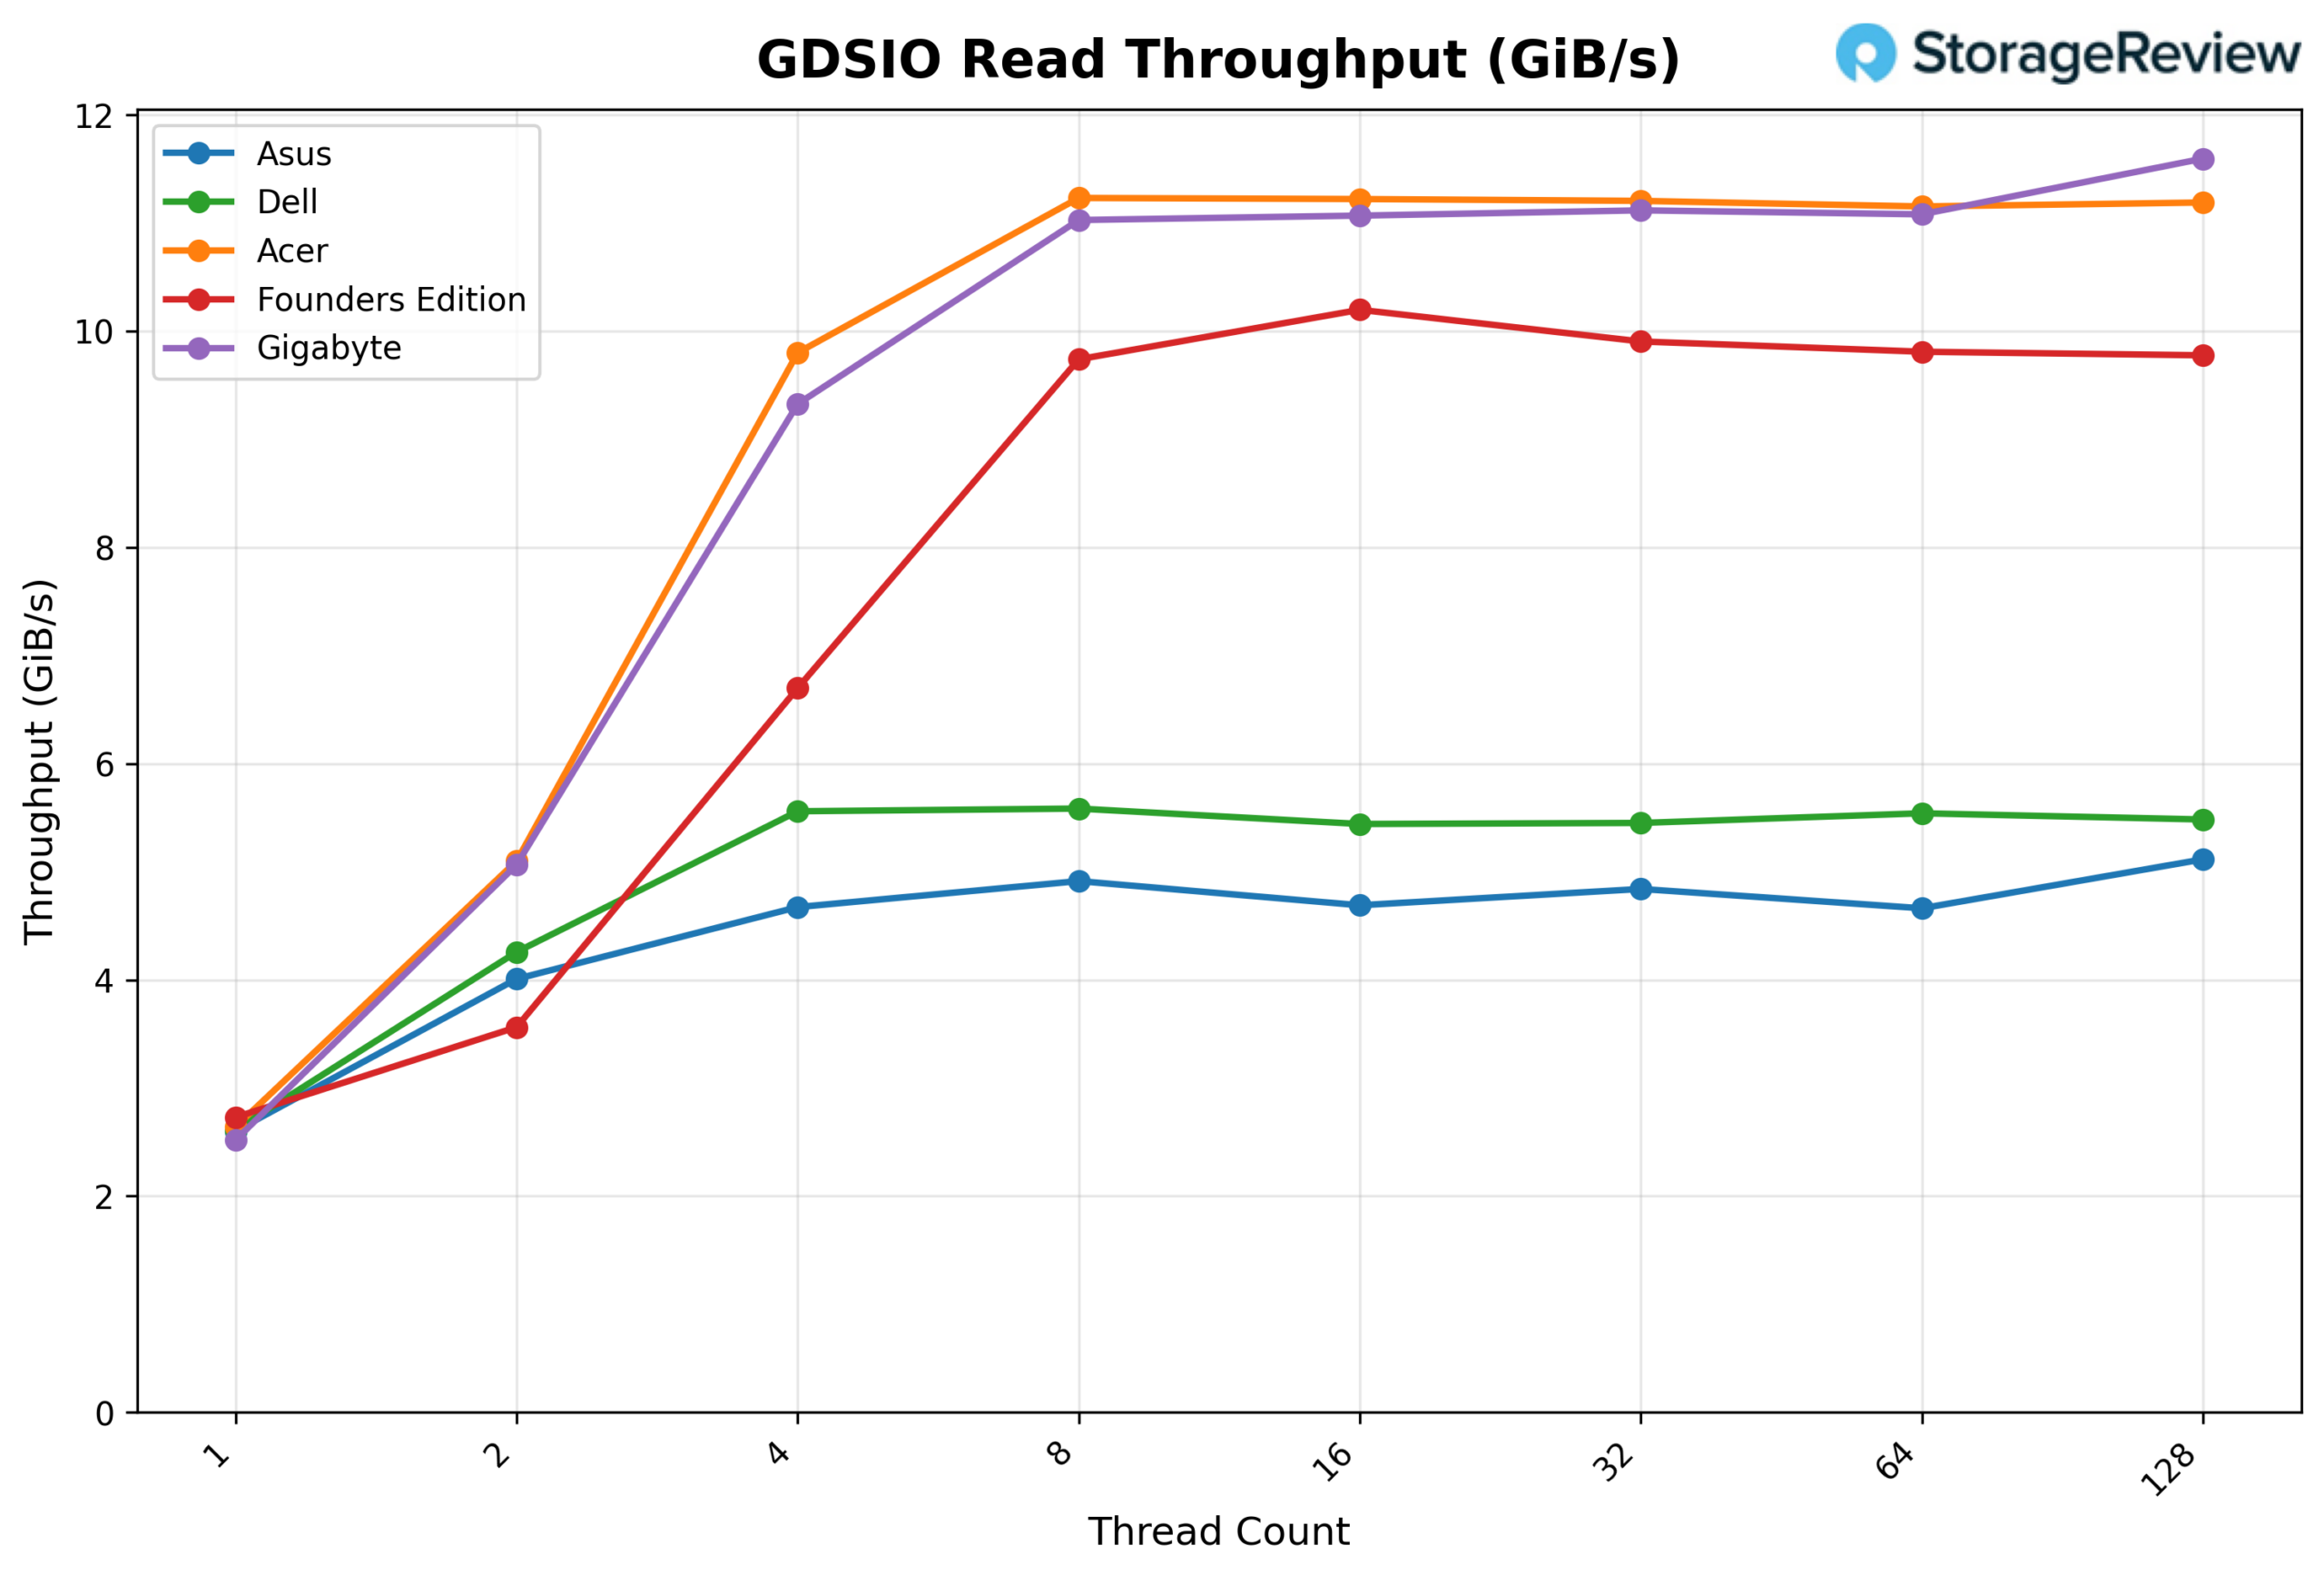
從 GDSIO 讀取吞吐量 1M 測試來看,Acer 平台在單線程下初始吞吐量為 2.64 GiB/s,雙線程下為 5.10 GiB/s,四線程下為 9.80 GiB/s。八線程時吞吐量達到 11.23 GiB/s,之後平台效能基本上達到飽和。在 16 執行緒(11.22 GiB/s)、32 執行緒(11.21 GiB/s)和 64 執行緒(11.15 GiB/s)下,效能保持穩定,呈現平台期。在 128 個執行緒時,吞吐量穩定在 11.19 GiB/s,證實了整個測試範圍內效能已達到飽和上限。
GDSIO 讀取平均延遲 1M
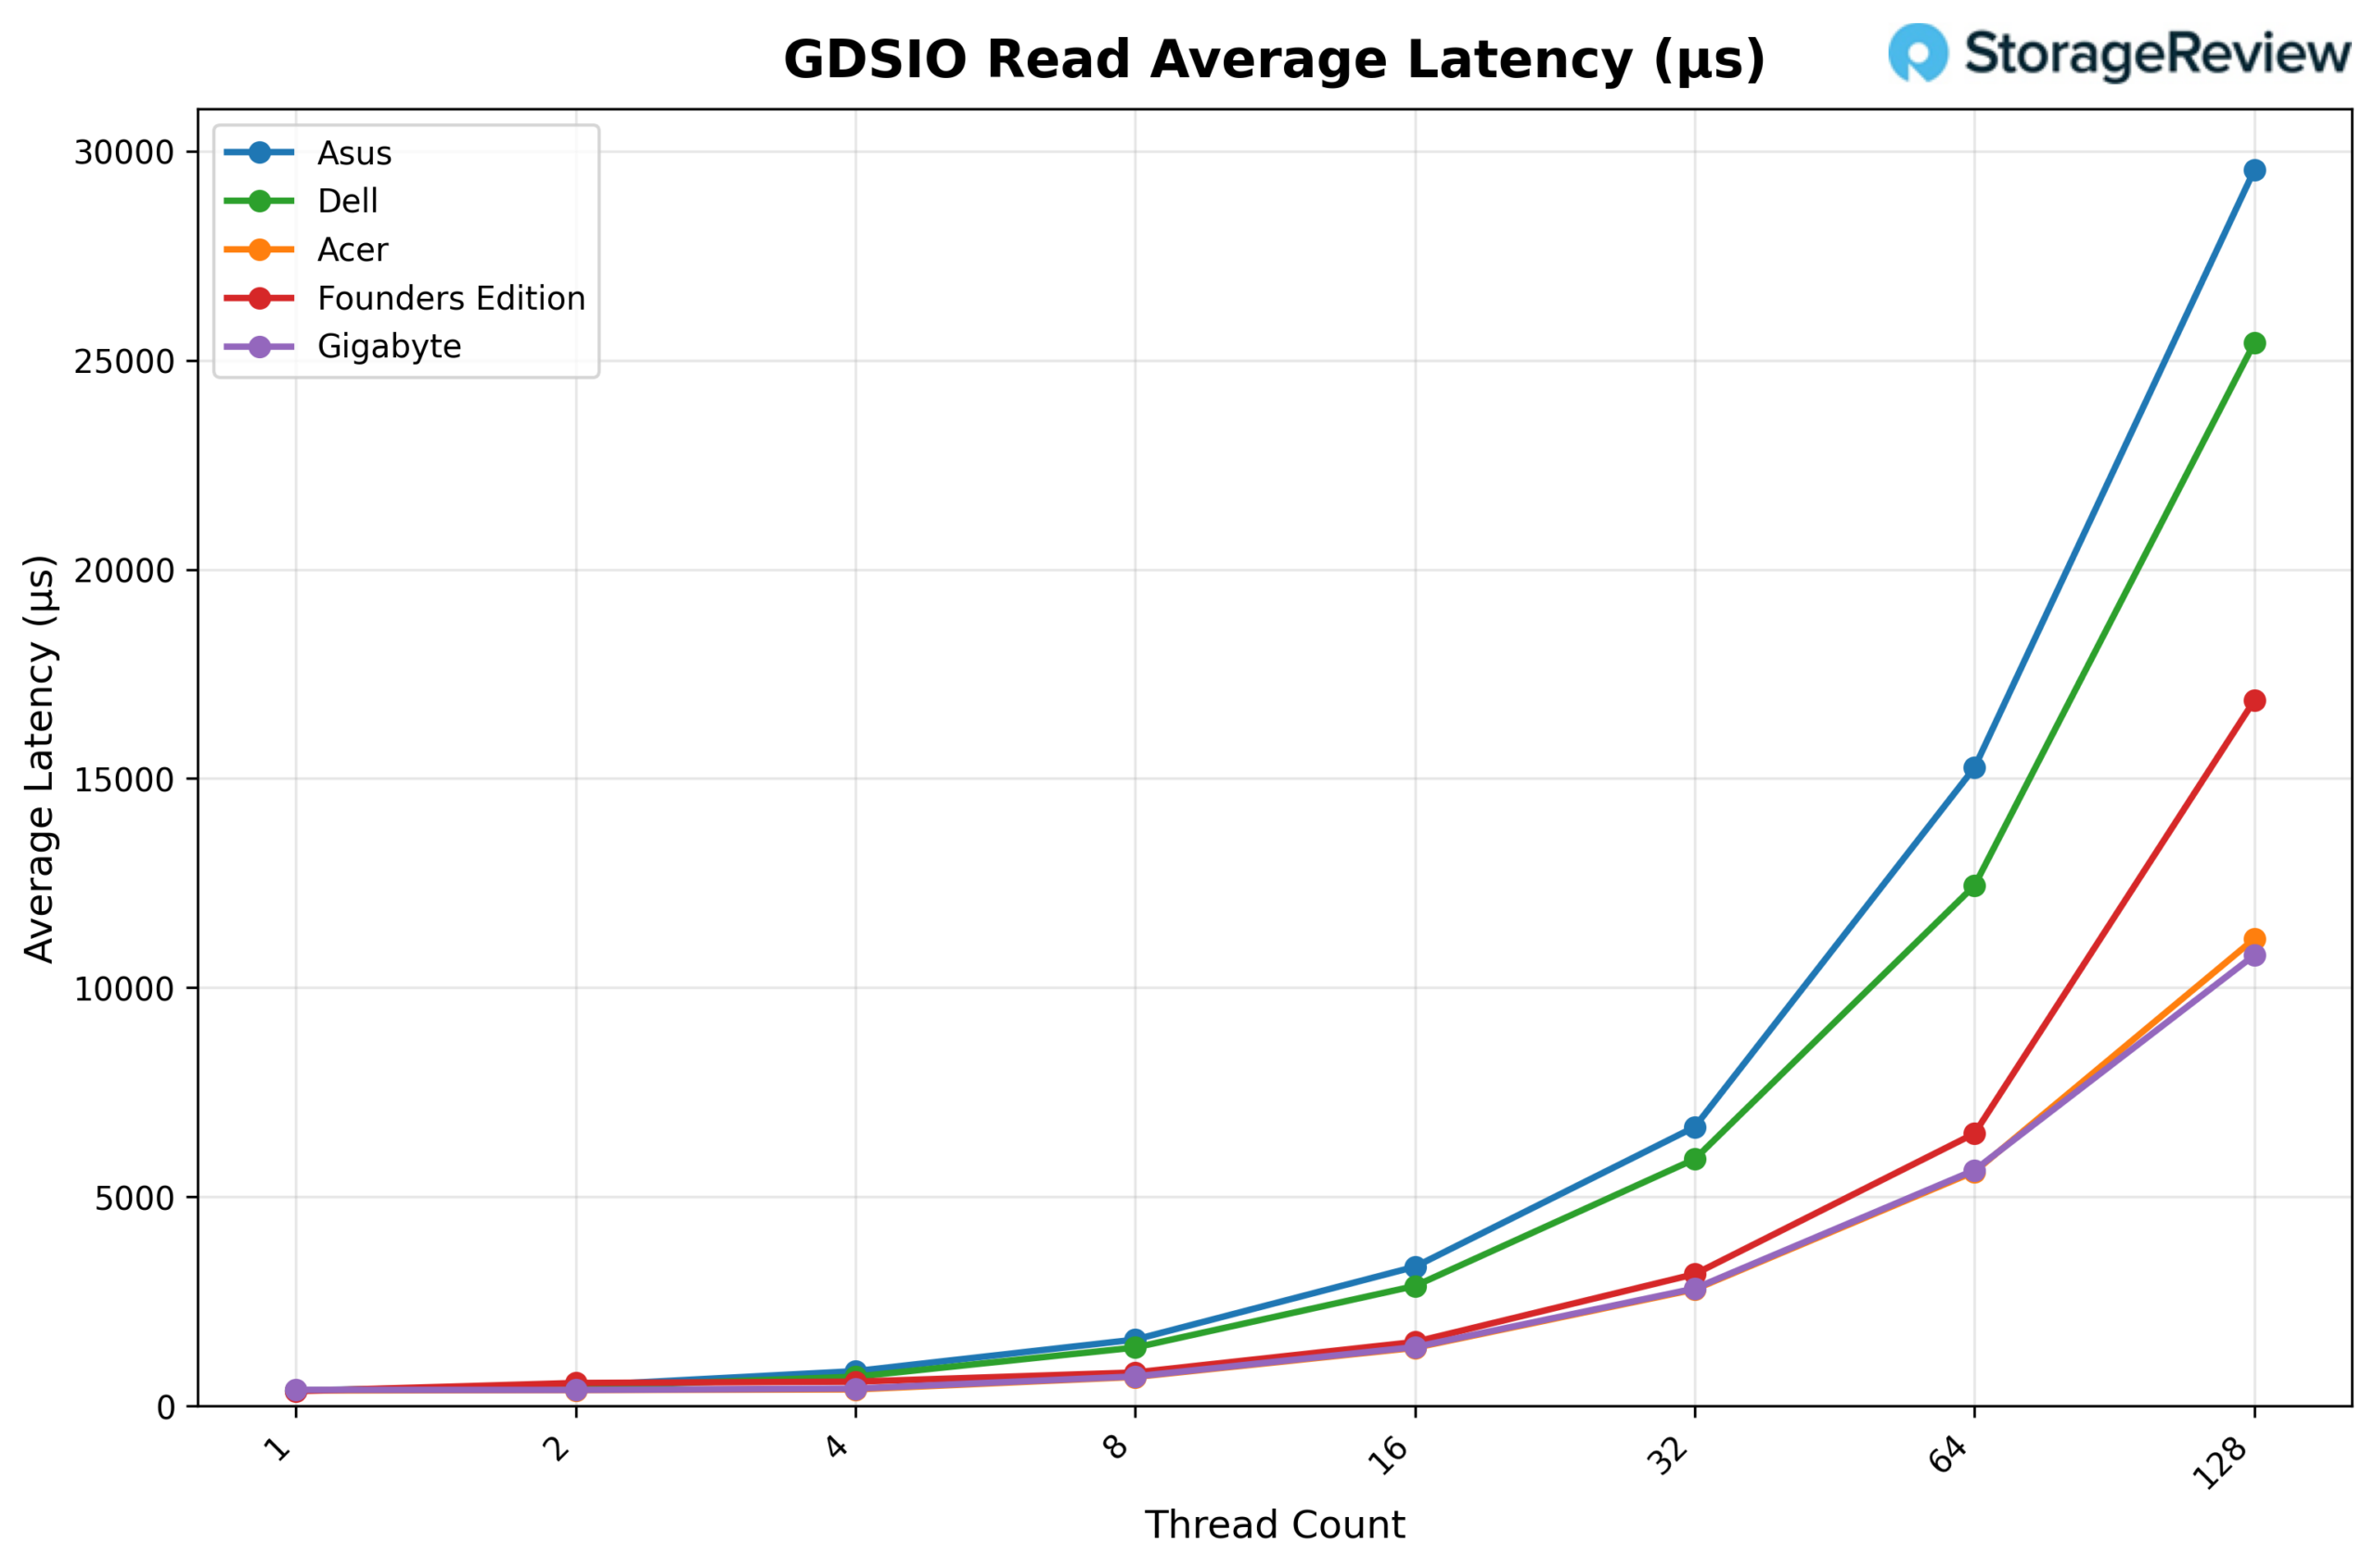
從 GDSIO 讀取平均延遲(1M)來看,Acer 的延遲在 1 個執行緒時約為 0.37 毫秒,在 2 個執行緒(0.38 毫秒)和 4 個執行緒(0.40 毫秒)時也保持相似水準。延遲隨著同時數量的增加而增加,在 8 個執行緒時上升至 0.70 毫秒,16 個執行緒時上升至 1.39 毫秒,32 個執行緒時上升至 2.79 毫秒。延遲在 64 個執行緒時繼續上升(5.60 毫秒),並在 128 個執行緒時達到 11.17 毫秒,這與峰值並發量相對應,而吞吐量基本上保持穩定。
GDSIO 寫入吞吐量 1M
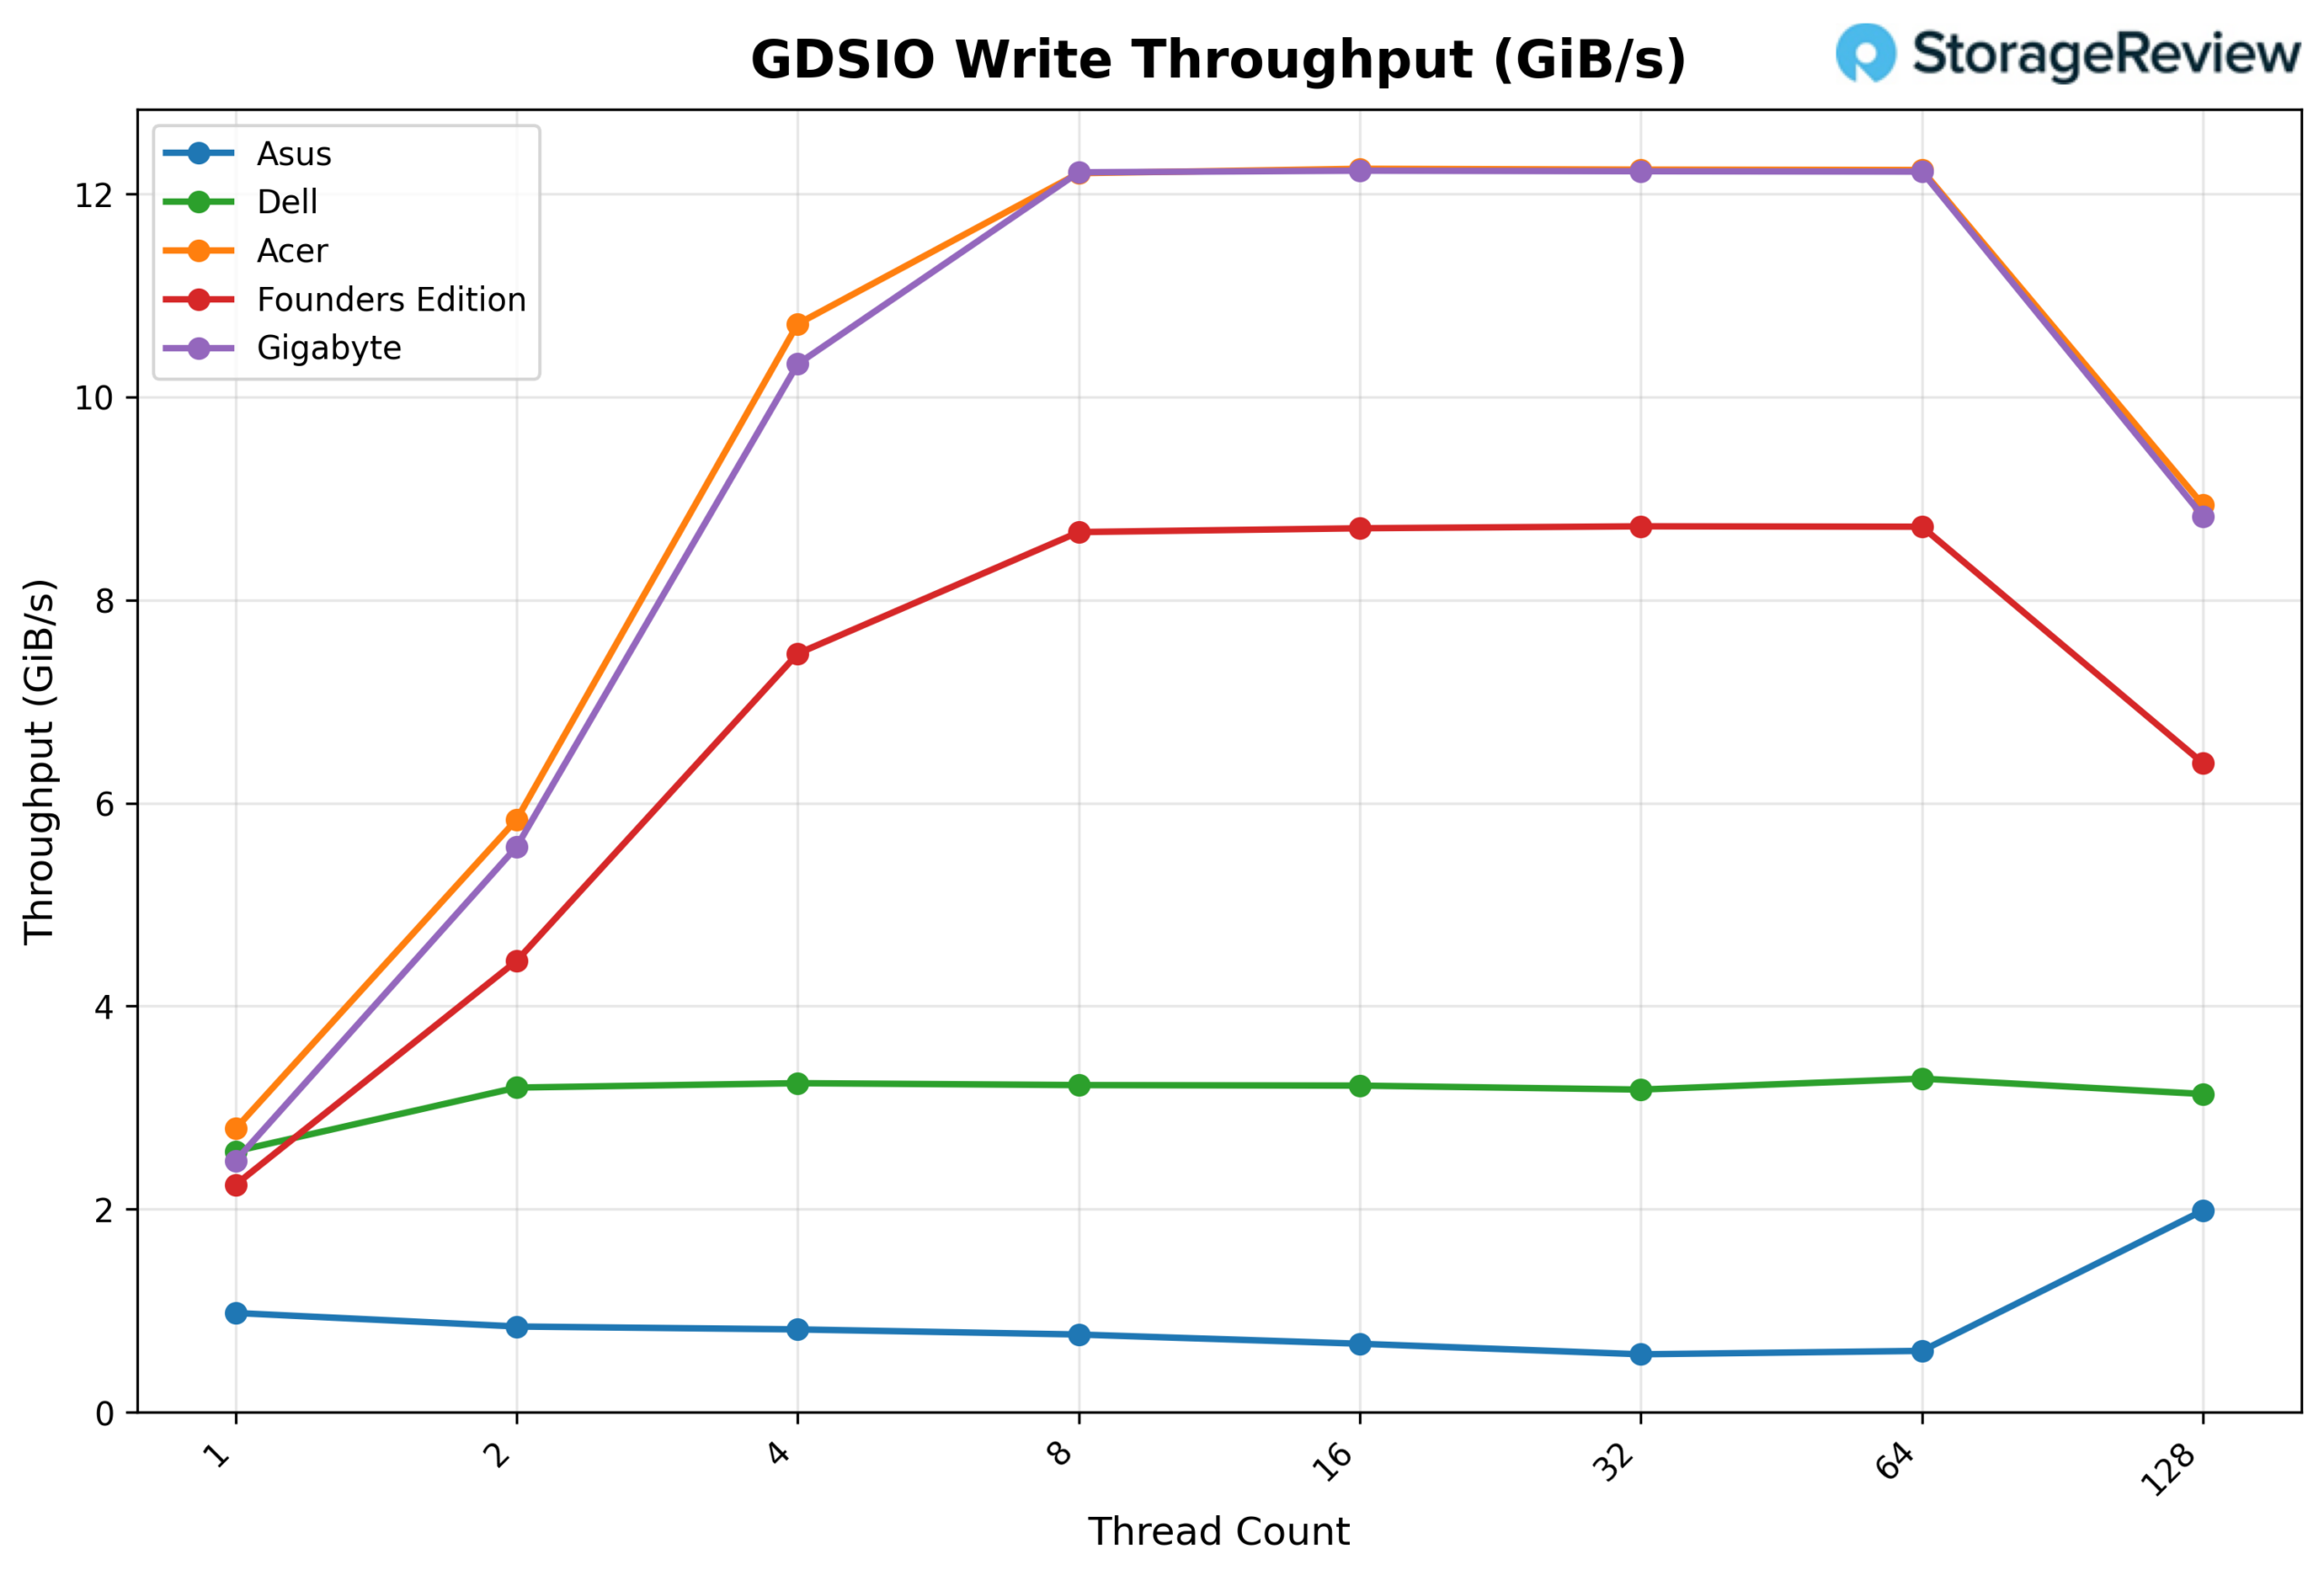
從 GDSIO 寫入吞吐量 1M 測試來看,Acer 平台在單線程下初始吞吐量為 2.79 GiB/s,並隨著線程數的增加而顯著提升,在雙線程下達到 5.84 GiB/s,在四線程下達到 10.72 GiB/s。當執行緒數達到 8 時,吞吐量達到 12.20 GiB/s,平台效能基本上達到飽和。在 16 執行緒(12.25 GiB/s)、32 執行緒(12.24 GiB/s)和 64 執行緒(12.23 GiB/s)下,效能保持穩定,呈現平穩狀態。然而,當執行緒數達到 128 時,吞吐量顯著下降至 8.94 GiB/s,顯示在最高並發等級下出現了資源爭用或資源耗盡的情況。
GDSIO 寫入平均延遲 1M
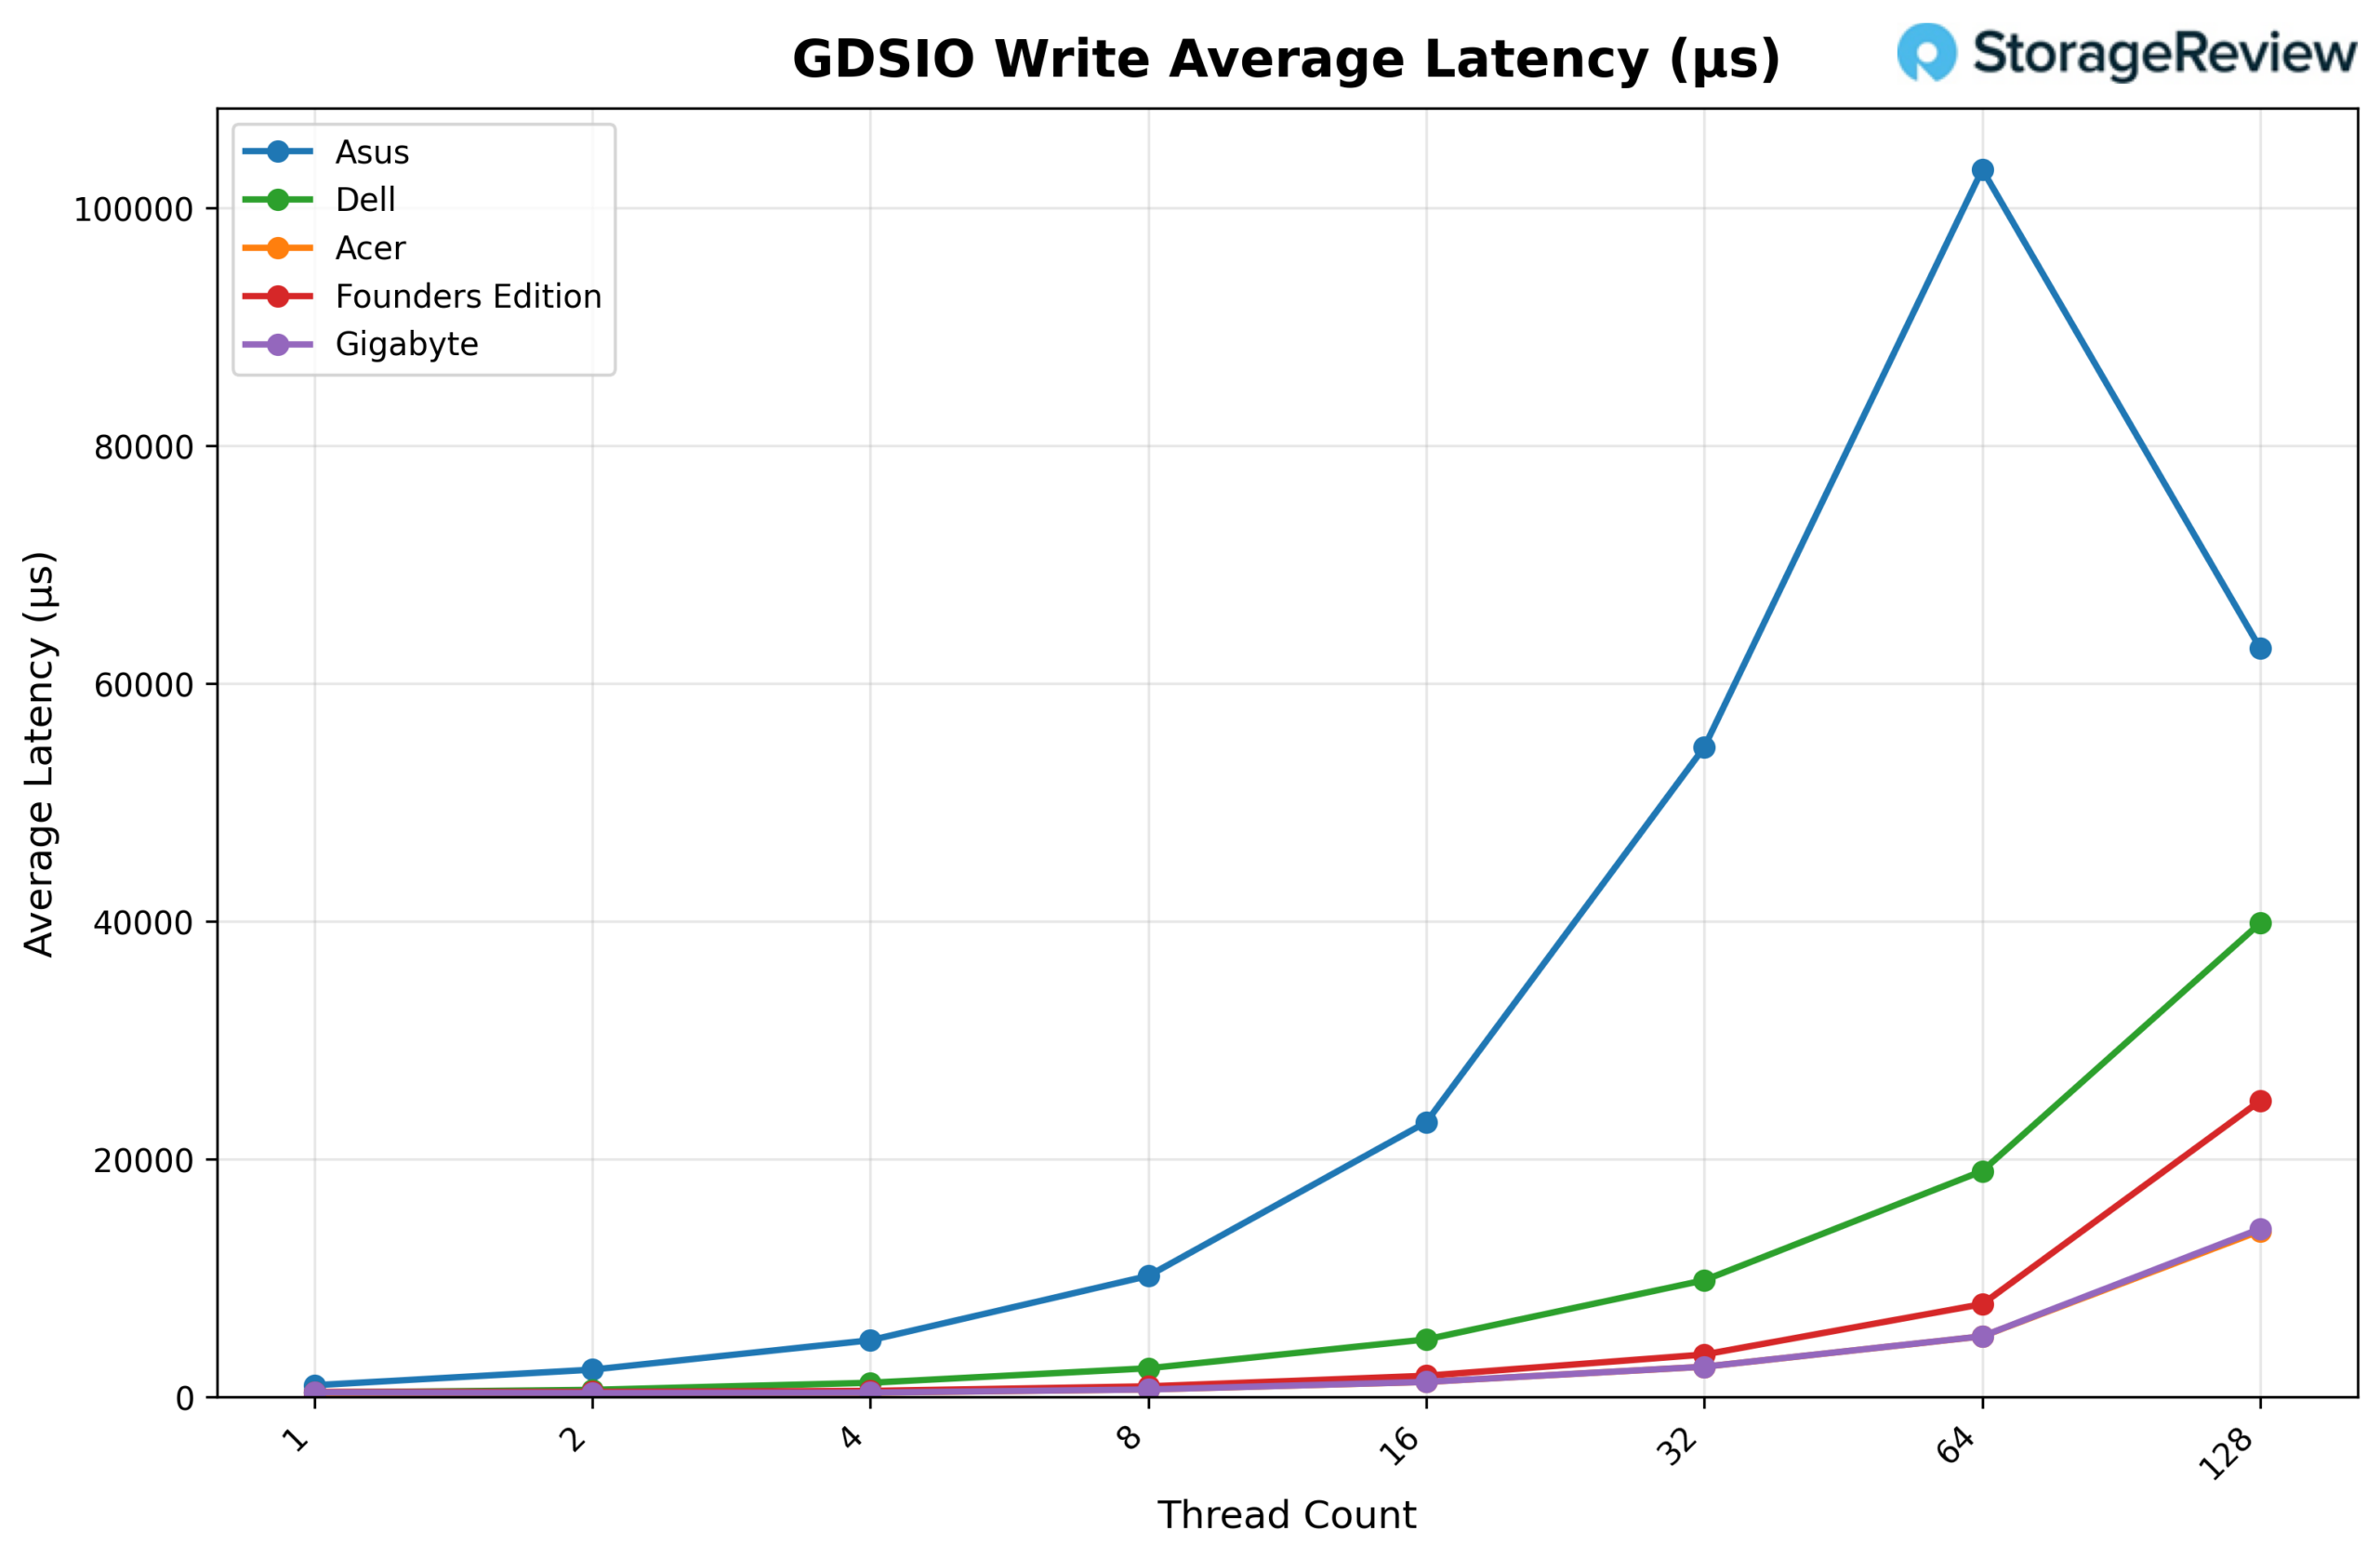
從 GDSIO 寫入平均延遲(1M)來看,Acer 的延遲在 1 個執行緒時約為 0.35 毫秒,在 2 個執行緒(0.33 毫秒)和 4 個執行緒(0.36 毫秒)時也保持較低水準。延遲隨著同時數量的增加而上升,在 8 個執行緒時達到 0.64 毫秒,16 個執行緒時達到 1.28 毫秒,32 個執行緒時達到 2.55 毫秒。這種上升趨勢在 64 個執行緒時繼續(5.11 毫秒),並在 128 個執行緒時急劇攀升至 13.98 毫秒,這與在最大並發數下觀察到的吞吐量下降相一致。
結語
在我們的Spark對比測試中,宏碁Veriton GN100的整體散熱表現最佳。在密集型預填充轉換和持續解碼工作負載下,它的CPU和GPU尖峰溫度始終低於其他測試機型。在負載運行時,它的溫度並沒有像其他機型那樣飆升至80°C以上,而是在長時間運行過程中保持在較為穩定的溫度範圍內,這表明其散熱設計和電源調校都非常出色。
儲存效能是另一大優勢。 GN100 配備了 4TB 三星 PM9E1 Gen5 SSD,在同組產品中實現了最強的 GPU 直接儲存 (GPU Direct Storage) 小塊資料擴充。在 16K 資料區塊大小下,讀寫延遲在不同執行緒數下保持了極低的水平,而吞吐量則平滑地提升至圖表頂部。在 1 萬次傳輸時,該平台迅速達到性能飽和,並在中等並發水平下保持了極具競爭力的性能上限,之後在高線程數下性能有所下降。
在 vLLM 推理測試中,其性能與更廣泛的 Spark 生態系統保持高度一致,這符合預期,因為它們都基於 GB10 架構。效能差異並非體現在原始運算輸出上,而是體現在負載下的散熱和儲存行為。
Spark 產品線架構的一致性確保了推理效能的緊密銜接。 GN100 在此輪測試中脫穎而出,其持續低溫度運行特性以及強大的第五代 NVMe 性能使其成為我們迄今為止測試過的散熱效率最高、存儲性能最強的產品之一。
產品頁面 – Acer Veritron GN 100 AI
排行榜:在我們的「最佳本地 AI 桌上型電腦」排行榜上,Acer Veriton GN100 佔據了「最佳 GB10 實現」的寶座。


 Amazon