

戴爾 Pro Max 16 Plus 包含兩個截然不同的面向。一方面,它是一款頂級行動工作站:搭載英特爾 24 核酷睿 Ultra 9 285HX 處理器,最高 256GB CAMM2 內存,三個 M.2 插槽,最高 NVIDIA RTX PRO Blackwell 5000 系列顯示卡(配備 24GB GDDR7 顯式機櫃功能設計機組符合標準 PIL-STD。
另一款是我們正在評測的產品,它以高通AIC100 PC推理卡取代了GPU。 AIC100是一款基於2019年Cloud AI 100晶片的雙SoC模組,其軟體堆疊使得大多數現代推理工作負載都變成了痛苦的探索過程。這是一個警示案例,說明了當旗艦級機箱搭配錯誤的加速器時會發生什麼,以及為什麼客戶在簽署採購訂單之前需要了解AI解決方案背後的軟體棧。在深入探討原因之前,讓我們先整體看一下這款筆記型電腦。
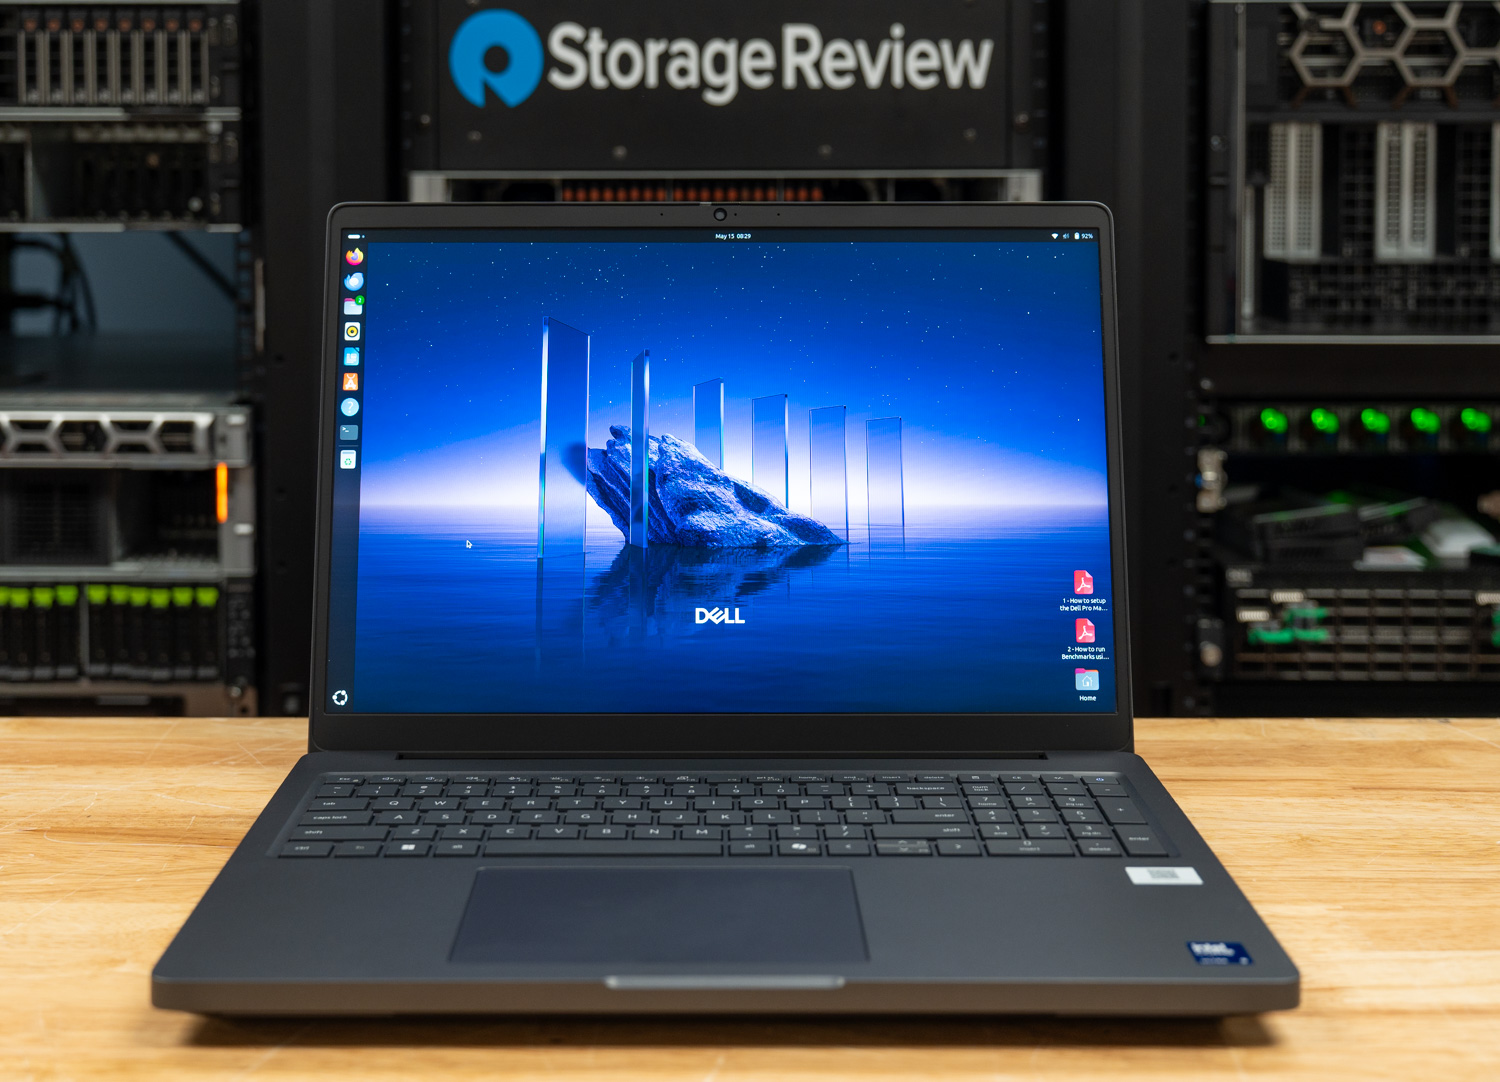
戴爾Pro Max 16 Plus是Pro Max工作站系列中的旗艦機型,其性能遠超入門級Pro Max 16和更輕薄的Pro Max 16 Premium。它搭載英特爾可擴充的酷睿Ultra 9 285HX處理器,這是一款55瓦、24核心的晶片,睿頻加速頻率可達5.5GHz。所有CPU配置均支援英特爾博銳企業版技術,進一步提升了這款筆記型電腦的企業級效能。起價為2,779美元。
顯示卡選項涵蓋從整合式英特爾顯示卡到基於 NVIDIA Blackwell 架構的 RTX PRO 1000,最高可達我們先前已評測的 RTX PRO 5000,後者配備了令人印象深刻的 24GB GDDR7 記憶體。儲存和記憶體配置同樣慷慨:最高支援 12TB 儲存空間(透過三個 M.2 Gen5 插槽),以及最高 128GB DDR5-6400 記憶體(透過戴爾 CAMM2 模組提供)。
顯示器選擇範圍廣泛,從基本的 1920 x 1200 IPS 面板到色彩鮮豔的 3840 x 2400 OLED 觸控屏,應有盡有。介於兩者之間的還有一款 1920 x 1200 中端選項,亮度提升 500 尼特,支援 120Hz 可變刷新率,並覆蓋完整的 DCI-P3 色域。憑藉超過 100 項 ISV 認證,創意專業人士可以期待他們的應用程式流暢運行。
安全功能達到企業級標準,包括指紋辨識器、智慧卡支援、NFC、用於臉部辨識的 8 兆像素紅外線攝影機以及戴爾 Control Vault 3。此外,還提供三年標準保修,進一步凸顯了這款筆記型電腦作為專業工作工具的地位。
Dell Pro Max 16 Plus 規格
| 規格 | 戴爾 Pro Max 16 Plus |
|---|---|
| 系統平台 | |
| 處理器 | 英特爾酷睿超 5 245HX 英特爾酷睿超 7 265HX 英特爾酷睿超 9 285HX |
| 操作系統 | Windows 11專業版 Ubuntu Linux 24.04 LTS |
| 記憶體應用 | 16GB-128GB CSoDIMM 或 CAMM2,1 個插槽 |
| 圖形和人工智慧加速 | |
| 顯卡 | 英特爾集成顯卡 NVIDIA RTX PRO 1000 8GB NVIDIA RTX PRO 2000 8GB NVIDIA RTX PRO 3000 12GB NVIDIA RTX PRO 4000 16GB NVIDIA RTX PRO 5000 24GB 高通 AI Cloud 100 64GB (2x 32GB) |
| 存儲和顯示 | |
| 儲存 | 最多 3 個 M.2 SSD,每個 4TB 可用的 RAID 0/1/5 |
| 顯示螢幕 | 16吋 16:10 1920×1200分辨率,300尼特亮度,45% NTSC色域,60Hz刷新率,非觸控式 1920×1200、500 尼特、100% DCI-P3、120Hz VRR、非觸控螢幕 3840×2400,500尼特,OLED,觸控 |
| 連接性和電源 | |
| 相機 | 8萬像素紅外線 |
| 無線網絡 | 英特爾 Wi-Fi 7 BE200,有或沒有藍牙 5.4 可用的行動寬頻 |
| 電池 | 6-cell 96Whr |
| 電源適配器 | 165W或280W |
| 安全和物理 | |
| 安全功能 | 紅外線網路攝影機 指紋識別器 智慧卡讀卡器 NFC 控制金庫 3 |
| 尺寸和重量 | 1.22 x 10.18 x 14.17 英寸 起始重量:5.63 磅 |
| 保固 | 標準三年,下一個工作日現場維修 |
構建和設計
與我們先前評測的機型一樣,Pro Max 16 Plus 毫不掩飾其堅固耐用的特性,並通過了 MIL-STD-810H 軍規認證,足以應對嚴苛環境下的考驗。戴爾在材料選擇上高度重視永續性,採用了消費後回收塑膠、回收鎂和鈷以及生物基塑膠。拿在手裡,機身感覺異常堅固,幾乎感覺不到任何彎曲變形。簡而言之,它堅固得像坦克一樣。
這是一台體積不小的機器。它的厚度為 1.22 英吋(含底座),重量為 5.63 磅起,並不適合頻繁攜帶。不過,對於一款 16 吋、16:10 的螢幕來說,其 10.18 x 14.17 吋的佔地面積還算緊湊。網路攝影機位於頂蓋頂部,配有滑動式隱私快門;我們評測的這款配備的是紅外線攝影機,支援人臉辨識。
戴爾的設計語言在美學上過於低調。灰黑色的外觀和低調的品牌標誌強調了功能至上的理念。 Pro Max Premium 系列雖然外觀更時尚,但性能和擴充性卻有所犧牲。
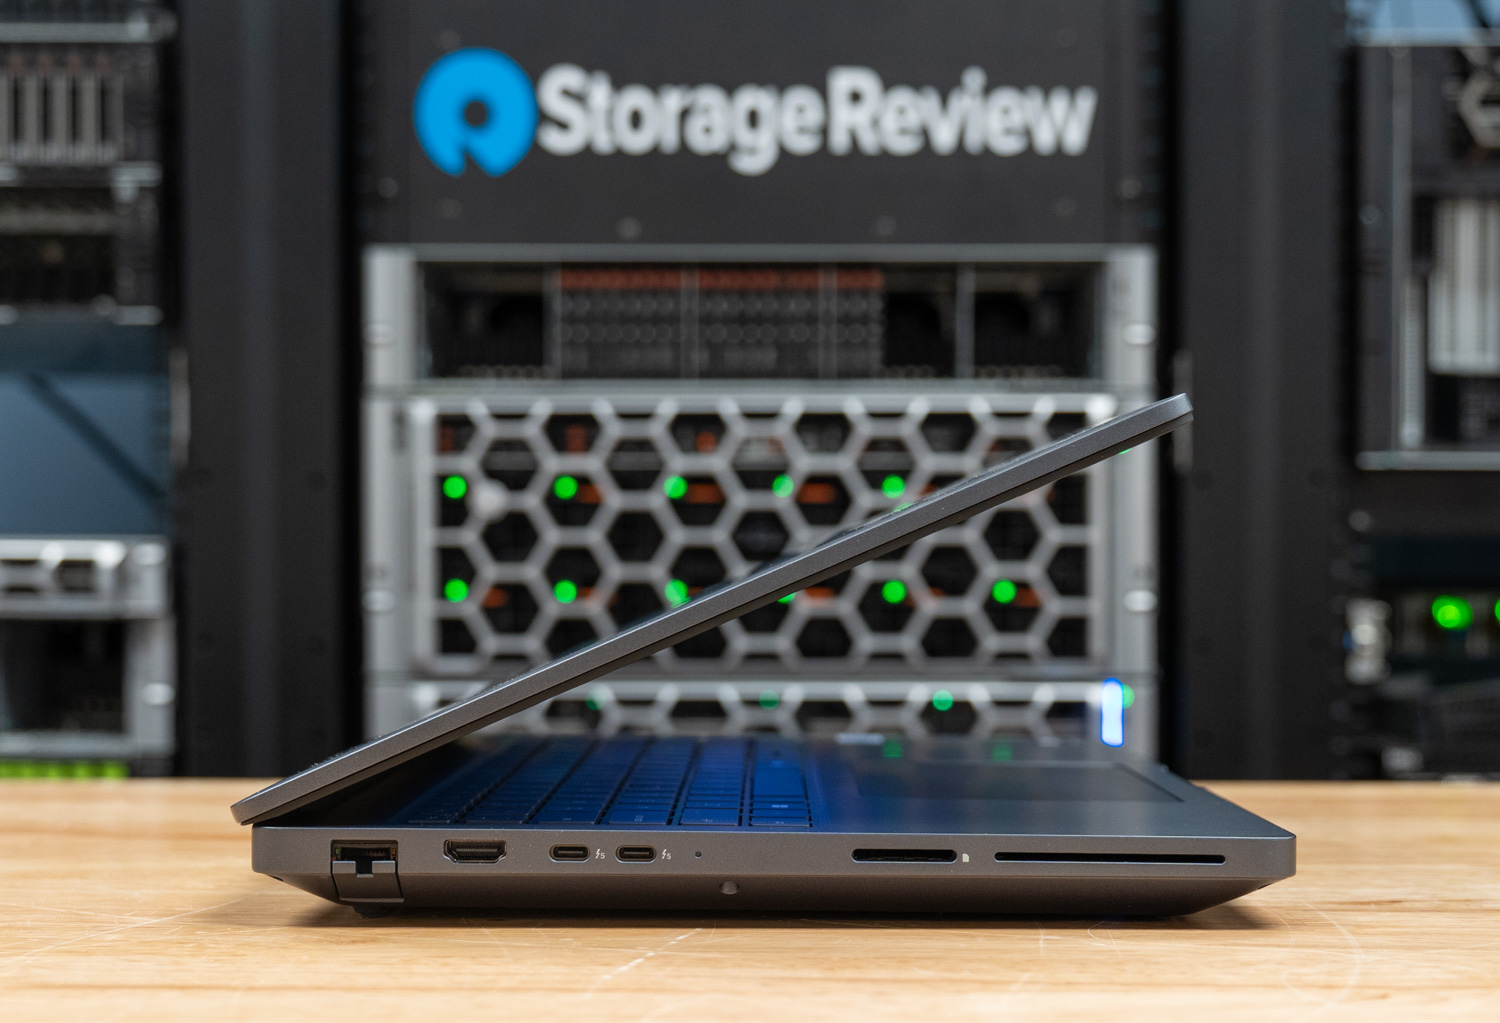
全面的連接埠選擇從左邊緣開始:
- 2.5Gbps RJ45 以太網
- HDMI 2.1輸出
- 兩個 Thunderbolt 5 (USB-C) 端口
- SD讀卡器
- 可選購智慧卡插槽
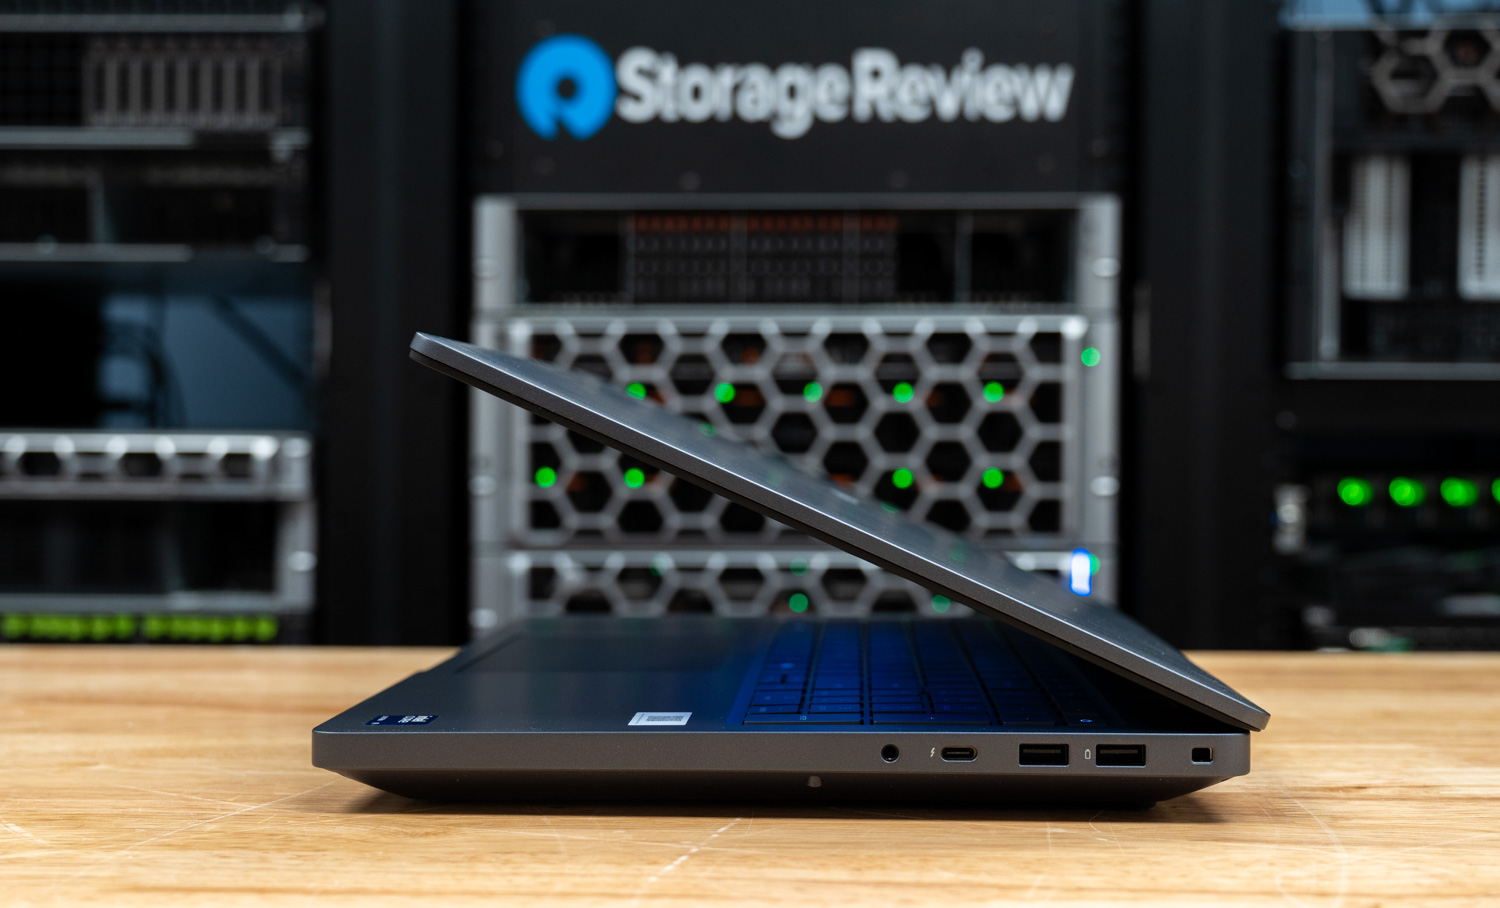
在右側:
- 3.5mm音頻插孔
- Thunderbolt 4(USB-C)
- 兩個 USB 3.2 Gen1 Type-A 端口
- 鎖槽
機身背面沒有接口。無線連線由英特爾BE200模組負責,支援Wi-Fi 7和藍牙5.4。在自訂配置中可以省略藍牙功能,並且還支援5G行動寬頻。
螢幕和輸入設備
我們評測的這款戴爾顯示器配備了16英寸1920×1200分辨率的顯示屏,採用120Hz VRR面板,日常使用效果出色。色彩鮮豔,並擁有100% DCI-P3色域覆蓋,校準後非常適合對色彩要求較高的工作流程。 500尼特的亮度也確保了即使在光線較亮的辦公室或工作室環境中也能舒適使用。
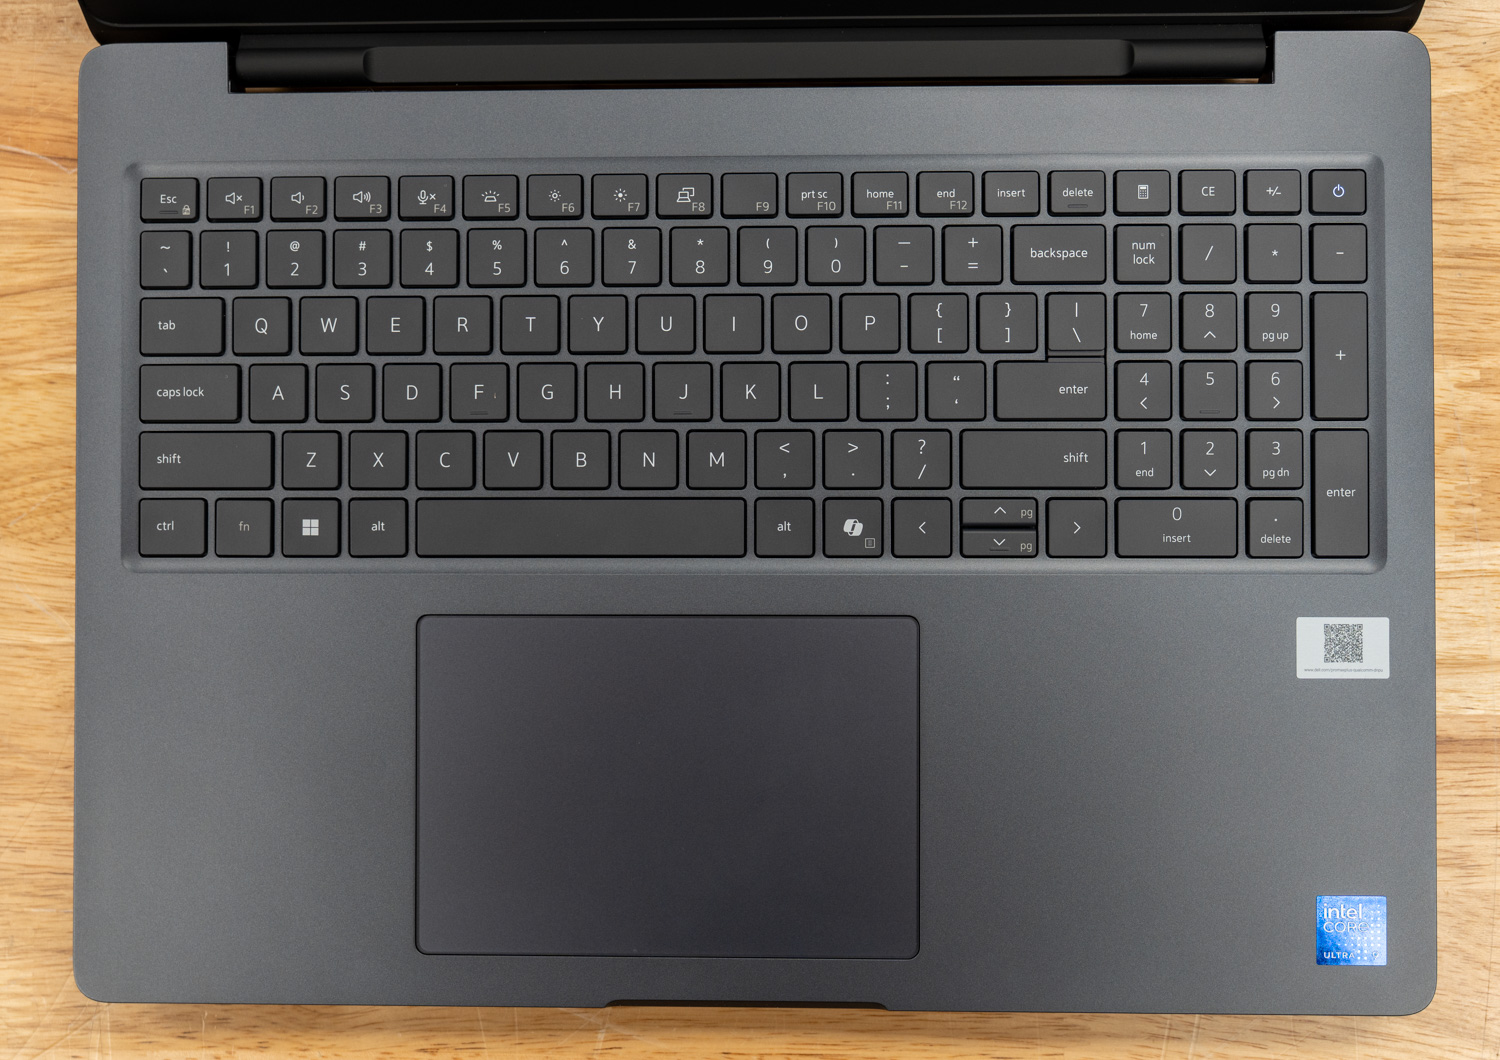
戴爾鍵盤非常適合長時間打字,全尺寸按鍵帶來輕盈靈敏的手感和清晰的觸覺回饋。白色背光使其在昏暗環境下也能清晰可見。鍵盤佈局基本傳統,但方向鍵大小不一,偶爾會導致誤觸,而Home鍵和End鍵的位置尤其令人詬病;它們與F11和F12鍵共用空間,因此啟用Fn鎖定(Fn + Esc)以優先使用功能鍵行時,必須同時按下Fn + F11或F12才能訪問它們。如果配備獨立的Page Up和Page Down鍵就更好了;然而,它們只是上下方向鍵的輔助功能,而上下方向鍵本身已經是鍵盤佈局中最不方便的按鍵了。位於右上角的電源按鈕同時也是指紋辨識器。
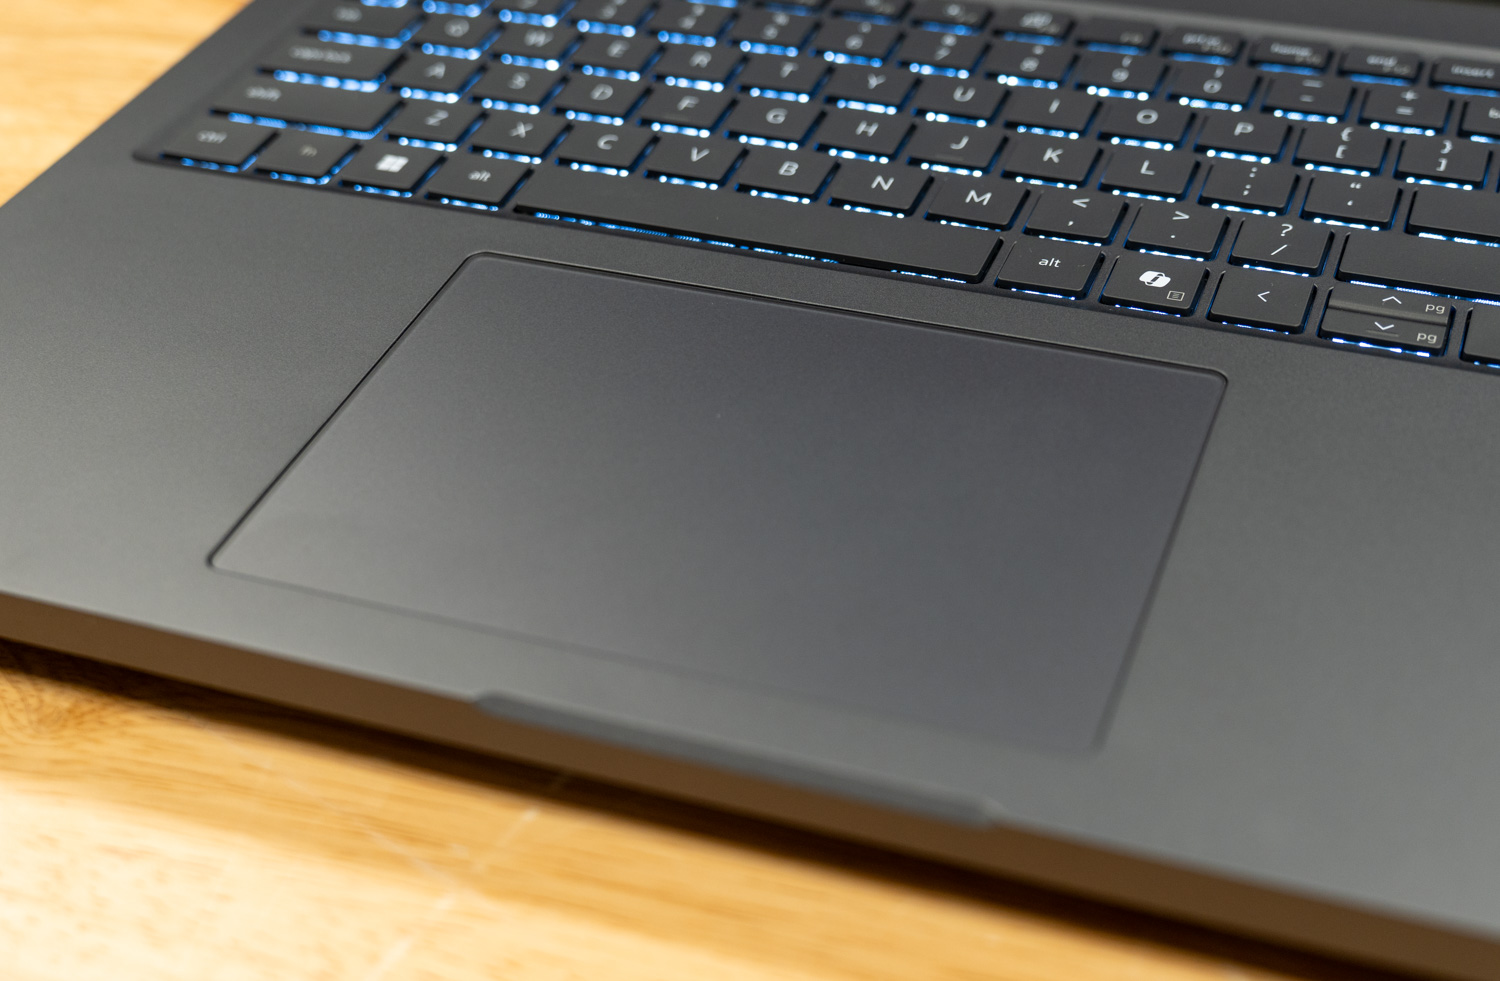
寬大的觸控板與16吋的機身尺寸相得益彰。其光滑的防眩光錶面追蹤精準,防誤觸功能在整個測試過程中表現完美。
可升級性
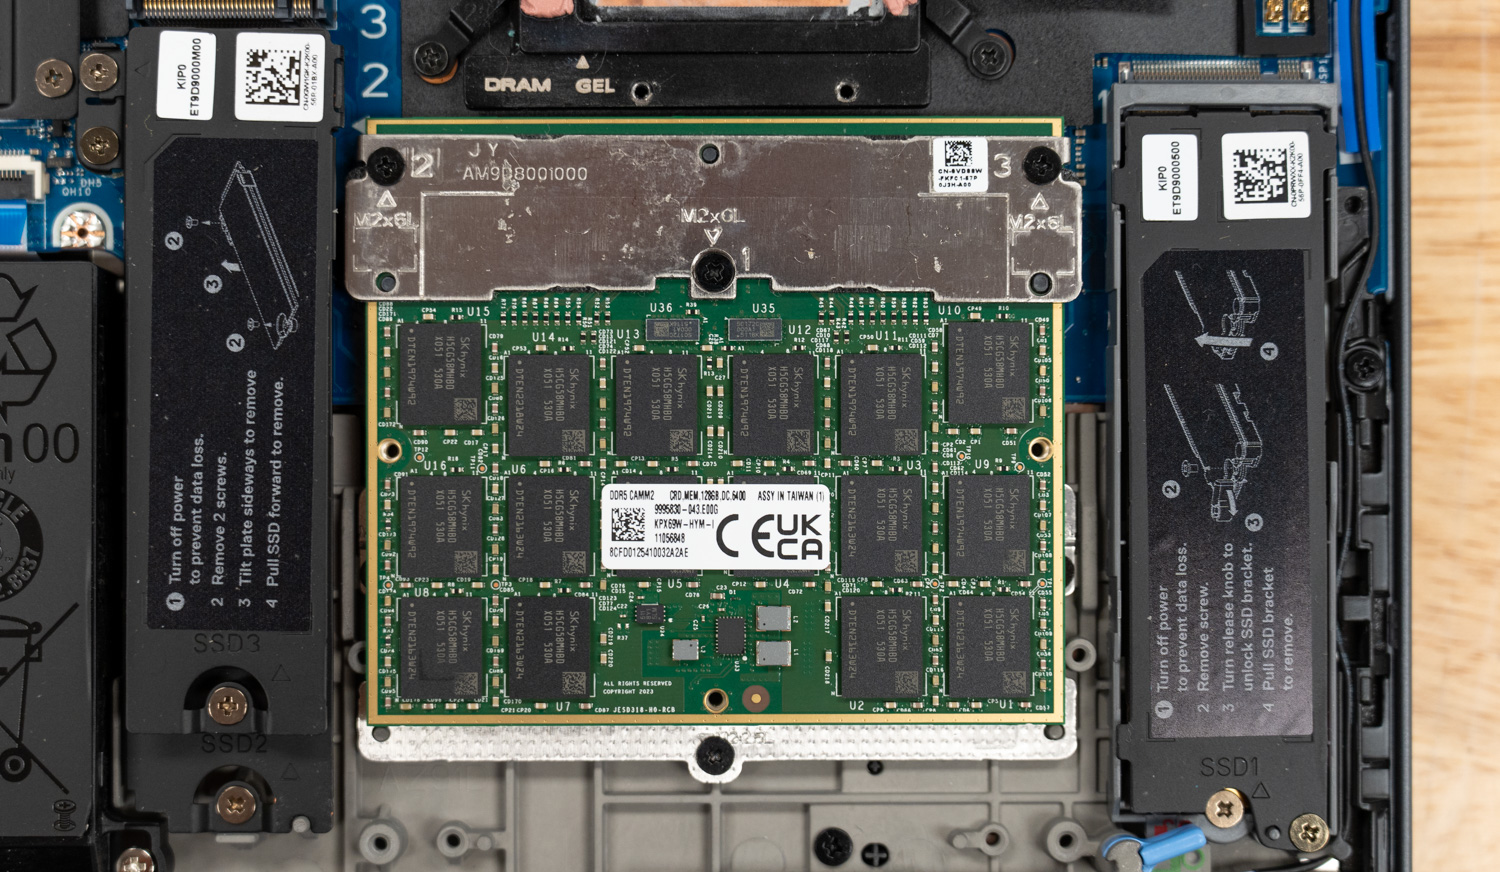
Pro Max 16 Plus 的設計充分考慮了擴展性,提供了巨大的升級潛力。它配備三個用於儲存的 M.2 Gen5 插槽、一個用於記憶體升級的 CAMM2 插槽,以及多個模組化組件,包括可更換的 USB-C 介面。
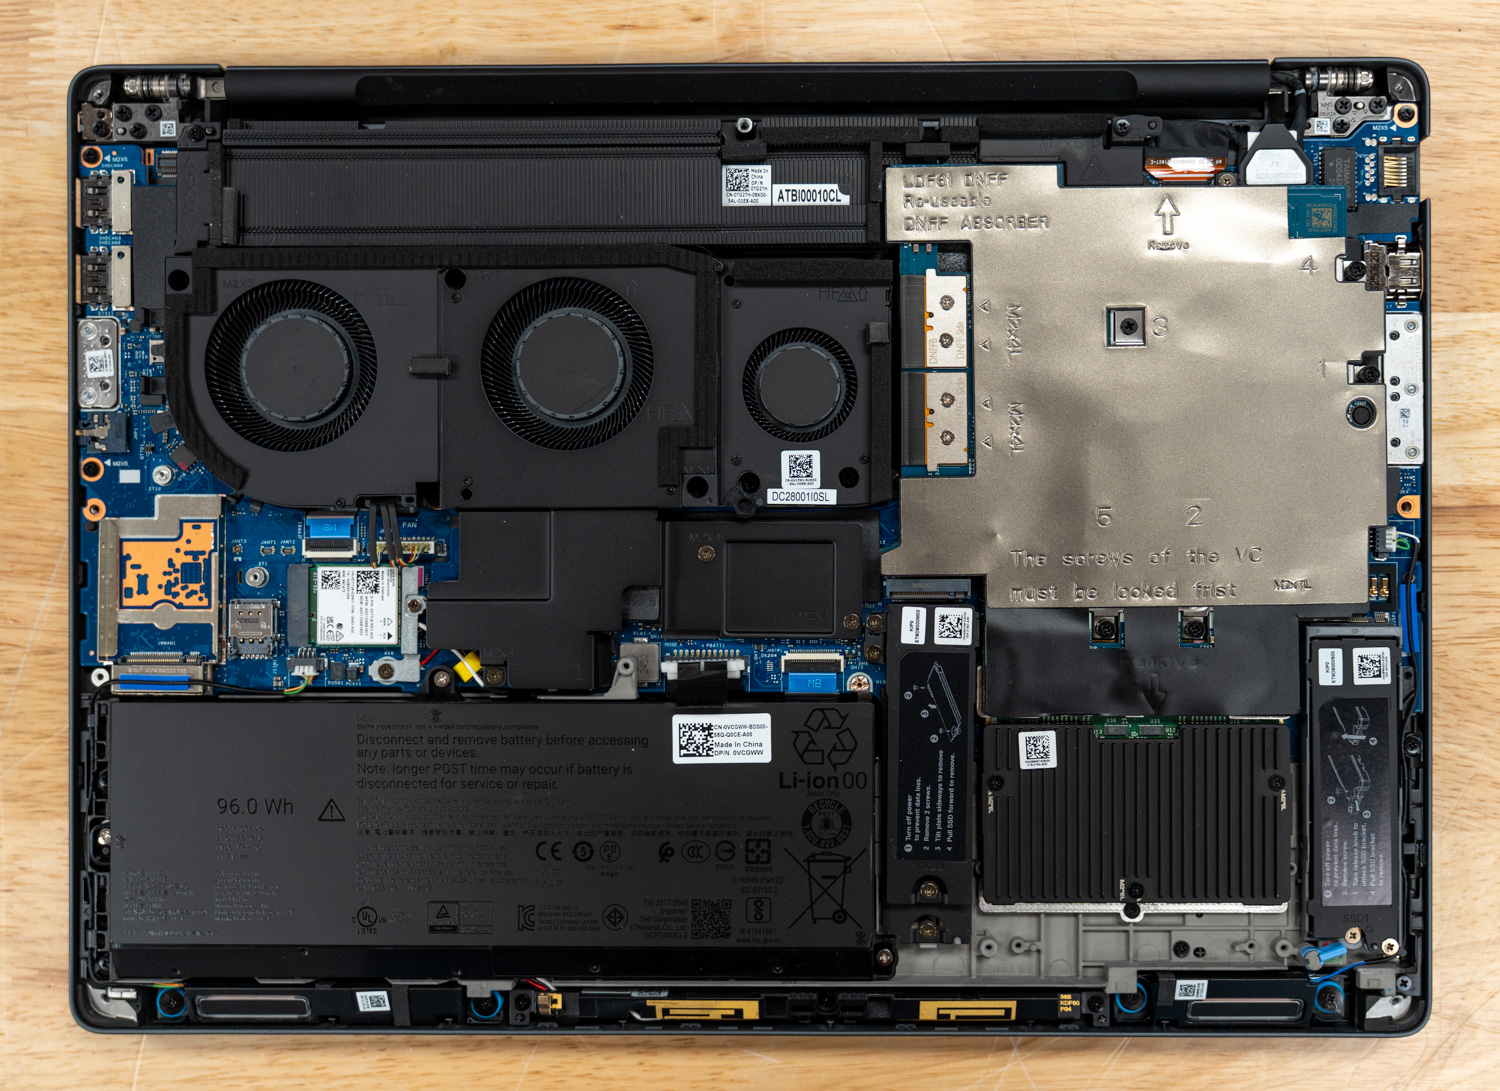
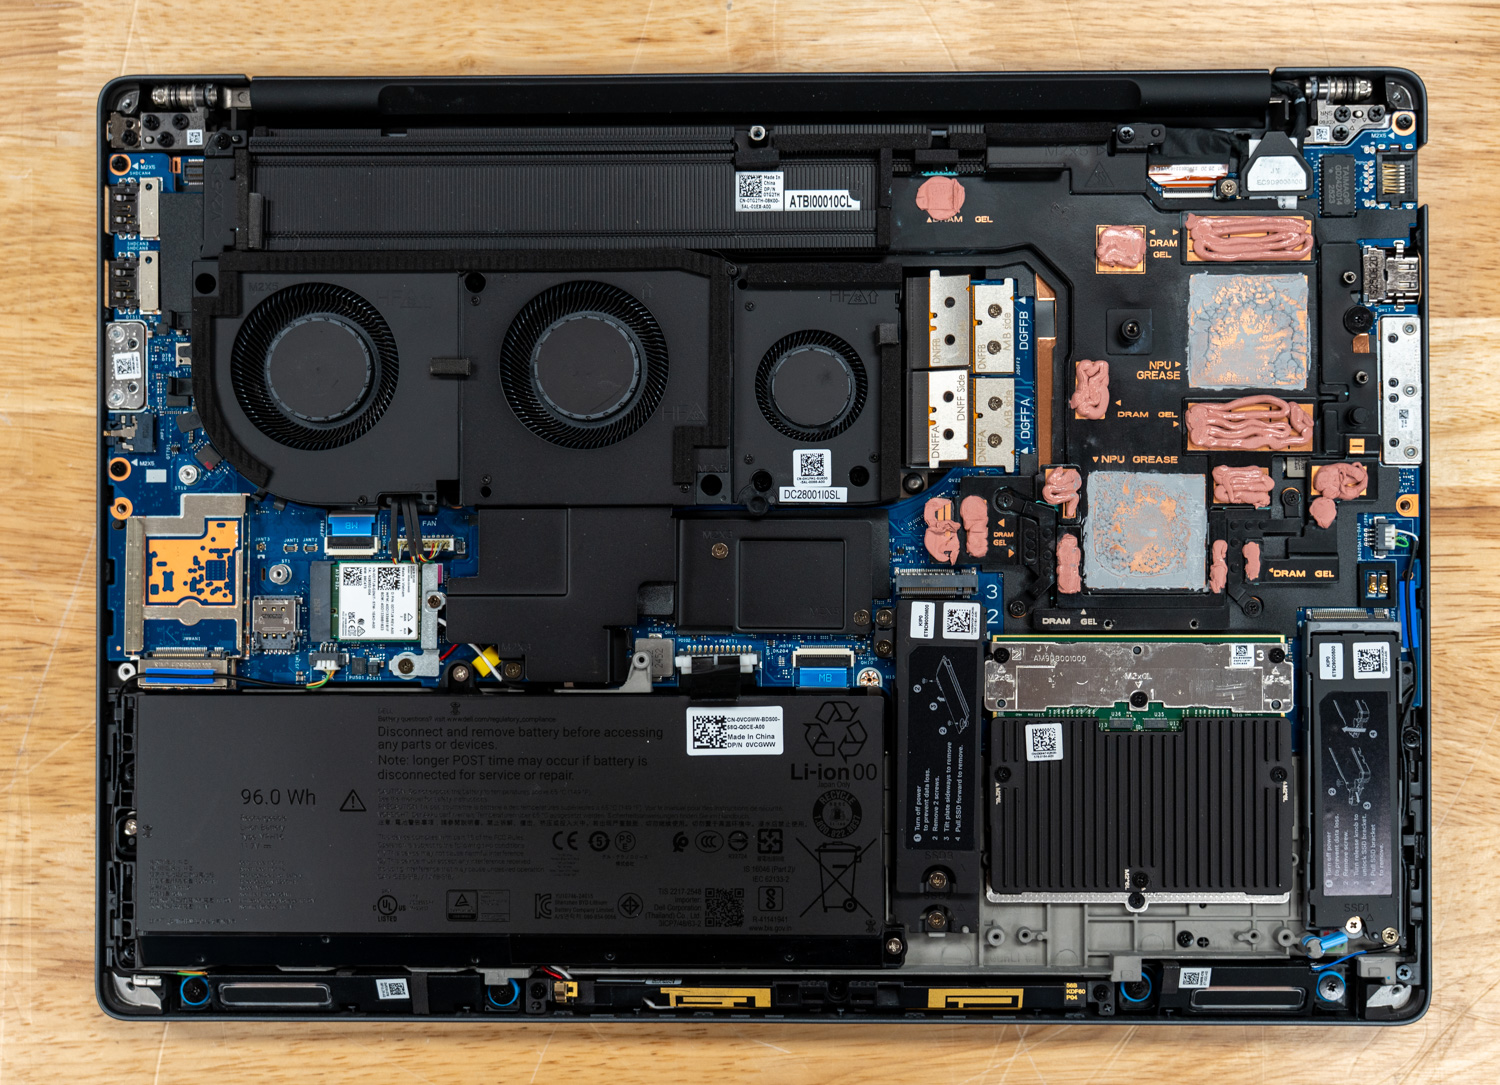
拆開機殼內部非常簡單:擰下周圍的螺絲,然後從後向前提起底蓋即可。打開機殼,你會看到一個強勁的三風扇散熱系統和一個容量可觀的 96Wh 電池。 CAMM2 記憶體模組位於右下角,下方是專用散熱片,兩側是 M.2 插槽。從照片上可能不太容易看出來,但左側的 M.2 插槽實際上是一個堆疊式插槽,可以容納兩個硬碟。 M.2 無線網路卡(使用者可自行更換)位於電池上方。
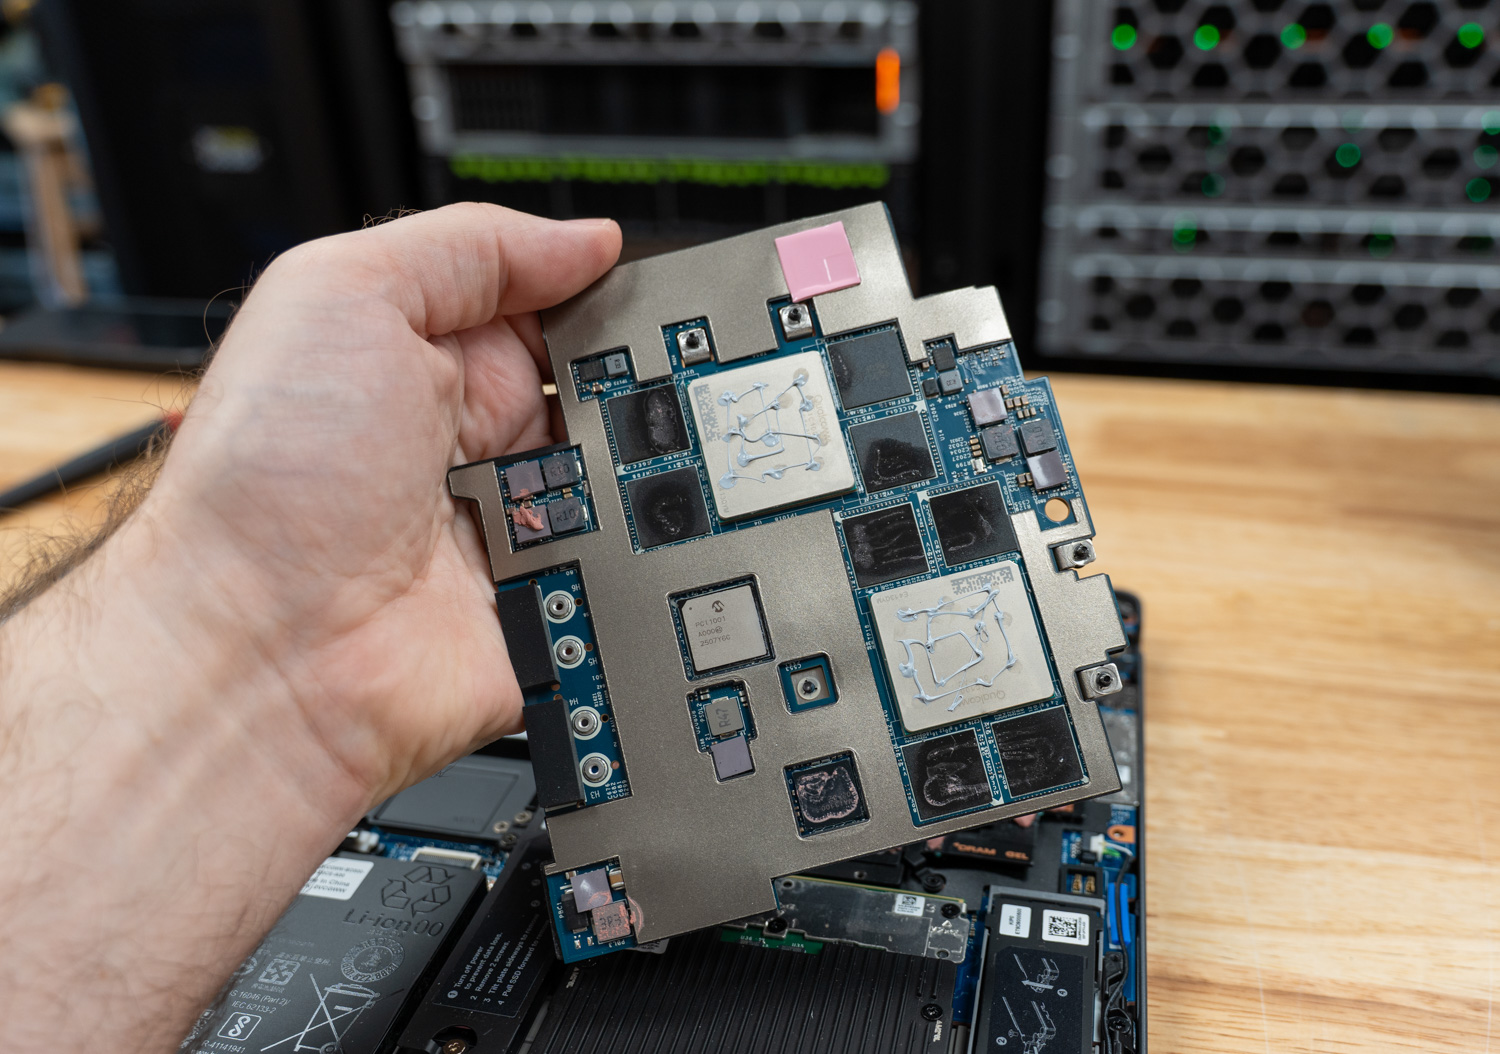
本次展會的明星商品:高通AIC100
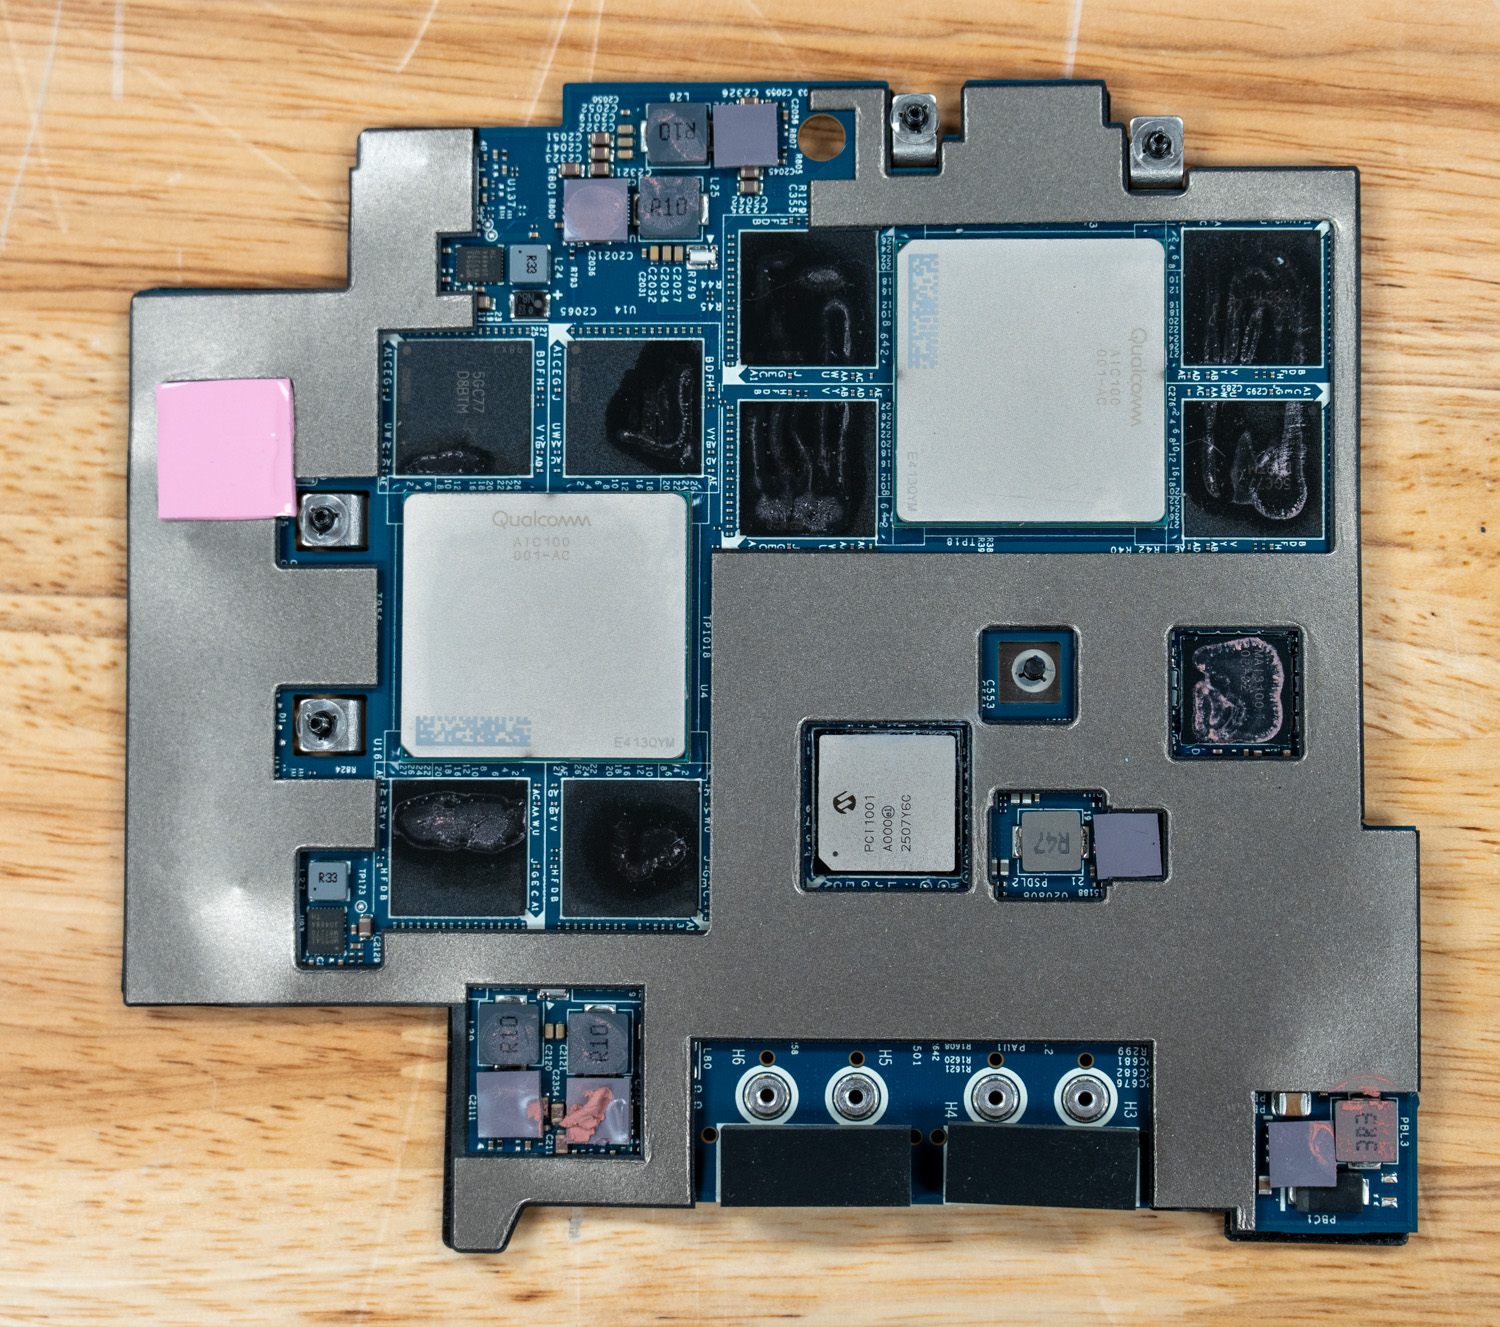
本次評測的戴爾產品搭載了高通AI 100 NPU,這是一個整合了兩個高通Cloud AI 100 SoC的單模組。每個SoC提供16個AI核心,模組內共32個,每個SoC都配備32GB LPDDR4x內存,並以兩個獨立的NPU形式呈現給主機。
戴爾和高通宣稱其晶片的 INT8 吞吐量約為 450 TOPS,並能夠運行參數量高達 100 億的模型。戴爾已公開展示了 Llama 4 Scout(109 億參數,MoE)在筆記型電腦本地運行。這兩款 SoC 透過 Linux QAIC 加速器驅動程式與主機通信,韌體代碼區塊已提交至 linux-firmware 上游。
目前來看,一切都還說得通。這些數字單獨來看確實很大。問題在於支撐這些數字的矽晶片本身。
高通公司於 2019 年 4 月發布了 Cloud AI 100,於 2020 年底提供了樣品,並於 2021 年上半年開始商業出貨。根據高通公司自己的 Cloud AI 架構文檔,該晶片採用 7nm 製程製造,使用四個運行頻率為 2100 MHz 的 64 位元 LPDDR4X 控制器(LPDDR4X-4200),每個 SoC 可提供 136 GB/s 的記憶體頻寬。
它最初的設計就考慮到了 PCIe 介面。將兩顆這樣的晶片塞進一個客製化模組,然後裝進一台 2025 年的筆記型電腦裡,並不會改變其根本的權衡取捨。這仍然是 2019 年的晶片,採用的是 2019 年的記憶體技術,只是進行了更新和更名,但架構上仍然屬於同一系列。當它被應用到戴爾 Pro Max 16 Plus 時,其他廠商已經完成了 HBM2e、HBM3、HBM3e 和 LPDDR5X 的迭代,現在正朝著高端 AI 加速器上的 GDDR7 和 HBM4 邁進。
但更深層的問題遠不止記憶體頻寬。業界有許多優秀的晶片設計和工程團隊,他們對人工智慧推理問題的理解非常深刻,Cloud AI 100 架構本身也可能相當出色。問題在於,真正決定產品成敗的軟體工程師已經在另一個生態系統——CUDA——上投入了大量資源。除非有強烈的動機促使他們切換,否則開發者會繼續使用已經擁有完善支援、文件和社群幫助的工具鏈。 NVIDIA 很早就贏得了開發者的青睞,並圍繞著它建立了一個龐大的社群。 AMD 在這方面多年來一直落後,但最近 ROCm 的版本確實非常出色,差距正在縮小。像 Modular 的 Mojo 和 MAX 這樣的解決方案甚至允許你使用同一套程式碼同時針對 NVIDIA 和 AMD 平台,有時甚至超越原生執行時間。然而,其他所有加速器都由於缺乏軟體支援而難以被大眾廣泛接受。
「公開採用」是關鍵所在。像Google這樣的大型組織可以投入數十億美元開發 XLA 和 JAX,讓 TPU 發揮最大效能。資金雄厚的私人新創公司和人工智慧實驗室可以為自身特定的模型集編寫定制內核,而無需在意其他人能否複製他們構建的這套技術棧——畢竟,他們並非為無限的公共用例而構建,而是為了解決自身面臨的問題。對於普通用戶,甚至大多數企業而言,如果沒有蓬勃發展的公共開發者生態系統,加速器實際上毫無用處。你可能要花費數週時間才能將模型移植到加速器上,而一旦 Hugging Face 發布新的架構,你就會面臨重新編譯的難題(或模型不支援的錯誤),而 CUDA 和 ROCm 的用戶卻能立即獲得支援。
所以我直說了:這台筆電裡的AIC100處理器已經徹底報廢了。任何個人都不應該購買它。任何組織也不應該購買它,除非它擁有足夠的工程資源,並且明確打算從零開始為特定的工作負載建立推理系統,並且已經接受自己需要維護這個系統。
軟體和工具的現狀
要了解為什麼這項建議如此嚴厲,你必須看看這張卡的運費推論實際上涉及什麼。
面向使用者的元件分為兩個 SDK 和一個封裝庫。高通雲 AI 平台 SDK 包含核心驅動程式(主線 Linux 中的上游 accel/qaic 驅動程式)、裝置韌體、板載執行時間和底層 API。應用 SDK 則位於其上,提供 qaic-exec 編譯器、qaic-runner 推理 CLI、透過 QAIC 執行提供者實現的 ONNX 執行時間整合、Python 綁定以及 vLLM 的一個分支。高通 efficient-transformers 庫(也稱為 QEfficient)是 Hugging Face Transformers 的封裝庫,它使用 AIC100 所需的靜態形狀、KV 快取佈局和圖變換重新實現了流行的 LLM 架構。高通 AI Hub 是一個獨立的模型目錄和編譯即服務產品,其目標用戶主要是驍龍級設備而非 AIC100,儘管兩者使用相同的品牌。
編譯路徑是固定的。你需要一個 PyTorch 模型,使用 torch.export 或 ONNX 導出,然後將其連同諸如 -convert-to-fp16、-mxfp6-matmul、批次大小、上下文長度和目標 SoC 數量等標誌一起提供給 qaic-exec。編譯器會進行預先調度和記憶體分配,然後產生一個 QPC(高通程式容器),這是一個密封的二進位文件,其中固定了記憶體佈局、鍵值快取形狀、批次大小、預填充序列長度和上下文長度。這裡沒有 JIT(即時編譯)。根據高通 LLM 文檔,預先編譯的 AI 100 編譯器會根據提示長度、生成長度、鍵值快取和批次大小預先分配設備資源,並且 Cloud AI 100 僅支援靜態輸入形狀。任何對這些編譯時參數的更改都會觸發另一次完整的編譯,對於小型模型可能需要幾分鐘,而對於大型模型則可能需要幾個小時。
支援的架構列表非常短。戴爾推薦客戶使用的 QEfficient 庫和 Zentree 託管的預建 QPC 目錄主要涵蓋較舊的型號,而到 2026 年,只有少數型號值得使用。
較新的 FP8 原生檢查點需要重新量化。如果模型以 MXFP4 格式原生發布(例如流行的 GPT-OSS 模型),則需要進行轉換和重新編譯,而不是直接導入權重。如果您願意付出努力,這些問題並非無法解決,但這確實會帶來持續的成本。
接下來是並發問題,這正是這款筆記型電腦的致命弱點,即使對於注重開箱即用性能的開發者來說也是如此。戴爾提供的容器鏡像(戴爾指示使用者拉取並使用 vLLM 運行)基於 Zentree 預編譯的特定形狀的 QPC,而這些容器的並發數僅為 1。無論輸入或輸出序列的形狀如何,對於給定的模型,吞吐量都是固定的。多個並行請求不會並發運行;它們會被排隊,並由 vLLM 按順序處理。你無法動態批次處理。你無法像在 Team Red 或 Green GPU 上那樣,使用 vLLM 或 SGLang 提供的連續批次功能。要獲得高於 1 的並發數,你必須使用更大的批次大小重新編譯 QPC。
戴爾的演示旨在向開發者展示這款筆記型電腦,而目前開發者最常用的AI應用場景是使用Claude Code、OpenCode等工具進行Vibe編碼。向這些工具發出的單一請求可以展開成多個並行LLM呼叫;這些NPU預設會將這些請求排隊並按順序處理,而不是並行處理,因此在NVIDIA Spark上只需幾秒鐘就能完成的任務,在這個配置下可能需要幾分鐘。
性能
戴爾提供的測試系統配置如下:
- 英特爾酷睿Ultra 9 285HX CPU
- 高通AIC100 PC推理卡
- 128GB 6400MTs CAMM2 DDR5
- 4TB SSD
在給出具體數據之前,先說明方法論。如上所述,AIC100 運行的是預先編譯的 QPC,其批次大小、序列長度和鍵值快取佈局均已固定。戴爾為這款筆記型電腦預先安裝了一組託管在 Zentree 上的精選預編譯 QPC,以及一個 vLLM 容器鏡像,該鏡像會在首次啟動時下載這些 QPC。這組預先編譯的 QPC 透過戴爾的參考容器以並發數 1 的方式提供,最終用戶在開箱並按照戴爾的文檔進行操作後實際獲得的就是這組 QPC,而這正是我們進行基準測試的配置。
我們擁有其他方法。我們可以拉取 qaic-exec,取得檢查點,透過 torch.export 運行,重新量化,使用更大的批次大小重新編譯 QPC,然後將其回饋給 vLLM。如果需要,我們也可以針對 QAIC 加速器驅動程式編寫自訂核心。但我們選擇不這麼做,因為這台筆記型電腦的目標市場——開發人員、對人工智慧感興趣的工程師和企業試點團隊——絕大多數買家都不會進行這些工作。他們會拉取容器,運行它,並根據輸出結果來評判產品。因此,這就是我們所衡量的。
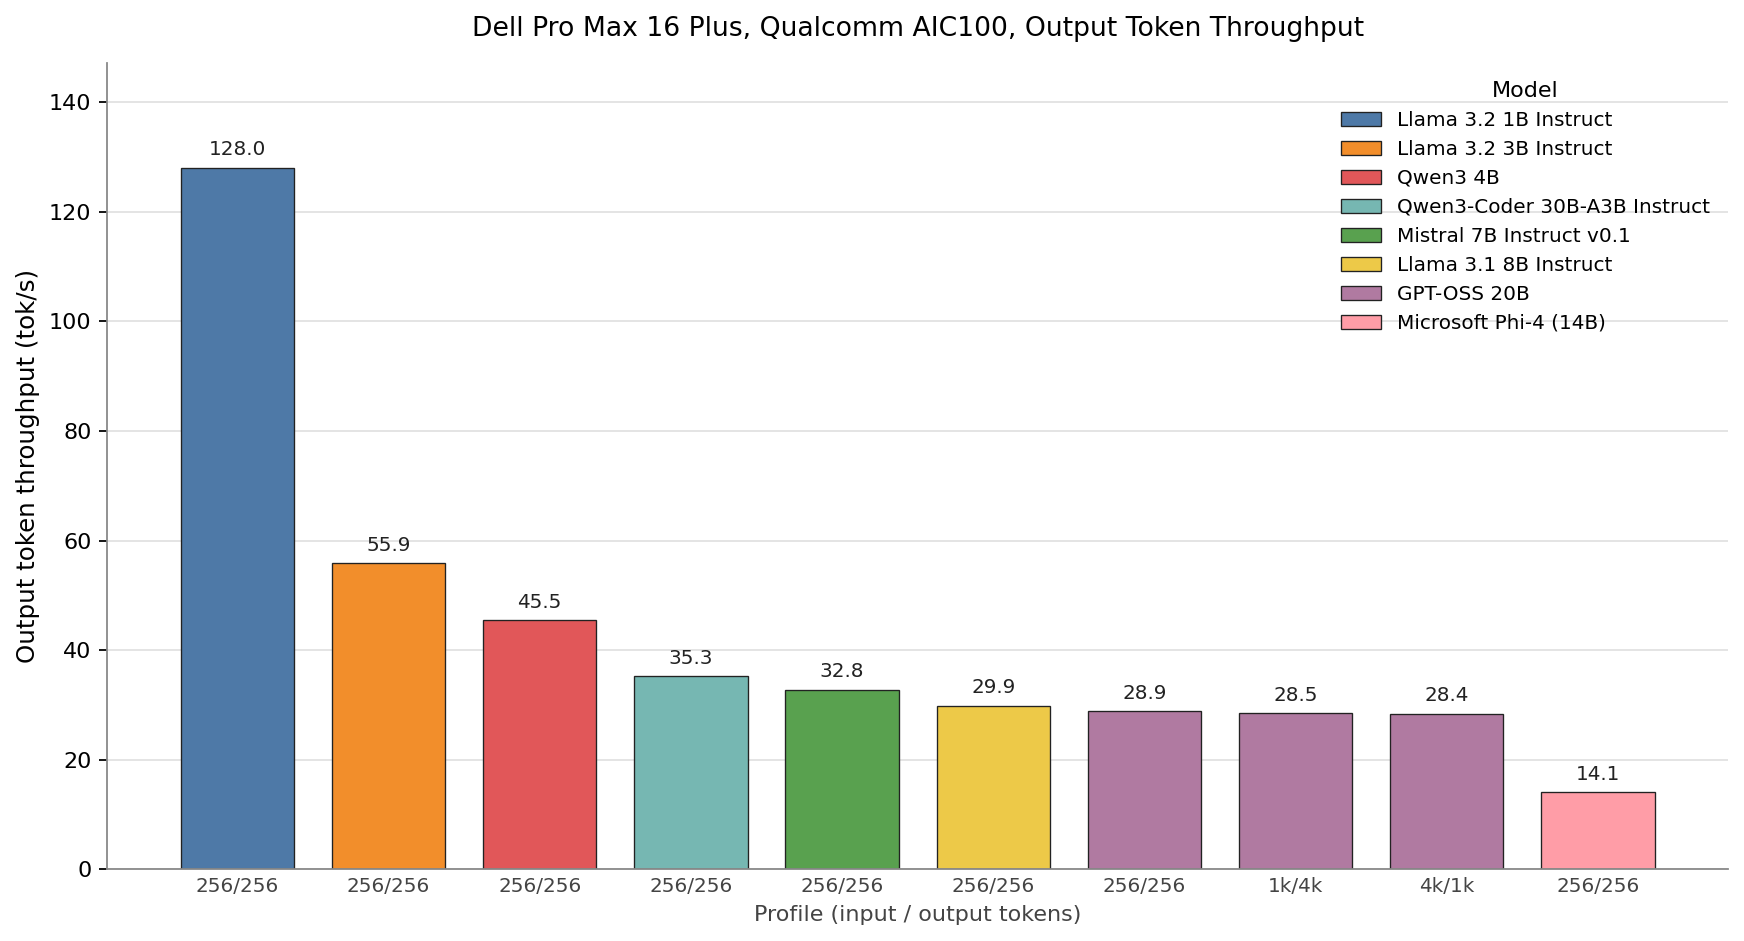
圖表中的每個長條圖代表一台使用高通編譯、MXFP6 權重和 MXINT8 KV 快取的 QPC 處理器,這是戴爾所有出貨產品通用的精度配置。圖表中只有 Llama 3.2 1B 的 TPS 超過 100,達到 128。緊隨其後的是 Llama 3.2 3B(56 TPS)、Qwen3 4B(45 TPS)、Qwen3-Coder 30B-A3B(35 TPS)、Mistral 7B(33 TPS)和 Llama 3.1 8B(30 TPS)。 GPT-OSS 20B 在 256/256、1k/4k 和 4k/1k 三種字面量下,TPS 分別為 28.9、28.5 和 28.4,這印證了高通文件中關於 AOT 編譯器的描述:一旦為每個字面符量構建了 QPC,這印證了高通文檔中關於 AOT 編譯器的描述:一旦為每個字面符量構建了 QPC,某個解碼速率就不會固定了,提示成本的長度。 Phi-4 以 14 TPS 的 TPS 位居榜單末尾。
雖然這張顯示卡可以容納比上述更大的型號,但我們並未對其進行基準測試。例如,要對戴爾公開演示的 Llama 4 Scout 型號進行基準測試,需要將精度進一步降低到 INT4。實際上,在許多工作負載下,量化程度較低、尺寸較小的型號的性能會優於量化程度較高、尺寸較大的型號。
已發布的 vLLM 容器也以 batch_size=1 運行每個 QPC,我們已在實踐中確認,同時發出兩個請求並不會使吞吐量翻倍。第二個請求只是在軟體佇列中等待,直到第一個請求完成。已發布的協定堆疊中沒有連續批次、傳輸中批次或推測性解碼功能。對於像 Claude Code 或 OpenCode 這樣從單一使用者回合發出多個平行 LLM 呼叫的編碼代理程式來說,這種單流限制會將原本幾秒鐘的回應時間變成幾分鐘的實際等待時間。提高批次大小需要在主機上重新編譯 QPC,這又讓我們回到了之前拒絕嘗試的陷阱。
我們不妨將它與 NVIDIA Spark 進行比較。在 256/256 輸入/輸出序列長度下,Spark 運行 120 位元組模型的速度比戴爾的 Qualcomm AIC 100 運行 20 位元組模型的速度更快。而且這還不是 Spark 的最佳效能,因為這些結果是在 Marlin 核心的早期軟體版本上測得的。
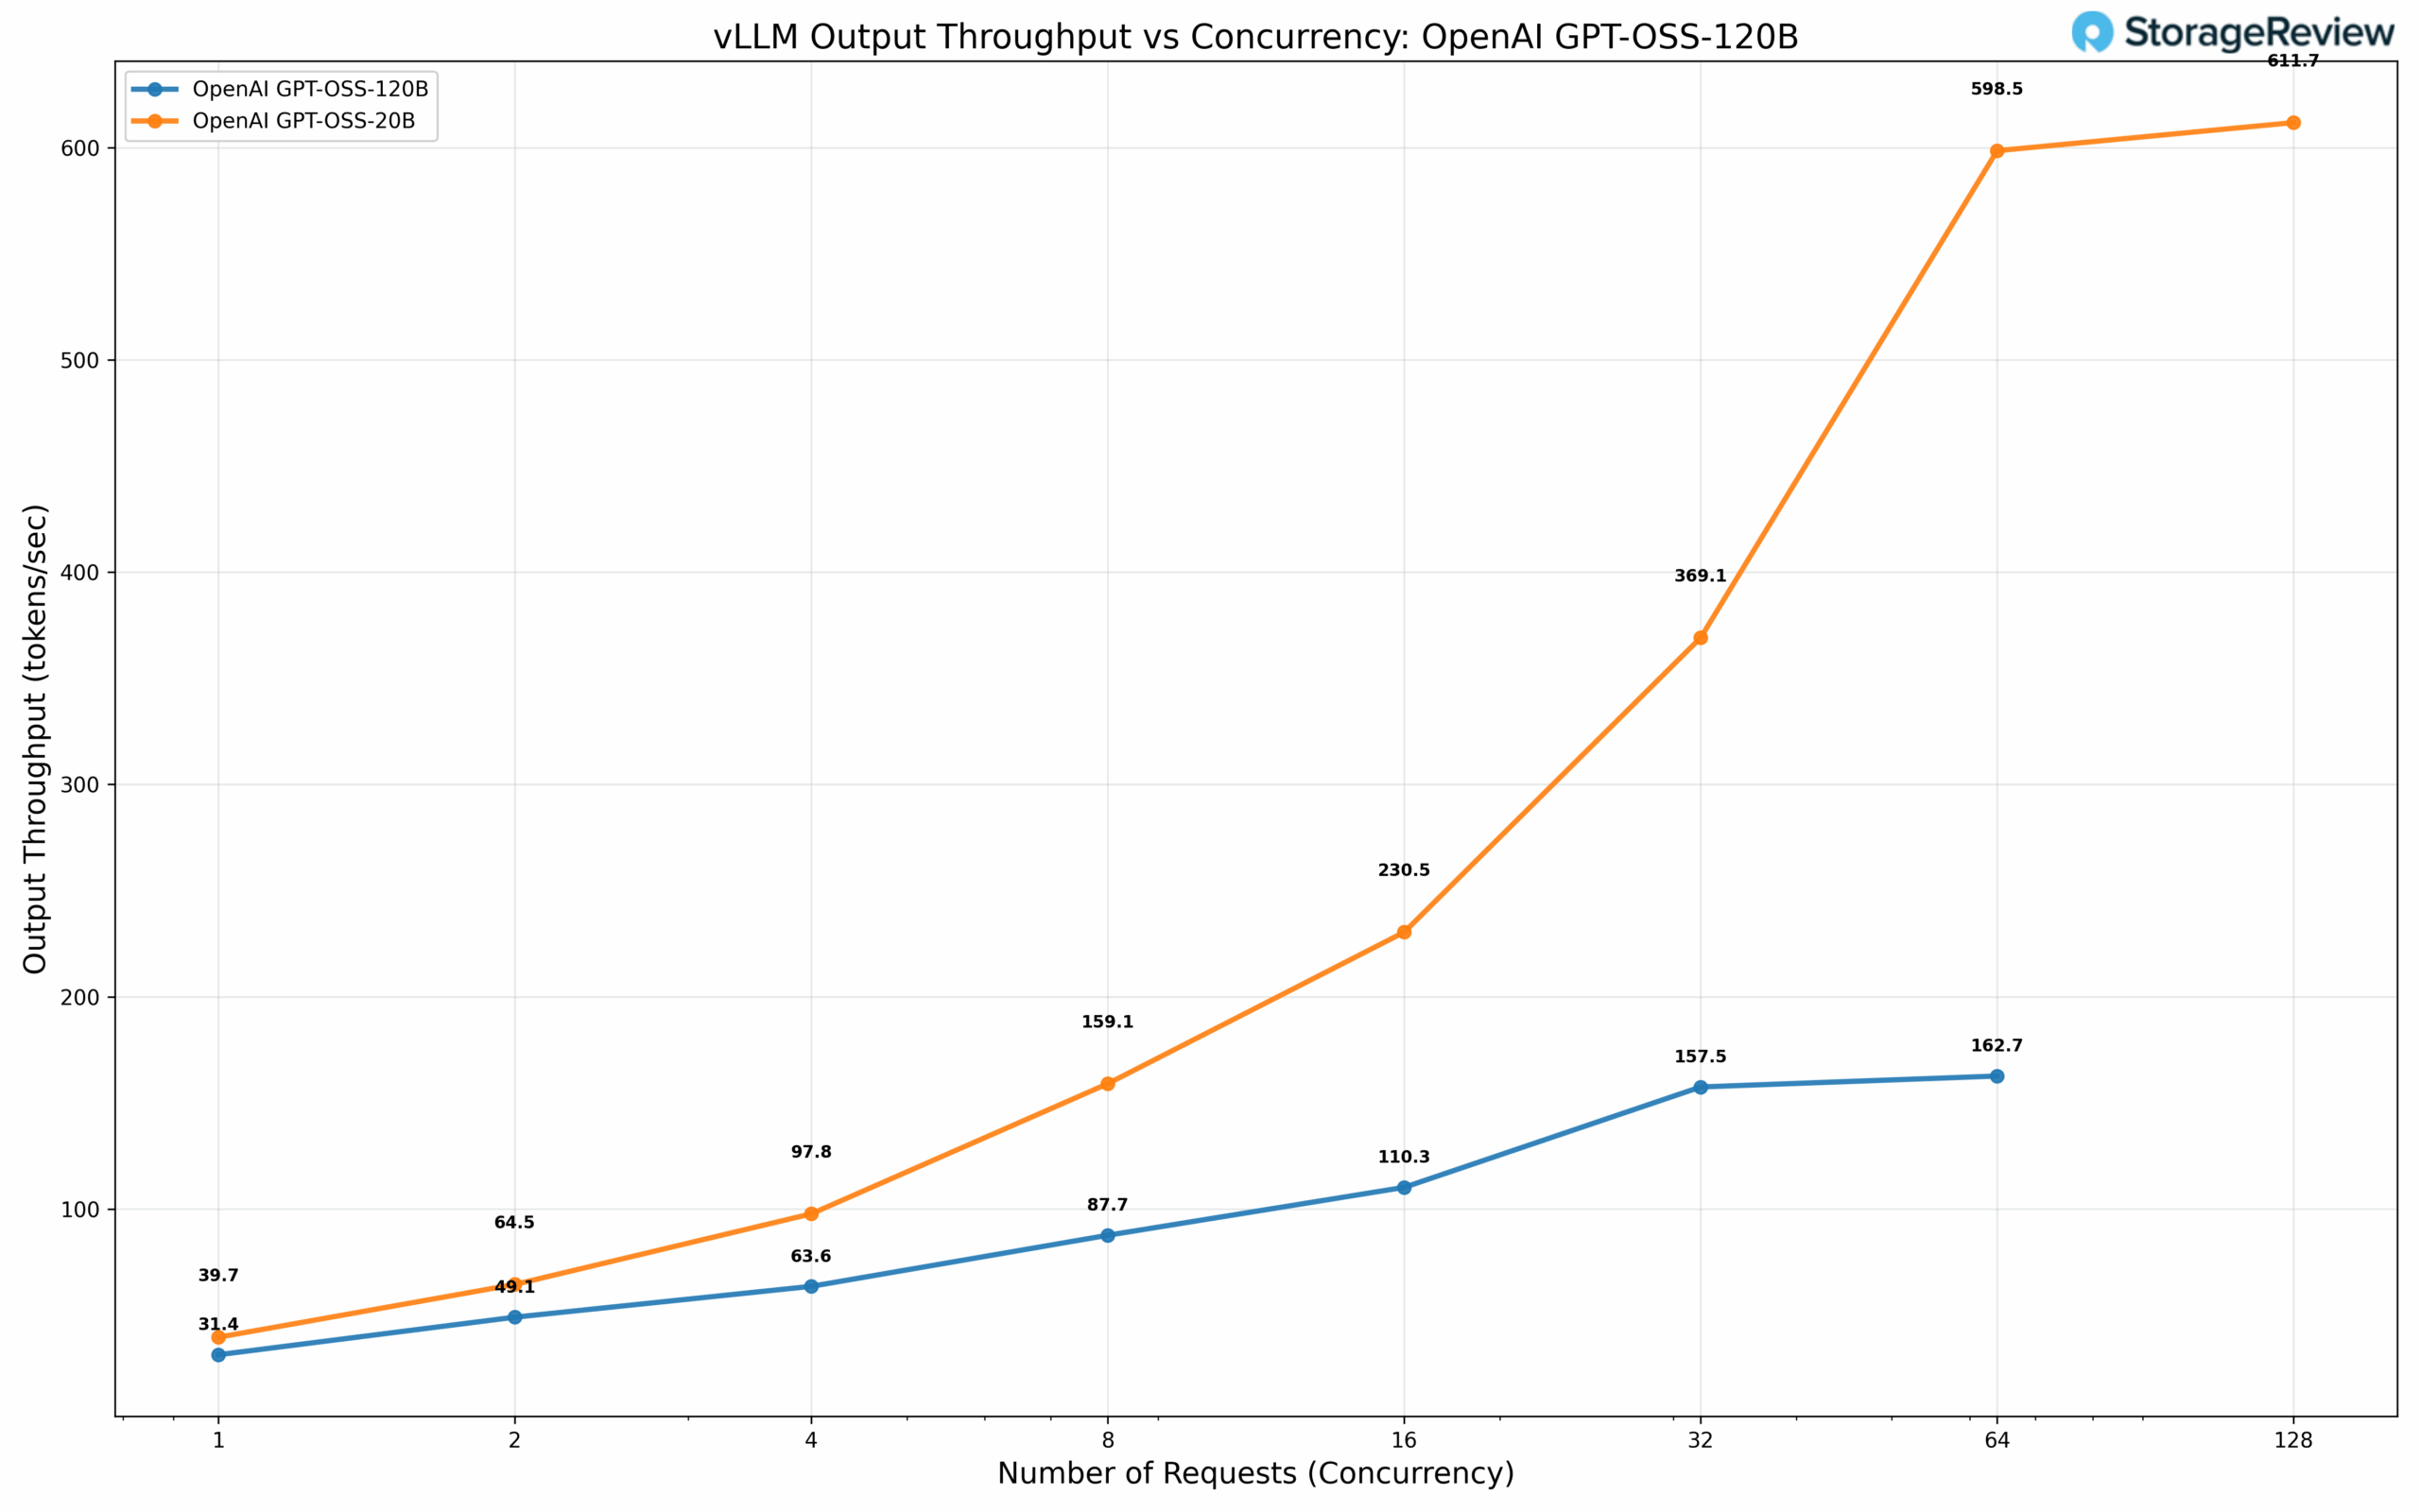
結論很明確。對於單一使用者、單次對話,以及足夠小的機型(例如 Llama 3.2 1B,以及勉強可以接受的 Llama 3.2 3B,因為 136 GB/s 的 LPDDR4X 記憶體並非瓶頸),這款筆記型電腦中的 AIC100 是可用的。但對於任何更大的應用,在客戶實際收到的配置中,單流解碼和靜態編譯流水線(對高通未預先優化的任何編譯形狀都進行懲罰)的組合,使得這款加速器的性能甚至落後於同系列 Intel Core Ultra HX 的集成 NPU 和集成 GPU,更不用說與該機型可選配的獨立 NVIDIA Intel Core Ultra HX 的集成 NPU 和集成 GPU,更不用說與該機型可選配的獨立 NVIDIA Intel Core Ultra HX 的集成 NPU 和集成 GPU,更不用說與該機型可選配的獨立 NVIDIA 顯卡了。
如果只比較原始規格,NVIDIA Spark 的讀寫速度為 273GB/s ,我們測試過其單晶片 FP8 (E4M3) 模式下的最大可實現浮點運算次數 (MAMF)為 200TFLOPS。 QAIC 的宣傳規格為兩顆晶片 272GB/s,在INT8 模式下為 435TFLOPS。因此,理論上它們的性能應該相近,但由於軟體方面的差異,高通晶片的性能略遜一籌。
這款產品適合哪些人?你應該購買嗎?
對於任何想要從事嚴肅人工智慧工作的人來說,答案是否定的。不要購買這種配置。
戴爾美國官網顯示,Pro Max 16 Plus 的 AIC100 SKU 型號售價分別為:頂級版(Core Ultra 9 285HX 處理器、128GB 記憶體、4TB 固態硬碟)14,871.56 美元;中配版(Core Ultra 7 265H4X 14,871.56 美元;中配版(Core Ultra 7 265H4X 1646496000 美元; AIC100 SKU 售價 8,831.56 美元。所有型號均預先安裝 Ubuntu Linux 系統,Windows 系統支援即將推出。經測試,該機型的售價在 14,000 美元至 15,000 美元之間。
作為參考,NVIDIA 的 DGX Spark 目前售價為 4,699 美元。這個價格包含GB10 Grace Blackwell 超級晶片、128GB 統一 LPDDR5X 記憶體、4TB NVMe 固態硬碟、Blackwell GPU 以及大約 1 petaflop 的 FP4 AI 運算能力,所有這些都由完整的 CUDA 軟體堆疊、TensorRT-LLM、NIM 以及整個生態系統提供支援。對於幾乎所有實際的 AI 工作負載,一台 DGX Spark 的性能都將超越這台筆記型電腦中的 AIC100,而且它使用的軟體是今年新入職的任何 AI 工程師都已經熟練掌握的。我們評測的這台 DGX Spark 的價格,足以購買三台,每台都配備顯示器、外設和辦公桌,而且還能剩下不少錢。如果你對小型 AI 不感興趣,那麼配備 Intel 285K 處理器、128GB DDR5 內存和 NVIDIA RTX Pro 6000 GPU 的戴爾 Pro Max Tower T2 工作站的價格也在 15,000 美元左右,具體價格取決於你搭配的 SSD 容量。
很難不讓人覺得戴爾把一些電子垃圾塞進了原本非常優秀的機殼裡。搭載 RTX PRO 5000 的 Pro Max 16 Plus 是一款出色的行動工作站。但同樣的機器,如果換成 AIC100,就成了戴爾保固期內一個糟糕的科學實驗品。
結語
如果你幾年後讀到這篇文章,並且碰巧在清倉貨架上看到一台這樣的筆記型電腦,價格在兩三百美元,那就千萬別錯過。這款電腦系統可維修、可升級,鍵盤手感不錯,週末花點時間改造AIC100模組,做一些有趣的事情,正是這台硬體應有的輕鬆樂趣。
如果您現在想認真從事人工智慧工作,那麼請為您的 Pro Max 16 Plus 配置任何其他加速器。 NVIDIA RTX PRO 行動 GPU,即使是入門級的 RTX PRO 1000,也比 AIC100 模組更適合您。在許多實際應用場景中,Intel Core Ultra HX 的整合 NPU 也更勝一籌,因為它至少可以與 Windows ML、OpenVINO 和現有的 PC AI 堆疊相容。
給戴爾的一個建議是:Pro Max 16 Plus 機殼非常出色,Pro Max 系列也是市場上最強大的行動工作站平台之一。然而,目前出廠的 AIC100 SKU 卻遠遠達不到這項標準。如果推出一條明確標註為實驗性或開發者預覽版的產品線,戴爾就可以向想要體驗新功能的客戶提供這些加速器,而無需將 Pro Max 這個大品牌與尚未成熟的產品捆綁在一起。 Pro Max 品牌值得保護,而且完全可以找到一種既能保護品牌又能為實驗性硬體找到合適歸宿的簡潔方法。


 Amazon