

邊緣伺服器透過在資料中心和雲端之外提供運算資源,協助即時決策。本文中,我們在 SuperMicro IoT SuperServer SYS-210SE-31A(一款功能強大的多節點邊緣伺服器)上執行了多項邊緣基準測試。顯然,工程師在設計這款伺服器時就考慮到了邊緣推理,因為它正是為推理而生的。
SuperMicro IoT SuperServer SYS-210SE-31A 概述
我們對 SuperMicro IoT SuperServer SYS-210SE-31A 的全面評測表明,它不僅在 5G 和物聯網領域具有應用前景,而且如果搭配 PCIe 記憶卡和高速網卡,在零售甚至儲存領域也具有應用前景。
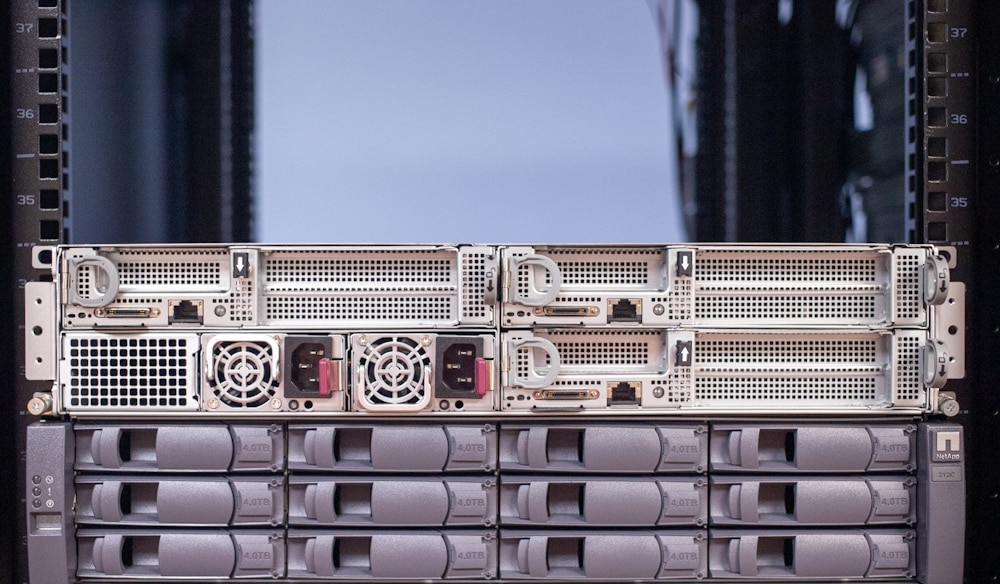
該服務器的多節點特性使其用途廣泛。 它適合三個 CPU 節點,每個節點具有以下內容:
- 一個第三代英特爾至強可擴展處理器(“Ice Lake”),最高 32C/64T 和 205W,可選配特殊配置的 270W 芯片。
- 四個風扇模塊。
- 八個 DIMM 插槽; 內存上限為 2TB,使用 256GB 3DS DIMM。
- 兩個 M.2 2280/22110 PCIe Gen4 插槽。
- 4個PCIe Gen16 x4全高/半長和16個PCIe GenXNUMX xXNUMX半高/半長。
- 一個用於 IMPI 2.0 的 GbE 和一個 KVM 軟件狗。
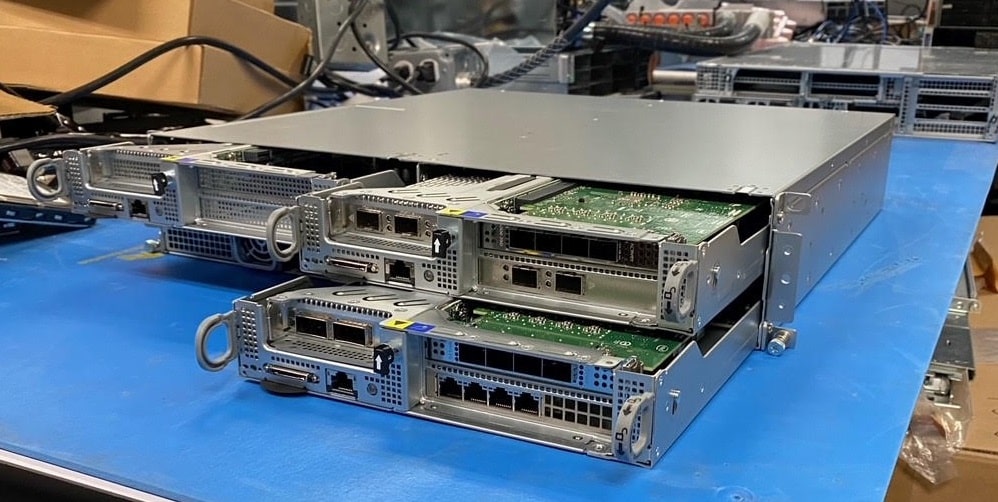
在這裡您可以看到拉出的節點,就像它們自己的迷你機架式服務器一樣。
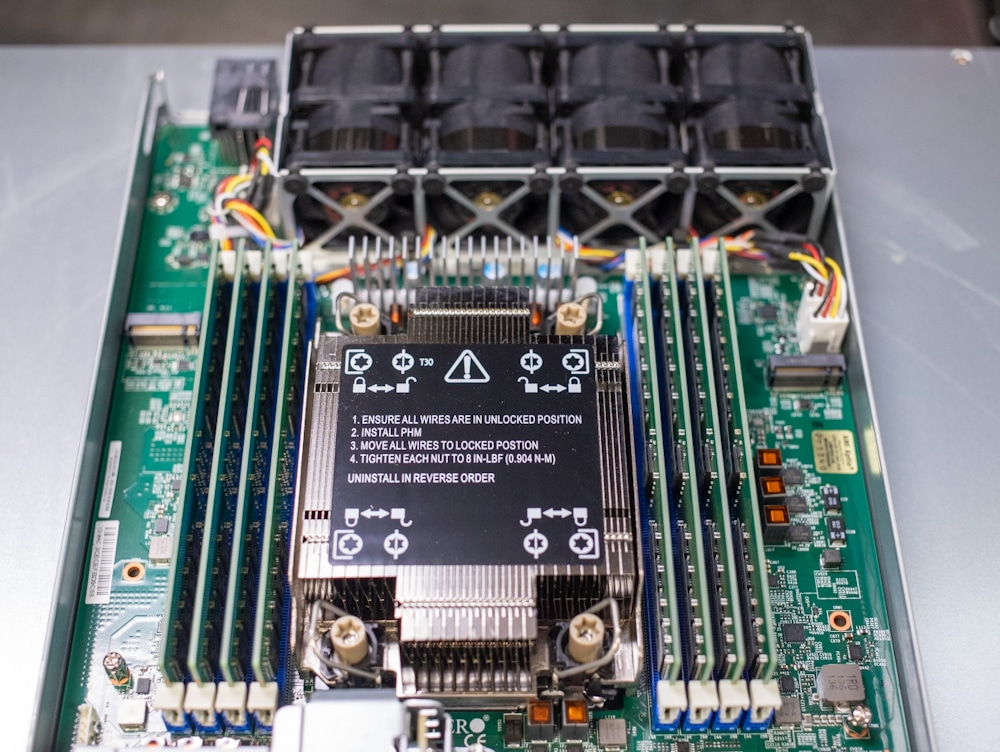
這是一個節點的內部。 請注意一切都緊密地結合在一起。
該服務器的主要弱點是存儲,節點內存儲僅限於兩個 M.2 引導驅動器插槽,沒有原生 2.5 英寸或 3.5 英寸托架。 如前所述,您可以相當輕鬆地添加 PCIe 存儲。 網絡存儲也是一種選擇; 其超過 1GbE 的連接性取決於擴展卡。
突出此服務器的邊緣焦點是它能夠在高達 45 攝氏度的環境中運行,並在 55 攝氏度的環境中短暫停留,以及其可用的灰塵過濾器。
邊緣推理:邊緣服務器案例
我們的專題文章《邊緣推理借助新硬體走向成熟》闡述了邊緣運算的現狀。如今向邊緣的遷移在傳統時代似乎是倒退之舉,因為當時採用的是層級式的「中心輻射」架構,目的是將資料傳回中央位置。即時決策是推動邊緣運算發展的動力,它能夠提供更快的洞察和響應速度,並降低對網路連接的依賴。
邊緣推理可以在雲端完成,但通常只適用於非時間敏感、非關鍵的應用程序。 當然,缺乏網絡連接意味著雲是行不通的。
在 SuperMicro IoT SuperServer SYS-210SE-31A 上測試邊緣
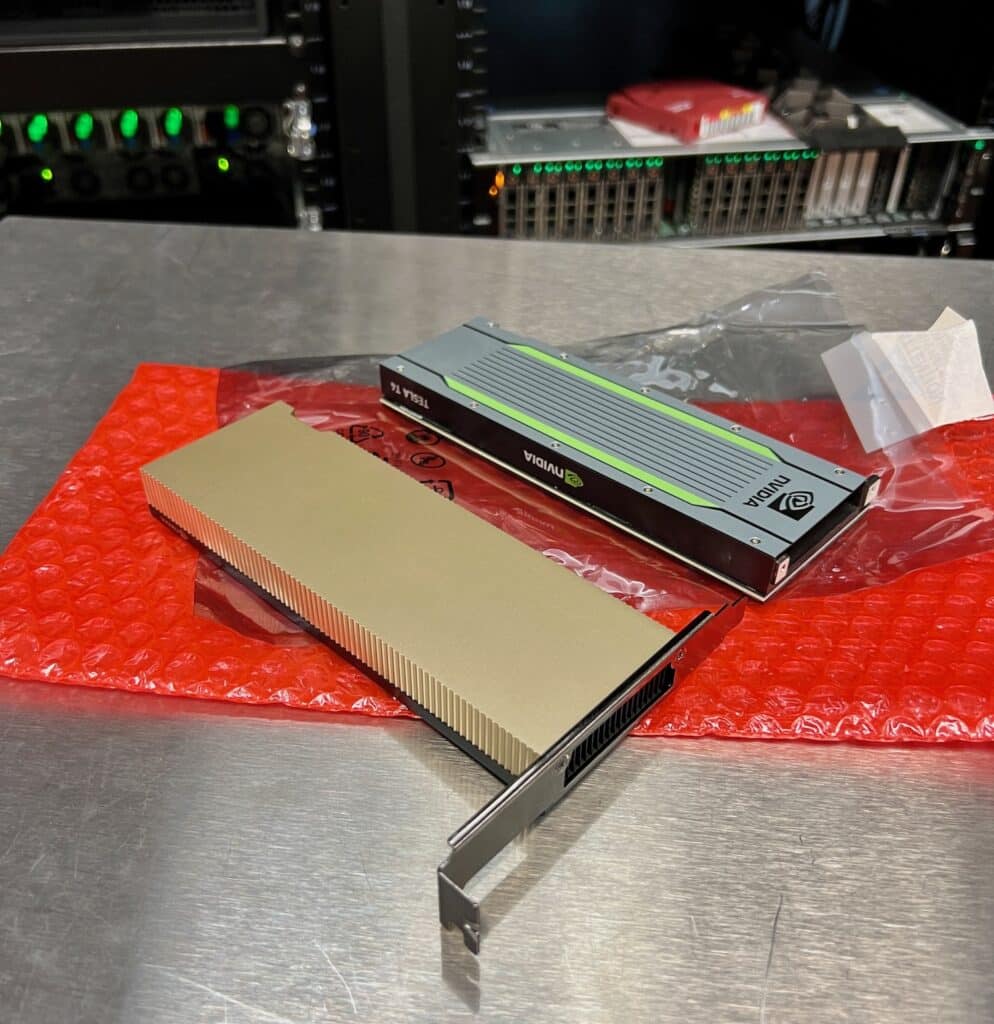
現在,進入我們的測試。 GPU 處理數據的能力推動了邊緣推理,而邊緣服務器通常堅持使用單槽、低配置的卡,如 NVIDIA A2 和較舊但流行的 T4。 我們正在評估的 SuperMicro IoT SuperServer SYS-210SE-31A 具有 T4。 下面是兩張牌,右邊是T4,左邊是A2。 每個節點的硬件配置包括 Intel Xeon Gold 6330 CPU 和 128GB DDR4 RAM。
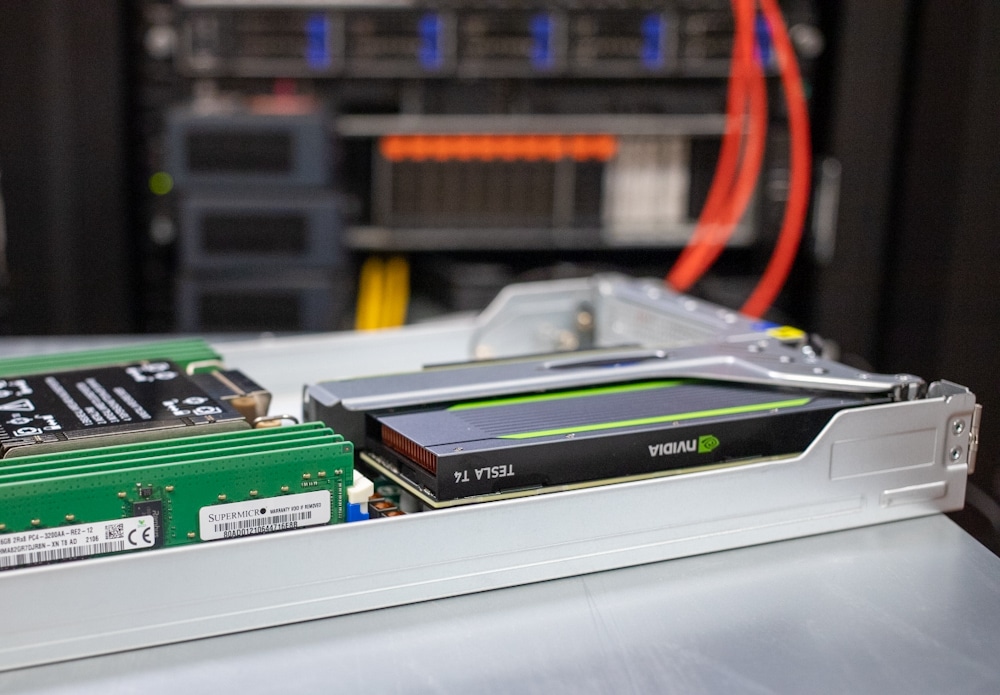
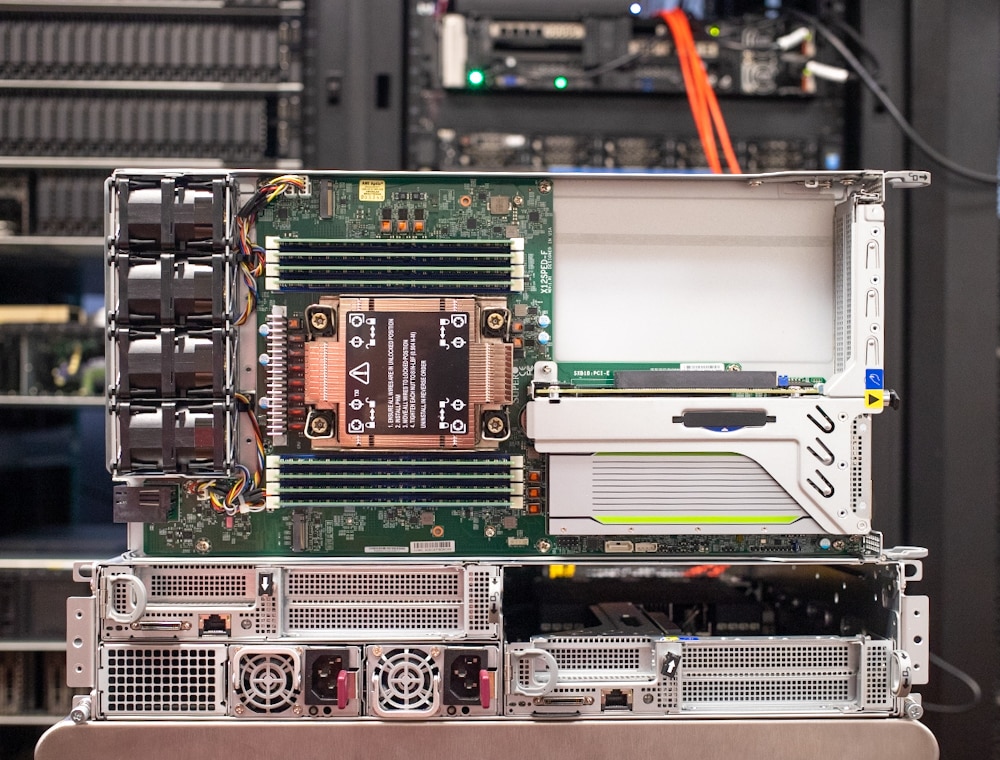
這是安裝在其中一個 SuperMicro 節點中的 T4。
T4顯示卡的功耗為70瓦,這意味著它的所有電力都來自PCIe插槽。其圖靈架構配備了張量核心,在FP32、FP16、INT8和INT4精度方面遠勝於CPU。 NVIDIA A2顯示卡的功耗略低,為40瓦至60瓦,但採用了更新、更有效率的架構。請參閱我們關於邊緣推理的文章,其中對這兩款顯示卡進行了比較,我們在聯想ThinkEdge SE450伺服器上對它們進行了測試。
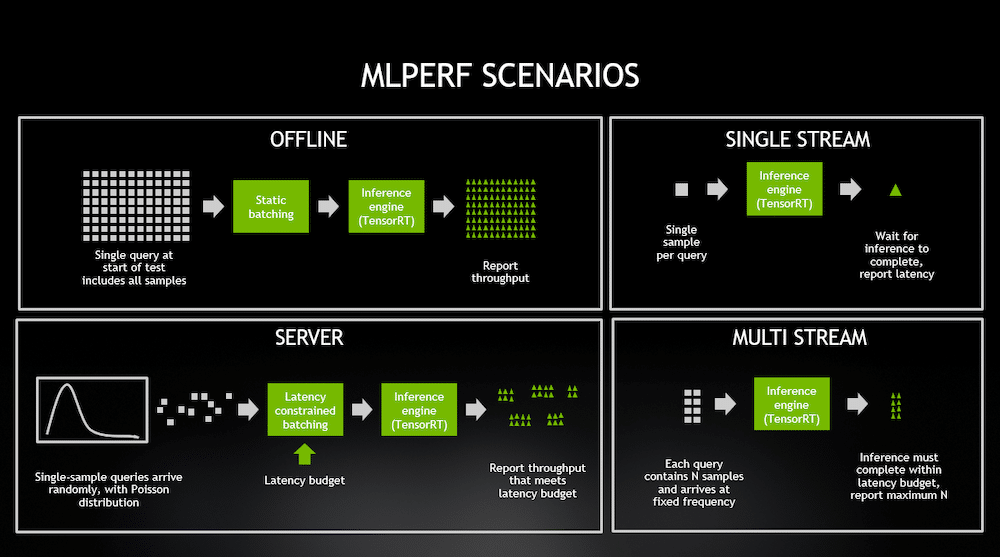
我們正在使用 MLPerf Inference: Edge 基準測試套件,它比較了各種現實世界邊緣場景中流行的 DL 模型的推理性能。 在我們的測試中,我們有 ResNet50 圖像分類模型和用於問答任務的 BERT-Large NLP 模型的數字。 兩者都在 Offline 和 SingleStream 配置中運行。
離線場景以“批處理模式”評估推理性能,此時所有測試數據都立即可用,並且不考慮延遲。 在這個任務中,推理腳本可以按任意順序處理測試數據,目標是最大化每秒的查詢數(QPS=吞吐量)。 QPS 數越高越好。
相比之下,單流配置一次處理一個測試樣本。 一旦對單個輸入執行了推理(在 ResNet50 的情況下,輸入是單個圖像),就會測量延遲,並使下一個樣本可供推理工具使用。 目標是最小化處理每個查詢的延遲; 延遲越低越好。 為簡潔起見,查詢流的第 90 個百分位延遲被捕獲為目標指標。
下圖來自NVIDIA 一篇關於 MLPerf 推理 0.5 的部落格文章,它很好地視覺化了各種場景。您可以在這裡閱讀 MLPerf 推理的原始論文,以了解更多關於各種場景的資訊。
我們測試了在 SuperMicro IoT SuperServer SYS-210SE-31A 內部的兩個節點上運行的工作負載。 第三個節點被設置為備用節點。
| 基準 | 節點 1 (NVIDIA T4) | 節點 3 (NVIDIA T4) |
| RestNet50 當前離線 | 5,587 個樣本/秒 | 5,492 個樣本/秒 |
| BERT 單流 | 6.8 毫秒(90th 百分比) | 7.0 毫秒(90th 百分比) |
| BERT 當前離線 | 397 個樣本/秒 | 396 個樣本/秒 |
NVIDIA T4 整體印象深刻。 節點 1 表現出略微更好的性能。 也就是說,T4 是一款較舊的卡,具有比較新的 A2 更高的功率配置文件。 我們看到在 ThinkEdge SE2 中測試 A450,它在某些地方的延遲也比 T4 低,同時使用更少的功率。 應用和功率考慮因素應決定兩者之間的選擇。 不過就目前而言,我們對 Supermicro 機箱可以為這些類型的工作負載提供的密度感到滿意。
最後的思考
邊緣競賽帶來了邊緣計算的快速進步。 沒有比 GPU 更明顯的了,特別是像 NVIDIA T4 和更新的 A2 這樣的低配置、低功耗選項。 我們在 SuperMicro IoT SuperServer SYS-4SE-210A(一種高度通用的三節點邊緣服務器)中測試了 T31。
T4 表現出卓越的性能,考慮到它的年齡,這更令人印象深刻。 不過,它確實比 A2 消耗更多的功率,因此請根據您的邊緣推理需求明智地選擇。 我們預計,隨著邊緣驅動型公司繼續優化 GPU 利用率,備受推崇的 GPU 仍有很長的路要走。
此外,Supermicro 物聯網服務器配備精良,可以處理這些卡,在邊緣提供非常密集的推理性能。


 Amazon