

聯想 ThinkStation P3 Tower Gen 2 是一款中階工作站,專為滿足工程、媒體、科學和軟體開發等各個領域的專業工作流程需求而設計。它專為注重可靠性和性能,同時又注重預算(相對而言)的用戶而設計。
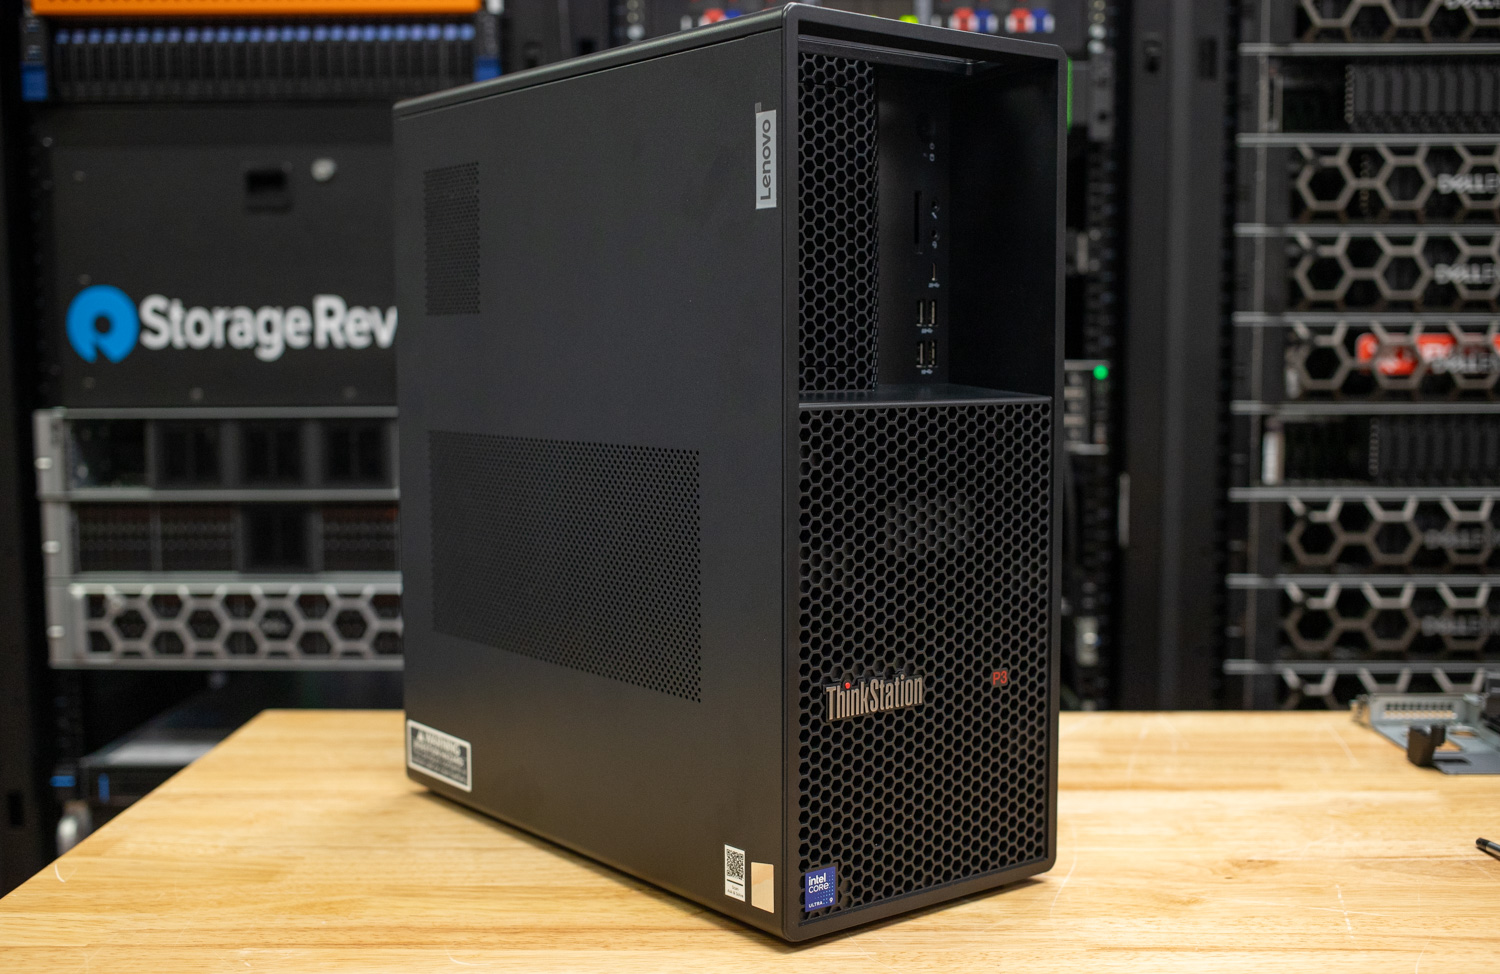
這款工作站採用時尚的機箱,幾乎無需工具即可輕鬆拆卸,方便升級和維護。它擁有豐富的 I/O 連接埠選擇,確保為各種週邊提供靈活的連接選項。
ThinkStation P3 的核心搭載英特爾酷睿 Ultra 9 285 處理器,該處理器包含 16 個高效核心,並透過其專用的神經處理單元 (NPU) 提供高達 36 TOPS(每秒萬億次運算)的強大性能。這種架構可實現高效的多任務處理,並支援線程應用程序,使其成為高要求計算任務的理想選擇,同時價格也比高端工作站更實惠。
基礎工作站配置配備 64GB RAM 和 1TB M.2 儲存空間,但可容納超出標準的配置。您也可以從三種高階 GPU 選項中進行選擇。
論文規範
| ThinkStation P3 Tower Gen 2(英特爾)- 技術規格 | 規格 | |
| 性能 | ||
| 處理器 |
|
|
| 操作系統 | Windows 11專業版 | |
| 神經處理單元 | 高達 36 TOPS 的 AI 效能 | |
| 圖像 | 整合式英特爾® 顯示卡
|
|
| 記憶體應用 | 高達 256GB DDR5 5600MT/s* | |
| 儲存 |
|
|
| 連接和連接埠 | ||
| 前端口 |
|
|
| 後端口 |
|
|
| 擴展選項 | 序列埠、擴充卡、Flex IO(HDMI、VGA、附 DP 的 USB-C、DisplayPort) | |
| 無線應用 | 選購 WiFi 7 BE200 (2×2) 和藍牙 5.4 vPro | |
| 設計與建造 | ||
| 尺寸(高×寬×深) | 415 × 180 × 370 毫米(16.34 吋 × 7.09 吋 × 14.57 吋) | |
| 重量 | 起始重量為 8.65 千克(19.07 磅) | |
| 顏色 | 黑色 | |
| 電源供應 | ||
| 選項 | 1100W / 750W / 500W,效率皆為 92% | |
| 安全性 | ||
| 產品特性 | ThinkShield 安全 dTPM 2.0、BIOS 管理員和開機密碼 UEFI 安全啟動、自我修復 BIOS Kensington® 鎖槽、掛鎖環 選購:機殼入侵開關、纜鎖、電子鎖 |
|
| 永續性與認證 | ||
| 材料種類 | 95% PCC 再生塑膠前擋板 90% EPE 緩衝材料 無塑膠包裝,90% 為再生材料/FSC 認證材料 |
|
| 認證 | 能源之星、RoHS、TCO 10.0、EPEAT Gold(附 Climate+) | |
| 軟體及包含物品 | ||
| 預裝軟件 | 聯想 Commercial Vantage、Office 365(試用版) | |
| 在包裝盒 | ThinkStation P3 Tower Gen 2、USB 鍵盤、USB 滑鼠、快速入門指南 | |
構建和設計
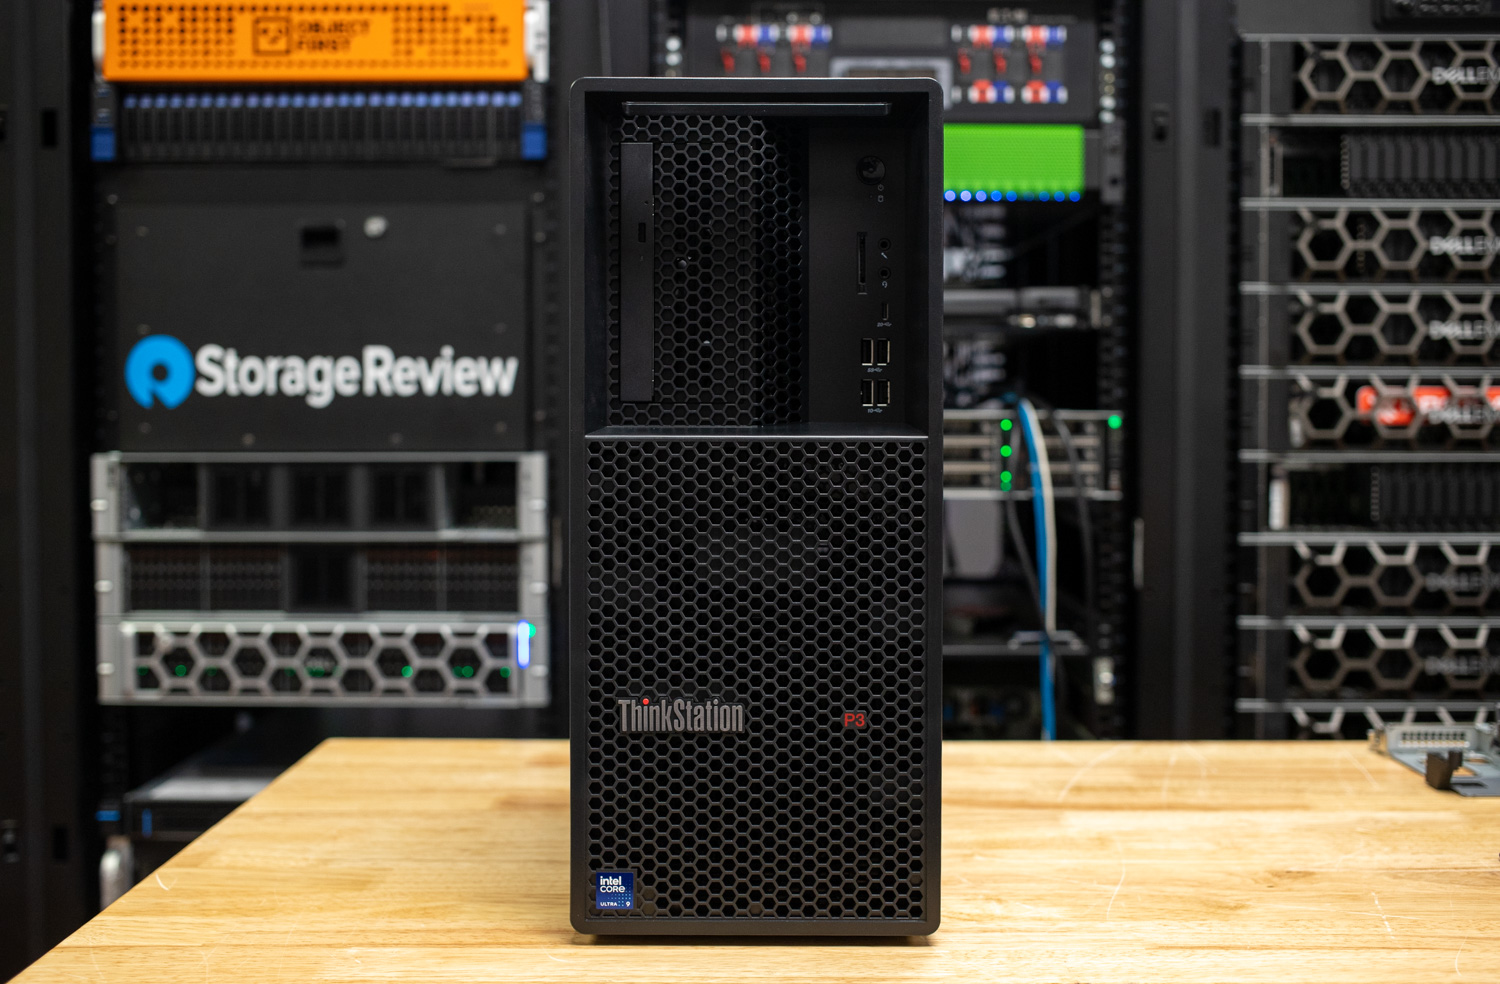
ThinkStation P3 Tower 的機殼設計著重優化氣流,以提升性能。其前面板採用蜂巢結構,不僅美觀大方,還有助於實現卓越的通風。此外,機殼左側和後方均設有明顯的鏤空設計,進一步提升了氣流管理的效率。整體設計採用光滑圓潤的邊緣,營造出現代而精緻的外觀。值得一提的是,一體式手柄與機箱頂部無縫銜接,方便移動和運輸。
該工作站尺寸為 16.3 英寸 x 14.6 英寸 x 7.1 英寸,外形相對緊湊,適合大多數設置。
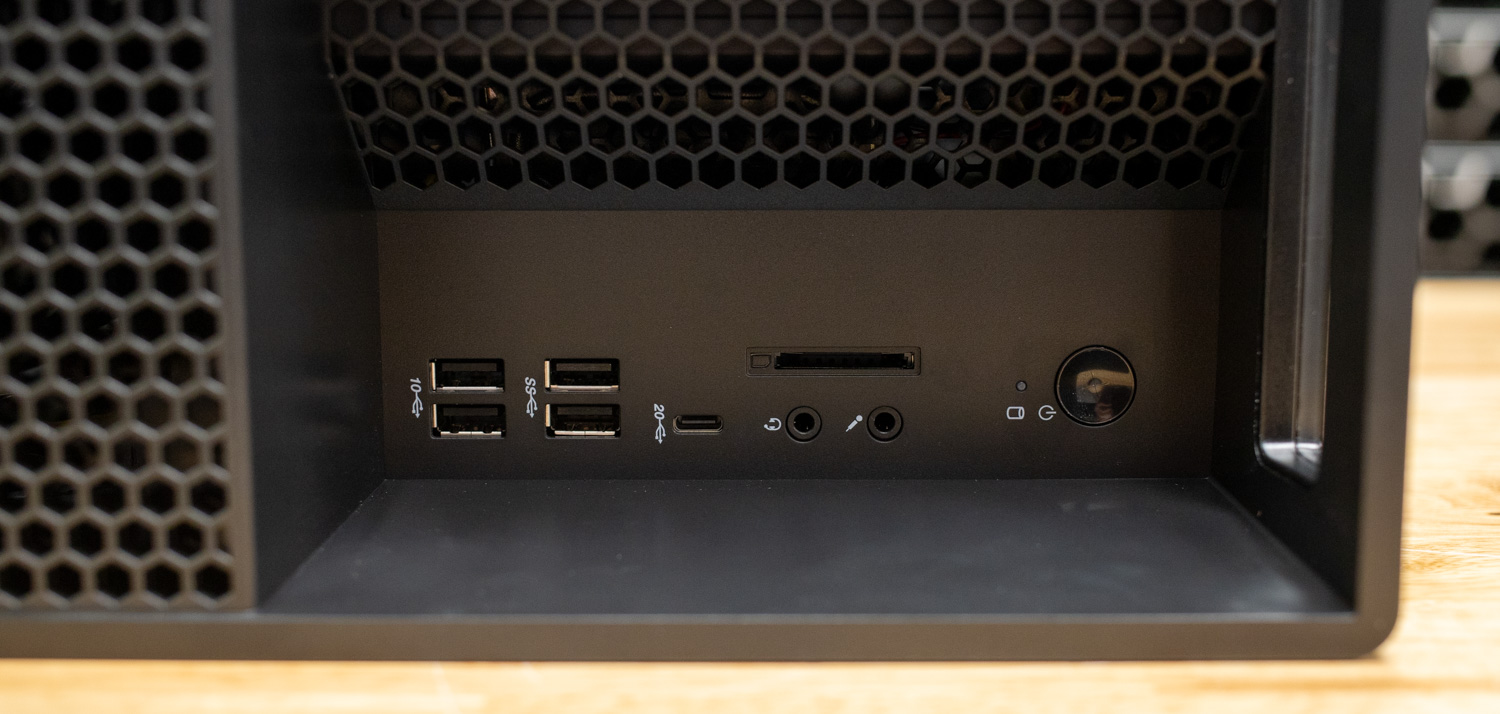
前面板包含兩個 USB-A Gen 1 連接埠、兩個 USB-A Gen 2 連接埠、一個媒體/記憶卡插槽以及兩個 3.5 毫米插孔(一個用於麥克風,一個用於線路輸出)。電源按鈕也位於前面板上。
背面有兩個 USB-A 2.0 連接埠、兩個 USB-A Gen 1 連接埠和一個 HDMI 2.1 連接埠。此外,還提供了 3.5 毫米耳機/麥克風組合插孔和一個千兆乙太網路連接埠。工作站共有七個 DisplayPort 連接埠:顯示卡上四個,主機板上兩個,以及一個 flexIO DisplayPort。我們評測系統上的 Flex IO 連接埠包括 DisplayPort、具有 DisplayPort 功能的 5GB USB-C 連接埠以及一個 HDMI 或 VGA 連接埠。
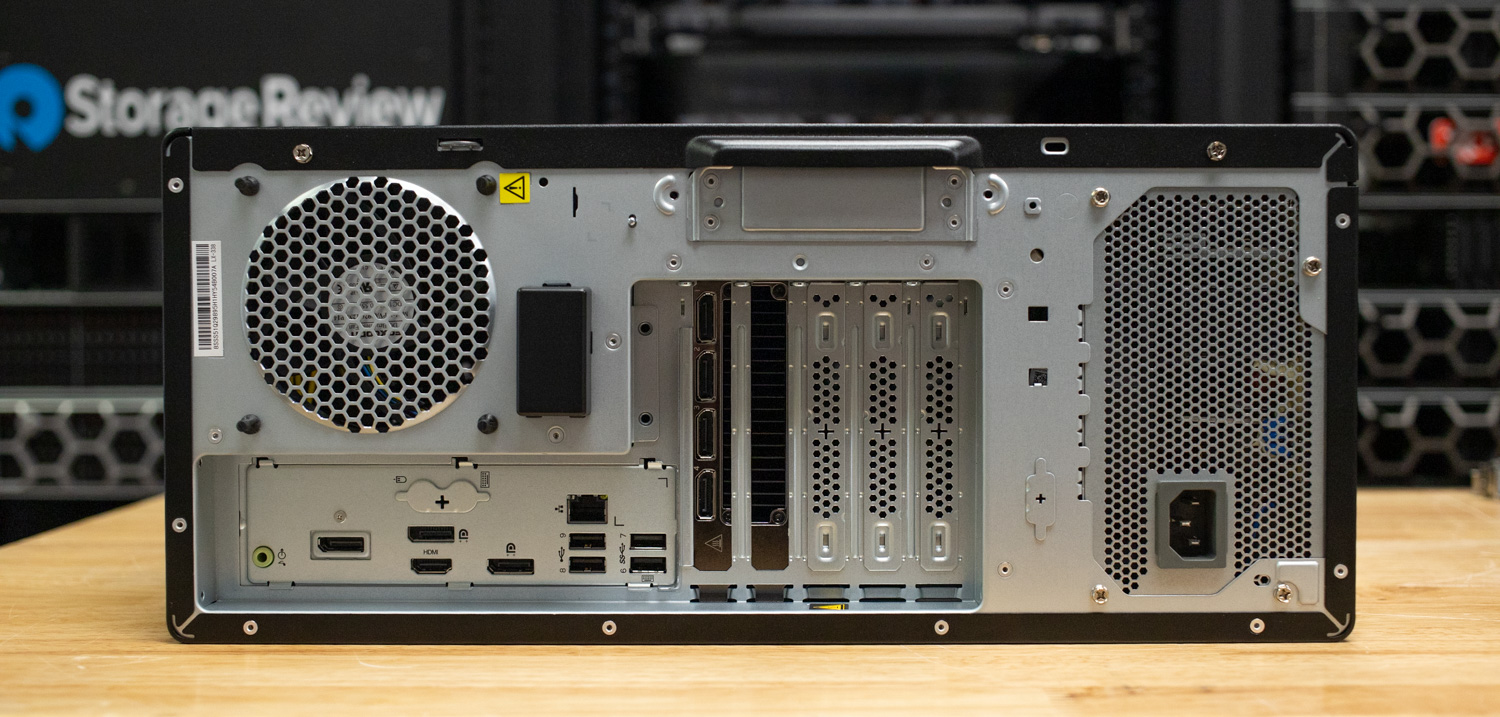
此型號不包含外部托架,但配備前置 HDD 托架。除了標準的 3.5 吋/2.5 吋托架外,使用者還可以透過三個可選的附加磁碟托架來擴展儲存容量。該系統最多支援七個驅動器,可配置為三個 SATA HDD/SSD 和四個 M.2 SSD,或四個 SATA HDD/SSD 和兩個 M.2 SSD。這種靈活性可實現顯著的儲存擴充。
ThinkStation P3 Tower Gen 2 擁有豐富的 M.2 插槽:一個用於 WLAN 的 M.2 插槽、兩個板載 M.2 PCIe 4.0 插槽、一個板載 M.2 PCIe 5.0 插槽(支援 PCIe 4.0 和 5.0 SSD),以及一個支援 M.2 PCIe 的轉接器。基本款配備 64GB DDR5 記憶體(2 x 32GB),但可擴充至最高 256GB。
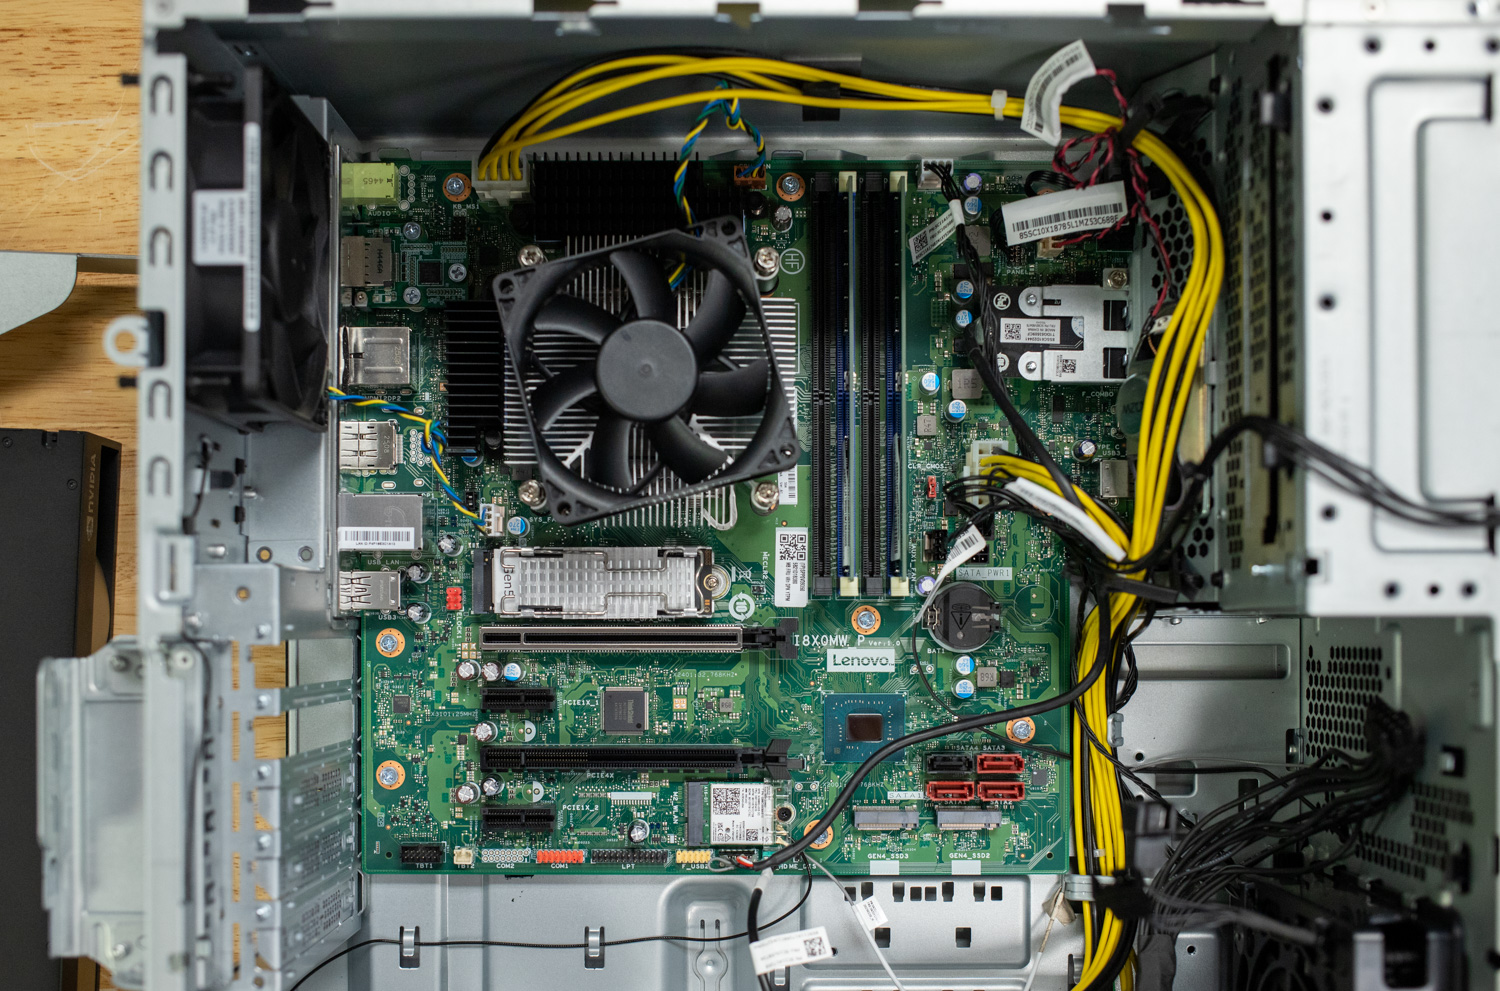
該工作站共有四個 PCIe 插槽。預先安裝的 GPU 連接到 PCIe 5.0 x16 全長插槽,可提供 75W 的功率。在此插槽下方,有一個 PCIe 3.0 x1 半長插槽(25W),但被已安裝的 GPU 覆蓋。再往下,您會發現一個 PCIe 4.0 x16 半長插槽(25W)和另一個 PCIe 3.0 x1 插槽。值得注意的是,電源供應器 (PSU) 的選擇(有 500W、750W 和 1100W 三種選擇)將影響工作站中可安裝的組件。
可維修性
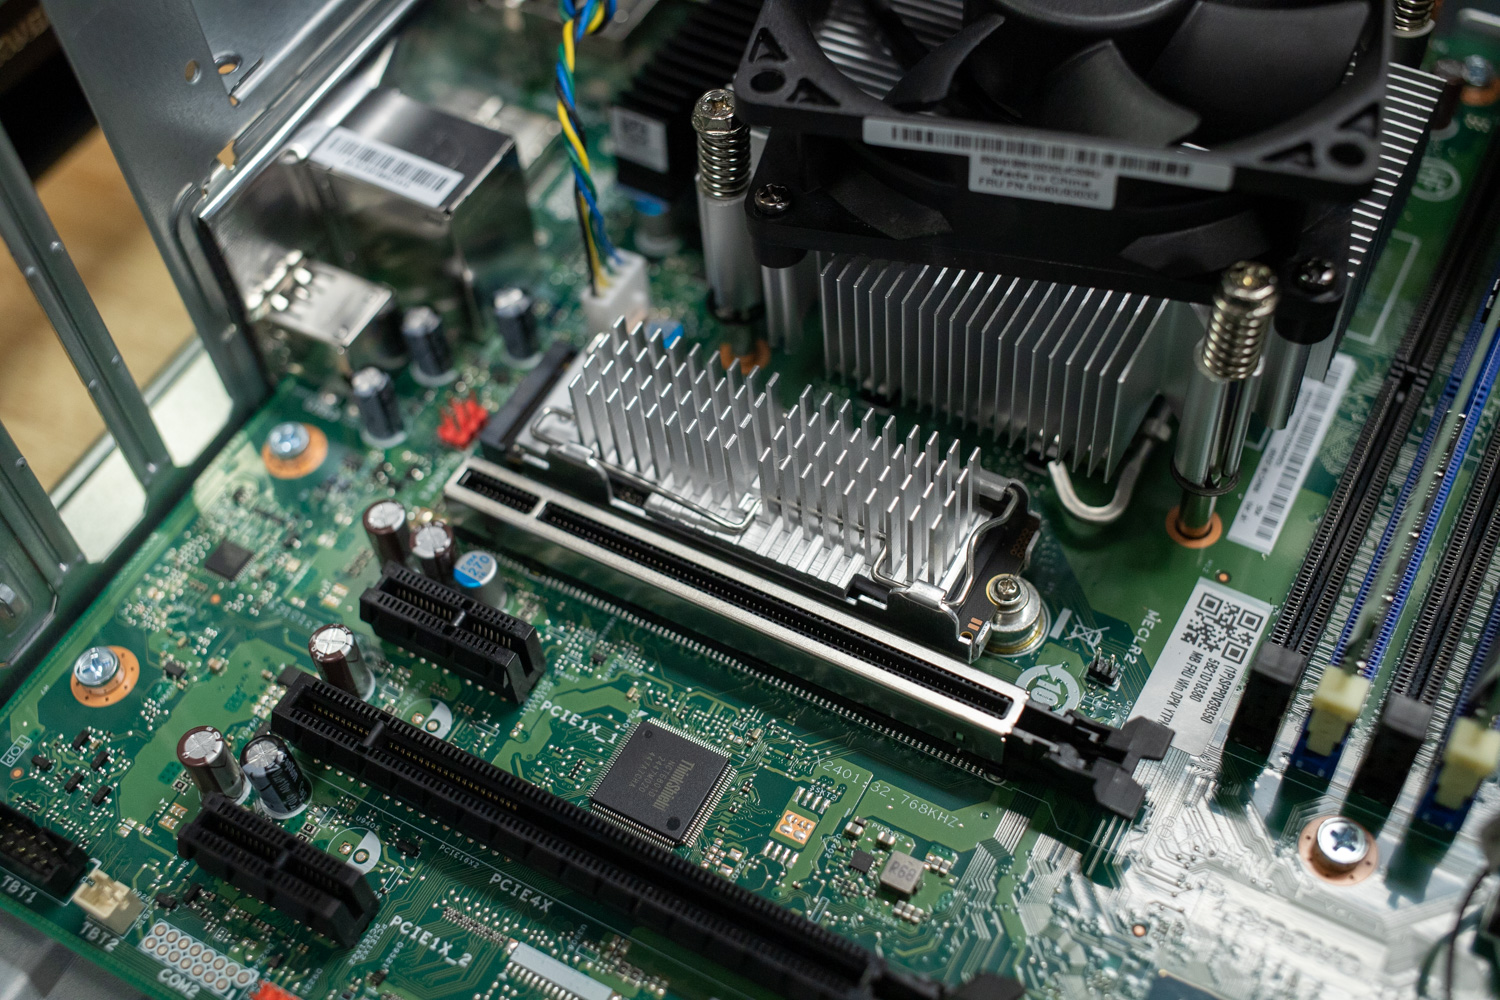
要維修此工作站中的大多數組件,只需卸下固定機殼側面板的兩顆十字槽螺絲即可。機箱內部維護非常簡單。唯一的障礙是風扇和驅動器托架,它們都可以輕鬆拆卸。
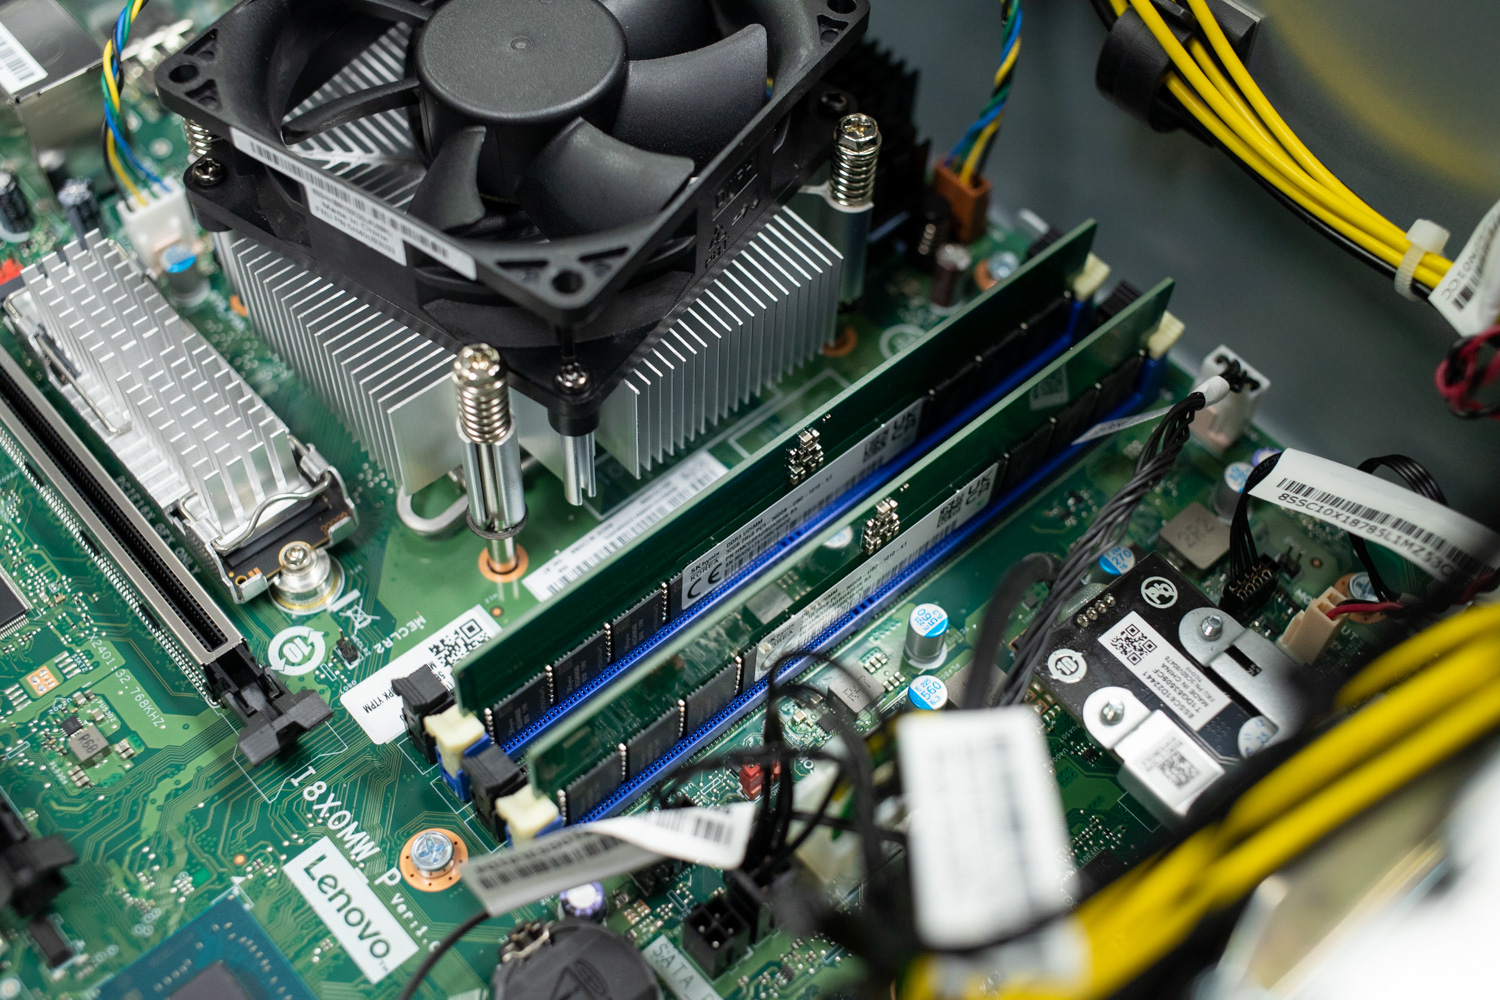
英特爾 CPU 上方安裝了一個緊湊型散熱器,方便拆卸維修。 M.2 SSD 位於 CPU 正下方,非常方便。
若要接觸四個 DDR5 插槽,您需要卸下覆蓋主機板該部分的磁碟機托架。電源已牢固地擰緊到位,但可以輕鬆拆卸以進行故障排除。所有線纜均以紮帶整理,以便有效率地維護。
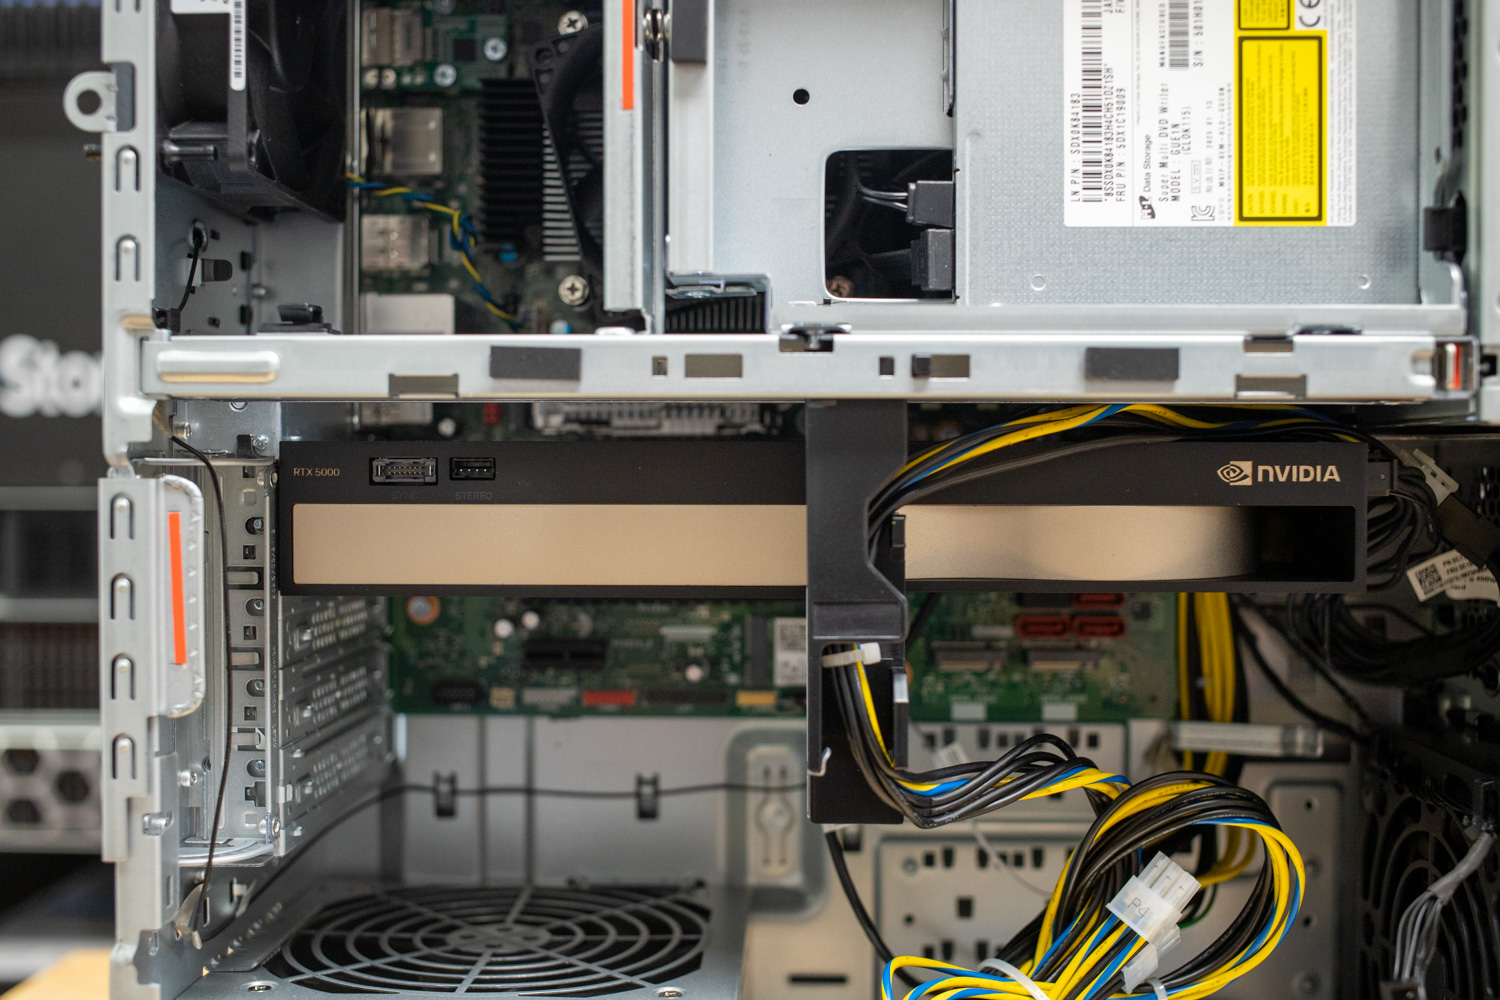
這款工作站頂部 PCIe 插槽安裝有一張 NVIDIA RTX 5000 Ada 顯示卡,並可選擇在其下方添加另一塊顯示卡。此外,工作站配備四個風扇,側板上還預留了兩個風扇空間,以確保所有組件的有效散熱。
性能
我們的 ThinkStation P3 Tower Gen 2 設定包括:
- 英特爾酷睿超9 285
- NVIDIA RTX 5000 Ada 一代
- RAM 64GB
我們的系統配備了強大的 CPU 和 GPU,並包含第二大容量的 RAM。這些配置組合使這款工作站非常適合其目標市場—中端用戶。 GPU 的選擇主要決定了這些套裝的定價。
我們將我們的系統與上一代ThinkStation PX進行了比較,配置如下:
- 英特爾至強金牌 5420+
- 英偉達 RTX A5500
- RAM 256GB
UL Procyon 人工智能推理基準
Procyon AI推理基準測試透過簡化跨平台AI推理評估,提供可靠且有效率的效能測試。該測試與領先的AI硬體供應商合作開發,最大限度地減少了模型和系統配置差異帶來的複雜性,從而實現一致且可重複的基準測試。它針對CPU、GPU或AI加速器進行了最佳化,能夠深入了解不同系統處理實際AI任務的能力。
Procyon AI 推理基準 CPU 測試衡量了 P9 Tower 上的英特爾酷睿 Ultra 285 3 處理器與 ThinkStation PX 上的英特爾至強金牌 5420+ 處理器之間的性能對比。總體而言,基準測試表明,英特爾酷睿 Ultra 9 處理器的性能優於至強金牌 5420+,得分分別為 196 分和 167 分。英特爾酷睿 Ultra 9 處理器的優勢在 MobileNet V3 測試中尤為明顯,其平均耗時為 0.94 毫秒,顯著優於英特爾至強金牌 3.29+ 的 5420 毫秒。
在 YOLO V3 和 REAL-ESRGAN 測試中,P3 Tower 的平均速度較慢,為 43.43 毫秒,而 PX 工作站則表現較佳,平均速度為 32.22 毫秒。在最大工作負載下,P3 Tower 的運行時間為 2,019.39 毫秒,而 ThinkStation PX 的運行時間則更短,為 1,433.09 毫秒。總體而言,英特爾酷睿 Ultra 9 在較小工作負載下表現良好;然而,當另一台 CPU 速度變慢時,英特爾至強金牌 5420+ 能夠快速運行較大的工作負載。
| CPU 結果(平均時間,以毫秒為單位) | 聯想 ThinkStation P3 Tower Gen 2(英特爾酷睿 Ultra 9 285) | 聯想 ThinkStation PX(英特爾)工作站(英特爾至強金牌 5420+) |
| AI電腦視覺總分 | 196 | 167 |
| 移動網V3 | 0.94毫秒 | 3.29毫秒 |
| 殘差網絡 50 | 6.83毫秒 | 7.17毫秒 |
| 盜夢空間V4 | 19.66毫秒 | 23.05毫秒 |
| 深實驗室V3 | 24.89毫秒 | 27.97毫秒 |
| 優洛V3 | 43.43毫秒 | 32.22毫秒 |
| 真愛斯甘 | 2019.39毫秒 | 1433.09毫秒 |
接下來,我們使用相同的基準測試將 NVIDIA Ada Generation RTX 5000 與 NVIDIA RTX A5500 進行比較。結果表明,我們的 P3 Tower 處理 GPU 任務的能力始終優於 ThinkStation PX,得分分別為 1,168 和 771。較新的 RTX 5000 Ada 在 MobileNet V3 測試中表現出顯著的效能提升,時間為 0.46 毫秒,而 A0.64 的平均時間為 5500 毫秒。這種趨勢在各種基準測試中都得以延續,記錄的時間如下:ResNet V3 為 1.07 毫秒,Inception V4 為 2.71 毫秒,DeepLab V3 為 12.27 毫秒,YOLO V3 為 4.63 毫秒,REAL-ESRGAN 為 81.82 毫秒。 GPU 為 AI 工作負載提供了上一代版本所不具備的效能提升。
| GPU 結果(平均時間,以毫秒為單位) | 聯想 ThinkStation P3 塔式機 第二代(NVIDIA RTX 2 Ada 代) | 聯想 ThinkStation PX(英特爾)工作站(NVIDIA RTX A5500) |
| AI電腦視覺總分 | 1,168 | 771 |
| 移動網V3 | 0.46毫秒 | 0.64毫秒 |
| 殘差網絡 50 | 1.07毫秒 | 1.60毫秒 |
| 盜夢空間V4 | 2.71毫秒 | 4.24毫秒 |
| 深實驗室V3 | 12.27毫秒 | 19.58毫秒 |
| 優洛V3 | 4.63毫秒 | 6.82毫秒 |
| 真愛斯甘 | 81.82毫秒 | 127.85毫秒 |
TensorRT 測試評估 AI 模型的吞吐量,同時最大限度地降低延遲。由於新型號具有 AI 加速功能,P3 Tower 表現出色,總分為 1,706 分,而 ThinkStation PX 為 1,308 分。對於較小的工作負載,P3 Tower 的時間為 0.24 毫秒,而 ThinkStation PX 需要 0.32 毫秒,這表明 P3 Tower 的平均時間更短。同樣,對於較大的工作負載,P84.04 Tower 的平均時間為 3 毫秒,PX 為 152.69 毫秒。唯一值得注意的例外是 DeepLab V3,P3 Tower 在這方面表現不佳,平均時間為 3.92 毫秒,而 ThinkStation PX 為 3.20 毫秒。儘管 ThinkStation P3 Tower Gen 2 設計為中階工作站,但它具有多項顯著優勢。
| TensorRT 結果(平均時間,單位:毫秒) | 聯想 ThinkStation P3 Tower Gen 2 | 聯想 ThinkStation PX(英特爾)工作站 |
| AI電腦視覺總分 | 1,706 | 1,308 |
| 移動網V3 | 0.24毫秒 | 0.32毫秒 |
| 殘差網絡 50 | 0.94毫秒 | 1.17毫秒 |
| 盜夢空間V4 | 2.76毫秒 | 3.82毫秒 |
| 深實驗室V3 | 3.92毫秒 | 3.20毫秒 |
| 優洛V3 | 3.09毫秒 | 4.45毫秒 |
| 真愛斯甘 | 84.04毫秒 | 152.69毫秒 |
UL Procyon:人工智慧文字生成
Procyon AI 文字產生基準測試透過提供簡潔一致的評估方法,簡化了 AI LLM 效能測試。它允許對多個 LLM 模型進行重複測試,同時最大限度地降低大型模型規模和可變因素帶來的複雜性。此基準測試由 AI 硬體領域的領導企業共同開發,優化了本地 AI 加速器的使用,從而實現更可靠、更有效率的效能評估。以下測試結果均使用 TensorRT 進行測試。
在 Procyon AI 文字產生測試中,P3 Tower 憑藉 NVIDIA 5000 Ada Generation 的處理能力佔據優勢,該處理器擁有 12,800 個 CUDA 核心和 256 位元記憶體匯流排,而 NVIDIA A5500 則擁有 10,240 個 CUDA 核心總線。 384 Ada 的 Phi 和 Mistral 得分分別為 5000 和 4,344,輸出令牌速率分別為 4,136 個令牌/秒和 160.757 個令牌/秒,明顯高於 A117.784 的 5500 個令牌/秒數和 142.314 個令牌。這一趨勢在 Llama108.534 和 Llama3 中延續,其中 2 Ada 領先,在 Llama5000 中總產出 96.565 個代幣/秒,耗時 30.285 秒;在 Llama3 中總產出 57.523 個代幣/秒,耗時 50.269 秒。 2 Ada 依然保持領先,在較重的機型上也表現良好。對於那些尋求 AI 加速系統但又不想支付更高價位的用戶來說,它提供了極具吸引力的價值。
| UL Procyon:人工智慧文字生成 | 聯想 ThinkStation P3 Tower Gen 2(NVIDIA RTX 5000 Ada 代) | 聯想 ThinkStation PX(英特爾)工作站(NVIDIA RTX A5500) |
| Phi 總分 | 4,344 | 3,118 |
| Phi 輸出到第一個代幣的時間 | 0.218小號 | 0.375小號 |
| Phi 每秒輸出令牌 | 160.757 令牌/秒 | 142.314 令牌/秒 |
| Phi 總持續時間 | 18.356小號 | 21.489小號 |
| 米斯特拉爾總分 | 4,136 | 3,045 |
| 米斯特拉爾輸出第一個令牌的時間 | 0.314小號 | 0.533小號 |
| 米斯特拉爾每秒輸出令牌 | 117.784 令牌/秒 | 108.534 令牌/秒 |
| 米斯特拉爾總持續時間 | 25.142小號 | 28.584小號 |
| Llama3 總分 | 3,611 | 2,792 |
| Llama3 輸出第一個令牌的時間 | 0.301小號 | 0.495s |
| Llama3 每秒輸出令牌 | 96.565 令牌/秒 | 95.027 令牌/秒 |
| Llama3 整體持續時間 | 30.285小號 | 32.223小號 |
| Llama2 總分 | 3,942 | 2,806 |
| Llama2 輸出第一個令牌的時間 | 0.502小號 | 0.806小號 |
| Llama2 每秒輸出令牌 | 57.623 令牌/秒 | 52.258 令牌/秒 |
| Llama2 整體持續時間 | 50.269小號 | 57.759小號 |
UL Procyon: 人工智能圖像生成
Procyon AI 影像產生基準測試提供了一種一致且精確的方法,用於衡量各種硬體(從低功耗 NPU 到高階 GPU)上的 AI 推理效能。它包含三個測試:針對高階 GPU 的 Stable Diffusion XL (FP16)、針對中等效能 GPU 的 Stable Diffusion 1.5 (FP16) 以及針對低功耗裝置的 Stable Diffusion 1.5 (INT8)。此基準測試會針對每個系統使用最佳推理引擎,確保結果的公平性和可比較性。
在 Procyon AI 影像產生基準測試中,P3 Tower 在 GPU 相關任務中繼續表現出色。 Stable Diffusion 1.5 FP16 測試得分為 3,734,遠遠領先 ThinkStation PX 的 2,386。1.674 Ada 的平均圖像生成時間為 5000 秒,遠快於 A5500 的每個圖像 2.619 秒。同一型號的 INT8 變體也表現出色,45,881 Ada 的得分為 5000,而 A27,743 的得分為 5500。其每張影像的生成時間為 0.681 秒,略快於對比系統的平均時間。在 Stable Diffusion XL FP16 測試中,這種模式仍然存在,3,293 Ada 的得分為 5000,而 A2,012 的得分為 5500。與先前的結果一致,這款較新的 GPU 的運作效率比 ThinkStation PX 上的 A5500 更高。
| UL Procyon:AI 影像生成 | 聯想 ThinkStation P3 Tower Gen 2(NVIDIA RTX 5000 Ada 代) | 聯想 ThinkStation PX(英特爾)工作站(NVIDIA RTX A5500) |
| 穩定擴散 1.5 (FP16) – 總分 | 3,734 | 2,386 |
| 穩定擴散 1.5 (FP16) – 總時間 | 26.779小號 | 41.911小號 |
| 穩定擴散 1.5 (FP16) – 影像產生速度 | 1.674 秒/影像 | 2.619 秒/影像 |
| 穩定擴散 1.5 (INT8) – 總分 | 45,881 | 27,743 |
| 穩定擴散 1.5 (INT8) – 總時間 | 5.449小號 | 9.011小號 |
| 穩定擴散 1.5 (INT8) – 影像生成速度 | 0.681 秒/影像 | 1.126 秒/影像 |
| 穩定擴散 XL (FP16) – 總分 | 3,293 | 2,012 |
| 穩定擴散 XL (FP16) – 總時間 | 182.179小號 | 298.158小號 |
| 穩定擴散 XL (FP16) – 影像產生速度 | 11.386 秒/影像 | 18.635 秒/影像 |
UL Procyon AI 電腦視覺
UL Procyon AI 推理測試旨在評估工作站運行專業應用程式的效能。需要注意的是,此測試未使用多核心 CPU 功能。具體而言,該工具主要測試工作站處理 AI 驅動的任務和工作流程的能力,並對其處理複雜 AI 演算法和應用程式的效率和速度進行詳細評估。
專為 AI 工作負載設計的 P3 Tower 在所有測試類別中都展現出與 ThinkStation PX 相當的效能。兩者在 AI 任務處理速度方面相近的一個有力證明是,它們的總得分均為 71 分。查看各項測試結果,我們發現 MobileNet V3 的計算時間為 1.62 毫秒,ResNet 50 的計算時間為 20.17 毫秒,Inception V4 的計算時間為 60.94 毫秒,DeepLab V3 的計算時間為 60.83 毫秒,YO V3 的計算時間為這款工作站的高效性使其性能堪比上一代工作站的高端水平。
| UL Procyon:AI 電腦視覺推理時間 CPU(越低越好) | 聯想 ThinkStation P3 Tower Gen 2 | 聯想 ThinkStation PX(英特爾)工作站 |
|---|---|---|
| 移動網V3 | 1.62毫秒 | 1.62毫秒 |
| 殘差網絡 50 | 20.17毫秒 | 20.02毫秒 |
| 盜夢空間V4 | 60.94毫秒 | 60.15毫秒 |
| 深實驗室V3 | 60.83毫秒 | 61.13毫秒 |
| 優洛V3 | 160.27毫秒 | 158.32毫秒 |
| 真實ESRGAN | 6259.97毫秒 | 6266.98毫秒 |
| 總分(越高越好) | 71 | 71 |
規格工作站 4
SPECworkstation 4.0 基準測試是一款綜合性工具,用於評估工作站效能的所有關鍵方面。它提供 CPU、圖形、加速器和磁碟效能的實際測量數據,確保專業人士能夠獲得所需數據,從而做出明智的硬體投資決策。此基準測試包含一套專門針對 AI 和 ML 工作負載的測試,包括資料科學任務和基於 ONNX 執行時間的推理測試,這反映了 AI/ML 在工作站環境中日益增長的重要性。它涵蓋七個行業垂直領域和四個硬體子系統,能夠提供對當今工作站性能的詳細且相關的衡量標準。
在SPECworkstation測試中,兩款系統的結果因工作負載而異。 PX塔式機在能源(3.16 vs. 2.49)、金融服務(3.84 vs. 2.44)和生命科學(3.78 vs. 2.84)三個類別中領先,展現了其伺服器級CPU在運算密集領域的優勢。媒體娛樂和產品設計的表現較為接近,PX略勝一籌,分別為2.78 vs. 2.69和2.73 vs. 2.46。生產力與開發是P3塔式機唯一領先的類別,其得分為1.50,而PX為1.09,這表明ThinkStation PX能夠更有效地應對CPU負載。
| SPECworkstation 4.0.0(越高越好) |
聯想 ThinkStation P3 Tower Gen 2 |
聯想 ThinkStation PX(英特爾)工作站 |
| 能源 | 2.49 | 3.16 |
| 金融服務 | 2.44 | 3.84 |
| 生命科學 | 2.84 | 3.78 |
| 媒體與娛樂 | 2.69 | 2.78 |
| 產品設計 | 2.46 | 2.73 |
| 生產力與發展 | 1.50 | 1.09 |
樂士馬克
Luxmark 是一種 GPU 基準測試,它利用開源光線追蹤渲染器 LuxRender 來評估系統處理高度詳細的 3D 場景的效能。此基準測試適用於評估伺服器和工作站的圖形渲染能力,特別是對於視覺效果和建築視覺化應用程序,其中準確的光線模擬至關重要。
在 LuxMark 測驗中,聯想 ThinkStation P3 填補了 ThinkStation PX 未能填補的表現差距。在 Hallbench 測試中,P3 得分 26,792,而 PX 得分 20,289;在 Food 測試中,P12,562 得分 7,827,而 PX 得分 3。這項優勢主要源自於 P5000 搭載的 NVIDIA RTX 5500 Ada GPU,其 OpenCL 渲染效能比 PX 的 RTX AXNUMX 更強大。
| Luxmark(越高越好) | 聯想 ThinkStation P3 Tower Gen 2 | 聯想 ThinkStation PX(英特爾)工作站 |
| 大廳長凳 | 26,792 | 20,289 |
| 食品 | 12,562 | 7,827 |
7-Zip 壓縮
7-Zip 壓縮基準測試評估 CPU 在壓縮和解壓縮任務中的效能,以 GIPS(每秒千兆指令數)和 CPU 使用率作為衡量標準。更高的 GIPS 和高效的 CPU 使用率表明性能卓越。
在 7-Zip 壓縮基準測試中,ThinkStation PX 在整體吞吐量方面佔據明顯優勢,總分為 202.384 GIPS,而 P3 Tower 僅為 138.701 GIPS。從反映持續表現的最終評分來看,PX 的壓縮和解壓縮表現分別以 206.619 GIPS 和 198.149 GIPS 領先,而 P3 則分別為 134.748 GIPS 和 142.655 GIPS。這些結果凸顯了 PX 在伺服器級 CPU 的幫助下,在持續、高度並行資料處理方面的優勢。 ThinkStation P3 Tower Gen 2 展現了高階機型 CPU 的效能如何超越中階機型。
| 7-Zip 壓縮基準(越高越好) | 聯想 ThinkStation P3 Tower Gen 2 | 聯想 ThinkStation PX(英特爾)工作站 | |||
| 壓縮 | |||||
| 當前 CPU 使用率 | |||||
| 電流額定值/使用 | 6.970 吉普斯 | 4.020 吉普斯 | |||
| 額定電流 | 132.461 吉普斯 | 206.868 吉普斯 | |||
| 產生的 CPU 使用率 | |||||
| 結果評級/使用 | 7.115 吉普斯 | 3.997 吉普斯 | |||
| 結果評級 | 134.748 吉普斯 | 206.619 吉普斯 | |||
| 減壓 | |||||
| 當前 CPU 使用率 | |||||
| 電流額定值/使用 | 6.937 吉普斯 | 4.027 吉普斯 | |||
| 額定電流 | 152.009 吉普斯 | 200.366 吉普斯 | |||
| 產生的 CPU 使用率 | |||||
| 結果評級/使用 | 7,209 吉普斯 | 3.815 吉普斯 | |||
| 結果評級 | 142.655 吉普斯 | 198.149 吉普斯 | |||
| 總評分 | |||||
| 總 CPU 使用率 | |||||
| 總評分/使用情況 | 7.162 吉普斯 | 3.906 吉普斯 | |||
| 總評分 | 138.701 吉普斯 | 202.384 吉普斯 | |||
Blackmagic RAW 速度測試
Blackmagic RAW 速度測試是一種效能基準測試工具,用於測量系統使用 Blackmagic RAW 編解碼器處理影片播放和編輯的能力。它評估系統解碼和播放高解析度視訊檔案的能力,為基於 CPU 和 GPU 的處理提供幀速率。
在 Blackmagic RAW 速度測試中,ThinkStation PX 工作站在 3K CPU 解碼方面略勝 P8 Tower,得分分別為 142 fps 和 125 fps。然而,P3 Tower 在 8K OpenCL 解碼方面佔據領先地位,達到了 179 fps,而 PX 僅為 150 fps。這幅精彩的視覺效果展現了兩款機型各自的優勢。
| Blackmagic RAW 速度測試 | 聯想 ThinkStation P3 Tower Gen 2 | 聯想 ThinkStation PX(英特爾)工作站 |
|---|---|---|
| 8K CPU | 125 | 142 |
| 8K 開放式 | 179 | 150 |
Blackmagic磁盤速度測試
Blackmagic Disk Speed Test 透過測量讀寫速度來評估儲存效能,從而深入了解系統處理資料密集型任務(例如影片編輯和大檔案傳輸)的能力。
聯想 ThinkStation P3 Tower Gen 2 具有出色的磁碟效能,讀取速度高達 7,304.2 MB/s,寫入速度高達 7,006.2 MB/s。這表明,它比 ThinkStation PX Workstation 具有更高的高速傳輸相容性,後者的讀取速度為 3,958.2 MB/s,寫入速度為 2,474.2 MB/s。
| 磁碟速度測試(越高越好) | 聯想 ThinkStation P3 Tower Gen 2 |
聯想 ThinkStation PX(英特爾)工作站 |
| 閱讀 | 7304.2 MB / s的 | 3958.2 MB / s的 |
| 寫 | 7006.2 MB / s的 | 2474.2 MB / s的 |
攪拌機4.3
Blender 是一款開源 3D 建模應用程式。本次基準測試使用 Blender Benchmark 實用程式運行。分數以每分鐘採樣數計算,數值越高,效能越好。
在 Blender 的 CPU 渲染測試中,ThinkStation PX Workstation 的取樣率高於 P3 Tower,這主要歸功於其伺服器級 CPU。在「怪物」場景中,PX 的取樣率達到了每分鐘 450.8 次,而 P3 的取樣率僅為 163.7 次;在「舊貨店」場景中,PX 的取樣率達到了每分鐘 319.9 次,而 P106.8 的取樣率僅為 222.7 次。 「課堂」場景也呈現類似的趨勢,PX 的取樣率達到了每分鐘 3 次,而 P80.9 的取樣率僅為 XNUMX 次。
| Blender CPU(每分鐘採樣數,越高越好) | 聯想 ThinkStation P3 Tower Gen 2 | 聯想 ThinkStation PX(英特爾)工作站 |
| Monster | 163.7 | 450.8 |
| 舊貨店 | 106.8 | 319.9 |
| 課堂 | 80.9 | 222.7 |
另一方面,配備 NVIDIA RTX 3 Ada 的 P5000 Tower 非常適合 Blender 的 GPU 渲染測試。在怪物場景中,它每分鐘產生 3,884.68 個樣本,而 PX 的每分鐘為 2,277.83 個。在 Junkshop 測試中,P3 的取樣率為 1,743.56,而 PX 的取樣率為 1,415.61;Classroom 的取樣率為 1,876.89,而 PX 的取樣率為 1,252.93。
| Blender GPU(每分鐘樣本數,越高越好) | 聯想 ThinkStation P3 Tower Gen 2 | 聯想 ThinkStation PX(英特爾)工作站 |
| Monster | 3,884.68 | 2,277.83 |
| 舊貨店 | 1,743.56 | 1,415.61 |
| 課堂 | 1,876.89 | 1,252.93 |
y 粉碎機
y-cruncher 是多線程可擴展程序,能夠計算圓周率 (Pi) 及其他精確到萬億位的數學常數。自 2009 年推出以來,它已成為超頻玩家和硬體愛好者的熱門基準測試和壓力測試應用程式。
在 Y-Cruncher 測驗中,ThinkStation PX 再次展現出 ThinkStation P3 所沒有的優秀處理能力。在 1 億位數字下,PX 的運行耗時為 6.389 秒,而 P3 則為 22.112 秒;在 10 億位數字下,PX 的運行耗時為 85.968 秒,而 P340.904 則為 3 秒。在更高的工作負載下,PX 也進一步擴大了領先優勢,253.808 億位數字下運行耗時為 25 秒,576.144 億位數字下運行耗時為 50 秒。而 P3 Tower 由於配置的記憶體大小,並未在這些規模下進行測試。
| Y-Cruncher(總計算時間) | 聯想 ThinkStation P3 Tower Gen 2 | 聯想 ThinkStation PX(英特爾)工作站 |
|---|---|---|
| 1億 | 22.112小號 | 6.389小號 |
| 2.5億 | 68.345小號 | 17.146小號 |
| 5億 | 146.977小號 | 38.561小號 |
| 10億 | 340.904小號 | 85.968小號 |
| 25億 | 不適用 | 253.808小號 |
| 50億 | 不適用 | 576.144小號 |
Geekbench 6
Geekbench 6 是一個跨平台基準測試,用於衡量整體系統效能。
在 Geekbench 6 跑分中,ThinkStation P3 在各方面均表現出色。 CPU 效能方面,P3 單核心得分 3,175 分,多核心得分 21,033 分,而 PX 的單核心得分分別為 2,193 分和 18,495 分。 GPU 效能方面,P3 搭載的 NVIDIA RTX 5000 Ada 在 OpenCL 測試中得分 244,185 分,而 PX 搭載的 RTX A178,307 顯示卡得分僅為 5500 分,兩者差距更大。
| Geekbench 6(越高越好) | 聯想 ThinkStation P3 Tower Gen 2 | 聯想 ThinkStation PX(英特爾)工作站 |
|---|---|---|
| CPU單核 | 3,175 | 2,193 |
| CPU 多核 | 21,033 | 18,495 |
| GPU OpenCL | 244,185 | 178,307 |
Cinebench R23
Cinebench R23 基準測試工具透過使用 Cinema 3D 引擎渲染複雜的 4D 場景來評估系統的 CPU 效能。它測量單核心和多核心效能,提供 CPU 處理 3D 渲染任務的能力的全面視圖。
在 Cinebench R23 測試中,聯想 ThinkStation P3 Tower Gen 2 的多核得分為 30,760,單核得分為 2,294;而 PX Workstation 的多核得分分別為 64,079 和 1,597。 PX 和 P3 Tower Gen 2 各有優勢——PX 的重點不同,而 P3 Tower Gen 2 的單核心表現則令人印象深刻。
| Cinebench R23(越高越好) | 聯想 ThinkStation P3 Tower Gen 2 | 聯想 ThinkStation PX(英特爾)工作站 |
|---|---|---|
| 多核 | 30,760 | 64,079 |
| 單核 | 2,294 | 1,597 |
Cinebench 2024
Cinebench 2024 透過新增 GPU 效能評估擴展了 R23 的基準測試功能。它繼續測試 CPU 效能,但也包括衡量 GPU 處理渲染任務能力的測試。
在 Cinebench 2024 測試中,聯想 ThinkStation P3 的多核得分為 1,851 分,單核得分為 142 分,而 PX 的得分分別為 3,354 分和 88 分。 GPU 效能方面,P3 也更勝一籌,其 NVIDIA RTX 5000 Ada 顯示卡的得分為 23,746 分,而 PX 的 RTX A16,672 顯示卡的得分為 5500 分。這些結果凸顯了 PX 在高執行緒 CPU 工作負載方面的主導地位,而 P3 在單核心效率和 GPU 渲染能力方面則更勝一籌。
| Cinebench 2024(越高越好) | 聯想 ThinkStation P3 Tower Gen 2 | 聯想 ThinkStation PX(英特爾)工作站 |
|---|---|---|
| 多核 | 1,851 | 3,354 |
| 單核 | 142 | 88 |
| GPU | 23,746 | 16,672 |
結語
在我們的測試中,聯想對 P3 Tower 的願景顯而易見。該系統始終提供可靠且高效的效能,證明了其能夠管理高要求工作負載的能力。尤其值得一提的是,P3 Tower 在 AI 基準測試中表現出色,性能堪比上一代 ThinkStation PX。這項性能凸顯了 AI 如何重新定義這個價位段的預期。
搭載 NVIDIA RTX 3 Ada GPU 的 P5000 Tower 顯著提升了實際效能,這在多項測試中均有體現。例如,在 UL Procyon AI 影像生成測試中,P3 Tower 取得了令人印象深刻的 3,734 分,而 NVIDIA RTX A5500 的得分僅為 2,386 分。在使用最佳推理引擎的情況下,P62 Tower 在所有三個 AI 影像生成基準測試中的成績都提升了 XNUMX%。
在 Luxmark 測試中,效能差異也十分顯著。 P3 Tower 在 Hallbench 測試中得分 26,792,而 PX 僅為 20,289。此外,在 Food 基準測試中,PX 得分為 7,827,而 P3 Tower 的表現則更勝一籌,得分高達 12,562。整體而言,P3 Tower 在效能方面展現出明顯的優勢。
P3 Tower 是一款中階機型,搭載 285 核心英特爾酷睿 Ultra 24 CPU。在我們的基準測試中,它展現出比至強金牌處理器更卓越的效率。例如,在 7-Zip Compression 基準測試中,至強金牌處理器的總 CPU 使用率為 5,184%,而酷睿 Ultra 僅為 1,937%。至強金牌處理器的 GIPS 效能為 3.906,而酷睿 Ultra 則為 7.162。因此,酷睿 Ultra 的總 GIPS 性能為 138.701,而至強金牌處理器為 202.384,這意味著總 GIPS 性能下降了近 46%。
高效的 CPU 和強大的 GPU 使 ThinkStation P3 Tower Gen 2 成為一款功能強大的中高階系統,售價 7,939 美元。它兼具高端性能與經濟實惠,是一款功能多樣的工作站,無需高昂的價格即可提供卓越的性能。
排行榜:聯想 ThinkStation P3 Tower Gen 2 在最佳桌上型工作站排行榜上佔據最佳中階塔式機的位置。


 Amazon