

聯想ThinkSystem SR650 V4是一款靈活強大的雙路2U機架式伺服器,旨在滿足雲端服務、電信和高效能運算 (HPC) 等產業的需求。無論是優化橫向擴展工作負載,還是透過高密度運算為資料中心的未來發展做好準備,SR650 V4 都比其前代產品 SR650 V3 有了顯著的升級。

聯想SR650 V4和SR650 V3的區別
處理器
處理器效能是SR650 V4最重要的升級之一。 SR650 V3採用的是第四代英特爾® 至強® 可擴充處理器,而SR650 V4則引進了英特爾® 至強® 第六代平台(原代號「Granite Rapids」)。我們的評測重點在於專為運算密集型工作負載設計的P核心(效能核心)架構。 V4支援單路或雙路處理器,每個插槽最多可配備86個P核心(最多172個執行緒),提供更高的核心頻率(最高可達4 GHz)和最高350W的TDP。
這種轉變使企業能夠在每台伺服器上處理更苛刻的應用,從而減少實體空間佔用。該架構為虛擬化和繁重的資料庫操作奠定了堅實的基礎。此外,V4 架構支援海量 PCIe 頻寬,每個處理器最多可支援 88 條 PCIe 5.0 通道,這對於為現代高速網路適配器和 NVMe 儲存陣列提供流暢的資料傳輸至關重要。
| CPU型號 | 內核/線程 | 基本頻率 | 最大渦輪 | L3緩存 | TDP |
|---|---|---|---|---|---|
| 6787P | 86 / 172 | 2.0 GHz | 3.8 GHz | 336 MB | 350W¯¯ |
| 6781P | 80 / 160 | 2.0 GHz | 3.8 GHz | 336 MB | 350W¯¯ |
| 6767P | 64 / 128 | 2.4 GHz | 3.9 GHz | 336 MB | 350W¯¯ |
| 6761P | 64 / 128 | 2.5 GHz | 3.9 GHz | 336 MB | 350W¯¯ |
| 6760P | 64 / 128 | 2.2 GHz | 3.8 GHz | 320 MB | 330W¯¯ |
| 6747P | 48 / 96 | 2.7 GHz | 3.9 GHz | 288 MB | 330W¯¯ |
| 6745P | 32 / 64 | 3.1 GHz | 4.3 GHz | 336 MB | 300W¯¯ |
| 6741P | 48 / 96 | 2.5 GHz | 3.8 GHz | 288 MB | 300W¯¯ |
| 6740P | 48 / 96 | 2.1 GHz | 3.8 GHz | 288 MB | 270W¯¯ |
| 6737P | 32 / 64 | 2.9 GHz | 4.0 GHz | 144 MB | 270W¯¯ |
| 6736P | 36 / 72 | 2.0 GHz | 4.1 GHz | 144 MB | 205W¯¯ |
| 6732P | 32 / 64 | 3.8 GHz | 4.3 GHz | 144 MB | 350W¯¯ |
| 6731P | 32 / 64 | 2.5 GHz | 4.1 GHz | 144 MB | 245W¯¯ |
| 6730P | 32 / 64 | 2.5 GHz | 3.8 GHz | 288 MB | 250W¯¯ |
| 6724P | 16 / 32 | 3.6 GHz | 4.3 GHz | 72 MB | 210W¯¯ |
| 6714P | 8 / 16 | 4.0 GHz | 4.3 GHz | 48 MB | 165W¯¯ |
| 6530P | 32 / 64 | 2.3 GHz | 4.1 GHz | 144 MB | 225W¯¯ |
| 6527P | 24 / 48 | 3.0 GHz | 4.2 GHz | 144 MB | 255W¯¯ |
| 6521P | 24 / 48 | 2.6 GHz | 4.1 GHz | 144 MB | 225W¯¯ |
| 6520P | 24 / 48 | 2.4 GHz | 4.0 GHz | 144 MB | 210W¯¯ |
| 6517P | 16 / 32 | 3.2 GHz | 4.2 GHz | 72 MB | 190W¯¯ |
| 6515P | 16 / 32 | 2.3 GHz | 3.8 GHz | 72 MB | 150W¯¯ |
| 6511P | 16 / 32 | 2.3 GHz | 4.2 GHz | 72 MB | 150W¯¯ |
| 6507P | 8 / 16 | 3.5 GHz | 4.3 GHz | 48 MB | 150W¯¯ |
| 6505P | 12 / 24 | 2.2 GHz | 4.1 GHz | 48 MB | 150W¯¯ |
記憶體應用
在記憶體方面,SR650 V4 相較於 V3 有了顯著提升,子系統效能得到了極大增強。它支援高達 6400 MHz 的 DDR5 記憶體速度(每個通道 1 個 DIMM),相比上一代 4800 MHz 的限制有了顯著提升。該系統配備 32 個 DIMM 插槽(每個處理器 16 個),每個處理器分佈在 8 個記憶體通道中。它支援標準 RDIMM、3DS RDIMM 以及新型多路復用 DIMM (MRDIMM),後者最高運行速度可達 8000 MHz,能夠滿足高頻寬應用的需求。使用 256GB 3DS RDIMM,該伺服器可支援高達 8TB 的系統記憶體。

此外,V4 版本還引入了對 CXL 2.0(Compute Express Link)記憶體擴充的支援。管理員可以在 E3.S 硬碟托架(特別是 E3.S 2T 規格)中安裝多達 12 個 CXL 記憶體模組。這使得系統能夠突破傳統處理器記憶體容量和頻寬的限制,從而降低下一代工作負載的運算延遲,並透過減少記憶體閒置來降低整體擁有成本 (TCO)。
儲存
聯想SR650 V4的儲存效能反映了其向高效能NVMe高密度和靈活外形尺寸方向發展的趨勢。 V4在支援傳統的3.5吋和2.5吋硬碟的同時,也大幅擴展了對E3.S NVMe外型尺寸的支援。該系統最多可容納32塊E3.S 1TB硬碟或12塊E3.S 2TB硬碟,與傳統的U.2 SSD相比,可提供更高的儲存密度和更佳的散熱性能。

至關重要的是,V4 支援直接的 NVMe 連接,無需超額分配(1:1),確保高速儲存不會因 PCIe 通道共用而受到瓶頸限制。此外,M.2 熱插拔啟動磁碟選項的加入進一步提升了可維護性。
網路相關
在網路方面,SR650 V4 配備了兩個專用的 OCP 3.0 插槽,均支援 PCIe Gen 5 x16。這是一項關鍵升級,無需佔用標準 PCIe 轉接卡插槽即可實現冗餘的高速網路連線(例如,雙埠 200GbE 或單埠 400GbE)。升級到 PCIe 5.0 後,理論頻寬翻倍(32 GT/s 對比 16 GT/s),使 V4 能夠處理要求最苛刻的雲端和 AI 網路流量。

電源和冷卻
SR650 V4 提供增強電源選項,功率範圍從 800W 到 3200W,並有鈦金和鉑金兩種能源效率等級可選。該系統還支援 -48V 直流和 HVAC/HVDC 選項,以滿足特定資料中心的需求。

為了因應高TDP處理器和記憶體產生的熱量,聯想推出了Neptune液冷散熱方案。 「Neptune核心模組」採用開式液冷技術,可有效散發處理器、記憶體和電壓調節器的熱量,能夠捕捉超過80%的伺服器熱量,從而顯著降低資料中心的冷卻成本。
整體而言,SR650 V4 在效能、密度和散熱效率方面實現了顯著提升,滿足了現代企業環境的需求。
Lenovo ThinkSystem SR650 V4 規格
| 規格 | 信息 |
|---|---|
| 系統規格 | |
| 外形 | 2U機架 |
| 處理器 | 最高可選配 2 個英特爾® 至強® 6700/6400 系列(P 核心)處理器;每個 CPU 最高可達 86 個核心;最高 TDP 可達 350W。 |
| 記憶體應用 | 32 個 DIMM 插槽(每個處理器 16 個);支援高達 6400 MHz 的 TruDDR5 RDIMM 和高達 8000 MHz 的 MRDIMM |
| 記憶體擴充 | 支援 E3.S 2T 外形尺寸的 CXL 2.0 記憶體模組(最多 12 個 DIMM 插槽) |
| 最大記憶體 | 最高支援 8TB 系統記憶體(使用 256GB 3DS RDIMM 記憶體條) |
| 磁碟機托架 | 接待: 最多可支援 24 個 2.5 吋 NVMe/SAS/SATA 硬碟位元、16 個 3.5 吋 SAS/SATA 硬碟位元或 32 個 E3.S NVMe 硬碟位元。 中: 最多可支援 8 個 2.5 吋簡易更換 背面: 最多可支援 8 個 2.5 吋或 4 個 3.5 吋熱插拔硬碟 |
| 儲存控制器 | 最多支援 36 個板載 NVMe 連接埠(1:1 連接);支援 RAID/HBA |
| 網絡接口 | 兩個 OCP 3.0 SFF 插槽,帶 PCIe 5.0 x16 主機接口 |
| PCI擴展槽 | 最多 10 個 PCIe 5.0 插槽(後);選購前置 PCIe 插槽 |
| GPU支持 | 多達 10 個單寬 GPU 或 2 個雙寬 GPU |
| 連接埠數量 | 接待: 外部診斷連接埠、可選 USB 介面和 Mini-DP 接口 背面: 2 個 USB 3.0 介面、1 個 VGA 介面、1 個 RJ-45 管理介面、選用串列埠 |
| 散熱 | 最多可支援 6 個熱插拔風扇(N+1 冗餘);可選配 Neptune 液冷模組 |
| 電源供應 | 最多可配備兩個熱插拔冗餘交流/直流電源(800W–3200W) |
| 系統管理 | XClarity Controller 3 (XCC3);選購 XCC3 Premier |
| 安全功能 | TPM 2.0、PFR 信任根(NIST SP800-193)、機箱入侵偵測、可上鎖邊框 |
| 操作系統 | Microsoft Windows Server、RHEL、SLES、Ubuntu Server |
| 保固 | 3年基礎保固(可設定) |
| 尺寸 | 高 87 毫米(3.4 英吋)x 寬 440 毫米(17.3 英吋)x 深 800 毫米(31.5 英吋) |
| 重量 | 最大重量:38.8 千克(85.5 磅) |
聯想 ThinkSystem SR650 V4 設計與構建
聯想ThinkSystem SR650 V4是一款標準的2U平台,它充分利用了實體空間,在元件密度、氣流和可維護性之間實現了平衡。機箱尺寸為高3.4英寸、寬17.3英寸、深31.5英寸,最大配置重量為85.5磅。這些尺寸使其與其他2U企業級伺服器完全一致,同時為高效能CPU、高密度記憶體配置和靈活的儲存背板提供了足夠的深度。
聯想ThinkSystem成熟的工業設計極具辨識度,堅固的鋼製機殼和清晰明了的功能性標誌令人印象深刻。內部佈局簡潔實用,注重直通式氣流、模組化組件分區以及無需工具即可輕鬆維護。整體結構堅固耐用,設計精良,體現了該平台專為資料中心環境下的持續運作而設計,而非追求美觀。
前面板
前面板高度可配置。我們的測試系統配備了 8 盤位 2.5 吋硬碟背板,但機殼可以輕鬆擴展至 16 盤位甚至 24 盤位,無需額外配置。客戶還可以選擇 3.5 吋硬碟位以獲得更高的原始容量,或選擇更新的 E3.S 背板選項以實現高效能 NVMe 硬碟密度。 AnyBay 支援允許 SAS、SATA 和 NVMe 硬碟共存於同一硬碟籠中,為混合儲存部署提供了極大的靈活性。

前面板包含必要的操作控制按鈕:電源按鈕、ID按鈕以及指示系統運作狀況和網路活動的狀態指示燈。一個可拉出的資訊標籤方便使用者快速存取XCC網路存取標籤和序號。可選的本地連接包括用於故障排查車存取的Mini DisplayPort和USB端口,這對於「無人值守」資料中心的故障排除至關重要。
後面板
機箱後部設計旨在實現最大的I/O密度。根據轉接卡配置的不同,最多可容納10個PCIe Gen 5插槽。此外,還預留了兩個OCP 3.0插槽,從而可以釋放標準PCIe轉接卡的空間,用於安裝其他擴充卡,例如GPU或儲存控制器。
除了擴充功能外,後面板還設有板載 BMC 管理網路連接埠、兩個 USB-A 連接埠以及用於本機控制台存取的 VGA 輸出連接埠。雙熱插拔電源安裝在後部,既保證了維護的便利性,又不會影響氣流或擴展佈局。
內部
內部佈局簡潔,並針對氣流進行了優化。 32 個 DIMM 記憶體插槽位於雙 CPU 插槽兩側,這樣的佈局確保了機殼前部六個高性能熱插拔風扇能夠提供暢通無阻的前後散熱。這些風扇完全免工具更換,整個風扇托架無需工具即可拆卸。拆卸托架後,即可直接存取 AnyBay 儲存區域,從而簡化了維護、升級和背板更換。

儲存線纜沿著機殼側面整齊佈線,避免阻礙CPU和記憶體的空氣流通。對於使用Neptune液冷模組的配置,內部佈局略有變化以適應冷卻液循環,但核心部件的維護性仍然很高。 M.2啟動盤模組安裝在導風板或硬碟籠上,無需拆卸其他組件即可輕鬆存取。
X清晰度控制器3
SR650 V4 搭載了全新的 XClarity Controller 3 (XCC3)。與前幾代產品相比,這款管理引擎效能顯著提升,啟動速度更快,HTML5 介面反應也更靈敏。平台資源管理器可提供詳細的電源和散熱狀態遙測數據,幫助管理員最佳化資料中心效率。
XCC3 支援多種遠端管理功能,包括遠端控制(KVM)、虛擬媒體掛載和韌體更新。其介面直觀,提供系統運作狀況、活動事件和硬體清單的儀錶板視圖。在自動化方面,XCC3 完全支援 Redfish REST API。
聯想 ThinkSystem SR650 V4 性能
本節將分析 Blender、y-cruncher、vLLM 和 Phoronix 的基準測試結果。初步測試在配備 Intel Xeon 6740P 處理器的 Lenovo ThinkSystem SR650 V4 上進行,以便評估該平台以性能為導向的 P 核架構以及在 CPU 密集型工作負載下的整體吞吐量。在評測過程中,我們調整了系統配置以啟用 GPU 加速測試。由於 Lenovo 的 GPU 加速套件,這個過渡過程非常順利。該套件包含高性能風扇、升級的散熱片、改進的導風罩以及支援更高效能加速器的 GPU 擴充卡。安裝過程無需對機殼進行任何重大改動,即可與現有系統佈局完美融合。
升級散熱和氣流組件後,我們在平台上增加了一塊NVIDIA L40S GPU。這使我們能夠擴展測試範圍,涵蓋Blender GPU渲染和推理基準測試等GPU加速工作負載,同時保持穩定的散熱和一致的系統效能。此升級的模組化設計凸顯了SR650 V4的靈活性,使其能夠輕鬆地從注重效率的CPU配置過渡到適用於混合運算工作負載的CPU+GPU平衡平台。
聯想ThinkSystem SR650 V4配置:
- 中央處理器: 2x 英特爾至強 6740P
- 內存: 1TB 內存
- 貯存: 4 x 960GB 固態硬碟
- GPU: 英偉達L40S
攪拌機4.5
Blender 是一款開源 3D 建模應用程式。本次基準測試使用 Blender Benchmark 實用程式運行。分數以每分鐘採樣數計算,數值越高,效能越好。
在 Blender CPU 基準測試中,聯想 ThinkSystem SR650 V4 在所有場景下均表現出色,渲染效能穩定,在 Monster 場景中達到每分鐘 1136.99 個樣本,在 Junkshop 場景中達到每分鐘 707.60 個樣本,在 Classroom 場景中達到每分鐘 562.53 個樣本。測試結果反映了雙 Intel Xeon 6740P 處理器強大的多執行緒擴充能力,即使場景複雜度增加,效能仍保持穩定。
| Blender CPU(每分鐘採樣數;越高越好) | 聯想 ThinkSystem SR650 V4(2x 英特爾至強 6740P,1TB 記憶體) |
|---|---|
| Monster | 1136.99 |
| 舊貨店 | 707.60 |
| 課堂 | 562.53 |
在Blender CPU無SMT基準測試中,SR650 V4的渲染吞吐量顯著提升,在Monster場景中達到每分鐘4686.40個樣本,在Junkshop場景中達到每分鐘2223.96個樣本,在Classroom場景中達到每分鐘2385.98個樣本。 GPU測試結果凸顯了此系統加速複雜渲染工作負載的能力,與僅使用CPU渲染相比,其吞吐量大幅提升。
| Blender CPU(無 SMT)(每分鐘採樣數;越高越好) | 聯想 ThinkSystem SR650 V4(2x 英特爾至強 6740P,1TB 記憶體) |
|---|---|
| Monster | 4686.40 |
| 舊貨店 | 2223.96 |
| 課堂 | 2385.98 |
y 粉碎機
y-cruncher 是一款多執行緒、可擴展的程序,能夠計算圓周率和其他數學常數,精度可達萬億位小數。自 2009 年發布以來,它已成為超頻玩家和硬體愛好者常用的基準測試和壓力測試應用程式。
在 y-cruncher 測試中,聯想 SR650 V4 的效能隨著問題規模的增加而平滑擴展,凸顯了該平台強大的多線程運算效能和記憶體頻寬。該系統配備雙 Intel Xeon 6740P 處理器和 1TB 內存,僅需 20 多秒即可完成 10 億位小數的圓周率計算,並且在計算 250 億位小數時仍保持穩定高效,耗時 362 秒。測試結果表明,在持續的 CPU 和記憶體壓力下,SR650 V4 的效能擴展性符合預期,使其非常適合處理繁重的數學運算和壓力測試場景。
| Y-Cruncher(總計算時間) | 聯想 ThinkSystem SR650 V4(2x 英特爾至強 6740P,1TB 記憶體) |
|---|---|
| 1億 | 20.715小號 |
| 2.5億 | 44.412小號 |
| 5億 | 81.937小號 |
| 10億 | 152.743 |
| 25億 | 362.566 |
vLLM 線上服務 LLM 推理效能
vLLM 是目前最受歡迎的 LLM 高吞吐量推理和服務引擎。 vLLM 線上服務基準測試是一種效能評估工具,用於衡量該推理引擎在並發請求下的實際服務能力。它透過向運行中的 vLLM 伺服器發送請求來模擬生產環境的工作負載,並可配置請求速率、輸入/輸出長度和並發客戶端數量等參數。此基準測試會測量關鍵指標,包括吞吐量(每秒令牌數)、首令牌時間 (TTF) 和單次輸出令牌時間 (TPOT),幫助使用者了解 vLLM 在不同負載條件下的效能。
我們測試了涵蓋各種架構、參數規模和量化策略的一系列模型的推理效能,並評估了不同並發配置下的吞吐量。
密集模型性能
密集模型遵循傳統的LLM架構,在推理過程中使用所有參數和活化值,因此其計算量比稀疏模型更大。為了全面評估不同模型規模和量化策略下的性能特徵,我們對Llama 3.1 8B系列中的多種密集模型配置進行了基準測試。
Llama 3.1 8B 精密 FP8
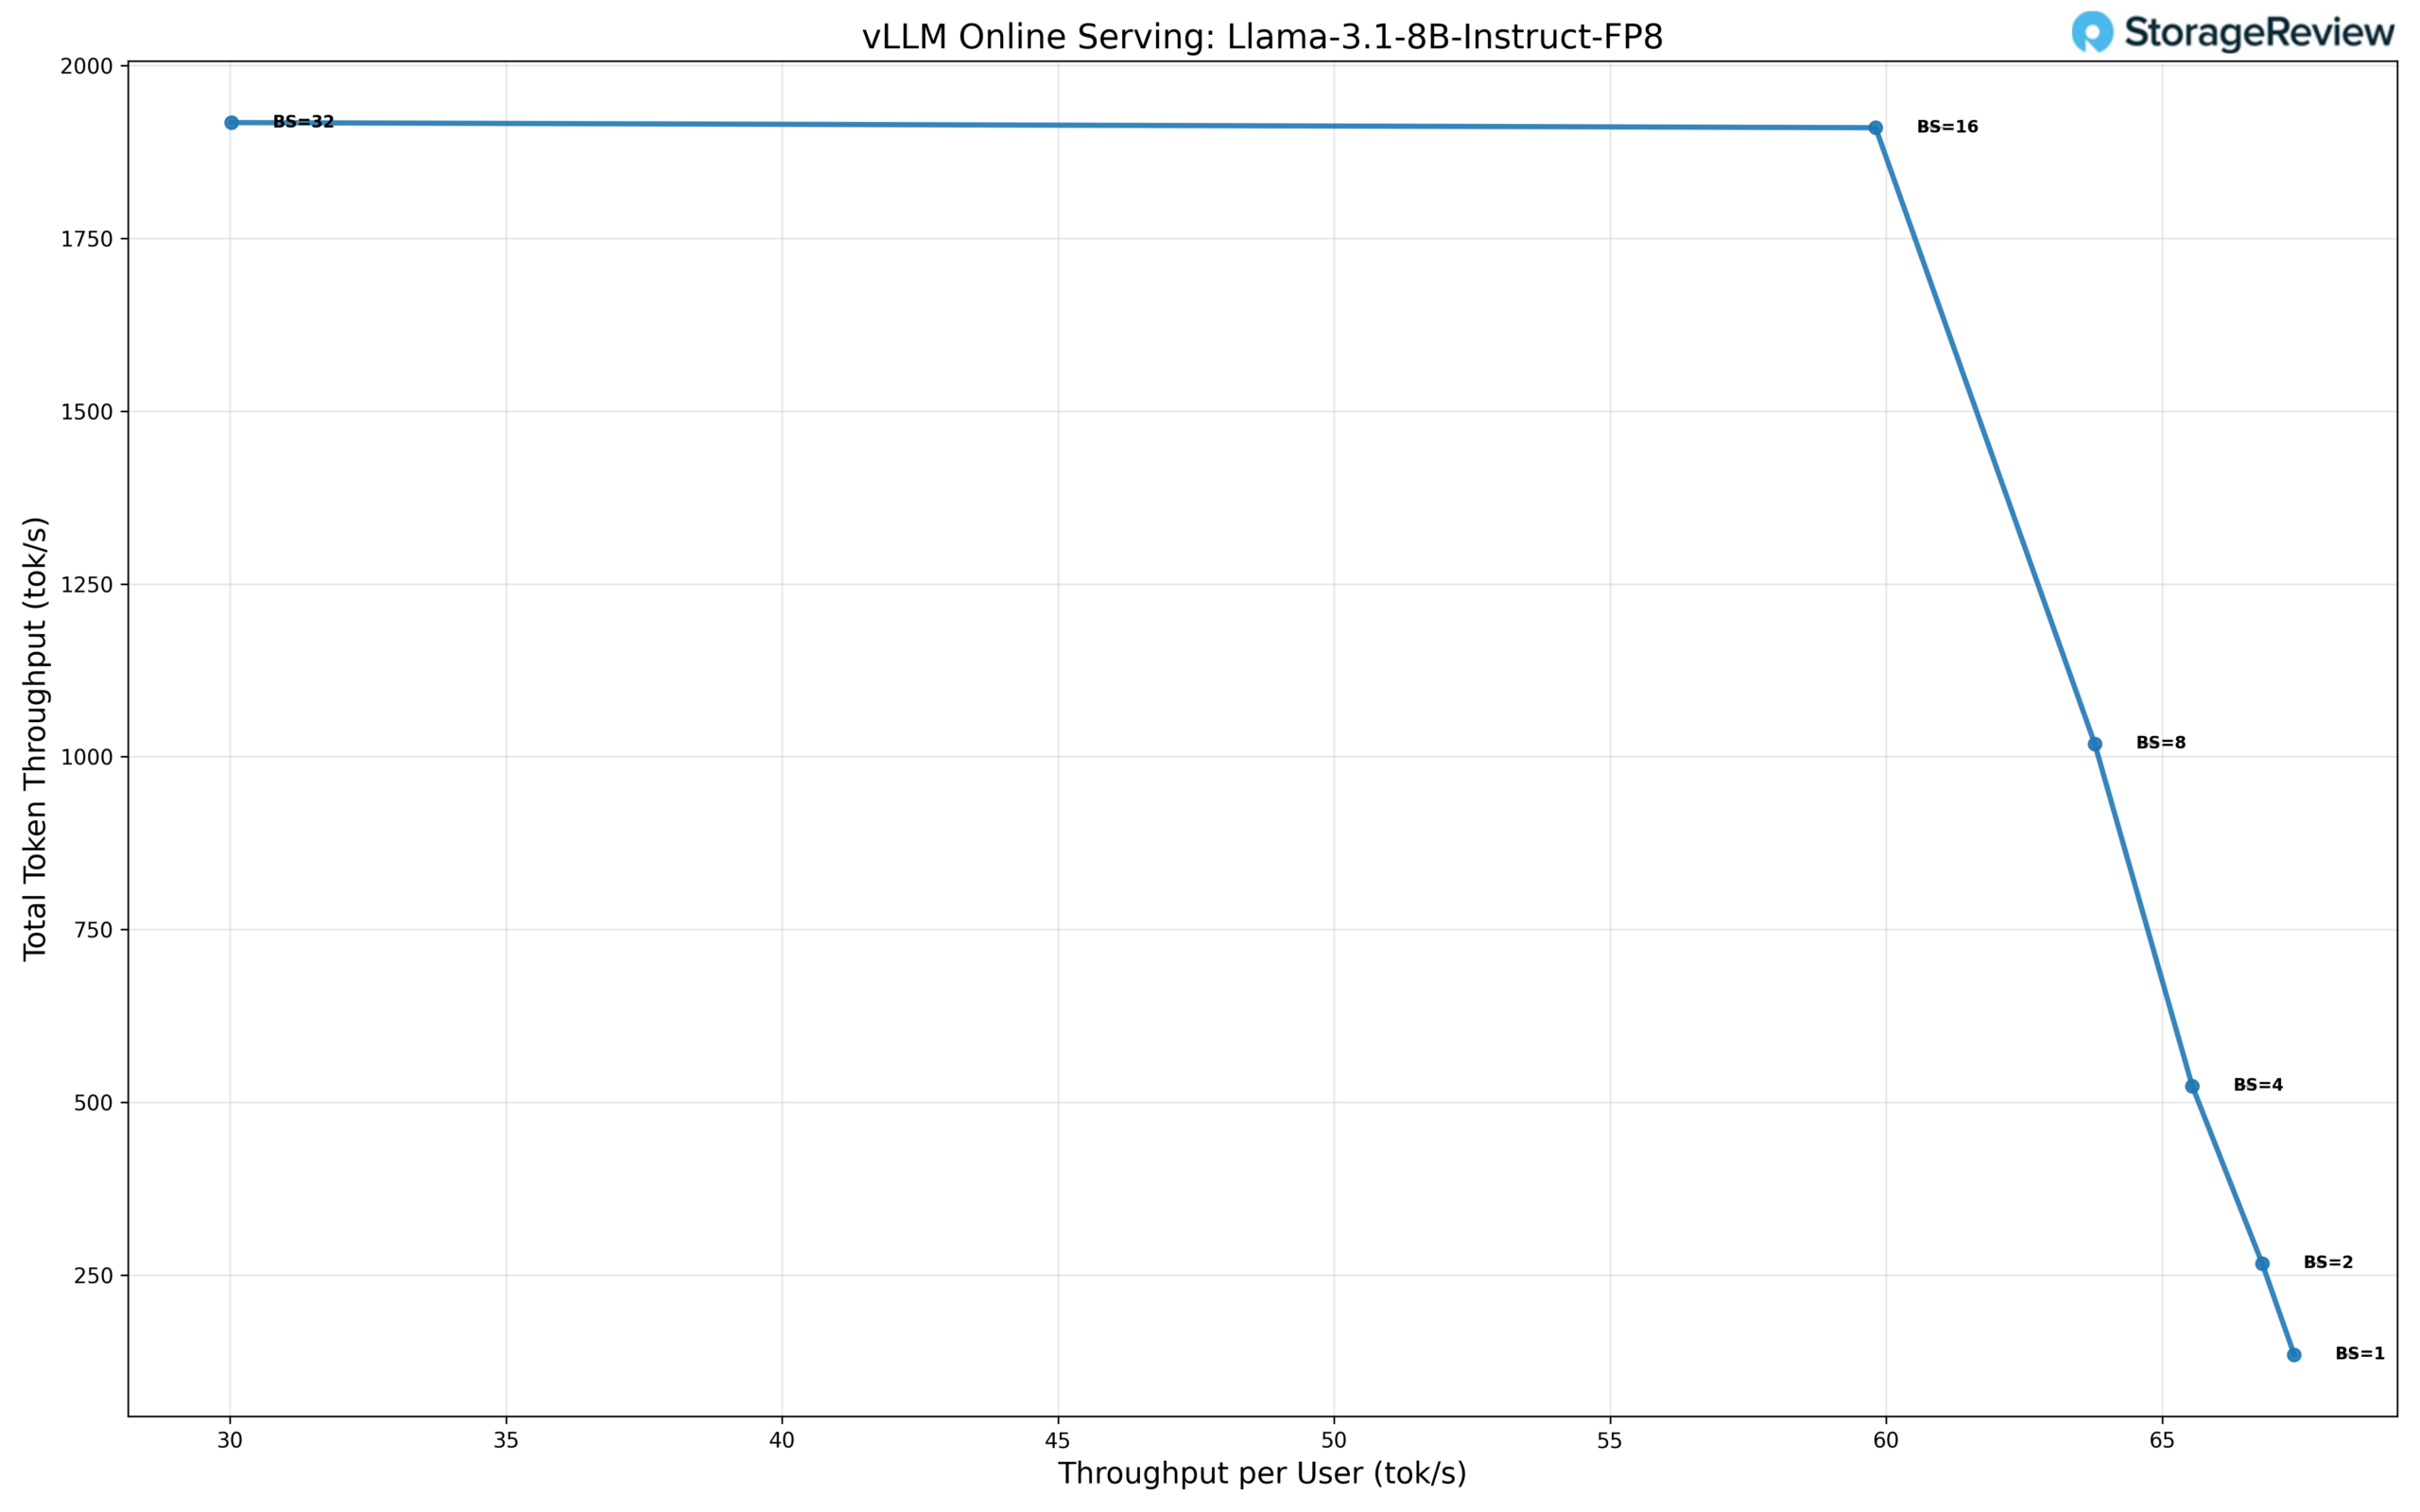
以 FP8 精度運行的 Llama 3.1 8B 模型展現出與標準精度配置不同的擴展特性,它在中等並發水平下優先考慮效率,但在較高批處理大小下犧牲峰值吞吐量。在單一使用者並發 (BS=1) 下,此模型每位使用者可提供 67.8 tok/s 的處理能力,總吞吐量為 135.6 tok/s,TPOT 約為 3.1 ms,與全精度相比,單流基線較低。
隨著批次大小的增加,總吞吐量迅速增長,而單一用戶吞吐量則以可控的方式下降。當批次大小為 2 時,總吞吐量增加到 271 tok/s,單一用戶吞吐量為 66.8 tok/s。當批次大小為 4 時,總吞吐量達到 523 tok/s;當批次大小為 8 時,模型吞吐量達到 1,017 tok/s,單一用戶吞吐量為 63.6 tok/s。在這些較低的同時水準下,延遲保持穩定,這使得 FP8 非常適合輕量級的多用戶推理場景。
擴展性持續到 BS=16,此時模型保持總吞吐量為 1,918 tok/s,每個用戶吞吐量為 60.0 tok/s。當 BS=32 時,總吞吐量趨於穩定,約為 1,920 tok/s,而每個用戶的吞吐量則下降至 30.0 tok/s。這一穩定狀態表明,FP8 配置比標準精度配置更早達到飽和點,其效率和可預測性優於最大總吞吐量。
總體而言,FP8 的總吞吐量從 BS=1 到 BS=16-32 的峰值大約提高了 14 倍。延遲在 BS=16 之前保持穩定,然後在更高的並發性下與吞吐量一起趨於平緩,這凸顯了 FP8 對於均衡的、對延遲敏感的推理工作負載來說是一個實用的選擇,而不是極端的批量擴展。
Llama 3.1 8B 標準精度
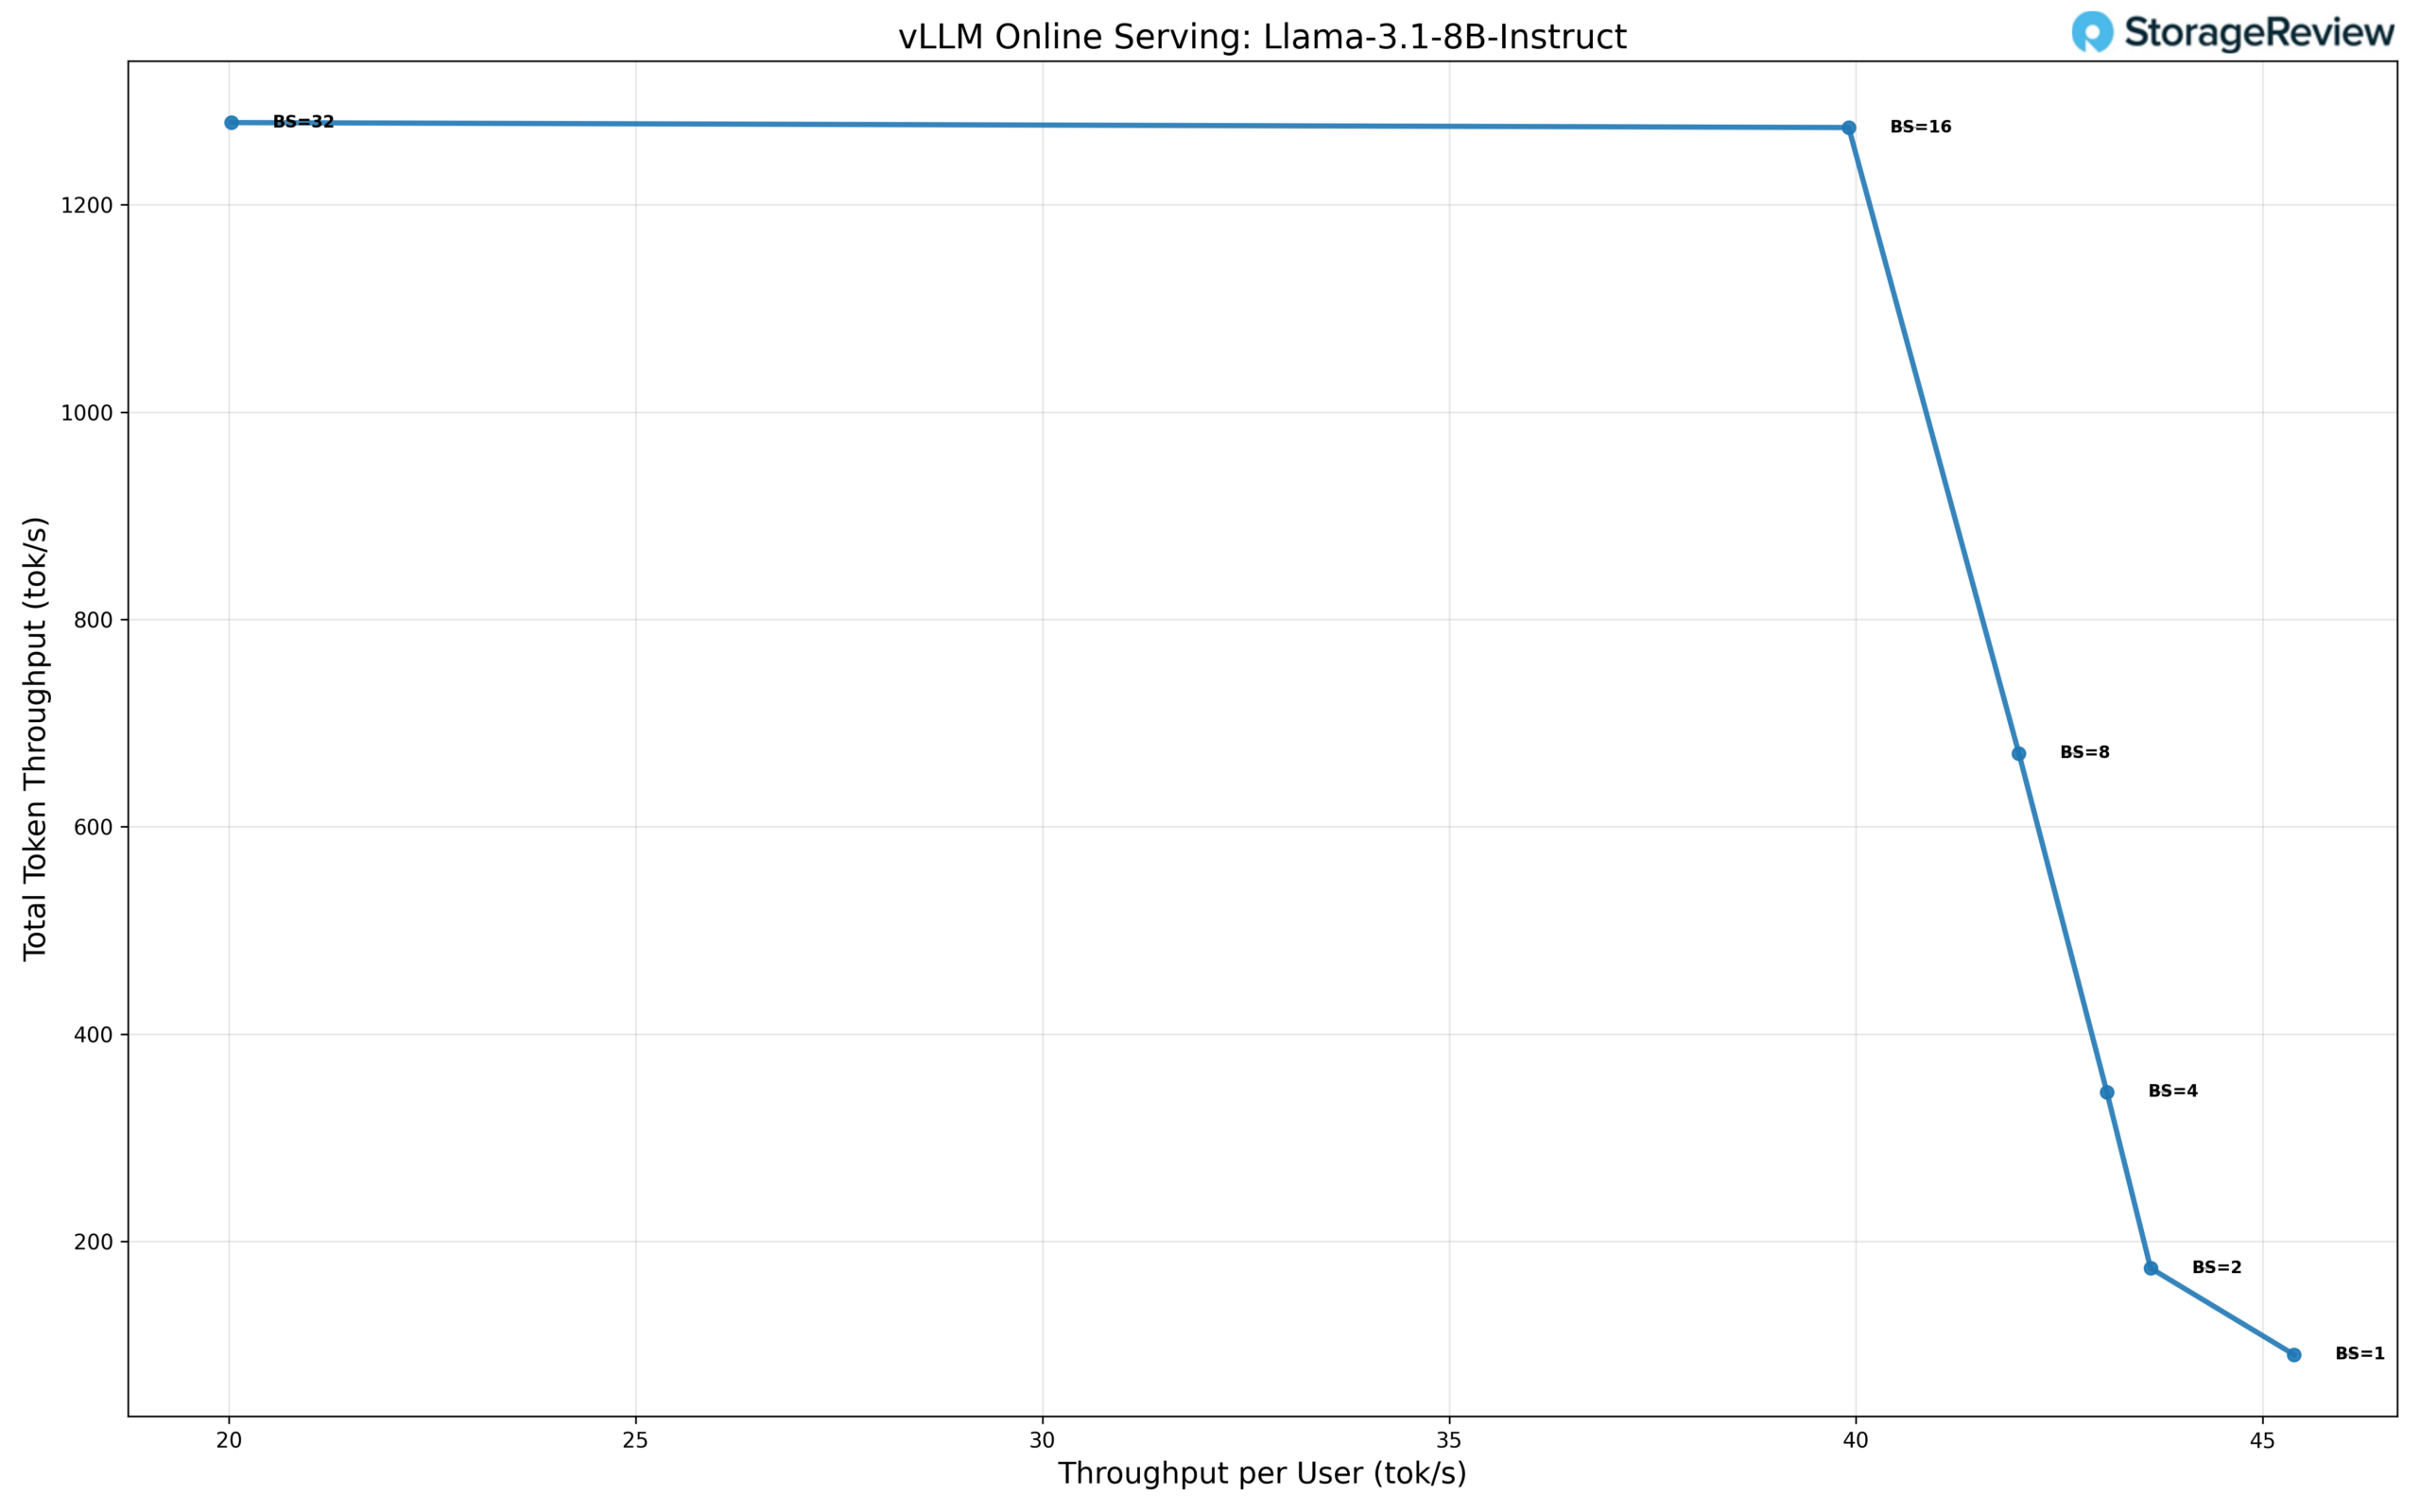
在標準精度下,Llama 3.1 8B 模型在較低並發水平下展現出可預測的擴展性,在小批處理規模下具有出色的單用戶性能,並隨著並發量的增加而穩步提升總吞吐量。在單一使用者操作(BS=1)下,此模型每個使用者可提供約 45.8 tok/s 的吞吐量,總吞吐量達到 91.6 tok/s,為延遲敏感型工作負載樹立了可靠的基準。
隨著並發量的增加,總吞吐量能夠高效擴展,而單用戶吞吐量則逐漸下降。當 BS=2 時,總吞吐量提升至 176 tok/s,單一用戶吞吐量為 44.0 tok/s;當 BS=4 時,吞吐量達到 344 tok/s,單一用戶吞吐量為 43.0 tok/s。這種趨勢一直持續到 BS=8,此時模型保持了 672 tok/s 的總吞吐量,單用戶吞吐量為 42.0 tok/s,表明資源利用率良好,且單用戶吞吐量沒有顯著下降。
擴展性持續到 BS=16,此時總吞吐量達到峰值,約為 1,280 tok/s,每個用戶吞吐量為 40.0 tok/s。當 BS=32 時,總吞吐量基本上保持穩定在 1,280 tok/s 左右,而每個用戶的吞吐量下降到 20.0 tok/s,表示執行管線已達到飽和。這個平台期表明,在標準精度下,該模型在 BS=16 左右達到最佳工作點,從而平衡了吞吐量和響應速度。
總體而言,標準精度在 BS=1 到峰值時,總吞吐量大約提升了 14 倍,並且在中等並發水平下保持了穩定的單一用戶效能。這種特性使得標準精度非常適合那些優先考慮穩定延遲和可預測擴展性而非激進批量擴展的部署場景。
稀疏模型效能
稀疏模型,特別是專家混合模型(MoE)架構,是一種新興的高效擴展語言模型的方法。這些架構在保持較高總參數數量的同時,每個詞元僅激活一部分參數,從而有可能提高每個激活參數的性能。
Qwen3-Coder-30B-A3B FP8 效能
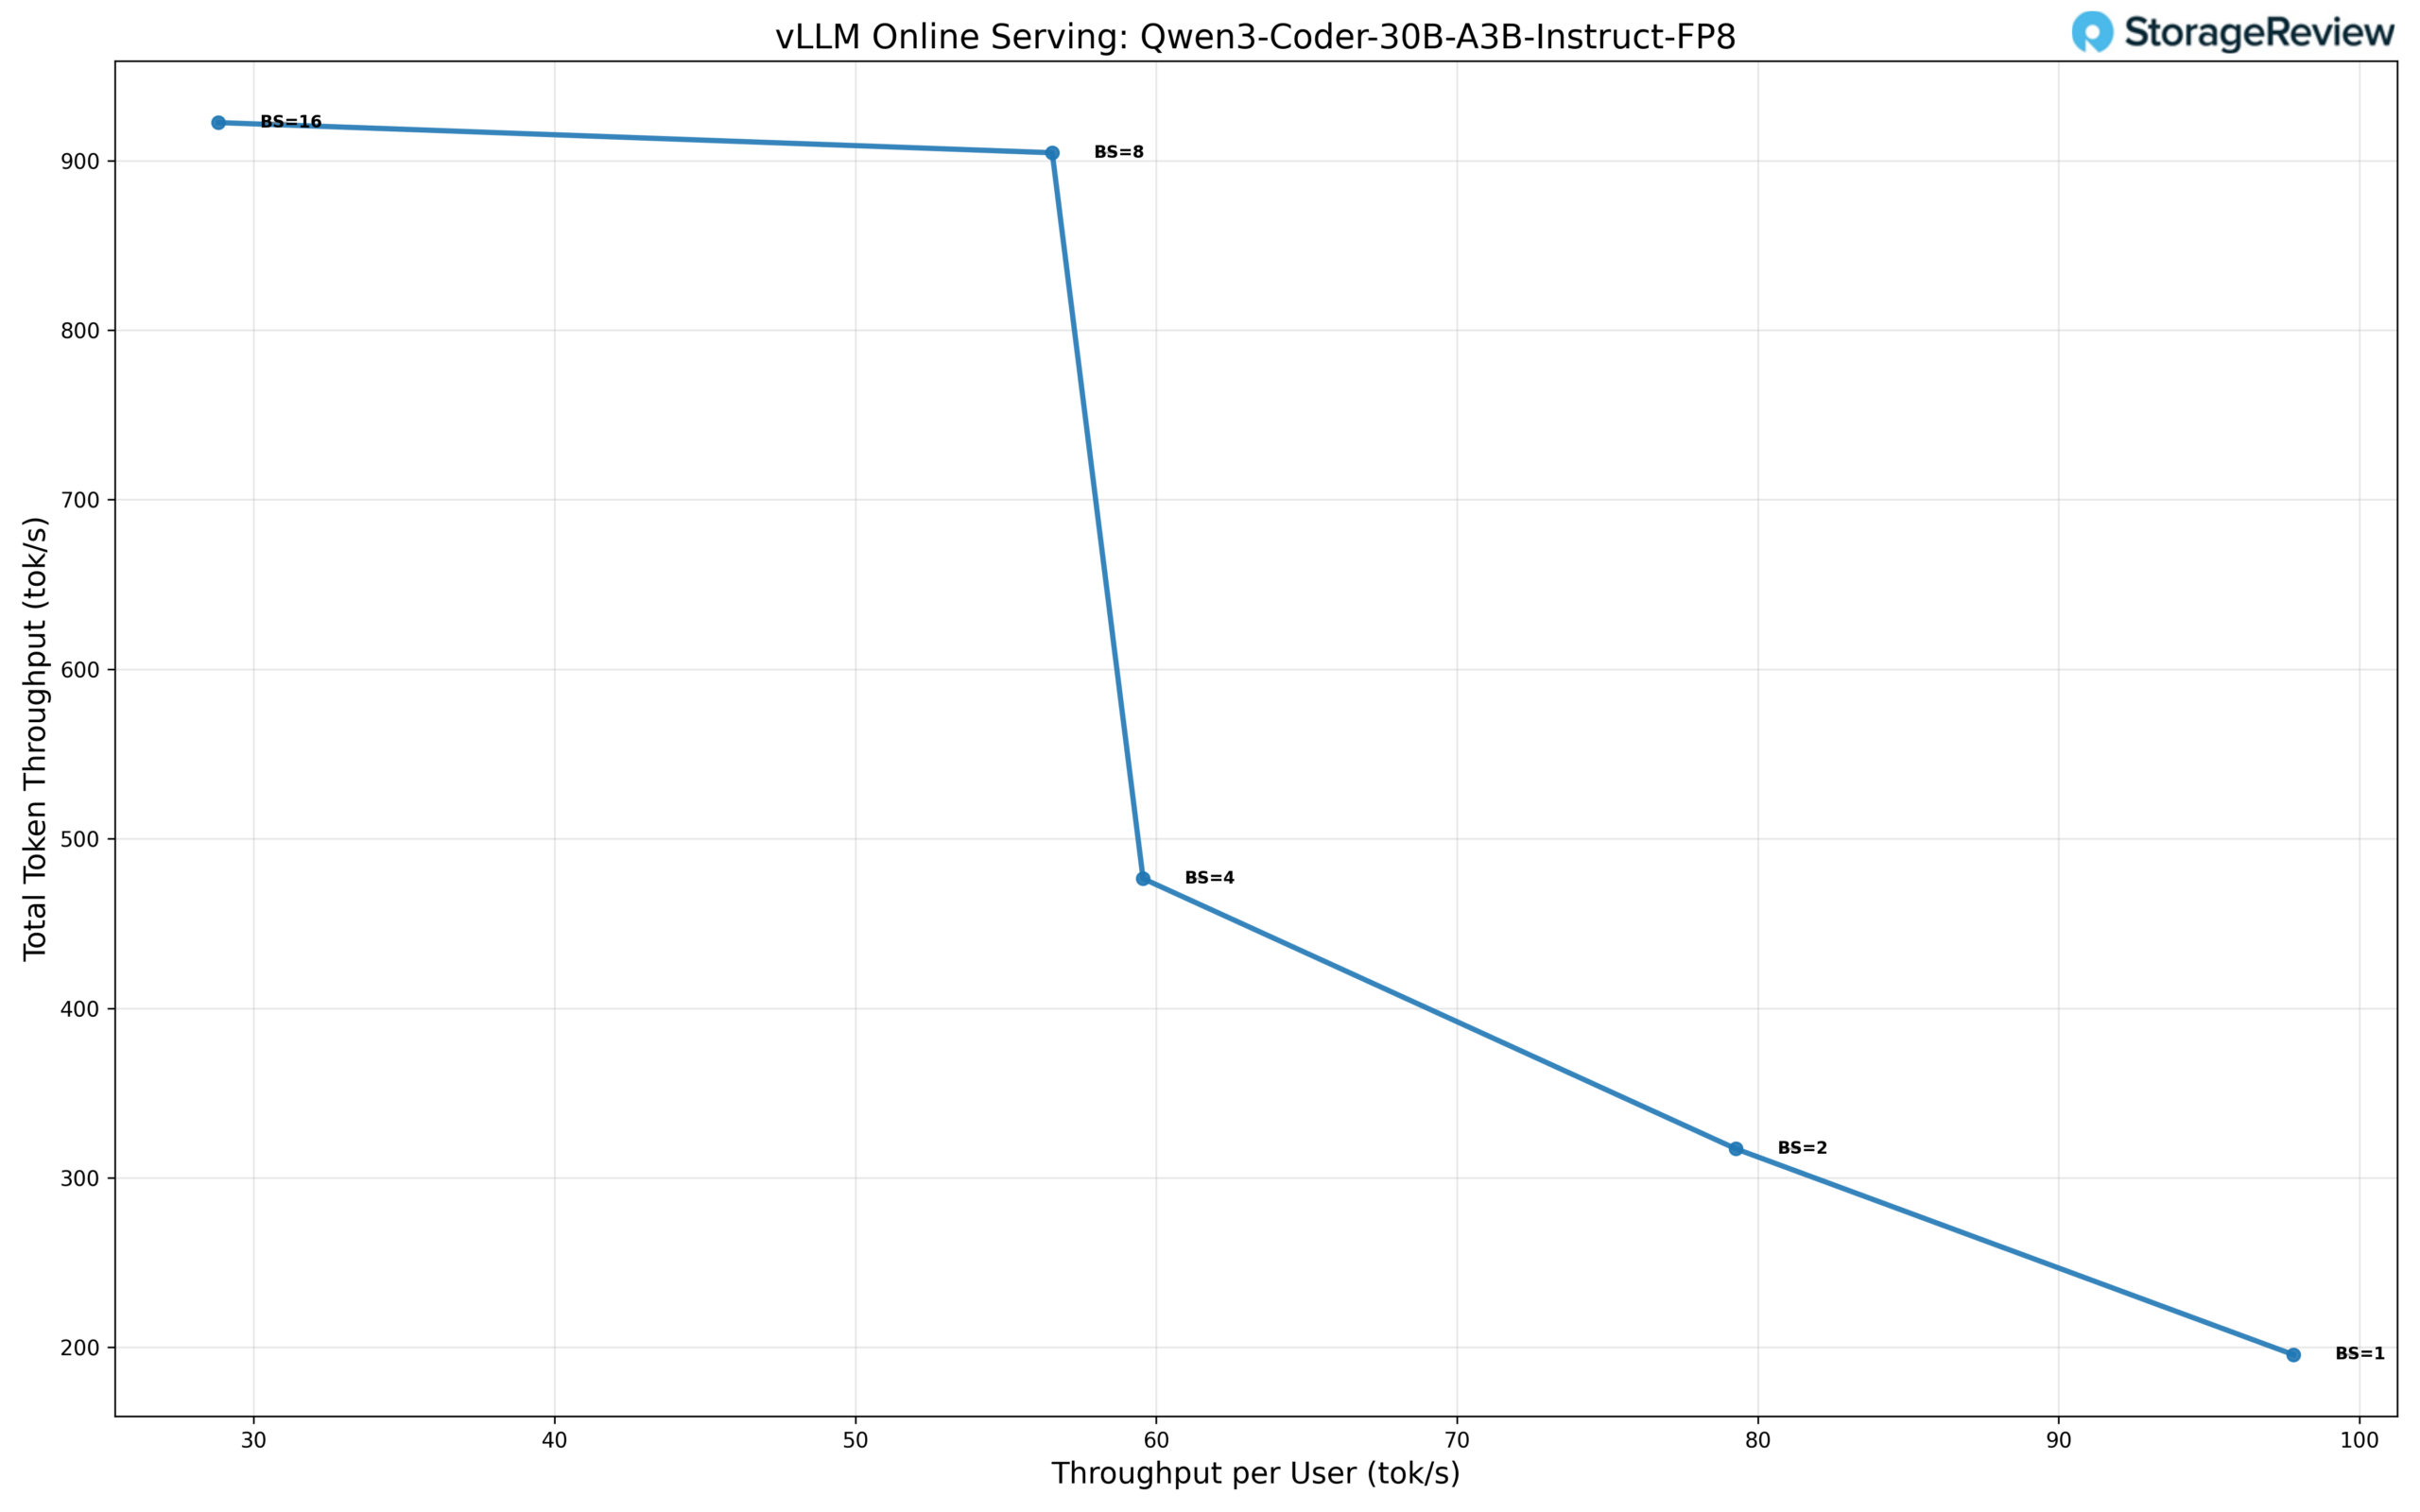
以 FP8 精度運行的 Qwen3-Coder-30B-A3B 模型展現出針對中等並發場景優化的擴展性能,在提供強大單用戶性能的同時,比小型模型更快達到性能飽和。在單一使用者操作 (BS=1) 下,此模型單一使用者吞吐量約為 98 tok/s,總吞吐量為 196 tok/s,建立了較高的單流基準,體現了此模型針對程式碼產生工作負載的最佳化。
隨著並發量的增加,總吞吐量能夠高效擴展,而單一用戶吞吐量則以可控的方式下降。當批次數 (BS) 為 2 時,總吞吐量提升至 317 tok/s,單一用戶吞吐量為 79 tok/s;當 BS 為 4 時,總吞吐量達到 477 tok/s,單一用戶吞吐量為 59 tok/s。這些結果表明,透過低到中等的批次處理,可以有效地利用可用的運算資源,而不會導致單一使用者回應速度的急劇下降。
該模型在 BS=8 時達到峰值總吞吐量,維持在約 905 tok/s 的總吞吐量,其中每個用戶 56 tok/s。在 BS=16 時,模型的擴展性略有提升,總吞吐量略微增加至 920 tok/s,而每個用戶的吞吐量則下降至 29 tok/s,表明推理管線已達到飽和。超過此點後,增加並發量對總吞吐量的提升微乎其微,卻會顯著影響每個用戶的效能。
整體而言,Qwen3-Coder-30B-A3B FP8 的總吞吐量從 BS=1 到 BS=16 的峰值提升了約 4.7 倍。延遲和吞吐量特性表明,此配置最適合對單次請求效能要求較高的中等規模多用戶編碼工作負載。不過,其主要目標並非極致的批量擴展。
微擴展資料類型效能
微尺度量化是一種先進的量化方法,它對小塊權重應用精細的縮放因子,而不是對大參數組進行均勻量化。 NVIDIA 的 NVFP4 格式透過分割浮點表示來實現這項技術,其中每個包含 8 到 32 個值的微尺度區塊共享一個典型的指數作為縮放因子。這種精細化的方法在保持數值精度的同時實現了 4 位元表示,從而維持了 Transformer 架構所需的動態範圍。此格式與 NVIDIA 的 Tensor Core 架構集成,支援高效的混合精度運算,並在矩陣運算期間進行即時解壓縮。
GPT-OSS-20b 效能
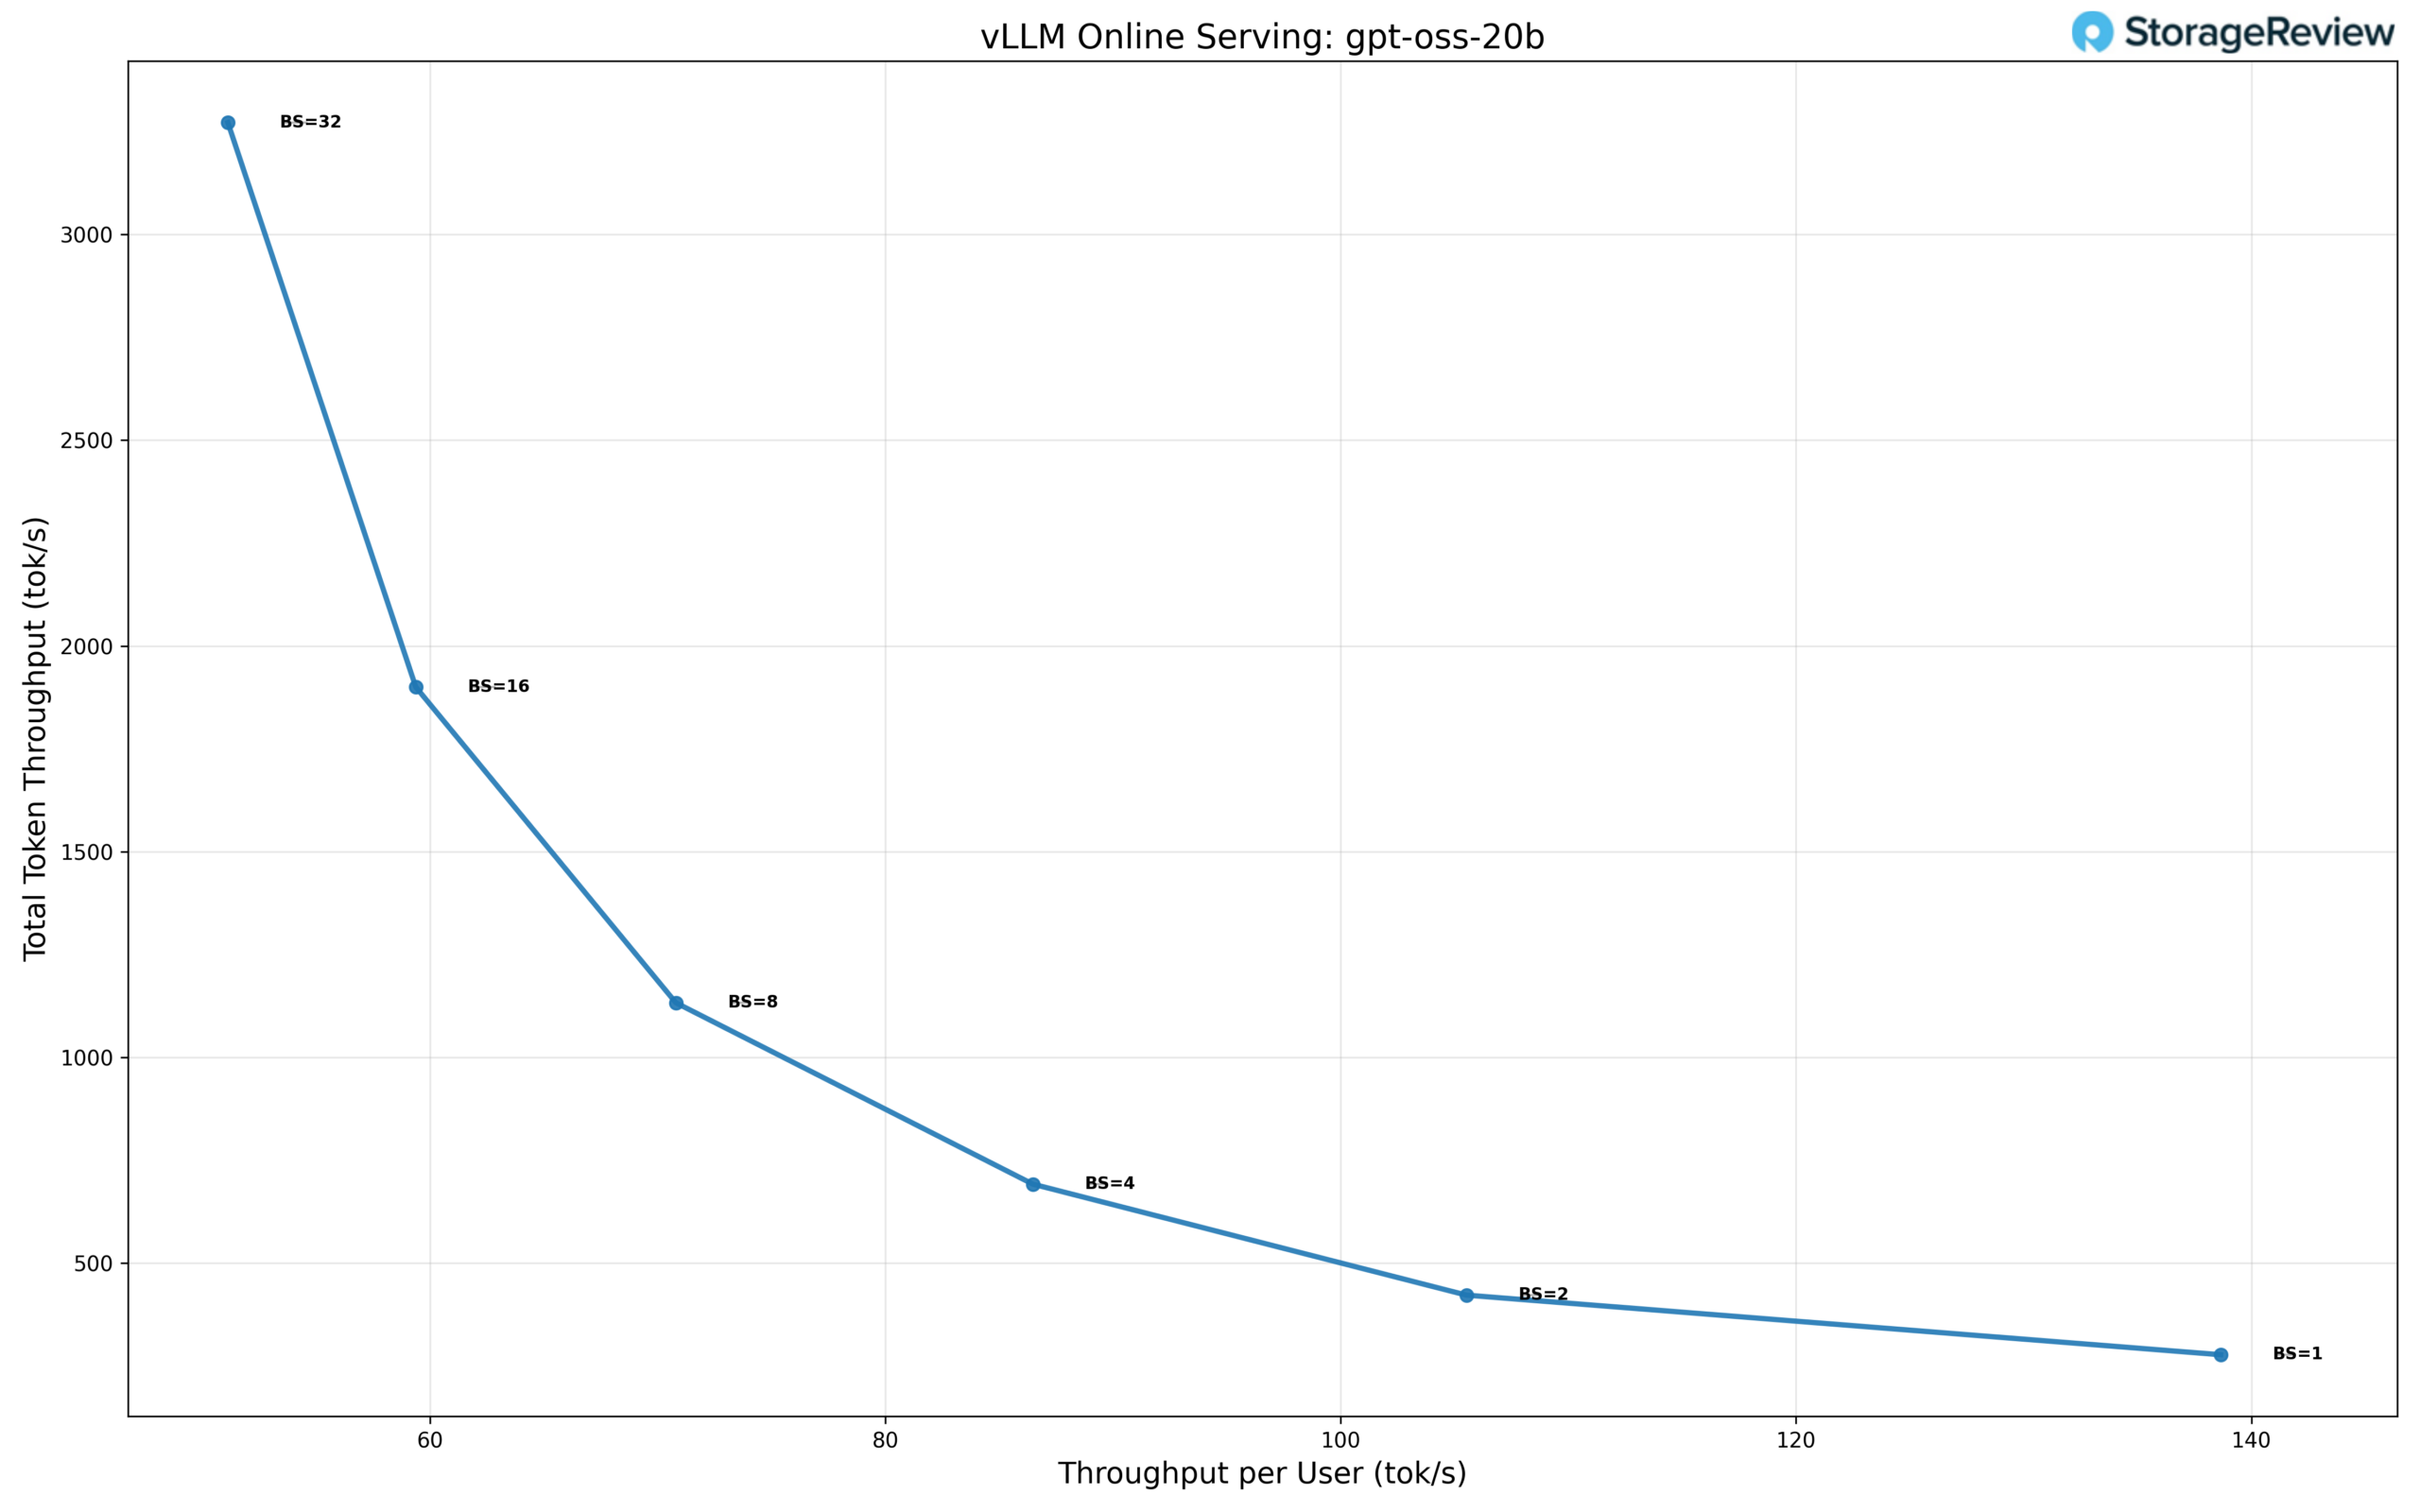
gpt-oss-20b 模型在不斷提高的並發等級下展現出強大的擴展性,尤其是在大批處理規模下具有極高的聚合吞吐量。在單一使用者並發(BS=1)下,此模型每個使用者的處理能力約為 138 tok/s,總吞吐量達到 276 tok/s,為單流推理樹立了良好的基準。
隨著併發量的增加,總吞吐量迅速成長,而單一用戶吞吐量則如預期般下降。當批次數 (BS) 為 2 時,總吞吐量提升至 420 tok/s,單一用戶吞吐量為 105 tok/s;當 BS 為 4 時,總吞吐量達到 690 tok/s,單一用戶吞吐量為 86 tok/s。這種穩定成長表明,透過低到中等的批次方式,可以有效地利用可用的運算資源。
擴展性在 BS=8 時持續提升,此時模型總吞吐量約為 1,120 tok/s,每個用戶吞吐量為 70 tok/s;在 BS=16 時,總吞吐量提升至 1,900 tok/s,每個用戶吞吐量為 60 tok/s。這些結果表明,即使併發量增加,gpt-oss-20b 仍能保持相對較高的單用戶效能,使其非常適合多用戶服務場景。
此模型在批次大小為 32 時達到峰值總吞吐量,約為 3,250 tok/s,此時單一用戶吞吐量降至 50 tok/s。與單一用戶效能相比,總吞吐量提高了 11.8 倍。雖然隨著批次大小的增加,單用戶吞吐量持續下降,但整體擴展效率依然強勁,表明該模型能夠從更高的並發性中獲益,而不會過早達到飽和點。
整體而言,gpt-oss-20b 展現出均衡的擴展性能,兼具出色的單用戶性能和強大的批量擴展能力。這使其成為在多用戶負載較高的情況下,既需要快速回應的單一用戶推理,又需要高聚合吞吐量的部署方案的理想選擇。
Phoronix 基準測試
Phoronix 測試套件是一個開源的自動化基準測試平台,透過 OpenBenchmarking.org 支援超過 450 個測試設定檔和 100 多個測試套件。它能夠處理從安裝依賴項到運行測試和收集結果的所有操作,使其成為效能比較、硬體驗證和持續整合的理想選擇。
串流記憶體頻寬
SR650 V4 提供了 369.6GB/s 的記憶體頻寬,展現了對資料密集型工作負載的強大吞吐量,並證實了健康的多通道記憶體效能。
7-Zip 壓縮
該系統擁有 584,499 MIPS 的效能,壓縮和解壓縮性能出色,體現了其強大的多核心效率和整數運算能力。
核心編譯
伺服器在 256.175 秒內完成了 allmod 內核構建,這是一個令人滿意的結果,突顯了其高效處理並行編譯和開發人員工作流程的能力。
Apache的Web服務器
SR650 V4 的請求吞吐量為 61,654 R/s,表現出強大的 Web 服務效能,能夠維持較高的請求吞吐量,適用於前端託管或輕量級虛擬化堆疊。
OpenSSL 驗證
該平台每秒處理 712.6 億位元組,展現了強大的加密驗證效能,證實了 CPU 具備安全、憑證密集型操作的能力。
| Phoronix 基準測試 | 聯想ThinkSystem SR650 V4 |
|---|---|
| 資訊 | 369,58.3 MB / s的 |
| 7-郵編 | 584,499米每秒 |
| 內核編譯(allmod) | 256.175秒 |
| Apache(每秒請求數) | 61,654.47 盧比/秒 |
| OpenSSL | 712,633,776,990 位元組/秒 |
結語
ThinkSystem SR650 V4 的平台更新意義非凡,因為它並非只是更換了 CPU。聯想利用這一代產品,在限制實際部署的許多方面進行了實質性的改進,包括記憶體頻寬、PCIe 通道可用性、儲存密度以及根據需求變化調整配置的能力。升級到英特爾至強 6 處理器帶來了更多核心選擇和每個插槽更大的 I/O 空間,而其他平台方面的改進,例如支援 MRDIMM 的更快 DDR5 記憶體和可選的 CXL 擴展,都使 SR650 V4 能夠在工作負載對記憶體需求日益增長的情況下保持競爭力。
在儲存方面,儘管我們此次評測的配置僅限於 U.2 接口,但聯想大力推廣的 E3.S 接口提供了更高的 NVMe 密度、1:1 連接以及更佳的散熱性能,這與現代基礎設施的構建方式相契合,尤其適用於需要更多本地閃存的虛擬化架構,以及對 GPU 的支持與原始計算能力同等重要的過程。此外,雙 OCP 3.0 Gen5 x16 插槽的加入也帶來了實用的升級:您可以部署強大的網路功能,而無需佔用原本用於加速器、儲存裝置或專用適配器的 PCIe 插槽。
如果您目前使用的是 SR650 V3,並且感覺記憶體速度、PCIe 擴展空間或 NVMe 容量限制了您的需求,那麼 SR650 V4 將是您理想的升級之選。它保留了 SR650 系列廣受歡迎的可維護性和可配置性,同時也提供了更大的平台擴充空間,幫助 IT 團隊避免陷入困境。無論您是建立虛擬化叢集、升級橫向擴展服務,還是組裝 CPU/GPU 均衡的節點,SR650 V4 都能滿足您的關鍵需求,並為未來的發展預留了空間。
排行榜:我們測試的 L40S 在我們的最佳企業級 GPU排行榜上保持著「最佳主流推理 GPU 仍在出貨」的稱號。


 Amazon