

NVIDIA GeForce RTX 5090 將於 30 年 2025 月 1,999 日推出,建議零售價為 32 美元,將重新定義高效能遊戲和人工智慧工作負載。這款旗艦 GPU 基於 Blackwell 架構構建,憑藉 7GB GDDR512 內存、50 位元內存總線以及 CUDA、Tensor 和 RT 核心性能的大幅提升,突破了計算能力的界限。至關重要的是,NVIDIA 對 XNUMX 系列平台有多項人工智慧主張,本次評測旨在探討這一點。
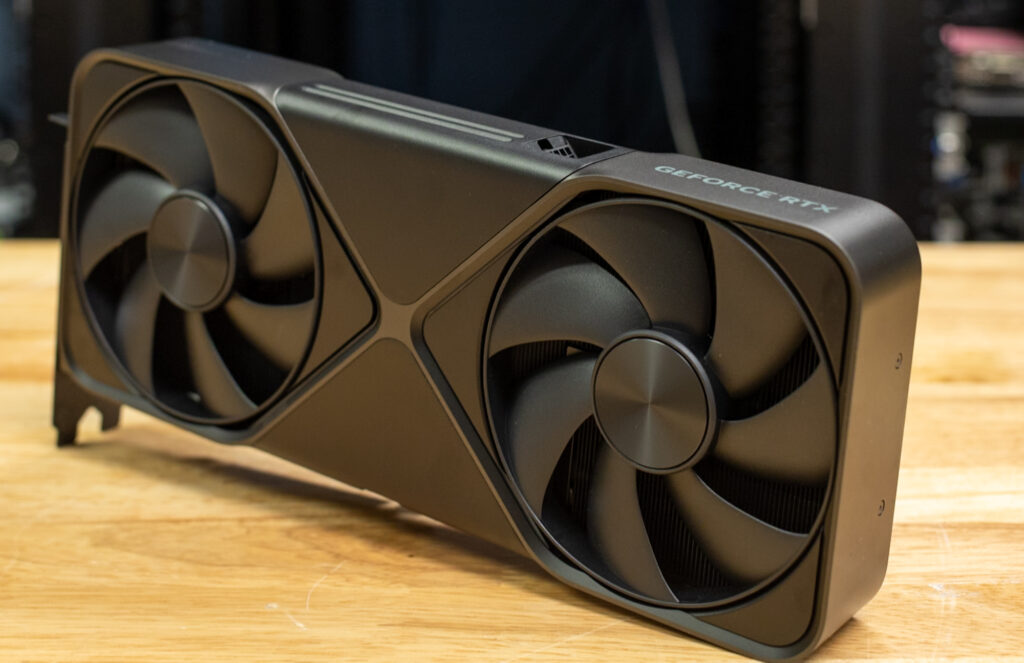
RTX 5090 進步的核心是具有多幀生成功能的 DLSS 4,利用 AI 在每個渲染幀中生成最多三個附加幀,從而在支援的遊戲中提供高達 8 倍的效能提升。基於 Transformer 的全新 AI 模型增強了光線重建、超解析度和 DLAA,顯著提高了視覺保真度,同時透過 NVIDIA Reflex 2 減少了延遲。
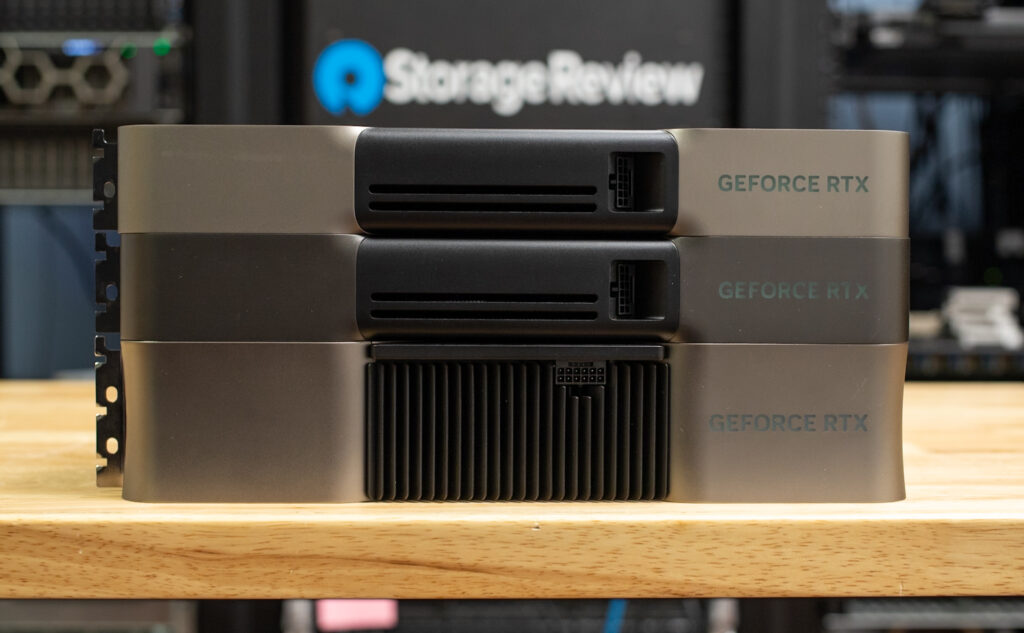
除了顯而易見的競技性能優勢外,RTX 5090 還被定位為 AI 強卡,它以原生 FP4 精度加速生成式 AI 工作流程,並將模型內存需求比之前的 FP16 實現方案降低了一半。我們最近比較了RTX 4090 和 RTX 6000 Ada,以檢驗一款主打遊戲效能的顯示卡能否在工作站 AI 工作負載方面與生產力強卡一較高下。結果顯示,6000 Ada 總體上佔優勢,但對於預算有限的用戶來說,4090 的表現卻出乎意料地好。全新的 RTX 5090 旨在透過多項嵌入式 AI 增強功能,進一步模糊遊戲 GPU 與生產力 GPU 之間的界線。
NVIDIA GeForce RTX 5090 Blackwell 架構與硬體創新
RTX 5090 的核心包含 21,760 個 CUDA 核心,比 RTX 33 的 4090 個核心增加了 16,384%。如此龐大的核心數量與第五代 Tensor 核心和第四代 RT 核心相結合,旨在在遊戲、計算密集型工作負載和 AI 加速方面提供無與倫比的性能。
RTX 4090 的 Tensor Core 數量從 512 個增加到 680 個,矩陣運算速度更快,從而實現更有效率的 AI 推理。同時,RT Core 數量從 RTX 4090 的 128 個增加到 170 個,提升了 33%,顯著增強了光線追蹤效能,使遊戲和專業渲染任務中的光照、陰影和反射效果更加逼真。這些升級最終帶來了驚人的 104.8 TFLOPS FP16 性能,比 RTX 4090 的 82.58 TFLOPS 提升了 27%。
RTX 5090也引進了32GB GDDR7記憶體,與RTX 4090的24GB GDDR6X相比,頻寬和容量都有顯著升級。 5090 在 512 位元記憶體匯流排上運行,記憶體頻寬達到驚人的 1.79 TB/s,幾乎是 RTX 1.01 4090 TB/s 的兩倍。 這種巨大的頻寬增加對於需要快速存取的人工智慧工作負載影響尤其大。來建模權重。更快的記憶體可以更順暢地處理複雜的人工智慧模型,從而減少推理過程中的延遲。此外,增加的頻寬可加速 GPU 直接存儲,從而允許直接從快速存儲設備順序加載大量模型權重等用例。這甚至可以運行最大的人工智慧模型,而無需將它們完全載入到記憶體中。
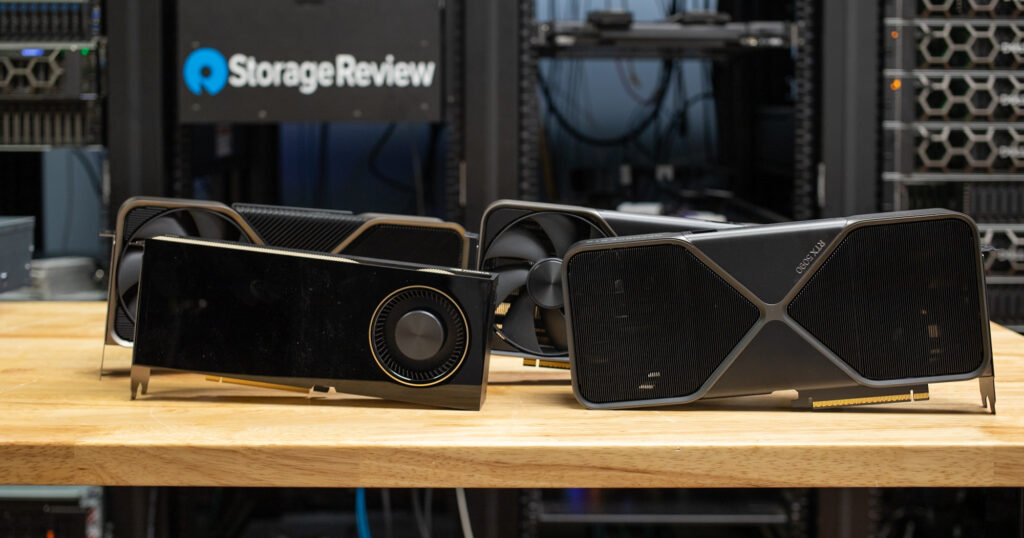
NVIDIA GeForce RTX 50 系列規格
Nvidia RTX 5090 幾乎在各方面都比 RTX 4090 進行了重大升級。以下是兩款 GPU 的詳細比較:
| GPU比較 | NVIDIA RTX 5090 | NVIDIA RTX 4090 | NVIDIA RTX 5080 | NVIDIA RTX 5070 |
| GPU名稱 | GB202 | AD102 | GB203 | GB205 |
| 卓越的建築 | 布萊克威爾2.0 | 艾達洛夫萊斯 | 布萊克威爾2.0 | 布萊克威爾2.0 |
| 進程大小 | 4納米 | 5納米 | 4納米 | 4納米 |
| 晶體管 | 92,200百萬 | 76,300百萬 | 45,600百萬 | 31,000百萬 |
| 密度 | 123.9M/平方毫米 | 125.3M/平方毫米 | 120.6M/平方毫米 | 117.9M/平方毫米 |
| 模具尺寸 | 744平方毫米 | 609平方毫米 | 378平方毫米 | 263平方毫米 |
| 槽寬 | 雙槽 | 三槽 | 雙槽 | 雙槽 |
| 尺寸 | 304 mm x 137 mm x 48 mm | 304 mm x 137 mm x 61 mm | 304 mm x 137 mm x 48 mm | 不適用 |
| TDP | 575W¯¯ | 450W¯¯ | 360W¯¯ | 250W¯¯ |
| 輸出 | 1 個 HDMI 2.1b,3 個 DisplayPort 2.1b | 1個HDMI 2.1、3個DisplayPort 1.4a | 1 個 HDMI 2.1b、3 個 DisplayPort 2.1b | 1 個 HDMI 2.1b、3 個 DisplayPort 2.1a |
| 電源連接器 | 1x 16 針 | 1x 16 針 | 1x 16 針 | 1x 16 針 |
| 總線接口 | PCIe 5.0 x16 | PCIe 4.0 x16 | PCIe 5.0 x16 | PCIe 5.0 x16 |
| 基地時鐘 | 2017 MHz | 2235 MHz | 2295 MHz | 2165 MHz |
| 提升時鐘 | 2407 MHz | 2520 MHz | 2617 MHz | 2510 MHz |
| 記憶時鐘 | 2209 MHz(28 Gbps 有效) | 1313 MHz(21 Gbps 有效) | 2366 MHz(30 Gbps 有效) | 2209 MHz(28 Gbps 有效) |
| 內存大小 | GB 32 | GB 24 | GB 16 | GB 12 |
| 內存類型 | GDDR7 | GDDR6X | GDDR7 | GDDR7 |
| 內存總線 | 512位 | 384位 | 256位 | 192位 |
| 內存帶寬 | 1.79 TB / s | 1.01 TB / s | 960.0 GB / s | 672.2 GB / s |
| CUDA核心 | 21,760 | 16,384 | 10,752 | 6,144 |
| 張量核心 | 680 | 512 | 336 | 192 |
| 個ROPs | 192 | 176 | 128 | 64 |
| SM 計數 | 170 | 128 | 84 | 48 |
| 張量核心 | 680 | 512 | 336 | 192 |
| RT核心 | 170 | 128 | 84 | 48 |
| L1緩存 | 128 KB(每個 SM) | 128 KB(每個 SM) | 128 KB(每個 SM) | 128 KB(每個 SM) |
| L2緩存 | 88 MB | 72 MB | 64 MB | 40 MB |
| 像素率 | 462.1 G像素/秒 | 443.5 G像素/秒 | 335.0 G像素/秒 | 160.6 G像素/秒 |
| 紋理速率 | 1,637 GTexel/秒 | 1,290 GTexel/秒 | 879.3 GTexel/秒 | 481.9 GTexel/秒 |
| FP16(半) | 104.8 兆次浮點運算 (1:1) | 82.58 兆次浮點運算 (1:1) | 56.28 兆次浮點運算 (1:1) | 30.84 兆次浮點運算 (1:1) |
| FP32(浮點) | 104.8 TFLOPS | 82.58 TFLOPS | 56.28 TFLOPS | 30.84 TFLOPS |
| FP64(雙) | 1.637 兆次浮點運算 (1:64) | 1,290 GFLOPS (1:64) | 879.3 GFLOPS (1:64) | 481.9 GFLOPS (1:64) |
| 發行價(美元) | $1,999 | $1,599 | $999 | $549 |
NVIDIA GeForce RTX 5090 建造與設計
RTX 5090 Founders Edition 保留了 Nvidia 時尚的工業設計語言,並進行了微妙的改進。該卡長 304 毫米,寬 137 毫米,適合標準 2 插槽配置,使其功能緊湊得令人驚訝。
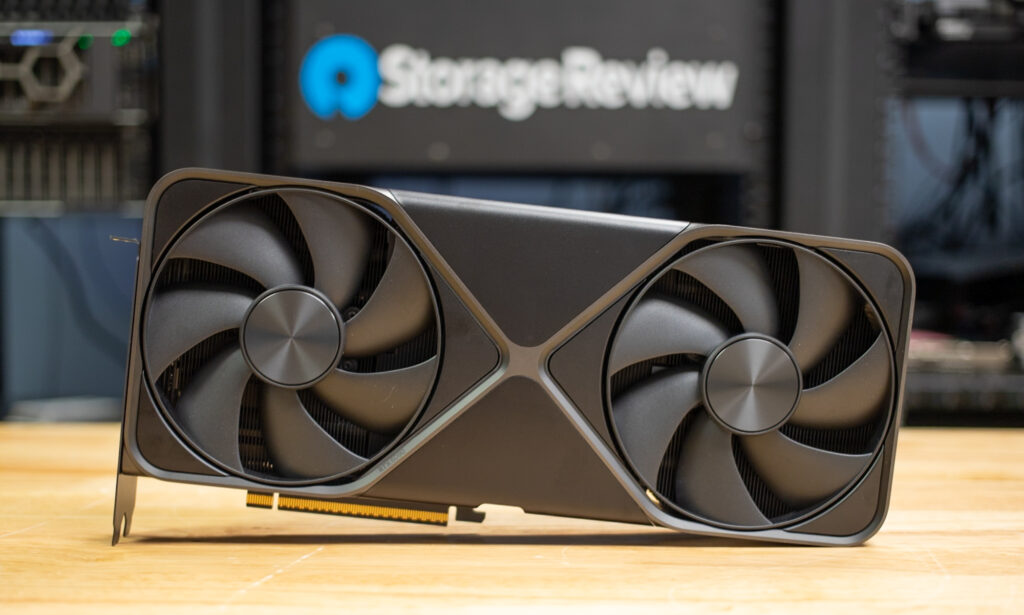
Nvidia為RTX 5090引入了雙流通設計,提高了冷卻效率和氣流。這張卡採用 Nvidia 所謂的 3D 均熱板,搭配雙軸流風扇,即使在繁重的工作負載下也能控制溫度。雖然如果不握在手中很難看到,但您可以透過每個風扇後面的兩個散熱器部分看到光線。
卡的中心部分有電路板,小管將電線連接到每個視訊輸出。這大大提高了 RTX 5090 的冷卻能力,使其能夠保持與 RTX 4090 相似的配置,即使功耗顯著增加。
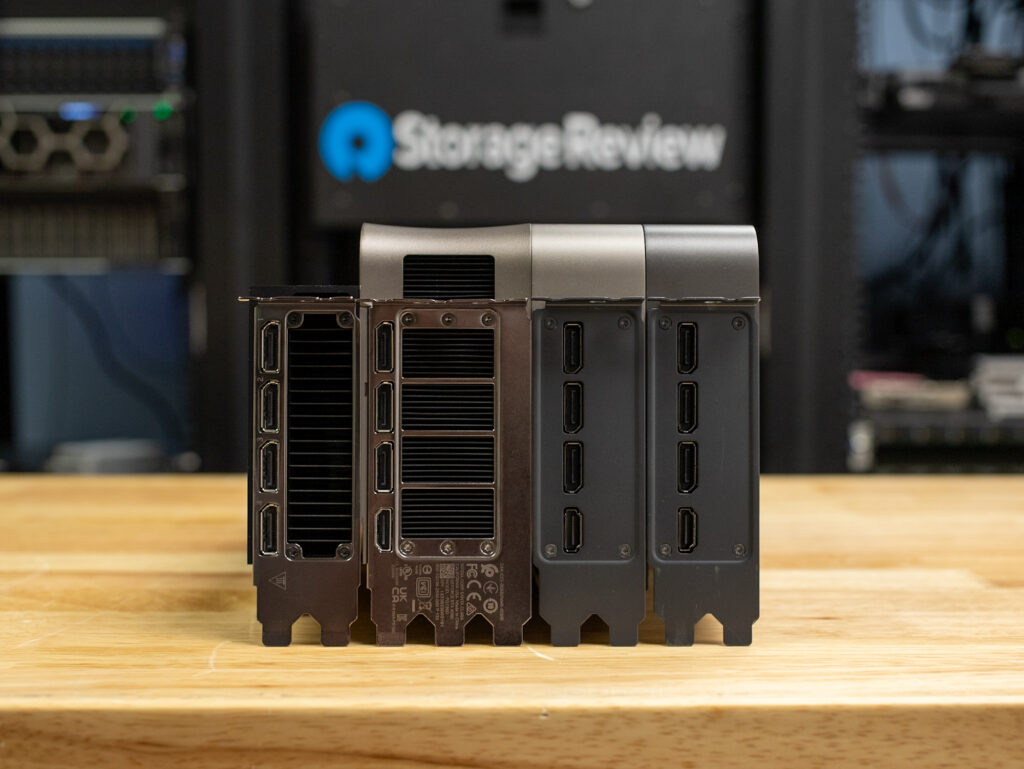
RTX 5090 的突出特點之一是包含從工廠直接應用的液態金屬導熱化合物。這確保了比傳統導熱膏更好的導熱性,使 GPU 能夠保持較低的溫度和更高的持續性能。
儘管最大功耗增加至 575W,RTX 5090 仍保留了緊湊的雙插槽外形,使其比笨重的三插槽 RTX 4090 更適合高階 PC 建置。
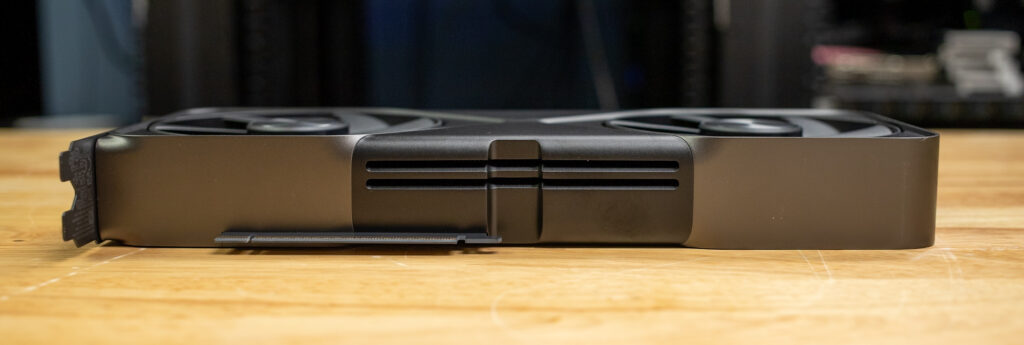
該卡還支援 PCIe Gen 5,為下一代主機板和周邊裝置提供更高的頻寬。因此,它已經為遊戲和內容創作的未來做好了準備。
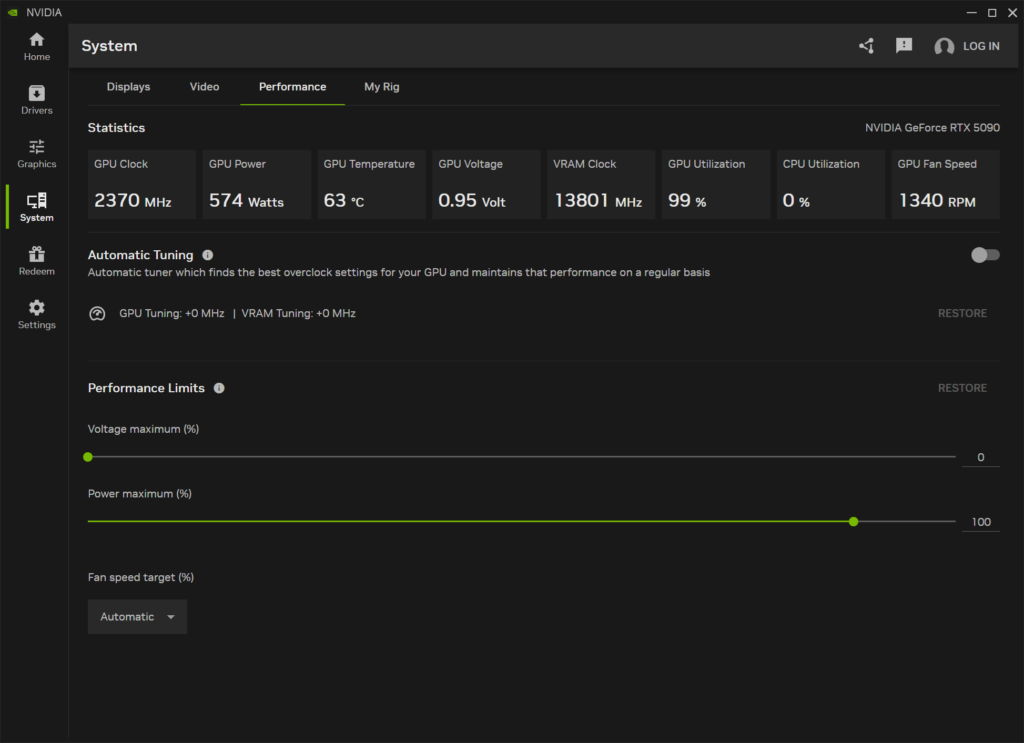
人工智慧遊戲時代
RTX 5090 不僅僅是原始功率。這是關於用人工智慧重新定義遊戲。 Nvidia 將其人工智慧驅動的功能提升到了一個新的水平,使這一代產品成為性能和視覺保真度方面的遊戲規則改變者。

DLSS 4:多幀生成
DLSS(深度學習超級取樣)多年來一直是 Nvidia GPU 的基石,但 RTX 5090 引入了 DLSS 4,這將事情提升到了一個全新的水平。雖然 DLSS 的早期版本可以為每個傳統渲染幀產生一個 AI 幀,但 DLSS 4 現在可以為每個渲染幀產生最多三個 AI 幀。

即使在最苛刻的遊戲中所有設定都達到最大,這也會帶來令人難以置信的流暢遊戲體驗。與 Nvidia 的延遲減少技術 Reflex 2 配合使用時,遊戲看起來比以往更好,感覺反應更靈敏。
射線重建
光線追蹤一直是一項要求很高的功能,但 RTX 5090 的 AI 驅動的光線重建改變了遊戲規則。透過以人工智慧訓練的網路取代傳統的降噪器,Nvidia 顯著提高了光線追蹤反射、陰影和照明的品質。
此功能透過為光線追蹤場景產生額外的像素來提高影像質量,使它們看起來更加真實和身臨其境。這是光線追蹤向前邁出的重要一步,尤其是在要求苛刻的遊戲中。
AV1編碼和解碼
對於內容創作者來說,RTX 5090 包括 3 個第 9 代 NVENC 編碼器和 2 個第 6 代 NVDEC 解碼器,具有完全的 AV1 相容性。這確保了更快、更有效率的視訊編碼和解碼,使其成為串流媒體和視訊編輯器的絕佳選擇。
NVIDIA GeForce RTX 5090 評測 – 效能基準
為了充分利用全新 NVIDIA GeForce RTX 5090 的優勢,我們利用了 AMD ThreadRipper 平台。根據配置,系統提供 64 核心 CPU 和水冷迴路。它擁有充足的底層 CPU 能力,讓 GPU 不受阻礙地完成工作。下面列出了系統的完整配置。
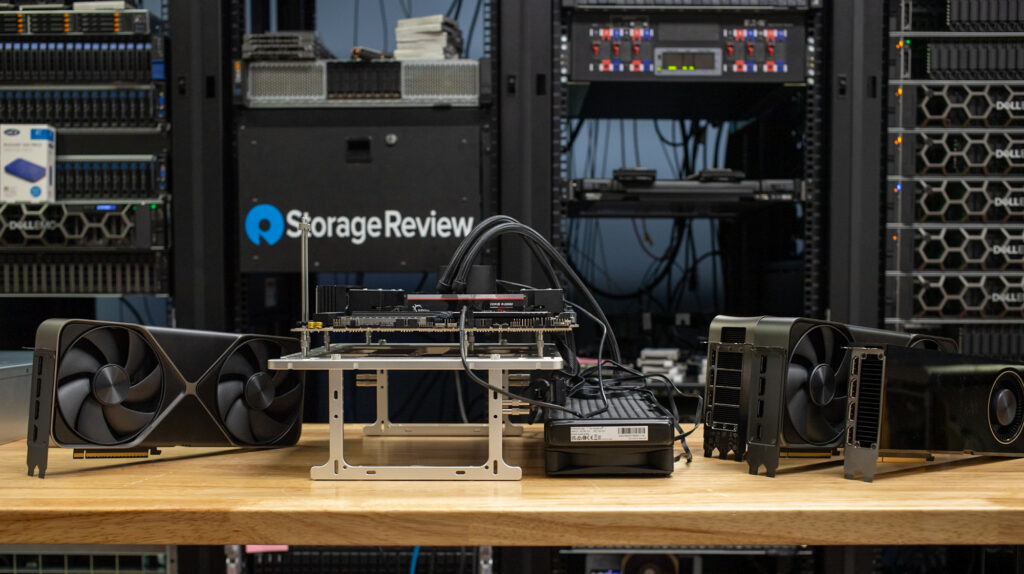
StorageReview AMD ThreadRipper 測試平台
- 主板: 華碩 Pro WS TRX50-SAGE WIFI
- 中央處理器: AMD 銳龍 Threadripper 7980X 64 核心
- 隨機存取存儲器: 32GB DDR5 4800MT/秒
- 貯存: 2TB 三星 980 Pro
- 操作系統: Windows 11 Pro for Workstations
- 司機: NVIDIA 571.86 GameReady 驅動程式
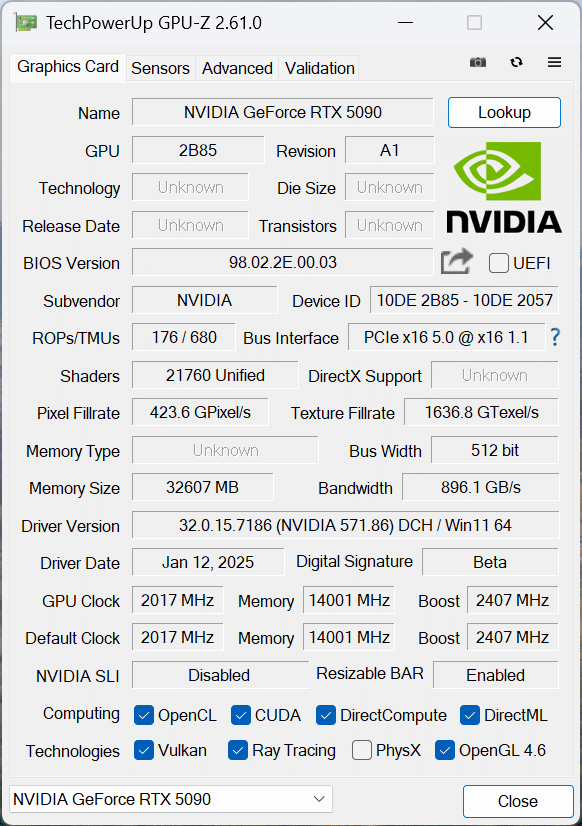
在撰寫這篇評測時,我們使用了NVIDIA 571.86 GameReady早期版本驅動程式來測試GPU。但要注意的是,並非所有應用程式都完全支援新的Blackwell架構。我們使用的許多測試案例已經更新,並且還有許多測試案例仍在更新中。因此,我們將持續探索那些針對NVIDIA全新50系列GPU進行最佳化的舊測試案例。
UL Procyon:人工智慧文字生成
Procyon AI 文字產生基準測試透過提供簡潔一致的評估方法,簡化了 AI LLM 效能測試。它允許對多個 LLM 模型進行重複測試,同時最大限度地降低大型模型規模和可變因素帶來的複雜性。此基準測試由 AI 硬體領域的領導企業共同開發,優化了本地 AI 加速器的使用,從而實現更可靠、更有效率的效能評估。以下測量結果均使用 TensorRT 進行測試。
在 Procyon® AI 文字產生基準測試中,Nvidia RTX 5090在所有測試型號中得分最高,效能最快:
- 披:5,749 RTX 5090,優於 RTX 4090 4,958 和 RTX 6000 Ada 4,508。
- 寒冷西北風:6,267 RTX 5090,其次是 RTX 4090 5,094 和 RTX 6000 Ada 4,255。
- 駱駝3:6,104 RTX 5090,RTX 4090 為 4,849,RTX 6000 Ada 為 4,026。
- 駱駝2:6,591 RTX 5090,領先 RTX 4090 5,013 和 RTX 6000 Ada 3,957。
就整體續航時間而言,RTX 5090 也優於其他 GPU:
- 披:RTX 10.280 5090 秒,比 RTX 4090 12.872 秒和 RTX 6000 Ada 13.869 秒更快。
- 寒冷西北風:RTX 12.593 為 5090 秒,RTX 4090 為 17.010 秒,RTX 6000 Ada 為 19.092 秒。
- 駱駝3:RTX 14.304 5090 秒,領先 RTX 4090 19.991 秒和 RTX 6000 Ada 22.062 秒。
- 駱駝2:RTX 23.018 5090 秒,比 RTX 4090 32.448 秒和 RTX 6000 Ada 38.923 秒更快。
在此測試中,RTX 5090 在每個類別中始終提供卓越的整體效能和更快的處理時間。
| UL Procyon:人工智慧文字生成 | NVIDIA RTX 5090 | NVIDIA RTX 4090 | NVIDIA RTX 6000 Ada |
| Phi 總分 | 5,749 | 4,958 | 4,508 |
| Phi 輸出到第一個代幣的時間 | 0.244小號 | 0.255小號 | 0.288小號 |
| Phi 每秒輸出令牌 | 314.435 令牌/秒 | 244.343 令牌/秒 | 228.359 令牌/秒 |
| Phi 總持續時間 | 10.280小號 | 12.872小號 | 13.869小號 |
| 米斯特拉爾總分 | 6,267 | 5,094 | 4,255 |
| 米斯特拉爾輸出第一個令牌的時間 | 0.297小號 | 0.322小號 | 0.419小號 |
| 米斯特拉爾每秒輸出令牌 | 255.945 令牌/秒 | 183.266 令牌/秒 | 166.633 令牌/秒 |
| 米斯特拉爾總持續時間 | 12.593小號 | 17.010小號 | 19.092小號 |
| Llama3 總分 | 6,104 | 4,849 | 4,026 |
| Llama3 輸出第一個令牌的時間 | 0.234小號 | 0.259小號 | 0.348小號 |
| Llama3 每秒輸出令牌 | 214.285 令牌/秒 | 150.039 令牌/秒 | 138.620 令牌/秒 |
| Llama3 整體持續時間 | 14.304小號 | 19.991小號 | 22.062小號 |
| Llama2 總分 | 6,591 | 5,013 | 3,957 |
| Llama2 輸出第一個令牌的時間 | 0.419小號 | 0.500小號 | 0.679小號 |
| Llama2 每秒輸出令牌 | 134.502 令牌/秒 | 92.853 令牌/秒 | 78.532 令牌/秒 |
| Llama2 整體持續時間 | 23.018小號 | 32.448小號 | 38.923小號 |
UL Procyon: 人工智能圖像生成
Procyon AI 影像產生基準測試提供了一種一致且準確的方法,用於衡量各種硬體(從低功耗 NPU 到高階 GPU)上的 AI 推理效能。它包含三個測試:針對高階 GPU 的 Stable Diffusion XL (FP16)、針對中等效能 GPU 的 Stable Diffusion 1.5 (FP16) 以及針對低功耗裝置的 Stable Diffusion 1.5 (INT8)。此基準測試會為每個系統使用最佳推理引擎,確保結果的公平性和可比較性。
在 Procyon AI 影像產生基準中,Nvidia RTX 5090 在所有測試中均優於其他 GPU:
- 穩定擴散 1.5 (FP16):RTX 5090 以 8,193 的總分領先,生成時間為 12.204 秒,影像產生速度為 0.763 秒/影像。
- 穩定擴散1.5 (INT8):RTX 5090 再次領先,總分為 79,272,生成時間為 3.154 秒,影像產生速度為 0.394 秒/影像。
- 穩定擴散 XL (FP16):最後,RTX 5090 再次以 7,179 分的成績領先,生成時間為 83.573 秒,影像產生速度為 5.223 秒/影像。
| UL Procyon:AI 影像生成 | NVIDIA RTX 5090 | NVIDIA RTX 4090 | NVIDIA RTX 6000 Ada |
| 穩定擴散 1.5 (FP16) – 總分 | 8,193 | 5,260 | 4,230 |
| 穩定擴散 1.5 (FP16) – 總時間 | 12.204小號 | 19.011小號 | 23.639小號 |
| 穩定擴散 1.5 (FP16) – 影像產生速度 | 0.763 秒/影像 | 1.188 秒/影像 | 1.477 秒/影像 |
| 穩定擴散 1.5 (INT8) – 總分 | 79,272 | 62,160 | 55,901 |
| 穩定擴散 1.5 (INT8) – 總時間 | 3.154小號 | 4.022小號 | 4.472小號 |
| 穩定擴散 1.5 (INT8) – 影像生成速度 | 0.394 秒/影像 | 0.503 秒/影像 | 0.559 秒/影像 |
| 穩定擴散 XL (FP16) – 總分 | 7,179 | 5,025 | 3,043 |
| 穩定擴散 XL (FP16) – 總時間 | 83.573小號 | 119.379小號 | 197.172小號 |
| 穩定擴散 XL (FP16) – 影像產生速度 | 5.223 秒/影像 | 7.461 秒/影像 | 12.323 秒/影像 |
樂士馬克
Luxmark 是一個 GPU 基準測試,它使用開源光線追蹤渲染器 LuxRender 來評估系統在處理高度詳細的 3D 場景方面的效能。此基準測試適用於評估伺服器和工作站的圖形渲染能力,特別是對於視覺效果和建築視覺化應用程序,其中準確的光模擬至關重要。
在 Luxmark OpenCL 基準測試中,NVIDIA RTX 5090 在 Hall 和 Food GPU 測試中都獲得最高分:
- 食物評分:23,141 RTX 5090,超過 RTX 4090 17,171 和 RTX 6000 Ada 14,873。
- 霍爾分數:51,725 RTX 5090,優於 RTX 4090 38,887 和 RTX 6000 Ada 32,132。
| Luxmark(越高越好) | NVIDIA RTX 5090 | NVIDIA RTX 4090 | NVIDIA RTX 6000 Ada |
| 食物評分 | 23,141 | 17,171 | 14,873 |
| 霍爾分數 | 51,725 | 38,887 | 32,132 |
Geekbench 6
Geekbench 6是一款跨平台基準測試軟體,用於衡量系統整體效能。 Geekbench 瀏覽器可讓您將任何系統與 Geekbench 6 進行比較。
NVIDIA RTX 5090 以 374,807 的優異 Geekbench GPU OpenCL 分數領先。該分數優於 RTX 6000 Ada 的 336,882 分和 RTX 4090 的 333,384 分,使其成為此次比較中表現最好的。
| Geekbench(越高越好) | NVIDIA RTX 5090 | NVIDIA RTX 4090 | NVIDIA RTX 6000 Ada |
| GPU OpenCL 分數 | 374,807 | 333,384 | 336,882 |
的V-Ray
V -Ray基準測試使用先進的 V-Ray 6 引擎,測量 CPU、NVIDIA GPU 或兩者的渲染效能。它採用快速測試和簡單的評分系統,使用戶能夠評估和比較系統的渲染能力。對於尋求高效性能洞察的專業人士而言,它是一款必不可少的工具。
在本次測試中,NVIDIA RTX 5090以令人印象深刻的14,764分取得領先,顯著優於RTX 4090 10,847和RTX 6000 Ada 10,766。 RTX 5090 在渲染效能方面再次明顯佔據主導地位。
| V-Ray(越高越好) | NVIDIA RTX 5090 | NVIDIA RTX 4090 | NVIDIA RTX 6000 Ada |
| 虛擬路徑 | 14,764 | 10,847 | 10,766 |
NVIDIA GeForce RTX 5090 功耗
功耗是任何高端運算平台的重要組成部分。每一代新一代 GPU 在負載下都會消耗更多電量,這意味著需要更大的電源和充足的冷卻氣流。然而,與效能相關的功耗還有另一個面向:更快的 GPU 可能會更高,但每個工作負載的持續時間會縮短。
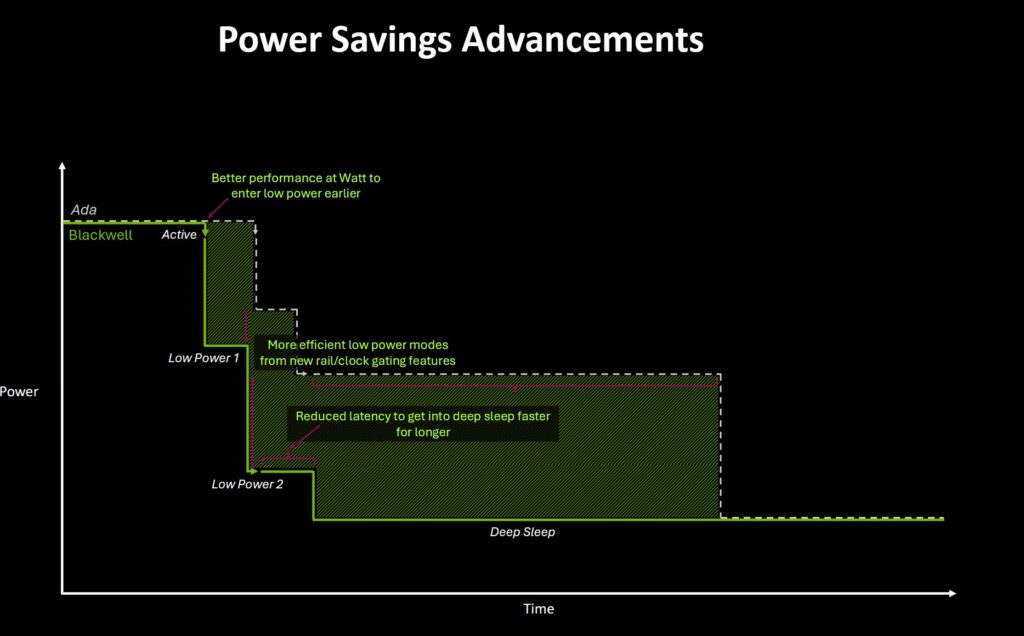
在 CES 2025 的編輯日上,NVIDIA 討論了 Blackwell 架構在能源效率方面的提升,我們希望在 AI 驅動的工作負載中驗證這項提升。我們利用測試實驗室中的Quarch Mains Analyzer ,測量了執行Procyon AI Image Generator Stable Diffusion XL FP16 測試時系統的總功耗。此工作負載將每塊 GPU 的功耗推至極限,每張生成影像的起始點和終止點都清晰可見。
首先我們來看看NVIDIA RTX 6000 Ada,其最大功耗為300W。在執行 Procyon AI 影像產生測試時,我們看到系統功率從後台負載的 235W 增加到 514W,負載下增加了 279W。當查看每個影像的時間時,倒數第二個影像的 GPU 負載持續了 12.6 秒。最後一次影像創建所消耗的總功耗為 1.76Wh。
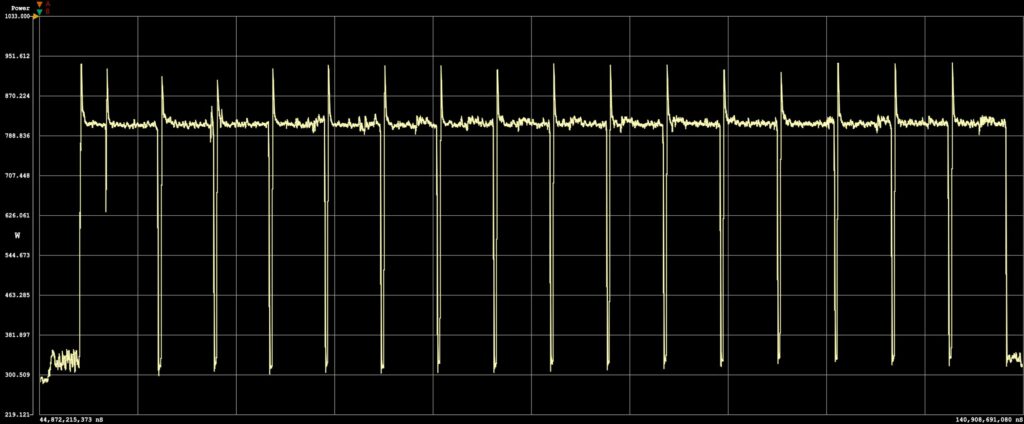
接下來,我們來看看使用 NVIDIA GeForce RTX 4090 運行的相同測試段,其最大功耗為 450W。在執行AI影像產生測試的測試中,系統從底層233W增加到平均669W,負載下增加了436W。查看建立的倒數第二個影像,測量負載下的時間為 2 秒。計算得出該期間消耗的總電量為 7.3Wh。
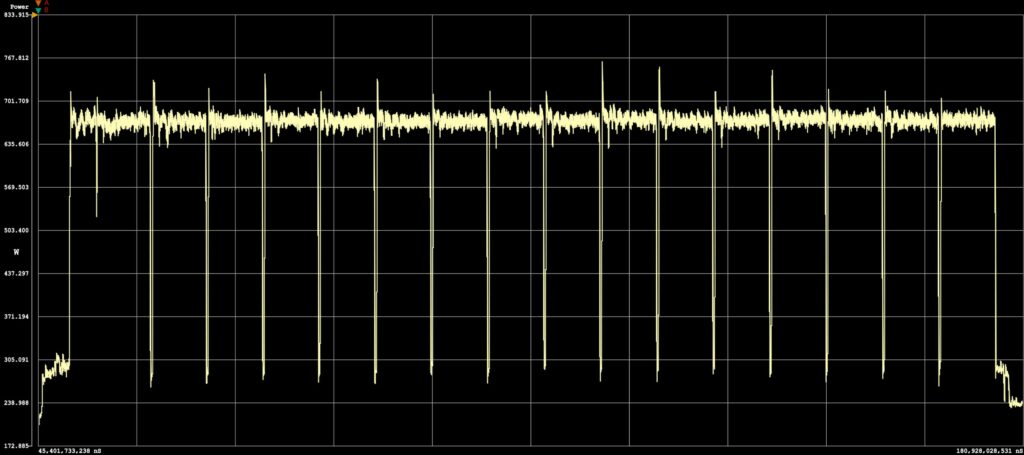
最後,我們來看看新的NVIDIA GeForce RTX 5090,它的最大功耗最高為600W。此卡在執行Procyon AI影像產生測試時,系統後台功率從272W提升至811W,工作時功率達到539W。測量產生倒數第二張影像的時間僅為 5.1 秒,在此期間使用了 1.16 瓦時的電量。
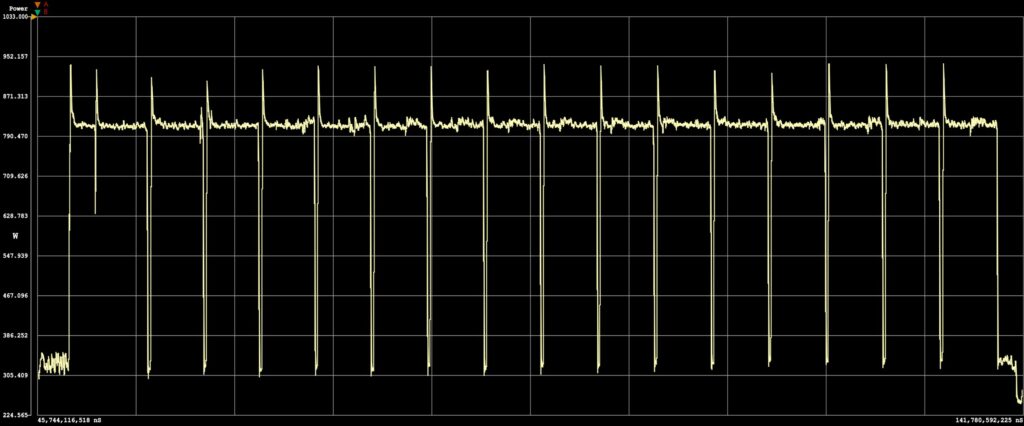
當我們研究所有這三款 NVIDIA GPU 時,雖然每個更快型號的峰值功率確實有所增加,但總能耗卻有所下降。在考慮為工作負載購買新 GPU 時,這是一個重要因素。功耗會增加,但完成特定工作負載所需的能量會減少。
結語
本評測提供了 NVIDIA GeForce RTX 5090 整體功能的早期了解。並非所有軟體都針對新架構進行了最佳化,並且要等到 XNUMX 月底該卡全面發售後,才能提供更多以 AI 為中心的工作負載的 Linux 驅動程式。
我們看到所有可以利用新 RTX 5090 的工作負載都獲得了巨大的性能提升。讓我們興奮的是看到這張卡所提供的性能潛力。與 RTX 4090 相比,RTX 5090 在 Procyon AI 文字和影像生成工作負載方面分別提供了 16% 和 56% 的提升。在V-Ray測量渲染效能中,RTX 5090的效能比前代提升了36%。我們看到的 GPU 加速工作負載都沒有縮減。事情變得越來越激烈。當你引入人工智慧助理的概念時,使用者將不再只是在玩遊戲或工作;而是在工作。您將有一個並行運行的人工智慧工作負載。這將需要額外的 GPU 資源以及另一個密集任務。
這就引出了價格和價值的問題。 GeForce RTX 4090 的初始售價為 1,599 美元,而新款 GeForce RTX 5090 的起始售價則漲至 1,999 美元,高階機型的價格上漲了 25%。這對很多人來說值得嗎?答案是肯定的。對於經常讓 GPU 滿載運轉的使用者來說,更快的 GPU 可以讓他們完成更多任務。如果工作負載運行時間更短,工作效率更高,那麼這筆費用分攤到電腦使用多年的時間裡,就非常划算了。每個人都需要頂級型號嗎?可能並非如此。 GeForce RTX 5090 將提供多種型號選擇,包括售價 549 美元的 RTX 5070,以及價格更低的 RTX 5060。
對於這款下一代卡,功耗是另一個需要記住的事情。 GeForce RTX 4090 的功耗為 450W,而 RTX 5090 將其提升到了高達 575W。這將為 PC 和工作站機箱設計帶來新的挑戰,因為它必須滿足額外的冷卻需求和更大的電源。
總體而言,新款 NVIDIA GeForce RTX 5090 給我們留下了深刻的印象,並渴望看到隨著應用程式支援的更加廣泛,效能將得到多大程度的提升。就像之前的 RTX 3090 和 A6000,或者 RTX 4090 和 6000 Ada 一樣,GeForce RTX 5090 指出了下一個工作站型號的發展方向,我們已經等不及了。


 Amazon