

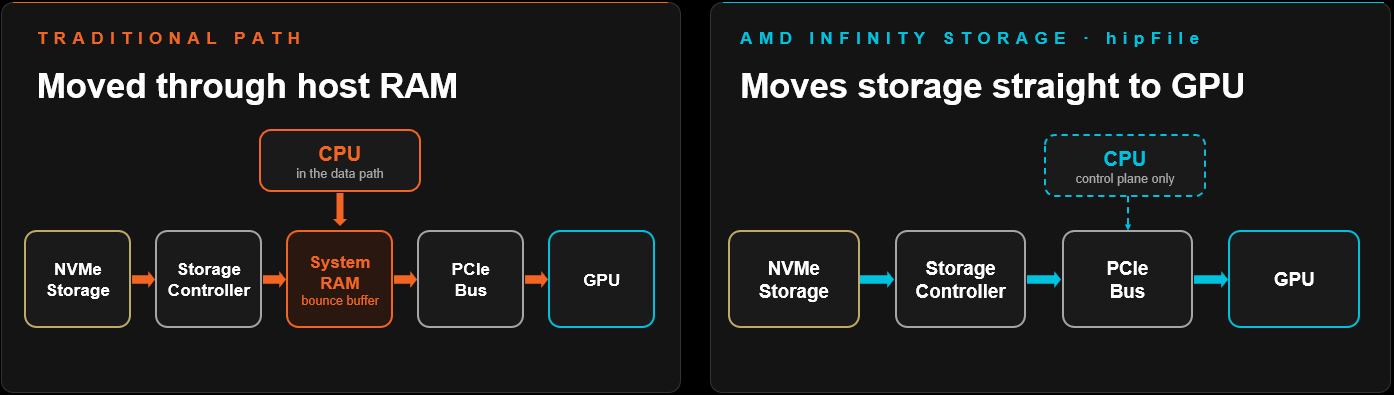
Verze AMD ROCm 10.1, vydaná 5. října, klade velký důraz na komunikaci mezi úložištěm a GPU. Soubory kontrolních bodů, mezipaměti klíč-hodnota a váhy modelů nyní běžně přerůstají paměť akcelerátoru a v takovém případě začíná čas strávený přesunem dat ovlivňovat dobu iterace více než matematika. Tato verze rozvíjí AMD Infinity Storage, stack pro přímé ukládání dat, který se objevil v ROCm 7.14, propojením přístupu k úložišti do běhového prostředí HIP a přidáním hostitelské paměti s podporou NUMA, takže data se dostanou k GPU bez okliky přes paměť CPU.
Přímé úložné kanály GPU a paměť s podporou NUMA
Knihovna hipFILE v úložišti AMD Infinity Storage získává asynchronní rychlou backendovou platformu. Požadavky na čtení a zápis běží přímo na streamu HIP, čímž se přeskakuje krok přípravy paměti hostitele, který vyžaduje tradiční cesta. AMD uvádí, že výsledkem je nižší latence pro enginy kontrolních bodů a odlehčení KV-cache, přičemž je zachována trvalá šířka pásma. Poznámky k verzi pojmenují volání: hipFileReadAsync() a hipFileWriteAsync() nyní podporují rychlou cestu.
Dávkové I/O API odesílá více požadavků na soubory najednou a rozděluje je mezi interní fond pracovních vláken, což udržuje fronty úložiště plné, když trénovací úloha stahuje velkou datovou sadu. Telemetrie s ní roste: hipFileGetStatsL1, L2 a L3 vracejí postupně podrobnější statistiky I/O a tyto čítače poskytují údaje profilerům ROCm, takže operátor může zjistit, zda je kanál omezen výpočetním výkonem, pamětí nebo doručováním dat.
Na dvousocketových hostitelích platí buffer alokovaný na nesprávném socketu při každém přenosu mezisocketovou penalizaci. ROCm 10.1 rozšiřuje API pro správu virtuální paměti HIP o hipMemLocationTypeHostNuma a hipMemLocationTypeHostNumaCurrent, takže paměť hostitele lze umístit na konkrétní uzel NUMA během celého životního cyklu vytváření, rezervování, mapování a demontáže. Knihovny jako RCCL dokáží nad tím vytvářet lokální komunikační buffery NUMA s nulovou kopií a udržovat provoz mezi hostitelem a zařízením mimo propojení socketů.
ROCm CLI v1.0.0 a pracovní postupy agentů s umělou inteligencí
Rozhraní ROCm CLI dosahuje verze 1.0.0 jako jediný binární soubor pro Linux, Windows a WSL2, který instaluje, konfiguruje a spouští lokální úlohy AI na grafických procesorech AMD. Detekuje ovladače flash-attn a amd-aiter, které vLLM potřebuje, podporuje aktualizované rozložení balíčků ROCm 10 a přidává příznak pro plně neinteraktivní instalace ve skriptovaných nebo CI prostředích. Celoobrazovkový dashboard TUI zobrazuje živou telemetrii GPU vedle obsluhy modelu a lokální okno chatu pro kontrolu, zda koncový bod odpovídá.
AMD Skills, balíček integrací pro kódovací agenty, jako jsou Claude Code a Codex, obsahuje další dva. quark-install nastavuje AMD Quark s odpovídajícím sestavením PyTorch a quark-torch-llm-ptq spouští kvantizaci po trénování na LLM PyTorch a Hugging Face se schématy, jako jsou FP8 a INT4.
Modernizace profilování a telemetrie
ROCprofiler-SDK přidává v beta verzi funkci kernel replay. Hardware GPU zpřístupňuje omezený počet čítačů výkonu na jedno odeslání, takže shromáždění celé sady čítačů dříve znamenalo opakované spuštění celé aplikace pro každou skupinu čítačů. Funkce kernel replay znovu spustí každé odeslání na místě, resetuje paměť GPU mezi průchody a shromáždí celou sadu v jednom běhu. SDK také umožňuje spustit a zastavit profilování kdykoli během běhu pro PyTorch Kineto a Triton Proton a dodává dovednost agenta pro vzorkování na PC, která provede asistenta kódování vzorkováním na PC v rocprofv3 a vyhledá výpočetní bloky.
Zpráva o střeše v nástroji ROCm Compute Profiler je nyní interaktivní HTML stránka, takže inženýr může izolovat jedno jádro a přepínat osu aritmetické intenzity mezi úrovněmi mezipaměti. Zprávy o vzorkování PC pro každé jádro, až po počty vzorků a zastavení u jednotlivých instrukcí, a nový průvodce zahrnuje profilování vLLM. ROCm Systems Profiler přidává trasování Linuxu pro APU Gorgon Point 1, 2 a 3 (gfx1150, gfx1152 a gfx1153) a ROCm Optiq nyní vizualizuje profily rocprofv3 spolu s trasováním Systems Profiler a analýzou Compute Profiler.
AMD SMI (amd-smi) nahrazuje ROCm SMI, které bylo v této verzi ze standardního sestavení odstraněno. Zahrnuje GPU, CPU a APU od AMD v systémech Linux a Windows, v holém i virtualizovaném prostředí, s CLI, knihovnou C (amd_smi_lib) a vazbami Pythonu, Go a Rustu. Povědomí o kontejnerech se vztahuje na containerd, CRI-O, Podman, LXC a LXD, včetně podů Kubernetes, takže správce clusteru může přizpůsobit procesy a využití GPU kontejneru, ve kterém jsou spuštěny.
Aktualizace základních kompilátorů, knihovny a podpora běhového prostředí
Sada nástrojů se přesouvá z LLVM 23 na LLVM 24 a makro clang_major nyní hlásí verzi 24, což by si měl každý, kdo připíná verze kompilátoru nebo linkuje s libLLVM, ověřit před upgradem. Inkrementální sestavení se zrychluje díky ukládání do mezipaměti oddílů, které vytváří optimalizace linkování kódu zařízení, takže nezměněné oddíly se znovu použijí při dalším sestavení.
Kompoziční jádro zrychluje práci s grafickými procesory Radeon a přidává do dispečeru více kvantizovaných typů násobení matic. MIGraphX nahrazuje backendový kompilátor z rocMLIR na rocMLIRTriton, což podle AMD zlepšuje výkon inference a často zkracuje dobu kompilace modelu, přičemž kompilátor udržuje krok s upstreamovým Tritonem. rocSPARSE spouští trojúhelníkové řešení přímo na maticích uložených ve formátu ELLPACK (ELL) bez nutnosti konverze.
hipThreads, novinka v rámci threadingových knihoven ROCm Core SDK, přináší standardní koncepty threadingu v C++ pro grafické karty AMD v systémech Linux a Windows. Cílem je zrychlit stávající kód s vlákny CPU na GPU bez nutnosti úplného přepisování do jader HIP a synchronizačních primitiv.
Windows Subsystem for Linux 2 vstupuje do technické preview, přičemž standardní linuxové balíčky se instalují v hostovaném systému a paravirtualizace GPU předává práci ovladači hostitele Windows. Preview zahrnuje balíčky .deb a Python wheels, ale nikoli RPM, a profilování, ladění a nástroje závislé na KFD zatím v WSL2 nefungují. Na straně virtualizace je nyní KVM SR-IOV podporován v Ubuntu 26.04 LTS jako hostitel i host, a to ve spojení s verzí 9.3.0.K virtualizačního ovladače GIM od AMD.
Seznam podporovaného hardwaru přidává Radeon AI PRO R9600 spolu s procesory Instinct MI355X, MI350X a MI350P, řadami MI300 a MI200, zbytkem rodiny Radeon AI PRO R9700 a procesory Ryzen AI.


 Amazon