

Společnost Cerebras Systems oficiálně představila CS-4 , čtvrtou generaci své platformy pro superpočítače s umělou inteligencí na waferech, která je navržena pro trénování na hranicích technologií a úlohy s vysokou souběžností inference. Systém je navržen na základě tří nově vyvinutých procesorů Wafer Scale Engine 3 (WSE-3) Turbo, které jsou umístěny v přepracované platformě Nexus pro rackové systémy. Společnost Cerebras tvrdí, že systém poskytuje až 30krát vyšší inferenční výkon než řešení založená na GPU. Toto číslo společnost zakládá na dokumentu GPT-OSS-120B , kde uvádí více než 4 400 tokenů za sekundu na uživatele a 10násobné zvýšení propustnosti na watt ve srovnání s předchozí generací CS-3.
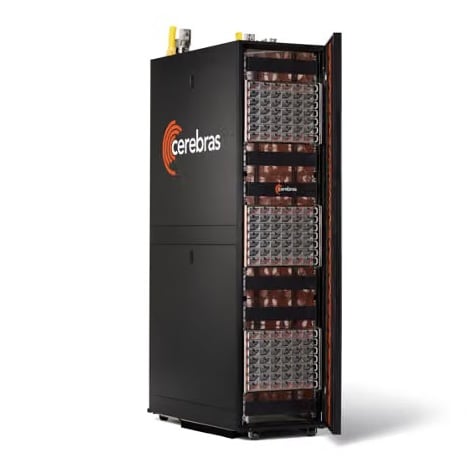
Platforma CS-4 je navržena tak, aby řešila systémová omezení škálování, která jsou vlastní diskrétním víceuzlovým clusterům GPU, kde komunikace mezi čipy, ztráty v převodu energie a tepelná omezení často omezují trvalou výpočetní efektivitu. Cerebras umisťuje platformu tak, aby obsluhovala oba extrémy spektra inferenčních úloh a poskytovala doby odezvy pod milisekundu potřebné pro komplexní agentní pracovní postupy a interaktivní uvažování, a zároveň poskytovala agregovanou kapacitu, kterou hyperškálovače potřebují k maximalizaci výpočetní hustoty na gigawatt.
Vylepšení propojovací struktury jsou klíčová pro možnosti škálování více procesorů platformy. CS-4 snižuje latenci propojení mezi destičkami na pouhé 2 mikrosekundy, což umožňuje vícedestičkovým strukturám fungovat s téměř monolitickou soudržností. Tato struktura s ultra nízkou latencí umožňuje CS-4 udržovat rychlost generování přesahující 1 000 tokenů za sekundu u modelů s více než 10 biliony parametrů, čímž se zmenšuje historická výkonnostní mezera, kdy škálování počtu parametrů vážně snižovalo rychlost doručování interaktivních tokenů.

Architektura racku Nexus a batoh v měřítku destiček
Významnou konstrukční změnou v CS-4 je architektura platformy Cerebras Nexus, modulární implementace racku postavená na nezávislých výpočetních, napájecích a I/O doménách. Výpočetní hustota je ukotvena nově navrženým, vzadu montovaným batohem Wafer-Scale, který se vertikálně připojuje k primárnímu napájecímu poli. Každý batoh je samostatná jednotka, která obsahuje rozdělovače kapalinového chlazení přímo na čip, stupně pro převod výkonu v bodě zátěže, vysokorychlostní síťové cesty a integrovanou řídicí elektroniku umístěnou přímo za křemíkovým waferem. Izolací základní výpočetní vrstvy od rámu pro rozvod energie společnost Cerebras snížila počet systémových komponent o 50 procent, zvýšila automatizovanou montáž o 60 procent a zkrátila dobu nasazení datového centra na pouhé hodiny.

Účinnost napájení byla zlepšena přemístěním modulů pro regulaci napětí DC-DC 100krát blíže k hranici křemíku než v typických implementacích serverových desek. Toto uspořádání bodu zátěže snižuje ztráty v odporové distribuční síti (PDN) a umožňuje rámu Nexus dodávat dvojnásobný výkon každému procesoru WSE-3 Turbo, což umožňuje vyšší trvalé taktovací frekvence bez tepelného škrcení.

I/O subsystém byl také rozšířen o programovatelný Wafer I/O modul, který zdvojnásobuje šířku pásma fabric mezi jednotlivými rozhraními a zároveň snižuje latenci přenosu. Systémové síťové připojení funguje ve dvou režimech: standardní rozhraní RoCE v2 (RDMA over Converged Ethernet) pro připojení fabric s nízkou latencí ke starším podnikovým sítím a akceleračním uzlům třetích stran a proprietární Direct Wafer Links, které poskytují přímé propojovací cesty bez přepínačů napříč sousedními systémy v rámci racků i mezi nimi.
Specifikace turbodmychadel CS-4 a WSE-3
| SYSTÉM CS-4 | |
| Architektura | Aktivní napájecí rack se třemi modulárními výpočetními batohy |
| Motory pro výrobu destiček | 3x WSE-3 turbodmychadla na systém |
| AI Compute | 750 PFLOPS* |
| Paměťová šířka pásma | 129.6 PB/s |
| Šířka pásma čipové tkaniny | 160.5 PB/s |
| Šířka pásma I/O | 7.2 Tbit/s |
| Latence I/O | 2 mikrosekundy |
| WSE-3 TURBO (NA PLÁTEK) | |
| Tranzistory / Křemík | 4 biliony tranzistorů; 46,225 2 mm², TSMC 5nm |
| Jádra umělé inteligence / SRAM na čipu | 900 000 jader; 44 GB SRAM |
| AI Compute | 250 PFLOPS* |
| Paměťová šířka pásma | 43.2 PB/s |
| Šířka pásma čipové tkaniny | 53.5 PB/s |
| Šířka pásma I/O | 2.4 Tbit/s |
| *Výpočetní operace umělé inteligence zobrazeny jako řídký FP16 | |
Dezagregovaná inference a dostupnost
Architektonicky je CS-4 postaven s nativní podporou pro dezagregované inferenční topologie. V podnikových a cloudových prostředích mohou operátoři oddělit výpočetní fáze inference pomocí specializovaných externích akcelerátorů předběžného vyplňování, jako je AMD Helios nebo AWS Trainium, k ingestování kontextů prompts a vytváření stavů modelů. Výpočetně vázaná mezipaměť KV je poté směrována přes vysokorychlostní linky do masivní SRAM fabric CS-4 pro generování autoregresních tokenů s ultra nízkou latencí.
Společnost Cerebras potvrdila, že počáteční nasazení a dodávky platformy CS-4 by měly začít v tomto čtvrtletí.


 Amazon