

Společnost IBM představila architekturu úložiště s ohledem na obsah (CAS), která integruje zpracování dat pomocí umělé inteligence přímo do úložné vrstvy. Tento přístup se zaměřuje na pracovní postupy generování s rozšířeným vyhledáváním (RAG) začleněním vektorizace dokumentů do úložného systému, čímž se snižuje potřeba externích kanálů pro předzpracování.
CAS přesouvá klíčovou funkci RAG, vkládání dokumentů pomocí technik založených na modelech velkých jazyků, do úložné infrastruktury. To umožňuje podnikům zpracovávat a indexovat data na místě, sladit úložné systémy s úlohami řízenými umělou inteligencí a snížit přesun dat mezi úrovněmi infrastruktury. IBM to prezentuje jako způsob, jak zjednodušit nasazení a zároveň zlepšit výkon a lokalitu dat pro aplikace umělé inteligence.
Vektorová databáze v měřítku
Ústředním bodem implementace CAS od IBM je vektorová databáze optimalizovaná pro sémantické vyhledávání. Vektorové databáze podporují přibližné vyhledávání nejbližšího souseda, což umožňuje systémům umělé inteligence načítat relevantní datové bloky na základě metrik podobnosti, jako je kosinová podobnost nebo vzdálenost L2. Tato schopnost je základem RAG, kde jsou uživatelské dotazy převedeny na vektory a porovnány s indexovanými podnikovými daty, aby se poskytly kontextově orientované odpovědi.
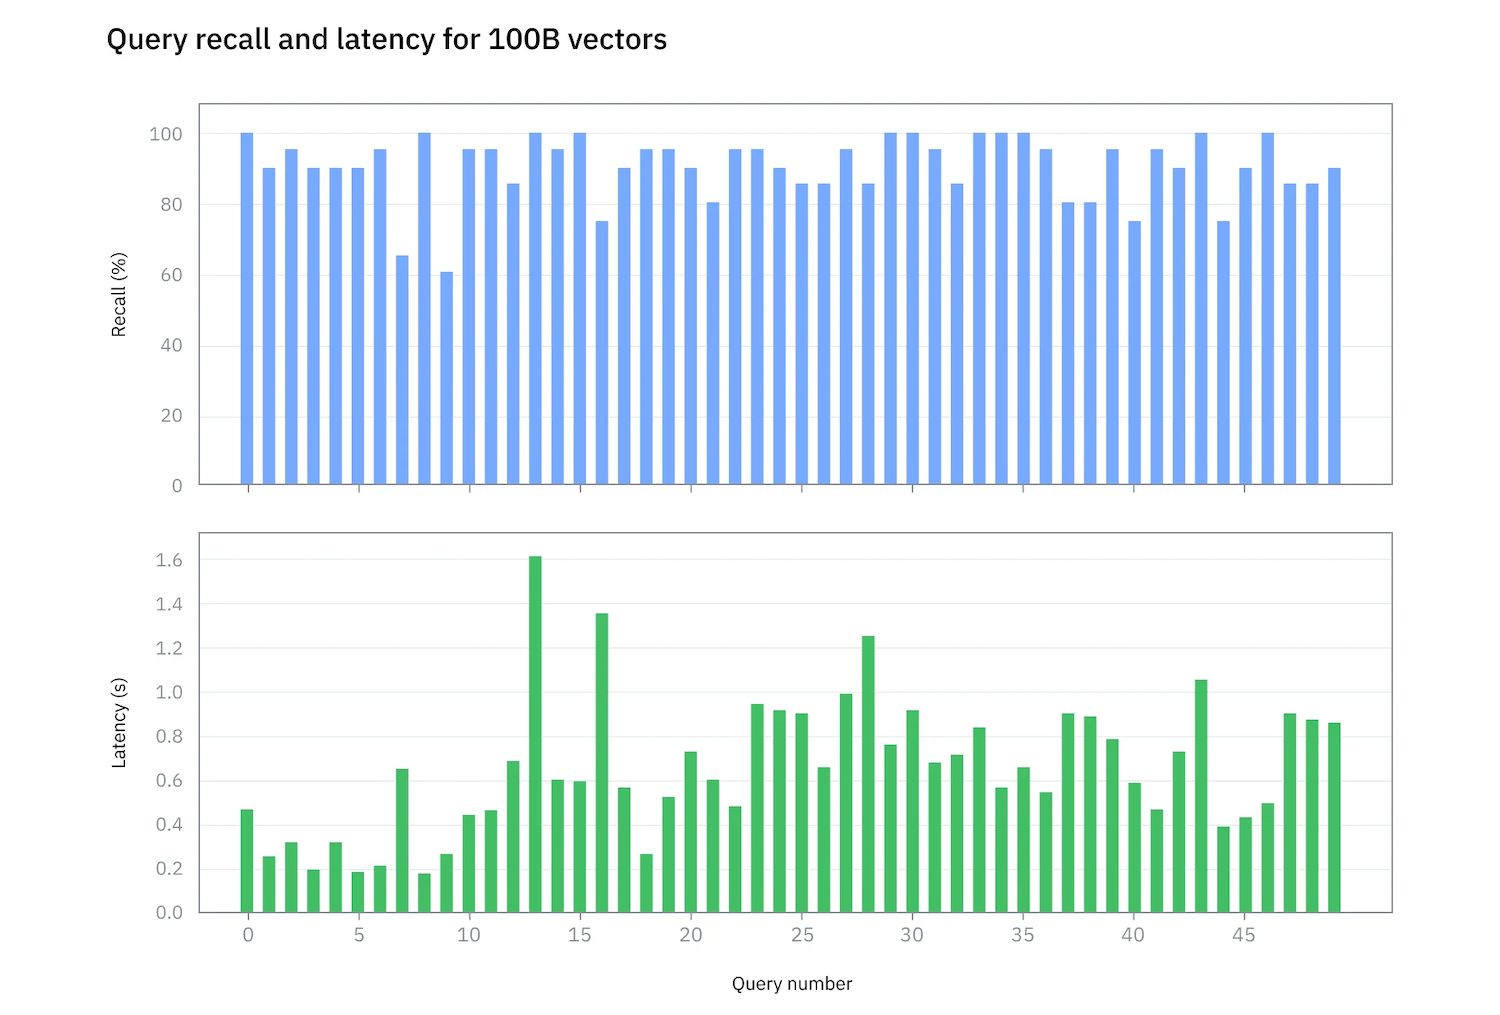
Zdroj: IBM
Společnost IBM Research ve spolupráci se společnostmi Samsung a NVIDIA předvedla prototyp systému schopného škálovat až 100 miliard vektorů na jednom serveru. Systém dosáhl více než 90% úplnosti a přesnosti s průměrnou latencí dotazů pod 700 milisekund. Toto škálování je zaměřeno na podniková prostředí, kde datové sady mohou zahrnovat miliardy souborů a po úplném indexování dosáhnout stovek miliard vektorů.
Integrace RAG Pipeline
RAG se stává preferovaným přístupem pro podnikovou umělou inteligenci, protože zlepšuje přesnost výstupu bez nutnosti přetrénování modelu. Funguje tak, že rozšiřuje výzvy o podniková data získaná z vektorové databáze.
Proces začíná příjmem dat, kde jsou dokumenty, jako jsou PDF soubory a prezentace, analyzovány, rozděleny do bloků a převedeny na embeddingy. Tyto embeddingy jsou uloženy ve vektorové databázi, která organizuje data pro efektivní vyhledávání podobností. Během dotazu je uživatelský vstup vkládán a porovnáván s uloženými vektory, přičemž relevantní obsah je předáván jazykovému modelu jako kontext. Tento uzemňovací mechanismus snižuje halucinace a zvyšuje důvěru ve výstupy generované umělou inteligencí.
CAS od IBM integruje tento kanál přímo do úložiště, čímž konsoliduje příjem, indexování a načítání blíže k datům.
Řešení problémů s rozsahem a náklady
Podnikové úložné systémy již fungují v petabajtovém měřítku. Po rozšíření na CAS může každý soubor generovat stovky vektorů, čímž se rychle zvětší velikost datové sady. Tradiční vektorové databáze se obvykle škálují na více serverů, což představuje náklady a provozní složitost. Indexování a reindexování velkých datových sad se také stává časově náročným.
Přístup společnosti IBM se zaměřuje na zlepšení hustoty vektorů a snížení režijních nákladů na indexování s cílem omezit rozrůstání infrastruktury. Architektura odděluje vektorové a indexové úložiště od výpočtů dotazů, což umožňuje nezávislé škálování úložných a výpočetních zdrojů. To je umožněno řešením IBM Storage Scale a jeho vysoce výkonným paralelním souborovým systémem.
Architektura úložiště a hardwaru
Implementace CAS využívá IBM Storage Scale System 6000 (ESS 6000), all-flash platformu navrženou pro AI a vysoce výkonné úlohy. Systém podporuje až 48 NVMe disků na 4U skříni s kapacitou od 7 TB do 60 TB na disk. Integruje PCIe Gen5, 400Gb InfiniBand nebo 200Gb Ethernet konektivitu a poskytuje propustnost čtení až 340 GB/s a zápisu 175 GB/s na uzel s až 7 miliony IOPS.
Platforma také podporuje úložiště NVIDIA GPUDirect, které umožňuje přímé datové cesty mezi úložištěm a grafickými procesory (GPU), a také procesory BlueField-3 DPU pro odlehčení sítě a zpracování dat.
SSD disky Samsung PM9D3a PCIe Gen5 NVMe poskytují vysokokapacitní úložiště s vysokou hustotou. Tyto disky, založené na osmé generaci paměti TLC V-NAND, poskytují až 30.72 TB na zařízení s rychlostí sekvenčního čtení až 12 GB/s a rychlostí zápisu až 6.8 GB/s. Použití komerčně dostupných podnikových SSD disků umožňuje škálování architektury s využitím standardních komponent.
Hierarchické indexování a akcelerace GPU
Pro řešení indexování ve velkém měřítku vyvinula společnost IBM hierarchický model indexování, který zahrnuje několik dílčích indexů, jež lze optimalizovat nezávisle. Tato struktura umožňuje postupné aktualizace a lokalizované reindexování bez narušení celé datové sady, což zlepšuje jak dostupnost, tak provozní efektivitu.
Akcelerace pomocí GPU výrazně zkracuje dobu indexování ve srovnání s přístupy využívajícími pouze CPU. Úkoly, které by na CPU trvaly hodiny, lze s GPU NVIDIA dokončit během několika minut. V testování trvalo vytváření indexů pro 100 miliard vektorů 4 dny s 6 GPU NVIDIA H200, ve srovnání s odhadovanými 120 dny na systému s dvěma paticemi CPU.
Celá datová sada, včetně vektorů a indexů, spotřebovala přibližně 153 TiB úložného prostoru. Počáteční načítání a rozdělení dat trvalo devět dní. Výsledný systém poskytoval průměrnou latenci dotazů 694 ms s 90% úplností, což bylo ověřeno pomocí výpočtů hrubou silou.
plán
Společnosti IBM a NVIDIA pokračují v optimalizaci platformy se zaměřením na snižování latence indexování a dotazů. Mezi současné cíle patří indexování 100 miliard nebo více vektorů během jednoho dne, zkrácení doby příjmu dat z devíti dnů na jeden den a snížení latence dotazů na 50–100 milisekund při zachování 90% úplnosti.
Integrace vektorového indexování do standardních souborových systémů má za cíl zjednodušit nasazení a snížit překážky pro přijetí umělé inteligence v podnicích. Zabudováním funkcí RAG přímo do úložiště IBM staví CAS do základní vrstvy pro infrastrukturu s podporou umělé inteligence.


 Amazon