

Akcelerátor hlubokého učení Intel Habana Gaudi2 a procesory Intel Xeon Scalable 4. generace dosáhly působivých výsledků v benchmarku MLPerf Training 3.0, uvádí se v tiskové zprávě společnosti. Benchmark, publikovaný společností MLCommons, je široce uznávaným průmyslovým standardem pro výkon umělé inteligence.
Výsledky zpochybňují převládající narativ v oboru, že generativní umělá inteligence a modely s velkými jazyky programování (LLM) mohou běžet pouze na grafických procesorech NVIDIA. Portfolio řešení umělé inteligence společnosti Intel nabízí konkurenceschopné alternativy pro zákazníky, kteří se chtějí odklonit od uzavřených ekosystémů omezujících efektivitu a škálovatelnost.
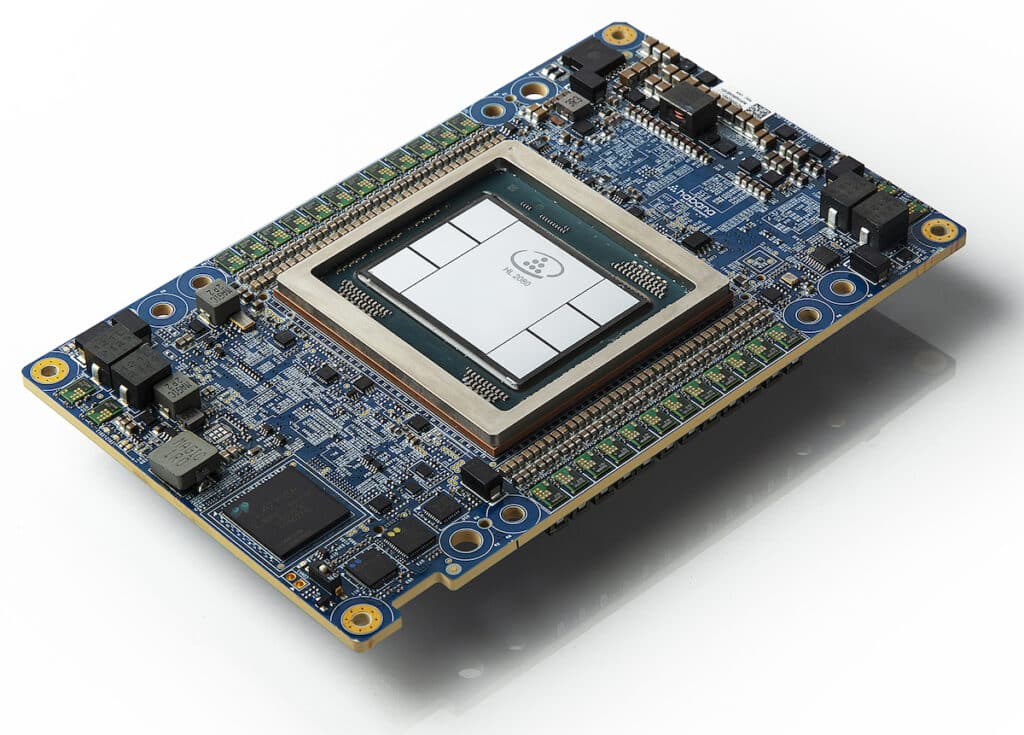
Fotografie ukazuje mezaninovou kartu Habana Gaudi2. Dne 10. května 2022 uvedl Habana Labs, tým datových center společnosti Intel zaměřený na technologie procesorů pro hluboké učení umělé inteligence, na trh své procesory pro hluboké učení druhé generace pro trénování a inferenci: Habana Gaudi2 a Habana Greco. (Zdroj: Intel Corporation)
Co je MLPerf?
Sada benchmarků MLPerf Training 3.0 měří rychlost, s jakou různé systémy dokáží trénovat modely tak, aby splňovaly zadanou metriku kvality. Benchmarky pokrývají různé oblasti, včetně vizuální analýzy, jazyka a obchodu, a používají různé datové sady a cíle kvality.
Podrobnosti o benchmarku
| Oblast | měřítko | Dataset | Cíl kvality | Referenční implementační model |
|---|---|---|---|---|
| Naše vize | Klasifikace obrázků | IMAGEnet | Klasifikace 75.90 % | ResNet-50 v1.5 |
| Naše vize | Segmentace obrazu (lékařská) | KitTS19 | 0.908 Průměrné skóre DICE | 3D U-Net |
| Naše vize | Detekce objektů (nízká hmotnost) | Otevřete obrázky | 34.0 % mAP | RetinaNet |
| Naše vize | Detekce objektů (těžká hmotnost) | Kokos | 0.377 minimálního AP pro krabici a 0.339 minimálního AP pro masku | Maska R-CNN |
| Jazyk | Rozpoznávání řeči | LibriSpeech | Míra chybovosti slov 0.058 | RNN-T |
| Jazyk | NLP | Wikipedie 2020/01/01 | Přesnost masky-LM 0.72 | BERT-velký |
| Jazyk | LLM | C4 | 2.69 logaritmická zmatenost | GPT3 |
| obchod | Doporučení | Criteo 4TB multi-hot | 0.8032 XNUMX XNUMX AUC | DLRM-dcnv2 |
V oblasti zorného pole zahrnují benchmarky klasifikaci obrazu pomocí datové sady ImageNet s cílovou kvalitou přesnosti klasifikace 75.90 %. Referenčním modelem pro tento úkol je ResNet-50 v1.5. Další benchmarky pro zrak zahrnují segmentaci obrazu pomocí lékařské datové sady KiTS19 a detekci objektů pomocí datových sad Open Images a COCO.
Pro jazykové úlohy zahrnují benchmarky rozpoznávání řeči s využitím datové sady LibriSpeech s cílovou hodnotou míry chybovosti slov 0.058. Referenčním modelem pro tuto úlohu je RNN-T. Další jazykové benchmarky zahrnují zpracování přirozeného jazyka (NLP) s využitím datové sady Wikipedie 2020/01/01 a trénování modelu velkých jazyků (LLM) s využitím datové sady C4.
V oblasti obchodu je benchmarkem doporučovací úloha využívající datovou sadu Criteo 4TB multi-hot s cílovou hodnotou kvality 0.8032 AUC. Referenčním modelem pro tuto úlohu je DLRM-dcnv2.
Metrika měření
Sada benchmarků měří čas potřebný k trénování modelu na konkrétní datové sadě za účelem dosažení zadaného cíle kvality. Vzhledem k inherentní variabilitě doby trénování strojového učení se konečné výsledky získávají opakovaným spuštěním benchmarku, přičemž se vynechají nejvyšší a nejnižší výsledky a zbývající výsledky se zprůměrují. Navzdory tomu se ve výsledcích stále vyskytuje určitá odchylka, přičemž výsledky benchmarků pro zobrazování mají odchylku zhruba +/- 2.5 % a ostatní benchmarky mají odchylku přibližně +/- 5 %.
Benchmarkové divize
MLPerf podporuje inovace v softwaru a hardwaru tím, že umožňuje účastníkům reimplementovat referenční implementace. V MLPerfu existují dvě divize: uzavřená a otevřená divize. Uzavřená divize je navržena pro přímé porovnání hardwarových platforem nebo softwarových frameworků a vyžaduje použití stejného modelu a optimalizátoru jako referenční implementace. Na druhou stranu otevřená divize podporuje vývoj rychlejších modelů a optimalizátorů a umožňuje jakémukoli přístupu strojového učení dosáhnout cílové kvality.
Dostupnost systému
MLPerf kategorizuje výsledky benchmarků na základě dostupnosti systému. Systémy kategorizované jako „Dostupné“ se skládají pouze z komponent, které lze zakoupit nebo pronajmout v cloudu. Očekává se, že systémy „Preview“ budou k dispozici v dalším kole podávání přihlášek. A konečně, systémy kategorizované jako „Výzkum, vývoj nebo interní (RDI)“ obsahují hardware nebo software, který je experimentální, ve vývoji nebo pro interní použití.
Objevuje se Intel Habana Guadi2
Zejména akcelerátor hlubokého učení Gaudi2 vykázal silný výkon na modelu velkého jazyka GPT-3, což z něj činí jedno ze dvou polovodičových řešení, která předložila výsledky výkonu pro LLM trénování GPT-3. Gaudi2 také nabízí značné cenové výhody v poměru ceny serveru a systému, což z něj činí přesvědčivou alternativu ceny/výkonu k modelu NVIDIA H100.
Procesory Xeon 4. generace s enginy Intel AI ukázaly, že zákazníci si mohou vytvořit univerzální systém umělé inteligence pro předzpracování dat, trénování modelů a nasazení, a to s ohledem na výkon, efektivitu, přesnost a škálovatelnost.
Gaudi2 dosáhl působivé doby trénování na GPT-3, kdy dosáhl 311 minut na 384 akcelerátorech a téměř lineárního 95% škálování z 256 na 384 akcelerátorů na modelu GPT-3. Také vykázal vynikající výsledky trénování v modelech počítačového vidění a zpracování přirozeného jazyka. Výsledky Gaudi2 byly odeslány „ihned po instalaci“, což znamená, že zákazníci mohou očekávat srovnatelné výsledky při implementaci Gaudi2 on-premise nebo v cloudu.
Procesory Xeon 4. generace, jakožto jediný CPU nabízený mezi mnoha alternativními řešeními, dokázaly, že procesory Intel Xeon poskytují podnikům okamžité možnosti nasazení umělé inteligence na univerzálních systémech, čímž se vyhnou nákladům a složitosti zavádění specializovaných systémů umělé inteligence.
Habana Gaudi2 8-uzlový cluster
V úloze zpracování přirozeného jazyka (NLP) s využitím datové sady Wikipedie a modelu BERT-large dosáhl Gaudi2 doby trénování 2.103 minuty s 64 akcelerátory.
V úloze segmentace obrazu (medicínského) s využitím datové sady KiTS19 a 3D modelu U-Net dosáhl Gaudi2 doby trénování 16.460 minut s TensorFlow a 20.516 minut s PyTorch, v obou případech s osmi akcelerátory.
V úloze Doporučení s využitím datové sady Criteo 4TB a modelu DLRM-dcnv2 dosáhl Gaudi2 doby trénování 14.794 minuty s PyTorch a 14.116 minuty s TensorFlow, v obou případech s osmi akcelerátory.
V uzavřené divizi dokázaly procesory Xeon 4. generace natrénovat modely BERT a ResNet-50 za méně než 50, respektive 90 minut. S BERT v otevřené divizi dokázal Xeon natrénovat model přibližně za 30 minut při horizontálním ...
Tyto výsledky zdůrazňují vynikající efektivitu škálování, kterou lze dosáhnout pomocí cenově dostupných a snadno dostupných síťových adaptérů Intel Ethernet řady 800, které využívají open-source software Intel Ethernet Fabric Suite založený na rozhraní Intel oneAPI.
Dopad na trh
Výsledky Intel Habana Gaudi2 v benchmarku MLPerf Training 3.0 podtrhují závazek společnosti poskytovat konkurenceschopná a efektivní řešení s využitím umělé inteligence (AI) pro širokou škálu aplikací, od datových center až po inteligentní edge computing. NVIDIA je v tomto ohledu jednoznačným lídrem a každý dodavatel serverů se snaží ukázat odvětví širokou škálu zařízení s velkým počtem grafických procesorů, která jsou připravena na úlohy s využitím umělé inteligence. Tato data však znovu potvrzují, že umělá inteligence není univerzální kategorií a Intel dělá vše pro to, aby odvětví nabídl možnost výběru. Čistým výsledkem je vítězství pro organizace, které umělou inteligenci nasazují, protože větší konkurence a větší výběr jsou obvykle velmi pozitivní.


 Amazon