

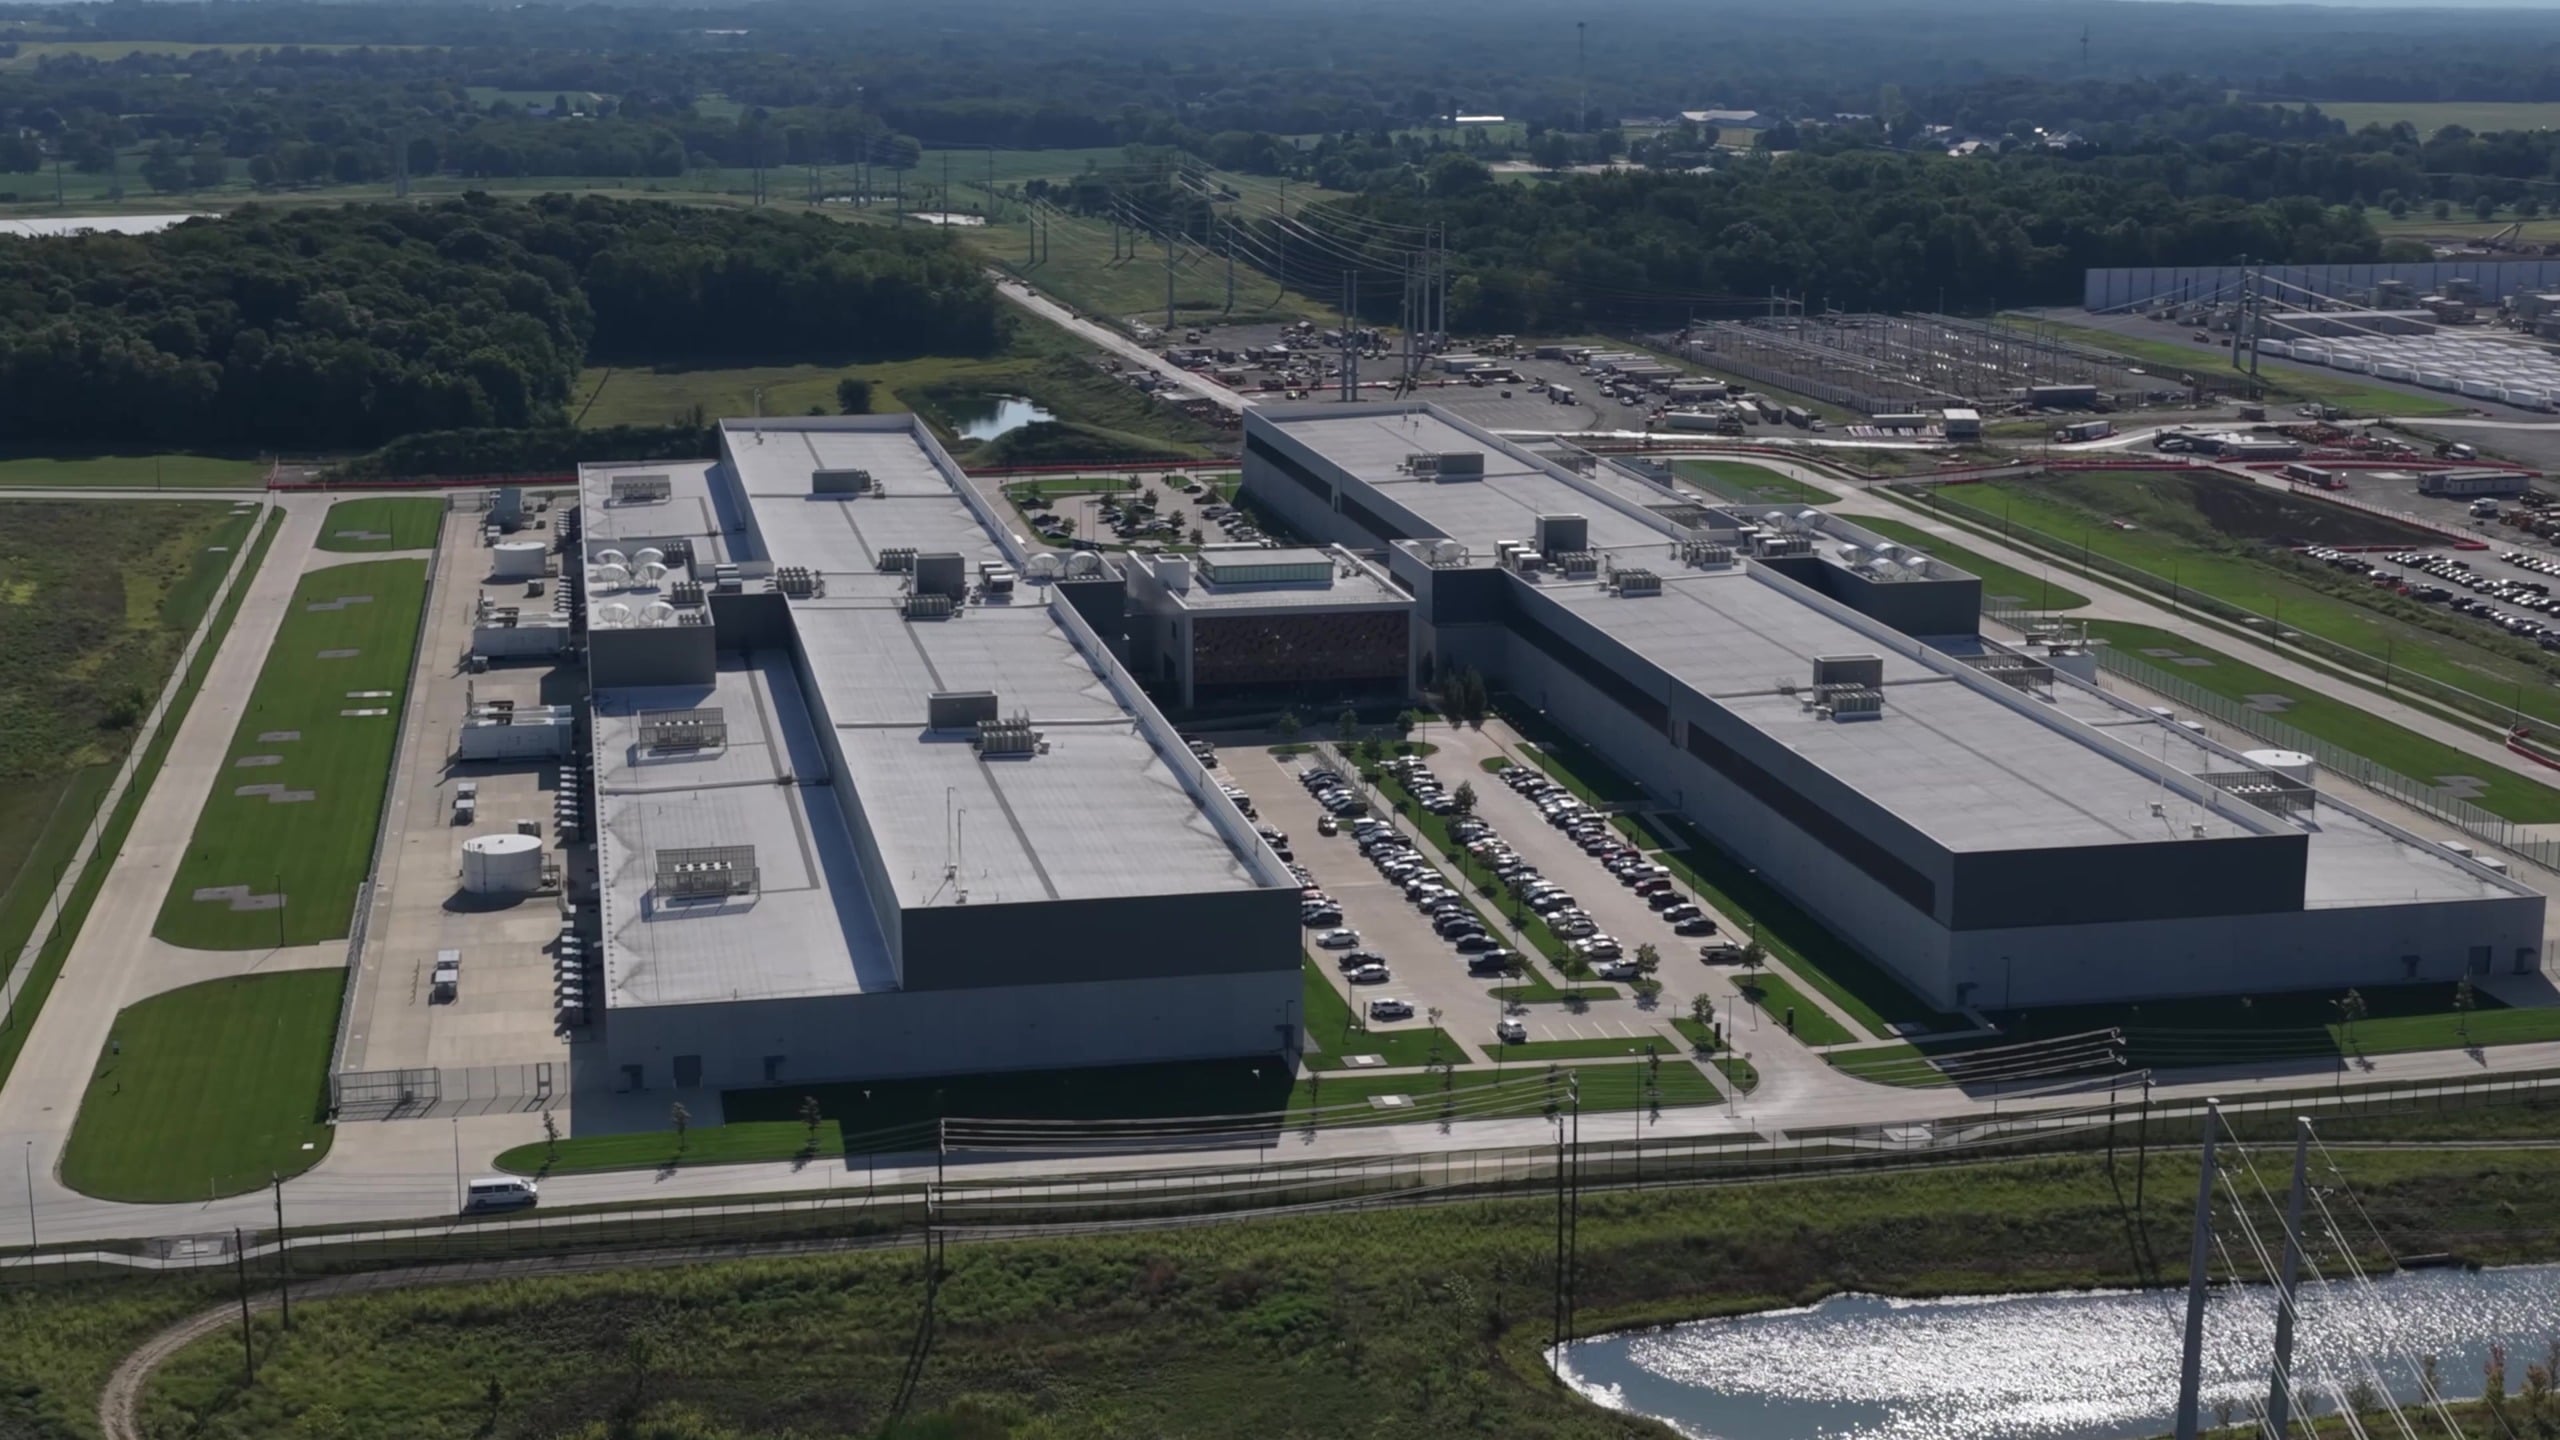
Společnost Meta dnes zveřejnila podrobný pohled do nitra Prometheusu, gigawattového superklastru umělé inteligence, který buduje v New Albany v Ohiu. První fáze je dokončena a v jejím rámci byla vytrénována rodina základních modelů Muse, včetně modelů Muse Wonder, a společnost Meta uvádí, že se lokalita rozšiřuje na zhruba 1 milion GPU. Před dvěma lety byl stejný kampus konvenčním datovým centrem obsluhujícím webový provoz. Příspěvek od inženýrů společnosti Meta Kevina Leeho, Yashara Bayaniho, Ahmeda Sharifa a Yee Jiun Songa se zabývá hardwarem, sítí a prací na spolehlivosti, které zajišťují běh trénovacích úloh.
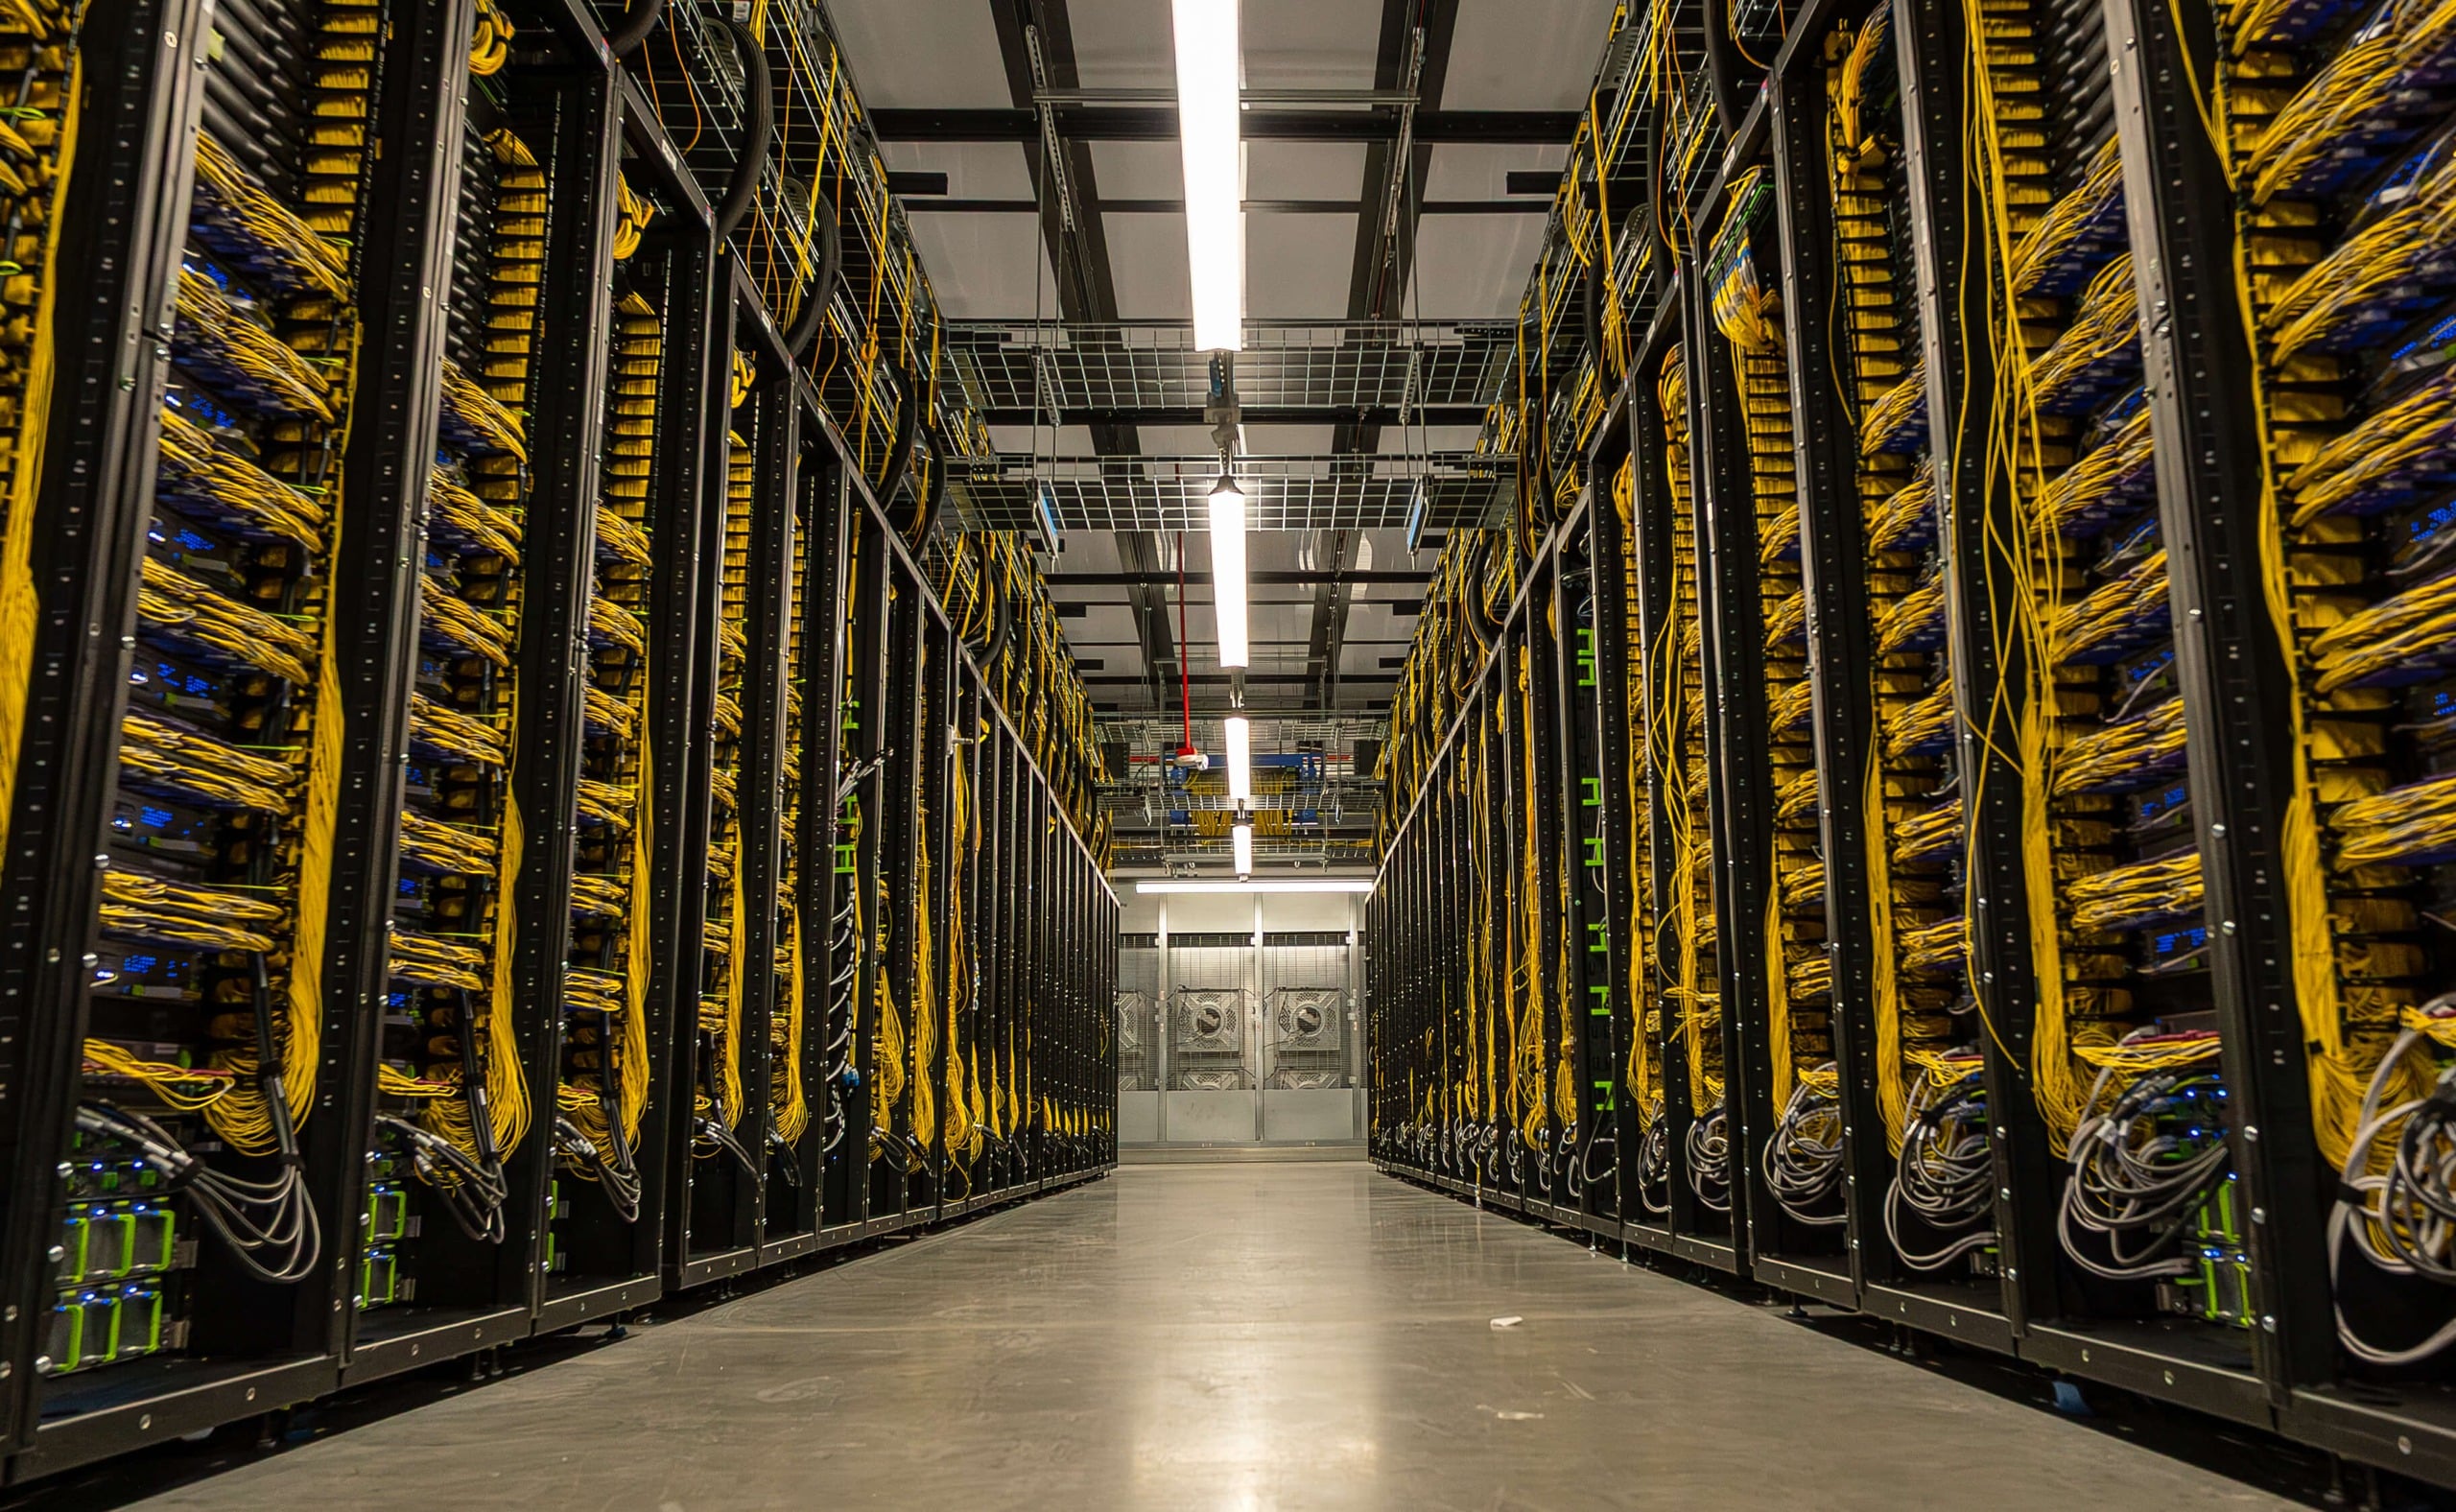
Společnost Meta také zveřejnila některá z nejzajímavějších dat týkajících se provádění velkých tréninkových úloh: údaje o spolehlivosti. Meta uvádí více než 85 procent úspěšnosti u předtréninkových běhů Muse Wonder a více než 90 procent u běhů s posilovacím učením, s průměrnou dobou mezi přerušeními přibližně 47 000 hodin GPU během těchto běhů. Opravy firmwaru, které byly od té doby vydány, posunuly MTBI přes 54 000 hodin GPU. Uvedeným cílem společnosti Meta jsou dvě přerušení na 8 000 GPU za den, což odpovídá zhruba 100 000 hodin GPU mezi přerušeními.
Dvě generace NVL72 ve výrobě, Vera Rubin Next
Společnost Prometheus v současnosti provozuje dvě platformy grafických procesorů NVIDIA, obě postavené na rackové architektuře NVL72, kde 72 grafických procesorů sdílí jednu doménu NVLink, přičemž třetí platforma založená na platformě Vera Rubin NVL72 dorazí brzy. První, kterou Meta nazývá Catalina, využívá GB200 NVL72 ve variantě Ariel: jde o konfiguraci se dvěma racky a 36 grafickými procesory na rack, postavenou na vysoce výkonném rackovém designu Meta Open Rack V3, který přispěl k projektu Open Compute Project. Každý grafický procesor Blackwell je spárován s procesorem Grace a dvěma síťovými kartami ConnectX-7 400G, což představuje poměr CPU k GPU 1:1, který poskytuje každému grafickému procesoru 800G škálovatelné šířky pásma.
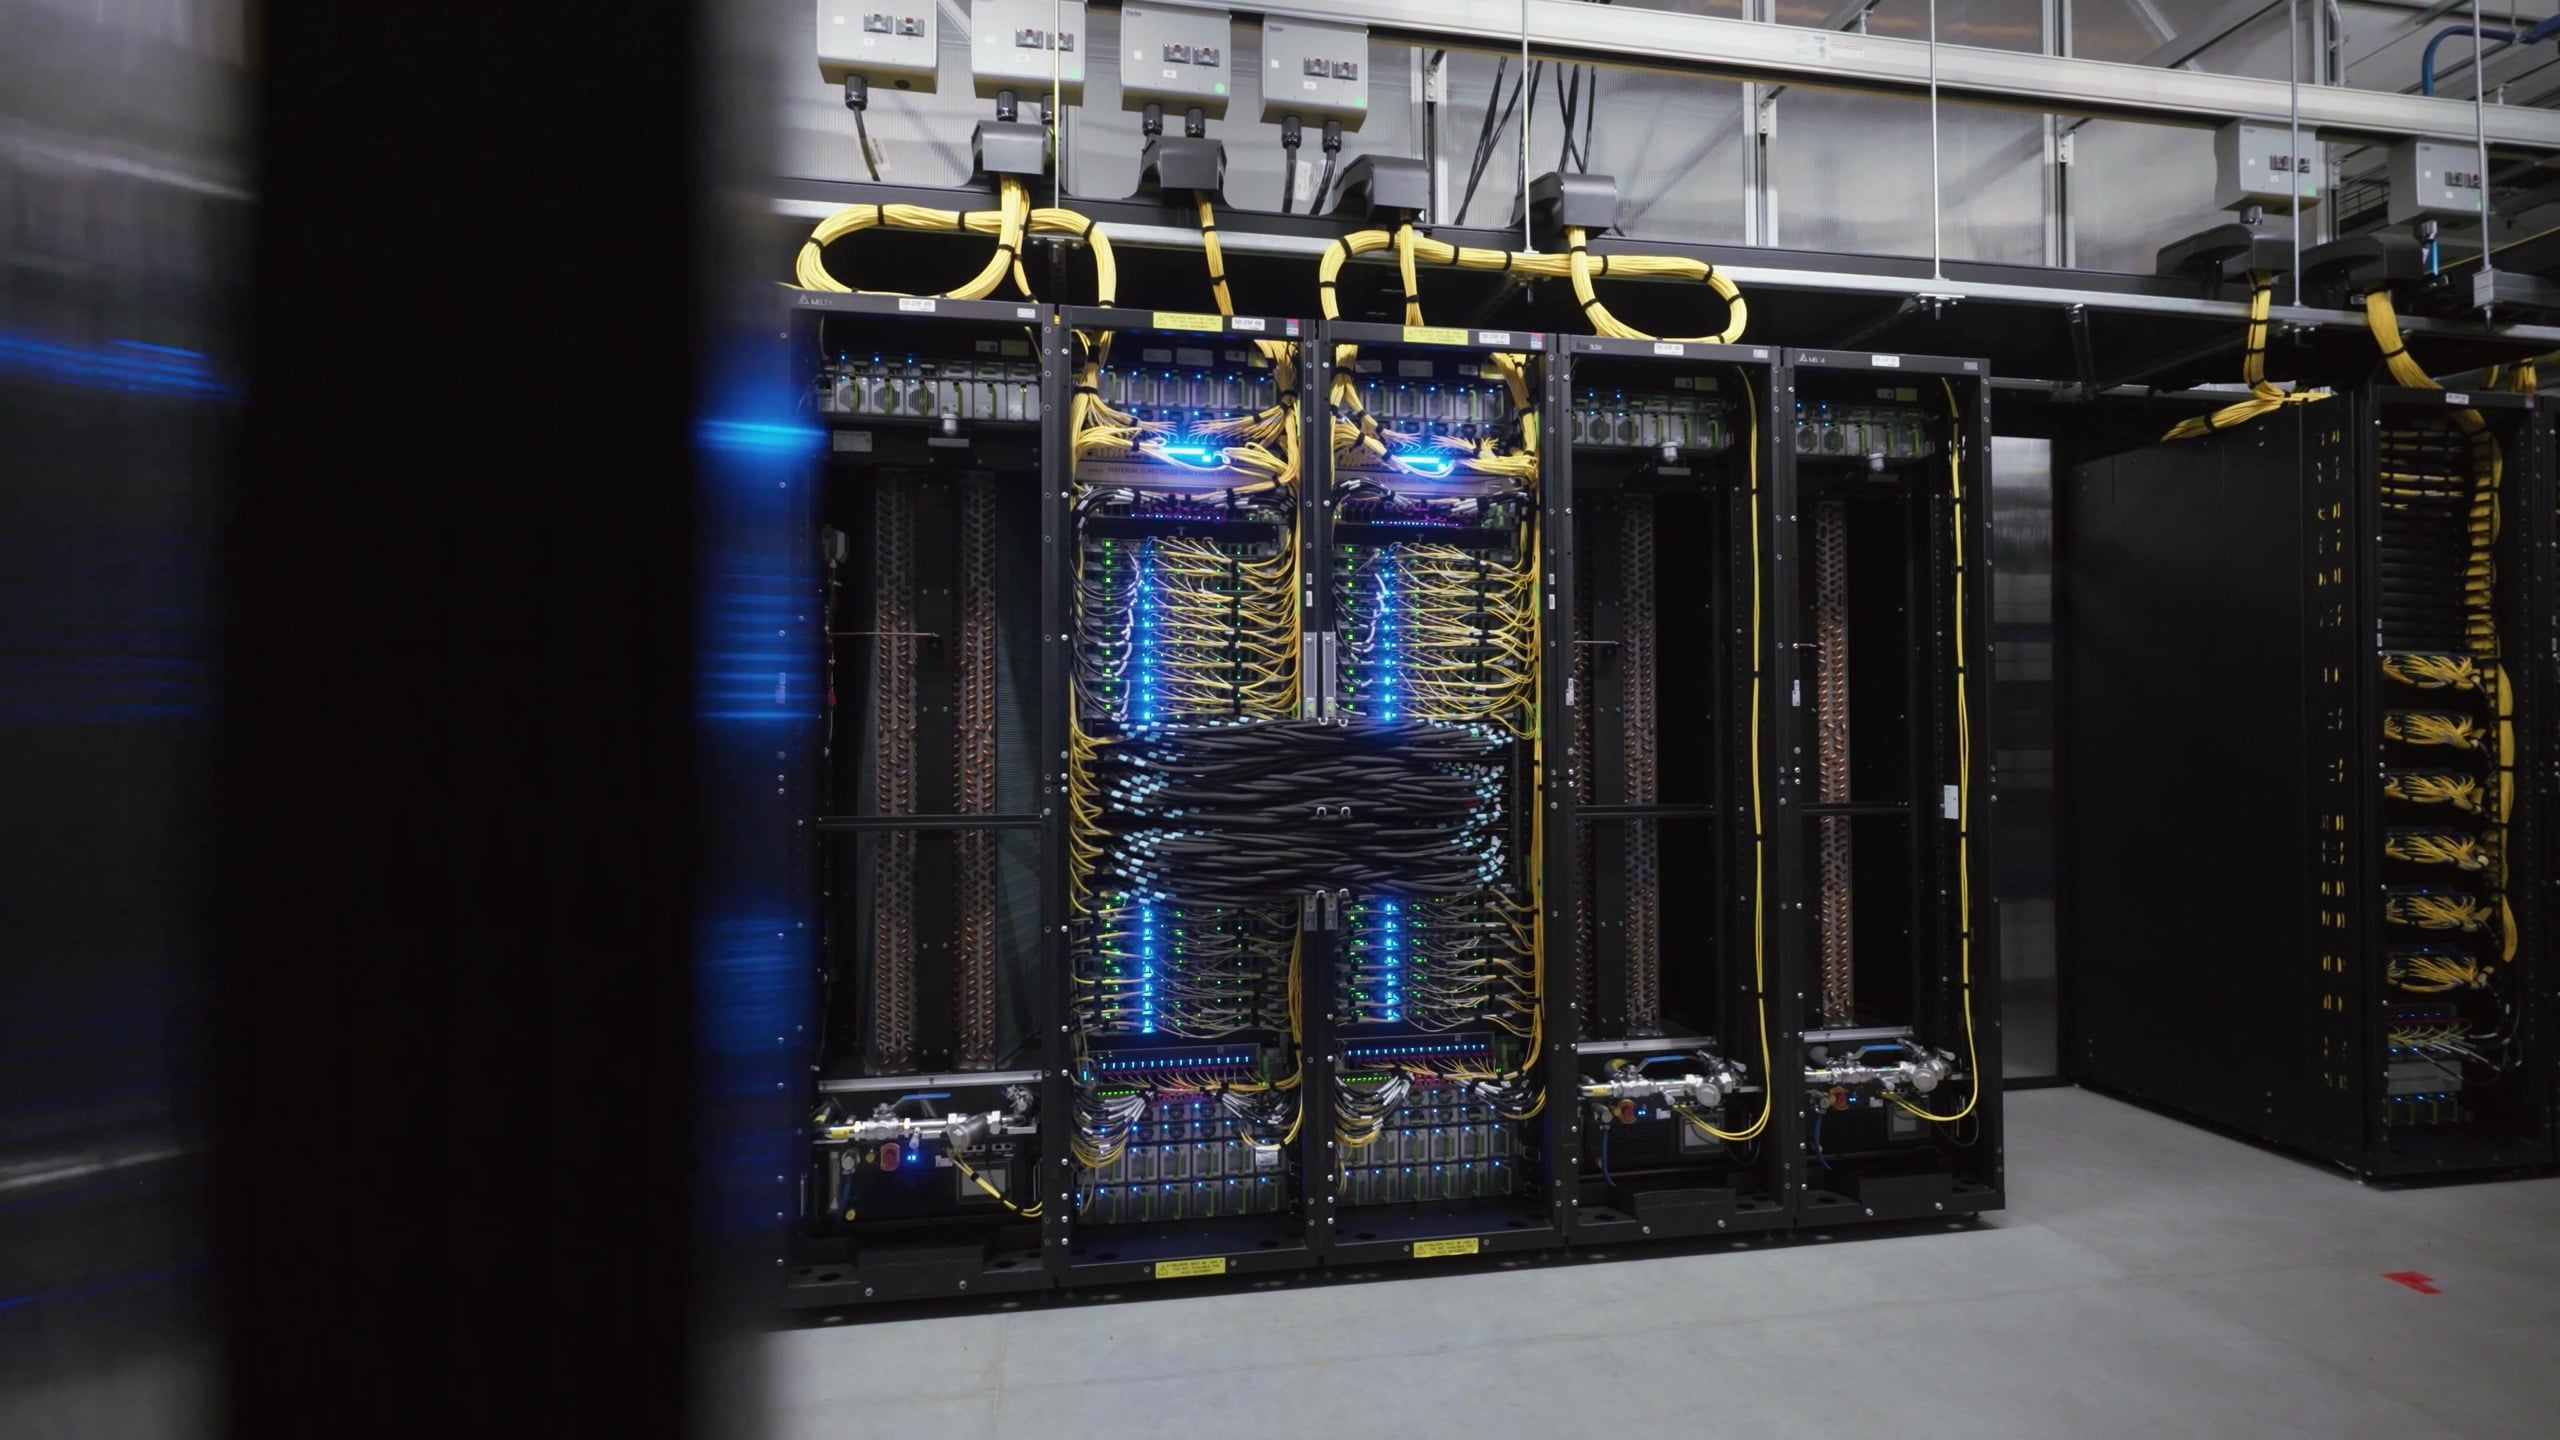
Společnost Meta uvádí, že si vybrala Ariel, protože GB200 NVL72 škáloval FLOPS, šířku pásma HBM, šířku pásma pro škálování a velikost domény výrazně převyšoval H100, zatímco standardní škálování by zůstalo na 400 G na GPU, a očekávala, že tato nerovnováha bude mít dopad na výkon. Podle společnosti Meta nese dvojice Catalina 72 GPU Blackwell s 13.4 TB HBM3e (192 GB na GPU), 720 PFLOPS špičkových výpočetních dat pro trénink FP8 (1 440 PFLOPS ve FP4), 130 TB/s šířky pásma NVLink v doméně, 576 TB/s celkové šířky pásma paměti a spotřebovává přibližně 120 kW napříč dvěma racky.
Druhá platforma, Clemente, přechází na GB300 NVL72. HBM na GPU se zvyšuje 1.5krát na 288 GB, hustá propustnost FP4 se zvyšuje podobně a zrychlení pozornosti se zhruba zdvojnásobuje. Síťové karty ConnectX-8 SuperNIC nativně poskytují 800 G na GPU, takže škálovatelný prostor, který je součástí Ariel, se stává základním standardem, a poměr GPU k CPU 2:1 umožňuje umístit celou doménu s 72 GPU do jednoho racku. Meta uvádí 20.7 TB HBM3e, což je více než exaFLOP špičkového výpočetního výkonu FP4, šířku pásma NVLink 130 TB/s (1.8 TB/s obousměrně na GPU), přibližně 135 kW na rack a 5 až 10procentní nárůst výkonu oproti GB200 NVL72.
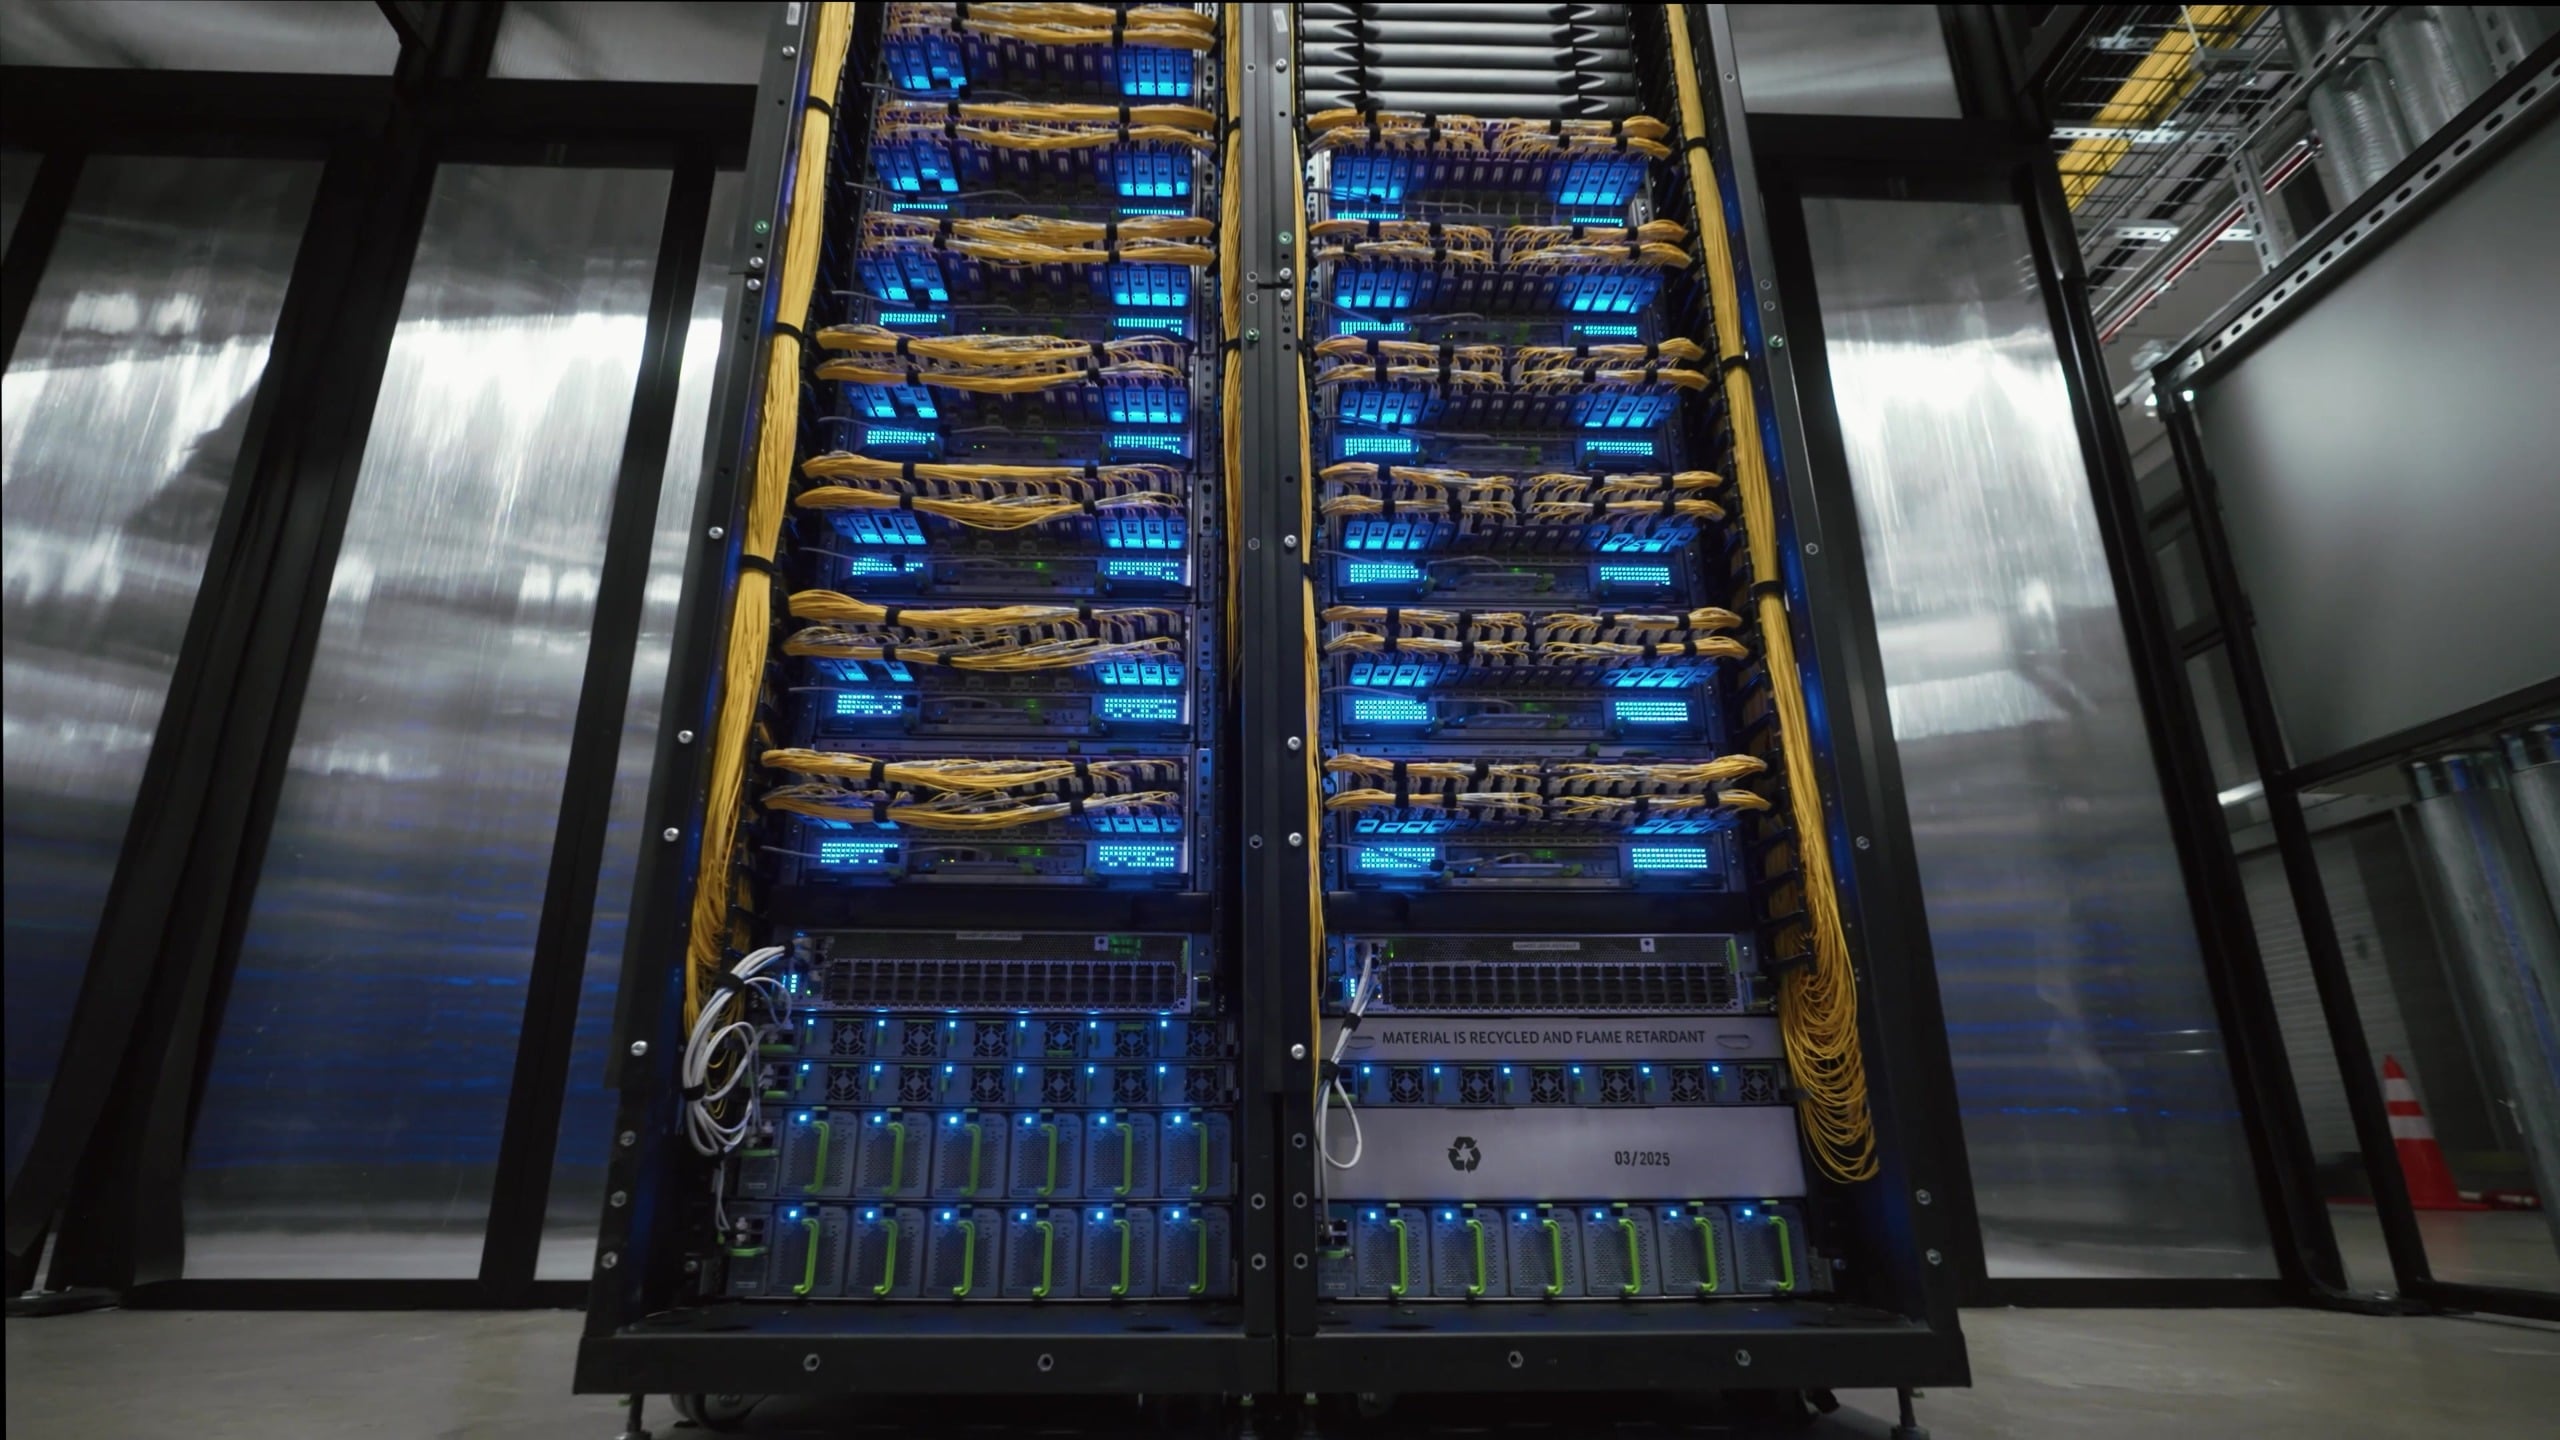
Společnost Clemente ve svých novějších budovách optimalizovaných pro umělou inteligenci nasazuje buď modulární vzduchové kapalinové chlazení od společnosti Meta, nebo kapalinové chlazení zařízení a společnost Meta tvrdí, že díky menšímu množství kabeláže se zlepšuje i provozuschopnost.
Další platforma od společnosti Meta, San Miguel, přinese do stejné síťové struktury i Vera Rubin NVL72. Údaje společnosti Meta pro tento rack jsou 288 GB HBM4 na GPU s rychlostí 19.2 TB/s, 2.52 exaFLOPS špičkového výpočetního výkonu pro trénink v FP4 a 1.26 exaFLOPS v FP8, šířka pásma NVLink 216 TB/s (3 TB/s na GPU), celková šířka pásma paměti přibližně 1 500 TB/s, plně kapalinou chlazené výpočetní moduly s výkonem více než 170 kW na rack a 10 až 20procentní nárůst výkonu na watt oproti GB300 NVL72. Společnost CoreWeave uvedla Vera Rubin NVL72 do výroby začátkem tohoto měsíce.
Vyhrazený ethernetový back-end propojený s budovami
Trénovací provoz probíhá v druhé síti datového centra přes Ethernet, odděleně od front-endové sítě, která přenáší běžný servisní provoz. Design kopíruje tvar trénovací úlohy: datově paralelní repliky uchovávají své kolektivy citlivé na latenci a šířku pásma uvnitř struktury budovy, zatímco tolerantnější provoz mezi replikami prochází agregační vrstvou, která propojuje budovy. Meta zabudovala stejnou hierarchii do svých dřívějších clusterů s 24 000 GPU v budovách a do svého regionálního clusteru s více než 100 000 GPU, než ji rozšířila do Prometheusu.
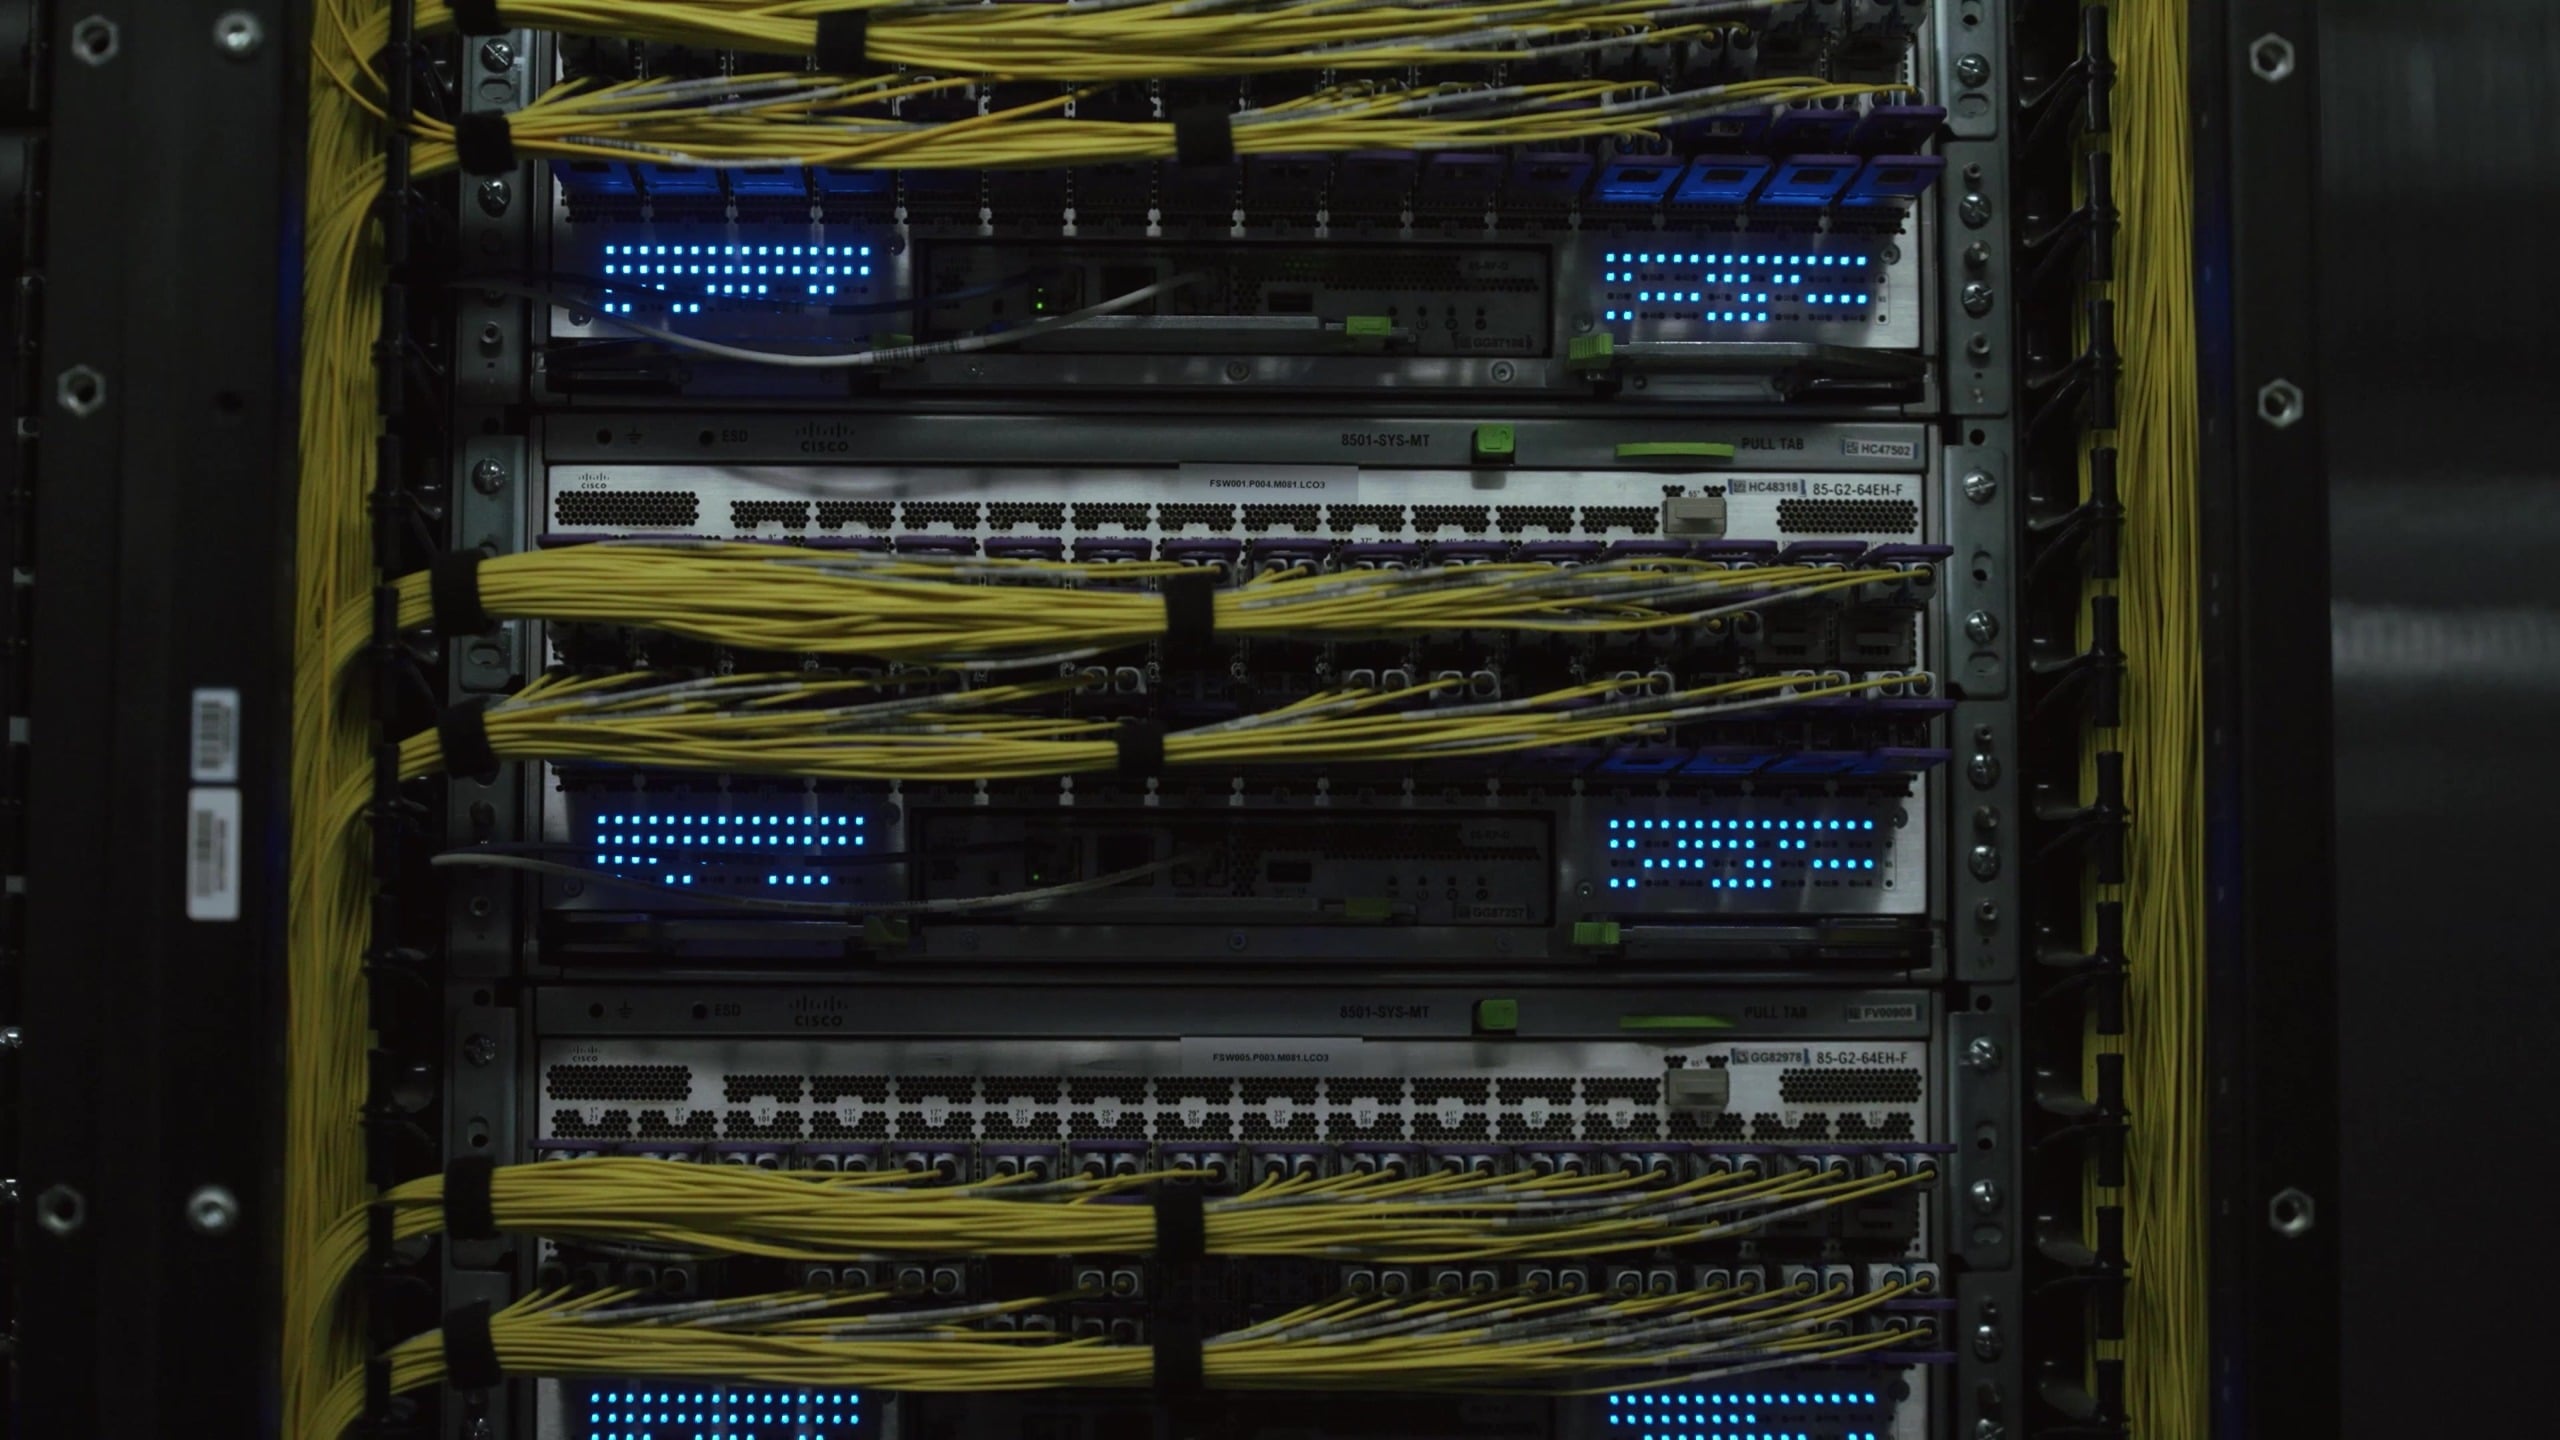
Každá budova fabric propojuje až 20 736 GPU. Prvním návrhem společnosti Meta byla disagregovaná plánovaná fabrica, která využívala vícecestné směrování podpaketů, přeskupování v rámci fabrice, virtuální výstupní fronty a řízení toku na základě kreditů, aby se zabránilo kolizi několika velkých, dlouhodobých toků trénovacího kolektivu. Jakmile síťové karty získaly schopnost přeskupovat pakety v koncovém bodě, Meta přešla na neplánovanou fabricu postavenou na přepínačích s malou vyrovnávací pamětí 51.2T: Minipack3 s dynamickým vyvažováním zátěže a Minipack3N, který používá ASIC NVIDIA Spectrum-4 s adaptivním směrováním na síťových kartách ConnectX, přičemž obě běžely na síťovém stacku FBOSS od společnosti Meta.
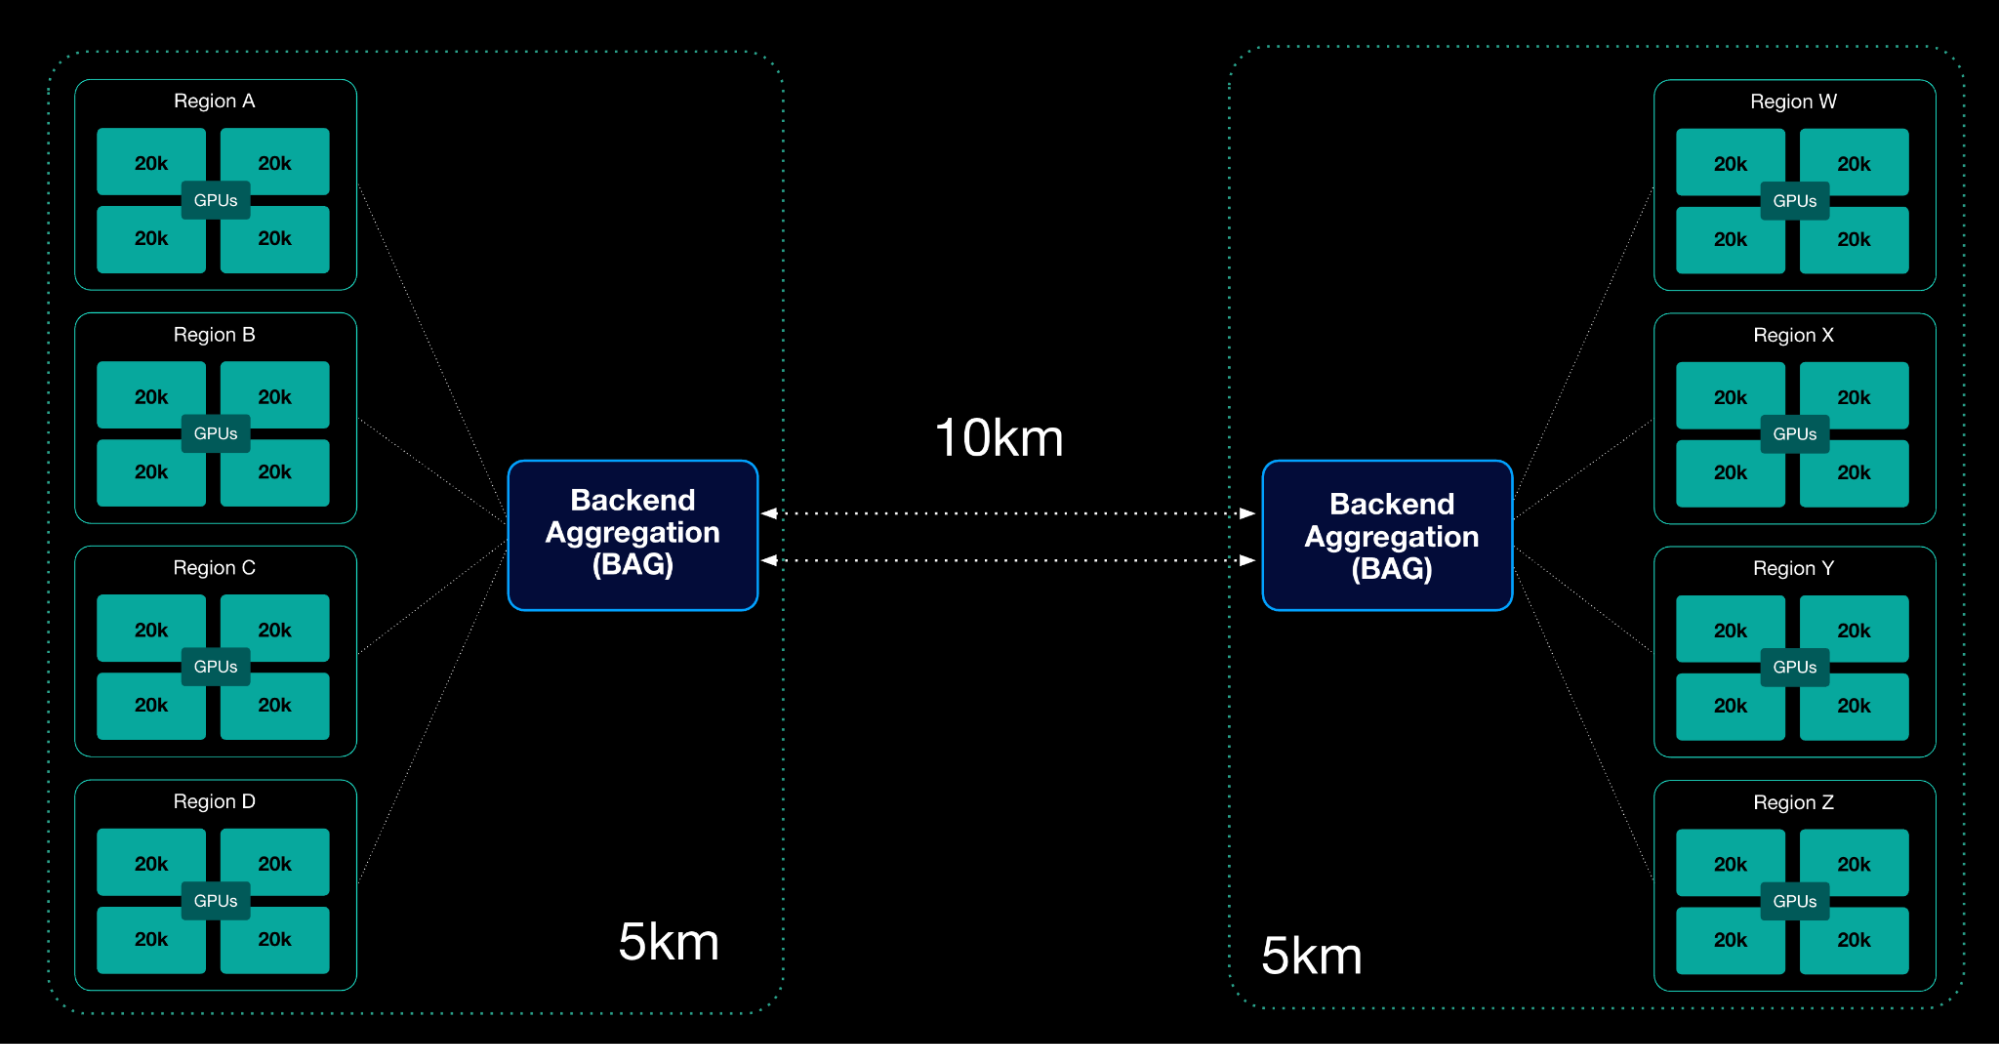
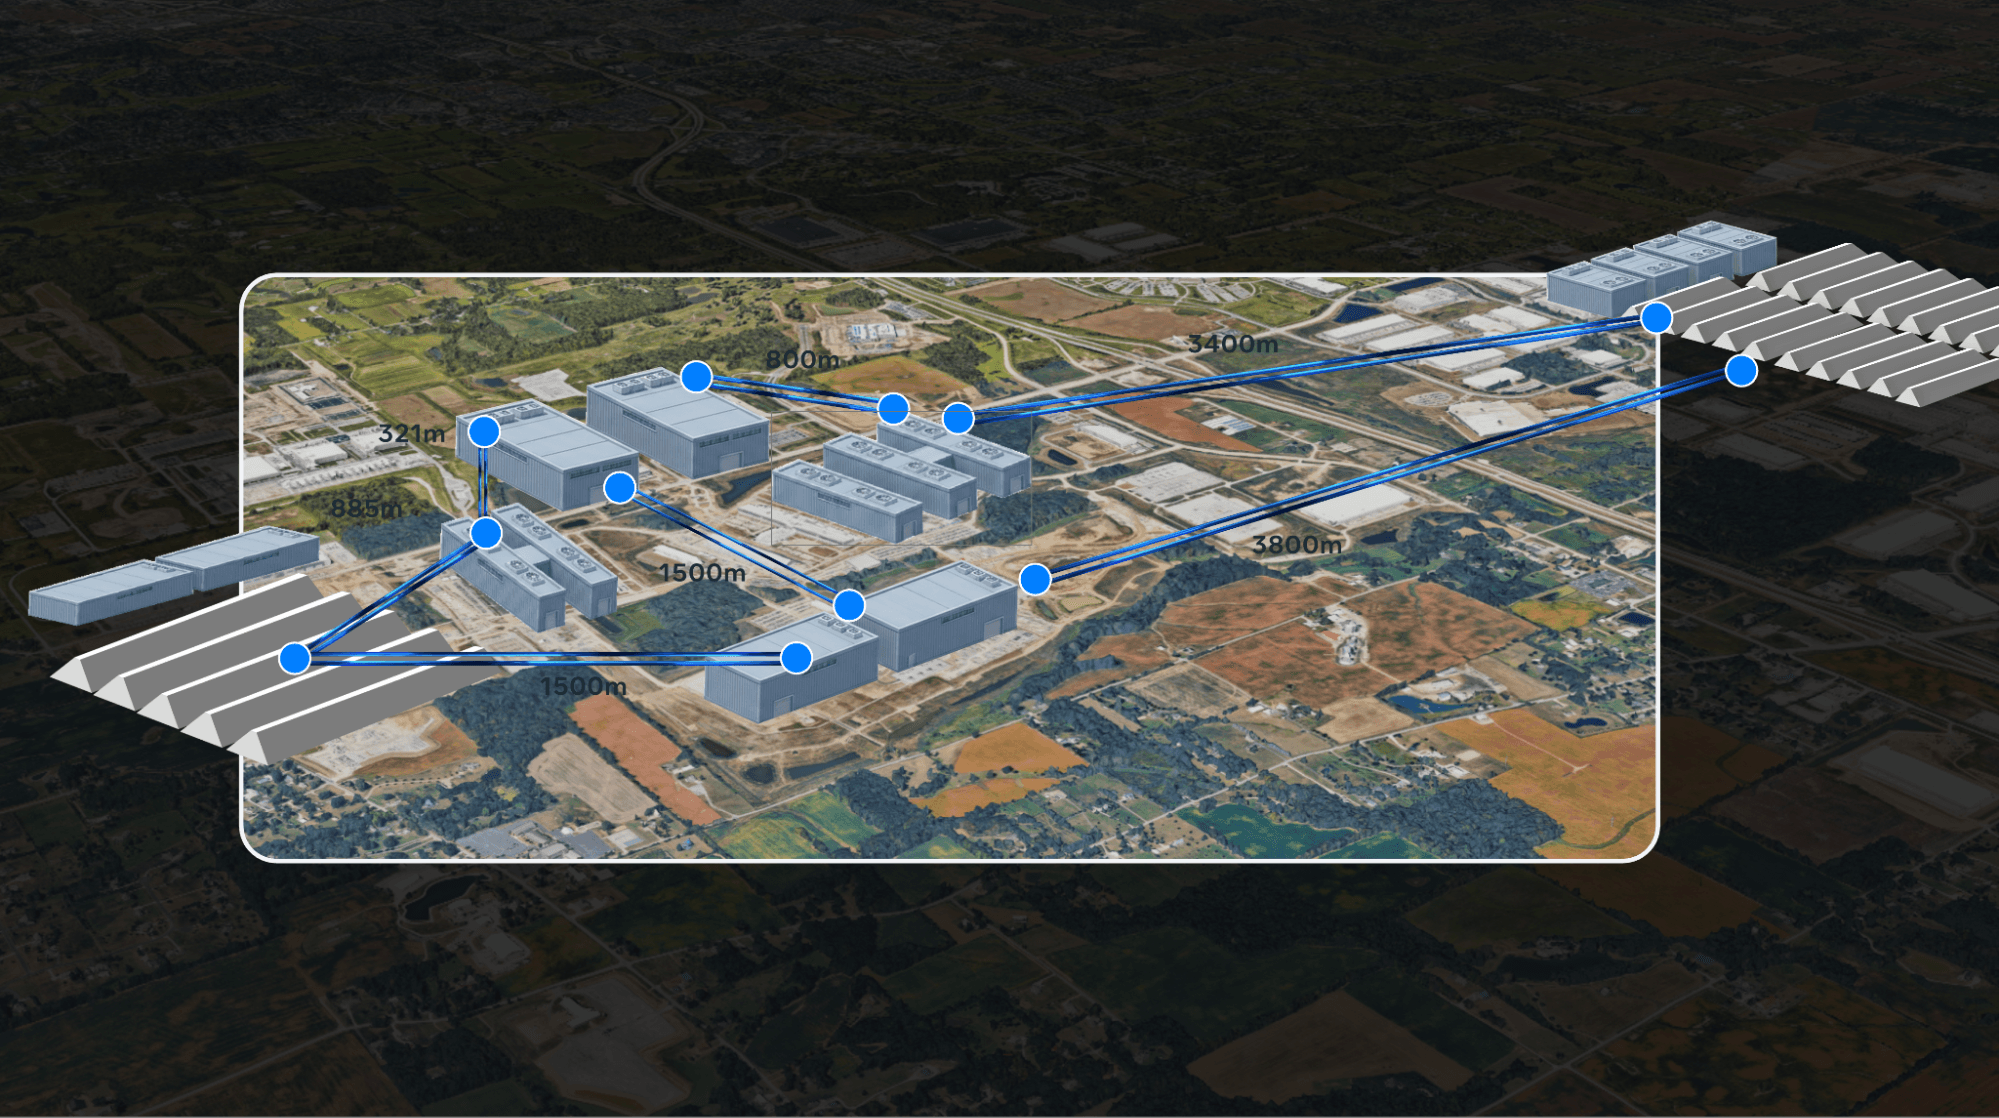
Nad budovami se nachází síť Backend Aggregation, vícevrstvá konstrukce typu hub-and-spoke postavená na šasi řady Arista 7800 s hluboce vyrovnávací pamětí Broadcom Jericho3. Pokrývá vzdálenost od 2 km do více než 100 km a mezi dvojicemi regionů přenáší několik petabitů za sekundu. Meta uvádí, že spuštění předběžného tréninku na tyto vzdálenosti si vyžádalo specializované optimalizační úsilí ve spolupráci s Meta Superintelligence Labs kvůli latenci dosahující rychlosti světla. Zařízení, které za ní stojí, zahrnuje miliony mil optických vláken, desítky tisíc přepínačů a miliony optiky, od 2x400G FR4 LITE zásuvných modulů uvnitř budov až po koherentní optiku 800G-ZR pro spojení na vzdálenost delší než 10 km.
64 z každých 72 GPU odvede práci
Přechod z domény NVLink s osmi GPU generace H100 na NVL72 znásobil poloměr selhání devítinásobkem a Meta nyní plánuje kapacitu kolem racku s 72 GPU. Protože se trénovací paralelismus nejlépe mapuje na velikosti skupin mocnin dvou, každá doména NVL72 provozuje segment s 64 GPU a zbývajících osm GPU drží jako náhradní v racku. Pokud selže jeden GPU, převezme jeho funkci náhradní a úloha se restartuje od posledního kontrolního bodu bez čekání na opravu. Pro poruchy celého racku si Meta ponechává v rezervě přibližně 2 procenta dalších racků.
Pro trénovací běh s 32 768 GPU: 523 racků NVL72, neboli 37 656 GPU, což je přibližně o 13 procent více než aktivní plocha, přičemž 11 bodů z toho pochází z geometrie řezů 64 ze 72. Zátěž integrity signálu, která stojí za touto spolehlivostí, je značná; jedna doména NVL72 nese 5 184 laděných diferenciálních párových linek s rychlostí 200 Gb/s, z nichž každá protíná SerDes GPU, desky plošných spojů výpočetních modulů, kabelové kazety a rozhraní přepínacích modulů.
Dvě cesty obnovy zvládají chyby, ke kterým dojde. Pokud lze selhání izolovat na jednu repliku paralelní s daty, tolerance chyb Meta s ohledem na paralelismus odstaví tuto repliku offline, zatímco zbytek clusteru krok opakuje a pokračuje v trénování. Slice se restartuje na náhradních hostitelích a znovu synchronizuje. Větší chyby odesílají celou úlohu zpět na její poslední kontrolní bod, takže Meta často používá kontrolní body a asynchronně ukládá stav modelu včetně gradientů a dat optimalizátoru do vícevrstvého úložiště s delta kontrolními body a in-memory staging, aby se omezil dopad na propustnost.
99procentní pokles přerušení
Přes veškerý pokrok, který tato čísla ukazují, Prometheus nezačínal stabilně. V polovině roku 2025, během počáteční fáze, dosáhla míra přerušení vrcholu téměř 1 000 událostí na 8 000 GPU za den. Rok mezifunkční práce tento počet snížil o 99 procent a cluster nyní paralelně udržuje několik tréninkových úloh s desítkami tisíc GPU. Meta připisuje zásluhy modelu společného inženýrství s NVIDIA, v němž týmy NVIDIA sedí v lokalitě New Albany, sdílejí telemetrii a provádějí společné třídicí sezení, která rozkládají každé zastavení podle hlavní příčiny, přičemž Meta je zodpovědná za plánování a opravy infrastruktury a NVIDIA se stará o firmware, diagnostiku signálů a práci s pamětí.
Integrita signálu NVLink byla prvním úzkým hrdlem na GB200. S více než 600 000 připojeními NVLink v clusteru spouštěly marginální linky časté cykly obnovy, takže Meta přidala kontinuální telemetrii, automatické označování a diagnostické vypalování L11, aby našla slabé linky před produkčním provozem. Chyby paměti v HBM a LPDDR se staly hlavní příčinou, protože GB300 dorazil s větší pamětí a reakcí je vylepšené nastavení firmwaru HBM, čištění paměti, vylepšený algoritmus korekce chyb LPDDR a prediktivní vyřazování degradujících zařízení. Stav přepínačů je monitorován s rozlišením milisekund a události linky v agregační vrstvě jsou přesměrovány v hardwaru bez přerušení provozu GPU.
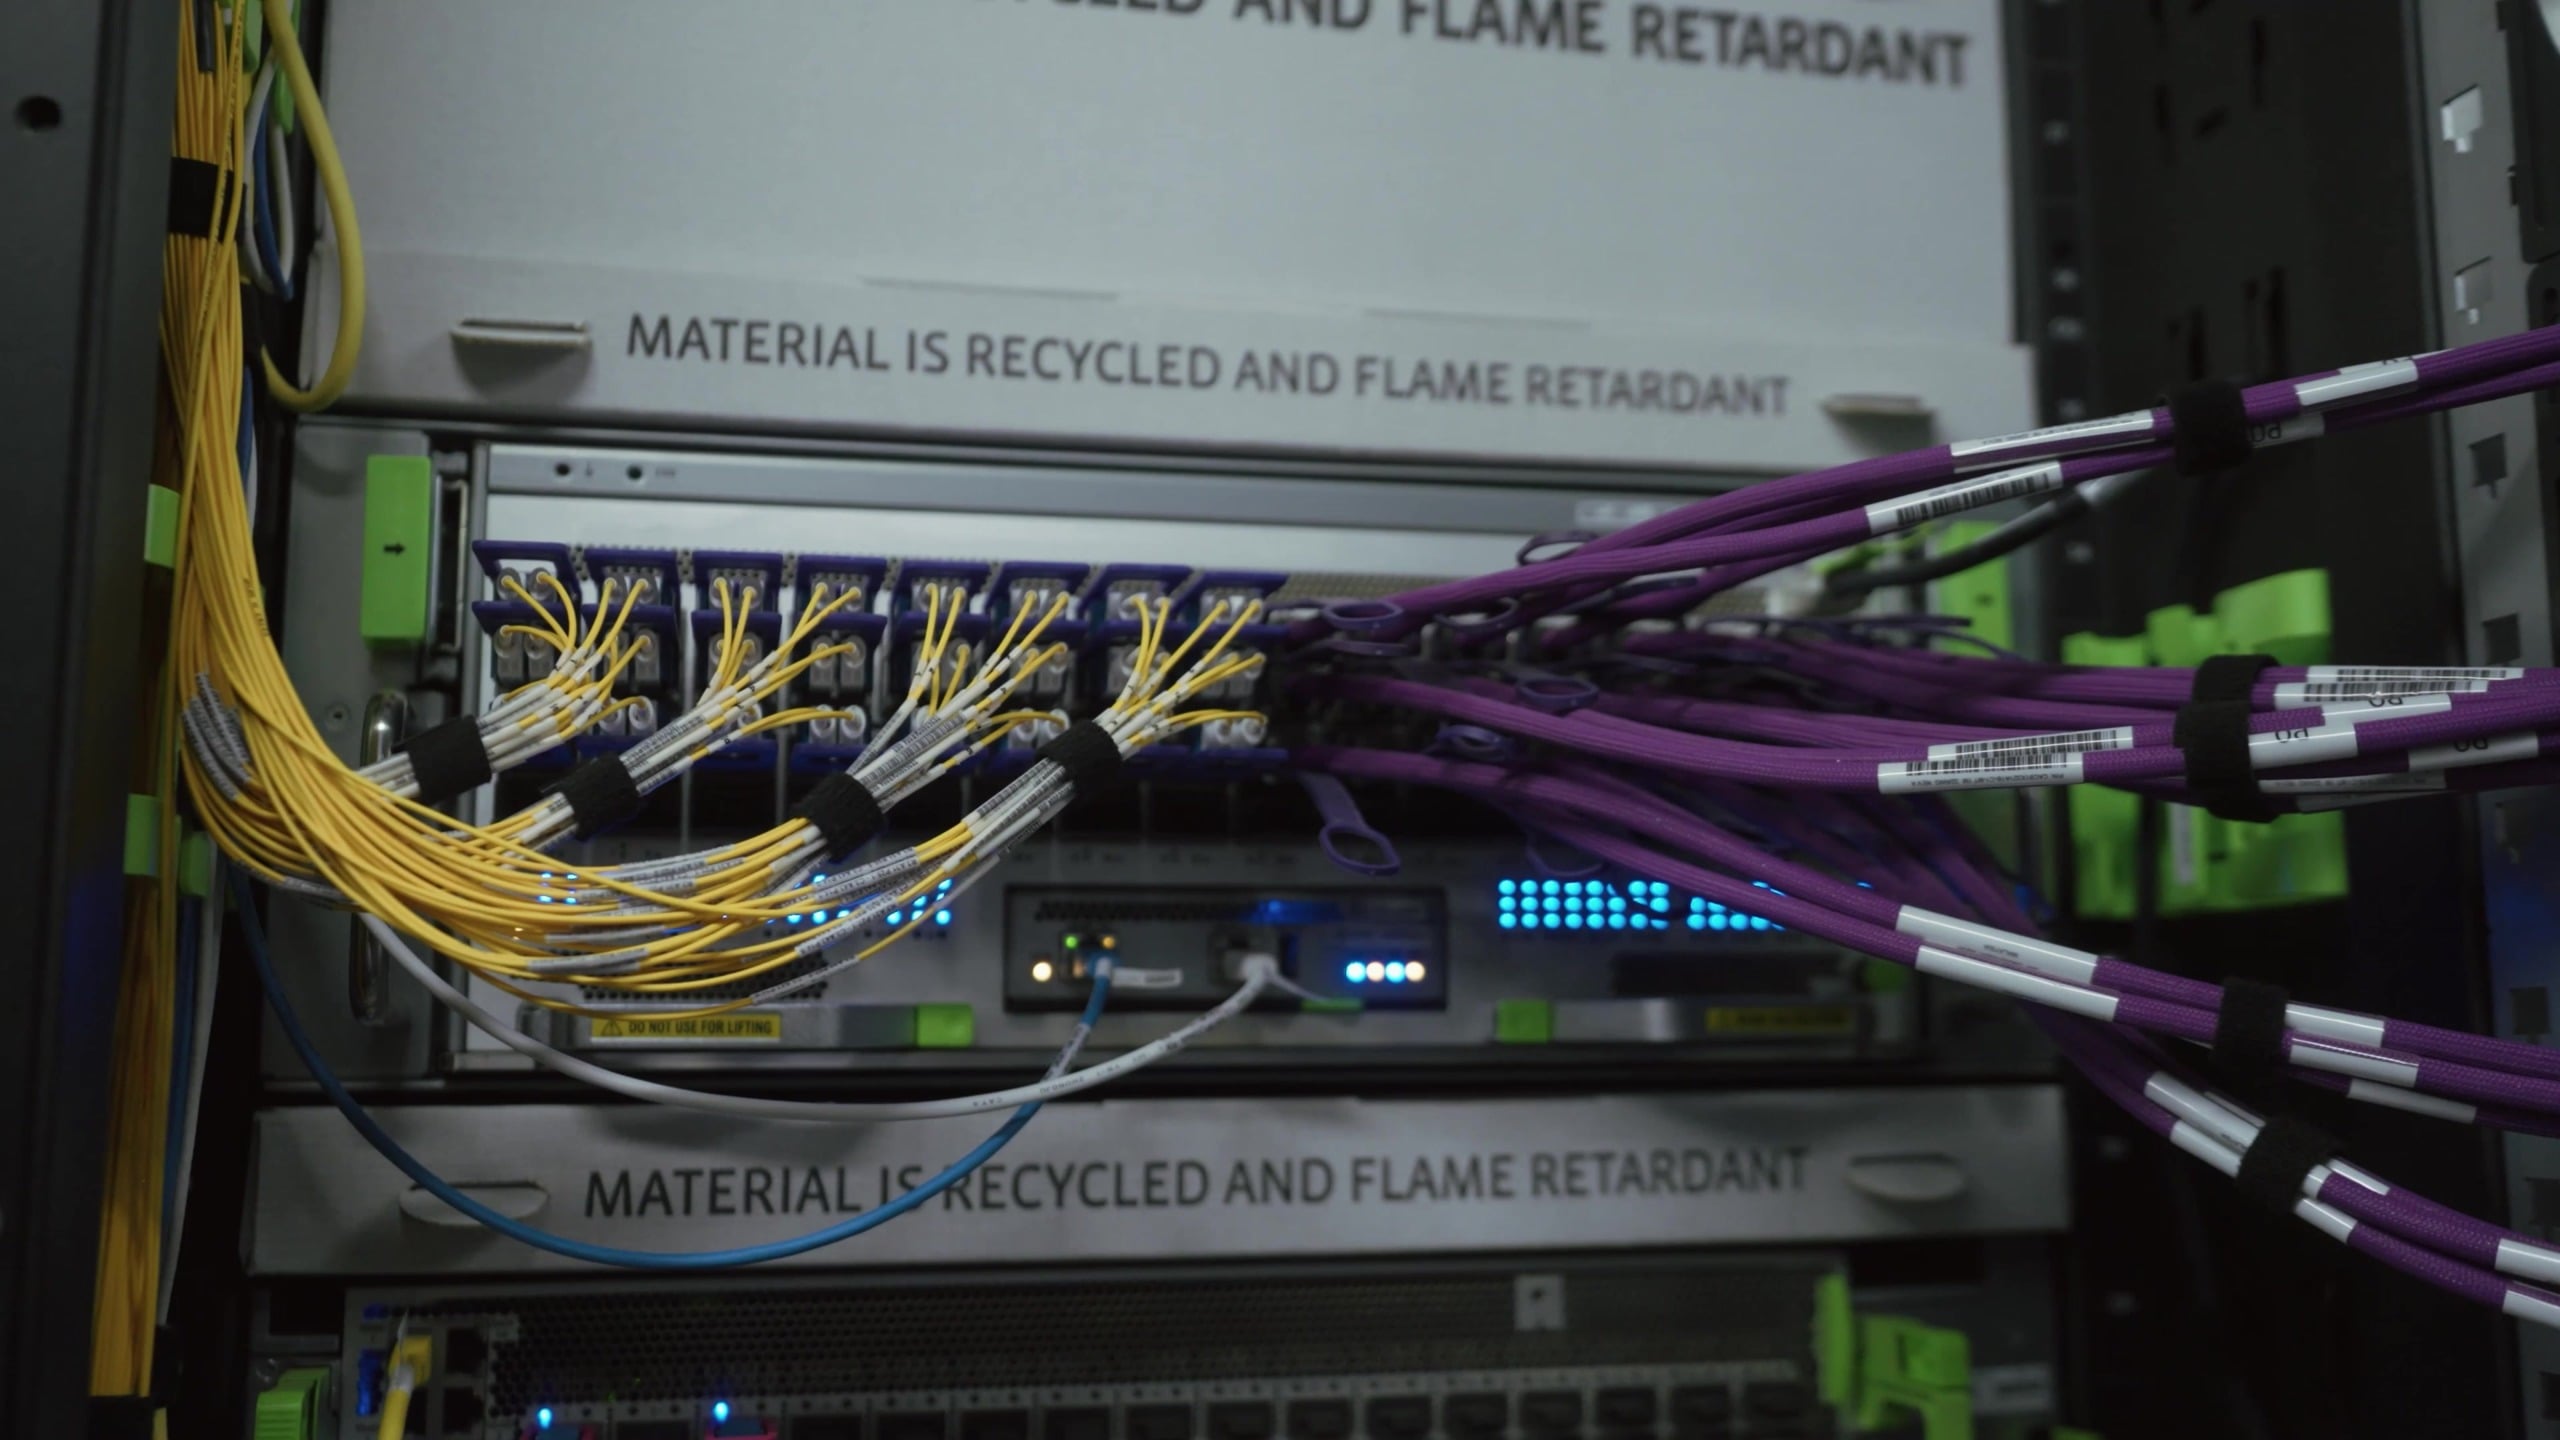
Provozování stovek tisíc akcelerátorů první generace proměnilo zrání hardwaru v samostatnou disciplínu. Automatizace firmwaru od Mety dokáže během několika hodin nainstalovat opravy ovladačů a firmwaru pro více než 100 000 GPU a doba potřebná k upgradu jednoho podu u P90 se zkrátila z více než sedmi hodin na začátku představení GB200 na dvě hodiny. Zátěžové testování napájení zkoumá, jak se moduly napájecích zdrojů a regulátory napětí chovají při zátěži 1,400 W jedné GPU, a každý opravený systém je v karanténě, dokud neprojde validací. Březnový sprint stability od Mety synchronizoval opravy napříč celým stackem.
Přechodové jevy výkonu a smíšený chladicí park
Synchronní trénování přesouvá výkon v souladu s očekáváním a desítky tisíc grafických procesorů (GPU), které společně vstupují do výpočetní nebo komunikační fáze, ovlivní zatížení clusteru o 30 až 40 procent a spuštění nebo pozastavení velké úlohy může během několika sekund změnit výkon desítek megawattů. Dynamo Dimmer, systém pro správu napájení celého clusteru od společnosti Meta, postupně omezuje výkon GPU, jakmile se cluster blíží svému elektrickému stropu, aby úlohy mohly pokračovat v provozu. Záložní bateriové moduly na úrovni racku absorbují špičky, kondenzátorové přihrádky vyhlazují špičky, za nimi se nachází bateriové úložiště energie v měřítku zařízení a Meta koordinuje s dodavateli energie profil zátěže.
Chlazení se liší podle budovy, protože Prometheus byl sestaven rychle v datových centrech s volným chlazením, strukturách pro rychlé nasazení, pronajaté kapacitě a účelově postavených budovách s umělou inteligencí. Starší prostory používají modulární kapalinové chlazení s asistencí vzduchu; budova optimalizovaná pro umělou inteligenci používá kapalinové chlazení zařízení v uzavřené smyčce, což Meta popisuje jako nejúčinnější způsob chlazení serverů s grafickými procesory a nejúspornější z hlediska spotřeby vody. Meta sdílela návrhy, jako je IcePack, její kapalinou chlazený síťový rack, prostřednictvím OCP. Podívejte se, co obnáší mnohem menší nasazení kapalinou chlazeného GB300 NVL72, na testovací platformě GAIFA od Giga Computing.
Hyperion přichází na řadu
Společnost Meta bude i nadále rozšiřovat systém Prometheus o kombinaci rozvaděčů GB300 NVL72 a Vera Rubin NVL72, přičemž Vera Rubin dorazí na platformu San Miguel na stávající síťovou strukturu. Ponaučení z projektu New Albany slouží i firmě Hyperion, superklastru, který Meta navrhuje od nuly v Richland Parish v Louisianě, s uzavřeným okruhem kapalinového chlazení, plnou konektivitou k síti prostřednictvím společnosti Entergy a návrhy sítí nové generace. Společnost Meta uvádí, že v obou lokalitách hradí plné náklady na energii a přizpůsobuje její spotřebu novým zdrojům čisté a obnovitelné energie.
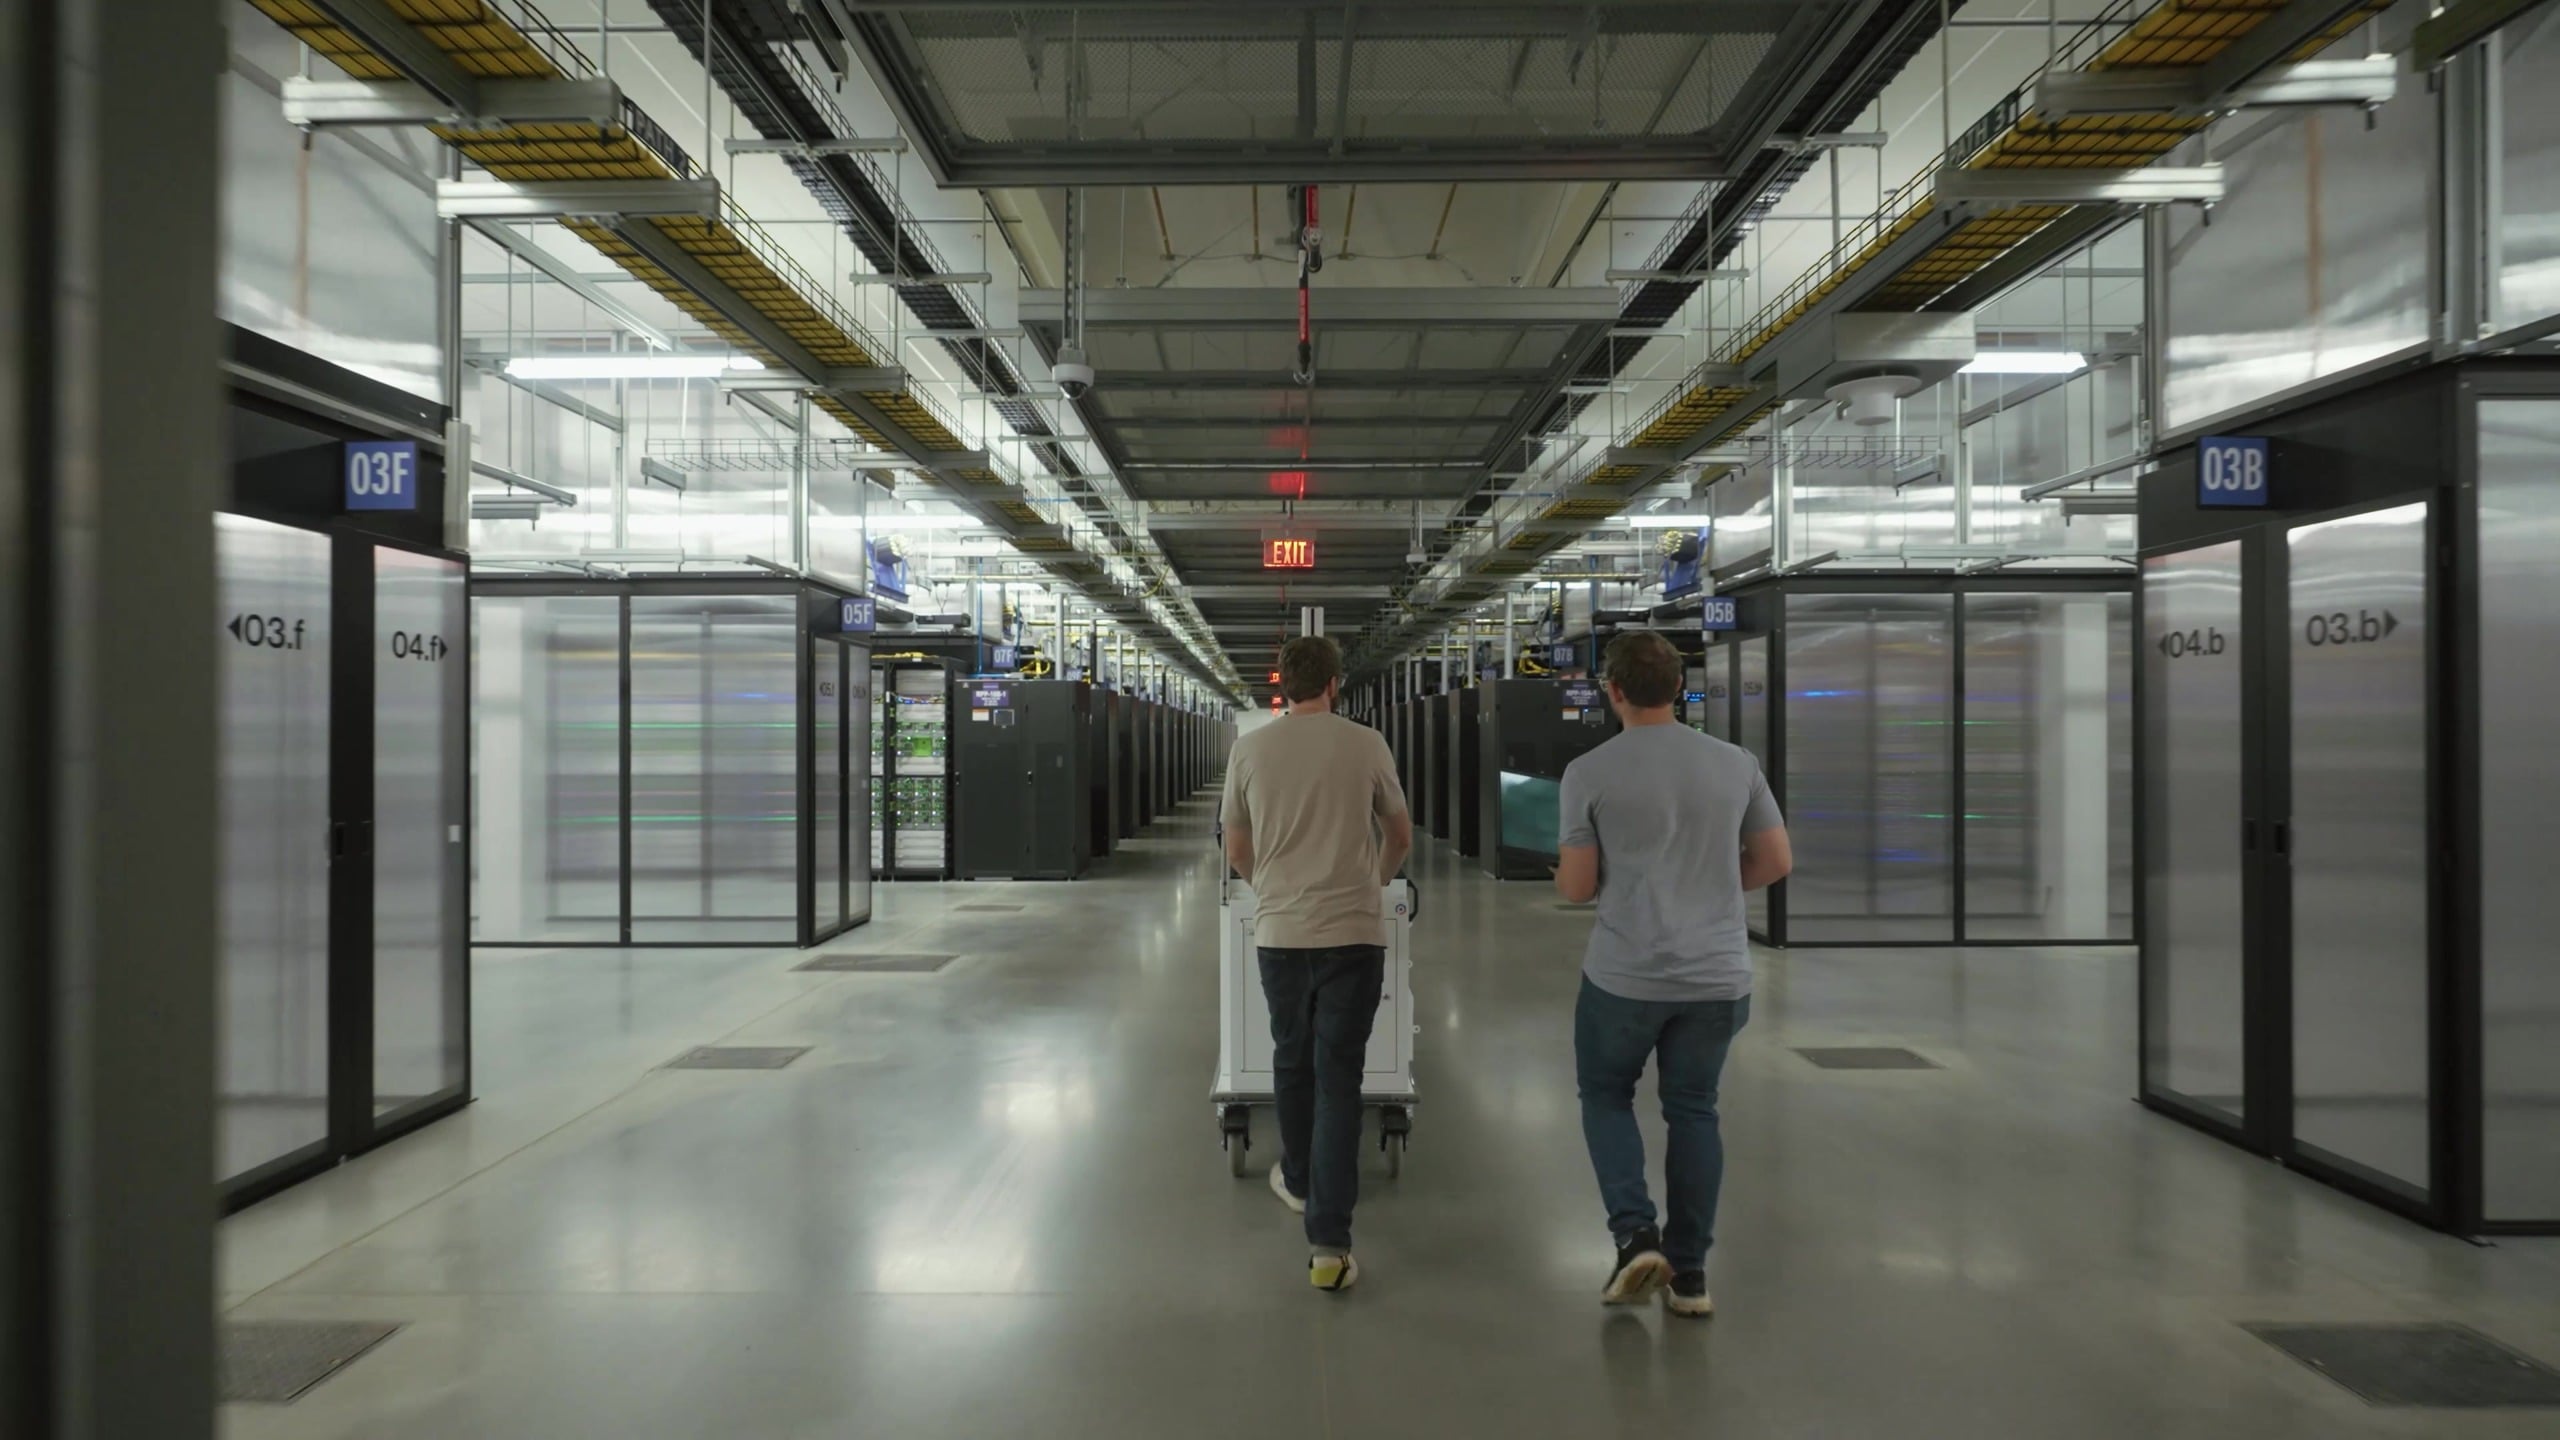
Většina toho, co Meta publikovala, jsou provozní detaily, které si hyperscaleři obvykle nechávají pro sebe: konfigurace náhradních GPU, míra přerušení, doba zavádění firmwaru a důvody pro volbu konfigurace Ariel. Podstatné je, že v tomto měřítku je hardware pouze výchozím bodem a práce, která promění stovky tisíc GPU v použitelnou trénovací kapacitu, se odehrává v síti, odolnosti proti chybám a telemetrii. Pro podniky, které chtějí nasadit umělou inteligenci ve velkém měřítku, je tento hloubkový průzkum Mety dobrým výchozím bodem k pochopení toho, kde mohou nastat problémy, aby organizace mohly plánovat dopředu v celém svém datovém centru.



 Amazon