

Společnosti NVIDIA a Cisco dnes oznámily plány na vývoj optického modulu Ultra-Dense Small Form Factor Pluggable (USFP), který je určen pro ethernet s rychlostí 400 Gb/s na linku v sítích s umělou inteligencí. První plánované transceivery umisťují 16 plně duplexních linek na ploše o velikosti modulu OSFP, což v přepočtu představuje rychlost 6.4 Tb/s na modul, a konektor je navržen tak, aby se dal rozšířit na 32 linek a rychlost 12.8 Tb/s. Společnosti NVIDIA a Cisco uvádějí, že USFP nabízí 4x větší šířku pásma a hustotu zásuvných modulů na předním panelu 200 Gb/s na linku při přibližně 1.3x vyšší energetické účinnosti.
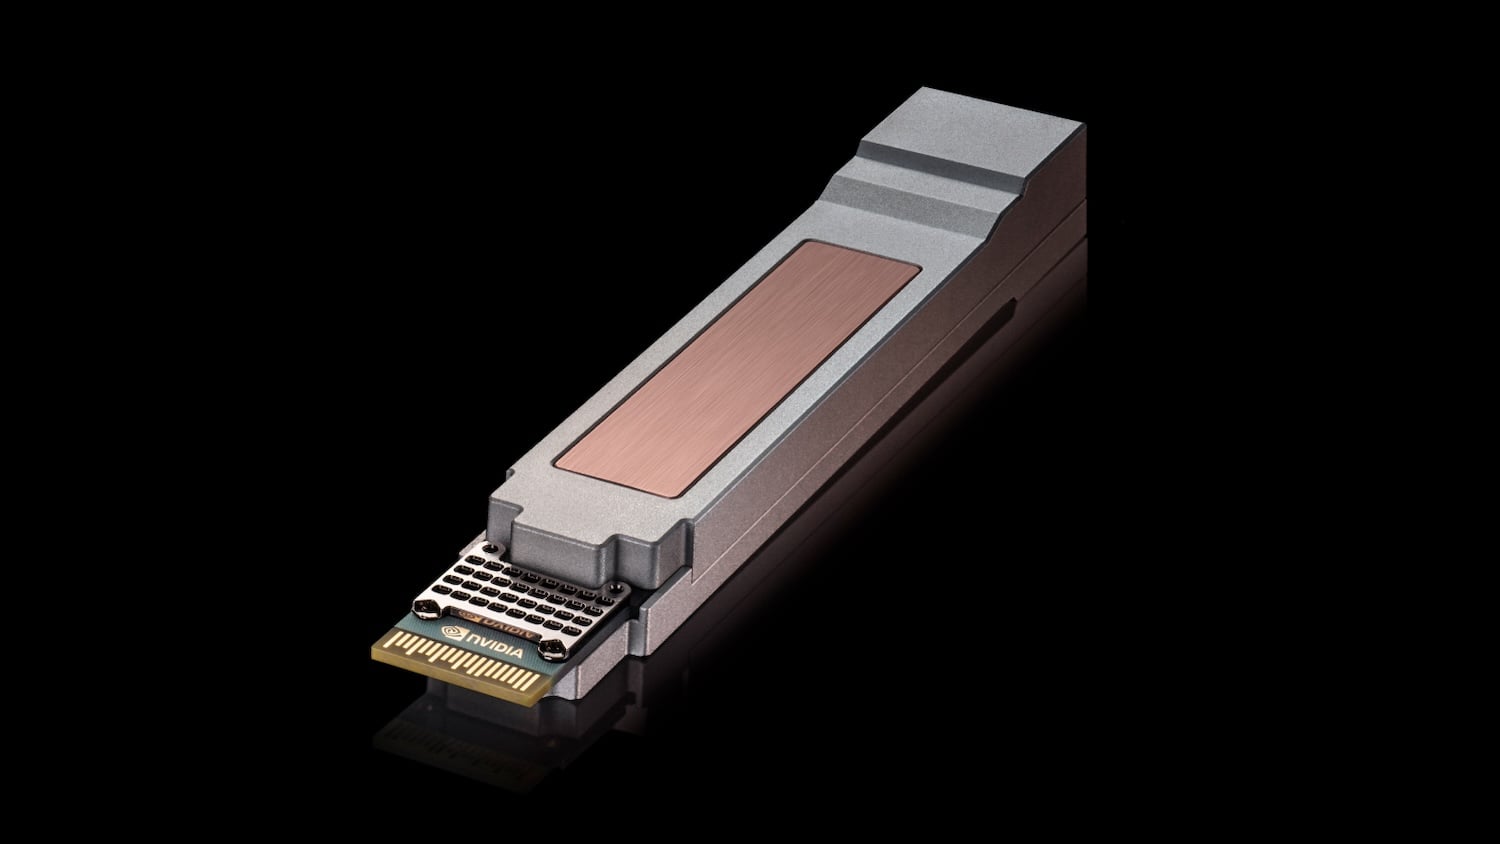
USFP je plán bez harmonogramu vzorkování ani data dostupnosti a společnosti NVIDIA a Cisco hodlají proměnit návrh v otevřenou průmyslovou specifikaci prostřednictvím komunitní dohody o spolupráci s více zdroji. Je to jedna část většího souboru příspěvků NVIDIA na globálním summitu OCP, který zahrnuje také návrhy racků Vera Rubin, tovární software DSX AI, specifikace zařízení a sítě, napájení 800 V DC a spolupráci s ethernetovými systémy Meta a Google.
USFP zvyšuje počet pruhů a hustotu šířky pásma na předním panelu
USFP zdvojnásobuje počet linek i rychlost na linii oproti dnešním modulům, což podle NVIDIA a Cisco umožňuje přepínači připojit více koncových bodů s rychlostí 1.6 Tb/s bez přidání síťové vrstvy. Moduly jsou určeny jak pro přepínače, tak pro SuperNIC. Společnosti považují hustotu předního panelu za limitující faktor růstu AI fabric: jakmile přepínači dojdou porty, dalším krokem je další vrstva přepínače s větším počtem optik, což zvyšuje latenci, výkon a náklady. USFP si zachovává model zásuvných modulů, takže moduly zůstávají vyměnitelné a provozuschopné v terénu.
„Budování největších továren umělé inteligence na světě začíná přehodnocením i těch nejmenších propojení,“ řekl Gilad Shainer, senior viceprezident společnosti NVIDIA. Bill Gartner, senior viceprezident a generální ředitel pro optické systémy a optiku ve společnosti Cisco, uvedl, že zvýšení rychlosti zásuvných optických systémů na 400 Gb/s na kanál vyžaduje více než jen postupné rozšiřování současných návrhů modulů.
Nový konektor podporuje signalizaci s rychlostí 400 Gb/s
Konektor je dvourozměrné kontaktní pole s dvoukrokovou sekvencí zasouvání, ve které se vysokorychlostní kontakty zapojí až po usazení modulu. Společnosti NVIDIA a Cisco tvrdí, že to snižuje opotřebení kontaktů, zlepšuje integritu signálu a zvyšuje předvídatelnost síly potřebné k zasunutí. Konektor je navržen pro rychlost 400 Gb/s na linku a podle společností také zlepšuje výkon na 200 Gb/s na linku.
Modul USFP může rozptýlit až 100 W bez vyhrazeného chladicího obvodu uvnitř transceiveru, což podle společností zjednodušuje návrh přepínače a zvyšuje spolehlivost. Každá konfigurace USFP podporuje optické návrhy, které zjednodušují zpracování signálu pro snížení latence a spotřeby energie, a formát zahrnuje řadu optických technologií a tříd dosahu. Společnosti NVIDIA a Cisco spolupracují se společnostmi TE Connectivity a Amphenol na klecích, konektorech a modulech a očekávají se další partneři, kteří navazují na stávající práci na interoperabilitě mezi ethernetovými sítěmi založenými na NVIDIA Spectrum-X a Cisco Silicon One.
MGX 1.2 rozšiřuje infrastrukturu racků Vera Rubin
Společnost NVIDIA přispěla svými návrhy rackových a výpočetních modulů Vera Rubin do OCP prostřednictvím své otevřené architektury MGX jako součást referenčního návrhu MGX třetí generace v iniciativě Open DC Initiative společnosti OCP, spolu s otevřenými návrhy kapalinového chlazení MQD a MQDB. Specifikace MGX 1.2 přidává kapalinové chlazení slepě spárovanými prvky v racku, interoperabilní propojovací infrastrukturu v racku a kapalinou chlazenou sběrnici 5 000 A s nativní podporou pro 19palcová zařízení a nasazení v racku až do 250 kW.
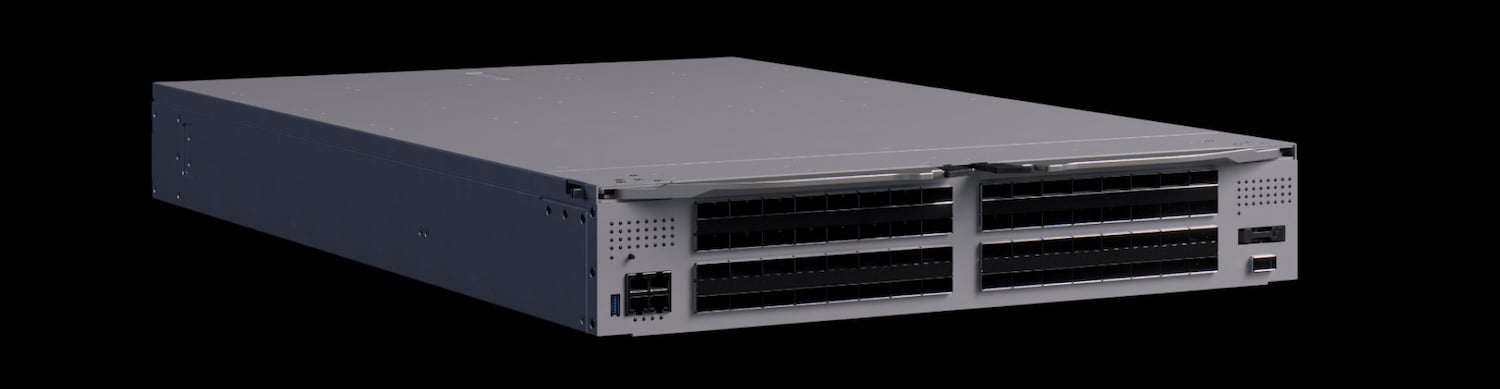
Specifikaci doplňují konfigurovatelné I/O pozice, bezventilátorové výpočetní přihrádky s kapalinovým chlazením a standardizovaná rozhraní pro napájení a chlazení. NVIDIA uvádí, že společná rozhraní zkracují časy montáže, testování a servisu pro partnery. Samostatná specifikace návrhu racku CPU Vera rozšiřuje MGX nad rámec akcelerovaných výpočtů. NVIDIA umisťuje Vera Rubin NVL72 jako platformu pro rozsáhlé školení a inferenci a rack CPU Vera pro volání nástrojů, orchestraci a sandboxové provádění, které agentní úlohy přidávají.
DSX OS přidává komponenty pro správu sítě, racku a clusteru
NVIDIA rozšířila operační systém DSX, otevřenou operační vrstvu své platformy DSX AI factory, o čtyři komponenty s otevřeným zdrojovým kódem. NVIDIA Config Manager automatizuje konfiguraci, ověřování a údržbu přepínačů napříč strukturami umělé inteligence. NVIDIA Cluster Readiness Engine provádí zátěžové testy clusterů GPU pomocí simulací pracovní zátěže před zahájením trénování, což podle NVIDIA zachycuje hardwarové problémy, které by jinak selhaly.

Služba NVIDIA Rack Management Service zachází s rackem jako s provozní jednotkou, přičemž na této úrovni probíhá abstrakce hardwaru a správa firmwaru. Poskytovatel Cluster API pro NVIDIA Infrastructure Controller se stará o nasazení na holém stroji a onboarding tenantů a NVIDIA tvrdí, že během několika hodin přemění surový hardware na clustery připravené k produkčnímu provozu. Komponenty vycházejí ze zkušeností společnosti NVIDIA s provozem DGX Cloud a mají umožnit poskytovatelům cloudových služeb a softwarovým partnerům integrovat provoz AI factory do platforem s více tenanty.
Otevřené specifikace pokrývají návrh zařízení a obnovu sítě
Společnosti NVIDIA, AMD, Google a Meta zveřejnily Open Data Center Specification v0.7, plán sdíleného zařízení zahrnující architekturu napájení, chlazení a fyzické uspořádání, podle kterého mohou výrobci zařízení, poskytovatelé kolokací a provozovatelé navrhovat. Google, Meta, Microsoft a NVIDIA také zveřejnily OCP Grid Resilience Specification, která definuje, jak by měla velká zařízení s umělou inteligencí překonávat narušení napájení: zůstat připojená, automaticky reagovat a vrátit se k téměř plnému zatížení za méně než dvě sekundy. NVIDIA uvádí, že obě specifikace jsou v souladu s jejím referenčním návrhem DSX.
Společnost Visionbay představila plány pro K-1, platformu pro výrobu umělé inteligence, která spojuje referenční architekturu NVIDIA s napětím 800 VDC s napájecím a tepelným zařízením Vertiv pro budoucí nasazení systémů Vera Rubin. K-1 přesouvá převod střídavého proudu na stejnosměrný proud (AC-DC) do napájecích center na úrovni clusterů a distribuuje 800 VDC blíže k výpočetním systémům s postupným zaváděním napájení 800 VDC, kapalinového chlazení a modulárního rozšíření. Visionbay zatím neuvedl datum nasazení.
Meta přijímá Spectrum-6 a víceplošné sítě
Společnost Meta pro své továrny s umělou inteligencí Vera Rubin použije ethernetovou technologii NVIDIA Spectrum-6 s rychlostí 102.4 Tb/s. NVIDIA uvádí, že Spectrum-6 zdvojnásobuje přepínací kapacitu a šířku pásma na linku oproti Spectrum-4 a pracuje s rychlostí 200 Gb/s na linku s izolací výkonu mezi úlohami. Přepínač Meta N-IceCube založený na technologii Spectrum-6 se instaluje do kapalinou chlazeného racku IcePack 100T a běží na něm FBOSS, otevřený software pro přepínače od společnosti Meta, který využívá rozhraní OCP Switch Abstraction Interface pro řízení hardwaru nezávislé na dodavateli.
Spectrum-X Multiplane spáruje přepínače Spectrum-6 s adaptéry ConnectX-9 SuperNIC a rozkládá provoz GPU v hardwaru až do osmi nezávislých síťových rovin. NVIDIA uvádí, že návrh škáluje více než 100 000 GPU s menším počtem úrovní přepínačů a že když některá komponenta selže, provoz se přesune na zbývající roviny, takže úlohy pokračují se sníženou šířkou pásma. Meta a NVIDIA uvádějí, že ověřily zvýšení odolnosti v místních podmínkách i v cloudu, aniž by zveřejnily konkrétní údaje.
Google Falcon Transport se zaměřuje na budoucí síťový hardware NVIDIA
Společnosti NVIDIA a Google oznámily podporu Falcon Transport pro budoucí síťové karty NVIDIA ConnectX-10 SuperNIC a procesory BlueField DPU. Falcon poskytuje spolehlivá data přes Ethernet díky vyvažování zátěže po více cestách, programovatelnému řízení přetížení, hardwarové obnově ztrát a zabezpečení pro každé připojení. NVIDIA to implementuje s hardwarovou akcelerací a softwarem DOCA, takže síťové karty NVIDIA a Google komunikují společným transportem, zatímco aplikace si zachovávají standardní rozhraní RDMA. Společnosti tvrdí, že to zlepšuje využití šířky pásma a předvídatelnost výkonu pro provoz umělé inteligence a úložiště s tím, jak se ethernetové sítě škálují.


 Amazon