

V bleskově rychlém a neustále se vyvíjejícím světě umělé inteligence (AI) se NVIDIA DGX GH200 stává majákem inovací. Tento výkonný systém, navržený s ohledem na nejnáročnější úlohy umělé inteligence, je kompletním řešením, které má revolucionizovat přístup podniků ke generativní umělé inteligenci. NVIDIA má nové podrobnosti o tom, jak GH200 funguje, a nabízí ukázku toho, jak vypadá výkon umělé inteligence s touto technologií GPU nejnovější generace.
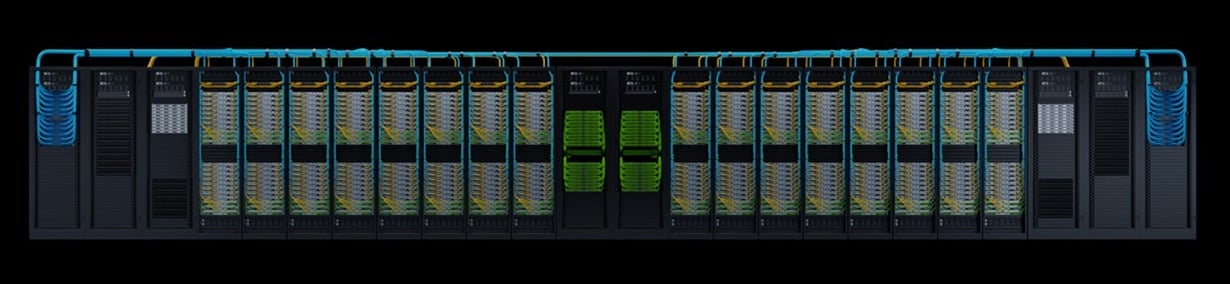
NVIDIA DGX GH200: Kompletní řešení
DGX GH200 není jen luxusní kus rackového hardwaru; je to komplexní řešení, které kombinuje vysoce výkonné výpočty (HPC) s umělou inteligencí. Je navrženo tak, aby zvládalo i ty nejsložitější úlohy s umělou inteligencí a nabízelo úroveň výkonu, která je skutečně bezkonkurenční.
DGX GH200 v sobě spojuje kompletní hardwarový stack, včetně superčipu NVIDIA GH200 Grace Hopper, NVIDIA NVLink-C2C, přepínacího systému NVIDIA NVLink a NVIDIA Quantum-2 InfiniBand, do jednoho systému. NVIDIA to vše podporuje optimalizovaným softwarovým balíčkem speciálně navrženým pro urychlení vývoje modelů.
| Specifikace | Detaily |
|---|---|
| GPU | Zásobník 96 GB HBM3, 4 TB/s |
| Procesor (CPU) | 72 Core Arm Neoverse V2 |
| Paměť CPU | Až 480 GB LPDDR5 s přenosovou rychlostí až 500 GB/s, 4x energeticky úspornější než DDR5 |
| CPU-GPU | Obousměrné koherentní spojení NVLink-C2C s rychlostí 900 GB/s, 5x energeticky úspornější než PCIe Gen5 |
| GPU-to-GPU | NVLink 900 GB/s obousměrný |
| Vysokorychlostní I/O | 4x PCIe Gen5 x16 s rychlostí až 512 GB/s |
| TDP | Konfigurovatelné od 450 W do 1000 W |
Rozšířená paměť GPU
Superčip NVIDIA Grace Hopper, vybavený funkcí Extended GPU Memory (EGM), je navržen pro zpracování aplikací s masivními paměťovými nároky, většími než kapacita jeho vlastních paměťových subsystémů HBM3 a LPDDR5X. Tato funkce umožňuje grafickým procesorům (GPU) přístup až ke 144 TB paměti ze všech CPU a GPU v systému, přičemž načítání, ukládání a atomické operace jsou možné při rychlostech LPDDR5X. EGM lze použít se standardními knihovnami MAGNUM IO a CPU a další GPU k němu mohou přistupovat prostřednictvím připojení NVIDIA NVLink a NVLink-C2C.
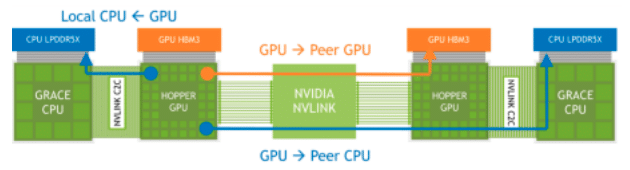
Přístupy k paměti NVLink napříč připojenými superčipy Grace Hopper
Společnost NVIDIA uvádí, že funkce Extended GPU Memory (EGM) na superčipu NVIDIA Grace Hopper výrazně vylepšuje trénování modelů velkých jazyků (LLM) tím, že poskytuje obrovskou paměťovou kapacitu. Důvodem je, že LLM obvykle vyžadují obrovské množství paměti pro ukládání svých parametrů, výpočtů a správu trénovacích datových sad.
Díky možnosti přístupu až ke 144 TB paměti ze všech CPU a GPU v systému lze modely trénovat efektivněji a účinněji. Velká paměťová kapacita by měla vést k vyššímu výkonu, složitějším modelům a schopnosti pracovat s většími a podrobnějšími datovými sadami, čímž by se potenciálně zlepšila přesnost a užitečnost těchto modelů.
Systém přepínačů NVLink
Vzhledem k tomu, že požadavky modelů velkých jazyků (LLM) nadále posouvají hranice správy sítí, zůstává přepínací systém NVLink od společnosti NVIDIA robustním řešením. Využívá sílu technologie NVLink čtvrté generace a architektury NVSwitch třetí generace a poskytuje vysokorychlostní připojení s nízkou latencí k působivým 256 superčipům NVIDIA Grace Hopper v systému DGX GH200. Výsledkem je ohromující plně duplexní šířka pásma 25.6 Tb/s, což představuje podstatný skok v rychlosti přenosu dat.
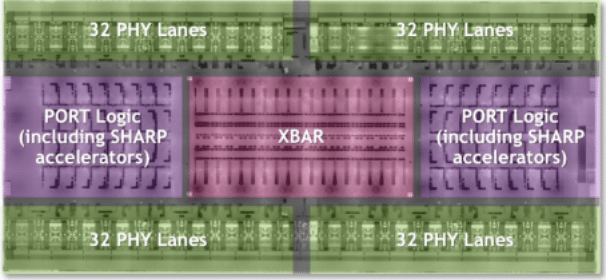
Přehled logiky NVLink 4. generace superpočítače DGX GH200
V systému DGX GH200 je každá GPU v podstatě „zvědavý soused“, který je schopen nahlížet do pamětí HBM3 a LPDDR5X svých protějšků v síti NVLink. Ve spojení s akceleračními knihovnami NVIDIA Magnum IO toto „zvědavé sousedství“ optimalizuje komunikaci GPU, efektivně škáluje a zdvojnásobuje efektivní šířku pásma sítě. Takže zatímco se váš LLM trénink navyšuje a komunikační režie rostou, operace umělé inteligence dostávají turbo impuls.
Přepínací systém NVIDIA NVLink v modelu DGX GH200 dokáže výrazně vylepšit trénování modelů, jako jsou LLM, a to usnadněním vysokorychlostní a nízkolatenční konektivity mezi velkým počtem GPU. To vede k rychlejšímu a efektivnějšímu sdílení dat mezi GPU, čímž se zlepšuje rychlost a efektivita trénování modelu. Navíc schopnost každé GPU přistupovat k peer paměti z jiných superčipů v síti NVLink zvyšuje dostupnou paměť, což je pro LLM s velkými parametry zásadní.
I když působivý výkon superčipů Grace Hopper je nepochybně průlomem v oblasti výpočtů umělé inteligence, skutečné kouzlo tohoto systému se odehrává v NVLinku, kde vysokorychlostní a nízkolatenční připojení napříč řadou GPU posouvá sdílení dat a efektivitu na zcela novou úroveň.
Architektura systému DGX GH200
Architektura superpočítače DGX GH200 je složitá, ale zároveň pečlivě navržená. Skládá se z 256 výpočetních modulů GH200 Grace Hopper a přepínacího systému NVLink, který tvoří dvouúrovňový NVLink fat tree. Každý výpočetní modul obsahuje superčip GH200 Grace Hopper, síťové komponenty, systém správy/BMC a SSD disky pro ukládání dat a spuštění operačního systému.
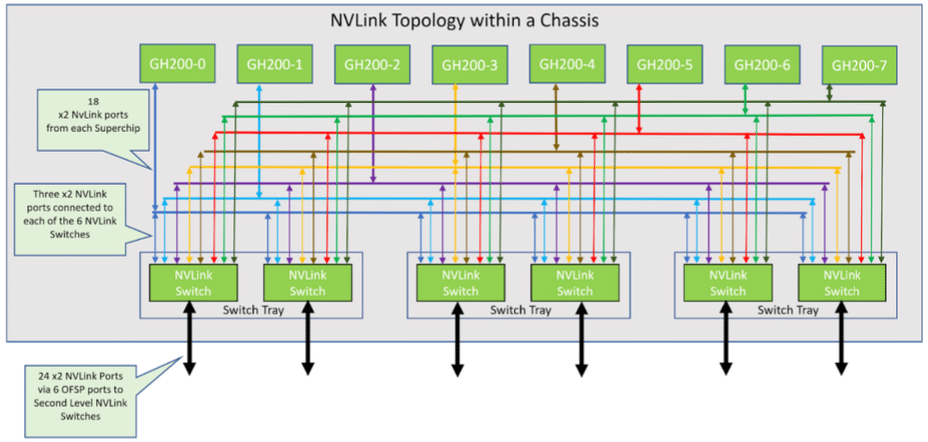
Topologie NVLink v šasi s 8 superčipy GraceHopper
| Kategorie | Detaily |
|---|---|
| CPU / GPU | 1x superčip NVIDIA Grace Hopper s technologií NVLink-C2C |
| Grafická karta/GPU | 18 portů NVLink čtvrté generace |
| networking | 1x NVIDIA ConnectX-7 s OSFP: > Výpočetní síť NDR400 InfiniBand 1x duální port NVIDIA BlueField-3 s 2x QSFP112 nebo 1x duální port NVIDIA ConnectX-7 s 2x QSFP112: > 200 GbE vnitropásmová ethernetová síť > Síť úložiště NDR200 IB Mimopásmová síť: > 1 GbE RJ45 |
| Skladování | Datový disk: 2x 4 TB (U.2 NVMe SSD) SW RAID 0 Operační disk: 2x 2 TB (M.2 NVMe SSD) SW RAID 1 |
V tomto uspořádání je osm výpočetních modulů propojeno se třemi moduly NVLink NVSwitch první úrovně a vytváří tak jedno šasi s 8 GPU. Každý modul přepínače NVLink obsahuje dva ASICy NVSwitch, které se k výpočetním modulům připojují pomocí vlastní zaslepovací kabelové kazety a k přepínačům NVLink druhé úrovně pomocí kabelů LinkX.
Výsledný systém se skládá z 36 přepínačů NVLink druhé úrovně, které propojují 32 šasi a tvoří tak komplexní superpočítač NVIDIA DGX GH200. Další informace naleznete v tabulce 2, kde jsou uvedeny specifikace výpočetního modulu s čipem Grace Hopper, a v tabulce 3, kde jsou uvedeny specifikace přepínače NVLink.
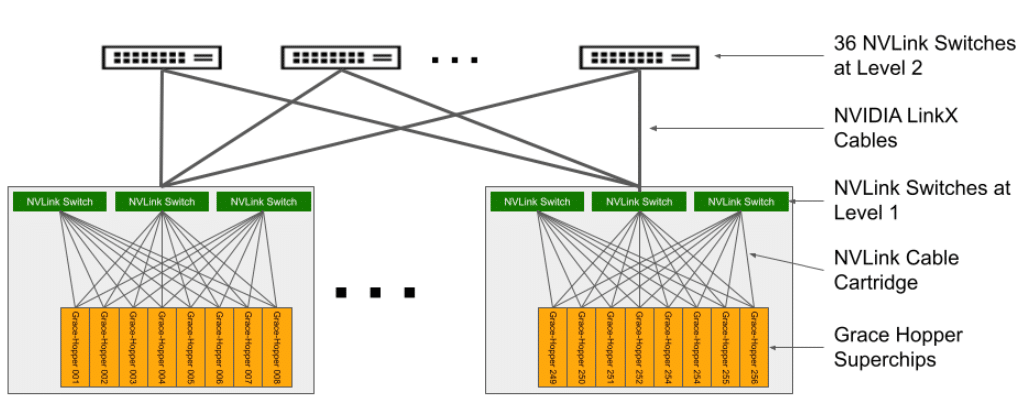
Topologie NVLink DGX GH200
Síťová architektura DGX GH200
Systém NVIDIA DGX GH200 zahrnuje čtyři sofistikované síťové architektury, které poskytují špičková výpočetní a úložná řešení. Za prvé, Compute InfiniBand Fabric, konstruovaná z přepínačů NVIDIA ConnectX-7 a Quantum-2, tvoří full-fat tree NDR400 InfiniBand fabric optimalizovanou pro lištu, která umožňuje bezproblémové propojení mezi více jednotkami DGX GH200.
Za druhé, úložná síť Storage Fabric, řízená datovou procesorovou jednotkou NVIDIA BlueField-3 (DPU), poskytuje vysoce výkonné úložiště prostřednictvím portu QSFP112. Tím vzniká vyhrazená, přizpůsobitelná úložná síť, která efektivně zabraňuje přetížení provozu.
In-band Management Fabric slouží jako třetí architektura, propojuje všechny služby správy systému a usnadňuje přístup k úložným fondům, systémovým službám, jako jsou Slurm a Kubernetes, a externím službám, jako je NVIDIA GPU Cloud.
A konečně, out-of-band Management Fabric, pracující na 1GbE, dohlíží na základní out-of-band správu superčipů Grace Hopper, BlueField-3 DPU a přepínačů NVLink prostřednictvím Baseboard Management Controller (BMC), optimalizuje provoz a předchází konfliktům s jinými službami.
Uvolnění síly umělé inteligence – softwarový stack NVIDIA DGX GH200
DGX GH200 má veškerý surový výkon, který si vývojáři mohou přát; je to mnohem víc než jen luxusní superpočítač. Jde o to využít tento výkon k posunu umělé inteligence vpřed. Softwarový balík, který je součástí DGX GH200, je nepochybně jednou z jeho výjimečných vlastností.
Toto komplexní řešení zahrnuje několik optimalizovaných SDK, knihoven a nástrojů navržených tak, aby plně využily možnosti hardwaru, zajistily efektivní škálování aplikací a lepší výkon. Šířka a hloubka softwarového balíčku DGX GH200 si však zaslouží více než jen letmou zmínku. Nezapomeňte se podívat na dokument NVIDIA Whitepaper na toto téma, kde se do softwarového balíčku ponoříte podrobněji.
Požadavky na skladování DGX GH200
Aby bylo možné plně využít možnosti systému DGX GH200, je zásadní jej spárovat s vyváženým a vysoce výkonným úložným systémem. Každý systém GH200 má kapacitu číst a zapisovat data rychlostí až 25 GB/s přes rozhraní NDR200. Pro konfiguraci DGX GH200 s 256 Grace Hoppery společnost NVIDIA doporučuje celkový úložný výkon 450 GB/s pro maximalizaci propustnosti čtení.
Potřeba podporovat projekty umělé inteligence a podkladové grafické procesory vhodným úložištěm je nejoblíbenější tématem letních veletrhů. Doslova každý veletrh, kterého jsme se zúčastnili, má část svého hlavního projevu věnovanou pracovním postupům a úložištím umělé inteligence. Uvidíme však, do jaké míry se tato přednáška týká pouze přehodnocení stávajících úložných produktů a do jaké míry povede k smysluplným vylepšením úložišť s umělou inteligencí. V tuto chvíli je příliš brzy na to, abychom to mohli říct, ale od dodavatelů úložišť slyšíme mnoho narážek na to, že by mohli vést k smysluplným změnám v oblasti úloh s umělou inteligencí.
Jedna překážka překonána, další následují
I když DGX GH200 zefektivňuje aspekt návrhu hardwaru při vývoji umělé inteligence, je důležité si uvědomit, že v oblasti generativní umělé inteligence existují i další značné výzvy, jako je generování trénovacích dat.
Vývoj generativního modelu umělé inteligence vyžaduje obrovské množství vysoce kvalitních dat. Data však v surové podobě nejsou okamžitě použitelná. Vyžaduje rozsáhlé úsilí o jejich sběr, čištění a označování, aby byla vhodná pro trénování modelů umělé inteligence.
Sběr dat je prvním krokem a zahrnuje získávání a akumulaci obrovského množství relevantních informací, což může být často časově náročné a nákladné. Následuje proces čištění dat, který vyžaduje pečlivou pozornost k detailům, aby se identifikovaly a opravily chyby, zpracovaly chybějící položky a odstranily irelevantní nebo nadbytečná data. Nakonec úkol označování dat, což je nezbytná fáze řízeného učení, zahrnuje klasifikaci každého datového bodu, aby mu umělá inteligence mohla porozumět a učit se z něj.
Kvalita trénovacích dat je prvořadá. Nečistá, nekvalitní nebo zkreslená data mohou vést k nepřesným předpovědím a chybnému rozhodování umělé inteligence. Stále je potřeba lidská expertíza a je zapotřebí obrovské úsilí k zajištění toho, aby data používaná při trénování byla dostatečná a v nejvyšší kvalitě.
Tyto procesy nejsou triviální a vyžadují značné zdroje, lidské i kapitálové, včetně specializovaných znalostí trénovacích dat, což podtrhuje složitost vývoje umělé inteligence nad rámec hardwaru. Část těchto problémů je řešena projekty, jako je NeMo Guardrails , který je navržen tak, aby udržel generativní umělou inteligenci přesnou a bezpečnou.
Závěrečné myšlenky
NVIDIA DGX GH200 je kompletní řešení, které má za cíl nově definovat oblast umělé inteligence. Díky svému bezkonkurenčnímu výkonu a pokročilým funkcím představuje průlom, který pohání budoucnost umělé inteligence. Ať už jste výzkumník v oblasti umělé inteligence, který chce posouvat hranice možného, nebo firma, která chce využít sílu umělé inteligence, DGX GH200 je nástroj, který vám pomůže dosáhnout vašich cílů. Bude zajímavé sledovat, jak se bude řešit generování trénovacích dat s tím, jak se hrubý výpočetní výkon stává stále rozšířenějším. Tento aspekt je v diskusích o vydáních hardwaru často přehlížen.
Celkově vzato je důležité uznat vysokou cenu systému DGX GH200. DGX GH200 není levný a jeho prémiová cena ho řadí přímo do kategorie největších podniků a nejlépe financovaných společností zabývajících se umělou inteligencí (NVIDIA, ozvěte se mi, chci jednu), ale pro ty subjekty, které si to mohou dovolit, představuje DGX GH200 revoluční investici, která má potenciál nově definovat hranice vývoje a aplikace umělé inteligence.
Vzhledem k tomu, že stále více velkých podniků tuto technologii přijímá a začíná vytvářet a nasazovat pokročilá řešení umělé inteligence, mohlo by to vést k širší demokratizaci technologie umělé inteligence. Inovace se snad promítnou do nákladově efektivnějších řešení, čímž se umělá inteligence stane dostupnější i pro menší firmy. Cloudový přístup k výpočetnímu výkonu podobnému DGX GH200 je stále dostupnější, což umožňuje menším podnikům využívat jeho schopnosti na základě platby za využití. I když počáteční náklady mohou být vysoké, dlouhodobý vliv DGX GH200 by se mohl rozšířit na celé odvětví a pomoci vyrovnat podmínky pro podniky všech velikostí.


 Amazon