

Hyperškálovači a provozovatelé infrastruktury zaměřené na umělou inteligenci stále častěji vyvíjejí proprietární akcelerátory umělé inteligence a XPU, aby drželi krok s rozsáhlými jazykovými modely a složitými úlohami uvažování. Aby se společnost NVIDIA vypořádala s fyzickými, paměťovými a síťovými výzvami spojenými s nasazením proprietárního křemíku ve velkém měřítku, podrobně představila svou propojovací architekturu NVLink Fusion a zakázkovou paměťovou architekturu NVHBM . Toto sjednocené portfolio je navrženo tak, aby propojilo zakázkový křemík se stávajícími škálovatelnými síťovými a rackovými platformami NVIDIA MGX.
Prvním zájemcem je společnost Annapurna Labs společnosti Amazon, jejíž plány na NVHBM se objevily spolu s rozšířením partnerství AWS o 2 miliony GPU . Toto oznámení poskytuje architekturu, která stojí za tímto propojením, a označuje Trainium4 za první generaci Trainium s podporou NVLink Fusion. NVIDIA také zavádí standardní implementaci NVHBM dostupnou od více dodavatelů pamětí, což podle ní snižuje inženýrské úsilí spojené s integrací a kvalifikací pamětí napříč dodavateli. „NVHBM představuje nový architektonický přístup k pokroku ve výkonu a efektivitě pamětí s vysokou šířkou pásma,“ uvedla Nafea Bshara, viceprezidentka Annapurna Labs ve společnosti Amazon. „Těšíme se, že tato technologická spolupráce bude přínosem pro budoucí návrhy infrastruktury AWS.“
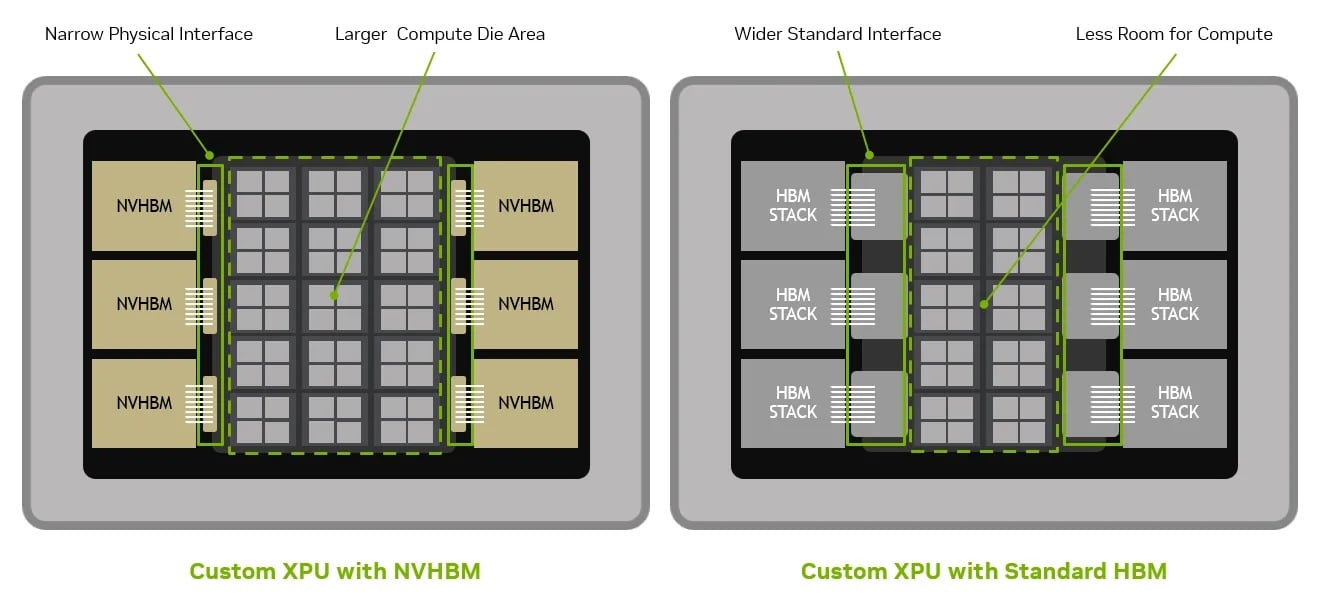
Nasazení vlastních XPU v datových centrech s vysokou hustotou vyžaduje vyvážení výpočetní logiky, distribuce napájení, tepelné režie a paměti s vysokou šířkou pásma. Integrace a kvalifikace špičkových paměťových zásobníků často vytváří značná úzká hrdla v oblasti balení a vývoje. Prostřednictvím NVLink Fusion a NVHBM mohou návrháři využít předem ověřené základní čipy a IP rozhraní, což snižuje složitost integrace a zrychluje dobu uvedení na trh.
Optimalizace šířky pásma paměti a latence
Moderní úlohy umělé inteligence, zejména inference velkých modelů a agentní pipeline, kladou vysoké nároky na propustnost paměti pro čtení vah modelů, aktivací a položek mezipaměti klíč-hodnota (KV). NVHBM poskytuje vlastní základní čip vyvinutý ve spolupráci s výrobci pamětí, který poskytuje až o 30 procent vyšší propustnost paměti na zásobník ve srovnání se standardní specifikací JEDEC HBM4E.
| vlastnost | Výhoda NVHBM |
| Šířka pásma | Až o 30 % větší šířka pásma paměti ve srovnání se standardním HBM4e |
| Oblast | Efektivnější připojení rozhraní umožňuje až o 25 % větší plochu výpočetního čipu pro další funkce XPU |
| Výkon | Až o 15 % nižší spotřeba energie HBM ve srovnání se standardním HBM4e se přidává k úsporám u tisíců XPU. |
Tabulka 1. NVHBM přináší programům akcelerátorů umělé inteligence tři hlavní výhody na úrovni platformy: vyšší šířku pásma paměti, větší plochu pouzdra a křemíku a nižší spotřebu energie HBM.
Toto zvýšení šířky pásma minimalizuje vyčerpání výpočetního enginu během fází provádění vázaných na paměť. Zrychlením přenosů dat mezi zásobníky HBM a integrovanou výpočetní logikou mohou akcelerátory udržet vyšší využití a zlepšit rychlost generování tokenů na uživatele během hustých inferenčních úloh.
Realokace plochy čipu a optimalizace PHY
Křemíkový prostor na moderních akceleračních pouzdrech je striktně omezený, což vyžaduje, aby konstruktéři vyvažovali prostor mezi výpočetními ALU, maticovými enginy, integrovanou SRAM pamětí a periferními rozhraními. Standardní architektury HBM vyžadují široká fyzická rozhraní, která spotřebovávají značnou plochu rozvržení.
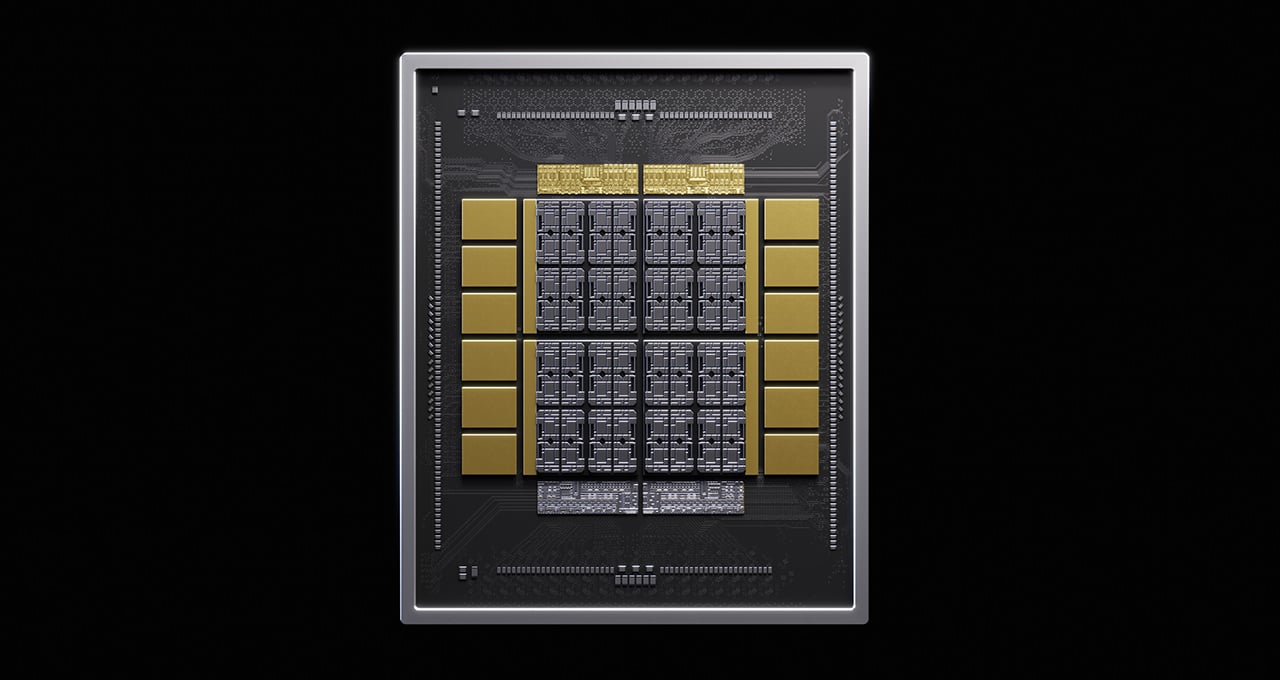
NVHBM řeší tento problém přesunutím paměťového řadiče přímo do 3D HBM stacku a využitím vlastní fyzické vrstvy (PHY). Tento přístup ve srovnání se standardními implementacemi HBM4E umožňuje až o 67 procent zmenšit plochu PHY a podpory periferií a zároveň zjednodušuje směrování tras interpozerů, čímž se v celém rozvržení získá až o 80 procent více použitelného křemíku. Užší paměťové rozhraní uvolňuje prostor v pouzdře, což umožňuje návrhářům rozšířit centrální výpočetní čip umělé inteligence až o 30 procent a přidat tak další maticová jádra, vektorové jednotky nebo hierarchii mezipaměti v rámci pevné fyzické obálky.
Energetická účinnost a prostor pro celé zařízení
Distribuce energie zůstává jedním z nejpřísnějších omezení v provozu hyperscale datových center, což má přímý dopad na tepelný návrh a požadavky na chlazení urychlovačů. NVHBM snižuje spotřebu energie HBM o 15 procent ve srovnání se standardním HBM4E.
Na úrovni křemíku snižuje snížená spotřeba paměti tepelný tlak, což poskytuje dodatečný elektrický prostor pro řízení výpočetních jader na vyšších trvalých frekvencích. V rozsahu zařízení se tyto úspory energie výrazně násobí. V teoretickém datovém centru o výkonu 1 gigawatt s nasazením 2 000wattových XPU může snížený profil spotřeby paměti uvolnit dostatek tepelné a elektrické kapacity pro podporu až 15 000 dalších XPU.
Integrace rackového systému pomocí NVLink Fusion
Zatímco NVHBM optimalizuje výkon na úrovni jednotlivých pouzder, NVLink Fusion slouží jako most na systémové úrovni. Využitím specializovaných chipletů NVLink Fusion se mohou vlastní XPU připojit přímo k šesté generaci škálovatelné struktury NVLink , čímž se všechny akcelerátory v racku spojí do jedné koherentní paměťové a výpočetní domény.
Tato škálovatelná struktura je klíčová pro pokročilá paralelizační schémata, jako je expertní paralelismus (EP) a WideEP, ve kterých distribuované modely směsi expertů vyžadují synchronizaci aktivací a skrytých stavů napříč více fyzickými zařízeními s nízkou latencí. Vlastní procesory se také mohou propojit s hostitelskými CPU prostřednictvím NVLink-C2C.
Integrací polozakázkového křemíku do širšího hardwarového a softwarového ekosystému NVIDIA umožňuje NVLink Fusion operátorům nasadit heterogenní prostředí, která kombinují zakázkové XPU se standardními GPU NVIDIA v rámci standardizované rackové architektury MGX, což zjednodušuje provoz a přidělování pracovních zátěží.


 Amazon