

Infrastruktury umělé inteligence jsou notoricky náročné na zdroje a podniky se neustále potýkají s problémem optimalizace využití grafických karet (GPU). Společnost Dell Technologies prostřednictvím své platformy AI Factory řeší tuto výzvu integrací nedávno získaného orchestračního řešení Run:ai od společnosti NVIDIA . V nedávném blogu společnosti Dell společnost zdůraznila, jak Run:ai maximalizuje využití zdrojů a urychluje výsledky umělé inteligence, čímž transformuje způsob, jakým podniky nasazují a spravují zdroje GPU ve velkém měřítku.
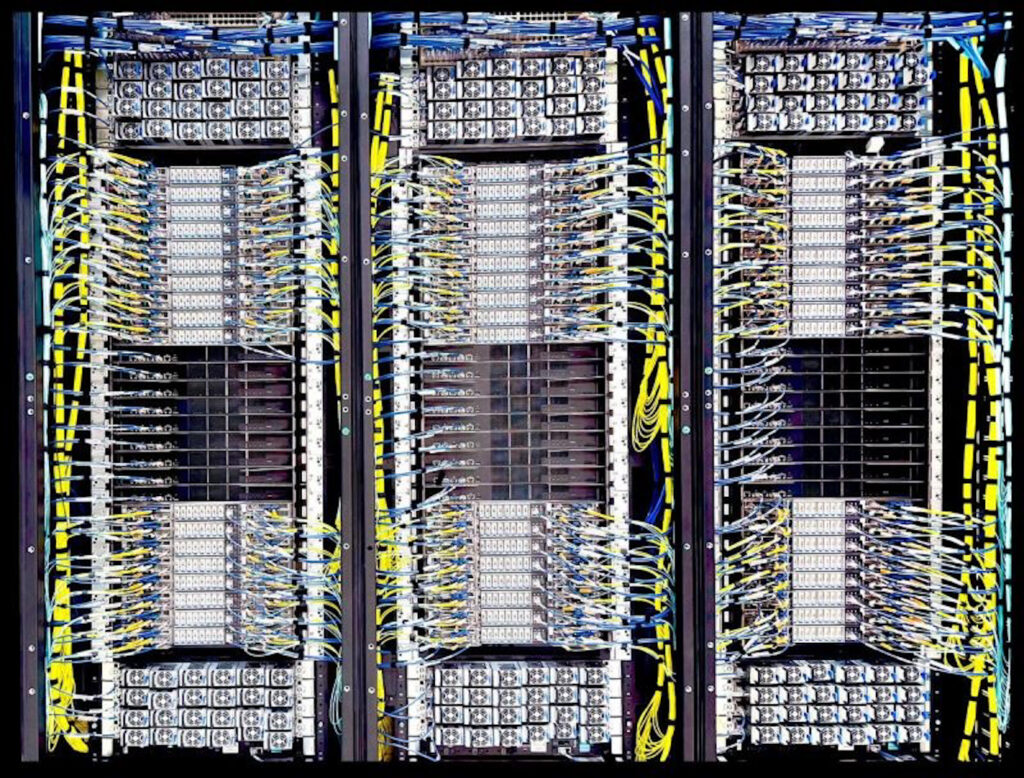
Cluster Dell NVL72
Co přesně je Run:ai?
Run:ai je orchestrační platforma postavená na Kubernetes, navržená speciálně pro úlohy zaměřené na GPU. Run:ai, založená v roce 2018, se prosadila řešením všudypřítomného problému v oboru: neefektivního využívání GPU. GPU přiřazené úlohám s umělou inteligencí tradičně často zůstávají nečinné nebo nedostatečně využívané. Run:ai tento problém řeší dynamickým sdružováním a inteligentním plánováním zdrojů GPU, což umožňuje částečnou alokaci GPU, efektivní nasazení více GPU a bezproblémovou správu v hybridních, cloudových i lokálních prostředích.
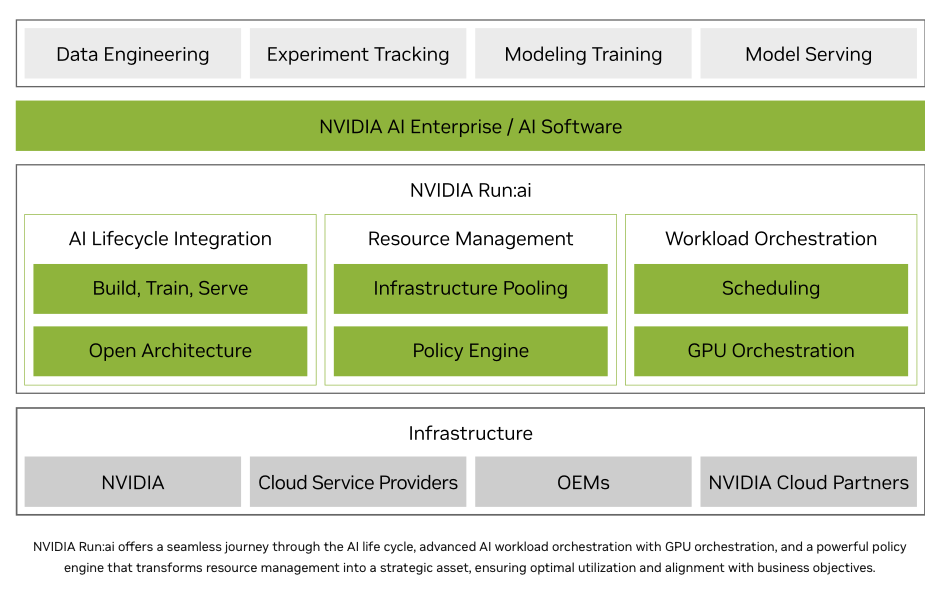
NVIDIA si uvědomila potenciál Run:ai dramaticky změnit infrastrukturu umělé inteligence a v prosinci 2024 dokončila akvizici této společnosti za přibližně 700 milionů dolarů. Zajímavé je, že se NVIDIA zavázala k tomu, že Run:ai nakonec zpřístupní jako open-source, čímž signalizuje svůj záměr podpořit široké přijetí ekosystému nad rámec svých hardwarových platforem. Očekává se, že tento krok dále urychlí inovace a efektivitu celého odvětví v celém odvětví.
Pro ty, kteří hledají hlubší technický pohled na správu zdrojů, dokumentace společnosti NVIDIA podrobně popisuje , jak je Run:ai nezbytný pro orchestraci úloh na systémech GB200 NVL72. Dokument zdůrazňuje kritickou mezeru: Kubernetes nativně nerozpoznává architekturu MNNVL od společnosti NVIDIA, což správu a plánování úloh v těchto vysoce výkonných doménách činí složitější. Run:ai tuto složitost abstrahuje automatickou detekcí domén NVLink a zjednodušením odesílání distribuovaných úloh. To zajišťuje, že pody jsou správně umístěny na uzlech s propojením NVLink, což eliminuje potřebu hlubokých znalostí hardwaru nebo ruční konfigurace pro každou úlohu. Tyto funkce ukazují, jak platforma zefektivňuje provoz v hustých tréninkových prostředích a umožňuje organizacím plně využít sílu pokročilých hardwarových konfigurací, jako je GB200 NVL72.
Proč je to pro podnik důležité
Pro organizace provozující úlohy náročné na GPU, zejména ty zahrnující generativní umělou inteligenci a rozsáhlé jazykové modely, představuje nedostatečné využití GPU značné riziko: plýtvání investicemi. Run:ai tyto neefektivity přímo řeší a NVIDIA uvádí , že organizace využívající tuto platformu mohou zaznamenat až pětinásobné zlepšení využití GPU.
Tato úroveň optimalizace nejen zvyšuje návratnost investic, ale také zásadně mění provozní efektivitu. Týmy, které byly dříve omezené zdroji a složitými procesy plánování, nyní mají nástroje pro současné nasazení více modelů, rychlé škálování a agresivnější experimentování, to vše bez dodatečných kapitálových výdajů na hardware. Zatímco tyto metodiky jsou běžné u velkých nasazení HPC, úroveň efektivity potřebná pro maximalizaci využití GPU je v podniku méně běžná.
Široce rozvíjející se odvětví
Několik významných poskytovatelů infrastruktury tuto platformu přijímá, což signalizuje rostoucí dynamiku v celém podnikovém IT prostředí.
Společnost Dell nadále rozšiřuje svůj rámec AI Factory, jehož jádrem jsou technologie NVIDIA, včetně Run:ai. Využití Run:ai společností Dell ilustruje, jak se podniky mohou posunout od izolované, manuální alokace zdrojů k dynamičtějšímu, automatizovanému plánování, které vede k vyšší efektivitě v prostředích s více klienty.
Společnost HPE nabízí Run:ai jako součást svého GreenLake Marketplace a integruje jej s platformou Ezmeral, což umožňuje pokročilé plánování GPU, částečnou alokaci a orchestraci hybridní infrastruktury. To zákazníkům umožňuje nasazovat a spravovat úlohy umělé inteligence s větší přesností a škálovatelností.
Společnost Cisco integruje Run:ai se svými servery UCS řady X a cloudovou operační platformou Intersight. Jejich řešení zdůrazňuje správu kvót, částečné sdílení GPU a monitorování v reálném čase pro podporu rozsáhlých lokálních nasazení umělé inteligence.
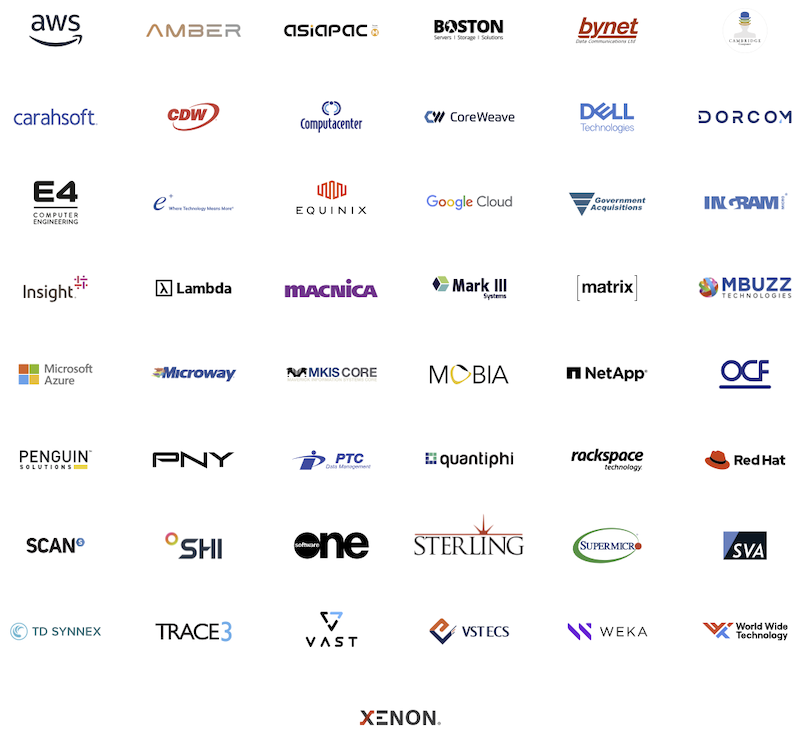
Zdůraznili jsme jen několik partnerů Run:ai. NVIDIA má rozsáhlý seznam log, jak je uvedeno výše. Přední výrobci OEM a poskytovatelé cloudových platforem se napříč všemi oblastmi spojují s Run:ai ve snaze poskytovat inovativnější a efektivnější řešení infrastruktury umělé inteligence.



 Amazon