

Společnost NVIDIA představila Helix Parallelism, novou metodu vyvinutou pro architekturu grafických procesorů Blackwell, jejímž cílem je zlepšit výkon umělé inteligence v reálném čase s velmi rozsáhlými datovými sadami. Tato technika reaguje na rostoucí potřebu LLM pro zpracování kontextů s mnoha miliony tokenů. NVIDIA prokazuje, že tento přístup může zvýšit rychlost zpracování až 32krát oproti konvenčním metodám, což umožňuje komplexnější a responzivnější aplikace umělé inteligence.
Výzva milionu tokenů: Proč umělá inteligence potřebovala nový přístup
Hranice umělé inteligence se posunula od jednoduchých dotazů ke komplexnímu, dlouhodobému uvažování. Pokročilé aplikace vyžadují k efektivnímu fungování nesmírně rozsáhlý kontext. Asistent umělé inteligence, který si pamatuje měsíce konverzací, právní nástroj, který analyzuje gigabajty judikatury najednou, nebo programátor, který rozumí celému repozitáři. Tyto úkoly vyžadují zpracování milionů tokenů.
Nicméně, škálování na tuto úroveň odhaluje dvě zásadní úzká hrdla.
- Úzké hrdlo KV mezipaměti: Během autoregresního generování tokenů modely počítají pozornost s dříve vygenerovanými tokeny, aby se zabránilo kvadratickému škálovacímu faktoru. Za tímto účelem se dříve vygenerované tokeny ukládají do mezipaměti, což je proces známý jako KV mezipaměť. V kontextech s více miliony tokenů se tato mezipaměť stává enormní, saturuje šířku pásma paměti GPU a dramaticky zpomaluje dobu odezvy.
- Úzké hrdlo vah FFN: Pro každý nový token, který model vygeneruje, musí z paměti načíst masivní váhy sítě Feed-Forward Network (FFN). V interaktivních aplikacích s nízkou latencí se tento proces neustálého načítání stává primárním zdrojem zpoždění.
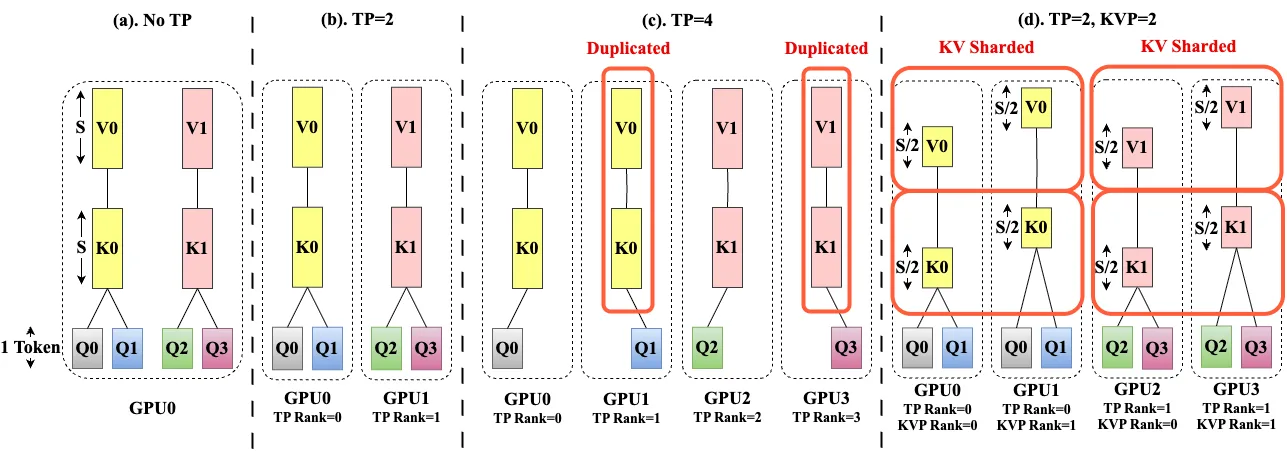
V současné době se spoléháme na metody, jako je tenzorový paralelismus, který rozděluje tenzory modelu, a tedy i paměť potřebnou k výpočtu, mezi více GPU. I když je efektivní pro některé úlohy, jeho výhody klesají s novějšími mechanismy pozornosti. V mechanismech pozornosti, jako je GQA (Grouped Query Attention) nebo MLA (Multi-Latent Attention), sdílí více hlav dotazů menší sadu KV hlav, aby se snížilo využití paměti. Pokud však velikost tenzorového paralelismu překročí počet KV hlav, je nutná duplikace KV hlav kvůli značné latenci způsobené komunikací mezi GPU v každém kroku. Tato duplikace neguje některé výhody tenzorového paralelismu.
Paralelismus šroubovice
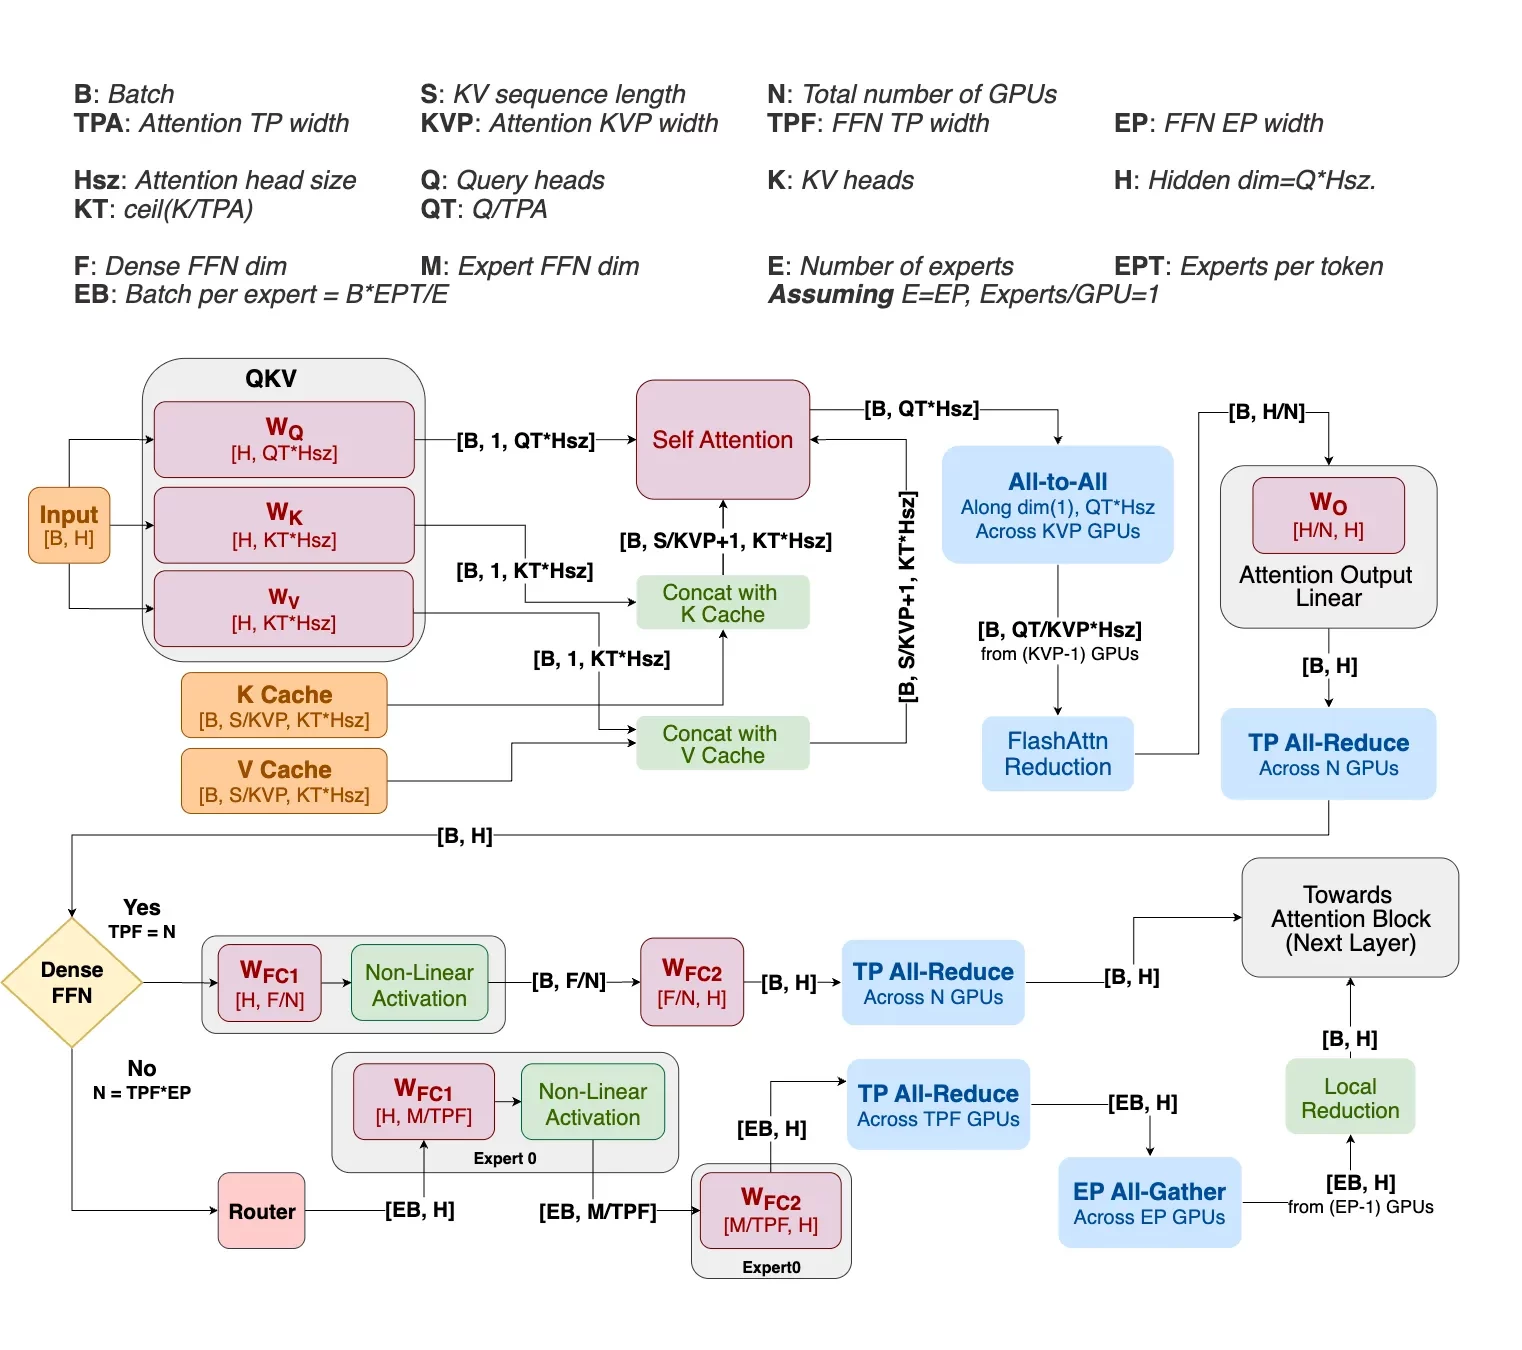
Aby se tato hádanka vyřešila, zavádí Helix Parallellism od společnosti NVIDIA hybridní strategii, která zachází s oběma úzkými hrdly jako s oddělenými problémy, které je třeba řešit v bezproblémovém, časovém postupu. Namísto použití jediné metody paralelismu pro celý proces Helix dynamicky rekonfiguruje stejný pool GPU tak, aby pro každou fázi výpočtu používal optimální strategii.
Proces lze rozdělit do dvou hlavních fází pro každou vrstvu modelu.
Fáze 1: Fáze pozornosti (zvládnutí KV cache)
Helix přímo řeší úzké hrdlo KV mezipaměti kombinací dvou forem paralelismu. Zaprvé aplikuje KV paralelismus, který rozděluje samotnou KV mezipaměť mezi více GPU podél dimenze sekvence. To znamená, že každá GPU uchovává pouze část celkového kontextu, což snižuje zátěž paměti.
Současně využívá tenzorový paralelismus k rozdělení hlav pozornosti, čímž zajišťuje, že počet rozdělení nepřekročí počet KV hlav. Tato kombinace zabraňuje duplikaci mezipaměti, která trápí tradiční tenzorový paralelismus. Výsledkem je 2D mřížka GPU, která dokáže efektivně vypočítat pozornost v masivním kontextu, aniž by byla kterákoli GPU zahlcena. Komunikace mezi těmito GPU je řešena jedinou, efektivní ústřednou typu „všechny“, jejíž náklady jsou nezávislé na délce kontextu, což ji činí vysoce škálovatelnou.
Fáze 2: Fáze FFN (zvládání vah FFN)
Komunikace mezi všemi na konci fáze pozornosti také rozděluje výstupní data mezi grafické procesory (GPU). To znamená, že data jsou již dokonale uspořádána pro okamžité zahájení výpočtu FFN.
Stejný fond GPU je znovu zřízen do velké skupiny Tensor Parallelism. Protože jsou data předem rozdělena, může každé GPU provádět lokální násobení matic s použitím svého shardu masivních vah FFN. Tento počáteční výpočet probíhá paralelně bez komunikace mezi GPU, což maximalizuje rychlost. Teprve po tomto kroku lokálního výpočtu se GPU zapojí do efektivní komunikace typu all-reduce, aby zkombinovaly své dílčí výsledky do konečného výstupu.
Posledním dílkem skládačky je, jak Helix spravuje mezipaměť KV, jak se rozrůstá. Jak model generuje nové tokeny, musí být do mezipaměti přidávány. Naivní přístup by mohl vytvořit hotspot paměti zápisem všech nových tokenů na jednu GPU. Helix tomu zabraňuje chytrým systémem aktualizace typu round robin. Například první blok nových tokenů by mohl jít na GPU 0, následující blok na GPU 1 atd. Tento stupňovitý přístup zajišťuje, že využití paměti roste rovnoměrně napříč všemi GPU ve skupině KV paralelismu, čímž se udržuje vyvážený výkon a konzistentní propustnost bez ohledu na velikost kontextu.
Nová hranice výkonu na Blackwellu
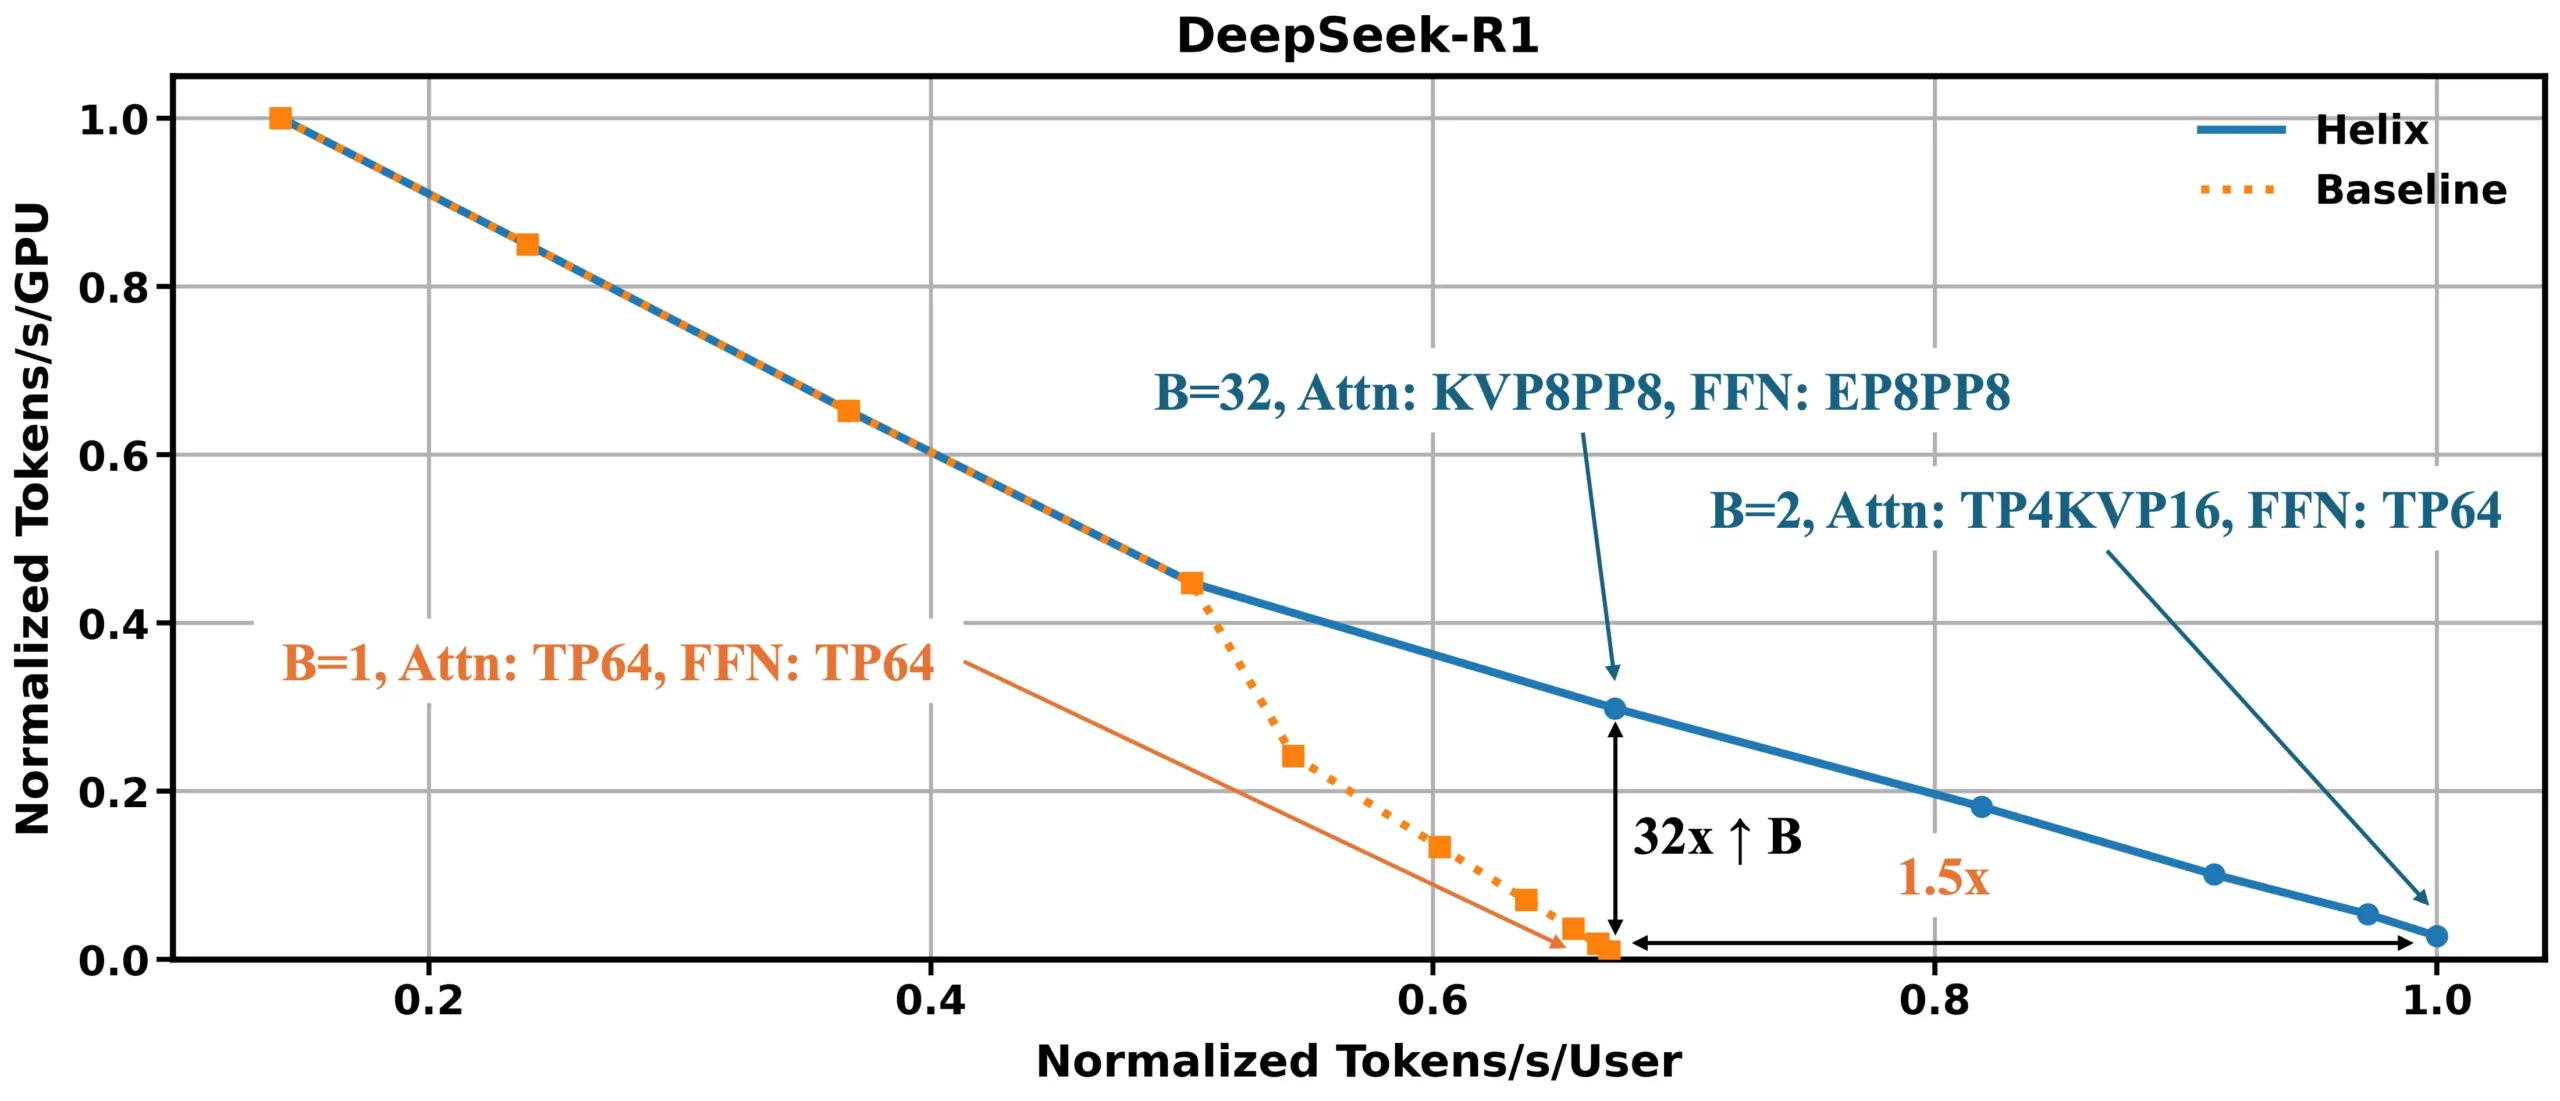
Helix nastavuje nový výkonnostní standard pro dekódování LLM s dlouhým kontextem. Výsledky jsou založeny na vyčerpávající simulaci na Blackwell NVL72 s využitím parametrického modelu DeepSeek R1 671B (FP4) s hypotetickým kontextem jednoho milionu tokenů, systematicky měnících se strategií dělení a velikostí dávek s cílem najít nejlepší kompromisy mezi propustností a latencí. Pro aplikace vyžadující masivní škálovatelnost, jako je například obsluha mnoha uživatelů současně, může Helix zvýšit počet souběžných uživatelů až 32krát při daném rozpočtu latence. Pro nastavení s nízkou souběžností, kde je kritická odezva jednoho uživatele, může tato technika zlepšit interaktivitu uživatelů až 1.5krát snížením minimální dosažitelné latence mezi tokeny. Těchto zisků je možné dosáhnout rozdělením vah mezi mezipaměť KV i FFN na všechna dostupná zařízení, což dramaticky snižuje zatížení DRAM a zlepšuje výpočetní efektivitu.
Pro hlubší technický pohled na metodologii a výsledky simulací je zde odkaz na celou zprávu.


 Amazon