

Summit AI Infra Summit zdůrazňuje výsledky MLPerf Inference od společností AMD a NVIDIA a také plán Vera Rubin společnosti NVIDIA pro rok 2026, konkrétně Rubin CPX.
Na konferenci AI Infra Summit 2025 společnost NVIDIA předvedla pokrok na dvou frontách: působivé nové výsledky MLPerf Inference ze svých systémů Blackwell Ultra a, co je důležitější, podrobný plán pro generaci Vera Rubin 2026, včetně Rubin CPX, nové třídy GPU určené pro masivní kontextovou inferenci.
Blackwell Ultra nastavuje nové výkonnostní standardy
Rackové systémy NVIDIA GB300 NVL72 již dosáhly pozoruhodného výkonu v testu MLPerf Inference v5.1, což ukazuje architektonickou vyspělost platformy Blackwell Ultra, a to i v době, kdy software nadále odemyká její plný potenciál. Tato síla se jasně projevuje v benchmarku Llama 2 70B, kde platforma v offline scénářích dosáhla působivých 12 934 tokenů za sekundu na GPU. Výkon v testu online obsluhy byl téměř identický s 12 701 tokeny za sekundu, což svědčí o výjimečné efektivitě architektury napříč různými pracovními zátěžemi.
Připravenost platformy pro reálné aplikace byla dále prokázána v nově zavedené interaktivní kategorii, která klade podstatně přísnější omezení latence, včetně požadavků na dobu do prvního tokenu pod 500 ms a prahové hodnoty 33 tokenů za sekundu na uživatele. I za těchto agresivních požadavků na kvalitu služeb si Blackwell Ultra udržel vysokou propustnost a poskytl 7 856 tokenů za sekundu na GPU. V benchmarku DeepSeek-R1 platforma stanovila další definitivní základní hodnotu na 5 842 tokenů za sekundu na GPU.
Tyto výsledky v konečném důsledku naznačují, že hardwarové možnosti převyšují možnosti současného softwarového balíčku. Stále existuje značný výkonnostní prostor, který je třeba uvolnit, jelikož se frameworky jako TensorRT-LLM a NVIDIA Dynamo vyvíjejí tak, aby plně využily architektonické výhody Blackwell Ultra, jako jsou vylepšené výpočetní cesty NVFP4 a masivní kapacita 288 GB HBM3e na GPU.
Zrychlení inovační kadence: Platforma Very Rubin
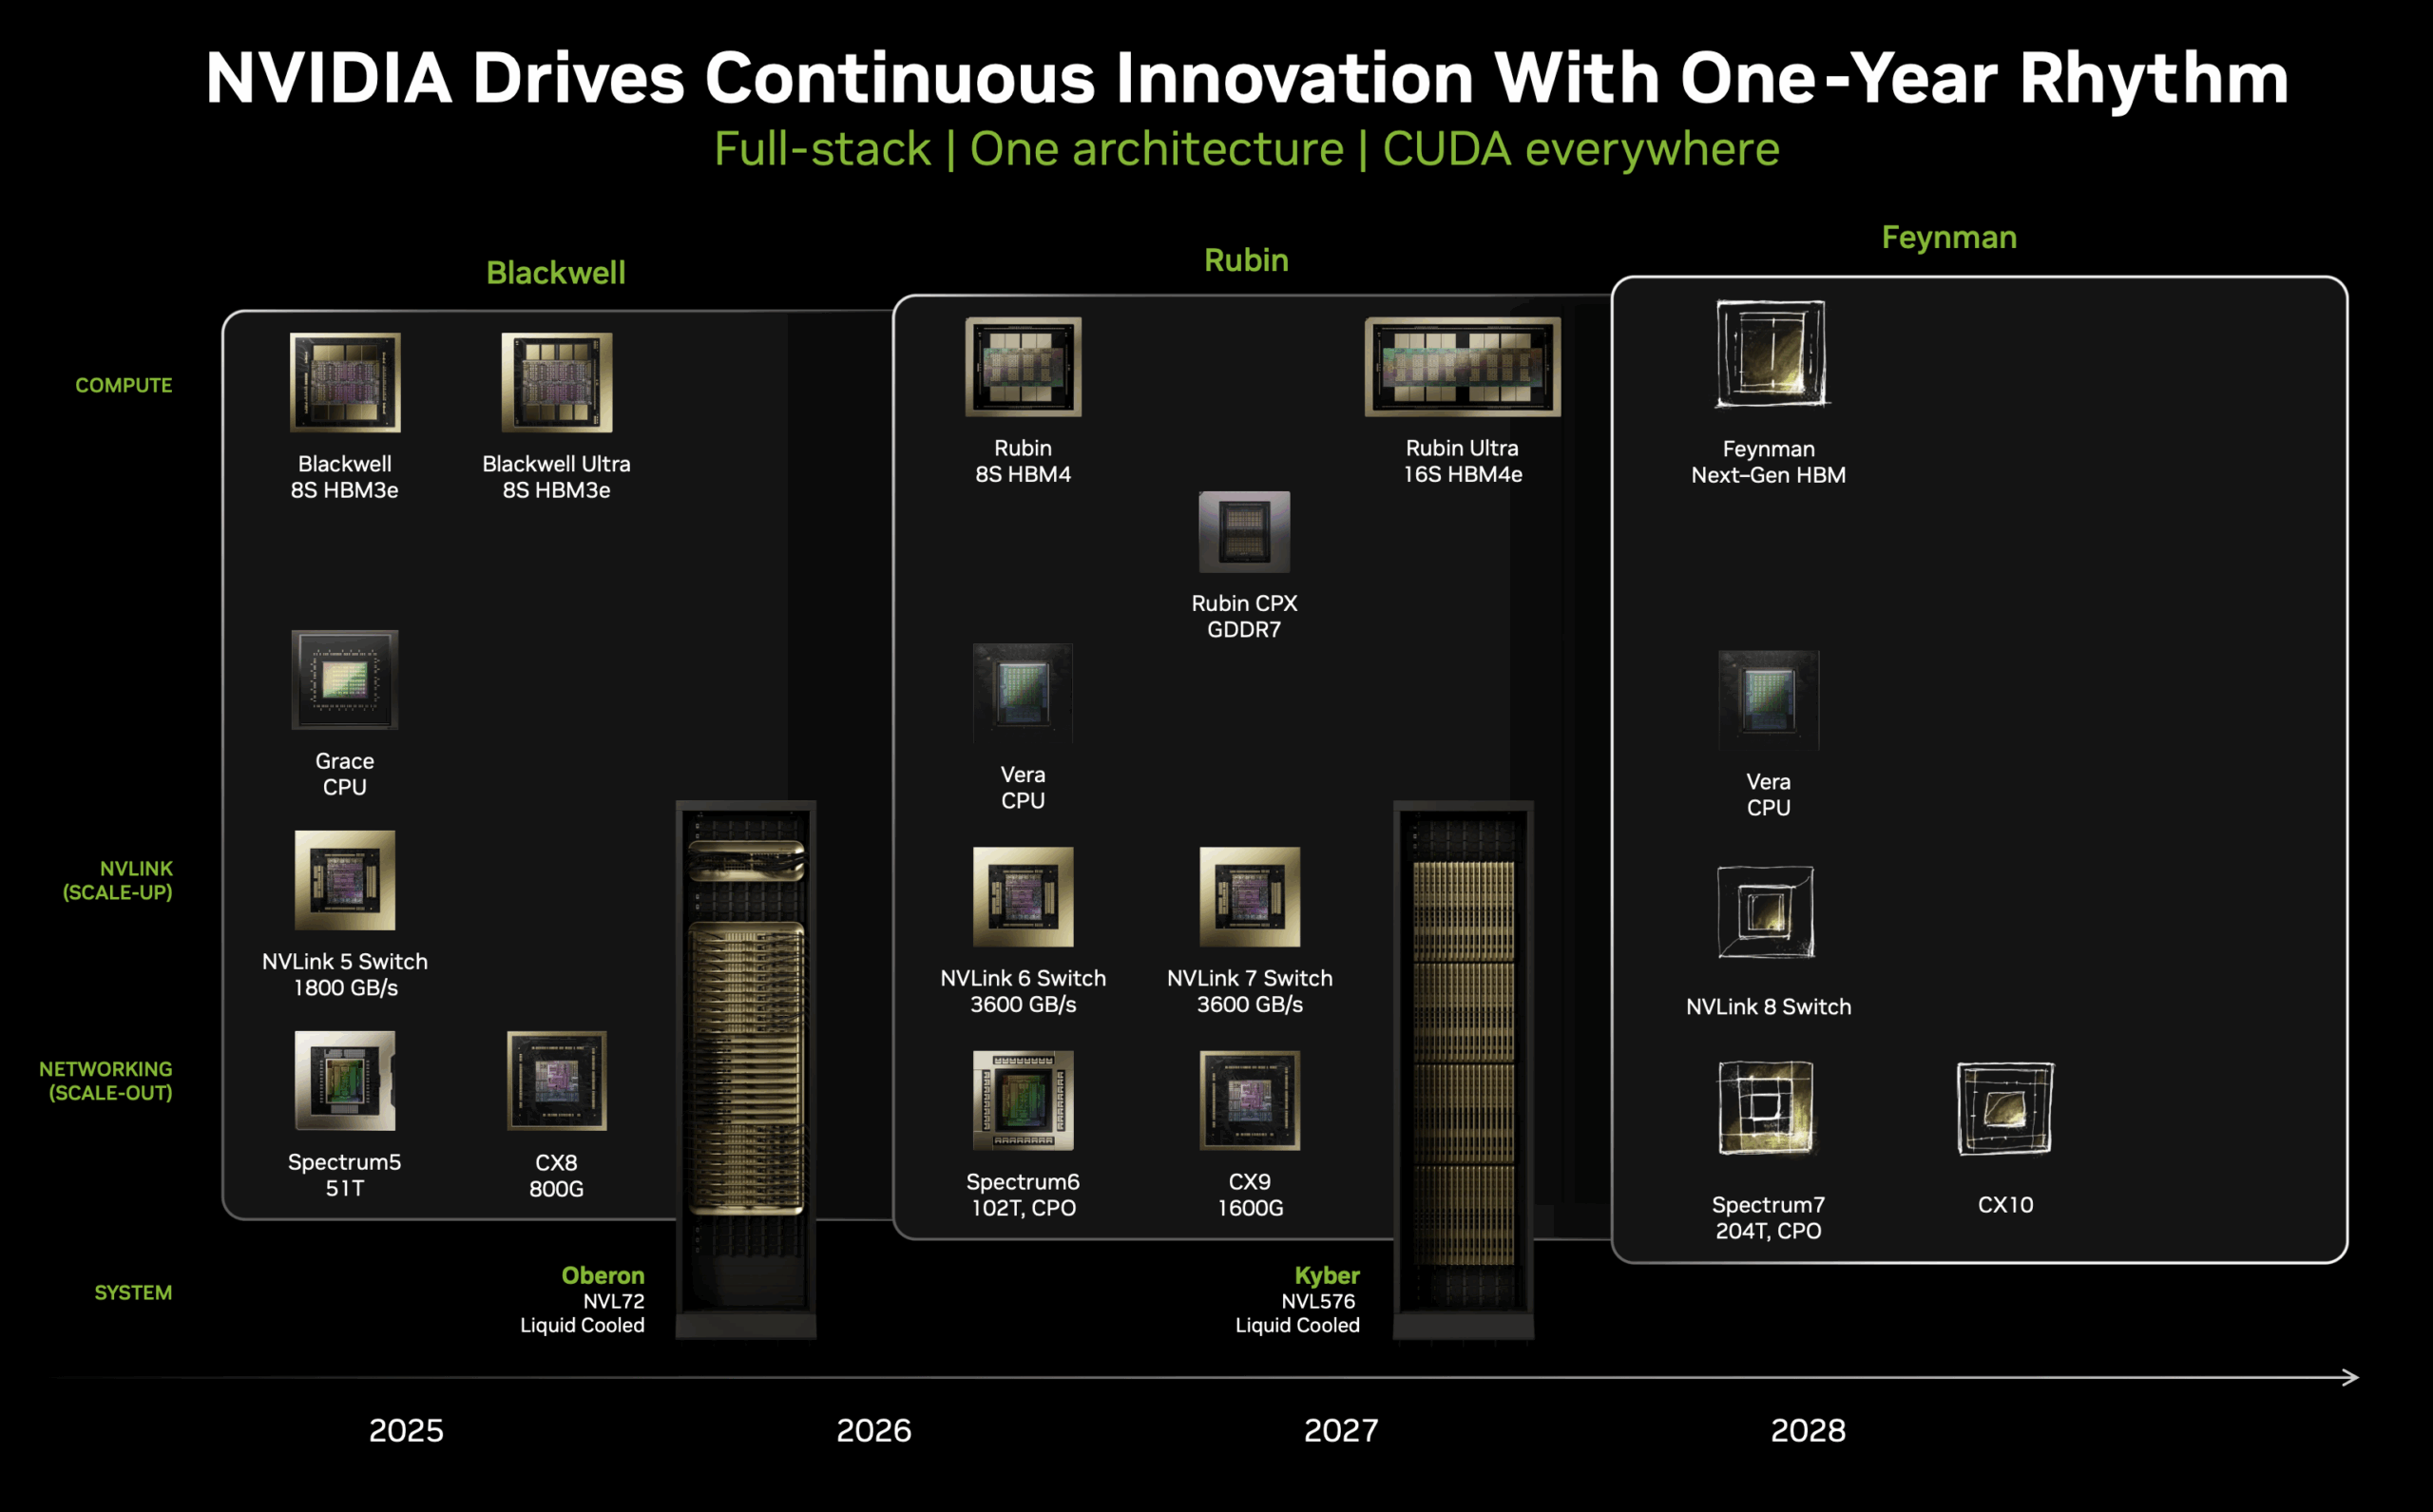
Společnost NVIDIA zavedla každoroční cyklus obnovy architektury jako strategickou reakci na exponenciální růst výpočetních nároků v oblasti umělé inteligence. V souladu s tímto agresivním časovým harmonogramem společnost NVIDIA oznámila, že generace Vera Rubin je již připravena a její nasazení v podnikových systémech je plánováno na druhou polovinu roku 2026.
Architektura Vera Rubin představuje komplexní aktualizaci platformy zaměřenou na integraci nových procesorů Vera a grafických karet Rubin. Procesor Vera představuje významný vývoj oproti třem generacím systémů NVIDIA Grace. Procesory Vera disponují 88 jádry ARM s podporou 176 vláken. Tyto procesory také zdvojnásobují šířku pásma propojení mezi čipy (C2C) na 1 800 GB/s, což umožňuje rychlejší propojení mezi procesorem, grafickou kartou a jejich sdílenými paměťovými zdroji.

Na propojovací vrstvě poskytuje NVLink šesté generace obousměrnou šířku pásma 3 600 GB/s, což zdvojnásobuje šířku pásma současných přepínačů NVLink 5. generace. Tato vylepšená konektivita se stává obzvláště důležitou, protože modely se neustále rozšiřují nad paměťovou kapacitu jednotlivých zařízení a vyžadují sofistikované strategie paralelního provádění, které vyžadují minimální komunikační latenci a maximální propustnost mezi uzly.
Přepínač Spectrum-6, který využívá technologii kombinované optiky (CPO), doplňuje pokročilou technologii NVLink a dosahuje přepínací kapacity 102 TB/s. Integrace optických komponent přímo do pouzdra přepínače eliminuje tradiční úzká hrdla při převodu elektrické energie na optickou, snižuje latenci a zároveň dramaticky zlepšuje energetickou účinnost – což je klíčové pro to, jak se továrny s umělou inteligencí škálují směrem k gigawattovým úrovním spotřeby energie.

Systémy VR NVL144 budou i nadále využívat osvědčenou rackovou platformu Oberon, která je v současnosti základem systémů Grace Hopper, Grace Blackwell a Grace Blackwell Ultra.
Vývoj architektonické nomenklatury: Od balíčků k razidlům
NVIDIA mění svou konvenci pojmenování z pouzdra na počet čipů. I když tato změna může být kontroverzní, jedná se o krok do budoucna, který poskytne větší přehled, zejména s ohledem na očekávané uvedení grafických procesorů Rubin Ultra na trh koncem roku 2026, u kterých se očekává, že budou obsahovat čtyři čipy o velikosti reticle.

S generací Rubin společnost NVIDIA zavádí nomenklaturu pro počítání čipů, která přímo odráží dostupné výpočetní zdroje. Označení NVL144 explicitně odkazuje na 144 čipů GPU, přičemž zachovává fyzickou konfiguraci s 72 pouzdry a poskytuje přesnější měření výpočetní kapacity. To je podobné systémům NVL72 současné generace GB200 a GB300, které obsahují 72 pouzder GPU, z nichž každé obsahuje dva čipy GPU, celkem tedy 144 výpočetních čipů.
Řešení problému zpracování kontextu
Oznámení o Rubin CPX, jehož dostupnost je plánována na konec roku 2026, je architektonickou reakcí společnosti NVIDIA na jednu z nejnaléhavějších výzev v inferenci LLM: zásadní nesoulad mezi výpočetními vzorci během různých fází generování tokenů. Abychom této inovaci porozuměli, musíme se podívat na charakteristické rysy inferenčních úloh LLM a omezení současných homogenních architektur GPU při řešení těchto rozmanitých výpočetních požadavků.
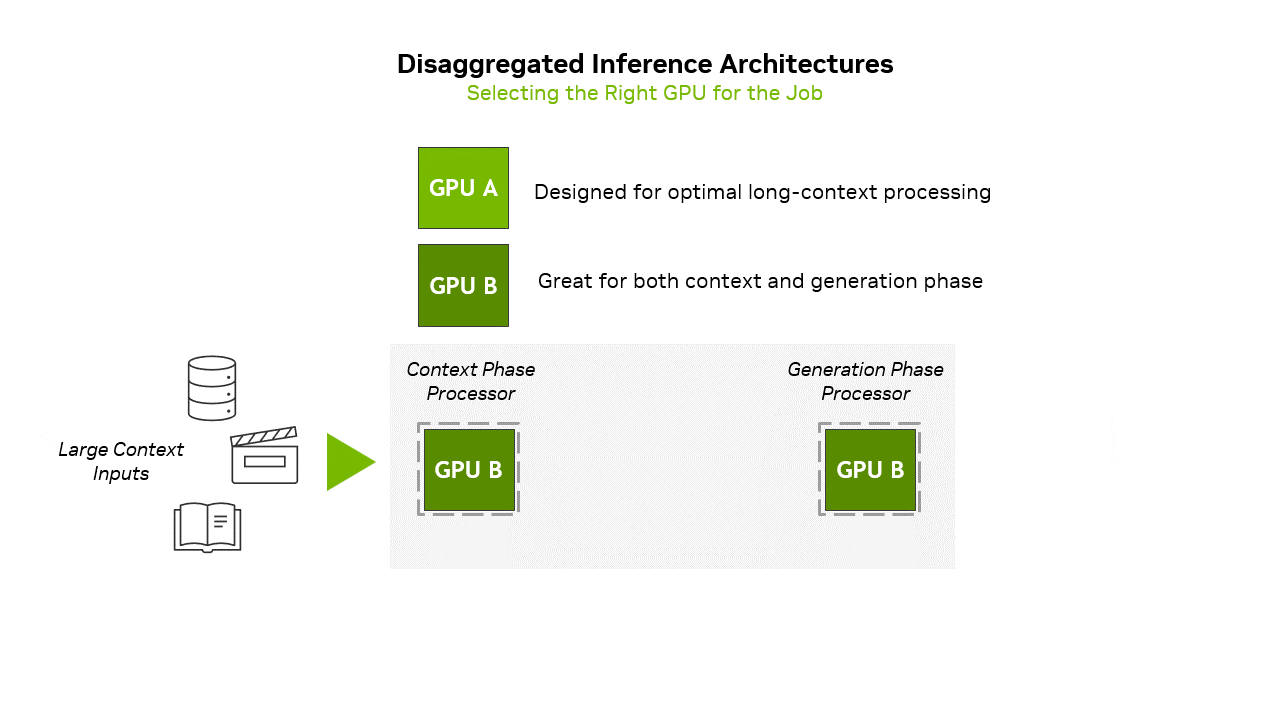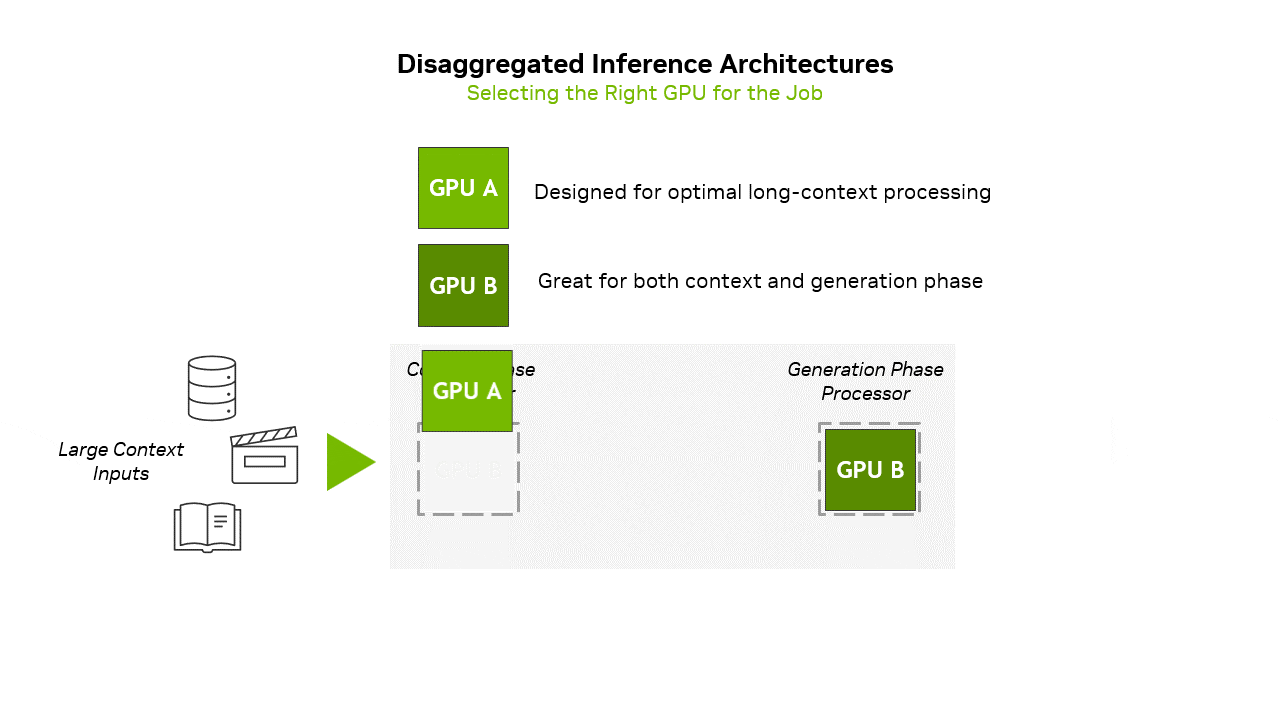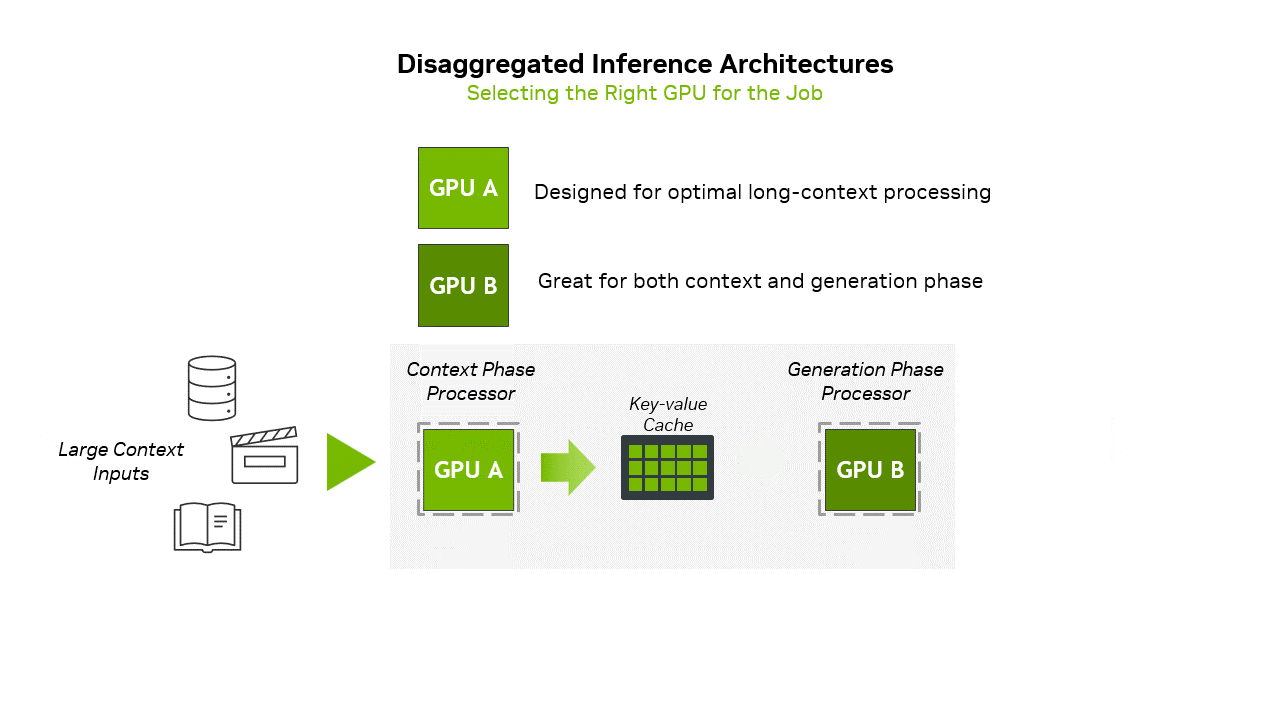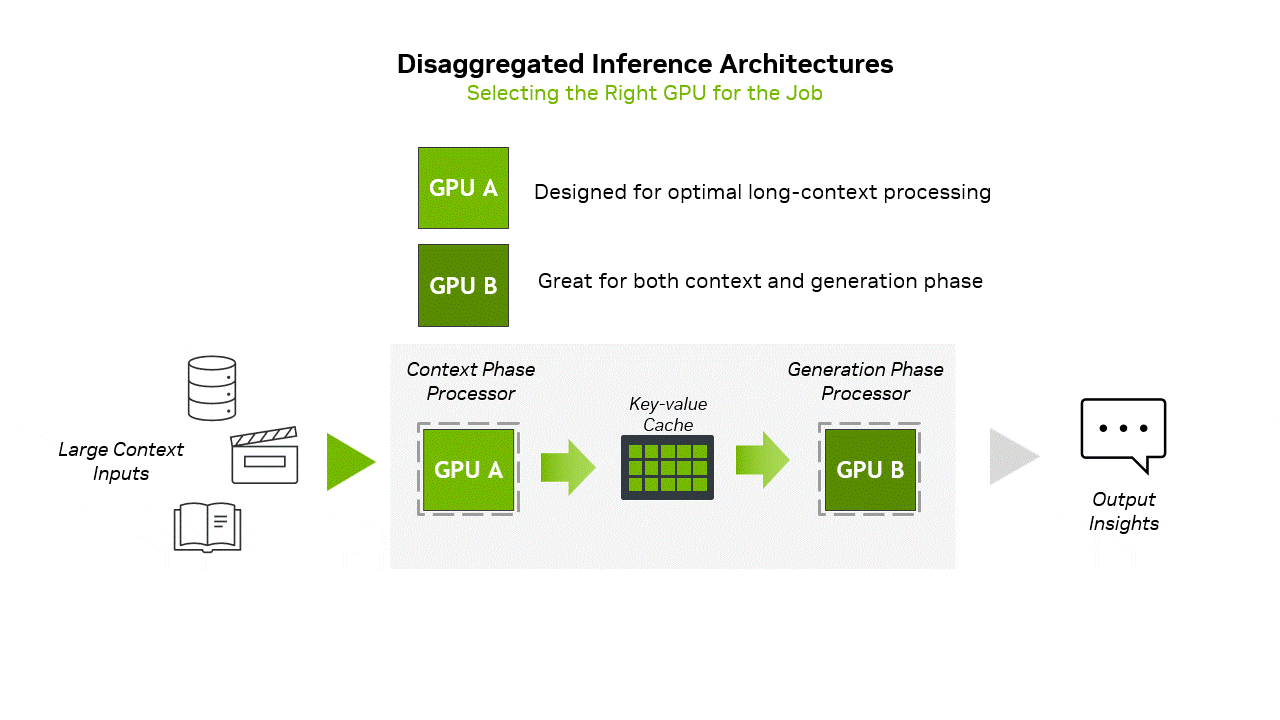
Inference modelů velkých jazyků probíhá ve dvou zásadně odlišných výpočetních fázích, které kladou dramaticky odlišné nároky na hardwarové zdroje. Fáze předběžného vyplňování zpracovává počáteční vstupní prompt a vypočítává matice klíčů a hodnot pro následné generování. Tato fáze je výpočetně náročná a efektivně využívá masivní propustnost moderních grafických procesorů pro operace s plovoucí desetinnou čárkou.
Fáze dekódování představuje zcela odlišnou výpočetní výzvu. Během dekódování model generuje výstupní tokeny autoregresivně, přičemž produkuje jeden token po druhém s ohledem na předchozí kontext. Každý nový token vyžaduje, aby mechanismus pozornosti zpracoval celou historii sekvence a vypočítal jeho vztah ke všem předchozím tokenům. To vytváří jedinečný výpočetní vzorec, kde se primárním úzkým hrdlem stává šířka pásma paměti, nikoli výpočetní propustnost. Dominantním spotřebitelem paměti se stává mezipaměť KV, která ukládá mezilehlé reprezentace potřebné k udržení kontextu.
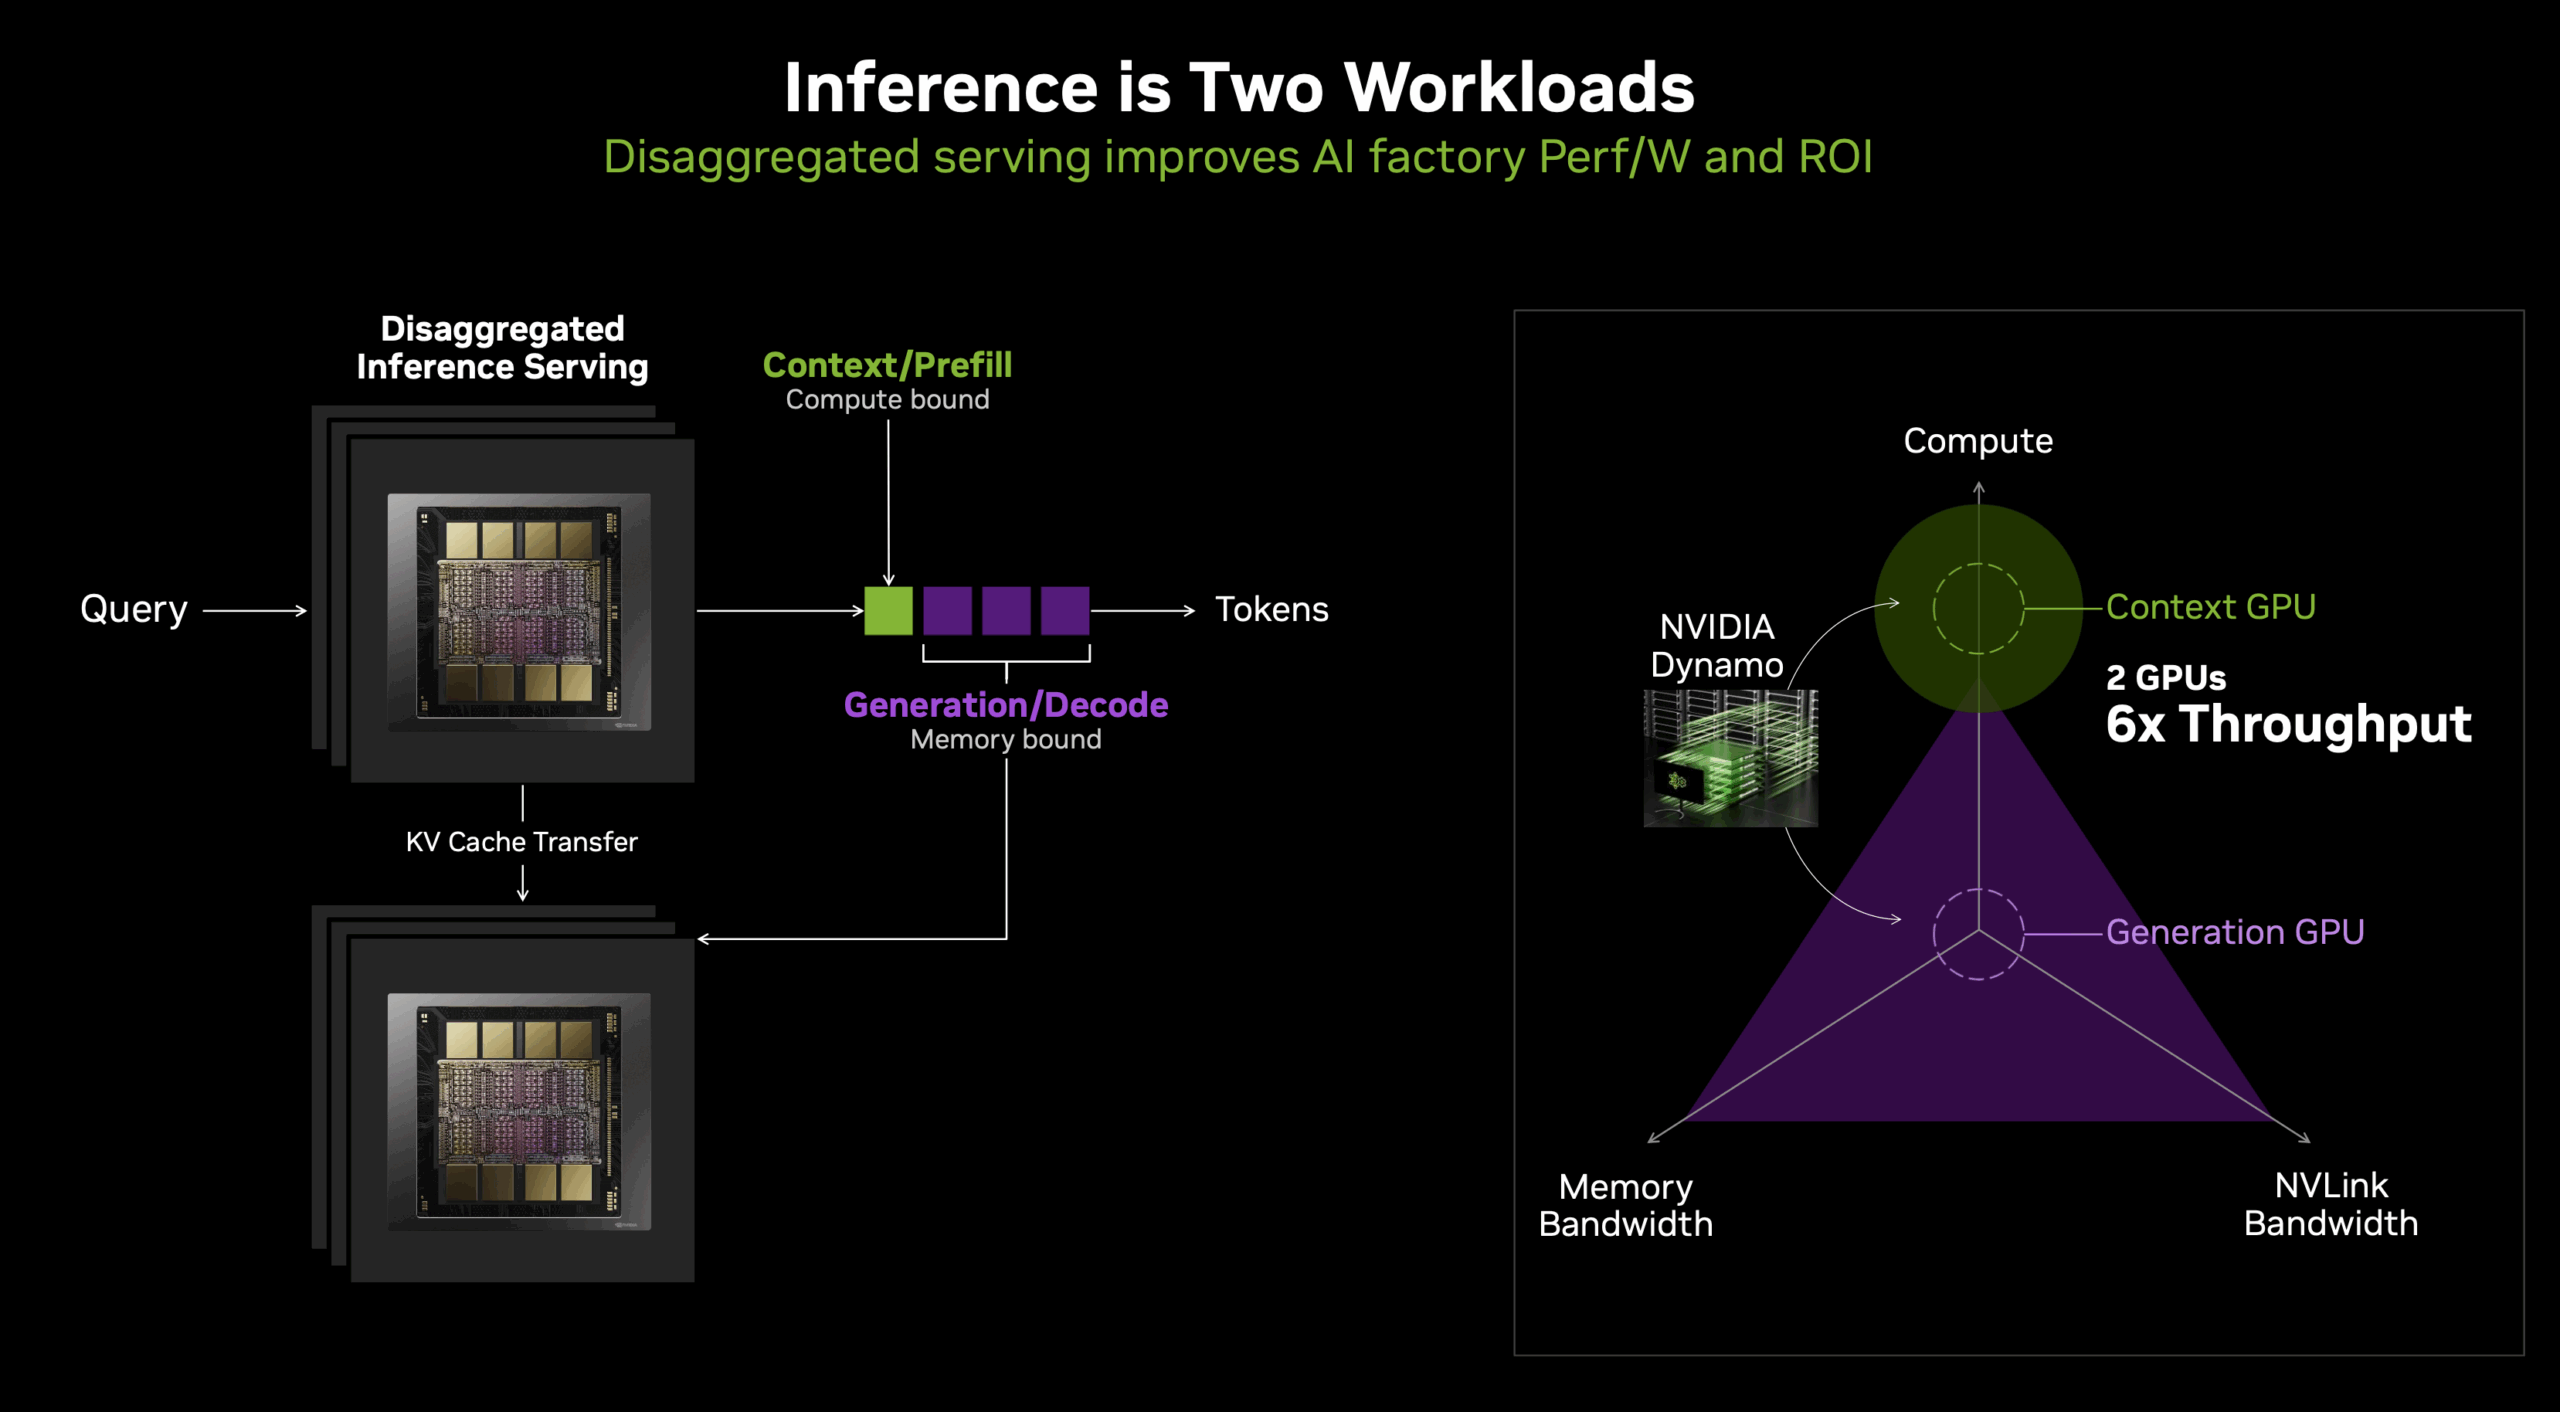
Škálovací charakteristiky mezipaměti KV představují v produkčním prostředí zvláštní výzvy. U modelu, jako je Llama 3.1 405B, který zpracovává rozšířené kontexty, může mezipaměť KV snadno spotřebovat desítky gigabajtů na sekvenci. V dávkových inferenčních scénářích, které jsou nezbytné pro dosažení vysoké propustnosti v produkčním prostředí, agregovaná velikost mezipaměti KV často překračuje velikost samotných vah modelu. Vzhledem k velkým velikostem dávek, které jsou možné ve velkých nasazeních NVL72, může mezipaměť KV dosáhnout velikosti několika terabajtů. I když tato data musí zůstat dostupná s rozumnou latencí, ne všechny přístupy k mezipaměti KV vyžadují extrémní šířku pásma paměti HBM. Mnoho operací s pozorností vykazuje přístupové vzory, které jsou přístupné hierarchickým paměťovým architekturám.
Rubin CPX: Účelová architektura pro zpracování kontextu
Rubin CPX řeší tyto architektonické neshody prostřednictvím účelového návrhu pro dlouhodobou LLM inferenci. Architektura se zaměřuje na 128 GB paměti GDDR7, což poskytuje velký a cenově dostupný paměťový fond pro operace s KV cache. Charakteristiky šířky pásma GDDR7, i když nižší než u HBM4, jsou dostatečné pro většinu operací zaměřených na pozornost, zejména v kombinaci s inteligentními strategiemi cachování.
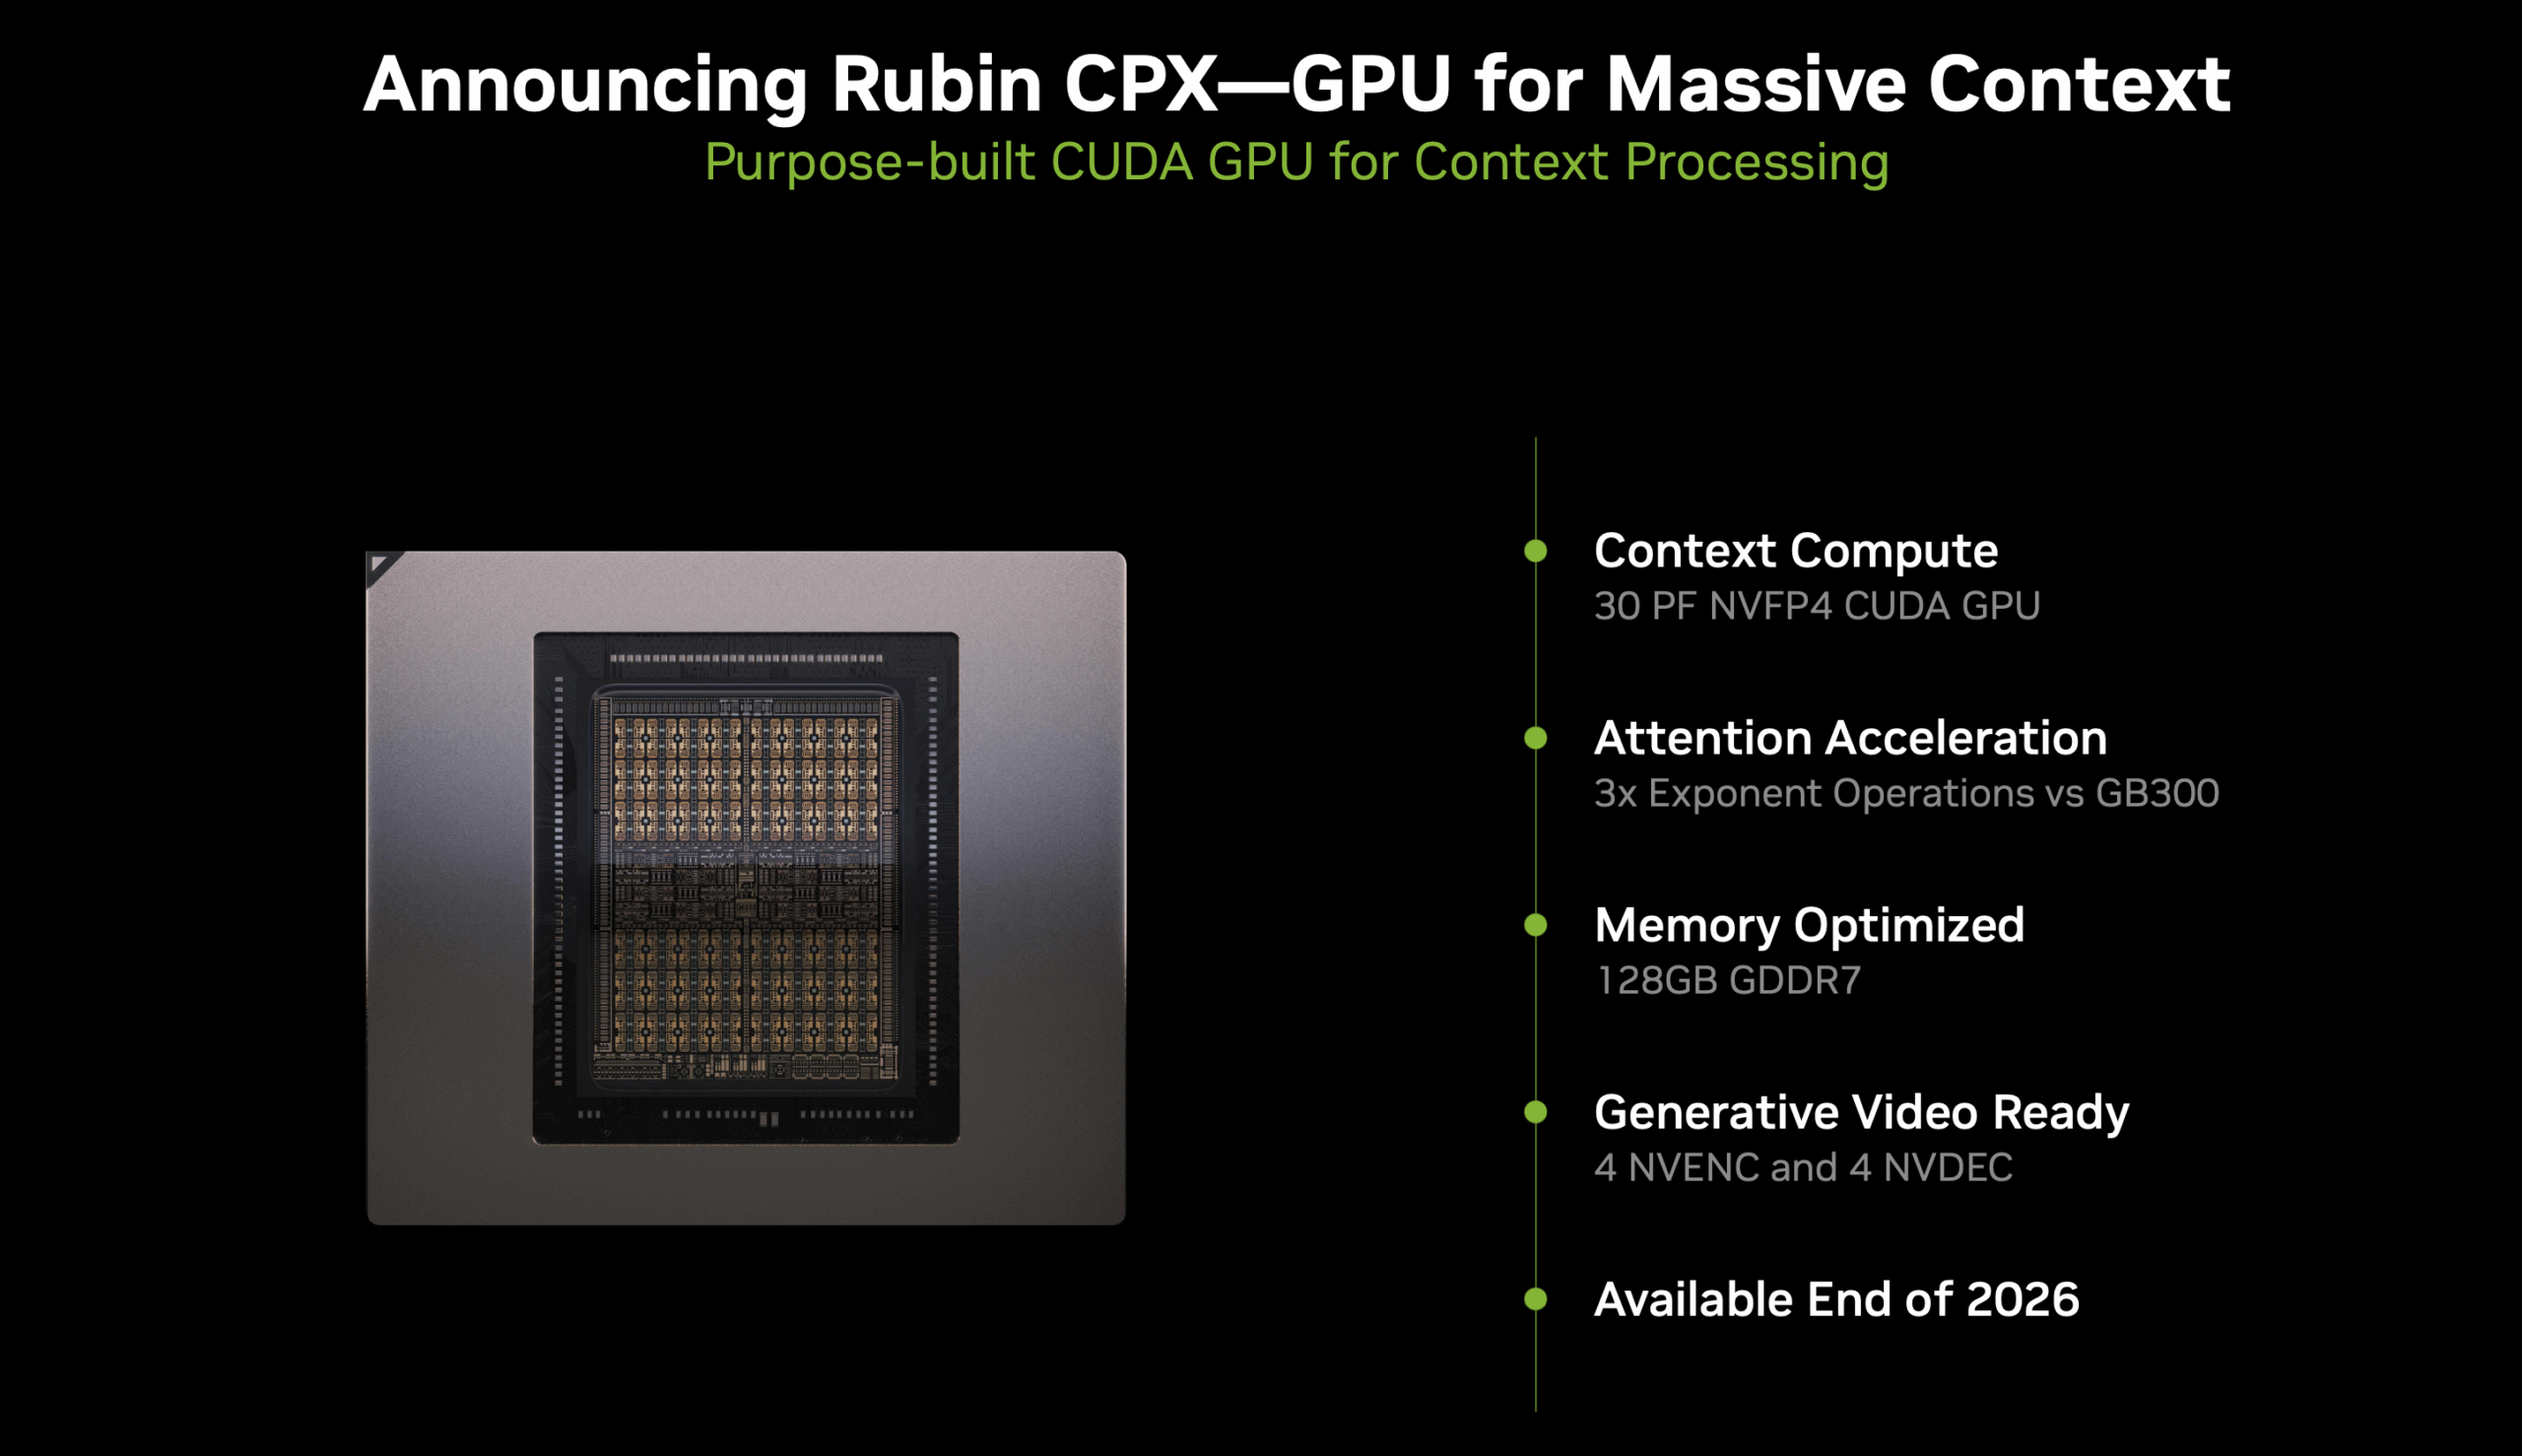
Integrace s širší platformou Vera Rubin v racku VR NVL144 CPX probíhá přes PCIe linky přes síťové karty ConnectX-9 a přepínací čipy, což usnadňuje hybridní modely provádění, kde výpočetně náročné operace probíhají na tradičních GPU. Správa kontextu náročná na paměť migruje na procesory CPX.
Flexibilní architektury nasazení a možnosti konfigurace
Modulární architektura platformy Vera Rubin umožňuje flexibilitu nasazení a organizacím umožňuje optimalizovat konfigurace pro specifické charakteristiky pracovní zátěže. Standardní konfigurace racku VR NVL144 obsahuje grafické procesory Vera Rubin s osmi síťovými kartami ConnectX-9, což poskytuje vyváženou architekturu vhodnou pro rozmanité pracovní zátěže s umělou inteligencí. Tato konfigurace poskytuje výpočetní výkon NVFP4 3.6 ExaFLOPS, což je 3.3násobné zlepšení oproti současným systémům GB300 NVL72, spolu s šířkou pásma HBM4 1.4 PB/s (2.5násobek současné generace) a kapacitou paměti HBM4 75 TB (2násobek současné generace).
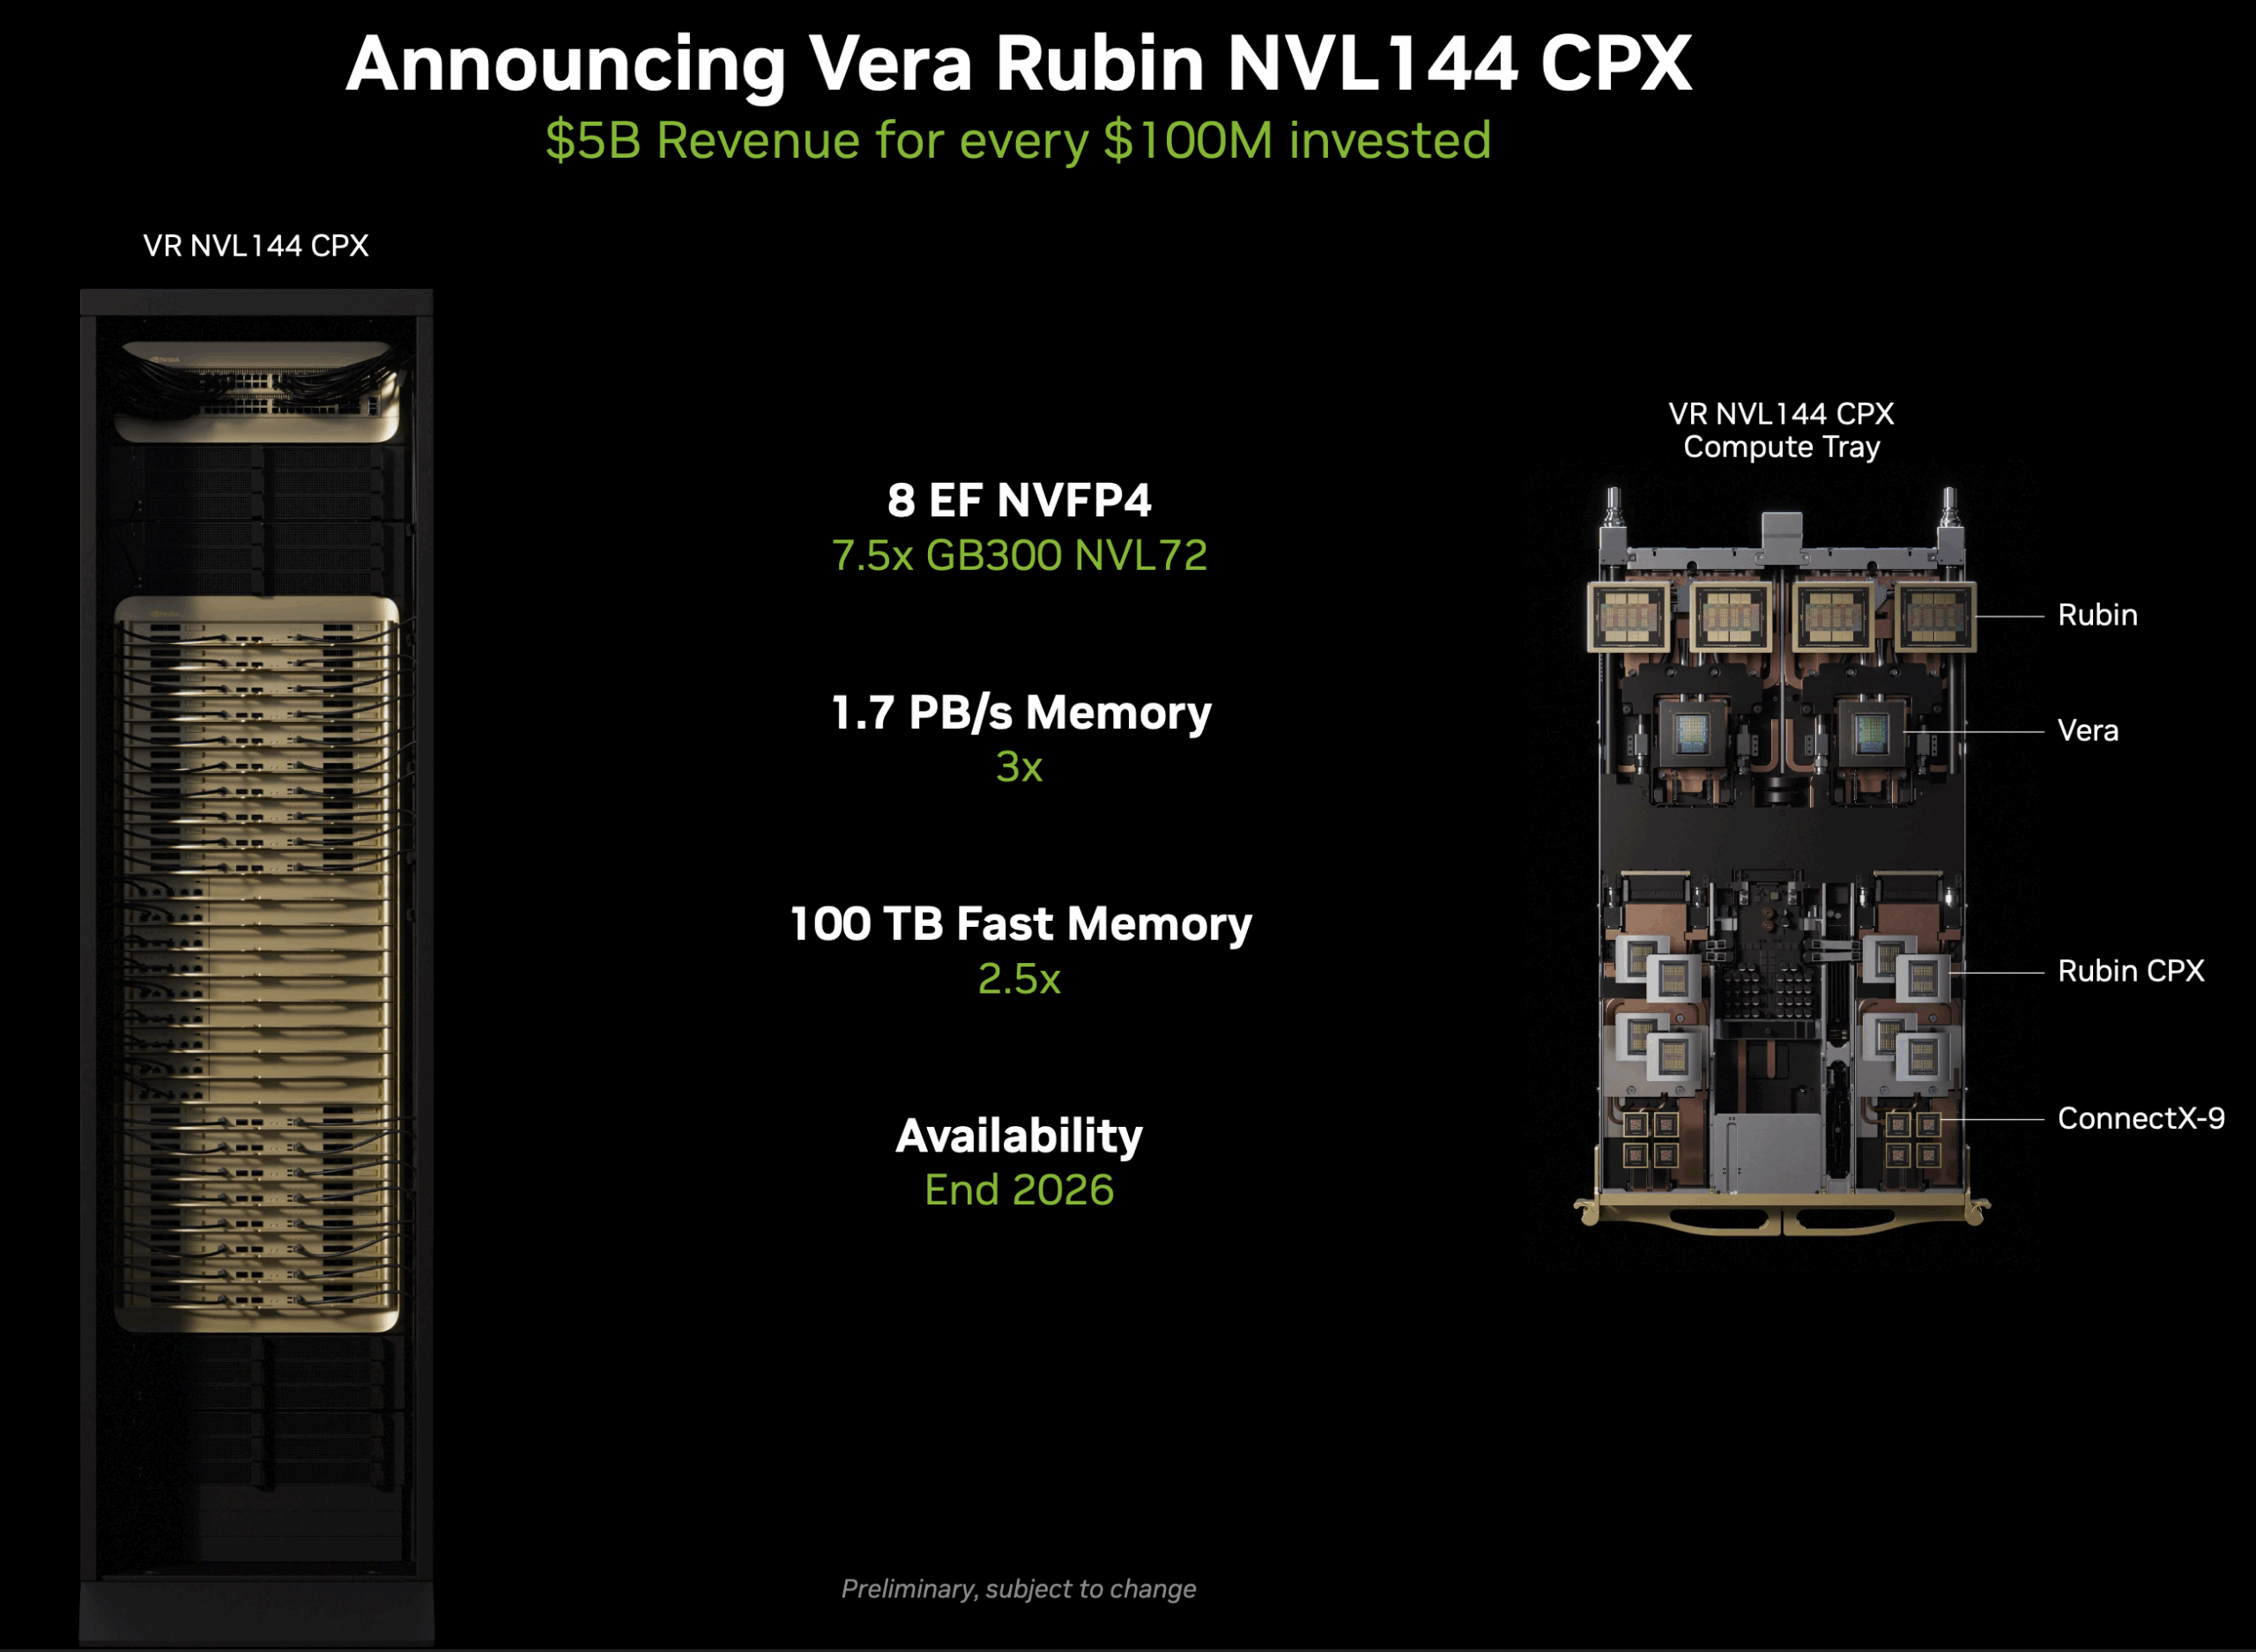
Pro organizace optimalizující inferenci a dlouhodobé RL po trénování je k dispozici ultrahustá výpočetní platforma VR NVL144 CPX. Každá platforma obsahuje čtyři balíčky VR GPU, z nichž každý obsahuje osm čipů GPU, čímž se zachovává výpočetní hustota standardní konfigurace, a zároveň se přidává osm grafických karet Rubin CPX. Osm čipů síťové karty/přepínače ConnectX-9 zajišťuje bezproblémový tok dat, který je nezbytný pro distribuovanou inferenci.
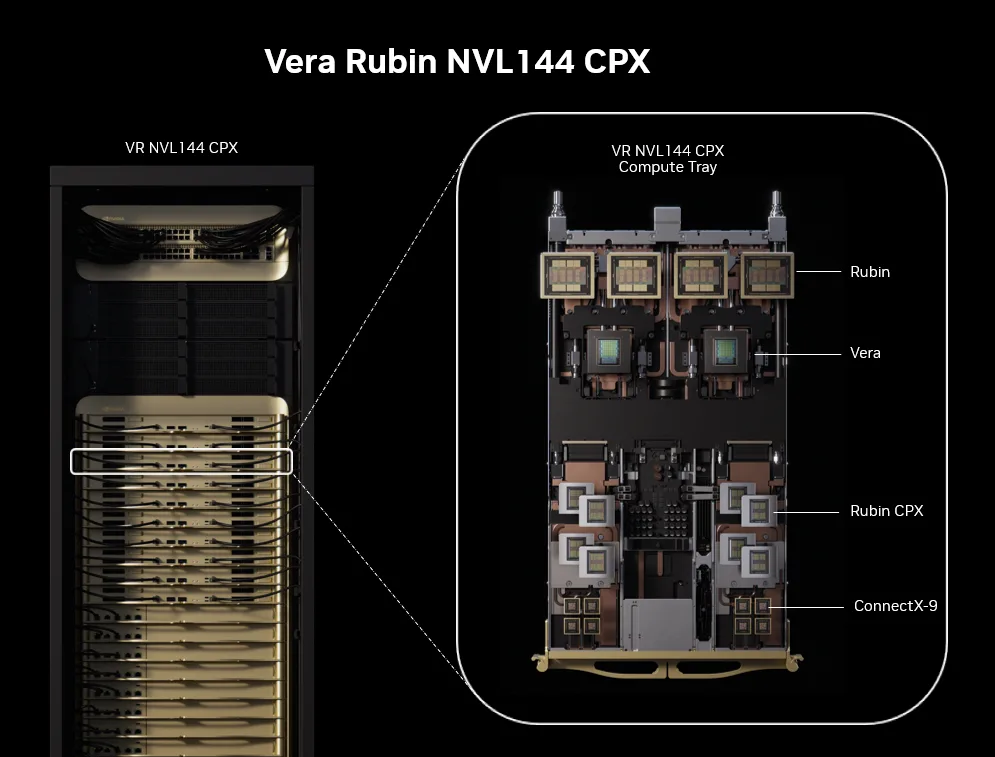
Modulární povaha architektury umožňuje mimořádně flexibilní strategie nasazení. Organizace mohou zpočátku nasadit standardní racky VR NVL144 a následně je rozšířit o specializované racky Rubin CPX, jakmile jejich požadavky na zpracování kontextu rostou. Tento přístup umožňuje infrastruktuře vyvíjet se v souladu s možnostmi modelu, čímž se zabrání nadměrnému zřizování.
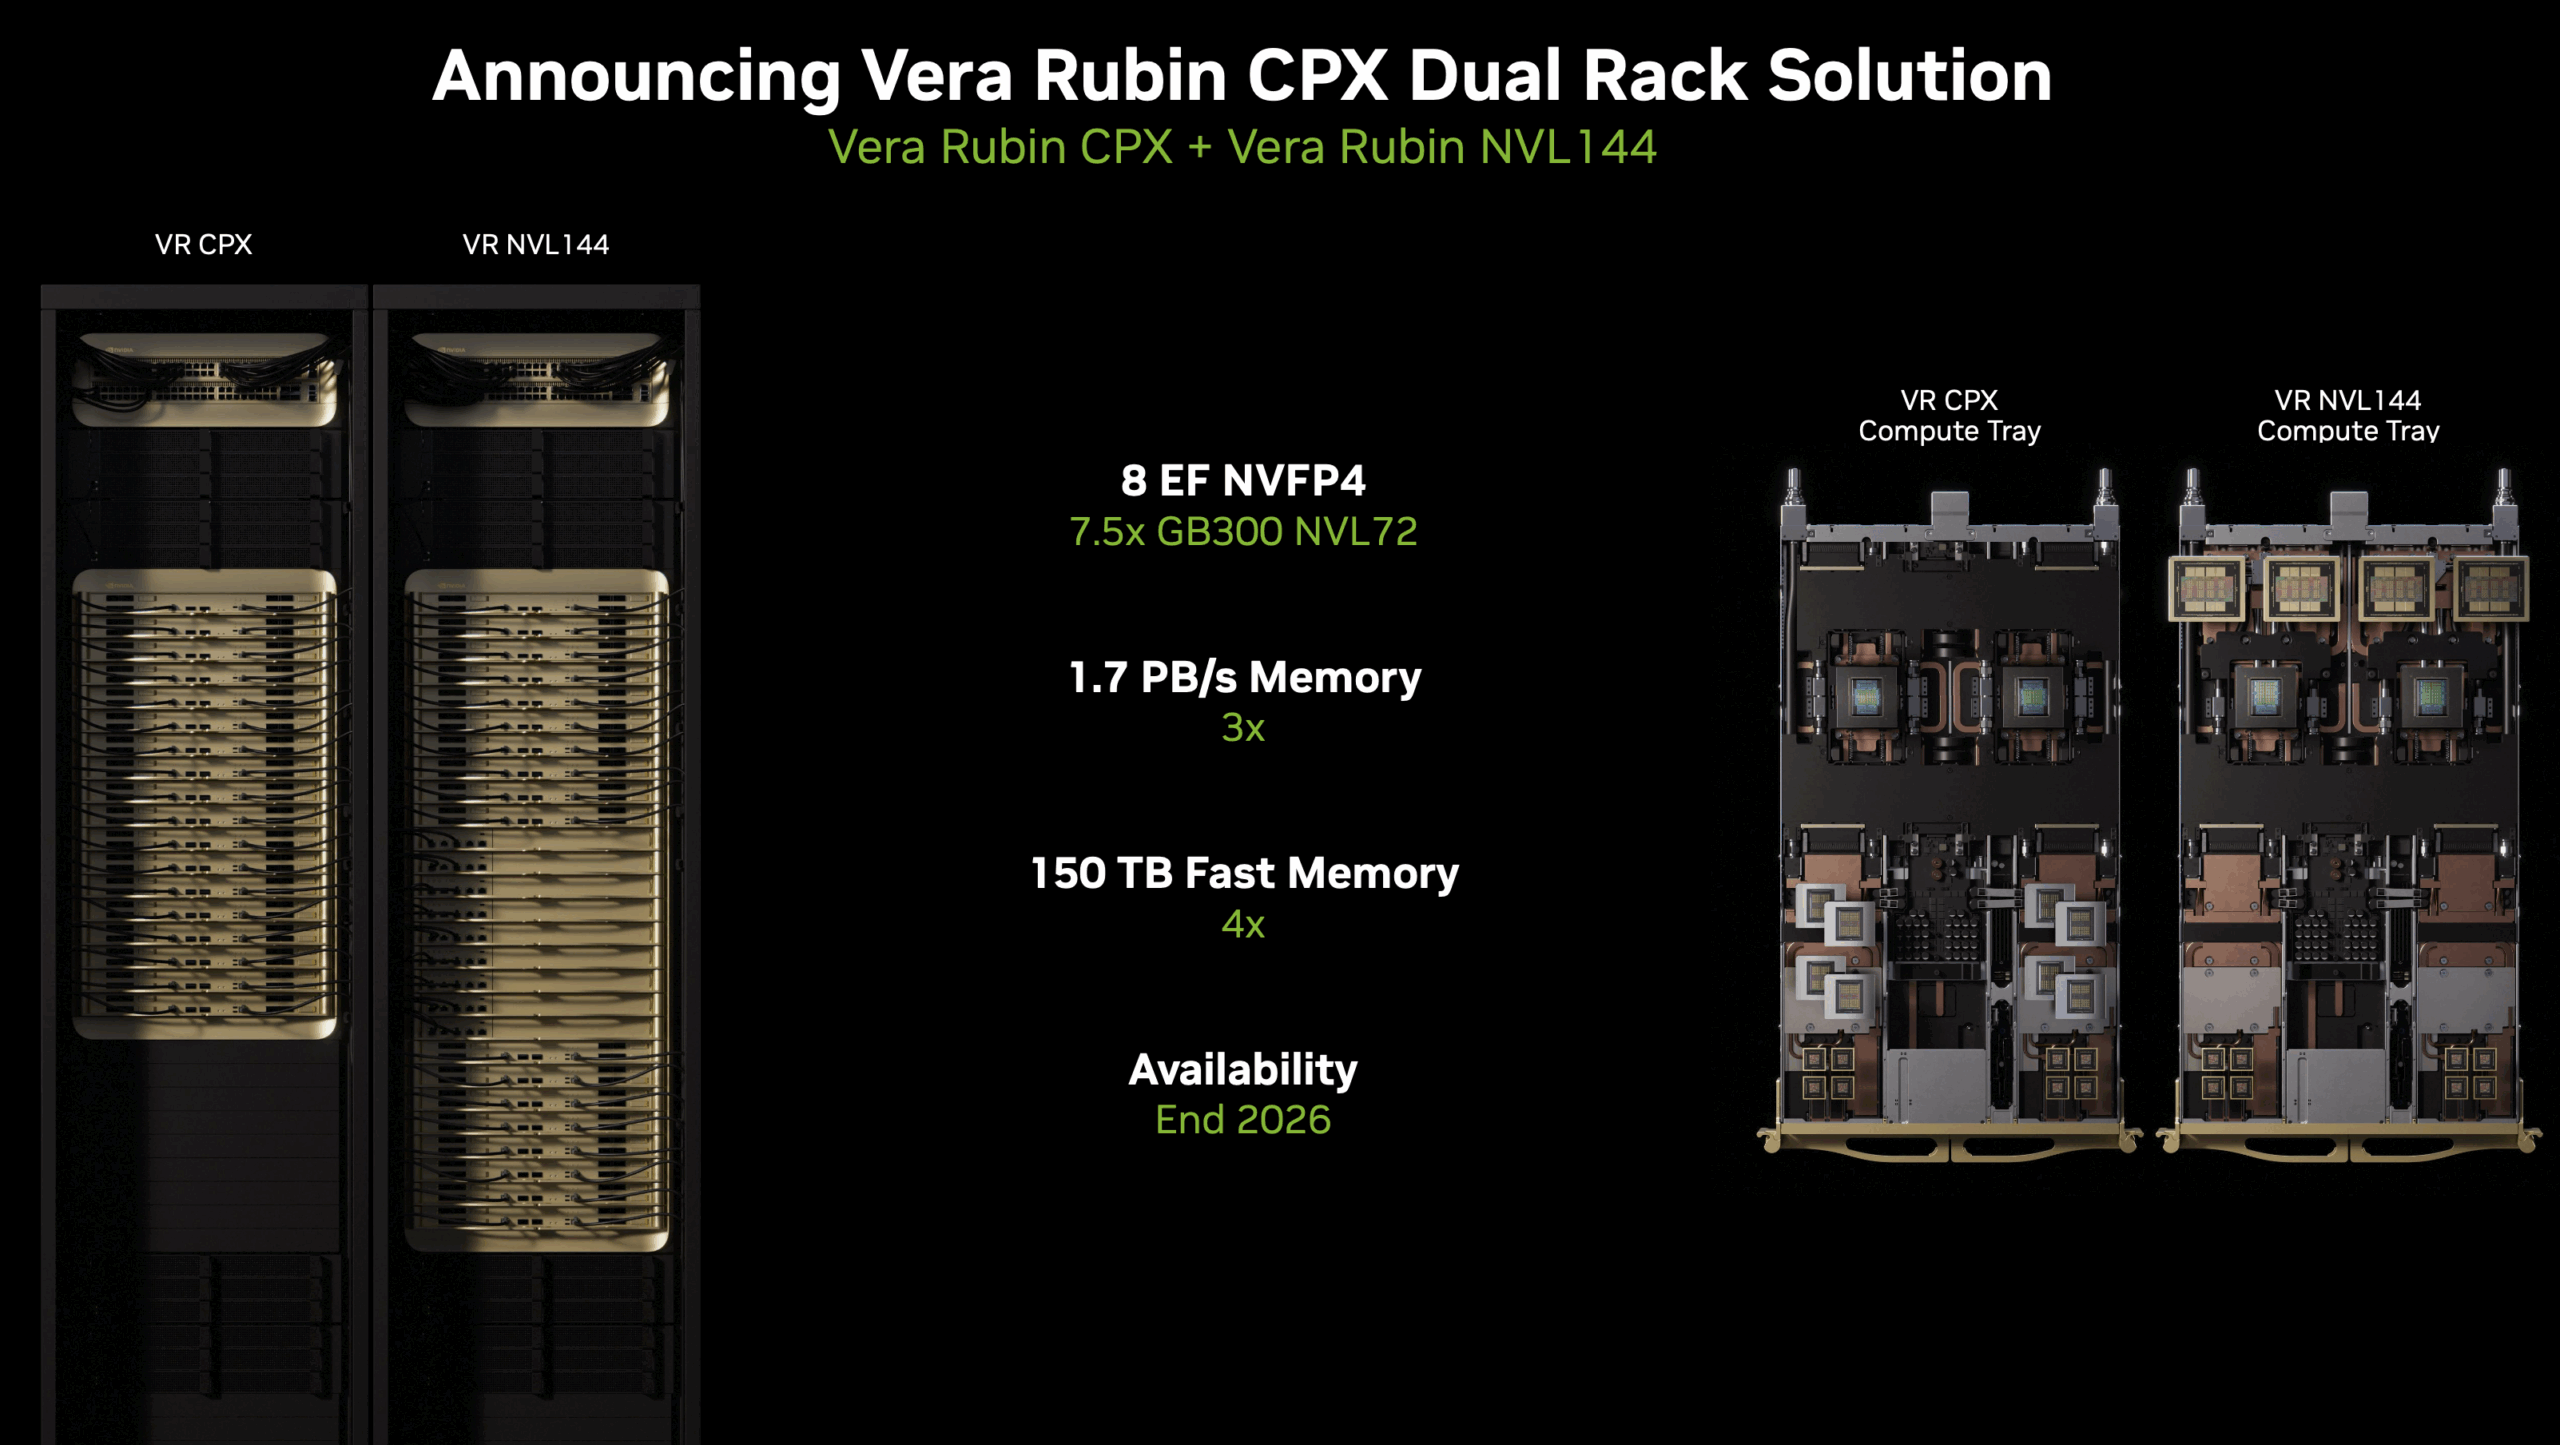
Kompletní konfigurace VR NVL144 CPX stanovuje novou základní úroveň výpočetního výkonu. Systém poskytuje 8 ExaFLOPS výpočetního výkonu NVFP4, což je 7.5násobné zlepšení oproti současným systémům GB300 NVL72. Tato masivní výpočetní kapacita je kombinována s celkovou šířkou pásma paměti 1.7 PB/s, čímž se s využitím HBM4 i GDDR7 dosahuje trojnásobné propustnosti paměti oproti současným systémům. Celková kapacita paměti dosahuje 100 TB, což poskytuje 2.5násobek paměťových zdrojů platforem současné generace.
NVIDIA cílí na dostupnost do konce roku 2026. To umožní nové kategorie aplikací umělé inteligence a zpřístupní kontextová okna s miliony tokenů pro produkční prostředí, což systémům umělé inteligence umožní zpracovávat celé kódové základny nebo dlouhé dokumenty v jednom průchodu. Tyto inovace také umožňují organizacím podporovat větší dávky, což snižuje náklady na inferenci a vytváří příznivější výpočet provozních nákladů (OPEX).
Plán infrastruktury v gigawattovém měřítku
Kromě individuálních systémových inovací společnost NVIDIA také představila referenční architektury pro továrny s umělou inteligencí v gigawattovém měřítku. Tyto plány, vyvinuté ve spolupráci s infrastrukturními partnery, včetně společností Jacobs, Schneider Electric, Siemens Energy a Vertiv, se zabývají kompletní infrastrukturou, od výroby energie až po výpočetní techniku. Referenční návrhy uznávají, že nasazení umělé inteligence nové generace vyžaduje holistickou optimalizaci, která sahá daleko za samotné výpočetní komponenty.
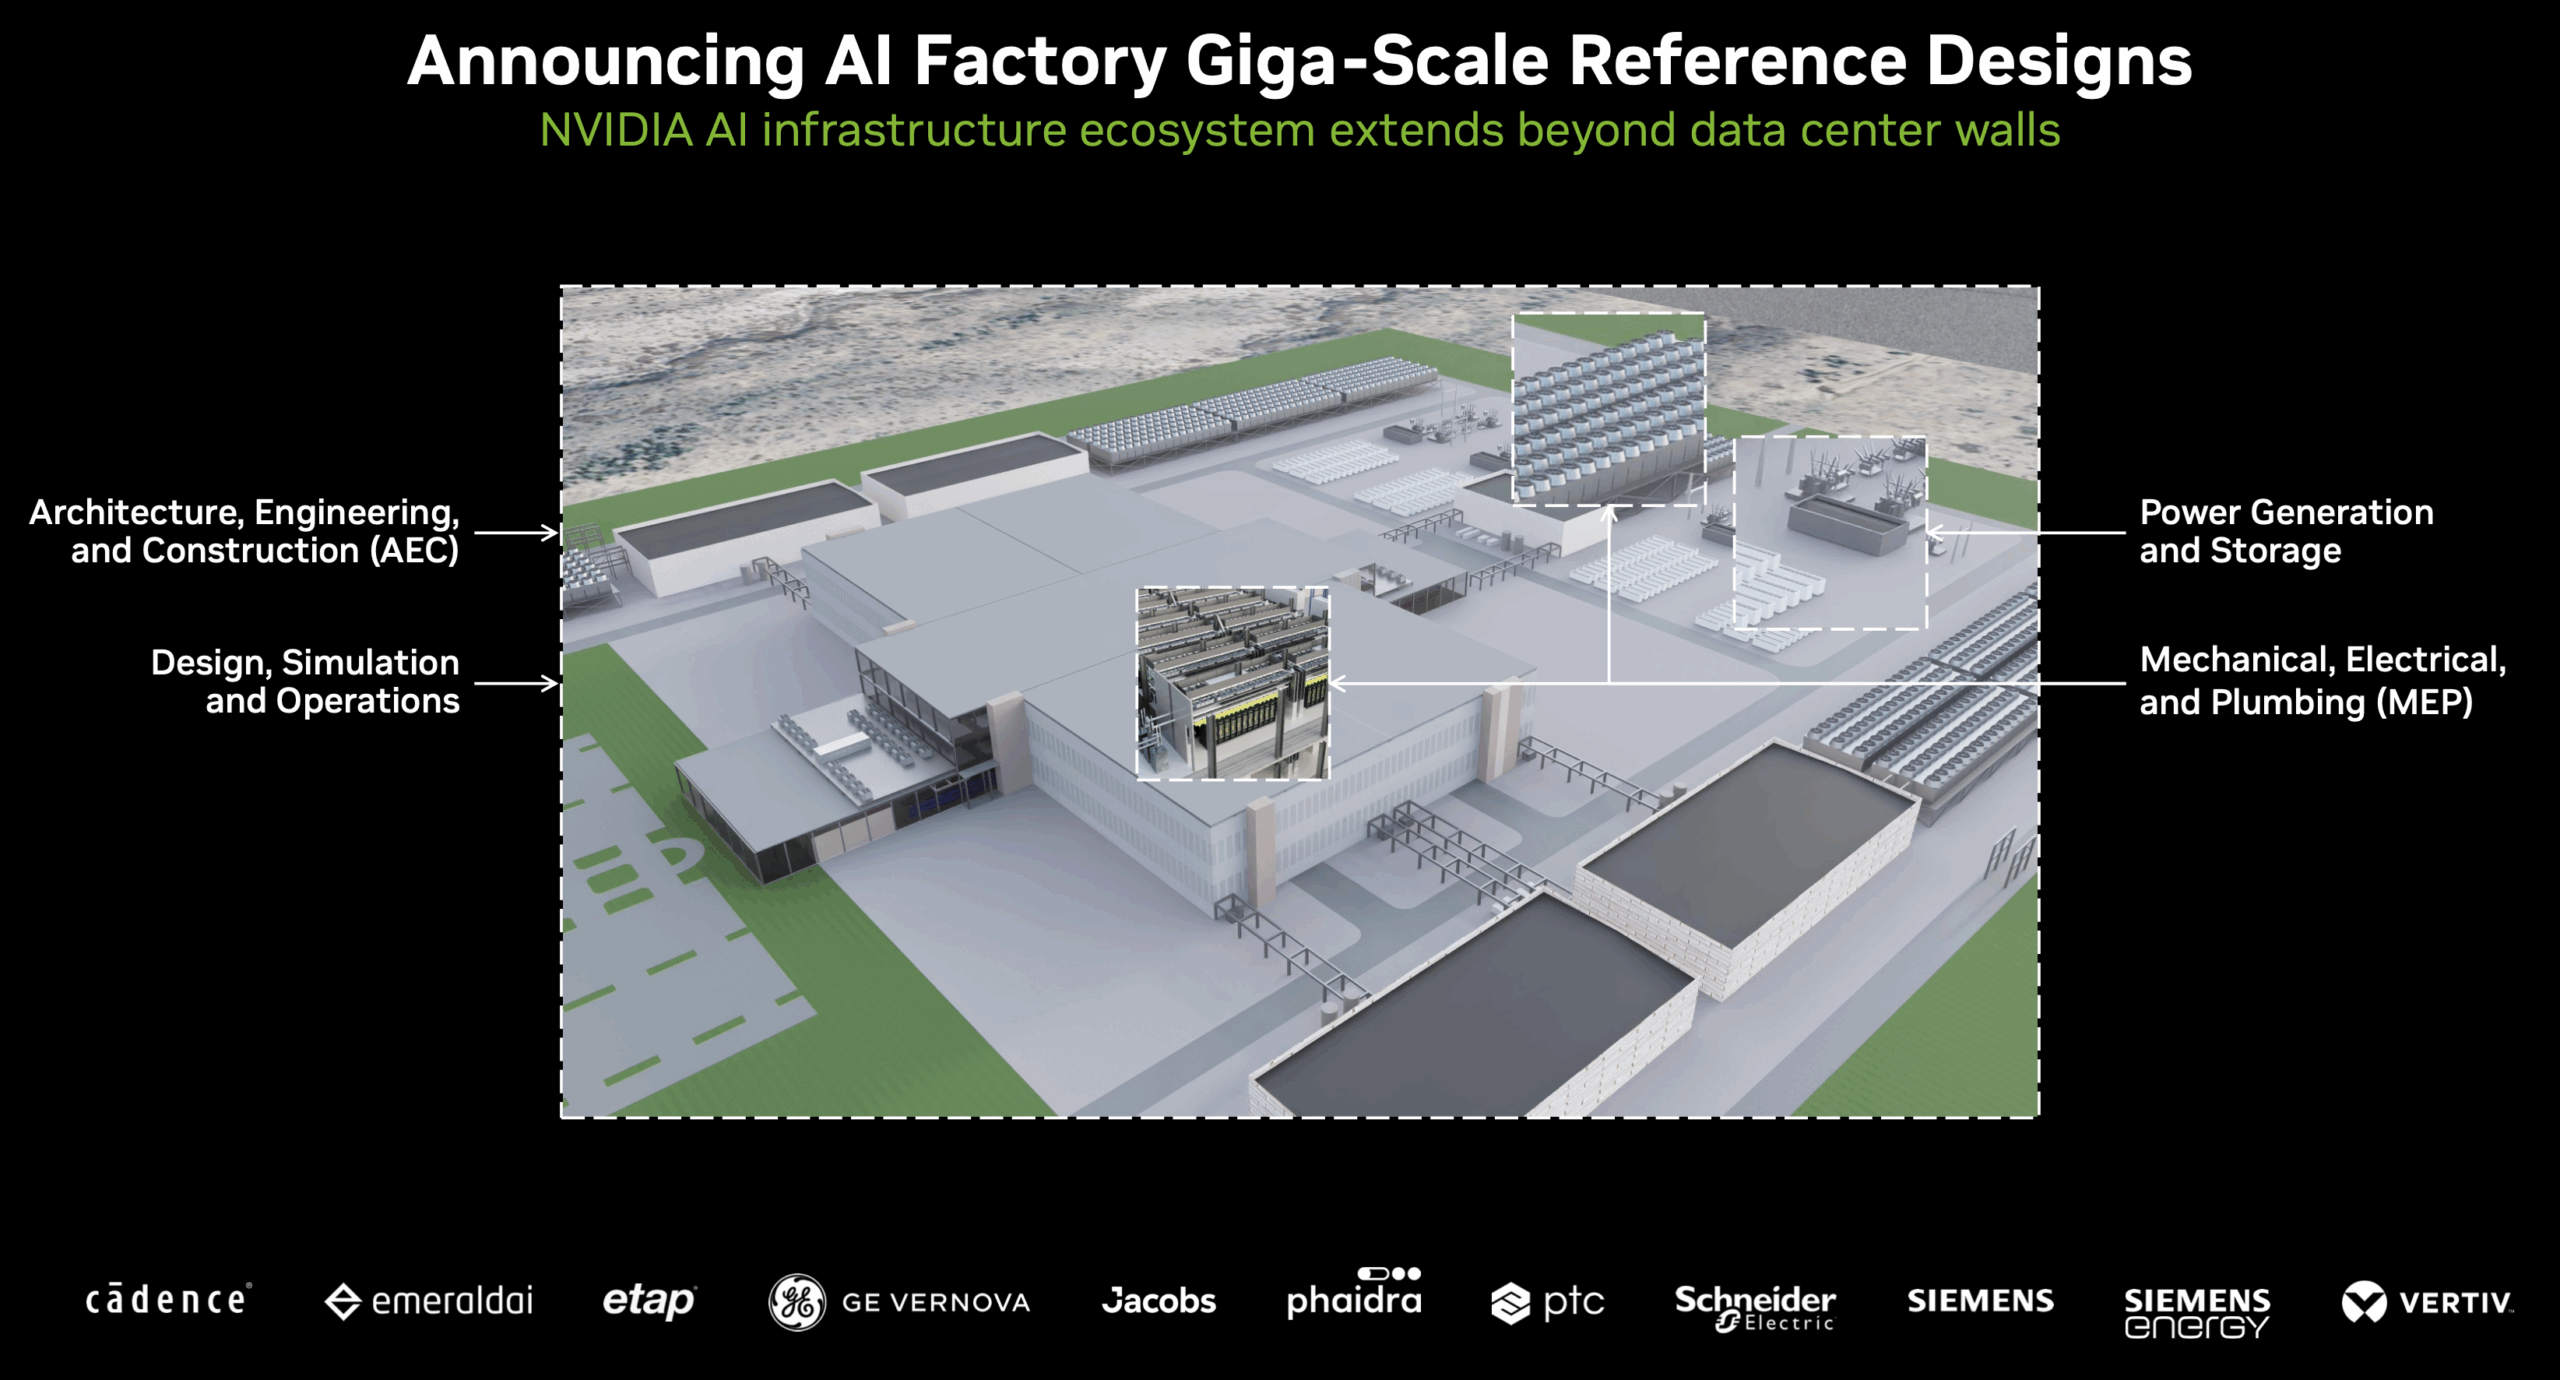
Tyto architektonické plány využívají digitální dvojčata NVIDIA Omniverse k usnadnění komplexní simulace zařízení před fyzickým nasazením. Organizace mohou modelovat distribuci energie, chladicí systémy a výpočetní zátěž v unifikovaných simulacích, identifikovat a řešit úzká hrdla předtím, než se zavážou k fyzické infrastruktuře.
Závěr
Společnost NVIDIA i nadále zaujímá vedoucí postavení v oblasti infrastruktury umělé inteligence s progresivním, na vývojáře zaměřeným přístupem, který přímo řeší problematická místa, kterým čelí organizace a laboratoře umělé inteligence. Přechod od univerzální akcelerace k architekturám specifickým pro danou pracovní zátěž, jehož příkladem je cílený přístup společnosti Rubin CPX ke zpracování kontextu, naznačuje, že budoucí systémy umělé inteligence budou stále více zahrnovat heterogenní výpočetní zdroje optimalizované pro každou fázi pracovních postupů umělé inteligence. Tento architektonický vývoj vyžaduje, aby organizace plánující víceleté investice do infrastruktury umělé inteligence zvažovaly nejen hrubou výpočetní propustnost, ale také sladění mezi hardwarovými možnostmi a vyvíjejícími se architekturami modelů.
Zrychlená inovační kadence, od Blackwell Ultra přes Vera Rubin až po Rubin CPX v krátkém časovém horizontu, je skutečně působivá. Tak rychlé tempo vyžaduje, aby organizace navrhovaly systémy schopné integrovat nová architektonická paradigmata, jakmile se objeví, a vyhnout se tak uvěznění, které charakterizovalo předchozí generace infrastruktury datových center. Pro řešení této výzvy poskytují referenční návrhy AI Factory a digitální dvojčata Omniverse od společnosti NVIDIA základní plány a simulační nástroje pro zajištění budoucí funkčnosti těchto kritických investic. Vzhledem k tomu, že modely umělé inteligence pokračují ve své trajektorii směrem k bilionovým parametrickým škálám a milionovým tokenovým kontextům, architektonické inovace představené na summitu AI Infrastructure Summit poskytují nezbytný základ pro tuto budoucnost výpočetní techniky. Stanovují rámce a technologie, které budou definovat schopnosti podnikové umělé inteligence v průběhu celého desetiletí.
Zmíněné články: Novinky o Nvidia GTC25
Všechny snímky a obrázky pocházejí z Nvidie


 Amazon