

V průběhu několika generací hardwaru identifikovali dodavatelé pamětí a síťových zařízení různá úzká místa ve vysoce výkonných výpočetních klastrech. Výrobci pamětí se zaměřili na šířku pásma paměti v pouzdře, zatímco dodavatelé síťové struktury se zaměřili na propustnost mezi šasi a napříč racky. Dnes se tyto dva pohledy sbíhají na stejném úzkém místě: překážce šířky pásma, která omezuje pohyb dat mezi distribuovanými výpočetními uzly a paměťovými fondy.
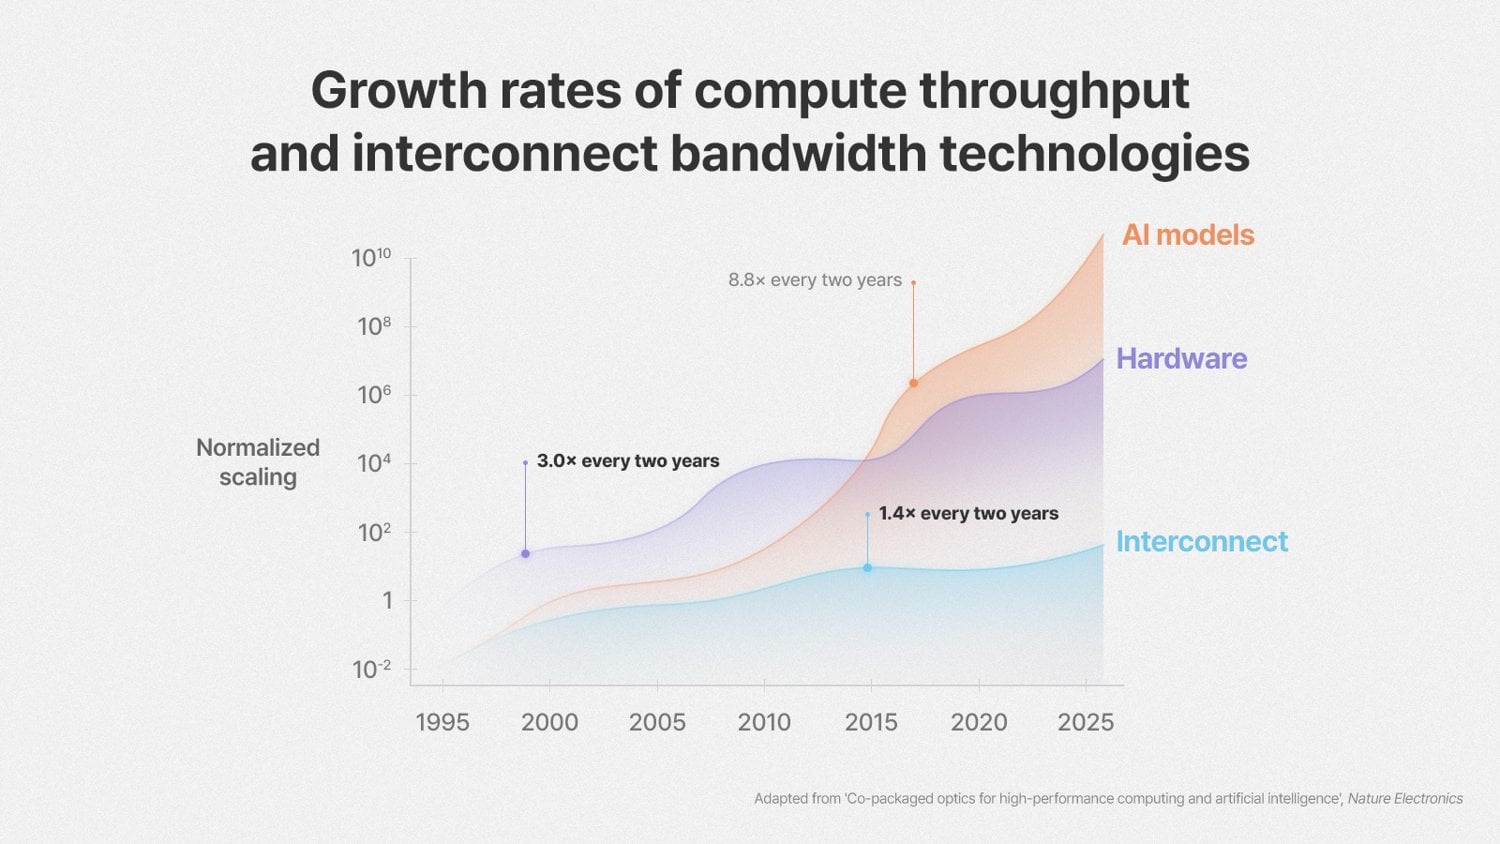
Zatímco paměť s vysokou šířkou pásma (HBM) efektivně řešila omezení šířky pásma na úrovni balíčků pro jednotlivé akcelerátory umělé inteligence, moderní hyperscale trénovací a inferenční úlohy se nyní škálují na desítky tisíc procesorů rozmístěných v raccích a podech. V těchto distribuovaných topologiích se výpočetní propustnost historicky zvyšovala zhruba 3krát každé 2 roky, zatímco šířka pásma propojení se za stejné období zvýšila přibližně 1.4krát. Výsledná nerovnováha umisťuje primární úzké hrdlo škálování přímo na vrstvu fyzického propojení.
Hodnocení vychází z perspektivního článku publikovaného 20. srpna v časopise Nature Electronics s názvem „Spolu-packaged optics for high-performance computing and artificial intelligence“ (Společně balená optika pro vysoce výkonné výpočty a umělou inteligenci), jehož spoluautory jsou společnost SK hynix a výzkumníci z University of Virginia, University of Illinois Urbana-Champaign, MIT, Nanyang Technological University a Yonsei University. Vedoucí týmu SK hynix AI Infra Team Seunghoon Hong a profesor UVA Kyusang Lee působili jako korespondující autoři.
| Fáze | Výsledek |
|---|---|
| Posun úzkého hrdla škálování AI clusteru | |
| HBM v balení | Vyřešeno úzké hrdlo paměti na čipu/v pouzdře |
| Stopy mědi | Dopadá na fyzický útlum / napájecí stěnu mimo čip |
| Integrace CPO | Sbíhá optickou tkaninu přímo na substrát |
Aby se toto omezení vyřešilo, publikovala společnost SK hynix ve spolupráci s výzkumníky z University of Virginia, UIUC, NTU, MIT a Yonsei University v časopise Nature Electronics studii s názvem „Společně balená optika pro vysoce výkonné výpočty a umělou inteligenci“. Článek podrobně popisuje, jak se musí společně balená optika (CPO) a optická výpočetní propojení (OCI) vyvíjet společně s architekturami pamětí a balení, aby se udrželo budoucí škálování clusterů.
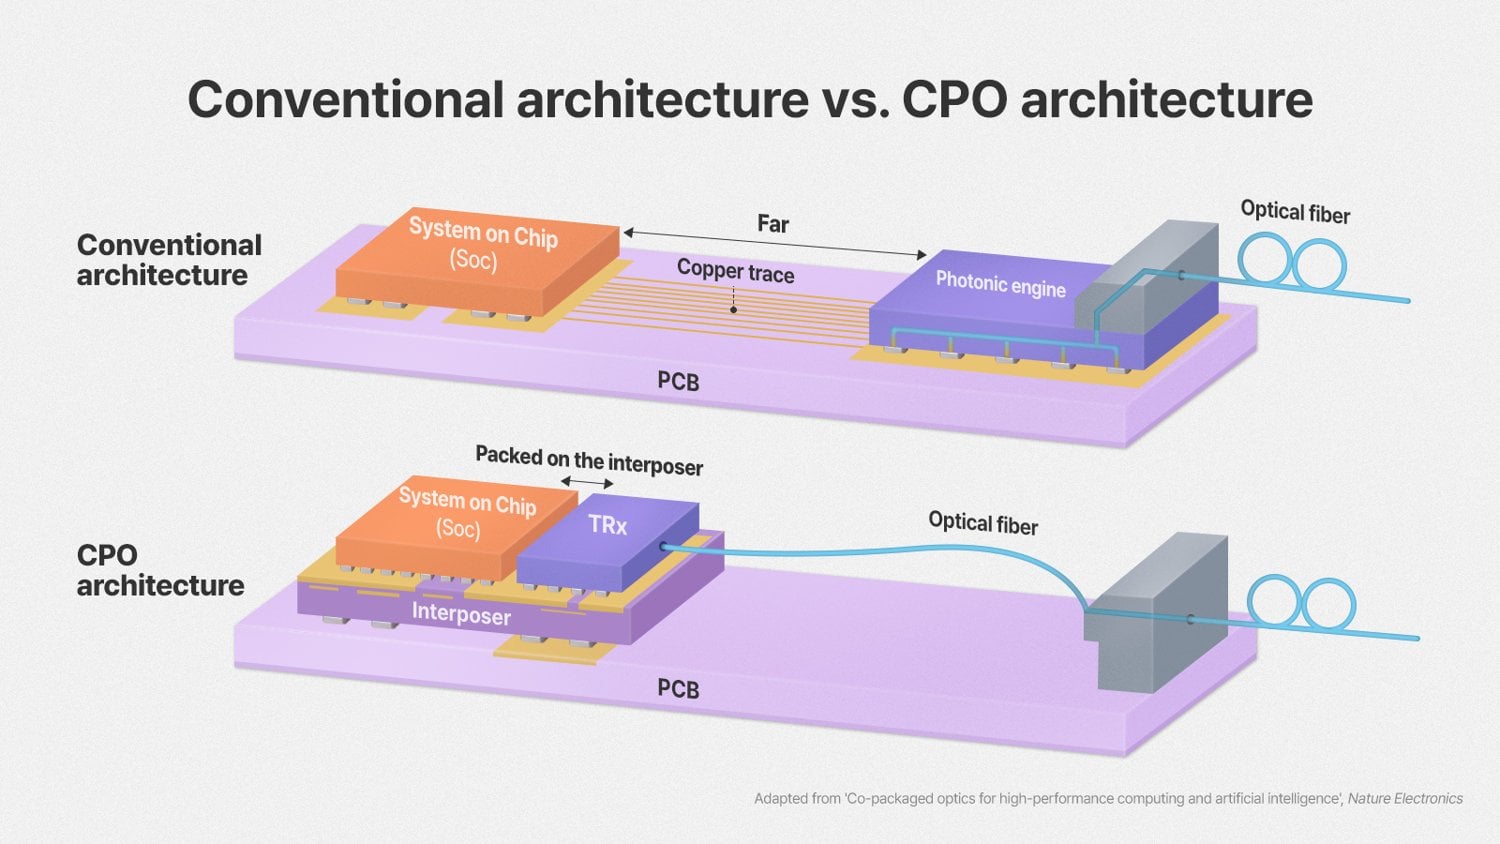
Fyzikální limity měděných propojovacích vodičů
Standardní elektrická propojení založená na měděných vodičích a přímo připojovaných měděných kabelech zůstávají praktická na krátké fyzické vzdálenosti. S rostoucími datovými rychlostmi však elektrická signalizace trpí silným útlumem signálu, vložnými ztrátami a zvýšenou spotřebou energie. Správa vysokorychlostních signálů napříč delšími vodiči a základními deskami vyžaduje složité obvody pro vyrovnávání a přečasování, což zavádí dodatečnou latenci a spotřebovává značné množství energie.
Jak kombinovaná optika mění směr
CPO řeší tato fyzikální omezení montáží optických transceiverů přímo na stejný substrát pouzdra jako hostitelské procesory nebo akcelerátory. Převod vysokorychlostních elektrických signálů na fotonické kanály přímo sousedící s výpočetním křemíkem minimalizuje délku elektrických stop, čímž zmírňuje parazitní kapacitu a degradaci signálu. Tato architektura umožňuje nízkoztrátový optický přenos s vysokou šířkou pásma napříč deskami, racky a pody a zároveň zachovává vyšší hustotu šířky pásma a vylepšenou imunitu vůči elektromagnetickému rušení.
| metrický | Cílová specifikace |
|---|---|
| Cílové specifikace pro uzly CPO | |
| Hustota šířky pásma uzlu | > 100 Tb/s na uzel |
| Energetická účinnost | < 1 pJ/bit |
| Latence propojení čipů s čipy | <10 ns |
| Integrační cesta | 2.5D interpozer do 3D heterogenního |
Plán předpokládá architektonický pokrok od standardních 2D vícečipových modulů a 2.5D integrace křemíkových interpozerů směrem k 3D heterogennímu stohování. Největším architektonickým milníkem je rozšíření optických linek přímo do samotného paměťového subsystému.
Použitím fotonického interpozéru k přímému propojení paměťových zásobníků s výpočetními enginy mohou systémy obejít konvenční omezení směrování na úrovni desek. Tento přístup umožňuje disagregované sdílené paměťové fondy s nízkou latencí, kde více výpočetních enginů může přistupovat ke sdílené kapacitě přes optickou základní desku bez serializace a deserializace typických pro tradiční síťové struktury.
Technické výzvy pro komerční nasazení
Přechod CPO z pokročilých demonstračních systémů pro pouzdra do hardwaru produkčních datových center představuje několik nevyřešených technických překážek. Integrace nízkoenergetických křemíkových fotonických zařízení spolu s vysoce výkonnou hostitelskou logikou vyžaduje sofistikovanou tepelnou izolaci a pokročilé mikrofluidní nebo přímo-do-pouzdra chlazení.
Kromě toho musí průmysl vyvinout standardizované protokoly koherence s nízkou latencí, které by dokázaly řídit transakce s opticky propojenou pamětí bez režijních nákladů na proprietární software. Spolehlivá komercializace bude vyžadovat komplexní hardwarový společný návrh zahrnující topologie čipů DRAM, vlastní řadiče pamětí, fotonické enginy a heterogenní pouzdra substrátů. Pro SK hynix jde optický plán vedle jeho konvenčního; společnost na veletrhu FMS 2026 podrobně představila 16vrstvou HBM4 a 375vrstvou NAND paměť spojenou na waferu.


 Amazon