

Posouvání hranic výpočtů nám není nováčkem, ale tentokrát se jedná o číslo pí (Pí). Hned po loňském benchmarku 100 bilionů číslic jsme se rozhodli to zrychlit a posunout počet známých číslic pí na 105 bilionů číslic. To je 105 000 000 000 000 čísel po trojce. Oproti loňskému roku jsme provedli několik aktualizací platformy, během cesty jsme objevili několik překvapivých věcí a cestou jsme se i leccos naučili – včetně 105 bilionů číslic pí;6!
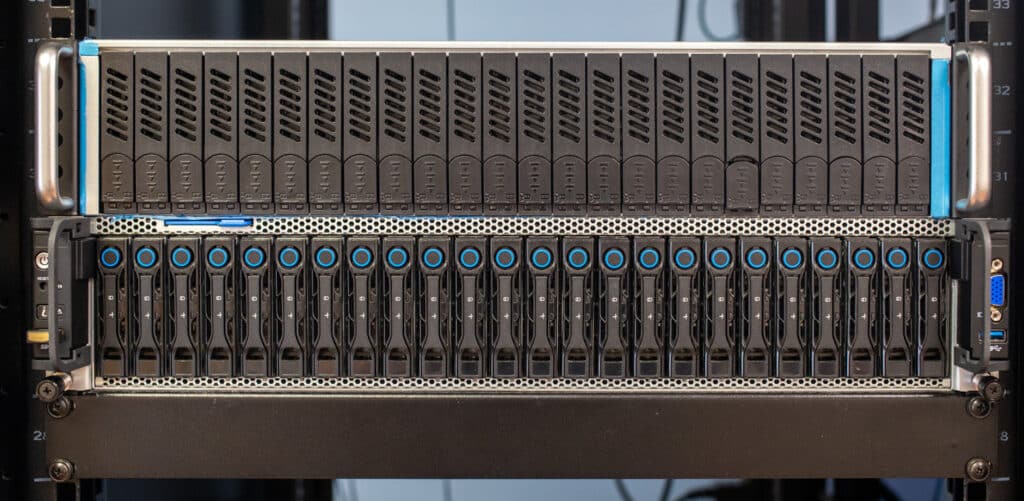
Laboratoř StorageReview dosáhla světového rekordu ve výpočtu čísla pí na 105 bilionů číslic a zdůraznila tak neuvěřitelné možnosti moderního hardwaru. Tento projekt, poháněný špičkovým 2P 128jádrovým systémem AMD EPYC Bergamo vybaveným 1.5 TB DRAM a téměř petabajtem SSD disků Solidigm QLC, představuje přelomový úspěch v oblasti výpočetní a úložné technologie.
výzva
Při digitálním běhu o objemu 100 bilionů jsme narazili na několik technologických omezení. Serverová platforma například podporovala pouze 16 NVMe SSD disků v předních slotech. I když jsme měli dostatek výkonu procesoru, tento výpočet vyžadoval masivní úložiště během procesu a na straně serveru při výstupu finálního TXT souboru.
Abychom minule vyřešili problém s úložištěm, použili jsme adaptéry PCIe NVME, abychom do nich vměstnali další tři SSD disky. Pro výstup jsme pak měli server s pevným diskem v RAID0, a to s iSCSI sdílenou složkou zpět k výpočetnímu systému. Tentokrát jsme chtěli být s tímto serverem trochu „podnikovější“, a tak jsme si na pomoc přizvali pár přátel. Zajímavé je, že přidat k serveru spoustu NVMe SSD disků není tak snadné, jak by se mohlo zdát.
Hardware
Srdcem tohoto monumentálního úkolu byl dvouprocesorový systém AMD EPYC 9754 Bergamo, každý se 128 jádry. Procesory AMD, známé svým výjimečným výkonem ve vysoce složitých výpočetních úlohách (AI, HPC, Big Data Analytics) , poskytovaly potřebný výkon. K tomu přispívalo 1.5 TB paměti DRAM, která zajišťovala rychlé zpracování dat a přenosové rychlosti. Zároveň téměř petabajt úložiště Solidigm QLC nabízel bezprecedentní kapacitu a spolehlivost.
Naše základní platforma šasi zůstala stejná jako v loňském roce (QCT box), ale upgradovali jsme CPU na čipy AMD EPYC 9754 Bergamo. Chtěli jsme dosáhnout zlepšení rychlosti a desetinné velikosti a zároveň se vyhnout použití úložiště pro výpočty, což znamenalo, že jsme museli požádat SerialCables o poskytnutí JBOF. To samo o sobě představovalo určité výzvy, které podrobněji popíšeme níže.
| Parametr | Hodnota |
|---|---|
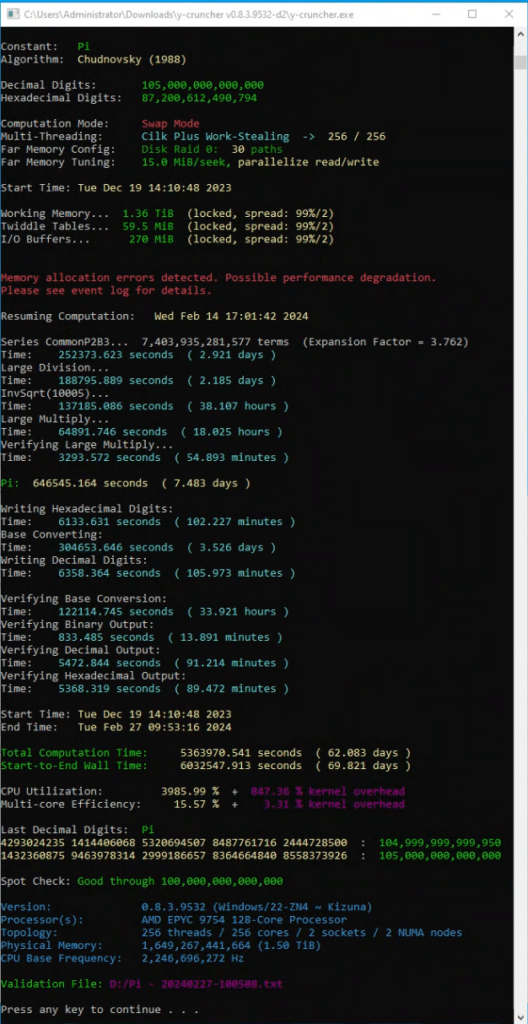
| Datum zahájení | Út 19. prosince 14:10:48 2023 |
| Datum ukončení | Út 27. února 09:53:16 2024 |
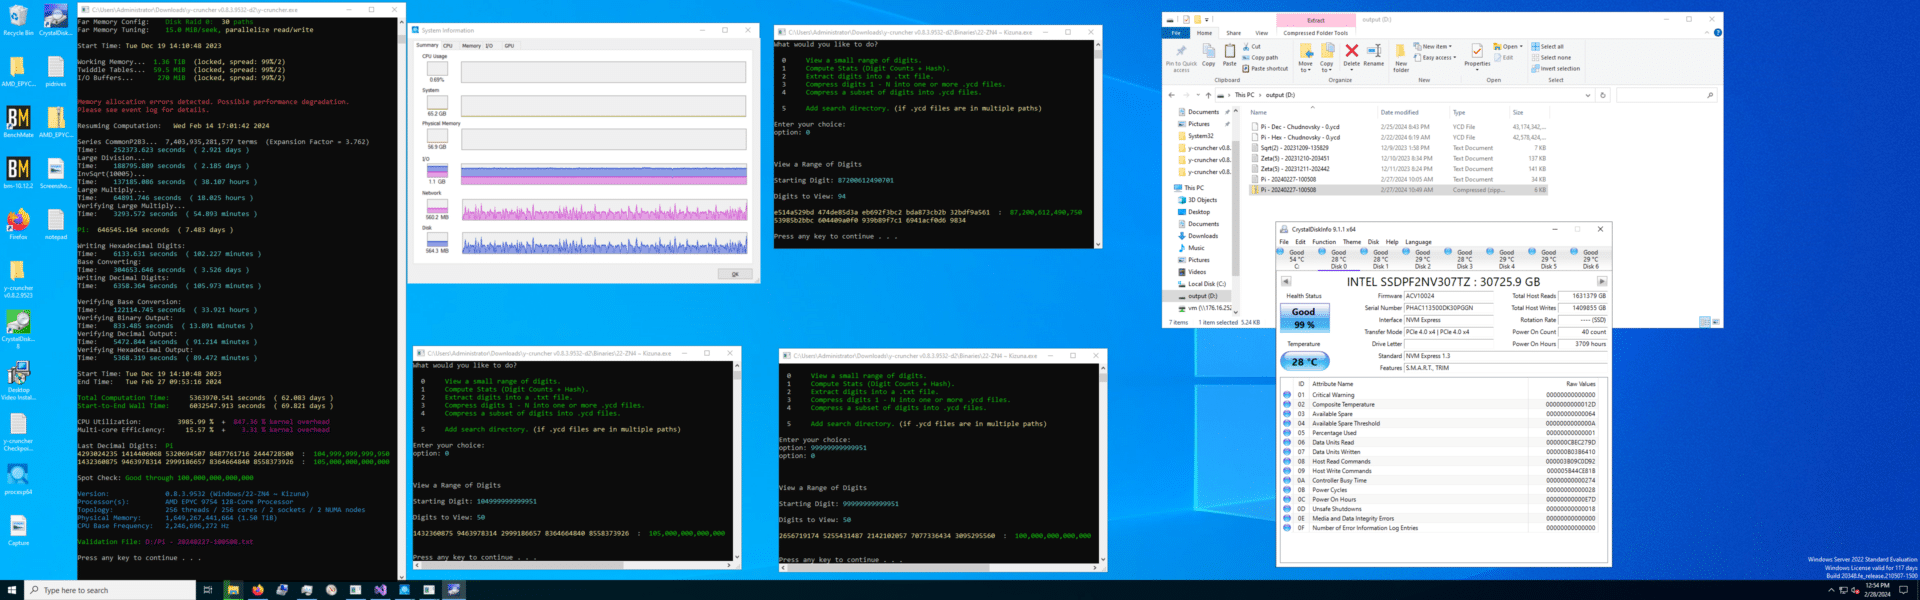
| Celkový výpočetní čas | 6 032 547,913 sekund / 62.08 dní |
| Čas na zdi od začátku do konce | 6 032 547,913 sekund / 69.82 dní |
Výpočtové období: 14. prosince 2023 – 27. února 2024, délka 75 dnů.
- CPU: Dva procesory AMD Epyc 9754 Bergamo, 256 jader s vypnutým simultánním multithreadingem (SMT) v BIOSu.
- Paměť: 1.5 TB paměti DDR5 RAM.
- Skladování: 36x 30.72TB SSD disky Solidigm D5-P5316.
- 24x 30.72TB SSD disky Solidigm D5-P5316 v JBOF od SerialCables
- 12x 30.72TB SSD disky Solidigm D5-P5316 v přímo připojeném serveru.
- Operační systém: Windows Server 2022 (21H2).
Cesta ke 105 bilionům
| Parametr | Hodnota |
|---|---|
| konstantní | Pi |
| Algoritmus | Čudnovský (1988) |
| Desetinná čísla | 105,000,000,000,000 |
| Šestnáctkové číslice | 87,200,612,490,794 |
| Režim vláknění | Cilk Plus krádež práce -> 256 / 256 |
| Pracovní paměť | 534 615 969 510 896 (1.36 TiB) |
| Celková paměť | 534 615 969 510 896 (1.36 TiB) |
| Logicky největší kontrolní bod | 534 615 969 510 896 (144 TiB) |
| Logické špičkové využití disku | 534 615 969 510 896 (486 TiB) |
| Počet čtených bajtů logického disku | 44,823,456,487,834,568 (39.8 PiB) |
| Zapsané bajty logického disku | 38,717,269,572,788,080 (34.4 PiB) |
Setkané výzvy
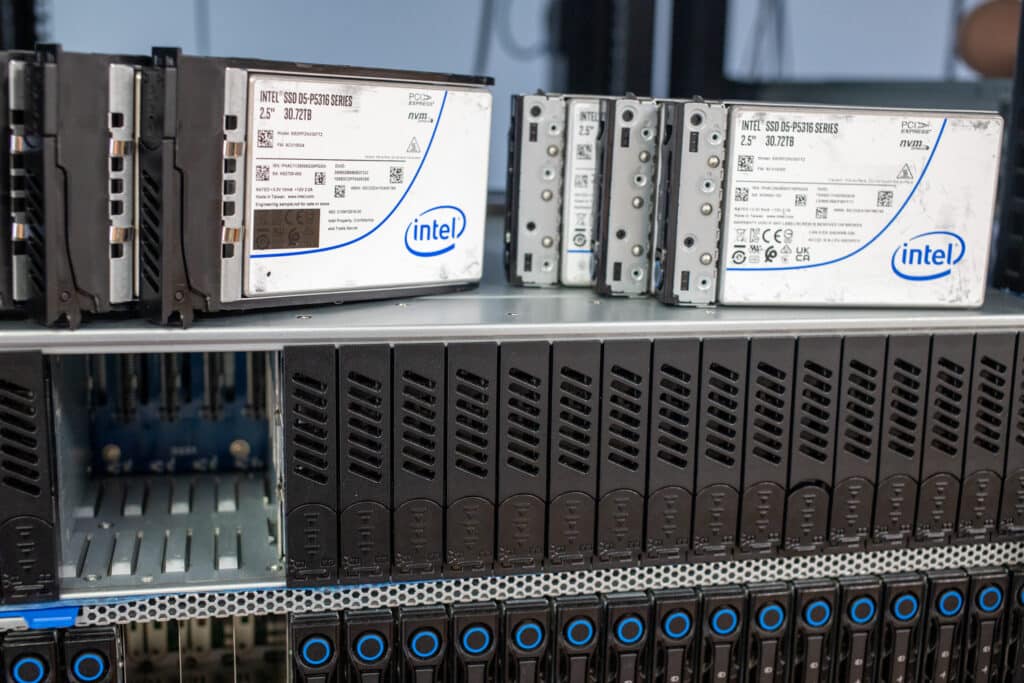
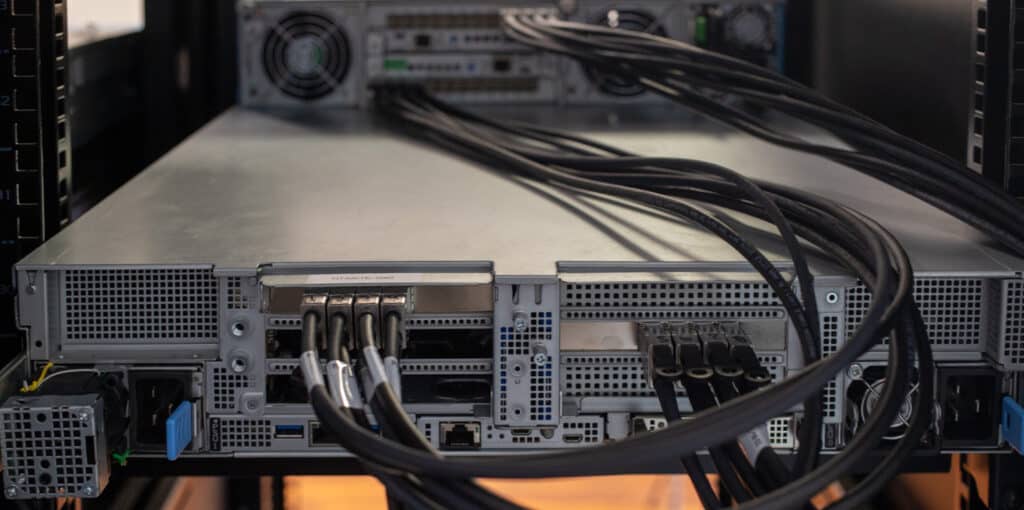
Novou součástí tohoto testu, která byla potřebná k rozšíření dostupného úložiště procesorů, bylo přidání NVMe JBOF. Naše testovací platforma nabízela 16 pozic NVMe, přičemž zbývajících osm bylo připojeno pouze k SATA. I když náš test se 100 biliony disků využíval tři interní adaptéry PCIe U.2 k rozšíření počtu našich NVMe disků na 19, nebylo to optimální. Pro toto opakované testování jsme přidali 24pozicový U.2 JBOF od Serial Cables , což výrazně pomohlo dvěma způsoby: více výpočetního swapového úložiště a interní úložiště výstupních souborů. Konec šíleného serveru s úložištěm RAID0 HDD!
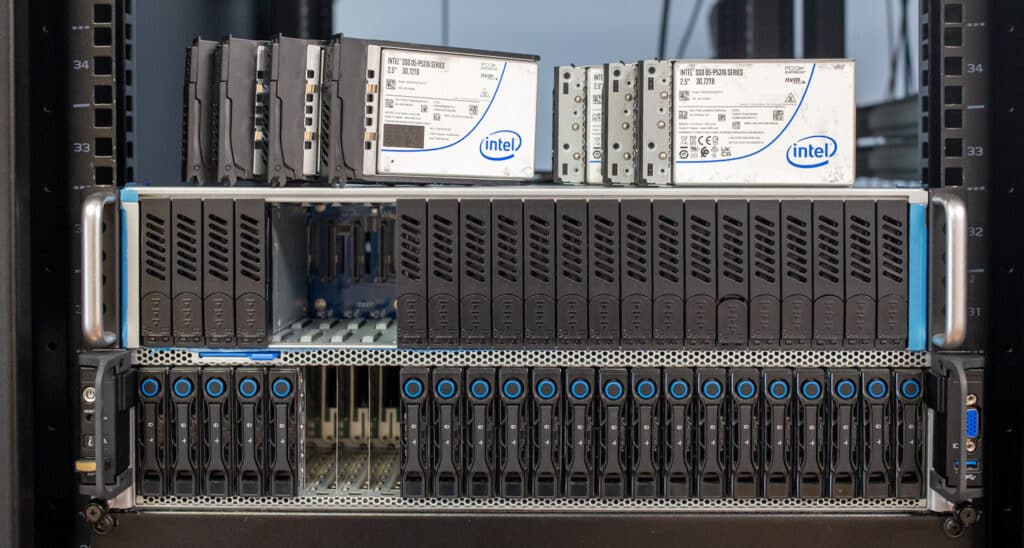
24pozicový JBOF od Serial Cables nám umožnil téměř zdvojnásobit počet disků oproti původnímu spuštění. Do odkládacího prostoru y-cruncher jsme přidělili 30 disků, čímž jsme pro výstupní svazek Storage Spaces RAID5 ponechali 6 SSD disků. Obrovská výhoda tohoto přístupu se projevila ve výstupní fázi, kde nás nebrzdila rychlost jednoho 10Gb připojení, jako u první iterace 100T Pi. JBOF sice řešil problém s celkovým počtem disků, ale zavedl jedno omezení: výkon jednotlivých disků.
V serveru s přímo připojenými SSD disky U.2 jsou na disk čtyři linky PCIe. Pokud je každý disk přímo připojen k základní desce, dává to 96 linek PCIe pro 24 SSD disků. Celková šířka pásma JBOF je omezena počtem linek PCIe, které může připojit zpět k hostiteli.
V tomto případě jsme použili dvě hostitelské karty s přepínačem PCIe, čímž jsme rozdělili JBOF do dvou skupin po 12 SSD. Každá skupina 12 SSD disků pak sdílela 16 PCIe linek. I když to stále nabízelo značné výhody při připojení SSD disků k našemu hostiteli, vyskytly se situace, kdy výměnné disky procházející JBOF zaostávaly za disky přímo připojenými k serveru. To není chyba JBOF. Je to pouze technické omezení, respektive omezení počtu PCIe linek, s nimiž může server pracovat.
Bystrí čtenáři by se mohli divit, proč jsme se v tomto případě zastavili na 36 SSD discích, místo abychom šli až na 40. Je to vtipný příběh. Adresovatelný prostor PCIe má u mnoha serverů svá omezení. V našem případě, při počtu 38 disků, poslední SSD disk obsadil adresu PCIe USB čipsetu a my jsme ztratili kontrolu nad serverem. Pro jistotu jsme počet SSD disků snížili na 36, abychom se stále mohli dostat do BIOSu nebo se přihlásit k serveru. Posouvání hranic vede k některým překvapivým objevům.
Diagnostický vhled a řešení
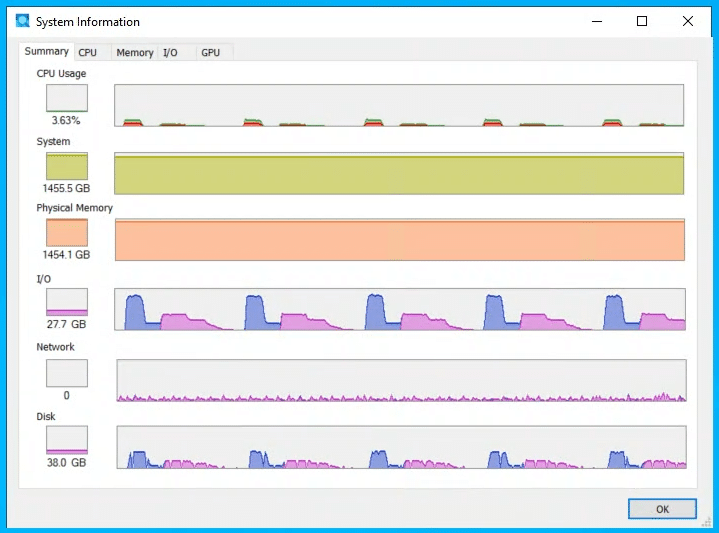
První ze dvou hlavních problémů, se kterými jsme se setkali, se týkal výkonu. Objevili jsme Amdahlův zákon v akci. Zvláštní problém se objevil, když se y-cruncher zdál „zaseknout“ na našem 256jádrovém systému AMD Bergamo během velkých operací v režimu swap. Toto zaseknutí, charakterizované nedostatkem aktivity CPU a disku I/O, zpochybnilo konvenční očekávání chování softwaru. To vedlo k hlubokému ponoření se do složitostí paralelních výpočtů a interakcí hardwaru.
Proces zjišťování odhalil, že program se ve skutečnosti nezasekával, ale fungoval s velmi omezenou kapacitou a běžel jednovláknově na rozsáhlém 256jádrovém systému. Toto neobvyklé chování vyvolalo otázky ohledně potenciálního dopadu Amdahlova zákona, zejména proto, že operace nebyly výpočetně náročné a neměly by způsobovat významná zpoždění na systému vybaveném 1.5 TB RAM.
Vyšetřování nabralo nečekaný směr, když byl problém replikován na spotřebitelském počítači, což zdůraznilo závažné důsledky Amdahlova zákona i na méně rozsáhlých systémech. To vedlo k hlubšímu zkoumání základních příčin, které odhalilo riziko specifické pro architekturu Zen4, které se týká super-zarovnání a jeho vlivu na vzorce přístupu k paměti.
Problém byl na procesorech AMD zhoršen smyčkou v kódu, která se vzhledem ke své jednoduché povaze měla provádět mnohem rychleji, než bylo pozorováno. Hlavní příčinou se zdálo být neefektivní zpracování aliasingu paměti jednotkou load-store od AMD. Řešení tohoto složitého problému vyžadovalo jak zmírnění rizika super-alignmentu vektorizací smyčky pomocí AVX512, tak i řešení zpomalení způsobeného Amdahlovým zákonem pomocí vylepšeného paralelismu. Tento komplexní přístup nejen vyřešil bezprostřední problém, ale také vedl k významné optimalizaci výpočetních procesů y-cruncheru, čímž vytvořil precedens pro řešení podobných výzev ve vysoce výkonných výpočetních prostředích.
Další problém se objevil v závěrečných krocích výpočtu, který se neočekávaně zastavil a neposkytl žádné informace o příčině havárie. Vzdálený přístup byl udělen Alexandru Yeeovi a poprvé za více než deset let vyžadovalo dokončení záznamu pí přímý zásah vývojáře.
Do tohoto diagnostického procesu jsme se nezapojili, ale v kódové cestě AVX512 algoritmu násobení N63 došlo k kritické aritmetické chybě s plovoucí desetinnou čárkou. Alexander byl schopen vzdáleně diagnostikovat chybu , poskytnout pevný binární kód a pokračovat z kontrolního bodu, což vyvrcholilo úspěšným výpočtem po implementaci klíčových softwarových oprav.
Reflexe a posun vpřed
Tato snaha ilustruje složitost a nepředvídatelnost vysoce výkonných výpočtů. Řešení těchto výzev stanovilo nový rekord ve výpočetním systému Pi a poskytlo cenné poznatky o metodikách vývoje a testování softwaru. Nejnovější verze y-cruncher, v0.8.4, obsahuje opravy identifikovaných problémů a slibuje zvýšenou stabilitu pro budoucí výpočty.
Výpočet čísla pí na 105 bilionů číslic nebyl snadný úkol. Vyžadoval pečlivé plánování, optimalizaci a provedení. Tým StorageReview optimalizoval algoritmický proces s využitím kombinace open-source a proprietárního softwaru tak, aby plně využil možnosti hardwaru, čímž se zkrátil výpočetní čas a zvýšila efektivita.
Díky saturačnímu výkonu čtení PCIe Gen4 a špičkové kapacitě až 61.44 TB dosahují SSD disky Solidigm QLC neuvěřitelných výsledků. „Představte si, co tyto disky dokáží ve vysoce výkonných výpočetních aplikacích nebo aplikacích náročných na umělou inteligenci,“ řekl Greg Matson, viceprezident pro strategické plánování a marketing ve společnosti Solidigm. Jsme nadšeni, že SSD disky Solidigm mohly pohánět druhý rekordní pokus společnosti Storagereview o výpočet čísla pí. Jejich úsilí dokazuje skutečné schopnosti úložných disků Solidigm a otevírá svět možností pro datově náročné aplikace umělé inteligence.“
Závěr
Cesta ke 105 bilionům číslic čísla pí byla mnohem složitější, než jsme očekávali. Po zamyšlení jsme měli očekávat, že narazíme na nové problémy; koneckonců dokončujeme výpočet, který nikdy předtím nebyl proveden. Ale s výpočtem 100 bilionů dokončeným s mnohem více „lepicí páskou a drátěným pletivem“ jsme si mysleli, že to máme zvládnuté. Nakonec to vyžadovalo společné úsilí, než jsme toto zařízení dostali do cíle.
I když se s našimi partnery radujeme z tohoto rekordního běhu, musíme si klást otázku: „Co to vůbec znamená?“ Pět bilionů číslic navíc pravděpodobně v matematice nic zásadního nezmění. Přesto můžeme stanovit hranice mezi výpočetním zatížením a potřebou moderního hardwaru, který by ho podporoval. Toto cvičení v zásadě odráží fakt, že správný hardware hraje klíčovou roli, ať už se jedná o cluster podnikového datového centra nebo rozsáhlou instalaci HPC.
Pro výpočet čísla pí jsme byli zcela omezeni úložištěm. Rychlejší procesory sice pomohou urychlit výpočty, ale limitujícím faktorem pro mnoho nových světových rekordů je množství lokálního úložiště v zařízení. Pro tento pokus opět využíváme SSD disky Solidigm D5-P5316 s kapacitou 30.72 TB , které nám pomohou získat v systému něco málo přes 1.1 PB nezpracované flash paměti. Tyto SSD disky jsou jediným důvodem, proč jsme dokázali překonat předchozí rekordy a dosáhnout 105 bilionů číslic čísla pí.
To ale vyvolává zajímavou otázku. Mnoho našich sledujících ví, že Solidigm má ve svém modelu D5-P5336 SSD disky s kapacitou 61.44 TB a v modelu D5-P5430 až 30.72 TB , které jsou k dispozici v různých provedeních a kapacitách. Disky jsme recenzovali a na sociálních sítích se objevilo mnoho příspěvků, které tyto úžasně husté disky prezentují. Vzhledem k tomu, že se 32 z těchto SSD disků blíží 2 PB úložného prostoru, člověk by se mohl ptát, jak dlouho si těchto 105 bilionů číslic pí vydrží jako největší číslo na světě. Rádi bychom si mysleli, že ne moc dlouho.
Největší známé desetinné číslice čísla pí
1432360875 9463978314 2999186657 8364664840 8558373926: Číslice do 105 000 000 000 000


 Amazon