

Oblast grafických procesorů (GPU) zažila v posledních dvou desetiletích zásadní změny, a to zejména v poslední době s nástupem umělé inteligence. Významnou součástí tohoto vývoje byl vývoj technologií, které umožňují souběžnou práci více GPU. Společnost NVIDIA, která je průkopníkem v oblasti GPU, stála v čele této revoluce se dvěma klíčovými technologiemi: Scalable Link Interface (SLI) a NVIDIA NVLink . Tento článek sleduje cestu od SLI k NVLink a zdůrazňuje, jak se NVIDIA neustále přizpůsobuje neustále se měnícím výpočetním požadavkům.
Úsvit SLI
NVIDIA představila SLI na začátku roku 2000. Původně jej vyvinula společnost 3dfx pro řadu grafických karet Voodoo2 a byla odpovědí společnosti NVIDIA na rostoucí poptávku po vyšší grafické věrnosti ve videohrách a spotřebitelských aplikacích. SLI ve své podstatě využívá techniku známou jako Alternate Frame Rendering (AFR) k rozdělení vykreslovací zátěže mezi více GPU. Každá karta vykreslovala každý druhý snímek nebo dokonce jeho část, čímž efektivně zdvojnásobovala grafický výkon. Ačkoli byl SLI v té době revoluční, měl svá omezení, včetně vyšší latence a nedostatečné flexibility při sdílení dat mezi GPU.
SLI vs. CrossFire: Rivalita v řešeních s více grafickými kartami
Ačkoliv SLI od NVIDIA udávalo tempo pro konfigurace s více GPU, neobešlo se bez konkurence. CrossFire od AMD byl jeho přímým rivalem a nabízel podobné možnosti pro sestavy s více GPU. Stejně jako SLI se i CrossFire snažil zvýšit grafický výkon pomocí technik, jako je Alternate Frame Rendering (AFR) a Split Frame Rendering (SFR).

Zdroj obrázku Dallas Moore
CrossFire však měl své vlastní výhody i výzvy. Obecně byl flexibilnější, co se týče kombinací použitelných GPU, což umožňovalo kombinaci různých karet AMD. Nevýhodou však byla častá kritika softwarového balíku CrossFire, který někteří uživatelé považovali za méně spolehlivý a složitější na konfiguraci než SLI od NVIDIA. Navzdory těmto rozdílům byly obě technologie zaměřeny na stejný cíl: vylepšení herního a grafického zážitku pro spotřebitele. Jejich omezení při zvládání pokročilejších úloh náročných na data nakonec vydláždila cestu pro řešení nové generace, jako je NVLink.
S příchodem roku 2010 se výpočetní prostředí začalo dramaticky měnit. Vzestup umělé inteligence (AI), vysoce výkonných výpočtů (HPC) a analýzy velkých dat si vyžádal robustnější řešení s více grafickými procesory (multi-GPU). Ukázalo se, že SLI, původně navržené s ohledem na herní a spotřebitelské úlohy, nebylo pro tyto výpočetně náročné úkoly dostatečné. NVIDIA potřebovala nové paradigma.
Éra grafických karet s dvěma grafickými procesory: Unikátní přístup k výpočtům s více grafickými procesory
Zatímco technologie jako SLI a CrossFire se zaměřovaly na propojení více samostatných grafických karet (GPU), existoval i jiný, méně běžný přístup k konfiguracím s více grafickými kartami: karty s dvěma grafickými kartami (dual GPU). Tyto specializované grafické karty obsahovaly dvě jádra GPU na jedné desce plošných spojů (PCB), čímž efektivně fungovaly jako sestava SLI nebo CrossFire na jedné kartě. Oblíbenými příklady tohoto přístupu byly karty jako NVIDIA GeForce GTX 690 a AMD Radeon HD 6990.
Karty s dvěma grafickými procesory (Dual-GPU) nabízejí několik výhod. Šetří místo tím, že dvě grafické karty jsou vloženy do jednoho slotu, což je činí atraktivními pro malé počítače. Zjednodušují také instalaci tím, že eliminují nutnost propojování samostatných karet s externími konektory. Tyto karty však nebyly bez problémů. Významným problémem byl odvod tepla, který často vyžadoval pokročilá řešení chlazení. Spotřeba energie byla také vysoká, což vyžadovalo robustní napájecí zdroje pro stabilizaci systému.
Je zajímavé, že karty s dvěma grafickými procesory (Dual GPU) představovaly jakýsi „to nejlepší z obou světů“, kombinující hrubý výkon více grafických karet s jednoduchostí jedné karty. Přesto byly kvůli svým vysokým nákladům a souvisejícím technickým problémům často vnímány jako specializovaný produkt. S tím, jak se technologie více grafických karet, jako je NVLink, vyvíjely a nabízejí vyšší šířku pásma a nižší latenci, potřeba karet s dvěma grafickými procesory klesala. Přesto zůstávají fascinující kapitolou v historii vývoje grafických karet (GPU).
Řada grafických procesorů Tesla od společnosti NVIDIA byla základním kamenem v oblasti podnikových výpočtů, zejména v datových centrech a vysoce výkonných výpočetních klastrech. Zatímco většina grafických procesorů Tesla jsou karty s jedním grafickým procesorem navržené pro maximální výkon a efektivitu, existovaly výjimky, jako například Tesla K80, která obsahuje dva grafické procesory na jednom čipu. Tyto vícenásobné grafické karty Tesla byly optimalizovány pro vysoce paralelní výpočty a byly základem vědeckého výzkumu, strojového učení a analýzy velkých dat. Jsou navrženy tak, aby splňovaly specifické požadavky těchto aplikací, a nabízejí vysokou výpočetní propustnost, velké paměťové kapacity a pokročilé funkce, jako je paměť s korekcí chyb (ECC). Ačkoli jsou méně běžné než jejich protějšky s jedním grafickým procesorem, tyto dvounásobné grafické karty Tesla představovaly výkonné, byť specifické, řešení v oblasti podnikových výpočtů.
Příchod NVLinku
Přichází NVLink, představený s architekturou Volta od NVIDIA v roce 2017. Tato technologie nebyla jen upgradem, ale zásadním přehodnocením způsobu propojení GPU. NVLink nabízel výrazně vyšší šířku pásma (až 900 GB/s u nejnovějších verzí), nižší latenci a síťovou topologii, která umožňovala složitější a četnější propojení mezi GPU. NVLink navíc zavedl koncept unifikované paměti, který umožňuje sdružování paměti mezi připojenými GPU, což je klíčová funkce pro úlohy vyžadující velké datové sady.
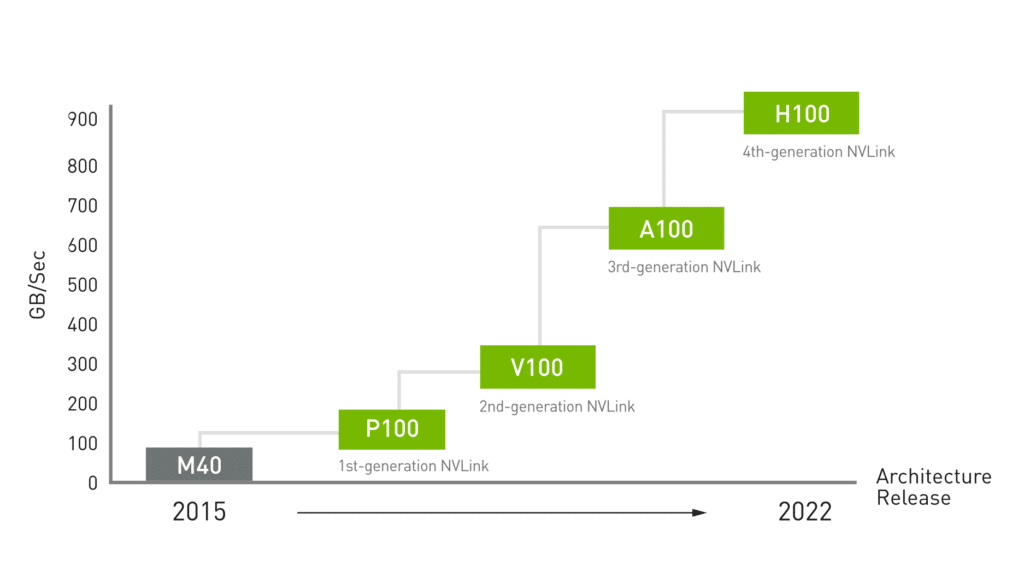
Vývoj výkonu NVLinku
SLI vs. NVLink
Na první pohled by se NVLink mohl jevit jako „SLI na steroidech“, ale to by bylo zjednodušení. Zatímco obě technologie se zaměřují na propojení více GPU, NVLink je navržen s ohledem na jiné publikum. Je určen pro vědecký výzkum, analýzu dat a především pro aplikace umělé inteligence a strojového učení. Vyšší šířka pásma, nižší latence a sjednocená paměť dělají z NVLink mnohem flexibilnější a výkonnější řešení pro dnešní výpočetní výzvy.
Technická páteř NVLinku
NVLink představuje logický vývoj v technologii propojení více grafických karet (MPI), a to nejen z hlediska rychlosti, ale i architektonického designu. Základní struktura NVLink se skládá z vysokorychlostních datových linek, které dokáží přenášet data obousměrně. Na rozdíl od tradičních systémů založených na sběrnici používá NVLink připojení typu point-to-point, čímž efektivně snižuje úzká hrdla a zlepšuje propustnost dat. Nejnovější verze nabízejí šířku pásma až 900 GB/s, což je významné vylepšení oproti možnostem SLI.
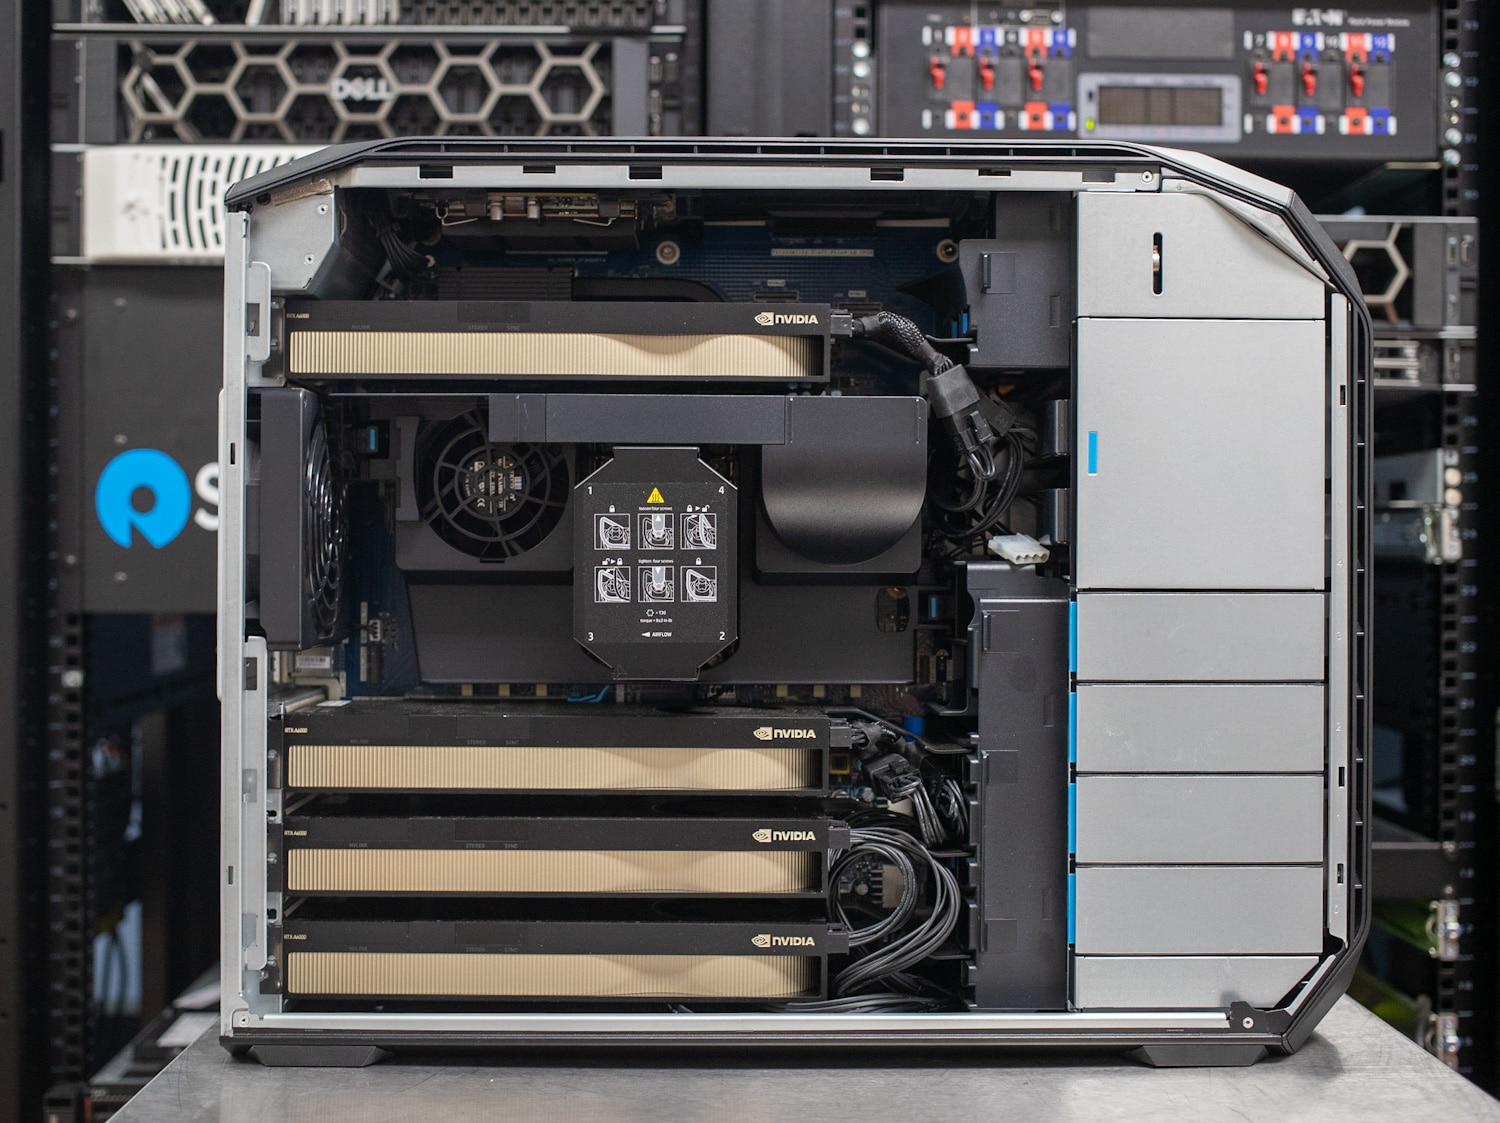
HP Z8 Fury G5 se 4 grafickými kartami A6000
Jednou z klíčových vlastností, která odlišuje NVLink, je jeho schopnost podporovat topologii mesh. Na rozdíl od topologií typu daisy chain nebo hub-and-spoke starších technologií umožňuje mesh nastavení všestrannější a četnější propojení mezi grafickými procesory. To je obzvláště užitečné v datových centrech a vysoce výkonných výpočetních aplikacích, kde jsou normou složité datové trasy.
Další funkcí NVLink je sjednocená paměť. Ta umožňuje grafickým procesorům (GPU) sdílet společný paměťový fond, což umožňuje efektivnější sdílení dat a snižuje potřebu kopírování dat mezi GPU. To je obrovský přínos pro aplikace, jako je strojové učení a analýza velkých dat, kde velké datové sady často překračují paměťovou kapacitu jednoho GPU.
NVLink také snižuje latenci, což je klíčový faktor v jakékoli vysoce výkonné výpočetní sestavě. Nižší latence zajišťuje rychlejší přenos dat a synchronizaci mezi grafickými procesory (GPU), což vede k efektivnějším paralelním výpočtům. Toho je dosaženo díky funkcím NVLink pro přímý přístup k paměti (DMA), které umožňují grafickým procesorům číst a zapisovat přímo do paměti ostatních procesorů bez zapojení CPU.
Dopad na umělou inteligenci a strojové učení
Vzhledem k rostoucímu významu umělé inteligence v moderních počítačích nejsou výhody NVLinku jen přírůstkové, ale transformační. V oblasti trénování modelů umělé inteligence a vytváření dat umožňuje NVLink rychlejší přenos dat mezi grafickými procesory (GPU), což umožňuje efektivnější paralelní zpracování. To je obzvláště výhodné při práci s velkými trénovacími datovými sadami, což je oblast, která úzce souvisí s nově vznikající oblastí tvorby trénovacích dat pro modely umělé inteligence.
S rostoucími požadavky na pokročilé výpočty, jako jsou kvantové simulace, analýzy v reálném čase a algoritmy umělé inteligence nové generace, můžeme očekávat další vylepšení schopností NVLinku. Ať už se jedná o zvýšení šířky pásma nebo nové funkce, které usnadní ještě větší spolupráci mezi GPU, NVLink nebo jeho nástupce nepochybně zůstanou klíčovými pro naplňování výpočetních potřeb zítřka.
Přechod od SLI k NVLink představuje významný milník pro technologie s více grafickými kartami (multi-GPU). Odráží závazek společnosti NVIDIA k inovacím a její hluboké pochopení měnícího se výpočetního prostředí. Od her po umělou inteligenci, od spotřebitelských aplikací po datová centra, kořeny NVLink v hraní her a SLI ilustrují, jak nutnost plodí inovace a posouvá technologie vpřed v nekonečném cyklu zlepšování.


 Amazon