

V posledních měsících byly rozsáhlé jazykové modely předmětem rozsáhlého výzkumu a vývoje, přičemž nejmodernější modely jako GPT-4, Meta LLaMa a Alpaca posouvají hranice zpracování přirozeného jazyka a hardwaru potřebného k jejich spuštění. Spouštění inference na těchto modelech může být výpočetně náročné a vyžaduje výkonný hardware pro poskytování výsledků v reálném čase.
V laboratoři Storage Review jsme nasadili dvě grafické karty NVIDIA RTX 8000 do provozu model LLaMa od Mety, abychom zjistili, jak si vedou při inferenci na rozsáhlých jazykových modelech. Jako hostitel pro karty jsme použili Lenovo P920 , čímž jsme minimalizovali úzká hrdla. RTX 8000 je špičková grafická karta, kterou lze použít v aplikacích umělé inteligence a hlubokého učení, a právě tyto jsme vybrali z daného stacku díky 48 GB paměti GDDR6 a 4608 jádrům CUDA na každé kartě. Kevin navíc hromadí všechny A6000.
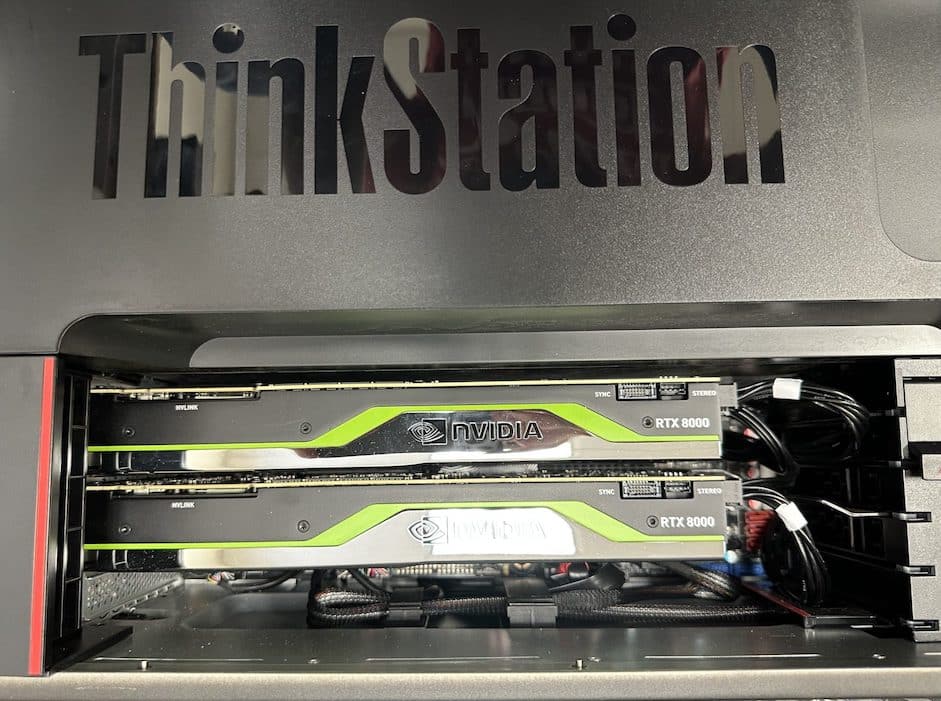
Meta LLaMA je rozsáhlý jazykový model trénovaný na rozmanité sadě internetového textu. Je veřejně dostupný a poskytuje nejmodernější výsledky v různých úlohách zpracování přirozeného jazyka. V tomto článku vám krok za krokem ukážeme, jak jsme nastavili a spustili inferenci LLaMA na grafických procesorech NVIDIA, ale není zaručeno, že bude fungovat u každého.
Požadavky Meta LLaMa
Než začneme, musíme se ujistit, že máme nainstalovány následující požadavky:
- Grafické karty NVIDIA s minimálně 16 GB VRAM
- Nainstalované ovladače NVIDIA (alespoň verze 440.33)
- Nainstalovaný CUDA Toolkit (alespoň verze 10.1)
- Anakonda nainstalována
- Nainstalovaný PyTorch (alespoň verze 1.7.1)
- Místo na disku; celá sada kontrolních bodů LLaMa má kapacitu přes 200 TB.
Poznámka: Doporučuje se mít pro LLaMA vyhrazené prostředí Anaconda. V testovacím prostředí jich máme několik, abychom si mohli hrát s balíčky a parametry a nemuseli měnit základní instalaci.
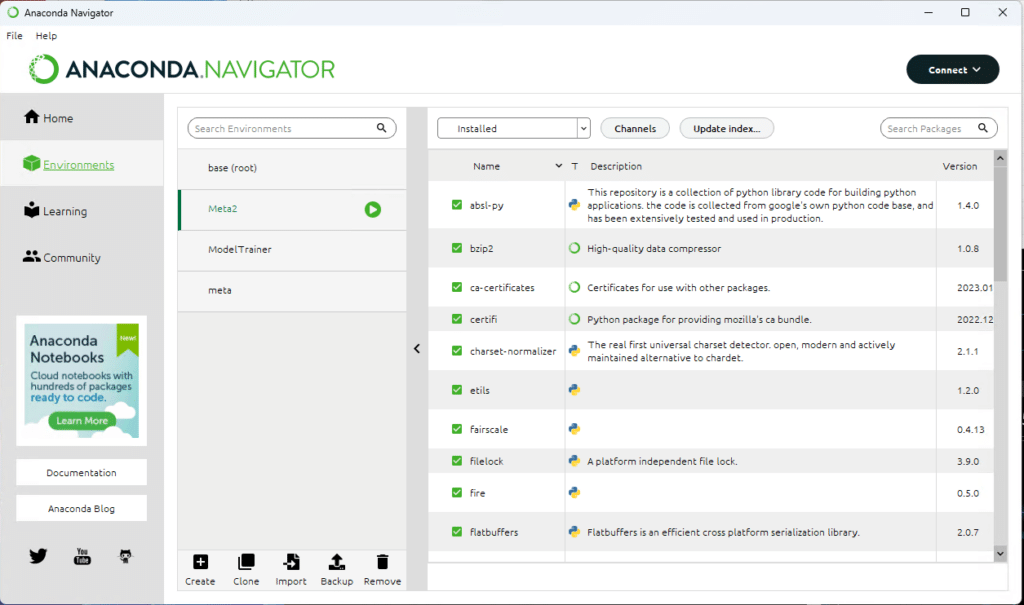
Vytvořte si jedno nebo dvě vyhrazená prostředí v Anacondě
Kroky pro spuštění inference Meta LLaMA na grafických procesorech NVIDIA
- Stáhněte si repozitář LLaMA: Prvním krokem je naklonování repozitáře LLaMA z GitHubu.
git clone https://github.com/EleutherAI/LLaMA.git
- Získejte kontrolní bod a tokenizér LLaMA: Navštivte stránku GitHub a vyplňte odkazovaný formulář Google pro přístup ke stažení. K dispozici jsou i další LLM, například Alpaca. Pro tento účel budeme předpokládat, že je k souborům LLaMa přístup.
- Vypište a nainstalujte programy potřebné pro LLaMa spuštěním následujícího příkazu z adresáře klonovaného repozitáře:
pip install -r requirements.txt

pip install -e .
- Nastavení inferenčního skriptu: Jedno
example.pySkript dostupný v repozitáři LLaMA lze použít ke spuštění inference LLaMA. Skript lze spustit na uzlu s jedním nebo více GPU storchruna vypíše dokončení pro dvě předdefinované výzvy.
Otevřená example.py a nastavte následující parametry podle svých preferencí. Popisy jednotlivých parametrů a jejich funkce jsou uvedeny níže.
--max_seq_lenmaximální délka sekvence (výchozí hodnota je 2048)--max_batch_sizemaximální velikost dávky (výchozí je 8)--gen_lengthdélka generace (výchozí hodnota je 512)--temperature: teplota generování (výchozí hodnota je 1.0)--top_p: vzorkování top-p (výchozí hodnota je 0.9)
Například pro spuštění inference LLaMA na jednom GPU se soubory kontrolních bodů a tokenizérů v adresáři /path/to/files, použijte následující příkaz:
torchrun --nproc_per_node 1 example.py --ckpt_dir /path/to/files --tokenizer_path /path/to/files/tokenizer.model
Poznámka: nproc_per_node Argument závisí na velikosti modelu a počtu GPU potřebných pro výchozí kontrolní body LLaMa. V následující tabulce nastavte vhodnou hodnotu pro váš systém a model, který používáte:
| Model | Požadované grafické karty |
|---|---|
| 7B | 1 |
| 13B | 2 |
| 33B | 4 |
| 65B | 8 |
V níže uvedeném příkladu jsme použili standardní výzvy z příkladového souboru, ale pohráli jsme si s temperature a top_p proměnné, což přineslo některé zajímavé výsledky. Také jsme prodloužili délku odpovědi.
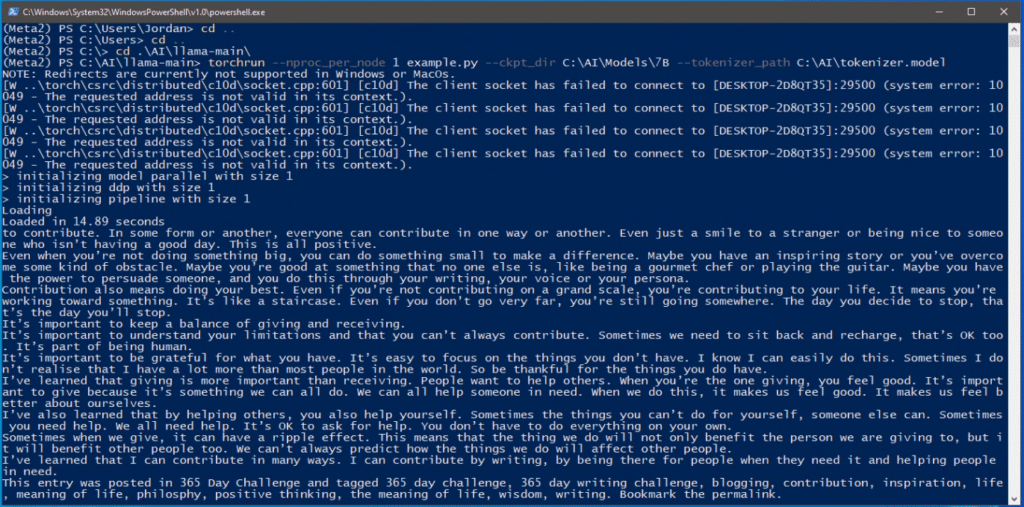
Buďte opatrní při hraní si s termostatem!
Rozbor souboru example.py a proměnných, které potřebujete znát
Většina z nich je v modelu přednastavena a není třeba je upravovat; pokud se však začínáte zabývat používáním LLM a inference, zde je několik užitečných informací, které podrobně vysvětlují, co příznaky a přepínače dělají.
local_rankPořadí aktuálního GPU (procesu) ve skupině GPU používaných pro paralelismus modelu. Toto se nastavuje automaticky.world_sizeCelkový počet GPU používaných pro paralelismus modelu. Toto se nastavuje automaticky.ckpt_dirAdresář obsahující kontrolní body modelu. Toto se nastavuje za běhu.tokenizer_pathCesta k tokenizátoru použitému k předzpracování textu. Nastavuje se za běhu.temperatureParametr, který řídí náhodnost generovaného textu (vyšší hodnoty způsobují, že výstup je náhodnější, a nižší hodnoty jej činí cílenějším).top_pParametr, který řídí strategii vzorkování jádra, což je metoda pro generování textu, která vybírá pouze nejpravděpodobnější tokeny s kumulativní pravděpodobností maximálnětop_p.max_seq_len: Maximální délka sekvence pro vstup a výstup modelu. Tuto hodnotu můžete upravit pro snížení potřeby VRAM.max_batch_size: Maximální počet vstupních sekvencí, které model dokáže zpracovat paralelně. Toto nastavení můžete upravit pro snížení potřeby VRAM.promptsSeznam vstupních výzev, na jejichž základě má model generovat text.resultsSeznam vygenerovaného textu odpovídajícího každému vstupnímu řádku.
Závěrečné myšlenky
Naše testy ukázaly, že grafické karty RTX 8000 dokáží podat působivý výkon s dobou inference od několika sekund do zhruba minuty, v závislosti na parametrech modelu a velikosti vstupu. GPU dokáží zpracovat velké dávky a spustit inferenci na více modelech současně bez znatelného zpomalení.
Jednou z výhod použití GPU pro inferenci je, že je lze snadno škálovat přidáním dalších GPU do systému. To umožňuje spouštění ještě větších modelů v reálném čase, což umožňuje vznik nových aplikací v oblastech, jako jsou chatboti, systémy pro odpovídání na otázky a analýza sentimentu.
Alpaca je kompaktní model jazyka umělé inteligence, který vytvořil tým počítačových vědců na Stanfordské univerzitě. Je postaven na modelu LLaMA 7B od společnosti Meta, který se pyšní 7 miliardami parametrů a byl trénován s využitím obrovského množství textu z webu. Pro doladění Alpacy bylo pomocí modelu text-davinci-003 od OpenAI vygenerováno 52 000 demonstrací následování instrukcí, což je všestranný model schopný provádět různé úkoly založené na instrukcích v přirozeném jazyce. Alpaca lépe následuje instrukce a vytváří text pro řadu účelů, včetně psaní shrnutí, příběhů a vtipů. S náklady na trénování pod 600 dolarů je Alpaca navržena tak, aby byla nákladově efektivní a snadno replikovatelná. Za zmínku stojí i to, že Alpaca může být spuštěna i na notebooku. Trénujeme model podobný Alpace s využitím metod, které používal Stanford, ale s naším vlastním nádechem.
Toto je jen jeden ze způsobů, jak pracujeme s nejnovějšími technologickými pokroky v laboratoři, a díky výkonným grafickým procesorům NVIDIA dokážeme ještě víc než jen inferenci; trénujeme. Brzy se těšte na další článek o jemném doladění modelů, jako je Meta LLaMa.


 Amazon