

NVIDIA DGX Spark představuje zlomový okamžik v oblasti přístupné infrastruktury umělé inteligence. V roce 2017 byl publikován přelomový článek „Attention is All You Need“ (Vše, co potřebujete, je pozornost), který představil architekturu Transformer, založenou na konfiguraci serveru P100 s osmi grafickými procesory, spotřebovávající desítky kilowatthodin a zabírající značný prostor v datových centrech. Dnes DGX Spark poskytuje vynikající výpočetní výkon v kompaktním stolním počítači s výkonem 240 wattů. Tento dramatický vývoj v energetické účinnosti a kompresi tvarového faktoru zpřístupňuje dříve exkluzivní funkce umělé inteligence pro datová centra jednotlivým výzkumníkům, malým týmům a distribuovaným vývojovým organizacím.
To, co odlišuje Spark od předchozích desktopových řešení umělé inteligence, je jeho komplexní přístup k celému životnímu cyklu vývoje. Spíše než nucené kompromisy mezi experimentováním, jemným dolaďováním a nasazením poskytuje Spark skutečnou funkcionalitu napříč všemi fázemi. Architektura unifikované paměti o velikosti 128 GB umožňuje úplné doladění parametrů modelů, které by na konvenčních pracovních stanicích vyžadovaly cloudové zdroje, a zároveň poskytuje propustnost stovek tokenů za sekundu, což je vhodné pro dávkové inferenční úlohy, včetně generování syntetických dat. Zahrnutí sítě ConnectX-7 s kapacitou 200Gb fabric znamená, že organizace mohou clusterovat více systémů Spark pro ještě rozsáhlejší průzkum modelů, ačkoli, jak si ukážeme, i jedna jednotka se ukazuje jako pozoruhodně výkonná.
Key Takeaways
Výkon datového centra ve stolním počítači : GB10 Grace Blackwell v 1.13litrové krabici s výkonem 240 W za cenu 3 999 dolarů, která poskytuje až 1 petaFLOP FP4 s nízkým výkonem.
Paměť, která mění pracovní postupy : 128GB unifikovaná paměť umožňuje lokální jemné ladění 8B modelů s plnými parametry a vysoce výkonnou inferenci. V testování jsme viděli, jak Llama 3.1 8B FP4 dosáhl ~924 tok/s při souběžnosti 128 bitů a Qwen3 Coder 30B-A3B FP8 dosáhl ~483 tok/s v dávce 64.
Připraveno k škálování a připojení rychlého úložiště : Integrovaný ConnectX-7 poskytuje 200G fabric pro clustering nebo NVMe-oF. Interní 2242 Gen5 NVMe je praktický, ale omezený pro náročné I/O operace, takže externí NVMe-oF přes RDMA je lepší cestou pro trvalou propustnost.
Zralost softwaru od prvního dne : Dodává se s DGX OS, CUDA, cuDNN, TensorRT, AI Workbench, kontejnery a workbooky, takže týmy mohou okamžitě spouštět reálné úlohy.
Osvědčený výkon v reálném provozu : MAMF naměřil ~99.8 TFLOPs BF16 a ~207.7 TFLOPs FP8. Čtení GDSIO dosáhlo interního maxima ~11.4 GiB/s, přičemž u 200G fabric se očekával vyšší limit.
Co je DGX Spark a kdo by ho měl zvážit?
NVIDIA DGX Spark je v podstatě kompletní platforma pro vývoj umělé inteligence, nikoli pouze komponenta GPU. Jeho jádrem je superčip GB10 Grace Blackwell, který integruje GPU s architekturou Blackwell s jádry Tensor páté generace s 20jádrovým procesorem Arm (10× Cortex-X925 + 10× Cortex-A725) připojeným přes NVLink-C2C. Tato koherentní propojovací architektura podle společnosti NVIDIA umožňuje až 5× vyšší šířku pásma ve srovnání s PCIe Gen 5, čímž vytváří jednotnou výpočetní strukturu namísto diskrétních procesních domén.
Aby uživatelé mohli začít, dodává NVIDIA operační systém DGX postavený na Ubuntu Desktop s kompletním předkonfigurovaným softwarovým balíčkem pro umělou inteligenci, včetně CUDA, cuDNN, TensorRT, NVIDIA Container Runtime a AI Workbench, čímž eliminuje typické problémy s ovladači a režijní náklady na konfiguraci prostředí, které trápí sestavení vlastních pracovních stanic. Systém nabízí flexibilní paradigmata nasazení: připojte periferie a používejte jej jako kompaktní pracovní stanici s plným zážitkem z Ubuntu nebo jej nasaďte jako bezhlavé síťové zařízení přístupné prostřednictvím NVIDIA Sync, které poskytuje bezproblémovou integraci s terminály JupyterLab, VS Code, Cursor IDE a SSH.
Jedná se o účelovou infrastrukturu pro odborníky z oblasti umělé inteligence, výzkumníky dolaďující jazykové modely, datové vědce akcelerující pracovní postupy RAPIDS, vývojáře implementující agentní systémy nebo týmy experimentující s architekturami s ablativními modely v malém měřítku. Spark cílí na profesionály, kteří potřebují seriózní výpočetní kapacitu umělé inteligence bez složitosti datového centra.
Technické specifikace NVIDIA DGX Spark
| Specifikace | Detaily |
|---|---|
| Architektura | |
| GPU | Architektura NVIDIA Blackwell |
| Procesor (CPU) | 20jádrové rameno (10x Cortex-X925 + 10x Cortex-A725) |
| Tenzorová jádra | 5th Generation |
| RT jádra | 4th Generation |
| NVENC / NVDEC | 1× / 1× |
| Memory | |
| Operační paměť | 128 GB LPDDR5X (jednotná systémová paměť) |
| Paměťové rozhraní | 256-bit |
| Paměťová šířka pásma | 273 GB / s |
| Výkon | |
| FP4 | až 1 petaFLOP (s řídkostí) |
| Skladování | |
| Skladování | 1 TB nebo 4 TB NVMe M.2 (samostatně šifrovaný) |
| Připojení | |
| USB | 4× USB 3.2 Gen 2×2 typu C (20 Gb/s) |
| Ethernet | 1× 10GbE RJ-45 |
| NIC | Inteligentní síťová karta ConnectX-7 – 2x 200G QSFP (umožňuje maximální šířku pásma 200G) |
| bezdrátový | WiFi 7, Bluetooth 5.3 |
| Zvukový výstup | Vícekanálový audio výstup HDMI |
| Konektory displeje | 1× HDMI 2.1a |
| mechanický | |
| Rozměry | 150 × 150 × 50.5 mm (5.9 × 5.9 × 1.98 palce) |
| Hmotnost | 1.2 kg |
| Spotřeba energie | 240 W |
Návrh a sestavení NVIDIA DGX Spark
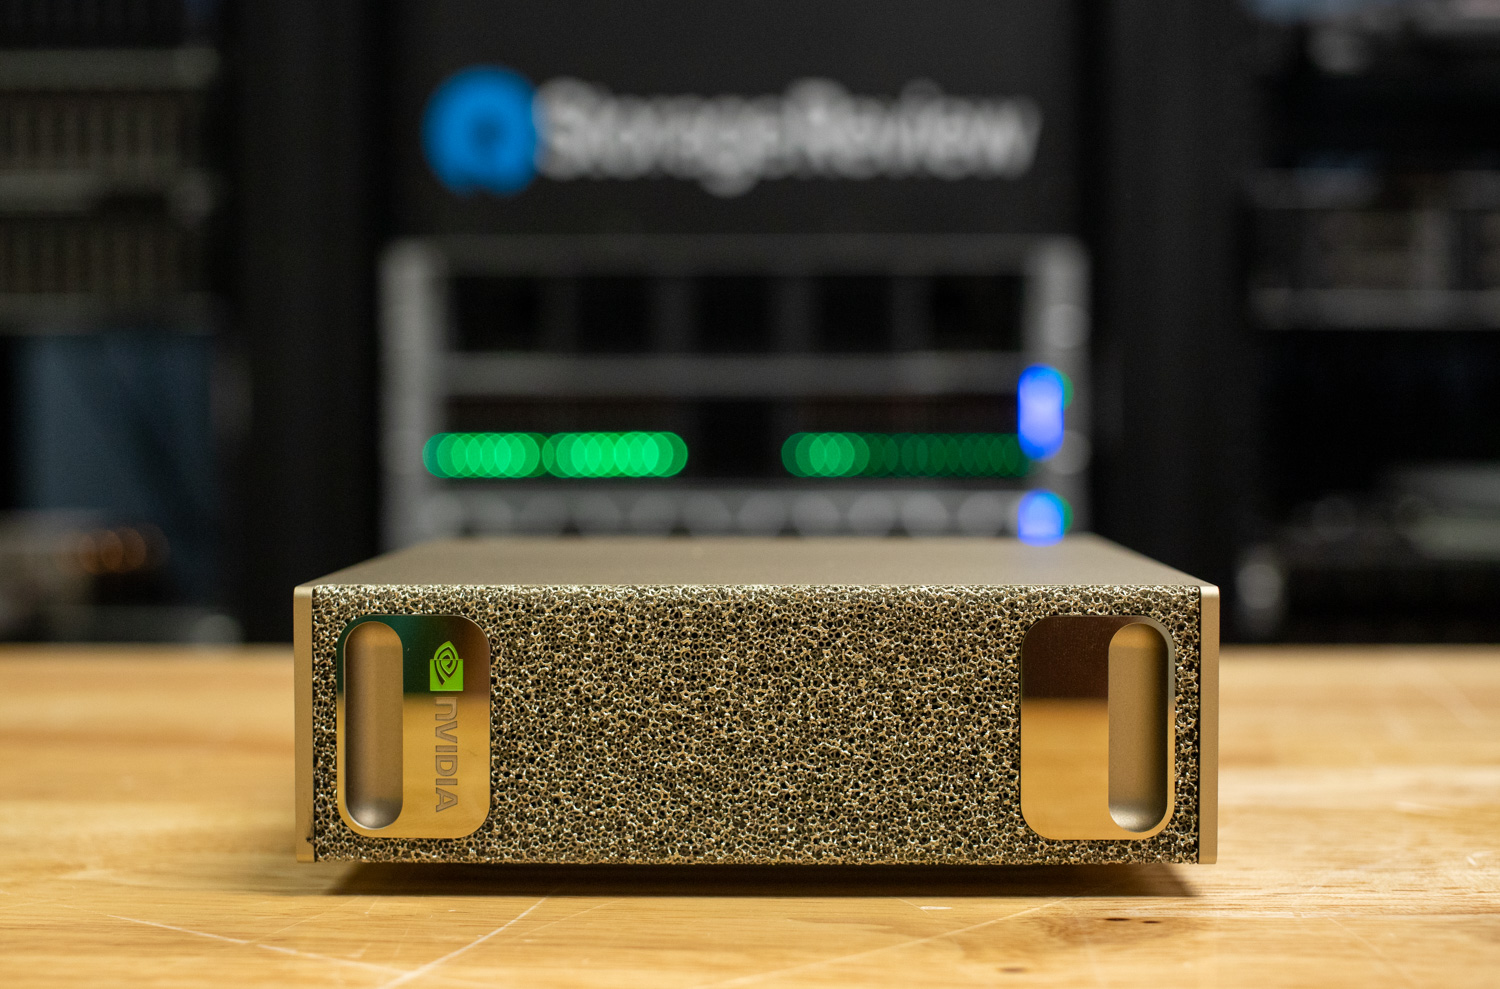
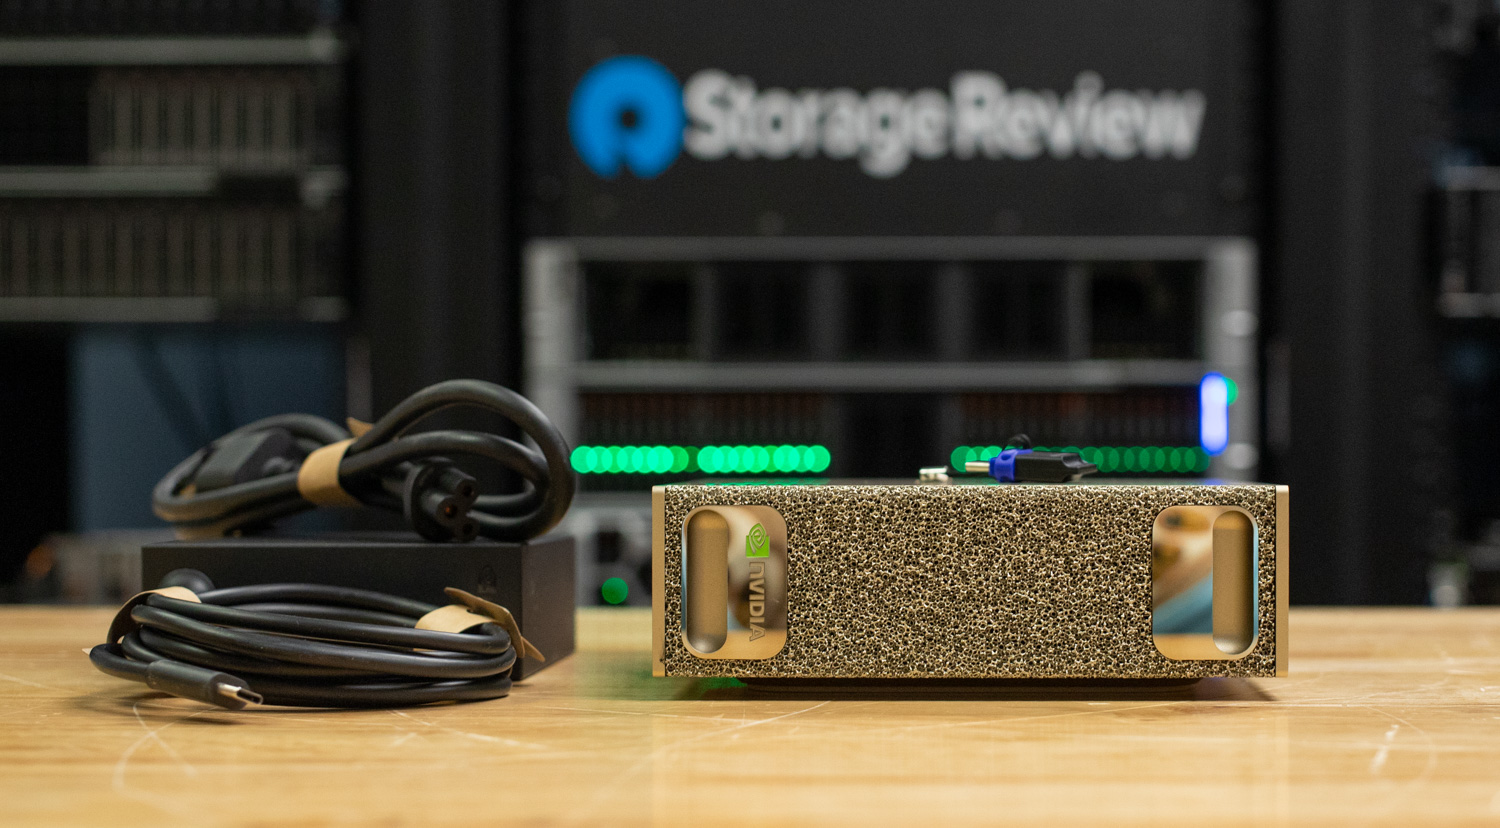
NVIDIA DGX Spark pokračuje v nezaměnitelném průmyslovém designovém jazyku NVIDIA a vyznačuje se kompaktním šasi, které odráží vzhled a dojem z větších systémů DGX. Přední panel se vyznačuje miniaturními výřezy pro úchopy, které odkazují na původní rukojeti jednotek DGX v plné velikosti, a zlatě tečkovanou kovovou povrchovou úpravou, která dodává rafinovanou, prémiovou texturu, zvýrazněnou ikonickým zeleným logem NVIDIA.
Fyzické rozměry DGX Spark činí 150 × 150 × 50.5 mm (5.9 × 5.9 × 1.98 palce) a váží 1.2 kg (2.6 liber), což mu dává celkový vnitřní objem 1.13 litru. To jej pevně řadí do třídy malých počítačů s objemem 1 litr. Navzdory minimálním rozměrům působí systém robustně a kompaktně díky celokovovému plášti, který slouží také jako pasivní rozvaděč tepla, a zachovává tak důraz na formu i funkčnost.
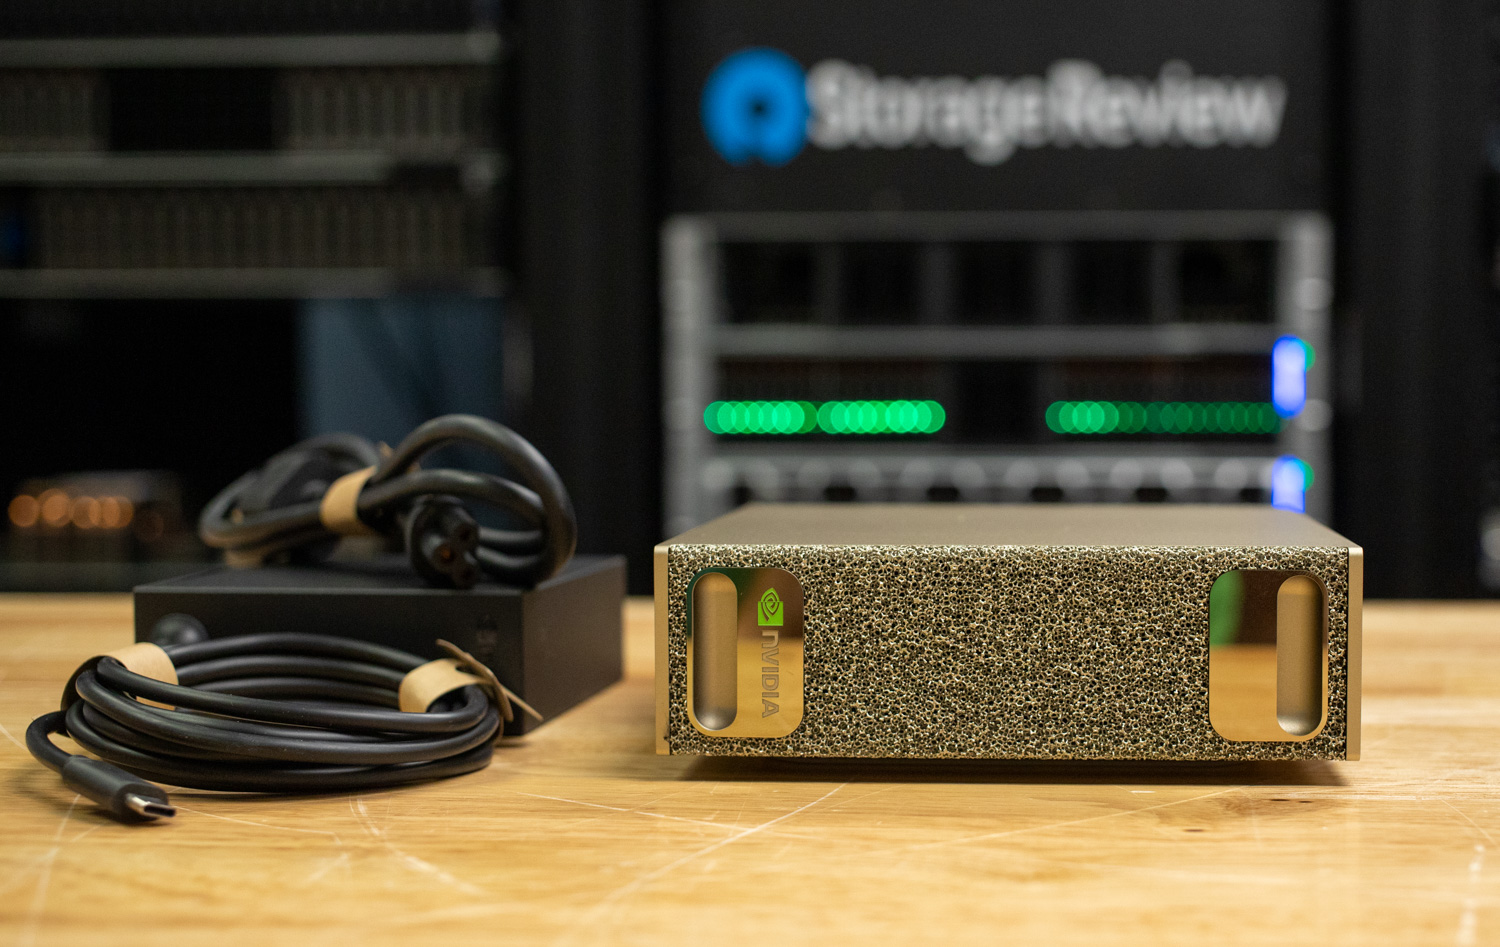
Napájení zajišťuje externí napájecí adaptér s výkonem 240 W a USB-C, který je na obrázku vidět vedle hlavní jednotky. Adaptér je kompaktní a dobře vyrobený, pro napájení používá standardní konektor C5 (cloverleaf) a odpovídá čistému a efektivnímu designu DGX Spark.
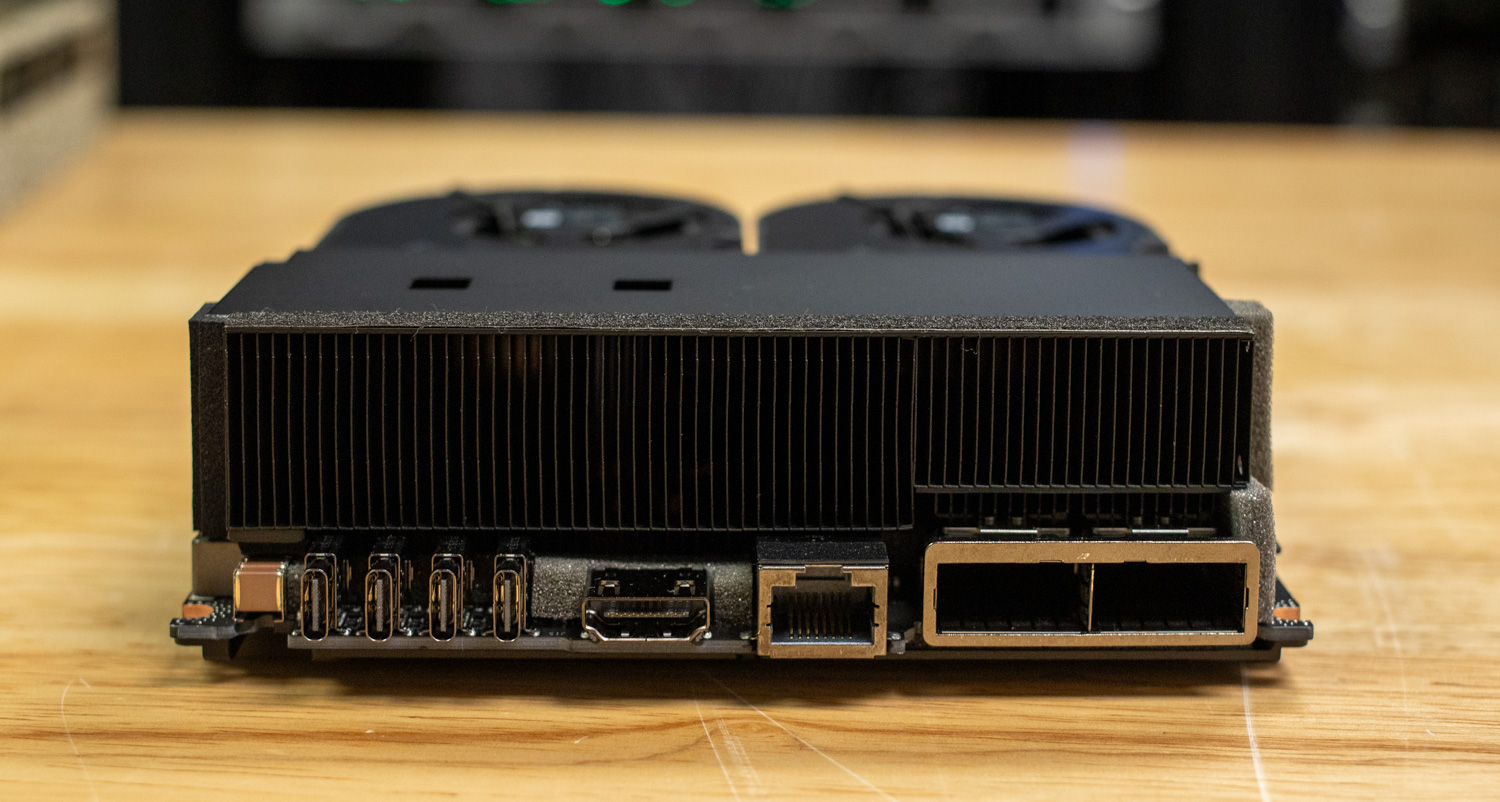
Na zadní straně si DGX Spark zachovává stejnou zlatavě skvrnitou texturovanou povrchovou úpravu jako přední strana, čímž si zachovává jednotný design celého šasi. Zleva se vedle tlačítka napájení nachází čtyři porty USB-C, z nichž jeden zajišťuje napájení. Následuje jeden výstup HDMI 2.1a, 10GbE port RJ-45 a zajímavostí tohoto zařízení jsou dvě rozhraní 200GbE QSFP56, která jsou poháněna integrovanou kartou NVIDIA ConnectX-7 SmartNIC.
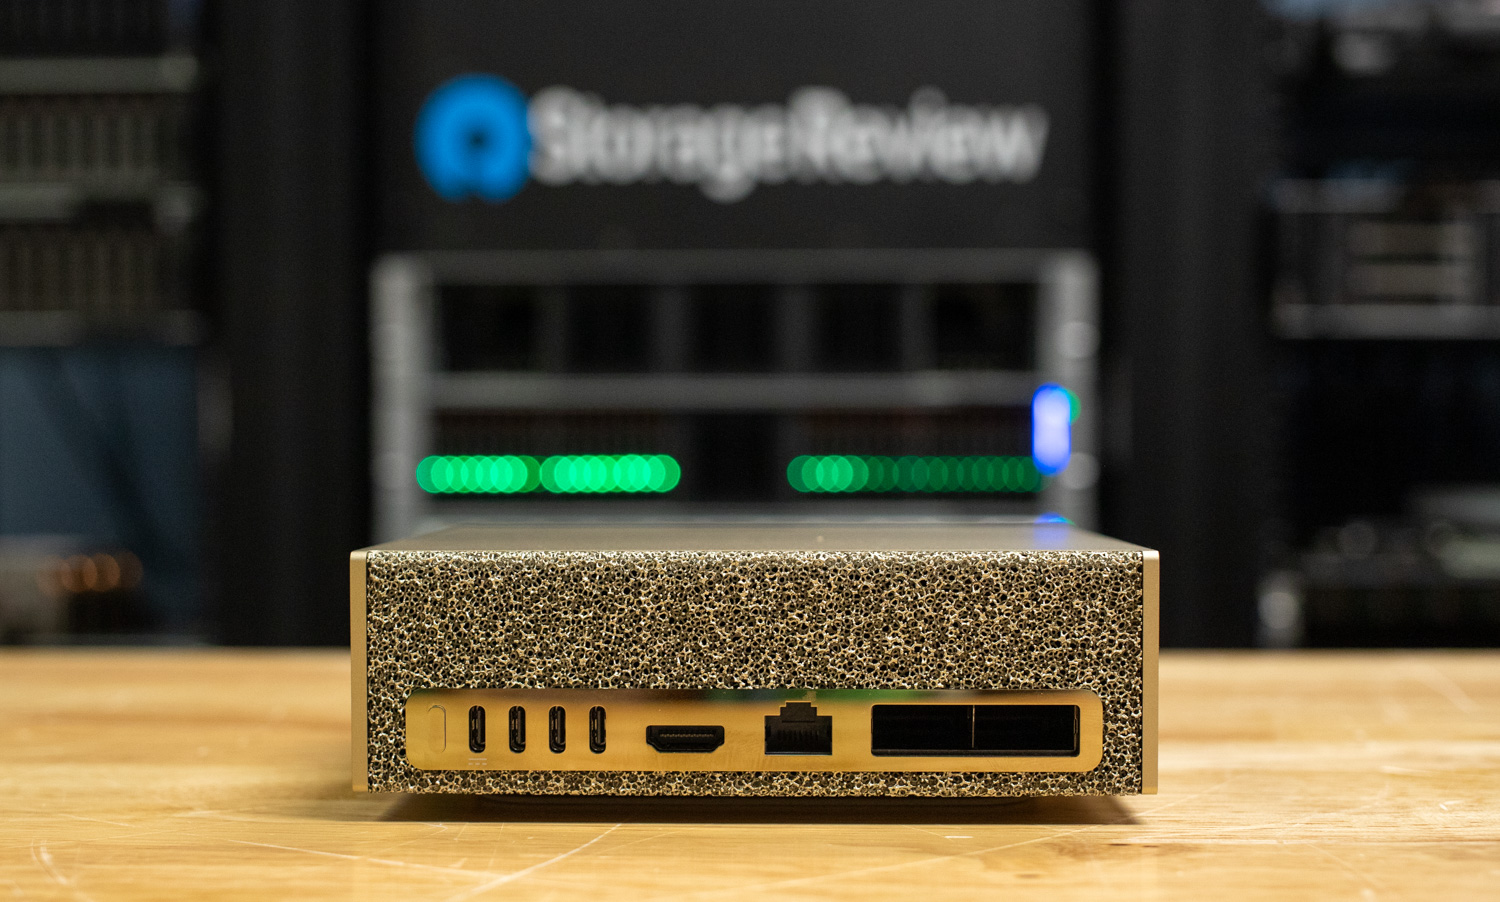
Na první pohled by se dalo usuzovat, že Spark umožňuje 400G konektivitu; bohužel kvůli omezením PCIe je Spark schopen poskytnout pouze 200G konektivitu. Abychom se dozvěděli více, ponořili jsme se hlouběji do topologie Sparka:
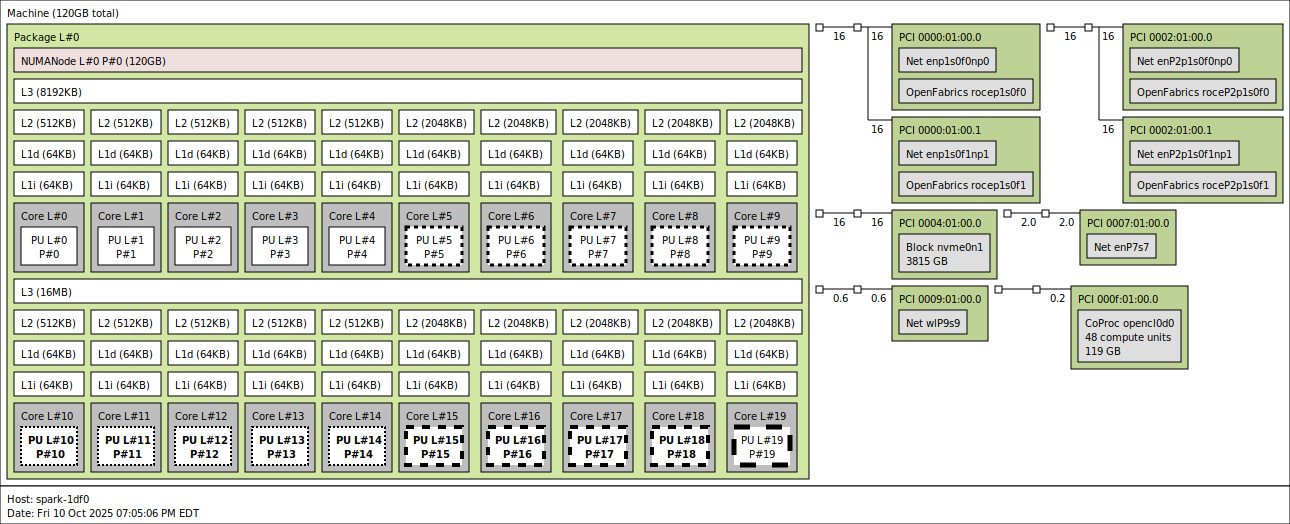
Pomocí nástroje lstopo sledujeme dva propojovací vodiče z CX7 NIC. Elektricky je CX7 připojen přes dva linky Gen5 x4. V operačním systému se tato připojení jeví jako čtyři rozhraní, z nichž každé podporuje maximální šířku pásma 200G. Vzhledem k omezenému času testování jsme nebyli schopni odhalit všechny síťové zvláštnosti této platformy mimo naše testy NVMe-oF, které jsou podrobněji popsány dále v článku. Plánujeme však tuto platformu dále prozkoumat a v budoucnu vydáme články, které se hlouběji ponoří do jejích možností, jako je shlukování více sparků dohromady do mini clusteru.
Pokud se podíváme na další připojená zařízení, dalším v pořadí je malý M.2 SSD disk s formátem 2242 připojený k Gen5 x4, následovaný řadičem Realtek RJ45 10GbE připojeným k linku PCIe Gen4 x1 a řadičem MediaTek Wi-Fi připojeným k linku PCIe Gen3 x1.
Pokud se ponoříme do CPU, Spark obsahuje 20jádrový procesor Arm s heterogenní velkou malou architekturou, podobnou nejnovějším procesorům Intelu, která se skládá z 10 efektivních jader Cortex-A725 a 10 výkonnostních jader Cortex-X925 rozdělených do dvou clusterů L3 cache. První cluster (8MB L3) obsahuje CPU 0-4 (Cortex-A725, max. 2808 MHz) a CPU 5-9 (Cortex-X925, max. 3900 MHz), zatímco druhý cluster (16MB L3) obsahuje CPU 10-14 (Cortex-A725, max. 2860 MHz) a CPU 15-19 (Cortex-X925, max. 3978-4004 MHz). Každé jádro má privátní 64KB L1 datovou a 64KB L1 instrukční mezipaměť, ale L2 mezipaměť se výrazně liší podle typu jádra: efektivní jádra Cortex-A725 mají 512KB L2 mezipaměť, zatímco výkonná jádra Cortex-X925 mají podstatně větší 2MB L2 mezipaměť (4× větší). Nejrychlejší jádra jsou CPU 15-19, která těží jak z větší 16MB L3 mezipaměti, tak z vyšších frekvencí, přičemž CPU 19 je jádro s nejvyšším výkonem na 4004 MHz. Tyto různé úrovně výkonu/frekvence jsou znázorněny přerušovanými čarami na jádru na výše uvedené topologii.
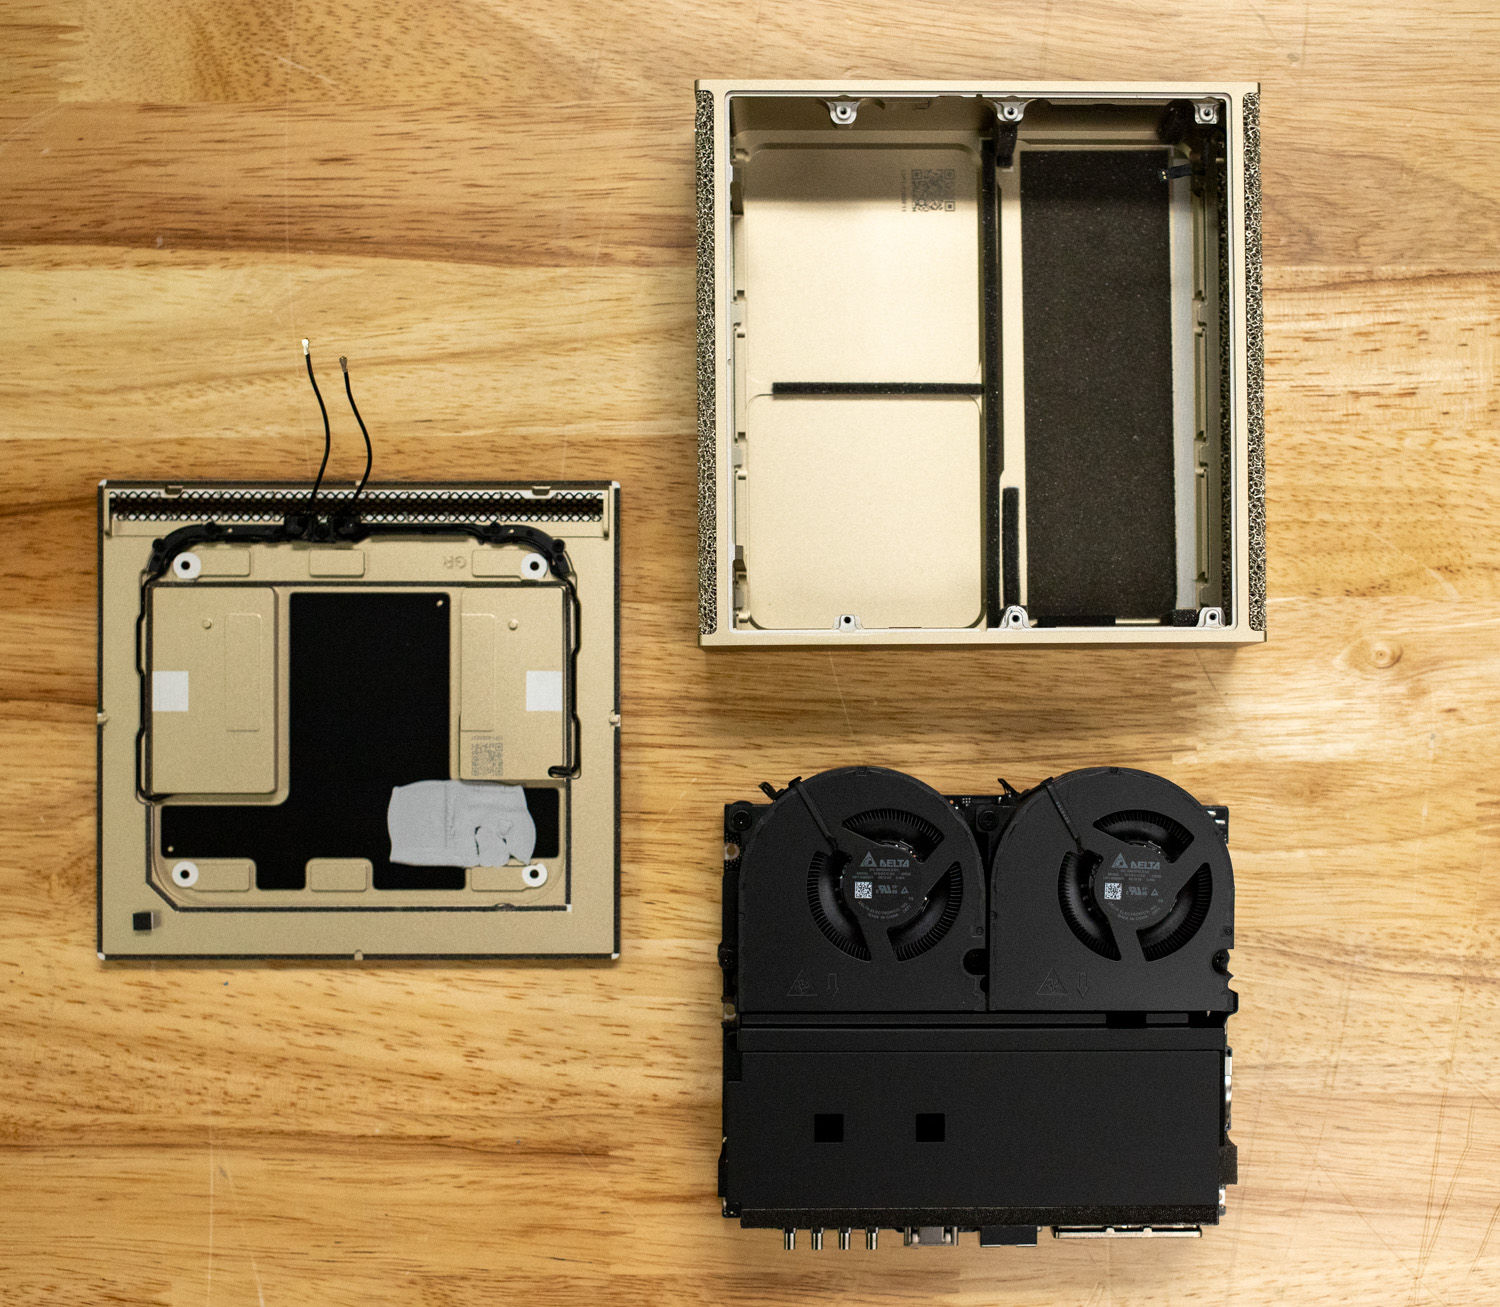
Při opětovném oddálení otočíme DGX Spark; jedinou viditelnou plastovou součástí je spodní kryt, který se magneticky připevňuje ke spodní části šasi. Tato konstrukce udržuje vnější povrch čistý a zároveň umožňuje rychlý přístup k vnitřním částem. Po odstranění magnetické základny se odkryjí čtyři šrouby, které umožňují přístup do hlavního vnitřního prostoru.
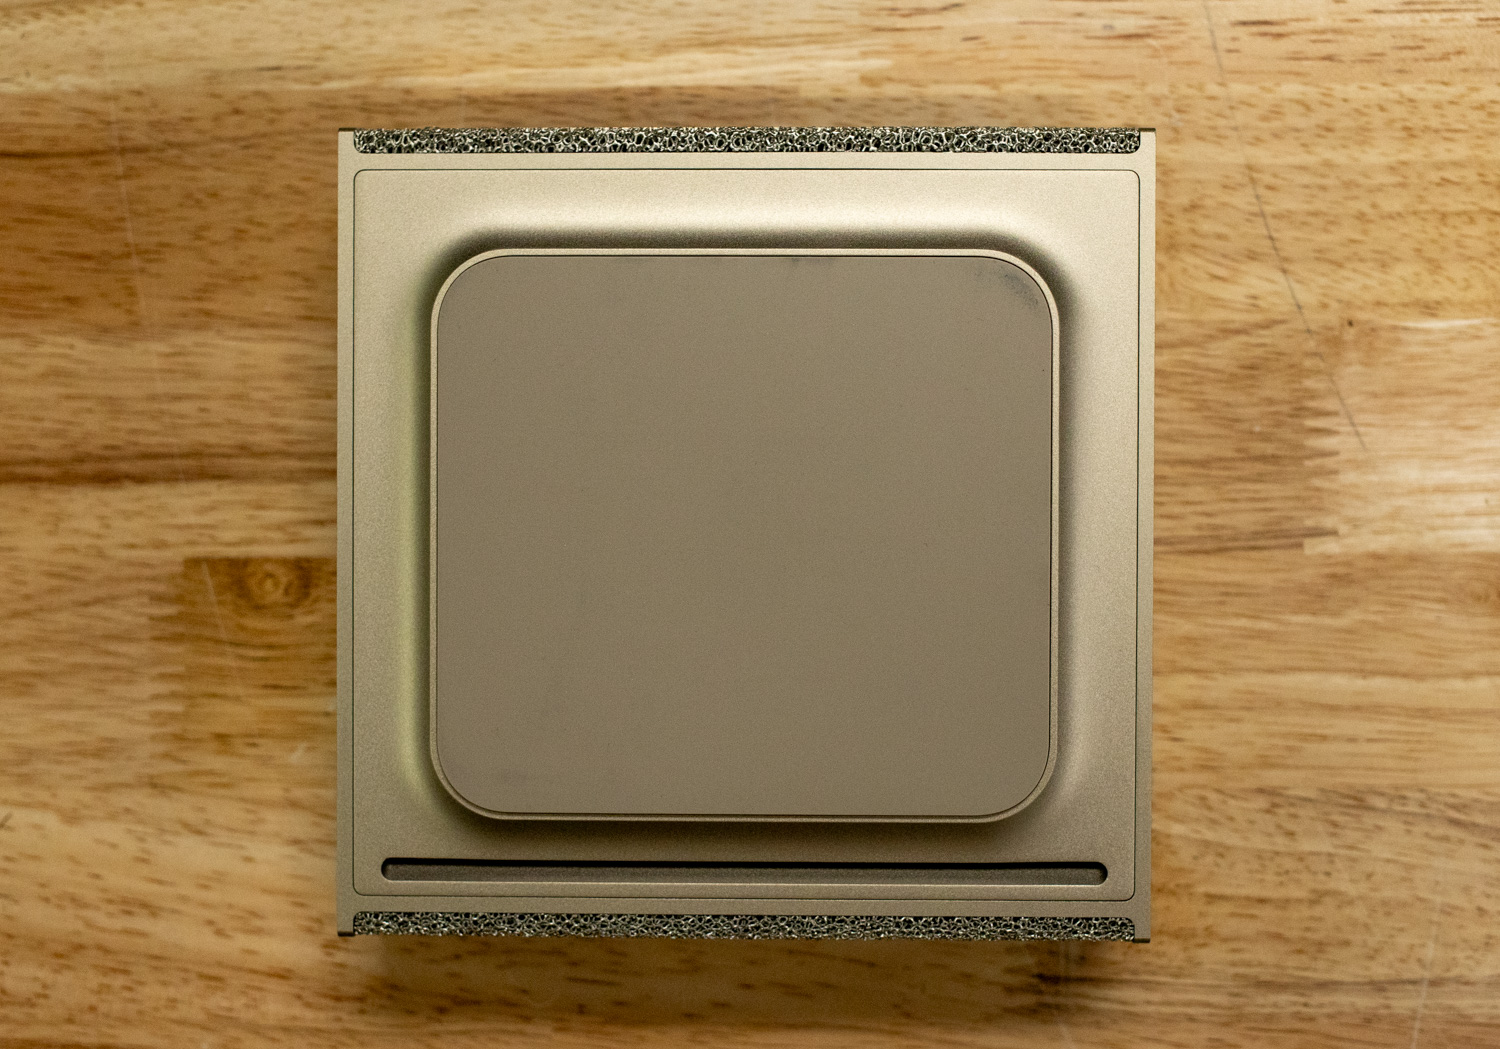
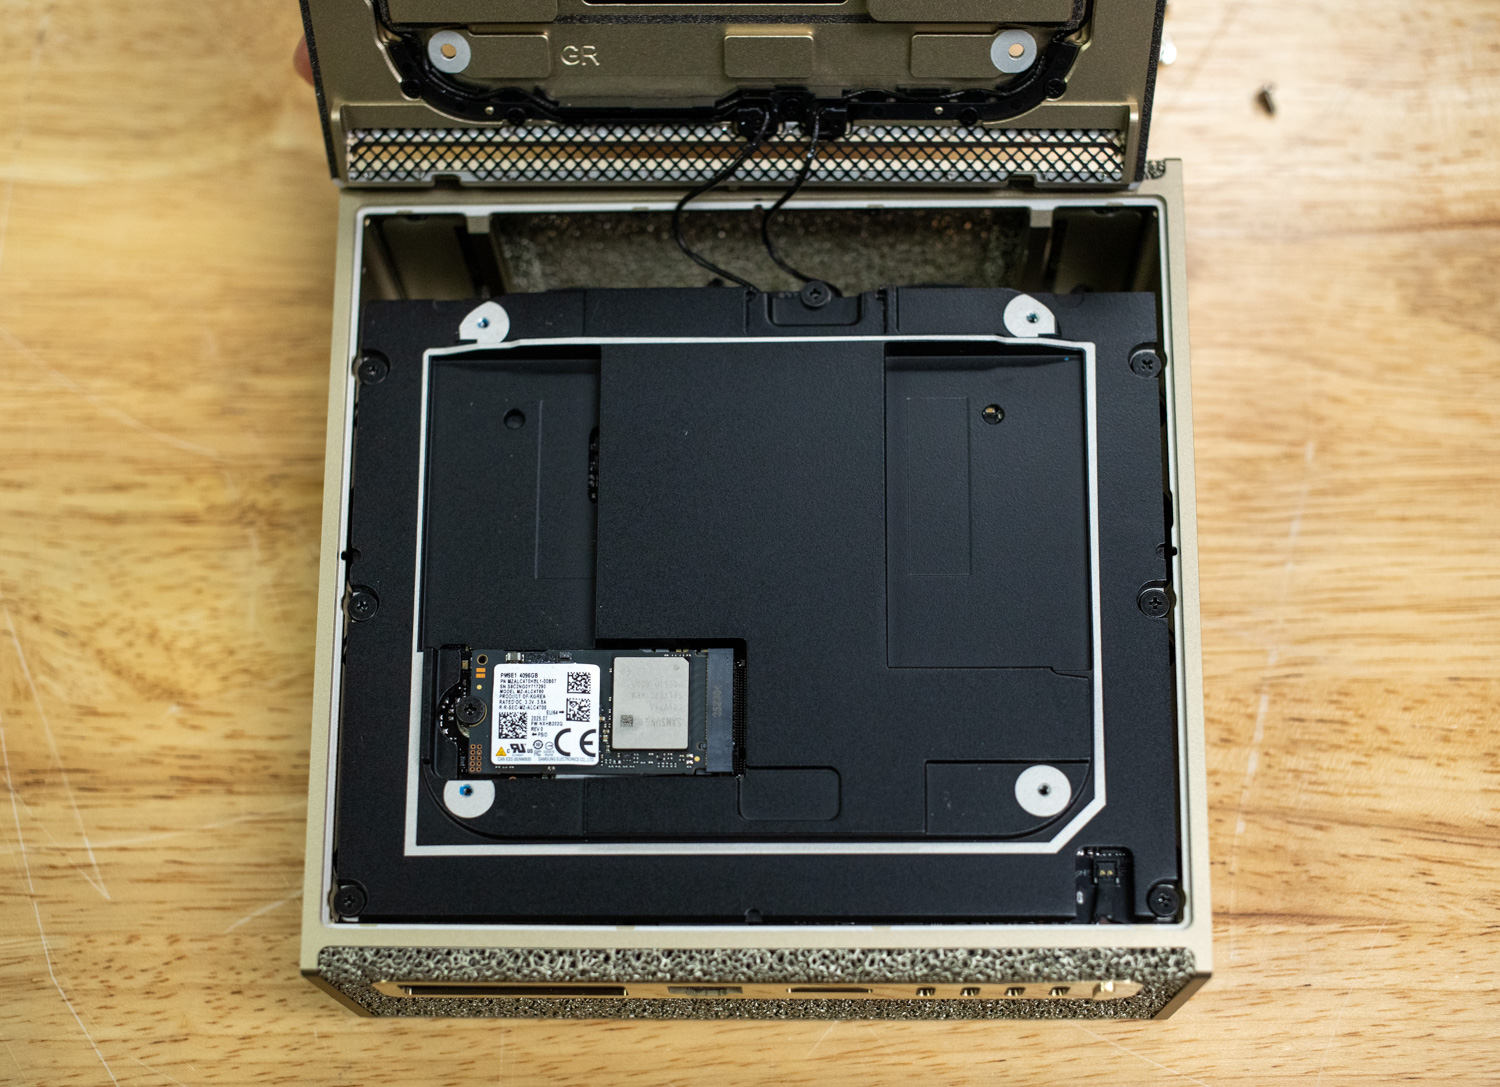
Uvnitř vidíme anténní kabeláž vedenou směrem k horní části jednotky, což potvrzuje přítomnost Wi-Fi 7 a Bluetooth 5.3. To poskytuje flexibilní možnosti síťového připojení, což je obzvláště užitečné pro mobilní nasazení nebo laboratorní nasazení, kde nemusí být k dispozici kabelový přístup.
Viditelné je také úložné řešení jednotky, PCIe Gen5 2242 M.2 SSD, což je méně obvyklý tvarový faktor pro takový vysoce výkonný hardware. Zde zobrazená konfigurace v naší konfiguraci obsahuje 4TB disk Samsung NVMe.
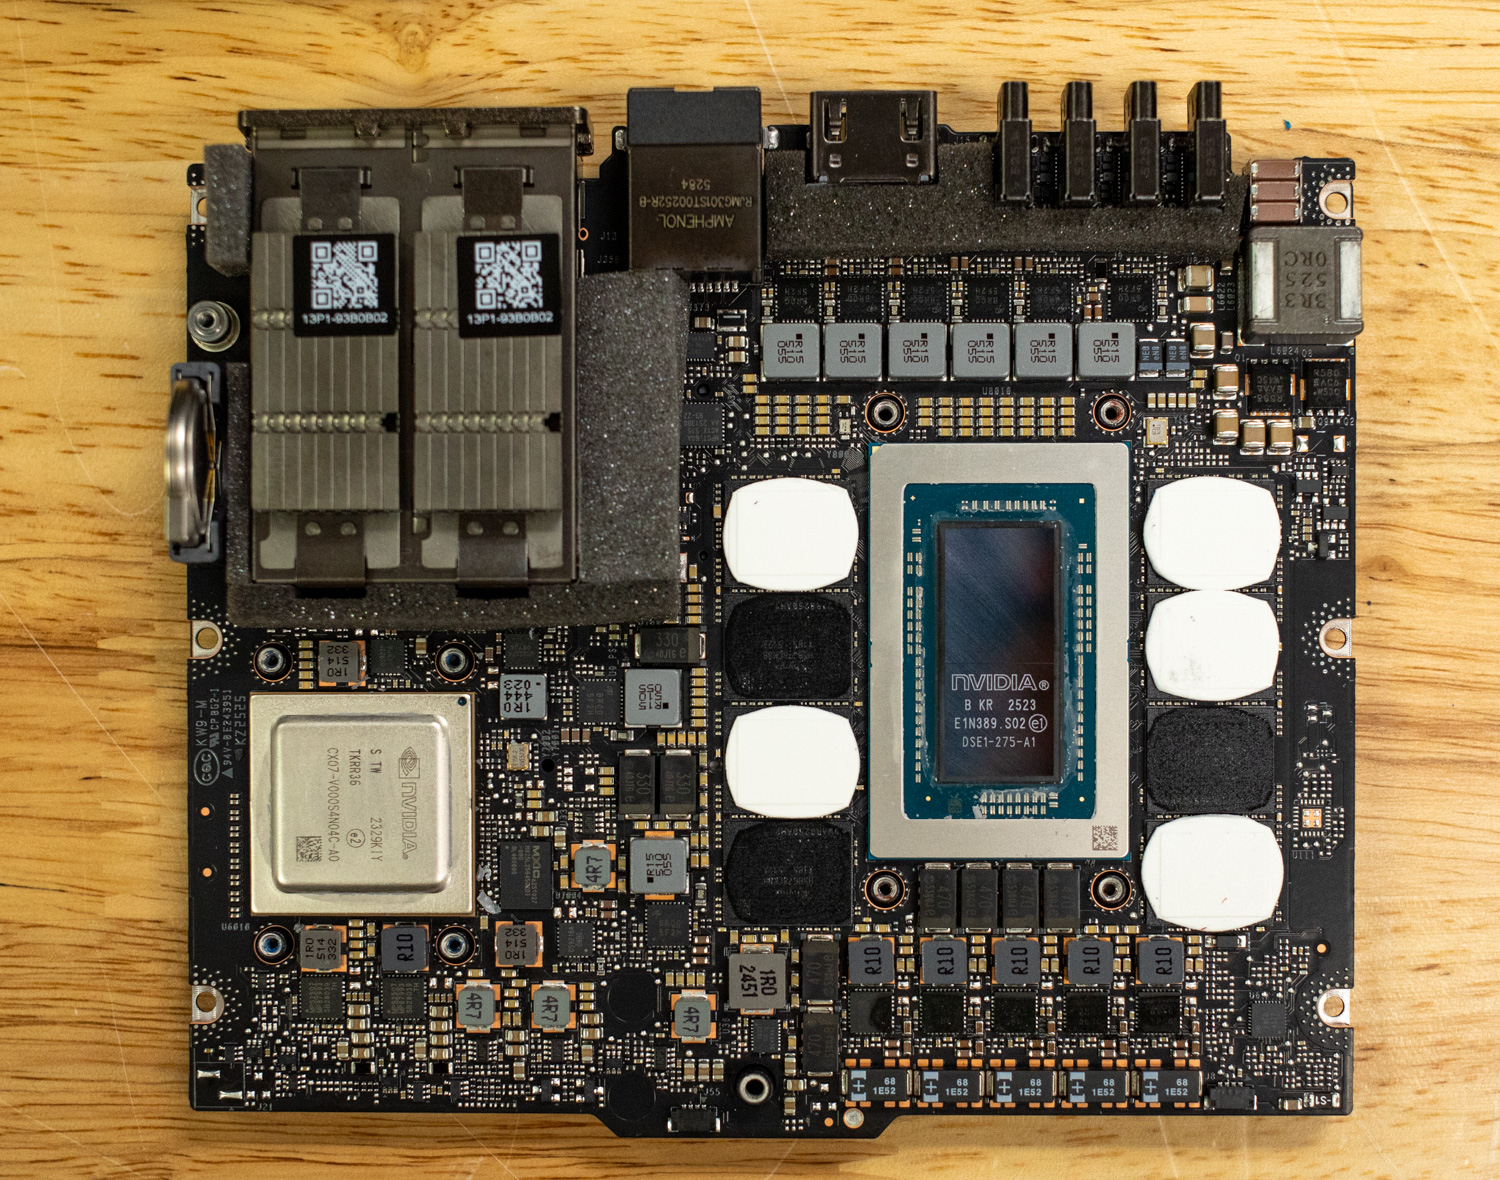
Hloubější ponoření se do DGX Spark odhalí srdce systému, superčip GB10 od NVIDIA Grace Blackwell. Po stranách superčipu GB10 se nachází 8 pájených unifikovaných systémových pamětí LPDDR5X s propustností 273 GB/s, což zajišťuje rychlý přístup k datům napříč operacemi CPU i GPU.
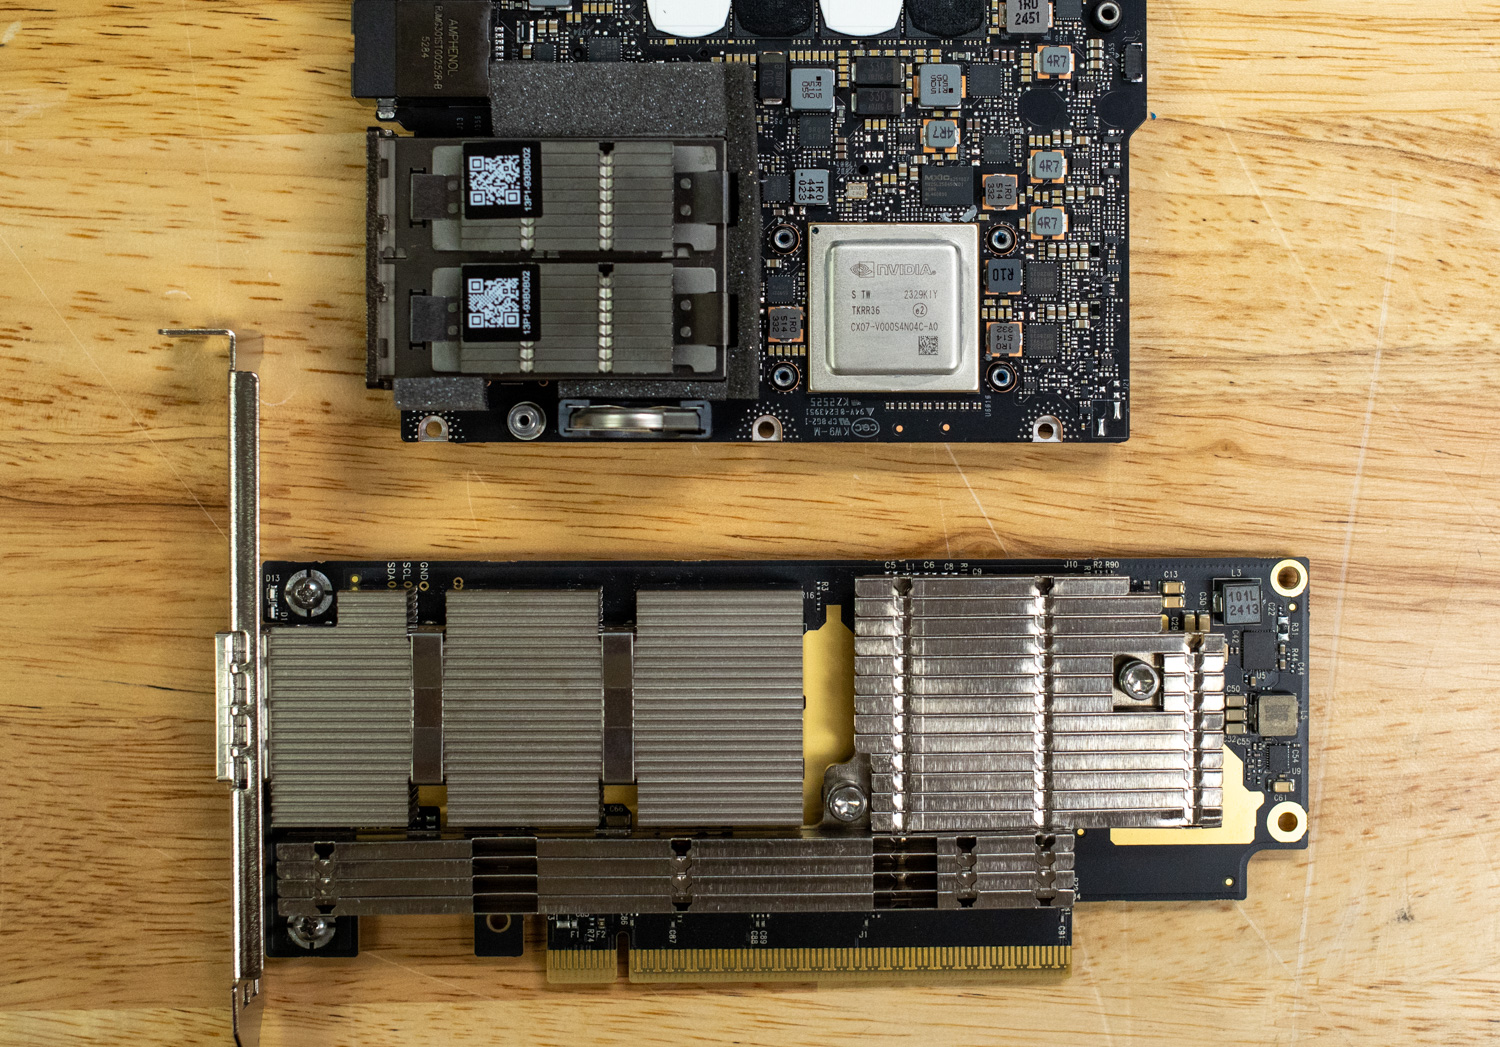
Hned vedle čipu se nachází síťová karta CX7, která, jak již bylo zmíněno, poskytuje 200G konektivitu. To umožňuje uživatelům připojit Spark k vysokorychlostnímu úložišti nebo dokonce shlukovat více instancí Sparku dohromady. NVIDIA ověřila a prodává shluk 2 Sparků, které lze přímo připojit pro podporu ještě větších modelů umělé inteligence.
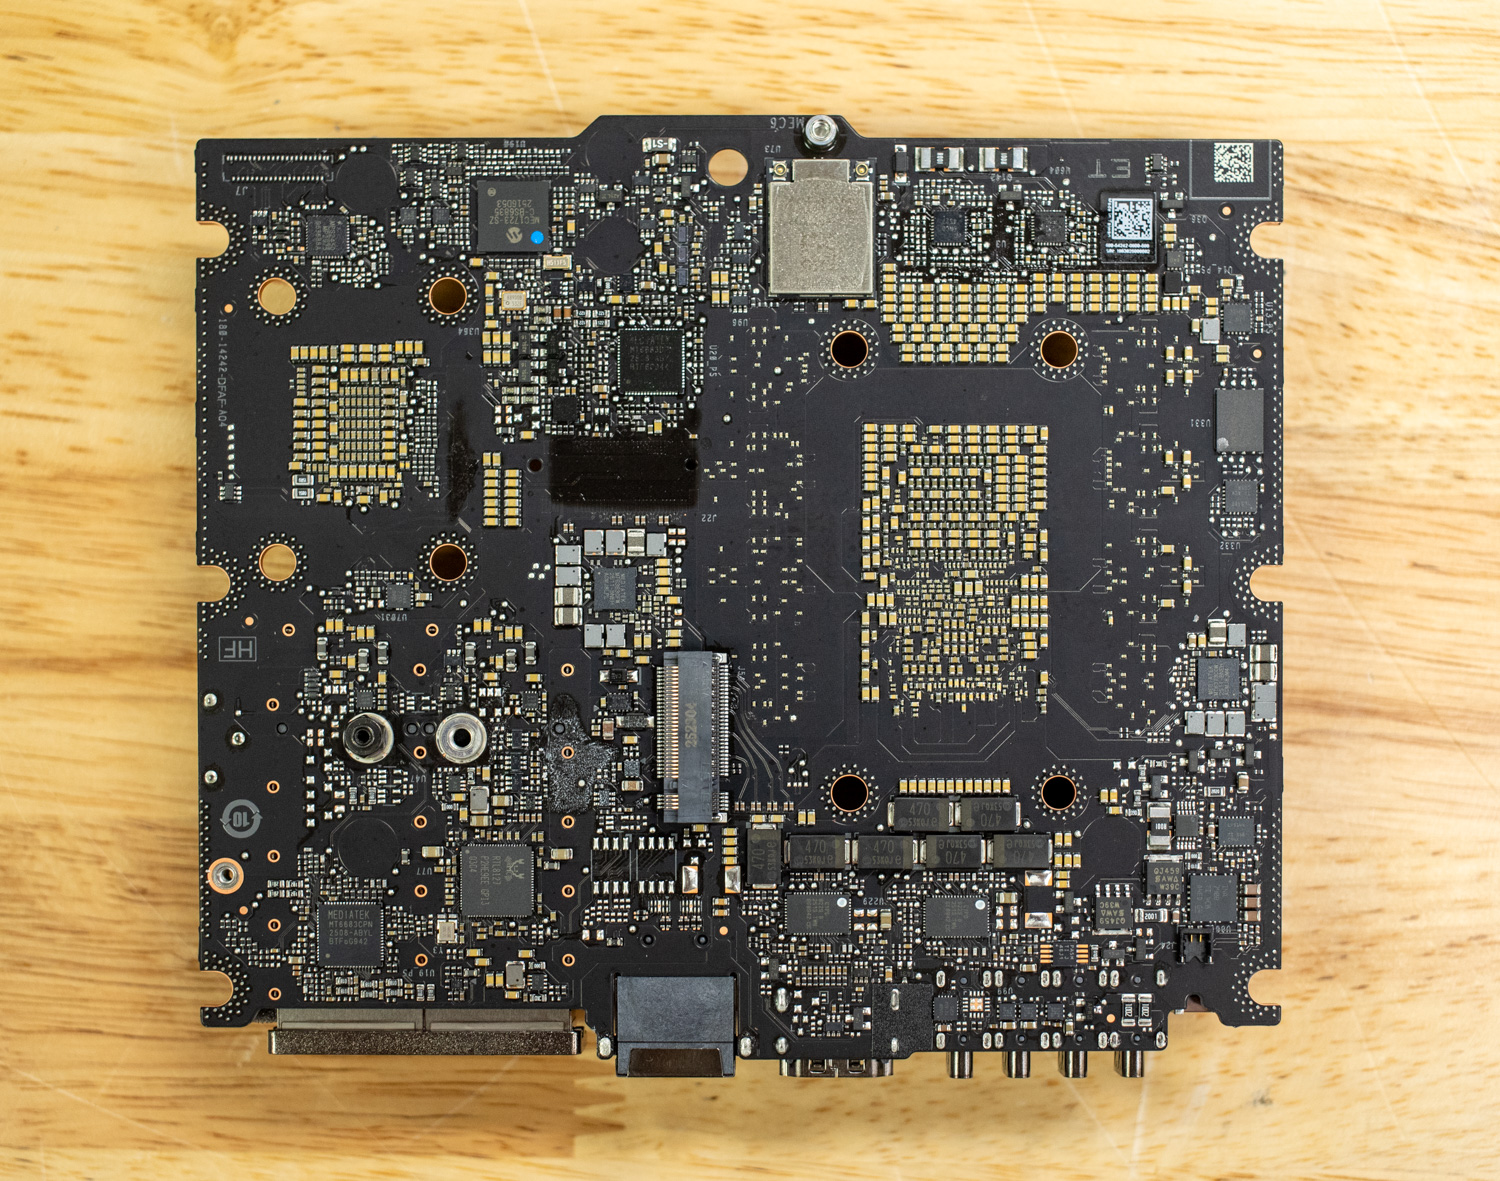
Nakonec, otočením desky se odhalí veškerá PCIe konektivita, včetně PCIe Gen5 x4 2242 M.2 SSD a PCIe Gen3x1 Wi-Fi adaptéru MediaTek.
Kde se Spark stává nepostradatelným: Moderní vývojové zařízení pro umělou inteligenci
DGX Spark se osvědčil v několika různých profesionálních kontextech, přičemž každý z nich těží z jedinečné kombinace unifikované paměti, kompaktního provedení a komplexní softwarové integrace.
Akcelerace datové vědy: Od PAND do produkce
Pro datové vědce představuje NVIDIA DGX Spark velké zlepšení v rychlosti pracovních postupů a zkušenostech. Síť ConnectX-7 poskytující šířku pásma 200 Gb/s v kombinaci s knihovnami akcelerovanými CUDA X transformuje předzpracování dat. Umělá inteligence a datová věda jsou postaveny na principu „dobrá data dovnitř, dobrá data ven“. Tradičně je časově nejnáročnější fází jakéhokoli konvenčního projektu strojového učení čištění dat a extrakce prvků. Konvenční pracovní postupy obvykle zahrnují načítání datových sad do nástrojů, jako jsou PANDAS, a provádění transformací na jádrech CPU, což je obecně pomalé. Manuální prozkoumávání a inženýrství prvků může být také významnou překážkou. Spark umožňuje komplexní akceleraci GPU prostřednictvím RAPIDS.
Typický scénář podnikové datové vědy zahrnuje inženýrství funkcí na datových sadách o velikosti 40–80 GB: spojování více tabulek, výpočet agregací napříč časovými okny, zpracování kategorického kódování a normalizaci distribucí. Na infrastruktuře CPU může toto předzpracování zabrat hodiny. Díky tomu, že RAPIDS cuDF načítá celou datovou sadu do 128GB unifikované paměti Spark, jsou tyto operace dokončeny během několika minut s 10× nebo vyšším zrychlením. Následné trénování modelu prospívá stejně, ať už se jedná o klasické strojové učení s cuML nebo hluboké učení s PyTorch, čímž se eliminuje tradiční úzké hrdlo, kdy datoví vědci čekají na infrastrukturu, místo aby iterovali na hypotézách.
Generování syntetických dat: Robotika a simulace
Zahrnutí RT jader čtvrté generace staví Spark do jedinečného postavení pro nově vznikající pracovní postup: generování syntetických dat pro trénování modelů světa. Trénování robustních manipulačních politik tradičně vyžaduje desítky tisíc reálných demonstrací, což je neúměrně drahé a časově náročné. Fotorealistická simulace na platformách jako Isaac Sim nebo Omniverse nabízí alternativu, ale vykreslování snímků s raytracingem s fyzikálně přesným osvětlením, odrazy a materiály historicky vyžadovalo drahé grafické karty pro pracovní stanice, jako jsou NVIDIA L40S a RTX 6000 Ada.
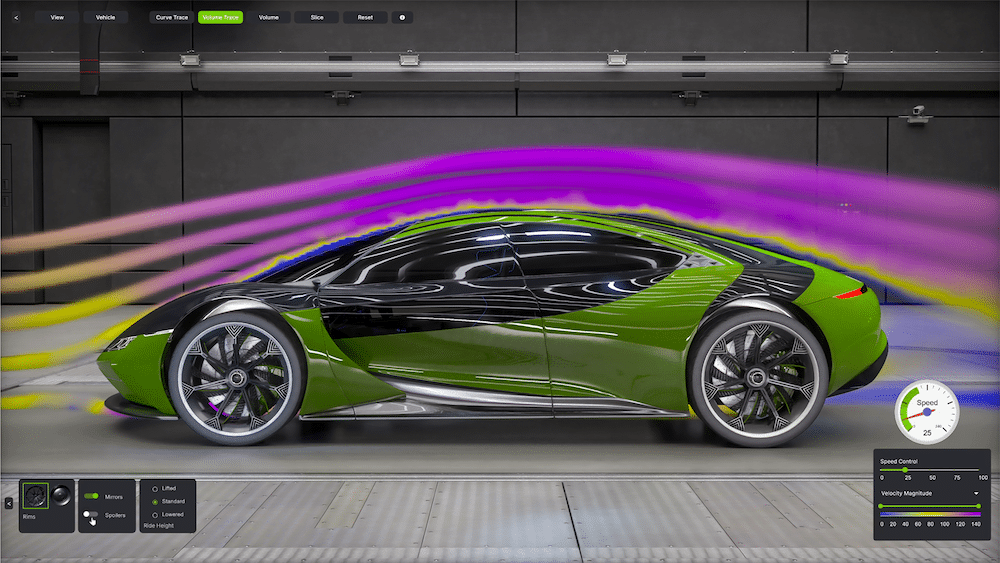
Zdroj: NVIDIA
Spark tento pracovní postup konsoliduje. RT Cores umožňují úlohám OpenUSD zpracovávat generování syntetických dat, zatímco Tensor Cores se používají pro inferenci umělé inteligence v rámci plánu/pracovního postupu. Dříve mohly organizace nasadit více počítačů pro vykreslování a samostatný server optimalizovaný pro inferenci. Nyní je to dosažitelné v jednom 240W zařízení. Pro robotické startupy, univerzitní laboratoře nebo výrobce automobilů, kteří zkoumají autonomní manipulaci, tato integrace výrazně zkracuje časové harmonogramy vývoje a kapitálové výdaje.
Podobné kanály pro generování syntetických dat s využitím specializovaných renderovacích systémů L40S spárovaných s H100 pro inferenci jsme již dříve zkoumali v našem dřívějším článku o NVIDIA L40S. Architektonická konsolidace těchto funkcí GB10 do jednotného vývojového zařízení představuje přesvědčivý vývoj tohoto pracovního postupu. V nadcházející analýze plánujeme provést další testování výkonu RT Core platformy Spark v porovnání s těmito diskrétními konfiguracemi, přičemž prozkoumáme renderování a další úlohy pro reprezentativní scénáře robotické manipulace.
Revoluce v kódování Vibe
Andrej Karpathy, bývalý ředitel pro umělou inteligenci ve společnosti Tesla a zakládající člen OpenAI, zavedl termín „vibe coding“ k popisu nově vznikajícího přístupu k rychlému vývoji softwaru s pomocí umělé inteligence. Namísto pečlivého psaní kódu řádek po řádku využívá vibe coding LLM jako interaktivní párové programátory: popisují funkcionalitu v přirozeném jazyce, generují implementační scaffolding, iterují v konverzačním zdokonalování a rychle prototypují funkce. Tento pracovní postup transformuje kódování z úmyslné konstrukce na řízenou konverzaci s umělou inteligencí, která rozumí kontextu, API a architektonickým vzorům, což umožňuje jednotlivým vývojářům vytvářet pozoruhodně sofistikované systémy bezprecedentní rychlostí.
Rozsah přijetí kódování s podporou umělé inteligence dokládá žebříček využití OpenRouteru , kde modely zaměřené na kódování trvale dominují v objemu inference. Techničtí profesionálové, primární demografická skupina Vibe kódujícího, obvykle pracují jako nároční uživatelé a provozují více kódovacích agentů paralelně v různých kontextech. A protože modely s otevřenou váhou se v klíčových benchmarkech stále více shodují s proprietárními alternativami , vývojáři zkoumají lokální nasazení inference, aby eliminovali omezení rychlosti, zajistili dostupnost během kritických vývojových oken a zachovali důvěrnost kódu pro proprietární projekty.
Komunita r/LocalLLaMA představuje skutečně působivé zakázkové sestavy, od pracovních stanic s více grafickými procesory až po servery slepené lepicí páskou s lokálními modely, distribuovanou inferenci napříč spotřebitelským hardwarem a propracovaná chladicí řešení, která umožňují trvale vysokou propustnost. Tyto konfigurace však představují značné překážky: kapitálové výdaje často přesahující desítky tisíc dolarů, značnou spotřebu energie, problémy s tepelným managementem vyžadující vyhrazené prostory namísto standardních kancelářských prostředí a značné technické znalosti pro konfiguraci, optimalizaci a řešení problémů.
Spark zásadně mění tuto hodnotovou nabídku. Za cenu 3 999 dolarů a 128 GB unifikované paměti nabízí působivý výkon inference modelů v tichém, kompaktním a energeticky úsporném zařízení se spotřebou pouhých 240 W. Uživatelé, kteří chtějí vytvořit lokální infrastrukturu programátorských asistentů, již nepotřebují složité domácí laboratoře, které spotřebovávají kilowatthodiny a generují značný tepelný výkon. Ověřený přístup zařízení s předkonfigurovaným operačním systémem DGX eliminuje složitost konfigurace, která dříve omezovala lokální nasazení LLM na uživatele s hlubokými znalostmi Linuxu a CUDA.
Kromě eliminace problémů s infrastrukturou řeší Spark kritické problémy týkající se soukromí kódu a přizpůsobení modelů. Cloudoví programátorští asistenti nutně přenášejí zdrojový kód na vzdálené servery, což není vhodné pro organizace pracující s proprietárními algoritmy, bezpečnostně kritickou infrastrukturou nebo regulovanými daty. Lokální inference ve Sparku zajišťuje, že kód nikdy neopustí vývojové prostředí. Kapacita paměti 128 GB navíc umožňuje plné doladění parametrů kódovacích modelů, což zkušeným vývojářům umožňuje specializovat modely na interních kódových bázích. Tato funkce je obzvláště cenná pro organizace s doménově specifickými jazyky, vlastními frameworky nebo architektonickými vzory, které nejsou dostatečně zastoupeny ve veřejných školicích datech.
Jemné ladění s NVIDIA NeMo na DGX Spark
Sjednocená paměť DGX Spark o velikosti 128 GB umožňuje úplné doladění parametrů 8B modelů, které tradičně vyžadovaly drahá cloudová nastavení s více GPU. Plné doladění Qwen3 8B se standardní optimalizací Adam vyžaduje přibližně 132 GB (16 GB váhy modelu, 96 GB stavy optimalizátoru, 16 GB gradienty plus aktivace), což překračuje duální konfigurace H100 80 GB. Použití paměťově efektivního 8bitového Adamu snižuje požadavky na přibližně 70 GB, v závislosti na velikosti dávky, což se pohodlně vejde do paměťového fondu Sparku. To je důležité, protože plné doladění poskytuje o 4–6 % lepší přesnost než LoRA u složitých úloh uvažování. Zatímco cloudová nastavení 2× H100 80 GB stojí přibližně 5 dolarů za hodinu s distribuovanou složitostí trénování, Spark poskytuje trénování jednoho systému s jednorázovou investicí 3 999 dolarů.
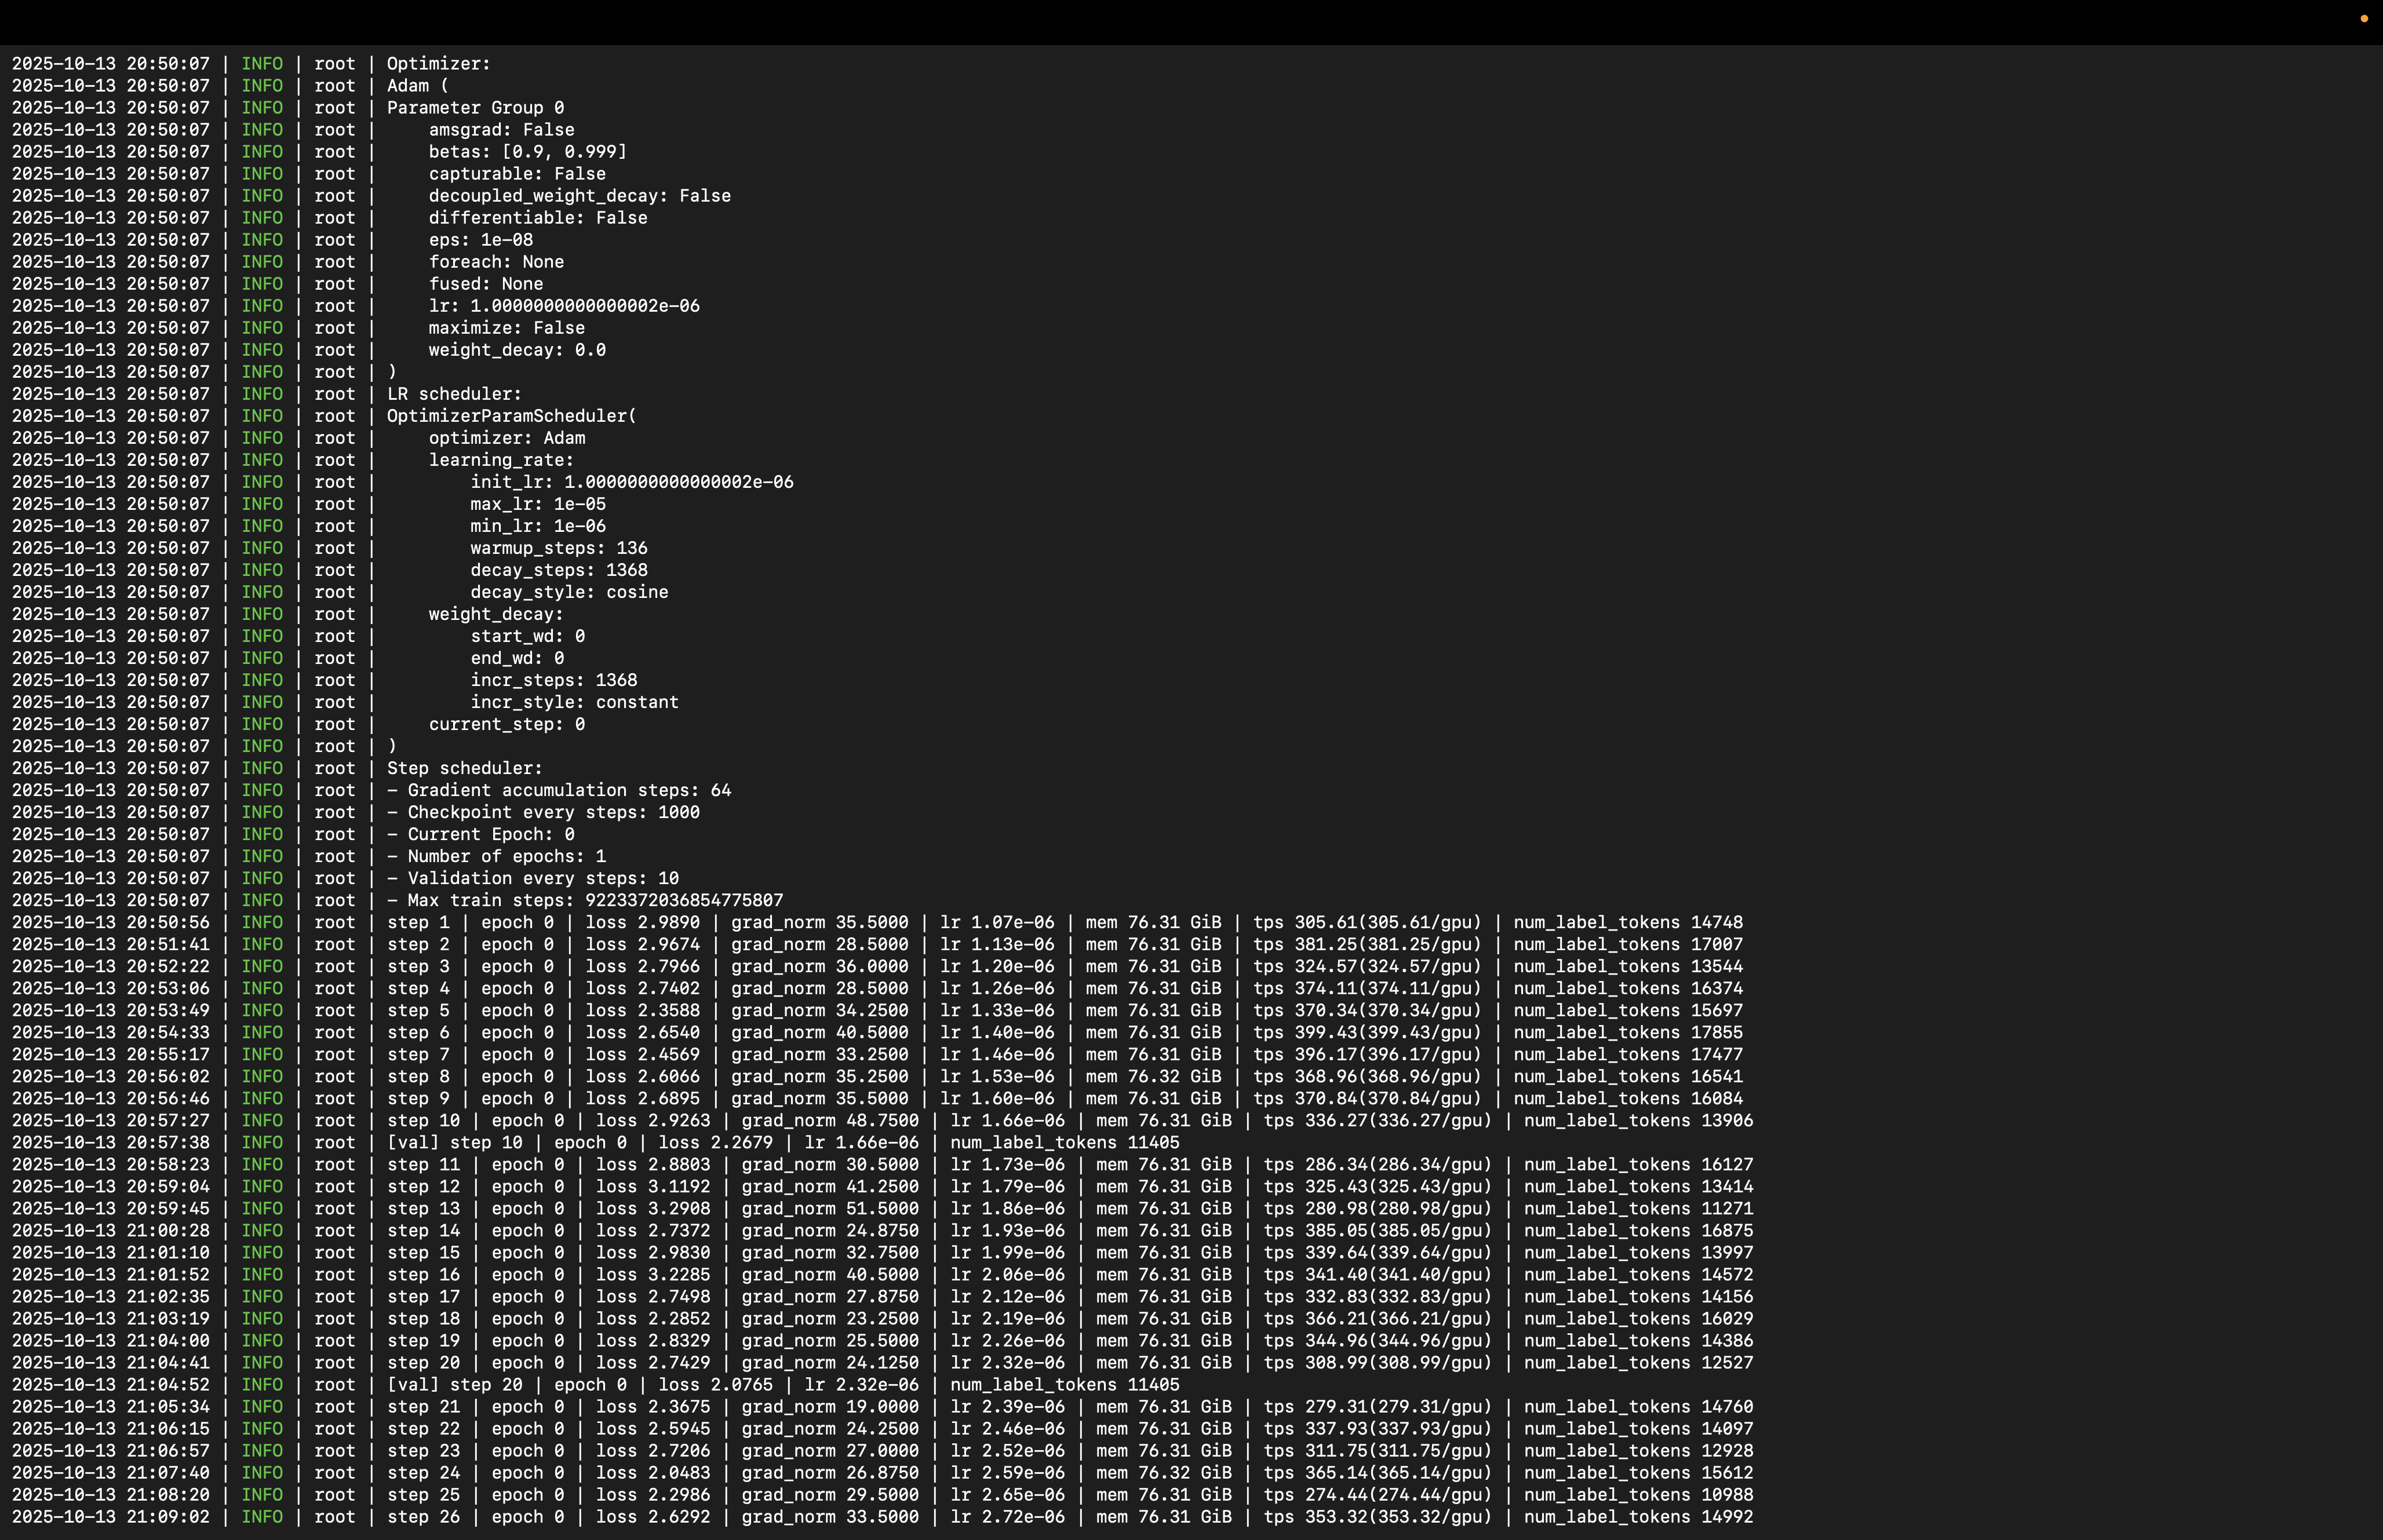
NVIDIA NeMo Automodel eliminuje problémy s podnikovým školicím frameworkem tím, že poskytuje podporu pro jakýkoli model Hugging Face od 0. dne bez konverze kontrolních bodů. Načtěte Qwen3 8B přímo z HuggingFace Hub a nakonfigurujte jemné doladění pomocí souborů YAML s určením zdrojů datových sad, nastavení optimalizátoru a cílů LoRA. NeMo automatizuje distribuované kontrolní body s kompatibilitou safetensorů, implementuje fused CUDA kernely pro 2–5× zrychlení a zvládá akumulaci gradientů.
Generování obrázků s pohodlným uživatelským rozhraním
ComfyUI poskytuje grafické rozhraní založené na uzlech, které transformuje Stable Diffusion a související difuzní modely do vysoce přizpůsobitelných kreativních kanálů. Na rozdíl od tradičních webových rozhraní, která abstrahují složitost za zjednodušené posuvníky parametrů, ComfyUI využívá vizuální grafovou architekturu, kde uživatelé vytvářejí pracovní postupy propojením diskrétních funkčních uzlů, z nichž každý představuje specifické operace, jako je načítání modelu, kódování promptu, vzorkování latentní difuze, dekódování VAE nebo upscaling transformací. Tento modulární design umožňuje granulární kontrolu nad celým generačním kanálem, takže každý výpočetní krok je transparentní a nastavitelný. Umožňuje také uživatelům řetězit více modelů, implementovat vlastní plány vzorkování nebo integrovat pokročilé techniky, jako je navádění ControlNet, což by ve zjednodušených rozhraních nebylo možné.
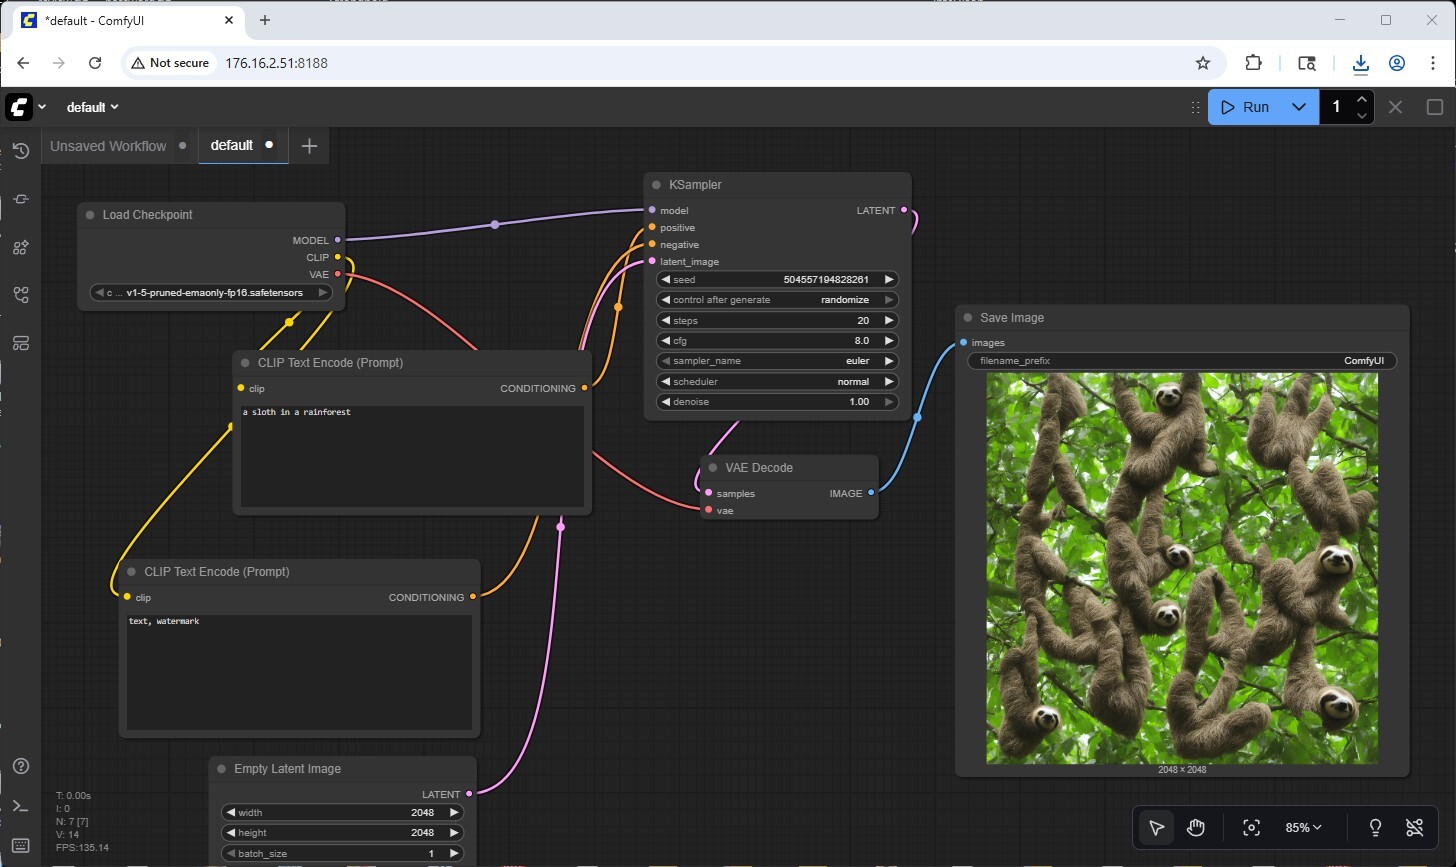
V DGX Spark využívá ComfyUI tenzorová jádra grafického procesoru Blackwell pro zrychlené difúzní vzorkování, přičemž generace se obvykle dokončí za 15–30 sekund v závislosti na složitosti vzorkování. Architektura unifikované paměti se 128 GB se ukazuje jako obzvláště výhodná, protože v paměti uchovává více modelů kontrolních bodů, adaptérů LoRA a dekodérů VAE současně, čímž eliminuje režijní náklady na opětovné načítání, které trápí systémy s omezenou pamětí VRAM. Uživatelé mohou efektivně generovat neomezený počet umělých dílek lokálně, bez omezení rychlosti API, nákladů na cloud na generování a obav o soukromí spojených s proprietárními kreativními pracovními postupy. Model perzistence pracovního postupu přidává provozní hodnotu: kompletní pipeline se serializují do souborů JSON, které lze řídit verzemi, sdílet mezi týmy nebo vkládat přímo do generovaných obrázků jako metadata, což umožňuje reprodukovatelnost, která je zásadní pro organizace vytvářející pipeline syntetických datových sad nebo udržující konzistentní umělecké styly napříč generovanými prostředky.
Testování výkonu NVIDIA DGX Spark
Online servírování vLLM – inferenční test LLM
vLLM je nejoblíbenější vysoce výkonný inferenční a obslužný engine pro LLM. Online serving benchmark vLLM je nástroj pro hodnocení výkonu určený k měření reálných obslužných schopností tohoto inferenčního enginu při zpracování souběžných požadavků. Simuluje produkční zátěž odesíláním požadavků na běžící server vLLM s konfigurovatelnými parametry, jako je frekvence požadavků, délka vstupů/výstupů a počet souběžných klientů. Benchmark měří klíčové metriky, včetně propustnosti, tj. tokenů za sekundu, času do prvního tokenu a času na výstupní token, což pomáhá uživatelům pochopit, jak si vLLM vede za různých podmínek zátěže.
Výkon inference jsme testovali napříč komplexní sadou modelů představujících nejoblíbenější architektury a typy modelů v dnešních produkčních nasazeních.
Směs expertních modelů
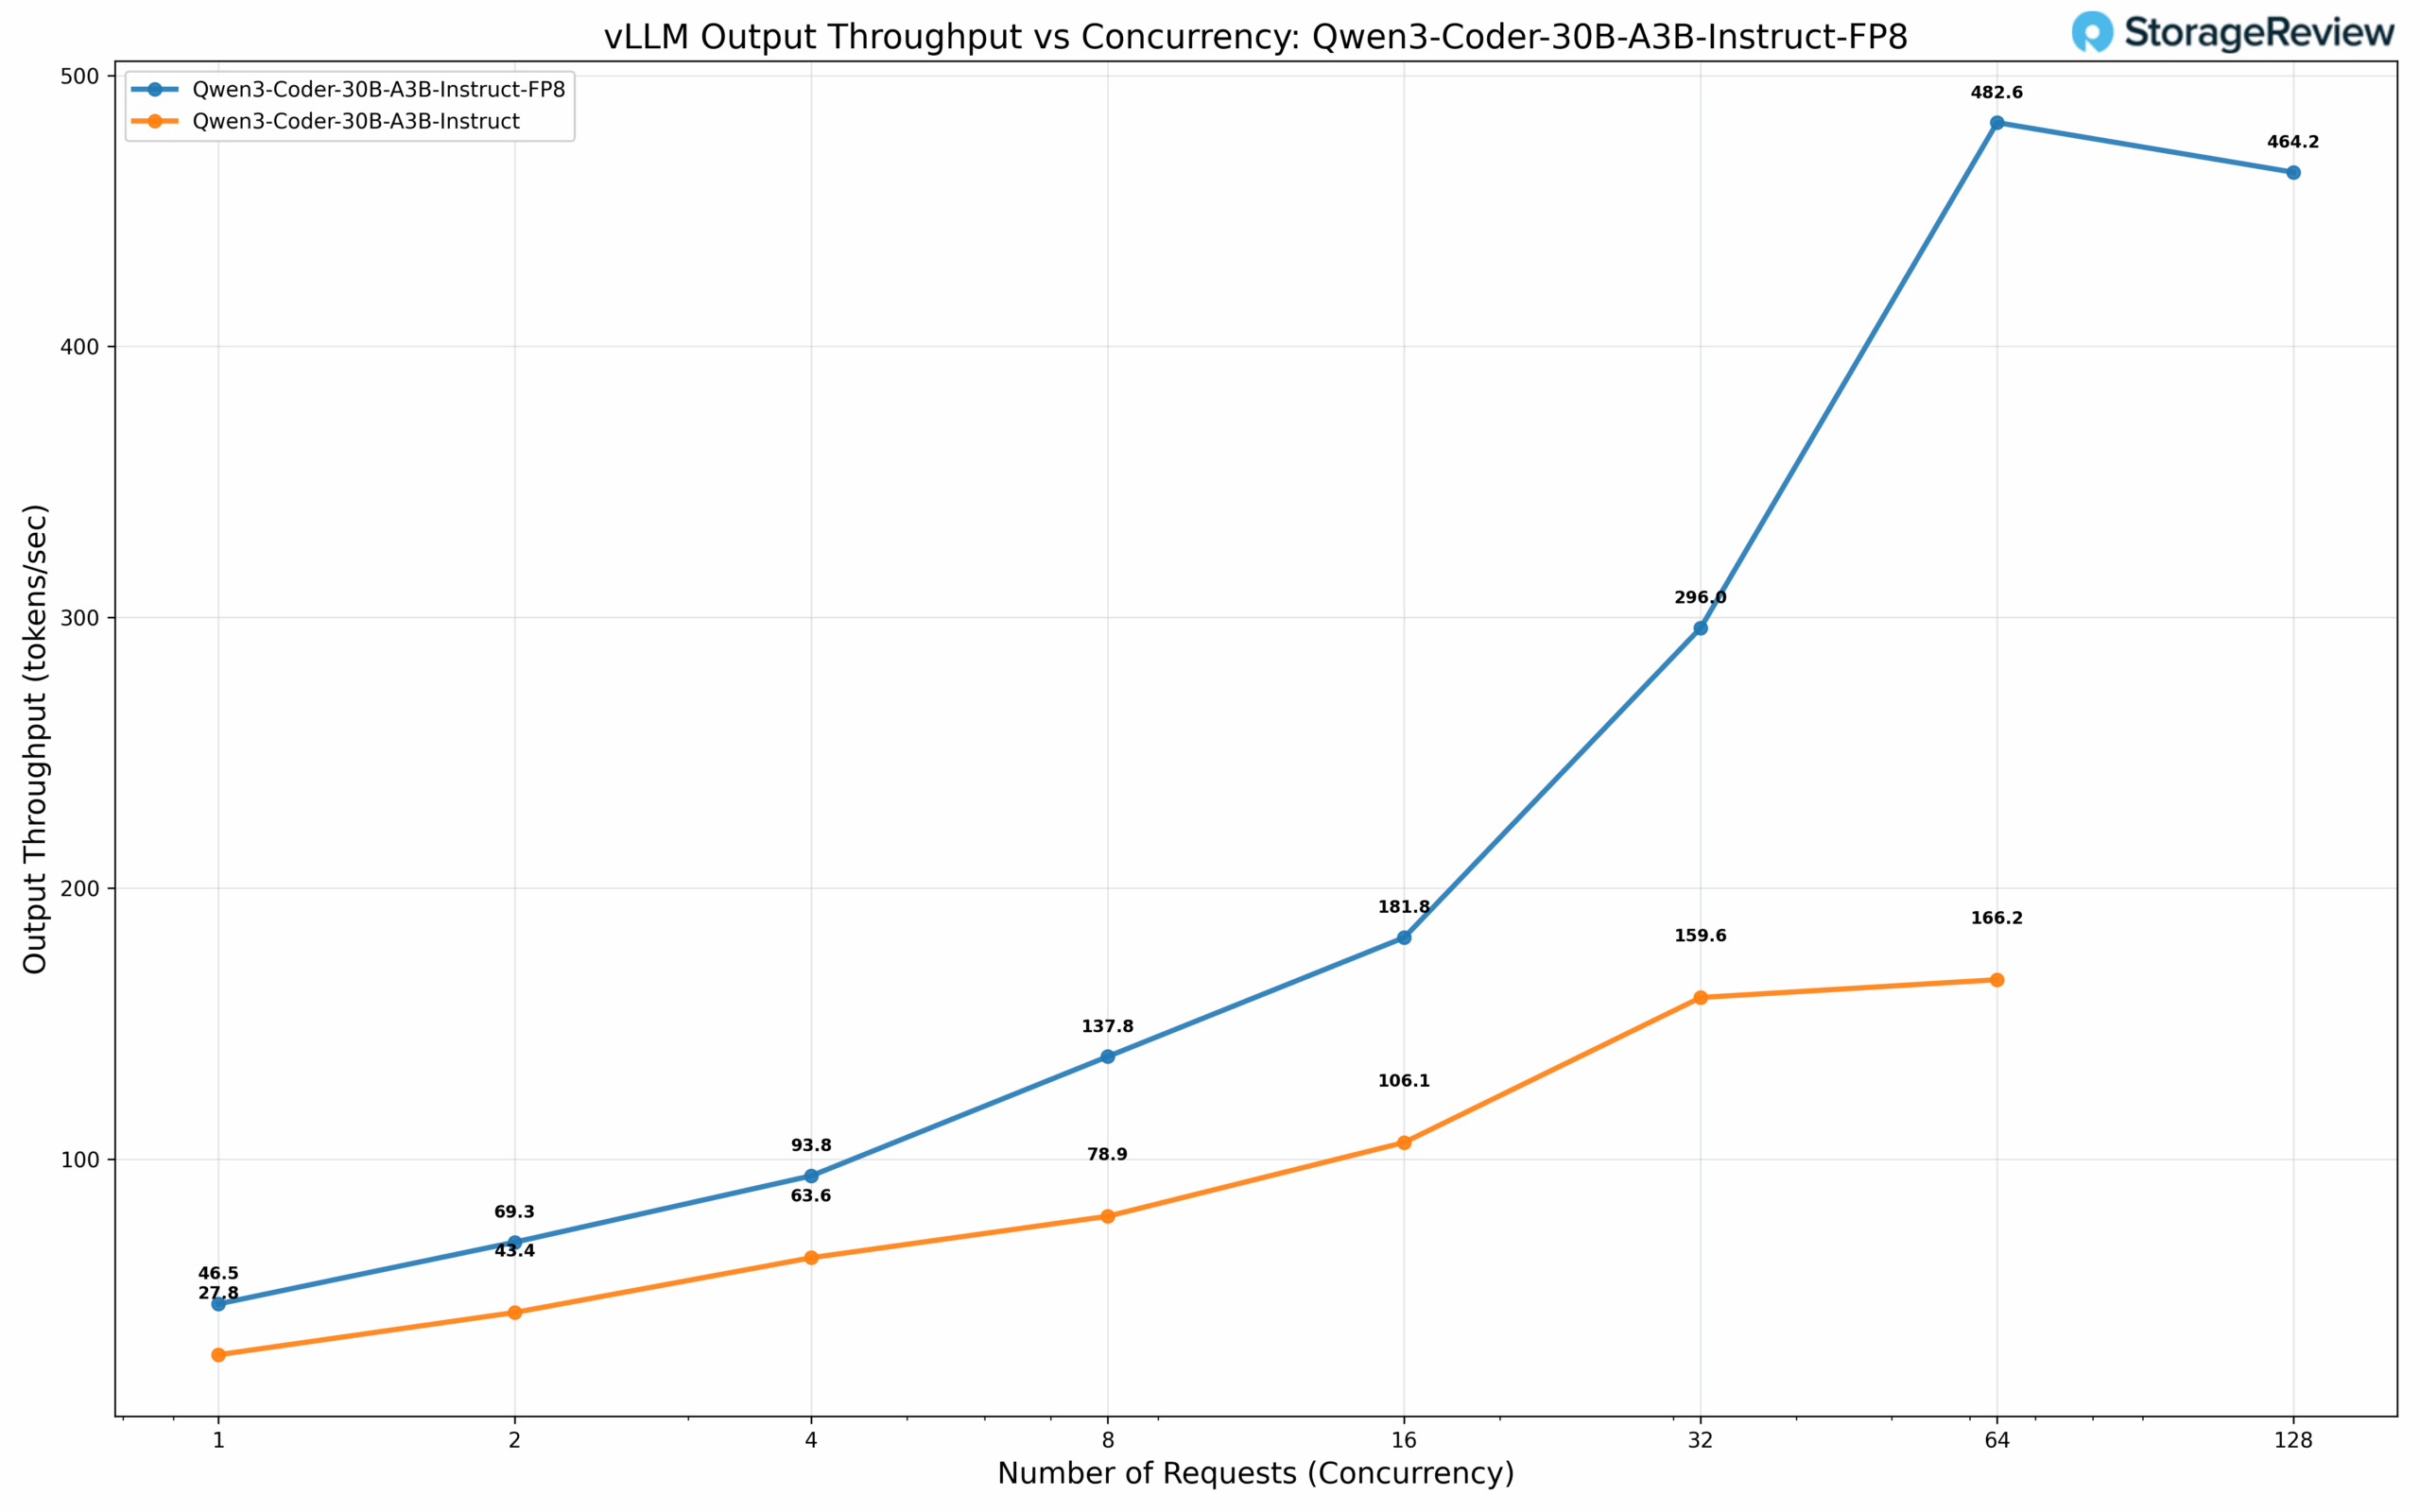
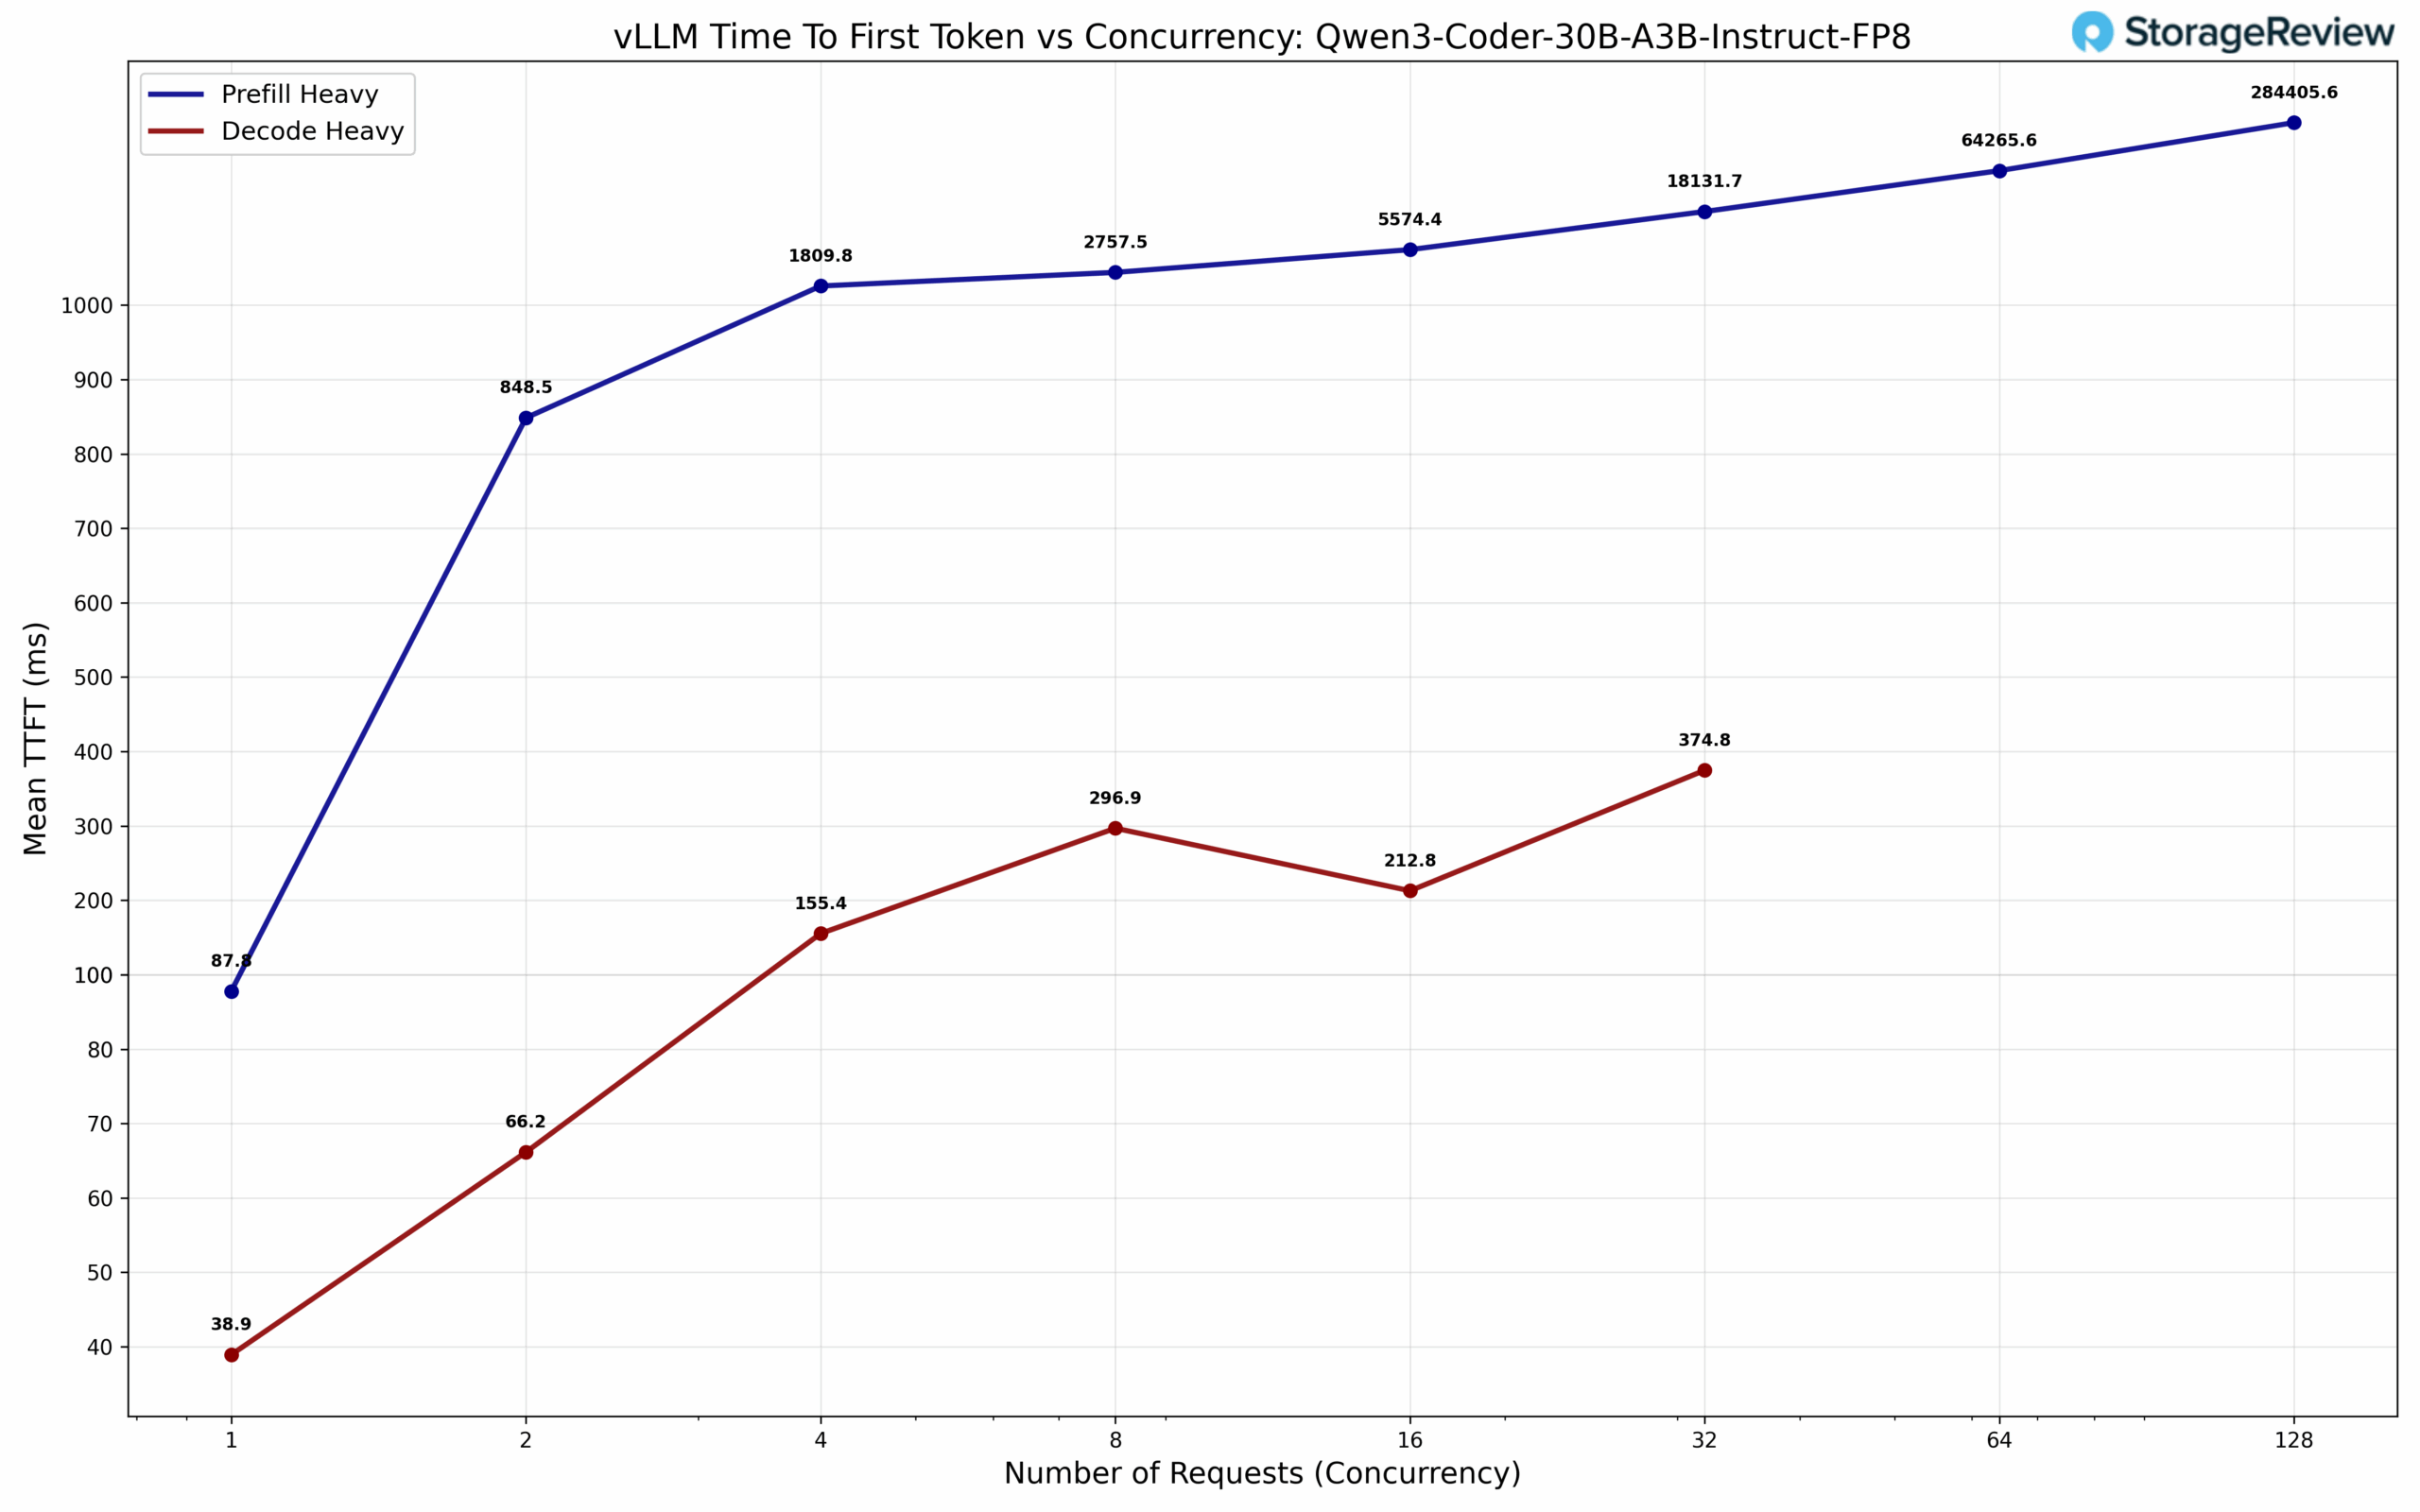
Vyhodnotili jsme Qwen3 Coder 30B-A3B, jeden z nejpopulárnějších kódovacích modelů pro lokální inferenční nasazení. Tato řídká architektura udržuje plnou velikost modelu 30B parametrů s přesností BF16 a zároveň aktivuje pouze 3B parametrů na jeden vygenerovaný token. Porovnali jsme jak standardní model, tak i kvantizovanou variantu FP8 od Qwen. Kvantovaný model FP8 vykazuje značné zvýšení výkonu: dosahuje 46.5 toků/s při souběžnosti 1 a škáluje se na působivých 482.6 toků/s při velikosti dávky 64. Standardní model BF16 poskytuje 27.8 toků/s při souběžnosti 1 a dosahuje 166.2 toků/s při velikosti dávky 64, což je téměř 3násobný rozdíl ve výkonu.
Husté modely
Husté modely představují konvenční architekturu LLM, kde jsou všechny parametry a aktivace zapojeny během inference, což má za následek výpočetně náročnější zpracování ve srovnání s jejich řídkými protějšky. Pro komplexní vyhodnocení výkonnostních charakteristik napříč škálami modelu a kvantizačními strategiemi jsme porovnali pět konfigurací hustých modelů.
Naše testovací sada zahrnovala Mistral Small 3.1 24B od Mistral AI s přesností BF16 a dynamicky kvantovanou variantu Mistral Small 3.1 24B FP8 od RedHat AI. Dynamická kvantizace využívá techniky selektivní váhové kvantizace k optimalizaci kompromisu mezi výkonem a přesností, strategicky snižuje přesnost a zároveň minimalizuje degradaci modelu. Tyto větší husté modely jsme doplnili o vyhodnocení Meta Llama 3.1 8B ve třech formátech přesnosti: standardní konfiguraci BF16 a kvantované verze FP8 a FP4 od NVIDIA. Tato strategie výběru modelu umožňuje přímé porovnání výkonu napříč měřítky modelu a zároveň izoluje dopad progresivní kvantizace na propustnost inference.
Analýza výkonu: Velké husté modely
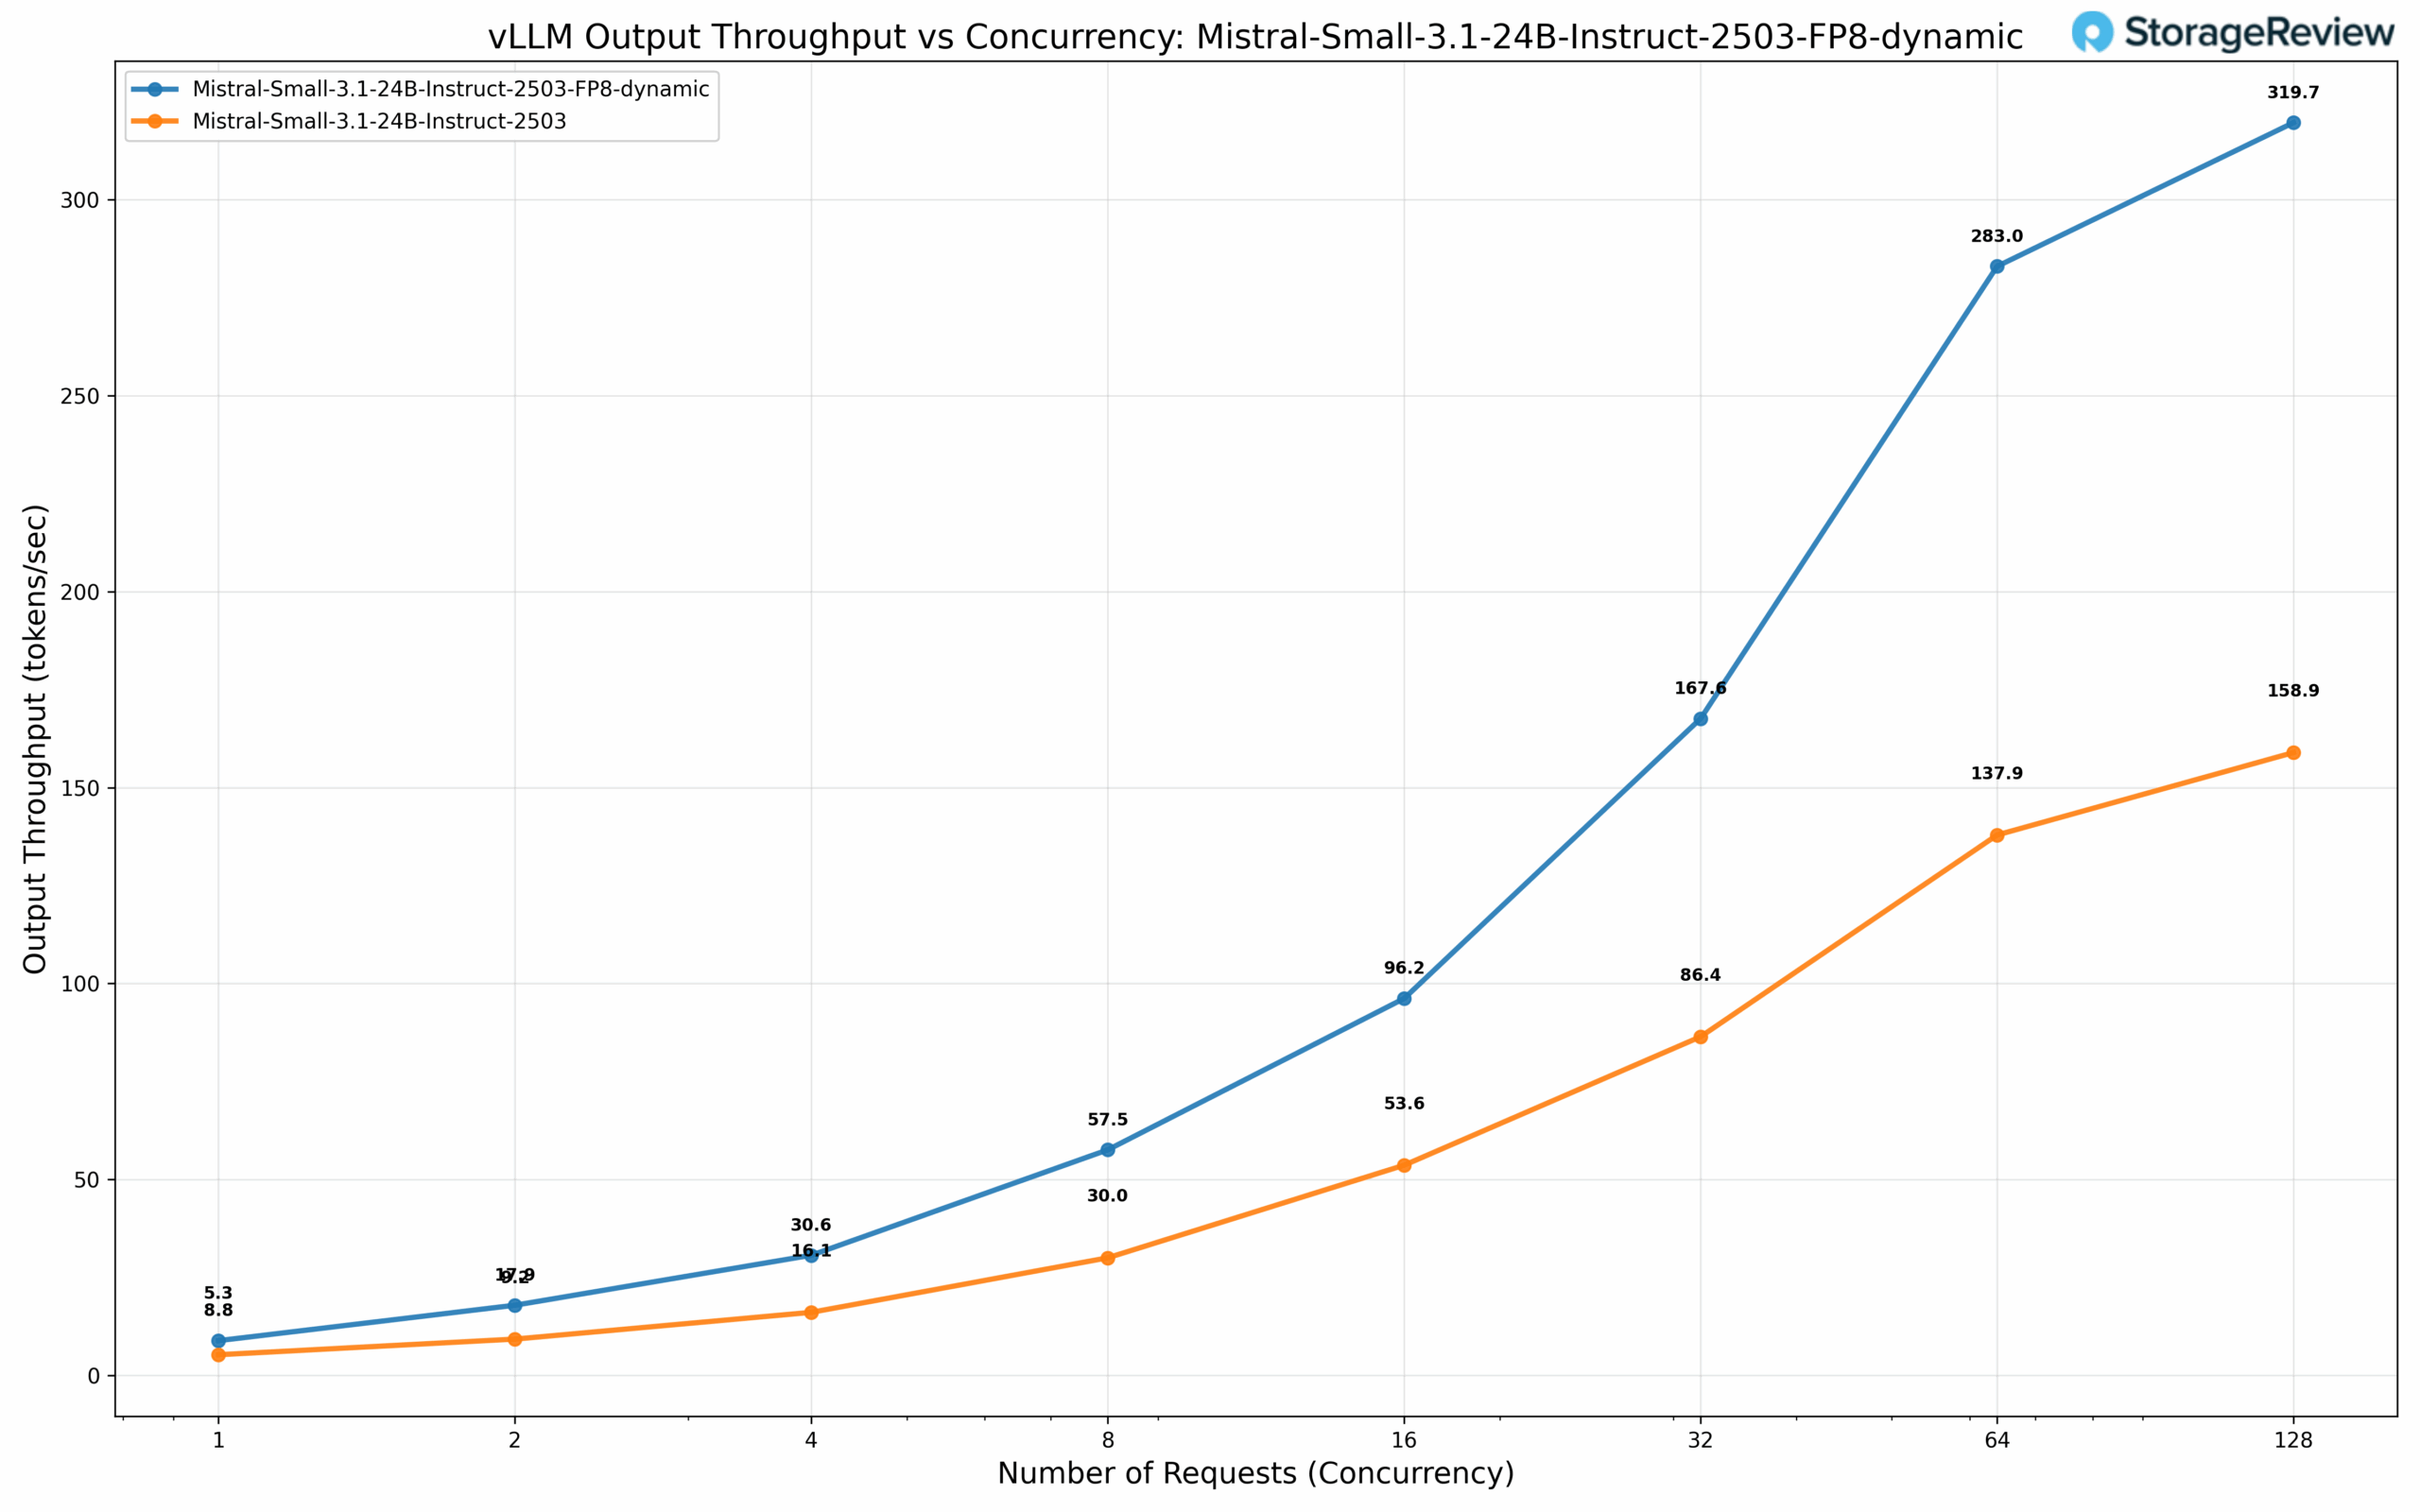
Mistral Small 3.1 24B s přesností BF16 vykazuje základní propustnost 5.3 tok/s při souběžnosti 1, která se škáluje na podstatných 158.9 tok/s při 128 souběžných požadavcích. Dynamicky kvantizovaná varianta FP8 vykazuje mírné zisky při nižší souběžnosti s 8.8 tok/s, ale ve velkém měřítku poskytuje přesvědčivý 2násobný multiplikátor výkonu a dosahuje 319.7 tok/s při souběžnosti 128 – což podtrhuje efektivitu dynamické kvantizace pro scénáře s vysokou propustností.
Analýza výkonu: Kompaktní husté modely
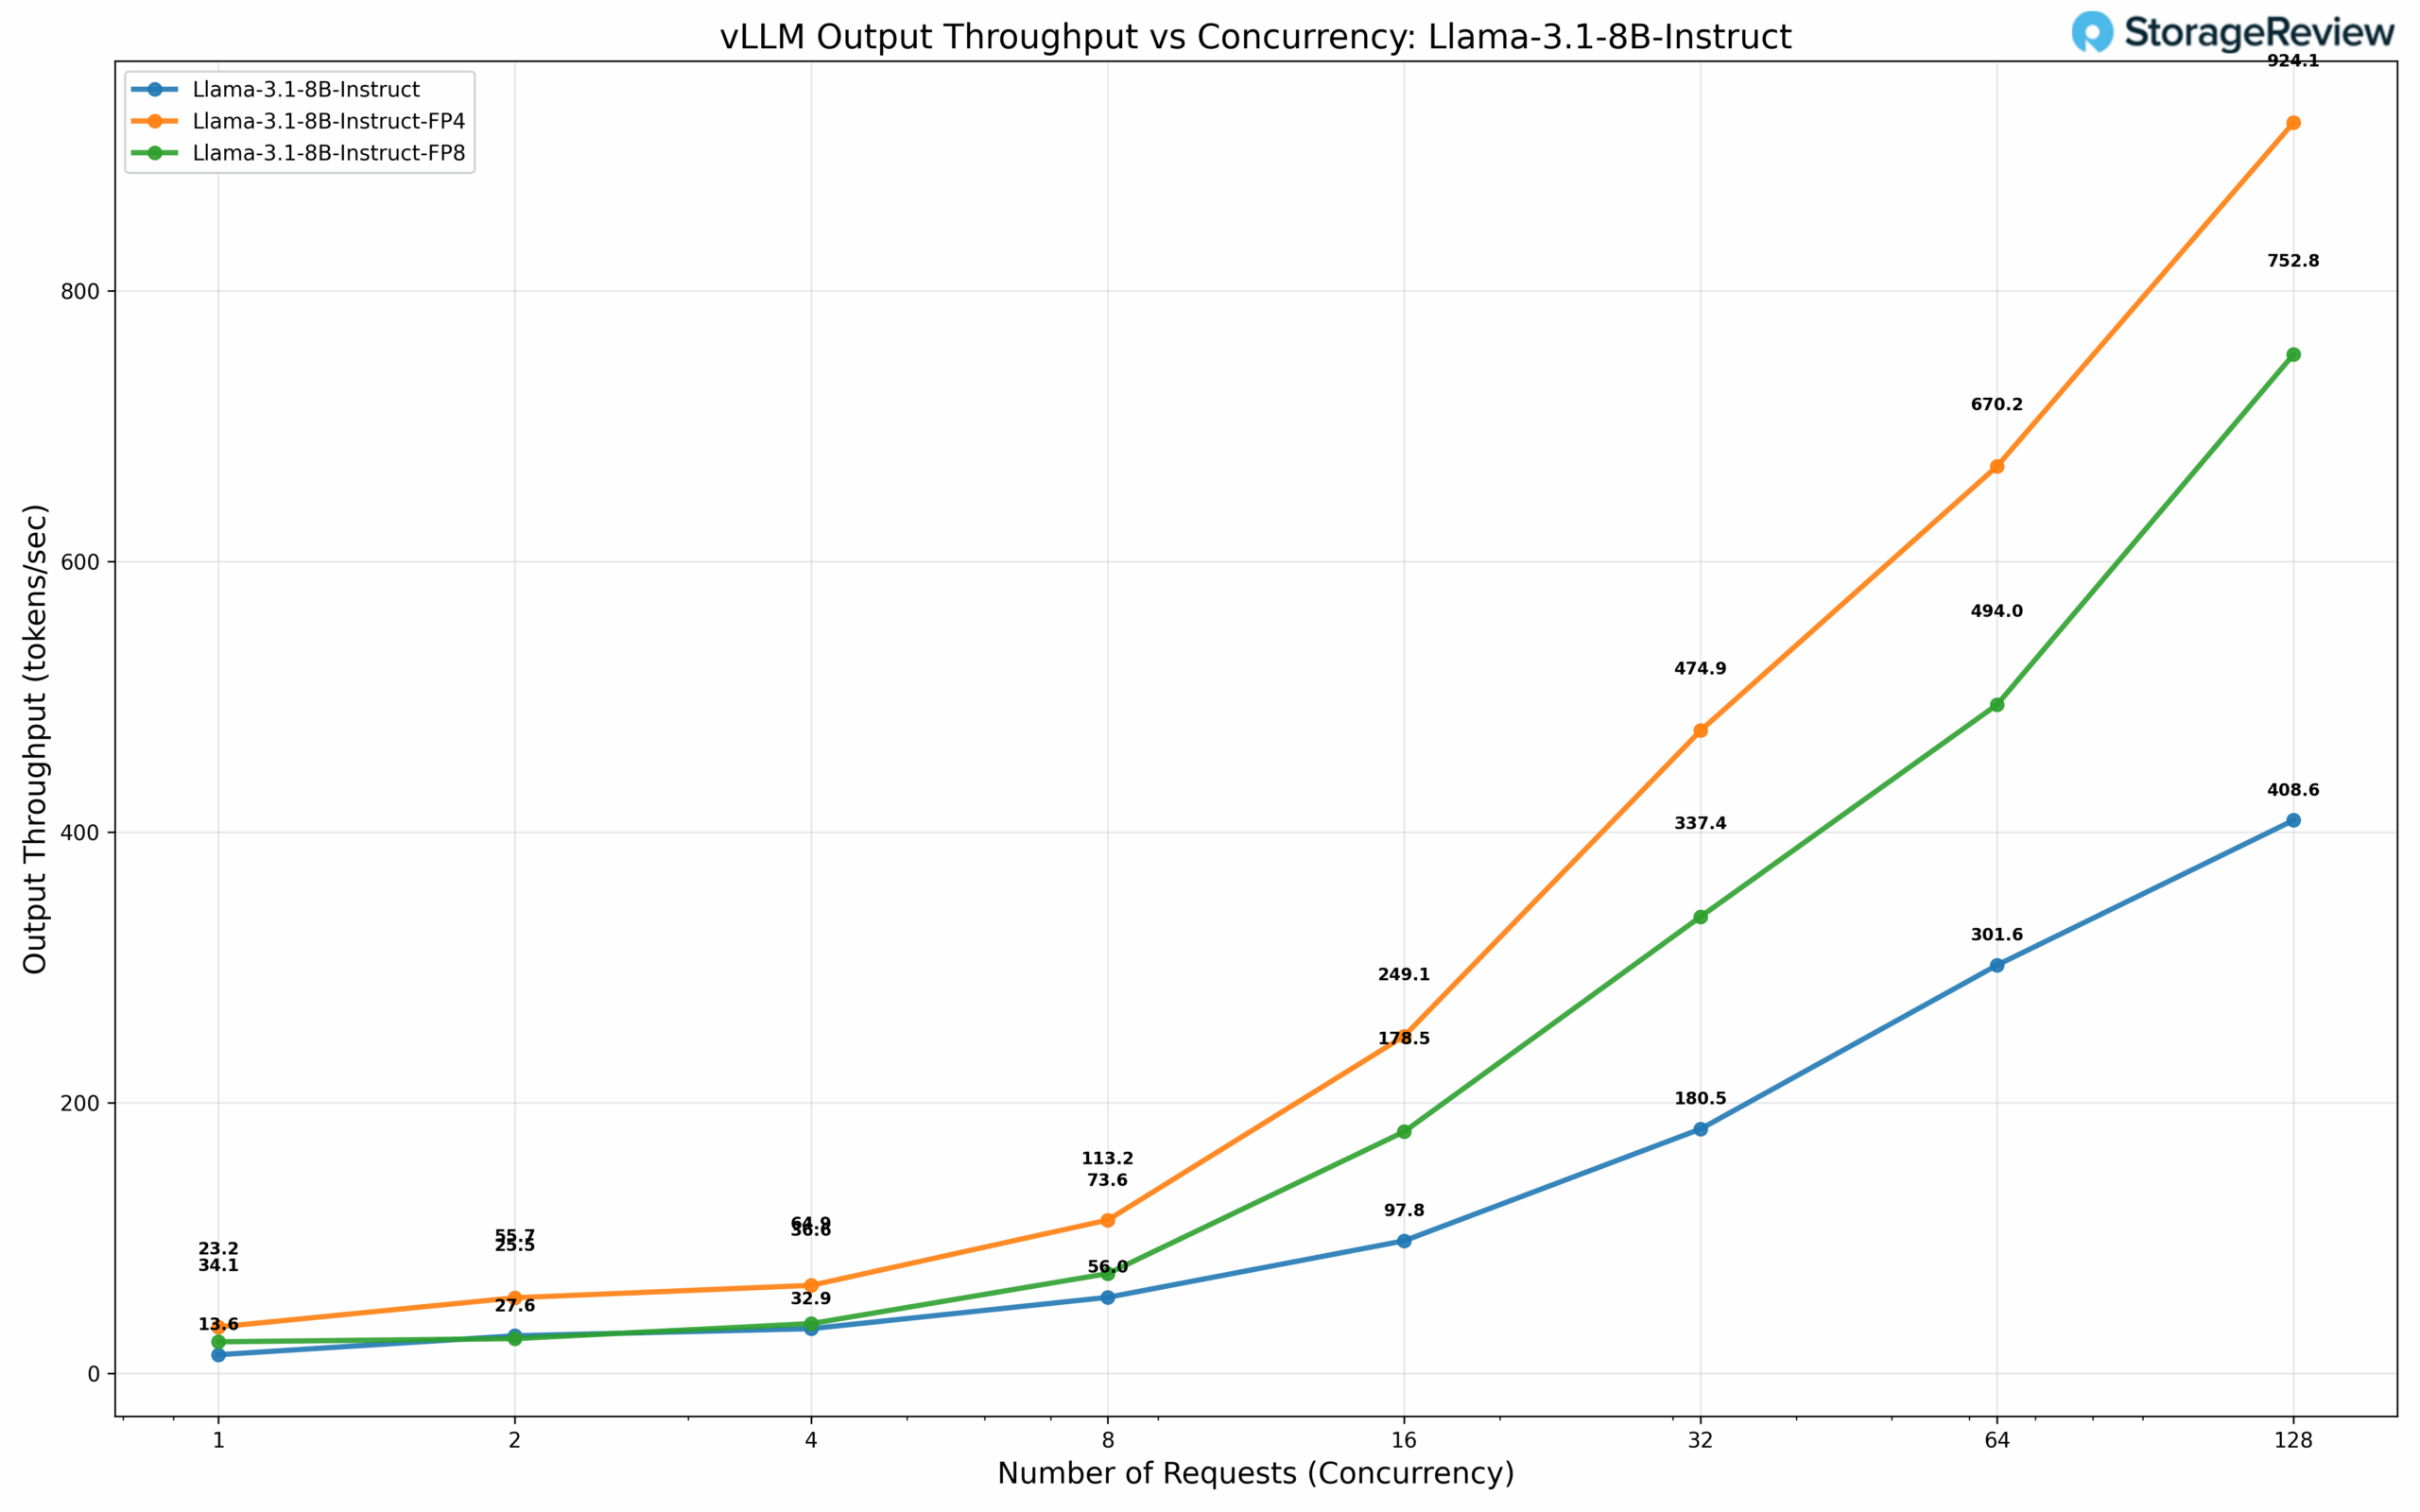
Architektura Llama 3.1 8B vykazuje výrazně odlišné výkonnostní charakteristiky napříč strategiemi kvantizace. Při přesnosti BF16 model poskytuje 13.6 tok/s při souběžnosti 1 a při 128 souběžných požadavcích se zvyšuje na 408.6 tok/s. Přechod na kvantizaci FP8 přináší 23.2 tok/s a 752.8 tok/s na úrovních souběžnosti 1 a 128 – což představuje 84% zlepšení propustnosti ve velkém měřítku. Konfigurace FP4 posouvá výkon dále a dosahuje 34.1 tok/s a 924.1 tok/s při stejných úrovních souběžnosti, což dokazuje, že agresivní strategie kvantizace mohou přinést 2.3násobné zvýšení výkonu oproti základní přesnosti a zároveň zachovat přijatelnou kvalitu modelu pro mnoho produkčních úloh.
Datový typ mikroškálování
Mikroškálování představuje pokročilý kvantizační přístup, který aplikuje jemnozrnné škálovací faktory na malé bloky vah, spíše než rovnoměrnou kvantizaci napříč velkými skupinami parametrů. Formát NVFP4 od společnosti NVIDIA implementuje tuto techniku prostřednictvím blokované reprezentace s plovoucí desetinnou čárkou, kde každý mikroškálový blok o 8–32 hodnotách sdílí společný exponent jako škálovací faktor. Tento granulární přístup zachovává numerickou přesnost a zároveň dosahuje 4bitové reprezentace, čímž se udržuje dynamický rozsah kritický pro transformátorové architektury. Formát se integruje s architekturou Tensor Core od společnosti NVIDIA, což umožňuje efektivní výpočet se smíšenou přesností s dekompresí za chodu během maticových operací.
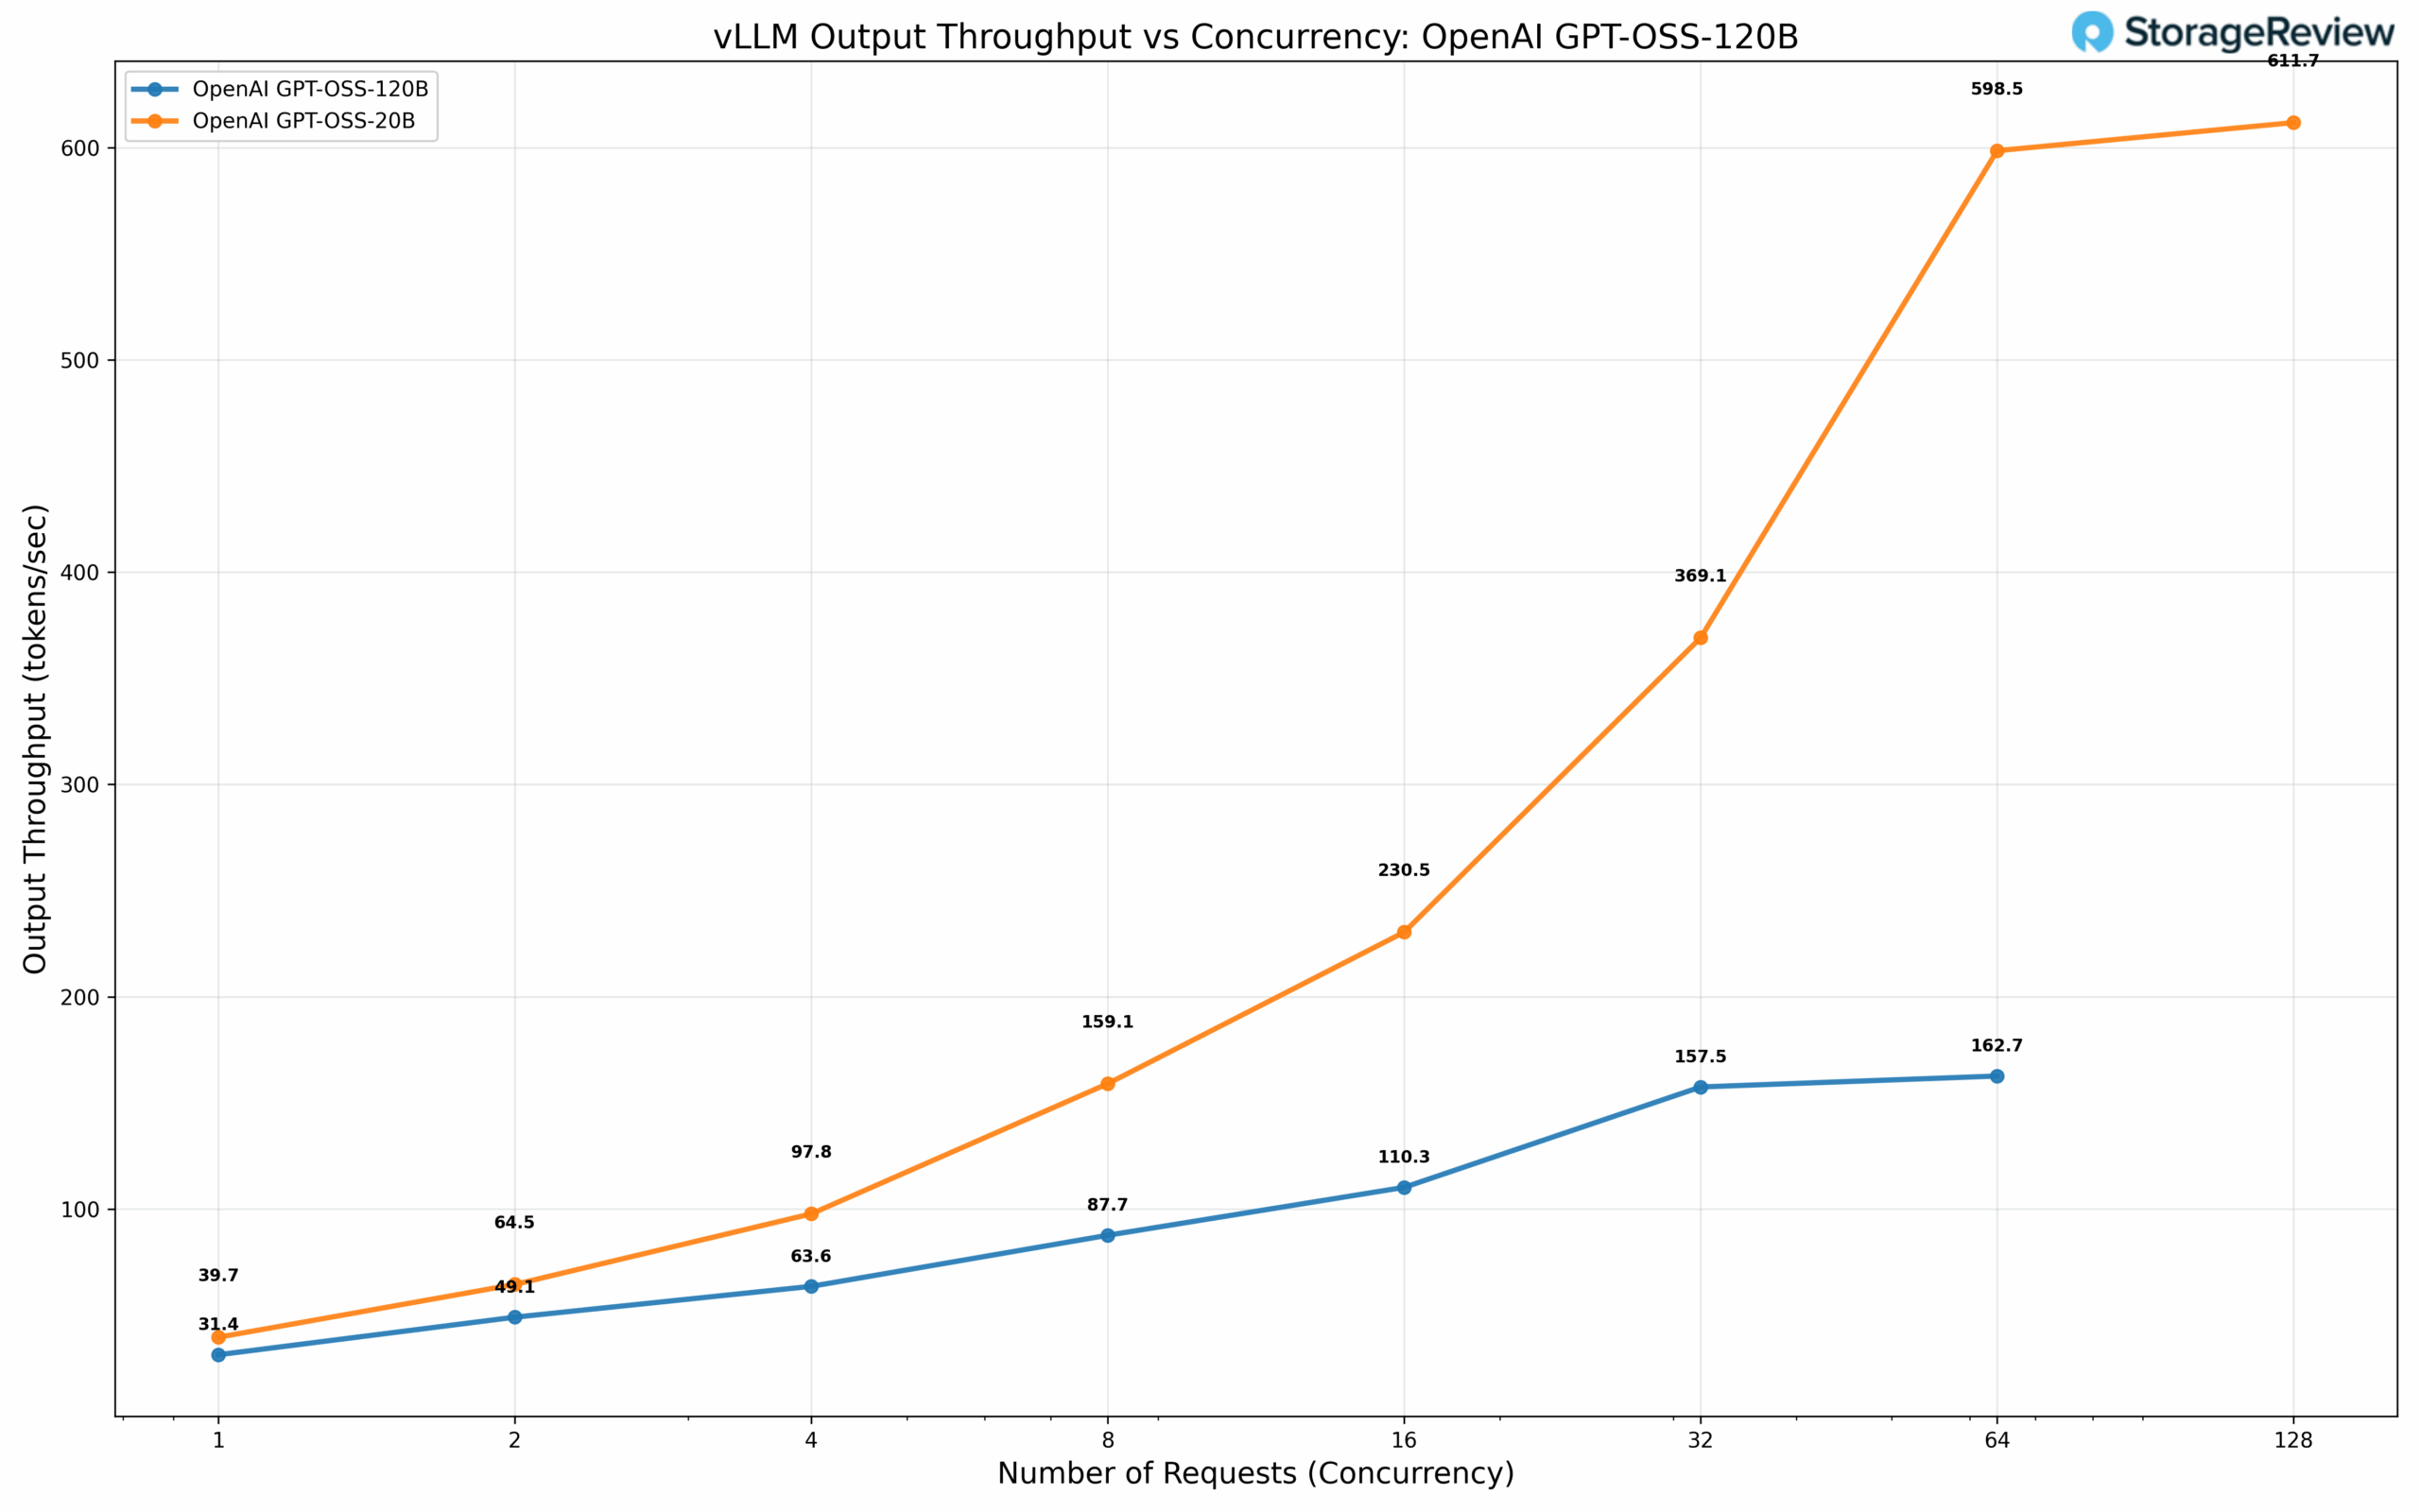
Modely GPT OSS od OpenAI jsme vyhodnotili na škálách parametrů 20B a 120B s využitím kvantizace NVFP4. Model s parametry 20B dosahuje rychlosti 39.7 tok/s při souběžnosti 1 a škáluje se na 611.7 tok/s při 128 souběžných požadavcích. Varianta s parametry 120B poskytuje rychlost 31.4 tok/s při souběžnosti 1 a 162.7 tok/s při 64 souběžných požadavcích.
Poznámka: Výstupní propustnost je propustnost napříč požadavky, nikoli propustnost na požadavek.
Kvůli omezenému času jsme nebyli schopni dokončit naše testy TensorRT, sledujte další články ve Sparku, kde se budeme zabývat výkonem na dalších inferenčních frameworkech.
Předvyplňování a dekódování těžké inference
Inferenci LLM lze zásadně rozdělit do dvou odlišných výpočetních fází, z nichž každá vykazuje výrazně odlišné výkonnostní charakteristiky a vzorce využití zdrojů. Fáze předběžného vyplňování zpracovává celý vstupní příkaz v jedné paralelní operaci a zároveň počítá mechanismy pozornosti napříč všemi vstupními tokeny. Jedná se o výpočetně náročnou operaci, která plně saturuje tenzorová jádra a výpočetní jednotky. Naopak fáze dekódování generuje výstupní tokeny autoregresivně a produkuje jeden token po druhém prostřednictvím sekvenčních operací, které vykazují nižší výpočetní náročnost, ale kladou značné nároky na šířku pásma paměti, protože model musí opakovaně přistupovat k vahám a rostoucí mezipaměti klíč-hodnota. To vytváří zásadně odlišné profily úzkých míst: operace předběžného vyplňování jsou obvykle vázány na výpočetní výkon, zatímco dekódovací operace se stávají náročnými na šířku pásma paměti, což je činí obzvláště náchylnými k omezením paměťového subsystému.
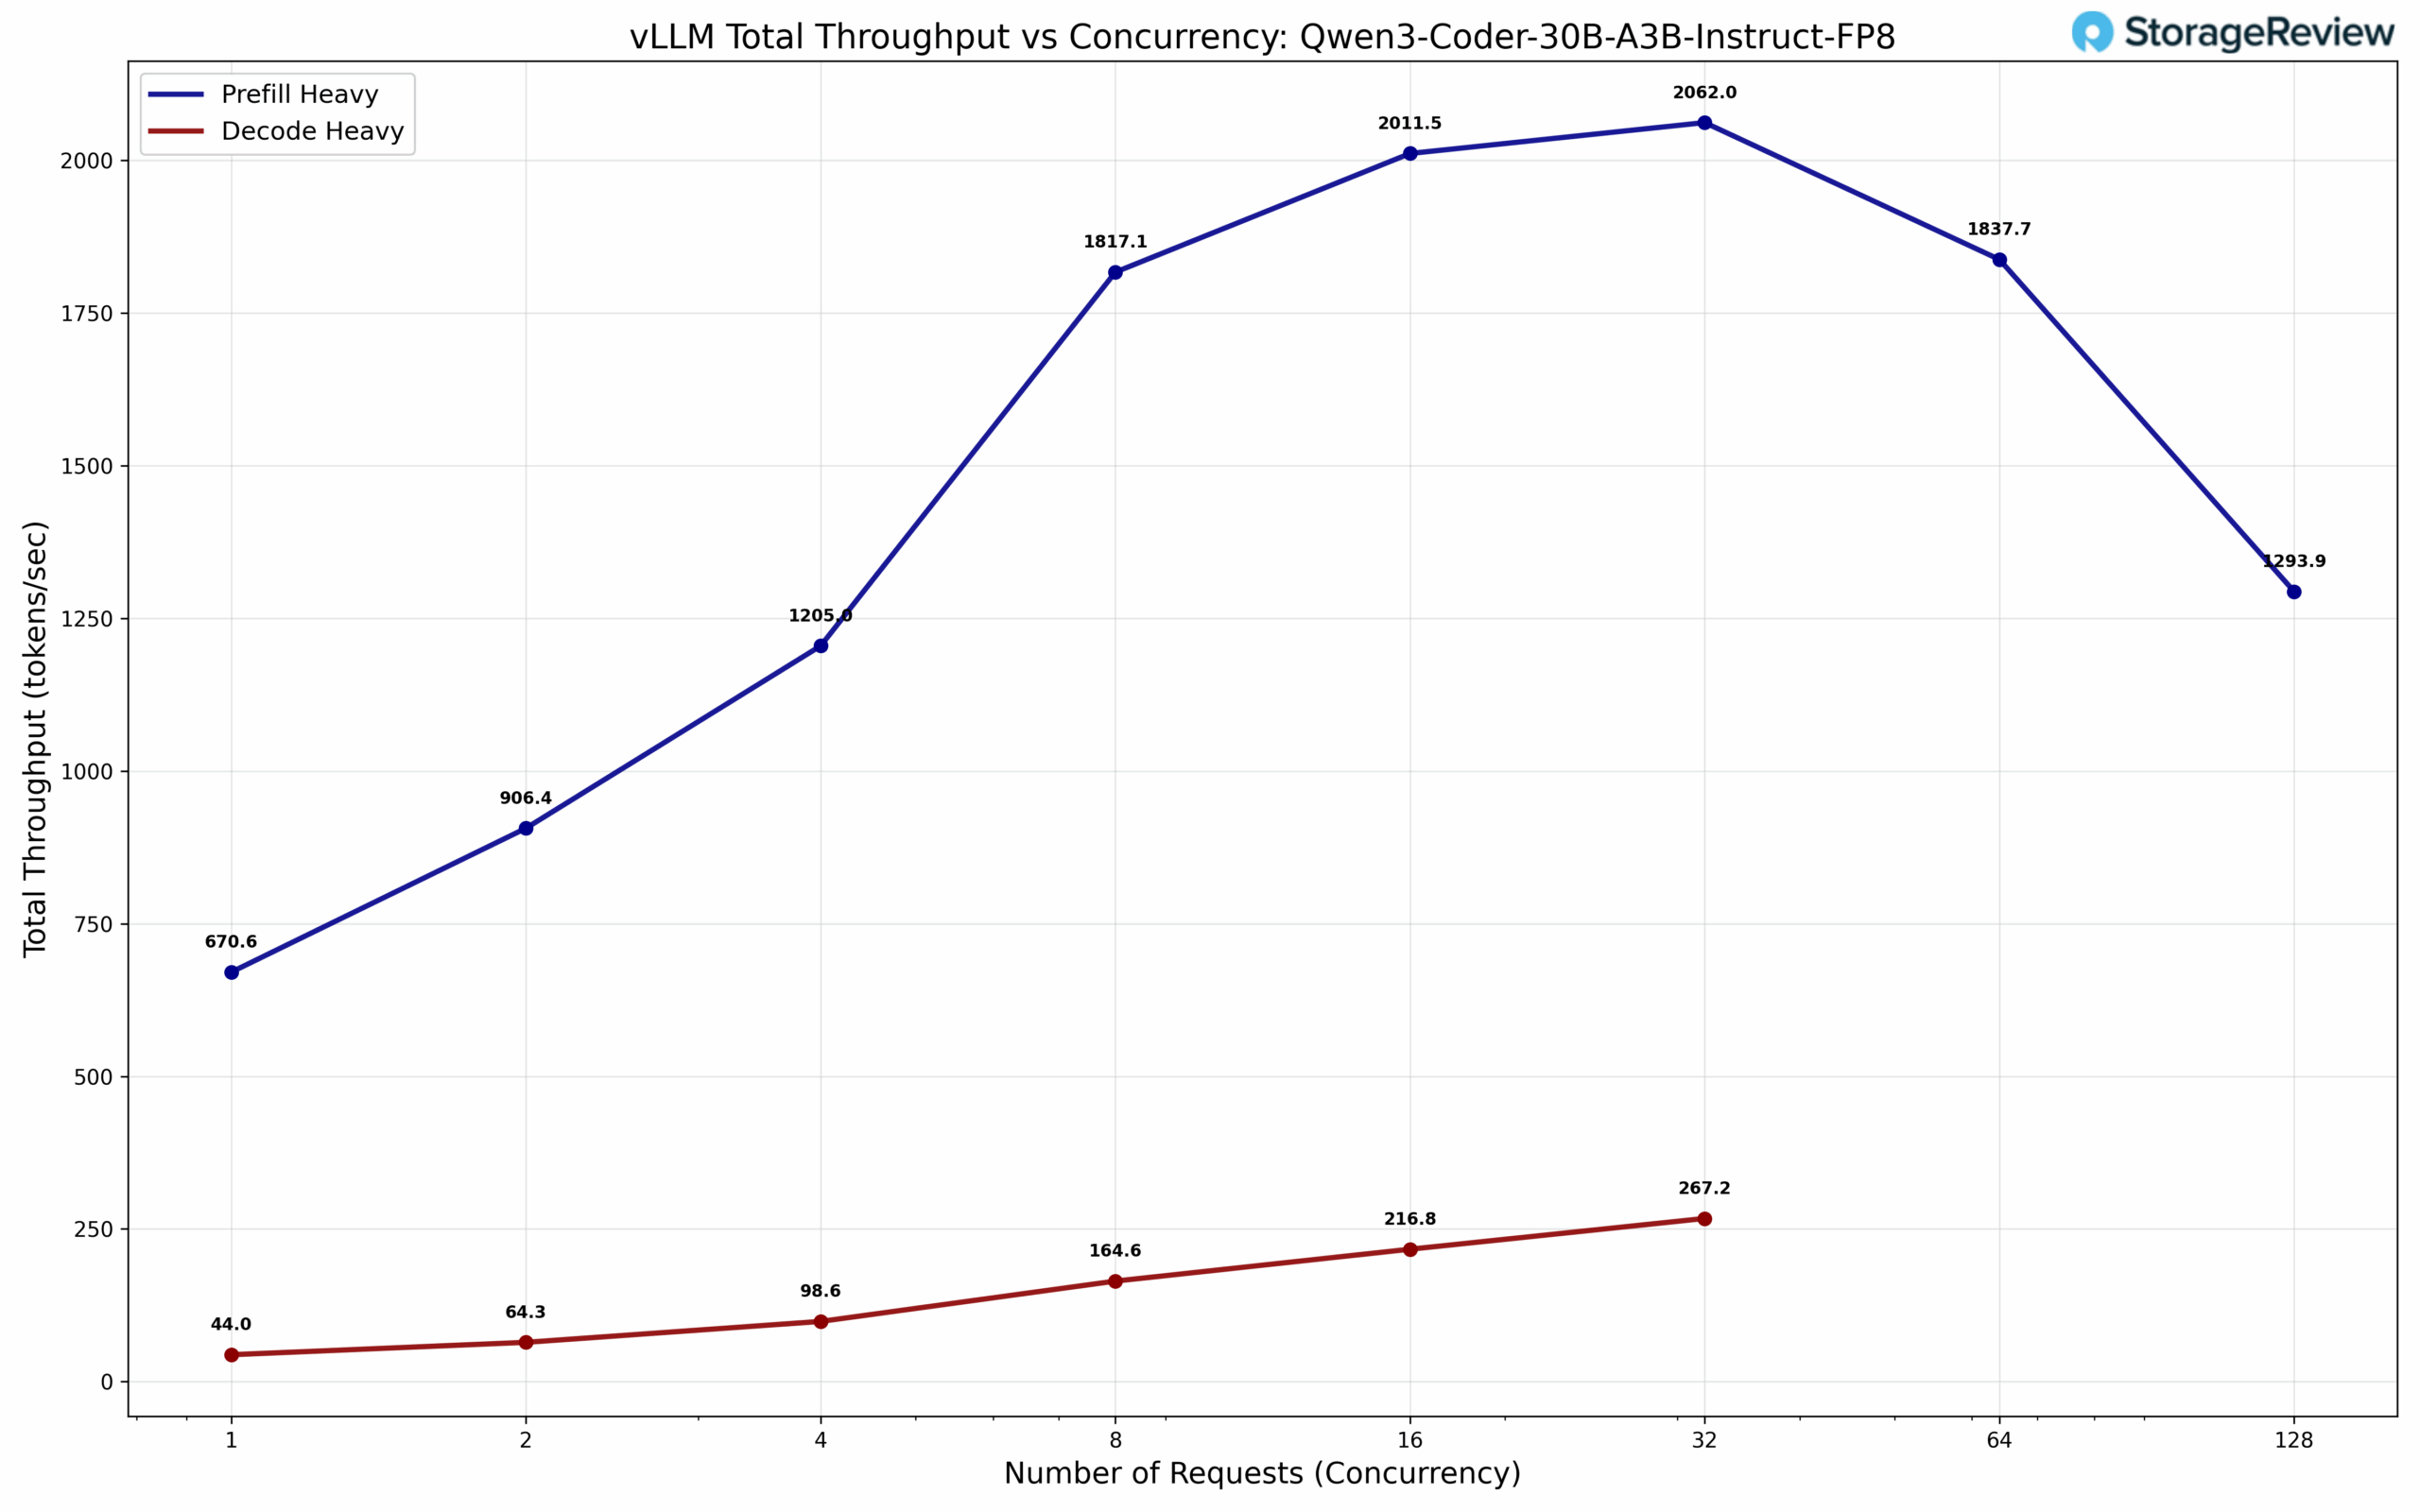
Provedli jsme komplexní testování dvou odlišných profilů pracovní zátěže: inference s vysokou mírou dekódování s 512 vstupními tokeny a 8 192 výstupními tokeny a inference s vysokou mírou předplnění s 8 192 vstupními tokeny a 512 výstupními tokeny. Charakterizace výkonu odhaluje očekávané architektonické kompromisy: Spark vykazuje konkurenceschopnou propustnost u pracovních zátěží s vysokou mírou předplnění, kde výpočetní zdroje zůstávají primárním úzkým hrdlem, ale vykazuje snížený výkon u scénářů s vysokou mírou dekódování. Tento výkonnostní rozdíl přesně odpovídá omezením šířky pásma paměti. Sekvenční povaha dekódovacích operací a intenzivní vzorce přístupu k paměti přímo odhalují omezení šířky pásma, která jsou vlastní architektuře Sparku. Tyto výsledky poskytují kritický kontext pro interpretaci měření MAMF v následující části, protože obě sady benchmarků konzistentně identifikují šířku pásma paměti jako základní faktor omezující výkon v reálných inferenčních nasazeních.
Maximálně dosažitelné Matmul FLOPS (MAMF)
MAMF (Maximum Achievable Matmul FLOPS) je praktická metrika výkonu určená k měření realistického špičkového počtu operací s plovoucí desetinnou čárkou za sekundu, kterého lze dosáhnout na akcelerátorech strojového učení během operací násobení matic. Nabízí tak přesnější benchmark než teoretický špičkový FLOPS často inzerovaný v hardwarových specifikacích. Používáme benchmark mamf-finder od Stase Beckmana.
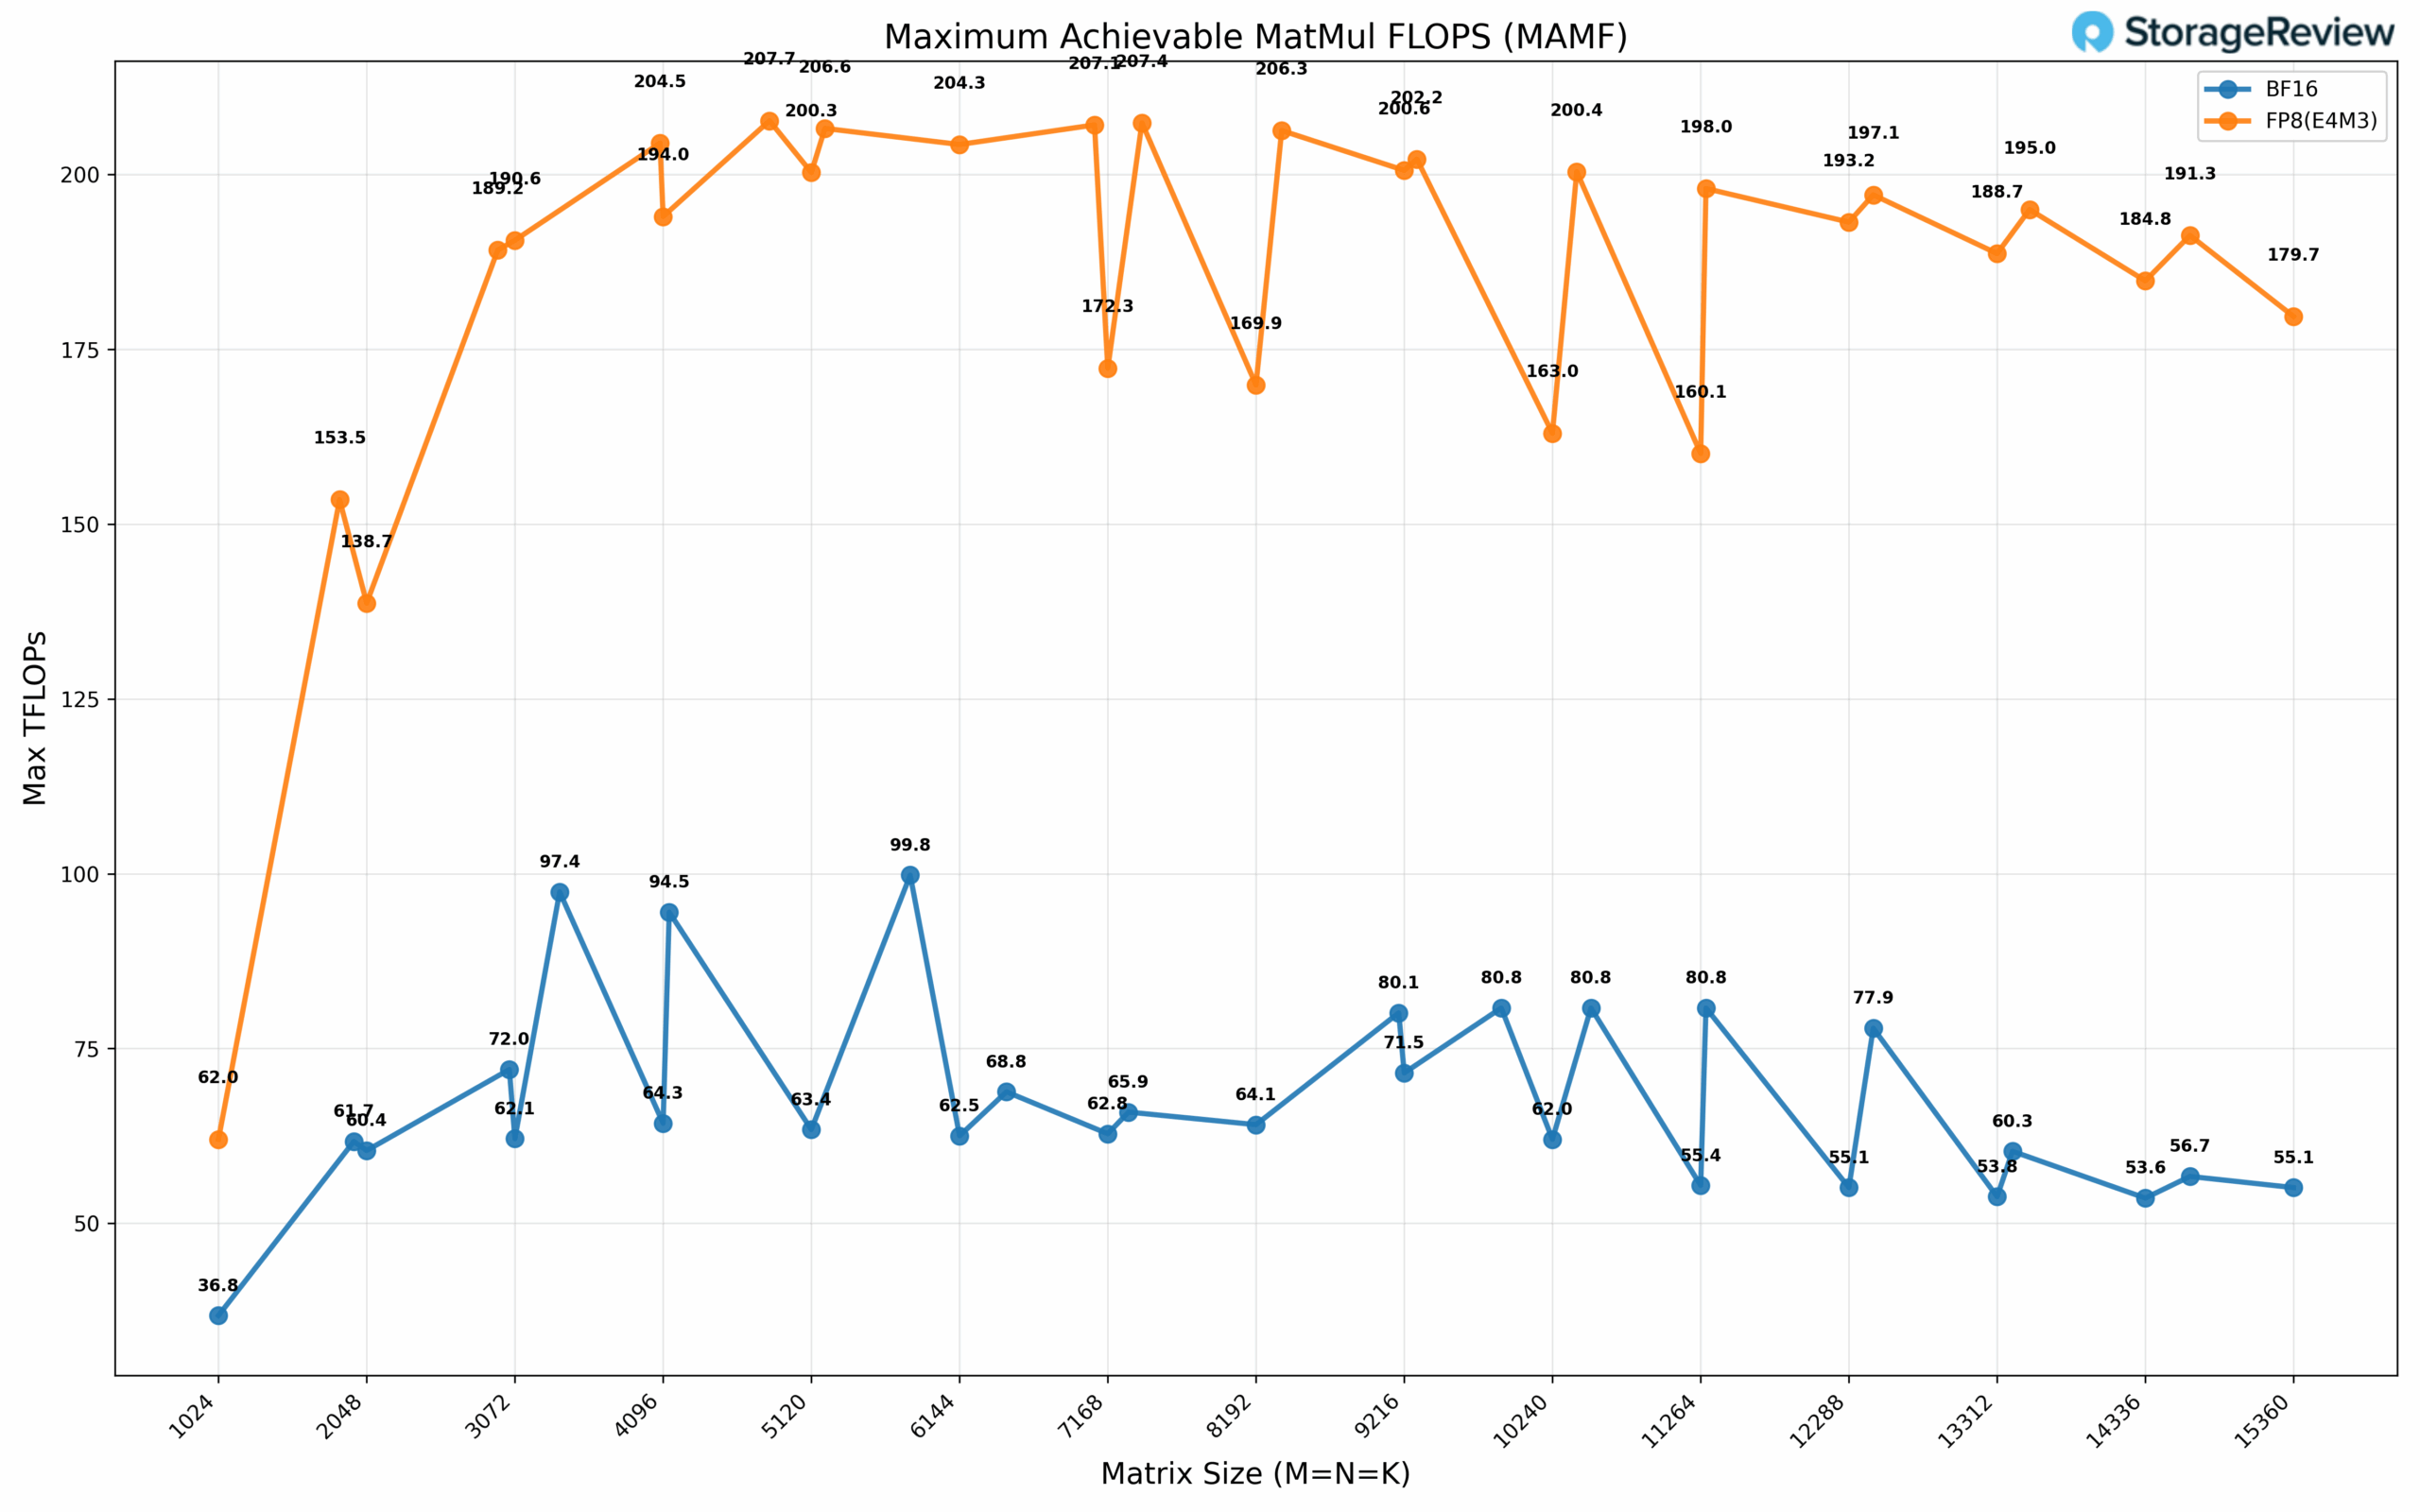
Při přesnosti BF16 pozorujeme MAMF 99.8 TFLOP, zatímco FP8 (E4M3) vykazuje MAMF 207.7 TFLOP. Kvůli časovým omezením jsme nebyli schopni provést komplexní charakterizaci MAMF FP4; extrapolací z pozorovaných vzorců škálování založených na přesnosti však očekáváme další 2× zvýšení výkonu oproti FP8, což by znamenalo přibližně 400 TFLOP pro husté operace FP4. Při započítání strukturované optimalizace řídkosti 2:1 se to promítá do zhruba 80 % teoretických možností výkonu FP4, čímž se dosahuje přibližně 800 TFLOP při řídkých výpočetních zátěžích. Je důležité poznamenat, že tato měření MAMF mohou být pod teoreticky inzerovanými specifikacemi z mnoha důvodů, kterými se v této recenzi nebudeme zabývat.
Přímé úložiště GPU
Jedním z testů, které jsme na Spark provedli, byl test MagnumIO GPU Direct Storage (GDS). GDS je funkce vyvinutá společností NVIDIA, která umožňuje grafickým procesorům obejít CPU při přístupu k datům uloženým na discích NVMe nebo jiných vysokorychlostních úložných zařízeních. Namísto směrování dat přes CPU a systémovou paměť umožňuje GDS přímou komunikaci mezi grafickým procesorem a úložným zařízením, což výrazně snižuje latenci a zlepšuje propustnost dat.
Jak funguje přímé úložiště GPU
Tradičně, když GPU zpracovává data uložená na disku NVMe, musí data nejprve projít procesorem a systémovou pamětí, než se dostanou k GPU. Tento proces zavádí úzká hrdla, protože CPU se stává prostředníkem, což zvyšuje latenci a spotřebovává cenné systémové prostředky. Funkce GPU Direct Storage eliminuje tuto neefektivitu tím, že umožňuje GPU přístup k datům přímo z úložného zařízení přes sběrnici PCIe. Tato přímá cesta snižuje režii spojenou s pohybem dat, což umožňuje rychlejší a efektivnější přenosy dat.
Pracovní zátěž umělé inteligence, zejména ta zahrnující hluboké učení, je vysoce datově náročná. Trénování velkých neuronových sítí vyžaduje zpracování terabajtů dat a jakékoli zpoždění v přenosu dat může vést k nedostatečnému využití grafických procesorů (GPU) a delší době trénování. Přímé úložiště na GPU (GPU Direct Storage) řeší tento problém tím, že zajišťuje co nejrychlejší doručení dat na GPU, minimalizuje dobu nečinnosti a maximalizuje výpočetní efektivitu.
Kromě toho je GDS obzvláště výhodný pro úlohy, které zahrnují streamování velkých datových sad, jako je zpracování videa, zpracování přirozeného jazyka nebo inference v reálném čase. Snížením závislosti na CPU GDS zrychluje pohyb dat a uvolňuje zdroje CPU pro jiné úkoly, čímž dále zvyšuje celkový výkon systému.
GDSIO – Interní 4TB M.2
NVIDIA DGX Spark má zajímavou volbu úložiště. Z hlediska velikosti uvnitř malé skříně zvolila NVIDIA méně obvyklý SSD Gen5 2242 M.2. Pro čtenáře, kteří s tímto typem SSD nejsou obeznámeni, jedná se o kratší 42mm verzi ve srovnání s 80mm, která je běžnější u stolních počítačů. Existuje méně možností disků, přičemž nejvyšší kapacita v této velikosti je 4 TB. Hlavním problémem je však výkon. Malé SSD disky, jako jsou modely 2242 a 2230, upřednostňují velikost, zatímco rychlost disku hraje druhořadou roli. Jsou běžné v přenosných herních konzolích, tabletech a některých noteboocích.
Na desce plošných spojů SSD 2230 a 2242 není mnoho místa, což má za následek méně místa pro řadiče, DRAM a NAND pouzdra. Některé z těchto kompromisů jsme pozorovali během našeho testování. Při aplikaci naší zátěže GDSIO v prostoru o velikosti 1 TB nebo 128 GB se SSD zasekával a vyžadoval přeprogramování disku Spark. Snížení testovací velikosti na 64 GB a také snížení vyššího počtu vláken tento problém vyřešilo. Tyto problémy se u běžnějších vysoce výkonných 80mm SSD disků obvykle nevyskytují.
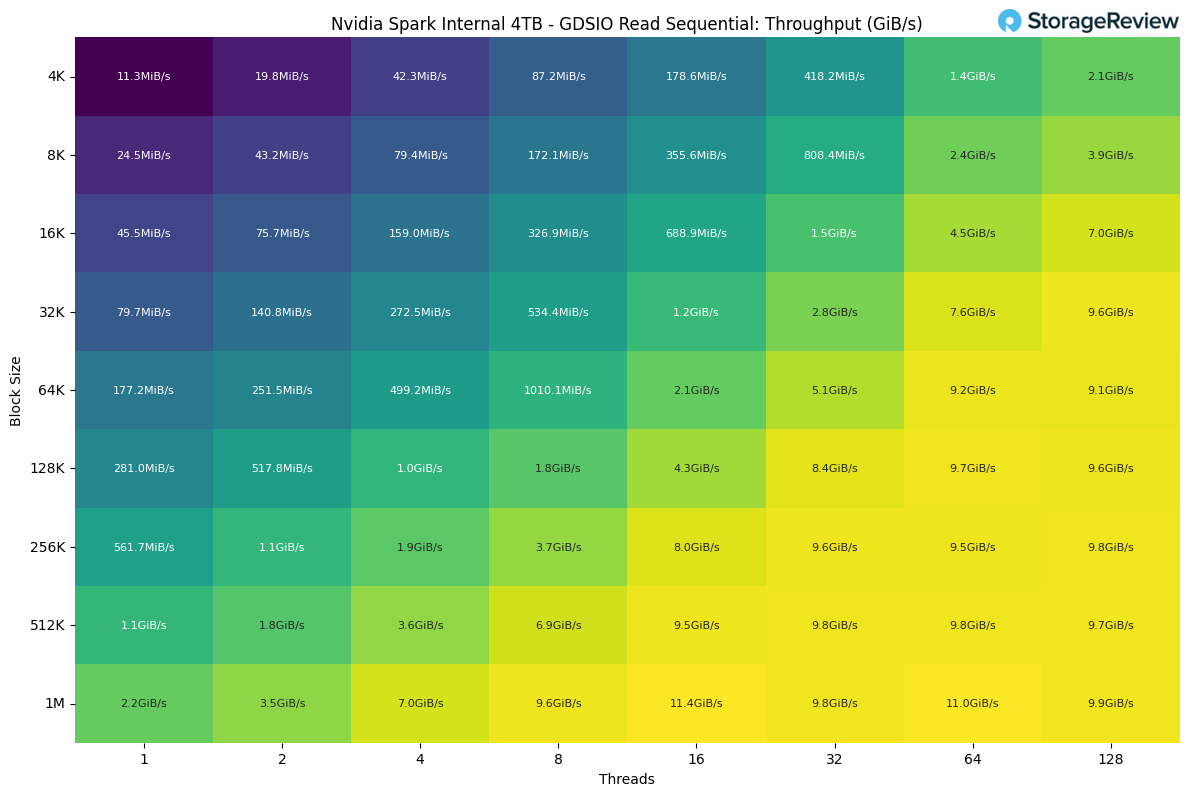
Při pohledu na výkon sekvenčního čtení interního disku vidíme nejvyšší propustnost při velikosti bloku 1 MB se 16 vlákny, kde dosahuje 11.4 GiB/s.
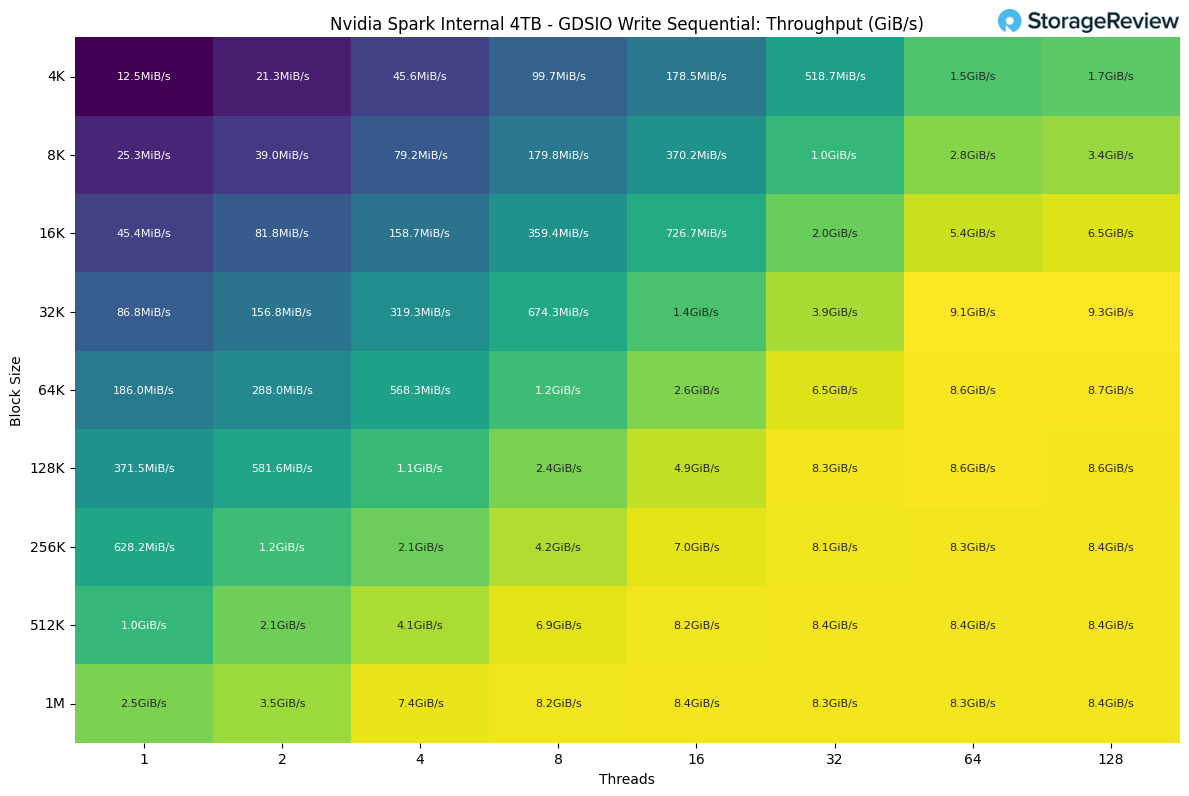
Při pohledu na výkon sekvenčního zápisu dosahuje disk nejvyšší propustnosti při velikosti bloku 32 kB se 128 vlákny. Při větších velikostech bloků se výkon zdá být stabilní a dosahuje průměrně 8.3 GiB/s.
Pro kupující, kteří chtějí pořídit NVIDIA DGX Spark pro náročnější vývojářské práce, zejména pro firmy, které by z nich mohly vytvářet malé clustery, důrazně doporučujeme využít integrovanou 200Gb síťovou kartu NVIDIA ConnectX-7.
GDSIO – NVMe-oF přes RDMA
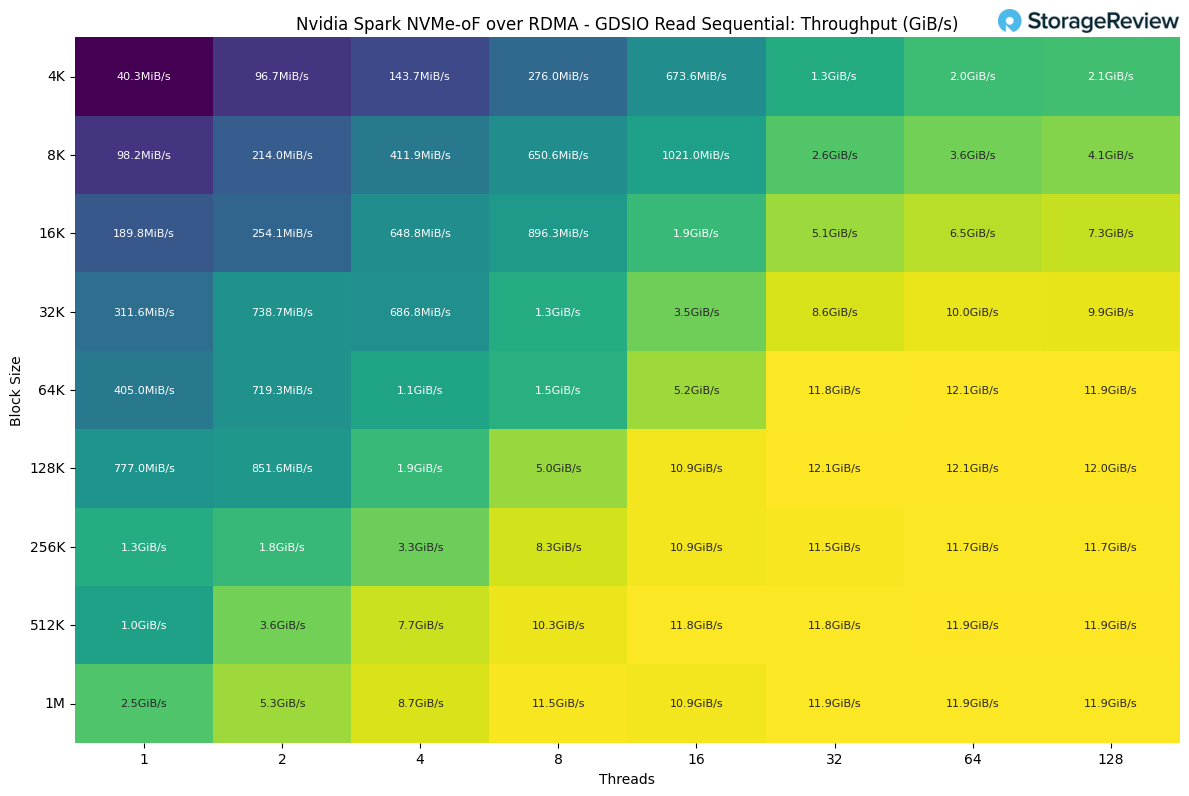
Pro testování NVMe-oF RDMA s kartou NVIDIA DGX Spark jsme použili software PEAK:AIO k vytvoření cíle NVMe-oF na serveru Dell PowerEdge R770 se šesti SSD disky Micron 9550 s kapacitou 3.84 TB a připojením přes RDMA. Jak jsme již zmínili, síťová karta CX7 v kartě Spark má své specifika a kvůli časové tísni jsme byli schopni testovat Spark pouze se 100G konektivitou. Spark i PEAK:AIO dosahují výrazně vyšších hodnot. V dalších dílech provedeme další testování úložiště a sítě se Sparkem.
Při pohledu na výkon sekvenčního čtení interního disku vidíme nejvyšší propustnost při velikosti bloku 128 kB s 32 vlákny, což dosahuje 12.1 GiB/s.
Při pohledu na výkon sekvenčního zápisu dosahuje disk nejvyšší propustnosti při velikosti bloku 128 kB se 16 vlákny. Při větších velikostech bloků se výkon zdá být stabilní a dosahuje průměrně 11.3 GiB/s.
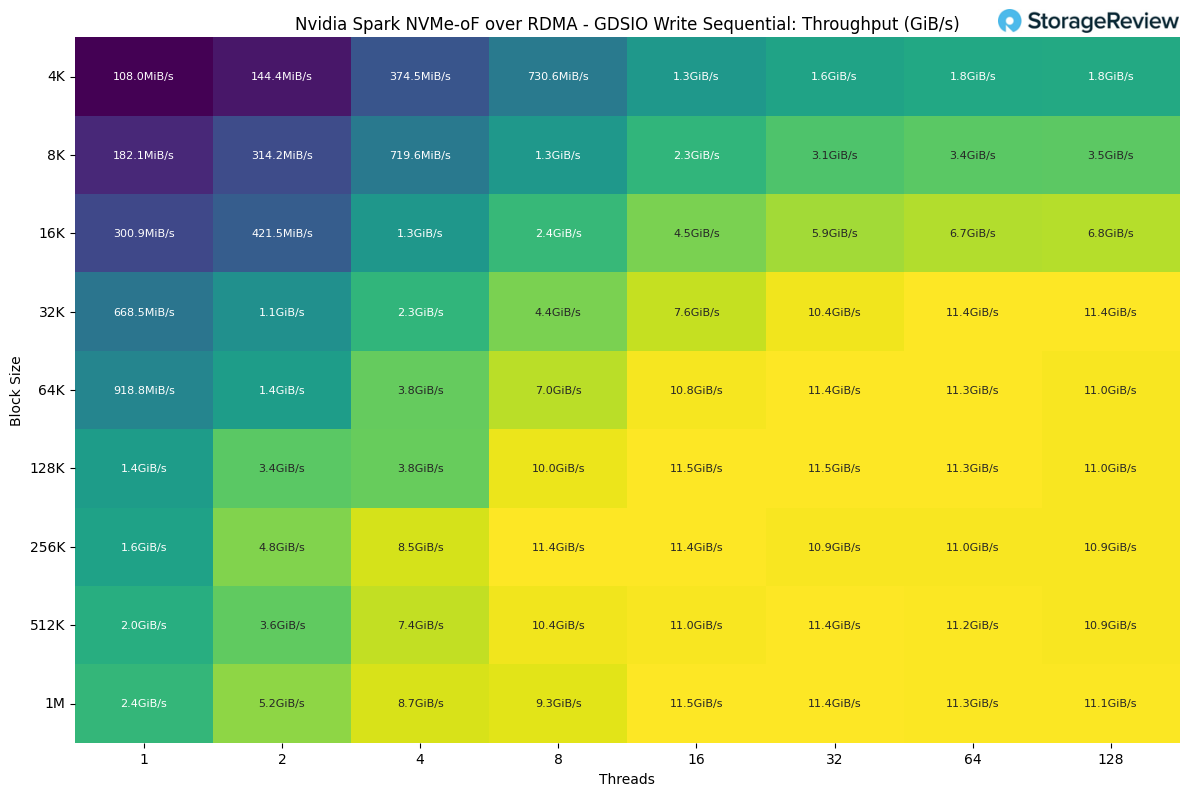
Tyto výsledky jsou dost nuanční, vidíme pouze polovinu teoretického maxima kvůli výše zmíněným důvodům souvisejícím s časem a sítí. Navíc nejvyšší propustnost při velikosti bloku 128 kB je ovlivněna řadou faktorů, jako jsou použité podnikové disky nebo způsob, jakým PEAK:AIO zpracovává tento vstup a výstup. Vaše propustnost se může lišit a v budoucnu plánujeme provést více testů se Sparkem.
Softwarový ekosystém prvního dne
NVIDIA a další dodavatelé investovali značné prostředky do připravenosti softwaru, což je výrazný odklon od typických hardwarových startů, kde se první uživatelé potýkají s neúplnou dokumentací a chybějícími nástroji. Spark uvádí na trh komplexní playbooky pokrývající běžné pracovní postupy: ComfyUI pro difúzní modely, TRT-LLM pro optimalizovanou inferenci, Ollama s Open WebUI pro lokální obsluhu modelů, Unsloth pro jemné ladění a multiagentní architektury s LangGraphem.
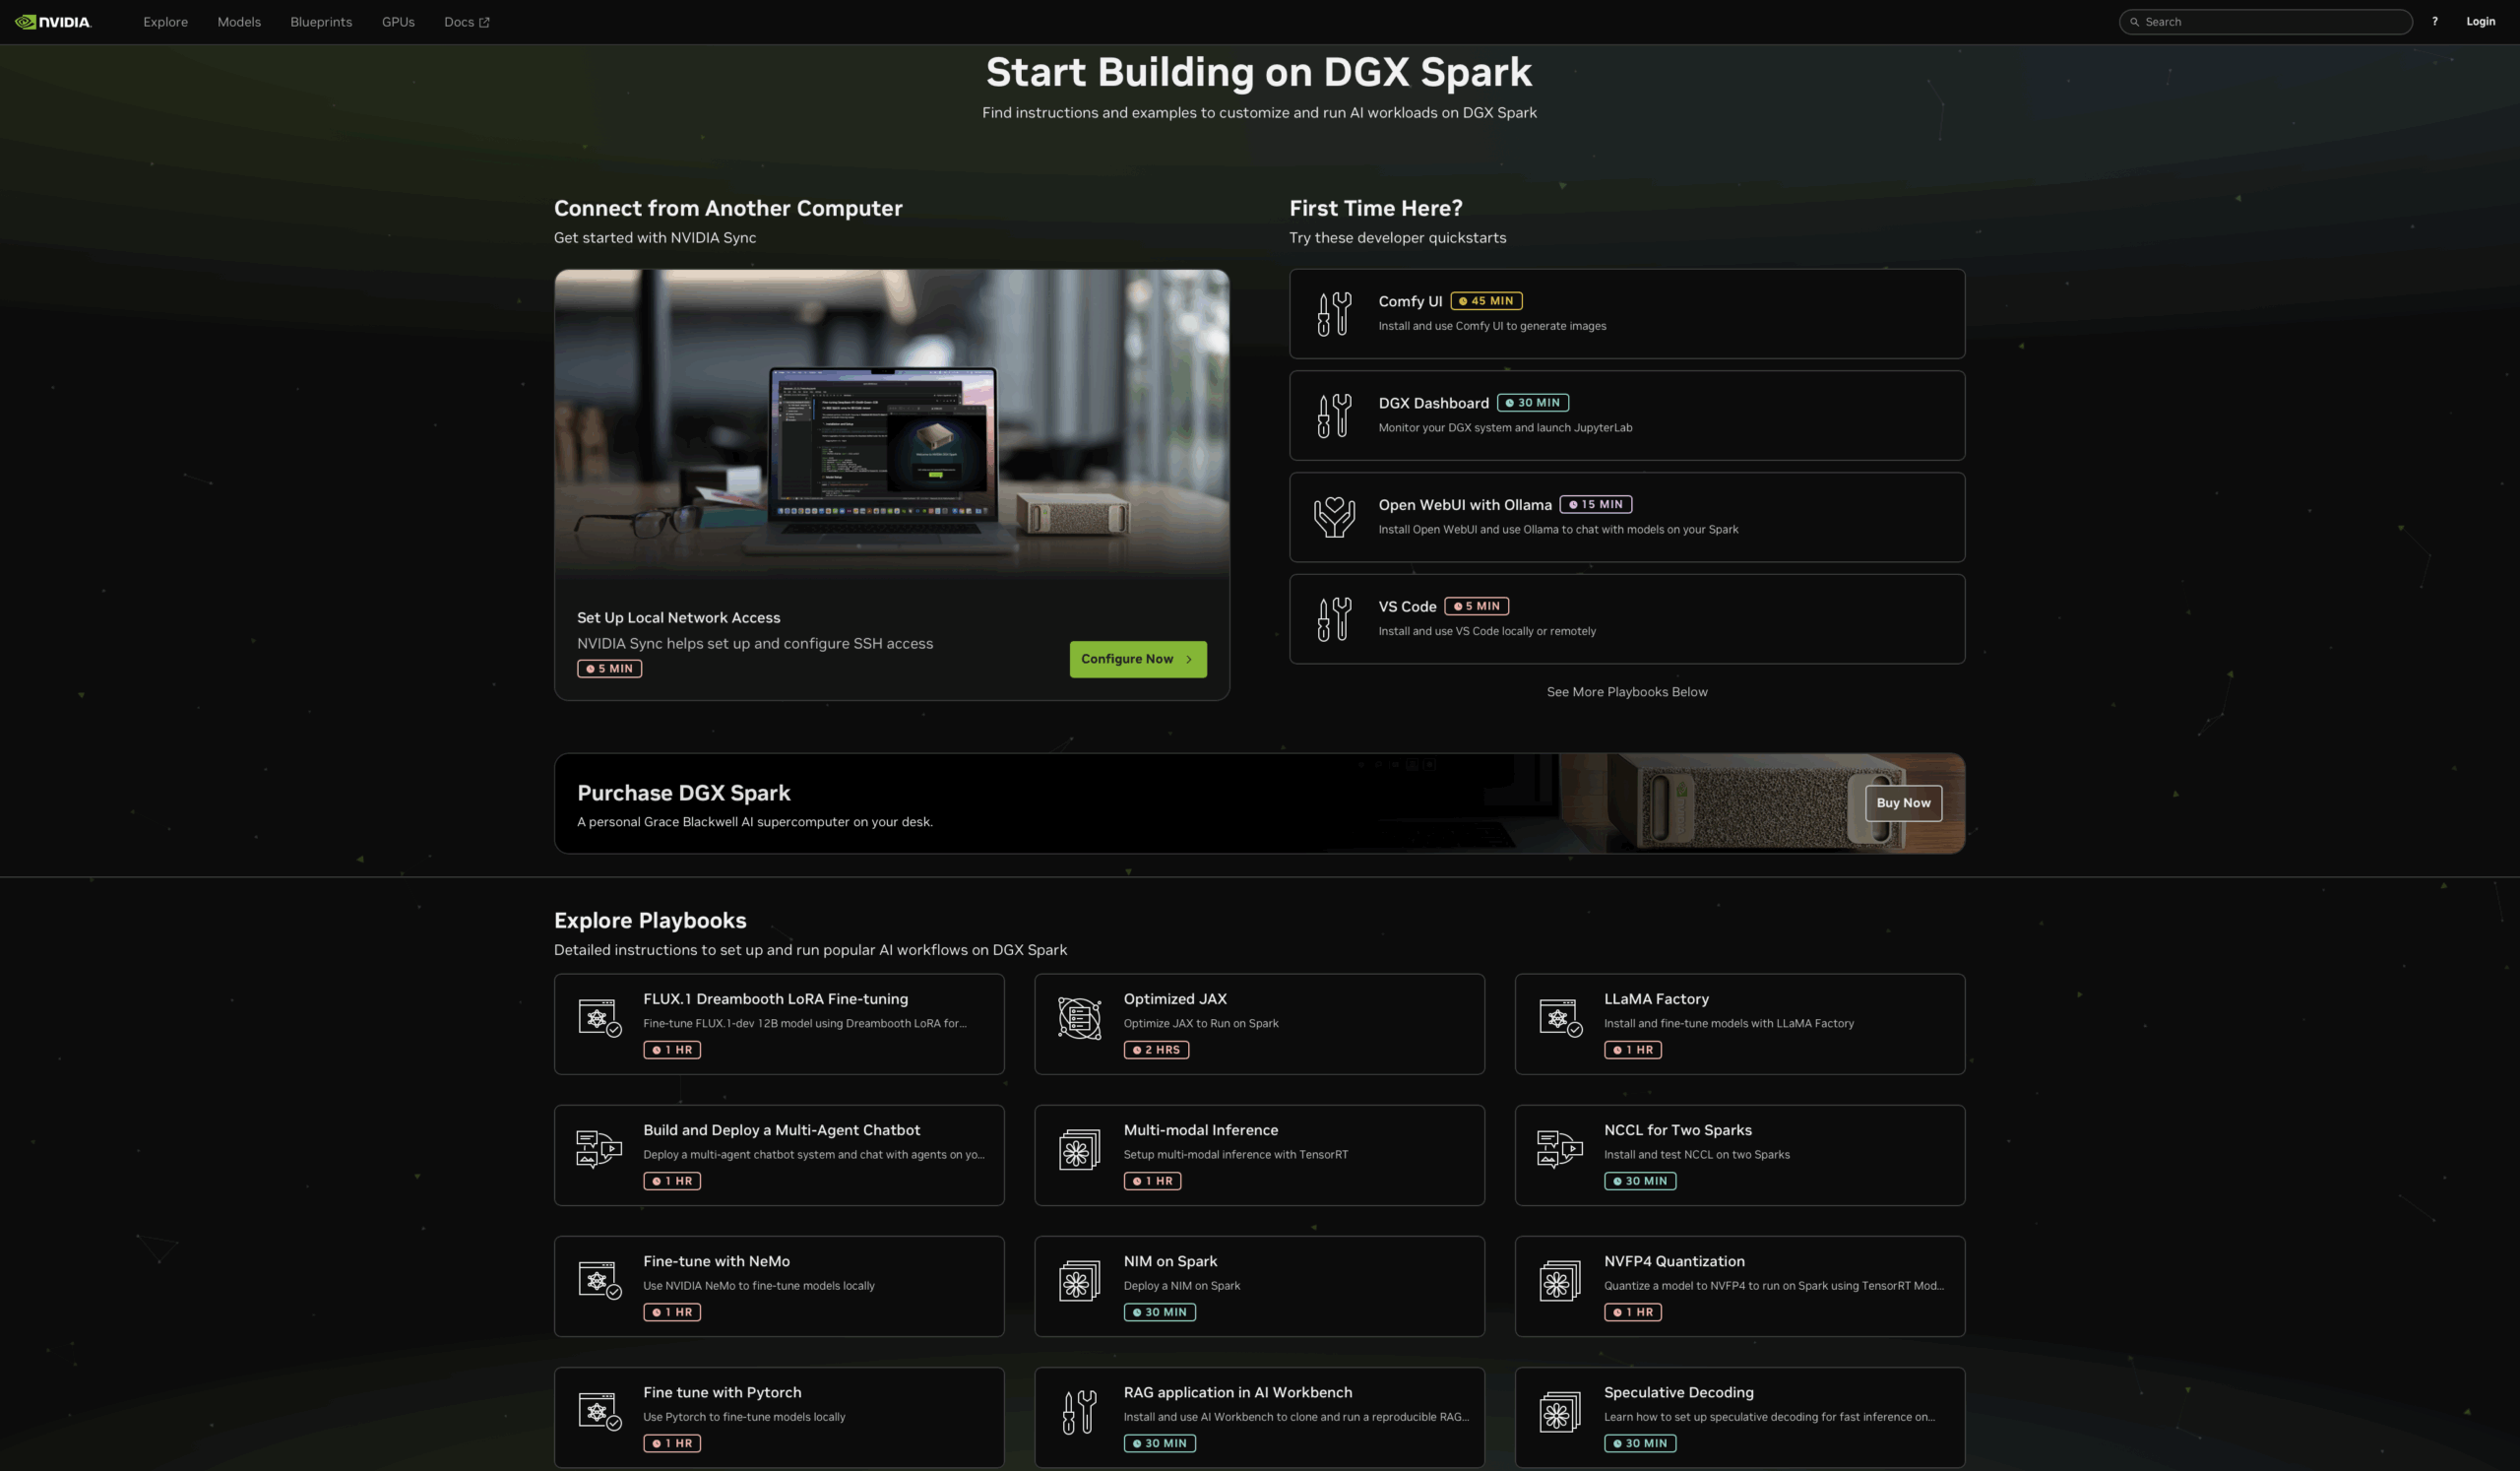
Tato softwarová vyspělost transformuje proces vyhodnocování. Vývojáři mohou namísto trávení dnů konfigurací prostředí okamžitě posoudit, zda Spark splňuje jejich požadavky, spuštěním reprezentativních úloh. Playbooky poskytují nejen instrukce, ale i kontejnerizovaná prostředí, ukázkové datové sady a očekávané metriky výkonu.
Dostupnost a OEM systémy
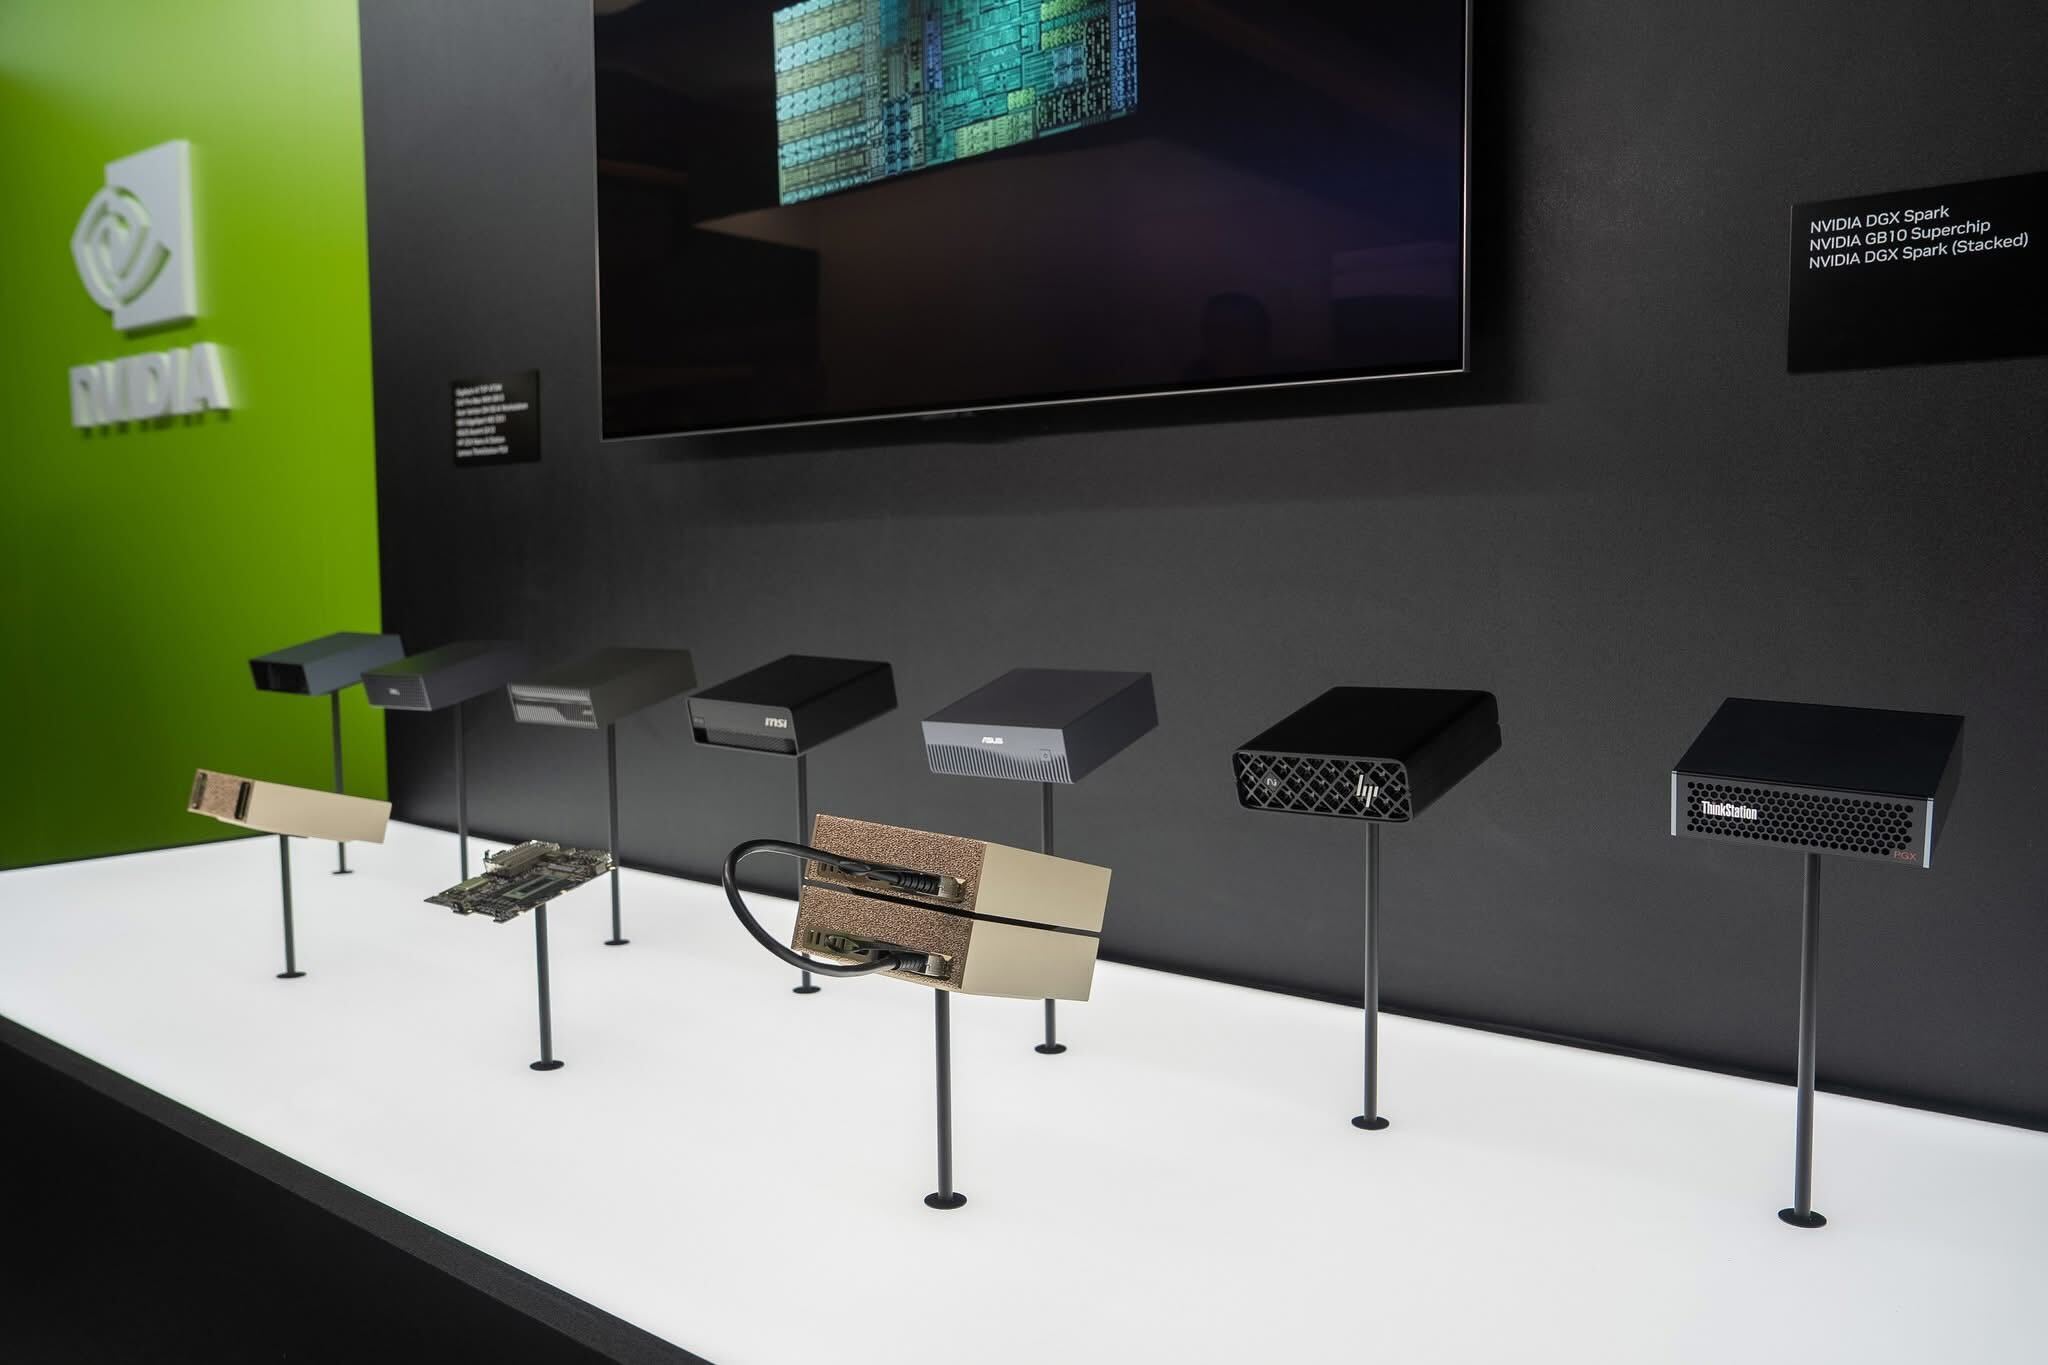
Edice Founders od společnosti NVIDIA je k dispozici k objednání za 3 999 dolarů v konfiguraci s 4 TB a všeobecná dostupnost začíná 15. října. Kromě vlastního modelu NVIDIA dorazí od velkých výrobců OEM i několik stolních počítačů s 10 GB RAM. Základní hardware bude u všech výrobců OEM docela podobný, ale může existovat malý prostor pro manévrování, aby se mohli odlišit, ačkoli většina cenových rozdílů bude pravděpodobně pramenit z výběru úložiště. Již jsme byli svědky mnoha oznámení, včetně Dell Pro Max s 10 GB RAM, Lenovo ThinkStation PGX, Acer Veriton GN100 a ASUS Ascent GX10.
Zdroj: Nvidia
Závěr
NVIDIA DGX Spark představuje zásadní inflexní bod v paradigmatu přístupnosti pokročilé infrastruktury pro výpočetní techniku s umělou inteligencí. Konsolidací schopností superčipu GB10 Grace Blackwell: 128 GB unifikované paměti, 1 petaFLOP řídkého výkonu FP4, RT jader čtvrté generace a síťového rozhraní ConnectX-7 do 240W zařízení s objemem 1.13 litru za cenu 3 999 dolarů, společnost NVIDIA efektivně zbořila bariéry, které historicky oddělovaly schopnosti umělé inteligence na úrovni datových center od jednotlivých výzkumníků a malých vývojových týmů.
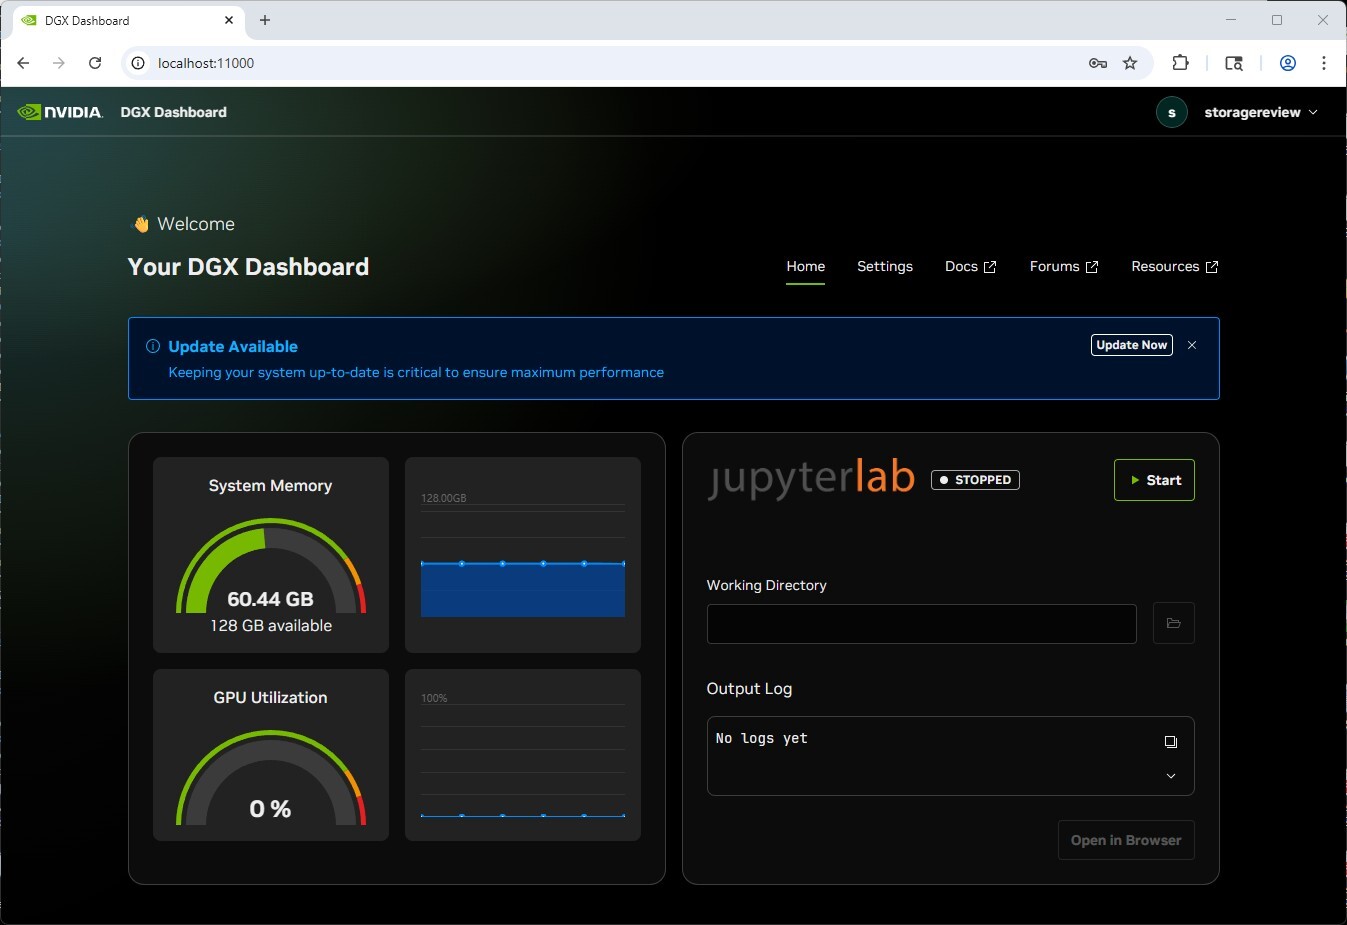
Validovaný přístup k zařízením řeší přetrvávající problém s nasazením infrastruktury umělé inteligence: provozní režii spojenou s údržbou vlastních konfigurací. Organizace nasazující jednotky Spark těží z komplexního testování a validace celého stacku společností NVIDIA, včetně operačního systému DGX, sady nástrojů CUDA, kontejnerů frameworků a hardwarového firmwaru, čímž eliminují konfigurační dluh, který trápí sestavení vlastních pracovních stanic. Integrovaná správa aktualizací, monitorování systému a zřizování JupyterLab v rámci DGX Dashboard dále snižují provozní zátěž, zatímco automatická distribuce klíčů SSH a správa tunelů v rámci NVIDIA Sync činí vzdálený přístup skutečně bezproblémovým. Pro škálovatelné organizace se to promítá do měřitelně rychlejšího zaškolení: noví výzkumníci získají standardizovaný hardware, připojí se ke stávající infrastruktuře prostřednictvím validované konfigurace clusteringu se dvěma uzly a začnou produktivně pracovat během několika hodin, nikoli dnů od řešení konfliktů ovladačů nebo konfigurace síťové struktury.
DGX Spark již nyní nabízí skutečný výkon umělé inteligence v kompaktním a tichém zařízení a naše první výsledky ukazují, proč je důležitý pro týmy, které chtějí seriózní funkce bez režijních nákladů na datová centra. Příběh teprve začíná. Plánujeme rozšířit naše testování o 200G fabric, cílové sítě NVMe-oF a víceuzlové clustering, abychom prozkoumali efektivitu škálování, větší rozměry modelů a architektury sdíleného úložiště. S tím, jak se softwarový a partnerský ekosystém bude rozvíjet, očekáváme, že se nasazení Spark vyvinou z výkonných jednouzlových nastavení do úzce integrovaných, vysoce výkonných mini clusterů, které tuto platformu dále vylepší.

Žebříček: NVIDIA DGX Spark se v našem žebříčku Nejlepší stolní počítače pro lokální umělou inteligenci umístil v kategorii Nejlepší celkově systém s umělou inteligencí pro stolní počítače.
Žebříček: Pokyny pro dimenzování pro tuto třídu systémů naleznete v našem průvodci RAM, GPU a úložištěm pro Agentic AI.


 Amazon