

Program JumpStart od společnosti Supermicro přistupuje k hodnocení hardwaru zcela odlišně. Namísto krátké, skriptované demoverze ve sdíleném laboratorním prostředí poskytuje JumpStart kvalifikovaným zákazníkům bezplatný, časově omezený a neprogramovaný přístup ke katalogu reálných produkčních serverů. Od nových platforem X14 s procesory Intel Xeon 6 až po systémy H14 s 5. generací AMD EPYC a rozsáhlými konfiguracemi grafických karet HGX si zákazníci mohou rezervovat systémy, přihlašovat se na dálku a spouštět vlastní úlohy, jako by hardware byl v jejich vlastním racku.
Obchodní hodnota se projeví při rychlém a informovaném rozhodování o platformě. Realistické ověřování konceptu pro umělou inteligenci nebo vysoce výkonné výpočty obvykle znamená čekání na testovací hardware, koordinaci s více dodavateli a doufání, že testovací konfigurace bude dostatečně blízká tomu, co plánujete nasadit. JumpStart toto tření odstraňuje. Týmy mohou ověřit výkon, zkontrolovat kompatibilitu softwaru, prozkoumat napájení a tepelné chování a porovnat architektury, aniž by musely spalovat interní laboratorní cykly nebo posílat paletu serverů po celé zemi. Pro většinu organizací stačí týden zaměřený na správnou konfiguraci k potvrzení, že platforma splňuje jejich potřeby, nebo k jejímu vyloučení dříve, než se stane závazkem.
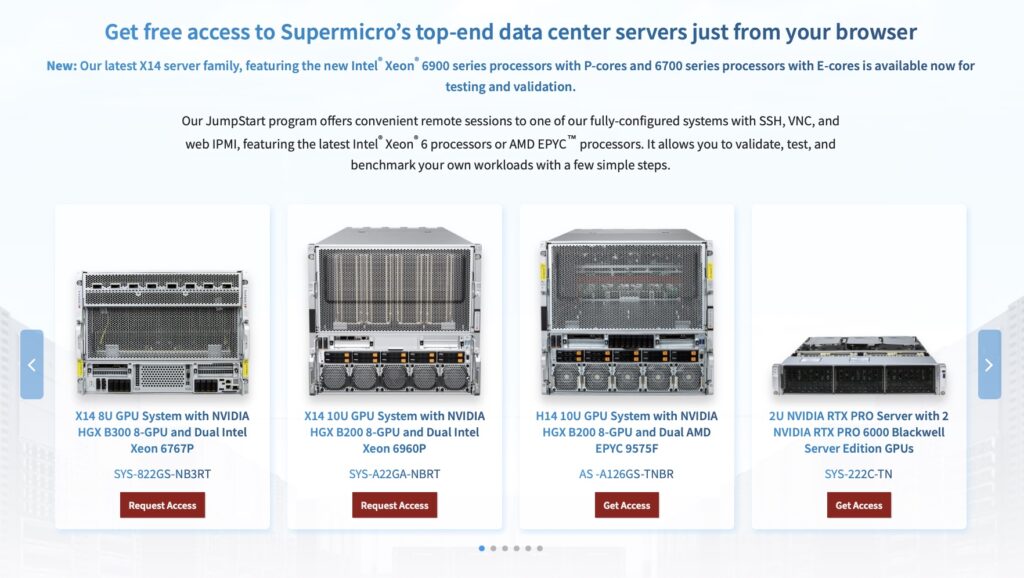
Úvodní stránka Supermicro JumpStart
JumpStart je obzvláště lákavý nejen počtem online systémů, ale také hloubkou technologií, které je Supermicro ochotno představit. Mezi oblíbené možnosti patří servery X14 GPU s procesory Intel Xeon 6 a akcelerátory NVIDIA, platformy H14 optimalizované pro husté výpočetní výkony CPU s procesory AMD EPYC 5. generace a systémy zaměřené na úložiště, které kombinují moderní CPU se všemi NVMe backendy. V oblasti high-end produktů Supermicro již nabízí přístup k systémům HGX třídy B200 a B300 pro trénování a inferenci umělé inteligence a využívá JumpStart k poskytování včasných, na dohodách o mlčenlivosti podmíněných prozkoumání platforem nové generace, které ještě nejsou široce dostupné. Neviděli jsme žádného jiného výrobce OEM, který by byl tak agresivní v proměně infrastruktury před GA ve strukturované a opakovatelné prostředí pro vzdálenou laboratoř.
Většina prostředí pro demonstrace dodavatelů se zastavuje u laboratoří s průvodcem řešeními nebo úzkých produktových sandboxů. Ty jsou užitečné pro učení se o nástrojích pro správu a orchestračních pracovních postupech, ale zřídka poskytují root přístup k serveru nejvyšší úrovně nebo svobodu instalovat a provozovat vlastní stack. JumpStart se chová mnohem spíše jako zapůjčený rack ve vzdáleném datovém centru. Když si rezervujete konkrétní systém, získáte po dobu rezervace úplnou kontrolu přes SSH, VNC a IPMI a Supermicro vymaže a znovu sestaví prostředí, než ho použije další zákazník. V praxi to méně působí jako marketingová demonstrace a spíše jako krátké, cílené setkání v dobře fungující vzdálené laboratoři.
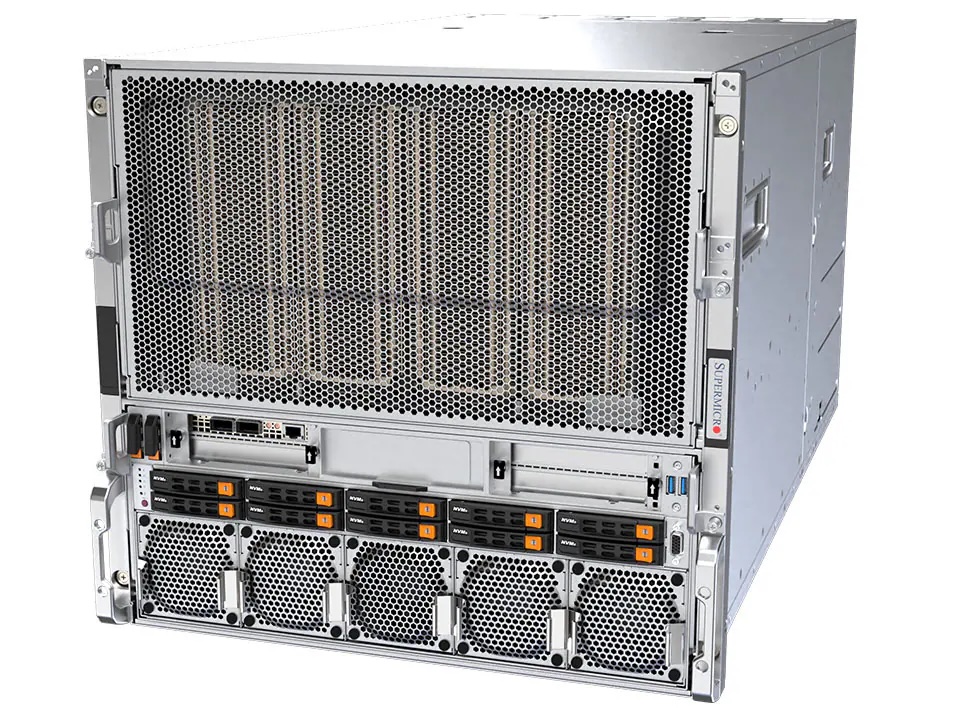
Systém Supermicro JumpStart X14 B200
Pro tuto analýzu poskytla společnost Supermicro serveru StorageReview přístup k JumpStart přesně tak, jak by ho zákazníci vnímali. Naplánovali jsme si čas na systému X14 10U GPU osazeném základní deskou NVIDIA HGX B200 s 8 GPU a dvěma procesory Intel Xeon Platinum 6960P 6. generace. Server byl konfigurován s 3 TB paměti DDR5-6400 ECC, kombinací disků SSD M.2 a U.2 NVMe pro lokální úložiště a osmi grafickými procesory B200, každý se 180 GB HBM3e. Během jednoho týdne jsme tuto platformu používali k namátkové kontrole pracovních zátěží umělé inteligence a chování systému se zaměřením na otázky, na které chtějí skuteční kupující odpovědět, než se zavážou k nové generaci infrastruktury.
Náš týden v programu Supermicro JumpStart
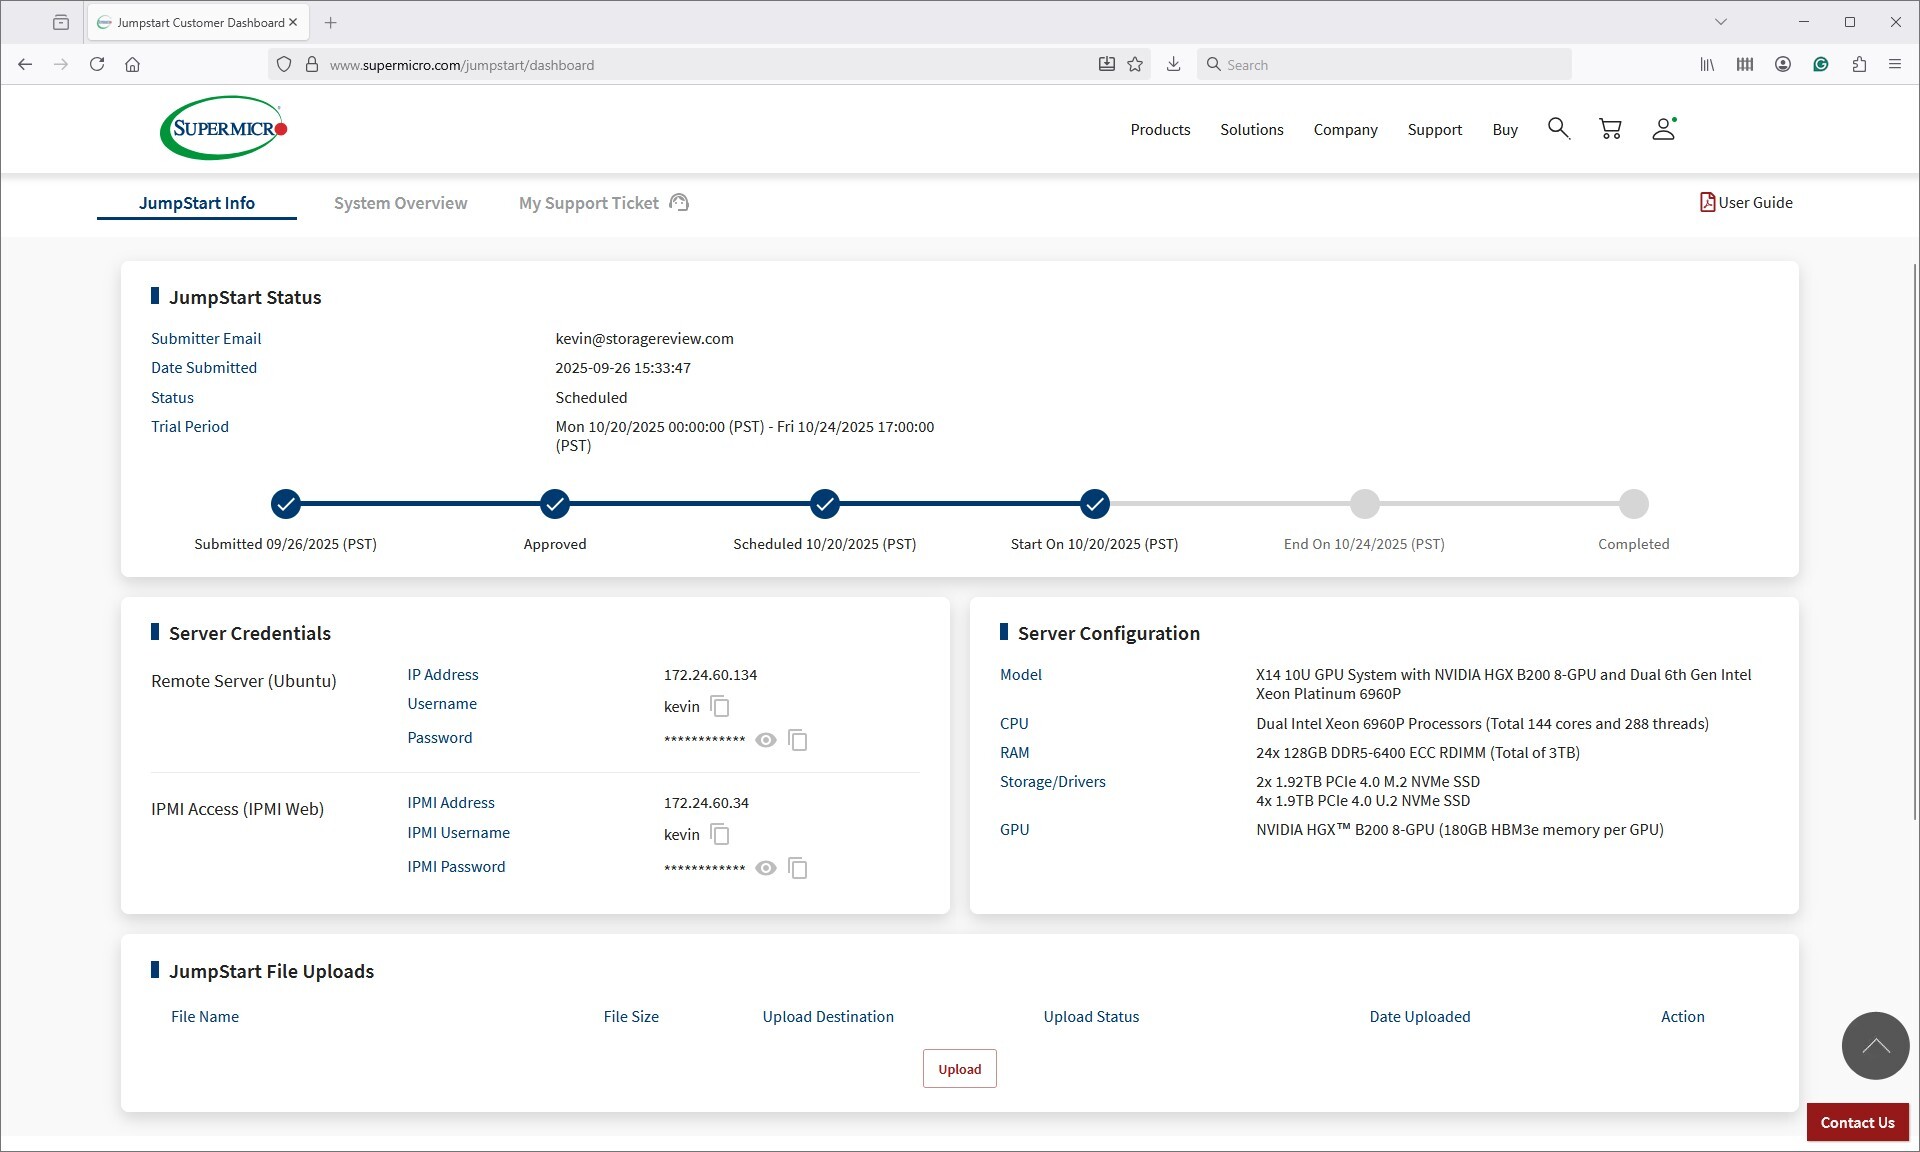
Jakmile se nám otevřelo rezervační okno, portál JumpStart se stal ústředním bodem pro naše testování. Úvodní dashboard, zobrazený níže, stanovil časový harmonogram rezervace a poskytoval vše potřebné k zahájení, včetně přihlašovacích údajů SSH pro vzdálené prostředí Ubuntu a plného přístupu IPMI. Díky okamžité dostupnosti obou rozhraní jsme mohli začít s ověřováním systému během několika minut, aniž bychom museli čekat na zprovoznění nebo zásah podpory.
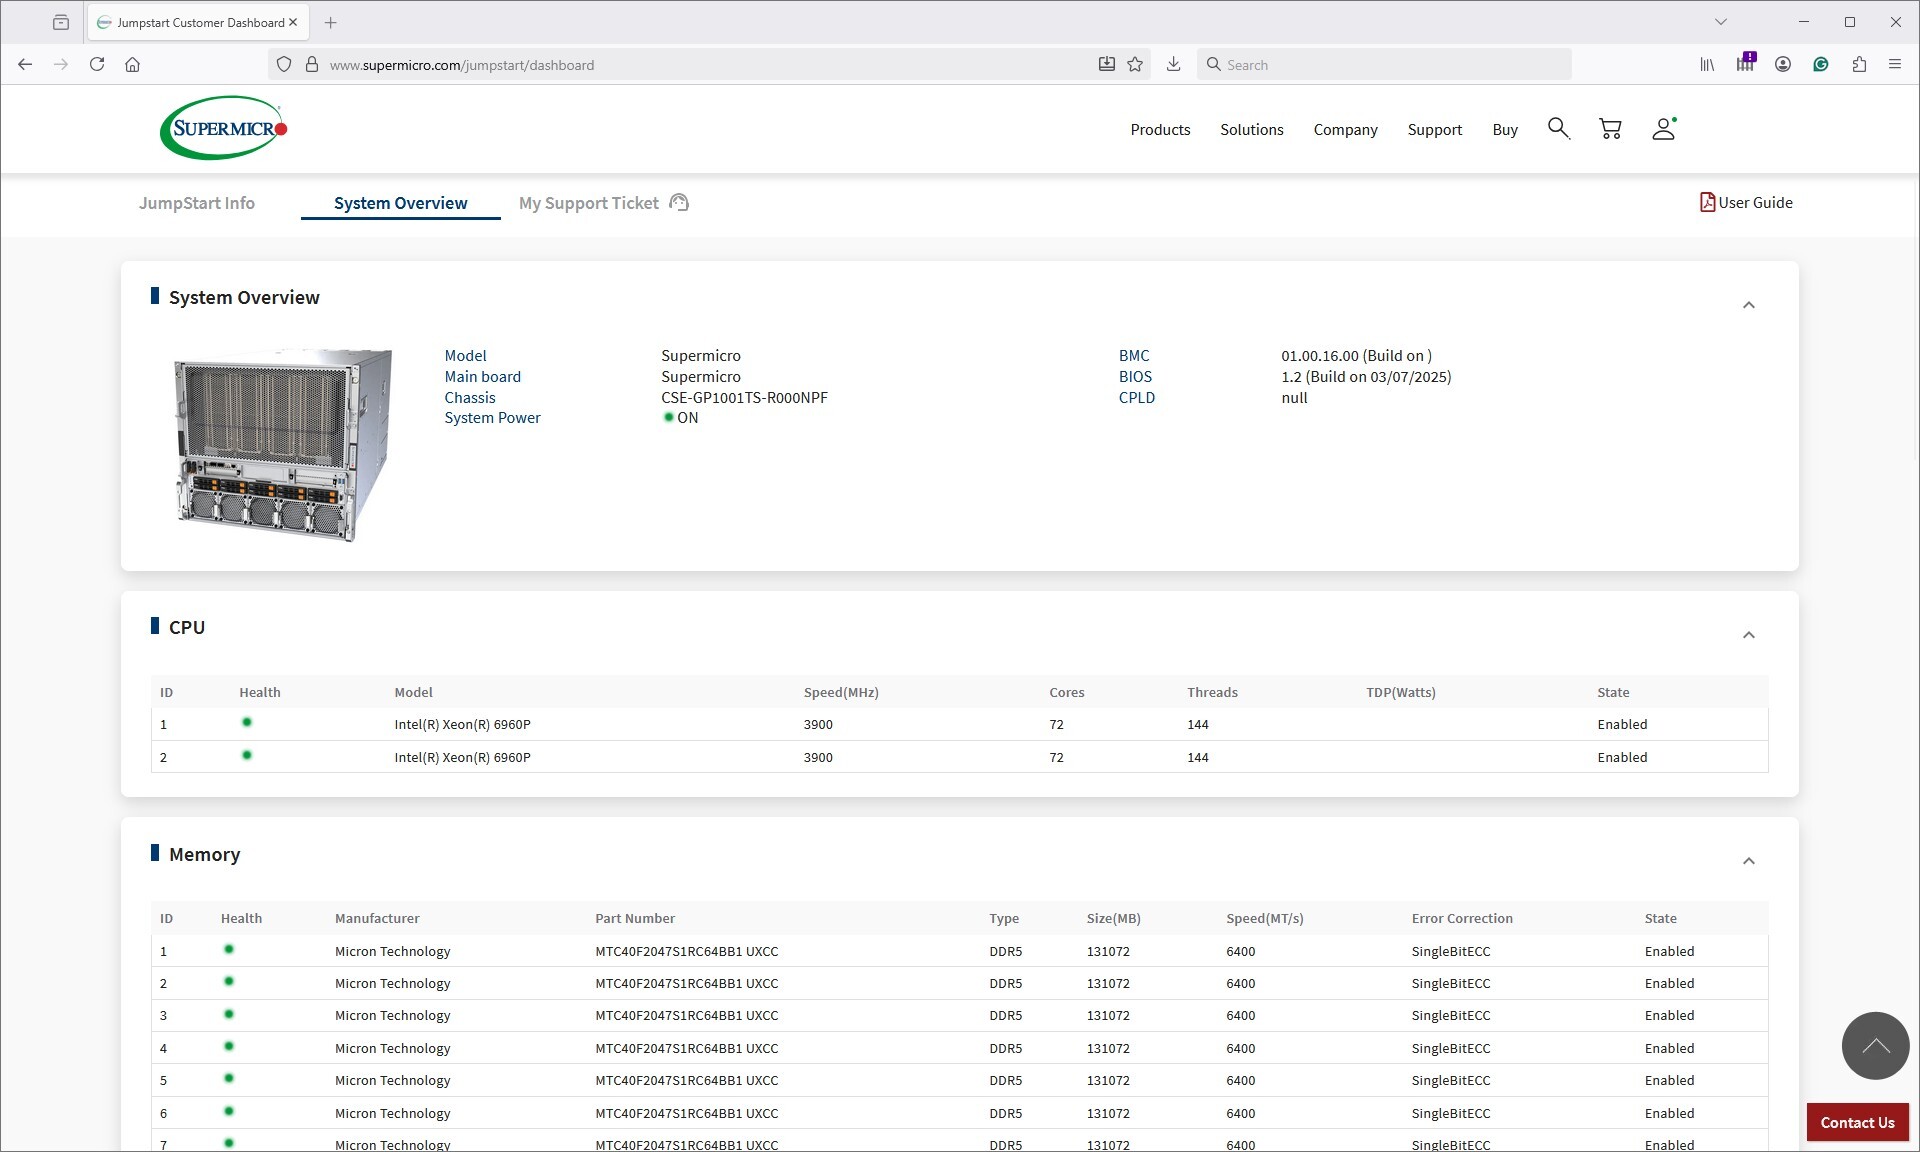
Prvním krokem v našem pracovním postupu bylo ověření, že je hardware připraven. Pomocí stránky Přehled systému na portálu (viz snímek obrazovky níže) jsme ověřili, že je šasi zapnuté, že byly detekovány oba procesory, že je paměť plně osazena a že řídicí jednotka BMC hlásí stav systému v zelené barvě. Tato rychlá kontrola se stala standardní praxí v našich laboratorních hodnoceních a vzdálený dohled prostřednictvím portálu tento proces zjednodušil.
Po validaci systému jsme přešli k praktické práci. Nahrávání souborů pro testovací datové zdroje bylo zpracováváno přímo přes rozhraní JumpStart, což odstranilo obvyklé tření spojené s přípravou datových sad na vzdálené platformě. Odtud jsme se připojovali přes SSH pro nasazení úloh a používali vzdálenou konzoli přes IPMI, když jsme potřebovali nízkoúrovňový přístup nebo pro sledování chování při spouštění.
Pracovní postup během celého týdne se velmi podobal obsluze zařízení v naší vlastní laboratoři. Byli jsme schopni rychle spouštět, zastavovat a iterovat na různých úlohách, restartovat platformu v případě potřeby a monitorovat chování hardwaru bez zapojení podpory od společnosti Supermicro. Kombinace přístupu na úrovni operačního systému a úplné kontroly mimo pásmo učinila prostředí předvídatelným a efektivním pro krátké testovací cykly.
Na konci rezervace byl systém automaticky obnoven a resetován, čímž se zakázka čistě uzavřela. Tato předvídatelná struktura nám umožnila soustředit se na testování spíše než na logistiku a zajistila, že jsme plně využili omezené přístupové okno.
Výkon úložiště GPUDirect
Jedním z testů, které jsme provedli na platformě Supermicro X14, byl test Magnum IO GPUDirect Storage (GDS). GDS je funkce vyvinutá společností NVIDIA, která umožňuje grafickým procesorům obejít CPU při přístupu k datům uloženým na discích NVMe nebo jiných vysokorychlostních úložných zařízeních. Namísto směrování dat přes CPU a systémovou paměť umožňuje GDS přímou komunikaci mezi grafickým procesorem a úložným zařízením, což výrazně snižuje latenci a zlepšuje propustnost dat.
Jak funguje úložiště GPUDirect
Tradičně, když GPU zpracovává data uložená na disku NVMe, musí data nejprve projít procesorem a systémovou pamětí, než se dostanou k GPU. Tento proces zavádí úzká hrdla, protože CPU se stává prostředníkem, což zvyšuje latenci a spotřebovává cenné systémové prostředky. GPUDirect Storage eliminuje tuto neefektivitu tím, že umožňuje GPU přístup k datům přímo z úložného zařízení přes sběrnici PCIe. Tato přímá cesta snižuje režii přesunu dat, což umožňuje rychlejší a efektivnější přenosy dat.
Pracovní zátěže umělé inteligence, zejména ty zahrnující hluboké učení, jsou datově velmi náročné. Trénování velkých neuronových sítí vyžaduje zpracování terabajtů dat a jakékoli zpoždění v přenosu dat může vést k nedostatečnému využití grafických procesorů (GPU) a delší době trénování. GPUDirect Storage řeší tento problém tím, že zajišťuje co nejrychlejší doručení dat do GPU, minimalizuje dobu nečinnosti a maximalizuje výpočetní efektivitu.
Kromě toho je GDS obzvláště výhodný pro úlohy, které zahrnují streamování velkých datových sad, jako je zpracování videa, zpracování přirozeného jazyka nebo inference v reálném čase. Snížením závislosti na CPU GDS zrychluje pohyb dat a uvolňuje zdroje CPU pro jiné úkoly, čímž dále zvyšuje celkový výkon systému.
Kromě čisté šířky pásma nabízí GPUDirect s NVMe-oF (TCP/RDMA) také ultranízkou latencí I/O. To zajišťuje, že GPU nikdy netrpí nedostatkem dat, což systém činí ideálním pro inferencing s využitím umělé inteligence v reálném čase, analytické kanály a přehrávání videa.
Sekvenční propustnost čtení GDSIO
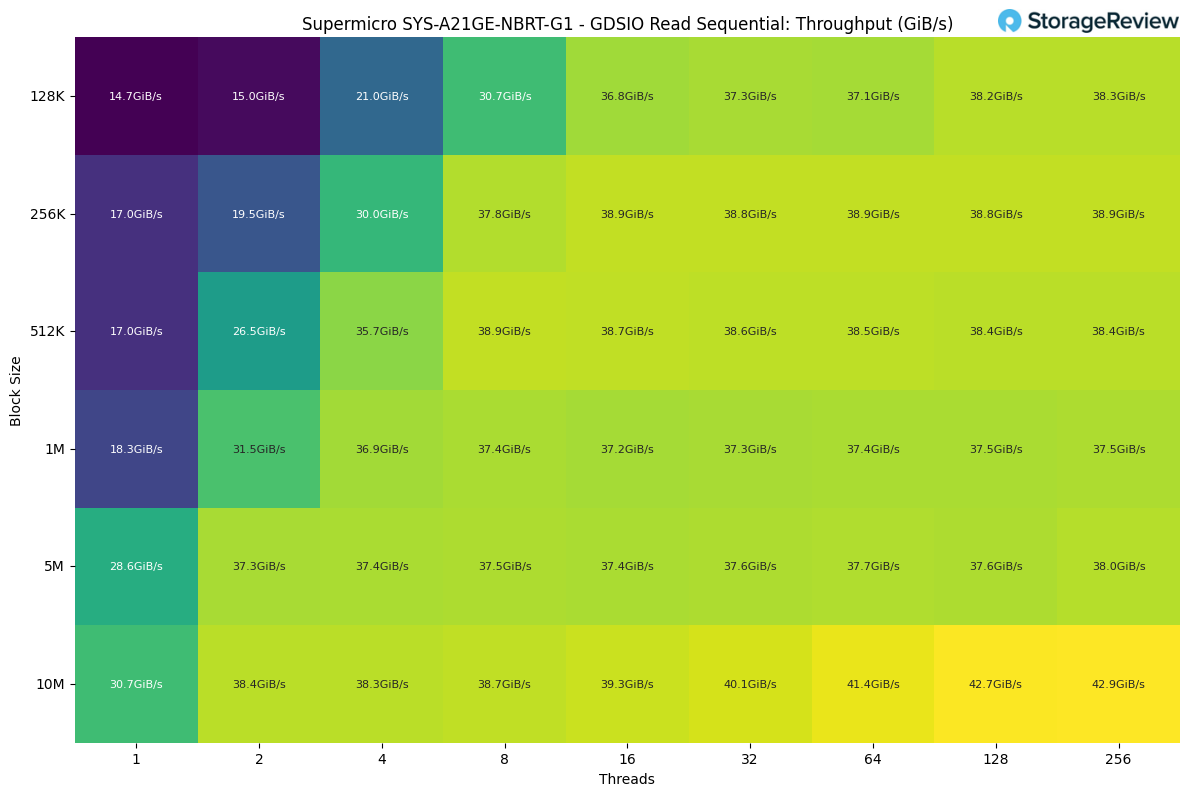
Pro naše testování sekvenčního čtení GDSIO na platformě B200 začala pracovní zátěž mírně, přičemž jedno vlákno dosahovalo rychlosti kolem 14 až 15 GiB/s v závislosti na velikosti bloku. Jakmile jsme zvýšili počet vláken i velikost bloku, výkon se rychle zlepšil. Přechod na 2 a 4 vlákna posunul propustnost do rozsahu 20 až 36 GiB/s, což ukazuje, jak dobře se systém škáluje po zavedení paralelismu.
Skutečné zrychlení nastalo, jakmile jsme dosáhli osmi nebo více vláken, kdy se většina úloh ustálila v rozsahu 30 GiB/s. Nejvíce z toho těžily větší bloky, přičemž velikosti 5M a 10M konzistentně přinášely silná čísla napříč všemi počty vláken.
Propustnost nakonec dosáhla maxima zhruba 43 GiB/s s velikostí bloku 10 MB při 256 vláknech, což představuje nejvyšší trvalou rychlost sekvenčního čtení, kterou jsme v tomto testu pozorovali.
Sekvenční latence čtení GDSIO
Co se týče latence, pracovní zátěž začala velmi rychle reagovat, přičemž čtení z jednoho vlákna se u menších bloků pohybovalo v rozmezí 0.06–0.1 ms. S rostoucím počtem vláken se latence postupně zvyšovala a u většiny pracovních zátěží zůstala pod 1 ms až do bodu s 8 vlákny.
Jakmile jsme překročili 16 vláken, začaly se větší velikosti bloků prohlubovat v řádu milisekund, protože úložná cesta se stala více nasycenou. Nejvyšší latence byla zaznamenána na konci testu, kde blok o velikosti 10 MB s 256 vlákny dosáhl vrcholu něco málo přes 1.2 sekundy (kolem 1200 ms), což odráží nejhorší možný případ zátěže navržené tak, aby systém přetížila.

Sekvenční propustnost zápisu GDSIO
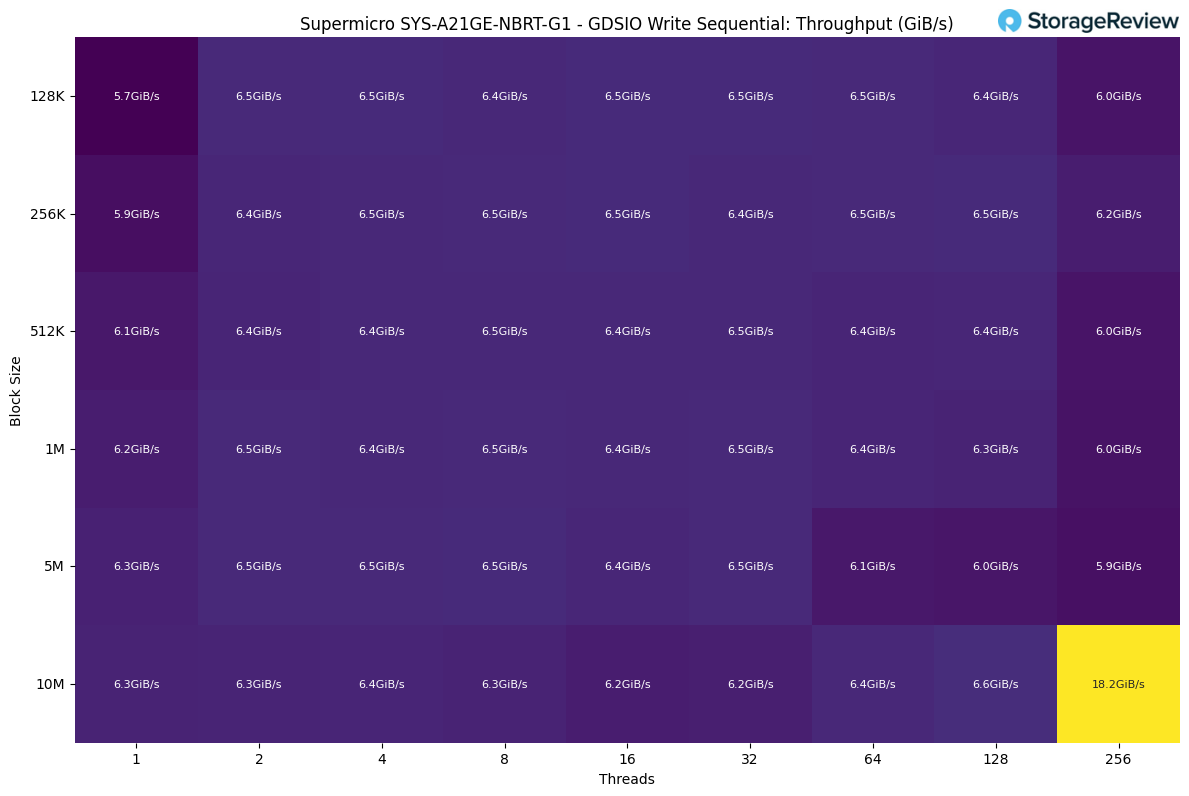
U sekvenčních zápisů byl výkon mnohem plošší než u čtení. Zátěž se rychle ustálila, přičemž většina kombinací velikostí vláken a bloků se pohybovala kolem 6.3–6.5 GiB/s. To naznačuje, že cesta zápisu dosahuje konzistentního stropu již na začátku, pravděpodobně spíše souvisejícího s úložnými médii a ukládáním do vyrovnávací paměti než s omezeními GPU nebo PCIe.
Zvýšení počtu vláken nemělo významný dopad, protože propustnost zůstala v podstatě nezměněna z 2 na 128 vláken. Jediný vynikající výsledek přišel na konci, kde velikost bloku 10 MB při 256 vláknech vzrostla na 18.2 GiB/s, což ukazuje na krátkodobou výhodu, když systém dokáže plně využít hluboké fronty a agregaci zápisu.
Sekvenční latence zápisu GDSIO
Latence zápisu byla zpočátku relativně nízká, přičemž úlohy s jedním vláknem se u menších bloků pohybovaly kolem 0.15–0.5 ms. S rostoucím počtem vláken se latence škálovala mnohem agresivněji než na straně čtení a posunula se do rozsahu 1–4 ms u čtyř vláken a 4–9 ms u osmi vláken.
Jakmile jsme dosáhli 32 vláken s většími velikostmi bloků, latence prudce vzrostla, přičemž bloky 5M a 10M vyskočily do rozsahu 170–350 ms. Nejextrémnějším případem byla velikost bloku 10M s 256 vlákny, která dosáhla vrcholu necelých 3 sekund (kolem 2900 ms), což jasně ukazuje, jak rychle se zápisová cesta při velké paralelní zátěži nasytí.

Propustnost náhodného čtení GDSIO
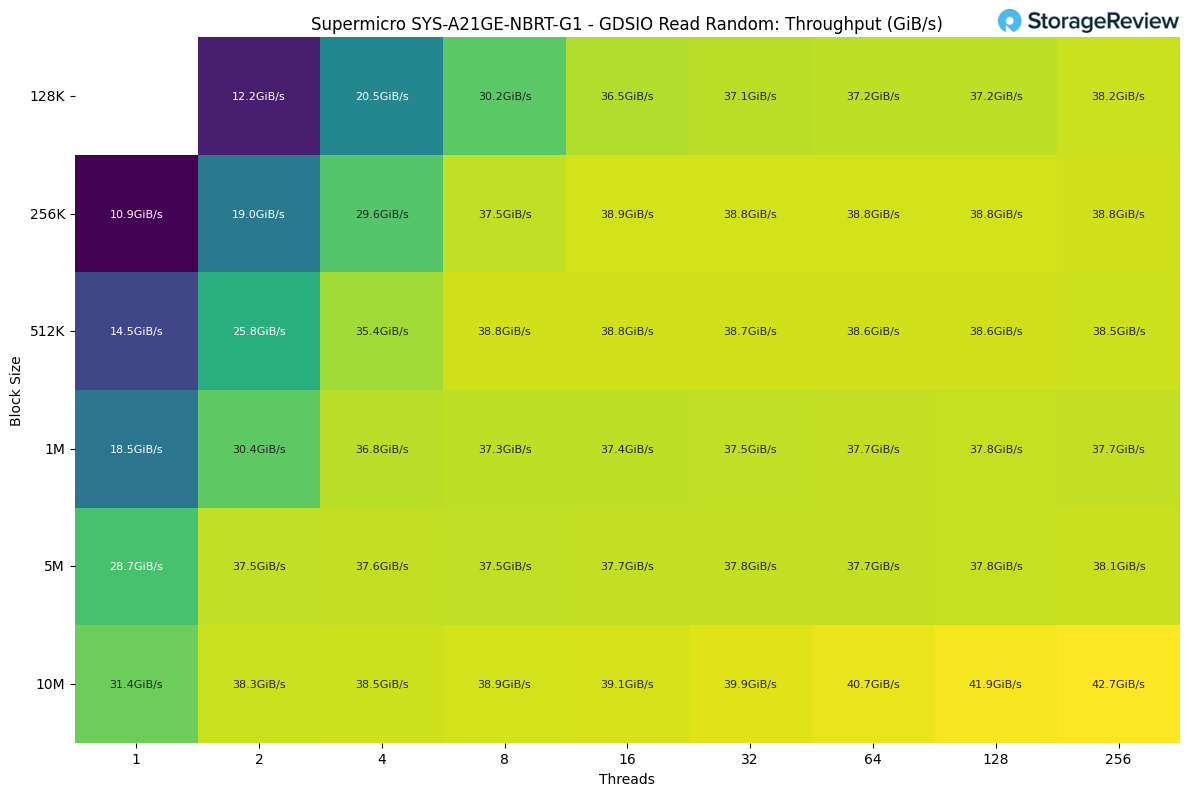
U náhodného čtení se pracovní zátěž rychle zvyšovala. Výkon jednoho vlákna se pohyboval v rozmezí zhruba 11–31 GiB/s v závislosti na velikosti bloku, přičemž větší bloky okamžitě těžily z vyšší šířky pásma. Jakmile jsme přešli na dvě a čtyři vlákna, propustnost se vyšplhala na rozsah 20–36 GiB/s, což vykazovalo silné škálování hned na začátku.
Od 8 vláken výše se systém ustálil na stabilní úrovni v rozsahu 30 GiB/s, což je velmi podobné tomu, co jsme viděli v testu sekvenčního čtení. Nejvyššího výsledku bylo dosaženo s velikostí bloku 10 MB a 256 vlákny, s vrcholem přibližně 42.7 GiB/s.
Latence náhodného čtení GDSIO
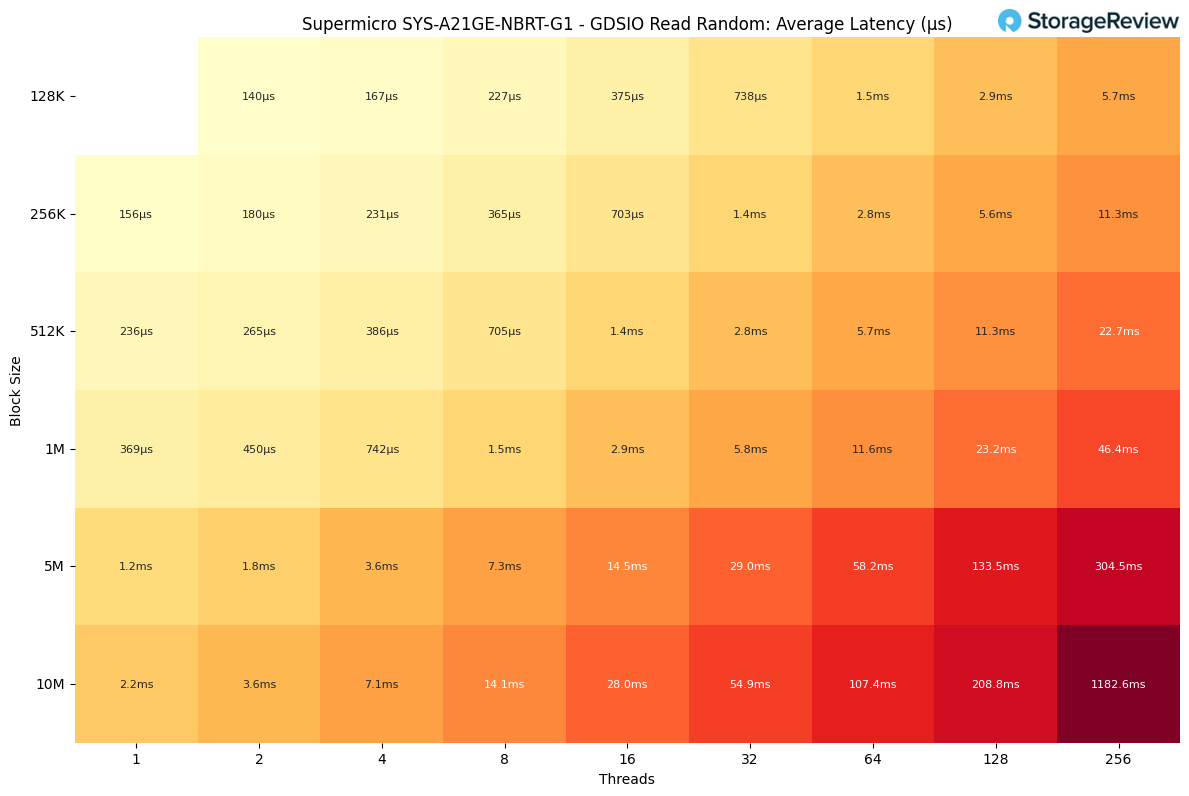
Latence náhodného čtení začala velmi nízko, přičemž úlohy s jedním vláknem se u menších bloků pohybovaly kolem 0.15–0.4 ms. S rostoucím počtem vláken se latence postupně zvyšovala, přičemž se udržela pod 1 ms do bodu se 4 vlákny a u osmi vláken dosáhla zhruba 1–3 ms.
Jakmile jsme přešli na 32 vláken a větší bloky, latence se prudce zvýšila, přičemž přenosy 5M a 10M se pohybovaly v rozmezí 30–55 ms. Nejextrémnější případ nastal u 256 vláken s velikostí bloku 10M, kde latence dosáhla vrcholu něco málo přes 1.1 sekundy (kolem 1180 ms).
Propustnost náhodného zápisu GDSIO
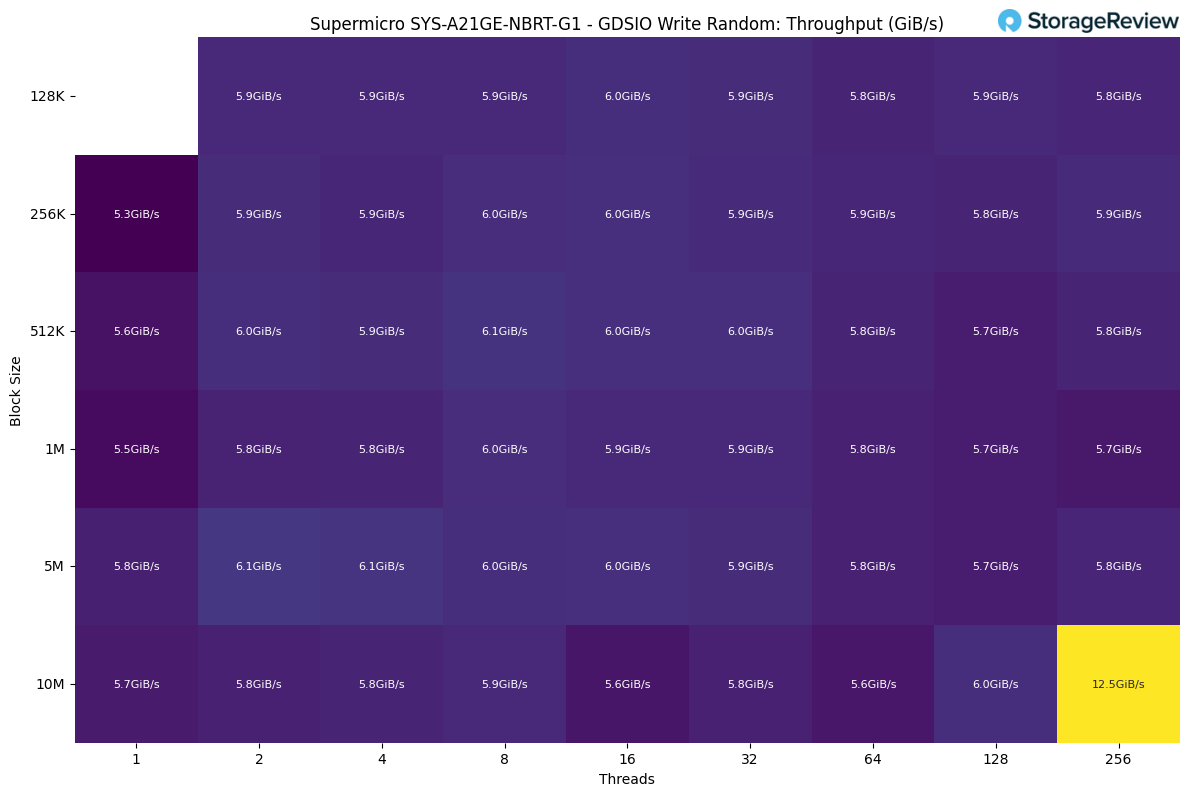
Výkon náhodného zápisu byl napříč všemi oblastmi velmi konzistentní, přičemž většina velikostí bloků a počtů vláken se pohybovala kolem 5.8–6.1 GiB/s. Pracovní zátěž dosáhla této úrovně téměř okamžitě a s přidáváním dalších vláken vykazovala minimální škálování, což naznačuje, že cesta zápisu brzy dosáhla svého limitu.
Jediný pozoruhodný výjimek se objevil na konci testu, kde velikost bloku 10 MB s 256 vlákny krátce vzrostla na 12.5 GiB/s, pravděpodobně díky hlubokému řazení do front a agregaci zápisu při velké paralelní zátěži.
Latence náhodného zápisu GDSIO
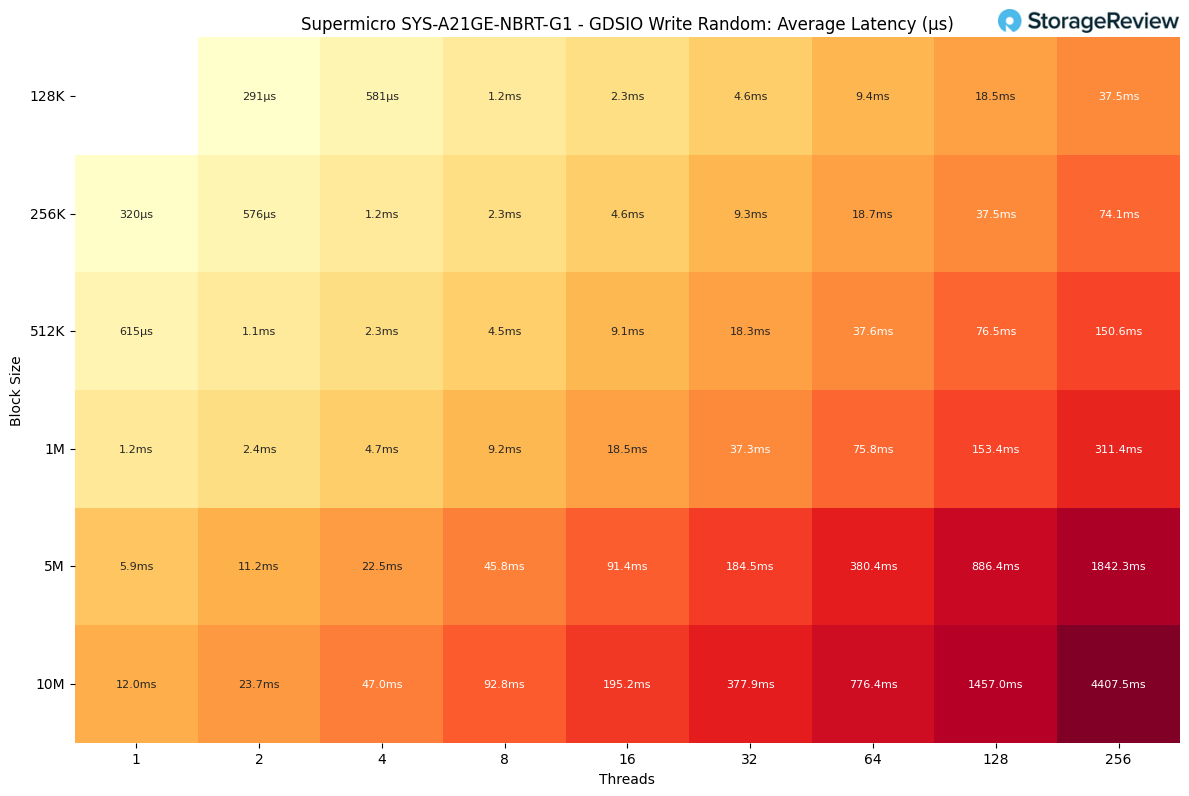
Latence náhodného zápisu byla zpočátku relativně nízká, s výkonem pro jedno vlákno v rozmezí přibližně 0.6–1.2 ms pro menší velikosti bloků a 5–12 ms pro největší přenosy. S rostoucí souběžností se latence rychle zvyšovala a dosáhla 4–9 ms pro osm vláken a 18–38 ms pro 32 vláken.
Za tímto bodem se zápisová cesta nasytila. Větší velikosti bloků se při 64 vláknech vyšplhaly do rozsahu 150–380 ms a pokračující škálování výrazně zvýšilo latenci. Nejhorší případ byl u bloku o velikosti 10 MB při 256 vláknech, kde dosáhl maxima zhruba 4.4 sekundy.
Online poskytování vLLM – Výkon inference LLM
vLLM je nejoblíbenější vysoce výkonný inferenční a obslužný engine pro LLM. Online serving benchmark vLLM je nástroj pro hodnocení výkonu, který měří reálné obslužné schopnosti tohoto inferenčního enginu za souběžných požadavků. Simuluje produkční zátěž odesíláním požadavků na běžící server vLLM s konfigurovatelnými parametry, včetně rychlosti požadavků, délky vstupů/výstupů a počtu souběžných klientů. Benchmark měří klíčové metriky, včetně propustnosti (tokeny za sekundu), doby do prvního tokenu a doby na výstupní token (TPOT), což pomáhá uživatelům pochopit, jak si vLLM vede za různých podmínek zátěže.
Testovali jsme výkon inference napříč komplexní sadou modelů zahrnujících různé architektury, škály parametrů a kvantizační strategie, abychom vyhodnotili propustnost za různých profilů souběžnosti.
Výkon hustého modelu
Husté modely se řídí konvenční architekturou LLM, kde jsou všechny parametry a aktivace zapojeny během inference, což má za následek výpočetně náročnější zpracování než jejich řídké protějšky. Pro komplexní vyhodnocení výkonnostních charakteristik napříč škálami modelu a kvantizačními strategiemi jsme porovnali několik konfigurací hustých modelů z rodiny Llama 3.1 8B.
Naše testovací sada zahrnovala vyhodnocení Meta Llama 3.1 8B ve třech přesných formátech: standardní konfiguraci a kvantované verze FP8 a FP4 využívající formát NVIDIA NVFP4. Je důležité poznamenat, že vLLM v současné době používá pro kvantované modely NVFP4 jádro Marlin a plné výkonnostní výhody tohoto kvantizačního formátu v těchto benchmarkech ještě nebyly realizovány. Budoucí optimalizace vLLM zaměřené na nativní operace s tenzorovým jádrem NVFP4 by mohly přinést další zlepšení výkonu. Tato strategie výběru modelu umožňuje přímé porovnání výkonu a zároveň izoluje dopad progresivní kvantizace na propustnost inference.
Výkon Lamy 3.1 8B
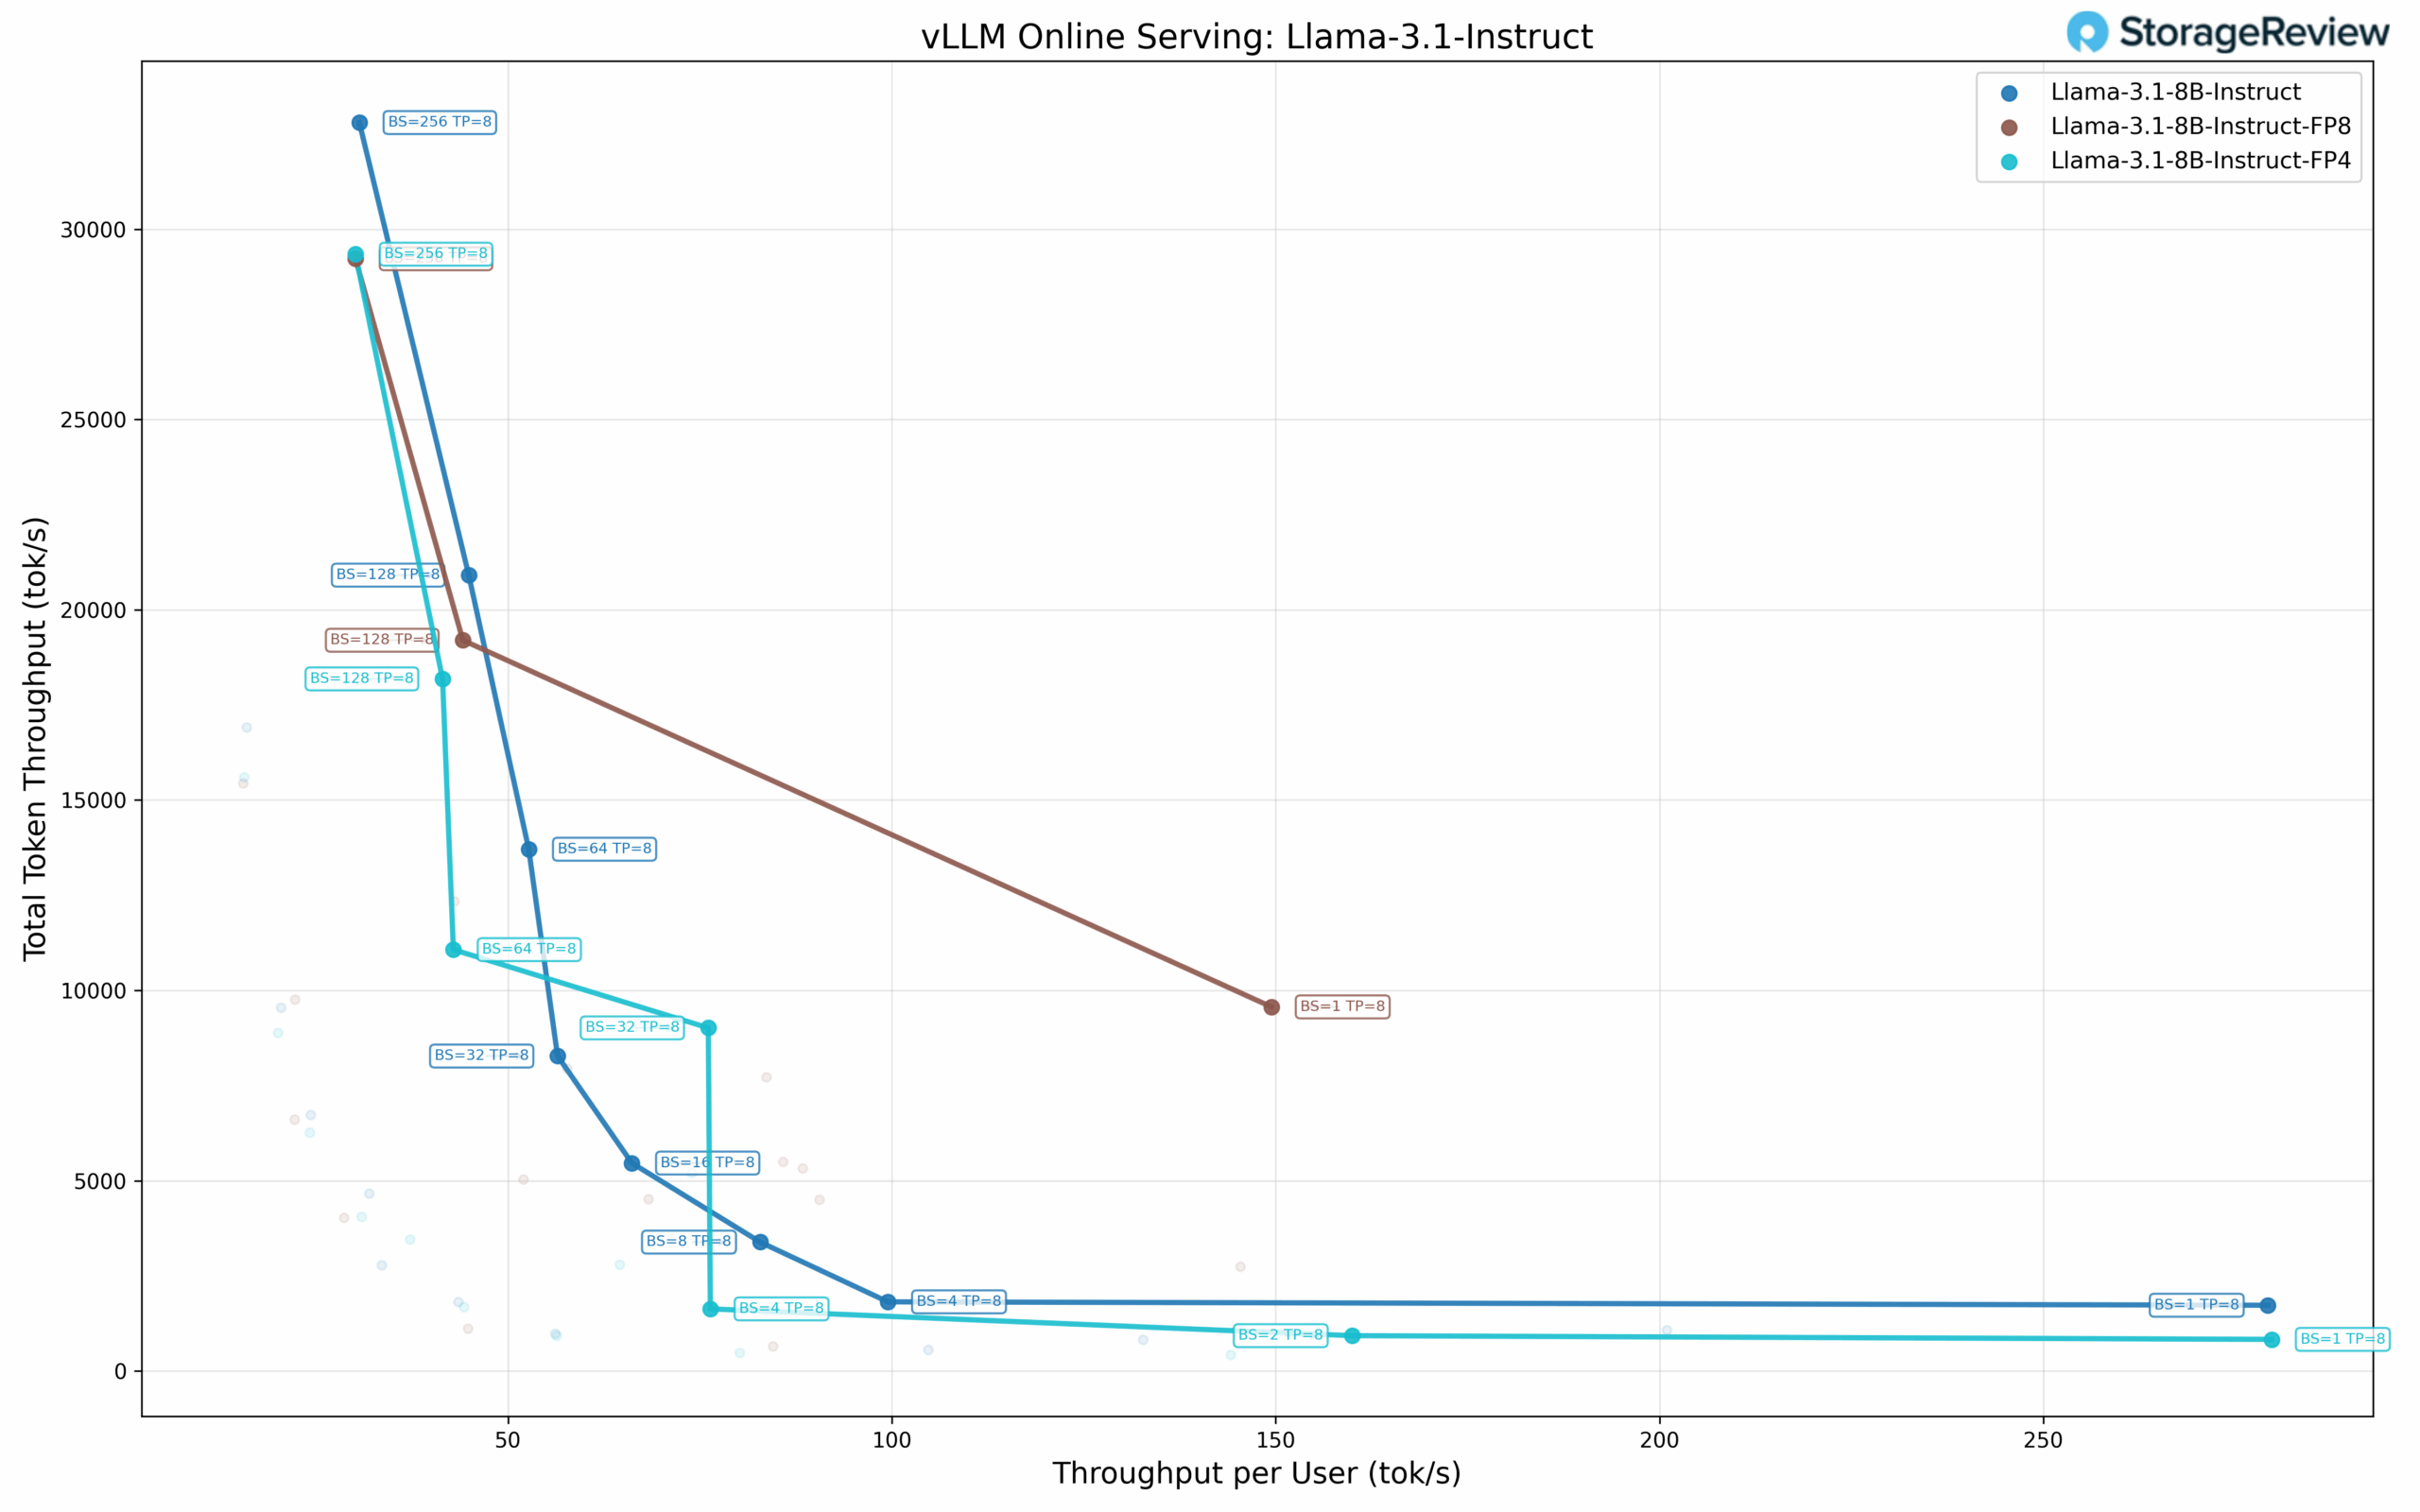
Llama 3.1 8B se standardní přesností vykazuje následující charakteristiky škálování napříč úrovněmi souběžnosti. Při souběžnosti jednoho uživatele (BS=1) model poskytuje 279.27 toků/s na uživatele s celkovou propustností 1 727,62 toků/s a TPOT 3.37 ms. S rostoucí velikostí dávky se propustnost na uživatele snižuje, zatímco celková propustnost se rozšiřuje. Při BS=8 model dosahuje 82.85 toků/s na uživatele s celkovou propustností 3 386,48 toků/s a TPOT 3.28 ms. Výkon se dále škáluje až do BS=32 (56.46 toků/s na uživatele, celkem 8 274,66 toků/s) a BS=64 (52.70 toků/s na uživatele, celkem 13 707,66 toků/s).
Model dosahuje maximální celkové propustnosti při BS=256, kdy poskytuje 32 797,67 tok/s, s 30.64 tok/s na uživatele a TPOT 16.13 ms. To představuje 19× nárůst celkové propustnosti ve srovnání s výkonem pro jednoho uživatele. Hodnoty TPOT zůstávají v rozsahu 3–4 ms až do BS=64 a při BS=256 se zvyšují na 16.13 ms.
Výkon Lamy 3.1 8B FP8
Kvantovaná varianta FP8 vykazuje odlišné charakteristiky. Při BS=1 dosahuje 149.46 toků/s na uživatele s celkovou propustností 9 565,20 toků/s a TPOT 3.44 ms. Analýza Pareto hranic odhaluje tři optimální body (BS=1, BS=128, BS=256).
Při BS=128 model poskytuje 44.12 tok/s na uživatele s celkovým počtem 19 198,40 tok/s a dobou přenosu 11.04 ms.
TPOT. Maximální celková propustnost je dosažena při BS=256 s celkem 29 219,67 toky/s, 30.13 toky/s na uživatele a TPOT 13.26 ms. Varianta FP8 dosahuje nižší maximální celkové propustnosti ve srovnání se standardní přesností (29.2K vs 32.8K toky/s).
Výkon Lamy 3.1 8B FP4
Kvantovaná konfigurace FP4 ukazuje následující výsledky. Při souběžném provozu jednoho uživatele (BS=1) dosahuje rychlosti 279.73 toků/s na uživatele, celkové propustnosti 830.46 toků/s a doby trvání přenosu 3.43 ms.
Model FP4 ukazuje sedm Pareto hraničních bodů. Při BS=2 dosahuje 159.95 tok/s na uživatele, celkem 928.60 tok/s a TPOT 3.43 ms. Výkon se dále škáluje až do BS=4 (76.36 tok/s na uživatele, celkem 1 631,69 tok/s) a BS=32 (76.09 tok/s na uživatele, celkem 9 014,29 tok/s). Model dosahuje maximální celkové propustnosti při BS=256 s celkem 29 340,89 tok/s, 30.13 tok/s na uživatele a TPOT 16.18 ms.
Výkon řídkého modelu
Řídké modely, zejména architektury Mixture of Experts (MoE), představují nový přístup k efektivnímu škálování jazykových modelů. Tyto architektury udržují vysoký celkový počet parametrů, ale zároveň aktivují pouze podmnožinu parametrů na token, což potenciálně nabízí lepší výkon na aktivní parametr.
Vyhodnotili jsme dvě architektury MoE: DeepSeek-R1, model zaměřený na uvažování, a Qwen3 Coder 30B-A3B, řídkou architekturu specializovanou na generování kódu. DeepSeek-R1 je nejoblíbenější model zaměřený na uvažování, který vykazuje odlišné výkonnostní charakteristiky ve srovnání s tradičními jazykovými modely. Model Qwen3 Coder si zachovává plnou velikost 30B parametrů, přičemž aktivuje pouze 3B parametrů na vygenerovaný token. Porovnali jsme Qwen3 Coder v základní i FP8-kvantizované variantě, abychom pochopili výkonnostní charakteristiky napříč kvantizačními strategiemi.
Výkon DeepSeek-R1
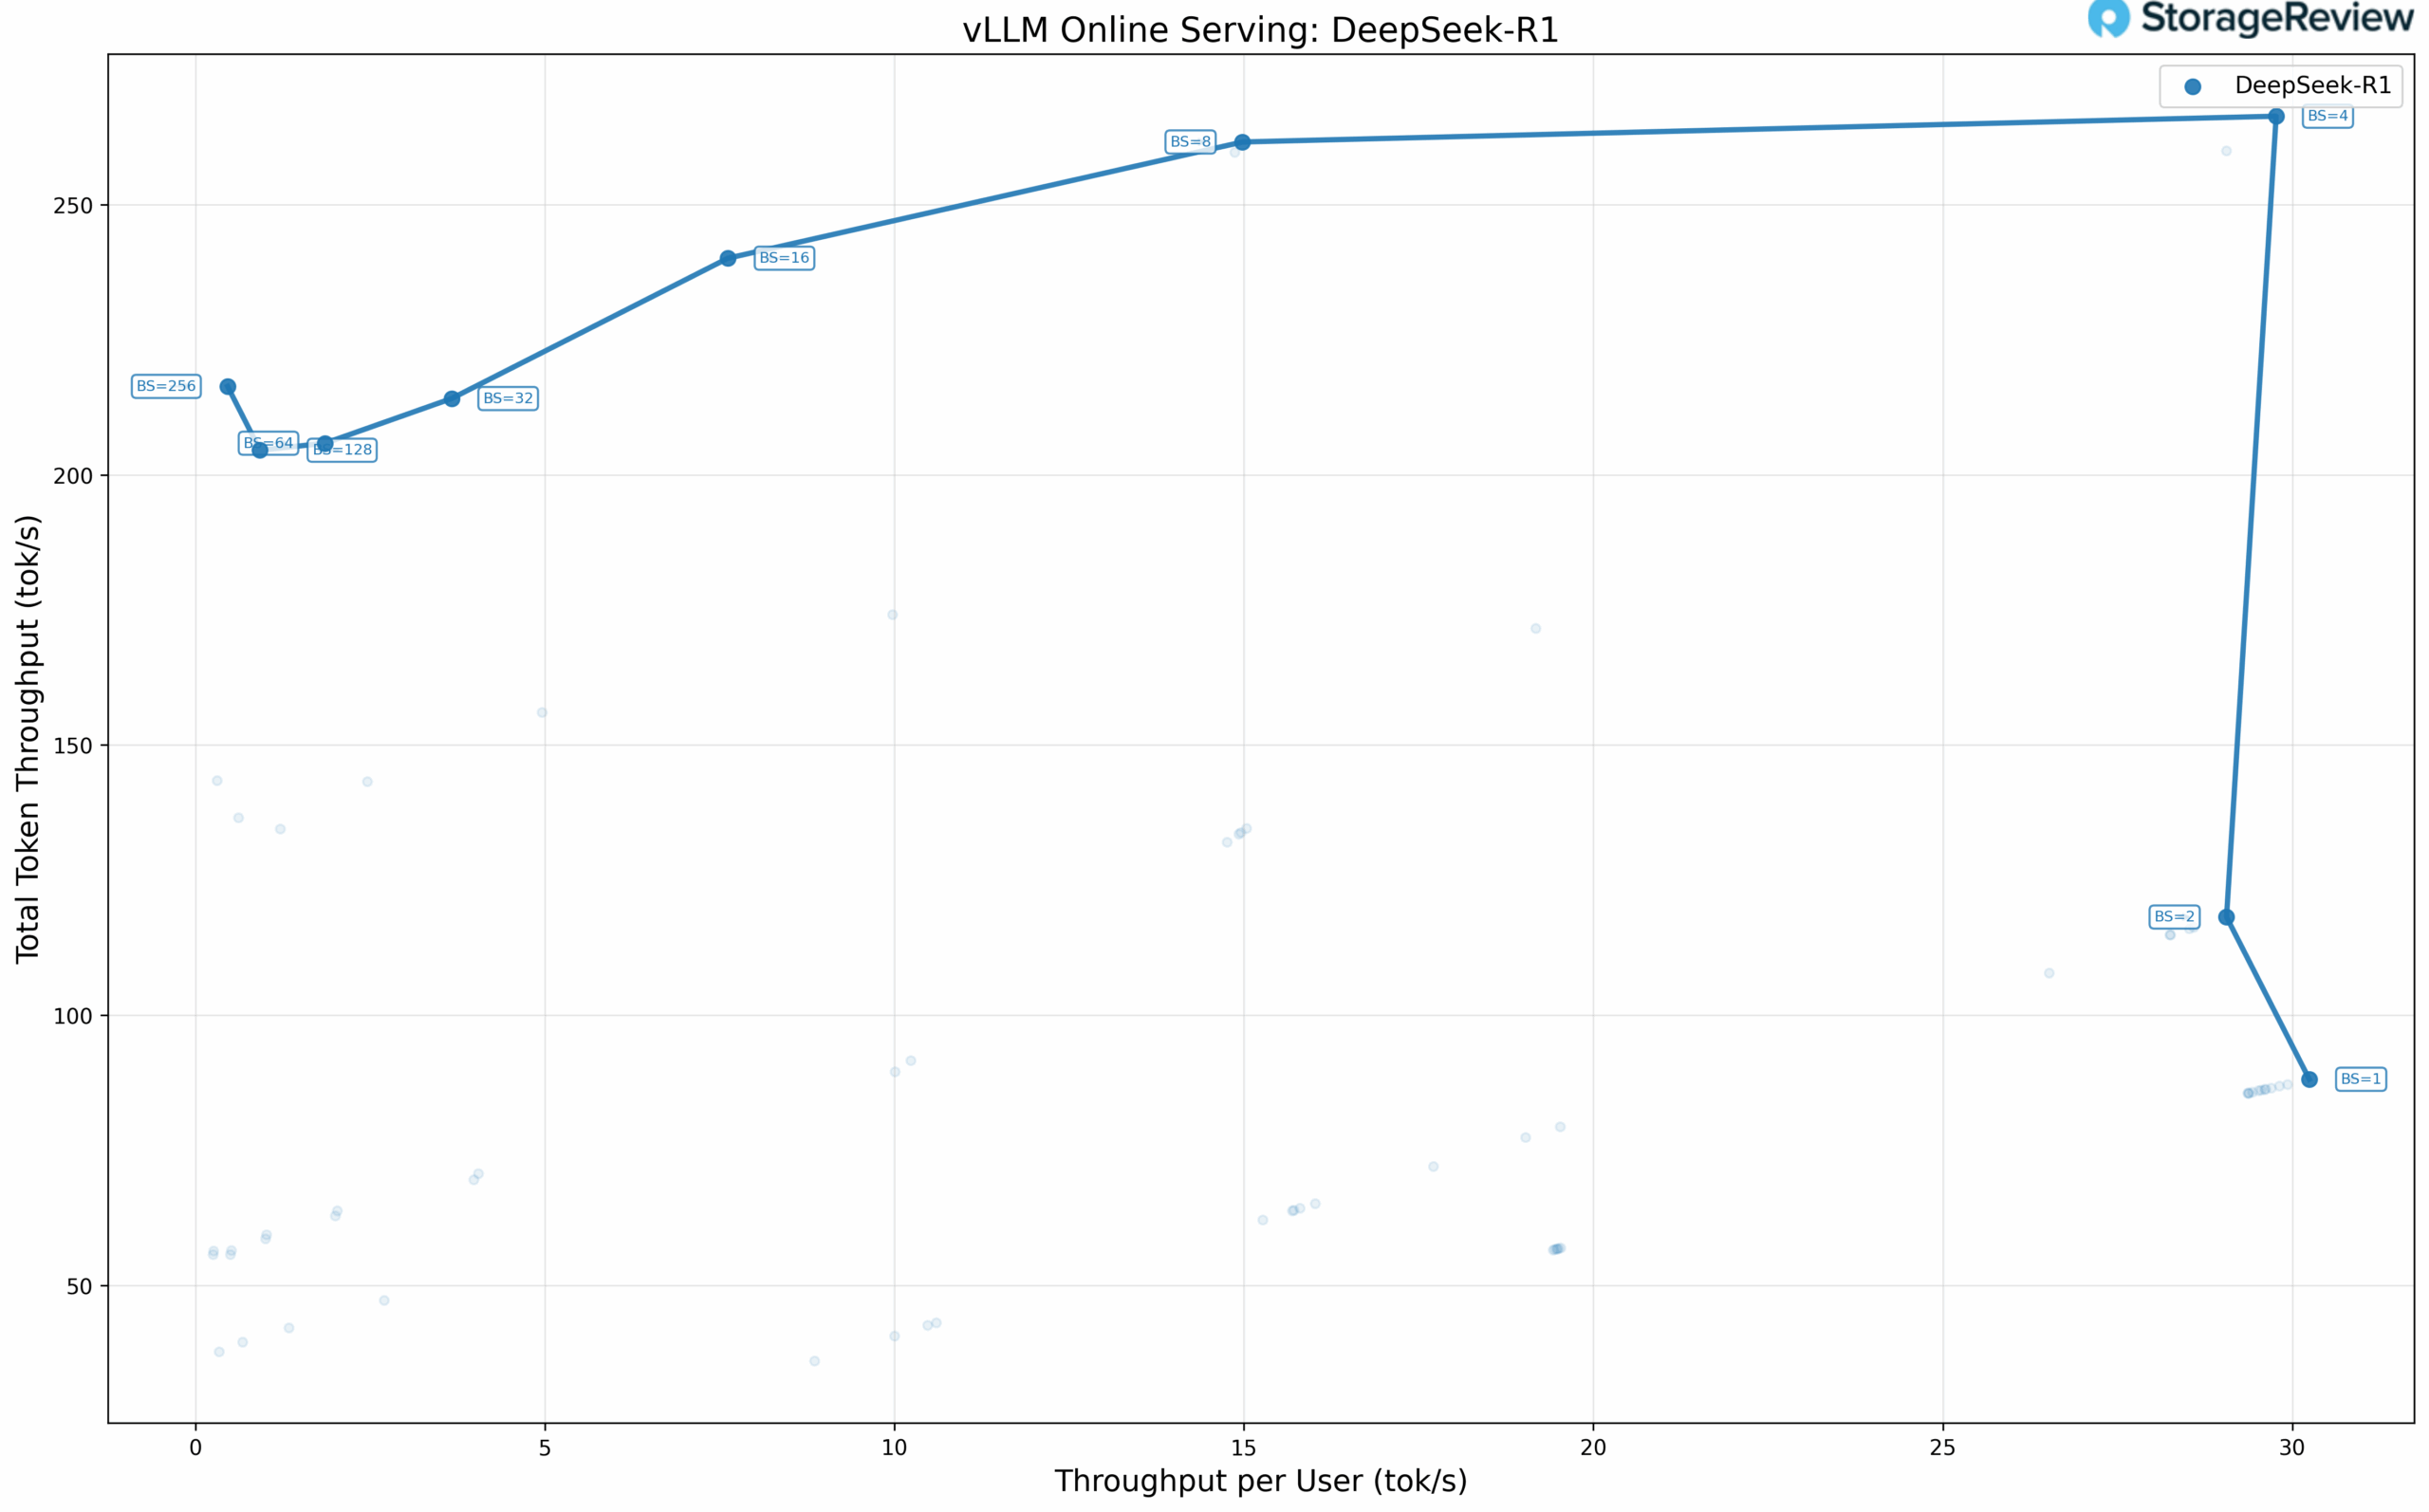
Model DeepSeek-R1 vykazuje zajímavé chování při škálování napříč velikostmi dávek. Při souběžném provozu jednoho uživatele (BS=1) dosahuje model rychlosti 30.24 tok/s na uživatele, celkové propustnosti 88.13 tok/s a doby odezvy (TPOT) 29.85 ms. Při škálování na BS=4 dosahuje výkon 29.77 tok/s na uživatele a zároveň poskytuje celkovou propustnost 266.40 tok/s s dobou odezvy (TPOT) 32.04 ms, což představuje maximální celkovou propustnost dosaženou napříč všemi konfiguracemi.
Výkon DeepSeek-R1 se za hranicí BS=4 ustálí. Při BS=8 propustnost na uživatele prudce klesá na 14.98 tok/s a pokles pokračuje i při vyšších velikostech dávek, přičemž při BS=256 dosahuje pouhých 0.46 tok/s na uživatele. Celková propustnost zůstává relativně stabilní mezi 200 a 260 tok/s v rozmezí od BS=4 do BS=256, protože model nelze škálovat s dalšími souběžnými požadavky na jednom uzlu, což vede ke zvýšení latence bez významného zvýšení propustnosti. Důležité je zde poznamenat, že B200 DGX je jedno z mála řešení s jedním serverem, které dokáže tento masivní model provozovat.
Výkon kodéru Qwen3 30B-A3B
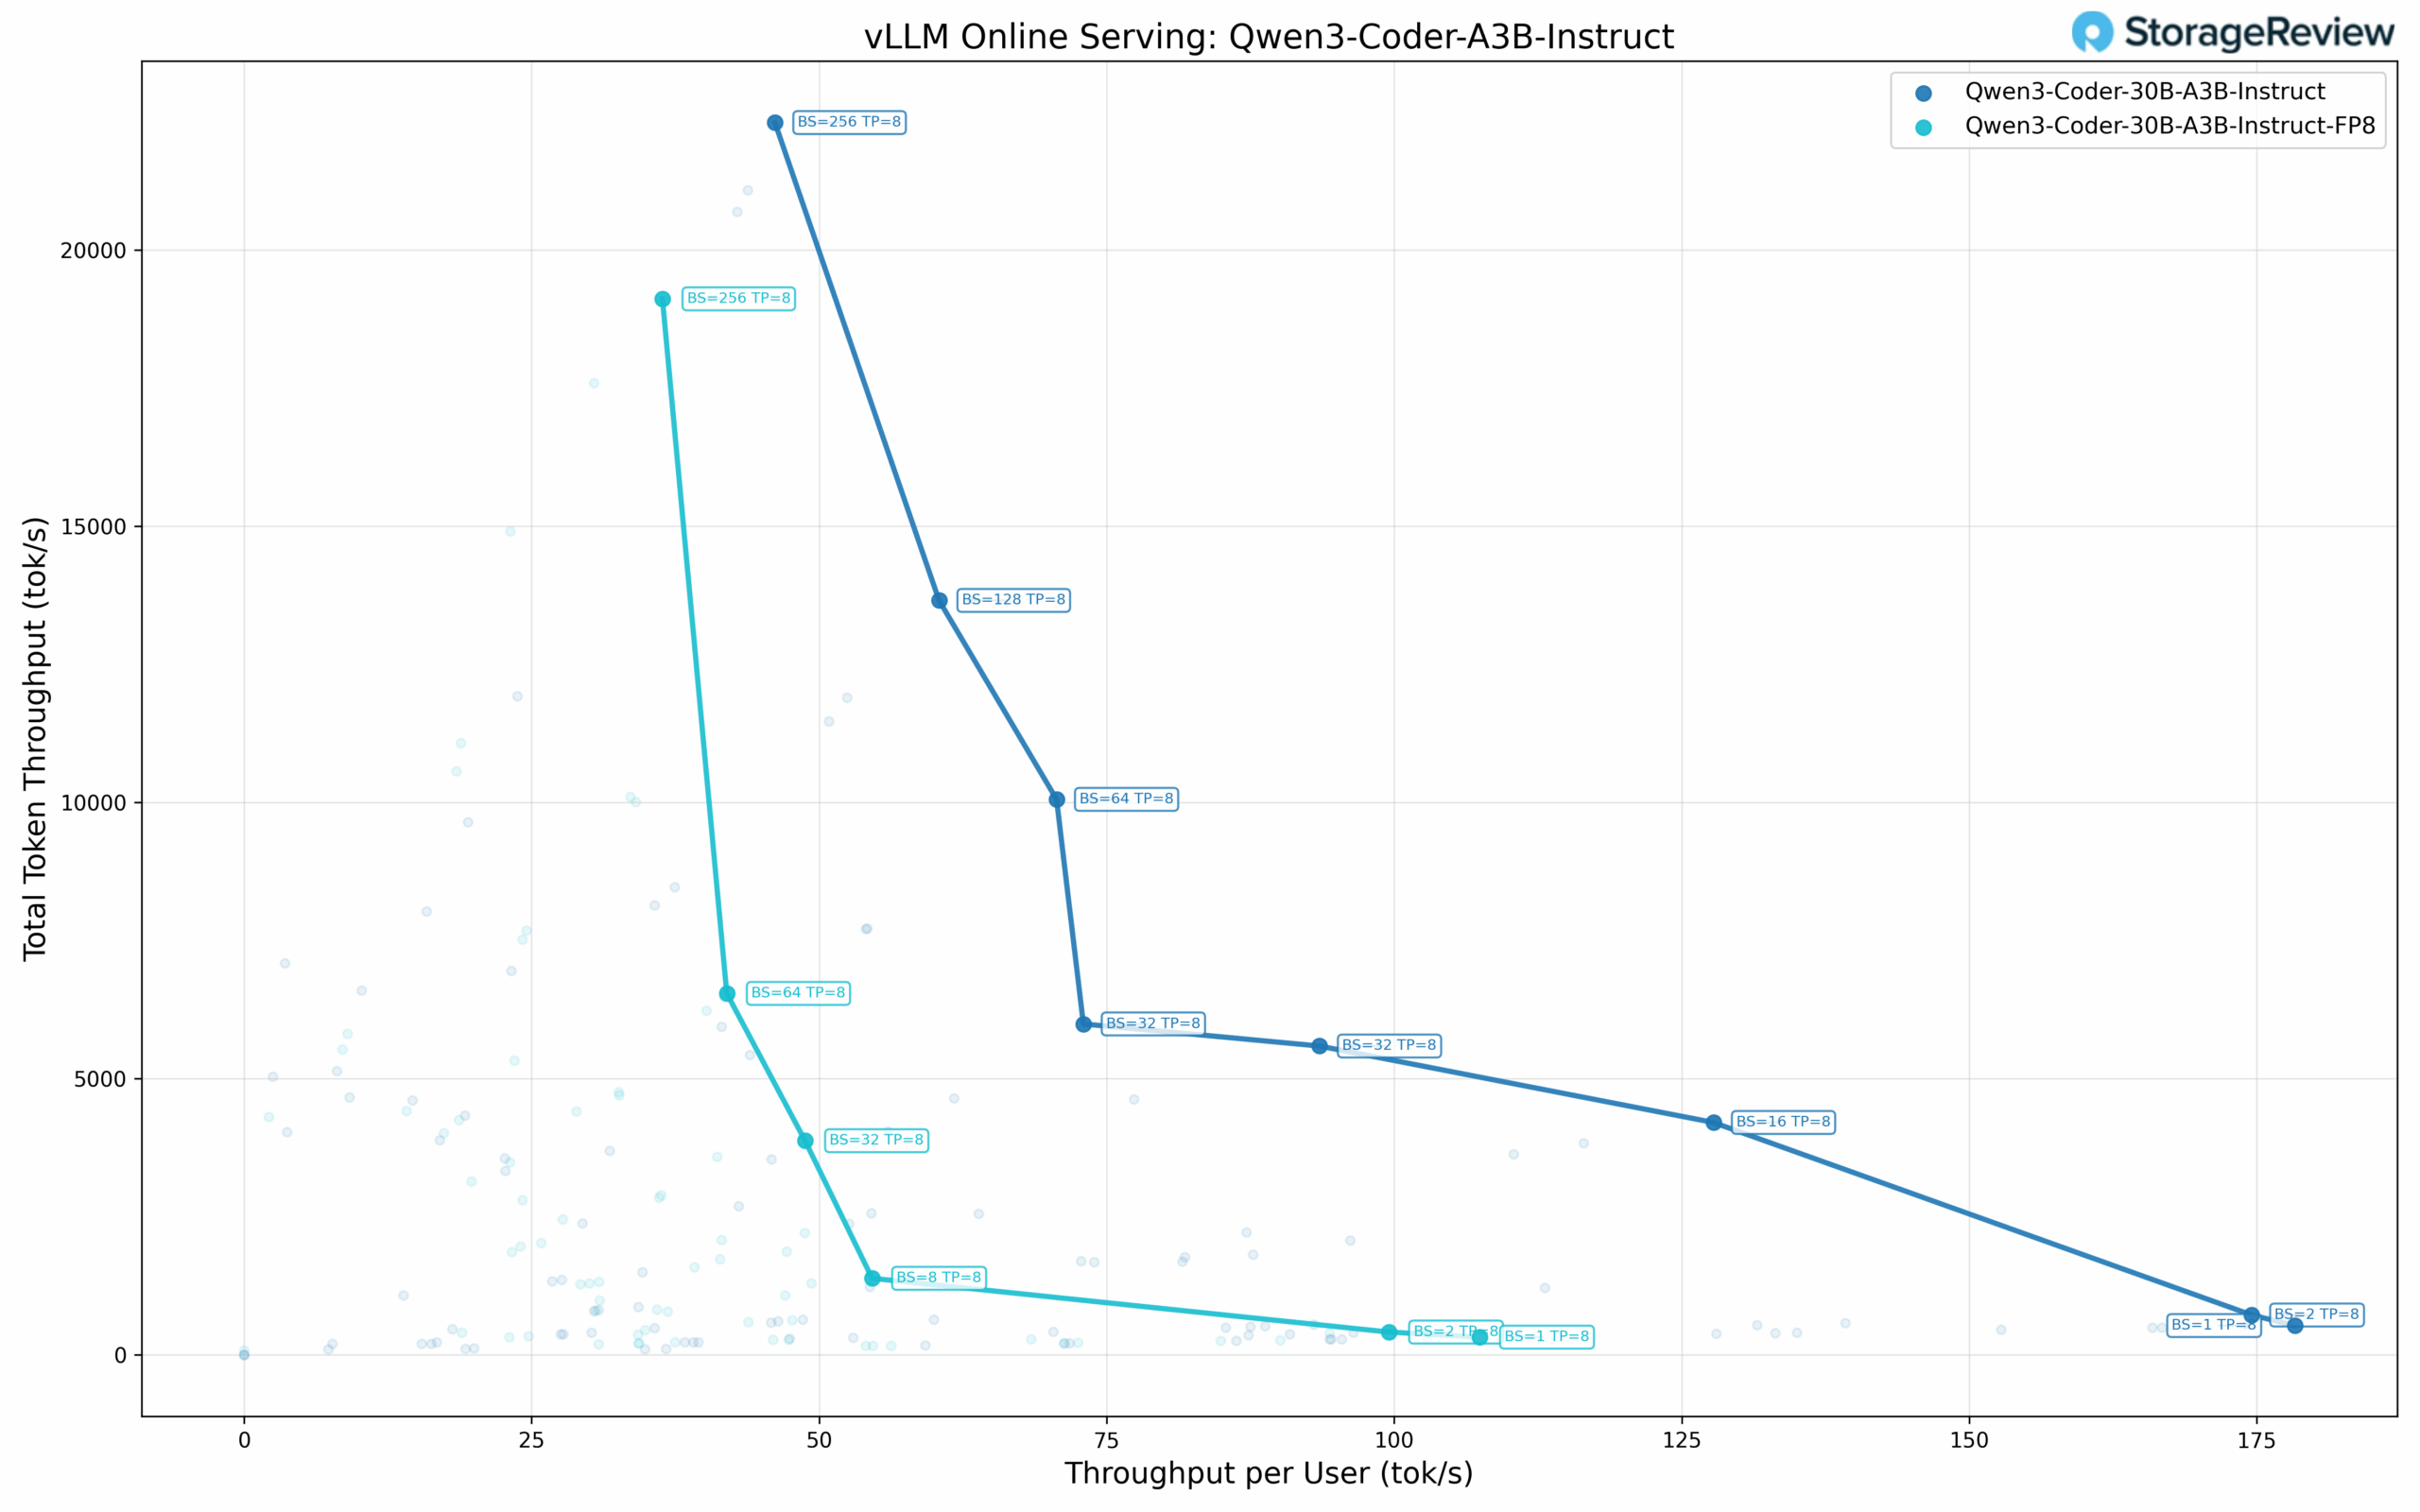
Standardní přesný kodér Qwen3 vykazuje následující škálování napříč úrovněmi souběžnosti. Při souběžnosti jednoho uživatele (BS=1) model dosahuje 178.30 tok/s na uživatele, celkové propustnosti 527.25 tok/s a doby odezvy (TPOT) 5.46 ms. Při BS=2 dosahuje výkon 174.56 tok/s na uživatele s celkovým výkonem 718.70 tok/s a dobou odezvy (TPOT) 5.60 ms. S rostoucí velikostí dávky se propustnost na uživatele snižuje, zatímco celková propustnost se dále škáluje: BS=16 poskytuje 127.76 tok/s na uživatele, celkem 4 204,40 tok/s a dobu odezvy (TPOT) 6.93 ms.
Model dosahuje maximální celkové propustnosti při BS=256, což je celkem 22 305,88 tok/s s 46.16 tok/s na uživatele a TPOT 17.64 ms. Paretova hranice zahrnuje osm odlišných bodů s duplicitním záznamem při BS=32 (72.97 tok/s a 93.50 tok/s na uživatele, což pravděpodobně představuje různé konfigurace). Hodnoty TPOT zůstávají v rozsahu 5–9 ms až do BS=64.
Výkon kodéru Qwen3 30B-A3B FP8
Kvantovaná varianta FP8 vykazuje následující výkonnostní charakteristiky. Při souběžném provozu jednoho uživatele (BS=1) dosahuje rychlosti 107.46 toků/s na uživatele, celkové propustnosti 317.75 toků/s a doby přenosu dat (TPOT) 9.16 ms. Při BS=2 model dosahuje rychlosti 99.55 toků/s na uživatele s celkovou propustností 409.87 toků/s a dobou přenosu dat 9.86 ms.
Škálování na vyšší velikosti dávek: BS=8 poskytuje 54.60 tok/s na uživatele s celkovým výkonem 1 383,13 tok/s a dobou přenosu dat 10.24 ms, zatímco BS=32 dosahuje 48.78 tok/s na uživatele s celkovým výkonem 3 874,21 tok/s a dobou přenosu dat 10.67 ms. Maximální celková propustnost je dosažena při BS=256 s celkovým výkonem 19 114,86 tok/s, 36.38 tok/s na uživatele a dobou přenosu dat 20.00 ms. To představuje přibližně 86 % maximální propustnosti se standardní přesností.
Výkon datových typů s mikroškálováním
Mikroškálování představuje pokročilý kvantizační přístup, který aplikuje jemnozrnné škálovací faktory na malé bloky vah, spíše než rovnoměrnou kvantizaci napříč velkými skupinami parametrů. Formát NVFP4 od společnosti NVIDIA implementuje tuto techniku prostřednictvím blokované reprezentace s plovoucí desetinnou čárkou, kde každý mikroškálový blok o 8–32 hodnotách sdílí společný exponent jako škálovací faktor. Tento granulární přístup zachovává numerickou přesnost a zároveň dosahuje 4bitové reprezentace, čímž se udržuje dynamický rozsah kritický pro transformátorové architektury. Formát se integruje s architekturou Tensor Core od společnosti NVIDIA, což umožňuje efektivní výpočet se smíšenou přesností s dekompresí za chodu během maticových operací.
Modely GPT OSS od OpenAI jsme vyhodnotili na dvou parametrických škálách s využitím kvantizace NVFP4: varianta 20B a větší varianta 120B. Tyto benchmarky demonstrují, jak si mikroškálová kvantizace vede napříč modely různých velikostí.
Výkon GPT-OSS-20B
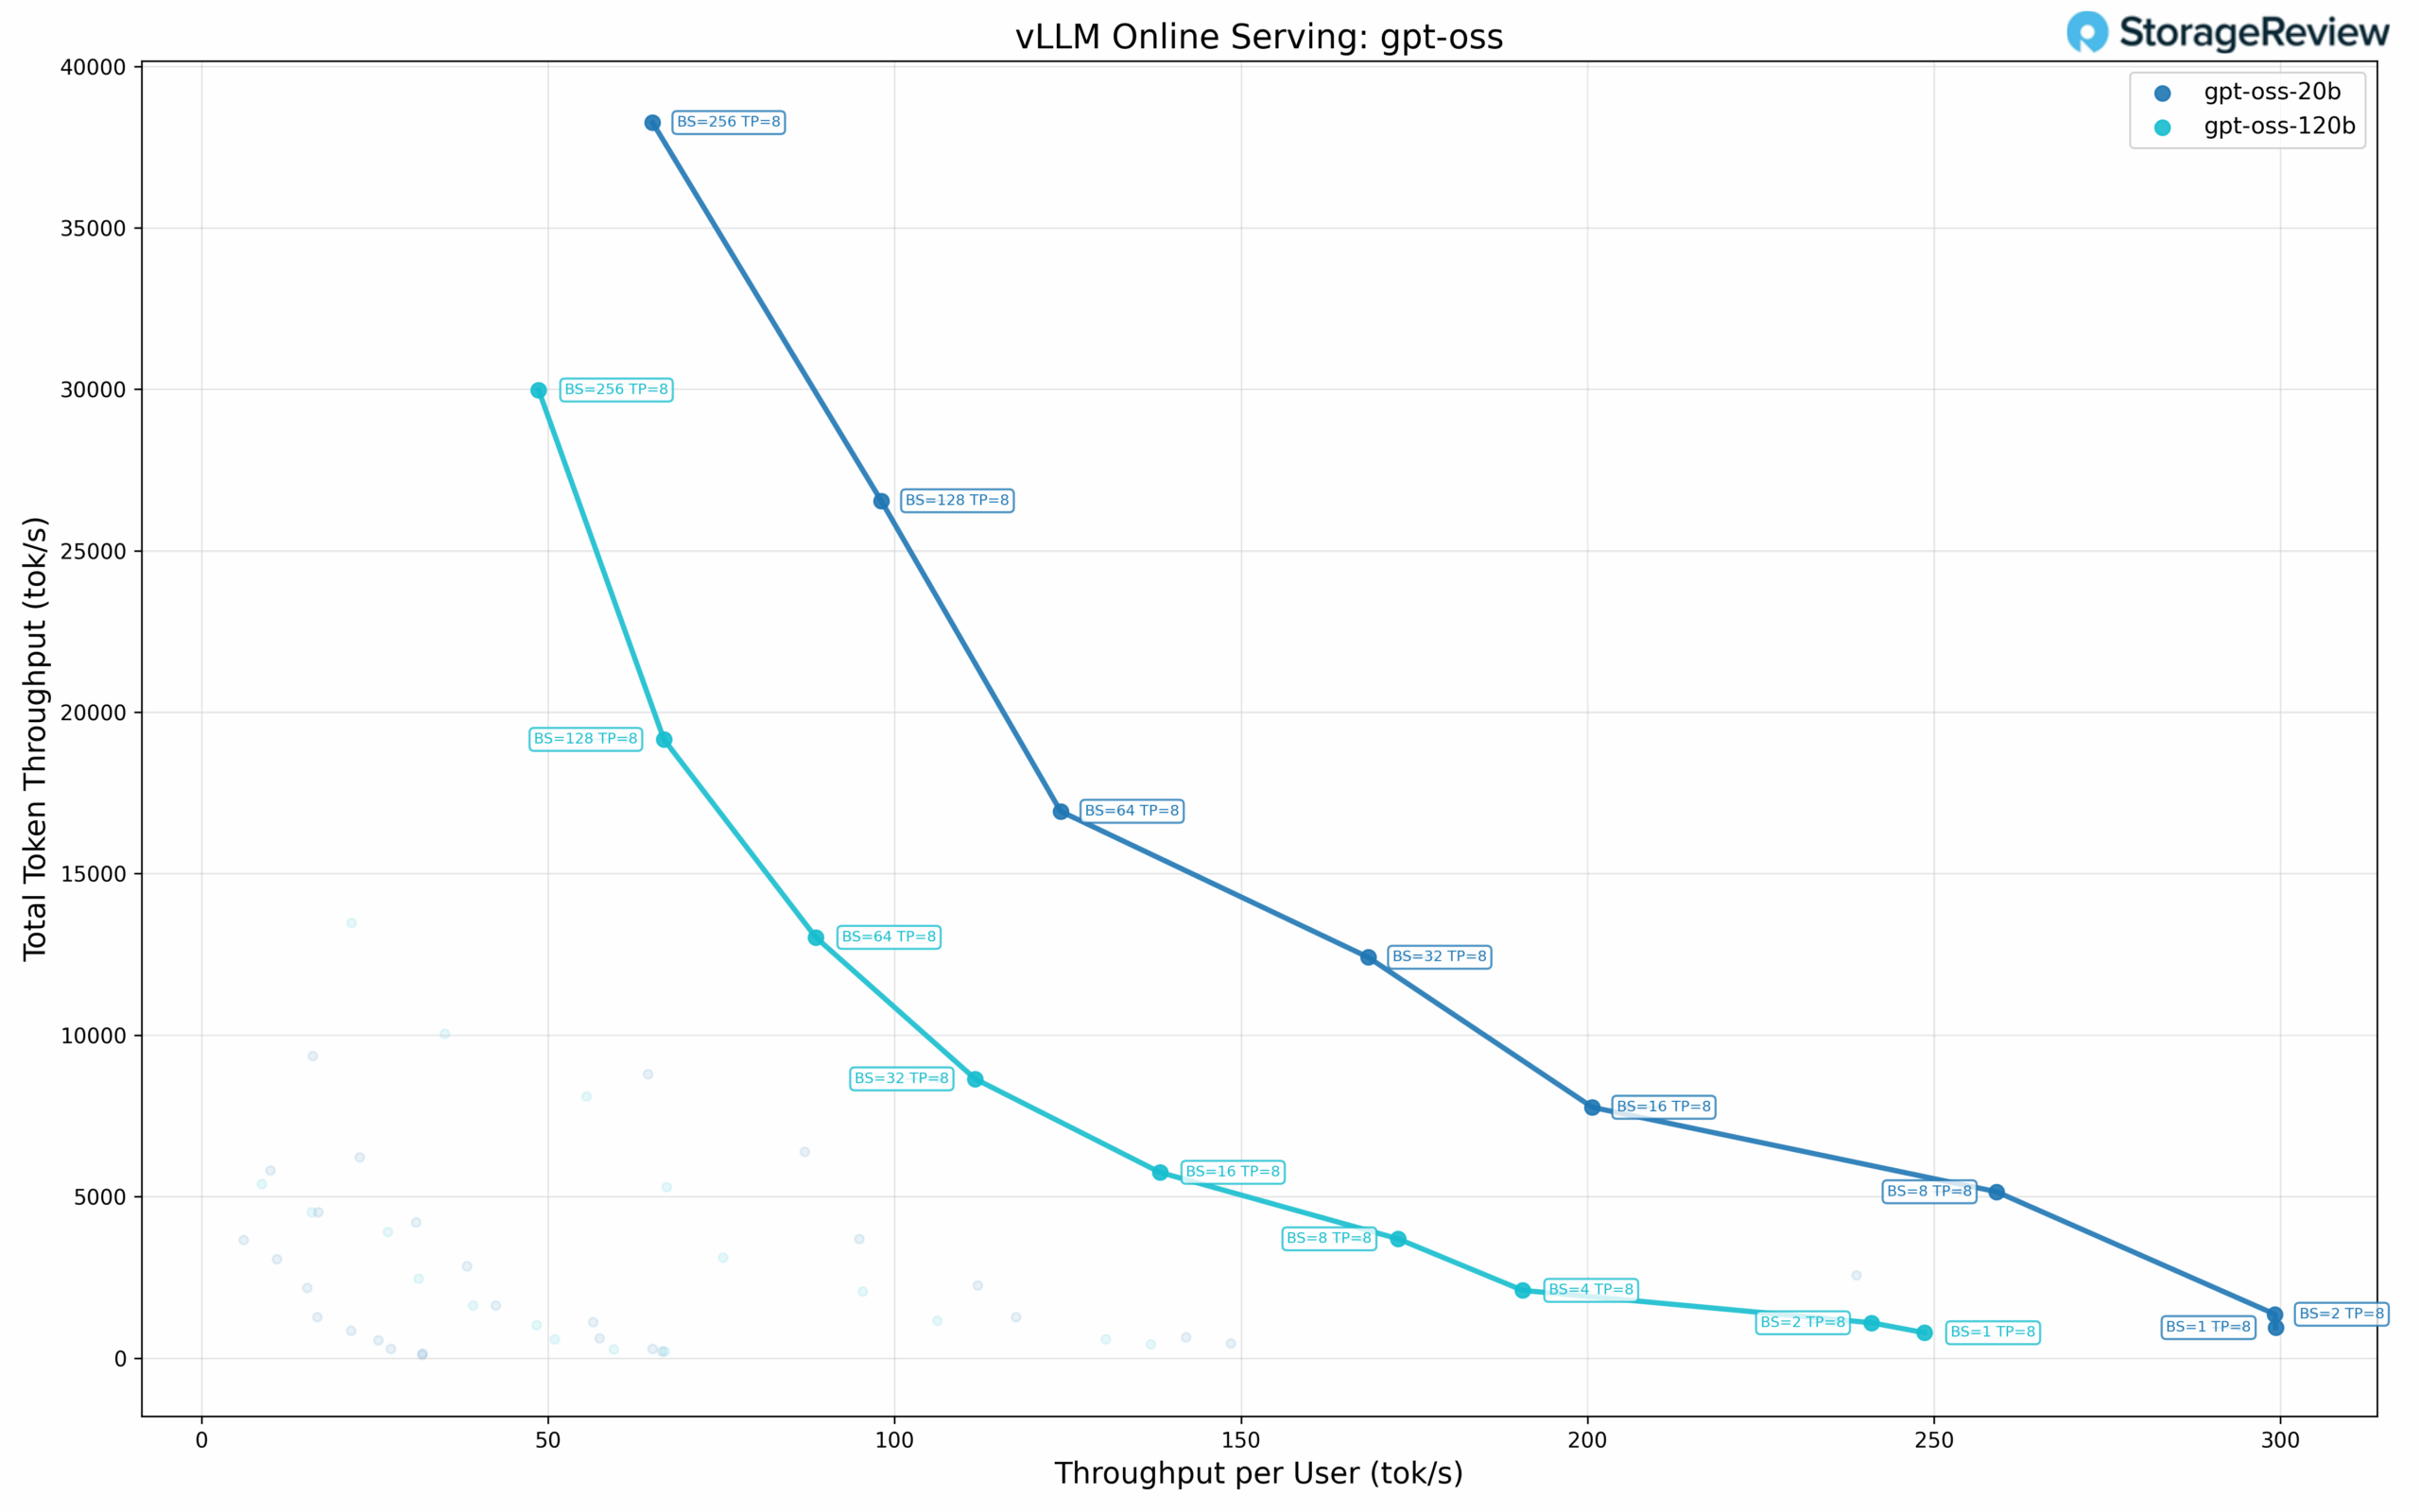
Model s parametry 20B dosahuje následujícího výkonu napříč velikostmi dávek. Při souběžném provozu jednoho uživatele (BS=1) poskytuje 299.28 tok/s na uživatele, celkovou propustnost 943.43 tok/s a TPOT 3.23 ms. Při BS=2 si model udržuje 299.19 tok/s na uživatele s celkovým výkonem 1 356,87 tok/s a TPOT 3.19 ms.
Škálování na vyšší velikosti dávek: BS=8 dosahuje 259.02 tok/s na uživatele s celkovým výkonem 5 149,59 tok/s a dobou přenosu energie 3.42 ms, zatímco BS=16 poskytuje 200.69 tok/s na uživatele s celkovým výkonem 7 765,73 tok/s a dobou přenosu energie 3.77 ms. Model pokračuje ve škálování až do BS=32 (168.34 tok/s na uživatele, celkem 12 411,72 tok/s) a BS=64 (123.96 tok/s na uživatele, celkem 16 931,47 tok/s).
Celková propustnost je dosažena při BS=256, dosahuje celkem 38 258,50 tok/s s 65.08 tok/s na uživatele a TPOT 9.39 ms. To představuje 40.5× nárůst celkové propustnosti ve srovnání s výkonem jednoho uživatele. Hodnoty TPOT zůstávají v rozsahu 3–5 ms až do BS=32. Paretova hranice zahrnuje osm odlišných bodů.
Výkon GPT-OSS-120B
Model s většími parametry 120B si i přes zvýšený počet parametrů zachovává následující výkon. Při souběžném provozu jednoho uživatele (BS=1) dosahuje 248.62 tok/s na uživatele, celkové propustnosti 783.73 tok/s a doby odezvy (TPOT) 3.89 ms. Při BS=2 model poskytuje 240.99 tok/s na uživatele, celkem 1 092,91 tok/s a dobu odezvy (TPOT) 3.99 ms.
Výkon se i nadále zvyšuje s vyššími velikostmi dávek: BS=4 dosahuje 190.63 toků/s na uživatele s celkovým výkonem 2 096,73 toků/s a dobou přenosu dat 4.22 ms, zatímco BS=8 poskytuje 172.66 toků/s na uživatele s celkovým výkonem 3 692,10 toků/s a dobou přenosu dat 4.54 ms. Škálování přes BS=16 (138.28 toků/s na uživatele, celkem 5 751,41 toků/s), BS=32 (111.63 toků/s na uživatele, celkem 8 646,05 toků/s) a BS=64 (88.64 toků/s na uživatele, celkem 13 027,97 toků/s) ukazuje konzistentní nárůst propustnosti.
Model dosahuje maximální celkové propustnosti při BS=256, což je 29 976,99 tok/s, s 48.64 tok/s na uživatele a TPOT 12.53 ms. To představuje 38.2× nárůst celkové propustnosti ve srovnání s výkonem pro jednoho uživatele. Maximální celková propustnost je přibližně 78 % vrcholu modelu 20B. Paretova hranice zahrnuje devět odlišných bodů, což je nejvíce ze všech testovaných modelů.
Neočekávaný výkon kvantovaného modelu
Výsledky kvantovaných modelů byly neočekávané a vyžadují další zkoumání. V několika případech kvantované verze modelů NVFP4 a FP8 nedosáhly očekávaného zlepšení výkonu oproti svým protějškům s nativní přesností. Například model Llama 3.1 8B FP4 dosáhl celkové propustnosti pouze 830.46 toků/s při BS=1, ve srovnání s 1 727,62 toků/s pro variantu se standardní přesností, a to i přes podobnou propustnost na uživatele. Při vyšších velikostech dávek, ačkoli se kvantované modely blížily propustnosti se standardní přesností (29.2 000–29.3 000 toků/s vs. 32.8 000 toků/s při BS=256), celkové výsledky naznačují, že současná implementace vLLM nemusí být plně optimalizována pro Blackwell.
Plánujeme provést další testování na vLLM a také jej porovnat s TensorRT-LLM, abychom zjistili, jaký výkon mohou koncoví uživatelé očekávat dnes.
Supermicro JumpStart mění pravidla hry s AI PoC
Program JumpStart od společnosti Supermicro splňuje své sliby: skutečný a neomezený přístup k hardwaru produkční třídy bez logistiky, zpoždění v dopravě nebo laboratorních režijních nákladů, které jsou typické pro tradiční PoC. Náš týden JumpStart na platformě X14 HGX B200 začal rychle, proběhl hladce a umožnil nám vyhodnotit výkon stejným způsobem, jako bychom to udělali s vybavením v našich vlastních raccích.
Pro organizace, které se rychle rozhodují o infrastruktuře umělé inteligence, může tento druh přístupu k platformě zkrátit týdny plánování na dny. Pokud je cílem ověřit propustnost GPU, chování úložiště, výkon modelu nebo jednoduše potvrdit kompatibilitu zásobníku, JumpStart vám poskytne odpovědi s minimálním třením. Jedná se o přístup k hodnocení hardwaru, který posiluje důvěru, a rádi bychom viděli, jak jej přijímá více dodavatelů.


 Amazon